
Dans le champ de l’analyse statistique contemporaine et des sciences empiriques, l’exploration graphique des distributions de fréquences constitue l’une des étapes les plus déterminantes du processus de modélisation. Qu’il s’agisse de comparer l’efficacité de deux protocoles pharmacologiques, d’évaluer l’évolution temporelle de scores psychométriques ou de mesurer la dispersion de signaux biométriques, l’histogramme demeure un outil fondamental d’inférence visuelle. Pourtant, la représentation conjointe de plusieurs cohortes au sein d’un espace graphique unifié pose des défis méthodologiques et sémiotiques considérables. Comment exposer simultanément la variabilité, la tendance centrale et les anomalies distributionnelles de plusieurs groupes sans altérer la lisibilité globale de la figure ?
Le langage de programmation statistique R s’est imposé au fil des décennies comme la référence incontestée pour la modélisation et la restitution visuelle des données scientifiques. Grâce à son moteur graphique natif historique et à l’avènement de l’écosystème Tidyverse incarné par l’extension ggplot2, R offre aux chercheurs une flexibilité algorithmique sans équivalent. Néanmoins, cette richesse syntaxique s’accompagne d’arbitrages techniques rigoureux : gestion des canaux de transparence alpha, synchronisation des fenêtres d’échantillonnage, harmonisation des découpages en classes ou conversion entre les formats de données matriciels et relationnels.
Ce traité exhaustif a pour vocation d’exposer avec une précision académique et didactique les différentes méthodologies permettant de tracer, superposer, juxtaposer et annoter plusieurs histogrammes dans l’environnement R. En explorant successivement les paradigmes graphiques natifs (Base R) et déclaratifs (ggplot2), ce guide détaille chaque étape du flux de travail statistique, de la structuration matricielle préliminaire jusqu’aux exigences typographiques et chromatiques des comités de lecture internationaux.
1. Introduction à la visualisation des distributions multiples dans R
1.1 Pertinence de la superposition d’histogrammes en recherche empirique
La recherche empirique repose fondamentalement sur l’évaluation comparative d’échantillons soumis à des conditions expérimentales distinctes ou issus de populations naturellement contrastées. Dans ce cadre, la réduction d’un jeu de données à de simples paramètres de centralité, tels que la moyenne arithmétique ou la médiane, engendre fréquemment une perte d’information préjudiciable. Deux groupes affichant des moyennes rigoureusement identiques peuvent en effet dissimuler des structures distributionnelles radicalement divergentes, marquées par une bimodalité latente, une forte asymétrie positive ou des variances hautement hétérogènes. La superposition d’histogrammes s’avère alors indispensable pour révéler la topographie intégrale des observations sans escamoter leur dispersion naturelle.
Cette approche prend une acuité toute particulière dans les domaines de la psychologie expérimentale, de la neurobiologie et des essais cliniques. Lorsque l’on analyse des scores cognitifs standardisés ou des temps de réaction chronométriques, la morphologie même de la courbe renseigne le chercheur sur les mécanismes sous-jacents. Une distribution des temps de réponse étirée vers la droite reflète classiquement des processus attentionnels intermittents, tandis qu’un profil tronqué peut trahir un effet de plancher ou de plafond propre à l’instrument de mesure psychométrique employé. Visualiser ces dynamiques au travers de distributions superposées permet de poser un diagnostic immédiat quant à la validité des postulats paramétriques.
Par ailleurs, la comparaison visuelle conjointe permet d’examiner simultanément le degré de symétrie (l’asymétrie statistique), l’aplatissement de la courbe (le kurtosis) et l’étendue de la zone de recouvrement mutuel. Cette zone de chevauchement distributionnel fournit une intuition probabiliste directe de la séparabilité des classes expérimentales. Elle permet d’anticiper la pertinence des tests d’hypothèses subséquents, tels que le test t de Student pour échantillons indépendants ou l’analyse de variance, tout en préservant le chercheur des interprétations biaisées induites par la présence insidieuse de valeurs aberrantes isolées au sein des queues de distribution.
1.2 Comparaison conceptuelle : Base R versus ggplot2
L’écosystème du logiciel R propose deux paradigmes fondamentaux pour l’élaboration graphique : le système de graphisme natif, couramment désigné sous le terme de Base R, et le système graphique fondé sur la grammaire des graphiques formalisée par Leland Wilkinson, implémenté au sein de l’extension renommée ggplot2 par Hadley Wickham. Chacune de ces approches repose sur une philosophie computationnelle spécifique qui influe directement sur le flux de travail analytique et le niveau de contrôle offert à l’utilisateur.
Le moteur graphique natif de Base R fonctionne selon le modèle dit du « tableau de peintre ». Les fonctions graphiques de haut niveau, à l’instar de la commande hist(), instancient un nouveau canevas de dessin, tandis que des fonctions secondaires de bas niveau viennent séquentiellement déposer des couches de peinture additionnelles sur cette surface déjà matérialisée. Cette conception offre une simplicité conceptuelle remarquable et une rapidité d’exécution quasi instantanée, idéale pour les phases exploratoires préliminaires ou pour les routines de calcul automatisées nécessitant un coût de calcul minimal. Cependant, cette méthode souffre d’un manque d’interdépendance structurelle : une fois un élément projeté sur l’écran graphique, il ne peut être modifié dynamiquement, imposant d’anticiper manuellement l’étendue globale des axes dès la première instruction.
À l’inverse, l’architecture de ggplot2 repose sur une approche déclarative et modulaire où le graphique est conçu comme un objet structuré agrégeant des données sources, des correspondances esthétiques et des calques géométriques interconnectés. L’intérêt majeur de ggplot2 réside dans son harmonisation automatique : le moteur recalcule intrinsèquement les échelles d’axes pour englober la totalité des sous-groupes statistiques, génère nativement des légendes contextuelles exhaustives et maintient une cohérence chromatique de haut niveau sans intervention fastidieuse. Le choix entre ces deux environnements sera donc dicté par la finalité du livrable : une analyse exploratoire ultra-rapide sur un serveur de calcul privilégiera l’immédiateté de Base R, tandis que la production de figures vectorielles haut de gamme destinées aux comités de lecture des revues scientifiques trouvera dans ggplot2 un allié d’une puissance expressive sans égal.
1.3 Structuration des jeux de données : formats large et long
L’étape préalable à toute construction graphique dans R implique une maîtrise rigoureuse de la topologie des structures de données manipulées. Deux formes de représentation tabulaire dominent la manipulation de données multidimensionnelles : le format large (wide format) et le format long (long format ou tidy data). Comprendre la dichotomie entre ces deux agencements s’avère indispensable, dans la mesure où Base R et ggplot2 n’exploitent pas les mêmes configurations relationnelles pour la gestion des groupes expérimentaux.
Dans un agencement au format large, chaque variable expérimentale ou condition de traitement occupe une colonne distincte au sein du tableau de données. Par exemple, si l’on compare les performances cognitives avant et après l’administration d’un principe actif, le tableau comportera une colonne pour le score initial et une seconde colonne pour le score final, chaque ligne représentant un individu unique. Cette disposition se prête parfaitement aux routines séquentielles de Base R, où l’analyste extrait successivement des vecteurs atomiques indépendants pour les transmettre aux instructions d’affichage successives.
À l’opposé, la philosophie du Tidyverse exige que les données soient restructurées sous un format long unifié. Dans ce paradigme, chaque ligne du tableau correspond à une observation singulière, une première colonne hébergeant l’ensemble des mesures quantitatives continues et une seconde colonne faisant office de variable de classification qualitative (facteur catégoriel). Cette morphologie structurelle permet d’associer la colonne catégorielle au canal esthétique de remplissage de ggplot2. La transition d’une structure large vers une structure longue s’opère couramment à l’aide des fonctions de pivotement matriciel modernes, garantissant ainsi un flux analytique fluide, reproductible et conforme aux meilleures pratiques du génie logiciel statistique.
2. Préparation et structuration des données expérimentales
2.1 Génération de données reproductibles avec set.seed et rnorm
Pour assurer la rigueur intellectuelle d’une démonstration méthodologique, il est primordial d’ancrer le propos sur un jeu de données synthétique dont les paramètres statistiques fondamentaux sont parfaitement connus et traçables. L’aléa computationnel au sein de R repose sur des générateurs de nombres pseudo-aléatoires déterministes. Afin de garantir qu’un script produise rigoureusement les mêmes figures et métriques descriptives sur n’importe quel ordinateur, l’exécution préalable de la primitive set.seed() est impérative.
Dans le cadre de nos démonstrations comparatives, nous simulons deux populations d’observations issues de distributions gaussiennes contrastées. L’appel à la fonction rnorm() permet de modéliser avec précision ces deux cohortes en spécifiant le volume d’échantillonnage, l’espérance mathématique (la moyenne empirique cible) ainsi que la dispersion standard (l’écart-type). À titre d’illustration, nous pouvons instancier un premier échantillon de référence représentant une condition contrôle caractérisée par une moyenne fixée à 50 et un écart-type de 10, puis un second échantillon figurant un groupe expérimental ayant bénéficié d’une intervention cognitive, caractérisé par une moyenne déplacée à 62 et un écart-type resserré à 7.5.
Avant d’engager le rendu graphique, une inspection numérique des grandeurs synthétisées doit être systématiquement opérée. L’application des fonctions de synthèse descriptive telles que summary() et sd() sur chacun des vecteurs numériques permet de confirmer l’adéquation empirique entre les valeurs générées et les postulats théoriques du protocole de simulation. Cet examen préliminaire prévient les incohérences d’échelle et valide la cohérence de l’intervalle d’observation avant l’étape de restitution géométrique.
2.2 Organisation vectorielle pour les fonctions graphiques de base
Le moteur graphique natif de Base R privilégie une manipulation directe d’objets vectoriels indépendants stockés dans la mémoire vive de l’interpréteur. Cette approche s’affranchit de l’obligation de regrouper impérativement les grandeurs dans une table de données formelle, autorisant une souplesse appréciable lorsque les groupes à comparer présentent des effectifs distincts. Ainsi, l’analyste peut sans difficulté manipuler un échantillon x1 comprenant mille observations et un échantillon x2 n’en comportant que sept cent cinquante, sans se heurter aux contraintes dimensionnelles des matrices rectangulaires.
Cette souplesse impose néanmoins une discipline analytique accrue concernant le nettoyage préalable des structures vectorielles. Toute présence inopinée de valeurs manquantes codées sous la forme NA ou de marqueurs indéterminés NaN peut interrompre le calcul des classes de fréquences ou générer des discontinuités dans l’estimation des bornes spatiales. Il convient d’appliquer rigoureusement des opérations de filtrage univarié, à l’aide d’instructions conditionnelles telles que x1[!is.na(x1)], afin de circonscrire l’échantillon aux observations valides.
De surcroît, le diagnostic précoce des observations extrêmes (outliers) revêt une importance capitale pour la stabilité des histogrammes de base. Une valeur isolée située à plusieurs dizaines d’écarts-types de la moyenne aura pour effet pervers d’étirer l’abscisse du canevas graphique, compressant l’ensemble de la masse distributionnelle informative dans un nombre infime de colonnes contiguës. La détection et, le cas échéant, la troncature méthodologique de ces valeurs aberrantes doivent donc être exécutées au niveau vectoriel avant tout appel aux primitives graphiques.
2.3 Assemblage d’un data frame conforme aux standards du Tidyverse
Pour exploiter pleinement la puissance analytique de ggplot2, il est requis de consolider l’ensemble des vecteurs de mesure et leurs métadonnées associées au sein d’une structure rectangulaire unifiée du type data.frame ou tibble. Cette étape de consolidation garantit que chaque unité d’observation conserve une traçabilité intégrale quant à son assignation expérimentale.
La construction s’effectue généralement par concaténation séquentielle des vecteurs numériques primaires au moyen de la commande c(), en miroir de la génération d’un vecteur de labels catégoriels instancié par la fonction rep(). Ce dernier duplique les identifiants textuels de chaque condition à proportion exacte de la cardinalité de chaque sous-échantillon. Le jeu de données final agrège ainsi deux champs directeurs : une variable continue quantitative répertoriant les grandeurs métriques et un facteur qualitatif spécifiant le groupe d’appartenance.
L’inspection finale de cet assemblage s’opère classiquement par le recours à la fonction head() ou str(). Ce diagnostic confirme le typage adéquat des colonnes : la variable dépendante doit être rigoureusement reconnue comme numérique (numeric ou double), tandis que l’indicateur de cohorte doit adopter le type textuel ou, préférentiellement, le statut de facteur (factor) afin d’assurer un tri ordonné lors de la production de la légende graphique et des assignations chromatiques au sein de l’environnement de tracé.
3. Méthode 1 – Superposer plusieurs histogrammes avec Base R
3.1 Implémentation du paramètre add = TRUE dans la fonction hist
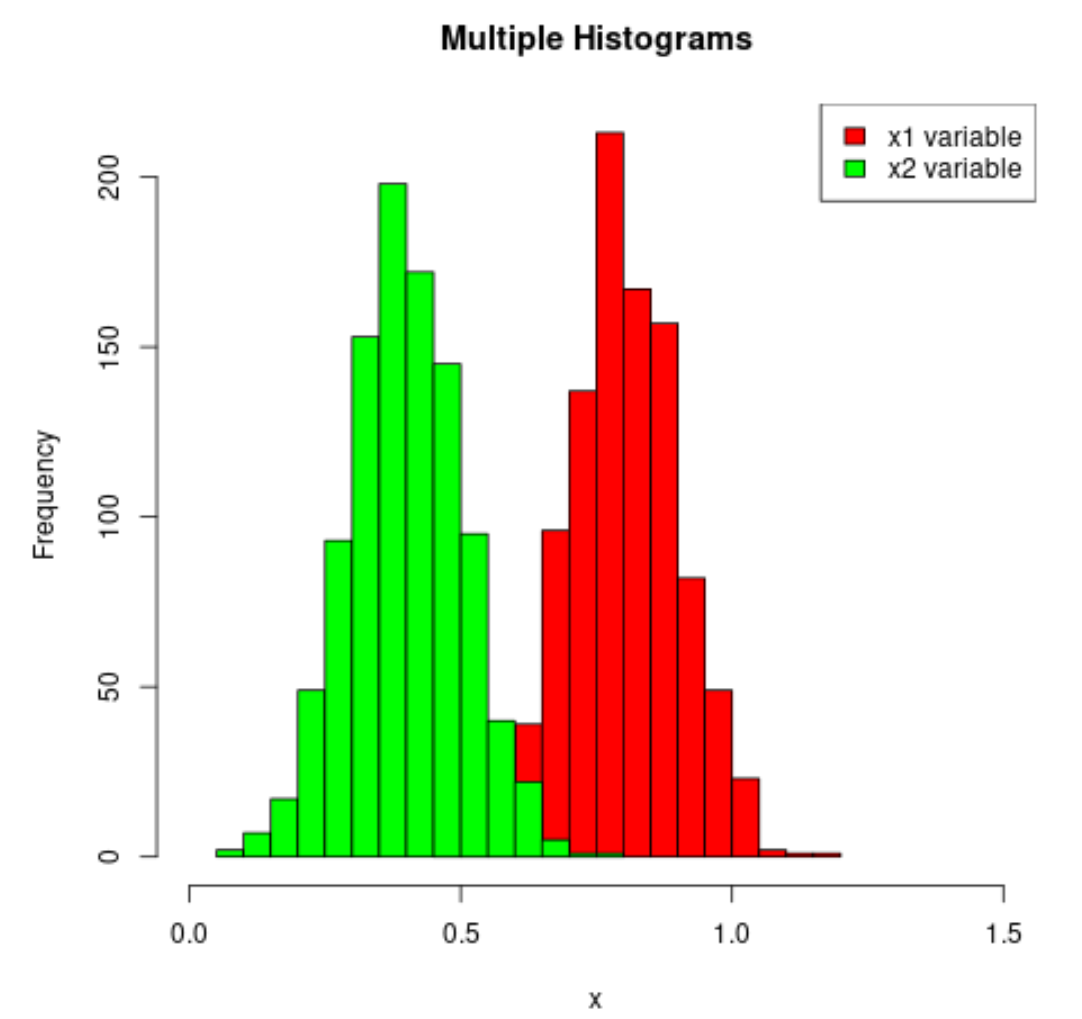
L’élaboration d’une superposition de distributions sous Base R repose sur l’enchaînement séquentiel de deux ou plusieurs invocations de la primitive hist(). La première exécution instancie le périphérique graphique, matérialise le système de coordonnées cartésiennes, gradue les axes et dessine les barres associées au premier groupe statistique. La seconde exécution, pour ne pas réinitialiser brutalement le canevas existant, doit impérativement comporter l’argument logique add = TRUE.
Par défaut, l’instruction hist() efface l’intégralité de la fenêtre de tracé active pour lui substituer une nouvelle composition. En activant l’attribut add = TRUE, l’interpréteur R modifie son comportement sous-jacent : il inhibe la phase de réinitialisation des axes et convertit temporairement le moteur d’affichage en une fonction graphique secondaire de bas niveau. Les nouvelles classes de fréquences viennent alors se dessiner directement par-dessus les éléments géométriques préexistants, respectant les coordonnées métriques déjà gravées sur le repère cartésien.
Cependant, cette mécanique d’addition graphique présente un piège architectural redoutable. Le premier appel à la fonction hist() détermine de manière définitive et immuable les bornes physiques du tracé (les limites horizontales et verticales). Si la seconde série d’observations présente une dispersion décalée vers des valeurs plus élevées ou une fréquence d’effectif maximale supérieure à celle de la première série, les barres du second histogramme seront tronquées de manière arbitraire au niveau des frontières invisibles du graphique, faussant irrémédiablement la perception du lecteur.
3.2 Calibration des limites d’axes avec xlim et ylim
Pour parer à tout risque de troncature visuelle ou de distorsion des fréquences, l’analyste doit impérativement procéder à une calibration manuelle préalable de l’espace métrique. Cette démarche implique de calculer dynamiquement l’enveloppe globale englobant l’intégralité des séries de données à superposer, tant sur l’axe des abscisses que sur l’axe des ordonnées.
Sur l’axe horizontal, l’intervalle optimal s’obtient en déterminant le minimum absolu et le maximum absolu calculés sur la réunion de tous les vecteurs d’échantillonnage. La fonction range(), appliquée à l’agrégation des données au moyen de l’instruction range(c(x1, x2)), fournit le vecteur de deux éléments requis pour renseigner l’argument xlim au sein du premier appel à hist(). De la sorte, le canevas initial offre une marge spatiale suffisante pour accueillir les observations du second groupe sans déborder de la zone visible.
Concernant l’axe vertical, l’opération requiert une subtilité computationnelle supérieure. Il ne suffit pas de considérer les valeurs brutes des données, mais bien les fréquences maximales atteintes par les classes d’intervalles respectives. Une méthode canonique et élégante consiste à exécuter la fonction hist() de manière fictive sur chaque échantillon en spécifiant l’argument plot = FALSE. Les objets résultants contiennent un attribut counts (ou density). Il suffit alors d’extraire le maximum global de ces vecteurs de comptage et d’assigner à ylim une plage allant de zéro jusqu’à ce plafond théorique, idéalement majoré d’une marge de dix à quinze pour cent afin de réserver l’espace nécessaire à l’implantation ultérieure d’une légende informative.
3.3 Gestion de l’opacité et palette de couleurs
Le principal écueil sémiotique de la superposition directe réside dans le phénomène d’occlusion : le premier plan graphique est susceptible de masquer irrémédiablement les éléments positionnés à l’arrière-plan si les surfaces géométriques sont rendues avec des teintes totalement opaques. L’emploi naïf des couleurs fondamentales du système préinstallé (telles que col = "blue" et col = "red") produit une figure visuellement inacceptable où la seconde distribution oblitère les variations structurelles de la première.
La résolution de cette impasse repose sur la gestion du canal alpha, qui régit le degré d’opacité ou de transparence des polygones affichés. Dans l’environnement Base R, la fonction rgb() s’avère la commande d’élection pour synthétiser des couleurs sur mesure intégrant cette composante de transparence. Elle requiert la spécification des trois composantes chromatiques fondamentales (rouge, vert, bleu) normalisées entre 0 et 1, complétées par un quatrième paramètre nommé alpha.
Un réglage empirique de la valeur alpha aux alentours de 0.4 ou 0.5 permet d’atteindre un équilibre perceptif optimal. À ce niveau de translucidité, la zone d’intersection spatiale où les deux distributions se recouvrent génère naturellement une troisième teinte par synthèse soustractive (par exemple, la conjonction d’un bleu translucide et d’un rouge translucide engendre un pourpre distinct). Cette coloration émergente délimite sans ambiguïté la surface de recouvrement inter-groupes, offrant au regard du statisticien une lecture simultanée des zones propres à chaque condition expérimentale et de leur domaine de variabilité partagée.
4. Personnalisation académique du tracé en Base R
4.1 Insertion et ancrage stratégique d’une légende explicative
Une figure scientifique dénuée de légende ou affichant des repères textuels ambigus est inexploitable dans le cadre d’un manuscrit soumis à l’évaluation par les pairs. Dans le moteur graphique de Base R, l’intégration d’une légende ne s’opère pas de façon automatisée ; elle exige l’appel explicite de la fonction secondaire de bas niveau nommée legend() après que l’ensemble des calques de distribution ont été projetés sur le canevas.
L’ancrage spatial de cet encart informatif doit faire l’objet d’une sélection minutieuse afin d’éviter tout recouvrement préjudiciable avec les zones de haute densité de données. La fonction legend() accepte des arguments de positionnement géométrique absolus (coordonnées x et y) ou, plus commodément, des chaînes de caractères topologiques normalisées telles que "topright", "topleft" ou "top". En ajustant préalablement l’ordonnée maximale via le paramètre ylim pour ménager une zone supérieure dégagée, l’insertion dans l’un des angles supérieurs du graphique garantit une lisibilité irréprochable sans parasiter le profil des cloches distributionnelles.
L’harmonisation sémiotique impose de corréler rigoureusement les étiquettes textuelles avec les propriétés matérielles du tracé. Le paramètre fill de la fonction legend() doit recevoir exactement le même vecteur de teintes translucidées configurées via la fonction rgb() que celui utilisé pour dessiner les colonnes des histogrammes. Pour affiner l’esthétique du manuscrit, il est conseillé de moduler l’échelle typographique via le paramètre cex, de spécifier la bordure de la boîte avec bty = "n" si l’on souhaite épurer le cadre, ou de maintenir un encadrement minimal discret via bty = "o" avec un fond blanc légèrement opaque pour préserver la netteté du texte face au quadrillage sous-jacent.
4.2 Harmonisation des intervalles de classe (breaks)
L’un des biais les plus insidieux lors de la comparaison conjointe de plusieurs histogrammes découle de la discordance potentielle des intervalles de discrétisation, techniquement désignés sous le terme de classes ou de coupures (breaks). Par défaut, l’algorithme sous-jacent de la fonction hist() recourt à la formule de Sturges pour déterminer le nombre optimal d’intervalles en fonction de la taille de l’échantillon. Si deux échantillons présentent des effectifs distincts ou des étendues asymétriques, R calculera des largeurs de classes différentes pour chacun d’eux, rendant toute comparaison visuelle rigoureusement caduque.
Des coupures asynchrones trompent l’œil humain : une barre plus étroite semblera spontanément représenter une fréquence relative moindre, tandis qu’un décalage des bornes peut masquer la coïncidence de modes distributionnels. Pour neutraliser ce facteur confondant, le chercheur doit imposer un découpage commun, strict et homogène à l’ensemble des distributions superposées. Cela se concrétise par la formulation explicite d’un vecteur numérique régulier transmis à l’argument breaks de chaque appel à la fonction hist().
La génération de ce vecteur partagé s’effectue avantageusement par le biais de la commande seq(). Il s’agit de définir une borne inférieure minimale, une borne supérieure maximale et un incrément constant (la largeur de classe), englobant l’intégralité des données expérimentales. Par exemple, l’instruction seq(min_global, max_global, by = 2) contraint l’interpréteur à découper chaque échantillon selon des compartiments d’exactement deux unités d’amplitude, alignés sur les mêmes frontières d’abscisse. Dès lors, toute disparité de hauteur de barre reflète une variation effective de densité statistique et non un artefact algorithmique lié au partitionnement des données.
4.3 Typographie et annotations formelles des axes
La conformité d’une figure graphique aux normes rédactionnelles académiques, à l’instar de celles préconisées par l’American Psychological Association (APA), impose de proscrire les intitulés automatiques générés par défaut par les logiciels statistiques. Le titre standard tel que « Histogram of x1 » doit impérativement être neutralisé ou remplacé par une titraille sobre et informative au travers de l’argument main = "".
Les désignations des axes d’abscisse et d’ordonnée méritent un soin particulier. L’argument xlab doit porter la mention exhaustive de la variable mesurée, incluant systématiquement entre parenthèses son unité métrique normalisée (par exemple, « Temps de réaction (en millisecondes) » ou « Score d’anxiété pré-opératoire (unités standardisées) »). L’axe des ordonnées, paramétré par l’argument ylab, doit expliciter la nature de la grandeur représentée : s’agit-il d’un simple dénombrement d’occurrences (« Fréquence » ou « Effectif ») ou d’une estimation normalisée (« Densité de probabilité ») ? Cette rigueur prévient toute ambiguïté interprétative chez le relecteur.
Enfin, l’adjonction de repères de tendance centrale enrichit considérablement la puissance d’analyse du graphique. L’utilisation de la fonction de bas niveau abline() permet de projeter des lignes verticales ponctuelles coïncidant avec l’espérance mathématique ou la médiane de chaque groupe expérimental. En spécifiant pour chaque droite le code couleur associé au groupe respectif, un style de tracé contrasté (tel que des tirets via lty = 2) et une épaisseur calibrée (lwd = 2), la figure combine immédiatement l’observation de la forme distributionnelle globale et la quantification visuelle de l’écartement des paramètres de position centrale.
5. Méthode 2 – Superposition d’histogrammes avec ggplot2
5.1 Fondements de la grammaire des graphiques appliquée aux distributions
L’extension ggplot2 repose sur les concepts théoriques de la grammaire des graphiques, un paradigme formel postulant que toute représentation visuelle de données est une combinatoire ordonnée de données sources, d’un système de coordonnées géométriques, d’associations esthétiques (aesthetic mappings) et d’entités géométriques tangibles (geoms). Appliquée à l’analyse distributionnelle comparative, cette architecture élimine les manipulations manuelles complexes inhérentes au système Base R.
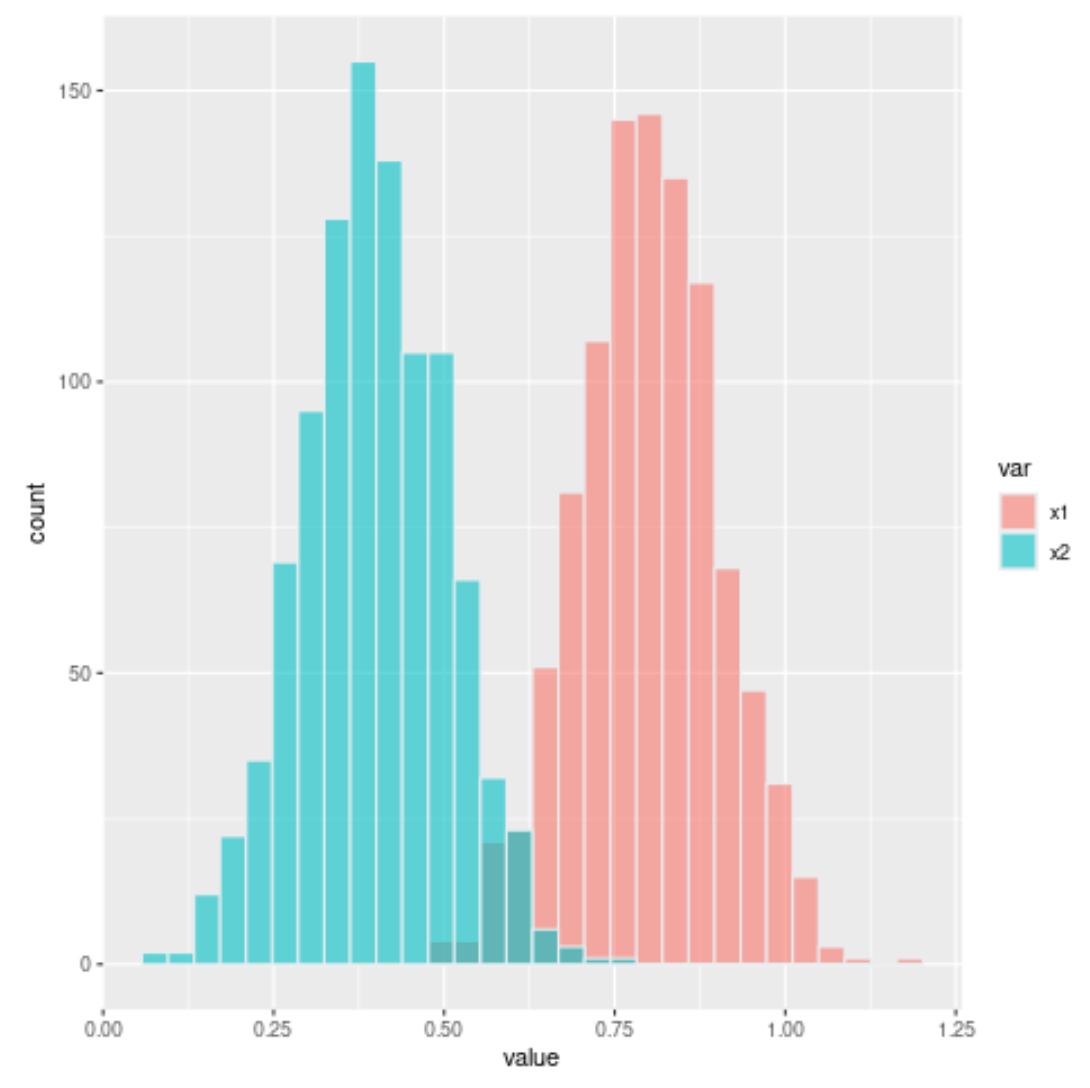
Pour construire une superposition d’histogrammes au sein de ggplot2, l’utilisateur instancie la toile de fond via la fonction ggplot(), en liant le jeu de données sous format long préalablement confectionné. La variable quantitative continue est projetée sur l’axe des abscisses par l’association aes(x = variable_mesure), tandis que la variable factorielle définissant les groupes d’appartenance est affectée au paramètre esthétique de remplissage via fill = variable_groupe. Cette simple déclaration indique à l’algorithme que les calculs de partitionnement des données et les attributions chromatiques devront être déclinés automatiquement selon les modalités de ce facteur.
Le calque effectuant le découpage en classes et le décompte des observations est instancié par la commande geom_histogram(). Contrairement aux approches procédurales, ggplot2 prend en charge de façon autonome l’estimation des échelles extrêmes : l’axe vertical est calibré dynamiquement pour héberger le sommet de la plus haute distribution, l’abscisse intègre la totalité des minima et maxima sans nécessiter de calcul préalable, et une légende analytique exhaustive est spontanément générée en marge droite du canevas, garantissant un flux de production graphique à la fois élégant et parfaitement reproductible.
5.2 Configuration du paramètre position = ‘identity’
L’un des comportements algorithmiques par défaut de la fonction geom_histogram() constitue une source fréquente de contresens pour le statisticien non averti. Par conception initiale dédiée aux variables qualitatives discrètes, le paramètre de positionnement spatial est fixé sur position = "stack". Dans ce mode empilé, les barres du second groupe statistique viennent se greffer physiquement au sommet des barres du premier groupe, le point de départ vertical de chaque segment étant la fréquence cumulée des catégories sous-jacentes.
Si l’empilement conserve la valeur de l’effectif global agrégé, il ruine totalement la lisibilité morphologique des sous-distributions. Le profil supérieur du second groupe se trouve déformé par les fluctuations d’amplitude du premier groupe, rendant l’appréciation de sa symétrie et de son centre de gravité rigoureusement impossible. Pour neutraliser cet artefact et contraindre les distributions à s’exprimer sur une ligne de base commune, il est absolument indispensable de forcer le positionnement au moyen de la clause position = "identity".
Avec position = "identity", chaque groupe voit ses fréquences mesurées et projetées à partir du zéro cartésien originel de l’axe des ordonnées. Les barres ne s’additionnent plus géométriquement dans l’espace vertical mais s’interpénètrent sur le même plan. Cette disposition permet une comparaison directe, rigoureuse et non faussée des hauteurs de colonnes respectives pour chaque intervalle de mesure continu, condition sine qua non d’une inférence visuelle recevable dans le cadre d’un rapport de recherche académique.
5.3 Optimisation du canal de transparence via l’argument alpha
L’activation de l’instruction position = "identity" soulève immédiatement la problématique de la dissimulation mutuelle des calques : par défaut, les formes pleines associées aux premières modalités déclarées dans le facteur risquent d’être masquées par les barres des modalités traitées ultérieurement lors de l’exécution graphique. La résolution de ce défi sémiotique requiert la modulation explicite de l’attribut de translucidité alpha au sein de l’instruction geom_histogram().
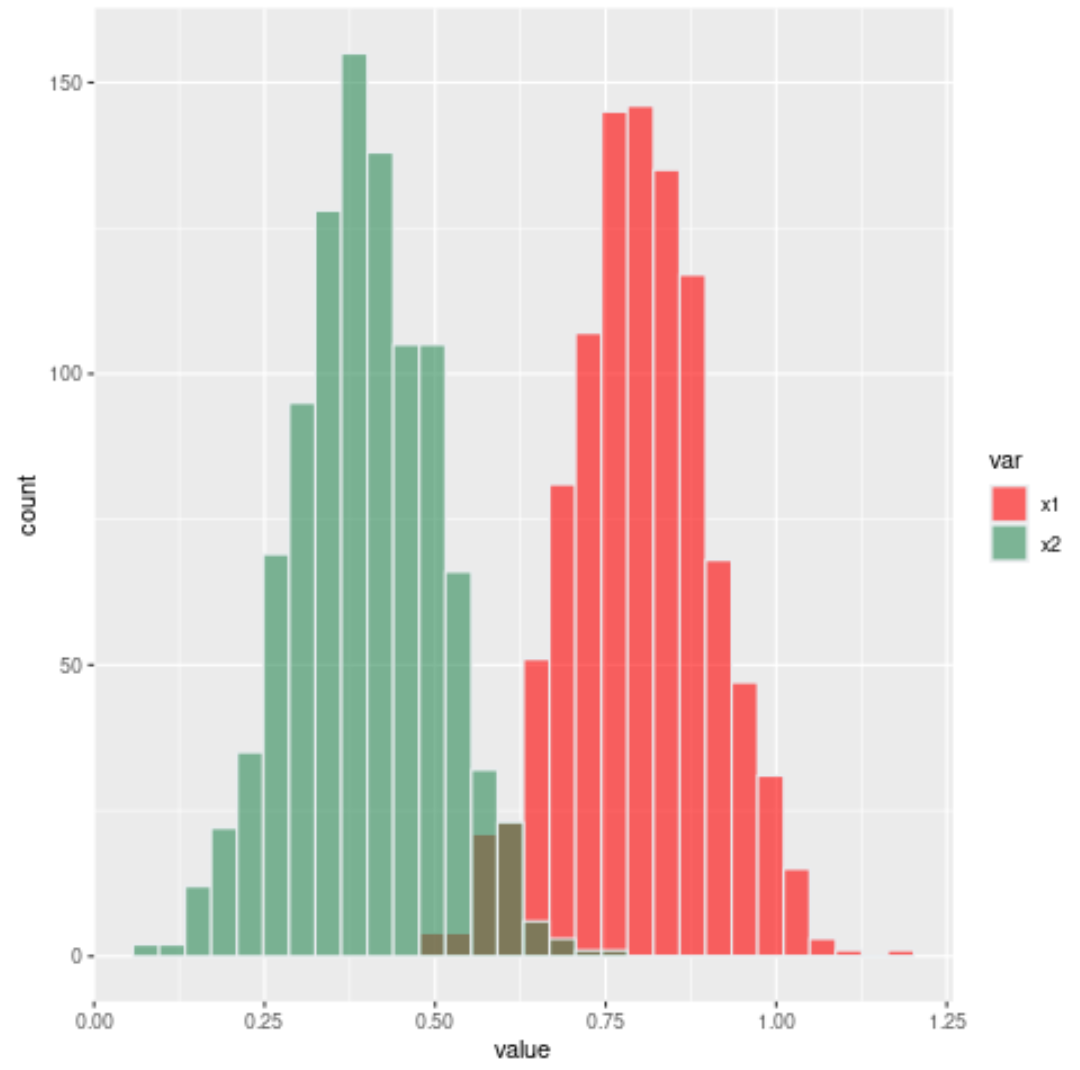
L’argument alpha prend pour valeur un nombre décimal compris sur le continuum unitaire allant de 0 (invisibilité absolue) à 1 (opacité totale). Dans le contexte spécifique de la superposition de distributions continues, une valeur paramétrée entre 0.35 et 0.50 s’impose comme le compromis idéal dans la littérature spécialisée. Ce niveau d’opacité modérée garantit que la teinte fondamentale de chaque groupe expérimental demeure nettement identifiable par le système visuel humain, tout en assurant une perméabilité lumineuse suffisante pour distinguer les contours des colonnes situées au second plan.
Il importe toutefois de souligner une limite méthodologique inhérente à la superposition directe : lorsque l’analyse vise à comparer simultanément plus de trois distributions distinctes, la combinatoire des transparences engendre une saturation perceptuelle importante. L’intersection de multiples couches translucides engendre une mosaïque de teintes composites complexes que l’œil humain peine à désenchevêtrer. Dans ce cas de figure précis, le chercheur devra arbitrer entre la superposition sous alpha réduit et le recours aux approches de juxtaposition partitionnée, comme nous le verrons ultérieurement.
6. Ajustements esthétiques et sémiotiques sous ggplot2
6.1 Attribution manuelle des palettes de couleurs
La restitution graphique de données scientifiques ne saurait se satisfaire des palettes de couleurs génériques saturées souvent proposées par défaut dans les logiciels non spécialisés. En recherche biomédicale et psychologique, l’attribution chromatique doit répondre à des critères d’accessibilité universelle et de rigueur sémiotique, notamment en garantissant la perceptibilité des contrastes par les lecteurs atteints de déficiences de la vision des couleurs (daltonisme sous ses formes deutéranope, protanope ou tritanope).
L’extension ggplot2 offre un contrôle total de la charte graphique par l’intermédiaire de la fonction scale_fill_manual(). Cette primitive permet à l’analyste d’injecter des vecteurs de codes hexadécimaux validés scientifiquement. L’emploi de palettes perceptuellement uniformes issues de projets reconnus, tels que la bibliothèque Viridis (via scale_fill_viridis_d()) ou les nuanciers de Cynthia Brewer formalisés dans RColorBrewer, est vivement préconisé. Ces palettes assurent une transition de luminosité constante même lors d’une impression du manuscrit en niveaux de gris purs.
En outre, pour parfaire la démarcation morphologique des colonnes lorsque des valeurs alpha faibles sont appliquées, il est particulièrement élégant de dissocier le remplissage intérieur des barres de leur délinéation périphérique. En insérant l’argument color = "black" (ou une tonalité gris sombre) directement à l’intérieur de geom_histogram(), tout en maintenant l’association de fill à la variable catégorielle, chaque barre reçoit une bordure linéaire opaque d’une netteté parfaite. Cette frontière géométrique résout élégamment le flou visuel pouvant naître de la superposition de teintes dégradées.
6.2 Étalonnage méthodique de la largeur des classes (binwidth)
L’un des avertissements les plus récurrents retournés par l’environnement ggplot2 lors de l’appel à geom_histogram() signale l’adoption automatique d’un partitionnement arbitraire en trente classes : « stat_bin() using bins = 30. Pick better value with binwidth ». Ce paramétrage standard, bien que commode pour générer un aperçu exploratoire sans blocage computationnel, s’avère dans l’immense majorité des contextes expérimentaux profondément inadapté à la structure sous-jacente des données observées.
Un nombre de classes exagérément faible engendre un phénomène de sous-lissage dévastateur, lissant les modes réels, masquant l’asymétrie potentielle et assimilant arbitrairement la distribution à un bloc uniforme monolithique. À l’inverse, une fragmentation démesurée (un nombre excessif de classes d’amplitudes infimes) produit un sur-lissage discontinu où chaque fluctuation échantillonnale mineure se traduit par des creux et des pointes artificiels, dénués de toute signification statistique populationnelle. La maîtrise de l’argument binwidth (qui définit l’amplitude numérique de chaque classe) est donc primordiale.
Pour fonder le calibrage de l’amplitude binwidth sur des bases objectives et réplicables, la littérature statistique recommande l’application de formules formalisées. La règle de Scott calibre l’amplitude des classes sur la variance de l’échantillon et la taille $n$ selon la formule $h = 3.49 \times s \times n^{-1/3}$, où $s$ désigne l’écart-type de l’échantillon. Pour les distributions s’écartant sensiblement de la normalité idéale ou présentant des queues allongées, la règle de Freedman-Diaconis s’impose comme une alternative robuste supérieure : elle substitue l’écart-type par l’écart interquartile (IQR), calculant l’amplitude selon l’expression mathématique $h = 2 \times \mathrm{IQR}(x) \times n^{-1/3}$. L’analyste averti calculera cette valeur théorique préalablement et l’assignera rigoureusement à l’argument binwidth.
6.3 Adoption d’un thème épuré pour manuscrit scientifique
L’environnement graphique par défaut de ggplot2 se singularise par son arrière-plan grisâtre quadrillé de sillons blancs. Si cette disposition sémiotique possède des vertus perceptives démontrées par Jacques Bertin pour la comparaison d’aires isolées, elle est formellement rejetée par la quasi-totalité des comités éditoriaux des revues scientifiques de premier rang, qui réclament des arrière-plans immaculés pour des impératifs d’économie d’encrage et de sobriété typographique.
Le remplacement du thème de base s’opère commodément par l’adjonction de couches thématiques préconfigurées intégrées au package. L’instruction theme_classic() constitue la référence par excellence pour satisfaire aux critères formels des publications internationales : elle supprime instantanément la trame de fond grise, élimine le quadrillage intérieur résiduel et matérialise des axes orthonormés continus accompagnés de graduations d’une sobriété exemplaire. Pour les chercheurs préférant conserver une trame structurelle discrète, la fonction theme_minimal() offre un compromis d’une grande distinction visuelle.
La personnalisation s’étend en outre à l’encapsulation sémantique des métadonnées grâce à l’opérateur polyvalent labs(). Cette instruction permet d’écraser les intitulés informatiques pour intégrer des libellés typographiquement soignés via labs(x = "Grandeur mesurée (unités)", y = "Effectif cumulé", fill = "Condition expérimentale"). Le sous-système theme() autorise enfin des réglages microscopiques sur la disposition spatiale de la légende : l’instruction theme(legend.position = "top") ou theme(legend.position = c(0.85, 0.85)) permet d’ancrer le bloc explicatif au cœur d’un quadrant dégagé du graphique, maximisant ainsi l’espace horizontal alloué à l’expression des données.
7. Approche alternative – La juxtaposition par facettage
7.1 Découpage horizontal ou vertical avec facet_wrap et facet_grid
Bien que la superposition directe demeure hautement efficace pour comparer deux cohortes statistiques distinctes, elle atteint rapidement ses limites cognitives dès lors que l’expérience met en scène trois, quatre ou cinq conditions factorielles. Dans de telles configurations, la complexité des zones de transparence croisées induit une surcharge visuelle préjudiciable à l’interprétation. L’alternative méthodologique majeure conceptualisée par Edward Tufte sous l’appellation de « petits multiples » réside dans la juxtaposition partitionnée, implémentée nativement dans ggplot2 via le mécanisme de facettage.
Le facettage consiste à décomposer le graphique global en une matrice de sous-graphiques autonomes partageant un système de coordonnées synchronisé, chaque panneau individuel isolant les observations associées à une modalité spécifique du facteur d’intérêt. La fonction facet_wrap() constitue l’outil de référence pour ventiler une séquence univariée de modalités. En formulant l’instruction facet_wrap(~ variable_groupe, ncol = 1), le chercheur agence l’ensemble des histogrammes sur une colonne verticale unifiée. Cet empilement vertical s’avère particulièrement pertinent pour comparer des distributions continues, dans la mesure où l’œil humain peut instantanément balayer de haut en bas les variations de positionnement horizontal de l’axe des abscisses.
Pour les plans expérimentaux croisés plus complexes impliquant deux variables indépendantes discrètes simultanées (par exemple, le sexe biologique croisé avec le statut du traitement thérapeutique), l’analyste mobilisera la commande facet_grid(facteur_A ~ facteur_B). Cette instruction projette une grille orthogonale rigoureuse où les lignes matérialisent les modalités du premier facteur et les colonnes celles du second. Chaque cellule héberge l’histogramme de la sous-population correspondante, autorisant une décomposition fine des interactions statistiques de second ordre.
7.2 Gestion stratégique de l’indépendance des échelles d’axes
La gouvernance des échelles d’axes au sein des panneaux facettés représente un enjeu critique de validité statistique. Par défaut, l’environnement ggplot2 impose un verrouillage absolu et homogène de l’ensemble des systèmes d’axes au travers du paramètre scales = "fixed". Dans cette configuration universelle, chaque sous-graphique partage rigoureusement les mêmes bornes minimales et maximales tant en abscisse qu’en ordonnée.
Le maintien d’échelles fixes constitue une règle méthodologique fondamentale pour garantir une comparaison non biaisée de la dispersion et de l’amplitude des fréquences. Autoriser une libération incontrôlée des échelles peut tromper l’interprétation : un sous-groupe comptant cinquante individus semblera graphiquement occuper le même volume vertical qu’un échantillon en comprenant cinq mille si l’axe des hauteurs est mis à l’échelle de façon autonome sur chaque sous-graphique.
Néanmoins, des circonstances expérimentales exceptionnelles justifient l’assouplissement de cette règle. Lorsque les effectifs inter-groupes sont structurellement déséquilibrés par conception d’échantillonnage, l’application de scales = "free_y" autorise l’axe vertical à épouser les maxima singuliers de chaque modalité, empêchant ainsi l’écrasement visuel complet du groupe minoritaire sous forme d’un trait horizontal imperceptible. En revanche, la libération de l’axe horizontal via scales = "free_x" doit être rigoureusement proscrite lors de la comparaison de distributions d’une même métrique, sous peine d’induire une confusion cognitive sévère en décalant artificiellement les repères d’abscisse d’un panneau à l’autre.
7.3 Comparatif décisionnel : superposition directe versus petits multiples
L’arbitrage entre la superposition directe d’histogrammes au sein d’un tracé unique et la juxtaposition facettée en petits multiples repose sur un compromis sémiotique entre acuité locale et évaluation globale du décalage distributionnel. Chacune de ces deux représentations privilégie une dimension spécifique de l’analyse inférentielle visuelle.
La superposition directe excelle de manière incomparable pour apprécier immédiatement un décalage de localisation centrale (translation de la moyenne ou de la médiane) ainsi que la proportion relative de recouvrement empirique entre deux échantillons. L’interpénétration visuelle des barres colorées offre au cortex visuel un indice immédiat sur la magnitude de la taille d’effet : plus la teinte intermédiaire est vaste, plus les populations partagent de variabilité commune. Dès lors qu’il s’agit d’un devis classique à deux groupes (témoin versus traité), la superposition demeure l’approche la plus synthétique et la plus percutante pour un auditoire scientifique.
À l’opposé, la juxtaposition partitionnée s’impose impérativement dès que l’analyste cherche à explorer la granularité structurelle interne de multiples cohortes. L’isolement de chaque histogramme sur son panneau dédié supprime totalement les occlusions parasites. Elle offre un confort visuel optimal pour diagnostiquer l’apparition de modes multiples secondaires, repérer des asymétries subtiles ou quantifier l’étalement idiosyncrasique des queues de distribution au sein de sous-groupes cliniques complexes. En pratique exploratoire, le chercheur avisé adoptera fréquemment une démarche complémentaire : le facettage pour l’audit approfondi de ses variables en phase de laboratoire, suivi de la superposition calibrée pour la communication synthétique des conclusions princeps dans l’article final.
8. Combinaison d’histogrammes et d’estimations de densité par noyau
8.1 Conversion de l’ordonnée des effectifs en densités de probabilité
La comparaison d’histogrammes au moyen de dénombrements bruts d’effectifs (le comptage d’occurrences sur l’axe vertical) devient méthodologiquement invalide dès lors que les cohortes statistiques soumises à examen comportent des volumes d’échantillonnage dissemblables. Une cohorte comprenant deux mille sujets affichera mécaniquement des colonnes dix fois plus volumineuses qu’un groupe de deux cents individus, occultant la réalité de leurs profils probabilistes respectifs. Pour restaurer l’équité comparative, il est impératif de normaliser les fréquences en densités statistiques.
Une densité statistique est calculée de sorte que l’aire cumulée de l’ensemble des rectangles formant l’histogramme soit rigoureusement égale à l’unité (soit une surface totale de 1). Dans le système Base R, cette normalisation s’opère de façon immédiate en renseignant l’argument freq = FALSE ou son alias sémantique prob = TRUE au sein de la fonction hist(). L’axe des ordonnées cesse alors d’exprimer des effectifs discrets pour graduer des probabilités par unité de mesure continue.
Au sein de l’environnement ggplot2, cette transmutation d’échelle s’accomplit en détournant le mécanisme interne de transformation statistique de geom_histogram(). Il convient de renseigner explicitement l’esthétique d’ordonnée via la syntaxe moderne d’évaluation différée aes(y = after_stat(density)). Sous cette directive computationnelle, le moteur graphique remplace les dénombrements bruts par les densités relatives calculées. Les distributions de deux échantillons d’amplitudes numériques hautement divergentes deviennent dès lors parfaitement superposables et directement comparables sur un pied d’égalité géométrique.
8.2 Tracé simultané des courbes de densité lissées
Bien que l’histogramme normalisé constitue une description empirique irréprochable de l’échantillon, sa morphologie en gradins discontinus demeure tributaire de l’ancrage et de l’amplitude des coupures de classes. Pour transcender cette fragmentation et modéliser le profil théorique générateur sous-jacent, la projection conjointe d’une estimation de densité par noyau (KDE pour Kernel Density Estimation) représente un raffinement analytique de premier ordre.
L’estimation par noyau substitue à chaque observation discrète une petite fonction gaussienne lissée centrée sur le point de mesure, puis procède à l’intégration continue de l’ensemble de ces contributions le long de l’axe réel. Dans Base R, l’adjonction s’effectue séquentiellement en appliquant l’instruction lines(density(x1), col = "blue", lwd = 2) après le tracé de l’histogramme probabiliste de référence. La largeur de bande (bandwidth), qui régit le degré de lissage du noyau, peut être modulée au sein de la fonction density() pour éviter le sur-ajustement des micro-fluctuations locales.
Dans ggplot2, l’intégration s’exécute de manière déclarative par l’adjonction d’un calque géométrique dédié geom_density() superposé à l’histogramme configuré en after_stat(density). Pour obtenir une figure harmonieuse, il est courant de dessiner l’histogramme avec une opacité très légère (par exemple, alpha = 0.2) pour faire office d’écho empirique discret, tandis que la courbe de densité associée est tracée au moyen de geom_density(fill = NA, size = 1). La courbe continue guide ainsi le regard du lecteur à travers les inflexions majeures de la distribution, offrant une lecture sémiotique double alliant la fidélité aux données discrètes brutes et la pureté d’un profil modélisé continu.
8.3 Ajout d’indicateurs de position centrale sur la distribution
L’interprétation visuelle d’une distribution probabiliste ne prend son plein sens que lorsqu’elle est mise en regard des paramètres synthétiques qui la caractérisent au plan inférentiel. Si l’histogramme déploie la forme intégrale des données, l’incorporation explicite de droites de tendance centrale structure le jugement critique de l’évaluateur quant à la séparation statistique effective des groupes examinés.
Dans ggplot2, cette contextualisation numérique s’opère magistralement par l’intermédiaire du calque geom_vline() (lignes de repère verticales). L’analyste peut préalablement assembler un petit tableau récapitulatif agrégeant les moyennes arithmétiques ou les médianes calculées pour chaque modalité factorielle. L’injection de ce tableau dans geom_vline() permet de relier le paramètre xintercept aux valeurs moyennes estimées, tout en synchronisant la coloration des traits au moyen de l’esthétique color = Groupe.
Pour optimiser la sémiotique de la figure, il est préconisé d’attribuer aux traits de tendance centrale un style distinctif, tel qu’un tracé tireté épais (linetype = "dashed", size = 0.8). Ce contraste de texture géométrique garantit que les axes de positionnement émergent nettement du remplissage translucide des colonnes d’histogrammes et des tracés de densité continus. L’observateur apprécie ainsi simultanément la translation spatiale de l’espérance mathématique inter-groupes et l’amplitude de chevauchement résiduelle qui subsiste au sein des distributions expérimentales respectives.
9. Application concrète à un devis de recherche psychologique
9.1 Cas pratique 1 : Évaluation de scores d’anxiété pré et post-intervention
Afin d’illustrer la mise en œuvre empirique de ces principes méthodologiques, considérons un protocole de recherche clinique quasi-expérimental à mesures répétées destiné à tester l’efficacité d’un protocole innovant de réduction du stress basé sur la méditation de pleine conscience. Cent cinquante participants souffrant de troubles anxieux modérés ont été évalués au moyen d’un inventaire psychométrique standardisé (score composite continu variant de 20 à 80) lors d’une phase pré-thérapeutique (T0), puis réévalués consécutivement après huit semaines d’entraînement intensif (T1).
La génération synthétique de ce devis psychologique sous R mobilise la fonction rnorm() pour instancier les mesures initiales (moyenne fixée à 58.5, écart-type de 7.2) et les scores postérieurs à l’intervention (caractérisés par un affaissement thérapeutique vers une moyenne de 43.1 et un écart-type de 8.4, traduisant une variabilité accrue de la réponse clinique). Ces deux séries sont encapsulées au sein d’un tableau au format long doté d’une variable de score quantitative et d’un facteur binaire désignant le temps de recueil expérimental.
Le script d’exploitation sous ggplot2 met en synergie l’ensemble des préceptes étudiés : utilisation de geom_histogram() calibré avec un binwidth = 2, forçage sur position = "identity" avec un indice d’opacité alpha = 0.45, et normalisation des densités via after_stat(density). L’application d’une palette contrastée associant une teinte chaude pour la condition pré-thérapeutique et une tonalité froide apaisante pour le post-traitement traduit graphiquement le soulagement symptomatique, tandis que la superposition d’un calque de densité geom_density() permet de constater d’un seul coup d’œil le glissement global de la distribution vers les faibles valeurs d’anxiété sans altération majeure de la symétrie unimodale.
9.2 Cas pratique 2 : Chronométrie mentale et temps de réaction cognitifs
Un second cas d’étude paradigmatique relève du domaine de la chronométrie mentale en psychologie cognitive expérimentale. Dans le cadre d’un paradigme de type interférence de Stroop, les chercheurs recueillent des temps de réaction latents (exprimés en millisecondes) sous deux conditions d’activation : une condition congruente où l’information sémantique facilite le traitement moteur, et une condition incongruente imposant la mise en jeu d’un contrôle exécutif inhibiteur pour juguler l’interférence cognitive.
Contrairement aux scores psychométriques globaux qui épousent fréquemment une distribution normale par agrégation de composantes discrètes, les temps de réaction chronométriques sont physiologiquement contraints par une frontière physique incompressible (le temps de conduction synaptique minimal, de l’ordre de 200 millisecondes) et caractérisés par une longue queue de distribution s’étirant vers les durées élevées. Cette structure distributionnelle asymétrique positive est rigoureusement modélisée par une loi log-normale au travers de la primitive rlnorm().
La superposition des distributions de temps de latence révèle des propriétés statistiques invisibles sur de simples diagrammes en barres d’erreurs. Dans la condition incongruente, non seulement le mode de la distribution subit un décalage vers la droite attestant du coût attentionnel de l’inhibition, mais la queue distributionnelle présente un étirement spectaculaire vers les valeurs extrêmes supérieures. L’emploi d’un histogramme superposé intégrant une échelle logarithmique sur l’axe des abscisses (via scale_x_log10()) offre à l’expérimentateur le moyen d’apprécier la normalisation du profil géométrique tout en mettant en relief la dérive de l’effort computationnel induite par la tâche d’interférence cognitive.
9.3 Diagnostic visuel de la normalité et des écarts types inter-groupes
Au-delà de la simple illustration de résultats descriptifs, la visualisation d’histogrammes superposés ou juxtaposés constitue un puissant protocole d’audit diagnostique préalable à la conduite de l’inférence formelle. De nombreuses modélisations statistiques fondamentales, à l’instar du modèle linéaire général, de l’ANCOVA ou des régressions hiérarchiques, reposent sur l’hypothèse de l’homoscédasticité (l’égalité des variances intra-groupes) et sur la normalité asymptotique des résidus d’échantillonnage.
L’inspection conjointe de la morphologie des histogrammes permet d’évaluer de façon intuitive la plausibilité de ces hypothèses fondamentales. L’égalité des variances se matérialise visuellement par une largeur d’empilement rigoureusement identique des bases de cloches. Si un groupe expérimental présente un profil étalé et aplati tandis que le groupe contrôle forme une colonne étroite et élancée, l’hétéroscédasticité est immédiatement flagrante, alertant le chercheur sur la nécessité de délaisser le test t classique au profit d’une correction robuste de Welch ou d’une modélisation linéaire généralisée appropriée.
Ce diagnostic morphologique opère en parfaite synergie avec les tests inférentiels canoniques de normalité et d’homoscédasticité, tels que le test de Shapiro-Wilk (shapiro.test()) ou le test de Levene pour l’homogénéité des variances. Il est notoire que les tests de normalité formels deviennent hypersensibles face à de très grands échantillons, rejetant fréquemment l’hypothèse nulle pour des écarts de symétrie minuscules et sans conséquence pratique sur la robustesse du modèle. L’histogramme superposé offre dans ce contexte l’arbitrage visuel qualitatif nécessaire pour corroborer la viabilité pratique des approximations statistiques adoptées.
10. Pièges statistiques fréquents et erreurs de visualisation
10.1 Biais d’interprétation induit par le masquage et l’opacité
La pratique de la superposition géométrique n’est pas exempte d’écueils cognitifs sévères. Le piège le plus insidieux réside dans le masquage structurel partiel ou total d’une sous-distribution par une autre, résultant d’un choix défaillant de l’ordre d’empilement des calques ou d’une saturation chromatique mal calibrée. Si une distribution étroite et concentrée se trouve positionnée à l’arrière-plan d’une distribution volumineuse et opaque, la silhouette de la première sera entièrement oblitérée du regard critique de l’analyste.
Dans l’environnement procédural de Base R, cet écueil découle directement de la chronologie des commandes graphiques. La première distribution tracée se situe immanquablement au niveau inférieur de l’empilement du canevas ; chaque appel ultérieur avec add = TRUE dépose une strate géométrique opaque qui recouvre physiquement la précédente. Inverser l’ordre séquentiel d’appel des fonctions hist() peut métamorphoser radicalement la physionomie perçue de la figure finale si les canaux alpha n’ont pas été calibrés avec un soin extrême, créant une asymétrie de visibilité hautement préjudiciable.
Pour neutraliser ce biais, il est impératif d’évaluer de manière systématique le contraste des zones d’interférence lumineuse. Le recours à des contours de démarcation linéaires sombres sur le périmètre des colonnes, conjugué à un niveau de translucidité ne dépassant jamais 50 %, permet de garantir que les arêtes de la forme d’arrière-plan demeurent visibles au travers de la masse géométrique du premier plan. En cas de chevauchement complexe impossible à démêler sans compromis, l’analyste se conformera aux impératifs d’honnêteté intellectuelle en migrant résolument vers une représentation facettée non ambiguë.
10.2 Disparités de calibrage des classes entre séries de données
Une altération majeure de la rigueur scientifique en matière de représentation distributionnelle consiste à laisser l’algorithme sous-jacent déterminer de façon disjointe le partitionnement en classes pour chacun des sous-échantillons comparés. Ce phénomène d’hétérogénéité des coupures engendre des distorsions d’interprétation massives, altérant gravement la comparabilité géométrique des distributions.
Supposons qu’un premier groupe d’individus soit discrétisé avec des classes d’une largeur de cinq unités, tandis que le second groupe, bénéficiant d’un effectif plus restreint, soit segmenté par l’algorithme par défaut en classes de dix unités. Les barres du second échantillon apparaîtront artificiellement larges et volumineuses, tout en lissant artificiellement les variations locales de fréquence. Le cerveau de l’observateur associe instinctivement l’élévation ou la compacité d’un rectangle à une concentration statistique plus ou moins dense, faussant radicalement l’inférence comparative.
Le respect absolu de la comparabilité distributionnelle exige donc d’imposer un vecteur de frontières (bins) rigoureusement invariant sur l’ensemble des cohortes examinées. Quelle que soit la plateforme logicielle mobilisée (paramètre breaks en Base R ou paramètre binwidth synchronisé sur geom_histogram() sous ggplot2), la grille spatiale de discrétisation doit être unitaire, uniforme et partagée par toutes les modalités factorielles sans la moindre exception technique.
10.3 Superposition trompeuse en présence d’échantillons déséquilibrés
L’écrasement visuel d’une distribution minoritaire face à une cohorte numériquement pléthorique représente un travers méthodologique fréquent lors de l’exploitation de données observationnelles, d’enquêtes démographiques ou de registres épidémiologiques massifs. Dans ces situations réelles, il n’est pas rare de devoir confronter un groupe témoin comprenant plusieurs milliers d’individus à un groupe pathologique rare ne regroupant qu’une centaine de sujets.
Si l’analyste génère une superposition d’histogrammes en calibrant l’axe des ordonnées sur le simple dénombrement des effectifs bruts (la métrique standard par défaut), la distribution du groupe rare sera compressée contre le plancher de l’axe des abscisses sous la forme d’un liséré horizontal indistinct. L’observateur sera incapable d’analyser la symétrie, le centre ou l’étalement de cette cohorte, concluant hâtivement à une absence de variabilité statistique significative.
L’obligation méthodologique impose, dans ce cas de figure précis, d’opérer une dissociation stricte entre le volume brut de l’échantillonnage et la morphologie probabiliste de la population sous-jacente. L’abandon impératif des fréquences absolues au profit des densités de probabilités (via after_stat(density) ou prob = TRUE) rétablit la stricte comparabilité géométrique des formes en assignant une aire unitaire normalisée à chaque groupe. En complément indispensable, la taille d’échantillon nominale $n$ de chaque cohorte devra être explicitement intégrée au sein des libellés textuels de la légende explicative, garantissant une transparence interprétative irréprochable.
11. Exportation haute résolution pour manuscrits et publications
11.1 Paramétrage de l’exportation matricielle et vectorielle avec ggsave
La finalisation d’un graphique au sein de R ne s’achève pas à sa simple visualisation dans la fenêtre de rendu dynamique du logiciel. L’intégration de la figure dans un manuscrit scientifique soumis à des revues à fort facteur d’impact impose de se conformer à des exigences éditoriales draconiennes relatives à la résolution typographique, aux chartes dimensionnelles et à l’encodage des formats d’enregistrement graphique.
Au sein du Tidyverse, la commande ggsave() s’impose comme l’utilitaire d’exportation de prédilection pour sauvegarder les objets générés par ggplot2. Cette fonction offre un contrôle direct sur le périphérique de sortie, la dimension géométrique exacte et la résolution spatiale. Le choix entre format matriciel (raster) et format vectoriel constitue la décision d’ingénierie préliminaire essentielle à opérer.
Les formats vectoriels, au premier rang desquels figurent le PDF (Portable Document Format) et l’EPS (Encapsulated PostScript), doivent être systématiquement privilégiés pour les figures destinées à l’édition typographique. En format vectoriel, chaque barre d’histogramme, chaque droite de tendance centrale et chaque glyphe textuel sont transcrits sous forme de primitives mathématiques pures. La figure bénéficie d’une capacité d’agrandissement infinie sans la moindre pixellisation, garantissant une netteté absolue à l’impression. La commande ggsave("figure1.pdf", plot = mon_graphique, width = 16, height = 10, units = "cm", device = cairo_pdf) incarne la norme académique par excellence.
Lorsque les exigences de l’éditeur réclament impérativement des formats d’images matricielles, l’analyste optera pour le format TIFF avec compression sans perte (compression LZW). L’attribut fondamental réside alors dans la densité d’échantillonnage de pixels : le paramètre dpi doit être fixé à un minimum de 300 pour les figures en demi-teintes et de 600 à 1200 DPI pour les schémas linéaires complexes, assurant une conformité parfaite aux critères de netteté des presses universitaires.
11.2 Exportation via les périphériques graphiques natifs de Base R
Pour les figures confectionnées au travers du système graphique natif de Base R, la fonction ggsave() n’est pas opérante. L’exportation académique repose sur la mécanique historique d’ouverture et de clôture explicite des périphériques virtuels d’impression du langage R.
Le protocole computationnel requiert d’invoquer en premier lieu la fonction ouvrant le périphérique ciblé, telle que pdf(), tiff() ou png(), en y spécifiant les dimensions physiques du fichier ainsi que la résolution requise. À titre d’exemple, pour instancier un fichier vectoriel haut de gamme, on exécutera l’instruction pdf("figure_base.pdf", width = 7, height = 5). À compter de cet instant précis, l’ensemble des instructions graphiques successives (les appels successifs à hist(), abline(), lines() et legend()) ne sont plus projetées à l’écran interactif mais gravées séquentiellement dans le fichier conteneur matérialisé sur le disque dur.
L’étape critique de ce flux procédural réside dans l’appel conclusif impératif à la primitive dev.off(). Cette commande ordonne au système d’exploitation de finaliser l’écriture binaire des flux de données graphiques, de purger les mémoires tampons et de clore formellement le descripteur de fichier. L’omission de cette directive laisse le fichier dans un état d’inachèvement corrompu, illisible par les visualiseurs de documents externes. Le contrôle systématique de ce triptyque (ouverture, tracé, clôture) est la clé d’une sauvegarde robuste sous Base R.
11.3 Automatisation et reproductibilité dans un pipeline computationnel
Dans la perspective contemporaine de la science ouverte et de la reproductibilité computationnelle, la génération de figures graphiques ne doit plus être abordée comme une séquence manuelle isolée, mais comme le maillon intégré d’un pipeline d’analyse entièrement automatisé et réplicable à l’infini.
Cette industrialisation méthodologique commence par l’encapsulation de la routine graphique au sein d’une fonction R personnalisée et paramétrable. En convertissant son script de tracé en une macro-fonction prenant en arguments un tableau de données, le nom de la variable dépendante, le facteur de stratification et le vecteur des couleurs, l’analyste peut générer de manière homogène des dizaines d’histogrammes comparatifs à travers une simple itération de type lapply() ou via les outils fonctionnels de la bibliothèque purrr.
L’intégration de ces flux au sein de documents de programmation lettrée, tels que des calepins dynamiques R Markdown ou des environnements de publication scientifique de nouvelle génération comme Quarto, parachève cette démarche d’excellence. La figure est compilée directement à partir des données brutes au moment précis du rendu du manuscrit, éliminant tout risque de désynchronisation accidentelle entre les estimations statistiques rapportées dans le corps du texte et les profils distributionnels illustrés par les histogrammes.
12. Synthèse méthodologique et recommandations comparatives
12.1 Tableau décisionnel : critères de choix entre Base R et ggplot2
Le choix judicieux du moteur d’affichage sous R dépend étroitement du contexte d’intervention, du degré de complexité du devis expérimental et des impératifs d’ingénierie logicielle associés à la recherche. Pour orienter l’analyste dans ses arbitrages quotidiens, un bilan synthétique des forces et contraintes inhérentes à chacune des deux philosophies s’avère précieux.
Le système Base R s’impose souverainement lorsque l’objectif premier réside dans la célérité d’exécution algorithmique et l’indépendance technologique. Ne requérant le chargement d’aucun package tiers ni la compilation de dépendances externes complexes, il s’avère particulièrement indiqué pour les scripts d’audit rapide exécutés sur des serveurs distants ou des clusters de calcul haute performance. En contrepartie, le coût de développement d’une figure soignée y est lourd : le calcul manuel des échelles d’axes (xlim, ylim), le calibrage explicite des coupures communes et le positionnement laborieux des légendes exigent un code volumineux, procédural et difficilement maintenable.
À l’opposé, l’architecture ggplot2 brille par sa cohérence conceptuelle et sa puissance déclarative. La prise en charge automatique et unifiée des échelles, des légendes et de la modularité des thèmes réduit considérablement la charge cognitive du statisticien dès lors qu’il manipule des plans d’expérience multi-groupes ou factoriels complexes. Bien qu’elle impose un coût d’apprentissage initial significatif et nécessite de structurer scrupuleusement les tables de données sous un format long conforme au Tidyverse, la bibliothèque ggplot2 s’affirme comme le standard absolu de production graphique pour l’élaboration de publications académiques contemporaines.
12.2 Directives de communication visuelle pour la rigueur scientifique
La puissance expressive d’un graphique n’est pas proportionnelle à sa complexité ornementale. Au contraire, l’efficacité de la transmission cognitive obéit au principe cardinal formulé par Edward Tufte sous le concept du ratio « données-encre » (data-ink ratio) : toute portion d’encre numérique allouée à une figure doit avoir pour finalité exclusive d’apporter une information quantitative substantielle, en éradiquant systématiquement tout bruit graphique superflu (chartjunk).
Les grilles de quadrillage massives, les effets de relief tridimensionnels dénués de fondement métrique et les bordures décoratives ostentatoires doivent être résolument éliminés au profit d’une typographie sobre et d’axes géométriques épurés. De surcroît, la rigueur éthique exige de ne jamais contraindre l’axe des ordonnées d’un histogramme à une graduation tronquée de façon fallacieuse : la ligne de base d’un histogramme exprime un dénombrement de fréquence ou une masse de probabilité qui prend obligatoirement sa source au zéro absolu de l’espace cartésien.
Enfin, une distribution graphique ne doit jamais être présentée de manière isolée dans le silence méthodologique. Elle doit systématiquement s’accompagner de ses métadonnées descriptives exhaustives : mention systématique des effectifs d’échantillonnage ($n$), de l’erreur standard de la moyenne ou des intervalles de confiance associés, et justification explicite de la méthode de partitionnement des classes retenue au sein de la légende textuelle accompagnant l’illustration dans le corps de l’article de recherche.
12.3 Extensions analytiques : vers l’interactivité et les graphiques de densité cumulée
Pour le chercheur souhaitant explorer des représentations visuelles plus sophistiquées, l’histogramme classique superposé ouvre la voie vers des architectures graphiques avancées d’une grande valeur heuristique.
Dans le domaine de l’exploration interactive et des tableaux de bord d’analyse de données, le passage d’une figure statique ggplot2 vers un rendu interactif dynamique s’accomplit sans effort grâce à la passerelle technologique ggplotly() offerte par l’extension Plotly. Par cette simple instruction, l’histogramme s’anime au passage du curseur de la souris : l’utilisateur peut interroger individuellement chaque classe d’intervalle, afficher dynamiquement les effectifs locaux précis et désactiver à la volée une modalité expérimentale pour observer la recomposition instantanée des strates distributionnelles.
Par ailleurs, lorsque le nombre de cohortes expérimentales devient trop massif pour autoriser une superposition intelligible au sein d’un canevas unifié, la transition vers les diagrammes en crêtes montagneuses, universellement désignés sous le terme de ridgeline plots ou joyplots (implémentés dans l’extension ggridges), représente une alternative visuelle prestigieuse. En décalant verticalement les distributions de densités continues sur une succession de strates parallèles étagées, ce dispositif sémiotique permet de comparer avec une élégance saisissante plusieurs dizaines d’échantillons temporels ou géographiques simultanés, matérialisant avec panache la quintessence de la visualisation statistique moderne dans l’environnement R.
Références
- Brewer, C. A. (2015). Designing better maps: A guide for GIS users (2nd ed.). Esri Press. https://colorbrewer2.org/
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman and Hall/CRC. https://doi.org/10.1201/9781315140919
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org/
- Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media. https://clauswilke.com/dataviz/
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0