
La visualisation des données quantitatives constitue le pivot méthodologique sur lequel repose l’ensemble du cycle de découverte scientifique en psychologie, en neurosciences cognitives et dans les sciences du comportement au sens large. Alors que la modélisation statistique inférentielle s’avère indispensable pour quantifier les effets et tester des hypothèses formelles, l’exploration graphique demeure la modalité cognitive primaire par laquelle le chercheur appréhende la complexité, détecte les artefacts d’échantillonnage et perçoit la dynamique temporelle ou structurale de ses observations empiriques. Dans les protocoles expérimentaux contemporains, la mesure d’une variable isolée constitue désormais l’exception plutôt que la norme : le recueil simultané de multiples indices physiologiques, de scores psychométriques multidimensionnels et de métriques comportementales impose une transition inévitable de l’analyse univariée vers la visualisation multivariée intégrée.
Au sein de l’écosystème statistique libre R, la représentation conjointe de plusieurs colonnes de données constitue l’une des démarches les plus fréquentes, mais paradoxalement l’une des plus susceptibles d’induire des erreurs conceptuelles ou de manipulation. La flexibilité presque infinie offerte par le langage implique une multiplicité d’approches concurrentes, allant du moteur graphique natif historique aux abstractions sémantiques sophistiquées introduites par la grammaire des graphiques. Cette richesse technique soulève une problématique architecturale fondamentale : comment articuler la structure interne des tableaux de données numériques avec les impératifs cognitifs de clarté visuelle, sans compromettre la rigueur méthodologique ni déformer l’interprétation des interactions entre les variables observées ?
Le présent article propose un guide d’ingénierie graphique sous R, conçu pour les chercheurs, analystes de données et biostatisticiens soucieux de maîtriser la projection bidimensionnelle de séries de variables parallèles. De la restructuration mathématique des matrices d’observation aux protocoles d’exportation vectorielle respectant scrupuleusement les exigences des revues à comité de lecture, nous explorerons exhaustivement les fondements théoriques, les mécanismes computationnels sous-jacents et les choix stylistiques qui permettent de transformer un ensemble tabulaire hétérogène en une figure scientifique rigoureuse, expressive et reproductible.
1. Introduction à la visualisation multivariée dans R pour les sciences du comportement
1.1 Nécessité de représenter simultanément plusieurs variables dépendantes
L’évaluation conjointe de trajectoires comportementales et psychométriques répond à une exigence épistémologique fondamentale : le comportement humain et les processus neurobiologiques ne se déploient jamais selon des dimensions scalaires indépendantes. Lorsqu’un protocole clinique évalue l’efficacité d’une intervention psychothérapeutique ou pharmacologique, il est d’usage d’enregistrer parallèlement les variations de l’anxiété état, du score d’affects dépressifs, de la réactivité électrodermale et de la latence de réponse à des paradigmes d’inhibition cognitive. Représenter ces dimensions au sein de graphiques univariés isolés génère une fragmentation de l’information préjudiciable à la synthèse intellectuelle. Le cerveau de l’expérimentateur se trouve alors contraint d’effectuer mentalement des alignements d’échelles, des recalages temporels et des inférences croisées, une tâche notoirement sujette aux biais de jugement heuristique.
Les limites cognitives et interprétatives des figures univariées présentées en séquence deviennent flagrantes dès lors que des interactions d’ordre supérieur ou des phénomènes de compensation physiologique entrent en jeu. Si une diminution progressive du rythme cardiaque s’accompagne d’une élévation conjointe de la pression artérielle systolique sous l’effet d’un stress aigu, seule la superposition ordonnée ou la juxtaposition synchronisée des deux courbes permet d’identifier l’activation du baroréflexe. Isoler ces deux mesures dans des tracés distincts obscurcit leur couplage fonctionnel direct et dilue la portée démonstrative de l’observation empirique, augmentant le risque de faux négatifs conceptuels lors de la phase d’exploration.
Parallèlement, les standards de recherche contemporains édictés par les sociétés savantes et les éditeurs internationaux imposent une densité informationnelle accrue, couplée à une transparence visuelle maximale. Les recommandations pour la transparence statistique proscrivent désormais les représentations réductrices qui masquent l’hétérogénéité des patrons individuels ou la dynamique temporelle fine des biomarqueurs. La visualisation simultanée de plusieurs colonnes de variables dépendantes, qu’elle prenne la forme de faisceaux longitudinaux superposés ou de mosaïques coordonnées, constitue aujourd’hui la réponse opérationnelle standard aux exigences de rigueur et d’honnêteté intellectuelle dans la communication des résultats scientifiques.
1.2 Comparaison entre les systèmes graphiques natifs et ggplot2
Le moteur graphique natif de R, souvent qualifié de « Base R », repose sur le paradigme séquentiel de la table à dessin (« painter’s model »). Dans ce schéma fonctionnel issu de l’architecture historique du langage S, chaque commande graphique applique immédiatement des pigments vectoriels sur un canevas numérique immuable. Lorsqu’une fonction d’initialisation telle que plot() est invoquée, le système détermine de manière rigide les limites des coordonnées cartésiennes, les marges périphériques et la position des axes. Toute opération ultérieure, matérialisée par des fonctions incrémentales comme lines(), points() ou polygon(), ne fait que superposer des couches d’encre sans que le système n’ait conscience de la sémantique statistique des objets dessinés. Cette logique offre une exécution computationnelle extrêmement véloce et une simplicité d’accès indéniable pour les tracés exploratoires instantanés, mais elle révèle rapidement ses limites structurelles lorsqu’il s’agit de synchroniser dynamiquement les échelles de plusieurs séries de données distinctes.
À l’opposé de cette approche procédurale, le package ggplot2, conçu par Hadley Wickham, implémente la théorie formelle exposée par Leland Wilkinson dans son ouvrage fondateur The Grammar of Graphics. Selon ce paradigme abstrait, un graphique statistique ne constitue pas une simple collection de segments et de polygones positionnés dans l’espace, mais une composition formelle reliant des variables issues d’une structure de données tabulaire à des propriétés esthétiques perceptibles, telles que la position spatiale, la couleur, la forme ou la taille, via un système de coordonnées précis et des transformations géométriques spécifiques. Cette formalisation sémantique découple entièrement la déclaration des relations conceptuelles de leur rendu graphique effectif, conférant à ggplot2 une puissance d’expression inégalée pour le traitement des données multivariées.
La modularité intrinsèque de ggplot2 procure des avantages décisifs pour l’analyse multivariée complexe. Contrairement au système natif où l’ajout d’une troisième ou quatrième variable impose le recalcul manuel des étendues d’axes, la gestion manuelle des palettes de couleurs et l’assemblage laborieux d’une légende à partir de vecteurs de chaînes de caractères, l’approche déclarative de ggplot2 orchestre automatiquement l’harmonisation des échelles, l’instanciation des légendes descriptives et le découpage en sous-panneaux. Cette cohérence interne réduit substantiellement le fardeau cognitif de programmation pesant sur le chercheur, lui permettant de se focaliser sur l’interprétation substantielle des contrastes graphiques plutôt que sur les détails d’implémentation de bas niveau.
1.3 Structure conceptuelle des données tabulaires en psychométrie
La modélisation graphique des données psychométriques requiert une distinction analytique préalable entre la nature conceptuelle des variables observées et la disposition matricielle de la table de données qui les contient. D’un point de vue théorique, les colonnes d’un jeu de données issu d’un protocole expérimental se répartissent généralement en variables mesurées (les réponses empiriques observées, telles que le temps de réaction, le score d’anxiété ou le potentiel évoqué cognitif) et en facteurs de conditions expérimentales (le statut clinique du participant, le groupe de traitement ou le type de stimulus présenté). La confusion fréquente observée chez les analystes novices découle du fait qu’une variable dépendante mesurée à différents instants temporels est souvent enregistrée sous la forme de plusieurs colonnes contiguës, fusionnant artificiellement la dimension temporelle de l’expérience avec la nature intrinsèque de la mesure.
Cette architecture particulière est indissociable des protocoles à mesures répétées intra-sujets, prédominants dans les sciences comportementales. Dans ces dispositifs, chaque participant subit plusieurs conditions successives ou est évalué à intervalles réguliers au cours d’un suivi longitudinal. Lorsque les données sont collectées, l’outil d’acquisition génère naturellement une ligne par sujet et une colonne distincte par instant d’observation, par exemple un score initial, un score intermédiaire et un score terminal. D’un point de vue informatique, ces colonnes matérialisent des entités physiques séparées, mais d’un point de vue conceptuel, elles ne constituent que les instances séquentielles d’un seul et même continuum de mesure, indexé par un facteur temporel latent.
L’architecture de la table détermine directement la faisabilité et la pertinence des algorithmes graphiques mobilisés sous R. Si le système natif s’accommode facilement de colonnes isolées qu’il suffit d’appeler séquentiellement via l’opérateur dollar, la grammaire des graphiques impose que chaque dimension visuelle (l’abscisse temporelle, l’ordonnée de réponse et la couleur différentielle) soit strictement mappée sur une colonne dédiée unique. Ainsi, la compréhension de la topologie des données tabulaires constitue la condition sine qua non pour réussir le tracé simultané de plusieurs variables,dictant impérativement la nécessité d’une phase de transformation structurale préliminaire avant tout appel aux primitives de rendu visuel.
2. Préparation et restructuration des données : Du format large au format long
2.1 Comprendre la dichotomie entre format large et format long
Dans l’analyse des données sous R, la disposition des tables obéit principalement à deux topologies antithétiques : le format large (« wide format ») et le format long (« long format »). Le format large se caractérise par une configuration où chaque unité expérimentale ou sujet d’étude n’occupe qu’une ligne unique, tandis que ses différentes mesures temporelles, ses scores à différentes sous-échelles ou ses réponses sous diverses conditions expérimentales s’étendent horizontalement à travers de multiples colonnes dédiées. Cette organisation est historiquement plébiscitée par les praticiens pour la saisie manuelle des données, l’exportation depuis des formulaires en ligne et l’exécution d’analyses multivariées classiques telles que l’analyse de variance à mesures répétées (ANOVA univariée ou multivariée de type MANOVA) dans les progiciels statistiques propriétaires.
À l’opposé, le format long structure les informations de manière verticale et relationnelle. Dans cette architecture opérationnelle, chaque ligne correspond à une observation singulière et unique au sein du protocole d’évaluation. Par conséquent, un même participant voit son identifiant répété sur autant de lignes qu’il y a eu de mesures ou d’instants de recueil le concernant. Deux colonnes pivots émergent alors obligatoirement de cette disposition : une première colonne catégorielle faisant office d’étiquette, qui explicite le nom de l’ancienne variable ou la condition d’appartenance de la mesure, et une seconde colonne quantitative, qui stocke la valeur numérique effective observée. Ce format long incarne la structure requise pour l’application directe des modèles mixtes linéaires ainsi que pour l’exploitation optimale du moteur graphique ggplot2.
Cette distinction s’inscrit au cœur du principe fondamental des données ordonnées (« tidy data »), formalisé par Hadley Wickham dans la littérature statistique computationnelle. Trois préceptes axiomatiques régissent ce paradigme méthodologique : chaque variable mesurée doit être contenue dans sa propre colonne, chaque observation doit constituer une ligne individuelle distincte, et chaque type d’unité observationnelle doit être stocké dans une table spécifique. Lorsqu’un tableau contient des scores d’anxiété mesurés à trois moments distincts répartis dans trois colonnes distinctes, les en-têtes de colonnes ne désignent pas des variables au sens propre, mais les modalités d’une variable sous-jacente non déclarée, à savoir le temps. Le passage méthodique du format large au format long rétablit la stricte conformité au principe de données ordonnées, préalable indispensable à toute représentation graphique modulaire.
2.2 Application de la fonction melt() du package reshape2
Pendant plus d’une décennie, le package reshape2 a représenté le standard technologique incontournable pour opérer le pivotement matriciel des structures tabulaires sous R. La fonction centrale de ce dispositif, melt(), réalise précisément la liquéfaction d’un tableau large en un flux relationnel étroit et vertical. Sa logique syntaxique canonique repose sur l’identification rigoureuse des colonnes invariantes qui définissent les unités d’observation individuelles, renseignées au moyen de l’argument id.vars. Les identifiants de sujets, les données démographiques stables ou les indicateurs d’appartenance à un groupe thérapeutique demeurent ainsi figés, servant d’ancrage relationnel à l’opération de transformation.
Les variables quantitatives destinées à être condensées verticalement sont ensuite déclarées explicitement par le biais du paramètre measure.vars. Si ce paramètre est omis, la fonction melt() subsume automatiquement l’ensemble des colonnes numériques non répertoriées dans id.vars, ce qui peut occasionner des erreurs silencieuses en cas de présence de variables d’indexation mal typées. Afin de conférer une lisibilité sémantique immédiate au tableau restructuré, l’opérateur configure conjointement les paramètres variable.name (permettant de baptiser la nouvelle colonne catégorielle recevant les anciens en-têtes) et value.name (assignant un libellé clair à la colonne vectorielle hébergeant les valeurs quantitatives empilées).
L’inspection des métadonnées et des structures de classes résultant d’un appel à melt() constitue une étape de contrôle qualité primordiale. Par défaut, la colonne catégorielle nouvellement créée est convertie en un vecteur de type factor, dont l’ordre des modalités reflète fidèlement la séquence horizontale d’origine des colonnes au sein du jeu de données source. Cette conservation de l’ordre d’apparition est particulièrement précieuse pour les représentations graphiques, car elle garantit que les tracés ultérieurs respecteront la chronologie des mesures sans nécessiter une réindexation manuelle complexe des niveaux de facteurs, sous réserve que l’intégrité des types de données numériques d’origine ait été scrupuleusement préservée lors de la fusion matricielle.
2.3 Alternative contemporaine avec pivot_longer() de tidyr
L’émergence de la suite logicielle tidyverse a conduit à une refonte ergonomique et conceptuelle profonde des routines de manipulation tabulaire, concrétisée par le déploiement du package tidyr. Au sein de cet environnement modernisé, la fonction pivot_longer() s’est substituée à melt() en tant que standard industriel et académique dominant. Conçue pour pallier certaines ambiguïtés syntaxiques historiques et s’intégrer harmonieusement au flux de travail séquentiel orchestré par l’opérateur de redirection (« pipe » natif |> ou hérité %>%), pivot_longer() offre une granularité de contrôle considérablement accrue sur l’opération de pivotement.
Le paramétrage fin de pivot_longer() s’articule autour de trois arguments directeurs : cols, qui sélectionne l’ensemble des colonnes cibles au moyen d’expressions d’aide à la sélection hautement expressives (telles que starts_with(), matches() ou la notation par intervalle numérique d’index) ; names_to, qui spécifie la chaîne de caractères désignant la future colonne des facteurs d’identification ; et values_to, qui explicite le nom attribué à la colonne consolidant les données d’amplitude mesurées. Cette formalisation fonctionnelle élimine la confusion conceptuelle inhérente aux terminologies historiques de fusion, en explicitant littéralement que les noms des colonnes cibles sont déroutés vers une nouvelle dimension, tandis que leurs valeurs intérieures alimentent une variable ordonnée unique.
Au-delà de cette réorganisation structurelle de base, pivot_longer() propose des capacités avancées de nettoyage dynamique des chaînes textuelles au moment même de l’exécution du pivotement. L’argument names_prefix permet d’expurger automatiquement un préfixe textuel récurrent présent dans les en-têtes d’origine (par exemple, éliminer le radical « Temps_ » pour ne conserver que la partie numérique informative). De surcroît, le paramètre names_transform offre l’opportunité d’opérer une conversion de type instantanée sur la nouvelle colonne, métamorphosant un facteur nominal en une variable temporelle quantitative continue de type integer ou double. Cette transformation directe fluidifie de manière spectaculaire la chaîne de traitement menant à l’affichage graphique multivarié, neutralisant les sources récurrentes d’incompatibilité de type lors du rendu sous ggplot2.
3. Tracer plusieurs colonnes sur un graphique unique avec ggplot2
3.1 Mappage esthétique des variables restructurées
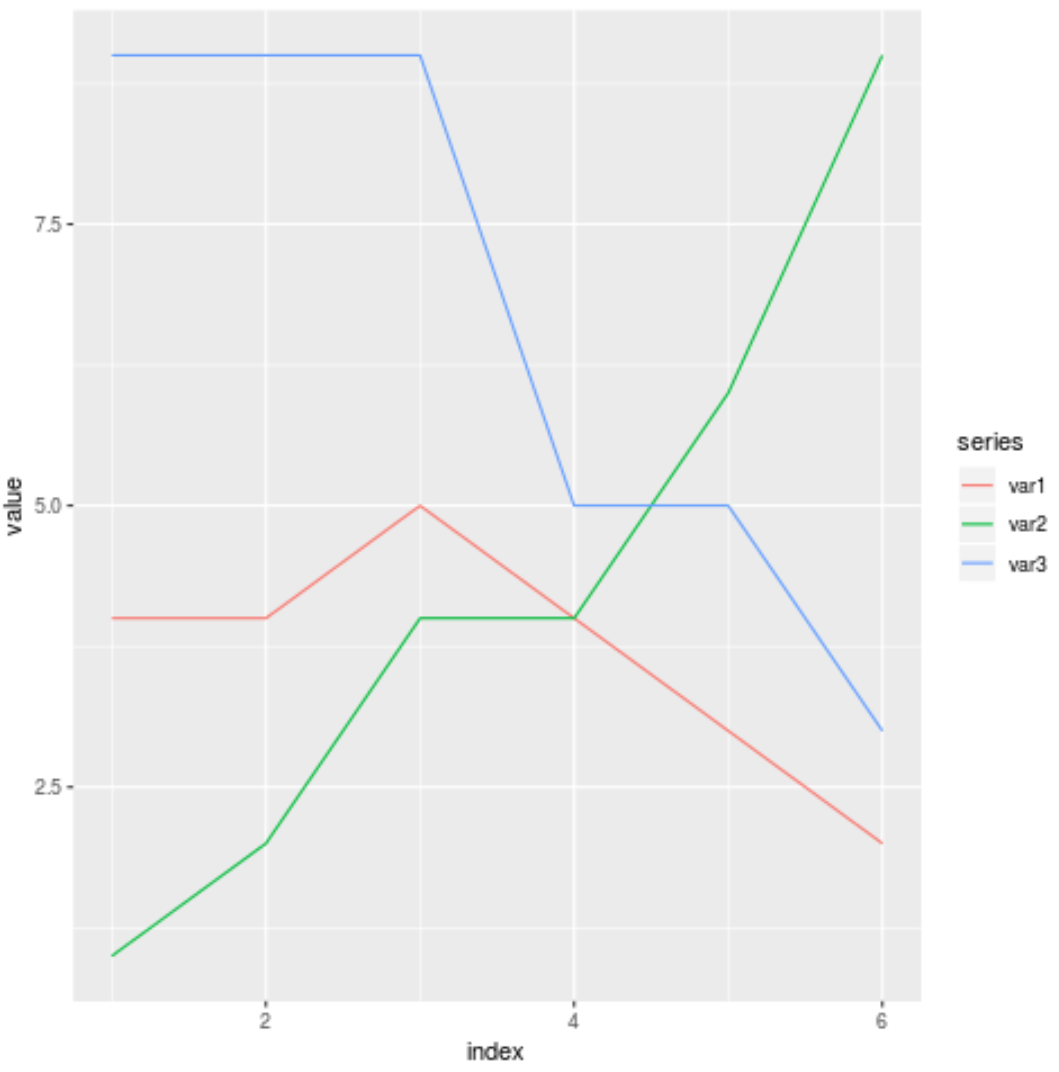
L’opération fondamentale permettant d’afficher simultanément plusieurs colonnes sur un canevas ggplot2 réside dans l’assignation adéquate des esthétiques au sein de la fonction aes(), appliquée sur une table préalablement convertie au format long. Dans cette configuration géométrique, l’axe orthogonal horizontal (abscisse, paramètre x) reçoit la variable temporelle ou ordinale indicatrice de l’itération, tandis que l’axe vertical (ordonnée, paramètre y) se voit allouer la colonne unifiée des grandeurs scalaires observées. Cette disposition spatiale pose le cadre topologique unifié dans lequel l’ensemble des mesures antérieures va coexister, partageant un référentiel orthonormé commun indispensable à la rigueur de la comparaison visuelle directe.
La différenciation optique des séries s’opère par l’association délibérée de la colonne contenant les anciens en-têtes à une dimension visuelle de discrimination, le plus souvent la couleur (paramètre colour pour les éléments filiformes ou fill pour les surfaces pleines). En déclarant par exemple aes(x = Temps, y = Valeur, colour = Indicateur), l’utilisateur n’ordonne pas simplement au système d’appliquer des teintes arbitraires sur des segments de pixels ; il établit un couplage formel entre les modalités discrètes du facteur psychométrique et un espace chromatique calibré. ggplot2 partitionne alors de manière autonome la structure de données interne en sous-ensembles logiques correspondant à chaque modalité d’indicateur, liant implicitement l’attribut de regroupement (group) à cette partition catégorielle.
Cette approche sémantique déclenche la construction entièrement automatisée de la légende scientifique latérale. Le moteur d’évaluation graphique calcule la palette de discrimination optimale, associe chaque libellé textuel à son témoin chromatique vectoriel exact, et garantit une cohérence absolue entre la symbologie déployée sur le plan cartésien et la clé de lecture périphérique. Dès lors, toute modification ultérieure apportée aux niveaux factoriels de la table sous-jacente ou tout filtrage dynamique en amont se répercute de façon immédiate et intègre sur l’ensemble de la composition visuelle, éliminant définitivement les discordances accidentelles entre le tracé et sa description textuelle.
3.2 Superposition de couches géométriques combinées
Dans la pratique de publication scientifique, la simple juxtaposition de lignes continues s’avère fréquemment insuffisante pour transmettre toute la densité informative requise par les pairs. L’implémentation conjointe de couches géométriques superposées, matérialisée par l’invocation coordonnée de geom_line() et de geom_point(), répond à cette exigence d’expressivité. La géométrie linéaire geom_line() trace le profil continu des tendances d’évolution moyenne ou individuelle, matérialisant la cinétique du processus psychologique observé, tandis que la géométrie ponctuelle geom_point() réaffirme la granularité temporelle effective en marquant visiblement les moments discrets où les mesures empiriques ont été substantiellement colligées.
Le contrôle rigoureux des attributs graphiques au sein de ces couches démultiplie leur lisibilité ergonomique. L’épaisseur des tracés linéaires, régulée via l’argument size (ou plus récemment linewidth dans les versions récentes de ggplot2), doit être ajustée de façon à assurer une distinction visuelle nette sans pour autant générer d’empâtements néfastes au niveau des intersections denses de séries multiples. Concomitamment, la modulation de la transparence par l’argument scalaire alpha (oscillant entre 0 pour une invisibilité totale et 1 pour une opacité complète) s’avère particulièrement utile pour reléguer les variations individuelles idiosyncrasiques au second plan tout en maintenant en forte visibilité les trajectoires moyennes représentées par des traits plus épais et saturés.
Afin d’assurer une discrimination visuelle robuste y compris lors de la reproduction d’articles scientifiques sur des supports d’impression monochromes ou auprès de lecteurs présentant des altérations de la perception des couleurs (daltonisme), la redondance des indices perceptifs s’impose comme une règle de l’art. L’assignation simultanée d’un style de trait différencié via l’esthétique linetype (combinant traits pleins, tiretés, pointillés et alternances régulières) et de glyphes géométriques distincts assignés aux points via l’argument shape (carrés, cercles, losanges, triangles) garantit une séparation visuelle non équivoque des différentes colonnes d’intérêt, attestant du soin méthodologique apporté à la formalisation du livrable graphique.
3.3 Représentation conjointe de colonnes sans restructuration préalable
Bien que la restructuration préalable en format long constitue le paradigme d’excellence promu par la communauté scientifique, il demeure techniquement concevable de tracer plusieurs colonnes numériques issues d’un format large sans altérer la topologie matricielle initiale du tableau. Cette alternative repose sur l’addition explicite et répétée de couches géométriques indépendantes au sein de l’instruction graphique globale. Concrètement, l’opérateur appelle de manière consécutive plusieurs primitives géométriques, en assignant à chaque fois une variable spécifique au paramètre d’ordonnée, par exemple geom_line(aes(y = Score_Anxiete), colour = "blue") suivi immédiatement de geom_line(aes(y = Score_Depression), colour = "red").
Cette approche directe présente l’avantage immédiat d’une apparente simplicité pour l’analyste débutant, qui s’épargne ainsi l’apprentissage des syntaxes de pivotement matriciel. Elle permet de générer à la volée un graphique comparatif en exploitant directement les colonnes telles qu’elles figurent dans leur fichier source tabulé. Toutefois, les limites ergonomiques et conceptuelles de cet artifice se révèlent particulièrement pénalisantes dès que le nombre de colonnes excède deux ou trois entités. L’écriture du code devient verbeuse, répétitive et hautement sujette aux erreurs de copier-coller, violant le principe d’ingénierie logicielle élémentaire consistant à ne pas répéter d’instructions redondantes (« Don’t Repeat Yourself »).
L’écueil majeur de cette stratégie réside dans la dégradation radicale de la gestion des légendes descriptives. Étant donné que les couleurs des traits sont fixées de manière absolue sous forme de constantes littérales en dehors de l’espace d’évaluation sémantique de l’argument aes(), le moteur graphique de ggplot2 s’abstient de générer une quelconque légende automatique, considérant qu’aucun mappage statistique n’a eu lieu. L’analyste se trouve alors contraint d’échafauder des artifices fastidieux, consistant à injecter des chaînes de caractères fictives au sein d’appels esthétiques détournés puis à forcer l’ajustement manuel des échelles via scale_colour_manual(), une démarche laborieuse qui confirme a posteriori la supériorité absolue de la conversion structurale préalable vers le format long.
4. Visualisation par facettes : Séparer les colonnes sur plusieurs sous-graphiques
4.1 Décomposition en panneaux avec facet_wrap()
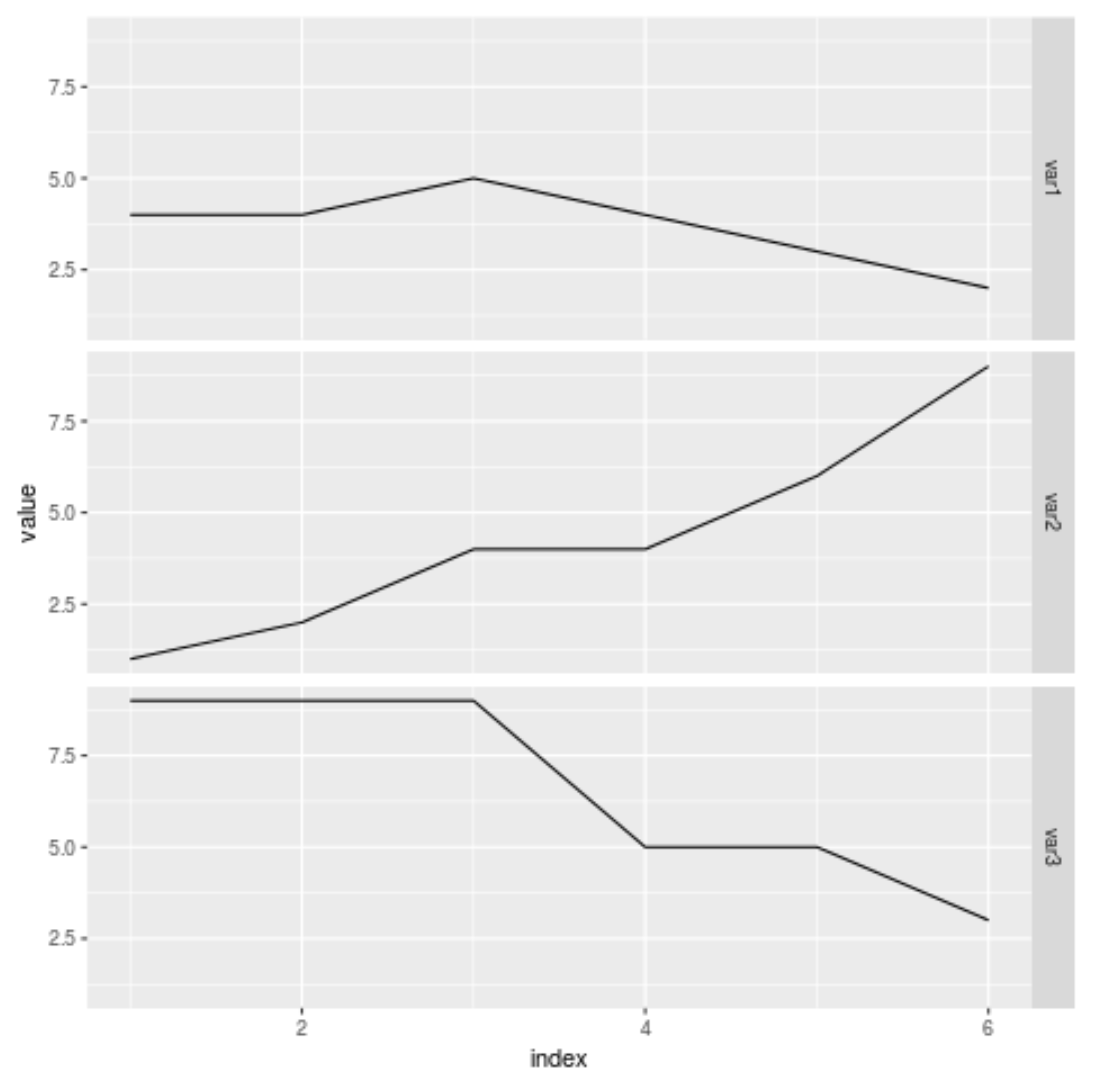
Lorsque le nombre de colonnes à représenter conjointement croît de façon substantielle ou que les profils temporels exhibent des fluctuations d’une grande densité, la superposition de l’ensemble des courbes sur un plan cartésien unique conduit inévitablement au phénomène d’encombrement graphique (« visual cluttering »). La saturation perceptive induite par le croisement désordonné de multiples tracés multicolores empêche l’extraction des signaux pertinents. Pour résoudre cette aporie visuelle sans sacrifier l’exhaustivité des séries analysées, la grammaire des graphiques introduit le concept de facettage, consistant à partitionner le jeu de données en sous-ensembles disjoints représentés chacun dans un sous-graphique dédié partageant des propriétés formelles coordonnées.
La fonction facet_wrap() constitue l’outil de référence pour ventiler les variables issues d’une structure de données pivotée en format long sur une séquence bidimensionnelle de panneaux d’affichage. La syntaxe canonique requiert l’incorporation d’une formule tildée déclarant la variable de partitionnement, sous la forme expressive facet_wrap(~ Variable). Ce mécanisme inspecte l’ensemble des modalités uniques hébergées dans la colonne catégorielle résultant du pivotement initial, instancie autant de canevas cartésiens distincts qu’il existe de colonnes de mesure à représenter, et y projette individuellement chaque profil spécifique en garantissant une typographie et une stylistique parfaitement normalisées.
La régulation spatiale de cet agencement matriciel est finement pilotée par le paramétrage des arguments numériques nrow et ncol, qui permettent d’imposer un nombre fixe de lignes ou de colonnes d’affichage pour la distribution globale des panneaux. Cette modularité architecturale permet d’optimiser l’occupation visuelle en fonction des dimensions du support de publication envisagé, qu’il s’agisse d’un format vertical sur une seule colonne typographique ou d’un affichage horizontal panoramique couvrant la double page d’un périodique académique. En prévenant tout chevauchement de lignes, la décomposition par facet_wrap() garantit que les particularités dynamiques propres à chaque variable psychométrique demeurent parfaitement identifiables et isolables par le regard clinique.
4.2 Organisation bidimensionnelle avec facet_grid()
Dans des configurations expérimentales plus complexes caractérisées par des plans factoriels croisés, la modularité unidimensionnelle de facet_wrap() cède le pas à la rigueur matricielle bidimensionnelle instaurée par la commande facet_grid(). Alors que le premier enroule séquentiellement des panneaux indépendants le long des axes, facet_grid() structure explicitement une grille cartésienne orthogonale où les lignes et les colonnes d’affichage matérialisent rigoureusement le croisement de deux facteurs de catégorisation expérimentale distincts. Cette organisation s’avère particulièrement adaptée lorsqu’il convient d’analyser simultanément plusieurs colonnes de scores longitudinaux à travers différentes cohortes ou strates cliniques de sujets.
La formulation syntaxique de facet_grid() adopte une syntaxe relationnelle rigoureuse de type formule = Facteur_Ligne ~ Facteur_Colonne. Si l’on souhaite examiner conjointement trois échelles de mesure psychométrique mesurées chez des patients répartis au sein de deux protocoles d’intervention distincts (par exemple, traitement actif versus placebo), la déclaration facet_grid(Traitement ~ Variable) générera une matrice invariable de deux lignes de graphiques coupées par trois colonnes thématiques. Chaque intersection de cette matrice spatiale offre une vue focale et synchronisée de l’évolution de la métrique ciblée pour la population clinique correspondante.
Cette rigueur géométrique apporte un bénéfice cognitif majeur pour la détection visuelle des interactions statistiques d’ordre supérieur. En maintenant un alignement spatial immuable le long des axes horizontaux et verticaux, facet_grid() permet à l’œil d’effectuer des balayages comparatifs directs de gauche à droite pour évaluer les disparités entre mesures, ou de haut en bas pour apprécier l’impact contrasté de l’appartenance de groupe sur une variable spécifique. Cet ordonnancement topologique rigide préserve l’intégrité cognitive de la comparaison inter-séries sans nécessiter d’efforts d’accommodation intellectuelle liés à des décalages d’axes d’un panneau à l’autre.
4.3 Contrôle de l’indépendance des axes orthonormés
Par défaut, l’architecture graphique de ggplot2 verrouille scrupuleusement l’étendue et la graduation des axes sur l’ensemble des panneaux générés par facettage, imposant une échelle orthonormée uniforme globale. Si cette standardisation constitue une garantie méthodologique contre les distorsions visuelles lorsqu’on compare des variables partageant une unité de mesure strictement identique, elle se transforme en une entrave majeure dès lors que les colonnes tracées présentent des ordres de grandeur ou des amplitudes de dispersion hétérogènes. Si une colonne exprime un ratio de temps de réaction borné entre 0 et 1 seconde tandis qu’une autre mesure un volume d’activité motrice oscillant entre 100 et 1000 unités, le maintien d’une échelle commune écrasera totalement la première courbe au ras de l’axe des abscisses, la rendant visuellement inexploitable.
Pour contourner cet écueil dimensionnel, les fonctions de facettage intègrent le paramètre scales, dont la valeur par défaut est "fixed". L’assignation de l’argument scales = "free_y" libère l’axe des ordonnées sur chaque panneau individuel, autorisant le système à calculer de manière autonome des bornes inférieure et supérieure parfaitement adaptées à l’amplitude effective de chaque série de données correspondante. L’argument scales = "free_x" accomplit une libération symétrique pour l’axe horizontal (notamment utile pour des suivis temporels de durées dissemblables), tandis que la directive scales = "free" désactive l’ensemble des contraintes d’alignement sur les deux dimensions spatiales.
Cependant, l’usage d’échelles libres soulève des enjeux méthodologiques et épistémologiques critiques en matière de perception scientifique des données. Lorsqu’un lecteur examine une série de sous-graphiques contigus, son système perceptif postule implicitement que la pente d’un trait ou l’amplitude verticale d’une variation traduit une intensité d’effet proportionnellement identique d’un panneau à l’autre. En autorisant des axes verticaux asymétriques, une fluctuation marginale observée sur une variable à faible variabilité peut artificiellement adopter une pente spectaculairement abrupte, créant une illusion visuelle d’effet massif alors même que sa portée clinique est infinitésimale comparativement aux variations d’une autre colonne. Le chercheur se doit donc de documenter explicitement ces asymétries dimensionnelles au sein des légendes de figures et d’évaluer scrupuleusement si la préservation de la rigueur comparative n’exigerait pas plutôt une standardisation numérique préalable des colonnes.
5. Représentation de plusieurs colonnes avec le système graphique natif de R
5.1 Initialisation du tracé avec la fonction plot()
L’implémentation graphique multivariée au moyen du moteur historique de Base R repose sur un protocole opératoire procédural strictement séquentiel. Contrairement aux approches déclaratives contemporaines, la mise en œuvre requiert une planification rigoureuse dès l’appel initial de la primitive plot(). Cette fonction assume la double responsabilité d’instancier la fenêtre graphique, de graver les axes cartésiens pourvus de leurs graduations numériques (« ticks »), d’imprimer les étiquettes textuelles périphériques et de projeter la première série de données sélectionnée parmi les colonnes de la matrice source.
L’écueil structurel prédominant de cette étape initiale réside dans le calcul des limites géométriques de l’axe vertical. Par défaut, plot() configure l’étendue de l’ordonnée en calquant ses bornes extrêmes uniquement sur le minimum et le maximum de la variable numérique fournie dans son appel immédiat. Si les colonnes subséquentes que le chercheur entend superposer comportent des valeurs numériques dépassant cette amplitude restreinte initiale, ces données additionnelles seront irrémédiablement tronquées lors des étapes suivantes, le moteur de Base R étant incapable d’étendre dynamiquement les frontières d’un canevas déjà matérialisé. Il est donc indispensable d’évaluer préalablement l’étendue globale absolue de l’ensemble des colonnes candidates au tracé au moyen de l’expression vectorielle range(c(colonne_1, colonne_2, colonne_3), na.rm = TRUE), et d’injecter explicitement ce vecteur de deux éléments au niveau du paramètre ylim de la fonction d’initialisation.
Le comportement formel du tracé est également assujetti à la configuration de l’argument type. Pour des séries longitudinales de mesures comportementales, l’affectation type = "l" matérialise une trajectoire purement filiforme continue, tandis que la désignation type = "o" (« overplotted ») ou type = "b" (« both ») combine de manière synchronisée les segments linéaires et les points d’ancrage empiriques. Ce premier niveau de déclaration fige l’infrastructure visuelle générale sur laquelle viendront se greffer, par itérations successives, les couches de données subsidiaires.
5.2 Incrémentation séquentielle avec lines() et points()
Une fois le cadre cartésien initialisé et la première colonne projetée sur le canevas, l’enrichissement multivarié s’effectue par l’invocation récurrente de fonctions graphiques dites de bas niveau, principalement lines() et points(). Ces primitives n’ouvrent pas de nouvelle fenêtre d’affichage et ne redessinent pas les bordures de la boîte d’encadrement ; elles exploitent les paramètres de transformation spatiale établis par l’appel plot() antérieur pour inscrire de nouveaux éléments vectoriels au sein de l’espace de coordonnées existant.
Pour superposer une deuxième puis une troisième colonne, l’opérateur exécute de façon séquentielle des instructions du type lines(x = temps, y = colonne_2, col = "red", lty = 2, lwd = 2) puis lines(x = temps, y = colonne_3, col = "darkgreen", lty = 3, lwd = 2). L’attribution raisonnée du paramètre col (assurant la distinction chromatique), couplée au contrôle de lty (« line type », régissant l’encodage des tirets et pointillés via des entiers ou des chaînes spécifiques) et de lwd (« line width », définissant le facteur scalaire d’épaisseur du trait), permet de construire pas à pas une figure multivariée hautement différenciée. L’adjonction complémentaire de la fonction points() permet de greffer sur ces lignes des symboles géométriques précis via le paramètre pch (« plotting character »).
Cette approche procédurale impose toutefois une vigilance constante concernant le confinement géométrique des éléments superposés. Tout point ou segment dont la coordonnée excède le domaine défini par le paramètre ylim initial sera purement et simplement éliminé de la vue sans émission d’avertissement formel dans la console R, ou viendra empiéter inélégamment sur les marges extérieures du graphique si les paramètres graphiques globaux d’écrêtage (« clipping », paramètre xpd) ont été préalablement déverrouillés. La rigueur de calcul amont conditionne ainsi intégralement la validité empirique du rendu multivarié dans le paradigme graphique natif.
5.3 Construction manuelle de la légende scientifique
L’absence de moteur de liaison sémantique entre les données et leurs attributs esthétiques dans Base R se manifeste avec une acuité particulière lors de la conception de la légende explicative. Contrairement à l’écosystème ggplot2 qui synthétise automatiquement les métadonnées déclarées, le système natif requiert une intervention humaine intégrale via l’appel explicite à la fonction de bas niveau legend(). Omettre cette formalisation manuelle aboutit à un graphique dépourvu de significativité scientifique, rendant impossible la discrimination des colonnes superposées par un lecteur externe.
L’ancrage spatial de la légende repose soit sur la déclaration de coordonnées cartésiennes absolues exprimées dans l’unité des données d’origine (valeurs x et y du coin supérieur gauche du pavé), soit sur l’emploi de mots-clés d’alignement intuitifs hautement recommandés tels que "topright", "topleft", "bottomright" ou "bottomleft". L’opérateur doit ensuite veiller à une synchronisation manuelle parfaite entre les attributs vectoriels fournis aux fonctions plot() et lines() et ceux déclarés à l’intérieur de legend(). Le vecteur des intitulés textuels assigné au paramètre legend doit correspondre scrupuleusement, tant au niveau de l’ordre d’énumération que de la longueur, aux vecteurs passés aux arguments de mise en forme col, lty, lwd et éventuellement pch.
Enfin, l’ajustement cosmétique de la boîte de légende conditionne sa bonne intégration typographique dans les manuscrits scientifiques. L’argument bty (« box type ») permet de réguler la présence de l’encadrement périphérique ; l’attribution bty = "n" supprime avantageusement le liseré rectangulaire, allégeant la charge graphique superflue conformément aux préceptes de minimalisme informationnel. L’ajustement d’échelle scalaire via cex (« character expansion ») garantit que la taille de la police de caractères s’harmonise avec l’ensemble des inscriptions figurant sur les axes, aboutissant à une figure d’une rigueur formelle apte à satisfaire les comités éditoriaux les plus exigeants.
6. Cas pratique : Évolution longitudinale d’échelles cliniques multiples
6.1 Génération et contextualisation d’un jeu de données synthétique
Afin de concrétiser l’application pratique de ces paradigmes graphiques, formalisons un protocole expérimental représentatif de la recherche contemporaine en psychiatrie translationnelle et psychologie de la santé. Imaginons une étude clinique longitudinale évaluant l’efficacité d’une thérapie comportementale intégrative dispensée à une cohorte de patients souffrant d’un trouble de l’adaptation lié au stress. Le protocole d’évaluation s’étend sur une période continue de douze semaines de suivi thérapeutique standardisé. À chaque intervalle hebdomadaire (semaine 0 à semaine 12), les investigateurs recueillent simultanément trois colonnes de variables dépendantes psychométriques distinctes mais théoriquement corrélées.
La première mesure correspond au score d’anxiété état issu de l’inventaire STAI-Y, une échelle quantitative continue oscillant empiriquement entre 20 et 80 points. La deuxième colonne capture le score de dépression évalué par l’inventaire de Beck (BDI-II), présentant une étendue théorique allant de 0 à 63 points. Enfin, la troisième colonne enregistre le niveau de stress perçu mesuré via l’échelle PSS-10 de Cohen, bornée entre 0 et 40 points. Ces trois indices partagent une même flèche temporelle d’évaluation mais possèdent des lignes de base, des cinétiques d’atténuation et des échelles de score substantiellement distinctes, configurant une problématique classique et délicate de visualisation multivariée conjointe.
La génération contrôlée de cette matrice de données sous R s’opère par l’intermédiaire d’équations déterministes modélisant des fonctions de décroissance exponentielle négative asynchrones, auxquelles est adjoint un terme stochastique résiduel gaussien simulant la variabilité inter-individuelle et les bruits de mesure instrumentaux. Une vérification d’intégrité numérique préliminaire garantit l’absence d’aberrations numériques, tandis que des valeurs manquantes sporadiques (NA) peuvent être délibérément disséminées pour tester la robustesse computationnelle et le comportement d’interpolation des algorithmes graphiques qui seront ultérieurement mobilisés.
6.2 Pipeline complet de transformation et de visualisation
L’implémentation opérationnelle de la chaîne de traitement informatique débute par l’importation synchronisée des composants centraux du tidyverse, au premier rang desquels figurent tidyr, dplyr et ggplot2. Le tableau de données d’origine, initialement architecturé selon un format large comportant quatre colonnes (Semaine, Anxiete_STAI, Depression_BDI, Stress_PSS), fait l’objet d’un pivotement vertical rigoureux via la fonction pivot_longer(). Dans cette séquence, nous sélectionnons l’ensemble des colonnes cliniques à l’exception de l’indicateur chronologique via l’instruction cols = -Semaine, réorientons leurs dénominations respectives vers un facteur d’identification names_to = "Echelle", et consolidons leurs valeurs numériques dans un vecteur unifié values_to = "Score".
Une fois cette mutation morphologique exécutée, le flux de données alimente directement l’opérateur d’initialisation de ggplot(). Le mappage relationnel assigne la variable temporelle hebdomadaire à l’axe des abscisses, le score numérique à l’axe des ordonnées, et associe le facteur identifiant l’échelle clinique à l’esthétique de coloration chromatique. Nous superposons immédiatement la géométrie filiforme geom_line(linewidth = 1.2) et la géométrie d’ancrage ponctuel geom_point(size = 3), ce qui permet de concilier la lecture globale des gradients d’évolution et l’identification visuelle des temps d’échantillonnage clinique discrets.
Le raffinement de la composition visuelle passe par la contextualisation méthodique des axes et des libellés légendaires via la fonction labs(). Nous spécifions un titre académique explicite, un sous-titre contextualisant la taille de l’échantillon, des intitulés d’axes enrichis de leurs unités de mesure dimensionnelles, ainsi qu’une requalification claire de la légende latérale. L’appel concomitant à scale_x_continuous(breaks = 0:12) garantit que chaque semaine de mesure bénéficie d’un repère numérique visible le long de l’axe horizontal, éliminant les extrapolations spatiales imprécises lors de la lecture du tracé.
6.3 Interprétation substantielle des courbes superposées
L’examen de la figure scientifique composite générée par ce pipeline met instantanément en lumière des dynamiques temporelles différentielles que l’inspection brute de colonnes tabulaires n’aurait pu révéler avec une telle clarté perceptive. On observe de prime abord une décélération asynchrone des différentes dimensions psychopathologiques sous l’effet du protocole thérapeutique. Tandis que la courbe relative au stress perçu manifeste une inflexion abrupte dès les trois premières semaines d’intervention, suggérant un bénéfice immédiat des techniques de relaxation et de régulation émotionnelle, la courbe matérialisant la symptomatologie dépressive présente une cinétique beaucoup plus inerte, son déclin ne s’amorçant véritablement qu’à compter de la sixième semaine d’exposition.
Cette cohabitation graphique sur un même canevas permet également de valider visuellement l’hypothèse clinique d’un découplage fonctionnel entre l’anxiété état et le sentiment dépressif à mesure que l’alliance thérapeutique se consolide. La superposition des profils autorise l’identification précise des points d’inflexion temporels critiques, tels que le moment où le score moyen d’anxiété franchit à la baisse le seuil clinique de significativité théorique, fournissant à l’équipe médicale un repère chronologique précieux pour évaluer la vitesse de rémission thérapeutique.
Pour parachever la démarche, l’exportation du livrable graphique s’accomplit par le recours à la commande ggsave(). Cet utilitaire gère avec précision le moteur de rastérisation ou d’encapsulation vectorielle, permettant de générer des fichiers aux formats haute définition (PDF vectoriel pour les soumissions académiques ou TIFF compressé sans perte avec une résolution minimale de 300 points par pouce). Cette étape finale assure l’intangibilité des proportions dimensionnelles, la fidélité de reproduction des fontes typographiques et la lisibilité irréprochable des symboles lors de l’intégration finale dans le rapport d’expertise ou le manuscrit de recherche.
7. Gestion des variables aux échelles hétérogènes : La question du double axe
7.1 Critique méthodologique du double axe des ordonnées
La tentation d’adjoindre un second axe des ordonnées sur la bordure droite d’un graphique cartésien constitue l’une des dérives les plus récurrentes lors de la tentative de représentation simultanée de colonnes affichant des amplitudes discordantes. Lorsqu’un chercheur souhaite juxtaposer une variable dont les valeurs oscillent entre 0 et 1 (comme une probabilité d’erreur comportementale) et une seconde variable s’étalant de 200 à 1000 (comme une latence de temps de réaction exprimée en millisecondes), la solution intuitive consiste fréquemment à superposer deux systèmes d’axes d’ordonnées indépendants au sein de la même surface de projection graphique.
Cette commodité apparente est néanmoins vivement récusée par la communauté des statisticiens méthodologistes et des ergonomes cognitifs en raison des risques massifs de manipulation visuelle et de déduction fallacieuse qu’elle engendre. Un graphique à double axe des ordonnées ne possède pas d’ancrage relationnel univoque : le calibrage des deux échelles verticales, la sélection de leurs origines respectives (point zéro) et le ratio de leurs intervalles relèvent d’un choix entièrement arbitraire opéré par l’analyste. En étirant ou en comprimant artificiellement l’axe secondaire par rapport à l’axe primaire, il est possible de faire coïncider visuellement deux trajectoires totalement déconnectées, suggérant l’existence d’une corrélation temporelle parfaite, ou à l’inverse de faire diverger des séries intrinsèquement solidaires en manipulant l’angle d’intersection apparent de leurs tracés.
Ces dérives interprétatives majeures ont conduit les comités éditoriaux les plus rigoureux, à l’instar des guides de normalisation stylistique de l’American Psychological Association (APA), à proscrire formellement ou à décourager fermement l’usage des doubles axes d’ordonnées dans les publications scientifiques de premier rang. La vulnérabilité du lecteur face à des effets d’illusion d’optique statistique impose le recours à des alternatives analytiques rigoureuses, préservant la fidélité de la perception visuelle et garantissant que les configurations spatiales observées découlent exclusivement des propriétés intrinsèques des données empiriques et non d’artifices de mise en page géométrique.
7.2 Implémentation technique via sec_axis() dans ggplot2
Conformément à la philosophie mathématique formalisée par Leland Wilkinson, les concepteurs de ggplot2 ont délibérément refusé d’intégrer un support natif pour les doubles axes d’ordonnées découplés et indépendants, considérant cette pratique comme fondamentalement erronée sur le plan statistique. Face aux sollicitations répétées de la communauté des utilisateurs confrontés à des cas d’usage spécifiques légitimes (tels que la conversion d’unités de mesure strictement équivalentes), une solution technique hautement contrainte a néanmoins été implémentée sous la forme de la fonction sec_axis(), qui s’intègre au sein de la directive d’échelle scale_y_continuous().
La particularité épistémologique de sec_axis() réside dans l’obligation formelle de fournir une transformation mathématique réversible de la variable d’ordonnée primaire. L’argument transform (anciennement trans) attend une formule analytique univoque établissant une correspondance bijective stricte entre l’axe gauche et l’axe droit, le plus souvent sous la forme d’une fonction linéaire affine de type ~ . * facteur_multiplicatif + constante_additive. L’analyste ne trace donc jamais une seconde série brute de données de manière autonome ; il applique manuellement une transformation multiplicative ou additive à la seconde colonne pour l’aligner numériquement sur l’espace d’amplitude de la première série, puis paramètre l’axe secondaire avec la fonction réciproque exacte afin de rétablir la lecture des graduations physiques d’origine sur la bordure droite.
Cette exigence computationnelle lourde garantit que le tracé demeure mathématiquement explicite dans le script de traitement, prévenant les manipulations inconscientes d’échelles arbitraires. Toutefois, la complexité de synchronisation du facteur d’échelle multiplicateur et le risque résiduel de mauvaise interprétation par les pairs confortent l’idée que cette modalité technique doit demeurer exceptionnelle, réservée à des situations méthodologiques rigoureusement justifiées où les deux séries partagent une relation mécanique ou physique indiscutable, telle que la conversion de températures en degrés Celsius et Fahrenheit ou de concentrations physiologiques brutes et relatives.
7.3 Stratégies alternatives rigoureuses : Normalisation et standardisation
Pour représenter de concert de multiples colonnes caractérisées par des étendues hétérogènes sans verser dans les ambiguïtés des doubles axes, la démarche statistique canonique privilégie la standardisation ou la normalisation préliminaire des variables d’intérêt. La transformation la plus universelle consiste à convertir chaque colonne quantitative brute en un vecteur adimensionnel de scores centrés-réduits (scores Z), opération réalisée instantanément sous R au moyen de la fonction fondamentale scale(). Cette procédure mathématique soustrait la moyenne arithmétique de la variable et divise le résultat par son écart-type empirique.
L’avantage graphique et analytique de cette transformation est immédiat : l’ensemble des colonnes ainsi modifiées se trouvent projetées dans un repère orthogonal universellement standardisé, caractérisé par une moyenne nulle (zéro devenant la ligne de flottaison centrale de la figure) et une unité d’ordonnée s’exprimant directement en déviations standards. Dès lors, superposer un temps de réaction en millisecondes et un taux de cortisol salivaire en microgrammes par décilitre devient parfaitement légitime et exempt de tout biais de distorsion d’échelle, les variations observées mesurant rigoureusement la divergence relative de chaque indicateur par rapport à sa propre variabilité biologique de référence.
Une stratégie alternative réside dans la normalisation par plage d’étendue numérique (procédure dite de « min-max scaling »), consistant à projeter linéairement l’amplitude de chaque colonne sur un intervalle adimensionnel strictement borné entre 0 et 1 (ou de 0 à 100%). Cette méthode se révèle particulièrement intuitive pour illustrer des cinétiques d’apprentissage ou des dynamiques d’épuisement comportemental, le zéro matérialisant systématiquement la performance minimale enregistrée et l’unité incarnant l’optimum atteint par la cohorte. En articulant ces métriques adimensionnelles avec un canevas graphique unifié, le chercheur préserve l’intégrité cognitive de l’observation scientifique tout en fournissant une lecture synthétique limpide des relations multivariées.
8. Visualisation de plusieurs colonnes discrètes : Diagrammes en barres et boîtes
8.1 Diagrammes en barres groupées avec geom_col()
L’exploration multivariée ne se cantonne pas aux trajectoires continues longitudinales ; elle embrasse également la comparaison transversale de multiples variables catégorielles ou quantitatives discrètes mesurées à travers diverses strates d’échantillonnage. Lorsque l’on souhaite représenter simultanément plusieurs colonnes d’agrégats (telles que des moyennes empiriques ou des pourcentages de réussite) réparties selon un ensemble de conditions expérimentales distinctes, le diagramme en barres groupées s’impose comme une modalité de formalisation d’une grande efficacité visuelle.
La mise en œuvre sous ggplot2 requiert la conversion préalable du tableau large en format long, permettant d’affecter le facteur de condition expérimentale à l’axe des abscisses spatiales et de mapper la colonne indicatrice des métriques multiples sur le paramètre de remplissage chromatique de surface fill. Pour empêcher le système d’empiler verticalement les segments de colonnes les uns sur les autres (comportement par défaut régulé par position = "stack"), l’opérateur doit déclarer explicitement le mode de juxtaposition horizontal en spécifiant l’argument fondamental position = "dodge" au sein de la primitive geom_col() (ou position = position_dodge(width = 0.9) pour un contrôle micrométrique de l’agencement).
L’ergonomie perceptive de ces constructions dépend fortement de l’optimisation des espacements inter-barres et de la gestion de la largeur relative des rectangles de score. L’ajustement du paramètre width permet d’éviter la formation de blocs compacts monolithiques indésirables, aérant la structure visuelle en ménageant des intervalles négatifs perceptibles entre les agrégats de données. Cette configuration permet une double lecture immédiate : l’évaluation locale des contrastes internes entre différentes colonnes au sein d’une condition donnée, et l’évaluation globale de l’évolution de chaque colonne spécifique à travers l’ensemble des conditions distribuées le long du plan horizontal.
8.2 Comparaison multidimensionnelle par boîtes à moustaches (geom_boxplot)
Si les diagrammes en barres rendent compte efficacement des mesures de tendance centrale agrégées, ils masquent intégralement la dispersion sous-jacente, la forme distributionnelle et la présence éventuelle de singularités statistiques au sein des données expérimentales brutes. Pour palier cette opacité, la boîte à moustaches de Tukey (instanciée via la primitive geom_boxplot()) constitue le standard de rigueur pour visualiser simultanément plusieurs colonnes de scores continus distribuées selon un ou plusieurs facteurs expérimentaux structurants.
Chaque boîte synthétise de manière standardisée l’architecture non paramétrique de la colonne observée, matérialisant par son corps rectangulaire l’intervalle interquartile (délimité par le premier et le troisième quartile et scindé par la ligne médiane), tandis que ses moustaches vectorielles s’étendent jusqu’aux valeurs extrêmes n’excédant pas 1,5 fois cet écart interquartile. Les observations empiriques situées au-delà de ce périmètre de tolérance sont automatiquement individualisées sous la forme de points flottants discrets, permettant une détection visuelle instantanée des valeurs aberrantes (« outliers ») univariées affectant chacune des colonnes sous revue.
Pour enrichir la fidélité informationnelle du tracé et prévenir les illusions d’optique inhérentes aux résumés de quantiles, il est d’usage dans la littérature expérimentale d’adosser à ces boîtes à moustaches une projection intégrale des données observationnelles réelles. Cet enrichissement s’opère par l’adjonction d’une couche geom_jitter(), qui dissémine aléatoirement les points individuels le long d’une déviation horizontale minime contrôlée par le paramètre width. Cette superposition permet de sonder instantanément la densité effective de l’échantillonnage, vérifiant visuellement que les médianes observées ne sont pas l’artefact d’un effectif squelettique ou d’une asymétrie de distribution dissimulée.
8.3 Violin plots et densités superposées pour colonnes continues
L’alternative la plus avancée pour la restitution visuelle de multiples colonnes continues repose sur l’exploitation des diagrammes en violon, matérialisés sous ggplot2 par la commande géométrique geom_violin(). Cette technique substitue ou associe aux quantiles rigides de la boîte à moustaches une estimation non paramétrique par noyau de la densité de probabilité (densité de Parzen-Rosenblatt) de la distribution sous-jacente. Le violon trace une enveloppe curviligne symétrique bilatérale dont l’épaisseur transversale est directement proportionnelle au volume de densité statistique des observations à chaque niveau d’amplitude scalaire.
Cette approche s’avère particulièrement irremplaçable pour détecter instantanément des particularités structurales complexes que ni la moyenne, ni la variance, ni les quartiles ne sauraient révéler, au premier rang desquelles figure la bimodalité ou la polymodalité de distribution au sein d’une colonne de données. L’argument trim = FALSE s’avère recommandé pour autoriser le lissage à s’étendre naturellement vers les queues de distribution extrêmes sans couper brutalement les profils aux minima et maxima d’échantillonnage, offrant une vue synoptique hautement fidèle du support stochastique réel de chaque métrique comportementale ou neurophysiologique.
L’excellence méthodologique contemporaine converge fréquemment vers des représentations composites hybrides, combinant au sein d’une même figure harmonisée le violon de densité de probabilité externe, une boîte à moustaches interne rétrécie (paramétrée via width = 0.1) identifiant les repères d’interquartiles fondamentaux, et un marqueur géométrique proéminent symbolisant la moyenne arithmétique encadrée de son intervalle de confiance à 95%. Cet agencement cumulatif procure une profondeur d’exploration inégalée, permettant au chercheur d’apprécier d’un seul coup d’œil la totalité des propriétés distributionnelles caractérisant chaque colonne de sa matrice d’étude.
9. Visualisation de matrices de colonnes : Corrélations et profils multivariés
9.1 Matrices de nuages de points avec GGally::ggpairs()
Lorsque le protocole de recherche embrasse une dizaine de colonnes quantitatives continues mesurées de manière concomitante, l’analyste se heurte à la complexité combinatoire inhérente à l’évaluation des associations bidimensionnelles croisées. Pour surmonter cette barrière analytique, le package spécialisé GGally, extension directe de l’écosystème ggplot2, met à disposition la fonction de haut niveau ggpairs(). Cet outil automatise la construction intégrale d’une matrice carroyée de nuages de points croisant exhaustivement chaque colonne de la matrice avec toutes les autres composantes de l’ensemble d’observation.
L’organisation topologique d’une matrice ggpairs() obéit à une logique géométrique d’une grande rigueur informationnelle. La diagonale principale de la matrice présente la distribution univariée propre à chaque colonne individuelle, sous la forme d’un histogramme de fréquences ou d’une courbe de densité continue lissée. Le triangle inférieur sous-jacent héberge l’ensemble des nuages de points bivariés traditionnels, révélant la présence de trajectoires fonctionnelles linéaires, quadratiques ou asymptotiques entre paires de variables. Enfin, le triangle supérieur symétrique affiche le coefficient de corrélation statistique correspondant (r de Pearson ou rho de Spearman) accompagné de son niveau d’étoilement de significativité inférentielle.
Cette infrastructure matricielle s’avère particulièrement puissante lorsqu’on lui adjoint une stratification factorielle au moyen de l’argument de regroupement esthétique mapping = aes(colour = Groupe_Clinique). En une seule instruction fonctionnelle, ggpairs() partitionne instantanément l’intégralité des densités diagonales, sépare les nuages de points inférieurs selon des nuances chromatiques dédiées, et recalcule des coefficients de corrélation spécifiques pour chaque sous-cohorte d’intérêt. L’analyste accède ainsi d’emblée à une cartographie synoptique des modérations et des dépendances croisées qui innervent son réseau de colonnes expérimentales.
9.2 Cartes thermiques (Heatmaps) pour grands ensembles de colonnes
Dans les contextes d’acquisition de données à haut débit, tels que l’analyse simultanée de scores obtenus à une batterie de soixante items psychométriques ou la cartographie de profils d’expression transcriptomique issus de micropuces, la projection individuelle de nuages de points individuels devient matériellement impossible. La carte thermique matricielle (« heatmap ») constitue alors la structure d’abstraction géométrique optimale pour appréhender la macrostructure de vastes ensembles tabulaires multidimensionnels.
La transcription d’une large matrice de colonnes en une carte thermique sous ggplot2 s’opère par l’entremise de la primitive de pavage orthogonal geom_tile(). Le jeu de données matriciel, préalablement projeté en format long relationnel à trois colonnes (identifiant de ligne du participant, nom de la colonne du test et magnitude numérique de la mesure), assigne les coordonnées horizontales et verticales aux dimensions d’identification, tandis que la valeur scalaire de chaque cellule régule le remplissage chromatique fill du rectangle unitaire correspondant. L’espace numérique se métamorphose ainsi en un paysage de couleurs continues, dont le regard synthétise sans effort les blocs d’homogénéité et les singularités aberrantes.
La pertinence diagnostique d’une carte thermique est indissociable de la sélection d’une palette chromatique perceptuellement uniforme, au premier rang desquelles figurent les gammes du package viridis. Les échelles continues telles que scale_fill_viridis_c() garantissent que les incréments de teintes perçus par le cortex visuel correspondent strictement à des pas d’accroissement métrique réguliers et proportionnels dans l’espace des données, éradiquant les discontinuités subjectives générées par les palettes spectrales historiques de type arc-en-ciel. L’agencement ordonné des colonnes au moyen d’un partitionnement hiérarchique préalable (« hierarchical clustering ») finalise ce dispositif, regroupant les variables présentant des affinités fonctionnelles mutuelles en modules visuellement denses.
9.3 Profils individuels et graphiques en coordonnées parallèles
L’écueil de l’analyse multivariée agrégée réside dans la dilution de l’individu au sein de moyennes d’échantillon potentiellement artefactuelles, qui ne reflètent parfois la réalité concrète d’aucun sujet particulier. Pour neutraliser ce biais, les graphiques en coordonnées parallèles offrent une modalité d’inscription graphique permettant de restituer le cheminement multidimensionnel unique de chaque participant à travers l’ensemble des colonnes de score qui le caractérisent.
Dans ce modèle de projection vectorielle, le repère orthogonal cartésien classique est supplanté par une séquence d’axes verticaux équidistants et parallèles, chaque axe symbolisant l’une des colonnes de test psychologique ou de mesure comportementale de l’expérience. Chaque participant n’est plus représenté par un point isolé, mais par une ligne polygonale brisée et continue reliant ses valeurs ponctuelles sur chacun des axes verticaux successifs. L’ensemble des sujets forme ainsi un faisceau de cordes entrelacées dont l’architecture géométrique révèle immédiatement l’existence de typologies latentes homogènes ou d’inversions de rangs individuelles.
L’implémentation de cette visualisation sous R est grandement facilitée par la fonction ggparcoord() disponible au sein du package GGally. Cette routine intègre nativement des algorithmes sophistiqués de standardisation automatique des axes (argument scale = "std" ou scale = "uniminmax"), indispensables pour permettre la traversée d’axes aux échelles initiales foncièrement disparates. En colorant les faisceaux de trajectoires selon le statut diagnostique des individus et en modulant la transparence globale des fibres visuelles au moyen d’un indice alpha restreint, le chercheur met en exergue avec une fulgurance graphique singulière les dissociations neurocognitives et les signatures comportementales caractéristiques de ses différents sous-groupes d’étude.
10. Standardisation esthétique et stylistique pour publication académique
10.1 Personnalisation intégrale du thème graphique
L’élaboration d’un graphique multivarié destiné aux colonnes d’une publication scientifique évaluée par les pairs exige un dépassement impératif des configurations esthétiques par défaut délivrées par les logiciels statistiques. Le fond grisâtre quadrillé d’origine emblématique de ggplot2, bien que conceptuellement motivé par des considérations de lisibilité des contrastes dans des contextes informels, est unanimement rejeté par les chartes graphiques de l’édition savante internationale. L’application d’un canevas épuré s’initie typiquement par l’invocation de thèmes minimaux normalisés tels que theme_classic() ou theme_bw(), qui éliminent instantanément les aplats de fond superflus pour recentrer l’attention optique sur les seules données réelles.
Le contrôle micrométrique de chaque composante visuelle s’exécute ensuite par le recours à la fonction structurelle theme(), complétée par les modificateurs sémantiques element_text(), element_line() et element_blank(). La mise en conformité avec les critères de publication exige un calibrage rigoureux des hiérarchies typographiques : les étiquettes des axes (paramètre axis.text) doivent adopter une taille de police suffisante pour résister aux facteurs de réduction d’échelle imposés lors de l’impression sur double colonne, tandis que les titres d’axes (axis.title) se parent d’une graisse renforcée (« bold ») afin d’asseoir solidement les coordonnées du plan.
La théorie de la visualisation de données articulée par Edward Tufte postule l’impératif de maximisation du « ratio encre-données » (« data-ink ratio »). Selon ce principe fondamental, chaque goutte d’encre numérique dispersée sur le canevas doit impérativement transmettre une information statistique nouvelle et non redondante. Par conséquent, il convient d’expurger impitoyablement les éléments cosmétiques distrayants (« chartjunk »), en supprimant les grilles de coordonnées secondaires intérieures via l’instruction panel.grid.minor = element_blank(), en allégeant les liserés de la grille primaire, et en épurant les bordures extérieures des facettes pour ne conserver que les lignes d’axes strictement nécessaires à la contextualisation numérique des mesures.
10.2 Sélection de palettes de couleurs accessibles et daltoniennes-compatibles
L’affectation chromatique dévolue à la discrimination de colonnes multiples constitue un choix de nature méthodologique et éthique, bien au-delà de pures considérations décoratives. Une proportion notable de la communauté scientifique mondiale et du lectorat général présente des déficits partiels ou totaux de la vision des couleurs, principalement sous la forme de deutéranopie ou de protanopie (confusion du rouge et du vert). Mobiliser des palettes standard non calibrées, articulées autour de contrastes binaires rouge-vert ou d’arcs-en-ciel intempestifs, exclut de facto ces lecteurs de la perception des résultats et altère la reproductibilité de la communication scientifique.
Pour immuniser les tracés multivariés contre ces biais perceptifs, l’intégration des palettes vectorielles du package viridis s’est imposée comme le standard d’excellence international contemporain. Les quatre variations algorithmiques fondamentales (viridis, magma, plasma et inferno), déployables au sein de ggplot2 par l’intermédiaire de scale_colour_viridis_d() pour les colonnes discrètes ou scale_colour_viridis_c() pour les dimensions continues, ont été conçues selon des critères de linéarité perceptive rigoureuse. Elles garantissent une séparation tonale optimale quel que soit le profil de vision du lecteur, tout en conservant une gradation de luminosité parfaitement exploitable lors d’une impression physique en niveaux de gris monochromes.
L’analyste dispose également des gammes qualitatives établies par Cynthia Brewer, regroupées dans le package RColorBrewer et accessibles via la fonction d’échelle scale_colour_brewer(). Les palettes d’harmonie qualitative telles que "Dark2" ou "Set2" procurent des teintes d’une excellente saturation, spécifiquement calibrées pour maximiser les contrastes de luminance et de chroma entre séries discrètes contiguës. En proscrivant les couleurs trop claires qui se délavent contre le blanc immaculé de la page et en validant systématiquement les figures au moyen de simulateurs de daltonisme, le chercheur s’assure d’une diffusion démocratique et sans équivoque de ses avancées scientifiques.
10.3 Formatage typographique et conformité aux standards APA
L’accession aux standards rédactionnels de la 7e édition du manuel de publication de l’American Psychological Association (APA) requiert une stricte conformité stylistique dans l’articulation de la figure et de son appareil paratextuel. Dans ce cadre conventionnel, le titre d’une figure ne figure plus à l’intérieur de la surface de dessin elle-même, mais se positionne au-dessus de celle-ci, en caractères droits et gras pour la mention du numéro de figure (par exemple, Figure 1), suivi à la ligne d’un intitulé descriptif concis composé en italique (par exemple, Trajectoires longitudinales des scores psychométriques selon la cohorte d’étude).
Les conventions typographiques gouvernant la désignation des variables et des statistiques au sein des axes et des légendes obéissent à des contraintes formelles rigides. Tout symbole statistique d’ordre mathématique ou inférentiel (tel que p pour le seuil de significativité, t de Student, F de Snedecor ou d de Cohen) doit être scrupuleusement composé en italique. De même, les désignations abrégées de colonnes ou d’échelles de mesure doivent être intégralement explicitées au sein d’une note méthodologique générale positionnée immédiatement sous la figure, initiée par la locution latine en italique Note., garantissant que le document visuel forme une unité d’information parfaitement autonome et autosuffisante.
Enfin, la préservation de cette minutie stylistique impose une maîtrise totale de l’étape d’exportation matérielle du fichier. La directive ggsave() doit être configurée avec des paramètres physiques explicites et non indiciaires, renseignant les dimensions exactes d’insertion souhaitées via les arguments scalaires width et height associés à l’unité normalisée units = "cm" ou "in". L’imposition d’une résolution de tramage stricte via dpi = 300 (ou 600 pour les figures au trait pur) prévient tout phénomène de pixellisation disgracieuse, tandis que le choix d’un format vectoriel encapsulé tel que le PDF garantit que les polices vectorielles et la géométrie des courbes conservent une netteté absolue quelle que soit la focale de grossissement appliquée par le comité éditorial.
11. Dépannage des erreurs courantes et optimisation du code
11.1 Correction des anomalies de pivotement et pertes de typage
L’opération de restructuration tabulaire préliminaire, bien qu’élégante sur le plan conceptuel, représente une source prolifique d’anomalies computationnelles silencieuses et d’erreurs d’exécution sous R. L’incident le plus classique réside dans l’hétérogénéité sous-jacente des types de données caractérisant les colonnes sélectionnées pour le pivotement. Si l’opérateur tente d’empiler verticalement des colonnes numériques entières avec une colonne par inadvertance convertie en chaîne de caractères (character) ou stockant des valeurs booléennes, les fonctions de pivotement réagissent de manière contrastée : là où pivot_longer() interrompt son flux en générant une exception d’incompatibilité de type explicite, l’ancienne fonction melt() convertit silencieusement l’intégralité du vecteur de sortie en type texte, détruisant instantanément la nature quantitative des mesures et bloquant toute projection sur l’axe continu de ggplot2.
La manipulation des colonnes chronologiques ou temporelles constitue un autre foyer récurrent de vulnérabilité technique. Lorsque les en-têtes d’origine contiennent des dates calendaires formalisées ou des intervalles temporels stricts, l’extraction textuelle génère une variable catégorielle nominale là où l’analyste escompte un continuum chronologique métrique. L’absence de conversion explicite via les routines du package lubridate ou au moyen de fonctions de coercition directe comme as.numeric() ou as.Date() conduit le moteur graphique à traiter chaque temps de mesure comme un point isolé d’un axe discret, rompant la continuité des tracés linéaires de geom_line() et aboutissant à des segments tronqués ou inexistants.
Pour prévenir ces écueils invalidants, l’implémentation systématique d’une étape de vérification structurelle en amont et en aval de la mutation matricielle s’avère impérative. L’invocation d’instructions diagnostiques fondamentales telles que str(), dplyr::glimpse() ou l’évaluation logique assertthat::assert_that() permet de confirmer la conformité dimensionnelle du tableau restructuré. Le chercheur s’assurera notamment que le nombre total de lignes de la table résultante équivaut strictement au produit du nombre de lignes de la table d’origine par le nombre de colonnes pivotées, attestant de l’exhaustivité de la restructuration sans duplication clandestine ni déperdition d’observations.
11.2 Résolution des problèmes d’ordre d’affichage des séries
L’un des motifs de perplexité les plus fréquents rencontrés par les chercheurs exploitant ggplot2 pour tracer plusieurs colonnes réside dans la disparité apparente entre l’ordre chronologique ou hiérarchique souhaité et la séquence spatiale effectivement dessinée sur le graphique ou dans la légende. Par défaut, lorsqu’une colonne textuelle est promue au rang d’esthétique catégorielle sans qualification supplémentaire, le système R opère une coercition automatique en facteur dont les modalités (« levels ») sont invariablement triées selon l’ordre alphabétique standard. Par conséquent, une série ordonnée de conditions telle que « Temps 1 », « Temps 2 », « Temps 10 » se trouvera intercalée de manière erratique sous la forme « Temps 1 », « Temps 10 », « Temps 2 ».
La résolution définitive de cette discordance impose une reprise en main explicite des métadonnées du facteur au sein du code de transformation statistique. L’analyste se doit de reconfigurer les niveaux factoriels au moyen de la fonction factor(), en fournissant manuellement le vecteur ordonné exhaustif au paramètre levels, ou en exploitant les commodités algorithmiques du package spécialisé forcats. La fonction fct_inorder() permet ainsi de verrouiller les modalités du facteur en calquant scrupuleusement leur hiérarchie sur leur ordre d’apparition textuel direct au sein du jeu de données source, rétablissant la validité séquentielle des représentations longitudinales.
Ce verrouillage structural des facteurs garantit une synchronisation parfaite et automatisée entre la disposition spatiale des facettes, la séquence chromatique des tracés et la déclinaison descendante des items au sein de la légende explicative. Si une inversion locale d’empilement demeure requise pour harmoniser la trajectoire visuelle des courbes avec l’ordre de lecture des légendes, la fonction de contrôle guides() couplée à l’instruction guide_legend(reverse = TRUE) offre la flexibilité nécessaire pour inverser la clé de lecture sans altérer la rigueur ordinale sous-jacente des données matricielles réelles.
11.3 Optimisation computationnelle pour volumétries élevées
Lorsque la démarche de visualisation multivariée est appliquée à des corpus massifs de données scientifiques, tels que des enregistrements électroencéphalographiques (EEG) haute densité à 1000 Hertz comportant des centaines de canaux d’électrodes ou des suivis actigraphiques s’étendant sur plusieurs millions de relevés par sujet, les mécanismes standards de R montrent de sévères goulets d’étranglement de performance. Le passage d’un tel jeu de données de format large en format long via les fonctions conventionnelles peut rapidement saturer la mémoire vive (RAM) disponible et paralyser le processus d’évaluation graphique.
Dans ce contexte de contrainte volumétrique, la substitution des routines de tidyr par les primitives hautement optimisées du package data.table devient un impératif d’ingénierie logicielle. La fonction data.table::melt(), écrite en langage C bas niveau avec allocation mémoire directe, opère le pivotement matriciel de dizaines de millions de lignes à une vitesse de plusieurs ordres de grandeur supérieure, réduisant considérablement l’empreinte mémoire volatile requise pour la préparation des tableaux de visualisation.
Sur le plan du rendu graphique proprement dit, la tentative de projeter des millions de points ou de minuscules segments vectoriels au moyen d’un canevas vectoriel standard (PDF) constitue une hérésie technique, aboutissant à des documents d’une lourdeur colossale incapables de s’afficher avec fluidité sur les visualiseurs conventionnels. L’analyste avisé privilégiera alors soit une phase préalable de sous-échantillonnage temporel intelligent (« downsampling ») préservant les extremums locaux, soit le couplage de ggplot2 avec le moteur de rendu matriciel accéléré fourni par le package scattermore ou ggrastr. Ces extensions rasterisent de façon chirurgicale la seule couche dense de données tout en conservant la structure vectorielle irréprochable des axes, des textes et des légendes, conciliant ainsi vélocité computationnelle et haute définition scientifique.
12. Synthèse comparative et recommandations méthodologiques
12.1 Matrice de décision : Sélectionner l’approche adaptée à l’objectif d’analyse
Au terme de cette exploration technique exhaustive des mécanismes permettant de tracer simultanément plusieurs colonnes dans l’environnement R, il apparaît fondamental de synthétiser les critères méthodologiques guidant le choix entre les différentes stratégies d’implémentation disponibles. L’analyste se trouve confronté à un arbitrage constant entre la célérité d’exécution, la flexibilité cosmétique et la pérennité architecturale de ses scripts d’analyse. Aucune modalité n’est intrinsèquement universelle ; chacune répond avec pertinence à un moment précis du cycle de traitement de la donnée scientifique.
Le système graphique natif de Base R conserve une utilité tactique indéniable lors des phases initiales de défrichage rapide et d’exploration informelle. Sa capacité à projeter instantanément des colonnes indépendantes via une succession directe de commandes plot() et lines() sans requérir le chargement de dépendances logicielles externes ni imposer de restructuration tabulaire en fait l’allié des vérifications diagnostiques à la volée. Toutefois, dès lors que la finalité s’oriente vers la production d’artefacts scientifiques de haute qualité, la publication académique ou l’intégration dans des chaînes d’analyse collaboratives, l’écosystème ggplot2 articulé autour d’un pivotement préalable en format long s’impose sans rival pour sa modularité, sa stabilité stylistique et sa parfaite maintenabilité.
Le dilemme opposant la superposition de multiples tracés sur un canevas unique à la décomposition ordonnée en facettes multiples (via facet_wrap() ou facet_grid()) doit être tranché à l’aune du volume de colonnes et de la compatibilité des unités de mesure. La superposition sur plan unique constitue l’étalon or lorsque l’on scrute les interactions d’un nombre restreint de variables (deux à quatre maximum) partageant rigoureusement une même échelle dimensionnelle, l’entrecroisement des lignes étant indispensable à la perception des corrélations instantanées. Dès que le nombre de séries croît ou que les ordres de grandeur divergent, la dispersion par facettes s’avère méthodologiquement obligatoire pour préserver la clarté cognitive et immuniser le regard contre toute contamination interprétative illusoire.
12.2 Garantie de la reproductibilité scientifique des graphiques multivariés
L’excellence méthodologique dans le traitement des graphiques multivariés culmine dans la garantie d’une reproductibilité computationnelle absolue. Une figure scientifique ne saurait être considérée comme un objet statique figé, déconnecté de son substrat empirique source ; elle doit matérialiser l’aboutissement transparent d’un pipeline d’instructions totalement traçable et réexécutable à l’identique par n’importe quel auditeur indépendant. Cette exigence épistémologique impose l’encapsulation intégrale des scripts de transformation et de visualisation au sein de documents de programmation lettrée, tels que des calepins Quarto ou des documents computationnels R Markdown.
La pérennité des résultats visuels requiert également un contrôle strict de l’environnement d’exécution informatique. Les variations mineures introduites lors des mises à jour incrémentales des packages graphiques de l’écosystème R (modifications des valeurs d’espacement par défaut, altération des palettes tonales) sont susceptibles de modifier insensiblement le rendu esthétique final de figures soumises à publication. Le verrouillage des versions logicielles et de leurs dépendances croisées, par l’entremise de gestionnaires d’environnements reproductibles comme le package renv, constitue un rempart indispensable contre l’obsolescence programmée des figures scientifiques.
Enfin, cette démarche s’inscrit pleinement dans le mouvement mondial de la science ouverte (« Open Science »). En archivant publiquement les scripts graphiques dans des dépôts ouverts pérennes aux côtés des données matricielles brutes, les chercheurs permettent à leurs pairs de disséquer, d’émuler et de perfectionner les protocoles visuels déployés. Tracer de multiples colonnes sous R dépasse ainsi la simple maîtrise d’une habileté syntaxique instrumentale pour s’ériger en un véritable vecteur d’intégrité, d’intelligibilité et d’universalité méthodologique dans la communication des savoirs contemporains.
Références
- Brewer, C. A. (2014). ColorBrewer: Color advice for cartography. Pennsylvania State University. https://colorbrewer2.org/
- Garnier, S., Ross, N., Rudis, B., Camargo, P. A., Sciaini, M., & Scherer, C. (2021). viridis: Colorblind-Friendly Color Maps for R (R package version 0.6.2). CRAN. https://cran.r-project.org/package=viridis
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.r-project.org/
- Schloerke, B., Cook, D., Larmarange, J., Briatte, F., Marbach, M., Thoen, E., Elberg, A., & Crowley, J. (2021). GGally: Extension to ‘ggplot2’ (R package version 2.1.2). CRAN. https://cran.r-project.org/package=GGally
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2007). Reshaping data with the reshape package. Journal of Statistical Software, 21(12), 1–20. https://doi.org/10.18637/jss.v021.i12
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wickham, H., & Grolemund, G. (2017). R for data science: Import, tidy, transform, visualize, and model data. O’Reilly Media.
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0