
Dans le champ contemporain de la psychométrie et de la modélisation statistique appliquée aux sciences humaines, l’analyse des données de comptage constitue un défi méthodologique fondamental. Contrairement aux variables continues qui se prêtent volontiers aux postulats d’une loi normale, de nombreux comportements humains, événements cliniques ou occurrences cognitives se manifestent sous la forme de dénombrements discrets, strictement non négatifs et intrinsèquement asymétriques. Qu’il s’agisse de mesurer la récurrence d’actes compulsifs au cours d’une semaine, le nombre d’erreurs d’inattention commises lors d’une tâche informatisée ou la fréquence d’épisodes de panique au sein d’une cohorte clinique, l’hypothèse de gaussianité s’avère non seulement inadéquate, mais susceptible d’induire des erreurs d’inférence substantielles.
Face à ces contraintes distributionnelles, la loi de Poisson s’impose comme le modèle paramétrique de référence pour décrire les processus générateurs d’événements rares ou discrets survenant dans un intervalle spatio-temporel déterminé. Son élégance conceptuelle réside dans son unique paramètre d’intensité, qui gouverne simultanément la tendance centrale et la dispersion de la variable aléatoire. Toutefois, l’appréhension rigoureuse de ce modèle stochastique ne saurait se limiter à une assimilation purement algébrique. La maîtrise de sa représentation graphique sous l’environnement de calcul statistique The R Project for Statistical Computing représente une compétence méthodologique essentielle, permettant aux chercheurs d’évaluer la pertinence de leurs hypothèses de modélisation, de diagnostiquer les écarts empiriques et de communiquer leurs résultats selon les critères d’excellence académique.
Cet article propose une exploration approfondie et exhaustive des techniques de visualisation de la loi de Poisson sous R. En cheminant depuis les fondements de la théorie des probabilités jusqu’aux approches graphiques sophistiquées offertes par le moteur de base et la bibliothèque ggplot2, ce guide a pour vocation de fournir aux psychologues quantitatifs, biostatisticiens et analystes de données un cadre de travail reproductible, rigoureux et directement transposable à leurs travaux de recherche.
1. Fondements théoriques de la loi de Poisson et pertinence en psychologie quantitative
1.1 Définition mathématique et fonction de masse de probabilité (PMF)
La loi de Poisson, introduite par le mathématicien Siméon Denis Poisson en 1837 dans ses recherches sur la probabilité des jugements en matière criminelle et civile, est une loi de probabilité discrète décrivant le nombre d’événements indépendants survenant dans un continuum temporel, spatial ou observationnel de dimension fixe. Une variable aléatoire discrète X suit une loi de Poisson de paramètre d’intensité lambda (noté λ, avec λ > 0) si son support est constitué de l’ensemble des entiers naturels, c’est-à-dire l’ensemble des entiers k supérieurs ou égaux à zéro. Le paramètre λ synthétise le taux d’occurrence attendu par unité d’observation. L’expression analytique de sa fonction de masse de probabilité (communément désignée par l’acronyme anglophone PMF pour Probability Mass Function) s’énonce selon la formulation canonique suivante : la probabilité que la variable aléatoire X prenne la valeur exacte k est égale au quotient du produit de lambda élevé à la puissance k par l’exponentielle de l’opposé de lambda, le tout divisé par la factorielle de k.
Cette formulation repose sur un socle d’hypothèses probabilistes strictes découlant de la théorie des processus ponctuels de Poisson. En premier lieu, les événements doivent se produire de manière indépendante : l’occurrence d’un événement à un instant donné n’exerce aucune influence causale, inhibitrice ou facilitatrice, sur la probabilité d’occurrence d’un autre événement dans le futur ou dans un voisinage immédiat. En second lieu, le taux moyen d’occurrence λ doit demeurer stationnaire et invariant sur toute l’étendue de l’intervalle d’observation considéré. En troisième lieu, la probabilité d’observer deux événements ou davantage dans un sous-intervalle infinitésimal est rigoureusement négligeable, ce qui garantit l’absence de regroupement instantané ou d’agrégation simultanée.
L’une des propriétés structurales les plus remarquables de la loi de Poisson réside dans le principe d’équidispersibilité. Sur le plan théorique, l’espérance mathématique de la variable X est rigoureusement égale à sa variance, toutes deux étant paramétrées par la quantité scalaire λ. Cette égalité mathématique, où E(X) = Var(X) = λ, confère au modèle une remarquable parcimonie paramétrique. Cependant, elle constitue également son talon d’Achille lors de l’application à des données comportementales réelles, où la variabilité empirique s’écarte fréquemment de la moyenne observée, nécessitant une vigilance diagnostique constante lors de la phase exploratoire.
1.2 Applications empiriques aux données de comptage en sciences psychologiques
Dans l’investigation empirique des processus psychologiques et comportementaux, les variables de comptage abondent et présentent des caractéristiques structurales incompatibles avec le modèle de régression linéaire classique fondé sur les erreurs gaussiennes. L’application de la distribution de Poisson trouve notamment une résonance majeure dans l’évaluation longitudinale des troubles affectifs et psychopathologiques. Par exemple, la quantification du nombre d’épisodes dépressifs majeurs ou de crises d’angoisse paroxystique survenant sur une période de six mois chez des patients suivis en psychiatrie ambulatoire génère des distributions caractérisées par un plancher structurel à zéro et une forte concentration des observations autour de valeurs faibles.
Dans le domaine des neurosciences cognitives et de la neuropsychologie expérimentale, la distribution de Poisson est fréquemment sollicitée pour formaliser le nombre de lapsus verbaux, d’oublis de consigne ou d’erreurs motrices lors d’épreuves mesurant l’attention soutenue, telles que les protocoles de performance continue (Continuous Performance Tasks). Dans ce contexte, chaque essai représente une opportunité infinitésimale de défaillance cognitive. Le nombre total d’erreurs commises au cours d’une session expérimentale de trente minutes constitue un processus d’événements discrets où le taux d’erreur de base d’un sujet neurotypique est particulièrement bas, conférant à la distribution une morphologie typique de Poisson.
De même, la psychologie du développement et la psychologie sociale exploitent fréquemment cette loi pour analyser la fréquence d’actes comportementaux spécifiques, tels que les interactions prosociales observées chez de jeunes enfants en milieu préscolaire, les comportements d’agression verbale dans la cour de récréation, ou le nombre de réveils nocturnes enregistrés chez des nourrissons. Le traitement méthodologique rigoureux de ces variables impose de rejeter la normalisation forcée par transformation logarithmique, traditionnellement employée de manière abusive, au profit d’une modélisation probabiliste directe respectant la nature discrète, non négative et asymétrique des comptages.
1.3 Comportement asymptotique selon la variation du paramètre lambda (λ)
La morphologie géométrique de la distribution de Poisson est conditionnée de manière exclusive par la magnitude de son paramètre scalaire λ. L’examen des variations de cette courbe de probabilité révèle des comportements asymptotiques capitaux pour le chercheur confronté au choix de ses outils d’analyse statistique. Lorsque λ adopte des valeurs faibles (typiquement λ < 3), la distribution est caractérisée par une forte asymétrie positive (ou asymétrie à droite). Le mode de la distribution est situé très près de l’origine (à zéro ou à un), et la probabilité décroît de façon exponentielle à mesure que k progresse vers des valeurs supérieures. Cette configuration reflète l’occurrence de phénomènes véritablement rares, où une fraction importante de l’échantillon ne présente aucun événement au cours de l’intervalle.
À mesure que le paramètre d’intensité s’accroît pour atteindre des valeurs intermédiaires (comprises par exemple entre 4 et 9), le centre de gravité de la masse de probabilité s’éloigne progressivement de l’abscisse zéro. La distribution commence à se détacher de la frontière d’impossibilité négative, et sa queue de distribution gauche s’allonge. Bien que le coefficient d’asymétrie de Fisher (calculé analytiquement par l’inverse de la racine carrée de λ) demeure strictement positif, la forme de la cloche distributionnelle s’épaissit et tend vers une configuration plus équilibrée autour de sa moyenne.
Enfin, lorsque λ franchit des seuils élevés (généralement λ > 15 ou λ > 20), la distribution de Poisson converge asymptotiquement vers une loi normale de paramètres de moyenne μ = λ et de variance σ² = λ, en parfaite conformité avec le théorème central limite. Cette convergence signifie que pour des taux moyens d’occurrence substantiels, la nature discrète de la variable s’estompe visuellement au profit d’un profil symétrique méso-kurtique. La compréhension de cette transition morphologique est déterminante : elle permet au chercheur d’anticiper visuellement si une approximation continue peut être tolérée ou si la préservation d’une structure discrète de Poisson demeure impérative pour préserver l’intégrité inférentielle de l’étude.
2. L’écosystème R pour la modélisation de Poisson : le quatuor dpois, ppois, qpois et rpois
2.1 Rôle précis de la fonction dpois() pour la fonction de masse
L’environnement statistique R implémente la distribution de Poisson par l’intermédiaire d’un ensemble de quatre fonctions primitives hautement optimisées, partageant une convention de nommage uniforme commune à toutes les lois de probabilité du système. Au cœur de cette infrastructure se trouve la fonction dpois(), conçue spécifiquement pour évaluer la fonction de masse de probabilité. Sa signature syntaxique standard s’organise autour de trois arguments : le vecteur des quantiles discrets x représentant le nombre d’occurrences dont on souhaite estimer la vraisemblance, le paramètre d’intensité lambda qui fixe le taux moyen de l’événement, et l’argument logique log, dont la valeur par défaut est fixée à faux.
D’un point de vue fonctionnel, dpois() calcule pour chaque élément du vecteur x la densité discrète théorique P(X = x). L’argument lambda accepte une valeur scalaire unique ou un vecteur de taux d’intensité, ce qui autorise une vectorisation complète des calculs sans recourir à des boucles itératives explicites. Si l’argument log est paramétré sur vrai, la fonction retourne le logarithme népérien des probabilités, une option computationnelle essentielle lors de l’estimation de modèles par le maximum de vraisemblance afin de prévenir les phénomènes d’évanouissement numérique sous le zéro machine.
Le comportement de dpois() face aux anomalies d’arguments reflète la rigueur de sa programmation interne. Si l’utilisateur transmet une valeur réelle non entière pour x, la fonction R émet un avertissement formel et renvoie une probabilité nulle, conformément à la définition stricte du support discret des entiers naturels. De même, toute valeur négative de x génère une probabilité théorique de zéro, tandis qu’une valeur négative ou nulle affectée à l’argument lambda déclenche l’émission d’une valeur indéterminée accompagnée d’un message d’erreur signalant l’invalidité du domaine paramétrique.
2.2 Distinction avec les fonctions ppois, qpois et rpois
Pour exploiter pleinement la modélisation stochastique sous R, il convient de distinguer avec une clarté absolue le rôle dévolu à chacune des trois autres composantes du quatuor fonctionnel. La fonction ppois() calcule la fonction de répartition cumulative, c’est-à-dire la somme ordonnée des probabilités pour toutes les valeurs inférieures ou égales à un seuil donné k. Elle permet de répondre à des interrogations cliniques cruciales telles que la détermination du risque cumulé qu’un sujet manifeste au plus k conduites dysfonctionnelles sur une période de suivi. Elle intègre l’argument lower.tail permettant de basculer instantanément vers le calcul des probabilités de survie dans la queue supérieure de la distribution.
À l’inverse symétrique de la fonction de répartition, la fonction qpois() met en œuvre la fonction quantile, parfois qualifiée de fonction de répartition inverse généralisée. Étant donné une valeur de probabilité comprise entre zéro et un, qpois() identifie le plus petit entier naturel k tel que la probabilité cumulative P(X ≤ k) égale ou dépasse le seuil probabiliste prescrit. Cet outil s’avère indispensable pour établir des seuils d’alerte psychométriques ou isoler les percentiles critiques (par exemple le 95e percentile) au-delà desquels la fréquence d’un comportement doit être qualifiée d’atypique ou de pathologique.
Enfin, la fonction rpois() constitue le générateur de nombres pseudo-aléatoires issu d’une distribution de Poisson. En spécifiant la taille d’échantillon souhaitée et le paramètre λ, le statisticien peut simuler des cohortes synthétiques entières de participants virtuels. Cette fonction est le pilier des démarches de rééchantillonnage, des protocoles de simulation de Monte-Carlo et des analyses de puissance a priori pour les modèles linéaires généralisés (GLM). L’articulation coordonnée de ces quatre fonctions offre au chercheur une panoplie complète pour modéliser, explorer et représenter les comportements de comptage avec un contrôle paramétrique absolu.
3. Construction élémentaire du graphique de la fonction de masse avec le moteur graphique de base
3.1 Initialisation du vecteur de succès et paramétrage du domaine discret
La restitution visuelle fidèle d’une loi de Poisson débute impérativement par la délimitation rigoureuse de son domaine de représentation. Bien que le support théorique de la variable X s’étende formellement jusqu’à l’infini positif, la fonction de masse décroît à un rythme supragéométrique sous l’effet du terme factoriel présent au dénominateur de sa formulation. Il est donc indispensable d’isoler un sous-ensemble fini et représentatif d’entiers naturels qui capture la quasi-totalité de la masse de probabilité tout en évitant une troncature dommageable de la queue de distribution.
En pratique, la définition de la borne supérieure dépend étroitement de la valeur attribuée à lambda. Une règle heuristique robuste consiste à étendre la séquence discrète depuis zéro jusqu’à une valeur maximale k_max définie par la moyenne augmentée de quatre à cinq écarts-types théoriques, soit k_max = λ + 4 * sqrt(λ). Par exemple, pour une modélisation calibrée sur un paramètre λ = 4, l’écart-type vaut exactement 2. Le domaine discret d’évaluation sera donc judicieusement initialisé par une séquence régulière de nombres entiers s’étendant de zéro à 12 ou 14. Cette séquence peut être instantanément générée sous R par l’opérateur deux-points ou par la fonction seq(), créant un vecteur numérique discret assigné dans l’environnement global de travail.
L’initialisation de ce vecteur discret de valeurs de succès conditionne directement la lisibilité de l’ordonnée. Si la séquence sélectionnée est trop courte, l’aire sous la courbe discrète sera visuellement amputée de son asymétrie résiduelle, induisant le lecteur en erreur quant à la sévérité des événements rares. Inversement, une séquence excessivement large comprimera la représentation visuelle dans la portion gauche du repère cartésien, reléguant la zone d’intérêt à une bande étroite peu informative. Le calibrage méthodique du domaine constitue ainsi la première exigence méthodologique du tracé.
3.2 Implémentation de l’argument type = ‘h’ dans la fonction plot()
Une fois le vecteur des valeurs discrètes et le vecteur de probabilités correspondantes calculés via dpois(), le chercheur doit sélectionner la géométrie de restitution adéquate au sein du système graphique de base de R. L’erreur la plus préjudiciable consisterait à exécuter la commande générique plot() sans spécifier de type de tracé, ce qui produirait par défaut un nuage de points isolés (type = ‘p’) ou, pire encore, une ligne continue brisée reliant les coordonnées (type = ‘l’). La connexion linéaire d’entiers naturels véhicule une contre-vérité mathématique flagrante en suggérant une continuité sous-jacente pour une variable qui ne peut exister que sous forme d’unités de comptage entières.
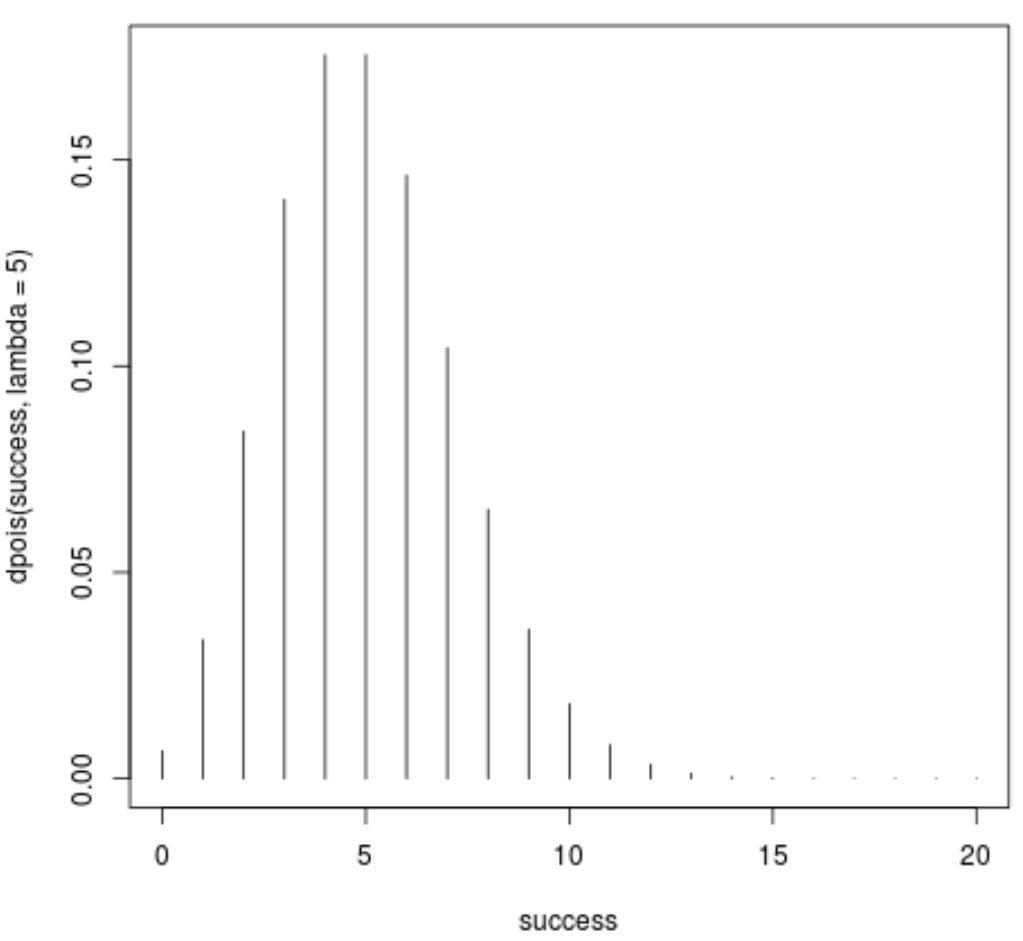
Pour respecter l’intégrité ontologique de la distribution discrète, l’implémentation de l’argument type = ‘h’ (pour histogram ou lignes verticales de haute impulsion) s’impose comme la solution canonique du moteur graphique de base. En renseignant cet argument au sein de l’appel fonctionnel de plot(), R trace pour chaque valeur discrète du domaine une ligne verticale partant strictement de l’axe des abscisses (y = 0) et s’élevant jusqu’à la hauteur exacte correspondant à la probabilité ponctuelle P(X = k). Cette géométrie filiforme traduit visuellement le concept de masse concentrée sur des points isolés de la droite réelle.
L’interprétation sémiotique de ce tracé d’impulsion est immédiate pour la communauté scientifique. L’axe horizontal consigne sans ambiguïté les valeurs discrètes des événements dénombrés, tandis que l’axe vertical mesure directement la probabilité unitaire associée à chaque réalisation. L’absence délibérée de surface étalée entre les barres rappelle instantanément au lecteur que la probabilité d’observer une valeur fractionnaire (telle que 2,5 erreurs cognitives) est rigoureusement nulle dans le cadre du modèle posé.
4. Optimisation esthétique et rigueur académique du tracé sous R de base
4.1 Enrichissement sémantique des étiquettes et du titre
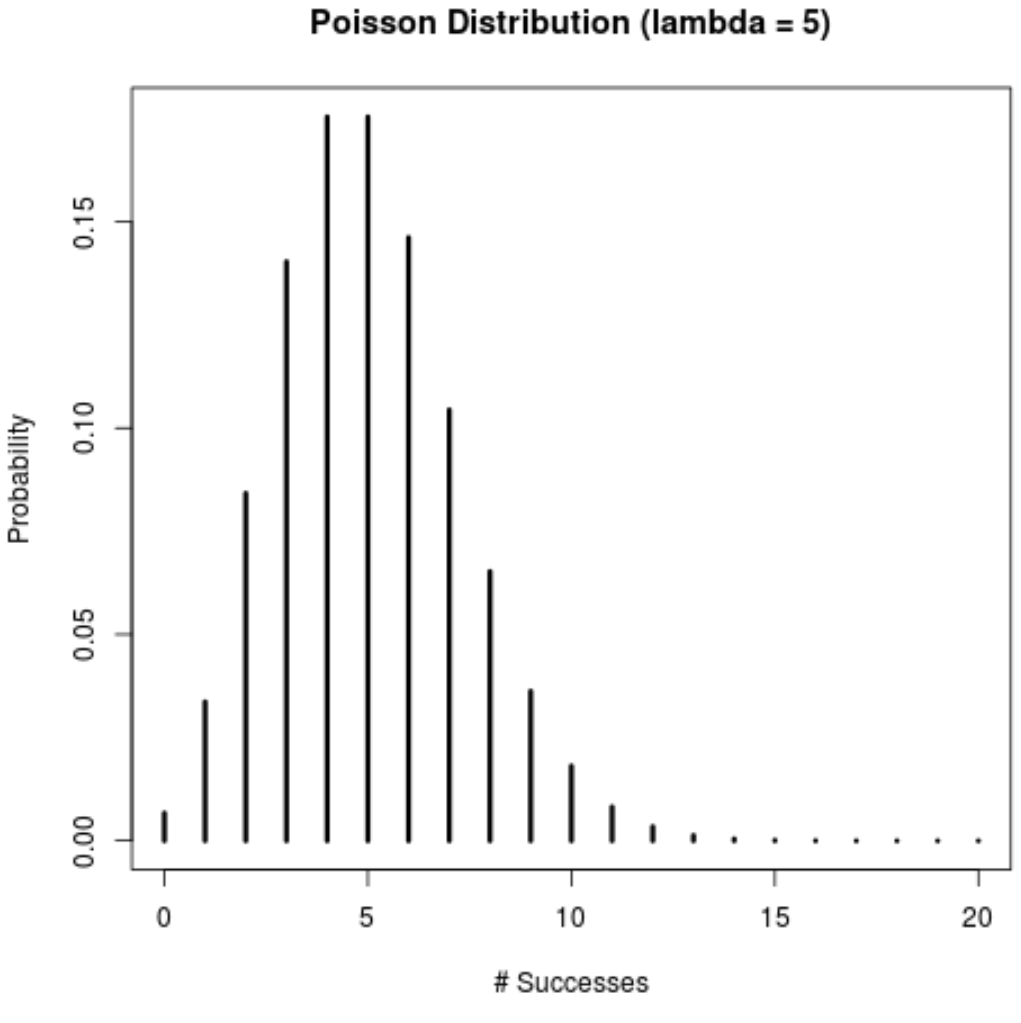
Un tracé statistique brut dépourvu de métadonnées sémantiques exhaustives s’avère inutilisable dans un rapport de recherche ou une publication soumise à l’évaluation par les pairs. L’optimisation académique du tracé sous le système graphique de base exige la spécification explicite des arguments textuels permettant de contextualiser immédiatement la figure. L’argument main doit être mobilisé pour expliciter la nature de la distribution représentée tout en déclarant la valeur paramétrique exacte attribuée à lambda. La mention formelle de ce paramètre permet au lecteur de reconstituer mentalement les propriétés théoriques de la distribution affichée.
De surcroît, la standardisation rigoureuse des étiquettes des axes s’opère au moyen des paramètres xlab et ylab. L’étiquette de l’axe horizontal ne doit pas se cantonner à une notation mathématique opaque, mais articuler le nom de la variable concrète observée et son statut de comptage discret (par exemple : « Nombre d’actes agressifs observés (k) »). De même, l’axe vertical requiert une formulation dépourvue d’ambiguïté, telle que « Probabilité théorique P(X = k) » ou « Densité discrète de probabilité ». Cette précision textuelle garantit que le graphique demeure autosuffisant et intelligible en dehors du corps principal du manuscrit.
Pour parfaire l’insertion éditoriale selon les normes typographiques internationales, telles que celles prescrites par l’American Psychological Association, il est recommandé d’éviter l’usage de polices décoratives et de veiller à ce que la taille relative des caractères soit uniformisée au moyen du paramètre d’expansion textuelle cex. L’ajustement coordonné de cex.main, cex.lab et cex.axis assure une lisibilité irréprochable des inscriptions lors de la réduction d’échelle imposée par la mise en page d’une revue scientifique.
4.2 Ajustement des propriétés géométriques et des couleurs
Par défaut, l’argument type = ‘h’ génère des segments verticaux d’une finesse extrême (lwd = 1), qui apparaissent fragiles et manquent d’impact visuel sur un tirage haute définition ou un écran haute densité de pixels. Pour conférer à la représentation une autorité visuelle et une robustesse graphique adéquates, il convient d’augmenter substantiellement l’épaisseur des traits à l’aide du paramètre lwd (line width). Une valeur calibrée entre lwd = 4 et lwd = 8, proportionnellement à la densité du vecteur discret, transforme ces lignes ténues en véritables piliers graphiques discrets d’une parfaite netteté.
Le choix de la palette chromatique via l’argument col doit obéir à des critères de sobriété et de contraste perceptif. Dans un contexte académique, les couleurs criardes ou purement ornementales sont formellement proscrites. L’adoption d’un bleu marine institutionnel, d’un gris ardoise soutenu ou d’un noir profond permet de focaliser l’attention sur la courbure de la masse de probabilité. L’ajout d’une commande complémentaire points(), exécutée immédiatement après l’appel principal de plot(), permet de superposer un point plein circulaire (pch = 19 ou pch = 16) au sommet exact de chaque segment vertical, scellant graphiquement la coordonnée de probabilité ponctuelle.
Enfin, la maîtrise de l’environnement graphique global s’obtient par la configuration préalable des paramètres marginaux à travers la fonction par(). L’argument mar permet de réduire les marges superflues entourant le tracé afin de maximiser la zone dévolue aux données empiriques ou théoriques. L’argument bty = ‘l’ permet quant à lui de supprimer les bordures supérieure et droite superflues de la boîte de traçage, créant un repère cartésien classique en équerre hautement recommandé par les guides de style scientifique pour éliminer toute pollution visuelle inutile.
5. Gestion de la précision numérique et extraction des probabilités discrètes
5.1 Neutralisation de la notation scientifique par options(scipen)
Lors de la manipulation de distributions de Poisson modélisant des taux d’occurrence faibles ou lors de l’exploration des extrémités distales de la distribution, le système de calcul de R bascule automatiquement vers une notation scientifique condensée (faisant intervenir l’exposant e-XX) dès lors que les probabilités franchissent un seuil de petitesse critique. Si cette convention d’écriture garantit la compacité numérique interne, elle s’avère profondément néfaste pour la communication visuelle et la compréhension immédiate des praticiens non statisticiens examinant des sorties graphiques ou des annotations tabulaires.
Pour contraindre R à restituer l’intégralité des décimales sous un format décimal standard explicite, il est nécessaire de modifier la pénalité appliquée à la notation scientifique via la fonction globale de configuration environnementale : options(scipen = 999). L’attribution d’une valeur positive élevée au paramètre scipen (pour scientific penalty) ordonne à l’interpréteur de privilégier systématiquement la représentation décimale étendue, sauf en présence d’un volume de zéros excédant les tolérances de mémoire allouées.
Cette manipulation technique s’avère particulièrement déterminante lorsque l’on s’intéresse à l’analyse des événements cliniques rares, tels que le risque hebdomadaire d’un passage à l’acte auto-agressif au sein d’une unité spécialisée. La lisibilité d’une probabilité résiduelle telle que 0,00042 s’avère infiniment plus intuitive pour un collège de cliniciens que sa transcription algorithmique obscure sous la forme 4.2e-04. La désactivation pérenne de ce mode d’affichage compact garantit la limpidité des graduations d’axes et des annotations numériques intégrées aux figures.
5.2 Génération de tables de probabilités et arrondi statistique
La génération graphique ne saurait être dissociée de la vérification arithmétique rigoureuse des données sous-jacentes. Avant même de finaliser une figure destinée à la diffusion, le chercheur a le devoir méthodologique de compiler une table de distribution associant explicitement chaque entier discret k à sa probabilité calculée, ainsi qu’à sa probabilité cumulée correspondante. Cette structure tabulaire est aisément instanciée en rassemblant les vecteurs dans un objet de type data.frame ou table matricielle au sein de l’environnement R.
La manipulation de ces estimations théoriques impose l’application contrôlée de la fonction round() afin de respecter scrupuleusement les exigences des manuels de publication en vigueur. La conservation d’une précision fixée à trois ou quatre décimales constitue la norme empirique consensuelle, éliminant les variations infinitésimales sans masquer les probabilités des quantiles éloignés. Le chercheur veille ainsi à aligner les grandeurs numériques des tableaux d’accompagnement sur les ordonnées des graphiques de masse.
Un contrôle diagnostique indispensable consiste à exécuter la somme vectorielle de la colonne de probabilités via la fonction sum(), ainsi que le calcul de la somme cumulative ordonnée par cumsum(). Cette démarche permet de vérifier de visu la normalisation unitaire fondamentale de la loi de Poisson : la somme des probabilités calculées sur un domaine suffisamment étendu doit converger de manière quasi parfaite vers la valeur 1. Tout écart substantiel à cette unité signale une troncature arbitraire prématurée du domaine discret sélectionné, imposant un réajustement immédiat de la borne k_max dans le script d’analyse.
6. Visualisation de la fonction de répartition cumulative (CDF)
6.1 Calcul vectoriel des probabilités cumulées sous R
Si la fonction de masse de probabilité détaille l’attribution ponctuelle de certitude pour chaque événement isolé, la fonction de répartition cumulative (désignée sous l’acronyme CDF pour Cumulative Distribution Function) offre une perspective complémentaire incontournable en matière d’évaluation du risque probabiliste. La fonction cumulative modélise la fonction F(k) = P(X ≤ k), représentant la probabilité globale d’observer au maximum k occurrences au sein de l’intervalle d’observation prescrit. Sous R, cette intégration discrète s’exécute nativement et instantanément au moyen de l’appel vectorisé de la fonction ppois().
Dans une perspective clinique ou diagnostique, cette perspective cumulative revêt une valeur décisionnelle prépondérante. Alors que la probabilité d’observer exactement cinq erreurs cognitives peut sembler modeste prise isolément, la probabilité d’en observer un nombre inférieur ou égal à cinq permet d’évaluer la représentativité normative globale de la performance du participant. Le calcul vectoriel de cette métrique s’opère en transmettant l’intégralité du vecteur de succès à ppois(k, lambda), générant une séquence monotone croissante débutant strictement au-dessus de zéro pour converger de manière asymptotique vers le plafond absolu fixé à 1.
L’analyse vectorielle des probabilités cumulées met en lumière l’accumulation rapide de la certitude statistique pour les distributions de Poisson à faible paramètre λ. Elle permet également d’extraire directement la probabilité complémentaire, dite fonction de survie, formulée mathématiquement par P(X > k) = 1 – P(X ≤ k), qui quantifie l’exposition à des charges comportementales particulièrement sévères dépassant les seuils habituels de tolérance clinique.
6.2 Tracé graphique en marches d’escalier (step plot)
La transcription visuelle de la fonction de répartition d’une variable aléatoire discrète obéit à des conventions géométriques rigides trop souvent ignorées par les utilisateurs peu avertis. Contrairement à la fonction de répartition d’une variable continue, qui s’affiche sous l’aspect d’une courbe sigmoïde lisse et progressive, la fonction de répartition de Poisson est intrinsèquement discontinue. Elle progresse exclusivement par sauts discrets survenant précisément à chaque valeur entière naturelle, demeurant strictement constante et plate sur les intervalles ouverts reliant deux entiers consécutifs.
Pour restituer cette réalité mathématique sous le moteur graphique de base de R, l’argument fondamental à intégrer dans la commande plot() est le paramètre type = ‘s’ (ou type = ‘S’), qui force le tracé en marches d’escalier (step plot). Cette géométrie traduit visuellement le fait que la probabilité cumulative accumulée jusqu’à k ne subit aucune modification incrémentale jusqu’à l’atteinte exacte du palier k + 1, instant où un saut vertical d’amplitude exactement égale à P(X = k + 1) vient rehausser le niveau de la marche d’escalier.
Pour parfaire l’utilité clinique de ce graphique en escalier, l’adjonction de lignes de référence horizontales et verticales s’avère particulièrement didactique. L’emploi judicieux de la commande abline(h = 0.95, lty = 2, col = ‘firebrick’) permet d’inscrire une ligne directrice en pointillés marquant le seuil critique conventionnel des 95 % de probabilité cumulée. En identifiant visuellement le point d’intersection où l’escalier franchit cette ligne horizontale, le chercheur et le lecteur repèrent sans effort le seuil de significativité empirique au-delà duquel un comptage comportemental devient exceptionnel au sens statistique du terme.
7. Tracé avancé de la distribution de Poisson avec la bibliothèque ggplot2
7.1 Préparation structurée des données en objet tibble ou data.frame
Bien que le système graphique natif de R offre une vélocité appréciable pour les diagnostics exploratoires immédiats, l’élaboration de figures destinées aux revues scientifiques internationales exige fréquemment la puissance, l’extensibilité et la rigueur architecturale de l’écosystème tidyverse, orchestré autour de la bibliothèque graphique ggplot2. Conçu selon les préceptes théoriques de la grammaire des graphiques formulés par Leland Wilkinson, ggplot2 proscrit l’utilisation de vecteurs isolés et impose la structuration préalable intégrale des données au sein d’un tableau de données rectangulaire formalisé sous la structure d’un data.frame ou d’un objet tibble.
La préparation méthodologique du jeu de données consiste à instancier explicitement une structure tabulaire regroupant, dans des colonnes dédiées et strictement typées, l’ensemble des coordonnées du modèle théorique. La première variable consigne les réalisations discrètes k, stockées sous un type numérique entier. La seconde variable encapsule la masse de probabilité théorique issue de l’évaluation de dpois(), tandis qu’une troisième variable peut avantageusement capturer la fonction cumulative dérivée de ppois(). Cette organisation matricielle garantit que chaque composant géométrique du tracé futur sera lié de manière déterministe à une colonne formellement déclarée.
Une vigilance particulière doit être accordée au typage des colonnes. Si le nombre d’occurrences k doit conserver son échelle numérique continue lors de l’application d’échelles d’axes graduées, il peut alternativement être converti en facteur ordonné lorsque l’on souhaite forcer une disposition en barres strictement disjointes sans interpolation spatiale. L’importation de l’environnement graphique via la commande d’attachement library(ggplot2) verrouille cette phase préparatoire en déployant un cadre computationnel adapté à la personnalisation visuelle de haut niveau.
7.2 Cartographie esthétique et sélection de géométries adaptées
L’initialisation de la toile graphique sous ggplot2 repose sur l’appel fondamental de la fonction ggplot(), au sein de laquelle le tableau de données préparé est déclaré conjointement à l’esthétique générale définie par la fonction aes(). Cette cartographie esthétique associe formellement l’axe horizontal x à la colonne des quantiles k, et l’axe vertical y à la colonne des masses de probabilité. À ce stade conceptuel, aucune forme géométrique n’est encore tracée : la toile de fond est simplement calibrée selon l’étendue numérique des variables déclarées.
Pour restituer la nature discrète de la distribution de Poisson, deux géométries alternatives se distinguent par leur élégance et leur rigueur méthodologique. La première approche exploite la couche geom_col(), qui produit un diagramme en barres verticales dont la hauteur correspond fidèlement aux valeurs fournies par la colonne des probabilités. Contrairement à geom_histogram(), qui procède lui-même au découpage en classes et au comptage des observations individuelles brutes, geom_col() respecte l’évaluation paramétrique précalculée. Le calibrage fin de la largeur des barres par le paramètre width (par exemple, width = 0.3 ou 0.4) permet de préserver un espacement visuel généreux entre les colonnes, dissipant toute confusion avec une variable continue.
La seconde approche, d’une sobriété mathématique remarquable, consiste à émuler le tracé d’impulsion via l’utilisation conjointe de geom_segment() et de geom_point(). La couche geom_segment() requiert la spécification des coordonnées quadri-dimensionnelles du trait : x = k, xend = k, y = 0, et yend = probabilité. Cette syntaxe engendre des hampes verticales impeccables, surmontées dans un second temps par geom_point(size = 3). La fusion de ces deux géométries crée un tracé en « sucette » (souvent désigné sous le terme de lollipop plot), plébiscité par les revues de biométrie et de psychologie mathématique pour sa capacité à représenter la masse probabiliste ponctuelle sans surcharger la surface d’encre d’impression.
7.3 Personnalisation du thème et conformité avec les directives éditoriales
L’esthétique graphique native de ggplot2, reconnaissable à son fond quadrillé grisâtre et ses traits d’axes implicites, s’avère généralement inadaptée aux exigences strictes de publication des revues internationales. Une personnalisation approfondie du thème graphique s’impose pour élever la figure aux standards professionnels. L’application immédiate de thèmes épurés préconfigurés, tels que theme_classic() ou theme_minimal(), constitue une première étape essentielle en substituant à l’arrière-plan grisâtre une toile immaculée d’une parfaite neutralité optique.
Le contrôle chirurgical des axes de coordonnées s’opère au moyen de la fonction scale_x_continuous(). Il est impératif d’ajuster l’argument breaks afin de forcer un pas de graduation rigoureusement unitaire (breaks = seq(0, k_max, by = 1)). Cette configuration empêche le moteur graphique d’intercaler de manière inappropriée des graduations décimales sur un axe représentant intrinsèquement des dénombrements d’événements indivisibles. Pour l’axe des ordonnées, la fonction scale_y_continuous() permet d’étendre légèrement la borne supérieure via l’argument limits afin d’éviter que le sommet du point le plus élevé ne vienne chevaucher la bordure supérieure de la zone de traçage.
Enfin, la fonction labs() orchestre la typographie complète de l’appareil textuel en définissant le titre principal (title), le sous-titre contextualisant (subtitle), l’intitulé des axes (x et y) et la source ou mention méthodologique en bas de page (caption). La surcharge finale via la fonction theme() permet d’affiner l’épaisseur des axes cartésiens, de spécifier des polices de caractères vectorielles institutionnelles sans empattement, et d’ajuster la position ou la justification des étiquettes afin de satisfaire à la lettre les critères de mise en page les plus rigoureux des comités de rédaction.
8. Analyse comparative multi-paramétrique : faire varier le paramètre lambda
8.1 Construction d’un jeu de données factoriel multi-conditions
L’exploration visuelle d’une loi de probabilité prend toute sa dimension heuristique lorsque le chercheur est en mesure d’illustrer la sensibilité du modèle à la variation systématique de ses paramètres régulateurs. Dans le cas de la loi de Poisson, concevoir une représentation comparative superposant ou juxtaposant plusieurs valeurs de lambda permet de saisir intuitivement la transition structurelle depuis l’asymétrie extrême des processus rares jusqu’à la symétrie quasi gaussienne des processus denses. Une telle démarche pédagogique ou démonstrative requiert la génération d’un jeu de données factoriel structuré selon les standards du format long (tidy data).
Pour construire ce jeu de données composite sous R, le moyen le plus idiomatique consiste à définir au préalable un vecteur regroupant un échantillon de valeurs contrastées de lambda, par exemple λ ∈ {1, 4, 8, 12}. L’emploi coordonné de la fonction expand.grid() ou des fonctions de mappage de la bibliothèque purrr permet de croiser exhaustivement cette série d’intensités moyennes avec un domaine discret k suffisamment étendu pour contenir la distribution la plus dispersée. Pour chaque croisement factoriel entre une réalisation k et un paramètre λ donné, la probabilité ponctuelle correspondante est évaluée dynamiquement via dpois().
Le point névralgique de cette étape d’ingénierie des données réside dans la conversion immédiate de la variable lambda en un facteur ordonné ou catégoriel au sein du tableau de données résultant. En transformant cette quantité continue en facteur de regroupement explicite (par exemple au moyen de factor(lambda, labels = c(« λ = 1 », « λ = 4 », « λ = 8 », « λ = 12 »))), le chercheur prépare les canaux esthétiques qui serviront à moduler la chromaticité ou le découpage morphologique du graphique dans l’environnement ggplot2.
8.2 Tracé multi-courbes et décomposition par facettes (facetting)
Dès lors que le jeu de données factoriel est compilé, deux stratégies de visualisation comparative s’offrent à l’analyste. La première méthode repose sur la superposition directe des tracés au sein d’un même repère cartésien en assignant le facteur lambda à l’argument chromatique aes(color = factor(lambda)). Dans cette configuration, le recours à geom_point() combiné à des lignes d’interpolation lissées via geom_line(aes(group = factor(lambda))) permet de distinguer visuellement le profil d’affaissement et d’étalement progressif de la distribution à mesure que λ augmente. Néanmoins, lorsque le nombre de niveaux paramétriques dépasse trois ou quatre, l’enchevêtrement des tracés peut nuire à la lisibilité sélective de la figure.
La seconde approche, reconnue pour sa clarté démonstrative irréprochable, met en œuvre la décomposition en sous-graphiques sériels via la puissante fonction facet_wrap(). En déclarant une formule de partitionnement basée sur le facteur lambda (facet_wrap(~ lambda, ncol = 2)), le moteur ggplot2 génère une grille ordonnée de vignettes graphiques autonomes mais partageant une échelle métrique commune. Cette disposition permet de contempler simultanément, d’un simple balayage oculaire, l’étiolement progressif du pic initial à zéro et l’aplatissement symétrique de la cloche de probabilité.
Le paramétrage des échelles au sein des facettes exige une décision méthodologique réfléchie. Par défaut, ggplot2 verrouille les échelles des abscisses et des ordonnées de manière identique sur l’ensemble des panneaux (scales = « fixed »). Ce comportement standard est fortement recommandé car il met spectaculairement en évidence la chute d’amplitude du mode probabiliste : la hauteur maximale passe en effet d’une certitude de plus de 0,35 pour λ = 1 à une modeste probabilité d’environ 0,11 lorsque λ atteint 12. La préservation d’une échelle ordonnée fixe ancre fermement la réalité mathématique de la redistribution de la masse totale de probabilité sur un support spatial de plus en plus large.
9. Confrontation visuelle : distribution théorique de Poisson versus données psychologiques empiriques
9.1 Collecte et agrégation d’un échantillon empirique d’événements discrets
La finalité ultime de la maîtrise du tracé de Poisson ne réside pas uniquement dans l’illustration de concepts théoriques abstraits, mais dans l’évaluation empirique de l’adéquation d’un modèle statistique à des observations psychologiques de terrain. Supposons un protocole expérimental conduit auprès d’une cohorte de 250 sujets examinant la fréquence de comportements compulsifs ritualisés enregistrés au moyen d’un carnet d’auto-observation numérique sur une période standardisée d’une semaine. L’agrégation de ces données brutes produit une série de dénombrements discrets caractérisés par une fréquence élevée de valeurs faibles et une traîne asymétrique constituée de participants présentant des scores sévères.
La première phase d’intégration analytique consiste à estimer le paramètre théorique d’intensité lambda à partir des données empiriques recueillies. En vertu de la théorie statistique de l’estimation par la méthode du maximum de vraisemblance, l’estimateur sans biais de lambda pour une distribution de Poisson correspond très exactement à la moyenne arithmétique empirique observée sur l’échantillon d’étude (notée x̄). Cet estimateur scalaire unique servira d’ancrage fondamental pour projeter le modèle théorique sous-jacent sur les manifestations comportementales effectives de la cohorte.
Simultanément, le chercheur doit calculer la distribution de fréquences relatives observées. Ce calcul s’obtient sous R en tabulant les occurrences via la fonction table() normalisée par la taille totale de l’échantillon, ou de manière moderne au sein de l’environnement tidyverse par l’agrégation conjointe de count() et d’une mutation calculant la proportion empirique de chaque entier k. L’alignement tabulaire entre la proportion empirique observée et la probabilité théorique attendue sous un paramètre de Poisson λ = x̄ pose les bases de l’évaluation visuelle d’adéquation.
9.2 Superposition géométrique du modèle théorique sur l’histogramme empirique
La confrontation visuelle directe s’orchestre sous ggplot2 au travers d’une superposition sémantique de géométries hétérogènes. La première couche graphique a pour vocation de représenter la réalité empirique observée. L’utilisation de geom_bar(aes(y = after_stat(prop))) ou d’un histogramme discret calibré sur des largeurs unitaires permet de projeter la distribution des proportions effectives sous la forme de larges colonnes rectangulaires ombrées d’un gris neutre semi-transparent. Cette semi-transparence, réglée finement par le paramètre d’opacité alpha (par exemple alpha = 0.5), prépare l’œil à recevoir la surimpression du modèle théorique sans risque d’occlusion perceptive.
La seconde couche graphique injecte la trajectoire théorique prédite par la loi de Poisson paramétrée par la moyenne d’échantillon. Cette composante théorique est idéalement dessinée au moyen d’un tracé d’impulsion contrasté ou d’une série de points circulaires d’une coloration vive (telle qu’un rouge écarlate ou un bleu cobalt) reliés par une trajectoire segmentée. En superposant rigoureusement les points de dpois(k, lambda = mean_empirique) sur le sommet des barres de proportions réelles, le chercheur offre une comparaison instantanée de la concordance ou de la discordance morphologique entre le phénomène observé et la loi stochastique postulée.
Cette inspection visuelle préliminaire remplit une fonction diagnostique de premier plan avant toute mise en œuvre de tests formels d’adéquation tels que le test du chi-deux ou le test de Kolmogorov-Smirnov adapté aux distributions discrètes. L’examen attentif des décalages verticaux entre les barres empiriques et les symboles théoriques met immédiatement en lumière les lacunes spécifiques de la modélisation : déficits d’occurrences sur certains quantiles médians, asymétrie empirique plus prononcée que prévue, ou anomalies manifestes localisées sur la valeur zéro.
10. Diagnostic visuel des limites du modèle : surdispersion et excès de zéros
10.1 Identification graphique de la surdispersion (Overdispersion)
Dans l’analyse quantitative des comportements humains, le postulat d’équidispersibilité intrinsèque à la loi de Poisson — stipulant la parfaite égalité entre l’espérance et la variance — est très fréquemment contredit par les observations cliniques. Les populations psychologiques se caractérisent en effet par une hétérogénéité non observée substantielle résultant de prédispositions génétiques, de variations environnementales ou d’interactions dynamiques. Cette variance non prise en compte induit un phénomène omniprésent qualifié de surdispersion (overdispersion), où la variance empirique observée excède significativement la moyenne d’échantillon.
L’identification graphique de la surdispersion s’opère de manière éloquente en confrontant visuellement l’ajustement d’une distribution de Poisson standard à celui d’une distribution alternative plus flexible, telle que la distribution binomiale négative. La loi binomiale négative introduit un paramètre de dispersion auxiliaire qui autorise la variance à s’accroître de manière quadratique par rapport à la moyenne, absorbant ainsi la variabilité résiduelle de l’échantillon. En projetant simultanément sur le même repère cartésien la distribution empirique surdispersée, la loi de Poisson sous-jacente et la loi binomiale négative ajustée, les déficiences du modèle de Poisson apparaissent avec une netteté incontestable.
Graphiquement, la surdispersion se traduit par deux défaillances systématiques et coordonnées du modèle de Poisson : d’une part, une sous-estimation notoire de la fréquence des observations situées sur le mode principal (le sommet empirique est substantiellement plus élevé que le sommet prédit par Poisson), et d’autre part, une incapacité criante à capturer la longueur et l’épaisseur de la queue de distribution distale. Le tracé théorique de Poisson s’effondre prématurément vers zéro, alors que les données empiriques continuent d’exhiber des valeurs extrêmes. Cette discordance géométrique signale impérativement l’obligation de basculer vers des modèles linéaires généralisés à erreurs binomiales négatives ou quasi-Poisson.
10.2 Représentation des distributions gonflées en zéros (Zero-Inflated Poisson)
Une seconde limite structurelle majeure rencontrée en psychométrie concerne l’accumulation anormale d’observations nulles au sein des protocoles longitudinaux ou transversaux. Ce phénomène, baptisé excès de zéros ou inflation de zéros, est particulièrement prégnant dans les études mesurant des conduites déviantes, des consommations de substances illicites ou des actes de violence interpersonnelle. Dans de tels contextes, la population est en réalité composée d’un mélange de deux sous-populations distinctes : un premier sous-groupe structurellement immunisé ou non exposé qui ne manifestera jamais le comportement quelle que soit la durée d’observation (zéros structurels), et un second sous-groupe à risque au sein duquel le comportement suit un processus de Poisson mais peut occasionnellement générer un zéro fortuit au cours de la fenêtre d’évaluation (zéros échantillonnaux).
L’application d’un modèle de Poisson standard à ce type de données débouche sur une distorsion graphique majeure. Pour tenter d’accommoder la proportion massive de zéros observée, le processus d’estimation par le maximum de vraisemblance est contraint de sous-estimer drastiquement le paramètre d’intensité lambda. Sur le plan visuel, la courbe théorique de Poisson qui en résulte s’avère incapable de restituer la hauteur vertigineuse du pic empirique à k = 0, tout en écrasant de manière indue les probabilités associées aux valeurs entières positives k ≥ 2.
La représentation comparative d’un modèle gonflé en zéros, désigné sous l’acronyme ZIP (pour Zero-Inflated Poisson), permet d’illustrer visuellement la résolution de cette distorsion. Un modèle ZIP segmente l’estimation en deux composantes stochastiques articulées : un modèle logistique de mélange prédisant l’appartenance à la classe des zéros structurels, combiné à un modèle de Poisson tronqué ou standard gouvernant les comptages chez les sujets susceptibles d’émettre le comportement. La projection graphique de la distribution théorique ZIP superposée aux barres empiriques met en évidence une réconciliation parfaite au point k = 0 sans altérer l’ajustement morphologique de la traîne positive, guidant de manière décisive le choix de modélisations mixtes ou à deux parties (hurdle models).
11. Automatisation et encapsulation : conception d’une fonction R personnalisée
11.1 Écriture d’une routine fonctionnelle modulaire
Dans un flux de travail académique moderne, la répétition servile de scripts graphiques monolithiques engendre une redondance de code source préjudiciable à la reproductibilité et augmente considérablement le risque d’erreurs d’inattention lors de l’ajustement itératif des paramètres de recherche. L’encapsulation de la logique de traçage au sein d’une routine fonctionnelle personnalisée et modulaire constitue l’étalon-or des bonnes pratiques de programmation statistique sous R. Une fonction judicieusement conçue doit automatiser la séquence complète des opérations : validation des arguments d’entrée, dérivation mathématique du domaine discret, calcul vectorisé des masses de probabilités, et assemblage élégant de l’objet graphique sous ggplot2.
Une implémentation exemplaire repose sur la création d’une routine modulaire intitulée, par exemple, plot_poisson_psych(). Cette fonction prendra comme arguments obligatoires le paramètre d’intensité lambda et autorisera des arguments facultatifs tels que la borne maximale k_max, le choix du style de tracé (sucette discrète ou colonnes pleines), ainsi qu’une bascule logique permettant d’activer ou désactiver l’affichage des annotations numériques au sommet de chaque impulsion. La première étape interne de la fonction consiste à implémenter des assertions de sécurité formelles : validation que l’argument lambda est un scalaire strictement positif et contrôle de validité des arguments typographiques.
Un atout déterminant de l’automatisation réside dans la gestion dynamique et intelligente des bornes graphiques. Si l’argument k_max est omis par l’utilisateur, la fonction évalue de façon autonome la borne supérieure en appliquant la fonction quantile qpois(0.999, lambda), garantissant de manière universelle que 99,9 % de la masse de probabilité sera visible sur le graphique, quelle que soit l’ampleur du paramètre d’intensité renseigné. La fonction retourne un objet formel de classe ggplot, qui demeure entièrement modifiable par l’utilisateur final au moyen de l’opérateur d’addition standard pour y adjoindre ultérieurement de nouvelles couches thématiques ou typographiques.
11.2 Exportation vectorielle haute résolution pour revues à comité de lecture
L’aboutissement du processus d’analyse statistique réside dans la génération de figures conformes aux spécifications techniques rigoureuses imposées par les éditeurs scientifiques internationaux (tels qu’Elsevier, Springer, Wiley ou l’American Psychological Association). La publication imprimée ou numérique haute définition réprouve formellement les formats matriciels compressés de faible qualité (tels que les captures d’écran standard ou les fichiers JPEG fortement pixellisés), exigeant des résolutions minimales de 300 à 600 points par pouce (DPI pour dots per inch) ou, idéalement, des représentations purement vectorielles.
La fonction ggsave() issue de l’écosystème ggplot2 constitue l’instrument d’exportation de référence pour garantir une fidélité graphique absolue. La maîtrise de ses paramètres requiert de configurer explicitement les dimensions physiques métriques de la figure au moyen des arguments width, height et units = « cm », en se conformant scrupuleusement aux gabarits de colonnes simples ou doubles imposés par le guide aux auteurs de la revue ciblée. La spécification de l’argument dpi = 600 garantit que les éléments graphiques non vectorisés éventuels conserveront une netteté microscopique irréprochable lors du prépresse.
Pour un rendu éditorial d’une perfection suprême, le recours au format vectoriel universel PDF via le périphérique graphique natif cairo_pdf() s’avère hautement recommandé. Contrairement aux sorties matricielles, le tracé vectoriel encode chaque ligne, segment vertical, point et glyphe typographique sous la forme d’équations géométriques scalables. Il en résulte une figure d’une netteté absolue, dont le redimensionnement à l’infini n’introduit aucune perte de définition, tout en garantissant une restitution fidèle des polices de caractères et des espacements typographiques prescrits par les manuels de style contemporains.
12. Synthèse méthodologique et recommandations pour l’analyse des données discrètes
12.1 Arbre de décision pour le choix de la représentation visuelle
Au terme de cette analyse approfondie des modalités de représentation de la distribution de Poisson sous R, il convient de synthétiser les critères méthodologiques guidant le chercheur face au choix de son dispositif visuel. L’architecture graphique ne doit jamais résulter d’une impulsion arbitraire ou d’une simple préférence esthétique subjective ; elle procède au contraire d’une adéquation raisonnée entre les contraintes théoriques de l’objet mathématique, la nature des données empiriques recueillies et la finalité épistémologique de la communication scientifique.
Dans une phase d’exploration préliminaire rapide, le recours au moteur graphique de base via la syntaxe élémentaire plot(…, type = ‘h’) demeure particulièrement pertinent pour le diagnostic interactif immédiat en raison de sa rapidité d’exécution et de son absence de dépendance logicielle externe. Il permet à l’analyste de sonder instantanément la morphologie d’une distribution sans charger de bibliothèques complémentaires.
En revanche, dès lors que l’objectif s’oriente vers la restitution de résultats probants au sein d’un manuscrit soumis à l’évaluation par les pairs, le moteur ggplot2 s’impose sans équivoque. La représentation par segments discrets surmontés de points d’impact (lollipop plot) doit être systématiquement préférée aux diagrammes en barres larges lorsque le spectre discret k est étendu, afin de souligner la nature ponctuelle des probabilités sans induire d’illusion de continuité surfacique. Enfin, lors de la confrontation entre théorie et empirie, le mélange hiérarchisé de barres semi-transparentes pour les données réelles et de points théoriques connectés pour le modèle théorique fournit la grille de lecture la plus intelligible et rigoureuse pour l’observateur scientifique.
12.2 Pièges fréquents et bonnes pratiques d’implémentation
L’application rigoureuse des modèles de Poisson requiert d’éviter scrupuleusement plusieurs pièges conceptuels et techniques récurrents documentés dans la littérature méthodologique. Le premier piège, omniprésent chez les praticiens débutants, consiste à superposer une courbe continue de densité lissée (telle qu’une fonction gaussienne ou un estimateur de densité par noyau continu) directement sur un histogramme de données de comptage pur. Ce procédé constitue une aberration formelle qui occulte la nature intrinsèquement discrète de la variable et crée des densités de probabilité fictives pour des valeurs non entières qui n’ont aucun sens dans la réalité empirique.
Le second écueil réside dans l’omission dogmatique de la vérification de l’équidispersibilité. L’analyste ne doit jamais présumer a priori de l’adéquation d’un modèle de Poisson sous le seul prétexte qu’il manipule des données de comptage. Le calcul systématique du ratio entre la variance et la moyenne empiriques doit constituer un réflexe immuable : tout ratio substantiellement supérieur à 1,2 signale la présence d’une surdispersion qui invalidera les erreurs-types estimées si elle est ignorée, imposant l’ajustement conjointe de représentations binomiales négatives à titre comparatif.
Enfin, la pérennité et l’intégrité de la démarche de recherche reposent impérativement sur la reproductibilité computationnelle intégrale des tracés statistiques. L’utilisateur rigoureux documentera avec une minutie exemplaire chaque ligne de code source dans un script R structuré ou un document computationnel dynamique (tel qu’un document Quarto ou R Markdown). Ce document consistera à déclarer explicitement la version de R employée, les versions exactes des packages sollicités, ainsi que la valeur d’initialisation du générateur de nombres pseudo-aléatoires via la commande fondamentale set.seed() lors de toute étape impliquant une simulation d’échantillon par rpois(). C’est à ce prix méthodologique que la visualisation scientifique s’émancipe de l’illustration illustrative pour devenir un instrument robuste de preuve et de découverte empirique.
Références
- Agresti, A. (2015). Foundations of Linear and Generalized Linear Models. John Wiley & Sons. https://www.wiley.com/en-us/Foundations+of+Linear+and+Generalized+Linear+Models-p-9781118730034
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Cameron, A. C., & Trivedi, P. K. (2013). Regression Analysis of Count Data (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9781139013567
- Hilbe, J. M. (2011). Negative Binomial Regression (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511973420
- Poisson, S. D. (1837). Recherches sur la probabilité des jugements en matière criminelle et en matière civile, précédées des règles générales du calcul des probabilités. Bachelier, Imprimeur-Libraire pour les Mathématiques.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.r-project.org/
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer Science+Business Media. https://doi.org/10.1007/0-387-28695-0