
L’exploration visuelle des relations bivariées constitue l’un des piliers méthodologiques les plus décisifs de la recherche empirique moderne. Dans les sciences comportementales, la psychologie cognitive, la sociologie quantitative ou la biométrie, postuler une homogénéité stricte au sein d’une population relève bien souvent d’une simplification excessive, voire d’une illusion réductrice. Lorsque des chercheurs analysent des dynamiques d’apprentissage, des réponses thérapeutiques ou des trajectoires de développement, les données brutes masquent fréquemment des dynamiques sous-jacentes contrastées. L’ajustement d’une unique droite de tendance à travers un nuage de points composite risque d’obscurcir des disparités structurelles fondamentales, conduisant dans les cas les plus critiques à des contresens méthodologiques tels que le paradoxe de Simpson.
Le recours à la stratification graphique s’avère donc indispensable pour décortiquer la complexité des données d’observation ou expérimentales. En séparant les flux d’informations selon des variables nominales ou ordinales prédéfinies — telles que des protocoles d’intervention, des cohortes générationnelles ou des profils cognitifs —, le chercheur s’accorde la possibilité d’évaluer visuellement la présence d’effets modérateurs préalablement à toute formalisation paramétrique. Cette étape d’analyse exploratoire des données, conceptualisée par John Tukey et prolongée par les travaux sur la sémiologie graphique, ne se substitue aucunement à l’inférence statistique ; elle la précède, la guide et en éclaire l’interprétation substantielle.
Dans l’écosystème du langage R, la bibliothèque ggplot2 s’est imposée comme la référence internationale absolue pour la production d’iconographies scientifiques. Fondée sur la grammaire des graphiques théorisée par Leland Wilkinson, cette boîte à outils offre un cadre formel où chaque composante visuelle correspond rigoureusement à une dimension statistique des données. Ce guide exhaustif explore l’art et la technique du tracé de lignes de régression linéaire par groupe à travers l’instruction geom_smooth(), en détaillant l’ensemble des fondements mathématiques, des subtilités d’encodage, des ajustements esthétiques conformes aux normes académiques internationales et des diagnostics d’adéquation nécessaires à la production de figures prêtes pour publication dans des revues à comité de lecture.
1. Introduction à l’analyse de régression groupée en sciences du comportement
1.1 Rôle de la visualisation des sous-groupes en psychométrie
La psychométrie et les sciences du comportement reposent intrinsèquement sur la mesure de construits latents et l’observation de réponses individuelles sujettes à une forte variabilité inter-individuelle. L’identification visuelle des hétérogénéités au sein d’échantillons comportementaux représente une étape analytique primordiale. Les scores obtenus à des batteries de tests cognitifs, à des inventaires de personnalité ou à des épreuves d’évaluation des apprentissages ne réagissent presque jamais de façon uniforme sous l’action d’une variable indépendante continue. Traiter un échantillon expérimental comme un ensemble monolithique entraîne inévitablement l’écrasement de la variance intergroupe au profit d’une variance globale mal décomposée.
La détection précoce des effets de modération avant la modélisation formelle constitue un avantage épistémologique majeur de l’approche graphique. Lorsqu’un investigateur observe que l’angle d’ajustement d’un score cognitif en fonction de la durée d’exposition à un stimulus varie de manière substantielle selon que le participant appartient au groupe contrôle, au groupe soumis à un entraînement métacognitif ou au groupe recevant une intervention par répétition espacée, l’hypothèse d’une interaction statistique prend corps avant même le calcul des tests de Fisher ou des coefficients de régression multiple. Cette inspection directe prévient l’omission de termes multiplicatifs cruciaux dans les modèles linéaires ultérieurs.
Enfin, il convient de souligner la complémentarité indissociable entre les représentations graphiques rigoureuses et les tests d’hypothèses classiques. Un graphique minutieusement calibré ne remplace pas une table d’analyse de variance ou une régression linéaire pondérée, mais il en constitue la boussole interprétative. Il protège le praticien contre les biais cognitifs générés par l’examen exclusif des valeurs de p, en restituant aux yeux de l’analyste l’échelle réelle des effets, la dispersion des erreurs et la plausibilité physique des estimations numériques obtenues par les algorithmes d’optimisation matricielle.
1.2 Le package ggplot2 et la grammaire des graphiques
L’avènement de ggplot2, développé par Hadley Wickham au sein de l’environnement tidyverse, a profondément transformé la visualisation de données scientifiques en informatisant les principes exposés par Leland Wilkinson dans son ouvrage fondateur The Grammar of Graphics. Selon ce paradigme structuraliste, une figure scientifique ne s’envisage pas comme une collection de primitives graphiques isolées (lignes, cercles, polygones tracés arbitrairement), mais comme une cartographie formelle reliant les variables d’une structure de données rectangulaire à des attributs esthétiques précis, projetés au sein d’un système de coordonnées spécifique.
Par rapport aux fonctionnalités graphiques traditionnelles du système de base de R (les fonctions plot(), lines() ou points() du module graphics), ggplot2 présente des avantages structurels déterminants. Le système de base exige une gestion manuelle fastidieuse des paramètres d’échelle, du calcul des limites d’axes, de la création des légendes et de la réitération de boucles pour tracer chaque droite de sous-groupe. Cette approche impérative augmente considérablement le risque d’erreurs de synchronisation entre les données et leurs représentations. À l’inverse, ggplot2 adopte une philosophie déclarative : l’analyste décrit la structure logique de la relation souhaitée, et le moteur graphique prend en charge l’assemblage cohérent des échelles, des légendes et du positionnement spatial.
Cette rigueur méthodologique garantit une cohérence esthétique immédiate et facilite le respect scrupuleux des normes de publication scientifique, telles que les préconisations graphiques de l’American Psychological Association (APA). La séparation stricte entre les données brutes, les transformations statistiques sous-jacentes (statistiques récapitulatives, lissages linéaires) et les couches géométriques de rendu assure une reproductibilité intégrale du code source à la figure finale soumise aux comités de lecture.
1.3 Objectifs pédagogiques et méthodologiques du tutoriel
Le présent tutoriel a été conçu pour guider les chercheurs, statisticiens et étudiants avancés à travers l’implémentation opérationnelle et l’interprétation méthodologique de la régression linéaire stratifiée. Le premier objectif réside dans la maîtrise technique avancée de la syntaxe de geom_smooth() lorsqu’elle est couplée à des covariables catégorielles. Comprendre comment le moteur de ggplot2 ventile les calculs d’estimation des paramètres en fonction des regroupements spécifiés dans l’environnement aes() représente le pivot de cette démarche.
Le deuxième objectif concerne l’interprétation graphique rigoureuse des pentes et des ordonnées à l’origine distinctes issues des ajustements linéaires. Loin d’être un simple exercice stylistique, la lecture conjointe des droites empiriques permet de diagnostiquer intuitivement la présence de modérations ordinales ou désordonnées, de repérer d’éventuels points de bascule théoriques et d’anticiper la structure de variance résiduelle propre à chaque sous-échantillon. L’analyste apprendra à évaluer l’intensité relative d’un effet en fonction de l’inclinaison des trajectoires modélisées.
Le troisième objectif vise la standardisation professionnelle des représentations graphiques pour les manuscrits académiques. Il ne suffit pas d’extraire une figure fonctionnelle sur son écran de développement ; il s’agit d’éditer une planche graphique impeccable répondant aux exigences typographiques, chromatiques, sémiologiques et dimensionnelles des revues internationales de premier rang. Du contrôle des intervalles de confiance à la gestion du daltonisme, chaque paramètre sera passé au crible pour garantir une communication scientifique irréprochable.
2. Fondements théoriques : Régression linéaire et modération graphique
2.1 Différenciation entre effets principaux et effets d’interaction
Sur le plan mathématique, l’analyse d’une relation bivariée conditionnée par l’appartenance à un groupe renvoie directement à la théorie du modèle linéaire général intégrant des termes de modération ou d’interaction. Lorsqu’une variable réponse continue notée Y est modélisée en fonction d’un prédicteur continu X et d’un facteur qualitatif G comportant plusieurs modalités, deux configurations conceptuelles majeures émergent : le modèle sans interaction (pentes parallèles) et le modèle avec interaction (pentes non parallèles).
Dans un système à pentes strictement parallèles, le coefficient de régression associé à X demeure invariant à travers les strates de G. Graphiquement, les droites associées à chaque modalité affichent une déclivité parfaitement identique, ne différant que par leur ordonnée à l’origine. Cette situation traduit l’existence d’effets principaux additifs : l’appartenance à un groupe particulier confère un décalage vertical constant sur la variable dépendante, mais l’efficacité ou la sensibilité marginale de X sur Y reste immuable quel que soit le sous-groupe considéré.
À l’opposé, la présence d’une interaction bivariée se matérialise graphiquement par des droites divergentes ou convergentes. Dans cette conjoncture, la dérivée première de la variable dépendante par rapport au prédicteur continu dépend expressément du niveau de la variable de groupement. Les implications scientifiques sont considérables : une méthode pédagogique ou une thérapeutique peut s’avérer hautement performante pour une sous-population (pente fortement positive) tout en manifestant une parfaite inefficacité, voire une toxicité (pente nulle ou négative), chez une autre. L’inspection des pentes constitue la transcription visuelle directe du terme d’interaction du modèle linéaire.
Une vigilance statistique particulière s’impose face au célèbre paradoxe de Simpson. Ce phénomène survient lorsqu’une tendance apparente au sein d’un échantillon global agrégé s’inverse de manière spectaculaire ou s’annihile lorsque la population est scindée en sous-groupes homogènes. En psychologie et en épidémiologie, ignorer une variable confondante majeure peut inciter à tracer une droite globale descendante suggérant un effet délétère, alors que l’ensemble des droites intra-groupes pointent sans équivoque vers le haut. Le tracé systématique de régressions par sous-groupe agit comme un antidote visuel préventif contre ces erreurs d’inférence dévastatrices.
2.2 Hypothèses sous-jacentes à la régression par groupe
L’estimation par les moindres carrés ordinaires (MCO) déployée par défaut dans les représentations linéaires exige le respect d’un ensemble de postulats probabilistes, regroupés sous les conditions de Gauss-Markov. Le premier de ces postulats concerne la linéarité intrinsèque de la fonction conditionnelle au sein de chaque strate d’observation. L’ajustement d’un segment rectiligne via method = "lm" postule que l’espérance mathématique de la variable réponse est une fonction strictement affine du régresseur dans chaque compartiment expérimental. Si la cinétique réelle sous-jacente est exponentielle, logarithmique ou sigmoïdale, la droite tracée introduit un biais d’approximation substantiel.
Le second postulat concerne l’homoscédasticité conditionnelle à travers les différents groupes expérimentaux. La théorie standard suppose que la variance des termes d’erreur résiduelle demeure stationnaire, non seulement sur l’ensemble de la plage des valeurs du prédicteur X, mais également entre les différents niveaux du facteur catégoriel. Or, dans les recherches appliquées, il est fréquent qu’un groupe expérimental présente une dispersion des réponses considérablement plus erratique qu’un groupe témoin. Cette hétérogénéité des variances conditionnelles n’invalide pas la pente moyenne, mais fausse l’amplitude des intervalles de confiance affichés autour de la trajectoire modélisée.
Enfin, la normalité des résidus intra-groupes et l’impact des effectifs réduits conditionnent directement la validité des déductions visuelles et inférentielles. Les bandes de confiance générées par le moteur graphique reposent sur l’hypothèse de distributions résiduelles gaussiennes autour de l’espérance conditionnelle. Si une strate d’échantillonnage ne compte qu’un effectif dérisoire — par exemple une dizaine de sujets dans un profil clinique rare —, la distribution t de Student utilisée pour le calcul des marges d’erreur engendre un évasement prononcé des intervalles. L’analyste doit impérativement garder à l’esprit la fragilité asymptotique des estimations conduites sur de petits sous-échantillons.
3. Préparation de l’environnement R et structure des données
3.1 Configuration des bibliothèques nécessaires
Pour assurer un environnement de travail stable, hautement fonctionnel et pérenne, il est impératif de charger les modules spécialisés développés au sein du réseau Tidyverse. Nous mobiliserons en premier lieu ggplot2 pour l’ensemble des opérations de rendu géométrique, complété par dplyr pour les manipulations tabulaires élégantes et tidyr pour la structuration éventuelle des formats longs ou larges. Ces bibliothèques forment un écosystème méthodologique cohérent garantissant l’interopérabilité des structures de données manipulées.
La vérification rigoureuse des versions logicielles installées participe directement à l’impératif de reproductibilité scientifique. Les fonctionnalités graphiques et les arguments de lissage connaissent des raffinements périodiques d’une mouture à l’autre de R. L’appel explicite de sessionInfo() en fin de script de traitement permet de consigner l’état précis du système, prévenant les incompatibilités de syntaxe ultérieures lors du partage du code entre laboratoires de recherche.
Il s’avère également judicieux de configurer en amont les paramètres généraux de la session de travail. Qu’il s’agisse de la fixation d’une graine aléatoire à l’aide de la commande set.seed() pour les simulations de données ou de la configuration par défaut de la résolution des périphériques d’affichage, ces précautions liminaires établissent un cadre propice à une démarche analytique rigoureuse, standardisée et exempte d’artéfacts non contrôlés.
3.2 Création du jeu de données d’étude de performance cognitive
Afin d’ancrer notre démonstration dans un cas concret issu des sciences comportementales, nous allons construire un jeu de données synthétique mais biologiquement et psychométriquement plausible. Imaginons une étude expérimentale évaluant l’efficacité de différentes techniques d’apprentissage sur l’acquisition de compétences chez des étudiants universitaires. La variable indépendante continue hours représente le nombre d’heures d’étude hebdomadaire consacrées à la matière, oscillant typiquement entre 2 et 35 heures. La variable dépendante continue score mesure la performance obtenue à un examen standardisé, étalonnée sur une échelle de 0 à 100 points.
La variable qualitative déterminante, nommée technique, catégorise les participants selon trois protocoles méthodologiques distincts : la relecture passive (Groupe A), la pratique de tests réguliers avec récupération en mémoire (Groupe B), et la méthode de répétition espacée assistée par algorithme adaptatif (Groupe C). Chaque groupe comporte une cohorte d’observations indépendantes, pour laquelle les trajectoires de progression présentent des caractéristiques spécifiques programmées par construction afin de simuler des effets d’interaction tangibles.
La génération programmatique s’effectue au sein d’un data frame rigoureusement balisé. Pour le groupe A, l’ordonnée initiale est moyenne mais le gain marginal par heure d’étude est modeste. Pour le groupe B, le gain par heure est nettement plus prononcé, illustrant l’efficacité reconnue de la pratique active des tests. Pour le groupe C, le socle initial démarre plus bas en raison de la complexité de l’outil, mais affiche une accélération spectaculaire par unité de temps investi. Un terme d’erreur stochastique normal est injecté dans chaque vecteur pour conférer au nuage de points le réalisme empirique nécessaire.
L’inspection de la structure du tableau ainsi forgé constitue le point de départ incontournable. L’exécution de la commande fondamentale str(df) confirme la nature tabulaire de l’objet, le décompte exact des lignes et la présence des colonnes spécifiées. L’instruction complémentaire summary(df) fournit une vision synoptique des quartiles, des moyennes empiriques et des étendues extrêmes pour chaque variable continue, validant la cohérence distributionnelle des mesures simulées.
3.3 Typage des variables et facteurs en R
L’une des sources les plus récurrentes de dysfonctionnement ou d’incompréhension lors de l’utilisation de ggplot2 réside dans l’inadéquation du typage des variables contenues dans le data frame. Si une variable de regroupement est encodée sous la forme d’un simple vecteur de chaînes de caractères (type character) ou pis, d’un identifiant numérique (type integer), le moteur graphique peut adopter des comportements inattendus, notamment en appliquant une échelle de dégradé continu de couleurs là où une palette discrète qualitative est requise.
Il est donc méthodologiquement impératif de procéder à la conversion explicite de la variable de regroupement en facteur catégoriel au moyen de l’instruction df$technique <- factor(df$technique). Ce typage formel instruit R sur le fait que la colonne représente une variable nominale comportant des modalités discrètes bien délimitées. C’est sur ce fondement que ggplot2 partitionnera automatiquement les calculs statistiques et affectera des valeurs esthétiques différenciées à chaque strate.
Par ailleurs, l’ordre intrinsèque des niveaux du facteur (factor levels) revêt une importance fonctionnelle majeure. Par défaut, R ordonne les modalités selon l’ordre alphabétique standard. Cet agencement conditionne directement l’attribution automatique des teintes de la palette, l’ordre d’empilement visuel des tracés sur la toile graphique et la séquence d’affichage des entrées dans la légende explicative. L’utilisation avertie de la fonction factor(..., levels = c(...)) permet au chercheur d’organiser la hiérarchie visuelle selon une logique théorique cohérente, en positionnant par exemple le groupe contrôle en première référence analytique.
4. Syntaxe fondamentale : Décomposition de l’instruction ggplot2
4.1 L’association esthétique aes() et l’argument de couleur
Au cœur de l’architecture de ggplot2 se trouve la fonction aes(), abréviation d’aesthetic mappings. Cette fonction a pour rôle exclusif de construire la passerelle relationnelle reliant les colonnes du tableau de données aux propriétés perceptuelles visibles du graphique. Lorsque l’on souhaite décomposer une régression par groupe, la décision syntaxique cruciale repose sur le positionnement de l’argument color = technique.
Il existe une frontière conceptuelle capitale entre la spécification globale et la spécification locale de cet argument. Lorsque color = technique est déclaré à l’intérieur de l’appel initial ggplot(data, aes(x = hours, y = score, color = technique)), cette association s’applique de manière universelle et récursive à l’ensemble des couches géométriques ultérieures qui viendront se greffer sur le canevas. Les points individuels hériteront de cette coloration différentielle, et la couche d’estimation statistique partitionnera automatiquement ses calculs pour tracer autant de droites qu’il existe de niveaux de facteurs.
Si, à l’inverse, l’argument de couleur est confiné à une couche spécifique, par exemple uniquement au sein de geom_point(aes(color = technique)), la propagation est rompue. Dans une telle hypothèse, la couche géométrique subséquente geom_smooth(method = "lm"), privée de l’instruction de partitionnement au niveau global ou local, agrégera l’ensemble des données pour tracer une droite unique monochrome écrasant la diversité des sous-groupes. La maîtrise de cet héritage structurel confère à l’analyste un contrôle absolu sur la granularité de son rendu visuel.
Il convient également d’anticiper la coordination entre l’attribut de contour (color) et l’attribut de surface ou de remplissage (fill). Alors que color dicte l’aspect chromatique des éléments unidimensionnels comme les segments rectilignes et les pourtours des marqueurs, fill pilote la coloration des zones bidimensionnelles, telles que les polygones matérialisant les bandes d’erreur type. L’omission de synchroniser ces deux paramètres aboutit fréquemment à des graphiques incohérents où des droites de couleurs variées sont flanquées de rubans de confiance uniformément grisâtres.
4.2 La couche géométrique des observations : geom_point()
La première couche graphique superposée au système de coordonnées cartésiennes correspond à la projection des observations individuelles sous forme de nuage de points via l’instruction geom_point(). En recherche expérimentale, il est méthodologiquement contestable d’afficher des courbes de tendance sans présenter simultanément les données empiriques brutes dont elles procèdent. La monstration des points garantit la transparence scientifique et permet au lecteur d’évaluer spontanément l’ampleur du bruit de mesure autour des trajectoires moyennes.
Cependant, la multiplication des observations au sein d’un même graphique génère fréquemment un problème perceptuel aigu : la surabondance ou le chevauchement massif des points (phénomène de overplotting). Lorsque plusieurs individus partagent des coordonnées identiques ou très proches, la densité locale de l’échantillon devient illisible. Pour pallier cet écueil, le chercheur doit moduler le coefficient d’opacité à l’aide du paramètre alpha, configuré par exemple à alpha = 0.6 ou alpha = 0.4. La transparence révèle les zones d’accumulation dense par saturation progressive des teintes.
Le calibrage dimensionnel des marqueurs participe également de l’ergonomie visuelle globale. L’argument size doit être dosé avec circonspection : des points démesurément volumineux créent une impression d’écrasement de l’espace graphique, occultant les lignes de régression sous-jacentes, tandis que des points microscopiques fatiguent inutilement l’acuité visuelle du lecteur. Une valeur comprise entre 1.5 et 2.5 unités assure généralement un équilibre irréprochable sur les formats de sortie standards des périodiques scientifiques.
4.3 L’estimation linéaire avec geom_smooth()
La transformation d’un nuage de points épars en une tendance mathématique rigoureuse s’opère par le truchement de la fonction geom_smooth(). Cette instruction ne se limite pas à tracer un trait décoratif ; elle encapsule un puissant moteur statistique qui interroge les données, exécute un modèle mathématique sous-jacent et convertit les prédictions résultantes en coordonnées géométriques exploitables par le moteur de rendu.
Par défaut, lorsque l’échantillon comprend plus de mille observations, geom_smooth() recourt à un modèle additif généralisé (GAM), et pour les échantillons de taille plus modeste, à une régression locale polynomiale non paramétrique (algorithme LOESS). Si ces approches d’ajustement souple s’avèrent hautement précieuses en phase purement exploratoire, elles ne correspondent pas au formalisme de la régression linéaire paramétrique classique. Il est donc formellement impératif de supplanter ce comportement par défaut en déclarant explicitement le paramètre method = "lm" (pour linear model).
Sur le plan computationnel, l’association conjointe de aes(color = technique) et de geom_smooth(method = "lm") intime à R d’isoler en coulisses chaque tranche indicée du data frame correspondant à une modalité du facteur. Pour chacune de ces strates, l’algorithme évalue indépendamment la formule bilatérale y ~ x, estime les estimateurs des moindres carrés pour la constante et la pente, calcule la matrice de covariance résiduelle correspondante, puis restitue un segment de droite borné sur l’étendue des observations locales, accompagné ou non de sa marge d’erreur stochastique.
5. Mise en œuvre pratique : Tracer les droites de régression par groupe
5.1 Exécution du code de base
L’assemblage des composantes précédemment disséquées aboutit à une séquence algorithmique d’une remarquable concision conceptuelle. L’intégration harmonieuse du flux de travail implique l’initialisation du canevas, l’ancrage esthétique universel de la variable de groupement, la projection spatiale des mesures observées et l’adjonction de la couche de modélisation linéaire. La syntaxe fondamentale prend la forme unifiée suivante :
ggplot(data = df, mapping = aes(x = hours, y = score, color = technique)) +

  geom_point(alpha = 0.6, size = 2) +

  geom_smooth(method = "lm")
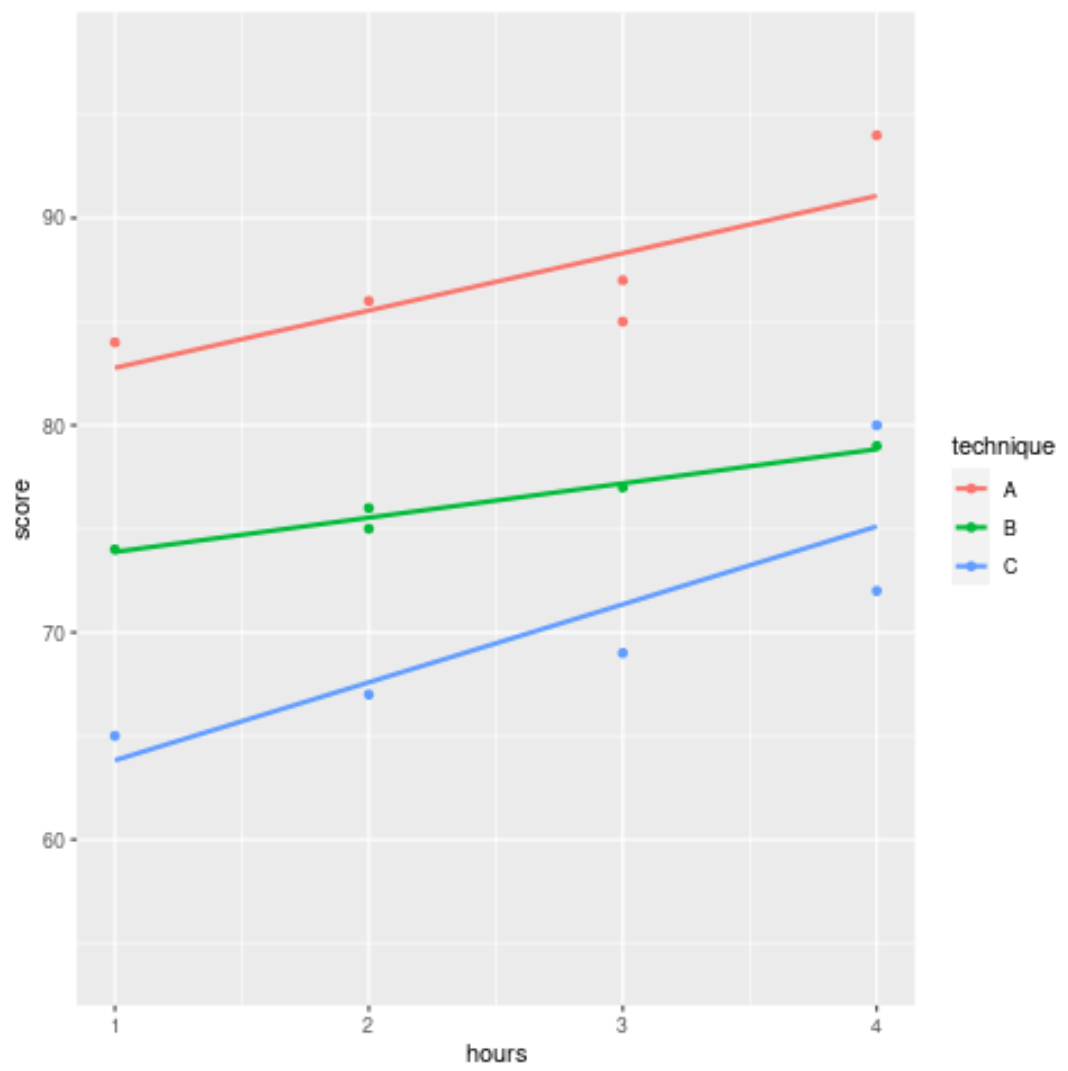
L’exécution de cette commande produit instantanément une planche graphique d’une richesse informationnelle immédiate. Le système graphique orchestre une triple opération : premièrement, les points individuels sont distribués sur le plan euclidien en fonction de leurs valeurs respectives sur les axes des abscisses et des ordonnées, adoptant une teinte distincte en accord avec la palette par défaut ; deuxièmement, trois segments rectilignes continus émergent du nuage de points, épousant fidèlement les trajectoires spécifiques inhérentes aux modalités de la variable d’apprentissage ; troisièmement, une légende synoptique rigoureusement étiquetée est automatiquement greffée sur le flanc droit de la figure.
L’examen du rendu permet d’attester de la séparation spatiale effective des dynamiques d’acquisition cognitive. Loin d’une superposition anarchique de données hétérogènes, le chercheur dispose immédiatement d’une vue structurée où les différences de niveau initial et les différentiels d’efficacité horaire apparaissent sans ambiguïté. Cette première figure constitue le pivot analytique à partir duquel les investigations statistiques formelles peuvent être engagées avec confiance.
5.2 Analyse empirique des pentes observées
L’observation détaillée de la figure issue de la mise en œuvre pratique permet de tirer des enseignements empiriques de premier ordre. Dans notre cas d’école simulant les méthodes d’apprentissage, la droite représentative de la technique A (relecture passive) présente une trajectoire caractérisée par une pente particulièrement faible. Même lorsque le temps consacré à l’étude hebdomadaire passe de 5 à 30 heures, l’ascension du score moyen demeure marginale. La rentabilité académique de l’effort consenti sous ce paradigme s’avère particulièrement décevante sur le plan psychologique.
À l’inverse, l’analyse de la droite associée à la technique B (évaluation formative régulière) exhibe un angle d’élévation vigoureux. Dès les premiers investissements temporels, chaque unité marginale d’étude hebdomadaire induit un gain tangible en termes de points à l’examen standardisé. La droite traverse le plan avec une régularité impressionnante, illustrant de manière vivante la robustesse cognitive du rappel en mémoire actif dans la consolidation mnésique à long terme.
Enfin, la trajectoire assignée à la technique C (répétition espacée algorithmique) illustre une dynamique d’interaction remarquable. Bien que le score moyen prédit pour un investissement quasi nul soit le plus bas des trois groupes — reflétant le coût cognitif initial lié à la prise en main de l’interface et à la complexité structurelle des algorithmes —, la pente affiche la plus forte inclinaison de l’ensemble de l’échantillon. Passé un certain seuil d’heures d’étude, la droite de la technique C croise et dépasse successivement les trajectoires des groupes A et B. L’investigateur identifie ainsi avec une remarquable clarté visuelle l’effet d’interaction non ordinal qui structure en profondeur son phénomène d’étude.
6. Gestion des bandes de confiance et variabilité statistique
6.1 L’argument se et l’affichage de l’erreur type
L’un des atouts analytiques majeurs de geom_smooth() réside dans sa capacité à incorporer spontanément l’incertitude d’échantillonnage sous la forme d’un ruban semi-transparent encadrant la droite de tendance. Cette enveloppe géométrique représente l’intervalle de confiance à 95 % calculé point par point pour l’espérance conditionnelle E(Y|X) le long de la plage des abscisses. La courbure caractéristique de ces bandes — plus resserrées au barycentre de l’échantillon et s’évasant symétriquement aux extrémités du domaine de définition — matérialise l’accroissement de la variance d’estimation lorsque l’on s’éloigne de la moyenne observée du prédicteur.
Cependant, dans le cadre spécifique d’une régression partitionnée par groupes multiples, l’inclusion systématique de ces zones d’erreur peut altérer considérablement la lisibilité de la figure. Lorsque trois, quatre ou cinq groupes sont projetés simultanément sur un espace cartésien restreint, les bandes de confiance respectives tendent à se superposer massivement. Cette imbrication de polygones produit des artefacts visuels indésirables, saturant l’image d’un enchevêtrement de grisés qui obscurcit tant les nuages de points que l’inclinaison relative des droites maîtresses.
Dans un tel contexte de saturation graphique, il devient méthodologiquement justifié de débrayer l’affichage de cette incertitude statistique en stipulant explicitement se = FALSE à l’intérieur de l’instruction geom_smooth(method = "lm", se = FALSE). Cette neutralisation délibérée allège substantiellement le tracé en réduisant l’information projetée à la pure cinétique moyenne des droites d’ajustement. Cette simplification est particulièrement recommandée lors des communications orales ou dans les synthèses exécutives où la clarté immédiate du message prime sur l’exposition exhaustive de la variance paramétrique.
6.2 Paramétrage du remplissage avec l’argument fill
Lorsque le maintien des bandes de confiance s’avère scientifiquement incontournable — notamment pour satisfaire aux exigences strictes de validation méthodologique d’une revue académique —, il devient crucial de maîtriser les paramètres de coloration et de transparence de ces surfaces d’erreur. Si l’analyste n’a spécifié que l’esthétique globale color = technique, le moteur ggplot2 applique par défaut un remplissage gris uniforme et opaque (grey70) sur l’ensemble des intervalles, créant une confusion optique majeure lors des intersections de groupes.
Pour résoudre ce dilemme sémiologique, il convient d’associer conjointement la variable de regroupement à l’esthétique de surface par la formulation syntaxique aes(color = technique, fill = technique). Cette double déclaration ordonne au système d’attribuer à la bande de confiance une chromaticité rigoureusement harmonisée avec celle de la droite qu’elle escorte. Dès lors, chaque trajectoire dispose d’un corridor d’incertitude immédiatement attribuable à sa modalité propre, rendant les croisements de tendances parfaitement discernables à l’œil nu.
Cette harmonisation chromatique doit impérativement s’accompagner d’un calibrage millimétré de la transparence de remplissage. Par l’ajustement direct du paramètre alpha = 0.2 ou alpha = 0.15 au sein de geom_smooth(), le chercheur atténue la densité optique des bandes d’erreur. Celles-ci deviennent suffisamment diaphanes pour ne pas masquer les points de données sous-jacents, tout en délimitant avec précision les marges de fluctuation stochastique requises pour l’inférence visuelle.
7. Personnalisation esthétique selon les normes de publication académique (APA)
7.1 Typographie, axes et étiquetage scientifique
L’habillage graphique par défaut proposé par ggplot2 — caractérisé par son célèbre fond gris quadrillé de lignes blanches — a été conçu pour maximiser le contraste des teintes primaires sur écran d’ordinateur. Toutefois, cette configuration initiale est formellement prohibée par les protocoles éditoriaux des principales sociétés savantes, à commencer par le manuel de style de l’American Psychological Association (APA 7e édition). Les standards académiques exigent un minimalisme rigoureux : fond blanc immaculé, absence de quadrillages superflus et délimitation franche des axes cartésiens.
La première transformation à opérer consiste à substituer le thème par défaut par une configuration épurée au moyen de theme_classic() ou de theme_minimal(). L’utilisation de theme_classic() constitue la solution d’élection pour l’édition scientifique : elle supprime instantanément le fond grisâtre, élimine les lignes de grille secondaires perturbatrices et rétablit les deux traits d’axe orthogonaux continus en noir pur, accompagnés de leurs graduations respectives (tick marks).
L’habillage typographique se poursuit par l’enrichissement sémantique de tous les intitulés textuels via l’instruction labs(). Les noms de variables informatiques tronqués (tels que hours ou score) doivent impérativement être remplacés par des libellés scientifiques complets, intégrant les unités de mesure entre parenthèses : x = "Temps hebdomadaire d'étude (heures)", y = "Score à l'évaluation cognitive (0-100)". L’en-tête de la légende doit également être renommé avec élégance via l’argument color = "Méthode pédagogique", conférant à la planche finale le statut d’objet de communication professionnelle parfaitement autonome.
7.2 Choix de palettes chromatiques accessibles
L’attribution aveugle des couleurs par défaut de ggplot2 repose sur la palette circulaire HSL, qui génère des teintes d’égale luminance réparties sur le spectre chromatique. Or, cette approche comporte deux faiblesses méthodologiques majeures : d’une part, elle présente une accessibilité extrêmement précaire pour les personnes présentant des déficiences de la vision des couleurs (notamment la deutéranopie et la protanopie, qui affectent jusqu’à 8 % de la population masculine) ; d’autre part, elle devient totalement indéchiffrable en cas d’impression papier en niveaux de gris, les différentes teintes se confondant en une nuance uniforme de gris moyen.
Pour surmonter cet obstacle éthique et technique, la communauté scientifique internationale plébiscite aujourd’hui l’adoption des palettes issues du projet viridis. Ces palettes — accessibles nativement dans ggplot2 via les fonctions scale_color_viridis_d() et scale_fill_viridis_d() pour les variables discrètes — ont été mathématiquement calibrées pour offrir une monotonie perceptive absolue : la luminosité croît de manière rigoureusement linéaire d’un bout à l’autre de l’échelle. Ainsi, l’information graphique reste parfaitement discriminable pour les lecteurs daltoniens tout comme sur un tirage noir et blanc classique.
Dans l’éventualité où une charte graphique institutionnelle ou des impératifs éditoriaux stricts imposent une gamme de couleurs spécifique, le statisticien peut recourir à la fonction de bas niveau scale_color_manual(values = c(...)). En renseignant des codes hexadécimaux soigneusement sélectionnés (par exemple issus d’outils de colorimétrie comme ColorBrewer), il devient possible d’instaurer des contrastes chromatiques d’une élégance souveraine, associant un bleu nuit profond, un ambre chaleureux et un sarcelle équilibré, en totale conformité avec les critères de lisibilité universelle.
7.3 Différenciation géométrique redondante : linetype et shape
La règle d’or de la sémiologie graphique contemporaine repose sur le principe de l’encodage redondant (redundant coding). Afin de garantir que l’interprétation d’un graphique ne dépende jamais exclusivement de la perception d’un canal sensoriel unique (en l’occurrence la couleur), il est hautement vertueux de coupler la différenciation chromatique à une différenciation morphologique des primitives géométriques.
Ce renforcement s’opère sur deux niveaux distincts. Pour la couche géométrique des observations ponctuelles, l’analyste associe la variable catégorielle à l’attribut de forme au sein des esthétiques : geom_point(aes(shape = technique)). R substituera alors les cercles pleins standard par une variété de symboles géométriques (des disques pour le groupe A, des triangles pour le groupe B, des carrés pour le groupe C). Même dépouillée de tout attribut de couleur, la nature de chaque observation individuelle demeure instantanément identifiable par sa seule géométrie.
Pour la couche géométrique de lissage, le même principe prévaut par la mobilisation de l’attribut de typologie de segment : geom_smooth(aes(linetype = technique), method = "lm"). ggplot2 modulera alors l’apparence des droites en combinant des lignes continues pleines (solid), des lignes en pointillés serrés (dotted) et des lignes en tirets espacés (dashed). La synchronisation parfaite entre les échelles manuelles (scale_color_manual, scale_shape_manual, scale_linetype_manual) permet de fusionner l’ensemble de ces informations au sein d’une unique légende épurée, atteignant le plus haut standard de rigueur documentaire.
8. Séparation par panneaux : L’alternative du facettage
8.1 Utilisation de facet_wrap() pour décomposer la complexité
Lorsque le protocole expérimental intègre un nombre élevé de sous-groupes — par exemple quatre modalités d’intervention déclinées sur deux tranches d’âge —, ou lorsque la variabilité intra-groupe est telle que les nuages de points se chevauchent dans une confusion inextricable, la superposition de toutes les données au sein d’un repère unique atteint ses limites cognitives. La surcharge visuelle contraint le lecteur à un effort de décodage laborieux, néfaste à l’appréciation immédiate des structures statistiques.
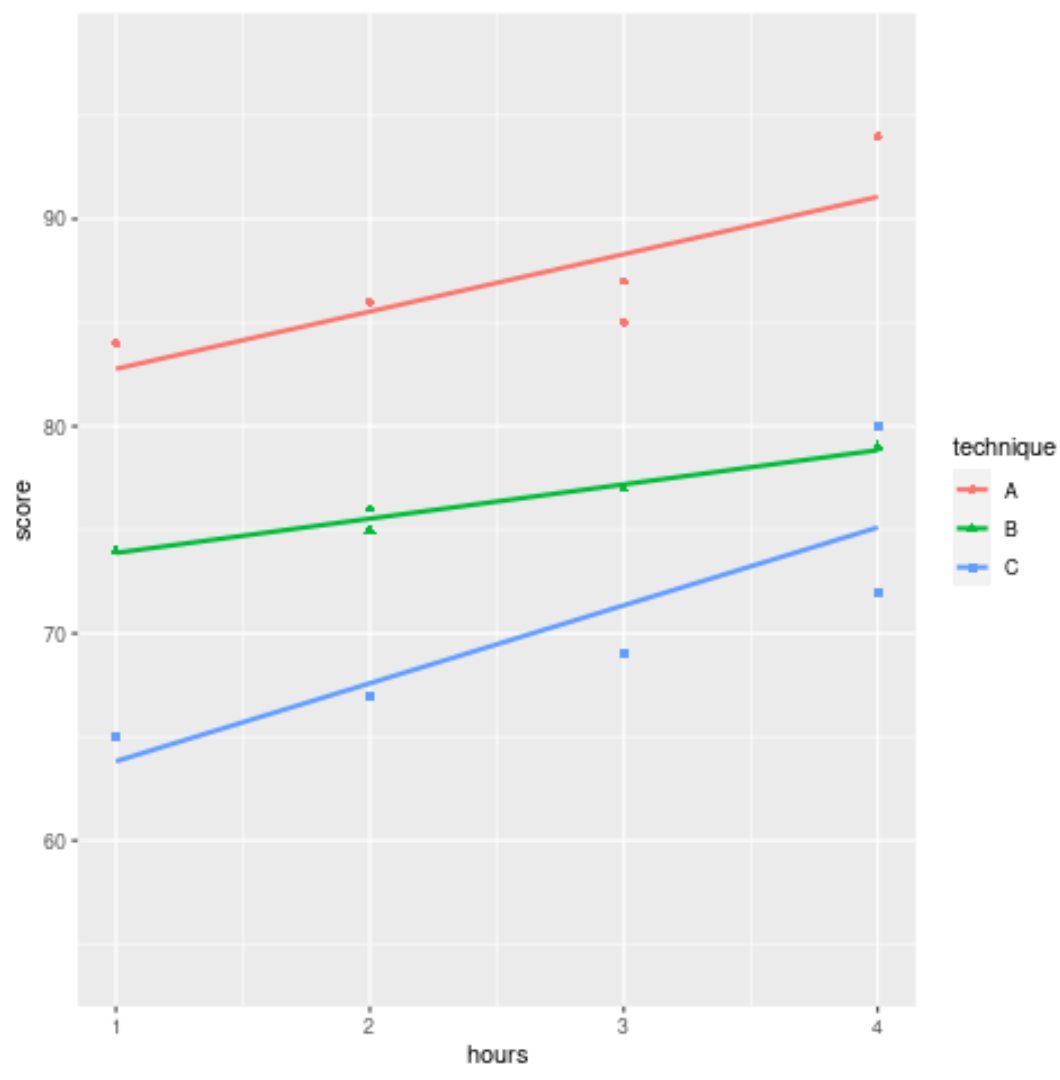
Pour répondre à cette problématique fondamentale, la grammaire des graphiques propose un mécanisme d’une puissance analytique remarquable : la partition en multiples petits panneaux ou facettage (small multiples, concept popularisé par Edward Tufte). Au lieu de fusionner les données, la fonction facet_wrap(~ technique) segmente le jeu de données selon les modalités du facteur spécifié et déploie une matrice de sous-graphiques autonomes disposés côte à côte, chacun dédié à une modalité singulière.
Cette décomposition spatiale dissout instantanément l’enchevêtrement des observations. Dans chaque panneau individuel, le chercheur observe avec une limpidité parfaite la dispersion propre au groupe, l’ajustement sans interférence de la droite de régression locale et la morphologie précise des résidus. La lecture comparative transversale demeure d’une fluidité absolue : le regard glisse d’une case à l’autre pour confronter l’inclinaison des pentes sans être troublé par la proximité physique d’observations hétérogènes.
8.2 Gestion des échelles avec facet_grid() et scales
L’implémentation du facettage exige une vigilance méthodologique sans faille quant au paramétrage des systèmes de coordonnées. Par défaut, les fonctions facet_wrap() et facet_grid() verrouillent strictement les échelles des abscisses et des ordonnées : tous les panneaux partagent rigoureusement les mêmes bornes minimales et maximales (scales = "fixed"). Cette contrainte d’invariance dimensionnelle constitue le garant absolu de la validité des comparaisons visuelles.
Modifier ce comportement en déclarant scales = "free_y" ou scales = "free" autorise chaque panneau à ajuster ses axes sur la seule étendue de ses données locales. Bien que cette option puisse sembler séduisante pour agrandir artificiellement un nuage de points resserré, elle introduit un biais cognitif majeur : une pente visuellement abrupte dans un panneau doté d’une échelle restreinte peut correspondre en réalité à un coefficient mathématique bien plus faible qu’une pente visuellement aplatie au sein d’un panneau à large échelle. L’observateur non averti est alors induit en erreur sur la magnitude relative des effets réels.
Par conséquent, en recherche quantitative rigoureuse, la libération des échelles cartésiennes ne doit être tolérée que dans des situations très exceptionnelles, notamment lorsque les domaines d’observation des sous-groupes sont structurellement disjoints et non comparables par essence. Dès lors qu’il s’agit d’évaluer l’impact différentiel d’un traitement sur une métrique comportementale standardisée, l’uniformité stricte des axes représente un impératif épistémologique absolu.
9. Comparaison méthodologique : Modèle linéaire global versus modèles stratifiés
9.1 Droites par groupe versus droite globale d’échantillon
L’un des défis pédagogiques les plus stimulants en analyse de données consiste à confronter, au sein d’un même espace visuel, la tendance centrale agrégée de l’ensemble de la population et les trajectoires idiosyncrasiques des sous-strates. Cette confrontation offre une illustration saisissante de la façon dont une moyenne d’échantillon peut déformer ou masquer les réalités opérationnelles locales.
D’un point de vue programmatique sous ggplot2, cette superposition s’opère avec une simplicité conceptuelle remarquable grâce à la modularité de la syntaxe par couches. Pour projeter une droite de régression globale non stratifiée au-dessus des nuages de points et des droites de groupes, il suffit d’ajouter une instruction geom_smooth() autonome dans laquelle on redéfinit localement l’association esthétique en neutralisant l’héritage du groupe :
ggplot(df, aes(x = hours, y = score)) +

  geom_point(aes(color = technique), alpha = 0.5) +

  geom_smooth(aes(color = technique), method = "lm", se = FALSE) +

  geom_smooth(method = "lm", color = "black", linetype = "dashed", size = 1.2, se = FALSE)
Dans cette architecture, la droite noire en pointillés traverse l’espace graphique en matérialisant l’estimation linéaire sans discernement catégoriel. L’observateur perçoit alors instantanément l’écart structurel qui sépare la tendance macroscopique moyenne des cinétiques microscopiques réelles. Cette visualisation conjointe révèle si la droite générale résume convenablement les processus sous-jacents ou si elle ne représente qu’un artefact mathématique dépourvu de pertinence concrète pour décrire un sous-groupe particulier.
9.2 Vérification inférentielle : Du graphique à l’interaction formelle
Si l’exploration graphique prépare le terrain de l’intuition scientifique, la rigueur méthodologique impose de valider formellement les divergences de pentes observées par une modélisation inférentielle adéquate. La correspondance formelle entre les tracés de régression stratifiés sous ggplot2 et le modèle linéaire d’interaction sous R s’établit via la fonction standard lm(). L’estimation s’écrit formellement : modele_inter <- lm(score ~ hours * technique, data = df).
Dans la syntaxe de R, l’opérateur astérisque * déploie de manière automatique le modèle factoriel complet, intégrant les effets principaux additifs ainsi que le produit vectoriel multiplicatif entre le prédicteur continu et les indicatrices de modalité : hours + technique + hours:technique. L’examen du tableau des coefficients extrait par summary(modele_inter) permet de raccorder directement chaque composante graphique à un paramètre statistique quantifié :
- L’ordonnée à l’origine (Intercept) quantifie la valeur prédite de score lorsque hours est égal à zéro pour le groupe de référence (modalité fixée par le premier niveau du facteur).
- Le coefficient associé à hours traduit l’inclinaison mathématique précise de la droite de régression du groupe de référence.
- Les coefficients différentiels associés aux termes multiplicatifs hours:techniqueB et hours:techniqueC mesurent exactement l’écart angulaire de pente entre les modalités concernées et la droite du groupe de référence.
L’évaluation de la signification statistique de ces écarts s’opère par l’examen des p-valeurs associées aux coefficients d’interaction ou par la conduite d’une analyse de variance de type III via car::Anova(modele_inter, type = "III"). L’obtention d’un terme multiplicatif significatif (p < 0.05) apporte la confirmation inférentielle irréfutable que la divergence des pentes matérialisée par geom_smooth(method = "lm") ne saurait être imputée aux seules fluctuations de l’échantillonnage aléatoire, sanctionnant ainsi la présence effective d’une authentique modération comportementale.
10. Gestion des pièges courants et des cas complexes
10.1 Points influents et valeurs aberrantes par sous-groupe
L’ajustement d’une droite de régression par les moindres carrés ordinaires possède une sensibilité notoire aux valeurs aberrantes et aux points de fort levier. Dans un sous-groupe aux effectifs modérés, une unique observation extrême — qu’elle découle d’une erreur de saisie, d’un défaut de calibration d’instrument ou d’une réponse physiologique atypique — est capable d’exercer un effet de torsion disproportionné sur la trajectoire estimée, modifiant radicalement l’inclinaison de la pente.
L’identification graphique préventive de ces observations singulières constitue une nécessité impérieuse. Le chercheur peut calculer la distance de Cook pour chaque observation au sein de chaque strate d’échantillonnage à l’aide des fonctions de diagnostic intégrées à R (telles que cooks.distance()). Les individus dont la contribution excède les seuils d’alerte méthodologiques classiques (souvent fixés à 4/n) peuvent être visuellement surlignés sur la figure par un anneau distinctif ou une étiquette spécifique générée par le package ggrepel.
Face à des données substantiellement contaminées par des valeurs extrêmes incontournables, il devient judicieux de substituer le lissage MCO standard par une régression linéaire robuste. ggplot2 autorise cette modularité statistique en adaptant les arguments internes de geom_smooth() : en configurant method = MASS::rlm, l’estimation des paramètres recourt à des M-estimateurs avec pondération de Huber ou de Tukey. Les droites résultantes traduisent fidèlement le comportement de la majorité centrale de l’échantillon sans être dévoyées par les points périphériques discordants.
10.2 Extrapolation abusive au-delà du support des données
Un écueil méthodologique récurrent lors de l’application de régressions par sous-groupe concerne l’extrapolation abusive en dehors de l’étendue empirique des observations. Par défaut, la fonction geom_smooth() borne scrupuleusement le tracé de chaque droite entre la valeur minimale et la valeur maximale observée pour la variable X au sein de la strate spécifique considérée. Ce comportement conservatoire est régi par l’argument par défaut fullrange = FALSE.
L’activation imprudente de l’argument fullrange = TRUE force le moteur graphique à prolonger artificiellement chaque segment rectiligne sur l’ensemble de la plage cartésienne couverte par la totalité du jeu de données agrégé. Si cette projection permet d’étendre visuellement les droites jusqu’aux bordures de la figure, elle expose l’analyste à des aberrations interprétatives majeures. Supposer qu’un groupe clinique restreint, observé uniquement entre 5 et 15 heures d’apprentissage, maintiendra un comportement strictement linéaire jusqu’à 40 heures relève d’une spéculation mathématique dénuée de fondement empirique.
Il est donc fortement recommandé de préserver le paramétrage fullrange = FALSE dans les publications scientifiques. Respecter le support réel des données pour chaque modalité témoigne d’une probité méthodologique exemplaire, en signalant explicitement au lecteur les frontières empiriques à l’intérieur desquelles chaque modèle conserve sa légitimité d’interpolation.
10.3 Disparités d’effectifs entre les modalités
Dans les plans d’échantillonnage quasi-expérimentaux ou observationnels, il est très fréquent de se heurter à des effectifs asymétriques selon les modalités de la variable d’intérêt. Par exemple, un groupe d’étudiants adeptes de la technique A peut rassembler 150 participants, tandis que le groupe expérimental novateur utilisant la technique C n’en compte qu’une vingtaine en raison de contraintes de recrutement ou de coûts d’équipement.
Cette asymétrie numérique engendre une disproportion immédiate dans la précision de l’estimation statistique. Alors que la droite adossée à la cohorte abondante est flanquée d’un ruban d’erreur extrêmement ténu et stable, la droite du sous-groupe marginal affiche une bande de confiance particulièrement béante, s’évasant de façon spectaculaire dès que l’on s’écarte du barycentre local. Cette distorsion visuelle n’est pas une anomalie algorithmique : elle reflète scrupuleusement la loi de distribution de Student et l’élévation de la variance d’échantillonnage inhérente aux faibles effectifs.
L’analyste doit formuler ses conclusions avec une prudence accrue face à ces disparités. L’examen des figures doit systématiquement intégrer cette réalité distributionnelle : une pente fortement inclinée mais cernée par un ruban d’incertitude massif ne saurait être interprétée avec le même degré de certitude qu’une pente plus modeste adossée à une marge d’erreur quasi imperceptible. L’adjonction d’un tapis de données univarié en bordure d’axe au moyen de geom_rug(sides = "b", alpha = 0.5) peut s’avérer très précieuse pour rendre compte en continu de la densité réelle des observations sur chaque segment d’abscisse.
11. Exportation haute définition pour les manuscrits scientifiques
11.1 Utilisation rigoureuse de la fonction ggsave()
L’élaboration d’une figure irréprochable au sein de la session interactive de travail R ne garantit pas automatiquement sa fidélité lors de l’intégration dans un manuscrit destiné à la publication. L’utilisation maladroite des fonctionnalités de capture d’écran ou d’exportation presse-papier du système d’exploitation dégrade irrémédiablement la qualité géométrique, introduit des compressions d’image destructrices et altère les proportions relatives des polices et des tracés.
L’outil normatif incontournable pour l’archivage et l’exportation des productions ggplot2 est la fonction dédiée ggsave(). Cette instruction prend en charge la compilation du graphique actif et son écriture directe sur le disque dur selon des spécifications dimensionnelles et matérielles rigoureusement contrôlées. Il est essentiel de stipuler explicitement les unités physiques de restitution (centimètres ou pouces) ainsi que les dimensions exactes correspondant à la maquette typographique de la revue cible (par exemple une largeur de 8.5 cm pour une figure sur une seule colonne, ou de 17.5 cm pour une double colonne dans un format A4 classique) :
ggsave(filename = "figure1_regression_groupes.tiff",

       plot = last_plot(),

       device = "tiff",

       width = 17.5,

       height = 11.5,

       units = "cm",

       dpi = 600,

       compression = "lzw")
Le paramétrage du niveau de résolution (exprimé en points par pouce ou dots per inch, DPI) conditionne la netteté à l’impression. Les directives des éditeurs scientifiques exigent de manière invariable une résolution plancher de 300 DPI pour les illustrations en tons continus et de 600 à 1200 DPI pour les graphiques au trait (line art). Le choix des formats matriciels sans perte avec compression LZW (comme le TIFF) garantit l’intégrité absolue des pixels sans alourdir indûment le volume des fichiers.
Pour une qualité de rendu suprême et une adaptabilité totale à la mise en page finale, le recours aux formats vectoriels tels que le PDF (device = "pdf") ou l’EPS (device = "eps") s’avère hautement préconisé. Contrairement aux images matricielles, les formats vectoriels encodent les éléments graphiques sous forme d’instructions mathématiques pures de dessin : les segments, les courbes et les caractères typographiques conservent une netteté infinitésimale quel que soit le niveau de grossissement appliqué par l’imprimeur professionnel.
11.2 Intégration dans des flux de travail reproductibles
L’excellence méthodologique contemporaine récuse la manipulation déconnectée des figures par retouches manuelles externes. La traçabilité computationnelle exige que chaque graphique inséré dans un article scientifique puisse être régénéré à l’identique, de manière entièrement automatisée, à partir du code source brut et des données originales. L’insertion du script graphique au sein d’environnements d’édition dynamique tels que R Markdown ou sa version évoluée Quarto représente le paradigme de référence de la science ouverte.
Au sein d’un document computationnel Quarto ou R Markdown, la cellule de code (chunk) hébergeant la commande ggplot2 doit être calibrée à l’aide d’options d’exécution précises. Les paramètres fig.width = 7, fig.height = 4.5, fig.align = "center" et fig.cap = "Évolution différentielle des scores cognitifs..." assurent la synchronisation directe entre l’interpréteur R et le compilateur typographique (LaTeX ou HTML). Cette intégration élimine définitivement les erreurs humaines liées aux copier-coller manuels et garantit l’actualisation dynamique instantanée des figures en cas de mise à jour du jeu de données.
La fixation stricte de l’environnement de rendu inclut également le verrouillage des facteurs d’échelle typographique via l’argument base_size au sein des thèmes ggplot2 (par exemple theme_classic(base_size = 11)). En calibrant la taille des polices de caractères pour qu’elle s’accorde naturellement avec celle du corps de texte principal de l’article, le chercheur s’assure que sa figure présentera une harmonie visuelle exemplaire une fois incorporée dans les épreuves finales de la publication.
12. Synthèse et guide de bonnes pratiques en psychologie quantitative
12.1 Arbre de décision pour le choix de la méthode de visualisation
Pour clore ce parcours méthodologique et technique, il est utile de structurer le processus décisionnel sous la forme d’un arbre d’orientation pratique destiné à guider le praticien face à ses données empiriques. Le choix de la modalité de représentation graphique ne doit rien au hasard ou aux préférences subjectives ; il dépend rigoureusement de la complexité intrinsèque de la structure de l’échantillon analysé :
- Nombre de groupes modérateurs limité (2 à 3 modalités) : Privilégier la superposition directe sur un repère unique, en combinant
aes(color = groupe, fill = groupe)etgeom_smooth(method = "lm")avec des bandes de confiance transparentes (alpha = 0.2). L’encodage redondant parlinetypeetshapeest vivement conseillé. - Nombre de groupes modérateurs élevé (4 modalités ou plus) : Basculer sans hésiter vers le facettage horizontal ou matriciel via
facet_wrap(~ groupe). Cette décision prévient la surcharge visuelle, préserve la lisibilité des distributions individuelles et autorise une comparaison ordonnée de la déclivité des droites avec des axes rigoureusement synchronisés. - Disparité majeure de variance intra-groupe : Conserver l’affichage des rubans d’erreur type (
se = TRUE) en veillant à une colorimétrie contrastée, afin de communiquer loyalement au lecteur les écarts de précision statistique d’une modalité à l’autre. - Audience de décideurs non statisticiens ou support de présentation orale : Alléger scrupuleusement la planche graphique en neutralisant les intervalles de confiance (
se = FALSE) et en renforçant l’épaisseur des traits directeurs (size = 1.3) pour focaliser l’attention cognitive sur les dynamiques moyennes d’apprentissage ou de réponse.
12.2 Check-list méthodologique avant diffusion des résultats
Avant d’apposer son approbation finale sur une figure statistique destinée à franchir le filtre des pairs au sein d’une revue internationale, l’analyste se doit d’exécuter un contrôle qualité exhaustif à travers la grille d’évaluation suivante :
- Concordance paramétrique formelle : Les segments de droite tracés par
geom_smooth(method = "lm")reflètent-ils rigoureusement les prédictions mathématiques issues du modèle linéaire d’interactionlm(Y ~ X * Groupe)exécuté en arrière-plan ? Les degrés d’inclinaison sont-ils mathématiquement cohérents avec les coefficients d’interaction calculés ? - Contrôle de l’extrapolation : L’étendue spatiale des segments de droite est-elle strictement circonscrite aux plages de valeurs réelles observées au sein de chaque groupe (
fullrange = FALSE), empêchant toute illusion d’interpolation infondée ? - Accessibilité visuelle universelle : La planche demeure-t-elle parfaitement déchiffrable lorsqu’elle est convertie intégralement en nuances de gris ? Les contrastes de luminance sont-ils conformes aux normes d’accessibilité pour les personnes malvoyantes ou daltoniennes grâce à l’adoption de palettes certifiées telles que Viridis ?
- Sémiologie des axes et des unités : Les libellés d’axes sont-ils entièrement explicités en langage naturel, exempts d’abréviations informatiques énigmatiques, et mentionnent-ils systématiquement les unités de mesure entre parenthèses ?
- Précision dimensionnelle et vectorielle : L’exportation a-t-elle été orchestrée via un flux vectoriel (PDF) ou un format matriciel haute densité (TIFF à 600 DPI) conforme au gabarit d’impression finale du journal ciblé ?
En observant scrupuleusement ces impératifs théoriques, computationnels et sémiologiques, le chercheur s’assure que sa production graphique constitue un vecteur de transmission scientifique d’une rigueur absolue, alliant la puissance narrative de l’image à la précision irréprochable de l’inférence statistique moderne.
Références
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.r-project.org/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://ggplot2-book.org/
- Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media. https://clauswilke.com/dataviz/
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0