
L’inférence statistique moderne repose sur la quantification rigoureuse de l’incertitude inhérente à l’échantillonnage empirique. Alors que les chercheurs et les analystes de données ont longtemps privilégié le test de signification de l’hypothèse nulle articulé autour de la valeur p, la communauté scientifique internationale, guidée par les recommandations méthodologiques de l’American Psychological Association et de l’American Statistical Association, exige désormais la présentation systématique des tailles d’effet accompagnées de leurs intervalles de confiance. L’estimation par intervalle transcende la dichotomie binaire du rejet ou du non-rejet d’une hypothèse en offrant une représentation spatiale continue de la plausibilité du paramètre inconnu de la population. Dans le langage de programmation statistique R, la visualisation de ces marges d’erreur ne constitue pas un simple raffinement graphique, mais s’affirme comme une étape fondamentale de validation des modèles, de communication transparente des résultats et d’aide à la décision empirique.
Le traçage d’un intervalle de confiance dans R met en jeu une interaction complexe entre concepts d’algèbre linéaire, distributions d’échantillonnage asymptotiques et moteurs de rendu graphique. Que l’on opère à travers le système graphique historique (Base R) ou que l’on mobilise la grammaire des graphiques structurée par la bibliothèque ggplot2, l’analyste doit articuler avec une exactitude scrupuleuse le modèle stochastique sous-jacent, le vecteur des erreurs types conditionnelles et les primitives géométriques d’affichage. Les enjeux oscillent entre la fidélité mathématique — consistant à ne pas déformer la concavité hyperbolique des enveloppes de confiance — et l’intelligibilité visuelle pour le lecteur non averti, qui confond fréquemment l’intervalle de confiance pour la moyenne avec la bande de dispersion des observations individuelles.
Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes théoriques, computationnels et esthétiques nécessaires à l’élaboration de visualisations d’intervalles de confiance irréprochables sous R. En partant de la formalisation fréquentiste de Neyman jusqu’aux extensions non paramétriques par rééchantillonnage et aux modèles linéaires généralisés à effets mixtes, chaque étape est explicitée d’un point de vue conceptuel et algorithmique. L’objectif est de doter les praticiens, doctorants et data scientists des compétences méthodologiques indispensables pour convertir des sorties matricielles complexes en représentations graphiques publiables dans les revues académiques de premier rang international.
1. Fondements théoriques de l’intervalle de confiance en statistique inférentielle
1.1 Définition mathématique et interprétation fréquentiste
D’un point de vue strictement formel dans le cadre de l’inférence fréquentiste développée par Jerzy Neyman en 1937, un intervalle de confiance à un seuil nominal déterminé ne mesure aucunement la probabilité que le paramètre inconnu se situe à l’intérieur des bornes calculées pour un jeu de données particulier. Le paramètre d’intérêt de la population générale, traditionnellement désigné par la lettre grecque thêta (θ), est une quantité fixe, constante mais non observable. Ce sont les estimateurs délimitant les bornes inférieure et supérieure qui constituent des variables aléatoires conditionnées par l’échantillonnage. Dès lors, lorsqu’un protocole méthodologique stipule un niveau de confiance fixé à un coefficient valant un moins alpha (1 – α), généralement établi à 0,95, l’assertion probabiliste porte sur le processus générateur et non sur le résultat isolé : si l’expérience empirique était répliquée une infinité de fois dans des conditions strictement identiques, 95 % des intervalles générés recouvriraient la valeur exacte et immuable du paramètre thêta, tandis que 5 % échoueraient à l’englober.
La confusion entre cette interprétation rigoureuse et la posture bayésienne d’intervalle de crédibilité représente l’une des erreurs conceptuelles les plus persistantes dans la littérature scientifique contemporaine. Un chercheur ne peut pas légitimement déclarer, après avoir collecté un échantillon unique et calculé un intervalle borné entre [12,4 ; 18,2], qu’il existe 95 % de chances que la moyenne de la population appartienne à cet intervalle concret. À ce stade de l’analyse, le paramètre réel s’y trouve ou ne s’y trouve pas ; la probabilité a posteriori est soit de 0, soit de 1. La force de l’estimation réside dans la fiabilité à long terme du protocole d’inférence. Cette largeur dépend intrinsèquement de l’erreur type de l’estimateur considéré et du quantile critique d’amplitude associé à la distribution théorique appropriée.
Dans le cas classique de l’estimation de la moyenne ou d’un coefficient de régression linéaire sous l’hypothèse de normalité des résidus avec une variance de population inconnue, la distribution de référence est la loi de Student. Les degrés de liberté, conditionnés par la taille de l’échantillon n et le nombre de paramètres estimés k, dictent l’épaisseur des queues de distribution. Lorsque le volume d’observations est restreint, le quantile de Student excède notablement le quantile de la distribution normale standard, élargissant ainsi mécaniquement l’intervalle de confiance pour compenser l’incertitude additionnelle introduite par l’estimation conjointe de la variance résiduelle. L’erreur type agit comme le facteur d’échelle fondamental : elle pondère la dispersion intrinsèque des observations par la racine carrée de la taille de l’échantillon, garantissant la convergence asymptotique de l’intervalle vers une largeur nulle à mesure que le nombre d’observations tend vers l’infini.
1.2 Pertinence méthodologique dans la recherche empirique
L’abandon progressif de la dépendance exclusive envers la valeur p s’explique par les apories documentées de la dichotomisation arbitraire du continuum scientifique. Une valeur p inférieure au seuil conventionnel de 0,05 atteste uniquement qu’une discordance observée entre les données et l’hypothèse nulle a peu de chances d’être attribuable aux seules fluctuations d’échantillonnage, sans renseigner le chercheur sur l’amplitude clinique, psychologique ou économique du phénomène. En intégrant la métrique de l’intervalle de confiance, le chercheur informe simultanément la communauté sur l’estimation ponctuelle de la taille de l’effet et sur la précision statistique de cette estimation. Un intervalle extrêmement resserré entourant un coefficient proche de zéro démontre avec rigueur l’absence d’effet substantiel, alors qu’une valeur p non significative issue d’un intervalle gigantesque signale une imprécision rédhibitoire due à un manque criant de puissance statistique.
Dans des disciplines expérimentales et corrélationnelles comme la psychologie cognitive, les neurosciences comportementales et la médecine factuelle, les exigences de réplicabilité ont poussé les comités éditoriaux à imposer des standards stricts. L’accumulation des savoirs exige la méta-analyse, et les méta-analyses s’appuient fondamentalement sur la combinaison des tailles d’effet et de leurs erreurs types respectives. La transcription graphique des intervalles de confiance permet aux lecteurs d’évaluer instantanément la robustesse d’un résultat, la compatibilité d’un échantillon avec des théories rivales antérieures et le degré de vulnérabilité aux bruits stochastiques d’instrumentation.
Les directives éditoriales de la septième édition du manuel de publication de l’American Psychological Association imposent une transparence absolue dans la communication visuelle de ces incertitudes. Les graphiques ne doivent plus se limiter à des histogrammes statiques représentant des moyennes arithmétiques tronquées, souvent qualifiés péjorativement de graphiques en bâtons dynamiques dénués d’information distributionaliste. La norme contemporaine prescrit l’affichage d’enveloppes continues d’incertitude ou de barres d’erreur explicites dont la nature précise — erreur type, intervalle à 90 %, 95 % ou 99 % — doit être sans ambiguïté documentée dans les légendes. Cette exigence garantit l’intégrité de la communication scientifique et prévient l’interprétation abusive des chevauchements visuels lors des comparaisons entre cohortes expérimentales.
2. Préparation de l’environnement de travail et génération des données
2.1 Initialisation de la session et reproductibilité
La reproductibilité computationnelle constitue le socle inaliénable de toute analyse statistique robuste réalisée sous le logiciel R. L’une des failles méthodologiques majeures rencontrées dans la pratique de la recherche découle de l’incapacité à régénérer à l’identique un jeu de données simulé ou une procédure d’optimisation stochastique. Pour prémunir le chercheur contre cette instabilité numérique, la session R doit impérativement être initialisée par la fixation de la graine du générateur de nombres pseudo-aléatoires à travers l’invocation explicite de l’instruction set.seed(). Le choix de l’entier numérique passé en argument importe peu sur le plan théorique, mais sa pérennisation dans le script assure que les algorithmes de tirage aléatoire produiront une suite invariable de valeurs à chaque exécution du code source.
Parallèlement à la reproductibilité des tirages aléatoires, l’environnement global de travail doit être préservé de toute contamination résiduelle issue de sessions antérieures. L’analyste consciencieux procède à l’assainissement de son espace de mémoire vive en éliminant les objets préexistants via la fonction rm(list = ls()). Cette pratique évite que des variables résiduelles ne viennent masquer des erreurs de portée ou corrompre les calculs vectoriels lors de l’exécution séquentielle. Il convient toutefois de maintenir une séparation claire entre l’état de la mémoire et la configuration logicielle sous-jacente afin de ne pas perturber l’interopérabilité des paquets installés.
La gestion rigoureuse des dépendances logicielles implique également la vérification de l’encodage des caractères et de la version du moteur de calcul. L’utilisation d’environnements virtualisés ou de systèmes de gestion de paquets autonomes permet de figer les versions des bibliothèques mobilisées, évitant ainsi que les modifications internes des fonctions graphiques au fil des mises à jour n’altèrent le rendu final. Cette hygiène de programmation garantit que les simulations bivariées développées pour illustrer la construction des intervalles de confiance demeurent parfaitement déterministes et auditables par les pairs.
2.2 Simulation d’un jeu de données bivarié
Afin de décomposer sans biais l’architecture d’un intervalle de confiance le long d’une droite d’ajustement, la modélisation synthétique d’un système bivarié offre une maîtrise parfaite des paramètres générateurs de la population. Soit une variable indépendante continue, notée X, simulant une mesure biométrique ou cognitive standardisée. Nous pouvons modéliser cette variable explicative en tirant aléatoirement un effectif de cent observations (n = 100) au sein d’une loi normale centrée réduite présentant une espérance mathématique nulle et une variance unitaire, au moyen de la fonction rnorm(100, mean = 0, sd = 1).
Le protocole stochastique liant la variable dépendante Y à la covariable X s’articule autour d’une relation linéaire théorique assujettie à une perturbation gaussienne. Définissons une ordonnée à l’origine égale à 5 et une pente paramétrique fixée à 2,5. Le terme d’erreur résiduelle stochastique, représentant la variance non observée et le bruit expérimental, est quant à lui généré par un échantillonnage indépendant suivant une loi normale d’espérance nulle et d’écart-type égal à 1,5. L’expression algorithmique de cette variable réponse s’écrit formellement sous la forme d’une combinaison linéaire vectorielle à laquelle s’additionne l’aléa résiduel : y <- 5 + 2.5 * x + rnorm(100, mean = 0, sd = 1.5).
Ces deux vecteurs atomiques de dimension identique sont ensuite encapsulés dans un tableau de données rectangulaire standardisé en exploitant la primitive data.frame(x = x, y = y). L’inspection immédiate de cet objet via les commandes d’investigation exploratoire head() et summary() permet de valider la conformité structurelle de l’échantillon généré. L’analyste s’assure ainsi que les métriques descriptives fondamentales — quartiles, médiane, moyenne arithmétique et étendue des valeurs — s’alignent étroitement sur les attentes théoriques dictées par les paramètres paramétrés en amont de la modélisation.
3. Modélisation de la régression linéaire simple
3.1 Ajustement du modèle avec la fonction lm()
L’estimation des paramètres de liaison repose sur la méthode des moindres carrés ordinaires, implémentée de manière native dans R au sein de la fonction lm(). La spécification syntaxique requiert la formulation d’une relation symbolique au moyen de l’opérateur tilde, reliant la variable réponse à la variable explicative : modele <- lm(y ~ x, data = donnees). Cet appel algorithmique résout le système d’équations normales par décomposition QR de la matrice des régresseurs, conférant au calcul une stabilité numérique optimale face aux risques de quasi-colinéarité ou d’arrondis machine.
L’interrogation de l’objet résultant via la commande summary(modele) délivre une décomposition matricielle complète de l’ajustement. L’analyste y extrait les estimateurs ponctuels des coefficients de régression : l’ordonnée à l’origine estimée (bêta 0) et le coefficient de pente empirique (bêta 1). Chacune de ces valeurs ponctuelles est assortie de son erreur type conditionnelle respective, matérialisant l’écart-type de la distribution d’échantillonnage du paramètre considéré. L’évaluation du ratio entre l’estimation et son erreur type permet de calculer la statistique t de Student associée, vérifiant la déviation par rapport à l’hypothèse de nullité de la liaison linéaire.
Au-delà des coefficients individuels, l’évaluation de la performance globale du modèle s’appuie sur la statistique de l’erreur type des résidus (Residual Standard Error) et sur le coefficient de détermination R-carré. Ce dernier quantifie la fraction de la variance globale de la variable dépendante absorbée par le modèle linéaire par rapport à la variance totale non expliquée. La qualité de cet ajustement gouverne directement la précision du faisceau de trajectoires admissibles : plus la variance résiduelle estimée est contenue, plus l’enveloppe de confiance délimitant l’espérance conditionnelle apparaîtra resserrée sur le plan cartésien.
3.2 Vérification des postulats statistiques fondamentaux
L’exactitude mathématique et la légitimité des intervalles de confiance calculés par la méthode paramétrique des moindres carrés reposent sur une série de postulats théoriques stricts, communément désignés sous l’acronyme des conditions de Gauss-Markov et de normalité. L’évaluation de ces hypothèses conditionne la validité des inférences futures. La violation de ces prérequis théoriques n’invalide pas nécessairement l’estimation ponctuelle des coefficients, mais déforme sévèrement la matrice de variance-covariance des paramètres, produisant des intervalles de confiance artificiellement étroits ou indûment larges, qui faussent le taux nominal de couverture à 95 %.
Le premier postulat crucial réside dans l’homoscédasticité des résidus, à savoir la constance absolue de la variance des erreurs quel que soit le niveau de la variable explicative X. L’inspection graphique s’opère usuellement par le traçage des résidus studentisés en fonction des valeurs ajustées, accessible via le diagnostic graphique natif plot(modele, which = 1) ou which = 3. Toute structure en entonnoir, révélant une dispersion croissante ou décroissante des erreurs le long de l’axe des abscisses, signale la présence d’hétéroscédasticité. Dans un tel contexte, le calcul standard des intervalles sous-estime l’incertitude dans les régions de forte variance et la surestime dans les zones de faible dispersion.
Le second prérequis indispensable concerne la normalité de la distribution des erreurs stochastiques dans la population, particulièrement critique lorsque l’échantillon disponible est modeste. Cette propriété est évaluée par l’observation du diagramme quantile-quantile (Q-Q plot), obtenu par plot(modele, which = 2), confrontant la distribution empirique des résidus aux quantiles théoriques d’une loi gaussienne standard. Une divergence marquée des points aux extrémités de la diagonale témoigne de queues épaisses ou d’une asymétrie résiduelle prononcée. Lorsque ces postulats sont enfreints, l’inférence fondée sur la loi de Student devient inadéquate, contraignant l’analyste à recourir soit à des estimateurs de variance robustes à l’hétéroscédasticité, soit à des méthodologies de rééchantillonnage non paramétriques.
4. Extraction matricielle des prédictions et des bornes de confiance
4.1 Génération d’une grille d’évaluation continue
Pour parvenir à un rendu graphique harmonieux, dépourvu de cassures angulaires inesthétiques, il est méthodologiquement incorrect de se limiter au calcul des intervalles de confiance sur les seuls points empiriques de la variable X constitutifs de l’échantillon. Étant donné que ces observations peuvent être irrégulièrement réparties dans l’espace multidimensionnel, le tracé direct des estimations calculées sur ces points produirait une série de segments brisés. La procédure standard requiert la création artificielle d’une grille continue d’évaluation, couvrant rigoureusement l’étendue observable du domaine de définition de la variable explicative.
La génération de cette grille algorithmique mobilise la fonction seq(), paramétrée pour balayer le spectre complet allant de la valeur minimale observée jusqu’au maximum empirique de la variable x. Le paramètre de granularité numérique, défini par l’argument length.out, est judicieusement fixé à une valeur comprise entre deux cents et cinq cents points d’évaluation : grille_x <- seq(min(donnees$x), max(donnees$x), length.out = 300). Cette résolution confère aux futures courbes vectorielles une continuité visuelle parfaite, simulant une infinité de points infinitésimaux sans saturer la mémoire vive de l’ordinateur.
L’étape indispensable suivante consiste à structurer ce vecteur sous la forme explicite d’un objet de type data.frame, en veillant scrupuleusement à ce que le nom de la variable corresponde exactement au libellé utilisé dans la formule initiale du modèle de régression : nouvelles_donnees <- data.frame(x = grille_x). Cette harmonisation nominale conditionne la capacité du moteur d’inférence de R à apparier les nouvelles coordonnées synthétiques avec la matrice du modèle préalablement estimée par la fonction d’ajustement linéaire.
4.2 Utilisation paramétrique de la fonction predict()
Une fois la grille de projection établie, le calcul des espérances mathématiques conditionnelles et de leurs enveloppes stochastiques est délégué à la méthode générique predict(). L’invocation paramétrique rigoureuse nécessite la conjonction de trois arguments fondamentaux : l’objet modèle issu de l’ajustement linéaire, le jeu de données contenant la nouvelle grille d’évaluation, et l’instruction explicite quant au type d’intervalle requis. Pour borner l’espérance de la droite moyenne, l’argument est formellement fixé sur la modalité textuelle : interval = "confidence", assortie optionnellement du niveau nominal via level = 0.95.
La structure retournée par cet appel algorithmique se matérialise sous la forme d’une matrice numérique bidimensionnelle comportant autant de lignes que la grille de projection compte de coordonnées d’évaluation, et exactement trois colonnes distinctes. La première colonne, libellée fit, héberge la valeur ajustée ponctuelle, correspondant à la coordonnée projetée sur la droite de régression linéaire. La deuxième colonne, nommée lwr (pour lower bound), quantifie la borne inférieure de l’intervalle de confiance, tandis que la troisième colonne, étiquetée upr (pour upper bound), encapsule la borne supérieure correspondante.
Avant d’engager les instructions de rendu graphique, l’analyste effectue une vérification métrologique de la concordance dimensionnelle des vecteurs. L’opération la plus lisible consiste à fusionner la grille d’origine et la matrice des estimations au sein d’une structure consolidée au moyen de l’instruction predictions_df <- cbind(nouvelles_donnees, as.data.frame(predict(modele, newdata = nouvelles_donnees, interval = "confidence"))). Ce tableau homogénéisé renferme désormais les coordonnées cartésiennes indispensables à la cartographie vectorielle de la bande d’incertitude dans n’importe quel sous-système graphique de R.
5. Construction graphique de l’intervalle avec le système de base R
5.1 Initialisation du canevas graphique
Le moteur graphique historique de R, couramment appelé Base R, offre un contrôle bas niveau extrêmement fin sur chaque instruction de rendu, opérant selon le paradigme de la toile de peintre (painter’s model) où chaque couche vient recouvrir irréversiblement les éléments dessinés en amont. La construction méthodique d’une figure commence par l’initialisation des dimensions et des échelles du système d’axes. Pour éviter tout débordement visuel des futures bandes de confiance en bordure de fenêtre, l’analyste doit déterminer au préalable les étendues globales minimales et maximales englobant à la fois les données empiriques dispersées et les limites extrêmes de la matrice des prédictions.
L’initialisation d’un canevas vierge s’opère par l’invocation de la fonction plot() associée à l’argument d’inhibition graphique type = "n". Cette instruction configure l’espace cartésien, calcule l’échelle des graduations et trace les axes et les marges sans dessiner le moindre symbole géométrique : plot(donnees$x, donnees$y, type = "n", xlim = range(donnees$x), y\lim = c(\min(predictions_df$lwr), max(predictions_df$upr)), xlab = "Covariable X (unités standardisées)", ylab = "Variable Réponse Y"). Ce dimensionnement préventif sur l’axe des ordonnées prévient toute troncature accidentelle de la bande d’incertitude dans les zones de forte courbure hyperbolique aux marges du domaine d’échantillonnage.
Une fois le cadre structural matérialisé, la première strate informative consiste à injecter les points d’observation discrets de l’échantillon collecté. L’analyste convoque la fonction vectorielle points() en sélectionnant un glyphe adapté au moyen de l’argument pch = 16 (disque plein plein de matière) et en régulant l’encombrement spatial par un calibrage de la taille des caractères via cex = 0.8. Le choix d’une teinte neutre, telle qu’un gris anthracite ou un bleu nuit atténué, garantit que l’œil de l’observateur puisse aisément distinguer le nuage de points probabiliste de la trajectoire déterministe modélisée qui viendra le transpercer.
5.2 Superposition de la droite d’ajustement et des limites
Sur cette surface préalablement peuplée de ses observations empiriques, l’étape suivante réside dans la superposition analytique de la trajectoire estimée centrale. Cette opération s’exécute à l’aide de la fonction de liaison séquentielle lines(), qui prend pour arguments les abscisses régulières de la grille de calcul et les ordonnées estimées de la colonne centrale predictions_df$fit. L’épaisseur du trait de la droite de régression est substantiellement renforcée en appliquant l’argument lwd = 2, conférant à la tendance centrale une visibilité immédiate qui s’affirme comme le point d’ancrage géométrique du graphique.
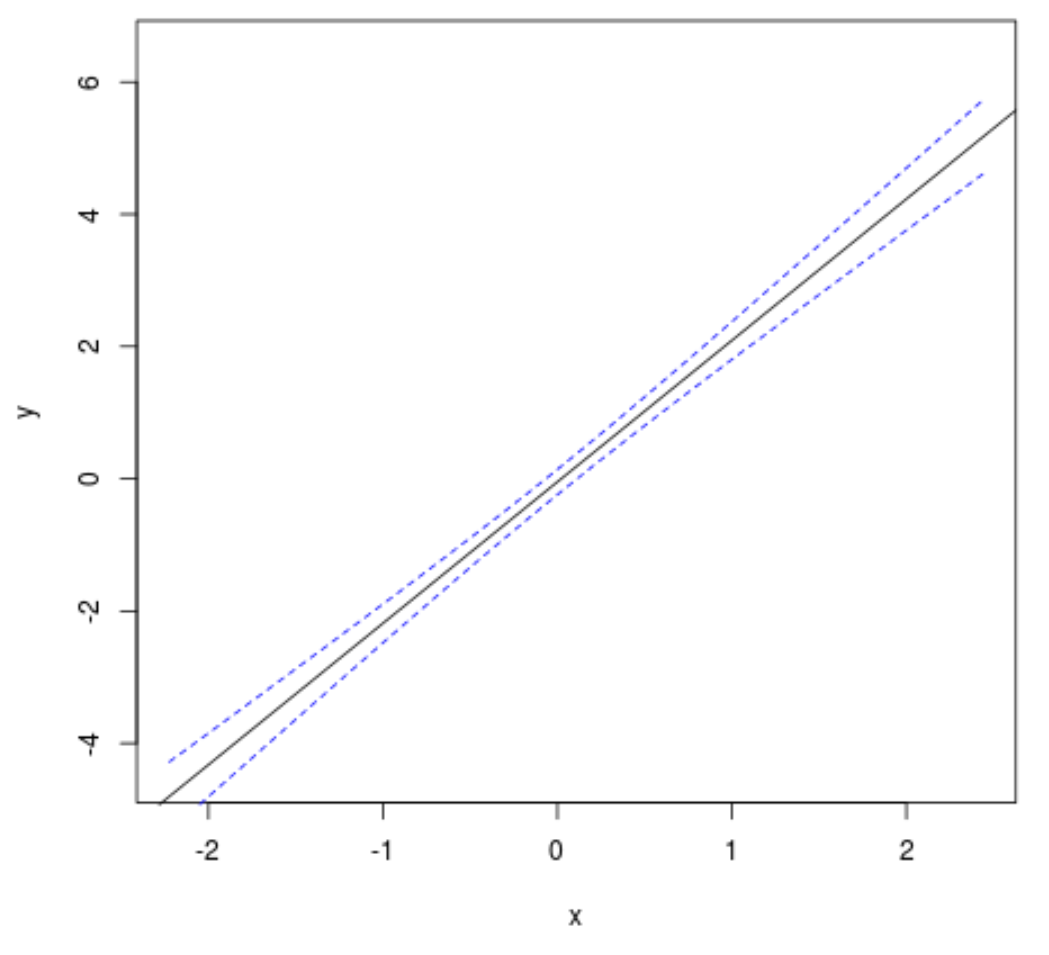
L’incertitude d’échantillonnage entourant cette trajectoire moyenne est ensuite visualisée par le tracé conjoint des deux frontières stochastiques inférieure et supérieure. L’analyste effectue deux appels successifs à la primitive lines() : le premier connectant les coordonnées (predictions_df$x, predictions_df$lwr) et le second les coordonnées (predictions_df$x, predictions_df$upr). Pour matérialiser visuellement la nature probabiliste et non déterministe de ces limites structurelles, le motif de ligne est configuré en pointillés au moyen de la directive lty = 2 ou lty = 3.
Le rendu obtenu à ce stade expose clairement la courbure hyperbolique théorique de l’intervalle de confiance d’une régression simple. Les frontières se resserrent nettement à proximité immédiate de la moyenne empirique de la variable explicative X — le barycentre de l’échantillon où l’information informationnelle est maximale — et divergent progressivement à mesure que l’on s’écarte vers les valeurs extrêmes du domaine observé. Cette forme caractéristique illustre concrètement l’incertitude accrue qui pèse sur l’estimation de la pente globale dès lors que l’on s’aventure vers les zones périphériques des données empiriques.
6. Optimisation visuelle en Base R : Ajout d’une bande ombrée
6.1 Géométrie vectorielle de la zone de confiance avec polygon()
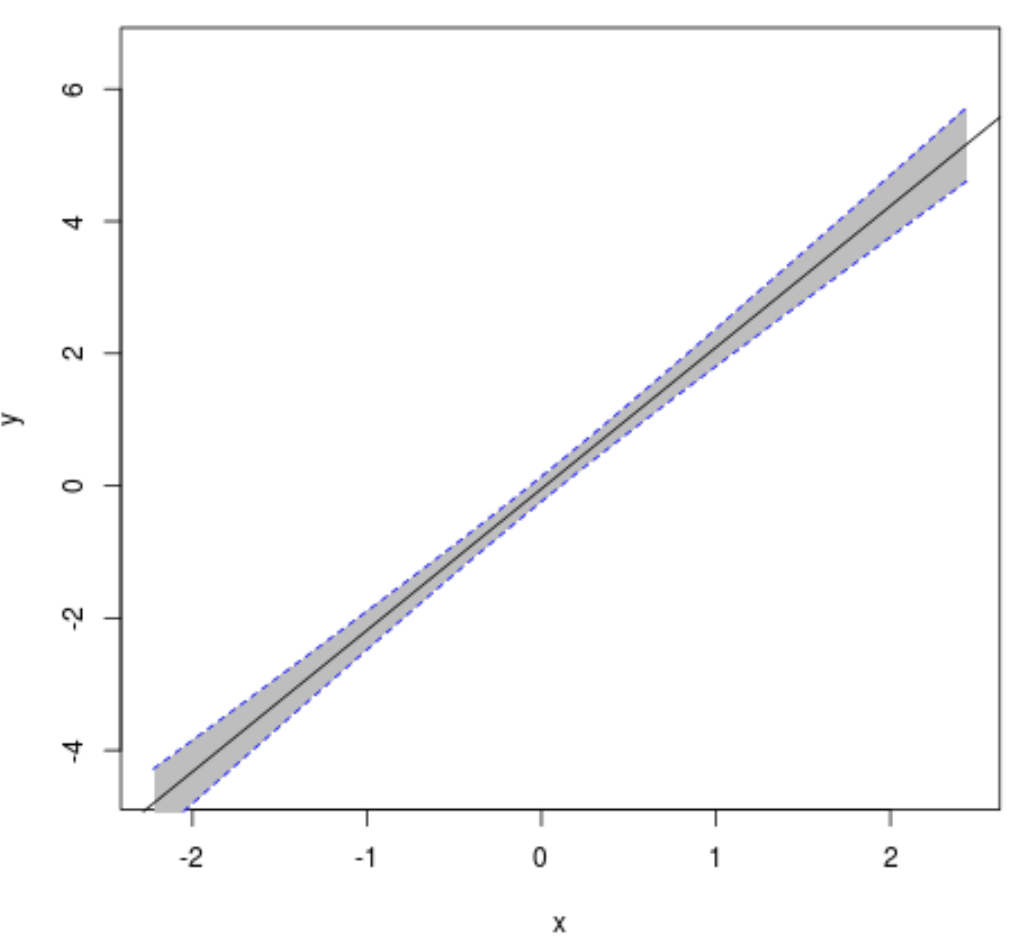
Bien que le traçage de lignes pointillées délimite formellement les seuils stochastiques d’exclusion, la perception cognitive de l’incertitude est considérablement accrue par l’adjonction d’une surface ombragée continue remplissant l’espace délimité par les bornes. Dans le système graphique natif de Base R, cette opération repose sur la géométrie vectorielle de la fonction primitive polygon(). Cet opérateur algorithmique construit un polygone fermé en reliant séquentiellement une chaîne de coordonnées cartésiennes en deux dimensions, puis applique un aplat chromatique à la surface circonscrite par ce contour fermé.
La difficulté majeure rencontrée lors de l’utilisation de polygon() réside dans le bon ordonnancement des vecteurs d’abscisses et d’ordonnées. Si un utilisateur tente d’injecter successivement le vecteur d’abscisses direct pour la borne inférieure puis à nouveau le vecteur d’abscisses direct pour la borne supérieure, le moteur de tracé créera un entrecroisement polygonal erroné ressemblant à un sablier ou à un nœud papillon distordu. Pour fermer topologiquement le polygone de manière fluide, le contour doit parcourir la limite inférieure de gauche à droite, puis remonter vers la limite supérieure pour la parcourir de droite à gauche, revenant ainsi naturellement à son point de départ sans aucune coupure.
Cette boucle topologique s’exécute avec élégance en inversant la séquence des coordonnées de la borne supérieure grâce à la commande native rev(). Ainsi, le vecteur global des coordonnées en abscisse s’écrit formellement : c(predictions_df$x, rev(predictions_df$x)). De manière strictement analogue et symétrique, le vecteur global des ordonnées appariées se formule par la concaténation de la borne inférieure directe et de la borne supérieure inversée : c(predictions_df$lwr, rev(predictions_df$upr)). L’appel de l’instruction polygon(x = c(predictions_df$x, rev(predictions_df$x)), y = c(predictions_df$lwr, rev(predictions_df$upr)), border = NA) remplit alors parfaitement la surface continue de l’intervalle d’estimation sans tracer de bordures parasites indésirables.
6.2 Gestion de la transparence et typographie des axes
Un écueil visuel fréquent lors de l’emploi de zones de remplissage opaques réside dans le masquage destructeur des points de données sous-jacents. Dans la mesure où les primitives graphiques de Base R sont appliquées par superposition successive, le dépôt d’un aplat de couleur standard dissimule définitivement les observations empiriques situées à l’intérieur du corridor d’incertitude. La résolution de ce conflit graphique repose sur l’exploitation du canal de transparence alpha dans la définition de l’espace chromatique, implémenté au sein de la fonction rgb().
En formulant la couleur sous la forme col = rgb(0.2, 0.4, 0.8, alpha = 0.25), l’analyste crée un bleu teinté d’une transparence de 75 %. Cette perméabilité optique garantit que les observations situées au centre du nuage de points demeurent parfaitement lisibles à travers la bande de confiance ombrée. Il convient par ailleurs d’organiser méthodiquement la chronologie d’exécution du script : tracer d’abord le canevas vierge, appliquer en deuxième lieu le polygone ombré transparent, redessiner en troisième étape la droite de régression centrale, et projeter en dernier lieu le nuage de points afin que les glyphes conservent une netteté de contour irréprochable au premier plan.
L’optimisation esthétique s’achève par la professionnalisation de l’appareil paratextuel et typographique. L’abandon des libellés par défaut générés automatiquement par R est obligatoire dans tout travail à visée de publication. L’utilisation des primitives title() et axis() permet de contrôler la taille des fontes (cex.lab = 1.1, cex.axis = 0.9), l’orientation des chiffres pour une lecture horizontale ergonomique (las = 1), et l’insertion d’une légende explicative rigoureuse via la commande legend(). Cette dernière doit impérativement spécifier la nature du modèle linéaire, l’estimation ponctuelle de la droite et la couverture exacte de la bande ombrée, explicitant le seuil alpha retenu (par exemple, « Intervalle de confiance à 95 % »).
7. Mise en œuvre moderne avec le formalisme ggplot2
7.1 Approche automatisée via geom_smooth()
L’écosystème contemporain du tidyverse et en particulier la bibliothèque ggplot2, formalisée par Hadley Wickham sur la base des travaux théoriques de Leland Wilkinson, ont révolutionné la production graphique scientifique en substituant au modèle de la toile de peintre une syntaxe déclarative et compositionnelle. L’intégration d’un intervalle de confiance pour une régression linéaire simple y atteint un niveau d’abstraction remarquable, permettant d’obtenir un résultat standardisé et esthétiquement abouti en une seule instruction analytique articulée autour de la fonction geom_smooth().
Dans cette approche déclarative, l’utilisateur associe d’abord les variables du tableau de données aux canaux esthétiques fondamentaux par l’opérateur ggplot(donnees, aes(x = x, y = y)) + geom_point(alpha = 0.6). L’adjonction de l’enveloppe de confiance s’effectue ensuite par la greffe directe de la composante de lissage : geom_smooth(method = "lm", level = 0.95, se = TRUE, color = "darkblue", fill = "lightblue", alpha = 0.3). Le moteur sous-jacent orchestre de manière entièrement automatique l’ajustement du modèle des moindres carrés en coulisses, calcule la matrice de projection sur une grille régulière interpolée, génère le polygone ombré avec la transparence souhaitée et trace la droite d’ajustement centrale.
L’opérateur conserve une maîtrise paramétrique intégrale via les arguments de contrôle de la fonction. L’argument method = "lm" force la contrainte de linéarité stricte, évitant l’application par défaut d’une régression non paramétrique locale de type LOESS adaptée aux petits volumes de données. L’argument booléen se = TRUE valide explicitement l’affichage du ruban de variance, tandis que le paramètre level permet de faire varier instantanément l’amplitude de la couverture stochastique, par exemple en la fixant à 0,99 pour un niveau de conservatisme accru à 99 %. Cette compacité syntaxique réduit considérablement les risques d’erreurs arithmétiques lors de la manipulation manuelle des bornes.
7.2 Approche manuelle explicite avec geom_ribbon()
Malgré l’efficacité indéniable de l’automatisation proposée par geom_smooth(), la modélisation statistique avancée confronte fréquemment le chercheur à des architectures empiriques où le calcul automatique s’avère inapplicable. C’est notamment le cas lors de l’application de corrections pour hétéroscédasticité, de modélisations non linéaires personnalisées, d’ajustements pondérés ou de régressions pénalisées où ggplot2 ne sait pas spontanément extraire la matrice de variance-covariance exacte. Dans ces scénarios méthodologiques rigoureux, l’approche manuelle explicite via geom_ribbon() devient incontournable.
Cette méthodologie dissocie rigoureusement la phase computationnelle de la phase d’affichage graphique. L’analyste mobilise d’abord la matrice de prédiction préalablement consolidée dans le tableau predictions_df issu de l’appel explicite à predict(modele, interval = "confidence"). La géométrie geom_ribbon() est ensuite greffée sur le graphique en liant de façon transparente les variables d’abscisse et les deux limites stochastiques au sein du mappage esthétique local : geom_ribbon(data = predictions_df, aes(x = x, ymin = lwr, ymax = upr), fill = "grey70", alpha = 0.4, inherit.aes = FALSE). L’argument inherit.aes = FALSE garantit qu’aucune contamination de variables non définies ne provienne de l’appel initial à la fonction ggplot().
La droite centrale est adjointe au moyen d’un appel distinct à geom_line(data = predictions_df, aes(x = x, y = fit), color = "black", linewidth = 1), tandis que les données d’observation sont superposées par geom_point(data = donnees, aes(x = x, y = y)). Cette décomposition confère une flexibilité absolue à l’analyste. Il peut ainsi harmoniser l’environnement graphique global en adoptant un thème épuré conforme aux exigences éditoriales internationales, tel que theme_classic() ou theme_minimal(), en personnalisant la taille des typographies et la disposition des axes pour une lisibilité optimale dans les formats imprimés.
8. Distinction critique : Intervalle de confiance vs Intervalle de prédiction
8.1 Divergence conceptuelle et formulation mathématique
L’une des ambiguïtés théoriques les plus préjudiciables constatées dans la restitution des modélisations linéaires concerne la superposition floue entre intervalle de confiance et intervalle de prédiction. Bien que ces deux instruments stochastiques s’expriment dans les mêmes unités métriques et dérivent du même modèle de régression sous-jacent, leurs fondements épistémologiques et leurs formulations mathématiques répondent à des questionnements radicalement divergents quant à la nature de la variabilité mesurée.
L’intervalle de confiance vise l’estimation de l’espérance conditionnelle mathématique, soit la moyenne de la sous-population des individus partageant une valeur déterminée de la covariable x. Son incertitude ne découle exclusivement que des fluctuations d’échantillonnage qui affectent la précision de l’estimation de l’ordonnée à l’origine et de la pente. Si la taille de l’échantillon n croissait vers l’infini, les coefficients convergeraient avec une variance tendant vers zéro, et la largeur de l’intervalle de confiance pour l’espérance s’amenuiserait asymptotiquement pour ne plus former qu’une ligne infiniment fine, coïncidant exactement avec la véritable droite paramétrique de la population.
À l’inverse, l’intervalle de prédiction ambitionne de borner la valeur probabiliste d’une observation individuelle future non encore mesurée (Y_nouveau). L’incertitude globale intègre alors nécessairement deux composantes additives indépendantes : d’une part, l’incertitude liée à l’estimation de la moyenne de la sous-population (la variance de l’espérance conditionnelle), et d’autre part, la variance résiduelle intrinsèque propre aux individus, modélisée par le paramètre d’aléa stochastique sigma carré. Même en supposant un échantillon de taille infinie où la droite théorique serait connue sans la moindre incertitude, l’intervalle de prédiction conserverait une largeur finie incompressible égale à deux fois le quantile critique multiplié par l’écart-type résiduel sigma. Ignorer cette variance résiduelle non réductible conduit à des jugements dramatiquement erronés lors du diagnostic individuel ou de l’évaluation de risques opérationnels.
8.2 Représentation simultanée des deux bandes sur un même graphique
La confrontation visuelle directe des deux enveloppes sur une même planche cartésienne offre une formidable plus-value didactique et méthodologique. Elle permet de conscientiser immédiatement le différentiel d’amplitude séparant l’incertitude sur la trajectoire moyenne de l’incertitude pesant sur le comportement d’un individu isolé. Pour concrétiser cette comparaison sous R, l’analyste procède à une double interrogation de la commande predict() sur la grille continue d’évaluation, en spécifiant d’abord interval = "confidence" puis interval = "prediction".
Les matrices extraites sont ensuite assemblées méthodiquement dans un tableau unifié. Sur le plan de la grammaire visuelle, il est recommandé de superposer les géométries de façon hiérarchisée : l’enveloppe de prédiction, structurellement beaucoup plus vaste, est dessinée en arrière-plan avec une teinte de saturation faible ou sous forme de lignes tiretées espacées. L’enveloppe de confiance, nettement plus étroite et concentrée autour de la ligne de tendance centrale, est ensuite apposée au premier plan avec une tonalité chromatique plus dense et contrastée, évitant ainsi que l’incertitude globale ne masque l’incertitude moyenne.
L’élaboration d’une légende comparative explicite constitue le garant ultime de l’intelligibilité de la figure. En recourant au formalisme de ggplot2, l’analyste peut concaténer les estimations dans un format long (tidy format) ou assigner manuellement des arguments esthétiques constants dans les fonctions geom_ribbon() en liant la couleur de remplissage à une étiquette textuelle distincte. Cette pratique permet au moteur graphique de concevoir automatiquement une échelle typographique séparant « Intervalle de confiance de la moyenne (95 %) » et « Intervalle de prédiction individuelle (95 %) », éliminant formellement tout risque de confusion chez les lecteurs du rapport d’étude.
9. Intervalles de confiance pour facteurs catégoriels et comparaisons de moyennes
9.1 Estimation des intervalles de moyennes intra et inter-groupes
Dans de nombreuses configurations expérimentales, notamment dans les devis factoriels déployés en sciences comportementales et biomédicales, les variables explicatives ne se présentent pas sous la forme de continuums linéaires mais sous celle de facteurs discrets partitionnant les observations en plusieurs groupes de comparaison. L’estimation des intervalles de confiance associés à la moyenne arithmétique de chaque condition implique le calcul minutieux de l’erreur type de la moyenne, formalisée par l’écart-type de l’échantillon divisé par la racine carrée du nombre d’unités d’observation du groupe considéré.
Une distinction statistique d’une importance capitale doit être opérée selon que l’architecture expérimentale relève d’un plan à mesures indépendantes (inter-sujets) ou d’un plan à mesures répétées (intra-sujets). Dans un plan inter-sujets, la dispersion des scores reflète simultanément la variabilité interindividuelle stable et les effets propres du traitement. Dans un protocole intra-sujets, où chaque participant est soumis successivement à l’ensemble des conditions expérimentales, l’intérêt statistique se focalise exclusivement sur les variations relatives au sein de chaque individu, la variance interindividuelle baseline agissant comme une variance parasite non pertinente pour les comparaisons appariées.
L’application d’un intervalle de confiance conventionnel sur des données appariées constitue une faute méthodologique conduisant à une surévaluation drastique de la marge d’erreur visuelle. La méthodologie de normalisation de Cousineau-Morey résout cette distorsion en soustrayant préalablement à chaque observation le score moyen individuel du sujet à travers toutes les conditions, avant de réassigner la moyenne générale de l’expérience, complétée d’un facteur de correction mathématique ajusté au nombre de conditions factorielles. De surcroît, lors de la réalisation de contrastes multiples simultanés post hoc, le recours à des ajustements de type Tukey ou Bonferroni s’avère indispensable pour garantir que le taux nominal de couverture de la famille d’intervalles demeure égal au seuil préétabli de 95 %.
9.2 Visualisation par barres d’erreur avec geom_errorbar()
La transcription graphique de moyennes discrètes assorties de leurs incertitudes s’affranchit des rubans continus au profit de géométries ponctuelles dotées de barres d’erreur verticales. L’agrégation préalable des données, exécutée commodément au moyen des verbes group_by() et summarise() du paquet dplyr, génère un tableau condensé référençant pour chaque condition factorielle la moyenne empirique, l’écart-type, le volume d’échantillonnage et les bornes d’inférence calculées en multipliant l’erreur type par le quantile critique approprié de la loi de Student.
Sous ggplot2, le déploiement de ces éléments s’articule autour de l’instruction geom_errorbar(), interconnectée à geom_point(). L’analyste configure le mappage esthétique en associant les colonnes de calcul aux arguments ymin et ymax : geom_errorbar(aes(ymin = moyenne - marge_erreur, ymax = moyenne + marge_erreur), width = 0.15, linewidth = 0.7, color = "black"). Le calibrage scrupuleux de l’argument width est essentiel : des empattements horizontaux excessifs surchargent le graphique, tandis qu’une largeur modérée confère à la barre d’erreur une finition géométrique claire et élégante.
Lorsque le protocole intègre une interaction factorielle entre deux variables catégorielles, la stratégie graphique repose sur l’introduction d’un décalage spatial horizontal afin de prévenir le chevauchement destructeur des barres d’erreur alignées sur la même coordonnée d’abscisse. L’utilisation de l’argument position = position_dodge(width = 0.3) au sein des géométries geom_point(), geom_line() et geom_errorbar() garantit une séparation visuelle parfaite des groupes expérimentaux. La combinaison harmonieuse de ces primitives permet d’appréhender instantanément la nature des interactions factorielles, facilitant l’évaluation clinique des écarts entre conditions sans introduire d’ambiguïté visuelle sur la magnitude des incertitudes.
10. Approches non-paramétriques : Intervalles de confiance par rééchantillonnage (Bootstrap)
10.1 Principes du bootstrap en présence de distribution non normale
Les dérivations analytiques classiques gouvernant l’établissement des intervalles de confiance reposent invariablement sur l’hypothèse de normalité des distributions sous-jacentes ou sur l’application mécanique du théorème central limite pour les grands échantillons. Néanmoins, dans une multitude de contextes empiriques réels — distributions fortement asymétriques des temps de réaction, scores bornés par des effets de plancher ou de plafond, proportions extrêmes ou paramètres mathématiques complexes pour lesquels aucune formule close d’erreur type n’existe (médianes, quantiles, rapports de cotes) — l’inférence paramétrique conventionnelle s’effondre et produit des taux de couverture empiriques s’écartant dramatiquement de la valeur nominale visée.
Introduite par Bradley Efron en 1979, la théorie non paramétrique du rééchantillonnage par bootstrap s’affranchit de toute conjecture aprioriste quant à la forme analytique de la population générale. Le postulat philosophique fondateur postule que l’échantillon empirique collecté constitue la meilleure approximation tangible disponible de la population inconnue. Dès lors, le mécanisme fondamental d’échantillonnage à partir de la population peut être fidèlement simulé par un tirage répété avec remise au sein même de l’échantillon initial, préservant la taille d’observation n à chaque itération algorithmique.
Sous R, l’architecture computationnelle de cette approche est prise en charge de manière optimale par le paquet spécialisé boot. L’analyste conçoit une fonction dédiée retournant la métrique statistique d’intérêt, dont les arguments reçoivent successivement le jeu de données d’origine et un vecteur d’indices stochastiques d’itération généré par le système de tirage. L’instruction pilote boot(data = donnees, statistic = fonction_statistique, R = 2000) exécute alors deux mille rééchantillonnages indépendants, construisant empiriquement une distribution d’échantillonnage artificielle à partir de laquelle les erreurs types et les déviations empiriques sont directement quantifiées sans faire appel à la loi normale.
10.2 Extraction et tracé des intervalles bootstrap
À partir de la distribution empirique générée par les réplicats bootstrap, l’extraction des intervalles de confiance requiert une attention méthodologique particulière quant à la méthode d’approximation retenue. L’interrogation de l’objet résultat s’exécute à travers la commande boot.ci(), qui propose une gamme de méthodes de calcul allant de l’intervalle percentile standard jusqu’aux formulations avancées intégrant des ajustements stochastiques fins.
Si la méthode des percentiles consiste simplement à isoler les coupures empiriques correspondant aux quantiles 2,5 % et 97,5 % de la distribution des réplicats, elle demeure vulnérable aux biais d’estimation et à l’hétéroscédasticité sous-jacente. Pour surmonter ces écueils, l’algorithme BCa (Bias-Corrected and accelerated) est universellement recommandé dans la littérature académique. Cette méthodologie calcule un paramètre d’ajustement du biais médian et un coefficient d’accélération mesurant la dépendance de l’erreur type vis-à-vis du paramètre, ajustant dynamiquement la position des percentiles de coupure pour assurer une couverture probabiliste d’une précision mathématique irréprochable même en présence d’asymétries résiduelles prononcées.
Le portage visuel de ces enveloppes bootstrap sur une régression ou une distribution univariée s’effectue en projetant directement les bornes quantiles empiriques ainsi obtenues. Dans le cas d’une régression non paramétrique, l’analyste peut générer une enveloppe polygonale complète en calculant les intervalles BCa sur chaque point d’une grille continue d’évaluation, puis en raccordant ces coordonnées locales via geom_ribbon() sous ggplot2. Le polygone résultant épouse fidèlement les asymétries réelles de l’incertitude d’échantillonnage, matérialisant visuellement un intervalle dont l’épaisseur peut être asymétrique par rapport à l’estimation centrale, reflétant la véritable structure stochastique sous-jacente des données analysées.
11. Extension aux modèles linéaires généralisés et modèles mixtes
11.1 Intervalles de confiance dans les régressions logistiques et de Poisson
L’inférence statistique sur des variables de réponse binaires, catégorielles ou de comptage s’opère dans le cadre unifié des modèles linéaires généralisés (GLM), au sein desquels l’espérance de la réponse est reliée à une combinaison linéaire de covariables par l’intermédiaire d’une fonction de lien monotone non linéaire. Dans une régression logistique binaire, par exemple, la fonction logit relie la probabilité de survenue d’un événement à l’échelle continue non bornée des logarithmes de cotes (log-odds). Le traçage d’un intervalle de confiance sur ces modèles confronte l’analyste à un problème géométrique fondamental : l’incertitude ne peut pas être calculée symétriquement sur l’échelle finale des probabilités, bornée par construction mathématique stricte entre 0 et 1.
L’erreur méthodologique classique consiste à invoquer prématurément le calcul des prédictions sur l’échelle de réponse (type = "response") et à tenter de construire les bornes d’incertitude en ajoutant et soustrayant deux fois l’erreur type calculée sur cette échelle. Une telle approximation produit une distorsion géométrique sévère et peut générer des bornes absurdes excédant les limites mathématiques de l’intervalle unité [0, 1]. La procédure formelle rigoureuse impose d’extraire les prédictions et leurs erreurs types exclusivement sur l’échelle du lien linéaire non borné en paramétrant l’appel : predict(modele_glm, newdata = grille, type = "link", se.fit = TRUE).
Sur cette échelle du prédicteur linéaire, la distribution d’échantillonnage de l’estimation ponctuelle est symétrique et asymptotiquement normale. L’analyste y calcule les bornes stochastiques inférieure et supérieure par simple translation linéaire : borne_lwr_link <- fit - 1.96 * se.fit et borne_upr_link <- fit + 1.96 * se.fit. L’ultime étape consiste à projeter simultanément l’estimation ponctuelle et les deux frontières calculées vers l’échelle des probabilités en appliquant la transformation mathématique réciproque, c’est-à-dire la fonction logistique inverse : plogis(). La représentation graphique de ces vecteurs transforme la bande linéaire en une sigmoïde d’incertitude asymétrique et naturellement contenue à l’intérieur de l’espace probabiliste admissible, illustrant avec rigueur la dynamique non linéaire du phénomène étudié.
11.2 Visualisation dans les modèles à effets mixtes
L’analyse de données hiérarchiques, longitudinales ou structurées en grappes (élèves nichés dans des classes, mesures répétées sur des patients) mobilise l’appareil formel des modèles linéaires mixtes, articulés autour du paquet canonique lme4. La complexité inhérente à ces modèles réside dans la partition de la variance entre des effets fixes globaux, partagés par l’ensemble de la population, et des effets aléatoires spécifiques décrivant les déviations structurelles propres à chaque grappe ou individu. Visualiser un intervalle de confiance dans ce paradigme confronte le modélisateur à un dilemme théorique : l’incertitude représentée doit-elle refléter la trajectoire marginale de la population ou la trajectoire conditionnelle spécifique d’une unité observée ?
L’extraction de l’incertitude sur la trajectoire moyenne de population requiert l’isolation des effets fixes et de leur matrice de variance-covariance globale, en neutralisant mathématiquement les composantes de variance aléatoire. Des bibliothèques spécialisées dans le post-traitement de modèles statistiques complexes, à l’instar de ggeffects ou de marginaleffects, automatisent ces calculs matriciels en employant des méthodes d’approximation fiables des degrés de liberté, telles que les ajustements de Satterthwaite ou de Kenward-Roger. Ces fonctions permettent de projeter sur une grille de valeurs de covariables l’enveloppe marginale exacte de la population en tenant compte de la corrélation intra-classe.
D’un point de vue de l’architecture graphique sous ggplot2, la visualisation combinée offre une puissance d’analyse remarquable en superposant sur le même plan cartésien les trajectoires conditionnelles individuelles tracées en lignes fines et translucides (via geom_line(aes(group = identifiant), alpha = 0.2)) et l’enveloppe marginale épaisse représentant l’effet moyen fixe de population encadré de son ruban de confiance transparent obtenu par geom_ribbon(). Cette cohabitation spatiale documente avec exhaustivité la tendance générale de la cohorte tout en révélant l’ampleur de l’hétérogénéité individuelle, fournissant une vue synoptique d’une richesse informationnelle inaccessible par de simples synthèses tabulaires.
12. Normes de publication scientifique et rigueur méthodologique
12.1 Conformité avec les directives éditoriales et APA 7
La finalisation d’un graphique destiné à la soumission dans une revue scientifique à comité de lecture nécessite une conformité rigoureuse avec les standards éditoriaux internationaux, particulièrement ceux énoncés par l’APA dans sa septième édition. L’une des exigences primordiales stipule que tout élément graphique porteur d’incertitude doit être explicitement documenté dans le corps textuel de la légende ou dans la note de bas de figure. L’analyste doit formellement préciser la métrique exacte projetée : il est rigoureusement proscrit de laisser le lecteur supposer si des barres d’erreur représentent des écarts-types descriptifs, des erreurs types de la moyenne, ou des intervalles de confiance à 90 %, 95 % ou 99 %.
Une vigilance épistémologique accrue s’impose quant à l’interprétation comparative visuelle d’intervalles de confiance adjacents. Un piège d’interprétation universellement documenté réside dans la déduction erronée qu’un chevauchement visuel partiel entre deux intervalles de confiance à 95 % implique l’absence de différence statistiquement significative entre deux moyennes. D’un point de vue mathématique, deux moyennes indépendantes peuvent présenter une divergence significative au seuil alpha conventionnel de 0,05 alors même que leurs intervalles de confiance à 95 % respectifs se chevauchent sur une proportion pouvant atteindre près de 25 % de leur étendue globale. Lorsque l’objectif réside dans la comparaison directe entre conditions, l’affichage de l’intervalle de confiance de la différence entre moyennes est infiniment plus rigoureux que la juxtaposition de deux intervalles indépendants.
Le contrôle des spécifications techniques du rendu graphique constitue l’ultime étape précédant l’intégration manuscrite. Les maisons d’édition scientifique imposent une résolution spatiale minimale de 300 à 600 points par pouce (DPI) pour les images matricielles afin d’éviter toute pixellisation dégradante lors de l’impression physique. Toutefois, la recommandation méthodologique préférentielle réside dans l’exportation des figures sous forme vectorielle pure en utilisant les formats PDF, EPS ou SVG via la commande ggsave("figure1.pdf", device = cairo_pdf, width = 7, height = 5, units = "in"). Cette approche préserve la netteté mathématique absolue de chaque segment de courbe, de chaque glyphe et de chaque caractère typographique, quelle que soit l’échelle finale de reproduction.
12.2 Garantir la reproductibilité du code source
L’intégrité de la recherche contemporaine exige que chaque visualisation graphique publiée soit rigoureusement adossée à un script computationnel vérifiable et réexécutable par la communauté des pairs. L’intégration de scripts dans des architectures de programmation lettrée — telles que les documents computationnels Quarto ou R Markdown — garantit que les calculs statistiques matriciels, l’ajustement des modèles sous-jacents et les instructions de rendu graphique demeurent organiquement imbriqués dans le texte narratif sans risque de déconnexion chronologique ou d’erreur humaine de copier-coller.
L’archivage pérenne des versions de l’environnement R représente un prérequis indispensable pour pallier l’obsolescence logicielle. Les paquets graphiques et computationnels évoluent continuellement, et des modifications mineures d’implémentation peuvent, après quelques années, altérer la reproductibilité exacte d’un graphique. L’utilisation du package renv permet de figer l’arbre des dépendances dans un fichier de verrouillage (lockfile), assurant que n’importe quel chercheur téléchargeant le répertoire d’analyse pourra réinstancier instantanément un environnement de travail aux versions logicielles strictement identiques à celles mobilisées par l’auteur original.
La structuration modulaire des scripts constitue le gage ultime d’une science ouverte et transparente. L’analyste veille à fragmenter son pipeline de traitement en étapes indépendantes et commentées : importation et assainissement des données brutes, ajustement des modèles statistiques, extraction des prédictions matricielles, et génération finale des visualisations. Le dépôt public de ce corpus computationnel sur des serveurs certifiés de science ouverte, tels que l’Open Science Framework (OSF) ou Zenodo, adossé à un identifiant d’objet numérique (DOI), confère aux visualisations statistiques une autorité méthodologique indiscutable et participe activement à la consolidation de la confiance publique dans la recherche empirique.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap Methods and their Application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Fox, J., & Weisberg, S. (2019). An R Companion to Applied Regression (3rd ed.). SAGE Publications.
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
- R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0