
L’analyse des données empiriques contemporaines, particulièrement au sein des sciences comportementales, cognitives et biomédicales, confronte continuellement les chercheurs à des dynamiques non linéaires d’une grande complexité. Si le modèle de régression linéaire simple demeure l’outil d’initiation privilégié et la référence fondamentale pour évaluer l’association entre une variable prédictive et une variable de réponse, il postule une constance du taux de variation qui s’avère fréquemment violée par la réalité des processus naturels. L’incapacité d’une droite à capturer des phases d’accélération, des rendements décroissants, des effets de saturation ou des inversions de polarité conduit inévitablement à une sous-spécification du modèle théorique, générant des résidus structurés et faussant l’inférence statistique. Face à cette limite, la régression polynomiale s’affirme comme une extension directe, flexible et rigoureuse du cadre linéaire général, permettant d’épouser les courbures sous-jacentes sans quitter la sécurité mathématique des moindres carrés ordinaires.
Au-delà de la simple estimation numérique de coefficients d’ordre supérieur, la représentation graphique de ces ajustements constitue une étape essentielle de la démarche scientifique. L’environnement computationnel R, enrichi par des décennies de développement statistique et par une communauté académique d’envergure internationale hébergée sur le réseau CRAN (Comprehensive R Archive Network), offre une infrastructure inégalée pour formaliser, calibrer et visualiser ces trajectoires non linéaires. Qu’il s’agisse du moteur graphique originel dit « Base R », remarquable par sa rapidité d’exécution et son contrôle granulaire des primitives vectorielles, ou de l’écosystème moderne fondé sur la grammaire des graphiques via le paquet ggplot2, le statisticien dispose d’outils puissants pour communiquer des résultats complexes avec une fidélité typographique irréprochable.
Ce guide exhaustif a pour vocation d’explorer l’intégralité du processus méthodologique et informatique présidant au tracé d’une courbe de régression polynomiale dans l’environnement R. En parcourant les soubassements de l’algèbre linéaire, la gestion de la multicolinéarité par orthogonalisation, les subtilités algorithmiques de l’ordonnancement vectoriel pour éviter les aberrations de tracé, ainsi que l’intégration rigoureuse des bandes d’incertitude et des diagnostics résiduels, cet article propose une trajectoire d’apprentissage intégrée. Conçu pour répondre aux exigences des revues académiques à fort impact et aux standards de la science ouverte reproductible, il permettra à tout analyste de transformer des nuages de points amorphes en démonstrations géométriques probantes et conformes aux meilleures pratiques scientifiques.
1. Fondements théoriques de la régression polynomiale et pertinence en sciences comportementales
1.1 Définition et formulation mathématique du modèle polynomial
La régression polynomiale d’ordre k constitue une forme spécifique de régression linéaire multiple où la variable dépendante continue Y est modélisée en fonction des puissances successives d’une variable explicative unique X. D’un point de vue formel, l’équation s’écrit sous la forme mathématique suivante : Y = bêta_0 + bêta_1 * X + bêta_2 * X^2 + … + bêta_k * X^k + epsilon, où bêta_0 représente l’ordonnée à l’origine (intercept), bêta_1 à bêta_k désignent les coefficients de régression partielle associés aux degrés polynomiaux respectifs, et epsilon symbolise le terme d’erreur stochastique, classiquement supposé distribué selon une loi normale centrée d’espérance nulle et de variance constante sigma carré.
Il est crucial de dissiper une confusion théorique fréquente : bien que la trajectoire géométrique tracée dans le repère cartésien soit indiscutablement non linéaire, le modèle demeure intrinsèquement linéaire au sens statistique du terme. Cette linéarité ne renvoie pas à la forme de la courbe dans le plan, mais à la relation algébrique reliant les paramètres inconnus bêta aux observations. Dans la mesure où l’équation est linéaire par rapport aux coefficients d’intérêt, les estimateurs peuvent être calculés directement via l’estimateur analytique des moindres carrés ordinaires (MCO), formalisé par le produit matriciel classique impliquant l’inversion de la matrice de transition transposée. Ainsi, les propriétés asymptotiques, les estimateurs non biaisés à variance minimale décrits par le théorème de Gauss-Markov et les procédures d’inférence standardisées s’appliquent sans qu’il soit nécessaire de recourir aux algorithmes itératifs complexes de l’optimisation non linéaire générale.
Sur le plan géométrique, l’élévation au degré k confère à la fonction la capacité de décrire jusqu’à k moins un changements de direction ou extrema locaux. Un modèle de degré deux générera une parabole présentant un extremum absolu unique (sommet ou creux), tandis qu’un degré trois autorisera l’apparition d’un point d’inflexion où la concavité s’inverse, permettant de modéliser des dynamiques sigmoïdes partielles ou des régimes transitoires asymétriques. L’estimation par moindres carrés cherche à minimiser la somme des carrés des écarts verticaux entre les coordonnées observées et la surface polynomiale, garantissant une projection orthogonale optimale au sein du sous-espace vectoriel engendré par les colonnes de la matrice d’expérience.
1.2 Non-linéarité des dynamiques psychologiques et cognitives
Dans l’investigation empirique des sciences humaines et cognitives, la linéarité stricte constitue une exception plutôt qu’une norme biologique ou comportementale. Les systèmes psychologiques vivants sont caractérisés par des boucles de rétroaction, des capacités limitées de traitement de l’information et des contraintes homéostatiques qui imposent intrinsèquement des non-linéarités fonctionnelles. L’illustration la plus emblématique réside sans conteste dans la célèbre loi de Yerkes-Dodson, théorisée en psychologie expérimentale et en neurosciences comportementales, qui postule une relation en U inversé entre le niveau d’éveil physiologique (ou de stress) et la performance à une tâche cognitive complexe. Une activation modérée optimise la disponibilité des ressources attentionnelles, tandis qu’un éveil insuffisant induit la léthargie et qu’une surcharge émotionnelle précipite l’effondrement des fonctions exécutives.
D’autres dynamiques comportementales manifestent des courbures systématiques analogues. L’acquisition de compétences motrices ou linguistiques suit fréquemment une trajectoire logarithmique ou cubique, caractérisée par une progression fulgurante lors des phases initiales d’apprentissage, suivie d’un plateau asymptotique dû à la consolidation synaptique, parfois relayé par une reprise de progression à la suite de restructurations stratégiques méta-cognitives. De même, les phénomènes d’épuisement professionnel (burnout) ou de fatigue cognitive en ergonomie de travail ne progressent pas de façon constante : ils manifestent une relative résistance initiale avant qu’un seuil critique de vulnérabilité ne déclenche une détérioration abrupte de la performance.
Dans ce contexte méthodologique, imposer a priori une trajectoire linéaire à de telles données constitue une erreur épistémologique grave, susceptible de masquer des dynamiques fonctionnelles capitales. La régression polynomiale offre aux chercheurs une passerelle d’une élégance rare : elle autorise l’intégration paramétrique de ces courbures au sein d’un cadre mathématique d’une grande rigueur, sans contraindre l’analyste à formuler des hypothèses mécanistes ultra-spécifiques souvent prématurées aux stades exploratoires de la recherche fondamentale.
1.3 Limites de la linéarisation standard face aux effets de seuil
La persistance dans l’usage d’une modélisation linéaire droite face à des phénomènes empiriquement courbes génère des conséquences statistiques préjudiciables. En premier lieu, l’imposition arbitraire d’un degré un induit un biais d’omission de variable d’ordre supérieur, conduisant à une sous-estimation systématique de l’espérance mathématique dans certaines zones du domaine expérimental et à une surestimation dans d’autres. Les coefficients de pente linéaire résultants deviennent des moyennes pondérées spatialement dépendantes de la distribution de la variable d’abscisse, perdant toute interprétabilité universelle et compromettant irrémédiablement la validité interne des conclusions scientifiques.
En second lieu, la linéarisation forcée anéantit la détection des points de basculement critiques, communément désignés sous les termes de seuils de transition de phase ou d’extrema locaux. En recherche translationnelle ou en santé publique, déterminer l’abscisse exacte correspondant à l’effet maximal d’un entraînement ou au seuil de toxicité cognitive d’un agent stressant s’avère bien plus déterminant que de quantifier un coefficient d’accroissement moyen global. Un modèle linéaire est, par construction ontologique, aveugle à la dérivée seconde de la trajectoire, et s’avère incapable d’identifier la racine de la dérivée première où s’annule la vitesse d’évolution du système.
Enfin, l’empreinte de la non-linéarité non modélisée se répercute avec sévérité sur les distributions d’erreurs. Les résidus d’une régression linéaire ajustée sur un nuage de points curviligne manifestent une autocorrélation géométrique manifeste et une violation flagrante de l’hypothèse d’homoscédasticité. Les tests d’inférence classiques basés sur les statistiques t de Student ou F de Fisher perdent leur fiabilité nominale, augmentant de façon dramatique les taux d’erreur de première espèce (rejet à tort de l’hypothèse nulle) ou de seconde espèce. Modéliser explicitement la courbure par un polynôme adapté restaure la blancheur gaussienne des résidus et assure la conformité du modèle aux postulats fondamentaux de la modélisation statistique.
2. Préparation de l’environnement de travail et structuration des données sous R
2.1 Configuration de la session R et initialisation des graines aléatoires
L’exécution d’analyses computationnelles rigoureuses exige l’établissement d’un environnement de travail vierge de tout artefact résiduel. Au commencement de chaque script d’analyse statistique dans l’interpréteur R, il est impératif de s’assurer de l’état de la mémoire vive et de réinitialiser, si nécessaire, les dispositifs graphiques ouverts lors de sessions antérieures. Cette précaution garantit qu’aucune variable globale masquée ne viendra altérer l’assignation des futurs objets vectoriels. Une bonne pratique consiste également à consigner dans l’en-tête du document la version précise du moteur R exécuté, accessible via la consultation de l’objet système d’environnement, afin de prévenir les disparités potentielles d’implémentation entre générations de compilateurs.
La reproductibilité computationnelle constituant le socle indépassable de l’intégrité scientifique contemporaine, toute génération de variables stochastiques ou d’échantillonnages simulés doit être rigoureusement encapsulée. L’appel à la fonction interne d’initialisation du générateur de nombres pseudo-aléatoires via l’instruction set.seed() constitue ici une obligation méthodologique incontournable. En fixant un entier arbitraire immuable au sein de cet appel, le chercheur s’assure que les suites numériques pseudo-aléatoires générées par les algorithmes sous-jacents, tels que le générateur Mersenne Twister par défaut dans R, produiront rigoureusement la même trajectoire empirique lors de chaque réévaluation du script.
Cette démarche de traçabilité intégrale permet aux pairs, aux comités de lecture et aux collaborateurs scientifiques de dupliquer fidèlement à l’identique les visualisations générées, les tables d’analyse de variance et les métriques d’erreur. Elle s’inscrit au cœur des préconisations promues par les consortiums internationaux de science ouverte pour l’éradication de la crise de la reproductibilité en sciences quantitatives.
2.2 Simulation d’un jeu de données synthétique non linéaire
Pour appréhender de façon exhaustive la dynamique des ajustements polynomiaux sans subir les perturbations cryptiques inhérentes aux bruits de mesure expérimentaux non contrôlés, la construction d’un jeu de données synthétique présente une vertu pédagogique et méthodologique remarquable. Nous initialisons une variable continue explicative x couvrant un domaine comportemental défini, par exemple une échelle de temps ou un indice de stress gradué de zéro à dix. L’utilisation de la fonction runif() permet de prélever un échantillon de taille n égale à deux cents observations réparties de manière uniforme et continue le long de cet intervalle fermé.
Sur cette assise scalaire, nous construisons une fonction déterministe sous-jacente d’allure cubique, intégrant à la fois une courbure ascendante initiale, un point d’inflexion intermédiaire et une décélération terminale. Les coefficients mathématiques choisis arbitrairement fixent l’ordonnée à l’origine, la pente locale de premier ordre, l’accélération quadratique négative et la modulation cubique positive. Cette trajectoire idéale représente la vérité terrain (ground truth) du mécanisme psychologique ou physique sous-jacent, totalement inaccessible dans des conditions de recueil naturel.
Afin d’émuler les fluctuations biologiques, l’imprécision inhérente aux appareils de mesure et la variabilité interindividuelle idiosyncrasique, nous injectons un terme de perturbation aléatoire. Ce bruit blanc stochastique est généré par un échantillonnage via la fonction rnorm(), calibrée avec une moyenne de zéro et un écart-type rigoureusement paramétré pour correspondre à un rapport signal-sur-bruit réaliste. L’ensemble de ces vecteurs est ensuite agrégé au sein d’une structure de tableau de données optimisée de type data.frame, garantissant une organisation matricielle standardisée prête pour la manipulation analytique.
2.3 Exploration préalable et validation des dimensions vectorielles
Avant toute tentative d’ajustement ou d’invocation des procédures graphiques, un diagnostic scrupuleux de l’intégrité vectorielle du tableau de données simulé s’impose. La fonction summary(), appliquée conjointement à la fonction fivenum() de John Tukey, permet d’inspecter l’amplitude de chaque variable en restituant le minimum, le premier quartile, la médiane robuste, la moyenne arithmétique, le troisième quartile et le maximum observé. Cette vérification immédiate confirme que les bornes empiriques de la variable simulée respectent scrupuleusement le domaine de définition initialement théorisé.
Il convient également d’interroger la structure formelle de l’objet pour attester de l’absence totale de valeurs manquantes (valeurs désignées par la constante NA dans l’interpréteur). La présence occulte de données incomplètes au sein d’un vecteur peut déclencher des exclusions silencieuses de lignes lors des phases d’ajustement linéaire, altérant subséquemment l’alignement des indices matriciels lors de la réinjection des prédictions sur le canevas graphique. La fonction anyNA() permet d’exclure instantanément cette source d’erreur technique.
Enfin, l’évaluation des étendues scalaires renseigne l’expérimentateur sur les futures exigences de calibrage des axes cartésiens. En identifiant les valeurs extrêmes des coordonnées d’abscisse et d’ordonnée, le chercheur prépare les limites géométriques (xmin, xmax, ymin, ymax) indispensables pour empêcher que le tracé ultérieur de la courbe polynomiale n’outrepasse les bordures physiques de la fenêtre graphique active, garantissant ainsi une lisibilité sémiologique optimale dès la première esquisse visuelle.
3. Visualisation préliminaire du nuage de points avec le moteur graphique de base
3.1 Construction du nuage de points élémentaire via plot()
L’exploration visuelle de la relation bivariée débute par l’instanciation d’un canevas cartésien au moyen de la fonction générique plot(), appartenant au sous-système graphique natif de R. Dans sa syntaxe la plus fondamentale, cette fonction accepte en paramètres primaires les deux vecteurs continus correspondant respectivement aux coordonnées d’abscisse et d’ordonnée. Dès son exécution, le moteur graphique calcule automatiquement la portée des données, dresse les axes gradués, dispose les encadrements périmétriques et projette chaque observation sous la forme d’un point géométrique discret.
Néanmoins, une pratique scientifique rigoureuse proscrit l’usage des étiquettes par défaut, qui se contentent d’imprimer textuellement le nom des variables du script. Il est impératif d’enrichir l’appel par la spécification explicite des arguments xlab et ylab, accueillant des chaînes de caractères descriptives complètes, mentionnant sans ambiguïté la nature des grandeurs physiques ou psychologiques observées ainsi que leurs unités de mesure formelles. L’argument main permet quant à lui d’apposer un titre général situant l’objet de l’expérience, tandis que le sous-titre optionnel sub peut être mobilisé pour expliciter la taille de l’échantillon ou les conditions du protocole.
L’esthétique de l’environnement graphique peut également être affinée en modifiant le paramètre bty (box type). Alors que la configuration par défaut trace un rectangle complet enfermant le graphique sur ses quatre côtés, attribuer à cet argument la valeur textuelle « l » restreint le cadre aux seuls axes inférieur et gauche. Cette épuration sémiologique, largement préconisée par les théoriciens de la visualisation de données comme Edward Tufte, allège la charge cognitive du lecteur en supprimant l’encre superflue et en focalisant l’attention sur la disposition spatiale des données.
3.2 Optimisation esthétique et sémiologie graphique
L’affichage par défaut des points sous forme de cercles évidés fins noirs peut rapidement présenter des faiblesses sémiologiques, en particulier lorsque la densité des observations entraîne un chevauchement spatial massif, connu sous le terme d’overplotting. L’analyste gagne à mobiliser l’argument pch (plotting character) pour choisir des glyphes géométriques adaptés à la morphologie de son échantillon. Le choix du symbole pch = 16 (disque plein) ou pch = 21 (cercle doté d’un contour et d’un remplissage distincts) permet d’optimiser le contraste visuel perçu par l’observateur.
Pour moduler la saillance des points sans occulter les concentrations spatiales locales, le paramètre d’expansion scalaire cex (character expansion) doit être ajusté avec finesse. Une valeur inférieure à l’unité, telle que cex = 0.8, réduit la taille relative des symboles et permet de dissocier des observations contiguës qui auraient fusionné en une masse indistincte à l’échelle standard. Cette réduction dimensionnelle autorise une lecture granulaire de la dispersion locale et facilite la perception de l’hétérogénéité de la variance le long de l’axe structural.
La gestion chromatique constitue le troisième levier fondamental. L’utilisation de l’argument col permet d’abandonner le noir absolu au profit de nuances de gris feutrées ou de teintes académiques sobres (par exemple, des tons bleu marine ou ardoise). Mieux encore, l’adjonction d’un canal de transparence alpha, manipulable via la fonction adjustcolor(), confère aux disques pleins une translucidité élégante. Lorsque deux ou plusieurs points se superposent dans une même région cartésienne, l’accumulation de couches transparentes génère spontanément une saturation colorimétrique plus sombre, traduisant visuellement la fonction de densité bidimensionnelle des données empiriques.
3.3 Diagnostic visuel de la courbure et identification des tendances
L’examen minutieux du nuage de points préliminaire remplit une fonction heuristique irremplaçable dans le cycle de modélisation. C’est lors de cette inspection oculaire initiale que le statisticien recherche les signatures qualitatives de la non-linéarité. La présence de courbures tangentielles manifestes, d’infléchissements graduels ou d’asymptotes suggère d’emblée l’inadéquation d’un simple ajustement linéaire de degré un et oriente l’analyste vers le choix d’un degré polynomial pertinent.
À ce stade, l’intuition morphologique s’exerce à discriminer entre les familles de profils. Une trajectoire manifestant une convexité ou une concavité univoque sur l’ensemble de l’étendue des abscisses plaide en faveur d’un polynôme quadratique d’ordre deux, typique des modélisations de retours décroissants ou de plafonnements adaptatifs. En revanche, la détection conjointe d’une concavité initiale suivie d’un redressement convexe dans la portion supérieure du domaine d’observation signale la présence probable d’un point d’inflexion, orientant résolument le diagnostic vers une formulation cubique de degré trois.
Cette phase exploratoire permet également de repérer d’éventuelles valeurs aberrantes ou atypiques (outliers) isolées aux marges extrêmes du nuage de points. En raison de la sensibilité extrême des termes de puissance polynomiale aux grandes amplitudes scalaires, un point atypique situé sur les frontières d’abscisse exerce un effet de levier disproportionné, capable d’induire une torsion artificielle de la trajectoire ajustée. Identifier précocement ces anomalies visuelles permet de décider, en amont de toute inférence formelle, si des procédures d’élagage raisonné ou des modélisations robustes complémentaires devront être déployées.
4. Ajustement mathématique du modèle de régression polynomiale avec lm()
4.1 Syntaxe formelle et opérateur d’inhibition I()
L’estimation des coefficients d’un modèle polynomial au sein de l’environnement R repose sur la fonction maîtresse lm() (linear models), qui implémente la résolution des moindres carrés ordinaires par décomposition QR de la matrice d’expérience. Cependant, la formulation syntaxique de la relation entre variables recèle un piège interprétatif fondamental propre au langage de spécification des formules de R. Dans l’écosystème conventionnel des formules symboliques de R, l’opérateur d’élévation à la puissance (l’accent circonflexe) ne possède pas sa signification arithmétique usuelle : il est réservé à la spécification des degrés d’interactions factorielles entre variables explicatives distinctes.
Par conséquent, si un utilisateur rédige ingénument l’instruction syntaxique formulant la régression sous la forme lm(y ~ x + x^2 + x^3), l’analyseur syntaxique interprète la tentative d’interaction d’une variable continue avec elle-même comme une redondance triviale, élimine silencieusement les puissances supérieures et ajuste en réalité une régression strictement linéaire de degré un. Pour contourner ce comportement intrinsèque et contraindre l’interpréteur à évaluer mathématiquement la puissance numérique avant d’intégrer le terme dans la matrice de modélisation, le recours à l’opérateur d’inhibition syntaxique I() devient strictement indispensable.
La formulation canonique rigoureuse d’un modèle cubique en variables brutes s’écrit donc obligatoirement : lm(y ~ x + I(x^2) + I(x^3), data = df). En encapsulant chaque terme exponentiel à l’intérieur de la fonction protectrice I(), l’utilisateur force R à calculer explicitement les vecteurs des carrés et des cubes des coordonnées de base, garantissant ainsi l’insertion conforme des colonnes d’ordre supérieur dans la matrice de plan d’expérience (design matrix) sous-jacente.
4.2 Polynômes orthogonaux versus polynômes bruts via poly()
Si la formulation via l’opérateur I() possède l’avantage d’une clarté pédagogique immédiate, elle expose l’analyse statistique à un écueil computationnel redoutable : la multicolinéarité sévère. Lorsque l’on élève un vecteur de valeurs strictement positives à des puissances croissantes (x, x^2, x^3), la corrélation mathématique entre ces nouvelles colonnes approche fréquemment des valeurs extrêmes supérieures à 0.99. Cette colinéarité artificielle gonfle démesurément la variance d’échantillonnage des coefficients estimés, déstabilise l’inversion numérique de la matrice de covariance et rend les p-values individuelles hautement instables et erronées.
Pour pallier cette pathologie structurelle, le langage R met à disposition la fonction de transformation avancée poly(). Par défaut, l’appel lm(y ~ poly(x, 3), data = df) ne génère pas de simples puissances monômes brutes, mais procède à une orthogonalisation rigoureuse des termes polynomiaux successifs à l’aide de l’algorithme de récurrence de Gram-Schmidt. Les vecteurs colonnes ainsi construits possèdent une corrélation strictement nulle entre eux, ce qui élimine toute multicolinéarité. Dans cette configuration orthogonale, la valeur numérique et la significativité du coefficient linéaire ne sont en rien altérées par l’adjonction ou la suppression ultérieure des termes quadratiques ou cubiques.
Néanmoins, cette élégance algébrique s’accompagne d’un coût non négligeable pour le praticien : les coefficients estimés pour des polynômes orthogonaux ne correspondent plus aux unités métriques physiques de la variable originelle et perdent leur interprétabilité intuitive directe. Pour restaurer des puissances brutes traditionnelles tout en bénéficiant de la compacité syntaxique de la fonction poly(), il suffit d’adjoindre l’argument formel raw = TRUE. L’arbitrage entre ces deux approches dépend donc des priorités du chercheur : privilégier l’orthogonalité pour la robustesse inférentielle et la sélection de modèle, ou préférer les polynômes bruts pour l’expression littérale et l’annotation graphique de l’équation d’ajustement.
4.3 Analyse rigoureuse de la table sommaire du modèle
L’extraction des résultats du modèle s’effectue traditionnellement par le truchement de la fonction générique summary() appliquée à l’objet retourné par l’ajustement. Cette restitution synthétique compile l’ensemble des métriques d’évaluation nécessaires à la validation de la théorie empirique. En premier lieu, la table des coefficients fournit, pour chaque terme de puissance intégré, son estimation ponctuelle, son erreur standard asymptotique, la statistique du test t de Student associée et la probabilité critique (p-value) correspondante évaluant l’hypothèse nulle d’un coefficient nul dans la population parente.
L’analyse séquentielle de la significativité des termes d’ordre supérieur s’avère déterminante : si le terme cubique I(x^3) ne franchit pas le seuil alpha conventionnel de significativité statistique (typiquement fixé à 0.05), le statisticien doit envisager la rétrogradation vers un modèle quadratique plus parcimonieux, conformément au principe du rasoir d’Ockham. Un modèle inutilement surchargé en termes de haut degré absorbe le bruit stochastique plutôt que le signal structural, dégradant substantiellement ses performances prédictives hors échantillon.
En second lieu, l’observateur examine le coefficient de détermination multiple (R-deux) ainsi que sa déclinaison ajustée (Adjusted R-squared). Alors que le R-deux ordinaire augmente mécaniquement dès qu’une variable explicative additionnelle est introduite dans le modèle, le R-deux ajusté intègre une pénalité directement proportionnelle au nombre de degrés de liberté consommés par les termes polynomiaux. Une augmentation notable du R-deux ajusté lors du passage de l’ordre un à l’ordre deux ou trois apporte la preuve mathématique irréfutable que le gain de variance expliquée surpasse largement le coût paramétrique induit par la complexification de la courbe.
5. Génération et ordonnancement rigoureux des valeurs prédictives
5.1 Extraction des valeurs prédites via la fonction predict()
Une fois le modèle polynomial calibré et validé sur le plan des coefficients, l’étape suivante consiste à calculer les valeurs d’ordonnées attendues qui serviront à tracer la courbe continue. L’outil générique central dans l’environnement R pour accomplir cette tâche est la fonction predict(). Dans sa forme d’utilisation la plus immédiate, l’invocation de predict(fit), où fit désigne l’objet résultant de l’ajustement linéaire préalable, extrait directement les prédictions correspondant rigoureusement à chaque observation présente au sein de l’échantillon d’apprentissage originel.
L’objet retourné par cette opération est un vecteur numérique continu dont la dimension scalaire coïncide fidèlement avec le nombre de lignes du jeu de données source. Chaque élément de ce vecteur représente la projection orthogonale de l’observation correspondante sur la surface de régression estimée par les moindres carrés. En soustrayant terme à terme ce vecteur prédictif des coordonnées réelles observées de la variable dépendante, le système dérive instantanément le vecteur des résidus d’estimation, dont la somme algébrique est mathématiquement contrainte à valoir zéro.
Cependant, s’appuyer exclusivement sur ces valeurs ajustées discrètes pour matérialiser visuellement la courbe polynomiale introduit des contraintes techniques substantielles. Si les points d’observation initiaux sont dispersés de manière hétérogène ou s’ils sont spatialement désordonnés le long de l’axe des abscisses, l’opération de liaison graphique linéaire entre points consécutifs générera un dysfonctionnement géométrique majeur, nécessitant un traitement algorithmique correctif préalable.
5.2 Résolution de l’écueil d’entrelacement : le tri des indices d’abscisses
L’écueil le plus universellement rencontré par les praticiens débutants lors du tracé d’une régression non linéaire sous R réside dans l’apparition d’un gribouillis géométrique aberrant, fréquemment désigné dans le jargon computationnel sous le sobriquet de « diagramme en toile d’araignée ». Ce phénomène chaotique se produit lorsque l’utilisateur tente d’invoquer une fonction de liaison de lignes en lui transmettant directement les vecteurs bruts de la variable explicative x et des valeurs prédites associées, alors que le jeu de données d’origine n’a pas été préalablement trié selon un ordre d’abscisses strictement monotone.
Par conception matérielle, les fonctions de tracé de lignes relient séquentiellement les coordonnées spatiales selon l’ordre exact d’apparition des indices vectoriels dans les tableaux en mémoire vive. Si la première observation possède une abscisse égale à huit, la seconde une abscisse de deux, et la troisième une valeur de six, le traceur virtuel oscillera anarchiquement d’avant en arrière à travers le plan cartésien, créant un réseau de segments sécants illisibles en lieu et place d’une courbe continue fluide.
Pour neutraliser définitivement cet écueil, le recours à la fonction de tri indiciel order() s’avère indispensable. En appliquant l’instruction indices_tries <- order(df$x), l’analyste obtient la permutation vectorielle exacte qui réorganise les abscisses de la plus faible à la plus élevée. Il suffit dès lors d’indexer simultanément le vecteur d’abscisse et le vecteur des prédictions à l’aide de cet opérateur de réarrangement pour garantir que le tracé graphique progresse de manière unidirectionnelle et harmonieuse de la bordure gauche vers la bordure droite du canevas cartésien.
5.3 Construction d’une grille prédictive continue à haute résolution
Bien que le tri des observations empiriques résolve le problème des segments entrecroisés, cette stratégie demeure tributaire de la densité locale de l’échantillon d’origine. Si le jeu de données comporte de larges plages d’abscisses dépourvues de mesures empiriques (lacunes d’échantillonnage), relier simplement les points observés consécutifs par des segments de droite créera des facettes anguleuses disgracieuses, trahissant une résolution spatiale insuffisante pour retranscrire la perfection mathématique d’un polynôme continu.
La méthodologie optimale, conforme aux standards éditoriaux les plus stricts, consiste à émanciper la trajectoire graphique des données brutes en érigeant une grille de prédiction synthétique indépendante à très haute résolution spatiale. À cet effet, l’analyste fait appel à la fonction d’interpolation vectorielle seq(), configurée pour générer un millier de valeurs équidistantes s’étendant sans discontinuité depuis la valeur minimale observée jusqu’au maximum empirique de la variable prédictive.
Cette grille continue est ensuite encapsulée au sein d’un nouveau data.frame dont le nom de variable doit impérativement reproduire à la lettre celui utilisé dans la formule du modèle initial. En injectant cette structure au paramètre newdata de la fonction predict(), le système procède à l’évaluation instantanée du polynôme sur chaque micro-intervalle de la grille. Le résultat est un vecteur prédictif d’une extrême fluidité géométrique, qui permettra de restituer les courbures et les points d’inflexion avec une fidélité visuelle absolue, dépourvue du moindre artefact de segmentation linéaire perceptible à l’œil nu.
6. Superposition de la courbe polynomiale sur le nuage de points en Base R
6.1 Utilisation de la fonction graphique de bas niveau lines()
Dans l’architecture du moteur graphique originel de R (Base R), une distinction taxinomique cardinale sépare les fonctions graphiques dites de « haut niveau » des fonctions de « bas niveau ». Les fonctions de haut niveau, à l’instar de plot(), possèdent la prérogative d’initialiser une nouvelle page de tracé, d’effacer le canevas précédent, de calculer l’échelle métrique des axes et d’imprimer les bordures structurelles. En revanche, tenter de superposer une courbe par un second appel successif à plot() conduirait inexorablement à la destruction immédiate du nuage de points préexistant et à l’ouverture d’un graphique vierge.
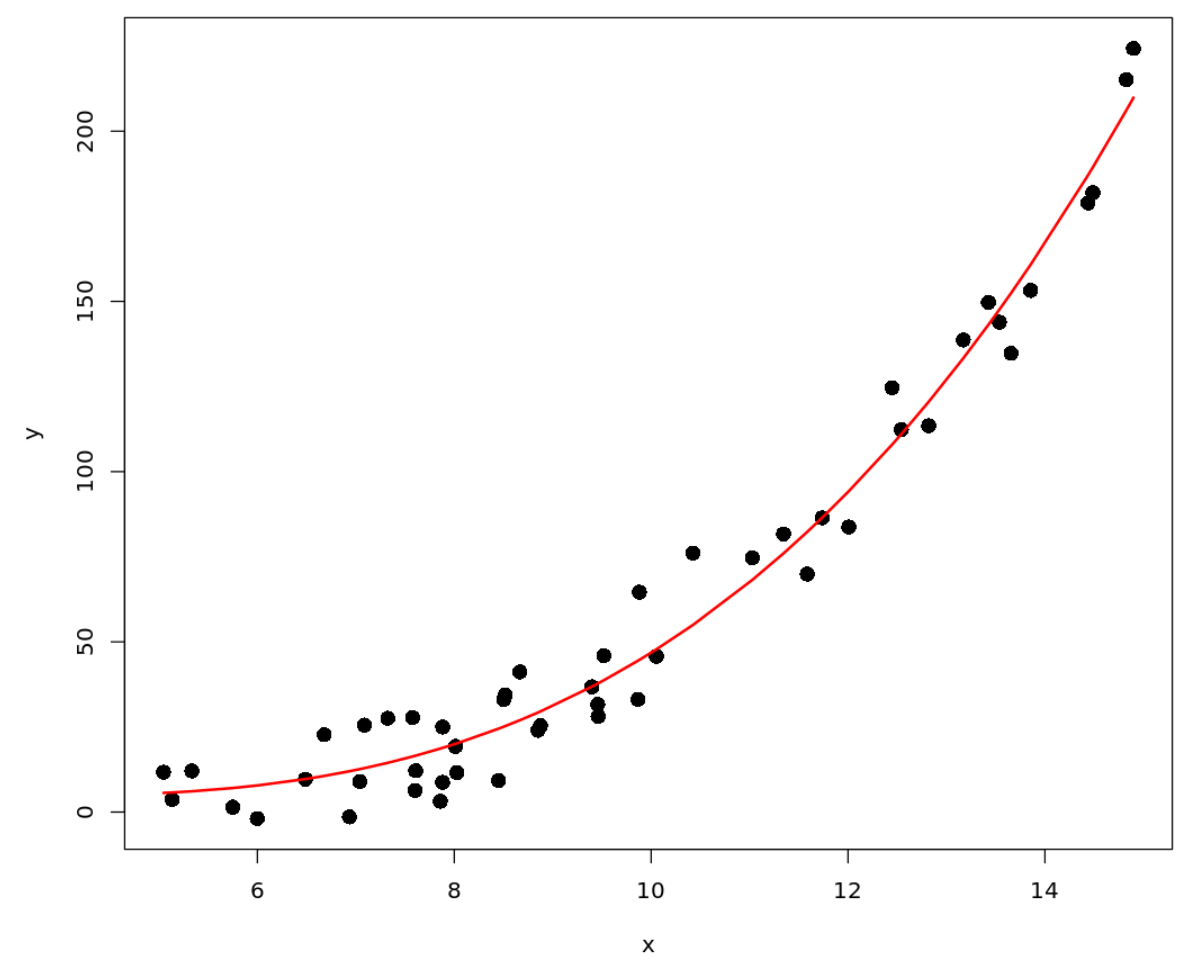
Pour projeter une trajectoire mathématique sur un nuage de points déjà matérialisé sans perturber le repère cartésien en place, il est indispensable de faire appel à la fonction de bas niveau lines(). Cette dernière n’a pas le pouvoir de redéfinir les bornes de la fenêtre : elle lit la configuration des coordonnées actives et dépose une couche vectorielle supplémentaire directement au sein de l’espace géométrique établi. La syntaxe canonique requiert simplement de lui assigner en abscisse la grille régulière préalablement construite, et en ordonnée le vecteur des prédictions correspondantes issu de la matrice du modèle.
Cette approche par empilement séquentiel de primitives offre une souplesse remarquable et une rapidité d’exécution quasi-instantanée, même sur des machines dotées de capacités de calcul modestes. Elle permet au chercheur d’enrichir progressivement sa représentation visuelle par des couches successives, en toute indépendance, sans devoir recompiler l’intégralité de la scène graphique à chaque ajustement paramétrique mineur.
6.2 Paramétrage chromatique et géométrique de la ligne
La simple projection d’un trait continu noir standard présente une lisibilité sémiologique souvent insuffisante au sein d’une figure académique composite. Le comportement géométrique de la ligne tracée via lines() peut être ajusté de manière exhaustive au moyen d’un ensemble de paramètres graphiques universels. Le premier d’entre eux est l’argument lwd (line width), qui contrôle l’épaisseur physique du segment exprimée sous forme de multiplicateur scalaire. Fixer un argument tel que lwd = 2.5 ou lwd = 3 confère à la courbe polynomiale une assise structurelle nette, affirmant sa prééminence visuelle en tant que modèle d’espérance conditionnelle face à la nébuleuse des points empiriques.
Le paramètre lty (line type) régit quant à lui le motif de tiretage de la trajectoire vectorielle. Si la valeur entière 1 (ou la chaîne « solid ») trace un segment plein traditionnel, les options alternatives telles que lty = 2 (« dashed » pour tirets réguliers) ou lty = 3 (« dotted » pour pointillés denses) permettent de distinguer visuellement des modèles concurrents sur une même figure. Ces alternatives s’avèrent indispensables pour concevoir des visualisations destinées à des revues scientifiques imprimées exclusivement en noir et blanc, garantissant que l’information demeure pleinement identifiable sans recours à la couleur.
Sur le plan chromatique, l’argument col accepte aussi bien des dénominations littérales standardisées issues de la palette interne de R (« darkred », « navyblue », « forestgreen ») que des codes hexadécimaux précis permettant de respecter scrupuleusement les chartes graphiques institutionnelles ou les exigences éditoriales d’accessibilité visuelle (notamment pour les lecteurs présentant des déficiences de la vision des couleurs). L’attribution d’une teinte vive et saturée à la courbe médiane crée un contraste d’amplitude avec le nuage de points sous-jacent, guidant le regard vers la forme fonctionnelle du processus modélisé.
6.3 Gestion de l’ordre d’affichage des couches graphiques
Dans l’univers du rendu vectoriel bidimensionnel, l’ordre chronologique d’appel des instructions de dessin détermine strictement l’ordre d’empilement spatial (le z-index virtuel) des éléments sur la figure finale. Une couche invoquée ultérieurement recouvrira impitoyablement les artefacts graphiques instanciés lors des étapes antérieures. La négligence de cette hiérarchie procédurale peut conduire à des imperfections sémiologiques dommageables, où une courbe opaque massive vient masquer l’agencement intime de points critiques situés dans des zones de forte densité d’échantillonnage.
Une séquence méthodologique d’excellence commande de structurer le script selon une stratification réfléchie :
1. Instanciation du cadre cartésien, des axes et des étiquettes via plot() en utilisant l’argument type = « n », ce qui réserve l’espace physique sans imprimer aucun point ;
2. Dessin éventuel d’une grille de repérage en arrière-plan à l’aide de la fonction grid(), facilitant la lecture quantitative des coordonnées sans encombrer la scène ;
3. Tracé des points d’observation empiriques individuels avec la fonction points(), configurés avec un indice de transparence suffisant pour laisser transparaître les intersections ;
4. Tracé terminal de la courbe de régression polynomiale de haut niveau au premier plan via lines().
En clôture de cette phase d’ordonnancement, il est impératif de veiller à la bonne gestion des paramètres globaux de l’environnement graphique. Si des modifications substantielles ont été apportées aux marges ou aux dispositifs d’échelles via la fonction par(), il convient de restaurer les constantes originelles afin de préserver l’intégrité des représentations graphiques subséquentes qui pourraient être générées dans la même session de travail.
7. Annotation mathématique et insertion de l’équation du modèle
7.1 Extraction programmatique des coefficients du modèle
L’intégration de l’équation fitted directement au sein de la figure graphique constitue un enrichissement précieux pour les publications savantes, affranchissant le lecteur de constants allers-retours fastidieux entre le corps textuel de l’article et la planche visuelle. Toutefois, une erreur classique consiste à recopier manuellement les valeurs numériques lues dans le tableau récapitulatif de summary(). Cette saisie manuelle présente deux écueils majeurs : elle introduit un risque élevé de coquille typographique et brise la chaîne d’automatisation du script, obligeant à réécrire la formule si l’échantillon vient à être amendé.
La démarche rigoureuse exige une extraction dynamique et programmatique intégrale des paramètres estimés au moyen de la fonction coef(). En appliquant cette fonction à l’objet de régression fit, R extrait un vecteur nommé contenant avec une précision machine absolue la valeur de l’intercept et de chaque pente polynomiale successive. L’analyste combine ensuite cette extraction avec la fonction d’arrondi numérique round(), en spécifiant un nombre raisonnable de décimales (par exemple, deux ou trois chiffres après la virgule) en adéquation avec la précision réelle du protocole de mesure expérimental.
Ces coefficients numériques extraits sont ensuite affectés à des variables scalaires dédiées dans l’environnement local. Ce découplage méthodologique garantit que si les données sous-jacentes évoluent à la suite d’un recalibrage ou de l’adjonction de nouvelles cohortes de sujets, la chaîne de caractères représentant l’équation finale sera automatiquement recalculée et réactualisée sur le graphique lors de la compilation suivante, sans qu’aucune intervention humaine ne soit requise au niveau du code de rendu.
7.2 Composition typographique d’expressions mathématiques avec bquote()
Le rendu typographique fidèle des formules mathématiques sur un canevas graphique dans l’interpréteur R constitue l’un de ses atouts les plus reconnus par les éditeurs scientifiques, mais il repose sur une logique d’évaluation interne exigeante. La simple concaténation de chaînes de caractères via la fonction paste() est incapable de produire de véritables exposants typographiques grecs ou latins : elle se contente d’imprimer platement le symbole de l’accent circonflexe ou les astérisques d’évaluation arithmétique, dégradant la finition éditoriale de la publication.
Pour mobiliser le puissant moteur de composition mathématique interne de R, inspiré du système typographique TeX de Donald Knuth, le recours aux expressions mathématiques formalisées s’avère indispensable. Alors que la fonction expression() permet de tracer des symboles statiques purs, elle est incapable d’incorporer de façon fluide des valeurs scalaires stockées dans des variables dynamiques. C’est ici que la fonction bquote() déploie toute son utilité algorithmique : elle permet de rédiger une expression formelle tout en désignant, au moyen de l’opérateur d’échappement .(), les objets dont l’interpréteur doit évaluer le contenu numérique avant l’affichage.
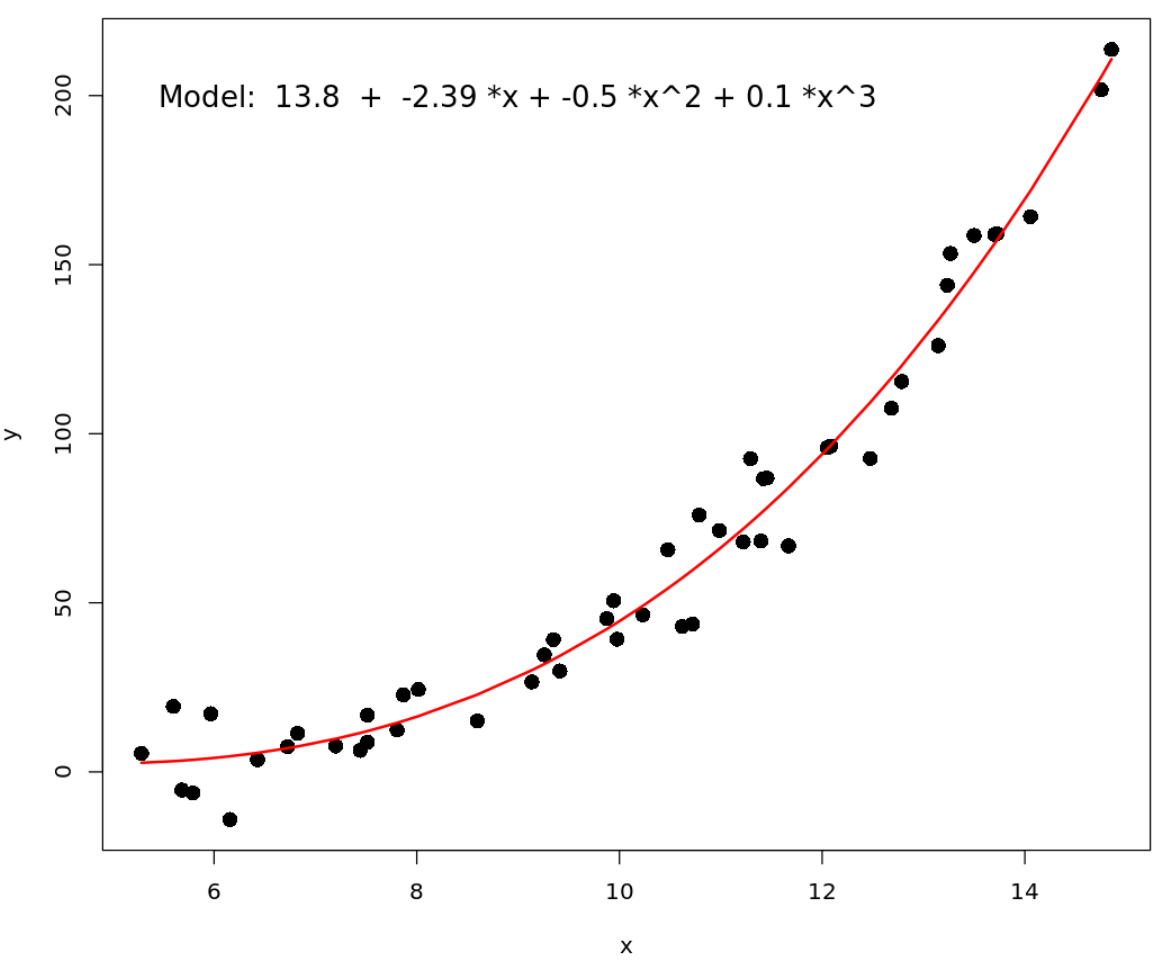
Grâce à ce mécanisme sophistiqué, l’instruction bquote(italic(Y) == .(b0) + .(b1)*italic(X) – .(b2)*italic(X)^2 + .(b3)*italic(X)^3) compile une formule visuelle d’une perfection absolue. Les variables mathématiques apparaissent en italique réglementaire, les puissances deux et trois sont positionnées en exposants surélevés impeccables, et les coefficients numériques extraits dynamiquement s’insèrent harmonieusement au cœur de l’expression mathématique formelle.
7.3 Positionnement stratégique du texte et des légendes avec text() et legend()
L’implantation spatiale de ces éléments d’annotation mathématique sur la figure doit être calibrée pour optimiser l’équilibre perceptif de l’image. L’injection d’annotations textuelles isolées s’exécute par le truchement de la fonction de bas niveau text(), qui réclame la définition précise de coordonnées d’ancrage en abscisse et en ordonnée. Plutôt que de fixer ces valeurs de manière empirique par tâtonnements successifs, il est judicieux de les indexer sur les fonctions min() et max() des axes actifs, assurant un positionnement proportionnel insensible aux variations d’échelles futures.
Les arguments d’ajustement géométrique pos et adj gouvernent l’orientation de la boîte englobante du texte par rapport au point d’ancrage choisi. Définir pos = 4 force l’alignement du bloc de texte à droite des coordonnées spécifiées, évitant ainsi que le libellé ne vienne chevaucher un point empirique situé à proximité immédiate. De surcroît, le paramètre cex peut être sollicité pour diminuer modérément le corps de police du cartouche d’équation, garantissant son intégration discrète et élégante sans concurrencer les étiquettes structurelles des axes gradués.
Enfin, lorsque la planche graphique présente simultanément plusieurs tracés ou combine données brutes et modélisations, la mobilisation de la fonction standardisée legend() devient incontournable. Positionnable intuitivement au moyen de coordonnées cartésiennes explicites ou de mots-clés directionnels réservés (« topleft », « bottomright »), elle récapitule rigoureusement la sémiologie employée en associant les symboles de points, les épaisseurs de traits, les motifs de tirets et les codes chromatiques à leurs significations expérimentales respectives, conférant ainsi au graphique une autonomie informative totale.
8. Visualisation de la régression polynomiale avec la grammaire graphique ggplot2
8.1 Implémentation directe et automatisée via geom_smooth()
Au cours des deux dernières décennies, l’écosystème graphique de R s’est profondément enrichi avec l’avènement de l’extension ggplot2, développée par Hadley Wickham et adossée aux préceptes théoriques de la grammaire des graphiques de Leland Wilkinson. Contrairement à la philosophie procédurale séquentielle du système Base R, ggplot2 traite la visualisation comme une composition déclarative où les données tabulaires sont associées (mapped) à des propriétés esthétiques (coordonnées, couleurs, tailles) puis projetées à travers des couches géométriques superposées.
Dans ce cadre paradigmatique, le tracé d’une régression polynomiale s’effectue avec une concision et une puissance d’automatisation exceptionnelles au moyen de la couche statistique spécialisée geom_smooth(). Après avoir initialisé le canevas cartésien en liant les variables d’abscisse et d’ordonnée dans l’instruction d’association aes(), et avoir matérialisé le nuage de points par geom_point(), il suffit d’adjoindre geom_smooth() en paramétrant ses arguments internes fondamentaux. L’assignation formelle method = « lm » force le moteur d’inférence à recourir aux modèles linéaires ordinaires plutôt qu’aux lisseurs non paramétriques locaux par défaut (tels que les splines ou l’algorithme LOESS).
Pour contraindre l’algorithme à estimer une courbure polynomiale de degré spécifique, l’utilisateur renseigne l’argument formula en exploitant les conventions de la fonction poly(). L’assignation formula = y ~ poly(x, 3, raw = TRUE) instruit ggplot2 d’exécuter de manière totalement autonome en arrière-plan l’ajustement du modèle cubique, le calcul de la grille prédictive continue à haute résolution ainsi que le tracé vectoriel de la trajectoire résultante, tout en générant simultanément et par défaut l’enveloppe d’incertitude associée à la prédiction moyenne.
8.2 Tracé découplé à partir d’un modèle externe précalculé
Bien que l’automatisation offerte par geom_smooth() se révèle d’une praticité remarquable pour l’exploration rapide des données, les exigences de la recherche avancée imposent fréquemment une architecture plus modulaire et rigoureusement découplée. Dans de nombreuses situations d’analyse, le modèle polynomial fait l’objet de diagnostics diagnostiques poussés, de pondérations par les variances d’échantillonnage ou d’ajustements multiplement imputés qui ne peuvent être délégués de façon aveugle à une formule simplifiée encapsulée à l’intérieur d’une couche graphique.
La méthodologie professionnelle consiste alors à scinder strictement la phase d’inférence statistique et la phase de rendu visuel. Dans un premier temps, l’analyste calibre son modèle personnalisé à l’aide de la fonction standard lm() dans l’environnement global, explore scrupuleusement la significativité de ses paramètres et valide ses postulats. Dans un second temps, il construit un data.frame prédictif dédié via la fonction seq(), calcule les valeurs attendues au moyen de predict(), et injecte cette structure externe directement dans une couche géométrique secondaire geom_line().
Cette dissociation méthodique procure au modélisateur un contrôle absolu sur chaque paramètre graphique. La couche geom_line(data = df_pred, aes(x = x_seq, y = y_pred), color = « steelblue », linewidth = 1.2) s’exécute en toute transparence par-dessus les données brutes initiales. Cette approche garantit une traçabilité intégrale du flux d’analyse computationnelle, élimine toute divergence potentielle entre les tables numériques insérées dans le manuscrit et la morphologie exacte de la courbe tracée sur la figure, et permet d’incorporer des prédictions issues de modèles mixtes ou pénalisés complexes.
8.3 Stylisation académique conforme aux standards des publications (normes APA)
L’apparence visuelle brute générée par les réglages par défaut de ggplot2—notamment son célèbre fond gris quadrillé de blanc—bien que reconnaissable, ne correspond pas aux normes de présentation austères exigées par les comités de lecture des revues académiques de premier plan, telles que celles affiliées à l’American Psychological Association (APA) ou aux presses universitaires internationales. Il est donc primordial d’appliquer une couche de thématisation experte pour transformer le graphique en une figure prête pour la publication sous presse.
La première transformation consiste à remplacer le thème générique par le thème épuré theme_classic() ou theme_bw(). L’application de theme_classic() élimine d’emblée la trame grise d’arrière-plan, supprime les lignes de grille secondaires superflues et rétablit des axes cartésiens nets et contrastés en noir absolu, conférant immédiatement au document une lisibilité et une clarté conformes aux exigences typographiques traditionnelles.
Cette épuration est complétée par la fonction labs(), qui permet de substituer aux identifiants informatiques des titres d’axes rigoureusement rédigés en toutes lettres, mentionnant impérativement les unités de mesure entre parenthèses conformément aux conventions internationales. Enfin, l’adjonction d’une couche de personnalisation typographique avancée via theme() permet d’ajuster millimétriquement la taille des polices de caractères des axes (axis.title, axis.text), l’orientation des graduations et l’espacement des marges, assurant une parfaite harmonie esthétique lors de la réduction dimensionnelle de la planche sur les colonnes des périodiques scientifiques.
9. Représentation graphique des intervalles d’incertitude et bandes de confiance
9.1 Distinguer intervalle de confiance et intervalle de prédiction
Une représentation visuelle de régression qui omettrait de retranscrire l’incertitude statistique sous-jacente commettrait une entorse sévère à la déontologie de la communication scientifique. Toute estimation ponctuelle issue d’un échantillonnage aléatoire fini est entachée d’une variance d’erreur qu’il convient de matérialiser fidèlement. À cet égard, une distinction théorique fondamentale sépare radicalement deux concepts d’incertitude fréquemment confondus par les praticiens : l’intervalle de confiance et l’intervalle de prédiction.
L’intervalle de confiance concerne exclusivement l’espérance mathématique conditionnelle de la variable de réponse Y pour une valeur d’abscisse donnée X. Il matérialise l’étendue probabiliste au sein de laquelle se situe la véritable droite (ou courbe) théorique inconnue de la population parente, à un seuil de confiance fixé (ordinairement 95 %). Sa largeur est gouvernée uniquement par l’erreur standard d’estimation des coefficients polynomiaux. Par conséquent, plus la taille globale de l’échantillon expérimental n augmente, plus la bande de confiance se rétrécit asymptotiquement, convergeant vers une largeur nulle à la limite infinie.
À l’opposé, l’intervalle de prédiction quantifie l’incertitude entourant la valeur concrète que prendra une observation future individuelle nouvelle issue de la même population. Cet intervalle doit donc incorporer deux sources de variance distinctes : la variance d’échantillonnage de l’estimation de la moyenne (identique à celle de l’intervalle de confiance) et la variance irréductible propre au terme d’erreur stochastique individuel sigma carré. Même si l’échantillon initial comportait plusieurs millions d’observations, l’intervalle de prédiction conserverait une largeur minimale incompressible proportionnelle à la dispersion naturelle des sujets autour de la trajectoire déterministe.
9.2 Calcul et extraction des bornes d’erreur avec predict()
L’évaluation rigoureuse de ces marges d’erreur s’opère dans l’environnement R en enrichissant les paramètres passés à la fonction d’inférence predict(). En conjonction avec le modèle ajusté et la grille prédictive continue à haute résolution introduite précédemment au paramètre newdata, l’utilisateur mobilise l’argument explicite interval, en lui affectant selon ses objectifs méthodologiques la valeur textuelle « confidence » ou la valeur « prediction ». Le paramètre de confiance sous-jacent est régulé par l’argument level, calibré par défaut sur la norme consensuelle de 0.95.
L’exécution de cette instruction ne renvoie plus un simple vecteur numérique unidimensionnel, mais génère une matrice structurée comportant trois colonnes distinctes : la colonne fit contenant l’espérance conditionnelle ajustée (la valeur moyenne centrale), la colonne lwr indiquant la borne inférieure du corridor d’incertitude, et la colonne upr bornant sa limite supérieure. Cette structure matricielle encapsule rigoureusement la modulation spatiale de l’erreur le long de l’axe structural.
Il est particulièrement instructif de constater sur le plan algébrique que ces bornes ne demeurent pas parallèles à la courbe centrale. L’erreur standard des estimations polynomiales augmente de manière exponentielle au fur et à mesure que l’on s’éloigne du barycentre de la distribution des abscisses empiriques vers la périphérie du domaine expérimental. Cette divergence géométrique engendre l’apparition caractéristique d’un étranglement resserré et précis au cœur des données, relayé par un évasement prononcé en forme d’entonnoir aux deux extrémités de la courbe, trahissant la fragilité inhérente aux extrapolations marginales.
9.3 Cartographie visuelle des rubans d’incertitude
La matérialisation graphique de ces corridors d’incertitude exige la mise en œuvre de techniques vectorielles avancées, adaptées à chaque moteur graphique disponible. Sous le moteur Base R, la réalisation d’une bande de confiance continue s’effectue au moyen de la fonction de bas niveau polygon(). Cette primitive géométrique réclame la définition d’un contour polygonal fermé composé par la concaténation de la trajectoire des abscisses d’aller, suivie de la séquence inverse de ces mêmes abscisses au retour, tandis que le vecteur d’ordonnées associe les valeurs de la borne supérieure aux valeurs rétrogrades de la borne inférieure.
Pour éviter que ce polygone opaque ne vienne recouvrir et oblitérer définitivement les points d’observation empiriques situés en arrière-plan, il est impératif d’utiliser l’argument border = NA pour supprimer le contour anguleux et d’attribuer à l’argument col une nuance semi-transparente issue de la fonction adjustcolor(), dotée d’un canal alpha de l’ordre de 0.15 à 0.25. La superposition séquentielle d’un ruban large de prédiction en gris très pâle, surmonté d’un ruban de confiance plus resserré d’une teinte légèrement plus saturée, produit une cartographie de l’incertitude statistique d’une clarté démonstrative absolue.
Dans l’univers de ggplot2, cette opération s’avère particulièrement fluide et élégante grâce à l’intermédiation de la couche géométrique dédiée geom_ribbon(). En renseignant au sein de son association esthétique aes() les bornes dynamiques ymin = lwr et ymax = upr extraites du tableau prédictif, le compilateur graphique déploie instantanément le ruban d’incertitude avec un lissage parfait, garantissant un rendu visuel vectoriel optimal pour l’édition savante internationale.
10. Comparaison visuelle et statistique de modèles polynomiaux de degrés multiples
10.1 Superposition simultanée de trajectoires polynomiales d’ordres différents
L’un des exercices méthodologiques les plus éclairants pour déterminer la forme fonctionnelle régissant un phénomène expérimental réside dans la comparaison visuelle directe de modèles concurrents de complexité croissante projetés sur une figure unique. Cette scénarisation comparative permet d’évaluer de façon intuitive si l’adjonction de degrés polynomiaux supplémentaires apporte un gain qualitatif tangible dans la restitution de la structure morphologique du nuage de points, ou si elle se borne à complexifier inutilement la trajectoire géométrique.
Pour orchestrer cette confrontation au sein du moteur Base R, l’expérimentateur commence par calibrer séquentiellement trois modèles emboîtés : un premier ajustement d’ordre un linéaire standard, un second d’ordre deux quadratique et un troisième d’ordre trois cubique. Après avoir généré les vecteurs de prédiction respectifs sur la grille continue commune à haute densité, le chercheur invoque successivement la fonction de bas niveau lines(), en assignant à chaque modèle une signature sémiologique contrastée associant une palette chromatique distincte et des motifs de traits spécifiques (par exemple, un trait continu pour le modèle complet, un tiretage moyen pour le modèle quadratique et une ligne pointillée pour la droite linéaire).
Cette composition graphique est obligatoirement parachevée par l’adjonction d’une légende comparative multi-lignes soigneusement positionnée dans une zone vierge de points. En juxtaposant visuellement l’inflexibilité rigide de la droite, la courbure parabolique unique et l’ondulation cubique souple, le chercheur offre à ses pairs une démonstration visuelle éclatante des compromis d’ajustement empirique en jeu.
10.2 Problématique du surajustement (overfitting) et oscillations aux bornes
La tentation naturelle du praticien novice consiste souvent à postuler qu’un degré polynomial plus élevé sera systématiquement supérieur, sous prétexte qu’il présente un R-deux toujours plus proche de l’unité. Cette vision pèche par une méconnaissance grave du phénomène de surajustement (overfitting) et du trade-off universel régissant l’arbitrage entre biais et variance. Si un modèle de faible complexité souffre d’un biais élevé par incapacité d’épouser le signal, un modèle doté d’un degré excessif (par exemple, un polynôme de degré huit ou neuf ajusté sur un échantillon d’une trentaine d’observations) développe une variance démesurée, apprenant par cœur les fluctuations aléatoires du bruit stochastique au détriment de la loi sous-jacente.
Sur le plan géométrique et mathématique, cette pathologie se manifeste de manière spectaculaire par le phénomène de Runge. Découvert à la fin du dix-neuvième siècle dans le cadre de l’interpolation numérique par polynômes d’ordre élevé sur des nœuds équidistants, ce théorème démontre que l’erreur d’interpolation tend vers l’infini au voisinage des extrémités de l’intervalle d’évaluation. Sur le graphique statistique, cette instabilité se traduit par l’apparition d’oscillations sauvages, d’ondulations erratiques non biologiques et de décrochages verticaux dramatiques dès que la courbe s’approche des marges extérieures des données observées.
L’inspection visuelle minutieuse des bordures du graphique constitue dès lors un test de réalité diagnostique impitoyable. Une trajectoire polynomiale qui plonge ou bondit abruptement dans les zones à faible densité d’échantillonnage, manifestant des extrema locaux dépourvus du moindre fondement théorique dans la discipline de référence, trahit immédiatement un surajustement pathologique. Elle signale à l’analyste que le modèle a perdu toute validité écologique et toute capacité de généralisation prédictive hors de son échantillon d’étalonnage.
10.3 Arbitrage statistique et critères d’information (ANOVA, AIC, BIC)
Face à la multiplicité des spécifications concurrentes, l’arbitrage scientifique ne saurait reposer sur une simple impression oculaire subjective ; il réclame une corroboration formelle par des critères de sélection de modèles éprouvés. Lorsque les modèles sont strictement emboîtés—ce qui est structurellement le cas des polynômes d’ordres successifs où le modèle de degré k moins un constitue une restriction du modèle de degré k obtenue en annulant le dernier coefficient—l’analyse de variance comparative par la commande anova(fit1, fit2, fit3) constitue la procédure de référence.
Ce test de rapport de vraisemblance séquentiel dérive une statistique F de Fisher évaluant si la réduction de la somme des carrés des résidus induite par l’adjonction d’un degré supplémentaire surpasse significativement ce que le simple hasard de l’échantillonnage aurait mécaniquement produit. Si la p-value associée à l’introduction du terme cubique s’avère non significative, la rigueur méthodologique impose de retenir le modèle quadratique d’ordre deux, conformément à l’impératif de parcimonie scientifique.
Pour départager des spécifications de manière pénalisée sans contrainte stricte d’emboîtement formel, l’analyste fait appel aux critères d’information de Kullback-Leibler, principalement l’Akaike Information Criterion (AIC) et le Bayesian Information Criterion (BIC), interrogeables dans R via les fonctions dédiées AIC() et BIC(). Ces indices quantifient la perte d’information statistique tout en infligeant une pénalité mathématique rigoureuse au nombre de paramètres libres mobilisés par le polynôme, le BIC appliquant une pénalité logarithmique proportionnelle à la taille de l’échantillon particulièrement sévère envers les degrés élevés. Le modèle optimal est celui qui minimise la valeur scalaire de ces critères, réalisant l’équilibre parfait entre adéquation empirique et parcimonie dimensionnelle.
11. Diagnostics graphiques des résidus et vérification des postulats du modèle
11.1 Analyse du graphique des résidus par rapport aux valeurs ajustées
La validation épistémologique finale d’une régression polynomiale ne s’achève pas avec le tracé élégant de sa courbe sur le nuage de points : elle requiert obligatoirement une vérification scrupuleuse des hypothèses distributionnelles classiques régissant les résidus d’estimation. L’outil diagnostique de premier rang réside dans la confection du graphique confrontant les résidus ordinaires (ou studentisés) aux valeurs ajustées prédites par le modèle, commodément extrait via l’appel plot(fit, which = 1) sous le moteur Base R.
L’objectif visuel fondamental de cette inspection consiste à attester de la disparition de tout motif fonctionnel ou géométrique persistant. Dans un modèle polynomial correctement spécifié ayant fidèlement capturé l’ensemble de la non-linéarité du processus physique, le nuage des résidus doit se répartir de manière totalement aléatoire, formant une constellation homogène et isotrope sans direction privilégiée, centrée symétriquement autour de la ligne horizontale d’ordonnée nulle. La présence d’une ligne de lissage rouge résiduelle parfaitement plane atteste de la justesse du degré sélectionné.
Si, en revanche, le graphique des résidus continue de manifester une silhouette incurvée en forme de parabole en U ou d’onde sinusoïdale caractérisée, ce patron démontre de manière univoque que le degré polynomial retenu s’avère insuffisant pour épuiser l’information structurelle des données. Le modèle souffre d’une sous-spécification flagrante. De surcroît, une morphologie en entonnoir (évasement progressif de la dispersion verticale le long de l’axe horizontal) révélerait une violation sévère du postulat d’homoscédasticité, imposant le recours à des estimateurs de variance robustes ou à des transformations préalables de la variable de réponse.
11.2 Diagramme Quantile-Quantile (Q-Q plot) de normalité
L’évaluation de la conformité du terme d’erreur stochastique à la loi normale univariée constitue le second pilier incontournable du diagnostic post-ajustement. Cette vérification s’exécute graphiquement via le diagramme Quantile-Quantile normal, obtenu directement au moyen de l’instruction plot(fit, which = 2). Ce graphique confronte les quantiles empiriques de la distribution des résidus standardisés de l’échantillon aux quantiles théoriques attendus d’une loi normale idéale de moyenne nulle et de variance unitaire.
Dans des conditions de validité parfaites, les points géométriques individuels doivent s’aligner de manière rigoureuse le long de la ligne diagonale de référence bissectrice en pointillé. Une superposition harmonieuse sur l’ensemble de l’étendue médiane certifie que les procédures d’inférence classiques basées sur la loi t de Student et les calculs d’intervalles de confiance matriciels sont pleinement légitimes et dénués de distorsions probabilistes.
À l’inverse, l’apparition de décrochages systématiques aux extrémités supérieures ou inférieures de la trajectoire diagonale fournit une indication précieuse sur la nature précise des déviations distributionnelles. Un infléchissement en forme de « S » inversé signale la présence de queues de distribution plus épaisses que ne le prédit la normalité (phénomène de leptokurticité ou d’hétérogénéité résiduelle latente). Ces écarts à la normalité compromettent la précision nominale des bandes d’incertitude tracées précédemment, soulignant la nécessité d’envisager des méthodes de rééchantillonnage non paramétriques (bootstrapping) pour recalibrer les enveloppes de confiance sans postulat de distributionnel a priori.
11.3 Repérage des points de levier et valeurs influentes
En raison de leur construction mathématique reposant sur l’élévation d’abscisses à des puissances croissantes, les régressions polynomiales manifestent une hypersensibilité aux observations périphériques, qui peuvent acquérir un statut de points de levier (leverage points) démesuré. Une observation isolée spatialement sur l’axe des abscisses, même si elle ne présente pas un résidu vertical exceptionnellement spectaculaire, possède un bras de levier considérable sur la matrice de projection, capable de modifier radicalement l’orientation globale de la courbure polynomiale.
L’identification de ces observations pivotales s’opère graphiquement par l’examen de la distance de Cook, accessible via l’appel plot(fit, which = 4) ou plot(fit, which = 5). La distance de Cook synthétise élégamment l’impact global qu’aurait la suppression d’une observation spécifique sur l’ensemble des coefficients estimés du modèle. Par convention analytique, toute observation franchissant le seuil critique d’une distance de Cook supérieure à quatre divisé par la taille de l’échantillon (ou s’approchant de l’unité) doit faire l’objet d’un examen critique attentif de la part de l’expérimentateur.
La visualisation simultanée des résidus standardisés en fonction du levier géométrique (termes diagonaux de la matrice de projection hat) et des lignes de niveau d’iso-distance de Cook permet de cartographier instantanément les points les plus déstabilisants. Face à une observation influente toxique résultant d’une erreur d’enregistrement instrumental, l’analyste justifiera son extraction raisonnée. S’il s’agit d’une observation biologique légitime, il conviendra d’envisager l’usage de régressions robustes par moindres carrés pondérés ou de modèles à courbure régularisée afin d’empêcher qu’un individu idiosyncrasique singulier ne dicte la topographie de la trajectoire scientifique générale.
12. Étude de cas empirique : Modélisation et publication d’une trajectoire comportementale
12.1 Mise en situation empirique : Relation entre anxiété de performance et efficacité motrice
Pour illustrer de manière concrète l’intégralité de ce pipeline analytique et graphique au sein d’une perspective éditoriale académique aboutie, envisageons une étude empirique translationnelle menée en psychologie du sport et en neurosciences comportementales. Le protocole d’investigation s’intéresse à l’impact de l’anxiété cognitive d’état sur l’efficacité de coordination motrice fine lors de l’exécution d’une tâche de précision neuromusculaire (par exemple, une séquence de pointage spatial assisté par capteurs optoélectroniques haute fréquence).
L’hypothèse théorique formulée par l’équipe scientifique, s’adossant aux modélisations de la théorie de l’efficacité du traitement attentionnel, postule explicitement une réponse non monotone en U inversé. Une anxiété d’état très faible engendre une sous-mobilisation des ressources d’éveil attentionnel et une variabilité motrice accrue. Une augmentation modérée de l’état d’anxiété canalise la focalisation attentionnelle sur les cibles spatiales, atteignant un pic d’optimisation neuromusculaire maximal. Enfin, un niveau d’anxiété aigu et panique induit un réflexe de co-contraction musculaire agoniste-antagoniste pathologique, précipitant l’effondrement spectaculaire de la vitesse et de la précision d’exécution motrice.
Pour tester empiriquement cette conjecture, un échantillon représentatif de deux cent cinquante athlètes et opérateurs a été soumis à divers niveaux de pression environnementale induite en laboratoire contrôlé. La variable explicative continue X consigne le score global obtenu à un inventaire d’anxiété cognitive validé (gradué sur un continuum standardisé), tandis que la variable dépendante continue Y quantifie un indice composite de précision spatio-temporelle continue, où des scores élevés traduisent une efficacité motrice optimale.
12.2 Pipeline complet sous R : du chargement des données au tracé finalisé
La concrétisation de cette démonstration empirique requiert la mobilisation ordonnée et fluide d’un script d’analyse reproductible, intégrant séquentiellement toutes les étapes méthodologiques rigoureuses détaillées au fil des sections précédentes. Le programme amorce la chaîne d’instructions par la simulation contrôlée du jeu de données comportemental expérimental, en initialisant expressément la graine de reproductibilité pseudo-aléatoire afin de stabiliser les résultats à des fins d’évaluation pédagogique.
Le pipeline computationnel enchaîne sans interruption sur l’ajustement du modèle de régression quadratique au moyen de la formulation explicite des moindres carrés ordinaires, combinant la fonction lm() et l’opérateur de protection syntaxique I() appliqué à l’élévation quadratique. Dès la convergence du modèle, le script extrait automatiquement les coefficients paramétriques estimés, calcule la significativité statistique de la courbure négative au sommet, et génère la grille continue à haute résolution spatiale couvrant l’intégralité du continuum de l’anxiété observée.
Enfin, le dispositif procède à l’évaluation des bornes d’incertitude matricielles via predict() en spécifiant un seuil de confiance rigoureux à 95 %, puis mobilise la grammaire déclarative de ggplot2 pour composer la planche finale : nuage des coordonnées individuelles semi-transparentes, ruban d’incertitude feutré, courbe maîtresse continue saturée, thématisation aux normes académiques APA via theme_classic(), titrage exhaustif et annotation dynamique de l’équation mathématique enrichie de ses métriques de performance au cœur d’un cartouche vectoriel impeccable.
12.3 Exportation vectorielle haute résolution pour revues scientifiques
L’étape ultime du travail académique consiste à matérialiser la planche graphique résultante sous la forme d’un fichier physique non compressé, conforme aux chartes techniques intransigeantes des éditeurs scientifiques internationaux (tels qu’Elsevier, Springer-Nature ou les presses de l’IEEE). Une erreur technique fréquente consiste à effectuer une simple capture d’écran matricielle ou à exporter la figure au format JPEG basse résolution, produisant des artéfacts de compression et un flou de pixellisation rédhibitoire lors de l’agrandissement typographique sous presse.
La règle éditoriale absolue commande de privilégier des formats de description vectorielle pure, au premier rang desquels figure le format Portable Document Format (PDF) encapsulé via le pilote vectoriel moderne cairo_pdf(), ou les fichiers d’encapsulation PostScript (EPS). L’intérêt fondamental de l’exportation vectorielle réside dans son indépendance d’échelle : les polices mathématiques, les glyphes de points et les segments de courbe demeurent d’une netteté mathématique absolue quel que soit le facteur de zoom appliqué lors de la mise en page finale.
Lorsque les directives éditoriales exigent impérativement la remise d’images matricielles rasterisées, l’exportation doit alors impérativement être opérée au format TIFF sans compression d’artefacts ou avec compression sans perte LZW, en mobilisant la fonction dédiée ggsave() ou le périphérique graphique standard tiff(). Il convient alors de calibrer explicitement la résolution spatiale à une densité minimale de 300 points par pouce (dpi) pour les photographies, et idéalement de 600 à 1200 dpi pour les schémas graphiques au trait comportant des équations typographiques complexes, tout en renseignant millimétriquement les largeurs et hauteurs physiques conformes aux dimensions exactes d’une colonne simple ou d’une page double du périodique de destination.
Références
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Chambers, J. M., & Hastie, T. J. (Eds.). (1992). Statistical models in S. Chapman & Hall/CRC.
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Harrell, F. E. (2015). Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-19425-7
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An introduction to statistical learning: With applications in R (2nd ed.). Springer. https://doi.org/10.1007/978-1-0716-1418-1
- Murrell, P. (2018). R graphics (3rd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9780429497018
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Runge, C. (1901). Über empirische Funktionen und die Interpolation zwischen äquidistanten Ordinaten. Zeitschrift für Mathematik und Physik, 46, 224–243.
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503