
L’analyse statistique appliquée repose sur un ensemble d’axiomes fondamentaux dont la vérification conditionne la robustesse, la validité interne et la portée inférentielle des conclusions scientifiques. Parmi ces postulats, l’hypothèse selon laquelle les variables aléatoires observées — ou plus précisément les perturbations stochastiques sous-jacentes — suivent une loi normale occupe une position prééminente dans la modélisation paramétrique. Que l’on mobilise l’économétrie, la biométrie, la psychométrie ou la sociologie quantitative, la loi de Gauss constitue le socle théorique de l’estimation par les moindres carrés ordinaires, de l’analyse de la variance (ANOVA) et des méthodes multivariées canoniques. Néanmoins, l’acceptation dogmatique de cette régularité distributionnelle expose le chercheur à des distorsions diagnostiques sévères, pouvant compromettre la significativité statistique des tests d’hypothèses et invalider les prédictions d’un modèle.
Dans l’environnement de calcul statistique Stata, l’évaluation de la normalité ne saurait se réduire à une routine mécanique ou à l’application aveugle d’un indicateur unique. Le logiciel fournit un éventail complet d’outils analytiques allant de représentations graphiques fines à des tests formels d’adéquation basés sur l’alignement des quantiles, les décompositions de moments ou la distance empirique globale. Comprendre les fondements théoriques, les équations sous-jacentes, les propriétés d’échantillonnage et les sensibilités relatives de ces procédures s’avère indispensable pour tout praticien soucieux d’intégrité méthodologique. Une telle démarche permet de dépasser l’opposition simpliste entre rejet et acceptation d’une distribution pour adopter une approche diagnostique intégrée et graduée.
Ce traité méthodologique propose une exploration exhaustive de l’ensemble des techniques diagnostiques de la normalité univariée, résiduelle et multivariée implémentées sous Stata. À travers un exposé méthodique associant la dérivation mathématique des statistiques de test, l’explication minutieuse de la syntaxe de programmation, l’analyse détaillée des sorties numériques et l’interprétation des structures graphiques, ce document fournit aux analystes de données, doctorants et chercheurs chevronnés une feuille de route rigoureuse pour auditer la conformité de leurs données empiriques aux exigences distributionnelles de la théorie statistique classique.
1. Introduction aux hypothèses distributionnelles et au postulat de normalité dans Stata
1.1 Importance de la distribution gaussienne en recherche empirique
La primauté de la distribution normale dans l’inférence statistique contemporaine découle de sa structure mathématique élégante, caractérisée par une symétrie parfaite autour de son espérance mathématique et une décroissance exponentielle de ses densités marginales. Dans le cadre de l’inférence paramétrique classique, la dérivation exacte des distributions d’échantillonnage des estimateurs — notamment les lois de Student pour les coefficients de régression et les lois de Fisher-Snedecor pour les contrastes linéaires simultanés — dépend de l’hypothèse de normalité des termes d’erreur. Lorsque cette condition d’ellipticité est enfreinte dans des échantillons de dimension restreinte, la distribution empirique des statistiques de test s’écarte substantiellement de leurs lois théoriques tabulées. Cela entraîne une altération de l’erreur de première espèce, augmentant le risque de faux positifs, ainsi qu’une détérioration de la puissance statistique des estimateurs.
Le théorème central limite (Central Limit Theorem) est fréquemment invoqué dans la pratique économétrique pour atténuer la portée des non-normalités. Selon ce principe fondamental formulé sous les conditions de Lindeberg-Lévy ou de Liapounov, la somme de variables aléatoires indépendantes et identiquement distribuées, dotées d’une variance finie, converge asymptotiquement vers une distribution gaussienne standardisée, quelle que soit la loi mère sous-jacente. Si ce mécanisme de convergence justifie l’application asymptotique des tests de Wald ou du multiplicateur de Lagrange sur des macro-échantillons, il ne saurait exonérer l’analyste d’une évaluation rigoureuse sur des cohortes limitées ou intermédiaires. Dans les échantillons finis, les écarts marqués par rapport à la normalité — en particulier les distributions bimodalités prononcées, les asymétries fortes ou les queues de distribution épaisses — dégradent l’efficacité relative des estimateurs linéaires sans biais et rendent imprécis le calcul des intervalles de confiance.
Au-delà de la simple inférence sur les moyennes conditionnelles, le maintien du postulat de normalité s’avère critique lors de la construction d’intervalles de prédiction individuels. Contrairement aux intervalles de confiance encadrant l’espérance de la variable dépendante, dont la précision bénéficie directement de la loi des grands nombres, la délimitation d’un intervalle de prévision pour une observation singulière incorpore directement la variance du terme résiduel individuel. Si la distribution des erreurs n’est pas strictement normale, les bornes de prédiction calculées sur la base de la loi de Student standard sous-estimeront ou surestimeront la probabilité réelle de couverture, induisant des erreurs de ciblage décisionnel dans les applications cliniques, actuarielles ou économétriques.
1.2 Distinction entre normalité univariée, résiduelle et multivariée
Une confusion méthodologique récurrente consiste à exiger la normalité marginale des variables dépendantes ou indépendantes observées avant toute démarche de modélisation. En réalité, le cadre du modèle linéaire généralisé n’impose aucune contrainte de normalité sur la distribution brute des régresseurs, ni même sur la distribution marginale inconditionnelle de la variable expliquée. Les prédicteurs peuvent être binaires, nominaux, polytomiques ou asymétriques sans enfreindre les propriétés des moindres carrés ordinaires. Ce qui importe pour la validité du modèle paramétrique n’est pas la normalité marginale d’une variable prise isolément, mais la conformité de la distribution conditionnelle de la variable dépendante sachant les prédicteurs, ce qui équivaut à exiger la normalité de la composante stochastique résiduelle non captée par le modèle.
La normalité résiduelle renvoie spécifiquement à la distribution du vecteur des perturbations inobservables dans la population parente. Dans une régression linéaire multiple, ces perturbations sont supposées être générées par un processus stochastique sphérique, caractérisé par une espérance mathématique conditionnelle nulle, une homoscédasticité et une indépendance sérielle, le tout sous-tendu par une distribution normale. L’audit de normalité doit par conséquent s’orienter en priorité vers les résidus estimés après convergence de l’algorithme d’optimisation, plutôt que vers la variable dépendante brute dont l’allure multimodale peut simplement refléter l’effet de stratification de covariables discrètes sous-jacentes.
Enfin, la normalité multivariée pose des exigences conceptuelles beaucoup plus restrictives que la juxtaposition de normalités marginales univariées. Un vecteur aléatoire multidimensionnel suit une loi normale multivariée si et seulement si toute combinaison linéaire scalaire de ses composantes suit une loi normale univariée. Il est mathématiquement démontré que l’existence de distributions marginales univariées parfaitement gaussiennes pour plusieurs variables distinctes ne garantit en rien que leur distribution conjointe respecte la normalité multivariée. Cette distinction est cruciale dans les architectures analytiques fondées sur l’estimation du maximum de vraisemblance à information complète, telles que l’analyse factorielle confirmatoire, la modélisation par équations structurelles (SEM) ou l’analyse discriminante linéaire de Fisher.
1.3 Présentation du jeu de données de travail et préparation de l’environnement
Afin de concrétiser l’ensemble des démarches diagnostiques présentées au sein de ce traité, nous mobiliserons le jeu de données classique intégré à l’environnement logiciel Stata, accessible via l’archive interne sysuse auto.dta. Ce corpus recueille les caractéristiques techniques, dimensionnelles et économiques d’une flotte de 74 modèles d’automobiles commercialisés en 1978. La composition de ce fichier combine des métriques continues affichant des niveaux variables d’asymétrie et d’aplatissement, ce qui permet d’illustrer la réponse empirique des différents algorithmes de test face à des configurations distributionnelles diversifiées.
L’initialisation d’un environnement d’analyse rigoureux dans Stata nécessite la configuration préalable d’un fichier journal permettant la traçabilité intégrale des manipulations et l’exécution d’une inspection préliminaire des observations manquantes. Les variables principales qui feront l’objet de nos expérimentations sont le prix (price), la consommation de carburant exprimée en miles par gallon (mpg), le poids du véhicule (weight) et la cylindrée du moteur (displacement). Les commandes fondamentales d’amorce se structurent comme suit :
sysuse auto, clear
describe price mpg weight displacement
summarize price mpg weight displacement
misstable summarize price mpg weight displacement
L’instruction misstable summarize garantit l’exhaustivité des sous-échantillons d’analyse en répertoriant les valeurs manquantes structurelles. La présence de valeurs absentes non aléatoires peut biaiser les distributions marginales en éliminant sélectivement les extrêmes. Dans le jeu de données auto.dta, l’intégrité des 74 observations est préservée pour ces vecteurs continus, fournissant un cadre de calibration stable pour l’ensemble des estimateurs univariés et multivariés.
2. Évaluation graphique préliminaire : L’histogramme et la superposition de densité normale
2.1 Syntaxe fondamentale et structure de la commande histogram
L’histogramme constitue la méthode exploratoire non paramétrique la plus intuitive pour visualiser la fonction de masse ou de densité empirique d’un vecteur continu. Dans l’écosystème Stata, la commande histogram (ou son abréviation autorisée hist) partitionne le support de la variable étudiée en une série d’intervalles contigus, appelés classes ou réceptacles statistiques, puis comptabilise la fréquence des réalisations observées au sein de chaque segment. Cette discrétisation permet d’identifier immédiatement les propriétés qualitatives de la distribution : la localisation du mode central, l’éventuelle bimodalité révélatrice d’hétérogénéités sous-jacentes, le sens de l’asymétrie latérale ainsi que l’épaisseur apparente des queues de distribution.
Le paramétrage par défaut de Stata calcule une ordonnée calibrée en densité statistique, assurant que la somme des aires des rectangles élémentaires soit rigoureusement égale à l’unité. Néanmoins, l’analyste peut modifier l’échelle verticale pour adapter la restitution aux conventions de son champ disciplinaire en mobilisant des options spécifiques :
density: option implicite traçant la densité empirique, où la surface totale correspond à 1.fraction: échelle normalisée représentant la proportion relative d’observations par classe par rapport à l’échantillon global.frequency: dénombrement absolu des observations contenues dans chaque intervalle.percent: conversion de la fraction en pourcentage cumulatif par classe.
L’exécution de la commande sous sa forme univariée élémentaire pour la variable du prix des véhicules se formule ainsi :
histogram price, frequency title("Distribution des fréquences du prix")
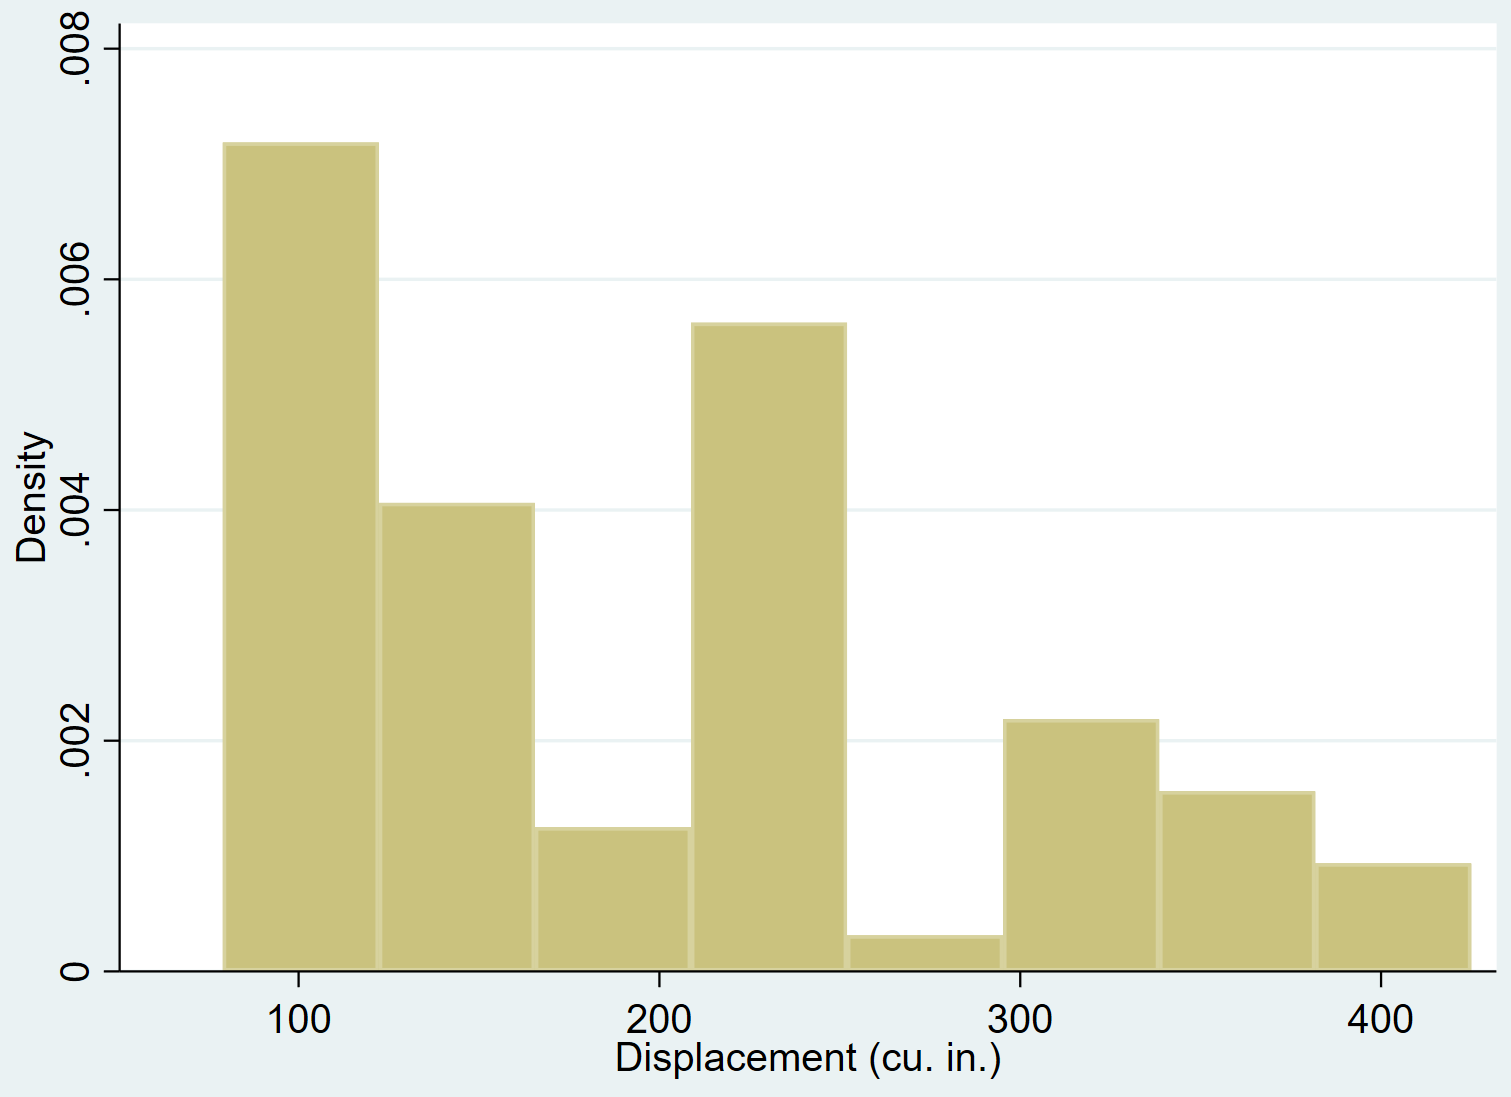
Ce premier tracé met en évidence la forte déviation de la variable price par rapport aux critères de symétrie théorique : la distribution est étirée vers la droite avec une concentration majeure d’observations dans les tranches tarifaires basses et médianes, complétée par une traîne d’observations extrêmes atteignant des valeurs supérieures à 15 000 dollars.
2.2 Superposition analytique de la courbe théorique avec l’option normal
L’appréciation visuelle d’un histogramme gagne en précision par la confrontation directe des fréquences observées avec la fonction de densité gaussienne paramétrique équivalente. L’option normal ordonne à Stata de calculer la moyenne arithmétique empirique et la variance corrigée de l’échantillon, puis de générer une courbe de densité théorique continue calibrée sur ces moments du premier et du second ordre :
histogram price, normal title("Histogramme de price avec densité normale superposée")
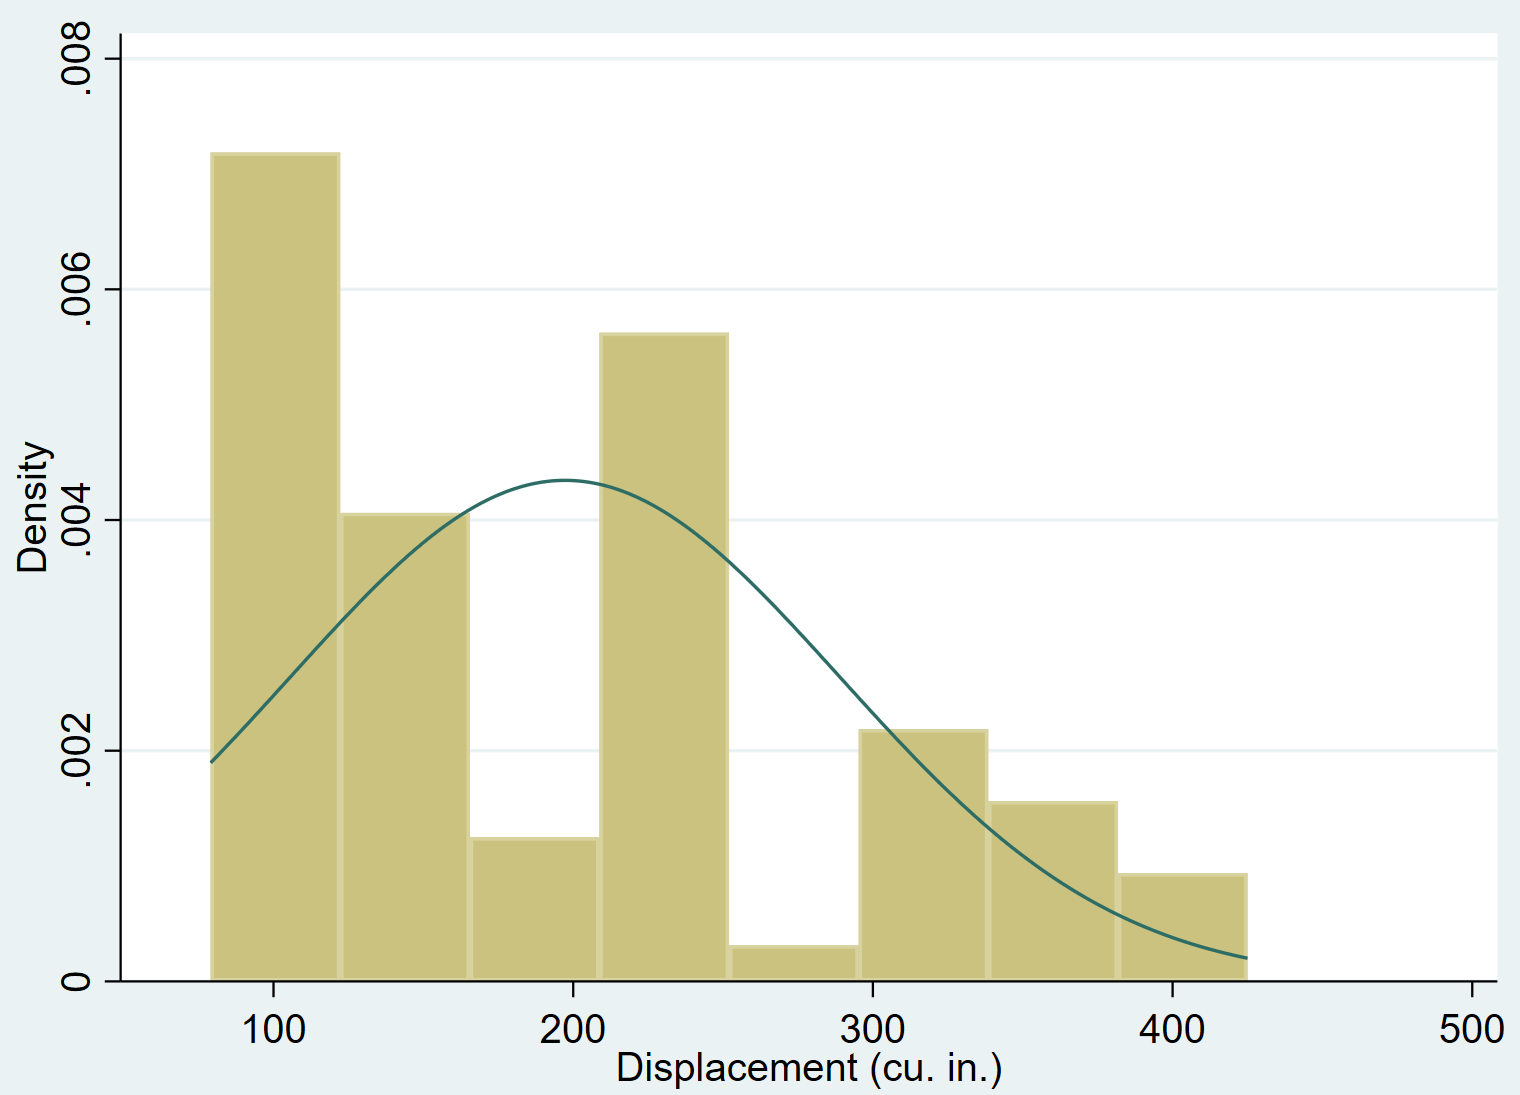
La présence de cette référence analytique révèle instantanément l’inadéquation de la loi normale pour modéliser cette variable brute. Alors que la courbe théorique impose un profil en cloche rigoureusement symétrique, les barres empiriques s’accumulent nettement à gauche du sommet de la cloche théorique, tout en laissant un déficit systématique d’observations dans la zone centrale droite et un excédent dans l’extrémité supérieure droite. Ce décalage illustre une asymétrie positive prononcée couplée à une structure leptokurtique.
À l’inverse, l’examen de la variable relative au poids du véhicule (weight) avec la même option :
histogram weight, normal title("Histogramme de weight avec densité normale superposée")
met en évidence un ajustement beaucoup plus régulier entre les barres d’échantillonnage et la fonction de densité gaussienne. L’absence de décrochages aberrants suggère une distribution empirique bien plus proche du modèle théorique de Gauss, bien que seule l’inférence formelle permette d’en certifier la validité statistique.
2.3 Optimisation du découpage en classes et limites de l’inspection visuelle
La morphologie d’un histogramme dépend étroitement de la stratégie de discrétisation adoptée. Le nombre et la largeur des intervalles conditionnent l’apparence du profil distributionnel : un nombre insuffisant de classes agrège des caractéristiques distinctes et occulte des bimodalités locales, tandis qu’un découpage excessif fragmente l’échantillon, générant des artefacts visuels causés par les fluctuations d’échantillonnage.
Stata met en œuvre par défaut une formule de discrétisation optimisée inspirée des travaux de Scott ou de Sturges, mais permet à l’utilisateur de prendre le contrôle paramétrique complet via deux options exclusives : bin(#), qui spécifie le nombre total d’intervalles verticaux, et width(#), qui définit la largeur absolue de chaque réceptacle sur l’axe des abscisses. Considérons la sensibilité de l’interprétation de la variable mpg face à ces variations de granularité :
histogram mpg, bin(5) normal title("Sur-lissage : 5 classes")
histogram mpg, bin(30) normal title("Sous-lissage : 30 classes")
histogram mpg, width(2) start(10) normal title("Largeur fixée à 2 unités")
Le sur-lissage induit par bin(5) masque les micro-déviations structurelles, donnant une illusion de normalité. À l’opposé, le découpage à 30 classes accentue artificiellement les discontinuités d’échantillonnage. Il est donc recommandé d’adopter une largeur de bande cohérente avec la formule de Freedman-Diaconis, basée sur l’écart interquartile :
h = 2 * IQR * n^(-1/3)
Malgré ces raffinements d’échelle, l’évaluation par histogramme reste une méthode purement qualitative, hautement dépendante de la subjectivité de l’observateur. Elle sert d’étape exploratoire préliminaire, mais doit impérativement être complétée par des représentations comparatives de rang et des tests inférentiels rigoureux.
3. Inspection visuelle avancée : Les diagrammes quantile-quantile et probabilité-probabilité
3.1 Principes géométriques et interprétation du diagramme Q-Q via qnorm
Le diagramme quantile-quantile normal, implémenté dans Stata via la commande qnorm, offre une résolution graphique bien supérieure à celle de l’histogramme pour identifier les anomalies aux extrémités d’une distribution. Le principe sous-jacent repose sur la confrontation directe entre les quantiles empiriques observés dans l’échantillon et les quantiles théoriques issus d’une distribution normale standardisée dotée de paramètres de moyenne et de dispersion identiques.
Sur le plan géométrique, si le vecteur étudié découle fidèlement d’un processus générateur gaussien, les points de coordonnées représentant chaque quantile se superposent le long d’une droite diagonale de référence à 45 degrés. Tout écart systématique par rapport à cette trajectoire linéaire traduit une non-conformité distributionnelle spécifique :
- Queues lourdes (leptokurticité) : Les quantiles observés inférieurs se placent sous la droite de référence à gauche, tandis que les quantiles supérieurs se placent au-dessus de la droite à droite, formant une courbure caractéristique en « S » inversé.
- Queues légères (platykurticité) : La trajectoire des quantiles croise la droite diagonale en sens opposé, générant une ondulation en « S ».
- Asymétrie positive (étalement à droite) : La trajectoire présente une courbure globalement convexe, restant sous la diagonale dans la région centrale avant de diverger fortement vers le haut pour les quantiles supérieurs.
- Asymétrie négative (étalement à gauche) : La série de points dessine une courbure concave au-dessus de la droite de référence sur la majorité du support.
L’exécution de la procédure pour la variable price met en évidence cette convexité :
qnorm price, title("Diagramme Q-Q de la variable Price")
Le tracé généré montre un alignement acceptable pour les valeurs centrales modestes, suivi d’une divergence exponentielle au-delà du quantile théorique d’ordre 1, ce qui confirme que la queue supérieure de la distribution des prix s’étend bien au-delà des bornes prévues par la théorie normale.
3.2 Évaluation de la région centrale par le diagramme P-P avec pnorm
Alors que le diagramme quantile-quantile accentue le comportement des valeurs extrêmes situées dans les queues, le diagramme probabilité-probabilité, piloté par l’instruction pnorm, concentre sa sensibilité analytique sur la zone centrale de la distribution. Cette technique juxtapose la fonction de répartition empirique standardisée d’un échantillon à la fonction de répartition théorique cumulative de la loi normale.
Le graphique représente en ordonnée la probabilité empirique cumulée associée à chaque observation ordonnée, et en abscisse la probabilité cumulative attendue sous l’hypothèse nulle de normalité :
pnorm price, title("Diagramme P-P de la variable Price")
Dans ce plan unitaire borné sur l’intervalle [0, 1], les points extrêmes convergent mécaniquement vers les coordonnées (0,0) et (1,1). Les déviations les plus prononcées s’observent au centre de la distribution :
- Une trajectoire s’élevant nettement au-dessus de la bissectrice au centre indique que les probabilités cumulées observées progressent plus vite que prévu par le modèle gaussien, révélant une forte concentration de données sur des valeurs inférieures à la moyenne.
- Une trajectoire sinusoïdale coupant la diagonale révèle des anomalies d’aplatissement ou des distributions multimodales au cœur de la distribution.
La complémentarité entre qnorm et pnorm constitue une méthode diagnostique visuelle robuste : le diagramme Q-Q sécurise l’analyste contre le risque d’ignorer des valeurs aberrantes ou des queues épaisses influentes, tandis que le diagramme P-P permet d’évaluer la régularité et la symétrie de la masse centrale de l’échantillon.
3.3 Personnalisation des tracés graphiques pour les publications académiques
L’intégration de diagnostics distributionnels dans des manuscrits soumis à évaluation par les pairs nécessite une mise en forme graphique soignée. Stata dispose d’options graphiques avancées permettant d’ajuster les contrastes visuels, d’appliquer des chartes graphiques adaptées à l’impression monochrome et de juxtaposer des diagnostics complémentaires au sein d’une même figure exportable en haute résolution vectorielle.
L’enchaînement méthodique ci-dessous combine l’histogramme, le diagramme Q-Q et le diagramme P-P au sein d’un canevas unifié, en s’appuyant sur le schéma de couleurs cleanplots ou le thème institutionnel classique sj (Stata Journal) :
set scheme s2mono
histogram price, normal frequency title("A: Histogramme & Densité", size(medium)) name(g1, replace)
qnorm price, grid title("B: Alignement des Quantiles", size(medium)) name(g2, replace)
pnorm price, grid title("C: Probabilités Cumulées", size(medium)) name(g3, replace)
graph combine g1 g2 g3, col(3) iscale(0.8) title("Audit Distributionnel Global : Variable Price", size(large))
graph export "diagnostic_normalite_price.eps", as(eps) preview(on) replace
L’utilisation de formats vectoriels tels que l’EPS (Encapsulated PostScript) ou le PDF préserve la netteté des courbes et des points de dispersion lors des réductions d’échelle imposées par les maquettes éditoriales. Cette combinaison graphique offre aux évaluateurs une vue d’ensemble du profil distributionnel de la variable étudiée.
4. Le test de normalité de Shapiro-Wilk sous Stata
4.1 Fondements méthodologiques et propriétés du coefficient W
Le test formalisé par Samuel Sanford Shapiro et Martin Wilk en 1965 est largement considéré comme l’un des tests d’adéquation univariés les plus puissants pour détecter les déviations par rapport à la loi normale. Le principe du test repose sur l’évaluation de la corrélation linéaire entre les statistiques d’ordre d’un échantillon observé et les espérances mathématiques des statistiques d’ordre d’un échantillon théorique de même taille issu d’une loi normale standardisée.
La statistique de test, désignée par la notation standard $W$, s’exprime comme le ratio de deux estimateurs distincts de la variance de la population :
W = (sum(a_i * x_(i)))^2 / sum((x_i - mean(x))^2)
Dans cette formulation mathématique, $x_{(i)}$ désigne la $i$-ème observation ordonnée de l’échantillon, $\bar{x}$ correspond à la moyenne empirique, et le vecteur des poids $a = (a_1, …, a_n)’$ est dérivé de la matrice de variance-covariance des statistiques d’ordre d’une distribution normale univariée selon l’équation :
a' = (m' * V^(-1)) / (m' * V^(-1) * V^(-1) * m)^(1/2)
où $m$ représente le vecteur des espérances des statistiques d’ordre gaussiennes et $V$ symbolise leur matrice de covariance. Le coefficient $W$ prend obligatoirement des valeurs contenues dans l’intervalle semi-ouvert ]0, 1]. Une valeur de $W$ très proche de l’unité indique un alignement presque parfait entre les quantiles empiriques et théoriques, apportant un soutien empirique à l’hypothèse nulle $H_0$ de normalité. À l’inverse, des valeurs de $W$ significativement inférieures à 1 indiquent une déformation distributionnelle, conduisant au rejet de $H_0$. L’algorithme développé par Patrick Royston a permis d’étendre la portée opérationnelle du test jusqu’à des échantillons atteignant 2 000 unités, tout en fournissant une transformation normalisée facilitant le calcul exact des p-valeurs associées.
4.2 Syntaxe opérationnelle et lecture des sorties de la commande swilk
L’implémentation de la procédure sous Stata s’effectue via l’appel direct de la commande swilk, suivie du nom de la variable inspectée ou d’une liste exhaustive de variables. Appliquons ce test à notre jeu de données :
swilk price
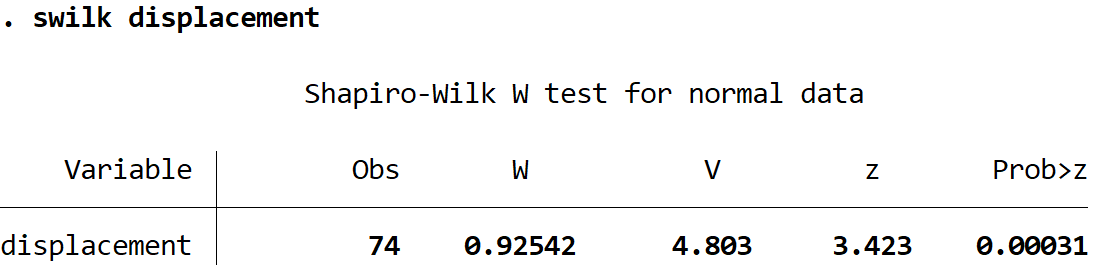
La sortie standard générée par Stata s’articule autour d’un tableau à colonnes multiples contenant des métriques fondamentales :
Obs: Le volume d’observations valides prises en compte dans le calcul (ici, $N = 74$).W: La statistique de Shapiro-Wilk calculée ($W = 0.758$ pourprice).V: L’indice standardisé développé par Royston, représentant le ratio entre la variance attendue sous $H_0$ et la variance observée. Une valeur de $V = 1$ correspond exactement au comportement théorique d’une distribution normale. Des valeurs de $V$ significativement supérieures à 1 signalent un éloignement marqué par rapport à la normalité.z: Le score $Z$ résultant de la transformation de la statistique $V$ en une déviation normale centrée réduite standard. Cette valeur permet d’ordonner l’intensité des rejets entre plusieurs variables.Prob > z: La valeur critique ($p$-value) associée au test d’hypothèse unilatéral.
Dans le cas d’espèce de la variable price, la statistique $W$ s’établit à un niveau très bas, générant un indice $V$ élevé et une $p$-value associée largement inférieure au seuil alpha traditionnel de 0,05 (affichée sous la forme 0.00000). L’hypothèse nulle de normalité est donc rejetée avec une marge d’erreur infinitésimale. À l’inverse, l’application de l’instruction sur la variable weight :
swilk weight
génère une valeur de $W = 0.941$ avec une p-valeur de 0.0017, ce qui conduit également au rejet formel de la normalité au seuil de 5 %, bien que l’amplitude de la déviation soit nettement moins marquée que pour le prix. L’analyste peut également exécuter le test simultanément sur une série étendue de variables continues :
swilk price mpg weight displacement trunk
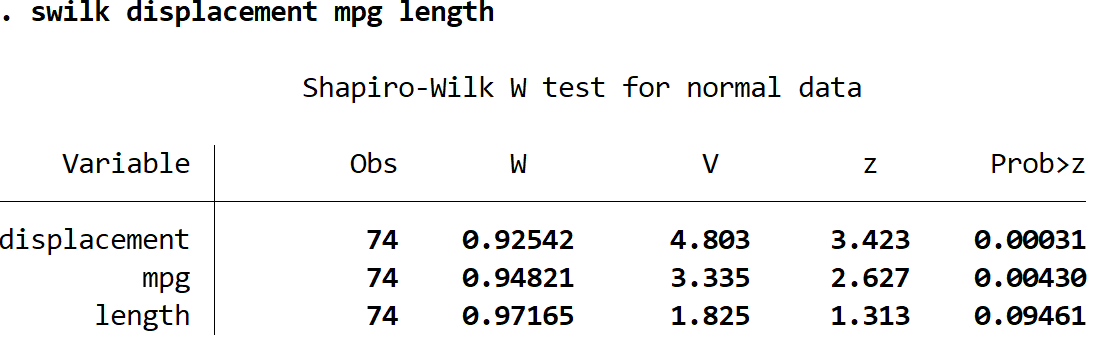
Cette approche groupée permet de comparer rapidement les degrés relatifs de conformité distributionnelle au sein d’une base de données.
4.3 Limites inhérentes à la taille de l’échantillon avec swilk
Bien que le test de Shapiro-Wilk affiche d’excellentes propriétés statistiques face à des alternatives très diverses, son interprétation pratique dépend fortement de la taille de l’échantillon $N$. Cette sensibilité reflète le compromis classique entre la puissance statistique du test et l’erreur d’échantillonnage.
Dans les échantillons de grande taille ($N > 500$ ou $1,000$), la puissance statistique de swilk devient si élevée que le test détecte la moindre déviation mineure par rapport à une distribution normale théorique idéale. Dès lors, des micro-asymétries sans impact pratique sur l’inférence des estimateurs OLS génèrent systématiquement des valeurs de $p < 0{,}001$, conduisant à rejeter l'hypothèse nulle à tort d'un point de vue fonctionnel. À l'opposé, sur de très petits échantillons ($N < 30$), le test manque de puissance : de réelles déformations distributionnelles peuvent échouer à franchir le seuil de significativité statistique, exposant le praticien à une erreur de seconde espèce (non-rejet d'une hypothèse nulle pourtant fausse).
L’application d’un seuil critique universel fixé à 5 % doit donc être modulée en fonction du volume d’observations disponibles :
- Petits échantillons ($N < 50$) : Un seuil de tolérance plus libéral ($\alpha = 0{,}10$) est parfois envisagé pour compenser le déficit structurel de puissance statistique.
- Grands échantillons ($N > 500$) : La valeur $p$ brute doit être mise en perspective avec l’amplitude du coefficient $W$ ; des valeurs de $W ge 0{,}98$ traduisent souvent une proximité empirique suffisante pour garantir la robustesse des modèles paramétriques, même en présence d’une $p$-value formellement significative.
5. Le test de Shapiro-Francia pour les échantillons de grande taille
5.1 Distinction algorithmique entre Shapiro-Wilk et Shapiro-Francia
Pour remédier aux contraintes computationnelles du calcul de la matrice inverse de variance-covariance des statistiques d’ordre sur des échantillons de taille modérée à grande, Shapiro et Francia ont proposé en 1972 une variante algorithmique simplifiée du test original. Alors que la statistique $W$ de Shapiro-Wilk incorpore l’ensemble des covariances entre les statistiques d’ordre théoriques, le test de Shapiro-Francia fait l’hypothèse d’une indépendance asymptotique relative de ces composantes ordonnées, ce qui revient à poser une matrice de covariance diagonale proportionnelle à l’identité.
La statistique résultante, formellement désignée sous le symbole $W’$, représente simplement le carré du coefficient de corrélation linéaire ordinaire calculé entre les statistiques d’ordre observées dans l’échantillon et les espérances des statistiques d’ordre correspondantes d’une loi normale univariée standard :
W' = (sum(m_i * x_(i)))^2 / (sum(m_i^2) * sum((x_i - mean(x))^2))
Cette simplification computationnelle, optimisée par les travaux ultérieurs de Royston en 1983, confère au test de Shapiro-Francia des propriétés asymptotiques remarquables. Il présente une puissance statistique équivalente — voire légèrement supérieure — à celle du test $W$ original face aux distributions dotées de queues lourdes ou platykurtiques, tout en supportant sans instabilité numérique des échantillons comprenant jusqu’à 5 000 observations sous Stata.
5.2 Exécution et analyse sous Stata avec la commande sfrancia
L’implémentation opérationnelle sous Stata s’effectue au moyen de la syntaxe sfrancia. La structure d’appel demeure similaire à celle de swilk, garantissant une cohérence d’utilisation pour l’analyste :
sfrancia price
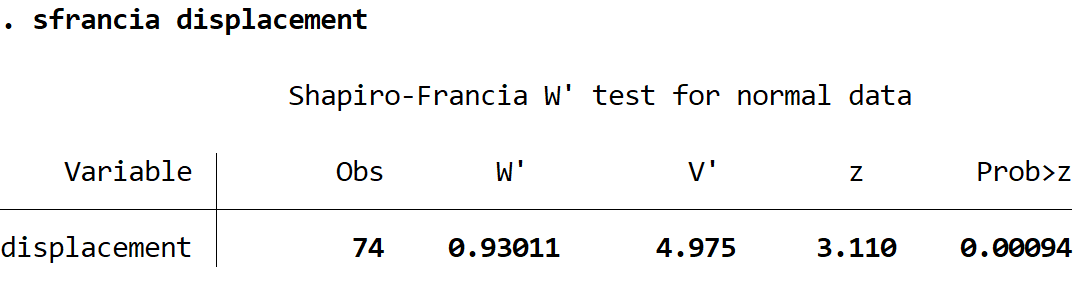
Le tableau de résultats généré par Stata fournit les indicateurs correspondants :
W': Le coefficient d’ajustement de Shapiro-Francia ($W’ = 0.751$ pour la variableprice).V': L’indice d’échelle standardisé analogue au facteur $V$ de Royston, calibré de sorte que sa valeur moyenne théorique soit rigoureusement égale à 1 sous l’hypothèse de normalité.z: La statistique de déviation standardisée utilisée pour le positionnement sur la fonction de survie normale.Prob > z: La probabilité critique d’erreur associée au rejet de l’hypothèse d’adéquation.
Sur le plan des directives d’application empirique, la règle de choix entre ces deux tests repose sur la taille de l’échantillon $N$ :
- Pour des cohortes comprises entre $N = 4$ et $N = 200$, la commande
swilkest généralement recommandée en raison de l’exactitude de ses coefficients de pondération sur les petites séries. - Pour des échantillons plus vastes, s’étendant de $N = 200$ jusqu’à $N = 5,000$, la commande
sfranciaest souvent privilégiée pour sa robustesse algorithmique et sa stabilité face aux distributions affichant des queues épaisses.
5.3 Applications empiriques par sous-groupes de variables
Il est fréquent en recherche empirique que l’hypothèse de normalité doive être examinée distinctement selon les modalités d’une variable de stratification ou de classification catégorielle. Par exemple, l’analyste peut souhaiter évaluer la normalité de la consommation énergétique (mpg) séparément pour les véhicules fabriqués sur le marché intérieur américain et pour les véhicules importés, codifiés par la variable binaire foreign.
Stata permet d’exécuter ces évaluations conditionnelles de façon élégante en associant les commandes de normalité au préfixe de partitionnement bysort :
bysort foreign: sfrancia mpg
L’exécution de cette instruction partitionne les observations selon le statut d’origine du véhicule, puis applique de façon séquentielle le test de Shapiro-Francia sur chaque sous-population. Cette approche permet de détecter si une non-normalité globale observée sur l’échantillon agrégé ne résulte pas simplement de la superposition de deux sous-populations homogènes mais décalées en moyenne (mélange de distributions normales). Si le déséquilibre d’effectif entre les groupes est important, l’analyste devra interpréter les statistiques $W’$ et $V’$ en tenant compte de la perte relative de puissance dans le sous-groupe le moins représenté.
6. L’analyse formelle des coefficients d’asymétrie et d’aplatissement
6.1 Définition mathématique de l’asymétrie et de l’aplatissement
L’architecture géométrique d’une fonction de densité de probabilité peut être décomposée au moyen de ses moments statistiques centrés d’ordre supérieur. Les moments du troisième et du quatrième ordre décrivent respectivement les déformations d’asymétrie (skewness) et d’aplatissement ou voussure (kurtosis). Ces deux paramètres caractérisent la nature des écarts par rapport à la distribution normale.
Le coefficient théorique d’asymétrie de Fisher, noté $\gamma_1$ ou $\sqrt{\beta_1}$, correspond au troisième moment centré normalisé par la troisième puissance de l’écart-type :
gamma_1 = E[(X - mu)^3] / (sigma^2)^(3/2)
Une distribution normale théorique est rigoureusement symétrique par rapport à sa moyenne, ce qui implique une asymétrie nulle ($\gamma_1 = 0$). Un coefficient positif ($\gamma_1 > 0$) signale une queue de distribution étirée vers les valeurs positives (asymétrie à droite), tandis qu’une valeur négative ($\gamma_1 < 0$) traduit un étirement vers les valeurs négatives (asymétrie à gauche).
Le coefficient d’aplatissement, noté $\beta_2$, découle quant à lui du quatrième moment centré standardisé :
beta_2 = E[(X - mu)^4] / (sigma^2)^2
Pour une loi normale univariée, ce ratio s’établit exactement à $\beta_2 = 3$. En conséquence, la littérature statistique emploie fréquemment la notion de kurtosis excessif (ou aplatissement centré), défini par la soustraction de cette constante :
Kurtosis_excessif = beta_2 - 3
Une distribution leptokurtique ($\beta_2 > 3$) présente un pic central plus aigu et des queues de distribution plus épaisses que la référence normale, ce qui accroît la probabilité de survenue d’événements extrêmes. Inversement, une distribution platykurtique ($\beta_2 < 3$) affiche une morphologie plus aplatie et des queues plus courtes.
6.2 Extraction des moments empiriques avec la commande summarize, detail
Le moyen le plus direct d’extraire les estimations d’échantillon des moments d’asymétrie et d’aplatissement sous Stata consiste à utiliser l’option détaillée de la procédure descriptive classique : summarize, detail.
Considérons l’application de cette instruction à la variable displacement :
summarize displacement, detail
Le tableau généré par Stata structure les descripteurs statistiques en quatre colonnes principales :
- Les centiles caractéristiques de la distribution (du 1er au 99e centile, incluant la médiane au 50e rang).
- Les quatre plus petites et quatre plus grandes valeurs ordonnées de la série (utiles pour repérer d’éventuelles valeurs aberrantes).
- Les statistiques de tendance centrale et de dispersion élémentaires (le nombre d’observations, la moyenne arithmétique et l’écart-type).
- Les deux moments d’ordre supérieur recherchés : Skewness et Kurtosis.
Pour la variable displacement, la sortie affiche un coefficient d’asymétrie de Skewness = 0.6726 et un coefficient d’aplatissement de Kurtosis = 2.2647. L’asymétrie est donc modérément positive, tandis que la valeur de kurtosis, inférieure au repère théorique de 3, confirme une distribution platykurtique, dépourvue de queues lourdes prononcées.
6.3 Seuils critiques et règles de décision empiriques
L’évaluation des moments empiriques permet d’apprécier la sévérité pratique des écarts à la normalité sans dépendre uniquement des tests d’hypothèse formels, souvent trop sensibles dans les grands échantillons. La communauté statistique a établi des repères empiriques d’acceptabilité pour l’application des estimateurs linéaires paramétriques :
- Zone de stricte normalité : L’asymétrie empirique est comprise entre -0,5 et +0,5, et le kurtosis global se situe entre 2,5 et 3,5. Dans cet intervalle, les distorsions inférentielles sont considérées comme négligeables.
- Zone de déviation modérée : L’asymétrie oscille entre l’intervalle [-1, -0,5] ou [+0,5, +1], et le kurtosis se situe entre 2 et 4. Les méthodes paramétriques conservent une bonne robustesse sur des échantillons de taille modérée ($N > 100$).
- Zone de déviation sévère : L’asymétrie absolue excède |1,5| ou |2|, et le kurtosis dépasse le seuil critique de 5 à 6 (ou tombe sous 1,5). Dans ce contexte, l’inférence fondée sur la loi de Student devient instable, imposant des corrections de type rééchantillonnage ou transformations non linéaires.
Il est également possible de tester la nullité statistique des écarts par un ratio critique standardisé simple :
z_skewness = Skewness / sqrt(6 / N)
z_kurtosis = (Kurtosis - 3) / sqrt(24 / N)
Si la valeur absolue de ces statistiques d’écart standardisé dépasse la valeur seuil de 1,96, l’écart par rapport à l’asymétrie ou à l’aplatissement normal est considéré comme statistiquement significatif au seuil bilatéral de 5 %.
7. Le test omnibus conjoint de D’Agostino-Pearson dans Stata
7.1 Mécanisme inférentiel et formulation du test sktest
Les tests d’hypothèses séparés portant sur l’asymétrie ou l’aplatissement présentent l’inconvénient d’ignorer la covariance distributionnelle conjointe de ces deux moments. Pour pallier cette limite, Ralph D’Agostino et Egon Pearson ont formalisé en 1973 un test omnibus d’adéquation. Ce test transforme simultanément les coefficients d’asymétrie et de kurtosis empiriques en variables standardisées approximativement gaussiennes, puis les combine au sein d’une métrique synthétique globale.
Dans sa version implémentée sous Stata, la commande sktest intègre les corrections analytiques d’asymétrie développées par D’Agostino combinées à l’algorithme d’approximation polynomiale du kurtosis conçu par Patrick Royston en 1991. Soit $Z_1(s)$ le score gaussien issu de la transformation de l’asymétrie empirique et $Z_2(k)$ le score correspondant dérivé de l’aplatissement ; la statistique de test conjointe s’exprime comme la somme quadratique de ces deux composantes indépendantes :
K^2 = [Z_1(s)]^2 + [Z_2(k)]^2
Sous l’hypothèse nulle $H_0$ stipulant que la population sous-jacente est régie par une loi normale, cette statistique quadratique $K^2$ converge asymptotiquement vers une loi du Chi-deux à deux degrés de liberté ($\chi^2(2)$). Ce test omnibus fournit ainsi une évaluation globale : il suffit que la distribution s’écarte significativement de la trajectoire normale soit par son asymétrie, soit par son aplatissement, soit par une combinaison des deux pour que la statistique conjointe conduise au rejet formel de l’hypothèse de normalité.
7.2 Mise en œuvre technique et interprétation des résultats de sktest
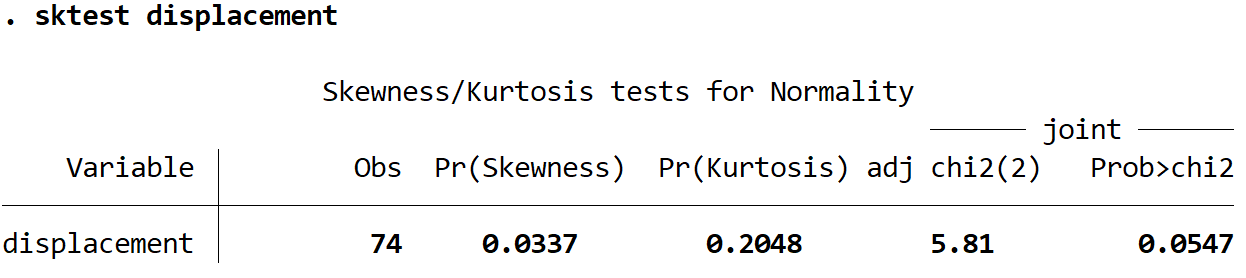
L’exécution du test omnibus sous Stata repose sur une syntaxe directe : la commande sktest suivie de la liste des variables continues à diagnostiquer. Appliquons cette analyse aux dimensions physiques des véhicules :
sktest weight length headroom
Par défaut, Stata applique la correction de Royston pour ajuster les moments sur les échantillons de taille modeste. Le tableau récapitulatif présente les sorties suivantes pour chaque variable auditée :
Pr(Skewness): La p-valeur unilatérale associée au test de conformité de l’asymétrie seule.Pr(Kurtosis): La p-valeur unilatérale testant l’adéquation de l’aplatissement seul.adj chi2(2): La statistique globale combinée du Chi-deux ajusté à deux degrés de liberté.Prob > chi2: La valeur critique omnibus finale régissant la décision d’inférence globale.
Prenons l’exemple de la variable length : si la p-valeur associée à l’asymétrie ressort à Pr(Skewness) = 0.3845 (indiquant une symétrie satisfaisante), mais que le kurtosis affiche Pr(Kurtosis) = 0.0210 (signalant un aplatissement non conforme), la statistique globale ajustée adj chi2(2) affichera une probabilité globale de Prob > chi2 = 0.0450. L’hypothèse nulle de normalité est alors rejetée au seuil conventionnel de 5 %, le test identifiant avec précision que l’infraction distributionnelle provient exclusivement d’une anomalie au niveau des queues de distribution, et non d’un défaut de symétrie centrale.
7.3 Comparaison méthodologique entre sktest et le test de Shapiro-Wilk
Le choix entre le test omnibus de D’Agostino-Pearson (sktest) et le test d’alignement de quantiles de Shapiro-Wilk (swilk) dépend de la structure de l’échantillon et des objectifs du diagnostic méthodologique. Ces deux tests reposent sur des prismes analytiques fondamentalement distincts :
- Diagnostic des sources de déviation :
sktestprésente l’avantage pédagogique et pratique d’isoler explicitement la part de non-normalité imputable à l’asymétrie de celle causée par l’épaisseur des queues de distribution. À l’inverse,swilkcondense l’ensemble de l’information dans un scalaire unique $W$, sans expliciter la géométrie de la déviation constatée. - Puissance face aux distributions bimodales : Face à des mélanges de distributions symétriques mais nettement bimodales,
swilkaffiche généralement une puissance de détection supérieure à celle desktest, ce dernier pouvant être trompé par une asymétrie apparente nulle compensée par un kurtosis ambigu. - Comportement asymptotique : Sur des échantillons intermédiaires ($100 le N le 1,000$),
sktestconserve d’excellentes propriétés de calibrage et présente une saturation moins rapide de sa p-valeur queswilk.
Une bonne pratique méthodologique consiste à pratiquer une triangulation analytique : confronter les résultats de sktest à ceux de swilk. Une convergence des conclusions vers le non-rejet confère un haut niveau de confiance quant à la régularité distributionnelle des séries examinées.
8. Les tests d’ajustement globaux : Kolmogorov-Smirnov et Lilliefors
8.1 Fondements du test de Kolmogorov-Smirnov à un échantillon
Le test d’ajustement global de Kolmogorov-Smirnov repose sur une métrique non paramétrique évaluant la distance maximale observée entre la fonction de répartition empirique d’un échantillon et la fonction de répartition cumulative théorique assignée a priori sous l’hypothèse nulle.
Soit $S_n(x)$ la fonction d’escalier représentant la proportion cumulée des observations empiriques inférieures ou égales au réel $x$, et soit $F_0(x)$ la fonction de répartition théorique normale continue postulée. La statistique de Kolmogorov-Smirnov correspond à la borne supérieure (distance suprême) des écarts absolus verticaux :
D = sup_x |S_n(x) - F_0(x)|
Dans l’environnement Stata, la commande native correspondante est ksmirnov. Toutefois, une condition théorique fondamentale restreint son application directe : le test de Kolmogorov-Smirnov classique impose que la distribution théorique $F_0(x)$ soit entièrement spécifiée a priori, c’est-à-dire que ses paramètres de moyenne ($\mu_0$) et de variance ($\sigma^2_0$) soient connus indépendamment des données de l’échantillon. Pour tester une variable continue avec cette procédure, il est donc nécessaire de calculer au préalable les valeurs standardisées z-score sur la base d’hypothèses fixées :
summarize weight
generate double z_weight = (weight - r(mean)) / r(sd)
ksmirnov z_weight = normal(z_weight)
La statistique $D$ retournée correspond au plus grand écart absolu constaté sur l’ensemble de la fonction de répartition empirique par rapport à la loi normale centrée réduite théorique standardisée.
8.2 Le problème des paramètres estimés et l’alternative de Lilliefors
L’utilisation de la commande standard ksmirnov pour tester la normalité d’une série pose un problème théorique majeur lorsque les paramètres de localisation ($\mu$) et d’échelle ($\sigma$) ne sont pas connus d’avance, mais estimés à partir de l’échantillon lui-même via la moyenne $\bar{x}$ et l’écart-type empirique $s$. Cette pratique très courante invalide les tables de probabilité critiques de Kolmogorov-Smirnov standard.
En effet, le fait d’ajuster la fonction théorique normale sur les données observées rapproche mécaniquement la courbe théorique de la distribution empirique. La distance suprême calculée $D$ est alors systématiquement sous-estimée par rapport à ce qu’elle serait face à une fonction indépendante. En utilisant les valeurs critiques usuelles de la commande ksmirnov, le test devient excessivement conservateur : la probabilité réelle de commettre une erreur de première espèce s’effondre bien en deçà du seuil nominal de 5 %, ce qui conduit à accepter à tort l’hypothèse de normalité dans des situations de déviation marquée (déficit prononcé de puissance statistique).
Pour corriger ce biais d’estimation, Hubert Lilliefors a dérivé en 1967 une table de valeurs critiques calibrées par simulations de Monte Carlo, adaptée à la situation où les paramètres sont estimés sur l’échantillon. Bien que Stata ne propose pas de commande native interne dédiée au test de Lilliefors, la communauté méthodologique a développé des modules externes exécutables, accessibles via le dépôt SSC :
ssc install lilliefors
lilliefors weight
L’algorithme de Lilliefors recalibre correctement la valeur critique du test en fonction de la taille $N$, rétablissant une taille de test conforme au seuil $\alpha$ nominal fixé.
8.3 Évaluation comparative de l’efficacité face à swilk et sktest
Sur le plan de l’efficacité statistique comparée, la littérature méthodologique spécialisée déconseille de manière unanime l’emploi du test de Kolmogorov-Smirnov (même corrigé par Lilliefors) pour diagnostiquer la normalité d’une variable continue. Les études comparatives de puissance par simulations de Monte Carlo mettent systématiquement en évidence l’infériorité de la statistique de Kolmogorov-Smirnov face aux tests de Shapiro-Wilk (swilk), de Shapiro-Francia (sfrancia) et de D’Agostino-Pearson (sktest).
Ce déficit structurel de puissance s’explique par la nature géométrique de la statistique $D$ :
- Le test de Kolmogorov-Smirnov ne prend en compte que la distance verticale maximale unique observée sur l’ensemble du domaine de distribution, ignorant les écarts cumulatifs réguliers répartis sur l’ensemble du support.
- Les déformations asymétriques ou les queues de distribution épaisses génèrent souvent des écarts verticaux faibles en valeur absolue sur la fonction de répartition cumulative, mais fondamentaux quant à la forme de la densité. Ces écarts passent inaperçus sous la statistique $D$, alors qu’ils sont immédiatement détectés par la corrélation des quantiles de
swilkou par les moments d’ordre supérieur desktest.
Le recours à la commande ksmirnov pour évaluer la normalité relève donc d’un héritage historique plutôt que d’un choix méthodologique moderne. Son usage dans les protocoles contemporains sous Stata doit être réservé à l’évaluation d’autres lois théoriques spécifiques entièrement paramétrées a priori, au profit exclusif de swilk et sktest pour la distribution gaussienne.
9. Diagnostics de la normalité des résidus dans les modèles de régression linéaire
9.1 Le postulat de Gauss-Markov et la distribution des erreurs
L’estimation des coefficients d’un modèle de régression linéaire par les moindres carrés ordinaires s’appuie sur le théorème classique de Gauss-Markov. Selon ce théorème, si les perturbations stochastiques inobservables ont une espérance conditionnelle nulle ($E[epsilon|X] = 0$) et sont sphériques (homoscédastiques et non autocorrélées), les estimateurs OLS constituent les meilleurs estimateurs linéaires sans biais (BLUE, Best Linear Unbiased Estimators). Il est fondamental de souligner que cette propriété d’efficacité linéaire minimale ne requiert en aucun cas que les perturbations suivent une distribution normale.
L’hypothèse de normalité des termes d’erreur :
epsilon | X ~ N(0, sigma^2 * I)
n’intervient qu’au stade de l’inférence statistique sur les paramètres estimés. Elle est indispensable pour établir la distribution exacte des coefficients sous des échantillons de dimension finie. Ce n’est que sous cette hypothèse que les ratios des coefficients estimés divisés par leurs erreurs-types respectives suivent exactement une distribution $t$ de Student à $(N – k)$ degrés de liberté, et que les tests d’hypothèses linéaires conjointes suivent une loi $F$ de Fisher-Snedecor.
Une distinction méthodologique essentielle sépare la distribution marginale inconditionnelle de la variable expliquée ($Y$) de sa distribution conditionnelle sachant les régresseurs ($Y|X$). Exiger que la variable dépendante brute soit normalement distribuée constitue une erreur conceptuelle : une variable dépendante peut présenter une distribution bimodale ou fortement étirée simplement parce qu’elle dépend d’un prédicteur binaire ou d’une covariable asymétrique. C’est uniquement la composante résiduelle inexpliquée par le modèle qui doit satisfaire au postulat de normalité gaussienne.
9.2 Extraction, standardisation et stockage des résidus post-estimation
Dans la pratique analytique sous Stata, l’audit de normalité intervient toujours comme une étape diagnostique post-estimation, exécutée consécutivement à l’ajustement du modèle de régression via l’instruction regress. Considérons l’estimation du prix d’un véhicule en fonction de son kilométrage, de son poids et de sa provenance :
regress price mpg weight i.foreign
Une fois le vecteur des coefficients obtenu, l’analyste extrait les perturbations résiduelles à l’aide de la commande predict. Stata propose plusieurs types de résidus adaptés à des finalités diagnostiques complémentaires :
predict res_bruts, residuals: Calcule les résidus ordinaires définis par la simple différence algébrique entre la valeur observée et la valeur ajustée : $e_i = y_i – \hat{y}_i$.predict res_std, rstandard: Calcule les résidus standardisés (internement studentisés), obtenus en divisant les résidus bruts par leur écart-type d’échantillon corrigé de l’effet de levier individuel :r_i = e_i / (s * sqrt(1 - h_ii))où $h_{ii}$ correspond au $i$-ème terme diagonal de la matrice de projection chapeau (hat matrix).
predict res_stud, rstudent: Calcule les résidus studentisés (externement studentisés ou jackknife), où la variance de l’erreur est estimée en omettant sélectivement la $i$-ème observation. Ce calcul évite qu’une valeur aberrante n’atténue elle-même l’ampleur de son résidu standardisé.
Pour auditer la normalité de la composante d’erreur résiduelle, l’utilisation des résidus standardisés ou studentisés est formellement recommandée : elle neutralise les variations artificielles de variance induites par l’éloignement spatial des observations au sein de l’espace des covariables (hétérogénéité des leviers $h_{ii}$).
9.3 Batterie complète d’évaluation des résidus générés
Une fois la variable résiduelle standardisée stockée en mémoire, l’analyste déploie l’ensemble des outils graphiques et inférentiels pour valider la conformité distributionnelle de l’erreur du modèle. Cette démarche diagnostique s’articule autour de trois étapes méthodologiques complémentaires :
1. Inspection de densité non paramétrique : L’utilisation combinée d’un estimateur à noyau de densité de type Epanechnikov via kdensity, avec superposition de la référence gaussienne théorique :
kdensity res_stud, normal kernel(epanechnikov) title("Densité à noyau des résidus studentisés")
Ce graphique permet de repérer d’éventuelles asymétries locales ou aplatissements excessifs que le lissage d’un histogramme standard pourrait masquer.
2. Tests inférentiels formels sur les résidus : Les tests de Shapiro-Wilk et de D’Agostino-Pearson sont appliqués directement sur la série des résidus standardisés générés :
swilk res_stud
sktest res_stud
Si la statistique conjointe de sktest et le coefficient $W$ de swilk indiquent un rejet formel de l’hypothèse nulle ($p < 0{,}05$), la validité des intervalles de confiance paramétriques des coefficients de régression se trouve compromise sur petit échantillon.
3. Vérification conjointe de l’homoscédasticité : L’analyse de la distribution résiduelle gagne à être confrontée au graphique de dispersion reliant les résidus aux valeurs prédites :
rvfplot, yline(0) title("Dispersion des résidus vs valeurs ajustées")
La présence d’hétéroscédasticité (structure en entonnoir sur le graphique rvfplot) biaise fréquemment les indicateurs de normalité globale des résidus. Dans ce cas, l’anomalie distributionnelle apparente n’est souvent que la conséquence directe d’une instabilité sous-jacente de la variance des erreurs conditionnelles.
10. Évaluation de la normalité multivariée sous Stata
10.1 Concepts fondamentaux de la loi normale multivariée
Dans les architectures statistiques fondées sur l’analyse simultanée de plusieurs variables interdépendantes — telles que les régressions multivariées, les modèles d’équations structurelles, l’analyse multivariée de la variance (MANOVA) ou l’analyse en composantes principales —, l’hypothèse de travail repose sur le respect d’une loi normale multivariée par le vecteur aléatoire $X = (X_1, X_2, dots, X_p)’$. Une distribution normale multivariée d’ordre $p$, notée $N_p(\mu, \Sigma)$, est entièrement caractérisée par son vecteur d’espérances mathématiques $\mu$ de dimension $(p \times 1)$ et sa matrice symétrique semi-définie positive de variance-covariance $\Sigma$ de dimension $(p \times p)$.
Une propriété géométrique fondamentale de cette distribution réside dans le fait que ses contours d’équidensité épousent des formes ellipsoïdales dans l’espace euclidien à $p$ dimensions. Pour chaque individu statistique $i$, l’éloignement spatial pondéré par rapport au centre de gravité du nuage de points est mesuré par le carré de la distance statistique de Mahalanobis :
D_i^2 = (x_i - mean(x))' * Sigma^(-1) * (x_i - mean(x))
Sous l’hypothèse nulle d’une stricte conformité à la loi normale multivariée, ces distances de Mahalanobis quadratiques $D_i^2$ suivent théoriquement une distribution du Chi-deux à $p$ degrés de liberté :
D_i^2 ~ chi^2(p)
La simple juxtaposition de normalités univariées marginales ne suffit pas à garantir la normalité conjointe du vecteur aléatoire. Bien que la normalité multivariée implique obligatoirement que chaque composante prise individuellement suive une loi normale univariée, la réciproque mathématique est fausse : il est tout à fait possible de concevoir un système où toutes les marges univariées sont gaussiennes sans que leur distribution conjointe ne respecte la structure matricielle normale.
10.2 La commande mvtest normality et les tests de Mardia
Stata dispose d’un module d’analyse dédié à l’évaluation de la normalité multivariée, accessible via l’instruction native mvtest normality. Ce module intègre les statistiques multivariées développées par Kanti Mardia en 1970, qui décomposent l’évaluation conjointe selon deux indices spécifiques : l’asymétrie multivariée de Mardia ($b_{1,p}$) et l’aplatissement multivarié de Mardia ($b_{2,p}$).
Pour soumettre simultanément les variables price, weight, mpg et length à cette procédure, la syntaxe s’articule comme suit :
mvtest normality price weight mpg length
Par défaut, l’instruction exécute le test de Mardia et retourne une matrice de sortie structurée autour de trois diagnostics complémentaires :
- Asymétrie de Mardia (Mardia Skewness) : Ce test évalue la somme des cubes des distances statistiques croisées entre observations. Stata affiche la statistique calculée $b_{1,p}$, sa conversion standardisée sous la forme d’un score $\chi^2$, ainsi que la p-valeur associée. Une asymétrie multivariée significative indique une déformation d’orientation dans l’espace multidimensionnel.
- Aplatissement de Mardia (Mardia Kurtosis) : Ce test examine la dispersion du carré des distances de Mahalanobis autour de leur espérance théorique $p(p + 2)$. Le logiciel produit la statistique d’aplatissement $b_{2,p}$, un score standardisé $z$, et la probabilité critique bilatérale correspondante. Une déviation significative à ce niveau révèle la présence de queues lourdes multidimensionnelles ou de valeurs aberrantes multivariées.
- Test conjointe d’asymétrie et de kurtosis : Combine les deux composantes précédentes en un critère omnibus unique.
Le rejet de l’hypothèse nulle sous la commande mvtest normality avertit l’analyste que les estimateurs du maximum de vraisemblance standard risquent de produire des erreurs-types biaisées lors de l’estimation de modèles d’équations structurelles multivariés.
10.3 Tests de Doornik-Hansen et de Henze-Zirkler
Outre la méthodologie de Mardia, Stata propose des procédures alternatives réputées pour leurs propriétés de puissance statistique supérieures face à des corrélations inter-variables élevées, accessibles via les options de la commande mvtest :
mvtest normality price weight mpg length, doornikhansen
mvtest normality price weight mpg length, henzezirkler
Le test de Doornik-Hansen (1994) s’appuie sur une transformation des coefficients d’asymétrie et de kurtosis univariés après orthogonalisation complète des variables par la décomposition de Cholesky de leur matrice de corrélation. La statistique globale résultante converge vers une loi du Chi-deux à $2p$ degrés de liberté. Cette approche affiche de meilleures propriétés d’échantillonnage sur les séries réduites ($N < 100$) que les statistiques asymptotiques de Mardia.
Le test de Henze-Zirkler (1990) mobilise quant à lui une fonction de distance globale basée sur la transformée de Fourier de la fonction caractéristique multivariée empirique. Une statistique $HZ$ élevée indique un écart significatif par rapport à l’hypothèse de normalité conjointe. En modélisation causale (SEM), la violation avérée de la normalité multivariée sous ces tests impose d’abandonner l’estimateur classique du maximum de vraisemblance au profit d’estimateurs quasi-maximum de vraisemblance robustes (QML) ou d’algorithmes asymptotiquement indépendants de la distribution (ADF / Satorra-Bentler).
11. Stratégies méthodologiques face à la violation de l’hypothèse de normalité
11.1 Transformations mathématiques univariées classiques
Lorsqu’une variable continue s’écarte substantiellement de la loi normale par suite d’une forte asymétrie unimodale, la solution méthodologique la plus directe consiste à appliquer une transformation mathématique non linéaire monotone. L’objectif est de recomprimer les écarts relatifs entre les observations de manière à rapprocher la distribution d’une forme symétrique gaussienne.
Pour les variables affichant une asymétrie positive étirée vers la droite (telles que le revenu, le coût ou les concentrations biologiques), la transformation logarithmique népérienne constitue le standard empirique :
generate double ln_price = ln(price)
histogram ln_price, normal
swilk ln_price
L’application du logarithme comprime l’éventail des grandes valeurs tout en étirant les écarts entre les valeurs proches de zéro, atténuant mécaniquement l’asymétrie positive. D’autres fonctions analytiques sont fréquemment mobilisées selon l’intensité de la déviation constatée :
- Racine carrée (
sqrt(x)) : Transformation modérée particulièrement adaptée aux variables de comptage ou aux asymétries positives légères. - Inverse (
1 / x) : Transformation plus radicale destinée aux asymétries positives extrêmes, inversant l’ordre de la série (sauf utilisation de $-1/x$). - Puissance carrée (
x^2) ou cubique : Indiquée pour traiter les distributions présentant une asymétrie négative étirée vers la gauche.
Pour identifier la transformation optimale sans procéder par tâtonnements, Stata propose l’algorithme de George Box et David Cox (1964) via la commande boxcox. Cette approche estime par le maximum de vraisemblance le paramètre $lambda$ régissant la famille de transformations paramétriques :
boxcox price
La valeur estimée du paramètre d’ajustement oriente le chercheur vers la fonction la plus appropriée : un $lambda$ proche de zéro justifie le recours au logarithme népérien naturel, une valeur avoisinant 0,5 préconise la racine carrée, tandis qu’une valeur proche de 1 signale qu’aucune transformation mathématique d’échelle n’est nécessaire.
11.2 Méthodes d’estimation robustes et alternatives non paramétriques
La transformation d’une variable présente l’inconvénient d’altérer l’échelle de mesure originale, ce qui complique l’interprétation directe des coefficients estimés (passage à des semi-élasticités ou élasticités pures). Lorsque l’analyste souhaite conserver l’échelle d’origine en présence de résidus non normaux ou hétéroscédastiques, l’économétrie moderne privilégie le recours à des méthodes d’estimation robustes.
Dans le cadre de la modélisation linéaire par les moindres carrés ordinaires, l’adjonction de l’option vce(robust) à l’instruction regress permet de mobiliser les estimateurs de variance asymptotique de White-Huber :
regress price mpg weight i.foreign, vce(robust)
Cette spécification n’altère en rien la valeur ponctuelle des coefficients estimés $\hat{\beta}$, mais recalcule la matrice de variance-covariance pour corriger l’hétéroscédasticité et mitiger l’impact des déviations de distribution des erreurs sur les erreurs-types des coefficients. La validité de cette correction repose toutefois sur l’hypothèse d’échantillons de taille suffisante pour assurer la convergence asymptotique.
Dans l’éventualité où l’analyste procède à des comparaisons de localisation sur de très petits effectifs ($N < 30$) où la normalité ne peut être ni établie ni compensée par les grands nombres, les tests d'hypothèses paramétriques usuels doivent être remplacés par leurs équivalents non paramétriques basés sur les rangs :
- Le test de Wilcoxon-Mann-Whitney remplace le test $t$ de Student pour deux échantillons indépendants :
ranksum mpg, by(foreign). - Le test des rangs signés de Wilcoxon remplace le test $t$ sur séries appariées :
signrank pre_mesure = post_mesure. - Le test de Kruskal-Wallis remplace l’ANOVA à un facteur pour les comparaisons à $k$ groupes :
kwallis price, by(rep78).
Ces méthodes évaluent les sommes de rangs sans imposer de distribution paramétrique théorique à la population sous-jacente.
11.3 Inférence par rééchantillonnage bootstrap dans Stata
L’inférence par rééchantillonnage bootstrap représente une alternative moderne puissante lorsque les perturbations résiduelles s’écartent manifestement du profil gaussien et que l’échantillon est trop modeste pour invoquer le théorème central limite avec confiance. Formalisée par Bradley Efron en 1979, cette approche s’abstient de formuler une hypothèse théorique préalable sur la loi d’erreur : elle utilise l’échantillon observé lui-même comme une approximation empirique de la population parente inobservable.
La commande préfixe bootstrap sous Stata tire avec remise un nombre élevé $B$ de pseudo-échantillons de même taille $N$ que la base originale, réestime les coefficients à chaque réplication, puis reconstruit la distribution empirique des paramètres d’intérêt :
bootstrap, reps(2000) seed(12345): regress price mpg weight i.foreign
Ce processus génère des intervalles de confiance non paramétriques robustes aux non-normalités distributionnelles :
estat bootstrap, normal: Calcule l’intervalle fondé sur l’erreur-type bootstrap standardisée.estat bootstrap, percentile: Calcule l’intervalle basé directement sur les centiles de la distribution d’échantillonnage empirique répliquée.estat bootstrap, bc: Établit l’intervalle de confiance corrigé des biais d’estimation (bias-corrected).estat bootstrap, bca: Fournit la correction conjointe des biais et de l’accélération (bias-corrected and accelerated), recommandée pour absorber les asymétries résiduelles complexes.
L’inférence par bootstrap dispense l’analyste de l’hypothèse de normalité des résidus pour dériver les intervalles de confiance et tester la significativité des estimateurs, sans imposer de modifications artificielles de l’échelle des variables dépendantes.
12. Protocole systématique de décision et restitution académique des résultats
12.1 Arbre de décision intégré pour l’analyste de données
Pour éviter les démarches ad hoc ou l’application désordonnée de tests d’adéquation multiples, le diagnostic de normalité sous Stata gagne à être structuré sous la forme d’un protocole d’analyse séquentiel et standardisé. La démarche décisionnelle préconisée s’articule autour des étapes méthodologiques suivantes :
- Phase 1 : Examen graphique exploratoire : Générer systématiquement un histogramme avec courbe normale superposée (
histogram, normal) complété d’un diagramme quantile-quantile (qnorm). Cette étape permet d’identifier la morphologie globale de la variable, la présence de valeurs aberrantes isolées et l’éventuelle bimodalité de la distribution. - Phase 2 : Calcul des moments empiriques : Exécuter l’instruction
summarize, detailpour extraire les valeurs de Skewness et de Kurtosis. Vérifier si les moments s’inscrivent dans l’intervalle empirique acceptable de modélisation linéaire ($|\text{Skewness}| < 1$ et $\text{Kurtosis} in [2, 4]$). - Phase 3 : Évaluation inférentielle adaptée à l’effectif :
- Si $N < 200$ : Exécuter le test de Shapiro-Wilk (
swilk) en fixant le seuil alpha nominal à 0,05. - Si $200 le N le 5,000$ : Exécuter le test de Shapiro-Francia (
sfrancia) conjointement au test omnibus de D’Agostino-Pearson (sktest). - Si $N > 5,000$ : Relativiser la significativité des p-valeurs formelles et prioriser l’examen de l’amplitude du coefficient $W’$ et des moments standardisés.
- Si $N < 200$ : Exécuter le test de Shapiro-Wilk (
- Phase 4 : Choix de la stratégie de traitement :
- En cas de non-rejet de l’hypothèse nulle : Conserver les méthodes paramétriques classiques sous hypothèse gaussienne.
- En présence d’asymétrie sévère sans changement de signe : Appliquer la transformation logarithmique ou la procédure de Box-Cox (
boxcox). - En présence de leptokurticité modérée sur grand échantillon : Invoquer le théorème central limite et adjoindre l’estimateur de variance robuste
vce(robust). - Sur petit échantillon en infraction distributionnelle sévère : Basculer vers l’inférence par rééchantillonnage bootstrap (
bootstrap) ou les tests non paramétriques sur les rangs.
12.2 Bonnes pratiques de communication des diagnostics selon les normes scientifiques
La restitution académique des diagnostics de normalité dans les sections méthodologiques des mémoires, thèses ou publications scientifiques évaluées par les pairs doit respecter des standards d’exhaustivité et de transparence statistique. Les formulismes vagues du type « la normalité a été vérifiée graphiquement » doivent être proscrits au profit d’énoncés précis détaillant les métriques calculées, les statistiques de test mobilisées et les niveaux de probabilité associés.
Voici un modèle rédactionnel recommandé pour présenter l’audit de normalité d’une variable dépendante continue :
« La conformité de la distribution de la variable de consommation énergétique (mpg) à l’hypothèse de normalité a fait l’objet d’un audit distributionnel approfondi. L’évaluation de la morphologie empirique met en évidence un coefficient d’asymétrie modéré de 0,39 (erreur-type = 0,28) et un coefficient d’aplatissement de 3,17 (erreur-type = 0,55), s’inscrivant dans l’intervalle d’ellipticité standard. Le test d’adéquation de Shapiro-Wilk confirme le non-rejet de l’hypothèse nulle de normalité univariée au sein de notre échantillon (W = 0,981, V = 1,18, z = 0,36, p = 0,359). Ces résultats sont corroborés par le tracé du diagramme quantile-quantile (Q-Q plot), attestant d’un alignement uniforme des quantiles observés le long du vecteur théorique diagonal, justifiant l’application ultérieure des modèles paramétriques linéaires ordinaires. »
Dans le cas d’une analyse multivariée ou d’une régression complexe ayant nécessité le recours à une correction robuste, la justification méthodologique doit expliciter le choix des estimateurs retenus :
« L’examen post-estimation des perturbations résiduelles standardisées révèle une violation de l’hypothèse de normalité (test omnibus de D’Agostino-Pearson : Chi-deux ajusté(2) = 14,82, p < 0,001 ; Mardia Kurtosis = 28,45, p = 0,004). En conséquence, et pour prémunir notre inférence contre les risques de sur-rejet d'hypothèse de type I liés aux queues épaisses résiduelles, l'ensemble des erreurs-types associées aux estimateurs a été calculé au moyen d'un rééchantillonnage bootstrap empirique avec correction d'accélération et de biais (BCa) fondé sur 2 000 réplications aléatoires avec remise. »
12.3 Automatisation et reproductibilité des diagnostics sous Stata
Dans un contexte de recherche moderne exigeant une stricte reproductibilité des calculs, le diagnostic de normalité ne doit pas être conduit de manière interactive et morcelée au sein de la ligne de commande, mais formalisé à travers un script de programmation complet (do-file) structuré et documenté. L’automatisation via des structures itératives permet de tester rapidement un ensemble de variables tout en centralisant les résultats au sein de matrices d’exportation réutilisables.
Le bloc de code ci-après montre l’utilisation d’une boucle itérative foreach pour évaluer séquentiellement une liste de variables continues et compiler leurs métriques d’asymétrie, d’aplatissement et de Shapiro-Wilk :
capture log close
log using "audit_normalite.log", text replace
sysuse auto, clear
local var_audit price mpg weight displacement trunk
display "----------------------------------------------------------------------"
display " VARIABLE | SKEWNESS | KURTOSIS | W SHAPIRO | P-VALUE (SWILK) "
display "----------------------------------------------------------------------"
foreach v of local var_audit {
quietly summarize `v', detail
local sk = r(skewness)
local ku = r(kurtosis)
quietly swilk `v'
local w_stat = r(W)
local p_stat = r(p)
display as text %-15s "`v'" " | " as result %8.4f `sk' " | " %8.4f `ku' " | " %9.5f `w_stat' " | " %15.5f `p_stat'
}
display "----------------------------------------------------------------------"
log close
Ce script extrait dynamiquement les scalaires calculés stockés en mémoire dans les structures système r(), puis formate les résultats sous une table consolidée claire. Cette approche évite les saisies redondantes, garantit l’auditabilité intégrale de la chaîne de traitement et assure la traçabilité des diagnostics préalables à la modélisation statistique définitive.
Références
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- D’Agostino, R. B., & Pearson, E. S. (1973). Tests for departure from normality. Empirical results for the distributions of $b_2$ and $\sqrt{b_1}$. Biometrika, 60(3), 613–622. https://doi.org/10.1093/biomet/60.3.613
- Doornik, J. A., & Hansen, H. (2008). An omnibus test for univariate and multivariate normality. Oxford Bulletin of Economics and Statistics, 70(s1), 927–939. https://doi.org/10.1111/j.1468-0084.2008.00537.x
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Henze, N., & Zirkler, B. (1990). A class of invariant consistent tests for multivariate normality. Communications in Statistics – Theory and Methods, 19(10), 3595–3617. https://doi.org/10.1080/03610929008830400
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519–530. https://doi.org/10.1093/biomet/57.3.519
- Royston, P. (1982). An extension of Shapiro and Wilk’s W test for normality to large samples. Journal of the Royal Statistical Society: Series C (Applied Statistics), 31(2), 115–124. https://doi.org/10.2307/2347973
- Royston, P. (1991). Approximating the Shapiro-Wilk W-test for non-normality. Statistics and Computing, 2(3), 117–119. https://doi.org/10.1007/BF01891203
- Shapiro, S. S., & Francia, R. S. (1972). An approximate analysis of variance test for normality. Journal of the American Statistical Association, 67(337), 215–216. https://doi.org/10.1080/01621459.1972.10481232
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- StataCorp. (2023). Stata Base Reference Manual: Release 18. Stata Press. https://www.stata.com/manuals/r.pdf