
Dans le domaine des sciences humaines, de la psychologie quantitative et de l’économétrie, la modélisation rigoureuse des données empiriques repose sur des postulats inférentiels stricts. Parmi ces exigences, l’hypothèse de normalité de la distribution sous-jacente conditionne l’application légitime des outils statistiques paramétriques classiques, tels que le test t de Student, l’analyse de variance (ANOVA) ou la régression linéaire standard. Lorsque ces postulats sont violés sans correction préalable, les estimations s’avèrent biaisées, augmentant de manière drastique les taux d’erreur de première ou de seconde espèce. Face à ce défi méthodologique, le chercheur ou l’analyste de données doit mobiliser des tests d’adéquation non paramétriques performants.
Le test de Kolmogorov-Smirnov se distingue comme l’un des dispositifs d’adéquation distributionnelle les plus élégants et les plus éprouvés de la statistique inférentielle. Conçu initialement pour comparer une fonction de répartition empirique à une loi théorique continue de référence, ce test opère sans nécessiter de découpage préalable des données en classes arbitraires, évitant ainsi les écueils inhérents au test du Chi-carré d’adéquation. Malgré sa sophistication mathématique, son implémentation intégrale ne requiert pas nécessairement de logiciels spécialisés ou onéreux : le logiciel Microsoft Excel offre l’ensemble des primitives fonctionnelles indispensables pour structurer, exécuter et automatiser ce test avec une précision absolue.
Ce guide exhaustif a pour vocation de vous accompagner pas à pas dans l’élaboration d’un banc de test de Kolmogorov-Smirnov complet au sein d’Excel. À travers une démarche pédagogique rigoureuse, nous aborderons les fondements probabilistes de la statistique de distance suprême, les exigences métriques propres à la psychométrie, les syntaxes fonctionnelles précises à employer, ainsi que les ajustements critiques indispensables tels que la correction de Lilliefors. En maîtrisant la décomposition transparente de chaque étape de calcul, vous consoliderez vos pratiques d’analyse de données tout en garantissant une traçabilité totale de vos inférences empiriques.
1. Fondements théoriques et pertinence du test de Kolmogorov-Smirnov en psychométrie
1.1 Origine et définition de la statistique de Kolmogorov-Smirnov
Les origines historiques du test d’adéquation distributionnelle remontent aux travaux fondamentaux des mathématiciens russes Andreï Kolmogorov, qui posa en 1933 les bases de la distribution asymptotique des écarts empiriques, et Vladimir Smirnov, qui étendit ces théorèmes en 1939 aux comparaisons bilatérales entre deux échantillons indépendants. Ce cadre probabiliste s’inscrit au cœur de la statistique non paramétrique, un domaine qui s’affranchit de présupposés stricts quant à la structure fonctionnelle de la population d’origine. Contrairement aux tests basés sur les moments d’ordre supérieur, le principe de Kolmogorov-Smirnov repose intégralement sur la comparaison globale de deux fonctions de distribution cumulative continue : d’une part, la fonction de distribution empirique générée par l’observation de l’échantillon, et d’autre part, la fonction de répartition théorique issue d’un modèle formel.
Une distinction méthodologique essentielle doit être opérée entre le test d’adéquation à un échantillon et le test d’homogénéité à deux échantillons. La version à un échantillon vise à vérifier si un ensemble d’observations peut être considéré comme issu d’une population gouvernée par une loi de probabilité spécifique, telle que la loi normale, la loi exponentielle ou la loi uniforme. La version à deux échantillons s’attache quant à elle à déterminer si deux jeux de données indépendants proviennent de la même population continue non spécifiée. Dans le cadre de cet article, nous focaliserons notre attention sur le test d’adéquation à un échantillon appliqué à l’hypothèse de normalité, pierre angulaire de l’analyse inférentielle.
Le rôle de cette procédure est capital lors des étapes préliminaires d’audit de données. En psychométrie et en sciences sociales, la vérification des postulats distributionnels ne constitue pas un simple formalisme académique, mais une condition nécessaire à la validité des modèles prédictifs. Avant d’engager des modélisations structurelles ou des calculs de fidélité métrique, s’assurer que la fonction empirique ne s’éloigne pas de manière significative de la trajectoire théorique permet de prémunir l’analyste contre des conclusions inférentielles infondées.
1.2 L’importance de l’hypothèse de normalité en psychologie quantitative
La psychologie quantitative et la psychométrie contemporaine opèrent fréquemment avec des variables latentes appréhendées par le biais d’échelles de mesure composites, à l’instar des inventaires de personnalité, des tests d’intelligence générale ou des échelles d’évaluation neuropsychologique. La quasi-totalité des paradigmes inférentiels classiques repose sur le théorème central limite et fait l’hypothèse d’une distribution gaussienne des résidus d’échantillonnage. Lorsque les distributions observées présentent des asymétries prononcées ou des queues anormalement épaisses, les tests de comparaison de moyennes comme le test t de Student ou les analyses factorielles voient leur robustesse substantiellement érodée.
L’asymétrie distributionnelle altère profondément la puissance statistique des tests paramétriques, c’est-à-dire leur capacité à détecter un effet réel lorsqu’il existe véritablement au sein de la population. Dans le contexte de l’évaluation clinique, un biais d’échantillonnage induisant une déviation par rapport à la courbe en cloche peut conduire à une surévaluation ou une sous-évaluation systématique du score standardisé d’un sujet, compromettant le diagnostic différentiel. Les questionnaires standardisés doivent ainsi garantir une stabilité métrique rigoureuse, où chaque échelon de score reflète fidèlement la progression du trait sous-jacent sans distorsion de la variance.
La violation non corrigée du postulat de normalité a des répercussions directes sur l’inflation du taux d’erreur de première espèce, conduisant le chercheur à rejeter indûment l’hypothèse nulle d’absence de différence. De manière symétrique, l’erreur de seconde espèce peut s’en trouver accrue, masquant des variations cliniques substantielles. Dès lors, le recours à un test de conformité rigoureux en amont de toute manipulation analytique devient un impératif épistémologique pour garantir la reproductibilité et la solidité des inférences psychométriques.
1.3 Propriétés mathématiques de la statistique D
D’un point de vue analytique, la statistique de test, conventionnellement désignée par la lettre D, mesure la distance supremum, c’est-à-dire le plus grand écart absolu constaté verticalement entre la fonction de répartition cumulative théorique et la fonction de distribution cumulative empirique. Mathématiquement, pour un échantillon d’observations ordonnées, cette grandeur se formalise par la borne supérieure de la différence absolue sur l’ensemble de l’axe réel. Cette formulation géométrique confère au test une interprétation visuelle directe : il s’agit de localiser le point sur l’abscisse où l’écart vertical entre la courbe continue modélisée et l’escalier des données observées atteint son apogée.
Une propriété fondamentale de la statistique D réside dans son invariance d’échelle face à toute transformation strictement croissante des variables continues d’origine. Cette invariance découle du fait que la fonction de répartition empirique opère une projection des observations sur l’intervalle unitaire fermé compris entre zéro et un. Que les scores psychométriques soient exprimés en millisecondes de temps de réaction, en points bruts d’une échelle d’anxiété ou en centimètres, la métrique sous-jacente à la comparaison demeure universelle et standardisée, éliminant tout artefact lié au choix arbitraire des unités physiques de mesure.
Néanmoins, il convient de souligner une caractéristique structurelle propre à la statistique de Kolmogorov-Smirnov : sa sensibilité différentielle le long du continuum de la variable. En raison des propriétés mathématiques du processus empirique sous-jacent, le test manifeste une vigilance maximale autour de la médiane de la distribution, zone où les densités de probabilité cumulées s’accumulent le plus rapidement. En contrepartie, il tend à présenter une sensibilité relative plus modérée au niveau des queues de distribution, comportement qui justifie une attention particulière lorsque l’évaluation de valeurs extrêmes ou aberrantes constitue l’enjeu central de la recherche.
2. Formulation des hypothèses et cadre méthodologique du test
2.1 Définition rigoureuse de l’hypothèse nulle et de l’alternative
L’articulation du test de Kolmogorov-Smirnov au sein du paradigme de la décision statistique requiert une formulation probabiliste sans ambiguïté des propositions théoriques en concurrence. L’hypothèse nulle, notée conventionnellement H0, stipule que les données observées proviennent d’une population dont la fonction de répartition cumulative réelle est strictement identique à la fonction de distribution théorique spécifiée a priori. Dans le cadre de notre problématique de normalité, H0 postule que la variable aléatoire sous-jacente suit une loi normale d’espérance mathématique mu et d’écart-type sigma donnés.
À l’opposé, l’hypothèse alternative, formalisée par H1, pose l’existence d’une divergence mesurable en au moins un point du domaine de définition. Cela signifie qu’il existe au moins une valeur de l’abscisse pour laquelle la proportion cumulée empirique diffère significativement de la probabilité cumulée modélisée par la loi normale théorique. Il s’agit d’un test fondamentalement bilatéral et non directionnel, car il sanctionne indifféremment une accumulation prématurée des probabilités (asymétrie positive), un retard de cumul (asymétrie négative) ou un étalement discordant des observations (aplatissement anormal).
Une distinction statistique d’une importance capitale doit être opérée à ce stade. Lorsque la distribution théorique est entièrement spécifiée en amont par la théorie, avec des paramètres mu et sigma fixés sans aucune référence aux données observées, le test de Kolmogorov-Smirnov standard s’applique dans sa forme exacte. En revanche, si ces paramètres fondamentaux doivent être estimés à partir de l’échantillon lui-même au moyen de la moyenne empirique et de l’écart-type d’échantillon, la distribution d’échantillonnage de la statistique D s’en trouve comprimée, imposant un ajustement critique du cadre décisionnel que nous expliciterons ultérieurement.
2.2 Fixation du seuil de significativité alpha
La fixation du risque de première espèce, désigné par la lettre grecque alpha, matérialise le seuil probabiliste au-delà duquel l’analyste accepte de rejeter l’hypothèse nulle alors même que celle-ci serait vraie. Dans les standards de la recherche quantitative en psychologie et en sciences sociales, la convention académique consacre généralement un seuil alpha fixé à 0,05, ce qui correspond à une marge d’erreur tolérée de 5 % d’affirmation erronée d’un écart à la normalité. Des contextes cliniques plus restrictifs ou des démarches de validation d’instruments de diagnostic peuvent exiger des seuils plus sévères, fixés à 0,01 voire 0,001.
Le chercheur doit néanmoins appréhender avec lucidité la relation dynamique reliant la taille de l’échantillon au risque de rejet. Sur des échantillons de taille modeste, un seuil alpha de 0,05 peut s’avérer insuffisant pour rejeter H0 en présence de déviations modérées, en raison d’une puissance statistique restreinte. Inversement, face à de grands jeux de données comptant plusieurs centaines ou milliers d’individus, la moindre variation infinitésimale par rapport à la gaussienne théorique, sans portée pratique réelle, conduira systématiquement à une p-valeur infinitésimale et au rejet d’H0.
Dans une perspective de science ouverte et de réplication empirique rigoureuse, la transparence méthodologique impose de définir et de justifier le niveau d’alpha préalablement à l’extraction des données d’Excel. Ajuster le seuil a posteriori en fonction de la proximité du résultat aux frontières de décision violerait les principes directeurs de l’inférence statistique et dégraderait la reproductibilité de l’étude menée.
2.3 Conditions d’application et exigences métriques
L’application rigoureuse du test de Kolmogorov-Smirnov est subordonnée au respect de conditions d’application précises définies par la théorie mathématique. La première exigence stipule que la variable étudiée doit être rigoureusement continue et mesurée sur une échelle d’intervalles égaux ou une échelle de rapports. Le test s’appuie en effet sur l’hypothèse que la probabilité d’observer deux valeurs rigoureusement identiques est théoriquement nulle, condition nécessaire pour que la fonction de répartition théorique soit strictement croissante et dérivable sur l’ensemble de son domaine.
La seconde condition fondamentale réside dans l’indépendance statistique stricte des observations au sein de l’échantillon d’analyse. Les données doivent avoir été recueillies selon un schéma d’échantillonnage aléatoire simple, garantissant que la mesure d’un participant n’exerce aucune influence directe ou indirecte sur celle d’un autre. Les plans d’expérimentation impliquant des mesures répétées dans le temps ou des regroupements hiérarchiques (comme des élèves nichés dans des classes scolaires) enfreignent ce principe et requièrent des modélisations mixtes préalables à toute évaluation globale.
Cette contrainte de continuité soulève une difficulté méthodologique aiguë dans le traitement des inventaires psychométriques modernes, largement dominés par les échelles de type Likert en cinq ou sept points. Bien que ces données ordinales soient fréquemment sommées pour constituer des scores composites traités ensuite comme des grandeurs quantitatives, la présence inhérente d’ex æquo (valeurs répétées identiques) et la troncature structurelle des échelles altèrent les hypothèses du test. L’analyste doit être pleinement conscient de ces approximations lorsqu’il applique la statistique D à des scores psychologiques discrétisés.
3. Préparation et structuration des données expérimentales dans Excel
3.1 Saisie et nettoyage préliminaire du jeu de données
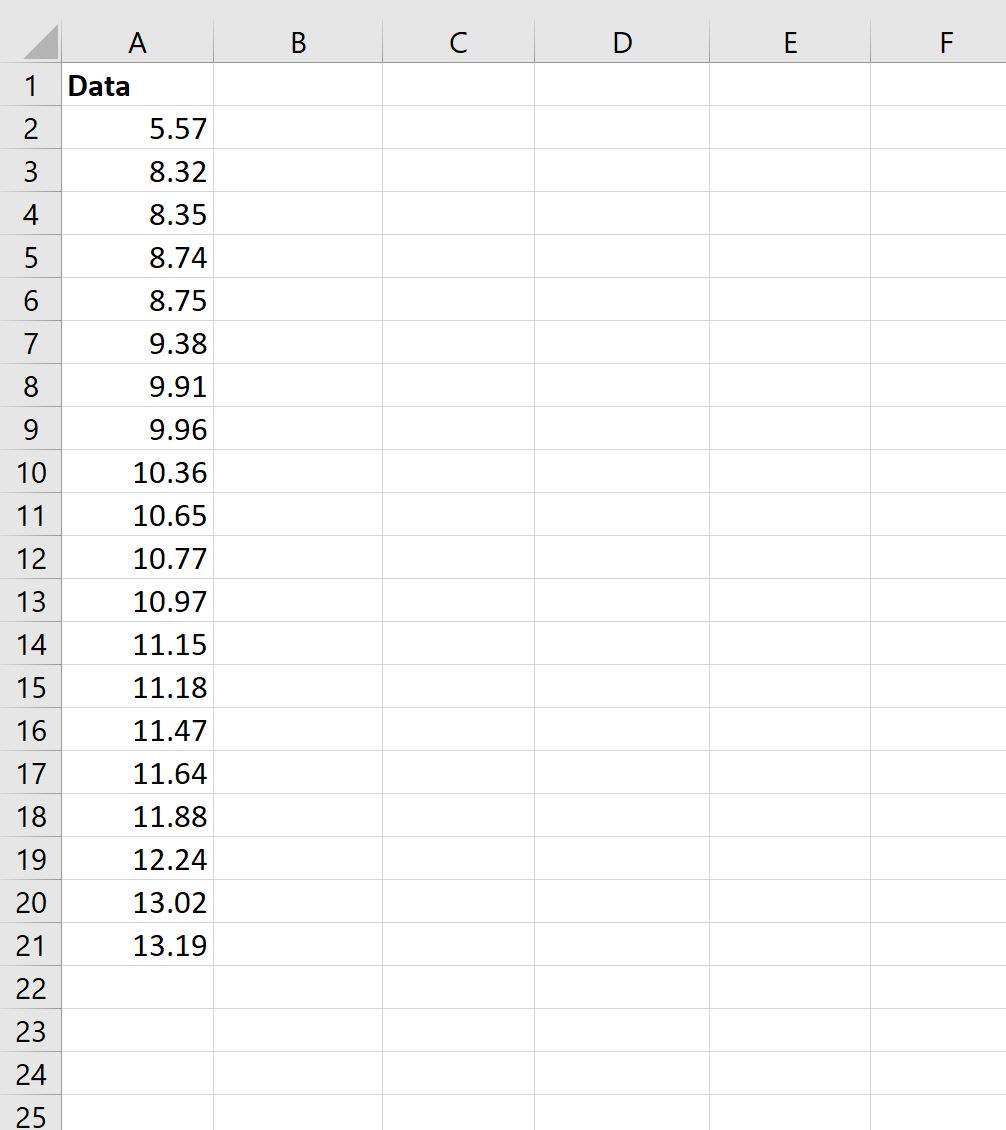
La réussite d’un calcul statistique complexe au sein d’Excel repose sur une discipline irréprochable d’agencement des données tabulaires. Pour garantir l’intégrité de la chaîne de traitement, le jeu de données brutes doit impérativement être consigné au sein d’une colonne vectorielle unique et continue, que nous désignerons par convention comme la colonne A, en réservant la cellule A1 pour l’en-tête nominatif de la variable (par exemple : Score_Anxiete). Aucun élément textuel, aucun séparateur vide ou total intermédiaire ne doit s’insérer au milieu de la plage de valeurs d’échantillonnage.
Une phase de nettoyage méthodique s’impose avant tout calcul algorithmique. Les erreurs de saisie numérique, telles que l’utilisation par inadvertance d’un point décimal au lieu d’une virgule (selon la configuration régionale des paramètres linguistiques de votre version d’Excel), constituent la première source d’échec des formules mathématiques, convertissant silencieusement des valeurs numériques en chaînes de texte ignorées par les fonctions de sommation. Il est recommandé de recourir à l’outil de validation des données d’Excel pour interdire toute entrée non comprise dans l’intervalle théorique admissible de votre instrument de mesure.
Par ailleurs, l’analyste doit identifier et traiter rigoureusement les cellules dépourvues de valeur. En statistique inférentielle, une omission involontaire ne saurait être implicitement assimilée à un score nul. Les observations incomplètes doivent être soit isolées par filtrage pour réaliser une analyse sur cas complets, soit soumises à une procédure d’imputation méthodique si le protocole expérimental le justifie, en veillant à ne pas altérer artificiellement la variance d’échantillonnage de la distribution.
3.2 Tri impératif des observations par ordre croissant
La construction de la fonction de répartition empirique exige formellement que les données soient structurées sous la forme d’une suite monotone non décroissante, désignée en mathématiques sous le vocable de statistique d’ordre. Sans cette opération séquentielle préalable, l’évaluation des probabilités cumulées par observation perdrait toute signification logique. L’analyste doit donc procéder au tri physique des données brutes au sein de la feuille de calcul.
Pour exécuter cette opération sans risque d’altération de la cohérence matricielle, sélectionnez l’intégralité de la colonne de données, dirigez-vous vers l’onglet Données du ruban Excel, puis activez la commande Trier de A à Z (ou du plus petit au plus grand). Si votre classeur comporte des colonnes adjacentes contenant des identifiants de participants ou des variables secondaires, veillez à valider l’option invitant à étendre la sélection afin de préserver l’appariement unitaire de chaque ligne expérimentale.
Une fois l’opération exécutée, un contrôle visuel immédiat s’impose. Vérifiez scrupuleusement que la première observation située en cellule A2 correspond effectivement au minimum observé dans votre étude, et que la dernière cellule occupée de la colonne reflète le maximum empirique absolu. Cette vérification prévient les décalages de rang qui fausseraient l’estimation subséquente des échelons de probabilité cumulée.
3.3 Organisation de la matrice de calcul pour la transparence analytique
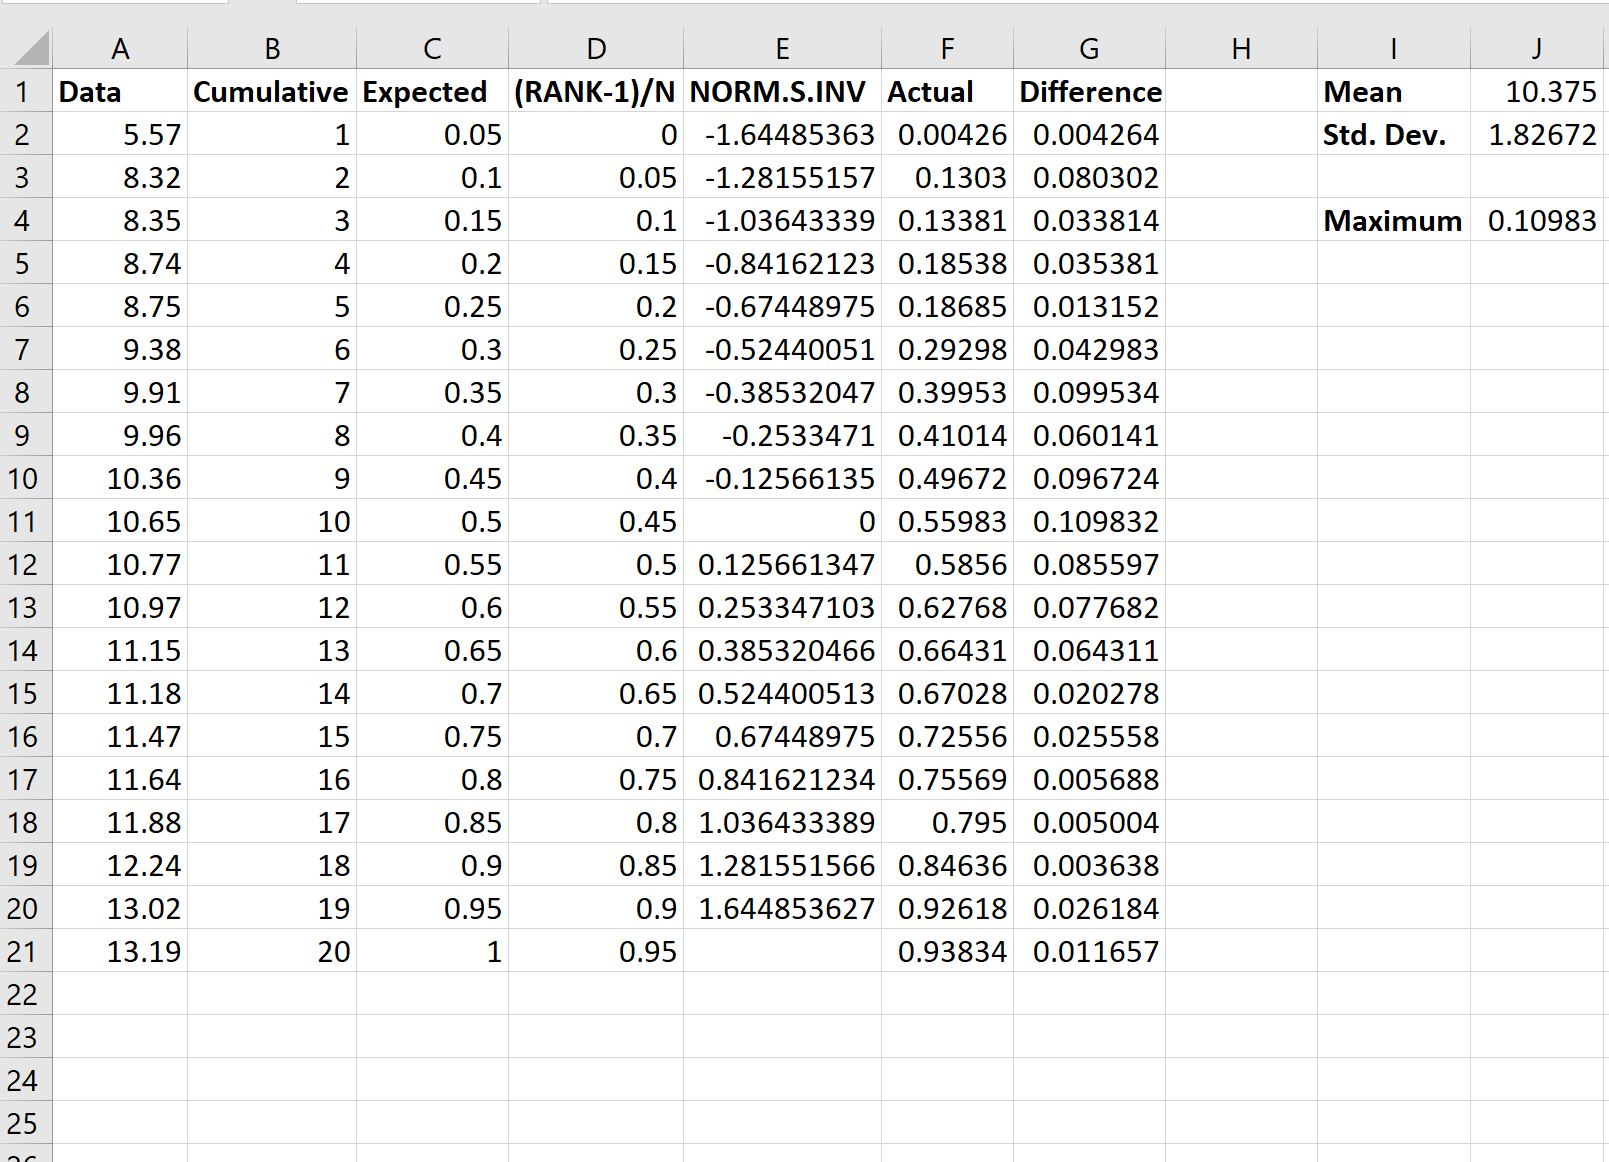
L’élaboration d’un modèle d’audit transparent dans Excel implique de segmenter les opérations intermédiaires en colonnes distinctes et clairement identifiées. Cette pratique permet d’isoler chaque composante du calcul mathématique, facilitant ainsi la vérification par des pairs et l’audit méthodologique. Nous structurerons la feuille de calcul en réservant les colonnes A à H pour le déroulement séquentiel du test, tandis qu’un bloc latéral dédié hébergera les paramètres d’échantillon globaux.
Attribuez des libellés précis à la première ligne de chaque colonne : la colonne A accueille les données ordonnées brutes x_i, la colonne B reçoit l’indice de rang i, la colonne C accueille la fonction de répartition empirique supérieure S(x_i), la colonne D enregistre la fonction empirique inférieure S(x_i-1), la colonne E héberge les valeurs de la fonction de répartition théorique normale F(x_i), tandis que les colonnes F et G mesurent respectivement les écarts verticaux absolus supérieur D+ et inférieur D-. La colonne H peut être utilisée pour enregistrer le maximum local d’écart par observation.
Parallèlement, réservez un encadré sur les colonnes J et K pour y implémenter les paramètres descriptifs globaux. Les cellules J1 à J3 accueilleront les libellés de la taille d’échantillon n, de la moyenne arithmétique et de l’écart-type d’échantillon, tandis que les cellules adjacentes K1 à K3 accueilleront les formules automatisées correspondantes. Lors de la saisie ultérieure des formules sur l’ensemble de la colonne d’observations, l’usage des références absolues au moyen du symbole dollar (comme $K$1 et $K$2) garantira le verrouillage strict de ces paramètres invariants lors de l’incrémentation automatique vers le bas.
4. Calcul des paramètres descriptifs fondamentaux dans Excel
4.1 Détermination de la taille de l’échantillon avec la fonction NB
Le calcul de la dimension de l’échantillon analysé, conventionnellement notée n, constitue le point de départ de tout le processus d’indexation cumulative. Dans l’environnement Excel, cette grandeur doit être quantifiée de manière dynamique au moyen de la fonction native NB. En insérant dans la cellule K1 la syntaxe =NB(A2:A1000) (en adaptant la plage à la dimension réelle de votre jeu de données), le classeur évalue instantanément le nombre de valeurs purement numériques présentes dans le vecteur d’entrée, sans risque d’interférence avec les cellules vides éventuelles.
La précision de cette valeur est capitale, car elle intervient directement comme dénominateur commun de toutes les fractions de probabilité empirique que nous serons amenés à calculer à chaque rang d’observation. De surcroît, la valeur de n constitue le paramètre central utilisé lors des étapes terminales pour déterminer les seuils critiques du test à partir des formules asymptotiques de Lilliefors.
Pour des classeurs destinés à accueillir ultérieurement de nouveaux jeux de données sans refactorisation des formules, il est possible de faire usage de plages dynamiques fondées sur la fonction DECALER ou de convertir au préalable la plage de données en un Tableau Excel structuré. Dans ce dernier cas, la référence à la colonne prendra une forme sémantique du type =NB(TableauDonnees[Scores]), garantissant que tout ajout ou retrait de sujet mettra instantanément à jour l’ensemble de la matrice de test de Kolmogorov-Smirnov.
4.2 Estimation sans biais de la moyenne arithmétique
Le centrage de la distribution théorique normale impose d’estimer l’espérance mathématique de la variable observée. À moins que cette valeur ne soit dictée a priori par des normes psychométriques populationnelles établies sur un étalonnage représentatif externe, la moyenne doit être dérivée de l’échantillon courant. Insérez dans la cellule K2 la formule =MOYENNE(A2:A1000) afin d’extraire la moyenne arithmétique de votre variable expérimentale.
Ce paramètre positionne le sommet de la fonction de densité de probabilité gaussienne et détermine le point d’inflexion central de la sigmoïde formée par la fonction de répartition cumulative théorique. En termes de probabilité intégrée, la valeur moyenne constitue le point précis où l’intégrale de la distribution normale standardisée atteint exactement la probabilité cumulée de 0,50.
Il importe de garder à l’esprit que la moyenne arithmétique présente une vulnérabilité reconnue face aux valeurs aberrantes ou aux scores extrêmes fréquents dans les échantillons cliniques. Une contamination locale de l’échantillon par des réponses atypiques peut induire un décalage substantiel du centre de gravité de la courbe normale de référence, ce qui tend à accroître artificiellement les écarts verticaux mesurés ultérieurement entre le modèle et la réalité empirique.
4.3 Estimation de l’écart-type d’échantillon
Le paramètre de dispersion de la courbe théorique est régi par l’écart-type, qui quantifie l’étalement de la distribution autour de sa tendance centrale. Pour obtenir un estimateur rigoureux et non biaisé de la variance au sein de la population parente, il est indispensable de faire appel à la formule d’échantillon intégrant la correction de Bessel (division par n-1 plutôt que par n). Dans Excel, cette estimation est garantie par l’utilisation exclusive de la fonction ECARTYPE.STANDARD.
Saisissez au sein de la cellule K3 la formulation =ECARTYPE.STANDARD(A2:A1000). L’utilisation erronée de la fonction concurrente ECARTYPE.PEARSON (qui applique une division par n) engendrerait une sous-estimation systématique de la dispersion réelle de la population, particulièrement sensible sur les petits échantillons d’analyse, et compromettrait l’exactitude de la calibration théorique ultérieure.
La valeur numérique obtenue régit la pente de la courbe sigmoïde modélisant la répartition cumulative normale : un écart-type faible traduit une concentration aiguë des observations autour de la moyenne, matérialisée par une montée très abrupte de la courbe au centre, tandis qu’un écart-type élevé produit une transition étalée et progressive entre les probabilités zéro et un.
5. Construction de la distribution cumulative empirique (ECDF)
5.1 Génération de l’indexation de rang avec la fonction LIGNE
La fonction de distribution cumulative empirique (notée ECDF pour Empirical Cumulative Distribution Function) est formellement une fonction en escalier, continue à droite et admettant des limites à gauche, qui progresse d’une valeur discrète égale à 1/n à chaque nouvelle observation distincte. Pour matérialiser cette montée échelonnée, chaque observation x_i doit être associée à son numéro d’ordre séquentiel ou rang i, variant de 1 pour la plus petite observation jusqu’à n pour la valeur maximale.
Afin de vous affranchir d’une numérotation manuelle sujette aux erreurs de saisie, implémentez dans la colonne B une formule d’indexation dynamique. Si votre première observation se situe sur la ligne 2 de la feuille de calcul (la ligne 1 étant dédiée aux en-têtes), inscrivez en cellule B2 la syntaxe :
=LIGNE()-1
En étirant cette cellule vers le bas jusqu’au terme de votre jeu de données, Excel incrémente automatiquement la valeur du rang d’une unité à chaque saut de ligne.
Ce rang i matérialise le nombre exact d’observations au sein de l’échantillon dont la valeur est inférieure ou égale au score x_i situé sur la même ligne. Il servira d’assise numérale directe au calcul des proportions relatives cumulées qui délimitent géométriquement chaque marche de l’escalier empirique.
5.2 Calcul de la proportion cumulée supérieure S(x_i)
À chaque marche i de l’escalier empirique correspond une hauteur supérieure qui intègre l’observation courante x_i dans le calcul de la probabilité cumulée observée. Cette proportion cumulée supérieure, que nous formaliserons conventionnellement par la notation S(x_i), correspond strictement au ratio i divisé par la taille totale d’échantillon n. Elle exprime la probabilité empirique d’observer une valeur inférieure ou égale à x_i.
Pour modéliser cette borne supérieure au sein de la colonne C de notre feuille Excel, insérez dans la cellule C2 la formule combinatoire faisant référence à la cellule de rang adjacente et au paramètre global n préalablement verrouillé en cellule K1 :
=B2/$K$1
Étendez cette formule par recopie incrémentée jusqu’à la dernière ligne de données de votre série.
Un mécanisme fondamental de validation interne s’opère sur cette colonne : la toute dernière cellule de la plage, correspondant au rang ultime i = n, doit afficher de manière irrévocable la valeur décimale 1,0000. Tout résultat divergent trahirait une distorsion dans le décompte de n ou une inadéquation dans le chaînage de l’indexation séquentielle des rangs.
5.3 Calcul de la proportion cumulée inférieure S(x_i-1)
En raison de la nature discontinue en échelons discrets de la distribution cumulative empirique, la distance maximale séparant cette dernière de la courbe théorique continue peut survenir soit au sommet de la marche d’escalier (sur la borne supérieure venant d’être calculée), soit immédiatement à la base de la marche, c’est-à-dire juste avant le saut infinitésimal de probabilité induit par l’observation x_i. Cette seconde valeur frontière correspond à la proportion cumulée d’observations strictement inférieures à x_i, notée mathématiquement S(x_i-1), et équivaut à la fraction (i – 1) / n.
Pour implémenter ce calcul d’une importance capitale dans la colonne D, saisissez dans la cellule D2 la formulation suivante :
=(B2-1)/$K$1
Recopiez cette syntaxe sur l’ensemble des rangs jusqu’au terme de votre échantillon.
Pour la première ligne d’observation (où le rang séquentiel i vaut 1), la valeur retournée par cette formule est rigoureusement égale à 0. Cette initialisation reflète la réalité probabiliste selon laquelle aucune observation n’est inférieure au minimum absolu du jeu de données. La double estimation de ces bornes supérieure et inférieure garantit qu’aucun écart géométrique vertical majeur n’échappera à la métrique de comparaison.
6. Modélisation de la distribution cumulative théorique normale
6.1 Paramétrage de la fonction LOI.NORMALE.N d’Excel
L’étape suivante consiste à quantifier, pour chaque observation x_i observée, la probabilité cumulée qu’aurait générée une distribution normale théorique parfaitement ajustée ayant pour paramètres la moyenne et l’écart-type estimés sur l’échantillon. Cette probabilité, désignée par F(x_i), correspond géométriquement à l’aire sous la courbe en cloche de Gauss comprise entre moins l’infini et la valeur ponctuelle x_i. Excel encapsule cette intégration mathématique complexe au sein de sa fonction LOI.NORMALE.N.
Dans la colonne E de la feuille de calcul, saisissez en cellule E2 la syntaxe complète suivante :
=LOI.NORMALE.N(A2; $K$2; $K$3; VRAI)
Cette instruction appelle le score brut issu de la cellule A2, le confronte à la moyenne de l’échantillon logée en $K$2 et à l’écart-type situé en $K$3. L’argument booléen terminal VRAI est rigoureusement obligatoire : il intime à l’algorithme d’Excel de renvoyer la fonction de distribution cumulative (l’intégrale de probabilité cumulée) et non pas la valeur de densité de probabilité au point considéré (qui correspondrait à l’argument FAUX).
En étendant cette formule vers le bas, vous générez une courbe théorique continue échantillonnée aux points précis de vos mesures réelles. Les valeurs résultantes sont nécessairement comprises dans l’intervalle ouvert ]0 ; 1[ et progressent de façon strictement monotone en conformité avec l’augmentation ordonnée des scores de la colonne A.
6.2 Option alternative via les scores z et LOI.NORMALE.STANDARD.N
Bien que la méthode directe reposant sur LOI.NORMALE.N soit particulièrement rapide, une approche alternative pédagogiquement précieuse consiste à opérer une standardisation explicite préalable des données sous la forme de cotes réduites ou scores z. Cette décomposition permet de visualiser clairement l’écart de chaque score brut à la moyenne exprimé en multiples d’écart-type, conformément à la relation classique z = (x – mu) / sigma.
Si vous privilégiez cette trajectoire pour une lisibilité didactique accrue, vous pouvez créer une colonne intermédiaire calculant le score z via l’instruction =(A2-$K$2)/$K$3. Dès lors, la probabilité cumulée théorique s’extrait par la fonction spécifique régissant la loi normale centrée réduite :
=LOI.NORMALE.STANDARD.N(cellule_z; VRAI)
D’un point de vue analytique et numérique, cette séquence standardisée produit des résultats rigoureusement indiscernables de la fonction directe LOI.NORMALE.N. Elle offre néanmoins l’avantage d’exposer clairement à l’analyste les observations s’éloignant de plus de deux ou trois écarts-types de la moyenne, fournissant un premier aperçu intuitif de la présence potentielle d’asymétries ou d’individus atypiques susceptibles d’induire le rejet final de l’hypothèse nulle.
6.3 Exploration des quantiles théoriques avec LOI.NORMALE.STANDARD.INVERSE.N
Une démarche avancée d’audit distributionnel invite souvent à inspecter la relation réciproque existant entre les proportions de rang empiriques et les projections quantilaires théoriques correspondantes. Cette approche sert de matrice algorithmique à l’élaboration des graphiques quantile-quantile (Q-Q plots). Excel dispose pour cette tâche de la fonction LOI.NORMALE.STANDARD.INVERSE.N, capable de convertir n’importe quelle probabilité cumulée p en la valeur z théorique associée sous l’hypothèse de normalité.
L’implémentation pratique requiert une précaution algorithmique essentielle : la fonction inverse normale tend vers plus l’infini lorsque l’argument p s’approche de 1, ce qui génère une erreur d’évaluation sur la dernière observation si l’on applique l’instruction directement sur la colonne S(x_i) où le rang terminal vaut exactement 1,0000. Pour contourner cet écueil mathématique, on emploie fréquemment une formule conditionnelle de sauvegarde du type :
=SI(C2<1; LOI.NORMALE.STANDARD.INVERSE.N(C2); "")
Ces quantiles projetés permettent de matérialiser les valeurs théoriques attendues pour chaque rang d’observation si la normalité était scrupuleusement respectée. Bien que cette colonne d’exploration ne soit pas directement requise pour extraire la statistique de distance D de Kolmogorov-Smirnov, elle constitue un adjuvant visuel précieux pour diagnostiquer précisément à quelle hauteur de l’échelle de mesure se matérialisent les écarts de projection les plus critiques.
7. Calcul des écarts verticaux absolus et extraction de la statistique D
7.1 Évaluation de la différence avec la borne supérieure de l’échelon
L’extraction de la statistique de Kolmogorov-Smirnov repose sur la confrontation absolue entre la trajectoire théorique et les contours de l’escalier empirique. Le premier vecteur d’écart, désigné par la métrique différentielle D+, évalue pour chaque individu de l’échantillon l’écart vertical séparant la fonction théorique modélisée F(x_i) de la borne supérieure empirique S(x_i). Mathématiquement, cette grandeur se définit par la formule :
D+ = |F(x_i) – i/n|
Pour concrétiser cette mesure au sein de la colonne F de votre classeur, inscrivez en cellule F2 l’instruction faisant intervenir la fonction de valeur absolue :
=ABS(E2-C2)
En propageant cette formule jusqu’au bas de la colonne, Excel calcule instantanément l’amplitude du différentiel au sommet de chaque marche de données.
Cette composante D+ capture spécifiquement les situations où la distribution théorique normale sous-estime la proportion cumulative réellement constatée sur l’échantillon. Un pic isolé au niveau de cette colonne traduit une concentration prématurée de scores empiriques, signalant couramment une asymétrie positive ou un phénomène de tassement des mesures vers les valeurs moyennes-basses.
7.2 Évaluation de la différence avec la borne inférieure de l’échelon
La seconde composante géométrique, désignée sous le symbole D-, quantifie la distance verticale absolue entre la distribution cumulative théorique F(x_i) et la borne inférieure de l’échelon empirique S(x_i-1). Cette différence est formellement exprimée par l’égalité :
D- = |F(x_i) – (i-1)/n|
Sur le plan opérationnel dans Excel, implémentez dans la cellule G2 la syntaxe relative :
=ABS(E2-D2)
Puis étendez cette formulation sur l’ensemble des lignes d’observations de votre matrice de traitement.
L’omission de cette composante D- constitue l’erreur la plus classique commise par les analystes construisant manuellement ce test dans un tableur. En se limitant au seul écart avec le sommet de marche D+, on occulterait les points de divergence où la courbe théorique dépasse de façon culminante l’escalier empirique juste avant que ce dernier ne s’élève, faussant ainsi à la baisse l’estimation de la véritable distance suprême.
7.3 Extraction de la divergence maximale absolue globale
La statistique D de Kolmogorov-Smirnov correspond par définition au supremum de l’ensemble des écarts D+ et D- répertoriés sur l’exhaustivité de l’échantillon. Elle représente la plus grande déviation verticale absolue possible, traduisant le pire point d’inadéquation spatiale entre le modèle gaussien proposé et la série de mesures empiriques collectées.
Pour synthétiser cette quête en une valeur scalaire unique, réservez une cellule dédiée au sein de votre bloc récapitulatif (par exemple en cellule K5, étiquetée « Statistique D »). Insérez la formule vectorielle native :
=MAX(F2:G1000)
(en adaptant la borne d’arrivée à la dernière ligne effective de vos données). Excel scrute en une fraction de seconde l’ensemble des calculs différentiels et extrait la valeur plafond de divergence.
La statistique D ainsi obtenue est intrinsèquement bornée entre 0 et 1. Une valeur de D proche de zéro traduit une concordance quasi parfaite entre les données empiriques et la loi normale de référence, tandis qu’une valeur de D substantiellement élevée indique une divergence structurelle manifeste. Cette statistique constitue l’argument d’entrée indispensable pour engager l’arbitrage décisionnel d’adéquation.
8. Détermination des valeurs critiques et calcul de la significativité
8.1 Utilisation des tables mathématiques standard de Kolmogorov-Smirnov
Une fois la statistique D observée extraite de la feuille de calcul, la phase d’inférence statistique impose de confronter cette grandeur empirique à une valeur critique seuil issue des distributions d’échantillonnage théoriques. Pour des échantillons de petite taille (n inférieur ou égal à 40), les statisticiens se réfèrent traditionnellement aux tables numériques exactes établies par Birnbaum ou Miller, qui fournissent les seuils d’acceptation en regard de n et du risque alpha consenti.
Pour des échantillons de dimension supérieure (n supérieur à 40), la théorie asymptotique formulée par Kolmogorov démontre que les seuils critiques convergent vers des fonctions proportionnelles à l’inverse de la racine carrée de n. Les formules d’approximation asymptotique canoniques pour le test standard s’expriment comme suit :
- Pour un seuil de significativité alpha = 0,05 : D_critique = 1,36 / RACINE(n)
- Pour un seuil de significativité alpha = 0,01 : D_critique = 1,63 / RACINE(n)
- Pour un seuil de significativité alpha = 0,10 : D_critique = 1,22 / RACINE(n)
Au sein de votre classeur Excel, il est aisé de modéliser ce seuil critique théorique standard en inscrivant dans une cellule dédiée (par exemple en K6) la formule :
=1,36/RACINE($K$1)
Si la statistique D calculée en K5 est strictement inférieure au résultat de cette formule, l’hypothèse nulle d’adéquation ne peut être formellement rejetée au seuil de confiance de 95 %.
8.2 La correction de Lilliefors : un ajustement indispensable
Une nuance méthodologique d’une importance extrême doit être introduite ici. Les seuils standards décrits au paragraphe précédent ne sont valides que sous l’hypothèse restrictive où la moyenne et l’écart-type de la loi normale théorique sont des constantes spécifiées a priori, en dehors de toute influence des données observées. Or, dans la quasi-totalité des recherches psychométriques réelles, ces deux paramètres sont directement estimés sur l’échantillon au moyen de MOYENNE et ECARTYPE.STANDARD.
Comme l’a démontré le statisticien Hubert Lilliefors en 1967, l’utilisation de paramètres estimés rapproche mécaniquement la courbe théorique normale de la fonction empirique correspondante. Il en résulte un biais conservateur sévère : la statistique D calculée est artificiellement comprimée par rapport à ce qu’elle serait sous des paramètres fixes, de sorte que l’application de la table standard de Kolmogorov conduit à sous-rejeter massivement l’hypothèse nulle, augmentant dangereusement l’erreur de type II.
Pour restaurer la rigueur du test lorsque les paramètres sont inférés de l’échantillon, il est impératif d’utiliser les formules asymptotiques ajustées issues de la table de Lilliefors. Pour un seuil alpha fixé à 0,05, la valeur critique ajustée ne s’évalue plus par le coefficient 1,36, mais par le coefficient beaucoup plus strict de 0,886 (certains manuels retiennent 0,895 selon les approximations numériques) :
D_Lilliefors = 0,886 / RACINE(n)
Dans votre feuille Excel, saisissez impérativement en cellule K7 la formule :
=0,886/RACINE($K$1)
C’est à cette valeur critique corrigée que votre statistique D observée doit être rigoureusement comparée.
8.3 Approximation de la p-valeur dans les feuilles de calcul
Bien que l’extraction directe de la p-valeur exacte associée au test de Kolmogorov-Smirnov avec correction de Lilliefors ne soit pas couverte par une fonction native simple d’Excel, il est possible d’implémenter des approximations polynomiales empiriques de haute fidélité documentées dans la littérature statistique spécialisée, notamment les approximations proposées par Dallal et Wilkinson (1986).
Pour un échantillon où n est suffisant, et lorsque la statistique D observée se situe dans la plage standard des rejets potentiels, la p-valeur sous correction de Lilliefors peut être approchée au moyen de la formule mathématique suivante :
P = exp(-7,012 * D^2 * n – 2,995 * D * RACINE(n) + 0,166)
Cette relation analytique peut être transcrite directement dans une cellule d’Excel en combinant les fonctions EXP et RACINE appliquées à vos cellules de paramètres existantes :
=EXP(-7,012 * PUISSANCE($K$5; 2) * $K$1 - 2,995 * $K$5 * RACINE($K$1) + 0,166)
Cette approximation numérique n’est valide que pour les p-valeurs inférieures à 0,10. Pour formaliser un statut binaire de décision automatisé sans risque d’erreur d’interprétation des approximations extrêmes, vous pouvez insérer dans une cellule d’état la fonction logique :
=SI($K$5 > $K$7; "Rejet de la normalité (H0 rejetée)"; "Adéquation à la loi normale (H0 non rejetée)")
Cette formulation sécurise l’arbitrage en liant dynamiquement la décision au franchissement du seuil critique officiel de Lilliefors.
9. Interprétation statistique et intégration aux rapports de recherche
9.1 Règles de décision statistique formelles
L’arbitrage formel de l’analyse inférentielle repose sur une confrontation binaire entre la métrique empirique et le seuil d’admissibilité théorique. Si la statistique de divergence D calculée sur votre jeu de données se révèle strictement supérieure à la valeur critique corrigée de Lilliefors (D_obs > D_crit), l’analyste se trouve dans l’obligation méthodologique de rejeter l’hypothèse nulle H0. L’inférence en conclut que l’écart séparant l’échantillon de la loi normale est trop marqué pour être raisonnablement imputable aux seules fluctuations aléatoires d’échantillonnage au risque alpha consenti.
Inversement, dans l’hypothèse où la statistique D observée demeure strictement inférieure au seuil critique (D_obs <= D_crit), la règle de décision impose de ne pas rejeter l’hypothèse nulle. Il s’agit d’un point d’ancrage épistémologique crucial trop souvent malmené : le non-rejet d’H0 ne prouve en aucun cas que la population d’origine est rigoureusement gaussienne. Il atteste simplement que les données disponibles ne fournissent pas de preuves statistiques suffisantes pour invalider l’approximation d’une distribution normale à ce niveau de puissance d’observation.
Cette distinction s’avère particulièrement prégnante lors du traitement d’échantillons restreints en milieu universitaire ou clinique. Une situation de non-rejet face à un échantillon réduit (par exemple n = 20) peut masquer un déficit criant de puissance statistique du test plutôt qu’une concordance réelle avec le modèle gaussien. La vigilance méthodologique interdit d’affirmer de manière dogmatique la normalité absolue d’une série métrique sur la seule base d’une absence de significativité statistique.
9.2 Rédaction des résultats selon les normes académiques et APA
La communication des résultats statistiques au sein des revues scientifiques internationales exige le respect des normes éditoriales formalisées par l’American Psychological Association (normes APA, 7e édition). Selon ces directives, la présentation d’un test d’adéquation distributionnelle doit expliciter la statistique de test mise en œuvre, la taille d’échantillon prise en compte, la valeur exacte de la distance D, ainsi que la p-valeur associée ou la référence explicite au seuil critique mobilisé.
Un modèle de rédaction académique standardisé peut être formulé selon les termes suivants :
« L’adéquation de la distribution des scores à l’hypothèse de normalité a été évaluée au moyen du test de Kolmogorov-Smirnov avec correction de Lilliefors. Les analyses révèlent que la distribution observée des scores d’anxiété ne s’écarte pas de manière statistiquement significative du modèle gaussien théorique, D(45) = 0,094, p > 0,05. En conséquence, l’application des procédures statistiques paramétriques apparaît méthodologiquement recevable pour cette variable. »
Dans l’éventualité où la normalité serait réfutée, la restitution textuelle doit être adaptée :
« Le test de Kolmogorov-Smirnov avec correction de Lilliefors indique une violation statistiquement significative du postulat de normalité pour le score de performance cognitive, D(120) = 0,142, p < 0,01. La distribution empirique présente un profil significativement discordant par rapport au modèle gaussien de référence. »
Cette transparence dans la communication scientifique garantit que les lecteurs et réviseurs puissent évaluer avec clarté la robustesse métrique des modélisations ultérieures.
9.3 Conséquences décisionnelles sur les analyses subséquentes
L’issue du test de Kolmogorov-Smirnov agit comme un aiguillage directionnel déterminant la suite des opérations analytiques au sein de votre protocole de recherche. Lorsque l’hypothèse de normalité est confortée par le test (non-rejet d’H0), le chercheur est légitimé à poursuivre l’exploitation des outils statistiques paramétriques à pleine puissance : calcul des corrélations de Pearson, régressions linéaires multiples, analyses factorielles exploratoires ou de variance factorielle.
En revanche, face au rejet franc de l’hypothèse de normalité, trois avenues méthodologiques distinctes s’offrent à l’analyste :
- Le basculement vers l’arsenal non paramétrique : Délaisser les tests de comparaison de moyennes au profit d’alternatives fondées sur l’analyse des rangs, telles que le test de Mann-Whitney (en lieu et place du test t pour échantillons indépendants), le test des rangs signés de Wilcoxon (pour mesures répétées) ou l’analyse de variance par rangs de Kruskal-Wallis (alternative à l’ANOVA unidirectionnelle).
- L’application de transformations stabilisatrices : Soumettre la variable brute à une transformation mathématique continue non linéaire afin de corriger les dissymétries structurelles. Les transformations courantes comprennent la fonction logarithmique naturelle
=LN(x)pour les asymétries positives marquées, la racine carrée=RACINE(x)pour les asymétries modérées, ou les familles de transformations paramétrées de Box-Cox. Le test de Kolmogorov-Smirnov doit alors être réappliqué sur la nouvelle variable transformée pour valider l’obtention effective d’une configuration gaussienne. - Le recours à l’inférence par rééchantillonnage (Bootstrapping) : Générer des distributions d’échantillonnage empiriques par tirages répétés avec remise, méthode particulièrement robuste et largement tolérante aux déviations de normalité pour l’estimation d’intervalles de confiance sans biais.
10. Confrontation critique : Kolmogorov-Smirnov face aux tests alternatifs dans Excel
10.1 Le test de Shapiro-Wilk : puissance et sensibilité
Dans l’arsenal des tests d’adéquation distributionnelle, le test de Shapiro-Wilk est quasi unanimement reconnu par les statisticiens théoriciens comme le dispositif offrant la puissance statistique la plus élevée face à un large spectre d’alternatives non gaussiennes, particulièrement pour les échantillons de taille modeste ou intermédiaire (n compris entre 10 et 50 observations). Fondé sur le rapport entre l’estimateur de la variance dérivé des statistiques d’ordre pondérées et l’estimateur usuel de la somme des carrés des écarts, il surpasse généralement le test de Kolmogorov-Smirnov standard en termes de capacité de détection des asymétries légères.
Néanmoins, le test de Shapiro-Wilk présente un coût d’implémentation algorithmique prohibitif au sein des feuilles de calcul brutes d’Excel. Son calcul requiert l’accès à des tables étendues de coefficients vectoriels de pondération empirique (les constantes a_i), dont les valeurs dépendent strictement de la taille n exacte de l’échantillon et de l’inversion de matrices de covariance complexes de statistiques d’ordre. Sans recourir à des macros VBA ou à des compléments spécialisés externes, son implémentation intégrale dans une grille Excel classique demeure d’une complexité décourageante pour l’utilisateur usuel.
À cet égard, la matrice de Kolmogorov-Smirnov détaillée dans notre méthodologie offre un compromis exceptionnel : bien que dotée d’une puissance marginalement inférieure sur les très faibles échantillons, elle s’élabore à partir de fonctions mathématiques standardisées universellement disponibles dans toutes les versions d’Excel, offrant une transparence de calcul et une traçabilité didactique inégalables.
10.2 Le test d’Anderson-Darling et sa sensibilité aux queues de distribution
Le test d’Anderson-Darling constitue une modification structurelle directe de la statistique de Cramér-von Mises et partage des liens de filiation évidents avec le test de Kolmogorov-Smirnov. Sa spécificité majeure réside dans l’intégration d’une fonction de pondération quadratique au dénominateur qui pénalise fortement les écarts survenant aux extrémités de la distribution, zones où les probabilités F(x) tendent vers 0 ou vers 1.
Cette particularité confère au test d’Anderson-Darling une vigilance analytique supérieure pour l’évaluation des pathologies de distribution caractérisées par des queues lourdes ou des aplatissements prononcés (leptokurtose). En recherche psychopathologique, où les comportements d’intérêt se traduisent fréquemment par des manifestations critiques situées aux extrêmes de l’échelle d’évaluation, ce test s’avère souvent plus informatif que le test de Kolmogorov-Smirnov, dont la statistique supremum D est naturellement dominée par les fluctuations survenant autour de la médiane.
Bien que son calcul vectoriel dans Excel soit plus accessible que celui de Shapiro-Wilk, il exige la sommation séquentielle d’expressions logarithmiques pondérées complexes pouvant devenir instables face à des données répétées ou en présence de petites erreurs d’arrondi numérique. Le test de Kolmogorov-Smirnov demeure par sa sobriété géométrique l’outil d’initiation et de diagnostic de référence le plus pédagogique en environnement tabulaire.
10.3 Indices d’asymétrie (Skewness) et d’aplatissement (Kurtosis)
Une évaluation distributionnelle rigoureuse ne devrait jamais s’enfermer dans l’arbitrage exclusif d’une unique statistique globale. Excel met nativement à disposition deux fonctions puissantes dédiées à l’évaluation quantitative des déformations géométriques de la courbe : la fonction COEFFICIENT.ASYMETRIE (mesure du Skewness d’échantillon) et la fonction KURTOSIS (qui évalue l’excès d’aplatissement par rapport à la valeur de référence de 0 propre à la gaussienne).
L’asymétrie documente l’orientation et l’ampleur du déséquilibre d’étalement : une valeur significativement positive traduit une queue allongée vers les valeurs fortes et une accumulation des sujets à gauche, tandis qu’une valeur négative dénote une prépondérance d’observations élevées avec une traîne vers les scores faibles. L’aplatissement informe quant à lui sur l’épaisseur relative des queues et l’acuité de la pointe centrale : un excès de kurtosis positif caractérise une distribution leptokurtique aux queues épaisses (surreprésentation des valeurs extrêmes), tandis qu’un coefficient négatif signale un profil platykurtique aux queues légères et au sommet arrondi.
La confrontation de la statistique D de Kolmogorov-Smirnov avec ces deux indicateurs de forme affine considérablement l’interprétation diagnostique. Si le test K-S rejette H0, l’observation immédiate des coefficients d’asymétrie et de kurtosis permet d’identifier sans ambiguïté la nature morphologique de l’écart à la gaussienne. Ces métriques s’associent avantageusement à la construction visuelle d’un diagramme quantile-quantile (Q-Q plot) au sein des outils graphiques d’Excel, matérialisant visuellement les décollements de trajectoire par rapport à la droite d’alignement théorique idéale.
11. Automatisation du test de Kolmogorov-Smirnov via VBA et macros
11.1 Architecture d’une fonction personnalisée (UDF) en VBA
Bien que la décomposition du test en colonnes tabulaires soit irremplaçable pour auditer méthodiquement chaque étape de modélisation, le traitement répété de dizaines de variables psychométriques rend cette manipulation manuelle fastidieuse. L’environnement Visual Basic for Applications (VBA) intégré nativement à Microsoft Excel permet de surmonter cette contrainte en encapsulant l’ensemble de l’algorithme au sein d’une fonction personnalisée (User Defined Function ou UDF) directement invocable dans n’importe quelle cellule du classeur.
Pour déployer cette architecture, ouvrez l’éditeur de code via la combinaison de touches Alt + F11, puis sélectionnez la commande Insertion > Module. Dans la fenêtre de code vierge qui apparaît, la fonction peut être déclarée sous l’intitulé formel suivant :
Public Function TEST_KOLMOGOROV_SMIRNOV(PlageDonnees As Range) As Double
L’architecture interne du script doit procéder en premier lieu à l’extraction des données de la plage d’entrée dans un tableau dynamique en mémoire vive, afin de s’affranchir des temps d’accès aux cellules de la feuille. Le code doit intégrer un algorithme de tri interne (tel qu’un tri rapide de type Quicksort) afin d’ordonner la série numérique sans modifier l’agencement physique des données sur la feuille de calcul de l’utilisateur.
11.2 Calcul vectoriel des probabilités et extraction dynamique de D
Une fois les données triées au sein d’un vecteur mémoire ordonné d’indice 1 à n, la macro calcule la moyenne arithmétique et l’écart-type d’échantillon au moyen des fonctions d’application natives WorksheetFunction.Average et WorksheetFunction.StDev_S. Le script engage ensuite une boucle séquentielle itérative balayant chaque rang i de 1 jusqu’à la dimension totale n de la série.
À chaque itération, l’algorithme calcule simultanément :
- La probabilité théorique cumulée au point analysé via l’appel à la fonction d’intégration gaussienne
WorksheetFunction.Norm_Dist(x_i, moyenne, ecart_type, True). - La borne empirique supérieure i / n et la borne empirique inférieure (i – 1) / n.
- Les écarts absolus D+ et D- vis-à-vis de ces deux frontières.
Une variable mémoire globale de type flottant double précision compare dynamiquement ces écarts locaux à la valeur maximale préalablement enregistrée. Dès qu’un écart local surpasse le maximum temporaire, la variable s’ajuste pour capturer cette nouvelle borne supérieure. Au terme de l’itération complète sur les n éléments, la fonction retourne la valeur maximale finale, correspondant très exactement à la statistique supremum D de Kolmogorov-Smirnov.
11.3 Gestion des exceptions et robustesse du code
Un code VBA destiné à des protocoles de recherche doit faire preuve d’une robustesse sans faille face aux anomalies de saisie courantes. La routine algorithmique doit incorporer des filtres de validation préliminaires interceptant les cellules vides, les valeurs non numériques accidentelles ou les éventuels codes d’erreur résiduels (tels que #DIV/0!) présents au sein de la plage sélectionnée par l’utilisateur.
Le script doit par ailleurs vérifier que le nombre d’observations exploitables est au minimum égal à 4 ou 5 observations, seuil arithmétique en deçà duquel le calcul d’un écart-type d’échantillon et d’une statistique d’adéquation perd toute pertinence inférentielle. Si ces conditions de validité ne sont pas honorées, la fonction VBA doit être programmée pour renvoyer une valeur non numérique contrôlée, telle que CVErr(xlErrNum) ou une chaîne explicative.
Enfin, il est impératif de rappeler à l’analyste que l’enregistrement d’un classeur hébergeant des procédures personnalisées VBA impose de sélectionner le format spécifique Classeur Excel prenant en charge les macros portant l’extension standardisée .xlsm. Tout enregistrement sous le format conventionnel .xlsx éliminerait irrémédiablement le code VBA sous-jacent, anéantissant l’automatisation développée.
12. Limites diagnostiques et recommandations méthodologiques avancées
12.1 La vulnérabilité du test K-S aux ex æquo (données discrétisées)
L’une des limites structurelles les plus fondamentales du test de Kolmogorov-Smirnov réside dans son postulat de continuité stricte de la variable sous-jacente. Dans les applications réelles en psychométrie et en sciences sociales, cette exigence se heurte fréquemment à la présence massive d’ex æquo, c’est-à-dire de scores rigoureusement identiques partagés par plusieurs sujets indépendants. Ce phénomène découle directement de la discrétisation des outils de mesure, tels que les échelles en cinq points, les chronomètres aux arrondis trop grossiers ou les inventaires sommatoires courts.
Lorsque des valeurs identiques s’accumulent au sein du vecteur d’analyse, la fonction de distribution cumulative empirique ne progresse plus par échelons unitaires réguliers d’amplitude 1/n, mais effectue un saut vertical d’amplitude k/n, où k représente le nombre de répétitions de la modalité considérée. Cette déformation géométrique altère la validité de la statistique D : elle introduit un biais systématique qui tend à dégrader artificiellement la fidélité de comparaison avec la courbe théorique continue et modifie la forme réelle de la distribution d’échantillonnage de la statistique de test.
Face à des données fortement discrétisées, l’application aveugle des tables critiques usuelles tend à accroître indûment le taux de faux positifs, conduisant à rejeter abusivement la normalité là où les écarts constatés ne reflètent que la grossièreté de la granularité instrumentale. Lorsque la proportion d’ex æquo dépasse 10 à 15 % de la série de données, il est vivement conseillé de préférer des tests spécifiquement adaptés aux variables discrétisées ou d’envisager des corrections par permutation aléatoire.
12.2 Le paradoxe de la taille d’échantillon : sur-rejet et sous-puissance
L’interprétation de la statistique d’adéquation ne peut être déconnectée de la dimension effective de l’échantillon sous observation, sous peine de succomber à un paradoxe méthodologique classique en statistique inférentielle. D’un côté, face à des échantillons de taille modeste (n inférieur à 25 ou 30 individus), le test de Kolmogorov-Smirnov souffre d’un déficit notoire de puissance statistique. De réelles asymétries ou aplatissements d’importance substantielle peuvent passer totalement inaperçus, générant une p-valeur de non-rejet qui procure un faux sentiment de sécurité quant à l’adéquation gaussienne.
À l’inverse, dès lors que l’échantillon atteint des volumes importants (n supérieur à 400 ou 500 observations), le comportement asymptotique du test inverse radicalement la nature du risque. Dans cette configuration, la puissance statistique devient si élevée que le test sanctionnera la moindre variation microscopique ou déviation locale par rapport au modèle théorique. La p-valeur chutera irrémédiablement sous le seuil critique alpha de 0,05, rejetant formellement l’hypothèse de normalité pour des anomalies sans aucun impact opérationnel ou clinique sur la validité des modèles paramétriques.
Pour dépasser ce paradoxe de taille d’échantillon, le chercheur aguerri ne doit pas borner son jugement à la seule significativité statistique p. Il convient d’évaluer conjointement l’amplitude brute de la statistique de distance D elle-même, qui fonctionne comme un indice d’ampleur de l’effet d’inadéquation spatiale. Une distance maximale D très faible (par exemple D = 0,03) accompagnée d’une p-valeur significative sur un échantillon de 2 000 sujets traduit une conformité pratique largement suffisante pour justifier le déploiement des tests paramétriques usuels, dont la robustesse naturelle tolère de légères imperfections distributionnelles.
12.3 Lignes directrices pour une pratique psychométrique rigoureuse
Au terme de cette analyse méthodologique et opératoire, il apparaît évident qu’une pratique psychométrique d’excellence ne saurait s’appuyer de façon dogmatique sur une procédure analytique unique et isolée. L’évaluation de l’hypothèse de normalité exige l’adoption délibérée d’une approche multiméthode, combinant intelligemment les tests de signification d’adéquation formels et les dispositifs d’inspection visuelle globale.
Nous recommandons d’adosser systématiquement le calcul de la statistique de Kolmogorov-Smirnov sous Excel à une triple vérification complémentaire :
- L’analyse fine des indicateurs d’asymétrie (Skewness) et d’aplatissement (Kurtosis) pour expliciter la typologie exacte des éventuelles déformations géométriques.
- L’inspection conjointe d’un graphique quantile-quantile (Q-Q plot) normal, qui expose immédiatement la nature des décollements locaux (en queue ou au centre) avec une précision visuelle bien supérieure à un test scalaire unique.
- L’observation attentive d’un diagramme en boîte à moustaches (Boxplot) afin de déceler l’existence d’observations discordantes extrêmes dont la présence isolée suffirait à gonfler indûment la statistique suprême D.
Enfin, toute décision méthodologique touchant à l’exclusion éventuelle d’individus atypiques ou à l’application de transformations correctrices de variables doit être rigoureusement documentée et justifiée sur le plan théorique préalablement aux analyses définitives. C’est à ce prix de transparence et de méthode que le statisticien, le psychologue ou le chercheur quantitatif confère à ses conclusions empiriques toute la rigueur et l’autorité requises par les standards scientifiques contemporains.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Birnbaum, Z. W. (1952). Numerical tabulations of the distribution of Kolmogorov’s statistic for finite sample size. Journal of the American Statistical Association, 47(259), 425–441. https://doi.org/10.1080/01621459.1952.10483440
Dallal, G. E., & Wilkinson, L. (1986). An analytic approximation to the distribution of Lilliefors’s test statistic for normality. The American Statistician, 40(4), 294–296. https://doi.org/10.1080/00031305.1986.10475419
Kolmogorov, A. N. (1933). Sulla determinazione empirica di una legge di distribuzione. Giornale dell’Istituto Italiano degli Attuari, 4, 83–91.
Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
Marsaglia, J., Tsang, W. W., & Wang, J. (2003). Evaluating Kolmogorov’s distribution. Journal of Statistical Software, 8(18), 1–4. https://doi.org/10.18637/jss.v008.i18
Miller, L. H. (1956). Table of percentage points of Kolmogorov statistics. Journal of the American Statistical Association, 51(273), 111–121. https://doi.org/10.1080/01621459.1956.10501314
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
Smirnov, N. V. (1939). Sur les écarts de la courbe de distribution empirique. Recueil Mathématique (Matematicheskii Sbornik), 6(48), 3–26.
Stephens, M. A. (1974). EDF statistics for goodness of fit and some comparisons. Journal of the American Statistical Association, 69(347), 730–737. https://doi.org/10.1080/01621459.1974.10480196