
Dans le domaine de la visualisation de données scientifiques et de l’analyse quantitative, la transmission efficiente d’un message analytique repose sur un équilibre subtil entre exhaustivité de l’information et épuration sémiotique. Le cadriciel graphique ggplot2, développé pour l’écosystème R, incarne aujourd’hui le standard de fait pour la création de représentations visuelles rigoureuses, publiables au sein de revues scientifiques internationales. Cependant, la production de figures à fort impact informatif impose fréquemment de s’affranchir des configurations par défaut générées par le moteur graphique, notamment en ce qui concerne la présence systématique des annotations marginales et des indicateurs de repère cartésien.
Le masquage méthodique des étiquettes d’axes ne relève nullement d’une simple coquetterie esthétique ou d’une simplification paresseuse de la mise en page. Au sein de contextes méthodologiques précis, tels que le traitement de signaux biophysiques continus, la projection d’espaces latents multidimensionnels ou la présentation de mosaïques multifactorielles complexes, la suppression des marqueurs textuels et numériques constitue un impératif d’optimisation cognitive. Selon les principes établis par les pionniers du design de l’information, éliminer l’encre non porteuse de signal mathématique permet de focaliser l’attention du lecteur sur les propriétés structurales des données, à l’instar de la morphologie d’une distribution, d’une rupture de pente ou de la convergence d’un algorithme d’apprentissage.
Ce guide exhaustif a pour vocation d’explorer l’ensemble des mécanismes techniques, des fondements sémiotiques et des ramifications pratiques liés à la suppression des étiquettes d’axes dans ggplot2. À travers une analyse comparative des couches thématiques et des fonctions d’échelles, nous détaillerons les protocoles programmatiques adaptés à chaque configuration expérimentale, tout en éclairant les pièges récurrents et les implications éthiques inhérents à l’altération des repères dimensionnels dans le champ académique.
1. Introduction aux conventions graphiques et à la manipulation des axes dans ggplot2
1.1 Fondements théoriques de la grammaire des graphiques
L’architecture interne du paquet ggplot2 trouve son ancrage épistémologique dans les travaux fondateurs du statisticien et informaticien Leland Wilkinson, formalisés dans son ouvrage séminal The Grammar of Graphics. Cette théorie postule qu’un graphique statistique ne doit pas être appréhendé comme une entité monolithique et statique, mais plutôt comme une combinatoire formelle de couches fonctionnelles indépendantes et ordonnées. Hadley Wickham a brillamment transposé ce paradigme conceptuel dans l’environnement R, structurant la manipulation visuelle autour d’une syntaxe déclarative où les données brutes sont progressivement liées à des propriétés esthétiques, projetées sur des topologies géométriques, puis intégrées dans un système de coordonnées spatiales rigoureusement calibré.
Au sein de cette décomposition en strates fonctionnelles, les axes cartésiens remplissent un rôle d’intermédiation critique entre l’espace abstrait des variables mathématiques et l’espace perceptif bidimensionnel de l’observateur. Lors de l’évaluation de construits latents, comme les scores d’anxiété ou les temps de latence cognitive, les axes constituent la structure d’ancrage permettant d’apprécier la magnitude, la dispersion et les relations fonctionnelles liant les prédicteurs au critère mesuré. Chaque graduation matérialise une quantification physique dont la perception spatiale doit idéalement correspondre, sans distorsion perceptive, aux propriétés métriques du phénomène sous-jacent.
Toutefois, la surcharge textuelle périphérique génère une friction interprétative délétère. Conformément aux théories de la charge cognitive développées par John Sweller, la capacité de traitement de la mémoire de travail humaine est strictement bornée. Lorsque l’appareil visuel est contraint de déchiffrer des dizaines de valeurs scalaires redondantes le long des bordures du panneau graphique, une part substantielle des ressources attentionnelles se trouve détournée de l’analyse des motifs primaires, tels que les agrégations géométriques ou les trajectoires longitudinales. L’épuration sélective des axes cartésiens devient alors une opération de dépouillement méthodologique visant à maximiser ce qu’Edward Tufte désigne sous le concept de ratio encre-données.
1.2 Pertinence méthodologique du masquage des étiquettes
L’élimination des étiquettes d’axes répond à des impératifs scientifiques rigoureux qui dépassent le simple cadre de l’esthétique minimale. Le premier scénario canonique concerne le traitement et la représentation des séries temporelles normalisées et des flux physiologiques continus. Dans le cas d’enregistrements magnétoencéphalographiques ou de signaux photopléthysmographiques, la quantification absolue du temps en secondes ou du potentiel en microvolts à chaque seconde de tracé s’avère souvent superflue par rapport à l’analyse morphologique des phases, des ondes ou des déflections locales. L’encombrement causé par des séries ininterrompues de chiffres nuit à la reconnaissance rapide des patterns pathologiques ou expérimentaux.
Dans un second registre, la modélisation conceptuelle et théorique en sciences comportementales requiert fréquemment l’illustration de dynamiques hypothétiques sans ancrage empirique immédiat. Lorsqu’un chercheur formalise la courbe théorique de la loi de Yerkes-Dodson reliant l’éveil cortical à la performance cognitive, l’affichage de valeurs métriques discrètes sur les axes X et Y introduirait un faux sentiment de précision numérique. Le masquage des étiquettes textuelles et des graduations préserve la nature qualitative et schématique de la proposition théorique, signalant sans équivoque au lecteur que la figure formalise un principe d’organisation générale plutôt qu’un relevé d’observations ponctuelles.
Enfin, la standardisation des échelles relatives dans les protocoles factoriels justifie pleinement cette démarche d’occultation marginale. Lorsque des variables sont préalablement centrées et réduites, exprimées en scores Z ou ramenées à des indices d’écart-type par rapport à une moyenne populationnelle, l’intérêt se déplace vers l’amplitude relative des contrastes inter-groupes. La suppression des étiquettes numériques élimine la fixation sur des valeurs absolues souvent arbitraires, favorisant une lecture globale des gradients. Dans les mosaïques multifactorielles denses comportant plusieurs dizaines de sous-graphiques, ce nettoyage typographique supprime un facteur d’interférence visuelle majeur entre cellules adjacentes.
1.3 Organisation modulaire de l’architecture graphique ggplot2
La puissance opérationnelle de ggplot2 réside dans sa séparation hermétique entre la géométrie des données et le système d’habillage thématique. Contrairement aux fonctions graphiques de base du moteur de rendu de R, où les paramètres d’axes sont étroitement intriqués avec l’algorithme de tracé primitif, ggplot2 encapsule la gestion stylistique au sein d’un composant thématique découplé. Cette modularité garantit que la modification ou la suppression complète d’une composante textuelle n’altère en aucun cas la fidélité géométrique de la distribution sous-jacente ni la validité mathématique du système de coordonnées sélectionné.
Cette architecture repose sur un principe d’héritage hiérarchique strict. Les éléments graphiques textuels dérivent de structures génériques qui transmettent leurs propriétés formelles à des sous-éléments de plus en plus spécialisés. L’élément parent universel régissant la typographie, désigné sous le terme de texte global, transmet ses paramètres de fonte, de taille et de couleur aux éléments secondaires relatifs aux titres de panneaux, aux légendes et aux composantes d’axes. Ainsi, modifier la spécification d’un axe particulier nécessite d’intervenir à l’échelon précis de la hiérarchie pour neutraliser la transmission des attributs hérités sans perturber le reste de l’édifice visuel.
Pour orchestrer ces modifications structurales, l’utilisateur dispose de trois mécanismes complémentaires au sein de l’environnement R. Le premier levier, et le plus couramment employé pour les retouches d’habillage, est la fonction générale de personnalisation thématique, au sein de laquelle des directives précises sont assignées à des arguments dédiés. Le deuxième levier implique les fonctions modulatrices de l’échelle de mesure, qui contrôlent la correspondance entre les données et les repères spatiaux. Enfin, le système de guides permet d’affiner l’agencement externe de ces marqueurs. La maîtrise conjointe de ces trois piliers offre un contrôle absolu sur le canevas de publication.
2. Distinction fondamentale : Titres d’axes (axis.title) versus Étiquettes de graduation (axis.text)
2.1 Définition sémiotique des composants d’un axe cartésien
Une ambiguïté terminologique récurrente chez les utilisateurs intermédiaires de R réside dans la confusion entre l’identifiant nominatif de la dimension observée et la séquence des valeurs de repère jalonnant l’axe. Dans le métalangage de ggplot2, cette dichotomie conceptuelle est formalisée par deux attributs distincts aux propriétés sémiotiques divergentes. Le titre d’axe, désigné sous le paramètre syntaxique axis.title, constitue le libellé catégoriel ou ontologique qui attribue un sens sémantique à l’espace dimensionnel. Il explicite la variable étudiée, telle que le Temps de réaction en millisecondes ou le Niveau d’oxygénation cérébrale, fournissant au lecteur le cadre d’interprétation contextuel indispensable.
À l’opposé, les étiquettes de graduation, régies par l’attribut axis.text, matérialisent les points d’ancrage métriques discrets le long de cette même dimension. Qu’il s’agisse de nombres cardinaux, d’intervalles temporels ou de dénominations ordinales pour des conditions expérimentales distinctes, ces étiquettes indiquent la localisation spatiale précise des données cartographiées. Confondre le titre d’axe et les étiquettes textuelles lors d’une tentative de suppression conduit fréquemment à des altérations graphiques involontaires, éliminant par exemple la désignation de la variable tout en conservant une suite incompréhensible de chiffres flottants, ou inversément, vidant l’axe de son échelle tout en maintenant un titre isolé.
Cette distinction revêt une importance critique au regard des normes éditoriales de la communauté scientifique, notamment les recommandations stylistiques de l’American Psychological Association. Les manuels de publication stipulent avec une rigueur absolue la manière dont les dimensions spatiales doivent être documentées. Dans certains types d’affichages standardisés, tels que les graphiques de profils factoriels ou les matrices de corrélation croisée, les directives prescrivent le maintien impératif du nom de la variable d’intérêt tout en autorisant explicitement l’effacement des étiquettes de graduation redondantes pour alléger l’agencement visuel global.
2.2 Ciblage précis des arguments de personnalisation
L’atomisation fine de la grammaire de ggplot2 permet d’isoler chirurgicalement chaque strate d’annotation par le biais de modificateurs ciblés au sein du panneau de contrôle thématique. Pour neutraliser l’identifiant sémantique sans modifier l’affichage des repères numériques, l’utilisateur s’adressera exclusivement à la famille d’arguments relevant d’axis.title. Cette commande peut être modulée de manière symétrique pour les deux axes simultanément, ou restreinte à l’abscisse (axis.title.x) ou à l’ordonnée (axis.title.y). Ce type d’intervention est particulièrement précieux lorsque le titre de la figure ou la légende explicative fournit déjà une description univoque du phénomène représenté, rendant caduque la répétition du libellé sur les bordures du tracé.
Inversement, lorsque l’objectif méthodologique consiste à préserver le nom de la variable tout en gommant la granularité des échelons scalaires, c’est l’ensemble des arguments affiliés à axis.text qui doit être mobilisé. De manière analogue, le système permet de viser axis.text pour une action universelle, ou de décomposer l’action sur axis.text.x et axis.text.y pour des adaptations asymétriques. Ce découplage fonctionnel garantit que le concepteur du graphique conserve une latitude totale dans l’agencement de ses figures scientifiques.
Dans de nombreuses situations expérimentales avancées, la suppression sélective conjointe ou disjointe de ces composantes devient une nécessité structurelle. Dans une architecture multipanneau visualisant des réponses physiologiques synchronisées à travers diverses conditions de tâche, il est courant de conserver le titre global d’axe sur la bordure externe gauche tout en supprimant l’ensemble des textes d’axes intérieurs. Cette approche supprime les redondances graphiques tout en prévenant les ambiguïtés de lecture, offrant une mise en page d’une lisibilité maximale conforme aux attentes des comités de lecture des revues savantes.
3. Syntaxe générale et utilisation de element_blank() dans la fonction theme()
3.1 Mécanisme de l’objet sentinelle element_blank()
Au cœur de l’infrastructure thématique de ggplot2 se trouve une structure fonctionnelle particulière désignée sous l’appellation d’objet sentinelle, matérialisée par la fonction constructrice element_blank(). Contrairement aux idées reçues qui assimilent cette fonction à un simple commutateur d’invisibilité, element_blank() opère une transformation fondamentale dans l’arborescence graphique de l’objet de traçage. Lors de la phase de compilation du graphique par le moteur sous-jacent grid, l’élément stylistique assigné à element_blank() est entièrement extrait du flux de rendu vectoriel. Il ne s’agit pas de peindre le texte en blanc ou d’appliquer une transparence absolue via un canal alpha nul, mais bien de supprimer le nœud de calcul correspondant.
Cette distinction technique engendre des répercussions spatiales majeures sur le calcul géométrique du canevas. Si un utilisateur se contentait de colorer les étiquettes d’axes dans la même teinte que l’arrière-plan, le moteur graphique réserverait néanmoins la surface physique nécessaire pour accueillir ces chaînes de caractères invisibles, induisant des espacements marginaux asymétriques et des vides périphériques disgracieux. En substituant l’élément textuel par l’entité structurelle element_blank(), l’algorithme d’agencement comprend que la boîte de délimitation n’a plus lieu d’être calculée, ce qui permet un redéploiement immédiat de l’espace vacant au bénéfice exclusif de la zone de visualisation des données.
Il importe également de distinguer rigoureusement element_blank() de la valeur NULL du langage R. Dans la logique interne de la fonction theme(), assigner la valeur NULL à un composant particulier ne provoque nullement son effacement. Au contraire, cette assignation commande au moteur de rétablir la valeur par défaut héritée du thème parent actif (qu’il s’agisse de theme_grey(), theme_minimal() ou de toute autre base stylistique préalablement définie). Par conséquent, element_blank() constitue la seule et unique instruction déclarative capable de briser intentionnellement la chaîne d’héritage thématique et de forcer la non-génération définitive de l’élément ciblé.
3.2 Structure syntaxique standardisée
L’implémentation pratique de ce mécanisme de neutralisation s’opère par le biais de l’opérateur d’addition unaire standard de l’écosystème, qui permet de greffer la fonction modulatrice theme() à la chaîne de construction de l’objet graphique. La syntaxe canonique implique de déclarer explicitement le sous-composant visé et de lui adjoindre l’appel à element_blank(). Cette approche respecte scrupuleusement la philosophie déclarative propre au Tidyverse, où chaque modification successive vient enrichir ou contraindre la spécification formelle de la figure sans impacter les opérations d’agrégation de données réalisées en amont.
L’application rigoureuse de cette structure s’illustre particulièrement lors du paramétrage des sous-composants directionnels. Pour intervenir sur la frange inférieure du graphique sans perturber le plan vertical, l’argument axis.text.x est configuré sur element_blank(). À l’inverse, une contrainte portant sur la marge latérale gauche mobilisera l’argument axis.text.y. Cette modularité permet d’ajuster individuellement chaque bordure, garantissant le respect scrupuleux des ratios d’aspect et des impératifs d’alignement géométrique, notamment lorsque plusieurs visualisations sont destinées à être assemblées dans un agencement composite.
Un aspect crucial réside dans le maintien de la cohérence dimensionnelle. Lorsqu’une étiquette d’axe est annihilée via element_blank(), l’utilisateur doit garder à l’esprit que le ratio d’aspect global du panneau de traçage est immédiatement recalculé par le moteur de rendu. Afin d’éviter des étirements intempestifs des figures lors de la phase de compilation finale, il est recommandé de coordonner ces ajustements thématiques avec des spécifications explicites de dimensions de sortie ou avec l’adjonction de systèmes de coordonnées contraints, assurant ainsi une reproductibilité absolue du rendu graphique sur différents supports de publication.
4. Exemple 1 : Suppression ciblée des étiquettes de l’axe des abscisses (axe X)
4.1 Construction du jeu de données expérimental
Afin d’illustrer la mise en œuvre empirique de ces principes de manipulation graphique, nous concevons un environnement d’expérimentation contrôlé reposant sur un tableau de données empiriques simulées. Imaginons un protocole de recherche en psychologie cognitive évaluant l’évolution longitudinale des scores de flexibilité exécutive auprès d’une cohorte d’individus soumis à un entraînement métacognitif intensif. Le tableau de données associe une variable indépendante discrète, formalisant les sessions d’évaluation temporelles successives, à une variable quantitative continue mesurant le score de performance psychométrique standardisé, complétée par un identifiant d’assignation expérimentale.
L’instanciation de cette structure dans R s’appuie sur la création d’un conteneur rectangulaire standard où les observations individuelles sont ordonnées séquentiellement. La mise en relation des variables s’opère ensuite dans l’instruction d’initialisation de ggplot, en affectant la variable temporelle discrète au canal esthétique horizontal et les scores de flexibilité au canal vertical. La projection visuelle primaire s’effectue au moyen de la géométrie de nuage de points, agrémentée d’une couche d’ajustement non paramétrique permettant de matérialiser la trajectoire moyenne de progression des participants au fil des mesures.
Par défaut, l’exécution d’un tel tracé engendre l’affichage mécanique de l’ensemble des dénominations textuelles de chaque session le long de la bordure horizontale inférieure. Dans les cas où ces sessions sont nombreuses, très rapprochées dans le temps, ou désignées par des codes expérimentaux longs et complexes, les chaînes de caractères se superposent de manière anarchique, rendant la lecture de l’abscisse totalement confuse et perturbant l’analyse visuelle de la dynamique longitudinale globale.
4.2 Application du filtre axis.text.x = element_blank()
Face à la dégradation de la lisibilité causée par cette saturation textuelle sur le plan horizontal, l’introduction de l’argument axis.text.x configuré sur element_blank() au sein de la fonction modélisatrice de thème constitue la solution de référence. Cette modification stylistique s’intègre naturellement dans le pipeline de tracé, venant s’additionner à la géométrie de points et à la courbe de régression préalablement déclarées. Dès la réévaluation du graphique, l’ensemble des descripteurs textuels juchés sur l’axe des abscisses s’évanouit instantanément de la composition visuelle.
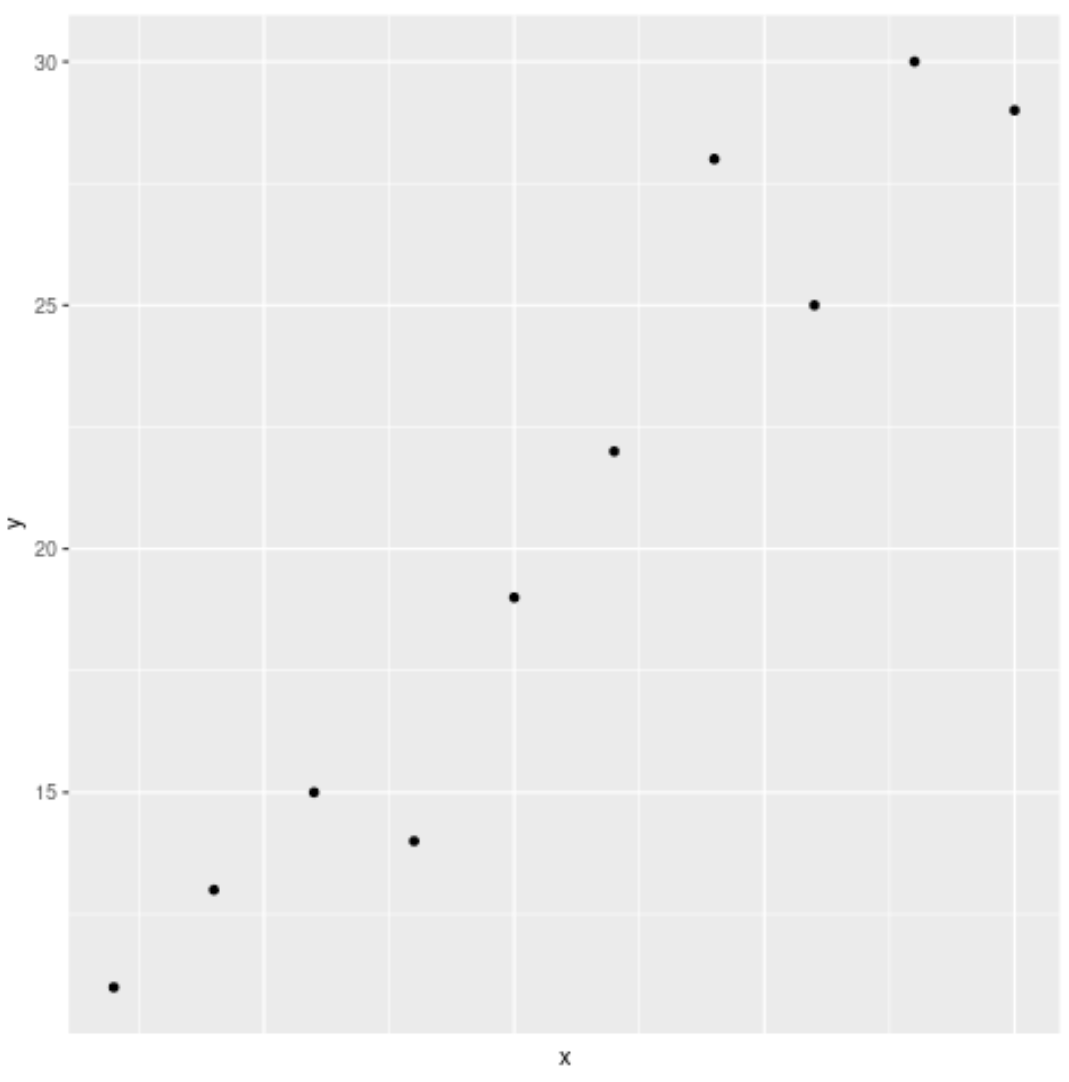
L’examen minutieux de la figure ainsi épurée met en exergue un comportement structurel fondamental du moteur de rendu. Alors que les étiquettes de graduation textuelles ont totalement disparu, la ligne directrice de l’axe ainsi que le titre nominatif global de la variable demeurent intacts à leur emplacement géographique d’origine. Le lecteur perçoit sans équivoque qu’il observe une progression ordonnée d’évaluations temporelles, mais son attention n’est plus détournée par la juxtaposition désordonnée de libellés alphanumériques redondants.
Néanmoins, une inspection rigoureuse de la bordure inférieure révèle un vestige graphique qui compromet l’harmonie de l’ensemble. Les petites marques de graduation linéaires, communément désignées sous le terme de tirets de repère ou coches, demeurent projetées perpendiculairement à l’axe horizontal. Cette présence résiduelle d’indicateurs de repérage vides de tout texte associé constitue une anomalie visuelle fréquente, nécessitant une étape complémentaire d’harmonisation de l’infrastructure marginale.
4.3 Suppression coordonnée des marques de graduation associées
Le maintien d’indicateurs de graduation dépourvus d’étiquettes textuelles sous-jacentes génère une dissonance sémiotique notable dans la transmission du message scientifique. Ces marques orphelines attirent inutilement le regard de l’analyste vers des coordonnées spatiales qui ne portent plus aucune valeur nominale explicite. Pour atteindre un degré d’épuration esthétique et conceptuelle irréprochable, conforme aux standards des figures publiables au sein des revues scientifiques de premier plan, il est impératif d’ordonner la neutralisation simultanée de ces repères physiques.
Cette opération s’effectue avec une remarquable simplicité au moyen de l’instruction axis.ticks.x = element_blank(), qui s’insère directement dans la liste des arguments de la fonction d’habillage thématique, aux côtés du modificateur de texte textuel. En procédant à cette double neutralisation, le système d’affichage supprime l’intégralité des coches pointant vers le bas, nettoyant impeccablement la marge horizontale inférieure. Le bord inférieur du panneau de données se trouve désormais matérialisé par un trait continu sobre ou par la simple délimitation du cadre rectangulaire du panneau de tracé.
La validation du rendu visuel consécutif à ce nettoyage révèle une amélioration sensible de la lisibilité de la figure. Le nuage de points et la courbe de tendance occupent l’espace central sans aucune interférence parasitaire à leur base. Cette démarche de purification marginale est particulièrement précieuse dans le cadre de présentations orales assistées par diapositives ou de disséminations scientifiques synthétiques, où la clarté du signal graphique doit prévaloir sur le détail exhaustif des calibrations intermédiaires.
5. Exemple 2 : Suppression ciblée des étiquettes de l’axe des ordonnées (axe Y)
5.1 Préparation du protocole graphique vertical
La neutralisation des étiquettes jalonnant la dimension verticale obéit à des motivations analytiques distinctes mais tout aussi prépondérantes. Considérons une recherche expérimentale en psychophysique visant à comparer les distributions empiriques de temps de réaction standardisés chez des participants soumis à différentes modalités d’amorçage cognitif. Dans ce contexte, la variable d’intérêt positionnée sur l’ordonnée est une mesure continue résultant d’une transformation logarithmique ou d’une normalisation en scores Z, dont la distribution globale importe bien davantage que les repères métriques absolus.
La transcription visuelle standard de cette architecture mobilise préférentiellement des géométries de distribution avancées, telles que des tracés en violon superposés à des diagrammes en boîte à moustaches miniatures, ou des représentations en nuages de points avec dispersion aléatoire contrôlée. L’abscisse accueille quant à elle les différentes conditions expérimentales discrètes (par exemple : amorçage congruent, incongruent et neutre). Initialement, le graphique génère une ordonnée saturée de valeurs chiffrées décimales, accompagnées de signes négatifs inhérents à la standardisation statistique.
Cette saturation numérique verticale s’avère particulièrement préjudiciable à l’analyse intuitive des données. Dans la mesure où l’attention du chercheur et de ses pairs doit se focaliser prioritairement sur le déplacement relatif des médianes et sur l’asymétrie comparée des densités de probabilité entre les trois conditions, l’affichage de valeurs métriques précises mais dépourvues de signification phénoménologique directe génère un encombrement visuel inutile le long de la marge gauche de la composition.
5.2 Implémentation de axis.text.y = element_blank()
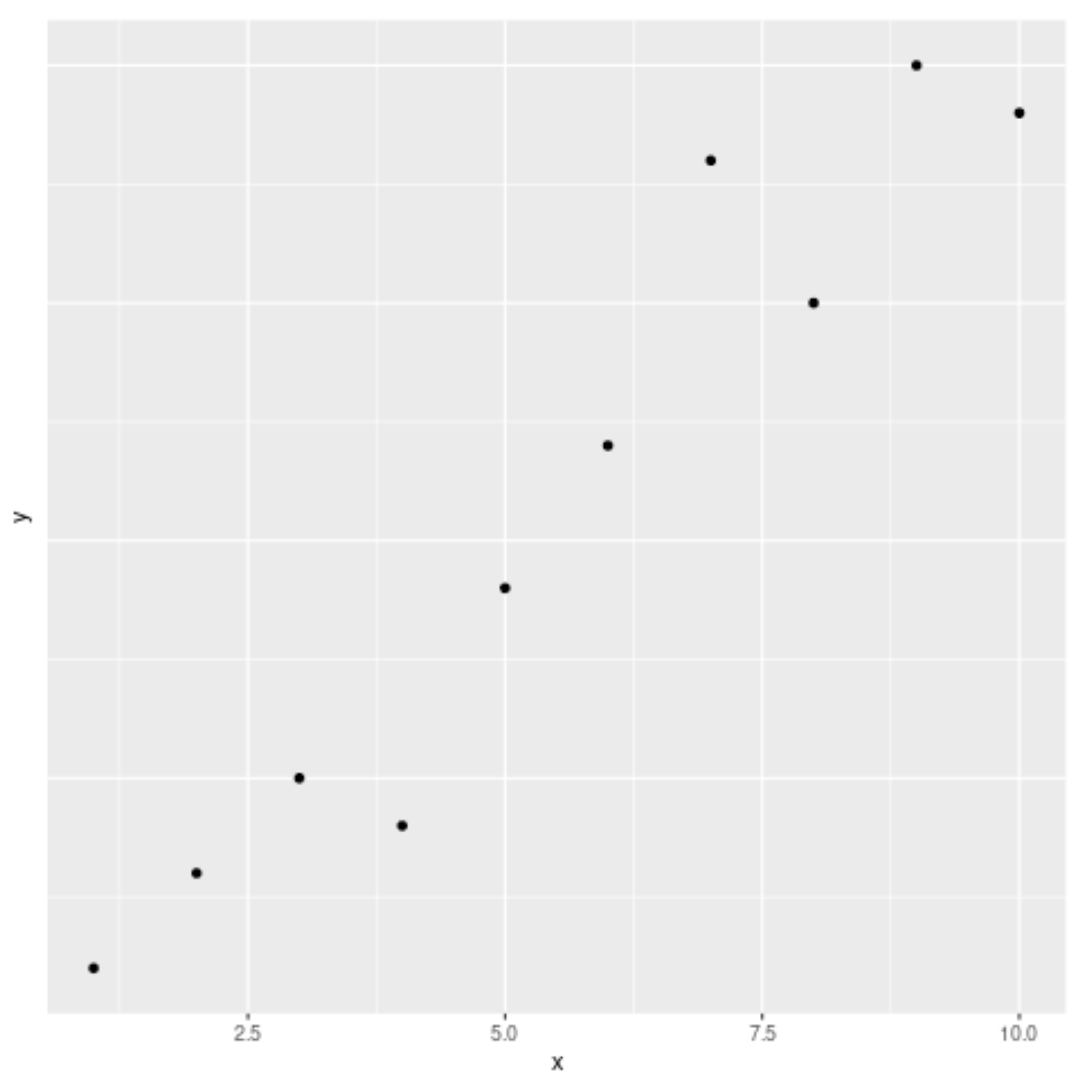
Pour délester le profil vertical de cet encombrement numérique, le recours ciblé à l’argument axis.text.y = element_blank() constitue la voie méthodologique la plus directe et la plus élégante. En adjoignant cette directive à la fonction de personnalisation thématique, l’environnement de tracé supprime instantanément la chaîne des valeurs numériques échelonnées sur le plan vertical, tout en maintenant intacte la structure textuelle catégorielle de l’axe des abscisses, préservant ainsi la lecture immédiate des différentes modalités d’amorçage expérimental.
L’effet architectural de cette instruction est immédiat et particulièrement spectaculaire sur la composition globale du tracé. En éliminant les étiquettes chiffrées de l’ordonnée, l’algorithme d’agencement géométrique de ggplot2 constate la libération de la bande d’emprise spatiale qui était jusqu’alors réservée au texte vertical. En conséquence directe, le panneau central de données s’étend automatiquement vers la gauche, récupérant une largeur d’affichage substantielle qui optimise l’espacement entre les violons de distribution et affine la perception des disparités de dispersion statistique.
Il convient de souligner que cette manipulation requiert une vigilance particulière quant à l’alignement des figures lors de la rédaction de rapports multipan面的. Si plusieurs graphiques sont disposés verticalement sur une même page de publication et que l’un d’entre eux subit une suppression de ses étiquettes d’ordonnée alors que les autres les conservent, un désalignement systématique des bordures gauches apparaîtra. La résolution de cette asymétrie spatiale nécessitera l’utilisation conjointe de modules de composition spécialisés afin de verrouiller rigidement la largeur des canevas de traçage.
5.3 Élimination des graduations via axis.ticks.y
À l’instar de la démarche d’épuration menée sur l’axe horizontal, la suppression des valeurs textuelles de l’ordonnée laisse subsister une série de marques de repérage verticales qui saillent de la ligne de démarcation gauche. Ces tirets résiduels, orphelins de tout calibrage chiffré, créent une irrégularité visuelle le long du panneau de données, brisant la netteté du contour rectiligne et suggérant à tort l’existence d’une échelle de mesure segmentée dont les descripteurs auraient été égarés lors du processus d’impression ou de compilation.
L’harmonisation définitive de la bordure verticale gauche s’obtient par l’intégration de la directive axis.ticks.y = element_blank(). Cette commande additionnelle éradique promptement l’ensemble des marques de graduation verticales, laissant une bordure latérale parfaitement linéaire et épurée. Si le chercheur a opté pour un thème graphique minimaliste ou classique, cette opération parachève la transformation de la figure en un profil de données sobre et percutant, où chaque élément graphique visible remplit une fonction sémiotique incontestable.
L’évaluation comparative entre la version initiale chargée de repères chiffrés décimaux et la mouture épurée confirme sans ambiguïté le gain qualitatif apporté par cette approche. La lecture visuelle gagne en fluidité, l’œil de l’analyste transitant de manière naturelle et immédiate entre les formes géométriques représentatives des distributions de probabilité sans buter sur des artefacts marginaux. Ce mode de représentation s’avère particulièrement recommandé lors de la réalisation de planches synthétiques destinées à la publication dans des revues d’excellence où la densité d’information par unité de surface fait l’objet d’un arbitrage éditorial sévère.
6. Exemple 3 : Suppression simultanée des étiquettes des axes X et Y
6.1 Scénarios graphiques nécessitant une isolation spatiale totale
Dans l’arsenal méthodologique contemporain de l’analyse des données complexes, un nombre croissant d’algorithmes et de techniques quantitatives génèrent des projections spatiales pour lesquelles les valeurs numériques scalaires individuelles des dimensions X et Y sont totalement dépourvues de signification physique intrinsèque. Les approches de réduction de dimensionnalité non linéaire, à l’image du t-SNE (t-Distributed Stochastic Neighbor Embedding) et de l’UMAP (Uniform Manifold Approximation and Projection), ainsi que les méthodes d’analyse en composantes principales appliquées aux données neuro-imagerie ou transcriptomiques, en fournissent une illustration exemplaire.
Dans de tels contextes géométriques, seules comptent la proximité topologique relative, la densité des regroupements d’observations et l’organisation des sous-populations dans l’espace bidimensionnel projeté. Afficher des valeurs arbitraires, issues de transformations matricielles abstraites, sur les axes d’abscisse et d’ordonnée ne fait qu’induire le lecteur en erreur en suggérant faussement l’existence d’une unité de mesure standardisée. L’isolation spatiale absolue par la suppression intégrale des repères cartésiens devient alors une nécessité méthodologique impérieuse pour prévenir toute interprétation erronée.
Par ailleurs, dans la conception de modèles schématiques abstraits, d’illustrations topologiques de paysages d’attracteurs neuronaux ou de figures d’introduction théorique, l’absence totale de repères métriques textuels permet de proclamer sans ambiguïté le statut conceptuel de la figure. L’observateur est invité à examiner la géométrie des flux, la courbure des trajectoires ou l’entrelacement des structures sans être pollué par une grille numérique cartésienne qui n’aurait aucun fondement observationnel direct.
6.2 Combinaison syntaxique exhaustive
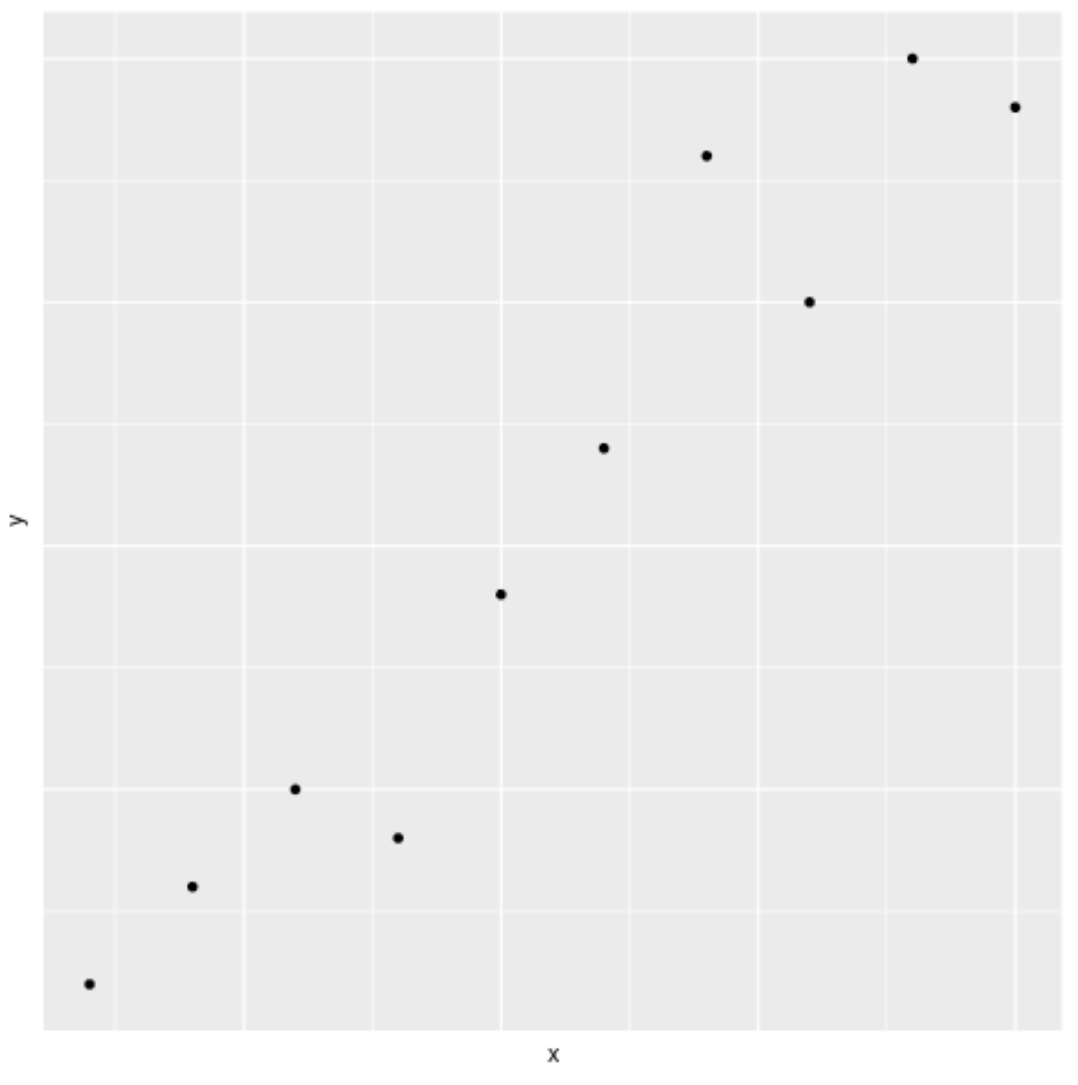
Pour instaurer cette neutralité spatiale intégrale, le pipeline de personnalisation graphique doit opérer une convergence de l’ensemble des modificateurs de structure thématique. La voie la plus explicite et la plus scrupuleuse sur le plan de la décomposition analytique consiste à déclarer individuellement chaque sous-composant au sein de la fonction theme(), en assignant le constructeur element_blank() à axis.text.x, axis.text.y, axis.ticks.x et axis.ticks.y. Cette écriture fine garantit une traçabilité parfaite de chaque opération graphique au sein du code source du chercheur.
Néanmoins, la puissance de l’arbre d’héritage thématique de ggplot2 autorise une formulation remarquablement condensée et élégante qui tire parti des propriétés de transmission ascendante. En affectant directement element_blank() aux nœuds génériques supérieurs axis.text et axis.ticks, l’utilisateur ordonne la neutralisation immédiate et simultanée de l’ensemble de leurs déclinaisons directionnelles respectives. En deux lignes de commande particulièrement limpides, les étiquettes et les repères des deux axes sont balayés de la mémoire d’affichage, simplifiant considérablement le bloc d’habillage graphique.
Il est primordial d’observer que cette double éradication n’altère en rien l’intégrité de la surface de dessin interne. Les éléments géométriques, qu’il s’agisse de millions de points issus d’un enregistrement d’activité monocellulaire ou de polygones délimitant des clusters fonctionnels, conservent scrupuleusement leurs positions relatives, leurs proportions mutuelles et leurs relations de distance. La matrice de pixels allouée aux données brutes se trouve maximisée, exploitant l’intégralité du champ de rendu délivré par la fenêtre d’affichage.
6.3 Évaluation comparative des résultats
Le résultat d’un tel traitement stylistique transforme radicalement la perception de l’objet graphique. Dépouillé de toute armature textuelle périphérique, le graphique s’apparente à une cartographie pure de données, où la géométrie visuelle s’exprime sans parasitage. Pour les visualisations de type UMAP en neurosciences computationnelles, cette présentation permet une appréciation instantanée de la partition des sous-groupes cellulaires et de la continuité des gradients d’activation, facilitant ainsi l’exploration exploratoire et la communication des résultats lors de colloques scientifiques.
Une précaution méthodologique s’impose toutefois lors de l’examen final du document produit. Il convient de vérifier avec soin si les titres d’axes doivent être préservés ou également effacés. Dans le cas d’une projection UMAP, conserver les mentions UMAP 1 et UMAP 2 sous forme d’axis.title tout en ayant supprimé les valeurs numériques numériques constitue une pratique académique hautement recommandable. Cette approche informe précisément le lecteur sur la nature de la transformation algorithmique déployée, tout en le préservant des valeurs chiffrées locales qui n’ont aucune signification interprétable.
Enfin, l’analyste devra contrôler avec discernement l’encadrement périphérique de la figure. L’effacement complet des textes et des graduations peut laisser une boîte de délimitation rectangulaire qui peut paraître incongrue si le style visuel général n’est pas convenablement harmonisé. L’arbitrage entre la conservation d’une ligne continue d’axe sobre ou l’effacement total des bordures au profit d’un canevas blanc flottant doit être guidé par les conventions de publication de la discipline et par la recherche d’une cohérence sémiotique globale au sein du manuscrit.
7. Gestion conjointe des marques de graduation (axis.ticks) et des lignes d’axes (axis.line)
7.1 L’importance de la cohérence structurelle de l’axe
L’un des écueils graphiques les plus fréquemment rencontrés dans les manuscrits soumis à évaluation scientifique tient à la fragmentation incohérente des éléments bordiers. Trop souvent, les figures présentent une suppression partielle des étiquettes numériques tout en laissant subsister des segments de traits d’axe fragmentés ou des marques de graduation isolées le long des marges. Cette incohérence structurelle trahit une méconnaissance de la mécanique d’affichage et confère au document un caractère inachevé et amateur, préjudiciable à la crédibilité scientifique du travail présenté.
Pour concevoir une figure irréprochable, il est indispensable de maîtriser la différenciation technique entre le trait d’axe principal, commandé par l’attribut axis.line, et les tirets de graduation, sous la tutelle d’axis.ticks. Le trait d’axe formalise la frontière géométrique séparant le plan d’expérience de l’espace marginal extérieur, tandis que les coches constituent des repères de projection orthogonaux. Selon la rhétorique visuelle adoptée, le chercheur peut choisir de conserver une armature de délimitation nette tout en gommant les subdivisions intérieures, ou au contraire d’éliminer toute séparation physique pour un rendu complètement ouvert.
Ce choix dépend étroitement de la stratégie adoptée pour la gestion de la boîte de délimitation du panneau. Dans les thèmes par défaut de ggplot2, une bordure continue matérialisée par panel.border entoure l’espace de traçage. Si cette bordure est active, conserver en sus des traits via axis.line engendre une double superposition de lignes qui peut provoquer des artefacts de rendu lors de l’export vectoriel en format PDF ou EPS. Une harmonisation rigoureuse exige de coordonner l’annulation d’axis.ticks avec une configuration claire soit d’axis.line, soit de panel.border, assurant une netteté absolue des arêtes de la figure.
7.2 Paramétrage exhaustif des bordures graphiques
L’éradication totale et méthodique de l’ensemble de l’infrastructure de repérage cartésien s’obtient par la conjonction harmonieuse des commandes d’habillage thématique. Pour concevoir un tracé épuré de tout artéfact linéaire périphérique, l’utilisateur combinera l’assignation de element_blank() à axis.ticks et axis.line, tout en veillant à désactiver la bordure du panneau de dessin. Cette configuration est particulièrement prisée lors de la publication de cartes thermiques, de visualisations de connectivité cérébrale ou de graphes de réseaux sociaux, où la présence d’une armature rectangulaire rigide n’apporte aucune information fonctionnelle.
À l’inverse, si les impératifs éditoriaux de la revue ciblée exigent le maintien d’une ligne d’ancrage continue pour soutenir visuellement les distributions sans afficher de graduations intermédiaires, le chercheur programmera l’affichage d’un trait sobre via element_line() appliqué à axis.line, tout en maintenant axis.ticks sur element_blank(). Cette technique permet de paramétrer finement l’épaisseur du trait, son type de continuité (solide ou pointillé) ainsi que sa tonalité chromatique, en privilégiant des nuances de gris neutres pour ne pas créer un contraste excessif avec les encres des données.
L’ajustement millimétrique de ces paramètres garantit une uniformité stylistique indispensable pour les publications à fort facteur d’impact. Les figures ainsi produites respectent scrupuleusement la hiérarchie visuelle des données : la trame géométrique principale supportant l’information statistique prévaut sur l’appareil de repérage secondaire, conférant au document final une prestance graphique et une sobriété hautement appréciées des éditeurs et des pairs évaluateurs.
8. Méthodes alternatives via les échelles scale_x_*() et scale_y_*() (labels = NULL)
8.1 L’approche fonctionnelle par les échelles de mesure
Bien que la manipulation stylistique via la fonction générale theme() constitue la voie la plus populaire pour modifier l’apparence des graphiques, l’écosystème ggplot2 propose une approche fonctionnelle alternative, conceptuellement plus profonde, reposant sur l’administration directe des échelles de mesure. Les fonctions de la famille scale_x_continuous() et scale_y_continuous(), ainsi que leurs équivalents discrets ou transformés, constituent les interfaces maîtresses contrôlant la manière dont les valeurs issues du jeu de données source sont converties en attributs spatiaux perceptibles.
Au sein de ces fonctions d’échelles, l’argument formel labels gouverne l’étiquetage textuel des valeurs de repère. En assignant explicitement la valeur sentinelle NULL à cet argument (soit labels = NULL), l’utilisateur intime au composant de mesure l’ordre de ne générer aucune chaîne textuelle lors de la projection des intervalles de calcul. Contrairement à la commande stylistique theme(axis.text = element_blank()), qui opère une destruction de l’élément textuel après sa phase d’évaluation, labels = NULL intervient en amont, empêchant purement et simplement le calcul et la génération de ces étiquettes lors du processus d’instanciation de l’échelle.
Cette distinction conceptuelle entre masquage cosmétique a posteriori et neutralisation computationnelle a priori revêt une portée théorique notable au sein de la grammaire des graphiques. L’approche par les échelles traite la présence des étiquettes comme une composante mathématique de la transformation des données, tandis que l’approche thématique l’appréhende comme un paramètre décoratif de surface. Dans la pratique quotidienne, bien que les deux méthodes aboutissent souvent à un résultat visuel similaire, leurs conséquences sous-jacentes sur la chaîne d’exécution logicielle divergent notablement.
8.2 Conséquences sur l’espacement et le calcul automatique du canevas
L’utilisation de la directive labels = NULL au sein d’une fonction d’échelle entraîne un impact immédiat sur le calcul topologique de l’espace périphérique par l’algorithme d’agencement géométrique. Lorsque les étiquettes sont désactivées à la source dans la fonction scale, le moteur graphique élimine instantanément le contingentement spatial requis pour le placement des chaînes de caractères, recalculant les marges extérieures de manière particulièrement abrupte et resserrée. Cette réactivité est souvent plus directe que celle constatée lors de certaines manipulations thématiques imbriquées complexes.
Toutefois, une particularité fondamentale de cette approche fonctionnelle réside dans le comportement résiduel des graduations physiques. En effet, spécifier labels = NULL au niveau de l’échelle de mesure annule le texte des indicateurs mais conserve intégralement le calcul de l’argument breaks. De ce fait, les marques de graduation perpendiculaires le long de l’axe continuent d’être projetées par défaut aux positions numériques prévues par l’algorithme d’échantillonnage de l’axe. Si l’intention de l’analyste était de faire disparaître simultanément le texte et les coches, cette méthode impose de renseigner conjointement breaks = NULL, ce qui entraîne la disparition absolue de l’ensemble du système de graduation.
Le choix stratégique entre la modification de l’échelle et le masquage thématique dépend de la finalité recherchée dans le pipeline d’automatisation des analyses. Si l’on souhaite modulariser un script de visualisation en séparant strictement la modélisation statistique des variables d’une part, et l’habillage graphique de publication d’autre part, la méthode thématique via theme() demeure la plus robuste et la plus polyvalente. En revanche, si l’absence d’étiquettes est intrinsèquement liée à la nature même de la transformation mathématique déployée, l’approche via les fonctions scale_*_continuous() est conceptuellement supérieure.
8.3 Gestion des variables discrètes et qualitatives
La modularité des échelles de mesure de ggplot2 s’étend avec une rigueur égale au traitement des variables catégorielles ou qualitatives au moyen de la fonction scale_x_discrete() et de son pendant vertical scale_y_discrete(). Dans les protocoles de psychologie différentielle comparant des cohortes cliniques distinctes, ou lors de plans factoriels croisant plusieurs modalités de traitement, il est fréquemment souhaitable d’ordonner spatialement les groupes sans pour autant alourdir l’axe avec leurs dénominations nominatives complètes, particulièrement lorsqu’un codage couleur spécifique ou une légende dédiée se charge déjà de leur identification explicite.
L’assignation de l’argument labels = NULL au sein de scale_x_discrete() préserve scrupuleusement l’ordre ordinal sous-jacent et les coordonnées d’espacement des facteurs expérimentaux sur l’axe, tout en neutralisant l’affichage textuel sous chaque colonne de données. Cette technique s’avère particulièrement utile lors de la conception de diagrammes en barres empilées ou de graphiques à bandes de grande dimension, évitant ainsi le chevauchement typographique des étiquettes de catégories sans dénaturer la position relative assignée à chaque modalité expérimentale.
Cette méthode démontre également son efficacité fonctionnelle lors de l’utilisation d’échelles transformées, à l’instar des projections logarithmiques via scale_y_log10(). Dans les études psychophysiques modélisant la loi de Fechner, l’évaluation des seuils différentiels de perception implique des progressions exponentielles de stimulus. En déployant scale_y_log10(labels = NULL, breaks = NULL), le chercheur préserve l’écartement spatial logarithmique réel des observations tout en nettoyant le tracé de notations scientifiques exponentielles parfois austères pour un public non initié, garantissant un équilibre idéal entre justesse mathématique et sobriété de présentation.
9. Suppression conditionnelle et personnalisée dans les facettes (facet_wrap et facet_grid)
9.1 Défis d’étiquetage dans les visualisations multipanneaux
La décomposition d’un ensemble complexe de données en sous-graphiques homogènes au moyen des mécanismes de facettage, qu’il s’agisse de facet_wrap() ou de facet_grid(), constitue l’un des fleurons analytiques de ggplot2. Cette stratégie visuelle permet d’isoler l’influence de variables modératrices en ventilant les observations sur une grille matricielle de sous-panneaux. Néanmoins, cette multiplication spatiale soulève d’épineuses difficultés en matière d’étiquetage typographique, risquant d’induire une redondance cognitive majeure si les axes sont répliqués aveuglément sur chaque cellule de la mosaïque.
Par défaut, l’architecture de facettage applique une contrainte d’échelles partagées rigides (scales = « fixed »), ce qui pousse le moteur de rendu à regrouper et afficher les étiquettes textuelles uniquement sur la périphérie externe du tableau de figures : le long de la rangée inférieure pour l’abscisse et le long de la colonne gauche pour l’ordonnée. Cependant, dès lors que le statisticien autorise des variations dimensionnelles libres au moyen du paramètre scales = « free » ou scales = « free_x », le comportement standard bascule vers une prolifération anarchique : chaque cellule de traçage génère son propre jeu indépendant d’étiquettes et de graduations, saturant instantanément la lisibilité globale de la planche de figures.
La surcharge visuelle qui en résulte compromet gravement l’efficience de la comparaison visuelle inter-panneaux. L’œil de l’analyste, au lieu de naviguer aisément entre les contrastes morphologiques des sous-populations représentées, se trouve heurté à répétition par des dizaines de séquences de chiffres identiques ou légèrement décalées. Pour restaurer l’équilibre de lecture sans sacrifier l’indépendance de calibrage des échelles libres, la mise en œuvre de protocoles de suppression conditionnelle et ciblée s’impose comme une nécessité méthodologique incontournable.
9.2 Suppression sélective selon la position du panneau
L’orchestration d’une épuration sélective des étiquettes au sein d’une structure de facettage avancée requiert des stratégies programmatiques adaptées à la géométrie de la grille. Lorsque l’objectif est d’éliminer méthodiquement les axes intérieurs tout en maintenant les repères d’identification sur les façades périphériques, le comportement natif de facet_grid() peut être modulé par des réglages précis de sa politique d’espacement. Toutefois, dès que la complexité des regroupements expérimentaux exige un traitement différencié selon le rang ou la colonne du sous-panneau, les instructions thématiques conventionnelles atteignent leurs limites opérationnelles.
Pour dépasser ces restrictions, le recours à l’extension spécialisée ggh4x offre une souplesse de personnalisation remarquable. Cette bibliothèque permet d’accéder individuellement à la microstructure thématique de chaque sous-panneau grâce à la fonction facetted_pos_scales(). Grâce à cette commande puissante, le chercheur peut décréter que les panneaux occupant le centre de la matrice verront leurs étiquettes d’abscisse et d’ordonnée neutralisées via labels = NULL, tandis que les cellules positionnées aux frontières stratégiques de la composition conserveront un étiquetage explicite et détaillé.
Cette granularité chirurgicale dans la gestion des facettes évite le piège du tout ou rien inhérent aux modifications thématiques globales. Elle permet d’alléger considérablement l’agencement visuel d’une recherche multifactorielle complexe sans priver le lecteur des balises de calibrage indispensables à l’évaluation des magnitudes extrêmes. L’élégance de cette solution optimise la transmission des interactions statistiques complexes au sein de rapports scientifiques particulièrement denses.
10. Applications empiriques en psychologie quantitative et sciences cognitives
10.1 Visualisation de tracés électroencéphalographiques (EEG) et potentiels évoqués
Le champ des neurosciences cognitives et de l’électrophysiologie humaine offre une illustration saisissante de l’utilité méthodologique de la suppression des étiquettes cartésiennes. Lors de la restitution de potentiels évoqués (Event-Related Potentials, ou ERP) recueillis lors de paradigmes d’attention visuelle sélective, les protocoles expérimentaux comparent l’émergence d’ondes spécifiques, telles que l’onde P300 ou la négativité de mésappariement (Mismatch Negativity), à travers des dizaines de dérivations scalaires enregistrées simultanément sur la surface crânienne.
Superposer ces différents tracés sur une matrice reproduisant la topographie du scalp impose d’éliminer rigoureusement l’ensemble des graduations numériques en microvolts sur l’axe vertical et en millisecondes sur l’axe horizontal pour chacun des sous-panneaux d’électrodes. Dans un tel montage topographique, l’affichage répété de dizaines de repères numériques transformerait la figure en un magma textuel illisible. La suppression totale des étiquettes via axis.text = element_blank() permet de valoriser la pureté de la déflexion temporelle de chaque onde cérébrale.
Pour garantir la validité métrique de ces visualisations sans encombrer la zone de tracé, la convention académique universellement admise dans la littérature neuroscientifique consiste à insérer, dans un coin dégagé de la composition globale, une unique barre d’échelle d’étalonnage isolée. Cette barre de calibrage géométrique indique sobrement, par exemple, un vecteur vertical correspondant à 5 microvolts et un segment horizontal représentant une fenêtre de 100 millisecondes. Ce compromis méthodologique assure la rigueur quantitative indispensable à l’évaluation par les pairs tout en offrant une épuration graphique irréprochable.
10.2 Trajectoires de suivi oculaire (Eye-Tracking) et cartes de chaleur
L’expérimentation en oculométrie quantitative constitue un autre domaine de prédilection illustrant la nécessité de neutraliser les axes conventionnels. Lorsque des chercheurs analysent la cinématique des fixations oculaires et les trajectoires saccadiques d’observateurs explorant une scène visuelle complexe ou une interface utilisateur, les coordonnées spatiales des enregistrements bruts sont initialement cartographiées dans un espace matriciel bidimensionnel dépendant de la résolution en pixels de l’écran expérimental.
Projeter les points de fixation ou superposer une carte de densité thermique directement au-dessus du stimulus visuel sous-jacent (une photographie, une page de texte ou une composition artistique) rend la présence des étiquettes d’axes en pixels totalement contre-productive et visuellement perturbatrice. Afficher des valeurs de 0 à 1920 sur l’abscisse et de 0 à 1080 sur l’ordonnée n’apporte aucun éclairage analytique pertinent quant à la saillance cognitive des zones d’intérêt et défigure l’intégrité esthétique du stimulus environnemental sous-jacent.
Dans ce cadre analytique précis, la commande axis.text = element_blank(), systématiquement associée à axis.ticks = element_blank() et axis.title = element_blank(), permet de dépouiller totalement l’arrière-plan expérimental de toute scorie informatique. Le stimulus visuel et la dynamique oculaire qui s’y superpose occupent l’intégralité du champ perceptif du lecteur. La clarté de l’analyse comportementale s’en trouve décuplée, autorisant une soutenance claire des résultats lors de l’examen collégial des patterns de fixation.
10.3 Modélisation d’équations structurelles et diagrammes de voies (Path Analysis)
Dans le domaine de la psychométrie multivariée et de la modélisation statistique avancée, la visualisation des modèles d’équations structurelles (Structural Equation Modeling, ou SEM) et des diagrammes de voies de causalité pose des défis visuels singuliers. Bien que ces représentations ne constituent pas des graphiques cartésiens traditionnels basés sur des séries de points, elles sont fréquemment générées ou post-traitées au sein de l’environnement R via des extensions spécialisées dérivées de ggplot2, telles que le paquet tidySEM.
Au sein d’un diagramme causal, les dimensions spatiales horizontale et verticale ne traduisent aucune métrique numérique mesurable. Elles ne servent qu’à organiser topologiquement la disposition relationnelle des variables manifestes rectangulaires et des construits latents elliptiques reliés par des flèches directionnelles d’influence. Dans ces conditions, conserver les étiquettes scalaires produites par le système de coordonnées sous-jacent constituerait un non-sens méthodologique complet susceptible de désorienter gravement le lecteur sur la nature du diagramme.
La neutralisation synchrone de l’ensemble des axes textuels, des graduations et des bordures marginales s’avère ici obligatoire. Cette épuration transforme le repère cartésien en une toile vectorielle neutre sur laquelle seuls émergent les coefficients de régression standardisés, les indices de corrélation bivariée et les charges factorielles associées aux différents flux causaux. Cette ascèse graphique sublime la rigueur analytique du modèle psychométrique proposé, mettant en exergue l’architecture conceptuelle sous-jacente sans aucun artefact spatial superflu.
11. Pièges courants, débogage et préservation de l’intégrité sémiotique du graphique
11.1 Erreurs de syntaxe récurrentes et messages d’alerte
L’apprentissage de la personnalisation thématique avancée dans ggplot2 est fréquemment jalonné de déconvenues syntaxiques susceptibles de bloquer l’exécution du script ou de produire des comportements visuels anormaux. L’une des erreurs les plus banales mais tenaces consiste à vouloir neutraliser un élément textuel en lui assignant la chaîne de caractères « blank » entre guillemets, au lieu d’invoquer la fonction sentinelle non cotée element_blank(). Cette substitution inadéquate provoque l’interruption immédiate de la chaîne de compilation graphique, le moteur R signalant l’impossibilité de convertir un vecteur textuel brut en un objet graphique de type thématique.
Un autre piège classique réside dans l’ordre d’évaluation des instructions au sein du pipeline graphique de Wickham. Il arrive couramment qu’un utilisateur configure soigneusement la suppression de ses étiquettes d’axes via une instruction theme() méticuleusement détaillée, pour ensuite appliquer en bout de chaîne un thème prédéfini généraliste, tel que theme_minimal() ou theme_bw(). En vertu du principe de séquençage additif propre à ggplot2, le thème global appelé en dernière position écrase brutalement l’ensemble des spécifications élémentaires programmées en amont, rétablissant sans préavis les étiquettes et graduations indésirables.
Pour prévenir cet écueil de programmation, la règle d’or consiste à systématiquement positionner le bloc de personnalisation thématique sur mesure en toute fin de pipeline de commande, impérativement après l’appel aux thèmes globaux préformatés. Cette hiérarchisation garantit que les modifications ciblées par element_blank() viendront amender et supplanter les valeurs de référence du thème d’arrière-plan sans être altérées par les mécanismes d’héritage par défaut de l’architecture graphique.
11.2 Gestion des espaces blancs résiduels et marges indésirables
Une source fréquente de frustration lors de l’épuration des bordures cartésiennes concerne la persistance de marges blanches asymétriques disproportionnées autour de la zone de tracé utile. Même après avoir méticuleusement nettoyé le texte et les coches de graduation via element_blank(), l’observateur averti remarque souvent un vide spatial résiduel entre la ligne de délimitation du graphique et le bord physique de l’image exportée. Cette anomalie découle des paramètres de marges par défaut alloués à la boîte globale de la figure (plot.margin).
L’algorithme de composition de ggplot2 alloue en effet par précaution une marge d’espacement tampon destinée à accueillir des étiquettes textuelles volumineuses ou inclinées. Lorsque ces éléments textuels sont évincés du tracé, l’espace tampon initial demeure figé dans la matrice d’agencement si aucune instruction corrective ne vient redéfinir la politique d’encadrement. Pour remédier à cet étalement et resserrer les limites du canevas sur les données réelles, il est impératif de reprogrammer explicitement l’attribut plot.margin au sein de la fonction theme(), en mobilisant la fonction d’unité de mesure unit().
En assignant des valeurs de marges compactes, par exemple via l’instruction margin(t = 5, r = 5, b = 5, l = 5, unit = « pt »), le chercheur comprime les espaces résiduels superflus, assurant un cadrage parfait de la figure géométrique. Cette maîtrise fine des bordures spatiales est absolument essentielle lors de la génération de planches composites destinées à l’impression haute résolution ou à l’insertion au sein de manuscrits rédigés sous des environnements typographiques stricts tels que LaTeX ou Quarto, où chaque millimètre carré de mise en page doit être optimisé.
11.3 Éthique et transparence dans la communication scientifique
Si la suppression des étiquettes d’axes répond fréquemment à des impératifs d’élégance et de lisibilité, elle engage également la responsabilité déontologique de l’analyste de données. Dans le contexte de la communication scientifique, altérer les repères de mesure cartésiens comporte un risque réel de manipulation visuelle, qu’elle soit délibérée ou accidentelle. Masquer l’ordonnée numérique d’un tracé de dispersion peut par exemple occulter commodément le fait que l’origine zéro a été tronquée, exacerbant ainsi artificiellement des variations infimes de moyennes entre conditions expérimentales.
De même, l’absence d’étiquetage métrique sur un axe continu peut masquer l’existence d’une échelle non linéaire sous-jacente ou d’une transformation logarithmique non explicitée, induisant le lecteur en erreur sur la magnitude proportionnelle des effets statistiques constatés. La transparence méthodologique exige que toute dérogation aux conventions d’affichage métrique standard soit rigoureusement documentée et justifiée dans le texte du protocole ou au sein de la légende textuelle accompagnant la figure.
Afin de préserver l’intégrité sémiotique du travail de recherche et d’assurer une parfaite reproductibilité pour l’évaluation par les pairs, il est impératif d’intégrer dans la note de légende descriptive une explicitation limpide des transformations appliquées (par exemple : « Les données sont présentées en scores standardisés Z ; les étiquettes numériques des ordonnées ont été omises par souci de concision visuelle »). Cette rigueur déontologique protège l’auteur de tout soupçon de distorsion graphique et confère à sa démarche d’épuration visuelle une légitimité académique inattaquable.
12. Synthèse méthodologique et recommandations de bonnes pratiques pour les publications scientifiques
12.1 Arbre de décision pour le choix de la méthode
Le choix de la stratégie d’occultation des axes ne doit rien laisser au hasard et doit découler d’un arbitrage méthodologique structuré. Lorsque la suppression des étiquettes relève d’un impératif universel lié à la nature mathématique des dimensions analysées (comme dans les projections t-SNE, UMAP ou les diagrammes causaux qualitatifs), l’application directe de labels = NULL et breaks = NULL au sein des fonctions constructrices d’échelles scale_*() représente l’approche la plus cohérente et la plus élégante sur le plan conceptuel.
En revanche, lorsque la démarche d’épuration poursuit un objectif purement contextuel d’adaptation typographique à un support de publication spécifique (tel que l’allègement visuel d’une grille multipanneau facettée ou la préparation d’une diapositive de soutenance orale synthétique), le recours aux modificateurs thématiques via theme(axis.text = element_blank()) doit être privilégié sans hésitation. Cette séparation méthodologique garantit que la couche de données sous-jacente reste indemne de manipulations cosmétiques, facilitant ainsi la réutilisation du code d’analyse pour d’autres formats de diffusion.
Par ailleurs, la destination finale de la production scientifique influence directement le degré d’intervention requis sur les composantes de bordure. Alors qu’une thèse de doctorat ou un rapport technique exhaustif tolère une granularité typographique plus dense avec maintien de la plupart des repères d’axes traditionnels, la publication au sein d’une revue internationale de premier rang exige une synthèse graphique impitoyable où chaque marque orpheline doit être traquée et éliminée. L’analyste adaptera ainsi sa programmation selon le public cible et les exigences normatives de sa discipline de rattachement.
12.2 Création d’un gabarit de thème personnalisé réutilisable
Pour inscrire ces règles d’ingénierie visuelle dans des flux de travail reproductibles et automatisés, la duplication fastidieuse de blocs de code theme() au fil de scripts dispersés constitue une pratique inefficace et propice à l’introduction d’erreurs humaines. L’approche professionnelle dans l’écosystème R repose sur la conception d’un gabarit thématique personnalisé encapsulant l’ensemble des directives de standardisation graphique de l’équipe de recherche au sein d’une fonction logicielle réutilisable.
Ce patron stylistique maison peut être élégamment construit par dérivation à partir d’un thème préétabli robuste, tel que theme_classic() ou theme_bw(), auquel viennent se greffer les règles de masquage sélectif des graduations, l’ajustement millimétré des marges et le calibrage de la typographie générale. En encapsulant ces instructions au sein d’une fonction dédiée, le chercheur dispose d’un modificateur unique qu’il peut invoquer en une ligne de code à l’extrémité de n’importe quel pipeline d’analyse, garantissant une harmonie visuelle absolue à travers l’ensemble des figures d’un manuscrit scientifique.
Cette standardisation programmatique s’intègre avec une fluidité remarquable au sein des carnets de recherche modernes compilés sous R Markdown ou Quarto. En déclarant ce thème personnalisé comme configuration graphique globale dès le bloc d’initialisation du document, tous les tracés générés au cours de l’exécution adoptent instantanément l’esthétique épurée souhaitée sans exiger la moindre retouche manuelle, matérialisant ainsi l’idéal de la recherche quantitative rigoureuse et entièrement reproductible.
12.3 Check-list finale avant soumission académique
Avant d’adresser un manuscrit scientifique aux comités de lecture des revues savantes, une vérification systématique de l’appareil graphique s’avère indispensable pour s’assurer de l’absence d’artefacts visuels dépréciatifs. Le premier contrôle porte sur l’éradication complète des graduations orphelines : chaque axe privé d’étiquettes textuelles doit impérativement avoir vu ses coches de repérage supprimées via axis.ticks = element_blank(), sous peine de donner une impression de négligence dans le rendu final du travail.
Le second point d’attention concerne la traçabilité des dimensions masquées : l’auteur doit vérifier avec soin que chaque dimension privée de graduation numérique fait l’objet d’une mention explicative claire au sein du corps du texte ou dans la légende de la figure, explicitant la signification relative des grandeurs illustrées. Enfin, il convient de contrôler l’équilibre de composition de l’ensemble de la figure en procédant à un export vectoriel haute résolution, en vérifiant que le rognage des marges via plot.margin n’a pas tronqué involontairement un titre d’axe pertinent ou une notation d’indice statistique.
En parachevant cette démarche de contrôle par l’archivage rigoureux du code source complet, incluant la fixation des graines aléatoires pour les tracés stochastiques et l’explicitation des numéros de version des bibliothèques logicielles employées, le chercheur offre à la communauté académique une visualisation de données qui conjugue beauté esthétique, perfection formelle et transparence scientifique absolue, s’inscrivant ainsi dans les plus nobles traditions de l’analyse quantitative moderne.
Références
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Cleveland, W. S. (1994). The elements of graphing data (2e éd.). Hobart Press.
- Sweller, J. (2011). Cognitive load theory. Dans J. P. Mestre & B. H. Ross (Éds.), The psychology of learning and motivation: Cognition in education (Vol. 55, pp. 37–76). Academic Press. https://doi.org/10.1016/B978-0-12-387691-1.00002-8
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- van der Maaten, L., & Hinton, G. (2008). Visualizing data using t-SNE. Journal of Machine Learning Research, 9(86), 2579–2605. https://jmlr.org/papers/v9/vandermaaten08a.html
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2e éd.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2e éd.). Springer Science+Business Media. https://doi.org/10.1007/0-387-28695-0