
Dans le champ de l’analyse exploratoire des données et de la communication scientifique, la restitution graphique constitue bien plus qu’une simple étape illustrative : elle incarne un instrument cognitif central pour la détection de structures latentes, l’évaluation de modèles statistiques et la mise à l’épreuve d’hypothèses empiriques. Au sein du langage de programmation statistique R, la capacité à juxtaposer et à superposer de multiples flux d’informations sur un même repère visuel représente une compétence fondamentale pour tout chercheur ou praticien de la science des données. Plutôt que de multiplier les panneaux disjoints — une approche qui fragilise la comparaison visuelle directe —, la superposition méthodique de couches de données permet d’ancrer immédiatement les contrastes, les similitudes, les trajectoires d’évolution temporelle et les écarts aux prédictions théoriques.
L’environnement R se distingue par une dualité architecturale singulière en matière de rendu graphique. D’un côté s’impose le moteur graphique traditionnel, communément désigné sous l’appellation de Base R, reposant sur un modèle séquentiel impératif où les primitives géométriques sont dessinées pas à pas sur un canevas numérique fixe. De l’autre se déploie l’écosystème déclaratif contemporain articulé autour de ggplot2 et de la grammaire des graphiques théorisée par Leland Wilkinson. Maîtriser l’art de la superposition dans R exige une compréhension approfondie de ces paradigmes : saisir comment les primitives de bas niveau interagissent avec l’infrastructure du moteur d’affichage sous-jacent, comment harmoniser les fenêtres métriques, et comment concevoir des figures conformes aux exigences les plus strictes de la communication académique internationale.
Le présent traité propose une exploration exhaustive, méthodique et avancée des techniques de superposition graphique au sein de R. De la manipulation élémentaire des fonctions de bas niveau telles que points() et lines() jusqu’à l’orchestration complexe d’axes secondaires via l’altération de l’état graphique par(new = TRUE), en passant par le tracé d’enveloppes d’incertitude polygonales et la transition vers l’architecture en couches de ggplot2, ce guide détaille l’ensemble des protocoles requis pour concevoir des visualisations multivariées d’une rigueur irréprochable.
1. Introduction à la superposition graphique dans l’environnement R
1.1 Fondements conceptuels de la visualisation multivariée en R
La visualisation de données empiriques ne se réduit pas à une transcription mécanique de tables numériques vers des coordonnées spatiales ; elle obéit aux lois de la perception visuelle humaine et à la nécessité de minimiser la charge cognitive lors de l’extraction d’inférences. L’importance de la superposition visuelle dans l’analyse comparative des données empiriques réside principalement dans l’exploitation des mécanismes pré-attentifs identifiés par la psychophysique. Lorsque deux séries d’observations partagent un même repère cartésien, l’œil humain peut évaluer instantanément les différentiels d’amplitude, les changements de courbure, les croisements de tendances ou l’hétérogénéité des variances locales. La séparation des données sur des sous-graphiques adjacents (ou facettes) contraint l’observateur à opérer des mouvements saccadiques oculaires répétés, ce qui sollicite la mémoire de travail à court terme et dégrade la précision de l’estimation quantitative relative.
L’évolution des systèmes graphiques dans R témoigne de cette quête perpétuelle d’équilibre entre flexibilité algorithmique et cohérence structurelle. Le moteur historique de Base R, issu du langage S développé aux Bell Laboratories par John Chambers et ses collègues, a été conçu selon une philosophie procédurale : l’utilisateur initialise une zone de tracé, puis y applique séquentiellement des couches d’encre numérique. En contraste, l’avènement des systèmes graphiques en grille (grid graphics) sous l’impulsion de Paul Murrell, suivi de l’implémentation de la Grammar of Graphics par Hadley Wickham, a formalisé la superposition non plus comme une succession temporelle d’instructions de dessin, mais comme une combinaison algébrique d’objets géométriques liés à des échelles de variables abstraites. Comprendre la dialectique entre ces deux approches constitue le socle méthodologique indispensable à toute production graphique de haut niveau.
Sur le plan méthodologique, l’intégration de multiples séries sur un repère orthogonal unique confère une puissance analytique singulière : elle permet d’aligner rigoureusement les distributions observées sur leurs lois limites théoriques, d’évaluer la proximité de deux trajectoires longitudinales concurrentes ou de projeter des estimations non paramétriques directement sur la dispersion brute des observations individuelles. Toutefois, cette concentration d’éléments informatifs impose une discipline stricte. Les critères de lisibilité scientifique exigent de préserver le ratio encre-données cher à Edward Tufte, d’éviter la saturation sensorielle et de prévenir toute ambiguïté sémiotique. La surcharge cognitive survient dès lors que l’enchevêtrement des couches graphiques dissimule les structures sous-jacentes au lieu de les révéler, transformant une figure scientifique rigoureuse en un artefact illisible.
1.2 Le modèle de dessin séquentiel du moteur graphique standard
Le moteur graphique standard de R fonctionne selon le paradigme universellement documenté de la « peinture sur canevas » (painter’s model). Dans cette architecture, chaque élément graphique nouveau est appliqué sur un plan bidimensionnel statique préalablement alloué en mémoire vive. Dès qu’un pixel ou un vecteur est projeté sur ce canevas, il modifie irréversiblement l’état des registres d’affichage pour la zone géographique concernée. Il n’existe pas, au sein des primitives de Base R, de structure de graphe de scène (scene graph) rétroactive permettant de modifier a posteriori la position ou les attributs d’un élément tracé précédemment, sans réinitialiser la totalité de la fenêtre graphique.
Ce fonctionnement impose une différenciation structurelle catégorique entre les fonctions graphiques de haut niveau (high-level plotting functions) et les fonctions de bas niveau (low-level plotting functions). Les fonctions de haut niveau, dont la commande emblématique est plot(), mais qui englobent également hist(), boxplot() ou barplot(), possèdent la double responsabilité de réinitialiser le canevas, de calculer les dimensions géométriques de la boîte englobante, de positionner les axes cartésiens avec leurs graduations respectives et d’allouer les marges périphériques. À l’inverse, les fonctions de bas niveau — telles que lines(), points(), polygon(), segments(), rect() ou abline() — sont strictement incapables d’engendrer un repère autonome. Elles requièrent impérativement l’existence préalable d’une fenêtre de coordonnées active au sein de laquelle elles viennent injecter leurs composantes spatiales.
Par voie de conséquence, la gestion de l’ordre d’empilement des couches (le concept de z-index dans les environnements graphiques vectoriels) est directement gouvernée par la chronologie d’exécution des commandes dans la console ou le script d’exécution. Une couche appelée ultérieurement viendra immanquablement recouvrir, masquer ou altérer la netteté des couches préalablement matérialisées. Si un praticien appelle un nuage dense de points opaques après avoir tracé une courbe de régression lissée, cette dernière sera partiellement ou totalement occultée, corrompant la lecture des tendances macroscopiques. La planification séquentielle rigoureuse des appels aux fonctions de dessin s’érige donc en exigence algorithmique incontournable.
2. Le moteur graphique de base (Base R) et les fonctions de bas niveau
2.1 Fonctionnement de base de l’instruction plot() initiale
L’amorce de toute composition graphique en Base R nécessite l’exécution délibérée d’une fonction de haut niveau destinée à configurer l’espace cartésien global. L’instruction fondamentale plot() assume cette prérogative architecturale en réalisant une série d’opérations d’étalonnage mathématique sous-jacentes. Dès sa sollicitation, elle analyse les vecteurs d’entrée afin d’en déduire les bornes extrêmes, calcule l’emprise requise pour les étiquettes textuelles périphériques et délimite la région de traçage (figure region) par rapport aux marges extérieures du périphérique d’affichage (configurées au niveau global par la variable interne par("mar")).
La sélection des arguments fondamentaux de configuration de la fenêtre d’affichage revêt une portée stratégique dès cette étape préliminaire. Les paramètres directeurs xlim et ylim permettent de contraindre explicitement les étendues minimale et maximale des axes abscisse et ordonnée, neutralisant les calculs automatiques parfois trop restrictifs du moteur d’inférence statistique. Par ailleurs, des arguments tels que xlab, ylab, main, sub, ainsi que les indicateurs de style d’axes tels que bty (définissant la topologie de la boîte englobante : complète, semi-ouverte en « L », ou totalement omise) constituent la structure d’accueil au sein de laquelle les éléments géométriques futurs viendront s’imbriquer sans distorsion métrique.
Une incompréhension fréquente chez les utilisateurs néophytes réside dans les conséquences de l’écrasement involontaire du canevas par des appels successifs non contrôlés de la commande plot(). L’émission d’une seconde commande plot(x2, y2) consécutive à une première instruction plot(x1, y1) n’aboutit aucunement à l’adjonction de la nouvelle série au tracé existant ; elle déclenche la réinitialisation immédiate du dispositif graphique actif (device), purgeant intégralement le canevas préalable pour y substituer un nouveau système de coordonnées. Pour déroger à cette réinitialisation destructrice et implémenter une véritable superposition, il est indispensable de déléguer l’ajout des flux d’observations subséquents aux fonctions de bas niveau dédiées.
2.2 Rôle et spécificités de la fonction lines()
La fonction lines() incarne la directive fondamentale pour l’adjonction de géométries unidimensionnelles continues au sein d’un tracé préétabli. Contrairement à l’instruction d’initialisation, lines() s’abstient rigoureusement de redéfinir les marges ou d’ajuster les bornes métriques : elle prend acte des coordonnées matricielles ou vectorielles qui lui sont soumises pour projeter une trajectoire segmentée reliant consécutivement les points d’inflexion dans l’ordre strict d’indexation de leur passage en paramètre.
Le contrôle de la sémantique visuelle du tracé s’opère au moyen de paramètres géométriques normalisés. L’argument lty (line type) permet d’attribuer une signature structurelle à la trajectoire au moyen de codages entiers ou de chaînes descriptives prédéfinies : plein (1 ou "solid"), tireté (2 ou "dashed"), pointillé (3 ou "dotted"), alterné trait-point (4 ou "dotdash"), tiret long (5 ou "longdash") ou double tiret (6 ou "twodash"). L’épaisseur de l’entité linéaire est quant à elle modulée via l’argument scalaire positif lwd (line width), où la valeur unitaire standard (lwd = 1) peut être démultipliée (par exemple lwd = 2.5) afin d’établir une hiérarchisation visuelle saillante au profit de modèles centraux ou de tendances asymptotiques majeures.
La gestion des séries temporelles discontinues et le traitement des valeurs manquantes (NA) constituent une spécificité technique déterminante de la fonction lines(). Lorsqu’un vecteur de données comporte une valeur manquante au sein de sa structure interne, le moteur de tracé interrompt mécaniquement la continuité du segment à l’emplacement exact de la valeur non définie pour la reprendre à la première observation valide ultérieure. Cette propriété garantit une intégrité épistémologique stricte dans les visualisations longitudinales : les phases de rupture d’acquisition instrumentale ou les arrêts de suivi de cohortes cliniques apparaissent explicitement sous la forme d’intervalles vides, empêchant l’interpolation erronée de données non observées.
2.3 Rôle et spécificités de la fonction points()
La projection de coordonnées ponctuelles discrètes sur un repère spatialisé préexistant relève exclusivement de la fonction de bas niveau points(). Tout comme sa contrepartie linéaire, points() n’altère en rien l’architecture paramétrique de la fenêtre active, mais itère sur les vecteurs d’abscisses et d’ordonnées transmis pour y matérialiser des glyphes géométriques discrets selon une précision subpixel.
L’expressivité analytique de points() est régie en premier lieu par l’argument typologique pch (plotting character), qui accepte des indices numériques compris entre 0 et 25 ou des caractères scalaires directs. Une distinction sémiotique cruciale sépare les symboles dits « ouverts » ou « linéaires » (indices 0 à 20) des glyphes dits « remplis » ou « composites » (indices 21 à 25). Tandis que les premiers modulent l’intégralité de leur silhouette via le paramètre de couleur générale col, les symboles 21 à 25 admettent une configuration orthogonale découplée : col pilote exclusivement la teinte du liseré périphérique de l’élément, tandis que le paramètre bg (background) gouverne l’ombrage ou le remplissage chromatique de son aire interne. Cette distinction offre un levier graphique de premier ordre pour superposer des distributions tout en conservant une netteté absolue des intersections spatiales.
L’utilisation concertée de points() s’avère particulièrement féconde dans le contexte de la mise en exergue de sous-populations expérimentales ou d’observations statistiquement atypiques (outliers). Après avoir généré un nuage général représentatif d’une population globale, le chercheur peut formuler un filtre d’indexation booléen pour isoler des vecteurs extrêmes satisfaisant un critère d’écart-type ou de distance de Mahalanobis, et les réinjecter via points() en modifiant drastiquement l’échelle de magnification cex (character expansion) ainsi que la signature colorimétrique. Cette démarche garantit une mise en relief ciblée sans nécessiter la partition de l’espace graphique global.
3. Superposition de diagrammes de dispersion : Méthodologie et exemples
3.1 Mise en place d’un protocole d’affichage de nuages de points multiples
L’affichage simultané de multiples nuages de points sur un repère orthogonal impose une discipline opératoire rigoureuse dès la structuration des tables de données. Les matrices ou data frames manipulés doivent présenter une homogénéité conceptuelle sur les axes de projection : les dimensions $X$ et $Y$ doivent impérativement exprimer des grandeurs commensurables ou normalisées selon des métriques communes afin de prévenir tout non-sens interprétatif lors de la lecture conjointe des séries.
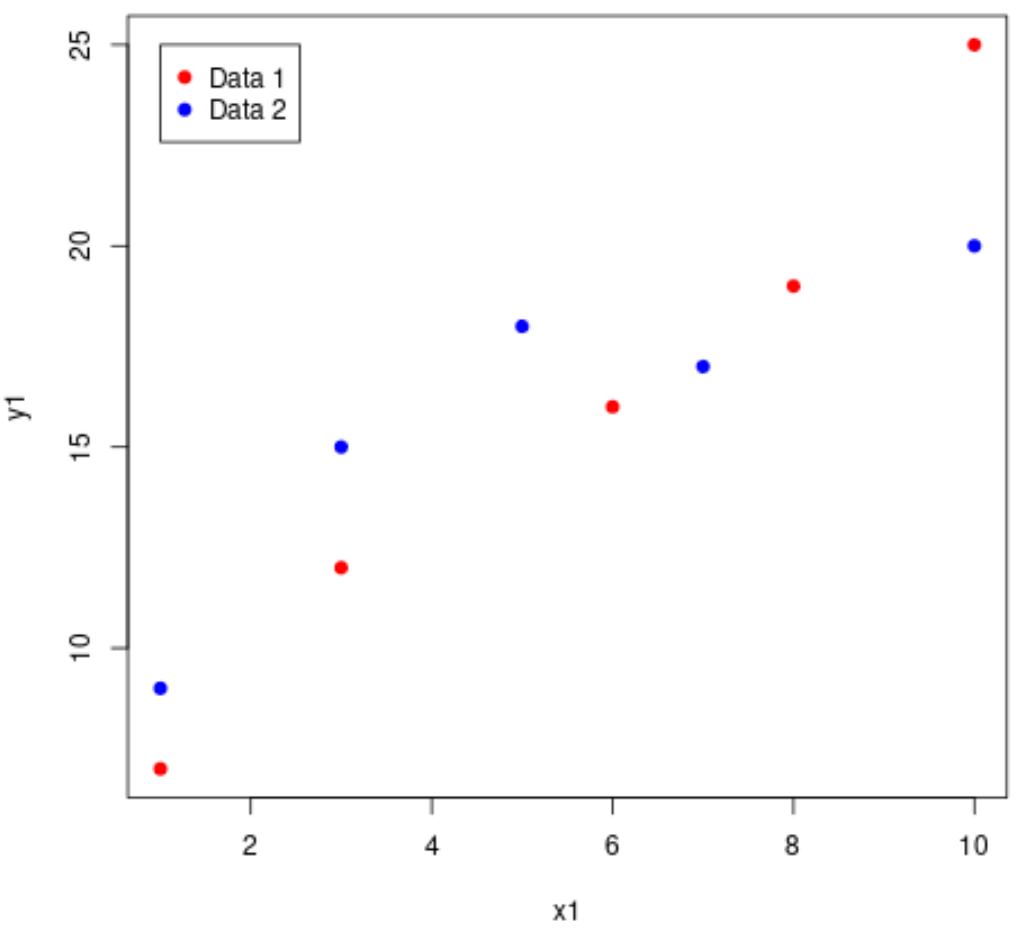
Le protocole algorithmique s’articule canoniquement en trois temps méthodologiques distincts. En premier lieu intervient l’étalonnage global de la boîte de visualisation par un appel à plot() sur le premier sous-ensemble de données ou sur une matrice vide délimitée par les extrema de tous les groupes combinés. Cette étape de calibrage dimensionnel est critique : les minima et maxima globaux doivent englober la totalité des cohortes prévues au tracé. Dans un second temps, le nuage primaire est rendu en spécifiant ses attributs sémiologiques propres. Enfin, le protocole procède à l’incrémentation successive de chaque cohorte secondaire au moyen d’appels dédiés à points(), chaque itération traduisant une modalité spécifique d’un facteur expérimental ou d’une strate démographique.
Cette approche systématique garantit que les observations marginales des groupes secondaires ne seront jamais tronquées par une fenêtre d’affichage calculée de manière myope sur la seule première cohorte. Elle permet en outre d’isoler au sein du script d’analyse des blocs syntaxiques étanches et reproductibles, où chaque couche de points peut faire l’objet de modifications paramétriques indépendantes sans perturber l’agencement structural de la figure d’ensemble.
3.2 Différenciation graphique des sous-groupes expérimentaux
La superposition de sous-groupes expérimentaux multiples au sein d’un même repère soulève le défi de la discriminabilité visuelle. Selon les principes de la sémiologie graphique développés par Jacques Bertin, l’assignation discriminatoire des formes de marqueurs doit s’appuyer sur des variables visuelles adaptées au niveau de mesure des données. Pour des variables catégorielles nominales, la variation conjointe du symbole géométrique (pch) et de la tonalité chromatique (col) constitue la méthode la plus robuste pour assurer une ségrégation perceptive immédiate et sans équivoque.
L’utilisation d’échelles chromatiques standardisées et de palettes issues de la recherche en perception visuelle — à l’instar des travaux de Cynthia Brewer disponibles via le paquet RColorBrewer ou des palettes perceptuellement uniformes de la famille Viridis — s’impose face aux couleurs primaires brutes de l’environnement standard (comme "red" ou "blue"), dont les contrastes de luminance disproportionnés faussent la hiérarchie visuelle. De surcroît, ces palettes modernes préservent l’intégrité du transfert d’information chez les lecteurs atteints de déficiences de la vision des couleurs (daltonisme, deutéranopie, protanopie).
Lorsque la densité d’échantillonnage s’accroît considérablement, le problème de l’occultation totale des observations (sur-traçage ou overplotting) menace directement la validité des conclusions empiriques tirées du graphique. La solution la plus rigoureuse consiste à mobiliser la transparence du canal alpha. Au sein de Base R, cette propriété est configurée par l’intermédiaire de la fonction rgb(red, green, blue, alpha) ou par l’ajout d’un suffixe hexadécimal à deux chiffres aux codes couleurs standards (par exemple "#0000FF40" pour un bleu à 25 % d’opacité). Cette transparence graduée permet aux points superposés de s’accumuler visuellement, traduisant mécaniquement les zones de concentration probabiliste élevée par une densité optique proportionnelle.
3.3 Exemple pratique documenté de dispersion superposée
Pour matérialiser ce protocole au sein d’un scénario de recherche empirique, considérons la comparaison de performances cognitives issues de deux cohortes d’évaluation psychométrique soumises à des conditions environnementales contrastées (condition témoin versus condition de stress cognitif aigu). L’objectif analytique consiste à projeter simultanément les scores d’attention soutenue (abscisse) et de mémoire de travail (ordonnée), tout en explicitant les singularités distributionnelles de chaque groupe expérimental.
Le code source suivant détaille la génération des données simulées, le calibrage géométrique global unifié et l’adjonction séquentielle des flux de mesures :
# Fixation de la graine du générateur aléatoire pour reproductibilité

set.seed(101)
# Simulation des données de la cohorte témoin (Groupe A, N = 120)
att_groupeA <- rnorm(120, mean = 50, sd = 10)
mem_groupeA <- 15 + 0.65 * att_groupeA + rnorm(120, mean = 0, sd = 5)
# Simulation des données du groupe de stress cognitif (Groupe B, N = 120)
att_groupeB <- rnorm(120, mean = 45, sd = 12)
mem_groupeB <- 25 + 0.35 * att_groupeB + rnorm(120, mean = 0, sd = 7)
# Calcul algorithmique des limites englobantes globales
bornes_x <- range(c(att_groupeA, att_groupeB))
bornes_y <- range(c(mem_groupeA, mem_groupeB))
# Initialisation du cadre d'affichage avec marges professionnelles
par(mar = c(4.5, 4.5, 2.5, 1.5))
# Tracé de haut niveau de la première cohorte avec bornes globales unifiées
plot(att_groupeA, mem_groupeA,
xlim = bornes_x, ylim = bornes_y,
pch = 21, col = "#1B9E77", bg = "#1B9E7780", cex = 1.2,
xlab = "Indice d'Attention Soutenue (Score Standardisé)",
ylab = "Capacité de Mémoire de Travail (Points)",
main = "Performance Psychométrique Comparative selon la Condition",
bty = "l", las = 1)
# Superposition de bas niveau de la seconde cohorte expérimentale
points(att_groupeB, mem_groupeB,
pch = 24, col = "#D95F02", bg = "#D95F0280", cex = 1.2)
# Intégration de la légende descriptive structurelle
legend("topleft", legend = c("Condition Témoin", "Stress Cognitif"),
pch = c(21, 24), col = c("#1B9E77", "#D95F02"),
pt.bg = c("#1B9E7780", "#D95F0280"), pt.cex = 1.2,
bty = "n", cex = 0.9)
L’analyse séquentielle de cette exécution démontre la rigueur de la méthode. L’utilisation explicite de range() agrège l’ensemble des extrema numériques, prévenant toute troncature des observations périphériques du Groupe B lors de l’exécution de plot() sur le Groupe A. L’emploi conjoint de symboles différentiés (cercle versus triangle orienté vers le haut) et de fonds semi-transparents permet d’identifier immédiatement les zones de forte densité d’intersection où les données des deux cohortes se chevauchent sans générer de confusion visuelle sur l’appartenance catégorielle des points.
L’interprétation visuelle de la figure produite éclaire directement la dynamique empirique : la cohorte témoin présente une corrélation linéaire positive marquée et une variance résiduelle resserrée autour de la droite de régression implicite, tandis que le groupe sous stress expérimental manifeste une dispersion nettement plus hétérogène, caractérisée par une pente de dépendance atténuée et un élargissement sensible de la variance des scores en mémoire de travail aux valeurs d’attention intermédiaires.
4. Tracé conjoint et superposition de courbes avec lines()
4.1 Construction séquentielle de graphiques linéaires multiples
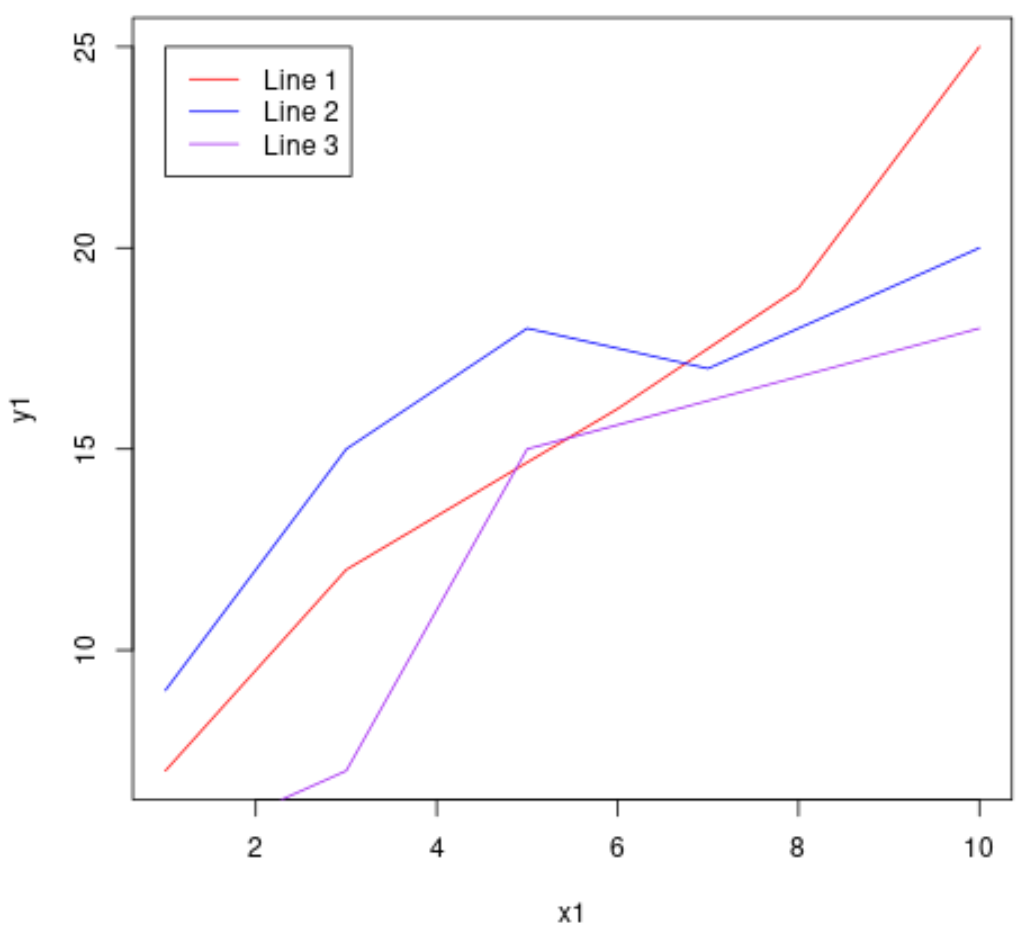
Le tracé conjoint de plusieurs séries continues répond à une logique similaire à celle observée pour les nuages de points, tout en imposant des contraintes strictes relatives à la continuité sémiotique des tracés. L’étape inaugurale repose sur l’appel à la fonction plot() configurée avec le paramètre structural type = "l" (ou alternativement type = "n" afin de n’instancier que le canevas vierge, les axes et les étiquettes sans inscrire de marqueurs immédiats).
L’ajout itératif de séries longitudinales au moyen d’appels répétés à la primitive lines() exige une attention accrue quant au tri des valeurs le long de l’axe des abscisses. Si un vecteur $X$ transmis à lines() n’est pas ordonné de manière strictement croissante, le moteur de tracé connectera les points selon leur séquence d’apparition dans le vecteur, engendrant une trajectoire chaotique et entrelacée (analogue à un tracé d’hystérésis ou de trajectoire orbitale) là où une courbe fonctionnelle univoque était escomptée. L’application préalable de l’instruction order() sur les données constitue donc une précaution de codage indispensable.
Dans la perspective d’une publication scientifique destinée à une diffusion multisupport incluant l’impression monochrome ou en niveaux de gris, l’encodage de l’information ne doit jamais reposer uniquement sur la chromaticité. Il convient d’articuler simultanément une modulation de l’épaisseur de ligne (lwd) et une assignation diversifiée des types de traits (lty). Cette redondance sémiotique contrôlée garantit que deux trajectoires se croisant sur le graphique demeureront parfaitement identifiables et dissociables même lorsque le document est reproduit sur un équipement d’impression dépourvu de reproduction trichromique.
4.2 Exemple reproductible de superposition de trajectoires temporelles
Illustrons cette méthodologie à travers la modélisation longitudinale de courbes d’apprentissage individuel ou organisationnel au cours de sessions temporelles successives. Nous analysons l’évolution des indices d’efficacité opératoire pour trois méthodologies pédagogiques distinctes (Standard, Intensive et Assistée par Intelligence Artificielle) mesurées sur vingt intervalles temporels discrets.
Voici l’implémentation de la procédure sous Base R :
# Séquence temporelle commune (axe X)

temps <- 1:20
# Modélisation mathématique des trois trajectoires asymptotiques
methode_standard <- 100 * (1 - exp(-0.08 * temps)) + rnorm(20, 0, 1.5)
methode_intensive <- 100 * (1 - exp(-0.16 * temps)) + rnorm(20, 0, 1.5)
methode_ia <- 100 * (1 - exp(-0.25 * temps)) + rnorm(20, 0, 1.5)
# Détermination unifiée des bornes métriques sur l'ordonnée
lim_y <- range(c(methode_standard, methode_intensive, methode_ia))
# Configuration du canevas et étalonnage initial
par(mar = c(4.5, 4.5, 2.5, 1.5))
plot(temps, methode_standard,
type = "l", lty = 1, lwd = 2, col = "#2C3E50",
ylim = lim_y, las = 1, bty = "l",
xlab = "Période d'Entraînement (Semaines)",
ylab = "Indice d'Efficacité Opératoire (0-100)",
main = "Cinétique d'Acquisition de Compétences selon le Protocole")
# Superposition de la deuxième série temporelle (Méthode Intensive)
lines(temps, methode_intensive, type = "l", lty = 2, lwd = 2, col = "#E74C3C")
# Superposition de la troisième série temporelle (Méthode Assistée par IA)
lines(temps, methode_ia, type = "l", lty = 4, lwd = 2.5, col = "#2980B9")
# Intégration de repères d'identification sans boîte superflue
legend("bottomright",
legend = c("Protocole Standard", "Protocole Intensif", "Assisté par IA"),
lty = c(1, 2, 4), lwd = c(2, 2, 2.5),
col = c("#2C3E50", "#E74C3C", "#2980B9"),
bty = "n", cex = 0.85)
Le résultat graphique offre un contraste visuel immédiat. Le protocole assisté par IA se distingue par une pente initiale extrêmement abrupte, atteignant son plateau de saturation asymptotique dès la huitième semaine. À l’opposé, le protocole standard manifeste une cinétique lente et progressive. Grâce à la sélection conjointe de codes couleurs contrastés en luminance et de motifs de tiretés différenciés, la lecture analytique des croisements et des phases de stabilisation demeure parfaitement fluide, y compris sous des conditions de reproduction graphique dégradées.
4.3 Superposition de modèles mathématiques et régressions lissées
L’une des utilisations les plus fécondes de la superposition de tracés linéaires réside dans la projection directe d’un modèle statistique inférentiel sur le nuage de points empiriques dont il est issu. Qu’il s’agisse d’une régression linéaire paramétrique, d’un polynôme d’ordre supérieur ou d’un ajustement non paramétrique local (LOESS), la démarche opérationnelle repose sur le calcul rigoureux d’un vecteur de valeurs prédites sur une grille dense de coordonnées d’abscisses.
Pour implémenter cette procédure avec un lissage non paramétrique de type LOESS (Locally Estimated Scatterplot Smoothing), le praticien commence par ajuster le modèle via la fonction loess(). Ensuite, plutôt que de relier grossièrement les prédictions calculées sur les seules valeurs observées du jeu de données (ce qui produirait une courbe rugueuse si les observations sont éparses), il génère une grille de points régulièrement espacés à l’aide de seq(), calcule les prédictions correspondantes via predict(), et projette le vecteur résultant à l’aide de la fonction lines() :
# Génération de données bruitées non linéaires

x_obs <- seq(1, 10, length.out = 80)

y_obs <- sin(x_obs) + rnorm(80, 0, 0.35)
# Ajustement du lissage non paramétrique loess
modele_loess <- loess(y_obs ~ x_obs, span = 0.5)
# Création d'une grille dense pour un tracé d'une fluidité parfaite
grille_x <- seq(min(x_obs), max(x_obs), length.out = 300)
y_pred <- predict(modele_loess, newdata = data.frame(x_obs = grille_x))
# Tracé du nuage de points empiriques initial
plot(x_obs, y_obs, pch = 16, col = "grey50", las = 1, bty = "l",
xlab = "Variable Explicative (X)", ylab = "Réponse Observée (Y)",
main = "Modélisation Non Paramétrique LOESS Superposée")
# Superposition de la courbe de tendance lissée continue
lines(grille_x, y_pred, col = "#8E44AD", lwd = 2.5)
Cette technique permet d’éviter l’écueil classique de la courbe hachurée ou anguleuse qui se produit invariablement lorsque les coordonnées interpolées ne sont pas préalablement ordonnées ou présentent une densité spatiale insuffisante. La régression lissée vient ainsi guider l’interprétation de la structure fonctionnelle sans masquer la réalité de la dispersion des résidus.
5. Gestion et harmonisation des échelles d’axes (xlim et ylim)
5.1 Le piège de la troncature des données secondaires
La source d’erreur la plus prévalente lors de la composition de graphiques superposés au moyen des fonctions de bas niveau réside dans la mécanique par défaut de fixation des bornes cartésiennes. Lorsqu’un chercheur initialise son graphique via plot(x1, y1), le moteur d’affichage calcule de façon autonome la valeur minimale et la valeur maximale des seuls vecteurs x1 et y1 (en y adjoignant une marge d’expansion interne de 4 % régie par le paramètre xaxs = "r"). Si une seconde série x2, y2 est injectée ultérieurement via points() ou lines(), et que les coordonnées de cette seconde série débordent du domaine initial de la première, les points excédentaires seront tout simplement éliminés du champ de vision sans qu’aucun message d’erreur ou d’avertissement ne soit émis par la console R.
Cette troncature silencieuse introduit un biais d’analyse majeur : des observations empiriques réelles, potentiellement représentatives de valeurs extrêmes fondamentales pour la prise de décision scientifique, disparaissent de la représentation. Pour prévenir ce phénomène d’exclusion graphique involontaire, il est impératif d’ériger en règle systématique l’évaluation globale préalable de la dynamique des données au moyen de la fonction range().
5.2 Algorithme d’unification des étendues de mesure
L’algorithme standard d’unification dimensionnelle repose sur l’extraction dynamique des extrema vectoriels à travers la totalité des flux à agréger. La syntaxe canonique implique la concaténation systématique des vecteurs d’abscisses au sein d’un appel à range(c(x1, x2, ..., xn), na.rm = TRUE), et l’application d’une démarche strictement identique pour l’ensemble des vecteurs d’ordonnées range(c(y1, y2, ..., yn), na.rm = TRUE).
Les deux vecteurs d’extrema résultants, composés chacun de deux valeurs scalaires [min, max], sont alors explicitement assignés aux arguments xlim et ylim de l’instruction plot() initiale. Cette précaution garantit que l’intégralité du volume des données futures disposera d’un espace géométrique alloué dès le traçage du cadre primaire. Dans certaines configurations éditoriales exigeant la préservation d’une marge de respiration esthétique supérieure, il est aisé d’étendre artificiellement ces bornes d’un pourcentage paramétrable (par exemple en multipliant l’étendue par un facteur d’amortissement de 10 % de part et d’autre des extrema absolus).
5.3 Cas particulier de dimensions asymétriques et redimensionnement
Un défi analytique plus complexe survient lorsque les séries à superposer partagent le même espace sémantique sur l’axe des abscisses (par exemple une progression chronologique), mais présentent des amplitudes de variance radicalement asymétriques ou des ordres de grandeur distants de plusieurs facteurs d’échelle sur l’axe des ordonnées. Tenter de forcer leur représentation sur une échelle $Y$ unifiée sans transformation préalable aboutit inéluctablement à l’écrasement visuel de la série à faible variabilité, qui se réduira à un profil horizontal plat et indéchiffrable le long du plancher du graphique.
Deux options épistémologiques se présentent alors au chercheur. La première, souvent la plus rigoureuse sur le plan méthodologique, consiste à opérer une standardisation mathématique préalable (telle que la conversion en scores $Z$ ou le centrage-réduction des données, via la fonction scale()). Les séries superposées n’expriment plus alors des unités physiques brutes, mais des déviations standardisées par rapport à leurs moyennes respectives, préservant ainsi la comparabilité des profils de dynamique et des synchronies temporelles. La seconde option, le recours à un axe secondaire d’échelle dissemblable, implique des manipulations techniques avancées qui feront l’objet d’un examen approfondi dans la section dédiée à l’instruction par(new = TRUE).
6. Intégration d’éléments informatifs : Légendes et annotations
6.1 Paramétrage exhaustif de la fonction legend()
Un graphique multivarié complexe superposant divers flux d’informations demeure incomplet, voire méthodologiquement inexploitable, en l’absence d’une clé de décodage sémiotique non ambiguë. La fonction de bas niveau legend() permet de greffer sur la figure active une légende d’identification dont la cohérence typologique avec les paramètres de dessin sous-jacents doit être absolue.
Le positionnement de l’élément peut être défini par des mots-clés spatiaux (tels que "topleft", "topright", "bottomleft", "bottomright", "center") qui procèdent à un ancrage automatique tenant compte des marges internes du repère. Alternativement, pour un contrôle micrométrique du placement dans des zones graphiques densément occupées, le chercheur peut spécifier directement les coordonnées cartésiennes $(x, y)$ précises du coin supérieur gauche de la boîte de légende. Une correspondance rigoureuse doit être maintenue : les vecteurs passés aux arguments pch, lty, lwd, col et pt.bg de la fonction legend() doivent reproduire à l’identique l’ordre et les spécificités des paramètres alloués lors des appels successifs à plot(), points() et lines().
Le contrôle de l’esthétique contextuelle est assuré par l’argument bty (fixé à "n" pour supprimer tout encadrement rectangulaire parasite et alléger le ratio d’encre), ainsi que par le paramètre d’opacité du fond bg. L’assignation d’une couleur d’arrière-plan semi-transparente à la boîte de légende (par exemple bg = rgb(1, 1, 1, 0.8)) constitue un compromis élégant permettant à la légende de masquer modérément les éléments situés sous elle pour en assurer la lisibilité textuelle, tout en évitant d’oblitérer totalement la perception des trajectoires géométriques qui traversent son périmètre.
6.2 Annotations localisées avec text() et mtext()
Si la légende assume une fonction de classification globale, l’annotation ponctuelle assure quant à elle une explicitation contextualisée des points singuliers, des seuils de rupture ou des valeurs aberrantes au sein même du corps de la visualisation. La fonction text() opère au sein du système cartésien intérieur du tracé, acceptant les coordonnées exactes des points à documenter pour y projeter des chaînes de caractères informatives.
L’argument directionnel pos de la fonction text() (prenant les valeurs 1, 2, 3 ou 4 pour désigner respectivement le positionnement en dessous, à gauche, au-dessus ou à droite de la coordonnée cible) couplé au paramètre de décalage offset permet de prévenir le chevauchement typographique direct entre le libellé textuel et le symbole géométrique du point annoté. Pour le signalement des singularités dans de vastes ensembles de données, il est d’usage d’exploiter la programmation vectorielle pour n’annoter que les observations excédant un certain seuil empirique (par exemple : text(x[outliers], y[outliers], labels = identifiants[outliers], pos = 3)).
À l’opposé de text(), la fonction mtext() (margin text) projette des inscriptions au-delà des limites du cadre cartésien, directement dans les marges périphériques. L’argument side (valeurs entières de 1 à 4, progressant dans le sens horaire depuis le bas, la gauche, le haut jusqu’à la droite) combiné à line (déterminant la distance par rapport au cadre) permet d’insérer des mentions méthodologiques additionnelles, des indications de sources de données, ou d’adosser des unités de mesure complémentaires aux graduations extérieures des axes.
6.3 Traçage de seuils de référence avec abline()
La contextualisation d’un graphique multivarié requiert fréquemment la matérialisation de repères de référence théoriques ou empiriques universels : niveaux de signification statistique (valeurs $p$ critiques), moyennes globales d’échantillons, lignes d’équivalence parfaite ou asymptotes fonctionnelles. La fonction abline() offre une interface directe pour implémenter ces superpositions géométriques sans avoir à manipuler des coordonnées matricielles complexes.
Les arguments h (horizontal) et v (vertical) acceptent des vecteurs scalaires pour tracer des droites infinies séquant le repère orthogonal à l’altitude ou à l’abscisse spécifiée. Ainsi, abline(h = mean(y), lty = 3, col = "darkgrey") ancre instantanément le niveau central de la population au sein d’un nuage dispersé. Pour le traçage de diagonales de corrélation parfaite ou de lignes d’identité (où $Y = X$), la commande abline(a = 0, b = 1) configure directement l’ordonnée à l’origine ($a$) et la pente unitaire ($b$). Ces lignes d’équivalence sont particulièrement prisées dans les études de reproductibilité instrumentale (méthode de Bland-Altman) ou lors de la comparaison conjointe de scores pré-test et post-test, permettant de scinder immédiatement l’espace graphique entre les sujets en progression et ceux en régression.
7. Combinaison hétérogène de structures visuelles
7.1 Superposition simultanée de points et de segments continus
Dans de nombreuses configurations analytiques, la compréhension exhaustive d’un phénomène scientifique requiert d’associer des modes de représentation formellement distincts au sein d’une composition visuelle unifiée : confronter un nuage de mesures ponctuelles brutes à une droite de régression paramétrique, ou relier des centres de gravité catégoriels par des segments de trajectoire moyenne tout en conservant visible la nébuleuse des observations individuelles.
Si la fonction générique plot() propose le mode combinatoire direct type = "b" (qui trace à la fois les points et les segments les reliant), cette option génère un rendu visuel souvent insatisfaisant en raison de l’interruption mécanique des segments autour de chaque marqueur et de l’incapacité d’appliquer des styles chromatiques disjoints aux points et aux lignes. La construction manuelle découplée s’impose comme le standard professionnel : on initialise d’abord le nuage de points au moyen de plot(..., type = "p") avec une transparence contrôlée, puis on vient adosser par-dessus la trajectoire synthétique modélisée via lines() avec une épaisseur renforcée (lwd = 2.5).
Le séquençage chronologique est ici déterminant. Placer la droite de tendance avant les points empiriques peut conduire à l’occultation visuelle de celle-ci si la densité de l’échantillon est massive. À l’inverse, déposer une ligne opaque au-dessus d’un semis de marqueurs semi-transparents assure que la modélisation mathématique macroscopique demeure parfaitement prééminente sans pour autant masquer l’hétérogénéité des variations individuelles sous-jacentes.
7.2 Intégration d’intervalles de confiance avec polygon()
La communication contemporaine des résultats scientifiques bannit de plus en plus les estimations ponctuelles isolées au profit de la restitution explicite de l’incertitude statistique. L’adjonction d’une enveloppe ou d’un ruban d’intervalle de confiance (généralement calculé à 95 %) autour d’une courbe de régression ou d’une cinétique temporelle s’opère dans Base R par le biais de la fonction polygon().
La modélisation géométrique d’un polygone continu requiert la fermeture stricte du contour spatial vectoriel. Sur le plan algorithmique, cela nécessite de construire un vecteur d’abscisses combinant la séquence ordonnée d’origine suivie de la même séquence inversée : c(x, rev(x)). Le vecteur d’ordonnées correspondant doit juxtaposer la borne supérieure de l’intervalle d’estimation avec la borne inférieure parcourue dans le sens rétrograde : c(borne_superieure, rev(borne_inferieure)). L’injection de ces vecteurs couplés dans polygon() engendre une forme fermée englobante.
Le paramètre déterminant pour assurer le succès de cette superposition réside dans l’élimination de la bordure du polygone (border = NA) et l’application d’un ombrage chromatique présentant un degré élevé de translucidité via l’argument col (par exemple col = rgb(0.2, 0.4, 0.8, 0.25)). Cette configuration permet d’obtenir un halo d’incertitude fluide au travers duquel les points de données empiriques initiaux et les graduations du quadrillage de fond demeurent parfaitement visibles sans créer de surcharge graphique.
7.3 Tracé de barres d’erreur empiriques sur nuages superposés
Lorsque les données agrégées expriment des moyennes factorielles associées à des dispersions de variance standardisée (écart-type, erreur standard ou intervalle de confiance délimité), l’intégration de barres d’erreur ponctuelles constitue le mode de restitution conventionnel dans de nombreuses disciplines expérimentales telles que la biomédecine, les neurosciences ou la psychologie cognitive.
En l’absence de fonction dédiée nommée errorbars() dans l’infrastructure centrale de Base R, la réalisation technique de ces indicateurs s’effectue avec une précision chirurgicale en détournant la fonction vectorielle arrows(). En configurant l’angle de la pointe de flèche à 90 degrés (angle = 90), la longueur du crochet terminal à une dimension proportionnée (par exemple length = 0.05 pouce) et en activant la bidirectionnalité via l’argument code = 3, arrows() trace une barre d’erreur classique rigoureusement étalonnée :
# Données factorielles synthétiques : moyennes et erreurs standards

groupes_x <- 1:4

moyennes <- c(24.5, 32.1, 28.4, 41.2)

erreurs_std <- c(1.8, 2.3, 1.5, 2.7)
# Initialisation du tracé avec bornes adaptées intégrant les marges d'erreur
plot(groupes_x, moyennes, pch = 19, col = "#2C3E50", cex = 1.3,
xlim = c(0.5, 4.5),
ylim = c(min(moyennes - erreurs_std) - 2, max(moyennes + erreurs_std) + 2),
xaxt = "n", bty = "l", las = 1,
xlab = "Condition Expérimentale", ylab = "Moyenne du Score de Réponse",
main = "Profils Factoriels avec Barres d'Erreur Standard")
# Substitution de l'axe discret par des libellés nominatifs clairs
axis(1, at = 1:4, labels = c("Ctrl", "Trait A", "Trait B", "Combiné"))
# Superposition rigoureuse des barres d'erreur via arrows()
arrows(groupes_x, moyennes - erreurs_std, groupes_x, moyennes + erreurs_std,
length = 0.06, angle = 90, code = 3, col = "#2C3E50", lwd = 1.5)
Cette approche permet d’associer sur une même figure des marqueurs discrets hautement précis, des barres de dispersion conformes aux standards de l’American Psychological Association (APA) et, le cas échéant, des lignes de liaison discontinues afin d’illustrer la dynamique des interactions factorielles globales.
8. Superposition de distributions : Histogrammes et densités
8.1 Confrontation directe d’histogrammes multiples
L’évaluation comparative de deux distributions continues constitue une démarche exploratoire classique. Toutefois, la juxtaposition superposée d’histogrammes au moyen de la fonction standard hist() se heurte à des pièges algorithmiques spécifiques. Par nature, hist() est une fonction de haut niveau qui tend à réinitialiser le périphérique de sortie. Pour superposer un second histogramme sur le premier, il est impératif d’activer le paramètre booléen add = TRUE lors du second appel.
Une contrainte méthodologique majeure doit alors être impérativement satisfaite : les distributions comparées ne possèdent généralement pas des effectifs totaux d’échantillonnage identiques. Conserver l’axe standard des fréquences absolues (les effectifs bruts) produit un artefact trompeur où l’échantillon le plus vaste semble dominer quantitativement l’autre en tout point du domaine. L’utilisateur doit impérativement basculer l’affichage sur une échelle de densité de probabilité en déclarant l’argument freq = FALSE (ou de manière équivalente prob = TRUE) au sein des deux instructions hist() successives.
Par ailleurs, pour que la superposition soit physiquement lisible et que le second histogramme ne masque pas intégralement les colonnes du premier, le choix des paramètres de remplissage s’avère stratégique : soit en recourant à des hachures croisées via le paramètre density combiné à l’orientation angle, soit en exploitant des tonalités chromatiques semi-transparentes par le biais de la fonction rgb(). Enfin, le calibrage manuel préalable de la boîte d’affichage (via xlim pour couvrir les domaines conjoints des données et ylim pour accueillir la hauteur maximale des densités des deux groupes) conditionne la réussite de la figure.
8.2 Superposition de courbes de densité continue (density())
Face aux rigidités formelles de l’histogramme — dont la silhouette demeure fortement tributaire du choix arbitraire de l’ancrage et de la largeur des intervalles de classe (bins) —, l’estimation de la densité par la méthode du noyau (Kernel Density Estimation ou KDE) offre une représentation continue et élégante de la distribution probabiliste sous-jacente.
Le calcul de densité s’effectue dans un premier temps au moyen de la fonction density(), qui détermine la fonction de répartition lissée sous l’hypothèse d’une fenêtre de lissage optimale (souvent selon l’algorithme de Silverman). L’assemblage superposé de plusieurs densités s’articule ensuite naturellement : on applique l’instruction plot() sur le premier objet de densité calculé, en prenant soin d’étendre artificiellement ylim pour englober le pic maximal de l’ensemble des séries à projeter. Les flux distributionnels subséquents sont alors injectés à l’aide de l’instruction lines() appliquée sur les objets de densité secondaires.
Pour démultiplier l’impact visuel et faciliter la différenciation spatiale des populations sans sacrifier la lisibilité, l’intégration de la fonction polygon() permet de remplir l’aire délimitée sous chaque profil de densité. En assignant des couleurs semi-transparentes distinctes aux diverses aires de répartition, les zones d’intersection distributionnelle apparaissent sous la forme de nuances chromatiques composées, révélant avec une clarté remarquable les degrés de chevauchement ou d’asymétrie relative des populations à l’étude.
8.3 Comparaison entre distribution empirique et loi théorique
Une application fondamentale de la superposition distributionnelle consiste à confronter graphiquement un jeu de données empiriques à une distribution théorique paramétrique idéale (telle que la loi normale de Gauss, la loi de Student ou la loi log-normale). Cette démarche d’adéquation visuelle offre un complément intuitif indispensable aux tests de normalité formels (tels que le test de Shapiro-Wilk ou de Kolmogorov-Smirnov), dont la sensibilité est notoirement hypersensible aux grands échantillons.
Le protocole technique combine l’affichage d’un histogramme de densité normalisé (freq = FALSE) avec la projection continue de la densité théorique calculée sur le domaine d’observation au moyen de la fonction mathématique correspondante, telle que dnorm() :
# Échantillonnage empirique légèrement asymétrique (N = 250)

donnees_empiriques <- rsnorm(250, mean = 100, sd = 15, xi = 1.3) # via fGarch ou simulation similaire

if(!exists("donnees_empiriques")) donnees_empiriques <- c(rnorm(200, 100, 12), rnorm(50, 120, 15))
# Estimation des paramètres gaussiens empiriques
moyenne_obs <- mean(donnees_empiriques)
ecart_type_obs <- sd(donnees_empiriques)
# Tracé initial de l'histogramme mis à l'échelle de densité probabiliste
hist(donnees_empiriques, freq = FALSE, breaks = 20,
col = "#ECF0F1", border = "#BDC3C7", las = 1,
xlab = "Valeur de la Variable d'Intérêt", ylab = "Densité Relative",
main = "Adéquation Distributionnelle : Données Observées vs Normale Théorique")
# Superposition de la densité empirique observée (KDE)
lines(density(donnees_empiriques), col = "#2980B9", lwd = 2.5)
# Grille fine pour projection de la courbe normale théorique exacte
abscisses_theorie <- seq(min(donnees_empiriques), max(donnees_empiriques), length.out = 500)
densite_gaussienne <- dnorm(abscisses_theorie, mean = moyenne_obs, sd = ecart_type_obs)
# Superposition de la courbe gaussienne théorique en trait discontinu contrasté
lines(abscisses_theorie, densite_gaussienne, col = "#C0392B", lwd = 2, lty = 2)
# Légende explicative détaillée
legend("topright",
legend = c("Histogramme des Données", "Densité Empirique Estimée", "Modèle Normal Théorique"),
fill = c("#ECF0F1", NA, NA), border = c("#BDC3C7", NA, NA),
lty = c(NA, 1, 2), lwd = c(NA, 2.5, 2),
col = c(NA, "#2980B9", "#C0392B"), bty = "n", cex = 0.85)
Cette confrontation tripartite (histogramme de base, profil empirique lissé par noyau et courbe normale de référence) met instantanément en exergue les déviations structurelles : asymétrie positive marquée (skewness), excès d’aplatissement ou épaississement des queues de distribution (kurtosis), fournissant une assise visuelle solide avant l’engagement de procédures d’inférence linéaire généralisée.
9. Superposition à double échelle avec la commande par(new = TRUE)
9.1 Principe de fonctionnement et mécanique interne de par(new = TRUE)
Dans l’architecture interne du moteur graphique de Base R, le paramètre graphique d’état new de la fonction par() contrôle le comportement du périphérique d’affichage lors de la réception d’un nouvel ordre de haut niveau. Dans son état par défaut (par(new = FALSE)), l’émission d’une fonction telle que plot() déclenche l’effacement immédiat du tampon d’affichage existant afin de préparer un nouveau canevas vierge. En forçant manuellement l’affectation par(new = TRUE), l’utilisateur trompe intentionnellement le moteur graphique : celui-ci agit comme si la fenêtre était vierge, sans procéder à la purge des éléments pixels ou vectoriels préalablement dessinés.
Cette fonctionnalité offre la possibilité technique de superposer deux tracés de haut niveau dotés de systèmes de coordonnées totalement hétérogènes sur la même zone physique d’affichage. Toutefois, cette puissance technique s’accompagne de risques considérables d’artefacts analytiques. Du point de vue épistémologique et selon les canons de la sémiologie graphique contemporaine, l’usage des graphiques à double axe d’ordonnées (dual-axis charts) est sujet à de vives controverses académiques.
En manipulant indépendamment les bornes minimales et maximales des deux ordonnées disjointes, l’expérimentateur a la capacité artificielle de rapprocher ou d’éloigner arbitrairement deux courbes, de créer de faux points d’intersection ou de suggérer visuellement une corrélation fallacieuse entre deux variables dont les variations absolues sont en réalité disproportionnées. Les règles d’intégrité scientifique exigent donc que le recours à par(new = TRUE) soit strictement réservé à la comparaison de séries temporelles synchrones exprimant des entités conceptuelles corrélées dont les unités physiques ne peuvent être ramenées à une dimension unifiée sans nuire à la compréhension immédiate du phénomène.
9.2 Protocole technique pour générer un axe secondaire à droite
L’implémentation opérationnelle et robuste d’un graphique à double axe ordonné requiert un protocole algorithmique rigoureux destiné à neutraliser les chevauchements parasites d’axes et de boîtes d’encadrement. Le canevas doit en premier lieu allouer une marge périphérique droite suffisamment généreuse pour accueillir les graduations et le titre du futur axe secondaire, configuration spécifiée via le quatrième élément du paramètre global de marge : par(mar = c(5, 4, 4, 5)).
La chronologie de codage se déroule selon les étapes strictes suivantes :
- Exécution du tracé primaire de haut niveau associé à la première variable, avec dessin des axes standard (gauche et bas) et de ses étiquettes descriptives.
- Activation du verrou de persistance du canevas par l’appel formel à
par(new = TRUE). - Exécution du second tracé de haut niveau associé à la seconde variable, en prenant soin de désactiver l’affichage de l’ensemble des axes et de la boîte englobante au moyen de l’argument
axes = FALSE, et d’annuler les titres automatiques en fixantxlab = ""etylab = "". - Matérialisation manuelle et ciblée de l’axe secondaire à droite de la région de tracé via la fonction de bas niveau
axis(side = 4, ...). - Adjonction de l’étiquette descriptive de l’ordonnée secondaire dans la marge droite par l’entremise de
mtext(..., side = 4, line = 3). - Harmonisation chromatique univoque : pour prévenir toute confusion cognitive chez le lecteur, l’axe secondaire, ses graduations textuelles et son intitulé marginal doivent adopter scrupuleusement la couleur spécifique de la courbe ou des marqueurs de données auxquels ils font référence.
9.3 Démonstration complète sur des données psychophysiologiques
Illustrons la mise en œuvre de ce protocole technique complexe à travers l’étude de la dynamique temporelle simultanée de deux biomarqueurs lors d’une épreuve d’effort cognitif aigu : le temps de réaction moteur (exprimé en millisecondes, oscillant entre 300 et 700 ms) et le taux de cortisol libre salivaire (exprimé en nanomoles par litre, variant sur une amplitude étroite de 5 à 25 nmol/L).
# Séquence temporelle de suivi (10 sessions expérimentales)

session <- 1:10

temps_reaction <- c(340, 360, 410, 490, 620, 680, 590, 480, 420, 380)

cortisol_saliv  <- c(6.2, 6.8, 7.5, 11.2, 18.5, 22.4, 21.0, 16.3, 11.8, 8.4)
# Ajustement des marges d'affichage : marge droite élargie à 5.5 lignes
par(mar = c(5, 4.5, 3, 5.5))
# Première couche de haut niveau : Temps de réaction (Axe Y primaire à gauche)
plot(session, temps_reaction,
type = "b", pch = 19, lwd = 2.5, col = "#2980B9",
yaxt = "s", bty = "u", las = 1,
xlab = "Paliere Temporel de l'Épreuve (Sessions)",
ylab = "Temps de Réponse Moteur (ms)",
main = "Cinétique Conjointe Psycho-Physiologique sous Stress")
# Teinte personnalisée de l'axe primaire gauche
axis(side = 2, col = "#2980B9", col.axis = "#2980B9", las = 1)
# Maintien d'état pour écriture de la seconde couche sur le canevas existant
par(new = TRUE)
# Seconde couche de haut niveau : Cortisol (Axes désactivés, échelle indépendante)
plot(session, cortisol_saliv,
type = "b", pch = 17, lty = 2, lwd = 2.5, col = "#C0392B",
axes = FALSE, xlab = "", ylab = "")
# Dessin ciblé de l'axe secondaire sur le flanc droit (side = 4)
axis(side = 4, col = "#C0392B", col.axis = "#C0392B", las = 1)
# Intégration de l'étiquette marginale droite dédiée
mtext("Cortisol Salivaire Libre (nmol/L)", side = 4, line = 3.5, col = "#C0392B")
# Insertion d'une légende conjointe synthétique
legend("topleft",
legend = c("Temps de Réaction (ms)", "Cortisol (nmol/L)"),
pch = c(19, 17), lty = c(1, 2), lwd = 2,
col = c("#2980B9", "#C0392B"), bty = "n", cex = 0.85)
La figure résultante préserve l’indépendance intégrale des plages de variation respectives tout en permettant de diagnostiquer visuellement une synchronisation quasi parfaite des deux phénomènes : le pic de sécrétion endocrinienne de cortisol concorde fidèlement avec la phase de ralentissement psychomoteur maximal observée à la sixième session. L’harmonisation systématique des couleurs entre les données, les symboles, les lignes et les axes d’ordonnées élimine tout risque d’inversion des échelles par le lecteur.
10. Approche alternative moderne : La superposition dans ggplot2
10.1 La grammaire des graphiques comme paradigme de couches natives
Bien que la maîtrise de Base R demeure une compétence analytique indispensable pour comprendre les fondations graphiques du langage, l’écosystème ggplot2 a profondément renouvelé la pratique de la superposition visuelle en la formalisant au sein d’une grammaire computationnelle cohérente. Au lieu de considérer la superposition comme une séquence temporelle d’injections de pigments sur un canevas statique, ggplot2 la conceptualise comme un empilement logique de couches (layers) déclaratives unies par l’opérateur arithmétique +.
Chaque couche graphique au sein de ggplot2 intègre cinq composantes structurelles fondamentales : un jeu de données (data), une correspondance esthétique (aesthetic mapping formalisée par l’opérateur aes()), une primitive géométrique (geom), une transformation statistique sous-jacente (stat), et un ajustement de position spatiale (position). La puissance fondamentale de ce paradigme réside dans le mécanisme de gestion automatisée des échelles (scales) et des limites : le système inspecte en continu l’ensemble des couches accumulées pour ajuster automatiquement les coordonnées cartésiennes globales (coord_cartesian()), éliminant de facto le piège de la troncature silencieuse rencontré lors de l’usage imprudent de Base R.
De plus, l’héritage des variables esthétiques procure une économie syntaxique majeure. Les assignations déclarées au sein de l’instruction inaugurale ggplot(data, aes(x, y)) se propagent en cascade à l’intégralité des géométries déclarées en aval, à moins qu’une couche spécifique ne redéfinisse localement ses propres données ou son propre mapping. La légende descriptive générale est quant à elle générée, mise à jour et harmonisée de façon strictement automatique d’après les correspondances esthétiques attribuées.
10.2 Combinaisons classiques : geom_point(), geom_line() et geom_smooth()
L’assemblage conjoint de multiples primitives géométriques s’opère dans ggplot2 avec une fluidité déconcertante par simple enchaînement additif de fonctions géométriques dédiées. La trilogie classique associant la dispersion empirique brute (geom_point()), la trajectoire longitudinale de liaison (geom_line()) et la tendance de régression ajustée avec son enveloppe d’erreur standard (geom_smooth()) s’exécute selon une syntaxe unifiée et remarquablement concise.
La distinction entre l’assignation globale d’un attribut visuel et son couplage à une variable statistique constitue un principe directeur essentiel :
- Lorsque la couleur, la forme ou le type de trait est assigné à une dimension de variabilité statistique factorielle, l’argument correspondant doit obligatoirement résider à l’intérieur de l’instruction
aes()(par exemple :geom_point(aes(color = Groupe, shape = Groupe))). - Lorsque l’attribut est une constante géométrique uniforme appliquée indistinctement à tous les points (par exemple une taille de marqueur ou un niveau de transparence globale), il doit être déclaré en dehors de
aes()(par exemple :geom_point(color = "steelblue", alpha = 0.6, size = 3)).
L’instruction geom_smooth() illustre la sophistication de l’approche en réalisant simultanément la régression paramétrique ou non paramétrique sous-jacente (par LOESS ou modèle linéaire généralisé method = "lm"), le calcul analytique des bornes de confiance à 95 %, le tracé du ruban polygonal d’incertitude (fill) et la matérialisation de la courbe moyenne (color), condensant en une seule ligne déclarative ce qui exigeait des dizaines de lignes de programmation matricielle en Base R.
10.3 Superposition de sources de données disparates sous ggplot2
L’un des atouts architecturaux les plus remarquables de ggplot2 réside dans sa capacité à superposer des géométries alimentées par des jeux de données (data frames) structurellement distincts au sein d’une seule et même figure intégrée. Cette faculté s’avère providentielle lorsqu’il s’agit de juxtaposer un échantillon de micro-données individuelles volumineuses avec un tableau synthétique contenant des moyennes agrégées, des cibles normatives préétablies ou des bornes de classification clinique issues d’une source externe.
Pour superposer une source d’information disjointe, il suffit de renseigner explicitement l’argument data au sein de la couche géométrique secondaire, court-circuitant ainsi l’héritage du jeu de données principal spécifié dans l’appel initial ggplot() :
# Exemple conceptuel d'injection hétérogène sous ggplot2

library(ggplot2)
# Visualisation combinant données brutes individuelles et moyennes de groupe pré-calculées
ggplot(data = donnees_individuelles, aes(x = Annee, y = Score)) +
geom_point(alpha = 0.2, color = "grey40") +
geom_line(data = moyennes_agregees, aes(x = Annee, y = ScoreMoyen, color = Categorie), linewidth = 1.2) +
scale_color_manual(values = c("Groupe1" = "#E67E22", "Groupe2" = "#27AE60")) +
theme_minimal()
Dans ce schéma, geom_line() opère sur la table agrégée moyennes_agregees tandis que geom_point() projette le semi de points issu de donnees_individuelles. Les deux couches s’accordent organiquement sur l’échelle commune de l’axe des abscisses (Annee) et de l’axe des ordonnées (Score), le moteur de ggplot2 se chargeant d’unifier l’espace cartésien global sans aucune intervention manuelle de calcul d’extrema.
11. Erreurs méthodologiques, artefacts visuels et pièges d’implémentation
11.1 Sur-traçage (overplotting) et perte de résolution de l’information
Le sur-traçage (overplotting) représente sans doute la menace la plus insidieuse pesant sur la véracité scientifique des graphiques superposés. Lorsqu’un échantillon expérimental agrège des milliers ou des dizaines de milliers d’observations individuelles, la superposition brute de marqueurs opaques aboutit à la formation d’amas chromatiques compacts. Dans ces zones de saturation dense, le graphique perd toute résolution distributionnelle : cent points parfaitement superposés renvoient exactement la même signature visuelle qu’un point isolé unique, annihilant toute perception de la densité relative de probabilité.
Pour restaurer l’intégrité de l’information sans renoncer à la superposition, plusieurs voies de remédiation méthodologique s’offrent au chercheur :
- L’application d’une dispersion aléatoire infime (jittering via la fonction
jitter()en Base R ougeom_jitter()sousggplot2), qui injecte un bruit stochastique contrôlé sur des variables discrètes afin de désagréger visuellement les nœuds d’empilement artificiel sans corrompre la métrique générale. - L’exploitation rigoureuse du canal de transparence alpha, calibré selon la relation inverse de la densité de l’échantillon, transformant l’occultation opaque en un dégradé de saturation volumique.
- La substitution du nuage de points brut par des représentations de densité bidimensionnelle continues (lignes de niveau de densité via
contour(), polygones de densité de typegeom_density_2d()ou pavages hexagonaux régularisés viageom_hex()).
11.2 Décalage et incohérence spatiale des systèmes de coordonnées
Un autre piège d’implémentation majeur, propre à la manipulation procédurale de Base R, concerne l’introduction involontaire d’asymétries dans les configurations spatiales d’état graphique. L’utilisation hasardeuse de multiples appels successifs à par() sans réinitialisation formelle préalable peut modifier subrepticeusement la taille relative des marges (mar), le mode de tracé des boîtes (bty) ou les facteurs d’expansion typographique (cex) d’une couche à l’autre.
Le cas le plus critique s’observe lors du recours à par(new = TRUE) pour l’élaboration de graphiques à axes doubles : si les marges périphériques (mar) ou la marge extérieure (oma) déclarées avant le second appel à plot() ne sont pas rigoureusement identiques à celles appliquées lors de l’initialisation du premier graphique, les deux systèmes de coordonnées projetés sur l’écran subiront une translation ou une distorsion d’échelle asymétrique. Les données du second tracé seront alors spatialement décalées par rapport au référentiel d’abscisse du premier tracé, induisant le lecteur en erreur sur la synchronie temporelle ou spatiale réelle des événements modélisés. Pour se prémunir contre ces dérives d’alignement géométrique, il est fortement recommandé de stocker les paramètres d’origine via anciens_par <- par(no.readonly = TRUE) afin de garantir une restauration systématique de l’état graphique.
11.3 Excès d’encombrement graphique et violations des normes APA
L’enthousiasme technique qui entoure la maîtrise de la superposition conduit fréquemment à l’écueil opposé : l’encombrement excessif du canevas, générant ce que la littérature de la conception de l’information qualifie de « fouillis graphique » (chartjunk). L’adjonction simultanée et effrénée de nuages de points denses, de multiples droites de régression concurrentes, de barres d’erreur dans toutes les directions, d’intervalles polygonaux ombrés et de repères de seuil disjoints sur un seul cadre d’affichage sature la capacité d’absorption cognitive du récepteur de l’information.
Les normes de publication de l’American Psychological Association (APA 7e édition) fournissent des critères directeurs stricts en matière d’affichage des figures scientifiques :
- Toute figure doit présenter un ratio données-encre maximal en éliminant les encadrements superflus, les ombrages décoratifs, les fonds de grille disproportionnés et les effets tridimensionnels non signifiants.
- Les typographies utilisées pour les annotations superposées et les légendes doivent maintenir une harmonie sans empattement (Arial, Helvetica) avec une taille de corps comprise entre 8 et 14 points afin de demeurer parfaitement lisibles après réduction d’échelle éditoriale.
- La figure doit pouvoir être décodée de manière autonome, ce qui impose que la légende explicative contienne la définition univoque de l’ensemble des symboles (
pch), types de lignes (lty) et unités physiques représentés. - L’encodage des contrastes doit garantir une intelligibilité parfaite sous accessibilité universelle, en vérifiant que le message informatif ne repose pas exclusivement sur une différenciation rouge/vert inopérante pour les lecteurs atteints de daltonisme.
12. Applications pratiques et protocoles pour la recherche scientifique
12.1 Modélisation de trajectoires individuelles et moyennes de groupe
L’un des défis analytiques les plus emblématiques de la recherche biomédicale, de l’épidémiologie et de la psychologie différentielle réside dans la restitution visuelle de données longitudinales issues de mesures répétées. La structure de superposition dite en « graphique en spaghettis » (spaghetti plot) permet de concilier la visualisation de la variabilité intra-individuelle chaotique et l’expression de la tendance développementale moyenne de l’échantillon global.
Le protocole technique repose sur une hiérarchisation sémiotique radicale en deux strates d’affichage :
# Simulation d'un suivi longitudinal de 20 sujets sur 5 points temporels

nb_sujets <- 20

temps_points <- 1:5

trajectoires <- matrix(NA, nrow = nb_sujets, ncol = 5)

set.seed(42)

for(i in 1:nb_sujets) {

  trajectoires[i, ] <- 10 + 2.5 * temps_points + rnorm(1, 0, 4) + rnorm(5, 0, 1.5)

}
# Calcul de la trajectoire moyenne de groupe
moyenne_groupe <- colMeans(trajectoires)
# Étalonnage du canevas initial
par(mar = c(4.5, 4.5, 2.5, 1.5))
plot(temps_points, trajectoires[1, ], type = "l",
ylim = range(trajectoires), xlim = c(1, 5),
col = rgb(0.5, 0.5, 0.5, 0.25), lwd = 1.2, las = 1, bty = "l",
xlab = "Visite d'Évaluation Clinique (V1 à V5)",
ylab = "Indicateur de Charge Symptomatique",
main = "Cinétiques Individuelles et Tendance Moyenne Globale")
# Superposition de l'ensemble des profils individuels en gris translucide
for(i in 2:nb_sujets) {
lines(temps_points, trajectoires[i, ], col = rgb(0.5, 0.5, 0.5, 0.25), lwd = 1.2)
}
# Surimpression saillante de la moyenne de population générale
lines(temps_points, moyenne_groupe, col = "#8E44AD", lwd = 4)
points(temps_points, moyenne_groupe, col = "#8E44AD", pch = 19, cex = 1.4)
# Légende explicative intégrée
legend("topleft",
legend = c("Trajectoires Individuelles (N = 20)", "Tendance Moyenne Estimée"),
col = c("grey60", "#8E44AD"), lwd = c(1.2, 4), pch = c(NA, 19),
bty = "n", cex = 0.9)
Cette composition graphique préserve l’intégrité de la dispersion empirique en arrière-plan (permettant d’identifier d’un coup d’œil les profils atypiques, les décrochages ou les non-répondeurs thérapeutiques) tout en faisant émerger sans ambiguïté la trajectoire macroscopique du groupe via une ligne de fort contraste optique et de chromaticité vive.
12.2 Visualisation de designs expérimentaux multifactoriels
Dans le cadre d’un protocole factoriel complexe croisant plusieurs facteurs fixes (par exemple : Facteur A à 2 modalités $\times$ Facteur B à 3 modalités), la mise en évidence des effets principaux et des effets d’interaction statistique repose sur la superposition méticuleuse de profils de réaction conjointe.
La figure doit juxtaposer les indicateurs ponctuels d’estimation centrale, les barres d’erreur standard matérialisant l’incertitude expérimentale de chaque cellule du plan, ainsi que des lignes d’interconnexion reliant les niveaux du premier facteur à travers les strates du second facteur. L’apparition de segments de droites non parallèles ou sécants offre une démonstration visuelle immédiate d’une interaction factorielle significative, préparant le lecteur aux interprétations des analyses de variance (ANOVA) ou des modèles mixtes présentés dans le corps textuel du rapport de recherche.
Dans un contexte de science ouverte et de reproductibilité computationnelle intégrale, l’automatisation de la génération de ces figures complexes au sein de flux documentaires standardisés (tels que R Markdown ou Quarto) garantit que toute mise à jour du jeu de données expérimental réactualisera de manière totalement transparente l’ensemble des couches superposées, des limites d’axes calculées et des annotations statistiques associées.
12.3 Exportation haute résolution et standardisation pour la publication
L’aboutissement de toute démarche de composition visuelle réside dans son exportation physique vers un périphérique de restitution numérique ou prépresse conforme aux standards les plus intransigeants des comités éditoriaux scientifiques (exigeant communément une résolution minimale de 300 à 600 DPI pour les formats matriciels ou une restitution vectorielle native pure).
Il est fondamental de dissocier le rendu produit sur la console interactive de RStudio des fichiers produits par les pilotes graphiques formels. Pour exporter une figure superposée complexe sans distorsion des rapports de taille textuelle ou des épaisseurs relatives de lignes, le chercheur doit encapsuler sa séquence de programmation graphique entre l’ouverture du pilote d’exportation dédié et sa fermeture irréversible via dev.off() :
# Exemple de pipeline d'exportation haute résolution TIFF prépresse

tiff(filename = "Figure1_Publication.tif",

     width = 17, height = 12, units = "cm",

     res = 300, compression = "lzw")
# [Insertion ici de l'ensemble des commandes graphiques superposées Base R]
# Clôture impérative du flux d'enregistrement et écriture physique sur disque
dev.off()
Pour les supports numériques contemporains et les publications en libre accès, le recours aux pilotes vectoriels tels que pdf(..., useDingbats = FALSE) ou svg() est hautement préconisé. Les formats vectoriels éliminent toute pixelisation lors du zoom interactif, réduisent drastiquement le poids mémoire des fichiers finaux et assurent une fidélité géométrique absolue de l’ensemble des superpositions de lignes, de polygones et de glyphes ponctuels élaborées au sein de l’environnement statistique R.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1983). Semiology of graphics: Diagrams, networks, maps. University of Wisconsin Press.
- Chambers, J. M., Cleveland, W. S., Kleiner, B., & Tukey, P. A. (1983). Graphical methods for data analysis. Wadsworth.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Murrell, P. (2018). R graphics (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429497018
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0