
L’exploration visuelle des distributions statistiques constitue le socle fondamental sur lequel repose toute inférence quantitative rigoureuse en psychologie et en sciences comportementales. Avant même d’envisager l’application de modèles linéaires généralisés, de régressions structurelles ou de tests d’hypothèses paramétriques, le chercheur doit impérativement appréhender la structure géométrique intrinsèque de ses variables empiriques. Dans l’écosystème du langage R, l’histogramme s’impose historiquement comme l’outil d’inspection de premier recours, permettant de transcrire un ensemble désordonné d’observations psychométriques en une représentation spatiale intuitive de fréquences et de densités.
Cependant, la simplicité apparente de l’histogramme dissimule une complexité mathématique et algorithmique souvent sous-estimée. Le passage d’un continuum d’observations scalaires à une représentation discrète compartimentée implique une décision méthodologique critique : la détermination des bornes d’intervalles, désignées techniquement sous le terme de coupures ou breaks. Une méconnaissance des mécanismes internes régissant ce partitionnement peut conduire à des distorsions perceptives majeures, masquant des sous-populations cliniques distinctes, créant des artefacts d’asymétrie ou induisant une fausse impression de normalité gaussienne.
Ce guide exhaustif a pour vocation d’analyser en profondeur les principes théoriques, les rouages algorithmiques et les applications pratiques de la spécification des coupures d’histogrammes au sein de l’environnement R. À travers l’examen détaillé des fonctions natives, des règles empiriques d’optimisation de largeur de classe et des implémentations graphiques contemporaines, cet article fournit aux chercheurs, psychomètres et analystes de données les compétences indispensables pour produire des visualisations irréprochables sur le plan méthodologique, conformes aux exigences de reproductibilité de la recherche scientifique moderne.
1. Introduction fondamentale à la visualisation des distributions en psychologie avec R
1.1 Rôle épistémologique de l’histogramme dans l’analyse quantitative
L’inspection visuelle des données psychométriques ne relève pas d’une simple étape illustrative préliminaire ; elle constitue une démarche épistémologique essentielle dans le cycle de la découverte scientifique. En psychologie quantitative, les variables mesurées — qu’il s’agisse de temps de latence cognitive, de scores composites de dépression ou d’indices de personnalité — ne se conforment que rarement aux postulats d’idéalité mathématique requis par les modèles statistiques classiques. L’histogramme permet de confronter immédiatement les données empiriques aux cadres théoriques sous-jacents, agissant comme un filtre de détection des anomalies, des asymétries prononcées et des discontinuités structurelles.
Il convient d’établir une distinction conceptuelle rigoureuse entre la fonction de densité de probabilité empirique et la discrétisation par classes. Alors que la densité continue cherche à estimer la loi sous-jacente génératrice des données sans contraindre l’espace à des frontières rigides, l’histogramme impose une partition artificielle de l’axe réel en segments mutuellement exclusifs. Ce processus de discrétisation condense l’information locale, transformant des valeurs continues individuelles en agrégats de fréquences au sein de bacs (ou bins). Cette agrégation introduit inévitablement une perte d’information fine au profit d’une lisibilité macroscopique.
Le choix délibéré ou implicite de ce découpage exerce un impact direct et déterminant sur l’interprétation clinique des résultats. Un partitionnement trop grossier peut amalgamer des sujets sains et des patients présentant des symptômes subcliniques au sein d’une même classe modale, neutralisant ainsi le pouvoir discriminant d’un instrument d’évaluation. À l’inverse, un découpage excessivement fragmenté expose le chercheur au risque d’interpréter des fluctuations d’échantillonnage aléatoires comme des signatures psychopathologiques spécifiques. La fidélité de l’interprétation dépend donc de l’adéquation entre l’échelle du découpage et l’échelle réelle du phénomène psychologique étudié.
Dans le contexte actuel de crise de la reproductibilité, la documentation explicite des paramètres de visualisation devient un impératif méthodologique. Des études démontrent que deux chercheurs analysant le même jeu de données psychologiques peuvent aboutir à des conclusions descriptives discordantes simplement en raison des variations de paramètres de tracé graphique par défaut. Rendre transparents et reproductibles les paramètres d’histogrammes dans les publications académiques constitue une condition sine qua non d’une science cumulative et rigoureuse.
1.2 Anatomie d’un histogramme généré via l’environnement statistique R
Au sein de l’environnement de base de R, la fonction hist() constitue le pilier fondamental pour l’élaboration de représentations distributionnelles. Son architecture interne s’articule autour d’un algorithme double qui combine la catégorisation mathématique des données continues et le rendu visuel sur le périphérique graphique actif. Lorsqu’un vecteur numérique est passé en argument à cette fonction, R exécute une séquence de calculs vectoriels visant à délimiter les classes, dénombrer les observations contenues dans chaque intervalle, et calculer les grandeurs dérivées nécessaires au tracé.
Les composantes structurelles de l’histogramme se déclinent en plusieurs métriques interdépendantes. La fréquence absolue, désignée par les comptages (counts), exprime le nombre brut d’observations chutant à l’intérieur de chaque segment. En revanche, la densité relative ajuste ces fréquences en divisant la proportion d’observations par la largeur de l’intervalle correspondant. Cette transformation est indispensable lorsque les largeurs de bacs sont inégales, garantissant ainsi que la surface totale de l’histogramme s’intègre exactement à l’unité. Les limites d’intervalles (breaks) forment l’ossature spatiale déterminant la disposition horizontale de chaque colonne sur l’axe des abscisses.
L’exécution de la fonction hist() ne se limite pas à l’affichage d’une figure ; elle renvoie, de manière invisible ou explicite, un objet structuré de classe histogram. Cet objet prend la forme d’une liste nommée comprenant des vecteurs essentiels : breaks (les frontières des classes), counts (les effectifs par bac), density (l’estimation de la densité pour chaque intervalle), mids (les points médians des classes servant au positionnement géométrique des barres), xname (le nom de la variable analysée) et equidist (un booléen indiquant si les classes possèdent des largeurs strictement équivalentes). L’inspection programmatique de ces métadonnées permet au statisticien de vérifier l’adéquation du partitionnement avant toute interprétation définitive.
La forme apparente de la distribution résultante présente une sensibilité extrême aux paramètres de discrétisation retenus. De légères variations dans la définition du nombre de classes ou dans le positionnement des origines de bacs peuvent modifier substantiellement la kurtose apparente, déplacer la médiane visuelle ou accentuer artificiellement des zones de creux distributionnel. Cette malléabilité plastique impose une compréhension rigoureuse des leviers algorithmiques disponibles dans R.
1.3 Typologie des données psychologiques et défis de partitionnement
La recherche en psychologie se caractérise par une diversité prononcée de structures de variables, chacune imposant des contraintes spécifiques lors du partitionnement en classes. Les scores composites issus d’inventaires d’auto-évaluation et d’échelles de Likert constituent un cas fréquent. Bien que ces mesures soient formellement discrètes — résultant de la sommation d’items ordinaux bornés —, la pratique psychométrique courante les traite fréquemment comme des approximations de variables continues sous-jacentes. Ce statut hybride engendre des artefacts graphiques majeurs, notamment des effets de peigne lorsque le nombre de classes de l’histogramme dépasse la cardinalité réelle des scores possibles.
Les données chronométriques, omniprésentes en neuropsychologie cognitive et en psychologie expérimentale sous la forme de temps de réaction (TR), présentent une signature distributionnelle radicalement différente. Elles sont invariablement marquées par une borne inférieure absolue déterminée par les contraintes physiologiques de conduction neuronale, une forte asymétrie positive et une queue de distribution étendue vers les valeurs élevées. De telles distributions sont classiquement modélisées par des lois ex-gaussiennes ou de Weibull. L’application d’un partitionnement linéaire naïf sur ce type de données tend à comprimer la majorité informative des temps de réaction rapides dans un nombre restreint de classes tout en dispersant la traîne supérieure dans de vastes zones quasi-vides.
La distinction entre variables continues pures, telles que les concentrations hormonales salivaires de cortisol, et variables discrètes à support borné, comme le nombre d’erreurs commises à une tâche mnésique, dicte directement la stratégie de discrétisation à adopter. Pour une variable à support entier fini, chaque valeur discrète devrait idéalement correspondre au centre d’une classe unitaire. Pour une variable continue, le choix des coupures doit répondre à des critères d’optimisation mathématique visant à minimiser l’erreur quadratique de l’estimation de densité.
Les conséquences d’une mauvaise sélection du schéma de découpage peuvent s’avérer dommageables pour l’avancement théorique. Un sur-découpage injecte du bruit graphique en érigeant en pics significatifs de simples fluctuations d’échantillonnage, poussant le chercheur à postuler l’existence de typologies cliniques imaginaires. Inversement, un sous-découpage produit un lissage artificiel masquant des patrons réels, telle qu’une discontinuité distributionnelle signalant un seuil de décompensation psychopathologique.
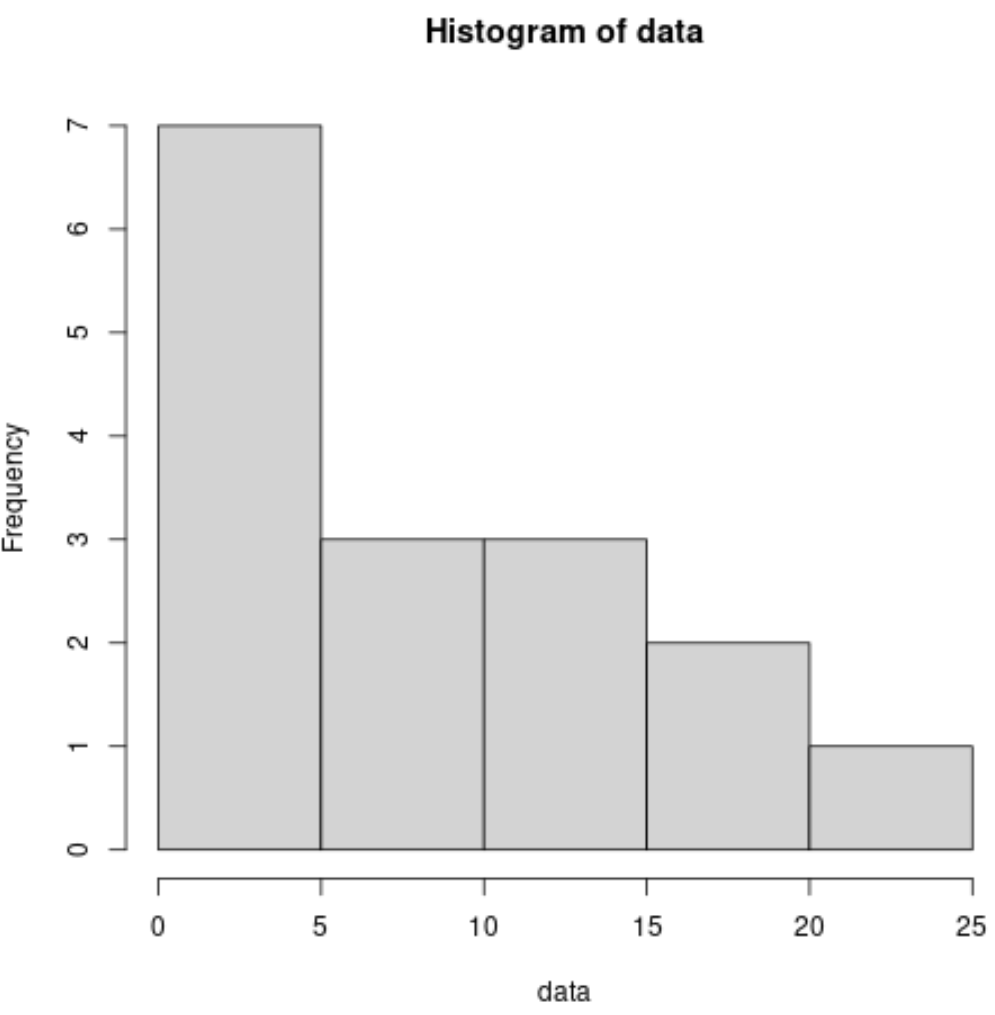
2. Le fonctionnement par défaut de la fonction hist() et la règle de Sturges
2.1 Dérivation mathématique et logique de la règle de Sturges
Par défaut, lorsque la fonction hist() est sollicitée sans paramétrage explicite de ses coupures, l’environnement R met en œuvre la règle historique formulée par le statisticien Herbert Sturges en 1926. Cette heuristique repose sur une construction théorique élégante mais fortement restrictive : l’analogie entre la forme d’une distribution normale continue et les coefficients binomiaux d’ordre n issus du développement du binôme de Newton. Sturges a postulé qu’une distribution empirique idéale peut être approchée par une série binomiale symétrique partitionnée en classes discrètes.
Sur le plan analytique, la dérivation mathématique s’établit à partir de l’expansion binomiale. Le nombre total d’observations n correspond à la somme des fréquences d’une distribution binomiale de paramètres k et p = 0.5, ce qui implique que la somme des coefficients binomiaux est égale à deux élevé à la puissance k. En isolant k, Sturges démontre que le nombre optimal d’intervalles k est rigoureusement proportionnel au logarithme en base 2 de la taille de l’échantillon augmenté d’une unité. La formulation mathématique formelle s’écrit de la manière suivante :
k = ceil(log2(n) + 1)
où la fonction ceil (plafond) désigne l’arrondi au nombre entier supérieur le plus proche, assurant que le nombre résultant d’intervalles demeure un entier strictement positif.
Considérons l’application pas-à-pas de ce calcul au sein d’une cohorte clinique standard de taille n = 31 observations, typique d’une étude pilote d’intervention psychothérapeutique. Le logarithme népérien de 31 divisé par le logarithme de 2 donne une valeur de 4.954. En ajoutant l’unité requise par la formule, le résultat théorique atteint 5.954. L’application de la fonction de plafonnement projette cette valeur à k = 6 classes. L’heuristique attribue ainsi 6 bacs théoriques pour cartographier la variabilité de ces 31 scores cliniques.
L’usage de la fonction d’arrondi ou de plafonnement n’est pas sans implications mathématiques. Pour des effectifs variant de 16 à 31 participants, le calcul produit rigoureusement les mêmes paliers de classes, créant des seuils de sensibilité discrets où l’ajout d’une seule observation supplémentaire dans l’échantillon peut brusquement forcer l’algorithme à ajouter un intervalle supplémentaire, modifiant la structure graphique perçue.
2.2 Implémentation technique native de l’algorithme dans le moteur R
Dans l’architecture logicielle de R, l’appel de l’argument breaks = "Sturges" constitue la valeur assignée par défaut au paramètre formel de la fonction hist.default(). Pour appréhender comment cette logique est exécutée, il convient d’examiner le code source interne du moteur statistique, plus spécifiquement la fonction dédiée intitulée nclass.Sturges(). Cette dernière encapsule l’algorithme sous une forme vectorielle hautement optimisée.
Le corps algorithmique de nclass.Sturges() est d’une grande concision : il calcule la longueur du vecteur d’entrée en éliminant au préalable les valeurs manquantes potentielles (NA), puis évalue l’expression mathématique ceiling(log2(length(x)) + 1). Cependant, l’évaluation de cette fonction ne produit pas directement les bornes numériques qui encadrent les colonnes de l’histogramme ; elle retourne uniquement un scalaire entier représentant le nombre théorique d’intervalles ciblés. C’est à ce stade précis qu’intervient une deuxième couche logicielle interne qui transforme cet entier en un vecteur de réels via des routines d’arrondi esthétique.
L’extraction des métadonnées générées par défaut révèle fréquemment un décalage structurel entre le nombre prescrit par nclass.Sturges() et la réalité graphique observée. Si l’on assigne le résultat d’un histogramme standard à une variable R (par exemple h <- hist(scores)) et que l’on extrait le vecteur h$breaks, on constate couramment que le nombre d’intervalles effectifs (égal à length(h$breaks) - 1) diverge de la valeur brute calculée par l’algorithme de Sturges. Cette divergence provient de l’intervention de fonctions d’ajustement destinées à produire des axes lisibles.
Cette interaction technique devient flagrante lors de la comparaison de sous-échantillons psychologiques distincts. Lorsque l’on analyse séparément un groupe témoin (n = 45) et un groupe clinique (n = 28), les histogrammes générés par défaut utilisent des pas de graduation différents non seulement en raison des tailles d’échantillons inégales, mais aussi du fait des ajustements scalaires automatisés du moteur graphique, rendant la comparaison visuelle directe hasardeuse.
2.3 Évaluation critique de l’heuristique pour les effectifs de petite taille
Bien que la règle de Sturges fasse preuve d’une robustesse computationnelle remarquable et garantisse une grande stabilité mathématique lors de faibles volumétries d’échantillons (n < 50), elle manifeste des faiblesses conceptuelles manifestes dans le champ de la psychométrie appliquée. Sa stabilité découle directement de sa dépendance logarithmique, qui amortit l’impact des variations d’effectifs, évitant ainsi la fragmentation excessive des tracés sur de petites séries expérimentales.
Cependant, cette stabilité apparente s’obtient au prix d’un sur-lissage systématique des distributions hétérogènes. Dans un échantillon de 40 participants soumis à une tâche de jugement émotionnel, l’heuristique impose généralement entre 6 et 7 classes. Si la population source comporte des profils psychologiques contrastés — par exemple, une sous-population réagissant avec une hyper-vigilance et une autre adoptant une stratégie d’évitement affectif —, le partitionnement de Sturges dilue ces deux polarités au sein d’intervalles larges, annihilant toute possibilité de détection visuelle précoce.
Cette limitation s’avère particulièrement pénalisante pour l’évaluation des seuils diagnostiques marginaux. En psychologie clinique, l’intérêt diagnostique réside fréquemment dans l’identification précise des sujets franchissant des scores seuils critiques (par exemple à une échelle de risque suicidaire ou d’anorexie mentale). Un découpage imposé par Sturges a de fortes probabilités de faire chevaucher la frontière clinique critique au milieu d’un intervalle générique, empêchant le clinicien d’isoler visuellement la sous-fraction des cas pathologiques avérés.
Le risque majeur demeure le masquage complet de la bimodalité. Les mélanges de distributions normales, fréquents dans les études explorant des sous-types d’affections psychiatriques hétérogènes comme le trouble du spectre de l’autisme ou les syndromes dépressifs majeurs, requièrent une résolution spatiale fine pour révéler l’existence de deux modes distincts. La règle de Sturges, intrinsèquement construite sur la prémisse d’une distribution unimodale symétrique, tend invariablement à raboter les creux distributionnels et à fusionner les modes multiples en un plateau artificiel uniforme.
3. Les limites de la règle de Sturges dans la recherche psychologique empirique
3.1 Inadéquation face aux très grands échantillons de données
L’avènement des mégadonnées dans les sciences comportementales contemporaines a mis en exergue l’obsolescence mathématique de la règle de Sturges face aux effectifs massifs. Avec le développement de cohortes populationnelles ouvertes telles que l’UK Biobank, le programme Adolescent Brain Cognitive Development (ABCD) ou les registres nationaux de santé mentale, les chercheurs traitent couramment des échantillons regroupant des dizaines de milliers, voire des centaines de milliers d’individus. Dans ces configurations massives, le comportement asymptotique de l’algorithme de Sturges s’effondre de manière spectaculaire.
L’insuffisance mathématique trouve sa source dans le taux de croissance excessivement lent de la fonction logarithmique. Lorsque la taille de l’échantillon passe de n = 100 à n = 100 000 — soit une multiplication par un facteur mille de la quantité d’information collectée —, le nombre d’intervalles théoriques calculé par Sturges ne passe que de 8 à seulement 18 classes. Il est statistiquement absurde de condenser cent mille observations psychométriques fines au sein d’une partition constituée d’à peine une vingtaine d’intervalles.
Cette sous-estimation sévère de la complexité structurelle conduit à une dégradation substantielle du signal empirique. Alors qu’un grand échantillon confère une puissance statistique suffisante pour observer des micro-variations, des asymétries locales et des sous-populations discrètes, l’application aveugle de Sturges écrase l’ensemble de ces détails architecturaux sous des barres massives et hautement agrégées. Les immenses gains informationnels permis par la recherche translationnelle à large échelle se trouvent ainsi visuellement neutralisés par un carcan algorithmique formulé il y a un siècle.
Sur le plan de l’estimation fonctionnelle, un estimateur non-paramétrique de densité converge vers la distribution sous-jacente à condition que la largeur de ses fenêtres tende vers zéro à mesure que la taille de l’échantillon tend vers l’infini, selon une vitesse de décroissance appropriée. Avec Sturges, la largeur des bacs diminue à un rythme logarithmique bien trop paresseux, ce qui empêche l’histogramme de converger vers la véritable fonction de densité continue et introduit un biais asymptotique incompressible.
3.2 Sensibilité aux distributions fortement asymétriques ou à queues lourdes
Le postulat de normalité symétrique qui sous-tend la dérivation de Sturges constitue une entrave méthodologique rédhibitoire pour l’analyse des phénotypes comportementaux asymétriques. En psychologie empirique, une proportion substantielle des données collectées viole frontalement l’hypothèse de symétrie gaussienne. C’est le cas emblématique des temps de latence de décision, des indices de consommation d’alcool chez les adolescents, des durées de fixation oculaire ou des mesures d’agressivité comportementale, qui exhibent des distributions fortement biaisées vers la droite avec d’importantes traînes positives.
Face à de telles distributions non-normales, la lisibilité de l’histogramme paramétré par Sturges se dégrade drastiquement. L’étendue totale de l’axe réel est dictée par les quelques valeurs extrêmes situées à l’extrémité de la queue de distribution. Sturges divisant cette étendue globale par un nombre d’intervalles excessivement restreint, les bacs résultants possèdent une largeur démesurée. En conséquence, la quasi-totalité des observations centrales se retrouve concentrée dans une ou deux classes titanesques au début de l’axe, tandis que la longue queue est représentée par une suite de barres microscopiques invisibles à l’œil nu.
Ce phénomène d’écrasement visuel prive le chercheur de la possibilité d’analyser la variabilité fine des réponses standard. Dans une tâche de Stroop, par exemple, la majorité des temps de réaction compris entre 400 et 800 millisecondes sera agrégée au sein d’une unique barre massive, occultant toute différence potentielle entre les conditions de facilitation et d’interférence cognitive, simplement parce qu’un petit nombre de réponses tardives au-delà de 2500 millisecondes aura étiré démesurément la fenêtre totale de discrétisation.
Il apparaît dès lors impératif de recourir à des heuristiques de partitionnement fondées sur des estimateurs robustes de la dispersion ou adaptées à la géométrie locale de la distribution. La dépendance exclusive envers l’étendue globale (valeur maximale moins valeur minimale) combinée à un comptage d’intervalles logarithmique fait de la règle par défaut un choix non approprié pour l’immense majorité des données comportementales asymétriques.
3.3 Émergence de fausses conclusions statistiques et biais de confirmation
L’utilisation non critique de la règle de Sturges peut induire en erreur les chercheurs en générant des artefacts visuels trompeurs qui influencent en cascade l’intégralité du processus d’analyse inférentielle. Le sur-lissage inhérent à l’algorithme a pour effet récurrent de gommer artificiellement les aspérités d’une distribution et de conférer à un ensemble d’observations hétérogènes une apparence de cloche symétrique rassurante mais fallacieuse.
Ce phénomène d’artefact normalisant incite fréquemment les psychologues à valider visuellement le postulat de normalité requis pour l’exécution d’analyses paramétriques classiques, telles que l’analyse de variance (ANOVA) ou la modélisation par équations structurelles. Conforté par un histogramme régulier généré par Sturges, le praticien négligera souvent les tests formels de normalité (comme le test de Shapiro-Wilk) ou rejettera les anomalies en les attribuant à du bruit expérimental négligeable, alors même que la population sous-jacente viole gravement les hypothèses distributives requises.
Plus dommageable encore est la dissimulation systématique de sous-populations cliniques distinctes. Dans les cohortes diagnostiques mixtes — regroupant par exemple des sujets souffrant de dépression unipolaire et de trouble bipolaire en phase dépressive —, des marqueurs biologiques ou cognitifs peuvent afficher des distributions bimodalement différenciées. L’écrasement de ces modes au sein d’un bac central commun empêche l’identification d’hétérogénéités phénotypiques fondamentales, orientant durablement la recherche vers des impasses théoriques.
Face à ces risques, les recommandations éditoriales des revues majeures et le manuel de publication de l’American Psychological Association (APA) préconisent une rigueur accrue dans la restitution graphique des distributions empiriques. Les chercheurs sont instamment invités à expliciter les choix techniques guidant leurs visualisations, à justifier le recours à des algorithmes alternatifs et à vérifier que les structures mises en évidence ne relèvent pas d’une contingence algorithmique de discrétisation.
4. Comprendre l’argument breaks : pourquoi R traite le nombre de classes comme une suggestion
4.1 Le comportement sous-jacent de l’algorithme d’arrondi esthétique
Une source récurrente de perplexité pour les utilisateurs de R réside dans le comportement singulier de l’argument breaks lorsqu’on lui transmet une valeur scalaire entière. Un chercheur souhaitant obtenir rigoureusement 7 classes pour cartographier les dimensions d’un questionnaire d’estime de soi écrira naturellement l’instruction hist(x, breaks = 7). Or, à l’affichage du graphique, l’histogramme présentera fréquemment 6, 8, voire 10 intervalles, ignorant ostensiblement la consigne numérique fournie par l’utilisateur.
Ce phénomène n’est en rien une défaillance logicielle ni un dysfonctionnement du système de calcul de R ; il découle d’un choix de conception délibéré privilégiant l’interprétabilité humaine sur la stricte contrainte formelle. Dans la philosophie graphique historique d’Unix et du langage S — dont R est l’implémentation ouverte —, la lisibilité immédiate des axes pour l’œil humain prime sur le respect aveugle d’un comptage arbitraire d’intervalles. R délègue ainsi la fixation effective des bornes à une routine algorithmique d’arrondi intelligent dénommée pretty().
Lorsque R reçoit un entier via l’argument breaks, il interprète cette valeur non pas comme un mandat strict et contraignant, mais comme une simple suggestion directionnelle ou un ordre de grandeur souhaitable. L’environnement intercepte ce chiffre, analyse les valeurs extrêmes de la variable x, et transmet ces paramètres à la fonction sous-jacente pretty(range(x), n = breaks) afin d’engendrer une suite de coupures positionnées sur des nombres harmonieux et faciles à lire pour un lecteur humain.
Il en résulte une divergence systématique et prévisible entre la volumétrie prescrite par l’utilisateur et le découpage effectif du graphique. Cette flexibilité algorithmique, bien que protectrice contre la création de graduations d’axes illisibles comportant de nombreuses décimales, s’avère particulièrement déconcertante pour le statisticien psychologue dont le plan expérimental requiert des découpages d’une précision millimétrique.
4.2 Déconstruction algorithmique de la fonction pretty() dans le contexte graphique
Pour maîtriser pleinement la génération des histogrammes dans R, il est nécessaire de déconstruire le mode opératoire de l’algorithme sous-jacent pretty(). Cette fonction a pour mission de déterminer une séquence de valeurs équidistantes couvrant l’intervalle des données tout en garantissant que les étiquettes numériques tombent sur des multiples entiers naturels d’unités graphiquement simples, principalement des puissances de dix multipliées par 1, 2 ou 5 (par exemple : …, 0.1, 0.2, 0.5, 1, 2, 5, 10, 20, 50, 100…).
Le mécanisme interne procède par étapes analytiques successives. Dans un premier temps, l’algorithme évalue l’étendue brute des données en calculant la différence entre le maximum et le minimum de la variable. Cette étendue est ensuite divisée par le paramètre de suggestion n fourni par l’argument breaks afin de calculer un pas théorique brut. Ce pas non arrondi fait alors l’objet d’une comparaison avec une grille de multiples décimaux standardisés afin de sélectionner la valeur « jolie » la plus proche au sens métrique défini par l’algorithme.
Dès lors que ce pas harmonisé est verrouillé, les bornes de classes sont recalculées à partir du plus petit multiple inférieur ou égal au minimum de l’échantillon jusqu’au plus grand multiple supérieur ou égal au maximum. Si, par une coïncidence arithmétique rare, le pas « esthétique » divise parfaitement l’étendue en respectant exactement le nombre de subdivisions demandé, R produira rigoureusement le nombre de classes attendu. Cependant, dans la vaste majorité des cas empiriques, ce recalcul induit l’ajout ou le retrait d’une à trois classes par rapport à la consigne initiale.
Le chercheur peut aisément vérifier cette mécanique en interrogeant la composante $breaks de l’objet graphique généré. L’exécution séquentielle des commandes h <- hist(scores, breaks = 7, plot = FALSE) puis length(h$breaks) - 1 permet de constater de visu l’écart entre la commande passée et le traitement exécuté par le moteur mathématique de R.
4.3 Conséquences pratiques pour le chercheur et la standardisation des protocoles
Ce traitement suggestif de l’argument breaks entraîne des complications méthodologiques non négligeables dans la pratique quotidienne de la recherche psychologique. La première concerne la reproductibilité exacte des protocoles visuels entre différents laboratoires ou au sein d’une même équipe de recherche. Si des expérimentateurs travaillant sur des cohortes d’effectifs légèrement contrastés appliquent une consigne identique (ex. breaks = 10), R adaptera dynamiquement et différemment les bornes pour chacun des sous-groupes, empêchant toute comparaison directe terme à terme des structures distributionnelles.
De surcroît, ce comportement est fondamentalement incompatible avec les protocoles psychométriques imposant un découpage standardisé a priori. Lorsqu’une échelle de dépression ou d’anxiété stipule que les scores doivent être analysés par tranches fixes de cinq points (ex. [0-5], [6-10], [11-15]…), l’introduction de l’argument breaks = 6 ne garantit absolument pas le respect de cette échelle clinique prédéfinie. L’arrondi dynamique de pretty() risque de déplacer les frontières vers des valeurs décimales ou des multiples non conformes au manuel du test.
Cette situation engendre une confusion récurrente chez les doctorants et les jeunes chercheurs, confrontés au refus silencieux du logiciel de se plier à leur instruction. L’incompréhension de cette nuance fonctionnelle conduit trop souvent à des tentatives infructueuses de manipulation logicielle ou à l’acceptation involontaire de visualisations non contrôlées scientifiquement.
Il apparaît dès lors indispensable, pour quiconque souhaite mener des analyses quantitatives rigoureuses et standardisées, d’abandonner la spécification de breaks par un scalaire entier indicatif au profit d’approches déterministes strictes, fondées sur des vecteurs de bornes explicites ou des générateurs fonctionnels rigoureusement contraints.
5. Méthode 1 : Forcer le nombre exact d’intervalles via un vecteur de bornes numériques
5.1 Définition explicite des limites de classes par assignation vectorielle
Pour contourner l’intervention arbitraire de l’algorithme d’arrondi esthétique et imposer un partitionnement absolu à la fonction hist(), la stratégie la plus directe consiste à lui transmettre directement un vecteur numérique contenant l’intégralité des bornes de classes souhaitées. Au lieu de spécifier un entier représentatif d’une quantité de bacs, le chercheur attribue à l’argument breaks un vecteur ordonné de valeurs limites délimitant sans équivoque chaque intervalle.
La syntaxe canonique repose sur l’assignation d’une structure vectorielle définie par l’opérateur de concaténation c(...). Dès l’instant où l’argument breaks reçoit un vecteur numérique comportant au moins deux éléments, le moteur interne de R désactive instantanément ses routines de calcul heuristique et l’appel à la fonction pretty(). Le logiciel se borne alors à exécuter le décompte des observations tombant strictement entre les balises définies par l’utilisateur, conférant à ce dernier un contrôle total sur la représentation graphique.
Pour qu’une telle assignation vectorielle soit valide, une condition mathématique sine qua non doit être impérativement satisfaite : le vecteur de coupures doit couvrir l’intégralité du domaine de variation de l’échantillon analysé. Cela implique que la première valeur du vecteur (la borne inférieure de la première classe) doit être rigoureusement inférieure ou égale au minimum observé dans les données, tandis que la dernière valeur (la borne supérieure de l’ultime classe) doit être strictement supérieure ou égale au maximum observé :
min(breaks) ≤ min(x) et max(breaks) ≥ max(x)
Considérons l’analyse empirique de scores de bien-être subjectif standardisés sur une échelle fermée allant de 0 à 100 points, mesurés au sein d’une cohorte d’étudiants. Si le chercheur souhaite isoler précisément quatre segments théoriques (par exemple : détresse [0-25], vulnérabilité [25-50], équilibre [50-75] et épanouissement [75-100]), l’instruction formelle s’écrira simplement sous la forme :
hist(scores, breaks = c(0, 25, 50, 75, 100), main = "Profil de bien-être subjectif")
Cette commande verrouille la structure spatiale de l’histogramme, garantissant la création de quatre classes de largeur identique (25 unités), indépendamment du volume d’observations ou des spécificités de la dispersion locale.
5.2 Gestion des erreurs critiques lors de la spécification vectorielle
L’abandon de la flexibilité de pretty() au profit d’un vecteur déterministe impose une responsabilité accrue au programmeur, car R met en œuvre des mécanismes stricts de vérification de cohérence vectorielle qui ne tolèrent aucune imperfection arithmétique. La violation de ces règles syntaxiques entraîne l’interruption immédiate de la commande et l’affichage de messages d’erreur explicites.
L’erreur la plus fréquente découle de l’omission d’une partie des données empiriques lors de la définition des frontières. Si la borne minimale du vecteur dépasse d’une fraction décimale la plus petite observation de l’échantillon, ou si la borne maximale se révèle inférieure à l’observation la plus élevée, R stoppe le processus et renvoie le message d’erreur caractéristique : ‘some observations falling outside of « breaks »‘. Le logiciel refuse catégoriquement d’ignorer silencieusement les valeurs situées hors limites, garantissant ainsi qu’aucun point de donnée ne soit occulté à l’insu de l’expérimentateur.
Une seconde contrainte structurelle concerne l’ordonnancement interne du vecteur. Les composantes du vecteur passé à breaks doivent être ordonnées de manière strictement croissante. Si un chercheur compose par inadvertance un vecteur désordonné ou contenant des inversions scalaires, le système déclenchera une erreur signalant que les valeurs de coupures ne sont pas ordonnées. De la même façon, la présence de valeurs dupliquées (ex. c(0, 10, 10, 20)) est strictement proscrite, car elle définirait un intervalle de largeur nulle, mathématiquement indéfini pour le calcul des densités.
Pour prémunir les scripts d’analyse contre les plantages de calcul lors du traitement de jeux de données dynamiques, il est vivement recommandé d’adopter des pratiques de programmation défensive. L’automatisation de la sécurisation des bornes peut être obtenue en combinant les fonctions floor() et ceiling() aux extrêmes empiriques, comme suit :
coupures_securisees <- c(floor(min(x)), 20, 40, 60, ceiling(max(x)))
Une telle précaution garantit une encapsulation hermétique de toutes les valeurs réelles au sein de la partition vectorielle.
5.3 Cas pratique : scores d’anxiété pré et post-traitement thérapeutique
L’utilité méthodologique de l’assignation vectorielle fixe se manifeste pleinement lors des protocoles longitudinaux pré-post interventionnels. Prenons le cas d’une étude clinique évaluant l’efficacité d’une thérapie comportementale et cognitive (TCC) digitalisée sur la réduction de l’anxiété, mesurée à l’aide du questionnaire STAI-T (State-Trait Anxiety Inventory, forme Trait), dont les scores s’échelonnent théoriquement de 20 à 80 points. L’échantillon comprend 60 patients évalués à l’inclusion (pré-traitement) puis à l’issue de huit semaines de protocole (post-traitement).
Si l’on recourait à la fonction hist() par défaut pour examiner l’évolution de la distribution, le déplacement massif de la moyenne clinique consécutif au succès thérapeutique modifierait l’étendue effective des valeurs observées, conduisant R à générer des coupures disparates pour la phase pré et la phase post. Cette hétérogénéité des axes rendrait toute comparaison visuelle directe trompeuse, un observateur non averti pouvant interpréter un décalage de largeur de bacs comme une modification substantielle de la variabilité psychologique des patients.
L’adoption d’un vecteur de coupures invariant résout radicalement ce problème de comparabilité métrique :
bornes_stai <- seq(20, 80, by = 10)
par(mfrow = c(1, 2))
hist(stai_pre, breaks = bornes_stai, col = "lightcoral", main = "Anxiété Pré-TCC", xlab = "Score STAI")
hist(stai_post, breaks = bornes_stai, col = "aquamarine3", main = "Anxiété Post-TCC", xlab = "Score STAI")
L’utilisation du vecteur bornes_stai contraint les deux visualisations à s’ancrer sur des classes de dix points rigoureusement superposables ([20-30], [30-40], …, [70-80]). L’impact clinique de l’intervention apparaît alors avec une clarté analytique totale : la masse distributionnelle, initialement concentrée au-delà de 50 points en phase pré-thérapeutique, se translate de manière univoque vers les bacs inférieurs [20-40] en post-traitement, sans la moindre interférence issue d’un recalcul opportuniste des graduations d’axes.
6. Méthode 2 : Définir des largeurs de classes uniformes avec la fonction seq()
6.1 Combinaison synergique entre hist() et seq() pour un pas constant
L’une des approches les plus puissantes et élégantes pour maîtriser la morphologie d’un histogramme consiste à associer la fonction hist() à la fonction génératrice de séquences régulières seq(). Cette combinaison synergique offre un contrôle métrique d’une extrême précision, permettant d’imposer une largeur de classe parfaitement constante (connue sous le terme technique de binwidth) sur l’ensemble du continuum psychométrique évalué.
La fonction seq() permet de piloter la discrétisation spatiale selon deux logiques distinctes mais complémentaires. La première méthode repose sur l’utilisation explicite de l’argument by, qui fixe la largeur absolue de l’intervalle entre chaque borne successive :
coupures <- seq(from = 0, to = 100, by = 5)
Cette commande garantit que chaque bac couvrira exactement cinq unités de mesure. La seconde approche privilégie l’argument length.out, qui contraint l’algorithme à subdiviser l’espace global en un nombre rigoureusement défini d’intervalles égaux :
coupures <- seq(from = 0, to = 100, length.out = 21)
ce qui produit exactement vingt intervalles équidistants.
L’imposition d’un pas rigoureusement constant présente des avantages épistémiques substantiels. Elle neutralise tout risque de distorsion visuelle de l’information où un œil peu accoutumé aux subtilités de la statistique descriptive interpréterait la hauteur d’une barre élargie comme une surreprésentation d’observations. Lorsque tous les bacs possèdent une dimension géométrique identique sur l’axe des abscisses, la hauteur du rectangle redevient strictement proportionnelle au dénombrement absolu d’individus, facilitant la lecture intuitive des dynamiques populationnelles.
De surcroît, la combinaison avec seq() offre la flexibilité nécessaire pour aligner les intervalles d’analyse sur des unités métriques psychologiquement sensées — par exemple des décalages d’un demi-écart-type, des portions déciles de centiles ou des tranches entières d’années d’âge dans les études de développement neurocognitif —, éliminant l’arbitraire des divisions par puissances décimales induites par d’autres routines logicielles.
6.2 Automatisation du calcul des bornes dynamiques en fonction des données
Dans le cadre de protocoles scientifiques industrialisés ou d’études longitudinales impliquant la mise à jour continue des bases d’échantillonnage, le codage en dur des valeurs from et to présente une fragilité opérationnelle majeure. Si de nouvelles données excèdent les bornes figées dans le script, l’exécution s’interrompt brutalement pour non-couverture de l’étendue. Il apparaît donc nécessaire d’automatiser le calcul dynamique des extrémités tout en préservant la fixité de la largeur des bacs.
Cette dynamisation s’effectue au moyen de fonctions d’arrondi de positionnement appliquées aux données observées. En combinant la fonction d’arrondi inférieur floor() sur la valeur minimale de l’échantillon et la fonction d’arrondi supérieur ceiling() sur la valeur maximale, le chercheur s’assure d’encadrer l’intégralité du nuage de points au sein de balises entières stables :
largeur_bac <- 5
borne_inf <- floor(min(scores) / largeur_bac) * largeur_bac
borne_sup <- ceiling(max(scores) / largeur_bac) * largeur_bac
coupures_auto <- seq(from = borne_inf, to = borne_sup, by = largeur_bac)
Cette construction algorithmique calcule le plus proche multiple inférieur de la largeur de classe pour ancrer le démarrage du premier intervalle, et le plus proche multiple supérieur pour sceller le terme du tracé. L’incorporation de cette logique au sein de fonctions utilitaires personnalisées optimise considérablement les flux de travail computationnels des projets psychométriques complexes.
Dans les pipelines de traitement de données par lots (batch processing) — où des dizaines de profils psychométriques individuels doivent être tracés et sauvegardés de façon sérialisée —, une telle routine garantit une exécution sans échec tout en maintenant une métrique de comparaison interindividuelle strictement homogène d’un sujet à l’autre.
6.3 Exemple appliqué : discrétisation standardisée de quotients intellectuels (WAIS)
L’évaluation psychométrique de l’efficience cognitive générale au moyen de l’échelle d’intelligence pour adultes de Wechsler (WAIS-IV) offre un cadre d’application idéal pour illustrer la pertinence du découpage régulier par seq(). Les scores de Quotient Intellectuel (QI) total sont standardisés pour afficher une distribution théorique gaussienne de moyenne μ = 100 et d’écart-type σ = 15. Les manuels cliniques d’interprétation neuropsychologique segmentent cette échelle en zones d’efficience correspondant précisément à des paliers d’un demi-écart-type, soit 7.5 points de QI.
Si l’on injecte un échantillon de quotients intellectuels mesurés chez 120 patients suspects de présenter un trouble du déficit de l’attention dans la fonction hist() non paramétrée, la règle de Sturges générera un découpage approximatif (par exemple des classes de 10 ou 20 points) calqué sur des paliers arbitraires (ex. [70, 90, 110, 130]), effaçant les subdivisions normatives fondamentales de la psychométrie contemporaine.
Pour aligner rigoureusement la visualisation graphique sur la sémiologie cognitive de la WAIS, il convient de concevoir un découpage synchronisé sur les déviations standard :
coupures_qi <- seq(from = 55, to = 145, by = 7.5)
hist(echantillon_qi, breaks = coupures_qi, col = "lightblue", border = "navy",
main = "Distribution des Quotients Intellectuels (Échelons σ/2)",
xlab = "Score de QI Total", xaxt = "n")
axis(side = 1, at = seq(55, 145, by = 15), labels = TRUE)
Ce partitionnement met en valeur les zones cliniques fonctionnelles : la tranche [92.5 – 107.5] correspond exactement à l’intervalle moyen central (±0.5σ), tandis que les bacs extérieurs isolent nettement les zones de fragilité cognitive subnormale [70 – 77.5] et les profils à haut potentiel intellectuel [> 130]. Le chercheur et le praticien disposent dès lors d’un outil d’inspection visuelle en harmonie avec le système d’inférence de leur spécialité clinique.
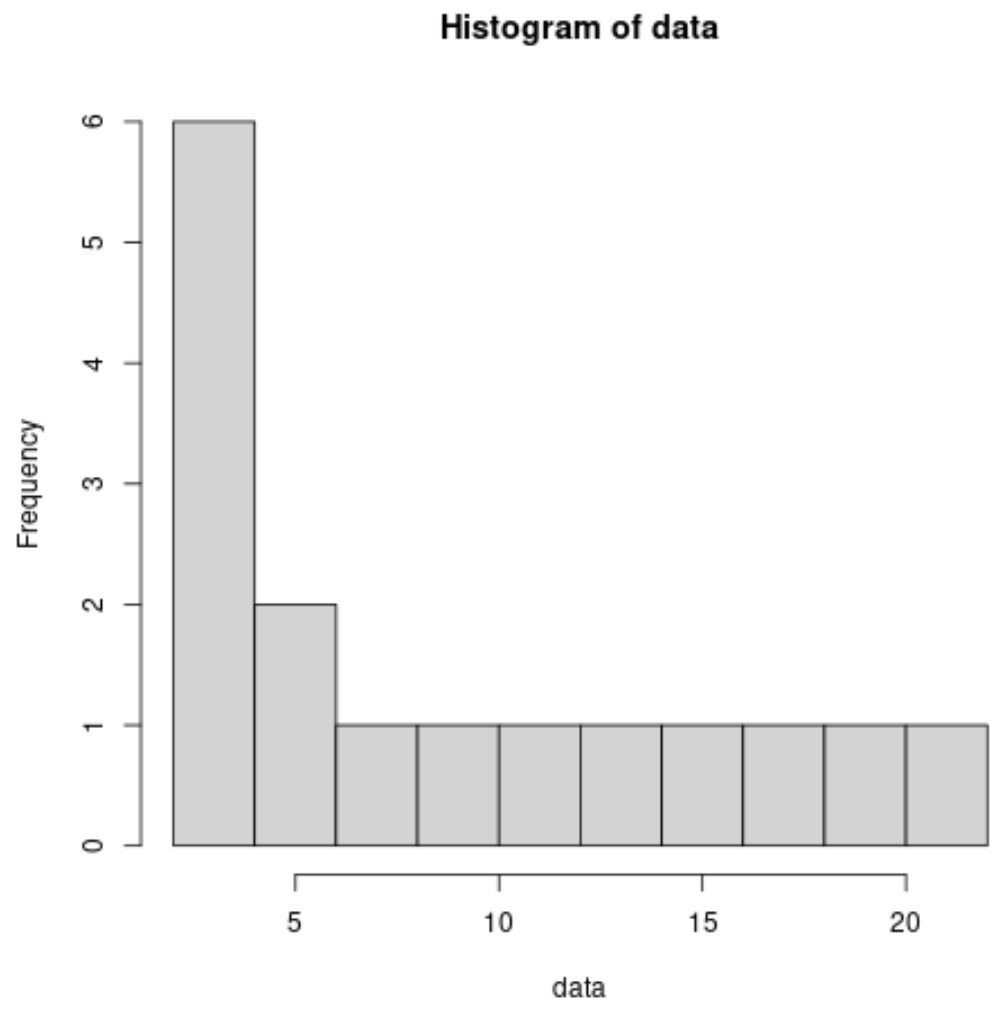
7. Méthode 3 : Configurer des intervalles inégaux pour les données psychométriques asymétriques
7.1 Fondements théoriques de l’histogramme à classes non uniformes
Si le découpage à classes uniformes constitue la norme opératoire dans l’analyse de données gaussiennes ou quasi-symétriques, l’existence de distributions fortement asymétriques nécessite parfois le recours à des intervalles de largeurs divergentes. L’élargissement ou le rétrécissement ciblé des bacs le long de l’axe des abscisses permet d’adapter la résolution spatiale de l’histogramme aux fluctuations locales de la densité des observations empiriques.
Cette flexibilité géométrique impose toutefois un changement paradigmatique majeur : l’abandon irréversible du dénombrement brut des effectifs (counts) au profit exclusif de la densité de probabilité (density). Dans un histogramme standard à classes régulières, la fréquence d’une catégorie est proportionnelle à la hauteur du rectangle. Dès l’instant où la largeur des classes varie, ce principe de proportionnalité univarié devient mathématiquement faux et graphiquement trompeur. Le principe géométrique fondamental de l’histogramme stipule en effet que :
L’aire de chaque rectangle doit être rigoureusement proportionnelle à la fréquence relative de la classe
Par conséquent, pour une classe i de fréquence relative fi et de largeur variable hi = bi – bi-1, la hauteur yi de la colonne tracée doit être calculée selon l’équation de densité di = fi / hi. Si un chercheur tente de tracer des classes inégales tout en conservant les effectifs bruts sur l’axe vertical, une classe d’une largeur décuplée accumulant un grand nombre d’individus s’élèvera sous la forme d’un monument graphique massif, suggérant à tort une forte concentration locale alors qu’il s’agit simplement d’un effet mécanique d’agrégation spatiale.
Fort heureusement, le moteur interne de R intègre cette exigence théorique. Dès que la fonction hist() détecte un vecteur de bornes numériques dont les espacements successifs ne sont pas strictement identiques (vérification opérée par le test logique equidist <- diff(breaks)), elle bascule automatiquement son axe des ordonnées en échelle de densité relative, neutralisant ainsi les tentatives involontaires d’affichage en comptages absolus non corrigés.
7.2 Programmation d’intervalles progressifs pour des variables hautement asymétriques
L’utilisation de classes inégales démontre sa pertinence lors de l’étude de marqueurs psychologiques exhibant des profils distributionnels ex-gaussiens prononcés, à l’instar des temps de réponse obtenus lors d’épreuves de vigilance psychomotrice sous condition de stress aigu ou de privation de sommeil. Dans ces contextes, la quasi-totalité des observations se regroupe dans une zone d’action ultra-rapide (ex. 200 à 600 millisecondes), tandis qu’une traîne d’échappement s’étend sporadiquement jusqu’à plusieurs milliers de millisecondes en raison de décrochages attentionnels passagers.
Pour cartographier adéquatement ce type de données sans masquer la structure du pic modal ni étaler la queue sur des dizaines de classes vides, il est pertinent d’adopter des classes à progression géométrique ou logarithmique. L’objectif consiste à concentrer des intervalles étroits là où la densité d’information est maximale, et à élargir progressivement les bacs au fur et à mesure que l’on progresse dans les zones de raréfaction des données.
La génération programmatique d’un tel vecteur de bornes s’appuie fréquemment sur la transformation exponentielle d’une séquence linéaire régulière :
log_bornes <- seq(from = log(200), to = log(5000), length.out = 15)
coupures_progressives <- round(exp(log_bornes))
hist(temps_reaction, breaks = coupures_progressives, col = "navajowhite",
main = "Latences cognitives sous stress (Classes progressives)",
xlab = "Temps de réaction (ms)")
Cette formulation produit des intervalles très serrés dans les faibles valeurs chronométriques (séparés d’à peine une trentaine de millisecondes autour du mode), autorisant la détection d’éventuels fractionnements subtils des temps de réaction sensorimoteurs. Au-delà de 2000 millisecondes, les intervalles s’élargissent pour atteindre des amplitudes de plusieurs centaines de millisecondes, agrégeant les quelques lapsus attentionnels tardifs au sein de surfaces géométriques justement calibrées sur le plan de la densité empirique.
7.3 Étude de cas empirique : seuillage psychopathologique selon les normes du DSM
Une seconde justification fonctionnelle des classes d’amplitudes variables réside dans la modélisation directe des seuils diagnostiques catégoriels définis par les classifications nosographiques internationales, telles que le DSM-5 (Manuel diagnostique et statistique des troubles mentaux) ou la CIM-11. Dans les protocoles de dépistage épidémiologique, l’intérêt statistique s’articule autour des catégories pronostiques opérationnelles plutôt qu’autour d’une découpe linéaire uniforme.
Prenons l’exemple de l’inventaire de dépression de Beck (BDI-II), dont le score total varie de 0 à 63 points. Les normes cliniques établissent quatre strates nosologiques distinctes aux amplitudes numériques inégales : dépression minimale ou absente [0 à 13], dépression légère [14 à 19], dépression modérée [20 à 28] et dépression sévère [29 à 63]. L’évaluation de l’impact populationnel d’une crise sanitaire majeure gagne à être représentée visuellement selon ces tranches normatives strictes.
La transcription technique de ce cadre clinique dans l’environnement R s’articule comme suit :
coupures_dsm <- c(0, 13.5, 19.5, 28.5, 63)
h <- hist(scores_bdi, breaks = coupures_dsm, col = c("darkseagreen1", "khaki1", "sandybrown", "indianred1"),
main = "Profil nosologique BDI-II en population clinique",
xlab = "Stades de sévérité de l'épisode dépressif",
ylab = "Densité probabiliste par classe nosologique",
xaxt = "n")
axis(side = 1, at = c(6.75, 16.5, 24, 45.75), labels = c("Minimale", "Légère", "Modérée", "Sévère"), tick = FALSE)
Le positionnement des frontières à .5 permet d’encapsuler rigoureusement les scores entiers au sein des catégories requises sans ambiguïté sur les frontières. Grâce à la correction par la densité nativement opérée par R, l’étendue substantielle de la classe sévère (34 points d’amplitude) est automatiquement ajustée, offrant une restitution visuelle non déformée de la prévalence relative de chaque tableau clinique. Ce type de graphique fournit un support d’aide à la décision pour le dimensionnement des structures hospitalières de prise en charge psychiatrique.
8. Algorithmes alternatifs intégrés dans R : Scott et Freedman-Diaconis
8.1 La règle de Scott : optimisation basée sur l’écart-type de l’échantillon
Conscient des faiblesses structurelles inhérentes à la formulation de Sturges, le statisticien David Scott a proposé en 1979 une règle de partitionnement optimisée reposant sur des fondements théoriques mathématiquement rigoureux issus de la théorie de l’estimation fonctionnelle non-paramétrique. La règle de Scott vise la minimisation asymptotique de l’erreur quadratique moyenne intégrée (MISE, pour Mean Integrated Squared Error), qui quantifie l’écart global d’ajustement entre l’histogramme empirique et la véritable fonction de densité de probabilité de la population parente.
Pour une variable distribuée selon une loi gaussienne, Scott a dérivé analytiquement la largeur de classe idéale h minimisant cette fonction de perte. La formulation mathématique s’exprime comme suit :
h = 3.49 × s × n-1/3
où s représente l’écart-type non biaisé de l’échantillon empirique et n l’effectif total d’observations valides. Une fois la largeur h calculée, le nombre de classes optimal découle de la division de l’étendue globale par cette valeur.
L’implémentation de cette heuristique est directement accessible dans R sans nécessiter de calculs manuels préalables, par l’assignation de la chaîne de caractères correspondante au sein de la commande : hist(x, breaks = "Scott"). En arrière-plan, R sollicite la fonction spécialisée nclass.scott() pour déterminer le nombre de subdivisions requises.
La règle de Scott surpasse nettement celle de Sturges dès lors que l’effectif atteint une taille moyenne ou grande (n > 100). Sa dépendance à la racine cubique inverse de la taille d’échantillon (n-1/3) assure un resserrement régulier de la largeur des bacs à mesure que le volume d’observations croît, permettant à l’histogramme de capter des variations locales de plus en plus subtiles. Elle demeure la méthode d’excellence pour l’analyse des mesures psychologiques unimodales et symétriques d’une variabilité homogène.
8.2 La règle de Freedman-Diaconis (FD) : robustesse accrue face aux valeurs aberrantes
Bien que mathématiquement élégante, la règle de Scott présente une vulnérabilité : son articulation exclusive autour de l’écart-type s la rend sensible à la présence de données aberrantes ou de queues de distribution asymétriques étendues. Un seul score clinique extrême peut faire gonfler artificiellement la variance de l’échantillon, conduisant Scott à prescrire des intervalles trop larges pour le corps principal des données.
Pour remédier à cette limitation, David Freedman et Persi Diaconis ont formulé en 1981 une déclinaison non-paramétrique hautement robuste de l’algorithme d’optimisation de l’erreur quadratique intégrée. L’approche de Freedman-Diaconis substitue à l’écart-type classique un estimateur de dispersion insensible aux valeurs extrêmes : l’écart interquartile (IQR, pour Interquartile Range), défini comme la distance séparant le premier quartile (25%) du troisième quartile (75%) :
h = 2 × IQR(x) × n-1/3
Cette approche s’invoque de manière native dans l’environnement R via l’argument direct : hist(x, breaks = "FD"), qui fait appel à la fonction sous-jacente nclass.FD().
L’utilisation de l’algorithme FD s’avère particulièrement adaptée pour la recherche en psychologie comportementale et en neurosciences. Dans les protocoles informatisés de temps de réaction, les jeux de données sont systématiquement pollués par des temps aberrants causés par des inattentions passagères ou des appuis accidentels sur le clavier. Ces valeurs extrêmes déforment l’écart-type mais n’ont aucune influence sur l’intervalle interquartile calculé sur les 50% centraux des données. L’application de la règle « FD » garantit ainsi le déploiement d’un partitionnement calculé sur le cœur informatif du phénomène cognitif, tout en assurant une résilience optimale face au bruit de mesure.
8.3 Analyse comparative empirique sur une distribution psychologique multimodale
Afin de mettre en exergue les performances comparées des différentes heuristiques intégrées dans R, analysons un échantillon bimodal synthétique modélisant les résultats d’un test d’empathie cognitive administré à une cohorte mixte de 300 individus, composée pour moitié de sujets neurotypiques et pour moitié de patients présentant des traits psychopathologiques marqués. Les données sont artificiellement générées par un mélange de deux gaussiennes distinctes : l’une centrée sur une moyenne de 35 (σ = 5) et l’autre centrée sur une moyenne de 55 (σ = 6).
L’application comparée des quatre approches majeures de découpage produit des contrastes graphiques saisissants :
par(mfrow = c(2, 2))
hist(empathie, breaks = "Sturges", col = "gray80", main = "Sturges (Défaut R)")
hist(empathie, breaks = "Scott", col = "slategray2", main = "Règle de Scott")
hist(empathie, breaks = "FD", col = "lightblue", main = "Freedman-Diaconis (FD)")
hist(empathie, breaks = seq(15, 75, by = 2), col = "cadetblue3", main = "Vecteur Fin (seq)")
L’inspection des tracés met en lumière les propriétés de chaque algorithme :
- L’histogramme gouverné par Sturges affiche une dizaine de classes massives. Il fusionne pratiquement les deux composantes de la distribution au sein d’un large plateau central, masquant la bimodalité et empêchant le clinicien de suspecter la présence de deux populations distinctes.
- La règle de Scott, dynamisée par l’effectif (n = 300), génère un nombre supérieur de subdivisions qui permet de deviner la présence d’un creux distributionnel autour de la valeur 45, bien que la transition demeure relativement adoucie en raison de la surévaluation de l’écart-type global induite par l’écartement des deux moyennes.
- L’heuristique de Freedman-Diaconis isole nettement les deux modes de manière saillante. En neutralisant l’effet d’étalement via l’usage de l’IQR, l’algorithme alloue des largeurs de classes suffisamment fines pour matérialiser le profil en double cloche caractéristique des populations mixtes.
- Le tracé paramétré manuellement via seq() avec un pas unitaire très resserré confirme avec précision la position exacte des deux modes mais laisse apparaître de légères irrégularités d’échantillonnage dans les creux, rappelant que le choix du partitionnement oscille continuellement entre le risque de sous-lissage (bruit visuel) et celui de sur-lissage (occultation structurelle).
9. Spécification avancée des coupures via des fonctions personnalisées dans l’argument breaks
9.1 Exploitation de la flexibilité fonctionnelle de l’argument breaks
L’une des caractéristiques les plus puissantes de l’architecture logicielle de R réside dans sa nature de langage de programmation fonctionnel. Cette particularité transparaît directement dans la signature de la fonction hist() : en plus des chaînes de caractères prédéfinies et des vecteurs numériques explicites, l’argument breaks possède la capacité d’accepter une fonction définie par l’utilisateur (user-defined function ou closure).
Cette fonctionnalité permet d’automatiser des logiques de partitionnement dynamiques répondant à des contraintes psychométriques personnalisées, sans avoir à pré-calculer manuellement les vecteurs de coupures en amont de chaque appel graphique. Pour être admise par le moteur graphique, la fonction passée en argument doit impérativement respecter une signature unaire stricte : elle doit être conçue pour recevoir un vecteur numérique unique en entrée (les données brutes x) et renvoyer en sortie soit un scalaire entier spécifiant le nombre de bacs souhaité, soit un vecteur numérique ordonné délimitant l’ensemble des frontières de classes.
Lorsque cette configuration est enclenchée (par exemple via hist(x, breaks = ma_fonction)), R intercepte le vecteur de données empiriques, l’injecte comme paramètre dans la fonction personnalisée, extrait la structure retournée et exécute consécutivement le tracé de l’histogramme. Ce mécanisme de rétroaction programmatique confère une flexibilité d’analyse précieuse pour la conception de protocoles exploratoires adaptatifs.
9.2 Conception d’une règle de partitionnement basée sur la déviation absolue médiane (MAD)
Dans de nombreux domaines de la psychologie différentielle, la dispersion des performances cognitives ou affectives s’avère hautement asymétrique et polluée par des perturbations non stationnaires, rendant l’écart interquartile lui-même vulnérable à certaines distorsions extrêmes. Pour pallier ce problème, les méthodologistes recommandent l’usage de la Déviation Absolue Médiane (MAD, pour Median Absolute Deviation), qui constitue l’estimateur de dispersion le plus robuste en présence de contamination lourde des données.
La formulation théorique standard établit que la MAD correspond à la médiane des écarts absolus par rapport à la médiane de l’échantillon :
MAD = median(|x – median(x)|)
Nous pouvons dès lors programmer une fonction sur mesure d’optimisation de classes en transposant la structure de la règle de Scott, en substituant à l’écart-type s la MAD préalablement normalisée pour être asymptotiquement équivalente à l’écart-type sous l’hypothèse de normalité :
nclass.mad <- function(x) {
x <- x[!is.na(x)]
n <- length(x)
dispersion <- mad(x, constant = 1.4826)
if (dispersion == 0) dispersion <- IQR(x) / 1.349
if (dispersion == 0) return(nclass.Sturges(x))
largeur <- 3.49 * dispersion * n^(-1/3)
bornes <- seq(floor(min(x)), ceiling(max(x)) + largeur, by = largeur)
return(bornes)
}
L’utilisation de cette fonction s’exécute de manière limpide au sein de l’environnement :
hist(temps_latence, breaks = nclass.mad, col = "thistle", main = "Découpage adaptatif fondé sur la MAD")
Cette approche défensive intègre des garde-fous essentiels : elle élimine les valeurs manquantes, ajuste la constante de normalisation et prévoit une dégradation gracieuse vers Sturges si la dispersion s’annule (par exemple dans le cas d’une accumulation massive de scores nuls), illustrant toute la rigueur exigée par le développement d’outils d’analyse psychométrique automatisés.
9.3 Conception d’une fonction de découpage par quantiles et rangs percentiles
Une démarche fréquemment mobilisée lors de l’étalonnage normatif de nouveaux instruments d’évaluation psychologique consiste à concevoir un découpage iso-fréquentiel, où chaque classe de l’histogramme accumule rigoureusement le même nombre d’observations ou d’individus. Cette logique s’oppose au découpage spatial équidistant en délimitant des intervalles dont les largeurs physiques varient afin de capturer des tranches fixes de pourcentages de la population.
Pour implémenter cette méthodologie, il est possible d’élaborer une fonction personnalisée exploitant les rangs percentiles via la commande quantile(). L’exemple suivant structure une partition de l’espace en quintiles (tranches de 20% de l’effectif) :
breaks_quintiles <- function(x) {
x <- x[!is.na(x)]
probabilites <- seq(0, 1, by = 0.20)
points_coupure <- quantile(x, probs = probabilites, names = FALSE, type = 7)
points_coupure <- unique(points_coupure)
return(points_coupure)
}
L’injection de cette fonction dans l’argument breaks d’un histogramme entraîne obligatoirement l’affichage de ce dernier sous l’échelle de densité de probabilité, comme l’exige la variabilité des largeurs de classes qui en résulte :
hist(scores_attachement, breaks = breaks_quintiles, col = "palegoldenrod",
main = "Histogramme iso-fréquentiel par Quintiles", xlab = "Scores continus d'attachement")
Bien que cette technique fournisse une vision analytique immédiate de la répartition par rangs (chaque bloc rectangulaire représentant rigoureusement un cinquième de la cohorte étudiée), elle impose une mise en garde méthodologique quant à l’interprétation graphique. L’axe horizontal subit une distorsion spatiale marquée : les rectangles les plus minces situés au niveau du pic de densité signalent une forte concentration d’individus dans une bande de score étroite, tandis que les rectangles larges situés aux extrémités reflètent l’espacement requis pour accumuler 20% d’individus dans les zones de raréfaction de l’échantillon.
10. Gestion des bornes fermées, ouvertes et des valeurs extrêmes : arguments right et include.lowest
10.1 Topologie des intervalles dans R : la distinction semi-ouvert à gauche ou à droite
Au-delà de la localisation arithmétique des coupures, la topologie des intervalles constitue un élément central de la précision graphique en statistique. Lorsqu’une observation empirique coïncide exactement avec une frontière numérique de classe, la décision de l’affecter à la classe inférieure ou à la classe supérieure relève d’une convention mathématique que le chercheur se doit de contrôler explicitement.
Par défaut, l’environnement R adopte une convention topologique d’intervalles semi-ouverts à gauche et fermés à droite. Cette configuration est pilotée par l’argument booléen right = TRUE au sein de la fonction hist(). Formellement, un intervalle défini par deux bornes successives a et b s’interprète sous la forme :
(a, b] ⇔ {x ∈ ℝ | a < x ≤ b}
Dans ce cadre par défaut, une observation présentant une valeur rigoureusement égale à b sera intégrée à l’intervalle [a, b], tandis qu’une valeur tombant exactement sur la borne a en sera exclue et basculera dans la classe précédente.
Inversement, le chercheur peut imposer la convention opposée en stipulant l’argument right = FALSE. Les intervalles deviennent alors semi-ouverts à droite et fermés à gauche :
[a, b) ⇔ {x ∈ ℝ | a ≤ x < b}
Cette distinction topologique n’a qu’un impact marginal lors du traitement de variables continues parfaites, la probabilité d’obtenir une observation coïncidant exactement avec un réel arbitraire étant théoriquement nulle. En revanche, pour des variables psychométriques discrètes prenant des valeurs entières — comme les scores totaux à des questionnaires de personnalité ou le nombre d’erreurs d’inattention —, cette convention détermine l’allocation d’effectifs massifs situés sur les frontières entières, modifiant potentiellement la morphologie globale de l’histogramme.
10.2 Le rôle crucial du paramètre include.lowest sur les frontières d’extrémité
L’application rigoureuse d’une règle d’intervalles semi-ouverts pose un dilemme mathématique aux extrémités absolues du support de données. Si l’on applique strictement la règle right = TRUE à l’ensemble du domaine, la toute première classe (a, b] devrait exclure son point de départ a. Dès lors, comment R procède-t-il pour intégrer l’observation minimale empirique si celle-ci est égale à la première borne spécifiée dans breaks ?
C’est ici qu’intervient l’argument include.lowest, dont la valeur est configurée par défaut sur include.lowest = TRUE dans la fonction hist(). Ce paramètre applique une exception topologique ciblée à la première ou à la dernière classe afin d’empêcher l’exclusion des valeurs extrêmes :
- Lorsque
right = TRUEetinclude.lowest = TRUE, la première classe est exceptionnellement fermée à gauche, prenant la forme [a, b], tandis que toutes les classes suivantes conservent la topologie semi-ouverte standard (b, c]. - Réciproquement, lorsque
right = FALSEetinclude.lowest = TRUE, c’est l’ultime classe qui devient fermée à droite, prenant la forme [y, z] pour intégrer le point maximal absolu.
Si un utilisateur passe imprudemment l’instruction include.lowest = FALSE alors qu’il a défini un vecteur de classes débutant rigoureusement au minimum de l’échantillon, R refusera d’inclure cette valeur minimale dans le décompte, provoquant l’éjection de l’observation et déclenchant une erreur de type ‘some observations falling outside of « breaks »‘.
Cette dynamique est fondamentale lors du traitement d’échelles présentant des scores planchers marqués. Si une échelle clinique d’idéation dépressive produit une forte proportion de scores nuls (score = 0), un découpage vectoriel breaks = c(0, 5, 10, 15) combiné avec les paramètres par défaut right = TRUE, include.lowest = TRUE garantira que la totalité des sujets présentant un score nul sera intégrée dans la première barre [0, 5], préservant ainsi l’intégrité de la cohorte évaluée.
10.3 Prévention des pièges de troncature et d’effets de plafond
L’interaction entre les coupures d’intervalles et les bornes fermées peut occasionner des biais perceptifs graves face aux effets de plafond ou de plancher, fréquents lors de l’utilisation d’instruments psychométriques à amplitude bornée. Dans les tests de performance cognitive à items limités ou lors d’épreuves d’anxiété au sein d’une population saine, il n’est pas rare qu’une proportion substantielle de participants atteigne le score maximal possible ou s’accumule au niveau minimal de l’échelle.
Si la stratégie de discrétisation place une coupure exactement sur la valeur de plafond maximale (par exemple un score de 30 au Mini-Mental State Examination), le rectangle d’extrémité risque de masquer l’intensité de l’accumulation pathologique ou fonctionnelle si l’intervalle correspondant agrège trop largement les valeurs sous-jacentes. Pour révéler sans équivoque un effet de plafond, il est méthodologiquement recommandé d’isoler le score limite au sein d’une classe unitaire ultra-fine :
coupures_mmse <- c(seq(15, 29, by = 1), 29.1, 30.1)
hist(scores_mmse, breaks = coupures_mmse, right = FALSE, include.lowest = TRUE,
col = "azure2", main = "Mise en évidence de l'effet de plafond au MMSE")
Dans ce scénario, la fixation de right = FALSE combinée à une délimitation fine autour du score de 30 permet d’ériger une colonne distincte visualisant la surreprésentation des sujets maximisant le test, sans risque de dilution avec les sujets obtenant un score de 29.
Pour assurer la conformité méthodologique des publications scientifiques, il est impératif d’inclure dans la section « Méthodes » des articles une description transparente des choix topologiques adoptés. Une formulation rigoureuse précisera par exemple : « Les distributions ont été visualisées par des histogrammes à pas constants de deux unités, segmentés selon des intervalles semi-ouverts à gauche et fermés à droite (a, b], avec inclusion de la borne inférieure pour la classe inaugurale via R 4.x ». Ce niveau de précision documentaire écarte toute ambiguïté interprétative et participe à la reproductibilité des visualisations.
11. Application comparative sous ggplot2 : transposer la gestion des coupures (binwidth et breaks)
11.1 Du moteur de base graphics au paradigme de la grammaire des graphiques
Si le moteur graphique de base de R (graphics) demeure incontournable pour l’exploration interactive rapide de données, le package ggplot2, issu des travaux d’Hadley Wickham, s’est imposé comme le standard prédominant pour la formalisation graphique dans la littérature scientifique internationale. Fondé sur le cadre théorique formalisé par Leland Wilkinson dans son ouvrage The Grammar of Graphics, ggplot2 aborde la visualisation des distributions selon une philosophie conceptuelle distincte de celle de la fonction hist().
Dans ggplot2, l’histogramme est instancié au travers de la couche géométrique geom_histogram(). La divergence fondamentale réside dans l’abandon de l’argument suggestif breaks en tant qu’entier unique, au profit d’un arbitrage explicite entre deux paramètres d’action directe : binwidth (la largeur constante d’un intervalle) ou breaks (un vecteur déterministe de frontières de classes). L’utilisateur est ainsi contraint de s’interroger activement sur la résolution spatiale de sa représentation dès l’écriture du code.
Par défaut, lorsqu’un utilisateur omet de spécifier l’un de ces paramètres directeurs, ggplot2 déclenche un message d’avertissement caractéristique rappelant que le système applique un partitionnement par défaut de 30 bacs (stat_bin() using bins = 30. Pick better value with ‘binwidth’). Ce comportement vise à éviter que l’analyste n’accepte passivement un rendu graphique non interrogé, l’incitant à tester des résolutions alternatives adaptées à ses données empiriques.
L’intégration au sein de l’écosystème tidyverse confère à ggplot2 une puissance de composition graphique remarquable pour les publications de recherche, facilitant l’habillage thématique aux normes de l’APA, la gestion automatisée des légendes et la reproductibilité des tracés vectoriels à haute résolution.
11.2 Spécification précise des coupures dans geom_histogram()
Pour reproduire fidèlement ou perfectionner sous ggplot2 un découpage d’histogramme préalablement conceptualisé, deux stratégies syntaxiques majeures s’offrent au chercheur selon qu’il souhaite fixer une largeur uniforme ou déployer une grille vectorielle arbitraire.
La première voie s’appuie sur la combinaison de binwidth et des arguments de centrage ou d’ancrage boundary (ou center). L’argument boundary joue un rôle déterminant : il ancre la position absolue de l’une des frontières de classe, à partir de laquelle l’ensemble de la grille régulière se déploie. Cette instruction permet d’éliminer tout flottement dans l’alignement des bacs :
library(ggplot2)
ggplot(data_psy, aes(x = score_epuisement)) +
geom_histogram(binwidth = 5, boundary = 0, closed = "right",
fill = "steelblue", color = "white") +
scale_x_continuous(breaks = seq(0, 100, by = 10)) +
labs(title = "Échelle d'épuisement professionnel (MBI)", x = "Score global", y = "Effectif")
La seconde approche reproduit à l’identique la logique vectorielle de hist() en injectant une séquence numérique complète directement au sein de l’argument breaks :
coupures_fixes <- seq(0, 100, by = 5)
ggplot(data_psy, aes(x = score_epuisement)) +
geom_histogram(breaks = coupures_fixes, closed = "right",
fill = "cornflowerblue", color = "black")
Lorsque le chercheur souhaite basculer d’une échelle de comptage absolu à une représentation de densité relative — indispensable lors de l’application de classes inégales —, ggplot2 nécessite l’utilisation d’une transformation esthétique explicite via l’expression aes(y = after_stat(density)). Cette formulation garantit que l’ordonnée cartographie rigoureusement l’estimation non biaisée de la densité de probabilité, alignant ainsi les sorties de ggplot2 sur les exigences théoriques les plus strictes.
11.3 Facettage et standardisation des classes entre sous-groupes cliniques
L’un des apports majeurs de ggplot2 réside dans sa capacité à sérialiser sans effort des analyses stratifiées grâce au mécanisme de facettage (faceting) implémenté par facet_wrap() ou facet_grid(). Dans la recherche en psychopathologie comparative, il est récurrent de confronter les distributions d’une même métrique à travers plusieurs strates cliniques distinctes (ex. témoins sains, dépression unipolaire, trouble bipolaire).
Lorsqu’un facettage est appliqué à un histogramme, ggplot2 applique de manière automatique et uniforme les mêmes paramètres binwidth, boundary ou breaks à l’ensemble des sous-graphiques générés. Cette harmonisation garantit une comparabilité visuelle totale entre les facettes :
ggplot(patients_data, aes(x = score_regulation, y = after_stat(density))) +
geom_histogram(binwidth = 2, boundary = 0, fill = "cadetblue4", color = "white") +
geom_density(color = "darkred", linewidth = 0.8) +
facet_wrap(~ diagnostic) +
theme_minimal() +
labs(title = "Densité de régulation émotionnelle par groupe nosographique",
x = "Score de régulation cognitive", y = "Densité")
Dans ce script, la superposition conjointe de l’estimation de densité par noyau continu (geom_density()) sur l’histogramme discrétisé à pas invariant (binwidth = 2) permet une double lecture des distributions : la capture des effectifs discrets au sein des classes calibrées et l’appréciation globale des continuités distributionnelles au sein de chaque groupe nosologique.
Pour la soumission de ces visualisations dans des périodiques académiques de premier rang, les figures résultantes peuvent être exportées directement via ggsave() aux formats vectoriels standardisés (PDF ou EPS) ou matriciels à haute résolution (TIFF 300 ou 600 DPI), assurant une restitution typographique et graphique conforme aux critères éditoriaux internationaux.
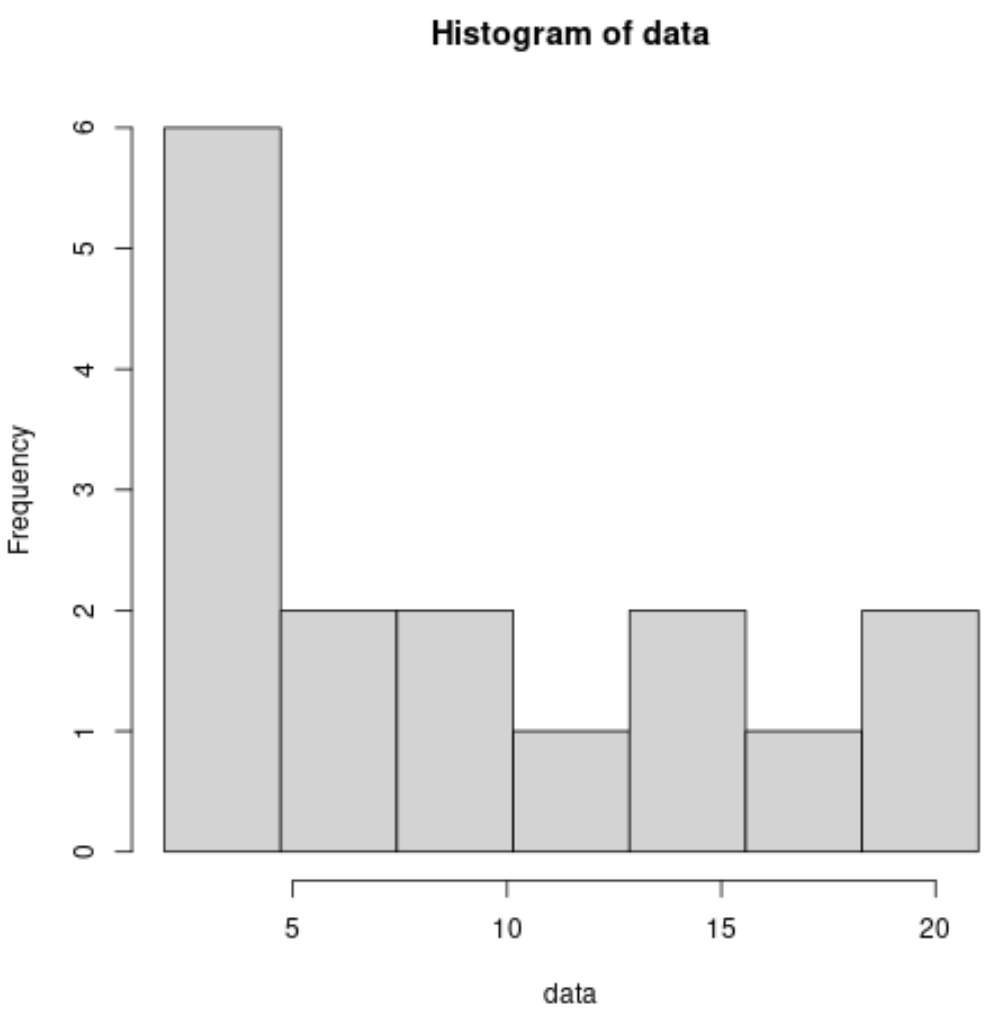
12. Étude de cas pratiques et erreurs courantes lors de la spécification des breaks en psychologie
12.1 Analyse détaillée d’un cas concret : distribution de scores au test de Stroop
Afin d’intégrer l’ensemble des compétences techniques et méthodologiques présentées, examinons l’analyse d’un cas concret : l’étude de l’effet d’interférence cognitive mesuré au cours du test informatisé de Stroop couleur-mot au sein d’une cohorte de 240 adultes d’âges variés. La variable d’intérêt opérationnelle est l’indice de coût d’interférence, calculé pour chaque participant par la différence entre son temps de réaction médian lors des essais incongrues (le mot ‘ROUGE’ affiché à l’encre bleue) et son temps médian lors des essais congruents (le mot ‘ROUGE’ à l’encre rouge), exprimé en millisecondes.
La première étape de la chaîne de traitement consiste à importer les données, à épurer les artéfacts expérimentaux (élimination des temps d’interférence négatifs résultant d’erreurs de passation ou de latences supérieures à trois déviations absolues de la médiane globale) et à inspecter les propriétés distributionnelles initiales :
# Nettoyage et vectorisation des indices Stroop
stroop_clean <- indice_stroop[indice_stroop > 0 & indice_stroop < 800]
n <- length(stroop_clean)
mediane_val <- median(stroop_clean)
iqr_val <- IQR(stroop_clean)
Une exécution de hist(stroop_clean) non paramétrée génère un tracé gouverné par Sturges comportant 9 classes d’une largeur approchant 85 millisecondes, masquant l’organisation interne du coût cognitif. Pour parvenir à une visualisation analytique optimale, le chercheur met en œuvre une discrétisation fine guidée par la règle robuste de Freedman-Diaconis combinée à une délimitation géométrique explicite :
# Dérivation mathématique de la largeur FD
largeur_fd <- 2 * iqr_val * n^(-1/3)
# Calibrage d'un pas harmonisé à l'entier dizaine le plus proche
largeur_optimale <- round(largeur_fd / 10) * 10
bornes_stroop <- seq(floor(min(stroop_clean)/10)*10, ceiling(max(stroop_clean)/10)*10, by = largeur_optimale)
# Génération de l'histogramme de publication
hist(stroop_clean, breaks = bornes_stroop, right = TRUE, include.lowest = TRUE,
col = "powderblue", border = "steelblue4", freq = TRUE,
main = "Distribution de l'interférence cognitive de Stroop (Coupures FD)",
xlab = "Coût d'interférence (TR Incongru - TR Congruent en ms)",
ylab = "Fréquence absolue (Participants)")
abline(v = mediane_val, col = "firebrick", lwd = 2, lty = 2)
legend("topright", legend = c("Médiane empirique"), col = "firebrick", lty = 2, lwd = 2, bty = "n")
Cette discrétisation rigoureusement paramétrée révèle immédiatement ce que Sturges dissimulait : la distribution de l’interférence n’est pas une gaussienne étalée, mais comporte un mode principal centré autour de 120 ms, suivi d’un second épaulement distributionnel distinct vers 280 ms. Sur le plan neuropsychologique, cette découverte oriente les investigations vers la mise en évidence de deux stratégies distinctes de résolution du conflit cognitif au sein de la cohorte étudiée.
12.2 Typologie des erreurs fréquentes commises par les chercheurs dans R
L’observation des pratiques de codage graphique en sciences comportementales révèle des récurrences régulières d’erreurs méthodologiques et techniques lors de l’usage des coupures d’histogrammes. La classification systématique de ces écueils permet de formuler des protocoles de vigilance adaptés.
Le premier piège concerne la confusion entre la transmission d’un entier suggestif et la définition d’un vecteur déterministe. De nombreux chercheurs pensent à tort que spécifier breaks = 12 garantira la création d’exactement douze classes. Constatant une divergence sur la figure sans en comprendre la cause liée à pretty(), certains en viennent à douter de la stabilité de leur système informatique plutôt que de recourir à un vecteur via seq().
Une seconde erreur critique réside dans la violation de l’échelle de densité lors de l’utilisation d’intervalles asymétriques. L’instruction fautive consiste à forcer l’argument freq = TRUE en conjonction avec un vecteur de coupures non équidistantes : hist(x, breaks = c(0, 10, 50, 100), freq = TRUE). Heureusement, R intercepte cette anomalie et interrompt son exécution par un message d’erreur explicite signalant que les fréquences absolues sont trompeuses lorsque les classes sont inégales. Cependant, dans des environnements personnalisés ou lors de la construction manuelle de graphiques via des barres génériques (barplot), cette erreur est fréquemment commise, produisant des figures scientifiquement non recevables.
Le sur-découpage et le sous-découpage constituent deux dérives symétriques aux conséquences théoriques dommageables :
- Le sur-découpage découle de la spécification de bacs excessivement étroits par rapport à l’effectif d’observations disponibles. L’histogramme se déchire en une succession de pics verticaux séparés de zones vides, érigeant de simples aléas de mesure en pseudo-structures multimodales.
- Le sous-découpage résulte de la paresse algorithmique consistant à conserver la règle de Sturges sur des bases de données volumineuses, lissant artificiellement les singularités cliniques de l’échantillon.
Enfin, l’omission de l’effet d’ancrage constitue une erreur subtile mais fréquente. Deux histogrammes adoptant rigoureusement la même largeur de classe binwidth peuvent arborer des morphologies contrastées si le point d’ancrage initial (la borne inférieure du premier bac) est déplacé d’une fraction décimale. Le contrôle du point de départ via boundary sous ggplot2 ou par la borne from de seq() s’avère indispensable pour garantir une invariance descriptive complète.
12.3 Synthèse méthodologique et grille décisionnelle pour les analyses futures
Pour orienter rationnellement le chercheur dans le choix de sa méthodologie de partitionnement graphique en R, une grille décisionnelle synthétique peut être articulée autour des propriétés de l’échantillon et des objectifs expérimentaux poursuivis :
- Objectif 1 : Exploration interactive rapide sur de très petits échantillons (n < 50) sans asymétrie extrême
Recommandation : Utiliser la règle par défauthist(x, breaks = "Sturges"). L’heuristique offre une stabilité visuelle suffisante pour un examen sommaire préliminaire. - Objectif 2 : Modélisation d’échantillons moyens à larges (n ≥ 50) de distributions quasi-gaussiennes ou symétriques
Recommandation : Appliquer la règle de Scott viahist(x, breaks = "Scott"). Cet algorithme minimise l’erreur quadratique d’ajustement globale et adapte automatiquement la largeur de classe au volume de données. - Objectif 3 : Analyse de données asymétriques, de temps de réaction ou de variables contaminées par des valeurs extrêmes
Recommandation : Mobiliser la règle de Freedman-Diaconis viahist(x, breaks = "FD")ou son équivalent sous ggplot2. L’usage de l’écart interquartile garantit une résistance optimale face aux biais de contamination. - Objectif 4 : Comparaison stricte de sous-groupes cliniques ou protocoles longitudinaux pré-post
Recommandation : Forcer un vecteur fixe régulier calculé dynamiquement par la combinaisonhist(x, breaks = seq(min_global, max_global, by = pas_fixe))ougeom_histogram(binwidth = pas_fixe, boundary = min_global). Cette stratégie assure une comparabilité géométrique terme à terme des représentations. - Objectif 5 : Alignement sur des classifications nosologiques ou des seuils diagnostiques catégoriels (ex. DSM, scores de coupure)
Recommandation : Transmettre un vecteur numérique de classes inégales délimitant précisément les seuils cliniques, en veillant impérativement à laisser l’histogramme s’afficher en échelle de densité probabiliste.
Le tableau méthodologique suivant récapitule les arguments fondamentaux de la fonction native hist() et leurs règles de manipulation en milieu de recherche quantitative :
breaks: Accepte un scalaire indicatif (suggestion pourpretty()), un vecteur explicite de bornes, une chaîne de caractères algorithmique (« Sturges », « Scott », « FD ») ou une fonction personnalisée. Détermine la structure spatiale de discrétisation.freq: Booléen. LorsqueTRUE, représente les comptages bruts (applicable uniquement avec des classes rigoureusement égales). LorsqueFALSE, trace l’estimation de la densité de probabilité (obligatoire pour classes inégales).right: Booléen. SiTRUE(défaut), structure des intervalles semi-ouverts à gauche (a, b]. SiFALSE, structure des intervalles semi-ouverts à droite [a, b). Arbitre l’affectation des observations tombant sur les frontières.include.lowest: Booléen. SiTRUE(défaut), force l’inclusion de la valeur extrême absolue dans la classe inaugurale (siright = TRUE) ou terminale (siright = FALSE). Prévient les erreurs d’exclusion de données limites.
En adoptant ces standards de programmation et en documentant méthodiquement chaque décision de partitionnement, les chercheurs en psychologie contribuent directement à l’effort collectif de rigueur, de transparence empirique et de reproductibilité qui fonde la science comportementale contemporaine.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605-610. https://doi.org/10.1093/biomet/66.3.605
Scott, D. W. (2015). Multivariate density estimation: Theory, practice, and visualization (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118575574
Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65-66. https://doi.org/10.1080/01621459.1926.10502161
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag New York. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science+Business Media. https://doi.org/10.1007/0-387-28695-0