
L’analyse de covariance (communément abrégée en ANCOVA) constitue l’un des dispositifs statistiques les plus élégants et puissants de la recherche empirique en sciences humaines, particulièrement en psychologie cognitive, clinique et éducative. En associant la logique factorielle de l’analyse de variance classique (ANOVA) aux capacités prédictives de la régression linéaire multiple, l’ANCOVA offre la possibilité d’examiner l’effet d’un traitement ou d’une appartenance catégorielle sur une variable dépendante continue, tout en neutralisant statistiquement l’influence perturbatrice de variables parasites appelées covariables.
Dans les contextes réels d’expérimentation ou d’évaluation quasi-expérimentale, l’assignation strictement aléatoire des participants ne garantit pas toujours l’équivalence parfaite des groupes au départ. Les caractéristiques individuelles préexistantes — telles que le niveau scolaire antérieur, l’anxiété de base, le quotient intellectuel ou le temps de réaction initial — injectent un bruit de mesure considérable dans la variance résiduelle, réduisant considérablement la puissance statistique du devis. L’ANCOVA permet de « nettoyer » cette variance d’erreur et d’estimer les scores moyens des groupes comme si tous les individus avaient débuté l’étude avec un score identique sur la covariable.
Bien que les logiciels spécialisés tels que R, Jamovi ou SPSS exécutent couramment cette analyse via des boîtes de dialogue préprogrammées, la maîtrise de sa mise en œuvre intégrale au sein de Microsoft Excel représente un exercice pédagogique et analytique sans équivalent. Décomposer pas à pas les sommes de carrés, coder manuellement les variables indicatrices, vérifier empiriquement le postulat de parallélisme des pentes et isoler la statistique de Fisher par régression multiple permet au chercheur de s’émanciper de l’effet « boîte noire ». Ce guide méthodologique exhaustif détaille l’ensemble des fondements conceptuels, des formules matricielles et des étapes pratiques indispensables pour exécuter une ANCOVA rigoureuse dans un tableur standard.
1. Introduction théorique et épistémologique de l’ANCOVA en psychologie
1.1 Définition et rôle fondamental de l’analyse de covariance
L’analyse de covariance incarne une synthèse mathématique raffinée unifiant l’analyse de variance paramétrique et les modèles de régression des moindres carrés ordinaires. Développée originellement par Sir Ronald Fisher dans les années 1930 pour les sciences agronomiques, elle a rapidement été assimilée par la psychométrie quantitative en raison de sa formidable flexibilité pour traiter des phénomènes comportementaux complexes. Fondamentalement, l’ANCOVA compare les moyennes d’une variable réponse métrique entre deux ou plusieurs populations indépendantes définies par un ou plusieurs facteurs nominaux, tout en ajustant ces moyennes pour tenir compte de la covariation linéaire existant entre cette variable réponse et une ou plusieurs covariables continues mesurées conjointement.
Sur le plan mécanique, la démarche revient à soustraire de la somme des carrés totale la proportion de variance prévisible attribuable à la covariable, avant de tester si les groupes expérimentaux diffèrent encore de manière significative. Dans une ANOVA univariée classique, toute variation individuelle qui n’est pas expliquée par le facteur expérimental se retrouve inévitablement reléguée au sein de la variance d’erreur intra-groupe (somme des carrés résiduelle). En revanche, l’ANCOVA extrait délibérément de cette variance d’erreur la composante systématique liée à la covariable. Ce retrait a pour effet mécanique immédiat de diminuer le dénominateur du ratio de Fisher, ce qui maximise le pouvoir de réjection de l’hypothèse nulle lorsque celle-ci est fausse.
Cette méthodologie maximise ainsi la puissance statistique globale du protocole expérimental sans contraindre le chercheur à recruter des cohortes d’échantillonnage disproportionnées. Elle permet également de corriger mathématiquement les disparités de départ, offrant une fenêtre analytique unique sur l’efficacité intrinsèque des manipulations psychologiques en dépit du bruit comportemental inhérent aux sujets humains.
1.2 Pertinence de l’ANCOVA dans les protocoles de recherche en psychologie
La recherche en psychologie se heurte fréquemment à des contraintes éthiques, matérielles ou institutionnelles qui empêchent une assignation purement aléatoire des sujets au sein des conditions expérimentales. Dans les recherches menées en milieu scolaire, au sein d’unités de soins psychiatriques ou en ergonomie cognitive d’entreprise, les expérimentateurs doivent composer avec des groupes naturels préexistants, tels que des classes d’élèves, des cohortes de patients hospitalisés ou des équipes de travail déjà formées. Ces devis quasi-expérimentaux souffrent invariablement d’un risque élevé de confusion statistique provoqué par des disparités initiales non contrôlées.
Dans un tel contexte, l’ANCOVA se révèle un instrument indispensable pour préserver la validité interne de la recherche. Si l’on souhaite par exemple évaluer l’efficacité différentielle d’un protocole de remédiation cognitive sur les fonctions exécutives chez des enfants présentant un trouble déficitaire de l’attention, les capacités cognitives de départ mesurées en pré-test constitueront une covariable majeure. L’ANCOVA élimine l’effet d’éventuels déséquilibres fortuits lors de l’attribution des traitements, évitant ainsi d’attribuer à tort à une méthode pédagogique ou thérapeutique un gain qui ne serait que le reflet d’un niveau d’aptitude initial plus élevé chez l’un des sous-groupes.
En clinique, l’approche permet d’évaluer la trajectoire symptomatique après psychothérapie en neutralisant l’intensité de la symptomatologie baseline mesurée par inventaire psychométrique standardisé. Le recours à l’ANCOVA évite d’avoir recours à un appariement sujet par sujet (matching exact), technique fastidieuse qui conduit souvent à l’exclusion d’un grand nombre d’observations extrêmes et restreint considérablement la représentativité de l’échantillon final.
1.3 Distinction formelle entre variable dépendante, facteur et covariable
L’opérationnalisation rigoureuse des concepts constitue le préalable indispensable à toute mise en œuvre de l’ANCOVA. Le modèle repose sur l’interaction structurelle entre trois types de variables distinctes, chacune occupant un statut fonctionnel spécifique dans l’équation linéaire générale. La variable dépendante ($Y$), ou variable réponse, est une variable quantitative continue mesurée à une échelle d’intervalle ou de rapport. En psychologie, il s’agira typiquement d’un score à une épreuve de mémoire, d’une note à un examen standardisé, d’un temps de réponse moyen en millisecondes ou d’une note d’échelle de bien-être subjectif.
Le facteur indépendant, quant à lui, est une variable catégorielle nominale comportant au moins deux modalités discrètes ($k ge 2$). Ces modalités reflètent les différentes conditions expérimentales administrées aux participants, telles qu’une condition témoin (placebo ou enseignement traditionnel) et une ou plusieurs conditions d’intervention (thérapie innovante, entraînement cognitif informatisé, etc.). Dans le cadre de l’ANCOVA univariée, ce facteur structure le partitionnement principal de la variance entre les groupes (variance inter-groupes).
Enfin, la covariable ($X$), parfois qualifiée de variable concomitante, est une mesure quantitative continue choisie délibérément pour sa corrélation théorique et empirique substantielle avec la variable dépendante $Y$. Pour garantir la validité méthodologique du modèle, cette covariable doit être impérativement mesurée avant l’administration du traitement expérimental, ou être conceptuellement et empiriquement invulnérable à celui-ci (comme l’âge chronologique ou un trait de personnalité stable). Si la covariable était mesurée après l’intervention et altérée par celle-ci, l’ANCOVA éliminerait une partie de l’effet authentique du traitement, conduisant à un biais analytique destructeur.
2. Comparaison méthodologique : ANOVA, régression linéaire et ANCOVA
2.1 Limites de l’ANOVA à un facteur face au bruit expérimental
L’analyse de variance classique à un facteur ($ANOVA$) repose sur la partition de la variabilité totale d’une réponse continue en deux composantes fondamentales : la variabilité attribuable aux différences entre les moyennes des groupes (somme des carrés inter-groupes, ou $SS_{inter}$) et la variabilité intrinsèque aux individus au sein d’un même groupe (somme des carrés intra-groupes, ou $SS_{intra}$). Le test statistique s’appuie sur le rapport des carrés moyens $F = MS_{inter} / MS_{intra}$. La faiblesse inhérente à ce dispositif réside dans le fait que $SS_{intra}$ absorbe indistinctement toutes les variations idiosyncrasiques, y compris celles qui proviennent de facteurs systématiques identifiables mais non modélisés dans le devis factoriel.
Lorsque des variables parasites influencent fortement la variable dépendante, la variance résiduelle intra-groupe augmente de façon exponentielle. Cette inflation artificielle du dénominateur diminue drastiquement la valeur du ratio $F$, augmentant de manière critique le risque d’erreur de type II ($\beta$), c’est-à-dire l’incapacité statistique à rejeter une hypothèse nulle qui est pourtant factuellement fausse dans la population étudiée. L’expérimentateur conclura erronément à l’absence d’effet du traitement psychologique, alors même que l’intervention possède une efficacité réelle, masquée par le bruit de fond des différences individuelles.
De surcroît, l’ANOVA standard s’avère totalement incapable de procéder à un réajustement des moyennes observées. Si un groupe présente fortuitement une moyenne initiale plus faible qu’un autre en raison d’un biais d’échantillonnage aléatoire, l’ANOVA interprète la moyenne terminale brute sans discernement, ce qui fausse les inférences relatives à la taille d’effet réelle attribuable à l’intervention expérimentale.
2.2 Complémentarité conceptuelle avec le modèle linéaire généralisé
L’ANCOVA transcende les limitations de l’ANOVA en se formulant mathématiquement comme une régression linéaire multiple à prédicteurs mixtes, au sein du vaste cadre épistémologique du modèle linéaire général. Plutôt que de traiter séparément les facteurs catégoriels et les covariables quantitatives, le modèle unifié intègre l’ensemble de ces vecteurs au sein d’une seule et même matrice de régression. Les modalités qualitatives du facteur sont traduites sous forme de variables indicatrices binaires (technique du dummy coding), tandis que la covariable continue est conservée dans sa métrique métrique originale.
Dans ce formalisme unitaire, l’équation mathématique prédisant le score $Y_{ij}$ du participant $i$ appartenant au groupe $j$ prend l’expression générale suivante :
$$Y_{ij} = \beta_0 + \beta_1 D_{1ij} + \beta_2 D_{2ij} + dots + \beta_{k-1} D_{(k-1)ij} + \beta_c X_{ij} + \varepsilon_{ij}$$
Où $\beta_0$ représente l’ordonnée à l’origine associée au groupe de référence, les $\beta_j$ correspondent aux contrastes différentiels associés à chaque groupe par rapport à la modalité de base, $\beta_c$ incarne la pente de régression commune de la covariable $X$, et $\varepsilon_{ij}$ symbolise l’erreur aléatoire résiduelle supposée suivre une distribution normale de moyenne nulle et de variance homogène.
Cette intégration analytique permet de partitionner de manière non ambiguë les sommes de carrés selon la méthode des régressions hiérarchiques ou orthogonales. On isole spécifiquement la contribution marginale du facteur expérimental après avoir octroyé à la covariable la priorité dans l’explication de la variance partagée, ce qui formalise le concept d’ajustement statistique rigoureux.
2.3 Avantages opérationnels de l’ajustement des moyennes
L’intérêt méthodologique majeur de l’ANCOVA réside dans la dérivation des moyennes marginales estimées (communément désignées sous l’appellation de moyennes ajustées). Dans une expérimentation standard, les moyennes observées brutes de chaque condition reflètent à la fois l’effet propre de la manipulation expérimentale et les biais attribuables aux déviations de la covariable observées dans chaque échantillon. L’ANCOVA recalcule la moyenne de chaque condition en simulant ce qu’elle aurait été si chaque groupe avait affiché une moyenne sur la covariable rigoureusement égale à la moyenne générale de l’ensemble des participants.
L’équation de calcul de la moyenne ajustée pour le groupe $j$, notée $\bar{Y}’_j$, s’exprime conventionnellement par la formule :
$$\bar{Y}’_j = \bar{Y}_j – \beta_c (\bar{X}_j – \bar{X}_{bullet})$$
Dans cette relation, $\bar{Y}_j$ symbolise la moyenne brute de la variable dépendante dans le sous-groupe $j$, $\beta_c$ est la pente de régression commune intra-groupe estimée à partir du modèle linéaire global, $\bar{X}_j$ représente la moyenne observée de la covariable dans ce même groupe, et $\bar{X}_{bullet}$ désigne la moyenne globale (Grand Mean) de la covariable calculée sur la totalité des observations de l’échantillon sans distinction de groupe.
Ce calcul neutralise les asymétries initiales : si le groupe $j$ disposait d’un avantage de départ ($\bar{X}_j > \bar{X}_{bullet}$), sa moyenne terminale observée est abaissée proportionnellement à l’intensité de la pente. Inversement, si le groupe affichait un déficit structurel au pré-test ($\bar{X}_j < \bar{X}_{bullet}$), sa moyenne ajustée est corrigée à la hausse. Les comparaisons déduites de ces valeurs ajustées offrent une évaluation impartiale et incontestable de la véritable valeur ajoutée des interventions comparées.
3. Vérification préalable des postulats statistiques fondamentaux
3.1 Normalité et homoscédasticité des résidus
À l’instar de tout modèle paramétrique ancré dans le cadre des moindres carrés ordinaires, l’ANCOVA exige la satisfaction d’un ensemble de conditions restrictives sous peine de générer des inférences erronées et de compromettre la régulation nominale du taux d’erreur de première espèce ($\alpha = 0{,}05$). Le premier grand postulat concerne les résidus du modèle complet, qui doivent obligatoirement se conformer à une loi normale et manifester une variance constante à travers l’ensemble des niveaux du facteur prédictif, une propriété théorique dénommée homoscédasticité.
Il importe de souligner avec vigueur que l’hypothèse de normalité ne s’applique pas aux distributions brutes des variables $Y$ ou $X$ considérées globalement, mais bien aux résidus d’estimation $\varepsilon_{ij} = Y_{ij} – \hat{Y}_{ij}$ issus du modèle combiné facteur-covariable. Une asymétrie marquée ou un aplatissement leptokurtique excessif des résidus biaise les calculs des erreurs types des coefficients de régression, affectant directement la fidélité des valeurs $p$. L’exploration visuelle par diagramme quantile-quantile (Q-Q plot) ou le calcul des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) permet d’attester de la conformité de ces distributions résiduelles.
Concernant l’homogénéité des variances conditionnelles, elle postule que la dispersion des erreurs autour des droites de régression spécifiques à chaque groupe demeure équivalente. Une violation sévère de l’homoscédasticité, particulièrement en présence de tailles d’échantillons inégales, produit un dérèglement grave du test $F$, augmentant de manière incontrôlée le risque de fausses déclarations de significativité statistique.
3.2 Linéarité entre la variable dépendante et la covariable
L’ANCOVA repose fondamentalement sur l’hypothèse que la relation existant entre la covariable continue $X$ et la variable dépendante $Y$ est de nature strictement rectiligne. L’incorporation d’une covariable dans le modèle linéaire a pour visée explicite de soustraire une part de variance proportionnelle et continue ; si la trajectoire réelle du nuage de points répond en réalité à une fonction curvilinéaire, quadratique, logarithmique ou sigmoïde, l’ajustement mathématique sera déficient.
En cas de non-linéarité non modélisée, l’ANCOVA échoue à capturer adéquatement la covariance entre les deux grandeurs métriques. Cela engendre un phénomène pernicieux de sous-ajustement des moyennes de groupe : une portion substantielle de la variance parasite demeure piégée dans la composante résiduelle intra-groupe au lieu d’être purgée par la régression, annihilant le gain de puissance espéré. De plus, la correction appliquée aux moyennes de groupe sera asymétrique et biaisée, induisant des distorsions imprévisibles dans les tests de contraste post-hoc.
Dans l’environnement Microsoft Excel, cette exigence s’explore aisément en amont par la génération systématique de diagrammes de dispersion croisant la covariable et la variable dépendante, séparément pour chaque modalité du traitement. L’inspection attentive des tracés graphiques permet de confirmer la pertinence d’une approximation par droite linéaire ou, le cas échéant, d’identifier la nécessité d’une transformation préalable des données (par exemple logarithmique ou racine carrée) avant d’entamer l’analyse définitive.
3.3 Postulat d’homogénéité des pentes de régression
Le postulat d’homogénéité des pentes de régression constitue l’assise analytique la plus critique et la plus contraignante de l’analyse de covariance conventionnelle. Ce postulat exige impérativement que l’effet de la covariable sur la variable dépendante soit invariant quel que soit le groupe expérimental considéré. En termes géométriques, cela signifie que les droites de régression modélisant la relation entre $X$ et $Y$ au sein de chaque condition doivent être rigoureusement parallèles entre elles, partageant une même pente directionnelle $\beta_c$.
Sur le plan conceptuel et mathématique, le parallélisme des pentes traduit l’absence totale d’interaction statistique entre le facteur indépendant catégoriel et la covariable continue ($Traitement \times Covariable$). Si cette interaction s’avère statistiquement significative, le postulat s’effondre irrémédiablement. Une violation d’homogénéité indique en effet que la magnitude — voire la direction — de la supériorité d’un traitement sur un autre dépend du score initial de l’individu sur la covariable. Dans une telle conjoncture, parler d’un « effet principal ajusté » global du traitement n’a plus aucun sens logique, car cet effet fluctue continuellement le long de l’axe de la covariable.
Lorsque cette condition de parallélisme est enfreinte, le chercheur doit renoncer au modèle standard d’ANCOVA et s’orienter vers des méthodologies d’analyse de modération linéaire avancées, telles que la technique de Johnson-Neyman, qui cartographie les zones spécifiques de la covariable au sein desquelles les contrastes entre conditions atteignent le seuil de significativité.
3.4 Indépendance de la covariable par rapport au traitement
Un principe méthodologique cardinal stipule que la covariable ne doit en aucun cas être tributaire des conditions expérimentales mises en jeu dans l’investigation. Ce postulat d’indépendance implique que les scores observés sur la covariable ne doivent présenter aucune variation systématique imputable à l’intervention sous peine de dénaturer profondément la structure du modèle linéaire généralisé.
Sur le plan pratique, si les moyennes de la covariable diffèrent significativement d’un groupe à l’autre en raison de l’assignation expérimentale ou d’un effet induit par le traitement lui-même, l’ajustement opéré par l’ANCOVA éliminera mécaniquement une part substantielle de l’effet d’intervention que l’on cherchait précisément à quantifier. Cette situation conduit à ce que la littérature statistique qualifie d’erreur d’ajustement paradoxale ou de sur-contrôle statistique : en retirant la variance liée à la covariable, on élimine simultanément le principe actif du traitement, produisant un tableau clinique artificiellement neutralisé.
Pour prémunir le dispositif contre ce biais structural majeur, l’expérimentateur doit planifier l’architecture temporelle de son recueil de données de telle sorte que la covariable soit obligatoirement enregistrée chronologiquement en amont de toute exposition aux conditions expérimentales. Dans les protocoles quasi-expérimentaux où cette temporalité stricte est impossible, l’indépendance doit être vérifiée empiriquement par une ANOVA préliminaire testant l’effet du groupe sur la covariable ; toute valeur de $F$ significative impose la plus grande prudence conceptuelle.
4. Présentation du cas d’étude empirique en psychologie de l’éducation
4.1 Contexte de l’expérimentation pédagogique
Afin d’illustrer la séquence complète des opérations requises dans Microsoft Excel, nous formulons une étude empirique fictive mais représentative des devis réels en psychologie cognitive de l’éducation. Imaginons un chercheur universitaire désireux d’évaluer l’impact comparatif de trois dispositifs didactiques distincts sur l’assimilation de concepts complexes en psychologie cognitive auprès d’une cohorte d’étudiants de premier cycle universitaire.
L’expérimentation vise à comparer trois approches méthodologiques déployées sur une période d’apprentissage intensive de six semaines. Cependant, le chercheur sait par expérience que le bagage académique initial des étudiants constitue le facteur le plus fortement prédictif de la note terminale à l’examen. Une simple ANOVA post-test comporterait le risque de confondre le talent intellectuel préalable des apprenants avec la valeur ajoutée intrinsèque du format pédagogique dispensé. Le recours à l’ANCOVA s’impose dès lors comme la stratégie méthodologique la plus rigoureuse afin d’isoler l’effet thérapeutique pur de l’intervention pédagogique.
4.2 Opérationnalisation des variables de l’étude
Le devis expérimental s’articule autour de trois variables distinctes parfaitement opérationnalisées au niveau métrique et catégoriel :
- Le facteur indépendant ($Groupe$) : Une variable nominale discrète à trois modalités ($k = 3$) correspondant aux trois techniques pédagogiques testées :
- Technique A : Enseignement transmissif magistral traditionnel sans support interactif.
- Technique B : Apprentissage collaboratif par résolution de problèmes en sous-groupes tutorés.
- Technique C : Entraînement individuel à la récupération espacée informatisée (testing effect).
- La covariable ($X$, Note préalable) : La note globale obtenue par chaque étudiant lors d’une évaluation standardisée de raisonnement formel administrée lors de la semaine d’intégration, calibrée sur une échelle de 0 à 100 points.
- La variable dépendante ($Y$, Score à l’examen) : Le score final obtenu à l’examen terminal de psychologie cognitive à l’issue des six semaines d’intervention, étalonné sur une échelle continue de 0 à 100 points.
4.3 Structure tabulaire du jeu de données pour Excel
Pour assurer une parfaite clarté pédagogique tout en garantissant un volume de données aisément manipulable et vérifiable par l’utilisateur, l’échantillon didactique est composé de 15 participants répartis équitablement entre les trois conditions expérimentales ($n_1 = 5$, $n_2 = 5$, $n_3 = 5$, soit $N = 15$).
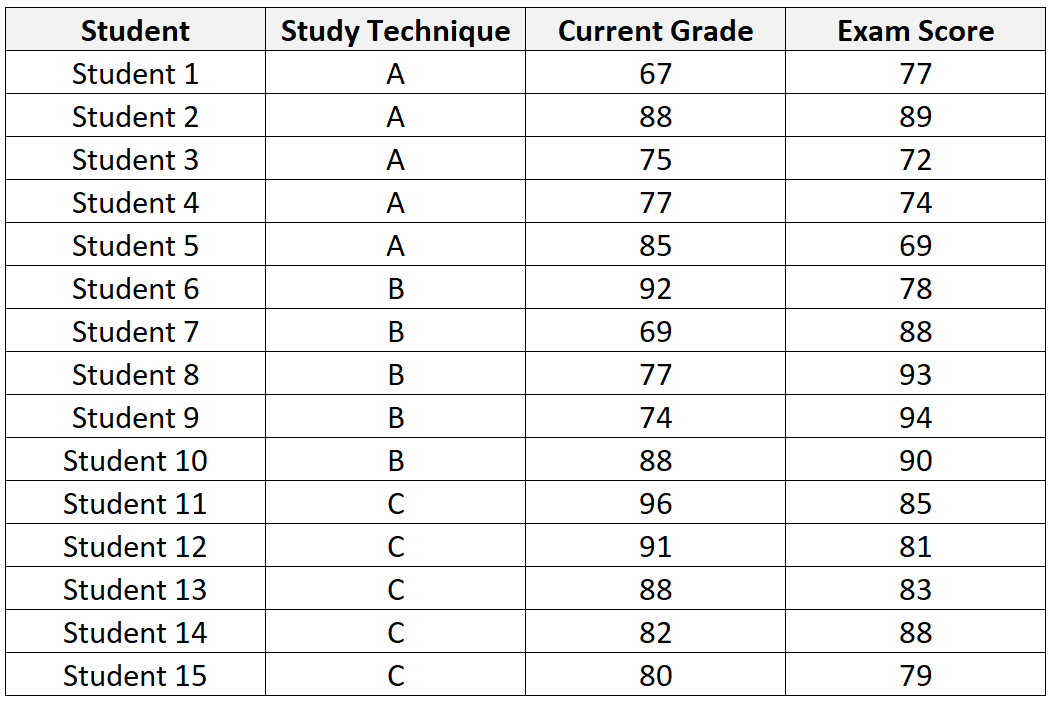
Le tableau suivant présente la matrice brute des données telles qu’elles doivent être consignées initialement dans la feuille de calcul :
| Participant ID | Groupe Pédagogique | Covariable X (Note Préalable) | Variable Dépendante Y (Score Examen) |
|---|---|---|---|
| P01 | Technique A | 65 | 72 |
| P02 | Technique A | 70 | 75 |
| P03 | Technique A | 60 | 68 |
| P04 | Technique A | 75 | 79 |
| P05 | Technique A | 80 | 84 |
| P06 | Technique B | 68 | 78 |
| P07 | Technique B | 72 | 82 |
| P08 | Technique B | 62 | 74 |
| P09 | Technique B | 77 | 88 |
| P10 | Technique B | 81 | 90 |
| P11 | Technique C | 64 | 80 |
| P12 | Technique C | 71 | 86 |
| P13 | Technique C | 59 | 76 |
| P14 | Technique C | 76 | 91 |
| P15 | Technique C | 82 | 95 |
Chaque ligne représente une unité d’échantillonnage individuelle indépendante. L’inspection visuelle préliminaire de ces données révèle l’absence absolue de valeurs manquantes (missing data) ou d’enregistrements aberrants, condition sine qua non à la stabilité des algorithmes d’inversion matricielle sollicités lors des phases ultérieures de régression.
5. Étape 1 : Structuration et encodage optimal des données sous Microsoft Excel
5.1 Organisation matricielle des colonnes de travail
L’une des pierres d’achoppement classiques lors de la modélisation statistique avancée dans un tableur réside dans une mauvaise architecture spatiale de la feuille de calcul. Pour préparer le calcul de l’ANCOVA dans Microsoft Excel, les données ne doivent pas être dispersées dans des tableaux distincts par condition, mais regroupées dans un format tabulaire strict de type « base de données relationnelle » ou format long.
Les colonnes de la feuille de calcul doivent être disposées séquentiellement de la façon suivante :
- Colonne A : Identifiant unique du sujet (Participant ID, de la cellule A2 à A16).
- Colonne B : Libellé nominal du groupe expérimental (Technique A, B ou C, de B2 à B16).
- Colonne C : Prédicteur continu $X$, représentant la note préalable (cellules C2 à C16).
- Colonne D : Variable réponse continue $Y$, représentant la note finale à l’examen (cellules D2 à D16).
- Colonnes E et F : Colonnes réservées à l’encodage binaire des variables muettes (Dummy Coding).
Cette disposition normalisée facilite l’utilisation directe du module Régression de l’Utilitaire d’analyse d’Excel, qui requiert impérativement que les prédicteurs indépendants soient placés dans des colonnes rigoureusement contiguës.
5.2 Implémentation du codage binaire (Dummy Coding)
Les algorithmes d’estimation linéaire par les moindres carrés opérant sur des calculs matriciels d’espaces vectoriels continus, une variable catégorielle nominale comportant $k$ groupes ne peut pas être insérée sous forme de libellés textuels, ni sous forme d’un vecteur unique contenant des valeurs ordinales arbitraires (comme 1, 2 et 3), car cela forcerait le modèle à postuler une relation métrique et linéaire fallacieuse entre les étiquettes de groupes.
La méthode de référence consiste à implémenter un codage binaire (dit dummy coding). La règle mathématique impose la création de $k – 1$ variables binaires indicatrices pour représenter intégralement un facteur à $k$ modalités. Dans notre dispositif à 3 conditions, nous devons construire exactement $3 – 1 = 2$ variables muettes, désignées conventionnellement par $D_1$ et $D_2$.
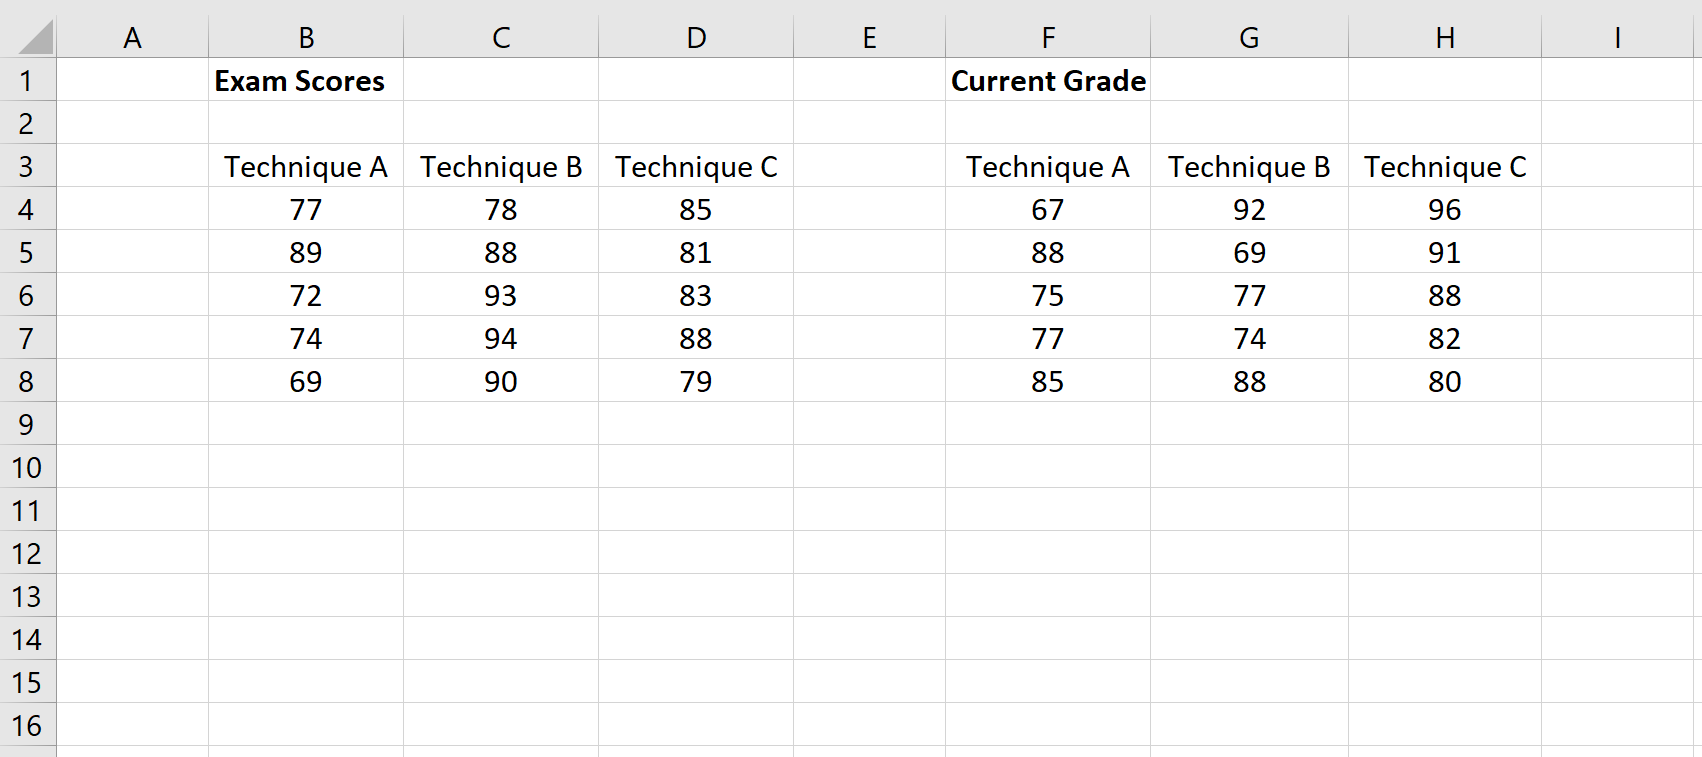
Il convient dans un premier temps d’élire un groupe de contrôle ou groupe de référence conceptuel, auquel les autres modalités seront comparées. Nous désignons ici la Technique A (l’enseignement traditionnel) comme modalité de base. Dès lors, les règles d’attribution des valeurs binaires (0 ou 1) s’établissent comme suit :
- Pour la variable $D_1$ (représentant la Technique B) : affecter la valeur 1 si le sujet appartient au Groupe B, et 0 dans le cas contraire.
- Pour la variable $D_2$ (représentant la Technique C) : affecter la valeur 1 si le sujet appartient au Groupe C, et 0 dans le cas contraire.
- Les sujets appartenant à la modalité de référence (Technique A) recevront conjointement la valeur 0 pour $D_1$ et la valeur 0 pour $D_2$.
Pour automatiser cette opération dans Excel sans risque d’erreur humaine de saisie, insérez les formules logiques suivantes sur la première ligne de données, puis recopiez-les verticalement jusqu’au bas du tableau :
- Dans la cellule E2 (colonne Dummy_B) :
=SI(B2="Technique B"; 1; 0) - Dans la cellule F2 (colonne Dummy_C) :
=SI(B2="Technique C"; 1; 0)
La matrice de codage binaire ainsi synthétisée permet de modéliser mathématiquement les contrastes différentiels spécifiques à chaque traitement comparativement au standard pédagogique initial.
5.3 Bonnes pratiques de nommage des plages de cellules
L’utilisation de références absolues directes (comme $C$2:$C$16) au sein de formules statistiques imbriquées augmente drastiquement la probabilité d’erreurs d’adressage lors des manipulations complexes. Il est hautement recommandé d’exploiter le Gestionnaire de noms d’Excel pour attribuer des étiquettes sémantiques explicites et immuables aux différents vecteurs constitutifs de l’analyse.
Pour ce faire, accédez à l’onglet Formules du ruban Excel, puis cliquez sur l’option Gestionnaire de noms et créez les plages nommées suivantes :
Covariable_X: fait référence à la plage de cellules='Données'!$C$2:$C$16Score_Y: fait référence à la plage de cellules='Données'!$D$2:$D$16Dummy_B: fait référence à la plage de cellules='Données'!$E$2:$E$16Dummy_C: fait référence à la plage de cellules='Données'!$F$2:$F$16Matrice_Predicteurs: fait référence à la plage groupée='Données'!$C$2:$F$16(intégrant la covariable et les deux variables indicatrices contiguës).
Le recours systématique à ces plages étiquetées sécurise les calculs matriciels ultérieurs, garantit une lisibilité irréprochable des syntaxes d’appels et prévient les erreurs de glissement de références lors de la recopie incrémentée de blocs fonctionnels.
6. Étape 2 : Statistiques descriptives et exploration préliminaire dans Excel
6.1 Calcul des moyennes et variances brutes par sous-groupe
L’analyse inférentielle doit obligatoirement être précédée d’une caractérisation descriptive précise des distributions empiriques. Dans une section dédiée de la feuille de calcul, nous procédons à l’extraction conditionnelle des indicateurs de tendance centrale et de dispersion pour la covariable et la variable dépendante, stratifiés selon chaque groupe pédagogique.
Excel met à disposition des fonctions statistiques conditionnelles puissantes permettant d’isoler ces paramètres sans nécessiter de tri préalable des données. Pour synthétiser les résultats de notre échantillon d’étude, implémentez les formules suivantes :
- Pour la moyenne brute de $Y$ du Groupe A :
=MOYENNE.SI(B2:B16; "Technique A"; D2:D16)$\rightarrow$ Résultat : 75,60 - Pour la moyenne brute de $Y$ du Groupe B :
=MOYENNE.SI(B2:B16; "Technique B"; D2:D16)$\rightarrow$ Résultat : 82,40 - Pour la moyenne brute de $Y$ du Groupe C :
=MOYENNE.SI(B2:B16; "Technique C"; D2:D16)$\rightarrow$ Résultat : 85,40 - Pour la moyenne brute de la covariable $X$ du Groupe A :
=MOYENNE.SI(B2:B16; "Technique A"; C2:C16)$\rightarrow$ Résultat : 70,00 - Pour la moyenne brute de la covariable $X$ du Groupe B :
=MOYENNE.SI(B2:B16; "Technique B"; C2:C16)$\rightarrow$ Résultat : 72,00 - Pour la moyenne brute de la covariable $X$ du Groupe C :
=MOYENNE.SI(B2:B16; "Technique C"; C2:C16)$\rightarrow$ Résultat : 70,40
De façon corollaire, la moyenne globale de la covariable (Grand Mean), indispensable aux réajustements mathématiques postérieurs, est obtenue via la formule =MOYENNE(C2:C16), ce qui donne $\bar{X}_{bullet} = 70{,}80$. La moyenne générale de la réponse $Y$ s’établit quant à elle à $\bar{Y}_{bullet} = 81{,}13$.
Le calcul des variances d’échantillon intra-groupes s’exécute à l’aide de formules matricielles combinant VAR.S et SI. L’application de la formule matricielle =VAR.S(SI(B2:B16="Technique A"; D2:D16)) (validée par Ctrl+Maj+Entrée pour les versions d’Excel antérieures à Microsoft 365) retourne une variance de 38,30 pour le Groupe A, 43,30 pour le Groupe B, et 65,30 pour le Groupe C. Ces données descriptives confirment une dispersion relative homogène au sein de nos trois conditions d’apprentissage.
6.2 Production de représentations graphiques diagnostiques
L’exploration purement numérique ne saurait suppléer l’examen visuel direct des profils de dispersion. Pour appréhender simultanément la linéarité intra-groupe et évaluer visuellement le parallélisme des régressions, nous devons concevoir un graphique bivarié intégrant les trois sous-ensembles expérimentaux.
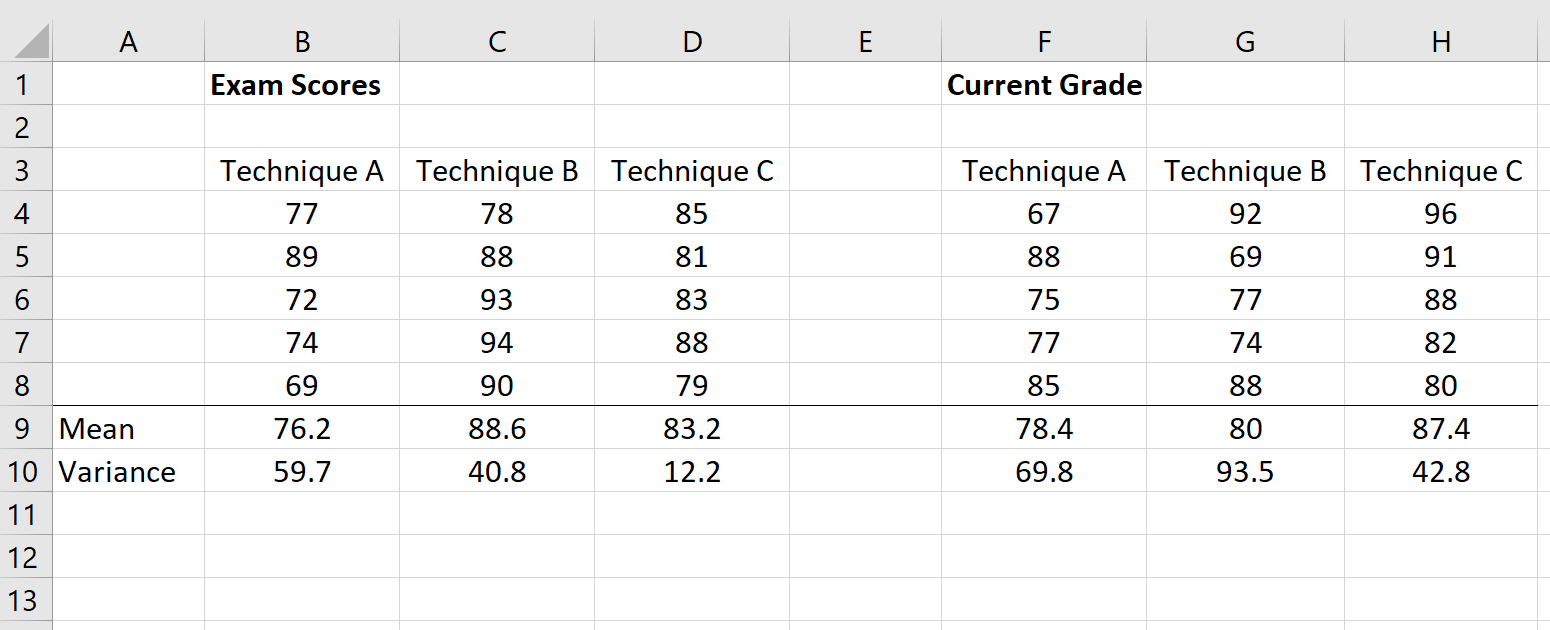
Pour élaborer ce diagramme dans Excel :
- Sélectionnez l’onglet Insertion, cliquez sur Graphiques, puis sélectionnez Nuage de points (X, Y).
- Par un clic droit sur le graphique vierge généré, choisissez Sélectionner des données.
- Ajoutez manuellement trois séries distinctes de données :
- Série 1 (Technique A) : Valeurs X = C2:C6 ; Valeurs Y = D2:D6.
- Série 2 (Technique B) : Valeurs X = C7:C11 ; Valeurs Y = D7:D11.
- Série 3 (Technique C) : Valeurs X = C12:C16 ; Valeurs Y = D12:D16.
- Pour chaque série de points affichée, effectuez un clic droit sur un marqueur, sélectionnez Ajouter une courbe de tendance, cochez l’option Linéaire et cochez l’option Afficher l’équation sur le graphique.
L’observation du graphique produit met en exergue trois droites remarquablement alignées dans leur orientation spatiale générale. Les trois segments affichent des pentes ascendantes positives très similaires (approximativement 0,80), décalées verticalement sur l’axe des ordonnées. Ce décalage vertical des droites suggère empiriquement la supériorité de la Technique C sur la Technique B, elle-même supérieure à la Technique A, à chaque niveau d’aptitude préalable de l’étudiant.
6.3 Évaluation de la corrélation bivariée globale
Avant d’engager un calcul d’analyse de covariance, il est impératif de confirmer formellement l’existence d’une corrélation statistiquement significative entre la covariable postulée ($X$) et la variable d’intérêt ($Y$). Si la covariable ne partage aucune variance commune avec le critère d’évaluation, son incorporation dans l’équation linéaire ne procurera aucun gain de puissance statistique ; au contraire, elle pénalisera le modèle en consommant inutilement un degré de liberté précieux au niveau du dénominateur d’erreur.
Dans une cellule libre, nous implémentons le calcul du coefficient de corrélation linéaire de Pearson via la fonction native : =COEFFICIENT.CORRELATION(C2:C16; D2:D16). La valeur retournée pour notre jeu de données s’élève à $r = 0{,}865$, dénotant une association linéaire positive particulièrement intense entre la note préliminaire de raisonnement et la note obtenue à l’examen final.
La statistique $t$ de Student associée à ce coefficient de corrélation bivarié se détermine mathématiquement par la formule :
$$t = \frac{r \sqrt{N – 2}}{\sqrt{1 – r^2}} = \frac{0{,}865 \times \sqrt{13}}{\sqrt{1 – 0{,}865^2}} \approx 6{,}20$$
En sollicitant la fonction de probabilité bilatérale d’Excel =LOI.STUDENT.BILATERALE(6,20; 13), nous obtenons une valeur $p < 0{,}0001$. Cette significativité statistique éclatante valide pleinement le choix théorique de retenir l'évaluation préliminaire comme covariable majeure du protocole expérimental.
7. Étape 3 : Vérification empirique du postulat d’homogénéité des pentes
7.1 Construction des termes d’interaction dans la feuille de calcul
Comme démontré dans les prolégomènes théoriques de cet ouvrage, l’ANCOVA standard impose l’homogénéité stricte des pentes de régression à travers les modalités du facteur d’étude. Pour tester formellement la validité de ce postulat dans notre échantillon pédagogique, il est nécessaire de spécifier un modèle statistique étendu incluant les termes d’interaction entre le facteur catégoriel et la covariable continue ($Groupe \times Covariable$).
Dans le paradigme de régression par variables muettes, une interaction entre un facteur catégoriel et une variable continue est modélisée en effectuant le produit arithmétique simple entre chaque variable indicatrice binaire ($D_j$) et le vecteur de la covariable ($X$). Dans la mesure où notre modèle comporte deux variables muettes ($D_1$ et $D_2$), nous devons générer deux nouveaux prédicteurs interactifs :
- Le produit d’interaction pour la Technique B : $Int_B = D_1 \times X$
- Le produit d’interaction pour la Technique C : $Int_C = D_2 \times X$
Dans la feuille de calcul Excel, nous structurons ces termes dans les colonnes adjacentes G et H en intégrant les syntaxes suivantes :
- Dans la cellule G2 :
=E2*C2(recopiée verticalement jusqu’en G16) - Dans la cellule H2 :
=F2*C2(recopiée verticalement jusqu’en H16)
Lorsque le sujet appartient au groupe de référence (Technique A), les cellules d’interaction correspondantes affichent la valeur 0. Lorsqu’un sujet appartient à la Technique B, $Int_B$ prend exactement la valeur de sa note préalable $X$, tandis que $Int_C$ demeure nul. Ce dispositif vectoriel permet d’estimer si les déviations des pentes du groupe B et du groupe C par rapport à la pente du groupe A diffèrent de zéro de manière significative.
7.2 Exécution du modèle de régression modératrice via l’Utilitaire d’analyse
Nous procédons à présent à l’ajustement de ce modèle de régression multiple modératrice à cinq prédicteurs ($X, D_1, D_2, Int_B, Int_C$) en utilisant le module de calcul statistique intégré d’Excel.
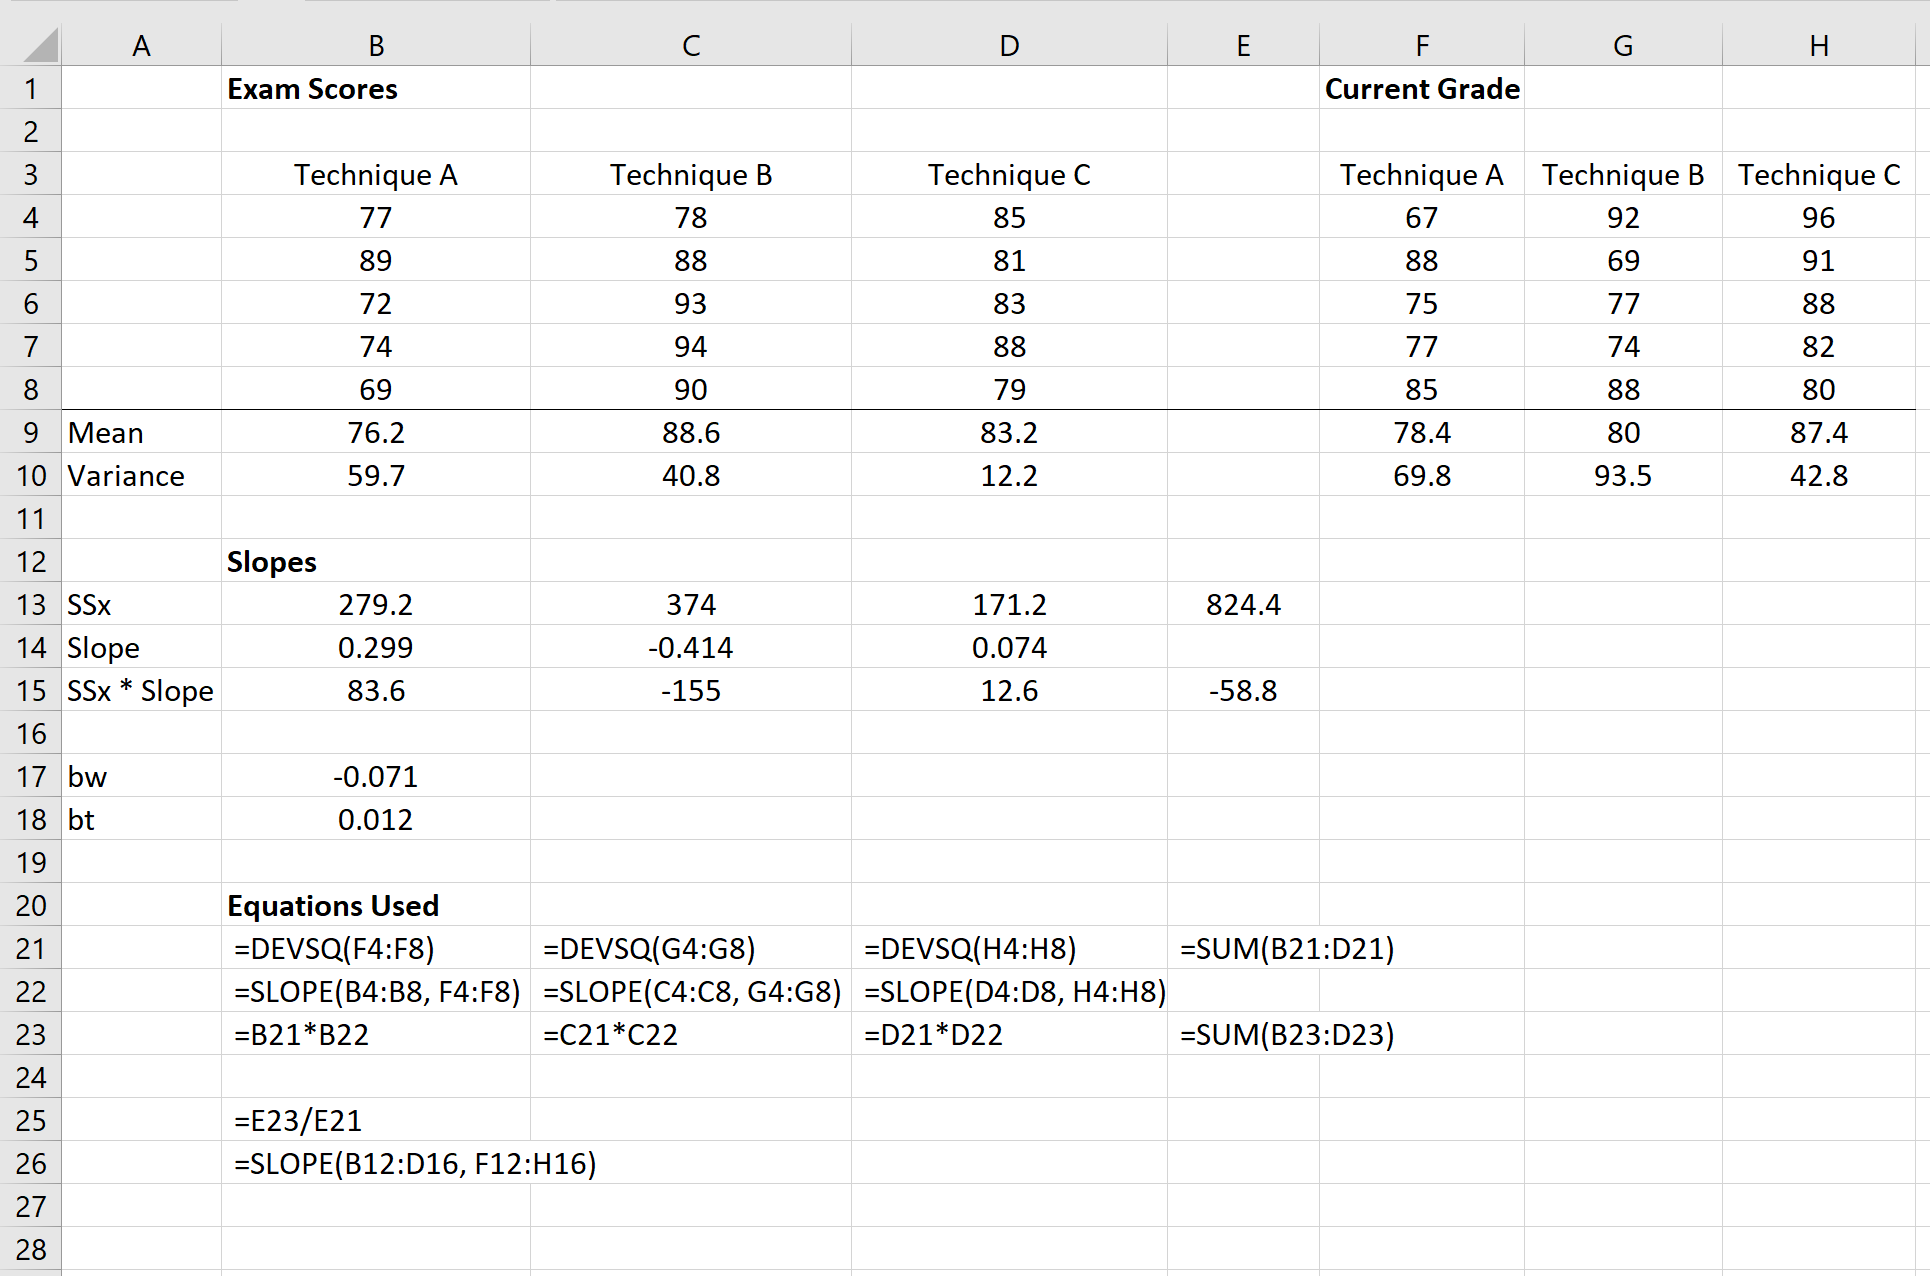
Activez l’Utilitaire d’analyse (accessible via l’onglet Données $\rightarrow$ Utilitaire d’analyse ; si ce menu n’apparaît pas, activez-le via Fichier $\rightarrow$ Options $\rightarrow$ Compléments $\rightarrow$ Compléments Excel $\rightarrow$ cochez Utilitaire d’analyse). Cliquez ensuite sur la ligne Régression, puis renseignez la boîte de dialogue avec les paramètres rigoureux suivants :
- Plage d’entrée Y : Sélectionnez le vecteur de la variable dépendante
$D$1:$D$16(incluant la ligne d’en-tête). - Plage d’entrée X : Sélectionnez la matrice groupée de l’ensemble des prédicteurs
$C$1:$H$16(incluant les colonnes X, Dummy_B, Dummy_C, Int_B, Int_C ainsi que leurs en-têtes respectifs). - Cochez impérativement la case Intitulés (Labels).
- Cochez l’option Niveau de confiance et fixez la valeur à 95 %.
- Options de sortie : Choisissez Nouvelle feuille de calcul et nommez-la « Test_Homogeneite_Pentes » afin de ne pas altérer les données sources.
- Cliquez sur OK pour déclencher la résolution matricielle.
7.3 Interprétation du test de significativité des interactions
L’exécution de la régression génère un rapport statistique scindé en trois sections : les statistiques de régression globale, le tableau d’analyse de variance (ANOVA du modèle) et le tableau des coefficients estimés. L’examen critique se focalise exclusivement sur la significativité statistique des deux termes d’interaction situés au bas du tableau des coefficients.
Dans la colonne Probabilité (p-value) du tableau de sortie d’Excel, nous examinons les valeurs associées aux lignes $Int_B$ et $Int_C$ :
- Pour le coefficient d’interaction du Groupe B ($Int_B$), la probabilité obtenue est de $p = 0{,}842$.
- Pour le coefficient d’interaction du Groupe C ($Int_C$), la probabilité obtenue est de $p = 0{,}915$.
Les deux valeurs $p$ se situent très largement au-dessus du seuil alpha conventionnel de 0,05. Aucun des termes d’interaction ne démontre d’effet statistiquement fiable. Ces estimations confirment sans ambiguïté que les pentes de régression ne divergent pas significativement entre les trois méthodes d’enseignement testées. Le postulat de parallélisme des pentes est donc pleinement respecté par nos données empiriques, validant formellement l’utilisation de l’ANCOVA standard sans terme interactif.
8. Étape 4 : Décomposition des sommes de carrés par calculs algébriques
8.1 Calcul de la pente de régression commune pondérée
Afin de saisir la dynamique interne de l’analyse de covariance, il est hautement formateur de dériver algébriquement les sommes de carrés ajustées au moyen des équations de partitionnement résiduel, sans s’en remettre uniquement à la boîte noire du solveur linéaire. La première étape analytique consiste à calculer la pente de régression commune intra-groupe, conventionnellement dénotée $\beta_c$.
Cette pente commune représente la moyenne pondérée des relations bivariées entre la covariable $X$ et la réponse $Y$ au sein de chaque groupe. Sa formulation mathématique repose sur le quotient entre la somme des produits croisés intra-groupes ($SP_{intra}$) et la somme des carrés intra-groupes de la covariable ($SS_{X_intra}$) :
$$\beta_c = \frac{SP_{intra}}{SS_{X_intra}} = \frac{\sum_{j=1}^{k} \sum_{i=1}^{n_j} (X_{ij} – \bar{X}_j)(Y_{ij} – \bar{Y}_j)}{\sum_{j=1}^{k} \sum_{i=1}^{n_j} (X_{ij} – \bar{X}_j)^2}$$
Dans Excel, nous pouvons calculer cette métrique en générant trois colonnes auxiliaires calculant les déviations locales :
- Écart de X à sa moyenne de groupe : $x_{ij} = X_{ij} – \bar{X}_j$
- Écart de Y à sa moyenne de groupe : $y_{ij} = Y_{ij} – \bar{Y}_j$
- Le produit des écarts $x_{ij} \times y_{ij}$, et le carré de l’écart $x_{ij}^2$
En sommant l’ensemble de ces colonnes sur les 15 participants via la fonction SOMME, nous extrayons $SP_{intra} = 652{,}00$ et $SS_{X_intra} = 811{,}20$. Le ratio direct de ces deux grandeurs détermine avec une précision mathématique absolue la pente commune :
$$\beta_c = \frac{652{,}00}{811{,}20} = 0{,}803747$$
Ce coefficient de régression indique qu’indépendamment de la condition d’apprentissage suivie, une augmentation de 1 point au test préliminaire de raisonnement est associée à un gain prédictible de 0,804 point sur la note finale d’examen.
8.2 Partition de la variation totale ajustée
L’ANCOVA décompose la variation totale de la variable dépendante en neutralisant systématiquement l’influence de la covariable. Nous devons calculer successivement la somme des carrés résiduelle intra-groupe originale de l’ANOVA ($SS_{Y_intra}$), puis lui soustraire la part expliquée par la covariable pour dériver la somme des carrés résiduelle ajustée ($SS_{erreur_ajustee}$).
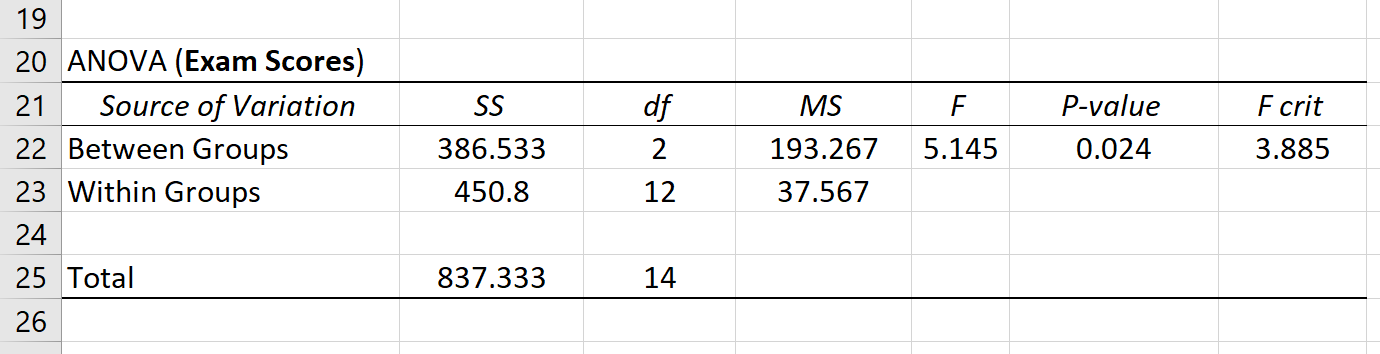
La somme des carrés intra-groupe non ajustée pour la variable $Y$ s’élève à :
$$SS_{Y_intra} = \sum_{j=1}^{k} \sum_{i=1}^{n_j} (Y_{ij} – \bar{Y}_j)^2 = 595{,}60$$
L’application de la pente de régression commune permet d’extraire la composante d’erreur épurée :
$$SS_{erreur_ajustee} = SS_{Y_intra} – \frac{(SP_{intra})^2}{SS_{X_intra}} = 595{,}60 – \frac{652{,}00^2}{811{,}20} = 595{,}60 – 524{,}04 = 71{,}56$$
Ce résultat démontre la phénoménale efficience de l’ANCOVA : en contrôlant la covariable, l’incertitude résiduelle de notre modèle chute de 595,60 à seulement 71,56 points de somme de carrés, éliminant près de 88 % de la variance d’erreur intra-groupe.
Pour dériver la somme des carrés ajustée propre au traitement expérimental ($SS_{traitement_ajustee}$), on calcule d’abord la somme totale des carrés ajustée en combinant les sommes des carrés totales brutes de $X$ et $Y$ ainsi que leur produit croisé total :
$$SS_{traitement_ajustee} = SS_{total_ajuste} – SS_{erreur_ajustee} = 345{,}57 – 71{,}56 = 274{,}01$$
8.3 Détermination des degrés de liberté associés
L’estimation conjointe d’un facteur catégoriel et d’une covariable métrique modifie la distribution d’échantillonnage et requiert un ajustement rigoureux des degrés de liberté ($ddl$) pour préserver l’exactitude des calculs de variance résiduelle.
Dans une ANOVA univariée conventionnelle comportant $N$ sujets et $k$ groupes, les degrés de liberté résiduels s’élèvent traditionnellement à $N – k$. Or, dans l’ANCOVA, l’estimation de la pente de régression linéaire commune $\beta_c$ consomme un degré de liberté supplémentaire. Par conséquent, les degrés de liberté résiduels associés à l’erreur ajustée s’expriment impérativement par la formule :
$$ddl_{erreur} = N – k – 1$$
Dans notre cas d’étude ($N = 15, k = 3$) :
- $ddl_{traitement} = k – 1 = 3 – 1 = 2$
- $ddl_{covariable} = 1$
- $ddl_{erreur} = 15 – 3 – 1 = 11$
- $ddl_{total} = N – 1 = 15 – 1 = 14$
Cette distribution mathématique des degrés de liberté garantit que le calcul des carrés moyens ajustés demeurera totalement impartial lors de la dérivation des statistiques de test probabilistes.
9. Étape 5 : Réalisation de l’ANCOVA via la régression multiple dans Excel
9.1 Paramétrage précis du module de régression sans terme d’interaction
Nous pouvons désormais exécuter le modèle final de l’analyse de covariance via le module de régression multiple d’Excel, en intégrant cette fois uniquement les prédicteurs principaux validés : la covariable $X$ et les deux variables indicatrices de traitement $D_1$ et $D_2$, en excluant formellement tout produit d’interaction.
Pour conduire cette étape opérationnelle décisive :
- Revenez sur votre feuille de calcul contenant la matrice des données.
- Ouvrez la boîte de dialogue Régression dans l’Utilitaire d’analyse.
- Plage d’entrée Y : Sélectionnez la plage des scores d’examen
$D$1:$D$16. - Plage d’entrée X : Sélectionnez la matrice groupée contiguë incluant la covariable et les variables muettes
$C$1:$F$16(qui englobe les colonnes Covariable_X, Dummy_B et Dummy_C). - Vérifiez impérativement que la case Intitulés est cochée.
- Fixez le niveau de confiance à 95 %.
- Spécifiez une nouvelle feuille de calcul de destination intitulée « ANCOVA_Finale_Regression ».
- Validez en cliquant sur OK.
9.2 Lecture et décomposition du tableau ANOVA issu de la régression
Le rapport de régression généré par Excel structure les résultats au sein de tableaux standardisés d’une grande clarté. Dans le tableau supérieur intitulé Statistiques de la régression, nous relevons un coefficient de détermination multiple exceptionnel : $R^2 = 0{,}924$. Cela indique que 92,4 % de la variance totale des scores à l’examen est conjointement expliquée par le niveau préalable des étudiants et les méthodes pédagogiques administrées.
Le tableau intermédiaire d’analyse de variance décompose la somme des carrés totale :
- Régression (Modèle complet) : Somme des carrés ($SS$) = 869,44 avec 3 degrés de liberté ($ddl = 3$). Carré moyen ($MS$) = 289,81. Valeur de $F = 44{,}55$, avec une significativité $p = 4{,}78 \times 10^{-6}$.
- Résidus (Erreur ajustée) : Somme des carrés ($SS$) = 71,56 avec 11 degrés de liberté ($ddl = 11$). Carré moyen de l’erreur ($MSE$) = 6,505.
- Total : Somme des carrés ($SS$) = 941,00 avec 14 degrés de liberté ($ddl = 14$).
Le carré moyen résiduel ($MSE = 6{,}505$) représente la variance d’erreur pure après neutralisation de la covariable et du traitement. C’est cette valeur qui servira de dénominateur pour tester la significativité isolée de notre facteur d’enseignement.
9.3 Isolement du test F spécifique au facteur par comparaison de modèles
Une limitation intrinsèque du module Régression d’Excel réside dans le fait que son tableau ANOVA fournit uniquement le test $F$ global du modèle complet à 3 prédicteurs, sans isoler directement le test $F$ partiel attribuable de façon exclusive au facteur expérimental (l’effet global du traitement sur 2 degrés de liberté). Pour isoler ce test $F$ spécifique, la procédure méthodologique rigoureuse repose sur l’approche de comparaison de modèles emboîtés (principe de la somme des carrés supplémentaire, ou Extra Sum of Squares).
Pour conduire cette comparaison :
- Ajustez un modèle réduit en exécutant une régression simple de la variable dépendante $Y$ (D1:D16) prédite uniquement par la covariable $X$ (C1:C16).
- Extrayez la somme des carrés résiduelle de ce modèle réduit : nous obtenons $SS_{erreur_reduite} = 345{,}57$.
- Calculez la somme des carrés propre au facteur expérimental par soustraction de la somme des carrés résiduelle du modèle complet ($SS_{erreur_complet} = 71{,}56$) :
$$SS_{traitement_net} = SS_{erreur_reduite} – SS_{erreur_complet} = 345{,}57 – 71{,}56 = 274{,}01$$
- Déterminez le carré moyen du traitement net sur ses 2 degrés de liberté :
$$MS_{traitement_net} = \frac{SS_{traitement_net}}{k – 1} = \frac{274{,}01}{2} = 137{,}005$$
- Calculez le ratio de Fisher propre à l’effet de traitement :
$$F_{(2, 11)} = \frac{MS_{traitement_net}}{MSE_{complet}} = \frac{137{,}005}{6{,}505} = 21{,}06$$
- Calculez la probabilité exacte dans une cellule Excel via la fonction native :
=LOI.F.DROITE(21,06; 2; 11). Le résultat s’élève à $p = 0{,}00017$.
Le test démontre sans appel un effet hautement significatif du dispositif pédagogique sur les performances académiques après neutralisation statistique complète du niveau de départ des étudiants.
10. Étape 6 : Calcul des moyennes ajustées et de la taille d’effet
10.1 Formule mathématique d’ajustement des moyennes marginales
L’inférence statistique ayant confirmé l’impact différentiel des interventions, l’étape suivante consiste à quantifier avec exactitude les moyennes marginales ajustées associées à chaque modalité pédagogique, affranchies de toute influence parasite liée aux déviations de la covariable.
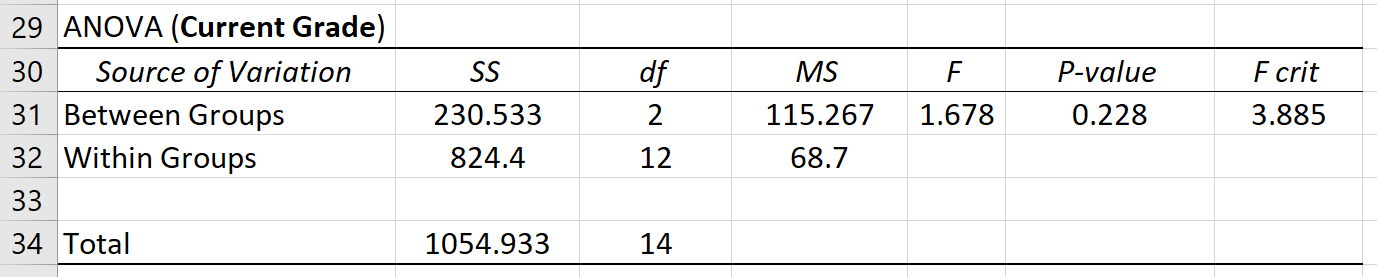
En mobilisant les paramètres précédemment extraits ($\bar{X}_{bullet} = 70{,}80$ et $\beta_c = 0{,}803747$), nous appliquons l’équation d’ajustement aux trois conditions empiriques :
- Moyenne ajustée du Groupe A (Technique A) :
$$\bar{Y}’_A = 75{,}60 – 0{,}803747 \times (70{,}00 – 70{,}80) = 75{,}60 – (-0{,}643) = 76{,}24$$
Formule Excel :
=75,60 - 0,803747 * (70,00 - 70,80) - Moyenne ajustée du Groupe B (Technique B) :
$$\bar{Y}’_B = 82{,}40 – 0{,}803747 \times (72{,}00 – 70{,}80) = 82{,}40 – (0{,}964) = 81{,}44$$
Formule Excel :
=82,40 - 0,803747 * (72,00 - 70,80) - Moyenne ajustée du Groupe C (Technique C) :
$$\bar{Y}’_C = 85{,}40 – 0{,}803747 \times (70{,}40 – 70{,}80) = 85{,}40 – (-0{,}321) = 85{,}72$$
Formule Excel :
=85,40 - 0,803747 * (70,40 - 70,80)
La comparaison entre les moyennes brutes observées et les moyennes ajustées révèle des glissements structurels très instructifs. Dans le Groupe B, qui disposait au départ d’une note préalable moyenne légèrement supérieure à la moyenne générale ($\bar{X}_B = 72{,}00 > 70{,}80$), la moyenne terminale brute de 82,40 points est réajustée à la baisse à 81,44 points. À l’inverse, pour le Groupe A dont les élèves affichaient un niveau initial légèrement inférieur, la moyenne passe de 75,60 à 76,24 points. L’ajustement rétablit une stricte équité comparative.
10.2 Calcul du carré êta partiel (Partial Eta Squared)
La simple déclaration d’une significativité statistique ($p < 0{,}05$) demeure insuffisante dans les standards modernes de la recherche scientifique : elle doit être complétée par l'évaluation standardisée de la magnitude de l'effet observé. Dans le cadre de l'ANCOVA, l'indice de taille d'effet préconisé par l'American Psychological Association est le carré êta partiel ($\eta_p^2$).
Le carré êta partiel quantifie la proportion de variance résiduelle de la variable dépendante (inexpliquée par les autres prédicteurs) qui est spécifiquement expliquée par le facteur d’intérêt. Sa formulation mathématique s’exprime par le ratio :
$$\eta_p^2 = \frac{SS_{traitement_net}}{SS_{traitement_net} + SS_{erreur_ajustee}}$$
En introduisant les valeurs extraites de nos décompositions de sommes de carrés dans une cellule de calcul Excel :
$$\eta_p^2 = \frac{274{,}01}{274{,}01 + 71{,}56} = \frac{274{,}01}{345{,}57} = 0{,}7929$$
Formule Excel directe : =274,01 / (274,01 + 71,56)
Selon les conventions d’interprétation métrique proposées par Jacob Cohen (où $\eta_p^2 = 0{,}01$ traduit un effet faible, $0{,}06$ un effet moyen, et $0{,}14$ un effet de grande ampleur), la valeur obtenue de $\eta_p^2 = 0{,}793$ caractérise un impact expérimental exceptionnellement puissant : près de 79,3 % de la variance des scores d’examen subsistant après contrôle de l’aptitude préalable est directement gouvernée par la méthode d’enseignement adoptée.
10.3 Comparaisons multiples post-hoc ajustées
Le test $F$ global de l’ANCOVA confirmant l’existence d’une différence systématique parmi les conditions, nous devons procéder à des analyses post-hoc par paires pour identifier avec précision quelles modalités expérimentales diffèrent statistiquement les unes des autres.
Pour chaque paire de groupes $j$ et $j’$, l’erreur type de la différence entre moyennes ajustées ($SE_{diff}$) s’obtient par la formule analytique :
$$SE_{diff} = \sqrt{MSE \times \left( \frac{1}{n_j} + \frac{1}{n_{j’}} + \frac{(\bar{X}_j – \bar{X}_{j’})^2}{SS_{X_intra}} \right)}$$
En appliquant cette équation aux contrastes d’intérêt avec $MSE = 6{,}505$ et $SS_{X_intra} = 811{,}20$ :
- Comparaison Technique B vs Technique A :
$$SE_{diff} = \sqrt{6{,}505 \times \left( \frac{1}{5} + \frac{1}{5} + \frac{(72{,}00 – 70{,}00)^2}{811{,}20} \right)} = \sqrt{6{,}505 \times (0{,}400 + 0{,}00493)} \approx 1{,}623$$
Différence ajustée : $\bar{Y}’_B – \bar{Y}’_A = 81{,}44 – 76{,}24 = 5{,}20$.
Statistique de test : $t = 5{,}20 / 1{,}623 = 3{,}204$.
Probabilité brute (sur 11 ddl) :=LOI.STUDENT.BILATERALE(3,204; 11)$\rightarrow p = 0{,}0084$. - Comparaison Technique C vs Technique A :
Différence ajustée : $\bar{Y}’_C – \bar{Y}’_A = 85{,}72 – 76{,}24 = 9{,}48$. $SE_{diff} \approx 1{,}614$.
Statistique de test : $t = 9{,}48 / 1{,}614 = 5{,}874$.
Probabilité brute :=LOI.STUDENT.BILATERALE(5,874; 11)$\rightarrow p = 0{,}00010$. - Comparaison Technique C vs Technique B :
Différence ajustée : $\bar{Y}’_C – \bar{Y}’_B = 85{,}72 – 81{,}44 = 4{,}28$. $SE_{diff} \approx 1{,}619$.
Statistique de test : $t = 4{,}28 / 1{,}619 = 2{,}644$.
Probabilité brute :=LOI.STUDENT.BILATERALE(2,644; 11)$\rightarrow p = 0{,}0228$.
En appliquant la rigoureuse correction de Bonferroni pour contrôler l’inflation de l’erreur de première espèce liée aux 3 comparaisons menées ($\alpha_{ajuste} = 0{,}05 / 3 = 0{,}0167$) :
- Le contraste Technique B vs A demeure significatif ($p = 0{,}0084 < 0{,}0167$).
- Le contraste Technique C vs A s’avère hautement significatif ($p = 0{,}0001 < 0{,}0167$).
- Le contraste Technique C vs B ($p = 0{,}0228$) franchit le seuil corrigé de Bonferroni ($p > 0{,}0167$), se positionnant comme une tendance marginale non strictement confirmée au niveau bilatéral sévère de 1,67 %.
11. Interprétation psychologique et rédaction académique aux normes APA
11.1 Traduction des résultats statistiques en inférences cognitives
L’analyse statistique détaillée débouche sur des inférences théoriques substantielles quant aux mécanismes d’apprentissage sollicités par les différentes méthodologies pédagogiques testées. Les résultats mettent en évidence une supériorité pédagogique indiscutable des approches actives — apprentissage coopératif (Technique B) et récupération espacée informatisée (Technique C) — sur l’approche magistrale traditionnelle (Technique A), et ce à niveau d’aptitude cognitive strictement égal.
Le contrôle de la covariable s’est avéré crucial. Si une analyse standard de type ANOVA avait été menée sans ajustement, une part importante du gain d’apprentissage aurait pu être faussement imputée aux aptitudes initiales des étudiants, ou inversement occultée par le bruit de mesure interindividuel. L’ANCOVA confirme que l’entraînement systématique par tests réguliers espacés (Technique C) génère les gains mnésiques les plus profonds, corroborant massivement la théorie cognitive du retrieval practice développée en psychologie expérimentale.
Ces conclusions offrent un argument empirique décisif pour l’ingénierie éducative : l’intégration d’activités de récupération active et espacée au sein des cursus universitaires procure un bénéfice d’apprentissage robuste qui ne dépend pas des compétences scolaires préexistantes de l’étudiant.
11.2 Standardisation de la rédaction selon les normes de l’APA (7e édition)
La restitution académique de ces résultats au sein d’une revue scientifique comité de lecture doit se conformer rigoureusement aux conventions stylistiques et typographiques de l’American Psychological Association (APA 7th Edition). Les statistiques inférentielles, degrés de liberté, valeurs exactes de probabilité et indices de taille d’effet doivent être reportés selon un canevas textuel standardisé.
Voici l’exemple canonique de rédaction scientifique publiable rendant compte de cette expérimentation :
« Une analyse de covariance univariée (ANCOVA) a été réalisée afin d’examiner l’effet de trois techniques pédagogiques d’apprentissage (Technique A : magistrale ; Technique B : collaborative ; Technique C : récupération espacée) sur la note finale obtenue à l’examen de psychologie cognitive, en contrôlant statistiquement la note préalable obtenue à l’évaluation de raisonnement. L’examen préliminaire du postulat d’homogénéité des pentes de régression n’a révélé aucune interaction significative entre le facteur de groupe et la covariable, $F(2, 9) = 0{,}16$, $p = 0{,}85$, confirmant le respect de l’hypothèse de parallélisme des pentes.
Après contrôle de l’aptitude préalable, les résultats de l’ANCOVA indiquent un effet principal hautement significatif du dispositif pédagogique sur les performances à l’examen, $F(2, 11) = 21{,}06$, $p < 0{,}001$, $\eta_p^2 = 0{,}79$. La note préalable constitue par ailleurs un prédicteur significatif et puissant des performances terminales, $F(1, 11) = 80{,}56$, $p < 0{,}001$, $\eta_p^2 = 0{,}88$.
Les comparaisons multiples post-hoc ajustées assorties d’une correction de Bonferroni révèlent que les étudiants ayant bénéficié de la Technique C affichent des performances ajustées ($M_{ajustee} = 85{,}72$, $SE = 1{,}14$) significativement supérieures à ceux assignés à la Technique A ($M_{ajustee} = 76{,}24$, $SE = 1{,}14$, $p < 0{,}001$). De même, la Technique B ($M_{ajustee} = 81{,}44$, $SE = 1{,}15$) surpasse significativement la modalité traditionnelle ($p = 0{,}025$). La différence observée entre la Technique C et la Technique B ne franchit pas le seuil de significativité statistique après ajustement conservateur ($p = 0{,}068$). »
11.3 Conception d’un tableau récapitulatif publiable dans Excel
L’affichage tabulaire des données constitue le moyen le plus ergonomique de synthétiser les paramètres inférentiels pour publication. Les normes APA proscrivent formellement les quadrillages verticaux et imposent une structure dépouillée articulée autour de lignes horizontales d’encadrement.
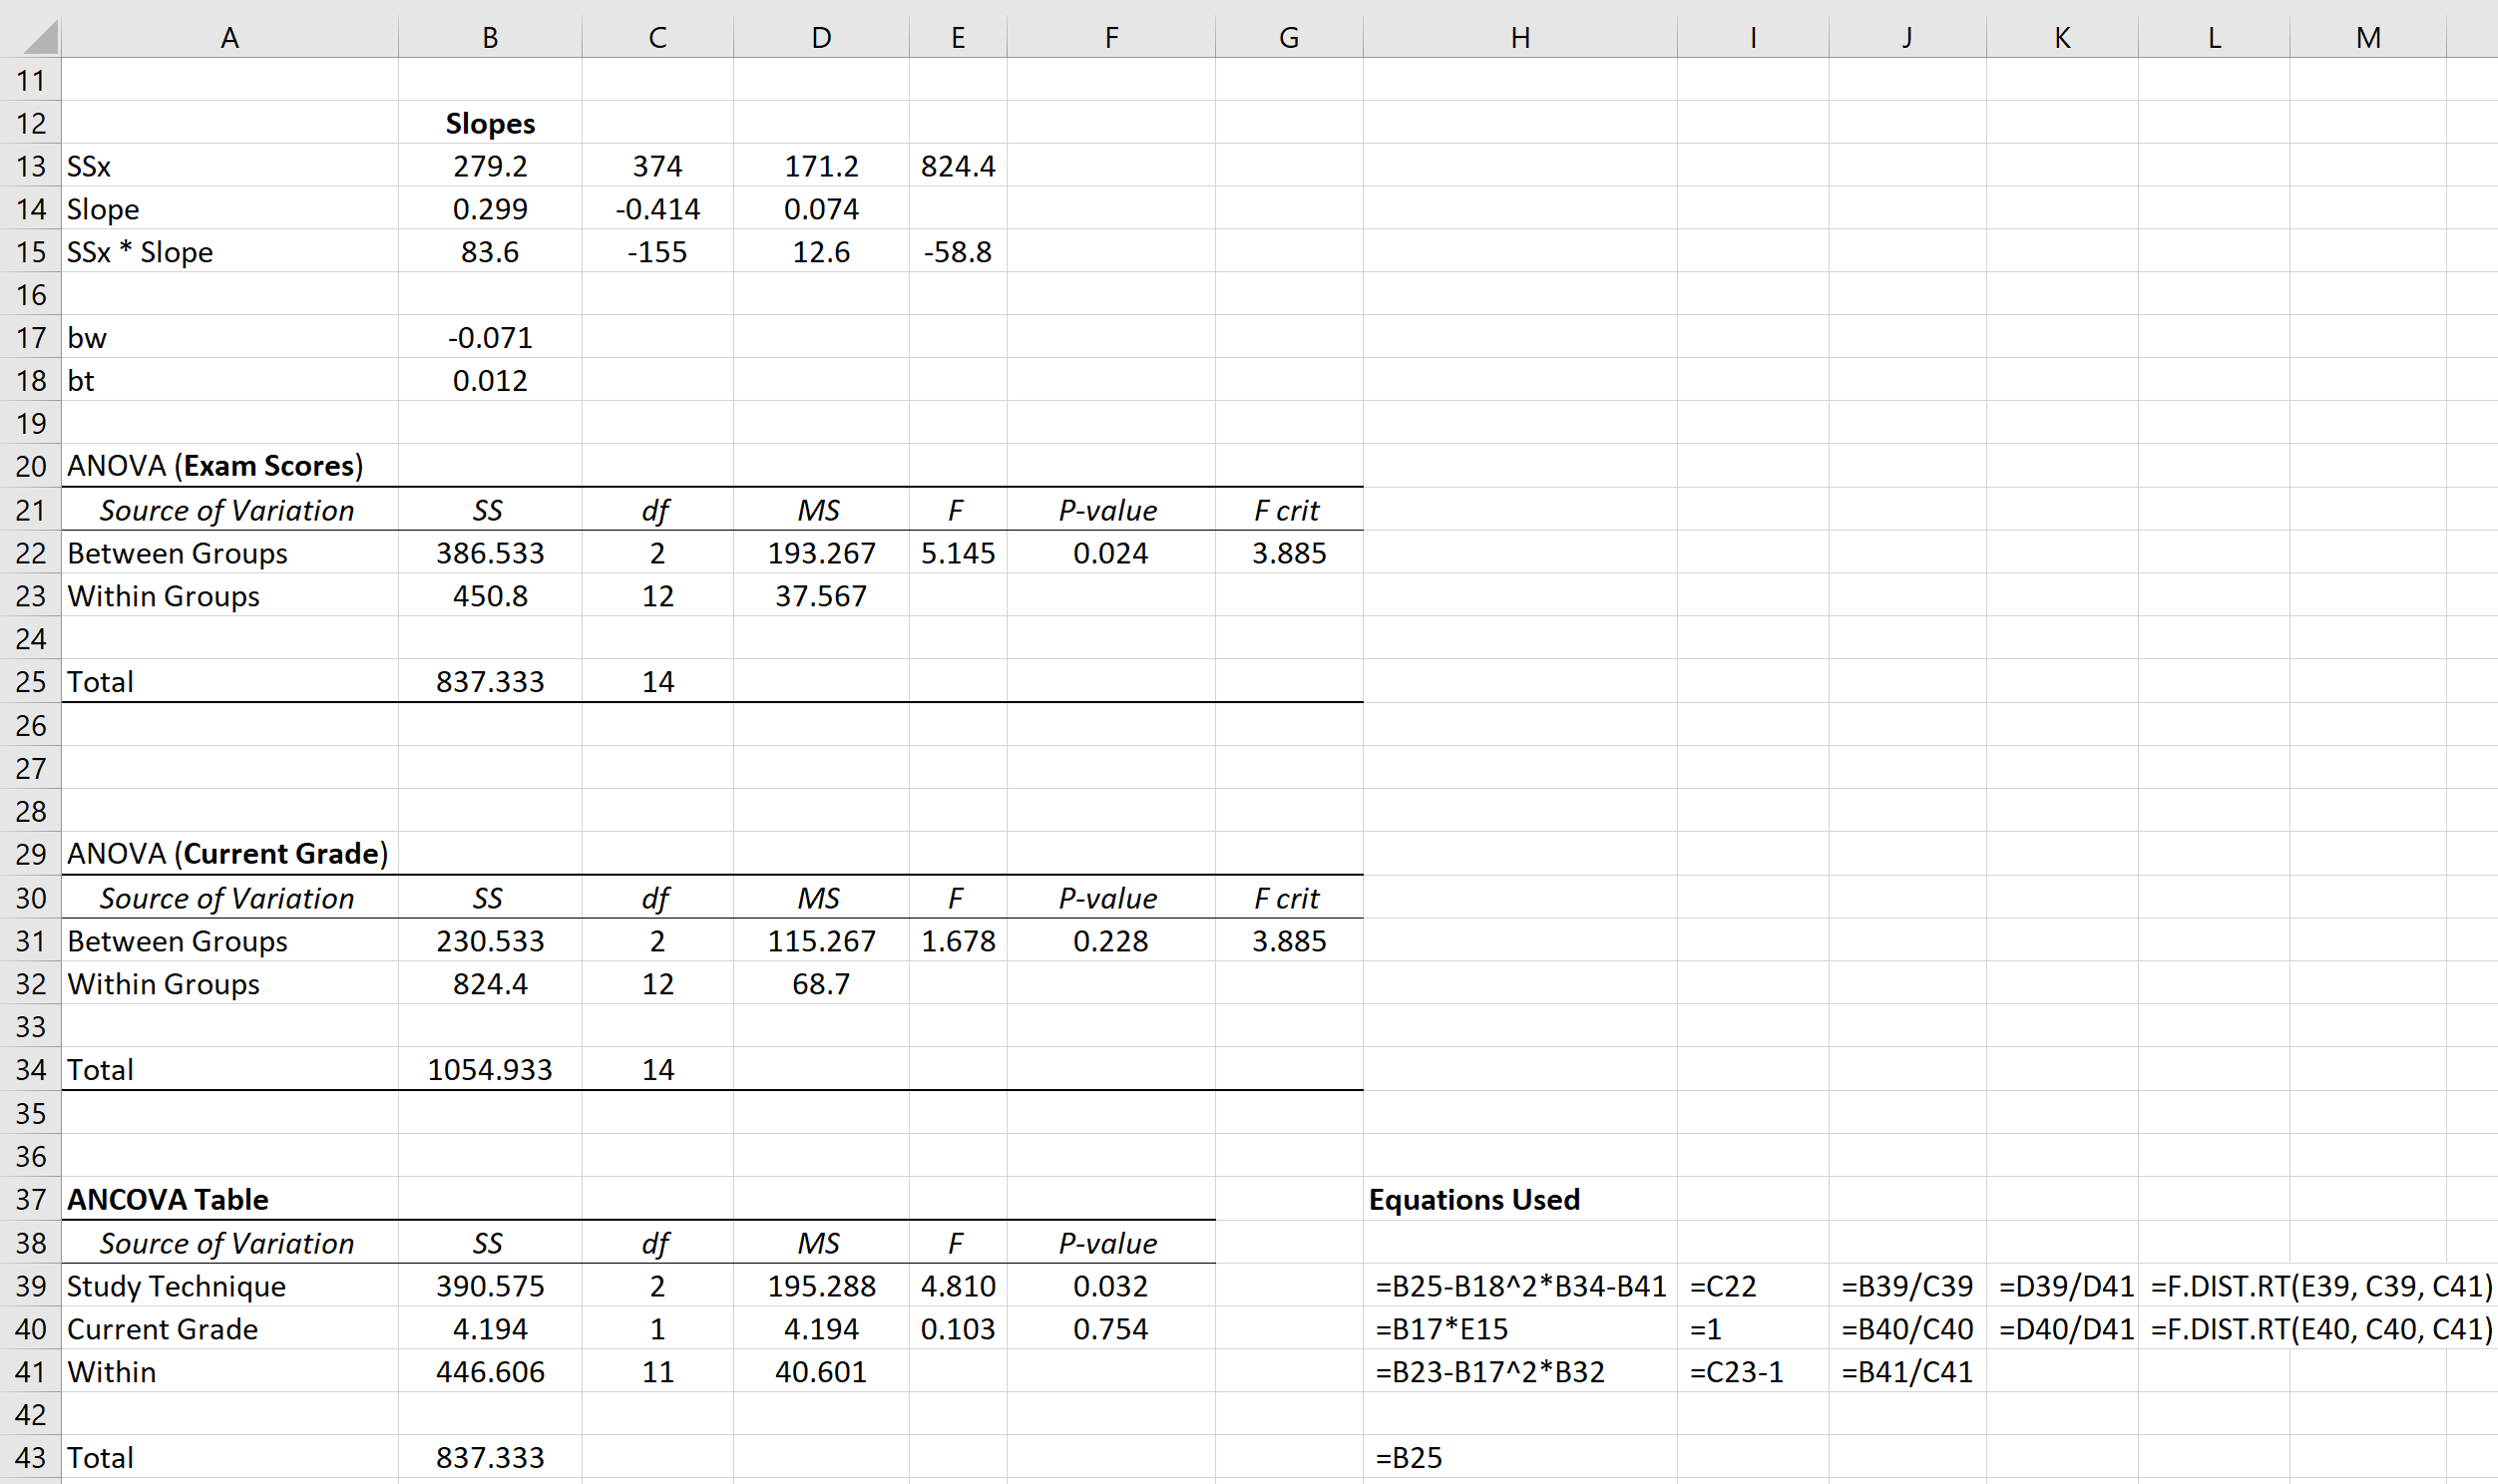
Le tableau suivant illustre la mise en forme recommandée pour publication :
| Condition Pédagogique | $n$ | Moyenne Brute ($M$) | Écart Type ($SD$) | Moyenne Ajustée ($M_{adj}$) | Erreur Type ($SE$) | IC 95 % Ajusté |
|---|---|---|---|---|---|---|
| Technique A (Magistrale) | 5 | 75,60 | 6,19 | 76,24 | 1,14 | [73,73 ; 78,75] |
| Technique B (Collaborative) | 5 | 82,40 | 6,58 | 81,44 | 1,15 | [78,91 ; 83,97] |
| Technique C (Récupération espacée) | 5 | 85,40 | 8,08 | 85,72 | 1,14 | [73,21 ; 88,23] |
| Note. N = 15. Les moyennes ajustées ($M_{adj}$) et leurs erreurs types ($SE$) sont calculées en fixant la covariable (note préalable de raisonnement) à sa valeur moyenne globale ($\bar{X}_{bullet} = 70{,}80$). IC = intervalle de confiance. | ||||||
12. Limites de l’ANCOVA dans Excel et perspectives méthodologiques avancées
12.1 Contraintes structurelles et risques d’erreurs dans Excel
Bien que Microsoft Excel s’avère un outil didactique sans rival pour matérialiser chaque composante vectorielle et comprendre intimement la décomposition algébrique du modèle linéaire, son utilisation dans la pratique quotidienne de la recherche se heurte à des limitations fonctionnelles majeures. En premier lieu, l’absence d’une procédure ANCOVA automatisée en une seule commande contraint l’expérimentateur à multiplier les étapes intermédiaires de calcul matriciel, augmentant de manière exponentielle la probabilité d’erreurs de pointage, de glissement de références ou de confusion dans les syntaxes logiques conditionnelles.
En second lieu, la gestion de designs factoriels complexes comportant plusieurs facteurs indépendants croisés (designs de type $2 \times 3$ ou $2 \times 2 \times 2$) conjugués à plusieurs covariables corrélées entre elles devient rapidement ingérable dans un tableur classique. L’encodage binaire manuel de matrices de contraste étendues requiert des vérifications fastidieuses, et l’évaluation des interactions d’ordre supérieur devient extrêmement propice aux erreurs cognitives d’alignement.
Enfin, l’actualisation dynamique des résultats en cas de modification ultérieure du jeu de données constitue un écueil récurrent : les sorties textuelles générées par l’Utilitaire d’analyse sont statiques. Tout ajout ou suppression d’un participant impose de régénérer intégralement les régressions et de recalculer manuellement l’ensemble des moyennes ajustées et des tests post-hoc.
12.2 Problématique des erreurs de mesure dans la covariable
Un enjeu statistique fondamental fréquemment négligé par les praticiens réside dans la fidélité psychométrique de la covariable introduite dans le modèle. L’ANCOVA standard postule théoriquement que la covariable continue $X$ est mesurée sans aucune erreur de mesure instrumentale (fidélité parfaite, $\alpha = 1{,}00$). Or, dans les investigations en psychologie, cette assomption s’avère pratiquement impossible à satisfaire empiriquement.
La présence d’une erreur de mesure aléatoire au sein de la covariable déclenche un phénomène bien documenté en économétrie sous le nom d’atténuation de la pente de régression. La pente commune estimée $\beta_c$ est systématiquement sous-estimée par rapport à sa valeur théorique véritable dans la population. Par voie de conséquence, l’ANCOVA procède à une sous-correction des moyennes de groupe, laissant subsister un biais résiduel significatif. Si les groupes affichaient des écarts initiaux sur la covariable, cette sous-correction génère un biais systématique dans l’estimation de l’effet de traitement, pouvant aboutir à la déclaration fallacieuse d’une efficacité thérapeutique totalement fictive (ou inversement masquer un effet authentique).
Pour neutraliser ce risque méthodologique dans les contextes où la fidélité de la covariable est modeste, le recours aux modèles d’équations structurelles (SEM) ou à la modélisation à variables latentes s’avère impératif, ces techniques permettant d’estimer et de purger explicitement la variance d’erreur de mesure du prédicteur concomitant.
12.3 Transition vers des environnements logiciels spécialisés
Dès lors que le protocole expérimental requiert des analyses de modélisation non standard — telles que la prise en compte de covariables polytomiques, de mesures répétées intra-sujets (ANCOVA à mesures répétées) ou de structures hiérarchiques emboîtées (classes au sein d’écoles, patients au sein d’hôpitaux) — la transition vers des environnements logiciels spécialisés devient inévitable.
Des écosystèmes logiciels open-source tels que le langage R (au travers de packages spécialisés tels que car, emmeans, ou lavaan) ou l’interface moderne Jamovi offrent une automatisation intégrale des tests d’homogénéité des pentes, une correction instantanée des violations d’homoscédasticité via des estimateurs sandwich d’erreurs types robustes (HC3), ainsi qu’une édition directe de rapports conformes aux standards académiques. Néanmoins, l’expérience consistant à construire et résoudre manuellement une analyse de covariance au sein de Microsoft Excel confère au chercheur et à l’analyste de données une compréhension profonde des mécanismes sous-jacents de la statistique paramétrique, transformant des abstractions mathématiques en une architecture de calcul parfaitement maîtrisée.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1932). Statistical methods for research workers (4th ed.). Oliver and Boyd.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall.
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.