
L’inférence statistique moderne repose sur une tension fondamentale entre l’élégance des formulations mathématiques analytiques et la complexité brute des données empiriques recueillies sur le terrain. Pendant près d’un siècle, l’édifice de la statistique paramétrique classique, largement développé sous l’impulsion de pionniers tels que Ronald Fisher, Jerzy Neyman et Karl Pearson, a contraint les chercheurs à formuler des hypothèses strictes quant aux distributions sous-jacentes des populations étudiées. Parmi ces postulats, la normalité univariée ou multivariée, l’homoscédasticité des résidus et la linéarité stricte des relations ont souvent été érigées en conditions préalables non négociables. Cependant, dans les sciences du comportement, en psychologie expérimentale, en neuropsychologie et dans les disciplines biomédicales, les données réelles défient constamment ces idéalisations théoriques. Les distributions asymétriques, les effets de plancher ou de plafond inhérents aux échelles d’évaluation psychométriques, ainsi que la prévalence d’échantillons de taille modeste rendent l’application aveugle des tests paramétriques conventionnels particulièrement vulnérable aux erreurs d’inférence de type I et de type II.
Face à ces limitations structurelles, l’émergence de la puissance de calcul informatique dans le dernier quart du vingtième siècle a permis l’avènement d’une révolution computationnelle silencieuse mais profonde. Au cœur de ce changement de paradigme se trouve le rééchantillonnage non paramétrique, conceptualisé sous le terme de bootstrapping par le statisticien américain Bradley Efron en 1979. En s’affranchissant du besoin de postuler une forme paramétrique a priori pour la population parente, le bootstrapping substitue à l’analyse déductive pure une modélisation empirique intensive par ordinateur. Au lieu de dériver théoriquement la variance d’un estimateur à partir de lois de probabilité idéalisées, l’approche par rééchantillonnage génère artificiellement des milliers de pseudo-échantillons à partir de l’ensemble d’observations initiales, permettant ainsi d’approcher la distribution d’échantillonnage de n’importe quelle statistique avec une fidélité remarquable.
Dans l’écosystème de la recherche contemporaine, le langage de programmation statistique R s’est imposé comme l’environnement de référence pour la mise en œuvre de ces méthodologies intensives. Doté de bibliothèques hautement optimisées à l’instar du package standardisé boot, R offre aux chercheurs, cliniciens et analystes de données un cadre de travail d’une flexibilité et d’une rigueur exceptionnelles. Ce guide exhaustif a pour vocation d’explorer en détail les fondements théoriques, l’architecture computationnelle et les applications pratiques du bootstrapping en R. À travers des cas d’étude représentatifs issus de la psychométrie et de la psychologie quantitative, nous détaillerons pas à pas la construction de fonctions d’estimation sur mesure, le calcul d’intervalles de confiance avancés et l’interprétation rigoureuse des résultats selon les normes académiques internationales.
1. Fondements théoriques et épistémologiques du bootstrapping
1.1 Définition formelle et principes du rééchantillonnage non paramétrique
Le terme bootstrap trouve son origine métaphorique dans les aventures picaresques du Baron de Münchhausen, réputé s’être extrait d’un marécage en tirant sur les lanières de ses propres bottes (to pull oneself up by one’s bootstraps). Sur le plan statistique, cette métaphore illustre un défi apparemment insoluble : comment obtenir des informations précises sur la variabilité d’une population inconnue en n’utilisant strictement rien d’autre que l’unique échantillon déjà observé ? La réponse apportée par Bradley Efron en 1979 réside dans un principe d’analogie élégant : l’échantillon observé est à la population ce que les rééchantillons bootstrap sont à l’échantillon observé.
Formellement, soit un échantillon aléatoire simple de variables aléatoires indépendantes et identiquement distribuées (i.i.d.) noté X = (x1, x2, …, xn), issu d’une population caractérisée par une fonction de répartition cumulative inconnue F. L’objectif classique de l’inférence statistique consiste à estimer un paramètre de population inconnu θ = t(F) au moyen d’un estimateur empirique θ̂ = t(F̂n), où F̂n représente la fonction de répartition empirique qui assigne une probabilité discrète égale à 1/n à chaque observation de l’échantillon initial.
Le mécanisme fondamental du bootstrapping non paramétrique consiste à tirer avec remise un grand nombre B de pseudo-échantillons, chacun de taille exactement égale à n, directement à partir de F̂n. Un pseudo-échantillon typique, noté X* = (x*1, x*2, …, x*n), contient donc certaines observations originales répétées plusieurs fois, tandis que d’autres en sont absentes. Sur chacun de ces B échantillons rééchantillonnés, l’estimateur d’intérêt est recalculé, produisant un ensemble d’estimations répliquées θ̂*1, θ̂*2, …, θ̂*B. La loi de probabilité de ces réplicats bootstrap converge asymptotiquement vers la véritable distribution d’échantillonnage de l’estimateur au fur et à mesure que la taille de l’échantillon n croît, offrant ainsi une approximation directe de l’erreur type et des quantiles sans nécessiter d’intégrations analytiques complexes.
1.2 Pertinence et justification méthodologique en sciences psychologiques
Dans le domaine des sciences psychologiques, de la psychiatrie biologique et des sciences cognitives, la violation des hypothèses de normalité univariée et multivariée ne constitue pas l’exception, mais la norme empirique. Les instruments de mesure psychométrique standardisés, tels que le questionnaire de dépression de Beck (BDI) ou l’inventaire d’anxiété état-trait (STAI), génèrent couramment des distributions marquées par une forte asymétrie positive au sein de populations non cliniques, où la grande majorité des répondants présente des scores faibles ou nuls, alors qu’une minorité présente des niveaux d’affliction élevés.
Face à ces distributions fortement asymétriques ou tronquées, les chercheurs ont traditionnellement recouru à des transformations mathématiques univariées, notamment les transformations logarithmiques, en racine carrée ou la famille des transformations de Box-Cox. Bien que ces transformations puissent occasionnellement stabiliser les variances et réduire l’asymétrie, elles introduisent un coût interprétatif prohibitif : elles modifient l’échelle de mesure originale, compliquent l’interprétation substantielle des effets thérapeutiques ou expérimentaux et échouent fréquemment à linéariser les relations multivariées complexes. De plus, pour de nombreuses métriques couramment utilisées en recherche clinique, telles que les temps de réaction, les taux de rechute ou les scores de changement post-intervention, aucune transformation mathématique simple ne permet de restaurer la normalité sous-jacente.
Le bootstrapping non paramétrique apporte une solution élégante et méthodologiquement supérieure en évitant toute altération artificielle de l’échelle des données. En traitant directement la distribution empirique observée comme le meilleur modèle disponible de la réalité, il permet d’estimer avec précision des erreurs types robustes, des intervalles de confiance asymétriques et des tests d’hypothèses valides, tout en préservant l’intégrité conceptuelle des métriques psychologiques initiales. De surcroît, le bootstrap se révèle particulièrement adapté aux échantillons cliniques de taille modeste, où le théorème central limite ne peut pas opérer efficacement pour garantir la normalité asymptotique de la moyenne ou d’autres paramètres structuraux.
1.3 Comparaison avec l’inférence asymptotique classique et les tests paramétriques
L’inférence paramétrique classique, fondée sur la théorie asymptotique, postule que lorsque la taille de l’échantillon tend vers l’infini, la distribution d’échantillonnage de l’estimateur converge vers une distribution théorique connue, presque universellement la loi normale ou la loi de Student. Cependant, l’adéquation de cette approximation dépend de façon critique de la régularité de la distribution parente et de la forme mathématique de l’estimateur considéré. Dès lors que l’on s’intéresse à des paramètres non linéaires, tels que la médiane, les quantiles conditionnels, les coefficients de corrélation intraclasse ou les rapports de cotes (odds ratios), la dérivation d’une formule analytique exacte pour l’erreur type devient soit mathématiquement insoluble, soit tributaire d’approximations de Taylor de premier ordre (la méthode delta) dont la précision est notoirement médiocre pour des effectifs restreints.
À l’inverse, l’approche par rééchantillonnage ne repose sur aucune hypothèse a priori quant à la symétrie de la distribution d’échantillonnage. Alors que les tests paramétriques classiques calculent des intervalles de confiance strictement symétriques autour de l’estimation ponctuelle, le bootstrap permet de dégager des intervalles empiriques intrinsèquement asymétriques, épousant fidèlement les courbures et les contraintes naturelles de l’espace des paramètres, par exemple la borne naturelle d’un coefficient de détermination R2 contraint entre 0 et 1. La variance d’échantillonnage n’est plus inférée à partir d’une équation dérivée sur papier blanc, mais observée directement par simulation numérique de tirages répétés.
En outre, la méthodologie bootstrap démontre une résilience remarquable face aux violations de l’homoscédasticité, un problème omniprésent dans les études observationnelles où la variabilité des réponses psychologiques s’accroît souvent avec la sévérité du tableau clinique. Contrairement aux procédures asymptotiques ordinaires qui sous-estiment l’erreur type en présence d’hétéroscédasticité non modélisée, le bootstrapping par paires conserve l’association multivariée naturelle entre prédicteurs et variance des résidus, fournissant une protection intrinsèque contre les fausses découvertes statistiques.
2. Prérequis techniques et préparation de l’environnement R
2.1 Installation et initialisation de la bibliothèque standard boot
L’environnement statistique R fournit une architecture native puissante pour le calcul matriciel et la modélisation statistique. Bien qu’il soit tout à fait envisageable de programmer des boucles itératives de rééchantillonnage à l’aide des structures syntaxiques fondamentales du langage (telles que for(), apply() ou replicate()), le développement de routines statistiques fiables et optimisées requiert le recours à des bibliothèques logicielles auditées et éprouvées au sein de la communauté scientifique internationale.
La bibliothèque de référence pour la conduite d’analyses par rééchantillonnage dans l’écosystème R est le package boot, conçu initialement par Angelo Canty et intégré à la distribution standard de R par Brian Ripley, en accompagnement de leur traité classique Bootstrap Methods and Their Application (Davison & Hinkley, 1997). Ce package fait partie intégrante du bundle recommended distribué d’office avec les versions binaires de base de R sur le Comprehensive R Archive Network (CRAN). Par conséquent, son installation via install.packages("boot") n’est généralement requise que dans des configurations hautement minimalistes de conteneurs de calcul.
L’initialisation de la bibliothèque au sein d’une session R s’effectue via la commande standard :
library(boot)
L’exécution de cette commande charge en mémoire les fonctions analytiques centrales boot(), dédiée à la génération des réplicats empiriques, et boot.ci(), réservée au calcul rigoureux des intervalles de confiance non paramétriques. Le package assure une compatibilité totale avec les architectures 64 bits contemporaines et s’intègre harmonieusement avec les fonctionnalités de calcul vectoriel optimisées permises par les liaisons BLAS et LAPACK sous-jacentes du moteur R.
2.2 Structuration des données psychométriques
La mise en œuvre sereine du bootstrapping requiert une préparation rigoureuse de la structure de données en mémoire. Contrairement à certaines fonctions de modélisation de haut niveau de R qui tolèrent implicitement des valeurs manquantes ou des formats mixtes en procédant à des conversions dynamiques opaques, la fonction boot() exige une clarté structurelle absolue pour garantir que les tirages avec remise n’induisent pas de ruptures logiques inattendues lors de l’indexation matricielle.
Les données destinées à l’inférence peuvent être organisées sous la forme de vecteurs atomiques numériques pour les analyses univariées, ou sous la forme de matrices et de cadres de données (data.frame) pour les approches bivariées et multivariées. L’un des aspects les plus critiques concerne la gestion des données manquantes (notées NA). Si une procédure de rééchantillonnage avec remise est appliquée à un cadre de données contenant des valeurs manquantes sans spécification préalable d’une politique de traitement, certains pseudo-échantillons pourront contenir une proportion anormalement élevée de données manquantes, causant l’effondrement numérique de la fonction d’estimation et l’interruption prématurée du calcul global.
Il est donc impératif de procéder à un nettoyage strict avant le lancement de la fonction de rééchantillonnage : soit par une suppression par liste (listwise deletion) au moyen de la commande na.omit() pour les sous-ensembles de variables explicitement retenus, soit en amont par des méthodologies d’imputation multiple contemporaines. Par ailleurs, la vérification des types de variables s’avère indispensable : les scores composites psychométriques doivent être strictement convertis en formats numériques (as.numeric()), tandis que les variables d’appartenance catégorielle doivent être formalisées en facteurs (as.factor()) pour prévenir tout comportement incohérent des fonctions de modélisation sous-jacentes lors de la réitération des calculs.
2.3 Garantie de reproductibilité par l’initialisation du générateur pseudo-aléatoire
L’un des défis inhérents à l’application des méthodes stochastiques réside dans le maintien d’une reproductibilité scientifique absolue. Par définition, le tirage avec remise simule un processus aléatoire uniforme. Dès lors, deux exécutions consécutives d’une même analyse bootstrap sur un même jeu de données produiront nécessairement des valeurs légèrement divergentes pour l’erreur type et les bornes des intervalles de confiance, à moins que l’état interne du générateur de nombres pseudo-aléatoires de R ne soit rigoureusement fixé.
Cette garantie de reproductibilité s’obtient par l’emploi systématique de la fonction set.seed(). Cette commande initialise l’algorithme sous-jacent de génération stochastique, qui par défaut dans R est l’algorithme Mersenne-Twister, réputé pour sa période colossale de 219937 − 1 et ses propriétés d’équirépartition multidimensionnelle exceptionnelles. En passant un entier arbitraire comme graine déterministe au sein du script d’analyse :
set.seed(12345)
le chercheur s’assure que la séquence précise de pseudo-échantillons tirés par la fonction boot() sera strictement identique lors de toute réanalyse ultérieure, que celle-ci s’opère sur la même station de travail ou sur un serveur de calcul distant fonctionnant sous un système d’exploitation distinct. Cette précaution est désormais exigée par la quasi-totalité des revues scientifiques de premier rang affiliées à l’American Psychological Association (APA) et s’inscrit au cœur des recommandations pour la science ouverte et transparente (principes FAIR).
3. Anatomie fonctionnelle de la fonction boot()
3.1 Paramétrage du vecteur de données et de la structure source
La fonction maîtresse du package boot, désignée par l’appel boot(), encapsule l’intégralité du protocole de rééchantillonnage au sein d’une interface standardisée. Sa signature canonique primaire s’articule autour de trois arguments obligatoires indispensables : data, statistic et R. La maîtrise conceptuelle de ces arguments conditionne la validité des calculs statistiques ultérieurs.
L’argument data reçoit l’objet contenant les observations empiriques originales. Il peut s’agir d’un vecteur numérique unidimensionnel (pour l’estimation de paramètres de tendance centrale ou de dispersion d’une variable isolée), d’une matrice mathématique ou, plus couramment dans la pratique psychologique, d’un data.frame structuré contenant des sujets en lignes et des mesures psychométriques en colonnes. Lorsque data est un tableau à deux dimensions, la fonction boot() opère le rééchantillonnage non pas au niveau des cellules individuelles prises isolément, mais au niveau des lignes entières du tableau. Cette caractéristique technique est d’une importance capitale : elle garantit la préservation absolue de la structure de dépendance et de covariance multivariée propre à chaque participant lors du tirage aléatoire des pseudo-échantillons.
3.2 Conception rigoureuse de la fonction d’estimation statistique
L’argument statistic exige la fourniture d’une fonction R personnalisée, conçue spécifiquement pour être appelée de manière itérative par le moteur de calcul du bootstrap. Contrairement à de nombreuses fonctions classiques de haut niveau où l’utilisateur fournit simplement le nom d’un test statistique prédéfini, l’architecture de boot() impose une signature fonctionnelle stricte comportant au minimum deux arguments formels :
ma_statistique <- function(data, indices) { ... }
Le premier argument, conventionnellement désigné par data, représente l’ensemble de données transmis à la fonction. Le second argument, presque invariablement nommé indices (ou i), constitue la clé de voûte du processus computationnel. Lors de chaque réplication, R génère un vecteur d’entiers aléatoires tirés avec remise parmi les entiers compris entre 1 et la taille d’échantillon originale n. Ce vecteur d’index est passé à la fonction personnalisée via cet argument formel.
À l’intérieur du corps de la fonction, l’analyste doit impérativement sous-ensembler le jeu de données d’origine en utilisant ce vecteur d’indices. Pour un vecteur simple, cela prend la forme syntaxique data[indices]. Pour un tableau de données ou une matrice à deux dimensions, l’indexation s’effectue nécessairement sur les lignes : data[indices, ]. C’est sur ce sous-échantillon réindexé que le calcul du paramètre d’intérêt (moyenne, coefficient de régression, corrélation, indice de fiabilité alpha de Cronbach) doit être conduit. La fonction personnalisée doit impérativement renvoyer la valeur numérique scalaire calculée, ou un vecteur de valeurs numériques scalaires si plusieurs paramètres sont estimés conjointement au sein du même modèle.
3.3 Détermination optimale du nombre de réplications R
L’argument R spécifie le nombre total d’itérations de rééchantillonnage stochastique à réaliser. Ce paramètre computationnel gouverne directement la précision de l’approximation de Monte-Carlo de la distribution d’échantillonnage bootstrap. Si le principe mathématique du bootstrap postule théoriquement un rééchantillonnage exhaustif de l’ensemble des nn combinaisons possibles avec remise, l’explosion combinatoire rend cette approche déterministe irréalisable pour tout échantillon supérieur à une dizaine d’observations. L’approximation stochastique par simulation de Monte-Carlo est donc indispensable.
Le choix de la valeur numérique assignée à R dépend étroitement des objectifs inférentiels poursuivis. Si le chercheur vise exclusivement l’obtention d’une erreur type empirique robuste ou l’évaluation du biais moyen d’un estimateur, les travaux fondateurs de Davison et Hinkley (1997) ainsi que d’Efron et Tibshirani (1993) démontrent qu’une valeur comprise entre 500 et 1 000 réplications s’avère généralement suffisante pour stabiliser les deux premiers moments de la distribution d’échantillonnage.
Toutefois, dès lors que l’objectif méthodologique s’étend à la construction d’intervalles de confiance non paramétriques, particulièrement via les méthodes des percentiles ou les intervalles ajustés pour le biais et accélérés (BCa), la stabilité des queues extrêmes de la distribution devient cruciale. La détermination précise des centiles 2,5% et 97,5% requiert une densité substantielle de points dans les zones de faible probabilité. Dans ce contexte, une valeur minimale de R = 2 000 est formellement requise par les normes méthodologiques actuelles, une valeur de R = 5 000 ou R = 10 000 étant aujourd’hui fortement encouragée pour éliminer l’erreur de simulation stochastique, d’autant que la puissance des processeurs contemporains permet de traiter de tels volumes en quelques secondes.
4. Exemple 1 : Estimation bootstrap d’une statistique univariée simple
4.1 Cas pratique : Moyenne d’un score d’anxiété clinique
Pour illustrer de manière concrète la mise en œuvre du bootstrap univarié, considérons un protocole de recherche clinique en psychologie de la santé évaluant la sévérité des symptômes anxieux auprès d’un échantillon de 60 patients admis dans un service de cardiologie après un infarctus aigu du myocarde. La sévérité anxieuse est mesurée au moyen de l’inventaire d’anxiété de Beck (BAI – Beck Anxiety Inventory). Les scores au BAI oscillent théoriquement de 0 à 63 points.
Dans ce contexte clinique spécifique, la distribution des scores présente une asymétrie positive très prononcée : une proportion importante de patients manifeste des niveaux de détresse émotionnelle faibles à modérés (scores groupés entre 5 et 18), tandis qu’un sous-groupe réduit présente une détresse aiguë marquée par des scores extrêmes atteignant 45 à 55 points. Face à cette distribution non gaussienne et à cet échantillon d’effectif modeste (n = 60), l’estimation de l’intervalle de confiance standard de la moyenne fondé sur la loi de Student t expose l’analyste à un risque non négligeable de couverture inadéquate du paramètre central réel de la population.
Le chercheur formule ainsi pour objectif d’estimer la moyenne réelle de détresse psychologique dans cette cohorte tout en quantifiant précisément son erreur type et son intervalle de confiance empirique sans contraindre la dynamique d’échantillonnage au moule restrictif de la symétrie gaussienne.
4.2 Implémentation pas à pas du script R
La première étape méthodologique consiste à définir formellement la fonction d’extraction statistique requise par l’architecture de la bibliothèque boot. Cette fonction prend en entrée les deux arguments formels prescrits et procède à l’extraction de la moyenne arithmétique sur le sous-échantillon indexé :
calculer_moyenne <- function(donnees, indices) {

  sous_echantillon <- donnees[indices]

  return(mean(sous_echantillon))

}
Ayant formalisé cette fonction, l’exécution du rééchantillonnage s’opère via la fonction principale en spécifiant l’échantillon clinique, la fonction statistique cible, le nombre de réplications stochastiques fixé ici à 2 000 pour assurer une stabilisation robuste des queues de distribution, et en veillant à initialiser préalablement la graine stochastique :
set.seed(42)

resultat_boot_anxiete <- boot(

  data = scores_bai,

  statistic = calculer_moyenne,

  R = 2000

)
L’objet retourné, resultat_boot_anxiete, est une structure de classe S3 nommée boot. L’affichage de cet objet dans la console R fournit immédiatement un récapitulatif synthétique de l’analyse, précisant la valeur empirique observée de la statistique sur les données d’origine, le biais moyen d’estimation bootstrap et l’erreur type empirique calculée sur les 2 000 réplicats.
4.3 Extraction et interprétation du biais empirique et de l’erreur type
L’exploration approfondie de l’objet resultat_boot_anxiete permet de disséquer les composantes numériques centrales générées par l’algorithme. La valeur resultat_boot_anxiete$t0 stocke la valeur de la statistique calculée sur l’échantillon d’origine non rééchantillonné. Supposons ici que cette valeur soit t0 = 16.42 points.
Le vecteur resultat_boot_anxiete$t contient quant à lui la totalité des 2 000 réplicats empiriques générés au fil des itérations. L’erreur type bootstrap est formellement définie comme l’écart-type d’échantillonnage de ces réplicats simulés :
se_boot <- sd(resultat_boot_anxiete$t)
Cette erreur type empirique, par exemple 1.28 points, intègre de facto les fluctuations stochastiques réelles sans faire appel à la formule analytique classique s / √n qui suppose la normalité de la variable parente.
Le biais bootstrap représente la différence mathématique entre la moyenne des réplicats rééchantillonnés et la statistique d’origine observée :
biais_boot <- mean(resultat_boot_anxiete$t) - resultat_boot_anxiete$t0
Dans le cas d’une statistique linéaire comme la moyenne arithmétique, le biais asymptotique théorique est rigoureusement nul. La valeur empirique du biais calculée par R oscillera donc généralement autour de zéro (par exemple, 0.008), traduisant uniquement la légère variance d’approximation propre à la méthode de Monte-Carlo. Un biais d’une telle petitesse par rapport à l’erreur type confirme l’adéquation absolue de la moyenne arithmétique comme estimateur non biaisé du paramètre de localisation au sein de cette population post-infarctus.
5. Exemple 2 : Bootstrapping d’indices d’association bivariée
5.1 Corrélation de Pearson face aux violations distributionnelles
L’évaluation du coefficient de corrélation linéaire produit-moment de Pearson (r) constitue l’un des piliers méthodologiques de la recherche psychologique corrélative et développementale. Toutefois, la théorie statistique classique stipule que les tests d’inférence standards sur r (tests de Student et intervalles fondés sur la transformation asymptotique z de Ronald Fisher) requièrent impérativement que le couple de variables suive une loi normale bivariée.
En pratique clinique, cette exigence est fréquemment mise en défaut. Considérons l’étude de l’association entre le niveau de stress perçu mesuré par l’échelle de Cohen (PSS-10) et la latence d’endormissement mesurée en minutes par polysomnographie chez des sujets souffrant d’insomnie chronique. La latence d’endormissement présente une distribution fortement asymétrique et leptokurtique, bornée inférieurement par zéro et marquée par la présence d’observations étalées dans la queue supérieure droite.
Lorsque la normalité bivariée est violée, ou lorsque la corrélation s’approche des bornes d’invariance -1 ou +1, la distribution d’échantillonnage de r devient intrinsèquement asymétrique. Dans ces circonstances, l’emploi de la transformation de Fisher peut s’avérer insuffisant pour garantir une inférence exacte, particulièrement en présence d’observations à fort effet de levier. Le rééchantillonnage non paramétrique offre un mécanisme de protection direct en permettant d’estimer la stabilité empirique de r sans modéliser a priori la structure bivariée théorique du nuage de points.
5.2 Définition de la fonction statistique pour un couple de variables
L’extension de la méthodologie bootstrap à une métrique bivariée requiert une adaptation précise de la fonction d’estimation statistique transmise à boot(). Puisque nous traitons désormais un tableau de données comportant plusieurs colonnes, l’indexation doit impérativement s’appliquer à la première dimension du tableau (les lignes) :
calculer_correlation <- function(donnees, indices) {

  echantillon_reindexe <- donnees[indices, ]

  r_estime <- cor(

    echantillon_reindexe$stress_percu,

    echantillon_reindexe$latence_sommeil,

    method = "pearson"

  )

  return(r_estime)

}
Cette programmation garantit que pour chaque participant sélectionné dans le pseudo-échantillon, la paire indissociable formée par son niveau de stress et sa durée de latence d’endormissement est préservée intacte. L’exécution du bootstrap bivarié sur un échantillon de 80 participants s’articule alors rigoureusement ainsi :
set.seed(8765)

resultat_boot_cor <- boot(

  data = donnees_sommeil,

  statistic = calculer_correlation,

  R = 2500

)
Cette procédure itérative génère 2 500 estimations de corrélations empiriques, cartographiant précisément l’étalement et l’asymétrie de la distribution d’échantillonnage de r face aux particularités empiriques du couple de variables analysé.
5.3 Évaluation de la robustesse face aux données aberrantes
L’un des apports majeurs de l’analyse bivariée par bootstrap réside dans la mise en évidence directe de la sensibilité de l’estimateur aux observations marginales ou discordantes (outliers). Dans le cadre d’un modèle corrélatif classique, un unique point isolé situé aux extrémités des deux distributions peut gonfler artificiellement ou écraser dramatiquement le coefficient de corrélation de Pearson sans que le chercheur n’en perçoive immédiatement l’ampleur.
Lors du déroulement du bootstrap, les tirages avec remise ont pour effet de dupliquer occasionnellement cette observation atypique plusieurs fois au sein de certains rééchantillons, tandis que d’autres rééchantillons en seront totalement exempts. Ce phénomène engendre une dispersion bivoque observable dans les réplicats resultat_boot_cor$t, se matérialisant graphiquement par une distribution bimodale ou une queue particulièrement étirée.
Si une telle sensibilité est détectée, la méthodologie bootstrap s’adapte sans effort conceptuel à l’utilisation d’estimateurs robustes d’association. Il suffit à l’analyste de modifier l’argument method = "pearson" par method = "spearman" ou method = "kendall" au sein de la fonction personnalisée pour obtenir immédiatement une inférence bootstrap non paramétrique sur le rho de Spearman ou le tau de Kendall. Cette souplesse conceptuelle évite d’avoir à recourir à des tables de seuils critiques asymptotiques parfois inexactes en présence d’ex-aequo (ties) massifs dans les rangs psychométriques.
6. Exemple 3 : Régression linéaire et estimation des coefficients psychométriques
6.1 Modélisation linéaire : Prédire l’épuisement professionnel par les stresseurs
La régression linéaire multiple par les moindres carrés ordinaires (MCO) représente l’une des architectures analytiques les plus répandues en psychologie organisationnelle et différentielle. À titre d’illustration méthodologique, formulons un modèle évaluant l’épuisement émotionnel (dimension centrale du syndrome de burnout mesuré par le MBI) prédit par deux facteurs stresseurs professionnels : la charge de travail perçue et le harcèlement psychologique perçu (mobbing).
Le modèle analytique théorique s’exprime classiquement sous la forme mathématique matricielle :
Y = β0 + β1X1 + β2X2 + ε
Dans de nombreuses configurations organisationnelles, la distribution des variables explicatives s’avère particulièrement déséquilibrée : le harcèlement perçu présente fréquemment une variance résiduelle fortement asymétrique (la plupart des salariés ne rapportant aucun acte de harcèlement, certains individus rapportant des occurrences critiques continues). Cette situation engendre une violation flagrante de l’hypothèse d’homoscédasticité et de normalité des résidus ε. En conséquence directe, les erreurs types calculées par la méthode MCO standard s’avèrent biaisées à la baisse, augmentant dramatiquement le risque d’erreur d’inférence de type I (rejet à tort de l’hypothèse nulle).
Le recours au bootstrapping par rééchantillonnage des lignes (souvent qualifié dans la littérature de pairs bootstrap ou bootstrap par cas) s’impose ici comme une stratégie d’inférence hautement protectrice, car il ne conditionne aucunement la validité des erreurs types à l’homogénéité de la dispersion des erreurs résiduelles.
6.2 Programmation de l’extraction multi-paramètres
Pour soumettre un modèle de régression multiple à l’algorithme boot(), la fonction statistique utilisateur doit être programmée de façon à extraire simultanément l’ensemble des coefficients de pente et la constante du modèle. Cette démarche multi-paramètres requiert le renvoi d’un vecteur numérique structuré :
extraire_coefficients_regression <- function(donnees, indices) {

  echantillon_reindexe <- donnees[indices, ]

  modele_lm <- lm(

    epuisement_emotionnel ~ charge_travail + harcelement,

    data = echantillon_reindexe

  )

  return(coef(modele_lm))

}
La commande coef(modele_lm) retourne un vecteur contenant trois éléments distincts : l’ordonnée à l’origine (β0), le coefficient associé à la charge de travail (β1), et le coefficient associé au harcèlement (β2). L’initialisation du calcul bootstrap s’opère ensuite en convoquant la routine computationnelle standard :
set.seed(3321)

resultat_boot_reg <- boot(

  data = donnees_burnout,

  statistic = extraire_coefficients_regression,

  R = 2000

)
R procède à l’ajustement du modèle de régression 2 000 fois consécutives sur 2 000 pseudo-échantillons d’individus tirés avec remise. La matrice résultante resultat_boot_reg$t présentera une dimension de 2 000 lignes par 3 colonnes, consignant les fluctuations stochastiques conjointes de chaque paramètre du modèle.
6.3 Analyse multidimensionnelle des résultats
L’affichage récapitulatif de resultat_boot_reg permet d’accéder à l’estimation point par point de la précision de chaque coefficient psychométrique. La console R présente une table synthétique organisée par ligne correspondant à chacun des coefficients : t1* (constante), t2* (charge de travail), et t3* (harcèlement perçu).
Pour chacun de ces paramètres, l’analyste examine attentivement l’écart entre l’erreur type asymptotique rapportée par le résumé classique summary(modele_lm) et l’erreur type empirique rapportée par le bootstrap :
# Erreurs types bootstrap pour les trois paramètres

apply(resultat_boot_reg$t, 2, sd)
Dans les contextes d’hétéroscédasticité avérée, il est fréquent de constater que l’erreur type bootstrap associée au harcèlement (t3*) est sensiblement plus élevée que l’erreur type théorique des MCO. Cette correction empirique protège le psychologue contre la formulation de conclusions prématurées quant à la portée d’un effet potentiellement instable.
De plus, cette approche multi-paramétrique permet de calculer la matrice de covariance empirique des estimateurs via cov(resultat_boot_reg$t). Cette matrice bootstrap reflète avec une fidélité absolue la colinéarité réelle des coefficients de pente, servant de base empirique pour construire des régions de confiance jointes ou tester des combinaisons linéaires de paramètres sans recourir au formalisme asymptotique de Wald.
7. Construction des intervalles de confiance avec boot.ci()
7.1 Typologie et principes mathématiques des intervalles disponibles
L’un des objectifs fondamentaux de l’inférence non paramétrique réside dans la délimitation d’un intervalle de valeurs plausibles pour le paramètre cible à un seuil de confiance prédéterminé (usuellement 1 – α = 0.95). La fonction spécialisée boot.ci() de la bibliothèque standard met à la disposition du chercheur cinq méthodes distinctes d’élaboration d’intervalles de confiance non paramétriques : l’intervalle Normal, l’intervalle Basique (empirique), l’intervalle Percentile, l’intervalle Studentisé et l’intervalle BCa (Bias-Corrected and Accelerated).
Le choix d’une méthode d’intervalle n’est aucunement neutre : chaque formulation mathématique sous-tend des hypothèses spécifiques quant à l’invariance de distribution sous transformation monotone et à la convergence de l’erreur de couverture vers le seuil nominal α. L’appel canonique pour obtenir simultanément la comparaison de ces méthodes s’articule ainsi :
intervalles_confiance <- boot.ci(

  boot.out = resultat_boot_anxiete,

  conf = 0.95,

  type = c("norm", "basic", "perc", "bca")

)
7.2 Intervalles Normal, Basique et Percentile
L’intervalle Normal constitue l’approche la plus naïve. Il postule que la distribution d’échantillonnage de l’estimateur est asymptotiquement normale et calcule les bornes selon la formule :
[t0 – Biais] ± z1-α/2 × SEboot
Bien que cet intervalle intègre une correction élémentaire pour le biais d’estimation, il échoue systématiquement à capturer l’asymétrie intrinsèque des queues de distribution, générant un intervalle strictement symétrique peu adapté aux distributions tronquées ou fortement asymétriques.
L’intervalle Basique (parfois qualifié d’intervalle empirique des pivots) s’appuie sur la distribution de l’écart empirique δ̂* = θ̂* – t0. Il inverse mathématiquement la distribution empirique de ces écarts pour encadrer le véritable paramètre inconnu, définissant les bornes inférieure et supérieure comme suit :
[2t0 – q*1-α/2 ; 2t0 – q*α/2]
où q* représente les quantiles calculés sur les réplicats bootstrap. Bien qu’il s’affranchisse du postulat de normalité, cet intervalle souffre d’un défaut théorique majeur : il n’est pas invariant sous transformation monotone non linéaire du paramètre.
L’intervalle Percentile, introduit historiquement par Bradley Efron, résout ce problème d’invariance en éliminant l’inversion des pivots. Les bornes inférieure et supérieure de l’intervalle de confiance sont directement définies par les quantiles empiriques α/2 et 1 – α/2 du vecteur ordonné des réplicats bootstrap θ̂* :
[q*α/2 ; q*1-α/2]
Cet intervalle présente l’avantage considérable d’être strictement invariant par transformation monotone (par exemple, l’intervalle percentile du logarithme d’un paramètre correspond exactement au logarithme de l’intervalle percentile du paramètre brut). Néanmoins, l’intervalle percentile présente une convergence asymptotique de premier ordre seulement (erreur de couverture d’ordre O(n-1/2)) et démontre une sensibilité marquée en présence de biais d’estimation substantiels ou d’hétéroscédasticité sous-jacente.
7.3 Intervalles Studentisé et BCa (Bias-Corrected and Accelerated)
Pour pallier les insuffisances théoriques des méthodes précédentes, Bradley Efron a développé l’intervalle BCa (ajusté pour le biais et accéléré), désormais considéré comme la référence méthodologique absolue en psychologie quantitative et en modélisation structurelle. L’intervalle BCa affine le découpage des quantiles de la distribution bootstrap en introduisant deux paramètres de correction correctifs : le paramètre de biais médian z0 et le paramètre d’accélération a.
Le paramètre z0 mesure la divergence entre la médiane des estimations rééchantillonnées et la statistique originale observée sur l’échelle normale standard :
z0 = Φ-1(Pr(θ̂* < t0))
Le paramètre d’accélération a quantifie quant à lui le taux de variation de l’erreur type de l’estimateur par rapport à la véritable valeur du paramètre de population, capturant ainsi la dérive d’asymétrie (skewness). Dans le package boot, ce paramètre a est estimé automatiquement de manière non paramétrique via une procédure de rééchantillonnage jackknife interne (suppression itérative d’une observation à la fois).
Les quantiles effectifs ajustés α1 et α2 retenus pour découper la distribution des réplicats bootstrap sont définis par l’équation de transformation :
αajusté = Φ( z0 + (z0 + zα) / [1 – a(z0 + zα)] )
Grâce à cette double correction, l’intervalle BCa possède une précision asymptotique de second ordre (erreur de couverture d’ordre O(n-1)), tout en conservant la propriété fondamentale d’invariance par transformation. Pour extraire spécifiquement l’intervalle BCa avec le package boot, la commande syntaxique s’écrit rigoureusement :
ci_bca <- boot.ci(resultat_boot_anxiete, conf = 0.95, type = "bca")
L’emploi de l’intervalle Studentisé (ou bootstrap-t), bien que très performant théoriquement, requiert pour sa part l’estimation de la variance spécifique de chaque réplicat au sein même de chaque itération (soit par formulation analytique, soit par un double bootstrap imbriqué), ce qui augmente substantiellement la charge de calcul sans surpasser les performances pratiques du BCa dans la majorité des configurations expérimentales.
8. Exemple 4 : Application avancée à l’analyse de médiation en psychologie
8.1 Cadre conceptuel de l’effet indirect selon Preacher et Hayes
L’analyse de médiation statistique vise à élucider les mécanismes psychologiques ou comportementaux par lesquels une variable prédictive indépendante (X) transmet son influence sur une variable dépendante d’intérêt (Y) à travers l’intervention d’une variable intermédiaire dite médiatrice (M). Dans le schéma classique de médiation simple formalisé par Baron et Kenny (1986), le modèle s’articule autour de deux équations régressives fondamentales :
M = i1 + aX + e1
Y = i2 + c’X + bM + e2
L’effet indirect quantifiant la dynamique de médiation est formellement défini comme le produit algébrique des deux coefficients de régression non standardisés : ab = a × b.
Historiquement, la significativité statistique de cet effet indirect était évaluée au moyen du célèbre test de Sobel. Néanmoins, les travaux méthodologiques majeurs de Preacher et Hayes (2004, 2008) ont démontré l’obsolescence méthodologique de cette approche. Même lorsque les coefficients élémentaires a et b suivent chacun individuellement une loi normale, la distribution de probabilité de leur produit mathématique ab n’est presque jamais normale : elle présente une distribution asymétrique marquée, caractérisée par un pic aiguisé et une kurtosis élevée, particulièrement prononcée lorsque la taille d’échantillon est modeste ou que les tailles d’effet sont ténues.
En conséquence, l’utilisation de tests paramétriques présumant la normalité symétrique de l’effet indirect engendre une chute substantielle de puissance statistique et fausse les conclusions scientifiques. Le consensus méthodologique actuel en psychologie quantitative impose donc l’utilisation du bootstrapping non paramétrique, spécifiquement assorti d’intervalles de confiance BCa ou percentiles, pour tester formellement l’existence d’un effet indirect.
8.2 Script R complet pour le calcul du produit des coefficients
La modélisation rigoureuse de l’effet de médiation en R nécessite une fonction statistique évaluant séquentiellement les deux équations de régression sur le même jeu de données réindexé, puis extrayant le produit croisé des coefficients d’intérêt. Considérons une étude clinique évaluant l’effet d’une thérapie basée sur la pleine conscience (X : variable binaire, 0 = groupe contrôle liste d’attente, 1 = groupe intervention) sur la réduction des symptômes dépressifs post-traitement (Y : score BDI), à travers l’amélioration de la régulation émotionnelle cognitive (M : score CERQ).
La fonction statistique d’extraction s’implémente comme suit :
effet_mediation <- function(donnees, indices) {

  d <- donnees[indices, ]


  # Modèle 1 : Prédiction du médiateur (Chemin a)

  modele_m <- lm(regulation_emotion ~ groupe_therapie, data = d)

  a <- coef(modele_m)["groupe_therapie"]


  # Modèle 2 : Prédiction du critère final (Chemins b et c')

  modele_y <- lm(depression_post ~ groupe_therapie + regulation_emotion, data = d)

  b <- coef(modele_y)["regulation_emotion"]

  c_prime <- coef(modele_y)["groupe_therapie"]


  # Calcul de l'effet indirect (ab) et de l'effet total (c = c' + ab)

  effet_indirect <- a * b

  effet_total <- c_prime + effet_indirect


  return(c(a = a, b = b, c_prime = c_prime, ab = effet_indirect, total = effet_total))

}
Cette fonction retourne un vecteur nommé de cinq paramètres psychométriques essentiels. Pour garantir une détection sans équivoque des queues asymétriques de la distribution du produit, nous recommandons d’exécuter l’analyse avec au minimum 5 000 réplications stochastiques :
set.seed(9943)

boot_mediation <- boot(

  data = donnees_cliniques_depression,

  statistic = effet_mediation,

  R = 5000

)
8.3 Interprétation statistique et conclusion méthodologique
L’inférence relative à l’effet indirect de médiation s’opère par l’extraction ciblée de son intervalle de confiance BCa. Dans le vecteur retourné par notre fonction personnalisée, le produit indirect ab occupe la quatrième position indiciaire (index = 4) :
ci_effet_indirect <- boot.ci(

  boot.out = boot_mediation,

  conf = 0.95,

  type = "bca",

  index = 4

)
La règle de décision inférentielle établie par Preacher et Hayes s’énonce avec une grande clarté : l’effet de médiation indirect est jugé statistiquement significatif au seuil de confiance de 95% si et seulement si l’intervalle de confiance non paramétrique obtenu n’inclut pas la valeur zéro entre sa borne inférieure et sa borne supérieure.
Supposons que la commande boot.ci() retourne une valeur observée ab = -2.85 points de dépression, accompagnée d’un intervalle BCa à 95% compris entre [-4.72 ; -1.14]. Puisque cet intervalle est entièrement confiné dans les valeurs négatives et exclut strictement zéro, le chercheur conclut formellement à l’existence d’une médiation significative : le programme de pleine conscience réduit la sévérité des symptômes dépressifs par le canal de l’amélioration de la régulation émotionnelle. L’asymétrie visible de l’intervalle (qui s’étire davantage vers la gauche) témoigne précisément de l’inadéquation qu’aurait eue un intervalle classique symétrique fondé sur l’erreur type de Sobel.
9. Diagnostics graphiques et validation des distributions bootstrap
9.1 Visualisation de la distribution d’échantillonnage avec plot.boot()
La conduite d’une analyse bootstrap rigoureuse ne s’achève pas à l’extraction brute de chiffres dans la console R ; elle exige une phase systématique de diagnostic visuel visant à inspecter la morphologie réelle de la distribution empirique générée par simulation. La bibliothèque standard intègre une méthode graphique spécialisée accessible via la commande générique plot() appliquée directement à l’objet de classe boot :
plot(resultat_boot_anxiete)
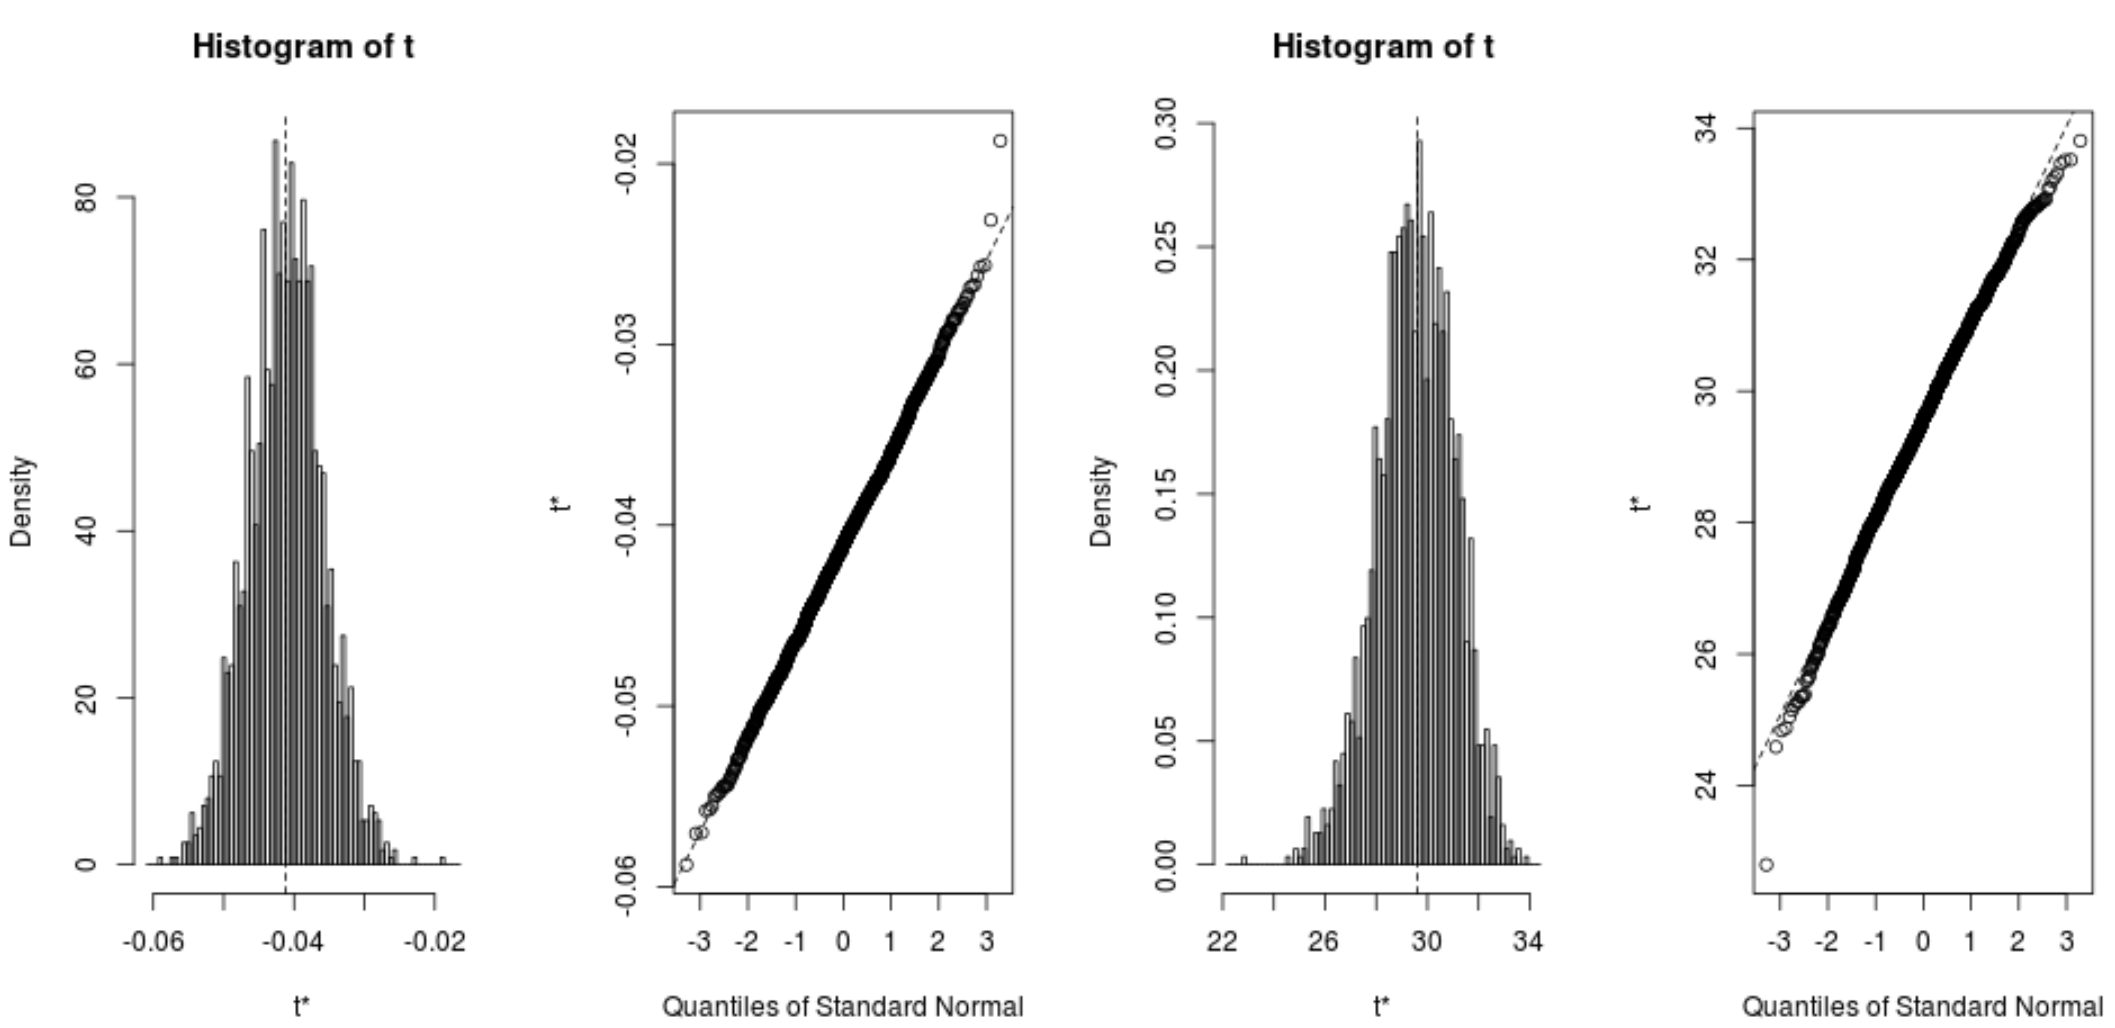
L’exécution de cette instruction génère une fenêtre graphique articulée autour de deux panneaux complémentaires. Le panneau supérieur affiche l’histogramme des fréquences empiriques des réplicats rééchantillonnés θ̂*. Superposée à cet histogramme, une ligne verticale pointillée ou continue matérialise l’emplacement exact de la statistique originale observée t0.
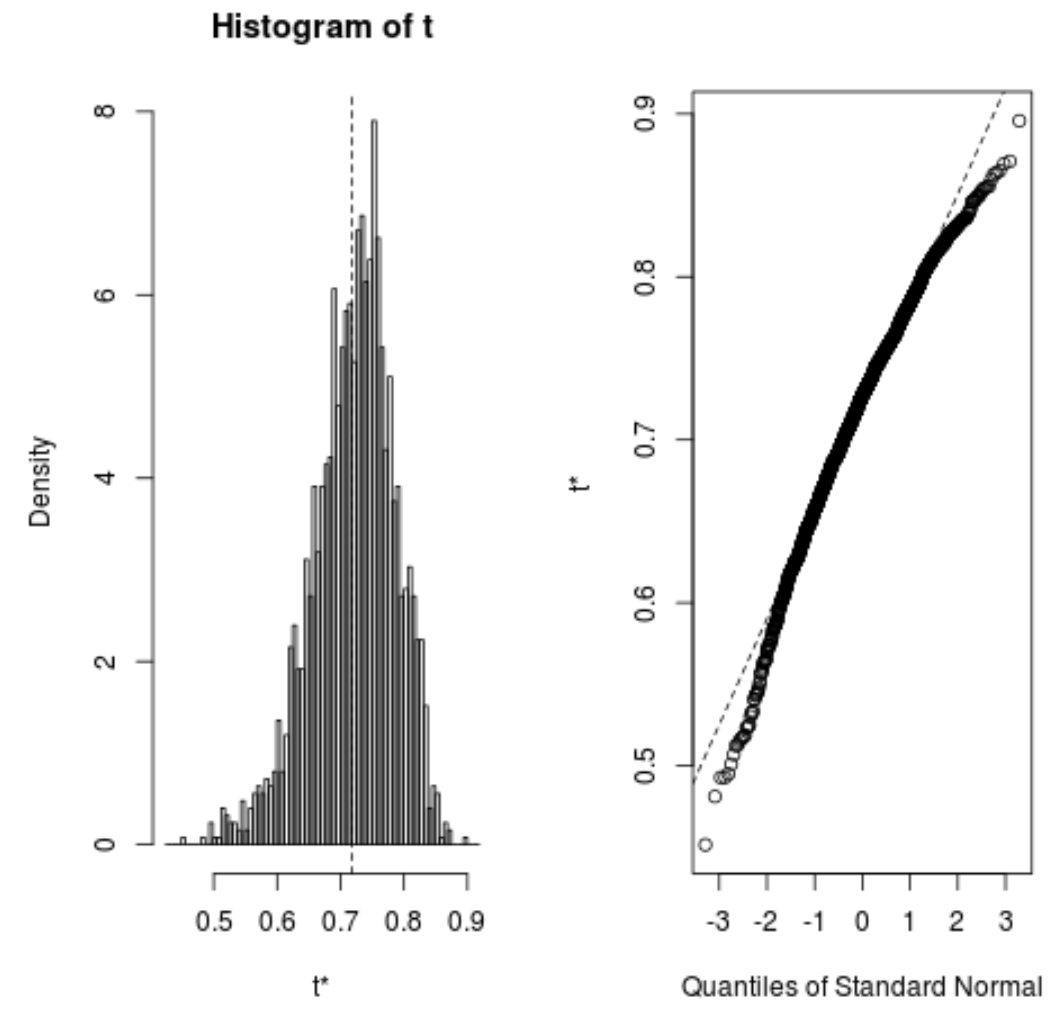
L’inspection attentive de ce premier panneau graphique permet de vérifier instantanément plusieurs propriétés structurales déterminantes : la régularité de la distribution, la présence éventuelle de multimodalités inattendues (qui pourraient traduire un échantillonnage accidentel de sous-groupes cliniques non homogènes ou latents), et l’étalement relatif des queues. Une asymétrie visible entre la masse centrale de l’histogramme et le positionnement de t0 signale d’emblée la présence d’un biais d’estimation empirique substantiel.
9.2 Diagrammes quantile-quantile (Q-Q plots) appliqués aux réplicats
Le panneau inférieur produit par la fonction plot.boot() présente un diagramme quantile-quantile (Normal Q-Q Plot). Ce graphique porte en abscisse les quantiles théoriques d’une distribution normale standardisée centrée réduite et en ordonnée les quantiles empiriques standardisés issus des réplicats de Monte-Carlo générés par l’analyse.
L’évaluation visuelle de ce diagramme fournit un diagnostic sans équivalent sur la conformité asymptotique de la statistique étudiée :
- Si l’ensemble des points empiriques s’aligne fidèlement le long de la diagonale de référence, la distribution d’échantillonnage de l’estimateur a atteint sa normalité asymptotique. Dans cette configuration géométrique, les intervalles de confiance Normal, Percentile et BCa convergeront vers des bornes rigoureusement quasi-identiques.
- Si le tracé dessine une courbure parabolique vers le haut ou vers le bas, cela traduit une asymétrie résiduelle persistante (skewness) dans la distribution du paramètre, démontrant l’inadéquation de l’intervalle Normal classique.
- Si le tracé prend une allure caractéristique en « S », cela révèle la présence de queues plus lourdes (leptokurtose) ou plus légères (platykurtose) que la théorie normale ne le prévoit. La divergence aux extrémités extrêmes du tracé Q-Q démontre impérativement l’obligation méthodologique de retenir l’intervalle BCa pour corriger l’accélération et le biais stochastique.
9.3 Évaluation de l’asymétrie empirique et détection de kurtosis anormal
Au-delà de l’inspection purement graphique, l’analyste peut procéder à la quantification analytique formelle des moments d’ordre 3 (asymétrie ou skewness) et d’ordre 4 (aplatissement ou kurtosis) sur le vecteur des réplicats boot_obj$t. L’utilisation conjointe des fonctions du package e1071 ou moments permet d’éclairer précisément cette évaluation :
skewness_empirique <- e1071::skewness(resultat_boot_anxiete$t)

kurtosis_empirique <- e1071::kurtosis(resultat_boot_anxiete$t)
Une valeur d’asymétrie empirique s’écartant sensiblement de l’intervalle [-0.2 ; +0.2] confirme que la distribution d’échantillonnage ne peut être considérée comme symétrique, invalidant formellement l’intervalle de confiance standard de Student ou l’intervalle bootstrap normal. De même, un excès de kurtosis substantiel signale que les observations marginales exercent une pression disproportionnée sur la variance d’échantillonnage.
Si la distribution bootstrap présente des discontinuités nettes ou une structure en peigne (comb-like appearance), cela traduit quasi systématiquement la présence d’une variable sous-jacente discrète comportant un nombre excessivement restreint de modalités distinctes, ou l’inadéquation de la taille de l’échantillon n face à la résolution numérique de l’instrument de mesure.
10. Pièges fréquents, limitations et erreurs d’implémentation
10.1 Oubli de l’indexation matricielle dans la fonction personnalisée
L’erreur la plus insidieuse, la plus répandue et pourtant la plus dévastatrice commise par les utilisateurs lors de l’apprentissage du package boot réside dans l’omission de l’application du vecteur d’indices à l’intérieur du corps de la fonction statistique personnalisée. Considérons le contre-exemple didactique suivant :
# ERREUR GRAVE DE PROGRAMMATION

fonction_erronee <- function(donnees, indices) {

  return(mean(donnees$score_depression)) # Ingestion sans réindexation !

}
Dans ce scénario erroné, la fonction accepte formellement l’argument indices généré par la routine boot(), mais ne l’utilise jamais pour sous-échantillonner le tableau donnees. En conséquence absolue, à chaque tour de boucle stochastique, la fonction calcule et recalcule inlassablement la moyenne arithmétique sur l’échantillon d’origine complet.
L’algorithme terminera son exécution sans renvoyer le moindre message d’erreur ou d’avertissement. Toutefois, les 2 000 réplicats contenus dans resultat$t seront rigoureusement identiques entre eux. La variance d’échantillonnage sera strictement égale à zéro et l’erreur type bootstrap sera faussement estimée à 0.0000. Pour détecter ce piège, l’analyste doit impérativement s’assurer en amont que la variance des réplicats var(resultat$t) est strictement positive et tester unitairement sa fonction avec un vecteur d’indices fictif (ex. : fonction(donnees, c(1, 1, 2, 3...))) avant de lancer l’analyse globale.
10.2 Sous-dimensionnement du nombre de réplications
L’évaluation superficielle des contraintes computationnelles conduit fréquemment certains chercheurs à sous-dimensionner massivement le paramètre R, en fixant par exemple R = 100 ou R = 200 réplications dans l’espoir d’accélérer le temps d’exécution sur de volumineuses bases de données. Ce sous-dimensionnement constitue une faute méthodologique lourde qui fragilise l’inférence.
Lorsque le nombre de réplications R est insuffisant, l’erreur de simulation de Monte-Carlo vient s’ajouter artificiellement à l’erreur d’échantillonnage réelle. Les bornes des intervalles de confiance calculées aux centiles extrêmes subissent alors une volatilité stochastique majeure : deux exécutions consécutives du script sur le même jeu de données, avec deux graines aléatoires différentes, aboutiront à des intervalles divergents, pouvant conduire à rejeter une hypothèse nulle dans un cas et à l’accepter dans l’autre.
Pour documenter empiriquement cette instabilité, le tableau suivant illustre la variabilité typique de l’estimation de l’erreur type et de la borne supérieure d’un intervalle de confiance à 95% selon le volume de réplications retenu pour un échantillon modeste :
Tableau 1. Stabilité computationnelle en fonction du nombre de réplications R
- R = 200 : Forte instabilité stochastique ; oscillation de la borne supérieure pouvant atteindre ±8% d’une exécution à l’autre ; erreur type imprécise. Inapproprié pour la publication académique.
- R = 500 : Stabilisation acceptable du biais et de l’erreur type globale ; variabilité résiduelle des centiles extrêmes de l’ordre de ±3%. Tolérable uniquement pour les phases exploratoires.
- R = 2 000 : Excellente stabilité des erreurs types ; variabilité des bornes de l’intervalle inférieure à ±0.8%. Seuil standard recommandé pour les intervalles percentiles et BCa.
- R = 5 000 à 10 000 : Convergence de Monte-Carlo quasi parfaite ; reproductibilité numérique absolue des centiles au centième près. Fortement préconisé pour les analyses de médiation et les paramètres non linéaires complexes.
10.3 Violation de l’indépendance des observations
Le bootstrapping non paramétrique standard mis en œuvre par défaut dans la fonction boot() repose sur un postulat mathématique incontournable : les observations individuelles composant l’échantillon doivent être indépendantes et identiquement distribuées (i.i.d.). L’application mécanique du tirage avec remise uniforme à des données violant ce principe d’indépendance aboutit à des estimations radicalement fallacieuses.
Ce problème survient avec acuité dans deux configurations empiriques omniprésentes en sciences humaines :
- Données longitudinales ou mesures répétées : Si les lignes du tableau représentent des points d’évaluation temporels multiples (T1, T2, T3) mesurés chez les mêmes sujets, le tirage uniforme traitera ces observations comme des entités indépendantes. Certains rééchantillons contiendront le point T1 d’un sujet sans son point T2, détruisant artificiellement la corrélation intra-sujet et sous-estimant dramatiquement l’erreur type des effets intra-individuels.
- Structures hiérarchiques ou emboîtées : Dans le cas d’élèves nichés au sein de classes scolaires, ou de patients suivis par différents psychothérapeutes, les individus partageant le même groupe présentent des covariances résiduelles non nulles (effet de grappe ou coefficient de corrélation intraclasse). Le rééchantillonnage naïf ignore cette dépendance contextuelle et génère des inférences exagérément optimistes (taux d’erreur de type I très élevé).
Face à de telles structures de données, le chercheur doit obligatoirement abandonner le bootstrap naïf au profit de stratégies adaptées, telles que le rééchantillonnage par blocs ou le bootstrap multiniveau par grappes.
11. Stratégies avancées : Bootstrapping stratifié, paramétrique et clusterisé
11.1 Le bootstrapping stratifié pour contrôler les sous-groupes
Lorsque la population d’intérêt comporte des sous-populations distinctes dont les effectifs relatifs doivent être impérativement préservés au cours de l’inférence (par exemple, un échantillon clinique composé de 40 patients bipolaires et de 60 témoins sains, ou une stratification par genre biologique), le tirage aléatoire uniforme avec remise standard présente un écueil : par le simple jeu du hasard de Monte-Carlo, certains pseudo-échantillons pourront contenir une proportion très déséquilibrée d’un sous-groupe, voire une absence totale des représentants d’une catégorie diagnostique rare.
Pour prévenir cette dérive, la fonction boot() intègre un paramètre dédié nommé strata. Cet argument attend un vecteur ou un facteur spécifiant l’appartenance de chaque observation à sa strate d’origine :
resultat_boot_stratifie <- boot(

  data = donnees_cliniques,

  statistic = ma_fonction_statistique,

  R = 2000,

  strata = donnees_cliniques$groupe_diagnostic

)
Sous cette configuration, l’algorithme partitionne automatiquement l’échantillon selon les niveaux du facteur stratifiant, puis effectue les tirages avec remise de manière rigoureusement indépendante et proportionnelle au sein de chaque strate. Ainsi, chaque pseudo-échantillon généré comportera exactement 40 patients bipolaires et 60 témoins sains, éliminant la variance inter-strates indésirable et garantissant une estimation conditionnelle optimale du paramètre cible.
11.2 Principes et mise en œuvre du bootstrapping paramétrique
Bien que le bootstrapping non paramétrique domine largement la pratique empirique en raison de son affranchissement de toute contrainte distributionnelle, il existe des situations où le chercheur dispose d’une certitude théorique quant à la loi génératrice des données (par exemple, une distribution de Poisson pour des fréquences d’actes comportementaux, ou une loi gamma pour des temps d’accès lexical), tout en souhaitant évaluer un paramètre pour lequel aucune dérivation analytique de l’erreur type n’existe.
Dans ce cadre spécifique, le bootstrapping paramétrique substitue à la fonction de répartition empirique F̂n un modèle distributionnel ajusté Fθ̂. Les étapes computationnelles se formalisent ainsi :
- Estimer les paramètres de la distribution théorique (ex. : moyenne μ et variance σ2) sur l’échantillon d’origine par le maximum de vraisemblance.
- Générer de nouveaux pseudo-échantillons non pas en rééchantillonnant les données observées, mais en effectuant des tirages aléatoires simulés directement à partir de la distribution paramétrique spécifiée au moyen des fonctions de génération de R (ex. :
rnorm(),rpois()). - Calculer la statistique d’intérêt sur ces échantillons générés.
Dans R, cette procédure s’orchestre en passant l’argument sim = "parametric" à la fonction boot(), accompagné d’une fonction de simulation génératrice spécifiée via l’argument ran.gen. Cette méthodologie offre une efficacité statistique supérieure à celle du bootstrap non paramétrique lorsque le modèle distributionnel spécifié est rigoureusement exact, mais perd toute robustesse si la forme paramétrique postulée est erronée.
11.3 Gestion des dépendances hiérarchiques par bootstrapping par grappes
Pour surmonter les limitations du rééchantillonnage simple face aux données hiérarchiques ou multiniveaux (élèves au sein d’écoles, patients au sein de cliniques), la méthodologie du bootstrap par grappes (cluster bootstrap) ou bootstrap par blocs constitue la réponse mathématique adéquate. Le principe consiste à déplacer le niveau de l’unité de rééchantillonnage : au lieu de tirer les individus avec remise, l’algorithme tire les grappes (les clusters) avec remise.
Lorsqu’une grappe est sélectionnée par le processus aléatoire, la totalité des individus appartenant à cette unité hiérarchique est incorporée d’un bloc dans le pseudo-échantillon. Cette procédure préserve intégralement la matrice de corrélation intra-grappe sans nécessiter la formulation d’hypothèses sur la structure paramétrique exacte des effets aléatoires.
Bien que le package boot standard puisse être adapté à cette fin au moyen de fonctions d’indexation élaborées sur les identifiants de grappes, la communauté R s’appuie fréquemment sur des bibliothèques dédiées plus intuitives pour les modèles mixtes, à l’instar de lme4 via la fonction spécialisée bootMer() :
# Exemple conceptuel avec un modèle linéaire à effets mixtes (lmer)

modele_mixte <- lme4::lmer(reaction ~ stress + (1 | sujet), data = donnees_neuro)

boot_mixte <- lme4::bootMer(

  modele_mixte,

  FUN = fixef,

  nsim = 1000,

  type = "parametric"

)
Cette intégration permet d’extraire des intervalles de confiance rigoureux sur les coefficients de pente fixes tout en tenant compte formellement de la variabilité issue des intercepts et des pentes aléatoires des différents niveaux d’emboîtement.
12. Bonnes pratiques de restitution académique et publication des résultats
12.1 Lignes directrices de l’APA pour rapporter les analyses bootstrap
La publication de résultats reposant sur des procédures de rééchantillonnage au sein des revues savantes régies par l’American Psychological Association (7e édition des normes APA) requiert une précision documentaire absolue. L’époque où un chercheur pouvait simplement mentionner l’adjectif « robuste » sans plus de précisions procédurales est révolue. La standardisation de la restitution garantit la lisibilité et l’évaluation critique des inférences rapportées.
Le manuscrit empirique doit obligatoirement expliciter dans la section Méthode ou Analyses statistiques :
- Le type exact de bootstrapping employé (ex. : rééchantillonnage non paramétrique par cas, bootstrap stratifié).
- Le nombre précis de réplications stochastiques R exécutées (ex. : R = 2 000 ou 5 000).
- Le type spécifique d’intervalle de confiance non paramétrique retenu, en motivant rigoureusement le choix (ex. : intervalles BCa recommandés pour corriger l’asymétrie et le biais d’échantillonnage).
- Le niveau de confiance nominal appliqué (ex. : 95%).
- L’environnement logiciel utilisé, incluant le nom de la bibliothèque et sa version précise (ex. : R package boot, version 1.3-28).
Au sein de la section Résultats, la formulation textuelle standardisée adoptera une structure synthétique formalisée. Par exemple :
« Le coefficient d’effet indirect de la pleine conscience sur la sévérité dépressive à travers la régulation émotionnelle cognitive est significatif, b = -2.85, SE = 0.91, 95% IC BCa [-4.72, -1.14]. Le fait que l’intervalle de confiance BCa à 95% fondé sur 5 000 réplications bootstrap exclue rigoureusement la valeur zéro confirme l’existence d’une médiation statistique robuste au sein de notre modèle. »
12.2 Transparence méthodologique, reproductibilité et partage de code
L’essor du mouvement pour la science ouverte (Open Science Framework, OSF) impose désormais des devoirs accrus envers la communauté scientifique pour assurer la reproductibilité computationnelle stricte des résultats statistiques publiés. Compte tenu du caractère intrinsèquement stochastique du rééchantillonnage, la communication transparente des routines de programmation est devenue un impératif déontologique.
Les auteurs doivent consigner au sein d’un dépôt public pérenne (tel qu’OSF, Zenodo ou GitHub) les éléments techniques indispensables suivants :
- L’entier exact assigné à la graine stochastique via la commande
set.seed(). - Le script R intégral et non tronqué, comprenant la définition syntaxique détaillée de la fonction statistique transmise à
boot(). - Les données brutes anonymisées ou, à défaut d’autorisation éthique de partage des données de santé, un jeu de données synthétiques possédant une matrice de covariance identique.
- Le résultat de l’instruction
sessionInfo(), documentant la version du système d’exploitation, la version exacte de l’interpréteur R et les versions des bibliothèques dépendantes chargées en mémoire.
Cette rigueur méthodologique prévient les litiges computationnels et permet aux relecteurs (peer reviewers) de reproduire au bit près les distributions d’échantillonnage et les bornes d’intervalles rapportées dans le manuscrit soumis.
12.3 Arbre décisionnel pour le chercheur en psychologie
Pour synthétiser la démarche inférentielle et guider le chercheur dans les méandres méthodologiques du rééchantillonnage, nous présentons ci-après une grille séquentielle de prise de décision appliquée aux analyses empiriques :
Étape 1 : Diagnostic des hypothèses distributionnelles classiques
- Les données respectent-elles rigoureusement la normalité multivariée et l’homoscédasticité, sur un échantillon de grande taille (n > 200) ? Si oui, les tests paramétriques classiques sont généralement fiables. Si non, ou en présence d’échantillons cliniques restreints, orientez-vous vers le rééchantillonnage.
Étape 2 : Évaluation de l’indépendance des observations
- Les observations sont-elles strictement indépendantes (i.i.d.) ? Si oui, appliquez le bootstrap non paramétrique standard. Si les données comportent des strates connues avec risques de déséquilibres, appliquez le bootstrap stratifié (
strata). Si les données sont longitudinales ou emboîtées (grappes), appliquez impérativement un bootstrap multiniveau ou par blocs.
Étape 3 : Spécification de la métrique et modélisation
- Le paramètre est-il linéaire simple (moyenne) ou non linéaire / asymétrique (corrélation, produit de médiation ab, quantiles, rapports de cotes) ? Pour tout paramètre non linéaire ou composite, fixez le nombre de réplications stochastiques à R ≥ 2 000 (voire R = 5 000 pour la médiation).
Étape 4 : Sélection de la méthode d’intervalle de confiance
- La distribution d’échantillonnage des réplicats est-elle parfaitement symétrique sur le Q-Q plot sans biais empirique ? Si oui, les intervalles Percentile ou Normal peuvent suffire. Si une asymétrie ou un biais est décelé (situation la plus fréquente en psychométrie), retenez exclusivement l’intervalle BCa (Bias-Corrected and Accelerated) via
boot.ci(..., type = "bca").
En adoptant cette démarche décisionnelle rigoureuse et en exploitant la puissance du package boot en R, le chercheur s’assure d’une inférence statistique solide, éthique et parfaitement reproductible, en adéquation totale avec les standards les plus exigeants de la psychologie quantitative contemporaine.
Références
- Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Canty, A., & Ripley, B. D. (2021). boot: Bootstrap R (S-Plus) Functions (R package version 1.3-28). Comprehensive R Archive Network. https://CRAN.R-project.org/package=boot
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap Methods and Their Application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Efron, B. (1987). Better bootstrap confidence intervals. Journal of the American Statistical Association, 82(397), 171–185. https://doi.org/10.1080/01621459.1987.10478410
- Efron, B., & Tibshirani, R. J. (1993). An Introduction to the Bootstrap. Chapman & Hall/CRC. https://doi.org/10.1201/9780429246593
- Hayes, A. F. (2017). Introduction to Mediation, Moderation, and Conditional Process Analysis: A Regression-Based Approach (2nd ed.). Guilford Press.
- Preacher, K. J., & Hayes, A. F. (2004). SPSS and SAS procedures for estimating indirect effects in simple mediation models. Behavior Research Methods, Instruments, & Computers, 36(4), 717–731. https://doi.org/10.3758/BF03206553
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879
- R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Wilcox, R. R. (2017). Introduction to Robust Estimation and Hypothesis Testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02380-1