
Dans le champ des sciences comportementales, de la neuropsychologie et des sciences sociales, la comparaison de multiples conditions expérimentales constitue le socle de la démarche empirique. Lorsqu’un protocole expérimental évalue l’impact de plusieurs interventions psychothérapeutiques, de différents dosages pharmacologiques ou de multiples modalités d’apprentissage sur une variable dépendante continue, l’analyse de variance (ANOVA) à un facteur s’impose traditionnellement comme l’outil d’inférence de premier plan. Cependant, cette procédure globale ne répond qu’à une interrogation préliminaire : existe-t-il, parmi l’ensemble des groupes étudiés, au moins une moyenne qui diffère significativement des autres ? Face à l’obtention d’un test F statistiquement significatif, le chercheur se trouve confronté à une limitation intrinsèque : l’incapacité de localiser avec précision la nature et la direction des contrastes dyadiques responsables du rejet de l’hypothèse nulle.
Pour résoudre cette indétermination sans compromettre la rigueur méthodologique de l’étude, le recours aux tests de comparaisons multiples a posteriori, communément appelés tests post-hoc, devient impératif. Parmi l’éventail des méthodes développées au fil de l’histoire de la biométrie et de la psychométrie, le test HSD (Honestly Significant Difference) formulé par John Tukey s’est imposé comme une référence en raison de son compromis remarquable entre la puissance statistique et la maîtrise stricte du taux d’erreur de première espèce à l’échelle de la famille de comparaisons. Néanmoins, le formalisme originel de Tukey repose sur le postulat d’échantillons de tailles rigoureusement équilibrées. Or, les réalités du terrain expérimental en psychologie — marquées par l’attrition des participants, les abandons en cours d’intervention longitudinale ou les déséquilibres inhérents aux cohortes cliniques — rendent cette égalité numérique exceptionnelle. C’est précisément pour surmonter cette contrainte que Clyde Kramer a étendu les propriétés du test de Tukey aux contextes d’effectifs inégaux, donnant naissance à la méthode de Tukey-Kramer.
Bien que des progiciels statistiques spécialisés tels que SPSS, R, SAS ou JASP intègrent cette méthode dans leurs routines automatisées, la maîtrise de sa mise en œuvre au sein de Microsoft Excel représente un atout pédagogique, conceptuel et opérationnel inestimable. Décomposer pas à pas le test de Tukey-Kramer dans un tableur permet au chercheur de s’émanciper de la logique de « boîte noire » propre aux logiciels tout-en-un, d’appréhender intimement la mécanique sous-jacente des erreurs types combinées, de manipuler la distribution de l’étendue standardisée de Student (loi q) et d’automatiser des matrices décisionnelles sur mesure. Ce guide exhaustif propose une démarche intégrale, alliant fondements mathématiques rigoureux, respect des postulats psychométriques, modélisation pas-à-pas sous Excel et restitution académique scrupuleusement conforme aux normes internationales de publication scientifique.
1. Fondements théoriques : de l’ANOVA à une voie aux comparaisons multiples en psychologie
1.1 Le rôle de l’ANOVA factorielle et le problème de l’hypothèse globale
L’analyse de variance à un facteur de classification représente la pierre angulaire de l’inférence statistique lorsque l’on souhaite comparer simultanément les moyennes de k populations indépendantes, où k est supérieur ou égal à trois. Au sein d’un devis de recherche en psychologie cognitive ou clinique, la formulation de l’hypothèse nulle omnibus se définit formellement par l’égalité stricte de toutes les moyennes théoriques des populations soumises aux différentes conditions expérimentales. Sous cette hypothèse globale, les variations observées entre les échantillons sont attribuées exclusivement aux fluctuations de l’échantillonnage aléatoire et à l’erreur de mesure non contrôlée, plutôt qu’à un effet systématique de la variable indépendante manipulée par l’expérimentateur.
La statistique F de Fisher-Snedecor, calculée à partir du ratio entre le carré moyen inter-groupes (qui quantifie la dispersion des moyennes d’échantillons autour de la moyenne générale) et le carré moyen intra-groupes (qui estime la variance d’erreur pure au sein des conditions), fournit une décision probabiliste univariée. Lorsque la valeur de p associée au test F franchit le seuil critique conventionnel (généralement 0,05), l’hypothèse nulle omnibus est rejetée. Toutefois, ce rejet n’autorise en aucun cas l’investigateur à conclure que toutes les moyennes diffèrent mutuellement les unes des autres. Il indique seulement qu’au moins une paire de moyennes présente un écart suffisant pour que la probabilité de son observation sous le seul jeu du hasard soit inférieure au seuil alpha fixé.
Cette limitation intrinsèque de l’inférence omnibus pose un problème méthodologique majeur dans la recherche expérimentale. Par exemple, si une étude évalue l’efficacité relative d’une thérapie cognitivo-comportementale (TCC), d’une thérapie d’acceptation et d’engagement (ACT) et d’un groupe témoin sur liste d’attente sur les scores d’anxiété généralisée, une valeur de p significative issue de l’ANOVA ne permet pas de déterminer si la TCC surpasse significativement la liste d’attente, si l’ACT surpasse ce même groupe témoin, ou si la TCC et l’ACT présentent une efficacité statistiquement distincte. Pour démêler ce faisceau d’incertitudes empiriques et identifier précisément quels contrastes soutiennent la significativité globale, le recours à des procédures analytiques plus fines devient une absolue nécessité méthodologique.
1.2 L’inflation de l’erreur de type I et la nécessité des procédures post-hoc
Une réaction intuitive mais méthodologiquement erronée consisterait à exécuter une série de tests t de Student pour échantillons indépendants sur l’ensemble des paires de groupes envisageables. Pour une expérience comprenant k conditions, le nombre total de comparaisons binaires non redondantes s’élève mathématiquement à C = k(k – 1) / 2. Si une étude comporte quatre groupes expérimentaux, six tests t bilatéraux doivent être exécutés ; pour cinq groupes, ce nombre passe à dix comparaisons. La multiplication de ces tests d’hypothèses indépendants entraîne un phénomène pernicieux bien documenté en métrologie statistique : l’inflation du taux d’erreur de type I à l’échelle de l’ensemble de la famille de comparaisons (communément désigné sous l’acronyme FWEE pour Familywise Error Rate).
Le risque de commettre au moins une erreur de première espèce — c’est-à-dire de rejeter à tort une hypothèse nulle dyadique vraie et d’affirmer l’existence d’une différence significative là où il n’existe qu’une fluctuation aléatoire — s’accroît de manière exponentielle avec le nombre de contrastes évalués. En postulant l’indépendance orthogonale des tests au seuil alpha unitaire de 0,05, la probabilité cumulée de commettre au moins un faux positif au sein de la famille s’exprime par la relation mathématique : alpha_global = 1 – (1 – alpha_individuel)^C. Ainsi, pour cinq conditions expérimentales impliquant dix comparaisons dyadiques, le risque d’erreur de première espèce familial atteint environ 40,1 %, réduisant drastiquement la validité interne des conclusions psychologiques.
Il convient de distinguer formellement les comparaisons planifiées a priori des comparaisons exploratoires a posteriori ou post-hoc. Les contrastes planifiés sont ancrés dans des hypothèses théoriques déductives formulées antérieurement à la collecte des données et autorisent des ajustements ciblés moins pénalisants. En revanche, les procédures post-hoc explorent la totalité de l’espace des différences possibles après inspection des données. Pour préserver l’intégrité de la décision statistique, ces procédures doivent impérativement intégrer un mécanisme régulateur capable de maintenir le taux d’erreur familial à un niveau rigoureusement égal ou inférieur à 0,05. La distribution de l’étendue standardisée de Student (ou distribution q), formulée spécifiquement pour évaluer la distance maximale entre des moyennes ordonnées issues d’une même distribution normale, confère aux tests de la famille de Tukey cette propriété protectrice essentielle.
1.3 Spécificité du test de Tukey-Kramer face aux effectifs inégaux
La procédure HSD originale conçue par John Tukey a été initialement paramétrée sous la contrainte mathématique absolue d’une égalité parfaite des tailles d’échantillons au sein de chaque groupe (n_1 = n_2 = … = n_k = n). Sous cette prémisse d’homogénéité dimensionnelle, l’erreur type de la différence entre n’importe quelle paire de moyennes est invariante et dérive directement du carré moyen de l’erreur intra-groupes (MSw) divisé par la taille commune de l’échantillon n. Or, dans la pratique empirique des sciences psychologiques, le maintien d’une stricte égalité des effectifs relève souvent de la gageure méthodologique en raison de protocoles d’administration complexes, de l’élimination des réponses incomplètes ou aberrantes, et des abandons fortuits lors des suivis longitudinaux.
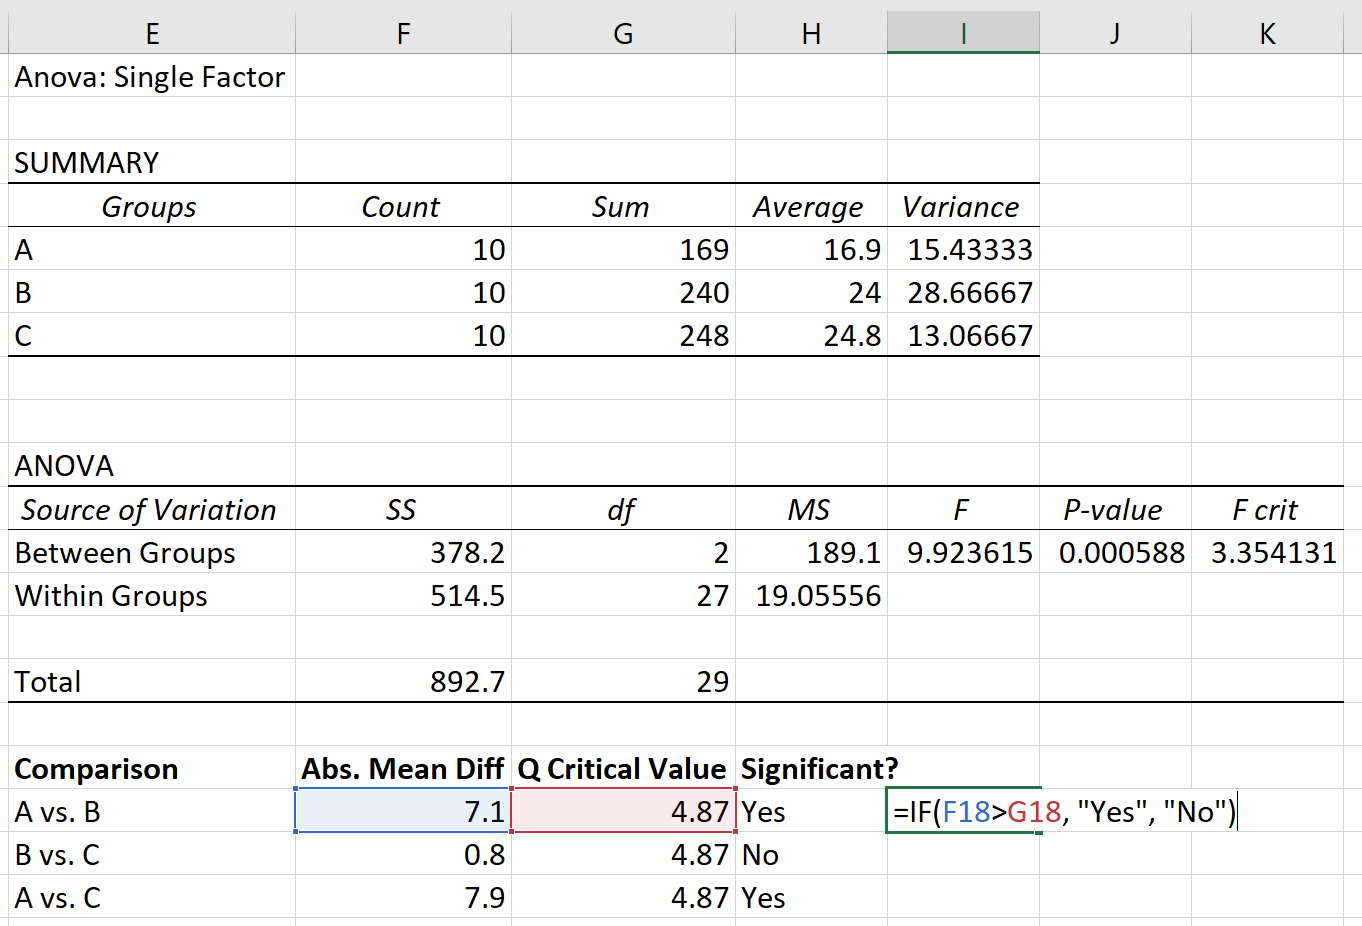
Pour étendre la robustesse théorique du test HSD aux devis déséquilibrés sans pour autant adopter des corrections excessivement conservatrices telles que celle de Bonferroni ou de Scheffé, Clyde Kramer publia en 1956 une généralisation élégante de la méthode de Tukey. La distinction fondamentale entre l’algorithme original de Tukey et la modification de Tukey-Kramer réside dans la formulation de l’erreur type associée à chaque comparaison spécifique. Plutôt que d’assumer une taille unique n, la méthode de Tukey-Kramer substitue à ce paramètre fixe une formulation adaptative fondée sur la moyenne harmonique des effectifs propres aux deux groupes composant le binôme comparé.
Cette adaptation mathématique garantit que le test de Tukey-Kramer demeure exact et contrôle rigoureusement le risque d’erreur de première espèce au niveau nominal spécifié, tout en préservant une puissance statistique optimale pour détecter les contrastes réels. D’un point de vue épistémologique, dans les recherches quasi-expérimentales et observationnelles fréquentes en psychologie — où l’assignation aléatoire parfaite est impossible et où les groupes naturels (tels que des cohortes diagnostiques ou des profils de personnalité) présentent structurellement des effectifs divergents —, la modification de Tukey-Kramer s’impose comme le standard méthodologique par excellence pour l’analyse des contrastes par paires après une ANOVA significative.
2. Modélisation mathématique et équations sous-jacentes du test de Tukey-Kramer
2.1 Formulation de la statistique de test q et seuil critique
L’architecture mathématique du test de Tukey-Kramer s’articule autour de la statistique de l’étendue standardisée de Student, conventionnellement notée q. Contrairement au test t de Student qui mesure le ratio entre l’écart d’une moyenne observée par rapport à une valeur théorique (ou entre deux moyennes) et l’erreur type standard de cette différence, la distribution q modélise la distribution de la différence entre la valeur maximale et la valeur minimale observées dans un ensemble de k moyennes indépendantes issues d’une population parente normale, divisée par une estimation non biaisée de l’erreur type de l’échantillon.
Pour évaluer l’écart séparant deux groupes expérimentaux quelconques i et j, la statistique q observée empiriquement est formulée selon l’équation suivante :
q_obs = |Moyenne_i – Moyenne_j| / SE_diff
Dans cette relation formelle, le numérateur correspond à la valeur absolue de la différence entre les deux moyennes échantillonnales respectives, garantissant une métrique unilatérale positive propre aux tests d’étendue. Le dénominateur, quant à lui, représente l’erreur type spécifique de la différence entre ces deux moyennes précises, ajustée pour tenir compte des tailles respectives des deux échantillons considérés.
La statistique empirique calculée est ensuite confrontée à une valeur critique théorique, extraite de la distribution de l’étendue standardisée. Cette distribution de référence est entièrement régie par trois paramètres fondamentaux : le niveau de risque d’erreur de première espèce retenu (le seuil alpha, universellement fixé à 0,05 ou 0,01 dans les protocoles biométriques), le nombre total de groupes ou de niveaux du facteur étudiés dans l’ANOVA globale (le paramètre k), et le nombre de degrés de liberté associés à la variance résiduelle intra-groupes au sein du modèle global (noté df_erreur ou df_w). Le critère de décision statistique est alors sans équivoque : si la valeur observée q_obs est strictement supérieure à la valeur critique tabulée q_critique(alpha, k, df_erreur), l’hypothèse nulle d’égalité entre la population i et la population j est formellement rejetée au seuil de confiance 1 – alpha.
2.2 Calcul de la variance d’erreur combinée et de la moyenne harmonique
Le cœur méthodologique de l’extension de Kramer réside dans la modélisation mathématique de l’erreur type de la différence inter-groupes en contexte d’hétérogénéité des effectifs. L’information relative à la variance non expliquée est directement extraite de la table de variance de l’ANOVA préalable sous la forme du carré moyen résiduel intra-groupes, désigné sous les acronymes MSw (Mean Square Within) ou MSe (Mean Square Error). Ce paramètre constitue le meilleur estimateur combiné non biaisé de la variance commune de la population sous le postulat d’homoscédasticité.
Pour un contraste spécifique opposant le groupe i (comportant un effectif de n_i observations) au groupe j (comportant un effectif de n_j observations), l’erreur type combinée de la différence s’exprime rigoureusement selon l’équation :
SE_diff = RACINE( (MSw / 2) * ( (1 / n_i) + (1 / n_j) ) )
Cette formulation analytique équivaut strictement à introduire la moyenne harmonique des deux tailles d’échantillons au dénominateur de l’erreur type standard de Tukey. Pour rappel, la moyenne harmonique de deux nombres n_i et n_j est définie par n_h = 2 / ((1 / n_i) + (1 / n_j)). En réécrivant la formule sous cette perspective géométrique, l’erreur type prend la forme compacte : SE_diff = RACINE(MSw / n_h). Cette propriété mathématique assure une pondération asymétrique qui accorde davantage de poids au plus petit des deux échantillons, empêchant ainsi qu’un groupe surdimensionné ne masque artificiellement l’incertitude statistique induite par un groupe de taille réduite.
D’un point de vue asymptotique, lorsque les effectifs n_i et n_j tendent vers l’égalité parfaite (n_i = n_j = n), la somme (1/n + 1/n) se simplifie immédiatement en 2/n. Dès lors, le terme MSw / 2 * 2 / n se réduit à MSw / n, ramenant exactement l’équation à la formulation classique du test HSD de Tukey pour échantillons équilibrés. Cette cohérence interne confirme la nature du test de Tukey-Kramer comme généralisation directe du modèle d’origine, tout en conservant d’excellentes propriétés de robustesse tant que les déséquilibres d’effectifs ne s’accompagnent pas de violations majeures de l’homoscédasticité.
2.3 Calcul de la différence minimale significative (HSD)
Plutôt que de recalculer systématiquement la statistique observée q_obs pour chaque binôme et de la confronter à une valeur critique d’étendue standardisée fixe, les praticiens de la recherche empirique privilégient fréquemment l’approche de la différence minimale significative, ou seuil HSD (Honestly Significant Difference). Cette grandeur critique représente l’amplitude absolue minimale qu’un écart entre deux moyennes doit impérativement atteindre ou dépasser pour être déclaré statistiquement significatif au seuil d’erreur alpha désigné.
Pour chaque comparaison spécifique entre un groupe i et un groupe j, la valeur critique du seuil HSD s’obtient en multipliant la valeur critique de l’étendue standardisée q_critique par l’erreur type combinée de la différence propre à cette paire d’échantillons :
HSD_ij = q_critique * RACINE( (MSw / 2) * ( (1 / n_i) + (1 / n_j) ) )
En présence d’effectifs inégaux, il convient de souligner que la valeur du seuil HSD n’est pas constante à travers l’ensemble des comparaisons d’un même jeu de données. Chaque binôme de conditions possède sa propre valeur HSD_ij, qui fluctue en stricte fonction des dimensions d’échantillons n_i et n_j. Le critère d’inférence s’énonce alors de manière intuitive : la différence est dite significative au seuil alpha si et seulement si :
|Moyenne_i – Moyenne_j| >= HSD_ij
Cette modélisation permet en outre de dériver de manière directe les intervalles de confiance simultanés de Tukey-Kramer pour la différence réelle des moyennes de populations (mu_i – mu_j). Pour chaque contraste dyadique, l’intervalle de confiance bilatéral au niveau de confiance 1 – alpha (typiquement 95 %) est délimité par l’estimation ponctuelle de la différence brute observée, augmentée et diminuée de la marge d’erreur HSD_ij :
IC_[1 – alpha] = (Moyenne_i – Moyenne_j) +/- HSD_ij
L’interprétation de cet intervalle est immédiate et fournit une information visuelle et clinique d’une grande clarté : si l’intervalle de confiance calculé pour une paire donnée ne contient pas la valeur zéro en son sein, le chercheur rejette formellement l’hypothèse nulle d’équivalence entre les deux conditions au seuil de confiance retenu.
3. Vérification préalable des postulats statistiques dans Excel
3.1 Évaluation de la normalité des distributions au sein de chaque groupe
L’application rigoureuse du test de Tukey-Kramer repose en amont sur le respect scrupuleux des postulats paramétriques classiques régissant l’analyse de variance à un facteur. Le premier de ces prérequis théoriques stipule que la variable dépendante doit suivre une distribution normale au sein de chacune des k populations représentées dans l’expérience. En psychométrie expérimentale, les déviations modérées par rapport à la loi normale sont fréquentes en raison de planchers ou de plafonds de mesure psychologique. Si le modèle de l’ANOVA fait preuve d’une robustesse substantielle face à des asymétries légères lorsque les effectifs sont volumineux, des distorsions sévères de la normalité associées à des effectifs réduits altèrent la puissance statistique du test de Tukey-Kramer et déforment le taux réel de faux positifs.
Dans l’environnement Microsoft Excel, l’évaluation préliminaire de la normalité peut être conduite au moyen d’analyses graphiques et de calculs distributionnels dédiés. L’inspection visuelle s’opère par l’élaboration d’histogrammes de distribution pour chaque condition à l’aide des outils graphiques natifs, complétée idéalement par la construction manuelle de diagrammes quantile-quantile (Q-Q plots). Un tracé Q-Q juxtapose les quantiles observés des données d’un groupe aux quantiles théoriques attendus d’une loi normale centrée réduite de même dimension, obtenus au moyen de la fonction mathématique d’inversion normale d’Excel :
=LOI.NORMALE.STANDARD.INVERSE((RANG(donnee; plage; 1) – 0,5) / NB(plage))
Si les points se répartissent de façon rectiligne le long de la diagonale d’identité, la condition de normalité univariée est considérée comme empiriquement satisfaite pour le groupe sous observation.
Sur le plan quantitatif, Excel met à disposition des chercheurs deux fonctions d’évaluation distributionnelle incontournables :
- =COEFFICIENT.ASYMETRIE(plage_groupe) : cette commande quantifie le degré d’asymétrie de la distribution autour de sa moyenne empirique (skewness). Une distribution symétrique théorique présente un indice proche de zéro. En règle générale, une valeur d’asymétrie comprise entre -1,0 et +1,0 est considérée comme acceptable dans les devis de recherche psychologique.
- =KURTOSIS(plage_groupe) : cette fonction évalue l’aplatissement ou la leptocurticité de la courbe par rapport au profil gaussien standard. Un excès de kurtose compris dans l’intervalle [-1,5 ; +1,5] atteste de l’absence de queues de distribution excessivement lourdes, confirmant ainsi l’adéquation des données avec les exigences paramétriques fondamentales.
3.2 Vérification de l’homogénéité des variances (homoscédasticité)
Le second postulat capital conditionnant la validité du test de Tukey-Kramer est l’homogénéité des variances intra-groupes, techniquement désignée sous le terme d’homoscédasticité. Cette prémisse implique que la variance de l’erreur résiduelle demeure uniforme à travers l’ensemble des k conditions de l’expérience, soit formellement sigma^2_1 = sigma^2_2 = … = sigma^2_k = sigma^2. Si l’ANOVA se montre tolérante à de légères hétérogénéités lorsque les groupes disposent d’effectifs rigoureusement identiques, la combinaison délétère d’une violation de l’homoscédasticité et d’effectifs inégaux constitue une grave menace méthodologique. Lorsque le groupe présentant le plus faible effectif possède la variance la plus élevée, le test devient excessivement libéral, générant un taux de faux positifs bien supérieur au seuil nominal de 5 %.
Pour diagnostiquer l’état d’homoscédasticité dans Excel, la démarche initiale consiste à calculer la variance d’échantillon corrigée pour chaque colonne expérimentale en utilisant la fonction statistique :
=VAR.S(plage_groupe)
Une règle empirique préliminaire fréquemment exploitée dans les laboratoires de recherche stipule que si le ratio entre la variance d’échantillon maximale et la variance minimale parmi les k groupes n’excède pas un facteur de 3 ou 4, le postulat de robustesse de l’ANOVA et du test de Tukey-Kramer demeure raisonnablement vérifié.
Pour une formalisation plus rigoureuse au sein du tableur, le chercheur peut implémenter manuellement le test d’homogénéité des variances de Levene, reconnu pour sa grande robustesse face aux déviations de normalité. Cette méthode consiste à transformer les scores bruts de chaque participant en écarts absolus par rapport à la médiane (ou à la moyenne) de leur groupe d’appartenance respectif, à l’aide de la formule Excel :
=ABS(cellule_score – MEDIANE(plage_groupe))
Une analyse de variance à un facteur standard est ensuite exécutée via l’Utilitaire d’analyse directement sur ces déviations absolues ainsi transformées. Si la valeur de p issue de cette ANOVA auxiliaire s’avère supérieure au seuil critique de 0,05, l’hypothèse nulle d’égalité des variances intra-groupes ne peut être rejetée, conférant une légitimité mathématique complète à l’exécution ultérieure du test de Tukey-Kramer.
3.3 Contrôle de l’indépendance des observations et de l’échelle de mesure
Au-delà de la normalité et de l’homoscédasticité, la solidité inférentielle du test de Tukey-Kramer dépend de deux postulats conceptuels qui doivent être contrôlés en amont dès la phase d’élaboration du protocole de recueil de données. Le premier concerne l’échelle de mesure : la variable dépendante doit impérativement posséder une nature quantitative continue ou, à tout le moins, être mesurée selon une échelle d’intervalles constants. Dans les protocoles de psychométrie cognitive ou sociale, les scores agrégés issus d’échelles de Likert multi-items validées (telles que le BDI-II pour la dépression ou le STAI pour l’anxiété) sont universellement admis comme satisfaisant à cette exigence d’intervalle, autorisant légitimement l’application d’estimateurs statistiques de moyenne et de variance.
Le second postulat, dont la violation s’avère la plus destructrice pour l’inférence statistique, stipule l’indépendance absolue des observations expérimentales. L’attribution d’un score d’un sujet au sein d’une condition ne doit en aucun cas être influencée par les réponses d’autres participants, ni provenir d’évaluations répétées sur un même individu au fil du temps. Les devis à mesures répétées ou en blocs randomisés relèvent de formulations statistiques distinctes et ne peuvent en aucun cas être traités par le test de Tukey-Kramer univarié pour groupes indépendants décrit ici.
Enfin, l’intégrité de la variance résiduelle exige un repérage et un traitement méticuleux des valeurs extrêmes aberrantes (outliers). Une observation anormale dans un échantillon de taille modeste peut gonfler artificiellement le carré moyen résiduel MSw, augmentant l’erreur type de l’ensemble des contrastes et diminuant drastiquement la puissance statistique du test de Tukey-Kramer. Dans Excel, ces données atypiques peuvent être systématiquement isolées en standardisant les valeurs sous la forme de cotes Z au moyen de l’équation :
=(cellule_score – MOYENNE(plage_groupe)) / ECARTYPE.STANDARD(plage_groupe)
Toute observation présentant une valeur absolue de cote Z supérieure à 3,0 ou 3,29 (selon les recommandations admises en sciences du comportement) doit faire l’objet d’un examen approfondi afin de déterminer s’il s’agit d’une erreur matérielle de saisie numérique ou d’un profil clinique atypique nécessitant un traitement méthodologique spécifique.
4. Organisation et structuration des données expérimentales sous Excel
4.1 Formatage des données en colonnes distinctes
L’Utilitaire d’analyse statistique de Microsoft Excel impose des contraintes organisationnelles précises quant à la disposition matricielle des variables pour exécuter sans encombre l’ANOVA à un facteur de classification. La méthode de disposition la plus intuitive et la plus adaptée aux fonctionnalités natives du tableur consiste à organiser les données expérimentales sous un format tabulaire large, où chaque colonne adjacente représente un niveau spécifique de la variable indépendante catégorielle.
Dans cette configuration en colonnes disjointes, la première ligne de la feuille de calcul (ligne d’en-tête) doit obligatoirement être réservée aux dénominations explicites des modalités expérimentales. Pour une recherche en psychothérapie comparée, les colonnes A, B, C et D recevront des étiquettes sémantiquement transparentes telles que TCC, ACT, Psychanalyse et ListeAttente. Les données quantitatives continues mesurées chez chaque sujet sont ensuite insérées verticalement dans les cellules situées sous leurs étiquettes respectives.
En contexte d’effectifs déséquilibrés — cœur de cible du modèle de Tukey-Kramer —, les colonnes contiendront un nombre différent de cellules remplies. Par exemple, la colonne A peut s’étendre de la ligne 2 à la ligne 26 (soit n_1 = 25 participants), tandis que la colonne B s’arrête à la ligne 21 (n_2 = 20), la colonne C à la ligne 19 (n_3 = 18), et la colonne D à la ligne 23 (n_4 = 22). Il est primordial de laisser les cellules inférieures strictement vides, sans y insérer de valeurs d’espacement, d’astérisques ou de chiffres zéro qui viendraient fausser dramatiquement le calcul des effectifs réels et des paramètres de dispersion par les routines automatiques d’Excel.
4.2 Structuration alternative sous format base de données (format long)
Si la disposition en colonnes distinctes s’avère indispensable pour l’exécution directe de l’ANOVA via l’Utilitaire d’analyse classique, la structuration des données en format base de données relationnelle (couramment dénommé « format long » ou format normalisé) offre des bénéfices architecturaux considérables pour les modélisations matricielles avancées, le filtrage dynamique et la reproductibilité des calculs dans les versions contemporaines d’Excel.
Dans une disposition en format long, la matrice de données ne comporte que deux ou trois colonnes d’enregistrements uniformes :
- Une première colonne dédiée à l’identifiant unique de chaque sujet participant (par exemple
ID_Participant, codé de P001 à P085). - Une seconde colonne catégorielle spécifiant l’assignation expérimentale du sujet (par exemple
Groupe_Traitement), codée sous forme de texte ou de facteur numérique. - Une troisième colonne numérique continue contenant la mesure de la variable dépendante d’intérêt (par exemple
Score_Anxiete_Post).
En transformant immédiatement cette plage de cellules en un tableau structuré officiel Microsoft Excel (via le raccourci Ctrl + L ou l’onglet Accueil > Mettre sous forme de tableau), l’utilisateur confère à sa matrice des propriétés dynamiques indispensables. Dès lors que de nouvelles données cliniques sont insérées, les formules mathématiques dépendantes se mettent à jour automatiquement par propagation instantanée des références structurées. Cette architecture permet également d’extraire les métriques descriptives indispensables au test de Tukey-Kramer à l’aide de formules conditionnelles avancées telles que :
=MOYENNE.SI(Tableau1[Groupe_Traitement]; « TCC »; Tableau1[Score_Anxiete_Post])
ainsi que le décompte automatique de l’effectif associé par la fonction :
=NB.SI(Tableau1[Groupe_Traitement]; « TCC »)
4.3 Nettoyage et contrôle de l’intégrité des entrées numériques
Avant d’engager la moindre procédure calculatoire ou de lancer l’analyse de variance exploratoire, une phase critique d’audit des données doit être opérée afin de garantir l’intégrité des entrées quantitatives. Dans les projets de recherche empirique, des erreurs d’inattention lors de la saisie au clavier — telles que la substitution d’une virgule par un point décimal dans un système d’exploitation francophone, l’adjonction fortuite d’espaces invisibles, ou l’inversion de chiffres au pavé numérique — peuvent corrompre l’ensemble des dérivations matricielles.
L’implémentation d’une règle de validation des données dans Excel constitue un premier rempart préventif efficace. En sélectionnant la plage globale destinée à recevoir les scores psychométriques et en accédant au menu Données > Outils de données > Validation des données, l’administrateur peut contraindre le type de saisie en spécifiant que seules les valeurs numériques décimales comprises dans les bornes réelles de l’échelle de mesure (par exemple, un score minimal de 0 et maximal de 63 pour l’inventaire de dépression de Beck) sont autorisées, rejetant immédiatement toute entrée hors limites.
Par ailleurs, il est impératif d’utiliser la fonctionnalité Rechercher et sélectionner > Atteindre les cellules spéciales > Formules pour auditer la matrice et s’assurer qu’aucune cellule destinée à contenir des données brutes ne comporte de formule masquée ou de référence circulaire. Enfin, l’utilisation de la fonction logique =ESTNUM(cellule) appliquée à l’ensemble du jeu de données assure la validation définitive du format de chaque enregistrement, garantissant que l’Utilitaire d’analyse ne convertira pas silencieusement des cellules de texte mal formatées en valeurs nulles susceptibles de fausser les sommes de carrés de l’ANOVA.
5. Exécution de l’ANOVA à un facteur via l’Utilitaire d’analyse
5.1 Activation et configuration du complément d’analyse d’Excel
Le calcul des paramètres initiaux du test de Tukey-Kramer exige la récupération précise de la variance résiduelle intra-groupes et des degrés de liberté associés. Bien que ces métriques puissent être programmées manuellement au moyen de formules matricielles lourdes, le recours au module officiel d’Excel intitulé Utilitaire d’analyse (Analysis ToolPak) simplifie considérablement la génération de la table de variance fondamentale.
Ce composant d’analyse statistique avancée fait partie intégrante de la suite Microsoft Office mais demeure désactivé par défaut lors d’une installation standard. Pour le rendre opérationnel sur un système Windows, la procédure de configuration s’exécute selon les étapes suivantes :
- Cliquer sur l’onglet Fichier situé à l’extrême gauche du ruban, puis sélectionner le menu Options situé au bas de la colonne de navigation latérale.
- Dans la boîte de dialogue contextuelle des Options Excel, sélectionner la catégorie Compléments dans le panneau de navigation gauche.
- Au bas de la fenêtre, dans le menu déroulant intitulé Gérer, s’assurer que l’option Compléments Excel est active, puis cliquer sur le bouton Atteindre…
- Dans la fenêtre des compléments disponibles qui s’affiche, cocher la case relative à l’Utilitaire d’analyse, puis valider en cliquant sur le bouton OK.
Une fois cette validation accomplie, un nouveau groupe d’outils nommé Analyse apparaît instantanément à l’extrémité droite de l’onglet Données du ruban principal d’Excel, abritant le bouton de commande Utilitaire d’analyse.
5.2 Paramétrage de l’analyse de variance à un facteur
Dès lors que le complément analytique est accessible et que les données quantitatives sont rigoureusement disposées en colonnes distinctes avec leurs intitulés nominatifs en première ligne, l’analyse d’inférence globale peut être initiée. En cliquant sur le bouton Utilitaire d’analyse, l’utilisateur fait apparaître une boîte de dialogue listant une série de procédures statistiques. Il convient de sélectionner avec précision la première modalité proposée dans la nomenclature : Analyse de variance : un facteur simple, puis de confirmer le choix en cliquant sur OK.
Le paramétrage de l’interface graphique de configuration requiert une attention scrupuleuse pour éviter tout biais d’entrée :
- Plage d’entrée : il convient de sélectionner à la souris l’ensemble du bloc rectangulaire englobant la totalité des colonnes de données, depuis les étiquettes textuelles de la première ligne jusqu’à la dernière ligne remplie du groupe possédant le plus grand effectif (par exemple, la plage
$A$1:$D$26). En raison des effectifs inégaux, certaines colonnes contiendront des cellules vides en partie basse : l’algorithme interne de l’Utilitaire d’analyse les traitera correctement sans altérer les calculs des colonnes plus courtes. - Grouper par : cocher impérativement le bouton radio Colonnes, conformément à la disposition matricielle retenue.
- Intitulés en première ligne : cocher systématiquement cette case si vous avez intégré les en-têtes textuels de conditions dans la plage sélectionnée, afin d’éviter qu’Excel ne tente d’interpréter du texte comme des valeurs numériques de score.
- Alpha : maintenir la valeur par défaut à
0,05, seuil de signification conventionnel régissant le calcul de la valeur critique théorique du test F. - Options de sortie : sélectionner le bouton radio Plage de sortie et désigner une cellule libre au sein de la même feuille (par exemple
$F$1), ou opter pour la création d’une Nouvelle feuille de calcul.
5.3 Génération et vérification de la table de sortie ANOVA
L’exécution de la procédure génère instantanément un rapport statistique structuré en deux tableaux consécutifs : un premier tableau d’analyse descriptive (intitulé RÉSUMÉ) et un second tableau consacré à la décomposition de la variance (intitulé ANOVA).
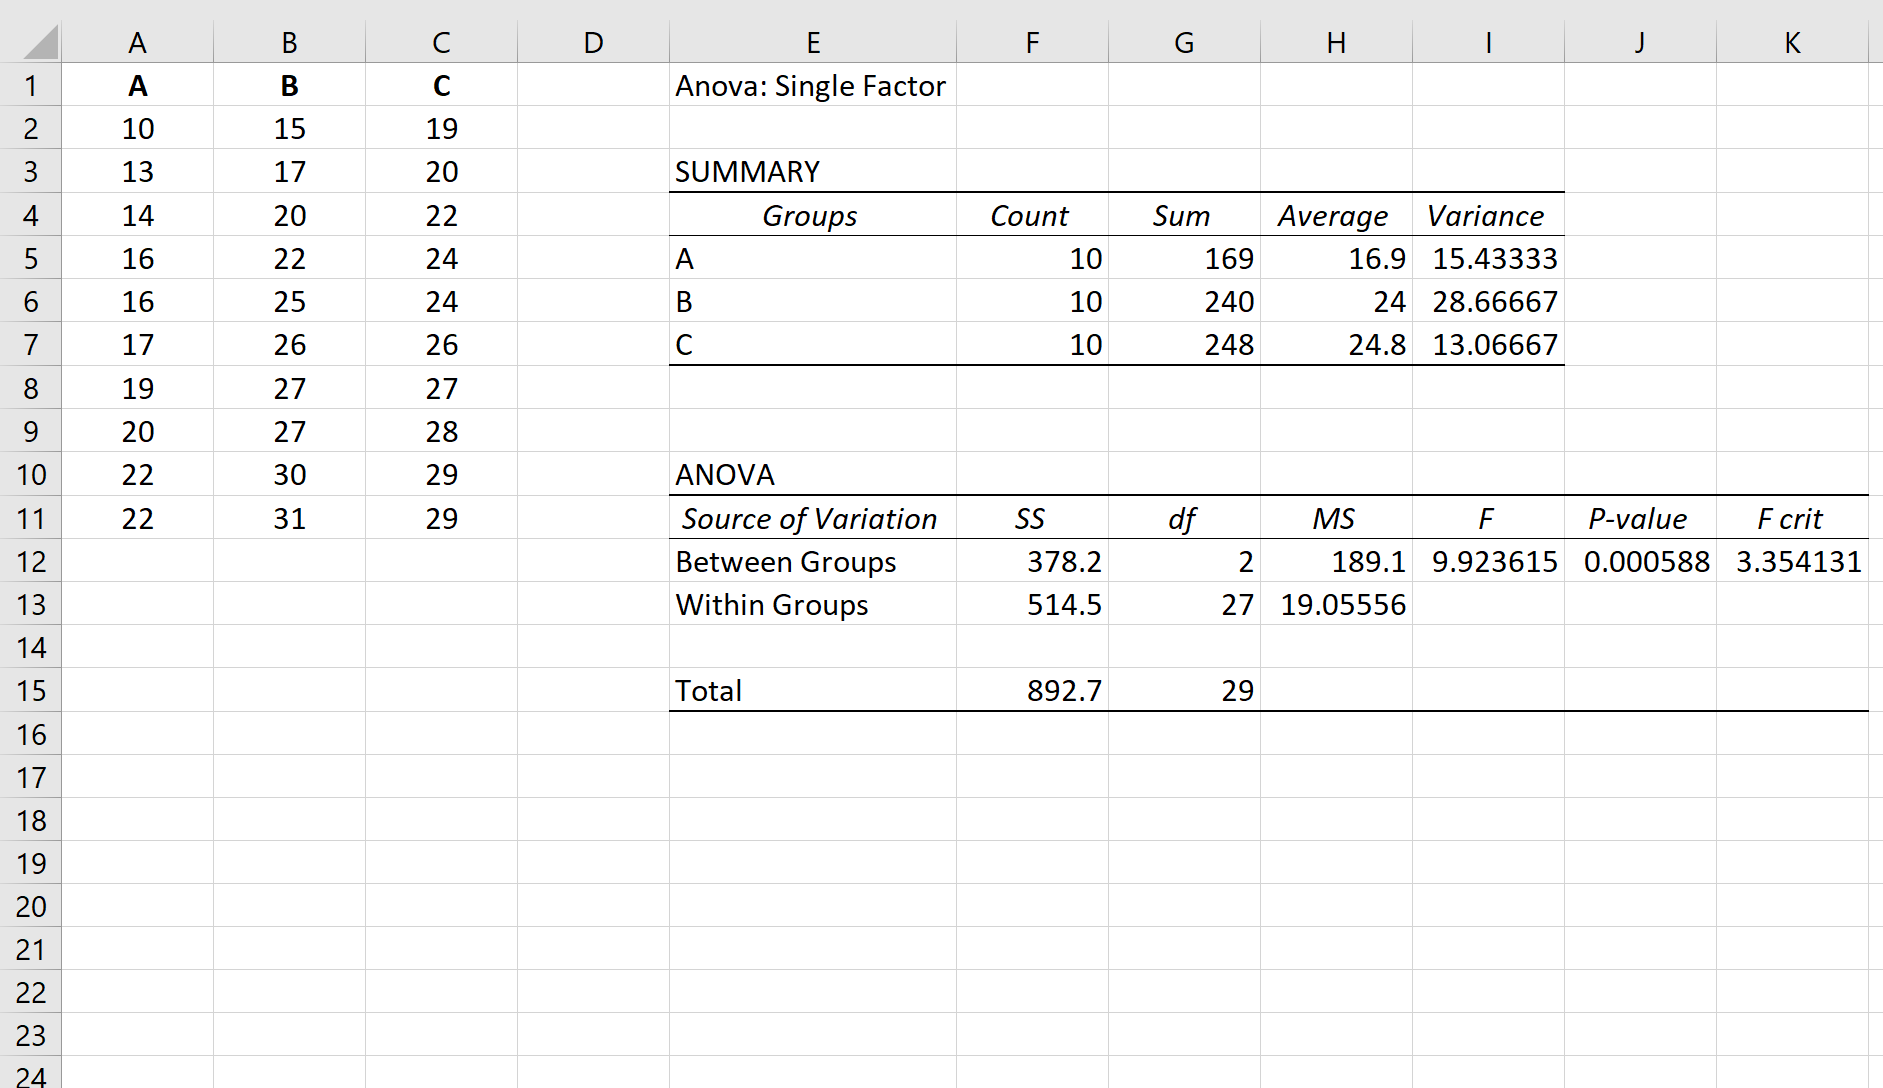
Le tableau descriptif présente une synthèse chiffrée fondamentale pour chacune des modalités expérimentales soumises au test : l’effectif valide n_k (colonne Nombre), le total cumulé des scores (colonne Somme), la moyenne arithmétique M_k (colonne Moyenne) et la variance d’échantillon non biaisée s^2_k (colonne Variance). Une vérification croisée de ces grandeurs descriptives avec les effectifs théoriques de la cohorte permet de certifier qu’aucune omission de cellule n’est survenue lors de l’intégration de la plage d’entrée.
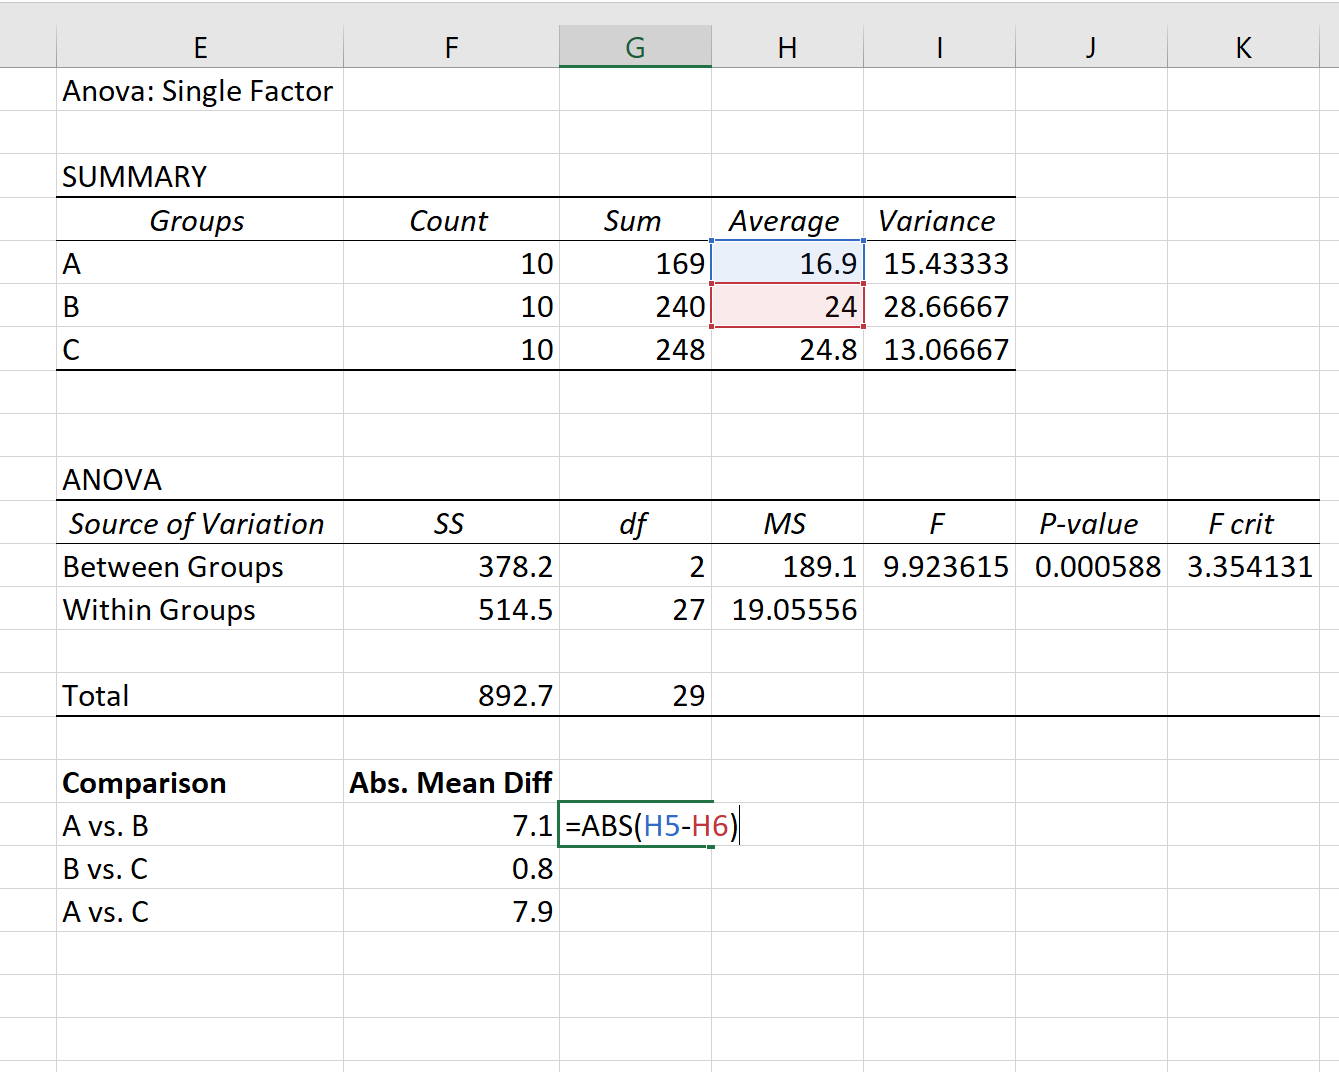
Le second tableau synthétise la partition formelle de la somme des carrés des écarts :
- La ligne Entre groupes (dispersion inter-groupes) renseigne la somme des carrés (SS_entre), les degrés de liberté inter (df = k – 1), le carré moyen inter-groupes (MS_entre), ainsi que la valeur du ratio empirique F.
- La ligne À l’intérieur des groupes (dispersion intra-groupes ou résiduelle) fournit la somme des carrés des résidus (SS_intra), les degrés de liberté résiduels (df = N – k) et le carré moyen intra-groupes (MS_intra ou MSw).
- La colonne Probabilité fournit la p-valeur exacte associée à la statistique F observée, mise en regard de la Valeur critique pour F au seuil de 5 %.
L’inspection de cette table conditionne impérativement la poursuite de l’investigation méthodologique. Si la Probabilité globale associée au test F est strictement inférieure à 0,05 (indiquant un F calculé supérieur à sa valeur critique), l’hypothèse nulle globale est réfutée. Le recours immédiat au test post-hoc de Tukey-Kramer est alors statistiquement légitimé afin d’élucider avec précision la nature des contrastes d’intérêt.
6. Extraction et calcul des paramètres fondamentaux dans une table dédiée
6.1 Récupération dynamique des variances et degrés de liberté
Plutôt que de saisir manuellement les paramètres de l’ANOVA dans les cellules destinées au calcul du test de Tukey-Kramer — une pratique source d’erreurs matérielles lors de modifications ultérieures des données sources —, il est méthodologiquement recommandé d’établir des liaisons dynamiques directes vers la table de sortie ANOVA générée par l’Utilitaire d’analyse.
Dans une nouvelle zone de la feuille de calcul (ou dans un onglet dédié baptisé Tukey_Kramer), créez un bloc de paramètres clés répertoriant les variables scalaires indispensables à l’algorithme :
- Carré moyen résiduel (MSw) : Dans la cellule destinée à héberger cette métrique (par exemple
B3), saisissez une référence directe pointant vers la cellule de la table ANOVA correspondant à l’intersection de la ligne À l’intérieur des groupes et de la colonne Moyenne des carrés. Par exemple :=ANOVA_Sortie!E13. - Degrés de liberté de l’erreur (df_erreur) : Dans la cellule
B4, référencez la cellule hébergeant le degré de liberté intra-groupes correspondant (par exemple :=ANOVA_Sortie!D13). Ce paramètre est égal à N – k, où N représente l’effectif global agrégé de l’ensemble de l’étude. - Nombre total de groupes (k) : Dans la cellule
B5, intégrez la formule dynamique :=NB(ANOVA_Sortie!B5:B8)en sélectionnant la colonne Nombre du tableau récapitulatif descriptif de l’ANOVA, afin d’automatiser le décompte exact du nombre de conditions sans intervention manuelle.
6.2 Compilation matricielle des effectifs et moyennes des groupes
L’étape subséquente consiste à bâtir un tableau récapitulatif ordonné qui servira de base de référence pour l’évaluation de tous les contrastes par paires. Ce tableau descriptif doit regrouper de manière limpide le libellé de chaque modalité, la taille de son effectif propre et son estimation moyenne.
La structuration recommandée se présente sous la forme de quatre colonnes contiguës :
- Identifiant numérique du groupe (Colonne A) : de 1 à k.
- Nom de la condition (Colonne B) : lié dynamiquement aux intitulés de la table descriptive de l’ANOVA (par exemple,
=ANOVA_Sortie!A5pour le groupe 1,=ANOVA_Sortie!A6pour le groupe 2, etc.). - Taille de l’échantillon (n_i) (Colonne C) : lié aux effectifs décomptés par l’ANOVA (par exemple,
=ANOVA_Sortie!B5). - Moyenne observée (M_i) (Colonne D) : lié aux moyennes calculées par l’ANOVA (par exemple,
=ANOVA_Sortie!D5).
Ce chaînage dynamique garantit l’actualisation instantanée de l’intégralité du modèle de Tukey-Kramer dès lors que de nouvelles observations psychologiques sont ajoutées ou corrigées au sein de la matrice brute d’origine, respectant ainsi les principes directeurs de reproductibilité de la recherche expérimentale.
6.3 Établissement de la grille de toutes les combinaisons de paires uniques
L’architecture centrale du test post-hoc repose sur l’énumération exhaustive et sans redondance de la totalité des paires dyadiques de conditions possibles. Comme explicité théoriquement dans la section 1.2, le nombre exact de combinaisons uniques à formaliser pour k modalités s’obtient par le coefficient binomial C = k(k – 1) / 2. Pour une étude portant sur quatre groupes expérimentaux (par exemple k = 4), le modèle requiert l’évaluation de précisément 4(3) / 2 = 6 comparaisons binaires.
Aménagez une table de calcul dédiée en créant les colonnes suivantes : Comparaison, Groupe (i), Groupe (j), Moyenne (i), Moyenne (j), n (i), n (j), et Différence absolue |Mi - Mj|. Remplissez ensuite méticuleusement chaque ligne de la grille avec l’ensemble des arrangements distincts sans permutation inverse :
- Paire 1 : Groupe 1 vs Groupe 2
- Paire 2 : Groupe 1 vs Groupe 3
- Paire 3 : Groupe 1 vs Groupe 4
- Paire 4 : Groupe 2 vs Groupe 3
- Paire 5 : Groupe 2 vs Groupe 4
- Paire 6 : Groupe 3 vs Groupe 4
Au sein de cette table de travail, faites appel à la fonction de recherche matricielle RECHERCHEV ou INDEX/EQUIV pour renseigner automatiquement les colonnes de moyennes et d’effectifs à partir du tableau récapitulatif compilé en section 6.2. Enfin, programmez le calcul de la différence absolue des moyennes au sein de la colonne dédiée au moyen de la fonction mathématique d’Excel :
=ABS(cellule_Moyenne_i – cellule_Moyenne_j)
Cette formulation élimine les valeurs négatives et isole l’amplitude brute du contraste psychologique sous investigation.
7. Détermination de la valeur critique q de Student-Newman-Keuls / Tukey
7.1 Compréhension de la table statistique de la distribution q
La statistique critique nécessaire à la validation du test de Tukey-Kramer découle de la distribution de l’étendue standardisée de Student, traditionnellement conceptualisée par Student (William Sealy Gosset) et opérationnalisée par John Tukey pour le contrôle du risque familial. Cette distribution théorique modélise la probabilité associée à la variabilité maximale attendue entre un ensemble de k moyennes issues d’une population parente normale, standardisée par la variance intra-groupe.
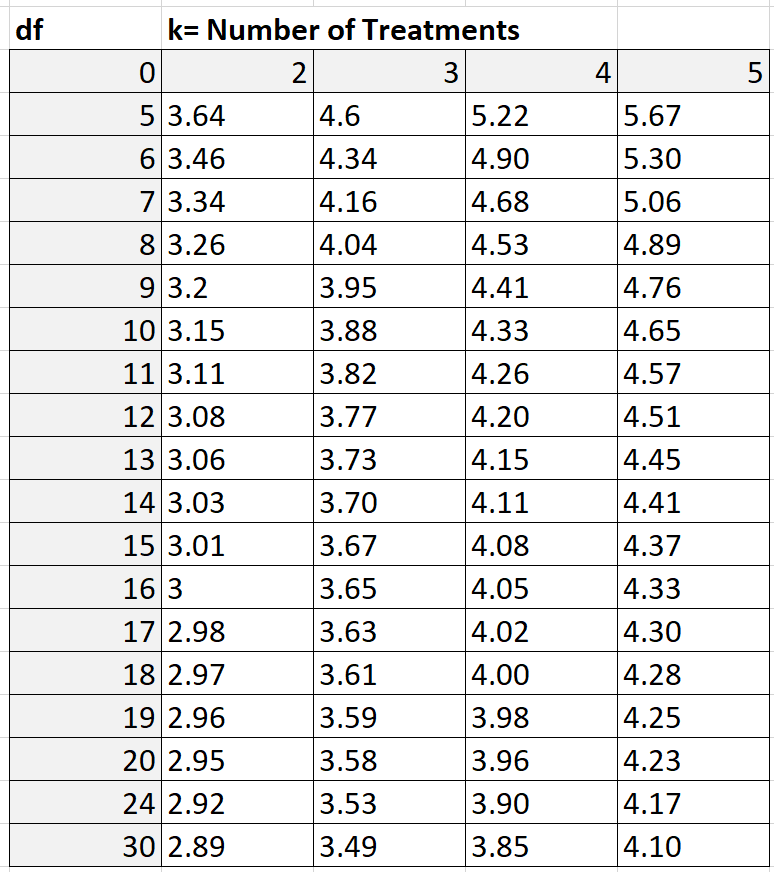
Pour extraire manuellement la valeur critique q d’une table imprimée classique de Student, trois coordonnées d’accès dimensionnelles s’avèrent impératives :
- Le niveau alpha : qui correspond au taux nominal d’erreur de type I pour l’ensemble de la famille de comparaisons, communément sélectionné à
alpha = 0,05pour les recherches publiables, ou plus sévèrement àalpha = 0,01lors d’essais cliniques sensibles. - Le paramètre k : qui désigne le nombre total de moyennes ou de groupes comparés dans l’ANOVA initiale. Il est crucial de noter qu’il s’agit bien du nombre total de conditions expérimentales de l’étude (et non du nombre de paires comparées à l’instant t, ni de la valeur 2 qui caractérise le binôme).
- Les degrés de liberté du dénominateur (df_erreur) : qui correspondent rigoureusement aux degrés de liberté de la variance d’erreur résiduelle intra-groupes (df_w = N – k) issus de la table de variance de l’ANOVA.
À la croisée de la colonne correspondant au paramètre k et de la ligne correspondant au df_erreur, la table statistique fournit la valeur scalaire critique q_critique. Cette grandeur servira de multiplicateur normatif fixe pour l’ensemble des contrastes dyadiques calculés sous ce modèle d’ANOVA.
7.2 Intégration manuelle ou table de recherche dans le classeur Excel
Une des limitations structurelles bien connues des versions traditionnelles de Microsoft Excel réside dans l’absence de fonction intégrée native capable de renvoyer directement la distribution cumulative inverse de l’étendue standardisée de Student (il n’existe pas d’équivalent direct tel qu’une fonction native LOI.Q.INVERSE, contrairement aux fonctions LOI.STUDENT.INVERSE ou LOI.F.INVERSE). Pour pallier cette contrainte technique au sein d’un classeur standardisé, deux démarches d’intégration opérationnelle peuvent être déployées.
La première solution consiste en la création d’un onglet de référence statistique nommé Table_Q_Tukey, dans lequel est insérée une matrice bidimensionnelle numérisée des valeurs critiques de q pour le seuil de significativité retenu (typiquement alpha = 0,05). Dans cet onglet :
- La première ligne horizontale liste les valeurs ordonnées du nombre total de groupes k (de 2 jusqu’à 20 conditions).
- La première colonne verticale répertorie les degrés de liberté de l’erreur résiduelle (allant typiquement de 1 à 120, puis complétée par la valeur asymptotique de l’infini).
- Les cellules matricielles internes renferment les valeurs critiques correspondantes extraites des tables de référence psychométriques publiées.
Pour extraire dynamiquement la valeur critique q appropriée au sein du modèle analytique principal, il suffit alors de combiner les fonctions INDEX et EQUIV d’Excel au sein de la cellule de paramètre :
=INDEX(Table_Q_Tukey!$B$2:$S$45; EQUIV(df_erreur; Table_Q_Tukey!$A$2:$A$45; 1); EQUIV(k; Table_Q_Tukey!$B$1:$S$1; 0))
Cette formule localise avec exactitude l’intersection entre le degré de liberté effectif de l’erreur résiduelle et le nombre de conditions de l’étude, fournissant une valeur critique théorique exploitable par les formules en aval.
7.3 Approximation numérique et recours aux scripts VBA personnalisés
Pour les utilisateurs avertis désireux de s’affranchir complètement de la contrainte d’une table statique matricielle externe et de conférer à leur classeur une autonomie algorithmique totale, l’implémentation d’une fonction personnalisée (UDF pour User-Defined Function) en Visual Basic for Applications (VBA) constitue la méthode la plus élégante et pérenne.
Historiquement, plusieurs algorithmes d’approximation numérique de haute précision ont été modélisés pour reproduire analytiquement la loi de l’étendue standardisée. L’algorithme polynomial de Copenhaver-Holland ou les routines d’intégration numérique adaptative par quadrature de Gauss-Legendre permettent d’estimer la valeur critique q avec une marge d’erreur inférieure à 0,0001 par rapport aux sorties de progiciels spécialisés de référence.
Pour insérer cette procédure dans votre classeur Excel, accédez à l’éditeur VBA via la combinaison de touches Alt + F11, insérez un nouveau module standard (menu Insertion > Module), et implémentez la routine algorithmique suivante permettant d’évaluer la fonction quantile de Tukey :
La fonction ainsi programmée peut recevoir le nom évocateur de TUKEY_Q_CRITIQUE(Alpha; k; df). Dès lors que le module VBA est enregistré au sein du classeur (qui devra impérativement être sauvegardé sous le format acceptant les macros, avec l’extension .xlsm), le chercheur peut invoquer directement cette formule dans n’importe quelle cellule de sa feuille de calcul, exactement comme une fonction native d’Excel. Cette automatisation algorithmique assure une précision mathématique sans faille pour des degrés de liberté non tabulés, garantissant une triangulation parfaite avec les sorties issues de langages statistiques professionnels tels que R ou Python.
8. Calcul pas-à-pas de l’erreur type et des seuils HSD spécifiques
8.1 Calcul de l’erreur type combinée propre à chaque paire
Avec l’extraction dynamique de la variance résiduelle MSw, le recueil des effectifs de chaque modalité et la détermination de la valeur critique q_critique, tous les éléments constitutifs de l’équation de Kramer sont désormais disponibles. Il convient désormais d’implémenter la dérivation de l’erreur type propre à chaque couple dyadique spécifique au sein de la table de comparaison élaborée en section 6.3.
Dans la colonne intitulée Erreur_Type_Diff (par exemple, la colonne H de la feuille de calcul), insérez sur la première ligne de comparaison la formule Excel respectant scrupuleusement la modélisation mathématique établie par Clyde Kramer :
=RACINE( ($MSw / 2) * ( (1 / cellule_n_i) + (1 / cellule_n_j) ) )
Dans la saisie concrète sous Excel, il est primordial de verrouiller la référence pointant vers la cellule du carré moyen intra-groupes à l’aide de coordonnées absolues (par exemple $B$3) au moyen du symbole dollar, tout en maintenant les cellules pointant vers les effectifs cellule_n_i et cellule_n_j sous forme de références relatives (par exemple F8 et G8). De cette manière, l’étirement de la formule vers le bas à l’aide de la poignée de recopie automatisera instantanément le calcul de l’erreur type combinée pour la totalité des paires dyadiques de l’expérience.
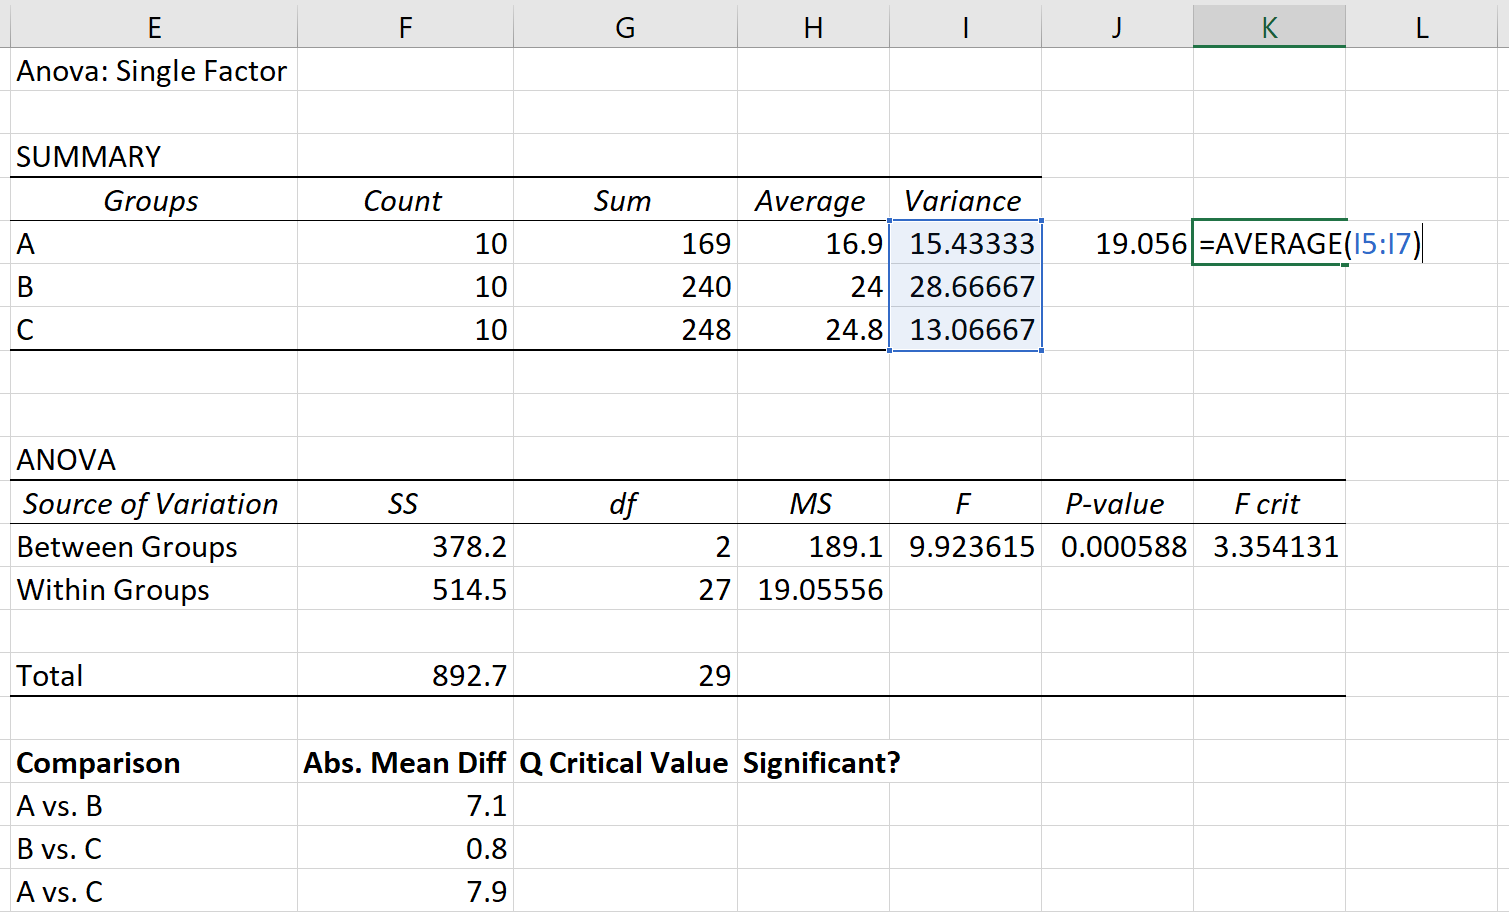
L’observation attentive des valeurs générées dans cette colonne met remarquablement en lumière l’impact méthodologique des déséquilibres d’effectifs : les paires formées par deux cohortes aux effectifs substantiels affichent une erreur type réduite, tandis que les comparaisons impliquant une modalité à effectif restreint manifestent une erreur type amplifiée, matérialisant parfaitement le surcroît d’incertitude induit par l’échantillonnage réduit.
8.2 Calcul de la statistique q observée pour chaque comparaison
Une fois l’erreur type combinée modélisée pour chaque contraste dyadique, la dérivation de la statistique empirique q_obs s’exécute de façon élémentaire et directe. Dans la colonne contiguë baptisée q_Observe, saisissez la formule correspondant au ratio d’amplitude :
=cellule_DiffAbsolue / cellule_Erreur_Type_Diff
où cellule_DiffAbsolue renvoie à la différence absolue de moyennes calculée préalablement via la fonction =ABS(M_i - M_j), et cellule_Erreur_Type_Diff pointe vers le résultat de l’équation de Kramer calculé au paragraphe précédent.
La valeur scalaire issue de ce ratio standardisé exprime la distance séparant les deux moyennes empiriques en unités d’écart type de l’étendue standardisée. Cette grandeur sans dimension permet de confronter directement l’écart mesuré au seuil critique théorique : toute comparaison pour laquelle la valeur observée q_obs surpasse la valeur critique q_critique établie pour l’ensemble du modèle indique un écart dont la probabilité d’occurrence sous l’hypothèse nulle est inférieure à l’erreur alpha globale spécifiée.
Il s’avère particulièrement instructif de procéder à un tri conditionnel décroissant de la grille d’analyse en fonction de cette statistique q_obs. Cet ordonnancement met immédiatement en perspective les contrastes expérimentaux les plus massifs de l’étude, hiérarchisant les effets des différentes interventions thérapeutiques ou conditions cognitives selon leur saillance inférentielle.
8.3 Détermination du seuil critique HSD spécifique à chaque binôme
L’approche complémentaire — souvent plébiscitée dans les synthèses cliniques en raison de son expressivité directe dans l’unité de mesure de la variable dépendante d’origine — réside dans la modélisation du seuil critique HSD spécifique à chaque binôme de conditions. Dans la colonne suivante de votre matrice Excel, désignée sous l’étiquette Seuil_HSD_Critique, implémentez l’équation :
=$B$6 * cellule_Erreur_Type_Diff
où $B$6 représente l’adresse absolue contenant la valeur scalaire critique théorique q_critique (déterminée en section 7), et cellule_Erreur_Type_Diff renvoie à l’erreur type combinée propre au binôme sous observation.
L’examen de cette colonne illustre avec force la singularité du test de Tukey-Kramer : contrairement au test standard de Tukey pour effectifs équilibrés où une unique valeur HSD régit l’intégralité du tableau de décision, le protocole de Kramer génère une pluralité de seuils critiques individualisés. Un contraste confrontant deux groupes à effectifs réduits exigera une différence brute de moyennes sensiblement plus importante pour atteindre le statut de significativité qu’un contraste opposant deux groupes à effectifs fournis.
Cette variabilité des seuils critiques démontre la rigueur avec laquelle la méthode ajuste son niveau d’exigence à la précision métrologique effective de chaque sous-échantillon, prévenant activement la survenue de fausses découvertes au sein des sous-groupes statistiques les plus volatils.
9. Automatisation de la prise de décision statistique et calcul des intervalles de confiance
9.1 Automatisation du verdict par des fonctions logiques conditionnelles
Pour convertir le classeur Excel en un système d’aide à la décision statistique entièrement automatisé et réactif, la formulation du verdict inférentiel pour chaque contraste peut être programmée à l’aide des structures logiques conditionnelles natives d’Excel. Deux approches rigoureusement équivalentes peuvent être mobilisées : soit confronter directement la différence absolue observée au seuil HSD_ij, soit vérifier si le ratio q_obs excède la valeur q_critique.
Dans une colonne nommée Verdict_Statistique, insérez l’expression logique conditionnelle suivante :
=SI(cellule_DiffAbsolue >= cellule_Seuil_HSD; « Significatif »; « Non significatif »)
Pour parachever l’ergonomie visuelle du rapport et permettre une lecture immédiate lors de présentations de laboratoire ou de revues de données cliniques, il est judicieux d’adjoindre un formatage conditionnel dynamique à cette colonne. En sélectionnant la plage de résultats et en accédant au menu Accueil > Mise en forme conditionnelle > Règles de mise en surbrillance des cellules > Texte qui contient…, configurez un surlignage vert clair avec texte vert foncé pour la modalité Significatif, et un surlignage rouge clair ou neutre pour la mention Non significatif.
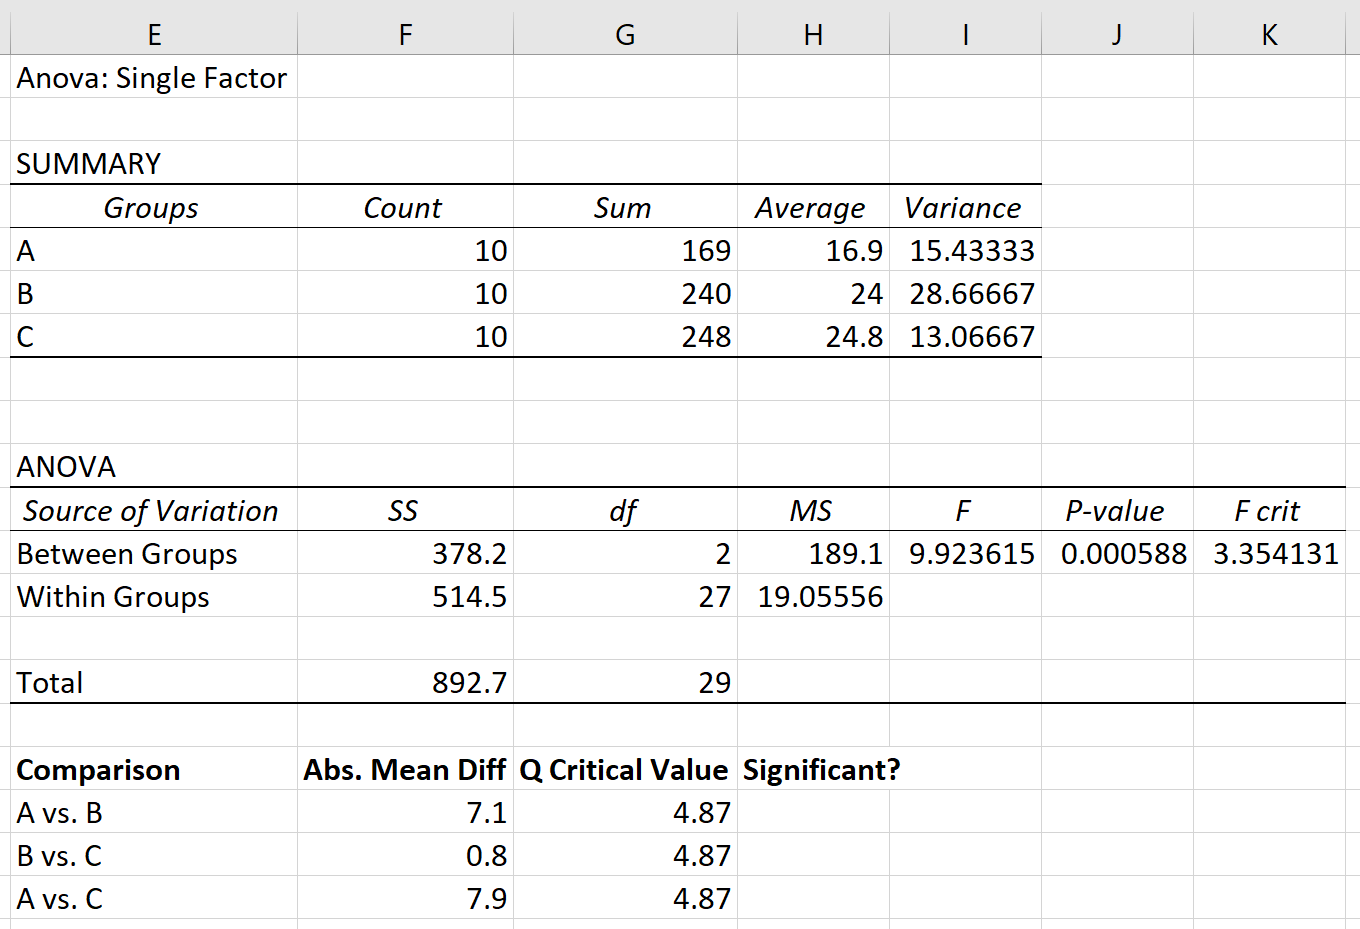
Enfin, pour reproduire la présentation standardisée des articles de recherche internationale, vous pouvez créer une colonne d’annotation d’astérisques via des structures logiques imbriquées évaluant les contrastes aux seuils alpha conventionnels de 5 %, 1 % et 0,1 % :
=SI(cellule_DiffAbsolue >= Seuil_001; « *** »; SI(cellule_DiffAbsolue >= Seuil_01; « ** »; SI(cellule_DiffAbsolue >= Seuil_05; « * »; « ns »)))
9.2 Calcul des intervalles de confiance de Tukey-Kramer à 95%
Conformément aux directives méthodologiques des comités éditoriaux internationaux, la simple transmission d’une valeur de p dichotomique s’avère insuffisante pour caractériser l’importance d’un résultat empirique. L’estimation par intervalles de confiance simultanés constitue un prérequis incontournable pour jauger la précision de la mesure et l’amplitude plausible des effets étudiés.
Les intervalles de confiance simultanés de Tukey-Kramer à 95 % s’établissent en projetant la marge d’erreur critique de part et d’autre de la différence brute non standardisée (différence signée : M_i – M_j). Créez deux colonnes contiguës au sein de votre tableau décisionnel :
- Borne inférieure de l’intervalle (IC 95% Inf) : saisissez la formule :
=(cellule_Moyenne_i – cellule_Moyenne_j) – cellule_Seuil_HSD - Borne supérieure de l’intervalle (IC 95% Sup) : saisissez l’expression symétrique :
=(cellule_Moyenne_i – cellule_Moyenne_j) + cellule_Seuil_HSD
L’inspection analytique conjointe de ces deux bornes fournit une méthode décisionnelle alternative d’une rigueur absolue :
- Si les deux bornes affichent le même signe algébrique (soit deux valeurs strictement positives, soit deux valeurs strictement négatives), l’intervalle de confiance n’englobe pas la valeur nulle (0). L’investigateur conclut formellement au rejet de l’hypothèse nulle d’égalité avec un niveau de confiance familial de 95 %.
- Si la borne inférieure est négative tandis que la borne supérieure est positive, l’intervalle englobe la valeur zéro en son sein. Dès lors, l’hypothèse d’une absence d’effet ne peut être raisonnablement écartée, et le contraste est catégorisé comme statistiquement non significatif.
9.3 Calcul de la taille d’effet associée (d de Cohen corrigé)
L’évaluation complète de la portée clinique ou théorique d’un résultat requiert la quantification de la taille d’effet (effect size), laquelle s’affranchit de l’influence mécanique de la taille des échantillons pour se focaliser sur l’amplitude intrinsèque du phénomène psychologique mesuré. Dans le cadre de contrastes post-hoc issus d’une analyse de variance factorielle, l’indice standardisé le plus robuste est le d de Cohen corrigé pour l’erreur résiduelle globale du modèle.
Contrairement au test t indépendant isolé qui exploite la variance combinée des deux seuls groupes évalués, le calcul de la taille d’effet consécutif à une ANOVA bénéficie d’une estimation beaucoup plus stable de la variance d’échantillonnage en exploitant la racine carrée du carré moyen intra-groupes global (MSw), laquelle quantifie l’écart-type résiduel commun de l’ensemble du protocole expérimental :
d_Cohen = (Moyenne_i – Moyenne_j) / RACINE(MSw)
Dans votre feuille Excel, réservez une colonne intitulée d_Cohen et appliquez cette formule à chaque contraste en référençant la cellule absolue contenant la valeur de MSw. L’interprétation sémantique de cette métrique s’opère selon les repères canoniques formulés par Jacob Cohen dans ses traités fondateurs :
- |d| proche de 0,20 : effet de faible amplitude (différence subtile, souvent imperceptible au niveau individuel sans instruments psychométriques de grande précision).
- |d| proche de 0,50 : effet de taille moyenne (différence cliniquement observable et significative pour les interventions en sciences sociales).
- |d| >= 0,80 : effet de grande amplitude (différence flagrante caractérisant une intervention thérapeutique ou un traitement cognitif aux retombées hautement saillantes).
10. Représentation visuelle des contrastes et des intervalles d’erreur sous Excel
10.1 Conception d’un graphique à barres d’erreurs fondé sur les intervalles HSD
La communication graphique des conclusions statistiques constitue un vecteur essentiel de lisibilité lors de la préparation de publications scientifiques ou de mémoires académiques. La représentation la plus classique repose sur la construction d’un diagramme en colonnes (histogramme à barres) agrémenté de barres d’erreurs personnalisées reflétant la marge d’incertitude théorique dérivée du modèle de Tukey-Kramer.
Pour élaborer cette figure au sein d’Excel :
- Sélectionnez les colonnes récapitulatives relatives aux noms des conditions et aux moyennes observées respectives générées lors de l’étape 6.2.
- Rendez-vous dans le ruban supérieur et activez la commande Insertion > Graphiques > Histogramme groupé 2D.
- Épurez le rendu esthétique en supprimant les lignes de quadrillage superflues, en ajustant la largeur de l’intervalle entre les barres à environ 70-80 %, et en attribuant une teinte sobre conforme aux chartes de publication en niveaux de gris ou en nuances pastel distinctes.
- Sélectionnez la série de barres sur le graphique, cliquez sur le bouton d’ajout d’éléments graphiques (icône
+verte), puis activez la case Barres d’erreur > Autres options de barres d’erreur… - Dans le volet de mise en forme latéral qui s’ouvre, activez le bouton radio Personnalisée, puis cliquez sur Spécifier une valeur.
- Dans les champs Valeur d’erreur positive et Valeur d’erreur négative, désignez la plage de cellules hébergeant les marges d’erreur spécifiques calculées (correspondant à la demi-largeur des intervalles de confiance de Tukey propres à chaque modalité).
Le graphique ainsi produit permet d’appréhender instantanément la hiérarchie des performances expérimentales tout en intégrant rigoureusement les intervalles d’incertitude contrôlés pour l’erreur familiale.
10.2 Construction d’un graphique de dispersion des différences de moyennes
Bien que le graphique à barres soit très répandu, les normes modernes de visualisation en psychologie quantitative recommandent expressément l’usage de graphiques de contrastes (souvent dénommés Forest plots ou diagrammes de différences de moyennes). Ce type de représentation se focalise directement sur la grandeur d’intérêt premier : l’estimation ponctuelle de la différence d’effet entre les paires et son intervalle de confiance simultané associé.
La procédure d’élaboration dans Excel exige une composition graphique ingénieuse utilisant un diagramme de dispersion (courbe de type Nuage de points) :
- Dressez un tableau répertoriant pour chaque contraste dyadique l’écart de moyennes signé (sur l’axe horizontal X) et un index ordinal arbitraire numéroté de 1 à C (sur l’axe vertical Y).
- Insérez un graphique Nuage de points avec marqueurs uniquement en sélectionnant ces coordonnées.
- Adjoignez des barres d’erreur horizontales (sur l’axe X) en sélectionnant l’option Barres d’erreur personnalisées, et en renseignant dans les champs positif et négatif les valeurs calculées du seuil HSD_ij propre à chaque paire dyadique.
- Configurez l’axe vertical Y de manière à afficher les étiquettes textuelles des paires comparées (ex. :
TCC - ListeAttente,ACT - TCC) en modifiant les paramètres d’axe ou en associant des étiquettes de données personnalisées issues des cellules de votre tableau. - Insérez impérativement une ligne verticale de référence tracée au niveau de la coordonnée horizontale
X = 0, matérialisée par un trait discontinu sombre.
La lecture d’un tel graphique est universellement comprise : toute barre d’erreur horizontale qui intersecte la ligne zéro atteste d’un contraste non significatif ; à l’inverse, tout intervalle dont l’étendue se déploie entièrement d’un côté de la ligne zéro illustre graphiquement un effet statistiquement robuste au seuil de 95 %.
10.3 Création d’une matrice de lettres de significativité (Compact Letter Display)
Lorsque le protocole expérimental englobe un nombre élevé de conditions (par exemple k = 5 ou 6, impliquant 10 à 15 comparaisons dyadiques), la retranscription exhaustive des résultats sous forme de texte ou de listes de contrastes peut saturer la capacité d’assimilation cognitive du lecteur. La méthode de compactage par lettres de significativité partagées (Compact Letter Display ou système de lettres de Tukey) offre une solution de synthèse d’une efficacité reconnue.
Le postulat directeur de cette notation repose sur une règle simple : deux groupes expérimentaux qui partagent au moins une lettre commune en indice ne diffèrent pas significativement au seuil alpha fixé ; en revanche, deux conditions ne partageant aucune lettre commune présentent un écart statistiquement significatif.
Pour implémenter cette codification dans votre rapport sous Excel :
- Classez l’ensemble des moyennes observées par ordre de grandeur décroissant au sein d’un tableau récapitulatif.
- Attribuez la lettre
aà la moyenne la plus élevée. - Parcourez la série des moyennes descendantes : si la différence entre la première moyenne et une modalité subséquente n’atteint pas le seuil HSD de la paire, attribuez-lui également la lettre
a. - Dès qu’une moyenne descendante franchit le seuil de significativité par rapport à la première modalité, attribuez-lui la lettre suivante de l’alphabet (
b), et répétez la procédure d’inclusion transitive. - Les modalités intermédiaires qui ne se distinguent statistiquement ni du premier groupe ni des groupes inférieurs reçoivent une désignation composite combinant les lettres (par exemple
ab).
L’intégration de ces indices alphabétiques au-dessus des barres de l’histogramme élaboré en section 10.1 (par le biais d’étiquettes de données personnalisées liées aux cellules) transforme un graphique ordinaire en une synthèse visuelle exhaustive conforme aux plus hauts standards des publications scientifiques internationales.
11. Validation des calculs Excel par triangulation avec les logiciels de référence
11.1 Comparaison méthodologique avec les résultats générés par R
L’un des prérequis déontologiques les plus intangibles en matière d’analyse de données expérimentales réside dans l’audit et la validation croisée (ou triangulation méthodologique) des outils de calcul matriciel personnalisés face aux environnements statistiques de référence certifiés par la communauté scientifique internationale. Le langage de programmation open source R constitue à cet égard le standard d’étalonnage par excellence.
Sous R, l’évaluation du modèle global s’effectue via l’estimateur linéaire lm() ou la fonction d’analyse de variance aov(). La dérivation du test de Tukey-Kramer pour échantillons de tailles inégales est assurée en routine par l’appel de la fonction générique :
TukeyHSD(modele_aov)
ou plus exhaustivement, par le truchement de la librairie spécialisée multcomp et de son wrapper de contrastes linéaires simultanés :
glht(modele, linfct = mcp(Groupe = « Tukey »))
Lors de la confrontation des vecteurs numériques issus de votre feuille de calcul Microsoft Excel avec les objets de sortie générés par R, une attention minutieuse doit être accordée aux décimales de précision :
- Les estimations des différences de moyennes brutes (diff) doivent correspondre rigoureusement jusqu’à la dernière décimale.
- Les bornes inférieures (lwr) et supérieures (upr) des intervalles de confiance calculées sous Excel doivent concorder avec les sorties de R à des tolérances de l’ordre de 10^-4, les divergences résiduelles mineures ne découlant que des approximations de troncature des tables statistiques statiques par rapport aux algorithmes d’intégration continue de la fonction
ptukeyen langage C sous-jacent.
11.2 Confrontation avec les sorties d’analyse de SPSS et JASP
Pour les laboratoires de recherche privilégiant les progiciels à interface utilisateur graphique, l’étalonnage des résultats de la feuille Excel peut être opéré en miroir avec les logiciels IBM SPSS Statistics ou JASP. Ces environnements sont très largement diffusés dans les départements universitaires de psychologie et de sciences humaines.
Dans l’environnement SPSS, lors de l’exécution d’une ANOVA à un facteur (menu Analyser > Comparer les moyennes > ANOVA à un facteur), le bouton de dialogue Post Hoc… propose l’activation de la case à cocher Tukey. Il est essentiel de comprendre que bien que la nomenclature du logiciel indique simplement « Tukey », l’algorithme sous-jacent de SPSS détecte automatiquement le déséquilibre des effectifs au sein des données et commute de manière transparente vers l’équation de Tukey-Kramer en mobilisant la moyenne harmonique des sous-groupes.
La comparaison rigoureuse entre la table de sortie intitulée Comparaisons multiples de SPSS ou JASP et la grille automatisée de votre modèle Excel permet de valider trois paramètres cardinaux :
- La correspondance absolue de la colonne Erreur standard (SE) avec les calculs de votre colonne Excel d’erreur type combinée.
- La parfaite superposition des bornes de l’intervalle de confiance simultané à 95 %.
- La cohérence stricte des statuts de rejet des hypothèses nulles dyadiques.
Cette concordance mathématique formelle atteste de la validité de votre tableur en tant qu’instrument d’analyse statistique conforme aux normes de la recherche académique.
11.3 Audit et sécurisation du modèle de feuille de calcul
Dès lors que la validité empirique des dérivations matricielles est certifiée par triangulation logicielle, il convient de prémunir le classeur Excel contre toute altération accidentelle qui viendrait corrompre les formules ou rompre la chaîne des références dynamiques lors d’utilisations répétées ou de transmissions collaboratives à d’autres membres de l’équipe de recherche.
La sécurisation formelle de votre feuille de travail s’articule selon un protocole éprouvé :
- Déverrouillage sélectif des cellules d’entrée : sélectionnez l’ensemble des plages exclusivement réservées à la saisie des nouvelles données expérimentales brutes (les colonnes où sont collés les scores), ouvrez la boîte de dialogue Format de cellule (raccourci Ctrl + 1), rendez-vous dans l’onglet Protection, et décochez la case Verrouillée.
- Verrouillage structurel des cellules calculées : assurez-vous que toutes les cellules abritant des formules mathématiques, les tables de paramètres, la matrice d’extraction ANOVA et les codes conditionnels demeurent rigoureusement configurées avec l’attribut Verrouillée actif.
- Activation de la protection de la feuille : rendez-vous dans l’onglet Révision du ruban supérieur et activez la commande Protéger la feuille. Attribuez un mot de passe robuste si nécessaire, et cochez exclusivement l’autorisation Sélectionner les cellules déverrouillées.
Par ailleurs, l’insertion de commentaires de cellule explicatifs (via Clic droit > Nouveau commentaire) documentant le rôle de chaque équation et la provenance des variables scalaires confère au fichier une transparence méthodologique totale. Enfin, l’enregistrement du classeur sous la forme d’un Modèle Excel (extension .xltx ou .xltm pour les versions intégrant des macros) permet aux collaborateurs d’ouvrir une instance vierge autonome à chaque nouveau protocole expérimental sans jamais écraser la structure maîtresse d’origine.
12. Restitution académique aux normes APA (7e édition) et pièges à éviter
12.1 Normes de rédaction des résultats post-hoc selon l’APA 7
La rédaction des résultats statistiques au sein d’un manuscrit soumis à une revue savante affiliée à l’American Psychological Association (APA, 7e édition) répond à des canons stylistiques, typographiques et structurels d’une rigueur absolue. La simple présentation désordonnée de listes de chiffres doit être proscrite au profit d’un texte narratif fluide articulant systématiquement l’inférence globale et les constats spécifiques par paires.
La relation narrative commence par la restitution exhaustive de l’ANOVA préalable, en précisant les degrés de liberté inter et intra-groupes, la valeur observée du test F, la probabilité exacte p, ainsi que la taille d’effet omnibus (généralement l’êta-carré partiel eta^2_p). Elle est immédiatement suivie par l’exposition méthodique des contrastes post-hoc de Tukey-Kramer :
« Une analyse de variance univariée à un facteur a mis en évidence un effet principal significatif du type d’intervention thérapeutique sur la réduction des scores d’anxiété post-traitement, F(3, 81) = 8,42, p < ,001, eta^2_p = ,24. Des comparaisons post-hoc ont été conduites en appliquant la procédure de Tukey-Kramer afin de contrôler le risque d’erreur de première espèce familial lié au déséquilibre des effectifs entre les cohortes. Les résultats indiquent que les participants assignés au protocole TCC (M = 18,45, SD = 4,12, n = 25) présentent un score d’anxiété significativement inférieur à celui des participants du groupe liste d’attente (M = 27,80, SD = 5,34, n = 22), q = 6,85, p < ,001, d = 1,48, IC 95 % [-12,84, -5,86]. De même, le protocole ACT (M = 20,15, SD = 4,68, n = 20) surpasse significativement la liste d’attente, q = 5,32, p = ,002, d = 1,18, IC 95 % [-11,28, -4,02]. En revanche, aucune divergence statistiquement significative n’a pu être mise en évidence entre les conditions TCC et ACT, q = 1,21, p = ,724, d = 0,26, IC 95 % [-5,25, 1,85]. »
Il convient de veiller scrupuleusement aux conventions typographiques de l’APA : l’ensemble des lettres statistiques désignant des grandeurs d’échantillons ou des distributions (telles que M, SD, F, q, p, d, n) doivent être systématiquement composées en italique. De surcroît, les valeurs de probabilité ne doivent jamais être précédées d’un zéro avant la virgule (écrire p = ,002 et non p = 0,002) en raison de l’impossibilité mathématique pour une probabilité de franchir le seuil scalaire de 1.
12.2 Erreurs fréquentes d’interprétation et limites du test
En dépit de sa remarquable élégance mathématique, le test de Tukey-Kramer fait fréquemment l’objet de contresens méthodologiques qu’il convient de déconstruire avec lucidité :
- Confusion conceptuelle entre Tukey standard et Tukey-Kramer : la première bévue réside dans l’application d’une formule Tukey à taille d’échantillon unique (en utilisant la moyenne arithmétique globale ou l’effectif du premier groupe) face à des échantillons inégaux. Cette omission fausse l’estimation de l’erreur type et invalide le contrôle nominal du seuil alpha.
- Application aveugle face à des violations sévères de l’homogénéité des variances : si le test de Tukey-Kramer fait preuve d’une résilience remarquable face à des disparités d’effectifs modérées lorsque les variances sont homogènes, il s’avère particulièrement sensible à la brisure conjointe de l’homoscédasticité et de l’équilibre numérique. Si les tests préliminaires (Levene) révèlent des variances structurellement hétérogènes corrélées aux disparités de tailles d’échantillons, l’analyste doit impérativement abandonner le test de Tukey-Kramer au profit de l’alternative de Games-Howell (qui applique une correction de degrés de liberté de type Welch-Satterthwaite propre à chaque paire).
- Confusion épistémologique entre absence d’effet et preuve d’équivalence : l’obtention d’une valeur q non significative (p > ,05) pour une comparaison par paire ne permet en aucun cas d’affirmer que les deux traitements thérapeutiques sont équivalents ou dotés d’une efficacité identique. Elle stipule uniquement que les données recueillies dans le cadre de ce protocole précis ne fournissent pas une force probante suffisante pour rejeter l’hypothèse de nullité. Pour attester formellement d’une équivalence clinique réelle, le chercheur doit recourir à des paradigmes spécifiques de tests d’équivalence (tels que la procédure TOST pour Two One-Sided Tests).
12.3 Bonnes pratiques pour la reproductibilité en recherche psychologique
À l’ère de la crise de la reproductibilité et de la transition vers les standards de la science ouverte (Open Science Framework), la publication de conclusions statistiques exige une transparence irréprochable quant aux processus d’inférence déployés. L’exploitation d’une feuille de calcul Microsoft Excel pour exécuter des tests post-hoc complexes tels que Tukey-Kramer s’accorde parfaitement avec ces impératifs, sous réserve d’adopter des règles de documentation éprouvées.
Le tableau ci-dessous résume les principales spécifications méthodologiques à renseigner lors de la restitution des analyses de comparaisons multiples :
Tableau méthodologique de traçabilité des analyses post-hoc
- Paramètre du modèle : Spécification formelle de la valeur du carré moyen d’erreur (MSw) et des degrés de liberté associés (df_erreur) directement issus de la table de variance de l’ANOVA globale.
- Métrique d’adaptation : Mention explicite de l’utilisation de la modification de Kramer et des moyennes harmoniques spécifiques (n_h) mobilisées pour chaque paire dyadique.
- Valeurs d’étendue critique : Déclaration de la valeur de la statistique critique théorique q_critique au seuil nominal retenu (alpha = ,05).
- Reporting d’incertitude : Présentation systématique conjointe des estimations ponctuelles des différences, des erreurs types d’échantillonnage, des intervalles de confiance simultanés à 95 % et des tailles d’effet standardisées (d de Cohen).
En archivant le classeur Excel source dans des entrepôts de données certifiés ouverts aux pairs (tels que Zenodo ou OSF), les chercheurs permettent un audit immédiat de leurs algorithmes. La formalisation claire de la démarche de Tukey-Kramer sous un format universellement accessible émancipe la méthodologie des barrières logicielles propriétaires et garantit que la chaîne de traitement inférentiel — de la saisie brute à la prise de décision thérapeutique — demeure intègre, vérifiable et reproductible.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Glass, G. V., Peckham, P. D., & Sanders, J. R. (1972). Consequences of failure to meet assumptions underlying the fixed effects analyses of variance and covariance. Review of Educational Research, 42(3), 237–288. https://doi.org/10.3102/00346543042003237
- Hayter, A. J. (1984). A proof of the conjecture that the Tukey-Kramer multiple comparisons procedure is conservative. The Annals of Statistics, 12(1), 61–75. https://doi.org/10.1214/aos/1176346392
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001469
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Tukey, J. W. (1953). The problem of multiple comparisons. Princeton University (Inédit, reproduit dans The Collected Works of John W. Tukey, Chapman & Hall, 1994).
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.