
L’analyse statistique des données catégorielles constitue l’un des piliers méthodologiques fondamentaux de la recherche quantitative moderne, particulièrement au sein des sciences humaines, de la psychologie, de l’épidémiologie comportementale et de la sociologie empirique. Alors que les modélisations linéaires classiques, telles que l’analyse de variance ou la régression multiple, s’appuient sur l’hypothèse de variables dépendantes continues et distribuées selon une loi normale, les chercheurs sont constamment confrontés à des réalités discrètes, qualitatives et nominales. Qu’il s’agisse de classifier des profils nosographiques, d’évaluer l’adhésion à des thérapeutiques ou d’analyser des comportements de vote selon des catégories sociodémographiques, la quantification rigoureuse des structures de dépendance entre variables qualitatives requiert un appareil inférentiel robuste, éprouvé et mathématiquement irréprochable.
Au cœur de cet arsenal se trouve le test d’indépendance du khi-deux, conceptualisé à l’aube du XXe siècle par Karl Pearson. Cette méthode d’inférence non paramétrique permet de tester formellement si deux critères de classification qualitatifs sont stochastiquement indépendants au sein d’une population cible, ou s’il existe une association statistique significative entre eux. Bien que son principe de base repose sur une confrontation élégante entre des fréquences observées sur le terrain et des fréquences théoriques calculées sous l’hypothèse nulle, sa mise en œuvre dans des contextes scientifiques rigoureux impose le respect strict de postulats distributionnels, une maîtrise fine des corrections asymptotiques et une interprétation prudente des métriques d’association.
Dans le paysage des logiciels d’analyse statistique avancée, l’environnement développé par le SAS Institute s’impose comme une référence incontestée, notamment dans les environnements soumis à des normes d’audit drastiques comme l’industrie biomédicale, les agences sanitaires internationales et les laboratoires de psychométrie. Grâce à sa procédure historique et polyvalente, la procédure standard d’analyse fréquentielle de SAS, le logiciel offre un cadre d’une exhaustivité inégalée pour paramétrer le test du khi-deux, extraire les décompositions résiduelles, calculer les tailles d’effet standardisées et générer des tests exacts lorsque les postulats asymptotiques vacillent. Ce guide exhaustif a pour vocation d’accompagner les chercheurs, statisticiens et étudiants de cycles supérieurs dans la maîtrise intégrale, théorique et appliquée, du test d’indépendance du khi-deux sous SAS, depuis ses fondements épistémologiques jusqu’à la rédaction finale de manuscrits conformes aux exigences éditoriales les plus strictes.
1. Introduction théorique et épistémologique au test d’indépendance du khi-deux en psychologie
1.1 Fondements de l’analyse des données catégorielles en sciences du comportement
L’investigation empirique en sciences du comportement repose traditionnellement sur la taxonomie fondamentale des échelles de mesure établie par Stanley Smith Stevens en 1946, laquelle distingue les niveaux nominal, ordinal, d’intervalle et de rapport. Si les sciences cognitives et la psychophysique ont souvent privilégié les échelles continues et d’intervalles afin de quantifier des latences de réponse ou des intensités perceptives, une part prépondérante de la psychologie clinique, différentielle et sociale opère nécessairement sur le plan des variables nominales. Ces variables, par définition non métriques, attribuent des étiquettes qualitatives à des classes d’individus sans postuler d’ordonnancement intrinsèque ni de distance métrique constante entre les modalités. Dès lors, chercher à appliquer des opérations arithmétiques standard telles que le calcul de moyennes ou de variances à ces variables constitue une faute méthodologique majeure pouvant conduire à des artefacts d’interprétation désastreux.
Sur le plan méthodologique, l’étude des processus psychologiques exige fréquemment l’exploration d’associations non linéaires et non monotones entre facteurs qualitatifs. Dans le domaine du diagnostic psychiatrique, par exemple, un chercheur peut souhaiter déterminer si la comorbidité entre les troubles anxieux sévères et les conduites addictives diffère significativement selon des sous-types de personnalités pathologiques répertoriés dans le DSM-5. De même, en psychologie politique et en sociologie électorale, l’analyse des comportements de vote ne saurait se réduire à un continuum unidimensionnel ; elle requiert la confrontation de typologies électorales qualitatives à des segments sociodémographiques précis, tels que la catégorie socioprofessionnelle, l’identification confessionnelle ou la zone de résidence géographique.
L’objectivation statistique de ces structures relationnelles s’avère indispensable pour prémunir le chercheur contre les biais cognitifs universels, au premier rang desquels figure le biais de confirmation et la propension humaine à identifier des corrélations illusoires. L’esprit humain, confronté à la coprésence de deux phénomènes saillants — par exemple, un trait de caractère spécifique et une orientation politique marginale —, a tendance à surestimer spontanément la force de leur liaison empirique en négligeant systématiquement les cas non confirmatoires. Le recours à une procédure inférentielle formalisée permet d’extirper l’analyse de la subjectivité de l’observateur pour la soumettre à un critère de réfutation probabiliste objectif et reproductible, condition sine qua non de la scientificité dans l’investigation du comportement humain.
1.2 Principe conceptuel du test d’indépendance de Karl Pearson
L’édifice du test d’indépendance repose sur les travaux fondateurs publiés en 1900 par le mathématicien et biostatisticien britannique Karl Pearson au sein des pages du Philosophical Magazine. Sur le plan conceptuel, Pearson a conçu cette méthode pour résoudre un problème probabiliste fondamental : comment déterminer si la répartition observée d’individus au sein des cellules d’un tableau à double entrée s’écarte de manière significative de la distribution que l’on observerait sous la stricte hypothèse d’indépendance stochastique au sens de Kolmogorov ?
L’hypothèse nulle, formellement désignée sous la notation conventionnelle H0, postule qu’il n’existe aucune relation structurelle entre la variable de ligne et la variable de colonne. En termes probabilistes formels, cela signifie que la probabilité conjointe qu’un individu appartienne simultanément à la modalité i de la première variable et à la modalité j de la seconde variable est strictement égale au produit de leurs probabilités marginales respectives. À l’inverse, l’hypothèse alternative H1 stipule qu’il existe une dépendance statistique, c’est-à-dire que la connaissance de l’état d’un sujet sur l’une des dimensions fournit une information prédictive sur son état relatif à l’autre dimension.
Le génie de Pearson a consisté à concevoir une métrique permettant de mesurer la déviation globale pondérée entre les distributions empiriques collectées sur l’échantillon et les distributions théoriques mathématiquement attendues si l’hypothèse nulle d’indépendance était rigoureusement vraie. Cette déviation globale s’exprime sous la forme d’une somme d’écarts quadratiques divisés par les fréquences attendues, garantissant ainsi que chaque cellule contribue proportionnellement à son effectif théorique. Pearson a démontré que, sous réserve d’un effectif suffisant, cette statistique suit asymptotiquement une loi de probabilité continue connue sous le nom de distribution du khi-deux, dont la forme mathématique exacte ne dépend pas des paramètres de la population mère, mais uniquement du nombre de degrés de liberté inhérents aux dimensions géométriques de la table de contingence.
1.3 Intégration de SAS dans l’écosystème de la recherche quantitative
Dans l’univers des logiciels d’analyse de données appliqués aux sciences biomédicales et psychologiques, le système SAS occupe une place prépondérante, conférée par des décennies d’exigence algorithmique et de validation statistique continue. Contrairement à de nombreux environnements d’analyse contemporains dont les modules sont maintenus de manière décentralisée par des communautés hétérogènes, SAS garantit une traçabilité numérique absolue et une conformité rigoureuse aux normes internationales les plus draconiennes, telles que les réglementations de la Food and Drug Administration (FDA) américaine et les recommandations du CDISC (Clinical Data Interchange Standards Consortium).
Cette rigueur de calcul est particulièrement critique lors du traitement de données catégorielles massives issues d’enquêtes épidémiologiques nationales, de registres hospitaliers ou d’études de cohortes pan-européennes comprenant des centaines de milliers de sujets. Le moteur de traitement séquentiel de SAS est spécifiquement optimisé pour manipuler des jeux de données d’une volumétrie extrême sans saturer la mémoire vive des calculateurs, exécutant les calculs matriciels des fréquences croisées, des résidus standardisés et des tests de rang avec une précision en virgule flottante d’une stabilité exemplaire.
En outre, la structure organisationnelle des programmes SAS, articulée autour de la séparation étanche entre les étapes de manipulation des données (étapes DATA) et les procédures de modélisation mathématique (étapes PROC), assure une reproductibilité scientifique intégrale. Les journaux d’exécution (logs) fournissent un historique infalsifiable de chaque étape de transformation, de chaque exclusion de valeur aberrante et de chaque algorithme d’inversion matricielle utilisé. Cette traçabilité répond directement aux impératifs d’intégrité scientifique exigés par les comités d’examen institutionnels (Institutional Review Boards – IRB) et les comités de lecture des revues internationales de premier rang, garantissant que les inférences tirées d’un croisement de variables catégorielles reposent sur des fondations computationnelles inattaquables.
2. Fondements mathématiques et conditions d’application du test
2.1 Formulation algébrique et calcul des fréquences théoriques
L’exécution rigoureuse du test du khi-deux d’indépendance de Pearson nécessite une compréhension précise de ses mécanismes algébriques. Considérons une table de contingence bidimensionnelle croisant deux variables catégorielles comportant respectivement r lignes (indexées par la lettre i variant de 1 à r) et c colonnes (indexées par la lettre j variant de 1 à c). L’effectif observé dans la cellule située à l’intersection de la i-ème ligne et de la j-ème colonne est noté O_ij. L’effectif total de l’échantillon, noté N, s’obtient par la double sommation de l’ensemble des cellules du tableau.
Pour chaque cellule, l’effectif théorique ou attendu sous l’hypothèse d’indépendance stochastique, noté E_ij, représente le nombre de cas que l’on devrait observer si la distribution conditionnelle des modalités de colonne était strictement identique quelle que soit la modalité de ligne considérée. Algébriquement, cette fréquence théorique dérive du produit des probabilités marginales empiriques et s’exprime par la formule canonique :
E_ij = (R_i * C_j) / N
Dans cette expression, R_i représente le total marginal de la i-ème ligne (la somme des effectifs observés sur toute la ligne i) et C_j représente le total marginal de la j-ème colonne (la somme des effectifs observés sur toute la colonne j). Une fois ces valeurs d’espérance calculées pour l’intégralité des cellules de la grille, la statistique globale du khi-deux de Pearson, traditionnellement notée par le symbole grec élevé au carré, est obtenue par la sommation de toutes les déviations quadratiques standardisées :
Khi2 = Somme_i Somme_j [ (O_ij – E_ij)^2 / E_ij ]
Cette sommation quantifie la magnitude globale de la discordance entre le modèle théorique d’indépendance et la réalité empirique des données. Le nombre de degrés de liberté (noté ddl ou DF pour degrees of freedom) associé à cette statistique détermine la forme exacte de la distribution de référence. Il se calcule par le produit des dimensions marginales libres de la table, c’est-à-dire :
ddl = (r – 1) * (c – 1)
Ce calcul traduit le fait que, lorsque les totaux marginaux de lignes et de colonnes sont fixés, seules (r – 1) * (c – 1) cellules peuvent varier librement ; les valeurs des autres cellules deviennent arithmétiquement contraintes pour que la somme marginale demeure exacte.
2.2 Hypothèses sous-jacentes et postulats méthodologiques
Le recours légitime au test d’indépendance du khi-deux de Pearson repose sur un ensemble de conditions méthodologiques et distributionnelles strictes que le chercheur doit scrupuleusement auditer avant toute tentative d’interprétation des résultats. Le premier postulat fondamental concerne l’indépendance mutuelle absolue des observations individuelles. Chaque unité statistique (patient, sujet expérimental, citoyen sondé) ne doit appartenir qu’à une seule et unique cellule de la table de contingence, et sa présence au sein de cette cellule ne doit en aucun cas influencer la probabilité d’assignation d’un autre individu.
Ce principe proscrit formellement l’utilisation du test du khi-deux d’indépendance sur des plans d’échantillonnage longitudinaux impliquant des mesures répétées dans le temps, des dispositifs pré-test/post-test ou des paires appariées (comme des études gémellaires ou des protocoles cas-témoins appariés). Pour de telles configurations, l’autocorrélation intrinsèque des mesures violerait l’hypothèse d’indépendance des erreurs, conduisant à une sous-estimation massive de la variance et à une prolifération incontrôlée de faux positifs ; des approches alternatives telles que le test de McNemar ou les modèles d’équations d’estimation généralisées (GEE) doivent alors être impérativement mobilisées.
Le deuxième postulat méthodologique impose que le système de catégorisation soit à la fois mutuellement exclusif et exhaustif. Chaque modalité doit être définie de manière non équivoque afin qu’aucune ambiguïté de codage ne permette à un participant de relever simultanément de plusieurs niveaux d’une même variable. Enfin, l’échantillonnage doit théoriquement relever d’un tirage aléatoire simple issu de la population parente que l’on souhaite modéliser. Si l’échantillonnage a été réalisé via des plans de sondage complexes à plusieurs degrés, avec stratification ou grappes, des ajustements statistiques spécifiques fondés sur des procédures de type pseudo-vraisemblance doivent être appliqués pour compenser les distorsions d’échantillonnage.
2.3 Critères de Cochran et sensibilité à la taille de l’échantillon
Puisque la statistique de Pearson ne suit la loi formelle du khi-deux que de manière asymptotique — c’est-à-dire lorsque la taille de l’échantillon N tend théoriquement vers l’infini —, la validité de l’approximation repose sur la consistance des effectifs théoriques calculés dans chaque cellule. En 1954, le statisticien William Gemmell Cochran a formalisé des critères empiriques d’admissibilité devenus le standard méthodologique universel en analyse de contingence :
- Dans une table de contingence de dimensions supérieures à 2×2, aucun effectif théorique (E_ij) ne doit être strictement inférieur à 1.
- Au maximum 20 % des cellules de l’ensemble de la table peuvent présenter un effectif théorique inférieur à 5.
- Pour les tables élémentaires de format 2×2, l’exigence minimale requiert traditionnellement que la totalité des quatre effectifs théoriques soit égale ou supérieure à 5.
Lorsque ces conditions de Cochran ne sont pas remplies, l’approximation asymptotique s’effondre : la distribution d’échantillonnage empirique de la statistique s’écarte substantiellement de la fonction de densité théorique du khi-deux. Ce phénomène induit une inflation critique de l’erreur de première espèce (taux alpha), augmentant la probabilité de déclarer à tort l’existence d’une association statistiquement significative alors que la variabilité observée relève uniquement des fluctuations d’échantillonnage dans des cellules clairsemées.
À l’autre extrémité du spectre, les chercheurs doivent composer avec l’extrême sensibilité du test du khi-deux à la surpuissance statistique induite par des échantillons de très grande taille (les méga-échantillons comprenant des dizaines de milliers d’enregistrements). Dans ce contexte, la statistique du khi-deux croissant de manière strictement proportionnelle à la taille globale de l’échantillon N, des déviations triviales, dénuées de la moindre pertinence clinique, théorique ou sociologique, atteindront inévitablement des seuils de significativité infinitésimaux (p < 0,0001). Il devient alors périlleux de confondre significativité statistique et importance substantielle, ce qui rend obligatoire la quantification de la taille d’effet.
3. Préparation et structuration des données sous l’environnement SAS
3.1 Importation et saisie des données individuelles brutes
Dans la pratique courante de la recherche en sciences psychosociales, les données se présentent initialement sous la forme d’un fichier désagrégé, parfois qualifié de format long ou de format microéconomique, où chaque ligne de la matrice correspond rigoureusement à une unité d’observation individuelle unique. Sous le système SAS, la structuration de ces données brutes s’opère au sein d’une étape DATA fondamentale, au cours de laquelle le compilateur lit les enregistrements séquentiellement pour alimenter la table de travail.
L’instruction INPUT constitue la pierre angulaire de ce processus d’ingestion. Elle permet de déclarer la nature sémantique de chaque champ recueilli. Lorsqu’il s’agit de variables qualitatives représentées par des chaînes de caractères (telles que le sexe biologique, une affiliation politique ou une catégorie diagnostique), il est impératif d’adjoindre le spécificateur dollar ($) immédiatement à la suite du nom de la variable déclarée. Dans le cas contraire, SAS interpréterait par défaut la colonne comme une grandeur numérique continue, générant des erreurs d’incompatibilité de type et convertissant indûment les modalités textuelles en valeurs manquantes.
La gestion des valeurs manquantes dans l’étape DATA requiert une rigueur exemplaire. Par défaut, SAS matérialise l’absence d’information numérique par un simple point (.) et l’absence d’information textuelle par un espace vide (‘ ‘). Il est crucial d’auditer ces omissions avant toute étape d’estimation car la procédure statistique d’analyse croisée exclut automatiquement de la construction de la table toute observation présentant une valeur manquante sur l’une des variables intervenant dans le tableau. Pour certifier l’intégrité structurelle des données importées, le chercheur fera exécuter la procédure PROC CONTENTS, qui renvoie un rapport d’audit exhaustif décrivant le nombre d’observations, le type de variables et les attributs d’encodage du fichier actif.
3.2 Structuration par données agrégées et instruction WEIGHT
Il arrive fréquemment, notamment lors de l’exploitation de rapports épidémiologiques publiés, de méta-analyses ou d’enquêtes démographiques pré-agrégées, que le chercheur ne dispose pas du fichier microéconomique individuel, mais directement d’un tableau croisé synthétisant les fréquences d’apparition conjointes. Tenter de réécrire manuellement des centaines ou des milliers de lignes identiques pour recréer artificiellement le fichier brut serait non seulement inefficace, mais source d’erreurs matérielles d’encodage.
SAS résout cette difficulté méthodologique grâce à l’instruction WEIGHT intégrée aux procédures statistiques. La structure du jeu de données synthétique se réduit alors à un tableau succinct ne comportant que r * c lignes d’enregistrements. Chaque observation comprend les identifiants de modalité pour les variables de ligne et de colonne, accompagnés d’une troisième variable numérique continue qui consigne le décompte exact ou la fréquence absolue constatée pour cette cellule spécifique.
Lors de l’appel ultérieur de la procédure d’analyse, l’instruction WEIGHT indique au moteur de calcul de SAS qu’il ne doit pas traiter chaque ligne du fichier comme un individu unique d’effectif 1, mais qu’il doit expanser arithmétiquement la cellule selon la valeur entière contenue dans la variable de pondération déclarée. La statistique de Pearson, les degrés de liberté ainsi que l’ensemble des totaux marginaux sont alors rigoureusement identiques à ceux qu’aurait produits l’analyse du fichier désagrégé complet. Une validation systématique de l’effectif global N via un simple appel à la procédure PROC PRINT ou PROC MEANS constitue une étape de contrôle qualité indispensable pour s’assurer qu’aucun coefficient de pondération n’a été tronqué ou mal interprété.
3.3 Nettoyage et étiquetage sémantique des variables catégorielles
L’excellence méthodologique dans l’écosystème SAS repose sur la dissociation claire entre les valeurs sous-jacentes des données, qui gagnent à être stockées sous forme de codes numériques courts ou de libellés synthétiques afin d’optimiser l’occupation mémoire, et leurs représentations textuelles destinées à la restitution scientifique. Cette élégance architecturale est orchestrée par la procédure PROC FORMAT, qui permet de créer des dictionnaires de formatage personnalisés.
L’emploi de PROC FORMAT permet d’associer des libellés intelligibles et parfaitement standardisés aux modalités cryptiques des variables (par exemple, assigner le libellé « Trouble Dépressif Majeur » au code clinique 1, et « Témoin Asymptomatique » au code 0). Ces formats, une fois liés aux variables correspondantes au moyen de l’instruction FORMAT dans l’étape DATA ou directement au sein de la procédure analytique, se propageront automatiquement dans l’ensemble des tables de contingence générées par SAS, prévenant toute ambiguïté sémantique lors de la lecture des résultats par des évaluateurs tiers.
Parallèlement, l’instruction LABEL permet d’assigner des titres descriptifs complets aux variables elles-mêmes, se substituant aux acronymes parfois réducteurs imposés par les conventions de nommage des systèmes d’exploitation. Cette étape de préparation inclut également le dépistage systématique des erreurs de saisie typographique (telles que des doublons lexicaux issus de fautes de frappe comme « Homme » et « homme », que SAS distinguerait par défaut en raison de sa sensibilité à la casse). Ce nettoyage garantit que le tableau final ne comportera pas de modalités fragmentées ou parasites qui fausseraient dramatiquement le calcul des degrés de liberté du test.
4. Mise en œuvre du test avec la procédure PROC FREQ de SAS
4.1 Syntaxe fondamentale et déclaration de la table de contingence
La procédure PROC FREQ constitue le moteur central dédié à la tabulation croisée et à l’inférence non paramétrique des données discrètes sous l’environnement SAS. Sa structure syntaxique fondamentale se caractérise par une concision remarquable conjuguée à une profondeur paramétrique d’une puissance exceptionnelle. Pour initier l’analyse, l’instruction de base appelle simplement la procédure en désignant la table de travail cible par l’option DATA= :
PROC FREQ DATA=nom_du_fichier;
TABLES variable_ligne * variable_colonne / options;
RUN;
L’opérateur astérisque (*) situé entre les deux noms de variables au sein de l’instruction TABLES indique formellement à SAS de construire le produit cartésien des modalités, générant une table de contingence à deux dimensions dans laquelle la première variable citée ordonne les rangées horizontales (lignes) et la seconde structure les subdivisions verticales (colonnes). Si le chercheur omet d’inclure l’astérisque et se contente de lister des variables séparées par un espace, SAS générera simplement des tableaux unidimensionnels de fréquences simples, omettant l’analyse croisée bivariée.
Le modificateur fondamental est la barre oblique (/), qui permet de séparer la déclaration géométrique de la table de l’énumération des options computationnelles et d’affichage. Par défaut, SAS présente dans chaque cellule un ensemble de quatre informations numériques superposées : l’effectif brut observé, le pourcentage par rapport à l’effectif total N de l’échantillon, le pourcentage relatif à la ligne (profil-ligne) et le pourcentage relatif à la colonne (profil-colonne). Si ces données peuvent enrichir l’évaluation globale, elles ont tendance à surcharger visuellement la table dans le cas de croisements polytomiques larges. L’insertion d’options telles que NOFREQ ou NOPERCENT permet d’épurer l’affichage pour se focaliser sur les métriques purement inférentielles.
4.2 Activation des options statistiques dédiées au khi-deux
L’estimation effective de la statistique de Pearson et de ses dérivés mathématiques n’est pas activée par défaut lors d’une simple tabulation croisée ; elle nécessite une demande explicite du statisticien par l’introduction d’options méthodologiques spécifiques placées en aval de la barre oblique de l’instruction TABLES. L’option pivot est l’instruction CHISQ. Dès son incorporation dans le code de la procédure, SAS calcule et restitue un ensemble exhaustif d’estimateurs de discordance comprenant la statistique du khi-deux de Pearson, le test du rapport de vraisemblance, ainsi que les coefficients d’association d’ordre supérieur.
Cependant, l’analyse académique moderne ne saurait se cantonner à la simple lecture d’une statistique globale et d’une p-valeur synthétique. L’investigation fine des mécanismes sous-jacents impose d’examiner le comportement individuel de chaque cellule de la matrice. À cette fin, SAS met à disposition des options d’une utilité diagnostique majeure :
- EXPECTED : Ordonne à SAS de calculer et d’afficher, immédiatement sous l’effectif observé dans chaque cellule, la fréquence théorique attendue sous l’hypothèse nulle de parfaite indépendance stochastique.
- DEVIATION : Extrait la différence arithmétique brute entre le décompte empiriquement observé et la valeur théorique (O_ij – E_ij), révélant d’un coup d’œil le sens de la déviation (surreprésentation positive ou sous-représentation négative).
- CELLCHI2 : Fournit la contribution unitaire de la cellule à la statistique globale du khi-deux, calculée par l’équation [(O_ij – E_ij)^2 / E_ij]. Cette métrique permet d’isoler instantanément les croisements de modalités qui pèsent de façon disproportionnée dans le rejet éventuel de l’hypothèse nulle.
L’activation coordonnée de ces trois options au sein de l’instruction TABLES transforme une table de contingence élémentaire en un instrument d’analyse diagnostique multidimensionnel d’une grande rigueur.
4.3 Paramétrage des pourcentages marginaux et conditionnels
Au-delà des fréquences brutes et des calculs d’espérance, l’interprétation théorique de la dépendance entre deux facteurs repose sur l’analyse approfondie des distributions conditionnelles, souvent désignées sous le vocable de profils sociologiques ou comportementaux. Selon la question de recherche posée, le chercheur cherchera à modéliser la distribution de la variable dépendante conditionnellement aux modalités de la variable explicative.
Lorsque la variable placée en ligne est conceptuellement définie comme le prédicteur ou la variable indépendante (par exemple, le groupe clinique ou la cohorte d’âge), l’attention doit impérativement se focaliser sur les profils-lignes, c’est-à-dire la distribution en pourcentage à l’intérieur de chaque rangée. Dans SAS, ce calcul s’effectue par défaut, mais il gagne à être isolé en neutralisant les métriques concurrentes au moyen de l’option NOCOL (suppression des pourcentages de colonne). Inversement, si le modèle épistémologique traite la colonne comme le facteur structurant, l’emploi de l’option NOROW s’avère opportun pour ne conserver que les profils-colonnes.
La comparaison systématique de ces pourcentages conditionnels avec la distribution marginale globale permet de caractériser précisément la direction de la dépendance. Si l’hypothèse d’indépendance était strictement validée, les pourcentages au sein de chaque ligne seraient rigoureusement identiques entre eux et refléteraient fidèlement le profil marginal global de l’échantillon. Toute fluctuation substantielle de ces profils relatifs signale une interaction statistique, dont la morphologie guidera le statisticien dans l’élaboration de ses conclusions scientifiques.
5. Analyse pas-à-pas d’un cas pratique : Genre et préférences politiques
5.1 Contexte de l’étude empirique et formulation des hypothèses
Afin d’illustrer concrètement l’implémentation opérationnelle et la chaîne décisionnelle du test du khi-deux d’indépendance sous SAS, considérons une investigation empirique menée en psychologie sociale et en sciences politiques. L’étude porte sur un échantillon probabiliste représentatif de N = 500 électeurs majeurs résidant sur le territoire national. La problématique scientifique vise à déterminer s’il existe une disparité statistiquement significative des préférences électorales en fonction du genre auto-déclaré des participants, ou si ces deux caractéristiques sont mutuellement indépendantes au sein du corps électoral.
Le plan factoriel retenu croise deux variables catégorielles distinctes : une variable binaire représentant le genre du participant (comportant deux modalités : Homme et Femme), et une variable nominale polytomique caractérisant l’affiliation partisane privilégiée, structurée en trois grands blocs doctrinaux (Gauche, Centre et Droite). Ce croisement configure une table de contingence d’ordre 2×3, présentant six cellules d’observation conjointe.
Sur le plan inférentiel, les hypothèses statistiques se formalisent rigoureusement selon les canons de la modélisation fréquentiste :
- Hypothèse nulle (H0) : Le genre de l’individu et son affiliation politique sont stochastiquement indépendants au sein de la population. Les probabilités d’adhésion aux différents partis politiques sont strictement invariantes quel que soit le genre des électeurs : P(Politique = k | Genre = Homme) = P(Politique = k | Genre = Femme) pour tout k appartenant à {Gauche, Centre, Droite}.
- Hypothèse alternative (H1) : Le genre et la préférence politique sont statistiquement dépendants. Il existe au moins une modalité politique pour laquelle la probabilité d’adhésion varie significativement selon le genre de l’électeur.
Le seuil de significativité conventionnel de première espèce (taux alpha) est préalablement fixé à la valeur standard de 0,05, conférant une sécurité probabiliste de 95 % face au risque de déclarer une association qui résulterait d’un simple artefact d’échantillonnage.
5.2 Programmation complète du script SAS pour le cas pratique
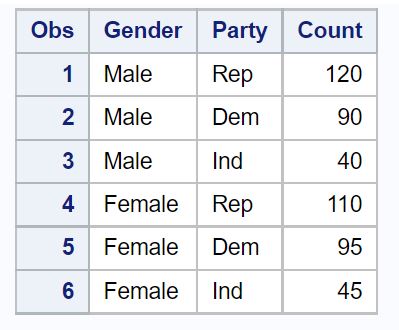
Pour des raisons de transparence et d’autonomie pédagogique, nous présentons ici l’intégralité du code SAS modélisant cette enquête, sous la forme d’un tableau synthétique agrégé utilisant l’instruction WEIGHT. Cette méthode permet de visualiser sans équivoque les données saisies avant leur traitement matriciel.
L’étape DATA initialise un jeu de données temporaire nommé election_study. L’instruction INPUT lit successivement la variable textuelle de ligne (Gender), la variable textuelle de colonne (Party) et la variable numérique entière représentant les fréquences empiriques observées (Count). Le bloc de saisie directe DATALINES intègre les effectifs recueillis lors de la campagne de sondage :
DATA election_study;
INPUT Gender $ Party $ Count;
DATALINES;
Homme Gauche 80
Homme Centre 60
Homme Droite 110
Femme Gauche 115
Femme Centre 70
Femme Droite 65
;
RUN;
Une inspection préliminaire rapide à l’aide de PROC PRINT confirme que la structure matricielle totalise 250 hommes et 250 femmes, garantissant une parité absolue des effectifs marginaux de ligne pour cet échantillon global de N = 500 sujets. L’appel analytique à la procédure PROC FREQ s’articule alors en combinant les directives méthodologiques précédemment détaillées :
PROC FREQ DATA=election_study;
WEIGHT Count;
TABLES Gender * Party / CHISQ EXPECTED CELLCHI2 DEVIATION NOROW NOCOL;
RUN;
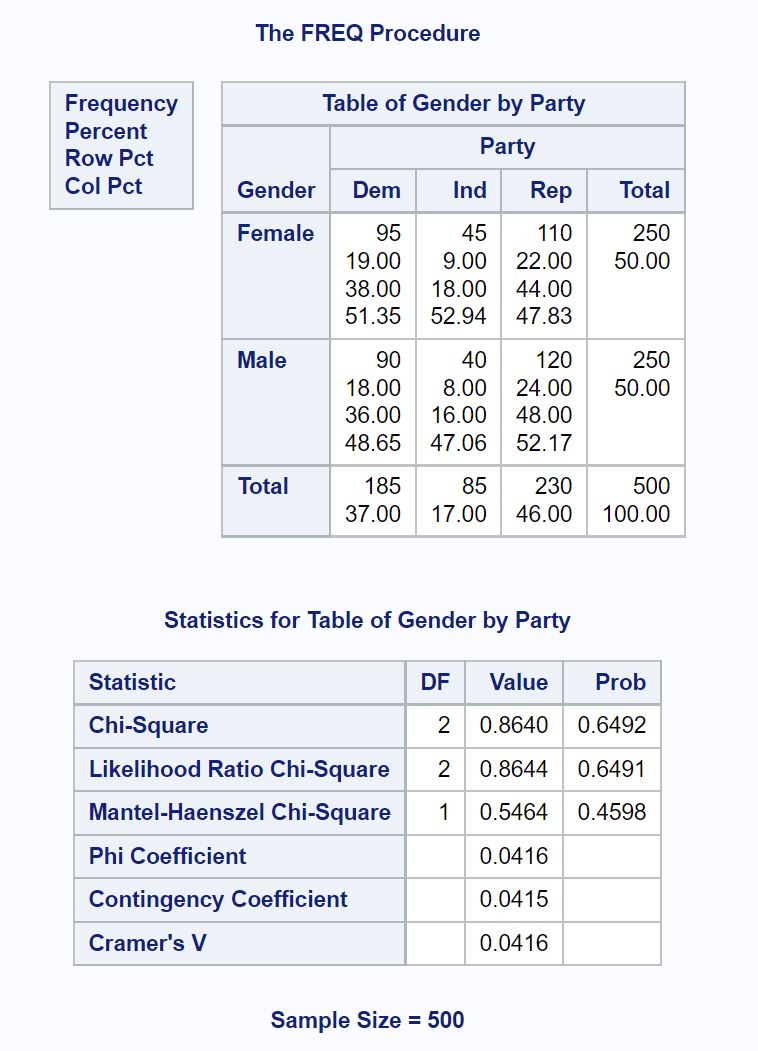
L’omission intentionnelle des pourcentages intra-lignes et intra-colonnes via les options NOROW et NOCOL permet de circonscrire l’affichage de chaque cellule aux seuls indicateurs requis pour la vérification mathématique : effectif observé, effectif attendu sous H0, écart brut de déviation et part contributive au khi-deux global.
5.3 Vérification des conditions préalables sur l’échantillon d’étude
Préalablement à tout examen de la significativité statistique, l’analyste se doit de valider rigoureusement le respect des conditions d’application de Cochran sur la sortie d’exécution émise par SAS. L’inspection des marges du tableau croisé révèle la distribution suivante : sur les 500 électeurs interrogés, 195 expriment une préférence pour la Gauche, 130 se rallient au Centre, et 175 soutiennent la Droite. Les effectifs marginaux de genre étant de 250 pour chaque sous-groupe, le calcul théorique des fréquences attendues s’opère sans ambiguïté :
- Pour la cellule (Homme, Gauche) : E = (250 * 195) / 500 = 97,50
- Pour la cellule (Femme, Gauche) : E = (250 * 195) / 500 = 97,50
- Pour la cellule (Homme, Centre) : E = (250 * 130) / 500 = 65,00
- Pour la cellule (Femme, Centre) : E = (250 * 130) / 500 = 65,00
- Pour la cellule (Homme, Droite) : E = (250 * 175) / 500 = 87,50
- Pour la cellule (Femme, Droite) : E = (250 * 175) / 500 = 87,50
L’examen de cette matrice de fréquences théoriques indique immédiatement que la plus petite valeur d’espérance calculée dans l’ensemble de la table est de 65,00 (observée dans les cellules associées au parti centriste). Cette valeur minimale dépasse très largement le seuil plancher critique de 5 formalisé par Cochran. De surcroît, le pourcentage de cellules affichant un effectif théorique inférieur à 5 est rigoureusement de 0,0 %, satisfaisant de façon éclatante la règle empirique exigeant que cette proportion demeure inférieure à 20 %.
Aucune cellule vide (effectif nul) n’étant répertoriée et l’indépendance mutuelle d’échantillonnage étant garantie par le protocole d’enquête probabiliste, la distribution empirique de la statistique de test converge de manière optimale vers la distribution théorique asymptotique du khi-deux. L’analyste peut ainsi procéder au décodage des sorties d’estimation avec une totale confiance méthodologique quant à la validité des seuils de décision utilisés.
6. Interprétation académique des sorties statistiques de SAS
6.1 Décodage du tableau des statistiques du khi-deux fourni par SAS
L’exécution de la procédure PROC FREQ génère deux blocs principaux d’information : le tableau de contingence enrichi des options matricielles et, immédiatement en aval, la table intitulée Statistics for Table of Gender by Party. Cette table synthétique rassemble l’ensemble des estimateurs inférentiels calculés par SAS. L’attention du chercheur doit se porter en premier lieu sur la ligne identifiée textuellement sous le libellé Chi-Square, qui correspond précisément à la statistique classique de Karl Pearson.
Dans notre cas d’application sur les préférences politiques, SAS affiche les résultats suivants pour la ligne Chi-Square :
- DF (Degrees of Freedom) : SAS indique la valeur 2. Ce chiffre découle directement de l’application de la formule des degrés de liberté pour une table 2×3 : ddl = (2 – 1) * (3 – 1) = 1 * 2 = 2.
- Value (Valeur de la statistique) : SAS indique une valeur empirique du khi-deux égale à 18,6374. Cette métrique synthétise la somme des six termes de divergence calculés au niveau de chaque cellule : [(80 – 97,5)^2 / 97,5] + [(115 – 97,5)^2 / 97,5] + [(60 – 65)^2 / 65] + [(70 – 65)^2 / 65] + [(110 – 87,5)^2 / 87,5] + [(65 – 87,5)^2 / 87,5] = 3,1410 + 3,1410 + 0,3846 + 0,3846 + 5,7857 + 5,7857 = 18,6226 (la légère variation décimale tenant à la précision de troncature interne du processeur SAS).
- Pr > ChiSq (Probabilité asymptotique associée) : SAS renvoie une p-valeur de < .0001 (ou 0.000089).
Cette probabilité asymptotique exprime la vraisemblance d’obtenir, par le seul jeu des fluctuations aléatoires d’échantillonnage, une statistique de Pearson égale ou supérieure à 18,63 dans une population où le genre et l’orientation politique seraient strictement indépendants. Cette p-valeur étant immensément inférieure au seuil alpha prédéterminé de 0,05, la divergence observée ne peut raisonnablement être imputée au hasard de l’échantillonnage.
6.2 Distinction entre les différentes statistiques générées par l’option CHISQ
L’une des richesses — mais aussi l’une des sources fréquentes de confusion pour les néophytes — de la procédure PROC FREQ réside dans le fait que l’option CHISQ ne se limite pas à imprimer la statistique de Pearson, mais produit systématiquement plusieurs indicateurs complémentaires au sein du même bloc de résultats :
1. Le khi-deux du rapport de vraisemblance (Likelihood Ratio Chi-Square) : Noté G^2 dans la littérature avancée, ce test repose sur le principe de la déviance logarithmique entre les fréquences observées et attendues [somme de 2 * O_ij * ln(O_ij / E_ij)]. Bien qu’il converge asymptotiquement vers la même valeur que le khi-deux de Pearson pour de grands échantillons, le rapport de vraisemblance présente des propriétés optimales pour l’imbrication de modèles hiérarchiques et sert de métrique de référence au sein des modèles log-linéaires explorés ultérieurement.
2. Le khi-deux de Mantel-Haenszel (Mantel-Haenszel Chi-Square) : Également désigné sous l’appellation de khi-deux de tendance linéaire, cet indicateur possède 1 degré de liberté, quelle que soit la dimension de la table. Mise en garde méthodologique majeure : ce test postule impérativement que les deux variables analysées possèdent une métrique ordinale sous-jacente. Il mesure l’existence d’une corrélation linéaire de rang entre les dimensions. Dans notre cas pratique, l’affiliation partisane (Gauche, Centre, Droite) ne pouvant être réduite à une gradation quantitative continue sans présupposés idéologiques discutables, et la variable Genre étant strictement dichotomique nominale, la ligne Mantel-Haenszel doit être totalement ignorée par l’analyste.
3. Le coefficient Phi et le V de Cramer : Destinés à évaluer l’intensité de l’association statistique indépendamment de la taille N, ces indices sont automatiquement intégrés en fin de rapport. Pour une table d’ordre supérieur à 2×2, seul le V de Cramer possède une validité interprétative, comme nous l’expliciterons dans la section dédiée à la taille d’effet.
6.3 Prise de décision statistique et conclusion substantielle
L’articulation formelle du processus inférentiel s’organise selon un protocole décisionnel sans équivoque. La p-valeur associée au test du khi-deux de Pearson étant de p = 0,000089, valeur nettement inférieure au risque consenti de première espèce alpha = 0,05, nous sommes conduits à rejeter formellement l’hypothèse nulle H0 d’indépendance stochastique au profit de l’hypothèse alternative H1.
Sur le plan substantiel, cette décision inférentielle atteste qu’il existe une disparité statistiquement hautement significative dans la répartition des affiliations politiques entre les hommes et les femmes au sein de la population étudiée. On ne peut soutenir l’affirmation selon laquelle les orientations électorales se distribuent de manière homogène quel que soit le genre des individus. La relation mise en évidence démontre que la variable sociodémographique exerce une contrainte ou s’associe structurellement aux positionnements idéologiques déclarés.
Néanmoins, le statisticien rigoureux se gardera d’assimiler hâtivement cette dépendance statistique à un mécanisme de causalité directe unidirectionnelle. La mise en évidence d’un khi-deux significatif prouve l’existence d’une structure d’association, mais demeure totalement muette quant aux facteurs médiateurs ou modérateurs susceptibles de sous-tendre ce lien (différences de socialisation précoce, vulnérabilités économiques différentielles face au marché de l’emploi, structures d’âge divergentes au sein des sous-groupes de genre, etc.). L’interprétation substantielle doit par conséquent contextualiser cette dépendance statistique sans verser dans le réductionnisme causal.
7. Évaluation de la taille d’effet et quantification de la force du lien
7.1 Limites inhérentes à la seule lecture de la p-valeur
Une dérive récurrente de la pratique scientifique consiste à confondre la significativité statistique — sanctionnée par le franchissement du seuil p < 0,05 — avec la magnitude substantielle ou l’importance pratique d’un phénomène. La p-valeur constitue exclusivement un indicateur de rareté conditionnelle de la donnée empirique sous le postulat de vérité du modèle théorique nul ; elle ne fournit rigoureusement aucune information sur l’amplitude clinique ou psychosociale de l’association découverte.
Comme l’a formellement établi la littérature méthodologique contemporaine, notamment soutenue par les déclarations officielles de l’American Statistical Association (ASA), la valeur du khi-deux de Pearson est arithmétiquement dépendante de l’effectif global de l’échantillon. À structure de déviation relative parfaitement constante au sein des pourcentages de cellules, multiplier la taille de l’échantillon N par dix multiplie exactement la statistique du khi-deux par dix, provoquant l’effondrement mécanique de la p-valeur vers des seuils microscopiques.
Dans le cadre d’enquêtes à grande échelle fondées sur des cohortes de plusieurs dizaines de milliers d’individus, une association statistique minuscule, expliquant moins de 0,01 % de la variance comportementale totale, sera quasi systématiquement déclarée « hautement significative » (p < 0,001). Réciproquement, sur un échantillon clinique restreint de 30 patients, un effet d’une intensité thérapeutique majeure pourrait échouer à atteindre le seuil de 0,05 par simple déficit de puissance statistique. Il est donc indispensable de compléter systématiquement l’inférence par le calcul d’une mesure standardisée de taille d’effet, exempte de l’influence de l’effectif total de l’échantillon.
7.2 Le V de Cramer et le coefficient Phi dans les tables complexes
Pour quantifier de manière standardisée l’intensité du lien statistique unissant deux variables qualitatives au sein d’une table de contingence, les statisticiens ont développé des métriques de corrélation non paramétriques dérivées de la statistique de Pearson elle-même. Pour les tables élémentaires de dimension 2×2, l’indicateur universel est le coefficient Phi (noté φ), défini algébriquement par la racine carrée du quotient du khi-deux par l’effectif total :
Phi = Racine_Carree( Khi2 / N )
Cependant, dès lors que la table de contingence présente un format supérieur (r > 2 ou c > 2), la valeur maximale théorique que peut atteindre le coefficient Phi n’est plus bornée à 1, ce qui rend son interprétation intuitive totalement caduque. Pour pallier cette anomalie structurelle, Harald Cramér a introduit en 1946 une généralisation élégante, universellement désignée sous le vocable de V de Cramér. Sa formulation mathématique s’énonce comme suit :
V = Racine_Carree[ Khi2 / ( N * min(r – 1, c – 1) ) ]
Dans cette équation, le terme min(r – 1, c – 1) représente la plus petite valeur entre le nombre de lignes diminué de un et le nombre de colonnes diminué de un. Grâce à cette normalisation par le rang minimal de la table, le V de Cramér est strictement borné au sein de l’intervalle fermé [0 ; 1], où 0 désigne une indépendance parfaite et 1 correspond à une association déterministe complète entre les deux dimensions.
Dans notre étude pratique portant sur le genre (2 modalités) et le parti (3 modalités), min(2 – 1, 3 – 1) = min(1, 2) = 1. L’équation de calcul se simplifie alors :
V = Racine_Carree[ 18,6374 / ( 500 * 1 ) ] = Racine_Carree[ 0,03727 ] = 0,1931
Pour interpréter qualitativement ce coefficient de V = 0,19, la communauté scientifique se réfère couramment aux balises d’intensité établies par le psychométricien Jacob Cohen en 1988, ajustées selon le nombre de degrés de liberté minimaux de la table :
- Pour ddl_min = 1 (ce qui est notre cas avec min(r-1, c-1) = 1) : un V d’environ 0,10 correspond à un effet de faible amplitude ; un V d’environ 0,30 reflète un effet de magnitude moyenne ; un V supérieur ou égal à 0,50 dénote une association de forte intensité.
Nous concluons ainsi que si l’effet du genre sur les préférences politiques est hautement significatif sur le plan inférentiel (p < 0,0001), son intensité empirique se classe comme un effet faible à modéré (V = 0,19). Le genre est une variable structurante indéniable, mais il est loin d’expliquer à lui seul l’hétérogénéité des choix électoraux de l’échantillon.
7.3 Rapports de cotes (Odds Ratios) et risques relatifs associés
Lorsque la structure de la table de contingence se restreint à une morphologie dichotomique stricte de format 2×2 — situation omniprésente en épidémiologie psychiatrique et en psychologie de la santé (par exemple, exposition à un traumatisme [Présent/Absent] croisée avec survenue d’un syndrome de stress post-traumatique [Déclaré/Non déclaré]) —, l’évaluation de la taille d’effet s’enrichit d’un indicateur clinique fondamental : le rapport de cotes, ou Odds Ratio (OR).
L’OR compare la cote (l’odds) de survenue d’un événement au sein d’un groupe exposé à la cote de ce même événement au sein du groupe non exposé. Algébriquement, pour une table croisant les lignes A et B avec les colonnes 1 et 2, le rapport de cotes s’obtient par le simple produit en croix des cellules : OR = (O_11 * O_22) / (O_12 * O_21). Une valeur de 1 indique une parfaite identité des cotes (absence d’effet) ; une valeur supérieure à 1 signale une majoration du risque ou de la probabilité de l’événement dans le premier groupe, tandis qu’une valeur inférieure à 1 indique un effet protecteur.
Sous la procédure PROC FREQ de SAS, l’obtention automatique des rapports de cotes et des risques relatifs s’opère par l’adjonction de l’option RELRISK au sein de l’instruction TABLES :
PROC FREQ DATA=clinique;
TABLES Traumatisme * PTSD / CHISQ RELRISK;
RUN;
SAS génère alors une table dédiée détaillant l’estimation ponctuelle de l’Odds Ratio, accompagnée de ses intervalles de confiance asymptotiques à 95 % (calculés selon la méthode de Wald via la transformation logarithmique de l’erreur-type). Si l’intervalle de confiance à 95 % n’englobe pas la valeur critique 1,00, le chercheur dispose d’une preuve robuste de l’impact significatif du facteur d’exposition sur l’événement étudié.
8. Gestion des violations des conditions : Test exact de Fisher et alternatives
8.1 Diagnostic des faibles effectifs et avertissements SAS
L’un des atouts prééminents de l’environnement SAS réside dans l’intégration de mécanismes d’audit automatique qui alertent l’utilisateur dès qu’un postulat statistique théorique est transgressé lors de l’exécution d’un traitement. Lorsque les données soumises à la procédure PROC FREQ violent l’un des critères de validité asymptotique de Cochran, le système n’interrompt pas brutalement l’exécution du code, mais émet un avertissement explicite imprimé en caractères distinctifs immédiatement sous la table des résultats.
Le message d’alerte standard prend la formulation suivante : « WARNING: 20% of the cells have expected counts less than 5. Chi-Square may not be a valid test. » (Avertissement : 20 % des cellules présentent des effectifs théoriques inférieurs à 5. Le test du khi-deux peut ne pas être valide). La présence de cet avertissement constitue un signal d’arrêt absolu pour le chercheur : poursuivre l’interprétation de la statistique de Pearson et de sa p-valeur asymptotique dans ces circonstances équivaudrait à publier un résultat potentiellement vicié par une inflation non maîtrisée de l’erreur de type I.
Face à ce diagnostic, deux orientations méthodologiques s’offrent au statisticien. La première, d’ordre substantiel, consiste à examiner la pertinence théorique d’un regroupement (collapsus) de certaines modalités de la variable qui seraient conceptuellement adjacentes ou sous-représentées (par exemple, regrouper les catégories de formation « Certificat d’études » et « Brevet des collèges » sous un libellé unique « Enseignement primaire et premier cycle »). Si cette fusion s’avère théoriquement indéfendable ou méthodologiquement préjudiciable, le recours impératif à des tests non asymptotiques, dits tests exacts, devient la seule stratégie scientifique recevable.
8.2 Implémentation du test exact de Fisher pour tables 2×2 et r x c
Développé historiquement par Ronald Aylmer Fisher pour pallier les défaillances du khi-deux sur des petits échantillons d’expérimentation agronomique, le test exact de Fisher s’affranchit totalement du recours à une approximation par la loi continue du khi-deux. Il opère sur le plan des probabilités combinatoires discrètes en conditionnant les calculs par la fixation stricte des totaux marginaux de la table.
Sous l’hypothèse nulle d’indépendance, la probabilité exacte d’observer une configuration matricielle spécifique de fréquences dans une table 2×2 répond à une distribution hypergéométrique. Le test exact de Fisher procède en calculant la probabilité hypergéométrique précise de la table observée sur le terrain, puis en y additionnant les probabilités de l’ensemble des autres configurations théoriquement possibles qui présenteraient des marges identiques mais afficheraient un écart à l’indépendance encore plus extrême que celui constaté empiriquement.
Dans l’environnement SAS, l’activation du test exact de Fisher ne nécessite aucune restructuration algorithmique complexe. Il suffit d’adjoindre l’instruction EXACT immédiatement après la déclaration de la table au sein de PROC FREQ :
PROC FREQ DATA=faibles_effectifs;
TABLES Diagnostic * Traitement / CHISQ;
EXACT FISHER;
RUN;
Si la table de contingence est d’ordre 2×2, SAS calcule automatiquement les probabilités unilatérales (One-Sided) et bilatérales (Two-Sided) exactes. Dans le cas hautement plus complexe d’une table de dimensions arbitraires r x c (comportant par exemple trois lignes et quatre colonnes avec des cellules clairsemées), SAS déploie de manière totalement transparente l’extension computationnelle de Freeman et Halton (1951), fournissant une p-valeur exacte bilatérale inattaquable sur le plan inférentiel.
8.3 Méthodes de rééchantillonnage Monte Carlo sous SAS
Si l’algorithme du test exact de Fisher excelle sur les tables de petites dimensions ou d’effectifs modérés, il se heurte à une limitation mathématique rédhibitoire connue sous le terme d’explosion combinatoire. Lorsque les dimensions de la table augmentent (par exemple, une table 6×8) et que la taille de l’échantillon global N se chiffre en plusieurs centaines d’individus tout en conservant quelques cellules locales clairsemées, le nombre de permutations marginales envisageables dépasse la puissance de calcul des processeurs, saturant l’espace mémoire et provoquant des temps d’exécution rédhibitoires.
Pour surmonter ce goulot d’étranglement informatique sans régresser vers des approximations asymptotiques invalides, SAS propose une alternative algorithmique : l’estimation de la p-valeur exacte par simulation stochastique de Monte Carlo. Cette méthode procède par le tirage aléatoire répété d’un nombre colossal de tables de contingence conformes aux marges observées, permettant d’estimer empiriquement la distribution d’échantillonnage avec une marge d’erreur maîtrisée.
La syntaxe de déclenchement associe l’option MC à l’instruction EXACT, en permettant d’ajuster le volume des tirages (généralement 10 000 ou 100 000 itérations) via l’option N= :
PROC FREQ DATA=grande_table_clairsemee;
TABLES Symptome * Profil / CHISQ;
EXACT CHISQ / MC N=100000 SEED=12345 ALPHA=0.05;
RUN;
L’assignation explicite d’une graine de randomisation (SEED) assure la reproductibilité scientifique stricte du tirage : deux chercheurs exécutant le script obtiendront rigoureusement les mêmes estimations décimales. Dans le rapport de sortie, SAS fournit l’estimation ponctuelle de la p-valeur de Monte Carlo, flanquée de son intervalle de confiance à 95 % (indiqué par Lower Bound et Upper Bound). Si la borne supérieure de cet intervalle de simulation demeure fermement inférieure au seuil de 0,05, le rejet de l’hypothèse nulle d’indépendance est méthodologiquement garanti.
9. Analyses post-hoc et décomposition des cellules contributives
9.1 Résidus bruts versus résidus standardisés de Pearson
L’obtention d’une statistique globale du khi-deux hautement significative (p < 0,001) permet d’affirmer avec certitude que l’hypothèse d’indépendance stochastique doit être rejetée. Toutefois, cette métrique synthétique souffre de la même limitation que le test F de Fisher dans une analyse de variance : elle présente un caractère strictement omnibus. Elle démontre l’existence d’une hétérogénéité structurelle au sein du tableau, mais demeure totalement incapable de préciser la localisation exacte des divergences, ni quelles cellules spécifiques s’écartent significativement du modèle d’indépendance.
Pour disséquer l’anatomie de cette dépendance, l’analyste doit impérativement procéder à une analyse résiduelle cellule par cellule. Le résidu brut (ou déviation simple), calculé par l’opération :
e_ij = O_ij – E_ij
indique certes si la modalité conjointe est surreprésentée (signe positif) ou sous-représentée (signe négatif), mais sa grandeur dépend totalement de l’ordre de grandeur de l’effectif théorique sous-jacent. Un écart brut de 15 cas présente une charge démonstrative infiniment plus forte si l’effectif attendu était de 5 cas que s’il était de 1 000 cas.
Pour standardiser cette mesure, Pearson a proposé le résidu standardisé (parfois qualifié de résidu de Pearson), qui s’obtient en divisant l’écart brut par la racine carrée de la fréquence théorique attendue :
r_ij = (O_ij – E_ij) / Racine_Carree(E_ij)
On remarque immédiatement que le carré de ce résidu standardisé [r_ij]^2 n’est autre que la contribution unitaire de la cellule au khi-deux global, obtenue sous SAS au moyen de l’option CELLCHI2. Dans notre cas d’école sur le genre et les préférences politiques, l’inspection des valeurs de CELLCHI2 révélait que les cellules (Homme, Droite) et (Femme, Droite) affichaient chacune une contribution de 5,7857, représentant à elles deux plus de 62 % de la valeur globale de la statistique de test (11,57 sur 18,63). L’association globale découle donc principalement d’une divergence massive d’adhésion envers l’électorat de Droite.
9.2 Calcul et interprétation des résidus ajustés standardisés (Haberman)
Bien que le résidu standardisé de Pearson constitue un progrès analytique indiscutable, il souffre d’une tare théorique identifiée par le statisticien Shelby Haberman en 1973 : sa variance théorique n’est pas rigoureusement égale à l’unité (1), car elle demeure tributaire des fractions marginales occupées par la ligne et la colonne considérées. Par conséquent, les résidus de Pearson ne suivent pas strictement une distribution normale centrée réduite N(0,1), ce qui rend incertaine l’utilisation des valeurs critiques classiques (comme le seuil de 1,96).
Pour résoudre ce problème, Haberman a développé le résidu ajusté standardisé (adjusted standardized residual), qui pondère l’écart brut par l’estimation exacte de son erreur-type asymptotique. Son équation mathématique s’exprime par la formule suivante :
z_ij = (O_ij – E_ij) / Racine_Carree[ E_ij * (1 – R_i / N) * (1 – C_j / N) ]
Dans cette formulation rigoureuse, R_i / N représente la proportion marginale de la i-ème ligne et C_j / N la proportion marginale de la j-ème colonne. Grâce à cette normalisation matricielle, z_ij suit asymptotiquement et de façon exacte une loi normale standard N(0,1) sous l’hypothèse nulle d’indépendance. Il devient dès lors possible d’appliquer des règles de décision probabilistes unifiées :
- Tout résidu ajusté z_ij supérieur à +1,96 (ou inférieur à -1,96) indique une cellule en déviation statistiquement significative par rapport au modèle d’indépendance au seuil bilatéral conventionnel de 5 % (alpha = 0,05).
- Tout résidu ajusté supérieur à +2,58 (ou inférieur à -2,58) signale une déviation hautement significative au seuil alpha = 0,01.
- Tout résidu ajusté excédant la borne de +3,29 (ou inférieur à -3,29) reflète une rupture d’indépendance critique au seuil alpha = 0,001.
Sous les versions modernes de SAS, l’extraction de ces résidus ajustés peut être activée au sein de PROC FREQ ou, de manière encore plus modélisatrice, en sollicitant la procédure de régression généralisée PROC GENMOD en paramétrant un modèle log-linéaire de Poisson dont les résidus de Haberman sont imprimés par l’option RESIDUALS.
9.3 Correction pour comparaisons multiples lors des tests post-hoc
L’évaluation simultanée de multiples résidus ajustés au sein d’une table de contingence expose l’analyste au redoutable phénomène méthodologique d’inflation du risque global de fausse découverte (l’inflation de l’erreur de première espèce au niveau de la famille de tests, ou family-wise error rate). Si un chercheur évalue indépendamment les résidus de six cellules au seuil nominal alpha = 0,05, la probabilité théorique d’observer au moins une cellule faussement significative par pur hasard probabiliste n’est plus de 0,05, mais avoisine arithmétiquement 1 – (1 – 0,05)^6 = 0,264, soit plus de 26 % de risque de faux positif.
Pour préserver l’intégrité de l’inférence post-hoc, il est impératif d’appliquer une procédure de correction pour tests multiples. La méthode la plus classique — bien que conservatrice — est l’ajustement de Bonferroni. Elle consiste à diviser le seuil alpha global visé (par exemple 0,05) par le nombre total de cellules k contenues dans la table (k = r * c) :
alpha_ajuste = alpha_global / (r * c)
Pour notre table 2×3 comportant 6 cellules, le seuil de significativité critique unitaire devient : alpha_ajuste = 0,05 / 6 = 0,00833. En consultant la table de la loi normale centrée réduite, la valeur critique bilatérale z associée à une probabilité d’erreur de 0,00833 n’est plus de 1,96, mais s’élève à z_critique = 2,64. Dès lors, seules les cellules présentant un résidu ajusté z_ij dont la valeur absolue dépasse strictement 2,64 pourront être formellement déclarées comme contributrices à la rupture d’indépendance sans risquer d’altérer la robustesse du protocole de découverte scientifique.
Une alternative plus souple et statistiquement plus puissante consiste à contrôler le taux de fausse découverte (False Discovery Rate – FDR) via l’algorithme séquentiel de Benjamini-Hochberg. Cette méthode réordonne les p-valeurs des cellules par ordre croissant et module les seuils de rejet selon leur rang ordinal, offrant un compromis idéal entre puissance empirique et contrôle strict des erreurs inférentielles.
10. Visualisation graphique des tables de contingence avec ODS Graphics
10.1 Activation et configuration du système ODS Graphics dans SAS
L’exploration et la communication scientifique des structures d’association discrètes ne sauraient se restreindre à la contemplation de matrices numériques denses. Le système graphique intégré de SAS, désigné sous l’acronyme d’ODS Graphics (Output Delivery System Graphics), permet de synthétiser visuellement les interactions multivariées avec une qualité typographique conforme aux critères des maisons d’édition scientifique internationales.
Dans les versions actuelles de SAS, le moteur graphique est généralement actif par défaut. Il demeure néanmoins recommandé, au sein d’un script d’analyse structuré, de l’initialiser formellement au moyen de l’instruction ODS GRAPHICS ON, en spécifiant les paramètres de restitution souhaités (taille de l’image, résolution spatiale en DPI, format de compression vectorielle ou matricielle). Le listing suivant illustre l’initialisation d’un environnement de rendu à haute résolution adapté aux critères éditoriaux des périodiques de l’American Psychological Association :
ODS GRAPHICS ON / RESET=INDEX IMAGENAME= »MosaicPlot_Khi2″ IMAGEFMT=PNG HEIGHT=600px WIDTH=800px BORDER=OFF;
Ce paramétrage garantit que toute figure générée par la suite sera exportée sous la forme d’un fichier PNG d’une densité de 300 ou 600 DPI, sans liséré de bordure parasite, prêt pour l’intégration directe au sein d’un traitement de texte académique.
10.2 Production de diagrammes en mosaïque (Mosaic Plots)
Parmi l’ensemble des représentations graphiques dédiées aux tables de contingence, le diagramme en mosaïque (Mosaic Plot), théorisé par Hartigan et Kleiner en 1981 et formalisé par Friendly en 1994, constitue indiscutablement l’outil heuristique le plus élégant et le plus puissant. Un diagramme en mosaïque représente l’intégralité de l’espace de données sous la forme d’un rectangle unitaire de surface égale à 1, subdivisé récursivement en tuiles rectangulaires dont les dimensions physiques traduisent les fréquences relatives observées.
La largeur horizontale de chaque colonne de tuiles est strictement proportionnelle à la fréquence marginale de la variable d’abscisse (dans notre exemple, les proportions d’électeurs masculins et féminins). Ensuite, à l’intérieur de chaque colonne, la hauteur verticale des tuiles individuelles correspond à la distribution conditionnelle des modalités de la seconde variable (les affiliations partisanes Gauche, Centre, Droite). Par voie de conséquence géométrique directe, la superficie surfacique de chaque cellule élémentaire est rigoureusement proportionnelle à l’effectif conjoint O_ij observé dans le jeu de données.
Pour générer cette visualisation au sein de la procédure PROC FREQ, il suffit de renseigner l’option PLOTS=MOSAICPLOT au niveau de l’instruction TABLES :
PROC FREQ DATA=election_study;
WEIGHT Count;
TABLES Gender * Party / CHISQ PLOTS=MOSAICPLOT(COLORING=RESIDUAL);
RUN;
L’adjonction de l’argument COLORING=RESIDUAL décuple la portée diagnostique du diagramme : SAS applique un dégradé colorimétrique dynamique aux tuiles en fonction de la valeur de leur résidu standardisé de Pearson. Les cellules statistiquement surreprésentées (déviation positive majeure) se teintent d’un bleu profond, tandis que les cellules sous-représentées (déviation négative marquée) apparaissent dans une nuance rouge saturée ; les cellules conformes à l’hypothèse d’indépendance conservent un ton neutre grisâtre. Le chercheur perçoit ainsi immédiatement l’architecture sous-jacente de la dépendance sans avoir à disséquer mentalement des colonnes de chiffres.
10.3 Visualisations avancées avec la procédure PROC SGPLOT
Bien que le diagramme en mosaïque excelle dans l’analyse exploratoire exhaustive, sa lecture fine peut parfois désarçonner un public non initié aux conventions sémiologiques de Hartigan. Dans un objectif de diffusion pédagogique large ou de publication généraliste, l’analyste privilégiera souvent le recours à la procédure PROC SGPLOT pour concevoir des diagrammes en barres empilées (Stacked Bar Charts) ou groupées (Clustered Bar Charts) exprimées en pourcentages intra-groupes.
La syntaxe de PROC SGPLOT permet de dissocier les barres physiques en faisant appel à l’instruction VBAR, tout en paramétrant le regroupement conditionnel :
PROC SGPLOT DATA=election_study;
VBAR Gender / RESPONSE=Count GROUP=Party GROUPDISPLAY=CLUSTER STAT=SUM DATALABEL;
YAXIS LABEL= »Effectifs cumulés des électeurs »;
XAXIS LABEL= »Genre auto-déclaré »;
RUN;
L’option GROUPDISPLAY=CLUSTER positionne les barres des trois formations politiques côte à côte pour chaque genre, permettant une comparaison transversale immédiate. Pour une élégance accrue, l’adjonction de schémas de couleurs universellement accessibles — optimisés pour les personnes atteintes de déficiences de la vision des couleurs (daltonisme) — garantit le respect des exigences d’accessibilité visuelle universelle édictées par les normes scientifiques internationales.
11. Normes de rédaction académique des résultats selon le format APA 7
11.1 Directives formelles de l’American Psychological Association
La transcription des résultats d’un test d’indépendance du khi-deux dans un article soumis à une revue scientifique à comité de lecture doit se plier aux règles stylistiques et typographiques rigoureuses édictées par la 7e édition du manuel de publication de l’American Psychological Association (APA 7). Le respect de ces canons d’écriture garantit l’intelligibilité universelle et la comparabilité des indices statistiques à travers la littérature internationale.
La notation standardisée impose que la lettre grecque représentant le test soit insérée en italique : χ² (ou écrite sous sa dénomination occidentale chi-deux en l’absence de module de symboles, mais jamais sous la forme d’un simple X majuscule standard). La structure syntaxique fondamentale de restitution d’un test d’indépendance se condense obligatoirement selon le modèle formalisé suivant :
χ²(degrés de liberté, N = effectif total) = valeur empirique, p = p-valeur, V = taille d’effet
Les règles formelles de mise en forme numérique de l’APA imposent des critères d’arrondi décimal immuables :
- La valeur de la statistique du khi-deux ainsi que les degrés de liberté sont systématiquement rapportés avec deux décimales (par exemple : χ² = 18,64).
- La taille d’effet (le V de Cramér ou le coefficient Phi) est également tronquée à deux décimales (par exemple : V = 0,19).
- La p-valeur doit impérativement être exprimée avec trois décimales (par exemple : p = 0,023).
- Si la p-valeur renvoyée par le logiciel est infinitésimale (comme le
< .0001de SAS), il est formellement interdit d’écrire p = 0,000 (ce qui constituerait une absurdité épistémologique désignant une certitude absolue impossible en échantillonnage aléatoire). L’écriture normalisée impose : p < ,001. - En typographie anglophone APA, les grandeurs qui ne peuvent théoriquement jamais dépasser la valeur absolue de 1 (telles que les p-valeurs, les corrélations ou le V de Cramér) s’écrivent sans zéro préliminaire devant le séparateur décimal (exemple : p < .001 ; V = .19). En rédaction francophone, l’usage autorise le maintien du zéro (p < 0,001 ; V = 0,19) accompagné de la virgule décimale.
11.2 Exemples textuels de formulation pour manuscrits scientifiques
Pour assurer une parfaite maîtrise de l’exercice rédactionnel, examinons comment articuler la section des résultats dans le corps de texte d’un article de recherche selon différentes configurations décisionnelles :
Exemple de formulation pour un résultat statistiquement non significatif :
« Afin d’examiner si le type de prise en charge thérapeutique (médicamenteuse vs psychothérapeutique) variait selon le milieu de résidence des patients (urbain vs rural), un test d’indépendance du khi-deux de Pearson a été conduit. Les conditions d’application de Cochran étaient pleinement satisfaites, la fréquence théorique minimale s’élevant à 14,2 cas. Les résultats révèlent l’absence d’association statistiquement significative entre le milieu de résidence et l’orientation thérapeutique, χ²(1, N = 180) = 0,84, p = 0,359, φ = 0,07. Ces données indiquent que la distribution des orientations de soins est indépendante de l’implantation géographique des sujets au sein de notre cohorte. »
Exemple de formulation complète pour notre cas pratique Genre et Préférences politiques (résultat hautement significatif avec analyse post-hoc) :
« Un test du khi-deux d’indépendance de Pearson a été réalisé pour déterminer si les préférences politiques déclarées (Gauche, Centre, Droite) variaient selon le genre des électeurs (Homme, Femme). L’ensemble des postulats d’application de Cochran a été validé avec succès, l’effectif théorique minimal étant de 65,00 et aucune cellule ne présentant d’espérance inférieure à 5. L’analyse met en évidence une association statistiquement hautement significative entre le genre de l’individu et son affiliation partisane, χ²(2, N = 500) = 18,64, p < 0,001. Selon les balises d’interprétation de Cohen, la force de cette association est qualifiée d’ampleur faible à modérée, comme l’atteste le coefficient de contingence, V de Cramér = 0,19.
L’analyse post-hoc des résidus ajustés standardisés de Haberman, assortie d’un seuil critique corrigé par l’ajustement de Bonferroni (z_critique = ±2,64 pour un risque alpha global maintenu à 0,05), révèle que cette dépendance est quasi exclusivement tirée par le positionnement envers l’électorat de Droite. En effet, les hommes manifestent une surreprésentation significative au sein du parti de Droite (z = +3,86, effectif observé = 110 pour un effectif attendu = 87,50), corrélative d’une sous-représentation symétrique chez les femmes (z = -3,86, observé = 65, attendu = 87,50). Les adhésions envers les partis de Gauche (z = -2,41 chez les hommes) et du Centre (z = -0,87 chez les hommes) ne franchissent pas le seuil de significativité post-hoc après contrôle conservateur des comparaisons multiples. »
11.3 Construction de tables de contingence conformes aux exigences APA
L’insertion d’un tableau synthétique au format APA doit obéir à une géométrie typographique stricte : l’emploi de bordures verticales y est formellement prohibé. Le tableau ne doit comporter que trois lignes horizontales principales délimitant l’en-tête supérieur, la base de l’en-tête et le pied de tableau. L’exemple ci-dessous illustre l’agencement normalisé de notre jeu de données sous format HTML :
| Genre | Gauche | Centre | Droite | Total |
|---|---|---|---|---|
| Homme | ||||
| Effectif observé (O) | 80 | 60 | 110 | 250 |
| Effectif théorique (E) | 97,50 | 65,00 | 87,50 | 250 |
| Résidu ajusté (z) | -2,41 | -0,87 | +3,86* | — |
| Femme | ||||
| Effectif observé (O) | 115 | 70 | 65 | 250 |
| Effectif théorique (E) | 97,50 | 65,00 | 87,50 | 250 |
| Résidu ajusté (z) | +2,41 | +0,87 | -3,86* | — |
| Total | 195 | 130 | 175 | 500 |
Note. N = 500. Les valeurs théoriques représentent les espérances calculées sous l’hypothèse nulle d’indépendance stochastique. Les résidus ajustés standardisés de Haberman suivent asymptotiquement une loi N(0,1). L’astérisque (*) signale une contribution unitaire statistiquement significative après application de la correction de Bonferroni pour six comparaisons simultanées (|z| > 2,64, p < 0,0083).
12. Erreurs méthodologiques courantes, limites et extensions modélisatrices
12.1 Pièges analytiques fréquents chez les chercheurs
L’accessibilité logicielle de la procédure PROC FREQ sous SAS ne doit pas masquer les multiples écueils méthodologiques qui jalonnent la trajectoire du chercheur non averti. Le premier piège, universel mais toujours vivace, réside dans l’extrapolation causale abusive à partir d’une simple dépendance stochastique. Conclure qu’un attribut individuel (comme l’orientation politique) est directement provoqué par une appartenance catégorielle (comme le genre) méconnaît l’action omniprésente de variables tierces confondantes ou modératrices (statut socioéconomique, niveau d’éducation, socialisation familiale) qui demeurent invisibles au sein d’une table bivariée.
Une seconde faute analytique fréquente concerne le traitement inapproprié de mesures répétées. Il n’est pas rare de voir des investigateurs appliquer un khi-deux standard de Pearson pour comparer l’état clinique d’une même cohorte de patients évalués à l’admission hospitalière puis à leur sortie de consultation. Dans ce schéma, l’hypothèse sacrosainte d’indépendance mutuelle des observations individuelles est violée : chaque cellule ne renferme pas des individus distincts, mais les états successifs d’un même groupe d’individus autocorrélés. Le statisticien doit impérativement abandonner le khi-deux d’indépendance au profit du test de McNemar (pour les tables 2×2 appariées) ou des modèles de symétrie marginale de Bowker (pour les tables carrées r x r).
Enfin, le p-hacking par fusion arbitraire de modalités constitue une dérive éthique et statistique pernicieuse. Confronté à un khi-deux échouant de peu au seuil de significativité (par exemple, p = 0,07), l’analyste peu scrupuleux peut être tenté de regrouper a posteriori deux modalités de colonnes dans le seul dessein mécanique d’abaisser artificiellement la p-valeur sous la barre symbolique de 0,05. Toute fusion de catégories catégorielles doit impérativement être justifiée a priori sur des bases théoriques solides, idéalement consignées au sein d’un protocole pré-enregistré (pre-registration), et ne saurait être guidée par la quête opportuniste de significativité.
12.2 Comparaison avec d’autres tests non paramétriques
La boîte à outils non paramétrique de SAS offre un spectre étendu de procédures alternatives adaptées aux singularités structurelles des données empiriques que l’analyste doit savoir mobiliser à bon escient :
- Le test de McNemar : Réservé aux plans à mesures répétées ou cas-témoins appariés en format 2×2. Activé sous SAS par l’option AGREE au sein de l’instruction TABLES de PROC FREQ, il concentre l’inférence sur les seules cellules discordantes (les sujets ayant changé d’état entre le temps 1 et le temps 2).
- Le test de Cochran-Mantel-Haenszel (CMH) : Destiné à tester l’association entre deux variables catégorielles tout en contrôlant ou en stratifiant par une troisième variable confondante (variable de bloc ou covariable catégorielle). Déclenché par l’option CMH au sein de l’instruction TABLES (sous la syntaxe
TABLES Strate * Exposition * Maladie / CMH;), il permet d’écarter le paradoxe de Simpson en calculant un Odds Ratio commun pondéré à travers l’ensemble des strates d’analyse. - Le test de tendance de Cochran-Armitage : Spécifiquement conçu pour les tables croisant une variable binaire avec une variable ordinale comportant k modalités ordonnées. Activé par l’option TREND sous PROC FREQ, ce test bénéficie d’une puissance statistique considérablement accrue par rapport au khi-deux de Pearson pour détecter une augmentation monotone ou linéaire des probabilités d’occurrence le long de la séquence ordinale.
Le choix raisonné entre ces différents outils méthodologiques conditionne la justesse et la robustesse des conclusions scientifiques que le chercheur soumettra au jugement de la communauté académique.
12.3 Transition vers la modélisation log-linéaire et la régression logistique
Malgré sa valeur heuristique inaltérable, le test d’indépendance du khi-deux bidimensionnel atteint ses limites intrinsèques dès lors que le phénomène étudié met en jeu plus de deux variables qualitatives interdépendantes. Réduire une recherche psychosociale complexe à une série de tests bivariés isolés revient à ignorer délibérément les phénomènes d’interactions d’ordre supérieur et expose le protocole à des biais massifs de mauvaise spécification.
L’extension mathématique naturelle du test du khi-deux vers le paradigme multivarié s’opère par le biais des modèles log-linéaires, implémentés sous SAS via les procédures PROC CATMOD ou PROC GENMOD. Le modèle log-linéaire modélise le logarithme népérien des effectifs attendus comme une fonction linéaire des effets principaux et des termes d’interaction entre l’ensemble des variables catégorielles introduites. La qualité d’ajustement global du modèle théorique aux données réelles est évaluée au moyen de la déviance du rapport de vraisemblance G^2, suivant formellement une distribution du khi-deux :
PROC GENMOD DATA=donnees_complexes;
MODEL Count = Genre Parti ClasseSociale Genre*Parti Genre*ClasseSociale / DIST=POISSON LINK=LOG;
RUN;
Enfin, lorsque l’une des variables catégorielles s’impose conceptuellement et sans ambiguïté comme la variable réponse à expliquer (la variable dépendante Y) en fonction d’un ensemble hétérogène de prédicteurs catégoriels et continus, l’analyste délaissera la modélisation log-linéaire symétrique pour adopter le cadre puissant de la régression logistique binaire ou multinomiale, exécutée sous SAS au moyen de la procédure PROC LOGISTIC. Cette transition modélisatrice parachève le parcours méthodologique du chercheur quantitativiste, reliant le test élémentaire de contingence fondé par Karl Pearson aux techniques contemporaines d’apprentissage statistique et d’inférence probabiliste généralisée.
Références
- Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249688
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Fisher, R. A. (1922). On the interpretation of χ² from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Freeman, G. H., & Halton, J. H. (1951). Note on an exact treatment of contingency, goodness of fit and other problems of significance. Biometrika, 38(1/2), 141–149. https://doi.org/10.2307/2332323
- Friendly, M. (1994). Mosaic displays for multi-way contingency tables. Journal of the American Statistical Association, 89(425), 190–200. https://doi.org/10.1080/01621459.1994.10476460
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Hartigan, J. A., & Kleiner, B. (1981). Mosaics for contingency tables. Computer Science and Statistics: Proceedings of the 13th Symposium on the Interface, 268–273.
- McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153–157. https://doi.org/10.1007/BF02295996
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine Series 5, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- SAS Institute Inc. (2021). SAS/STAT 15.2 user’s guide: The FREQ procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/index.html
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108