
Dans le domaine des sciences comportementales, de la psychologie organisationnelle et de l’épidémiologie sociale, la collecte de données primaires se heurte continuellement à des contraintes matérielles, budgétaires et géographiques considérables. Alors que l’échantillonnage aléatoire simple constitue souvent l’idéal théorique pour garantir la représentativité statistique, sa mise en œuvre sur le terrain s’avère fréquemment irréalisable lorsqu’il s’agit d’enquêter sur des populations dispersées. C’est précisément dans cette brèche opérationnelle que s’inscrit l’échantillonnage en grappes, une méthode d’échantillonnage probabiliste puissante permettant de sélectionner non pas des individus isolés, mais des regroupements naturels préexistants au sein desquels les observations sont ensuite recueillies de manière exhaustive ou sous-échantillonnée.
Le recours à un logiciel ubiquitaire tel que Microsoft Excel pour orchestrer un tel protocole statistique offre une flexibilité remarquable, pourvu que la démarche méthodologique soit exécutée avec une rigueur absolue. Loin d’être un simple outil de calcul bureautique, le tableur moderne intègre désormais des moteurs de calcul matriciel dynamique, des générateurs probabilistes et des environnements d’automatisation capables de traiter des architectures de données hiérarchiques complexes. La maîtrise de ces fonctionnalités permet aux chercheurs et aux analystes quantitatifs d’assurer une traçabilité totale du tirage, de limiter les erreurs de manipulation humaine et de garantir la réplicabilité scientifique des résultats obtenus dans le strict respect des canons de la recherche expérimentale.
Ce guide exhaustif propose une déconstruction minutieuse, étape par étape, de la procédure d’échantillonnage en grappes sous Excel. De la clarification des fondements épistémologiques sous-jacents aux arbitrages techniques entre tirages à un ou deux degrés, en passant par le calcul déterminant du coefficient de corrélation intraclasse (ICC) et de l’effet de plan (Design Effect), chaque phase fait l’objet d’un examen critique approfondi. À travers une démarche pédagogique et empirique, ce document constitue le manuel de référence indispensable pour implémenter des plans de sondage robustes et méthodologiquement irréprochables au moyen de vos feuilles de calcul.
1. Fondements théoriques de l’échantillonnage en grappes en recherche comportementale
1.1 Définition conceptuelle et principes de l’échantillonnage par grappes
L’échantillonnage en grappes repose sur une prémisse fondamentale qui le distingue radicalement des autres techniques d’échantillonnage probabiliste : l’unité d’échantillonnage primaire (UEP) n’est point l’individu isolé, mais un ensemble collectivement constitué d’unités secondaires d’observation. Dans la terminologie de la statistique inférentielle, une grappe se définit comme un agrégat préexistant au sein de la population cible, caractérisé de manière idéale par une forte hétérogénéité interne tout en présentant une relative homogénéité lorsqu’elle est comparée aux autres grappes de l’univers d’étude. Ce principe d’hétérogénéité intra-grappe constitue la pierre angulaire théorique du paradigme, car il postule que chaque grappe devrait idéalement fonctionner comme un microcosme représentatif de la population globale.
D’un point de vue mathématique et probabiliste, la sélection des grappes s’opère selon une loi de probabilité rigoureuse où chaque entité collective dispose d’une chance connue et non nulle d’être intégrée à l’échantillon final. La justification logistique et économique de cette approche s’avère particulièrement prégnante dans les investigations menées en psychologie institutionnelle, en sociologie du travail et en santé publique. Il est manifestement plus efficient et considérablement moins onéreux de dépêcher des équipes de recherche au sein d’un nombre restreint d’hôpitaux, d’écoles ou d’entreprises géographiquement circonscrits plutôt que de disperser des ressources limitées à travers un territoire infini pour interroger des sujets individuels isolés issus d’un tirage aléatoire simple.
Au-delà des impératifs économiques, le recours aux grappes permet de préserver de façon optimale la validité écologique de la recherche comportementale. En étudiant les individus au sein même de leurs micro-environnements naturels sans rompre les interactions systémiques, les hiérarchies informelles et les dynamiques de groupe inhérentes à ces écosystèmes, le chercheur recueille un matériau empirique qui reflète fidèlement la réalité phénoménologique des sujets observés, évitant ainsi les artefacts expérimentaux générés par la décontextualisation sociale.
1.2 Distinction épistémologique entre échantillonnage stratifié et en grappes
La confusion conceptuelle entre l’échantillonnage stratifié et l’échantillonnage en grappes constitue l’un des écueils méthodologiques les plus récurrents chez les praticiens de la recherche. Bien que ces deux méthodologies fassent intervenir une partition initiale de la population en sous-ensembles distincts, leurs fondements épistémologiques et leurs structures de variance reposent sur des logiques rigoureusement inverses. L’échantillonnage stratifié exige une homogénéité intra-strate maximale et une hétérogénéité inter-strates prononcée relativement à la variable d’intérêt. À l’inverse, l’échantillonnage en grappes présuppose théoriquement une hétérogénéité maximale au sein de chaque grappe et une grande similarité entre les différentes grappes composant la population.
Cette divergence structurelle entraîne des répercussions directes sur l’erreur d’échantillonnage et la précision de l’estimation des construits psychologiques. Alors que la stratification réduit mécaniquement la variance de l’estimateur en éliminant la variabilité entre les strates (toutes les strates étant obligatoirement échantillonnées), l’échantillonnage en grappes tend invariablement à accroître l’erreur standard de l’estimation. En ne sélectionnant qu’une fraction des grappes existantes, le statisticien introduit une variance d’échantillonnage inter-grappes supplémentaire, généralement amplifiée par le fait que les individus regroupés partagent souvent des traits communs, violant ainsi l’hypothèse canonique d’indépendance statistique des observations.
Le choix entre ces protocoles découle directement de la structure hiérarchique de la population cible et des objectifs épistémologiques assignés à l’étude. Si l’objectif prioritaire réside dans l’optimisation de la précision mathématique et la comparaison détaillée de sous-groupes mutuellement exclusifs (par exemple, analyser les écarts de stress perçu entre différents corps de métier hospitaliers), la stratification s’impose sans équivoque. En revanche, si la population se structure naturellement en entités physiques coalescentes et que les contraintes d’accès rendent tout recensement individuel préalable impossible ou financièrement prohibitif, l’échantillonnage en grappes constitue l’unique voie probabiliste praticable.
1.3 Applications pratiques dans les protocoles de recherche en psychologie
En psychologie du travail et du comportement organisationnel, l’échantillonnage en grappes s’avère particulièrement fécond pour ausculter des construits tels que le climat de sécurité, l’épuisement professionnel ou l’engagement institutionnel au sein de vastes organisations corporatives ou hospitalières. Dans un centre hospitalier universitaire comptant plusieurs dizaines de services cliniques distincts, un protocole peut consister à tirer au sort huit divisions hospitalières (les grappes) et à solliciter l’ensemble du personnel soignant rattaché à ces unités. Ce design permet non seulement d’évaluer les variables psychométriques cibles, mais également de modéliser les effets de groupe et l’impact du style de leadership local sur le bien-être des soignants.
Dans le domaine de la psychologie du développement et de l’éducation, cette méthode trouve un terrain d’application privilégié lors de l’investigation des dynamiques socio-émotionnelles, des phénomènes de harcèlement entre pairs ou des processus d’apprentissage coopératif. L’unité scolaire, et plus spécifiquement la classe d’âge ou la cohorte académique, forme une grappe par excellence. Les élèves interagissant en permanence au sein de ces entités régulées, administrer une batterie de tests psychologiques à l’échelle de classes entières préalablement tirées au sort permet d’observer les conduites sociales en situation écologique tout en maximisant le taux de réponse effectif par rapport à des envois individualisés hors contexte scolaire.
Enfin, les enquêtes épidémiologiques axées sur la santé mentale des populations recourent massivement à l’échantillonnage en grappes aréolaires ou géographiques. Lorsqu’il s’agit de cartographier la prévalence des troubles anxio-dépressifs à la suite d’un événement traumatique majeur ou d’une crise environnementale, les chercheurs découpent le territoire en mailles géographiques ou districts sanitaires. Ces districts sont ensuite échantillonnés de manière aléatoire, offrant une infrastructure opérationnelle robuste pour déployer des évaluateurs sur le terrain et recueillir des données de haute qualité psychométrique dans des zones géographiquement concentrées.
2. Structuration et nettoyage de la base de données préliminaire dans Excel
2.1 Organisation matricielle des variables de niveau individuel et groupé
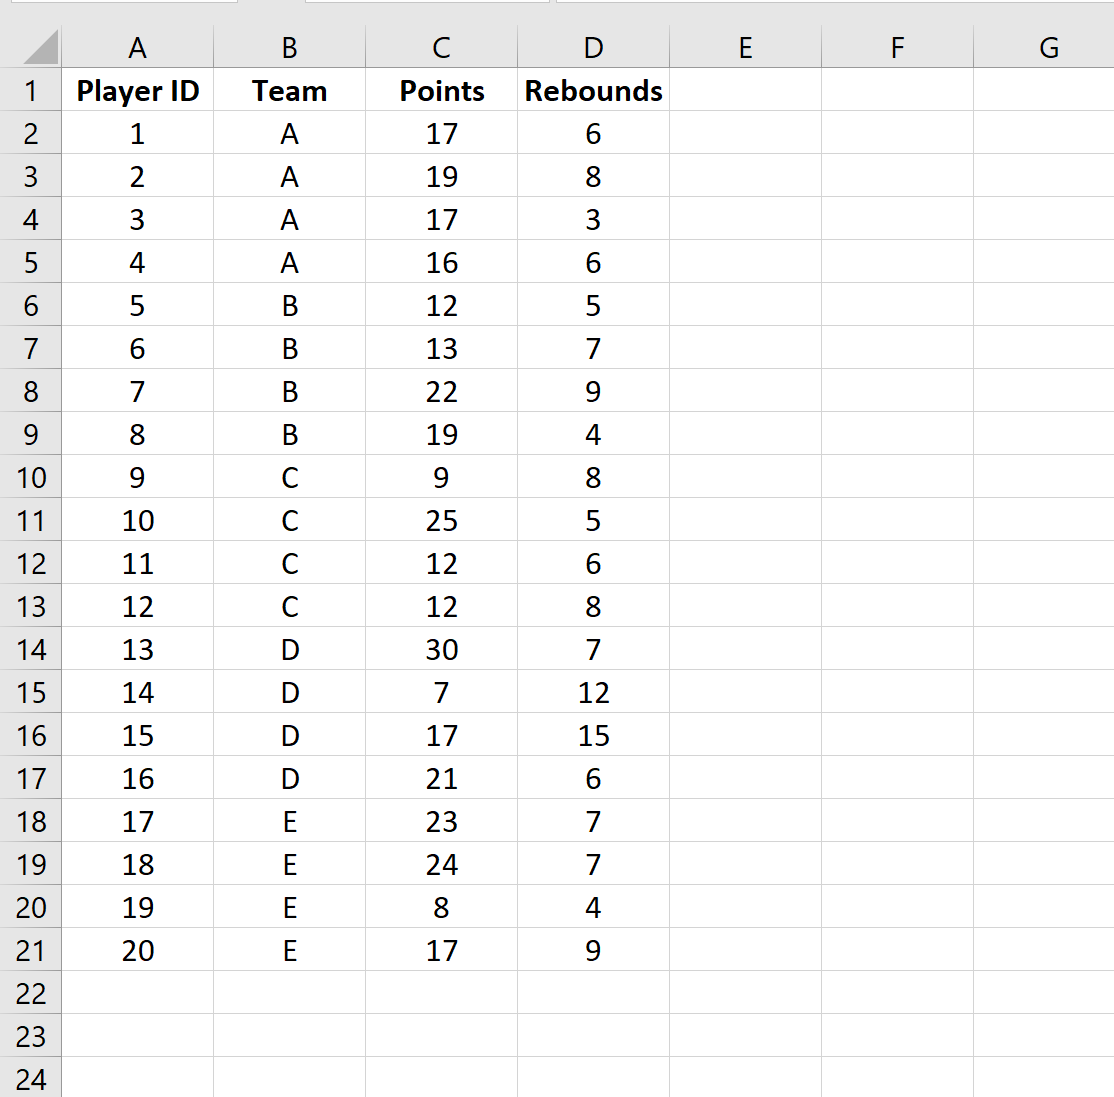
L’implémentation rigoureuse d’un échantillonnage en grappes dans Microsoft Excel exige en tout premier lieu une organisation matricielle irréprochable de la base de données source. La règle d’or consiste à adopter une structure tabulaire plate où chaque ligne représente une et une seule unité d’observation secondaire (l’individu ou le sujet d’étude), tandis que les colonnes détaillent les attributs individuels ainsi que les identificateurs hiérarchiques de rattachement. Pour exploiter pleinement la puissance analytique d’Excel, il est vivement recommandé de convertir la plage de cellules brute en un tableau de données officiel via le raccourci clavier Ctrl + L ou Ctrl + T. Cette conversion dote la matrice d’une référence structurée dynamique, facilitant l’adressage automatique des variables dans les formules ultérieures.
La nomenclature des champs doit obéir à des standards stricts pour prévenir toute ambiguïté lors de l’exécution des requêtes algorithmiques. Deux colonnes critiques doivent impérativement figurer à l’extrême gauche de la matrice : un identifiant individuel unique et invariant (par exemple, ID_Sujet) garantissant l’atomicité de l’enregistrement, suivi immédiatement de l’étiquette de grappe correspondante (par exemple, ID_Grappe ou Division_Hospitaliere). Les cellules fusionnées doivent être rigoureusement éradiquées de l’ensemble de la feuille de calcul. La présence d’une seule cellule fusionnée brise irrémédiablement l’adressage matriciel, perturbe les fonctions d’itération dynamique et génère des erreurs bloquantes lors du calcul des formules d’extraction conditionnelle.
Par ailleurs, il convient de veiller à ce que les variables contextuelles de niveau groupé (telles que le type d’établissement, la région géographique ou l’effectif théorique du département) soient renseignées de manière uniforme sur chaque ligne individuelle affiliée à la grappe en question. Cette redondance contrôlée est indispensable pour permettre ultérieurement des calculs d’agrégation, des segmentations descriptives rapides et des filtres croisés sans avoir à solliciter continuellement des fonctions de recherche externes complexes qui alourdiraient inutilement le classeur.
2.2 Validation et audit de l’intégrité des données
Avant d’engager la moindre procédure de tirage au sort, la base de données doit faire l’objet d’un audit minutieux afin de détecter d’éventuelles anomalies structurelles susceptibles d’invalider le processus probabiliste. L’identification des doublons d’identification s’avère capitale. Une simple duplication accidentelle d’un identifiant individuel dans la colonne ID_Sujet biaise la représentativité de la grappe et compromet l’intégrité référentielle des analyses inférentielles subséquentes. L’utilisation du formatage conditionnel (règles de mise en surbrillance des cellules pour les valeurs en double) combinée à l’outil natif de suppression des doublons accessible dans le ruban Données permet de neutraliser prestement ces anomalies.
Le traitement des données manquantes constitue une seconde exigence méthodologique majeure, particulièrement au sein des bases de données psychométriques où l’absence de réponses à un ou plusieurs items d’une échelle (par exemple, l’inventaire de dépression de Beck ou l’échelle d’anxiété de Spielberger) peut corrompre le score global du sujet. Le chercheur doit statuer en amont sur la politique de gestion de ces valeurs vacantes : suppression systématique des cas présentant des omissions majeures (suppression par liste), imputation par la moyenne intra-grappe ou recours à des techniques plus sophistiquées d’imputation multiple avant le tirage au sort, afin de garantir que les grappes sélectionnées disposeront d’un matériau empirique exploitable dans sa totalité.
Enfin, la normalisation typographique des intitulés de grappe requiert une vigilance extrême. Dans Excel, les chaînes de texte sont comparées au caractère près. Par conséquent, des disparités typographiques mineures telles que l’insertion involontaire d’une espace en fin de chaîne, des variations d’accents ou des abréviations discordantes scinderont artificiellement une même entité collective en plusieurs sous-grappes fantômes aux yeux de l’algorithme de tri. L’application préventive de la fonction =SUPPRESPACE() couplée à =EPURAGE() et =MAJUSCULE() sur l’ensemble de la colonne d’assignation collective permet de juguler définitivement ce risque de fragmentation.
2.3 Paramétrage de l’environnement de calcul statistique sous Excel
La précision et la réplicabilité d’un protocole d’échantillonnage sous Excel dépendent fondamentalement de la configuration technique de son moteur de calcul. En premier lieu, l’analyste doit vérifier et activer l’Utilitaire d’analyse statistique (Analysis ToolPak). Cet ensemble d’outils complémentaires officiels de Microsoft fournit des routines d’échantillonnage et des procédures d’analyse de variance indispensables pour modéliser ultérieurement l’effet de grappe. L’activation s’effectue via les Options d’Excel, dans la section Compléments, en gérant les Compléments Excel et en cochant explicitement l’Utilitaire d’analyse.
Une attention toute particulière doit être accordée au mode de calcul du classeur. Par défaut, Excel recalcule l’intégralité des formules de manière automatique dès qu’une modification intervient dans la feuille de calcul. Or, l’utilisation de fonctions génératrices de nombres pseudo-aléatoires telles que =ALEA() ou =ALEA.ENTRE.BORNES() entraîne une régénération instantanée des tirages à chaque saisie ou validation de cellule, modifiant rétroactivement la composition de l’échantillon sélectionné. Il est donc hautement préconisé de basculer temporairement le mode de calcul en mode Manuel (onglet Formules, groupe Calcul, Options de calcul) pendant l’élaboration des matrices probabilistes, ou d’appliquer des protocoles stricts de figeage des valeurs que nous détaillerons dans les sections suivantes.
Enfin, il est impératif de s’assurer de la compatibilité de l’environnement logiciel avec les formules matricielles dynamiques introduites dans les versions modernes de Microsoft 365 et Office 2021. Des fonctions hautement sophistiquées comme =UNIQUE(), =FILTRE() ou =TRIERPAR() transforment radicalement l’architecture d’un plan d’échantillonnage en éliminant le besoin de formules matricielles désuètes nécessitant la combinaison classique Ctrl + Maj + Entrée. Si l’environnement de travail repose sur une version antérieure d’Excel, des solutions de contournement algorithmiques basées sur les fonctions d’indexation traditionnelles devront être préalablement configurées.
3. Étape 1 : Extraction et indexation univoque des grappes d’échantillonnage
3.1 Génération de la liste des unités primaires par la fonction UNIQUE
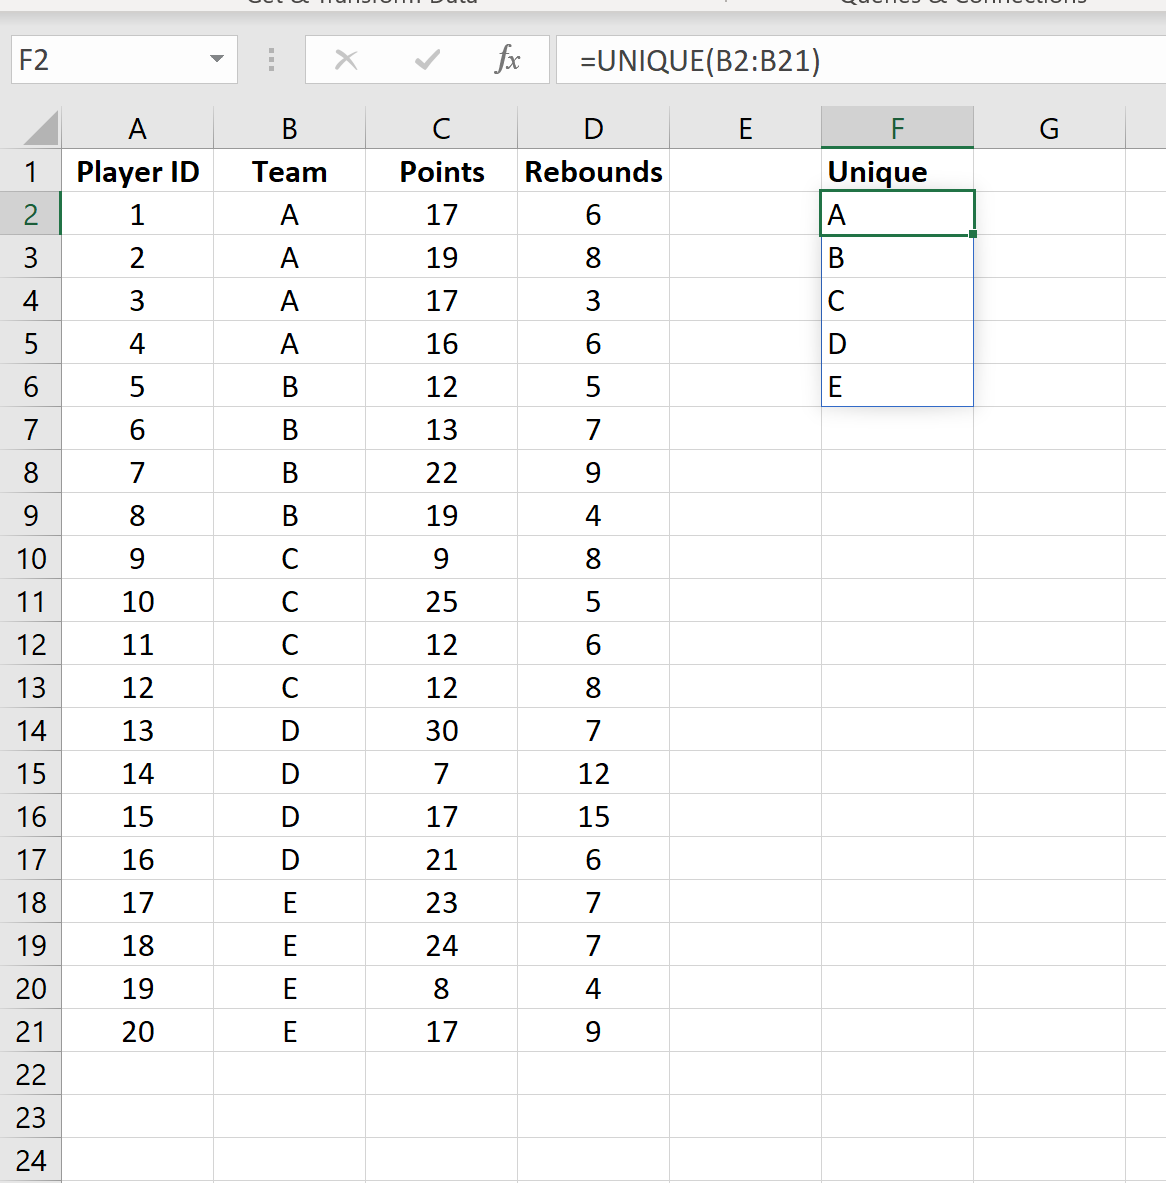
Une fois la base de données brute épurée et structurée sous forme de tableau officiel nommé par exemple T_Population, la première phase algorithmique consiste à isoler le registre exhaustif des unités d’échantillonnage primaires. Dans la version moderne d’Excel, cette tâche d’une importance capitale s’exécute avec une élégance remarquable grâce à la fonction de tableau dynamique =UNIQUE(). Dans une nouvelle feuille de calcul spécifiquement allouée à la gouvernance de l’échantillonnage, l’opérateur saisit en cellule A2 la formule suivante :
=UNIQUE(T_Population[ID_Grappe])
Cette commande interroge instantanément la colonne dédiée aux grappes dans le tableau source, en extrait chaque modalité distincte en éliminant toutes les récurrences et projette les résultats vers le bas sous forme de matrice propagée (spill range). Il est impératif de veiller à ce que les cellules situées sous la formule soient totalement vierges de tout contenu textuel ou numérique ; à défaut, Excel renverra immédiatement l’erreur caractéristique #PROPAGATION! (ou #SPILL! dans les versions anglophones), signalant qu’un obstacle physique empêche le déploiement complet de la matrice résultante.
Dans l’éventualité où l’analyste serait contraint d’opérer sur une version antérieure d’Excel dépourvue du moteur de calcul matriciel dynamique, l’extraction des grappes uniques s’effectuera soit par l’outil de Filtre Avancé avec l’option « Extraction sans doublon » cochée vers un nouvel emplacement, soit par l’entremise d’une formule matricielle combinant INDEX, EQUIV et NB.SI, bien que cette dernière approche s’avère particulièrement gourmande en ressources processeur lors du traitement de volumétries excédant plusieurs milliers de lignes.
3.2 Assignation d’identifiants numériques discrets aux grappes répertoriées
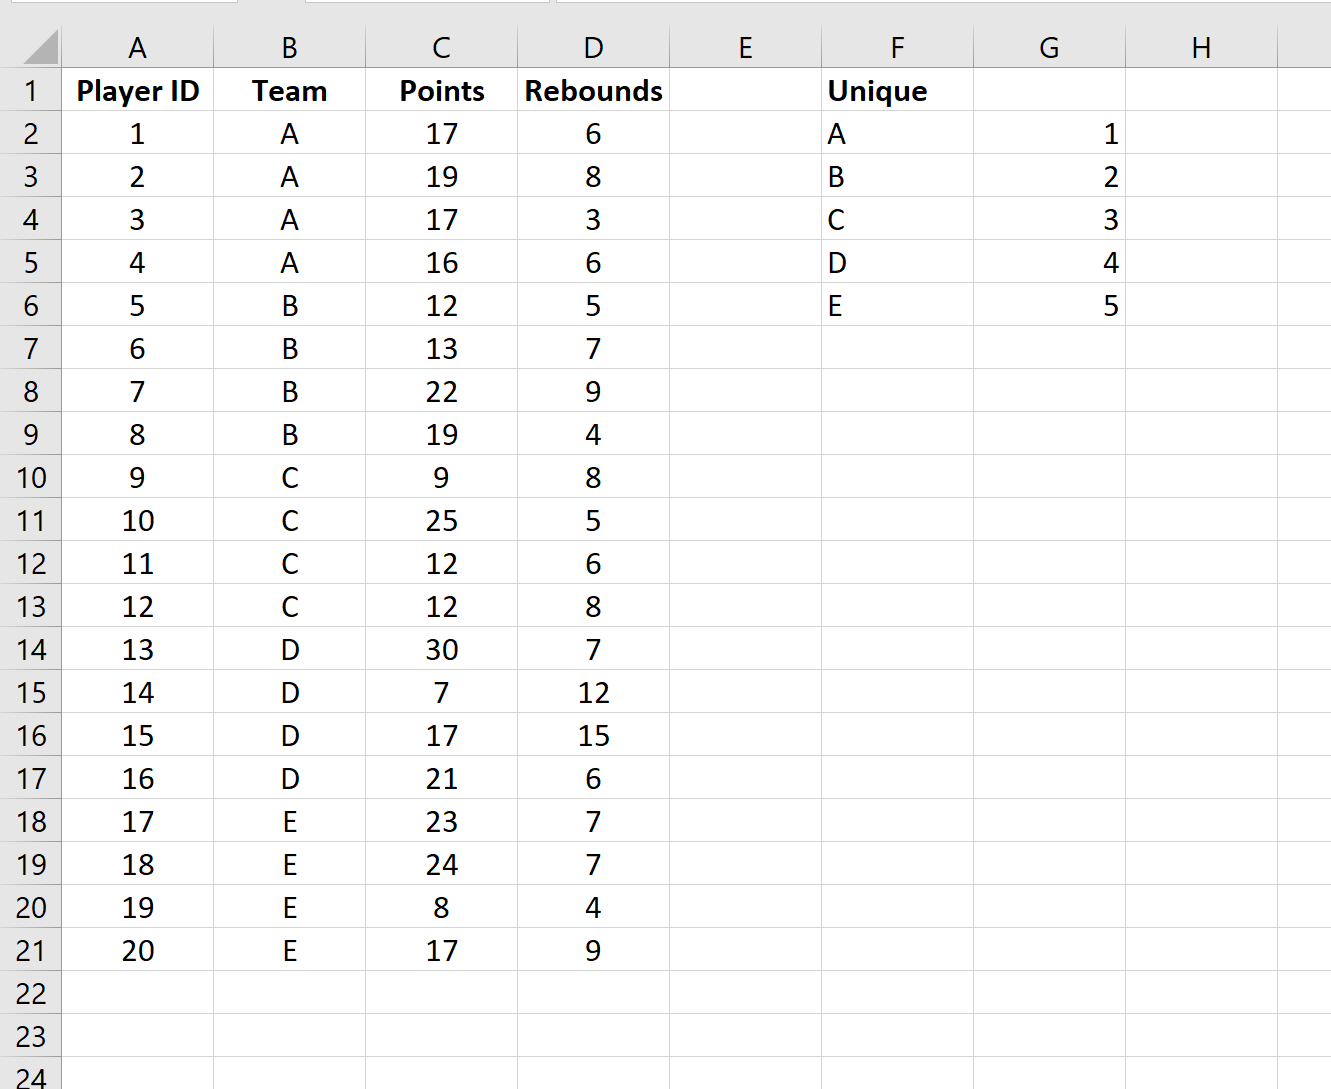
Pour soumettre les grappes répertoriées à un algorithme d’échantillonnage probabiliste rigoureux, il est essentiel d’assigner à chacune d’entre elles un identifiant numérique discret, contigu et séquentiel, s’étendant de 1 à $N$, où $N$ matérialise la cardinalité totale des grappes disponibles au sein de la population cible. Cette indexation numérique servira de référentiel univoque pour le tirage pseudo-aléatoire ultérieur. En supposant que la liste propagée des grappes uniques s’étende à partir de la cellule B2, l’indexation peut être automatisée dans la colonne adjacente A2 au moyen de la formule dynamique :
=SEQUENCE(LIGNES(B2#))
L’opérateur dièse (#) apposé à la référence B2# constitue une syntaxe matricielle essentielle désignant l’intégralité de la plage propagée générée par la fonction UNIQUE. Ainsi, si la population source comprend 45 grappes distinctes, la fonction SEQUENCE générera instantanément et de façon totalement synchronisée un vecteur vertical d’entiers s’échelonnant strictement de 1 à 45. Toute modification ultérieure de la base source entraînant l’apparition ou la disparition d’une grappe ajustera automatiquement la longueur de cette série numérique.
Cette étape formalise le cadre de tirage primaire. L’analyste doit impérativement procéder à une validation croisée de la valeur cardinale maximale obtenue. Ce nombre total de grappes candidates doit correspondre exactement aux données de cadrage institutionnelles ou administratives (par exemple, le nombre officiel de lycées d’un district scolaire ou le répertoire exhaustif des succursales bancaires régionales). Toute divergence à ce stade trahit généralement la présence de coquilles typographiques non assainies lors de la phase préliminaire de nettoyage.
3.3 Détermination de la représentativité descriptive des grappes identifiées
Avant d’engager le tirage probabiliste, il est méthodologiquement impératif d’évaluer la dimension volumétrique de chaque grappe répertoriée. Cette caractérisation descriptive permet d’établir si le plan de sondage sera confronté à des grappes d’effectifs approximativement égaux ou si la population se caractérise par une forte hétérogénéité dimensionnelle, facteur qui déterminerait la nécessité d’une pondération statistique a posteriori. Dans la colonne C2, adjacente à la désignation textuelle de la première grappe, la formule de comptage conditionnel suivante est insérée :
=NB.SI(T_Population[ID_Grappe]; B2)
En étendant cette formule à l’ensemble du registre des grappes, l’analyste obtient le recensement exhaustif des unités secondaires ($m_i$) abritées par chaque unité primaire. L’analyse descriptive de cette série statistique (calcul de la moyenne, de la médiane, de l’écart-type et du ratio d’asymétrie dimensionnelle calculé par le ratio entre la taille maximale et la taille minimale des grappes) éclaire directement le choix du design d’échantillonnage.
Ce tableau récapitulatif constitue formellement le registre d’échantillonnage initial. Il scelle la traçabilité expérimentale en archivant les paramètres de structure de la population parente avant toute altération ou extraction sélective, se conformant ainsi aux exigences de transparence méthodologique préconisées par la communauté scientifique internationale.
4. Étape 2 : Procédure probabiliste de sélection aléatoire des grappes cibles
4.1 Application des générateurs de nombres pseudo-aléatoires
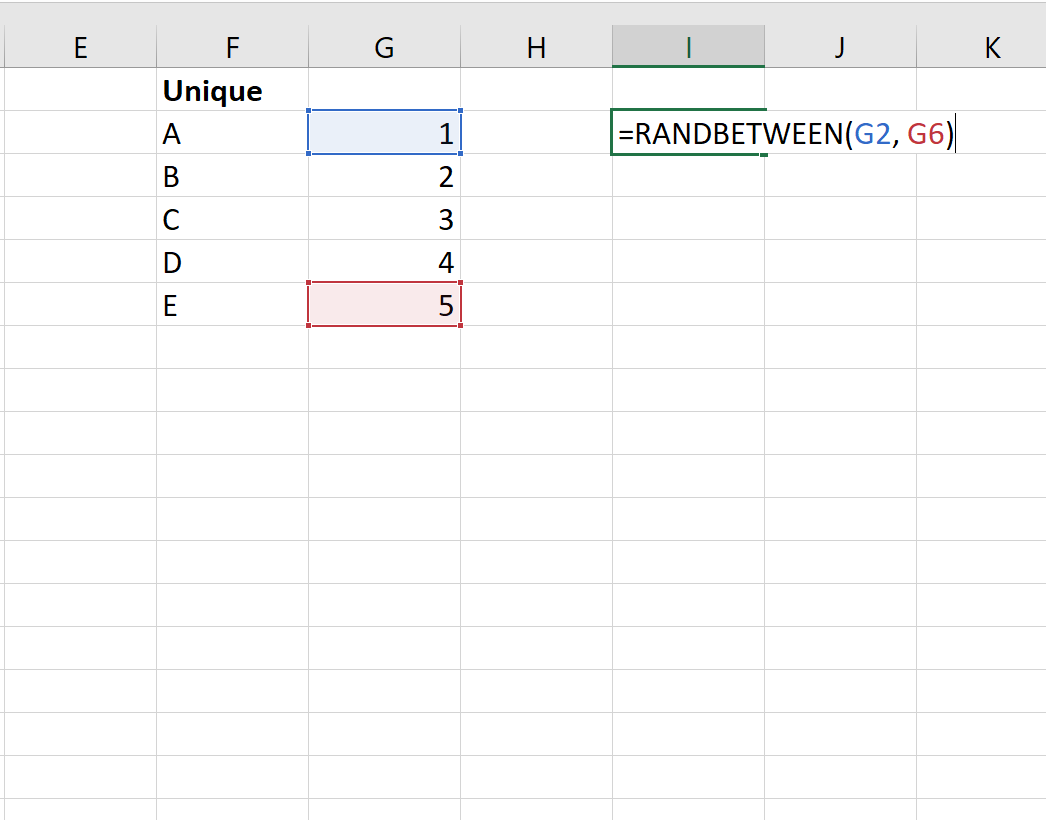
La sélection aléatoire des unités primaires repose sur des générateurs d’aléa mathématiquement calibrés. Excel met à disposition deux fonctions élémentaires principales : =ALEA(), qui génère un nombre réel uniformément distribué sur l’intervalle semi-ouvert $[0, 1[$, et =ALEA.ENTRE.BORNES(bas; haut), qui renvoie un entier discret compris inclusivement entre deux bornes spécifiées. Dans le cadre d’un protocole scientifique, l’utilisation directe et naïve de =ALEA.ENTRE.BORNES() pour sélectionner les indices de grappes présente un écueil majeur : le tirage s’effectue avec remise, ce qui expose l’expérimentateur à la désignation itérative multiple de la même unité primaire, situation méthodologiquement proscrite dans un schéma d’échantillonnage sans remise standard.
Pour assurer un tirage équiprobable global, l’approche préférentielle consiste à affecter à chaque grappe recensée une valeur pseudo-aléatoire continue issue de la fonction =ALEA(). La densité de probabilité de cette loi uniforme continue garantit avec une probabilité asymptotiquement égale à 1 l’unicité de chaque valeur générée, éliminant quasi universellement le risque de doublons de rang (ex æquo). Cette colonne de variables aléatoires servira de clé de tri probabiliste pour réorganiser l’ordre d’apparition des grappes de manière totalement indépendante de leur ordre alphabétique ou dimensionnel d’origine.
L’analyste doit toutefois maîtriser parfaitement la nature « volatile » intrinsèque de ces fonctions d’aléa sous Excel. Chaque manipulation, saisie de formule ou commande de calcul force une réévaluation instantanée de l’algorithme sous-jacent (l’algorithme Mersenne Twister implémenté dans les versions modernes d’Excel). Sans une stratégie rigoureuse d’immobilisation de l’aléa, la composition des grappes retenues fluctuerait perpétuellement au fil du travail d’analyse, anéantissant toute tentative de réplication des traitements statistiques.
4.2 Mise en œuvre d’un protocole d’échantillonnage aléatoire simple sans remise
Pour matérialiser un échantillonnage aléatoire simple sans remise (EASSR) du nombre requis $k$ de grappes, la méthodologie matricielle contemporaine d’Excel fournit une solution particulièrement élégante via la combinaison des fonctions TRIERPAR et PRENDRE. Supposons que le registre des identifiants uniques de grappes réside dans la plage propagée B2:B46 et que l’analyste doive sélectionner aléatoirement et rigoureusement $k = 5$ grappes parmi les 45 disponibles. Dans une nouvelle zone dédiée, la formule suivante assure l’extraction probabiliste intégrale :
=PRENDRE(TRIERPAR(B2:B46; ALEA.ENTRE.BORNES(1; 1000000 + LIGNES(B2:B46)*0 + LIGNE(B2:B46)))); 5)
Ou, de manière encore plus robuste et canonique en exploitant une colonne auxiliaire contenant les valeurs de tirage générées par =ALEA() : en supposant que la colonne D2:D46 contienne des scores uniformes aléatoires générés individuellement, la formule de sélection dynamique s’articule comme suit :
=PRENDRE(TRIERPAR(B2:B46; D2:D46); 5)
Cette construction algorithmique réordonne le vecteur spatial des grappes selon les grandeurs aléatoires assignées, puis la fonction =PRENDRE() extrait séquentiellement les $k$ premières observations de la matrice réorganisée. Ce processus émule rigoureusement un tirage de boules sans remise dans une urne de Bernoulli. La probabilité d’inclusion $f$ de chaque grappe dans l’échantillon final est strictement uniforme et s’établit avec une exactitude mathématique absolue à :
$$f = \frac{k}{N} = \frac{5}{45} \approx 0,1111$$
4.3 Figeage des valeurs probabilistes pour la réplicabilité scientifique
La recherche scientifique repose impérativement sur le principe de réplicabilité méthodologique. Un échantillon statistique dont la composition se métamorphoserait à chaque ouverture du classeur ou à chaque recalcul de feuille de calcul contreviendrait aux normes de rigueur déontologique les plus élémentaires. Par conséquent, dès l’instant où le tirage aléatoire a été exécuté et que la liste des $k$ grappes désignées apparaît dans la feuille de synthèse, l’expérimentateur doit procéder au figeage immuable de l’état probabiliste.
Cette opération s’effectue au moyen de la séquence de commande universelle d’Excel : sélectionner l’ensemble de la zone contenant les formules aléatoires ou les résultats matriciels tirés, exécuter la commande de copie (Ctrl + C), puis appliquer immédiatement sur la même zone ou sur une plage dédiée le Collage spécial en valeurs (via le raccourci Ctrl + Alt + V suivi de la touche V, ou via le menu contextuel en sélectionnant l’icône « 123 »). Cette action substitue définitivement les constantes scalaires textuelles ou numériques aux équations génératrices dynamiques sous-jacentes.
Pour satisfaire pleinement aux exigences des comités d’éthique et des protocoles de science ouverte, il est vivement recommandé d’immortaliser les paramètres contextuels de l’extraction dans une table de métadonnées adjacente : date et heure précises du tirage probabiliste, version exacte du système d’exploitation et d’Excel employée, nombre total de grappes éligibles ($N$), taille de l’échantillon extrait ($k$) et signature numérique de l’opérateur ayant procédé à l’opération de sélection.
5. Étape 3 : Extraction exhaustive des observations individuelles des grappes sélectionnées
5.1 Filtrage matriciel dynamique au moyen de la fonction FILTRE
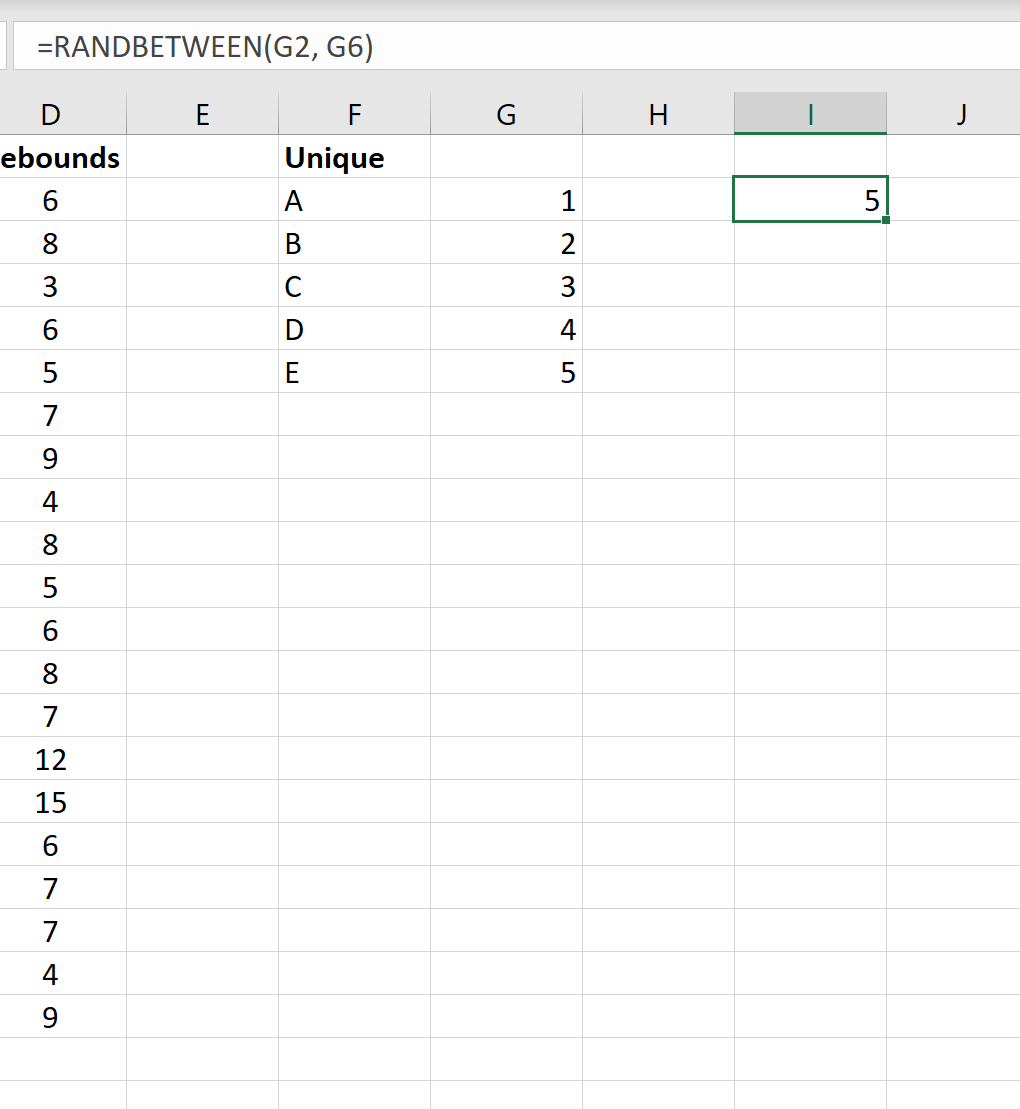
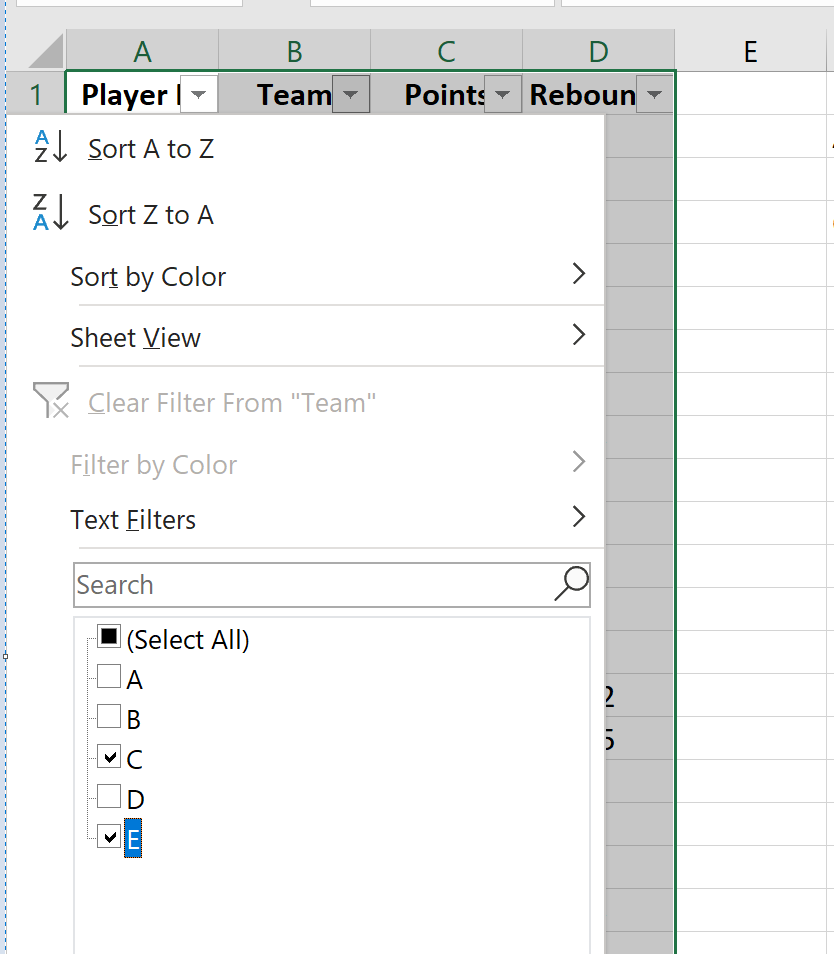
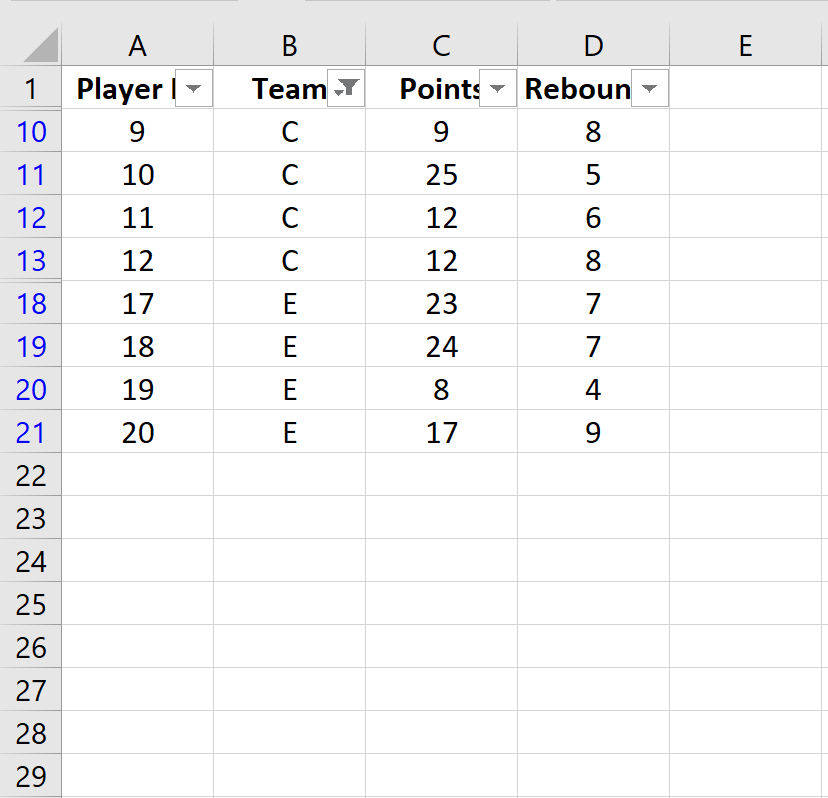
Dès lors que la liste des $k$ grappes cibles a été formellement extraite et figée (considérons, à titre d’illustration, que les grappes sélectionnées soient localisées dans les cellules fixes G2:G6), l’étape suivante consiste à rapatrier l’intégralité des lignes individuelles associées à ces grappes depuis la base de données source T_Population. Dans l’écosystème moderne de Microsoft 365, cette opération d’extraction sélective d’une complexité jadis redoutable s’accomplit avec une efficacité mathématique exceptionnelle au moyen de la fonction =FILTRE() combinée à des disjonctions booléennes.
La logique d’inclusion sous Excel s’articule autour de l’opérateur d’addition arithmétique (+), lequel opère la conversion logique de l’union booléenne « OU ». La formule à consigner dans la cellule maîtresse de la feuille d’échantillon final s’énonce comme suit :
=FILTRE(T_Population; (T_Population[ID_Grappe]=G2) + (T_Population[ID_Grappe]=G3) + (T_Population[ID_Grappe]=G4) + (T_Population[ID_Grappe]=G5) + (T_Population[ID_Grappe]=G6); "Aucun enregistrement correspondant")
Lors de l’évaluation de cette expression, le moteur d’Excel calcule un vecteur colonne de valeurs booléennes pour chaque grappe cible. En additionnant ces vecteurs terme à terme, toute ligne individuelle dont l’attribut ID_Grappe coïncide avec l’une quelconque des unités primaires retenues génère un résultat entier supérieur ou égal à 1 (évalué à VRAI par la fonction de filtrage), tandis que les lignes affiliées aux grappes rejetées accumulent un score nul (évalué à FAUX). La fonction FILTRE matérialise alors instantanément la sous-matrice complète regroupant l’intégralité des participants affiliés aux cinq grappes sélectionnées.
5.2 Méthodes alternatives d’extraction pour environnements Excel hérités
Pour les contextes institutionnels ou hospitaliers contraignant l’analyste à évoluer sur des versions patrimoniales de tableurs (telles qu’Excel 2016 ou Excel 2013), l’absence des fonctions matricielles dynamiques impose le déploiement d’une architecture algorithmique alternative fondée sur des colonnes d’assistance indicatrices et l’imbrication des fonctions classiques INDEX, EQUIV et PETITE.VALEUR. Cette approche garantit une rigueur d’extraction équivalente en dépit d’une syntaxe plus laborieuse.
La première phase consiste à insérer une colonne indicatrice au sein de la base de données T_Population, intitulée Selection_Flag. Dans cette colonne, l’opérateur intègre une formule d’appartenance utilisant NB.SI pour déterminer si le sujet appartient au groupe d’intérêt :
=SI(NB.SI($G$2:$G$6; [@[ID_Grappe]])>0; MAX($H$1:H1)+1; "")
Cette formulation incrémente un index séquentiel strictement positif uniquement sur les lignes répondant au critère d’échantillonnage. Ensuite, dans la feuille réceptrice de l’échantillon, l’extraction de chaque observation individuelle s’opère par l’imbrication matricielle suivante, étirée vers le bas et vers la droite :
=SIERREUR(INDEX(T_Population; EQUIV(LIGNE(A1); T_Population[Selection_Flag]; 0); COLONNE(A1)); "")
Une alternative non négligeable pour les vastes jeux de données consiste à utiliser le Filtre Avancé d’Excel. En définissant une zone de critères listant verticalement l’en-tête ID_Grappe surmontant les valeurs G2 à G6, l’expérimentateur peut copier instantanément les lignes filtrées vers un autre emplacement, s’affranchissant totalement de la charge computationnelle inhérente aux formules matricielles étirées sur des dizaines de milliers de cellules.
5.3 Contrôle d’intégrité de la cohorte finale échantillonnée
L’extraction physique des observations individuelles ne saurait clore la procédure sans un contrôle qualité formel attestant de l’intégrité de la cohorte constituée. L’analyste doit impérativement exécuter une série de tests de conformité croisée pour certifier qu’aucun biais de transfert ou artefact technique n’est venu altérer le corpus d’analyse. Le premier test consiste à sommer les effectifs théoriques individuels des grappes sélectionnées ($m_i$) préalablement calculés dans le tableau de bord initial et à vérifier que ce total coïncide à l’unité près avec le nombre de lignes effectives de la matrice échantillonnée :
=SOMME(NB.SI(FeuilleEchantillon!B:B; G2:G6)) = LIGNES(FeuilleEchantillon!A2:A421)
Le second contrôle porte sur l’audit de non-contamination de l’échantillon. Il s’agit de prouver statistiquement l’absence totale de tout sujet résiduel appartenant à une grappe non sélectionnée. Une formule logique de vérification basée sur NB.SI ou EQUIV confrontant la colonne d’appartenance de la cohorte finale à la liste blanche des $k$ grappes validées permet d’obtenir un statut binaire infaillible (CONFORME / ALERTE_CONTAMINATION).
Une fois ces contrôles exécutés avec succès, la cohorte extraite est formalisée au sein d’une feuille de travail spécifique, verrouillée en écriture pour prévenir toute modification involontaire. Ce jeu de données finales constitue le socle opérationnel définitif sur lequel porteront les investigations descriptives et les modélisations inférentielles du protocole de recherche comportementale.
6. Distinction technique : Échantillonnage en grappes à un degré versus à deux degrés
6.1 Modélisation de l’échantillonnage en grappes à un degré
L’architecture méthodologique déployée jusqu’à présent illustre avec précision la mise en œuvre d’un échantillonnage en grappes à un degré (parfois qualifié d’échantillonnage en grappes simple ou complet). Dans ce paradigme particulier, le tirage probabiliste ne s’exerce qu’à un seul et unique niveau hiérarchique : celui des unités primaires d’échantillonnage (UEP). Une fois les grappes sélectionnées par la procédure aléatoire, l’investigateur procède à l’inclusion exhaustive et systématique de l’intégralité des individus qui les composent, sans opérer la moindre sélection ultérieure parmi les unités secondaires.
Ce schéma méthodologique trouve sa justification par excellence dans les contextes où l’administration des mesures psychométriques bénéficie d’un effet d’échelle maximal au sein des entités retenues. Par exemple, lorsqu’une intervention organisationnelle ou l’administration collective d’un questionnaire d’évaluation du bien-être au travail est autorisée au sein d’un département corporatif ou d’une école, il est logistiquement beaucoup plus aisé et fédérateur de solliciter l’ensemble des membres du groupe naturel plutôt que d’en exclure arbitrairement une partie, ce qui pourrait engendrer des dynamiques relationnelles délétères ou des sentiments de mise à l’écart.
Cependant, le corollaire statistique direct de cette exhaustivité intra-grappe réside dans une vulnérabilité accrue à l’inflation de la variance d’échantillonnage. Dans la mesure où les sujets d’une même unité partagent un environnement physique, managérial ou social rigoureusement identique, leurs réponses tendent à présenter une forte corrélation résiduelle. L’inclusion de tous les individus d’une grappe n’apporte donc pas une quantité d’information statistique proportionnelle au nombre de sujets observés, conduisant à une redondance informationnelle qu’il conviendra de quantifier mathématiquement par l’effet de plan.
6.2 Protocole d’échantillonnage à deux degrés (sous-échantillonnage intra-grappe)
Lorsque les grappes primaires retenues abritent des populations secondaires volumineuses dont l’évaluation exhaustive saturerait les capacités budgétaires ou analytiques de la recherche, le chercheur s’oriente vers un protocole d’échantillonnage à deux degrés (ou échantillonnage polyétapique). Ce modèle introduit un second cycle probabiliste formel : après avoir sélectionné de manière aléatoire les unités primaires d’échantillonnage au premier degré, l’analyste exécute un tirage aléatoire secondaire parmi les individus constituant chacune de ces grappes primaires retenues.
Ce design méthodologique permet de calibrer et d’équilibrer précisément la charge de collecte. Considérons une étude transversale portant sur l’anxiété professionnelle menée au sein d’un conglomérat industriel comprenant plusieurs usines de fabrication (grappes). L’échantillonnage à un degré contraindrait l’équipe de recherche à interroger parfois plus de 800 ouvriers au sein d’un seul site sélectionné. L’approche à deux degrés permet de sélectionner d’abord quatre usines au premier degré, puis de n’extraire aléatoirement que 50 ouvriers au sein de chacune de ces quatre usines sélectionnées au second degré, aboutissant à une cohorte finale parfaitement équilibrée de 200 participants.
Sur le plan de l’efficience statistique, le tirage à deux degrés tempère substantiellement la perte de précision induite par l’effet de grappe. En dispersant l’effort d’échantillonnage sur un spectre plus large et en limitant le nombre d’observations individuelles prélevées au sein d’une même entité, on atténue significativement l’impact de la corrélation intra-grappe sur l’erreur standard des estimateurs, tout en préservant une grande partie des bénéfices logistiques liés à la concentration spatiale de la recherche.
6.3 Mise en œuvre algorithmique du sous-échantillonnage sous Excel
L’implémentation d’un échantillonnage probabiliste au second degré au sein de la feuille de calcul requiert une stratification conditionnelle de l’aléa. Pour extraire un nombre constant de sujets $n_{sous}$ (par exemple, exactement 10 sujets par grappe retenue), l’utilisation combinée des fonctions de filtrage matriciel et de manipulation d’ordre offre une architecture d’une redoutable efficacité. Dans l’écosystème Microsoft 365, l’extraction pour une grappe sélectionnée identifiée en cellule G2 peut s’écrire ainsi :
=PRENDRE(TRIERPAR(FILTRE(T_Population; T_Population[ID_Grappe]=G2); ALEA.ENTRE.BORNES(1; 100000 + SEQUENCE(NB.SI(T_Population[ID_Grappe]; G2))*0 + LIGNE(INDIRECT("1:" & NB.SI(T_Population[ID_Grappe]; G2))))); 10)
Pour operationaliser ce processus sans complexité syntaxique excessive, la méthode la plus transparente consiste à adjoindre à la table source une colonne calculée assignant un rang aléatoire intra-grappe. Dans le tableau T_Population, la colonne Rang_Intra calcule le classement séquentiel d’une valeur aléatoire assignée au sujet, borné exclusivement aux participants partageant son identifiant de grappe, via une combinaison des fonctions RANG et NB.SI.ENS. Dès lors, l’extraction au second degré se réduit à un simple filtrage des lignes vérifiant simultanément :
(Appartenance_Grappes_Cibles = VRAI) * (Rang_Intra <= n_sous)
Cette élégante procédure algorithmique assure une équiprobabilité stricte du sous-échantillonnage individuel au sein de chaque cluster primaire préalablement tiré au sort, conférant au dispositif d’échantillonnage à deux degrés une reproductibilité opérationnelle totale sous Excel.
7. Modélisation de l’effet de grappe et du coefficient de corrélation intraclasse (ICC)
7.1 Fondements du coefficient de corrélation intraclasse en psychométrie
L’analyse de données recueillies au moyen d’un échantillonnage en grappes impose une rupture épistémologique absolue avec les méthodes statistiques inférentielles traditionnelles qui reposent sur l’hypothèse de l’indépendance mutuelle et identique des résidus d’observation (hypothèse IID). Dans un protocole par grappes, les participants regroupés au sein d’une même unité partagent des déterminants contextuels, historiques et environnementaux communs, induisant une dépendance statistique des mesures psychométriques. L’ampleur de cette dépendance est formellement modélisée par le coefficient de corrélation intraclasse (souvent noté $rho$ ou $ICC$).
Sur le plan mathématique, le coefficient de corrélation intraclasse décompose la variance phénotypique totale de la variable d’intérêt ($\sigma^2_{totale}$) en deux composantes orthogonales : la variance inter-grappes ($\sigma^2_{inter}$ ou variance entre les groupes) et la variance intra-grappe ($\sigma^2_{intra}$ ou variance résiduelle au sein des groupes). L’équation fondamentale s’établit selon le ratio classique :
$$\rho = \frac{\sigma^2_{inter}}{\sigma^2_{inter} + \sigma^2_{intra}}$$
L’interprétation théorique de $rho$ s’appréhende sous deux angles complémentaires : d’une part, il quantifie la proportion de la variance totale du trait psychologique attribuable à l’effet de groupe ; d’autre part, il mesure le degré de ressemblance ou d’homogénéité phénotypique entre deux observations individuelles prélevées au hasard au sein d’une même grappe. Plus le coefficient $rho$ tend vers 1, plus les individus au sein des grappes sont rigoureusement identiques entre eux et dissemblables d’une grappe à l’autre. En revanche, un $rho$ approchant de zéro atteste de l’absence de structuration groupale, rendant le design assimilable à un échantillonnage aléatoire simple.
7.2 Calcul opérationnel de l’ICC à l’aide des outils de variance sous Excel
Pour calculer empiriquement le coefficient ICC sous Microsoft Excel sur les scores psychométriques issus de l’échantillon, le recours à l’Utilitaire d’analyse de données constitue l’approche la plus accessible et directe. L’expérimentateur utilise la routine intitulée Analyse de variance : à un facteur (ANOVA unidirectionnelle). Les données doivent être organisées en colonnes contiguës représentant chacune une grappe, ou formatées de manière à alimenter la routine d’analyse.
À l’issue de l’exécution de l’ANOVA, Excel génère une table récapitulative fournissant deux estimateurs cruciaux : le Carré Moyen Inter-Groupes (noté $MSB$ pour Mean Square Between) et le Carré Moyen Intra-Groupes (noté $MSW$ pour Mean Square Within ou variance résiduelle d’erreur). En considérant la taille moyenne des grappes de l’échantillon, notée $m$, le coefficient de corrélation intraclasse se déduit algébriquement dans une cellule de la feuille de résultats au moyen de l’équation standard dérivée des espérances mathématiques des carrés moyens :
$$ICC = \frac{MSB – MSW}{MSB + (m – 1) \cdot MSW}$$
Dans la syntaxe de calcul d’Excel, en supposant que la cellule E5 héberge la valeur numérique du $MSB$, la cellule E6 celle du $MSW$ et la cellule B10 la dimension moyenne $m$, la formule s’écrit littéralement :
=(E5 - E6) / (E5 + (B10 - 1) * E6)
Dans les sciences comportementales et l’investigation clinique, une valeur d’ICC excédant 0,05 est d’ores et déjà considérée comme révélatrice d’une dépendance groupale substantielle, invalidant l’application naïve des tests de Student ou des régressions linéaires ordinaires qui ignoreraient cette structure hiérarchique.
7.3 Estimation de l’effet de plan (Design Effect) et correction d’échantillon
L’effet de plan, universellement formalisé par l’abréviation Deff (pour Design Effect), modélise le facteur multiplicatif par lequel la variance d’échantillonnage théorique d’un tirage aléatoire simple doit être gonflée pour refléter l’imprécision inhérente au regroupement des données en grappes. Formalisé initialement par le statisticien Leslie Kish, le Deff s’exprime au moyen d’une équation linéaire d’une clarté fondamentale :
$$Deff = 1 + (m – 1) \cdot ICC$$
Où $m$ représente la taille moyenne des grappes échantillonnées et $ICC$ le coefficient de corrélation intraclasse préalablement déterminé. Dans votre feuille de calcul Excel, en réservant la cellule B12 pour le calcul du Deff, l’analyste insère simplement :
=1 + (B10 - 1) * B11
Les conséquences méthodologiques de ce coefficient sont capitales. Si une étude intègre des grappes d’une taille moyenne de 30 individus et présente un ICC modéré de 0,10, le Deff s’élève à :
$$Deff = 1 + (30 – 1) \cdot 0,10 = 1 + 2,9 = 3,9$$
Ce résultat signale sans appel que la variance de l’estimateur est 3,9 fois plus large que celle qu’aurait fournie un échantillon aléatoire simple de dimension équivalente. Par voie de conséquence, la taille effective d’échantillon ($n_{eff}$), qui mesure la véritable puissance informative du corpus, ne représente qu’une fraction de la taille nominale brute $n$ :
$$n_{eff} = \frac{n}{Deff} = \frac{300}{3,9} \approx 77$$
Ainsi, 300 sujets agrégés dans ce réseau de grappes ne fournissent que l’équivalent statistique de 77 sujets indépendants. Tout test d’hypothèse (tests $z$, $t$, ou calculs d’intervalles de confiance) conduit sous Excel doit obligatoirement intégrer cette correction en ajustant l’erreur type standard par la multiplication de son estimation classique par $\sqrt{Deff}$, sous peine de propulser le risque d’erreur de type I (rejet à tort de l’hypothèse nulle) vers des sommets scientifiquement inacceptables.
8. Traitement de l’inégalité de taille des grappes et techniques de pondération
8.1 Problématique méthodologique des grappes à effectifs déséquilibrés
Dans la quasi-totalité des investigations réelles en sciences humaines et sociales, les unités naturelles de regroupement se caractérisent par une disparité volumétrique prononcée. Les départements d’une organisation ne comptent pas le même nombre de salariés, les divisions hospitalières diffèrent en capacité d’accueil et les cohortes scolaires présentent des effectifs variables. Lorsque l’analyste applique un échantillonnage aléatoire simple de grappes sans tenir compte de ces déséquilibres, deux distorsions méthodologiques majeures surviennent immédiatement.
D’une part, la probabilité d’inclusion globale d’un individu $j$ appartenant à la grappe $i$ devient inégale. En effet, un sujet appartenant à une micro-grappe (par exemple, un service de 10 personnes) bénéficie d’une probabilité conditionnelle d’inclusion intra-grappe beaucoup plus forte qu’un individu résidant au sein d’une macro-grappe (un service de 100 personnes). Dès lors que la taille des grappes est corrélée de près ou de loin avec la variable psychologique mesurée (par exemple, des micro-équipes favorisant une cohésion accrue et réduisant le stress perçu), l’échantillon global souffre d’un biais d’agrégation sévère qui fausse l’estimation de la moyenne populationnelle globale.
D’autre part, la variabilité dimensionnelle des grappes accroît dramatiquement la variance d’échantillonnage de l’estimateur total, générant ce que les méthodologistes nomment le « paradoxe de composition ». Pour rétablir l’équiprobabilité de tirage ou corriger les distorsions phénotypiques résultant de ces disparités dimensionnelles, l’analyste sous Excel doit mobiliser soit un protocole de tirage avec probabilité proportionnelle à la taille, soit un système rigoureux de pondération statistique a posteriori.
8.2 Implémentation de l’échantillonnage avec probabilité proportionnelle à la taille (PPT)
L’échantillonnage avec probabilité proportionnelle à la taille (PPT, ou Probability Proportional to Size – PPS) constitue la réponse théorique par excellence à l’hétérogénéité structurelle des grappes. Sous ce paradigme probabiliste, la chance qu’a une grappe donnée d’être retenue lors du tirage n’est plus uniforme ($1/N$), mais directement asservie à son effectif relatif ($m_i / M_0$, où $M_0$ désigne l’effectif cumulé total de la population parente). Combiné à un sous-échantillonnage de taille fixe au second degré, ce mécanisme rétablit une probabilité d’inclusion globale constante pour chaque individu (plan auto-pondérant).
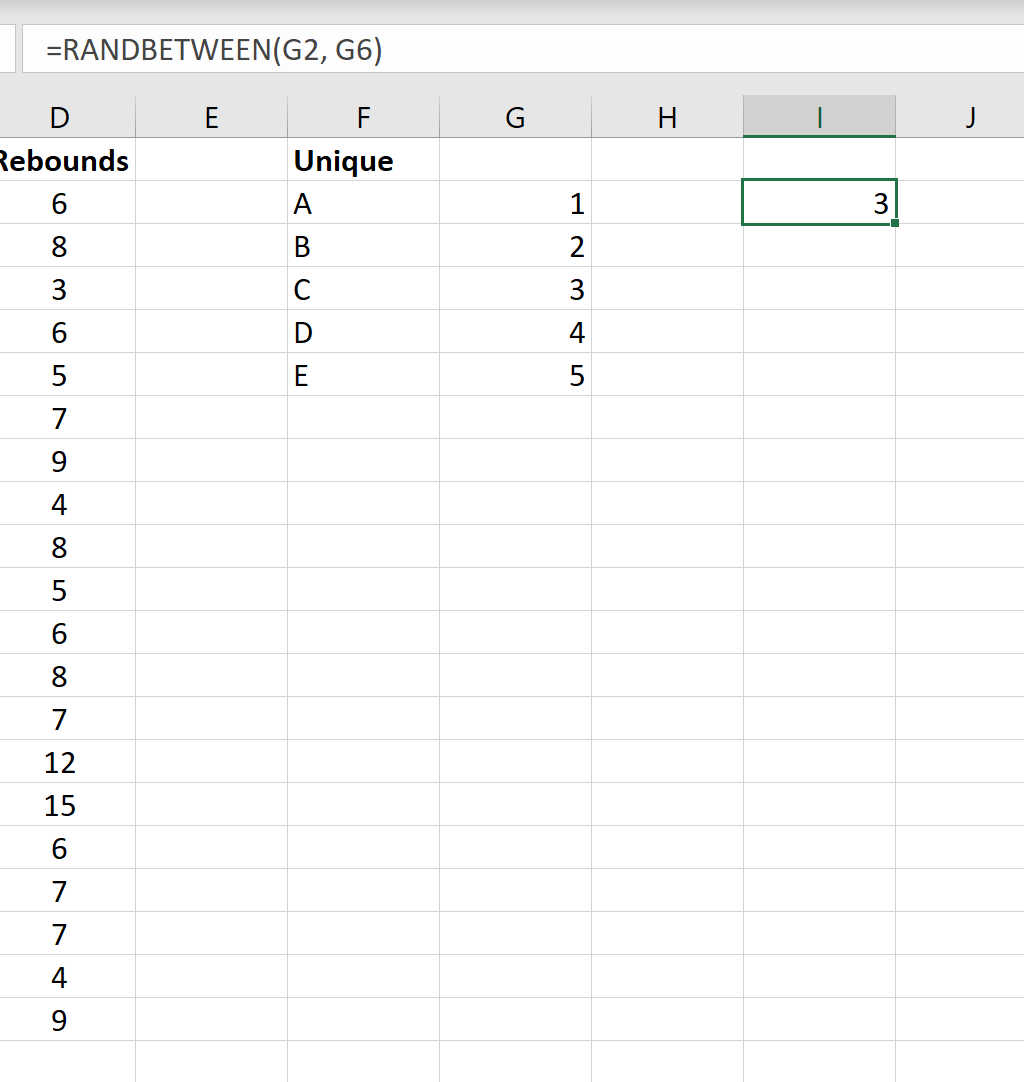
L’opérationnalisation du tirage PPT sous Excel s’exécute avec une remarquable fluidité algorithmique via l’établissement d’intervalles de cumul dimensionnel. Dans la table récapitulative des grappes, l’analyste insère une colonne calculant l’effectif cumulé des unités secondaires :
En cellule D2 : =C2
En cellule D3 : =D2 + C3, formule ensuite étirée jusqu’au bas du registre.
Une colonne de borne inférieure est immédiatement déduite en plaçant 0 en E2, puis =D2 en E3. Dès lors, chaque grappe se voit assigner un segment probabiliste proportionnel à sa taille au sein du continuum $[0, M_0[$. Pour procéder au tirage aléatoire, l’opérateur génère un nombre réel aléatoire distribué sur la dimension totale de la population :
=ALEA() * $D$46
L’identification de la grappe désignée s’effectue instantanément au moyen de la fonction RECHERCHEV en mode de correspondance approximative (argument VRAI ou 1) :
=RECHERCHEV(Valeur_Aleatoire; E2:B46; 2; VRAI)
Grâce à ce mécanisme séquentiel, une macro-grappe abritant 15 % de la main-d’œuvre totale occupera 15 % de l’intervalle numérique global et détiendra mathématiquement 15 % de chances d’être extraite à chaque cycle probabiliste, garantissant une justice distributionnelle parfaite conforme aux exigences du sondage PPT.
8.3 Calcul et assignation des poids de sondage (pondération statistique)
Lorsque le chercheur n’a pas pu recourir à un tirage PPT au moment de la collecte et qu’il a conduit un échantillonnage aléatoire simple de grappes aux dimensions très dissemblables, la correction mathématique doit impérativement intervenir lors de la phase analytique via l’assignation de poids de sondage (poids de calage ou poids d’échantillonnage de Horvitz-Thompson). Le principe statistique stipule que le poids $w_i$ assigné à chaque observation individuelle d’une grappe est égal à l’inverse de sa probabilité globale d’inclusion dans l’échantillon final :
$$w_i = \frac{1}{\pi_i} = \frac{1}{P(\text{Grappe } i \text{ sélectionnée}) \times P(\text{Individu sélectionné } | \text{ Grappe } i)}$$
Dans le cadre d’un échantillonnage en grappes à un degré où toutes les grappes avaient une chance uniforme $k / N$ d’être choisies et où tous les membres de la grappe sont observés, la probabilité d’inclusion individuelle se résume à $\pi_i = k / N$, ce qui confère un poids uniforme constant. En revanche, si un sous-échantillonnage de taille fixe $n_{sous}$ a été appliqué au second degré au sein de grappes de tailles dissemblables $m_i$, la probabilité d’inclusion individuelle s’exprime comme suit :
$$\pi_{ij} = \left(\frac{k}{N}\right) \times \left(\frac{n_{sous}}{m_i}\right)$$
Le poids statistique individuel s’obtient alors sous Excel par l’inversion de cette grandeur :
= (N / k) * (T_Echantillon[Taille_Grappe_m_i] / n_sous)
Pour calculer la moyenne psychométrique corrigée (pondérée) d’une échelle de bien-être ou de détresse psychologique au sein de la cohorte finale, l’opérateur ne saurait employer la fonction standard =MOYENNE(). Il mobilise obligatoirement la fonction matricielle =SOMMEPROD() :
=SOMMEPROD(T_Echantillon[Score_Psy]; T_Echantillon[Poids_Sondage]) / SOMME(T_Echantillon[Poids_Sondage])
Cette pondération rééquilibre le poids relatif de chaque participant dans l’estimation finale : les individus appartenant à de vastes collectifs voient leur contribution descriptive amplifiée, neutralisant définitivement le biais de sélection lié aux micro-grappes.
9. Étude de cas empirique : Échantillonnage en grappes appliqué au stress organisationnel
9.1 Mise en situation et contextualisation de l’investigation empirique
Pour ancrer ces développements théoriques dans la réalité pratique de la recherche empirique, considérons une investigation quantifiée menée par un consortium de psychologues du travail et de médecins épidémiologistes. L’objectif de la recherche consiste à évaluer l’intensité du syndrome d’épuisement professionnel (burnout) au sein du personnel infirmier d’un vaste groupement hospitalier régional. L’univers d’investigation réunit $N = 20$ centres hospitaliers autonomes (les grappes) totalisant une population parente de $M_0 = 2,000$ personnels soignants en exercice actif.
L’administration individuelle du protocole psychométrique via un envoi postal ou numérique généralisé a été rejetée par le comité de pilotage en raison du faible taux d’adhésion historiquement constaté lors d’enquêtes antérieures décontextualisées. L’équipe privilégie donc une passation écologique en présentiel, animée par des coordinateurs de recherche clinique se rendant physiquement au sein des services hospitaliers. Néanmoins, les ressources d’intervention sur site contraignent formellement l’équipe à limiter les déplacements à $k = 4$ établissements hospitaliers distincts.
La variable dépendante principale retenue pour cette étude est le score quantitatif d’épuisement émotionnel mesuré par l’Inventaire d’épuisement professionnel de Maslach (MBI – Maslach Burnout Inventory). Les scores individuels s’échelonnent de 0 à 54 points, les valeurs élevées signifiant une détresse psychologique sévère. L’impératif méthodologique réside dans la constitution sous Excel d’un échantillon en grappes probabiliste garantissant la validité écologique et la précision inférentielle de l’évaluation du burnout à l’échelle de l’ensemble du groupement régional.
9.2 Déroulement séquentiel complet des manipulations dans la feuille de calcul
La première feuille de travail, baptisée POPULATION_SOURCE, accueille la matrice brute des $2,000$ soignants structurée en un tableau officiel Excel nommé T_Soignants. Ce tableau comprend les colonnes ID_Soignant, Centre_Hospitalier, Anciennete_Service et Score_MBI. Une seconde feuille, DESIGN_ECHANTILLON, est immédiatement initiée pour gouverner le tirage au sort des quatre établissements cibles.
En cellule A2 de la feuille de design, la liste des 20 hôpitaux est extraite sans redondance via la formule :
=UNIQUE(T_Soignants[Centre_Hospitalier])
Dans la colonne adjacente B2, un tirage uniforme continu est assigné à chaque site au moyen de la formule :
=ALEA()
Dès l’évaluation de ces formules, la matrice A2:B21 est figée par un Collage spécial en valeurs. Les quatre grappes lauréates sont alors isolées dans la plage D2:D5 au moyen de la formule matricielle :
=PRENDRE(TRIERPAR(A2:A21; B2:B21); 4)
Supposons que cette procédure probabiliste désigne les centres hospitaliers Hôpital Alpha, Hôpital Gamma, Hôpital Kappa et Hôpital Sigma.
L’extraction intégrale des infirmiers affiliés à ces quatre sites hospitaliers est réalisée sur une troisième feuille de travail, nommée COHORTE_FINALE, au moyen de la syntaxe de filtrage booléen :
=FILTRE(T_Soignants; (T_Soignants[Centre_Hospitalier]=DESIGN_ECHANTILLON!$D$2) + (T_Soignants[Centre_Hospitalier]=DESIGN_ECHANTILLON!$D$3) + (T_Soignants[Centre_Hospitalier]=DESIGN_ECHANTILLON!$D$4) + (T_Soignants[Centre_Hospitalier]=DESIGN_ECHANTILLON!$D$5))
Le moteur d’Excel matérialise instantanément une cohorte de 420 soignants. Un audit d’intégrité exécuté par =NB.SI() atteste de la parfaite concordance numérique entre la taille des effectifs théoriques déclarés par ces quatre hôpitaux et les 420 lignes d’enregistrements rapatriées dans la feuille finale.
9.3 Comparaison inférentielle : Échantillon retenu versus Population parente
La validité méthodologique du protocole s’apprécie par la confrontation des paramètres descriptifs de l’échantillon extrait ($n = 420$) avec les paramètres réels de la population parente ($M_0 = 2,000$). Dans un tableau de comparaison inférentielle configuré sous Excel, l’analyste renseigne les métriques comparatives suivantes :
| Paramètre Psychométrique | Population Parente (N=2000) | Échantillon Grappes (n=420) | Écart Relatif |
|---|---|---|---|
| Moyenne MBI (Épuisement) | 26,42 | 26,85 | + 1,62 % |
| Écart-Type MBI | 8,35 | 8,51 | + 1,91 % |
| Ancienneté Moyenne (années) | 11,20 | 10,95 | – 2,23 % |
| Proportion Sévère (Score > 30) | 28,30 % | 29,05 % | + 2,65 % |
Pour confirmer formellement l’absence de distorsion systématique ou d’artefact technique lié à la procédure de sélection sous Excel, l’expérimentateur conduit un test $t$ pour échantillons indépendants au moyen de la formule native :
=TEST.T(T_Soignants[Score_MBI]; COHORTE_FINALE!D2:D421; 2; 3)
Le test statistique renvoie une p-valeur bilatérale de $p = 0,38$. Dans la mesure où cette valeur excède très largement le seuil de significativité conventionnel de $\alpha = 0,05$, l’hypothèse nulle d’égalité des moyennes ne peut être rejetée. La cohorte constituée via cette procédure d’échantillonnage en grappes sous Excel démontre ainsi une fidélité psychométrique remarquable vis-à-vis de l’univers de référence des personnels soignants de la région.
10. Automatisation industrielle de la procédure via Power Query et scripts VBA
10.1 Automatisation déclarative du pipeline d’échantillonnage avec Power Query
Pour les organisations conduisant des vagues d’enquêtes longitudinales ou itératives répétées, le recours aux formules directes de feuilles de calcul peut s’avérer fastidieux et sensible aux erreurs de manipulation. L’utilisation de Power Query, le moteur ETL (Extract, Transform, Load) intégré nativement à Excel, permet d’automatiser le pipeline d’échantillonnage de manière déclarative, robuste et totalement reproductible.
La première phase dans Power Query consiste à importer la table de population source et à dupliquer la requête pour générer une branche dédiée à l’isolation des unités primaires. Au sein de cette branche, l’analyste applique l’étape « Supprimer les doublons » sur la colonne ID_Grappe, produisant instantanément la liste des grappes d’échantillonnage. Pour insuffler la composante probabiliste dans le langage M sous-jacent, une colonne personnalisée est insérée en appelant la fonction Number.Random(), laquelle assigne à chaque grappe une grandeur pseudo-aléatoire continue comprise entre 0 et 1 lors de l’exécution de la requête :
Table.AddColumn(EtapePrecedente, "Aleatoire", each Number.Random(), type number)
Ensuite, l’opérateur ordonne la table par ordre croissant de cette colonne aléatoire et applique la commande « Conserver les premières lignes » en paramétrant le seuil à $k$ grappes (par exemple 4). La dernière étape consiste à réaliser une opération de fusion interne (Inner Join) entre cette table de grappes retenues et la table initiale des observations individuelles, sur la base de la clé d’appartenance commune ID_Grappe. Power Query filtre alors instantanément la masse des sujets pour ne renvoyer que les membres des grappes lauréates. Dès lors, à chaque nouvelle vague d’enquête ou mise à jour de la base source, un simple clic droit suivi de la commande Actualiser recalcule l’intégralité du plan d’échantillonnage en quelques fractions de seconde.
10.2 Développement d’une procédure macro VBA pour tirages itératifs répétables
L’exploration approfondie des propriétés d’échantillonnage ou la conduite de simulations de Monte-Carlo appliquées à l’évaluation des erreurs types requiert une puissance d’itération que les formules de cellules ne peuvent assumer. L’écriture d’une routine programmée en Visual Basic for Applications (VBA) offre la flexibilité nécessaire pour répliquer le tirage en grappes des centaines de fois consécutives sans dégrader les performances de la machine.
Une macro VBA dédiée à l’échantillonnage en grappes sans remise repose sur l’instanciation d’une collection ou d’un dictionnaire d’objets pour extraire les identifiants uniques de grappes, couplée à un algorithme de mélange pseudo-aléatoire d’une rigueur absolue tel que le mélange de Fisher-Yates (ou Knuth Shuffle). Le bloc algorithmique fondamental se formalise conceptuellement à travers la structure de procédure suivante :
Une routine Sub Echantillonnage_Grappes() dimensionne les tableaux dynamiques en mémoire vive, extrait la liste des grappes uniques, applique le mélange aléatoire sur ce vecteur par permutation indiciaire au moyen de l’instruction Rnd, sélectionne les $k$ premières entités issues de la permutation, puis scanne la table de données initiale pour transférer instantanément vers une nouvelle feuille de calcul dédiée l’intégralité des enregistrements correspondants, le tout en suspendant préalablement le rafraîchissement d’écran via Application.ScreenUpdating = False pour maximiser la vélocité d’exécution.
Cette approche par macro VBA présente l’avantage décisif d’offrir une interface utilisateur hautement ergonomique pour les équipes non-techniciennes de recherche : un simple bouton de formulaire inséré sur la feuille d’accueil d’Excel permet de déclencher l’extraction probabiliste, tandis que des boîtes de dialogue interactives (InputBox) sollicitent le chercheur pour définir le nombre de clusters souhaité et la graine de tirage (seed) garantissant la réplicabilité expérimentale.
10.3 Documentation de l’architecture algorithmique pour l’intégrité de la recherche
Qu’elle repose sur Power Query ou sur un module de script VBA, toute architecture logicielle assurant un échantillonnage statistique au sein d’une institution doit faire l’objet d’une documentation méticuleuse pour satisfaire aux audits de conformité réglementaire et aux exigences des comités d’éthique scientifique. L’opacité algorithmique (l’illusion de la « boîte noire ») constitue une source récurrente de contestation méthodologique lors de la publication de rapports d’évaluation comportementale.
Dans le code VBA, chaque procédure doit être accompagnée d’en-têtes standardisés explicitant les préconditions matérielles, les variables d’entrée et de sortie, l’algorithme probabiliste mobilisé et la version de calcul ciblée. De surcroît, le script doit obligatoirement inclure un module de journalisation automatique (logging). Lors de chaque exécution du tirage, une ligne d’audit infalsifiable doit être consignée au bas d’une feuille masquée ou d’un fichier texte externe, précisant :
- L’identifiant réseau de l’utilisateur ayant ordonnancé le tirage d’échantillon.
- L’horodatage universel précis de l’opération (date, heure, minute, seconde).
- Le condensat cryptographique ou l’empreinte de la table de population source pour certifier son immuabilité avant le tirage.
- La liste explicite des grappes primaires tirées au sort et le nombre total d’unités secondaires sélectionnées.
Enfin, le classeur final doit être sauvegardé sous le format ouvert prenant en charge les macros (.xlsm) ou converti en un modèle verrouillé (.xltm). Les feuilles sources et les modules de code doivent être protégés par des clés d’accès administratives pour interdire toute altération malveillante ou modification accidentelle des algorithmes de sélection probabiliste par des tiers non accrédités.
11. Diagnostics statistiques et écueils méthodologiques majeurs sous Excel
11.1 Biais de confusion conceptuelle et erreurs d’assignation technique
L’un des écueils les plus pernicieux constatés lors de la mise en œuvre de plans de sondage sous tableur réside dans la dérive opérationnelle conduisant à traiter un échantillonnage en grappes comme s’il s’agissait d’un échantillonnage stratifié, ou vice-versa. Dans de multiples rapports d’évaluation psychologique, des analystes affirment avoir réalisé une « stratification » alors qu’ils ont tiré au sort un nombre réduit de divisions institutionnelles au sein desquelles ils ont interrogé tous les membres présents. Ce glissement sémantique s’avère lourd de conséquences : les formules analytiques d’erreur standard de la stratification sous-estiment drastiquement la véritable variance d’un échantillon en grappes, générant des intervalles de confiance artificiellement resserrés et une fausse impression de haute précision métrique.
Sur le plan purement technique dans Excel, une erreur dramatique mais fréquente réside dans l’omission du figeage des valeurs aléatoires générées par =ALEA() ou =ALEA.ENTRE.BORNES(). Lorsqu’un analyste maintient des formules volatiles dans son registre de tirage pendant qu’il exécute des filtres, ordonne des colonnes ou supprime des lignes, le moteur de recalcul d’Excel redéclenche imperceptiblement de nouveaux tirages d’aléa. Il en résulte un phénomène désastreux d’attrition et de contamination dynamique : l’échantillon extrait en fin de journée ne correspond plus du tout à celui qui figurait sur la feuille le matin, rendant toute validation croisée impossible et invalidant l’intégrité de l’étude.
Un autre piège classique concerne l’utilisation imprudente de =ALEA.ENTRE.BORNES() appliquée de manière itérative dans une plage verticale de cellules pour désigner plusieurs grappes. Comme souligné précédemment, cette fonction exécute un tirage avec remise stricte. Si la population de référence compte peu de grappes (par exemple 15 divisions), la probabilité de tirer accidentellement deux fois le même indice de grappe est extrêmement élevée. Si l’analyste ne prend pas la précaution de dédupliquer formellement la liste d’indices ainsi obtenue, la même grappe sera comptabilisée deux fois dans la cohorte finale, violant les degrés de liberté théoriques des modèles statistiques subséquents.
11.2 Sous-estimation de l’erreur d’échantillonnage et tests statistiques invalides
La défaillance analytique la plus dévastatrice consécutive à l’échantillonnage en grappes sous Excel réside dans l’utilisation des fonctions statistiques natives d’inférence (telles que =TEST.T(), =TEST.F() ou les courbes de régression linéaire de l’Utilitaire d’analyse) sans appliquer la moindre correction d’effet de plan. Les algorithmes d’Excel partagent tous l’hypothèse axiomatique que chaque ligne d’observation représente un vecteur indépendant et identiquement distribué provenant d’un échantillonnage aléatoire simple.
Or, en présence d’une corrélation intra-grappe non nulle ($ICC > 0$), l’erreur type standard conventionnelle d’un estimateur de moyenne, calculée sous Excel par la formule naive $s / \sqrt{n}$, sous-évalue considérablement la dispersion réelle de l’estimateur d’échantillonnage. En réalité, l’erreur type ajustée $SE_{cluster}$ obéit à la relation de correction fondamentale :
$$SE_{cluster} = SE_{EAS} \times \sqrt{Deff} = \frac{s}{\sqrt{n}} \times \sqrt{1 + (m – 1) \cdot ICC}$$
Ignorer cette équation multiplicatrice conduit à gonfler artificiellement les statistiques de test $t$ ou $F$. Des différences interindividuelles totalement aléatoires ou de simples artefacts contextuels de grappe apparaissent alors trompeusement comme « hautement significatifs » ($p < 0,01$), exposant la recherche au fléau des faux positifs scientifiques (erreur de type I).
Bien que les macros et les formules élaborées sous Excel permettent de corriger ponctuellement l’erreur type des statistiques descriptives élémentaires, le tableur de Microsoft atteint ici ses limites intrinsèques. Dès lors que l’analyste ambitionne d’ajuster des modèles de régression multivariés, d’analyser des médiations causales ou de tester des interactions complexes entre variables de niveau individuel (niveau 1) et variables de niveau groupé (niveau 2), la transition vers des logiciels biostatistiques spécialisés dans la modélisation hiérarchique linéaire (Multilevel Modeling) tels que R (packages lme4, survey), Jamovi ou Mplus devient une nécessité méthodologique incontournable.
11.3 Biais de non-réponse différentielle au niveau du groupe
Dans un schéma d’échantillonnage individuel, le refus d’un participant d’achever un questionnaire psychométrique n’ampute l’échantillon global que d’une seule unité d’observation, altérant très marginalement la puissance statistique. Dans un protocole d’échantillonnage en grappes, le refus d’adhésion ou la défection inattendue d’une unité primaire complète (par exemple, la direction d’un hôpital ou d’un établissement scolaire tiré au sort refusant in fine d’accorder l’accès à ses locaux) revêt un caractère méthodologiquement catastrophique.
La perte soudaine d’un cluster entier amputera instantanément l’échantillon final de 20 % ou 25 % de son effectif théorique lorsque le plan de tirage ne repose que sur $k = 4$ ou $k = 5$ grappes. Plus grave encore, ce refus est rarement le fruit du pur hasard : un établissement caractérisé par un climat organisationnel délétère ou des tensions managériales exacerbées est précisément plus enclin à rejeter une intervention d’évaluation psychologique portant sur le burnout ou la détresse au travail. Cette non-réponse différentielle de groupe induit un biais de sélection massif qui décapite la variance phénotypique réelle de l’étude.
Pour parer méthodologiquement à cette éventualité sous Excel, l’expérimentateur doit planifier une stratégie de réserve probabiliste intégrée lors de la phase initiale de sélection. Il convient de pré-tirer au sort un ensemble ordonné de « grappes de réserve » (par exemple, désigner formellement les grappes de rang aléatoire $k+1$ et $k+2$). Si et seulement si un cluster primaire initialement tiré oppose un refus formel et documenté de participation, la grappe de substitution est mobilisée selon l’ordre strict déterminé lors de la séquence aléatoire initiale figée. Ce protocole transparent consigné dans le cahier d’échantillonnage prévient toute substitution discrétionnaire ou arbitraire de convenance sur le terrain.
12. Protocoles de reporting académique et standards de transparence méthodologique
12.1 Conformité aux recommandations internationales (APA, STROBE, CONSORT)
La restitution académique ou professionnelle d’une investigation empirique fondée sur un échantillonnage en grappes doit se conformer aux standards internationaux les plus rigoureux régissant la transparence méthodologique, notamment les recommandations éditoriales de l’American Psychological Association (APA 7th edition) et les déclarations CONSORT (extension pour les essais en grappes) ou STROBE (pour les études épidémiologiques observationnelles).
Dans la section « Méthode / Participants » du manuscrit de recherche, l’auteur ne saurait se contenter d’indiquer l’effectif final de répondants. Il est formellement exigé de divulguer en détail :
- La justification théorique et logistique du recours exclusif à l’échantillonnage en grappes plutôt qu’à un tirage individuel simple.
- Le nombre total d’unités primaires constituant le cadre d’échantillonnage ($N$) et le nombre exact de grappes tirées au sort ($k$).
- La méthode probabiliste précise mise en œuvre sous Excel (EASSR ou tirage PPT), en mentionnant les versions logicielles et les algorithmes mobilisés.
- L’estimation quantitative rigoureuse du coefficient de corrélation intraclasse ($ICC$) et de l’effet de plan ($Deff$) calculés sur la variable d’intérêt principale.
- La démarche adoptée pour corriger les erreurs types et les degrés de liberté lors des tests d’hypothèse inférentiels.
La production d’un diagramme de flux méthodologique standardisé constitue un atout indiscutable pour illustrer l’entonnoir d’échantillonnage : de l’énumération des grappes éligibles jusqu’au décompte précis des participants effectivement interrogés, en consignant minutieusement le nombre et les motifs des exclusions ou des défections enregistrées à chaque niveau hiérarchique.
12.2 Archivage pérenne et pratiques de science ouverte (Open Science)
L’essor contemporain du mouvement de la science ouverte (Open Science) engage les chercheurs à rendre leurs protocoles de calcul et leurs matériaux empiriques accessibles, transparents et auditables par l’ensemble de la communauté scientifique internationale sur des entrepôts de données certifiés, à l’instar de l’Open Science Framework (OSF) ou de Zenodo.
L’archivage d’une feuille de travail Excel ayant servi à l’échantillonnage impose le respect de précautions déontologiques majeures, au premier rang desquelles figure l’anonymisation intégrale et définitive de la base de données préliminaire. Toute variable d’identification directe (noms de famille, adresses postales, numéros de sécurité sociale ou coordonnées électroniques) doit être rigoureusement purgée avant tout partage public. Les identifiants de grappes eux-mêmes doivent faire l’objet d’une pseudonymisation cryptographique (par exemple, substituer un hash ou un label abstrait tel que Grappe_A aux véritables dénominations institutionnelles) afin de prémunir les établissements participants contre toute identification stigmatisante de leurs résultats psychométriques.
Le classeur Excel mis en ligne doit intégrer une feuille d’accueil faisant office de livre de codes exhaustif (Codebook). Ce dictionnaire de données documente la signification précise de chaque colonne, les échelles de mesure des scores psychologiques, la structure des tables et l’explication des formules matricielles ou du code VBA implémenté. Pour garantir l’immuabilité du document archivé, les feuilles de calcul doivent être verrouillées en lecture seule et associées à un identifiant d’objet numérique pérenne (DOI) garantissant la traçabilité bibliographique de l’architecture méthodologique.
12.3 Arbre décisionnel pour le choix du design d’échantillonnage en sciences humaines
Pour synthétiser la gouvernance méthodologique de la collecte quantifiée en recherche comportementale, le chercheur peut s’appuyer sur une matrice d’arbitrage décisionnelle évaluant les compromis incontournables entre contraintes opérationnelles de terrain et précision statistique pure. Le déploiement d’un échantillonnage en grappes sous Excel ne doit jamais être un choix par défaut, mais l’aboutissement d’une réflexion épistémologique structurée :
| Critère de Décision | Échantillonnage Aléatoire Simple | Échantillonnage Stratifié | Échantillonnage en Grappes |
|---|---|---|---|
| Registre de population préalable | Exhaustif individuel obligatoire | Exhaustif individuel avec attributs | Registre des groupes uniquement |
| Coûts logistiques et déplacements | Très élevés (dispersion maximale) | Modérés à très élevés | Très faibles (concentration spatiale) |
| Structure de variance intra-groupe | Non applicable (absence de groupes) | Homogène intra / Hétérogène inter | Hétérogène intra / Homogène inter |
| Précision relative de l’estimation | Standard de référence (Deff = 1) | Optimisée (Deff < 1) | Dégradée (Deff > 1) |
| Complexité analytique sous Excel | Élémentaire (formules directes) | Modérée (pondérations proportionnelles) | Élevée (ICC, Deff, modèles hiérarchiques) |
En dernière analyse, si la population cible se compose d’entités coalescentes dont le recensement individuel s’avère physiquement ou économiquement impossible, l’échantillonnage en grappes demeure l’unique alternative scientifiquement légitime. En appliquant avec rigueur les procédures logicielles, les contrôles d’intégrité matriciels et les corrections d’effet de plan formalisés dans ce guide, Microsoft Excel s’affirme comme un environnement d’ingénierie statistique remarquablement puissant, capable de concilier les impératifs pratiques des enquêtes de terrain avec les plus hauts standards de validité et de réplicabilité scientifique internationale.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Campbell, M. K., Piaggio, G., Elbourne, D. R., & Altman, D. G. (2012). Consort 2010 statement: Extension to cluster randomised trials. BMJ, 345, e5661. https://doi.org/10.1136/bmj.e5661
Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
Eldridge, S. M., & Kerry, S. (2012). A practical guide to cluster randomised trials in health services research. John Wiley & Sons. https://doi.org/10.1002/9781119966241
Hayes, R. J., & Moulton, L. H. (2017). Cluster randomised trials (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370286
Kish, L. (1965). Survey sampling. John Wiley & Sons.
Maslach, C., Jackson, S. E., & Leiter, M. P. (1996). Maslach Burnout Inventory manual (3rd ed.). Consulting Psychologists Press.
Microsoft Corporation. (2024). Fonctions et utilitaires d’analyse statistique dans Excel. Support technique Microsoft Office. https://support.microsoft.com/fr-fr/excel
Snijders, T. A. B., & Bosker, R. J. (2012). Multilevel analysis: An introduction to basic and advanced multilevel modeling (2nd ed.). Sage Publications.
von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., & Vandenbroucke, J. P. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. The Lancet, 370(9596), 1453-1457. https://doi.org/10.1016/S0140-6736(07)61602-X