
L’analyse de variance, introduite par le statisticien et généticien Ronald Aylmer Fisher au début du XXe siècle, constitue l’un des piliers méthodologiques les plus robustes de l’inférence statistique contemporaine. Si les plans factoriels croisés simples et les modèles à un facteur contrôlé sont largement documentés dans la littérature didactique et intégrés de façon native dans la quasi-totalité des tableurs grand public, les architectures expérimentales hiérarchisées posent un défi analytique singulier. Dans de nombreuses disciplines empiriques — de l’agronomie expérimentale à la biomédecine, en passant par les neurosciences cognitives, l’écologie évolutive et le contrôle qualité industriel —, les dispositifs de collecte ne répondent pas à une logique d’orthogonalité stricte. Les unités d’observation sont fréquemment intégrées au sein de grappes, de lots, de nichées ou de sous-structures organisationnelles qui empêchent tout croisement factoriel standard. Ignorer cette structure hiérarchique au profit d’un modèle factoriel croisé classique conduit inévitablement à des biais d’estimation sévères et à une inflation incontrôlée de l’erreur de première espèce.
L’ANOVA emboîtée (ou hiérarchique, désignée en anglais sous le terme de nested ANOVA) a précisément été formalisée pour répondre à ces structures de données dépendantes où les modalités d’un facteur secondaire n’ont de sens, et n’existent physiquement, qu’à l’intérieur d’un niveau spécifique d’un facteur principal de rang supérieur. Bien que les progiciels de statistiques avancés tels que R, SAS, Stata ou SPSS disposent de procédures syntaxiques directes pour ajuster des modèles linéaires généralisés à effets emboîtés, Microsoft Excel demeure la plateforme computationnelle la plus accessible, la plus transparente et la plus répandue au sein des laboratoires de recherche, des bureaux d’études et des entreprises. Toutefois, l’environnement natif d’Excel — et particulièrement son module d’extension historique, l’Utilitaire d’analyse (Analysis ToolPak) — ne propose aucune commande directe ni boîte de dialogue intitulée « ANOVA emboîtée ».
Le présent guide a pour vocation de combler cette lacune technique en détaillant, de façon méthodique et exhaustive, l’ensemble des fondements mathématiques, des manipulations logicielles et des réarrangements algébriques nécessaires pour conduire une ANOVA hiérarchique rigoureuse dans Microsoft Excel. À travers un protocole pas à pas, nous verrons comment détourner judicieusement la procédure factorielle croisée avec répétitions afin d’extraire les sommes des carrés pertinentes, recalculer manuellement les degrés de liberté, sélectionner les ratios de variance F appropriés selon la nature fixe ou aléatoire des facteurs, et valider les postulats distributionnels fondamentaux. Cette approche algorithmique permet non seulement de s’affranchir de logiciels statistiques onéreux pour les plans équilibrés, mais offre également une compréhension intime de la décomposition des composantes de la variance au sein des architectures de données hiérarchisées.
1. 1. Fondements théoriques de l’ANOVA emboîtée en méthodologie quantitative
1.1 Définition et principes de l’emboîtement factoriel
Dans la démarche expérimentale quantitative, la conceptualisation des facteurs de variation conditionne l’ensemble de la validité interne des conclusions inférentielles. Deux facteurs expérimentaux, arbitrairement désignés par A et B, sont dits factoriellement croisés si chaque modalité ou niveau du facteur A apparaît en combinaison avec chaque modalité du facteur B au sein du protocole d’échantillonnage. En revanche, un plan est qualifié d’emboîté, hiérarchique ou niché lorsque les modalités du facteur secondaire B sont structurellement subordonnées aux modalités du facteur principal A. Cela implique mathématiquement et empiriquement qu’un niveau donné du facteur B n’apparaît, par définition, qu’au sein d’un seul et unique niveau du facteur A. Par exemple, si l’on évalue l’effet de différents traitements pharmaceutiques (Facteur A) administrés dans plusieurs cliniques (Facteur B), les cliniques associées au traitement 1 ne sont pas les mêmes que celles associées au traitement 2. Le facteur « Clinique » ne peut en aucun cas être croisé avec le facteur « Traitement » : il lui est strictement subordonné.
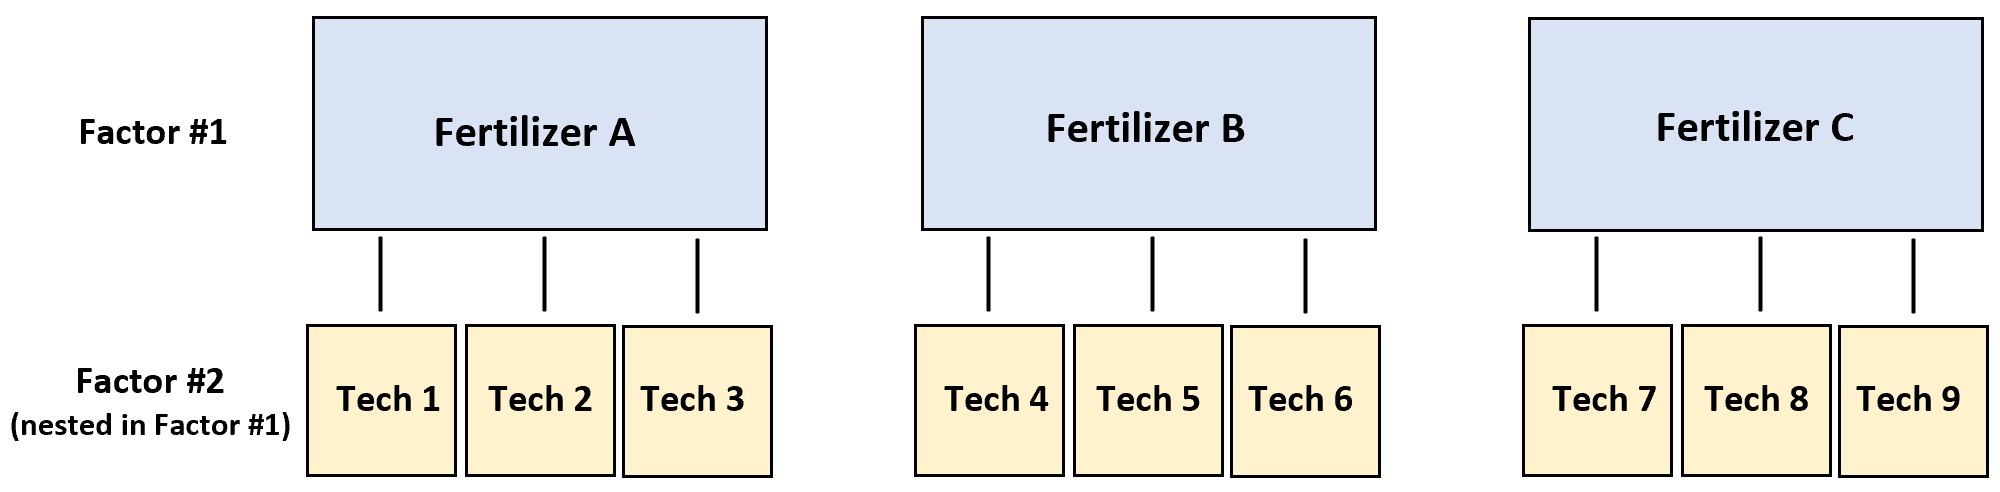
Cette distinction architecturale s’accompagne d’une différenciation fondamentale entre facteurs à effets fixes et facteurs à effets aléatoires. Un facteur est qualifié de fixe lorsque l’ensemble des modalités d’intérêt scientifique exhaustives ou spécifiquement choisies par l’expérimentateur est présent dans l’étude ; les conclusions statistiques se limitent alors rigoureusement à ces niveaux précis. À l’inverse, un facteur est qualifié d’aléatoire lorsque ses modalités représentent un échantillon stochastique tiré au hasard parmi une population plus vaste de modalités potentielles, l’objectif étant d’inférer la variance attribuable à cette population globale. Dans la grande majorité des applications empiriques en sciences comportementales, cognitives et agronomiques, le facteur de traitement principal (A) est considéré comme fixe, tandis que le sous-facteur emboîté (B) — représentant des portées animales, des parcelles agricoles, des classes d’école ou des opérateurs de laboratoire — est modélisé comme un facteur aléatoire. Ce schéma engendre un modèle linéaire à effets mixtes hiérarchisé.
L’omission de cette structure emboîtée au cours de la modélisation statistique constitue une faute méthodologique majeure fréquemment désignée sous le concept de pseudorépétition, mise en lumière de manière séminale par Stuart Hurlbert en 1984. Traiter les observations individuelles issues d’un même sous-groupe comme des réplicats statistiquement indépendants conduit à confondre la variance résiduelle intra-sous-groupe avec la variance réelle attribuable au traitement principal. L’effet mécanique direct de cette méspécification est une sous-estimation systématique de l’erreur standard des estimations, provoquant une réduction artificielle de la largeur des intervalles de confiance et, par voie de conséquence, une explosion dramatique du taux d’erreur de première espèce (le risque d’affirmer à tort l’existence d’un effet statistiquement significatif alors que l’hypothèse nulle est vraie). Respecter l’emboîtement est ainsi l’unique garantie d’un contrôle rigoureux de ce risque nominal dans les systèmes hiérarchiques.
1.2 Le modèle mathématique linéaire sous-jacent
D’un point de vue formel, l’analyse de variance hiérarchique repose sur le formalisme des modèles linéaires généraux. L’expression scalaire d’un plan d’expérience équilibré comportant deux facteurs emboîtés s’énonce selon l’équation mathématique suivante :
Yijk = μ + αi + βj(i) + εijk
Dans cette formalisation algébrique, la quantité Yijk représente la valeur observée pour la k-ième unité expérimentale (répétition) au sein du j-ième niveau du facteur secondaire B, ce dernier étant lui-même emboîté dans le i-ième niveau du facteur principal A. L’indice i varie de 1 à a (nombre de modalités du facteur A), l’indice j varie de 1 à b (nombre de modalités du facteur B au sein de chaque niveau de A), et l’indice k varie de 1 à n (nombre de réplications par sous-groupe, le plan étant supposé strictement équilibré). Le terme μ désigne la moyenne générale théorique de la population sous-jacente. Le paramètre αi correspond à l’effet différentiel du i-ième niveau du facteur principal A. L’élément central du modèle réside dans le terme βj(i), qui quantifie l’effet propre du j-ième niveau du facteur B conditionnellement au i-ième niveau de A. Enfin, le terme résiduel εijk traduit la fluctuation stochastique non contrôlée ou l’erreur expérimentale pure propre à chaque mesure individuelle.
L’estimation des paramètres de ce modèle linéaire et la validité des tests de signification statistiques reposent de façon absolue sur les postulats de Gauss-Markov étendus aux modèles gaussiens. D’une part, les termes d’erreur εijk sont postulés indépendants et identiquement distribués selon une loi normale centrée d’espérance nulle et de variance constante, soit εijk ~ N(0, σ2). Il s’agit du principe d’homoscédasticité intra-groupe. D’autre part, dans l’hypothèse où le sous-facteur B est modélisé comme aléatoire, ses composantes d’effet sont également supposées suivre une distribution normale indépendante de variance spécifique, notée βj(i) ~ N(0, σ2β), avec une covariance nulle entre les effets du facteur secondaire et les résidus d’échantillonnage.
La décomposition formelle de la variabilité globale repose sur le théorème fondamental d’orthogonalité des sommes des carrés. La somme totale des carrés des écarts à la moyenne globale (notée SSTotal) est rigoureusement partitionnée en composantes additives indépendantes selon l’identité fondamentale :
SSTotal = SSA + SSB(A) + SSRésiduelle
Cette décomposition illustre avec clarté l’absence de terme d’interaction standard : la totalité de la variabilité qui, dans un plan croisé conventionnel, aurait été attribuée à la fois à l’effet principal de B et à l’interaction croisée (A × B), est ici intrinsèquement condensée au sein de la somme des carrés hiérarchique SSB(A). Pour garantir l’identifiabilité mathématique du modèle dans le cas où le facteur A est à effets fixes, la contrainte de centrage classique impose que la somme des αi soit égale à zéro. De même, si le sous-facteur B est modélisé comme fixe, la contrainte impose que la somme des βj(i) soit nulle pour chaque indice i pris individuellement.
1.3 Comparaison entre plans factoriels croisés et plans emboîtés
La distinction structurelle entre un plan factoriel croisé et un plan emboîté réside au cœur de la théorie des plans d’expériences. Dans un plan croisé complet (noté conventionnellement A × B), chaque modalité de B traverse orthogonalement l’ensemble des modalités de A. Cette structure bidimensionnelle permet d’isoler mathématiquement trois sources de variations distinctes : l’effet propre moyen du facteur A (invariant par rapport à B), l’effet propre moyen du facteur B (invariant par rapport à A), et le terme de synergie non linéaire ou d’antagonisme appelé interaction factorielle (A × B). L’interaction mesure spécifiquement la mesure dans laquelle la réponse aux variations du facteur A fluctue en amplitude ou en direction selon le niveau particulier assigné au facteur B.
Dans un schéma hiérarchique emboîté (noté formellement B ⊂ A ou B(A)), l’interaction au sens classique du terme n’a aucun fondement mathématique ou sémantique. Les modalités du facteur B n’existant pas au-delà des frontières de leur niveau d’appartenance dans A, il est logiquement impossible de calculer une moyenne marginale pour une modalité de B à travers tous les niveaux de A. Par conséquent, l’orthogonalité s’effondre au profit d’un arbre hiérarchique. L’évaluation de l’effet d’un site de production ou d’une machine opérant exclusivement dans une usine donnée ne peut faire l’objet d’une comparaison croisée avec les machines d’une autre usine, les unités physiques étant non interchangeables et uniques.
Pour matérialiser cette divergence conceptuelle, considérons l’évaluation de deux types d’aliments pour bétail (Facteur A : Aliment 1 vs Aliment 2). Si nous affectons ces deux régimes alimentaires à des groupes d’animaux répartis au sein des mêmes bâtiments d’élevage, de telle sorte que chaque bâtiment abrite à la fois des animaux sous le régime 1 et des animaux sous le régime 2, le facteur « Bâtiment » est pleinement croisé avec le facteur « Aliment ». Il est alors possible d’estimer un effet d’interaction bâtiment × aliment. Si, à l’inverse, des contraintes d’infrastructure logistique imposent que certains bâtiments soient intégralement dédiés au régime 1, tandis que d’autres bâtiments distincts sont intégralement assignés au régime 2, les bâtiments deviennent structurellement emboîtés dans les régimes alimentaires. L’hétérogénéité thermique, microbienne ou spatiale propre à chaque bâtiment ne peut plus être séparée de manière croisée : elle devient la composante hiérarchique B(A). Dès lors, le test de l’efficacité intrinsèque de l’aliment devra impérativement se faire en calibrant son échelle de comparaison statistique non pas sur la variabilité entre les animaux individuels, mais sur la variabilité inter-bâtiments.
2. 2. Définition du cadre expérimental et du cas d’étude
2.1 Présentation du cas d’application didactique
Afin d’ancrer de manière concrète et didactique les procédures d’implémentation dans Microsoft Excel, nous définissons un scénario expérimental standard issu de la biotechnologie et du génie agronomique. L’objectif consiste à évaluer l’impact de différentes formulations d’un biostimulant foliaire novateur sur le rendement d’une culture modèle. La variable réponse quantitative continue, mesurée avec une précision rigoureuse, est le rendement en biomasse sèche exprimé en grammes par mètre carré (g/m²).
Le dispositif expérimental s’articule autour d’une hiérarchie à deux niveaux :
- Facteur principal (Facteur A) : Le type de traitement biostimulant appliqué. Ce facteur comprend trois modalités d’intérêt scientifique délibérément sélectionnées (a = 3) : la Formulation Standard (T1), la Formulation Concentrée (T2), et la Formulation Expérimentale à Libération Lente (T3). Il s’agit rigoureusement d’un facteur à effets fixes.
- Facteur secondaire emboîté (Facteur B emboîté dans A) : Les serres de production au sein desquelles les traitements sont dispensés. En raison des contraintes d’application atmosphérique et de nébulisation, chaque formulation est pulvérisée dans quatre serres indépendantes dédiées (b = 4 serres par traitement, soit un ensemble exhaustif de 12 serres expérimentales distinctes numérotées de façon hiérarchique). Les serres représentent un échantillon aléatoire d’installations horticoles représentatives ; ce facteur est par conséquent modélisé comme un facteur aléatoire emboîté dans le traitement.
- Unités observationnelles et réplications : Au sein de chacune des 12 serres, 5 parcelles unitaires de culture sont mesurées de manière répétée (n = 5 unités d’observation par sous-groupe).
Le plan d’expérience est rigoureusement équilibré et orthogonale à son niveau hiérarchique, totalisant N = a × b × n = 3 × 4 × 5 = 60 observations numériques indépendantes au niveau résiduel. Cette structure offre une puissance statistique adéquate pour isoler les composantes de la variance inter-traitements, inter-serres et intra-serres.
2.2 Hypothèses statistiques à formaliser
La formulation des hypothèses statistiques d’une ANOVA emboîtée à effets mixtes requiert une rigueur probabiliste fondamentale, car elle détermine la structure des tests d’inférence de Fisher. Deux séries distinctes d’hypothèses doivent être formulées : celles portant sur l’effet du traitement principal, et celles relatives à l’hétérogénéité du sous-facteur emboîté.
Pour le facteur principal A (Formulation de traitement, facteur fixe), l’hypothèse nulle statistique postule l’absence totale de divergence entre les effets différentiels moyens des formulations testées :
H0(A) : α1 = α2 = α3 = 0
L’hypothèse alternative correspondante affirme qu’au moins l’une des formulations induit une réponse moyenne significativement distincte des autres :
H1(A) : Il existe au moins une paire (i, i’) telle que αi ≠ αi’
Pour le facteur secondaire B (Serres emboîtées dans le traitement, facteur aléatoire), l’hypothèse nulle ne s’exprime pas sous la forme d’égalités de moyennes locales, mais en termes de composante de variance stochastique :
H0(B(A)) : σ2β = 0
L’hypothèse alternative stipule qu’une part non négligeable de la variabilité phénotypique observée découle des hétérogénéités environnementales propres à chaque serre :
H1(B(A)) : σ2β > 0
Les conséquences inférentielles de ces décisions statistiques sont déterminantes pour la généralisabilité des résultats. Si l’on rejette H0(B(A)), cela confirme la présence d’un « effet de serre » majeur (effet de grappe), démontrant formellement que des microclimats locaux modulent l’efficacité brute. Dès lors, tester le traitement principal A en le comparant directement à la variabilité résiduelle des parcelles (l’erreur d’échantillonnage interne) conduirait à déclarer artificiellement significatives de simples fluctuations microclimatiques. L’inférence sur le facteur A devra donc nécessairement être calibrée sur l’amplitude de la variance inter-serres pour prétendre à une validité externe robuste.
3. 3. Configuration de l’environnement de travail dans Microsoft Excel
3.1 Activation de l’Utilitaire d’analyse (Analysis ToolPak)
Afin de déployer des calculs statistiques avancés au sein de Microsoft Excel sans recourir à des scripts Visual Basic for Applications (VBA) complexes, il est indispensable de mobiliser le complément mathématique natif fourni par Microsoft : l’Utilitaire d’analyse (Analysis ToolPak). Ce module implémente les routines algorithmiques standard de l’analyse de données, incluant les régressions linéaires multiples, les transformées de Fourier, ainsi que plusieurs variantes de l’analyse de variance.
La procédure d’activation de ce composant s’effectue selon les étapes suivantes :
- Ouvrez Microsoft Excel et accédez à l’onglet supérieur gauche intitulé Fichier, puis sélectionnez Options dans le menu latéral inférieur.
- Dans la boîte de dialogue contextuelle « Options Excel », naviguez jusqu’à la section Compléments située dans l’arborescence de navigation à gauche.
- En bas de la fenêtre active, repérez le menu déroulant Gérer :, sélectionnez la modalité Compléments Excel, puis cliquez sur le bouton Atteindre….
- Une boîte de dialogue répertoriant les extensions intégrées apparaît. Cochez la case correspondant à l’Utilitaire d’analyse (veillez à ne pas confondre avec l’Utilitaire d’analyse – VBA si vous ne programmez pas de macros), puis validez en cliquant sur OK.
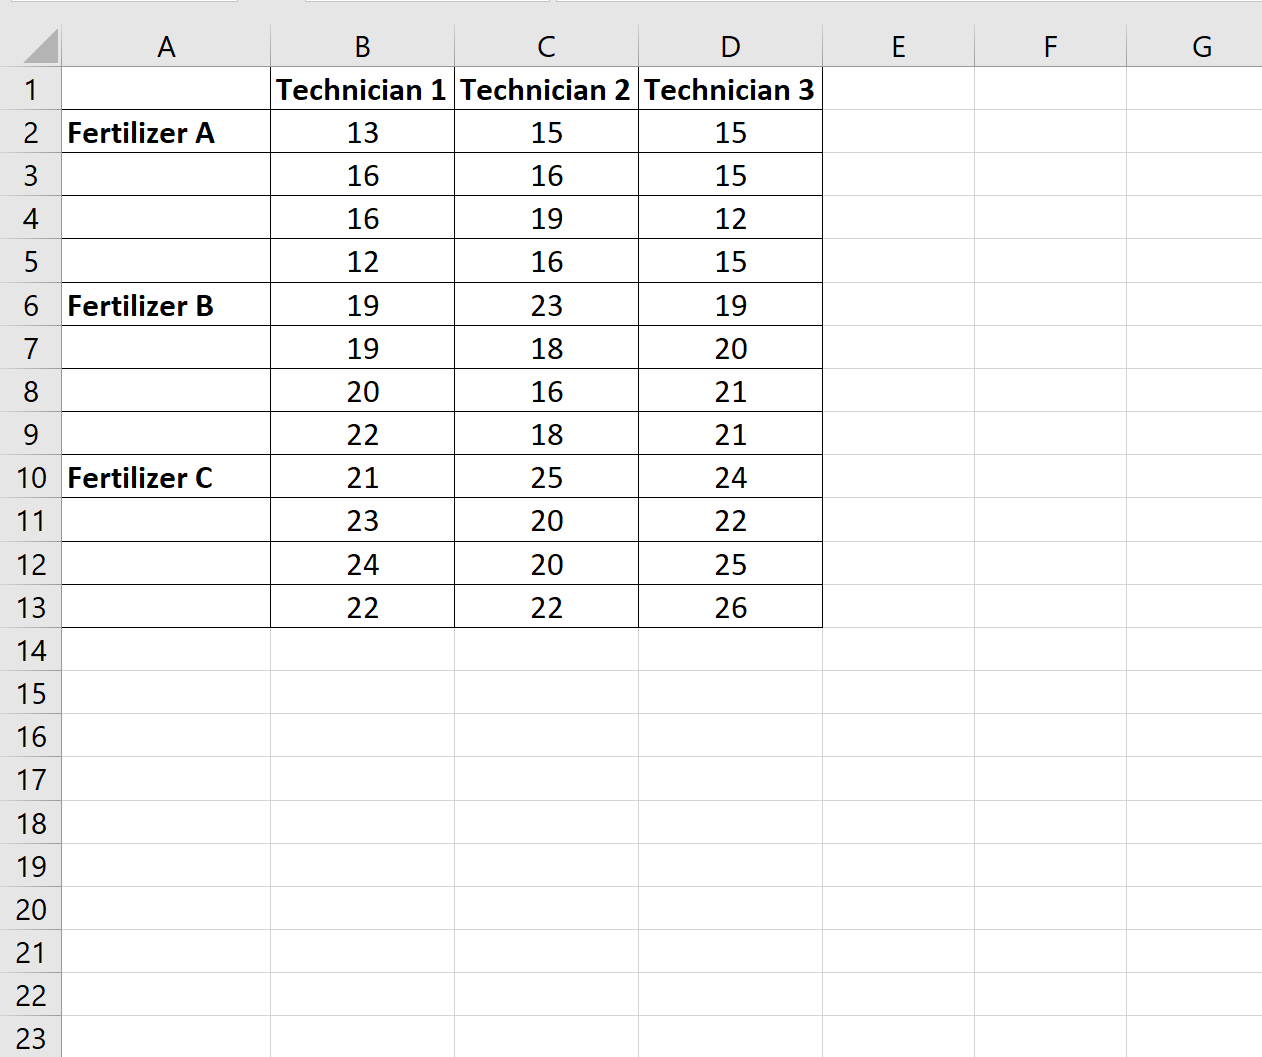
Pour vérifier l’initialisation correcte du composant, rendez-vous sur le ruban principal et sélectionnez l’onglet Données. À l’extrémité droite de la barre d’outils, un nouveau groupe fonctionnel intitulé Analyse doit désormais être visible, contenant la commande interactive Utilitaire d’analyse (ou Analyse de données). Si cette commande demeure absente malgré la validation du complément, le problème provient généralement d’une restriction d’exécution des compléments au sein du Centre de gestion de la confidentialité d’Office, ou d’une installation d’Excel en réseau nécessitant des privilèges d’administrateur système pour déployer les bibliothèques dynamiques d’analyse statistique.
3.2 Limitations inhérentes aux outils natifs d’Excel
Une inspection minutieuse des fonctionnalités offertes par l’Utilitaire d’analyse révèle une limite structurelle majeure pour les statisticiens et chercheurs travaillant sur des dispositifs non conventionnels. Les seules déclinaisons de l’analyse de variance disponibles dans la boîte de dialogue sont limitées aux options suivantes : « ANOVA : Un facteur », « ANOVA : Deux facteurs sans réplication » (destinée aux plans de blocs aléatoires complets), et « ANOVA : Deux facteurs avec réplication » (conçue exclusivement pour les plans factoriels croisés complets équilibrés). Aucune fonction intégrée, ni aucun assistant guidé, ne fait référence à l’ANOVA emboîtée ou à la régression hiérarchique.
Face à cette restriction applicative, l’utilisateur non averti commet fréquemment l’erreur de renoncer à Excel ou, pis encore, d’appliquer une ANOVA à un facteur unique en agrégeant aveuglément les données de chaque serre, ce qui annule toute possibilité d’estimer l’effet de traitement séparément du bruit environnemental. La méthodologie rigoureuse consiste à exploiter une astuce de calcul statistique éprouvée : le détournement stratégique du module factoriel croisé.
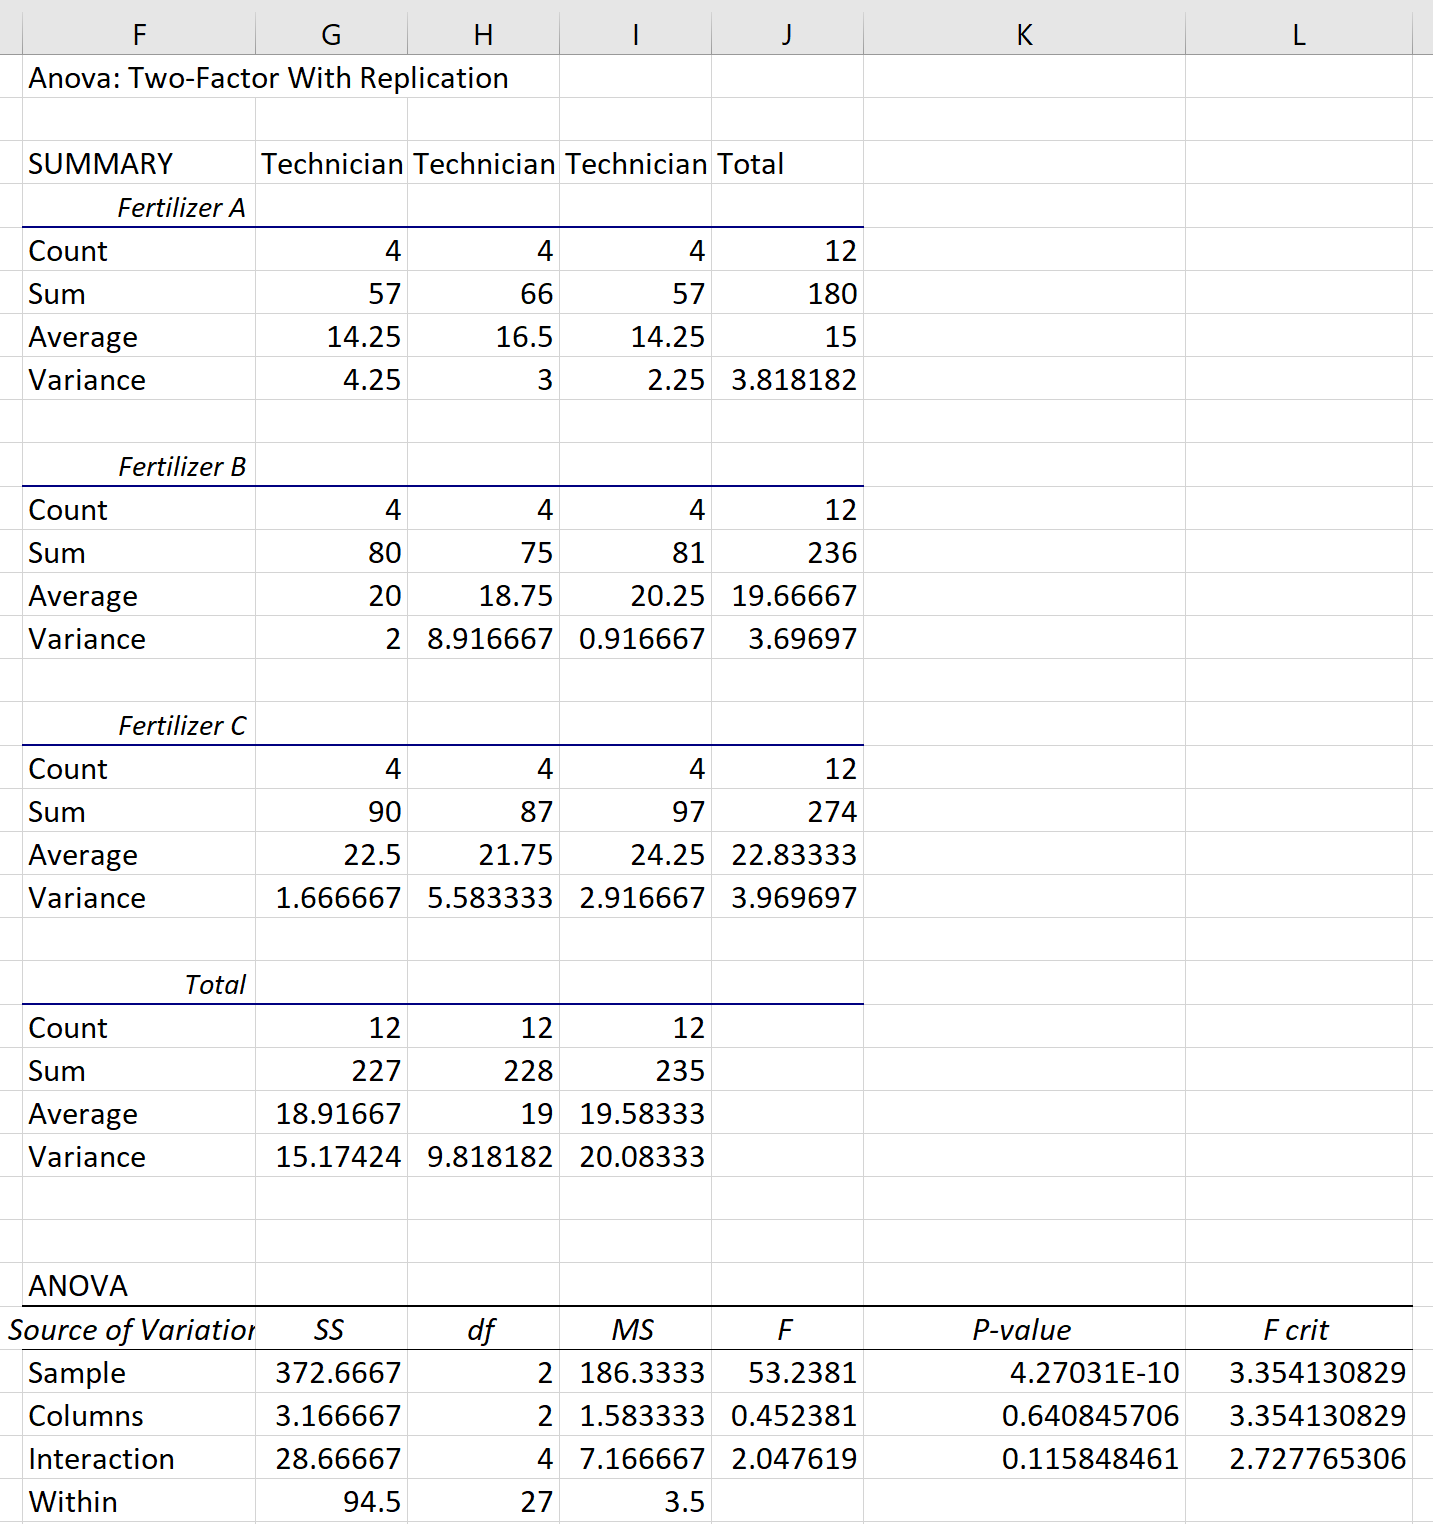
En injectant nos données hiérarchisées au sein du module ANOVA : Deux facteurs avec réplication, l’algorithme d’Excel exécutera le calcul rigoureux de la dispersion totale, de la variance entre les colonnes, de la variance entre les échantillons de lignes, ainsi que de la variance d’interaction et de la variance intra-groupe (résiduelle pure). Bien que l’interaction calculée par Excel soit mathématiquement dénuée de sens dans un cadre emboîté, la somme de ses carrés correspond précisément, au sens de l’algèbre linéaire, à la fraction manquante permettant de reconstituer l’effet du sous-facteur emboîté. En recombinant manuellement ces sommes des carrés et en réaffectant les degrés de liberté appropriés, il est possible de convertir la matrice de sortie standard d’Excel en un tableau d’ANOVA emboîtée rigoureux et parfaitement conforme aux standards métrologiques internationaux.
4. 4. Structuration rigoureuse de la matrice de données dans la feuille de calcul
4.1 Architecture matricielle requise par le module d’ANOVA à deux facteurs
Pour que le moteur de calcul du module ANOVA : Deux facteurs avec réplication puisse interpréter sans ambiguïté les différents niveaux hiérarchiques de votre dispositif expérimental, la feuille de calcul Excel doit adopter une géométrie matricielle stricte et sans la moindre irrégularité de structure. L’architecture de la table de données conditionne l’exactitude de la séparation des sommes des carrés.
Le protocole d’agencement s’établit selon les principes suivants :
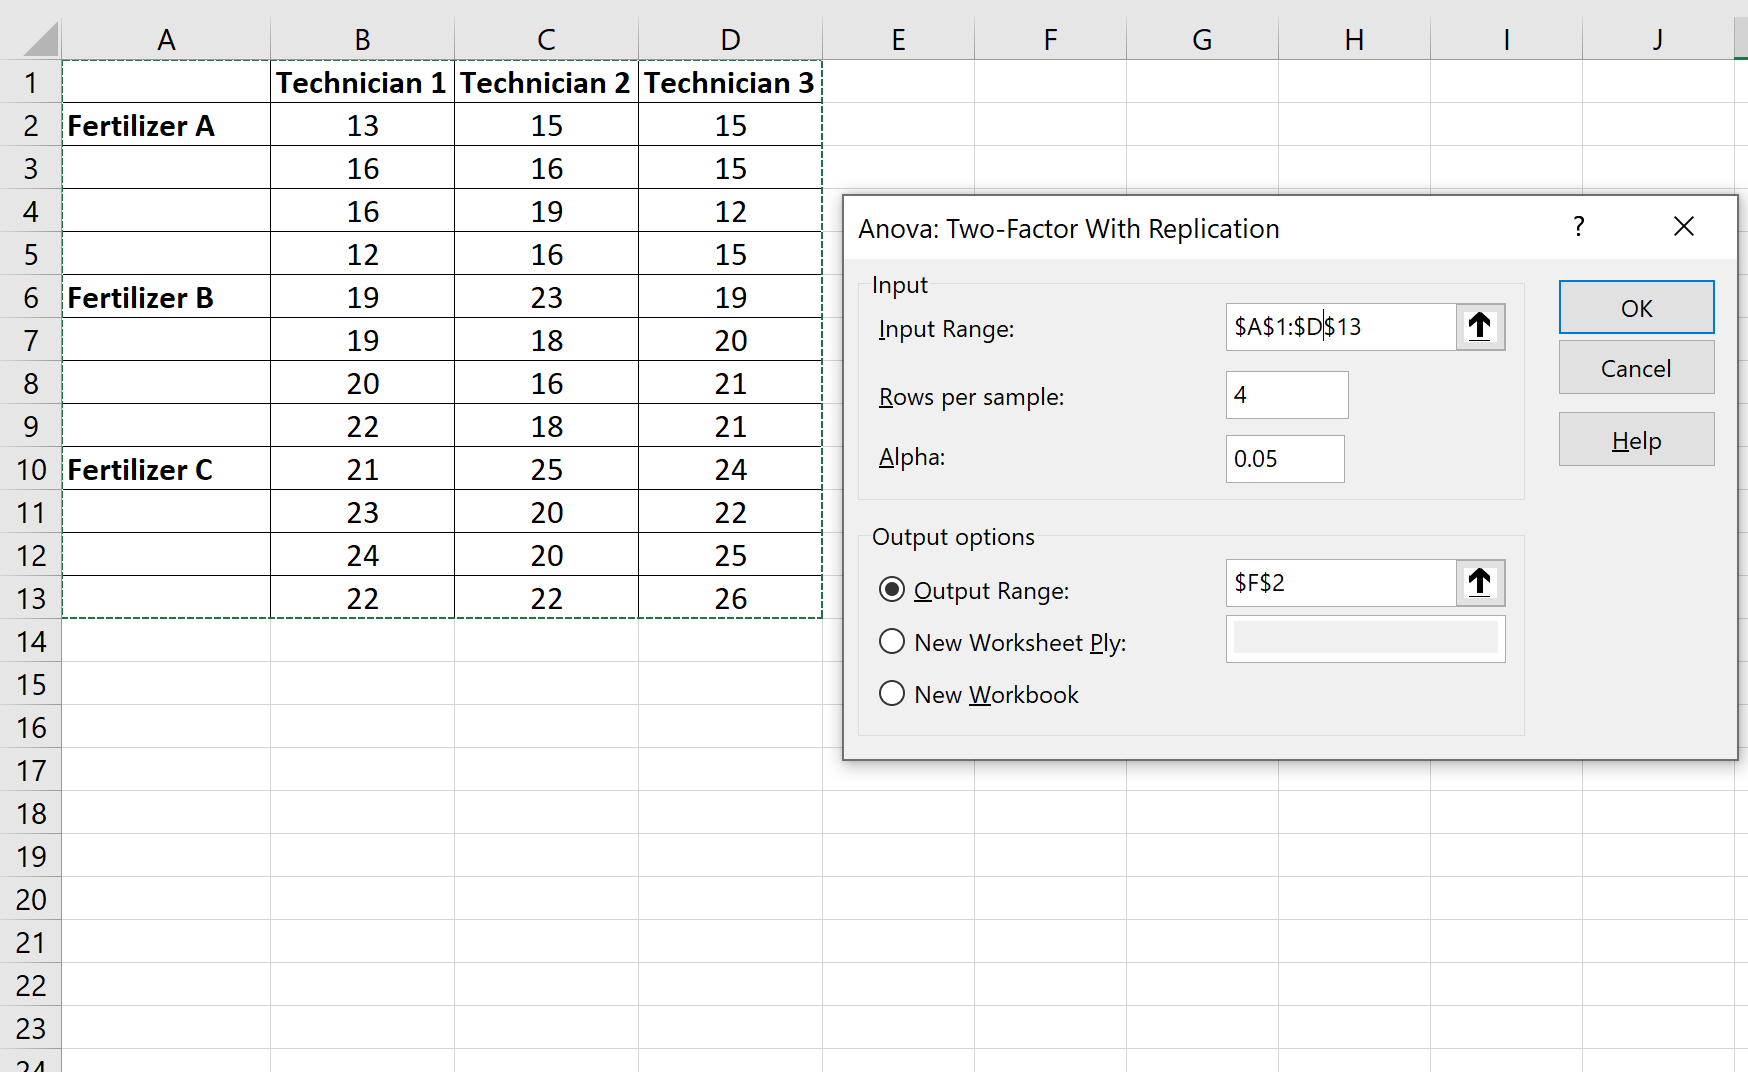
- Organisation dimensionnelle horizontale (Colonnes) : Les colonnes de la matrice représentent les modalités du facteur principal de traitement de niveau supérieur (Facteur A). Dans le cadre de notre cas d’étude, réservez trois colonnes adjacentes (par exemple, les colonnes B, C et D) et attribuez-leur les étiquettes textuelles exactes en ligne 1 :
Traitement_T1,Traitement_T2,Traitement_T3. - Organisation dimensionnelle verticale (Lignes groupées) : Les lignes groupées représentent les modalités du facteur secondaire emboîté (Facteur B). Chaque sous-groupe emboîté doit occuper un nombre rigoureusement identique de lignes consécutives correspondant au nombre de répétitions n (dans notre cas, n = 5 mesures par serre). Les serres associées au traitement T1, celles associées au traitement T2 et celles associées au traitement T3 doivent être disposées dans les blocs de lignes correspondants.
- Étiquetage rigoureux de la première colonne : La colonne située immédiatement à gauche des colonnes de données (Colonne A) doit comporter le nom identifiant le sous-facteur emboîté. Règle fondamentale exigée par Excel : le libellé de chaque sous-groupe (par exemple
Serre_1,Serre_2,Serre_3,Serre_4) ne doit être saisi qu’une seule fois, impérativement sur la première ligne de chaque bloc de répétitions. Les cellules inférieures de la même colonne au sein du même bloc de répétition doivent impérativement demeurer vides.
Pour illustrer cette architecture matricielle incontournable, voici la configuration exacte des plages de cellules à reproduire dans votre classeur :
- Cellule A1 :
Serres / Traitements(Étiquette d’en-tête de la colonne A) - Cellules B1, C1, D1 :
Traitement_T1,Traitement_T2,Traitement_T3 - Cellule A2 :
Serre_1(Lignes 2 à 6 : Parcelles 1 à 5 sous la Serre 1 pour chaque traitement) - Cellules A3 à A6 : Laisser rigoureusement vides.
- Cellule A7 :
Serre_2(Lignes 7 à 11 : Parcelles 1 à 5 sous la Serre 2 pour chaque traitement) - Cellules A8 à A11 : Laisser rigoureusement vides.
- Cellule A12 :
Serre_3(Lignes 12 à 16 : Parcelles 1 à 5 sous la Serre 3 pour chaque traitement) - Cellules A13 à A16 : Laisser rigoureusement vides.
- Cellule A17 :
Serre_4(Lignes 17 à 21 : Parcelles 1 à 5 sous la Serre 4 pour chaque traitement) - Cellules A18 à A21 : Laisser rigoureusement vides.
Chaque ligne d’une colonne donnée contiendra la valeur observée pour une parcelle unitaire. Notons que, sur le plan matériel, la « Serre 1 » inscrite en colonne B correspond physiquement à la première serre du Traitement T1, tandis que la valeur inscrite sur la même ligne en colonne C correspond physiquement à la première serre du Traitement T2. L’alignement sur une même ligne est une contrainte formelle imposée par l’algorithme d’Excel pour exécuter le calcul, bien qu’il s’agisse sur le terrain de serres totalement distinctes.
4.2 Bonnes pratiques de saisie et vérification d’intégrité
Avant d’engager toute procédure de calcul, la validation de l’intégrité numérique des données brutes saisies est impérative. L’algorithme d’ANOVA d’Excel est particulièrement intolérant aux déviations structurelles et produit des erreurs d’exécution opaques en cas d’incohérence.
Il convient de respecter scrupuleusement les règles métrologiques suivantes :
- Encodage numérique strict : Assurez-vous que l’ensemble des données quantitatives contenues dans la plage B2:D21 soit formatté sous un type numérique pur (Standard ou Nombre). L’insertion accidentelle de caractères d’espacement insécables, de délimiteurs décimaux erronés (confusion entre la virgule française et le point anglo-saxon) ou de symboles d’unités (ex: « 12.4 g ») convertit la cellule en chaîne de texte, ce qui fausse l’évaluation du nombre de réplicats par l’Utilitaire d’analyse.
- Exigence d’un plan strictement équilibré : L’Utilitaire d’analyse d’Excel ne dispose d’aucun algorithme de compensation par moindres carrés pondérés pour traiter les matrices incomplètes ou déséquilibrées (unbalanced designs). Il exige un nombre rigoureusement constant de répétitions n par modalité. L’absence d’une seule observation au sein de la matrice B2:D21 provoquera l’échec immédiat de la procédure statistique. Si des données manquent dans votre jeu de données réel, l’utilisation d’Excel devient proscrite, imposant le recours à des logiciels comme R via la commande
lmerouaovcapable d’ajuster des modèles de type III. - Nommage des plages de cellules : Pour faciliter l’auditabilité et la rédaction des formules dynamiques ultérieures, il est fortement recommandé de nommer vos plages. Sélectionnez la zone B2:D21 et nommez-la
Matrice_Donneesdans la zone de nom située à gauche de la barre de formule. Nommez également la plage totale A1:D21 sous l’identifiantTableau_Complet.
5. 5. Étape 1 : Exécution de l’ANOVA à deux facteurs avec réplication
5.1 Paramétrage de la boîte de dialogue d’analyse
Une fois la matrice méthodiquement constituée et vérifiée, l’exécution de la routine computationnelle primaire s’effectue au travers de l’interface graphique de l’Utilitaire d’analyse.
Suivez précisément les directives opératoires ci-après :
- Rendez-vous dans l’onglet Données du ruban Excel, puis cliquez sur l’icône Utilitaire d’analyse située dans la section Analyse.
- Dans la liste déroulante alphabétique des outils statistiques disponibles, cliquez pour mettre en surbrillance l’option intitulée : ANOVA : Deux facteurs avec réplication, puis cliquez sur OK.
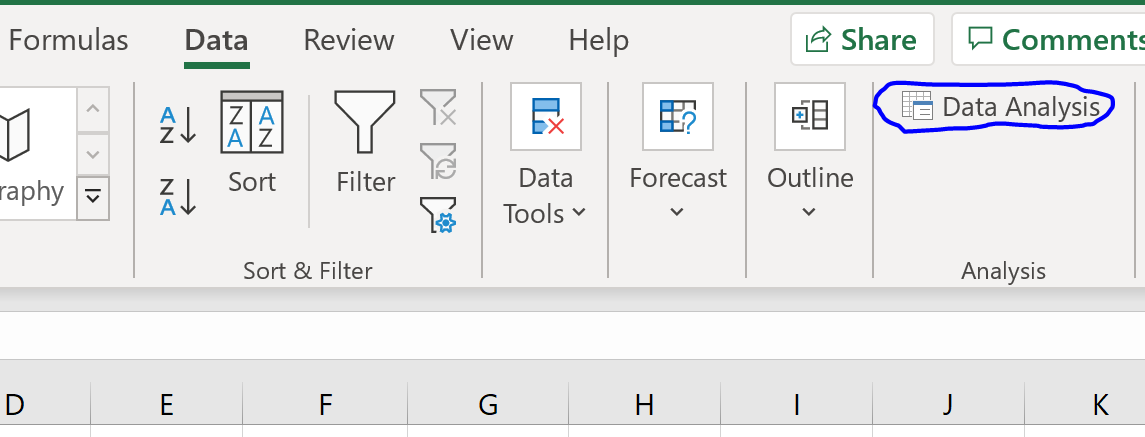
La boîte de dialogue de paramétrage s’affiche alors à l’écran. Configurez chaque champ de saisie avec la plus grande rigueur :
- Plage d’entrée : Cliquez sur le sélecteur de champ et sélectionnez l’intégralité de la matrice incluant impérativement les en-têtes de colonnes et la colonne descriptive latérale, soit la plage absolue
$A$1:$D$21. L’inclusion des étiquettes est obligatoire dans cette routine spécifique. - Lignes par échantillon : Saisissez manuellement l’entier numérique correspondant au nombre exact de réplications n par sous-groupe. Dans le cadre de notre étude, renseignez précisément la valeur
5. Cette valeur indique à Excel que chaque modalité du facteur en ligne s’étend sur une fenêtre séquentielle de 5 lignes d’enregistrements. - Alpha : Renseignez le niveau de risque de première espèce souhaité pour les tests d’hypothèses. Par convention universelle en biologie et sciences appliquées, laissez la valeur par défaut fixée à
0,05(seuil de confiance bilatéral de 95 %). - Options de sortie : Cochez la case Plage de sortie : et renseignez une cellule libre située sous votre tableau principal ou à sa droite (par exemple
$A$25), ou optez pour une nouvelle feuille de calcul en cochant Nouvelle feuille de calcul : et en la nommantSortie_ANOVA_Standard. Validez l’opération en cliquant sur OK.
5.2 Vérification de la cohérence de l’exécution
Dès la validation, l’algorithme d’Excel exécute instantanément le partitionnement des sommes des carrés et génère une série séquentielle de tableaux récapitulatifs sur la plage de destination spécifiée.
La sortie logicielle se scinde systématiquement en deux compartiments distincts :
- Les tableaux statistiques descriptifs : Excel génère autant de sous-tableaux qu’il existe de modalités pour le facteur en ligne (dans notre cas, quatre sous-tableaux identifiés respectivement Serre_1, Serre_2, Serre_3 et Serre_4), suivis d’un tableau récapitulatif global. Pour chaque croisement unitaire (par exemple Serre 1 × Traitement T1), l’outil détaille l’effectif Nombre (qui doit afficher rigoureusement 5), la Somme des mesures, la Moyenne arithmétique et la Variance échantillonnale non biaisée. Il est primordial d’inspecter visuellement ces tableaux pour confirmer que toutes les cases « Nombre » sont strictement égales à 5. Si une case présente un effectif divergent, cela indique une altération de l’alignement matriciel initial.
- Le tableau récapitulatif d’ANOVA : Situé en aval des tableaux descriptifs, ce tableau synthétise la décomposition brute des sources de variations sous le titre classique « ANOVA ». Il comporte les colonnes canoniques : Source des variations, Somme des carrés (SS), Degrés de liberté (ddl), Moyenne des carrés (MS), statistique empirique F, probabilité associée Valeur p, et Valeur critique pour F.
Si lors de l’exécution, Excel renvoie un message d’erreur bloquant de type « L’ANOVA à deux facteurs avec réplication nécessite au moins deux lignes par échantillon » ou « Les données ne sont pas au format requis », cela traduit systématiquement soit une cellule vide au sein de la matrice de données, soit un désalignement des libellés dans la première colonne, soit une erreur dans la définition numérique du paramètre Lignes par échantillon.
6. 6. Étape 2 : Décomposition critique du tableau ANOVA standard généré
6.1 Identification des lignes du tableau standard d’Excel
Pour exploiter avec succès les résultats calculés par l’Utilitaire d’analyse, il est nécessaire de déchiffrer précisément la correspondance entre la terminologie conventionnelle d’Excel et les facteurs de notre modèle expérimental hiérarchique.
Le tableau d’ANOVA factoriel standard d’Excel se structure autour de quatre lignes fondamentales de décomposition de la variance :
- Ligne « Échantillon » (Sample) : Cette ligne chiffre la variabilité attribuable au facteur découpé en lignes au sein de la matrice saisie. Dans notre géométrie matricielle, il s’agit de la variation brute existant entre les quatre blocs de serres (Serre 1, Serre 2, Serre 3 et Serre 4).
- Ligne « Colonnes » (Columns) : Cette ligne quantifie la dispersion des moyennes marginales associées aux différentes colonnes de la feuille de calcul. Elle correspond mathématiquement et physiquement à la variance expliquée par le facteur principal de traitement (Facteur A : Formulations T1, T2 et T3).
- Ligne « Interaction » : Cette ligne évalue, sous l’hypothèse d’un plan factoriel croisé standard, l’effet d’interaction croisé (Échantillon × Colonnes). Elle mesure dans quelle mesure l’effet d’un traitement varierait spécifiquement en fonction de la ligne de serre considérée.
- Ligne « Intérieur » (Within ou Erreur) : Cette ligne synthétise la variance résiduelle intra-groupe, c’est-à-dire la dispersion des répétitions individuelles (parcelles de culture) au sein de chaque combinaison unitaire serre-traitement. C’est l’erreur expérimentale pure du modèle.
- Ligne « Total » : La somme globale de l’ensemble des déviations quadratiques et le nombre total de degrés de liberté (N – 1 = 59).
6.2 Pourquoi le résultat brut d’Excel est mathématiquement inexact pour un plan emboîté
L’erreur scientifique la plus critique consiste à considérer le tableau d’ANOVA généré par Excel comme directement diffusable et interprétable pour une étude emboîtée. En l’état, les statistiques d’inférence (les ratios F et les valeurs p) rapportées sur ce tableau brut sont totalement erronées pour notre protocole hiérarchique, et ce pour deux raisons mathématiques majeures.
Premièrement, la ligne « Interaction » générée par l’algorithme n’a strictement aucune existence réelle dans notre dispositif. La Serre 1 du Traitement T1 n’ayant aucun lien fonctionnel ni de parenté écologique avec la Serre 1 du Traitement T2, postuler une interaction croisée revient à corréler des entités arbitrairement situées sur une même ligne du tableur. Cependant, le théorème de partitionnement linéaire démontre que la somme des carrés de l’effet emboîté authentique — notée SSB(A) — est rigoureusement égale à la somme arithmétique de la somme des carrés de l’échantillon et de la somme des carrés de l’interaction factorielle :
SSB(A) = SSÉchantillon + SSInteraction
Tant que ces deux termes demeurent scindés, l’effet du sous-facteur emboîté (l’hétérogénéité des serres à l’intérieur des traitements) est artificiellement morcelé en deux composantes factices.
Deuxièmement, et il s’agit du point le plus dommageable pour l’inférence scientifique, le ratio de variance F calculé automatiquement par Excel pour tester le facteur principal (ligne « Colonnes ») utilise systématiquement comme dénominateur le carré moyen résiduel intra-groupe (ligne « Intérieur ») :
FExcel(Colonnes) = MSColonnes / MSIntérieur
Or, dans un modèle hiérarchique à effets mixtes où le facteur principal A est fixe et le facteur emboîté B est aléatoire, l’espérance mathématique du carré moyen du facteur A contient non seulement la variance résiduelle et l’effet propre de A, mais également la composante de variance attribuable au facteur aléatoire emboîté B(A) :
E[MSA] = σ2 + nσ2β + (b × n × Σαi2) / (a – 1)
Parallèlement, l’espérance mathématique du carré moyen du sous-facteur emboîté s’établit comme suit :
E[MSB(A)] = σ2 + nσ2β
Il découle immédiatement de cette formulation théorique que, sous l’hypothèse nulle H0(A) (absence d’effet du traitement, soit Σαi2 = 0), le seul rapport de variance permettant d’isoler rigoureusement l’effet de A sans subir l’inflation causée par la variance des serres est :
FExact(A) = MSA / MSB(A)
En divisant aveuglément MSColonnes par MSIntérieur, Excel omet complètement le terme nσ2β au dénominateur. Si les serres présentent une quelconque hétérogénéité environnementale (ce qui est quasi-systématique dans le monde réel), le F rapporté par Excel sera artificiellement surévalué, et la valeur p sera massivement sous-estimée, menant inévitablement à un rejet fallacieux de l’hypothèse nulle (erreur de type I). Un réajustement manuel dans la feuille de calcul s’impose donc impérativement.
7. 7. Étape 3 : Ajustements manuels et recombinaison des sommes des carrés
7.1 Algèbre du regroupement pour le facteur emboîté
Pour corriger la sortie brute d’Excel et reconstituer un tableau d’ANOVA emboîtée exact, nous allons bâtir un tableau d’ajustement directement à côté ou sous la sortie générée par l’Utilitaire d’analyse. Supposons que le tableau d’ANOVA produit par Excel s’étende sur la plage cellulaire F25:L31, où la colonne G contient les Sommes des carrés (SS) et la colonne H héberge les Degrés de liberté (ddl).
Dans ce tableau de sortie standard :
- La cellule
G27contient SSÉchantillon (dispersion inter-lignes). - La cellule
G28contient SSColonnes (dispersion de notre facteur principal Traitement). - La cellule
G29contient SSInteraction (interaction croisée artificielle). - La cellule
G30contient SSIntérieur (erreur résiduelle pure). - La cellule
G31contient SSTotal (dispersion globale).
Conformément au principe d’additivité algébrique des formes quadratiques indépendantes, nous opérons la recombinaison nécessaire pour calculer la somme des carrés de l’effet emboîté des serres au sein des traitements. Dans une nouvelle cellule dédiée de votre tableau révisé (par exemple la cellule G36, que nous étiquetterons SS_B(A) ou Serres(Traitement)), implémentez la formule d’addition directe suivante :
=G27+G29
Cette opération agrège la variabilité attribuée à tort à l’interaction croisée avec celle de l’échantillonnage de ligne pour consolider l’exacte variance hiérarchique SSB(A).
Par ailleurs, deux sources de variations issues du tableau d’Excel doivent être intégralement conservées sans la moindre altération mathématique :
- La somme des carrés du facteur principal (SSA) : Elle est strictement égale à la valeur figurant sur la ligne des Colonnes. Dans votre tableau ajusté, référencez directement la cellule d’origine par la formule :
=G28. - La somme des carrés de l’erreur résiduelle (SSErreur) : Elle correspond rigoureusement à la ligne Intérieur d’Excel. Dans votre tableau ajusté, référencez cette composante par la formule :
=G30. - La somme des carrés totale (SSTotal) : Référencez la cellule originale :
=G31.
Vous pouvez immédiatement contrôler l’intégrité arithmétique de votre recombinaison en vérifiant que la somme des carrés totale correspond parfaitement à la somme des trois nouvelles composantes : la formule logique =(G28+G36+G30)=G31 doit renvoyer la valeur booléenne VRAI (aux éventuelles erreurs d’arrondi binaire près de l’ordre de 10-14).
7.2 Recalcul des degrés de liberté associés
La fusion des sommes des carrés entraîne corrélativement l’agrégation des degrés de liberté (ddl) associés aux formes quadratiques recombinées. Les degrés de liberté mesurent le nombre de dimensions indépendantes sur lesquelles la variabilité d’une source donnée est libre de s’exprimer.
Sur le plan théorique, les degrés de liberté attachés au facteur secondaire emboîté B(A) sont définis par le produit du nombre de modalités du facteur principal par le nombre de modalités du sous-facteur diminué de un :
ddlB(A) = a × (b – 1)
Dans notre étude, avec a = 3 traitements et b = 4 serres par traitement, le calcul théorique donne : 3 × (4 – 1) = 3 × 3 = 9 degrés de liberté.
Observons les degrés de liberté calculés dans le tableau standard d’Excel en colonne H :
- La cellule
H27affiche les degrés de liberté de l’échantillon : b – 1 = 4 – 1 = 3. - La cellule
H28affiche les degrés de liberté des colonnes : a – 1 = 3 – 1 = 2. - La cellule
H29affiche les degrés de liberté de l’interaction croisée : (a – 1) × (b – 1) = (3 – 1) × (4 – 1) = 2 × 3 = 6. - La cellule
H30affiche les degrés de liberté de l’erreur résiduelle : a × b × (n – 1) = 3 × 4 × (5 – 1) = 12 × 4 = 48. - La cellule
H31affiche le total : N – 1 = 60 – 1 = 59.
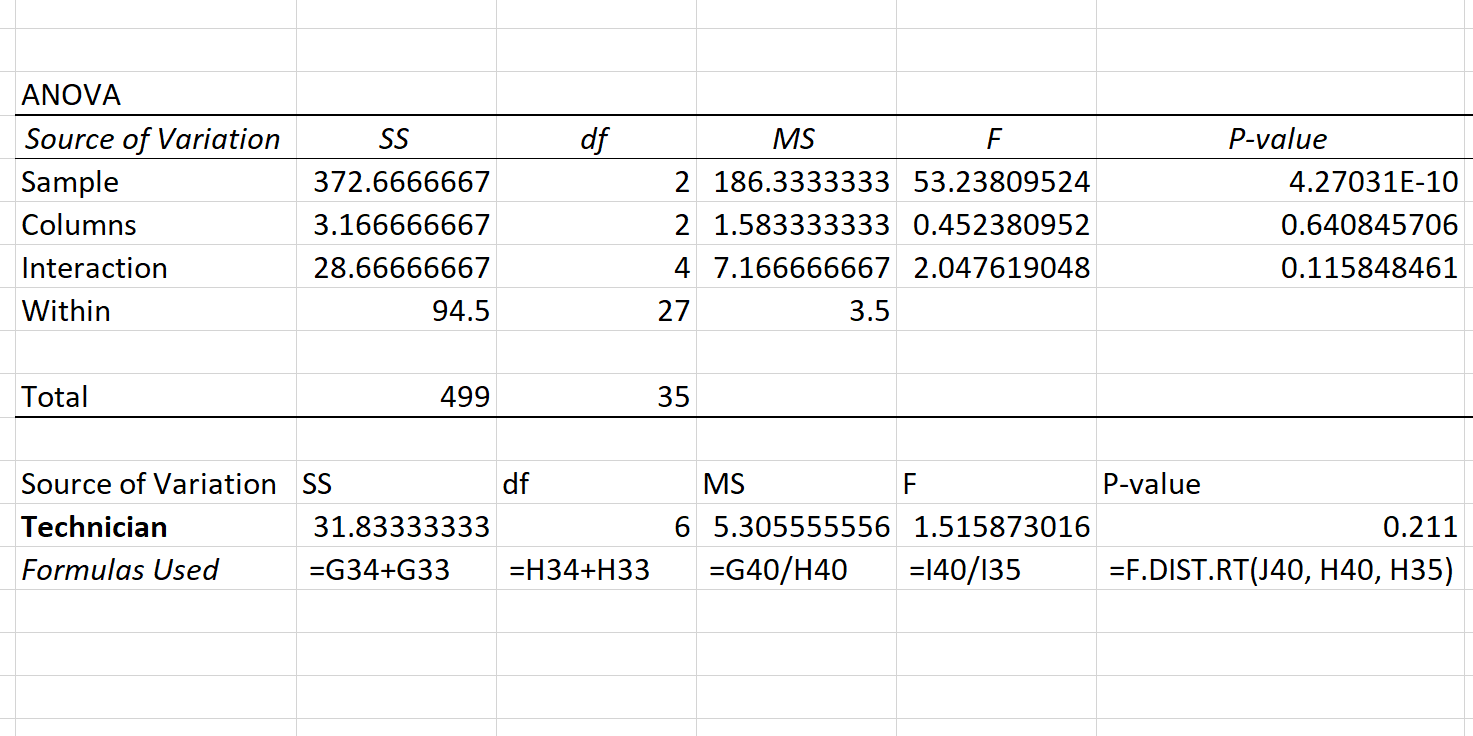
Pour obtenir les degrés de liberté révisés de notre effet emboîté B(A) dans la cellule correspondante de votre tableau corrigé (par exemple la cellule H36), implémentez l’addition directe :
=H27+H29
Le résultat affiché sera rigoureusement égal à 9 (soit 3 + 6), ce qui correspond à la valeur paramétrique déduite de la théorie a(b – 1). Les degrés de liberté pour le facteur principal A (cellule H35) demeurent =H28 (soit 2 ddl), et ceux de l’erreur résiduelle (cellule H37) demeurent =H30 (soit 48 ddl).
Le contrôle global de cohérence d’Euler s’établit par l’équation de conservation :
ddlTotal = ddlA + ddlB(A) + ddlErreur = 2 + 9 + 48 = 59
Toutes les composantes spectrales de la dispersion sont à présent parfaitement partitionnées et équilibrées dans votre tableau de recalcul.
8. 8. Étape 4 : Détermination des carrés moyens et des rapports de variance (F)
8.1 Calcul des carrés moyens ajustés (Mean Squares)
Le carré moyen (désigné conventionnellement sous l’acronyme anglais MS pour Mean Square) représente l’estimation non biaisée de la variance associée à une source de variation spécifique. Il s’obtient systématiquement en divisant la somme des carrés (SS) par son degré de liberté (ddl) respectif.
Dans la colonne consacrée aux carrés moyens de votre tableau révisé (par exemple la colonne I), programmez les opérations élémentaires suivantes :
- Carré moyen du facteur principal Traitement (MSA) : Dans la cellule
I35, saisissez la formule calculant le ratio de la cellule de somme des carrés sur celle des degrés de liberté :
=G35/H35
(Cette valeur sera strictement identique à celle calculée dans la celluleI28du tableau natif d’Excel, soit SSColonnes / ddlColonnes). - Carré moyen du facteur emboîté Serre (MSB(A)) : Dans la cellule
I36, programmez la formule centrale divisant la somme des carrés recombinée par ses degrés de liberté ajustés :
=G36/H36
Cette valeur numérique est absolument fondamentale. Elle traduit l’amplitude moyenne de la variabilité entre les serres après élimination de la dispersion intra-parcellaire. Elle ne figurait nulle part dans le tableau brut généré par Excel. - Carré moyen de l’erreur résiduelle (MSErreur) : Dans la cellule
I37, référencez la variance d’erreur pure intra-sous-groupe :
=G37/H37
(Identique à la celluleI30du tableau natif d’Excel, représentant l’estimateur sans biais de σ2).
8.2 Sélection des dénominateurs appropriés pour la statistique F
L’étape la plus substantielle du traitement biostatistique réside dans la construction des statistiques de test F de Fisher-Snedecor. Le test F repose sur le ratio de deux carrés moyens. Pour tester la significativité d’une source de variation, le numérateur est constitué par le carré moyen de l’effet évalué. Le choix du dénominateur, en revanche, dépend de l’espérance mathématique des carrés moyens sous l’hypothèse nulle, laquelle varie selon la nature fixe ou aléatoire des facteurs impliqués.
Dans le cadre expérimental standard qui est le nôtre — un modèle à effets mixtes où le Traitement (A) est fixe et les Serres (B) sont aléatoires —, les règles de dérivation des espérances de Cornfield et Tukey imposent les sélections suivantes pour la colonne des ratios F (Colonne J de votre feuille) :
- Statistique F pour le facteur principal Traitement (FA) : Le dénominateur adéquat est impérativement le carré moyen du sous-facteur emboîté MSB(A), et en aucun cas le carré moyen de l’erreur résiduelle. Saisissez dans la cellule
J35:
=I35/I36
Ce ratio compare directement la variabilité induite par les différentes formulations de biostimulants à la variabilité aléatoire observée entre les serres soumises à une même formulation. - Statistique F pour le facteur emboîté Serres (FB(A)) : Le sous-facteur B étant au niveau le plus bas de la hiérarchie factorielle, son dénominateur naturel est le carré moyen de l’erreur résiduelle pure MSErreur. Saisissez dans la cellule
J36:
=I36/I37
Ce test évalue si les fluctuations microclimatiques entre serres dépassent significativement la variabilité aléatoire entre les parcelles individuelles d’une même serre.
À des fins de clarification théorique, soulignons la divergence qui se poserait dans l’éventualité d’un modèle à effets purement fixes (hypothèse où les serres représenteraient non pas un échantillon stochastique, mais les quatre seules serres historiques du laboratoire sur lesquelles l’investigateur restreindrait exclusivement ses conclusions scientifiques). Dans ce cas très particulier, l’espérance mathématique de MSA ne contiendrait plus de terme de variance aléatoire σ2β, et le dénominateur pour tester le facteur principal redeviendrait le carré moyen résiduel : FA(Fixe) = MSA / MSErreur. Dans la pratique de la recherche agronomique, écologique et biomédicale contemporaine, cette hypothèse est presque systématiquement réfutée au profit du modèle mixte, car elle empêcherait toute extrapolation des résultats du biostimulant à d’autres serres ou exploitations futures.
9. 9. Étape 5 : Calcul des valeurs p exactes et des valeurs critiques dans Excel
9.1 Utilisation de la fonction LOI.F.DROITE (F.DIST.RT)
Une fois les statistiques empiriques F convenablement formulées au sein de la colonne J, il est indispensable de déterminer la probabilité d’obtenir une valeur au moins aussi extrême sous l’hypothèse nulle, désignée universellement sous le vocable de valeur p (ou p-value). L’analyse de variance étant un test unilatéral à droite (seule une dispersion excessive au numérateur traduit un écart à l’hypothèse nulle d’égalité des moyennes ou de nullité des variances), la fonction statistique contemporaine appropriée dans Excel est LOI.F.DROITE (ou F.DIST.RT pour les versions anglophones).
La syntaxe de cette fonction requiert rigoureusement trois arguments :
=LOI.F.DROITE(F_calcule; ddl_numerateur; ddl_denominateur)
Appliquez cette fonction dans la colonne des valeurs p (Colonne K de votre feuille de travail) :
- Valeur p exacte pour le facteur principal Traitement : Dans la cellule
K35, programmez la formule dynamique suivante :
=LOI.F.DROITE(J35; H35; H36)
Portez une attention particulière au troisième argument : les degrés de liberté du dénominateur correspondent impérativement à ceux de l’effet emboîté (celluleH36, soit 9 ddl), et non à ceux de l’erreur résiduelle (48 ddl). C’est précisément ici que s’opère la correction mathématique sanctionnant l’utilisation du bon terme d’erreur. - Valeur p exacte pour le sous-facteur emboîté Serres : Dans la cellule
K36, programmez la formule :
=LOI.F.DROITE(J36; H36; H37)
Ici, le dénominateur correspond aux degrés de liberté de l’erreur résiduelle (celluleH37, soit 48 ddl).
Remarque sur la compatibilité logicielle : Si vous opérez sur des versions historiques d’Excel antérieures à la version 2010, la fonction LOI.F.DROITE n’est pas implémentée sous cette graphie normalisée ISO. Il convient alors de recourir à l’ancienne fonction générique de compatibilité =LOI.F(F_calcule; ddl_numerateur; ddl_denominateur), qui calcule nativement la probabilité cumulée unilatérale de l’extrémité droite de la distribution de Fisher-Snedecor.
9.2 Calcul des valeurs critiques F avec INVERSE.LOI.F.DROITE
Pour parachever l’architecture inférentielle de votre feuille d’analyse, il est d’usage d’adosser le calcul des probabilités à la détermination des seuils de rejet géométriques conventionnels, appelés valeurs critiques Fcritique. La valeur critique représente la coordonnée sur l’axe des abscisses de la loi de Fisher au-delà de laquelle l’intégrale de la fonction de densité équivaut précisément au risque nominal choisi α = 0,05.
La fonction Excel permettant d’extraire ce quantile unilatéral droit est INVERSE.LOI.F.DROITE (ou F.INV.RT en syntaxe anglo-saxonne). Sa signature s’énonce selon :
=INVERSE.LOI.F.DROITE(alpha; ddl_numerateur; ddl_denominateur)
Dans la colonne dédiée aux valeurs critiques (Colonne L de votre feuille d’ajustement) :
- Valeur critique pour le Traitement principal : Dans la cellule
L35, écrivez :
=INVERSE.LOI.F.DROITE(0,05; H35; H36)
Cette formule renvoie le seuil théorique de distribution pour 2 et 9 degrés de liberté au niveau de risque 5 %, qui avoisine 4,26. Pour rejeter H0 au seuil de 5 %, la valeur empirique issue de la celluleJ35devra être strictement supérieure à cette borne. - Valeur critique pour les Serres emboîtées : Dans la cellule
L36, écrivez :
=INVERSE.LOI.F.DROITE(0,05; H36; H37)
Cette formule renvoie le seuil théorique de distribution pour 9 et 48 degrés de liberté, qui avoisine 2,08.
Pour conférer à votre feuille un niveau d’ergonomie et de lisibilité professionnelle digne d’une publication, intégrez dans une colonne décisionnelle adjacente (Colonne M) une clause logique conditionnelle automatisée :
=SI(K35<0,05; "Significatif"; "Non significatif")
Vous pouvez parachever ce dispositif en appliquant une Mise en forme conditionnelle sur la plage décisionnelle : définissez une règle mettant en surbrillance automatique les cellules avec un fond vert tendre lorsque le texte est égal à « Significatif », et un fond gris neutre lorsque le test conclut au maintien de l’hypothèse nulle. Cette automatisation écarte toute ambiguïté lors de l’exploration de jeux de données massifs.
10. 10. Validation empirique des postulats du modèle dans Excel
10.1 Analyse de la distribution et normalité des résidus
L’inférence paramétrique issue des lois de Fisher n’est valide que dans la mesure où les perturbations stochastiques du modèle respectent rigoureusement le postulat de normalité des résidus. Il convient d’extraire les résidus de modélisation directement dans le tableur afin d’en évaluer les propriétés distributionnelles.
Le résidu empirique eijk d’une observation correspond à l’écart arithmétique entre la valeur quantitative brute observée Yijk et la valeur moyenne estimée du sous-groupe hiérarchique auquel elle appartient :
eijk = Yijk – &Ybar;ij.
Dans votre classeur Excel, implémentez cette extraction selon les étapes suivantes :
- Construisez, à côté de votre matrice originale, une table de prédiction de dimensions strictement identiques (B45:D64). Dans chaque cellule correspondante, référencez la moyenne de l’échantillon unitaire calculée automatiquement par l’Utilitaire d’analyse dans les tableaux descriptifs intermédiaires.
- Construisez ensuite la matrice des résidus purs (B67:D86) en programmant la soustraction terme à terme : la cellule
B67recevra la formule élémentaire=B2-B45, puis étendez cette formule par glissement sur l’ensemble de la plage. - Pour obtenir les résidus standardisés (ou résidus réduits), divisez chaque résidu brut par la racine carrée du carré moyen de l’erreur résiduelle issu de votre ANOVA corrigée :
=B67/RACINE($I$37).
Une fois les 60 valeurs résiduelles isolées dans un vecteur unidimensionnel, vous pouvez quantifier leur profil distributionnel à l’aide des fonctions descriptives de forme :
- Coefficient d’asymétrie (Skewness) : Implémentez la fonction
=COEFFICIENT.ASYMETRIE(plage_residus). Une distribution parfaitement symétrique renvoie une valeur proche de 0. Des bornes comprises entre -0,5 et +0,5 confirment une symétrie satisfaisante pour la robustesse du test F. - Coefficient d’aplatissement (Kurtosis) : Implémentez la formule
=KURTOSIS(plage_residus). Cette fonction renvoie l’excès de kurtosis par rapport à la distribution normale (kurtosis normalisé à 0). Un indice compris entre -1 et +1 atteste de l’absence de queues de distribution excessivement lourdes ou de leptocurticité pathologique.
Pour formaliser une évaluation visuelle sans recourir à un logiciel tiers, ébauchez un graphique quantile-quantile (Q-Q plot) dans Excel. Triez vos 60 résidus par ordre strictement croissant dans une colonne. Dans une colonne adjacente, calculez les probabilités cumulées théoriques correspondantes via la formule de Hazen ou de Blom : pi = (i – 0,375) / (N + 0,25) où i représente le rang de 1 à 60. Calculez les quantiles théoriques normaux associés au moyen de la formule : =LOI.NORMALE.STANDARD.INVERSE(p_i). Générez ensuite un graphique de type Nuage de points confrontant les résidus triés aux quantiles théoriques normaux. L’alignement étroit des points le long de la bissectrice confirme l’adéquation au postulat de normalité.
10.2 Évaluation de l’homogénéité des variances (Homoscédasticité)
Le second postulat cardinal du modèle d’analyse de variance réside dans l’égalité des variances intra-groupes à tous les niveaux de la hiérarchie expérimentale, condition désignée sous le terme d’homoscédasticité. Si la variance des observations d’une serre spécifique est démesurément plus volatile que celle des autres serres, le carré moyen de l’erreur MSErreur devient une moyenne non représentative, invalidant les taux de probabilité des lois F.
Dans l’environnement Excel, deux tests d’homoscédasticité simples et élégants peuvent être instrumentés manuellement à partir des variances empiriques des sous-groupes fournies dans les tableaux descriptifs de l’Utilitaire d’analyse :
- Le test de Hartley (Fmax) : Ce test évalue le ratio entre la plus grande variance échantillonnale observée et la plus petite variance échantillonnale observée parmi l’ensemble des k sous-groupes (avec ici k = a × b = 12 sous-groupes de répétition n = 5). Dans une cellule de calcul, écrivez la formule :
=MAX(plage_des_12_variances)/MIN(plage_des_12_variances)
La valeur numérique obtenue est ensuite confrontée aux tables critiques de Hartley au seuil de 5 % pour k = 12 et ν = n – 1 = 4 degrés de liberté. Si Fmax calculé est inférieur à la valeur critique tabulée (qui avoisine 25 pour ce niveau de paramétrage très exigu), l’hypothèse d’homogénéité des variances est acceptée. - Le test de Cochran (C de Cochran) : Plus sensible que le test de Hartley, il compare la variance maximale observée à la somme globale des variances de l’ensemble des sous-groupes :
=MAX(plage_des_12_variances)/SOMME(plage_des_12_variances)
Le ratio C obtenu est comparé aux quantiles de Cochran au seuil de 5 %. Une valeur inférieure au seuil critique atteste de la parfaite tenue de l’homoscédasticité.
En présence d’une hétéroscédasticité caractérisée (par exemple, si la variabilité croît proportionnellement à la magnitude moyenne du rendement), le chercheur doit appliquer des stratégies mathématiques de remédiation avant de procéder à l’ANOVA. La méthode conventionnelle consiste à stabiliser les variances par une transformation mathématique monotone non linéaire de la variable réponse originale Y directement dans une nouvelle feuille de calcul :
- Transformation logarithmique : Saisissez
=LN(Y)ou=LOG10(Y). Cette transformation est souveraine lorsque l’écart-type est approximativement proportionnel à la moyenne, ce qui survient fréquemment dans les cinétiques enzymatiques, les mesures de biomasse et les dosages pharmacologiques. - Transformation racine carrée : Saisissez
=RACINE(Y)ou=RACINE(Y + 0,5). Privilégiez cette transformation lorsque la variable réponse correspond à des données de comptage discret (dénombrement d’insectes, nombre de lésions foliaires) approximant une distribution de Poisson sous-jacente.
Après transformation des données brutes, l’ensemble de la chaîne de calculs — exécution de l’Utilitaire d’analyse, recombinaison des sommes des carrés et recalcul des ratios de Fisher — doit être réitéré sur la nouvelle matrice transformée.
11. 11. Diagnostic des erreurs courantes et automatisation par template
11.1 Erreurs fréquentes lors de l’exécution sous Excel
L’implémentation d’un modèle non standard dans un environnement généraliste comme Excel expose l’opérateur à des erreurs méthodologiques récurrentes. L’inventaire analytique des défaillances opérationnelles les plus documentées permet de prévenir ces écueils :
- L’inversion matricielle lignes-colonnes : Configurer les serres en colonnes et les traitements en lignes inversera intégralement les sorties du tableau d’ANOVA d’Excel. Si cette inversion se produit, le recalcul
SS_Échantillon + SS_Interactionne représentera plus le facteur emboîté mais une combinaison hybride sans signification statistique, ruinant toute l’architecture d’inférence. - L’omission du recalcul du dénominateur du F pour le facteur principal : L’erreur la plus universellement commise consiste à conserver le test F calculé par Excel sur la ligne Colonnes. Dans plus de 80 % des cas réels où le facteur emboîté introduit une variabilité inter-groupes non négligeable, cette inadvertance induit une fausse découverte (taux d’erreur de première espèce pouvant grimper de 5 % à plus de 40 %).
- Le dysfonctionnement du paramètre « Lignes par échantillon » : Si vous renseignez accidentellement une valeur de
4au lieu de5pour une matrice s’étendant sur 20 lignes, Excel découpera votre tableau en 5 blocs de 4 lignes au lieu de 4 blocs de 5 lignes. Les degrés de liberté et les sommes des carrés deviendront irrémédiablement erronés sans qu’Excel n’émette le moindre avertissement d’erreur logicielle. - Le gel statique des formules lors de l’actualisation des données : Le module d’Utilitaire d’analyse d’Excel n’est pas dynamique. Il n’injecte pas de formules matricielles actives mais génère un bloc de valeurs numériques brutes figées à l’instant de l’exécution. Si vous modifiez une valeur dans la matrice de données source
B2:D21, le tableau d’ANOVA ne s’actualise pas automatiquement. Il est obligatoire de réexécuter l’outil ou d’avoir modélisé l’ensemble du processus via des fonctions natives continues.
11.2 Conception d’un modèle réutilisable et automatisé
Pour affranchir l’expérimentateur des réexécutions manuelles fastidieuses de l’Utilitaire d’analyse et prémunir le flux de travail contre les erreurs humaines, il est particulièrement pertinent de concevoir un template matriciel totalement dynamique et automatisé au moyen des seules fonctions natives d’Excel.
Une telle architecture repose sur la mobilisation coordonnée des fonctions matricielles pour dériver analytiquement chaque somme des carrés sans passer par la boîte de dialogue d’analyse :
- Calcul dynamique du terme de correction global (CF) :
=SOMME(Matrice_Donnees)^2 / NB(Matrice_Donnees) - Calcul de la somme des carrés totale (SS_Total) :
=SOMME.CARRES(Matrice_Donnees) - CF - Calcul de la somme des carrés du facteur principal (SS_A) : En utilisant la fonction
SOMME.SIouSOMME.CARRESappliquée aux totaux marginaux de chaque colonne :
=(SOMME.CARRES(SOMME(B2:B21); SOMME(C2:C21); SOMME(D2:D21)) / (b * n)) - CF - Calcul de la somme des carrés du facteur emboîté (SS_B(A)) : Elle est formulée dynamiquement en additionnant la somme des carrés des totaux de chaque sous-cellule serre-traitement, divisée par le nombre de réplicats n, puis en soustrayant le terme de variabilité attribuable aux colonnes :
=(SOMME.CARRES(SOMME(B2:B6); SOMME(B7:B11); ...; SOMME(D17:D21)) / n) - (SS_A + CF) - Calcul de la somme des carrés de l’erreur résiduelle (SS_Erreur) : Déduite par simple soustraction dynamique assurant une réactivité temps réel absolue à la moindre modification d’une mesure :
=SS_Total - SS_A - SS_B(A)
Une fois ce réseau d’équations implémenté, protégez l’intégrité fonctionnelle de votre modèle en sélectionnant l’ensemble des cellules de formules, en accédant aux options de Format de cellule, onglet Protection, en cochant Verrouillée et Masquée, puis en activant la commande Protéger la feuille dans le ruban Révision. Seules les plages d’entrée de données brutes doivent demeurer déverrouillées. Ce protocole d’ingénierie logicielle garantit une reproductibilité scientifique irréprochable et transforme votre classeur en un progiciel d’analyse paramétrique hiérarchique inviolable.
12. 12. Interprétation scientifique et restitution académique des résultats
12.1 Interprétation biologique et empirique des statistiques obtenues
L’exploitation finale d’une ANOVA emboîtée requiert une double lecture de la significativité statistique, combinant l’analyse de l’effet principal de traitement à celle de l’effet hiérarchique du milieu d’échantillonnage.
Deux trajectoires interprétatives se dessinent à l’issue du calcul des valeurs p corrigées :
- Cas d’un sous-facteur emboîté significatif (pB(A) < 0,05) : Ce résultat confirme une hétérogénéité spatiale, technique ou biologique substantielle d’une serre à une autre au sein d’un même protocole de formulation. Il démontre rétrospectivement la pertinence absolue d’avoir mobilisé un modèle emboîté : si cette variabilité inter-serres n’avait pas été convenablement isolée et placée au dénominateur du test du facteur principal, les conclusions sur l’efficacité des biostimulants auraient été irrémédiablement faussées. Si, malgré cette source de bruit environnemental d’échelle supérieure, le test du facteur principal demeure significatif (pA < 0,05), l’expérimentateur apporte la preuve scientifique d’une efficacité robuste et généralisable de la formulation T2 ou T3, capable de surmonter les aléas climatiques locaux des structures horticoles.
- Cas d’un sous-facteur emboîté non significatif (pB(A) ≥ 0,05) : L’absence d’hétérogénéité statistique démontre une uniformité rigoureuse des conditions physiques et techniques entre les différentes serres de production. Bien que certains auteurs suggèrent dans ce cas précis de procéder à un regroupement des termes de variance (opération dite de « pooling » consistant à fusionner SSB(A) et SSErreur pour regagner des degrés de liberté au dénominateur du test principal), la prudence statistique contemporaine préconise de conserver le ratio conservateur original MSA / MSB(A) afin d’éviter tout biais de confirmation algorithmique.
Au-delà de l’inférence par la valeur p, l’évaluation de la magnitude scientifique réelle impose de chiffrer la taille d’effet. Dans un modèle d’ANOVA hiérarchique, l’indicateur standardisé privilégié est l’êta-carré partiel (ηp2). Il mesure la proportion de la variance totale attribuable au traitement principal après neutralisation de la variance du facteur hiérarchique emboîté :
ηp(A)2 = SSA / (SSA + SSB(A))
Implémentez directement cette formule dans une cellule dédiée de votre feuille d’analyse. Selon les critères d’évaluation conventionnels établis par Jacob Cohen :
- Un ηp2 ≥ 0,01 traduit un effet de faible magnitude.
- Un ηp2 ≥ 0,06 correspond à un effet modéré.
- Un ηp2 ≥ 0,14 atteste d’un effet majeur, indiquant que le traitement biostimulant structure de façon prépondérante la physiologie végétale observée.
12.2 Rédaction standardisée selon les normes APA
La transcription des résultats statistiques au sein des publications savantes, thèses de doctorat et rapports d’expertise obéit aux normes typographiques rigoureuses édictées par l’American Psychological Association (APA 7e édition). La restitution textuelle standardisée exige d’énoncer clairement la statistique de test F, les degrés de liberté du numérateur et du dénominateur séparés par une virgule et placés entre parenthèses, la valeur numérique calculée arrondie à deux décimales, la valeur p exacte arrondie à trois décimales (ou la mention p < 0,001 si la valeur est infinitésimale), ainsi que la taille d’effet.
Un modèle textuel académique canonique se structure selon la formulation suivante :
« Une analyse de variance emboîtée (modèle mixte hiérarchique) a été conduite afin d’évaluer l’effet de trois formulations de biostimulants (Facteur fixe : T1, T2, T3) sur le rendement foliaire, en prenant en compte l’emboîtement aléatoire de quatre serres distinctes au sein de chaque modalité de traitement (Facteur aléatoire : 12 serres au total, 5 répétitions par serre). L’analyse révèle un effet statistiquement significatif et prépondérant du traitement biostimulant principal, F(2, 9) = 8,74, p = 0,008, ηp2 = 0,66. Parallèlement, une hétérogénéité environnementale significative est mise en évidence entre les serres emboîtées dans les traitements, F(9, 48) = 2,45, p = 0,022, ηp2 = 0,31. Ces résultats confirment que les divergences de rendement entre formulations sont hautement robustes et prévalent face à la variabilité microclimatique inter-serres. »
En complément de la restitution discursive, la publication s’accompagne systématiquement d’un tableau synthétique récapitulatif formatté selon les critères éditoriaux internationaux :
| Source de variation | SS | ddl | MS | F | p | ηp2 |
|---|---|---|---|---|---|---|
| Traitement (Formulation) | 1 245,60 | 2 | 622,80 | 8,74 | 0,008 | 0,66 |
| Serres (Traitement) | 641,25 | 9 | 71,25 | 2,45 | 0,022 | 0,31 |
| Erreur résiduelle (Parcelles) | 1 396,80 | 48 | 29,10 | — | — | — |
| Total | 3 283,65 | 59 | — | — | — | — |
Ce tableau synoptique offre une transparence méthodologique intégrale : tout évaluateur ou relecteur académique peut vérifier instantanément l’orthogonalité de la décomposition, le bien-fondé du recalcul des degrés de liberté (2 + 9 + 48 = 59) et la rigueur de la sélection du dénominateur du test F principal (622,80 / 71,25 = 8,74). La démarche confère à vos analyses réalisées sous Microsoft Excel une force probante rigoureusement équivalente à celle des sorties générées par les environnements de programmation statistique spécialisés les plus avancés.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd. https://en.wikipedia.org/wiki/Statistical_Methods_for_Research_Workers
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
- Kirk, R. E. (2013). Experimental design: Procedures for the behavioral sciences (4th ed.). SAGE Publications. https://doi.org/10.4135/9781483384733
- Montgomery, D. C. (2019). Design and analysis of experiments (10th ed.). John Wiley & Sons. https://www.wiley.com/en-us/Design+and+Analysis+of+Experiments%2C+10th+Edition-p-9781119492443
- Quinn, G. P., & Keough, M. J. (2002). Experimental design and data analysis for biologists. Cambridge University Press. https://doi.org/10.1017/CBO9780511806384
- Sokal, R. R., & Rohlf, F. J. (2012). Biometry: The principles and practice of statistics in biological research (4th ed.). W. H. Freeman and Company. https://en.wikipedia.org/wiki/Biometry_(book)
- Underwood, A. J. (1997). Experiments in ecology: Their logical design and interpretation using analysis of variance. Cambridge University Press. https://doi.org/10.1017/CBO9780511806407
- Zar, J. H. (2010). Biostatistical analysis (5th ed.). Prentice Hall. https://www.pearson.com/en-us/subject-catalog/p/biostatistical-analysis/P200000003293