
Dans le champ foisonnant de l’analyse quantitative et des sciences empiriques, le traitement initial des données constitue le socle sur lequel repose l’ensemble de l’édifice inférentiel. Qu’il s’agisse d’évaluer l’efficacité d’une intervention clinique en psychologie cognitive, de mesurer les fluctuations de rendements boursiers en économie financière ou de vérifier la conformité d’un processus de fabrication industrielle, la tentation est grande de plonger immédiatement au cœur de modélisations complexes, telles que les régressions multivariées ou les analyses en composantes principales. Pourtant, s’affranchir d’un examen minutieux et méthodique de chaque variable prise individuellement expose le chercheur et le praticien à des biais d’interprétation majeurs et à la violation fatale des postulats statistiques sous-jacents aux tests d’hypothèses.
L’analyse univariée s’impose ainsi non pas comme une simple étape préliminaire accessoire, mais comme une discipline exploratoire et diagnostique fondamentale. Elle consiste à décomposer le jeu de données pour en scruter chaque dimension constitutive, afin d’en cartographier la tendance centrale, d’en évaluer la dispersion, d’en caractériser la morphologie distributionnelle et d’y dépister d’éventuelles anomalies métrologiques. Réalisée avec méthode, elle permet d’éclairer la nature intime des phénomènes observés avant toute tentative de mise en relation bivariée ou multivariée.
Bien que des progiciels spécialisés tels que R, Python, SPSS ou Stata soient couramment mobilisés dans les laboratoires de recherche, le tableur Microsoft Excel demeure l’environnement de calcul et de modélisation le plus universellement déployé dans le monde professionnel, institutionnel et académique. Doté d’une bibliothèque de fonctions mathématiques exhaustives, d’un moteur de calcul matriciel réactif et de fonctionnalités d’automatisation avancées comme l’Utilitaire d’analyse (Analysis ToolPak), Excel offre un cadre d’une puissance insoupçonnée pour mener une analyse univariée exhaustive et rigoureuse. Ce guide magistral a pour vocation de détailler pas à pas, à travers un prisme méthodologique et pratique exigeant, l’ensemble des concepts, fonctions et visualisations indispensables pour maîtriser l’analyse univariée sous Microsoft Excel.
1. Fondements épistémologiques et théoriques de l’analyse univariée
1.1 Définition et objectifs en méthodologie quantitative
L’analyse univariée trouve son ancrage étymologique dans la concaténation du préfixe latin unus (un seul) et du substantif variabilis (susceptible de changer). Sur le plan épistémologique, cette approche se définit comme l’exploration statistique isolée et exhaustive d’une variable unique au sein d’une population ou d’un échantillon déterminé, indépendamment de toute corrélation, causalité ou interaction avec d’autres mesures. Contrairement à une idée reçue qui la relèguerait au statut de statistique élémentaire, l’analyse univariée représente la pierre angulaire de l’analyse exploratoire des données, conceptualisée historiquement par le statisticien John Tukey. Son rôle premier consiste à décrire avec une fidélité absolue la distribution empirique d’un phénomène, en résumant une multiplicité d’observations individuelles en un nombre restreint d’indicateurs numériques intelligibles et synthétiques.
Dans la validation des données empiriques, l’analyse univariée opère comme un filtre critique. Elle permet de s’assurer que les valeurs recueillies reflètent fidèlement le phénomène étudié et ne constituent pas des artefacts méthodologiques. La distinction entre les approches univariée, bivariée et multivariée est d’ordre structurel : l’analyse univariée s’intéresse à la distribution intrinsèque d’une grandeur unique (par exemple, le score d’anxiété d’une cohorte) ; l’analyse bivariée examine les covariations et dépendances mutuelles entre deux grandeurs (la relation entre l’anxiété et le temps de sommeil) ; enfin, l’analyse multivariée modélise simultanément un réseau complexe de dépendances conditionnelles et d’interactions croisées (l’impact conjoint de l’anxiété, du sommeil, du statut socio-économique et de marqueurs génétiques sur la réussite académique). Omettre l’étape univariée revient à concevoir un modèle architectural complexe sans avoir préalablement vérifié la composition minéralogique et la résistance des fondations matérielles.
Dans les disciplines relevant des sciences humaines, du comportement et de la psychométrie, l’analyse univariée assume une fonction essentielle d’étalonnage et de standardisation d’instruments d’évaluation. Lors du développement d’une échelle psychométrique mesurant des construits latents non observables directement (tels que la résilience, la dépression ou l’intelligence émotionnelle), l’évaluation univariée de chaque item permet de déceler les effets de plancher ou de plafond. Elle indique si les propositions formulées parviennent à discriminer convenablement les sujets le long du continuum du trait mesuré. Pour approfondir les mécanismes de standardisation de ces mesures, on pourra consulter les ressources de l’American Psychological Association, qui régit les standards méthodologiques de la discipline.
1.2 Typologie des variables dans les protocoles de recherche
L’application rigoureuse des outils statistiques sous Excel requiert une maîtrise sans faille de la théorie de la mesure, formalisée initialement par le psychologue Stanley Smith Stevens en 1946. Stevens a structuré l’information quantitative en quatre échelles fondamentales : nominale, ordinale, d’intervalle et de rapport. Le choix d’un paramètre de position ou de dispersion sous un tableur n’est jamais neutre : il découle directement de la nature intrinsèque de l’échelle considérée, sous peine de produire des contresens mathématiques majeurs, tels que le calcul d’une moyenne arithmétique sur des données purement qualitatives.
Les échelles nominales représentent le niveau de mesure le plus élémentaire. Elles établissent une simple différenciation qualitative entre des entités, sans hiérarchie ni ordre logique sous-jacent. Elles peuvent être purement binaires (ou dichotomiques), à l’image du sexe biologique (homme/femme), du statut vital (vivant/décédé) ou de la réponse à une question fermée (oui/non), ou bien polytomiques, comme le groupe sanguin (A, B, AB, O), la nationalité ou l’affiliation professionnelle. Les chiffres éventuellement attribués à ces modalités dans une feuille de calcul Excel ne possèdent aucune signification arithmétique ; ils ne sont que des étiquettes ou des codes catégoriels.
Les échelles ordinales introduisent une dimension d’ordonnancement hiérarchique entre les modalités, bien que la distance mathématique séparant deux rangs consécutifs demeure inconnue ou non uniforme. Les exemples canoniques en sciences sociales sont les échelles de Likert (mesurant le degré d’accord de 1 « Pas du tout d’accord » à 5 « Tout à fait d’accord »), les stades cliniques d’une pathologie (I, II, III, IV) ou les classements de performance sportive. Si l’on sait pertinemment qu’une modalité de rang 4 est supérieure à une modalité de rang 3, on ne peut affirmer que l’écart qualitatif entre ces deux rangs équivaut rigoureusement à l’intervalle séparant les rangs 2 et 1.
Les échelles d’intervalle et de rapport constituent les variables quantitatives continues ou discrètes proprement dites. L’échelle d’intervalle possède une unité de mesure constante et arbitraire, mais est dépourvue d’un zéro absolu représentant l’absence totale de la propriété mesurée. La température en degrés Celsius ou les scores standardisés d’un test de quotient intellectuel (QI) en sont des illustrations typiques : une température de 0 °C n’indique point une absence absolue d’énergie thermique, et l’on ne peut prétendre qu’un environnement à 40 °C est « deux fois plus chaud » qu’un milieu à 20 °C. En revanche, l’échelle de rapport (ou de ratio) dispose d’un zéro naturel absolu, rendant légitimes toutes les opérations arithmétiques fondamentales, y compris les rapports multiplicatifs. Les grandeurs physiques telles que la masse corporelle, le temps de réaction en millisecondes, la distance kilométrique ou le revenu mensuel relèvent de cette échelle. Le tableau ci-dessous synthétise la compatibilité des opérations statistiques selon l’échelle de mesure :
| Échelle de mesure | Propriétés fondamentales | Mesure de tendance centrale valide | Mesure de dispersion valide |
|---|---|---|---|
| Nominale | Égalité / Différence (=, ≠) | Mode | Indice de diversité / Entropie |
| Ordinale | Ordre / Hiérarchie (<, >) | Médiane, Mode | Écart interquartile, Rang centile |
| Intervalle | Intervalles constants (+, -) | Moyenne, Médiane, Mode | Écart-type, Variance |
| Rapport | Zéro absolu (×, ÷) | Moyenne géométrique, Moyenne, Médiane | Coefficient de variation, Écart-type |
1.3 Place de l’analyse univariée dans la démarche scientifique
Loin d’être un exercice de style purement descriptif, l’analyse univariée remplit trois fonctions épistémiques majeures dans le cadre d’une démarche empirique rigoureuse : la vérification des postulats, le contrôle de la qualité des données et l’émergence d’hypothèses heuristiques. En premier lieu, la plupart des modèles inférentiels paramétriques (tels que le test t de Student, l’analyse de variance factorielle ou la régression linéaire ordinaire) reposent sur l’hypothèse explicite que les résidus ou les variables dépendantes suivent une loi normale au sein de la population parente. L’examen univarié de la distribution via l’analyse de la symétrie et de l’aplatissement permet d’évaluer la légitimité de ces prérequis mathématiques et d’orienter le chercheur vers des alternatives robustes ou des modélisations non paramétriques si ces critères ne sont pas honorés.
En second lieu, l’analyse univariée représente la sentinelle par excellence contre les défaillances métrologiques, les biais d’échantillonnage et les grossières erreurs de saisie humaine. La consultation d’un simple tableau de minimums et de maximums permet d’identifier instantanément une valeur biométrique biologiquement impossible (comme un âge de 250 ans ou une pression artérielle systolique négative), consécutive à une coquille typographique lors de la numérisation des protocoles d’enquête. Enfin, le profilage des distributions stimule l’intuition scientifique : la découverte inattendue d’une distribution bimodale dans ce que l’on présumait être un échantillon homogène signale fréquemment l’existence d’une sous-population latente ou d’un facteur modérateur non identifié a priori, générant ainsi de nouvelles pistes de recherche avant même d’avoir procédé aux tests d’hypothèses programmés.
2. Préparation et structuration rigoureuse des données sous Excel
2.1 Formatage et hygiène des feuilles de calcul
La crédibilité d’une investigation quantitative dépend de la rigueur architecturale de la base de données brute. Dans un tableur tel que Microsoft Excel, il est impératif d’adopter sans compromis une organisation matricielle normalisée de type « données tabulaires » (ou tidy data). Cette convention repose sur une règle simple mais intangible : chaque ligne doit correspondre de manière univoque à une seule unité d’échantillonnage ou sujet d’expérimentation (l’observation), tandis que chaque colonne doit représenter exclusivement une et une seule variable mesurée. Les croisements non conformes, les tableaux empilés sur une même feuille ou les cellules de résumé intercalées au milieu des séries de données sont à proscrire formellement, car ils corrompent les plages de référence utilisées par les algorithmes de calcul automatique.
La première colonne d’une matrice expérimentale bien conçue doit impérativement être réservée à l’attribution d’un identifiant unique (ID) anonymisé pour chaque observation (par exemple, SUJ_001, SUJ_002). Cet identifiant constitue la clé primaire assurant la traçabilité continue de l’information. Concernant la ligne d’en-tête (située systématiquement en ligne 1), il convient d’adopter des conventions de nommage standardisées : pas d’espaces (remplacés par des tirets bas ou l’usage du format CamelCase), aucun caractère accentué ni caractère spécial susceptible de provoquer des erreurs de syntaxe lors de l’exportation vers des langages d’analyse statistique comme R ou Python. Par exemple, au lieu de nommer une variable « Réaction à l’épreuve n°1 (en secondes) », on privilégiera Temps_Reaction_Epreuve1_Sec.
L’hygiène informatique sous Excel impose également une gestion rigoureuse des types de données sous-jacents aux cellules. Excel classifie nativement ses entrées sous divers formats : numérique, texte, date, booléen. Il arrive fréquemment que des chiffres soient importés par inadvertance sous un format texte (souvent signalés par un petit triangle vert d’avertissement dans le coin supérieur gauche de la cellule ou par un alignement automatique à gauche par défaut). Si des valeurs numériques sont traitées comme des chaînes textuelles, les fonctions d’agrégation statistique renverront un résultat nul ou erroné sans nécessairement générer de message d’alerte explicite. Enfin, une règle d’or immuable consiste à sanctuariser les données brutes : la feuille de calcul d’origine doit être verrouillée en lecture seule et dupliquée sous un nouvel onglet de travail (par exemple, Data_Working) avant toute opération de nettoyage, de tri ou de recodage, garantissant ainsi l’intégrité de la traçabilité expérimentale.
2.2 Traitement des valeurs manquantes et incohérentes
Dans toute campagne de collecte empirique, l’exhaustivité totale relève de l’exception : des répondants omettent de renseigner certains items, des capteurs électroniques subissent des micro-coupures de signal, ou des échantillons biologiques s’avèrent inexploitables. L’identification rigoureuse de ces cellules vides s’effectue sous Excel à l’aide de formules dédiées. La fonction =NB.VIDE(A2:A151) renvoie le décompte absolu des valeurs absentes sur la plage spécifiée, tandis que la combinaison conditionnelle =ESTVIDE(A2) permet d’isoler au cas par cas le statut d’une cellule dans une colonne de contrôle logique.
La gestion sémiotique des données manquantes doit être standardisée selon les conventions de la psychométrie et de la statistique descriptive. Laisser une cellule purement vide sous Excel peut être source de confusion pour certains modules analytiques qui oscillent entre l’interprétation d’un vide comme une valeur nulle (0) ou comme une valeur non renseignée (missing value). L’attribution de codes explicites tels que NA (Not Available) ou NR (Non Renseigné) est recommandée dans la phase descriptive. Si la chaîne textuelle risque de perturber des fonctions numériques strictes, l’utilisation de valeurs numériques sentinelles conventionnelles (comme -999) peut être envisagée, à la condition expresse d’exclure rigoureusement ce code numérique des plages de calcul statistique via des filtres ou des formules conditionnelles (ex. : =MOYENNE.SI(A2:A151; ">-900")).
Face aux valeurs manquantes, deux grandes stratégies méthodologiques s’opposent : l’exclusion pure et simple (suppression par liste ou par observation univariée) et l’imputation de données. Dans le cadre strict d’une analyse univariée sur de grands échantillons, l’exclusion ponctuelle est souvent privilégiée si le mécanisme de disparition est aléatoire. Cependant, sur des cohortes restreintes, l’imputation univariée peut être mise en œuvre directement sous Excel, soit par la substitution par la moyenne arithmétique de la série, soit préférentiellement par la médiane pour les distributions asymétriques. Enfin, le dépistage des valeurs incohérentes ou hors plage s’appuie élégamment sur l’outil natif de Validation des données d’Excel (accessible via l’onglet Données). Il permet de contraindre une colonne à n’accepter que des nombres entiers compris dans un intervalle strict (par exemple, de 1 à 7 pour une échelle de Likert à 7 points), rejetant immédiatement toute valeur aberrante lors de la saisie ou surlignant rétrospectivement les entrées non conformes via la commande « Entourer les données non valides ».
2.3 Transformation et recodage préalable des items
L’une des étapes préparatoires fondamentales en analyse univariée concerne la transformation et le recodage des variables avant tout calcul d’indicateurs agrégés. En psychométrie, la plupart des batteries de tests intègrent intentionnellement des items formulés de manière négative (items inversés) afin de neutraliser le biais d’acquiescement, c’est-à-dire la tendance systématique de certains répondants à cocher les modalités d’accord indépendamment de la sémantique de l’énoncé. Avant d’agréger ces données, il est requis de procéder à leur inversion arithmétique. Si l’on administre une échelle d’évaluation de l’optimisme mesurée de 1 à 5, un item inversé (mesurant en réalité le pessimisme) doit être transformé selon la formule algébrique :
Valeur_Recodée = (Valeur_Max + Valeur_Min) – Valeur_Originale
Dans l’environnement Excel, pour une échelle bornée entre 1 et 5 où la note brute se situe en cellule B2, la formule s’écrit tout simplement : =(5 + 1) - B2, soit =6 - B2. Cette opération élémentaire rétablit la polarité axiale du construit psychologique mesuré.
Une autre transformation univariée incontournable est la standardisation des scores sous la forme de cotes centrées réduites, universellement désignées sous le vocable de scores Z. Le score Z exprime la distance séparant une observation particulière de la moyenne arithmétique de son groupe de référence, exprimée en unités d’écart-type. Sa formule mathématique canonique est :
z = (x – μ) / σ
Dans Excel, cette standardisation s’exécute de façon dynamique pour une valeur située en C2 via la formule =(C2 - MOYENNE($C$2:$C$151)) / ECARTYPE.STANDARD($C$2:$C$151), ou de manière encore plus directe grâce à la fonction statistique dédiée =CENTREE.REDUITE(C2; MOYENNE($C$2:$C$151); ECARTYPE.STANDARD($C$2:$C$151)). Enfin, le chercheur a souvent besoin de discrétiser une variable continue en classes ordinales (par exemple, regrouper des âges en cohortes décennales). Cette opération s’implémente avec élégance sous Excel par le truchement de la fonction RECHERCHEV configurée avec une correspondance approximative (argument VRAI ou omis), s’appuyant sur une table de bornes inférieures ordonnées au préalable.
3. Mesures de tendance centrale : Fondements mathématiques et fonctions Excel
3.1 La moyenne arithmétique : Calcul et sensibilité
La moyenne arithmétique représente sans conteste l’indicateur de tendance centrale le plus abondamment calculé, tant dans la littérature savante que dans les rapports opérationnels. Sur le plan de la physique mathématique, la moyenne se conçoit comme le centre de gravité d’une distribution : elle est le point exact d’équilibre mécanique autour duquel la somme algébrique des écarts individuels est rigoureusement égale à zéro. Pour un échantillon composé de n observations réelles notées xi, la formulation mathématique s’établit comme suit :
x̄ = (1 / n) * ∑ (i=1 à n) xi
Dans l’écosystème d’Excel, l’évaluation de cette grandeur s’effectue au moyen de la fonction native =MOYENNE(plage), comme par exemple =MOYENNE(D2:D151). Cette fonction possède l’avantage d’ignorer automatiquement les cellules textuelles ou strictement vides au sein de la plage sélectionnée, ne divisant la somme que par le nombre réel de valeurs numériques détectées.
Toutefois, cette élégance arithmétique masque une vulnérabilité méthodologique majeure : une sensibilité exacerbée aux valeurs extrêmes, communément appelées données aberrantes ou outliers. Étant donné que chaque valeur participe directement et proportionnellement à la constitution de la somme globale, une unique observation démesurément élevée ou faible suffit à déplacer substantiellement le centre de gravité de la distribution vers l’une des queues, faussant la représentativité du paramètre pour caractériser le profil typique de l’échantillon. Pour pallier cette instabilité lors du traitement de distributions asymétriques ou contaminées par du bruit expérimental, les statisticiens recourent à la moyenne tronquée (ou trimmed mean). Excel offre à cet égard une fonction particulièrement performante : =MOYENNE.REDUITE(plage; proportion). Par exemple, la syntaxe =MOYENNE.REDUITE(D2:D151; 0,10) éliminera les 10 % d’observations les plus extrêmes (5 % au plancher et 5 % au plafond) avant de calculer la moyenne des 90 % restants, fournissant un compromis d’une robustesse remarquable.
3.2 La médiane : Valeur de position et robustesse
Face aux écueils de la moyenne arithmétique, la médiane se présente comme l’indicateur de position et de tendance centrale robuste par excellence. Définie sur un plan purement ordinal, la médiane constitue la valeur centrale qui partitionne une série statistique ordonnée en deux effectifs rigoureusement identiques : exactement 50 % des observations lui sont inférieures ou égales, et 50 % lui sont supérieures ou égales. Si l’échantillon comprend un effectif n impair, la médiane correspond précisément à la valeur positionnée au rang (n + 1) / 2. Lorsque l’effectif n est pair, la médiane s’obtient classiquement par la demi-somme des deux valeurs occupant respectivement les rangs centraux n / 2 et (n / 2) + 1.
L’implémentation algorithmique de cette statistique dans Excel ne requiert aucun tri préalable des données brutes par l’utilisateur ; le moteur sous-jacent exécute le tri de manière virtuelle et instantanée via la fonction =MEDIANE(plage) (par exemple, =MEDIANE(D2:D151)). La propriété essentielle de la médiane réside dans sa résistance absolue aux aberrations expérimentales : que la valeur maximale observée d’une série soit de 100 ou qu’elle soit remplacée accidentellement par 1 000 000 à la suite d’un décalage décimal, la médiane demeurera rigoureusement inchangée.
Cette insensibilité aux extrêmes fait de la médiane le rapporteur central incontournable pour l’étude des grandeurs hautement asymétriques en sciences sociales et biomédicales. C’est le cas paradigmatique des distributions de revenus, du patrimoine des ménages, des temps de survie post-thérapeutiques en oncologie ou des durées de latence cognitive dans les épreuves de temps de réaction informatisées. Les normes de publication scientifique en psychologie recommandent de systématiquement privilégier ou adjoindre la médiane à la moyenne dès lors que les données s’écartent manifestement d’un profil symétrique gaussien.
3.3 Le mode : Indicateur de fréquence dominante
Le mode (ou valeur modale) correspond au score, à la modalité ou à la classe qui enregistre l’effectif ou la fréquence d’apparition la plus élevée au sein de la série statistique. Il représente en termes graphiques le point culminant, ou pic de densité, de l’histogramme des fréquences. Contrairement à la moyenne et à la médiane, le mode est la seule mesure de tendance centrale universellement applicable à l’ensemble des échelles de mesure, y compris les variables purement qualitatives nominales pour lesquelles aucune opération de somme ou d’ordonnancement n’a de sens (par exemple, déterminer le profil de diagnostic psychopathologique le plus fréquemment posé dans un service hospitalier).
Microsoft Excel propose deux déclinaisons algorithmiques distinctes pour évaluer la modalité numérique d’une série :
=MODE.SIMPLE(plage): Cette fonction renvoie la première valeur modale univoque rencontrée. Toutefois, si la distribution comporte plusieurs maxima locaux d’égale fréquence, cette fonction tronque la réalité analytique en ne restituant qu’un seul sommet arbitraire.=MODE.MULTIPLE(plage): Introduite pour gérer la bimodalité et la multimodalité, cette fonction matricielle dynamique renvoie l’ensemble des valeurs modales ex æquo sous la forme d’un vecteur vertical étendu automatiquement sur les versions modernes d’Excel.
L’interprétation des profils multimodaux s’avère particulièrement riche dans l’analyse comportementale. L’identification d’une distribution bimodale dans une batterie de tests psychotechniques ne doit jamais être assimilée à un bruit de mesure aléatoire. Elle met presque invariablement en évidence l’agrégation non contrôlée de deux sous-populations distinctes au sein du même groupe expérimental (par exemple, des experts employant une stratégie cognitive heuristique face à des novices appliquant un raisonnement séquentiel laborieux). Le mode permet alors de documenter ces polarisations comportementales avec une netteté qu’une moyenne globale masquerait irrémédiablement.
3.4 Critères de sélection entre moyenne, médiane et mode
Le choix raisonné du paramètre central pour résumer une distribution statistique continue dépend fondamentalement de la configuration géométrique de la courbe de densité et de l’alignement mutuel des trois indicateurs. Dans le cas idéal d’une distribution parfaitement symétrique et unimodale (incarnée par la courbe de Gauss ou loi normale), la moyenne arithmétique, la médiane et le mode coïncident théoriquement en un point d’inflexion unique :
Moyenne = Médiane = Mode
Dès lors que la distribution présente une asymétrie marquée vers la droite (étalement positif), la moyenne est aspirée par les valeurs extrêmes situées dans la longue traîne supérieure, tandis que le mode demeure fixé sur le pic de densité originel et que la médiane s’établit à une position intermédiaire d’équilibre ordinal. On observe alors la relation d’inégalité classique : Mode < Médiane < Moyenne. Inversement, en présence d’une asymétrie vers la gauche (étalement négatif), la relation s’inverse symétriquement : Moyenne < Médiane < Mode.
Les directives méthodologiques internationales prescrivent dès lors les règles de décision suivantes :
- Pour les variables quantitatives continues répondant au postulat de normalité : rapporter prioritairement la moyenne arithmétique (associée à l’écart-type), car elle mobilise la totalité de l’information quantitative disponible et dispose d’une efficacité d’échantillonnage supérieure.
- Pour les variables quantitatives manifestant une asymétrie prononcée, des queues épaisses ou polluées par des valeurs extrêmes avérées : rapporter la médiane (associée à l’écart interquartile) à titre d’estimateur central non biaisé.
- Pour les variables ordinales strictes (scores discrets sur échelles sans métrique continue) : privilégier la médiane ou le mode.
- Pour les variables nominales qualitatives : restreindre impérativement le rapportage au mode (accompagné des fréquences absolues et relatives).
4. Mesures de dispersion : Analyse de l’hétérogénéité des scores
4.1 Étendue et écart interquartile
Décrire une distribution statistique par sa seule tendance centrale revient à tronquer la réalité scientifique. Deux échantillons expérimentaux distincts peuvent afficher une moyenne rigoureusement identique de 100 points, tout en présentant des profils phénoménologiques radicalement opposés : le premier regroupant des scores ultra-concentrés entre 98 et 102, le second dispersant ses valeurs de 20 à 180. L’évaluation de la dispersion mesure la variabilité, l’incertitude ou l’hétérogénéité intrinsèque des données.
La mesure la plus intuitive de la dispersion est l’étendue (ou range), qui quantifie l’espacement total séparant la valeur minimale de la valeur maximale observée. Dans Excel, cette métrique s’obtient instantanément par la soustraction arithmétique : =MAX(plage) - MIN(plage). Si l’étendue offre une vision d’ensemble du spectre de la variable, elle s’avère d’une instabilité rédhibitoire, puisqu’elle dépend exclusivement de deux points extrêmes de la distribution, se trouvant de fait surexposée aux fluctuations d’échantillonnage et aux erreurs de saisie.
Pour s’affranchir de cette fragilité, la décomposition fractile en quartiles s’impose comme une alternative robuste. Les quartiles fractionnent la distribution triée en quatre portions d’effectifs égaux à 25 %. Le premier quartile (Q1) isole les 25 % des valeurs les plus basses, tandis que le troisième quartile (Q3) sépare les 75 % des valeurs inférieures des 25 % des valeurs les plus élevées. Microsoft Excel intègre deux algorithmes de calcul des quartiles, dont la divergence mathématique doit être scrupuleusement comprise par le chercheur :
=QUARTILE.INC(plage; quart): Implémente la méthode inclusive, où les percentiles 0 et 1 correspondent respectivement au minimum et au maximum réels de l’échantillon. C’est l’algorithme standard traditionnel d’Excel.=QUARTILE.EXC(plage; quart): Implémente la méthode exclusive, qui considère que la population parente s’étend au-delà des bornes observées dans l’échantillon empirique. Cette méthode est préconisée par de nombreux manuels d’économétrie et de statistique avancée, mais nécessite un effectif d’échantillon suffisant pour éviter les erreurs d’exécution.
L’écart interquartile (EIQ ou IQR en anglais) mesure la largeur de l’intervalle hébergeant les 50 % centraux de la cohorte d’étude. Il s’évalue sous Excel par la différence : =QUARTILE.INC(plage; 3) - QUARTILE.INC(plage; 1). Doté d’une insensibilité remarquable aux observations extrêmes, l’écart interquartile constitue l’associé descriptif naturel de la médiane pour toutes les métriques non gaussiennes.
4.2 Variance et écart-type de l’échantillon
Lorsque la distribution répond aux critères de métrique continue et de quasi-symétrie, l’écart-type (ou déviation standard) s’établit comme le paramètre d’hétérogénéité prééminent. La genèse mathématique de l’écart-type passe par la notion d’écart à la moyenne. Comme la somme simple des déviations (xi - x̄) s’annule obligatoirement par compensation mécanique, la solution théorique consiste à élever ces écarts au carré pour les rendre universellement positifs, puis à calculer leur moyenne : ce résultat définit la variance statistique (s²).
Toutefois, une distinction méthodologique majeure intervient selon que l’analyse porte sur la population exhaustive ou sur un échantillon extrait par sondage. Lorsque l’on travaille sur un échantillon pour inférer les paramètres de la population, la somme des carrés des écarts doit être divisée non pas par l’effectif n, mais par ses degrés de liberté résiduels, soit (n - 1). Cette manipulation est connue sous le nom de correction de Bessel. L’omission de cette correction produit un biais systématique sous-estimant la dispersion réelle de la population parente. L’écart-type correspond ensuite à la racine carrée positive de la variance, ce qui lui confère l’immense avantage pratique de s’exprimer rigoureusement dans la même unité de mesure physique ou psychométrique que la variable d’origine.
Excel traduit cette distinction fondamentale à travers des fonctions spécialisées distinctes :
=ECARTYPE.STANDARD(plage): Calcule l’écart-type d’échantillon sans biais, en divisant par(n - 1). C’est cette formule qu’il convient de mobiliser dans 99 % des recherches empiriques où l’on analyse une cohorte pour en généraliser les enseignements.=ECARTYPE.PEARSON(plage): Calcule l’écart-type de la population exhaustive, en divisant strictement par N. À réserver exclusivement aux situations où la base de données recense l’intégralité exhaustive sans exception d’une population finie (ex. : la totalité des employés d’une entreprise spécifique).
De même, pour le calcul intermédiaire de la variance, le chercheur choisira entre =VAR.S(plage) pour la variance échantillonnale corrigée et =VAR.P(plage) pour la variance de population. Une consultation des manuels méthodologiques disponibles sur le portail de l’INSEE permettra d’approfondir l’impact de l’échantillonnage probabiliste sur ces estimateurs sans biais.
4.3 Coefficient de variation : Mesure relative de dispersion
L’écart-type absolu présente une limite d’usage notable : étant intrinsèquement dépendant de l’unité de mesure choisie, il interdit toute comparaison directe de la dispersion entre des variables de natures différentes ou d’ordres de grandeur divergents. Il est absurde de comparer directement l’écart-type d’un temps de réaction mesuré en fractions de millisecondes avec celui d’un score d’anxiété totalisant 100 points, ou même de comparer la variabilité du poids de souris de laboratoire avec celle d’éléphants d’Afrique.
Le coefficient de variation (CV), conceptualisé par Karl Pearson, transcende cet écueil métrologique en standardisant la dispersion sous la forme d’un ratio sans dimension. Il s’exprime comme le quotient de l’écart-type d’échantillon par la moyenne arithmétique, usuellement converti en pourcentage :
CV = (s / x̄) * 100
Excel ne dispose pas d’une fonction dédiée spécifique pour ce paramètre, mais son évaluation dynamique se réalise en composant les fonctions fondamentales : =(ECARTYPE.STANDARD(plage) / MOYENNE(plage)) * 100, ou en appliquant un format de cellule en « Pourcentage » à la formule =ECARTYPE.STANDARD(plage) / MOYENNE(plage). Il convient de souligner que le coefficient de variation n’a de validité épistémologique stricte que pour des variables mesurées sur des échelles de rapport pourvues d’un zéro absolu naturel, la valeur de la moyenne étant dépourvue de signification d’ancrage sur des échelles d’intervalles arbitraires comme les degrés Celsius.
Dans la pratique de la recherche expérimentale et du contrôle de qualité clinique, le coefficient de variation sert de critère diagnostic pour évaluer l’homogénéité d’un groupe expérimental ou la reproductibilité d’un dosage biochimique :
- CV < 10 % : Distribution hautement homogène, variabilité résiduelle très faible, grande fidélité du protocole de mesure.
- 10 % ≤ CV ≤ 30 % : Homogénéité modérée, représentative des variabilités biologiques ou psychologiques standards dans les populations naturelles.
- CV > 30 % : Forte hétérogénéité de la distribution, signalant une dispersion considérable ou la présence de profils atypiques méritant une stratification analytique secondaire.
5. Indicateurs de forme de distribution : Asymétrie et aplatissement
5.1 Asymétrie (Skewness) : Évaluation du biais directionnel
Au-delà de la localisation centrale et de l’étendue de l’étalement, la morphologie intrinsèque d’une série continue est régie par ses moments statistiques d’ordre supérieur. Le troisième moment centré renvoie à la notion d’asymétrie (ou skewness), qui quantifie l’écart directionnel de la distribution par rapport à une morphologie parfaitement symétrique en cloche. L’équation canonique de l’asymétrie échantillonnale corrigée du biais d’estimation, telle qu’implémentée au sein des progiciels de référence, s’exprime ainsi :
g₁ = [n / ((n – 1)(n – 2))] * ∑ [ (xi – x̄) / s ]³
Sous Microsoft Excel, le calcul rigoureux de ce coefficient s’exécute de façon instantanée au travers de la fonction statistique =COEFFICIENT.ASYMETRIE(plage) (à ne pas confondre avec =COEFFICIENT.ASYMETRIE.P qui ne corrige pas le biais d’échantillonnage pour les petits effectifs). L’analyse de la valeur numérique produite éclaire précisément la structure du phénomène mesuré :
- Asymétrie nulle (≈ 0) : La distribution est rigoureusement symétrique de part et d’autre de son centre de gravité. La moitié gauche forme le miroir géométrique de la moitié droite.
- Asymétrie positive (g₁ > 0) : La distribution est étirée vers la droite. La grande masse des observations se concentre sur des valeurs faibles ou modérées, tandis qu’une minorité d’individus atypiques s’étend très loin dans les valeurs positives supérieures, formant une queue effilée vers l’extrémité droite de l’axe horizontal. C’est la configuration typique observée lors de l’enregistrement des temps de réaction motrice ou de l’évaluation de la consommation toxique d’une population générale.
- Asymétrie négative (g₁ < 0) : La distribution est déportée vers la gauche. La concentration majoritaire des scores siège au niveau des bornes hautes de l’instrument d’évaluation, tandis qu’une traîne de valeurs dispersées s’étire vers les minima. Ce profil s’observe classiquement dans les examens académiques excessivement faciles générant un effet de plafond massif, ou lors de l’évaluation de la satisfaction client dans des services performants.
5.2 Aplatissement (Kurtosis) : Mesure des queues de distribution
Le quatrième moment centré formalise la notion d’aplatissement (ou kurtosis), souvent défini à tort comme la simple « pointicité » du sommet de la courbe, mais qui traduit plus rigoureusement l’épaisseur relative des queues de distribution et la propension de la variable à générer des valeurs extrêmes ou aberrantes. Pour faciliter l’interprétation scientifique, les algorithmes modernes opèrent systématiquement une normalisation appelée « excès d’aplatissement » (excess kurtosis), retranchant la valeur constante 3 (qui caractérise le coefficient brut de la loi normale théorique). La formule échantillonnale sans biais est hautement élaborée sur le plan combinatoire :
g₂ = { [n(n + 1) / ((n – 1)(n – 2)(n – 3))] * ∑ [ (xi – x̄) / s ]⁴ } – [ 3(n – 1)² / ((n – 2)(n – 3)) ]
Dans l’interface francophone d’Excel, l’utilisateur sollicite la fonction native =KURTOSIS(plage), qui intègre directement cet ajustement et renvoie la valeur de l’excès d’aplatissement par rapport à zéro. La typologie distributionnelle se décline ainsi :
- Distribution mésocurtique (g₂ ≈ 0) : Les queues de la distribution présentent une épaisseur et un taux de décroissance strictement identiques à ceux de la distribution normale gaussienne de référence.
- Distribution leptocurtique (g₂ > 0) : La distribution manifeste un pic central acéré et, surtout, des queues particulièrement épaisses et longues (phénomène de queues lourdes ou fat tails). Cela signifie que la probabilité d’occurrence d’événements extrêmes s’avère considérablement supérieure à ce que prédirait le modèle gaussien standard. En finance de marché ou en psychopathologie des crises aiguës, la leptocurticité signale des risques systémiques accrus de survenue de chocs majeurs.
- Distribution platycurtique (g₂ < 0) : La distribution présente un sommet aplati, émoussé, avec des queues d’épaisseur très réduite. Les valeurs se dispersent de façon relativement uniforme autour du centre, sans générer de points déviants dans les marges de l’espace échantillonnal.
5.3 Diagnostic préliminaire de normalité statistique
L’évaluation combinée du coefficient d’asymétrie et de l’aplatissement permet d’établir un diagnostic préliminaire de normalité statistique, une étape requise pour déterminer si l’on peut recourir à des analyses paramétriques ou s’il est impératif d’adopter des tests non paramétriques (tels que le test U de Mann-Whitney ou le test de Kruskal-Wallis). Les manuels avancés de psychométrie quantitative et de biostatistique, notamment les travaux fondateurs de West, Finch et Curran (1995), ont établi des règles empiriques robustes pour statuer sur la sévérité des déviations :
- Si la valeur absolue de l’asymétrie
|g₁| < 2et celle de l’aplatissement|g₂| < 7, la déviation par rapport à la normalité théorique est considérée comme modérée et tolérable pour l’application d’analyses de variance ou de modélisations linéaires sans perte majeure de puissance ni distorsion inacceptable du taux d’erreur de première espèce (alpha). - Pour des critères plus exigeants d’inférence en petits échantillons, de nombreux statisticiens recommandent de s’assurer que
|g₁| ≤ 1et|g₂| ≤ 1,5.
Excel permet de pousser plus loin la validation inférentielle en calculant les ratios critiques (scores Z de normalité). L’erreur-type théorique de l’asymétrie sous hypothèse nulle de normalité s’approxime par la formule SE_skew = RACINE(6 / n), et celle de l’aplatissement par SE_kurt = RACINE(24 / n). L’utilisateur peut ainsi structurer un test d’hypothèse formel dans une cellule Excel en calculant le ratio critique :
Z_skewness = COEFFICIENT.ASYMETRIE(plage) / RACINE(6 / NB(plage))
Si la valeur absolue de ce Z_skewness excède le seuil critique bilatéral de 1,96 (au seuil alpha conventionnel de 5 %), l’hypothèse nulle de symétrie gaussienne est formellement rejetée. Un calcul rigoureusement identique appliqué au kurtosis permet d’évaluer la déviation d’aplatissement avec une précision méthodologique irréprochable.
6. Automatisation via l’Utilitaire d’analyse de données (Analysis ToolPak)
6.1 Activation et configuration du complément statistique
Bien que la maîtrise des fonctions unilatérales sous Excel (MOYENNE, MEDIANE, ECARTYPE.STANDARD, etc.) soit indispensable pour la conception de tableaux de bord vivants et interactifs, l’exécution manuelle de ces formules item par item s’avère fastidieuse lorsqu’il s’agit de balayer de larges batteries de variables. Conscient de ces impératifs de productivité, Microsoft intègre nativement au tableur un module d’extension puissant dédié aux biostatisticiens, financiers et chercheurs : l’Utilitaire d’analyse (ou Analysis ToolPak). Ce composant logiciel n’étant pas systématiquement activé lors du déploiement initial de la suite bureautique, sa mise en service requiert une manipulation de configuration élémentaire.
Pour activer ce complément, la procédure opérationnelle se déploie comme suit :
- Cliquer sur le menu Fichier situé dans le coin supérieur gauche du ruban, puis sélectionner Options dans la barre latérale inférieure.
- Dans la fenêtre modale des Options d’Excel qui apparaît, cliquer sur la rubrique Compléments dans le menu de navigation vertical.
- Au bas de la boîte de dialogue, dans le champ déroulant intitulé Gérer, vérifier que la mention « Compléments Excel » est bien sélectionnée, puis cliquer sur le bouton d’exécution Atteindre….
- Une boîte de dialogue compacte s’affiche, présentant les modules statistiques disponibles. Cocher la case associée à l’intitulé Utilitaire d’analyse (il est inutile pour notre propos d’activer l’Utilitaire d’analyse VBA, sauf pour des développements de macros automatisées).
- Valider l’opération en cliquant sur OK.
Dès cet instant, un nouveau groupe analytique étiqueté Analyse apparaît à l’extrémité droite de l’onglet Données du ruban principal d’Excel, arborant le bouton de commande officiel Utilitaire d’analyse.
6.2 Génération du tableau complet des statistiques descriptives
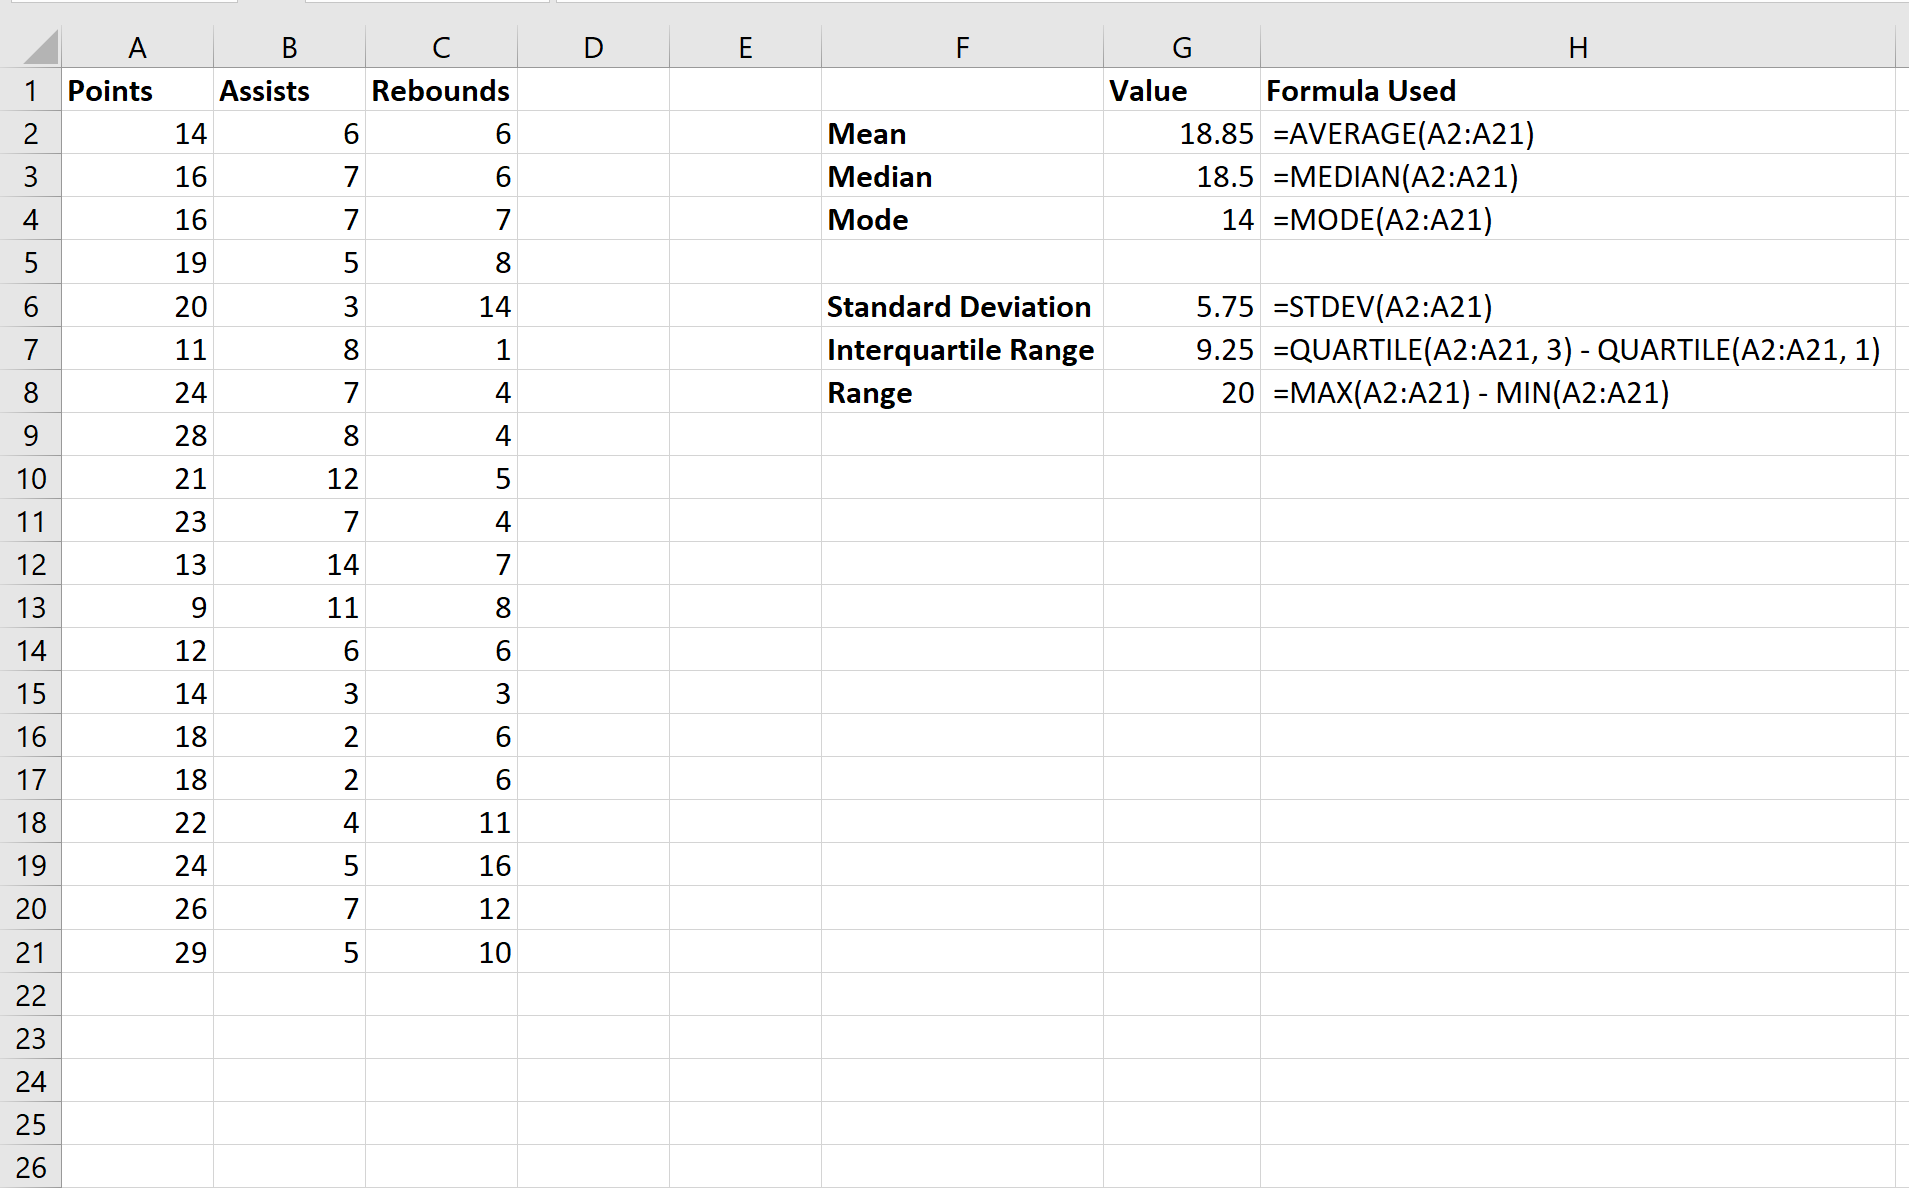
L’Utilitaire d’analyse permet de générer, en une manipulation unique et en une fraction de seconde, une cartographie univariée exhaustive regroupant jusqu’à seize paramètres statistiques fondamentaux pour une ou plusieurs colonnes de données adjacentes. Pour initialiser cette extraction automatisée, cliquer sur le bouton Utilitaire d’analyse dans l’onglet Données, puis sélectionner l’option méthodologique Statistiques descriptives dans la liste alphabétique des outils disponibles avant de cliquer sur OK.
Le panneau de configuration contextuel qui s’ouvre impose un paramétrage scrupuleux pour garantir l’intégrité de la sortie :
- Plage d’entrée : Sélectionner l’ensemble de la colonne contenant la variable continue d’intérêt, en incluant délibérément la première cellule textuelle faisant office d’en-tête (par exemple,
$D$1:$D$151). - Groupé par : Maintenir l’option cochée sur « Colonnes » (sauf configuration atypique où les observations seraient structurées horizontalement en lignes).
- Intitulés en première ligne : Il est impératif de cocher cette case si la sélection d’entrée englobe le nom de la variable en ligne 1. Excel utilisera ce libellé pour baptiser automatiquement le tableau récapitulatif résultant et évitera de corrompre l’analyse en tentant d’interpréter le titre textuel comme un chiffre.
- Options de sortie : Choisir d’implanter la restitution soit sur la même feuille en désignant une cellule cible non occupée (ex. :
$F$1), soit préférentiellement dans une « Nouvelle feuille de calcul » pour préserver la propreté de l’espace de données brutes. - Cases de validation descriptive : Cocher impérativement la case maîtresse Statistiques récapitulatives. Pour enrichir la portée inférentielle, on pourra également cocher Niveau de confiance pour la moyenne (en laissant le seuil standard de 95 %), ainsi que K-ième plus grande et K-ième plus petite valeur pour repérer les rangs extrêmes.
Après validation par le bouton OK, Excel déploie instantanément un tableau normé structuré de façon immuable, restituant la moyenne, l’erreur-type, la médiane, le mode, l’écart-type, la variance de l’échantillon, le kurtosis, l’asymétrie, l’étendue, le minimum, le maximum, la somme arithmétique globale et l’effectif valide total (compte).
6.3 Limites de l’outil d’analyse automatisé
Bien que l’Utilitaire d’analyse séduise par son immédiateté et sa richesse descriptive, le chercheur ou l’analyste chevronné doit garder à l’esprit ses faiblesses techniques intrinsèques. La limitation la plus critique réside dans le caractère purement statique des résultats générés. Contrairement aux cellules nourries par des formules dynamiques du type =MOYENNE(D2:D151), le tableau de l’Utilitaire d’analyse n’imprime que des valeurs numériques figées (hardcoded). Si une coquille typographique est rectifiée dans la colonne de données sources, si des participants sont ajoutés ou supprimés du protocole, les indicateurs produits par le complément statistique ne s’actualiseront absolument pas en cascade. L’analyste se trouve contraint de réexécuter intégralement la procédure pour réaligner le rapport avec l’état réel des données.
Par ailleurs, la présentation brute issue de l’outil présente des défauts typographiques patents : les libellés de colonnes manquent d’élasticité de formatage, les décimales sont projetées sans homogénéisation visuelle (débordant fréquemment sur huit ou dix décimales parasites), et l’absence de certains indices modernes (comme l’écart interquartile robuste) impose des calculs complémentaires manuels. Par conséquent, l’Utilitaire d’analyse est à concevoir comme un formidable outil de dégrossissage exploratoire au moment de la réception d’une base de données, mais doit céder le pas à une architecture de formules dynamiques natives dès lors qu’il s’agit de construire un rapport de recherche pérenne, reproductible et évolutif.
7. Visualisation graphique univariée : Histogrammes et fréquences
7.1 Construction d’une distribution de fréquences groupées
La synthèse numérique des données par la moyenne et l’écart-type doit obligatoirement s’accompagner d’une traduction visuelle de la distribution globale des scores. La construction d’une table de fréquences groupées constitue le passage obligé pour convertir un continuum de valeurs disparates en un dénombrement géométrique structuré en classes disjointes. La première difficulté réside dans le calibrage du nombre optimal de classes (noté k) pour éviter tant le sur-lissage (un nombre trop restreint de classes gommant la morphologie fine de la distribution) que le sous-lissage (une fragmentation excessive créant un profil en peigne haché d’artéfacts de dispersion).
Pour déterminer rigoureusement ce paramètre de discrétisation, la méthode statistique préconise l’application de la règle empirique de Sturges, idéale pour les distributions approximativement normales de taille modérée (n < 200) :
k = 1 + 3,322 * log₁₀(n)
Dans une feuille Excel hébergeant 150 observations, le nombre optimal s’évalue dynamiquement par la syntaxe =ARRONDI.SUPERIEUR(1 + 3,322 * LOG10(NB(plage)); 0), ce qui fournit théoriquement k = 9 classes d’intervalles. L’analyste détermine ensuite la largeur constante de chaque compartiment (h) par la division de l’étendue globale par le nombre de classes : h = (MAX(plage) - MIN(plage)) / k. Une fois ces classes définies, on dresse une colonne auxiliaire stipulant la borne d’échappement supérieure de chaque intervalle.
Le calcul effectif des occurrences s’exécute élégamment grâce à la fonction matricielle historique =FREQUENCE(plage_donnees; plage_intervalles). Contrairement à une série de NB.SI.ENS laborieux, la fonction FREQUENCE examine en un passage unique l’ensemble de la série continue et renvoie un vecteur vertical dénombrant le nombre exact d’observations tombant dans chaque interstice (les bornes supérieures étant inclusives). Les fréquences relatives se déduisent par la division du vecteur par l’effectif global =NB(plage), et les fréquences cumulées ascendantes s’obtiennent par l’addition progressive des effectifs le long de la colonne ordonnée.
7.2 Création et optimisation d’un histogramme standardisé
Depuis ses versions récentes, Microsoft Excel intègre un type de graphique d’insertion directe étiqueté « Histogramme », accessible via le ruban Insertion > Graphiques statistiques > Histogramme. Si cette fonctionnalité moderne offre un gain de temps appréciable en discrétisant automatiquement les données sans nécessiter la création manuelle d’une table de classes, elle requiert un paramétrage graphique manuel rigoureux pour être conforme aux standards des publications savantes.
Dès l’insertion du graphique natif, l’analyste doit effectuer un double-clic sur l’axe horizontal des abscisses pour déployer le volet latéral Format de l’axe. Dans la section dédiée aux options d’axe, Excel permet d’abandonner le mode « Automatique » au profit d’un calibrage analytique contrôlé :
- Largeur de bande : L’analyste peut forcer manuellement la largeur exacte de chaque classe numérique selon le pas théorique calculé précédemment via la règle de Sturges.
- Nombre de compartiments : Alternativement, l’utilisateur peut imposer le nombre fixe de classes désiré (par exemple, 9).
- Compartiment de débordement et de sous-dépassement : Ces options permettent de regrouper d’autorité l’ensemble des valeurs extrêmes au-delà d’un seuil prédéfini dans une classe ouverte terminale, évitant ainsi un étalement graphique inutile de l’axe.
Sur le plan de la sémiologie graphique propre aux histogrammes de variables continues, il existe une convention formelle absolue : les barres verticales représentant les classes contiguës ne doivent comporter aucun interstice vide entre elles, traduisant graphiquement la continuité sous-jacente du domaine mathématique de la variable. Pour matérialiser cette exigence académique sous Excel lorsque l’on trace un histogramme à partir d’un graphique à colonnes classique nourri par la table de FREQUENCE, il est impératif d’ajuster l’option Largeur du fractionnement (ou Gap Width) à 0 %. Enfin, il est de bonne pratique méthodologique d’ajouter une ligne verticale de repère ou un marqueur spécifique pour signaler la position de la moyenne arithmétique et de la médiane au sein du profil.
7.3 Interprétation visuelle du profil distributionnel
L’observation attentive de l’histogramme achevé affine le diagnostic univarié bien au-delà de ce que permettent de simples valeurs tabulaires numériques. L’œil humain excelle à identifier la structure globale de l’échantillon. L’analyste recherchera en priorité l’unimodalité, la bimodalité ou la multimodalité de la figure. Un pic unique et centré renforce la confiance dans l’homogénéité globale du protocole de recueil, tandis qu’un profil asymétrique fortement déporté vers l’origine démasque graphiquement la présence d’un effet de plancher (l’instrument utilisé était incapable d’enregistrer des performances inférieures à un seuil matériel trop élevé). Inversement, un empilement massif d’observations contre la limite supérieure signale un effet de plafond invalidant l’étalement haut de l’échelle d’évaluation.
L’histogramme s’érige également en révélateur privilégié de biais psychosociaux lors de l’administration de questionnaires d’auto-évaluation. Dans les protocoles portant sur des sujets sensibles (consommation d’alcool, pratiques sexuelles, éthique professionnelle), la morphologie distributionnelle révèle souvent une chute brutale de la densité sur les scores socialement réprouvés, suivie d’une surreprésentation artificielle des classes intermédiaires ou politiquement valorisées. Cette altération visuelle traduit graphiquement le biais de désirabilité sociale, alertant immédiatement le chercheur sur la nécessité d’opérer des redressements méthodologiques avant d’entamer la phase d’inférence statistique.
8. Détection visuelle et mathématique des valeurs aberrantes (Outliers)
8.1 Construction et lecture du diagramme en boîte (Boxplot)
Le diagramme en boîte à moustaches, conceptualisé par John Tukey en 1977 sous l’appellation de box-and-whisker plot, s’érige en outil de synthèse non paramétrique par excellence pour visualiser simultanément la tendance centrale, la dispersion et les anomalies extrêmes d’une variable continue. Dans les versions modernes d’Excel, l’insertion de ce graphique s’exécute directement depuis le ruban Insertion > Graphiques statistiques > Boîte et moustaches, après avoir préalablement sélectionné la colonne de données d’intérêt.
L’anatomie méthodologique d’une boîte à moustaches repose sur une scénarisation géométrique standardisée :
- Le corps rectangulaire central (la boîte) matérialise l’écart interquartile. La bordure inférieure correspond précisément au premier quartile (Q1), tandis que la bordure supérieure coïncide avec le troisième quartile (Q3). La hauteur totale de la boîte représente donc l’étendue des 50 % centraux de la distribution.
- À l’intérieur de la boîte, une ligne horizontale continue marque la position de la médiane (Q2). Les versions récentes d’Excel intègrent également de façon native une petite croix (x) désignant l’emplacement de la moyenne arithmétique, offrant un diagnostic immédiat : si la croix s’écarte substantiellement de la ligne médiane, la distribution souffre d’une asymétrie patente.
- Les segments verticaux linéaires émergeant des parois supérieure et inférieure de la boîte constituent les « moustaches ». Selon la convention classique de Tukey, la longueur maximale d’une moustache ne peut excéder 1,5 fois l’écart interquartile (1,5 * IQR) calculé à partir de chaque charnière quartilique. Les moustaches se terminent sur la valeur observée la plus éloignée qui s’inscrit encore à l’intérieur de cette frontière.
- Tout point de donnée empirique situé au-delà de la terminaison des moustaches est formellement catégorisé comme une valeur aberrante (outlier) et représenté graphiquement par un point circulaire isolé.
8.2 Identification algorithmique par critères numériques sous Excel
Si le boxplot fournit une confirmation visuelle éclatante de la présence de valeurs atypiques, la rigueur de l’analyse empirique impose d’extraire et de marquer ces anomalies par des critères algorithmiques programmés dans la feuille de calcul. La méthode standard de Tukey établit des frontières formelles, qualifiées de clôtures intérieures (inner fences) :
Clôture_Inférieure = Q1 – (1,5 * IQR)
Clôture_Supérieure = Q3 + (1,5 * IQR)
Pour automatiser ce dépistage sous Excel au sein d’une colonne dédiée (par exemple, la colonne E, parallèlement à la valeur brute située en D2), l’analyste implémente la formule logique matricielle suivante :
=SI(OU(D2 < (QUARTILE.INC($D$2:$D$151; 1) - 1,5 * (QUARTILE.INC($D$2:$D$151; 3) - QUARTILE.INC($D$2:$D$151; 1))); D2 > (QUARTILE.INC($D$2:$D$151; 3) + 1,5 * (QUARTILE.INC($D$2:$D$151; 3) - QUARTILE.INC($D$2:$D$151; 1)))); "Aberrante"; "Normale")
Une démarche alternative, particulièrement plébiscitée dans les cadres expérimentaux paramétriques et le contrôle industriel, repose sur la règle de déviation standardisée des scores Z. Dans ce paradigme, une observation est qualifiée d’aberrante dès lors que sa valeur centrée réduite dépasse un seuil de dispersion conventionnel :
|z| > 3 (ou |z| > 2,5 dans les designs conservateurs)
La transcription sous Excel s’opère par le test logique : =SI(ABSO(CENTREE.REDUITE(D2; MOYENNE($D$2:$D$151); ECARTYPE.STANDARD($D$2:$D$151))) > 3; "Outlier"; "Conforme"). Pour décupler l’impact visuel de cet audit qualité, il est hautement recommandé d’appliquer une Mise en forme conditionnelle sur la plage de données brutes, en configurant une règle personnalisée basée sur ces formules pour surligner automatiquement en rouge pâle les cellules abritant des données atypiques dès leur encodage.
8.3 Protocole décisionnel face aux valeurs aberrantes
L’identification d’une valeur aberrante ne doit en aucun cas déclencher son élimination automatique et irréfléchie. Une telle pratique, assimilable à une altération délibérée de la preuve empirique, introduirait un biais d’optimisation majeur dans la recherche. L’analyste doit impérativement déployer un protocole d’audit séquentiel structuré en trois paliers déontologiques :
- Vérification de l’intégrité instrumentale et typographique : L’aberration résulte-t-elle d’une erreur matérielle avérée ? Une pression artérielle de 1200 au lieu de 120, un sujet de 999 ans (code manquant mal encodé) ou une défaillance électrique d’un chronomètre doivent être corrigés par retour à la fiche d’observation manuscrite originale, ou à défaut purgés de la base.
- Caractérisation de la validité écologique : Si la mesure est authentique et valide, correspond-elle à un sujet appartenant légitimement à la population cible ? Un temps de réponse anormalement long chez un participant s’étant assoupi pendant la passation relève d’une rupture du protocole et justifie son exclusion motivée. En revanche, un score de créativité phénoménalement élevé chez un sujet atypique représente une variation biologique authentique et précieuse qui doit être impérativement préservée dans l’analyse.
- Stratégie d’ajustement ou de winsorisation : Lorsque des valeurs aberrantes légitimes menacent de distordre gravement les modélisations paramétriques sans que leur exclusion pure et simple ne soit méthodologiquement justifiable, le chercheur peut recourir à la winsorisation. Cette technique consiste à ramener les valeurs extrêmes situées au-delà des percentiles critiques (par exemple, le 5e et le 95e percentile) à la valeur exacte de ces bornes. Sous Excel, cette opération se programme via la formule conditionnelle :
=MIN(MAX(D2; CENTILE.INC($D$2:$D$151; 0,05)); CENTILE.INC($D$2:$D$151; 0,95)). Les scores sont ainsi tempérés sans altérer le volume global de l’échantillon.
9. Analyse univariée des variables catégorielles et ordinales
9.1 Tableaux croisés dynamiques à une dimension
Si les variables quantitatives continues monopolisent l’attention mathématique par leur infinité de valeurs potentielles, les variables qualitatives nominales et les échelles ordinales structurent l’immense majorité des données signalétiques et sociodémographiques (sexe, statut matrimonial, niveau de formation, sévérité symptomatique). Pour ces dimensions non métriques, l’analyse univariée ne recherche point des moyennes continues, mais vise à quantifier la répartition d’effectifs à travers des tables de fréquences et d’occurrences. Le Tableau croisé dynamique (TCD) univarié représente l’instrument d’investigation le plus rapide et flexible sous Excel pour accomplir cette tâche.
La mise en place d’un TCD univarié s’opère en sélectionnant la colonne d’intérêt (par exemple, Niveau_Etude), puis en activant le menu Insertion > Tableau croisé dynamique. Dans le volet de configuration des champs situé à droite de l’écran, la manipulation ne requiert que deux actions élémentaires :
- Faire glisser l’identifiant de la variable catégorielle dans la zone Lignes : les modalités textuelles uniques de la variable s’affichent instantanément sous la forme d’une liste épurée de doublons.
- Faire glisser cette même variable une seconde fois, mais cette fois-ci dans la zone Valeurs : par défaut, reconnaissant un format textuel, Excel applique la fonction d’agrégation « Nombre », dénombrant le volume absolu d’occurrences pour chaque modalité.
Pour convertir ces effectifs bruts en proportions relatives intelligibles, il suffit d’effectuer un clic droit sur l’une des valeurs numériques du tableau généré, d’accéder au sous-menu Afficher les valeurs, et de sélectionner l’option % du total général. Dès cet instant, la table univariée affiche la répartition en pourcentages stricts. Dans le cas de variables purement ordinales (ex. : Débutant, Intermédiaire, Avancé), l’utilisateur a la possibilité de réorganiser manuellement les lignes par simple glisser-déposer pour restaurer la logique ascendante naturelle de l’échelle, rompant avec le tri alphabétique par défaut d’Excel. En cas d’adjonction de nouvelles lignes d’enquête dans la base source, un simple clic droit suivi de Actualiser remet la totalité du tableau à jour de manière instantanée.
9.2 Formules statistiques pour données non numériques
Pour les utilisateurs souhaitant concevoir des modèles d’analyse intégrés directement dans des feuilles de calcul sans dépendre des mécanismes d’actualisation des tableaux croisés dynamiques, Excel met à disposition un ensemble de fonctions logiques de dénombrement non métrique d’une grande efficacité. La fonction reine pour quantifier la fréquence absolue d’une modalité textuelle s’avère être =NB.SI(plage; critère). Par exemple, pour extraire le décompte exact d’individus détenant le statut « Cadre » au sein d’une variable signalétique occupant les cellules C2 à C151, la syntaxe s’établit comme suit :
=NB.SI($C$2:$C$151; « Cadre »)
Le calcul immédiat de la proportion relative (ou fréquence empirique) correspondante s’obtient en divisant ce résultat par le volume total d’observations non vides, capturé par la fonction NBVAL :
=NB.SI($C$2:$C$151; « Cadre ») / NBVAL($C$2:$C$151)
Il ne reste plus qu’à appliquer à la cellule le format d’affichage « Pourcentage » avec une ou deux décimales pour obtenir une présentation rigoureuse. L’environnement Excel offre en outre la possibilité de gérer des critères d’appariement complexes grâce aux caractères génériques (wildcards). L’astérisque (*), qui représente une séquence arbitraire de caractères, permet de procéder à des dénombrements thématiques au sein de questions à choix multiples concaténées dans une seule cellule textuelle : =NB.SI($C$2:$C$151; "*Anxiété*") dénombrera toute observation mentionnant le mot anxiété, quelle que soit sa position dans la chaîne de caractères recueillie.
9.3 Représentation graphique adaptée aux données catégorielles
La sémiologie graphique contemporaine impose des directives strictes quant au choix des représentations visuelles pour les dimensions qualitatives. Le diagramme en bâtons ou en barres représente le modèle canonique incontournable. Une règle d’ergonomie cognitive majeure préside à son orientation spatiale :
- Les diagrammes à colonnes verticales sont réservés aux variables ordinales dont les modalités jouissent d’une séquence directionnelle intuitive (ex. : de « Faible » à « Critique ») ou aux variables catégorielles comportant un nombre très restreint de modalités (moins de cinq) pourvues d’intitulés textuels courts.
- Les diagrammes à barres horizontales doivent être impérativement privilégiés dès lors que la variable nominale comporte de multiples modalités (plus de six) ou lorsque les libellés textuels sont longs et élaborés. L’orientation horizontale permet une lecture naturelle de gauche à droite sans inclinaison acrobatique des textes d’axe, garantissant une lisibilité optimale.
À l’inverse, l’usage des diagrammes circulaires (couramment appelés « camemberts » ou pie charts) fait l’objet d’une réprobation quasi unanime parmi les statisticiens et spécialistes de la visualisation de données. Le système visuel humain possède une très faible acuité pour évaluer et comparer avec précision des surfaces angulaires bidimensionnelles. Dès que le nombre de secteurs dépasse trois ou quatre, ou dès que les proportions relatives s’avèrent proches (par exemple, distinguer à l’œil un secteur de 23 % d’un secteur de 27 %), le diagramme circulaire devient illisible et induit des biais d’estimation massifs. De surcroît, les artifices décoratifs d’effets tridimensionnels (3D) offerts par Excel distordent dramatiquement les proportions géométriques par anamorphose perspective : les secteurs positionnés au premier plan apparaissent artificiellement hypertrophiés par rapport à ceux situés à l’arrière-plan. Enfin, pour maximiser l’efficience informative d’un diagramme en barres catégoriel nominal, il convient d’ordonner systématiquement les modalités par ordre décroissant de fréquence (diagramme de Pareto), facilitant l’identification instantanée des composantes prépondérantes.
10. Étude de cas empirique : Analyse complète d’un score psychométrique
10.1 Présentation du jeu de données et contexte expérimental
Afin de cristalliser l’ensemble des protocoles théoriques et des syntaxes de calcul exposés précédemment dans un cadre scientifique appliqué, nous déployons une étude de cas empirique intégrale. Imaginons un protocole de recherche conduit en psychologie clinique universitaire visant à mesurer la sévérité de l’anxiété pré-examen chez des étudiants de premier cycle confrontés à leur session terminale d’évaluations. Une cohorte probabiliste de n = 150 étudiants a été soumise à une passation standardisée de l’Inventaire d’Anxiété Situationnelle (IAS), un instrument psychométrique validé restituant un score global continu échelonné théoriquement de 0 point (sérénité absolue, absence totale de tension somatique ou cognitive) à 100 points (état de panique aiguë invalidante).
La variable d’intérêt continue, étiquetée Score_Anxiete, est hébergée sur la feuille de calcul Excel dans la plage unitaire allant de B2 à B151 (la cellule B1 hébergeant l’intitulé de la variable). Les questions de recherche univariées formulées par l’équipe d’investigation sont triples :
- Quel est le niveau d’anxiété typique de cette cohorte estudiantine, et cette tendance centrale est-elle adéquatement caractérisée par la moyenne arithmétique ou par la médiane ?
- Quelle est l’ampleur de la dispersion et de l’hétérogénéité émotionnelle des sujets au sein du groupe ?
- La distribution des scores respecte-t-elle le postulat de normalité gaussienne, ou révèle-t-elle des déviations morphologiques ou la présence d’individus aux profils cliniquement pathologiques (valeurs aberrantes supérieures) nécessitant un repérage et un soutien psychologique institutionnel ?
10.2 Mise en œuvre pas à pas des calculs sous Excel
Pour orchestrer cette investigation avec une rigueur totale, nous concevons un tableau descriptif dynamique sur une feuille dédiée. Ce tableau compile l’intégralité des formules statistiques natives nécessaires à l’analyse univariée. Le tableau ci-dessous explicite les syntaxes implémentées, les valeurs numériques empiriques obtenues sur notre cohorte de 150 étudiants, ainsi que la signification métrologique de chaque sortie :
| Paramètre statistique | Formule Excel appliquée | Valeur obtenue | Interprétation méthodologique |
|---|---|---|---|
| Effectif valide (n) | =NB(B2:B151) |
150 | Complétude intégrale de l’échantillon, aucune cellule vide. |
| Moyenne arithmétique | =MOYENNE(B2:B151) |
62,40 | Centre de gravité des scores d’anxiété de la cohorte. |
| Médiane | =MEDIANE(B2:B151) |
58,50 | 50 % des étudiants présentent un score ≤ 58,50 points. |
| Mode | =MODE.SIMPLE(B2:B151) |
55,00 | Score d’anxiété le plus fréquemment observé. |
| Minimum observé | =MIN(B2:B151) |
28,00 | Score d’anxiété le plus faible de la cohorte. |
| Maximum observé | =MAX(B2:B151) |
96,00 | Score d’anxiété le plus élevé de la cohorte. |
| Étendue globale | =MAX(B2:B151)-MIN(B2:B151) |
68,00 | Dispersion totale absolue de l’instrument sur l’échantillon. |
| Premier quartile (Q1) | =QUARTILE.INC(B2:B151; 1) |
47,25 | 25 % des scores sont inférieurs ou égaux à 47,25 points. |
| Troisième quartile (Q3) | =QUARTILE.INC(B2:B151; 3) |
74,00 | 75 % des scores sont inférieurs ou égaux à 74,00 points. |
| Écart interquartile (IQR) | =QUARTILE.INC(B2:B151; 3)-QUARTILE.INC(B2:B151; 1) |
26,75 | Largeur de l’intervalle hébergeant les 50 % centraux. |
| Variance d’échantillon (s²) | =VAR.S(B2:B151) |
248,38 | Dispersion quadratique moyenne (avec correction n-1). |
| Écart-type standard (s) | =ECARTYPE.STANDARD(B2:B151) |
15,76 | Variabilité standard moyenne autour de la moyenne. |
| Erreur-type de la moyenne | =ECARTYPE.STANDARD(B2:B151)/RACINE(NB(B2:B151)) |
1,29 | Précision de l’estimation de la moyenne populationnelle. |
| Coefficient de variation (CV) | =(ECARTYPE.STANDARD(B2:B151)/MOYENNE(B2:B151))*100 |
25,26 % | Variabilité relative modérée à substantielle du groupe. |
| Asymétrie (Skewness) | =COEFFICIENT.ASYMETRIE(B2:B151) |
+0,58 | Asymétrie positive modérée (traîne vers les scores sévères). |
| Aplatissement (Kurtosis) | =KURTOSIS(B2:B151) |
-0,31 | Légère platycurticité, absence de queues excessivement lourdes. |
L’examen simultané des indicateurs centraux révèle d’emblée une divergence informative capitale : la moyenne arithmétique (62,40) est nettement supérieure à la médiane (58,50), elle-même supérieure au mode (55,00). Cet étagement strict Mode (55) < Médiane (58,5) < Moyenne (62,4) constitue la signature géométrique indiscutable d’une distribution asymétrique positive, étirée vers les valeurs supérieures par une cohorte d’étudiants en détresse émotionnelle sévère.
L’évaluation des clôtures de Tukey permet ensuite de sonder mathématiquement la présence d’outliers cliniques. La borne supérieure se calcule via la formule :
Clôture_Supérieure = Q3 + (1,5 * IQR) = 74,00 + (1,5 * 26,75) = 74,00 + 40,125 = 114,125 points.
Le score maximal observé étant de 96 points (inférieur à 114,13), aucune observation ne franchit le seuil d’anomalie de Tukey. De même, sur le plan des scores Z, le score maximal de 96 points produit un écart centré réduit de :
z = (96 - 62,40) / 15,76 = +2,13.
Ce résultat étant inférieur au seuil critique de convention |z| > 3, nous concluons qu’aucun étudiant ne constitue une valeur aberrante statistique isolée au sens mathématique strict. Les scores élevés constituent une manifestation clinique authentique de détresse psychologique pré-examen au sein de la population étudiée.
10.3 Synthèse interprétative clinique et psychométrique
L’analyse univariée réalisée livre un diagnostic clinique et psychométrique sans ambiguïté. Le niveau d’anxiété globale de la cohorte étudiée est substantiellement élevé : la médiane s’établissant à 58,50 points et le premier quartile à 47,25 points, cela indique que plus de 75 % des participants manifestent une anxiété pré-examen nettement supérieure à la médiane normative théorique (fixée usuellement à 40 points sur cet instrument lors des périodes académiques régulières sans enjeu).
L’hétérogénéité des réactions émotionnelles est marquée, comme l’atteste un écart-type de 15,76 points et un coefficient de variation de 25,26 %. Bien que la majorité des étudiants parvienne à contenir son activation anxieuse dans une zone de stress adaptatif modéré (autour du mode à 55 points), la longue traîne d’asymétrie positive (g₁ = +0,58) confirme qu’une fraction substantielle de l’effectif bascule dans une symptomatologie aiguë. Plus précisément, l’examen des percentiles révèle que 25 % des étudiants (le quartile supérieur Q3) atteignent ou dépassent le seuil critique de 74 points, niveau couramment corrélé dans la littérature clinique à des blocages cognitifs majeurs, des insomnies sévères et une dégradation des performances mnésiques. Sur le plan de l’action institutionnelle, ces données univariées démontrent le bien-fondé du déploiement d’ateliers de gestion du stress et de cellules d’écoute psychologique dans les jours précédant l’ouverture de la session d’examens.
11. Restitution académique des résultats selon les normes de l’APA
11.1 Rédaction textuelle standardisée des statistiques univariées
La phase finale de la recherche quantitative consiste à restituer les indicateurs univariés au sein de publications savantes ou de rapports d’évaluation selon les normes internationales établies par l’American Psychological Association (APA 7e édition). La rigueur de la restitution impose des conventions typographiques et syntaxiques strictes qui ne souffrent aucun compromis :
- Toutes les abréviations alphabétiques représentant des statistiques empiriques ou des paramètres doivent être obligatoirement composées en italique : la moyenne est désignée par M, l’écart-type par SD (de l’anglais Standard Deviation, préconisé même en français dans les revues internationales), la médiane par Mdn, l’écart interquartile par IQR, l’effectif par n (pour un sous-groupe) ou N (pour la cohorte totale), et la valeur de probabilité par p. Les indices grecs en revanche ne s’italisent traditionnellement pas.
- Les règles d’arrondi décimal doivent être rigoureusement appliquées : il convient de rapporter la quasi-totalité des statistiques descriptives (moyenne, écart-type, quartiles) avec deux décimales. L’erreur commune consistant à copier-coller les huit décimales brutes générées par Excel est à proscrire impérativement.
- L’insertion textuelle doit intégrer harmonieusement les indicateurs de position et de dispersion : toute mention d’une mesure de tendance centrale doit être systématiquement et immédiatement associée à sa mesure de dispersion correspondante.
Voici un exemple paradigmatique de formulation académique conforme aux normes APA 7e édition pour la restitution de notre étude de cas :
« Les scores d’anxiété pré-examen enregistrés au sein de la cohorte (N = 150) révèlent une tendance centrale modérément élevée, caractérisée par une moyenne arithmétique de 62,40 points (SD = 15,76 ; IC à 95 % [59,85 ; 64,95]) et une médiane de 58,50 points (IQR = 26,75). La distribution des scores s’étend de 28,00 à 96,00 points et manifeste une asymétrie positive modérée (asymétrie = 0,58 ; aplatissement = -0,31), traduisant une concentration accrue des scores le long de l’extrémité clinique supérieure sans présence d’anomalies aberrantes multivariées. »
11.2 Conception de tables descriptives conformes aux revues à comité de lecture
L’insertion directe de captures d’écran de grilles de calcul Excel au sein d’un manuscrit scientifique constitue une faute méthodologique majeure. Les revues internationales à comité de lecture imposent une mise en forme typographique épurée pour les tables de statistiques descriptives, régie par des principes canoniques intangibles :
- Suppression intégrale des lignes verticales : Les tableaux ne doivent jamais comporter de quadrillage vertical. Seules trois lignes horizontales majeures sont autorisées : une bordure horizontale supérieure au-dessus des en-têtes de colonnes, une ligne horizontale délimitant la base des en-têtes, et une ligne horizontale de clôture marquant la fin du tableau avant les notes de bas de page.
- Alignement décimal rigoureux : Toutes les données numériques inscrites au sein d’une même colonne doivent être impérativement alignées sur la virgule décimale, facilitant la comparaison visuelle instantanée des grandeurs par le lecteur.
- Notes de tableau explicatives : Chaque table doit être autonome et immédiatement compréhensible sans recours obligé au corps de texte. Elle se structure avec un titre numéroté en italique en tête et se conclut par des notes générales (définissant les acronymes), spécifiques ou de probabilité initiées par la mention Note.
Voici l’architecture formelle d’un tableau synthétique univarié sous format APA, aisément transposable depuis Excel vers Microsoft Word :
| Variable psychométrique | n | M | SD | Mdn | IQR | Min | Max | Asymétrie |
|---|---|---|---|---|---|---|---|---|
| Score d’anxiété situationnelle (IAS) | 150 | 62,40 | 15,76 | 58,50 | 26,75 | 28,00 | 96,00 | 0,58 |
Note. N = 150. IAS = Inventaire d’Anxiété Situationnelle (échelle de 0 à 100). M = moyenne arithmétique ; SD = écart-type standard de l’échantillon ; Mdn = médiane ; IQR = écart interquartile (Q3 – Q1).
11.3 Exportation et intégration des visualisations graphiques
L’intégration d’histogrammes ou de diagrammes en boîte générés sous Excel dans des manuscrits scientifiques exige un travail de finition esthétique approfondi afin de se conformer au principe d’élégance sobre défendu par Edward Tufte. L’analyste doit impérativement purger le graphique Excel de tout « chartjunk » (éléments graphiques superflus qui encombrent l’espace visuel sans apporter d’information utile) :
- Supprimer les titres de graphiques intégrés directement dans l’image : dans un rapport académique, le titre figure obligatoirement en dessous ou au-dessus de la figure sous la forme d’une légende textuelle dactylographiée (ex. : Figure 1. Distribution des scores d’anxiété pré-examen).
- Éliminer les quadrillages d’arrière-plan lourds et sombres. S’ils sont nécessaires pour la lecture de valeurs d’ordonnées, les convertir en lignes très fines et discrètes de couleur gris clair.
- Bannir formellement les biseautages, ombres portées, dégradés de couleurs criards et autres représentations pseudo-tridimensionnelles (3D) proposées par les styles par défaut d’Excel. Les aplats de couleur doivent être sobres (nuances de gris, bleu marine ou teintes pastel neutres).
- Optimiser la résolution d’exportation : pour éviter toute pixellisation floue lors de l’impression, copier le graphique dans Excel et le coller dans Microsoft Word en utilisant la commande Coller spécial > Fichier image métafichier amélioré (.EMF) ou Graphique Microsoft Office lié. Ce procédé garantit un rendu vectoriel d’une netteté absolue quelle que soit la mise à l’échelle finale.
12. Erreurs fréquentes, biais méthodologiques et bonnes pratiques sous Excel
12.1 Biais de calcul et confusions récurrentes de formules
Même les analystes chevronnés commettent des bévues d’implémentation sous Excel en raison de confusions récurrentes de syntaxe ou d’incompréhensions algorithmiques sous-jacentes. L’erreur la plus ubiquitaire en biostatistique réside dans l’utilisation aveugle de la fonction =ECARTYPE.PEARSON (ou de l’ancienne syntaxe obsolète =ECARTYPEP) en lieu et place de =ECARTYPE.STANDARD. En divisant la somme des carrés des écarts par n au lieu de (n - 1), le chercheur applique l’estimateur biaisé de population, sous-estimant la variance réelle de son phénomène d’étude. Cette erreur se propage ensuite aux calculs d’erreurs-types et gonfle artificiellement le taux de faux positifs lors des démarches inférentielles subséquentes.
Un autre piège pernicieux réside dans la gestion asymétrique des zéros et des cellules vides. La fonction =MOYENNE(A1:A10) ignore purement et simplement les cellules contenant des vides stricts. Cependant, si l’opérateur a encodé le chiffre 0 pour signifier qu’un sujet n’a pas répondu ou que la mesure n’a pas été prise, Excel intègre ce zéro comme une valeur arithmétique pleine et entière, tirant artificiellement et violemment la moyenne vers le bas et gonflant démesurément la dispersion. Inversement, l’usage inconsidéré de la fonction NBVAL sur des cellules contenant des formules renvoyant une chaîne vide ("") comptabilise ces dernières comme des données valides, distordant les calculs de proportions relatives.
Enfin, la non-maîtrise de l’adressage absolu et dynamique des plages de cellules génère des décalages dramatiques lors du recopiage incrémentiel de formules. L’omission des symboles de dollar ($) pour verrouiller la matrice de référence (écrire D2:D151 au lieu de $D$2:$D$151) provoque un glissement progressif de la plage d’analyse lors du glissement de la formule vers le bas, altérant irrémédiablement l’intégrité des calculs statistiques sans lever le moindre code d’erreur.
12.2 Pièges visuels et manipulation involontaire de graphiques
La puissance graphique d’Excel peut involontairement se muer en un puissant vecteur de manipulation cognitive si l’analyste ne contrôle pas rigoureusement les propriétés métrologiques de ses axes. Le biais de visualisation le plus délétère concerne la troncature de l’axe des ordonnées sur les diagrammes à colonnes verticales. Par commodité de cadrage automatique, Excel choisit fréquemment d’ancrer la base de l’axe vertical non pas à zéro, mais à une valeur proche du minimum observé (par exemple, faire débuter l’axe à 50 pour une variable évoluant entre 55 et 65). Cet artifice produit un effet de loupe dramatiquement trompeur : un écart marginal de 2 points apparaît visuellement comme un doublement de la grandeur, induisant chez le lecteur une perception erronée de variabilité spectaculaire là où ne règne qu’une relative uniformité.
Un second piège réside dans le calibrage inadéquat des intervalles de classes lors du traçage d’histogrammes. Un choix arbitraire d’intervalles excessivement étroits fragmente la série et génère de multiples pics artificiels, incitant l’analyste à suspecter une bimodalité fantôme qui n’est que le reflet du bruit d’échantillonnage. Inversement, un regroupement en classes grossièrement larges noie les asymétries et étouffe la détection d’effets de plancher ou de plafond majeurs. L’analyste se conformera donc scrupuleusement aux algorithmes de discrétisation théoriques (tels que la règle de Sturges ou la règle de Freedman-Diaconis basée sur l’écart interquartile) pour fixer ses classes de manière objective et reproductible.
12.3 Protocole de contrôle qualité et audit des calculs
Pour prémunir les projets d’analyse quantitative contre les erreurs matérielles et garantir une traçabilité d’audit répondant aux critères scientifiques les plus exigeants, tout protocole sous Excel doit s’achever par une démarche d’assurance qualité documentée. Ce protocole de contrôle s’articule autour de trois impératifs méthodologiques :
- La vérification croisée triangulaire : Il est vivement recommandé de contrôler systématiquement les résultats produits par les formules manuelles écrites dans la feuille de travail en les comparant aux sorties générées de manière indépendante par l’Utilitaire d’analyse de données (Analysis ToolPak). Toute discordance numérique démasque immédiatement une erreur de sélection de plage ou une coquille de syntaxe.
- L’audit de dépendance et documentation des formules : En activant la commande Formules > Afficher les formules (ou le raccourci clavier
Ctrl + "), l’analyste peut embrasser d’un regard l’ensemble de l’architecture logicielle de sa feuille, s’assurant de la cohérence des références matricielles. L’outil Repérer les antécédents permet en outre de tracer visuellement par des flèches graphiques les cellules sources irriguant chaque calcul statistique d’agrégation. - Sanctuarisation et documentation métrologique : Pour assurer la reproductibilité de l’analyse, l’analyste doit adjoindre un onglet de métadonnées (ou dictionnaire de données) explicitant pour chaque colonne la désignation textuelle complète, l’unité de mesure physique, l’échelle métrologique sous-jacente, la signification des codes de substitution et les éventuelles opérations d’inversion ou de standardisation opérées. Enfin, la protection en écriture des cellules hébergeant les formules fondamentales (via la commande Protéger la feuille) prémunit la base contre tout écrasement accidentel lors des manipulations quotidiennes.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bessel, F. W. (1815). Über den Ort des Polarsterns. Astronomisches Jahrbuch für das Jahr 1818, 233-240.
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
Microsoft Corporation. (2023). Documentation sur les fonctions statistiques dans Microsoft Excel. Microsoft Support. https://support.microsoft.com/fr-fr/office/fonctions-statistiques-r%C3%A9f%C3%A9rence
Pearson, K. (1895). Contributions to the mathematical theory of evolution.—II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343-414. https://doi.org/10.1098/rsta.1895.0010
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65-66. https://doi.org/10.1080/01621459.1926.10502161
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
West, S. G., Finch, J. F., & Curran, P. J. (1995). Structural equation models with nonnormal variables: Problems and remedies. In R. H. Hoyle (Ed.), Structural equation modeling: Concepts, issues, and applications (pp. 56-75). Sage Publications, Inc.
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10