
La recherche empirique en psychologie et en sciences comportementales repose fondamentalement sur la rigueur de l’inférence statistique. Lorsqu’il s’agit d’analyser des variables catégorielles, les chercheurs se tournent traditionnellement vers le test d’indépendance du khi-carré de Pearson. Toutefois, la réalité du terrain clinique, de la neuropsychologie expérimentale ou de l’étude de populations marginalisées confronte régulièrement les investigateurs à des contraintes d’échantillonnage sévères. Face à des cohortes restreintes, des événements rares ou des distributions asymétriques où les effectifs théoriques s’effondrent sous les seuils d’admissibilité asymptotique, l’utilisation aveugle du khi-carré expose à un risque majeur de biais de décision statistique, menaçant la reproductibilité des conclusions scientifiques.
Dans ce contexte méthodologique précis, le test exact de Fisher s’impose comme la référence méthodologique absolue pour l’analyse des tables de contingence deux par deux, et plus largement pour les agencements discrets de petite taille. Conçu pour calculer la probabilité exacte d’observer une distribution de fréquences donnée sous l’hypothèse nulle d’indépendance, il affranchit l’analyste des approximations d’échantillonnage propres aux distributions continues. Néanmoins, l’application d’un test exact ne constitue que la première étape d’une démarche scientifique valide : la restitution textuelle, tabulaire et interprétative de ses résultats dans un manuscrit scientifique conditionne directement la transparence et la portée des découvertes auprès de la communauté des pairs.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, doctorants et cliniciens dans la maîtrise intégrale du rapportage du test exact de Fisher, en parfaite conformité avec les directives de la 7e édition des normes de l’American Psychological Association (APA). Des fondements probabilistes sous-jacents aux formulations narratives canoniques, en passant par le calcul impératif des tailles d’effet, l’arbitrage entre tests uni- et bilatéraux et la transcription des sorties des principaux logiciels statistiques, ce document détaille chaque étape rédactionnelle pour transformer une simple sortie logicielle en un compte rendu académique irréprochable et méthodologiquement étanche.
1. Fondements théoriques et pertinence du test exact de Fisher en psychologie
1.1 Nature et logique mathématique du test exact
Le test exact de Fisher repose sur une approche mathématique radicalement différente de celle des tests asymptotiques traditionnels. Alors que le test d’indépendance du khi-carré compare une statistique observée à une distribution théorique continue qui n’est valide qu’à l’infini (la distribution du khi-carré), le test développé par Sir Ronald Aylmer Fisher calcule la probabilité combinatoire exacte de la disposition des fréquences observées sous l’hypothèse nulle. Cette prouesse calculatoire repose directement sur la loi hypergéométrique, une loi de probabilité discrète décrivant les tirages simultanés ou successifs sans remise au sein d’une population finie composée de deux catégories mutuellement exclusives.
Le mécanisme central du test repose sur le conditionnement par les totaux marginaux du tableau de contingence. Fisher a postulé que si les marges horizontales (les totaux par ligne) et les marges verticales (les totaux par colonne) sont considérées comme fixes et connues a priori, la variabilité aléatoire de la table entière se résume à la valeur prise par une seule de ses cellules. Dès lors, la probabilité d’obtenir une configuration spécifique de fréquences conjointes se formule comme le produit des combinaisons des effectifs marginaux divisé par la combinaison de l’effectif global. En sommant les probabilités hypergéométriques de la table observée et de toutes les tables théoriquement possibles qui présentent un déséquilibre plus marqué encore en faveur de l’association postulée, le test délivre une valeur p rigoureusement exacte, exempte de toute distorsion d’approximation.
Cette divergence épistémologique entre probabilité exacte et approximation asymptotique est cruciale pour le chercheur en psychologie. Lorsque les hypothèses de grand échantillon sont violées, la statistique du khi-carré ne suit plus fidèlement la distribution tabulée, ce qui dérègle le taux d’erreur de type I (α), conduisant soit à une inflation des faux positifs, soit à une perte dramatique de puissance statistique. Le test de Fisher évite ces écueils en fournissant une valeur de probabilité empirique pure, ancrée dans la réalité combinatoire des données recueillies sans recourir à un artifice de lissage infinitésimal.
1.2 Critères d’application face au test d’indépendance du khi-carré
L’arbitrage méthodologique entre le test du khi-carré et le test exact de Fisher s’articule autour des caractéristiques distributives de la table de contingence. La règle décisionnelle canonique la plus répandue en psychométrie découle des travaux fondateurs de William Gemmell Cochran. Selon la règle empirique de Cochran, l’approximation du khi-carré s’avère recevable si aucune cellule du tableau croisé ne possède un effectif théorique (attendu) inférieur à 1, et si au moins 80 % des cellules présentent des effectifs théoriques strictement supérieurs ou égaux à 5. Dans une table de contingence élémentaire de format deux par deux comportant quatre cellules, cette exigence implique qu’aucune cellule ne doit afficher un effectif théorique inférieur à 5.
Dès l’instant où un seul effectif théorique descend sous cette barre critique de 5, la probabilité asymptotique calculée par le khi-carré perd sa robustesse, augmentant significativement le risque de rejeter à tort l’hypothèse nulle ou de masquer des associations réelles. Le test de Fisher devient alors le recours obligatoire. En recherche clinique, expérimentale ou en psychopathologie, où les groupes de participants sont structurellement contraints par la rareté des phénotypes ou la lourdeur des protocoles d’intervention, cette situation de violation des effectifs attendus représente la norme plutôt que l’exception.
En outre, l’asymétrie sévère des distributions marginales constitue un facteur aggravant souvent sous-estimé dans les écrits académiques. Même en présence d’un effectif total qui semblerait superficiellement suffisant (par exemple, un échantillon total de 40 participants), si une variable présente un déséquilibre marginal prononcé — comme un groupe clinique ne comprenant que 6 individus face à 34 témoins sains —, les fréquences attendues pour les cellules croisant ce groupe rare avec une issue clinique peu fréquente s’effondrent mécaniquement sous le seuil de Cochran. Dans ces conditions de marginales fortement polarisées, le recours au test de Fisher ne relève pas d’une simple option stylistique, mais d’un impératif de validité interne incontournable.
1.3 Rôle du test dans les protocoles de recherche en psychologie
L’utilisation du test exact de Fisher s’avère fondamentale dans les designs expérimentaux et quasi-expérimentaux propres aux sous-disciplines de la psychologie contemporaine. En psychopathologie et en neuropsychologie clinique, les protocoles impliquent fréquemment l’évaluation de cohortes hautement sélectionnées, à l’instar de patients présentant des lésions cérébrales focales exceptionnelles, des syndromes génétiques orphelins ou des profils de pharmacorésistance sévères. Dans ces cohortes, la taille de l’échantillon ne peut matériellement pas être accrue à volonté ; l’analyse de contingence binaire (par exemple, succès thérapeutique versus échec) exige un outil d’inférence capable de garantir une étanchéité probabiliste totale malgré la faiblesse numérique des effectifs.
En psychologie cognitive et comportementale, le test de Fisher trouve une pertinence toute particulière lors du recueil de données issues de paradigmes de choix forcés ou de prises de décision morales en situation extrême. Dans ces paradigmes, le comportement cible peut se manifester avec une prévalence marginale, engendrant des tables de contingence très creuses. De même, les recherches de terrain s’intéressant à des populations d’accès difficile, telles que les individus sans domicile fixe souffrant de comorbidités psychiatriques complexes ou les victimes de traumatismes aigus récents, génèrent des données qualitatives hautement sensibles où chaque observation individuelle pèse lourdement sur la configuration globale du tableau.
Enfin, dans le champ des petits essais contrôlés randomisés (ECR) pilotes évaluant des innovations psychothérapeutiques, la vérification de l’homogénéité des groupes pré-intervention et le calcul exact des taux de rémission post-intervention reposent sur ce test. Il assure aux évaluateurs que les effets de catégorisation observés ne procèdent pas d’artefacts d’échantillonnage, garantissant un contrôle impeccable du risque d’erreur de type I avant de décider de la transposition de l’intervention à des cohortes de grande envergure.
2. Justification méthodologique de l’emploi du test dans le manuscrit
2.1 Rédaction de la sous-section Analyse des données
L’intégration du test exact de Fisher dans un manuscrit conforme aux exigences académiques débute bien en amont de la section des résultats. Elle requiert une explicitation transparente et précoce au sein de la sous-section consacrée à la stratégie analytique dans la partie Méthode. Le rédacteur doit y formaliser les raisons méthodologiques qui justifient la déviation par rapport au test classique du khi-carré de Pearson, prévenant ainsi les interrogations légitimes des évaluateurs quant à la pertinence du choix statistique.
Cette description doit obligatoirement définir les variables qualitatives catégorielles mises en relation, en spécifiant leurs modalités mutuellement exclusives et exhaustives. Il convient d’indiquer sans ambiguïté si l’analyse vise à tester l’indépendance de deux facteurs observés ou à comparer les distributions de proportions entre deux populations indépendantes. L’identification rigoureuse des variables indépendantes et dépendantes permet d’ancrer le test de contingence dans le modèle conceptuel de l’étude.
Par ailleurs, la rigueur de la science ouverte exige la mention scrupuleuse de l’environnement logiciel employé pour conduire l’inférence. Le chercheur doit déclarer le nom du programme statistique, sa version exacte, ainsi que les packages spécialisés le cas échéant. Qu’il s’agisse de la fonction de base d’un environnement comme The R Project for Statistical Computing, d’un module d’IBM SPSS Statistics, ou d’outils open-source tels que JASP ou jamovi, la reproductibilité computationnelle du calcul dépend entièrement de cette transparence documentaire.
2.2 Documentation de la violation des effectifs attendus
Pour qu’un comité de lecture valide l’emploi du test exact de Fisher, la démonstration empirique de la défaillance des postulats asymptotiques doit être formellement documentée dans le texte. Il est méthodologiquement insuffisant d’affirmer de manière générique que l’échantillon était « de petite taille ». Le texte doit rapporter avec exactitude le pourcentage de cellules du tableau de contingence dont l’effectif attendu descend en deçà du seuil critique de 5, ainsi que la valeur minimale absolue des effectifs théoriques calculés.
Cette documentation chiffrée prend généralement la forme d’une phrase explicative insérée soit en préambule du résultat, soit dans la méthodologie d’analyse : par exemple, le chercheur précisera qu’en raison de la présence de 50 % de cellules présentant un effectif théorique attendu inférieur à 5 (avec une fréquence théorique minimale observée de 1,82), le test exact de Fisher a été substitué au test d’indépendance du khi-carré. Cette formulation élimine toute suspicion d’arbitraire ou de sélection opportuniste de test statistique.
Dans cette même perspective, il est hautement recommandé d’expliciter le rejet des corrections de continuité traditionnelles, telle que la correction de Yates pour le khi-carré. Bien que la correction de Yates ait été historiquement conçue pour réduire l’erreur asymptotique sur les tables deux par deux de taille modeste, la littérature biométrique contemporaine a démontré qu’elle tend à se montrer indûment conservatrice, entraînant une diminution notable de la puissance statistique. Le recours direct au test exact de Fisher offre une solution mathématiquement élégante et intrinsèquement exacte, rendant les approximations corrigées parfaitement superflues.
2.3 Formulation des hypothèses statistiques sous-jacentes
Toute démarche d’inférence statistique gagne en clarté dès lors que les hypothèses sous-jacentes sont formulées avec une précision chirurgicale. Dans le cadre du test de Fisher, l’hypothèse nulle statistique ($H_0$) postule l’indépendance stochastique absolue entre les deux variables catégorielles considérées. En termes épidémiologiques et psychologiques, cela revient à affirmer que la distribution relative des modalités de la variable d’intérêt au sein du premier groupe est strictement identique à celle observée au sein du second groupe, ce qui équivaut à un rapport des cotes (Odds Ratio) théorique égal à 1,00.
L’hypothèse alternative ($H_1$), quant à elle, doit faire l’objet d’une déclaration réfléchie quant à sa directionnalité. Dans une approche bidirectionnelle (bilatérale), $H_1$ affirme simplement l’existence d’une dépendance ou d’une différence de proportions sans préjuger du sens du déséquilibre observé. Si le chercheur postule a priori une hypothèse directionnelle unilatérale — par exemple, l’affirmation théoriquement étayée qu’une thérapie comportementale ciblée entraînera nécessairement un taux de rémission supérieur au traitement usuel —, cette orientation doit être explicitée et verrouillée avant toute inspection des données empiriques.
Enfin, la question de la puissance statistique a priori doit être abordée avec lucidité intellectuelle. Dans les contextes où le test de Fisher est mobilisé, les contraintes d’échantillonnage limitent fréquemment la puissance statistique nominale (la probabilité $1 – \beta$ de détecter un effet réel). Mentionner ces contraintes dès l’élaboration des hypothèses témoigne d’une probité scientifique indispensable, évitant de surinterpréter ultérieurement un résultat statistiquement non significatif comme la preuve formelle d’une absence d’effet dans la population générale.
3. Directives de rédaction selon les normes de l’APA (7e édition)
3.1 Typographie statistique et conventions de formatage
L’American Psychological Association a établi, dans sa 7e édition, des normes typographiques extrêmement précises pour l’ensemble des grandeurs mathématiques rapportées dans un manuscrit scientifique. En ce qui concerne le test exact de Fisher, la lettre latine désignant la probabilité critique, la lettre p, doit impérativement être typographiée en caractères italiques et en bas de casse. L’emploi fautif d’une majuscule (P) ou d’un caractère romain standard (p) constitue une infraction élémentaire aux standards éditoriaux internationaux.
Une règle cardinale de l’APA concerne l’omission du zéro initial devant les valeurs numériques dont la limite théorique ne peut en aucun cas excéder 1,00. Étant donné qu’une probabilité statistique est par définition strictement bornée au sein de l’intervalle fermé $[0, 1]$, le chiffre zéro précédant le séparateur décimal doit être systématiquement éliminé dans les publications anglophones (ex. p = .034). En langue française académique, bien que l’usage de la virgule décimale demeure la norme typographique nationale, de nombreuses revues psychologiques internationales francophones tolèrent ou préconisent la suppression du zéro initial sous la forme p = ,034, ou adoptent les conventions typographiques anglophones pour faciliter l’indexation internationale. Il importe de vérifier la ligne éditoriale précise de la revue visée.
La particularité structurelle majeure du test exact de Fisher réside dans son absence de degré de liberté ($dl$ ou $df$) dans sa formulation textuelle. Contrairement au test du khi-carré qui requiert la spécification systématique de ses degrés de liberté — par exemple $\chi^2(1, N = 40) = 4,52$ —, la distribution hypergéométrique ne repose sur aucun paramètre de liberté asymptotique. Ainsi, le chercheur ne doit en aucun cas fabriquer artificiellement un paramètre inexistant tel que « F(1) » ou « Fisher(1) ». La statistique s’exprime uniquement à travers sa valeur de probabilité exacte, accompagnée de la taille de l’échantillon global N et de la métrique de taille d’effet correspondante.
3.2 Précision et seuils de signification statistique
Les directives de l’APA imposent de rapporter la valeur numérique exacte de la probabilité p avec une précision de deux ou trois décimales (par exemple, p = .023 ou p = .418), plutôt que de se retrancher derrière des seuils d’inégalité génériques tels que p < .05 ou ns (non significatif). La communication de la valeur exacte permet au lecteur d’évaluer avec finesse la proximité des données vis-à-vis du seuil de décision conventionnel et facilite les futures synthèses méta-analytiques.
La seule exception formelle à cette règle de précision exacte concerne les probabilités infinitésimales générées par des déséquilibres massifs au sein de données très contrastées. Lorsque le logiciel d’analyse affiche une valeur arrondie à p = .000 (ce qui correspond informatiquement à un arrondi d’une probabilité inférieure à .0005), il ne faut jamais écrire « p = .000 », car une probabilité ne saurait être rigoureusement nulle dans le cadre d’un échantillonnage aléatoire. La convention APA impose de retranscrire ce résultat sous la forme stricte de p < .001.
Il convient de bannir formellement les périphrases équivoques et les formules stylistiques obsolètes relatives aux prétendues « tendances statistiques marginales » (ex. « une tendance vers la significativité a été observée, p = .072 »). Sous le paradigme décisionnel de Neyman-Pearson, l’inférence obéit à un critère dichotomique préétabli par le seuil α. Un résultat est soit statistiquement significatif au seuil retenu, soit non significatif. Le recours à des qualificatifs flous tend à introduire un biais de confirmation interprétatif unanimement réprouvé par les relecteurs méthodologiques.
3.3 Harmonisation stylistique dans la section Résultats
La section Résultats ne doit pas consister en une énumération télégraphique de métriques isolées entre parenthèses, mais en un récit fluide où les indices statistiques complètent naturellement la démonstration théorique. L’harmonisation stylistique exige une concordance stricte entre l’affirmation verbale décrivant la direction de l’effet observé et les grandeurs mathématiques présentées. Par exemple, affirmer qu’un groupe présente un « taux de succès notablement plus élevé » impose que cette supériorité soit immédiatement étayée par les pourcentages correspondants et la mesure de taille d’effet appropriée.
Le choix des temps verbaux obéit à des conventions académiques immuables. Le chercheur relate des opérations de collecte et des observations qui appartiennent désormais au passé de l’expérimentation ; l’usage du passé composé ou du passé simple (selon la convention stylistique de la revue) s’impose pour décrire les constatations empiriques (« le test exact de Fisher a révélé une association… », « la proportion de rémission a été significativement plus élevée… »). L’imparfait peut être convoqué pour expliciter des contextes méthodologiques préalables.
L’insertion des résultats statistiques doit s’opérer de manière organique dans le corps du texte. Les parenthèses statistiques doivent s’intégrer en fin de proposition ou s’arrimer immédiatement à l’élément démonstratif qu’elles soutiennent. L’enchaînement canonique recommande de formuler d’abord le constat qualitatif en langage naturel, d’indiquer les données descriptives entre parenthèses, puis d’énoncer le verdict inférentiel scellé par la probabilité exacte et la taille d’effet.
4. La structure narrative canonique du paragraphe de résultats
4.1 Énoncé contextuel et identification des variables
L’ouverture du paragraphe de résultats doit immédiatement situer l’enjeu conceptuel de l’analyse menée. Le lecteur ne doit à aucun moment éprouver le sentiment d’une rupture narrative entre la présentation théorique du problème psychologique et l’apparition des données de contingence. L’investigateur prendra soin de rappeler brièvement la question de recherche spécifique et d’identifier avec clarté les deux variables qualitatives soumises à l’épreuve du test croisé.
Il est impératif de déclarer le nombre total de participants ($N$) effectivement inclus dans l’analyse de contingence. Si des données manquantes ont conduit à l’exclusion de certaines observations préalablement décrites dans la sous-section Échantillon de la méthode, cette diminution de l’effectif valide analysé doit être explicitée sans détour afin de garantir une comptabilité des effectifs parfaitement transparente.
L’énoncé contextuel se conclut par l’affirmation formelle de l’outil statistique déployé, prévenant toute ambiguïté quant au modèle d’inférence sélectionné. Une formulation typique débutera par une structure du type : « Afin d’évaluer l’existence d’une association entre la modalité de prise en charge psychothérapeutique et le statut clinique post-intervention, un test exact de Fisher a été réalisé sur l’ensemble de la cohorte analysable ($N = 32$). »
4.2 Exposé descriptif des proportions observées
Le cœur informatif de la description statistique repose sur la présentation conjointe et équilibrée des effectifs bruts (les fréquences absolues, notées $n$) et des fréquences relatives correspondantes (les pourcentages, notés %). La communication exclusive des pourcentages sans leurs effectifs bruts sous-jacents constitue une faute méthodologique majeure dans les études sur petits échantillons, car un taux apparemment spectaculaire de 75 % peut simplement masquer une réalité numérique de 3 observations sur un groupe de 4 individus.
Le chercheur doit veiller à orienter le calcul de ses pourcentages dans le sens logique de l’inférence théorique. Lorsque l’on étudie l’impact d’une condition d’exposition ou d’une appartenance à un groupe clinique (variable indépendante en ligne) sur une issue comportementale ou symptomatique (variable dépendante en colonne), les pourcentages doivent impérativement être exprimés en pourcentages intra-groupes (pourcentages en ligne). Cette présentation permet une comparaison intuitive directe des probabilités conditionnelles de survenue de l’événement cible d’un groupe à l’autre.
La clarté rédactionnelle implique de mettre en exergue le contraste empirique fondamental qui structure la table. Par exemple, il convient de spécifier que « parmi les participants ayant suivi le protocole d’exposition virtuelle narrative, 9 sur 12 (75,0 %) ont atteint les critères de réponse clinique, contre seulement 3 sur 14 (21,4 %) au sein du groupe assigné à la thérapie supportive conventionnelle ». Cette mise en mots prépare rigoureusement l’esprit du lecteur à accueillir le test d’hypothèse qui lui succède immédiatement.
4.3 Conclusion inférentielle et rattachement théorique
Une fois les jalons contextuels posés et les métriques descriptives exposées, le paragraphe doit formuler la conclusion inférentielle de manière formelle. Cette conclusion stipule si la disparité observée dans les données d’échantillon permet ou non de rejeter l’hypothèse nulle d’indépendance au seuil critique $\alpha$ prédéterminé (usuellement fixé à .05 dans les sciences humaines et du comportement).
La statistique inférentielle ne prend son plein sens que lorsqu’elle est directement réarrimée à la problématique psychologique initiale. Le rédacteur ne doit pas se borner à conclure froidement à « une liaison statistiquement significative entre la variable A et la variable B », mais expliciter la portée concrète de cette association quant aux processus psychologiques sous-jacents. Ce rattachement conceptuel permet de boucler la boucle narrative amorcée lors de l’introduction contextuelle du résultat.
Une mise en garde épistémologique stricte s’impose néanmoins à ce stade : le test exact de Fisher teste une simple dépendance distributionnelle ou une disparité de proportions dans une table de contingence. En aucun cas il n’autorise, à lui seul, des déductions de nature strictement causale. Sauf dans le cadre très contrôlé d’un essai randomisé prévoyant une manipulation expérimentale pure sans biais de confusion potentiel, le chercheur doit s’interdire toute affirmation suggérant que la première variable « produit », « provoque » ou « détermine » directement la variation de la seconde. Les termes d’« association », de « concordance » ou de « disparité significative » doivent être privilégiés avec discernement.
5. Gestion et rapportage des valeurs p unilatérales et bilatérales
5.1 Distinction conceptuelle entre approche unilatérale et bilatérale
La gestion de la bilatéralité constitue l’un des aspects les plus délicats et méthodologiquement controversés de l’utilisation du test exact de Fisher. Dans un test unilatéral (à une queue), la probabilité $p$ s’obtient simplement en additionnant la probabilité hypergéométrique de la table observée à celles de toutes les tables théoriquement possibles partageant les mêmes marges fixes et présentant une déviation encore plus extrême dans la direction théoriquement prédite. Ce calcul ne pose aucune ambiguïté mathématique.
En revanche, la transposition bilatérale (à deux queues) soulève des difficultés computationnelles majeures en raison de la nature asymétrique de la distribution hypergéométrique lorsque les totaux marginaux sont déséquilibrés. Contrairement à la courbe de Gauss ou à la distribution de Student qui sont parfaitement symétriques autour de leur moyenne, la distribution des probabilités hypergéométriques ne possède pas d’axe de symétrie naturel. Deux approches mathématiques principales s’opposent alors : la méthode originelle préconisée par Fisher (connue sous le nom de méthode par seuil de probabilité ou point-probability approach), qui somme les probabilités de toutes les tables dont la vraisemblance est inférieure ou égale à celle de la table observée, et l’approche consistant à doubler purement et simplement la valeur de la probabilité unilatérale.
L’arbitrage post-hoc vers un test unilatéral après avoir pris connaissance des données est unanimement condamné par la déontologie scientifique contemporaine. Modifier l’orientation du test pour transformer un résultat bilatéral marginalement non significatif (par exemple, $p = .076$) en un résultat unilatéral artificiellement significatif ($p = .038$) représente une pratique de recherche douteuse (dite p-hacking) qui gonfle dramatiquement le taux réel d’erreur de type I. Toute décision de directionnalité doit être hermétiquement verrouillée en amont de la phase de dépouillement statistique.
5.2 Justification théorique préalable du test unilatéral
Bien que les standards académiques contemporains découragent l’emploi des tests à une queue en l’absence de contraintes structurelles exceptionnelles, le recours à une valeur $p$ unilatérale peut demeurer méthodologiquement acceptable sous réserve d’une justification théorique irréprochable. Cette légitimité repose aujourd’hui quasi-exclusivement sur la pratique du pré-enregistrement des protocoles de recherche auprès de registres ouverts reconnus (tels que l’Open Science Framework ou ClinicalTrials.gov).
Si le manuscrit s’appuie sur une hypothèse formellement directionnelle étayée par un corpus théorique inattaquable ou des données de réplication directe, l’investigateur doit expliciter ce positionnement dès la section Méthode. Il est formellement exigé d’exposer la rationalité conceptuelle qui rendait invraisemblable, voire totalement dénuée de sens théorique, une variation empirique s’orientant dans la direction inverse de celle postulée.
Sur le plan textuel, chaque fois qu’un test unilatéral est retenu, la transparence éditoriale commande d’en faire la notification explicite au lecteur à proximité immédiate de la statistique rapportée. L’abréviation de la valeur $p$ doit alors être précisée entre parenthèses sous une graphie sans équivoque, telle que p (unilatéral) = .028 ou p (1-tailed) = .028 selon la langue de rédaction de la revue scientifique ciblée.
5.3 Pratique standard et recommandation académique universelle
Face à la pluralité des méthodes de calcul de la bilatéralité et aux risques inhérents de sélection post-hoc, la communauté des éditeurs et réviseurs en psychologie a établi une règle d’usage sans équivoque : l’approche bilatérale représente le choix par défaut, la norme incontournable de rigueur académique. Sauf mention explicite et justifiée en amont, tout résultat rapporté sans qualificatif est présumé procéder d’une inférence bilatérale.
La règle d’or pour les auteurs consiste à dissiper d’emblée toute ambiguïté de lecture en précisant systématiquement la nature bilatérale du test dans le corps du texte ou en note de bas de tableau. L’utilisation d’une mention clarifiée comme « test exact de Fisher bilatéral » prévient toute conjecture de la part d’un relecteur suspicieux quant à un éventuel basculement opportuniste vers un seuil unilatéral.
Il importe enfin de souligner les divergences d’interprétation clinique que ces choix induisent. Adopter une démarche bilatérale témoigne d’une posture épistémologique humble, reconnaissant la possibilité inhérente que des interventions psychologiques ou des facteurs cognitifs puissent produire des résultats contre-intuitifs, voire délétères, qu’un test unilatéral ignorerait par construction mathématique en assimilant tout effet inverse au simple hasard de l’échantillonnage.
6. Calcul et communication des tailles d’effet complémentaires
6.1 L’Odds Ratio (rapport des cotes) et son intervalle de confiance
L’une des dérives les plus sévèrement critiquées par la 7e édition des normes APA consiste à réduire le résultat d’une inférence à sa seule valeur de significativité statistique ($p$). Une probabilité ne fournit aucune indication sur l’amplitude, l’intensité ou la portée pratique d’un phénomène comportemental. Pour les tables de contingence deux par deux, la métrique de taille d’effet standard par excellence est l’Odds Ratio (OR), désigné en français sous le terme de rapport des cotes.
L’Odds Ratio quantifie le rapport entre la cote d’apparition d’un événement au sein d’un groupe exposé (ou clinique) et la cote d’apparition de ce même événement au sein d’un groupe témoin (ou contrôle). Une cote (odds) se définit comme le ratio entre la probabilité de survenue d’un phénomène et la probabilité de sa non-survenue ($P / (1 – P)$). Un Odds Ratio strictement égal à 1,00 traduit une égalité d’association parfaite, signifiant que la cote de l’issue clinique est strictement identique quel que soit le groupe d’appartenance. Une valeur substantiellement supérieure à 1,00 caractérise une augmentation du risque ou de la probabilité de l’issue, tandis qu’une valeur inférieure à 1,00 reflète un rôle protecteur ou réducteur de la condition observée.
La déclaration éditoriale d’un Odds Ratio doit impérativement s’accompagner de son intervalle de confiance à 95 % (IC 95 %). L’intervalle de confiance reflète l’imprécision statistique inhérente à l’échantillonnage : un intervalle de confiance exceptionnellement large — situation fréquente avec les très faibles effectifs — avertit le lecteur que, bien que l’estimation ponctuelle semble élevée, la véritable magnitude du phénomène dans la population sous-jacente demeure mal circonscrite. L’intégration textuelle canonique s’articule ainsi : $OR = 4,50$, IC 95 % $[1,15, 17,62]$. Sur le plan clinique, un chercheur pourra traduire cette métrique en expliquant que les participants sous condition expérimentale possèdent une cote de rémission 4,50 fois supérieure à celle des participants sous condition témoin.
6.2 Le coefficient Phi (φ) et le V de Cramer
Dans les contextes de psychologie différentielle, psychométrique ou expérimentale, les investigateurs préfèrent fréquemment exprimer l’intensité d’une association sous la forme d’un indice de corrélation standardisé normalisé entre -1,00 et +1,00 (ou entre 0,00 et 1,00). Pour une table de contingence binaire de dimension 2 × 2, le coefficient Phi (φ) constitue l’indicateur d’association privilégié, mathématiquement équivalent au coefficient de corrélation de Pearson calculé sur deux variables dichotomiques codées 0 et 1.
L’interprétation de la magnitude du coefficient φ s’appuie généralement sur les repères conventionnels établis par Jacob Cohen : une valeur de φ avoisinant 0,10 reflète un effet de faible amplitude ; une valeur comprise autour de 0,30 dénote un effet de magnitude moyenne ; et un coefficient atteignant ou dépassant 0,50 caractérise une association d’intensité forte. Lorsque la table s’étend au-delà de deux lignes ou deux colonnes, le coefficient Phi laisse place au V de Cramer ($V$), lequel applique un ajustement mathématique prenant en compte les dimensions dimensionnelles minimales de la table.
Cependant, le rédacteur rigoureux doit garder à l’esprit une limitation psychométrique majeure de ces indices : le coefficient Phi est extrêmement sensible aux distributions marginales inégales. Dès lors que les fréquences marginales s’écartent sensiblement d’une répartition 50/50, la valeur maximale théorique que peut mathématiquement atteindre le coefficient φ est drastiquement tronquée, plafonnant fréquemment à des valeurs bien inférieures à 1,00. Rapporter l’Odds Ratio en conjonction avec le coefficient φ permet d’offrir au lecteur une vision pluridimensionnelle de la force de la relation étudiée.
6.3 Le risque relatif (RR) et la différence de proportions
Dans le domaine des essais cliniques randomisés ou des protocoles d’études de cohortes prospectives, le Risque Relatif ($RR$) et la Différence de Proportions ($DP$) — ou Réduction Absolue du Risque ($RAR$) — représentent des métriques éminemment informatives, souvent bien plus aisément appréhendées par les cliniciens que le rapport des cotes.
Le risque relatif compare directement la probabilité de survenue d’un événement au sein d’un groupe par rapport à un autre ($P_1 / P_2$). Contrairement à l’Odds Ratio qui calcule un ratio de cotes mathématiques, le $RR$ raisonne sur le ratio des proportions brutes. Il requiert néanmoins que le dispositif méthodologique soit strictement prospectif ou expérimental ; dans une étude cas-témoins rétrospective où les ratios de sujets sont arbitrairement fixés par l’expérimentateur, le calcul du risque relatif est formellement interdit, seul l’Odds Ratio restant valide.
La différence de proportions offre l’avantage indéniable d’une intuitivité clinique totale : déclarer que l’écart absolu de réponse thérapeutique entre deux groupes s’élève à 35,0 % (IC 95 % $[12,1 %, 57,9 %]$) s’avère immédiatement compréhensible pour tout lecteur profane ou praticien de santé mentale. Pour incorporer harmonieusement ces grandeurs dans le manuscrit, l’auteur formulera une phrase liant la statistique inférentielle de Fisher à cette métrique de santé publique : « L’incidence des épisodes d’abandon était significativement plus basse dans le protocole bref que dans la condition standard ($RR = 0,33$, IC 95 % $[0,12, 0,89]$, test exact de Fisher $p = .021$). »
7. Mise en page des tableaux de contingence selon les critères de publication
7.1 Organisation visuelle de la table de contingence APA
L’esthétique et la conformité visuelle des tableaux dans les manuscrits scientifiques régis par les normes APA obéissent à un principe de sobriété draconien. La règle fondamentale réside dans l’éradication absolue de toute ligne verticale. Un tableau académique selon l’APA ne doit jamais comporter de quadrillage ou de bordures séparatrices de colonnes. Seules trois lignes horizontales principales doivent composer la structure de base : une première ligne fermant le haut du tableau sous le titre, une deuxième ligne démarquant les en-têtes de colonnes du corps des données, et une troisième ligne délimitant le bas du tableau au-dessus des notes explicatives.
L’agencement cartésien des variables doit respecter une cohérence ergonomique. Par convention générale, la variable indépendante, le facteur de stratification expérimentale ou la condition de traitement est assignée aux lignes horizontales de la table. Les modalités de la variable dépendante, l’issue clinique observée ou la catégorie comportementale enregistrée viennent garnir les colonnes verticales. Cette disposition permet une lecture séquentielle naturelle de gauche à droite.
L’insertion des totaux marginaux est obligatoire. La dernière colonne doit impérativement afficher le total marginal de chaque ligne, tandis que la dernière ligne du tableau doit faire figurer les totaux marginaux de chaque colonne. La cellule située à l’intersection inférieure droite contiendra la taille globale de l’échantillon analysé ($N$). Cette disposition exhaustive permet aux évaluateurs de vérifier instantanément la balance de randomisation et de contrôler la concordance combinatoire du calcul hypergéométrique.
7.2 Formatage des cellules : effectifs et pourcentages
La standardisation du contenu des cellules constitue un indicateur immédiat du professionnalisme de l’auteur. À l’intérieur de chaque cellule de croisement empirique, la norme éditoriale préconise d’afficher conjointement l’effectif brut observé et le pourcentage correspondant sous une graphie harmonieuse de type $n$ (%), où la fréquence absolue est immédiatement suivie de sa proportion entre parenthèses.
L’auteur a l’obligation de préciser, dans l’en-tête de la colonne ou en note de bas de tableau, l’orientation de référence du calcul des pourcentages. Si les proportions ont été calculées en lignes — ce qui est le standard le plus fréquent en psychologie pour comparer les taux de réponse entre deux conditions —, la mention explicite « % en ligne » doit être lisible afin d’éviter toute confusion avec des pourcentages établis sur la colonne ou sur l’effectif total.
La gestion des décimales pour les fréquences relatives doit rester strictement constante à travers l’ensemble des cellules du tableau. Les normes de l’APA recommandent de consigner les pourcentages avec un seul chiffre après le séparateur décimal (par exemple, 42,9 % et non 42,857 %). Le choix de cette précision à une décimale garantit une lisibilité visuelle optimale sans encombrer la table d’une précision artificielle sans pertinence clinique.
7.3 Rédaction des notes de bas de tableau explicatives
Les notes disposées au bas du tableau jouent un rôle fonctionnel crucial dans l’appareil critique d’un article scientifique. Selon l’APA (7e édition), les notes de tableau se divisent en trois catégories hiérarchisées : les notes générales, les notes spécifiques et les notes de probabilité. Les notes générales sont introduites par le mot Note en italique, suivi d’un point.
La note générale d’un tableau de contingence doit impérativement définir les abréviations mobilisées dans les en-têtes ou les cellules (telles que $OR$ pour rapport des cotes, ou $IC$ pour intervalle de confiance) et notifier formellement l’utilisation du test exact de Fisher pour évaluer la dépendance des données présentées. C’est à cet emplacement privilégié que l’auteur communique les paramètres inférentiels globaux qui s’appliquent à l’ensemble du tableau.
La valeur de la probabilité exacte et de la taille d’effet sera ainsi formellement consignée dans cette note générale sous une forme standardisée : « Note. Les pourcentages sont calculés en ligne. $N = 28$. La valeur de $p$ a été obtenue au moyen d’un test exact de Fisher bilatéral. $OR = 6,25$, IC 95 % $[1,08, 36,12]$, $p = .039$. » Une telle explicitation rend le tableau parfaitement autonome et intelligible sans qu’il soit impératif de se reporter au corps du texte.
8. Exemples concrets de rédaction par sous-discipline psychologique
8.1 Cas en psychologie clinique et psychopathologie
Considérons une étude clinique menée auprès de patients souffrant d’un trouble de panique résistant aux thérapies standards. Les investigateurs comparent l’efficacité d’un protocole novateur de réalité virtuelle augmentée couplé à une restructuration cognitive ($n = 11$) face au traitement pharmacologique conventionnel maintenu sans changement ($n = 11$). L’issue clinique évaluée à 6 mois post-intervention est la rémission complète des attaques de panique (Oui vs Non). Le tableau croisé révèle que 8 des 11 patients sous réalité virtuelle atteignent la rémission (72,7 %), contre seulement 2 des 11 patients sous traitement usuel (18,2 %). L’effectif théorique attendu le plus bas est de 5,0, mais compte tenu de la modeste taille globale de la cohorte ($N = 22$), le test exact de Fisher a été sélectionné pour assurer une inférence sans faille.
Voici le modèle de paragraphe rédigé pour publication académique :
« Une analyse de contingence a été menée pour évaluer l’efficacité différentielle du protocole de réalité virtuelle augmentée ($n = 11$) par rapport au traitement conventionnel ($n = 11$) sur l’obtention d’une rémission complète des attaques de panique à six mois d’évolution ($N = 22$). En raison de la petite taille de l’échantillon clinique, un test exact de Fisher bilatéral a été appliqué. Les proportions de patients en rémission étaient de 72,7 % ($n = 8$) dans la condition de réalité virtuelle et de 18,2 % ($n = 2$) dans la condition conventionnelle. L’analyse a mis en évidence une association statistiquement significative entre le protocole thérapeutique administré et le statut de rémission, le test exact de Fisher produisant une valeur de p = .030. L’Odds Ratio associé ($OR = 12,00$, IC 95 % $[1,47, 98,11]$) indique que les patients assignés au protocole de réalité virtuelle affichent une cote de rémission substantiellement supérieure à celle des participants sous prise en charge usuelle, suggérant une supériorité prometteuse de cette approche thérapeutique novatrice. »
8.2 Cas en psychologie sociale et cognitive
Imaginons une recherche expérimentale examinant l’influence d’un amorçage implicite de sécurité affective sur la propension à adopter un comportement de sacrifice altruiste dans un dilemme moral binaire (Accepter de s’exposer pour protéger autrui : Oui vs Non). Un groupe de 20 participants a été soumis à une tâche d’amorçage de sécurité (évocation de figures d’attachement sécures), tandis qu’un groupe témoin de 20 participants effectuait une tâche d’amorçage neutre. Dans la condition de sécurité affective, 14 participants sur 20 (70,0 %) ont consenti au choix altruiste, comparativement à 7 participants sur 20 (35,0 %) au sein de la condition contrôle.
Voici la retranscription académique conforme aux normes internationales :
« Afin de déterminer si l’activation cognitive implicite du sentiment de sécurité d’attachement accroît l’engagement moral altruiste, les fréquences de choix sacrificiels ont été comparées entre la condition d’amorçage de sécurité ($n = 20$) et la condition d’amorçage neutre ($n = 20$). Les données de contingence révèlent que 70,0 % ($n = 14$) des participants exposés à l’amorçage de sécurité ont opté pour la décision altruiste, contre 35,0 % ($n = 7$) des sujets du groupe témoin. Le test exact de Fisher bilatéral a confirmé l’existence d’une dépendance significative entre le type d’amorçage et le comportement décisionnel moral ($p = .049$). L’intensité de la relation s’établit à un niveau modéré à fort, comme en témoignent le coefficient Phi ($phi = .35$) et le rapport des cotes ($OR = 4,33$, IC 95 % $[1,16, 16,19]$). Ces données corroborent l’hypothèse cognitive selon laquelle la disponibilité mentale de schémas affectifs sécurisants réduit l’inhibition défensive face au coût du comportement prosocial. »
8.3 Cas en neuropsychologie et réhabilitation
Considérons enfin un protocole de réhabilitation cognitive post-lésionnelle évaluant la récupération d’un niveau d’autonomie fonctionnelle complète (Récupération : Présente vs Absente) chez 19 patients victimes d’un accident vasculaire cérébral (AVC) ischémique unilatéral récent, stratifiés selon la latéralité hémisphérique de l’atteinte : cérébrolésion gauche ($n = 9$) versus cérébrolésion droite ($n = 10$). Lors du bilan standardisé à 3 mois, 3 patients sur 9 (33,3 %) du groupe lésion gauche ont recouvré une autonomie complète, contre 5 patients sur 10 (50,0 %) au sein du groupe lésion droite. Le tableau croisé présente un effectif théorique minimal de 3,79 dans l’une des cellules, ce qui invalide le khi-carré de Cochran et impose l’inférence exacte de Fisher.
Le compte rendu d’un résultat non significatif se structure ainsi :
« La dépendance potentielle entre la latéralité lésionnelle de l’AVC ischémique (hémisphère gauche vs hémisphère droit) et la restauration d’une autonomie fonctionnelle à trois mois de la réhabilitation a été soumise à l’épreuve du test exact de Fisher ($N = 19$), en raison de la présence de deux cellules affichant un effectif théorique inférieur à 5 (effectif théorique minimal attendu : 3,79). Les taux de récupération fonctionnelle complète s’élevaient respectivement à 33,3 % ($n = 3$) chez les patients cérébrolésés gauches et à 50,0 % ($n = 5$) chez les cérébrolésés droits. Le test exact de Fisher bilatéral n’a pas révélé de différence de proportions statistiquement significative entre les deux sous-groupes cliniques ($p = .650$, $OR = 0,50$, IC 95 % $[0,07, 3,46]$, $phi = -.17$). Bien que la proportion observée soit descriptivement plus favorable dans la cohorte lésée droite, l’imprécision inhérente à cet échantillon exploratoire — attestée par l’amplitude majeure de l’intervalle de confiance — interdit de conclure à un impact déterminant de la latéralité cérébrale sur la récupération fonctionnelle précoce dans cette population. »
9. Extension aux tableaux de contingence complexes de dimension r × c
9.1 Le test d’extension de Fisher-Freeman-Halton
Bien que le test exact classique ait été initialement forgé pour les agencements deux par deux, les réalités de la recherche en psychologie confrontent fréquemment l’investigateur à des variables polychotomiques. Qu’il s’agisse de comparer trois orientations psychothérapeutiques distinctes face à trois niveaux d’amélioration symptomatique ordonnée (absence, amélioration partielle, rémission), la structure de contingence adopte une dimension $r \times c$ (où $r$ est le nombre de lignes et $c$ le nombre de colonnes). Dans de telles configurations dépassant le format $2 \times 2$, l’algorithme originel de Fisher se trouve mathématiquement généralisé sous la dénomination de test exact de Fisher-Freeman-Halton.
Le principe mathématique demeure identique : conditionner sur l’ensemble complet des marges fixes observées du tableau et sommer la probabilité hypergéométrique multivariée de toutes les matrices envisageables dont la vraisemblance est égale ou inférieure à la matrice empirique observée. Toutefois, la combinatoire sous-jacente subit une explosion factorielle phénoménale à mesure que le nombre de lignes et de colonnes s’accroît. Pour les grands tableaux ou les effectifs intermédiaires, le calcul analytique intégral de chaque configuration devient numériquement intraitable.
Les logiciels modernes contournent cette barrière computationnelle en proposant, à côté de l’algorithme exact analytique déterministe (utilisable sur de très petites tables), une méthode d’approximation stochastique hautement robuste reposant sur des simulations d’échantillonnage de Monte-Carlo. Dans un manuscrit, le chercheur doit alors expliciter le recours à cette procédure computationnelle en précisant la méthode et le volume des itérations déployées : par exemple, en mentionnant que « le test d’indépendance de Fisher-Freeman-Halton a été calculé au moyen d’un échantillonnage de Monte-Carlo basé sur 100 000 réplications aléatoires (IC 99 % pour la valeur p : [.018, .024]) ».
9.2 Analyses post-hoc et ajustement du seuil alpha
L’obtention d’un test exact de Fisher-Freeman-Halton statistiquement significatif sur un tableau de dimension $r \times c$ autorise uniquement le rejet de l’hypothèse nulle globale d’indépendance. Il signale l’existence d’une dépendance générale au sein de la matrice sans toutefois renseigner le clinicien sur les cellules ou les paires de modalités responsables de ce déséquilibre statistique global. L’investigateur est alors impérativement tenu de déployer des analyses post-hoc ciblées.
La méthodologie canonique de décomposition consiste à réaliser une série de sous-tableaux de contingence $2 \times 2$ contrastant deux à deux les niveaux des facteurs étudiés. Cependant, la multiplication de ces contrastes catégoriels partiels entraîne une inflation mécanique catastrophique du risque global d’erreur de type I (taux d’erreur pour l’ensemble de la famille de tests). Il est méthodologiquement intolérable de tester ces paires au seuil usuel non ajusté de $\alpha = .05$.
L’auteur doit rigoureusement intégrer une procédure de contrôle du risque d’erreur d’échantillonnage multiple. Deux approches principales dominent la pratique rédactionnelle : l’austère mais robuste correction de Bonferroni — qui divise le seuil critique $\alpha$ par le nombre total $k$ de comparaisons par paires réalisées ($alpha’ = \alpha / k$) —, ou les procédures plus puissantes contrôlant le taux de fausses découvertes (False Discovery Rate, FDR), à l’instar de la méthode de Benjamini-Hochberg. Dans le manuscrit, chaque contraste post-hoc sera documenté en rapportant à la fois la probabilité brute observée, le facteur d’ajustement appliqué et la valeur de $p$ ajustée finale.
9.3 Taille d’effet globale pour les configurations r × c
Sur une table $r \times c$, l’Odds Ratio classique est inapplicable en tant qu’indice unique en raison de la pluralité des combinaisons dimensionnelles. Dès lors, le V de Cramer ($V$) devient la métrique de taille d’effet globale standard imposée par les critères de publication. Il mesure l’intensité de l’association globale entre les deux variables polychotomiques, sur une échelle standardisée s’étendant de 0 (indépendance absolue) à 1 (dépendance fonctionnelle parfaite).
L’interprétation de la force du V de Cramer ne peut s’effectuer au moyen des seuils naïfs du coefficient de Pearson. Les seuils de Cohen pour le V de Cramer doivent impérativement être calibrés en fonction des degrés de liberté marginaux minimaux de la table, définis par la formule $dl_{\min} = \min(r – 1, c – 1)$. Ainsi, au sein d’une table de dimension $3 \times 3$ où $dl_{\min} = 2$, les paliers empiriques de Cohen qualifiant un effet de faible, moyen ou fort correspondent respectivement à des valeurs de V d’environ 0,07, 0,21 et 0,35, alors qu’ils s’établissent à 0,10, 0,30 et 0,50 sur une table $2 \times 2$.
Dans la section Résultats, la restitution des paramètres combinera harmonieusement le résultat du test omnibus et sa taille d’effet globalisante, avant d’engager la discussion des contrastes post-hoc. La syntaxe canonique prendra la forme suivante : « L’extension de Fisher-Freeman-Halton a révélé une association globale significative entre les trois orientations psychothérapeutiques et les trois paliers d’évolution clinique ($p = .014$, $V = .29$). Les analyses post-hoc par paires sous correction de Bonferroni ont permis de localiser la divergence entre le protocole cognitif et la condition de contrôle sur liste d’attente ($p_{\text{ajusté}} = .008$), tandis qu’aucune disparité robuste n’a été détectée entre les deux approches actives ($p_{\text{ajusté}} = .420$). »
10. Traduction académique des sorties de logiciels d’analyse de données
10.1 Exploitation et conversion des résultats SPSS
IBM SPSS Statistics est l’un des logiciels les plus largement diffusés dans les départements universitaires de psychologie. Toutefois, la complexité de ses tableaux de sortie impose une vigilance constante pour extraire les bonnes métriques sans importer le jargon informatique propre au logiciel dans un manuscrit académique formalisé.
Lors de l’exécution de la commande de tableaux croisés (Crosstabs), SPSS produit un tableau récapitulatif intitulé Chi-Square Tests. Dans ce tableau, l’utilisateur doit délibérément ignorer les lignes Pearson Chi-Square et Continuity Correction dès lors que les postulats asymptotiques sont violés, pour se concentrer exclusivement sur la ligne intitulée Fisher’s Exact Test. SPSS y présente deux colonnes critiques : Exact Sig. (2-sided) pour la valeur de probabilité bilatérale, et Exact Sig. (1-sided) pour la probabilité unilatérale. C’est la valeur issue de Exact Sig. (2-sided) qu’il faut extraire dans l’immense majorité des contextes.
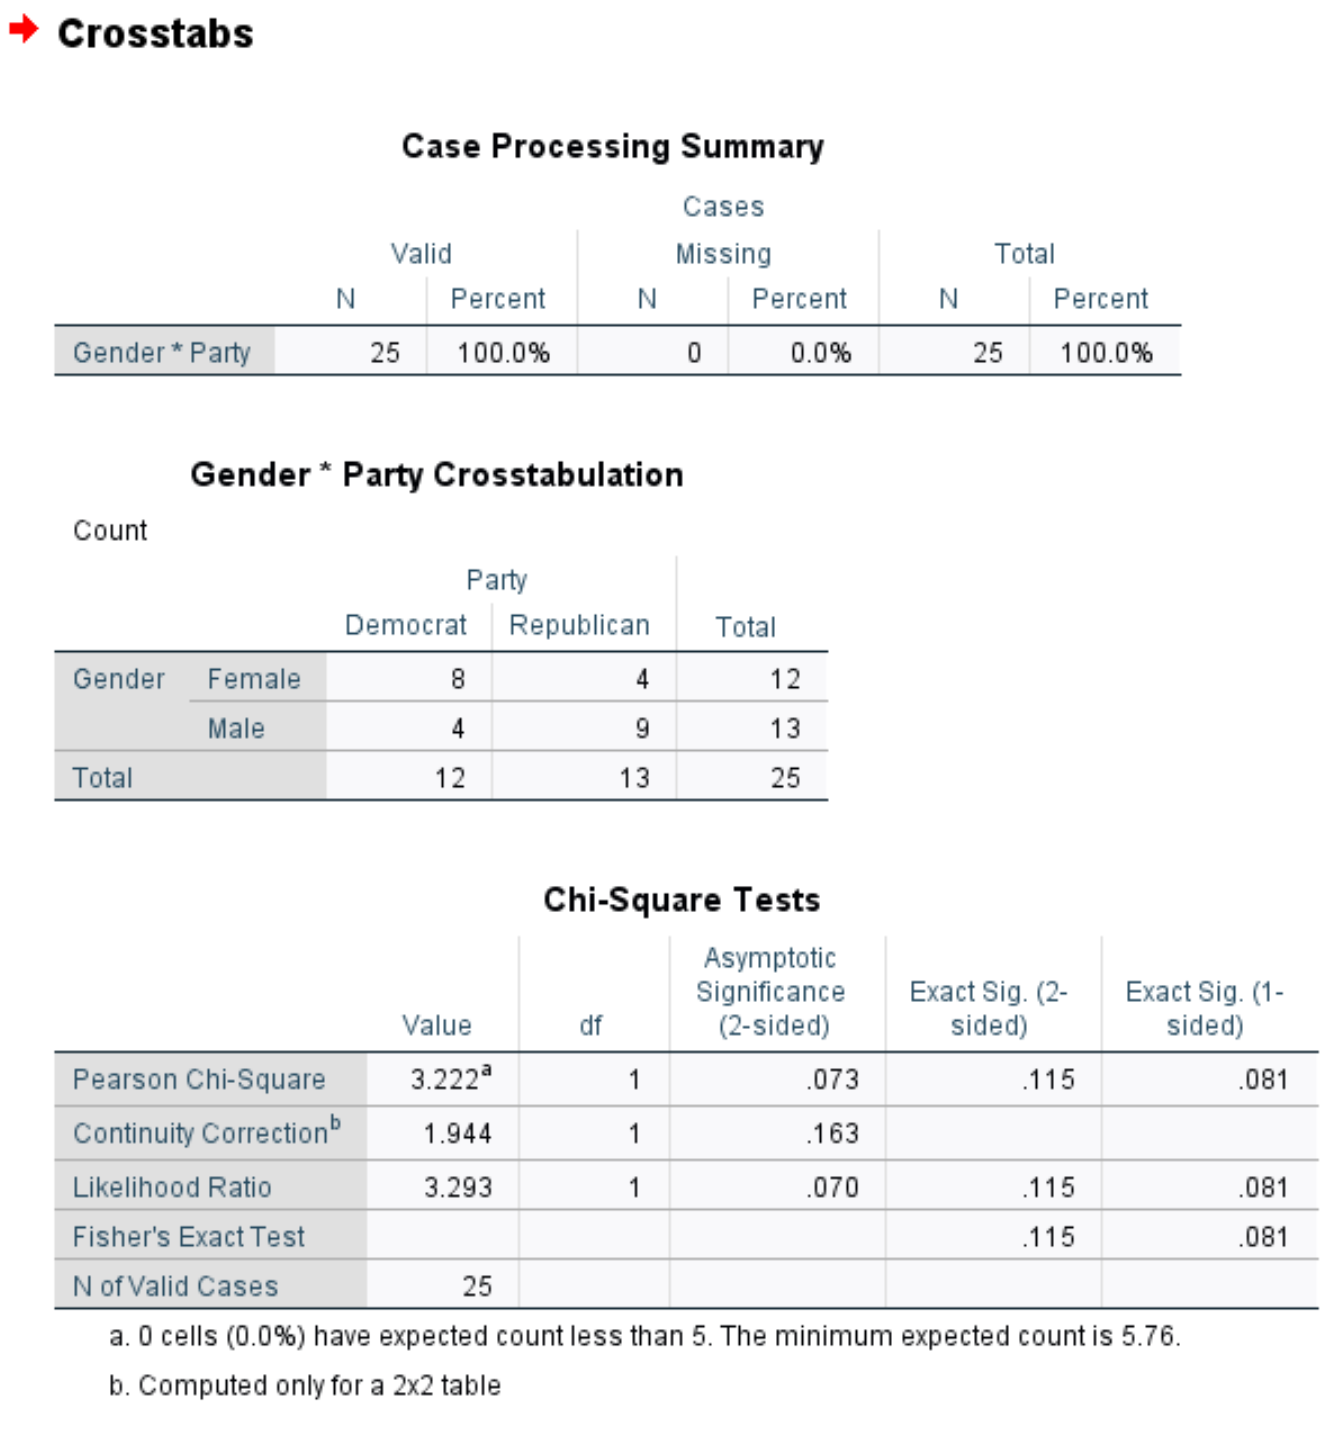
Pour la taille d’effet, l’activation de la sous-option Risk dans SPSS génère un tableau intitulé Risk Estimate. La première ligne (Odds Ratio for [Variable]) indique l’estimation ponctuelle du rapport des cotes ainsi que les bornes inférieure et supérieure de son intervalle de confiance à 95 % (95% Confidence Interval). Le rédacteur doit impérativement convertir ces libellés techniques bruts en syntaxe narrative conforme à l’APA : le libellé « Exact Sig. (2-sided) = .037 » devient ainsi dans le texte « test exact de Fisher bilatéral, p = .037 », sans jamais faire mention du tableau SPSS ni copier-coller ses en-têtes informatiques.
10.2 Extraction des commandes et sorties sous langage R
L’environnement statistique open-source R propose une implémentation native particulièrement pure du test via sa fonction fondamentale fisher.test() appartenant au package pré-intégré stats. Lorsqu’un tableau de contingence de deux lignes et deux colonnes est soumis à cette fonction, l’objet résultant fournit de manière synthétique l’intégralité des indicateurs nécessaires à la publication.
La sortie console de R affiche successivement la valeur p (introduite par la ligne p-value = ...), l’hypothèse alternative évaluée (alternative hypothesis: true odds ratio is not equal to 1), l’intervalle de confiance calculé de manière conditionnelle exacte au seuil de 95 % (95 percent confidence interval: ...) et enfin l’estimation ponctuelle du rapport des cotes sous l’intitulé odds ratio. Contrairement à SPSS qui recourt à un calcul d’Odds Ratio asymptotique de Wald standard dans son module Risk, R calcule par défaut un Odds Ratio exact conditionnel au maximum de vraisemblance (estimateur de Fisher-Cornfield), ce qui offre une cohérence mathématique supérieure avec la philosophie du test exact.
Pour les auteurs composant leurs manuscrits via R Markdown ou Quarto, l’extraction et l’insertion des paramètres peuvent être automatisées sans risque d’erreur de saisie humaine. Le code sous-jacent récupère directement les éléments dans la liste générée par l’objet : resultat$p.value pour la valeur de probabilité exacte, resultat$estimate pour l’Odds Ratio, et resultat$conf.int[1:2] pour borner l’intervalle de confiance. La phrase narrative générée dans le document final s’intègre alors parfaitement à la trame du texte scientifique sans couture apparente.
10.3 Transcription des rapports JASP et jamovi
Ces dernières années ont vu l’émergence spectaculaire des interfaces logicielles libres JASP et jamovi, conçues spécifiquement pour allier la convivialité visuelle des menus déroulants à la puissance computationnelle du moteur de programmation R. Ces outils ont pour immense avantage d’exporter des tableaux d’emblée formatés selon les exigences visuelles élémentaires des normes APA.
Dans le module Contingency Tables de jamovi ou de JASP, l’utilisateur coche la case Fisher’s exact test au sein de la section des tests d’hypothèse. Le tableau de contingence affiche alors instantanément la valeur de significativité exacte sous l’en-tête Fisher’s exact. Pour obtenir les mesures de taille d’effet correspondantes, l’analyste sélectionne simultanément les options Odds ratio et Cramer’s V dans le menu des coefficients d’association comparative.
Cependant, la transcription dans le manuscrit ne doit pas se limiter à un duplicata paresseux des tableaux exportés. Le rédacteur doit faire preuve d’un esprit critique de synthèse : s’assurer que les pourcentages affichés correspondent à la direction théorique pertinente (pourcentages en lignes plutôt qu’en colonnes), reformater les chiffres selon les conventions typographiques requises par la revue (usage de la virgule ou du point décimal), et réintégrer les paramètres clés au sein d’un paragraphe discursif substantiel plutôt que d’accumuler des éléments visuels superflus pour une analyse qui se résume fondamentalement à quatre chiffres d’effectifs.
11. Erreurs fréquentes et écueils à éviter lors de la communication des résultats
11.1 Attribution erronée de paramètres statistiques inexistants
L’une des anomalies les plus couramment relevées par les relecteurs méthodologiques au sein de manuscrits de psychologie soumis pour publication réside dans l’attribution erronée de paramètres inexistants au test exact de Fisher. Par mimétisme avec la formulation du test du khi-carré — qui prend traditionnellement la forme $\chi^2(dl, N) = \text{valeur}, p = \text{valeur}$ —, de nombreux chercheurs inexpérimentés s’évertuent à forger une statistique artificielle sous la forme « $Fisher(1) = …$ » ou « $p(1, N = 30) = …$ ».
Il est fondamental de réitérer qu’en bonne théorie des probabilités, le test exact de Fisher ne produit aucune statistique d’épreuve intermédiaire dotée d’une distribution tabulée ou de degrés de liberté formels. Le test calcule directement la probabilité hypergéométrique cumulative. Dès lors, toute tentative d’accoler un degré de liberté (comme $dl = 1$) ou une prétendue « valeur de test de Fisher » relève d’une méconnaissance conceptuelle majeure de la nature du test exact, décrédibilisant immédiatement l’expertise statistique de l’auteur auprès des évaluateurs.
Une confusion tout aussi préjudiciable consiste à assimiler le test exact de Fisher au test de McNemar. Le test de Fisher suppose strictement l’indépendance de deux échantillons distincts. Lorsque le design expérimental repose sur des mesures répétées appariées — par exemple, évaluer la présence ou l’absence d’un symptôme chez un même groupe de patients avant et après psychothérapie —, les données croisées sont dépendantes. Mobiliser le test de Fisher dans un protocole pré-post apparié constitue une faute épistémologique sévère : seul le test de McNemar (ou sa version exacte pour petits effectifs) est alors habilité à traiter la dépendance intra-individuelle des observations appariées.
11.2 Omission des indicateurs de magnitude et de dispersion
La publication scientifique contemporaine est engagée dans une transition salutaire visant à dépasser le « tout-au-significatif » et la fixation dogmatique sur le seuil $p < .05$. Une erreur fréquente dans le rapportage du test de Fisher consiste à isoler la seule valeur $p$ au sein du texte (« la différence s’est avérée significative selon le test de Fisher, $p = .041$ ») en omettant totalement d’indiquer l’Odds Ratio, le coefficient Phi et leurs intervalles de confiance respectifs.
Une probabilité isolée est incapable de révéler si l’association observée reflète un effet modeste détecté au sein d’un échantillon intermédiaire ou un effet d’une intensité clinique titanesque s’exprimant au sein d’une minuscule cohorte de 12 individus. La communication obligatoire de la métrique de taille d’effet permet de situer la pertinence pratique de la découverte au-delà de sa pure existence statistique.
Parallèlement, l’omission des fréquences brutes ($n$) au profit des seuls pourcentages relatifs représente un écueil dénoncé de longue date par les méthodologistes. Formuler qu’un groupe clinique présente « 66,7 % de rechute » sans révéler que cette statistique repose en réalité sur 2 patients ayant rechuté parmi une cohorte de 3 individus occulte délibérément l’extrême instabilité d’échantillonnage de la mesure. Les effectifs absolus doivent impérativement cheminer aux côtés des pourcentages.
11.3 Surinterprétation des contrastes non significatifs
Le piège de la surinterprétation d’un résultat non significatif est particulièrement prégnant dans les études reposant sur le test exact de Fisher. En raison même des faibles tailles d’échantillon qui motivent son utilisation, le test souffre intrinsèquement d’une puissance statistique bornée a priori. En d’autres termes, la probabilité d’échouer à rejeter l’hypothèse nulle alors qu’il existe une disparité substantielle dans la population clinique sous-jacente est particulièrement élevée.
Commettre l’erreur logique classique consistant à affirmer que « l’absence de significativité statistique ($p = .180$) démontre l’absence d’effet ou l’équivalence parfaite des deux approches psychothérapeutiques » procède d’une confusion entre absence de preuve et preuve de l’absence. L’investigateur doit se garder de toute affirmation péremptoire d’invariance ou d’équivalence thérapeutique basée sur un test d’indépendance de Fisher non concluant.
De surcroît, le phénomène inverse est tout aussi dangereux : discuter avec emphase d’un « effet thérapeutique majeur cliniquement évident » en se fondant sur des variations de proportions descriptives alors que le tableau de contingence compte des cellules quasi-vides et que le test exact délivre un verdict inférentiel non significatif. Le chercheur doit faire preuve d’une rigoureuse neutralité scientifique, en reconnaissant explicitement que les contraintes d’échantillonnage restreignent la portée concluante de son investigation exploratoire.
12. Protocole de vérification finale et modèles de phrases prêts à l’emploi
12.1 Grille d’auto-évaluation avant soumission du manuscrit
Avant d’adresser formellement un manuscrit pour évaluation par les pairs, les auteurs doivent soumettre leur section Résultats à une vérification méthodologique rigoureuse. Cette grille d’auto-évaluation garantit la conformité totale de la restitution statistique avec les critères de publication les plus stricts du champ académique :
- Justification des effectifs : La défaillance de la règle de Cochran (pourcentage de cellules à effectif attendu inférieur à 5 et valeur de l’effectif théorique minimal) est-elle formellement consignée dans le texte ?
- Identification des variables : Les deux variables qualitatives mises en relation sont-elles clairement définies avec leurs modalités mutuelles exhaustives ?
- Taille de l’échantillon : L’effectif total d’analyse ($N$) et les sous-effectifs par ligne et colonne sont-ils systématiquement indiqués ?
- Typographie APA : La lettre p est-elle en italique bas de casse ? Le zéro initial a-t-il été rigoureusement supprimé devant la décimale (ex. p = .023) ? Les degrés de liberté inexistants ont-ils été éradiqués ?
- Nature de la bilatéralité : Le caractère bilatéral de l’inférence est-il sans ambiguïté (explicité dans le texte ou la note de tableau) ? En cas de test unilatéral, une justification théorique préalable et un pré-enregistrement sont-ils documentés ?
- Concordance des données : Les effectifs bruts ($n$) et les pourcentages (%) rapportés dans la narration textuelle correspondent-ils rigoureusement aux données consignées dans le tableau de contingence ?
- Taille d’effet et précision : L’Odds Ratio ($OR$) ou le coefficient φ est-il accompagné de son intervalle de confiance à 95 % ? Les bornes de l’intervalle sont-elles plausibles et fidèles aux calculs logiciels ?
- Neutralité du ton : Les inférences causales indues sont-elles proscrites ? L’absence de significativité est-elle traitée avec prudence sans affirmer l’équivalence absolue des conditions ?
12.2 Modèles de phrases types pour résultats statistiquement significatifs
Pour faciliter la rédaction de vos manuscrits scientifiques, voici trois formulations canoniques calibrées selon différents degrés d’exhaustivité et orientations sous-disciplinaires :
Modèle standard minimal pour revue de psychologie générale :
« Un test exact de Fisher bilatéral a révélé une association statistiquement significative entre l’exposition au protocole d’entraînement attentionnel et le franchissement du seuil d’efficience mnésique chez les participants ($N = 26$, p = .034, OR = 6,67, IC 95 % [1,18, 37,84]). La proportion de réussite atteignait 69,2 % ($n = 9/13$) au sein de la condition active, comparativement à 23,1 % ($n = 3/13$) dans la condition témoin. »
Modèle approfondi avec métriques multiples (psychologie cognitive/expérimentale) :
« Afin d’examiner la distribution des choix préférentiels en fonction de la valence de l’amorce émotionnelle, un tableau de contingence $2 \times 2$ a été analysé ($N = 30$). En raison de la présence d’une cellule présentant un effectif théorique inférieur à 5 (effectif attendu minimal : 4,13), le test exact de Fisher a été privilégié. Le test bilatéral indique une différence de répartition hautement significative entre les groupes (p = .008). Les participants exposés à une amorce positive ont manifesté une probabilité nettement plus élevée de sélectionner l’alternative prosociale ($80,0 %, n = 12/15$) que les individus soumis à une amorce neutre ($26,7 %, n = 4/15$). Cette association présente une taille d’effet robuste, attestée par un coefficient Phi de .53 et un rapport des cotes substantiel (OR = 11,00, IC 95 % [1,96, 61,72]). »
Modèle épidémiologique et psychopathologique (orienté risques de santé mentale) :
« L’évaluation de l’incidence des comportements d’automutilation non suicidaires à l’issue du suivi thérapeutique a mis en évidence un contraste statistiquement significatif entre les deux cohortes cliniques ($N = 28$, test exact de Fisher bilatéral, p = .022). Parmi les adolescents ayant complété le programme de régulation émotionnelle dialectique, seuls 2 sur 14 (14,3 %) ont présenté au moins un épisode au cours du trimestre de suivi, contre 8 sur 14 (57,1 %) chez les patients pris en charge dans le cadre du traitement usuel. La taille de cet effet s’avère clinique et statistiquement prégnante, avec une réduction absolue du risque de 42,8 % (IC 95 % [10,7 %, 74,9 %]) et un Odds Ratio de 0,12 (IC 95 % [0,02, 0,81]), soulignant le rôle protecteur marqué du protocole ciblé. »
12.3 Modèles de phrases types pour résultats non significatifs
La communication d’un résultat statistiquement non significatif impose une grande probité intellectuelle afin de concilier la réalité des données avec la réserve méthodologique de rigueur :
Modèle d’objectivité neutre standard :
« L’analyse des fréquences d’observance thérapeutique entre le groupe bénéficiant de rappels téléphoniques hebdomadaires ($n = 12$) et le groupe contrôle sous protocole standard ($n = 13$) n’a pas permis d’identifier d’association statistiquement significative au seuil conventionnel ($N = 25$, test exact de Fisher bilatéral, p = .413). Les proportions de pleine adhésion au traitement étaient respectivement de 58,3 % ($n = 7$) et de 38,5 % ($n = 5$). L’Odds Ratio calculé (OR = 2,24, IC 95 % [0,43, 11,62], $phi = .20$) englobe la valeur nulle d’indépendance (1,00), interdisant de conclure formellement à une supériorité systématique du dispositif de relance dans cette cohorte pilote. »
Modèle prudent avec discussion de l’intervalle d’imprécision (neuropsychologie/échantillon rare) :
« La proportion de patients manifestant une désinhibition comportementale ne différait pas significativement entre le sous-groupe souffrant d’une démence frontotemporale variante comportementale ($60,0 %, n = 6/10$) et celui présentant une atrophie corticale postérieure ($33,3 %, n = 3/9$), le test exact de Fisher bilatéral délivrant une probabilité de p = .370 ($N = 19$, OR = 3,00, IC 95 % [0,45, 19,83]). Bien que la prévalence observée soit descriptivement deux fois plus marquée dans la cohorte frontotemporale, l’extrême amplitude de l’intervalle de confiance démontre l’imprécision statistique induite par la taille restreinte de cette série clinique. Ces résultats soulignent l’impératif de répliquer l’investigation au sein d’une collaboration multicentrique afin d’obtenir la puissance statistique nécessaire à la détection rigoureuse d’une éventuelle divergence neurocomportementale. »
En adoptant ces pratiques d’écriture transparentes, rigoureuses et scrupuleusement conformes aux recommandations de l’American Psychological Association, les chercheurs en psychologie et sciences du comportement s’assurent que leurs travaux valorisent pleinement la richesse empirique de leurs données tout en maintenant les plus hauts standards de validité inférentielle et de reproductibilité académique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1952). The $\chi^2$ test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1922). On the interpretation of $\chi^2$ from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Fisher, R. A. (1935). The logic of inductive inference. Journal of the Royal Statistical Society, 98(1), 39–82. https://doi.org/10.2307/2342435
- Freeman, G. H., & Halton, J. H. (1951). Note on an exact treatment of contingency, goodness of fit and other problems of significance. Biometrika, 38(1/2), 141–149. https://doi.org/10.2307/2332323
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher’s exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152
- Mehta, C. R., & Patel, N. R. (1983). A network algorithm for performing Fisher’s exact test in $r \times c$ contingency tables. Journal of the American Statistical Association, 78(382), 427–434. https://doi.org/10.1080/01621459.1983.10477989
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Yates, F. (1934). Contingency tables involving small numbers and the $\chi^2$ test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604