
La normalisation des données constitue l’un des piliers méthodologiques fondamentaux de l’analyse quantitative contemporaine. Que ce soit au sein des laboratoires de psychométrie, des départements de neurosciences computationnelles ou des unités de recherche en sciences du comportement, les chercheurs sont invariablement confrontés au problème critique de l’hétérogénéité des métriques. Mesurer des phénomènes psychologiques ou physiologiques complexes implique souvent de juxtaposer des chronométries précises à la milliseconde près, des scores discrets issus d’échelles ordinales de type Likert, et des indices composites étalonnés arbitrairement. Sans une transformation mathématique appropriée visant à harmoniser ces distributions disparates, toute tentative d’agrégation, de corrélation ou de modélisation statistique avancée s’expose à des biais d’échelle rédhibitoires, faussant irrémédiablement les conclusions scientifiques tirées des protocoles expérimentaux.
Le tableur en ligne Google Sheets s’est progressivement imposé comme une plateforme collaborative incontournable pour la collecte, l’apurement et le traitement préliminaire des matrices de données de recherche. Toutefois, l’utilisation de cet outil dans un cadre scientifique rigoureux exige une compréhension approfondie de ses fonctions internes, de ses subtilités d’arrondi numérique et des implications théoriques des opérations appliquées aux variables d’observation. Trop souvent, la normalisation y est abordée de façon superficielle, sans distinction adéquate entre la standardisation linéaire par cote Z et la mise à l’échelle unitaire Min-Max, ni considération pour la préservation des propriétés distributionnelles fondamentales des populations étudiées.
Ce guide exhaustif a pour vocation de fournir aux chercheurs, statisticiens et analystes un cadre opératoire exhaustif pour normaliser avec rigueur des jeux de données complexes au sein de Google Sheets. En combinant les fondements conceptuels de la statistique mathématique avec des protocoles pas-à-pas, des automatisations matricielles avancées et des études de cas issues de la psychologie différentielle, ce document expose l’ensemble des démarches nécessaires pour convertir des métriques brutes hétérogènes en indices comparables, robustes et conformes aux exigences les plus strictes de la recherche empirique.
1. Fondements conceptuels et théoriques de la normalisation statistique
1.1 Définition mathématique du score Z et de la cote standard
La standardisation statistique, communément désignée sous le terme de calcul du score Z ou de centrage-réduction, représente une transformation linéaire fondamentale d’une variable aléatoire continue. D’un point de vue algébrique formel, pour une observation brute individuelle notée x, appartenant à une distribution caractérisée par une espérance mathématique notée μ (ou une moyenne empirique notée x̄) et un écart-type noté σ (ou un écart-type échantillonnal noté s), la cote standardisée z s’obtient par la formule canonique : z = (x – μ) / σ. Cette opération se décompose rigoureusement en deux temps distincts : le centrage, qui soustrait la mesure de tendance centrale pour déplacer l’origine de la distribution vers zéro, et la réduction, qui divise l’écart obtenu par la mesure de dispersion afin de comprimer ou dilater la variance vers une valeur unitaire strictement égale à 1.
Sur le plan géométrique et probabiliste, cette opération n’altère en aucun cas la morphologie intrinsèque de la distribution initiale. La distance relative entre les observations, les rapports de proportions et les coefficients d’asymétrie ainsi que d’aplatissement demeurent rigoureusement invariants après transformation. Ainsi, si la variable brute initiale suit une loi gaussienne, la variable transformée suivra fidèlement une loi normale centrée réduite. Cette invariance structurelle garantit que l’ordonnancement hiérarchique des participants au sein d’une cohorte expérimentale est scrupuleusement respecté, tout en éliminant l’unité de mesure physique ou arbitraire sous-jacente.
Dans le domaine des sciences comportementales et de la psychométrie, cette invariance des relations d’ordre et la suppression des effets d’échelle jouent un rôle déterminant. Les chercheurs doivent fréquemment agréger des indicateurs dont les amplitudes numériques n’ont aucun dénominateur commun, tels que la conductance cutanée mesurée en microsiemens et le temps de fixation oculaire mesuré en millisecondes. En convertissant ces mesures brutes en cotes Z, la valeur transformée exprime directement la distance géométrique séparant l’individu de la moyenne de sa population de référence, exprimée en unités universelles d’écart-type, ce qui neutralise efficacement l’écueil de la dominance artificielle des variables à forte variance.
1.2 Importance méthodologique en recherche psychologique et psychométrie
L’hétérogénéité des outils d’évaluation constitue un obstacle historique majeur à l’évaluation diagnostique et au développement des théories psychologiques. En psychométrie clinique, par exemple, un praticien cherchant à quantifier la sévérité d’un épisode dépressif peut administrer simultanément l’Inventaire de Dépression de Beck (BDI), dont l’échelle s’étend de 0 à 63 points, et l’Échelle d’Évaluation de la Dépression de Hamilton (HAM-D), calibrée sur des amplitudes et des seuils cliniques totalement divergents. L’analyse brute conjointe de ces scores s’avère impossible sans générer un biais de pondération proportionnel à l’étendue numérique propre à chaque questionnaire. La standardisation Z résout ce défi en projetant les scores de chaque instrument sur une métrique commune centrée sur le comportement moyen de la population cible.
De surcroît, le traitement des échelles de réponse polytomiques, telles que les échelles de Likert à 5 ou 7 points, engendre fréquemment des biais de réponse individuels systématiques, notamment les biais d’acquiescement ou les tendances à l’évitement des valeurs extrêmes. L’application d’un centrage intra-sujet, consistant à calculer le score Z des réponses d’un individu par rapport à sa propre moyenne et sa propre variabilité personnelle, permet d’isoler la structure relative des préférences du sujet indépendamment de son style de réponse global. Cette standardisation ipsative s’avère décisive dans l’administration des inventaires de personnalité multidimensionnels.
Enfin, la standardisation offre un critère objectif et standardisé pour l’identification des données aberrantes ou atypiques dans les protocoles expérimentaux. Dans une distribution approximativement gaussienne, la règle empirique stipule que moins de 0,3 % des observations se situent au-delà de trois écarts-types de la moyenne. L’isolation des observations présentant un score Z absolu supérieur à 3,00 fournit aux investigateurs une justification statistique transparente pour inspecter, investiguer ou éventuellement neutraliser des anomalies d’échantillonnage, des erreurs d’encodage ou des artéfacts instrumentaux avant toute modélisation inférentielle.
1.3 Différenciation critique entre standardisation Z et normalisation Min-Max
Il règne au sein de la littérature appliquée une confusion terminologique récurrente entre la standardisation par score Z et la normalisation par remise à l’échelle unitaire, couramment désignée sous l’appellation Min-Max. Bien que ces deux méthodologies visent l’harmonisation des ordres de grandeur, leurs fondements mathématiques et leurs conséquences analytiques divergent substantiellement. La normalisation Min-Max opère une transformation géométrique bornée qui comprime l’ensemble des valeurs d’une série continue dans un intervalle fermé prédéterminé, généralement compris entre 0 et 1, en appliquant l’équation : (x – Min) / (Max – Min). Contrairement au score Z, la variance finale obtenue n’est pas contrainte à l’unité, mais dépend intégralement de la dispersion relative interne de la série d’origine.
La distinction la plus critique réside dans la vulnérabilité différentielle face aux valeurs extrêmes ou aberrantes. La méthode Min-Max est hyper-sensible aux valeurs résiduelles situées aux confins de la distribution. Si un échantillon comporte une seule valeur exceptionnellement élevée due à un artefact de mesure, celle-ci deviendra la borne supérieure absolue égale à 1,00, tandis que l’écrasante majorité des observations valides se trouvera écrasée et condensée dans une fraction infime de l’intervalle, par exemple entre 0,00 et 0,15. Cette contraction artificielle détruit l’information fine relative aux variations intermédiaires. En revanche, le calcul de la cote standardisée Z disperse les scores de part et d’autre de l’origine sans imposer de frontières arbitraires, les valeurs extrêmes se manifestant simplement par des scores Z très élevés en valeur absolue sans compresser le reste de la distribution.
Dans le domaine des neurosciences cognitives et de la modélisation psychométrique, le choix entre ces deux paradigmes doit découler rigoureusement de la nature distributionnelle des données et des algorithmes prévus en aval. Le centrage-réduction par score Z est la méthode d’élection lorsque les distributions sont théoriquement fondées sur des processus stochastiques sous-jacents gaussiens, comme les scores d’intelligence générale ou les temps de réponse filtrés. La normalisation Min-Max est quant à elle privilégiée lorsque les données doivent alimenter des architectures algorithmiques sensibles aux limites d’activation strictes, telles que certains réseaux de neurones artificiels ou des calculs de distance euclidienne nécessitant un espace vectoriel strictement borné.
2. Préparation et audit des données préalables dans Google Sheets
2.1 Structuration optimale des variables observationnelles
Avant d’initier toute formule mathématique au sein de Google Sheets, la disposition physique des matrices de données brutes doit répondre aux normes strictes de la méthodologie expérimentale et des principes du formatage de données structurées. Une organisation matricielle canonique impose impérativement que chaque ligne représente une unité d’échantillonnage unique et non fragmentée, c’est-à-dire un participant, un patient ou une session expérimentale distincte, identifiée par un code alphanumérique d’anonymisation dans la première colonne. Réciproquement, chaque colonne doit être exclusivement allouée à une variable observationnelle unique, sans jamais fusionner des cellules d’en-tête ni juxtaposer des résumés statistiques dans la même trajectoire vectorielle.
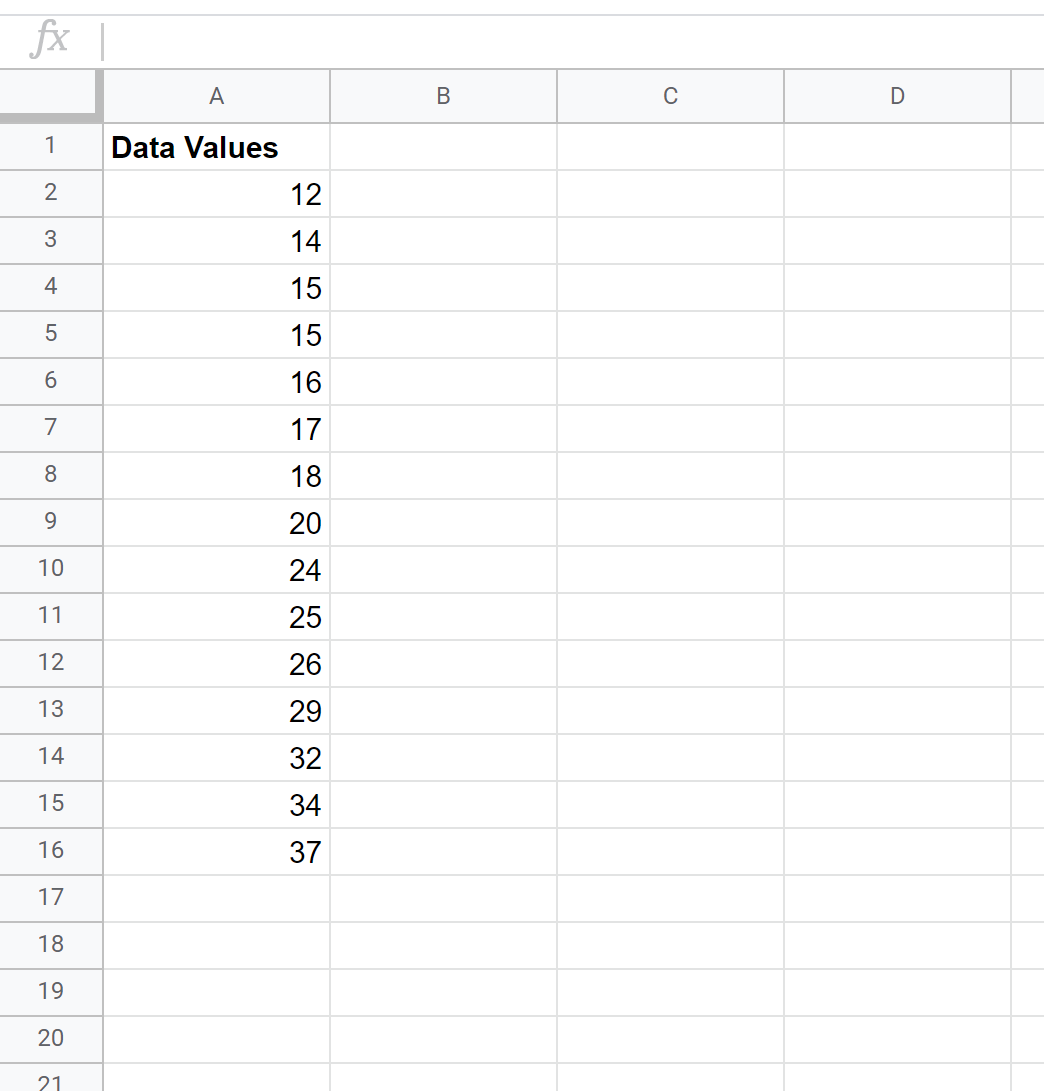
Le contrôle de la typographie numérique dans Google Sheets requiert une vigilance technique particulière. En fonction des paramètres régionaux de votre compte Google, le séparateur décimal peut être configuré par défaut comme une virgule (norme francophone standard) ou comme un point (norme anglo-saxonne). Une importation brute de fichiers issus de plateformes d’expérimentation en ligne génère fréquemment des chaînes de caractères textuelles non reconnues arithmétiquement lorsque les points décimaux ne concordent pas avec les préférences locales de la feuille de calcul. Il est impératif d’auditer l’alignement naturel des cellules : par convention fondamentale dans les tableurs, les données numériques authentiques s’alignent automatiquement à droite, tandis que les valeurs textuelles s’alignent à gauche.
La gestion rigoureuse des données manquantes doit également être établie en amont, conformément aux prescriptions éthiques et méthodologiques de l’American Psychological Association (APA). Laisser une cellule entièrement vide peut conduire Google Sheets à ignorer l’observation dans certaines fonctions d’agrégation, mais peut fausser d’autres calculs personnalisés. Il convient de statuer explicitement sur la stratégie : exclusion univariée des lignes comportant des données manquantes, ou application préalable de procédures d’imputation statistique, telles que l’imputation par la moyenne conditionnelle ou l’imputation multiple réalisée hors du tableur, afin de ne pas fausser la taille effective de l’échantillon N.
2.2 Identification exploratoire des distributions asymétriques
L’application non critique du centrage-réduction présuppose une distribution unimodale relativement symétrique. Il est dès lors fondamental d’exécuter un audit exploratoire de la forme des distributions avant de procéder à la standardisation. Google Sheets propose à cet effet des fonctions statistiques d’analyse distributionnelle permettant d’évaluer les moments d’ordre supérieur. Le coefficient d’asymétrie empirique peut être quantifié directement à l’aide de la fonction dédiée au calcul de l’asymétrie d’un échantillon, laquelle mesure le degré d’écart par rapport à une symétrie idéale autour de la moyenne arithmétique.
Une distribution symétrique présente un coefficient d’asymétrie proche de 0. Dans les protocoles comportementaux, il n’est pas rare de constater une asymétrie positive prononcée, caractérisée par une longue traîne s’étirant vers les valeurs élevées, notamment dans l’analyse des chronométries mentales où les temps de réaction minimaux sont limités par la physiologie nerveuse, tandis que les temps longs sont théoriquement infinis. Un coefficient d’asymétrie dépassant la valeur absolue de 1,00 signale une déviation substantielle de la normalité, justifiant une extrême circonspection quant à l’utilisation directe de la moyenne arithmétique comme repère de centrage.
Parallèlement, la mesure du coefficient d’aplatissement, communément désigné sous le terme de kurtosis, doit être calculée à l’aide de la fonction native appropriée de Google Sheets. Cette métrique quantifie l’épaisseur relative des queues de distribution par rapport à la loi normale de référence. Un kurtosis positif élevé (distribution leptokurtique) indique une concentration aiguë autour du mode accompagnée d’un excédent de valeurs extrêmes dans les queues, tandis qu’un kurtosis négatif (distribution platykurtique) traduit un écrasement plat du sommet. L’ignorance de ces anomalies de courbure compromet la validité inférentielle ultérieure des scores Z, car la règle empirique associant le score standardisé à des percentiles fixes devient mathématiquement erronée en l’absence de normalité univariée.
2.3 Paramétrage des plages et nomenclature des variables
Afin de garantir l’intégrité, la robustesse et la pérennité des formules computationnelles au sein d’un grand classeur de recherche, il est vivement déconseillé de manipuler des coordonnées de cellules dynamiques volatiles de type relatif sans précaution. L’attribution systématique de plages nommées constitue une pratique exemplaire incontournable. Dans Google Sheets, la sélection d’une colonne de données brutes, suivie de son enregistrement via le gestionnaire de plages nommées sous un libellé explicite tel que Temps_Reaction_Brut ou Score_Anxiete_V1, élimine les erreurs de ciblage vectoriel lors de l’écriture des équations de normalisation complexes.
Lorsque des plages nommées ne sont pas exploitées, la maîtrise rigoureuse de la syntaxe des références absolues s’impose. L’utilisation du caractère typographique dollar devant l’indice de colonne et le numéro de ligne permet d’ancrer de manière permanente les paramètres de référence lors du glissement latéral ou vertical des formules sur des milliers de lignes de participants. Une défaillance dans ce verrouillage absolu conduit inévitablement au glissement mécanique de la cellule cible de calcul vers des cellules vierges sous-jacentes, corrompant de façon silencieuse et invisible les cotes standardisées générées.
Enfin, une séparation structurelle stricte doit être instaurée entre la matrice contenant les données brutes initiales et la matrice destinée à recevoir les données normalisées transformées. Cette séparation peut prendre la forme de blocs de colonnes distincts clairement partitionnés au sein de la même feuille de calcul, ou idéalement, d’onglets de classeur indépendants : un onglet dédié à la saisie brute immuable et un second onglet dédié au traitement analytique et à la projection standardisée. Cette étanchéité méthodologique protège l’investigateur contre toute modification accidentelle des données d’observation originales, assurant une parfaite traçabilité des opérations de transformation.
3. Étape 1 : Calcul de la tendance centrale via la fonction MOYENNE
3.1 Mise en œuvre mathématique de la fonction AVERAGE dans Google Sheets
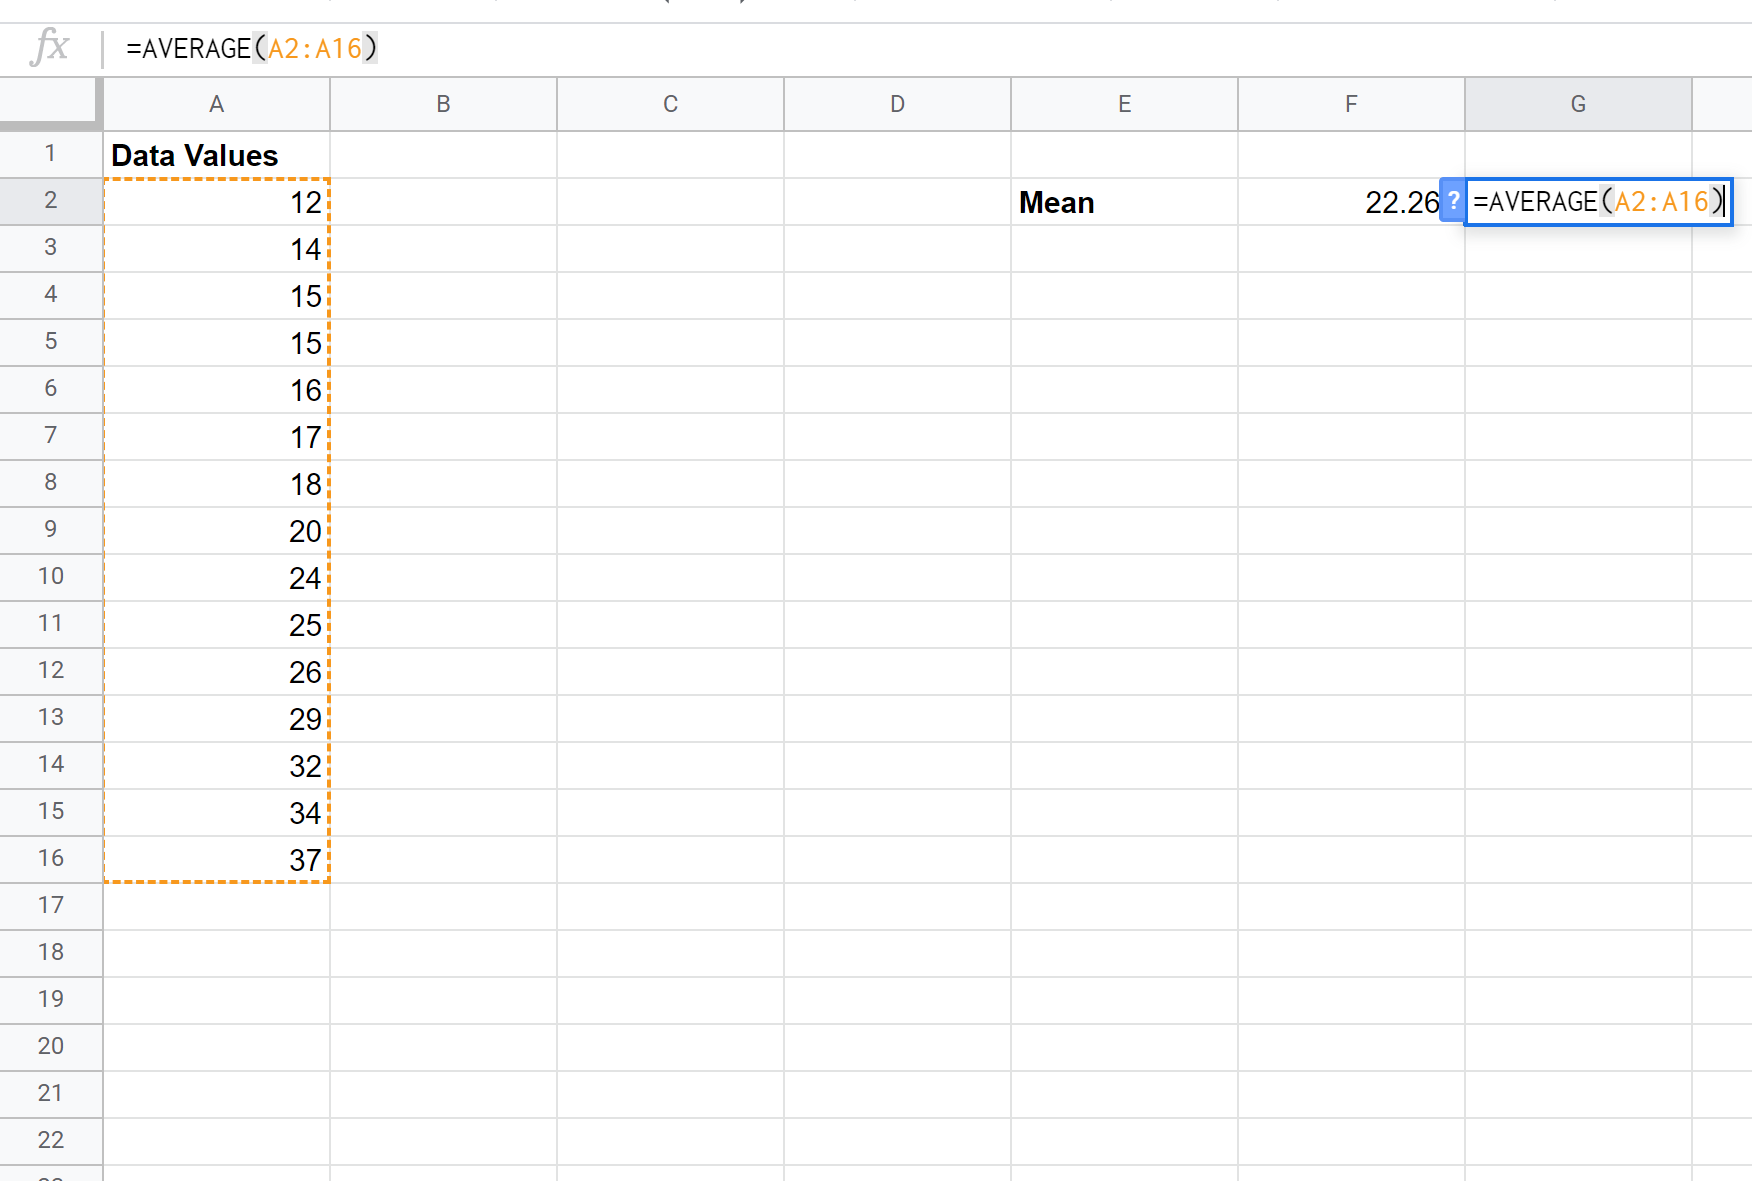
Le calcul de la moyenne arithmétique constitue la première étape opérationnelle requise pour le centrage des données. Dans Google Sheets, la fonction standard s’écrit sous la désignation française MOYENNE, ou sous sa désignation universelle en langue anglaise AVERAGE. Cette fonction algorithmique procède à la sommation de toutes les valeurs scalaires contenues dans le vecteur d’arguments spécifié et divise la quantité résultante par le cardinal exact n des observations numériques valides. L’incorporation typique prend la forme syntaxique suivante : =MOYENNE(B2:B101) pour une série expérimentale regroupant cent sujets d’étude.
Il est fondamental de comprendre le comportement logique interne de Google Sheets face aux cellules sans valeur par rapport aux cellules contenant la valeur numérique zéro. La fonction MOYENNE contourne de façon autonome et systématique les cellules totalement vides ainsi que celles contenant des chaînes de texte, ce qui préserve l’estimation moyenne de l’échantillon sans sous-estimer artificiellement la valeur par l’incorporation d’éléments nuls fantômes. Cependant, si un participant a obtenu un score réel égal à zéro dans une évaluation psychométrique et que cette valeur a été saisie explicitement sous forme numérique, Google Sheets l’intègre pleinement dans le dénominateur de division, ce qui modifie substantiellement le résultat final.
Sur le plan de l’inférence statistique, la moyenne calculée sur l’échantillon de recherche est appréhendée comme l’estimateur sans biais le plus efficient de l’espérance mathématique de la population parente, pour autant que la distribution d’échantillonnage satisfasse aux critères du théorème central limite. Ce paramètre de centralité servira de point d’ancrage zéro pour l’intégralité du système métrique dérivé, représentant le niveau de performance ou de comportement attendu moyen au sein du groupe de référence.
3.2 Précautions relatives à la sensibilité aux valeurs aberrantes
La moyenne arithmétique présente une faiblesse mathématique notoire : son manque absolu de résistance face aux perturbations extrêmes situées dans les queues de distribution. Une unique valeur marginale résultant par exemple d’une inattention passagère d’un participant lors d’une tâche de vigilance continue, générant une latence de réponse aberrante de 12 000 millisecondes là où la moyenne se situe à 400 millisecondes, suffit à déplacer artificiellement la moyenne globale du groupe de plusieurs dizaines de points. En conséquence, centrer l’ensemble des données d’un échantillon sur une moyenne biaisée par des observations atypiques induit une distorsion systématique de toutes les cotes Z qui en découlent.
Pour prévenir cette dérive métrologique, l’analyste se doit de comparer systématiquement la moyenne arithmétique à la médiane de la variable, calculée via la commande MEDIANE dans Google Sheets. La médiane étant invariante face aux déviations unilatérales extrêmes, un écart quantitatif prononcé entre ces deux mesures de tendance centrale constitue l’indice diagnostique irréfutable d’une distorsion de la distribution. Si cet écart se révèle significatif, le chercheur doit s’interroger sur l’opportunité d’une transformation préalable des données ou sur la pertinence de tronquer formellement les distributions.
Lorsque la justification théorique ou clinique est avérée, des techniques de moyenne tronquée peuvent être déployées directement à l’aide de la fonction matricielle MOYENNE.REDUITE (ou TRIMMEAN). Cette fonction permet d’exclure une proportion prédéterminée des observations les plus extrêmes situées symétriquement aux deux extrémités de la distribution avant de calculer la moyenne des valeurs résiduelles. Une telle approche stabilise l’estimateur de tendance centrale et assure que le centrage des observations s’effectue par rapport au véritable barycentre représentatif du phénomène étudié.
4. Étape 2 : Estimation de la dispersion via les fonctions d’écart-type
4.1 Arbitrage méthodologique entre ECARTYPE (STDEV.S) et ECARTYPEP (STDEV.P)
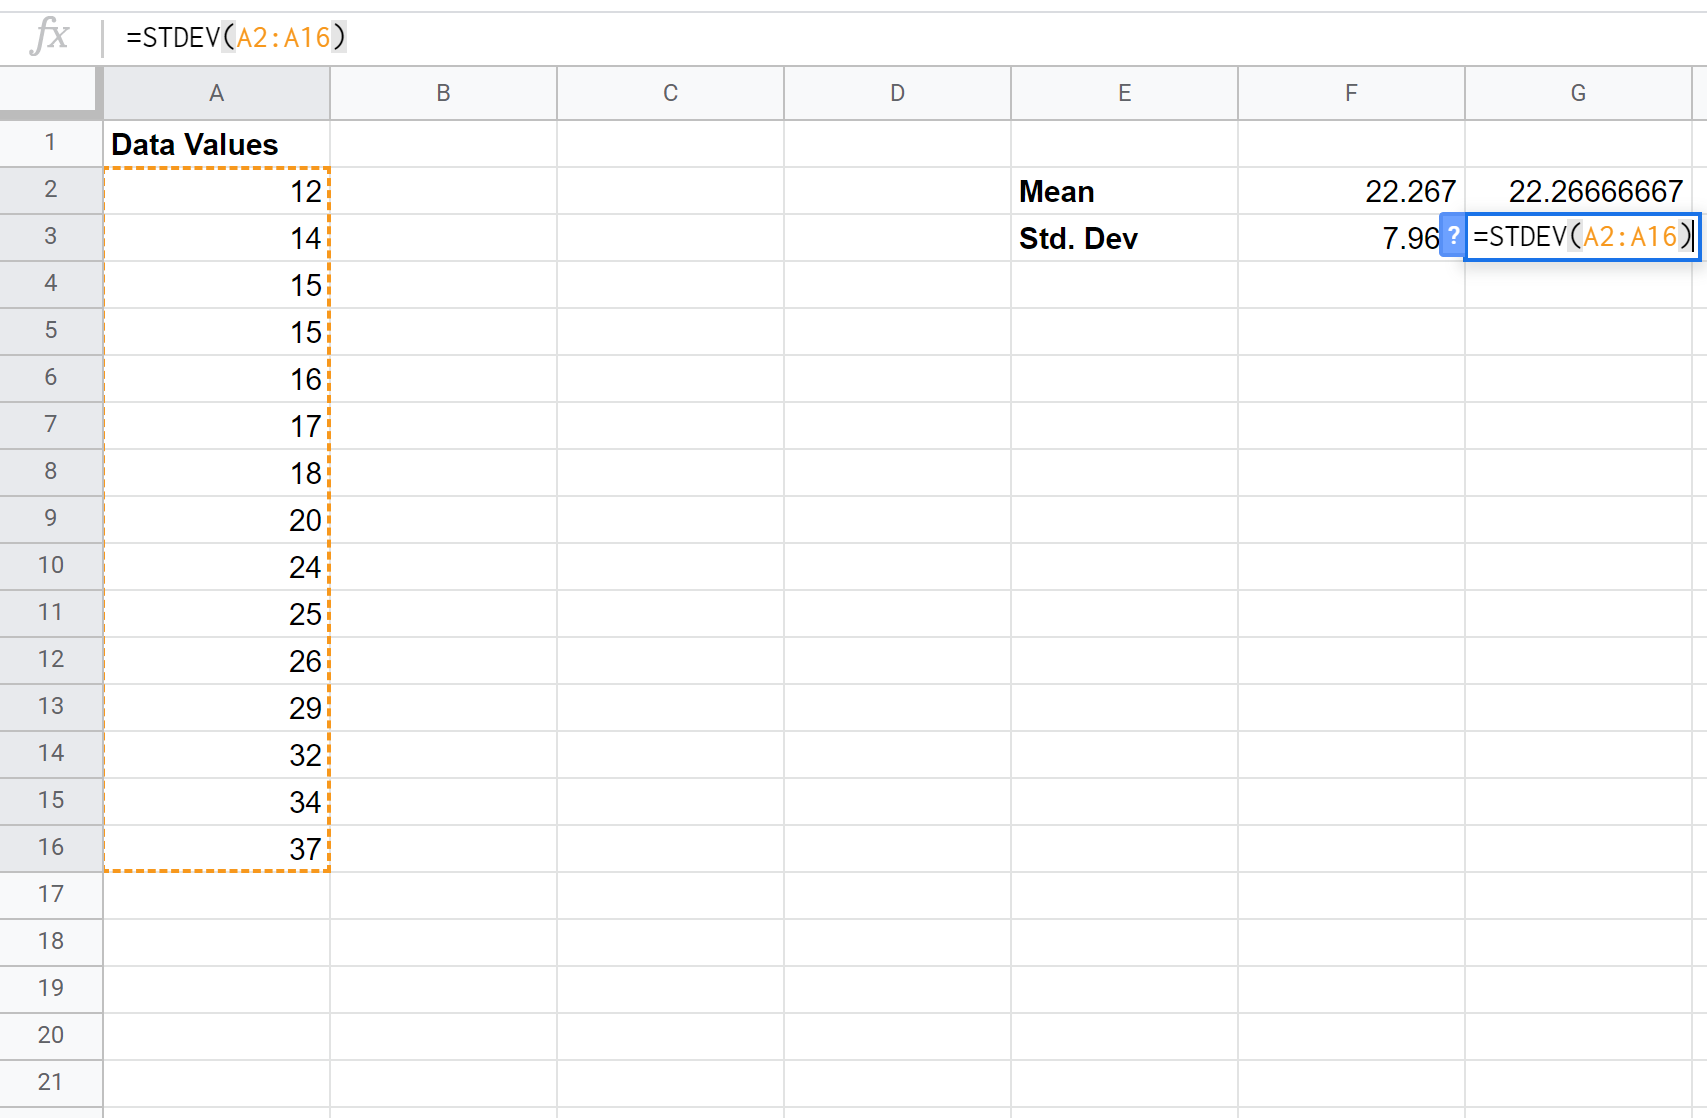
La quantification de la dispersion est l’étape mathématique qui permettra de calibrer l’échelle métrique unitaire lors de la division du score centré. Google Sheets met à la disposition des utilisateurs deux fonctions principales d’écart-type qui ne doivent en aucun cas être confondues sous peine d’introduire des biais inférentiels majeurs : la fonction ECARTYPE (équivalente à la syntaxe internationale STDEV.S) et la fonction ECARTYPEP (équivalente à STDEV.P). Le choix entre ces deux équations renvoie directement à la nature du statut de l’échantillon d’étude.
La fonction ECARTYPE met en application la correction mathématique de Bessel, laquelle divise la somme des carrés des écarts à la moyenne par (n – 1) degrés de liberté plutôt que par n. Cette correction compense le fait que la dispersion observée au sein d’un sous-échantillon empirique a une propension probabiliste systématique à sous-estimer la dispersion réelle de la population intégrale. Dans la quasi-totalité des recherches en psychologie, en sociologie et en médecine expérimentale, les données collectées proviennent d’un échantillon restreint issu d’une population parente infinie ou indéterminée ; il est donc méthodologiquement impératif d’utiliser exclusivement ECARTYPE afin d’obtenir un estimateur sans biais de la dispersion.
À l’inverse, la fonction ECARTYPEP réalise le calcul direct basé sur un dénominateur strict égal à N, sans soustraire de degré de liberté. Cette seconde équation n’est légitime que dans le cas extrêmement circonscrit où l’analyste dispose de l’exhaustivité absolue des données de la population d’intérêt, par exemple lors d’un recensement démographique exhaustif d’une institution fermée, ou dans le cadre d’une étude portant sur l’ensemble d’une cohorte clinique historique qui ne fera l’objet d’aucune généralisation ultérieure. Dans le doute, l’usage académique universel prescrit le recours systématique à la correction d’échantillon (n – 1).
4.2 Validation de la variance non nulle
L’opération de réduction inhérente au score Z impliquant une division algébrique formelle par l’écart-type empirique, il est absolument indispensable de vérifier que la dispersion de la variable étudiée est strictement supérieure à zéro. Si l’ensemble des sujets d’un protocole expérimental fournit rigoureusement la même réponse numérique à un item d’évaluation, ou si un test cognitif présente un effet plafond ou un effet plancher absolu où 100 % de la cohorte obtient le score maximal ou nul, la variance devient strictement égale à 0. L’évaluation de l’écart-type renverra alors la valeur 0,00.
L’introduction d’un écart-type nul au dénominateur de la formule de standardisation déclenche inévitablement une erreur d’exécution mathématique critique dans Google Sheets, affichée sous le message explicite d’erreur de division par zéro. Cette anomalie informatique interrompt la chaîne de calculs matriciels et paralyse l’ensemble des tableaux de bord analytiques connectés. Il convient donc de prévenir cette interruption en intégrant des vérifications conditionnelles en amont de toute phase de traitement automatisée.
Au-delà de la contrainte purement informatique, une variance nulle invalide conceptuellement la métrique de standardisation. Si tous les participants ont le même score brut, la notion même de positionnement relatif individuel par rapport au groupe s’évanouit. Dans une telle situation, la variable n’apporte aucune variance explicative et doit être exclue des modèles psychométriques plutôt que d’être soumise de force à une standardisation artificielle dénuée de signification statistique.
5. Étape 3 : Transformation standardisée avec la fonction CENTRER.REDUIRE
5.1 Syntaxe formelle et exécution de STANDARDIZE dans Google Sheets
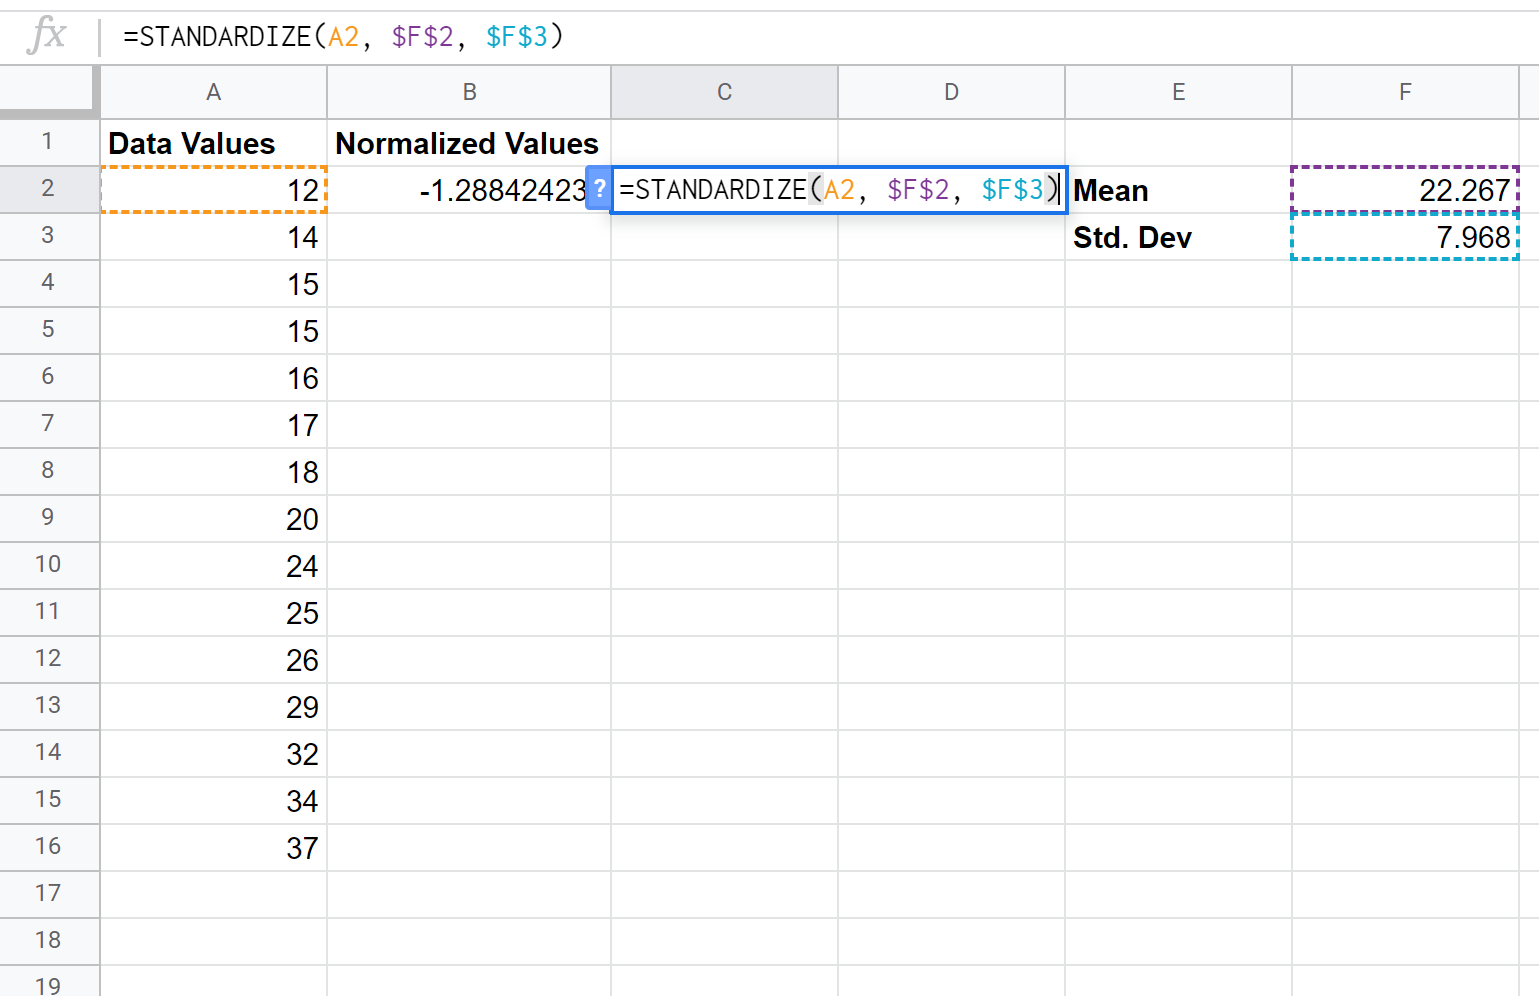
Google Sheets propose une fonction native spécifiquement dédiée au centrage-réduction des données d’observation, accessible sous l’appellation francophone CENTRER.REDUIRE, ou sous sa désignation anglophone canonique STANDARDIZE. Cette fonction d’ingénierie statistique encapsule l’intégralité de l’algorithme du score Z au sein d’une commande simplifiée et sécurisée. La structure syntaxique exige obligatoirement trois paramètres d’entrée ordonnés : la valeur brute à convertir x, la valeur représentative de la moyenne x̄, et la valeur scalaire de l’écart-type s.
Considérons une situation d’analyse psychologique où le score brut du premier participant se trouve consigné dans la cellule A2, tandis que la moyenne de l’échantillon a été préalablement calculée et logée dans la cellule D1 et que l’écart-type échantillonnal réside dans la cellule D2. L’instruction mathématique déployée prendra la formulation exacte : =CENTRER.REDUIRE(A2; $D$1; $D$2). Dès l’exécution de la touche de validation, Google Sheets soustrait la moyenne de la valeur d’observation et divise le solde par l’écart-type, renvoyant instantanément la cote Z correspondante.
La conformité dimensionnelle du résultat doit être immédiatement vérifiée. La valeur produite est un nombre pur, adimensionnel, affranchi de toute unité physique d’origine. Si le score d’origine était exprimé en centimètres ou en secondes, la cote standardisée résultante ne porte plus aucune unité matérielle. Elle exprime une position spatiale relative dans l’espace distributionnel de l’échantillon, positive si le participant dépasse la moyenne du groupe, négative s’il se situe en deçà, et strictement nulle s’il s’aligne fidèlement sur le barycentre arithmétique de la cohorte.
5.2 Verrouillage absolu des paramètres d’échelle
L’une des sources les plus prévalentes d’erreurs statistiques chez les praticiens manipulant des tableurs réside dans la non-maîtrise de l’ancrage référentiel lors de la réplication des équations. Si un utilisateur applique la fonction =CENTRER.REDUIRE(A2; D1; D2) sans utiliser les symboles de blocage monétaires, l’étirement mécanique de la cellule vers le bas pour le sujet suivant transformera la formule en =CENTRER.REDUIRE(A3; D2; D3), modifiant erronément la moyenne ciblée et tentant de diviser par une cellule potentiellement vide ou textuelle.
Le verrouillage par l’opérateur dollar constitue le garant de la conformité référentielle de la modélisation. En saisissant $D$1 pour la moyenne et $D$2 pour l’écart-type, le chercheur fige rigoureusement les coordonnées scalaires de la distribution sur l’ensemble de l’axe vertical et horizontal. La première composante, relative au sujet A2, demeure en revanche volontairement libre d’ancrage (référence relative) pour s’incrémenter naturellement en A3, A4, et ainsi de suite le long des lignes de participants successives.
Après application de ce verrouillage absolu, la propagation du calcul s’opère instantanément à l’aide d’un double-clic sur le coin inférieur droit de la cellule active (poignée de recopie) ou par glissement continu. Il demeure judicieux de procéder à un audit visuel d’intégrité en cliquant sur la formule de la dernière ligne générée afin de s’assurer que les références de moyennes et d’écarts-types pointent toujours avec une précision chirurgicale sur les cellules de synthèse dédiées, sans glissement intempestif.
5.3 Formulation manuelle alternative sans fonction dédiée
Bien que la fonction standardisée intégrée simplifie la composition textuelle des équations, la transcription manuelle de l’expression algébrique fondamentale présente des vertus pédagogiques et pratiques non négligeables, en particulier dans l’enseignement des biostatistiques ou lors de l’intégration dans des pipelines de traitement complexes. Cette construction manuelle repose sur l’implémentation arithmétique directe des opérations : =(A2 – $D$1) / $D$2.
L’utilisation scrupuleuse des parenthèses algébriques s’avère ici incontournable en raison des règles universelles de priorité des opérateurs arithmétiques. L’omission des parenthèses dans une saisie telle que =A2 – $D$1 / $D$2 aboutirait à une erreur grossière consistant à diviser d’abord la moyenne par l’écart-type en vertu de la priorité de la division, avant de retrancher ce quotient de la valeur du participant, altérant totalement le sens de la transformation.
Sur le plan de l’optimisation des performances de calcul au sein du moteur interne de Google Sheets, l’équivalence entre l’utilisation de CENTRER.REDUIRE et la formule arithmétique manuelle parenthésée est computationnellement absolue. Les deux démarches mobilisent le même nombre d’opérations en virgule flottante au processeur. La formulation manuelle offre toutefois l’avantage d’une lisibilité universelle lors du transfert d’un classeur vers d’autres logiciels propriétaires ou open-source dont les fonctions natives pourraient adopter des désignations divergentes.
6. Automatisation matricielle et dynamique des calculs standardisés
6.1 Vectorisation des scores avec la fonction ARRAYFORMULA
L’étirement manuel de formules sur des cohortes regroupant plusieurs milliers d’observations s’avère inefficace, consommateur de temps et propice aux altérations de consistance dues aux manipulations humaines répétées. Google Sheets propose un mécanisme supérieur d’évaluation vectorielle unifiée via la commande ARRAYFORMULA. Cette fonction avancée permet d’exécuter un calcul matriciel sur l’ensemble d’un vecteur d’entrée en ne renseignant la formule que dans la cellule d’en-tête initiale.
La transcription d’une normalisation Z vectorisée s’effectue en associant l’expression matricielle à la plage intégrale des données d’observation. Dans la cellule réceptrice supérieure de la colonne normalisée, l’analyste peut insérer la construction : =ARRAYFORMULA((A2:A101 – MOYENNE(A2:A101)) / ECARTYPE(A2:A101)). De façon instantanée et sans nécessiter aucune action mécanique d’étirement, Google Sheets propage le calcul sur l’intégralité des cent lignes de données désignées, bloquant l’édition accidentelle des cellules inférieures qui dépendent directement de la matrice maîtresse.
Cette approche vectorisée présente un avantage fonctionnel déterminant lors de la collecte continue de données en recherche expérimentale. Si la plage vectorielle est configurée sous une forme ouverte, telle que A2:A, chaque nouvelle saisie de données générée par un formulaire connecté ou par une saisie en laboratoire verra sa cote Z calculée immédiatement et dynamiquement, sans intervention manuelle de reprogrammation sur le classeur de travail.
6.2 Masquage conditionnel des lignes vierges
Le déploiement d’une formule matricielle ouverte sur une colonne entière présente un désavantage collatéral si elle n’est pas conditionnée : Google Sheets tentera d’évaluer les lignes vierges inférieures jusqu’à la limite du tableur, générant des scores artificiels basés sur l’hypothèse erronée que les cellules vides correspondent à la valeur zéro. Pour préserver la propreté visuelle de la feuille de calcul et alléger la consommation de mémoire vive de la session de navigation, il est capital d’encapsuler la formule matricielle dans une structure conditionnelle logique.
L’articulation syntaxique requiert la fonction logique SI combinée à la détection de vacuité ESTVIDE. L’architecture optimale de l’instruction prend alors la forme suivante : =ARRAYFORMULA(SI(ESTVIDE(A2:A); « »; (A2:A – MOYENNE(A2:A)) / ECARTYPE(A2:A))). Sous cette configuration, l’algorithme teste au préalable si la cellule d’observation comporte un contenu tangible. Si la cellule est vide, la commande renvoie une chaîne vide sans exécuter l’équation ; si la cellule est renseignée, la standardisation s’exécute avec rigueur.
Cette optimisation préventive empêche la saturation inutile du cache de rendu de Google Sheets, évitant les ralentissements fréquents constatés lors du défilement des bases de données massives. De plus, elle supprime tout risque de pollution des analyses ultérieures par des valeurs parasites dérivées de l’interprétation par défaut des cases vierges, garantissant que seuls les véritables sujets évalués intègrent la métrique de restitution.
6.3 Utilisation avancée des fonctions LAMBDA et BYROW
Les versions récentes de Google Sheets intègrent des capacités de programmation fonctionnelle d’un niveau d’abstraction avancé grâce à l’implémentation de la fonction LAMBDA et de ses fonctions d’assistance itérative comme BYROW. Ces outils de pointe permettent d’écrire des algorithmes modulaires sur des matrices multidimensionnelles complexes, particulièrement utiles lorsqu’une batterie d’évaluation psychologique comporte des dizaines de sous-échelles réparties en blocs horizontaux.
En employant BYROW, il devient possible de calculer de manière autonome une normalisation intra-individuelle (centrage à la ligne) sans avoir à répéter manuellement les formules pour chaque sous-ensemble de l’échantillon. La syntaxe prend la forme générale suivante : =BYROW(A2:E100; LAMBDA(ligne; (ligne – MOYENNE(ligne)) / ECARTYPE(ligne))). Dans cette architecture de calcul, l’argument ligne agit comme une variable temporaire encapsulée qui itère successivement sur chaque participant pour renvoyer une ligne matricielle normalisée complète.
Cette modularité algorithmique favorise la reproductibilité scientifique et réduit considérablement le risque d’erreur humaine dans la maintenance de protocoles longitudinaux. Les équations ne sont plus dispersées à travers des milliers de cellules fragmentées, mais condensées dans une routine fonctionnelle unique et déclarative, facilitant l’audit statistique par des pairs ou par les comités de relecture des revues scientifiques dans le cadre de la démarche de science ouverte.
7. Interprétation quantitative et psychométrique des scores normalisés
7.1 Lecture probabiliste selon la loi normale standardisée
L’intérêt diagnostique et scientifique majeur d’une variable centrée-réduite réside dans sa lecture probabiliste immédiate, pour autant que la distribution empirique initiale respecte les postulats de gaussianité. Dans ce référentiel universel, un score Z strictement égal à 0,00 indique que le sujet se situe exactement au niveau de la performance moyenne de sa cohorte de référence. Une cote positive traduit une performance au-dessus de la moyenne, tandis qu’une cote négative signale un résultat inférieur.
En application de la règle de décomposition empirique de Gauss, les propriétés de l’aire sous la courbe d’une densité de probabilité normale standardisée permettent de segmenter l’échantillon en intervalles probabilistes fixes et universels. Approximativement 68,26 % des observations se concentrent dans l’intervalle délimité par [-1,00 ; +1,00] écart-type autour de la moyenne. En étendant l’intervalle entre [-2,00 ; +2,00] écarts-types, on englobe 95,44 % de la population globale, et l’intervalle [-3,00 ; +3,00] couvre quant à lui 99,74 % de l’ensemble des observations mesurables.
Dans la pratique psychologique et neuropsychologique internationale, ces bornes numériques constituent des seuils conventionnels essentiels pour la décision clinique. Une déviation négative inférieure à -1,65 (correspondant au 5e percentile inférieur) est fréquemment retenue comme le seuil de fragilité cognitive ou de risque clinique. Un score plongeant sous la barre des -2,00 écarts-types signe généralement un déficit sévère ou une pathologie avérée, tandis qu’à l’opposé du spectre, un score Z dépassant +2,00 ou +2,33 identifie les aptitudes exceptionnelles ou les profils dits à haut potentiel au sein des batteries psychométriques étalonnées.
7.2 Conversion des scores Z en rangs centiles et stanines
Bien que le score Z représente l’unité analytique par excellence pour le statisticien, sa communication directe auprès de patients, d’équipes pluridisciplinaires ou de commanditaires d’études s’avère souvent complexe, le signe négatif étant fréquemment mal interprété comme une évaluation péjorative dénuée de fondement scientifique. Il est dès lors d’usage de convertir les cotes standardisées en rangs centiles ou en échelles cliniques dérivées plus accessibles.
Google Sheets dispose de la fonction probabiliste LOI.NORMALE.STANDARD.N (ou NORM.S.DIST), qui permet de calculer instantanément la probabilité cumulée associée à un score Z sous l’hypothèse d’une loi normale univariée. La syntaxe canonique s’exprime sous la forme : =LOI.NORMALE.STANDARD.N(C2; VRAI), où la cellule C2 contient le score Z calculé et le booléen VRAI ordonne l’évaluation de l’intégrale cumulative de moins l’infini jusqu’au score Z. Multiplié par 100, le résultat renvoie le percentile exact : un score Z de 0 renvoie le 50e percentile, tandis qu’un score Z de +1,96 renvoie approximativement le 97,5e percentile.
Par ailleurs, la cote Z sert de passerelle mathématique pour projeter les scores sur des échelles classiques de standardisation clinique n’admettant pas de valeurs négatives. C’est notamment le cas de l’échelle des scores T de McCall (où la moyenne est fixée à 50 et l’écart-type à 10, calculée par l’équation =50 + (Z * 10)) ou de l’échelle standard du Quotient Intellectuel de Wechsler (moyenne fixée à 100 et écart-type à 15, obtenue via =100 + (Z * 15)). Ces conversions préservent la totalité de l’information statistique tout en facilitant la transmission et la compréhension des bilans psychologiques individuels.
7.3 Comparaison inter-individuelle et intra-individuelle de profils psychologiques
L’apport le plus décisif de la normalisation réside dans la possibilité d’analyser simultanément des aptitudes cognitives hautement hétérogènes sur un graphique unifié de profil individuel. Un clinicien évaluant un participant peut juxtaposer la vitesse de traitement de l’information (initialement mesurée en millisecondes), la mémoire de travail (mesurée par un empan spatial de 0 à 16 blocs) et la fluence verbale phonémique (mesurée par le dénombrement lexical brut en 60 secondes). Une fois ces trois variables réduites en cotes Z, les dissociations cognitives significatives apparaissent immédiatement.
La détection d’une dissociation neuropsychologique repose sur l’écart standardisé séparant deux fonctions chez le même individu. Si un patient présente un score Z de +1,50 en mémoire verbale mais un score Z de -2,20 en fonctions exécutives, l’écart de 3,70 écarts-types constitue une anomalie statistique majeure qui ne saurait être attribuée à une simple fluctuation de mesure. Cette analyse intra-individuelle différentielle guide les démarches diagnostiques de rééducation ciblée avec une rigueur analytique impossible à atteindre à partir des simples scores bruts.
Enfin, la standardisation ipsative permet d’étudier l’organisation relative des forces et faiblesses d’un profil sans subir l’influence du niveau moyen général du participant. En retranchant à chaque cote Z individuelle la moyenne propre de l’ensemble de ses scores standardisés, le profil est centré sur les aptitudes globales du sujet. Cette cartographie met en relief les spécificités de l’organisation cognitive du profil, indépendamment du fait que la personne se situe globalement dans la moyenne supérieure ou inférieure de la population.
8. Méthode alternative : La mise à l’échelle Min-Max dans Google Sheets
8.1 Formulation mathématique de la mise à l’échelle unitaire
La normalisation Min-Max représente une méthode alternative d’harmonisation métrique qui s’abstrait des notions d’espérance et d’écart-type pour ancrer rigidement les observations sur les bornes géométriques extrêmes observées dans la cohorte. L’équation mathématique universelle s’exprime par le ratio : x_norm = (x – Min) / (Max – Min), où Min et Max désignent respectivement les valeurs inférieure et supérieure identifiées sur l’ensemble de la distribution vectorielle analysée.
Cette fonction de projection linéaire applique une compression d’échelle rigoureuse qui confine la totalité des données transformées dans l’intervalle continu unitaire [0, 1]. La valeur brute minimale de l’échantillon reçoit obligatoirement et par définition la valeur transformée 0,00, tandis que la valeur brute maximale se voit attribuer la valeur 1,00. Toutes les valeurs intermédiaires sont réparties linéairement le long de ce spectre sans distorsion des rapports de distance initiaux : le milieu exact entre les deux bornes brutes recevra rigoureusement la valeur 0,50.
Contrairement au centrage-réduction par score Z, la mise à l’échelle unitaire ne modifie pas l’origine de la distribution vers le barycentre du groupe, mais vers la limite observationnelle inférieure. Il en découle que les cotes générées par la normalisation Min-Max sont strictement non négatives, une caractéristique particulièrement recherchée dans les protocoles nécessitant des entrées strictement positives, comme le calcul de certains indices géométriques de dissimilarité ou de probabilité empirique.
8.2 Transcription technique en formules Google Sheets
L’implémentation opérationnelle de la mise à l’échelle unitaire dans Google Sheets requiert la composition des fonctions d’encadrement statistique MIN et MAX. Étant donné une variable brute consignée dans la plage A2:A100 et une première valeur de sujet en A2, l’instruction algorithmique prend la formulation canonique suivante : =(A2 – MIN($A$2:$A$100)) / (MAX($A$2:$A$100) – MIN($A$2:$A$100)).
Le strict verrouillage absolu des plages d’analyse via le symbole dollar sur les indices de ligne et de colonne au sein des arguments de MIN et MAX est indispensable afin d’éviter que la fenêtre de balayage des extremums ne glisse verticalement au fur et à mesure que la formule est dupliquée vers le bas de la colonne. Tout défaut de verrouillage mènerait à ce que chaque ligne redéfinisse artificiellement ses propres bornes extrêmes partielles, faussant irrémédiablement l’échelle de projection globale.
De surcroît, cette équation de base peut être modulée à volonté pour projeter la distribution brute sur une échelle personnalisée arbitraire différente de l’intervalle unitaire standard. Si une équipe de recherche désire normaliser une variable continue sur une échelle allant de 1 à 10 ou de 0 à 100 (pour créer des indices de notation normalisés par exemple), la formulation est généralisée sous la syntaxe : =Borne_Inf + ((A2 – MIN($A$2:$A$100)) / (MAX($A$2:$A$100) – MIN($A$2:$A$100))) * (Borne_Sup – Borne_Inf). Cette flexibilité de mise à l’échelle unitaire s’adapte à une grande variété de cahiers des charges analytiques.
8.3 Critères de sélection entre centrage-réduction et Min-Max
L’arbitrage scientifique entre le centrage-réduction Z et la normalisation Min-Max ne doit jamais être conduit au hasard, mais guidé par des critères méthodologiques stricts liés à la nature des modèles analytiques déployés en aval de l’apurement des données. La standardisation par score Z constitue l’option obligatoire pour l’ensemble des analyses statistiques paramétriques classiques, incluant l’analyse de régression linéaire multiple, l’analyse de variance factorielle (ANOVA), l’analyse en composantes principales (ACP) et la modélisation en équations structurelles (SEM). Ces approches reposent sur l’estimation de matrices de covariance ou de corrélation, lesquelles nécessitent des distributions centrées autour d’une espérance nulle avec une variance unitaire.
En contrepartie, la normalisation Min-Max trouve son domaine de prédilection dans les architectures de traitement algorithmique contemporaines et d’apprentissage automatique supervisé ou non supervisé. Les algorithmes basés sur le calcul des plus proches voisins (k-NN) ou les réseaux de neurones profonds mobilisant des fonctions d’activation bornées, telles que la sigmoïde (qui compresse les valeurs entre 0 et 1) ou la tangente hyperbolique, requièrent une mise à l’échelle préalable de type Min-Max pour éviter la saturation prématurée des gradients de rétropropagation et pour empêcher qu’une variable à large amplitude numérique n’écrase artificiellement la topologie de l’espace des données.
Néanmoins, la vulnérabilité intrinsèque de la mise à l’échelle Min-Max face aux valeurs atypiques doit constamment tempérer son emploi. Si un nouvel arrivant dans une base de données présente une valeur supérieure au maximum historique lors d’un protocole d’acquisition en continu, la formule de projection renverra une valeur supérieure à 1,00, violant le postulat du bornage unitaire strict et contraignant l’analyste à recalculer l’intégralité de la métrique historique. La standardisation Z ne souffre pas de cette rupture structurelle, car elle absorbe sans discontinuité géométrique l’arrivée de nouvelles observations au sein de l’espace infini de la loi normale.
9. Vérification empirique et contrôle qualité des données transformées
9.1 Validation des postulats d’invariance statistique
Une démarche de recherche scientifique rigoureuse impose d’auditer systématiquement la conformité des transformations effectuées avant d’engager toute modélisation décisionnelle. L’intégrité numérique d’une normalisation par centrage-réduction repose sur la vérification empirique de deux postulats mathématiques d’invariance stochastique : la moyenne arithmétique de la variable transformée doit être rigoureusement égale à 0, et son écart-type doit être exactement égal à 1.
Pour mener cet audit au sein de Google Sheets, il suffit d’implémenter les fonctions =MOYENNE(plage_z) et =ECARTYPE(plage_z) sous la colonne hébergeant les scores Z calculés. Alors que l’écart-type affichera sans ambiguïté la valeur exacte de 1,000, il est fréquent que le calcul de la moyenne affiche une valeur non strictement nulle au niveau des dernières décimales, par exemple de l’ordre de -1,42E-16. Cette notation scientifique correspond à un nombre extrêmement proche de zéro, attribuable aux limitations inhérentes au calcul binaire en virgule flottante régi par la norme internationale IEEE 754.
Ce phénomène d’arrondi numérique résiduel au dix-septième ordre de décimale ne constitue pas une erreur computationnelle et ne remet nullement en cause la validité de la standardisation. Si l’affichage visuel requiert une propreté stricte pour l’exportation des tableaux de résultats ou la communication publique, l’analyste peut encapsuler le résultat d’audit dans la fonction d’arrondi de Google Sheets sous la commande : =ARRONDI(MOYENNE(plage_z); 4), laquelle restituera un zéro net et sans artéfact.
9.2 Contrôle visuel par l’histogramme de distribution
L’audit numérique doit être systématiquement corroboré par une évaluation graphique exploratoire. L’inspection visuelle demeure l’outil le plus robuste pour identifier les artefacts distributionnels que les statistiques de synthèse globales peuvent masquer. Dans Google Sheets, la génération d’un histogramme de distribution s’effectue aisément en sélectionnant la colonne des scores standardisés, puis en naviguant vers le menu d’insertion graphique et en définissant le type de diagramme sur Histogramme dans le panneau de configuration latérale.
Le contrôle visuel doit examiner en priorité la régularité de la forme en cloche caractéristique de la loi gaussienne théorique. La distribution standardisée empirique doit exhiber une symétrie équilibrée de part et d’autre de l’axe central passant par le score Z = 0, accompagnée d’un effilement continu et proportionnel des effectifs le long des queues de distribution s’étirant vers les bornes -3 et +3. L’analyste peut ajuster la granularité des intervalles (largeur des classes) dans les options de personnalisation graphique afin d’affiner la précision visuelle de l’inspection.
L’apparition flagrante d’une bimodalité (deux sommets distincts) sur l’histogramme des scores Z révèle immédiatement l’existence sous-jacente de deux sous-populations hétérogènes amalgamées à tort au sein du même échantillon, comme une disparité majeure liée au sexe, à l’âge ou à un sous-type pathologique clinique non contrôlé. Dans cette situation, standardiser la cohorte d’un seul bloc constitue une faute méthodologique majeure : les données doivent être partitionnées et chaque sous-groupe doit faire l’objet d’une normalisation spécifique fondée sur ses propres paramètres d’étalonnage respectifs.
10. Gestion des violations de postulats et normalisation non linéaire
10.1 Conséquences de la non-gaussicité sur l’interprétation des cotes Z
L’une des dérives les plus critiques en psychologie différentielle et en analyse quantitative réside dans l’assimilation abusive de la standardisation linéaire Z à une véritable « normalisation » de la forme géométrique de la distribution. Il est impératif de réitérer ce principe de statistique mathématique : le calcul du score Z centre et réduit l’échelle numérique d’une variable, mais ne modifie en aucun cas la morphologie de sa distribution. Si la variable brute initiale est asymétrique, bimodale ou étalée de façon chaotique, la distribution des scores Z résultants sera strictement et identiquement asymétrique, bimodale ou chaotique.
L’impact méthodologique de cette non-gaussicité sur l’interprétation inférentielle est considérable. Lorsqu’un praticien affirme sans précaution qu’un score Z de -1,65 correspond précisément au 5e percentile inférieur de la population, cette équivalence est strictement conditionnée au respect scrupuleux du postulat de normalité univariée de la distribution. Si les données sous-jacentes présentent une asymétrie positive marquée, un score Z de -1,65 peut en réalité correspondre au 12e percentile ou au 1er percentile de la distribution réelle observée.
Il en résulte des risques élevés de fausses classifications cliniques ou diagnostiques. Un participant peut être diagnostiqué à tort comme présentant un déficit cognitif sévère sur la base d’une table théorique de loi normale, alors qu’en réalité, sa position relative dans la distribution empirique asymétrique est nettement moins marginale. Face à des violations sévères des postulats de symétrie, l’analyste doit impérativement recourir à des transformations mathématiques préalables correctrices ou à des techniques de normalisation par les rangs non paramétriques.
10.2 Transformations mathématiques préalables à la standardisation
Lorsque la distribution d’une variable continue présente une asymétrie unilatérale modérée à forte, l’application de fonctions mathématiques non linéaires préalablement à la standardisation par score Z permet souvent de ramener la morphologie de la distribution vers une symétrie compatible avec les exigences gaussiennes. Google Sheets intègre nativement l’ensemble des fonctions analytiques nécessaires pour implémenter ces corrections structurelles sur les variables d’observation brutes.
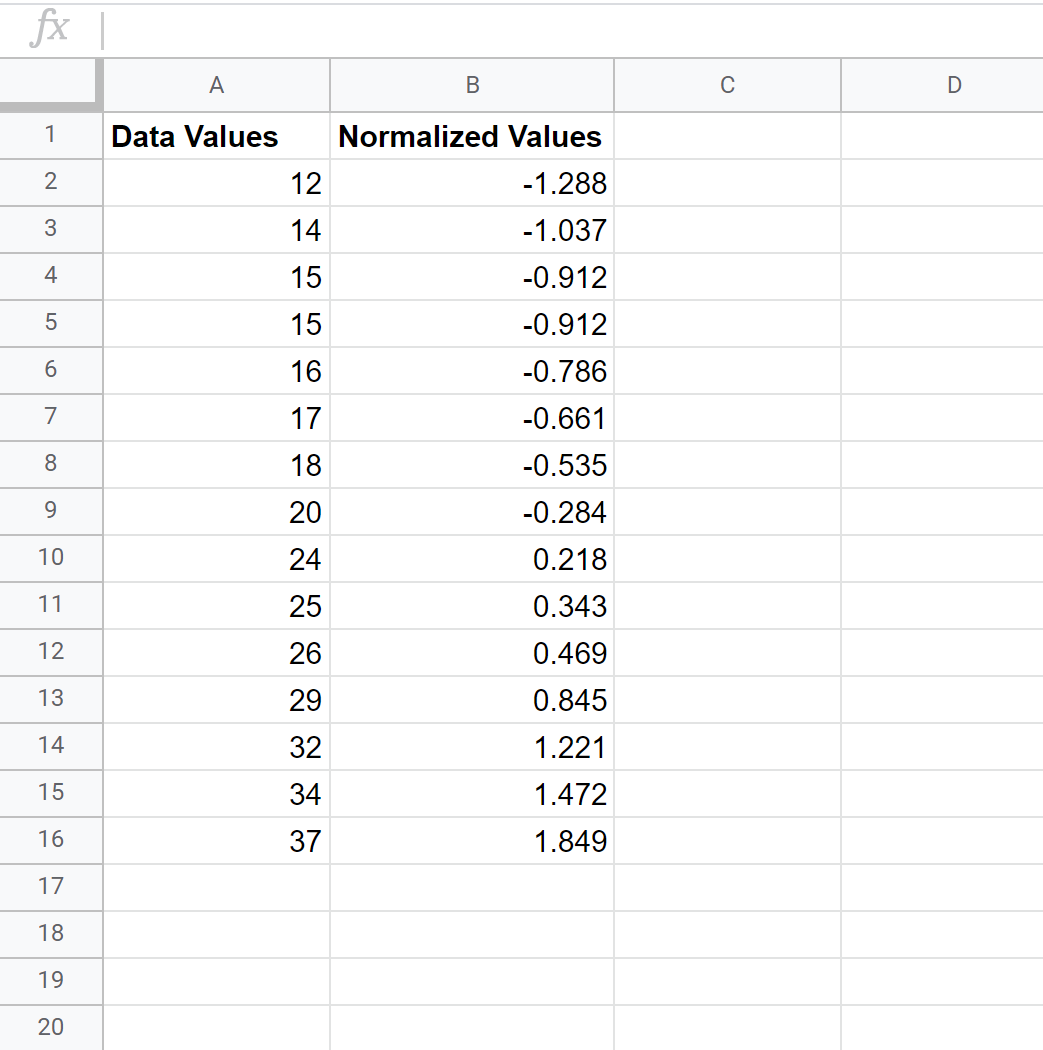
Pour corriger une asymétrie positive caractérisée par une longue queue de distribution orientée vers la droite — profil classique des temps de réaction, des concentrations de biomarqueurs salivaires ou des indicateurs de latence cognitive —, la transformation logarithmique népérien s’avère la plus efficiente. Elle se déploie via la fonction LN sous la syntaxe : =LN(A2), à la condition stricte que toutes les valeurs soient strictement positives. Si la distribution comporte des valeurs nulles, la transformation semi-logarithmique ajustée =LN(A2 + 1) garantit la stabilité du calcul.
Pour des variables fondées sur des comptages discrets d’événements à faible occurrence, tels que le nombre d’erreurs commises lors d’une tâche de mémoire ou les omissions attentionnelles dans un test de vigilance soutenue, la distribution se rapproche fréquemment d’une loi de Poisson. Dans ce scénario, la transformation racine carrée, implémentée via la fonction RACINE sous la formulation : =RACINE(A2), stabilise la variance et réduit l’étalement des grands nombres. Enfin, pour les asymétries positives extrêmes, la transformation inverse =1 / A2 comprime radicalement les valeurs éloignées, convertissant par exemple un temps de latence en un indicateur dimensionnel de vitesse de traitement avant l’application définitive du centrage-réduire.
10.3 Technique de normalisation par les rangs (Score de Van der Waerden)
Lorsque les distributions empiriques se révèlent réfractaires à toute transformation analytique classique en raison d’une morphologie hautement irrégulière ou de discontinuités marquées, la méthode de normalisation par les rangs, historiquement théorisée sous l’appellation de transformation de Van der Waerden ou normalisation par quantiles, constitue la démarche empirique la plus robuste pour obtenir une variable rigoureusement gaussienne.
Ce protocole non paramétrique s’articule en trois opérations successives réalisables au sein de Google Sheets. La première étape consiste à attribuer un rang ordinal à chaque observation de l’échantillon à l’aide de la fonction RANG. Dans une colonne adjacente, pour une observation logée en A2 au sein d’une cohorte de taille N = 100, l’instruction s’écrit : =RANG(A2; $A$2:$A$101; 1), le dernier argument précisant un ordonnancement croissant régulier.
La seconde étape convertit ce rang ordinal en une position probabiliste cumulative proportionnelle sur l’intervalle unitaire, en appliquant un correcteur de continuité pour prévenir l’atteinte des bornes absolues zéro et un. La formule de Blom préconise la structure : =(Rang – 0,375) / (N + 0,25). Enfin, la troisième étape projette ces percentiles empiriques dans l’espace de la loi normale standardisée à l’aide de la fonction quantile inverse : =LOI.NORMALE.STANDARD.INVERSE((RANG(A2; $A$2:$A$101; 1) – 0,375) / (100 + 0,25)). Le résultat génère une distribution artificielle parfaitement normale centrée en 0 et de variance 1, s’affranchissant totalement des déformations de la métrique d’origine tout en respectant scrupuleusement la hiérarchie ordinale des sujets.
11. Étude de cas appliquée : Normalisation de batteries de tests psychologiques
11.1 Présentation du protocole expérimental et des données brutes
Afin de concrétiser l’ensemble de ces préceptes théoriques dans un cas pratique, considérons un protocole de recherche neuropsychologique portant sur une cohorte de 100 participants adultes (N = 100). Chaque individu a été soumis à une batterie d’évaluation cognitive comprenant trois épreuves expérimentales indépendantes explorant des facettes complémentaires du fonctionnement cérébral, mais mesurées sur des échelles numériques incommensurables.
La première variable observationnelle, le Test A, mesure un temps de réaction discriminatif psychomoteur enregistré avec une précision à la milliseconde près, dont les valeurs s’échelonnent typiquement entre 320 ms et 980 ms. La deuxième épreuve, le Test B, est un test de rétention mnésique visuo-spatiale évaluant le nombre d’items correctement remémorés, dont le score est borné discrètement sur un intervalle entier de 0 à 30 points. La troisième variable, le Test C, consiste en une échelle psychométrique d’anxiété situationnelle dérivée d’un questionnaire d’auto-évaluation dont le score global composite fluctue entre 20 et 100 points.
La problématique centrale du chercheur réside dans l’incommensurabilité absolue de ces métriques brutes. Un décalage de 50 millisecondes sur le Test A n’a aucun équivalent structurel direct avec un gain de 5 points au Test B ou une diminution de 10 points au Test C. De plus, les polarités de performance divergent : pour le test de mémoire, un score numérique élevé traduit une performance cognitive optimale, tandis que pour le temps de réaction et l’échelle d’anxiété, un score numérique élevé reflète respectivement un ralentissement pathologique ou une détresse émotionnelle accrue.
11.2 Implémentation pas-à-pas de la normalisation sous Google Sheets
La première démarche opérationnelle consiste à établir une ligne de synthèse paramétrique sous la matrice des données brutes au sein de la feuille de calcul. Dans les lignes réservées aux indicateurs statistiques situées sous la dernière observation (lignes 102 et 103 par exemple), l’analyste implémente la formule =MOYENNE(B2:B101) puis =ECARTYPE(B2:B101) pour le Test A consigné en colonne B, et duplique horizontalement ces instructions sous les colonnes C et D allouées aux Tests B et C.
Avant d’engager la réduction mathématique, une harmonisation de la polarité directionnelle s’impose pour que l’ensemble des cotes normalisées pointent dans la même direction sémantique (la réussite cognitive). Pour le temps de réaction (Test A), où la vitesse constitue le facteur de succès, il convient d’inverser la cote Z finale afin qu’un temps court (inférieur à la moyenne) se matérialise par un score standardisé positif. L’équation de transformation appliquée dans la première cellule normalisée du Test A (cellule F2) s’exprime donc par la forme inversée : =-1 * CENTRER.REDUIRE(B2; $B$102; $B$103).
Pour le score de mémoire (Test B), dont la valence est naturellement positive, l’instruction classique sans inversion est déployée dans la cellule G2 : =CENTRER.REDUIRE(C2; $C$102; $C$103). Pour l’échelle d’anxiété (Test C), si l’objectif est d’évaluer la stabilité émotionnelle favorable à la cognition, la formule inversée sera également privilégiée dans la cellule H2 : =-1 * CENTRER.REDUIRE(D2; $D$102; $D$103). Ces formules sont ensuite propagées verticalement sur l’ensemble des cent participants, assurant que pour chaque variable transformée, une cote positive signale systématiquement une aptitude cognitive ou émotionnelle favorable par rapport à la moyenne du groupe.
11.3 Agrégation en un indice composite et prise de décision diagnostique
Dès lors que les trois épreuves expérimentales reposent sur une échelle métrique commune, invariante, centrée sur 0 et régie par une variance unitaire, l’investigateur peut procéder à leur synthèse mathématique pour dériver un indice global de performance cognitive générale. Dans une nouvelle colonne I intitulée Score_Composite, l’instruction moyenne est appliquée ligne par ligne pour chaque participant : =MOYENNE(F2:H2).
Cet indice composite unifié neutralise les effets d’échelle et confère un poids équivalent à chacune des trois dimensions cognitives mesurées. L’analyste peut alors automatiser la détection diagnostique des participants en situation de vulnérabilité clinique sévère en intégrant une formule logique conditionnelle dans la colonne J : =SI(I2 < -1,96; "Alerte Clinique"; "Profil Typique"). L’ancrage de la décision sur le seuil critique de -1,96 écarts-type garantit que seuls les individus se situant dans les 2,5 % les plus faibles de la distribution globale de la cohorte seront ciblés pour une investigation médicale approfondie.
Enfin, ces résultats transformés peuvent être synthétisés dans un tableau de bord récapitulatif exploitant les règles de mise en forme conditionnelle de Google Sheets. En appliquant un dégradé de couleurs bicolore centré sur zéro (bleu pour les scores Z positifs, rouge pour les scores Z négatifs), les cliniciens visualisent d’un seul coup d’œil l’équilibre neuropsychologique de chaque participant au sein de la matrice, permettant une restitution claire et visuelle des conclusions de l’évaluation.
12. Bonnes pratiques, erreurs fréquentes et recommandations méthodologiques
12.1 Pièges computationnels majeurs dans Google Sheets
L’exécution de transformations statistiques avancées au sein d’un tableur collaboratif comme Google Sheets expose l’analyste à des écueils techniques récurrents qu’il convient de circonscrire minutieusement. Le premier piège réside dans la disparité de syntaxe des séparateurs d’arguments et de décimales dictée par la langue de l’interface du compte Google. Alors qu’une feuille configurée en français requiert impérativement un point-virgule pour séparer les composantes d’une formule telle que =CENTRER.REDUIRE(valeur; moyenne; ecart_type), une configuration anglo-saxonne déclenchera une erreur de syntaxe irrécupérable si l’utilisateur ne substitue pas ce séparateur par une virgule standard.
Le second dysfonctionnement réside dans la manipulation non contrôlée des fonctions de recalcul automatique volatiles. L’intégration de fonctions dynamiques comme AUJOURDHUI ou ALEA au sein des matrices de normalisation force Google Sheets à réévaluer l’intégralité des formules à chaque ouverture de page ou modification périphérique, déstabilisant les analyses figées et entraînant une instabilité des jeux de données d’évaluation. Il est impératif d’isoler les calculs de standardisation de toute dépendance volatile extérieure.
Enfin, une négligence fréquente consiste à modifier l’ordre de tri des participants dans l’onglet des données brutes après avoir implémenté des formules de normalisation liant plusieurs onglets sans utiliser de clés de jointure relationnelles de type RECHERCHEV ou XLOOKUP. Si les calculs de scores Z reposent sur des coordonnées matricielles fixes d’un autre onglet, tout tri alphabétique ou numérique partiel sur les données initiales désynchronise irrémédiablement les identifiants de participants de leurs cotes standardisées respectives, introduisant des corruptions de données catastrophiques pour la validité de l’étude.
12.2 Directives de transparence scientifique et de reproductibilité
L’adhésion aux standards de la science ouverte et aux lignes directrices pour la reproductibilité expérimentale impose d’organiser les classeurs de données selon des protocoles documentaires rigoureux. La première prescription fondamentale réside dans l’intégrité absolue de l’onglet source. Les données brutes d’observation recueillies auprès des participants ne doivent jamais faire l’objet de modifications directes, d’écrasements de valeurs ou d’arrondis a posteriori. Cet onglet source doit être formellement verrouillé en écriture via les options d’autorisation d’accès de Google Sheets, agissant comme un coffre-fort de référence immuable.
Chaque classeur de recherche doit impérativement comporter un onglet introductif réservé aux métadonnées descriptives (souvent désigné sous le terme de Codebook ou dictionnaire de données). Cet onglet documente pour chaque colonne de l’étude : la dénomination exacte de la variable, sa définition opérationnelle, son unité de mesure d’origine, le protocole de standardisation appliqué (score Z, Min-Max, transformation logarithmique préalable), ainsi que les versions des algorithmes de calcul utilisés. Cette documentation détaillée garantit qu’un relecteur indépendant puisse reconstituer avec une exactitude totale le pipeline de transformation sans ambiguïté interprétative.
De plus, lors du partage des jeux de données sur des entrepôts de données scientifiques ouverts (tels que le réseau Open Science Framework ou Zenodo), il est fortement recommandé d’archiver une copie du classeur au format CSV non dynamique pour les données brutes, tout en conservant le lien vers la feuille Google Sheets active afin de rendre accessibles aux auditeurs l’ensemble des formules algorithmiques sous-jacentes. Cette double transmission protège la démarche contre tout soupçon de manipulation arbitraire des distributions statistiques.
12.3 Synthèse procédurale pour les chercheurs et praticiens
Pour guider le praticien et le chercheur dans le choix optimal de la technique d’harmonisation métrique au sein de Google Sheets, l’arbre de décision méthodologique suivant synthétise les arbitrages fondamentaux à opérer face à une distribution de données brutes :
- Évaluation de la forme distributionnelle univariée : Calculer préalablement les coefficients d’asymétrie et d’aplatissement. Si les coefficients se situent dans la tolérance classique de [-1,00 ; +1,00], la distribution peut être considérée comme symétrique et unimodale.
- Vérification de la présence de valeurs aberrantes : Examiner la cohérence entre la moyenne arithmétique et la médiane. En présence de points extrêmes atypiques avérés, privilégier le filtrage méthodique théorique, le recours aux moyennes tronquées, ou l’adoption du score Z qui résiste mieux que la mise à l’échelle unitaire à l’écrasement distributionnel.
- Sélection du paradigme de normalisation :
- Opter impérativement pour la standardisation Z (via CENTRER.REDUIRE ou formulation manuelle) si les données sont destinées à des tests statistiques paramétriques univariés ou multivariés (régressions, ANOVA, corrélations de Pearson, factorisation) ou à des bilans psychométriques standardisés rapportés à une courbe de Gauss.
- Opter pour la mise à l’échelle Min-Max si la variable doit impérativement être bornée dans un intervalle fermé déterminé (par exemple [0, 1]) pour alimenter des architectures algorithmiques d’apprentissage automatique non paramétriques (réseaux de neurones, calculs de similarité euclidienne, classificateurs k-NN).
- Opter pour une transformation non linéaire préalable (logarithme avec LN, racine carrée avec RACINE) ou pour une normalisation par les rangs de Van der Waerden si la distribution d’origine viole sévèrement et irréductiblement les postulats de normalité univariée.
- Contrôle qualité systématique : Valider formellement après calcul que la série standardisée présente une moyenne vérifiée à 0,000 et un écart-type unitaire de 1,000, et inspecter visuellement l’histogramme de distribution avant de procéder à l’interprétation diagnostique ou à la modélisation finale.
Bien que Google Sheets constitue un environnement analytique remarquable pour l’apurement, la préparation et la mise à l’échelle de cohortes de recherche préliminaires, l’investigateur doit être conscient de ses frontières méthodologiques. Lorsque les jeux de données dépassent plusieurs dizaines de milliers de lignes ou que les protocoles impliquent des modélisations mixtes longitudinales à effets aléatoires, la transition vers des environnements de programmation statistique dédiés tels que le langage R (via des packages spécialisés comme psych ou scale) ou Python (via la bibliothèque scikit-learn) s’impose comme l’étape ultérieure naturelle pour pérenniser et automatiser les analyses computationnelles de pointe.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anastasi, A., & Urbina, S. (1997). Psychological testing (7th ed.). Prentice Hall.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Glass, G. V., & Hopkins, K. D. (1996). Statistical methods in education and psychology (3rd ed.). Allyn & Bacon.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Van der Waerden, B. L. (1953). Order tests for the two-sample problem and their power. Proceedings of the Koninklijke Nederlandse Akademie van Wetenschappen: Series A: Mathematical Sciences, 56(4), 303-316.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). Pearson Assessment.
- Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594