
La quantification des phénomènes empiriques constitue l’un des piliers méthodologiques fondamentaux des sciences contemporaines, qu’il s’agisse des neurosciences cognitives, de la psychométrie, de la sociologie quantitative ou de la science des données appliquée. Néanmoins, l’observation brute engendre quasi systématiquement des métriques hétérogènes, caractérisées par des unités de mesure disparates, des amplitudes arbitraires et des propriétés distributionnelles singulières. Face à cette dispersion structurelle, le chercheur et l’analyste se heurtent à une exigence incontournable : celle d’harmoniser ces grandeurs sans pour autant altérer l’intégrité de l’information sous-jacente ni dénaturer la géométrie relationnelle qui unit les observations au sein d’un échantillon.
Parmi l’arsenal des transformations linéaires et non linéaires à la disposition des statisticiens, la projection sur un continuum standardisé borné entre 0 et 100 occupe une posture singulière. Loin d’être un simple artifice cosmétique ou une commodité graphique, l’attribution d’un intervalle unitaire centésimal répond à des impératifs épistémologiques précis : offrir une lisibilité immédiate en ancrant l’interprétation dans une métrique intuitive, neutraliser les biais de pondération inhérents à l’addition de sous-échelles aux amplitudes divergentes, et optimiser le conditionnement numérique des jeux de données préalablement à leur modélisation probabiliste ou algorithmique.
Le présent traité méthodologique propose une exploration exhaustive, rigoureuse et formalisée de la normalisation Min-Max appliquée au segment $[0, 100]$. À travers une déconstruction analytique de ses fondements mathématiques, une mise en perspective avec la théorie axiomatique de la mesure et une confrontation détaillée avec les pratiques computationnelles modernes, ce guide aspire à doter les chercheurs d’une grille de lecture critique. Il s’agira d’examiner tant les vertus opératoires de cette métrique que ses limites intrinsèques, notamment face aux perturbations induites par les valeurs aberrantes et les dérives d’échantillonnage longitudinales.
1. Introduction épistémologique et contextuelle à la normalisation des données
1.1 Définition fondamentale de la normalisation d’échelle
Dans l’architecture du prétraitement statistique, il est impératif d’établir une ligne de démarcation conceptuelle stricte entre trois démarches fréquemment confondues dans la littérature empirique : la mise à l’échelle (scaling), la standardisation (standardization) et la transformation de distribution (distributional transformation). La mise à l’échelle désigne l’application d’une fonction affine visant à translater et dilater un vecteur de valeurs afin de contraindre son étendue au sein d’un intervalle prédéterminé, sans altérer la morphologie de sa distribution originale. À l’inverse, la standardisation, illustrée par la transformation en scores réduits (Z-score), opère un recentrage sur la moyenne empirique couplé à une division par l’écart-type, ce qui stabilise la variance à l’unité mais laisse les bornes extrêmes libres et dépendantes de la dispersion échantillonnale. Enfin, les transformations de distribution (telles que les fonctions logarithmiques ou les extensions de Box-Cox) cherchent à corriger activement l’asymétrie ou le kurtosis pour approcher une loi normale théorique.
La projection de variables continues sur un intervalle borné standardisé découle d’une nécessité fonctionnelle : rendre commensurables des grandeurs physiques, physiologiques ou psychologiques dont les échelles brutes sont le produit direct d’instruments arbitraires. Lorsqu’un chercheur manipule conjointement des temps de réaction exprimés en millisecondes et des scores d’inventaires cliniques échelonnés de zéro à quelques dizaines de points, l’absence de mise à l’échelle commune introduit une asymétrie injustifiée dans les calculs de distance euclidienne ou dans les matrices de variance-covariance.
Le principe cardinal de toute normalisation linéaire repose sur la conservation rigoureuse de l’ordre relatif (monotonie stricte) et des rapports de distance entre les observations. Formellement, si trois observations brutes vérifient la relation métrique $(x_k – x_j) / (x_j – x_i) = \lambda$, la transformation linéaire garantit que le ratio homologue calculé sur les valeurs transformées $(z_k – z_j) / (z_j – z_i)$ demeure strictement égal à $lambda$. Cette invariance géométrique assure que la structure interne du nuage de points n’est ni comprimée de façon anisotrope, ni déformée par l’opération mathématique, préservant ainsi l’intégralité des inférences corrélationnelles.
L’essor de ces procédures s’inscrit au cœur des méthodologies quantitatives contemporaines. Alors que l’analyse statistique classique privilégiait historiquement des méthodes fondées sur les moments distributionnels (moyenne et variance), l’émergence des protocoles d’apprentissage automatique, de la rétropropagation de gradient dans les réseaux neuronaux profonds et des techniques d’analyse factorielle confirmatoire a rendu indispensable le contrôle déterministe des bornes de variation des entrées prédictives.
1.2 Importance de la métrique [0, 100] en analyse quantitative
Le choix délibéré de l’intervalle fermé $[0, 100]$, par opposition au segment unitaire canonique $[0, 1]$, répond à des exigences cognitives et de médiation scientifique profondément ancrées dans la psychologie de la perception numérique. Le système décimal et la notation centésimale constituent une grammaire universelle intuitive : le cerveau humain appréhende avec une aisance remarquable les grandeurs calibrées sur une base 100, associant spontanément le zéro à l’absence de magnitude ou au seuil minimal observable, et le cent au potentiel maximal ou à l’accomplissement exhaustif d’une échelle donnée.
Cette intelligibilité cognitive spontanée présente un intérêt majeur lorsqu’il s’agit d’harmoniser des métriques hétérogènes pour la comparaison inter-individuelle. Dans le cadre d’évaluations psychométriques ou scolastiques, l’énonciation d’un score brut de 43 sur une échelle plafonnée à 68 exige une gymnastique mentale constante de conversion relative. À l’inverse, l’attribution d’un score normalisé sur 100 positionne immédiatement l’individu sur une échelle d’intensité relative directement appréhendable par le clinicien, l’expérimentateur ou le sujet lui-même, sans requérir la mémorisation préalable des tables de cotation spécifiques à chaque sous-épreuve.
Au-delà de la sphère académique, la communication des résultats statistiques à des tiers — décideurs institutionnels, comités éthiques, praticiens de santé ou grand public — bénéficie grandement de cette transformation. Présenter l’évolution d’un symptôme ou d’une performance par le prisme d’une trajectoire sur $[0, 100]$ désamorce les biais d’interprétation liés aux échelles à valeurs négatives (telles que les scores factoriels centrés) ou aux fractions décimales infinitésimales issues de la normalisation unitaire standard.
Enfin, le segment $[0, 100]$ matérialise un étalon universel d’évaluation de la dispersion relative. Alors que deux distributions empiriques possédant des variances identiques peuvent masquer des densités relatives totalement différentes si leurs moyennes diffèrent substantiellement, la projection sur une amplitude fixe de 100 unités offre un cadre homogène pour apprécier, par simple inspection descriptive, la variabilité relative des comportements ou des réponses au sein de cohortes indépendantes.
1.3 La place de la normalisation dans la recherche psychologique et psychométrique
Dans les sciences du comportement, la construction des outils de collecte s’appuie massivement sur des formats de réponse gradués, dont les échelles de Likert constituent l’archétype méthodologique. Toutefois, la disparité règne au sein de la littérature : certains instruments exploitent des formats à 4 modalités pour forcer un choix binaire sous-jacent, tandis que d’autres recourent à des formats à 5, 7 ou 9 ancrages sémantiques afin de capturer des nuances plus fines de la variabilité attitudinale. Cette variabilité structurelle pose un défi insurmontable dès lors que le chercheur souhaite comparer des construits théoriquement proches issus de batteries distinctes. La normalisation sur $[0, 100]$ permet d’uniformiser ces métriques discordantes, réduisant la variabilité artificielle imputable aux seuls choix d’ingénierie du questionnaire.
L’agrégation d’indices composites représente un autre domaine d’élection de cette démarche. Lors de l’évaluation de fonctions exécutives complexes, les protocoles cliniques mobilisent couramment des tâches hétérogènes : empans mnésiques mesurés en nombre d’items restitués, flexibilité cognitive mesurée par le nombre d’erreurs persévératives, et vitesse de traitement quantifiée en secondes. La sommation brute de ces valeurs s’avère mathématiquement invalide en raison de la prépondérance écrasante des unités numériques les plus élevées sur le résultat composite final. Par la mise à l’échelle sur $[0, 100]$, chaque sous-test se voit doté d’un poids structural nominal équivalent, garantissant une pondération équilibrée des dimensions lors de la synthèse diagnostique.
Enfin, la comparabilité des profils psychologiques sur des échelles normées universelles constitue un impératif en psychométrie appliquée. Qu’il s’agisse d’établir un phénotype comportemental dans le champ des troubles neurodéveloppementaux ou de tracer les facettes de personnalité selon le modèle à cinq facteurs (Big Five), l’utilisation d’une échelle commune calibrée de 0 à 100 permet une visualisation synoptique des forces et déficits d’un individu. Cette projection facilite la lecture des profils ipsatifs tout en maintenant un ancrage rigoureux dans les propriétés métriques de l’échantillon de référence.
2. La formulation mathématique de la mise à l’échelle Min-Max sur l’intervalle [0, 100]
2.1 Dérivation de l’équation standard Min-Max bornée à [0, 1]
La normalisation Min-Max repose sur les propriétés fondamentales des fonctions affines définies sur le corps des réels $\mathbb{R}$. Soit un vecteur unidimensionnel d’observations $X = {x_1, x_2, dots, x_n} \subset \mathbb{R}$, où les valeurs minimale et maximale observées sont formellement désignées par :
$$x_{\min} = \min_{1 le i le n} (x_i) \quad \text{et} \quad x_{\max} = \max_{1 le i le n} (x_i)$$
Sous l’hypothèse de stricte non-dégénérescence de l’échantillon, c’est-à-dire que l’étendue empirique $\Delta x = x_{\max} – x_{\min} > 0$, la fonction de transformation canonique projetant le support $[x_{\min}, x_{\max}]$ vers l’intervalle unitaire $[0, 1]$ s’énonce comme suit :
$$f(x_i) = \frac{x_i – x_{\min}}{x_{\max} – x_{\min}}$$
Cette expression réalise une double opération algébrique. Premièrement, le numérateur $(x_i – x_{\min})$ opère une translation d’origine. En soustrayant le minimum à chaque élément, l’ensemble des données subit un glissement rigide le long de l’axe réel, ancrant la valeur la plus basse exactement en 0 sans modifier la variance ni les écarts relatifs entre les points. Deuxièmement, le dénominateur effectue une contraction homothétique en divisant chaque valeur translatée par l’amplitude totale $\Delta x$. Cette dilatation inverse réduit l’étendue globale à exactement 1 unité métrique.
L’invariance par changement d’échelle de cette formulation assure un comportement asymptotique parfaitement stable : quelle que soit l’unité originelle (degrés Celsius, millisecondes, microvolts), le ratio obtenu est une grandeur adimensionnelle. Cette dérivation algébrique élémentaire constitue la brique fondatrice sur laquelle se greffent les extensions d’échelle arbitraires.
2.2 Extension linéaire à l’amplitude cible [0, 100]
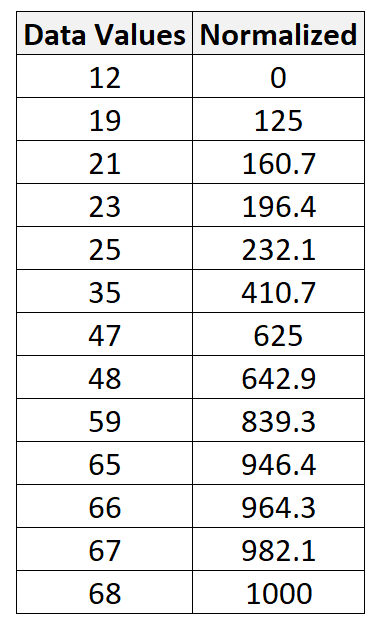
Pour transférer le support unitaire $[0, 1]$ vers l’intervalle centésimal cible $[0, 100]$, il convient d’appliquer une homothétie de rapport scalaire $k = 100$ à l’équation canonique. La transformation globale, notée $z_i = g(x_i)$, s’exprime par la relation formelle :
$$z_i = \left( \frac{x_i – x_{\min}}{x_{\max} – x_{\min}} \right) \times 100$$
La présence du scalaire 100 n’altère en rien la linéarité de l’opérateur. En effet, en développant l’expression sous la forme canonique d’une fonction affine $g(x) = \alpha x + \beta$, nous obtenons :
$$g(x_i) = \left( \frac{100}{x_{\max} – x_{\min}} \right) x_i – \left( \frac{100 \cdot x_{\min}}{x_{\max} – x_{\min}} \right)$$
avec la pente $\alpha = \frac{100}{x_{\max} – x_{\min}}$ et l’ordonnée à l’origine $\beta = -\frac{100 \cdot x_{\min}}{x_{\max} – x_{\min}}$. Puisque $\Delta x > 0$, la pente $\alpha$ est strictement positive, ce qui constitue la démonstration formelle de la stricte monotonie de la transformation. Ainsi, pour tout couple d’observations $(x_a, x_b)$, la condition $x_a < x_b iff g(x_a) < g(x_b)$ est rigoureusement satisfaite.
Par ailleurs, cette extension préserve sans distorsion l’égalité des rapports de distance métrique. Si l’on considère quatre observations $x_1, x_2, x_3, x_4$ telles que $x_2 – x_1 = x_4 – x_3$, la soustraction des images normalisées démontre immédiatement l’invariance structurelle :
$$z_2 – z_1 = \alpha(x_2 – x_1) = \alpha(x_4 – x_3) = z_4 – z_3$$
Cette conservation absolue des espacements relatifs garantit que la métrique conserve son statut d’échelle d’intervalles au sens de la métrologie classique.
2.3 Propriétés analytiques de la variable transformée
L’examen des propriétés statistiques de la variable résultante $Z = {z_1, z_2, dots, z_n}$ met en lumière un ancrage rigoureusement déterministe de ses valeurs extrêmes. Par construction algébrique :
$$z_{\min} = g(x_{\min}) = \left( \frac{x_{\min} – x_{\min}}{x_{\max} – x_{\min}} \right) \times 100 = 0$$
$$z_{\max} = g(x_{\max}) = \left( \frac{x_{\max} – x_{\min}}{x_{\max} – x_{\min}} \right) \times 100 = 100$$
Concernant les moments distributionnels de premier et de second ordre, la moyenne arithmétique $\mu_z$ et la variance $\sigma_z^2$ subissent des modifications proportionnelles dictées par les propriétés de l’espérance et de la variance sous transformation affine :
$$\mu_z = \mathbb{E}[Z] = \alpha \mathbb{E}[X] + \beta = \left( \frac{100}{x_{\max} – x_{\min}} \right) \mu_x – \left( \frac{100 \cdot x_{\min}}{x_{\max} – x_{\min}} \right)$$
$$\sigma_z^2 = \mathbb{V}\text{ar}(Z) = \alpha^2 \mathbb{V}\text{ar}(X) = \left( \frac{100}{x_{\max} – x_{\min}} \right)^2 \sigma_x^2$$
En revanche, une propriété fondamentale de cette mise à l’échelle réside dans l’invariance absolue des moments centrés standardisés d’ordres trois et quatre. Le coefficient d’asymétrie de Fisher-Pearson (skewness, noté $\gamma_1$) et le coefficient d’aplatissement (kurtosis, noté $\beta_2$ ou l’excès $\gamma_2$) demeurent strictement inchangés :
$$\gamma_1(Z) = \frac{\mathbb{E}[(Z – \mu_z)^3]}{\sigma_z^3} = \frac{\alpha^3 \mathbb{E}[(X – \mu_x)^3]}{\alpha^3 \sigma_x^3} = \gamma_1(X)$$
$$\gamma_2(Z) = \frac{\mathbb{E}[(Z – \mu_z)^4]}{\sigma_z^4} – 3 = \frac{\alpha^4 \mathbb{E}[(X – \mu_x)^4]}{\alpha^4 \sigma_x^4} – 3 = \gamma_2(X)$$
Cette démonstration prouve que la normalisation Min-Max sur $[0, 100]$ ne modifie en aucune manière l’allure morphologique de la distribution. Une distribution bimodale, fortement étirée à droite ou leptokurtique conservera trait pour trait ces singularités structurales après transformation.
3. Démonstration étape par étape et résolution manuelle d’exemples empiriques
3.1 Identification des paramètres critiques du jeu de données
La mise en œuvre pratique de l’algorithme requiert un protocole d’inspection préliminaire du vecteur de données brutes. Cette étape d’audit vise à extraire avec une certitude absolue les deux paramètres cardinaux de la transformation, à savoir le minimum empirique $x_{\min}$ et le maximum empirique $x_{\max}$, tout en confirmant la validité opérationnelle de la série statistique.
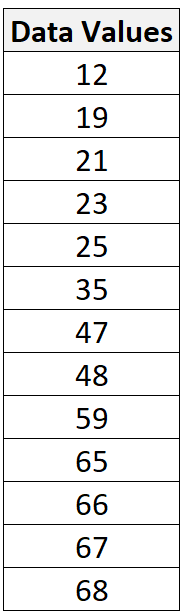
Considérons à titre d’illustration méthodologique une série empirique issue de l’évaluation d’un score de détresse psychologique administré auprès d’un sous-échantillon de sujets :
$$X = {12, 19, 21, 28, 35, 42, 47, 53, 61, 68}$$
L’exploration séquentielle du vecteur permet d’isoler immédiatement :
- La borne inférieure observée : $x_{\min} = 12$
- La borne supérieure observée : $x_{\max} = 68$
Dès lors, l’amplitude empirique absolue, désignée par le delta d’échelle $\Delta x$, se calcule par la différence arithmétique simple :
$$\Delta x = x_{\max} – x_{\min} = 68 – 12 = 56$$
À ce stade, une vérification algorithmique s’impose : l’analyste doit impérativement attester que $\Delta x ne 0$. Dans l’éventualité où $x_{\max} = x_{\min}$, la série présenterait une variance nulle (vecteur d’observations constantes). Une telle situation entraînerait une indétermination mathématique majeure sous la forme d’une division par zéro, rendant la mise à l’échelle linéaire impossible sans une convention de substitution préalable (telle que l’assignation arbitraire de la valeur médiane 50 à l’ensemble des points).
3.2 Normalisation manuelle pas à pas des observations clés
Une fois les paramètres $\Delta x = 56$ et $x_{\min} = 12$ consolidés, l’application séquentielle de la formule de mise à l’échelle peut être conduite sur les points représentatifs de la série statistique afin d’observer la mécanique de redistribution.
Pour la première observation de la série, correspondant au minimum empirique $x_1 = 12$ :
$$z_1 = \left( \frac{12 – 12}{56} \right) \times 100 = \left( \frac{0}{56} \right) \times 100 = 0{,}0000$$
Ce résultat confirme l’ancrage rigoureux de la borne inférieure à l’origine exacte de l’intervalle cible.
Examinons ensuite une valeur intermédiaire basse, $x_2 = 19$ :
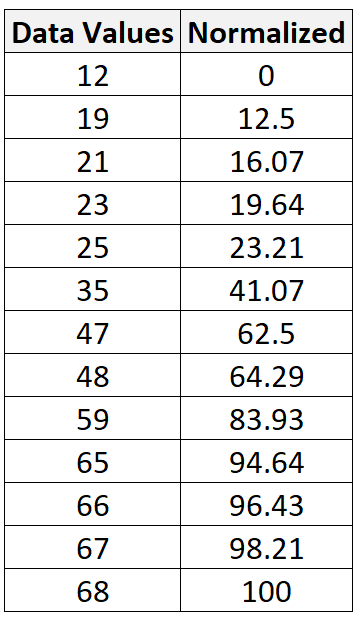
$$z_2 = \left( \frac{19 – 12}{56} \right) \times 100 = \left( \frac{7}{56} \right) \times 100 = 0{,}125 \times 100 = 12{,}5000$$
Poursuivons avec une valeur intermédiaire non réductible à une fraction décimale simple, $x_3 = 21$ :
$$z_3 = \left( \frac{21 – 12}{56} \right) \times 100 = \left( \frac{9}{56} \right) \times 100 = 0{,}16071428dots \times 100 \approx 16{,}0714$$
Enfin, appliquons la procédure à la valeur maximale observée dans l’échantillon, $x_{10} = 68$ :
$$z_{10} = \left( \frac{68 – 12}{56} \right) \times 100 = \left( \frac{56}{56} \right) \times 100 = 1{,}0000 \times 100 = 100{,}0000$$
La mécanique calculatoire met en évidence la parfaite linéarité de la projection : chaque incrément unitaire sur l’échelle d’origine correspond exactement à un déplacement de $100 / 56 \approx 1{,}7857$ unités sur l’échelle normalisée centésimale.
3.3 Gestion de l’arrondi et précision des décimales
L’opération de division inhérente à la formule Min-Max génère très fréquemment des quotients irrationnels ou des fractions périodiques infinies, comme l’illustre le calcul de $z_3 = 16{,}071428dots$. Cette réalité numérique pose la question critique de la gestion des erreurs de troncature et d’arrondi dans la chaîne de traitement statistique.
Une troncature prématurée ou un arrondi trop agressif (par exemple à l’entier le plus proche) introduit un bruit de mesure artificiel susceptible de compromettre les calculs d’agrégation subséquents, en particulier lors de l’estimation de matrices de corrélation ou de l’exécution de régressions multiples. L’accumulation de micro-erreurs d’arrondi sur de grands échantillons peut induire des biais systématiques non négligeables lors de l’inversion matricielle ($X^T X)^{-1}$.
Il est donc méthodologiquement recommandé de distinguer deux phases impératives :
- La phase computationnelle : Les valeurs normalisées doivent être conservées en mémoire machine sous format de virgule flottante double précision (standard IEEE 754, soit 64 bits), sans aucun arrondi intermédiaire.
- La phase de restitution des résultats : Selon les recommandations standardisées de l’American Psychological Association (APA 7th edition), les scores standardisés et les statistiques descriptives doivent être rapportés avec deux décimales significatives (ex. $z_3 = 16{,}07$), sauf exigence spécifique liée à des seuils critiques de coupure diagnostique où une précision à trois décimales s’avère indispensable.
4. Fondements théoriques de la mesure et échelles en psychométrie
4.1 Typologie des échelles de Stevens et compatibilité de la normalisation
L’application d’opérations arithmétiques sur des données empiriques ne peut s’affranchir d’une réflexion sur le statut épistémologique de la mesure. Dans sa taxonomie fondatrice de 1946, le psychologue et métrologue Stanley Smith Stevens a formalisé quatre niveaux de mesure : nominal, ordinal, d’intervalles et de rapports. La validité de la normalisation Min-Max dépend intrinsèquement de l’adéquation entre la nature de l’échelle d’origine et les opérations algébriques mobilisées.
La normalisation linéaire présuppose impérativement que la variable d’origine appartienne au minimum au niveau de mesure des échelles d’intervalles ou de rapports. Sur une échelle d’intervalles (telle que la température en degrés Celsius ou un score d’intelligence standardisé), les distances numériques possèdent une signification constante le long du continuum, bien que le zéro soit purement conventionnel. La transformation affine $g(x) = \alpha x + \beta$ préserve rigoureusement cette égalité des intervalles : le rapport des différences entre observations demeure invariant, ce qui maintient intacte la validité de construit de l’instrument de mesure.
À l’inverse, l’application aveugle de la formule Min-Max à des variables purement ordinales (par exemple, le rang d’arrivée à une épreuve, ou des modalités de réponse qualitatives ordonnées sans garantie de distances sous-jacentes égales) constitue une entorse méthodologique sévère. Transformer un ordre de préférence codé de 1 à 4 en une échelle de 0 à 100 confère une apparence fallacieuse de continuité et de précision métrique à des grandeurs qui ne possèdent intrinsèquement aucune métrique d’espacement. Cette pratique expose l’analyste à des distorsions d’interprétation en postulant arbitrairement que la distance séparant les rangs 1 et 2 est rigoureusement identique à celle séparant les rangs 3 et 4.
4.2 Minima et maxima : Échantillonnage versus bornes théoriques de l’instrument
Une décision architecturale cruciale lors de l’implémentation de la normalisation consiste à trancher entre deux approches pour la fixation des paramètres d’ancrage : l’utilisation des bornes observées dans l’échantillon empirique ($x_{\min}^{\text{e\mp}}, x_{\max}^{\text{e\mp}}$) ou le recours aux bornes théoriques permises par l’instrument d’évaluation ($x_{\min}^{\text{theo}}, x_{\max}^{\text{theo}}$).
L’ancrage empirique présente une vulnérabilité majeure : il lie indissolublement l’échelle transformée aux particularités stochastiques du groupe évalué à un instant $t$. Si, dans une cohorte clinique spécifique, le score maximal observé à un inventaire d’anxiété n’atteint que 45 sur un maximum théorique de 80, ce score de 45 se verra attribuer la valeur normalisée maximale de 100. Cette approche induit deux risques méthodologiques majeurs :
- L’impossibilité de comparer directement les scores entre différentes études, puisque les paramètres de conversion fluctuent au gré de la composition des échantillons.
- L’incapacité d’intégrer longitudinalement de nouveaux participants dont les scores dépasseraient les extrema initiaux, sous peine d’obtenir des scores normalisés aberrants excédant 100 ou devenant négatifs.
Pour parer à ces écueils, l’exploitation des bornes théoriques de l’instrument doit systématiquement être privilégiée en psychométrie. Si un inventaire clinique comprend 20 items cotés de 0 à 3, les bornes absolues sont irrévocablement fixées à $x_{\min}^{\text{theo}} = 0$ et $x_{\max}^{\text{theo}} = 60$. La normalisation appliquée à l’aide de ces paramètres théoriques constants garantit une comparabilité parfaite entre cohortes, préserve la signification absolue du continuum et assure la cohérence des modélisations longitudinales.
4.3 Préservation des propriétés psychométriques fondamentales
L’un des atouts déterminants de la mise à l’échelle linéaire réside dans sa parfaite neutralité vis-à-vis des indicateurs psychométriques fondamentaux qui qualifient la robustesse d’un test. Étant une transformation strictement linéaire, elle laisse intactes toutes les propriétés fondées sur la théorie classique des tests (TCT).
En premier lieu, la fidélité test-retest demeure rigoureusement invariante. Le coefficient de corrélation linéaire de Pearson $r_{xy}$ calculé entre deux temps de mesure successifs n’est en rien affecté par un changement d’échelle affine :
$$r(g(X), g(Y)) = r(X, Y)$$
En deuxième lieu, la cohérence interne d’une batterie d’items, mesurée traditionnellement par le coefficient alpha de Cronbach ($\alpha$) ou le coefficient oméga de McDonald ($\omega$), bénéficie de la même invariance mathématique. L’alpha de Cronbach repose sur la décomposition de la variance de la somme des items et de la somme de leurs covariances :
$$\alpha = \frac{k}{k – 1} \left( 1 – \frac{\sum_{j=1}^k \sigma_{Y_j}^2}{\sigma_X^2} \right)$$
Puisque chaque variance d’item $\sigma_{Y_j}^2$ et la variance globale $\sigma_X^2$ sont multipliées par le même facteur scalaire $\alpha^2 = (100 / \Delta x)^2$, ce coefficient se simplifie intégralement au numérateur et au dénominateur du ratio. La structure factorielle sous-jacente, les saturations factorielles issues d’une analyse confirmatoire et les corrélations inter-items sont conservées avec une fidélité absolue.
5. Justifications méthodologiques et bénéfices de l’intervalle [0, 100]
5.1 Amélioration de l’interprétabilité clinique et diagnostique
Dans la pratique clinique, l’interprétation diagnostique requiert une transmission rapide et sans équivoque d’informations complexes. Les praticiens sont régulièrement confrontés à une multitude d’échelles d’évaluation symptomatique dont la multiplicité des bornages bruts constitue une source substantielle de fatigue cognitive et d’erreurs d’évaluation. L’harmonisation sur le continuum $[0, 100]$ optimise considérablement l’ergonomie cognitive du diagnostic.
Cette standardisation facilite la fixation de seuils de sévérité partagés et immédiatement assimilables. Un consensus clinique peut plus aisément s’établir autour de repères universels : par exemple, considérer arbitrairement qu’un score normalisé inférieur à 25 traduit une symptomatologie subclinique, qu’un intervalle compris entre 25 et 50 caractérise une atteinte légère à modérée, tandis qu’un score franchissant le seuil des 75 dénote une détresse aiguë nécessitant une intervention immédiate.
De surcroît, la mise à l’échelle $[0, 100]$ permet la conception de tableaux de bord cliniques unifiés pour le suivi thérapeutique longitudinal. Lorsqu’un patient est soumis à une prise en charge psychothérapeutique ou pharmacologique, la représentation synoptique de ses progrès à travers diverses dimensions (qualité du sommeil, anxiété psychologique, réactivité émotionnelle) sur un repère orthonormé borné à 100 offre au thérapeute ainsi qu’au patient une lecture visuelle limpide de l’efficacité différentielle du protocole.
5.2 Fusion et agrégation de sous-échelles multidimensionnelles
L’évaluation des construits psychologiques complexes mobilise quasi invariablement des inventaires structurés en sous-échelles factorielles. Or, la composition de ces instruments présente couramment un déséquilibre structurel dans le nombre d’items assignés à chaque dimension en raison des impératifs d’échantillonnage de contenu. Considérons le cas classique d’un inventaire de bien-être où la dimension relationnelle comporte 15 items et la dimension existentielle n’en comporte que 5, chaque item étant coté sur une échelle de 1 à 5.
Si le chercheur procède à une sommation brute pour calculer un indice global de bien-être, la dimension relationnelle (amplitude potentielle de 15 à 75) pèsera mathématiquement trois fois plus lourd dans la variance totale que la dimension existentielle (amplitude de 5 à 25). Cette distorsion fausse substantiellement le construit composite global en accordant une prédominance injustifiée à la facette la plus prolifique en items.
La normalisation préalable de chaque sous-échelle sur le segment $[0, 100]$ résout élégamment ce problème de pondération différentielle. Une fois que chaque facette est ramenée à une amplitude identique de 100 points, le calcul du score composite global peut s’opérer par une moyenne arithmétique simple non biaisée, conférant à chaque dimension un poids structurel rigoureusement équitable, ou par une moyenne pondérée explicitement justifiée par la théorie sous-jacente.
5.3 Préparation des données pour la modélisation statistique avancée
Au-delà de la psychométrie descriptive, la normalisation des variables sur l’intervalle $[0, 100]$ (ou sa version unitaire homologue $[0, 1]$) joue un rôle technique fondamental dans le conditionnement numérique des algorithmes de modélisation statistique et d’apprentissage automatique (Machine Learning).
Lorsque des prédicteurs exhibent des ordres de grandeur radicalement dissemblables, la surface de la fonction de perte (loss surface) exploitée lors de l’estimation par descente de gradient prend une morphologie hautement elliptique et étirée. Cette anisotropie géométrique génère des oscillations pathologiques du gradient, ralentissant dramatiquement la convergence computationnelle ou piégeant les algorithmes d’optimisation dans des minima locaux sous-optimaux. Ramener l’ensemble des prédicteurs sur une échelle compacte et uniforme régularise la surface de coût et accélère la vitesse de convergence de façon substantielle.
De même, dans le cadre d’analyses multivariées exploratoires telles que l’Analyse en Composantes Principales (ACP), si l’analyse est conduite sur la matrice de covariance brute sans mise à l’échelle préalable, les premières composantes orthogonales extraites captureront quasi exclusivement la variance des variables dont l’amplitude brute est la plus vaste, reléguant les variables à faible étendue au rang d’artefacts négligeables, nonobstant leur pertinence théorique réelle.
6. Implémentations algorithmiques et computationnelles dans les logiciels de recherche
6.1 Implémentation sous le langage R
Le langage R constitue le standard d’excellence pour l’analyse computationnelle en sciences sociales et en psychologie. L’implémentation de la normalisation Min-Max sur $[0, 100]$ peut s’effectuer au moyen d’une fonction personnalisée vectorisée assurant une exécution hautement optimisée, tout en intégrant des mécanismes robustes de tolérance aux valeurs manquantes.
L’écriture d’une fonction modulaire native garantit une transparence méthodologique totale :
scale_0_100 <- function(x, na.rm = TRUE) {

  min_val <- min(x, na.rm = na.rm)

  max_val <- max(x, na.rm = na.rm)

  if (max_val == min_val) {

    warning("Étendue nulle détectée : division par zéro évitée.")

    return(rep(50, length(x)))

  }

  ((x - min_val) / (max_val - min_val)) * 100

}
Dans le cadre de l’écosystème moderne tidyverse, cette transformation s’intègre avec élégance au sein d’un pipeline de manipulation avec dplyr. Pour appliquer cette fonction simultanément à plusieurs colonnes d’un jeu de données cliniques :
library(dplyr)

df_normalized <- df %>%

  mutate(across(c(score_depression, score_anxiete), ~ ((.x - min(.x, na.rm = TRUE)) / (max(.x, na.rm = TRUE) - min(.x, na.rm = TRUE))) * 100, .names = "{.col}_norm100"))
L’argument na.rm = TRUE est capital : l’omission de cette précaution entraînerait la propagation de valeurs NA à l’ensemble du vecteur transformé dès lors qu’une seule observation manquante s’y trouverait logée.
6.2 Implémentation sous Python (NumPy, Pandas, Scikit-Learn)
Dans l’écosystème Python, dédié tant à la recherche expérimentale qu’au déploiement de modèles prédictifs, plusieurs approches coexistent pour exécuter cette normalisation, chacune répondant à des contraintes opérationnelles distinctes.
Avec la bibliothèque pandas, l’application vectorisée directe sur une structure de données de type DataFrame s’avère particulièrement concise pour l’analyse exploratoire :
import pandas as pd

df['score_norm'] = ((df['score_brut'] - df['score_brut'].min()) / (df['score_brut'].max() - df['score_brut'].min())) * 100
Toutefois, dans une architecture de modélisation prédictive ou d’apprentissage automatique rigoureux, le recours à la classe spécialisée MinMaxScaler de la bibliothèque scikit-learn est impératif afin de prévenir toute fuite de données (data leakage) entre la cohorte d’entraînement et la cohorte de test :
from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler(feature_range=(0, 100))

# Ajustement exclusif sur le jeu d'entraînement

X_train_scaled = scaler.fit_transform(X_train)

# Projection du jeu de test à partir des paramètres appris

X_test_scaled = scaler.transform(X_test)
Cette distinction méthodologique est primordiale : appliquer fit_transform sur l’ensemble complet de la cohorte avant partitionnement contamine l’échantillon d’apprentissage par la connaissance préalable des valeurs extrêmes de la cohorte de validation, invalidant formellement l’indépendance statistique des tests d’évaluation prédictive.
6.3 Procédures pas à pas sous SPSS et tableurs (Excel)
Pour les environnements de recherche s’appuyant sur des interfaces graphiques ou des logiciels statistiques dédiés tels qu’IBM SPSS Statistics, l’automatisation de la normalisation passe préférentiellement par l’interpréteur de syntaxe, garantissant ainsi la traçabilité intégrale du protocole analytique.
Sous SPSS, la procédure implique l’extraction préalable des statistiques descriptives ou l’utilisation directe de l’instruction COMPUTE couplée aux fonctions d’agrégation matricielle :
AGGREGATE

  /OUTFILE=* MODE=ADDVARIABLES

  /MIN_score = MIN(score_brut)

  /MAX_score = MAX(score_brut).

COMPUTE score_norm100 = ((score_brut - MIN_score) / (MAX_score - MIN_score)) * 100.

EXECUTE.
Dans un tableur tel que Microsoft Excel ou Google Sheets, l’analyste procède en fixant de manière absolue les plages de référence afin d’éviter tout décalage lors de l’incrémentation automatique des cellules. Pour une colonne de données brutes s’étendant de la cellule A2 à la cellule A150, la formule à implémenter dans la cellule adjacente B2 s’énonce :
=((A2 - MIN($A$2:$A$150)) / (MAX($A$2:$A$150) - MIN($A$2:$A$150))) * 100
L’emploi judicieux des symboles de dollar ($) ancre immuablement le champ d’extraction des extrema. Il convient ensuite de contrôler l’intégrité numérique des cellules générées, en vérifiant systématiquement l’absence de code d’erreur de type #DIV/0! qui surviendrait si la sélection couvrait une variable sans variance.
7. Comparaison critique : Normalisation [0, 100] vs Z-Score vs Centiles
7.1 Confrontation conceptuelle avec le Z-Score (standardisation gaussienne)
La normalisation Min-Max sur $[0, 100]$ et la standardisation par le score Z incarnent deux paradigmes méthodologiques distincts répondant à des finalités analytiques non superposables. Le score standardisé Z opère un recentrage distributionnel sur la moyenne empirique $\mu$ pondéré par la dispersion interne de la série via l’écart-type $\sigma$ :
$$z_{\text{score}} = \frac{x_i – \mu}{\sigma}$$
Cette approche présente un avantage déterminant pour l’inférence probabiliste : sous l’hypothèse de normalité gaussienne de la distribution parente, le score Z relie directement chaque valeur à une table de probabilité unitaire (ex. environ 68% des données se situent entre -1 et +1, et 95% entre -1,96 et +1,96). Cependant, le score Z souffre d’une lisibilité ergonomique déficiente auprès des utilisateurs finaux, confrontés à des valeurs décimales négatives et à une absence délibérée de bornage absolu (les scores extrêmes pouvant théoriquement diverger vers l’infini).
Pour pallier ce déficit d’intelligibilité tout en préservant l’assise probabiliste de la standardisation gaussienne, il est envisageable d’établir une passerelle algorithmique convertissant un Z-score tronqué vers l’intervalle $[0, 100]$. En fixant arbitrairement des seuils de troncature clinique à $\pm 3\sigma$ (couvrant $99{,}73%$ d’une distribution normale), la fonction de conversion s’énonce :
$$z_{[0,100]} = \left( \frac{\text{clip}(z_{\text{score}}, -3, +3) – (-3)}{3 – (-3)} \right) \times 100 = \left( \frac{\text{clip}(z_{\text{score}}, -3, +3) + 3}{6} \right) \times 100$$
Cette transformation hybride confère une forme d’intelligibilité centésimale à une métrique issue de la dispersion gaussienne standardisée.
7.2 Démarcation vis-à-vis des rangs centiles et de la normalisation non linéaire
Une confusion récurrente observée dans la littérature consiste à assimiler indûment la normalisation sur $[0, 100]$ à la transformation en rangs centiles (percentile ranks). Il s’agit pourtant de deux démarches mathématiquement orthogonales dans leurs effets sur la géométrie des données.
La normalisation Min-Max est une fonction strictement linéaire : elle préserve rigoureusement la métrique d’espacement originale entre les observations. Si deux sujets présentent des scores bruts distants de 10 points dans une région dense de la distribution, leur écart sur l’échelle $[0, 100]$ sera strictement identique à celui de deux sujets distants de 10 points dans la queue de la distribution. En revanche, le calcul des rangs centiles est une transformation non linéaire monotone qui projette les observations selon leur fréquence cumulée empirique :
$$PR(x_i) = \left( \frac{\text{Rang}(x_i) – 0{,}5}{n} \right) \times 100$$
Cette transformation modifie radicalement la morphologie de la distribution d’origine : elle « rectifie » activement les données en les étirant artificiellement dans les zones de forte densité (le centre de la courbe) et en comprimant les écarts dans les zones de faible densité (les extrémités). Le tableau suivant synthétise les divergences structurelles fondamentales entre ces approches :
- Conservation de la métrique d’intervalle : Absolue dans la normalisation $[0, 100]$ ; Nulle dans les rangs centiles (réduction au niveau ordinal pur).
- Forme de la distribution résultante : Rigoureusement identique à la distribution brute dans la normalisation $[0, 100]$ ; Forme uniforme (rectangulaire) plate dans les rangs centiles.
- Sensibilité aux valeurs extrêmes : Très forte pour $[0, 100]$ (écrasement potentiel de la variance centrale) ; Quasiment nulle pour les centiles (insensibles à la magnitude des extrêmes).
- Finalité scientifique dominante : Agrégation factorielle, modélisation mathématique et maintien des distances physiques ; Positionnement normatif d’un individu au sein d’une population de référence.
7.3 Comparaison avec les scores standardisés psychométriques (T-Scores, Sten, Stanines)
L’histoire de la psychométrie a vu éclore une multiplicité de formats standardisés conçus pour transcender les limites brutes du Z-score tout en contournant l’écueil de la division arbitraire. Parmi les plus emblématiques figurent les scores T de McCall, l’échelle Sten (Standard Ten) et les Stanines (Standard Nines).
Le score T applique une transformation linéaire au Z-score selon la formule $T = 50 + 10 \cdot z$. Il ancre délibérément la moyenne à 50 et calibre l’écart-type à 10 unités. Ce formalisme garantit que la quasi-totalité de la population ($99{,}7%$) s’inscrit dans un intervalle compris entre 20 et 80, éliminant ainsi les nombres négatifs. Toutefois, l’échelle des scores T ne possède pas de bornage strict : un événement exceptionnel à $+4{,}5\sigma$ engendrera un score T de 95, rendant le plafond conceptuel mouvant.
Les échelles Sten (moyenne de 5,5, étendue de 1 à 10, écart-type de 2) et Stanine (moyenne de 5, étendue de 1 à 9, écart-type de 2) opèrent un partitionnement discret de la courbe normale en classes ordonnées. Bien qu’elles bornent de façon déterministe le résultat entre 1 et 10 ou 1 et 9, elles introduisent une discrétisation forcée qui détruit l’information continue fine présente dans la mesure d’origine.
La normalisation directe sur $[0, 100]$ s’affranchit de toute hypothèse distributionnelle préalable : elle n’exige ni distribution unimodale, ni symétrie gaussienne, et préserve scrupuleusement la nature continue de la variable tout en offrant un ancrage absolu indépassable.
8. Sensibilité aux valeurs aberrantes (outliers) et alternatives robustes
8.1 Vulnérabilité intrinsèque de la formule Min-Max face aux extrêmes
En dépit de son élégance algébrique et de sa simplicité calculatoire, la formule canonique Min-Max souffre d’un talon d’Achille méthodologique notoire : sa sensibilité extrême aux valeurs aberrantes (outliers) et aux observations atypiques isolées. Cette vulnérabilité découle directement de sa dépendance exclusive envers les statistiques d’ordre extrêmes du vecteur de données, à savoir le minimum et le maximum empiriques.
Dans la théorie des estimateurs robustes, le minimum et le maximum possèdent un point de rupture (breakdown point) asymptotique égal à $\varepsilon^* = 1/n$. Cela signifie qu’il suffit de contaminer une unique observation parmi les $n$ valeurs d’un échantillon pour altérer de manière arbitrairement vaste l’étendue de l’échelle $\Delta x$.
L’effet mécanique induit par la présence d’une valeur anormalement élevée est dévastateur pour la variance de la sous-population normale. Si un jeu de données comprend 99 observations échelonnées entre 10 et 50, et qu’une unique valeur erronée ou exceptionnelle culmine à 500, la normalisation basée sur ce maximum empirique ($x_{\max} = 500$) va contracter la quasi-totalité des participants légitimes dans un sous-espace minuscule de l’intervalle cible, typiquement entre 0 et 8. La variance utile du groupe principal se trouve littéralement laminée, détruisant tout pouvoir discriminant entre les observations centrales.
8.2 Stratégies de prétraitement : Winsorisation et troncature
Pour immuniser la normalisation sur $[0, 100]$ contre les perturbations pathologiques induites par les valeurs aberrantes sans renoncer à l’intervalle métrique cible, le chercheur doit recourir à des techniques de régularisation préalables. La stratégie la plus solide sur le plan théorique réside dans la winsorisation distributionnelle.
Le principe de la winsorisation consiste à seuiller de façon déterministe les queues de distribution à des fractiles empiriques prédéterminés — typiquement les 1ers et 99èmes centiles, ou les 5èmes et 95èmes centiles. Soient $Q_{\delta}$ et $Q_{1-\delta}$ les quantiles d’ancrage choisis (par exemple $\delta = 0{,}02$ pour un seuillage bilatéral à 2%). La fonction de winsorisation $w(x_i)$ redéfinit toute valeur excédant ces bornes par la valeur du seuil lui-même :
$$w(x_i) = \begin{\cases} Q_{\delta} &a\mp; \text{si } x_i Q_{1-\delta} \end{\cases}$$
La normalisation sur $[0, 100]$ est subséquemment appliquée non point sur les minima et maxima bruts non contrôlés, mais sur les bornes de winsorisation :
$$z_i^{\text{win}} = \left( \frac{w(x_i) – Q_{\delta}}{Q_{1-\delta} – Q_{\delta}} \right) \times 100$$
Cette approche hybride constitue un compromis d’une remarquable efficacité : elle préserve la linéarité métrique stricte pour l’immense majorité des données situées dans le cœur de la distribution ($96%$ ou $98%$ des sujets), tout en évitant l’écrasement global causé par une poignée d’anomalies de mesure ou d’extrema biométriques non représentatifs.
8.3 Normalisation robuste sur l’intervalle [0, 100] basée sur la médiane et le MAD
Une alternative radicalement robuste à l’équation Min-Max consiste à s’affranchir totalement des extrema empiriques pour ancrer la projection d’échelle sur des estimateurs à haut point de rupture. Cette démarche substitue la médiane empirique ($\text{Med}$) à la moyenne, et l’écart absolu médian (MAD, Median Absolute Deviation) ou l’écart interquartile (IQR) à l’écart-type.
Le MAD se définit mathématiquement par :
$$\text{MAD} = \text{Med}(|x_i – \text{Med}(X)|)$$
Pour concevoir une échelle robuste projetée sur $[0, 100]$, l’algorithme définit une fenêtre de variabilité attendue ancrée sur la médiane et s’étendant à $\pm k$ fois le MAD (où $k$ est classiquement fixé à une valeur comprise entre 2,5 et 3,5, assimilable à la couverture gaussienne standard après multiplication par le facteur de cohérence $1{,}4826$) :
$$\text{Borne}_{\text{\inf}} = \text{Med}(X) – k \cdot (1{,}4826 \cdot \text{MAD})$$
$$\text{Borne}_{\text{\sup}} = \text{Med}(X) + k \cdot (1{,}4826 \cdot \text{MAD})$$
Toute observation est alors normalisée selon cette échelle de robustesse, couplée à un écrêtage final pour garantir le respect strict des bornes métriques cibles :
$$z_i^{\text{rob}} = \text{clip}\left( \left[ \frac{x_i – \text{Borne}_{\text{\inf}}}{\text{Borne}_{\text{\sup}} – \text{Borne}_{\text{\inf}}} \right] \times 100, , 0, , 100 \right)$$
Cette formulation possède un point de rupture théorique atteignant $50%$. Même si près de la moitié de l’échantillon est altérée par des perturbations asymétriques ou des artéfacts d’acquisition massifs, le calibrage du repère $[0, 100]$ conserve une stabilité structurelle absolue, immunisant l’analyse contre tout biais distributionnel majeur.
9. Études de cas appliquées en sciences psychologiques et comportementales
9.1 Évaluation clinique : Normalisation d’échelles de dépression et d’anxiété
Considérons une investigation clinique portant sur l’évaluation de la comorbidité anxio-dépressive chez des patients souffrant de douleurs chroniques. Le protocole méthodologique administre conjointement deux instruments d’auto-évaluation diagnostique majeurs : l’Inventaire de Dépression de Beck dans sa deuxième révision (BDI-II, coté de 0 à 63 points) et l’Inventaire d’Anxiété État-Trait de Spielberger sous sa forme État (STAI-Y1, dont les scores bruts s’échelonnent de 20 à 80 points).
Examinons le profil clinique brut d’un patient particulier, désigné par l’identifiant $P_{402}$, dont les relevés indiquent $x_{\text{BDI}} = 38$ et $x_{\text{STAI}} = 56$. Une comparaison visuelle non avertie des scores bruts inciterait à conclure fallacieusement à une sévérité prépondérante de la composante anxieuse (56 surpassant largement 38).
L’application rigoureuse de la normalisation sur $[0, 100]$ en mobilisant les bornes théoriques des manuels psychométriques modifie fondamentalement cette interprétation :
Pour le score de dépression BDI-II ($x_{\min}^{\text{theo}} = 0, x_{\max}^{\text{theo}} = 63, \Delta x = 63$) :
$$z_{\text{BDI}} = \left( \frac{38 – 0}{63 – 0} \right) \times 100 = \left( \frac{38}{63} \right) \times 100 \approx 60{,}32$$
Pour le score d’anxiété STAI-Y1 ($x_{\min}^{\text{theo}} = 20, x_{\max}^{\text{theo}} = 80, \Delta x = 60$) :
$$z_{\text{STAI}} = \left( \frac{56 – 20}{80 – 20} \right) \times 100 = \left( \frac{36}{60} \right) \times 100 = 60{,}00$$
Une fois les grandeurs projetées sur l’intervalle centésimal universel, la distorsion s’évanouit : les intensités symptomatiques normalisées se révèlent d’une parfaite équivalence nosologique (environ 60 sur 100 pour les deux dimensions). Le calcul d’un indice composite de détresse affective générale peut alors s’effectuer de manière parfaitement intègre via la moyenne arithmétique simple : $I_{\text{détresse}} = (60{,}32 + 60{,}00) / 2 = 60{,}16$.
9.2 Psychologie cognitive expérimentale : Normalisation des temps de réaction
Dans les paradigmes d’attention sélective ou de flexibilité motrice (tels que la tâche de Stroop ou la tâche de Simon), les temps de réaction chronométriques constituent la variable dépendante privilégiée. Or, l’analyse directe de ces données se heurte à un double obstacle : d’une part, les distributions de temps de réaction violent systématiquement l’hypothèse de normalité en adoptant une forme asymétrique positive unimodale (couramment modélisée par une loi ex-gaussienne ou log-normale) ; d’autre part, la variabilité inter-individuelle des vitesses de traitement neuromoteur brutes masque les variations subtiles induites par les conditions expérimentales.
Avant d’envisager une normalisation linéaire sur $[0, 100]$, l’analyste doit impérativement linéariser la métrique temporelle par une transformation préalable non linéaire, telle que la transformation logarithmique $y_i = \ln(x_i)$ ou la vitesse de traitement réciproque $y_i = 1 / x_i$. Supposons qu’après transformation logarithmique, les bornes de latence physiologiquement plausibles pour une tâche Stroop d’inhibition cognitive s’étendent de $y_{\min} = \ln(350\text{ ms}) \approx 5{,}858$ à $y_{\max} = \ln(1200\text{ ms}) \approx 7{,}090$.
La normalisation sur $[0, 100]$ permet alors d’inverser conventionnellement le sens de l’échelle afin d’optimiser son intelligibilité cognitive : l’expérimentateur peut assigner la valeur 100 à la réponse la plus véloce (performance optimale de capture attentionnelle) et 0 au seuil maximal d’inhibition :
$$z_i^{\text{perf}} = \left( \frac{y_{\max} – y_i}{y_{\max} – y_{\min}} \right) \times 100$$
Cette approche méthodologique rigoriste garantit la normalité résiduelle des scores tout en projetant l’efficacité cognitive sur un axe d’évaluation universellement décryptable par l’ensemble de la communauté scientifique.
9.3 Psychologie du travail : Évaluation de la performance et du bien-être en entreprise
L’audit organisationnel et la psychologie du travail recourent fréquemment à des démarches d’évaluation multi-sources, communément dénommées revues à 360 degrés. Dans ce dispositif, les compétences professionnelles, le climat de travail et l’épuisement professionnel (burnout) sont mesurés à travers des outils divergents administrés conjointement aux employés, à leurs pairs et à leur encadrement managérial direct.
Une difficulté méthodologique classique émerge lorsque la performance opérationnelle est évaluée par les supérieurs hiérarchiques sur une échelle d’évaluation continue de 1 à 10, tandis que l’auto-évaluation du sentiment d’auto-efficacité repose sur l’échelle de Schwarzer et Jerusalem échelonnée de 10 à 40 points, et que la charge mentale perçue est mesurée via l’indice NASA-TLX fragmenté en scores allant de 0 à 100. La fusion de ces métriques pour forger un diagnostic de santé au travail cohérent pose un défi structurel évident.
En convertissant chaque dimension évaluative sur l’espace d’amplitude unifié $[0, 100]$, l’analyste RH neutralise les décalages d’échelle tout en préservant l’intégrité de la dispersion empirique. Cette normalisation autorise la construction de cartographies factorielles bidimensionnelles rigoureuses croisant, par exemple, le score normalisé d’accomplissement au travail ($[0, 100]$) avec le niveau d’épuisement émotionnel normalisé ($[0, 100]$), isolant ainsi sans ambiguïté les segments de salariés requérant une intervention ergonomique ou organisationnelle ciblée.
10. Pièges méthodologiques, distorsions distributionnelles et erreurs d’interprétation
10.1 L’illusion du pourcentage : Confondre score sur 100 et proportion d’items réussis
Le piège interprétatif le plus pernicieux associé à la métrique $[0, 100]$ découle directement de son mimétisme graphique avec le système d’expression des pourcentages. Une proportion ou un pourcentage absolu quantifie un rapport strict d’accomplissement par rapport à une totalité théorique : obtenir 75% à un examen signifie formellement que l’étudiant a résolu avec succès 75 items sur un total de 100 présentés.
À l’inverse, un score normalisé $z_i = 75$ issu de la transformation Min-Max ne traduit en aucun cas la réussite de 75% des sollicitations expérimentales. Il indique exclusivement que l’observation se situe à $75%$ de la distance relative séparant l’ancre minimale ($x_{\min}$) de l’ancre maximale ($x_{\max}$). Si cette mise à l’échelle a été exécutée à l’aide des extrema observés au sein d’un groupe excessivement faible (où la meilleure performance individuelle n’était que de 40 items réussis sur 100), un score normalisé de 100 masquera en réalité un niveau d’accomplissement effectif de seulement $40%$.
Cette assimilation abusive entre rang centésimal, proportion d’exactitude brute et position affine Min-Max induit des erreurs majeures en diagnostic psychologique. L’analyste se doit de préciser sans équivoque dans ses restitutions la nature exacte de la grandeur : il ne s’agit pas d’un taux de réponse correcte, mais d’une position d’intensité relative indexée sur un intervalle d’étalonnage déterminé.
10.2 Biais induits par la variation de l’échantillon au fil du temps
Dans les devis de recherche longitudinaux, les études de panel ou les protocoles d’évaluation continue (Ecological Momentary Assessment), l’application inconsidérée d’une normalisation Min-Max recalculée de façon dynamique à chaque vague d’acquisition engendre un phénomène pathologique connu sous le nom de dérive d’ancrage (min/max shifting).
Supposons qu’au temps $T_1$, l’échantillon initial produise des extrema empiriques de $x_{\min}^{(1)} = 10$ et $x_{\max}^{(1)} = 50$. Un patient présentant un score de 30 verra son niveau d’anxiété chiffré à :
$$z^{(1)} = \left( \frac{30 – 10}{50 – 10} \right) \times 100 = 50{,}00$$
Si, lors de la seconde vague d’évaluation au temps $T_2$, de nouveaux participants introduisent des scores plus dispersés modifiant les extrema empiriques à $x_{\min}^{(2)} = 0$ et $x_{\max}^{(2)} = 100$, le même patient maintenant rigoureusement son niveau brut de 30 obtiendra désormais un score normalisé de :
$$z^{(2)} = \left( \frac{30 – 0}{100 – 0} \right) \times 100 = 30{,}00$$
L’analyste observant la trajectoire individuelle pourrait conclure à une diminution salutaire de 20 points de l’anxiété du patient, alors que son état pathologique intrinsèque est demeuré absolument stationnaire. Ce biais dévastateur souligne l’impératif méthodologique de « geler » immuablement les paramètres de normalisation sur une cohorte de référence initiale étalonnée, et d’appliquer ces ancres historiques fixes à toutes les mesures ultérieures.
10.3 Effets de plancher et de plafond artificiels
Bien que la transformation linéaire ne modifie pas intrinsèquement la forme géométrique d’une distribution, son application dans des contextes d’asymétrie sévère combinée à des troncatures numériques (ou des bornages forcés pour traiter les valeurs hors bornes) induit fréquemment des effets de plancher ou de plafond artificiels.
Lorsqu’un inventaire clinique mesurant des comportements très rares (tels que les idéations suicidaires au sein d’une population non clinique) est normalisé, une masse considérable d’observations s’agglutine exactement sur la valeur brute minimale 0. Après normalisation sur $[0, 100]$, cette concentration massive génère une fonction de masse discrète écrasée contre l’abscisse 0, tandis que le reste du spectre métrique de 1 à 100 n’est occupé que par quelques rares observations éparses.
Dans ce contexte, la variable normalisée perd une fraction substantielle de son pouvoir discriminant effectif : elle ne se comporte plus comme une variable continue normale, mais comme une variable censurée de type Tobit. Tout modèle d’analyse linéaire classique (ANOVA, régression ordinaire) appliqué aveuglément sur ces données normalisées violera drastiquement les postulats d’homoscédasticité et de normalité des résidus, imposant le recours préalable à des modélisations semi-paramétriques ou à des régressions à inflation de zéros (zero-inflated models).
11. Bonnes pratiques de reporting académique et visualisation des données normalisées
11.1 Normes de rédaction scientifique (style APA et équivalents)
La transparence méthodologique constitue une exigence centrale dans le contexte de la crise de la reproductibilité qui traverse les sciences empiriques contemporaines. Dès lors qu’une variable fait l’objet d’une mise à l’échelle sur $[0, 100]$, le corps de l’article scientifique doit expliciter avec précision les choix opérationnels adoptés.
Dans la section « Méthode / Analyse des données », la rédaction doit respecter scrupuleusement les canons formels des standards APA (7e édition) :
- Formulation univoque de l’équation mathématique mobilisée pour la transformation.
- Précision explicite de la nature des paramètres d’ancrage retenus : s’agit-il d’extrema théoriques instrumentaux ou d’extrema empiriques dérivés de l’échantillon ? Si des extrema empiriques sont utilisés, le chercheur doit obligatoirement reporter leurs valeurs brutes exactes ($x_{\min}$ et $x_{\max}$).
- Rapport exhaustif, dans les tableaux de statistiques descriptives, des métriques brutes conjointement aux métriques normalisées (mentionnant systématiquement les moyennes, écarts-types, médianes et écarts interquartiles des deux états de la variable).
- Justification théorique et méthodologique motivant le rejet éventuel du Z-score au profit de la mise à l’échelle centésimale.
11.2 Visualisation graphique rigoureuse des données sur l’axe [0, 100]
La représentation graphique des données normalisées obéit à des conventions strictes destinées à prévenir toute manipulation sémiotique de l’amplitude des effets mesurés. L’erreur la plus commune consiste à tronquer artificiellement l’axe des ordonnées pour amplifier visuellement une différence minime entre groupes.
Lors de la production de diagrammes en boîtes (boxplots) ou de graphiques en violon (violin plots) illustrant des variables mises à l’échelle sur $[0, 100]$ :
- L’axe graphique doit impérativement s’étendre sur l’intégralité du continuum théorique, de 0 à 100, sans aucune rupture d’axe ni zoom opportuniste. Restreindre arbitrairement l’affichage au sous-segment $[45, 60]$ induit en erreur le lecteur en transformant une variation modeste de 5 points en un gouffre visuel disproportionné.
- Pour la restitution de profils multidimensionnels (ex. comparaison intra-individuelle de facettes de personnalité), les graphiques en radar (radar charts) ou diagrammes en coordonnées parallèles constituent un choix esthétique et technique de premier ordre, sous réserve expresse que l’ensemble des axes rayonnants partagent rigoureusement le même zéro central et le même plafond périphérique calé à 100.
11.3 Reproductibilité et partage du code de calcul
Dans le droit fil des recommandations de l’Open Science Framework (OSF), la publication d’analyses statistiques reposant sur des données normalisées doit s’accompagner de la mise à disposition publique des scripts exécutables au sein de dépôts pérennes (GitHub, Zenodo, OSF).
Les scripts d’analyse doivent intégrer une fonction modulaire réutilisable documentant explicitement :
- La gestion appliquée aux valeurs manquantes et aberrantes.
- Les tests unitaires vérifiant l’absence d’inversion des extrema ($x_{\max} > x_{\min}$).
- Le dictionnaire des données consignant les règles d’ancrage fixes appliquées aux différentes cohortes.
Cette rigueur de documentation assure aux pairs la possibilité de répliquer à l’identique l’ensemble des calculs métriques, condition sine qua non de la validité de la recherche quantitative contemporaine.
12. Synthèse méthodologique et directives décisionnelles pour les chercheurs
12.1 Arbre décisionnel pour le choix d’une technique de transformation
Pour guider l’analyste face au choix complexe de la transformation idoine, l’arbre de décision méthodologique suivant synthétise les arbitrages formels à opérer en amont de toute modélisation statistique :
1. Niveau de mesure de la variable brute :
– Niveau ordinal pur : Rejet catégorique de la mise à l’échelle linéaire Min-Max. Privilégier la transformation non paramétrique en rangs centiles ou la modélisation sous théorie de la réponse à l’item (TRI).
– Niveau d’intervalles ou de rapports : Passage à l’étape 2.
2. Présence de valeurs aberrantes (outliers) sévères :
– Présence avérée d’outliers non corrigibles : Rejet de la formule Min-Max classique. Implémenter une winsorisation préalable aux quantiles 1%-99% ou déployer l’algorithme robuste fondé sur la médiane et le MAD.
– Absence d’outliers pathologiques : Passage à l’étape 3.
3. Objectif analytique prédominant :
– Inférence paramétrique probabiliste pure : Privilégier la standardisation gaussienne par le Z-Score ($mu=0, sigma=1$).
– Agrégation composite, lisibilité ergonomique clinique, apprentissage automatique : Déployer la normalisation affine sur l’intervalle $[0, 100]$.
12.2 Liste de contrôle (Checklist) pré-analytique avant normalisation
Avant d’exécuter la projection d’un vecteur statistique sur l’intervalle $[0, 100]$, l’analyste méthodologique se doit de valider rigoureusement la liste de contrôle séquentielle suivante :
- [ ] Non-nullité de l’étendue : Attester impérativement que $x_{\max} – x_{\min} > 0$ afin d’écarter tout risque d’indétermination par division par zéro.
- [ ] Typologie des extrema : Identifier clairement si les bornes mobilisées sont empiriques (issues du jeu de données courant) ou théoriques (dictées par le constructeur de l’instrument psychométrique).
- [ ] Traitement des valeurs manquantes : Vérifier l’exclusion explicite ou l’imputation contrôlée des valeurs
NApréalablement à l’extraction des minima et maxima. - [ ] Alignement dimensionnel : Dans le cas d’une fusion composite de plusieurs sous-échelles, vérifier que toutes les sous-échelles ont été orientées dans la même polarité sémanthique (inverser les items codés en miroir le cas échéant avant mise à l’échelle).
- [ ] Stratégie de gel longitudinal : En situation d’analyses répétées dans le temps, s’assurer que les extrema de référence ont été définitivement fixés sur la cohorte étalon de base.
12.3 Recommandations pour l’évolution des pratiques psychométriques quantitatives
À l’heure où les sciences quantitatives convergent vers une intégration croissante de la science des données, de l’apprentissage automatique et des méthodologies psychométriques computationnelles, la standardisation des métriques d’évaluation requiert une vigilance épistémologique accrue. La mise à l’échelle sur $[0, 100]$ ne saurait être perçue comme un remède universel dispensant le chercheur d’une interrogation fondamentale sur la nature de ses construits.
Les perspectives contemporaines invitent à conjuguer l’ergonomie de l’intervalle centésimal avec la puissance théorique des modèles modernes de mesure. Notamment, le couplage de la théorie de la réponse à l’item (TRI) — qui calibre les traits latents individuels ($\theta$) sur une échelle logistique continue en modélisant les paramètres de difficulté et de discrimination de chaque item — avec une transformation logistique postérieure vers l’espace $[0, 100]$ préfigure les standards de l’évaluation quantitative de demain. Cette alliance vertueuse assure l’adéquation parfaite entre la robustesse axiomatique de la métrologie fondamentale et la clarté opérationnelle exigée par la pratique clinique, industrielle et académique.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation. https://www.pearsonassessments.com/
Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
Han, J., Kamber, M., & Pei, J. (2012). Data mining: Concepts and techniques (3rd ed.). Morgan Kaufmann. https://doi.org/10.1016/C2009-0-61819-5
IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://doi.org/10.1109/IEEESTD.2019.8766229
McCall, W. A. (1939). Measurement. Macmillan.
McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates.
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.csail.mit.edu/papers/v12/pedregosa11a.html
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273–1283. https://doi.org/10.1080/01621459.1993.10476408
Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Tobin, J. (1958). Estimation of relationships for limited dependent variables. Econometrica, 26(1), 24–36. https://doi.org/10.2307/1907382
Weisstein, E. W. (2023). Standard score. In MathWorld–A Wolfram Web Resource. Wolfram Research, Inc. https://mathworld.wolfram.com/StandardScore.html
Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), Article 1686. https://doi.org/10.21105/joss.01686
Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/B978-0-12-804566-4.00001-9