
L’exploration visuelle des distributions de données constitue une étape fondamentale et incontournable de toute démarche d’analyse quantitative, qu’il s’agisse de recherche académique fondamentale, d’études cliniques ou de modélisation prédictive en entreprise. Parmi l’arsenal des représentations graphiques disponibles, l’histogramme occupe une place prépondérante depuis son introduction formelle par Karl Pearson à la fin du dix-neuvième siècle. Cet outil fournit une approximation empirique de la fonction de densité de probabilité sous-jacente d’une variable aléatoire continue. Cependant, la fidélité de cette représentation dépend de manière critique d’un paramètre technique souvent sous-estimé par les praticiens : le partitionnement de l’axe des abscisses, communément désigné sous le terme de largeur de classe ou bin width.
Dans l’environnement contemporain du tableur Microsoft Excel, omniprésent dans les organisations et les laboratoires, la génération d’un histogramme a été grandement simplifiée depuis l’introduction d’un type de graphique statistique dédié et dynamique. Néanmoins, l’automatisation algorithmique par défaut du logiciel repose sur des heuristiques généralistes qui échouent fréquemment à révéler les singularités morphologiques des séries observées. Qu’il s’agisse de masquer un bimodalisme structurel par un sur-lissage excessif ou, inversement, d’introduire un bruit d’échantillonnage déroutant par une fragmentation microscopique, le calibrage arbitraire d’Excel exige une reprise en main méthodique et instruite par le statisticien.
Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements théoriques, les mécanismes logiciels et les implications cognitives associés à la modification de la largeur des classes dans Excel. En combinant rigueur épistémologique et directes méthodologiques pas à pas, ce document détaille la totalité des manipulations requises pour dominer l’interface de mise en forme, implémenter les règles formelles de discrétisation optimale, gérer les valeurs aberrantes et garantir une conformité absolue avec les exigences de publication académique internationale.
1. Fondements statistiques de l’histogramme et rôle de la granularité
Pour appréhender pleinement les enjeux techniques liés au réglage de la largeur de classe dans un tableur, il est indispensable de revisiter les principes mathématiques et théoriques qui sous-tendent la construction d’un histogramme, en insistant sur la portée épistémologique de cet estimateur de densité non paramétrique.
1.1 Définition théorique et utilité de l’histogramme dans l’analyse de distribution
L’histogramme se distingue fondamentalement du simple diagramme en barres (ou graphique à colonnes), bien qu’une confusion visuelle persiste fréquemment chez les analystes débutants. Alors que le diagramme en barres juxtapose des catégories discrètes ou nominales dont l’ordonnancement peut souvent être interverti sans altérer la sémantique de l’observation, l’histogramme s’applique exclusivement à des variables quantitatives continues ou discrètes à large support. Dans un histogramme continu, l’axe horizontal représente une ligne numérique continue et orientée, découpée en intervalles contigus et mutuellement exclusifs appelés « classes » ou « bacs » (bins). La surface de chaque rectangle érigé au-dessus d’un intervalle est rigoureusement proportionnelle à la fréquence relative ou absolue des observations qui y chutent, incarnant ainsi le concept mathématique d’intégrale locale d’une densité empirique.
L’utilité première de ce dispositif réside dans sa capacité à offrir une visualisation immédiate des caractéristiques distributionnelles majeures d’un échantillon : la tendance centrale (position du mode, de la médiane et de la moyenne), la dispersion globale, le degré d’asymétrie statistique (mesuré formellement par le coefficient de skewness) et le niveau d’aplatissement ou d’épaisseur des queues de distribution (estimé par le kurtosis). Cette exploration préliminaire conditionne la validité des inférences subséquentes, orientant l’analyste vers des modélisations paramétriques linéaires ou vers des méthodes robustes non paramétriques.
Dans le domaine spécifique des sciences comportementales, de la psychométrie et de la psychologie différentielle, l’histogramme s’avère un instrument de diagnostic capital. L’évaluation de constructs latents tels que l’anxiété-trait, l’estime de soi ou les quotients d’efficience cognitive repose sur des agrégations de scores qui doivent être scrutées afin de détecter d’éventuels effets de plafond (saturation des scores dans les classes supérieures) ou effets de plancher. De surcroît, l’émergence d’une distribution bimodale dans un protocole d’évaluation clinique signale immanquablement l’hétérogénéité de la cohorte, trahissant la coexistence de deux sous-populations distinctes que l’analyse univariée aveugle aurait masquées.
1.2 Le concept de largeur de classe (bin width) et son impact interprétatif
La largeur de classe, formellement désignée par le symbole mathématique h, définit l’amplitude numérique de chaque sous-intervalle partitionnant l’espace des données. La relation mathématique fondamentale liant l’étendue globale de la série (différence entre la valeur maximale et la valeur minimale observées), l’effectif total de l’échantillon n et le nombre total d’intervalles k s’exprime par le ratio où la largeur h est approximativement égale à l’étendue divisée par k. Ce paramètre de maille spatiale constitue le levier de réglage exclusif de la granularité descriptive du phénomène étudié.
La fixation de h engage l’analyste dans un compromis classique en théorie de l’estimation : le compromis entre le biais et la variance. Lorsque l’analyste sélectionne une largeur de classe excessivement grande, un phénomène délétère de sur-lissage (oversmoothing) se produit. Les détails structurels fins de la série sont anéantis au profit d’une courbe macroscopique artificielle. Ce sur-lissage comprime les écarts, écrase les modes secondaires et peut conduire à interpréter à tort une distribution intrinsèquement complexe ou polymodale comme une loi normale unimodale parfaitement symétrique. Les spécificités cliniques ou comportementales locales sont alors purement et simplement effacées du champ perceptif.
À l’inverse, l’adoption d’une largeur de classe excessivement étroite induit un sous-lissage (undersmoothing) préjudiciable. L’histogramme se morcelle en une succession de pics vertigineux et de vallées artificielles, parfois séparés par des classes vides ne contenant aucune observation. Dans cette configuration, la représentation graphique ne reflète plus la fonction de densité théorique sous-jacente de la population mère, mais amplifie de manière désordonnée les artefacts stochastiques et les fluctuations aléatoires inhérentes à l’échantillonnage. L’observateur est alors exposé à des signaux trompeurs, le poussant à postuler des régularités là où ne réside qu’un bruit statistique sans signification clinique ou théorique.
1.3 Spécificités algorithmiques du tracé par défaut dans Microsoft Excel
Lorsqu’un utilisateur sollicite la création d’un histogramme natif via le ruban de Microsoft Excel, le moteur graphique interne n’interroge pas l’opérateur sur ses présupposés méthodologiques. Le logiciel applique de manière automatisée une routine déterministe de discrétisation. Historiquement et fonctionnellement, l’algorithme d’Excel recourt à une déclinaison implicite de formules de partitionnement inspirées de conventions classiques, cherchant à générer un nombre de classes restreint, perçu par les concepteurs comme visuellement équilibré sur un écran bureautique standard.
Cette approche systématique présente de sévères défaillances face à des distributions réelles qui s’écartent de la distribution gaussienne idéale. Si les données présentent une forte asymétrie positive (par exemple, des données de temps de réaction en laboratoire de neurosciences ou des distributions de revenus économiques), l’algorithme calcule une étendue totale démesurée en raison de quelques observations lointaines situées dans la queue supérieure. En divisant cette étendue par un nombre conventionnel d’intervalles, le tableur impose une largeur uniforme démesurément large pour la zone dense de l’échantillon, agrégeant la quasi-totalité des participants dans les deux premières barres et étirant des classes quasi désertes sur le reste du graphique.
Par conséquent, le paramétrage automatique délivré par Excel ne saurait en aucun cas être considéré comme une finalité scientifique. L’intervention experte de l’analyste pour ajuster manuellement la finesse de ce partitionnement n’est pas un simple raffinement esthétique : elle constitue une exigence déontologique et méthodologique visant à restaurer l’intégrité de l’information statistique transmise au lectorat.
2. Préparation et structuration rigoureuse du jeu de données dans Excel
Avant d’initier la moindre manipulation graphique au sein du tableur, une phase préparatoire d’assainissement et de structuration matricielle des données s’avère indispensable pour éviter les blocages de l’interface ou la génération d’artefacts d’affichage.
2.1 Organisation tabulaire conforme aux standards d’analyse quantitative
Pour être exploitée avec succès par le module de graphiques statistiques d’Excel, la variable cible doit être structurée sous la forme d’un vecteur vertical unidimensionnel au sein d’une feuille de calcul propre. Cela implique de consigner l’ensemble des observations dans une colonne unique, surmontée impérativement d’un en-tête descriptif textuel sans équivoque (par exemple, « Score_Anxiete_STAI » ou « Temps_Reponse_ms »). L’agencement tabulaire doit proscrire formellement toute cellule fusionnée dans la zone de données ou dans les zones adjacentes, les cellules fusionnées perturbant irrémédiablement le mécanisme de référencement matriciel du moteur graphique.
Une vigilance particulière doit être accordée à l’encodage numérique strict. Dans les versions francophones d’Excel, le séparateur décimal par défaut est la virgule, alors que les banques de données issues de logiciels d’expérimentation psychologique (comme PsychoPy, E-Prime ou des plateformes en ligne comme Qualtrics) exportent généralement les fractions numériques avec un point décimal anglo-saxon. Si un nombre comporte un point au lieu d’une virgule, Excel interprète l’entrée comme une chaîne de caractères textuelle (alignée par défaut à gauche de la cellule). La présence d’une seule valeur textuelle au sein d’une colonne empêche l’histogramme de fonctionner correctement ou exclut silencieusement ces enregistrements du décompte fréquentiel.
Le traitement des données manquantes exige également une formalisation rigoureuse. Les logiciels statistiques institutionnels (tels que SPSS ou SAS) utilisent fréquemment des codes numériques conventionnels arbitraires (comme -99, 999 ou 9999) pour désigner une non-réponse, une omission ou un abandon de protocole. Si ces codes sont laissés bruts dans la colonne lors de la création de l’histogramme, Excel les traitera comme des valeurs réelles continues. L’étendue sera instantanément faussée et le tracé sera totalement corrompu par l’inclusion de ces valeurs aberrantes fictives. Il convient donc de vider purement et simplement ces cellules ou d’utiliser le filtre de données pour éliminer préalablement les observations non valides.
2.2 Typologie des données adaptées au tracé d’histogrammes
Tous les types de données ne sont pas recevables pour une analyse par histogramme continu. En référence à la classification fondamentale des échelles de mesure formalisée par Stanley Smith Stevens, seules les variables mesurées sur une échelle d’intervalles ou sur une échelle de rapports possèdent les propriétés mathématiques requises pour autoriser une discrétisation spatiale en classes d’amplitudes égales. Les variables purement qualitatives nominales (telles que le genre ou la catégorie socioprofessionnelle) ou ordinales restreintes (échelles de Likert à 3 ou 5 points discrets) doivent être traitées par des diagrammes en barres catégoriels et non par des histogrammes, sous peine de suggérer une métrique continue fallacieuse.
L’effectif de l’échantillon conditionne également la faisabilité et la pertinence du tracé. Sur des cohortes très restreintes (par exemple, n < 30), la puissance d’estimation d’un histogramme est extrêmement faible ; la forme globale du graphique fluctue violemment au gré de la moindre modification de la largeur de classe, conférant aux observations une instabilité trompeuse. Dans ces contextes, un diagramme de dispersion individuel (strip plot) ou un tracé en boîte à moustaches (box plot) s’avère nettement plus honnête sur le plan scientifique. En revanche, dès lors que l’échantillon atteint des volumes intermédiaires ou massifs (de quelques centaines à plusieurs dizaines de milliers d’unités), l’histogramme déploie toute son efficacité pour résumer la structure statistique du phénomène sous-jacent.
Considérons à titre d’illustration empirique l’étude des scores obtenus par un échantillon de 1 200 participants soumis à l’inventaire d’anxiété état-trait de Spielberger. Cette échelle génère un score continu théorique compris entre 20 et 80. Dans un autre registre méthodologique, examinons les données relatives aux rémunérations mensuelles brutes au sein d’une grande entreprise multinationale, exprimées en euros. Dans le premier cas, la distribution s’approche généralement d’une forme en cloche avec une légère asymétrie vers les valeurs élevées en population clinique ; dans le second, la distribution des revenus exhibe une forte asymétrie à droite avec une queue très étirée. Ces deux scénarios exigeront une stratégie de sélection de largeur de classe radicalement différenciée lors de la phase de manipulation dans Excel.
3. Procédure pas à pas de génération de l’histogramme natif dans Excel
Depuis la version d’Excel intégrée à Microsoft 365 et les versions d’Excel 2016 et ultérieures, la création d’un histogramme s’appuie sur un objet graphique vectoriel autonome hautement dynamique, distinct des anciens outils statiques basés sur des macros ou des modules complémentaires.
3.1 Sélection des plages de données et navigation dans le ruban
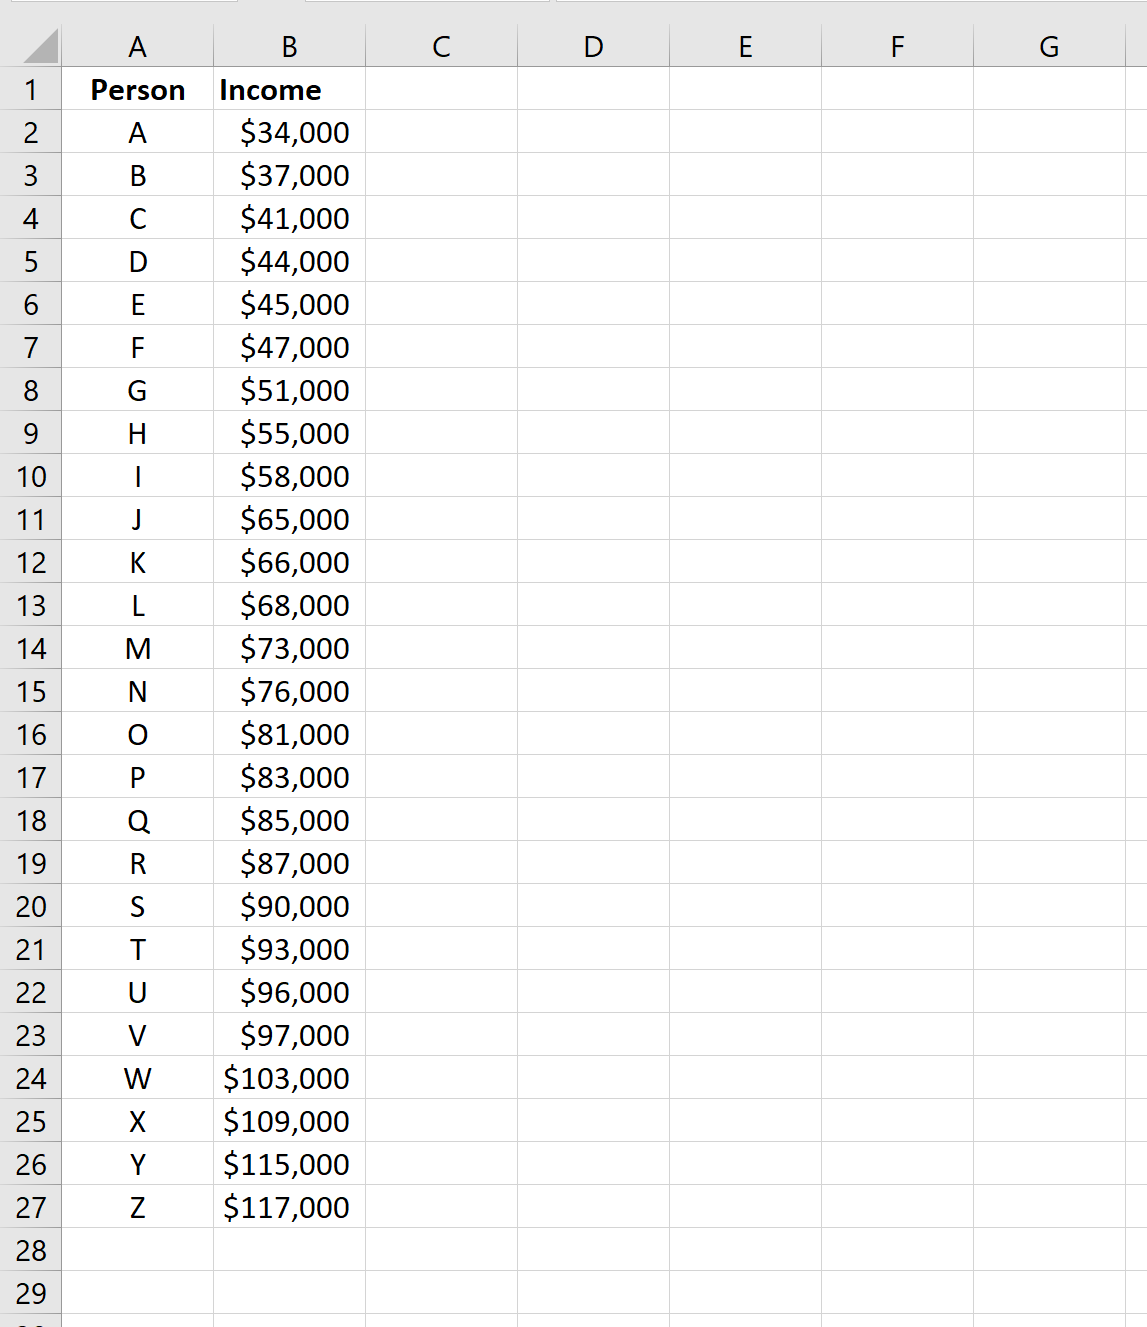
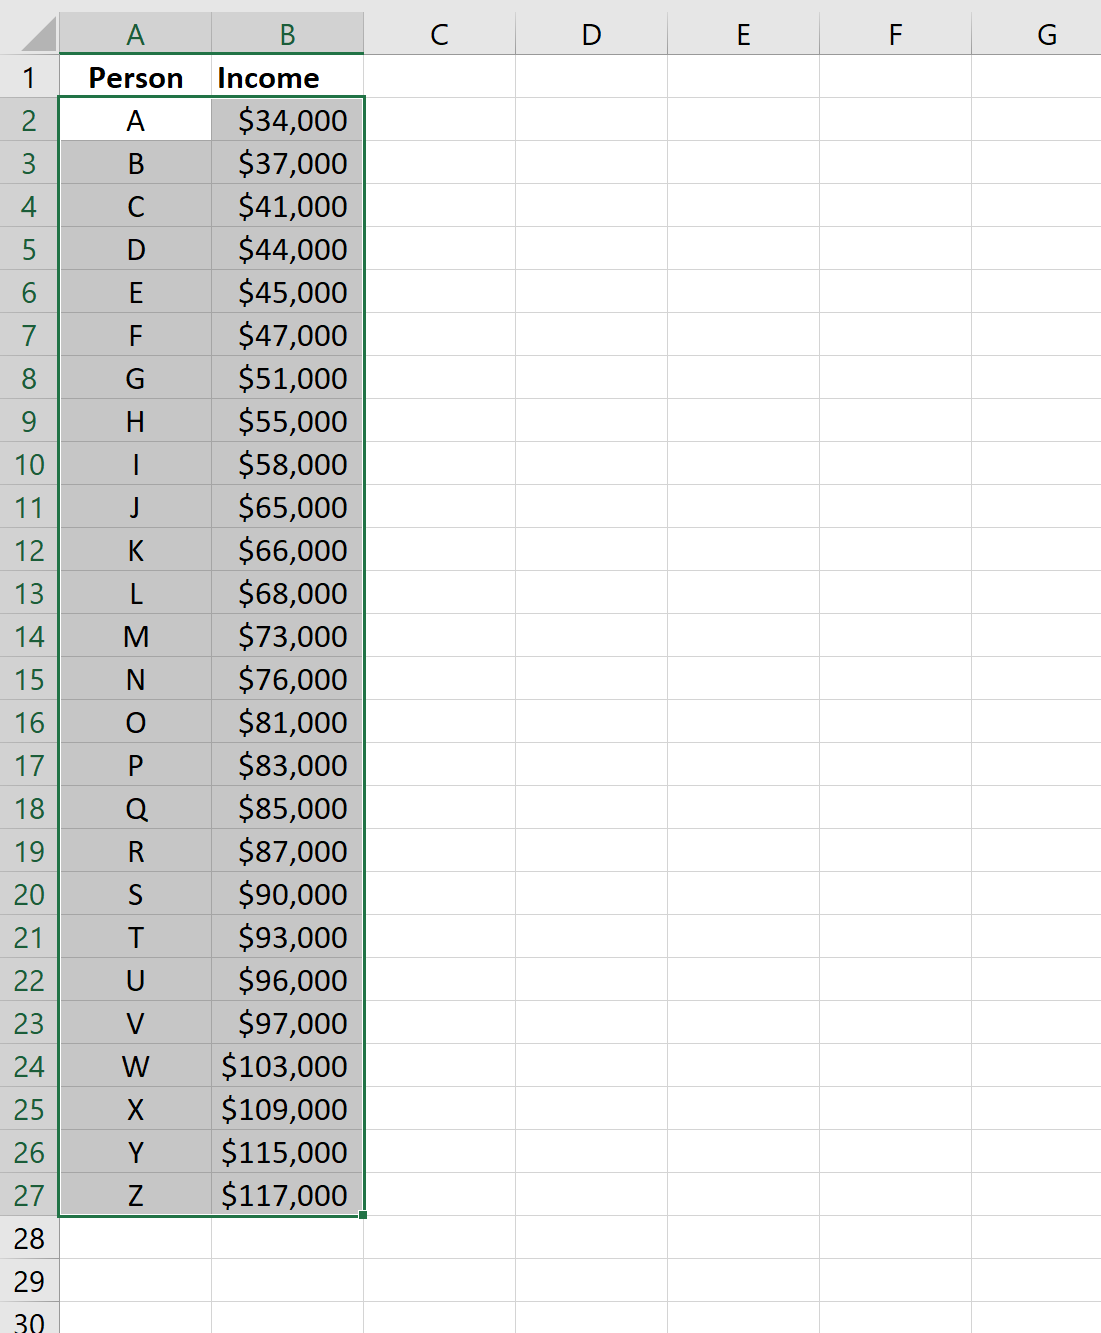
La première phase opérationnelle réside dans la délimitation précise de la matière première informationnelle. L’utilisateur doit positionner le curseur actif sur la cellule d’en-tête de la colonne contenant les valeurs numériques continues. À l’aide du raccourci clavier standard (Ctrl + Maj + Flèche vers le bas sous Windows ou Cmd + Shift + Flèche vers le bas sous macOS), l’intégralité du vecteur de données est sélectionnée instantanément, sans risque d’omettre des enregistrements situés en bas de page. Il est impératif d’inclure l’en-tête textuel dans la sélection : le moteur d’Excel l’identifiera automatiquement pour baptiser le graphique et éviter d’interpréter le premier libellé comme un point de données nul ou corrompu.
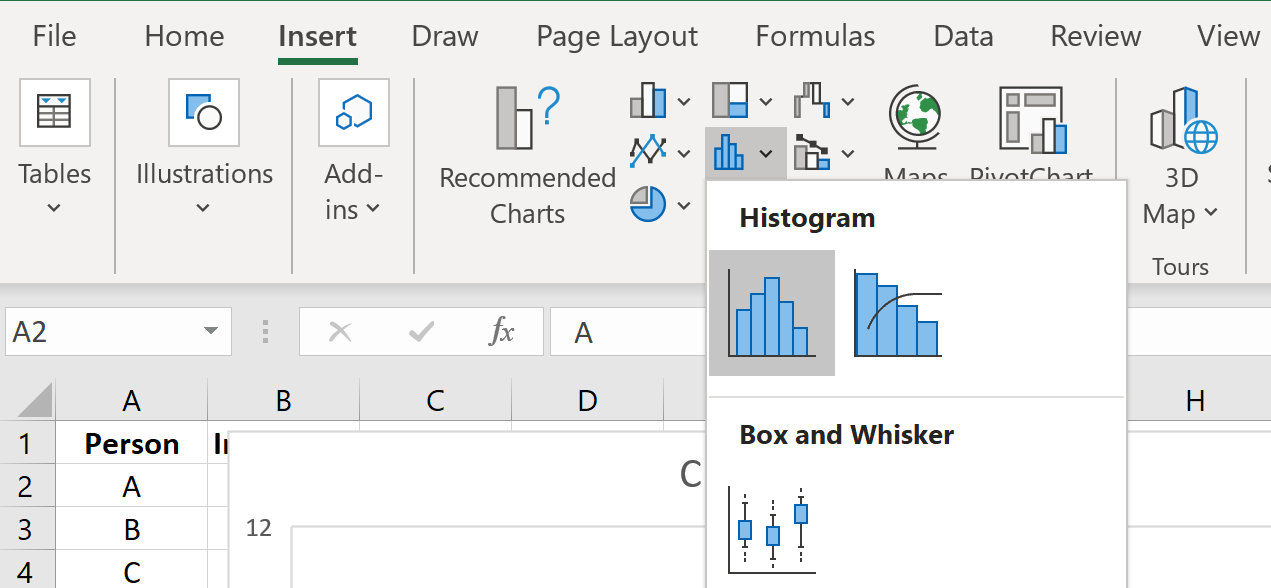
Une fois la sélection active stabilisée, dirigez-vous vers le sommet de l’interface et cliquez sur l’onglet contextuel Insertion situé dans le ruban Office. Au sein du groupe d’outils labellisé Graphiques, localisez l’icône représentant de petites barres bleues ordonnées sous forme de distribution statistique, intitulée officiellement Insérer un graphique statistique. En cliquant sur le menu déroulant adjacent, l’interface présente plusieurs options visuelles réparties en catégories distinctes.
Il importe de ne pas confondre le modèle Histogramme standard avec le modèle Pareto juxtaposé. Le diagramme de Pareto combine un tracé en colonnes triées par ordre décroissant de fréquence avec une courbe cumulative en pourcentage, un outil purement dédié au contrôle de qualité industrielle et à la loi des 80/20. Pour l’analyse de distribution continue univariée, cliquez strictement sur la première miniature représentant l’Histogramme simple. Excel insère alors instantanément un nouvel objet graphique flottant au milieu de la feuille de calcul active.
3.2 Génération de l’objet graphique et diagnostic du rendu automatisé
Dès l’apparition de l’objet sur le canevas d’Excel, le statisticien doit poser un regard critique sur le résultat brut généré par le moteur logiciel. Par défaut, Excel applique sa propre heuristique de partitionnement. Examinez attentivement l’axe horizontal des abscisses : les étiquettes ne présentent pas des valeurs ponctuelles uniques, mais des descriptions d’intervalles fermés ou ouverts, généralement formulées sous une syntaxe entre crochets et parenthèses (par exemple, [20, 27,5), indiquant que la borne inférieure 20 est incluse tandis que la borne supérieure 27,5 en est exclue).
Dans une immense majorité de configurations expérimentales, ce rendu initial se révèle insatisfaisant. Les classes peuvent présenter des amplitudes numériques baroques comportant de multiples décimales superflues (par exemple, une largeur d’intervalle calculée à 7,3333 unités), ce qui heurte violemment la lisibilité cognitive du document. Dans d’autres contextes, le nombre d’intervalles arbitrairement choisi par le logiciel compresse l’information jusqu’à transformer une distribution riche en une masse indifférenciée de quatre ou cinq colonnes massives, occultant les spécificités structurelles de la variable.
Ce diagnostic initial confirme la nécessité absolue de passer outre le paramétrage passif proposé par défaut. L’analyste doit désormais accéder aux commandes d’ingénierie fine du graphique afin de reprendre la main sur la géométrie des intervalles et d’aligner la granularité visuelle sur les standards théoriques et empiriques de son champ de recherche.
4. Accès à l’interface de configuration de l’axe horizontal
L’ajustement de la largeur des classes ne s’effectue pas via les options habituelles de redimensionnement de séries de données, mais par une intervention ciblée sur les propriétés géométriques de l’axe horizontal, lequel porte la responsabilité du partitionnement spatial dans le modèle d’Excel.
4.1 Sélection ciblée de l’axe des abscisses
Pour intervenir sur la granularité du graphique, il convient d’atteindre avec exactitude l’élément constitutif idoine au sein du document graphique. L’approche la plus directe consiste à déplacer le curseur de la souris directement au-dessus des étiquettes numériques de l’axe horizontal (les valeurs textuelles figurant entre crochets au bas des colonnes). Cliquez avec le bouton droit de la souris sur cette zone précise. Un menu contextuel surgissant apparaît à l’écran ; sélectionnez l’ultime commande située au bas de cette liste, intitulée Format de l’axe….
Une méthode alternative hautement sécurisée, particulièrement recommandée lorsque la densité graphique rend le clic de souris imprécis, consiste à cliquer n’importe où dans le corps du graphique pour faire apparaître les onglets contextuels spécialisés dans le ruban supérieur d’Excel : Création de graphique et Mise en forme. Cliquez sur l’onglet Mise en forme. À l’extrême gauche de ce ruban, dans le groupe Sélection active, déroulez la liste des composants du graphique et choisissez explicitement Axe horizontal (catégories), puis cliquez sur le bouton Mise en forme de la sélection positionné immédiatement en dessous.
L’écueil le plus fréquent lors de cette manipulation réside dans la sélection accidentelle de la série de données (c’est-à-dire le corps bleu des barres verticales) en lieu et place de l’axe lui-même. Si la série est sélectionnée, le volet contextuel s’ouvrira sur le titre Format de la série de données, lequel propose uniquement de régler la couleur de remplissage, les bordures ou la superposition, sans offrir le moindre accès aux paramètres mathématiques de partitionnement des classes. Il est donc crucial de vérifier la mention figurant au sommet du volet latéral pour garantir que vous pilotez bien le format de l’axe.
4.2 Exploration du volet Office contextuel ‘Format de l’axe’
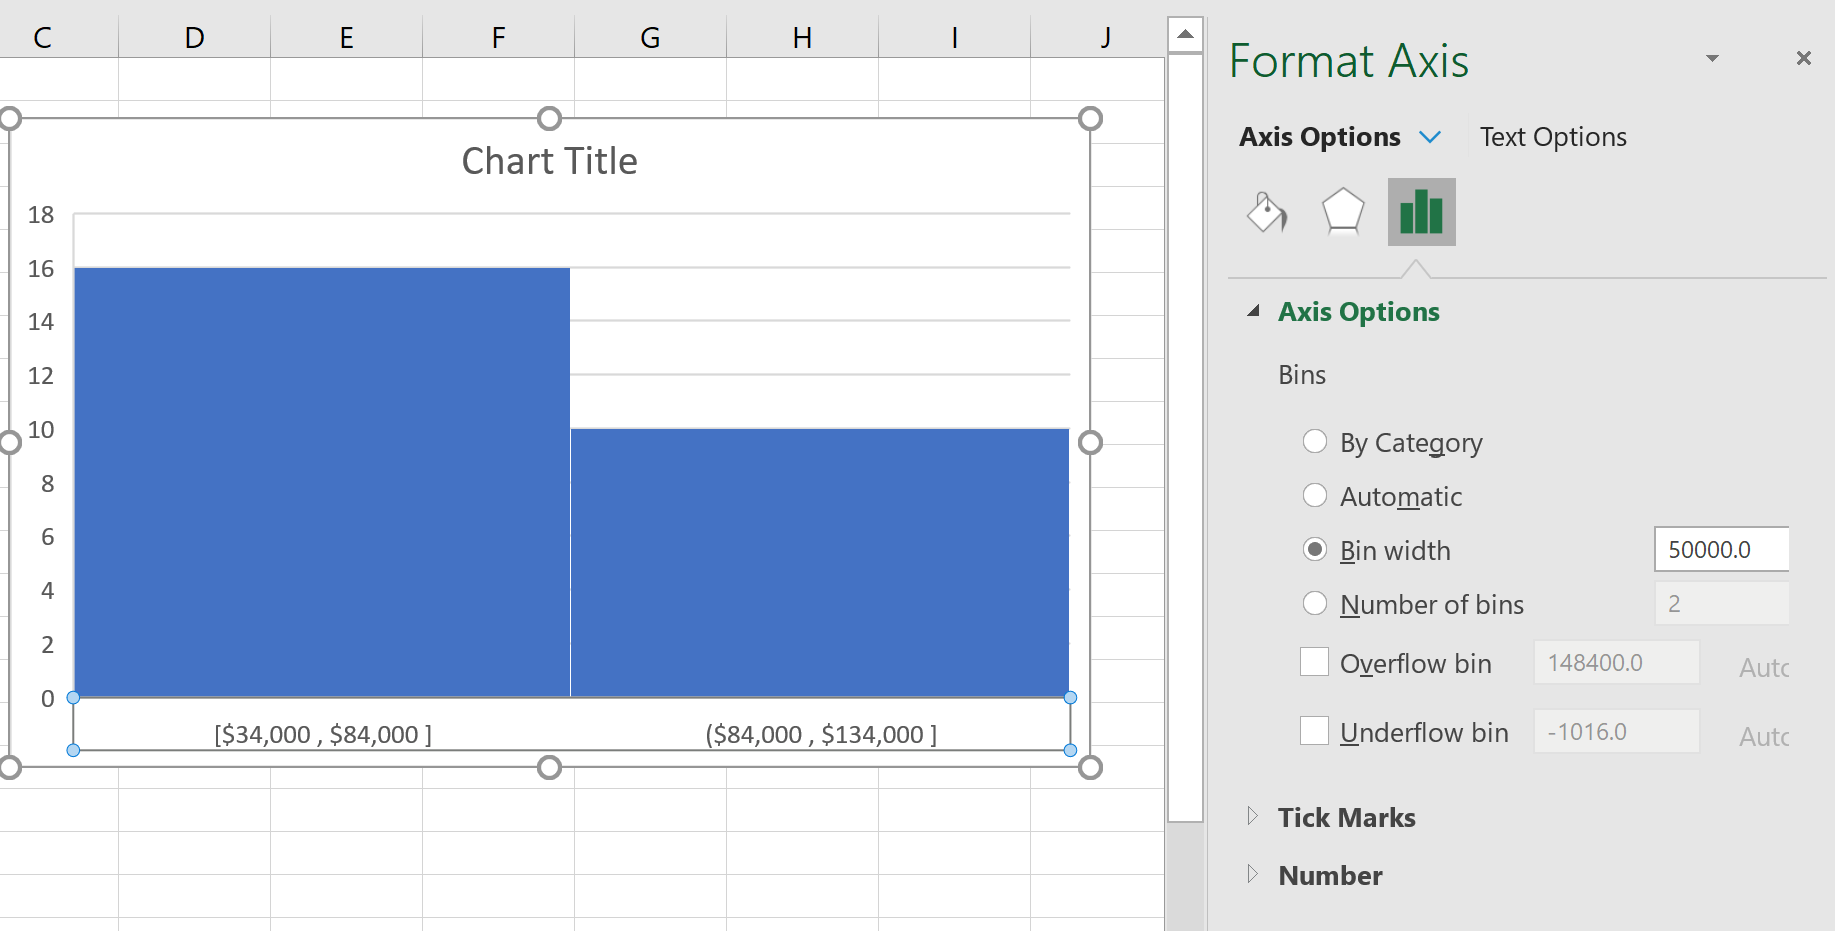
Une fois l’action validée, un volet d’ancrage latéral intitulé Format de l’axe s’ouvre sur le flanc droit de l’espace de travail d’Excel. Ce panneau technique regroupe l’ensemble des leviers typographiques, décoratifs et structurels applicables à l’axe ciblé. Au sommet de ce volet, sous le libellé principal, se trouvent plusieurs icônes de navigation : le pot de peinture (remplissage et trait), les effets visuels (ombres et reflets), les options d’alignement et, enfin, une icône représentant trois petites barres verticales stylisées dénommée Options d’axe.
Cliquez impérativement sur cette quatrième icône, Options d’axe, puis développez la section éponyme située en dessous en cliquant sur la petite flèche triangulaire si celle-ci n’est pas déjà déployée. C’est ici que se dévoile le cœur fonctionnel du moteur statistique d’Excel. L’interface abandonne ici le formalisme conventionnel des axes cartésiens classiques (qui affichent habituellement le minimum, le maximum et les graduations principales) pour présenter une nomenclature propre aux distributions statistiques.
Vous observez alors un groupe structuré de boutons radio et de champs numériques exclusifs :
- Par catégorie : traite chaque valeur distincte comme un libellé textuel isolé (déconseillé pour les données continues).
- Automatique : le mode algorithmique initial imposé par défaut par le logiciel.
- Largeur de bande (ou Largeur de classe selon les versions linguistiques de la suite Office) : le paramètre clé d’ajustement arithmétique de l’amplitude de chaque intervalle.
- Nombre de classes : le paramètre concurrent permettant de fixer le contingent global de bacs.
- Bac de débordement : seuil supérieur de troncature des queues de distribution.
- Bac de sous-dépassement : seuil inférieur de regroupement des valeurs minimales.
Cette nomenclature technique confère à l’analyste un contrôle absolu sur la topologie de sa représentation graphique.
5. Modification manuelle de la largeur de classe (Largeur de bande)
La modification directe de la largeur de bande constitue la méthode d’intervention privilégiée lorsque la variable étudiée possède une unité de mesure physique, temporelle ou psychométrique naturelle dont l’incrémentation fait sens pour la communauté scientifique.
5.1 Activation et saisie de la valeur numérique de largeur
Pour dicter souverainement l’amplitude numérique de chaque intervalle, cliquez sur le bouton radio intitulé Largeur de bande (correspondant au terme technique Bin Width dans l’environnement anglophone). Dès cette activation, le champ textuel situé immédiatement à droite de cette mention se dégrise, devenant modifiable, et le mode de calcul automatique est instantanément désactivé.
Saisissez au clavier la valeur arithmétique rigoureusement déterminée lors de votre réflexion préalable. Par exemple, si vous étudiez les scores de l’échelle d’anxiété STAI (échelonnée de 20 à 80 points) et que vous souhaitez des paliers cognitifs réguliers de 5 points, entrez le chiffre 5 dans la zone de texte. Appuyez ensuite sur la touche Entrée de votre clavier pour forcer la validation de la saisie.
Instantanément, le moteur graphique d’Excel recalcule l’intégralité du graphique sous vos yeux, sans qu’il soit nécessaire de recharger la sélection source. L’axe des abscisses se restructure : le nombre total de classes s’ajuste dynamiquement en divisant l’étendue globale par la valeur 5 nouvellement allouée, et la hauteur de chaque colonne se redéfinit proportionnellement au nouvel effectif d’observations recensées dans chaque segment de 5 unités. Le champ adjacent Nombre de classes se met à jour en arrière-plan, affichant la quantité de bacs résultant mathématiquement de votre choix d’amplitude.
5.2 Conséquences empiriques de l’accroissement de la largeur
Le fait d’augmenter délibérément la valeur numérique de la largeur de bande entraîne une simplification drastique et une consolidation de la morphologie de la distribution visualisée. Prenons l’exemple concret d’une variable économique portant sur les rémunérations annuelles de cadres supérieurs, où l’étendue des données s’étale de 40 000 € à 280 000 €. Si l’analyste fait passer la largeur de bande d’un réglage initial étroit de 10 000 € à un réglage élargi de 50 000 €, les répercussions empiriques sont immédiates et profondes.
En agrégeant les fréquences au sein d’intervalles plus vastes, les barres individuelles fusionnent. Les fluctuations mineures d’une tranche de 10 000 € à l’autre s’annulent mutuellement au sein d’une moyenne locale consolidée. Ce lissage volontaire est d’une grande valeur heuristique lors des phases d’exploration préliminaire : il permet d’éradiquer le bruit statistique stochastique imputable à la taille limitée de l’échantillon et met en exergue l’allure macroscopique générale de la population. Il devient aisé pour un décideur ou un lecteur non spécialiste de percevoir la masse centrale de la cohorte sans être distrait par des aspérités numériques secondaires.
Néanmoins, cet accroissement doit demeurer mesuré. Si la largeur est poussée à l’excès (par exemple en choisissant une classe de 120 000 € dans notre exemple), le graphique est réduit à deux ou trois blocs massifs sans pouvoir discriminant. L’analyste perd toute capacité à repérer une éventuelle asymétrie fine ou à déceler la présence de sous-groupes salariaux spécifiques au sein de la tranche médiane.
5.3 Conséquences empiriques de la réduction de la largeur
À l’autre extrémité du spectre méthodologique, la décision de contracter la largeur de classe vers une valeur unitaire ténue déclenche une décomposition morphologique chirurgicale de la série de données. Supposons que dans une tâche informatisée d’évaluation des temps de réaction psychomoteurs, mesurés en millisecondes, l’analyste décide de réduire la largeur de bande d’un palier conventionnel de 100 ms à une granularité fine de 15 ms.
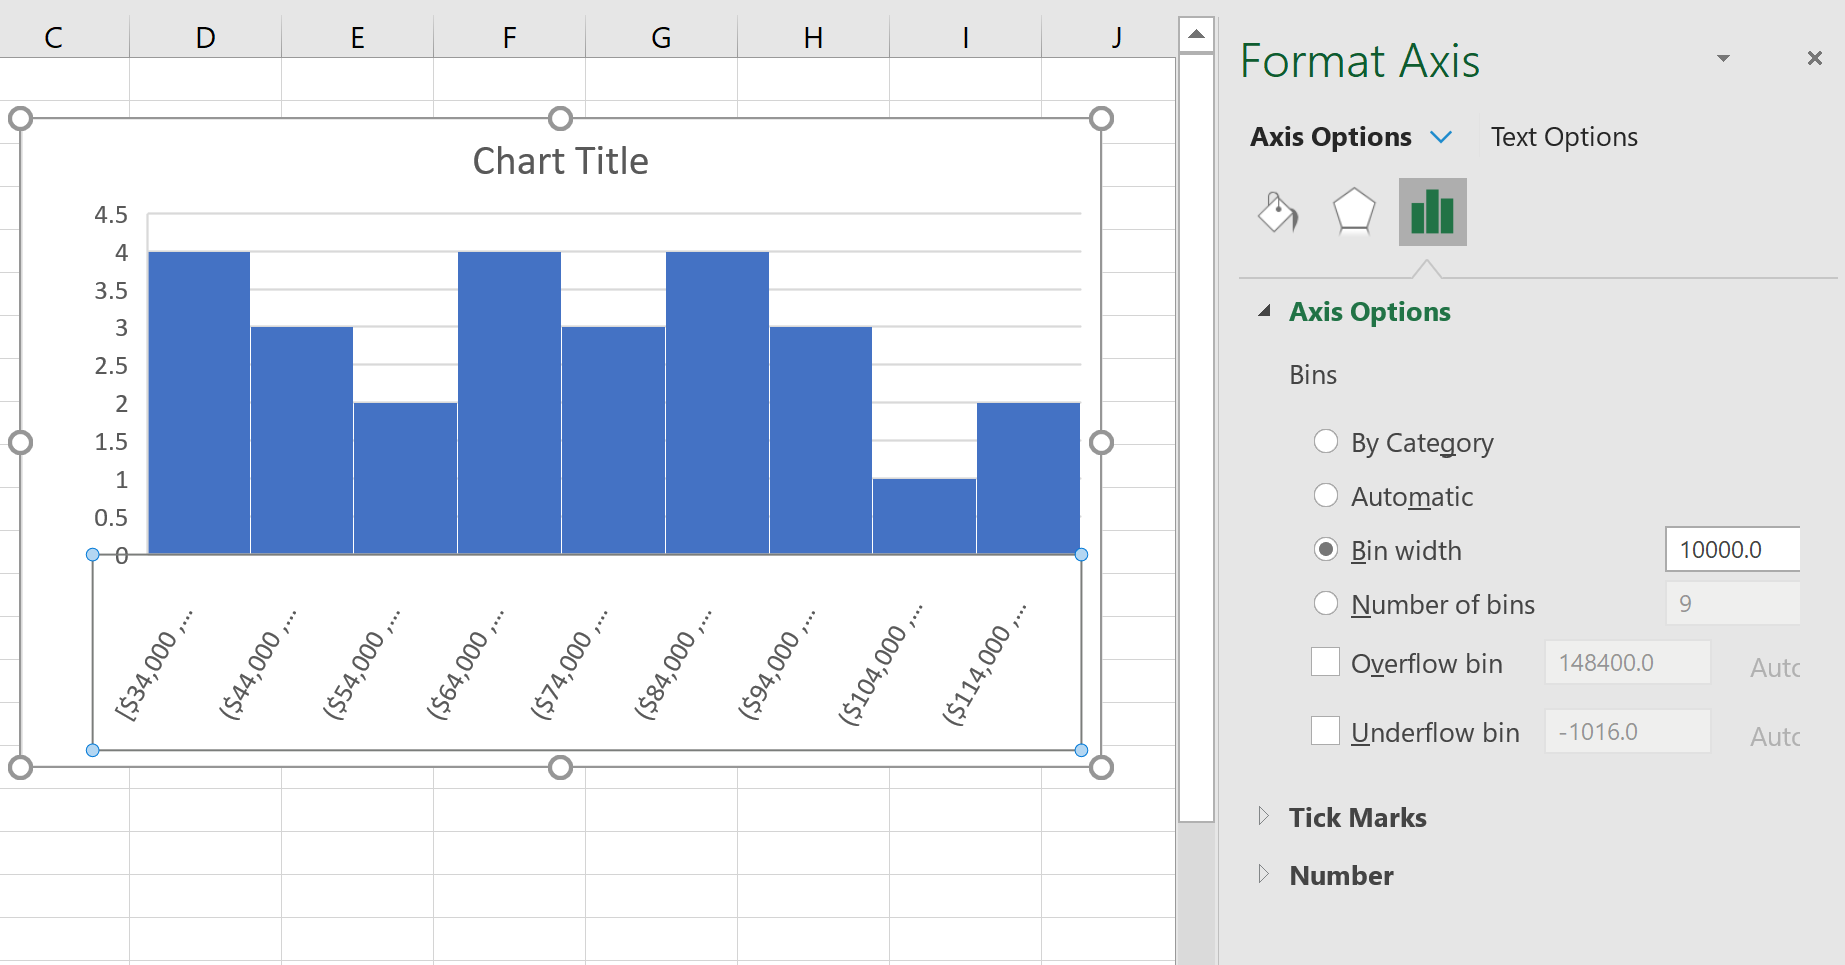
Cette fragmentation microscopique dévoile des subtilités distributionnelles invisibles à plus grande échelle. Des pics multiples peuvent soudainement émerger, signalant par exemple que les sujets manifestent deux modes cognitifs distincts : un processus de réponse motrice ultra-rapide automatisé (premier mode autour de 220 ms) et un processus décisionnel délibératif plus lent (second mode autour de 380 ms). De surcroît, cette finesse de découpage permet de détecter des ruptures franches ou des classes totalement désertes (fréquence nulle), trahissant des seuils physiologiques infranchissables ou des anomalies dans l’appareil d’enregistrement expérimental.
Le risque majeur inhérent à cette réduction drastique réside dans la vulnérabilité extrême du graphique à la variance d’échantillonnage. Dès lors que l’effectif moyen d’observations par classe devient trop restreint, la hauteur relative des barres adjacentes est dominée par le hasard probabiliste plutôt que par la loi distributionnelle fondamentale. L’histogramme adopte alors une texture déchiquetée, confuse, rendant la communication scientifique illisible et incitant le chercheur à sur-interpréter de simples artefacts d’échantillon.
6. Stratégie alternative : Contrôle par le nombre de classes
Si la fixation manuelle de l’amplitude numérique constitue la voie directe d’intervention sur l’axe, Excel autorise une approche duale rigoureusement équivalente sur le plan algébrique, mais procédant d’une logique méthodologique différente : le verrouillage du nombre total de classes.
6.1 Paramétrage via le champ ‘Nombre de classes’
Au sein du volet contextuel Format de l’axe, sous la section des Options d’axe, l’utilisateur a la possibilité de délaisser le champ Largeur de bande au profit du bouton radio concurrent libellé Nombre de classes (ou Number of Bins). En cochant ce bouton, la saisie manuelle de la largeur se verrouille et le curseur s’établit dans le champ numérique dédié au décompte global.
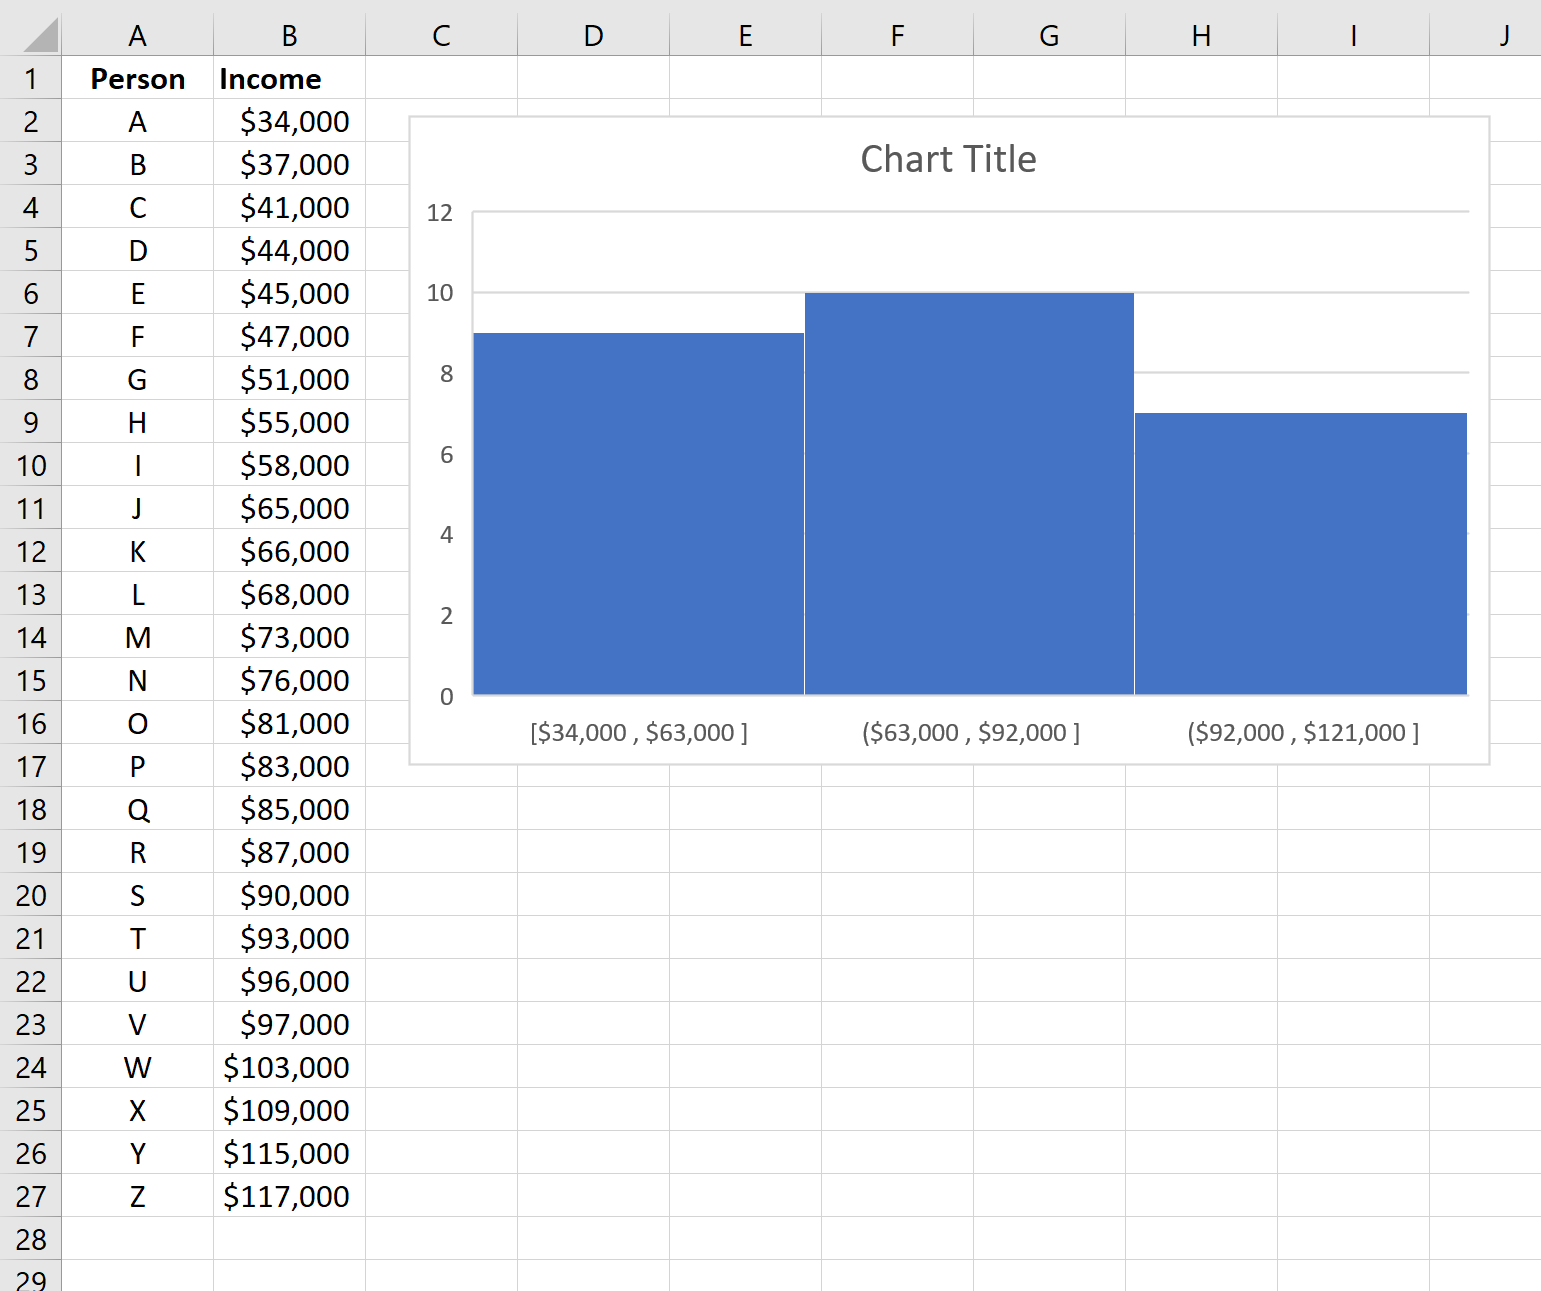
L’opérateur peut alors taper directement la quantité intégrale d’intervalles souhaitée pour le partitionnement total de la série (par exemple, taper 10 ou 20). Dès la frappe de la touche de validation, Excel prend le contrôle de l’opération arithmétique inverse : il soustrait la valeur minimale absolue de la valeur maximale recensée dans l’échantillon, puis divise cette étendue par le nombre de classes que vous avez imposé. Le quotient obtenu devient instantanément la nouvelle largeur de bande appliquée de manière uniforme à chaque rectangle du graphique.
Cette stratégie s’avère particulièrement commode lorsqu’un protocole d’évaluation scientifique ou une convention sectorielle impose une division standardisée de la cohorte selon un nombre prédéfini de tranches d’observation. C’est typiquement le cas lors des analyses orientées vers le découpage en déciles (exigeant 10 classes) ou en quartiles visuels (4 classes larges), bien que l’histogramme classique construise des intervalles d’amplitudes égales en valeurs de variables plutôt qu’en effectifs cumulés constants comme le feraient de purs quantiles.
6.2 Arbitrage méthodologique entre fixation de la largeur et fixation du nombre
Le choix délibéré entre fixer la largeur de classe ou fixer le nombre d’intervalles engage une réflexion méthodologique substantielle qui dépend des objectifs finaux de l’analyse et du public auquel se destine le document graphique. Le tableau synthétique suivant met en perspective les avantages comparatifs et les limites inhérentes à chacune de ces deux démarches :
- Approche par la largeur fixe (Largeur de bande) :
- Avantages majeurs : Lisibilité cognitive supérieure grâce à l’attribution d’unités rondes, intelligibles et signifiantes pour l’esprit humain (ex. pas de 10 ans d’âge, tranches de 500 € ou paliers de 5 points psychométriques). Préservation rigoureuse de la signification d’échelle lors de l’intégration de nouvelles données au sein de la même base.
- Limites : Impossibilité de prédire a priori le nombre exact de colonnes qui apparaîtront à l’écran si l’échantillon est régulièrement augmenté d’observations extrêmes élargissant l’étendue globale.
- Approche par le nombre fixe de classes :
- Avantages majeurs : Garantie d’une occupation spatiale visuelle constante et parfaitement maîtrisée au sein de la mise en page d’un rapport ou d’un manuscrit scientifique. Idéal pour comparer visuellement la forme morphologique de deux cohortes d’effectifs divergents en leur assignant un découpage structurel strictement équivalent.
- Limites : Génération presque systématique de bornes d’intervalles aux fractions décimales illisibles (par exemple, des tranches d’âges progressant par pas de 6,842 ans), perturbant la compréhension rapide des seuils par les lecteurs.
Dans la pratique académique rigoureuse, la fixation de la largeur numérique uniforme sur un entier remarquable ou une fraction signifiante demeure la méthode hautement recommandée par les comités de lecture, car elle évite d’imposer des coupures artificielles sans ancrage théorique au sein de l’axe réel de mesure.
7. Gestion des valeurs extrêmes : Classes de débordement inférieur et supérieur
L’une des difficultés majeures de la visualisation par histogramme réside dans la présence fréquente de valeurs aberrantes (outliers) ou d’observations isolées positionnées très loin du cœur de la distribution, lesquelles peuvent étirer démesurément l’axe horizontal et écraser visuellement l’ensemble des données d’intérêt.
7.1 Configuration du bac de débordement inférieur (Underflow Bin)
Le concept de bac de débordement inférieur (désigné sous le vocable Underflow Bin dans la documentation technique internationale) formalise un principe mathématique fondamental : la censure ou le regroupement sous un seuil plancher unique de toutes les observations inférieures ou égales à une valeur critique prédéterminée par le chercheur.
Pour activer ce mécanisme dans l’environnement Excel, retournez dans le volet latéral Format de l’axe, sous les Options d’axe. Cochez explicitement la case à cocher intitulée Bac de sous-dépassement. Le champ de texte situé en regard devient instantanément éditable. Vous devez y inscrire la valeur seuil en deçà de laquelle toute granularité fine devient superflue ou méthodologiquement non pertinente.
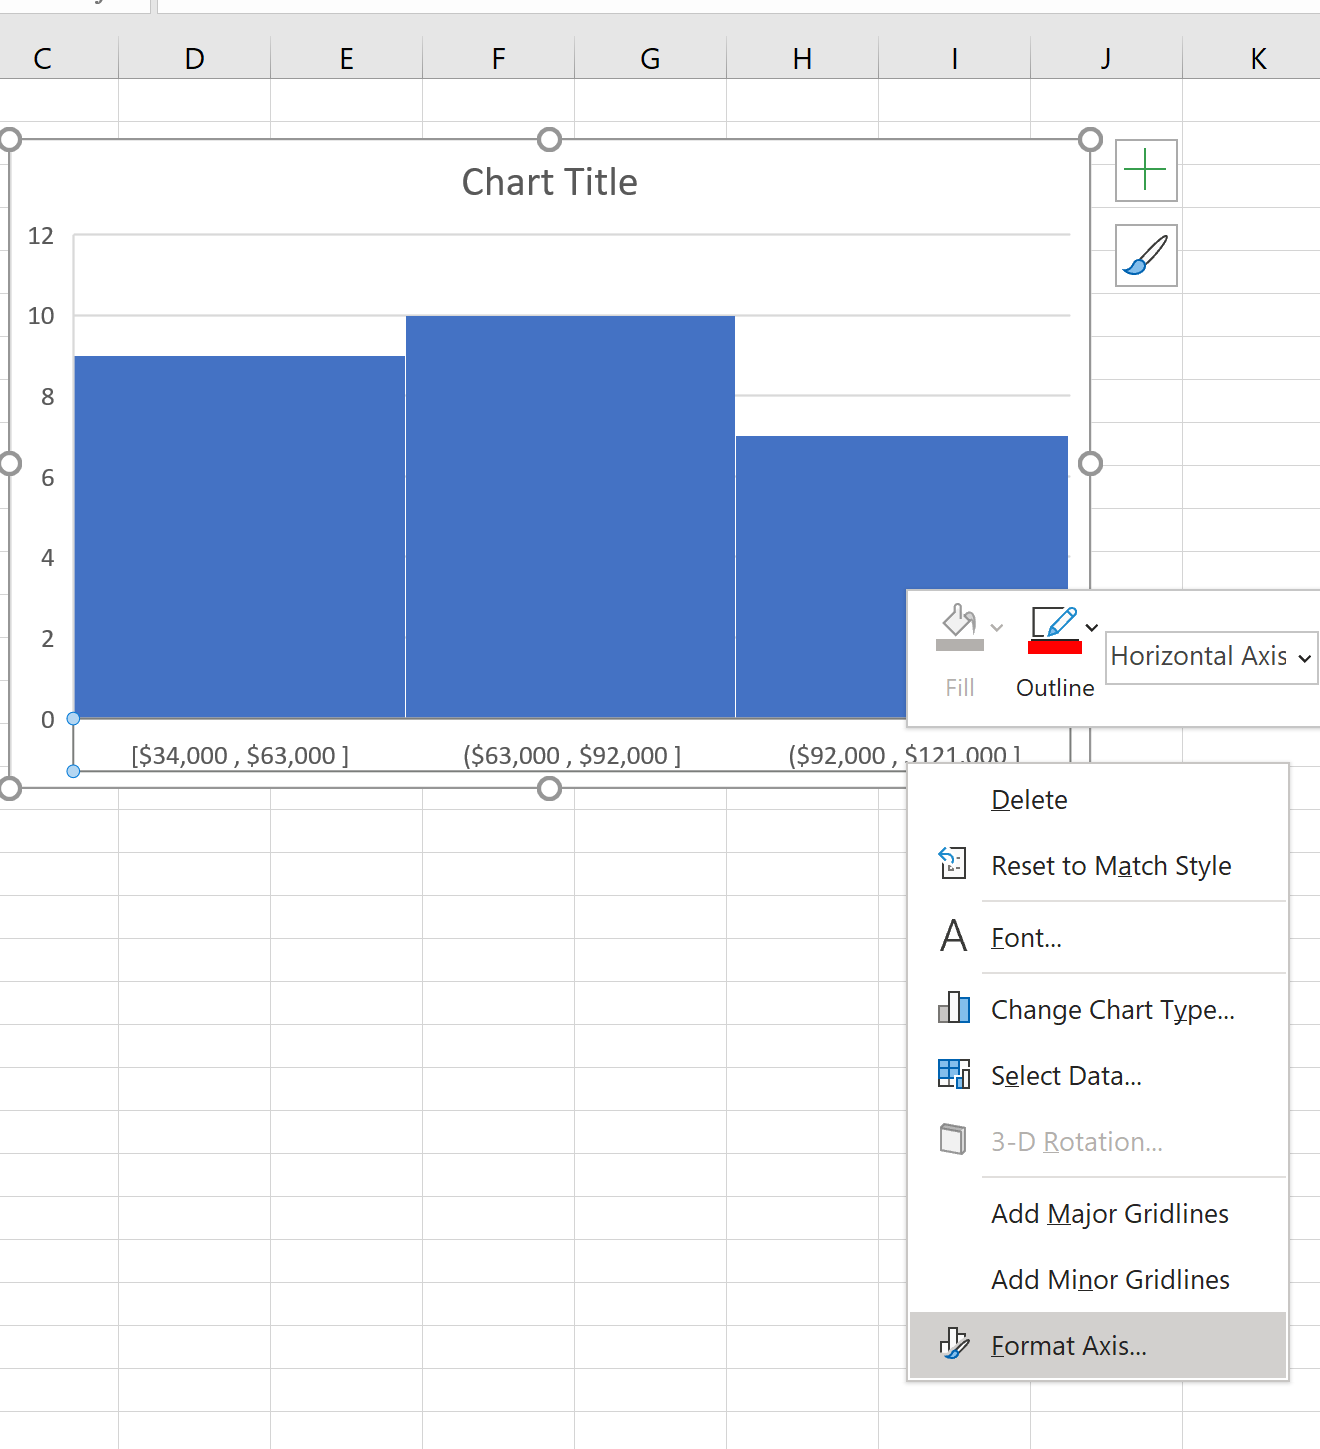
Cette manœuvre est particulièrement indiquée dans les contextes psychométriques où s’appliquent des effets de plancher instrumentaux ou des seuils de normalité clinique. Par exemple, si une échelle d’évaluation d’un déficit cognitif considère que tout score inférieur à 15 relève d’une incapacité sévère indifférenciée, l’analyste peut positionner le seuil du bac de sous-dépassement à 15. Dès lors, la première barre à l’extrême gauche de l’histogramme agrégera sans distinction toutes les valeurs situées dans l’intervalle semi-infini ]-∞ ; 15], portant une étiquette claire du type ≤ 15, libérant l’intégralité de la résolution graphique pour analyser les nuances distributionnelles des scores compris entre 15 et le maximum théorique.
7.2 Configuration du bac de débordement supérieur (Overflow Bin)
À l’autre extrémité de la courbe, le bac de débordement supérieur (Overflow Bin) répond à la problématique symétrique mais infiniment plus commune en sciences sociales et en économie : l’étalement démesuré des queues de distribution vers la droite en présence de distributions leptokurtiques ou exponentielles.
L’activation de cette modalité s’opère de manière analogue. Cochez la case Bac de débordement dans le panneau de formatage de l’axe et renseignez la valeur numérique choisie comme plafond d’affichage détaillé. Par exemple, dans une analyse de la distribution des temps de séjour aux urgences hospitalières, une poignée de patients victimes de complications exceptionnelles peuvent afficher des durées d’hospitalisation de 96 ou 120 heures, alors que 98 % des flux se résolvent en moins de 24 heures. Si l’on laisse le tableur tracer le graphique sans contrainte, l’axe s’étendra jusqu’à 120 heures, comprimant 98 % de la cohorte dans une grappe de colonnes microscopiques entassées à gauche.
En fixant le bac de débordement supérieur à la valeur 24, Excel rassemble instantanément l’ensemble des cas extrêmes au sein d’une unique barre terminale positionnée à droite du tracé, étiquetée > 24. L’espace visuel compris entre 0 et 24 heures bénéficie alors d’un partitionnement fin et harmonieux, restituant toute la complexité interne de la dynamique hospitalière courante sans distorsion d’échelle.
7.3 Précautions méthodologiques quant à l’interprétation des aires
Bien que l’usage des bacs de débordement et de sous-dépassement résolve avec brio les contraintes d’encombrement graphique, il introduit un biais perceptif et épistémologique majeur que le statisticien ne doit jamais occulter. Dans la théorie classique de l’histogramme, la surface physique de chaque barre verticale doit être proportionnelle à l’effectif représenté, l’aire totale sous le tracé équivalant à l’unité (100 % des données).
Or, en imposant à un bac de débordement une largeur physique standard égale à celle des classes régulières adjacentes alors qu’il couvre conceptuellement un intervalle semi-infini (par exemple, de 24 à l’infini), le logiciel viole artificiellement le principe d’équivalence entre l’aire et la probabilité. La hauteur de la barre terminale peut suggérer à un lecteur non averti une densité locale gigantesque, alors qu’il ne s’agit que d’un conglomérat d’observations hautement dispersées dans l’espace sous-jacent. Il est donc impératif de respecter une règle déontologique de transparence : toute publication incorporant des bacs de débordement doit obligatoirement comporter une légende ou une note explicative précisant la troncature appliquée et stipulant expressément les caractéristiques d’étalement des données agrégées dans ces classes marginales.
8. Règles formelles de calcul pour déterminer la largeur optimale
Le choix d’une largeur de classe ne saurait relever du simple caprice esthétique ou d’un tâtonnement empirique hasardeux. La littérature statistique contemporaine offre des fondations mathématiques solides pour objectiver le calcul de la granularité optimale, minimisant formellement l’erreur quadratique moyenne intégrée (Integrated Mean Squared Error ou IMSE) entre l’histogramme empirique et la véritable densité théorique.
8.1 La règle empirique de Sturges et ses limites
Formulée en 1926 par le mathématicien américain Herbert Sturges, la règle de Sturges demeure sans doute la formule de discrétisation la plus célèbre et la plus largement disséminée dans les manuels scolaires et les logiciels généralistes. Elle repose sur l’hypothèse sous-jacente d’une distribution normale idéale issue d’une série de tirages binomiaux symétriques. L’équation dérive le nombre optimal de classes k en fonction directe de la taille de l’échantillon n selon la relation logarithmique en base 2 suivante :
k = 1 + log2(n) = 1 + 3,322 * log10(n)
Une fois le nombre de classes k obtenu, la largeur de bande optimale h se déduit simplement en divisant l’étendue globale R (Maximum – Minimum) par k :
h = R / (1 + 3,322 * log10(n))
Bien que d’une remarquable simplicité de calcul par l’intermédiaire des fonctions de base d’Excel (à l’aide de la formule =1+LOG(NB(Plage);2)), la règle de Sturges présente des limites théoriques rédhibitoires unanimement dénoncées par les statisticiens modernes. D’une part, son assise conceptuelle dépend strictement de la normalité de la distribution : face à des données fortement asymétriques ou plurimodales, la formule échoue totalement à capter les aspérités de la série. D’autre part, son comportement mathématique logarithmique s’avère particulièrement paresseux face aux larges cohortes ; pour des échantillons massifs excédant plusieurs milliers d’observations, la règle de Sturges sous-estime dramatiquement le nombre de bacs nécessaires, induisant un sur-lissage délétère qui étouffe l’information disponible.
8.2 La règle de Scott et l’estimation de la dispersion
Pour pallier les défaillances structurelles de Sturges face aux grands échantillons, David W. Scott a proposé en 1979 une approche fondée sur l’optimisation asymptotique de l’erreur quadratique moyenne intégrée pour des variables continues régulières. La règle de Scott abandonne le découpage aveugle de l’étendue pour ancrer la détermination de la largeur de classe sur l’écart-type de l’échantillon, noté s, et sur la racine cubique de l’effectif n :
h = (3,49 * s) / (n^(1/3))
L’implémentation de cette équation dans une feuille de calcul Excel est immédiate et s’effectue au moyen des fonctions statistiques intégrées : =(3,49 * ECARTYPE.STANDARD(Plage)) / (NB(Plage)^(1/3)).
La règle de Scott confère une bien meilleure robustesse que celle de Sturges, car la largeur des bacs décroît de manière proportionnelle à la racine cubique du volume de données, garantissant que l’estimateur affine continuellement sa résolution spatiale au fur et à mesure que la puissance statistique de l’échantillon s’accroît. Elle s’avère extrêmement performante et rigoureusement adaptée pour toutes les séries quantitatives unimodales continues modérément symétriques ne présentant pas d’aplatissement ou d’épaisseur de queue excessifs.
8.3 La règle de Freedman-Diaconis pour distributions asymétriques
Dans les champs de la recherche empirique appliquée, en particulier en psychologie, en médecine et en économie comportementale, la normalité des distributions constitue une exception rarissime plutôt que la règle. La présence fréquente d’asymétries prononcées et d’observations extrêmes invalide l’usage de l’écart-type standard, lequel est hautement vulnérable à la moindre valeur aberrante. C’est précisément pour remédier à cette faille que David Freedman et Persi Diaconis ont élaboré en 1981 leur règle de partitionnement robuste non paramétrique.
La règle de Freedman-Diaconis substitue à l’écart-type l’utilisation de l’écart interquartile (noté IQR, pour Interquartile Range), lequel mesure l’étendue occupée par les 50 % centraux de la population observée (différence arithmétique entre le troisième quartile Q3 et le premier quartile Q1). La formule formelle s’établit comme suit :
h = 2 * IQR * (n^(-1/3)) = (2 * (Q3 - Q1)) / (n^(1/3))
Pour calculer directement cette largeur théorique idéale dans une cellule utilitaire d’Excel avant de la reporter manuellement dans le volet graphique, vous pouvez combiner harmonieusement les fonctions matricielles suivantes :
=(2 * (QUARTILE.INC(Plage; 3) - QUARTILE.INC(Plage; 1))) / (NB(Plage)^(1/3)).
En fondant le calcul de l’amplitude sur l’intervalle interquartile, la règle de Freedman-Diaconis neutralise totalement l’influence perturbatrice des observations atypiques logées dans les queues lointaines. Elle empêche le sur-lissage artificiel du corps dense de la distribution tout en garantissant un compromis optimal entre le contrôle du biais et la limitation de la variance stochastique. C’est sans conteste le standard méthodologique contemporain à privilégier pour toute publication quantitative exigeante.
9. Répercussions cognitives et psychologiques du choix de segmentation
La datavisualisation n’est pas un processus mathématique neutre et désincarné ; elle constitue une interface d’intermédiation cognitive entre un jeu de données abstrait et le système perceptif d’un lecteur humain. Les arbitrages appliqués à la discrétisation spatiale modifient directement les jugements intuitifs et les prises de décision.
9.1 Biais d’ancrage et perception de la normalité
Le système visuel humain possède une prédisposition cognitive puissante à la recherche de symétrie, d’harmonie et de régularité globale, un phénomène abondamment documenté par les théories de la psychologie de la forme (Gestalt). Confronté à un histogramme aux classes excessivement larges, le cerveau du lecteur comble spontanément les vides et opère une interpolation perceptuelle inconsciente en faveur de la classique courbe de Gauss en cloche. Si un sur-lissage dissimule une encoche ou un repli central, l’évaluateur conclura sans hésitation à l’homogénéité du groupe observé.
Ce biais de perception recèle des dangers particulièrement graves dans la pratique diagnostique ou clinique. Masquer la scission d’un groupe de patients en deux grappes distinctes (par exemple, des répondeurs à un traitement pharmacologique versus des non-répondeurs) sous prétexte d’adopter un pas de classe grossier conduit à des conclusions erronées sur l’efficacité générale d’une thérapie. L’analyste porte dès lors une responsabilité éthique substantielle : le choix de la largeur de classe engage directement la transparence de la transmission des preuves empiriques et ne doit jamais servir à fabriquer une illusion de normalité rassurante pour simplifier un modèle statistique.
9.2 Clarté cognitive et charge de travail visuelle
Au-delà du réalisme statistique de la forme observée, la conception graphique doit respecter les contraintes intrinsèques de la théorie de la charge cognitive formalisée par John Sweller. La mémoire de travail humaine dispose d’une bande passante extrêmement limitée lors de l’intégration simultanée de stimuli numériques complexes. Le choix des valeurs délimitant les bornes des bacs joue à cet égard un rôle ergonomique de premier plan.
L’affichage d’intervalles aux bornes fractionnaires aberrantes (telles que [13,47 ; 21,89)) impose au lecteur une dépense métacognitive inutile : l’individu s’épuise à décoder la délimitation technique au lieu de mobiliser son attention sur la signification phénoménologique de la fréquence observée. À l’inverse, l’alignement méthodique de la largeur de bande sur des unités arithmétiques remarquables, des nombres ronds et congruents avec le système métrique mental usuel (par exemple, des classes de 5, 10, 50 ou 100 unités), fluidifie instantanément le traitement de l’information.
Cette économie cognitive libère les ressources attentionnelles du destinataire, facilitant la comparaison visuelle immédiate entre les différentes tranches de la population et accélérant la mémorisation pérenne des ordres de grandeur exposés dans le rapport ou l’article scientifique.
10. Diagnostics et résolutions d’erreurs fréquentes dans Excel
L’implémentation pratique des histogrammes dans l’environnement Microsoft Excel se heurte régulièrement à des dysfonctionnements techniques récurrents, susceptibles de désarçonner l’analyste et de paralyser le flux de travail analytique.
10.1 Données non reconnues comme numériques et axes figés
Le dysfonctionnement le plus couramment rencontré se traduit par une interface où, après avoir ouvert le volet Format de l’axe, l’utilisateur découvre avec stupeur que l’ensemble des boutons radio relatifs au partitionnement (Largeur de bande, Nombre de classes, etc.) apparaissent grisés, inaccessibles ou totalement absents de la boîte de dialogue, le logiciel traitant l’axe comme un banal axe de catégories qualitatives.
Ce phénomène trahit presque systématiquement la présence d’au moins une valeur textuelle dissimulée au sein de la colonne de données source. Cela se produit fréquemment lorsque des espaces insécables invisibles ont été importés lors d’une extraction de base de données web, ou lorsque le séparateur décimal (point au lieu de virgule) corrompt la typologie de la variable. Pour assainir la colonne défaillante sans reprendre manuellement des milliers de lignes, appliquez la procédure suivante :
- Sélectionnez l’intégralité du vecteur de données dans votre tableau.
- Rendez-vous dans l’onglet Données du ruban supérieur et cliquez sur la commande Convertir (située dans le groupe d’outils d’ingénierie des données).
- Dans l’assistant d’importation qui s’affiche, choisissez le mode Délimité, cliquez sur Suivant, désélectionnez tous les séparateurs, puis cliquez sur le bouton Avancé….
- Indiquez formellement à Excel la nature du séparateur décimal d’origine présent dans votre extraction (par exemple, forcez le point comme décimale), validez puis cliquez sur Terminer.
Cette opération force la réévaluation et la conversion immédiate de l’intégralité du vecteur en nombres purs conformes au paramétrage régional de votre système. L’histogramme réactualisera instantanément ses propriétés et l’accès aux commandes de largeur de bande sera pleinement débloqué.
10.2 Histogrammes créés par mégarde via l’outil ‘Histogramme’ de l’utilitaire d’analyse
Une confusion historique majeure réside dans la coexistence au sein d’Excel de deux mécanismes de tracé de nature radicalement dissemblable : l’objet graphique natif moderne (introduit à partir d’Excel 2016) et l’ancien outil « Histogramme » hébergé dans le complément obsolète intitulé Utilitaire d’analyse (Analysis ToolPak).
Si vous avez généré votre graphique en passant par l’onglet Données puis Utilitaire d’analyse, Excel n’a pas créé un véritable histogramme statistique paramétrique dynamique. Il a exécuté une macro de dénombrement ponctuelle qui a copié un tableau statique de fréquences dans une nouvelle feuille et tracé un graphique en colonnes catégoriel ordinaire à partir de ce tableau figé. Sur ce type d’objet dérivé, toute tentative d’accéder au volet « Format de l’axe » pour y modifier la largeur de bande est totalement vaine, car le logiciel ne considère ces barres que comme des catégories de texte disjointes sans intelligence distributionnelle continue.
La résolution de cette impasse impose d’abandonner l’usage de l’Utilitaire d’analyse pour cette tâche spécifique. Supprimez purement et simplement le graphique figé, retournez sur votre colonne de données numériques brute et insérez exclusivement l’objet graphique moderne dynamique via l’onglet Insertion > Graphiques statistiques > Histogramme, lequel dispose en natif des algorithmes de modulation interactive de classes documentés dans ce guide.
10.3 Incohérences d’affichage des étiquettes d’intervalles
Une autre source majeure d’irritation technique réside dans la dégradation esthétique de l’étiquetage de l’axe horizontal. Dès lors que le nombre d’intervalles devient substantiel, les libellés de classes formulés sous la syntaxe syntaxique [a, b) s’entrecroisent, se chevauchent de manière illisible ou adoptent des rotations obliques chaotiques qui enlaidissent le document scientifique.
Pour restaurer une présentation visuelle impeccable, plusieurs interventions de mise en forme s’imposent dans le volet Format de l’axe :
- Accédez à la section Nombre située au bas des options d’axe. Assurez-vous que la catégorie est paramétrée sur Standard ou Nombre, et réduisez impérativement le nombre de décimales affichées à
0ou1selon l’ordre de grandeur de votre métrique, évitant ainsi l’encombrement par des traînes de zéros inutiles. - Basculez sur l’icône Taille et propriétés (l’icône d’équerre adjacente) dans le volet latéral. Sous le menu déroulant Alignement, forcez l’orientation du texte : vous pouvez imposer un angle personnalisé de -45° pour préserver l’élégance du tracé, ou opter pour une orientation strictement horizontale en ajustant la taille de la police de caractères (corps 8 ou 9 points) via l’onglet d’accueil du ruban.
- Si la surcharge persiste, augmentez simplement la largeur physique du cadre du graphique en étirant ses poignées vectorielles latérales, offrant à l’axe la spatialisation nécessaire pour étaler harmonieusement ses libellés d’intervalles.
11. Méthode avancée alternative : Construction manuelle par la fonction FREQUENCE
Si l’histogramme natif d’Excel offre une remarquable réactivité pour la majorité des cas d’usage courants, il impose une contrainte algorithmique inflexible : toutes les classes de la distribution doivent impérativement posséder une largeur rigoureusement uniforme et constante sur l’ensemble de l’axe (à l’exception des bacs de débordement terminaux). Pour s’émanciper de cette bride et concevoir des histogrammes hautement personnalisés à classes d’amplitudes variables, il est nécessaire de recourir à la méthode matricielle experte.
11.1 Définition matricielle d’intervalles personnalisés
La première phase de cette méthodologie avancée consiste à créer manuellement, dans une table auxiliaire positionnée à l’écart des données brutes, la nomenclature exacte des seuils de découpage souhaités. Dans une colonne dédiée, intitulée « Bornes_Superieures », saisissez de haut en bas les limites d’inclusion maximales de chaque intervalle d’observation (par exemple : 10, 20, 25, 30, 50, 100). Cette liberté totale vous permet de modéliser des classes fines au cœur de la distribution et des classes plus larges au niveau des queues, adaptant précisément l’observation à la densité empirique.
Dans la colonne immédiatement voisine, réservez les cellules destinées à recueillir les décomptes d’occurrences et sollicitez la puissance de la fonction matricielle FREQUENCE. La syntaxe officielle de cette commande s’exprime comme suit :
=FREQUENCE(tableau_données; tableau_intervalles)
Dans les versions modernes de Microsoft 365 bénéficiant du moteur de matrices dynamiques, il vous suffit de vous positionner sur la première cellule de sortie et de valider la formule pour que le calcul se propage instantanément de façon fluide vers le bas. Dans les déclinaisons plus anciennes du tableur (Excel 2013, 2010), l’opération exige une validation matricielle formelle : vous devez impérativement sélectionner préalablement l’ensemble de la plage verticale de destination, saisir la formule dans la barre d’édition, puis enfoncer simultanément la célèbre combinaison de touches Ctrl + Maj + Entrée. La fonction retourne alors de manière déterministe le vecteur exact du décompte des effectifs contenus dans chaque tranche délimitée.
11.2 Tracé sous forme de diagramme en colonnes personnalisé
Une fois le tableau fréquentiel formalisé, sélectionnez la série des effectifs dénombrés ainsi que les libellés décrivant les intervalles, puis rendez-vous dans l’onglet Insertion pour y générer cette fois-ci un Graphique en colonnes 2D groupées standard. À ce stade de la démarche, le graphique obtenu n’est pas encore un histogramme au sens statistique du terme, mais un diagramme en barres classique séparé par d’épais couloirs blancs entre les rectangles.
Pour transformer cette vue catégorielle en un véritable histogramme continu respectant les conventions géométriques de la discipline, appliquez la manipulation de compacité suivante :
- Cliquez avec le bouton droit de la souris sur n’importe laquelle des colonnes verticales du graphique et sélectionnez la commande Mettre en forme une série de données….
- Dans le volet latéral qui s’ouvre, activez l’icône Options des séries figurant les barres d’histogramme.
- Localisez le curseur de réglage intitulé Largeur du coup d’œil (ou Largeur de l’intervalle / Gap Width). Par défaut, ce paramètre est étalonné à une valeur proche de 219 %, créant un large vide inter-colonnes.
- Saisissez rigoureusement le chiffre
0%au clavier ou déplacez le curseur totalement vers la gauche. - Passez ensuite sur l’icône du pot de peinture (Remplissage et courbes), développez l’onglet Bordure, cochez Ligne pleine et attribuez une couleur de trait constrastée (comme un gris foncé ou un blanc pur) avec une épaisseur fine de 0,75 pt.
Par l’annulation complète de la largeur d’intervalle à zéro, les rectangles se touchent de manière contiguë et ininterrompue sur toute la ligne des abscisses, matérialisant visuellement la continuité sous-jacente de la variable quantitative. Cette approche confère une liberté totale de typographie et de mise en scène graphique, idéale pour les présentations professionnelles complexes exigeant des standards éditoriaux sur mesure.
12. Bonnes pratiques de formalisation et d’intégration académique
La production d’un histogramme statistiquement irréprochable au sein de la feuille de calcul ne constitue que la première moitié du travail analytique. L’intégration de cette figure au sein d’un rapport de recherche, d’un mémoire doctoral ou d’un manuscrit soumis à une revue internationale à comité de lecture requiert une formalisation rigoureuse selon les conventions académiques établies.
12.1 Conformité aux normes de publication scientifique (style APA)
Dans la sphère des sciences psychologiques, de l’éducation, des neurosciences et des sciences comportementales au sens large, les directives graphiques formulées par l’American Psychological Association (APA 7e édition) font office de référence d’autorité mondiale. L’adaptation d’un graphique natif d’Excel aux standards APA impose un assainissement stylistique intransigeant visant à éradiquer tout artifice décoratif superflu (ce que le théoricien Edward Tufte qualifie de chartjunk) :
- Suppression des fioritures visuelles : Éliminez immédiatement le quadrillage horizontal d’arrière-plan en cliquant sur les lignes de guidage grises puis en appuyant sur la touche Suppr. Supprimez également la bordure rectangulaire externe encadrant l’objet graphique afin que la figure fusionne élégamment avec la blancheur de la page manuscrite.
- Sobriété des palettes chromatiques : Abandonnez les couleurs criardes ou les dégradés complexes par défaut d’Office. Privilégiez un remplissage sobre et monochrome pour les barres (un gris neutre à 40 % ou un bleu marine profond) bordé d’un contour noir ou anthracite fin, assurant une parfaite lisibilité aussi bien à l’écran que lors d’une impression papier en niveaux de gris.
- Étiquetage univoque et complet : Chaque axe doit impérativement porter un titre explicite et exhaustif. L’axe vertical ne doit pas porter la simple mention « Fréquence », mais préciser l’unité de dénombrement (par exemple, « Nombre de participants (n) » ou « Fréquence relative (%) »). L’axe horizontal doit mentionner sans ambiguïté le nom formel de la variable mesurée assorti de son unité physique ou psychométrique entre parenthèses (par exemple : « Score d’anxiété préopératoire (échelle STAI-Y, points) »).
- Structure formelle de la légende APA : Selon la 7e édition du style APA, le graphique ne doit pas porter de titre générique intégré à l’intérieur du cadre supérieur de la figure. Le titre s’établit au-dessus du tracé, en caractères gras (ex. Figure 1), suivi à la ligne d’une brève description en italique (ex. Distribution des temps de réaction lors de la tâche d’attention soutenue). Sous la figure s’insère obligatoirement une section Note. décrivant les caractéristiques techniques du tracé, notamment l’effectif global N, la règle de sélection de la largeur de classe appliquée (ex. « Largeur de classe h = 25 ms fixée selon la règle de Freedman-Diaconis ») et l’explication des bacs de débordement éventuels.
12.2 Documentation de la chaîne de traitement statistique
La crise contemporaine de la reproductibilité scientifique impose aux chercheurs une traçabilité intégrale de l’ensemble des opérations de manipulation de données ayant conduit à la génération des figures publiées. Un graphique dont les paramètres ont été modifiés à l’aveugle sans consignation méthodologique fragilise l’ensemble de la démonstration expérimentale.
Il est vivement recommandé de dédier, au sein du classeur Excel de travail, une zone tabulaire standardisée archivant les étapes de calcul de discrétisation. Documentez-y explicitement les valeurs des paramètres d’entrée fondamentaux :
- La taille exacte de l’échantillon analysé (
nvia la fonctionNB). - L’écart-type standardisé de la série (
sviaECARTYPE.STANDARD). - Les valeurs du premier et troisième quartiles (via
QUARTILE.INC) ainsi que l’écart interquartile résultant (IQR). - La formule mathématique d’arbitrage convoquée (Scott, Sturges ou Freedman-Diaconis) et le résultat arithmétique brut de la largeur théorique recommandée.
- La justification explicite de l’arrondi pratique retenu pour la fixation finale de la largeur dans le volet graphique.
Enfin, lors de l’exportation de l’histogramme vers un logiciel de traitement de texte scientifique (tel que Microsoft Word ou des éditeurs de composition LaTeX), proscrivez impérativement la capture d’écran par outil matriciel basse résolution qui génère un crénelage flou préjudiciable à la réputation de vos travaux. Utilisez le copier-coller vectoriel enrichi (commande Coller en tant qu’image vectorielle EMF / Windows Metafile) ou effectuez une exportation directe au format PDF haute résolution via l’utilitaire d’impression vectorielle d’Excel. Vous garantirez ainsi une restitution typographique d’une netteté absolue, conforme aux critères d’excellence des plus prestigieuses revues scientifiques internationales.
Références
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Microsoft Corporation. (2023). Créer un histogramme dans Excel. Support technique Microsoft Office. https://support.microsoft.com/fr-fr/office/cr%C3%A9er-un-histogramme-85680173-064b-40aa-ba34-e4c1a0d3336f
- Pearson, K. (1895). Contributions to the mathematical theory of evolution.—II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Scott, D. W. (2015). Multivariate density estimation: Theory, practice, and visualization (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118575574
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Sweller, J. (2011). Cognitive load theory. In J. P. Mestre & B. H. Ross (Eds.), The psychology of learning and motivation: Cognition in education (Vol. 55, pp. 37–76). Academic Press. https://doi.org/10.1016/B978-0-12-387693-5.00002-8
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000