
La représentation graphique des données empiriques constitue l’un des piliers méthodologiques les plus critiques de la démarche scientifique contemporaine. Dans les disciplines quantitatives telles que la psychométrie, les neurosciences cognitives, l’épidémiologie ou l’économétrie, la lisibilité et l’exactitude de la restitution visuelle d’un phénomène conditionnent directement la validité des inférences établies par les pairs. Or, si le logiciel d’analyse statistique R s’est imposé comme le standard académique mondial par excellence, son moteur graphique natif adopte par défaut un comportement probabiliste d’ajustement des échelles qui, bien que pratique pour l’exploration rapide, s’avère souvent inadapté aux contraintes rigoureuses de la publication scientifique. Les algorithmes d’optimisation automatisée sélectionnent des repères numériques fondés sur des divisions canoniques génériques qui masquent fréquemment des seuils cliniques fondamentaux, tronquent des dynamiques d’intérêt ou induisent des distorsions interprétatives majeures.
Le contrôle manuel millimétré des intervalles d’axes au sein des graphiques de base (le système base R graphics) représente ainsi un savoir-faire technique indispensable pour tout chercheur ou analyste désireux de s’affranchir des approximations algorithmiques. Maîtriser l’architecture qui sépare le tracé des points de données de la matérialisation physique des axes permet non seulement d’aligner les repères visuels sur des modèles théoriques sous-jacents, mais également d’optimiser l’ergonomie cognitive des figures destinées aux revues à comité de lecture. Cet ajustement ne se résume pas à un simple artifice esthétique ; il incarne une obligation de transparence scientifique où chaque marqueur, chaque pas d’échantillonnage graphique et chaque libellé textuel doit refléter avec exactitude la structure mathématique des mesures recueillies.
Ce guide exhaustif expose de manière méthodique l’ensemble des concepts, fonctions et stratégies permettant de modifier avec une précision absolue les intervalles des axes dans les graphiques R natifs. De la désactivation élémentaire des repères automatiques par les arguments d’atténuation graphique jusqu’au déploiement de séquences dynamiques complexes, en passant par le paramétrage typographique, l’exploitation des échelles temporelles et logarithmiques, ainsi que la synchronisation d’espaces multi-panneaux, ce manuel offre une référence opérationnelle complète, rigoureusement documentée et illustrée d’exemples analytiques concrets.
1. Introduction aux mécanismes de graduation des axes dans les graphiques R de base
Le système graphique fondamental de R repose sur une philosophie séquentielle issue du langage S, où chaque composant visuel est projeté sur un canevas matriciel selon un ordre déterminé. Comprendre les fondements théoriques et algorithmiques de cette structure est indispensable avant d’entreprendre toute manipulation chirurgicale des échelles d’abscisses et d’ordonnées.
1.1 Importance de la précision visuelle des axes dans l’analyse quantitative
Dans l’analyse des distributions quantitatives, l’axe graphique ne joue pas un simple rôle de délimitation géométrique ; il sert d’ancrage métrique direct à la perception humaine. Les travaux séminaux de Jacques Bertin sur la sémiologie graphique et les recherches de William S. Cleveland sur la perception visuelle des données ont amplement démontré que l’œil humain évalue les grandeurs relatives en comparant la distance linéaire des marqueurs par rapport aux graduations les plus proches. Lorsqu’un intervalle d’axe est mal calibré, ou lorsque les repères sont espacés de façon contre-intuitive (par exemple par tranches de 3,33 ou d’autres fractions non naturelles), la charge cognitive requise pour décoder l’information s’accroît exponentiellement, multipliant les risques de contresens analytique.
En psychométrie et en neuropsychologie clinique, ce phénomène prend une dimension critique. Les outils d’évaluation standardisés reposent sur des bornes interprétatives précises, telles que les écarts-types autour d’une moyenne normalisée (échelles T, notes standardisées ou scores de quotient intellectuel) ou des scores seuils attestant d’une sévérité pathologique (comme sur les échelles d’évaluation de la dépression ou de l’anxiété). Un tracé automatisé qui omet d’implanter une graduation sur ces points de rupture théoriques contraint le lecteur à une interpolation hasardeuse, réduisant la portée de la démonstration expérimentale. De plus, la reproductibilité scientifique impose une standardisation des échelles entre différentes cohortes ou études comparatives, ce que les routines automatiques ne peuvent garantir en raison de leur sensibilité aux variations minimes d’échantillonnage.
1.2 Fonctionnement du moteur graphique natif de R pour les échelles
Le moteur graphique natif encapsulé dans la fonction de base fait appel à un algorithme interne d’ajustement automatique hérité de la fonction de bas niveau nommée communément l’algorithme des repères élégants (pretty breakpoints). Lorsqu’un utilisateur exécute une instruction standard sans paramétrage préalable des axes, le système analyse l’étendue dynamique des données fournies, calcule l’amplitude globale entre les extrema, puis détermine une puissance de dix adéquate pour définir un nombre approximatif d’intervalles réguliers, souvent centré sur un facteur de division par 2, 5 ou 10.
Bien que cet algorithme soit mathématiquement élégant pour offrir une vue d’ensemble instantanée, il manifeste rapidement des limites structurelles insurmontables dès que les données présentent une asymétrie marquée, des valeurs extrêmes ou une nature strictement ordinale. L’automate tente systématiquement d’englober la totalité des points tout en sélectionnant des valeurs arrondies qui peuvent trahir la résolution réelle de l’instrument de mesure. Le paradigme fondamental à assimiler pour contourner cette contrainte réside dans le découplage conceptuel entre l’espace des données et la couche visuelle de restitution des axes : dans le système graphique de R, la projection des données sur le plan cartésien et le tracé physique des axes constituent deux opérations logicielles totalement indépendantes qui peuvent être dissociées sans altérer l’intégrité des coordonnées analytiques.
1.3 Vue d’ensemble de la fonction axis() et de son environnement
La fonction axis() constitue le pivot central de la personnalisation des graduations dans l’écosystème graphique natif de R. Conçue comme une fonction de bas niveau, elle intervient postérieurement à l’ouverture d’un dispositif d’affichage ou à l’exécution d’une commande de traçage de haut niveau. Son rôle consiste à injecter, sur l’une des bordures du repère orthonormé, une structure personnalisée comprenant une ligne d’axe, des tirets de graduation (les tick marks) et des étiquettes alphanumériques positionnées selon des coordonnées strictement définies par l’expérimentateur.
Le fonctionnement optimal de cette fonction dépend d’une interaction étroite avec les paramètres graphiques globaux administrés par l’intermédiaire de la commande par(). Ces paramètres définissent l’allocation spatiale des marges internes et externes de la figure, l’orientation de l’écriture typographique, ainsi que la distance relative entre le texte des étiquettes et la bordure du canevas. Dès lors, le flux de travail rigoureux pour le contrôle des intervalles d’axes s’articule toujours selon un protocole ternaire invariable : premièrement, la préparation de la fenêtre graphique et le tracé des données assorti de la suppression délibérée des axes par défaut ; deuxièmement, l’invocation séquentielle de la fonction axis() pour sculpter manuellement chaque dimension spatiale ; troisièmement, l’adjonction éventuelle d’éléments de titrage et de légende pour parachever l’appareil critique de la figure.
2. La syntaxe fondamentale : suppression des axes par défaut avec xaxt=’n’ et yaxt=’n’
Pour construire des graduations d’axes parfaitement calibrées, la première exigence technique consiste à empêcher le moteur graphique de générer ses propres repères automatiques. Sans cette neutralisation préalable, toute nouvelle graduation tracée viendra se superposer aux repères d’origine, créant une illisibilité graphique immédiate et rédhibitoire.
2.1 Désactivation des graduations automatiques de l’axe des abscisses
La neutralisation de l’axe horizontal dans une instruction graphique de haut niveau, telle que la fonction de traçage élémentaire, s’opère par l’adjonction de l’argument formel xaxt=’n’. Cette instruction transmet au sous-système de dessin l’ordre explicite d’omettre la construction de la ligne d’axe inférieure, de ses tirets réguliers ainsi que des étiquettes numériques correspondantes, tout en conservant scrupuleusement la géométrie interne de projection calculée à partir des vecteurs de données transmis en entrée.
Il importe de souligner que l’utilisation de cet argument modifie sélectivement le rendu de l’axe des abscisses sans dégrader la délimitation de la boîte d’encadrement globale, à moins que celle-ci ne soit spécifiquement modifiée par d’autres arguments. L’espace cartésien demeure donc parfaitement étalonné : les coordonnées relatives des observations demeurent inscrites dans la mémoire du périphérique d’affichage, garantissant que les futures graduations ajoutées manuellement s’aligneront avec une précision géométrique sans faille sur les points de données invisibles mais spatialement actifs.
2.2 Désactivation simultanée ou sélective de l’axe des ordonnées
De façon rigoureusement analogue à la gestion de la dimension horizontale, l’inhibition du système d’axe vertical s’obtient au moyen de l’argument yaxt=’n’. Cette séparation sélective est précieuse dans les contextes expérimentaux où une seule dimension nécessite un remaniement structurel : un chercheur peut souhaiter conserver un axe temporel standard en abscisse tout en personnalisant intégralement l’axe des ordonnées pour faire apparaître des unités psychométriques non linéaires.
Lorsque la figure exige une refonte globale, les deux arguments sont combinés simultanément dans l’appel initial sous la syntaxe coordonnée intégrant xaxt=’n’ et yaxt=’n’. Dans les publications nécessitant un design graphique épuré de type minimaliste, il est fréquent d’adjoindre également l’argument bty=’n’, lequel élimine l’intégralité de la boîte rectangulaire englobante (box type). Dans une telle configuration, le tracé se résume temporairement à un nuage de points ou à une courbe flottant librement dans l’espace graphique, prêt à recevoir un squelette d’axes sur mesure dénué de tout bruit visuel parasite.
2.3 Exemple d’initialisation d’un canevas neutre pour les données expérimentales
Afin d’illustrer la mise en œuvre empirique de ce protocole, considérons la simulation d’un protocole expérimental mesurant l’évolution de performances attentionnelles chez des sujets soumis à une tâche chronométrée répétée au cours de sessions successives. Les données se composent d’une variable indépendante discrète représentant les sessions expérimentales et d’une variable dépendante continue correspondant au temps de réaction moyen mesuré en millisecondes.
Pour initialiser ce canevas, le chercheur prépare les vecteurs de variables, puis invoque la fonction de base en neutralisant l’ensemble des axes automatiques via les arguments mentionnés. L’instruction spécifie explicitement les limites spatiales globales afin d’assurer une couverture visuelle exhaustive, tout en supprimant l’affichage des axes par défaut. Le résultat visuel immédiat est un espace vierge de toute graduation où seuls les points expérimentaux sont projetés avec rigueur. Cette table rase constitue la condition technique absolue pour pouvoir ensuite édifier une infrastructure d’axes personnalisée, exempte de tout chevauchement ou artefact d’interpolation algorithmique.
3. Personnalisation discrète des intervalles d’axes via des vecteurs de valeurs spécifiques
Une fois le canevas expérimental préparé, l’implantation d’intervalles spécifiques répond souvent au besoin d’afficher des valeurs cibles précises plutôt qu’une suite mathématique abstraite. Cette méthode offre une souplesse totale pour marquer des discontinuités ou des repères d’intérêt théorique majeur.
3.1 Syntaxe et mécanisme de la fonction c() au sein de l’argument at
Le positionnement direct de graduations discrètes s’effectue par l’entremise de l’argument primordial at au sein de la fonction axis(). Cet argument attend un vecteur numérique unidimensionnel, généralement structuré à l’aide de la fonction d’agrégation de base c(), énumérant l’ensemble des coordonnées exactes où une encoche physique et une étiquette textuelle doivent être dressées sur la figure.
Le moteur graphique procède à une translation bijective entre les valeurs inscrites dans ce vecteur numérique et l’espace de coordonnées sous-jacent du système d’affichage. Si une valeur spécifiée dans le vecteur dépasse l’emprise maximale définie lors de l’appel initial, elle est silencieusement ignorée par le système, préservant ainsi l’intégrité de la fenêtre de traçage. Ce comportement permet de concevoir des échelles asymétriques ou à pas variable, par exemple pour souligner des zones critiques de la distribution où la concentration d’événements expérimentaux est particulièrement dense, ou au contraire pour espacer les repères dans les régions d’accalmie comportementale.
3.2 Exemple pratique : modification ciblée de l’axe horizontal (side=1)
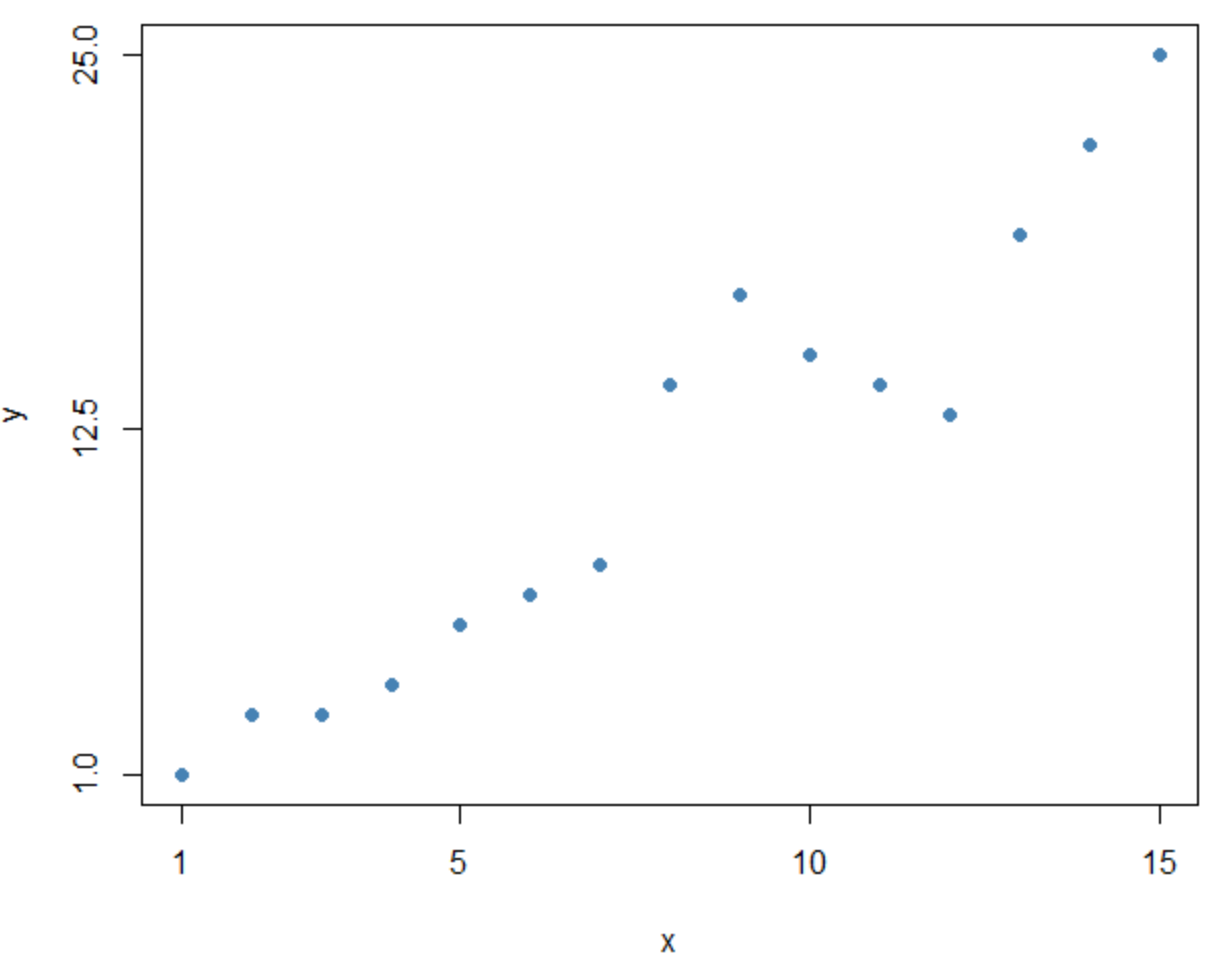
L’argument positionnel side régit l’emplacement périphérique de l’axe au sein du rectangle d’affichage. La valeur conventionnelle side=1 fait référence à la marge inférieure du graphique, c’est-à-dire à l’axe des abscisses standard. Supposons une recherche en psycholinguistique cognitive analysant les temps de fixation oculaire lors de la lecture d’énoncés syntaxiquement complexes, où les mesures critiques ont été relevées à des fenêtres temporelles précises de 1, 5, 10 et 15 secondes après l’apparition du stimulus visuel.
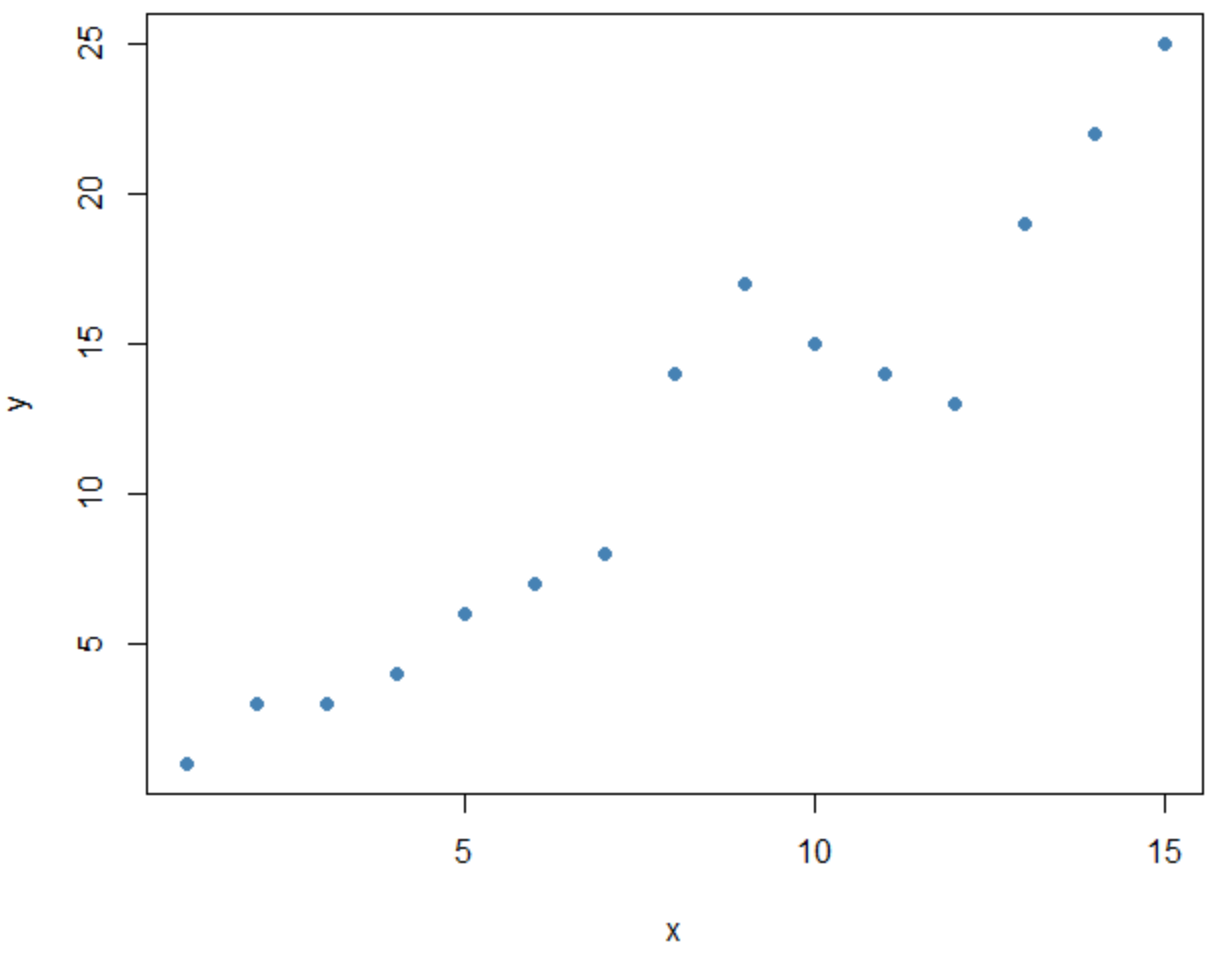
Après avoir généré le tracé initial avec l’argument neutralisant l’abscisse automatique, l’adjonction de l’axe personnalisé s’effectue au moyen de l’appel spécifique combinant side=1 et un vecteur de localisation intégrant strictement les valeurs 1, 5, 10 et 15 au sein de l’argument at. Dès lors, le système ne produit aucune graduation superflue sur les intervalles intermédiaires non pertinents pour l’hypothèse de recherche. La comparaison visuelle entre ce tracé ciblé et la graduation automatique par défaut met en exergue un gain significatif de concision : l’attention du lecteur est immédiatement canalisée vers les repères temporels structurants du protocole sans dispersion cognitive.
3.3 Exemple pratique : ciblage des seuils cliniques sur l’axe vertical (side=2)
Dans de nombreuses disciplines biomédicales et psychométriques, les variables dépendantes sont mesurées via des inventaires cliniques dont l’interprétation repose sur des scores de coupure internationalement validés. Prenons le cas d’une étude évaluant des scores d’anxiété au moyen d’un instrument psychométrique étalonné de 0 à 60, pour lequel les consensus diagnostiques fixent des seuils distincts de symptomatologie légère (score de 10), modérée (score de 25) et sévère (score de 40).
Pour matérialiser ces paliers diagnostiques sur l’axe vertical, l’opérateur recourt à la fonction d’axe en précisant l’argument side=2, qui désigne la marge gauche du tracé. En fixant l’argument at sur le vecteur combinant les seuils d’intérêt clinique (par exemple 0, 10, 25, 40 et 60), les marques d’axe s’alignent fidèlement sur la nosographie de l’affection étudiée. Les tirets ne répondent plus à un découpage arithmétique dénué de sens médical, mais structurent activement la lecture des trajectoires de patients, rendant immédiatement perceptible le franchissement d’un seuil critique lors d’une intervention thérapeutique.
4. Automatisation des graduations régulières : utilisation avancée de seq() pour les intervalles
Bien que la définition discrète soit idéale pour des points de coupure spécifiques, la majorité des représentations quantitatives exige des échelles métriques linéaires pourvues d’un pas d’échantillonnage régulier et hautement reproductible. L’imbrication de la fonction génératrice de suites numériques constitue l’approche programmatique la plus robuste pour atteindre ce standard.
4.1 Principes de génération de séquences numériques régulières pour les échelles
L’utilisation de la fonction seq() au sein du système graphique de R offre une flexibilité algorithmique absolue pour paramétrer la densité des intervalles. Cette fonction s’appuie sur trois paramètres fondamentaux : le point d’origine (from), le point de terminaison (to) et le pas d’incrémentation arithmétique (by). En injectant dynamiquement cette instruction dans l’argument at, l’analyste détermine avec une rigueur mathématique le rythme précis des graduations sur l’ensemble du continuum considéré.
Une alternative élégante consiste à exploiter l’argument length.out de la fonction génératrice, qui divise un segment numérique donné en un nombre prédéterminé de sous-intervalles équidistants. Cette méthode s’avère particulièrement puissante lors de la conception de figures normalisées pour des publications, car elle permet de garantir que, quelle que soit l’amplitude globale des mesures, le nombre de repères visuels restera constant d’une planche graphique à l’autre. Cette standardisation élimine les disparités visuelles susceptibles d’altérer la comparaison perceptive entre plusieurs panels de données.
4.2 Implémentation d’un quadrillage régulier sur l’axe des ordonnées
La calibration d’un axe vertical de performance cognitive, s’étendant par exemple de 0 à 100 pour cent de réponses correctes, illustre l’intérêt méthodologique de l’incrémentation séquentielle. Si l’automate graphique standard choisit fréquemment des paliers de 20 unités, l’expérimentateur peut souhaiter implémenter une finesse de lecture supérieure par tranches de 10 unités pour détecter des variations subtiles entre plusieurs conditions de charge cognitive.
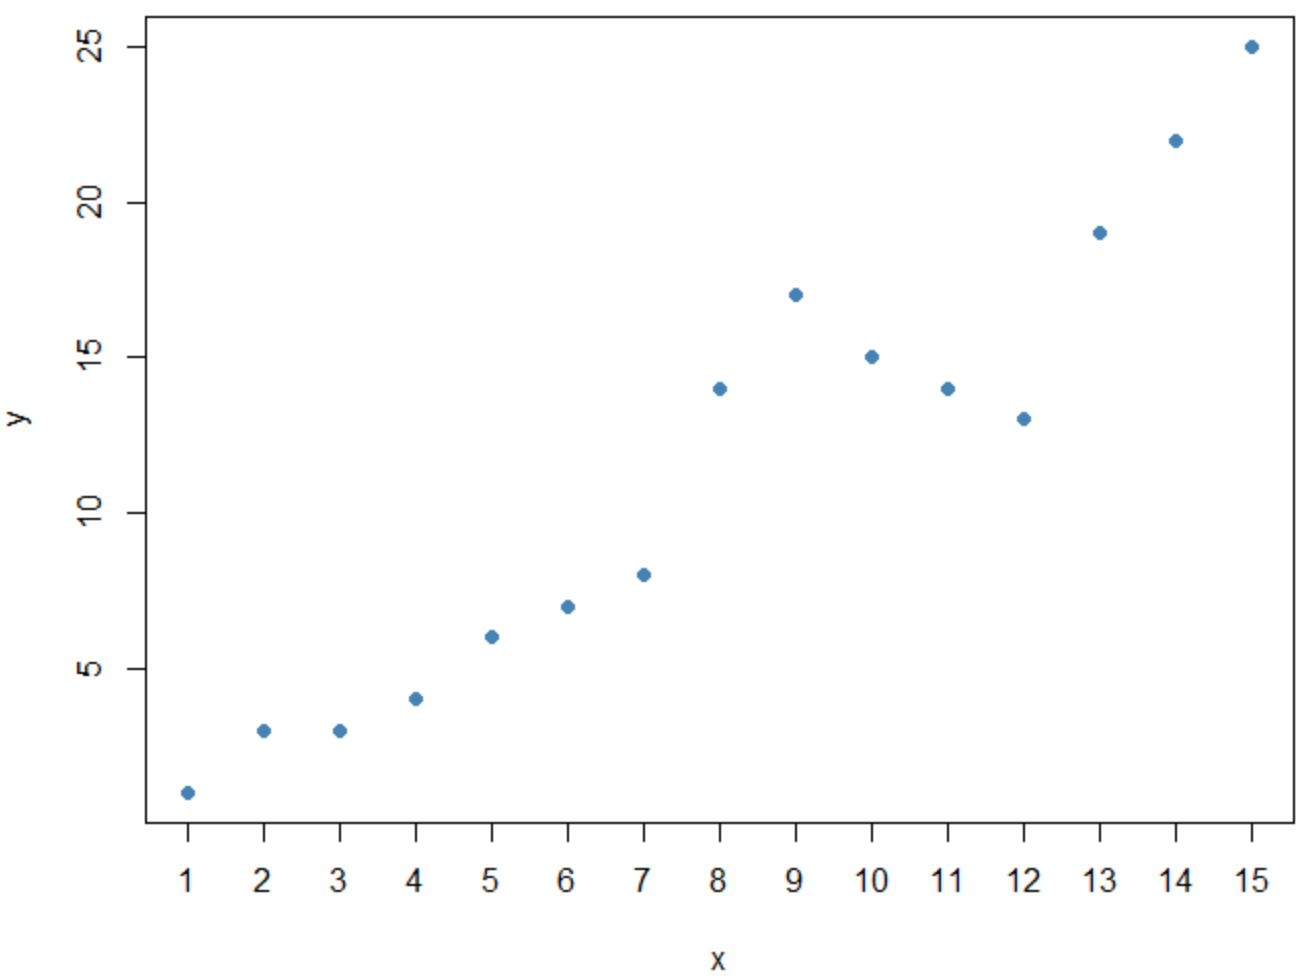
L’intégration de la séquence définie de 0 à 100 avec un pas de 10 unités sur l’axe vertical (side=2) produit un rythme graphique homogène. Il convient néanmoins d’évaluer la densité visuelle résultante afin de prévenir tout encombrement typographique. La multiplication excessive de tirets peut engendrer une saturation perceptive délétère. Le choix du pas doit résulter d’un arbitrage minutieux entre la résolution analytique nécessaire et l’épuration visuelle prescrite par les canons de la communication scientifique.
4.3 Combinaison simultanée de séquences sur l’abscisse et l’ordonnée
L’harmonie globale d’une figure dépend de la coordination structurelle des deux dimensions de l’espace graphique. L’utilisation conjointe de séquences programmées sur l’axe horizontal et sur l’axe vertical garantit le respect scrupuleux des ratios d’aspect et prévient toute distorsion visuelle dans l’analyse des régressions ou des corrélations bivariées.
Pour concevoir un script totalement dynamique, il est fortement recommandé d’indexer les arguments from et to sur les fonctions descriptives fondamentales calculées directement à partir du jeu de données, telles que les valeurs minimales et maximales arrondies à l’entier le plus proche. En liant le domaine des graduations à la dispersion empirique des observations, le code R conserve une reproductibilité totale en cas d’actualisation de la base de données ou de réplication de l’expérience sur une cohorte ultérieure, garantissant une automatisation pérenne du rendu visuel sans intervention manuelle corrective.
5. Paramétrage géométrique et orientation des graduations avec les arguments side, las et tck
La simple disposition mathématique des repères d’axes ne suffit pas à garantir leur efficacité communicationnelle. La micro-géométrie des tirets, leur orientation spatiale et la disposition typographique des étiquettes textuelles représentent des déterminants majeurs de l’ergonomie visuelle globale.
5.1 Contrôle de la position spatiale des axes avec l’argument side
L’architecture interne du moteur graphique de R modélise la zone de traçage comme un rectangle circonscrit par quatre marges périphériques universellement numérotées dans le sens des aiguilles d’une montre : le chiffre 1 désigne le bord inférieur (abscisse principale), le chiffre 2 identifie le flanc gauche (ordonnée principale), le chiffre 3 correspond au bord supérieur, et le chiffre 4 désigne le flanc latéral droit. Cette nomenclature offre une polyvalence graphique remarquable pour la construction de représentations bi-dimensionnelles enrichies.
Dans les protocoles de psychologie expérimentale complexe ou d’électrophysiologie, il est fréquent de recourir à des axes secondaires positionnés sur les côtés 3 et 4 pour superposer deux échelles de lecture distinctes mais conceptuellement liées. Par exemple, un chercheur peut projeter des mesures brutes de potentiels évoqués sur l’ordonnée gauche (side=2) tout en matérialisant leur conversion en scores standardisés (unités z) sur la bordure droite (side=4). L’exploitation rigoureuse des quatre points cardinaux du tracé permet d’enrichir considérablement la quantité d’informations transmises sans surcharger la zone centrale d’interaction des données.
5.2 Gestion de l’orientation des étiquettes de texte avec l’argument las
L’un des défis ergonomiques récurrents dans la construction d’axes verticaux réside dans l’inclinaison par défaut des étiquettes numériques, qui sont fréquemment positionnées parallèlement à la ligne d’axe, contraignant le lecteur à une torsion inconfortable de la tête ou à un effort de rotation mentale. L’argument las (pour label style) régit précisément cette cinématique typographique au travers de quatre valeurs entières fondamentales : 0 pour une orientation systématiquement parallèle à l’axe, 1 pour une orientation rigoureusement horizontale en toute circonstance, 2 pour un alignement perpendiculaire à la bordure de l’axe, et 3 pour une orientation strictement verticale.
L’adoption quasi-systématique de la configuration las=1 est préconisée par les experts internationaux de la visualisation de données. En forçant l’horizontalité des étiquettes, y compris sur l’axe vertical des ordonnées, le concepteur garantit une lecture immédiate, naturelle et fluide des valeurs quantitatives. Toutefois, cette orientation horizontale impose d’accroître la largeur de la marge correspondante afin d’éviter que les nombres à plusieurs chiffres ne viennent buter contre le bord externe de la fenêtre graphique ou ne soient tronqués par le périphérique d’affichage.
5.3 Modification de la longueur et de la direction des tirets avec tck et tcl
Les tirets de graduation (tick marks) peuvent être minutieusement sculptés à l’aide de deux paramètres distincts du moteur graphique : les arguments tck et tcl. La nuance technique entre ces deux options réside dans l’unité de mesure employée pour définir l’extension de la ligne du tiret. L’argument tck spécifie la longueur du tiret en proportion relative de la zone de traçage globale (une valeur positive pointant vers l’intérieur du tracé, une valeur négative pointant vers l’extérieur), tandis que tcl quantifie cette longueur par rapport à la hauteur d’une ligne de texte standard.
Dans la typographie scientifique d’élite, il est généralement d’usage de privilégier des tirets courts orientés vers l’extérieur (obtenus par exemple avec une valeur de tcl=-0.3 ou tck=-0.02) afin d’empêcher que les marques ne viennent interférer visuellement avec les points de données situés à proximité immédiate des bordures. Dans certains contextes éditoriaux très spécifiques ou pour créer des figures de style tableau de bord contemporain, la neutralisation complète des tirets par l’attribution de la valeur zéro permet de concevoir des axes épurés où seule subsiste la régularité textuelle des étiquettes.
6. Étiquetage personnalisé et formatage numérique des intervalles avec l’argument labels
La position physique d’une graduation n’est pas obligatoirement asservie à l’affichage de sa valeur numérique brute. La dissociation complète entre les coordonnées structurales et les symboles textuels projetés décuple le potentiel expressif des graphiques scientifiques.
6.1 Dissociation entre les positions géométriques et les étiquettes textuelles
La dissociation entre la structure géométrique et l’habillage sémantique s’opère par la collaboration des arguments at et labels au sein de la fonction d’axe. Alors que l’argument at stipule impérativement les coordonnées mathématiques réelles dans l’espace métrique du graphique, l’argument labels reçoit quant à lui un vecteur de chaînes de caractères qui seront imprimées exactement à l’aplomb de chaque repère correspondant.
Cette distinction s’avère particulièrement féconde dans le traitement des variables ordinales ou des échelles qualitatives discrètes. Ainsi, des scores entiers sous-jacents peuvent être traduits visuellement par des concepts sémantiques compréhensibles au premier coup d’œil, sans nécessiter la consultation fastidieuse d’une légende extérieure. Une contrainte informatique rigoureuse doit cependant être scrupuleusement observée : la dimension vectorielle du paramètre labels doit concorder de manière exacte avec la longueur du vecteur fourni à l’argument at. Toute asymétrie dimensionnelle entraîne soit un recyclage erroné des étiquettes textuelles par le moteur R, soit une erreur d’exécution interrompant le script de rendu.
6.2 Formatage typographique et notation mathématique des graduations
L’exactitude formelle d’une publication de haut niveau exige fréquemment l’intégration de notations mathématiques complexes, de fractions, de lettres grecques ou d’unités de mesure psychophysiques élaborées. Le système graphique natif de R excelle dans ce domaine grâce à la prise en charge native de la fonction expression() au sein du vecteur d’étiquetage.
L’utilisation d’expressions mathématiques permet d’insérer sans difficulté des exposants, des indices ou des symboles d’écart-type directement sur les encoches de graduation. Parallèlement, le formatage rigoureux des valeurs décimales représente un impératif de précision : l’affichage hétérogène de nombres comportant tantôt une décimale, tantôt deux, dégrade l’aspect professionnel d’une figure. L’imbrication judicieuse de la fonction de formatage textuel sprintf() garantit une harmonie typographique irréprochable en verrouillant un nombre fixe de décimales après la virgule, renforçant ainsi la rigueur formelle de la communication statistique.
6.3 Exemple pratique : étiquetage d’une échelle ordinale de Likert
Les enquêtes psychosociales et les protocoles psychométriques s’appuient massivement sur des échelles d’évaluation ordinale de type Likert en cinq ou sept points. Si le statisticien manipule en interne des entiers arbitraires s’étendant de 1 à 5 pour réaliser ses modélisations linéaires, la communication des résultats gagne en transparence lorsque ces entiers sont transcrits par leurs ancrages verbaux explicites.
Pour construire une telle figure, l’opérateur configure l’argument at sur l’ensemble discret de 1 à 5, tandis que l’argument labels reçoit un vecteur de libellés textuels articulés de façon croissante, allant de l’ancrage minimal au pôle d’adhésion maximal. Étant donné l’encombrement spatial généré par des formulations textuelles développées, il devient indispensable d’ajuster l’orientation via las=2 ou las=1 et d’étendre la marge d’accueil correspondante par le biais de la commande globale des paramètres graphiques, garantissant une disposition typographique limpide sans troncature des termes périphériques.
7. Gestion des axes continus complexes : échelles logarithmiques et transformations de variables
Les distributions empiriques ne se conforment pas toujours aux postulats de linéarité de l’espace euclidien. Les processus sensoriels, les dynamiques électrophysiologiques ou les temps de latence cognitive exigent fréquemment des conversions non linéaires qui complexifient le paramétrage des intervalles d’axes.
7.1 Calibration des graduations sur les échelles logarithmiques
Dans l’écosystème graphique natif de R, l’application d’une échelle logarithmique peut être déclarée directement au sein de la fonction de traçage de base par le biais de l’argument log=’x’, log=’y’ ou log=’xy’. Cependant, le comportement automatique du moteur graphique face à une variable transformée tend souvent à produire des graduations fondées sur des puissances entières ou des subdivisions logarithmiques parfois déroutantes pour un lectorat non mathématicien.
Lorsqu’un chercheur neutralise les axes automatiques sur une projection logarithmique pour implanter ses propres repères avec axis(), il est capital de comprendre que l’argument at attend les valeurs exprimées dans l’échelle d’origine des données (et non leurs logarithmes calculés), car le système graphique opère la déformation géométrique de manière transparente en sous-main. L’expérimentateur peut dès lors injecter une séquence de puissances de dix (par exemple 1, 10, 100, 1000) ou des multiples constants, puis configurer les étiquettes correspondantes sous forme de notations exponentielles grâce à la fonction expression(), conférant ainsi à l’axe une lisibilité conforme aux meilleurs standards de la littérature scientifique.
7.2 Graduations primaires et secondaires pour les distributions asymétriques
Les temps de réaction chronométriques mesurés au niveau cognitif présentent systématiquement une asymétrie positive prononcée (queue de distribution étirée vers la droite), caractérisée par une forte densité d’observations sur les latences brèves et une dispersion étendue sur les temps longs. L’affichage d’un pas d’intervalle uniforme s’avère dans ce contexte sous-optimal : il sature la zone critique des temps rapides et appauvrit la visualisation des latences extrêmes.
Pour résoudre ce dilemme, l’élaboration d’un système à double niveau de graduation représente la solution méthodologique optimale. L’analyste procède par appels successifs de la fonction axis() : un premier appel configure les repères majeurs pourvus de tirets longs et d’étiquettes textuelles bien visibles (par exemple par tranches de 250 millisecondes), tandis qu’un second appel trace des repères mineurs plus denses (par pas de 50 millisecondes), caractérisés par des tirets raccourcis et l’absence délibérée d’étiquettes grâce à l’argument labels=FALSE. Cette hiérarchie visuelle guide le regard de manière intuitive à travers les concentrations de densité empirique.
7.3 Exemple appliqué : analyse de la loi de Stevens en psychophysique
La psychophysique quantitative étudie la relation formelle unissant l’intensité physique d’une stimulation sensorielle à la magnitude de la sensation psychologique perçue. Selon la loi de puissance formulée par S. S. Stevens, cette relation répond à une fonction exponentielle dont l’ajustement linéaire classique exige une double transformation logarithmique.
Dans le cadre d’un script visualisant l’estimation de brillance lumineuse ou de sonie auditive, l’espace graphique est paramétré en mode bi-logarithmique. Les graduations sont alors minutieusement sculptées pour afficher des repères physiques réels (en décibels ou en lumens) sur l’axe des abscisses, tandis que l’axe des ordonnées affiche les indices d’estimation subjective. L’alignement strict de ces repères géométriques sur les puissances fondamentales du stimulus permet d’observer sans distorsion la rectitude de la droite de régression psychophysique, validant ainsi expérimentalement l’exposant théorique du modèle.
8. Intervalles temporels et chronologiques : dates, temps de réaction et séries longitudinales
L’analyse des séries temporelles, qu’il s’agisse de suivis cliniques longitudinaux s’étendant sur des mois ou d’enregistrements neurophysiologiques à haute résolution temporelle en millisecondes, confronte le chercheur à des contraintes de périodicité spécifiques.
8.1 Utilisation de la fonction spécialisée axis.Date() pour les axes temporels
Lorsque la variable portée en abscisse est instanciée sous la classe canonique Date de R, l’invocation de la fonction générique d’axe peut produire des anomalies de conversion arithmétique, le moteur interne traitant parfois les objets temporels comme un nombre entier de jours écoulés depuis le point d’époque de référence. Pour surmonter cette limitation, l’environnement de base propose la fonction spécialisée axis.Date().
Cette fonction dédiée interprète nativement la structure calendaire des données. Elle permet d’assigner à l’argument at des séquences temporelles générées via la commande étendue seq.Date(), autorisant la définition directe d’intervalles exprimés en unités sémantiques intuitives telles que les jours, les semaines, les mois ou les trimestres d’évaluation. De surcroît, le paramètre format encapsule les conventions standards de mise en forme temporelle, permettant de styliser l’affichage textuel des graduations (par exemple afficher le mois sous forme abrégée suivi de l’année civile) avec une souplesse typographique absolue.
8.2 Ajustement des intervalles sur des variables continues en millisecondes
À l’autre extrémité du spectre chronologique, les paradigmes de chronométrie mentale issus de la psychologie cognitive analysent des variations de latence oscillant à l’échelle de la milliseconde. Dans l’étude des potentiels évoqués visuels ou des paradigmes de décision lexicale, le décours temporel d’intérêt s’étend généralement de -200 millisecondes (période de ligne de base pré-stimulus) à +800 millisecondes post-stimulation.
La calibration d’un tel axe horizontal requiert l’éradication des divisions automatiques au profit d’un ancrage strict sur l’instant zéro de délivrance du stimulus. L’opérateur paramètre une séquence débutant précisément à l’origine théorique et progressant selon des incréments constants correspondant aux fenêtres de traitement cortical identifiées dans la littérature empirique (par exemple les composants précoces N100, P200 ou la positivité tardive P300). La présence obligatoire d’une marque d’axe sur le point zéro constitue une exigence fondamentale pour l’interprétation chronométrique des cascades attentionnelles.
8.3 Exemple concret : suivi thérapeutique longitudinal sur plusieurs mois
Pour matérialiser l’application de ces principes sur des séries cliniques, examinons le suivi d’une cohorte de patients engagés dans un protocole de remédiation cognitive sur une durée de six mois, avec des évaluations hebdomadaires de l’humeur et du fonctionnement exécutif. L’affichage automatique des dates hebdomadaires produit une saturation graphique illisible par empilement des mentions textuelles sur l’axe inférieur.
La stratégie méthodique consiste à projeter l’ensemble des points hebdomadaires tout en bridant l’axe inférieur grâce à axis.Date() pour ne faire apparaître que les jalons mensuels cardinaux. En associant une séquence calée sur le premier jour de chaque mois civil et un format typographique épuré, le tracé gagne instantanément en lisibilité. L’évolution temporelle des scores individuels ou agrégés s’inscrit dès lors dans un cadre chronologique limpide où l’observateur distingue aisément les inflexions thérapeutiques majeures sans être distrait par le fourmillement des dates intermédiaires.
9. Délimitation des bornes et synchronisation avec xlim, ylim et xaxs/yaxs
Un contrôle parfait des intervalles d’axes ne peut être dissocié de la gestion des frontières globales de la fenêtre graphique. Des interactions méconnues entre l’algorithme d’expansion des marges et les paramètres de limites peuvent compromettre la précision des graduations souhaitées.
9.1 Rôle de xlim et ylim dans la définition de l’emprise des intervalles
Les arguments xlim et ylim constituent les régulateurs d’emprise spatiale de haut niveau passés à la fonction de traçage de base. Ils stipulent de façon catégorique les coordonnées extrêmes au sein desquelles le moteur de rendu projette l’information visuelle. La cohérence entre ces limites déclarées et les séquences injectées ultérieurement dans l’argument at de la fonction d’axe doit être rigoureuse.
Si un analyste définit par inadvertance une séquence de graduations dont les bornes excèdent la plage circonscrite par xlim ou ylim, les tirets extralimitrophes sont systématiquement supprimés par le moteur de découpage (clipping). Inversement, si la plage délimitée est excessivement large par rapport au domaine des graduations personnalisées, l’axe apparaîtra flottant, laissant des portions vides inesthétiques en bordure de cadre. Une synchronisation méthodique implique donc de coordonner les variables de bornage du modèle afin que les extrêmes de la séquence d’axe coïncident harmonieusement avec les limites d’affichage fixées.
9.2 Suppression de l’extension automatique de 4% avec xaxs=’i’ et yaxs=’i’
L’une des singularités les plus trompeuses du système graphique de R réside dans son comportement par défaut d’extension marginale. Par construction, le logiciel applique un étirement automatique d’environ 4 pour cent de chaque côté des plages spécifiées par xlim et ylim (un mode dénommé techniquement le style d’axe régulier, encodé par la valeur xaxs=’r’ et yaxs=’r’). Ce mécanisme vise à éviter que des données situées sur les extrema ne viennent heurter la bordure de la boîte englobante.
Cependant, dans de nombreux contextes scientifiques, cette marge résiduelle de 4 pour cent empêche un calage parfait des graduations aux extrémités exactes du graphique, créant un espace résiduel indésirable entre le dernier tiret et l’angle du cadre. Pour forcer le système à respecter strictement les bornes indiquées sans la moindre expansion arbitraire, il est impératif de déclarer les arguments xaxs=’i’ et yaxs=’i’ (le mode interne). Sous cette configuration rigoureuse, la ligne d’axe et ses graduations démarrent et s’interrompent avec une précision chirurgicale sur les valeurs exactes transmises à xlim et ylim.
9.3 Étude de cas : alignement strict d’un zéro absolu pour des données de fréquence
L’intérêt de la neutralisation de l’extension d’axe apparaît particulièrement lors de la représentation de données de fréquences, de pourcentages d’erreurs ou de concentrations biochimiques, pour lesquelles la valeur zéro possède un statut de zéro absolu naturel ne tolérant aucun artefact de projection visuelle flottante. Un graphique conventionnel montrant des taux d’erreurs au-dessus d’un axe horizontal décalé vers le bas peut créer l’illusion trompeuse que des valeurs négatives sont théoriquement envisageables.
Pour illustrer ce cas, configurons un canevas graphique dédié au tracé de taux d’erreurs s’étendant de 0 à 50 pour cent. En assignant l’argument ylim=c(0, 50) conjointement à l’instruction yaxs=’i’ et en neutralisant l’axe automatique, l’ordonnée tracée manuellement ancre son origine au niveau géométrique exact du niveau zéro. L’axe des abscisses vient couper l’ordonnée perpendiculairement à son point d’origine véritable. Cette construction confère à la figure une rigueur mathématique irréprochable, supprimant tout flou visuel quant à la positivité stricte de l’espace métrique représenté.
10. Extension aux graphiques multivariés et sous-graphiques : gestion globale avec par()
La conception d’articles de recherche exige régulièrement l’assemblage de figures composites rassemblant plusieurs panels comparatifs au sein d’une même planche visuelle. La standardisation des échelles d’axes devient alors une condition sine qua non de la validité des comparaisons inter-groupes.
10.1 Coordination des intervalles au sein d’une matrice mfrow ou mfcol
L’organisation matricielle de sous-graphiques s’opère de façon privilégiée via les paramètres globaux mfrow ou mfcol configurés en amont par la commande d’environnement par(). Dans une telle structure multi-panneaux, l’écueil méthodologique majeur consisterait à laisser l’automate calculer indépendamment les graduations de chaque volet : des variations minimes de variance entre les conditions expérimentales produiraient des repères désynchronisés, invalidant toute lecture synoptique immédiate.
L’implémentation méthodique impose d’homogénéiser les intervalles sur l’ensemble de la grille graphique. L’expérimentateur extrait préalablement les bornes absolues couvrant la totalité des sous-groupes étudiés (par exemple en calculant les extrema globaux de la variable dépendante sur l’ensemble de la cohorte), puis applique une boucle itérative appliquant systématiquement les mêmes valeurs limites et la même séquence vectorielle au sein des fonctions axis() de chaque sous-graphique. Cette coordination visuelle garantit que des distances géométriques identiques sur le papier correspondent fidèlement à des magnitudes d’effet rigoureusement équivalentes à travers toutes les conditions expérimentales.
10.2 Gestion des marges graphiques globales avec par(mar) et par(mgp)
Le raffinement de la disposition d’un axe requiert une maîtrise avancée de l’allocation spatiale des marges via l’argument matriciel mar et du positionnement relatif des composants de l’axe via l’argument mgp au sein de la fonction par(). L’argument mar reçoit un vecteur de quatre valeurs réelles chiffrant l’épaisseur respective des marges inférieure, gauche, supérieure et droite en nombre de lignes de texte. L’affichage d’étiquettes de grandes amplitudes numériques ou orientées horizontalement (las=1) exige couramment d’élargir la marge gauche au-delà de sa valeur par défaut.
Parallèlement, l’argument mgp régit la micro-distance séparant trois éléments fondamentaux de l’axe : le titre de l’axe, les étiquettes textuelles de graduation, et la ligne matérielle de l’axe elle-même. La syntaxe standard attend un triplet numérique (par exemple mgp=c(3, 1, 0)). En modifiant ces proportions, l’analyste peut rapprocher judicieusement les étiquettes des tirets pour compacter l’encombrement global ou, au contraire, les espacer pour éviter toute collision graphique, optimisant ainsi l’emprise spatiale de la figure selon les normes éditoriales les plus strictes.
10.3 Partage d’axes communs sans répétition des graduations
Dans une matrice graphique présentant des distributions comparatives adjacentes, la répétition redondante des étiquettes d’axes sur chaque volet constitue une source majeure de bruit visuel, en contradiction directe avec le principe d’économie graphique popularisé par Edward Tufte (le fameux ratio encre-données). L’élimination des axes intérieurs superflus permet d’agrandir substantiellement la surface utile consacrée à la matérialisation des données réelles.
Pour concrétiser cette optimisation, l’architecture du code désactive sélectivement les axes sur les sous-graphiques intermédiaires. Dans une matrice de deux lignes par deux colonnes, par exemple, la fonction axis(side=1, …) n’est invoquée que sur les panneaux situés sur la rangée la plus basse, tandis que axis(side=2, …) n’est déclenchée que pour les figures positionnées sur la colonne d’extrême gauche. Les bordures de marges internes sont parallèlement réduites à zéro via par(mar=…), créant un continuum visuel élégant et parfaitement unifié où une graduation unique guide la lecture de multiples facettes expérimentales.
11. Comparaison méthodologique : syntaxe de base R versus extensions modernes (ggplot2)
Si le système graphique de base demeure une référence absolue pour la personnalisation fine et l’exécution sans dépendance logicielle, il est éclairant de situer sa syntaxe au regard des extensions modernes fondées sur la grammaire des graphiques, incarnée par le paquet ggplot2.
11.1 Parallèle conceptuel entre base R et le formalisme de la grammaire des graphiques
La divergence entre le moteur de base et l’extension ggplot2 relève d’une dichotomie fondamentale entre paradigme impératif et paradigme déclaratif. Dans le système graphique de base de R, la manipulation des intervalles d’axes adopte une logique procédurale pas-à-pas : le chercheur trace d’abord les géométries sans axes, puis donne l’ordre explicite d’ajouter un axe sur un côté spécifique en fournissant les vecteurs de coordonnées physiques. L’utilisateur contrôle l’outil de dessin comme un traceur technique traçant des segments sur une table à dessin.
À l’inverse, l’approche déclarative formulée par Leland Wilkinson et opérationnalisée dans l’environnement ggplot2 appréhende l’axe non comme un élément graphique autonome ajouté a posteriori, mais comme la concrétisation visuelle d’une échelle métrique (un scale). L’ajustement des intervalles ne consiste plus à dessiner un objet, mais à paramétrer les propriétés intrinsèques de l’échelle au sein de l’instruction scale_x_continuous() ou scale_y_continuous() par l’intermédiaire de l’argument formel breaks. Bien que conceptuellement plus abstraite, cette méthode assure une intégration native au modèle de données sous-jacent.
11.2 Traduction de cas d’usage réels : de la base R vers ggplot2
Pour un analyste habitué à la syntaxe classique désireux d’assurer la translittération de ses scripts vers les standards du tidyverse, la correspondance entre les arguments est directe et hautement structurée. L’instruction fondamentale de base utilisant axis(side=1, at=seq(0, 100, by=10), labels=…) trouve son équivalent fonctionnel exact dans la structure scale_x_continuous(breaks = seq(0, 100, by = 10), labels = …) du formalisme déclaratif.
Toutefois, des disparités de flexibilité émergent à l’usage. Si ggplot2 propose des mécanismes d’assistance très performants via des bibliothèques satellites (telles que le paquet scales) pour la mise en forme monétaire, logarithmique ou en pourcentages, la personnalisation chirurgicale atypique (telle que l’adjonction d’un tiret unique asymétrique ou la suppression arbitraire d’une encoche isolée) s’avère souvent plus directe et moins contraignante dans le moteur de base. Ce dernier ne subit pas la rigidité des thèmes standardisés et permet des ajustements géométriques ad hoc d’une liberté totale sans devoir surcharger le système de classes de la grammaire sous-jacente.
11.3 Performance et intégration dans des rapports automatisés
Sur le plan de l’ingénierie logicielle et de l’intégration dans des chaînes de production de rapports volumineux (tels que des pipelines de traitement automatisé de données de neuro-imagerie ou de bio-informatique génomique), les graphiques de base conservent des avantages comparatifs déterminants. L’argument principal réside dans leur rapidité d’exécution brute : le moteur natif ne chargeant aucune couche d’abstraction supplémentaire, il génère des graphiques vectoriels avec une vélocité computationnelle nettement supérieure à celle des bibliothèques plus récentes.
De surcroît, le moteur de base bénéficie d’une stabilité absolue dans le temps. Un script graphique élaboré au début des années 2000 avec les fonctions fondamentales de traçage et de paramétrage d’axes s’exécute encore aujourd’hui sur les versions actuelles de R avec une reproductibilité visuelle rigoureusement identique. Cette pérennité du code source constitue un gage de sécurité fondamental pour les laboratoires de recherche et les structures industrielles soumis à des exigences d’audit réglementaire et de traçabilité décennale.
12. Résolution des erreurs courantes et bonnes pratiques de lisibilité dans les publications scientifiques
Même lorsque la syntaxe théorique est acquise, l’implémentation pratique se heurte régulièrement à des artefacts d’affichage ou à des erreurs d’inattention qui compromettent la recevabilité d’un manuscrit soumis à évaluation par les pairs.
12.1 Diagnostic des anomalies récurrentes de tracé des axes
L’un des dysfonctionnements les plus fréquents concerne la troncature pure et simple des étiquettes numériques de l’axe des ordonnées lorsque l’orientation horizontale (las=1) est appliquée. L’analyste constate avec dépit que les valeurs élevées (par exemple des milliers) apparaissent amputées de leurs chiffres initiaux. Ce problème découle exclusivement d’une insuffisance de l’espace alloué par la marge gauche par défaut du périphérique d’affichage. La résolution méthodique exige d’intervenir en amont via l’instruction par(mar = c(5, 5, 4, 2)) en augmentant le deuxième terme du vecteur pour créer le recul spatial indispensable.
Une autre anomalie classique réside dans l’effet visuel de texte gras et baveux observé sur les lignes d’axes et leurs graduations. Ce symptôme trahit immanquablement une omission de l’argument neutralisant xaxt=’n’ ou yaxt=’n’ lors de l’appel initial à la fonction de traçage : la fonction d’axe manuelle est alors venue superposer ses propres éléments sur la graduation par défaut préexistante, doublant le dépôt de pixels sans le substituer. Enfin, le passage accidentel d’arguments textuels ou de facteurs à l’argument at (au lieu de coordonnées numériques pures) produit une erreur d’exécution immédiate ou un blocage du traçage, rappelant que la géométrie de positionnement n’accepte que des scalaires quantitatifs réels.
12.2 Directives ergonomiques pour la clarté visuelle en psychologie et neurosciences
La calibration des axes doit se conformer aux principes cardinaux de la cognition humaine. La célèbre loi psychologique empirique de Miller relative aux capacités de traitement de la mémoire de travail (le nombre magique sept plus ou moins deux) trouve une application directe dans la conception graphique : une figure dont l’axe comporte plus de dix graduations majeures surcharge inutilement l’attention sélective du lecteur et dégrade la mémorisation du patron d’ensemble.
Il importe également de proscrire les illusions d’optique générées par des troncatures d’échelles arbitraires. Supprimer la partie inférieure d’un axe vertical pour exagérer artificiellement une faible variance inter-groupes constitue une faute méthodologique récurrente fréquemment dénoncée par les comités éditoriaux. Sauf impératif théorique explicite, l’échelle des ordonnées doit s’étendre sur une plage reflétant fidèlement l’amplitude réelle du phénomène ou le domaine complet de validité psychométrique de l’instrument d’évaluation, prévenant ainsi toute distorsion cognitive de la taille d’effet.
12.3 Check-list finale pour des graphiques prêts pour la soumission en revue à comité de lecture
Avant d’exporter définitivement une figure destinée à enrichir un manuscrit académique, le chercheur méthodique doit valider point par point un ensemble de critères de conformité rigoureux. La vérification commence par la cohérence entre les valeurs de tirets sélectionnées et les indicateurs de tendance centrale ou de dispersion évoqués dans le corps du texte statistique. Les unités de mesure associées aux repères de graduation doivent être explicitement explicitées sans la moindre ambiguïté terminologique.
Le second contrôle porte sur l’homogénéité typographique et le calibrage de l’argument cex.axis, qui détermine le facteur d’échelle multiplicateur de la police de caractères des graduations. À la réduction d’impression finale opérée par l’éditeur de la revue, les textes d’axes doivent conserver une taille strictement lisible et harmonisée avec la police du corps de l’article scientifique. Enfin, l’exportation doit impérativement privilégier des formats vectoriels encapsulés haute résolution, tels que le format PDF ou le PostScript encapsulé (EPS), au détriment des formats matriciels compressés, garantissant une conservation intégrale de la netteté mathématique des axes et de leurs intervalles, quelle que soit la résolution de restitution du support de publication.
Références
Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
Cleveland, W. S. (1985). The Elements of Graphing Data. Wadsworth Advanced Books and Software.
Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
Friendly, M., & Denis, D. J. (2005). The early origins and development of the scatterplot. Journal of the History of the Behavioral Sciences, 41(2), 103-130. https://doi.org/10.1002/jhbs.20078
Murrell, P. (2018). R Graphics (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429443596
R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Stevens, S. S. (1957). On the psychophysical law. Psychological Review, 64(3), 153-181. https://doi.org/10.1037/h0046162
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0