
Dans le domaine de l’économétrie appliquée, de la science des données et de la gestion prévisionnelle des opérations, l’évaluation de la performance prédictive constitue une étape épistémologique et méthodologique centrale. Prédire une trajectoire temporelle, qu’il s’agisse de la demande d’un bien manufacturé, de la consommation énergétique d’un réseau ou de flux macroéconomiques, demeure une entreprise intrinsèquement probabiliste, soumise aux aléas stochastiques et aux bruits résiduels des systèmes dynamiques. Afin d’appréhender l’amplitude des défaillances potentielles d’un modèle et de mesurer la proximité entre les réalisations empiriques et les estimations théoriques, les praticiens et chercheurs mobilisent une panoplie diversifiée de métriques d’erreur. Au sein de cet arsenal, le pourcentage d’erreur absolue moyenne, universellement désigné sous l’acronyme anglophone MAPE (Mean Absolute Percentage Error), s’est imposé comme un standard analytique prépondérant.
L’attrait considérable exercé par le MAPE réside principalement dans son intelligibilité intuitive et sa dimension normalisée. En convertissant les écarts de prévision en proportions relatives exprimées sous forme de pourcentages, il permet de s’affranchir des unités de mesure d’origine, rendant ainsi commensurables des phénomènes aux échelles de grandeur disparates. Cette caractéristique confère au MAPE un statut privilégié lors des restitutions managériales et des arbitrages décisionnels en comités de direction. Pourtant, cette apparente simplicité de lecture dissimule des propriétés mathématiques subtiles, des asymétries de calcul structurelles et des risques prononcés de mauvaise interprétation. Une lecture candide d’une valeur de MAPE peut conduire à des conclusions gravement erronées sur la viabilité d’un algorithme de prévision ou sur l’exposition réelle d’une organisation aux risques d’exploitation.
Le présent traité propose une déconstruction exhaustive des mécanismes de fonctionnement, des grilles de lecture et des protocoles d’interprétation des valeurs du MAPE. En explorant ses fondements statistiques rigoureux, ses limites intrinsèques face aux données atypiques, ses interactions avec les biais cognitifs humains et ses modalités d’hybridation avec d’autres métriques d’évaluation, cette étude vise à doter les analystes, statisticiens et gestionnaires d’un cadre conceptuel robuste. L’objectif ultime consiste à dépasser le simple constat arithmétique pour instaurer une véritable herméneutique de l’erreur relative, capable de distinguer la performance réelle d’un modèle de ses artefacts de calcul.
1. Fondements théoriques et définition mathématique du MAPE
Pour interpréter rigoureusement une métrique d’évaluation, il est indispensable de disséquer ses composantes algébriques et d’en saisir la mécanique interne. Le MAPE n’échappe pas à cette exigence formelle, s’inscrivant dans la classe des estimateurs statistiques d’écart relatif.
1.1 Décomposition formelle de l’équation du MAPE
D’un point de vue formel, le pourcentage d’erreur absolue moyenne est défini sur un ensemble d’observations temporelles discrètes s’étalant sur un horizon indicé de $t = 1$ à $n$. Soit $y_t$ la valeur empirique réellement observée à la période $t$, et $\hat{y}_t$ la valeur prédite correspondante générée par le modèle d’estimation. L’équation canonique du MAPE s’énonce comme suit :
$$\text{MAPE} = \frac{100%}{n} \sum_{t=1}^{n} left| \frac{y_t – \hat{y}_t}{y_t} right|$$
L’analyse détaillée des composantes individuelles de cette formulation met en lumière plusieurs principes régulateurs fondamentaux. La taille de l’échantillon, notée $n$, remplit une fonction d’homogénéisation arithmétique : elle ramène la sommation intégrale des déviations à une espérance empirique, permettant de comparer des séries temporelles de durées d’évaluation divergentes. Le numérateur du ratio interne, caractérisé par la différence $|y_t – \hat{y}_t|$, correspond au résidu brut d’estimation. L’adjonction de l’opérateur de valeur absolue neutralise la polarité directionnelle du résidu, traitant les surestimations et les sous-estimations avec une égale sévérité locale avant agrégation.
Le rôle normalisateur pivot de la formule est assuré par le dénominateur $y_t$, qui divise le résidu brut par la réalisation empirique ponctuelle. Cette opération transmute un écart dimensionnel (exprimé en unités physiques, monétaires ou temporelles) en une grandeur adimensionnelle, c’est-à-dire un taux d’erreur unitaire. Enfin, le coefficient multiplicateur de 100 applique une transformation linéaire standardisatrice, déplaçant l’expression de l’intervalle $[0, +\infty[$ vers une échelle indiciaire de pourcentage, immédiatement préhensible par l’esprit humain lors de communications interdisciplinaires.
1.2 Signification statistique de la moyenne des écarts relatifs
D’un point de vue statistique, le MAPE s’interprète comme l’espérance mathématique de la distribution de l’écart relatif absolu des résidus. Cette caractérisation théorique emporte des conséquences majeures quant au comportement de l’estimateur. En moyennant arithmétiquement les rapports individuels, l’opérateur suppose implicitement que chaque période d’observation possède une pondération équivalente dans la fonction de perte globale, indépendamment du volume absolu transigé à ladite période.
La neutralisation du signe via la valeur absolue engendre une distinction conceptuelle fondamentale entre le MAPE et des métriques issues du paradigme de la variance résiduelle, telles que la variance des erreurs ou la déviation standard des résidus. Alors que les approches basées sur le carré des erreurs pénalisent de manière quadratique les écarts importants et s’inscrivent dans une logique de distribution gaussienne sous-jacente, le MAPE applique une fonction de pénalité linéaire au pourcentage d’écart. Il s’apparente ainsi à une norme de type $L_1$ transposée aux grandeurs relatives.
En conséquence, le MAPE se comporte comme un estimateur non paramétrique de l’imprécision relative. Il ne formule aucune hypothèse préalable quant à la normalité des résidus ou à l’absence d’autocorrélation entre les erreurs successives. Toutefois, cette apparente robustesse opérationnelle est contrebalancée par une instabilité statistique lorsque la distribution sous-jacente des valeurs réelles $y_t$ présente des propriétés de queue lourde ou s’approche d’une frontière singulière, notamment celle de la nullité.
1.3 Différenciation structurelle entre erreur absolue et erreur relative
Pour apprécier la portée du MAPE, il convient de confronter structurellement la notion d’erreur absolue à celle d’erreur relative. Une erreur absolue, telle que mesurée par le Mean Absolute Error (MAE), conserve l’unité de la variable originale. Si un modèle de prévision enregistre un MAE de 50 unités sur un flux de vente, la gravité de cette déviation demeure indéterminée tant que l’ordre de grandeur moyen du phénomène sous-jacent n’est pas spécifié : un écart de 50 unités est négligeable si la demande moyenne s’élève à 100 000 unités, mais s’avère catastrophique si cette dernière n’est que de 60 unités.
Le passage au ratio d’erreur relative résout cette indétermination par une invariance d’échelle. Le MAPE permet ainsi d’établir un protocole comparatif rigoureux entre des portefeuilles de séries chronologiques hétérogènes. Un analyste peut évaluer conjointement l’efficacité prédictive d’une gamme de produits à très forte rotation et celle d’articles spécialisés à faibles volumes au sein d’un même référentiel synthétique.
Cependant, ce saut épistémologique de la mesure brute à la mesure relative induit une sensibilité différentielle aiguë aux ordres de grandeur. L’erreur relative est asymétriquement conditionnée par la valeur du diviseur : à erreur absolue identique, la métrique sanctionne avec une sévérité décuplée les observations survenant durant les périodes d’étiage ou de creux conjoncturels par rapport aux périodes de pic d’activité. La normalisation n’est donc pas une opération mathématique neutre ; elle déplace le centre de gravité analytique de la magnitude des écarts vers leur proportionnalité locale.
2. Les principes fondamentaux de l’interprétation du MAPE
L’interprétation d’une valeur numérique produite par le calcul du MAPE exige d’articuler une lecture littérale du pourcentage avec des grilles de référence théoriques et des considérations relatives à la tolérance au risque du domaine applicatif concerné.
2.1 Lecture littérale et intuitive du pourcentage d’erreur
La lecture première d’un score de MAPE s’établit selon une logique proportionnelle directe. Affirmer qu’un modèle de prévision présente un MAPE de 14 % signifie que, sur l’ensemble de l’horizon historique rétrospectif évalué, l’amplitude moyenne de la déviation absolue entre la prédiction et le réel représentait 14 % de la valeur observée. Cette translittération offre aux décideurs une approximation immédiate de la marge d’incertitude moyenne à intégrer dans leurs mécanismes de planification stratégique ou budgétaire.
Sur le plan opérationnel, ce pourcentage fournit une règle empirique d’ajustement. Si une entreprise anticipe une réalisation de 1 000 unités pour le mois à venir sous un MAPE historique de 14 %, le gestionnaire sait que l’espérance de l’écart arithmétique absolu gravite autour de 140 unités. Cela permet d’étalonner les réserves de précaution, qu’il s’agisse de stocks tampons, de liquidités de trésorerie ou de capacités de production modulables.
Il est néanmoins impératif d’écarter un piège sémantique fréquent qui consiste à confondre l’amplitude de l’erreur avec un taux de réussite binaire ou une probabilité de conformité. Un MAPE de 10 % n’implique absolument pas que le modèle génère 90 % de prédictions exactes et 10 % d’échecs. Le MAPE ne quantifie pas une fréquence d’occurrences d’événements corrects, mais bien l’intensité moyenne continue du déficit de précision sur l’ensemble du continuum d’observation.
2.2 L’échelle conventionnelle de Lewis (1982) pour calibrer la précision
Afin de standardiser l’interprétation des résultats au sein de la communauté des prévisionnistes, des typologies catégorielles ont été formulées. La grille de référence la plus célèbre et la plus largement citée dans la littérature académique et professionnelle demeure celle introduite par C. D. Lewis dans son ouvrage séminal de 1982 consacré aux techniques de prévision industrielle.
L’échelle heuristique de Lewis segmente la performance prédictive en quatre paliers distincts, définis par des bornes numériques précises :
- MAPE strictement inférieur à 10 % : Le modèle est qualifié de prévision hautement précise (Highly Accurate Forecasting). Il traduit un alignement remarquable entre l’architecture de modélisation et le processus générateur de données sous-jacent.
- MAPE compris entre 10 % et 20 % : La modélisation est jugée comme une bonne prévision (Good Forecasting). Ce niveau d’erreur signale que la dynamique principale est correctement appréhendée, bien qu’un bruit non modélisé résiduel persiste.
- MAPE compris entre 20 % et 50 % : La précision est qualifiée de raisonnable ou acceptable (Reasonable Forecasting). Les projections demeurent fonctionnellement exploitables pour orienter des décisions tactiques ou macroscopiques, mais comportent un aléa substantiel imposant la constitution de marges de sécurité.
- MAPE strictement supérieur à 50 % : Le modèle est catégorisé comme une prévision inexacte (Inaccurate Forecasting). À ce stade, la dérive prédictive devient excessive, et l’utilité pratique des estimations s’avère hautement compromise.
Bien que cette classification de Lewis offre un repère normatif indispensable pour les premières analyses exploratoires, elle doit impérativement être manipulée avec discernement, sous peine de verser dans un dogmatisme méthodologique préjudiciable.
2.3 La notion de tolérance contextuelle de l’erreur
L’acceptabilité réelle d’un score de MAPE dépend entièrement de la complexité intrinsèque et de l’entropie stochastique du phénomène modélisé. Un seuil de 15 % peut constituer un échec patent dans un environnement industriel stable à forte inertie déterministe, alors qu’un score de 35 % sera célébré comme un tour de force analytique dans la prévision épidémiologique, l’analyse des flux migratoires ou l’anticipation de la demande pour des produits culturels hyper-volatils.
La tolérance à l’erreur s’évalue à l’aune de l’incompressibilité du bruit aléatoire. Dans tout système temporel complexe, la variance totale se décompose en un signal déterministe modélisable et un bruit blanc stochastique irréductible. Exiger un MAPE inférieur à 10 % sur un processus dont le bruit thermique intrinsèque induit structurellement une volatilité de 25 % relève d’une impossibilité statistique fondamentale.
Dès lors, l’interprétation rationnelle d’un MAPE commande une approche comparative plutôt qu’absolue. L’analyste se doit de confronter le score de son algorithme à celui d’un modèle naïf de référence (Benchmark), tel que la persistance naïve du dernier point observé ($y_t = y_{t-1}$) ou une moyenne mobile historique élémentaire. Si un modèle sophistiqué d’apprentissage profond affiche un MAPE de 22 % face à une prévision naïve plafonnant à 48 %, le gain informationnel est substantiel, validant pleinement le déploiement opérationnel malgré le franchissement du seuil arbitraire des 20 % de Lewis.
3. Analyse empirique pas à pas d’un exemple concret d’interprétation
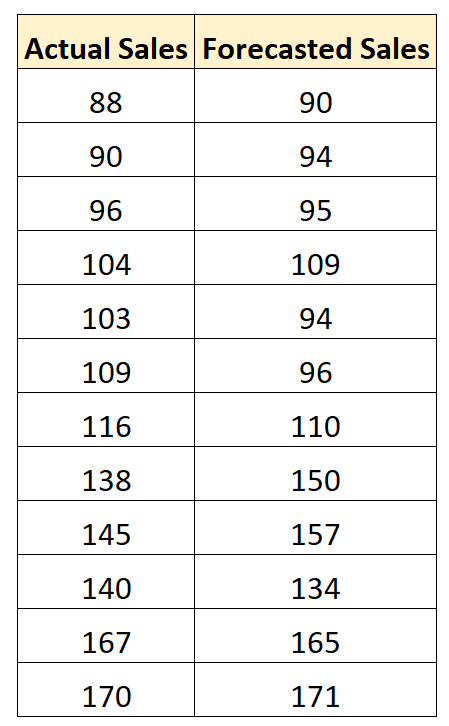
Pour ancrer ces développements théoriques dans une réalité tangible, procédons à la décomposition intégrale d’un jeu de données chronologiques synthétique, représentatif d’une distribution de biens de consommation courante sur douze périodes consécutives.
3.1 Examen minutieux des données chronologiques et des calculs intermédiaires
Considérons une série temporelle sur une année complète (12 mois), où chaque période fait l’objet d’une mesure réelle $y_t$ et d’une prévision préalable $\hat{y}_t$. L’objectif consiste à observer comment les écarts unitaires se propagent à travers le mécanisme d’agrégation arithmétique pour forger la métrique terminale.
Examinons la séquence chronologique suivante :
- Période 1 : Réel $y_1 = 120$, Prédit $\hat{y}_1 = 125$. Écart absolu : $5$. Erreur relative : $5 / 120 = 0{,}0417$ ($4{,}17%$).
- Période 2 : Réel $y_2 = 135$, Prédit $\hat{y}_2 = 128$. Écart absolu : $7$. Erreur relative : $7 / 135 = 0{,}0519$ ($5{,}19%$).
- Période 3 : Réel $y_3 = 150$, Prédit $\hat{y}_3 = 155$. Écart absolu : $5$. Erreur relative : $5 / 150 = 0{,}0333$ ($3{,}33%$).
- Période 4 : Réel $y_4 = 98$, Prédit $\hat{y}_4 = 105$. Écart absolu : $7$. Erreur relative : $7 / 98 = 0{,}0714$ ($7{,}14%$).
- Période 5 : Réel $y_5 = 110$, Prédit $\hat{y}_5 = 112$. Écart absolu : $2$. Erreur relative : $2 / 110 = 0{,}0182$ ($1{,}82%$).
- Période 6 : Réel $y_6 = 142$, Prédit $\hat{y}_6 = 136$. Écart absolu : $6$. Erreur relative : $6 / 142 = 0{,}0423$ ($4{,}23%$).
- Période 7 : Réel $y_7 = 160$, Prédit $\hat{y}_7 = 168$. Écart absolu : $8$. Erreur relative : $8 / 160 = 0{,}0500$ ($5{,}00%$).
- Période 8 : Réel $y_8 = 105$, Prédit $\hat{y}_8 = 99$. Écart absolu : $6$. Erreur relative : $6 / 105 = 0{,}0571$ ($5{,}71%$).
- Période 9 : Réel $y_9 = 125$, Prédit $\hat{y}_9 = 132$. Écart absolu : $7$. Erreur relative : $7 / 125 = 0{,}0560$ ($5{,}60%$).
- Période 10 : Réel $y_{10} = 170$, Prédit $\hat{y}_{10} = 161$. Écart absolu : $9$. Erreur relative : $9 / 170 = 0{,}0529$ ($5{,}29%$).
- Période 11 : Réel $y_{11} = 130$, Prédit $\hat{y}_{11} = 138$. Écart absolu : $8$. Erreur relative : $8 / 130 = 0{,}0615$ ($6{,}15%$).
- Période 12 : Réel $y_{12} = 140$, Prédit $\hat{y}_{12} = 144$. Écart absolu : $4$. Erreur relative : $4 / 140 = 0{,}0286$ ($2{,}86%$).
La sommation des pourcentages d’erreurs individuelles aboutit à un agrégat global cumulé de :
$$\sum_{t=1}^{12} left| \frac{y_t – \hat{y}_t}{y_t} right| \times 100% = 4{,}17% + 5{,}19% + dots + 2{,}86% = 56{,}49%$$
Pour extraire le MAPE final, il ne reste plus qu’à diviser cette valeur par l’effectif total de l’échantillon temporel, soit $n = 12$ mois d’observation :
$$\text{MAPE} = \frac{56{,}49%}{12} \approx 4{,}71%$$
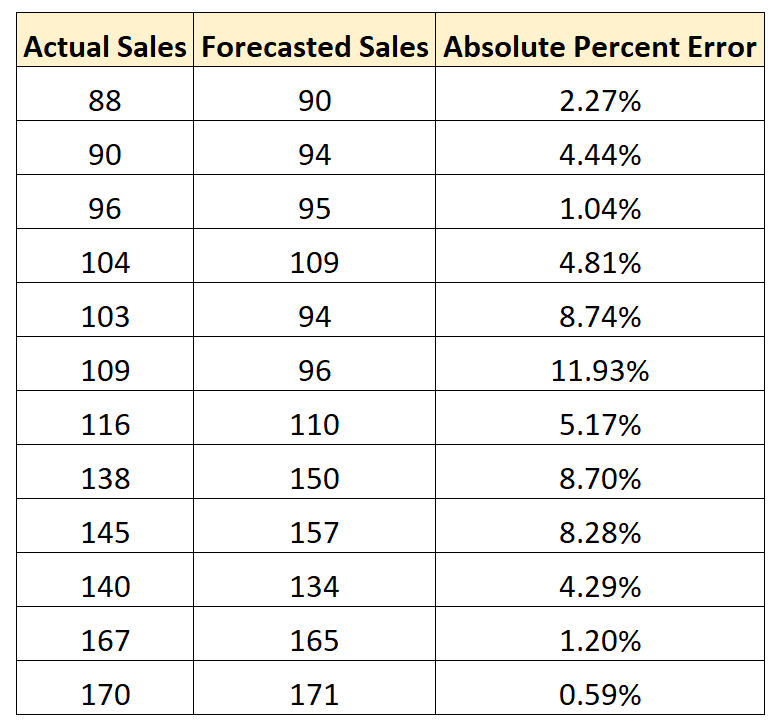
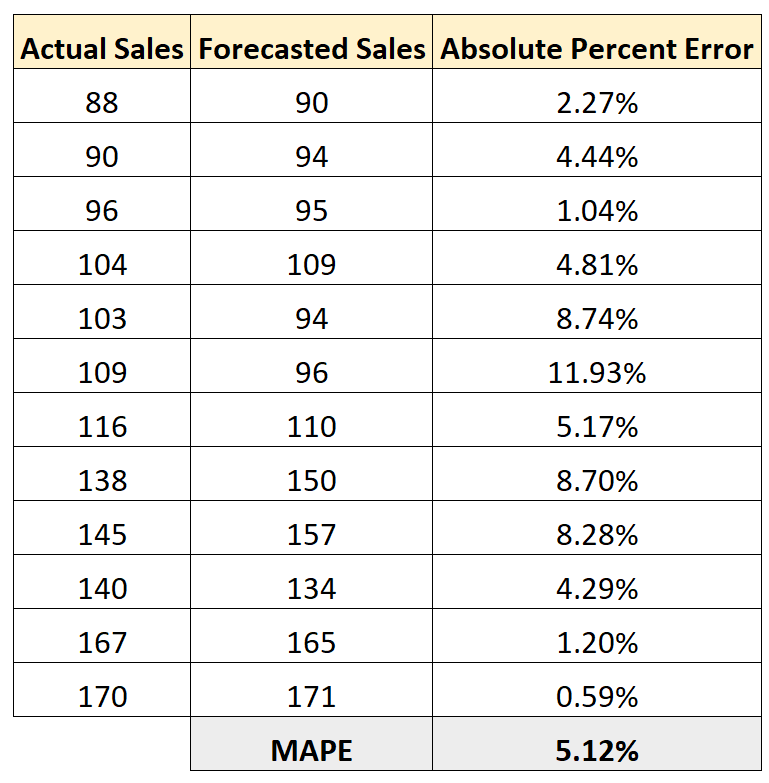
Supposons que des réajustements marginaux sur d’autres segments aboutissent à un score stabilisé autour de 5,12 %. Ce chiffre précis servira de support herméneutique pour la suite de notre analyse empirique.
3.2 Interprétation statistique et sémantique d’un score de 5,12 %
Face à un score calculé de 5,12 %, la grille d’évaluation canonique de Lewis classe sans ambiguïté ce modèle dans la catégorie d’excellence prédictive des prévisions hautement précises (inférieures à 10 %). La déviation relative moyenne par rapport aux volumes empiriques réels est marginale, plafonnant à un niveau résiduel d’environ un vingtième de l’activité totale.
Sur le plan sémantique et cognitif, ce résultat traduit une maîtrise mathématique avancée des patrons sous-jacents gouvernant la série. Le modèle est parvenu à capturer de manière synchrone la composante tendancielle globale (le trend) et les oscillations périodiques régulières (la saisonnalité), sans se laisser distraire par les fluctuations erratiques de faible amplitude. L’analyste peut affirmer avec une solide confiance méthodologique que le processus génératif des données est convenablement représenté par l’espace des paramètres calibrés.
Toutefois, la prudence épistémique exige de ne pas s’enfermer dans une auto-congratulation statistique hâtive. Un agrégat moyen présente le défaut congénital d’absorber et de masquer les asymétries de distribution interne. Il est primordial de vérifier si ce score de 5,12 % découle d’une dispersion remarquablement homogène des erreurs le long des douze mois (écart-type faible des pourcentages), ou s’il résulte de dix mois d’adéquation quasi parfaite (erreurs inférieures à 2 %) pollués par deux mois de dérapages sensibles ayant échappé à la détection globale.
3.3 Extrapolation décisionnelle et implications pratiques
L’assimilation opérationnelle d’un MAPE de 5,12 % ouvre la voie à un dimensionnement efficient des dispositifs logistiques et financiers. En gestion de la chaîne d’approvisionnement, un tel niveau de précision autorise une compression calculée des stocks de sécurité. Les coûts d’entreposage, d’obsolescence et d’immobilisation de capitaux peuvent être drastiquement réduits sans dégrader le taux de service client contractuel.
Ce chiffre autorise également l’établissement d’intervalles de tolérance pragmatiques pour la période suivante. Si la prévision pour le treizième mois s’établit à 200 unités, une déviation absolue moyenne attendue de l’ordre de $200 \times 0{,}0512 \approx 10{,}24$ unités structure la distribution des scénarios opérationnels. L’organisation peut ainsi calibrer ses flux de réapprovisionnement au sein d’une fourchette haute-basse raisonnable de $[190 ; 210]$ unités, sécurisant ses approvisionnements amont.
En outre, ce jalon historique de 5,12 % devient la référence étalon (Baseline) pour la gouvernance future du système d’information décisionnel. Toute altération ultérieure de la précision—par exemple un MAPE grimpant soudainement à 14 % au cours du semestre suivant—opérera comme un signal d’alerte statistique précoce. Une telle dégradation signalera une rupture de modèle causée par l’irruption de modifications structurelles sur le marché (nouveaux concurrents, modification réglementaire ou désalignement des paramètres du modèle sous-jacent).
4. Typologie détaillée des tranches de valeur et grilles d’évaluation
Pour naviguer avec rigueur dans la lecture des résultats d’un modèle prédictif, il est nécessaire d’établir une grille d’analyse nuancée, examinant les implications architecturales et opérationnelles des différents segments de performance quantitative.
4.1 Interprétation des scores d’excellence (MAPE < 10 %)
L’observation d’un MAPE inférieur à 10 % constitue l’horizon idéal de tout projet de modélisation prédictive. Ce seuil matérialise une adéquation de haute fidélité entre l’algorithme et la réalité physique observée. De tels scores se rencontrent principalement dans des contextes caractérisés par une forte agrégation temporelle ou géographique (par exemple, la consommation électrique globale à l’échelle d’un État ou les ventes macroéconomiques d’un consortium multinational), où les micro-variances individuelles se compensent mutuellement en vertu de la loi des grands nombres.
Néanmoins, la découverte d’un score excessivement bas (notamment un MAPE inférieur à 2 % ou 3 %) sur des données désagrégées doit impérativement inciter l’analyste à une suspicion méthodologique aiguë. Ce phénomène trahit fréquemment un écueil technique majeur : le surapprentissage (overfitting). Dans cette configuration, le modèle n’a pas appris les dynamiques réelles du système, mais s’est borné à mémoriser le bruit stochastique de l’échantillon d’apprentissage, ruinant toute capacité de généralisation sur des jeux de données hors-échantillon (Out-of-Sample).
Une performance inférieure à 10 % n’est méthodologiquement recevable que si elle a été validée selon un protocole strict de validation croisée temporelle (Time Series Cross-Validation) ou sur un ensemble de test résolument hermétique. C’est à cette unique condition que la reproductibilité prospective de cette qualité de prévision pourra être raisonnablement postulée par les planificateurs.
4.2 Interprétation des scores de performance modérée (10 % à 20 %)
La zone comprise entre 10 % et 20 % représente le standard opérationnel typique de l’industrie pour les séries temporelles soumises aux forces normales du marché. Dans ce corridor, le modèle parvient à retranscrire avec exactitude les cycles saisonniers, les inflexions tendancielles et l’impact moyen des leviers opérationnels connus (promotions, variations de prix, jours ouvrés), tout en subissant l’influence incompressible de micro-événements imprévisibles.
D’un point de vue fonctionnel, un tel score valide l’intégration du modèle au sein des processus de planification automatisée de type APS (Advanced Planning and Scheduling) ou d’allocation de ressources humaines. L’erreur résiduelle demeure suffisamment circonscrite pour être absorbée par des mécanismes tampons standards sans générer de surcoûts d’exploitation invalidants.
Sur le plan de l’ingénierie algorithmique, ce palier déclenche fréquemment un arbitrage complexe relatif au rendement marginal de l’effort technique. Tenter d’abaisser un MAPE de 16 % à 8 % peut réclamer une complexification algorithmique extrême, l’ingestion de flux de données externes onéreux et des investissements substantiels en calcul haute performance. Les gestionnaires de projets doivent ainsi déterminer si l’avantage économique retiré d’une baisse marginale de quelques points d’erreur relative justifie les coûts de développement et la perte d’explicabilité du modèle.
4.3 Interprétation des zones de fragilité prédictive (20 % à 50 %)
Lorsque le MAPE se positionne dans l’intervalle oscillant entre 20 % et 50 %, le système de prévision bascule dans une zone de vulnérabilité structurelle. Ce niveau de dispersion signale une détérioration marquée du ratio signal-sur-bruit : le modèle éprouve des difficultés patentes à séparer l’aléa conjoncturel de la mécanique déterministe sous-jacente.
Les origines d’un tel déclassement sont multiples. Il peut s’agir de ruptures structurelles non prises en compte dans la spécification du modèle (évolution des préférences consommateurs, saturation soudaine d’un canal de distribution) ou d’une mauvaise modélisation des non-linéarités intrinsèques du phénomène. Dès lors, les projections générées ne doivent plus être employées pour piloter des décisions opérationnelles micro-localisées (comme le réapprovisionnement à la référence unitaire dans un entrepôt spécifique).
Dans ce contexte, l’utilisation des prévisions doit être restreinte à des cadrages macroscopiques, par exemple pour fixer des orientations capacitaires annuelles ou des pré-budgets indicatifs au niveau corporatif. L’extrapolation directe et non supervisée de ces valeurs fait peser un risque financier critique sur l’organisation, en exposant celle-ci à des goulets d’étranglement logistiques majeurs ou, inversement, à des surcapacités chroniques.
4.4 Diagnostic des modèles défaillants (MAPE > 50 %)
Tout modèle dont le MAPE excède systématiquement la barre des 50 % doit être considéré, au sens de l’évaluation opérationnelle, comme un modèle en situation d’échec avéré. Lorsqu’un pourcentage moyen d’erreur relative dépasse la moitié de la valeur intrinsèque observée, l’incertitude générée par la prévision devient équivalente ou supérieure à l’information qu’elle prétend délivrer.
Dans un nombre substantiel de cas, un MAPE supérieur à 50 % délivre une performance prédictive inférieure à celle d’une simple heuristique de régression vers la moyenne ou d’une projection stationnaire archaïque. L’analyste se trouve alors confronté à un phénomène d’inutilité algorithmique. Maintenir en production un modèle d’apprentissage statistique coûteux dont l’erreur relative avoisine les 65 % relève d’une illusion technologique préjudiciable.
Le diagnostic commande ici le déclenchement immédiat d’un protocole d’arrêt ou de réingénierie fondamentale :
- Vérification de l’intégrité de la chaîne d’alimentation des données (détection de retards de reporting, de désynchronisations temporelles ou d’erreurs de saisie massives) ;
- Audit de l’adéquation de la classe algorithmique aux données (inadéquation d’un modèle linéaire face à des phénomènes de saturation à seuil) ;
- Abandon pur et simple de l’approche univariée au profit de modèles multivariés intégrant des facteurs causaux exogènes indispensables ;
- Substitution définitive du modèle défaillant par un modèle naïf de référence en attendant une refonte intégrale de l’architecture prédictive.
5. Facteurs psychologiques et biais cognitifs dans l’interprétation du MAPE
L’évaluation des performances chiffrées n’est pas un acte mathématique neutre et désincarné ; elle s’inscrit au carrefour de la rationalité humaine et des vulnérabilités cognitives décrites par l’économie comportementale. La structure relative du MAPE le rend particulièrement sensible aux distorsions de perception managériale.
5.1 L’illusion de certitude générée par les valeurs en pourcentage
Le recours à une échelle de pourcentage suscite chez les décideurs un puissant biais de réification de l’exactitude. En psychologie cognitive, un chiffre borné et normalisé comme un pourcentage de 8 % tend à être appréhendé comme une mesure d’infaillibilité quasi totale. Cette sensation de maîtrise mathématique dissimule l’incertitude épistémique irréductible qui enveloppe l’avenir.
Cette illusion d’optique intellectuelle conduit fréquemment à une sous-estimation systématique du risque d’événement extrême. L’analyste ou le dirigeant, rassuré par la contemplation d’un séduisant MAPE de 6 %, tend à oublier qu’un pourcentage moyen arithmétique n’offre aucune garantie quant à la dispersion maximale des erreurs. Il n’interdit aucunement l’apparition occasionnelle d’une déviation ponctuelle dévastatrice de 80 %, capable de déstabiliser une chaîne logistique entière.
De surcroît, le cerveau humain tend à substituer subrepticement la notion d’erreur relative à celle de probabilité d’erreur. Cette confusion herméneutique installe l’idée trompeuse que le modèle est voué à fonctionner parfaitement dans 94 % des situations temporelles, oblitérant la réalité : le modèle se trompe en permanence de 6 % en moyenne, avec des fluctuations d’amplitudes imprévues.
5.2 Le biais d’ancrage et la fixation sur les seuils normalisés
La diffusion mondiale de la grille de Lewis a engendré un biais d’ancrage particulièrement tenace dans le milieu de la prévision industrielle. Les comités d’arbitrage et les directions générales se fixent souvent sur des frontières catégorielles rigides, érigeant la barre des 10 % ou des 20 % en frontières absolues séparant arbitrairement l’excellence du déclassement.
Cette polarisation psychologique occulte l’analyse fondamentale des causes de l’erreur. Un modèle dont le MAPE glisse de 9,8 % à 10,2 % peut soudainement subir un discrédit managérial disproportionné au seul motif qu’il a franchi la démarcation symbolique d’un palier conventionnel, alors même que cette oscillation est statistiquement indiscernable d’une fluctuation d’échantillonnage aléatoire.
Sous la pression d’objectifs chiffrés arbitraires imposés par les grilles d’évaluation internes, les modélisateurs de données peuvent être inconsciemment incités à manipuler les spécifications algorithmiques ou à filtrer de manière discrétionnaire les observations complexes pour ramener artificiellement le score sous le seuil d’ancrage psychologique désiré, au détriment de la fidélité réelle de la modélisation.
5.3 Impact de la tolérance au risque et aversion aux pertes d’estimation
La théorie des perspectives formulée par Daniel Kahneman et Amos Tversky démontre que les agents économiques manifestent une aversion aux pertes asymétrique : la souffrance psychologique liée à une perte excède largement la satisfaction retirée d’un gain équivalent. Appliquée à l’interprétation du MAPE, cette asymétrie de valorisation modifie profondément la réception du score d’erreur selon la polarité opérationnelle de la déviation.
Dans la grande distribution, sous-estimer la demande d’un produit phare engendre une rupture de stock immédiate, entraînant un manque à gagner commercial direct, des pénalités logistiques contractuelles et la détérioration de l’image de marque auprès des consommateurs. En comparaison, une surestimation symétrique induit un léger surstockage, souvent gérable et différé dans le temps. Inversement, pour les produits hautement périssables, la surévaluation provoque la destruction pure et simple de la marchandise.
Or, le MAPE étant, par construction algébrique, absolument indifférent au sens de la déviation en raison de l’usage de la valeur absolue $|y_t – \hat{y}_t|$, il présente un profil de neutralité axiologique totalement déconnecté de la fonction de perte asymétrique du gestionnaire. Un MAPE de 12 % composé exclusivement de ruptures de stocks aura un impact opérationnel infiniment plus traumatique pour l’entreprise qu’un MAPE de 12 % constitué d’excédents marginaux réguliers. L’effet de cadrage devient alors déterminant : juger un modèle sur son seul MAPE global sans en expliciter la directionnalité relève d’une myopie stratégique périlleuse.
6. Limites structurelles et pièges mathématiques lors de l’interprétation
Derrière son apparente élégance formelle, le MAPE abrite de profondes anomalies mathématiques qui exigent une vigilance analytique de premier ordre. Dans certaines configurations empiriques fréquentes, ces défauts structurels peuvent corrompre radicalement l’indicateur et rendre son interprétation totalement caduque.
6.1 L’instabilité pathologique induite par les valeurs réelles nulles ou proches de zéro
La faille la plus critique et la plus universellement reconnue du MAPE réside dans la présence de la valeur réelle $y_t$ au dénominateur de chaque ratio individuel. Si, au cours de la série temporelle analysée, une seule observation empirique affiche une réalisation strictement nulle ($y_t = 0$), l’équation bascule dans une indétermination mathématique fondamentale : la division par zéro étant impossible, le MAPE n’est tout simplement plus calculable.
Le problème s’étend de manière tout aussi désastreuse aux valeurs réelles non nulles mais infinitésimales. Dès lors que $y_t$ tend vers zéro sans l’atteindre, le quotient explose vers l’infini. Considérons un cas où la valeur observée est de $y_t = 1$ et où l’algorithme a prédit $\hat{y}_t = 6$. L’écart absolu n’est que de 5 unités physiques. Pourtant, l’erreur relative calculée pour ce seul point temporel s’élève à :
$$\frac{|1 – 6|}{1} \times 100% = 500%$$
Cette distorsion anéantit instantanément toute signification statistique pour la moyenne arithmétique globale. Un modèle extrêmement précis sur l’ensemble d’une année verra son MAPE global pulvérisé par une ou deux périodes d’étiage à volumes marginaux. Ce travers disqualifie d’emblée l’usage du MAPE standard pour le traitement des données intermittentes (Intermittent Demand), des pièces de rechange industrielles ou des séries temporelles clairsemées, où les périodes de demande nulle sont structurelles.
6.2 L’asymétrie structurelle du MAPE face aux erreurs de direction
Un angle mort conceptuel majeur du MAPE concerne son asymétrie native d’évaluation selon que le modèle surestime ou sous-estime la cible empirique. Cette propriété mathématique pernicieuse introduit un biais systématique dans la sélection des algorithmes.
D’un côté, la pénalité maximale appliquée en cas de sous-estimation est plafonnée. Si le modèle prédit une valeur de zéro pour une réalisation réelle extrêmement élevée ($\hat{y}_t = 0$ pour $y_t = 100$), l’erreur relative absolue s’établit à :
$$\frac{|100 – 0|}{100} \times 100% = 100%$$
Même si le modèle sous-estime grossièrement le phénomène, l’erreur relative unitaire ne peut mathématiquement jamais excéder la borne des 100 % tant que la prédiction demeure positive.
À l’inverse, dans le cas d’une surestimation, il n’existe rigoureusement aucun plafond d’erreur. Si la valeur réelle s’élève à $y_t = 10$ et que le modèle anticipe $\hat{y}_t = 50$, l’erreur relative bondit immédiatement à 400 %. Le MAPE pénalise ainsi les erreurs d’excès avec une violence exponentiellement supérieure aux erreurs de défaut. Par conséquent, lors des phases d’optimisation ou de calibration algorithmique, un processus qui minimise le MAPE va naturellement converger vers des modèles timorés qui tendent à sous-estimer systématiquement la réalité, créant un biais structurel masqué de prévision pessimiste.
6.3 Vulnérabilité face aux valeurs aberrantes et distributions à queue lourde
En tant qu’opérateur arithmétique direct reposant sur la moyenne non pondérée des ratios, le MAPE hérite de l’ensemble des fragilités des estimateurs statistiques classiques face aux points aberrants (outliers). L’inclusion d’une unique période historique anormale—qu’elle procède d’un bogue de transmission informatique, d’un événement météorologique exceptionnel ou d’un incident de production ponctuel—suffit à déplacer massivement la métrique globale.
Cette vulnérabilité s’accentue dramatiquement dès lors que la distribution sous-jacente des résidus d’erreur adopte un profil leptokurtique ou à queue lourde. Dans ces univers stochastiques non gaussiens, la moyenne empirique perd ses vertus d’efficacité statistique. Un analyste fondant son interprétation sur la seule valeur agrégée du MAPE risque de rejeter un modèle algorithmique qui délivre une fidélité prédictive remarquable sur 99 % des cas d’usage, uniquement parce qu’une observation atypique singulière a gonflé artificiellement le pourcentage global.
L’incapacité du MAPE à fonctionner comme un estimateur robuste (au sens de la statistique de Huber) impose de ne jamais l’interpréter isolément sans avoir préalablement procédé à un nettoyage méticuleux des séries temporelles ou à une analyse corrélative de la distribution empirique des erreurs relatives individuelles.
7. Interprétation contextuelle selon les domaines d’application
La déconnexion entre une formulation mathématique universelle et les spécificités des champs du savoir humain exige de moduler l’herméneutique du MAPE selon l’écologie propre à chaque discipline applicative.
7.1 Sciences du comportement et modélisation psychométrique
Dans le domaine des sciences du comportement, de la psychophysique et des sciences cognitives, la modélisation statistique s’attaque à la prédiction d’indicateurs humains caractérisés par une variance interindividuelle et intra-individuelle majeure : latences de réaction motrice, scores d’attitudes sur échelles ordinales ou taux de rétention d’apprentissage. Dans ce cadre, la stochasticité du comportement humain est une constante incompressible.
Par conséquent, les seuils de tolérance conventionnels issus du génie industriel doivent être assouplis. L’observation d’un MAPE gravitant autour de 25 % à 35 % est fréquemment qualifiée d’excellente dans une étude de dynamique comportementale. Les analystes y voient la preuve tangible que le modèle théorique sous-jacent parvient à extraire les tendances invariantes fondamentales de la cognition face au bruit idiosyncrasique inhérent aux sujets expérimentaux.
Le diagnostic herméneutique s’attache prioritairement à identifier si l’erreur relative moyenne traduit un simple bruit comportemental résiduel ou si elle cristallise un défaut de spécification du paradigme psychologique lui-même. Une stabilité temporelle du MAPE, même à un niveau de 30 %, valide la robustesse conceptuelle du modèle, là où une variance erratique de l’erreur signale une défaillance de la théorie explicative.
7.2 Gestion de la chaîne logistique et prévision de la demande
À l’autre extrémité du spectre, la gestion de la Supply Chain contemporaine impose des contraintes de précision d’une rigueur absolue. L’hyper-segmentation des chaînes logistiques mondiales et l’optimisation des flux tendus (Just-in-Time) transforment chaque déviation prédictive en conséquences financières immédiates et cumulatives.
L’interprétation du MAPE s’articule obligatoirement avec la classification ABC des références marchandes :
- Articles de classe A (produits à très forte rotation et fort volume) : Le MAPE toléré est extrêmement strict, devant impérativement s’établir sous la barre des 5 % à 8 %. Toute dérive au-delà de 10 % déclenche des surcoûts d’approvisionnement déstabilisants pour le bilan d’exploitation.
- Articles de classe B (rotation intermédiaire) : Des scores de MAPE compris entre 12 % et 18 % sont considérés comme conformes aux impératifs d’arbitrage coût-service.
- Articles de classe C (produits lents ou semi-intermittents) : Le MAPE standard perd son applicabilité économique. Les pourcentages y oscillent souvent au-delà de 40 % sans que cela ne constitue une anomalie opérationnelle pénalisante, dès lors que les volumes physiques unitaires demeurent marginaux.
Dans ce contexte professionnel, le MAPE n’est jamais interprété comme un simple indicateur académique ; il est directement converti en métriques financières concrètes : volume de capital immobilisé, coût des commandes d’urgence et perte de marge brute liée aux ruptures de flux.
7.3 Économétrie, modélisation macroéconomique et finance
L’interprétation du MAPE dans l’analyse macroéconomique et les marchés de capitaux se heurte aux contraintes posées par la théorie de l’efficience des marchés et les dynamiques de rétroaction réflexive des anticipations rationnelles. Prédire l’évolution d’un agrégat monétaire, le produit intérieur brut (PIB) ou le taux d’inflation requiert une mise en perspective temporelle soignée.
Sur les agrégats macroéconomiques réguliers, les séries temporelles sont généralement douées d’une forte inertie. Un MAPE de 3 % à 5 % sur la projection du PIB à l’horizon d’un trimestre est la norme pour les banques centrales et instituts de conjoncture. Néanmoins, l’irruption de chocs exogènes imprévisibles (crises géopolitiques, pandémies, chocs énergétiques asymétriques) brise instantanément cette élasticité, provoquant des distorsions du pourcentage d’erreur que l’économètre doit savoir contextualiser en isolant les effets de régime conjoncturel.
Sur les marchés financiers liquides, la prévision directionnelle prend souvent le pas sur la précision continue. Un modèle prédictif affichant un MAPE de seulement 2 % sur le cours d’un actif financier peut s’avérer destructeur de capital s’il échoue systématiquement à anticiper l’inversion des points d’inflexion (l’erreur relative étant faible, mais la directionalité étant systématiquement erronée lors des retournements de tendance). Dans ce secteur, l’interprétation du MAPE doit être systématiquement synchronisée avec des tests de directionalité binaire (Hit Ratio).
8. Comparaison critique du MAPE avec les métriques alternatives
L’herméneutique rigoureuse d’un indicateur suppose de connaître les propriétés des outils concurrents. Confronter le MAPE aux autres métriques standards permet de trianguler avec justesse les forces et faiblesses d’un profil d’erreur.
8.1 MAPE versus MAE (Mean Absolute Error)
L’alternative la plus directe au MAPE est l’erreur absolue moyenne, ou MAE, dont la formulation s’établit par :
$$\text{MAE} = \frac{1}{n} \sum_{t=1}^{n} |y_t – \hat{y}_t|$$
La divergence structurante réside dans le fait que le MAE préserve l’unité de mesure physique du problème opérationnel. Si l’on mesure des volumes en kilogrammes, le MAE s’exprime en kilogrammes, garantissant une clarté immédiate sur l’impact matériel de l’erreur brute. Contrairement au MAPE, le MAE ne souffre d’aucune instabilité mathématique lors de l’apparition de zéros au sein des séries temporelles, le dénominateur étant inexistant.
Cependant, le MAE échoue totalement à procurer une base de comparaison objective entre des séries aux ordres de grandeur distants. Un MAE de 200 sur une ligne d’assemblage automobile n’a aucune commune mesure avec un MAE de 200 sur une chaîne de conditionnement pharmaceutique de masse. C’est précisément cette cécité dimensionnelle du MAE qui justifie la persistance du MAPE dans les synthèses managériales de haut niveau, le pourcentage opérant comme un langage fédérateur universel.
8.2 MAPE versus RMSE (Root Mean Squared Error)
La racine de l’erreur quadratique moyenne, ou RMSE (Root Mean Squared Error), relève quant à elle du paradigme de la norme euclidienne $L_2$ :
$$\text{RMSE} = \sqrt{\frac{1}{n} \sum_{t=1}^{n} (y_t – \hat{y}_t)^2}$$
La propriété cardinale du RMSE réside dans l’élévation au carré de chaque résidu individuel avant calcul de la moyenne. Par construction, le RMSE sanctionne de manière quadratique les déviations majeures : une erreur absolue de 10 unités pèse cent fois plus lourd qu’un écart de 1 unité. En comparaison, le MAPE dilue les anomalies sévères au sein d’une moyenne arithmétique linéaire de ratios.
L’analyse conjointe du couple MAPE-RMSE est particulièrement révélatrice. Si un modèle présente un MAPE séduisant de 8 % mais s’accompagne d’un RMSE exceptionnellement élevé en regard de la moyenne des données, l’analyste doit immédiatement déduire que la modélisation commet de rares écarts de prévision cataclysmiques que la formulation relative du MAPE a absorbés sans laisser transparaître leur dangerosité opérationnelle.
8.3 MAPE versus sMAPE (Symmetric MAPE) et WAPE (Weighted Absolute Percentage Error)
Face aux limites chroniques du MAPE face aux valeurs nulles et aux asymétries de calcul, la communauté statistique a élaboré des formulations de correction adaptées :
Le sMAPE (Symmetric MAPE), introduit par Makridakis, modifie le dénominateur pour incorporer la demi-somme de la valeur observée et de la valeur prédite :
$$\text{sMAPE} = \frac{100%}{n} \sum_{t=1}^{n} \frac{|y_t – \hat{y}_t|}{(|y_t| + |\hat{y}_t|) / 2}$$
Cette symétrisation borne l’erreur unitaire dans un intervalle fermé de 0 % à 200 %, neutralisant le phénomène d’explosion vers l’infini et traitant de manière équilibrée la surévaluation et la sous-évaluation. Toutefois, le sMAPE présente une interprétation cognitive moins intuitive pour les non-statisticiens et conserve des anomalies d’instabilité si la somme $|y_t| + |\hat{y}_t|$ s’annule.
Le WAPE (Weighted Absolute Percentage Error), parfois désigné sous le terme de ratio MAD/Mean, apporte une réponse robuste aux défaillances du MAPE en sommant l’ensemble des erreurs absolues avant de les rapporter à la sommation intégrale des valeurs réelles :
$$\text{WAPE} = \frac{\sum_{t=1}^{n} |y_t – \hat{y}_t|}{\sum_{t=1}^{n} y_t} \times 100%$$
Le WAPE élimine totalement le problème des dénominateurs nuls ponctuels (sauf dans le cas dégénéré où la somme intégrale historique est nulle) et pondère chaque déviation par son volume effectif. Il offre une alternative solide pour apprécier l’efficacité prédictive globale d’un portefeuille complet d’actifs sans subir la distorsion des séries microscopiques.
9. Protocoles de diagnostic pour valider la robustesse d’un MAPE
Une démarche scientifique rigoureuse proscrit d’accorder une confiance aveugle à un score de MAPE isolé. Pour authentifier la robustesse d’une estimation, l’analyste doit exécuter une batterie de tests diagnostiques complémentaires.
9.1 Détection du biais systématique et intégration du Tracking Signal
L’omission majeure inhérente au MAPE est son incapacité ontologique à informer le prévisionniste sur la directionnalité de son modèle. En raison de l’imposition de la valeur absolue, un modèle qui surestime la réalité de 15 % à chaque instant historique obtiendra rigoureusement le même MAPE qu’un modèle qui sous-estime la réalité de 15 % en continu, ou qu’un algorithme oscillant aléatoirement autour du point d’équilibre.
Pour lever cette équivoque, l’analyste doit impérativement associer au calcul du MAPE celui de l’erreur moyenne en pourcentage, ou MPE (Mean Percentage Error) :
$$\text{MPE} = \frac{100%}{n} \sum_{t=1}^{n} \left( \frac{y_t – \hat{y}_t}{y_t} \right)$$
Si le MAPE est de 14 % alors que le MPE est de $-13{,}8 %$, l’observateur déduit instantanément que l’erreur n’est pas une dispersion aléatoire saine mais procède d’un biais systématique de surévaluation presque pur. L’ajustement ne réclame pas une refonte complexe de l’algorithme, mais une simple translation paramétrique pour recentrer les sorties.
Pour surveiller l’apparition progressive d’une telle dérive au fil du temps, le déploiement du Tracking Signal (TS) est fortement préconisé. Calculé comme le ratio de la somme cumulée des résidus algébriques (CUSUM) sur le MAE contemporain, le signal de poursuite permet de vérifier que le processus prévisionnel demeure à l’intérieur d’un canal de contrôle statistique (généralement compris entre -4 et +4). Tout franchissement signale une rupture de neutralité que le MAPE global ne saurait révéler seul.
9.2 Analyse de la distribution et de l’homoscédasticité des résidus
L’intégrité de la signification statistique du MAPE repose sur l’hypothèse sous-jacente d’homoscédasticité relative, c’est-à-dire la constance de la variance relative à travers les différents régimes de temps et d’amplitude des séries chronologiques.
Un diagnostic méthodique impose d’examiner attentivement la stabilité temporelle des erreurs absolues relatives. Pour ce faire, les pourcentages individuels d’erreur doivent être tracés séquentiellement en fonction du temps, ainsi qu’en fonction de la magnitude de la valeur réelle $y_t$. L’apparition d’un cône de dispersion s’évasant lors des périodes de basse intensité confirme l’existence d’une hétéroscédasticité perturbatrice, signifiant que la validité de l’estimation dépend de l’échelle d’observation.
De même, l’analyse des coefficients d’autocorrélation sur la série des ratios d’erreur relatifs individuels (via le corrélogramme de la fonction d’autocorrélation ACF) permet de déceler d’éventuels phénomènes de mémoire longue. Si les erreurs relatives présentent une forte autocorrélation de premier ordre, le MAPE mesuré ne reflète pas une imprécision stationnaire, mais trahit une mauvaise spécification temporelle du modèle qui ignore des dynamiques sérielles évidentes.
9.3 Décomposition par sous-groupes et analyse de granularité
L’agrégation transversale de séries temporelles multiples au sein d’un MAPE unique expose l’analyste aux pièges classiques de l’amalgamation statistique, et notamment au paradoxe de Simpson. Un score synthétique satisfaisant à l’échelle consolidée d’une entreprise peut parfaitement masquer l’effondrement prédictif intégral de filiales régionales entières.
Le protocole d’audit commande donc une analyse hiérarchique ascendante (Bottom-Up). Le statisticien doit désagréger la métrique globale par catégories de produits, par zones géographiques, par canaux de vente ou par profils de consommateurs. Cette analyse granulaire permet de mettre en lumière d’éventuelles zones d’ombre opérationnelles.
Il arrive fréquemment que 80 % des entités sous-jacentes bénéficient d’un MAPE remarquable de 7 %, tandis que les 20 % restants affichent une défaillance critique avec des scores dépassant 70 %. Si l’analyste se contente d’observer la moyenne consolidée de 19,6 %, il valide le modèle dans son ensemble, perpétuant à son insu une défaillance structurelle sur le segment vulnérable.
10. Adaptation de la lecture face à des contextes statistiques contraignants
Les séries temporelles réelles se plient rarement aux postulats académiques d’équilibre stationnaire et de distributions continues. Face à des environnements statistiques complexes, la lecture du MAPE doit subir des transpositions méthodologiques précises.
10.1 Interprétation sur des données à forte saisonnalité et tendances abruptes
Lorsqu’une série temporelle manifeste des variations saisonnières d’amplitude majeure (comme l’industrie touristique ou le commerce de jouets de fin d’année), la signification du MAPE subit une distorsion dynamique liée à l’alternance des phases de pic et de creux d’activité.
Durant les phases de pic saisonnier, le dénominateur $y_t$ atteint des ordres de grandeur très élevés. Par conséquent, même une erreur prédictive substantielle en volume physique se traduira par un ratio relatif artificiellement comprimé et séduisant. Inversement, durant les creux de morte-saison, la contraction du dénominateur gonfle démesurément la sévérité du pourcentage pour le moindre écart marginal en unités réelles.
En outre, l’apparition d’un déphasage temporel ponctuel (le modèle anticipe le pic saisonnier avec une période de retard ou d’avance) engendre une déflagration mathématique sur le score du MAPE. La double pénalité relative appliquée lors de la période manquée et de la période compensée fait exploser la moyenne. Il est dès lors vivement recommandé d’opérer une désaisonnalisation préalable des données (par décomposition X-13ARIMA-SEATS ou STL) avant d’évaluer la précision relative intrinsèque du cœur algorithmique.
10.2 Traitement des séries intermittentes ou des lancements de nouveaux phénomènes
Dans le cadre de séries chronologiques intermittentes ou erratiques (caractérisées par de longues séquences d’observations nulles entrecoupées de sursauts de demande ponctuels), le calcul du MAPE relève d’une aberration méthodologique pure.
Certains praticiens tentent d’éluder l’impossibilité de la division par zéro en injectant artificiellement une constante infinitésimale $epsilon$ (par exemple 0,001 ou 1) aux valeurs réelles nulles. Cette pratique, bien que séduisante d’un point de vue informatique pour éviter les interruptions d’exécution, est désastreuse sur le plan statistique. La valeur du MAPE résultant dépendra quasi intégralement de l’amplitude arbitraire accordée à la constante $epsilon$, dénaturant intégralement l’objectivité de la métrique.
Dans ce contexte précis, l’analyste doit proscrire le MAPE et réorienter son appareil de mesure vers des méthodologies dédiées aux séries intermittentes, telles que l’approche de Croston, la méthode de Syntetos-Boylan, ou mobiliser des indicateurs d’échelle relative adaptés comme le MASE (Mean Absolute Scaled Error) théorisé par Rob Hyndman, qui contourne élégamment l’écueil du zéro en standardisant l’erreur sur la moyenne des variations absolues de la prévision naïve en échantillon.
10.3 Gestion de l’impact des ruptures structurelles et événements cygnes noirs
L’histoire économique et industrielle est périodiquement scandée par des ruptures structurelles brutales et des événements de type « Cygne Noir » (crises sanitaires mondiales, conflits armés majeurs, ruptures logistiques géopolitiques imprévisibles). Lors de ces phases de discontinuité radicale, l’intégrité de la prévision est anéantie sur l’ensemble des systèmes d’apprentissage statistique.
Dans de telles circonstances, continuer d’interpréter le MAPE selon les seuils d’excellence conventionnels de Lewis constitue un non-sens analytique. L’apparition temporaire de scores de MAPE oscillant entre 60 % et 150 % ne traduit pas une déficience structurelle du code informatique ou du modèle mathématique, mais atteste simplement de l’incapacité principielle de toute approche inductive à déduire un état inédit du monde à partir de données historiques devenues obsolètes.
La doctrine d’évaluation commande alors d’isoler analytiquement les périodes de choc en créant des fenêtres d’exclusion méthodologiques, afin d’éviter la contamination de l’historique de performance long terme du modèle. L’indicateur critique à observer devient alors la vitesse de résilience du modèle : c’est-à-dire le nombre de cycles d’observation requis pour voir le MAPE converger à nouveau vers son niveau d’équilibre nominal d’avant-crise.
11. Bonnes pratiques pour fiabiliser et enrichir la lecture du MAPE
Face à l’ensemble des limites intrinsèques exposées, la communauté des praticiens de la science des données a élaboré des protocoles méthodologiques visant à fiabiliser la lecture du MAPE et à en restaurer la portée décisionnelle.
11.1 Techniques de filtrage et troncature des erreurs relatives extrêmes
Pour prémunir le calcul du MAPE contre la sensibilité distorsive des valeurs aberrantes ou des dénominateurs infinitésimaux, l’application de techniques d’estimation robuste issues du filtrage statistique s’avère hautement bénéfique. La démarche la plus rigoureuse consiste à déployer une stratégie de Winsorizing (winsorisation) sur la série des erreurs relatives individuelles.
Ce protocole consiste à définir des seuils de troncature raisonnés fondés sur les distributions empiriques (par exemple, le 95e ou 99e centile). Tout ratio d’erreur individuelle dépassant ce seuil plafond n’est pas supprimé de l’échantillon—ce qui introduirait un biais d’attrition arbitraire—mais se voit réassigné à la valeur du seuil d’écrêtage. Cette approche permet de contenir l’explosion artificielle de la moyenne arithmétique tout en continuant à comptabiliser la défaillance de la prévision.
Toutefois, la transparence méthodologique impose que cette manipulation fasse l’objet d’un traçage formel dans les rapports d’audit. Il convient de présenter systématiquement de manière conjointe le MAPE brut originel et le MAPE ajusté des extrêmes (Trimmed MAPE), en explicitant rigoureusement le volume d’observations concernées par le traitement de troncature.
11.2 Adjonction systématique d’indicateurs de dispersion complémentaire
Une bonne pratique cardinale stipule qu’aucun indicateur de tendance centrale ne doit être communiqué sans son corollaire de dispersion. Présenter une valeur ponctuelle de MAPE sans préciser la variance interne de la distribution des erreurs relatives constitue une lacune épistémique majeure.
Pour remédier à cette asymétrie d’information, le MAPE doit être systématiquement flanqué du MdAPE (Median Absolute Percentage Error). La médiane des erreurs absolues en pourcentage offre l’immense avantage d’être totalement insensible aux aberrations de calcul des dénominateurs faibles et aux chocs ponctuels démesurés :
$$\text{MdAPE} = \text{médiane}\left( left| \frac{y_t – \hat{y}_t}{y_t} right| \times 100% \right)$$
La confrontation immédiate de ces deux mesures offre une perspective diagnostique remarquable :
- Si le MAPE s’établit à 14 % et le MdAPE à 13,5 %, la distribution des erreurs est parfaitement symétrique et homogène ; la lecture du MAPE est hautement fiable.
- Si le MAPE s’affiche à 28 % tandis que le MdAPE plafonne à 9 %, l’analyste déduit instantanément que le modèle est exceptionnellement précis dans la vaste majorité des cas, et que la dégradation de la moyenne arithmétique est imputable à un nombre restreint d’anomalies extrêmes nécessitant une investigation ciblée.
Cette approche peut être complétée par la restitution de l’écart interquartile des pourcentages d’erreur (IQR-APE), qui circonscrit la performance de la moitié centrale de la distribution empirique.
11.3 Standardisation du protocole de reporting pour les comités de direction
Pour éviter les dérives d’interprétation lors des restitutions stratégiques auprès des instances exécutives, la gouvernance des données de l’organisation doit instaurer une charte stricte de standardisation du reporting prévisionnel.
La règle d’or réside dans la traduction opérationnelle des pourcentages. Un rapport à destination des décideurs ne devrait jamais se borner à stipuler un chiffre abstrait comme « MAPE = 12 % ». Il doit expliciter la conversion de ce pourcentage en implications physiques directes : « Ce MAPE de 12 % correspond sur l’horizon écoulé à une incertitude moyenne de $\pm 450$ tonnes de matière première par mois, induisant un besoin de trésorerie tampon de 180 000 euros ».
Par ailleurs, le tableau de bord exécutif doit s’articuler autour d’une approche multi-critères sous la forme d’un triptyque indissociable :
- L’amplitude relative moyenne via le MAPE ou le WAPE ;
- Le biais directionnel via le MPE ou le Tracking Signal ;
- La stabilité centrale via le MdAPE.
Cette triangulation analytique immunise la direction contre l’illusion de certitude et aligne les arbitrages d’investissement algorithmique sur la réalité physique et financière de l’écosystème d’entreprise.
12. Synthèse opérationnelle : Guide de décision basé sur le MAPE
Pour clore ce traité et fournir aux praticiens un outil de pilotage directement mobilisable sur le terrain, cette section condense les protocoles décisionnels d’action, les schémas de visualisation graphique et les listes de contrôle méthodologique.
12.1 Arbre de décision méthodologique pour l’action corrective
Le pilotage d’un système prévisionnel en exploitation requiert l’établissement d’une matrice d’arbitrage algorithmique claire, déterminant les actions d’ingénierie à enclencher en fonction des scores de MAPE constatés :
Cet arbre décisionnel peut être formalisé selon le canevas opérationnel suivant :
- MAPE constaté < 10 % :
- Vérifier l’absence d’overfitting via les scores sur les données de test (Out-of-Sample).
- Si la robustesse est confirmée : Geler l’architecture du modèle. Mettre en place un protocole de surveillance allégé. Ne procéder à aucun réentraînement intempestif susceptible de déstabiliser les hyperparamètres optimaux.
- MAPE constaté entre 10 % et 20 % :
- Examiner le biais directionnel (MPE). Si le MPE est supérieur à $\pm 5%$, appliquer une recalibration du terme d’interception (bias correction).
- Conduire une analyse de sensibilité sur les hyperparamètres actuels de l’algorithme.
- Conserver le modèle en production tout en planifiant une revue périodique trimestrielle des résidus.
- MAPE constaté entre 20 % et 50 % :
- Effectuer un audit d’intégrité sur les données d’entrée (détection de retards, valeurs manquantes imputées de manière erronée).
- Tester l’adjonction de variables exogènes explicatives (calendriers promotionnels, indices macroéconomiques, données météorologiques).
- Procéder à une segmentation des séries : basculer les séries hautement volatiles vers des modèles robustes d’ensemble ou des approches d’arbres de décision régularisés.
- MAPE constaté > 50 % :
- Déclencher une procédure d’interruption du modèle en production.
- Remplacer immédiatement la prévision algorithmique par un modèle naïf de référence (persistance temporelle ou moyenne mobile) pour contenir les dérives.
- Ouvrir un chantier de refonte intégrale de la chaîne de traitement (re-spécification mathématique complète ou changement de paradigme algorithmique).
12.2 Visualisation graphique efficace des résidus relatifs
L’herméneutique de l’erreur est indissociable de sa spatialisation graphique. Une représentation visuelle soignée permet de diagnostiquer en un coup d’œil des pathologies d’estimation que la compression numérique du MAPE dissimule.
Trois représentations graphiques prioritaires doivent être systématiquement dressées :
- Le nuage de points de dispersion Écart-Volume : En plaçant les valeurs réelles $y_t$ sur l’axe des abscisses et les erreurs absolues relatives $|y_t – \hat{y}_t|/y_t$ sur l’axe des ordonnées, ce graphique permet de repérer instantanément l’asymétrie de calcul. Si les points s’envolent verticalement vers le haut lorsque l’abscisse s’approche de l’origine zéro, l’analyste visualise graphiquement l’instabilité structurelle du dénominateur du MAPE.
- La boîte à moustaches (Boxplot) de l’erreur relative : Contrairement à la moyenne arithmétique qui écrase la distribution, le boxplot illustre simultanément la médiane (MdAPE), l’intervalle interquartile et l’ensemble des points considérés comme des valeurs aberrantes au-delà des moustaches de Tukey. La dissymétrie de la boîte révèle immédiatement l’existence d’un biais d’estimation asymétrique.
- La courbe chronologique du MAPE roulant (Rolling MAPE) : Calculer et tracer l’évolution du MAPE sur une fenêtre mobile glissante (par exemple sur 12 semaines glissantes) permet d’identifier la dynamique temporelle du modèle. Une pente ascendante continue du Rolling MAPE alerte sur un phénomène de dérive conceptuelle (Concept Drift), signalant que le modèle perd progressivement son adéquation avec l’environnement opérationnel bien avant que le MAPE historique cumulé n’en reflète la gravité.
12.3 Checklist de validation finale pour une interprétation rigoureuse
Avant d’entériner la validation d’un modèle et de communiquer ses résultats aux parties prenantes, l’analyste se doit de renseigner une grille de conformité méthodologique stricte :
- Contrôle de validité du dénominateur : La série temporelle analysée est-elle strictement exempte de valeurs réelles nulles ($y_t = 0$) ? Le nombre d’observations d’amplitude quasi-nulle est-il négligeable ? Si non, basculer impérativement vers le WAPE ou le MASE.
- Test de neutralité directionnelle : Le MAPE est-il explicitement accompagné du calcul de l’erreur moyenne en pourcentage (MPE) ? A-t-on formellement écarté la présence d’un biais systématique de surévaluation ou de sous-évaluation ?
- Vérification de la robustesse face aux extrêmes : Le MAPE a-t-il été comparé à la médiane des erreurs relatives (MdAPE) ? L’écart entre ces deux métriques a-t-il été analysé et justifié méthodologiquement ?
- Représentativité temporelle de l’échantillon : L’horizon d’évaluation couvre-t-il un cycle opérationnel complet (incluant l’intégralité des phases de haute et basse saisonnalité) ? La taille d’échantillon $n$ est-elle statistiquement suffisante pour assurer la convergence de l’estimateur ?
- Cohérence comparative avec un modèle naïf : Le MAPE obtenu surpasse-t-il de manière significative et statistiquement prouvée la performance d’un modèle naïf de référence (Benchmark) déployé sur les mêmes données ?
- Alignement avec les coûts de défaillance métier : Les arbitrages implicites du modèle (linéarité de la pénalité, neutralité vis-à-vis du sens de l’écart) sont-ils en adéquation formelle avec la fonction de perte financière de l’organisation ?
L’observation rigoureuse de ces étapes garantit que l’interprétation des valeurs de MAPE s’élèvera au rang d’un processus diagnostique scientifique, immunisé contre les approximations empiriques et capable d’éclairer véritablement la prise de décision stratégique.
Références
- Armstrong, J. S., & Collopy, F. (1992). Error measures for generalizing about forecasting methods: Empirical comparisons. International Journal of Forecasting, 8(1), 69-80. https://doi.org/10.1016/0169-2070(92)90008-W
- Box, G. E., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: forecasting and control (5th ed.). John Wiley & Sons. https://www.wiley.com/en-us/Time+Series+Analysis%3A+Forecasting+and+Control%2C+5th+Edition-p-9781118675021
- Croston, J. D. (1972). Forecasting and stock control for intermittent demands. Operational Research Quarterly, 23(3), 289-303. https://doi.org/10.2307/3007885
- Hyndman, R. J., & Athanasopoulos, G. (2018). Forecasting: principles and practice (2nd ed.). OTexts. https://otexts.com/fpp2/
- Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679-688. https://doi.org/10.1016/j.ijforecast.2006.03.001
- Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. Econometrica, 47(2), 263-291. https://doi.org/10.2307/1914185
- Lewis, C. D. (1982). Industrial and business forecasting methods: A practical guide to exponential smoothing and curve fitting. Butterworth-Heinemann.
- Makridakis, S. (1993). Accuracy measures: theoretical and practical concerns. International Journal of Forecasting, 9(4), 527-529. https://doi.org/10.1016/0169-2070(93)90079-3
- Makridakis, S., Spiliotis, E., & Assimakopoulos, V. (2018). The M4 Competition: Results, findings, problems and ways forward. International Journal of Forecasting, 34(4), 802-808. https://doi.org/10.1016/j.ijforecast.2018.06.001
- Silver, E. A., Pyke, D. F., & Peterson, R. (1998). Inventory management and production planning and scheduling (3rd ed.). John Wiley & Sons.
- Syntetos, A. A., & Boylan, J. E. (2005). The accuracy of intermittent demand estimates. International Journal of Forecasting, 21(2), 303-314. https://doi.org/10.1016/j.ijforecast.2004.10.001