
Dans le domaine de la modélisation statistique appliquée aux sciences comportementales, à la psychologie cognitive et à la recherche biomédicale, l’évaluation de la qualité d’un modèle de régression linéaire représente une étape méthodologique fondamentale. Trop souvent, les chercheurs et les analystes de données concentrent leur attention de manière quasi exclusive sur le coefficient de détermination, le classique R², ou sur la significativité statistique des coefficients de régression au travers des valeurs de p. Pourtant, ces indicateurs normalisés masquent fréquemment une réalité clinique et pratique déterminante : l’incertitude concrète des estimations exprimée dans l’unité même de la mesure psychologique étudiée. C’est précisément à cet endroit que s’impose l’erreur type résiduelle, souvent désignée dans la littérature anglophone sous l’appellation de Residual Standard Error (RSE) ou d’erreur type de l’estimation.
L’erreur type résiduelle quantifie l’écart type de la composante stochastique ou inexpliquée du modèle de régression. Loin d’être un simple sous-produit calculatoire destiné à alimenter les tableaux d’analyse de variance, la RSE constitue l’étalon de mesure par excellence de l’imprécision prédictive. Alors qu’un indice de corrélation ou une proportion de variance expliquée peut être artificiellement gonflé par l’hétérogénéité de l’échantillon ou le choix d’un devis expérimental particulier, l’erreur type résiduelle conserve une signification concrète et opérationnelle directement adossée aux instruments d’évaluation : qu’il s’agisse de points sur une échelle d’évaluation de la dépression, de millisecondes mesurant un temps de réaction attentionnel ou de microvolts enregistrés lors d’un protocole électroencéphalographique.
Le présent article propose une analyse approfondie et exhaustive des fondements théoriques, des applications diagnostiques et des enjeux interprétatifs de l’erreur type résiduelle. Conçu à l’intention des chercheurs, psychométriciens, cliniciens et étudiants avancés en méthodologie quantitative, ce guide détaille pas à pas la mécanique mathématique de cet estimateur, examine sa sensibilité aux violations des postulats gaussiens, compare ses performances aux critères usuels de sélection de modèles et expose la manière d’intégrer rigoureusement sa valeur dans la construction d’intervalles de prédiction clinique individualisés.
1. Fondements théoriques et mathématiques de l’erreur type résiduelle
1.1 Définition conceptuelle de l’écart résiduel
Pour appréhender la nature profonde de l’erreur type résiduelle, il convient d’examiner en premier lieu la notion même de résidu statistique dans le cadre d’un modèle linéaire généralisé ou d’une régression par la méthode des moindres carrés ordinaires. Soit une observation empirique quelconque, notée yi, recueillie auprès d’un participant au sein d’un protocole d’évaluation psychologique. Lorsque cette mesure est confrontée à la valeur prédite par l’équation de régression, notée ŷi, la différence arithmétique ei = yi – ŷi constitue l’écart résiduel individuel. Cet écart résiduel matérialise l’inaptitude du modèle déterministe à reproduire fidèlement l’état cognitif, émotionnel ou comportemental manifesté par ce sujet singulier à partir des variables prédictives intégrées.
Sur le plan géométrique, l’écart résiduel représente la distance verticale orthogonale projetée depuis le point de données empirique jusqu’à la droite, au plan ou à l’hyperplan de régression ajusté dans l’espace multidimensionnel des variables. Contrairement à une distance euclidienne minimale perpendiculaire à l’hyperplan, cette projection verticale découle directement de l’asymétrie fonctionnelle inhérente à la régression : les variables explicatives sont considérées comme fixes ou exogènes, et seule la variabilité de la variable dépendante fait l’objet d’une tentative de prédiction et de minimisation des erreurs.
D’un point de vue conceptuel et épistémologique en psychométrie, le résidu n’est pas un simple bruit mécanique dépourvu de sens ; il représente la sommation de l’aléa fondamental du comportement humain, des fluctuations temporelles non contrôlées de l’état du patient, de l’erreur de mesure inhérente à l’instrument d’évaluation psychologique et des effets cumulés d’une multitude de variables causales non captées par le modèle théorique formulé par l’investigateur. L’erreur type résiduelle vise ainsi à synthétiser cette nébuleuse d’influences non modélisées sous la forme d’un paramètre de dispersion scalaire unique.
1.2 Formulation algébrique et décomposition du calcul
L’estimation ponctuelle de la variance de la perturbation stochastique sous-jacente au modèle statistique s’obtient par l’agrégation quadratique des résidus individuels. La formulation de base repose sur le calcul de la somme des carrés résiduels, universellement désignée par le sigle SSE (Sum of Squared Errors) ou SCR (Somme des Carrés des Résidus). Algébriquement, cette grandeur s’exprime comme l’accumulation de la somme, pour chaque participant allant de i = 1 à n, de la différence au carré entre l’observation empirique et la prédiction calculée :
SSE = ∑ (yi – ŷi)² = ∑ ei²
Cette somme des carrés des erreurs matérialise la quantité absolue de déviance non expliquée par l’architecture mathématique choisie. Toutefois, cette métrique globale présente un double inconvénient : d’une part, elle croît de manière monotone avec le nombre d’observations intégrées à l’échantillon, interdisant toute interprétation standardisée ; d’autre part, elle s’exprime dans le carré de l’unité de mesure de la variable dépendante, ce qui obère son interprétation clinique intuitive.
Pour remédier à ces contraintes, l’erreur type résiduelle effectue une normalisation par les degrés de liberté résiduels suivie d’une extraction de la racine carrée. L’équation formelle se présente ainsi :
se = √ [ SSE / (n – p – 1) ]
où n représente la taille totale de l’échantillon et p le nombre de variables explicatives ou régresseurs intégrés dans l’équation linéaire (l’entier 1 représentant le terme de constante ou d’ordonnée à l’origine). L’application de l’opérateur racine carrée joue ici un rôle épistémologique fondamental : elle annule la distorsion quadratique introduite lors de la sommation et ramène la valeur de l’indice de dispersion à l’échelle originale de l’instrument clinique, qu’il s’agisse de points sur l’inventaire de dépression de Beck, de quotients intellectuels ou de millisecondes.
1.3 Rôle crucial des degrés de liberté
Le dénominateur de la fraction résiduelle, défini par l’expression gl = n – p – 1, incarne le principe statistique de correction pour degrés de liberté. Dans une régression linéaire simple comportant un unique prédicteur, le dénominateur se simplifie sous la forme n – 2, dans la mesure où deux paramètres géométriques (l’ordonnée à l’origine et la pente de la droite) doivent être préalablement estimés à partir des données avant de pouvoir calculer le moindre résidu. Chaque paramètre estimé impose une contrainte linéaire stricte sur les résidus, réduisant d’autant la dimensionnalité de l’espace dans lequel les perturbations peuvent librement fluctuer.
Si l’on divisait naïvement la somme des carrés résiduels par la taille brute de l’échantillon n, comme cela est fait pour calculer la variance résiduelle au sens de la méthode du maximum de vraisemblance non corrigée, l’estimateur obtenu présenterait un biais négatif systématique. En effet, la méthode des moindres carrés garantit par construction que la droite choisie est celle qui minimise la somme des carrés des écarts pour cet échantillon spécifique. Dès lors, les résidus calculés par rapport à cette droite optimisée ont tendance à être artificiellement plus resserrés que les écarts véritables qui existeraient si l’on confrontait les données à la véritable fonction génératrice sous-jacente de la population générale. La division par n – p – 1 constitue la correction formelle exacte assurant que l’erreur type résiduelle au carré (la variance résiduelle) est un estimateur non biaisé de la variance théorique de l’erreur stochastique de la population, notée σ².
Les conséquences méthodologiques de ce mécanisme correcteur se révèlent particulièrement critiques dans les protocoles de psychologie ou de neuro-imagerie caractérisés par des échantillons de taille modeste confrontés à un nombre important de prédicteurs psychométriques ou démographiques. Lorsque le nombre de paramètres p s’accroît sans augmentation proportionnelle de la taille d’échantillon n, le dénominateur n – p – 1 chute drastiquement. Dès lors, même si l’ajout d’une variable superficielle ou fallacieuse permet de réduire très marginalement le numérateur SSE, l’effet de pénalité imposé au dénominateur peut surpasser ce gain arithmétique et conduire à une inflation mécanique de l’erreur type résiduelle. Ce comportement illustre le rôle de garde-fou exercé par la RSE contre les dérives du surajustement statistique.
2. Interprétation directe de l’amplitude numérique de l’erreur
2.1 Compréhension à travers l’unité de mesure psychométrique
L’avantage fonctionnel le plus éclatant de l’erreur type résiduelle réside dans sa totale transparence dimensionnelle. Contrairement aux coefficients standardisés ou aux indices adimensionnels comme le coefficient de Pearson, l’erreur type résiduelle s’exprime rigoureusement dans la même métrique physique ou psychométrique que la variable d’intérêt modélisée. Cette caractéristique confère à la RSE une pertinence clinique immédiate lors de l’interprétation des résultats d’un protocole de recherche ou d’un bilan d’évaluation individuel.
Considérons, à titre d’illustration, une équation de régression visant à modéliser le niveau de sévérité des symptômes dépressifs évalué par l’inventaire de dépression de Beck de deuxième édition (BDI-II), dont les scores s’échelonnent théoriquement de 0 à 63 points, à partir de covariables telles que la qualité subjective du sommeil et le niveau d’isolement social. Si le modèle statistique affiche une erreur type résiduelle de se = 4,20, ce chiffre possède une signification substantielle limpide : il indique que la marge d’imprécision moyenne ou l’écart d’erreur type anticipé entre la sévérité dépressive observée chez un patient et la sévérité calculée par l’algorithme est approximativement de 4,20 points sur l’échelle du BDI-II. Le clinicien habitué à manipuler cet instrument sait immédiatement situer cette magnitude par rapport aux seuils diagnostiques usuels (dépressions minimale, légère, modérée et sévère).
Cette logique s’applique de manière identique à l’ensemble des instruments psychométriques. Dans le cadre de l’évaluation cognitive par l’échelle d’intelligence de Wechsler pour adultes (WAIS-IV), où l’indice de quotient intellectuel total est standardisé avec une moyenne théorique de 100 et un écart type de 15 dans la population générale, une régression affichant une RSE de 6,5 points informe l’évaluateur que le modèle conserve une imprécision typique équivalente à un peu moins d’un demi-écart type de la population. À l’inverse, dans les paradigmes de chronométrie mentale évaluant les processus exécutifs au travers de temps de réaction, une RSE de 45 millisecondes s’interprète comme la dispersion résiduelle typique de la latence de traitement une fois contrôlés les facteurs d’âge ou de charge de travail en mémoire de travail.
2.2 Distinguer une valeur résiduelle faible d’une valeur élevée
La qualification d’une erreur type résiduelle comme étant « faible » ou « élevée » ne saurait découler d’un seuil absolu ou universel applicable à tous les pans de la recherche quantitative. Cette caractérisation exige une mise en relation systématique de l’amplitude de l’erreur avec deux entités fondamentales : la dispersion globale non conditionnelle de la variable dépendante et l’écart cliniquement significatif reconnu par la communauté scientifique au sein du domaine considéré.
Sur le plan statistique, le référentiel d’ancrage fondamental de l’erreur type résiduelle est l’écart type global de la variable cible, souvent noté sy. En effet, un modèle de régression totalement dénué de pouvoir prédictif (un modèle ne comportant que la constante) engendre une erreur type résiduelle rigoureusement égale à l’écart type global de l’échantillon :
se(vide) = √ [ ∑ (yi – ȳ)² / (n – 1) ] = sy
Par conséquent, l’efficacité d’un modèle prédictif se traduit par l’écrasement de se en deçà de sy. Une RSE équivalente à 0,30 × sy signale un resserrement remarquable des observations autour de la droite de régression, traduisant une excellente adéquation prédictive. En revanche, si se oscille autour de 0,95 × sy, le modèle n’extrait qu’une fraction marginale d’information, laissant les observations empiriques dispersées à une amplitude quasi identique à celle d’une distribution brute non informée.
Sur le plan substantiel et clinique, une valeur résiduelle élevée trahit une forte hétérogénéité des patrons de réponse au sein de la population. Si deux patients présentant des caractéristiques sociodémographiques et cognitives rigoureusement identiques voient leurs scores réels d’anxiété diverger de 15 points en présence d’une RSE estimée à 8 points, cette dispersion traduit l’intervention puissante de régulateurs affectifs singuliers, de mécanismes d’adaptation ou d’altérations contextuelles non pris en charge par le modèle. La valeur élevée de l’erreur rappelle aux praticiens les dangers inhérents à une foi aveugle dans un déterminisme statistique simplificateur.
2.3 Contextualisation selon la variabilité intrinsèque du construit
L’évaluation critique de l’erreur type résiduelle impose de prendre en compte la nature du construit psychologique sous-jacent et son niveau intrinsèque d’erreur d’échantillonnage ou d’erreur instrumentale. Selon la théorie classique des tests, toute variance empirique observée se décompose en une variance de score vrai et une variance d’erreur de mesure pure. Il en résulte que l’erreur type résiduelle ne peut en aucun cas être comprimée en deçà du plancher incompressible constitué par l’erreur type de mesure (ETM) de l’outil employé.
Dans les neurosciences cognitives quantitatives et l’évaluation neurophysiologique, où les outils de mesure physiques bénéficient d’une fidélité test-retest extrêmement solide (par exemple, la volumétrie cérébrale par résonance magnétique ou les potentiels évoqués de latence précoce), le bruit de mesure instrumental pur est comparativement faible. Dans ces conditions, les chercheurs sont fondés à exiger des erreurs types résiduelles très réduites lorsqu’ils prédisent ces paramètres à l’aide de modèles fonctionnels sophistiqués. Une RSE représentant plus de 10 à 15 % de l’étendue de l’échelle y sera perçue comme un indicateur d’insuffisance explicative du modèle.
À l’extrême opposé, dans le champ de la psychologie sociale expérimentale, de la psychologie de la personnalité ou de l’étude des dynamiques organisationnelles, les construits évalués (l’empathie dispositionnelle, le sentiment d’aliénation professionnelle, la flexibilité cognitive perçue) sont soumis à une variabilité intra-individuelle majeure dépendante de l’humeur fluctuante, de la désirabilité sociale et de l’ambiguïté linguistique des items des questionnaires d’auto-évaluation. Dans ces disciplines, l’erreur de mesure pure absorbe fréquemment 20 à 30 % de la variance totale du phénomène. Par conséquent, l’obtention d’une erreur type résiduelle modérément élevée ne signe pas nécessairement l’échec de la modélisation statistique, mais reflète fidèlement la limite épistémique supérieure imposée par la volatilité du construit étudié.
3. Analyse comparative entre l’erreur type résiduelle et le coefficient de détermination
3.1 Mesure absolue contre mesure relative de l’ajustement
L’un des écueils les plus récurrents de la pratique statistique consiste à juger de la pertinence d’une régression exclusivement au travers de son coefficient de détermination multiple R², tout en négligeant l’erreur type résiduelle. Bien que ces deux grandeurs dérivent des mêmes composantes fondamentales de la somme des carrés, elles interrogent la performance du modèle sous deux perspectives fondamentalement divergentes : le R² constitue une mesure de précision relative, adimensionnelle et bornée, tandis que la RSE incarne une mesure de précision absolue ancrée dans l’espace physique de la métrique.
Le lien algébrique fondamental entre ces deux entités s’établit au travers de l’équation suivante :
R² = 1 – (SSE / SST) = 1 – [ (se² × (n – p – 1)) / (sy² × (n – 1)) ]
où SST (Total Sum of Squares) représente la somme totale des carrés de la variable dépendante par rapport à sa propre moyenne d’échantillon. Cette formulation met en exergue la vulnérabilité mathématique inhérente au R² face à l’étendue de la variance totale de l’échantillon sélectionné. Si un chercheur recrute une cohorte extrêmement hétérogène, caractérisée par une dispersion globale SST hypertrophiée, la fraction SSE / SST s’effondre de manière mécanique, conduisant à un accroissement spectaculaire du R² sans que le modèle n’ait gagné la moindre parcelle de fidélité prédictive individuelle.
À l’inverse, l’erreur type résiduelle se demeure en principe invariante face aux manipulations artificielles de la variance totale induites par l’échantillonnage, pourvu que le postulat d’homoscédasticité soit respecté sur l’ensemble du continuum de la variable explicative. La RSE quantifie l’incertitude intrinsèque attachée à chaque prédiction singulière, indépendamment du fait que la cohorte d’étude soit homogène ou extraordinairement dispersée. Elle constitue, à ce titre, un étalon d’évaluation beaucoup plus honnête et stable pour le praticien soucieux de la fidélité clinique concrète.
3.2 Scénarios psychométriques divergents
Pour illustrer la nécessité d’une évaluation conjointe et critique de ces indices, il est instructif d’analyser deux scénarios d’incongruence statistique couramment rencontrés dans les publications empiriques mais fréquemment mal interprétés par les reviewers et les cliniciens.
Le premier scénario correspond au cas d’un modèle affichant un R² très élevé couplé à une erreur résiduelle cliniquement inacceptable. Imaginons une étude portant sur la prédiction de la trajectoire du déclin cognitif global évalué par le score total au Mini-Mental State Examination (MMSE, échelle de 0 à 30 points) au sein d’une cohorte combinant des adultes jeunes en parfaite santé intellectuelle (scores de 29 à 30) et des patients souffrant de maladie d’Alzheimer à des stades sévères (scores de 2 à 12). En raison de la dispersion gigantesque de la variable dépendante dans cet échantillon artificiellement polarisé, le modèle peut facilement afficher un R² impressionnant de 0,88. Néanmoins, le calcul de l’erreur type résiduelle peut révéler un se = 4,5 points. Or, sur l’échelle du MMSE, une imprécision de prédiction moyenne de 4,5 points est énorme : elle correspond à la différence entre un déclin léger et une démence avérée. Le modèle, malgré son R² flatteur, s’avère totalement inapproprié pour le monitoring clinique individuel.
Le second scénario, inverse, met en scène un R² très faible associé à une erreur type résiduelle extrêmement étroite. Soit un protocole de neuro-ergonomie visant à prédire les variations de diamètre pupillaire (en dixièmes de millimètre) associées à un effort cognitif soutenu chez des contrôleurs aériens hautement entraînés. Du fait de l’extrême sélection et de l’homogénéité physiologique de cette population d’élite, la variance totale observée du diamètre pupillaire est infime. Le modèle de régression développé peut n’expliquer qu’un modeste R² = 0,12. Pourtant, l’erreur type résiduelle s’établit à se = 0,08 millimètre. Cette imprécision résiduelle est si ténue qu’elle garantit une prédiction quasi parfaite du comportement biométrique des opérateurs. Rejeter un tel modèle sous prétexte d’un R² décevant constituerait une erreur méthodologique substantielle.
3.3 Complémentarité diagnostique pour l’évaluation globale
La saine pratique de la modélisation statistique en psychologie et en épidémiologie exige de ne jamais isoler ces indices mais d’orchestrer leur complémentarité fonctionnelle au sein d’un protocole d’analyse rigoureux. Le tableau suivant schématise la grille de lecture décisionnelle résultant du croisement entre l’amplitude du coefficient de détermination et le niveau d’erreur type résiduelle :
- R² élevé et RSE faible : Configuration optimale. Le modèle parvient à restructurer une part prépondérante de la dispersion des données tout en garantissant un intervalle de prédiction individuel très resserré, adapté tant à la validation de théories psychologiques générales qu’à la prise de décision diagnostique individuelle.
- R² élevé et RSE élevée : Alerte sur l’hétérogénéité de l’échantillon. Cette situation trahit fréquemment une variance totale initiale hypertrophiée, induite par un échantillonnage artificiellement étendu ou bimodal. Si le modèle valide globalement des tendances de groupe macroscopiques, son imprécision résiduelle interdit son utilisation pour statuer sur le cas d’un patient particulier.
- R² faible et RSE faible : Restriction de variance ou phénomène ultra-précis. Le modèle souffre d’un échantillon extrêmement homogène où la variance totale est quasi inexistante, ou capture un processus physiologique très contraint. La précision prédictive individuelle est remarquable malgré l’apparence mathématique modeste du pouvoir explicatif relatif.
- R² faible et RSE élevée : Invalidation théorique et empirique. Le modèle échoue à capturer la logique des données, et la dispersion des résidus démontre une imprécision prédictive disqualifiant toute application concrète.
Lors de la soumission de manuscrits scientifiques aux revues à comité de lecture affiliées à l’American Psychological Association, la présentation explicite de ces deux grandeurs côte à côte protège les auteurs contre les accusations d’inflation fallacieuse de leurs résultats et témoigne d’une maturité statistique exemplaire.
4. Inspection graphique de la dispersion résiduelle autour de la régression
4.1 Visualisation de l’ajustement en régression bivariée
L’évaluation numérique brute de l’erreur type résiduelle ne saurait remplacer l’analyse graphique minutieuse des résidus. Dans le cas élémentaire de la régression linéaire bivariée, l’erreur type résiduelle se matérialise graphiquement par la densité de l’enveloppe ou bande de dispersion entourant la droite d’estimation. Si l’on trace deux droites parallèles situées verticalement à une distance de ±1 se et ±2 se au-dessus et en dessous du vecteur de régression, on délimite les zones au sein desquelles doivent théoriquement se concentrer la majorité des observations sous condition de normalité.
Cette inspection visuelle permet d’identifier immédiatement la fidélité de la modélisation le long de l’ensemble du continuum de la variable indépendante. L’observateur avisé vérifie si l’enveloppe résiduelle conserve une largeur uniforme depuis les scores les plus faibles jusqu’aux scores les plus élevés du prédicteur. Si les points de données s’agglutinent de façon très serrée au centre de l’amplitude expérimentale mais se dispersent de façon erratique vers les extrémités, la valeur globale de la RSE représentera une moyenne composite trompeuse, masquant une dégradation sélective de la précision prédictive pour les individus manifestant des profils psychologiques extrêmes.
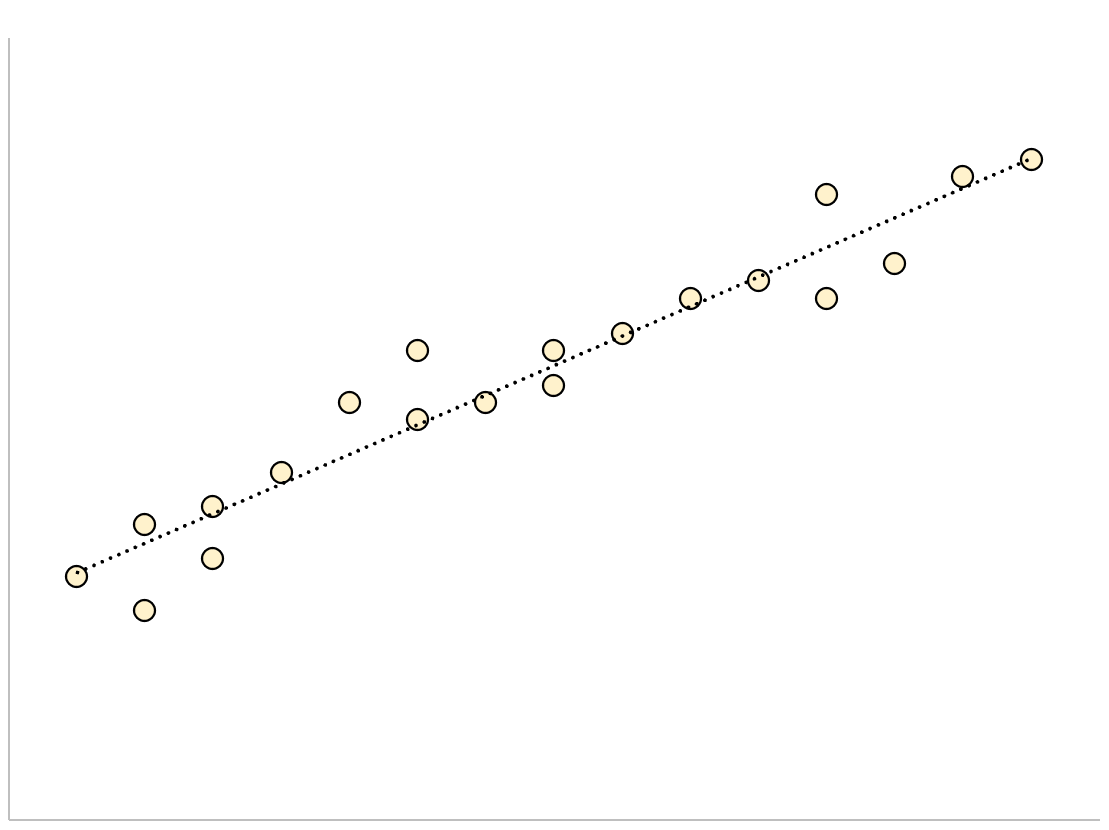
De surcroît, la visualisation directe de la dispersion permet de repérer instantanément des courbures structurales ou des patrons méandriques dans l’agencement des données empiriques. Lorsqu’une relation psychologique obéit à une loi de type U inversé, comme c’est classiquement le cas dans la loi de Yerkes-Dodson reliant l’éveil motivationnel et la performance cognitive, l’ajustement d’un modèle purement linéaire génère une dispersion résiduelle structurée. Les résidus seront systématiquement négatifs aux extrémités et massivement positifs dans la plage médiane, gonflant artificiellement l’erreur type résiduelle globale qui tente désespérément d’absorber une non-linéarité fondamentale.
4.2 Influence des valeurs aberrantes sur l’inflation résiduelle
Parce que le calcul de l’erreur type résiduelle repose intrinsèquement sur la mise au carré des écarts individuels dans la SSE, cet indice présente une hypersensibilité aux observations extrêmes et aux valeurs aberrantes (outliers). Un unique participant ayant mal compris les consignes expérimentales, ayant coché aléatoirement les items d’un inventaire clinique ou ayant manifesté une distraction massive lors d’une tâche informatisée est susceptible de générer un écart résiduel ei de grande magnitude. Lors de l’élévation au carré, cette seule observation peut générer une valeur quadratique ei² représentant 20, 30 voire 50 % de la somme des carrés résiduels de l’ensemble de la cohorte.
Il importe d’opérer une distinction méthodologique rigoureuse entre deux typologies de données aberrantes : les points à fort résidu vertical sans levier et les points à fort levier (leverage points). Un participant présentant une valeur extrême sur la variable prédictive X (point à fort levier) mais dont la valeur dépendante s’aligne fidèlement sur la trajectoire théorique prédite n’altérera que modérément l’erreur type résiduelle ; il aura en revanche un poids démesuré sur la pente de la droite. À l’inverse, une observation située au cœur de la distribution des variables explicatives mais manifestant une valeur dépendante aberrante engendre un résidu vertical colossal qui fait bondir la RSE sans nécessairement dévier l’inclinaison globale de la droite de régression.
La détection de ces perturbations implique le recours à des métriques diagnostiques éprouvées, telles que la distance de Cook et les valeurs de DFFITS. Lorsqu’un chercheur identifie qu’un résidu extrême gonfle indûment l’erreur type résiduelle, une analyse de sensibilité s’impose : recalculer le modèle avec et sans l’observation litigieuse permet de quantifier avec exactitude le degré d’inflation de l’imprécision prédictive imputable à cette anomalie de recueil.
4.3 Cartographie des résidus standardisés et studentisés
L’exploitation opérationnelle des résidus bruts ei est souvent entravée par le fait que leur variance n’est pas mathématiquement constante sur l’ensemble de l’échantillon : les résidus associés à des valeurs de X proches de la moyenne de l’échantillon possèdent intrinsèquement une variance théorique plus élevée que les résidus situés aux confins de la distribution. Pour standardiser le diagnostic et autoriser une lecture universelle, la statistique moderne préconise la transformation des résidus en résidus standardisés ou, idéalement, en résidus studentisés (aussi nommés résidus supprimés avec ré-échantillonnage).
Le résidu standardisé s’obtient en divisant le résidu brut par son erreur type estimée, laquelle intègre l’erreur type résiduelle globale et la valeur de levier (hat value, notée hii) propre à chaque sujet :
ri = ei / [ se √(1 – hii) ]
Sous condition de validité du modèle linéaire, les résidus standardisés se comportent approximativement comme une variable normale centrée réduite de variance unitaire. Dès lors, s’applique la règle empirique de la distribution normale : environ 68 % des résidus standardisés doivent être compris entre -1 et +1, approximativement 95 % entre -2 et +2, et moins de 1 % doivent franchir les frontières critiques de ±3 écarts types. La présence d’un ou plusieurs cas s’écartant au-delà de |3| constitue un signal d’alarme sans équivoque d’une inadéquation locale ou générale de l’erreur type résiduelle.
La cartographie de ces résidus au travers d’un graphique confrontant les résidus studentisés aux valeurs prédites (fitted values) permet d’inspecter visuellement d’éventuels décrochages de structure. L’identification de cas extrêmes ne doit pas conduire à une suppression automatique et mécanique de ces profils ; en psychologie clinique, ces cas récalcitrants représentent fréquemment des patients atypiques manifestant des résistances thérapeutiques insoupçonnées, dont la caractérisation clinique est susceptible d’enrichir la théorie psychopathologique au-delà des simplifications du modèle moyen.
5. Vérification des postulats statistiques conditionnant l’interprétation
5.1 Postulat d’homoscédasticité et constance de la variance
L’ensemble de l’édifice interprétatif de l’erreur type résiduelle repose sur une hypothèse fondamentale de la modélisation linéaire gaussienne : le postulat d’homoscédasticité. Ce postulat stipule que la variance des termes d’erreur stochastiques demeure rigoureusement constante sur l’intégralité du continuum défini par les combinaisons de variables indépendantes, c’est-à-dire :
Var(εi | X = x) = σ² pour tout x
Dans la pratique de la recherche psychologique, ce postulat est très fréquemment transgressé au profit d’un état d’hétéroscédasticité, se matérialisant visuellement par un patron résiduel en entonnoir (ou en éventail). Par exemple, dans les études consacrées au développement de l’intelligence chez l’enfant ou à l’apprentissage de la lecture, la variabilité interindividuelle des scores de compétence a naturellement tendance à s’accroître avec l’âge des participants. Les jeunes enfants affichent des performances relativement groupées, tandis que les adolescents se dispersent très largement le long du continuum de compétences.
Lorsque l’hétéroscédasticité s’installe, l’erreur type résiduelle calculée par la méthode des moindres carrés ordinaires devient un indicateur profondément trompeur. Elle représente une agrégation moyenne hybride qui sous-estime systématiquement la véritable incertitude prédictive chez les participants situés dans la zone de forte variance, tout en surestimant l’imprécision chez les sujets situés dans la zone de faible variance. Le clinicien qui utiliserait cette RSE globale pour établir une marge d’erreur diagnostique commettrait une double erreur d’appréciation selon le profil de son patient.
Pour attester formellement de la constance de la variance résiduelle, les chercheurs doivent implémenter des tests statistiques d’hypothèse spécifiques tels que le test de Breusch-Pagan, le test de Koenker-Bassett ou le test de White. En présence d’une hétéroscédasticité confirmée, l’interprétation standard de la RSE doit être amendée au profit de modèles de régression aux moindres carrés pondérés (WLS) ou de modélisations semi-paramétriques intégrant des fonctions d’estimation de la variance résiduelle hétérogène conditionnelle.
5.2 Normalité de la distribution des termes d’erreur
L’inférence statistique formelle entourant la régression linéaire, l’estimation des intervalles de confiance des prédictions et la validité probabiliste de l’erreur type résiduelle requièrent que les perturbations stochastiques non observées soient distribuées selon une loi gaussienne : εi ~ N(0, σ²). Il importe de souligner avec force que ce postulat concerne exclusivement la distribution des résidus du modèle et non la distribution marginale univariée des variables dépendantes ou explicatives brutes.
Pour ausculter cette normalité résiduelle, le diagramme quantile-quantile normal (Q-Q plot) constitue l’outil diagnostique de référence. Ce graphique confronte les quantiles empiriques de la distribution des résidus studentisés aux quantiles théoriques attendus d’une loi normale standard. Tout décollement systématique des points par rapport à la bissectrice idéale matérialise une distorsion distributionnelle. Deux anomalies majeures sont fréquemment détectées dans les données comportementales : l’asymétrie (skewness) et l’aplatissement anormal caractérisé par des queues de distribution épaisses (kurtosis leptokurtique).
Lorsqu’une distribution résiduelle affiche des queues épaisses, la valeur numérique calculée de l’erreur type résiduelle continue de mesurer la dispersion moyenne quadratique, mais la règle empirique associant 1 se à 68 % de confiance et 2 se à 95 % de confiance devient caduque. L’incertitude dans les zones extrêmes est notablement plus lourde que ce qu’anticiperait une distribution gaussienne idéale. Dans de telles circonstances, l’analyste doit s’abstenir de convertir machinalement la RSE en intervalles d’imprécision probabilistes sans avoir au préalable recouru à des techniques de rééchantillonnage de type bootstrap ou à des transformations non linéaires de la variable cible.
5.3 Linéarité et absence d’autocorrélation résiduelle
L’erreur type résiduelle ne peut prétendre refléter la véritable marge d’aléa stochastique que si le modèle a correctement extrait l’intégralité du signal déterministe accessible dans les données. Si la relation sous-jacente entre le phénomène cognitif et le prédicteur est quadratique, exponentielle ou logarithmique, mais que le chercheur impose une spécification strictement rectiligne, les écarts structurels non captés vont venir s’empiler directement au sein de la somme des carrés résiduels. Ce phénomène produit une inflation artificielle et injustifiée de l’erreur type résiduelle, qui cesse alors de refléter le bruit aléatoire pour devenir le réceptacle d’une erreur de modélisation théorique.
D’autre part, la dérivation mathématique garantissant que la RSE est un estimateur optimal et non biaisé suppose l’indépendance statistique absolue des termes d’erreur entre les différentes observations du devis expérimental :
Cov(εi, εj) = 0 pour tout i ≠ j
Cette condition d’absence d’autocorrélation est massivement violée dans deux designs méthodologiques classiques en psychologie : les études longitudinales impliquant des mesures répétées chez les mêmes sujets au fil du temps (effets de fatigue, d’apprentissage ou de rémission cyclique) et les protocoles nichés ou hiérarchiques où les individus partagent un environnement commun (élèves au sein d’une même classe, patients pris en charge par le même thérapeute hospitalier).
En présence d’une autocorrélation positive des résidus, détectable par des tests formels tels que la statistique de Durbin-Watson, l’erreur type résiduelle standard est calculée à partir d’un nombre de degrés de liberté effectifs nettement inférieur à la quantité nominale n – p – 1. L’information apportée par chaque observation n’étant pas indépendante des précédentes, le modèle génère une vision faussée de sa précision réelle. La transition vers des modèles linéaires à effets mixtes (LMM) ou des modèles autorégressifs s’avère dans ce cas indispensable pour isoler la variance résiduelle intra-sujet de la variance inter-sujet.
6. Utilisation de l’erreur type résiduelle pour la sélection de modèles
6.1 Arbitrage entre complexité structurelle et parcimonie
Dans l’élaboration de théories scientifiques, le principe du rasoir d’Ockham préconise de privilégier l’explication la plus sobre compatible avec les données empiriques. En régression statistique, ce principe s’incarne dans le compromis universel entre complexité structurelle (nombre de variables explicatives incorporées) et parcimonie du modèle. Alors que le coefficient de détermination R² brut présente le défaut rédhibitoire de croître inexorablement à chaque addition d’un prédicteur — même si cette variable n’est qu’un vecteur de nombres aléatoires sans lien théorique avec le phénomène —, l’erreur type résiduelle opère un arbitrage mathématique rigoureux.
Ce mécanisme d’autorégulation s’explique par la dynamique antagoniste régissant la fraction se = √ [ SSE / (n – p – 1) ]. L’introduction d’un nouveau prédicteur psychologique produit mécaniquement deux effets opposés :
- Au numérateur, la somme des carrés résiduels SSE diminue obligatoirement (ou au minimum reste identique), ce qui tend à faire baisser la valeur de l’erreur type résiduelle.
- Au dénominateur, les degrés de liberté résiduels sont amputés d’une unité (la quantité n – p – 1 diminue), ce qui tend inversement à accroître la valeur globale de la fraction.
Dès lors, l’erreur type résiduelle ne diminuera que si et seulement si la réduction de la somme des carrés résiduels apportée par la nouvelle variable surpasse la pénalisation imposée par la perte du degré de liberté. Si la variable ajoutée n’apporte qu’un gain prédictif dérisoire, l’effet de dénominateur l’emporte, et l’erreur type résiduelle augmente. L’analyste dispose ainsi d’un critère empirique spontané : tout modèle qui commence à voir sa RSE stagner ou croître est entré dans la zone critique du surajustement statistique (overfitting), captant le bruit d’échantillonnage aux dépens de la généralisabilité théorique.
6.2 Comparaison de spécifications concurrentes
L’erreur type résiduelle s’avère particulièrement puissante lors de l’évaluation de modèles emboîtés testant des théories cognitives concurrentes. Prenons l’exemple d’une controverse théorique portant sur la prédiction de la performance de lecture chez des enfants scolarisés en cours préparatoire. Un premier modèle minimaliste, ancré dans une approche purement phonologique, ne mobilise qu’un prédicteur unique de conscience phonologique. Un second modèle, plus intégratif, incorpore en sus des mesures de fluence de dénomination rapide et de capacité de mémoire de travail verbale.
L’examen comparé de l’erreur type résiduelle permet de quantifier avec précision le gain clinique concret généré par la théorie intégrative. Si le passage du modèle univarié au modèle multivarié abaisse la RSE de 8,50 points de score standardisé à 5,20 points, cette contraction de l’imprécision résiduelle démontre sans ambiguïté que l’intégration des fonctions exécutives n’est pas un luxe théorique superficiel : elle resserre substantiellement la marge d’erreur diagnostique autour de chaque jeune lecteur.
Cependant, une limite méthodologique stricte doit être scrupuleusement respectée par les chercheurs : la comparaison directe de l’erreur type résiduelle n’est rigoureusement licite qu’entre des modèles opérant sur la même variable dépendante et exprimés dans la même échelle de mesure. Si l’on compare un modèle prédisant des temps de réaction bruts en millisecondes avec un modèle concurrent prédisant le logarithme népérien de ces mêmes temps de réaction, leurs erreurs types résiduelles respectives (par exemple 45 ms contre 0,08 log-ms) n’appartiennent plus au même univers dimensionnel et ne peuvent faire l’objet d’aucune confrontation ordinale directe sans reconversion métrique préalable.
6.3 Articulation avec d’autres indices de sélection
L’erreur type résiduelle entretient des liens mathématiques et fonctionnels très étroits avec les critères de sélection modernes issus de la théorie de l’information et de l’apprentissage automatique. En particulier, elle présente une parenté directe avec la racine de l’erreur quadratique moyenne, le classique Root Mean Square Error (RMSE). La seule distinction arithmétique réside dans le dénominateur : le RMSE divise généralement la somme des carrés par n (dans sa formulation purement prédictive), tandis que la RSE divise par n – p – 1. Sur les grands échantillons, la convergence entre RMSE et RSE est quasi parfaite ; sur les petits échantillons, la RSE offre une estimation plus réaliste et non biaisée de l’erreur de généralisation dans la population.
Parallèlement, la RSE s’articule intimement avec le Critère d’Information d’Akaike (AIC) et le Critère d’Information Bayésien (BIC). Sous l’hypothèse de normalité des résidus, le logarithme de la vraisemblance maximale d’un modèle linéaire est directement proportionnel au logarithme de la variance résiduelle non corrigée SSE / n. Il en résulte que minimiser la RSE lors de la comparaison de modèles dotés du même nombre de paramètres revient rigoureusement à minimiser l’AIC.
Toutefois, lors du choix final d’un modèle d’analyse pour un protocole de recherche clinique, l’arbitrage ne doit pas reposer aveuglément sur un critère purement mathématique. Un modèle affichant un AIC légèrement supérieur ou une RSE marginalement plus élevée de quelques dixièmes de points peut néanmoins s’avérer infiniment supérieur sur le plan scientifique s’il préserve la parcimonie conceptuelle, évite d’incorporer des variables coûteuses ou invasives à recueillir chez les patients, et garantit une interprétabilité causale directe des processus psychologiques modélisés.
7. Construction et interprétation des intervalles de prédiction clinique
7.1 Distinction cruciale entre confiance et prédiction
L’une des confusions les plus dommageables observées dans la pratique de la psychométrie appliquée réside dans l’incapacité à différencier l’intervalle de confiance associé à la valeur espérée moyenne de l’intervalle de prédiction individualisé. Cette méprise conduit fréquemment les cliniciens à sous-estimer de manière colossale l’incertitude entourant le pronostic établi pour un patient particulier.
L’intervalle de confiance de la moyenne conditionnelle vise à quantifier l’imprécision d’échantillonnage pesant sur l’estimation de la moyenne de la sous-population des sujets partageant un profil spécifique de variables prédictives X₀. Parce qu’il s’intéresse à une moyenne asymptotique, la largeur de cet intervalle dépend de l’erreur type de l’estimation moyenne, laquelle se comprime inexorablement vers zéro à mesure que la taille globale de l’échantillon n grandit vers l’infini. Il reflète l’incertitude épistémique de l’investigateur quant à la véritable position de la droite de régression dans la population générale.
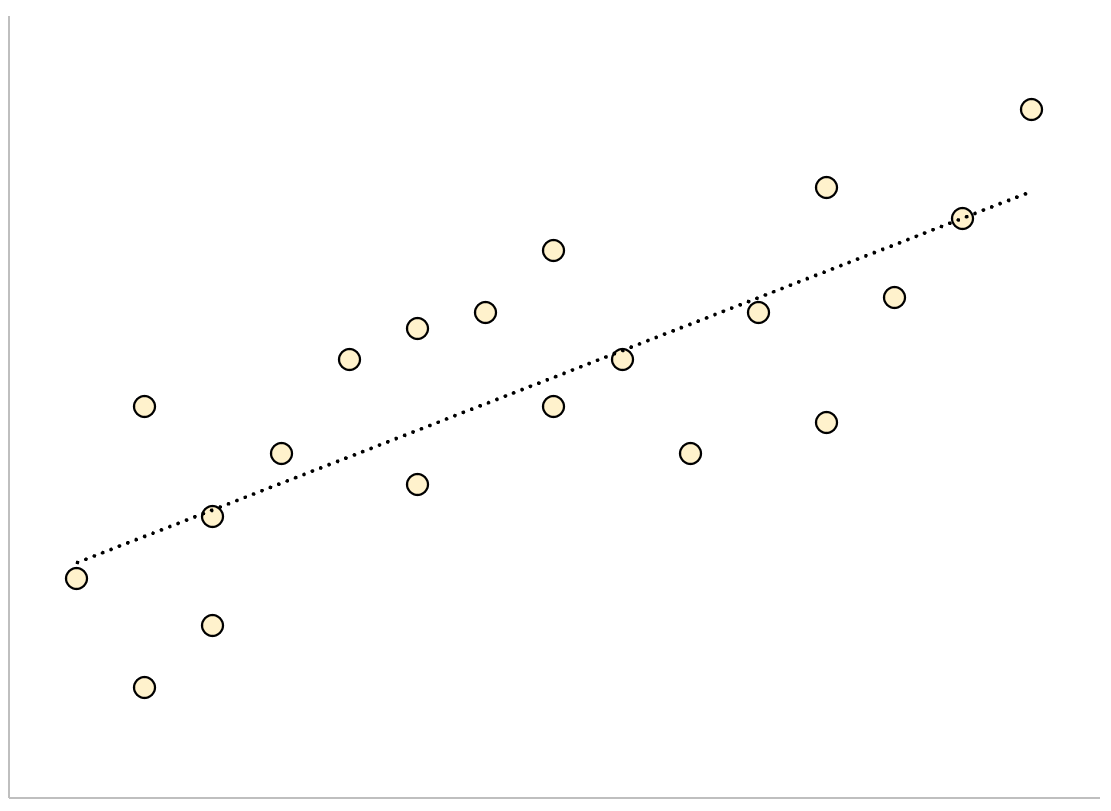
À l’opposé, l’intervalle de prédiction individuel vise à délimiter la zone au sein de laquelle se situera le score effectif d’un individu singulier se présentant au cabinet de consultation avec le profil X₀. Cet intervalle doit obligatoirement sommer deux sources d’incertitude indépendantes : d’une part, l’imprécision sur la localisation de la droite de régression moyenne, et d’autre part, la dispersion stochastique individuelle incompressible des sujets autour de cette droite, matérialisée précisément par l’erreur type résiduelle. Même si l’échantillon de recherche comportait un million de participants, réduisant l’erreur sur la moyenne à une valeur quasi nulle, l’incertitude sur l’individu resterait massivement conditionnée par la RSE.
7.2 Calcul opérationnel de l’intervalle de prédiction individuel
L’intégration formelle de ces deux composantes de variabilité se traduit dans l’équation mathématique définissant l’erreur type de prédiction pour une observation individuelle, notée spred :
spred = se × √ [ 1 + (1 / n) + ((X₀ – X̄)² / ∑ (xi – X̄)²) ]
L’analyse attentive des termes abrités sous le radical est particulièrement éclairante. Le premier terme, la constante unitaire « 1 », représente la contribution de la variance résiduelle propre au sujet individuel. Le deuxième terme 1 / n reflète l’incertitude sur la constante globale du modèle. Le troisième terme quantifie l’éloignement du profil du patient par rapport au barycentre de l’échantillon expérimental : plus le sujet présente des caractéristiques atypiques s’écartant de la moyenne X̄, plus l’incertitude d’extrapolation s’accroît, courbant les bornes de prédiction vers l’extérieur.
Pour un échantillon de taille raisonnable (par exemple n > 100) et pour un individu dont les caractéristiques prédictives ne sont pas excessivement extrêmes, les termes 1 / n et la fraction de distance s’avèrent infinitésimaux comparativement à la constante 1. Dès lors, l’expression sous le radical converge très étroitement vers √1 = 1, ce qui conduit à l’équivalence opérationnelle suivante :
spred ≈ se
Cette simplification fondamentale donne naissance à la célèbre règle empirique clinique : l’intervalle de prédiction individuel à 95 % de confiance se déploie approximativement sur une marge de deux erreurs types résiduelles de part et d’autre de la valeur ponctuelle calculée :
IP₉₅% ≈ [ ŷ₀ – 1,96 × se ; ŷ₀ + 1,96 × se ]
Cette formule pratique confère à l’erreur type résiduelle un rôle absolument central : elle détermine à elle seule l’épaisseur de la gaine d’incertitude encadrant toute prédiction individualisée.
7.3 Enjeux éthiques et translationnels en pratique psychologique
La prise en considération de l’erreur type résiduelle dans la restitution des bilans psychologiques et neuropsychologiques soulève des enjeux éthiques fondamentaux de transparence et de déontologie. Dans le contexte de l’expertise médico-légale, de l’orientation scolaire spécialisée ou de l’évaluation du risque de récidive criminelle, communiquer un chiffre prédictif ponctuel brut sans l’assortir de son intervalle fondé sur la RSE relève d’une négligence méthodologique grave.
Supposons qu’un algorithme prédictif multivarié soit utilisé pour pronostiquer l’autonomie fonctionnelle résiduelle d’un patient victime d’un traumatisme crânien sur une échelle d’incapacité de 0 à 100. L’algorithme fournit un score ponctuel de 62. Si le modèle présente une erreur type résiduelle se = 8 points, l’intervalle de prédiction à 95 % s’étend approximativement de 46 à 78 points. Ce large spectre couvre aussi bien un statut de dépendance sévère exigeant une aide humaine permanente qu’un état d’autonomie partielle compatible avec un maintien à domicile supervisé.
L’omission de cette dispersion résiduelle entretient chez les prescripteurs, les juges ou les familles une illusion d’infaillibilité algorithmique et de déterminisme mathématique. Sensibiliser les praticiens à la manipulation de la RSE permet de promouvoir une pratique translationnelle responsable, où la modélisation statistique n’est plus perçue comme un oracle absolu, mais comme un instrument d’aide à la décision contraignant le décideur à composer en permanence avec une marge d’incertitude irréductible.
8. Sensibilité de l’erreur type résiduelle aux propriétés de l’échantillon
8.1 Taille de l’échantillon et convergence de l’estimateur
Le comportement de l’erreur type résiduelle face à l’accroissement de la taille d’échantillon n est souvent source de malentendus chez les praticiens non statisticiens. Contrairement à l’erreur type d’une moyenne ou à l’erreur type d’un coefficient de régression, qui régressent vers zéro à la vitesse 1 / √n à mesure que l’échantillon s’accroît indéfiniment, l’erreur type résiduelle ne décroît pas avec n. Elle converge asymptotiquement vers la vraie valeur paramétrique du bruit stochastique de la population générale :
plimn → ∞ se = σ
Dans les vastes cohortes épidémiologiques réunissant plusieurs milliers de participants, l’erreur type résiduelle calculée se caractérise par une stabilité numérique remarquable. L’incorporation de centaines de sujets supplémentaires ne modifie plus que les troisièmes ou quatrièmes décimales de la valeur de se, garantissant une estimation d’une robustesse maximale de la variabilité inexpliquée.
À l’inverse, au sein d’échantillons cliniques restreints (par exemple n < 30), typiques de la recherche en neuropsychologie des lésions rares ou en psychométrie des syndromes génétiques orphelins, l’erreur type résiduelle fait preuve d’une instabilité analytique substantielle. Sa distribution d’échantillonnage dépend étroitement d’une loi de khi-carré divisée par ses degrés de liberté. Il en résulte que, sur de faibles effectifs, un hasard de recrutement défavorable peut gonfler ou comprimer artificiellement la valeur de la RSE de 30 à 40 % par rapport à sa valeur populationnelle, rendant précaires les conclusions relatives à l’ajustement du modèle.
8.2 Phénomène de restriction de variance
L’une des anomalies distributionnelles les plus puissantes susceptibles de distordre l’erreur type résiduelle est le phénomène de restriction d’étendue (range restriction). Ce biais méthodologique survient dès lors que l’échantillon analysé n’est pas recruté aléatoirement au sein de la population générale, mais se trouve sélectionné ou tronqué sur la base d’un critère préalable lié directement ou indirectement aux variables d’étude.
Examinons l’impact de ce phénomène selon que la sélection opère sur la variable explicative X ou sur la variable dépendante Y. Si la restriction d’étendue s’exerce strictement sur la variable indépendante X (par exemple, si l’on étudie la relation entre le quotient intellectuel et la réussite académique uniquement chez des étudiants admis dans une université ultra-sélective où QI > 125), et pourvu que le postulat d’homoscédasticité soit respecté, l’erreur type résiduelle se demeure théoriquement non biaisée. Elle continue de refléter fidèlement l’écart type des résidus locaux. En revanche, le coefficient de corrélation de Pearson et le R² s’effondrent spectaculairement en raison de l’écrasement de la variance totale de X.
En revanche, si la troncature porte directement sur la variable dépendante Y (par exemple, dans une étude évaluant des prédicteurs de la symptomatologie anxieuse menée exclusivement au sein d’une unité psychiatrique fermée où seuls sont admis les patients dépassant un seuil clinique drastique), le phénomène de troncature comprime artificiellement la distribution verticale des résidus aux bornes de la sélection. Dans ce cas de figure, l’erreur type résiduelle subit un biais négatif direct : elle apparaît faussement restreinte et flatteuse au sein de la cohorte clinique, masquant l’imprécision prédictive majeure qui se manifesterait immédiatement si le modèle était déployé dans la population globale non tronquée.
8.3 Fidélité des instruments et accumulation de l’erreur de mesure
L’amplitude numérique de l’erreur type résiduelle est intimement assujettie à la consistance interne et à la stabilité métrologique des instruments employés pour recueillir les données empiriques. En psychométrie moderne, l’indice le plus usité pour caractériser cette cohérence est le coefficient alpha de Cronbach ou le coefficient omega de McDonald, mesurant la proportion de variance du score total imputable au construit latent théorique.
Lorsque la fidélité de l’instrument mesurant la variable dépendante se dégrade, l’erreur de mesure non systématique s’accroît. Or, la méthode des moindres carrés ordinaires ne peut distinguer la variance liée à l’imparfaite spécification de l’équation de la variance induite par les faiblesses psychométriques du questionnaire. Toutes deux fusionnent indifféremment dans la somme des carrés résiduels. Si un chercheur évalue un construit complexe au travers d’un questionnaire hâtif présentant un coefficient alpha modeste de 0,60, au moins 40 % de la variance observée est constituée de bruit d’échantillonnage aléatoire pur. Ce bruit instrumental vient gonfler de façon massive et mécanique l’erreur type résiduelle.
Pour dépasser cette limitation inhérente aux modèles linéaires manifestes, les chercheurs recourent aux techniques de modélisation par équations structurelles (SEM). En séparant formellement le modèle de mesure (qui extrait les saturations factorielles et l’erreur spécifique de chaque item) du modèle structural reliant les construits latents, ces méthodes permettent d’isoler l’erreur type résiduelle de structure de l’erreur de mesure instrumentale pure, offrant une vision purifiée des véritables capacités explicatives de la théorie psychologique explorée.
9. Comportement de l’erreur résiduelle dans les architectures multivariées
9.1 Introduction de covariables et régression multiple
Le passage d’une régression linéaire bivariée à une architecture de régression multiple modifie en profondeur la dynamique de décomposition de la variance. L’incorporation méthodique de covariables démographiques ou de facteurs de contrôle cognitifs vise explicitement à purger la variance inexpliquée résiduelle en capturant des pans successifs de covariation empirique.
Considérons l’évaluation de l’efficacité d’un protocole de réhabilitation cognitive chez des patients cérébrolésés. Un modèle n’intégrant que le nombre d’heures d’entraînement cognitif affiche initialement une erreur type résiduelle substantielle de se = 12,4 points sur l’indice de mémoire de travail. Lorsque l’analyste introduit successivement l’âge chronologique, le niveau d’éducation formelle antérieur et la taille volumétrique de la lésion cérébrale en tant que covariables exogènes, ces variables absorbent une proportion importante de la déviance résiduelle. La SSE diminue plus rapidement que la décrémentation des degrés de liberté, et l’erreur type résiduelle s’abaisse consécutivement à se = 6,8 points.
Cette contraction de la RSE traduit une amélioration fondamentale de la netteté diagnostique : en neutralisant le bruit systématique induit par les disparités démographiques et neurologiques de base, le modèle réduit l’incertitude entourant l’effet thérapeutique spécifique du programme de réhabilitation. Inversement, l’introduction de covariables superflues, non corrélées à la variable dépendante, ne produit aucune baisse de la SSE tout en amputant inutilement les degrés de liberté, ce qui se traduit par une remontée graduelle de l’erreur type résiduelle, signalant l’inefficacité de la stratégie de modélisation.
9.2 Impact de la multicolinéarité sur l’erreur globale
L’un des comportements les plus fascinants de l’erreur type résiduelle réside dans sa résilience remarquable face au fléau de la multicolinéarité. Dans les protocoles de psychologie où de multiples échelles corrélées sont introduites simultanément comme régresseurs (par exemple, différentes sous-échelles d’anxiété-trait, d’anxiété-état et de névrosisme), la corrélation interne élevée entre ces variables indépendantes induit une instabilité redoutable dans le modèle.
Sous l’effet d’une forte multicolinéarité, l’erreur type des coefficients individuels (les erreurs types des coefficients bj) explose de manière exponentielle, rendant les coefficients partiels instables, fluctuants et statistiquement non significatifs en raison du facteur d’inflation de la variance (VIF). Face à ce chaos micro-analytique touchant les paramètres individuels, un observateur non averti pourrait supposer que l’erreur type résiduelle globale se du modèle subit une dégradation analogue. Il n’en est rien.
L’erreur type résiduelle évalue la fidélité globale avec laquelle l’hyperplan conjointement formé par l’ensemble des prédicteurs approche la variable cible. Même si l’orientation respective des axes individuels au sein de cet hyperplan est imprécise et redondante, la surface prédictive globale demeure remarquablement stable. Dès lors, la RSE reste préservée et conserve sa pleine pertinence pour quantifier la marge d’erreur globale des prédictions, pourvu que l’on ne cherche pas à extrapoler le modèle sur des profils de prédicteurs violant la matrice de covariance originale observée dans l’échantillon d’étalonnage.
9.3 Modèles d’interaction et effets non linéaires
L’intégration de termes d’interaction multiplicative (modération statistique) et de transformations polynomiales (effets quadratiques ou cubiques) complexifie l’analyse de l’erreur résiduelle tout en décuplant son potentiel d’optimisation prédictive. En modélisation psychologique, les phénomènes sont rarement strictement additifs ; l’impact d’un stress biologique majeur sur la survenue d’un épisode dépressif est fréquemment modéré par le niveau de soutien social ou la présence d’allèles génétiques spécifiques.
Lorsqu’un terme de produit X₁ × X₂ est adjoint à une équation de régression linéaire, l’évaluation de son utilité substantielle ne doit pas s’appuyer uniquement sur la valeur de p associée à ce coefficient d’interaction. Les analystes doivent scruter attentivement l’évolution différentielle de l’erreur type résiduelle :
Δse = se(modèle additif) – se(modèle avec interaction)
Une régression de la RSE atteste que la conceptualisation modératrice permet d’affiner concrètement la marge de prédiction pour les profils combinatoires complexes. De même, face à des décélérations d’apprentissage répondant à des lois de puissance ou des plafonnements cognitifs, l’introduction judicieuse d’un terme quadratique X² permet d’aplatir les résidus structurés, diminuant drastiquement la somme des carrés résiduels et rétablissant l’homogénéité de l’erreur résiduelle le long de l’axe prédictif.
10. Erreurs d’interprétation fréquentes et écueils méthodologiques
10.1 Confusion terminologique dans la littérature
La littérature scientifique internationale en sciences sociales et biomédicales est régulièrement entachée d’erreurs sémantiques et conceptuelles relatives au terme « erreur type ». Il règne en particulier une confusion omniprésente entre trois métriques aux finalités fondamentalement distinctes, confusion fréquemment exacerbée par la nomenclature elliptique adoptée par les logiciels statistiques grand public :
La première méprise fondamentale consiste à confondre l’erreur type résiduelle du modèle (la RSE, notée se) avec l’erreur type d’un coefficient de régression spécifique (notée SE(bj)). Alors que la RSE quantifie la dispersion des résidus empiriques autour du modèle complet dans l’unité de la variable dépendante, l’erreur type d’un coefficient quantifie l’incertitude d’échantillonnage attachée à la pente de ce régresseur particulier sous l’effet des fluctuations de réplication de l’étude. Confondre ces deux indices dans un rapport méthodologique fausse totalement l’évaluation de la robustesse des résultats.
La seconde méprise réside dans la confusion entre l’erreur type résiduelle et l’écart type brut de la variable dépendante (sy). Certains auteurs non spécialistes rapportent la valeur de se en affirmant qu’il s’agit de la dispersion normale des participants dans la population, omettant que la RSE correspond à la dispersion résiduelle conditionnelle résidant après prise en compte des prédicteurs théoriques. Les environnements logiciels tels que SPSS, SAS, Stata ou le langage de programmation statistique R emploient des libellés parfois ambigus (« Std. Error of the Estimate » sous SPSS contre « Residual standard error » sous R), exigeant une vigilance méthodologique constante lors de l’extraction des paramètres.
10.2 Comparaisons inter-échelles inappropriées
Comme l’erreur type résiduelle conserve scrupuleusement l’unité physique ou psychométrique de la variable dépendante, toute tentative de confrontation directe entre des modèles explorant des variables cibles distinctes ou employant des échelles aux métriques divergentes est dénuée de sens mathématique. Il est méthodologiquement absurde de prétendre qu’un modèle prédisant l’anxiété au moyen de l’échelle de Hamilton (HAM-A, dont les scores s’étendent de 0 à 56) avec une RSE de 4,2 est « plus précis » qu’un modèle prédisant le bien-être subjectif sur une échelle visuelle analogique de 0 à 10 avec une RSE de 1,8.
Un piège encore plus insidieux apparaît lors de l’application de transformations mathématiques destinées à linéariser les relations ou stabiliser la variance, au premier rang desquelles figure la transformation logarithmique népérienne : y* = ln(y). Le modèle résultant génère une erreur type résiduelle exprimée en unités logarithmiques sans dimension physique immédiate. Un chercheur qui comparerait naïvement la RSE du modèle brut (par exemple se = 250 ms) à celle du modèle transformé (par exemple se = 0,18 log-ms) en conclurait faussement à une réduction miraculeuse de l’erreur d’estimation.
Pour autoriser une comparaison rigoureuse, il est impératif de reconvertir les prédictions du modèle transformé vers l’échelle métrique originelle au travers de la fonction réciproque (l’exponentiation, en appliquant le cas échéant le facteur de correction de biais logarithmique de Neyman-Scott), puis de recalculer les résidus réels et l’erreur type résiduelle sur cette métrique brute réconciliée.
10.3 Négligence de la pertinence clinique au profit du résultat brut
L’adhésion aveugle à la minimisation purement arithmétique de l’erreur type résiduelle expose les chercheurs au risque d’attribuer une supériorité statistique formelle à des modèles qui s’avèrent scientifiquement invalides ou dépourvus de validité de construit. Un modèle prédictif n’est pas un simple automate de compression de résidus ; il doit incarner une architecture théorique intelligible et féconde.
Il est aisé de fabriquer un modèle affichant une erreur type résiduelle spectaculairement basse en introduisant une variable explicative qui n’est qu’une paraphrase tautologique de la variable dépendante (par exemple, prédire le score total à un inventaire d’évaluation de l’état de stress post-traumatique en incorporant dans les prédicteurs les réponses à trois items spécifiques de ce même inventaire évaluant les réviviscences intrusives). L’effondrement de la RSE obtenu dans ces conditions n’apporte aucune découverte clinique : il sanctionne simplement une circularité méthodologique fallacieuse.
De surcroît, une erreur type résiduelle extrêmement resserrée observée au sein d’un échantillon ultra-homogène issu d’un laboratoire universitaire ne garantit nullement la transposabilité du modèle dans des contextes cliniques réels caractérisés par la comorbidité, la diversité ethnoculturelle et la précarité socioéconomique. L’évaluation de la qualité de la RSE doit toujours être contextualisée par l’examen minutieux de la validité externe du protocole et de l’intégrité écologique des conditions de recueil des données.
11. Applications pratiques et études de cas en psychologie
11.1 Étude 1 : Prédiction du niveau d’anxiété par les perturbations du sommeil
Pour matérialiser l’interprétation concrète de l’erreur type résiduelle dans un cadre clinique standardisé, considérons un protocole de recherche portant sur un échantillon de n = 120 patients consultant dans un centre hospitalier pour des troubles anxio-dépressifs. L’objectif consiste à modéliser la sévérité de l’anxiété clinique évaluée par l’inventaire d’anxiété de State-Trait (STAI-Y, échelle de score s’étalant de 20 à 80 points) à partir de biomarqueurs nocturnes recueillis par actimétrie continue au domicile des participants. La variable explicative principale retenue est l’indice de fragmentation du sommeil (IFS), exprimé en pourcentage.
L’analyse descriptive révèle que l’écart type global de la sévérité anxieuse au sein de cette cohorte s’établit à sy = 14,2 points, traduisant une forte dispersion initiale des manifestations d’angoisse. L’ajustement du modèle de régression linéaire bivarié produit l’équation suivante :
STAI_prédit = 24,50 + 0,65 × IFS
Le calcul statistique indique une somme des carrés des erreurs SSE = 12 508. Les degrés de liberté résiduels s’élèvent à gl = 120 – 1 – 1 = 118. L’erreur type résiduelle qui en découle est donc :
se = √ (12 508 / 118) = √ 106,0 = 10,3 points
L’interprétation clinique de ce résultat s’articule comme suit : l’intégration de la fragmentation actimétrique du sommeil a permis de comprimer la variabilité du phénomène anxieux, faisant régresser l’écart type non conditionnel de 14,2 points à une incertitude résiduelle de 10,3 points. Le coefficient de détermination affiche un R² = 0,48. Si un patient se présente avec un indice de fragmentation élevé de 60 %, le modèle prédit un score d’anxiété moyen ponctuel de 24,50 + 0,65 × 60 = 63,5 points. En mobilisant la RSE, le clinicien sait qu’il doit adosser à cette prédiction un intervalle à 95 % s’étendant approximativement sur 63,5 ± 1,96 × 10,3, soit de 43,3 à 83,7 points (borné empiriquement à 80 points). Cette marge résiduelle informe le thérapeute que, si l’actimétrie constitue un biomarqueur corrélatif avéré à l’échelle du groupe, elle demeure insuffisante pour asseoir à elle seule un diagnostic catégoriel infaillible au niveau individuel sans recueil anamnestique complémentaire.
11.2 Étude 2 : Évaluation des scores dépressifs après psychothérapie
Cette seconde étude de cas se place dans la perspective de l’évaluation de la réponse thérapeutique individualisée. Un essai clinique randomisé évalue l’efficacité d’un protocole novateur de thérapie cognitivo-comportementale (TCC) digitalisée chez n = 85 adultes souffrant d’un épisode dépressif majeur caractérisé. Le critère d’évaluation principal est le score obtenu au terme des 12 semaines de thérapie à l’inventaire de dépression de Montgomery-Åsberg (MADRS, score de 0 à 60 points). Le modèle multivarié intègre trois prédicteurs : le score initial au MADRS à l’inclusion, le score d’alliance thérapeutique perçue à la semaine 2 et le niveau d’observance des modules interactifs.
Le modèle complet affiche un R² = 0,64. La somme des carrés résiduels s’établit à SSE = 1 976,4. Avec p = 3 prédicteurs, les degrés de liberté résiduels sont de 85 – 3 – 1 = 81. L’erreur type résiduelle s’établit précisément à :
se = √ (1 976,4 / 81) = 4,94 points
Dans la pratique clinique psychiatrique, le seuil de changement cliniquement signifiant et perceptible sur la MADRS est communément fixé entre 4 et 5 points. Le constat d’une erreur type résiduelle de 4,94 points confère au modèle une puissance translationnelle majeure. En effet, l’imprécision moyenne de prédiction du score post-traitement est contenue dans l’épaisseur même du seuil de détection clinique.
Le médecin psychiatre peut ainsi modéliser de façon fiable le pronostic de son patient. Si l’équation pronostique un score final attendu de 12 points (zone de rémission clinique), l’incertitude individuelle typique est d’environ 5 points. L’intervalle prédictif garantit avec une très forte probabilité que le patient atteindra un statut de réponse clinique favorable (score < 20). La RSE sert ici d’étalon direct pour arbitrer la pertinence d’orienter le sujet vers cette modalité psychothérapeutique numérique ou d’envisager une pharmacothérapie d’emblée plus agressive.
11.3 Étude 3 : Modélisation des temps de réaction dans une tâche d’attention
La troisième application illustre le traitement des variables chronométriques, réputées pour leur asymétrie distributionnelle prononcée et leur forte sensibilité à la fatigue cognitive. Dans une tâche psychophysique informatisée d’attention soutenue de type psychomotor vigilance task (PVT) d’une durée de 20 minutes, n = 50 participants privés de sommeil pendant 24 heures sont soumis à des stimuli visuels aléatoires. La variable cible est la latence de réponse médiane, mesurée en millisecondes. Les prédicteurs incorporés sont l’âge du participant et l’accumulation continue du temps passé sur la tâche (time-on-task, de 1 à 20 minutes).
L’estimation sur les temps de réaction bruts révèle une erreur type résiduelle très élevée de se = 86,5 ms, associée à un profil résiduel fortement hétéroscédastique et étalé vers les scores élevés (trainées résiduelles massives induites par les micro-sommeils des participants). Devant la violation manifeste des postulats gaussiens, l’analyste applique une transformation réciproque classique en chronométrie mentale : la transformation en vitesse de traitement, définie par Vitesse = 1 000 / TR (exprimée en s⁻¹).
L’ajustement du modèle linéaire sur cette métrique stabilisée engendre une erreur type résiduelle de se = 0,22 s⁻¹ pour une moyenne de vitesse de 2,85 s⁻¹. L’inspection du Q-Q plot résiduel valide parfaitement la normalisation gaussienne et l’homoscédasticité. En reconvertissant les prédictions et leur enveloppe d’erreur au niveau de l’échelle d’origine, le chercheur observe que l’intervalle d’imprécision prédictive autour d’un temps de réaction médian de 350 ms s’établit entre 325 et 380 ms, traduisant une excellente précision locale une fois neutralisée la distorsion distributionnelle. Cette étude de cas démontre avec force que l’interprétation féconde de la RSE passe impérativement par une réconciliation rigoureuse entre contraintes méthodologiques formelles et nature métrique des processus cognitifs sous-jacents.
12. Normes de communication et rédaction scientifique
12.1 Règles de restitution selon les directives de l’APA
La diffusion transparente des résultats de modélisation au sein de la communauté scientifique internationale obéit aux normes rédactionnelles standardisées édictées dans le manuel de publication de l’American Psychological Association (7e édition). Selon ces directives, l’omission de l’erreur type résiduelle au profit exclusif du coefficient de détermination ou des statistiques de test F constitue un manquement aux standards actuels de rigueur empirique.
Sur le plan typographique et symbolique, l’erreur type résiduelle ou l’erreur type de l’estimation doit être désignée par l’abréviation latine en italique se ou par l’expression explicite SEE (Standard Error of the Estimate). Lors de la description textuelle des résultats d’une régression multiple au sein de la section « Résultats » d’un manuscrit empirique, il est recommandé de lier organiquement la taille d’échantillon, les degrés de liberté, la proportion de variance expliquée et l’erreur type résiduelle au sein d’une même phrase de synthèse.
Une formulation textuelle canonique conforme aux exigences de l’APA se structure selon le modèle suivant :
« L’analyse de régression linéaire multiple indique que l’ensemble des prédicteurs psychologiques explique de façon statistiquement significative la variance de la symptomatologie dépressive, F(3, 116) = 24,18, p < ,001, R² = ,385, R² ajusté = ,369. L’erreur type résiduelle du modèle s’établit à se = 4,32 points de score BDI-II, attestant que l’imprécision prédictive typique du modèle n’excède pas un demi-écart type de la distribution clinique de référence. »
12.2 Structuration optimale dans les tableaux de régression
L’organisation typographique des tableaux de résultats représente un enjeu de clarté majeur. Une erreur méthodologique fréquente consiste à reléguer l’erreur type résiduelle au sein du corps principal du tableau aux côtés des variables explicatives, créant une confusion désastreuse avec les erreurs types propres à chaque coefficient partiel de régression (SE B).
La disposition conventionnelle standardisée préconise de structurer le tableau de régression en réservant les colonnes aux coefficients non standardisés (B), à leurs erreurs types individuelles (SE B), aux coefficients standardisés (β), aux statistiques de test (t) et aux intervalles de confiance afférents. L’erreur type résiduelle doit, quant à elle, figurer systématiquement dans les notes de bas de tableau ou au sein d’une section récapitulative dédiée aux propriétés globales de l’équation, immédiatement adjacente à la taille de l’échantillon N, au R² brut, au R² ajusté et à la valeur de la statistique de Durbin-Watson.
Dans le cas d’analyses de régression hiérarchique par étapes (stepwise ou hierarchical regression), la présentation tabulaire gagne considérablement en lisibilité si chaque étape de modélisation (Modèle 1, Modèle 2, Modèle 3) affiche sa propre erreur type résiduelle dans la ligne récapitulative inférieure. Ce dispositif permet aux relecteurs de suivre d’un coup d’œil la décroissance séquentielle de l’incertitude absolue au fur et à mesure de l’incorporation de blocs successifs de variables théoriques.
12.3 Médiation des résultats auprès des praticiens non statisticiens
Au-delà de la sphère académique des publications entre pairs, les chercheurs en psychométrie et les biostatisticiens sont continuellement sollicités pour communiquer les conclusions de leurs modélisations à des praticiens de terrain non statisticiens : médecins généralistes, psychologues scolaires, directeurs de ressources humaines ou travailleurs sociaux. Pour ces interlocuteurs, les concepts abstraits de sommes de carrés, de degrés de liberté ou d’homoscédasticité sont totalement hermétiques.
Pour assurer une médiation scientifique efficace et exempte de jargon mathématique superflu, l’erreur type résiduelle doit être traduite sous la forme d’une marge d’incertitude concrète et opérationnelle. Le communicant gagne à reformuler la RSE sous l’analogie d’une « marge d’imprécision moyenne typique ». Présenter un modèle prédisant l’absentéisme au travail en expliquant que « le modèle présente un se = 3,2 jours » est infiniment plus parlant que d’affirmer que « le modèle affiche un R² = 0,22 ». Tout praticien comprend instantanément que le pronostic informatisé oscille typiquement à plus ou moins trois jours de la réalité du terrain.
La conception de supports visuels clairs s’avère ici décisive. Dans les rapports de bilan psychologique individualisés générés à l’intention des patients ou des prescripteurs médicaux, il convient de substituer aux traditionnels graphiques en barres des diagrammes de prédiction en bande, visualisant la valeur prédite centrale entourée de son halo d’incertitude résiduelle délimité par ±1 et ±2 se. En matérialisant graphiquement le caractère probabiliste de l’évaluation, cette approche pédagogique démystifie la puissance de l’outil statistique, prévient le piège du fétichisme du chiffre ponctuel et réaffirme la primauté irremplaçable du jugement clinique humain face à l’aléa de la psychologie de l’individu.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation.
- Bollen, K. A. (1989). Structural equations with latent variables. John Wiley & Sons. https://doi.org/10.1002/9781118619179
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Gelman, A., & Hill, J. (2007). Data analysis using regression and multilevel/hierarchical models. Cambridge University Press. https://doi.org/10.1017/CBO9780511790942
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Montgomery, S. A., & Åsberg, M. (1979). A new depression scale designed to be sensitive to change. British Journal of Psychiatry, 134(4), 382–389. https://doi.org/10.1192/bjp.134.4.382
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). Psychological Corporation.
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934