
L’avènement des tableurs infonuagiques dans l’écosystème de la recherche scientifique et de la gouvernance informationnelle a transformé de manière irréversible la manipulation quotidienne des matrices de données. Parmi les opérations élémentaires qui sous-tendent la structuration des corpus analytiques, l’incrémentation automatisée de valeurs constitue une pierre angulaire méthodologique. Loin de se réduire à un simple artifice ergonomique d’économie gestuelle, cette opération engage des mécanismes sophistiqués d’inférence algorithmique, de modélisation séquentielle et de préservation de l’intégrité référentielle. Dans un environnement partagé tel que Google Sheets, maîtriser les dynamiques de progression séquentielle permet non seulement d’optimiser les flux de travail mais également de prémunir le chercheur contre les biais systématiques d’encodage manuel.
La génération de séries de données ordonnées répond à des exigences formelles strictes, qu’il s’agisse de construire des indexations primaires uniques pour des cohortes expérimentales, de discrétiser des variables temporelles continues ou d’implémenter des plans factoriels complets. Dès lors que les jeux de données s’étendent sur plusieurs milliers d’observations, la manipulation manuelle devient une source rédhibitoire d’erreurs stochastiques et cognitives. Le recours à l’automatisation numérique — qu’elle prenne la forme de la manipulation directe de l’interface via la poignée de recopie, de l’évaluation dynamique de fonctions matricielles ou du déploiement de scripts événementiels — s’impose comme une nécessité épistémologique et opérationnelle.
Le présent traité propose une analyse exhaustive et rigoureuse des paradigmes d’incrémentation au sein de Google Sheets. En examinant successivement les fondements théoriques des suites arithmétiques dans les systèmes de calcul distribué, l’ergonomie cinétique des outils de recopie, la combinatoire des fonctions de tableau et la programmation procédurale, ce document offre une grille de lecture scientifique et pratique. À travers des protocoles pas à pas, des cas d’usage contextualisés et des diagnostics d’anomalies structurelles, ce guide fournit aux analystes et scientifiques les compétences requises pour concevoir des architectures tabulaires robustes, pérennes et reproductibles.
1. Fondements conceptuels de l’incrémentation automatisée de données
1.1 Définition opératoire et taxonomie des suites numériques dans les tableurs
Au sens mathématique fondamental, une suite numérique est une application définie sur l’ensemble des entiers naturels qui associe à chaque rang un élément scalaire appartenant à un ensemble déterminé. Dans le paradigme applicatif d’un tableur tel que Google Sheets, l’incrémentation automatisée représente la matérialisation calculatoire de cette progression. L’opération repose majoritairement sur le concept de suite arithmétique d’ordre un, dans laquelle chaque terme successif est obtenu par l’addition d’une constante scalaire, dénommée raison ou pas d’incrémentation, au terme immédiatement antérieur. Cette formalisation s’exprime canoniquement par la relation de récurrence élémentaire U(n+1) = U(n) + r, où r désigne la raison arithmétique et n l’indice positionnel de l’enregistrement.
Il convient d’établir une distinction théorique fondamentale entre la simple duplication de valeurs et la projection algorithmique de motifs. La duplication, ou clonage scalaire, est une opération idempotente qui reporte invariablement la valeur d’une cellule source sur une plage réceptrice sans altération de son contenu sémantique ou quantitatif. En revanche, l’incrémentation implique une projection vectorielle dynamique régie par une fonction de transition. Le moteur de calcul ne se borne pas à copier l’information brute ; il évalue l’historique positionnel des cellules antécédentes afin d’en déduire une régularité sous-jacente, puis applique cette loi d’évolution aux coordonnées spatiales adjacentes sélectionnées par l’utilisateur.
Dans le contexte expérimental et statistique, ce processus joue un rôle cardinal dans la standardisation des ensembles de variables de recherche. L’affectation d’index croissants continus garantit l’unicité de la clé primaire de chaque observation, préservant ainsi l’indépendance des lignes face aux réordonnancements ultérieurs résultant de tris multidimensionnels. L’incrémentation algorithmique élimine tout risque d’omission d’indice, de duplication involontaire ou de dérive fractionnaire, conférant à la matrice d’analyse une consistance structurelle indispensable à la validité interne des traitements inférentiels ultérieurs.
1.2 L’environnement Google Sheets et le moteur de reconnaissance heuristique
Contrairement aux tableurs traditionnels compilés localement en langage machine, Google Sheets fonctionne au sein d’une architecture client-serveur hautement distribuée, orchestrée par un moteur JavaScript côté navigateur qui communique de manière asynchrone avec les serveurs de calcul de Google. Lorsqu’un utilisateur sollicite une extension séquentielle, le moteur de reconnaissance heuristique du logiciel est mobilisé. Ce composant analyse en temps réel la charge sémantique, la typologie des données et l’ordonnancement des cellules initialement sélectionnées afin de formuler une hypothèse sur l’intention analytique de l’opérateur.
L’interprétation sous-jacente des formats de données par ce compilateur Web repose sur un système d’évaluation contextuelle rigoureux. Une cellule contenant une chaîne de caractères brute ne sera pas traitée selon la même grammaire computationnelle qu’une cellule encapsulant une valeur numérique formatée en notation scientifique, une coordonnée temporelle sérialisée ou un identifiant alphanumérique normalisé. Le moteur sépare la valeur intrinsèque sous-jacente de sa représentation graphique superficielle. Par exemple, une date est instantanément convertie en son équivalent numérique séquentiel représentant le nombre de jours écoulés depuis l’époque pivot du système avant que la raison arithmétique ne lui soit appliquée, puis reformatée selon le schéma local de l’utilisateur.
Cette sophistication algorithmique soulève d’importants enjeux d’exactitude dans l’enregistrement de séries expérimentales ou observationnelles. Si les données sources présentent des ambiguïtés sémantiques — telles qu’un séparateur décimal non conforme aux paramètres régionaux du classeur ou des espaces insécables parasites —, l’heuristique prédictive peut échouer et basculer subrepticement vers une réplication scalaire brute plutôt qu’une incrémentation arithmétique. Cette rupture silencieuse du patron de progression est susceptible d’introduire des biais majeurs dans la collecte de données. Une compréhension fine des mécanismes d’inférence de Google Sheets s’avère donc indispensable pour tout analyste soucieux de la reproductibilité de ses protocoles.
2. La poignée de recopie (Fill Handle) : Mécanique et cinétique d’utilisation
2.1 Anatomie de la cellule active et repérage de l’interface d’ancrage
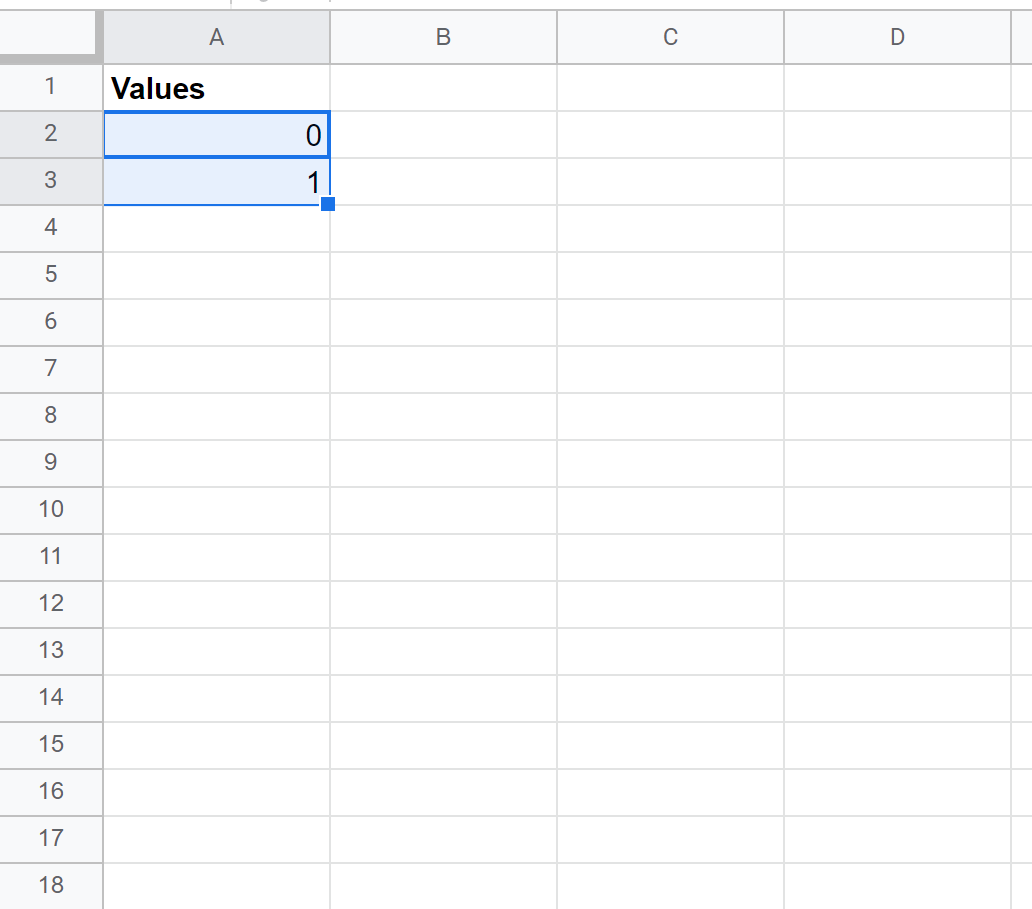
L’interaction fondamentale avec le modèle de données de Google Sheets s’effectue via la grille bidimensionnelle, au sein de laquelle la cellule active constitue l’entité interactive primaire. Lorsqu’un utilisateur sélectionne une cellule ou une plage matricielle contiguë, le logiciel délimite graphiquement cette sélection au moyen d’une bordure colorée contrastée, généralement bleue. À l’angle inférieur droit de ce périmètre de sélection se situe un élément géométrique miniature mais hautement fonctionnel : la poignée de recopie, communément désignée sous le vocable technique de fill handle.
Ce carré de préhension, mesurant quelques pixels de côté, constitue un nœud de capture événementiel dans le Document Object Model (DOM) de l’interface utilisateur. D’un point de vue sémiotique, le système informe visuellement l’opérateur de la prise en charge de cette zone d’ancrage par une mutation instantanée du pointeur de la souris : le curseur fléché conventionnel se transforme en une croix réticulaire noire fine et symétrique. Cette altération morphologique signale que l’interface a basculé du mode de sélection standard au mode d’extension séquentielle contextuelle.
L’utilisation de cette poignée requiert une précision cinématique rigoureuse. L’opérateur peut opérer une traction bidirectionnelle, soit le long de l’axe vertical (vers le bas ou vers le haut), soit le long de l’axe horizontal (vers la droite ou vers la gauche). Cette sensibilité ergonomique engage un mécanisme d’écoute d’événements de glisser-déposer qui capture les coordonnées spatiales du pointeur en temps réel, projetant une zone fantôme semi-transparente pour matérialiser la future plage réceptrice avant la confirmation terminale de l’action lors du relâchement du clic.
2.2 Nécessité de la sélection double pour la détection du pas de progression
L’un des écueils opérationnels les plus fréquents réside dans la confusion entre les propriétés sémiotiques d’une valeur isolée et celles d’un intervalle défini. Lorsqu’une unique cellule contenant une valeur purement scalaire est étirée à l’aide de la poignée de recopie, le système d’inférence algorithmique de Google Sheets se trouve dans l’impossibilité mathématique d’établir un différentiel. En l’absence d’un second terme référentiel permettant de calculer une dérivée discrète, l’application applique la règle du moindre engagement cognitif en déclenchant une opération de réplication pure et simple de la valeur source sur l’ensemble de la trajectoire.
Pour forcer le moteur heuristique à initialiser une incrémentation arithmétique constante, il est impératif d’établir au préalable un vecteur directeur constitué par la sélection conjointe d’au moins deux cellules spatialement contiguës. La relation spatiale entre ces deux cellules définit le sens et l’axe de la propagation, tandis que leur écart numérique détermine la raison arithmétique r = U(2) – U(1). En traitant cette sélection double comme une unité sémantique indissociable, l’utilisateur communique au compilateur la règle de transition qui devra gouverner la projection séquentielle.
Il importe de souligner que cette contrainte varie selon le typage de la donnée sous-jacente. Certains formats porteurs d’une sémantique intrinsèquement ordonnée — tels que les dates complètes ou les chaînes alphanumériques indexées — intègrent une règle d’incrémentation unitaire par défaut, autorisant une dérivation séquentielle à partir d’une sélection unaire. Cependant, pour l’ensemble des données scalaires numériques conventionnelles, la sélection d’au moins deux coordonnées successives demeure une exigence structurelle incontournable pour éviter la reproduction passive de la valeur de départ.
2.3 Le double-clic contextuel pour l’extension automatique verticale
Au-delà de la cinétique classique de glisser-déposer, l’interface de Google Sheets offre une modalité d’extension accélérée d’une grande valeur ergonomique : le déclenchement par double-clic sur la poignée de recopie. Cette commande gestuelle mobilise un algorithme de détection topologique qui analyse l’occupation matricielle des colonnes immédiatement adjacentes, avec une priorité heuristique accordée à la colonne située à gauche de la cellule active.
Le fonctionnement de cette automatisation repose sur l’identification d’une plage continue de données contiguës. Lorsque l’opérateur double-clique sur le carré d’ancrage, le système évalue la longueur vectorielle de la colonne témoin et propage instantanément la séquence arithmétique verticalement vers le bas jusqu’à ce qu’il rencontre la première cellule vide dans cette colonne adjacente. Le processus s’interrompt net dès l’interruption de la continuité des données de référence, assurant un alignement parfait sans nécessiter de défilement visuel fastidieux.
Cette fonctionnalité confère une économie de geste substantielle lors du traitement de corpus volumineux comportant plusieurs dizaines de milliers d’enregistrements. En éliminant la manipulation manuelle prolongée du curseur — source fréquente de dépassement involontaire de la plage cible ou d’interruptions prématurées liées aux latences d’affichage du navigateur —, le double-clic vertical minimise de manière drastique les biais de manipulation et préserve l’intégrité de la structure tabulaire.
3. Exemple 1 : Incrémentation linéaire unitaire (pas de un)
3.1 Protocole pas à pas pour générer une série de 0 à 20
Afin d’illustrer la mécanique fondamentale de l’incrémentation unitaire continue, considérons le protocole de génération d’une séquence ordonnée d’indices entiers s’étendant de la borne inférieure 0 à la borne terminale 20. Ce type de série constitue typiquement le socle d’indexation d’un échantillon expérimental ou le repère ordinal d’une suite chronologique discrétisée.
Le protocole analytique se déploie selon les étapes suivantes :
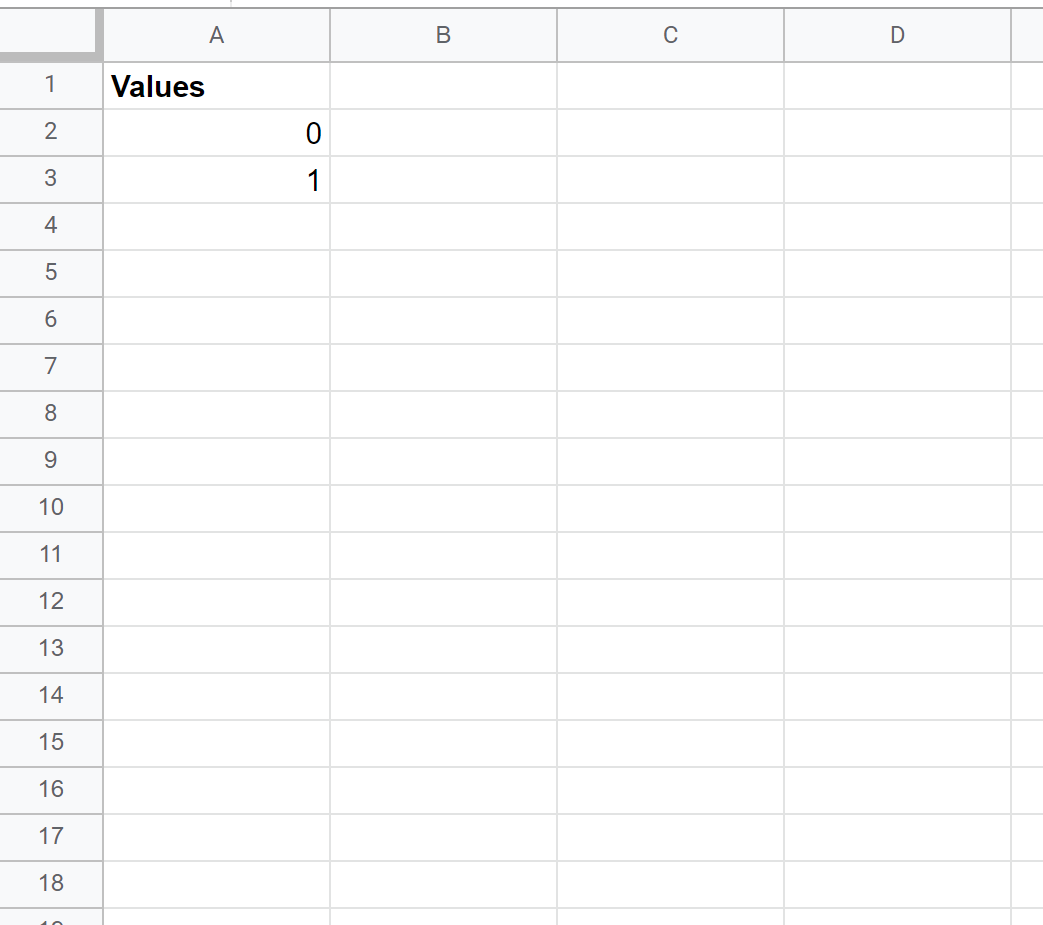
- Initialisation matricielle : L’opérateur accède à la cellule cible initiale, par exemple A1, et y encode la valeur scalaire entière 0. Immédiatement en dessous, dans la cellule spatialement contiguë A2, l’opérateur consigne la valeur 1. Cette phase d’amorce constitue la définition des conditions initiales de la progression.
- Agrégation vectorielle : À l’aide du dispositif de pointage, l’utilisateur active la sélection conjointe de la plage A1:A2. Cette étape est critique : le cadre de sélection englobe désormais les deux valeurs, et la poignée de recopie se positionne à l’angle inférieur droit de la cellule A2. Le système calcule immédiatement le différentiel implicite : 1 – 0 = 1.
- Traction cinétique : L’utilisateur positionne le curseur sur le carré de préhension jusqu’à observer la réticulation en croix, effectue une pression continue sur le bouton gauche de la souris, puis déplace le curseur verticalement vers le bas le long de la colonne A. Durant le glissement, une infobulle d’aide visuelle s’affiche dynamiquement à proximité du curseur, indiquant la valeur projetée pour la cellule courante.
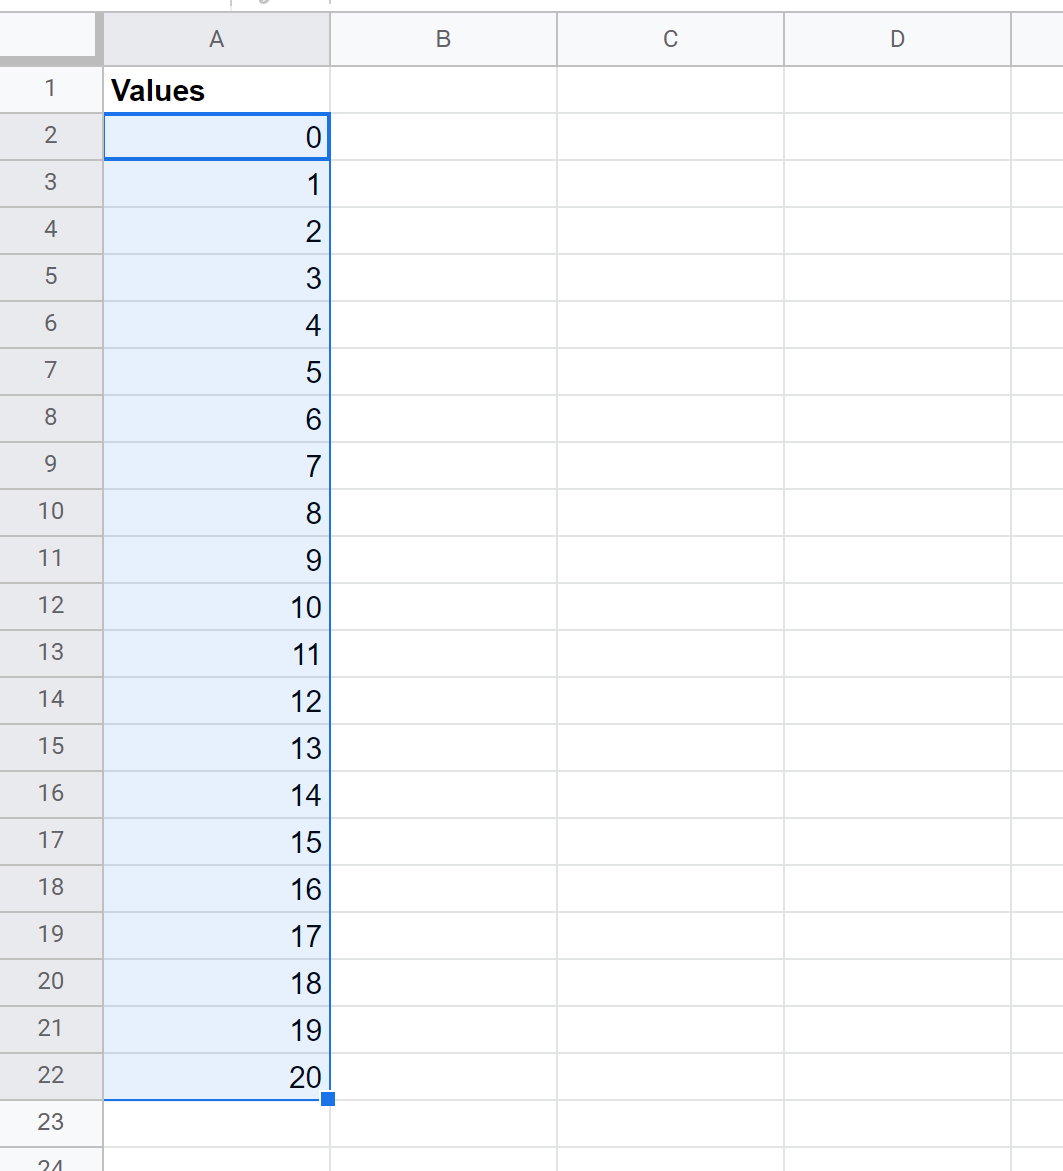
- Clôture et contrôle d’intégrité : Le glissement est interrompu lorsque l’infobulle indique la valeur cible 20, ce qui correspond à la cellule A21. L’opérateur relâche la pression. L’ensemble des cellules de la plage A1:A21 se trouve alors instancié de manière séquentielle et ininterrompue, validant la rigueur de la chaîne arithmétique.
L’intégrité de la série séquentielle obtenue peut être vérifiée mathématiquement en s’assurant que la cardinalité de l’ensemble généré respecte la propriété fondamentale des intervalles discrets : le nombre d’éléments est rigoureusement égal à la différence entre la borne supérieure et la borne inférieure, incrémentée d’une unité, soit (20 – 0) + 1 = 21 cellules actives.
3.2 Variantes structurelles : Séries négatives et progressions décroissantes
La logique d’incrémentation linéaire unitaire ne se limite aucunement aux progressions strictement monotones croissantes dans le sous-espace des entiers positifs. Le moteur de projection algorithmique de Google Sheets est conçu pour manipuler avec une rigueur égale les vecteurs orientés vers des valeurs négatives ou des dynamiques de décroissance continue, indispensables à la formalisation de certains protocoles scientifiques.
Pour implémenter une séquence décroissante de 0 à -20, le protocole requiert une configuration initiale symétrique. L’opérateur saisit la valeur 0 en A1, puis la valeur -1 en A2. L’algorithme d’inférence dérive la raison différentielle négative r = -1 – 0 = -1. Lors du déploiement vertical descendant de la poignée de recopie le long de la colonne, le compilateur procède par soustractions itératives successives, atteignant le terme terminal -20 à la ligne 21. Inversement, l’utilisateur peut amorcer une série avec 20 et 19 pour décroître progressivement vers zéro.
Ces variations structurelles trouvent une utilité méthodologique de premier ordre dans l’étalonnage des échelles de mesure en psychologie expérimentale et en sciences sociales, notamment lors de l’élaboration de variables de type échelle de Likert bipolaire centrée sur un zéro neutre (par exemple, s’étendant de -5 à +5). Elles permettent en outre de modéliser des comptes à rebours chronologiques rigoureux pour des événements programmés dans le cadre de protocoles d’observation temporelle standardisés.
4. Exemple 2 : Incrémentation arithmétique par multiples et intervalles constants
4.1 Implémentation pratique d’un pas non unitaire : Le cas des multiples de quatre
Dans de nombreuses configurations analytiques, la discrétisation des observations exige l’adoption d’un intervalle d’échantillonnage non unitaire. La quantification temporelle par trimestres, l’attribution d’identifiants de blocs randomisés ou la structuration de paliers de concentration expérimentale nécessitent fréquemment l’application d’une raison arithmétique supérieure à un.
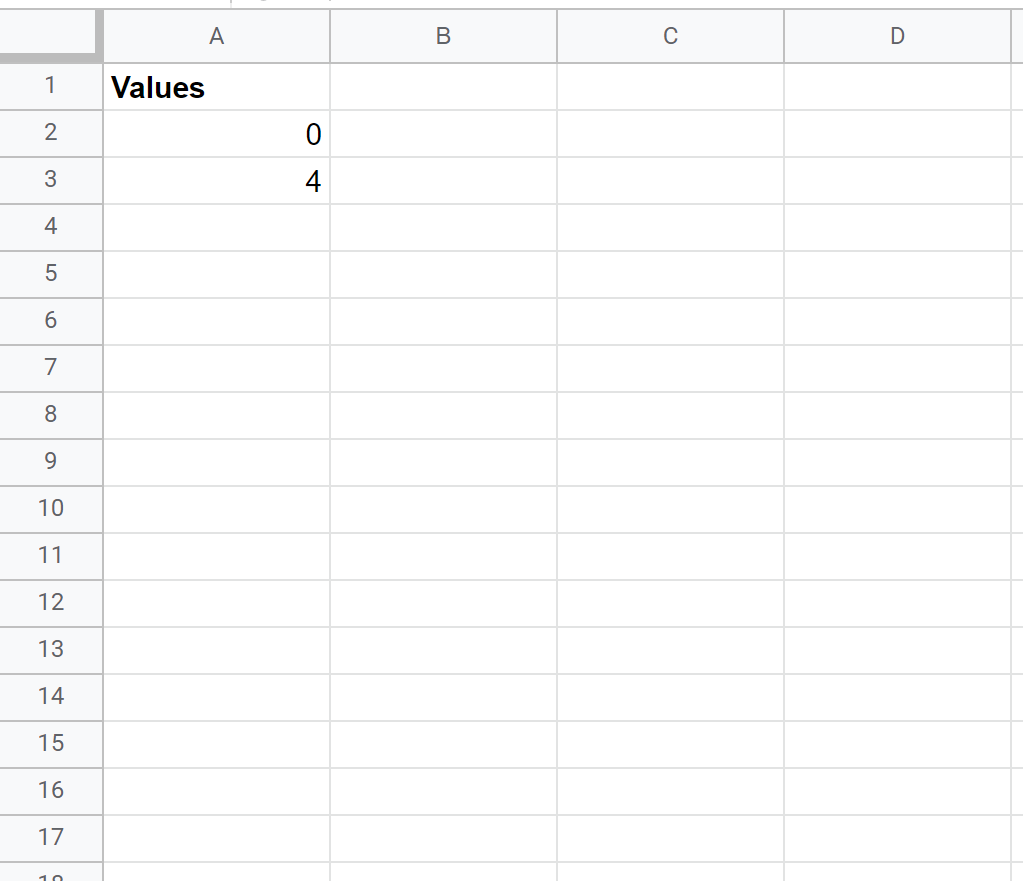
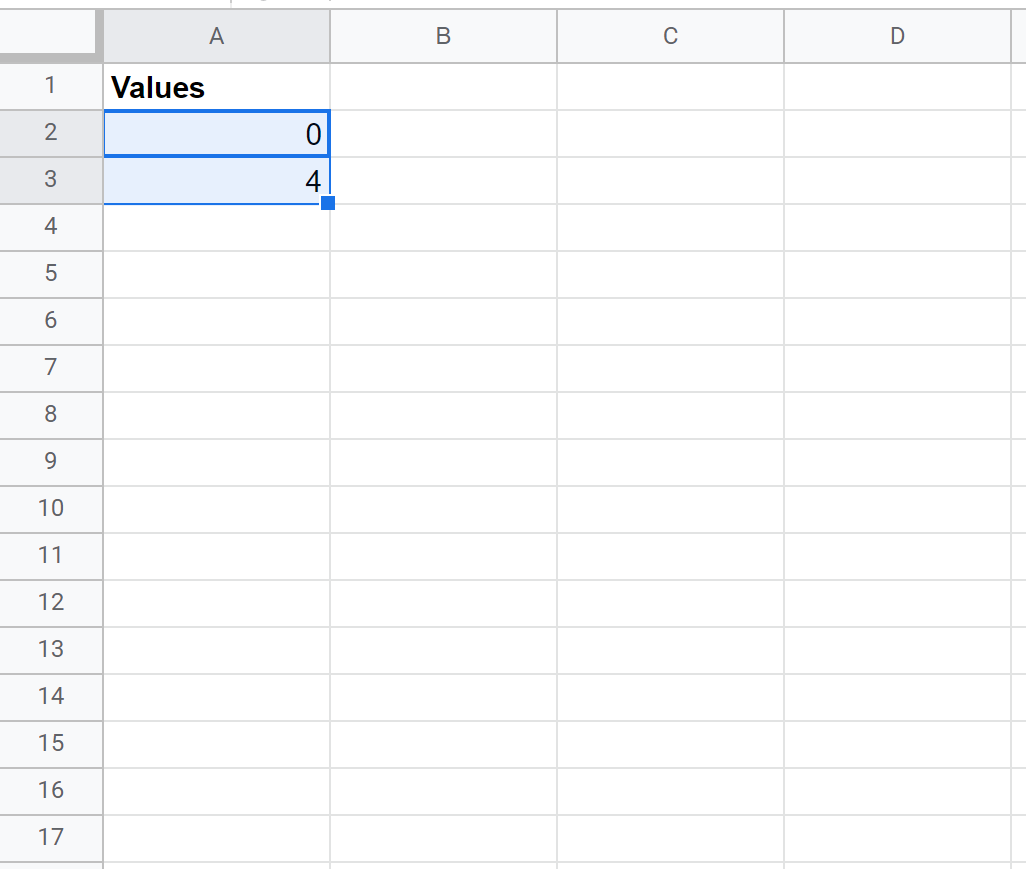
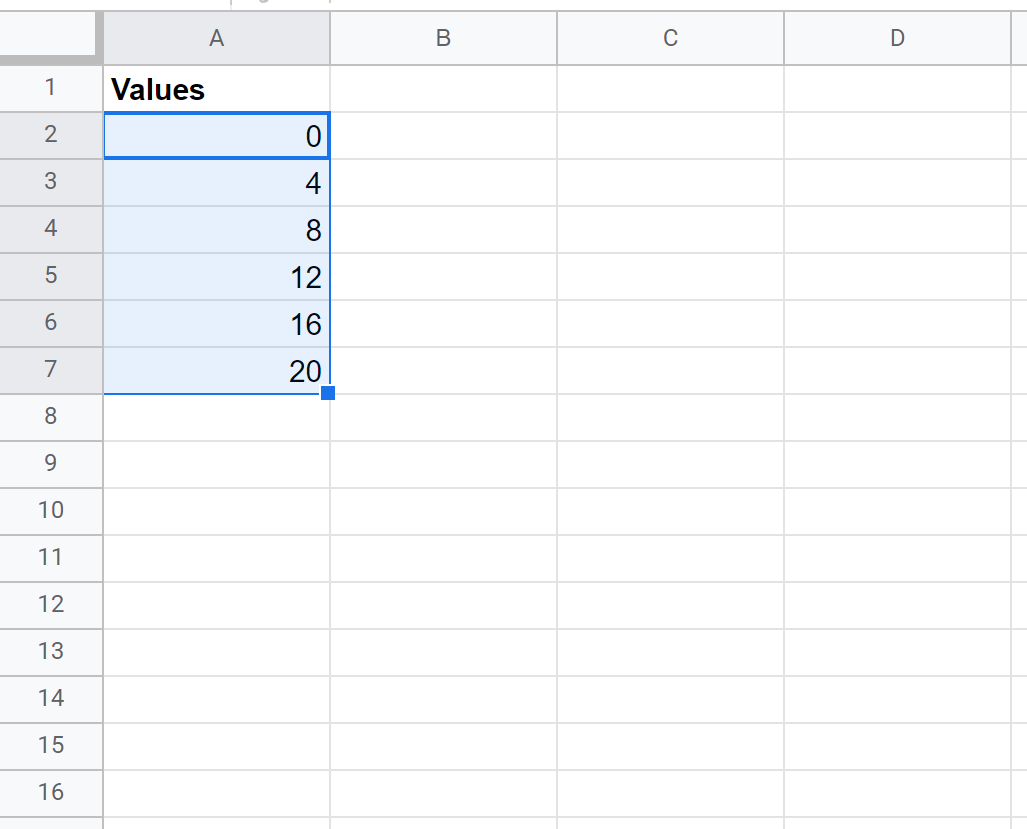
Considérons l’implémentation d’une progression structurée selon les multiples consécutifs de quatre, débutant à zéro et culminant à vingt. L’analyste initie le protocole en déclarant la valeur 0 dans la cellule B1, suivie de la valeur 4 dans la cellule B2. Lors de la capture de la sélection conjointe B1:B2, le compilateur de Google Sheets applique l’équation de détection de l’écart : r = 4 – 0 = 4. Le vecteur d’accroissement constant se trouve formellement validé au niveau du cache d’exécution de la feuille.
En étirant la poignée de recopie vers le bas jusqu’à la cellule B6, le moteur génère de manière instantanée la série discrète : 0, 4, 8, 12, 16, 20. Le tableau ci-dessous illustre l’alignement théorique et structurel de cette séquence au sein de la grille computationnelle :
| Coordonnée spatiale | Formule mathématique sous-jacente | Valeur scalaire résultante | Interprétation méthodologique |
|---|---|---|---|
| Cellule B1 | U(0) = 0 | 0 | Point d’origine (terme initial) |
| Cellule B2 | U(1) = 0 + 4 | 4 | Premier palier d’incrémentation |
| Cellule B3 | U(2) = 4 + 4 | 8 | Deuxième intervalle de variation |
| Cellule B4 | U(3) = 8 + 4 | 12 | Troisième intervalle de variation |
| Cellule B5 | U(4) = 12 + 4 | 16 | Quatrième intervalle de variation |
| Cellule B6 | U(5) = 16 + 4 | 20 | Borne supérieure de l’échantillon |
L’évaluation rigoureuse de la série démontre la constance absolue du delta entre chaque nœud du vecteur, garantissant qu’aucune anomalie de graduation n’altérera les calculs subséquents de variance ou de régression linéaire reposant sur cette variable explicative.
4.2 Modularité des intervalles fractionnaires et décimaux
La capacité d’inférence arithmétique de la poignée de recopie ne se cantonne pas aux sous-ensembles des nombres entiers ; elle englobe avec une précision computationnelle rigoureuse les valeurs à virgule flottante. La formalisation de gradients de concentration chimique (par exemple, 0,1 mol/L ; 0,2 mol/L) ou de pas d’ajustement micro-économiques (intervalles de 0,25 ou 0,5 unité monétaire) répond strictement aux mêmes lois de dérivation matricielle.
Pour implémenter une séquence décimale continue basée sur un pas de 0,25, l’opérateur saisit 0,00 en C1 et 0,25 en C2. La sélection conjointe suivie de la propagation verticale engendre sans altération la suite 0,50, 0,75, 1,00, 1,25, etc. Il est toutefois impératif de veiller à la conformité des paramètres régionaux du classeur (accessibles via Fichier > Paramètres > Paramètres régionaux). En environnement francophone, l’usage du point en lieu et place de la virgule comme séparateur décimal mutera la donnée numérique en chaîne textuelle brute non calculable, paralysant immédiatement l’algorithme d’incrémentation au profit d’une duplication passive.
Un autre défi méthodologique concerne la prévention des dérives d’arrondi binaire inhérentes à la norme IEEE 754 gouvernant le calcul à virgule flottante dans les moteurs d’exécution JavaScript. Lors d’extensions portant sur des centaines d’itérations de fractions infinitésimales (telles que 0,1), des résidus d’imprécision computationnelle microscopiques peuvent s’accumuler à la quinzième décimale. Il est donc recommandé d’appliquer un formatage numérique explicite à deux décimales sur l’ensemble de la colonne réceptrice pour garantir l’uniformité visuelle et la rigueur de l’arrondi analytique.
5. Incrémentation temporelle et chronologique avancée
5.1 Séries calendaires simples : Jours, semaines et mois
La dimension chronologique occupe une place prépondérante dans l’analyse de séries temporelles, le suivi épidémiologique et les modèles de gestion longitudinale. Google Sheets intègre une couche de reconnaissance sémantique dédiée qui confère à l’incrémentation calendaire un degré élevé d’intelligence contextuelle. Contrairement aux scalaires purs, une valeur de date standardisée permet une incrémentation séquentielle immédiate à partir d’une sélection unaire.
Lorsqu’une cellule isolée encapsulant une date conforme au standard international ISO 8601 (par exemple 2025-01-01) ou au standard francophone (01/01/2025) est étendue via la poignée de recopie, le système applique par défaut une raison arithmétique de +1 jour. L’algorithme prend intrinsèquement en compte les contraintes astronomiques et calendaires complexes, telles que le nombre variable de jours constituant les mois de l’année grégorienne et l’intercalation quadriennale des années bissextiles. L’utilisateur est ainsi exempté de tout recalibrage manuel lors du franchissement du 28 février ou des transitions mensuelles à 30 ou 31 jours.
De surcroît, le moteur heuristique reconnaît nativement les désignations textuelles complètes ou abrégées des composantes temporelles. La saisie initiale de la chaîne Lundi en cellule active produira, lors de l’extension verticale, l’apparition cyclique ordonnée de Mardi, Mercredi, Jeudi, etc. Il en va de même pour les nomenclatures mensuelles (Janvier, Février, Mars…). Lorsque le cycle calendaire atteint son terme (Dimanche ou Décembre), l’algorithme réinitialise automatiquement la boucle séquentielle sans rupture structurelle, assurant une régularité absolue dans l’étiquetage des périodicités observées.
5.2 Incrémentation conditionnelle de dates ouvrées
Dans la gestion de projets de recherche, les essais cliniques avec administration en milieu hospitalier ou les contextes industriels, l’incrémentation chronologique linéaire brute s’avère souvent inadaptée en raison de la neutralisation des périodes non travaillées. L’exigence opérationnelle réside alors dans la constitution de séries composées exclusivement de jours ouvrés, avec exclusion systématique des week-ends (samedis et dimanches).
La poignée de recopie standard ne dispose pas d’un commutateur contextuel direct pour filtrer nativement les jours de repos lors d’un étirement manuel simple. Pour contourner cette limitation tout en maintenant une ergonomie optimale, deux méthodologies s’offrent à l’analyste. La première consiste à amorcer manuellement une séquence sur une semaine complète (du lundi au vendredi), à omettre le samedi et le dimanche lors de la saisie des deux premiers jours de la semaine suivante, puis à appliquer la recopie en exploitant la reconnaissance de motifs plus complexes. Toutefois, cette approche manuelle présente une fragilité heuristique sur les grands volumes.
La solution méthodologique la plus robuste réside dans l’hybridation de l’incrémentation avec des fonctions dédiées au calcul calendaire ouvré, en combinant la formule dynamique SERIE.JOUR.OUVRE avec la cellule initiale. En saisissant en D2 la formule =SERIE.JOUR.OUVRE(D1; 1) et en étendant cette relation le long de la colonne, le tableur évalue de manière dynamique le saut calendaire requis. Dès lors que la date source correspond à un vendredi, l’algorithme incrémente la valeur séquentielle de trois unités pour pointer rigoureusement vers le lundi suivant, garantissant ainsi l’intégrité opérationnelle du calendrier de suivi de la cohorte.
5.3 Incrémentation des variables horaires et durées
L’enregistrement continu de mesures physiques, les études observationnelles d’éthologie ou les journaux de connexion télémétriques nécessitent fréquemment la structuration d’intervalles temporels réguliers discrétisés à l’échelle de l’heure, de la minute ou de la fraction de seconde. Google Sheets traite les données horaires comme des fractions décimales d’une journée de 24 heures, où une heure équivaut mathématiquement à la valeur scalaire 1/24.
Pour générer un journal d’événements paramétré selon des tranches de 15 minutes, l’opérateur consigne 08:00 en E1 et 08:15 en E2. L’écart temporel est interprété par le compilateur comme une progression d’une raison de 15/(24*60), soit approximativement 0,01041667 jour. L’extension via la poignée de recopie déploie fidèlement les jalons successifs : 08:30, 08:45, 09:00, et ainsi de suite. Cette mécanique assure une synchronisation temporelle rigoureuse des matrices de recueil.
Un écueil analytique majeur survient lors du dépassement du seuil critique de 24 heures (minuit). Si la cellule est configurée selon le format d’affichage horaire standard (hh:mm), l’incrémentation continue réinitialisera l’affichage visuel à 00:00 au terme de la journée, occultant le caractère cumulatif de la durée observée. Pour pallier cette distorsion sémiotique sans altérer la valeur sous-jacente, il est impératif de modifier le format de la colonne cible via le menu Format > Nombre > Durée, ou en définissant un masque personnalisé de type [hh]:mm:ss. Les crochets indiquent au moteur de rendu d’afficher la somme cumulée des heures au-delà de l’enveloppe journalière, assurant la parfaite lisibilité des séries de longue durée.
6. Incrémentation alphanumérique et codification textuelle structurée
6.1 Génération automatique d’identifiants de recherche (ID sujets)
Dans tout protocole scientifique impliquant des sujets humains ou des unités expérimentales individualisées, l’anonymisation et la traçabilité reposent sur l’attribution d’identifiants alphanumériques formalisés. Ces identificateurs se composent généralement d’un préfixe sémantique constant désignant le projet ou le groupe expérimental, suivi d’un index numérique séquentiel normé (par exemple : SUJET-001, OBS_002, SAMPLE-A-101).
L’heuristique textuelle de Google Sheets excelle dans le traitement de ces chaînes mixtes. Lorsque la cellule source renferme une séquence de caractères alphabétiques se terminant par un suffixe numérique, le compilateur isole automatiquement la portion littérale de la composante scalaire. Lors de la manœuvre de recopie, le préfixe textuel demeure rigoureusement invariant, tandis que la fraction numérique finale est soumise à une incrémentation unitaire standardisée. Une simple sélection de la cellule unique SUJET-001 permet ainsi de générer par étirement la séquence ordonnée SUJET-002, SUJET-003, jusqu’aux bornes terminales requises.
Un aspect méthodologique crucial réside dans la préservation des zéros initiaux (padding zeros), indispensables à l’ordonnancement lexicographique harmonieux des bases de données relationnelles. Si l’identifiant est saisi sous la forme simplifiée SUJET-1, un tri alphabétique ultérieur placera arbitrairement SUJET-10 avant SUJET-2, générant des désordres d’indexation majeurs. En adoptant dès l’origine le patron SUJET-001, le moteur de Google Sheets maintient la longueur fixe de la chaîne de caractères lors de l’incrémentation automatique jusqu’à atteindre la valeur 999, garantissant ainsi l’alignement typographique et la compatibilité avec les systèmes de gestion de bases de données relationnelles (SGBD).
6.2 Gestion des séries catégorielles personnalisées et ordonnées
En dehors des suites arithmétiques pures et des nomenclatures calendaires universelles, l’analyse scientifique et organisationnelle manipule une grande diversité d’échelles ordinales ou de nomenclatures catégorielles ordonnées : phases d’un protocole clinique (Phase 1, Phase 2, Phase 3), trimestres budgétaires (T1, T2, T3, T4), ou niveaux d’une échelle d’évaluation qualitative (Niveau A, Niveau B, Niveau C).
Face à ces séries, la poignée de recopie exhibe des comportements différenciés dictés par le degré d’intégration des termes dans le dictionnaire interne du logiciel :
- Séquences alphanumériques pré-indexées : Les motifs intégrant un préfixe textuel couplé à un entier (tels que Trimestre 1, Vague 1, ou Groupe 1) bénéficient de l’isolation du suffixe numérique et s’incrémentent naturellement de manière cyclique ou continue.
- Séries littérales ordonnées non numériques : À l’inverse, des listes fondées sur l’alphabet pur (ex. : Condition A, Condition B) ne sont pas systématiquement interprétées comme des séquences arithmétiques par dérivation d’une seule cellule. Étirer une cellule contenant Groupe A tendra fréquemment à cloner passivement la mention Groupe A plutôt qu’à progresser vers Groupe B.
Pour surmonter ces contraintes heuristiques sans recourir à des saisies manuelles fastidieuses, l’analyste doit employer des stratégies structurelles de contournement. La démarche la plus rigoureuse consiste à mobiliser la concaténation dynamique d’une chaîne fixe avec le résultat d’une fonction d’indexation séquentielle, via une syntaxe telle que ="Condition " & CAR(65 + LIGNE() - 1) pour faire défiler harmonieusement les lettres de l’alphabet latin selon la norme ASCII, ou encore à définir des tables de correspondance matricielles dédiées.
7. L’approche matricielle algorithmique : La fonction SEQUENCE
7.1 Syntaxe et morphologie mathématique de SEQUENCE()
Bien que la poignée de recopie offre une prise en main intuitive, elle relève d’une cinétique manuelle fondamentalement sensible aux erreurs de manipulation et présente une faible adaptabilité face aux architectures de calcul dynamiques. Pour répondre aux impératifs d’automatisation des flux de traitement massifs, Google Sheets met à disposition des analystes la fonction matricielle native SEQUENCE. Cet opérateur de calcul avancé génère une matrice ordonnée de nombres entiers ou réels à partir d’une seule formule déclarative.
La signature formelle de la fonction se décompose en quatre arguments positionnels rigoureusement définis :
SEQUENCE(lignes; [colonnes]; [début]; [pas])
- lignes (obligatoire) : Valeur scalaire entière déterminant la dimension vectorielle verticale de la matrice générée (cardinalité des rangs).
- colonnes (facultatif, valeur par défaut = 1) : Entier spécifiant la dimension vectorielle horizontale de la plage de sortie (cardinalité des colonnes).
- début (facultatif, valeur par défaut = 1) : Terme initial U(0) de la progression arithmétique.
- pas (facultatif, valeur par défaut = 1) : Raison arithmétique r appliquée de manière itérative entre chaque cellule consécutive.
L’avantage computationnel de la fonction SEQUENCE sur les méthodes de glisser-déposer réside dans son immatérialité opératoire : aucune intervention physique n’est nécessaire sur l’interface graphique. La saisie de la formule instancie de manière asynchrone et quasi instantanée un vecteur de plusieurs centaines de milliers d’éléments avec un coût algorithmique minimal pour le processeur de la machine cliente.
7.2 Exemples comparatifs reproduisant les cas manuels
L’ensemble des cas d’usage manuels détaillés dans les sections antérieures peut être transposé dans l’univers fonctionnel de SEQUENCE avec une reproductibilité mathématique absolue, affranchie des biais de trajectoire de la souris. Cette approche consolide l’infrastructure documentaire du classeur.
Pour répliquer rigoureusement l’Exemple 1 — à savoir la génération linéaire unitaire de la suite des entiers de 0 à 20 (soit une population globale de 21 observations) —, l’analyste inscrit dans la cellule supérieure gauche de la plage de destination l’instruction canonique suivante :
=SEQUENCE(21; 1; 0; 1)
Cette déclaration explicite ordonne au compilateur d’allouer exactement 21 lignes sur une colonne unique, d’initialiser le compteur à zéro et d’appliquer une incrémentation stricte de un par bond positionnel.
De même, pour reproduire fidèlement l’Exemple 2 — la séquence des multiples de quatre s’étendant de zéro à vingt, soit six valeurs distinctes —, l’instruction se formalise avec une clarté algorithmique totale :
=SEQUENCE(6; 1; 0; 4)
Le tableau comparatif suivant synthétise le gain de rigueur opérationnelle obtenu par l’abandon des processus physiques au profit des déclarations fonctionnelles formelles :
| Objectif séquentiel | Paramétrage manuel classique | Formule algorithmique équivalente | Avantage méthodologique majeur |
|---|---|---|---|
| Indexation unitaire (1 à 1000) | Saisie de 1 et 2, puis glissement sur 1000 lignes | =SEQUENCE(1000) |
Suppression totale des risques de dépassement d’arrêt |
| Multiples de 5 (0 à 50) | Saisie de 0 et 5, puis extension sur 11 lignes | =SEQUENCE(11; 1; 0; 5) |
Pérennité du pas en cas d’insertion de lignes périphériques |
| Décrémentation (-10 à -20) | Saisie de -10 et -11, puis traction descendante | =SEQUENCE(11; 1; -10; -1) |
Formalisation explicite de la polarité de la raison |
7.3 Débordement matriciel et intégrité structurelle de la feuille
Le déploiement d’une fonction matricielle dynamique telle que SEQUENCE s’articule autour du concept d’étalement ou de débordement matriciel (spill behavior). La formule n’est inscrite physiquement que dans une seule coordonnée matricielle d’ancrage (la cellule d’origine), mais ses résultats se déversent dynamiquement dans l’espace contigu nécessaire à sa résolution dimensionnelle.
Ce mécanisme impose une exigence d’intégrité topologique absolue : la plage d’extension prévisionnelle doit être rigoureusement vierge de tout contenu préexistant. Si une seule cellule située sur la trajectoire d’expansion renferme une valeur scalaire, un espace textuel invisible ou une formule concurrente, le moteur de calcul bloque instantanément l’exécution globale et renvoie l’erreur de référence critique #REF!, assortie du message informatif : « La formule développée n’a pas été étendue, car elle écraserait les données de la plage ». La libération physique de l’obstacle résout immédiatement le blocage.
Ce comportement matriciel offre une protection structurelle remarquable contre les altérations involontaires. Dans une séquence générée par la poignée de recopie classique, chaque cellule héberge une valeur indépendante statique ; un utilisateur inattentif peut modifier accidentellement une valeur intermédiaire sans que le système n’émette d’alerte, introduisant une fracture invisible dans l’indexation. À l’inverse, avec SEQUENCE, toute tentative d’écrasement manuel d’une cellule intermédiaire entraîne le basculement immédiat de l’intégralité du vecteur vers l’état d’erreur explicite, rendant toute corruption de données instantanément détectable.
8. Incrémentation bidimensionnelle et cartésienne
8.1 Extension horizontale le long des colonnes
Si la littérature technique privilégie conventionnellement la projection verticale en raison de la structure naturelle des bases de données orientées lignes, les protocoles d’expérimentation en laboratoire et les formats de saisie croisée requièrent régulièrement une incrémentation le long du vecteur horizontal. L’indexation des vagues successives d’administration d’un questionnaire ou l’étiquetage des réplicats techniques d’un dosage biologique s’organisent fréquemment de gauche à droite sur une même ligne d’en-tête.
La mécanique de la poignée de recopie s’adapte avec une stricte isométrie à cet axe dimensionnel. L’opérateur encode ses conditions initiales dans deux cellules adjacentes sur un même rang (par exemple Rép_1 en B1 et Rép_2 en C1). La sélection conjointe de cette plage horizontale suivie d’un glissement vers la droite via le carré d’ancrage propage fidèlement la série ordonnée vers D1, E1, etc. L’inférence arithmétique et la reconnaissance de préfixes textuels opèrent selon des lois computationnelles identiques à celles régissant les déplacements verticaux.
Il importe toutefois de souligner une limitation ergonomique notable : le double-clic contextuel vertical décrit au point 2.3 ne possède pas d’équivalent horizontal standardisé. Le système ne dispose pas d’heuristique prédictive fiable pour anticiper la largeur terminale d’un tableau basée sur les lignes inférieures. Dès lors, l’extension longitudinale d’en-têtes horizontaux repose nécessairement sur la cinétique du glisser-déposer manuel continu ou sur l’emploi explicite de fonctions matricielles dédiées.
8.2 Génération de grilles coordonnées bidimensionnelles
L’investigation scientifique multi-factorielle impose fréquemment la mise en œuvre de grilles cartésiennes exhaustives, où chaque intersection matricielle formalise une combinaison paramétrique singulière (par exemple, tester 5 concentrations différentes sous 10 conditions thermiques distinctes). Dans cette configuration, l’analyste doit pouvoir matérialiser un espace à deux dimensions sans recourir à des duplications linéaires fastidieuses.
La fonction SEQUENCE démontre ici sa suprématie opérationnelle grâce à l’exploitation simultanée de ses deux premiers arguments dimensionnels. En formulant l’instruction canonique :
=SEQUENCE(5; 10; 1; 1)
l’analyste instancie d’un coup une matrice rectangulaire intégrale de 5 rangées par 10 colonnes. Le moteur arithmétique peuple l’espace par balayage horizontal progressif (de la première rangée jusqu’à la colonne 10, puis basculement à la ligne suivante), générant une numérotation continue de 1 à 50.
Cette structuration cartésienne matricielle sert de substrat analytique à la construction de tables d’échantillonnage factoriel ou de coordonnées de microplaques de titration (au format 96 puits, soit 8×12). Couplée à des opérations de modularité mathématique élémentaire (via les fonctions ENT et MOD), cette méthode permet de générer instantanément l’intégralité des combinaisons de variables indépendantes requises pour les plans d’expériences randomisés.
9. Formules dynamiques avancées combinant ROW, COLUMN et ARRAYFORMULA
9.1 Incrémentation dynamique basée sur la position physique des cellules
L’un des défis structurels majeurs inhérents à l’exploitation des tableurs réside dans la vulnérabilité des suites incrémentées statiques face aux opérations de restructuration de la feuille. Dans une colonne indexée manuellement de 1 à 100, la suppression accidentelle ou délibérée d’une ligne intermédiaire engendre une discontinuité immédiate et définitive de la chaîne numérique (par exemple : le saut abrupt du rang 4 au rang 6 consécutivement à l’expulsion de la ligne 5).
Pour immuniser l’architecture tabulaire contre ces ruptures d’indexation, la méthode de référence consiste à dériver la valeur séquentielle directement des propriétés topologiques de la grille de calcul via la fonction LIGNE() (ou ROW() en nomenclature internationale). Cette fonction retourne l’indice numérique absolu de la coordonnée physique occupée par la cellule dans la feuille de calcul.
Afin de neutraliser le décalage spatial généré par la présence d’en-têtes de colonnes ou de zones de métadonnées supérieures, l’analyste applique une correction par soustraction scalaire constante. Si la table de données débute formellement à la ligne 4 de la grille, l’insertion en A4 de l’expression :
=LIGNE() - 3
attribuera dynamiquement la valeur 1 à cet enregistrement. La recopie de cette formule sur l’ensemble de la colonne établit une numérotation virtuellement inaltérable : toute insertion ou suppression physique de ligne recalcule instantanément l’ensemble des termes sous-jacents, préservant la continuité intégrale de l’index séquentiel sans aucune intervention réparatrice manuelle.
9.2 Déploiement automatisé avec ARRAYFORMULA
La dérivation par LIGNE() conserve néanmoins une contrainte résiduelle : elle nécessite la réplication de la formule dans chaque cellule réceptrice. Pour atteindre un niveau d’automatisation optimal, particulièrement dans les architectures interfacées avec des outils de collecte en flux continu tels que Google Forms, l’analyste combine cette logique avec la fonction matricielle enveloppante ARRAYFORMULA.
Le problème récurrent des formulaires connectés réside dans le fait que chaque nouvelle soumission insère une ligne physique brute dans la feuille, rompant fréquemment les liaisons de recopie descendante classiques. Pour déployer une indexation pérenne et conditionnelle sur l’intégralité d’une colonne à partir de la seule cellule d’en-tête, on implémente en ligne 1 la structure matricielle de référence suivante :
=ARRAYFORMULA(SI(LIGNE(A:A)=1; "Index_ID"; SI(NON(ESTVIDE(B:B)); LIGNE(A:A)-1; "")))
Cette construction algorithmique complexe se décompose analytiquement comme suit :
- Condition d’en-tête : L’instruction
SI(LIGNE(A:A)=1; "Index_ID"; ...)identifie la première coordonnée du vecteur et y assigne automatiquement la dénomination textuelle de la colonne, éliminant le besoin de dissocier l’en-tête du corps de calcul. - Test de présence contextuelle : Le sous-bloc
SI(NON(ESTVIDE(B:B)); ...; "")conditionne l’incrémentation à l’existence effective d’une donnée d’observation enregistrée dans la colonne adjacente B. - Attribution dynamique : Si la cellule adjacente est occupée, le moteur matriciel applique l’ajustement arithmétique
LIGNE(A:A)-1; dans le cas inverse, la cellule demeure vierge de tout contenu visuel, évitant la pollution esthétique et computationnelle du classeur par des milliers de zéros prématurés.
10. Diagnostic des dysfonctionnements et résolution des anomalies d’incrémentation
10.1 Problème de la répétition non désirée au lieu de la progression
L’anomalie structurelle la plus couramment rapportée par les utilisateurs de Google Sheets se caractérise par la réplication passive et indésirable d’une valeur scalaire sur l’axe de recopie alors qu’une progression arithmétique continue était explicitement attendue. La compréhension de l’étiologie de ce dysfonctionnement permet d’y remédier de manière ciblée.
Dans plus de 80 % des cas diagnostiqués, la défaillance procède d’un conflit de typage sous-jacent. Si la valeur source a été importée depuis un fichier CSV mal structuré ou saisie avec une chaîne textuelle inséparable, le moteur de calcul classe la donnée sous la catégorie String (texte brut) et non Number (valeur quantitative). Dès lors, l’heuristique prédictive refuse d’appliquer des lois arithmétiques à ce qu’elle interprète comme une étiquette littérale pure, et bascule par mesure conservatoire vers la duplication scalaire statique.
Pour corriger cette pathologie de données :
- Vérifiez l’alignement naturel de la cellule non formatée : par convention standard dans Google Sheets, les nombres sont systématiquement cadrés à droite, tandis que les chaînes de texte sont alignées à gauche.
- Forcez la conversion numérique en appliquant la fonction
CNUM()sur la plage source ou en utilisant l’outil natif Format > Nombre > Automatique. - Vérifiez l’absence d’une apostrophe introductive masquée (
'), fréquemment insérée par les processus d’exportation pour neutraliser l’interprétation des formules. - Assurez-vous d’avoir fourni au minimum deux cellules distinctes lors de la saisie initiale afin d’expliciter le pas différentiel requis par l’algorithme, conformément aux principes démontrés dans la section 2.2.
10.2 Perturbation du pas arithmétique par des cellules masquées ou filtrées
L’interaction entre les mécanismes cinétiques d’incrémentation manuelle et les couches de filtrage conditionnel de données constitue une zone de friction méthodologique critique. Lorsqu’une feuille de calcul fait l’objet d’un filtre actif ou que certaines de ses lignes sont manuellement masquées par l’opérateur, l’intégrité de la projection par glisser-déposer est compromise.
L’utilisation de la poignée de recopie à travers une plage visuellement tronquée par un filtre applique la transformation arithmétique à la continuité physique spatiale sous-jacente des cellules, et non à leur visibilité logique superficielle. En conséquence, les enregistrements masqués temporairement par le critère de filtrage sont irrémédiablement écrasés et modifiés lors du passage du curseur, introduisant des corruptions de données majeures au sein de sous-populations expérimentales invisibles à l’écran.
Pour prémunir le chercheur contre ces altérations accidentelles dévastatrices, il convient d’adopter des règles de gouvernance strictes : toute opération d’incrémentation de structure doit impérativement être exécutée sur des tables brutes exemptes de filtres actifs et purgées de tout masquage de lignes. Si une indexation sélective doit être implémentée au sein d’un tableau filtré, il est indispensable de renoncer au glisser-déposer manuel au profit de fonctions logiques conditionnelles dynamiques élaborées via SOUS.TOTAL ou FILTRE.
10.3 Conflits de typage et altération du format d’affichage
Une autre manifestation pathologique fréquente réside dans la dérive inattendue des formats de présentation au cours de l’extension séquentielle. Lors de l’utilisation de la poignée de recopie, Google Sheets propage non seulement le contenu computationnel sous-jacent, mais également l’intégralité de la feuille de style graphique associée à la cellule souche (teinte de fond, bordures matricielles, règles de mise en forme conditionnelle et masques de typographie numérique).
Cette transmission mimétique peut engendrer des dysfonctionnements majeurs d’interprétation. Par exemple, si une cellule source intégrant une date formatée en « Année-Mois » est étendue sur une zone préalablement typée en monétaire, le moteur heuristique impose de manière agressive le style source, écrasant les attributs locaux des cellules réceptrices. Pire encore, lors d’incrémentations de grands volumes de données décimales, un arrondi d’affichage tronqué (par exemple l’occultation des décimales via le bouton d’interface de réduction de précision) peut donner l’illusion graphique d’une série unitaire discontinue alors que le moteur interne accumule des fractions réelles invisibles.
La résolution de ces incohérences implique de procéder à une réinitialisation structurelle des styles d’affichage. L’analyste doit sélectionner la plage résultante complète, purger les scories typographiques superflues via le menu Format > Effacer la mise en forme, puis réappliquer formellement le masque de métadonnées numériques approprié. La préservation de l’homogénéité visuelle constitue un prérequis indispensable à la clarté sémiotique des publications scientifiques.
11. Automatisation programmée via Google Apps Script
11.1 Création d’une fonction d’incrémentation sur mesure en JavaScript
Lorsque les exigences de traitement dépassent le cadre des fonctions matricielles natives ou que les séquences d’incrémentation doivent répondre à des logiques conditionnelles fortement ramifiées, le recours à l’environnement de programmation procédurale intégré Google Apps Script s’impose comme la solution d’ingénierie logicielle par excellence. Reposant sur un standard moderne dérivé de JavaScript (moteur V8), Apps Script permet d’interagir directement avec l’arbre d’objets du tableur.
L’accès à l’IDE s’effectue via le menu Extensions > Apps Script. L’algorithme d’incrémentation par script doit être conçu dans le respect scrupuleux des normes d’optimisation de l’environnement infonuagique de Google. Le code ci-dessous illustre l’implémentation d’une fonction d’incrémentation industrielle optimisée, évitant les appels d’écriture itératifs lents au profit d’une assignation vectorielle groupée en mémoire tampon :
L’analyse structurelle de cette routine met en lumière deux impératifs de performance : d’une part, le peuplement d’un tableau vectoriel JavaScript pur (matriceResultat) via une boucle d’itération interne rapide ; d’autre part, la mobilisation unique de la méthode atomique setValues(). Cette architecture permet d’instancier 10 000 enregistrements incrémentés en une fraction de seconde, contournant les limitations d’exécution associées aux temps d’appel API de l’infrastructure de Google.
11.2 Déclencheurs événementiels (onEdit) pour l’incrémentation conditionnelle
La quintessence de l’ingénierie documentaire réside dans l’attribution autonome d’un identifiant d’enregistrement lors de la survenue d’un événement de saisie externe, sans aucune action réflexive requise de la part de l’opérateur de collecte. Ce mécanisme est rendu possible par l’instrumentation du déclencheur événementiel natif onEdit(e).
Ce gestionnaire d’événements intercepte toute modification physique opérée sur la matrice de données. L’événement contextualisé contient l’ensemble des métadonnées requises : les coordonnées spatiales de la cellule éditée, sa valeur antérieure et sa nouvelle charge informative. L’architecture scriptée analyse si la mutation intervient dans la colonne cible désignée et, le cas échéant, calcule et verrouille définitivement le nouvel index dans la cellule contiguë dédiée.
L’intérêt capital de cette méthodologie logicielle réside dans l’immutabilité absolue des index ainsi générés. Contrairement aux formules matricielles dynamiques dont le recalcul permanent est susceptible d’altérer l’ordre relatif lors d’opérations de tri complexes, l’identifiant apposé par Apps Script est gravé sous la forme d’une constante scalaire figée dans le marbre numérique du classeur. Cette approche offre la sécurité cryptographique et opérationnelle indispensable aux bases de données de recherche multi-utilisateurs et aux protocoles soumis à des audits de conformité réglementaire stricts.
12. Synthèse méthodologique et arbre décisionnel pour l’analyse de données
12.1 Matrice comparative des méthodes d’incrémentation
Le choix de la méthode d’incrémentation optimale ne doit pas résulter d’une habitude opérationnelle routinière, mais d’une analyse rationnelle des contraintes de scalabilité, de dynamicité et de sensibilité aux erreurs inhérentes au corpus d’étude. Le tableau comparatif suivant synthétise les propriétés structurelles des quatre paradigmes d’incrémentation analysés au sein de ce traité :
| Paradigme d’implémentation | Vitesse de déploiement | Scalabilité (volume) | Sensibilité aux corruptions | Cas d’usage préférentiel |
|---|---|---|---|---|
| Poignée de recopie (Glisser) | Instantanée | Faible (< 500 lignes) | Très élevée (erreur manuelle) | Prototypage exploratoire rapide |
| Fonction SEQUENCE | Très rapide | Excellente (jusqu’aux limites de la feuille) | Faible (protection par étalement) | Tables statiques normées, grilles cartésiennes |
| ARRAYFORMULA + LIGNE | Intermédiaire | Élevée (dépend du recalcul) | Nulle (résilience absolue aux tris) | Formulaires en flux continu, bases dynamiques |
| Google Apps Script (onEdit) | Avancée (requiert dev) | Maximale (traitement serveur) | Nulle (indexation scalaire figée) | Environnements collaboratifs critiques, audits |
Cette cartographie comparative démontre l’absence de solution universelle : la pertinence d’un choix technique dépend intimement de l’équilibre recherché entre l’économie de conception initiale et l’exigence de robustesse à long terme de l’architecture informationnelle.
12.2 Protocoles recommandés pour préserver l’intégrité scientifique des données
Pour clore ce cadre méthodologique, l’analyste rigoureux doit intégrer un ensemble de bonnes pratiques destinées à immuniser ses ensembles de variables contre toute altération accidentelle. La première règle de gouvernance consiste en la consignation systématique des formules génératrices et des pas d’incrémentation au sein d’un dictionnaire de données ou d’un onglet de métadonnées dédié, garantissant la parfaite transparence épistémologique du protocole de recherche.
La seconde recommandation concerne le verrouillage défensif de l’intégrité matricielle. Lorsque des formules dynamiques complexes (telles que ARRAYFORMULA ou SEQUENCE) sont déployées pour structurer les index primaires d’une cohorte, il est impératif de protéger formellement la plage de cellules correspondante via le menu Données > Feuilles et plages protégées. Cette mesure préventive neutralise tout risque d’écrasement involontaire par des utilisateurs tiers partageant l’accès au document.
Enfin, tout pipeline de traitement quantitatif doit inclure une phase de contrôle qualité préalable à l’analyse inférentielle. L’analyste exécutera des requêtes de diagnostic visant à confirmer l’unicité stricte des index générés (au moyen de fonctions telles que NB.SI ou UNIQUE) et l’absence totale de ruptures de monotonie arithmétique. Cette vigilance méthodologique sans faille garantit que l’infrastructure sous-jacente soutient avec une rigueur inattaquable la validité scientifique des conclusions analytiques élaborées.
Références
- Google. (2025). Fonction SEQUENCE – Centre d’aide Google Docs. Support Google. https://support.google.com/docs/answer/9368489
- Google. (2025). Remplir automatiquement des données dans Google Sheets. Support Google. https://support.google.com/docs/answer/75509
- Google Developers. (2024). Google Apps Script: Spreadsheet Service (Class Sheet & Class Range). Google Workspace Documentation. https://developers.google.com/apps-script/reference/spreadsheet
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). Institute of Electrical and Electronics Engineers. https://ieeexplore.ieee.org/document/8766229
- International Organization for Standardization. (2019). Date and time — Representations for information interchange — Part 1: Basic rules (ISO 8601-1:2019). ISO. https://www.iso.org/standard/70907.html
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10