
L’analyse quantitative et la modélisation statistique occupent une place prépondérante dans l’édifice contemporain de la recherche en sciences humaines, sociales et comportementales. Au sein de cet arsenal mathématique, la distribution normale, immortalisée par Carl Friedrich Gauss et Pierre-Simon de Laplace, s’érige comme le modèle paramétrique fondamental sur lequel reposent la majorité des théories de la mesure, des méthodes d’inférence et des protocoles psychométriques. Qu’il s’agisse d’évaluer les aptitudes cognitives générales, d’étalonner un inventaire de personnalité ou d’analyser des temps de réponse lors d’épreuves de chronométrie mentale, l’hypothèse de gaussianité constitue la pierre angulaire de l’interprétation des scores individuels et collectifs.
Le langage de programmation et environnement computationnel The R Project for Statistical Computing s’est imposé au fil des trois dernières décennies comme la référence académique incontournable pour la manipulation, la modélisation et la simulation de ces structures stochastiques. Sa flexibilité native, combinée à la robustesse de ses algorithmes générateurs de nombres pseudo-aléatoires, offre aux chercheurs et analystes de données un laboratoire virtuel sans équivalent. Maîtriser la génération de données synthétiques conformes à une loi normale sous R ne relève pas d’un simple exercice de syntaxe logicielle ; il s’agit d’une compétence méthodologique essentielle conditionnant la conduite d’études de puissance statistique a priori, le test d’algorithmes d’apprentissage automatique, ainsi que la validation empirique d’échelles de mesure standardisées.
Ce guide exhaustif propose une exploration approfondie des mécanismes théoriques, computationnels et appliqués entourant la génération de variables aléatoires gaussiennes dans l’environnement R. À travers une démarche progressive articulée autour des exigences rigoureuses de la psychologie quantitative, nous examinerons la syntaxe des fonctions fondamentales, la préservation de la reproductibilité scientifique par le contrôle des germes algorithmiques, la modélisation de constructs psychologiques complexes, l’évaluation descriptive et inférentielle des échantillons simulés, ainsi que le déploiement d’architectures multivariées et tronquées indispensables à la recherche empirique moderne.
1. Fondements théoriques de la distribution normale en psychologie quantitative
1.1 La loi gaussienne au cœur des sciences comportementales
La distribution normale, souvent désignée sous le vocable de courbe en cloche ou loi de Laplace-Gauss, constitue sans conteste l’un des piliers conceptuels les plus structurants des sciences du comportement. Sur le plan de ses propriétés mathématiques fondamentales, cette loi de probabilité continue se distingue par une symétrie axiale rigoureuse autour de son paramètre de position, une unimodalité stricte assurant la coïncidence parfaite entre sa moyenne, sa médiane et son mode, ainsi qu’une décroissance exponentielle rapide de sa densité de probabilité à mesure que l’on s’éloigne de son centre. Ces caractéristiques morphologiques ne découlent pas d’un simple postulat esthétique, mais s’enracinent dans les démonstrations probabilistes formalisées par le théorème central limite. Selon ce principe directeur, la somme ou la résultante linéaire d’un nombre élevé de variables aléatoires indépendantes et identiquement distribuées tend inévitablement vers une loi gaussienne, quelles que soient les distributions sous-jacentes d’origine, pourvu que la variance individuelle demeure finie. En psychologie cognitive et différentielle, cette réalité mathématique offre une justification théorique élégante à la distribution des phénotypes complexes : les compétences cognitives et les dimensions de la personnalité résultent de l’agrégation d’une myriade d’influences génétiques, environnementales et neurodéveloppementales infinitésimales interagissant de manière cumulative.
Dans la pratique de la modélisation psychométrique, les traits latents non observables directement, tels que le facteur général d’intelligence conceptualisé par Charles Spearman, les aptitudes mnésiques de travail ou encore les polarités fondamentales du modèle à cinq facteurs de la personnalité, sont quasi universellement postulés comme suivant une loi normale au sein de la population générale parente. La distribution normale fournit une métrique naturelle permettant de transformer un continuum comportemental continu en scores standardisés interprétables à l’échelle diagnostique. L’équation canonique de sa fonction de densité de probabilité, notée f(x) pour toute valeur réelle x, est définie mathématiquement par l’expression où l’espérance mathématique (notée mu) dicte le centre de gravité gravitationnel du trait psychologique, tandis que la variance (notée sigma au carré) et son corollaire direct, l’écart-type (noté sigma), quantifient la variabilité et l’hétérogénéité des performances interindividuelles au sein du groupe de référence. Le facteur de normalisation garantit que l’intégrale de cette fonction sur l’ensemble de l’axe des nombres réels équivaut rigoureusement à l’unité, conférant ainsi aux aires sous la courbe une équivalence directe avec des probabilités d’occurrence cumulées indispensables au diagnostic clinique standardisé.
1.2 Importance de la simulation numérique pour la recherche empirique
L’utilisation de la simulation numérique et de la génération de données pseudo-aléatoires s’est érigée en un impératif méthodologique de premier ordre au sein de la recherche psychologique contemporaine. Loin d’être restreinte à des considérations purement théoriques, la génération contrôlée d’échantillons synthétiques autorise une planification expérimentale proactive et une modélisation prédictive d’une précision inaccessible par les seuls protocoles observationnels traditionnels. Face à la complexité grandissante des plans expérimentaux impliquant des mesures répétées, des structures hiérarchiques à niveaux multiples ou des covariables dynamiques, la simulation permet d’anticiper les dynamiques distributionnelles avant même la collecte du premier sujet humain. Elle sert de banc d’essai virtuel pour estimer les comportements asymptotiques des estimateurs et concevoir des designs méthodologiques efficients minimisant à la fois les coûts matériels et les contraintes éthiques inhérentes aux protocoles cliniques invasifs.
Au-delà de la planification empirique, la création d’échantillons gaussiens artificiels joue un rôle déterminant dans le développement, l’étalonnage et la validation psychométrique des instruments de mesure standardisés. Les psychomètres s’appuient massivement sur la génération de pseudo-données pour vérifier la robustesse des modèles d’équations structurelles, tester l’invariance de mesure à travers des sous-groupes démographiques théoriques et diagnostiquer l’impact des biais d’échantillonnage sur les indices de fidélité tels que le coefficient alpha de Cronbach ou l’oméga de McDonald. Enfin, la simulation de Monte-Carlo représente l’étalon-or pour confronter la robustesse des méthodes statistiques paramétriques classiques lorsque les données réelles violent modérément les postulats de normalité. En confrontant des modèles statistiques linéaires à des pseudo-données générées sous des conditions contrôlées d’hétéroscédasticité ou de contamination distributionnelle, les chercheurs peuvent circonscrire avec rigueur les limites de validité de leurs inférences décisionnelles.
2. La fonction fondamentale rnorm() : Syntaxe, paramètres et fonctionnement
2.1 Anatomie technique de l’instruction rnorm()
Dans l’écosystème du logiciel R, la fonction rnorm() constitue l’instruction primitive dédiée à l’échantillonnage de valeurs scalaires issues d’une loi normale univariée. Sa signature syntaxique, d’une grande concision opérationnelle, se déploie selon la forme canonique standard rnorm(n, mean = 0, sd = 1). Le premier argument, formellement désigné par le paramètre n, correspond à un entier strictement positif définissant de façon explicite le cardinal de l’échantillon à générer, c’est-à-dire le nombre d’observations indépendantes qui composeront le vecteur numérique résultant. Si un utilisateur transmet un argument décimal pour ce paramètre, l’interpréteur R procédera de façon implicite à une troncature entière, tandis que la spécification d’un vecteur transmettra une longueur équivalente au nombre d’éléments le constituant. Le second argument, libellé mean, détermine le centrage arithmétique de la distribution théorique cible ; en l’absence de saisie explicite, cet argument hérite d’une valeur par défaut fixée à zéro, positionnant ainsi l’origine de la distribution au point d’équilibre symétrique du continuum réel.
Le troisième argument constitutif, intitulé sd (abréviation terminologique de l’anglais standard deviation), régit l’échelle ou le degré de dispersion latérale des réalisations stochastiques autour de la moyenne spécifiée. À l’instar de l’espérance, sa valeur par défaut est unitairement calibrée sur un, instanciant ainsi mécaniquement le cadre d’une loi normale centrée réduite standard. Il convient de souligner que ce paramètre exige impérativement une valeur strictement positive ; l’attribution d’une valeur négative déclenchera immédiatement l’interruption du calcul assortie d’un avertissement d’invalidation, tandis qu’une valeur nulle générera une dégénérescence déterministe où chaque observation sera rigoureusement égale à la moyenne. Sur le plan algorithmique sous-jacent, R n’opère pas un simple tirage probabiliste naïf : la fonction mobilise en coulisses des algorithmes de transformation mathématique hautement optimisés, tels que l’inversion de la fonction de répartition empirique ou la méthode géométrique polaire de Box-Muller, alimentés par un flux continu de variables uniformes discrètes produites par le générateur de nombres pseudo-aléatoires principal du noyau logiciel.
2.2 Génération de la loi normale centrée réduite standard
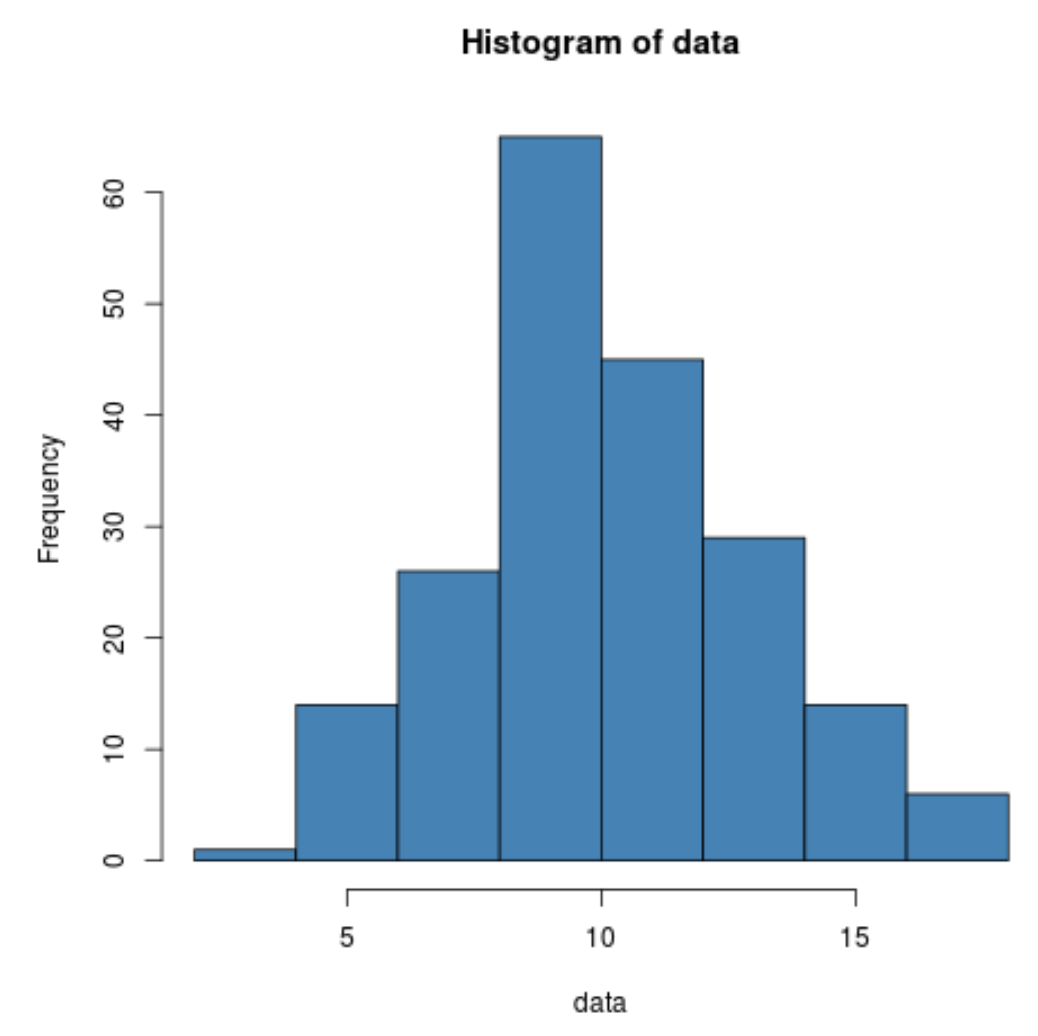
L’exécution la plus élémentaire de la fonction repose sur l’omission délibérée des arguments optionnels de position et d’échelle, capitalisant ainsi sur les pré-configurations d’usine du langage. Lorsqu’un utilisateur formule l’instruction minimale rnorm(100), l’environnement procède à l’extraction immédiate d’un vecteur atomique à double précision composé de cent réalisations indépendantes gouvernées par les paramètres canoniques mu égal à zéro et sigma égal à un. Les réalisations numériques générées s’apparentent rigoureusement, dans le contexte des sciences psychologiques, aux célèbres scores réduits dits « scores Z ». Dans la taxonomie de l’évaluation psychométrique, un score Z permet de situer tout comportement, toute latence ou toute performance cognitive par rapport à la moyenne de son groupe de référence, le score exprimant la déviation relative en multiples d’unités d’écart-type standard.
L’inspection immédiate de l’objet vectoriel ainsi instancié confirme la conformité de ses propriétés structurelles avec les standards internes de gestion de la mémoire du système R. L’application des fonctions réflexives de base démontre que le type primitif de données renvoyé correspond invariablement à la classe numeric (ou double), stockée de manière séquentielle et contiguë en mémoire vive pour optimiser les performances de calcul vectoriel ultérieures. Les valeurs générées oscillent de façon prévisible dans l’intervalle théorique attendu : la quasi-totalité des observations se situe spontanément entre les bornes négative et positive de moins trois et plus trois, reproduisant fidèlement la rareté probabiliste des manifestations extrêmes inhérentes aux scores Z empiriques observés lors de tests neuropsychologiques d’aptitude cognitive générale.
3. Reproductibilité scientifique et contrôle du générateur avec set.seed()
3.1 Nécessité de la reproductibilité dans l’analyse computationnelle
La recherche contemporaine est confrontée à un impératif épistémologique absolu de transparence méthodologique et de reproductibilité computationnelle. Les ordinateurs digitaux étant des architectures strictement déterministes, ils demeurent intrinsèquement incapables de produire un hasard ontologique pur sans recourir à la mesure de bruits physiques externes spécialisés. Par conséquent, les environnements statistiques comme R s’appuient sur des générateurs de nombres pseudo-aléatoires (dits PRNG, pour Pseudo-Random Number Generators). Par défaut, R emploie l’algorithme sophistiqué de Mersenne-Twister (implémenté sous sa variante périodique MT19937), réputé pour sa période astronomique de deux à la puissance 19937 moins un et ses propriétés multidimensionnelles exceptionnelles d’équidistribution spectrale.
En l’absence d’une intervention explicite de l’analyste, le générateur dérive son état interne initial à partir de sources d’entropie volatiles issues du système d’exploitation hôte, telles que la date système fractionnée en microsecondes ou l’identifiant du processus d’exécution actif. Cette initialisation implicite engendre une variabilité stochastique systématique : deux exécutions consécutives du même script de simulation produiront des séries de valeurs divergentes, rendant la réplication exacte des résultats rigoureusement impossible pour des pairs académiques évaluant un manuscrit scientifique. La recherche ouverte, promue par les directives internationales du consortium FORCE11 sur les données FAIR (Faciles à trouver, Accessibles, Interopérables et Réutilisables), prescrit l’ancrage déterministe absolu de toute chaîne de traitement numérique impliquant des simulations stochastiques afin de garantir que chaque estimation, graphique ou modélisation inférentielle demeure invariante au cours du temps et de l’espace computationnel.
3.2 Implémentation technique de set.seed()
Le contrôle rigoureux et la maîtrise absolue du déterminisme stochastique sous R s’opèrent par l’intermédiaire de la fonction primitive set.seed(). Cette instruction reçoit pour argument principal un entier arbitraire qui sert d’amorce ou de « graine » numérique initiale destinée à calibrer le registre d’état interne du générateur de Mersenne-Twister. En fixant délibérément cette amorce avant tout appel subséquent à une procédure d’échantillonnage probabiliste telle que rnorm(), le chercheur impose une trajectoire de tirages entièrement prédictible et parfaitement reproductible sur n’importe quel ordinateur doté d’une version équivalente du runtime R. L’arbitraire du choix de la constante numérique (qu’il s’agisse de la valeur canonique 123, 42 ou de toute autre désignation entière) n’exerce aucune incidence sur les propriétés stochastiques de la séquence produite, à condition de conserver scrupuleusement la même valeur de départ tout au long des itérations comparatives.
Une démonstration computationnelle immédiate permet d’attester empiriquement cette invariance déterministe. Lorsqu’un analyste initialise l’environnement par l’instruction set.seed(2024) puis génère une séquence de cinq valeurs gaussiennes standards, l’observation des valeurs résultantes affiche une chaîne spécifique de décimales. Si l’on réitère l’appel sans réinitialiser la graine, les cinq valeurs suivantes empruntent la suite de la trajectoire du générateur et diffèrent totalement des premières. En revanche, si l’on réexécute set.seed(2024) en amont d’un nouvel appel à la fonction de génération, les valeurs obtenues s’avèrent rigoureusement identiques, au bit près, à celles de la première extraction. Dans le cadre des projets collaboratifs d’envergure et des scripts analytiques multivariés, la bonne pratique de programmation consiste à positionner un appel unique à set.seed() au sommet du script principal ou à l’intérieur de modules fonctionnels isolés, assurant ainsi l’intégrité pérenne des pipelines de traitement psychométrique automatisés.
4. Simulation d’échantillons psychométriques concrets
4.1 Simulation d’une échelle d’efficience intellectuelle standardisée
L’évaluation standardisée de l’efficience cognitive chez l’humain s’appuie depuis près d’un siècle sur les échelles d’intelligence construites par David Wechsler, telles que la WAIS (Wechsler Adult Intelligence Scale) ou le WISC pour la population pédiatrique. Par convention psychométrique universelle, les scores bruts issus des différentes épreuves subtestées sont normalisés et convertis linéairement en un quotient intellectuel (QI) total étalonné de telle sorte que l’espérance mathématique du groupe normatif est rigoureusement assignée à la valeur numérique de 100, tandis que l’écart-type de cette métrique est calibré à 15 unités. La simulation d’une cohorte clinique virtuelle sous R requiert la saisie de ces grandeurs anthropométriques dans les paramètres respectifs de la fonction génératrice, matérialisée par l’instruction rnorm(n = 500, mean = 100, sd = 15) pour constituer un échantillon représentatif de cinq cents participants.
L’exploitation analytique de cet échantillon simulé de 500 individus permet de matérialiser les points de démarcation nosographiques classiques de la psychologie différentielle. Par application de la théorie gaussienne, l’identification du haut potentiel intellectuel (HPI) s’établit conventionnellement à deux déviations standards au-dessus de la moyenne de référence, correspondant au seuil psychométrique critique de 130 points, lequel délimite les 2,27 % supérieurs de la population générale. Inversement, la zone de déficience intellectuelle ou de fragilité neurocognitive majeure s’articule symétriquement en dessous du seuil des 70 points, matérialisant deux écarts-types sous la tendance centrale. L’extraction des percentiles au moyen de la fonction native quantile() sur le vecteur simulé permet aux chercheurs d’évaluer la proportion exacte d’individus captés au sein de ces zones d’exclusion clinique et de corroborer le calibrage empirique de l’échantillon par rapport aux fréquences théoriques postulées par les tables de normalisation de l’éditeur psychométrique.
4.2 Simulation d’échelles de personnalité de type Big Five
L’architecture paradigmatique de la psychologie de la personnalité moderne s’incarne de manière prééminente à travers le modèle à cinq facteurs (Big Five), formalisé notamment par les travaux de Costa et McCrae à l’aide de l’inventaire NEO-PI. Ce modèle postule l’existence de cinq dimensions orthogonales fondamentales régissant les variations dispositionnelles humaines : l’Ouverture à l’expérience (Openness), la Conscience ou caractère consciencieux (Conscientiousness), l’Extraversion (Extraversion), l’Agréabilité (Agreeableness) et le Névrosisme ou instabilité émotionnelle (Neuroticism). Les praticiens et chercheurs étalonnent couramment ces traits sous la forme de « scores T », une transformation standardisée normalisée caractérisée par une moyenne fixée à 50 et un écart-type unitaire étalonné à 10 points. Cette métrique prémunit les psychologues contre l’ambiguïté des valeurs négatives inhérentes aux scores Z bruts, facilitant ainsi la communication des bilans aux patients.
La génération simultanée d’un profil multidimensionnel complet pour une cohorte de trois cents volontaires virtuels s’effectue avec élégance sous R en encapsulant des appels coordonnés à rnorm() au sein d’une structure de tableau de données rectangulaire de type data.frame. En instanciant cinq colonnes indépendantes alimentées par les paramètres mean = 50 et sd = 10, l’analyste crée un univers simulé dans lequel chaque ligne modélise un sujet expérimental unique caractérisé par son vecteur de personnalité complet. Cette matrice de données synthétique devient immédiatement éligible à la manipulation computationnelle via des packages d’ingénierie de données spécialisés comme dplyr, permettant le calcul d’indices composites, la stratification en sous-groupes typologiques ou l’injection ultérieure de perturbations stochastiques mimant la désirabilité sociale.
4.3 Modélisation de latences cognitives et temps de réaction
L’étude chronométrique du traitement de l’information constitue un domaine d’investigation fondamental au sein duquel l’application brute d’une loi normale univariée rencontre des limites théoriques et pratiques évidentes. Les temps de réaction (TR) enregistrés lors de tâches d’attention visuelle soutenue ou d’interférence stroopienne s’expriment typiquement en millisecondes le long d’une échelle absolue débutant rigoureusement à zéro. La loi gaussienne théorique attribuant une densité de probabilité non nulle sur la totalité de l’axe des nombres réels, un modèle normal direct générant des latences avec une moyenne basse et une dispersion large engendre inéluctablement l’apparition aberrante de temps de réaction négatifs, ce qui constitue une impossibilité physique et cognitive flagrante défiant les lois élémentaires de la conduction neuronale synaptique.
De surcroît, les distributions chronométriques réelles se caractérisent empiriquement par une asymétrie positive systématique très prononcée : la masse centrale des réponses s’agrège rapidement autour d’un seuil minimal physiologique (typiquement 200 à 300 millisecondes), tandis qu’une longue queue d’observations ralenties s’étire vers les valeurs temporelles élevées en raison de fluctuations attentionnelles ou de micro-lapsus cognitifs. Pour surmonter l’inadéquation de la normalité symétrique pure sans renoncer à la puissance computationnelle des générateurs gaussiens de R, les chercheurs ont recours à des transformations paramétriques préalables. L’approche standard consiste à simuler une variable gaussienne sous-jacente au moyen de rnorm() dans l’espace logarithmique népérien, puis à appliquer la fonction réciproque exponentielle exp() au vecteur résultant, générant ainsi une distribution log-normale rigoureusement bornée à zéro et dotée de l’asymétrie structurelle caractéristique des latences de traitement de l’information humaine.
5. Exploration descriptive et confirmation des métriques de l’échantillon
5.1 Vérification des statistiques de tendance centrale
Dès lors qu’un échantillon aléatoire est synthétisé par des moyens computationnels, la première démarche méthodologique consiste à auditer formellement ses caractéristiques descriptives internes afin de certifier son alignement avec les paramètres théoriques assignés lors de l’appel logiciel. L’évaluation de la tendance centrale mobilise au premier chef la fonction mean(), laquelle procède à la sommation arithmétique de l’ensemble des éléments vectoriels rapportée à la taille totale n. L’analyste averti constatera systématiquement un écart résiduel, couramment baptisé erreur d’échantillonnage, entre la moyenne empirique observée et l’espérance mathématique théorique introduite dans la fonction génératrice. Ce différentiel stochastique ne traduit nullement une défaillance de l’algorithme sous-jacent, mais reflète fidèlement la fluctuation inhérente à l’induction statistique probabiliste.
L’ampleur de cet écart résiduel est directement subordonnée à la taille de l’échantillon généré, gouvernée de façon formelle par la formule de l’erreur standard de la moyenne, laquelle équivaut au ratio de l’écart-type sur la racine carrée du nombre d’observations. Dans un échantillon modeste de vingt observations simulées avec un écart-type unitaire, l’incertitude autour de la tendance centrale demeure conséquente, induisant des oscillations fréquentes de la moyenne empirique dans un intervalle compris entre moins 0,4 et plus 0,4. En revanche, l’accroissement massif de l’échantillon jusqu’à dix mille ou un million d’observations contracte asymptotiquement cette erreur standard vers zéro, assurant une convergence spectaculaire de la moyenne observée vers la cible théorique conformément à la loi forte des grands nombres. Conjointement, le calcul de la médiane par l’instruction median() permet de confirmer la symétrie centrale de l’échantillon : dans un tirage gaussien pur, la divergence absolue entre la moyenne et la médiane se maintient à des niveaux infinitésimaux non statistiquement significatifs.
5.2 Évaluation de la variabilité et de la dispersion
La caractérisation approfondie d’un jeu de données synthétique requiert l’estimation rigoureuse des indicateurs de dispersion latérale. Dans le système R, la fonction canonique sd() calcule l’écart-type de l’échantillon en appliquant systématiquement la correction de Bessel au dénominateur, divisant la somme des carrés des écarts à la moyenne par n – 1 plutôt que par n afin d’annuler le biais d’échantillonnage et de délivrer un estimateur sans biais de la variance populationnelle parente. Le calcul direct de la variance s’opère quant à lui par l’instruction var(), laquelle fournit le carré exact de la quantité délivrée par sd(). La comparaison méthodique entre ces métriques empiriques et le paramètre théorique spécifié au niveau de l’argument sd de rnorm() constitue une étape obligatoire du protocole de contrôle de qualité des données simulées.
Parallèlement aux statistiques paramétriques sensibles aux éventuelles valeurs atypiques produites aux extrémités du domaine de définition, les métriques robustes apportent un éclairage complémentaire sur la structure interne de l’échantillon. La fonction IQR() calcule l’écart interquartile, défini mathématiquement comme la différence arithmétique séparant le troisième quartile (percentile 75) du premier quartile (percentile 25). Dans le cadre d’une distribution normale pure, il est théoriquement établi que l’écart interquartile équivaut approximativement à 1,34898 fois l’écart-type. La vérification empirique de ce ratio au moyen de la comparaison entre les quantiles extraits par la commande quantile(x, probs = c(0.25, 0.75)) et la valeur de la dispersion standard offre un indicateur robuste de la conformité de l’agencement interne des données avec les postulats du modèle théorique de Gauss.
5.3 Indices de forme distributionnelle : Asymétrie et aplatissement
Au-delà de la position centrale et de la dispersion, l’évaluation complète d’une distribution statistique exige l’analyse minutieuse des moments d’ordre supérieur, lesquels gouvernent la forme morphologique géométrique de la masse de probabilité. Le troisième moment centré normalisé correspond au coefficient d’asymétrie, universellement désigné sous le terme anglais de skewness. Une distribution normale théorique étant parfaitement symétrique par rapport à son axe médian, son coefficient de skewness est rigoureusement égal à zéro. Une valeur empirique significativement positive dénote un étirement asymétrique de la queue de distribution vers la droite (valeurs positives extrêmes), tandis qu’une valeur négative indique une prédominance de la traîne vers la gauche. Dans les échantillons psychologiques simulés de taille finie, les oscillations stochastiques autour de zéro doivent être appréciées au regard de leur erreur standard asymptotique, couramment estimée par la racine carrée du ratio de six sur la taille d’échantillon.
Le quatrième moment centré correspond au coefficient d’aplatissement ou d’acuité sommitale, désigné sous le vocable de kurtosis. En psychométrie quantitative, on distingue classiquement le kurtosis brut de Pearson, qui prend la valeur de trois pour une loi normale parfaite, de l’excès de kurtosis (excess kurtosis), lequel soustrait trois à la quantité précédente afin de positionner la référence normale à zéro. Une valeur d’excès positive signale une distribution leptokurtique, caractérisée par un pic central acéré et des queues épaisses peuplées d’observations extrêmes, alors qu’une valeur négative traduit une distribution platykurtique au profil aplati et aux queues tronquées. L’environnement R ne proposant pas ces mesures sophistiquées dans son noyau d’installation minimal, les analystes mobilisent couramment le package spécialisé psych via sa fonction englobante describe(), ou la bibliothèque moments avec ses fonctions dédiées skewness() et kurtosis(), afin de valider sans équivoque la mésokurticité des données générées.
6. Représentation graphique de la distribution normale sous R de base
6.1 Construction d’histogrammes ajustés avec hist()
La restitution visuelle constitue le vecteur privilégié de la validation empirique et de la communication pédagogique des résultats de simulation. Au sein du moteur graphique natif intégré de R, la commande fondamentale hist() permet de projeter la distribution fréquentielle d’un vecteur continu sous la forme d’un histogramme en barres verticales. Pour transformer ce tracé élémentaire en une représentation académique de standard publicationnel, l’analyste doit impérativement neutraliser le comportement par défaut de l’axe des ordonnées. Par défaut, la fonction dénombre les fréquences absolues d’apparition des observations au sein de chaque classe d’intervalle. L’adjonction systématique du paramètre logique freq = FALSE ou de la directive équivalente prob = TRUE recalibre l’axe vertical sur la densité de probabilité continue, condition sine qua non pour autoriser une comparaison géométrique valide avec la fonction mathématique gaussienne théorique.
Le paramétrage esthétique et structural de l’histogramme requiert une modulation fine de ses arguments secondaires. Le paramètre breaks contrôle le découpage des intervalles ; l’utilisation de l’algorithme de Scott ou de Freedman-Diaconis optimise la largeur des bandes en fonction de la dispersion et de la taille de l’échantillon, évitant ainsi les artefacts de surlissage ou de fragmentation excessive. Une fois l’histogramme projeté sur le périphérique graphique, l’analyste peut convoquer la fonction graphique de bas niveau curve() dotée de l’argument d’addition add = TRUE pour tracer une ligne continue fluide représentant la densité théorique dnorm(x, mean, sd). Ce croisement graphique direct entre les barres polygonales empiriques et la ligne idéale permet de vérifier d’un simple coup d’œil l’ajustement global de la simulation aux propriétés de la distribution normale parente.
6.2 Diagrammes de dispersion quantile-quantile avec qqnorm() et qqline()
Bien que l’histogramme offre une appréciation globale intuitive de l’unimodalité et de la symétrie, il s’avère structurellement déficient pour diagnostiquer les anomalies locales localisées aux marges extrêmes de la distribution. Le diagramme de dispersion quantile-quantile normal, universellement désigné par l’acronyme de graphique Q-Q (Quantile-Quantile plot), s’impose comme l’outil diagnostique graphique par excellence en modélisation linéaire et psychométrie avancée. Sous le système de base R, l’exécution conjointe des deux instructions coordonnées qqnorm() et qqline() permet de générer instantanément cette confrontation spatiale sans nécessiter l’installation de bibliothèques tierces.
Le principe fondamental sous-jacent au graphique Q-Q repose sur l’appariement bijectif de deux ensembles de quantiles : les quantiles empiriques, calculés directement à partir des données observées triées par ordre croissant d’amplitude le long de l’axe vertical, sont tracés contre les quantiles théoriques attendus d’une loi normale univariée parfaite le long de l’axe horizontal. La fonction complémentaire qqline() calcule et trace une droite de référence rectiligne reliant de façon déterministe les premier et troisième quartiles de la distribution. Si l’échantillon généré dérive rigoureusement d’une loi normale, l’ensemble des points d’échantillonnage s’aligne de manière quasi fusionnelle le long de cette trajectoire oblique. Les écarts perceptibles aux extrémités fournissent un diagnostic nosographique immédiat : une déviation en forme de « S » inversé signale des queues trop épaisses (leptokurticité), tandis qu’une courbure unilatérale vers le haut ou vers le bas trahit une asymétrie marquée nécessitant un réajustement des paramètres du générateur.
7. Visualisation graphique avancée avec ggplot2
7.1 Création d’histogrammes et d’estimations par noyau de densité
Le développement moderne de l’ingénierie statistique privilégie très largement l’écosystème graphique unifié apporté par la bibliothèque ggplot2, conçue sur les bases conceptuelles de la grammaire des graphiques théorisée par Leland Wilkinson. L’élaboration d’un graphique de haute technicité démarre par l’encapsulation du vecteur simulé au sein d’une structure de table rectangulaire, condition structurelle requise par l’architecture du package. L’initialisation de l’espace d’affichage via la commande ggplot() s’articule autour de l’assignation esthétique de la variable étudiée à l’axe horizontal, couplée à l’instruction fondamentale aes(y = after_stat(density)) au sein de la couche géométrique geom_histogram() afin de normaliser les hauteurs de barres en unités de densité continue plutôt qu’en effectifs bruts.
La puissance d’abstraction de ggplot2 réside dans sa capacité à superposer des couches analytiques indépendantes sur une même scène graphique. L’analyste peut ainsi enrichir instantanément la visualisation en y intégrant un lissage empirique non paramétrique au moyen de la géométrie geom_density(), dont l’opacité peut être nuancée via le paramètre alpha afin de préserver la visibilité des classes d’histogrammes sous-jacentes. Pour parachever la confrontation théorique, l’incorporation de la directive stat_function() permet de projeter la trajectoire mathématique exacte de la fonction dnorm calibrée sur les paramètres de moyenne et d’écart-type de l’échantillon. Cette superposition tripartite — barres de discrétisation empirique, courbe par noyau d’estimation non paramétrique et tracé théorique paramétrique continu — offre une perspective analytique exhaustive et d’une remarquable élégance visuelle pour les publications scientifiques internationales.
7.2 Diagrammes Q-Q graphiques conformes aux standards de publication
L’implémentation des diagrammes quantile-quantile au sein du paradigme ggplot2 s’affranchit des limites stylistiques des graphiques du système de base pour répondre aux exigences éditoriales les plus strictes des revues à comité de lecture en psychologie expérimentale et clinique. La génération d’un diagramme Q-Q sous ggplot2 repose sur l’articulation coordonnée des composants spécialisés stat_qq() et stat_qq_line(). L’utilisateur configure l’esthétique d’ancrage en déclarant l’argument sample orienté vers le vecteur de scores psychométriques cibles, déléguant au moteur de calcul sous-jacent l’extraction et la mise en correspondance algorithmique des quantiles théoriques sur l’abscisse.
Pour hisser le rendu visuel aux standards typographiques de l’American Psychological Association (APA), l’analyste applique des thèmes d’épuration graphique prédéfinis tels que theme_classic() ou theme_minimal(), lesquels purgent l’affichage de la grille de fond grise par défaut et renforcent le contraste des axes cartésiens. En recourant à des bibliothèques d’extension sophistiquées comme car ou qqplotr, il devient en outre possible de projeter des bandes de confiance ponctuelles ou simultanées à 95 % sous forme d’enveloppes ombrées délimitées le long de la droite d’invariance normale. Tout point d’échantillonnage s’échappant de cette bande de tolérance paramétrique matérialise une violation statistically significative de la normalité locale, conférant à la visualisation graphique une véritable portée inférentielle objective.
8. Évaluation inférentielle de la normalité des échantillons générés
8.1 Le test de normalité de Shapiro-Wilk avec shapiro.test()
L’inspection graphique qualitative, bien qu’indispensable, doit être corroborée par des tests d’hypothèse formels capables de délivrer un verdict probabiliste univoque. Parmi l’éventail des tests de normalité documentés en statistique mathématique, le test de Shapiro-Wilk, implémenté sous R via la commande shapiro.test(), s’impose empiriquement comme l’épreuve paramétrique la plus puissante face à un large éventail d’alternatives non gaussiennes, particulièrement au sein des échantillons de taille modeste à modérée. L’hypothèse nulle (notée H0) stipule formellement que l’échantillon observé dérive d’une population parente normalement distribuée, tandis que l’hypothèse alternative (H1) postule une divergence structurelle vis-à-vis du modèle gaussien canonique.
Le calcul délivre deux grandeurs fondamentales : la statistique de test, notée W, et la probabilité critique d’erreur de première espèce, universellement désignée par le terme de p-value. La statistique W s’évalue dans un intervalle borné entre zéro et un ; une valeur strictement proche de l’unité indique un alignement remarquable entre les quantiles ordonnés de l’échantillon et les pondérations de variance espérées. Lorsque la p-value excède le seuil de significativité conventionnellement assigné à 0,05, l’analyste conclut à l’absence de preuves statistiques suffisantes pour rejeter l’hypothèse nulle, validant ainsi la plausibilité de l’hypothèse gaussienne. Néanmoins, une grande lucidité méthodologique s’impose quant à l’interprétation de ce test : en vertu de sa puissance asymptotique extrême, le test de Shapiro-Wilk tend à rejeter systématiquement l’hypothèse de normalité dans les très grands échantillons (typiquement lorsque n dépasse plusieurs milliers d’observations) en raison d’infimes fluctuations d’échantillonnage totalement dépourvues de pertinence pratique ou clinique.
8.2 Tests complémentaires d’adéquation distributionnelle
En complément de l’épreuve de Shapiro-Wilk, le répertoire statistique met à disposition d’autres formalismes inférentiels reposant sur des métriques d’adéquation distinctes. Le test classique de Kolmogorov-Smirnov, exécutable sous R par l’instruction ks.test(), évalue la déviation verticale maximale observée entre la fonction de répartition cumulative empirique de l’échantillon et la fonction de répartition théorique cumulative continue. Lorsqu’il s’agit d’évaluer la conformité à une loi normale dont les paramètres sont spécifiés a priori, la commande prend la forme ks.test(x, "pnorm", mean = mean(x), sd = sd(x)). Toutefois, l’estimation conjointe des paramètres de position et d’échelle à partir de l’échantillon étudié invalide la table standard des valeurs critiques de Kolmogorov-Smirnov, exigeant le recours à la variante de Lilliefors pour éviter une inflation pernicieuse du taux d’erreur de première espèce.
Pour surmonter ces contraintes, les psychométriciens plébiscitent le test d’Anderson-Darling, rendu accessible au sein de l’environnement R par le package spécialisé nortest au travers de la commande ad.test(). Cette méthode sophistiquée constitue une extension pondérée du cadre de Kolmogorov-Smirnov, accordant un poids statistique accru aux écarts distributionnels situés précisément dans les queues de distribution. Cette sensibilité exacerbée aux marges confère au test d’Anderson-Darling une capacité remarquable à détecter les contaminations platykurtiques ou leptokurtiques subtiles. L’arbitrage final entre ces différents instruments d’évaluation inférentielle doit toujours être coordonné avec le jugement clinique de l’analyste : un écart statistiquement significatif au sens des tests formels n’invalide pas nécessairement l’utilisation des modèles paramétriques généraux si l’inspection visuelle des diagrammes de dispersion confirme une proximité acceptable avec le modèle théorique.
9. L’écosystème complet des fonctions gaussiennes : rnorm, dnorm, pnorm et qnorm
9.1 Calcul de la densité de probabilité avec dnorm()
L’implémentation du formalisme gaussien sous le logiciel R ne se cantonne pas à la seule génération d’échantillons stochastiques via rnorm() ; elle se déploie à travers un quatuor fonctionnel cohérent articulé autour d’un radical commun précédé d’un préfixe sémantique standardisé. La fonction dnorm() hérite ainsi du préfixe « d » pour densité (density). Contrairement à une croyance répandue chez les débutants en analyse de données quantitatives, cette fonction ne délivre en aucune manière une probabilité discrète ponctuelle. Dans le domaine continu des variables réelles, la probabilité exacte d’observer une valeur infiniment précise est formellement égale à zéro, car une coordonnée isolée ne possède aucune épaisseur géométrique sous la courbe intégrale.
La valeur numérique renvoyée par un appel de la forme dnorm(x, mean = 0, sd = 1) correspond rigoureusement à la hauteur instantanée de l’ordonnée de la courbe de densité de probabilité pour l’abscisse x fournie. Cette quantité représente le taux instantané d’accumulation de probabilité par unité de mesure continue dans le voisinage infinitésimal de ce point. Sur le plan opérationnel, la maîtrise de dnorm() s’avère indispensable pour calculer des fonctions de vraisemblance au sein des procédures d’estimation par le maximum de vraisemblance (MLE) ou pour concevoir des visualisations théoriques continues idéales le long d’une grille vectorielle régulière de points générée par l’opérateur seq(), s’affranchissant totalement du besoin de simuler des cohortes d’individus virtuels.
9.2 Calcul des probabilités cumulées avec pnorm()
Le second pilier de cet écosystème fonctionnel s’incarne à travers la fonction pnorm(), dont le préfixe « p » renvoie au concept probabiliste de probabilité cumulée (cumulative probability). Cette instruction modélise de façon computationnelle la fonction de répartition canonique, universellement désignée par la notation grecque Phi majuscule dans la littérature académique. Mathématiquement, pnorm(q, mean = 0, sd = 1) calcule l’intégrale définie de la fonction de densité gaussienne depuis l’infini négatif jusqu’à la borne supérieure spécifiée par l’argument de quantile q. La valeur scalaire renvoyée appartient strictement à l’intervalle ouvert zéro-un et exprime la probabilité objective qu’une variable aléatoire normale prenne une valeur inférieure ou égale au score clinique considéré.
Cette commande trouve une application directe et quotidienne en psychologie clinique et en neuropsychologie diagnostique lorsqu’il s’agit d’estimer des taux de prévalence théoriques ou de déterminer le rang percentile normatif associé au bilan d’un patient. Par exemple, l’introduction d’un quotient intellectuel de 115 dans pnorm(115, mean = 100, sd = 15) délivre la valeur de 0,8413, signifiant que 84,13 % de la population générale parente manifeste une performance cognitive égale ou inférieure à cette cote. L’exploitation du paramètre logique complémentaire lower.tail = FALSE modifie instantanément l’orientation de l’intégration pour calculer la probabilité unilatérale supérieure (la survie probabiliste), indiquant que 15,87 % de la population surpasse ce niveau. Cette manipulation simple élimine les erreurs d’inversion arithmétique manuelles lors de la détermination des niveaux de rareté comportementale.
9.3 Calcul des quantiles inversés avec qnorm()
Pour parachever l’architecture matricielle des fonctions univariées de base, l’instruction qnorm() mobilise le préfixe « q » pour implémenter la fonction quantile, laquelle correspond mathématiquement à la fonction inverse de la fonction de répartition cumulative formalisée au paragraphe précédent. En recevant pour argument d’entrée une probabilité cumulée p comprise entre zéro et un, qnorm() restitue la valeur exacte de l’abscisse x dont la surface intégrée à sa gauche équivaut précisément à ce quota probabiliste. Cette opération de conversion s’avère particulièrement utile lors de la calibration d’échelles de cotation ou de la détermination de scores seuils d’admissibilité académique ou clinique.
L’utilisation de qnorm() permet notamment de dériver les valeurs critiques standardisées régissant les tests d’inférence statistique. Ainsi, la saisie de l’argument de probabilité 0,975 dans une loi normale centrée réduite par qnorm(0.975) renvoie la constante emblématique de 1,959964 (usuellement arrondie à 1,96), matérialisant la frontière supérieure bilatérale de l’intervalle de confiance canonique à 95 %. Il existe une réciprocité mathématique déterministe parfaite entre ces primitives : soumettre le résultat d’un calcul qnorm(p) à la fonction pnorm() restitue rigoureusement la probabilité originelle p, confirmant l’harmonie algorithmique du sous-système de calcul stochastique du langage R.
10. Génération de distributions normales multivariées corrélées
10.1 Nécessité de la modélisation multidimensionnelle en psychologie
L’exploration des phénomènes psychologiques réels se heurte immédiatement aux limites de l’analyse univariée indépendante. Les constructs humains se déploient au sein de réseaux dynamiques complexes où les aptitudes, traits et états émotionnels manifestent des intercorrélations structurelles systématiques. Dans le domaine de l’évaluation intellectuelle, les subtests mesurant la vitesse de traitement de l’information et la mémoire de travail ne fluctuent pas de manière isolée ; ils covarient positivement sous l’égide de covariations biologiques et développementales partagées. De même, en psychopathologie quantitative, les dimensions cliniques de l’anxiété généralisée et de la symptomatologie dépressive affichent une corrélation positive substantielle qui interdit de simuler ces deux affections de manière stochastiquement disjointe sous peine de générer des profils nosographiques virtuels totalement irréalistes.
La modélisation rigoureuse de ces profils intriqués exige l’extension du cadre mathématique vers la distribution normale multivariée continue. Une loi gaussienne multidimensionnelle d’ordre k n’est plus simplement régie par une moyenne et un écart-type scalaires, mais nécessite la formulation conjointe d’un vecteur de moyennes de longueur k et d’une matrice symétrique carrée de variance-covariance d’ordre k × k, notée conventionnellement Sigma majuscule. Les éléments diagonaux de cette matrice quantifient la variance propre de chaque dimension psychométrique, tandis que les éléments extradiagonaux hébergent les covariances bilatérales régentant la force et l’orientation des relations linéaires inter-variables. Pour être valide sur le plan calculatoire, cette matrice de dispersion doit satisfaire à la contrainte algébrique stricte d’être semi-définie positive, ce qui garantit que la surface quadratique résultante ne présente aucune variance imaginaire ou impossible.
10.2 Mise en œuvre pratique avec la fonction mvrnorm() du package MASS
Le noyau standard d’installation de R ne disposant pas d’une primitive multivariée directe, l’échantillonnage de telles structures s’appuie historiquement sur l’extension académique de référence MASS (Modern Applied Statistics with S), incluse de façon native dans toutes les distributions courantes du logiciel. La fonction centrale de ce module, intitulée mvrnorm(), procède à l’extraction computationnelle d’échantillons multidimensionnels au moyen de la décomposition spectrale par valeurs propres ou de la factorisation de Cholesky appliquée à la matrice de dispersion déclarée. La syntaxe opérationnelle requiert la définition du nombre d’observations souhaité n, du vecteur des espérances mu et de la matrice de covariance Sigma.
Pour concrétiser la simulation conjointe de deux échelles cliniques (par exemple l’anxiété et la dépression calibrées en scores T avec des moyennes de 50 et des déviations standards de 10) affichant une corrélation empirique attendue de 0,60, l’analyste procède à la construction formelle de la matrice de covariance. La variance de chaque échelle étant égale à cent (dix au carré), la covariance croisée s’obtient en multipliant le coefficient de corrélation par les deux écarts-types, aboutissant à une valeur de soixante. En injectant cette matrice symétrique d’ordre deux dans mvrnorm(), l’algorithme délivre une matrice rectangulaire d’observations dont l’intercorrélation empirique peut être vérifiée immédiatement par l’appel à la fonction cor(). Les coefficients calculés sur l’échantillon simulé s’alignent de manière remarquable sur la structure paramétrique assignée a priori, offrant un matériau synthétique irréprochable pour former des modèles de régression multivariée ou calibrer des classificateurs diagnostiques automatisés.
11. Gestion des contraintes : Distributions normales tronquées
11.1 Le problème des effets de plancher et de plafond psychométriques
La modélisation mathématique pure se heurte fréquemment à la matérialité physique et ergonomique des instruments d’évaluation psychologique. Dans de multiples contextes d’investigation, les outils d’observation imposent des limitations structurelles absolues se traduisant par des effets de plancher (impossibilité d’obtenir un score inférieur à une borne minimale, couramment zéro) ou des effets de plafond (saturation de la performance au score maximal théorique permis par l’épreuve). L’utilisation naïve de la fonction de génération rnorm() engendre inéluctablement des artefacts computationnels préjudiciables : un modèle générant des niveaux d’anxiété sur une échelle de Likert bornée entre 0 et 30 produira des scores virtuels négatifs ou excédant la limite supérieure, constituant des aberrations méthodologiques rédhibitoires.
Face à cette aporie, une pratique empirique désastreuse consiste à appliquer une coupure post-hoc déterministe (dite troncature naïve ou clamping), consistant à réassigner arbitrairement toute valeur générée inférieure à zéro à la valeur plancher, et toute valeur excédant le maximum à la valeur plafond. Ce procédé engendre une distorsion structurelle dramatique du jeu de données : la masse de probabilité normalement distribuée au-delà des bornes s’accumule artificiellement sur les valeurs limites exactes, créant des pointes de fréquence discrètes aberrantes, ruinant la normalité sous-jacente et induisant une sous-estimation systématique sévère de la variance populationnelle réelle du phénomène étudié. La gestion rigoureuse des limites dimensionnelles exige par conséquent le recours à la théorie mathématique de la distribution normale tronquée conditionnelle, au sein de laquelle la densité de probabilité est recalculée et renormalisée exclusivement sur l’intervalle de définition autorisé.
11.2 Utilisation du package truncnorm pour des échantillons contraints
L’implémentation opérationnelle de la troncature conditionnelle sans altération des propriétés fondamentales de l’échantillonnage s’effectue sous R grâce aux fonctionnalités avancées de la bibliothèque dédiée truncnorm. Ce package spécialisé met à disposition des chercheurs la fonction génératrice rtruncnorm(), dont l’algorithme repose sur l’échantillonnage par rejet optimisé ou sur l’inversion analytique de la fonction de répartition conditionnellement restreinte entre deux bornes d’exclusion arbitraires. La signature syntaxique introduit deux arguments fondamentaux : le paramètre a représentant la borne inférieure de troncature (pouvant être fixée à moins l’infini en cas de troncature unilatérale), et le paramètre b spécifiant la borne supérieure de troncature.
L’application clinique de rtruncnorm() pour simuler un inventaire d’évaluation de la dépression borné rigoureusement entre 0 et 63 points permet d’obtenir un vecteur numérique où chaque observation demeure strictement confinée dans l’espace des valeurs empiriquement possibles, sans qu’aucune accumulation artificielle ne vienne saturer les bornes extrêmes. Il importe toutefois de garder à l’esprit une propriété mathématique cruciale : l’application d’une troncature asymétrique ou resserrée modifie mécaniquement la moyenne et l’écart-type effectifs observés sur l’échantillon final par rapport aux paramètres nominaux mean et sd transmis en argument à la fonction génératrice. L’analyste doit donc mobiliser des formules d’ajustement analytique ou des démarches d’optimisation numérique itérative s’il souhaite que la distribution tronquée résultante affiche exactement la moyenne et la dispersion finale escomptées au sein de son design expérimental.
12. Applications avancées : Simulations de Monte-Carlo et calcul de puissance
12.1 Planification de la puissance statistique a priori par simulation
L’une des contributions les plus remarquables de la génération stochastique sous R à l’intégrité de la recherche contemporaine réside dans l’exécution de simulations de Monte-Carlo appliquées à la planification de la puissance statistique. La détermination de la taille d’échantillon requise pour détecter un effet expérimental donné s’avère souvent complexe lorsque les modèles statistiques s’écartent des designs élémentaires couverts par les logiciels d’analyse de puissance conventionnels. En simulant numériquement le déroulement intégral d’une expérience un grand nombre de fois sous des conditions d’hypothèse alternative contrôlées, le chercheur peut dériver empiriquement la puissance statistique a priori avec une flexibilité conceptuelle inégalée.
Le protocole opératoire consiste à concevoir une routine itérative simulant, à chaque boucle d’exécution, deux cohortes distinctes générées via rnorm() : un groupe témoin calibré sur une espérance donnée et un groupe expérimental dont la moyenne intègre une déviation paramétrique calibrée sur l’indice de taille d’effet escompté, tel que le d de Cohen standardisé. À chaque itération de la simulation de Monte-Carlo, un test inférentiel (tel qu’un test t de Student pour échantillons indépendants) est exécuté sur les données artificielles, et la significativité de la p-value au seuil alpha de 0,05 est enregistrée sous la forme d’un booléen. En répétant ce cycle stochastique sur dix mille réplications virtuelles, la proportion exacte d’itérations aboutissant au rejet légitime de l’hypothèse nulle fournit une estimation non biaisée et empirique de la puissance statistique réelle associée au design d’étude programmé.
12.2 Optimisation computationnelle et vectorisation sous R
La conduite de simulations intensives de Monte-Carlo impliquant des millions d’itérations stochastiques soulève immédiatement la problématique critique de l’efficience algorithmique et de la gestion des ressources matérielles. L’interpréteur R étant un langage dynamique de haut niveau, l’utilisation naïve de boucles de contrôle itératives de type for pour générer et manipuler séquentiellement des scalaires stochastiques engendre une dégradation dramatique des performances d’exécution en raison des coûts de réallocation dynamique de la mémoire vive et de l’évaluation syntaxique récurrente à chaque pas de calcul.
L’optimisation des performances sous R requiert l’adoption systématique du paradigme de vectorisation computationnelle. Au lieu d’invoquer la fonction rnorm() de manière répétée au sein d’une boucle temporelle séquentielle, l’analyste chevronné génère l’ensemble de la masse stochastique en un seul appel massif, encapsulant le résultat dans une matrice bidimensionnelle de dimensions appropriées (où chaque colonne modélise une itération expérimentale complète et chaque ligne un participant virtuel). La manipulation de cette structure s’appuie ensuite sur des opérations matricielles natives implémentées en langage C ou Fortran sous-jacent, ou sur les primitives de la famille fonctionnelle apply(), décuplant ainsi la vitesse de traitement de plusieurs ordres de grandeur. L’intégration de ces patrons d’architecture logicielle, couplée au respect rigoureux des standards de reproductibilité computationnelle, offre aux chercheurs en sciences comportementales un environnement d’une puissance méthodologique absolue pour faire progresser la rigueur de leurs investigations empiriques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Box, G. E., & Muller, M. E. (1958). A note on the generation of random normal deviates. The Annals of Mathematical Statistics, 29(2), 610-611. https://doi.org/10.1214/aoms/1177706645
- Costa, P. T., & McCrae, R. R. (2008). The Revised NEO Personality Inventory (NEO-PI-R). SAGE Publications. https://doi.org/10.4135/9781849200479.n9
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3-30. https://doi.org/10.1145/272991.272995
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Revelle, W. (2023). psych: Procedures for psychological, psychometric, and personality research. Northwestern University. https://CRAN.R-project.org/package=psych
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson. https://www.pearsonassessments.com/
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0