
L’essor contemporain de l’ingénierie des données et de l’analytique computationnelle a profondément reconfiguré l’usage des tableurs infonuagiques dans les organisations modernes. Autrefois cantonnés à de simples registres comptables ou à des compilations scalaires élémentaires, des outils collaboratifs tels que Google Sheets sont aujourd’hui érigés en véritables systèmes d’information décisionnels légers. Face à des matrices de données dont la cardinalité et la dimensionnalité croissent de manière exponentielle, les analystes, chercheurs et gestionnaires sont confrontés au défi de l’extraction ciblée du signal au sein d’un bruit informationnel dense. Cette tâche opérationnelle requiert une maîtrise avancée des méthodes de segmentation et de filtrage multicritère.
Le filtrage multi-colonnes ne relève pas d’une simple manipulation technique superficielle ; il s’inscrit au cœur de la formalisation logique des problèmes d’aide à la décision. Qu’il s’agisse d’isoler des cohortes d’individus répondant à des critères sociodémographiques stricts, de segmenter des transactions financières selon des seuils géographiques et monétaires combinés, ou d’auditer des chaînes d’approvisionnement globales, l’application concomitante de filtres sur plusieurs attributs structurels conditionne la pertinence empirique de toute déduction ultérieure. L’erreur conceptuelle ou syntaxique dans l’imbrication des prédicats expose l’analyste à des biais de sélection majeurs, faussant irrémédiablement les inférences statistiques tirées des sous-ensembles extraits.
Le présent traité vise à délivrer une théorisation exhaustive et une méthodologie opérationnelle rigoureuse du filtrage multicritère dans l’écosystème Google Sheets. En explorant successivement les paradigmes du masquage d’interface natif, l’algèbre booléenne appliquée aux formules personnalisées, les fonctions de tableau dynamique matriciel telles que FILTER, ainsi que la puissance déclarative du langage quasi-SQL intégré via la fonction QUERY, ce document constitue un guide de référence exhaustif. À travers une formalisation conceptuelle et des cas empiriques détaillés, chaque praticien découvrira les protocoles nécessaires pour manipuler des jeux de données complexes avec exactitude mathématique et efficience cognitive.
1. 1. Introduction aux mécanismes de filtrage multicritère dans Google Sheets
1.1 1.1 Importance du filtrage dans l’analyse de données multidimensionnelles
Dans l’univers de la science des données appliquée et de la gouvernance informationnelle, la segmentation analytique représente une opération fondamentale qui consiste à isoler une sous-matrice cohérente au sein d’un ensemble de données plus vaste, sans porter atteinte à l’intégrité de la structure source. Lorsqu’un jeu de données comprend des milliers d’observations distribuées sur des dizaines d’attributs vectoriels, la tentative d’appréhender le tableau dans sa globalité sans filtrage préalable induit une surcharge cognitive sévère pour l’opérateur humain. La psychologie cognitive démontre que l’attention visuelle et le traitement de l’information sont drastiquement limités face à des matrices denses ; la réduction de l’espace visible à un échantillon précis répondant à des axiomes définis permet de focaliser les capacités analytiques sur le phénomène sous-jacent étudié.
D’un point de vue théorique, il convient de tracer une démarcation nette entre la sélection univariée et le filtrage multivarié. La sélection univariée n’examine qu’un seul vecteur de variables (par exemple, retenir uniquement les transactions d’une année donnée). Si cette approche suffit pour des questions périphériques, elle s’avère incapable de répondre aux problématiques empiriques complexes qui caractérisent les systèmes socio-économiques, logistiques ou épidémiologiques contemporains. Le filtrage multivarié ou multicritère opère une projection relationnelle contrainte : il évalue simultanément plusieurs vecteurs de dimensions distinctes (comme le temps, l’espace géographique, la typologie des produits et la performance volumétrique) afin d’extraire l’intersection ou l’union logique répondant au cadre de recherche posé.
Les applications directes de cette discipline se manifestent quotidiennement dans la recherche quantitative et le traitement de données empiriques. En épidémiologie, isoler des patients selon une tranche d’âge précise, des antécédents médicaux particuliers et une zone géographique ciblée constitue l’essence même du profilage de risque. En économétrie d’entreprise, évaluer la rentabilité d’un segment de marché spécifique exige de contraindre à la fois les colonnes de canaux d’acquisition, de coûts opérationnels et de fenêtres de conversion. Dès lors, le filtrage multicritère ne se résume pas à un confort cosmétique, mais constitue la condition sine qua non de la validité de toute exploration analytique sur tableur.
1.2 1.2 Principes fondamentaux de la logique booléenne dans les tableurs
L’ensemble des moteurs de calcul sous-jacents aux feuilles de calcul électroniques modernes, dont fait partie Google Sheets, repose sur les fondements mathématiques de l’algèbre de Boole, théorisée au milieu du XIXe siècle par le mathématicien George Boole. Transposée à l’architecture d’un chiffrier, cette algèbre manipule deux états discrets fondamentaux : la valeur de vérité VRAI (encodée numériquement par 1) et la valeur de fausseté FAUX (encodée numériquement par 0). Toute condition formulée au sein d’une règle de filtrage n’est rien d’autre qu’une fonction propositionnelle qui prend en entrée une ou plusieurs valeurs de cellules et renvoie un état booléen unitaire pour chaque ligne d’enregistrement analysée.
Les deux opérateurs fondamentaux régissant le filtrage multicritère sont la conjonction logique (l’opérateur ET) et la disjonction logique (l’opérateur OU). La conjonction logique impose une sévérité cumulative absolue : l’expression globale n’est évaluée à VRAI que si et seulement si l’intégralité des prédicats unitaires constitutifs est simultanément vérifiée. Si un seul prédicat échoue, la ligne est marquée comme FAUSSE et se voit exclue du jeu résultant. À l’inverse, la disjonction logique adopte une posture inclusive : il suffit qu’au moins l’un des prédicats soit vérifié pour que l’enregistrement entier soit retenu. La manipulation rigoureuse de ces connecteurs booléens détermine l’exactitude de l’espace échantillonnal généré.
Sur le plan computationnel, l’évaluation de ces prédicats booléens s’effectue séquentiellement ou vectoriellement le long de la dimension verticale de la matrice. Le moteur d’évaluation de Google Sheets alloue des cycles de calcul proportionnels à la complexité des prédicats et au nombre total de rangées. Lorsqu’un filtre multicritère est déployé sur des centaines de milliers de cellules, des expressions logiques inefficientes ou des fonctions volatiles imbriquées peuvent dégrader les performances de calcul du chiffrier. Comprendre comment le processeur logique traite ces conditions permet donc non seulement de garantir la justesse de l’analyse, mais également de préserver la réactivité du logiciel face à des jeux de données denses.
1.3 1.3 Vue d’ensemble des architectures de données compatibles
La faisabilité technique et la fiabilité algorithmique du filtrage multicritère dépendent intégralement de la topologie du jeu de données hébergé dans le tableur. Une structure tabulaire standardisée impose que chaque colonne corresponde à une variable aléatoire ou un attribut invariable unique (dimension ou mesure), et que chaque ligne représente une observation empirique distincte et indivisible (enregistrement). Tout écart par rapport à ce paradigme relationnel normalisé introduit des anomalies computationnelles susceptibles de rendre les algorithmes de filtrage inopérants ou silencieusement erronés.
L’un des écueils méthodologiques les plus destructeurs réside dans l’utilisation de cellules fusionnées au sein de la matrice de données. Sur le plan architectural, une cellule fusionnée n’assigne sa valeur sous-jacente qu’à la coordonnée matricielle supérieure gauche de la plage couverte, attribuant une valeur nulle ou vide aux autres coordonnées de la zone fusionnée. Lorsqu’un filtre évalue une telle plage, les lignes subséquentes subissent une défaillance logique immédiate puisqu’elles sont lues comme vides par le moteur d’évaluation. De même, l’insertion de lignes de totaux intermédiaires ou de ruptures visuelles brise la contiguïté vectorielle et provoque des tronquages arbitraires lors de l’application des règles conditionnelles.
Enfin, la normalisation typologique des données est une condition préalable impérative. Chaque colonne doit préserver une stricte homogénéité de type : une colonne de dates ne doit contenir aucun texte libre, une colonne numérique ne doit pas héberger de résidus typographiques monétaires non standardisés, et les valeurs catégorielles doivent être épurées des variations de casse ou d’espacements parasites. Sans cette discipline d’hygiène des données, un opérateur d’égalité booléenne échouera à identifier des similitudes sémantiques pourtant évidentes pour l’humain, menant à l’occultation involontaire de pans entiers de l’échantillon d’étude.
2. 2. Fondements méthodologiques : Préparation et structuration rigoureuse du jeu de données
2.1 2.1 Définition du modèle de données d’exemple
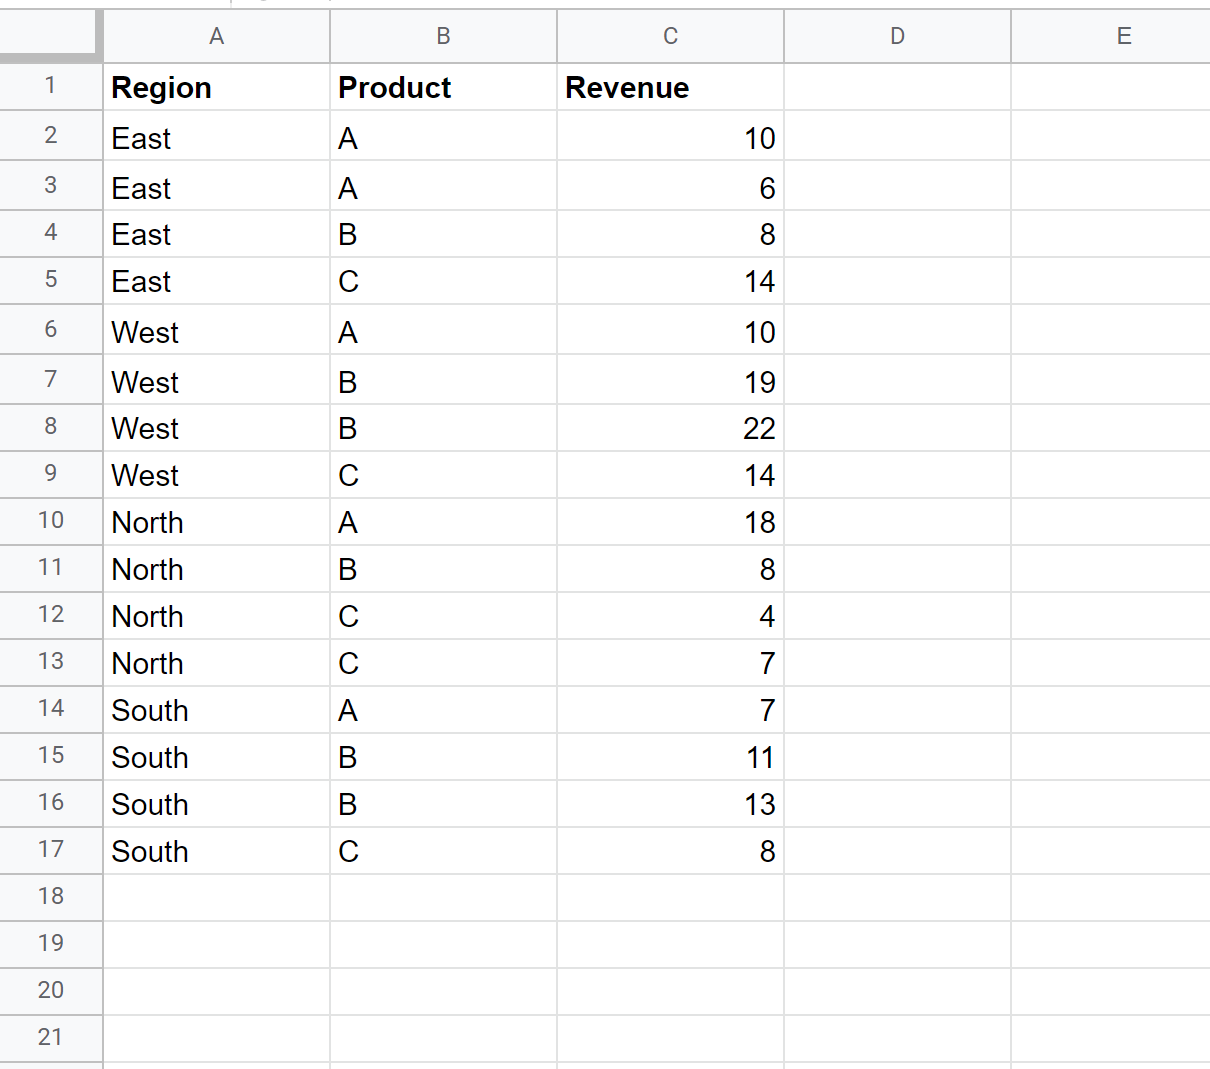
Afin d’ancrer les démonstrations théoriques dans un cadre expérimental reproductible, nous établissons un modèle de données empirique représentatif des problématiques de gestion commerciale et d’audit logistique. Ce jeu de données synthétique se compose d’une matrice tridimensionnelle standardisée contenant des variables catégorielles, qualitatives et des métriques continues quantitatives. La première ligne de la feuille (Ligne 1) est impérativement dédiée aux en-têtes de colonnes, sanctuarisant ainsi l’adressage sémantique indispensable au bon fonctionnement des interfaces et des formules relationnelles.
Le schéma relationnel adopté pour notre référentiel s’articule comme suit : la Colonne A est assignée à la variable nominale Région (abritant des chaînes de caractères telles que « East », « West », « North », « South ») ; la Colonne B contient la variable nominale Produit (segmentée en catégories discrètes désignées par « A », « B », « C », « D ») ; enfin, la Colonne C héberge la métrique d’échelle de rapport Ventes (exprimée sous forme de valeurs numériques décimales continues représentant des volumes financiers ou d’unités écoulées). Ce modèle compact offre un terrain d’investigation idéal pour tester l’ensemble des combinaisons logiques possibles, depuis les disjonctions élémentaires jusqu’aux imbrications quantitatives et qualitatives les plus denses.
La cohérence des types de données au sein de ce modèle d’exemple garantit la totale impartialité des évaluations booléennes. Aucun format monétaire complexe n’altère la valeur brute stockée en mémoire dans la colonne C, et les colonnes A et B sont strictement circonscrites à des chaînes de caractères ASCII sans fioritures typographiques. Ce schéma standard permettra d’illustrer avec une clarté limpide la transmission des requêtes de filtrage au moteur de calcul, fournissant une base d’évaluation empirique incontestable lors de la vérification croisée des résultats.
2.2 2.2 Nettoyage et assainissement préliminaire des données
Avant d’initier la moindre tentative de filtrage multicritère, une phase critique d’assainissement préalable s’impose. L’échec le plus commun lors de l’application d’un prédicat d’égalité textuelle comme A:A="East" provient de la présence d’espaces typographiques invisibles en tête ou en fin de chaîne. Pour éradiquer ces artefacts de saisie manuelle ou d’exportation de base de données imparfaite, l’usage de la fonction SUPPRESPACE (ou TRIM en environnement anglophone) est prescrit. En appliquant cette transformation sur l’ensemble des colonnes textuelles, l’analyste neutralise les discordances de longueur de chaîne qui altèrent les tests d’équivalence binaire.
Parallèlement à l’épuration des espacements, l’harmonisation de la casse des caractères constitue une mesure de prudence méthodologique essentielle. Bien que certains opérateurs de base soient insensibles à la casse dans Google Sheets, l’introduction de fonctions plus strictes ou d’expressions rationnelles avancées peut induire des discriminations inattendues entre « EAST », « East » et « east ». L’application systématique des fonctions MAJUSCULE (UPPER), MINUSCULE (LOWER) ou NOMPROPRE (PROPER) standardise la morphologie des données textuelles, garantissant une cohérence lexicale totale au sein de la cohorte d’observations.
Enfin, le traitement des cellules vides (valeurs manquantes ou nulls) doit être conduit avant toute opération de tri ou de filtrage. Une cellule non renseignée au sein d’une variable numérique peut être interprétée de manière ambiguë (tantôt comme un zéro arithmétique, tantôt comme un élément non comparable selon la nature de la formule invoquée). L’identification préalable de ces lacunes à l’aide de la fonction ESTVIDE (ISBLANK) permet soit d’imputer méthodologiquement les valeurs manquantes, soit d’exclure formellement ces lignes de l’échantillon d’analyse afin de ne pas fausser le dénominateur des futures agrégations.
2.3 2.3 Sécurisation de l’intégrité référentielle
La pérennité d’un protocole d’analyse de données repose sur la reproductibilité des résultats et l’inviolabilité des données sources. Dans le cadre de modélisations complexes sous Google Sheets, la sécurisation de l’intégrité référentielle commence par la définition rigoureuse de plages nommées. En assignant un libellé clair et immuable à une plage matricielle (par exemple en nommant la colonne A Reg_Territoire et la colonne B Ref_Produit), l’analyste s’affranchit des erreurs d’adressage matriciel et renforce l’intelligibilité sémantique de ses expressions algorithmiques, limitant drastiquement les risques de glissement d’index lors des extensions de calcul.
Un autre pilier de la gouvernance des données tabulaires réside dans le verrouillage préventif des plages primaires. Google Sheets propose une fonctionnalité native de protection des cellules et des feuilles de calcul, accessible via le menu Données. L’assignation de droits de modification restreints aux seules cellules de commande, tout en verrouillant la matrice de données brutes, immunise le classeur contre les suppressions d’enregistrements accidentelles, les écrasements malencontreux de formules par les collaborateurs et les modifications typologiques sauvages. Cette mesure garantit que les filtres appliqués s’exécutent toujours sur une assise de données certifiée et stable.
Pour parachever cette sécurisation méthodologique, la documentation formelle des variables au sein d’un dictionnaire de données dédié (métadonnées) constitue une pratique d’excellence. Documenter la source d’extraction, la fréquence de rafraîchissement, la typologie exacte et la plage de valeurs admissibles pour chaque colonne confère à l’architecture du classeur une transparence institutionnelle. Cette discipline permet à n’importe quel auditeur indépendant de rejouer l’ensemble des filtres multicritères et de parvenir à des conclusions analytiques strictement identiques, répondant ainsi aux exigences fondamentales de la méthode scientifique.
3. 3. L’outil de filtrage natif : Activation et paramétrage standard
3.1 3.1 Activation du mode filtre sur une plage matricielle
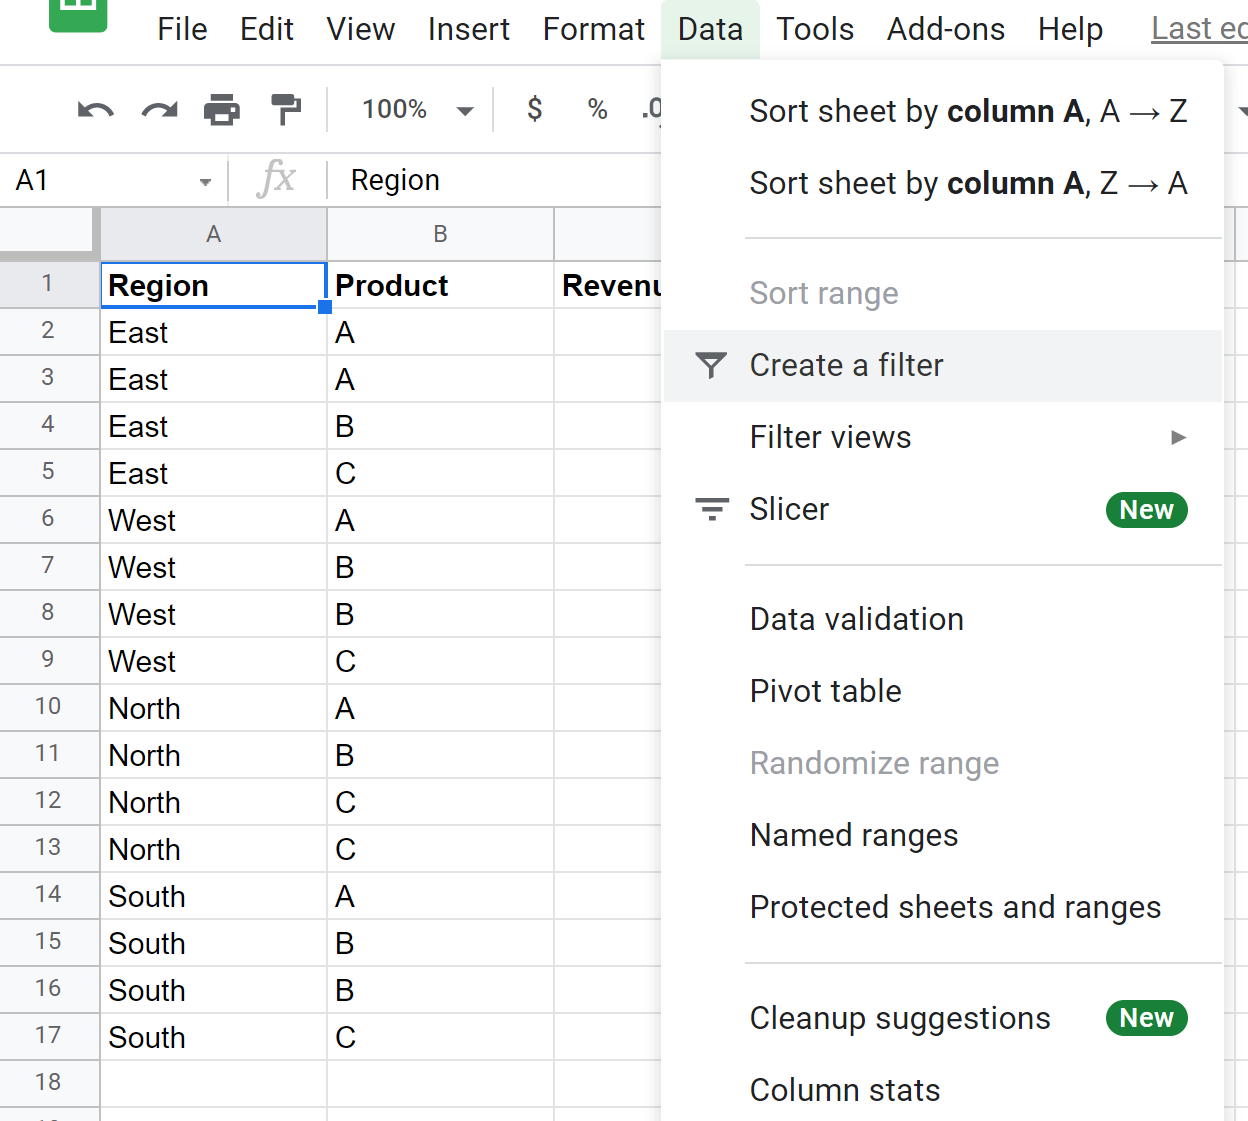
L’accès aux fonctionnalités primaires de segmentation sous Google Sheets s’effectue par l’activation du mode filtre natif, un outil d’interface conçu pour masquer sélectivement les lignes non pertinentes directement au sein de la grille de visualisation. Pour initier ce processus selon les règles de l’art, il est recommandé de sélectionner explicitement l’intégralité de la matrice de données, de la cellule supérieure gauche A1 jusqu’à la limite inférieure droite des données utiles (par exemple C100), ou de cliquer sur la cellule pivot A1 afin de laisser le moteur heuristique de Google Sheets identifier automatiquement les contours contigus du tableau de données.
Une fois le focus matriciel établi, l’analyste accède au ruban supérieur, sélectionne le menu Données, puis clique sur la commande Créer un filtre (alternativement accessible via l’icône d’entonnoir présente sur la barre d’outils contextuelle). Cette action produit une altération visuelle immédiate et normalisée sur la rangée d’en-tête : de petites icônes triangulaires inversées, matérialisant des entonnoirs stylisés, apparaissent à l’extrémité droite de chaque cellule de titre de colonne. Ces icônes constituent les déclencheurs des menus d’interrogation conditionnelle propres à chaque variable.
Il est impératif d’effectuer une vérification visuelle de la délimitation automatique opérée par l’outil. Google Sheets matérialise le périmètre actif du filtre par un liseré vert discret encadrant l’ensemble de la matrice couverte. Si le tableau d’origine contenait une ligne entièrement vide ou une colonne scindée par inadvertance, l’algorithme d’encadrement s’est potentiellement arrêté prématurément au niveau de cette frontière vide. L’analyste vigilant doit impérativement s’assurer que la frontière verte englobe l’exhaustivité des observations empiriques, sous peine d’ignorer systématiquement les données situées en aval de la discontinuité structurelle lors de l’application des critères de tri et de filtrage.
3.2 3.2 Anatomie de l’interface de filtrage conditionnel
En déployant le menu contextuel lié à l’icône de filtre d’une colonne spécifique, l’utilisateur accède à une arborescence décisionnelle hiérarchisée, scindée en plusieurs modules fonctionnels distincts. La section supérieure est généralement dévolue aux opérations de tri (croissant ou décroissant selon la typologie lexicographique ou numérique des données). La section centrale se subdivise quant à elle en deux paradigmes distincts d’interrogation : Filtrer par valeurs et Filtrer par condition. Cette dichotomie ergonomique reflète des niveaux de maturité analytique radicalement différents.
Le module Filtrer par valeurs affiche une liste exhaustive des éléments discrets recensés au sein de la colonne active, assortie de cases à cocher individuelles. Si cette méthode offre une intuitivité appréciable pour des segmentations ponctuelles et rapides, elle présente des faiblesses méthodologiques rédhibitoires pour l’analyse rigoureuse : elle est purement statique et statufie le choix sur les valeurs historiquement présentes. Si de nouveaux enregistrements introduisant une nouvelle catégorie sont ultérieurement insérés dans la base source, ils seront exclus ou inclus de manière imprévisible sans recalcul logique explicite.
À l’opposé, le module Filtrer par condition permet d’assujettir la visibilité des lignes à des règles fonctionnelles dynamiques (textes contenant un motif particulier, bornes numériques strictes, dates antérieures à un repère temporel). Le sommet de la flexibilité analytique au sein de cette interface réside dans la sélection de l’option terminale : La formule personnalisée est. Ce champ textuel spécifique déverrouille l’intégration directe de l’algèbre booléenne au sein de l’interface graphique de Google Sheets, autorisant le franchissement des limitations inhérentes aux colonnes isolées et permettant le déploiement de règles multicritères sophistiquées croisant simultanément plusieurs dimensions vectorielles.
4. 4. Filtrage multicritère avec disjonction logique : Utilisation de la formule OU (OR)
4.1 4.1 Formalisation mathématique du problème disjonctif
La disjonction logique inclusive, couramment désignée sous l’appellation booléenne OR (ou OU dans sa déclinaison francophone), intervient dès lors qu’une démarche exploratoire vise à agréger des sous-ensembles hétérogènes non exclusifs. Considérons la problématique suivante au sein de notre matrice d’exemple : l’analyste cherche à isoler l’ensemble des enregistrements où la variable Région correspond à « East », OU la variable Produit correspond à « A ». Il s’agit d’une inclusion élargie : le résultat attendu doit contenir les lignes de la région East quel que soit le produit, les lignes du produit A quelle que soit la région, ainsi que l’intersection conjointe des lignes vérifiant simultanément les deux caractéristiques.
Sur le plan de la théorie des ensembles, cette opération correspond à l’union de deux sous-ensembles $A$ et $B$, dénotée $A cup B$. L’espace résultant englobe tous les éléments $x$ vérifiant la proposition $P(x) lor Q(x)$, où $P$ formalise l’appartenance géographique et $Q$ la spécification produit. Dans l’écosystème de calcul de Google Sheets, cette opération booléenne est transcrite sous forme fonctionnelle préfixée selon la syntaxe suivante :
=OR(A:A="East", B:B="A")
ou dans sa déclinaison avec les identifiants francophones si les paramètres régionaux du chiffrier l’imposent :
=OU(A:A="East"; B:B="A")
Il est impératif de souligner l’erreur d’interprétation fréquente commise par les débutants qui confondent la disjonction du langage naturel avec l’exclusion. Dans le langage courant, « ou » possède fréquemment une valeur exclusive (fromage ou dessert). Dans l’algèbre booléenne des tableurs, la disjonction est fondamentalement inclusive. L’évaluation pour une ligne comportant à la fois Région = « East » et Produit = « A » renverra sans équivoque la valeur VRAI, intégrant cet enregistrement au périmètre visible avec une exactitude logique irréprochable.
4.2 4.2 Implémentation pas à pas dans l’interface de Google Sheets
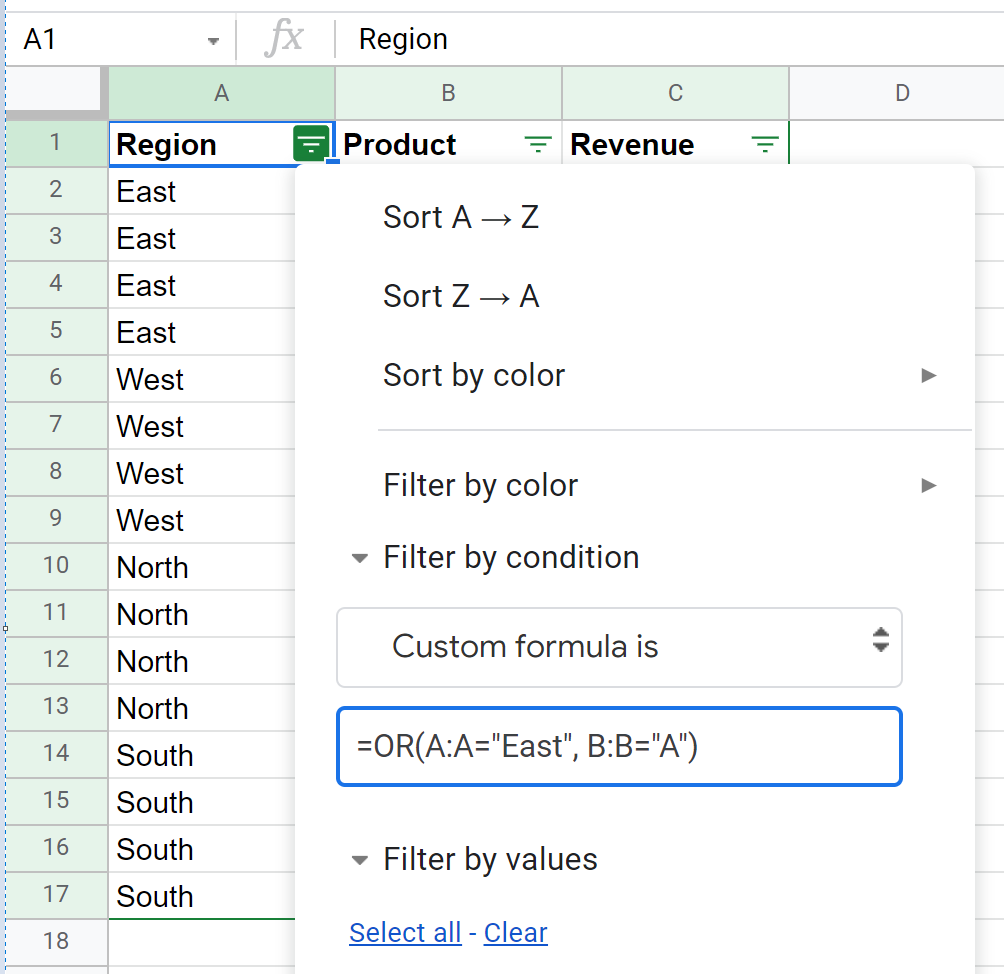
Pour transposer cette formalisation théorique au sein de l’interface visuelle native de Google Sheets sans générer de table dérivée, la procédure requiert une rigueur d’exécution absolue. La première étape consiste à cliquer sur l’icône de filtre de l’une des colonnes impliquées dans la requête (par exemple, la Colonne A représentant la Région). L’analyste déploie l’accordéon intitulé Filtrer par condition, fait défiler la liste des prédicats préétablis jusqu’au bas de l’arborescence, et sélectionne formellement l’intitulé La formule personnalisée est.
Une boîte de dialogue textuelle s’ouvre alors pour accueillir l’expression algorithmique. C’est à cet emplacement précis que doit être introduite la formule booléenne unifiée. Contrairement à une croyance répandue, il n’est pas nécessaire d’appliquer un filtre sur la colonne A puis un autre sur la colonne B (ce qui produirait une conjonction restrictive involontaire). En saisissant :
=OR(A2="East", B2="A")
directement dans le champ de condition de la colonne A, le moteur de filtrage applique la règle à l’ensemble du tuple horizontal pour chaque ligne d’observation.
L’utilisation de la référence relative A2 et B2 constitue un point d’attention technique capital. Le moteur de calcul itère virtuellement cette formule sur chaque ligne de la plage filtrée en incrémentant automatiquement les index de rangée (évaluant A3 et B3 pour la troisième ligne, A4 et B4 pour la quatrième, et ainsi de suite). Dès que l’utilisateur valide l’opération en cliquant sur le bouton OK situé au bas du panneau contextuel, la feuille de calcul recalcule instantanément l’état booléen de chaque rangée, occultant les lignes dont l’évaluation globale équivaut à FAUX et réorganisant la matrice visible selon le critère d’union spécifié.
4.3 4.3 Analyse des résultats et validation de la fidélité de l’extraction
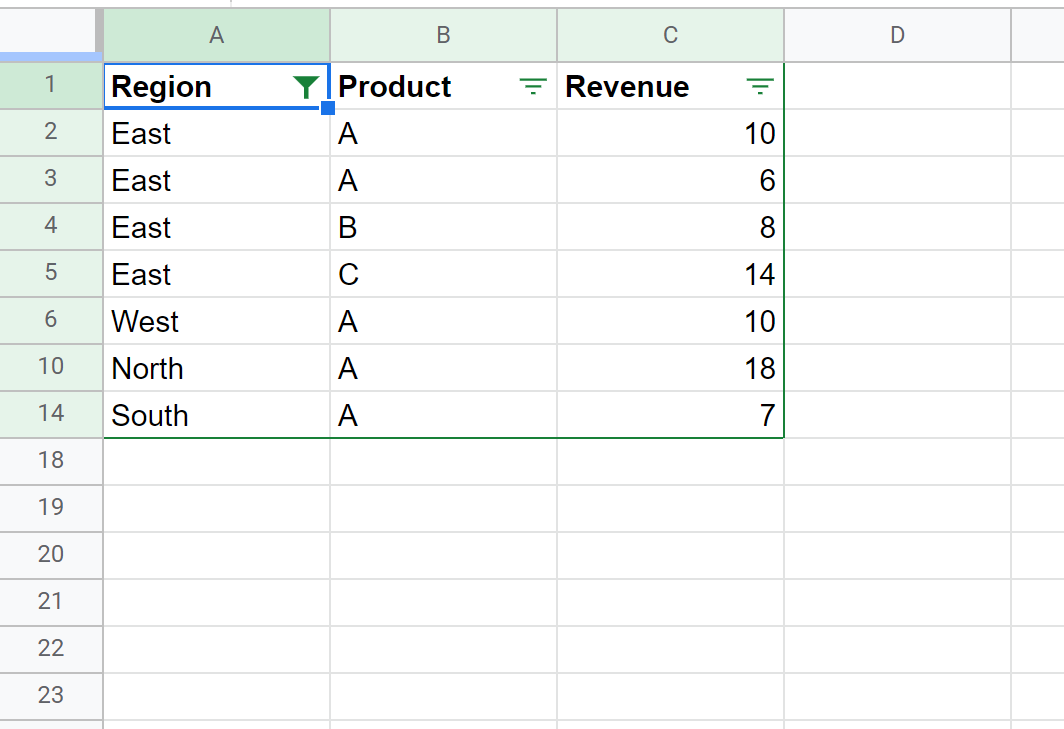
Une fois le filtre disjonctif appliqué, une phase systématique d’audit empirique doit être mise en œuvre pour attester de la fidélité de l’extraction. En observant le tableau résultant, l’analyste doit constater la présence de trois typologies de lignes : premièrement, des lignes affichant la région « East » associées à des produits disparates tels que « B », « C » ou « D » ; deuxièmement, des lignes hébergeant le produit « A » mais implantées dans des régions alternatives telles que « West », « North » ou « South » ; et troisièmement, des lignes cumulant simultanément « East » et « A ». L’absence d’une seule de ces catégories révélerait un biais d’encodage ou un problème d’adressage référentiel.
Pour garantir l’absence de faux négatifs (enregistrements indûment exclus), il convient d’examiner le statut des lignes occultées. Dans Google Sheets, les lignes masquées par le filtre natif se signalent visuellement par des discontinuités dans la numérotation séquentielle des bordures gauches (par exemple, un passage immédiat de la ligne 4 à la ligne 8, signalant que les lignes 5, 6 et 7 ont été rejetées par le prédicat booléen). En déployant ponctuellement ces lignes masquées pour échantillonnage, l’auditeur doit vérifier qu’aucune d’entre elles ne présentait ni « East » dans la colonne A, ni « A » dans la colonne B.
Un avantage fondamental de ce mécanisme de filtrage par formule personnalisée réside dans sa réactivité face aux mutations ultérieures de la base source. Si un utilisateur insère une nouvelle observation à la ligne 101 affichant « East » et « C », le filtre natif re-évalue immédiatement la fonction OR(A101="East", B101="A"), résolvant l’expression à VRAI et maintenant la ligne visible sans exiger la moindre intervention de réétalonnage manuel. Cette dynamique garantit la robustesse du protocole d’analyse dans des contextes de flux de données continus.
5. 5. Filtrage multicritère avec conjonction logique : Application de la logique ET (AND)
5.1 5.1 Modélisation de la restriction stricte
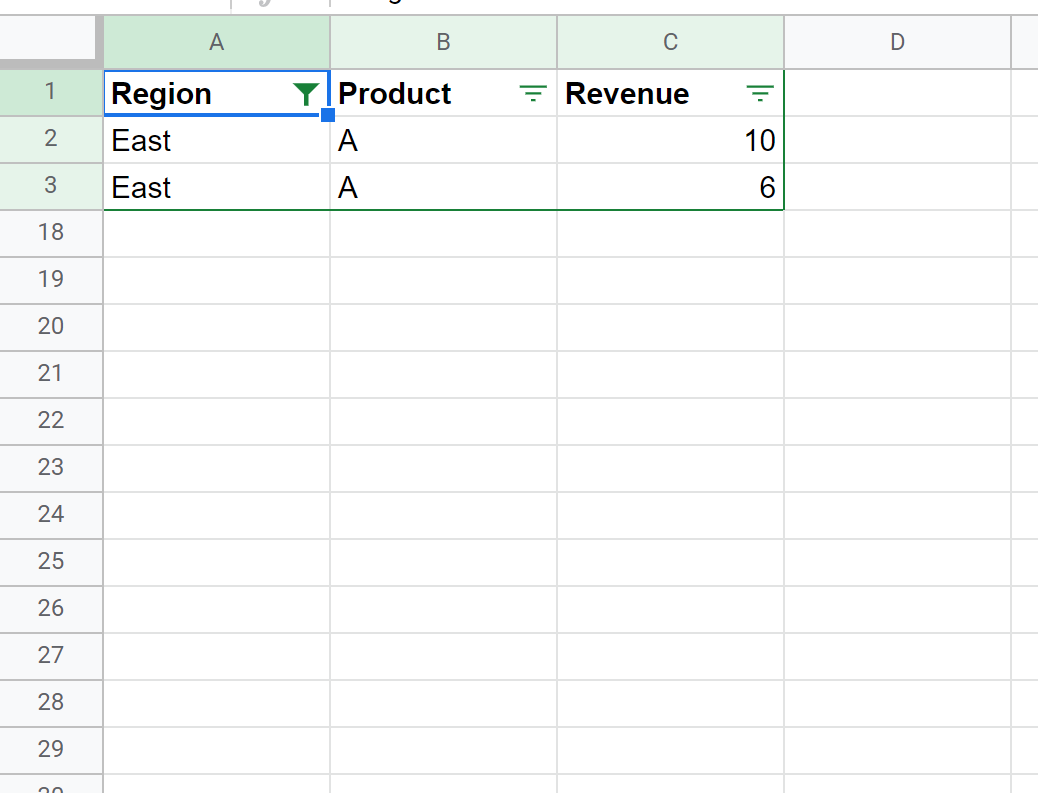
À l’opposé diamétral de l’expansion inclusive observée lors de la disjonction, la conjonction logique – modélisée par l’opérateur AND (ou ET) – matérialise le principe de restriction stricte et d’amenuisement de l’espace échantillonnal. Dans ce cas de figure, l’objectif consiste à n’extraire que les observations empiriques qui satisfont de façon absolue et simultanée l’ensemble des conditions formulées. Par exemple, l’analyste souhaite isoler les transactions qui se déroulent exclusivement dans la région « East » ET qui concernent sans exception le produit « A ».
En termes ensemblistes, cette opération formalise l’intersection de deux ensembles $A$ et $B$, symbolisée par $A cap B$. Un enregistrement n’appartient à cet espace que s’il est membre à part entière de la cohorte $A$ tout en appartenant parallèlement à la cohorte $B$. Si une ligne satisfait le critère géographique mais dévie d’un millimètre sur la variable produit, elle est formellement répudiée. La transcription canonique de cette logique prend la forme suivante au sein de l’interpréteur de Google Sheets :
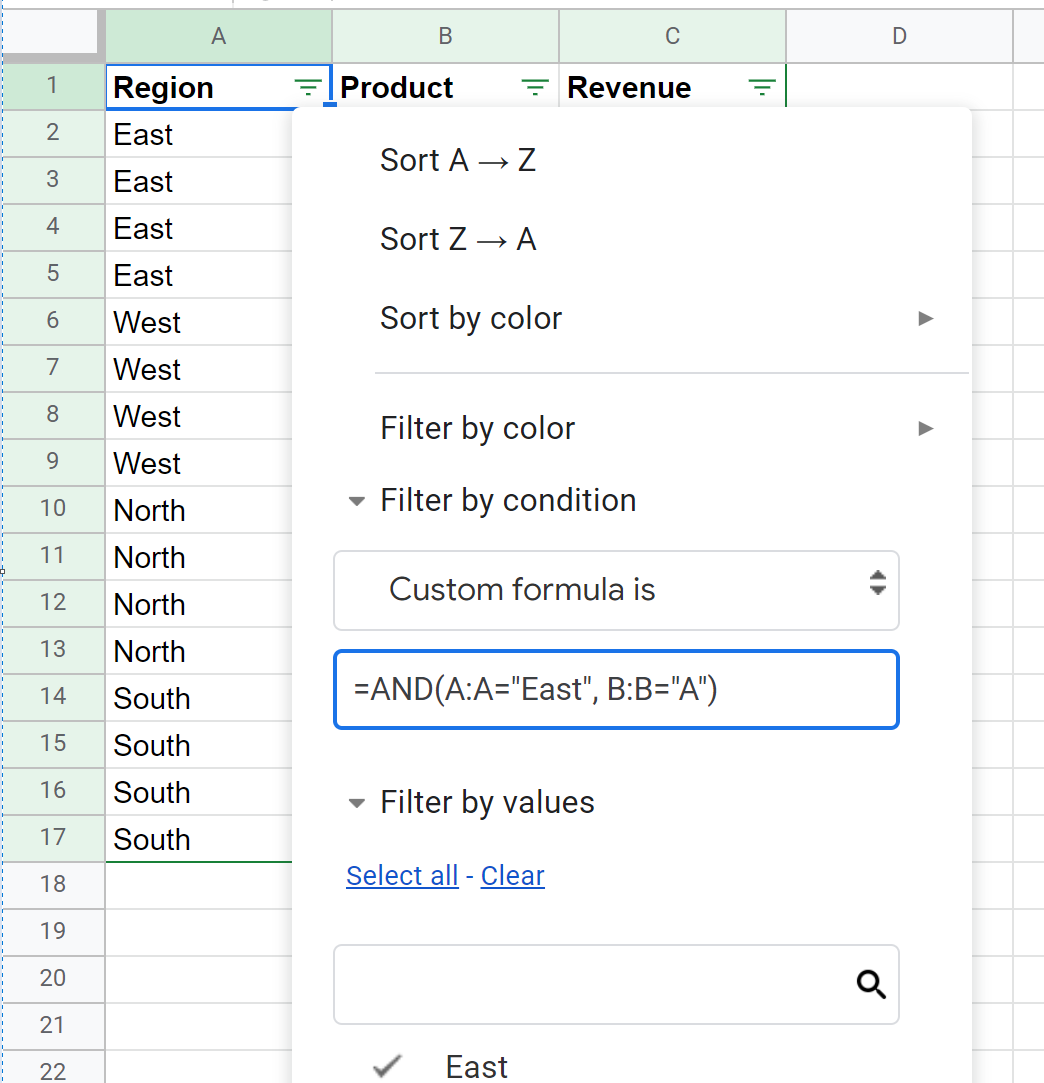
=AND(A:A="East", B:B="A")
ou dans sa graphie francophone :
=ET(A:A="East"; B:B="A")
La conjonction logique constitue la pierre angulaire des analyses de corrélation et des études de segmentation approfondie. En réduisant drastiquement le nombre de lignes observables, elle élimine le bruit de fond pour concentrer l’observation sur des niches structurelles précises. La modélisation de cette restriction stricte exige une propreté clinique des données, car la moindre coquille orthographique, la présence d’une espace parasite ou une dérive typologique dans l’une quelconque des colonnes évaluées condamne immédiatement la ligne correspondante à l’invisibilité analytique.
5.2 5.2 Procédure d’application via la formule personnalisée
L’application d’un filtre conjonctif par le truchement de l’interface graphique emprunte un cheminement analogue à celui exposé pour la disjonction, mais recèle des subtilités opératoires déterminantes pour la cohérence du système de calcul. L’opérateur sélectionne le menu de filtrage de la colonne A, navigue jusqu’à l’option La formule personnalisée est sous la rubrique Filtrer par condition, et injecte avec rigueur la formule indexée sur la première ligne d’observation :
=AND(A2="East", B2="A")
La question du choix entre les références relatives (comme A2) et les références absolues (comme $A$2) doit être impérativement clarifiée. Dans le cadre précis d’une formule personnalisée de filtrage sur une grille de données, les références doivent impérativement rester relatives quant à l’indice de ligne (pas de symbole dollar devant le chiffre 2). Si l’analyste avait commis la bévue de saisir =AND($A$2="East", $B$2="A"), le moteur évaluerait perpétuellement l’état booléen de la deuxième ligne pour décider du sort de toutes les autres lignes du tableau. Si la ligne 2 était valide, toutes les lignes apparaîtraient ; si elle était fausse, le tableau entier s’effacerait instantanément.
Dès l’application de la syntaxe relative adéquate, l’interpréteur de Google Sheets applique la fonction de transfert booléen de manière séquentielle sur l’axe des ordonnées. Chaque ligne dont la valeur en A n’est pas strictement identique à « East », ou dont la valeur en B diffère de « A », génère une réponse FAUX en sortie du circuit logique et voit ses coordonnées masquées de l’affichage actif. La matrice résultante affiche désormais une pureté thématique absolue, concentrant l’attention de l’auditeur sur l’exact sous-ensemble ciblé.
5.3 5.3 Comparaison critique entre filtrage successif manuel et formule unifiée
Une interrogation récurrente chez les praticiens concerne la différence entre l’application d’une formule unifiée =AND(A2="East", B2="A") et l’usage classique du filtrage manuel successif, consistant à cocher « East » dans le filtre de la colonne A, puis à cocher « A » dans le filtre de la colonne B. Sur le strict plan arithmétique de la sélection résultante, les deux approches aboutissent au même ensemble visible. Toutefois, sur le plan de l’ingénierie informationnelle, de l’ergonomie cognitive et de la traçabilité des processus, la formule personnalisée unifiée démontre une nette supériorité opérationnelle.
Le filtrage successif manuel présente une opacité structurelle majeure : pour connaître les critères exacts qui s’appliquent au tableau, un tiers collaborateur est contraint d’ouvrir individuellement le menu déroulant de chaque colonne pour examiner les cases cochées ou les conditions élémentaires empilées. Si le jeu de données compte cinquante colonnes, cette gymnastique de vérification s’avère fastidieuse et source d’erreurs d’interprétation. À l’inverse, l’insertion d’une formule unifiée centralise l’intégralité de l’arbre logique en une seule déclaration explicite, lisible et auditable instantanément au sein d’un unique panneau de contrôle.
En outre, l’approche par formule personnalisée prévient les dérèglements accidentels lors des sessions collaboratives asynchrones. Il est fréquent qu’un utilisateur, en voulant ajuster un critère univarié, déprogramme involontairement les conditions appliquées sur les colonnes adjacentes par manque de visibilité globale. La centralisation des règles dans une formule unifiée sanctuarise le protocole d’extraction et permet une duplication rapide de la logique par simple copier-coller de l’instruction textuelle vers d’autres feuilles ou classeurs de l’organisation.
6. 6. Combinaisons logiques avancées : Structures conditionnelles imbriquées
6.1 6.1 Articulation conjointe des opérateurs ET et OU
L’analyse décisionnelle avancée exige fréquemment de modéliser des problématiques dont la complexité transcende les simples alternatives unilatérales. Il devient alors nécessaire d’articuler conjointement les connecteurs ET (AND) et OU (OR) au sein d’architectures conditionnelles imbriquées. Considérons un cas classique d’audit commercial : l’organisation souhaite isoler simultanément les ventes de la région « East » portant sur le produit « A », ainsi que les ventes de la région « West » associées au produit « B », tout en excluant toutes les autres associations géographiques ou matérielles.
Ce schéma analytique répond à une structure de disjonction de conjonctions, formalisée algébriquement par $(P land Q) lor (R land S)$. Au sein de l’interpréteur de Google Sheets, cette imbrication exige une rigueur syntaxique millimétrée pour respecter les règles de précédence des opérateurs et la hiérarchie des parenthèses fermantes. La syntaxe canonique de cette instruction se transcrit ainsi :
=OR(AND(A2="East", B2="A"), AND(A2="West", B2="B"))
ou dans sa configuration linguistique francophone :
=OU(ET(A2="East"; B2="A"); ET(A2="West"; B2="B"))
Pour assurer la lisibilité et la maintenabilité de telles constructions au fur et à mesure que les prédicats prolifèrent, l’analyste doit cultiver une grande vigilance visuelle. L’interpréteur de Google Sheets surligne brièvement les parenthèses appariées lors de la saisie, facilitant le repérage des déséquilibres d’ouverture et de fermeture. Une imbrication incorrecte transforme radicalement le comportement logique de l’expression : fermer une parenthèse prématurément peut rétrograder un bloc conjonctif au rang d’argument disjonctif unilatéral, faussant silencieusement l’ensemble de l’extraction sans qu’aucun message d’erreur d’exécution ne soit levé par le logiciel.
6.2 6.2 Inclusion de prédicats quantitatifs et d’inégalités
Les segmentations multidimensionnelles ne se limitent que rarement à des taxonomies catégorielles textuelles ; elles fusionnent presque systématiquement des critères nominaux avec des seuils quantitatifs continus ou discrets. Imaginons que notre protocole d’extraction doive isoler les performances exceptionnelles au sein de zones géographiques cibles, en contraignant simultanément la région « East » et un volume de ventes supérieur ou égal à 5 000 unités monétaires dans la Colonne C. L’intégration d’inégalités mathématiques au sein du bloc logique s’opère par l’usage des opérateurs de comparaison relationnelle (>, <, >=, <=, <>).
La formulation de ce critère mixte au sein de l’outil de formule personnalisée s’articule comme suit :
=AND(A2="East", C2>=5000)
Dans cette configuration, le moteur de calcul évalue pour chaque ligne deux types de vérifications de nature divergente : une équivalence textuelle binaire sur la première cellule et une évaluation différentielle d’ordre métrique sur la seconde. La ligne n’est retenue que si les deux assertions convergent vers l’état VRAI.
Une vigilance particulière doit être portée au comportement des cellules vides et des chaînes résiduelles face aux opérateurs de comparaison numérique. Dans l’architecture interne des tableurs, une chaîne textuelle accidentellement insérée dans une colonne numérique (par exemple la mention « N/A » ou « En attente ») est fréquemment considérée comme supérieure en ordre lexicographique à n’importe quel nombre fini lors d’un test d’inégalité stricte ("Texte" > 5000 peut être évalué à VRAI). Pour immuniser la formule contre ce comportement aberrant, l’adjonction préventive de la fonction ESTNUM (ISNUMBER) est recommandée :
=AND(A2="East", ESTNUM(C2), C2>=5000)
Cette précaution sanctuarise le traitement quantitatif et élimine le risque d’inclusion d’artefacts non numériques.
6.3 6.3 Utilisation de l’opérateur de négation (NOT)
La puissance de l’algèbre booléenne s’exprime pleinement à travers l’exploitation méthodique de l’opérateur de complémentation ou d’inversion logique : la fonction NOT (ou NON). Cet opérateur a pour mission sémiotique de renverser systématiquement la valeur de vérité du prédicat auquel il s’applique, transformant un VRAI en FAUX et inversement. Dans les processus d’épuration de données ou d’analyse d’anomalies, il est souvent bien plus économique en termes de complexité algorithmique d’exclure formellement un sous-ensemble marginal que d’énumérer laborieusement l’ensemble des éléments admissibles.
Supposons que nous souhaitions examiner l’ensemble des transactions de la région « East », à l’exception formelle de celles concernant le produit « A » dont les volumes sont atypiques et perturbent l’étalonnage des modèles prédictifs. La syntaxe canonique d’exclusion ciblée prend la forme suivante :
=AND(A2="East", NOT(B2="A"))
Cette expression retient sans ambiguïté les produits B, C, D et toute autre référence existante ou future au sein de la région East, tout en dressant une barrière infranchissable devant la modalité toxique A.
Dès lors que l’opérateur de négation interagit avec des blocs logiques complexes combinant conjonctions et disjonctions, la maîtrise des lois de De Morgan devient impérative pour prévenir les erreurs conceptuelles. Ces théorèmes mathématiques stipulent formellement que :
- La négation d’une conjonction est équivalente à la disjonction des négations :
NOT(P AND Q)équivaut strictement à(NOT P) OR (NOT Q). - La négation d’une disjonction est équivalente à la conjonction des négations :
NOT(P OR Q)équivaut strictement à(NOT P) AND (NOT Q).
L’omission de ces équivalences fondamentales conduit fréquemment des analystes non avertis à concevoir des expressions erronées telles que AND(NOT(A2="East"), NOT(A2="West")) en croyant appliquer une disjonction, introduisant des distorsions préjudiciables dans les jeux de données restitués.
7. 7. L’alternative fonctionnelle dynamique : Exploitation de la fonction FILTER()
7.1 7.1 Théorie et avantages des formules de tableau dynamique
Bien que le système de filtrage natif par interface visuelle offre une solution pratique pour l’exploration immédiate sur une feuille donnée, il souffre d’une limite conceptuelle fondamentale : il s’agit d’un mécanisme destructif au niveau de la présentation visuelle. Le masquage des lignes modifie directement l’état de l’écran pour l’ensemble des utilisateurs consultant le document en direct (sauf en cas d’utilisation de vues temporaires), empêche la réutilisation fluide des données filtrées par d’autres algorithmes d’aval, et ne permet pas d’afficher simultanément la base source exhaustive et ses multiples déclinaisons segmentées sur le même classeur.
Pour dépasser ces entraves architecturales, Google Sheets a démocratisé l’usage des formules de tableaux dynamiques (dynamic array formulas), incarnées au premier chef par la fonction native FILTER. À l’inverse du filtre d’interface, la fonction FILTER opère une extraction matricielle purement logicielle et non-destructive. Elle lit une plage de données source invariable, évalue les vecteurs de conditions booléennes en mémoire vive, et projette dynamiquement la matrice résultante sur une plage de destination vierge, sans altérer d’un iota l’affichage ou l’intégrité de la table d’origine.
Cette approche dynamique présente une valeur ajoutée computationnelle inestimable : toute modification, insertion ou suppression d’un enregistrement au sein du tableau primaire est instantanément propagée au sein de la sous-matrice dérivée par le moteur de recalcul réactif de Google Sheets. Dès lors, l’analyste peut bâtir des tableaux de bord interactifs, des chaînes de traitement par lots et des rapports d’audit dont les visualisations aval se synchronisent en temps réel avec la source de vérité, abolissant toute nécessité de réapplication manuelle des critères de sélection.
7.2 7.2 Syntaxe formelle de la fonction FILTER() pour critères multiples
La formalisation algorithmique de la fonction FILTER repose sur une architecture syntaxique claire, conçue pour ingérer une matrice source d’ordre quelconque et une série subséquente d’arguments de contrainte vectorielle. La signature générique de la fonction s’établit comme suit :
=FILTER(plage_source, condition_vectorielle_1, [condition_vectorielle_2, ...])
Dans cette structure, plage_source désigne le bloc matriciel bidimensionnel à extraire (par exemple A2:C100), tandis que chaque argument de condition représente un vecteur unidimensionnel (une colonne unique de même hauteur que la matrice source) contenant des valeurs booléennes résultant d’une comparaison logique.
Le comportement natif de la fonction FILTER lorsqu’on lui transmet plusieurs arguments de condition séparés par une virgule (ou un point-virgule) est d’implémenter une conjonction logique stricte (ET). Chaque condition additionnelle resserre le tamis de sélection ; la fonction n’extrait que les rangées pour lesquelles l’intégralité des vecteurs de condition affiche simultanément la valeur VRAI à l’indice de ligne considéré. Par exemple, pour extraire de manière dynamique l’ensemble des tuples associant la région « East » au produit « A », la syntaxe canonique s’écrit :
=FILTER(A2:C100, A2:A100="East", B2:B100="A")
Une exigence structurelle absolue doit être impérativement respectée pour que le moteur de calcul ne lève pas une exception d’incompatibilité de dimensions (erreur #VALUE!) : l’amplitude verticale des vecteurs conditionnels doit être strictement identique à celle de la plage source. Si la plage à extraire s’étend de la ligne 2 à la ligne 100 (A2:C100), tous les vecteurs de condition doivent scrupuleusement démarrer à l’indice 2 et s’interrompre à l’indice 100 (A2:A100). Tout décalage d’indexation, par exemple une condition formulée sur A1:A100 ou A2:A101, provoquera un échec algorithmique immédiat en raison du non-alignement des dimensions matricielles.
7.3 7.3 Implémentation de la logique disjonctive (OU) dans FILTER()
Une limitation syntaxique majeure frappe l’analyste débutant lorsqu’il tente de transposer une logique disjonctive (OU) au sein de la fonction FILTER : la syntaxe native à arguments multiples séparés par des virgules n’admet rigoureusement aucune disjonction native. De surcroît, l’encapsulation naïve des conditions au sein d’une fonction OR classique, telle que =FILTER(A2:C100, OR(A2:A100="East", B2:B100="A")), conduit à une impasse fonctionnelle tragique. La fonction OR standard n’est pas vectorisée nativement dans ce contexte ; elle agrège l’ensemble des colonnes en une valeur scalaire unique (un seul VRAI ou FAUX pour l’intégralité du tableau), détruisant l’évaluation séquentielle ligne par ligne et provoquant l’effondrement de la formule matricielle.
Pour contourner élégamment cette barrière et matérialiser la logique OU au sein de FILTER, l’analyste doit mobiliser l’isomorphisme entre l’algèbre de Boole et l’arithmétique binaire ordinaire. Dans ce cadre mathématique :
- L’addition algébrique (
+) correspond rigoureusement à la disjonction logique inclusive (OU). - La multiplication algébrique (
*) correspond rigoureusement à la conjonction logique stricte (ET).
Lorsqu’un test conditionnel vectoriel tel que (A2:A100="East") est évalué par Google Sheets, il génère un tableau virtuel de valeurs booléennes {VRAI; FAUX; ...}. En soumettant deux tableaux booléens à l’opérateur d’addition arithmétique, le logiciel force la conversion des booléens en entiers naturels (VRAI devient 1, FAUX devient 0). Dès lors, la somme arithmétique des deux vecteurs produit les résultats suivants pour chaque rangée :
- 0 + 0 = 0 (l’équivalent de FAUX $lor$ FAUX = FAUX)
- 1 + 0 = 1 (l’équivalent de VRAI $lor$ FAUX = VRAI)
- 0 + 1 = 1 (l’équivalent de FAUX $lor$ VRAI = VRAI)
- 1 + 1 = 2 (l’équivalent de VRAI $lor$ VRAI = VRAI)
Tout résultat strictement supérieur à zéro étant interprété comme sémantiquement équivalent à VRAI par le sélecteur matriciel, la formulation disjonctive parfaite au sein de FILTER s’écrit sans artifice additionnel :
=FILTER(A2:C100, (A2:A100="East") + (B2:B100="A"))
Il convient de noter l’importance vitale des parenthèses isolant chaque prédicat conditionnel. En vertu des règles universelles de priorité opératoire, l’opérateur de comparaison d’égalité possède une priorité différente de l’addition arithmétique ; l’omission des parenthèses engendre des corruptions de calcul lors de l’analyse lexicographique de la formule par l’interpréteur. Enfin, dans l’éventualité où aucun enregistrement ne satisferait les conditions disjonctives posées, la fonction FILTER lèverait par défaut une exception #N/A (aucun résultat correspondant trouvé). Pour offrir une restitution élégante exempte de scories visuelles d’erreur, l’analyste sécurisera systématiquement son appel à l’aide de la fonction d’interception d’erreur :
=SI.NON.DISP(FILTER(A2:C100, (A2:A100="East") + (B2:B100="A")), "Aucune correspondance")
8. 8. Filtrage multi-colonnes via la fonction QUERY() : Analyse syntaxique de type SQL
8.1 8.1 Présentation du langage de requête Google Visualization API
Si la fonction FILTER résout avec brio la plupart des défis d’extraction matricielle, l’écosystème Google Sheets met à la disposition des utilisateurs avancés une technologie encore plus puissante et conceptuellement plus robuste : la fonction QUERY. Cette fonction constitue une interface directe avec le moteur de requête du protocole Google Visualization API. Elle introduit le paradigme déclaratif au cœur du tableur, permettant de manipuler les structures tabulaires non plus par des imbrications procédurales de formules géométriques, mais par l’émission de requêtes textuelles calquées sur la syntaxe universelle du langage relationnel SQL (Structured Query Language).
La signature générale de la fonction QUERY s’articule autour de trois paramètres fondamentaux :
=QUERY(données, requête, [nombre_en_têtes])
L’argument données spécifie la matrice tabulaire intégrale incluant les en-têtes (par exemple A1:C100). L’argument requête encapsule l’instruction déclarative sous la forme d’une chaîne de caractères entre guillemets doubles. Enfin, le paramètre facultatif mais méthodologiquement crucial nombre_en_têtes informe explicitement le parseur du nombre de lignes consacrées aux titres de colonnes (généralement fixé à 1 pour notre modèle d’exemple).
L’adoption du paradigme déclaratif confère une clarté conceptuelle incomparable lors de la manipulation de jeux de données massifs. Au lieu de combiner des opérateurs d’addition et de multiplication matricielle au sein de blocs de parenthèses obscurs, l’analyste rédige une instruction lisible formulant explicitement ce qu’il souhaite obtenir plutôt que la mécanique algorithmique pour l’extraire. La flexibilité de cette syntaxe autorise, au sein d’une seule et même expression unifiée, le filtrage multicritère, la projection sélective des colonnes utiles, l’ordonnancement séquentiel des résultats et l’exécution d’agrégations statistiques groupées.
8.2 8.2 Écriture de requêtes multicritères complexes
L’exécution de segmentations multicritères à travers la fonction QUERY s’articule autour du déploiement méthodique de la clause WHERE au sein de la chaîne de requête. Cette clause permet d’adjoindre une diversité de prédicats logiques reliés par les mots-clés normalisés AND, OR et NOT, avec une fidélité absolue à la grammaire SQL conventionnelle. Pour implémenter la conjonction stricte isolant les ventes de la région « East » relatives au produit « A », la requête se formalise comme suit :
=QUERY(A1:C100, "SELECT * WHERE A = 'East' AND B = 'A'", 1)
De façon symétrique, la modélisation de la disjonction inclusive élargie s’opère avec une simplicité déconcertante, en substituant le connecteur conjonctif par son pendant disjonctif :
=QUERY(A1:C100, "SELECT * WHERE A = 'East' OR B = 'A'", 1)
Dans ce contexte déclaratif, les identifiants de colonnes sont référencés par leurs étiquettes alphabétiques brutes (A, B, C) lorsque la source est une plage directe, ou par des index relationnels standardisés (Col1, Col2, Col3) lorsque la source est une matrice dérivée préalablement encapsulée entre accolades {}.
Il est impérieux de prêter une attention rigoureuse au formalisme typologique imposé par le compilateur de requêtes. Les valeurs textuelles constantes insérées au sein de la chaîne de requête doivent impérativement être ceintes d’apostrophes simples (guillemets simples 'East'), afin de les distinguer des identifiants structurels du système. De plus, contrairement à de nombreuses fonctions natives de Google Sheets, l’opérateur d’égalité textuelle au sein de la clause WHERE de QUERY est strictement sensible à la casse. Une requête stipulant WHERE A = 'east' échouera irrémédiablement à extraire les enregistrements encodés sous la forme « East », confirmant la nécessité impérieuse de l’assainissement préalable standardisé documenté en section 2.2.
8.3 8.3 Comparaison des performances : FILTER() vs QUERY()
Face à ces deux alternatives d’extraction matricielle dynamique que sont FILTER et QUERY, le data analyst doit fonder son arbitrage méthodologique sur une analyse objective de leurs profils computationnels et de leurs forces et vulnérabilités respectives. Le choix entre ces architectures ne relève pas d’une préférence stylistique superficielle, mais d’une adéquation stricte aux contraintes d’infrastructure et aux caractéristiques volumétriques du jeu de données hébergé.
Sur le registre de la pure vitesse de calcul et de la frugalité en cycles processeur, la fonction FILTER s’impose très largement face à QUERY. Étant codée dans le noyau C++ bas-niveau sous-jacent de Google Sheets et opérant directement sur des vecteurs booléens compilés, FILTER s’exécute avec une vélocité foudroyante sur de vastes plages matricielles (dépassant couramment plusieurs centaines de milliers de lignes). À l’inverse, QUERY impose une surcharge computationnelle significative : le moteur doit d’abord instancier le sous-système Google Visualization, analyser syntaxiquement la chaîne de caractères de la requête (phase de parsing lexicale et sémantique), construire un plan d’exécution relationnel temporaire, puis convertir les structures avant d’émettre la matrice finale. Sur un classeur saturé de requêtes QUERY simultanées, des ralentissements notables de réactivité peuvent se manifester.
Néanmoins, la fonction QUERY reprend l’avantage ergonomique absolu dès lors que l’extraction s’accompagne de transformations structurales concomitantes : elle permet de réordonner les colonnes (SELECT B, A, C), de renommer les étiquettes dynamiquement (LABEL C 'Montant Global'), d’exécuter un tri immédiat (ORDER BY C DESC) ou d’agréger les volumes (SUM(C) GROUP BY A, B), le tout sans nécessiter l’empilement complexe de multiples fonctions annexes telles que SORT ou INDEX. Son talon d’Achille structurel réside cependant dans sa vulnérabilité majeure aux colonnes de types mixtes : le moteur de QUERY détermine un type unique par colonne à partir d’un échantillonnage majoritaire de données. Si une colonne contient 80 % de nombres et 20 % de chaînes textuelles explicatives, QUERY convertira silencieusement l’ensemble des éléments minoritaires textuels en valeurs nulles (cellules vides), corrompant ainsi gravement l’intégrité de l’audit.
9. 9. Gestion collaborative : Exploitation des vues filtrées (Filter Views)
9.1 9.1 Problématique de la concurrence d’accès en environnement collaboratif
L’un des atouts différentiels les plus célébrés de Google Sheets réside dans son architecture nativement conçue pour la co-édition et la synchronisation collaborative synchrone d’équipes pluridisciplinaires. Toutefois, cette accessibilité ubiquitaire multilocataire devient une source majeure de friction et de chaos informationnel dès lors que les outils de filtrage conventionnels sont mal maîtrisés. Lorsqu’un opérateur applique un filtre natif d’interface standard (celui activé via Données > Créer un filtre documenté au chapitre 3), l’occultation des lignes non retenues est répercutée de façon instantanée et planétaire sur les écrans de tous les collaborateurs connectés au même classeur à cet instant précis.
Cette concurrence d’accès produit des perturbations opérationnelles dévastatrices au sein des flux de travail d’entreprise. Un contrôleur de gestion inspectant les données financières de la région « North » masquera involontairement les données nécessaires au responsable commercial de la région « South » engagé simultanément dans une revue d’affaires, rompant la concentration cognitive de son collègue et risquant de provoquer des saisies d’erreurs en cascade. De surcroît, le masquage imprévu de lignes au cours d’un appel vidéo ou d’une présentation de rapport devant un comité de direction déstabilise la démonstration et entame la crédibilité des indicateurs partagés.
Face à cette aporie collaborative, Google Sheets propose une solution architecturale d’une élégance absolue : les vues filtrées (Filter Views). Contrairement au filtre standard direct, une vue filtrée crée un environnement de travail asynchrone, une couche logicielle de visualisation totalement isolée et étanche. Lorsqu’un analyste active une vue filtrée, les modifications de masquage, de tri et d’affichage qu’il opère ne sont visibles que par lui seul, sanctuarisant la paix visuelle de l’ensemble des autres collaborateurs qui continuent à contempler le tableau complet ou leurs propres vues filtrées parallèles sans la moindre interférence mutuelle.
9.2 9.2 Création et paramétrage d’une vue filtrée multicritère
Le protocole de déploiement d’une vue filtrée multicritère s’exécute avec une grande simplicité depuis le ruban supérieur de l’application. Après avoir présélectionné le périmètre complet de la matrice tabulaire (A1:C100), l’opérateur navigue vers le menu Données, positionne son curseur sur le sous-menu Vues filtrées, puis sélectionne la commande Créer une vue filtrée. L’interface de Google Sheets subit instantanément une métamorphose visuelle emblématique : un bandeau contextuel sombre (généralement noir ou anthracite) vient coiffer la périphérie supérieure de la grille matricielle, confirmant l’entrée dans un bac à sable analytique privatif et sécurisé.
La première règle de bonne conduite ergonomique consiste à nommer sans délai cette vue filtrée au sein du champ d’édition textuel disponible dans le bandeau sombre. Au lieu de tolérer le libellé par défaut impersonnel « Vue filtrée 1 », l’analyste rigoureux attribuera un intitulé hautement sémantique et explicatif, tel que « [AUDIT] – Région East OU Produit A » ou « [Q4] – Focus Ventes Sup 5000 ». Ce nommage explicite permet à n’importe quel membre autorisé de l’équipe de comprendre d’un coup d’œil l’objectif sous-jacent à cette projection dimensionnelle.
Une fois le conteneur configuré, l’application des prédicats multicritères s’effectue exactement selon les protocoles d’interface documentés précédemment pour les formules personnalisées unifiées (sections 4 et 5). L’analyste clique sur l’entonnoir de la colonne A, sélectionne Filtrer par condition > La formule personnalisée est, et implémente la règle de disjonction ou de conjonction requise :
=OR(A2="East", B2="A")
La grille matricielle se configure instantanément pour n’afficher que les lignes validant le critère, sans que les utilisateurs distants ne perçoivent le moindre frémissement sur leur propre interface de travail.
9.3 9.3 Partage et archivage des paramètres de filtrage
Au-delà de l’indépendance de consultation synchrone, la technologie des vues filtrées confère une avancée déterminante pour la traçabilité et la transmissibilité des flux d’audit au sein des organisations : l’encapsulation d’état d’adressage hypertexte. À chaque fois qu’une vue filtrée est créée et active dans Google Sheets, le logiciel génère un identifiant alphanumérique d’instance unique (désigné par le paramètre d’URL fvid, acronyme de filter view ID) et l’agrège automatiquement à l’adresse URL du classeur présente dans la barre d’adresse du navigateur web. L’URL prend alors une structure reconnaissable :
https://docs.google.com/spreadsheets/d/.../edit#gid=0&fvid=1849204859
Cette propriété architecturale ouvre des horizons opérationnels remarquables pour le partage d’information au sein des équipes. Au lieu de transmettre un classeur entier en adressant un long courriel didactique (« Ouvrez le classeur, activez le filtre sur la colonne A pour East, puis sur la colonne B pour A… »), l’analyste copie simplement l’URL porteuse du jeton fvid et la transmet à son collègue, son supérieur hiérarchique ou un auditeur légal. Lorsque le destinataire clique sur le lien hypertexte, Google Sheets ouvre le document et charge instantanément l’état exact de la vue filtrée multicritère spécifiée, garantissant que les parties prenantes observent exactement la même fraction d’échantillon sans exiger de leur part la moindre manipulation technique.
Enfin, les vues filtrées résolvent la problématique de l’archivage pérenne des requêtes récurrentes. Elles demeurent attachées à la structure du fichier de manière persistante jusqu’à leur suppression délibérée par un administrateur. Une équipe financière préparant les clôtures trimestrielles peut ainsi capitaliser une bibliothèque de vingt ou trente vues filtrées multicritères prédéfinies (« Écarts budgétaires Q1 », « Factures non lettrées > 10k », etc.). Les auditeurs n’ont plus qu’à sélectionner la vue correspondante au sein du menu pour vérifier les indicateurs sans jamais risquer de déstructurer la présentation globale de la matrice source.
10. 10. Résolution des erreurs communes et écueils techniques lors du filtrage croisé
10.1 10.1 Discordance d’indexation et décalage des références de plages
L’écueil méthodologique le plus prévalent et le plus insidieux rencontré lors de la configuration de formules personnalisées au sein des filtres d’interface réside dans la désynchronisation verticale entre l’indice de ligne de la formule et l’indice effectif de la première ligne de données de la matrice couverte. Cette pathologie logique, bien que totalement invisible lors de la compilation syntaxique de la formule, fausse silencieusement l’intégralité du tableau extrait, produisant soit des faux positifs généralisés, soit un décalage structurel d’une rangée sur toutes les évaluations booléennes du tableau.
Illustrons cette anomalie par un cas clinique typique : supposons une table dont les en-têtes résident sur la ligne 1, et dont les observations empiriques débutent formellement à la ligne 2. Si l’analyste, influencé par la notation des colonnes complètes ou par inattention, saisit dans la boîte de dialogue de formule personnalisée :
=AND(A1="East", B1="A")
au lieu de référencer la coordonnée relative A2 et B2, une catastrophe computationnelle se produit. Pour décider du sort de la première rangée de données (la ligne 2), le moteur de filtre va interroger l’état booléen des cellules A1 et B1 (les titres de colonnes !). Pour la ligne 3, il évaluera les cellules de la ligne 2, et ainsi de suite. Chaque enregistrement du tableau est ainsi assujetti à la conformité de l’enregistrement qui le précède dans la grille spatiale, annihilant toute validité scientifique à l’extraction sans qu’aucun message d’alerte ne signale le sinistre.
Pour prévenir cette dérive catastrophique, une règle cardinale d’hygiène logicielle doit être rigoureusement observée : l’index de ligne spécifié dans la formule personnalisée d’un filtre d’interface doit coïncider rigoureusement avec le numéro de rangée de la toute première ligne de données couverte par la sélection. Si le filtre englobe A2:C100, la formule doit impérativement s’adosser à A2 et B2. De même, l’introduction de références de colonnes entières sans indices (comme A:A) au sein du filtre personnalisé natif doit être proscrite, cette notation étant réservée exclusivement à certaines fonctions vectorielles globales.
10.2 10.2 Conflits d’encodage et typologie des variables
Un dysfonctionnement fréquent observé lors de la mise en œuvre de filtres multicritères concerne les échecs d’appariement textuel en apparence inexplicables, où le chiffrier refuse d’extraire une cellule affichant visuellement la chaîne exacte « East ». Dans une écrasante majorité de cas, ce phénomène s’explique par la présence sous-jacente de caractères typographiques d’espacement non standardisés, au premier rang desquels figure l’espace insécable (encodé sous le code Unicode U+00A0 ou code ASCII 160). Fréquemment importé lors de copier-coller depuis des pages web, des progiciels de gestion intégrée (ERP) ou des fichiers PDF, l’espace insécable n’est pas purgé par la fonction standard SUPPRESPACE de base dans certaines configurations.
Pour neutraliser ces artefacts et restaurer une stricte conformité binaire lors des tests d’équivalence, le recours à la fonction de substitution combinée à la fonction CAR (CHAR) s’avère indispensable :
=SUBSTITUE(A2, CAR(160), "")
Cette expression remplace impitoyablement tout espace insécable par une chaîne vide. Une autre source récurrente d’égarement logique réside dans la manipulation des colonnes numériques ayant accidentellement basculé vers le type chaîne de caractères (par exemple un chiffre précédé d’une apostrophe masquée ou importé sous forme textuelle). Si la colonne C stocke la chaîne de caractères "5000" au lieu du scalaire numérique 5000, un filtre quantitatif stipulant C2>=5000 peut adopter un comportement erratique ou exclure systématiquement la valeur selon les subtilités du moteur d’évaluation.
La résolution définitive de ces ambiguïtés typologiques exige la conversion explicite des flux de variables avant ou pendant le traitement analytique. L’emploi de la fonction CNUM (VALUE) garantit la coercition d’une pseudo-chaîne textuelle en un nombre réel pur manipulable par les opérateurs d’inégalité :
=AND(A2="East", CNUM(C2)>=5000)
Inversement, pour les comparaisons textuelles insensibles aux variations de casse et de format, l’invocation prudente de l’expression régulière native REGEXMATCH permet de sécuriser des appariements morphologiques souples tout en restant d’une précision mathématique irréprochable :
=AND(REGEXMATCH(A2, "(?i)^East$"), B2="A")
10.3 10.3 Erreurs de propagation matricielle (#PROPAGATION! / #REF!)
Lorsqu’on bascule vers les méthodes d’extraction matricielle dynamique articulées autour des fonctions FILTER ou QUERY (chapitres 7 et 8), une famille d’erreurs entièrement nouvelle surgit au niveau de la grille de calcul : les erreurs de collision d’expansion spatiale, historiquement identifiées sous le code d’erreur #REF! avec la mention explicite « Impossible de développer la formule, car elle écraserait les données dans la cellule… » (ou #PROPAGATION! / #SPILL! selon les itérations linguistiques de la plateforme).
Ce phénomène découle de la nature même des formules de tableau dynamique. Une fonction telle que =FILTER(A2:C100, ...) ne loge pas ses résultats au sein d’une seule cellule ; elle s’ancre dans la cellule pivot supérieure gauche de la zone de destination et ordonne au moteur de calcul de « déverser » (spill) une matrice bidimensionnelle d’ampleur variable vers le bas et vers la droite. Si un seul obstacle physique – qu’il s’agisse d’une constante numérique, d’un caractère textuel d’espace invisible, ou même d’une formule résiduelle obsolète – se trouve localisé sur la trajectoire géographique exacte de ce déversement, le processus d’expansion est stoppé net et l’erreur d’écrasement matriciel est levée sur l’ensemble de la sortie.
Pour résoudre cette entrave, l’opérateur doit procéder à l’assainissement physique de la zone d’atterrissage matriciel. En sélectionnant la cellule portant l’erreur #REF!, une bordure en pointillés bleus trace visuellement le contour théorique de la matrice tentant de s’étendre. L’analyste n’a plus qu’à inspecter visuellement ce périmètre, identifier la cellule obstruante et appuyer sur la touche Supprimer pour effacer son contenu. Immédiatement, le moteur réactif de Google Sheets comble le vide libéré et projette l’intégralité des lignes filtrées avec une fluidité instantanée.
11. 11. Optimisation cognitive et ergonomique des tableaux pour l’analyse de données
11.1 11.1 Allègement de la charge mentale par la scénarisation visuelle
L’efficacité d’un système d’analyse de données sous tableur ne se mesure pas uniquement à la virtuosité algorithmique de ses formules d’extraction ; elle se juge également à l’aune de sa capacité à délivrer une information immédiatement assimilable par l’esprit humain, tout en minimisant la déperdition d’énergie cognitive. Un tableau brut surchargé de données alphanumériques denses génère ce que la théorie cognitive nomme une charge extrinsèque superflue, ralentissant la détection des signaux faibles et augmentant la probabilité d’erreurs de jugement chez le décideur.
Pour sublimer l’exploitation des filtres multicritères, la scénarisation visuelle par le formatage conditionnel représente un levier ergonomique d’une rare efficacité. En alignant rigoureusement les règles de mise en surbrillance colorimétrique sur les critères booléens exacts formulés dans le filtre, l’analyste crée un écho visuel immédiat. Par exemple, appliquer un fond vert d’eau très discret sur les lignes répondant à =AND($A2="East",$B2="A") permet à l’œil de valider instantanément la conformité de l’extraction au moment même où la matrice filtrée se déploie à l’écran, opérant un pré-traitement cognitif automatique par le canal de la perception pré-attentive.
Il importe toutefois de respecter une stricte tempérance chromatique afin d’éviter le piège de la pollution visuelle (le « syndrome du sapin de Noël »). Les palettes de couleurs doivent être hiérarchisées, privilégiant des tons pastels désaturés pour les catégories standard et réservant les teintes saturées (telles que le rouge cerise ou l’ambre éclatant) aux seules anomalies critiques, déviations budgétaires majeures ou ruptures de seuil quantitatif. Cette discipline d’épuration esthétique préserve la vigilance de l’observateur et maximise la concentration sur l’interprétation sémantique des résultats plutôt que sur le décodage graphique du support.
11.2 11.2 Normalisation des flux de travail pour la prise de décision
Dans un contexte d’industrialisation des processus décisionnels au sein d’une organisation, l’accès au filtrage multicritère ne doit pas contraindre les utilisateurs finaux à manipuler directement des syntaxes de formules complexes au sein des cellules de travail. La bonne pratique méthodologique impose la conception de pupitres de commande simplifiés ou de tableaux de bord interactifs où la complexité logique est sanctuarisée et dissimulée derrière des composants d’interface utilisateur standardisés et ergonomiques.
La concrétisation de cette architecture s’appuie sur le déploiement de règles de validation des données couplées à des listes déroulantes contextuelles. L’architecte du classeur réserve une cellule spécifique pour le choix de la région cible (par exemple la cellule E1) et une seconde cellule pour la sélection du produit (par exemple la cellule F1). La matrice d’extraction matricielle dynamique est ensuite raccordée organiquement à ces deux cellules de contrôle par une formule dynamique paramétrée :
=FILTER(A2:C100, (A2:A100=E1) * (B2:B100=F1))
Dès cet instant, le flux de travail de prise de décision atteint une ergonomie optimale : un dirigeant, un auditeur ou un partenaire opérationnel dépourvu de toute compétence technique avancée en syntaxe booléenne sélectionne simplement « East » dans le premier menu déroulant et « A » dans le second. Instantanément, la matrice sous-jacente se recompose sous ses yeux par l’effet de la propagation réactive, délivrant les métriques requises sans risque de rupture d’intégrité algorithmique. L’instantanéité du retour visuel renforce la confiance du décideur dans la fidélité des données restituées et accélère considérablement les cycles de délibération stratégique.
12. 12. Étude de cas empirique et synthèse opérationnelle des flux de travail
12.1 12.1 Mise en situation : Traitement d’un audit de ventes régionales
Pour illustrer la convergence pratique des concepts théoriques disséqués tout au long de cet ouvrage, nous déployons une étude de cas opérationnelle intégrale consacrée à l’audit d’un fichier de performances commerciales distribué. Soit une matrice de données brutes s’étendant sur les colonnes A, B et C (comportant les variables Région, Produit et Ventes). La direction générale formule deux exigences d’audit divergentes nécessitant chacune le déploiement méthodique d’un schéma logique spécifique.
La première mission consiste en une phase d’investigation restrictive prioritaire : il s’agit d’extraire de manière isolée l’ensemble des transactions où la région est formellement égale à « East » ET où le produit concerné est sans équivoque le produit « A », dans le but d’analyser le taux de pénétration de cette gamme phare sur son marché historique. La seconde mission adopte quant à elle une posture d’exploration globale de couverture de risque : la direction souhaite isoler toutes les lignes où la région est égale à « East » OU le produit est égal à « A », afin de mesurer l’exposition totale du chiffre d’affaires dépendant soit de cette implantation géographique, soit de cette ligne de produits spécifique.
Pour la mission restrictive, l’analyste implémente la conjonction stricte en mobilisant la formule matricielle dynamique suivante sur un onglet de rapport dédié :
=SI.NON.DISP(FILTER(Donnees_Brutes!A2:C100, Donnees_Brutes!A2:A100="East", Donnees_Brutes!B2:B100="A"), "Aucun flux identifié")
Pour la mission d’exploration disjonctive, il déploie l’alternative arithmétique booléenne sur un second onglet analytique :
=SI.NON.DISP(FILTER(Donnees_Brutes!A2:C100, (Donnees_Brutes!A2:A100="East") + (Donnees_Brutes!B2:B100="A")), "Aucune occurrence identifiée")
L’audit croisé de ces deux tables dérivées permet à la gouvernance de confronter avec une exactitude mathématique irréfutable l’intersection cœur de cible et l’enveloppe globale de son portefeuille commercial.
12.2 12.2 Matrice décisionnelle pour le choix de la méthode idoine
Afin de guider l’ingénieur des données ou l’analyste dans le choix de l’architecture de filtrage multicritère la plus efficiente en regard de ses impératifs de production, nous formalisons ci-dessous une matrice décisionnelle comparative synthétisant les quatre grandes approches étudiées au sein de ce traité :
- Filtre natif standard d’interface : Recommandé exclusivement pour l’exploration univariée ou bivariée ponctuelle, individuelle et rapide sur des jeux de données de faible à moyenne volumétrie (< 10 000 lignes). Inadapté au travail collaboratif synchrone en raison de l’impact perturbateur des masquages d’écran globaux. Zéro réutilisabilité par formule en aval.
- Vues filtrées (Filter Views) : Solution absolue pour tout environnement collaboratif partagé entre plusieurs dizaines d’utilisateurs simultanés. Parfaitement adapté à la création de rapports récurrents via le partage d’URL intégrant le jeton
fvid. Absence totale d’interférence entre collègues. Maintient la logique directement encapsulée dans l’interface sans exiger de colonnes ou d’onglets de déversement supplémentaires. - Formule matricielle FILTER() : Méthode privilégiée pour la construction de pipelines de données dynamiques, d’architectures de tableaux de bord en temps réel et de chaînes de traitement par lots. Offre la vélocité computationnelle la plus élevée sur les grands volumes de données. Nécessite une rigueur arithmétique (usage de
+pour OU et de*pour ET) et une zone spatiale vierge exempte d’obstacles pour garantir la propagation matricielle sans erreur#REF!. - Requête déclarative QUERY() : Choix par excellence pour les opérations de manipulation multidimensionnelle complexes exigeant simultanément filtrage multicritère, projection arbitraire de colonnes, tri hiérarchique et calcul d’agrégats (sommes, moyennes groupées) en une seule instruction compacte. Exige des données à typologie strictement homogène par colonne et tolère une surcharge de calcul (phase de parsing) sur les jeux de données extrêmement massifs.
12.3 12.3 Synthèse des meilleures pratiques méthodologiques
En guise de synthèse opérationnelle, tout praticien opérant sur Google Sheets se doit de consigner et d’appliquer une check-list de conformité méthodologique stricte avant de livrer un jeu de données filtré à des fins décisionnelles. Ce protocole se structure autour de quatre impératifs indérogeables :
- Sanctification de la source : Éliminer impérativement toute cellule fusionnée de la matrice brute, harmoniser la casse des libellés catégoriels, expurger les espaces invisibles ou insécables via
SUPPRESPACEet la purge du caractère ASCII 160, et convertir formellement les colonnes numériques hybrides à l’aide deCNUM. - Cohérence de l’adressage : Lors de l’usage des formules personnalisées dans les filtres d’interface, vérifier que l’index de ligne coïncide de façon absolue avec la première ligne d’observation (ligne 2 pour une table dont les titres sont en ligne 1). Dans les formules vectorielles (
FILTER), s’assurer d’une identité dimensionnelle stricte entre la hauteur de la matrice d’extraction et celle des vecteurs de contrainte. - Protection collaborative : Bannir le recours aux filtres natifs directs sur les feuilles de travail partagées en temps réel avec des équipes métiers ; institutionnaliser l’usage systématique des vues filtrées nommées et sécuriser le classeur par le verrouillage préventif des plages primaires.
- Pérennité et automatisation : Pour les flux d’extraction hautement standardisés ou exécutés selon des cadences industrielles, documenter formellement les expressions booléennes au sein d’un dictionnaire de bord. Dans les contextes où les volumétries dépassent les limites physiques des formules de chiffrier conventionnelles, envisager la transition vers des scripts d’arrière-plan automatisés via Google Apps Script ou la synchronisation vers des entrepôts de données plus massifs de type Google BigQuery.
Références
- Boole, G. (1854). An Investigation of the Laws of Thought on Which Are Founded the Mathematical Theories of Logic and Probabilities. Walton and Maberly.
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
- Google. (2023). Google Sheets training and help: Filter and sort your data. Google Workspace Learning Center. https://support.google.com/docs/answer/9331169
- Google Developers. (2023). Google Visualization API Query Language. Google Developers Documentation. https://developers.google.com/chart/interactive/docs/querylanguage
- Mayer, R. E. (2009). Multimedia Learning (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511811678
- Sweller, J. (2011). Cognitive load theory. In J. P. Mestre & B. H. Ross (Eds.), The Psychology of Learning and Motivation: Cognition in Education (Vol. 55, pp. 37–76). Academic Press. https://doi.org/10.1016/B978-0-12-387693-5.00002-8
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Weisstein, E. W. (2002). de Morgan’s Laws. From MathWorld–A Wolfram Web Resource. https://mathworld.wolfram.com/deMorgansLaws.html