
L’exploration visuelle des distributions quantitatives constitue l’un des piliers méthodologiques fondamentaux de la recherche contemporaine en psychologie cognitive, clinique et différentielle. Lorsque le praticien ou l’enseignant-chercheur recueille un ensemble massif d’observations empiriques — qu’il s’agisse de temps de réaction mesurés en millisecondes, de scores composites à des batteries d’évaluation de l’efficience intellectuelle ou d’indices de détresse psychologique issus d’inventaires d’auto-évaluation —, la simple inspection des matrices de données numériques brutes s’avère incapable de révéler la morphologie sous-jacente des phénomènes étudiés. La structuration graphique devient alors un impératif heuristique, permettant d’appréhender de manière synoptique les propriétés centrales d’une distribution : la tendance centrale, la dispersion des mesures, le degré d’asymétrie ainsi que l’éventuelle présence de singularités morphologiques telles que la bimodalité ou les anomalies aux extrémités de l’échantillonnage.
Dans cet arsenal d’outils d’analyse exploratoire, le polygone de fréquences occupe une place épistémologique et pratique de premier ordre. Si l’histogramme classique à barres contiguës est traditionnellement privilégié lors des premières phases d’investigation descriptive, il montre de sévères limites cognitives et visuelles dès lors que l’analyste cherche à superposer plusieurs cohortes ou à apprécier la continuité théorique d’une variable sous-jacente. Le polygone de fréquences, par sa nature linéaire reliant des coordonnées définies par des couples rigoureux (centres de classes et effectifs associés), convertit l’information statistique discrète en une trajectoire géométrique fluide. Cette stylisation géométrique offre une passerelle directe vers les concepts d’ajustement aux lois de densité de probabilité, au premier rang desquelles trône la loi normale de Gauss-Laplace, cadre de référence quasi universel des modèles de la théorie classique des tests psychométriques.
Toutefois, la concrétisation informatique d’un polygone de fréquences rigoureux dans un environnement bureautique répandu comme Microsoft Excel représente un défi méthodologique fréquemment sous-estimé. Conçu initialement pour des applications économiques et de gestion financière, le tableur de Microsoft ne dispose pas, de manière native et immédiate, d’un bouton automatisé intitulé « polygone de fréquences » respectant d’emblée l’intégralité des canons de la statistique descriptive académique. L’expérimentateur doit donc déployer une suite logique de manipulations mathématiques et techniques : formalisation du partitionnement en classes selon des critères d’optimalité stochastique, calcul précis des barycentres ou points médians d’intervalles, dénombrement matriciel automatisé des effectifs, fermeture géométrique impérative sur l’axe des abscisses par l’adjonction de classes virtuelles à effectif nul, et ajustement typographique méticuleux conforme aux normes éditoriales savantes, notamment celles de l’American Psychological Association (APA). Ce manuel intégral a pour vocation d’exposer pas à pas cette démarche méthodologique d’une rigueur absolue, en alliant la théorie statistique la plus solide aux manipulations pratiques avancées du tableur.
1. Introduction théorique au polygone de fréquences en analyse de données psychologiques
1.1 Définition épistémologique et morphologie du graphique
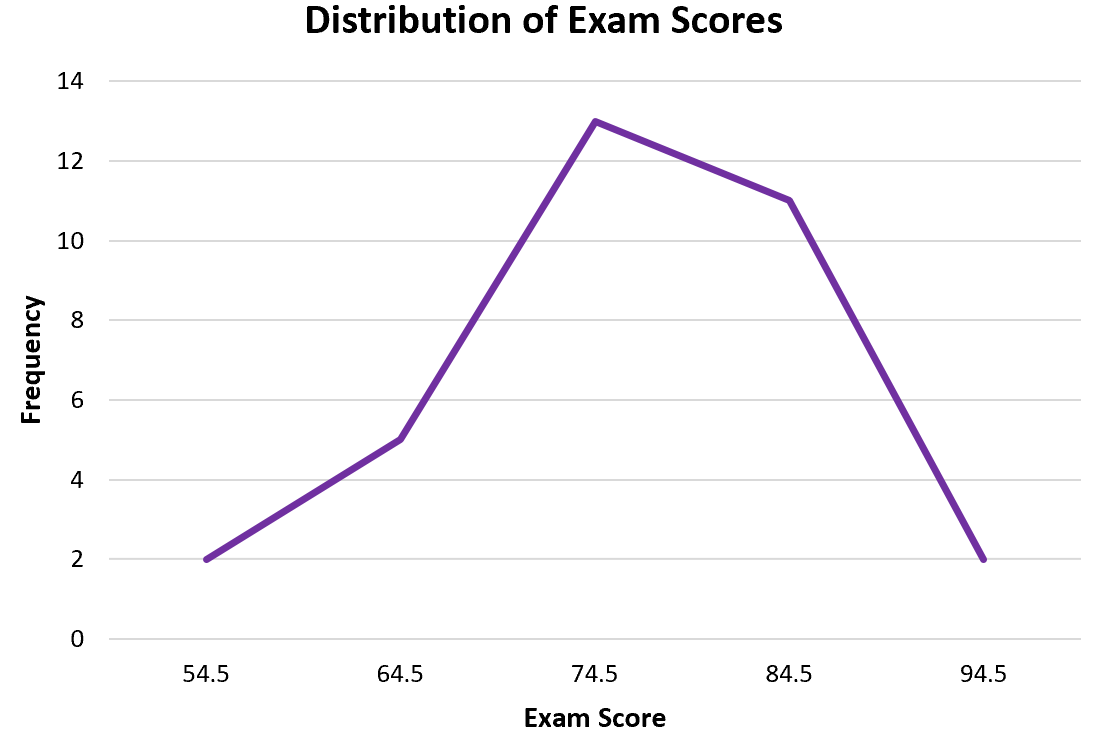
Sur le plan de l’épistémologie de la mesure statistique, le polygone de fréquences est une représentation géométrique bidimensionnelle univariée qui traduit graphiquement la distribution d’une variable quantitative, qu’elle soit continue par essence ou discrétisée par les contraintes de l’instrument d’évaluation. Sa morphologie repose sur une ligne brisée continue reliant une succession ordonnée de points nodaux dans un repère cartésien orthogonal. Chaque point nodal est rigoureusement défini par un couple de coordonnées : en abscisse figure le centre de classe (ou point médian) d’un intervalle de valeurs déterminé, tandis qu’en ordonnée est projeté l’effectif observé au sein de cette classe, exprimé sous la forme d’une fréquence absolue, d’une fréquence relative (proportion) ou d’un pourcentage du total de l’échantillon examiné.
La transformation opérée par le polygone de fréquences est fondamentale : il ne s’agit pas simplement d’une variante esthétique de l’histogramme, mais d’une translation conceptuelle majeure. En substituant aux surfaces rectangulaires discontinues une courbe polygonale unifiée, l’analyste fait l’hypothèse sous-jacente d’une continuité du phénomène latent évalué. Dans le champ de la psychométrie différentielle, où les attributs psychologiques tels que l’anxiété-trait, l’extraversion ou l’aptitude verbale sont postulés comme variant continûment au sein de la population générale, le polygone matérialise l’échantillonnage empirique comme une approximation discrète d’une fonction de densité théorique sous-jacente. Il offre ainsi une lisibilité immédiate du profil de densité géométrique de la distribution des traits latents mesurés.
De surcroît, la nature géométrique de cette ligne polygonale permet d’appréhender d’un seul coup d’œil l’équilibre dynamique de la population étudiée. Contrairement aux représentations tabulaires denses qui obligent le chercheur à réaliser des opérations cognitives de comparaison numérique itératives, le polygone mobilise les processus perceptifs précoces de la vision humaine. La pente de ses segments ascendants et descendants indique directement la vitesse de variation de la densité d’individus à travers le continuum psychométrique, signalant immédiatement les zones de forte concentration de scores autour des paramètres de tendance centrale ainsi que la rareté relative des profils extrêmes situés aux frontières de la distribution.
1.2 Spécificités d’application dans la recherche en psychologie
L’utilisation du polygone de fréquences trouve une pertinence toute particulière dans les protocoles de recherche en psychologie clinique, en neuropsychologie et en sciences du comportement, où la confrontation de scores composites standardisés constitue la matière première du diagnostic et de la validation empirique. À titre d’illustration, l’administration d’inventaires d’évaluation clinique comme l’échelle de dépression de Beck (Beck Depression Inventory, BDI-II) ou le questionnaire d’anxiété état-trait de Spielberger (STAI) génère des distributions dont la configuration morphologique informe directement le chercheur sur la représentativité de son groupe d’étude par rapport aux normes cliniques validées.
Dans le domaine des comparaisons inter-groupes — par exemple lorsqu’il s’agit de contraster les performances mnésiques d’une cohorte de patients atteints de troubles cognitifs légers face à un groupe témoin apparié en âge et en niveau socioculturel —, le polygone de fréquences déploie une supériorité opérationnelle incontestable. Tandis que la juxtaposition de deux histogrammes distincts engendre une charge cognitive élevée et que leur superposition directe sur un même axe aboutit à un chevauchement visuel inextricable de barres opaques, le polygone autorise le tracé simultané de multiples lignes différenciées par leur couleur et leur texture de trait. Les zones de divergence clinique, le déplacement transversal des modes de distribution et les chevauchements populationnels apparaissent avec une clarté analytique irréprochable.
Enfin, l’avantage heuristique du polygone de fréquences s’étend à la communication scientifique au sein des publications à comité de lecture et des communications orales. Dans les phases exploratoires d’une étude d’intervention psychothérapeutique ou pharmacologique, présenter l’évolution d’une cohorte avant et après traitement sous la forme de deux polygones de fréquences calés sur le même référentiel métrique permet au lectorat de visualiser instantanément non seulement le déplacement moyen du score clinique, mais aussi la restructuration globale de la variabilité intra-groupe et l’amenuisement progressif de la queue de distribution pathologique.
1.3 Distinction comparative : polygone de fréquences versus histogramme
La distinction entre l’histogramme et le polygone de fréquences soulève des considérations méthodologiques fondamentales qui dépassent le simple choix sémiologique. L’histogramme matérialise l’information statistique par une série de rectangles contigus dont l’aire totale est proportionnelle à la somme des effectifs de la distribution. Cette contiguïté des rectangles insiste délibérément sur l’appartenance des observations à des intervalles de classes disjoints et cloisonnés, induisant une perception visuelle d’escalier ou de blocs discontinus. Cette fragmentation visuelle peut s’avérer avantageuse lorsque l’objectif premier est de mettre en exergue le dénombrement brut d’individus tombant strictement dans une tranche score spécifique.
À l’inverse, le polygone de fréquences s’affranchit de cette segmentation physique en reliant les sommets centraux de ces classes par des segments rectilignes continus. Cette morphologie linéaire présente une propriété mathématique cruciale : l’aire totale délimitée entre la ligne brisée du polygone et l’axe horizontal des abscisses est rigoureusement identique à l’aire cumulée de l’ensemble des rectangles de l’histogramme correspondant, à condition formelle que le tracé soit convenablement fermé à ses extrémités par le raccordement aux points médians de classes fictives contiguës de fréquence nulle. Le polygone préserve donc intégralement la vérité quantitative des masses de probabilité tout en offrant une gestalt globale plus fluide.
Le tableau analytique ci-dessous synthétise les propriétés différentielles qui guident l’arbitrage entre ces deux modes de représentation dans la pratique du chercheur :
- Continuité visuelle : L’histogramme met l’accent sur les partitions d’intervalles distincts via des blocs verticaux, tandis que le polygone privilégie la perception d’un continuum sous-jacent et la fluidité des transitions de densités.
- Superposition multivariée : L’histogramme supporte très mal la comparaison de plus de deux groupes en raison de l’occlusion des surfaces, alors que le polygone permet d’afficher avec netteté trois, quatre ou cinq distributions concomitantes au sein du même espace cartésien.
- Détection des moments de la distribution : Le polygone facilite l’estimation visuelle intuitive de l’asymétrie (skewness) et de l’acuité sommitale ou aplatissement (kurtosis), en permettant à l’œil d’interpoler mentalement une courbe continue de type gaussien.
- Fermeture géométrique : L’histogramme repose naturellement sur l’axe horizontal par la base de ses barres, tandis que le polygone requiert impérativement un artifice de calcul (points d’ancrage à fréquence zéro) pour délimiter une surface géométrique fermée.
2. Fondements mathématiques et structure des distributions statistiques
2.1 Typologie des fréquences : absolues, relatives et cumulées
La formalisation mathématique de toute représentation par polygone exige une compréhension univoque de la typologie des métriques de fréquences mobilisables en psychologie descriptive. Soit un échantillon aléatoire de taille globale notée N, issu de la mesure d’une variable quantitative continue discrétisée en k classes disjointes notées Ci (avec i variant de 1 à k). La fréquence absolue, notée ni, représente le nombre brut d’observations individuelles dont la mesure est comprise entre la limite inférieure et la limite supérieure de la classe considérée. Si la fréquence absolue présente l’avantage de refléter la taille réelle de l’effectif sous étude, elle s’avère totalement inappropriée pour comparer deux échantillons de tailles divergentes (par exemple, 250 patients hospitalisés face à 1 500 témoins sains de la population générale).
Pour affranchir l’analyse de la contingence de la taille d’échantillon, la fréquence relative, notée fi, est définie comme le quotient de la fréquence absolue par l’effectif total : fi = ni / N. Cette proportion sans dimension vérifie rigoureusement la condition de sommation unitaire, la somme de tous les fi pour i allant de 1 à k étant strictement égale à 1 (ou 100 lorsqu’elle est convertie en pourcentage). Le tracé d’un polygone de fréquences relatives normalise l’ordonnée et permet la comparaison visuelle objective de cohortes disparates sur une échelle commune de probabilité empirique unifiée.
Enfin, la fréquence cumulée (qu’elle soit absolue ou relative) est obtenue par la sommation progressive des fréquences des classes antérieures et de la classe courante. Le polygone reliant les limites supérieures des classes à ces effectifs cumulés prend la dénomination spécifique d’ogive de Galton ou polygone de fréquences cumulées. Contrairement au polygone de fréquences standard qui présente une allure en cloche ou polymodale, l’ogive de Galton est une fonction strictement monotone non décroissante, indispensable pour déterminer graphiquement les rangs centiles, les déciles et les quartiles d’un instrument psychométrique standardisé.
2.2 Lissage conceptuel et approximation de la courbe normale de Gauss
L’un des fondements théoriques les plus stimulants de l’usage du polygone de fréquences réside dans son comportement asymptotique face à la distribution normale de Gauss. La loi normale, caractérisée par sa fonction de densité symétrique entièrement définie par sa moyenne μ et son écart-type σ, constitue le modèle idéal vers lequel tendent les distributions de nombreuses caractéristiques cognitives et physiologiques selon le théorème central limite, pour peu que la variable observée résulte de l’addition d’une multitude de facteurs indépendants non prépondérants.
Lorsque la taille de l’échantillon N croît indéfiniment vers l’infini et que, simultanément, la largeur des intervalles de classe se contracte vers zéro (h → 0), le polygone de fréquences relatives tend formellement, par convergence stochastique, vers la courbe continue de densité de probabilité f(x). Dans le contexte de la pratique psychologique de terrain où les échantillons oscillent généralement entre une cinquantaine et quelques centaines de sujets, le polygone de fréquences offre une approximation visuelle directe de cette courbe théorique. Il permet à l’investigateur d’apprécier si l’hypothèse de normalité univariée est soutenable au regard des données empiriques recueillies.
Cette évaluation visuelle revêt une importance opérationnelle déterminante : elle constitue l’étape liminaire obligatoire conditionnant le recours aux techniques de statistique inférentielle paramétrique. La validité mathématique du test t de Student pour échantillons indépendants, de l’analyse de variance univariée ou factorielle (ANOVA) et du calcul du coefficient de corrélation linéaire de Pearson repose sur l’hypothèse stricte de normalité de la distribution des variables dépendantes ou des résidus du modèle linéaire. Le polygone de fréquences permet d’identifier précocement toute déviance structurelle majeure susceptible d’invalider ces procédures paramétriques et de contraindre l’expérimentateur à s’orienter vers des tests non paramétriques robustes tels que le U de Mann-Whitney ou le H de Kruskal-Wallis.
2.3 Indicateurs de forme : asymétrie (skewness) et aplatissement (kurtosis)
L’évaluation visuelle d’un polygone de fréquences se structure autour de l’identification morphologique des déviations par rapport à la symétrie gaussienne idéale, que la statistique formalise par les moments d’ordre 3 et d’ordre 4 de la distribution. Le premier de ces indicateurs est le coefficient d’asymétrie (skewness de Fisher-Pearson). Une distribution parfaitement symétrique affiche un coefficient nul, caractérisé sur le polygone par une superposition parfaite de la moyenne, de la médiane et du mode sous le sommet central de la courbe.
Dans les cohortes psychologiques, l’asymétrie positive (ou déviation vers la droite) se traduit sur le polygone par un étirement substantiel de la queue de distribution vers les valeurs élevées de l’axe des abscisses, tandis que la masse des observations est concentrée à gauche sur les scores modestes. Ce profil morphologique est typiquement constaté lors de l’administration d’échelles de détresse psychologique au sein de la population générale, où la majorité des individus manifestent des scores faibles ou nuls, alors qu’une minorité clinique génère de longues traînes positives. À l’inverse, une asymétrie négative (queue étirée vers la gauche) indique une accumulation de sujets sur les valeurs hautes, phénomène couramment observé dans les examens académiques peu sélectifs ou les évaluations d’aptitudes simples en présence d’effets d’apprentissage majeurs.
Le second paramètre morphologique central est le coefficient d’aplatissement (kurtosis de Pearson), qui évalue la propension de la distribution à concentrer sa masse de probabilité soit au centre et dans les queues extrêmes, soit de manière diffuse dans ses flancs intermédiaires. Un tracé leptokurtique (kurtosis supérieur à 0 en valeur normalisée) présente un sommet remarquablement acéré, traduisant une homogénéité extrême d’une fraction centrale des sujets accompagnée de traînes lourdes pouvant abriter des profils atypiques. Un tracé platykurtique (kurtosis inférieur à 0) exhibe au contraire un sommet aplati voire une allure de plateau régulier, signalant une dispersion uniforme des scores sans concentration modale prononcée, caractéristique fréquente d’un trait hétérogène mal capturé par une métrique trop globale.
3. Préparation méthodologique des données psychologiques sous Excel
3.1 Nettoyage et codification de la matrice de scores
La validité scientifique de toute représentation graphique découle invariablement de la pureté méthodologique de la matrice de données primaires. Sous Microsoft Excel, la phase initiale d’ingénierie statistique consiste à nettoyer minutieusement la colonne d’observations issues des protocoles d’évaluation. Il est fréquent que les fichiers compilés à partir de formulaires de passation informatisée comportent des scories susceptibles de corrompre les calculs d’intervalles ultérieurs : chaînes de caractères typographiques insérées par mégarde (espaces insécables, virgules au lieu de points décimaux selon les paramètres régionaux), scores négatifs interdits par le plan de cotation de l’inventaire psychométrique ou codes d’erreurs logicielles.
Une étape d’audit systématique impose de vérifier l’adéquation de chaque cellule au format numérique standard. L’application des fonctions natives de vérification logique comme =ESTNUM() sur l’ensemble de la plage d’intérêt permet d’identifier instantanément toute cellule traitée de façon pernicieuse comme une chaîne textuelle par le moteur du tableur. De même, la gestion des données manquantes (missing data) doit obéir à une politique délibérée : l’omission d’une réponse à un item d’une échelle composite ne doit jamais être enregistrée par le chiffre zéro, sous peine de distordre violemment le polygone vers l’origine, mais doit être laissée strictement vide ou codifiée par une valeur conventionnelle isolée (ex. -999) impérativement filtrée hors de la plage analysée.
La détection des valeurs aberrantes ou extrêmes (outliers) doit être effectuée avant tout découpage en classes. Un sujet ayant répondu de façon aléatoire ou ayant appuyé frénétiquement sur une touche lors d’une tâche de temps de réaction peut générer une valeur hors norme qui étirerait artificiellement l’amplitude globale du graphique, compressant l’ensemble de la véritable distribution clinique au sein de deux ou trois classes étroites. L’usage conjoint du calcul des bornes de Tukey (1,5 fois l’écart interquartile au-delà des quartiles Q1 et Q3) permet d’isoler ces anomalies pour décider méthodologiquement de leur exclusion ou de leur traitement spécifique selon les protocoles préenregistrés de l’étude.
3.2 Organisation tabulaire des données brutes dans le tableur
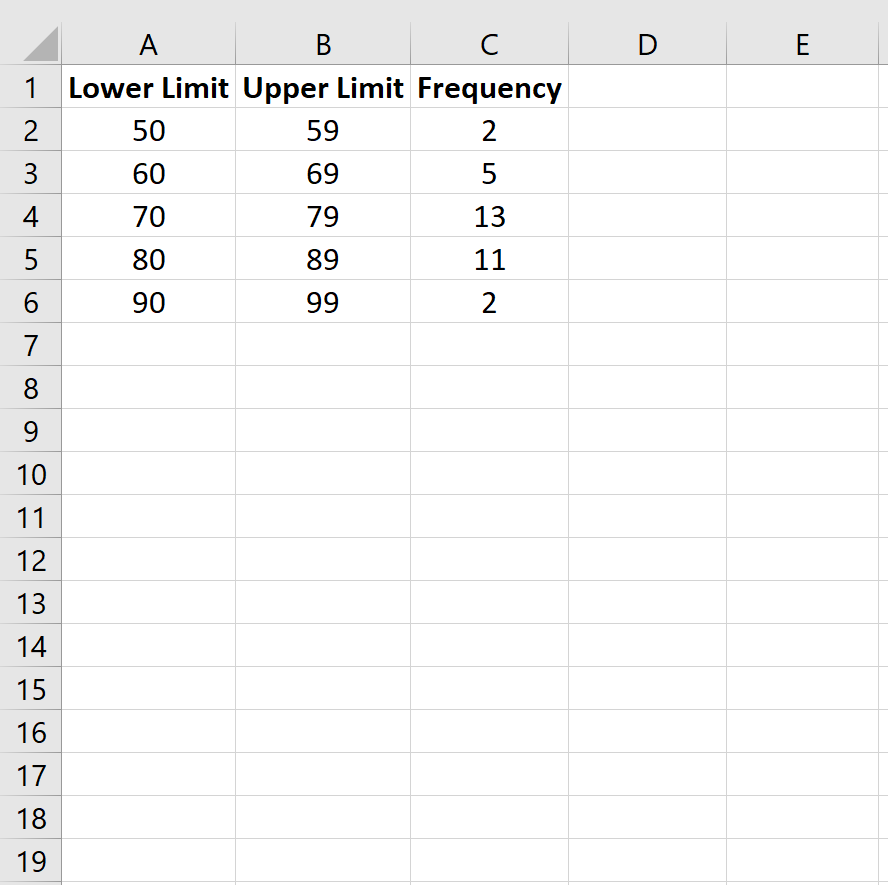
Pour assurer la pérennité et la reproductibilité des analyses, l’organisation spatiale des données dans la feuille de calcul Excel doit se conformer aux principes des données ordonnées (tidy data). Les scores individuels de l’échantillon doivent impérativement être structurés sous la forme d’un vecteur univarié continu, disposé au sein d’une seule colonne clairement étiquetée dans sa cellule d’en-tête (par exemple, Score_BDI_II_Total en cellule A1). Les scores individuels occupent ensuite consécutivement les cellules de A2 jusqu’à A(N+1), sans aucune ligne vierge ni rupture structurelle.
L’utilisation de la fonctionnalité officielle de tableau structuré de Microsoft Excel — activable via le raccourci clavier universel Ctrl + L ou par le menu Accueil > Mettre sous forme de tableau — constitue une pratique d’excellence hautement recommandée. En transformant la simple plage matricielle en un tableau nommé (par exemple, TableauScores), toute référence ultérieure dans les formules de calcul d’intervalles ou de fréquences s’effectuera par référence structurée explicite (ex. TableauScores[Score_BDI_II_Total]). Cette méthode garantit une totale réactivité dynamique : si de nouveaux participants sont inclus dans la cohorte lors d’un protocole d’échantillonnage continu, le tableau s’étend automatiquement, propageant instantanément les mises à jour aux formules statistiques et aux tracés polygonaux associés.
Il convient également de figer le formatage d’affichage de cette colonne de scores. Même si les mesures psychologiques composites sont le plus souvent représentées par des entiers naturels discrets résultant de l’addition de cotations sur échelles de Likert, certaines variables de conversion (notes standardisées en z, scores T de McCall ou scores de déviation de QI de Wechsler) comportent des décimales. Il est impératif d’ajuster l’affichage à un nombre constant de décimales (par convention, deux décimales significatives) via l’inspecteur de format de cellule (Ctrl + 1 > Nombre), sans jamais tronquer la précision mathématique sous-jacente conservée dans la mémoire vive du logiciel.
3.3 Détermination de la dispersion et de l’étendue des données
L’architecture d’un polygone de fréquences harmonieux dépend intrinsèquement des paramètres fondamentaux de dispersion de la série statistique. Avant toute tentative d’insertion de graphique, l’analyste doit implémenter un bloc dédié aux métriques descriptives préliminaires au sein d’une zone périphérique de la feuille de calcul, distincte du vecteur de données primaires. Ce bloc statistique doit impérativement calculer l’effectif valide de l’échantillon, la valeur minimale observée, la valeur maximale observée et l’étendue totale de la distribution.
L’effectif valide total, noté N, s’obtient instantanément par l’écriture de la formule =NB(A2:A151) (en supposant un échantillon de 150 participants situés dans la plage A2:A151). Cette fonction ignore d’emblée les cellules textuelles ou accidentellement vides, garantissant la précision du dénominateur pour les futurs calculs de fréquences relatives. Les valeurs extrêmes empiriques sont quant à elles extraites à l’aide des fonctions mathématiques standard =MIN(A2:A151) et =MAX(A2:A151), assignées respectivement à des cellules clairement identifiées comme paramètres d’entrée du modèle descriptif.
L’étendue totale de la distribution, notée R (pour Range), correspond à la différence arithmétique directe entre le maximum et le minimum empiriques, soit la formule explicite =Cellule_Max - Cellule_Min. Cette grandeur représente l’espace métrique total que l’analyste va devoir partitionner en intervalles réguliers lors de la phase subséquente. Une étendue anormalement resserrée ou excessivement dilatée doit inciter le chercheur à vérifier une dernière fois l’intégrité de ses données, car une partition arbitraire construite sur une étendue biaisée fausserait la résolution visuelle de l’ensemble du profil morphologique du polygone.
4. Définition des intervalles de classe et calcul des fréquences
4.1 Règles d’optimisation du nombre de classes (Sturges et Freedman-Diaconis)
Le découpage d’un continuum quantitatif en classes ne doit sous aucun prétexte procéder d’un choix intuitif ou arbitraire de l’utilisateur. Le nombre de classes, traditionnellement noté k, conditionne directement la validité sémiologique du polygone : un nombre k trop faible conduit à un phénomène de sous-lissage dévastateur masquant les singularités morphologiques locales (l’information est alors trop condensée), tandis qu’un k excessif engendre un sur-lissage caractérisé par une fragmentation stochastique erratique (la ligne polygonale oscille follement en dents de scie en raison du faible effectif au sein de chaque tiroir statistique).
La règle classique d’optimisation la plus universellement répandue pour les échantillons de taille modérée et asymptotiquement normaux est la règle de Sturges. Formulée sur la base d’une décomposition binomiale, elle postule que le nombre optimal de classes se calcule par la relation : k = 1 + log2(N), ce qui s’exprime sous Excel en logarithme décimal par la formule =1 + 3,322 * LOG10(N) ou de façon plus moderne par =ARRONDI.SUPERIEUR(1 + LOG(N; 2); 0). Pour un échantillon classique de 200 participants en psychométrie expérimentale, la formule de Sturges prescrit rigoureusement k = 9 classes d’amplitudes homogènes.
Toutefois, lorsque les données manifestent une asymétrie marquée ou la présence de queues de distribution modérément lourdes, la règle de Freedman-Diaconis s’impose comme une alternative statistique nettement supérieure. Fondée sur la robustesse de l’écart interquartile (IQR), elle définit la largeur idéale de classe h par l’équation : h = 2 * IQR(X) * N-1/3. Sous Excel, cela se matérialise en combinant les fonctions de quartiles : =2 * (QUARTILE.EXCLURE(A2:A151; 3) - QUARTILE.EXCLURE(A2:A151; 1)) * (NB(A2:A151)^(-1/3)). Une fois la largeur h déterminée par cette approche non paramétrique, le nombre de classes se déduit immédiatement en divisant l’étendue globale par h et en arrondissant à l’entier supérieur.
4.2 Délimitation rigoureuse des bornes inférieures et supérieures
Une fois le nombre de classes k arrêté, l’analyste doit déterminer l’amplitude de classe, notée c. Pour garantir l’intelligibilité cognitive du lecteur, cette amplitude doit être fixée à une valeur arrondie élégante (par exemple 2, 5, 10, 20 points de cotation), obtenue en divisant l’étendue R par le nombre de classes k et en arrondissant à l’entier d’échelle supérieur adéquat via la formule =PLAFOND(R / k; 1) ou =PLAFOND(R / k; 5).
La délimitation des bornes impose une rigueur d’exclusion absolue afin de prévenir tout problème de double affectation d’un score pivot situé exactement à la frontière de deux intervalles adjacents. La convention standard en psychologie expérimentale consiste à définir des intervalles fermés à gauche et ouverts à droite, ou l’inverse, selon le format mathématique : [Borne_Inférieure, Borne_Supérieure[ ou ]Borne_Inférieure, Borne_Supérieure]. La borne inférieure de la toute première classe doit débuter à une valeur légèrement inférieure ou égale au minimum observé, tout en s’alignant sur un chiffre rond cohérent avec la structure de l’instrument d’évaluation.
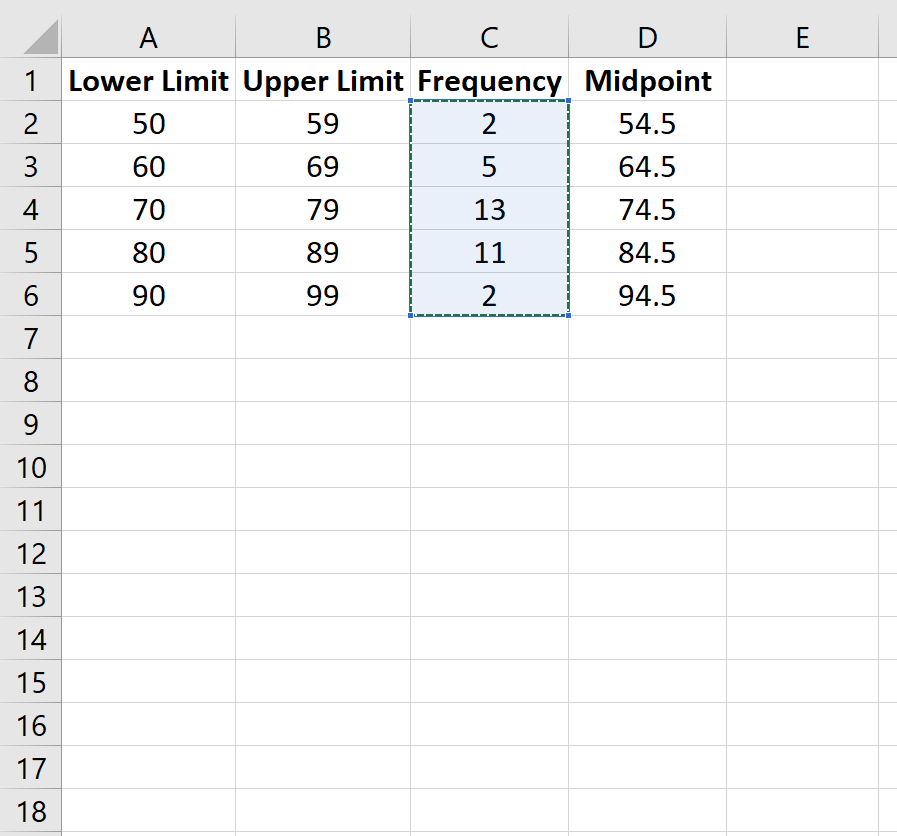
Dans la feuille Excel, l’analyste organise cette table de fréquences en insérant deux colonnes adjacentes : l’une listant les Bornes_Inferieures et l’autre les Bornes_Superieures. La borne inférieure de la première classe étant fixée en cellule D2, la borne supérieure en E2 s’obtient par la simple addition de l’amplitude : =D2 + Amplitude. La borne inférieure de la classe subséquente en D3 est alors strictement égale à E2, et cette logique algorithmique est incrémentée vers le bas jusqu’à ce que la borne supérieure de la dernière classe k englobe parfaitement la valeur maximale absolue de la distribution empirique.
4.3 Dénombrement automatisé avec la fonction FREQUENCE ou NB.SI.ENS
Le dénombrement des effectifs au sein de chaque tiroir statistique ne doit en aucun cas s’opérer manuellement, source inévitable d’erreurs humaines massives. Excel fournit un outil mathématique nativement optimisé pour cette tâche : la fonction FREQUENCE(). Cette fonction fonctionne sur un mode matriciel puissant qui requiert deux paramètres fondamentaux : la matrice des données brutes (tableau_données) et la matrice des limites supérieures des classes (matrice_intervalles). Sa syntaxe formelle s’écrit : =FREQUENCE(A2:A151; E2:E10).
Dans les versions contemporaines d’Excel (Microsoft 365 et Excel 2021 dotés du moteur de tableaux dynamiques), il suffit d’entrer la formule dans la première cellule de la colonne d’effectifs (par exemple F2) et de valider par la touche Entrée : la fonction s’écoule (spill) instantanément vers le bas pour remplir automatiquement l’ensemble des cellules correspondant aux classes. Pour les versions historiques antérieures du tableur, l’utilisateur doit impérativement sélectionner au préalable la plage entière des cellules cibles, saisir la formule dans la barre d’édition, puis valider impérativement par la combinaison de touches matricielle historique Ctrl + Maj + Entrée afin d’encadrer la fonction d’accolades système.
Une alternative tout aussi rigoureuse et souvent préférée par les chercheurs désireux de maintenir un contrôle unitaire sur chaque cellule sans contrainte matricielle consiste à utiliser la fonction conditionnelle NB.SI.ENS(). Pour une classe dont la borne inférieure est en D2 et la borne supérieure en E2, la formule s’écrit de manière univoque : =NB.SI.ENS(A$2:A$151; ">=" & D2; A$2:A$151; "<" & E2). Cette syntaxe dénombre exclusivement les scores strictement supérieurs ou égaux à la limite inférieure et strictement inférieurs à la limite supérieure. Enfin, une somme de contrôle indispensable doit être apposée au bas de la colonne des fréquences calculées par la formule =SOMME(F2:F10). Ce total doit afficher une congruence absolue avec le N total calculé au préalable : tout écart numérique signale une fuite d’observations liée à une mauvaise définition des frontières extrêmes.
5. Calcul des points médians (centres de classe) avec les fonctions Excel
5.1 Rôle conceptuel du point médian en abscisse
L’implantation des coordonnées d’abscisse pour un polygone de fréquences représente le pivot mathématique qui sépare une représentation amatrice d’une construction scientifique rigoureuse. Contrairement à l’histogramme, dont la barre s’étale physiquement sur toute l’amplitude séparant la borne inférieure de la borne supérieure, le polygone ne dispose que d’un point géométrique unique pour projeter la totalité de l’effectif recensé dans cet intervalle. Ce point focal doit être le point médian (ou centre de classe), noté mi.
Sur le plan mathématique, le point médian correspond au barycentre géométrique de l’intervalle de classe. En postulant une répartition localement uniforme des observations à l’intérieur de chaque tiroir d’amplitude resserrée, le centre de classe constitue la valeur espérée (l’espérance locale) la plus représentative de l’ensemble des sujets regroupés dans cette division. Assigner le score de la borne inférieure ou celui de la borne supérieure constituerait un biais systématique de translation artificielle vers la gauche ou vers la droite de l’intégralité du profil de densité, invalidant tout diagnostic visuel de la moyenne ou de la normalité de la distribution.
De plus, cette position médiane est la condition mathématique sine qua non garantissant que la superficie géométrique délimitée sous le polygone compense exactement les déficits et les excédents triangulaires par rapport aux rectangles de l’histogramme. Les segments obliques du polygone coupent les arêtes supérieures des barres de l’histogramme en leur milieu précis : le triangle excédentaire situé hors de l’histogramme compense au millimètre carré près le triangle vacant laissé libre à l’intérieur de la barre adjacente. L’aire sous le polygone demeure donc rigoureusement égale à l’aire de l’histogramme sous-jacent, préservant la fidélité de l’intégrale empirique des fréquences.
5.2 Implémentation technique via la fonction MOYENNE
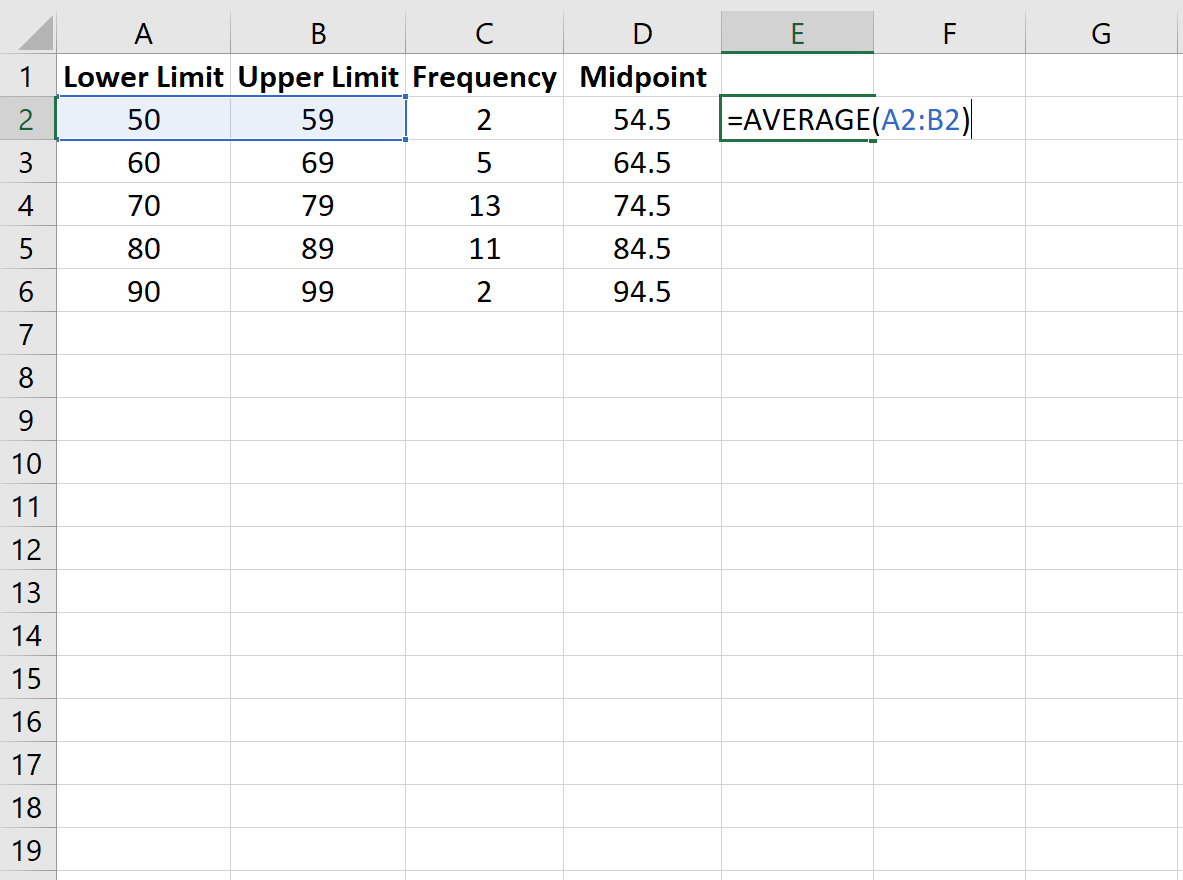
Dans l’architecture de la table de fréquences sous Excel, une colonne spécifique intitulée Point_Median ou Centre_Classe doit être obligatoirement insérée, de préférence immédiatement à gauche de la colonne des effectifs calculés. Le calcul de ce centre s’effectue par la moyenne arithmétique simple des deux frontières géométriques délimitant l’intervalle considéré. Pour une classe dont la limite inférieure se situe dans la cellule D2 et la limite supérieure dans la cellule E2, la formulation technique sous Excel s’écrit élégamment : =MOYENNE(D2; E2), ou plus prosaïquement par l’expression arithmétique élémentaire : =(D2 + E2) / 2.
Une fois saisie en cellule C2 (ou dans la colonne dédiée), cette formule est propagée le long de la colonne par un double-clic sur la poignée de recopie située dans le coin inférieur droit de la cellule sélectionnée. L’utilisateur doit impérativement veiller à ce que les références aux cellules de bornes soient des références relatives (sans symboles de verrouillage $), afin que l’incrémentation ligne par ligne s’opère de façon parfaitement fluide le long des k classes constitutives de la table statistique.
Le contrôle typographique du format numérique de cette colonne des points médians doit être rigoureusement ajusté. Dans l’éventualité où l’amplitude des classes serait un nombre impair (par exemple, des classes d’amplitude 5 réparties de [10 à 15[, [15 à 20[), les centres de classes présenteront systématiquement une décimale terminale en ,5 (respectivement 12,5 et 17,5). Il convient de configurer les cellules via l’inspecteur Format de cellule > Nombre avec une décimale visible constante pour prévenir tout décalage d’affichage textuel préjudiciable à la lisibilité de la graduation.
5.3 Vérification de l’isométrie et de la régularité des intervalles
Une erreur fréquente dans l’exploitation des graphiques sous tableur découle d’intervalles d’amplitudes inégales non maîtrisés. Le polygone de fréquences repose sur le postulat implicite d’une isométrie parfaite des classes : chaque pas transversal sur l’axe des abscisses doit représenter une quantité métrique strictement identique. Si les classes ne présentaient pas une largeur rigoureusement constante, la hauteur des points nodaux n’exprimerait plus la densité statistique réelle, induisant une distorsion optique majeure analogue à une faute d’échelle en cartographie.
Pour certifier cette isométrie au sein d’Excel, l’analyste peut implémenter une colonne de contrôle temporaire calculant le delta entre deux points médians successifs via la syntaxe élémentaire =C3 - C2, étirée vers le bas. La totalité des cellules résultantes doit afficher sans exception une valeur identique, rigoureusement égale à l’amplitude c initialement arrêtée. Toute divergence décimale démasquerait une erreur dans la progression des bornes inférieures et supérieures au sein du tableau.
Cette vérification méthodique clôture la phase d’ingénierie préliminaire des données. À ce stade du protocole, l’utilisateur dispose d’une table de synthèse parfaitement consolidée, prête à être couplée au moteur de rendu graphique d’Excel. Cette table comporte désormais les centres de classes isométriques alignés en face de leurs effectifs bruts (ou fréquences relatives) respectifs, fournissant les matrices de coordonnées vectorielles indispensables pour générer la trajectoire de la ligne polygonale.
6. Procédure pas à pas d’insertion du polygone de fréquences dans Excel
6.1 Sélection des séries de données d’effectifs
L’initiation de la procédure de tracé graphique sous Microsoft Excel exige une rigueur opératoire totale quant à la sélection initiale des plages de cellules. Une source constante d’anomalies graphiques réside dans la tentative de sélectionner simultanément la totalité du tableau statistique (incluant les colonnes de bornes, les points médians et les fréquences). Le moteur d’analyse visuelle d’Excel tend alors à interpréter l’ensemble des colonnes numériques comme des séries indépendantes à projeter sur l’axe des ordonnées, aboutissant à un fouillis illisible de plusieurs lignes superposées.
La règle méthodologique fondamentale prescrit de ne sélectionner, dans un tout premier temps, strictement et exclusivement que la plage des données d’effectifs (les fréquences absolues ou relatives calculées). L’analyste met donc en surbrillance, à l’aide de la souris ou par la combinaison de touches Maj + Flèche Bas, la série de cellules numériques d’effectifs (par exemple, la plage F2:F10). Il est impératif d’exclure délibérément de cette première sélection la cellule d’en-tête textuelle si celle-ci comporte des caractères complexes ou une syntaxe ambigüe, ainsi que la cellule sommitale de totalisation (somme de contrôle), sous peine de voir apparaître un pic terminal artificiel écrasant le reste du tracé.
Il convient également de vérifier méticuleusement qu’aucune cellule masquée, aucune formule renvoyant une erreur système de type #VALEUR! ou #N/A, et aucun caractère d’espacement accidentel ne s’est glissé dans cette colonne de fréquences. Le moteur graphique réagit immédiatement aux discontinuités : une cellule erronée provoquerait une rupture béante de la ligne brisée ou un arrêt brutal du graphique en plein milieu du domaine de variation psychométrique.
6.2 Sélection du type de graphique dans le ruban Insertion
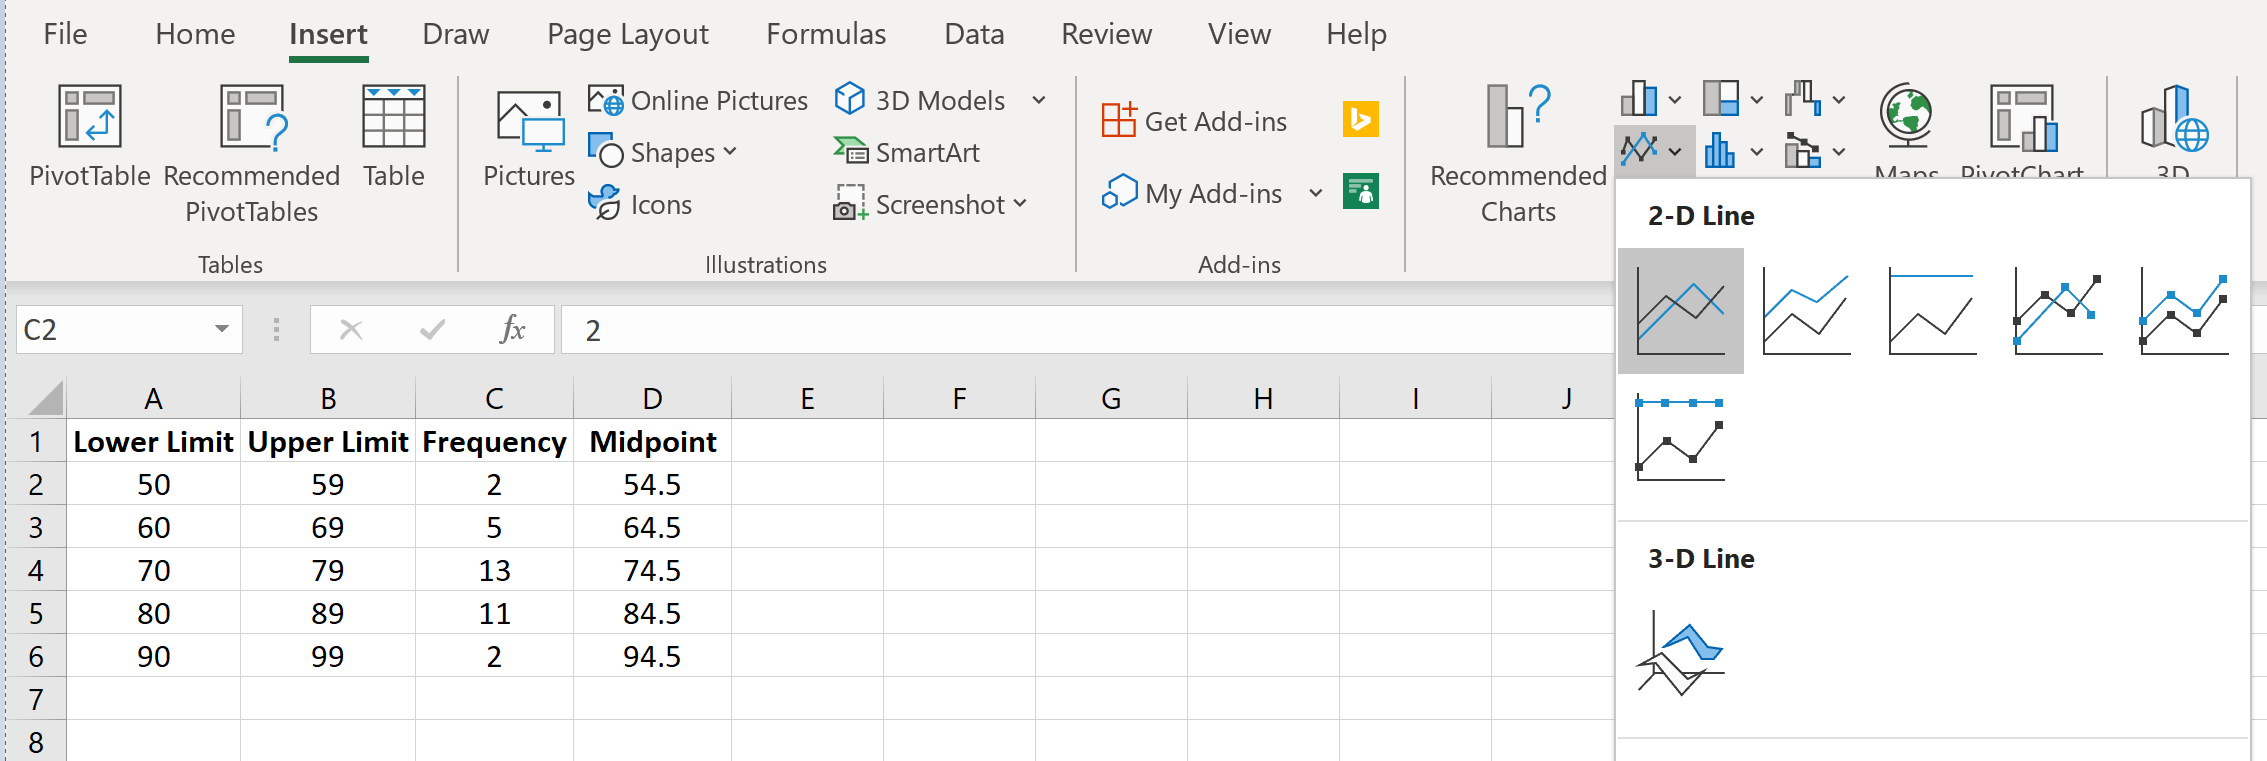
La plage des effectifs étant rigoureusement active en surbrillance, l’analyste dirige son curseur vers le ruban supérieur d’Excel et clique sur l’onglet Insertion. Au sein du groupe d’outils contextuel dénommé Graphiques, se présente un panel de typologies géométriques. L’utilisateur doit impérativement porter son choix sur la commande Insérer un graphique en courbes ou sur des aires (représentée par une icône stylisée de lignes en escalier).
Dans le sous-menu déroulant qui se déploie, il existe plusieurs variantes de tracés linéaires. Le choix méthodologique optimal pour un polygone de fréquences académique est sans conteste le graphique intitulé « Ligne avec marqueurs » (Line with Markers). Il convient d’éviter résolument les courbes 2D lissées (courbes splines) proposées dans certains sous-menus de mise en forme avancée : bien que visuellement flatteuses et rappelant les cours de mathématiques pures, ces courbes lissées procèdent par interpolation cubique automatique et inventent littéralement des ondulations statistiques inexistantes dans les données empiriques réelles, pouvant même descendre visuellement sous l’ordonnée zéro dans les zones de transition creuses.
L’avantage scientifique déterminant de l’option « Ligne avec marqueurs » réside dans la présence de repères discrets explicites (disques, losanges ou carrés) ancrés exactement sur les coordonnées des points nodaux. Ces marqueurs signalent honnêtement au lecteur de la publication scientifique la localisation empirique exacte des centres de classes mesurés, tandis que les segments linéaires rectilignes qui les relient assument leur simple statut de vecteurs d’interpolation visuelle continue sans trahir la densité d’échantillonnage.
6.3 Génération initiale et diagnostic des paramètres par défaut
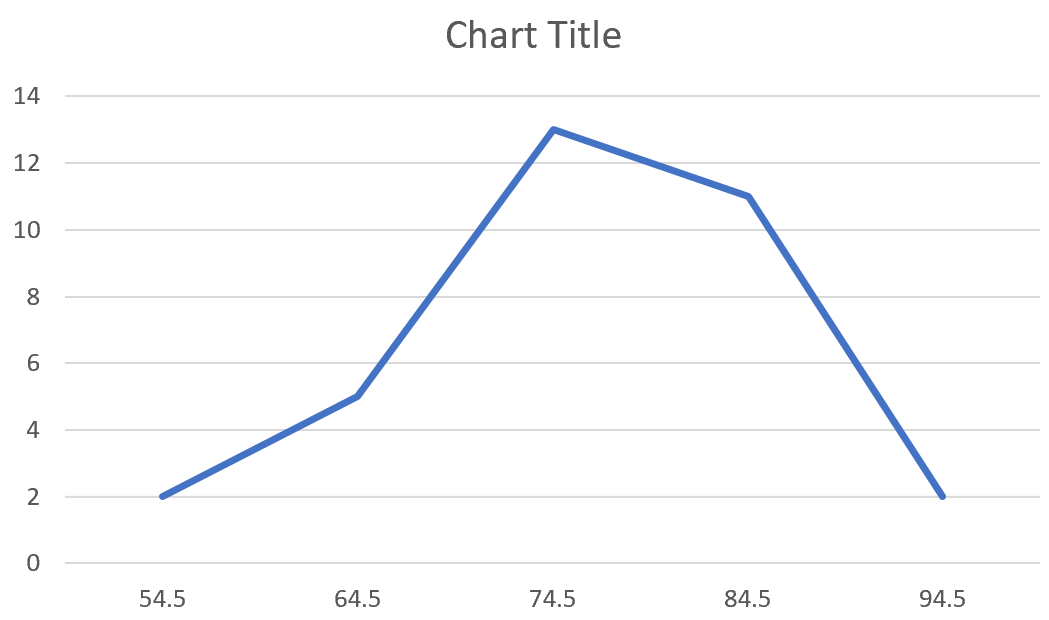
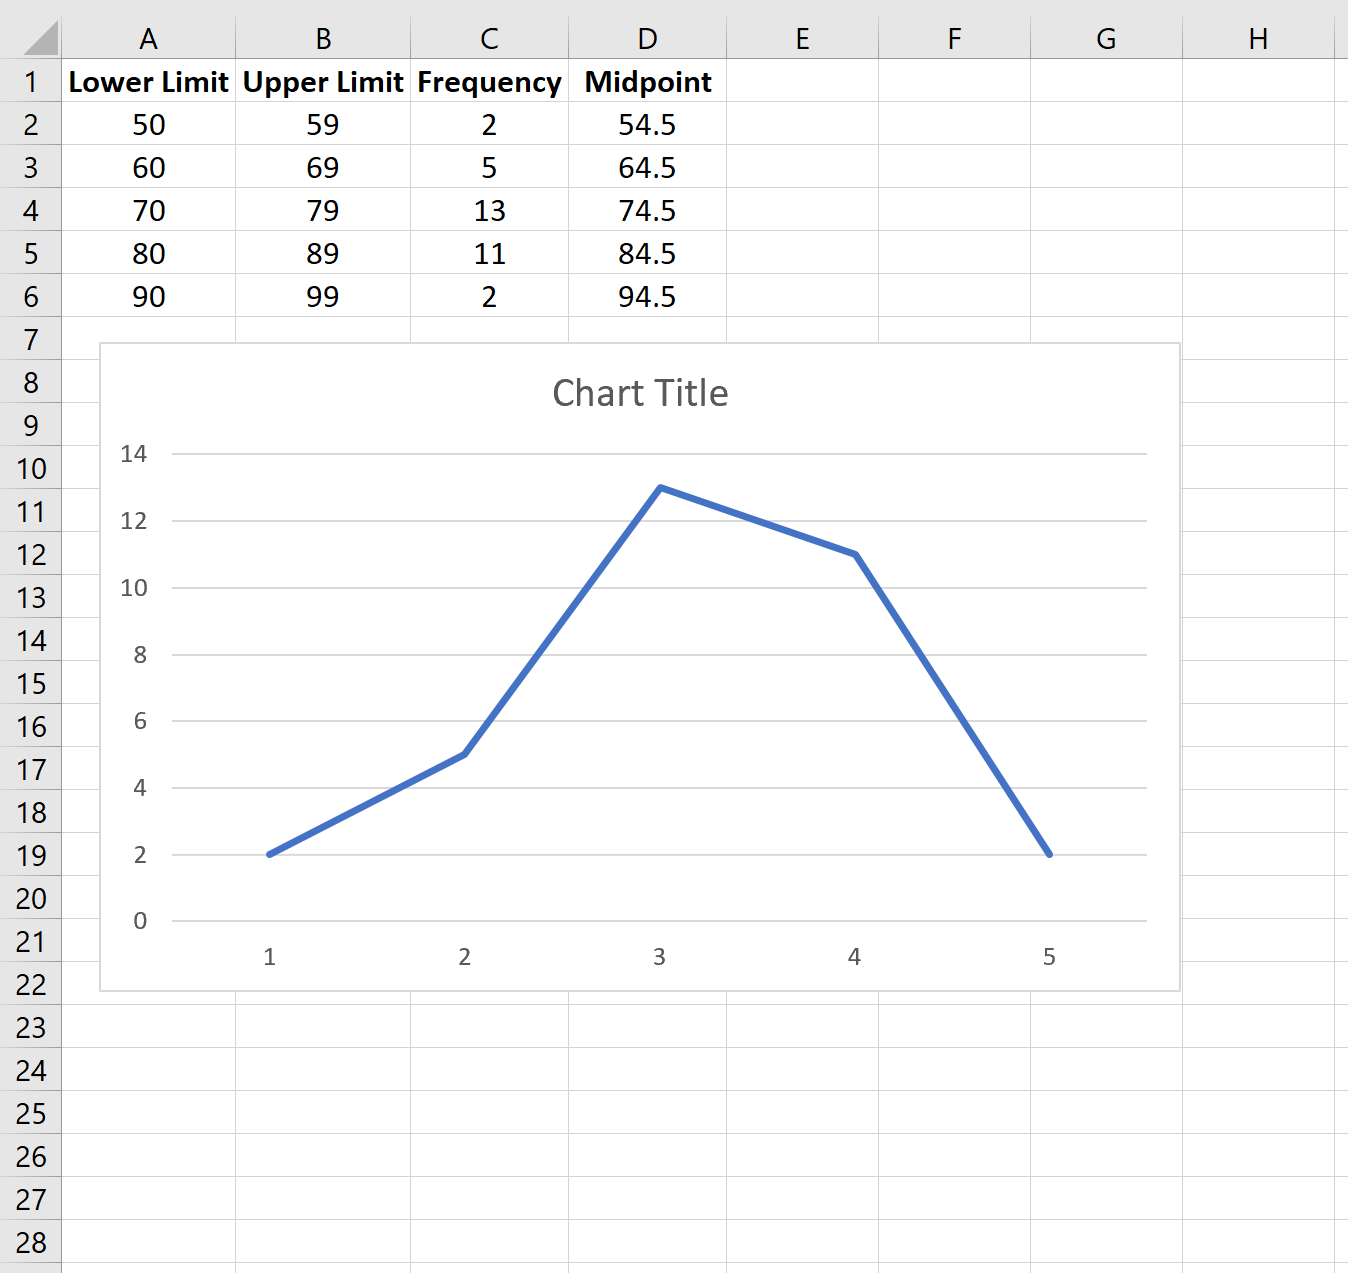
Dès la validation de l’insertion, Excel génère dynamiquement un graphique brut au centre de la feuille de travail active. Si l’allure générale de la ligne brisée reflète fidèlement la modulation des effectifs de la variable étudiée, ce graphique natif souffre immédiatement d’une tare statistique rédhibitoire qui le rend totalement inexploitable pour une utilisation académique : l’axe horizontal des abscisses est erroné.
En l’absence d’instructions préalables spécifiques, le tableur de Microsoft attribue arbitrairement à l’axe des abscisses une séquence séquentielle d’entiers naturels ordinaux débutant par 1, 2, 3, 4, jusqu’à k. Ce comportement par défaut assigne ainsi au premier point nodal le libellé « 1 » au lieu de refléter la valeur métrique du centre de la première classe (par exemple, un score de 32,5 points au BDI-II). Cette distorsion confère au graphique un statut d’échelle ordinale catégorielle déconnectée de la réalité quantitative de l’évaluation psychologique sous-jacente.
Un diagnostic méthodique du graphique brut révèle également d’autres lacunes d’ergonomie par défaut : absence de titres explicites d’axes, présence d’un quadrillage horizontal souvent trop contrasté et envahissant, taille inadaptée des polices de caractères et ligne de tracé d’une teinte d’accentuation standard (souvent le bleu bureautique d’Office) dépourvue du contraste requis pour l’impression en niveaux de gris des revues scientifiques. Il incombe donc à l’analyste de basculer dans la phase d’ajustement paramétrique structurel du graphique.
7. Configuration et ajustement précis de l’axe horizontal des abscisses
7.1 Accès à la gestion des séries de données
Pour corriger la graduation ordinale par défaut de l’axe des abscisses et lui conférer sa pleine légitimité métrique, l’analyste doit accéder au panneau de gestion des sources de données d’Excel. La méthode la plus directe consiste à effectuer un clic droit avec la souris directement au sein de la zone de traçage ou sur la ligne du graphique généré, puis à sélectionner l’élément contextuel Sélectionner des données... dans le menu déroulant. Alternativement, l’utilisateur peut cliquer sur le graphique pour faire apparaître le ruban contextuel Création de graphique, puis cliquer sur l’icône Sélectionner des données située dans le groupe Données.
Cette action provoque l’ouverture de la boîte de dialogue centrale intitulée Sélectionner la source de données. Cette interface cardinale d’Excel est partitionnée en deux volets structurels majeurs : à gauche se trouve la section Entrées de légende (Série), qui régit les données projetées sur l’axe vertical (ordonnées), et à droite se déploie le volet Étiquettes de l'axe horizontal (abscisse). C’est ce volet droit qui affiche actuellement la suite numérique désuète 1, 2, 3, 4... qu’il convient impérativement de neutraliser.
Il est fondamental de comprendre le fonctionnement de cette interface : l’utilisateur ne doit pas tenter d’ajouter une nouvelle série à gauche pour afficher les centres de classes, car cela créerait une seconde ligne polygonale représentant les points médians sur l’axe vertical. L’intervention doit se focaliser exclusivement sur le bouton de réassignation des étiquettes d’abscisse localisé dans le volet droit de la fenêtre contextuelle.
7.2 Assignation de la plage des points médians calculés
Au sein du volet droit Étiquettes de l'axe horizontal (abscisse), l’analyste clique avec précision sur le bouton Modifier. Cette action déclenche l’apparition d’une sous-boîte de dialogue épurée intitulée Plage d'étiquettes des axes, pourvue d’un champ de saisie unique accompagné d’une icône de réduction de plage.
Le curseur étant positionné à l’intérieur de ce champ, l’expérimentateur bascule vers sa feuille de calcul et sélectionne méticuleusement la plage de cellules hébergeant les centres de classes (points médians) calculés lors de l’étape précédente (par exemple, la plage C2:C10). Le champ de saisie se remplit alors de la référence absolue correspondante sous la syntaxe standardisée =Feuil1!$C$2:$C$10. Il est impératif de veiller à ce que l’étendue de cette plage sélectionnée comprenne rigoureusement le même nombre exact de cellules que la plage des effectifs saisie à l’étape 6.1 (soit k cellules).
Dès que l’utilisateur valide l’opération en cliquant sur le bouton OK de la sous-boîte, puis réitère la validation sur la boîte de dialogue principale, le graphique d’Excel s’actualise instantanément en mémoire vive. L’axe des abscisses se métamorphose : les entiers abstraits 1, 2, 3... s’éclipsent pour laisser place aux véritables valeurs numériques médianes de chaque intervalle de score psychométrique. Chaque point nodal du graphique se trouve désormais positionné à la verticale exacte de son barycentre statistique authentique.
7.3 Résolution des problèmes d’échelle catégorielle versus numérique
Bien que l’assignation des points médians résolve l’affichage des valeurs numériques, il subsiste une subtilité architecturale propre à Excel que tout chercheur rigoureux doit maîtriser : la distinction entre un axe de texte (catégoriel) et un axe chronologique ou numérique. Par défaut, lorsqu’un graphique en courbes reçoit une plage d’étiquettes d’abscisses, Excel traite ces valeurs comme des chaînes de caractères textuelles indépendantes, réparties à intervalles géométriques strictement équidistants sur le dessin.
Si la méthodologie décrite à la section 4 a été scrupuleusement respectée, toutes les classes possèdent une amplitude rigoureusement constante, ce qui rend le traitement catégoriel visuellement acceptable puisque l’isométrie empirique coïncide avec l’équidistance géométrique du tableur. Cependant, si pour une raison expérimentale impérative l’analyste a dû composer avec des classes d’amplitudes inégales ou si des classes intermédiaires d’effectif nul ont été escamotées de la table de fréquences, le format catégoriel fausserait gravement l’espace métrique en maintenant un espacement visuel constant entre des points qui devraient être spatialement distants.
Pour verrouiller la cohérence de l’axe, l’utilisateur effectue un double-clic directement sur les valeurs numériques de l’axe horizontal pour faire surgir le panneau latéral Format de l'axe. Sous l’onglet symbolisé par un triple barreau (Options d'axe), il convient d’examiner la section Type d'axe. L’option Sélectionner automatiquement selon les données ou Axe de texte doit être paramétrée en pleine conscience de cause. Pour une distribution standard à classes équidistantes, le mode texte garantit un calage parfait des étiquettes médianes sous chaque graduation principale sans extrapolation intempestive du moteur de rendu.
8. Ancrage aux extrémités et fermeture géométrique du polygone
8.1 Nécessité théorique du raccordement à l’axe des ordonnées nulles
Un tracé qui débuterait en suspension dans le vide au niveau du premier point nodal de classe et s’interromprait abruptement au niveau du dernier point nodal ne constitue pas, sur le plan de la taxonomie statistique formelle, un polygone. L’étymologie même du mot polygone (du grec polugônos : « à plusieurs angles ») renvoie à une figure géométrique plane délimitée par une séquence fermée de segments de droite. En l’état actuel de la construction dans Excel, la ligne brisée flotte au-dessus de l’axe des abscisses sans délimiter d’espace clos.
Sur le plan mathématique et physique, la fermeture du tracé répond au principe de conservation de l’aire et de délimitation de la masse de probabilité. L’intégrale définie sous la fonction empirique doit être confinée par une frontière continue. Le raccordement de la ligne brisée à l’ordonnée zéro matérialise le fait incontestable qu’au-delà des bornes extrêmes observées dans la cohorte, la densité d’individus tombe à une probabilité nulle. Cette clôture géométrique permet également de vérifier visuellement le théorème selon lequel l’aire totale enserrée sous le polygone fermé équivaut méticuleusement à l’aire cumulée des rectangles de l’histogramme affilié.
Enfin, les critères de soumission des manuels de statistique expérimentale et les normes éditoriales académiques internationales requièrent unanimement cette fermeture. Un graphique linéaire non fermé induit le lecteur en erreur en laissant suggérer que la distribution se poursuit au-delà des limites du graphique avec des effectifs non nuls ou que les données ont été arbitrairement tronquées aux extrémités par l’expérimentateur.
8.2 Création des classes fictives adjacentes à effectif zéro
L’implémentation de la fermeture géométrique dans Microsoft Excel ne peut s’effectuer de manière purement esthétique en tirant manuellement un trait avec l’outil de dessin vectoriel : elle doit procéder d’une extension rigoureuse de la table statistique de fréquences. L’analyste doit intégrer deux classes virtuelles supplémentaires d’effectif rigoureusement nul (0) : l’une positionnée immédiatement en amont de la première classe réelle, et l’autre positionnée immédiatement en aval de la dernière classe réelle.
La détermination des points médians de ces classes fictives obéit à une règle mathématique d’une simplicité totale, dictée par le respect de l’amplitude constante c :
- Point médian fictif inférieur : Il se calcule en soustrayant l’amplitude de classe c au point médian de la première classe empirique : m0 = m1 – c. Si le premier centre empirique était 32,5 avec une amplitude de 5, le centre fictif s’établit impérativement à 27,5.
- Point médian fictif supérieur : Il s’obtient symétriquement en additionnant l’amplitude de classe c au point médian de la dernière classe empirique : mk+1 = mk + c. Si le dernier centre empirique était 67,5 avec une amplitude de 5, le centre fictif devient rigoureusement 72,5.
Dans la feuille de calcul, l’utilisateur insère une nouvelle ligne au sommet de sa table de données (juste sous la ligne d’en-tête) et une nouvelle ligne au pied de sa table. Sur la ligne supérieure, il saisit manuellement ou par formule le point médian fictif inférieur m0 et assigne la valeur 0 dans la colonne des effectifs. Sur la ligne inférieure, il renseigne le point médian fictif supérieur mk+1 et lui attribue similairement un effectif de 0. Les bornes d’intervalles associées peuvent être laissées vides ou renseignées à titre purement indicatif.
8.3 Extension de la plage source et fermeture visuelle du graphique
Les deux classes virtuelles d’ancrage étant désormais intégrées à la structure tabulaire, il ne reste plus qu’à actualiser l’emprise vectorielle du graphique pour contraindre ses extrémités à rejoindre l’axe horizontal des ordonnées nulles. Cette réassignation s’opère rapidement en rouvrant la boîte de dialogue Sélectionner la source de données par un clic droit sur le graphique.
Dans le volet gauche Entrées de légende (Série), l’analyste sélectionne sa série de fréquences, clique sur le bouton Modifier et redéfinit la plage des Valeurs de la série afin d’englober les cellules de fréquences nulles supérieure et inférieure nouvellement créées (la plage s’étend désormais de la ligne de m0 à celle de mk+1). Simultanément, dans le volet droit Étiquettes de l'axe horizontal (abscisse), l’analyste clique sur Modifier et étire la sélection des étiquettes pour couvrir la totalité de la colonne des points médians, incluant m0 et mk+1.
Dès la validation par le bouton OK, le polygone de fréquences opère sa métamorphose géométrique définitive : la ligne brisée plonge élégamment à ses deux terminaisons pour toucher de façon nette et irréprochable la ligne de flottaison d’ordonnée zéro. Le graphique constitue désormais un polygone authentique, rigoureusement scellé sur le plan topologique et conforme aux critères les plus drastiques de la sémiologie graphique universitaire.
9. Personnalisation visuelle et mise en forme selon les normes académiques (APA)
9.1 Intégration et normalisation des titres et libellés d’axes
La communication scientifique impose une normalisation stricte de la titraille et des métadonnées accompagnant les figures. Conformément aux directives éditoriales de l’American Psychological Association (normes APA, 7e édition), une figure ne doit jamais arborer un titre décoratif informel incorporé à l’intérieur du cadre du graphique par le bandeau natif d’Excel. Le titre d’un graphique scientifique est traditionnellement rejeté au-dessus de la figure sous forme de texte dactylographié dans le traitement de texte (ex. Figure 1 en gras, suivi d’une ligne sautée avec le titre descriptif de l’étude en italique). Il convient donc d’activer l’élément de titre natif d’Excel et de le supprimer purement et simplement pour libérer l’espace visuel supérieur.
En revanche, l’étiquetage exhaustif des deux axes orthogonaux est une exigence absolue et non négociable. Pour insérer ces libellés, l’analyste clique sur le graphique, fait apparaître le bouton vert en forme de croix Éléments de graphique situé dans l’angle supérieur droit (ou passe par le menu Création de graphique > Ajouter un élément de graphique), puis coche la case Titres des axes.
L’axe des ordonnées (vertical) doit stipuler explicitement la nature de la métrique représentée, par exemple : Fréquence absolue (n), Fréquence relative ou Pourcentage (%). L’axe des abscisses (horizontal) doit mentionner sans la moindre équivoque le nom de la variable psychologique mesurée, son acronyme standard ainsi que l’unité ou la métrique d’évaluation employée, par exemple : Score total au BDI-II (Points médians de classe) ou Temps de réaction moyen (ms). L’absence de mention du point médian induirait le lecteur en erreur en lui faisant croire que les graduations marquent des seuils coupants stricts plutôt que des centres d’intervalles d’échantillonnage.
9.2 Ajustement du style graphique, des lignes et des marqueurs
L’esthétique bureautique multicolore par défaut d’Excel doit être totalement bannie pour adopter un style épuré et sobre, maximisant ce que l’éminent statisticien Edward Tufte qualifie de « ratio données/encre » (data-ink ratio). L’analyste effectue un double-clic sur la ligne du polygone pour faire surgir le panneau latéral Mettre en forme la série de données, sous l’icône de pot de peinture (Remplissage et ligne).
Dans la section Ligne, l’utilisateur sélectionne un trait continu de teinte neutre foncée (idéalement le noir pur #000000 ou un gris ardoise soutenu #333333). La largeur du trait doit être calibrée entre 1,5 pt et 2 pt : une ligne trop fine se brise à l’impression ou lors de la réduction typographique, tandis qu’un trait trop épais empâte les sommets et masque la localisation précise des maxima locaux. Le type de jointure doit être paramétré sur Arrondi ou En onglet pour assurer une transition nette aux sommets angulaires.
Dans la sous-section adjacente Marqueur, l’utilisateur déploie le volet Options de marqueur, coche la case Intégré, et sélectionne un symbole géométrique élémentaire : le cercle plein ou le carré plein d’une taille calibrée entre 5 et 6 pt. La couleur de remplissage du marqueur doit être harmonisée avec celle de la ligne (ou blanche à contour noir contrasté pour accentuer la perception nodale). Il est crucial de veiller à ce que l’option de bordure du marqueur ne génère pas de bavure visuelle. Enfin, les lignes de quadrillage horizontales majeures grises affichées par défaut dans l’arrière-plan doivent être soit totalement supprimées pour épurer le fond, soit atténuées dans un gris très pâle (ex. Trame 25%) avec une épaisseur minimale de 0,5 pt.
9.3 Gestion de la typographie, des contrastes et de l’accessibilité
La lisibilité universelle d’un polygone de fréquences passe par un calibrage typographique soigné. Les polices fantaisistes ou trop condensées doivent être proscrites au profit des polices académiques standard sans empattement universellement admises telles que Arial, Calibri, ou avec empattement comme Times New Roman, en stricte conformité avec le corps de texte du manuscrit de recherche qui accueillera l’illustration. L’analyste sélectionne le graphique entier et harmonise la police de caractères à une taille de 10 pt ou 11 pt pour les valeurs des axes, et 11 pt ou 12 pt en demi-gras pour les titres d’axes.
Le contraste chromatique doit répondre aux normes d’accessibilité visuelle (critères du W3C et des revues internationales). La publication scientifique imposant fréquemment des contraintes drastiques de reproduction ou des frais supplémentaires exorbitants pour l’impression couleur, le graphique doit demeurer parfaitement intelligible et discriminable lorsqu’il est photocopié ou converti en niveaux de gris purs. Le texte des étiquettes d’axes ne doit jamais être affiché dans le gris clair par défaut d’Office, mais forcé en noir pur pour garantir un contraste maximal sur fond blanc.
Pour l’exportation finale vers le logiciel de traitement de texte (Microsoft Word, LibreOffice Writer ou un environnement LaTeX), il est fortement recommandé d’éviter la capture d’écran matricielle pixelisée à basse résolution. L’analyste doit effectuer un copier-coller direct du graphique Excel en tant qu’objet vectoriel incorporé, ou exporter la feuille de calcul au format PDF haute résolution avant de découper la figure. Cette manipulation préserve la nature vectorielle des tracés et garantit un rendu d’une netteté typographique irréprochable atteignant les 300 à 600 DPI requis par les comités de lecture des revues scientifiques internationales.
10. Superposition et comparaison de plusieurs distributions de données
10.1 Conception méthodologique de l’analyse comparative inter-groupes
L’intérêt méthodologique suprême du polygone de fréquences s’exprime pleinement dans la comparaison visuelle directe de plusieurs distributions issues d’échantillons appariés ou indépendants. En psychopathologie cognitive ou en psychopharmacologie clinique, le paradigme expérimental classique repose sur l’affrontement d’une condition témoin (groupe contrôle) et d’une ou plusieurs conditions expérimentales (groupes cliniques ou sous traitement). Représenter l’impact d’une thérapie comportementale par la superposition de polygones de scores pré-thérapeutiques et post-thérapeutiques permet d’embrasser d’un seul regard non seulement le gain moyen, mais également l’amenuisement de l’hétérogénéité intra-groupe.
Sur le plan géométrique, le polygone résout la crise d’encombrement spatial inhérente à l’histogramme comparatif. Dès lors que l’on tente de juxtaposer trois séries de barres pour dix classes d’intervalles sur un même graphique, l’œil du chercheur est submergé par trente rectangles entrelacés dont la superposition génère des effets d’occlusion rédhibitoires. Le polygone de fréquences multiple décharge la mémoire de travail visuelle en ne superposant que de fines lignes filaires clairement traçables, dont les points d’intersection matérialisent avec précision les seuils métriques de bascule d’une population à l’autre.
Toutefois, une telle comparaison visuelle n’est méthodologiquement valide qu’à une condition formelle intransigeante : les deux distributions comparées doivent impérativement être découpées selon la même grille de classes. Les limites de classes (bornes inférieures et supérieures) ainsi que les points médians assignés en abscisse doivent être rigoureusement identiques pour toutes les séries. Il est totalement exclu de comparer un groupe partitionné en tranches de 5 points avec un groupe partitionné en tranches de 10 points : le calibrage spatial doit être strictement commun.
10.2 Normalisation des fréquences en pourcentages pour effectifs inégaux
Dans la recherche observationnelle en milieu hospitalier ou universitaire, il est exceptionnel que les cohortes comparées bénéficient d’un équilibre numérique parfait. Il est fréquent d’analyser un groupe clinique restreint de 45 patients atteints d’un syndrome rare face à une cohorte de référence de 450 sujets sains. Si l’analyste commettait l’erreur de tracer les polygones superposés à partir des fréquences absolues brutes, la courbe du groupe témoin écraserait verticalement de façon démesurée celle du groupe clinique, reléguant cette dernière au rang d’un tracé résiduel imperceptible au ras de l’axe des abscisses.
Pour neutraliser ce biais d’échelle colossal, la transformation des fréquences absolues en pourcentages (fréquences relatives multipliées par 100) s’impose comme un impératif méthodologique catégorique. Dans la feuille Excel, l’analyste crée deux colonnes de proportions distinctes calculées en divisant les effectifs de chaque tiroir statistique par la somme totale spécifique de leur propre cohorte. Pour le groupe clinique, la formule s’écrira =(F2 / N_Clinique) * 100, tandis que pour le groupe témoin, elle sera =(H2 / N_Temoin) * 100.
En projetant sur l’axe vertical une échelle partagée exprimée en Pourcentage du groupe (%), l’intégrale géométrique (l’aire globale) enserrée sous chaque polygone devient rigoureusement identique et égale à 100 unités relatives. Dès cet instant, les amplitudes sommitales, les largeurs de dispersion et les aplatissements respectifs des deux courbes deviennent directement et objectivement comparables, affranchis de toute interférence liée à la dissymétrie des effectifs de recrutement.
10.3 Intégration d’une seconde série dans le graphique Excel
L’intégration technique de la cohorte secondaire au sein du graphique préexistant sous Excel s’exécute avec une grande fluidité algorithmique. L’utilisateur effectue un clic droit sur le polygone du premier groupe et rouvre la boîte de dialogue Sélectionner la source de données. Au sein du volet gauche Entrées de légende (Série), il clique sur le bouton Ajouter.
Une fenêtre secondaire intitulée Modifier la série apparaît à l’écran. Dans le premier champ, Nom de la série, l’analyste pointe vers la cellule d’en-tête de la seconde cohorte (par exemple Groupe Clinique). Dans le second champ, Valeurs de la série, il efface la séquence par défaut ={1} et sélectionne minutieusement l’ensemble de la colonne des fréquences relatives (ou pourcentages) du groupe clinique, en veillant scrupuleusement à englober les bornes de fermeture à 0% calculées aux extrémités. L’utilisateur valide par OK.
Pour assurer la discrimination perceptive immédiate des séries superposées sans recourir obligatoirement à la couleur, il convient d’adopter des textures de traits contrastées via le menu Mettre en forme la série de données :
- Groupe Témoin : Ligne continue noire (épaisseur 1,75 pt) associée à des marqueurs circulaires pleins.
- Groupe Expérimental/Clinique : Ligne discontinue à tirets réguliers ou pointillés longs (épaisseur 1,75 pt) associée à des marqueurs triangulaires ou carrés pleins.
Enfin, l’activation d’une légende explicite devient obligatoire. Accessible via la case à cocher Légende du menu contextuel Éléments de graphique, celle-ci doit être positionnée de préférence en haut à droite à l’intérieur du champ de traçage ou au-dessus de la zone graphique, dans un encadrement discret sans ombre portée, permettant une identification univoque et instantanée de chaque profil clinique représenté.
11. Interprétation psychométrique et clinique des profils de courbes obtenus
11.1 Détection des sous-populations et analyse de bimodalité
Une fois le polygone de fréquences rigoureusement érigé selon les canons méthodologiques, commence l’étape cardinale de l’interprétation substantielle de sa morphologie. L’un des apports diagnostiques les plus spectaculaires du polygone par rapport aux indices numériques synthétiques globaux (tels que la moyenne et l’écart-type) réside dans sa capacité à démasquer instantanément la présence d’une distribution bimodale ou polymodale.
Si la distribution sous-jacente est homogène, le polygone ne dessine qu’un sommet unique (distribution unimodale) s’élevant harmonieusement au-dessus des classes centrales. En revanche, l’apparition de deux pics distincts séparés par un creux ou une vallée statistique significative signale sans ambiguïté que l’échantillon analysé n’est pas unitaire, mais agrège en réalité deux sous-populations hétérogènes aux caractéristiques psychologiques divergentes. Dans une étude portant sur l’anxiété préopératoire, une courbe bimodale peut révéler l’existence de deux typologies d’adaptation cognitive radicalement opposées : les sujets déployant des stratégies de coping par évitement défensif (scores très bas) face aux sujets utilisant des stratégies de vigilance anxieuse focalisée (scores très hauts).
Face à une telle configuration graphique, le calcul aveugle d’une moyenne arithmétique globale constitue une aberration méthodologique majeure : la moyenne tomberait exactement dans le creux central de la vallée, décrivant un profil moyen fantomatique qui ne correspond à la réalité d’aucun des participants de l’étude. Le polygone de fréquences alerte immédiatement le clinicien ou le psychométricien sur la nécessité impérieuse de ventiler son échantillon en sous-groupes selon des variables modératrices latentes (sexe, diagnostic différentiel, statut médicamenteux, profil de personnalité) avant de poursuivre toute modélisation statistique avancée.
11.2 Évaluation de la sensibilité du test : effets plancher et effets plafond
L’examen minutieux des terminaisons latérales du polygone de fréquences renseigne directement l’analyste sur la qualité métrologique et la sensibilité discriminative de l’instrument d’évaluation psychologique utilisé. Dans un instrument psychométrique bien étalonné au sein d’une population cible, le polygone doit s’amortir graduellement pour rejoindre l’axe des abscisses à bonne distance des bornes physiques minimales et maximales permises par l’échelle de cotation.
L’observation d’un effet plancher (floor effect) se manifeste sur le polygone par une accumulation vertigineuse et anormale des effectifs sur la toute première classe empirique de gauche, créant un mur vertical artificiel au ras de la borne théorique minimale de l’instrument. Ce profil indique sans équivoque que le test est excessivement difficile pour la population évaluée (en neuropsychologie cognitive) ou que l’échelle est incapable de différencier les degrés subtils de sévérité subclinique chez les individus sains. L’instrument est pour ainsi dire aveugle en deçà d’un certain seuil critique.
Symétriquement, l’effet plafond (ceiling effect) se caractérise par un tassement substantiel de la masse des fréquences contre la borne supérieure droite de l’axe horizontal, le polygone s’achevant de façon abrupte sans transition douce. Ce profil traduit l’incapacité de l’outil d’évaluation à discriminer les compétences cognitives supérieures des participants les plus performants, tous agglutinés sur la note maximale possible. La présence de tels effets plancher ou plafond, trahie avec éclat par le polygone, ruine la validité de construit de la mesure et interdit formellement le recours aux modèles prédictifs linéaires classiques fondés sur la variance continue.
11.3 Diagnostic de normalité face aux modèles prédictifs linéaires
Dans la démarche hypothético-déductive standard de la recherche en psychologie, le recours aux régressions linéaires multiples, aux modèles d’équations structurelles ou aux analyses factorielles exploratoires et confirmatoires requiert la satisfaction préalable de l’hypothèse de normalité multivariée, dont la normalité univariée de chaque variable constitutive est le prérequis incompressible. Le polygone de fréquences constitue le premier filtre de diagnostic exploratoire visuel incontournable.
En confrontant le profil empirique du polygone à la silhouette idéale d’une cloche gaussienne, le chercheur repère immédiatement les dérives de symétrie et de voussure qui échappent parfois aux tests statistiques d’ajustement formels. En effet, des tests d’adéquation classiques comme le test de Shapiro-Wilk ou de Kolmogorov-Smirnov s’avèrent hypersensibles aux variations triviales dans les très grands échantillons (conduisant à rejeter systématiquement la normalité pour des déviations insignifiantes) tout en manquant cruellement de puissance dans les cohortes restreintes (incapables de rejeter la normalité face à des distorsions pourtant sévères).
Le polygone de fréquences restitue au chercheur son jugement critique qualitatif : une distribution affichant une légère déviation sommitale mais préservant une symétrie bilatérale globale et des queues asymptotiques étalées sera jugée visuellement tolérable pour l’application d’un modèle linéaire robuste (selon le principe de robustesse de l’ANOVA aux écarts mineurs de normalité sous le théorème central limite). À l’inverse, un polygone affichant une asymétrie brutale en J inversé impose d’emblée une transformation mathématique préalable des données brutes (transformation logarithmique, racine carrée ou transformation de Box-Cox) avant toute tentative de modélisation inférentielle.
12. Erreurs courantes, dépannage technique et bonnes pratiques sous Excel
12.1 Résolution des décalages d’alignement et erreurs de liaison
L’utilisation d’Excel pour la modélisation statistique graphique est fréquemment émaillée de déconvenues techniques frustrantes résultant de comportements algorithmiques semi-automatiques du logiciel. L’une des erreurs les plus récurrentes survient lorsque l’utilisateur, tentant d’ajouter les points médians dans la boîte de dialogue des sources de données, clique par inadvertance sur le bouton Ajouter du volet des séries d’ordonnées plutôt que sur le bouton Modifier du volet des étiquettes horizontales. Le résultat graphique se traduit par l’apparition aberrante de deux lignes distinctes : une ligne aplatie représentant les effectifs et une longue ligne ascendante diagonale représentant la séquence des centres de classes. Le dépannage exige la suppression immédiate de la seconde série parasite dans le volet gauche et la réaffectation stricte des centres de classes au sein du volet droit réservé aux étiquettes d’abscisse.
Un autre désordre technique majeur concerne la gestion des cellules vides ou nulles au sein de la plage source. Si une classe intermédiaire ne recueille aucun individu (fréquence absolue de zéro), l’expérimentateur peut être tenté de laisser la cellule d’effectif totalement vide dans la table Excel. Par défaut, le moteur de tracé d’Excel réagit souvent en créant une interruption physique spectaculaire de la ligne brisée, laissant un vide béant entre les classes adjacentes au lieu de faire descendre le sommet sur l’axe horizontal.
Pour résoudre définitivement ce comportement pernicieux, l’analyste doit effectuer un clic droit sur le graphique, cliquer sur Sélectionner des données, puis cliquer en bas à gauche de la boîte de dialogue sur le bouton spécialisé Cellules masquées et cellules vides. Dans la sous-fenêtre qui s’affiche, l’utilisateur coche impérativement l’option « Afficher les cellules vides sous forme de : Valeur zéro ». Cette configuration ordonne au tableur de considérer toute absence de valeur textuelle comme une fréquence mathématiquement nulle, garantissant la parfaite continuité linéaire du tracé polygonal sans aucune rupture visuelle non désirée.
12.2 Optimisation dynamique par l’emploi des tableaux structurés et formules
L’un des défis majeurs dans la gestion de protocoles expérimentaux longitudinaux ou d’études épidémiologiques réside dans l’intégration continue de nouveaux participants au fil des mois de passation. Dans une architecture Excel figée conventionnelle, chaque vague d’inclusion de sujets oblige le chercheur à redéfinir manuellement les plages de cellules dans les fonctions statistiques (MIN, MAX, FREQUENCE) et à réassigner laborieusement les sources matricielles du graphique.
Pour éliminer définitivement cette maintenance manuelle propice aux erreurs de copie, l’adoption de tableaux structurés officiels d’Excel couplée à des formules matricielles dynamiques constitue une bonne pratique d’ingénierie statistique absolue. Lorsque la colonne des scores bruts est formatée en tant que tableau officiel (Ctrl + L, nommé par exemple Tbl_Scores), la table de fréquences peut être entièrement automatisée par des fonctions modernes interconnectées.
Pour les utilisateurs avancés disposant de versions récentes d’Excel intégrant les fonctions matricielles de nouvelle génération (telles que LET, LAMBDA ou SEQUENCE), il est désormais possible de générer l’intégralité de la grille de points médians et des fréquences associées au sein d’une unique formule matricielle déployée dynamiquement. Cette formulation s’adapte en temps réel dès qu’une nouvelle ligne est injectée dans le tableau de scores bruts : l’étendue est recalculée instantanément, le nombre optimal de classes de Sturges est ajusté, les fréquences sont recomptabilisées et le polygone de fréquences se métamorphose à l’écran de manière 100% automatisée, incarnant le standard contemporain de la recherche reproductible sous environnement tableur.
12.3 Check-list de contrôle avant soumission ou publication académique
Avant d’insérer définitivement un polygone de fréquences au sein d’un mémoire clinique, d’une thèse de doctorat en psychologie ou d’un manuscrit soumis à une revue internationale dotée d’un comité de lecture exigeant, l’expérimentateur doit soumettre sa figure à un audit critique méthodique. Cette grille d’auto-évaluation structurelle prévient tout rejet éditorial fondé sur des manquements formels ou méthodologiques élémentaires :
- Vérification de la fermeture géométrique : Le tracé du polygone est-il scellé de part et d’autre par un raccordement direct et irréprochable à l’axe des ordonnées nulles via deux points médians fictifs calculés ?
- Concordance des barycentres : Les étiquettes jalonnant l’axe des abscisses correspondent-elles rigoureusement aux points médians (centres de classe) et non aux bornes arbitraires inférieures ou à des indices séquentiels ordinaux (1, 2, 3…) ?
- Isométrie des classes : L’amplitude séparant chaque point médian successif est-elle rigoureusement constante sur l’intégralité du continuum représenté ?
- Précision des libellés terminologiques : Les deux axes disposent-ils d’un intitulé complet mentionnant clairement la nature de la fréquence en ordonnée et le nom exact de la variable avec son unité métrique en abscisse ?
- Conformité au data-ink ratio : Les éléments décoratifs superflus (titres internes grandiloquents, effets de relief 3D, arrière-plans colorés, bordures d’encadrement épaisses) ont-ils été supprimés pour maximiser l’élégance et la netteté du graphique ?
- Équité comparative (en cas de superposition) : Si plusieurs cohortes sont comparées, les fréquences ont-elles été impérativement converties en pourcentages normalisés, et une légende contrastée permet-elle une discrimination immédiate en niveaux de gris ?
- Résolution de sortie vectorielle : L’exportation finale vers le traitement de texte garantit-elle une finesse d’impression optimale sans pixellisation visible des segments angulaires ni des marqueurs nodaux ?
En observant scrupuleusement chacune de ces étapes de contrôle, le chercheur s’assure que sa représentation graphique ne constitue pas un simple schéma approximatif, mais une véritable pièce d’orfèvrerie statistique descriptive, conjuguant l’intégrité de la théorie psychométrique à l’efficacité visuelle de la transmission des connaissances scientifiques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation. https://www.pearsonassessments.com/
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Cengage Learning.
- Microsoft Corporation. (2024). Fonction FREQUENCE dans Microsoft Excel. Support Microsoft. https://support.microsoft.com/fr-fr/office/frequence-fonction-frequence-44e3be2b-de50-4952-b05b-8664b4c7333d
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0