
L’appariement de données au sein d’environnements tabulaires constitue l’un des piliers méthodologiques fondamentaux du traitement quantitatif de l’information contemporaine. Qu’il s’agisse de fusionner des registres administratifs, de corroborer des mesures empiriques ou de consolider des systèmes d’information décisionnels hétérogènes, la capacité à mettre en correspondance deux vecteurs d’observations pour en extraire un troisième représente une compétence analytique déterminante. Sous l’apparente simplicité de l’opération, qui consiste à localiser une valeur de référence au sein d’une matrice pour en extraire un attribut adjacent, se dissimulent des impératifs rigoureux d’algèbre relationnelle, de fidélité sémiotique et d’intégrité référentielle qui conditionnent la validité des conclusions scientifiques et opérationnelles.
Dans l’écosystème du tableur Microsoft Excel, cette opération a longtemps reposé sur des paradigmes algorithmiques historiques, au premier rang desquels figure la fonction de recherche verticale. Si cette dernière a permis la démocratisation des jointures relationnelles auprès de générations d’analystes, les exigences croissantes de volumétrie, de dynamicité structurelle et de reproductibilité computationnelle ont favorisé l’émergence d’architectures fonctionnelles alternatives. De l’articulation matricielle des fonctions d’indexation et d’équivalence jusqu’à la mise en place de primitives contemporaines conçues pour s’affranchir des limitations directionnelles, la palette d’outils analytiques s’est profondément sophistiquée, exigeant du praticien une compréhension intime des mécanismes sous-jacents.
Le présent article propose une exploration épistémologique et technique exhaustive des méthodologies d’appariement de colonnes sous Excel. En articulant théorie des bases relationnelles, décomposition algorithmique détaillée et protocoles de validation empirique, cette étude ambitionne d’offrir un cadre de référence pérenne aux chercheurs, analystes et ingénieurs de données désireux de garantir la résilience de leurs chaînes de traitement quantitatif face aux anomalies de typage, aux ruptures de cardinalité et aux dégradations de performance sur grands ensembles.
1. Fondements méthodologiques de l’appariement de données dans Excel
1.1 La logique de réconciliation des données tabulaires
La réconciliation de données au sein d’un tableur relève des principes généraux formulés par Edgar F. Codd dans le cadre du modèle relationnel. Dans une approche univariée ou multivariée, l’objectif fondamental consiste à établir une fonction de projection liant un ensemble de départ à un ensemble d’arrivée au travers d’un prédicat d’égalité. Contrairement aux systèmes de gestion de bases de données relationnelles traditionnels dotés d’optimiseurs de requêtes déclaratifs, Excel impose à l’utilisateur de définir explicitement la topologie de ce croisement. Il est impératif d’identifier la table source contenant la variable discriminante, la table cible réceptrice du transfert, et le vecteur d’extraction qui encapsule la dimension informationnelle à importer.
Sur le plan théorique, l’établissement d’une correspondance biunivoque sans ambiguïté exige la présence d’un identifiant unique partagé, désigné sous le terme de clé primaire ou de clé de concordance. Cette clé garantit que chaque observation de l’échantillon cible pointe vers une entité sémantiquement équivalente dans la matrice de référence. L’absence de cet invariant logique dégrade la réconciliation en une heuristique incertaine, exposant l’analyste à des approximations préjudiciables.
D’un point de vue épistémologique, la fidélité des données lors de fusions d’échantillons conditionne l’ensemble des inférences statistiques ultérieures. Toute altération survenant lors de la jonction entre la table source et la table cible compromet la validité interne du protocole expérimental. Les disparités d’encodage, les variations chronologiques de capture ou les désynchronisations de granularité transforment une simple opération de lecture matricielle en un point de vulnérabilité majeur au sein de la chaîne de traitement.
1.2 Typologie des variables et structure relationnelle
L’appariement tabulaire repose sur une typologie rigoureuse des variables mobilisées comme pivots d’association. Les variables catégorielles nominales, bien que fréquemment employées dans le langage usuel, présentent une vulnérabilité élevée aux discordances orthographiques et aux ambiguïtés sémantiques. À l’inverse, les identifiants alphanumériques formalisés, dénués de charge signifiante intrinsèque, offrent une stabilité informationnelle optimale pour sécuriser l’alignement des enregistrements.
La dimension relationnelle introduit la notion fondamentale de cardinalité, régissant les rapports entre les ensembles appariés. Dans une relation de type un-à-un, chaque occurrence de la clé pivot dans la table d’interrogation possède une et une seule contrepartie dans la matrice de consultation, assurant un déterminisme parfait lors de la restitution de la troisième colonne. En revanche, les configurations de type un-à-plusieurs ou plusieurs-à-plusieurs complexifient la démarche analytique.
Face à une multiplicité d’occurrences correspondant à une même valeur pivot, les algorithmes standards de recherche d’Excel adoptent un comportement déterministe mais unilatéral en renvoyant systématiquement la première occurrence rencontrée dans l’ordre de balayage séquentiel. Ce biais de sélection peut introduire une distorsion statistique substantielle si l’analyste ignore l’existence de doublons sous-jacents, faussant la représentativité de la variable transférée.
1.3 Importance de l’intégrité référentielle dans les analyses quantitatives
L’intégrité référentielle constitue la garantie logique que chaque référence déclarée par un enregistrement pointe effectivement vers une entité existante et valide de la table de comparaison. Dans les environnements statistiques ouverts comme Excel, cette contrainte n’est pas nativement coercitive, ce qui expose l’architecture des données à des phénomènes d’orphelinat référentiel où des entités de la table réceptrice se trouvent privées d’ancrage dans la matrice source.
Les protocoles de standardisation préalables à tout appariement exigent une vérification rigoureuse de la complétude des domaines de définition. Cela implique l’harmonisation typographique, l’éradication des artéfacts d’importation et la convergence stricte des syntaxes d’encodage des clés candidates. Négliger cette phase de préparation revient à accepter un taux d’échec silencieux lors de la propagation des fonctions de recherche.
Enfin, la validation méthodologique impose de comparer systématiquement les distributions univariées et multivariées de la variable extraite avant et après son injection dans la table cible. Une modification anormale des moments statistiques, tels que la moyenne, la variance ou l’aplatissement, trahit fréquemment des anomalies d’appariement structurelles causées par des correspondances manquées ou des assignations erronées sur des doublons non maîtrisés.
2. Anatomie fonctionnelle de la fonction RECHERCHEV (VLOOKUP)
2.1 Analyse du paramètre de la valeur cherchée (lookup_value)
La fonction RECHERCHEV repose sur un premier argument dénommé lookup_value, représentant le critère pivot servant de point de comparaison entre les ensembles. Ce paramètre constitue l’opérande initial qui sera comparé terme à terme avec les éléments constitutifs du vecteur d’entrée de la table matrice. Sa détermination requiert une précision conceptuelle irréprochable quant à l’unité statistique ciblée par l’analyse.
L’évaluation scalaire de cette valeur cherchée dépend intimement du type de données sous-jacent alloué en mémoire par le moteur d’Excel. Si la valeur cherchée est stockée sous la forme d’une chaîne de caractères tandis que la colonne de recherche héberge des scalaires numériques purs, le prédicat d’équivalence logique échouera inexorablement, même si leurs représentations graphiques s’avèrent rigoureusement identiques à l’écran.
L’analyste doit par ailleurs arbitrer entre l’emploi d’adresses cellulaires relatives et de constantes littérales. L’utilisation d’une référence relative permet à la valeur cherchée de se translater dynamiquement lors de la recopie verticale de la formule le long du corpus d’observations, tandis que l’injection d’une constante fixe l’évaluation sur une cible invariable, ce qui n’a de sens que dans des scénarios de filtrage unitaire ou d’étalonnage isolé.
2.2 Définition et contraintes de la table matrice (table_array)
Le second argument, table_array, délimite l’espace matriciel bidimensionnel au sein duquel s’opérera la double manœuvre de balayage comparatif et d’extraction de la dimension cible. L’architecture historique de la fonction RECHERCHEV impose une contrainte géométrique inaliénable : la colonne renfermant les éléments de comparaison homologues à la valeur cherchée doit obligatoirement occuper la première position ordinale (colonne 1) de la matrice déclarée.
Cette rigidité spatiale interdit formellement toute extraction d’attributs situés sur la gauche de la colonne de concordance au sein de la grille de données source. La délimitation du champ de référence doit être précisément calibrée pour englober à la fois le vecteur de recherche initial et le vecteur de retour final, établissant ainsi un périmètre continu sur le plan de la feuille de calcul.
La stabilité géométrique de cette matrice s’avère particulièrement sensible à l’accroissement longitudinal des données au fil du temps. Si de nouvelles observations sont insérées au-delà des coordonnées de bordure définies lors de l’instanciation de la formule, ces dernières sont purement et simplement ignorées par le processus d’appariement, introduisant une troncature progressive et silencieuse de l’espace d’échantillonnage.
2.3 Le numéro d’index de colonne (col_index_num) et son calcul
L’argument col_index_num prescrit l’indice ordinal entier positif matérialisant la distance géométrique entre la colonne pivot de recherche et la colonne réceptrice de la valeur à restituer. Cet indice ne fait nullement référence au nom absolu de la colonne dans le tableur (tel que A, B ou C), mais procède d’un dénombrement relatif interne à la table matrice, où la première colonne d’interrogation se voit systématiquement assigner la valeur ordinale 1.
Cette spécification par constante entière introduit une vulnérabilité structurelle majeure au sein des feuilles de calcul pérennes. Toute modification dimensionnelle de la table source intervenant ultérieurement, telle que l’insertion impromptue d’une colonne intermédiaire par un tiers collaborateur, entraîne un décalage immédiat du champ de restitution sans que l’index numérique ne s’adapte, extrayant ainsi une information non pertinente.
Afin de pallier cette fragilité inhérente, les modélisateurs avancés recourent à des techniques d’automatisation consistant à remplacer la constante numérique rigide par des fonctions de localisation dynamique, telles que la primitive EQUIV ou COLONNE. Cette approche permet de recalculer dynamiquement l’indice ordinal en fonction des en-têtes de colonnes, assurant une robustesse accrue face aux restructurations tabulaires.
2.4 Le paramètre de correspondance exacte versus approximative (range_lookup)
Le quatrième argument de la fonction, range_lookup, régit la logique d’appariement binaire sous-jacente par l’entremise d’un opérateur booléen, formellement exprimé par FAUX (ou sa valeur numérique équivalente 0) pour une concordance exacte, et VRAI (ou 1) pour une correspondance approximative. Ce paramètre, bien qu’optionnel dans la grammaire formelle d’Excel, revêt une importance cardinale quant au déterminisme du calcul.
Par défaut, l’omission intentionnelle ou accidentelle de cet argument bascule le moteur d’évaluation vers le mode approximatif. Dans cette configuration algorithmique, le système suppose que la première colonne de la matrice est rigoureusement triée par ordre croissant et procède par dichotomie numérique, renvoyant la valeur immédiatement inférieure la plus proche en l’absence d’égalité stricte, ce qui induit des anomalies méthodologiques considérables lors de l’évaluation d’identifiants discrets.
Sur le plan mathématique, l’usage du mode exact (FAUX) est rigoureusement indispensable pour le traitement de clés primaires univoques, qu’elles soient composées de numéros d’immatriculation, de codes d’assurés ou d’identifiants taxonomiques. Seule l’instruction explicite FAUX garantit la formulation d’une égalité logique au sens strict de l’algèbre booléenne, levant toute ambiguïté sur la véracité de l’association opérée.
3. Mise en œuvre pratique pas à pas de RECHERCHEV
3.1 Configuration de la feuille de calcul et disposition des colonnes
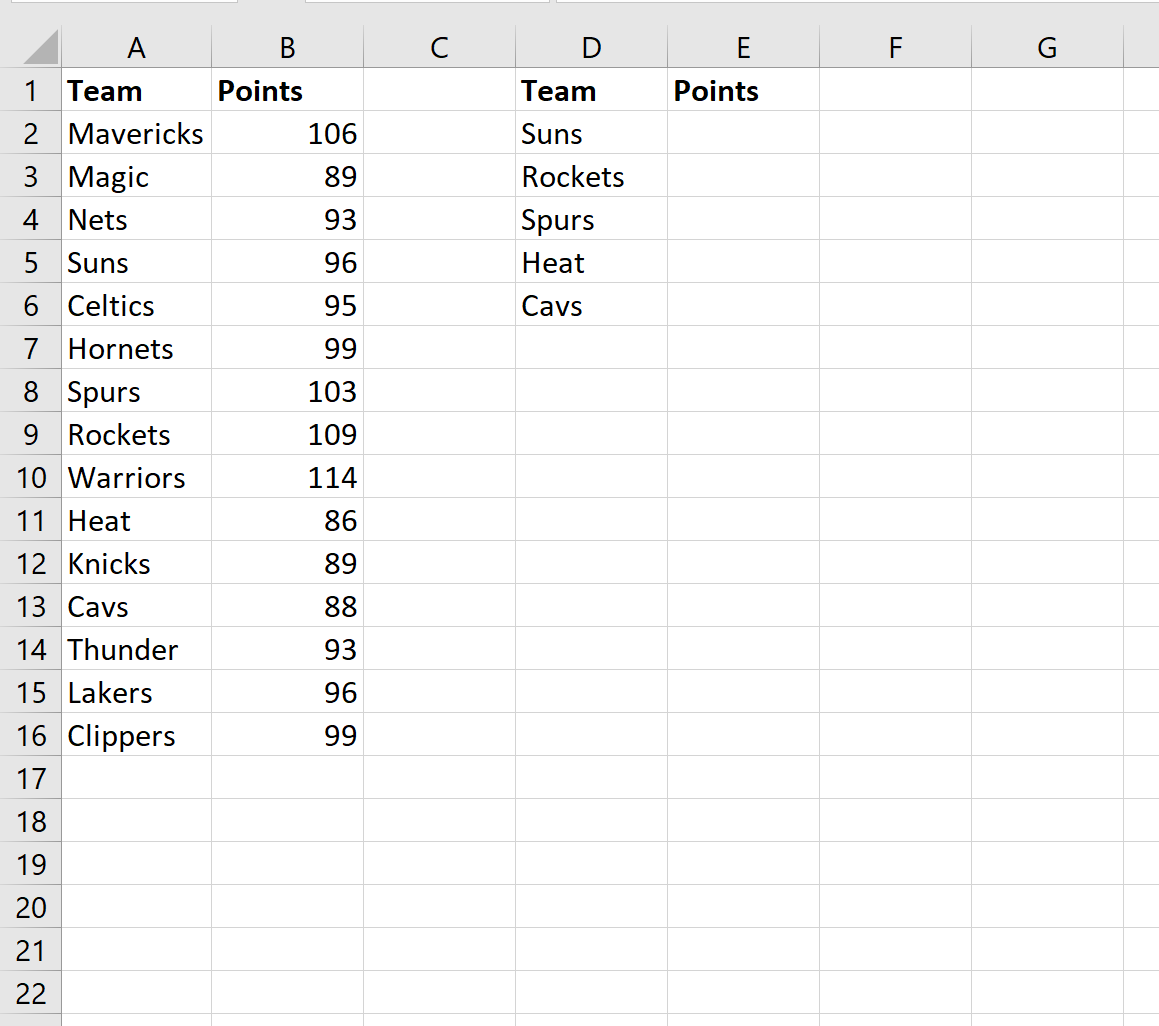
Pour illustrer la mise en œuvre pratique de cette architecture de calcul, considérons un cas d’étude standardisé issu de la recherche en psychométrie expérimentale ou de la gestion de données de cohortes. Nous disposons d’un premier tableau de référence situé dans les colonnes A et B d’une feuille de calcul, où la colonne A héberge les identifiants uniques alphanumériques des sujets expérimentaux (par exemple, de SUJ-101 à SUJ-115) et la colonne B compile leurs scores standardisés respectifs à une épreuve cognitive spécifique.
Parallèlement, une seconde table d’investigation est positionnée sur la plage D2:E16. La colonne D présente une série d’identifiants de sujets collectés lors d’une phase de test longitudinale subséquente, disposés dans un ordre différent ou ne constituant qu’un sous-ensemble non ordonné de la cohorte d’origine. La colonne E est destinée à recueillir, pour chaque sujet de la colonne D, le score initial correspondant issu de la colonne B.
La disposition spatiale répond scrupuleusement aux contraintes théoriques exposées préalablement : la variable pivot de la table source se situe en colonne A, assurant son positionnement en première colonne de la matrice de recherche, tandis que le vecteur d’extraction se situe sur sa droite immédiate en colonne B. Cette disposition linéaire garantit l’alignement géométrique nécessaire à la projection des informations.
3.2 Rédaction syntaxique de la formule et verrouillage absolu
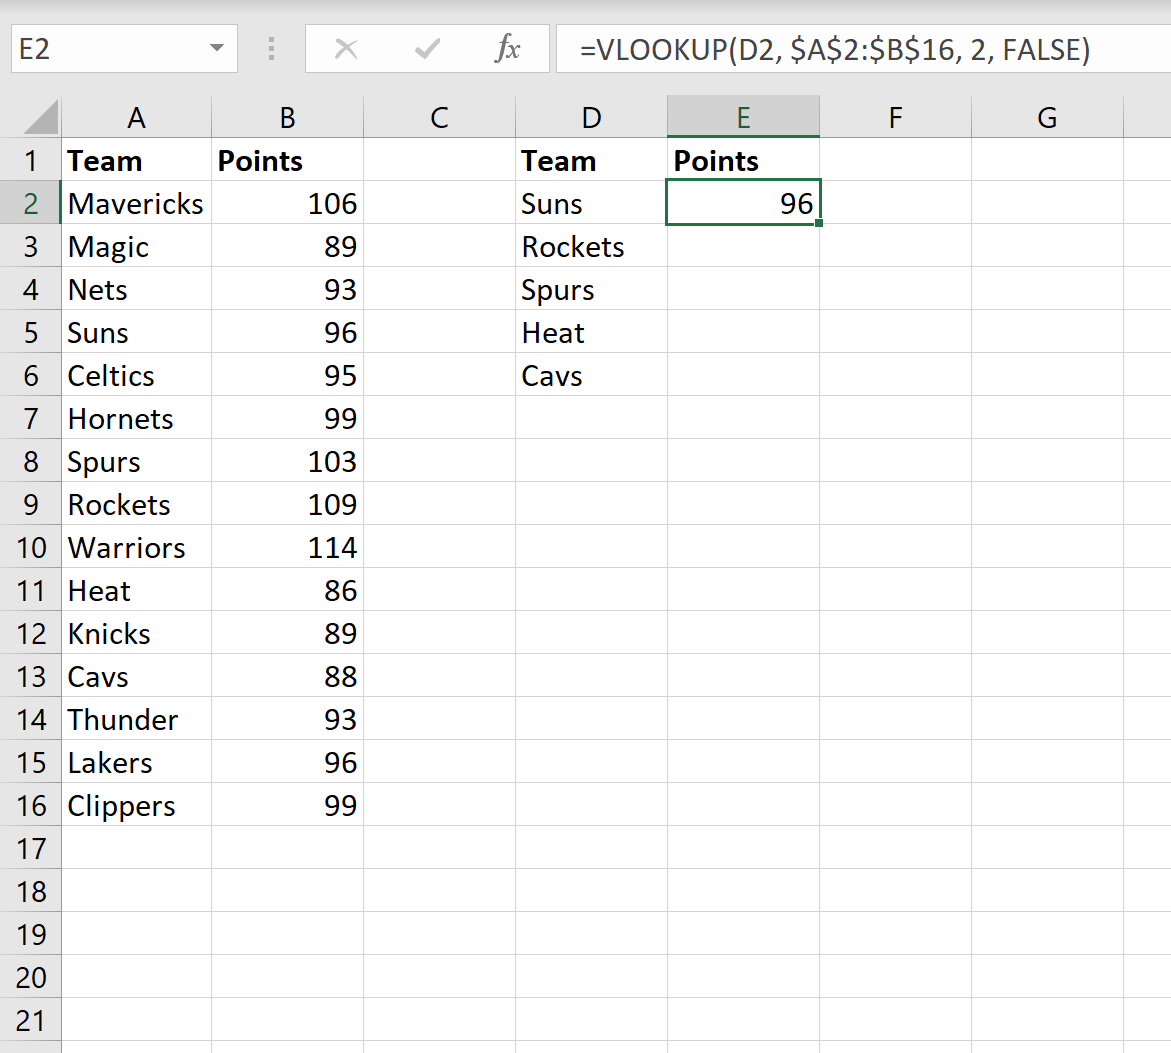
L’implantation débute par la sélection de la cellule cible E2, point d’entrée initial de la colonne de sortie. L’analyste y rédige la formule formelle suivante : =RECHERCHEV(D2; $A$2:$B$16; 2; FAUX). Cette syntaxe explicite décompose les étapes fondamentales de la requête en articulant la référence à la valeur d’entrée, la délimitation de la matrice de données et les modalités d’extraction ordinale.
L’inclusion systématique des symboles dollar ($) au sein du deuxième argument ($A$2:$B$16) constitue un impératif technique non négociable. Ce formalisme transforme les coordonnées en références absolues, immobilisant la zone matricielle dans l’espace bidimensionnel du tableur. Sans cet ancrage rigoureux, toute translation ultérieure de la formule altérerait le cadre de référence spatial, compromettant l’intégrité de la recherche.
La validation unitaire de cette première cellule permet de contrôler la conformité de l’évaluation scalaire. Le moteur interne lit le contenu de la cellule D2, parcourt séquentiellement la plage A2:A16 jusqu’à identifier l’exacte équivalence typographique et binaire, puis bascule sur le deuxième vecteur pour extraire la mesure scalaire correspondante et l’injecter au sein de la cellule E2.
3.3 Propagation dynamique de la formule le long du jeu de données
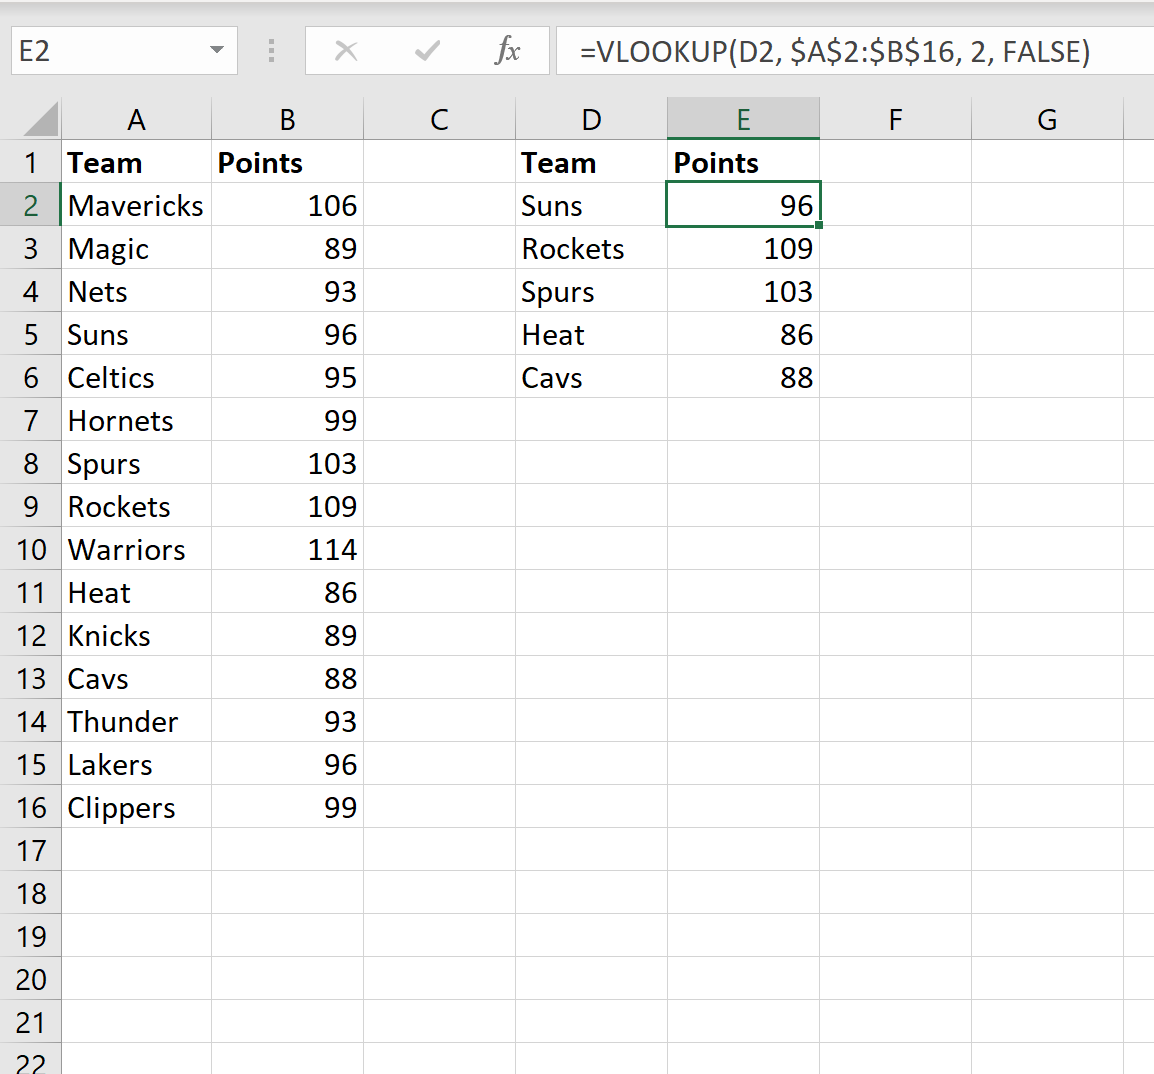
Une fois la formule inaugurale validée en E2, il convient de propager le calcul le long de l’ensemble du vecteur récepteur. L’analyste utilise à cette fin la technique d’extension verticale par double-clic sur la poignée de recopie située à l’angle inférieur droit de la cellule active, ou procède par glissement contrôlé jusqu’à la cellule limite E16.
Durant cette propagation, le comportement différentiel des modes d’adressage s’illustre avec limpidité : l’argument de la valeur cherchée s’incrémente de manière continue pour devenir D3, D4, puis D16, épousant fidèlement la trajectoire des sujets de la table d’étude. Simultanément, la table de référence demeure immuablement fixée sur $A$2:$B$16 grâce au verrouillage absolu précédemment opéré.
Le contrôle méthodologique final consiste à auditer visuellement et logiquement l’ensemble des valeurs projetées sur le vecteur cible. L’analyste s’assure de l’absence de rupture dans la chaîne de transmission, de la cohérence de l’ordre de grandeur des scores restitués, et vérifie qu’aucun artefact de décalage vertical ne vient fausser l’assignation des grandeurs métriques aux identifiants correspondants.
4. Gestion des références absolues et relatives dans l’extraction
4.1 L’utilisation cruciale des symboles dollar ($) pour la stabilité matricielle
La distinction conceptuelle entre adressage relatif (A1) et adressage absolu ($A$1) représente l’un des postulats fondamentaux de la mécanique computationnelle sous Excel. Une référence relative décrit un vecteur de déplacement spatial relatif à la position courante de la cellule qui héberge la formule. Par conséquent, lors de la duplication d’une formule vers le bas, toute référence relative voit ses coordonnées de ligne s’incrémenter proportionnellement au nombre d’itérations effectuées.
Dans le cadre strict des fonctions d’appariement matriciel, l’absence délibérée ou accidentelle des symboles dollar au sein de la plage table_array transforme cette dernière en un champ mobile. Si la formule initiale saisie en E2 stipule A2:B16 sans verrouillage, la formule copiée en E3 ciblera automatiquement A3:B17, puis A4:B18 en E4, et ainsi de suite. Ce comportement produit un phénomène pervers de glissement matriciel continu.
L’omission de ces ancres dimensionnelles dégrade la validité de l’appariement en excluant arbitrairement les observations situées au sommet de la table source. Les premiers enregistrements du corpus d’origine cessent ainsi d’exister pour les calculs situés en aval de la colonne d’extraction, générant des dysfonctionnements majeurs au fur et à mesure que l’on progresse vers le bas de la feuille de calcul.
4.2 Conséquences du glissement non contrôlé des plages de recherche
Les répercussions analytiques du glissement non contrôlé s’avèrent insidieuses dans la mesure où elles ne déclenchent pas nécessairement d’erreurs d’exécution bloquantes au niveau du logiciel. Le moteur d’Excel continue d’exécuter l’instruction tant que la zone translatée demeure à l’intérieur des limites physiques de la grille, tout en masquant le fait qu’une proportion substantielle de l’échantillon source est progressivement soustraite à l’analyse.
Une simulation expérimentale menée sur un échantillon de 1000 lignes révèle qu’un adressage relatif non verrouillé génère un taux d’erreur incrémental direct : les observations de la table cible dont les clés primaires figuraient aux premières rangées de la matrice source renverront l’erreur d’échec #N/A dès lors que la fenêtre glissante aura dépassé leur rangée d’implantation. La structure des résultats se trouve alors asymétriquement corrompue.
Les protocoles d’audit recommandent d’activer le mode d’affichage textuel des formules (par la combinaison de touches Ctrl + Guillemet ou via l’onglet Formules) afin de procéder à une vérification visuelle systématique des ancrages de coordonnées avant d’exploiter statistiquement les variables transférées vers d’autres environnements de calcul.
4.3 Automatisation via les tableaux structurés Excel (ListObjects)
La substitution des plages cellulaires standard par des tableaux structurés Excel, techniquement désignés sous l’appellation d’objets ListObject, constitue une avancée méthodologique substantielle pour éliminer définitivement les risques liés aux décalages de références. Ces structures relationnelles introduisent un système d’adressage sémantique où les coordonnées géométriques sont remplacées par des références explicites aux colonnes et aux tables.
Dans cette syntaxe normalisée, une requête s’articule sous la forme : =RECHERCHEV([@Identifiant]; TableScore[[#Tout];[Identifiant]:[Score]]; 2; FAUX). L’opérateur [@Identifiant] cible l’intersection de la ligne courante avec la colonne pivot au sein de la table d’interrogation, tandis que l’expression TableScore[[#Tout];[Identifiant]:[Score]] encapsule l’intégralité dimensionnelle de la table de référence sans risque d’altération spatiale.
L’emploi de ces références structurées offre une résilience native face à l’extension longitudinale du corpus : tout ajout d’observation au sein de la table source élargit instantanément les frontières du champ de recherche sans nécessiter la moindre retouche syntaxique des formules de consultation. De plus, la lisibilité documentaire du classeur s’en trouve notablement accrue, facilitant l’évaluation croisée et les audits de conformité du code d’analyse.
5. Diagnostic et résolution des erreurs courantes (#N/A, #REF!, #VALEUR!)
5.1 Traitement de l’erreur d’absence de concordance (#N/A)
L’affichage du code d’erreur #N/A (dérivé de l’expression anglo-saxonne Not Available ou Non Applicable) matérialise l’impossibilité pour l’algorithme d’identifier une occurrence correspondant strictement au critère stipulé dans le premier argument. Sur le plan sémiotique, cette notification signale une absence formelle d’équivalence logique au sein du vecteur de balayage, selon les règles déterminées par le mode de recherche sélectionné.
Il est impératif de distinguer une absence légitime d’appariement d’une anomalie technique sous-jacente. Une absence légitime survient lorsque l’entité interrogée dans la table cible n’a effectivement jamais été enregistrée au sein de la base source, situation fréquente lors de processus d’attrition au sein d’études longitudinales. L’erreur #N/A joue alors son rôle d’indicateur de données manquantes (missing data).
À l’inverse, l’apparition inattendue d’un code #N/A pour une observation réputée présente dans les deux fichiers impose une vérification de l’espace d’échantillonnage de référence. L’analyste doit immédiatement sonder la présence de discordances cryptiques entre les valeurs, en comparant les encodages binaires des deux chaînes de caractères au moyen de tests logiques stricts tels que la fonction =A2=D2, qui renverra la valeur booléenne FAUX en présence de variations imperceptibles à l’œil nu.
5.2 Détection des discordances typographiques et espaces invisibles
Les discordances typographiques invisibles représentent la cause la plus récurrente d’échec d’appariement au sein des corpus de données tabulaires. Parmi celles-ci, la présence d’espaces typographiques ordinaires (caractère ASCII 32) ou d’espaces insécables (caractère ASCII 160), fréquemment insérés lors de l’extraction de données depuis des systèmes ERP ou des pages web, modifie profondément la chaîne de caractères sous-jacente.
Aux yeux de l’observateur humain, les mentions « ID-404 » et « ID-404 « (comportant une espace résiduelle terminale) paraissent rigoureusement identiques. Toutefois, pour le moteur de comparaison d’Excel, ces deux entités constituent deux suites d’octets distinctes ne présentant pas la même équivalence scalaire. De même, la gestion des accents et des caractères diacritiques exige une homogénéité absolue sous peine de provoquer des ruptures de corrélation.
Pour diagnostiquer ces altérations imperceptibles, l’analyste utilise judicieusement la fonction de dénombrement scalaire NBCAR, appliquée parallèlement à la valeur cherchée et à la valeur cible potentielle au sein de la table matrice. L’observation d’un différentiel dans le nombre total de caractères confirme instantanément la présence de résidus invisibles parasitant la phase de recherche exacte.
5.3 Résolution des erreurs d’index hors limites (#REF!)
L’erreur critique #REF! signale une rupture d’intégrité spatiale liée à la définition de l’argument ordinal col_index_num. Elle intervient principalement lorsque l’entier spécifié pour désigner la colonne d’extraction dépasse le nombre total de colonnes physiquement comprises au sein de la matrice délimitée par le paramètre table_array.
Ce dysfonctionnement survient classiquement à la suite de manipulations manuelles de la structure tabulaire, telles que la suppression inopinée d’une colonne située à l’intérieur du champ de référence, réduisant ainsi la dimension totale de la matrice sous le seuil fixé par l’indice ordinal. Par exemple, si la plage s’étend sur trois colonnes (A à C) et que l’index de restitution stipule la valeur 4, le moteur de calcul se heurte à une frontière dimensionnelle infranchissable.
La remédiation exige une réévaluation immédiate de la structure matricielle. L’analyste doit recalculer le décompte des colonnes à partir du vecteur de recherche (colonne 1) jusqu’au vecteur d’extraction souhaité, et mettre à jour en conséquence l’entier ordinal. Le recours aux fonctions d’indexation dynamique, comme exposé ultérieurement, permet d’immuniser structurellement le système contre ces ruptures géométriques.
5.4 Incompatibilités des formats de données numériques et textuels
L’incompatibilité de typage entre scalaires numériques purs et représentations textuelles de chiffres constitue l’un des pièges les plus redoutables du traitement de données tabulaires. Sous Excel, le nombre entier 10025 et la chaîne textuelle « 10025 » constituent deux objets informatiques de classes typologiques fondamentalement disjointes, stockés de manière asymétrique au sein de la mémoire vive.
Lorsqu’une procédure de recherche exacte tente de faire correspondre un critère de classe textuelle avec une colonne matrice stockée au format numérique (ou réciproquement), le moteur de comparaison échoue de manière systématique, aboutissant à la génération généralisée du code d’erreur #N/A. Cette discordance se manifeste souvent visuellement par la présence d’un marqueur triangulaire vert dans le coin supérieur gauche de la cellule, notifiant que le nombre est stocké sous forme de texte.
Pour résoudre ce conflit sans altérer l’intégrité de la base brute, il convient d’appliquer des mécanismes de conversion coercitive. L’application d’opérations neutres, telles que la multiplication par l’élément unitaire (D2*1) ou l’usage de la primitive CNUM, force le transtypage immédiat du texte en valeur numérique. À l’inverse, l’adjonction d’une chaîne vide (D2& » ») transforme instantanément un scalaire numérique en chaîne de caractères manipulable.
6. Sécurisation des résultats avec les fonctions de gestion des erreurs
6.1 Encapsulation conditionnelle pour assainir les rapports de données
La prolifération non contrôlée de codes d’erreur bruts au sein des matrices de sortie compromet la lisibilité des synthèses décisionnelles et bloque la propagation des calculs analytiques en aval, tels que les agrégations statistiques univariées (sommes, moyennes, écarts-types). L’encapsulation défensive des fonctions de recherche au sein d’opérateurs de filtrage conditionnel constitue une règle d’or de l’ingénierie des feuilles de calcul.
L’architecture canonique de sécurisation consiste à imbriquer l’expression d’appariement au sein de la fonction SIERREUR, selon le formalisme suivant : =SIERREUR(RECHERCHEV(D2; $A$2:$B$16; 2; FAUX); « Non répertorié »). Cette construction logique ordonne au tableur de tenter l’évaluation nominale de la recherche et, en cas de défaillance critique générant un quelconque code d’erreur, d’intercepter la levée d’exception pour substituer une valeur alternative préalablement définie.
Sur le plan professionnel, cette approche garantit la continuité opérationnelle du flux de travail tout en offrant une interface épurée aux utilisateurs finaux des données. La substitution de balises d’information explicites aux messages cryptiques natifs d’Excel confère aux livrables un niveau de finition et de rigueur conforme aux exigences des environnements scientifiques et corporatifs.
6.2 Différence analytique entre SIERREUR et SINON.SI.N/A (IFNA)
Bien que la fonction SIERREUR soit largement plébiscitée pour sa concision, son recours indiscriminé induit un risque épistémologique significatif : celui d’étouffer indistinctement des erreurs de natures méthodologiques fondamentalement dissemblables. En masquant indifféremment #N/A, #REF!, #VALEUR!, #DIV/0! ou #NOM?, elle empêche le praticien de détecter d’éventuelles corruptions syntaxiques ou dimensionnelles au sein du modèle.
Pour cette raison, les standards de modélisation préconisent l’adoption prioritaire de la primitive SINON.SI.N/A (ou IFNA dans les environnements anglophones). Cette fonction intercepte exclusivement le signal #N/A, c’est-à-dire l’absence légitime de correspondance au terme du processus d’exploration matricielle. Tous les autres signaux d’erreur demeurent perceptibles à l’écran, alertant instantanément l’analyste sur une rupture de référence (#REF!) ou une faute de frappe dans la nomenclature des fonctions (#NOM?).
La syntaxe normalisée =SINON.SI.N/A(RECHERCHEV(D2; $A$2:$B$16; 2; FAUX); « Identifiant absent ») répond aux exigences de validation scientifique. Elle isole strictement l’incertitude empirique inhérente à la non-concordance des données tout en maintenant une vigilance absolue quant à l’intégrité mathématique et structurelle du classeur de recherche.
6.3 Remplacement systématique des erreurs par des valeurs sentinelles ou nulles
Le choix de la valeur de substitution injectée en lieu et place des discordances constatées ne relève pas d’une simple convenance cosmétique, mais engage la validité mathématique des calculs cumulatifs ultérieurs. L’analyste doit choisir avec discernement entre l’attribution d’une chaîne vide (« »), d’une valeur textuelle explicite ou d’une sentinelle numérique (telle que 0 ou -9999).
L’introduction d’un zéro numérique (0) à titre de valeur de remplacement s’avère particulièrement périlleuse si la variable extraite fait l’objet d’un traitement statistique descriptif en aval. Dans le cadre d’un calcul de tendance centrale via la primitive MOYENNE, l’inclusion de ces zéros artificiels biaise sévèrement l’estimation en intégrant des observations factices dans le dénominateur de l’échantillon, faussant la réalité du phénomène observé.
Il est donc préconisé de remplacer les correspondances infructueuses soit par une chaîne de caractères textuelle documentée au sein du dictionnaire des variables, soit par la conservation explicite de valeurs reconnues comme nulles par les moteurs d’inférence statistique. Toute convention d’imputation doit obligatoirement être explicitée dans les protocoles méthodologiques accompagnant le jeu de données.
7. L’alternative moderne et supérieure : INDEX et EQUIV
7.1 Limites structurelles intrinsèques de RECHERCHEV vers la gauche
En dépit de sa longévité et de son universalité, la fonction RECHERCHEV présente des tares de conception majeures inhérentes à l’architecture computationnelle des tableurs des années 1980. La plus restrictive d’entre elles réside dans son incapacité native à projeter des données situées sur la gauche spatiale de sa colonne d’interrogation. Cette directivité unidirectionnelle impose à l’analyste de restructurer perpétuellement ses fichiers sources pour satisfaire aux exigences du logiciel.
Cette contrainte oblige fréquemment les utilisateurs à procéder à des duplications redondantes de colonnes ou à des réorganisations physiques risquées de la structure relationnelle, altérant par contrecoup l’intégrité des autres modules de calcul dépendant de l’agencement initial. De surcroît, la dépendance structurelle à un index numérique fixe rend le modèle particulièrement instable lors de réagencements tabulaires ultérieurs.
L’émergence d’architectures tabulaires complexes, caractérisées par des croisements multidirectionnels et des enrichissements dynamiques continus, a rendu indispensable l’adoption d’un paradigme de recherche dissociant la localisation topographique du critère de la procédure effective d’extraction de la mesure cible.
7.2 Décomposition mécanique de la fonction EQUIV (MATCH)
L’échafaudage de cette alternative supérieure repose sur l’exploitation synergique de deux primitives complémentaires : INDEX et EQUIV. La fonction EQUIV assume un rôle purement topologique : elle n’a pas pour vocation d’extraire une quelconque dimension quantitative, mais de déterminer la position ordinale relative d’un élément cherché au sein d’un vecteur unidimensionnel discret.
Sa syntaxe générale se formalise comme suit : =EQUIV(valeur_cherchée; plage_recherche; type_recherche). Le troisième paramètre, configuré systématiquement sur la valeur entière 0 dans le cadre de recherches strictes, ordonne l’exécution d’un appariement d’égalité absolue sans présupposer le tri préalable du vecteur d’accueil. La sortie renvoyée par la fonction consiste exclusivement en un scalaire entier positif matérialisant le rang de l’élément au sein du tableau linéaire d’interrogation.
Cette isolation vectorielle confère à EQUIV une efficience conceptuelle remarquable : en confinant son calcul à une colonne ou une ligne unique, elle s’affranchit totalement du besoin de déclarer une matrice multidimensionnelle large, réduisant considérablement la surface d’exploration mobilisée en mémoire vive lors de l’exécution de la requête.
7.3 Extraction bidimensionnelle avec la fonction INDEX
La primitive INDEX opère pour sa part en tant que mécanisme universel d’extraction scalaire par coordonnées géométriques. Contrairement à RECHERCHEV, elle n’effectue aucune opération de comparaison par elle-même ; elle se contente d’accéder instantanément à un emplacement spécifique au sein d’un espace matriciel unidimensionnel ou bidimensionnel, en fonction d’un indice de ligne et, facultativement, d’un indice de colonne qui lui sont soumis.
La convergence synergique s’opère en substituant la sortie ordinale dynamique fournie par EQUIV à l’argument de rangée de la fonction INDEX. L’architecture syntaxique universelle prend dès lors la forme canonique : =INDEX(vecteur_retour; EQUIV(valeur_cherchée; vecteur_recherche; 0)). Dans cette articulation, le vecteur contenant les informations à extraire est rigoureusement séparé du vecteur soumis à l’évaluation de la clé pivot.
Cette configuration permet de réaliser des recherches bidirectionnelles avec une souplesse absolue : le vecteur d’extraction peut se positionner indifféremment à gauche, à droite, au-dessus ou en dessous du vecteur de consultation. Plus aucune contrainte de précédence spatiale ne pèse sur la construction de la base de données, conférant au modélisateur une totale autonomie de conception relationnelle.
7.4 Avantages en matière d’efficacité de calcul et de flexibilité structurelle
L’architecture modulaire associant INDEX et EQUIV surpasse significativement RECHERCHEV sur le terrain de la flexibilité structurelle et de la robustesse computationnelle. En premier lieu, l’insertion, la suppression ou le déplacement de colonnes intermédiaires entre la clé de recherche et l’information à extraire ne perturbe en rien l’exécution du calcul, puisque les deux vecteurs sont explicitement et indépendamment référencés.
Sur le plan des performances globales du tableur, cette approche allège substantiellement l’arbre des dépendances mémoire. RECHERCHEV contraint le moteur de calcul à surveiller l’ensemble des cellules constituant l’enveloppe rectangulaire de la table matrice, y compris les colonnes intermédiaires inutiles au transfert d’information. En ciblant strictement deux vecteurs linéaires distincts, INDEX/EQUIV minimise la charge d’évaluation lors des cycles de recalcul.
Cette supériorité technique a consacré le couplage INDEX/EQUIV comme le standard d’excellence reconnu par la communauté internationale des modélisateurs financiers et des scientifiques de données durant plusieurs décennies, constituant l’armature logique indispensable de tout système d’information tabulaire pérenne et évolutif.
8. Révolution par la fonction XLOOKUP (RECHERCHEX)
8.1 Avantages architecturaux de RECHERCHEX sur RECHERCHEV
Avec l’introduction de la fonction RECHERCHEX (dénommée XLOOKUP dans sa version originale), Microsoft a profondément refondu le paradigme de recherche au sein des feuilles de calcul. Conçue pour supplanter conjointement RECHERCHEV et le couplage INDEX/EQUIV, cette primitive moderne élimine les faiblesses historiques des fonctions de première génération tout en intégrant des fonctionnalités natives de pointe adaptées au traitement contemporain des données.
L’architecture de RECHERCHEX consacre la séparation explicite entre le vecteur de recherche et le vecteur de restitution au travers de ses deux premiers arguments obligatoires : =RECHERCHEX(valeur_cherchée; tableau_recherche; tableau_renvoyé). Cette syntaxe universelle neutralise définitivement la contrainte directionnelle de RECHERCHEV, autorisant nativement les appariements vers la gauche sans exiger l’imbrication de primitives complémentaires.
Une rupture majeure réside dans le paramétrage par défaut de son mode de correspondance : RECHERCHEX applique systématiquement un appariement exact strict. Contrairement à son aînée, l’omission des paramètres optionnels n’expose plus l’analyste au risque d’une recherche approximative intempestive, garantissant d’emblée une intégrité référentielle absolue sans exiger la spécification explicite du booléen FAUX.
8.2 Paramétrage natif des valeurs par défaut en l’absence de correspondance
L’un des apports majeurs de RECHERCHEX réside dans l’intégration d’un quatrième argument positionnel optionnel intitulé [si_non_trouvé]. Ce paramètre interne permet de prescrire directement la chaîne textuelle, la valeur numérique ou l’instruction scalaire à substituer en cas d’absence avérée de correspondance, rendant ainsi caduque l’imbrication fastidieuse au sein des fonctions SIERREUR ou SINON.SI.N/A.
La formulation syntaxique s’en trouve allégée et s’énonce sous la forme : =RECHERCHEX(D2; $A$2:$A$16; $B$2:$B$16; « Donnée manquante »). Cette centralisation du mécanisme de gestion des exceptions directement au sein du moteur d’exécution de la recherche réduit la complexité de l’arbre syntaxique, optimise la vitesse d’exécution logicielle et accroît notablement la clarté visuelle du code pour les procédures d’audit collégial.
De plus, cette évaluation conditionnelle interne empêche le déclenchement intempestif des mécanismes d’interception globaux, garantissant que seules les absences réelles de clés pivot sont neutralisées, sans occulter les éventuelles erreurs d’adressage ou de syntaxe interne pouvant affecter la robustesse du modèle sous-jacent.
8.3 Recherche bidirectionnelle et indépendance de l’ordre des colonnes
La flexibilité de RECHERCHEX s’étend également à la direction du balayage de recherche au sein du vecteur d’accueil. Grâce à son sixième argument optionnel, [mode_recherche], l’analyste peut instruire la primitive d’opérer un balayage descendant classique (valeur 1) ou d’exécuter une recherche rétrograde inversée, du dernier élément vers le premier (valeur -1), répondant avec aisance aux scénarios exigeant l’extraction de la dernière occurrence enregistrée chronologiquement au sein d’une base non consolidée.
Au-delà de cette maîtrise de la directivité, RECHERCHEX gère nativement le retour de plages matricielles multidimensionnelles. En désignant un bloc rectangulaire composé de plusieurs colonnes contiguës au niveau du paramètre tableau_renvoyé, la fonction s’appuie sur le moteur de calcul à tableaux dynamiques d’Excel pour propager spontanément l’ensemble des dimensions cibles sur les colonnes adjacentes via le mécanisme de déversement (spill).
Cette prouesse technique transforme l’appariement de données : une formule unitaire saisie au sein d’une cellule unique est désormais capable de réconcilier et d’extraire instantanément un ensemble de trois, dix ou cinquante colonnes parallèles, garantissant une cohérence relationnelle parfaite et éliminant la nécessité de copier et maintenir des formules distinctes pour chaque dimension importée.
8.4 Rétrocompatibilité et gestion des versions antérieures d’Excel
Malgré sa supériorité technique incontestable, le déploiement généralisé de RECHERCHEX se heurte à des contraintes opérationnelles de rétrocompatibilité logicielle. Cette primitive nécessite impérativement les versions récentes du moteur de calcul d’Excel, n’étant disponible nativement que sur Microsoft 365 et les versions perpétuelles supérieures ou égales à l’édition 2021.
La transmission d’un classeur exploitant RECHERCHEX vers des environnements institutionnels exécutant des versions antérieures (telles qu’Excel 2016 ou Excel 2013) provoque la dégradation immédiate de toutes les instances d’appariement en erreurs critiques de type #NOM?. Le moteur hérité s’avère incapable d’interpréter cette primitive, paralysant instantanément les chaînes de traitement quantitatif du destinataire.
Il incombe donc au chef de projet d’effectuer un arbitrage technologique rigoureux en amont de la modélisation. Dès lors que l’écosystème de partage implique des tiers aux infrastructures hétérogènes, le recours conservateur au couplage universel INDEX/EQUIV demeure la stratégie de mitigation la plus sûre, garantissant une exécution sans faille sur l’ensemble du parc informatique mondial, sans compromettre la flexibilité géométrique du traitement.
9. Appariement sur critères multiples et conditions complexes
9.1 Concaténation de clés primaires pour requêtes composites
Les réalités empiriques de la collecte de données confrontent régulièrement l’analyste à des scénarios où aucune variable isolée ne dispose d’un pouvoir discriminant suffisant pour constituer une clé primaire univoque. La réconciliation d’observations exige alors d’interroger conjointement une pluralité d’attributs (par exemple, l’association indissociable d’un nom patronymique, d’une date d’intervention et d’un code de localisation géographique) afin de délimiter une unité statistique unique.
La méthode historique la plus accessible pour résoudre cette problématique consiste à concevoir une clé de concordance artificielle par concaténation sérielle. L’opérateur perluète (&) permet de fusionner ces attributs au sein d’une colonne auxiliaire aménagée dans chaque table : =A2& »| »&B2. L’insertion d’un caractère délimiteur neutre (tel que la barre verticale pipe) évite les collisions de chaînes accidentelles susceptibles d’intervenir lors de la juxtaposition de segments hétérogènes (évitant que l’association « A » et « 12 » ne produise le même résultat textuel que « A1 » et « 2 »).
Bien qu’efficace et aisément compréhensible, cette méthodologie présente le désavantage structurel d’alourdir la feuille de calcul par l’adjonction de colonnes intermédiaires, accroissant le poids du fichier et complexifiant la maintenance des tables sources lors de transferts de bases de données volumineuses.
9.2 Combinaison d’INDEX et EQUIV avec critères booléens multiples
Pour s’affranchir du recours aux colonnes auxiliaires, les analystes chevronnés mobilisent la puissance de l’évaluation matricielle booléenne au travers de la formule canonique combinant INDEX et EQUIV. Cette méthode exploite les propriétés de l’arithmétique binaire, où les conditions logiques vraies sont évaluées à l’entier 1 et les conditions fausses à l’entier 0.
L’architecture formelle de cette solution s’énonce ainsi : =INDEX(Plage_Retour; EQUIV(1; (Critère1=Plage1) * (Critère2=Plage2); 0)). L’opérateur de multiplication astérisque (*) agit comme un opérateur logique intersectionnel ET : le produit des deux expressions booléennes ne renvoie la valeur 1 que si et seulement si l’ensemble des égalités testées est rigoureusement validé sur une même ligne d’observation.
Dans les versions modernes d’Excel pourvues du moteur de calcul matriciel dynamique, cette formule s’évalue directement par une simple pression sur la touche Entrée. Pour les versions historiques héritées, sa validation exige l’exécution d’une commande matricielle globale par la combinaison de touches Ctrl + Maj + Entrée, instruisant le logiciel d’évaluer vectoriellement les segments conditionnels avant d’exécuter la recherche ordinale.
9.3 Utilisation de formules matricielles dynamiques avec la fonction FILTRE
L’introduction des fonctions matricielles modernes au sein de l’environnement Microsoft 365 propose une approche déclarative alternative pour résoudre les appariements multicritères, matérialisée par la primitive FILTRE. Cette dernière ne simule pas un balayage ordonné à l’aide d’un index, mais extrait directement le sous-ensemble d’observations répondant à une batterie de prédicats logiques.
La formulation syntaxique adopte la structure : =FILTRE(Plage_Retour; (Plage1=Critère1) * (Plage2=Critère2); « Aucune correspondance »). Lorsque le modèle garantit l’unicité de la concordance, la fonction restitue directement la valeur scalaire unique attendue, tout en offrant une gestion intégrée et native des situations de non-correspondance grâce à son troisième argument positionnel.
Dans les configurations où la requête multicritère identifie plusieurs enregistrements valides, FILTRE propage spontanément l’ensemble des solutions sur les lignes sous-jacentes. Cette caractéristique transforme la démarche analytique, permettant à l’analyste de traiter avec la même rigueur les relations un-à-un et les projections un-à-plusieurs, tout en s’assurant qu’aucune observation homologue ne soit omise lors de l’exploration des données.
10. Nettoyage et normalisation préalable des vecteurs d’appariement
10.1 Élimination des caractères non imprimables avec SUPPRESPACE et EPURAGE
La réussite opérationnelle de toute démarche d’appariement de données repose en amont sur la pureté syntaxique des vecteurs pivots mobilisés. Les transferts d’informations entre progiciels d’entreprise, bases de données relationnelles SQL et classeurs bureautiques génèrent fréquemment des scories typographiques invisibles à l’œil nu mais rédhibitoires pour les moteurs de comparaison exacte. Le déploiement d’un protocole d’assainissement préalable constitue un prérequis incontournable.
La primitive SUPPRESPACE (dénommée TRIM) constitue le premier levier de cette normalisation : elle élimine systématiquement les espaces parasites situés en début et en fin de chaîne de caractères, tout en réduisant les séries d’espaces consécutives internes à un espacement simple normalisé. Elle s’avère toutefois inopérante face aux caractères de contrôle non imprimables et aux sauts de ligne intégrés lors d’extractions télématiques.
L’analyste lui adjoint donc la fonction EPURAGE (CLEAN), spécifiquement programmée pour purger le texte des trente-deux premiers caractères du code ASCII standard (caractères de contrôle de 0 à 31). La composition défensive =SUPPRESPACE(EPURAGE(A2)) permet ainsi de neutraliser la quasi-totalité des artéfacts invisibles, restaurant les conditions nécessaires à l’évaluation stricte des prédicats d’égalité logique.
10.2 Harmonisation de la casse avec MAJUSCULE et MINUSCULE
Par conception fondamentale, les primitives standards de consultation d’Excel, qu’il s’agisse de RECHERCHEV, d’EQUIV ou de RECHERCHEX, opèrent de manière insensible à la casse typographique (case-insensitive). Pour ces fonctions, la séquence de caractères « VALEUR » est réputée strictement identique à « valeur » ou « Valeur », ce qui convient à l’immense majorité des applications analytiques courantes.
Néanmoins, certains contextes de recherche spécialisés, notamment dans le codage génomique, les répertoires de hachage cryptographique ou les nomenclatures chimiques, exigent une sensibilité absolue à la casse (case-sensitivity). Tenter d’apparier ces données via des fonctions traditionnelles expose l’analyste à des collisions informationnelles faussant entièrement les assignations ordinales.
Pour forcer une correspondance sensible à la casse, il convient de conjuguer la fonction EXACT avec le couple INDEX/EQUIV. La formule matricielle s’articule ainsi : =INDEX(Plage_Retour; EQUIV(VRAI; EXACT(Plage_Recherche; Valeur_Cherchée); 0)). La fonction EXACT procédant à une comparaison binaire octet par octet, elle isole avec une fidélité irréprochable la ligne dont la casse typographique concorde exactement avec la variable cible.
10.3 Conversion coercitive des chaînes de caractères numériques
La conversion coercitive des vecteurs d’appariement vise à éradiquer les asymétries de typage entre scalaires numériques purs et représentations textuelles de chiffres. L’origine de cette divergence réside le plus souvent dans l’application de formats de cellules divergents lors de l’importation de fichiers tabulaires délimités (fichiers CSV ou exports textuels TXT).
Pour forcer un vecteur numérique encodé sous forme textuelle à retrouver son statut de scalaire mathématique, l’analyste peut recourir à l’opérateur unaire double (—) ou à la fonction CNUM : =–A2. Cette formulation contraint le moteur de calcul à appliquer une opération arithmétique neutre sur la chaîne de caractères, induisant un transtypage immédiat en nombre flottant sans altérer sa magnitude intrinsèque.
Inversement, pour standardiser des identifiants numériques en chaînes de texte pérennes (gage de sécurité pour préserver les zéros initiaux des codes postaux ou des numéros de sécurité sociale), la fonction TEXTE permet d’assigner un formatage structurel rigoureux, garantissant la concordance absolue des classes d’objets lors de l’exécution ultérieure des procédures de recherche : =TEXTE(A2; « 00000 »).
11. Optimisation des performances pour les volumes de données massifs
11.1 Impact algorithmique des recherches exactes sur de grands ensembles
Dans le domaine des mégadonnées et des modèles complexes réunissant plusieurs centaines de milliers d’enregistrements, le choix de la méthode d’appariement exerce une influence déterminante sur le temps de recalcul global du processeur. Les algorithmes de recherche exacte déployés par RECHERCHEV, EQUIV ou RECHERCHEX opèrent selon une complexité temporelle linéaire, formellement notée O(N) dans la hiérarchie des complexités algorithmiques.
Cette complexité linéaire implique que, dans le pire des scénarios, le moteur doit examiner séquentiellement l’intégralité des N lignes de la matrice avant d’établir une correspondance ou de conclure à l’échec #N/A. Si cette opération élémentaire est répétée pour M requêtes distinctes, la complexité globale de la feuille de calcul s’élève à O(M * N), conduisant rapidement à une saturation des cycles CPU et à des temps de recalcul rédhibitoires.
Les mesures empiriques révèlent qu’un classeur exécutant 100 000 recherches exactes linéaires au sein d’une matrice source de 100 000 lignes monopolise les ressources computationnelles durant plusieurs dizaines de secondes, voire plusieurs minutes. Ce coût temporel élevé justifie l’exploration de stratégies d’optimisation structurelles fondées sur la modification des algorithmes sous-jacents.
11.2 Stratégie du double RECHERCHEV avec tri préalable (recherche dichotomique)
Pour contourner l’écueil de la complexité linéaire, les architectes de données mobilisent une technique d’optimisation algorithmique avancée désignée sous le terme d’approche du « double RECHERCHEV ». Cette méthode substitue à la recherche linéaire une recherche binaire dichotomique opérant en complexité logarithmique, notée O(log N), dont la célérité d’exécution surpasse de plusieurs ordres de grandeur celle des parcours séquentiels.
L’implémentation de cette stratégie exige une condition préalable absolue : le tri rigoureux de la table de référence selon un ordre ascendant sur sa colonne pivot. La formule s’articule ensuite autour d’une double vérification logique : =SI(RECHERCHEV(D2; $A$2:$A$100000; 1; VRAI)=D2; RECHERCHEV(D2; $A$2:$B$100000; 2; VRAI); « Non répertorié »). Le premier test exécute une recherche approximative ultra-rapide pour vérifier l’existence exacte de la clé recherchée ; si la correspondance est validée, la seconde instruction extrait instantanément la valeur cible associée.
Cette prouesse algorithmique réduit drastiquement le nombre d’opérations comparatives nécessaires. Pour une matrice de 100 000 observations, une recherche dichotomique n’exige qu’un maximum d’environ 17 itérations binaires, contre 100 000 comparaisons potentielles en mode linéaire. Les gains de performance atteignent couramment des facteurs de réduction de temps de calcul supérieurs à 95 % sur les grands corpus.
11.3 Réduction de la dette technique dans les modèles Excel volumineux
L’optimisation des performances d’un classeur volumineux implique également une gestion rigoureuse de la dette technique inhérente à la structure des formules. Une pratique dommageable consiste à employer des références à des colonnes entières (telles que A:B au lieu de $A$1:$B$50000). Cette convention oblige le moteur de calcul à initialiser des arbres de dépendances couvrant potentiellement plus d’un million de cellules virtuelles, surchargeant inutilement l’empreinte mémoire vive du système.
Une fois les opérations de réconciliation et de contrôle qualité définitivement menées à bien, la bonne pratique méthodologique commande de figer les vecteurs d’extraction en remplaçant les formules dynamiques par leurs valeurs scalaires pures (via la commande Copier puis Collage spécial en valeurs). Cette opération neutralise la charge de recalcul dynamique et immunise le jeu de données contre toute défaillance de référence ultérieure.
Enfin, dès lors que la volumétrie dépasse les limites architecturales optimales d’Excel (au-delà de quelques centaines de milliers d’enregistrements), il devient impératif de migrer les opérations d’appariement vers des moteurs relationnels spécialisés, tels que le module Power Query intégré (utilisant le langage M) ou le moteur d’analyse relationnelle Power Pivot (fondé sur les modèles tabulaires en mémoire et le langage DAX), capables de gérer des millions de lignes avec une résilience et une vitesse incomparables.
12. Applications concrètes et protocoles d’audit dans la recherche empirique
12.1 Réconciliation de scores psychométriques et de données démographiques
Afin d’illustrer la mise en pratique de ces règles au sein d’un protocole expérimental normé, considérons une étude empirique menée en neurosciences cognitives. L’équipe d’investigation dispose de deux fichiers distincts : le premier réunit les résultats bruts obtenus par des sujets d’étude à une batterie d’évaluations de mémoire de travail (identifiant d’inclusion, score de rappel, latence de réaction), tandis que le second archive les variables démographiques et cliniques des participants (identifiant d’inclusion, groupe d’âge, statut génétique, niveau d’éducation).
L’objectif consiste à fusionner de manière irréprochable la variable « groupe d’âge » au sein de la matrice de scores psychométriques afin de procéder à une analyse de covariance (ANCOVA). L’utilisation de la primitive moderne RECHERCHEX ou du couple INDEX/EQUIV s’impose immédiatement pour lier les deux tableaux au travers de l’identifiant univoque d’inclusion du participant, en prévoyant une sentinelle explicite en cas de défection d’un sujet entre les deux phases d’acquisition.
L’intégrité de la fusion conditionne directement la rigueur des conclusions scientifiques : une erreur d’alignement unitaire attribuant le profil démographique d’un participant âgé à un sujet jeune fausserait complètement le modèle d’interaction statistique, invalidant l’ensemble de la publication soumise à l’évaluation par les pairs. Cette réalité souligne que la maîtrise technique des fonctions tabulaires relève directement de la déontologie de la recherche expérimentale.
12.2 Protocoles de double vérification et validation croisée des données fusionnées
L’application d’un protocole d’audit méthodique constitue une exigence fondamentale préalablement à toute dissémination de données fusionnées. L’analyste doit instaurer une colonne de contrôle d’intégrité référentielle s’appuyant sur des prédicats booléens d’évaluation. Une approche éprouvée consiste à comparer le décompte absolu des occurrences uniques présentes dans la table cible avec le volume effectif de lignes validées au terme de l’extraction.
Il est également recommandé d’exécuter un contrôle par échantillonnage aléatoire stratifié assisté par les fonctions stochastiques d’Excel (telles que ALEA.ENTRE.BORNES). Cette procédure sélectionne de manière totalement aléatoire 5 % à 10 % des enregistrements fusionnés pour les soumettre à une inspection manuelle ou à une contre-vérification algorithmique croisée via un script d’audit indépendant codé sous R ou Python.
Enfin, l’activation ciblée de la mise en forme conditionnelle permet de faire ressortir instantanément les valeurs sentinelles ou les anomalies de transfert. L’application d’un surlignage chromatique d’alerte sur les cellules renvoyant des mentions de non-concordance attire immédiatement l’attention du réviseur sur les failles d’appariement, facilitant la correction préventive des ruptures d’intégrité avant la consolidation finale du modèle.
12.3 Documentation méthodologique et traçabilité des transformations tabulaires
La reproductibilité computationnelle représente une exigence contemporaine cardinale partagée par l’ensemble de la communauté scientifique et industrielle. Toute altération, fusion ou extraction de données opérée au moyen d’un tableur doit pouvoir être rigoureusement retracée, auditée et reproduite par un tiers indépendant ne disposant que des tables brutes initiales.
Ce niveau de rigueur exige l’élaboration systématique d’un journal des opérations analytiques (codebook ou dictionnaire de transformation). Ce document technique archive explicitement l’ensemble des formules mobilisées, la justification des modes d’appariement sélectionnés (par exemple, le choix explicite de la correspondance exacte stricte), ainsi que la chronologie précise des traitements de normalisation syntaxique préalables (suppression des espaces insécables, harmonisation de la casse, coercition typologique).
De plus, l’adoption d’une politique stricte de contrôle de version garantit la sanctuarisation des tables sources originales, qui doivent être maintenues en lecture seule sous leur forme native non altérée. Toutes les manipulations de mise en correspondance doivent être cantonnées à des feuilles d’analyse dérivées, garantissant une étanchéité absolue entre le corpus de données primaires et les produits d’enrichissement analytique résultants.
Références
Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
Microsoft Corporation. (2024). Fonction RECHERCHEV. Support Microsoft. https://support.microsoft.com/fr-fr/office/fonction-recherchev-0bbc80c2-ad61-4428-8612-74142f47a177
Microsoft Corporation. (2024). Fonction RECHERCHEX. Support Microsoft. https://support.microsoft.com/fr-fr/office/fonction-recherchex-b7fd9a4e-6ddc-49f7-a16e-6a4a6e84d436
Microsoft Corporation. (2024). Fonctions INDEX et EQUIV. Support Microsoft. https://support.microsoft.com/fr-fr/office/recherche-de-valeurs-avec-recherchev-index-ou-equiv-670183ac-3d71-4775-9c86-13a968652078
Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.
Winston, W. (2021). Microsoft Excel Data Analysis and Business Modeling (7e éd.). Microsoft Press.