
Dans le champ contemporain de l’analyse exploratoire des données et de l’économétrie appliquée, la représentation graphique bivariée demeure le socle irremplaçable sur lequel se cristallise l’intuition statistique. Le nuage de points, formalisé historiquement dans les travaux pionniers de John Herschel et popularisé par les développements séminaux de Francis Galton, permet de projeter dans un plan euclidien bidimensionnel les interactions complexes qui unissent deux variables continues. Toutefois, une projection brute, dépouillée de repères nominatifs ou sémiotiques, réduit fréquemment l’observateur à une appréhension purement globale des tendances stochastiques, oblitérant de facto la singularité des unités observationnelles sous-jacentes. L’adjonction méthodique d’étiquettes textuelles au sein de ces canevas géométriques constitue ainsi un enjeu fondamental de communication scientifique, transformant une simple distribution ponctuelle en une narration analytique intelligible, rigoureuse et directement exploitable pour la prise de décision empirique.
La mise en œuvre de cette annotation textuelle dans le langage de programmation statistique R soulève des questions à la fois théoriques, ergonomiques et informatiques d’une remarquable subtilité. Loin de se réduire à un simple artifice cosmétique, l’étiquetage d’un nuage de points mobilise des concepts cruciaux de géométrie computationnelle, de gestion des collisions typographiques, d’optimisation du ratio encre-données cher à Edward Tufte, et de conformité aux protocoles rigides de restitution des résultats scientifiques. Les praticiens se trouvent continuellement confrontés à un arbitrage complexe : comment enrichir l’information sémantique transmise par chaque marqueur sans pour autant saturer l’espace graphique, générer une cacophonie visuelle délétère ou masquer les structures de corrélation primaires ? C’est précisément à cette intersection entre rigueur mathématique et efficience perceptive que se situe la maîtrise des mécanismes d’annotation sous R.
Le présent traité propose une déconstruction exhaustive des méthodologies d’étiquetage de nuages de points au sein de l’écosystème R. En explorant successivement l’architecture impérative du moteur graphique natif de Base R et le paradigme déclaratif incarné par l’extension ggplot2 et ses extensions algorithmiques sophistiquées comme ggrepel, cet ouvrage fournit les clefs conceptuelles et pratiques nécessaires pour concevoir des visualisations bivariées d’une irréprochable clarté. À travers des cas d’usage ancrés dans les sciences comportementales et psychométriques, nous détaillerons les stratégies permettant d’isoler des profils idiosyncrasiques, d’automatiser le traitement des collisions de glyphes, de formater des notations statistiques avancées et de concevoir des représentations prêtes pour l’évaluation par les pairs au sein des revues internationales les plus exigeantes.
1. Introduction à la visualisation et à l’annotation de nuages de points dans R
1.1 Rôle épistémologique de l’annotation graphique en sciences comportementales
L’acte d’annoter un document graphique en sciences du comportement transcende la simple fonction signalétique : il s’inscrit au cœur même de la démarche heuristique et diagnostique du chercheur. Lorsque l’on analyse des constellations de variables psychologiques continues, telles que la corrélation postulée entre l’anxiété situationnelle et l’empan de la mémoire de travail, l’étiquetage permet d’ancrer l’abstraction numérique dans une réalité clinique tangible. Les observations ne représentent pas de simples coordonnées orthogonales anonymes ; elles renvoient à des entités d’observation singulières, des sujets expérimentaux ou des cohortes épidémiologiques spécifiques dont la trajectoire méthodologique mérite d’être scrutée avec une attention méticuleuse.
En outre, l’annotation graphique joue un rôle capital dans l’identification et la mise en exergue des profils atypiques. Dans le cadre de l’investigation des dissociations cognitives rares, un sujet présentant un temps de réaction remarquablement conservé en dépit d’une lésion cérébrale focale étendue constitue un fait clinique majeur qu’un nuage de points standard tendrait à assimiler à un simple bruit de mesure. L’attribution d’une étiquette explicite isole instantanément cette déviance et oriente l’inférence théorique en signalant une possible invalidation d’une loi générale ou la présence d’une variable modératrice occulte.
Sur le plan de la sémiotique visuelle et de la psychologie cognitive, l’annotation obéit à la nécessité d’alléger la charge de la mémoire de travail du lecteur, conformément aux modèles d’intégration cognitive de l’information visuelle formulés par Jacques Bertin. En l’absence de libellés positionnés au plus près des singularités géométriques, le lecteur est contraint d’opérer des mouvements saccadiques incessants entre le corps principal du graphique, la légende périphérique et les tableaux de régression insérés dans le texte. L’ancrage textuel direct supprime cette surcharge cognitive d’intégration spatiale, permettant une appréhension holistique et synoptique des phénomènes empiriques sous-jacents.
1.2 Comparaison structurelle entre les environnements Base R et ggplot2
L’écosystème R offre deux voies philosophiquement antinomiques pour aborder la construction visuelle : le système graphique historique (communément désigné sous l’appellation Base R) et l’environnement moderne fondé sur la grammaire des graphiques conceptualisée par Leland Wilkinson et matérialisée par Hadley Wickham dans l’extension ggplot2. Le système graphique natif de Base R repose sur un modèle d’exécution strictement impératif. Dans ce paradigme, la création d’un nuage de points équivaut à peindre sur un canevas numérique vierge : chaque commande trace de manière irrévocable des pixels ou des primitives vectorielles par-dessus les éléments préexistants. L’annotation textuelle via des fonctions bas niveau offre un contrôle granulaire direct et absolu sur les coordonnées physiques du périphérique de sortie, sans imposer la médiation d’une structure de données intermédiaire complexe.
À l’inverse, ggplot2 adopte une approche déclarative. L’utilisateur ne décrit pas la séquence temporelle des opérations de dessin, mais spécifie formellement les correspondances sémantiques entre les colonnes d’une structure tabulaire et des attributs géométriques et esthétiques. L’annotation textuelle n’est plus une instruction de traçage isolée, mais une couche géométrique à part entière, assujettie aux mêmes règles de mise à l’échelle, de partitionnement et de calcul esthétique que les points de données eux-mêmes. Cette encapsulation structurelle assure une cohérence interne remarquable et une modularité poussée, bien qu’elle limite dans sa configuration native certaines interventions manuelles ad hoc sur la topologie spatiale des glyphes.
Le choix de l’environnement dépend en dernière instance des impératifs éditoriaux et de la nature de la chaîne de traitement. Base R conserve une supériorité incontestable en matière de vélocité computationnelle, d’absence de dépendances externes et de rapidité d’exécution pour les inspections de routine dans des scripts d’analyse exploratoire légère. En revanche, pour la confection de figures destinées à l’édition savante internationale, ggplot2 s’impose par sa gestion rigoureuse des thèmes typographiques, sa standardisation des légendes et son intégration sans couture avec des extensions sophistiquées dédiées à l’évitement des superpositions d’étiquettes.
1.3 Organisation méthodologique des jeux de données d’illustration
Pour assurer la rigueur méthodologique et la parfaite reproductibilité des exemples développés tout au long de ce guide, il convient d’établir un cadre de données canonique, stable et doté de propriétés psychométriques plausibles. Nous nous appuierons sur la simulation contrôlée d’une cohorte de participants évalués sur des dimensions cognitives et affectives typiques de la recherche expérimentale. Cette approche garantit la transparence des coordonnées statistiques tout en illustrant de manière vivante les défis concrets posés par les grappes de points denses et les valeurs marginales.
Le jeu de données prototypique que nous manipulons structure trois variables fondamentales au sein d’un format rectangulaire normalisé : le niveau d’anxiété pré-expérimentale (évalué sur une échelle continue de 0 à 100), la capacité de rétention en mémoire de travail (mesurée via une épreuve de rappel séquentiel inversé, échelonnée sur une métrique standardisée) et le temps de réaction moyen lors d’une tâche d’attention soutenue (exprimé en millisecondes). Chaque observation est attachée à un identifiant alphanumérique non ambigu, permettant d’étudier la manipulation vectorielle des étiquettes individuelles sans ambiguïté référentielle.
La structuration de cette armature tabulaire sous R requiert le recours scrupuleux aux types de données appropriés. Les identifiants sont strictement formatés sous forme de chaînes de caractères pour prévenir toute coercition implicite en valeurs numériques ou facteurs désordonnés qui pourrait altérer le comportement des fonctions d’annotation graphique. La définition préalable d’une graine déterministe via la commande d’initialisation du générateur congruentiel de nombres pseudo-aléatoires constitue le garant impératif d’une réplication exacte de l’espace spatial et des collisions géométriques qui feront l’objet de nos démonstrations algorithmiques.
2. Fondements théoriques de l’étiquetage en Base R : La fonction text()
2.1 Syntaxe formelle et décomposition des paramètres cardinaux
Le mécanisme élémentaire d’incorporation de texte dans le moteur graphique fondamental de R réside dans l’appel à la fonction text(). Cette primitive graphique opère en tant qu’opérateur de second plan, ce qui implique qu’elle ne peut être convoquée de manière autonome sans qu’un repère orthonormé n’ait été préalablement instauré par un appel de haut niveau à plot(). La signature canonique de cette fonction exige l’assignation de trois paramètres primaires qui conditionnent son ancrage : les composantes vectorielles x et y, définissant le centre géométrique d’insertion dans le système de coordonnées de la fenêtre active, et le vecteur labels, renfermant les représentations textuelles explicites à transcrire.
L’élégance de text() réside dans son architecture nativement vectorisée. Si les arguments transmis correspondent à des séries de longueurs identiques, l’interpréteur parcourt en parallèle les index respectifs pour instancier chaque élément lexical à ses coordonnées homologues au sein du plan cartésien. Par ailleurs, la fonction hérite dynamiquement des attributs environnementaux régis par les paramètres graphiques globaux configurés via par(), tels que la couleur de fond ou les dimensions relatives des marges périphériques. Cette interaction entre paramètres locaux passés à la fonction et état global du périphérique constitue la pierre angulaire de l’écosystème impératif de Base R.
Une compréhension rigoureuse des limites dimensionnelles du canevas est impérative lors de l’usage de text(). Tout texte positionné à des coordonnées excédant les bornes configurées pour les axes sera impitoyablement rogné par le moteur de rendu, à moins que le paramètre de masquage périphérique ne soit explicitement désactivé. Il est donc indispensable d’appréhender le fonctionnement de cette fonction non comme un processus d’ajustement dynamique automatisé, mais comme un calcul géométrique précis où chaque glyphe est projeté à l’emplacement mathématique exact dicté par le flux d’instructions.
2.2 Positionnement relatif à l’aide de l’argument pos
L’ancrage direct d’une étiquette sur les coordonnées exactes d’une observation génère par construction une superposition entre le marqueur graphique (tel que le glyphe circulaire standard pch) et les caractères typographiques, ruinant immédiatement la lisibilité de la figure. Pour pallier cette contrainte structurelle sans recourir à des modifications arithmétiques complexes des vecteurs de données, la fonction text() implémente l’argument numérique discret pos. Ce paramètre gouverne l’orientation spatiale de l’étiquette par rapport au centre géométrique spécifié par les composantes cartésiennes.
L’argument pos accepte exclusivement des valeurs scalaires entières codées de 1 à 4 selon une convention trigonométrique modifiée propre à la tradition graphique du logiciel S. La valeur 1 instancie l’étiquette directement sous le point de coordonnées (au sud) ; la valeur 2 la translate latéralement vers la gauche (à l’ouest) ; la valeur 3 la projette au-dessus du marqueur (au nord) ; enfin, la valeur 4 la positionne vers la droite (à l’est). Lors de l’assignation de l’une de ces quatre valeurs cardinales, R calcule automatiquement un décalage de sécurité proportionnel à la taille de la police de caractères active (régulé par le paramètre global offset, dont la valeur par défaut est exprimée en fractions de largeur de caractère), prévenant ainsi toute collision physique entre le tracé du symbole et le début de la chaîne textuelle.
L’omission pure et simple de l’argument pos induit un comportement par défaut radicalement distinct : l’étiquette est insérée de telle sorte que son barycentre géométrique corresponde exactement aux coordonnées vectorielles fournies. Dès lors, pour toute visualisation scientifique conventionnelle où les points de dispersion doivent demeurer intégralement perceptibles afin d’autoriser la vérification visuelle des distributions, l’usage d’une valeur cardinale explicite pour pos (le plus couramment 3 pour une surélévation verticale, ou 4 pour une lecture de gauche à droite) est fortement préconisé par les standards éditoriaux.
2.3 Contrôle précis de l’alignement typographique avec adj
En dépit de son évidente commodité, l’argument pos souffre d’une rigidité inhérente qui limite son efficacité lors d’ajustements micrométriques complexes. Pour acquérir une maîtrise absolue sur l’ancrage spatial des glyphes, le praticien doit se tourner vers l’argument adj. Ce paramètre offre une flexibilité vectorielle continue en permettant de stipuler, sous la forme d’une paire ordonnée de valeurs décimales comprises conventionnellement entre 0 et 1, la fraction exacte de la boîte englobante du texte qui doit être alignée sur la coordonnée cible.
Dans sa modalité d’utilisation bidimensionnelle, le premier élément de l’argument adj régule l’alignement horizontal : une valeur de 0 aligne le bord gauche de la chaîne sur la coordonnée, 0.5 centre parfaitement le mot horizontalement, et 1 plaque le bord droit contre le point de référence. Le second élément assure rigoureusement le même étalonnage sur le vecteur vertical, où 0 correspond à la ligne de base inférieure des caractères et 1 à l’apex supérieur de la boîte typographique. Il est crucial de souligner que les spécifications pos et adj s’excluent mutuellement : le recours à l’une neutralise immédiatement l’interprétation de l’autre au sein de la machine de rendu interne de R.
L’avantage cardinal d’adj réside dans la possibilité de franchir le seuil des valeurs canoniques [0, 1]. En introduisant des valeurs négatives ou supérieures à l’unité, l’analyste peut induire des micro-décalages continus arbitraires sans altérer le vecteur sous-jacent des données empiriques. Ainsi, spécifier un ajustement vectoriel horizontal légèrement négatif équivaut à décoller élégamment le libellé du point vers la droite tout en maintenant un ancrage vertical parfaitement aligné sur le centre de masse du marqueur géométrique, répondant ainsi à des exigences de lisibilité microscopique particulièrement strictes.
3. Étiquetage sélectif d’un point unique avec Base R
3.1 Identification et indexation du point cible
Dans une perspective d’économie cognitive et de focalisation visuelle, étiqueter la totalité des observations d’un échantillon exhaustif se révèle fréquemment contre-productif, submergeant le lecteur sous une nuée d’informations redondantes. L’investigation empirique requiert très couramment la mise en lumière chirurgicale d’un cas indicatif isolé, qu’il s’agisse du recordman absolu d’une épreuve psychomotrice, d’un individu manifestant une non-conformité patente au modèle de régression envisagé, ou d’une observation suspectée de contamination par erreur instrumentale. La première phase de cette annotation ciblée consiste en l’extraction déterministe de l’indice de l’élément au sein de l’armature de données.
Cette identification peut s’opérer par indexation positionnelle statique si le cas d’intérêt a été préalablement caractérisé lors de la phase de nettoyage tabulaire. Toutefois, pour garantir la reproductibilité et l’automatisation du flux d’analyse, l’approche optimale repose sur l’évaluation d’un prédicat logique. L’analyste convoque des fonctions de recherche d’extremum statistique, telles que which.max() ou which.min(), appliquées à la variable de réponse, ou encore la fonction générique d’extraction conditionnelle which() couplée à une équation booléenne complexe formalisant un critère clinique rigoureux.
Cette opération retourne un scalaire ou un vecteur d’indices discrets préservant l’intégrité de la structure relationnelle du tableau de données. La rigueur analytique impose de vérifier impérativement l’unicité de l’indice extrait avant de procéder à l’affichage graphique : si une condition booléenne capture involontairement une pluralité d’individus partageant la même modalité seuil, les instructions d’étiquetage ultérieures superposeront aveuglément les libellés les uns sur les autres, annihilant toute possibilité de déchiffrement visuel au point géométrique concerné.
3.2 Implémentation algorithmique de l’ancrage ponctuel
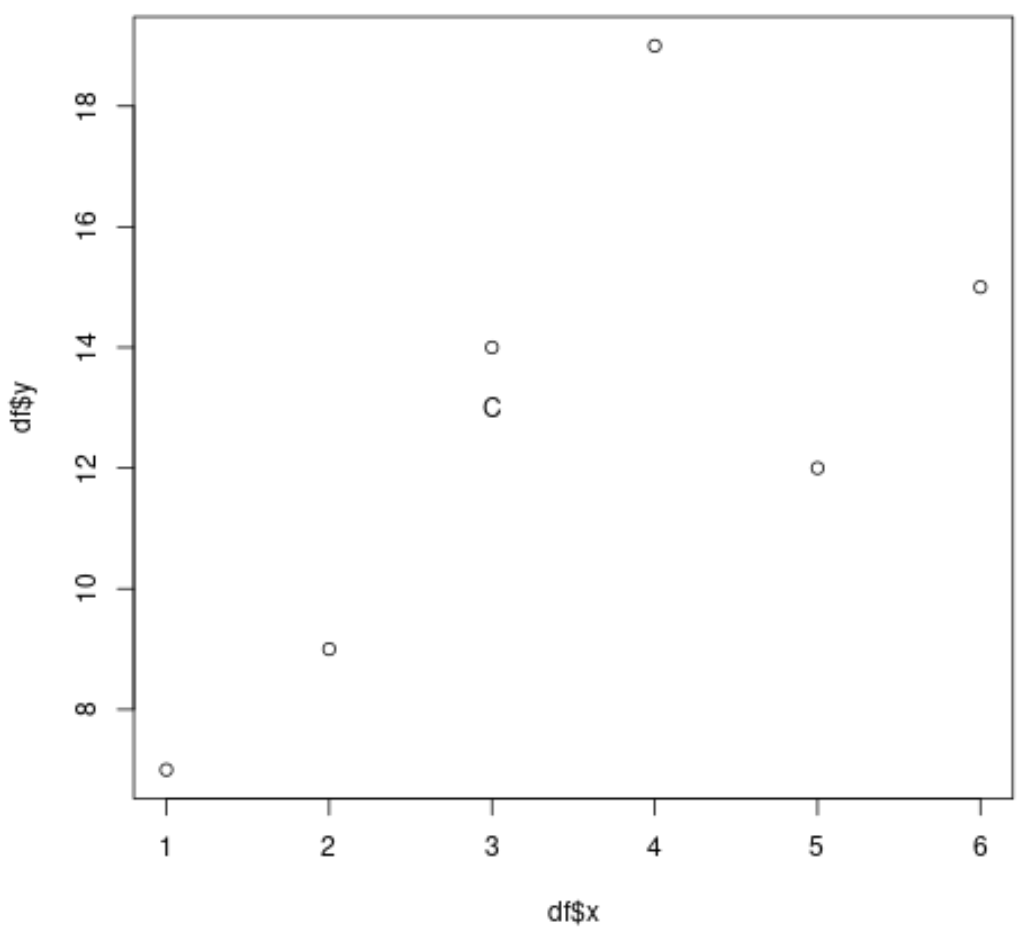
Une fois l’indice vectoriel de l’observation cible irrévocablement séquestré dans une variable d’environnement dédiée, la séquence graphique s’articule en deux temps distincts et rigoureusement ordonnancés. En premier lieu, la primitive globale plot() projette l’ensemble des données numériques sur le système d’axes cartésiens, matérialisant l’ensemble de la cohorte par des symboles discrets uniformes garantissant la vue synoptique de la dispersion. À ce stade, aucun artefact textuel ne vient encore perturber la pureté de la distribution statistique brute.
Dans un second temps, le script exécute la fonction text() en bridant délibérément ses arguments aux seuls éléments sous-indexés par l’indice préalablement isolé. Les vecteurs de positionnement spatial ne reçoivent que le scalaire de l’abscisse et celui de l’ordonnée appartenant au profil sélectionné, tandis que le libellé textuel est extrait de la colonne des identifiants nominatifs au moyen du même opérateur de sélection entre crochets. Cette approche sélective confère une économie de calcul optimale et garantit l’absence totale de traces parasites sur les autres observations.
Pour parfaire l’ancrage ponctuel, il est souvent d’usage d’accompagner l’étiquette textuelle d’un rehaussement esthétique du symbole géométrique sous-jacent. Par l’invocation subsidiaire de la fonction points() ciblée sur ce même index, le praticien peut surimprimer un cercle de diamètre supérieur, doté d’une teinte contrastante ou d’un style de trait renforcé. La conjonction de ce marquage topologique amplifié et de l’étiquette textuelle immédiatement adjacente concourt à focaliser instantanément l’attention du réviseur scientifique sur l’anomalie ou la découverte fondamentale incarnée par ce point singulier.
3.3 Application psychométrique : Isolation d’une observation aberrante
Pour matérialiser ce protocole théorique dans le champ des neurosciences comportementales, considérons l’étude de l’impact de l’anxiété chronique sur la latence cognitive lors d’une épreuve de flexibilité attentionnelle. Dans une distribution théorique conventionnelle, le postulat de la théorie de l’interférence cognitive prédit une corrélation linéaire positive : à mesure que le score d’anxiété croît, le temps de réponse s’allonge consécutivement aux intrusions de pensées non pertinentes pour la tâche en cours. Cependant, le traitement informatisé révèle la présence d’un individu singulier caractérisé par une anxiété pathologique extrême combinée à une vélocité motrice fulgurante défiant les prédictions du modèle univarié.
L’extraction de cette observation dissidente s’effectue formellement par le repérage de la distance résiduelle maximale issue d’un modèle linéaire standard, ou par l’application d’un critère multivarié basé sur la distance de Mahalanobis. Dès son isolement algorithmique, le point est documenté sur le nuage de points par une étiquette clinique explicite indiquant le code anonymisé du sujet ainsi que ses coordonnées multidimensionnelles. Cette intervention permet d’exhiber immédiatement la dissociation sans obliger l’audience à consulter un fastidieux tableau d’analyse des résidus.
L’adjonction de la droite de régression des moindres carrés ordinaires via la commande abline() met visuellement en exergue le levier substantiel et l’influence disproportionnée exercés par ce participant atypique sur la pente globale de l’échantillon. L’annotation textuelle sert alors d’avertisseur épistémologique : elle rappelle à la communauté scientifique que l’estimation des paramètres de population ne peut être envisagée sereinement sans une prise en compte minutieuse des caractéristiques cliniques spécifiques portées par cette observation idiosyncrasique.
4. Étiquetage exhaustif de tous les points avec Base R
4.1 Vectorisation de l’annotation sur l’ensemble du corpus
Bien que la mise en valeur de points isolés réponde à une logique de démonstration ciblée, certaines investigations requièrent la désignation nominative de l’intégralité des entités constitutives de l’espace d’échantillonnage. Ce besoin s’exprime avec une acuité particulière dans le cadre des études écologiques, de la psychologie différentielle comparant des macro-structures territoriales, ou des protocoles psychophysiques impliquant un effectif restreint de volontaires ultra-caractérisés où chaque profil individuel possède une valeur informative intrinsèque.
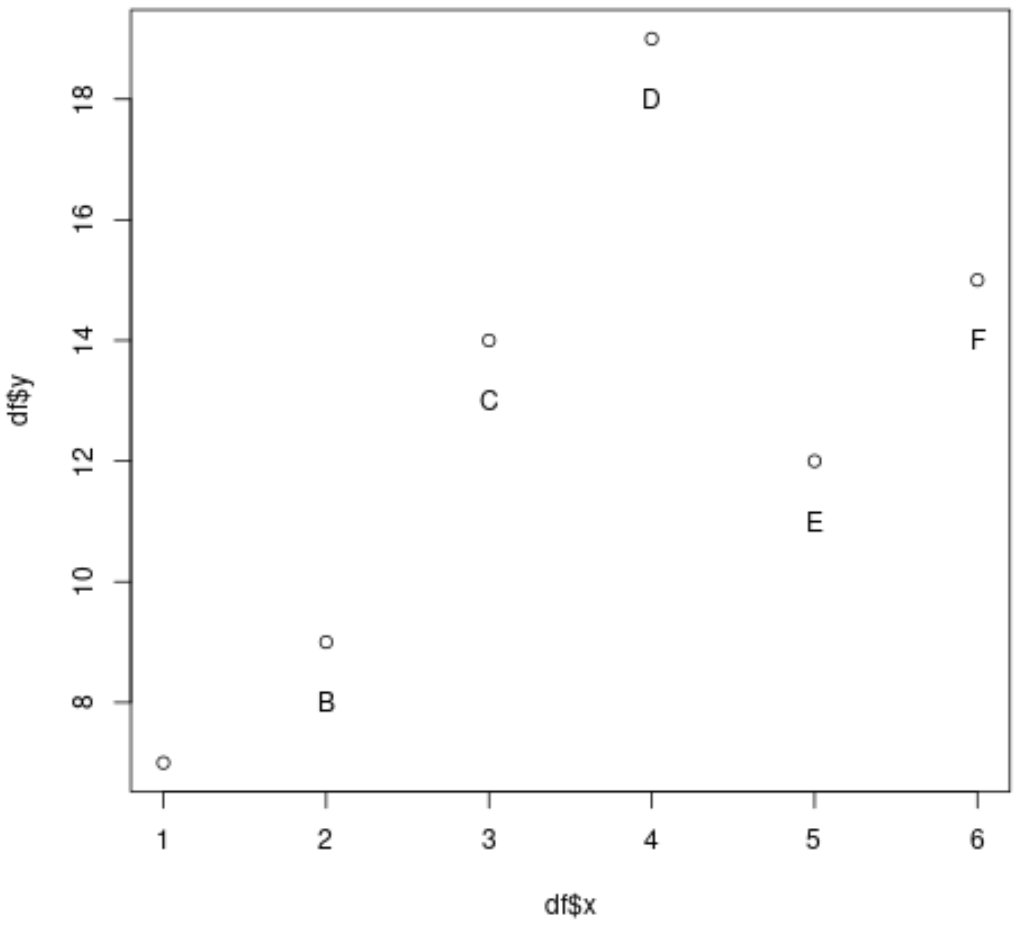
Le moteur de Base R excelle dans cette tâche d’étiquetage exhaustif grâce à la vectorisation intégrale de ses opérations primitives. L’analyste transmet simplement le vecteur intégral des abscisses à l’argument x, la série complète des ordonnées à l’argument y, et la totalité du vecteur de caractères identifiant les sujets à l’argument labels de la fonction text(). L’interpréteur interne de R effectue une itération computationnellement transparente au niveau du code C sous-jacent, apposant en une unique instruction l’ensemble des descripteurs textuels sans exiger la lourdeur d’une boucle itérative explicite au niveau utilisateur.
Néanmoins, la contrepartie inévitable de cette vectorisation naïve réside dans l’émergence immédiate d’un état de saturation topologique, communément désigné sous le terme d’encombrement graphique. Dès lors que la taille de l’échantillon dépasse quelques dizaines d’unités, la densité spatiale moyenne excède la capacité d’accueil visuelle du plan euclidien. Les chaînes de caractères se croisent, s’entremêlent et occultent tant les marqueurs de dispersion que les textes avoisinants, ce qui oblige le statisticien à instaurer des garde-fous géométriques rigoureux pour maintenir l’intelligibilité globale de son document.
4.2 Techniques de compensation manuelle des marges et collisions
Le premier écueil technique d’un étiquetage exhaustif sous Base R réside dans l’amputation périphérique des textes situés aux frontières du canevas. Dans la mesure où la fonction de haut niveau plot() calcule les limites géométriques des axes (les paramètres vectoriels xlim et ylim) en se fondant strictement sur le domaine de variation des données brutes, toute étiquette textuelle projetée à la droite d’une valeur maximale ou au-dessus d’un plafond empirique verra ses derniers glyphes impitoyablement tronqués par la ligne de cadre délimitant la région de traçage active.
La résolution élégante de ce désagrément impose une compensation manuelle programmatique de l’amplitude des axes cartésiens. L’analyste doit préalablement quantifier l’étendue des séries statistiques au moyen de la fonction range(), puis appliquer un facteur multiplicatif d’élargissement aux bornes extrêmes (généralement une extension symétrique de l’ordre de 5 à 15 % de l’intervalle interquartile ou de l’étendue globale) avant d’injecter explicitement ces limites corrigées dans l’appel initial à plot(). Ce dégagement périphérique assure que les boîtes d’encapsulation textuelles des données marginales bénéficient de l’espace physique nécessaire à leur complet déploiement graphique.
Parallèlement, la compensation des collisions proximales entre le marqueur et son propre libellé requiert un calcul précis du décalage additif vertical ou horizontal. Loin de s’en remettre aveuglément à la constante interne d’offset de l’argument pos, il s’avère particulièrement fécond de calculer un vecteur de translation proportionnel à l’écart-type de la variable d’ordonnée. En surélevant artificiellement l’ancrage textuel d’une fraction constante de la dispersion empirique, on préserve l’intégrité de lecture du symbole ponctuel tout en inscrivant le libellé dans une zone de respiration spatiale favorable à l’examen optique soutenu.
4.3 Gestion des chevauchements d’étiquettes en Base R
La limite méthodologique la plus sévère du moteur graphique natif réside dans son incapacité intrinsèque à détecter les collisions mutuelles entre les différentes instances de texte projetées sur le plan. Dépourvu d’un modèle sous-jacent de perception spatiale dynamique, Base R trace chaque étiquette de manière strictement indépendante de celles qui la précèdent ou lui succèdent. Dès lors que deux observations partagent des coordonnées étroitement corrélées dans une région à forte concentration distributionnelle, leurs identifiants respectifs fusionnent visuellement en un amas typographique illisible.
Pour endiguer ce phénomène sans faire appel à des dépendances logicielles extérieures, le chercheur doit concevoir des règles heuristiques élémentaires d’évitement reposant sur l’orientation cardinale différenciée. Une méthode couramment déployée consiste à conditionner dynamiquement le paramètre pos à la position de l’observation au sein des quadrants locaux de la distribution. En évaluant si le voisin le plus proche se situe dans l’hémisphère supérieur ou inférieur (par le calcul matriciel des distances euclidiennes par paires), le script peut assigner alternativement la valeur 3 (haut) ou 1 (bas), voire orienter le texte vers la gauche pour les coordonnées situées au-dessus de la médiane et vers la droite pour celles situées en deçà.
Bien que ces heuristiques artisanales atténuent marginalement la sévérité des chevauchements dans des configurations d’échantillonnage modéré, elles démontrent rapidement leurs limites mathématiques face à des regroupements denses non linéaires. Cette impasse algorithmique de Base R souligne la pertinence d’adopter des systèmes de calcul de forces de répulsion plus raffinés ou de basculer vers des architectures graphiques spécifiquement outillées pour arbitrer ces compromis d’allocation spatiale, comme nous le verrons ultérieurement avec les bibliothèques spécialisées.
5. Personnalisation stylistique avancée des étiquettes en Base R
5.1 Modulation de l’échelle typographique et de la famille de polices
La valeur informative d’une annotation ne dépend pas exclusivement de son positionnement spatial ; elle est intimement tributaire de sa hiérarchisation sémiotique, rendue possible par la modulation fine de ses propriétés typographiques. Dans le système Base R, l’amplitude dimensionnelle du texte est régie par le coefficient d’agrandissement scalaire cex (acronyme de character expansion). Fixé canoniquement à la valeur unitaire 1.0, ce paramètre peut être réduit (par exemple à 0.7 ou 0.8) pour tempérer la présence d’étiquettes denses ou amplifié pour rehausser une annotation cardinale, assurant une subordination visuelle harmonieuse entre le fond de dispersion et les points clés.
La structure formelle du texte s’ajuste avec une égale rigueur au moyen du paramètre font, qui prend en charge la modulation de la graisse et de l’inclinaison des caractères typographiques via un code numérique entier. La valeur 1 instancie un tracé régulier standard, la valeur 2 commande une graisse renforcée (caractères gras indispensables pour faire ressortir une déviance statistique majeure), la valeur 3 incline le texte sous forme italique (idéale pour désigner des taxons biologiques ou des variables latentes selon les canons académiques), et la valeur 4 combine la graisse et l’italique pour une emphase maximale.
En matière d’adéquation éditoriale, l’argument family autorise la sélection explicite des fontes vectorielles reconnues par le périphérique graphique sous-jacent. L’adhésion aux exigences des maisons d’édition académiques réclame la sélection de polices sans empattement universelles telles que sans (mappée vers Helvetica ou Arial selon les systèmes d’exploitation) ou de polices avec empattement comme serif (mappée vers Times New Roman). Le calibrage rigoureux de ces trois dimensions typographiques au sein de l’appel à text() transforme une figure vernaculaire en une pièce de communication visuelle répondant aux standards les plus élevés de la publication scientifique internationale.
5.2 Attribution chromatique différentielle et conditionnelle
L’argument col au sein de la primitive text() offre un vecteur de différenciation catégorielle et continue d’une redoutable efficacité d’encodage. Au lieu d’imposer un noir typographique monotone à l’ensemble du corpus lexical, l’analyste peut coupler l’attribution chromatique de chaque étiquette aux niveaux discrets d’un facteur nosographique ou psychométrique. Ce mécanisme permet de superposer un canal d’information supplémentaire sur une représentation bivariée sans accroître la complexité géométrique de la figure.
L’implémentation opérationnelle de cette stratégie repose sur la création d’une table de correspondance chromatique. En indexant un vecteur de codes hexadécimaux ou de dénominations de couleurs standardisées (telles que définies par la palette colors() native) par les niveaux ordonnés d’une variable clinique, R réalise un mappage vectoriel déterministe attribuant à chaque étiquette la couleur exacte dévolue à sa classe d’appartenance. De surcroît, cette coloration de l’étiquette peut être rigoureusement synchronisée avec la teinte du marqueur ponctuel associé, instaurant une gestalt visuelle unifiée qui accélère l’identification catégorielle par le cortex visuel du lecteur.
Dans la perspective d’une diffusion au sein de périodiques imprimés traditionnels soumettant l’auteur à des contraintes de tarification pour la quadrichromie, cette modularité chromatique autorise une déclinaison immédiate en échelles de gris perceptuellement uniformes. Par l’intermédiaire de fonctions dédiées comme gray() ou de palettes calibrées pour le contraste lumineux, le chercheur ajuste la brillance relative des étiquettes pour garantir que les contrastes sémantiques demeurent parfaitement discriminables une fois la figure convertie en mode monochrome, prévenant ainsi les dégradations d’information fréquemment induites par les photocopies ou les numérisations dégradées.
5.3 Inclusion d’expressions mathématiques et de symboles statistiques
L’annotation scientifique franchit un palier qualitatif fondamental dès lors qu’elle s’affranchit du carcan des chaînes de caractères brutes pour véhiculer des notations mathématiques rigoureuses, des lettres grecques formalisant des paramètres de population ou des indices de significativité statistique formalisés. Le moteur de rendu de R intègre à cette fin un interpréteur typographique sophistiqué, basé sur le métalangage TeX, activé par les fonctions spécialisées expression() et bquote().
Lorsqu’une expression formelle est transmise à l’argument labels de la fonction text(), R ne restitue pas les caractères littéraux mais interprète la grammaire mathématique sous-jacente. Ainsi, les mots-clefs réservés sont automatiquement convertis en glyphes helléniques conventionnels (le terme mu engendrant le symbole de la moyenne de population, ou sigma l’écart-type théorique), tandis que les opérateurs de mise en indice ouvrent l’accès aux notations hiérarchiques rigoureuses requises par la modélisation statistique avancée. Les fractions, les radicaux et les symboles d’inférence s’insèrent avec une précision vectorielle irréprochable au sein de la zone graphique.
L’usage de bquote() s’avère particulièrement providentiel lorsqu’il s’agit de fusionner dynamiquement une constante mathématique formalisée et la valeur numérique contingente d’une statistique d’échantillon issue du flux d’exécution. Grâce à l’opérateur d’évaluation différée incorporé (l’encapsulation sous la forme du tilde pointé .()), le script peut extraire la valeur exacte d’un coefficient de corrélation de Pearson ou d’une probabilité critique issue d’un test d’hypothèse et la fondre au sein d’une équation typographique élégante. Cette synchronisation étroite entre les résultats du modèle inférentiel et leur rendu visuel garantit l’exactitude des valeurs affichées en éliminant les risques d’erreurs humaines inhérents à la saisie manuelle des annotations.
6. Introduction à l’étiquetage déclaratif avec ggplot2 et geom_text()
6.1 Intégration du composant textuel dans l’aesthetic mapping
L’avènement de la grammaire des graphiques formalisée dans l’environnement ggplot2 a profondément reconfiguré la pratique de l’annotation dans l’écosystème R. Dans ce paradigme déclaratif, le texte n’est plus envisagé comme un tracé secondaire superposé de manière anarchique sur un canevas préalablement dessiné, mais comme une couche géométrique à part entière (layer). Cette entité architecturale participe activement à la construction holistique de l’espace graphique au même titre que les points, les barres ou les polygones de densité spatiale.
L’intégration sémantique de l’information textuelle requiert la déclaration explicite de l’attribut esthétique label au sein de l’instruction de projection aes(). Cette déclaration lie directement une variable présente dans l’armature de données d’origine à la dimension textuelle de la couche. La couche géométrique geom_text() hérite alors automatiquement du système de coordonnées cartésiennes instauré globalement, ainsi que de l’ensemble des règles de mise à l’échelle chromatique ou morphologique définies pour l’objet graphique composite.
Cette approche apporte une clarté conceptuelle majeure : si la variable associée à l’esthétique label correspond à un vecteur numérique continu, ggplot2 applique de façon cohérente les règles d’évaluation sans qu’aucune coercition manuelle ne soit impérative. De plus, la couche conserve un lien ombilical avec la structure de données relationnelle sous-jacente, ce qui autorise l’application immédiate de facettages multidimensionnels via facet_wrap() ou facet_grid(), propageant automatiquement l’étiquetage textuel sur l’ensemble des sous-graphiques partitionnés sans la moindre ligne de code supplémentaire.
6.2 Contrôle géométrique via vjust, hjust et nudge
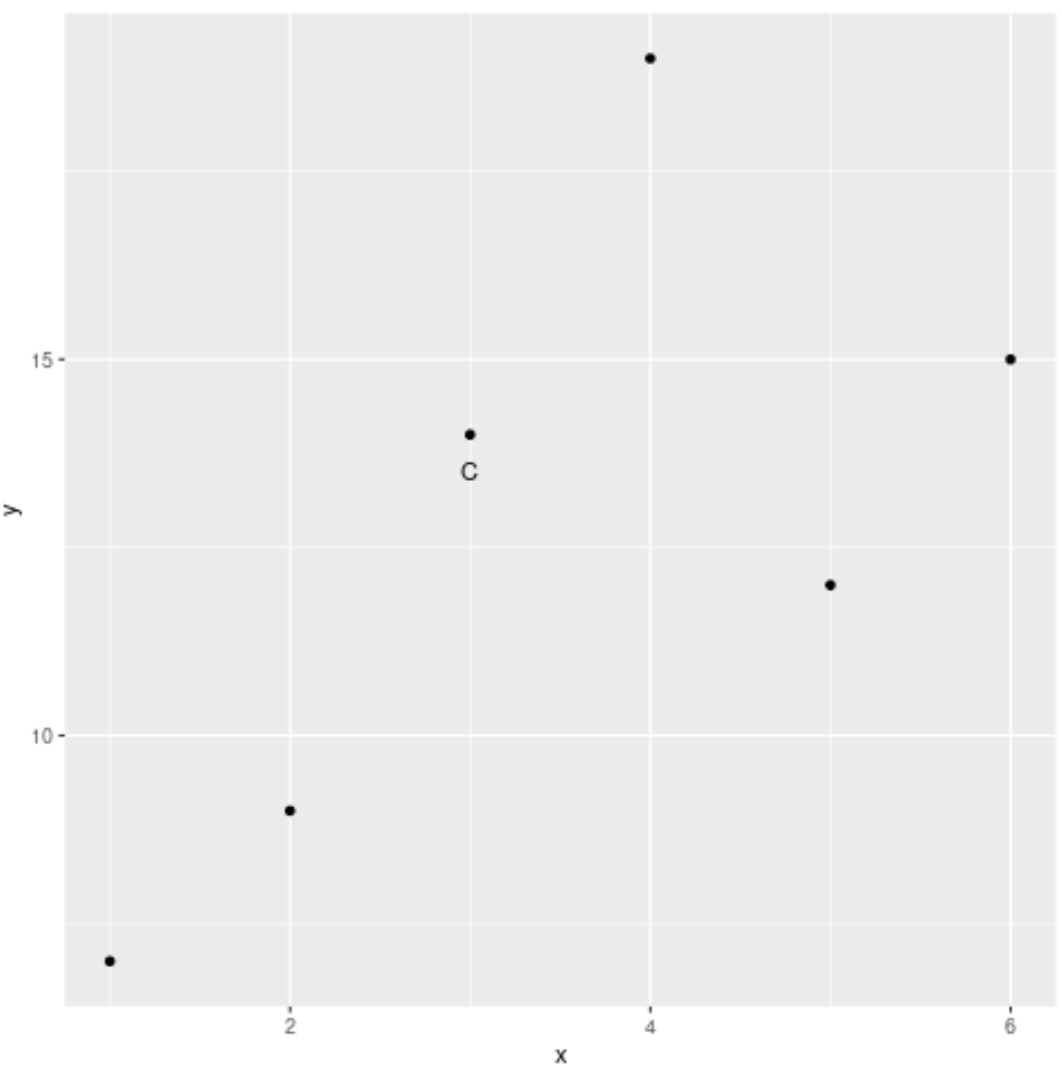
Pour réguler la dispersion spatiale et prévenir la superposition immédiate des textes sur les centroïdes des marqueurs géométriques générés par geom_point(), ggplot2 met à la disposition du praticien deux mécanismes géométriques distincts et complémentaires : l’alignement relatif via vjust et hjust, et le déplacement spatial absolu gouverné par nudge_x et nudge_y.
Les paramètres d’ajustement continu vjust (ajustement vertical) et hjust (ajustement horizontal) fonctionnent selon une échelle proportionnelle analogue à l’argument adj de Base R, mais intégrée dans l’espace unifié des unités relatives du graphique. Une valeur de vjust = 0 ancre le bord inférieur de la chaîne textuelle sur la coordonnée empirique en projetant le corps du mot vers le haut, tandis qu’une valeur de 1 l’ancre par son sommet en le déployant vers le bas. Les valeurs textuelles descriptives telles que « top », « bottom », « left » ou « right » sont nativement reconnues, simplifiant l’intelligibilité du script d’analyse.
À l’inverse de ces alignements proportionnels, les arguments nudge_x et nudge_y appliquent une translation arithmétique rigide exprimée directement dans les unités réelles des axes de données cartésiennes. Ainsi, assigner un décalage vertical modéré au moyen de nudge_y déporte le barycentre du texte vers le haut d’une fraction connue de la métrique mesurée. Il est toutefois essentiel de souligner une contrainte opérationnelle fondamentale : les paramètres de décalage rigide nudge ne peuvent être invoqués conjointement avec des spécifications de positionnement dynamique sous peine de générer des conflits d’assignation au sein du moteur d’évaluation interne de la couche géométrique.
6.3 Harmonisation esthétique avec le thème global
L’un des atouts prééminents de l’architecture ggplot2 réside dans sa capacité à maintenir une syntonie typographique irréprochable entre les éléments d’annotation interne et le système thématique régissant la périphérie du canevas. La taille des glyphes au sein de geom_text() est régulée par le paramètre dimensionnel size. Cependant, un piège de dimensionnement guette fréquemment le praticien novice : tandis que les tailles des polices configurées au sein de la fonction globale theme() sont rigoureusement calibrées en points typographiques traditionnels (pt), la taille spécifiée à l’intérieur de geom_text() est interprétée en millimètres physiques (mm).
Pour assurer une parfaite cohérence visuelle, il est méthodologiquement recommandé d’appliquer le facteur de conversion universel (approximativement 2.845 points par millimètre) afin de synchroniser exactement la stature des étiquettes ponctuelles avec celle des axes gradués ou des titres de facettes. Parallèlement, l’attribution chromatique de la typographie peut être connectée au canevas global via l’argument color ou gouvernée par les échelles manuelles déclaratives telles que scale_color_manual(), conférant une unité chromatique absolue à l’ensemble du document scientifique.
Enfin, l’inclusion d’une esthétique textuelle au sein du mappage global tend, par construction, à polluer les légendes générées automatiquement en incrustant la lettre alphabétique « a » en surimpression sur les symboles géométriques de référence. L’éradication de cet artéfact parasitaire s’effectue simplement et élégamment par l’adjonction explicite de l’instruction show.legend = FALSE directement au sein de la déclaration de geom_text(). Cette précaution garantit que la légende demeure strictement dédiée à la discrimination des symboles factoriels sans être dégradée par des résidus de glyphes textuels.
7. Étiquetage conditionnel et ciblé dans l’écosystème ggplot2
7.1 Stratégies de filtrage au sein de la couche géométrique
L’élégance architecturale de ggplot2 se manifeste avec éclat lorsqu’il s’agit de restreindre l’affichage textuel à une portion infinitésimale de la distribution de données sans altérer la projection synoptique des autres observations. Contrairement à d’autres outils exigeant la duplication préalable des structures tabulaires en mémoire vive, ggplot2 autorise l’injection d’un sous-ensemble filtré directement au niveau de l’argument data propre à la couche geom_text().
Cette opération peut s’exécuter canoniquement par l’encapsulation d’une fonction d’extraction standard telle que subset(), bornant le champ d’action textuel aux enregistrements validant une condition empirique stricte. Ainsi, l’ensemble du jeu de données continue d’alimenter la géométrie générale des points via geom_point(), garantissant que la topologie globale de l’échantillon demeure intégralement visible, tandis que la couche d’annotation ne reçoit et ne traite que les quelques lignes satisfaisant au critère analytique établi.
Dans les versions modernes de l’écosystème tidyverse, cette technique atteint son niveau d’expressivité ultime grâce à l’incorporation de fonctions anonymes ou de formules déclaratives (syntaxe lambda ~ filter(.x, …)). Cette approche permet de chaîner des filtres statistiques sophistiqués sans jamais rompre le flux d’instructions du graphique, assurant une maintenabilité exceptionnelle du code source et garantissant que l’annotation demeure dynamiquement asservie aux données brutes même si celles-ci font l’objet de mises à jour subséquentes en amont du script.
7.2 Création d’attributs binaires ou catégoriels pour l’affichage
Une alternative méthodologique robuste au filtrage local de couche consiste à enrichir préalablement la structure de données tabulaire d’une colonne spécifiquement dédiée à la restitution textuelle. En amont du pipeline de visualisation, le statisticien génère une nouvelle variable via l’invocation de structures conditionnelles vectorisées telles que ifelse() ou dplyr::case_when(), isolant les profils d’intérêt tout en assignant une valeur neutre aux observations non ciblées.
Le secret technique d’une exécution irréprochable de cette stratégie réside dans la nature de la valeur attribuée aux observations exclues de l’annotation. Deux options formelles s’offrent à l’analyste : l’assignation d’une chaîne textuelle vide (« ») ou l’injection de valeurs manquantes explicites (NA_character_). Le recours à la chaîne vide préserve l’intégrité géométrique sans générer de tracé visible, mais contraint le moteur graphique à évaluer inutilement des centaines d’objets textuels dépourvus de contenu, ce qui alourdit inutilement le fichier vectoriel final produit lors de l’exportation.
L’utilisation de la valeur manquante NA constitue incontestablement la démarche la plus rigoureuse sur le plan computationnel et sémiotique. Lors de la compilation graphique, ggplot2 détecte automatiquement l’absence de donnée textuelle et omet purement et simplement l’instanciation de la primitive pour ces enregistrements, émettant un avertissement bénin parfaitement contrôlé dans la console. Cette méthode optimise drastiquement le temps de rendu sur les volumétries d’échantillons substantielles et allège substantiellement le poids en octets des figures vectorielles destinées à l’impression numérique haute fidélité.
7.3 Cas empirique : Signalement des scores cliniquement significatifs
Afin d’illustrer la puissance diagnostique de l’étiquetage conditionnel dans une cohorte clinique, étudions le dépistage d’épisodes dépressifs majeurs au moyen de l’inventaire standardisé de Beck (BDI-II) mis en corrélation avec une mesure psychophysiologique de variabilité de la fréquence cardiaque (VRC). Dans ce contexte épidémiologique, l’écrasante majorité de la cohorte manifeste des scores oscillant dans des zones infracliniques ou modérées ne requérant aucune individualisation graphique immédiate. Seuls les sujets franchissant le seuil critique d’alerte diagnostique — conventionnellement fixé à deux écarts-types au-dessus de la moyenne de l’échantillon normatif — méritent une extraction sémantique visuelle prioritaire.
Grâce à la formalisation d’une mutation conditionnelle en amont, seules les coordonnées des participants manifestant une détresse aiguë se voient attribuer leur numéro d’anonymat clinique dans la colonne d’affichage. Les données physiologiques sous-jacentes demeurent projetées sous forme d’un nuage de points translucides, permettant d’apprécier la morphologie globale de la corrélation négative unissant la variabilité cardiaque à la sévérité de la symptomatologie dépressive.
L’insertion d’une ligne de démarcation horizontale via geom_hline(), calibrée sur le seuil pathologique théorique, parachève l’édifice démonstratif. Les étiquettes textuelles émergent ainsi exclusivement au-dessus de cette frontière nosographique, orientant instantanément l’attention des cliniciens et des relecteurs méthodologiques vers les cas d’urgence absolue, tout en préservant le nuage sous-jacent de tout parasitage visuel néfaste à l’évaluation de la dispersion générale des observations contrôles.
8. Utilisation de geom_label() pour maximiser le contraste et la lisibilité
8.1 Propriétés morphologiques de l’étiquette encapsulée
Si la géométrie textuelle conventionnelle geom_text() s’avère irremplaçable pour de multiples scénarios, elle manifeste une vulnérabilité critique dès lors qu’elle est projetée sur des zones à forte densité où les marqueurs empiriques sous-jacents se disputent l’espace optique. Les glyphes tendent alors à fusionner avec les tracés circulaires des points voisins ou les lignes de grille du panneau cartésien, compromettant irrémédiablement la lisibilité. Pour pallier cette faiblesse structurelle, l’architecture ggplot2 met à disposition une variante hautement spécialisée : la couche geom_label().
La particularité morphologique de geom_label() réside dans la génération automatique d’une boîte englobante rectangulaire opaque venant s’interposer directement entre le plan des données et les caractères typographiques. Ce socle matériel crée un arrière-plan privatif qui masque les éléments graphiques préexistants, offrant un contraste de lecture optimal indépendamment de la complexité topologique environnante. L’aspect architectural de cette boîte est contrôlé de façon millimétrique par l’argument label.r, qui définit le rayon de courbure des quatre coins du rectangle (une valeur nulle produisant un parallélogramme rigide aux angles vifs, tandis qu’une valeur plus élevée adoucit les arêtes sous forme d’arrondis subtils).
L’espace intérieur séparant le texte des frontières du rectangle est gouverné par l’argument label.padding, qui prend en compte une unité de mesure formelle définie via la fonction unit() du package grid (par exemple 0.25 lignes de texte ou un quantum calibré en millimètres). Ce dégagement intérieur garantit que les ascendantes et descendantes des glyphes typographiques ne heurtent pas physiquement la ligne de délimitation externe, conférant à la figure un équilibre graphique digne des traités de cartographie de précision les plus rigoureux.
8.2 Gestion de la transparence et des bordures
L’opacité totale introduite par défaut par geom_label(), si elle résout le problème du contraste, génère un coût épistémologique non négligeable : le masquage destructeur de points de données contigus situés fortuitement sous la surface de la boîte englobante. Ce phénomène d’occlusion accidentelle peut induire le lecteur en erreur en occultant l’existence d’amas statistiques sous-jacents. La maîtrise du paramètre d’opacité alpha au sein du composant constitue la réponse technique appropriée à ce défi géométrique.
En assignant une valeur décimale fractionnaire (par exemple alpha = 0.65) au rectangle d’arrière-plan, l’analyste crée un voile semi-translucide qui préserve un contraste de lecture satisfaisant pour la chaîne de caractères tout en laissant transparaître en filigrane les marqueurs géométriques positionnés sous l’étiquette. Ce procédé évite la dissimulation involontaire de la densité locale de l’échantillon tout en garantissant que l’annotation demeure perceptible et distincte du fond.
De surcroît, la périphérie de l’étiquette encapsulée peut être finement ciselée au moyen du paramètre label.size, qui régit l’épaisseur du trait de contour du cadre en millimètres. En affectant la valeur zéro à cette instruction, on dissout totalement la bordure extérieure pour ne conserver qu’un aplat de couleur amorti, éliminant ainsi le bruit visuel associé aux arêtes rectangulaires dures. Enfin, la teinte du contour peut être découplée de la couleur d’encre des glyphes textuels en assignant des valeurs chromatiques divergentes aux attributs color et fill, offrant un vocabulaire visuel riche pour coder simultanément plusieurs facettes diagnostiques d’une même observation.
8.3 Arbitrage méthodologique entre geom_text() et geom_label()
Le choix raisonné entre l’usage de geom_text() et celui de geom_label() ne relève pas d’une préférence stylistique superficielle, mais d’une décision méthodologique fondée sur les principes de la charge cognitive et de la préservation de l’intégrité des distributions statistiques. Dans les représentations bivariées hautement épurées comportant un nombre restreint de points et bénéficiant de vastes étendues d’espace négatif, geom_text() demeure l’option la plus recommandée en vertu du principe de parcimonie sémiotique d’Edward Tufte : il n’introduit aucun élément non porteur de données primaires dans le périmètre du tracé.
À l’opposé, dans les configurations à densité distributionnelle moyenne, ou lorsque la figure est appelée à être projetée sur des supports de diffusion à basse résolution (tels que les écrans lors de colloques scientifiques ou les affiches de grand format lues à distance par une assemblée mouvante), geom_label() apporte une netteté visuelle irremplaçable. Le rectangle protecteur neutralise efficacement le bruit de fond induit par les axes, les courbes de tendance et les intervalles de confiance semi-transparents qui s’entrecroisent au cœur des nuages de points complexes.
Toutefois, le statisticien consciencieux doit s’abstenir de déployer massivement geom_label() sur des corpus statistiques saturés. La juxtaposition non régulée de boîtes rectangulaires opaques génère un effet de carrelage visuel dévastateur qui fragmente le plan cartésien et détruit irrémédiablement la perception des structures de covariance globales. L’arbitrage exige donc une modération stricte : réserver geom_label() à un sous-ensemble marginal d’observations d’une portée heuristique majeure, et privilégier geom_text() ou des solutions d’évitement algorithmique sophistiquées dès que le nombre d’annotations excède une fraction minime de l’échantillon global.
9. Résolution algorithmique du chevauchement avec le package ggrepel
9.1 Principes physiques des algorithmes de répulsion
Lorsque la densité d’un nuage de points s’accroît, les ajustements manuels d’alignement par translations statiques atteignent une limite mathématique absolue : l’analyste se trouve confronté à un problème d’optimisation combinatoire NP-difficile pour positionner un ensemble d’étiquettes rectangulaires de telle sorte qu’aucune d’entre elles n’entre en collision avec ses homologues ni avec les marqueurs empiriques du tracé. C’est pour surmonter cette impasse que Kamil Slowikowski a développé l’extension fondamentale ggrepel, qui révolutionne l’annotation sous R en s’appuyant sur un modèle physique de répulsion dynamique.
L’algorithme sous-jacent à ggrepel assimile chaque étiquette textuelle et chaque point de données à des corps physiques chargés électrostatiquement d’une même polarité qui se repoussent mutuellement selon une loi inspirée de l’électromagnétisme de Coulomb. Simultanément, chaque étiquette demeure reliée à son marqueur source par une force de rappel élastique proportionnelle à la distance euclidienne qui les sépare, matérialisant une contrainte physique analogue à un ressort régi par la loi de Hooke. L’algorithme résout itérativement ce réseau d’équations différentielles au moyen d’une technique de recuit simulé afin d’atteindre un état d’énergie minimale globale où les collisions sont intégralement éradiquées sans que les annotations ne soient déportées excessivement loin de leurs ancrages empiriques respectifs.
Étant donné la nature heuristique et stochastique de cette optimisation spatiale, deux exécutions successives d’un même script pourraient théoriquement aboutir à des configurations géométriques légèrement divergentes si le modèle n’était pas rigoureusement canalisé. Pour garantir la reproductibilité computationnelle absolue imposée par les exigences de la recherche reproductible, il est impératif de fixer l’état initial du générateur pseudo-aléatoire interne de la couche via l’argument dédié seed au sein même de l’instruction d’appel, assurant ainsi la parfaite immutabilité de la disposition des étiquettes lors de chaque recompilation de la figure.
9.2 Mise en œuvre de geom_text_repel() et geom_label_repel()
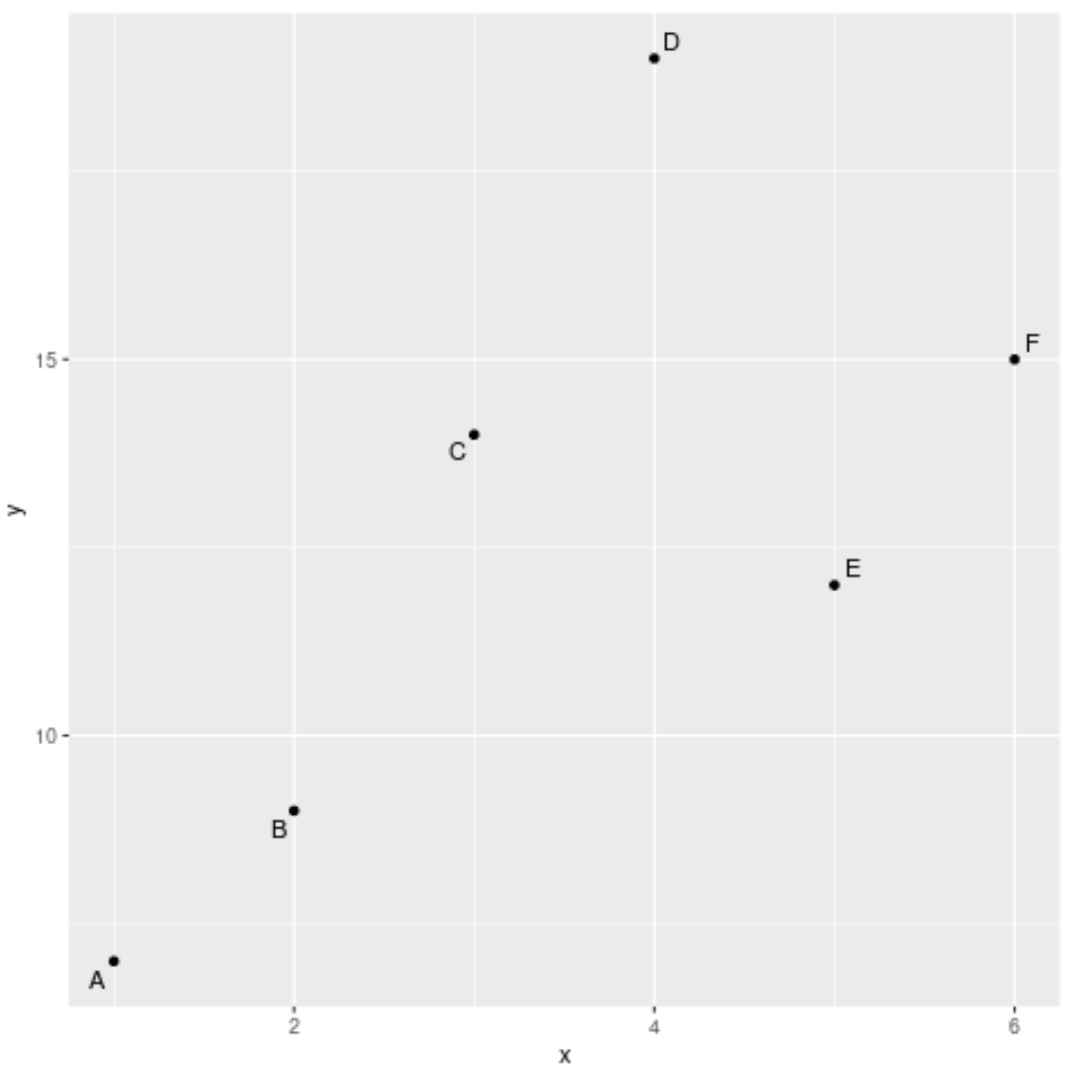
L’intégration de la puissance computationnelle de ggrepel au sein d’un pipeline graphique préexistant a été conçue pour offrir une ergonomie d’utilisation maximale. L’utilisateur se contente de substituer les fonctions natives de ggplot2 par leurs équivalents répulsifs directs : geom_text_repel() pour les chaînes typographiques libres, et geom_label_repel() pour les annotations protégées par une boîte d’encapsulation. Les correspondances esthétiques déclarées au préalable au sein de aes() sont intégralement préservées sans exiger la moindre refactorisation syntaxique.
La valeur ajoutée phénoménale de ggrepel réside dans la matérialisation automatique de segments de connexion (ou lignes de rappel) reliant chaque étiquette déportée au marqueur ponctuel exact dont elle émane. Cette fonctionnalité lève toute incertitude référentielle lorsque la force de répulsion électrostatique a projeté un libellé à une distance substantielle de son centroïde d’origine pour contourner un amas dense de points concurrents. L’observateur suit sans effort le segment guide pour réassocier le descriptif sémantique à sa coordonnée cartésienne véridique.
Ces segments de rappel bénéficient d’un paramétrage morphologique exhaustif. L’analyste module leur finesse via segment.size, leur teinte au moyen de segment.color (ou en synchronisant dynamiquement leur coloration avec l’esthétique du point via segment.color = NA), et leur texture géométrique via segment.linetype (permettant d’instancier des pointillés discrets pour ne pas alourdir la trame générale). Il est également envisageable d’adjoindre une pointe de flèche orientée au moyen de l’argument arrow = arrow(), conférant au graphique un caractère directionnel précieux lors de la présentation d’analyses longitudinales ou de trajectoires évolutives au sein du plan factoriel.
9.3 Paramètres avancés de contrôle de la dispersion
Pour dompter le comportement du moteur physique dans des espaces géométriques particulièrement contraints, ggrepel expose un ensemble de paramètres d’étalonnage micrométrique d’une efficacité chirurgicale. Le paramètre box.padding régule l’amplitude de l’enveloppe protectrice invisible ceinturant chaque boîte textuelle : une valeur généreuse force les étiquettes à maintenir une distance de sécurité accrue les unes par rapport aux autres, fluidifiant la circulation visuelle au détriment potentiel d’une occupation spatiale plus vaste.
Parallèlement, l’argument point.padding orchestre la zone d’exclusion entourant les symboles de données réels. Une configuration fine de ce paramètre empêche que les segments de connexion ne viennent physically heurter ou recouvrir le contour extérieur des marqueurs géométriques, préservant la netteté optique des glyphes de dispersion. De surcroît, le paramètre directionnel direction autorise le confinement de la répulsion le long d’un unique axe cartésien (par exemple direction = « y » pour imposer une dispersion strictement verticale des étiquettes en maintenant leurs abscisses rigoureusement alignées sur celles des observations d’origine).
Enfin, la gestion des contextes de saturation critique s’opère au moyen de l’argument d’arbitrage max.overlaps. Si une région de l’espace statistique présente une concentration d’observations telle qu’il devient mathématiquement impossible de caser l’ensemble des descripteurs sans violer les contraintes de distance minimale dans un nombre fini d’itérations, ggrepel tronque délibérément l’affichage des étiquettes les plus conflictuelles pour préserver l’harmonie globale du document. En fixant cette valeur à l’infini (max.overlaps = Inf), le statisticien intime à l’algorithme l’ordre d’épuiser toutes les combinaisons computationnelles concevables pour afficher impérativement l’intégralité du corpus d’annotations, conférant une robustesse sans égale aux restitutions de données les plus complexes.
10. Formatage typographique et mathématique avancé des étiquettes
10.1 Concaténation dynamique de texte et de métriques statistiques
La force d’un étiquetage analytique réside fréquemment dans sa capacité à délivrer une information composite, fusionnant au sein d’une même unité sémantique l’identification nominale de l’observation et la quantification métrique de son positionnement d’échelle. Dans l’écosystème R, cette construction multi-dimensionnelle s’opère par l’articulation de fonctions de manipulation de chaînes vectorisées hautement optimisées, au premier rang desquelles trônent les primitives paste() et paste0().
Toutefois, la concaténation brute de valeurs numériques à virgule flottante génère immanquablement des artefacts de précision d’une laideur rédhibitoire pour l’édition scientifique, affichant des chaînes d’une douzaine de décimales issues des artefacts d’arrondi binaire du processeur. L’emploi conjoint de la fonction de formatage formel sprintf(), calquée sur les spécifications de la bibliothèque standard du langage C, s’avère ici incontournable. En recourant à des chaînes de contrôle de conversion explicites (telles que « %.2f » pour contraindre l’affichage à deux décimales invariables, ou « %03d » pour insérer des zéros de remplissage), le chercheur modèle avec une précision millimétrique l’aspect du texte généré.
De surcroît, l’architecture textuelle moderne gère parfaitement l’adjonction de retours à la ligne au moyen du métacaractère standard d’échappement séquentiel n. L’insertion calculée de ce saut de ligne au sein de la formule de concaténation scinde instantanément l’étiquette en deux segments superposés verticalement : le registre supérieur accueille l’identifiant nominal du sujet, tandis que le registre inférieur expose ses scores chiffrés entre parenthèses. Cette morphologie bipartite compacte permet de diviser par deux l’encombrement horizontal de l’étiquette sur le nuage de points, réduisant mécaniquement les risques de collisions proximales avec les observations adjacentes.
10.2 Interprétation des syntaxes mathématiques avec l’argument parse
Si la concaténation alphanumérique standard répond aux exigences signalétiques élémentaires, elle capitule dès qu’il s’agit d’intégrer des notations formalisées imposant des exposants, des indices imbriqués ou des équations de modèles statistiques. Pour activer la machinerie de rendu mathématique au sein de geom_text(), geom_label() ou de leurs pendants répulsifs dans ggrepel, le praticien doit impérativement activer le paramètre logique parse = TRUE.
L’activation de parse modifie profondément le comportement du moteur graphique : la chaîne textuelle transmise à l’esthétique label n’est plus traitée comme une suite de caractères littéraux, mais comme une chaîne syntaxique soumise à l’évaluateur de la fonction interne plotmath de R. Ainsi, une séquence textuelle stipulant une formulation rigoureuse sera compilée pour restituer une équation typographique élégante où le coefficient de détermination statistique trône majestueusement avec son exposant carré parfaitement proportionné et aligné sur la ligne de flottaison du glyphe principal.
Cette approche réclame néanmoins une rigueur syntaxique impitoyable de la part de l’utilisateur. Toute tentative d’insérer des espaces textuels bruts au sein de la chaîne déclenchera une rupture immédiate de l’analyseur syntaxique, qui interprète l’espace comme une erreur grammaticale de l’expression mathématique. L’analyste doit substituer aux espaces les opérateurs de liaison réservés du moteur de tracé, principalement l’opérateur tilde (~) pour générer un espace visuel régulier ou l’opérateur astérisque (*) pour juxtaposer immédiatement deux éléments sans espacement perceptible. La maîtrise de cette grammaire rigoureuse ouvre la voie à des annotations d’une sophistication visuelle exceptionnelle, directement conformes aux conventions typographiques des revues de mathématiques appliquées et de psychométrie computationnelle.
10.3 Intégration d’échelles de transformation avec le package scales
Dans de nombreuses applications d’évaluation psychométrique ou socio-économique, les coordonnées projetées sur les axes du nuage de points découlent de transformations fonctionnelles non linéaires, telles que des échelles logarithmiques destinées à linéariser les distributions asymétriques de temps de réponse, ou des échelles de rangs percentiles. L’incohérence la plus dommageable consisterait à étiqueter les points au moyen de valeurs brutes déconnectées de la métrique perceptible affichée sur les axes de coordonnées gradués. La bibliothèque scales fournit le cadre d’harmonisation idéal pour garantir une conformité totale entre graduation périphérique et libellé ponctuel.
Les fonctions spécialisées de ce package, telles que label_percent(), label_scientific() ou label_number(), opèrent en tant que générateurs de fermetures fonctionnelles (function closures) capables d’ingérer un vecteur de données brutes pour restituer une série de chaînes textuelles impeccablement formatées selon les normes internationales. L’utilisateur peut ainsi spécifier en une unique ligne de code le nombre de décimales autorisées, l’adjonction d’un suffixe symbolique unifié, ainsi que l’encadrement des séparateurs d’ordres de grandeur.
Un apport majeur de cette boîte à outils pour la communauté scientifique francophone réside dans la normalisation culturelle des marqueurs numériques. Par simple paramétrage de l’argument decimal.mark = « , » au sein de la fonction d’échelle, l’ensemble des métriques statistiques associées aux étiquettes ponctuelles convertit automatiquement le point anglo-saxon en virgule décimale conforme aux impératifs stylistiques de l’Office québécois de la langue française et de l’Académie des sciences. Cette standardisation rigoureuse élimine les disparités de notation et confère à la figure une cohérence éditoriale d’un professionnalisme exemplaire.
11. Étiquetage interactif pour l’exploration de données multidimensionnelles
11.1 Passage du graphique statique à l’interactivité avec plotly
Bien que l’optimisation des annotations statiques constitue un savoir-faire fondamental pour la littérature scientifique destinée à l’impression physique, l’avènement des rapports numériques reproductibles et des plateformes de découverte visuelle a propulsé l’interactivité au rang d’outil d’investigation primordial. L’insertion textuelle dynamique permet de s’affranchir définitivement du dilemme classique d’encombrement graphique : les points de dispersion conservent une pureté géométrique absolue sur le canevas de base, tandis que les annotations exhaustives ne se matérialisent qu’à la demande explicite de l’observateur via le survol du curseur.
La transition de l’univers statique de ggplot2 vers la réactivité dynamique s’accomplit avec une fluidité remarquable grâce au package plotly conçu par Carson Sievert. La fonction pivot ggplotly() ingère directement l’objet graphique généré au sein de la grammaire de Wickham pour le convertir en une structure JSON interprétable par le moteur de rendu vectoriel JavaScript client-side D3.js. L’utilisateur bénéficie ainsi immédiatement d’outils d’agrandissement dynamique, de panoramique cartésien et d’isolation d’intervalles sans avoir rédigé la moindre ligne de code Web natif.
Le contrôle de l’étiquetage interactif s’opère alors au moyen de l’argument stratégique tooltip de la fonction de conversion. En réassignant cet argument à une variable esthétique personnalisée préalablement déclarée au sein de aes() (comme l’esthétique fictive text), l’analyste décide souverainement de la nature exacte des métadonnées qui doivent se déployer au sein de l’info-bulle flottante lorsque la souris vient effleurer l’un quelconque des centroïdes du tracé, métamorphosant un graphique passif en un instrument de forage analytique puissant.
11.2 Personnalisation des info-bulles pour les bilans psychologiques
La personnalisation des info-bulles dynamiques ouvre des perspectives considérables pour la communication de profils diagnostiques individuels approfondis. Dans le cadre de l’exploitation d’un nuage de points modélisant l’évaluation neuropsychologique d’une cohorte de patients cérébro-lésés, la projection brute ne peut raisonnablement porter que deux indices synthétiques globaux (tels que le quotient intellectuel d’une part et un indice de mémoire de travail d’autre part). Les sous-échelles factorielles détaillées ne sauraient être inscrites statiquement sur le graphique sous peine d’anéantir toute lisibilité d’ensemble.
L’étiquetage interactif résout cette limitation avec une élégance structurelle sans égale. Par l’intermédiaire d’une étape de pré-traitement mobilisant paste0(), le concepteur du graphique assemble une chaîne de caractères composite incorporant des fragments de code HTML standard. L’usage de balises telles que <b> pour renforcer l’identifiant du patient, couplé à des retours de paragraphe formels <br> et à des énumérations à puces, permet d’échafauder un véritable bulletin clinique individualisé au format miniature.
Lors de l’examen de la figure sous un environnement interactif moderne (tel qu’un document Quarto, un tableau de bord Shiny ou un rapport d’évaluation généré sous R Markdown), le praticien inspectant un cas divergent voit surgir instantanément la totalité des scores indicatifs aux sous-tests cliniques par simple survol du point correspondant. Cette synchronisation étroite entre macro-visualisation distributionnelle et micro-exploration sémantique sublime la fonction de diagnostic sans exiger le feuilletage laborieux d’annexes tabulaires volumineuses.
11.3 Considérations ergonomiques et limites de l’interactivité
En dépit de son évidente séduction instrumentale, l’étiquetage interactif ne constitue pas une panacée universelle et soulève des problématiques ergonomiques et déontologiques substantielles que le méthodologiste doit appréhender avec discernement. La première contrainte d’importance concerne la portabilité éditoriale : les formats de publication académique conventionnels imposés par les revues de référence demeurent massivement tributaires du support PDF statique ou du papier imprimé, contextes d’usage au sein desquels toute composante interactive s’évanouit purement et simplement, rendant la maîtrise des annotations statiques vue aux sections antérieures résolument indispensable.
La seconde limitation est d’ordre computationnel et architectural. Tandis qu’un fichier graphique vectoriel statique encapsule des descriptions géométriques compactes, l’exportation interactive via des bibliothèques JavaScript embarque la totalité des structures de métadonnées associées à chaque observation au sein du corps du document HTML produit. Face à des cohortes colossales (telles que celles rencontrées dans les études de bio-informatique ou les enquêtes pan-européennes intégrant des dizaines de milliers de répondants), le poids du document s’accroît de façon exponentielle, saturant la mémoire du navigateur client et altérant gravement la fluidité de consultation de la figure.
Enfin, l’accessibilité numérique pour les usagers en situation de handicap (notamment les personnes utilisant des synthétiseurs vocaux ou des périphériques de lecture braille) impose des exigences strictes en matière de restitution de l’information. Les info-bulles basées sur le survol de coordonnées canvas échappent fréquemment aux arbres d’accessibilité des technologies d’assistance. Le chercheur éthique veillera donc systématiquement à doubler toute visualisation interactive d’une table d’accessibilité textuelle exhaustive ou d’un résumé de synthèse accessible, garantissant une transmission équitable des découvertes scientifiques à l’ensemble de la communauté des chercheurs.
12. Bonnes pratiques éditoriales, reproductibilité et pièges méthodologiques
12.1 Conformité aux normes de publication de l’APA (7e édition)
La diffusion de résultats empiriques dans les revues d’autorité en psychologie, en neurosciences et en sciences de l’éducation impose une soumission méticuleuse aux préceptes éditoriaux édictés par l’American Psychological Association dans la 7e édition de son manuel de publication. Les prescriptions de l’APA relatives aux documents visuels reposent sur une trilogie cardinale : clarté géométrique, frugalité ornementale et neutralité typographique absolue. L’étiquetage des nuages de points doit impérativement se conformer à cette orthodoxie sous peine de rejet formel lors des phases initiales de relecture par les pairs.
Sur le versant typographique, l’APA prescrit sans équivoque le recours à des polices de caractères sans empattement (sans-serif) d’une lisibilité cristalline, recommandant explicitement des familles universelles telles qu’Arial, Calibri ou Helvetica. La taille des glyphes au sein du canevas graphique doit être calibrée pour s’inscrire rigoureusement dans un intervalle compris entre 8 et 14 points typographiques, prévenant à la fois les écritures microscopiques indéchiffrables et les lettrages surdimensionnés qui dégraderaient l’équilibre spatial de la planche. L’emploi d’effets visuels superflus, tels que les ombres portées, les dégradés chromatiques décoratifs ou les encadrements sur-épaissis autour des étiquettes textuelles, est formellement proscrit en vertu du rejet du bruit graphique (chartjunk).
Par ailleurs, l’APA accorde une importance critique à la traçabilité textuelle des abréviations mobilisées. Dès lors qu’une observation est signalée par un acronyme technique (par exemple le code anonymisé d’un sujet clinique ou l’abréviation d’une sous-échelle diagnostique), l’auteur est tenu d’expliciter sans exception la signification intégrale du libellé dans le corps de la note de figure (figure note) disposée immédiatement sous le tracé. Cette rigueur garantit qu’une figure scientifique demeure un artéfact autonome et auto-suffisant, susceptible d’être appréhendé et compris de façon indépendante sans exiger la lecture préalable intégrale de la section méthodologique du manuscrit.
12.2 Garantie de reproductibilité computationnelle des étiquettes
Dans le contexte actuel de la crise internationale de la réplication qui secoue les sciences expérimentales, la transparence algorithmique de la production graphique est devenue une exigence déontologique aussi impérieuse que la communication des données brutes ou des scripts de modélisation mathématique. La génération d’annotations sur un nuage de points n’échappe nullement à cet impératif catégorique, particulièrement lorsque l’on mobilise des couches logicielles intégrant des processus d’optimisation stochastiques comme les algorithmes de répulsion de forces.
L’obligation méthodologique première réside dans la fixation systématique et inconditionnelle d’une graine de pseudo-aléatoire au moyen de l’instruction canonique set.seed() au tout début de chaque script d’analyse, ainsi qu’au niveau des paramètres dédiés des fonctions d’annotation répulsives. L’omission de cette précaution élémentaire engendre une dérive visuelle insidieuse : à chaque nouvelle compilation du code source ou lors de la génération d’un document computationnel sous Quarto, les étiquettes se repositionnent selon une trajectoire légèrement modifiée, entraînant des variations inacceptables d’une version à l’autre d’un même article scientifique.
De surcroît, la reproductibilité pérenne implique une gestion rigoureuse de l’environnement logiciel lui-même. Les évolutions de version des bibliothèques graphiques peuvent altérer silencieusement les constantes internes de dimensionnement ou de calcul des boîtes de collision. L’utilisation d’outils de capture environnementale tels que le package renv garantit que l’ensemble des dépendances logicielles (incluant les versions exactes de R, de ggplot2, de ggrepel et des périphériques de rendu vectoriel) sont figées et archivées avec le projet de recherche, immunisant le travail contre toute dépréciation logicielle future lors des phases ultérieures d’audit scientifique.
12.3 Diagnostic et résolution des dysfonctionnements fréquents
La pratique quotidienne de l’étiquetage sous R confronte inévitablement le statisticien à une série d’anomalies visuelles récurrentes dont l’élucidation réclame une compréhension intime des mécanismes de bas niveau du moteur de rendu. L’incident le plus classiquement documenté réside dans le tronquage mutilant des étiquettes positionnées aux confins extrêmes du canevas cartésien au sein de ggplot2. Par défaut, le moteur applique une opération géométrique de rognage (clipping) qui sectionne aveuglément tout objet graphique franchissant la ligne de démarcation du panneau central.
La remédiation orthodoxe à cette mutilation périphérique ne réside pas dans des bricolages d’alignement empiriques, mais dans la désactivation programmée du rognage cartésien via l’instruction formelle coord_cartesian(clip = « off »). Concomitamment à cette levée de masque, l’analyste accroît symétriquement les marges extérieures de la figure par l’intermédiaire de l’argument plot.margin dans la fonction de thème global theme(). Cette double intervention octroie à la couche d’annotation une liberté d’extension totale au-delà des axes sans risque d’amputation typographique des données marginales d’intérêt.
Un second écueil critique survient lors de l’inversion d’axes ou de l’application de transformations non linéaires (telles que des transformations logarithmiques ou inverses). Si le chercheur applique manuellement la fonction mathématique sur les vecteurs bruts plutôt que de déléguer la transformation aux échelles géométriques natives de ggplot2 (via scale_x_log10()), l’espace euclidien d’ancrage des boîtes d’étiquetage se trouve déformé de manière asymétrique, induisant des décalages d’offset aberrants. Le tableau suivant dresse une synthèse décisionnelle synoptique guidant l’arbitrage méthodologique entre les différents environnements graphiques examinés dans cet ouvrage :
- Système Base R (plot + text) : Idéal pour l’inspection exploratoire immédiate, le prototypage rapide en script léger, et l’absence totale de dépendances logicielles externes. Faible prise en charge automatisée des collisions typographiques.
- Écosystème ggplot2 (geom_text / geom_label) : Recommandé pour la publication scientifique standard, la structuration déclarative des données complexes, l’intégration de thèmes éditoriaux stricts (normes APA) et les facettages multidimensionnels.
- Extension ggrepel (geom_text_repel) : Indispensable pour la résolution rigoureuse et automatisée des superpositions d’étiquettes dans les nuages denses et l’édition de figures à haute intégrité géométrique dotées de lignes de rappel automatiques.
- Bibliothèque plotly (ggplotly) : Dédiée à l’exploration interactive des données multidimensionnelles, aux bilans cliniques personnalisés sur le Web et aux rapports dynamiques sous Quarto ou Shiny. Incompatible avec l’édition papier statique.
En observant rigoureusement ces préceptes algorithmiques, méthodologiques et déontologiques, l’analyste transcende les embûches techniques de la programmation graphique sous R pour produire des nuages de points annotés alliant une impeccable exactitude scientifique à une élégance visuelle d’une remarquable puissance démonstrative.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1983). Semiology of graphics: Diagrams, networks, maps. University of Wisconsin Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Sievert, C. (2020). Interactive web-based data visualization with R, plotly, and shiny. Chapman & Hall/CRC The R Series. https://plotly-r.com/
- Slowikowski, K. (2023). ggrepel: Automatically position non-overlapping text labels with ‘ggplot2’ (R package version 0.9.3). https://CRAN.R-project.org/package=ggrepel
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science & Business Media.