
L’analyse inférentielle des données discrètes constitue l’un des piliers méthodologiques les plus sollicités au sein des sciences empiriques contemporaines, qu’il s’agisse de la psychologie cognitive, de la neuropsychologie clinique, de l’épidémiologie ou des sciences sociales computationnelles. Lorsqu’un protocole expérimental nécessite de comparer l’efficacité de deux interventions distinctes, l’adhésion à deux thérapies comportementales différentes ou la survenue d’un comportement spécifique chez deux populations indépendantes, les chercheurs sont fréquemment confrontés à des variables d’intérêt de nature binaire dichotomique (succès/échec, présence/absence, rémission/rechute). Dans ce contexte précis, l’évaluation empirique ne repose pas sur la comparaison de moyennes d’échelles continues, mais sur la comparaison probabiliste de proportions ou de fréquences relatives issues d’échantillons probabilistes distincts.
Le test Z pour deux proportions — communément désigné dans la littérature biométrique sous le nom de two-proportion Z-test — représente l’outil paramétrique standard pour tester l’hypothèse de l’égalité de deux paramètres binomiaux dans des populations indépendantes de grande taille. Fondé théoriquement sur le théorème central limite et la convergence asymptotique de la distribution binomiale vers la distribution normale continue, ce test permet de quantifier avec une extrême rigueur la probabilité d’observer une divergence donnée entre deux pourcentages d’échantillon sous l’hypothèse nulle d’invariance populationnelle. Si les logiciels spécialisés de traitement statistique tels que R, SPSS ou SAS sont traditionnellement employés dans les laboratoires de recherche, l’environnement Microsoft Excel offre un cadre computationnel d’une puissance sous-estimée, permettant non seulement d’automatiser le calcul des métriques de décision, mais également de décortiquer explicitement chaque maillon algorithmique du test, garantissant ainsi une parfaite transparence méthodologique et une auditabilité complète des données.
Ce guide exhaustif a pour vocation d’exposer en détail l’ensemble du processus théorique, mathématique et pratique requis pour mettre en œuvre un test Z pour deux proportions au sein de Microsoft Excel, depuis la formulation rigoureuse des hypothèses scientifiques jusqu’à la restitution académique des résultats aux normes de l’American Psychological Association (APA). Chaque étape algorithmique — structuration de la matrice de données, calcul de la proportion combinée pondérée, dérivation de l’erreur type asymptotique, programmation de la statistique de Wald standardisée, détermination de la valeur p par les fonctions d’intégration cumulative et construction des intervalles de confiance — sera analysée avec une profondeur analytique garantissant une conformité méthodologique sans faille pour la recherche scientifique de haut niveau.
1. Fondements théoriques du test Z pour deux proportions
1.1 Définition et objectifs en méthodologie expérimentale
Dans le domaine de l’inférence statistique appliquée aux sciences expérimentales, la comparaison de deux proportions observées au sein d’échantillons indépendants répond à un objectif fondamental : déterminer si la divergence empirique relevée entre deux taux d’occurrence traduit une véritable hétérogénéité structurelle au niveau des populations sous-jacentes ou si elle peut être raisonnablement attribuée aux simples fluctuations d’échantillonnage aléatoire. Soient deux populations indépendantes régies par des paramètres binomiaux inconnus $p_1$ et $p_2$, représentant les probabilités théoriques de survenue d’un événement binaire spécifique. Lorsque les chercheurs extraient deux échantillons probabilistes indépendants de tailles respectives $n_1$ et $n_2$, les estimateurs ponctuels sans biais de ces paramètres sont fournis par les proportions échantillonnales $\hat{p}_1 = x_1 / n_1$ et $\hat{p}_2 = x_2 / n_2$, où $x_1$ et $x_2$ quantifient le nombre brut d’occurrences du succès observé dans chaque cohorte.
Le test Z pour deux proportions repose sur l’évaluation empirique de l’écart standardisé par rapport à l’hypothèse de nullité. Il quantifie la distance entre la différence observée $(\hat{p}_1 – \hat{p}_2)$ et la différence postulée sous l’hypothèse nulle (habituellement fixée à zéro), cette distance étant normalisée par l’erreur type de la distribution d’échantillonnage de la différence de proportions. Cette démarche trouve des applications majeures dans les études neuropsychologiques et comportementales, où l’on souhaite par exemple évaluer si le taux d’abandon thérapeutique au sein d’un groupe soumis à une thérapie cognitivo-comportementale digitalisée diffère significativement de celui constaté chez des patients bénéficiant d’un protocole standard en face-à-face, ou si la prévalence de déficits de mémoire de travail consécutifs à un traumatisme crânien est plus élevée chez les patients présentant une lésion frontale unilatérale comparativement à une cohorte témoin appariée.
Sur le plan distributionnel, la variable aléatoire sous-jacente mesurant le nombre de succès dans chaque échantillon obéit rigoureusement à une loi discrète binomiale définie sur l’ensemble des entiers naturels compris entre zéro et la taille de l’échantillon. Toutefois, à mesure que l’effectif des cohortes croît, l’application directe des probabilités combinatoires binomiales devient numériquement lourde et superflue. En vertu du théorème central limite et du théorème de De Moivre-Laplace, la distribution binomiale discrète $B(n, p)$ converge en loi vers une distribution gaussienne continue d’espérance $\mu = n p$ et de variance $\sigma^2 = n p (1 – p)$. Le test Z exploite précisément cette approximation normale continue, en transformant la différence discrète des proportions empiriques en une variable continue centrée réduite suivant de manière asymptotique une loi normale standard $N(0, 1)$.
1.2 Principe de l’échantillonnage et taille d’échantillon requise
L’admissibilité théorique de l’approximation normale pour des variables fondamentalement discrètes est assujettie au respect strict de critères de validité empirique liés à la distribution des effectifs observés et attendus. Si la distribution binomiale est parfaitement symétrique pour une probabilité théorique $p = 0{,}5$, elle présente une asymétrie d’autant plus prononcée que le paramètre s’approche des bornes extrêmes zéro ou un. Par conséquent, pour que l’approximation gaussienne de la distribution d’échantillonnage soit suffisamment robuste et que l’erreur d’approximation ne fausse pas le taux nominal de commettre une erreur de première espèce, la règle empirique de conformité la plus rigoureuse impose que chaque groupe présente un nombre minimal de succès et d’échecs.
En pratique biométrique, la condition standard stipule que pour chacun des deux groupes expérimentaux, le produit de la taille d’échantillon par la proportion observée ou attendue, ainsi que le produit de la taille par son complémentaire, doivent être au moins égaux à dix. Mathématiquement, ces quatre conditions doivent être simultanément vérifiées au sein de la matrice de données :
- $n_1 \cdot \hat{p}_1 ge 10$ (au moins 10 succès dans le groupe 1)
- $n_1 \cdot (1 – \hat{p}_1) ge 10$ (au moins 10 échecs dans le groupe 1)
- $n_2 \cdot \hat{p}_2 ge 10$ (au moins 10 succès dans le groupe 2)
- $n_2 \cdot (1 – \hat{p}_2) ge 10$ (au moins 10 échecs dans le groupe 2)
Certains auteurs libéraux admettent un seuil minimal de cinq occurrences, mais dans le cadre d’un protocole expérimental exigeant, la conservation du seuil de dix garantit la préservation des propriétés asymptotiques du théorème central limite et prévient l’effondrement de la puissance statistique du test. La violation de cette taille minimale entraîne une asymétrie résiduelle substantielle de la distribution d’échantillonnage, induisant une distorsion sensible de la valeur p calculée et gonflant artificiellement le taux d’erreur de première espèce ($\alpha$). Dans de telles configurations de rareté de l’événement d’intérêt, le chercheur doit impérativement abandonner l’approximation continue du test Z au profit de méthodes combinatoires exactes adaptées aux tables de contingence réduites.
1.3 Différenciation avec d’autres tests statistiques univariés
Il est indispensable, pour tout chercheur ou analyste de données, d’établir une démarcation formelle entre le test Z pour deux proportions et les autres procédures inférentielles univariées disponibles au sein de la boîte à outils statistique. L’analogie la plus fréquente s’observe avec le test du Chi-deux ($\chi^2$) d’indépendance de Pearson appliqué à une table de contingence de dimensions 2×2. D’un point de vue purement mathématique, pour une hypothèse bilatérale, le test Z pour deux proportions et le test du Chi-deux sans correction de continuité de Yates sont rigoureusement équivalents : la statistique calculée du Chi-deux est exactement égale au carré de la statistique de Wald standardisée ($Z^2 = \chi^2$). Néanmoins, le test Z offre une flexibilité conceptuelle et computationnelle nettement supérieure en permettant de formuler et tester des hypothèses alternatives unilatérales directionnelles (supériorité ou infériorité), ce qui est intrinsèquement impossible avec le test du Chi-deux, dont la distribution asymétrique ne teste qu’une déviation globale et bidirectionnelle de l’indépendance.
Parallèlement, il convient de distinguer catégoriquement le test Z de la famille des tests t de Student pour échantillons indépendants. Le test t de Student a pour vocation de modéliser des variables dépendantes continues distribuées normalement au sein de la population (ou s’appuyant sur de grands échantillons), dont l’écart-type de la population est inconnu et doit être estimé à partir des données de l’échantillon, introduisant ainsi une incertitude supplémentaire captée par les degrés de liberté de la loi de Student. À l’inverse, dans le cadre binomial propre au test Z, la variance est une fonction déterministe directe de la proportion elle-même ($\sigma^2 = p(1-p)$). Dès lors que la proportion est estimée, la variance est simultanément contrainte, dispensant l’analyse de l’usage des degrés de liberté de la distribution de Student et autorisant l’exploitation directe de l’asymptote normale standard.
Enfin, sur le plan computationnel, le test Z présente des avantages manifestes pour le traitement des cohortes volumineuses dans des environnements matriciels comme Excel. Tandis que l’application de tests non paramétriques basés sur les rangs (tels que le test de Mann-Whitney U) devient prohibitive en termes de ressources de calcul lors du traitement de dizaines de milliers de lignes, le test Z réduit l’ensemble de l’information brute à quatre scalaires élémentaires ($x_1, n_1, x_2, n_2$), autorisant une exécution instantanée, élégante et parfaitement stable d’un point de vue algorithmique.
2. Hypothèses scientifiques et prérequis statistiques
2.1 Indépendance des observations et échantillonnage aléatoire
L’échafaudage probabiliste du test Z pour deux proportions repose sur le postulat cardinal de l’indépendance statistique des observations, tant à l’intérieur de chaque échantillon qu’entre les deux groupes soumis à comparaison. Pour que l’estimateur de la variance d’échantillonnage conserve sa propriété de non-biais, la sélection de chaque participant au sein de la population cible doit être régie par les principes d’un échantillonnage aléatoire simple ou d’un échantillonnage probabiliste stratifié rigoureux. Dans les protocoles cliniques ou les expérimentations comportementales, chaque sujet doit être assigné de manière aléatoire aux conditions expérimentale et témoin, garantissant l’absence totale de liens d’appariement, de gémellité, de corrélation temporelle ou de mesures répétées longitudinales.
L’existence d’une dépendance structurelle — telle que l’inclusion de membres d’une même cellule familiale, l’évaluation de patients admis dans le même centre hospitalier sans modélisation de l’effet centre, ou le recueil de données auprès d’individus interagissant socialement au cours de l’expérimentation — viole dramatiquement le postulat d’indépendance. Cette violation engendre une corrélation intra-classe positive qui a pour conséquence systématique de sous-estimer la variance réelle de l’estimateur, conduisant à un rétrécissement artificiel de l’erreur type et à une inflation incontrôlée des faux positifs statistiques. De surcroît, les biais d’échantillonnage non probabilistes, tels que le recours exclusif à des volontaires autodésignés, compromettent la représentativité des paramètres calculés et rendent caduque toute extrapolation des inférences dérivées.
Il est également nécessaire que la taille de chaque échantillon demeure une fraction marginale de la population parente globale. Selon la théorie des sondages en population finie, dès lors qu’un échantillon extrait sans remise excède 5 % de la population totale ($n > 0{,}05 N$), il devient impératif d’appliquer un facteur de correction pour population finie sous la forme $\sqrt{(N – n) / (N – 1)}$. Dans l’immense majorité des applications en sciences du comportement et en recherche biomédicale, les populations cibles théoriques sont présumées infinies ou suffisamment vastes pour que cette correction soit négligée sans compromettre la validité des conclusions.
2.2 Formulation formelle de l’hypothèse nulle et alternative
La démarche de test d’hypothèse de Neyman-Pearson requiert une formulation mathématique préalable, explicite et non ambiguë des hypothèses concurrentes avant toute inspection empirique des données tabulées dans la feuille de calcul. L’hypothèse nulle, immuablement notée $H_0$, postule l’absence absolue de différence entre les probabilités de succès au niveau des populations sous-jacentes. Elle s’énonce selon l’expression :
$H_0 : p_1 – p_2 = 0 \quad \text{ou de façon équivalente} \quad H_0 : p_1 = p_2$
L’hypothèse alternative, désignée par $H_1$ ou $H_a$, formalise la conjecture opérationnelle du chercheur et peut être structurée selon deux architectures inférentielles distinctes en fonction des fondements théoriques présidant à l’expérimentation :
- Spécification bilatérale (non directionnelle) : $H_1 : p_1 – p_2 ne 0$. Le chercheur postule l’existence d’une divergence entre les deux populations, sans toutefois préjuger du signe algébrique de cette disparité. Toute déviation extrême, qu’elle soit positive ou négative, est susceptible de conduire au rejet de l’hypothèse nulle. Cette formulation représente le standard conservateur recommandé par les comités de lecture académiques.
- Spécification unilatérale directionnelle (supériorité ou infériorité) : $H_1 : p_1 – p_2 > 0$ (soit $p_1 > p_2$) ou $H_1 : p_1 – p_2 < 0$ (soit $p_1 < p_2$). Cette approche est réservée aux contextes méthodologiques stricts où une direction théorique unique est admissible sur le plan logique ou déontologique, par exemple pour tester la supériorité attendue d'un traitement neuroprotecteur innovant face à un placebo inerte.
Le paramétrage du risque d’erreur de première espèce, conventionnellement symbolisé par la lettre grecque $\alpha$, quantifie la probabilité maximale tolérée de rejeter à tort l’hypothèse nulle alors que celle-ci est fondamentalement vraie dans la réalité ontologique. En psychométrie et en sciences expérimentales, ce seuil est fixé a priori au niveau conventionnel de $\alpha = 0{,}05$, bien que des protocoles requérant une vigilance accrue face aux faux positifs adoptent couramment des seuils décisionnels plus rigoureux fixés à $\alpha = 0{,}01$ ou $\alpha = 0{,}001$.
2.3 Vérification des postulats dans les protocoles de recherche
Avant d’engager la puissance computationnelle d’Excel dans le traitement du test Z, l’analyste se doit d’opérer un contrôle d’audit méthodologique méticuleux sur les protocoles de recherche afin d’identifier d’éventuelles failles structurelles. En premier lieu, il convient de scruter attentivement les dynamiques de déperdition expérimentale ou d’attrition. Si des participants ont abandonné le protocole en cours de route de façon différentielle entre la cohorte expérimentale et la cohorte témoin, cette attrition sélective peut induire un biais de survie altérant profondément la comparabilité des taux d’occurrence binaires finaux.
En second lieu, l’encodage des données primaires requiert un assainissement rigoureux. Dans les fichiers matriciels volumineux, des valeurs aberrantes ou mal codées (par exemple, la saisie accidentelle de chiffres tels que 2, 99 ou de chaînes textuelles dans un champ strictement réservé à un code binaire 0 ou 1) risquent de fausser l’agrégation des succès et d’invalider les effectifs totaux réels. L’usage de filtres logiques et de masques de saisie au sein du tableur permet d’écarter toute incohérence avant l’extraction des sommes marginales.
Enfin, le chercheur doit s’assurer de l’absence totale de corrélation intra-classe résiduelle liée à des variables de confusion non contrôlées. Si l’exposition au facteur expérimental s’est déroulée par vagues successives ou par cohortes géographiques distinctes, une analyse de sensibilité préalable doit être conduite afin de vérifier que la proportion de succès ne dissimule pas un effet de grappe qui imposerait l’abandon du modèle Z standard au bénéfice de modèles linéaires généralisés à effets mixtes.
3. Structuration et encodage des données dans Excel
3.1 Organisation de la feuille de calcul
La rigueur de l’analyse inférentielle sous Microsoft Excel est indissociable d’une architecture matricielle méthodique et documentée. Une feuille de calcul destinée à accueillir un test statistique universitaire ne doit jamais mélanger de manière désordonnée les enregistrements primaires désagrégés et les cellules de calculs synthétiques. Il est hautement recommandé d’adopter une organisation modulaire divisant l’espace de travail en trois quadrants distincts : une zone de métadonnées méthodologiques, un tableau d’encodage des observations brutes et un tableau de synthèse inférentielle dédié aux paramètres statistiques dérivés.
La zone d’en-tête (lignes 1 à 5) accueille les métadonnées descriptives du projet : identification du protocole expérimental, date de l’analyse, nom de l’investigateur principal, définition opérationnelle de l’événement codé comme un « succès » et rappel explicite du niveau alpha de tolérance retenu. Les colonnes suivantes sont dédiées aux groupes expérimentaux, dotées d’étiquettes sémantiques claires et non équivoques (par exemple, Groupe_A_Intervention et Groupe_B_Controle), bannissant les nomenclatures cryptiques susceptibles de générer des inversions d’indices lors de l’écriture ultérieure des différences mathématiques.
Chaque cellule destinée à accueillir des quantités calculées doit faire l’objet d’un formatage numérique préalable strict au sein du ruban Excel. Les effectifs bruts et les comptages de succès doivent être rigoureusement verrouillés au format « Nombre » sans aucune décimale, tandis que les proportions calculées et les statistiques intermédiaires doivent être configurées pour afficher quatre décimales significatives, prévenant ainsi toute illusion de divergence induite par des troncatures d’affichage visuel trompeuses.
3.2 Agrégation des données primaires
Dans la configuration expérimentale la plus fréquente, le chercheur dispose d’une feuille de calcul regroupant les données au niveau individuel, où chaque participant est documenté sur une ligne distincte et dont la réponse binaire est codée numériquement par la convention binaire standard : 1 pour l’occurrence du succès (rémission clinique, réussite à une épreuve cognitive, rétention d’apprentissage) et 0 pour l’échec ou la non-occurrence de l’événement.
Pour condenser cette masse d’enregistrements bruts en indicateurs synthétiques directement exploitables par la statistique de test Z, le recours aux fonctions logiques de dénombrement d’Excel s’avère indispensable. Supposons que les observations du groupe expérimental soient consignées dans la plage A2:A151 et celles du groupe témoin dans la plage B2:B165. Pour quantifier le nombre total de succès dans chaque groupe respectif, l’analyste insère les formules conditionnelles suivantes :
- Pour le groupe expérimental ($x_1$) :
=NB.SI(A2:A151; 1) - Pour le groupe témoin ($x_2$) :
=NB.SI(B2:B165; 1)
Parallèlement, la quantification des tailles d’échantillons totales ($n_1$ et $n_2$) est obtenue via la fonction de dénombrement des cellules non vides NB.VAL, ou via la fonction NB si les cellules contiennent exclusivement des marqueurs numériques :
- Pour l’effectif du groupe 1 :
=NB(A2:A151) - Pour l’effectif du groupe 2 :
=NB(B2:B165)
Une procédure de validation logique croisée consiste à sommer les succès et les échecs dénombrés (via NB.SI(A2:A151; 0)) afin de vérifier que leur agrégation arithmétique coïncide rigoureusement avec le décompte obtenu via NB(A2:A151), éliminant tout risque d’omission de cellules mal codées ou corrompues par des caractères invisibles.
3.3 Calcul direct des proportions observées
Une fois les scalaires élémentaires $x_1$, $n_1$, $x_2$ et $n_2$ fermement établis dans le tableau de synthèse, le calcul des proportions empiriques observées s’opère par une formulation divisionnaire élémentaire. Si la cellule D4 contient le nombre de succès $x_1$ et la cellule D5 l’effectif total $n_1$, la proportion empirique $\hat{p}_1$ s’obtient dans la cellule D6 par l’expression syntaxique :
=D4/D5
De manière strictement analogue, avec le succès $x_2$ en cellule E4 et l’effectif $n_2$ en cellule E5, la proportion observée $\hat{p}_2$ s’implémente en cellule E6 par la formule :
=E4/E5
Afin de prévenir l’apparition de l’erreur fatale de division par zéro (#DIV/0!) dans le cas d’une matrice partiellement complétée ou en cours d’alimentation dynamique, il est judicieux d’encapsuler ces divisions au sein d’une structure conditionnelle préventive de type =SI(D5>0; D4/D5; ""). Les cellules accueillant ces ratios doivent ensuite être typées au format « Pourcentage » avec deux décimales visibles pour la communication générale des résultats, tout en veillant à conserver la valeur numérique réelle sous-jacente en virgule flottante pour l’alimentation des calculs ultérieurs.
4. Calcul de la proportion combinée pondérée
4.1 Justification théorique du regroupement sous H0
Le traitement rigoureux du test Z pour deux proportions se distingue fondamentalement de l’estimation d’un intervalle de confiance par l’obligation théorique d’adopter une stratégie de regroupement des données (procédure dite de pooling). Sous l’empire de l’hypothèse nulle $H_0$, les deux populations sous-jacentes partagent une probabilité de succès absolument identique, telle que $p_1 = p_2 = p$. En conséquence logique de ce postulat d’homogénéité parfaite, les deux échantillons extraits lors de l’expérimentation ne constituent pas deux entités disjointes, mais proviennent en réalité d’une seule et même population parente sous-jacente vis-à-vis du paramètre d’intérêt.
Il découle de cette considération qu’il serait statistiquement inefficace et biaisé d’estimer séparément la variance d’échantillonnage de chaque cohorte à partir de leurs proportions empiriques respectives $\hat{p}_1$ et $\hat{p}_2$. La méthode du maximum de vraisemblance démontre que le meilleur estimateur sans biais, convergent et à variance minimale de ce paramètre théorique commun $p$ s’obtient en fusionnant l’ensemble des observations disponibles au sein des deux cohortes.
Cette mise en commun des données expérimentales permet de stabiliser de façon optimale l’estimation de la variance d’échantillonnage de base. En regroupant les données, on maximise les degrés d’information disponibles, ce qui conduit à une réduction substantielle de l’erreur d’estimation globale et assure que la statistique Z calculée converge très exactement vers une loi normale centrée réduite théorique lorsque l’hypothèse nulle est valide.
4.2 Formule mathématique du paramètre combiné
Sur le plan mathématique, l’estimateur de la proportion combinée pondérée, universellement désigné par le symbole $\hat{p}_c$ (ou $\bar{p}$), est défini comme le rapport arithmétique entre la somme intégrale de l’ensemble des événements de succès observés dans les deux cohortes et la somme globale des effectifs des deux échantillons réunis :
$$\hat{p}_c = \frac{x_1 + x_2}{n_1 + n_2}$$
Il est impératif de souligner une erreur méthodologique trop fréquente : la proportion combinée pondérée n’est pas, sauf dans le cas très particulier où les effectifs d’échantillons sont rigoureusement égaux ($n_1 = n_2$), la simple moyenne arithmétique des deux proportions individuelles $(\hat{p}_1 + \hat{p}_2) / 2$. Elle représente une moyenne pondérée par les poids respectifs des effectifs de chaque échantillon :
$$\hat{p}_c = \left(\frac{n_1}{n_1 + n_2}\right) \hat{p}_1 + \left(\frac{n_2}{n_1 + n_2}\right) \hat{p}_2$$
Un critère absolu de contrôle de cohérence algorithmique réside dans la propriété de barycentre mathématique : la valeur numérique de la proportion combinée pondérée doit impérativement être strictement encadrée par les deux proportions individuelles. Si $\hat{p}_1 < \hat{p}_2$, alors la relation d'ordre $\hat{p}_1 le \hat{p}_c le \hat{p}_2$ doit être rigoureusement satisfaite au sein de la feuille Excel. Toute violation de cette inégalité témoigne d'une erreur de parenthésage ou de référencement de cellules dans la formule saisie.
4.3 Implémentation de la syntaxe dans Excel
Au sein de l’environnement Excel, la mise en œuvre computationnelle de la proportion combinée requiert une attention soutenue quant à l’ordre des priorités opératoires arithmétiques. En reprenant l’agencement matriciel précédemment défini — avec $x_1$ en D4, $n_1$ en D5, $x_2$ en E4 et $n_2$ en E5 — la transcription de la formule mathématique dans une cellule dédiée (par exemple D8) doit obligatoirement encapsuler le numérateur et le dénominateur entre des parenthèses distinctes :
=(D4+E4)/(D5+E5)
L’omission des parenthèses, sous la forme erronée =D4+E4/D5+E5, conduirait le moteur de calcul d’Excel à exécuter prioritairement la division de E4 par D5 avant de procéder à l’addition des termes restants, aboutissant à une valeur aberrante dénuée de tout sens statistique.
Afin de conférer une clarté optimale au classeur et de simplifier l’écriture des formules subséquentes complexes, il est vivement recommandé d’utiliser le gestionnaire de noms d’Excel. En attribuant explicitement le nom de variable p_pooled à la cellule D8 (via le menu Formules > Définir un nom), les algorithmes d’erreur type et de test Z pourront faire directement référence à ce paramètre textuel intelligible plutôt qu’à une coordonnée alphanumérique abstraite.
5. Calcul de l’erreur type de la différence
5.1 Composantes mathématiques de la dispersion
L’erreur type de la différence de proportions constitue le dénominateur de normalisation de la statistique de test Z. Elle matérialise l’écart-type de la distribution d’échantillonnage de la variable aléatoire $(\hat{p}_1 – \hat{p}_2)$ sous l’hypothèse nulle d’un paramètre populationnel commun unique. En vertu des propriétés fondamentales de l’algèbre des variables aléatoires indépendantes, la variance de la différence de deux estimateurs sans corrélation est égale à la somme de leurs variances d’échantillonnage respectives :
$$Var(\hat{p}_1 – \hat{p}_2) = Var(\hat{p}_1) + Var(\hat{p}_2)$$
Puisque la variance d’un estimateur de proportion binomiale basé sur un échantillon de taille $n$ et un paramètre $p$ s’exprime par le ratio $p(1 – p) / n$, et étant donné que sous l’hypothèse nulle $H_0$ le paramètre $p$ est estimé de façon congruente par la proportion combinée pondérée $\hat{p}_c$, la variance de la différence se formule mathématiquement comme suit :
$$Var(\hat{p}_1 – \hat{p}_2) = \frac{\hat{p}_c (1 – \hat{p}_c)}{n_1} + \frac{\hat{p}_c (1 – \hat{p}_c)}{n_2} = \hat{p}_c (1 – \hat{p}_c) \left( \frac{1}{n_1} + \frac{1}{n_2} \right)$$
L’erreur type asymptotique combinée, symbolisée par $SE_0$ ou $\sigma_{\hat{p}_1 – \hat{p}_2}$, est extraite en appliquant la racine carrée arithmétique à cette variance consolidée :
$$SE_0 = \sqrt{\hat{p}_c (1 – \hat{p}_c) \left( \frac{1}{n_1} + \frac{1}{n_2} \right)}$$
5.2 Construction de l’algorithme sous Excel
La transcription de l’expression mathématique de l’erreur type dans le tableur fait intervenir la fonction d’extraction de racine carrée RACINE (ou SQRT dans les versions anglophones d’Excel). En considérant que la cellule D8 renferme la valeur de la proportion combinée $\hat{p}_c$ (ou est nommée p_pooled), et que les effectifs $n_1$ et $n_2$ sont localisés respectivement en D5 et E5, la syntaxe intégrale doit être codée au sein de la cellule D10 selon le schéma suivant :
=RACINE(D8*(1-D8)*((1/D5)+(1/E5)))
Si la cellule a été préalablement nommée, la formule acquiert une élégance scripturale et une lisibilité analytique immédiate :
=RACINE(p_pooled*(1-p_pooled)*((1/D5)+(1/E5)))
Le contrôle de l’intégrité numérique du calcul impose que le terme interne à la fonction RACINE soit strictement supérieur à zéro. Ce postulat est toujours vérifié dès lors que la proportion combinée n’est ni strictement égale à zéro ni strictement égale à un (ce qui signifierait une absence totale ou une omniprésence absolue du succès dans les deux cohortes, rendant toute inférence comparative dépourvue de sens méthodologique) et que les effectifs d’échantillons sont des entiers strictement positifs.
5.3 Analyse de sensibilité de l’erreur type
L’erreur type n’est pas un scalaire figé ; elle fluctue dynamiquement en réponse aux propriétés structurelles des données collectées. Une compréhension aiguë de son comportement mathématique permet au chercheur d’anticiper la sensibilité de son dispositif expérimental. En premier lieu, l’erreur type est inversement proportionnelle aux racines carrées des tailles d’échantillons : tout quadruplement de l’effectif combiné $(n_1 + n_2)$ a pour conséquence mécanique de réduire l’erreur type de moitié, resserrant la distribution d’échantillonnage et augmentant spectaculairement la précision de l’estimation de la différence.
En second lieu, l’équilibre numérique entre les deux cohortes exerce une influence décisive sur la stabilité de la variance. Pour un effectif total constant ($N = n_1 + n_2$), l’erreur type atteint son minimum absolu lorsque les deux échantillons présentent une parité d’effectif parfaite ($n_1 = n_2$). À mesure que le déséquilibre s’accentue (par exemple, dans un ratio 10:1 fréquent dans les études cliniques de maladies rares avec témoins abondants), le terme $(1/n_1 + 1/n_2)$ est dominé par l’échantillon le plus restreint, limitant drastiquement les gains de précision induits par l’accumulation d’observations dans le grand échantillon.
Enfin, le facteur $\hat{p}_c (1 – \hat{p}_c)$ atteint son maximum arithmétique lorsque la proportion combinée est exactement de 0,50 (valeur égale à 0,25). À mesure que les proportions se rapprochent des valeurs marginales 0,00 ou 1,00, le produit s’effondre, réduisant l’erreur type apparente mais accroissant paradoxalement la vulnérabilité de l’approximation normale aux distorsions d’asymétrie.
6. Détermination de la statistique de test Z
6.1 Dérivation du score standardisé
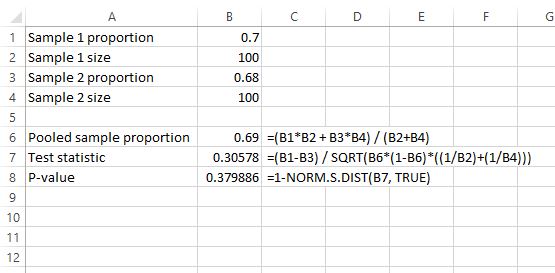
La statistique de test Z — historiquement qualifiée de statistique de score de Wald pour la différence de proportions — incarne la métrique de normalisation permettant de confronter l’hypothèse nulle à la réalité empirique. Elle représente le ratio entre l’amplitude du signal statistique (l’écart brut constaté entre les deux proportions échantillonnales) et le bruit de fond méthodologique inhérent au processus d’échantillonnage (l’erreur type calculée sous l’hypothèse nulle) :
$$Z = \frac{\hat{p}_1 – \hat{p}_2 – 0}{SE_0} = \frac{\hat{p}_1 – \hat{p}_2}{\sqrt{\hat{p}_c (1 – \hat{p}_c) \left( \frac{1}{n_1} + \frac{1}{n_2} \right)}}$$
Sur le plan physique et conceptuel, la statistique Z mesure le nombre d’écarts-types dont la différence observée s’éloigne de la différence théorique nulle postulée sous $H_0$. Si le score $Z$ obtenu s’établit à une valeur de $+2{,}50$, cela signifie sans équivoque que la proportion du premier échantillon surpasse celle du second d’une magnitude équivalente à deux écarts-types et demi de la distribution d’échantillonnage théorique attendue en cas d’équivalence absolue des populations.
L’orientation algébrique du signe de la statistique Z dépend exclusivement de l’ordre d’agencement des groupes lors de la soustraction. Si l’on calcule $(\hat{p}_1 – \hat{p}_2)$, un score positif reflète une proportion supérieure dans le groupe 1, tandis qu’un score négatif dénote une proportion plus élevée dans le groupe 2. Cette orientation est purement conventionnelle et n’affecte en rien la puissance ou la conclusion du test, pourvu que la structure des hypothèses alternatives et le calcul des probabilités de queue de distribution soient paramétrés en parfaite concordance.
6.2 Programmation de la formule z dans la feuille de calcul
Au sein de la matrice de travail sous Excel, le calcul du score Z mobilise les cellules hébergeant les proportions observées ($\hat{p}_1$ en D6, $\hat{p}_2$ en E6) et celle contenant l’erreur type asymptotique combinée ($SE_0$ en D10). Dans la cellule désignée pour afficher la statistique de décision (par exemple D12), la formule est encodée de la façon suivante :
=(D6-E6)/D10
Là encore, la présence rigoureuse de parenthèses autour du numérateur (D6-E6) est formellement requise pour empêcher toute dérive opératoire. Le résultat affiché par cette cellule doit être formaté au format numérique avec une précision minimale de trois décimales (par exemple, $+2{,}345$ ou $-1{,}982$), facilitant ainsi les contrôles croisés immédiats avec les tables de la distribution normale standard imprimées dans les manuels de référence ou générées par d’autres environnements de script tels que le logiciel R via la commande native prop.test(..., correct=FALSE).
Pour immuniser le tableur contre les ruptures de séquence de calcul au cas où l’erreur type s’avérerait indéterminée ou nulle, l’expression peut être avantageusement sécurisée par l’utilisation conjointe de la fonction SI.NON.DISP ou SIERREUR :
=SIERREUR((D6-E6)/D10; "Calcul non disponible")
6.3 Interprétation de la grandeur du score z
L’évaluation intuitive de la grandeur de la statistique de test Z repose sur la géométrie immuable de la courbe de distribution gaussienne standardisée. Sous l’hypothèse de nullité, la variable aléatoire Z se distribue selon la loi normale $N(0, 1)$, caractérisée par une moyenne nulle et un écart-type unitaire. Selon les propriétés empiriques de la loi normale, approximativement 68,27 % de la densité de probabilité se concentre dans l’intervalle compris entre $-1$ et $+1$, 95,45 % se situe entre $-2$ et $+2$, et plus de 99,73 % demeure confiné entre $-3$ et $+3$.
En pratique, l’obtention d’un score Z dont la valeur absolue est inférieure à 1,960 indique que la différence observée s’inscrit pleinement dans le cadre des fluctuations stochastiques prévisibles sous l’hypothèse d’une stricte identité populationnelle, au seuil bilatéral usuel de $\alpha = 0{,}05$. En revanche, dès lors que $|Z| ge 1{,}960$, la déviation empirique pénètre dans les zones critiques distales de la distribution, indiquant un écart trop substantiel pour être raisonnablement attribué au hasard de l’échantillonnage.
Un score Z dépassant les seuils absolus de 2,576 ou de 3,291 matérialise une divergence d’une magnitude extrême, correspondant respectivement aux niveaux de signification statistiques hautement conservateurs de $\alpha = 0{,}01$ et $\alpha = 0{,}001$. Quelle que soit la grandeur du score Z calculé, son interprétation scientifique formelle exige l’extraction exacte de la probabilité d’occurrence associée, couramment désignée sous le vocable de valeur p (p-value).
7. Calcul de la valeur p via les fonctions Excel
7.1 Exploitation de la fonction LOI.NORMALE.STANDARD.N
La valeur p matérialise la probabilité exacte, calculée sous l’hypothèse nulle $H_0$, d’obtenir une statistique de test au moins aussi extrême que la valeur empiriquement constatée dans l’échantillon expérimental. Au sein des versions actuelles de Microsoft Excel (éditions 2010, 2013, 2016, 2019, 2021 et Microsoft 365), la fonction standard dédiée à l’évaluation de la fonction de répartition cumulative de la loi normale standardisée est LOI.NORMALE.STANDARD.N (ou NORM.S.DIST dans les distributions en langue anglaise).
Cette fonction algorithmique sollicite impérativement deux arguments distincts :
z: la coordonnée numérique du score standardisé calculé (référence à la celluleD12).cumulative: un paramètre logique booléen. L’attribution de la valeurVRAI(ou du chiffre 1) ordonne à Excel de retourner la probabilité intégrale cumulée depuis l’infini négatif jusqu’au point $z$ considéré, soit mathématiquement la fonction de distribution $Phi(z) = P(Z le z)$. L’argumentFAUXne retournerait quant à lui que la densité de probabilité de l’ordonnée, totalement inadéquate pour le calcul inférentiel d’une valeur p.
Dans la perspective d’un test unilatéral à gauche (visant à prouver que la proportion du premier groupe est significativement inférieure à celle du second, $p_1 < p_2$), la probabilité de queue gauche est fournie directement par l'expression :
=LOI.NORMALE.STANDARD.N(D12; VRAI)
Inversement, dans le cadre d’un test unilatéral orienté à droite (supposant que $p_1 > p_2$), la valeur p représente la probabilité de queue supérieure $P(Z ge z)$, obtenue par le complément à l’unité de la probabilité cumulée :
=1 - LOI.NORMALE.STANDARD.N(D12; VRAI)
7.2 Calcul automatisé pour un test bilatéral
Dans l’immense majorité des protocoles de recherche en sciences comportementales et biomédicales, les investigateurs retiennent une hypothèse alternative bilatérale non directionnelle ($H_1 : p_1 ne p_2$). Dans cette perspective, la valeur p doit impérativement comptabiliser la masse de probabilité symétrique localisée dans les deux queues extrêmes de la distribution normale standard, indépendamment du fait que la statistique Z observée soit dotée d’un signe positif ou d’un signe négatif.
Pour concevoir un algorithme Excel robuste, insensible au sens algébrique initial du score Z, l’intégration de la fonction de valeur absolue ABS s’impose avec une impérieuse nécessité. L’expression ABS(D12) convertit tout score Z négatif en son équivalent positif, garantissant le positionnement systématique de la valeur dans l’aile droite supérieure de la distribution.
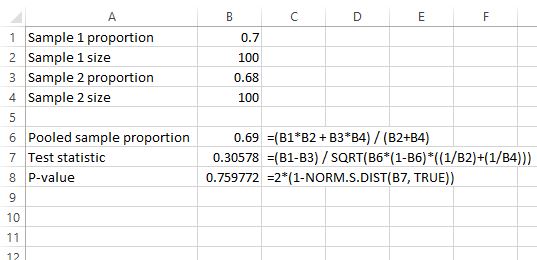
Dès lors, la probabilité cumulée de la queue supérieure extrême est calculée par la formule soustractive 1 - LOI.NORMALE.STANDARD.N(ABS(D12); VRAI). Pour obtenir l’intégralité de la valeur p bilatérale, cette probabilité unilatérale droite doit être rigoureusement doublée pour compenser la symétrie de la queue opposée :
=2 * (1 - LOI.NORMALE.STANDARD.N(ABS(D12); VRAI))
Cette architecture computationnelle présente une élégance méthodologique irréprochable : elle renvoie avec une fiabilité algorithmique parfaite la valeur p bilatérale exacte, que le score Z s’élève à $+2{,}15$ ou à $-2{,}15$, prévenant ainsi toute erreur de manipulation liée aux inversions manuelles de signes au niveau du tableur.
7.3 Gestion des fonctions héritées et compatibilité logicielle
Les concepteurs d’analyses statistiques déployées au sein de consortia multicentriques internationaux doivent impérativement veiller à la rétrocompatibilité des classeurs Excel partagés. Antérieurement à l’itération logicielle Microsoft Office 2010, le calcul de la distribution normale standard cumulée reposait sur la fonction héritée LOI.NORMALE.STANDARD (dépourvue du suffixe .N), dont la syntaxe n’acceptait qu’un paramètre unique, le score Z :
=2 * (1 - LOI.NORMALE.STANDARD(ABS(D12)))
Bien que Microsoft garantisse le maintien de cette ancienne fonction à des fins d’interopérabilité ascendante, les algorithmes de calcul sous-jacents aux versions héritées présentaient des limitations de précision numérique dans l’évaluation des queues de distribution extrêmement profondes (scores Z supérieurs à $\pm 5$). La fonction contemporaine LOI.NORMALE.STANDARD.N intègre des algorithmes d’approximation polynomiale de Tchebychev et de fractions continues substantiellement plus précis, recommandés par les comités d’intégrité logicielle.
Lors de l’exportation ou de l’ouverture de feuilles de calcul au format .xlsx au sein d’alternatives libres telles que LibreOffice Calc ou Google Sheets, la nomenclature fonctionnelle est automatiquement traduite en syntaxe ouverte internationale LEGACY.NORMSDIST ou NORM.S.DIST. L’utilisation du standard moderne LOI.NORMALE.STANDARD.N garantit ainsi une parfaite portabilité multiplateforme exempte d’erreurs d’incompatibilité de type #NOM?.
8. Définition de la zone critique et seuils de décision
8.1 Extraction de la valeur critique z*
L’approche classique de test d’hypothèse de Fisher-Neyman-Pearson requiert la confrontation de la statistique empirique calculée avec une valeur seuil théorique abstraite, appelée valeur critique $z^*$. Cette valeur délimite précisément la frontière de la région de rejet — ou zone critique — au-delà de laquelle l’écart observé est jugé incompatible avec les variations stochastiques aléatoires sous-tendues par l’hypothèse nulle.
L’extraction de ces coordonnées de coupure théoriques s’effectue au sein d’Excel par le déploiement de la fonction de répartition inverse de la loi normale centrée réduite : LOI.NORMALE.STANDARD.INVERSE.N (ou NORM.S.INV en anglais). Supposons que le risque de première espèce consenti $\alpha$ soit formellement encodé dans la cellule D14 (par exemple la valeur $0{,}05$).
- Pour un cadre bilatéral : Le risque d’erreur de 5 % est symétriquement fractionné en deux demi-zones de 2,5 % ($0{,}025$) réparties aux deux extrémités distales de la courbe. La valeur critique bilatérale supérieure s’obtient par la formule :
=LOI.NORMALE.STANDARD.INVERSE.N(1 - D14/2)
Pour $\alpha = 0{,}05$, Excel retourne la constante classique $z^* = 1{,}95996… \approx 1{,}960$. - Pour un cadre unilatéral : L’intégralité du risque $\alpha$ est concentrée dans une seule aile distributionnelle. La valeur critique supérieure s’obtient alors par :
=LOI.NORMALE.STANDARD.INVERSE.N(1 - D14)
Pour $\alpha = 0{,}05$, le seuil unilatéral d’exclusion s’abaisse à $z^* = 1{,}64485… \approx 1{,}645$.
Le tableau théorique des correspondances conventionnelles s’établit ainsi :
- Pour $\alpha = 0{,}10$ : Seuil bilatéral $|z^*| = 1{,}645$ | Seuil unilatéral $z^* = 1{,}282$
- Pour $\alpha = 0{,}05$ : Seuil bilatéral $|z^*| = 1{,}960$ | Seuil unilatéral $z^* = 1{,}645$
- Pour $\alpha = 0{,}01$ : Seuil bilatéral $|z^*| = 2{,}576$ | Seuil unilatéral $z^* = 2{,}326$
- Pour $\alpha = 0{,}001$ : Seuil bilatéral $|z^*| = 3{,}291$ | Seuil unilatéral $z^* = 3{,}090$
8.2 Automatisation de la règle de décision par formules logiques
Afin de minimiser le risque d’erreur humaine dans l’arbitrage statistique final, il est fortement judicieux de déléguer l’évaluation de la règle de décision au moteur logique d’Excel en programmant des conditions déclaratives à l’aide de la fonction SI.
La décision inférentielle peut être rigoureusement arbitrée selon deux algorithmes miroirs d’une stricte équivalence mathématique :
Option A : Décision gouvernée par la valeur p. En reliant directement la cellule hébergeant la valeur p calculée (par exemple D13) à la cellule spécifiant le seuil nominal $\alpha$ (en D14), la sentence académique textuelle est produite par l’instruction :
=SI(D13 < D14; "Rejet de H0 : Différence statistiquement significative"; "Non-rejet de H0 : Absence de différence significative")
Option B : Décision gouvernée par la statistique de Wald standardisée. En comparant la magnitude absolue du score empirique $Z$ (cellule D12) à la valeur critique théorique dérivée (cellule D15), la condition logique s’écrit :
=SI(ABS(D12) >= D15; "Rejet de H0 : Différence statistiquement significative"; "Non-rejet de H0 : Écart non significatif")
Cette formalisation logique élimine toute ambiguïté interprétative en produisant un verdict immédiat, parfaitement synchronisé avec les variations dynamiques des données d’entrée.
8.3 Visualisation de la zone de rejet dans Excel
L’enrichissement visuel du classeur statistique favorise grandement la communication scientifique des résultats lors de présentations de laboratoires ou d’audits méthodologiques. En premier lieu, l’application d’une mise en forme conditionnelle sur les cellules de synthèse (notamment les cellules de valeur p et de verdict textuel) permet de modifier dynamiquement le style graphique : un fond vert d’atténuation pour un rejet de $H_0$ ($p < 0{,}05$) ou un fond vermillon discret signalant l'absence de significativité statistique.
En second lieu, les fonctionnalités graphiques de tracé matriciel d’Excel autorisent la schématisation directe de la courbe de densité gaussienne standardisée. En générant une série linéaire de coordonnées allant de $-4{,}0$ à $+4{,}0$ par pas de $0{,}1$ dans une colonne dédiée, et en calculant les ordonnées correspondantes au moyen de la fonction de densité LOI.NORMALE.STANDARD.N(valeur_x; FAUX), le chercheur peut tracer un diagramme en nuage de points avec lignes lissées.
En superposant à cette courbe théorique des barres verticales distinctives positionnées aux coordonnées d’abscisse $-z^*$ et $+z^*$, ainsi qu’une ligne de repère dynamique pointant très exactement sur la statistique empirique calculée $Z$, l’analyste obtient une visualisation pédagogique éclatante. Le lecteur observe alors sans la moindre ambiguïté si le score calculé s’enfonce profondément dans la queue distale de la zone de rejet ou s’il s’inscrit au cœur du plateau central d’admissibilité de l’hypothèse de nullité.
9. Interprétation psychologique et rapport des résultats
9.1 Formalisation selon les standards académiques de l’APA
La communication des résultats d’un test Z pour deux proportions dans une revue académique à comité de lecture est assujettie au respect scrupuleux des directives typographiques édictées par l’American Psychological Association (7e édition du manuel de publication de l’APA). La formalisation textuelle exige la transmission exhaustive de plusieurs paramètres descriptifs et inférentiels essentiels : l’indication explicite des pourcentages observés avec leurs effectifs bruts et totaux respectifs, la valeur numérique exacte de la statistique de Wald standardisée $z$, le niveau de probabilité associé de la valeur p, ainsi que l’estimation de la marge d’incertitude via l’intervalle de confiance.
Sur le plan des conventions typographiques internationales, les lettres représentant des paramètres d’échantillons ou des statistiques de test doivent être systématiquement composées en italique (par exemple, z, p, n). La valeur p doit être restituée avec trois décimales significatives sans zéro initial si la valeur est strictement inférieure à l’unité (puisqu’une probabilité ne peut mathématiquement jamais excéder 1). Lorsque la valeur p calculée s’effondre sous le seuil d’arrondi de trois décimales, il est proscrit d’écrire p = 0,000 ; la notation canonique impose de formuler p < 0,001.
Voici un gabarit canonique d’intégration textuelle conforme aux standards académiques :
« Une analyse inférentielle fondée sur un test Z pour deux proportions indépendantes a été conduite afin de vérifier si l’adhésion au traitement cognitivo-comportemental différait selon le mode de délivrance du protocole. La proportion de rémission complète observée au sein du groupe bénéficiant de la thérapie digitalisée s’élève à 68,00 % (soit 102 succès sur 150 participants), contre une proportion de 51,52 % (soit 85 succès sur 165 participants) chez les patients assignés au protocole clinique standard en présentiel. L’analyse révèle que cette divergence de 16,48 points de pourcentage est hautement significative sur le plan statistique, z = 2,975, p = 0,003 (test bilatéral), IC à 95 % pour la différence [0,057 ; 0,273]. »
9.2 Distinction entre pertinence statistique et clinique
Une défaillance d’interprétation récurrente dans la littérature empirique consiste à confondre aveuglément la significativité statistique d’un résultat avec sa significativité clinique, pratique ou écologique réelle. La valeur p est le produit conjoint de deux forces distinctes : la taille de l’effet sous-jacent et la taille de l’échantillon d’investigation. Par conséquent, dans le cadre de recherches mobilisant des cohortes massives (fréquentes dans les méga-bases de données de santé ou le criblage en ligne), des divergences de proportions microscopiques et parfaitement futiles d’un point de vue médical (par exemple, une différence entre 50,1 % et 50,5 % sur des échantillons de cent mille sujets) déclencheront des scores Z imposants et des valeurs p substantiellement inférieures à 0,001.
Le chercheur averti doit se prémunir contre toute inférence hâtive dictée par le franchissement du seuil conventionnel arbitraire de 0,05. L’évaluation de l’impact psychologique ou médical réel impose d’analyser la divergence brute entre les groupes à l’aune du contexte théorique : une augmentation de 5 % du taux de rétention d’une information complexe dans un protocole d’apprentissage scolaire peut justifier une refonte des méthodes pédagogiques, tandis qu’une modification d’amplitude similaire dans un traitement chimiothérapeutique lourd assorti d’effets secondaires sévères pourrait être jugée cliniquement marginale.
En somme, le test Z fournit une réponse catégorique quant à la probabilité de réplication de l’effet en éliminant l’hypothèse du bruit de fond d’échantillonnage, mais il demeure totalement muet quant à l’importance théorique ou sociétale du phénomène quantifié.
9.3 Calcul de la taille d’effet et indices complémentaires
Pour affranchir l’évaluation empirique de la contingence liée à la taille de l’échantillon, les comités de rédaction scientifique exigent l’adjonction systématique d’indices de taille d’effet standardisés. Dans le champ des proportions binaires, l’indicateur universellement préconisé en psychométrie est le h de Cohen (Cohen’s h). La métrique $h$ de Cohen repose sur une transformation stabilisatrice de variance — la transformation arcsinus de la racine carrée de la proportion — qui garantit que l’écart métrique calculé conserve une valeur informative invariable, quelle que soit la localisation des proportions de départ sur l’échelle de 0 à 1.
La formulation mathématique du $h$ de Cohen s’énonce comme suit :
$$h = 2 \arcsin(\sqrt{\hat{p}_1}) – 2 \arcsin(\sqrt{\hat{p}_2})$$
Sous Microsoft Excel, la programmation du $h$ de Cohen exploite les fonctions ASIN (arc sinus) et RACINE appliquées aux cellules de proportions D6 et E6 :
=2*ASIN(RACINE(D6)) - 2*ASIN(RACINE(E6))
Selon les conventions canoniques établies par Jacob Cohen (1988), la magnitude absolue de l’indice $h$ est classifiée selon les seuils directeurs suivants :
- $|h| \approx 0{,}20$ : Effet de petite magnitude (différence discrète mais détectable).
- $|h| \approx 0{,}50$ : Effet de magnitude moyenne (différence cliniquement visible à l’œil nu).
- $|h| ge 0{,}80$ : Effet de grande magnitude (divergence majeure aux conséquences pratiques substantielles).
En complément du $h$ de Cohen, le chercheur peut enrichir sa feuille de calcul par la dérivation du Risque Relatif ($RR = \hat{p}_1 / \hat{p}_2$, encodé par =D6/E6) et du Rapport des Cotes (Odds Ratio, $OR = [\hat{p}_1 / (1 – \hat{p}_1)] / [\hat{p}_2 / (1 – \hat{p}_2)]$, codé par =(D6/(1-D6))/(E6/(1-E6))), fournissant un panorama épidémiologique complet de la force de l’association observée.
10. Calcul de l’intervalle de confiance pour la différence
10.1 Erreur type non pondérée pour l’intervalle
L’une des subtilités méthodologiques les plus cruciales de la statistique inférentielle réside dans la distinction fondamentale entre la mécanique du test d’hypothèse et la mécanique d’estimation par intervalle de confiance. Tandis que le test Z est rigoureusement contraint par le postulat de l’hypothèse nulle ($p_1 = p_2$), imposant le calcul d’une erreur type combinée pondérée $SE_0$ via la proportion combinée $\hat{p}_c$, l’intervalle de confiance vise au contraire à borner la véritable valeur inconnue de la différence populationnelle $(\Delta = p_1 – p_2)$ dans le monde réel, sans présumer a priori que celle-ci soit nulle.
Par conséquent, pour la dérivation de l’intervalle de confiance de Wald pour la différence de deux proportions, il est formellement interdit d’employer la proportion combinée pondérée. La variance de la distribution d’échantillonnage doit impérativement être estimée de manière non pondérée, en agrégeant directement les variances d’échantillonnage empiriques distinctes propres à chaque groupe étudié :
$$SE_{diff} = \sqrt{\frac{\hat{p}_1 (1 – \hat{p}_1)}{n_1} + \frac{\hat{p}_2 (1 – \hat{p}_2)}{n_2}}$$
Dans l’environnement Excel, la modélisation de cette erreur type non pondérée s’effectue dans une cellule dédiée (par exemple D17) en articulant les proportions observées ($\hat{p}_1$ en D6, $\hat{p}_2$ en E6) et les effectifs ($n_1$ en D5, $n_2$ en E5) à l’aide de la syntaxe matricielle suivante :
=RACINE((D6*(1-D6)/D5) + (E6*(1-E6)/E5))
10.2 Calcul des bornes inférieure et supérieure dans Excel
L’intervalle de confiance asymptotique à un niveau de confiance fixé à $(1 – \alpha)$, généralement calibré à 95 %, est délimité autour de l’estimateur ponctuel brut de la différence $(\hat{p}_1 – \hat{p}_2)$ par une marge d’erreur maximale tolérée ($ME$). Cette marge d’erreur représente le produit scalaire de la valeur critique théorique bilatérale $z^*$ (environ 1,960 pour un intervalle à 95 %) et de l’erreur type non pondérée :
$$ME = z^* \times SE_{diff}$$
Les bornes inférieure et supérieure de l’intervalle se définissent mathématiquement selon l’expression canonique :
$$IC_{1-\alpha} = [(\hat{p}_1 – \hat{p}_2) – z^* \times SE_{diff} \quad ; \quad (\hat{p}_1 – \hat{p}_2) + z^* \times SE_{diff}]$$
Sous Excel, avec la différence des proportions $(\hat{p}_1 – \hat{p}_2)$ calculée en cellule D18 par la formule =D6-E6, la valeur critique bilatérale $z^*$ en D15 et l’erreur type non pondérée en D17, les deux bornes paramétriques sont programmées dans des cellules dédiées de la manière suivante :
- Borne inférieure (cellule
D19) :=D18 - (D15 * D17) - Borne supérieure (cellule
D20) :=D18 + (D15 * D17)
Un contrôle de concordance théorique immédiat s’applique : au seuil bilatéral nominal équivalent (par exemple $\alpha = 0{,}05$), la décision du rejet de l’hypothèse nulle ($p < 0{,}05$) est rigoureusement équivalente au fait que l'intervalle de confiance à 95 % n'englobe pas la valeur zéro. Si la borne inférieure et la borne supérieure sont toutes deux strictement positives (ou toutes deux strictement négatives), le zéro est formellement exclu de l'intervalle, corroborant la significativité statistique de la différence observée.
10.3 Intérêt scientifique des intervalles pour les réplications
L’American Psychological Association et les grandes instances de standardisation méthodologique insistent lourdement sur la primauté des intervalles de confiance par rapport au formalisme binaire de la valeur p. Si la valeur p n’apporte qu’une décision dichotomique (significatif versus non significatif) sans quantifier la précision de la mesure, l’intervalle de confiance encapsule simultanément l’estimation de la taille de l’effet et l’étendue de l’incertitude expérimentale résiduelle.
Un intervalle particulièrement large (par exemple de $+0{,}01$ à $+0{,}35$), bien que statistiquement significatif au sens où il exclut le zéro, témoigne d’un manque d’information substantiel dû à des effectifs d’échantillon trop restreints, signalant au chercheur que la véritable amplitude de la supériorité du traitement demeure hautement imprécise dans la population générale. Inversement, un intervalle étroit (par exemple de $+0{,}14$ à $+0{,}18$) confère un niveau de confiance épistémique remarquable pour les modélisations théoriques.
De surcroît, les intervalles de confiance constituent le matériau brut irremplaçable pour la recherche cumulative contemporaine et l’élaboration de méta-analyses quantitatives. En restituant systématiquement les bornes $[IC_{\inf} ; IC_{\sup}]$, les auteurs fournissent directement aux futurs méta-analystes les éléments requis pour agréger les résultats d’études indépendantes via des modèles de pondération par l’inverse de la variance.
11. Conception d’un modèle interactif réutilisable
11.1 Paramétrage des cellules d’entrée et validation des données
Pour transformer une simple feuille de calcul ponctuelle en un véritable modèle interactif, robuste et pérenne — diffusable en toute sécurité au sein d’une équipe de recherche ou d’étudiants en méthodologie —, la mise en œuvre de dispositifs de sécurisation des données s’avère indispensable. La première étape consiste à paramétrer les règles de Validation des données au niveau du ruban Excel (menu Données > Validation des données) pour les quatre cellules fondamentales d’entrée ($x_1, n_1, x_2, n_2$).
Pour les cellules dédiées aux effectifs totaux $n_1$ et $n_2$ (cellules D5 et E5), l’analyste configure la validation de manière à n’autoriser que les nombres entiers strictement positifs :
- Autoriser : Nombre entier
- Données : supérieur à
- Minimum : 1
Pour les cellules destinées à accueillir les dénombrements de succès $x_1$ et $x_2$ (cellules D4 et E4), la logique probabiliste impose qu’un nombre de succès ne puisse être ni négatif ni supérieur à l’effectif global de l’échantillon correspondant. La règle de validation s’établit donc ainsi :
- Autoriser : Nombre entier
- Données : compris entre
- Minimum : 0
- Maximum pour $x_1$ :
=D5(référence dynamique à la taille de l’échantillon 1) - Maximum pour $x_2$ :
=E5(référence dynamique à la taille de l’échantillon 2)
Tout utilisateur tentant d’enregistrer une valeur textuelle ou d’insérer par mégarde un nombre de succès de 120 sur un échantillon de 100 individus se verra instantanément bloqué par un message d’alerte d’interruption logicielle, sanctuarisant la cohérence de l’architecture mathématique.
11.2 Génération de menus déroulants pour le type de test
Un modèle paramétrique interactif de haut niveau doit être capable de s’adapter automatiquement aux desiderata méthodologiques de l’expérimentateur, notamment en ce qui concerne l’orientation directionnelle de l’hypothèse de recherche. Pour matérialiser cette fonctionnalité, on implémente en cellule B14 un menu déroulant via la commande Validation des données > Autoriser : Liste, en inscrivant comme source de critères textuels prédéfinis :
Bilatéral (p1 ≠ p2); Unilatéral Droit (p1 > p2); Unilatéral Gauche (p1 < p2)
La cellule de calcul de la valeur p dynamique (en D13) est alors reconfigurée pour s’adapter dynamiquement au choix opéré dans cette liste déroulante au moyen d’une structure logique imbriquée exploitant la fonction SI :
=SI(B14="Bilatéral (p1 ≠ p2)"; 2*(1-LOI.NORMALE.STANDARD.N(ABS(D12); VRAI)); SI(B14="Unilatéral Droit (p1 > p2)"; 1-LOI.NORMALE.STANDARD.N(D12; VRAI); LOI.NORMALE.STANDARD.N(D12; VRAI)))
De façon rigoureusement synchrone, la cellule de la valeur critique théorique $z^*$ s’ajuste immédiatement pour afficher la valeur de coupure exacte correspondant à la directionnalité spécifiée :
=SI(B14="Bilatéral (p1 ≠ p2)"; LOI.NORMALE.STANDARD.INVERSE.N(1-D14/2); LOI.NORMALE.STANDARD.INVERSE.N(1-D14))
Ce niveau d’automatisation transforme le classeur en un simulateur décisionnel complet, capable de recalculer instantanément l’intégralité du statut inférentiel en fonction du cadre expérimental retenu.
11.3 Documentation interne et ergonomie de la feuille
L’expérience utilisateur et l’ergonomie fonctionnelle conditionnent la longévité et la transférabilité des outils de calcul en laboratoire. Un schéma de codification par couleurs standardisé doit être appliqué de façon rigoureuse à l’ensemble du modèle :
- Cellules d’entrée manuelle (données primaires et paramètres ajustables comme le seuil alpha) : Fond pastel bleu ou vert pâle délimité par une bordure distinctive.
- Cellules d’agrégation et calculs intermédiaires (proportions, proportions combinées, erreurs types) : Fond neutre grisé clair, signalant qu’aucune saisie manuelle ne doit y être opérée.
- Cellules de résultats critiques et verdicts (statistique Z, valeur p, intervalle de confiance, conclusion textuelle) : Fond blanc rehaussé d’un encadrement gras ou d’une typographie contrastée.
L’insertion d’infobulles et de commentaires explicatifs via le menu Nouveau commentaire permet de guider l’utilisateur pas à pas, en rappelant par exemple la définition d’un risque d’erreur alpha ou en explicitant le fonctionnement du menu déroulant.
Enfin, la finalisation du gabarit requiert le verrouillage de la feuille de calcul (via le menu Révision > Protéger la feuille). En veillant à déverrouiller préalablement les seules cellules d’entrée de données (via l’onglet Format de cellule > Protection > décocher Verrouillée), le concepteur garantit que les utilisateurs ne pourront jamais altérer ou écraser accidentellement les formules d’inférence sous-jacentes, scellant ainsi l’intégrité fonctionnelle définitive de l’instrument.
12. Biais méthodologiques, erreurs courantes et alternatives
12.1 Erreurs fréquentes d’implémentation sur Excel
Même au sein d’équipes de recherche chevronnées, la mise en œuvre du test Z pour deux proportions sur Excel est régulièrement entachée d’erreurs algorithmiques récurrentes qui peuvent altérer dramatiquement l’intégrité des conclusions publiées. L’écueil méthodologique le plus largement documenté réside dans la confusion entre l’erreur type combinée pondérée ($SE_0$) et l’erreur type non pondérée ($SE_{diff}$). L’utilisation erronée de l’erreur type non pondérée dans le dénominateur de la statistique de test Z viole le principe fondamental de modélisation sous l’hypothèse nulle et aboutit à un score standardisé biaisé, tout comme l’emploi de l’erreur type combinée pour borner un intervalle de confiance génère une marge d’incertitude mathématiquement fallacieuse.
Une seconde bévue algorithmique très courante consiste en l’omission du doublement de la probabilité unilatérale lors de la restitution d’un test bilatéral. L’analyste se contente fréquemment de coder 1 - LOI.NORMALE.STANDARD.N(D12; VRAI), divisant par deux la véritable valeur p bilatérale et exposant la recherche à un risque massif d’inflation des faux positifs statistiques en concluant à tort à une découverte significative.
Enfin, le phénomène de l’arrondi prématuré représente un risque insidieux. Lorsque l’analyste recopie manuellement des résultats intermédiaires arrondis à deux décimales (par exemple en saisissant une proportion combinée de 0,43 au lieu de sa valeur réelle en virgule flottante 0,4285714…) pour alimenter les calculs suivants, cette troncature se propage et s’amplifie dans les fonctions de racine carrée et de distribution cumulative, induisant des distorsions numériques notables sur les valeurs p critiques situées à la marge de significativité.
12.2 Limites inhérentes à l’approximation par la loi normale
L’analyste quantitatif doit constamment garder à l’esprit que le test Z ne constitue pas un calcul exact des probabilités combinatoires, mais une simple approximation asymptotique basée sur le théorème central limite. Dès lors que les conditions de validité empiriques énoncées dans la section 1.2 sont compromises — notamment lorsque les effectifs d’échantillons sont faibles ou lorsque les proportions observées s’approchent des limites asymptotiques 0,00 ou 1,00 —, le comportement de la statistique de Wald se dégrade sévèrement.
Dans ces zones marginales, la distribution d’échantillonnage réelle de la différence présente une asymétrie marquée (skewness) et un kurtosis anormal que la fonction continue gaussienne symétrique s’avère incapable de modéliser fidèlement. Il en résulte que le taux réel d’erreur de première espèce s’écarte substantiellement du niveau alpha nominal fixé à 0,05, générant soit une sévérité excessive (perte de puissance statistique), soit une libéralité indue (multiplication des faux rejets de $H_0$).
Dans de telles conditions d’échantillonnage restreint ($n_i p_i < 10$), l'abandon pur et simple du test Z s'impose comme une nécessité déontologique. Le chercheur doit alors réorienter ses analyses vers le test exact de Fisher, une méthode combinatoire non paramétrique fondée sur la distribution hypergéométrique qui calcule avec une exactitude absolue la probabilité combinatoire de la table de contingence sans solliciter aucune approximation continue gaussienne.
12.3 Contrôle des variables modératrices et confusionnelles
Enfin, la limite épistémologique majeure du test Z univarié pour deux proportions réside dans son incapacité structurelle à prendre en compte l’interférence de tierces variables modératrices ou de facteurs de confusion. L’analyse bivariée simple expose directement l’expérimentateur au redoutable paradoxe de Simpson, une configuration statistique où une divergence observée entre deux groupes peut s’inverser totalement lorsqu’on stratifie les données selon une variable sous-jacente non contrôlée (telle que l’âge des participants, le niveau socio-économique ou la gravité initiale du tableau clinique).
Si la répartition d’une variable confondante diffère substantiellement entre le groupe expérimental et le groupe témoin, la significativité statistique décelée par le test Z peut n’être qu’un pur artefact imputable à cette asymétrie distributionnelle préexistante plutôt qu’à l’efficacité intrinsèque de l’intervention étudiée.
Lorsque le dispositif expérimental ne permet pas de neutraliser ces biais par un échantillonnage randomisé stratifié idéal, le test Z pour deux proportions doit céder le pas à des approches multivariées considérablement plus puissantes, au premier rang desquelles figure la régression logistique binaire. Cette dernière autorise la modélisation rigoureuse de la probabilité de survenue de l’événement en estimant l’impact du facteur expérimental principal tout en ajustant simultanément pour l’ensemble des covariables confondantes continues et qualitatives.
En synthèse, le test Z pour deux proportions implémenté dans Microsoft Excel représente un outil d’une remarquable élégance computationnelle et d’une rigueur absolue pour l’analyse des variables binaires en grands échantillons indépendants, pourvu que l’analyste respecte scrupuleusement l’ensemble de ses postulats sous-jacents et sache identifier les frontières précises de sa validité méthodologique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fleiss, J. L., Levin, B., & Paik, M. C. (2003). Statistical methods for rates and proportions (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471445428
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. <a href="https://doi.org/10.1002/(sici)1097-0258(19980430)17:83.0.co;2-i » target= »_blank » rel= »noopener noreferrer »>https://doi.org/10.1002/(sici)1097-0258(19980430)17:83.0.co;2-i
- Rosner, B. (2015). Fundamentals of biostatistics (8th ed.). Cengage Learning.
- Triola, M. F. (2018). Elementary statistics (13th ed.). Pearson.