
Dans le champ des sciences humaines et sociales, et plus particulièrement en psychologie clinique, en neuropsychologie et en sciences cognitives, l’évaluation rigoureuse de l’efficacité d’une intervention thérapeutique constitue une exigence méthodologique primordiale. Qu’il s’agisse de mesurer l’impact d’une psychothérapie cognitive et comportementale sur les symptômes anxieux, de quantifier les progrès mnésiques consécutifs à un protocole de remédiation cognitive, ou d’évaluer la modification d’attitudes après une campagne de sensibilisation, les chercheurs et praticiens ont constamment recours à des protocoles longitudinaux dits « pré-test et post-test ». Dans ce cadre expérimental intra-sujet, chaque participant devient son propre témoin, générant deux observations interdépendantes recueillies à des moments temporels distincts.
Pour tester scientifiquement si l’évolution observée entre ces deux temps de mesure traduit un véritable effet de l’intervention ou si elle relève simplement des fluctuations aléatoires inhérentes à l’échantillonnage, l’outil inférentiel paramétrique de référence demeure le test t de Student pour échantillons appariés (souvent qualifié de test t pour mesures répétées ou test t dépendant). Bien que les progiciels statistiques contemporains tels que SPSS, R, JASP ou Jamovi permettent d’exécuter cette procédure en une fraction de seconde, la maîtrise de sa résolution manuelle, pas à pas et à l’aide d’une simple calculatrice, conserve une valeur heuristique et pédagogique inestimable. Effectuer un test t apparié à la main permet de démystifier les équations sous-jacentes, d’appréhender intimement la mécanique du ratio signal-sur-bruit qui gouverne l’inférence statistique, et de développer un regard critique indispensable face aux sorties automatisées d’ordinateurs.
Ce guide exhaustif a été conçu pour accompagner pas à pas les étudiants de master, les doctorants, les cliniciens et les chercheurs en psychologie dans la réalisation intégrale, rigoureuse et entièrement manuelle d’un test t apparié. En partant des fondements métrologiques jusqu’à la restitution finale des résultats selon les normes éditoriales de l’American Psychological Association (APA 7e édition), nous détaillerons chaque formule, chaque manipulation algébrique et chaque arbitrage décisionnel. À travers l’analyse méticuleuse d’un jeu de données cliniques concret portant sur douze patients souffrant de troubles anxieux, vous découvrirez comment convertir deux séries d’observations corrélées en une unique distribution différentielle, comment isoler la variance d’erreur, et comment interpréter la significativité statistique en conjonction étroite avec la taille d’effet et les intervalles de confiance.
1. Fondements théoriques et pertinence du test t apparié en psychologie
1.1 Définition et nature des mesures répétées en recherche psychologique
Le plan à mesures répétées, couramment dénommé plan intra-sujets (ou within-subjects design dans la littérature anglophone), représente l’une des structures expérimentales les plus élégantes et les plus puissantes de la recherche empirique. Dans une telle architecture, chaque unité statistique — c’est-à-dire chaque individu participant à l’étude — est soumise successivement à l’ensemble des conditions expérimentales, ou évaluée à plusieurs reprises sur une même échelle psychométrique au fil du temps. Le cas prototypique le plus fréquent en psychologie appliquée demeure le protocole pré-post intervention : le chercheur administre un instrument de mesure étalonné au temps initial (T1, phase pré-thérapeutique), applique un traitement spécifique (par exemple, huit semaines de thérapie cognitive), puis réévalue le même individu au moyen du même instrument au terme du processus (T2, phase post-thérapeutique).
La distinction conceptuelle fondamentale entre les échantillons indépendants et les échantillons appariés (ou dépendants) repose sur l’existence d’une corrélation intrinsèque entre les scores. Lorsque l’on compare deux groupes indépendants — par exemple, un groupe de patients recevant une molécule pharmacologique et un groupe distinct recevant un placebo —, la valeur obtenue par un sujet du groupe expérimental n’entretient aucun lien systématique avec la valeur d’un sujet particulier du groupe témoin. À l’inverse, dans un plan apparié, le score recueilli au temps T2 dépend étroitement des caractéristiques individuelles stables manifestées au temps T1 : un sujet intrinsèquement très réactif sur le plan émotionnel obtiendra fréquemment des scores plus élevés que ses pairs lors des deux sessions de mesure.
D’un point de vue métrologique et mathématique, cette dépendance sérielle confère aux plans intra-sujets un avantage considérable en matière d’efficience statistique : la réduction drastique de la variance interindividuelle. Dans un plan à groupes indépendants, les différences individuelles non contrôlées (telles que le niveau intellectuel général, les traits de personnalité stables, le statut socio-économique ou la réactivité neurovégétative) s’amalgament directement dans le terme d’erreur statistique. Dans un plan apparié, ces facteurs de confusion stables demeurent constants au sein de chaque individu ; ils sont ainsi neutralisés lors de la soustraction des scores, ce qui assainit la mesure du changement et procure un gain spectaculaire de puissance statistique (notée 1 – β). Les applications sont légion, s’étendant des essais contrôlés évaluant la restructuration cognitive chez des patients déprimés jusqu’aux paradigmes de psycholinguistique mesurant la réduction des temps de réaction après un entraînement attentionnel informatisé.
1.2 Objectif statistique : inférence sur les différences appariées
Face à une série de couples de scores obtenus avant et après intervention, l’esprit humain est naturellement enclin à observer les moyennes des deux distributions distinctes : la moyenne initiale et la moyenne terminale. Cependant, sur le plan de la théorie statistique de l’échantillonnage, maintenir l’analyse au niveau de deux distributions distinctes s’avère particulièrement complexe et sous-optimal en raison de la covariance non nulle qui lie les deux moments d’évaluation. L’innovation conceptuelle fondamentale introduite par William Sealy Gosset — qui publia sous le célèbre pseudonyme de « Student » en 1908 — consiste à opérer un changement d’espace géométrique en modélisant le changement individuel comme unité d’analyse primaire.
Au lieu de considérer la variable aléatoire X1 (le score avant traitement) et la variable aléatoire X2 (le score après traitement) comme deux entités distinctes, le statisticien synthétise chaque dyade d’observations en une nouvelle variable aléatoire unique, notée D, définie par la soustraction différentielle de chaque score pour chaque individu. Par cette opération de projection algébrique, le problème métrologique initial — comparer deux séries bivariées appariées — est élégamment réduit à l’analyse univariée classique d’un échantillon unique de scores différentiels. L’objectif inférentiel devient alors limpide : il ne s’agit plus de vérifier si la distribution au temps 2 est différente de la distribution au temps 1, mais de déterminer si l’espérance mathématique de la distribution des différences dans la population parente, formellement désignée par le paramètre grec μD, diffère de manière statistiquement significative de zéro.
Ce basculement méthodologique permet d’appliquer la totalité de l’appareil déductif du test t pour échantillon unique à cette série de différences. Si l’intervention thérapeutique n’exerce aucune influence véritable, les écarts individuels observés ne traduiront que des bruits de mesure aléatoires, des erreurs instrumentales ou des fluctuations circonstancielles ; en conséquence, les différences positives et négatives tendront à s’annihiler mutuellement, produisant une moyenne différentielle d’échantillon oscillant étroitement autour de zéro. En revanche, si la thérapie induit un soulagement systématique de la symptomatologie, la distribution empirique des écarts se trouvera déplacée unilatéralement, fournissant la preuve empirique nécessaire au rejet de l’hypothèse d’absence d’effet.
2. Conditions d’application et postulats métrologiques indispensables
2.1 Niveau de mesure et indépendance des paires d’observations
Avant de procéder au moindre calcul arithmétique, l’analyste des données doit s’assurer scrupuleusement que son protocole de recherche satisfait aux postulats mathématiques sous-jacents au modèle linéaire général et au test t de Student. Le premier prérequis concerne la nature métrologique de la variable dépendante mesurée. Le test t étant une statistique paramétrique fondée sur le calcul de moyennes et de variances empiriques, la variable d’intérêt doit impérativement posséder des propriétés quantitatives continues, relevant au minimum d’une échelle d’intervalles égaux ou d’une échelle de rapports, au sens de la célèbre typologie de Stanley Smith Stevens. Les opérations d’addition et de soustraction n’ayant de signification métrologique que si la distance séparant deux unités consécutives demeure constante sur l’ensemble du continuum (l’écart entre 20 et 25 points doit représenter la même quantité psychologique que l’écart entre 45 et 50 points), l’usage de données purement ordinales brutes est formellement proscrit.
Une question récurrente en psychométrie clinique porte sur la légitimité d’appliquer le test t apparié à des scores composites issus d’échelles de Likert. Si un item de Likert isolé (gradué par exemple de 1 à 5) possède indéniablement un caractère ordinal, la littérature méthodologique contemporaine (Norman, 2010) admet très largement que la sommation ou la moyenne d’un grand nombre d’items de Likert — comme c’est le cas au sein de l’Inventaire d’Anxiété de Beck ou de l’Échelle d’Évaluation de la Dépression de Hamilton — engendre un score total quasi-continu qui peut être traité de manière robuste par les tests paramétriques, pourvu que la distribution ne présente pas d’effets de plancher ou de plafond massifs.
Le second postulat métrologique indispensable, souvent mal compris, concerne l’indépendance stricte entre les différentes unités statistiques d’observation. S’il est établi que les deux mesures composant une paire sont dépendantes (puisqu’elles proviennent du même sujet), chaque paire d’observations (chaque dyade pré-post) doit être totalement indépendante de toutes les autres paires constituant l’échantillon. Cela implique que l’inclusion, le comportement ou la réactivité d’un participant n’exerce aucune influence directe ou indirecte sur les réponses des autres participants. Ce postulat exclut d’emblée l’analyse non ajustée de données recueillies au sein de dyades interactives (couples, jumeaux) ou de groupes thérapeutiques où des dynamiques de contagion émotionnelle ou d’apprentissage vicariant ont pu biaiser l’indépendance des résidus sans recours à la modélisation multiniveau.
2.2 Normalité de la distribution des différences
Le postulat distributionnel du test t apparié fait fréquemment l’objet d’une confusion conceptuelle majeure dans la pratique de la recherche académique. Bon nombre d’expérimentateurs s’évertuent à évaluer la normalité de la distribution des scores pré-test, puis celle des scores post-test, séparément. Or, la théorie mathématique du test t pour mesures répétées n’exige nullement que les distributions initiales X1 et X2 soient individuellement distribuées selon la loi normale de Laplace-Gauss. L’exigence formelle porte exclusivement et strictement sur la distribution de la nouvelle variable aléatoire créée : la distribution des scores de différence individuelle (D = X2 – X1).
Il est tout à fait possible que la variable brute au temps T1 soit fortement asymétrique (par exemple, dans un échantillon clinique où les scores de détresse psychologique sont très concentrés vers les valeurs pathologiques extrêmes) et que la variable au temps T2 le soit tout autant, mais que leur différence algébrique individuelle suive une distribution parfaitement normale et symétrique autour de son espérance. Le chercheur doit donc soumettre la série empirique des différences aux épreuves classiques d’adéquation distributionnelle : examen de l’asymétrie (skewness) et de l’aplatissement (kurtosis), inspection visuelle du diagramme quantile-quantile (Q-Q plot), ou tests formels d’adéquation tels que le test de Shapiro-Wilk (pour les effectifs réduits) ou de Kolmogorov-Smirnov.
Toutefois, en vertu du théorème central limite, le test t apparié présente une robustesse asymptotique remarquable face aux déviations modérées de la normalité lorsque la taille de l’échantillon est suffisante (généralement n ≥ 30). En revanche, lorsque le protocole clinique repose sur un effectif restreint (comme n = 12 dans notre démonstration pratique ultérieure), la normalité de la variable différentielle devient cruciale. En particulier, la statistique t est hautement vulnérable à la présence de valeurs aberrantes (outliers) parmi les scores de différence. Un individu isolé ayant présenté une aggravation massive de ses symptômes pour des motifs extérieurs au protocole thérapeutique peut, à lui seul, gonfler artificiellement la variance d’échantillonnage et déplacer la moyenne différentielle, annihilant la puissance du test et menant à une erreur de type II. La détection et le traitement préalable de telles valeurs extrêmes constituent un prérequis incontournable de l’analyse exploratoire.
3. Formulation rigoureuse des hypothèses statistiques (H0 et H1)
3.1 L’hypothèse nulle (H0) et sa signification clinique
Dans l’architecture de l’inférence statistique fréquentiste, héritée des travaux conjoints de Ronald Fisher, Jerzy Neyman et Egon Pearson, la formulation des hypothèses précède obligatoirement tout examen des données recueillies. L’analyste se trouve dans l’obligation de poser une hypothèse de référence conservatrice, désignée sous le terme d’hypothèse nulle et notée formellement H0. Dans le contexte précis du test t apparié, cette hypothèse postule l’absence intégrale de différence systématique entre les deux moments d’évaluation à l’échelle de la population théorique parente dont est extrait l’échantillon.
Mathématiquement, l’hypothèse nulle s’exprime de la manière suivante :
H0 : μD = 0 (ou, de manière strictement équivalente : μ2 – μ1 = 0)
où μD représente la moyenne théorique de la population des différences individuelles, et μ1 et μ2 désignent respectivement les moyennes populationnelles aux temps T1 et T2. Traduite sur le plan de la réalité clinique en psychologie, cette formalisation signifie que le protocole thérapeutique administré n’exerce aucune action mesurable sur le construit psychologique évalué. Si l’on observe empiriquement des variations positives ou négatives chez les différents patients d’une étude, l’hypothèse nulle attribue l’intégralité de ces fluctuations à l’erreur d’échantillonnage, aux imperfections métrologiques des questionnaires, ou encore aux effets non spécifiques d’ordre temporel (tels que la régression vers la moyenne ou l’histoire conjoncturelle).
Il est essentiel de souligner que, dans l’épistémologie de l’inférence par test d’hypothèse, l’hypothèse nulle joue le rôle d’une présomption d’innocence méthodologique. Elle est considérée comme exacte a priori jusqu’à ce que les données empiriques apportent une charge de preuve suffisamment discordante et improbable pour contraindre le statisticien à la rejeter avec un risque d’erreur contrôlé.
3.2 L’hypothèse alternative (H1) : tests bilatéraux vs unilatéraux
Face à l’hypothèse nulle se dresse l’hypothèse alternative, notée H1 (ou HA), qui incarne l’affirmation scientifique substantielle que le chercheur aspire à étayer empiriquement. L’hypothèse alternative postule que l’intervention psychologique a effectivement induit une modification non nulle de la variable dépendante au sein de la population. Dès lors, le statisticien est confronté à un arbitrage méthodologique de première importance : choisir entre une formulation bilatérale (non directionnelle) et une formulation unilatérale (directionnelle).
Dans le cadre d’un test bilatéral, le chercheur postule simplement l’existence d’un changement au fil du temps, sans présumer a priori du sens de cette évolution. L’hypothèse s’écrit formellement :
H1 : μD ≠ 0
Cette approche est épistémologiquement la plus conservatrice et la plus prudente. Elle prend en compte l’éventualité qu’une intervention psychologique puisse non seulement améliorer l’état clinique du patient (diminution des scores de pathologie), mais également, dans certains contextes iatrogènes ou imprévus, aggraver paradoxalement la symptomatologie (augmentation des scores). Les risques alpha (erreur de type I) sont alors distribués équitablement aux deux extrémités de la distribution de probabilité théorique.
À l’opposé, le test unilatéral implique une prédiction directionnelle stricte et a priori, étayée par une revue exhaustive de la littérature théorique et des essais empiriques antérieurs :
H1 : μD < 0 (si l’on s’attend à une diminution des symptômes avec la convention D = Post – Pré)
ou bien H1 : μD > 0 (si l’on évalue un construit positif tel que l’estime de soi ou le bien-être subjectif)
Bien que le test unilatéral offre l’attrait statistique d’abaisser le seuil critique nécessaire pour atteindre la significativité dans le sens prédit — maximisant ainsi la puissance statistique de l’essai —, son adoption impose une contrainte épistémologique drastique : si les résultats empiriques révèlent une modification massive dans le sens opposé à celui théoriquement postulé, le chercheur a l’obligation formelle de considérer cette découverte comme non significative et attribuable au hasard. En psychologie académique contemporaine, les comités de lecture privilégient quasi-systématiquement les tests bilatéraux, à moins qu’une justification méthodologique irréfutable n’ait été préenregistrée avant le recueil des données.
4. Constitution du jeu de données expérimental : protocole pré-post intervention
4.1 Scénario d’étude : mesure de l’anxiété avant et après thérapie cognitive
Afin d’ancrer de manière irréprochable l’ensemble des dérivations mathématiques dans la réalité pratique de la recherche psychologique, considérons un scénario d’étude clinique typique. Une équipe de psychologues chercheurs en santé mentale s’intéresse à l’efficacité d’un nouveau protocole structuré de Thérapie Cognitive et Comportementale (TCC), axé sur la restructuration des pensées automatiques catastrophistes et l’exposition intéroceptive, appliqué à des patients souffrant de trouble panique avec agoraphobie.
L’échantillon clinique est constitué de n = 12 participants consécutifs répondant aux critères diagnostiques standardisés. Chaque patient fait l’objet d’une première passation métrologique rigoureuse au temps T1 (avant la première séance thérapeutique), au moyen d’un inventaire d’anxiété standardisé — tel que l’Inventaire d’Anxiété de Beck (Beck Anxiety Inventory, BAI). Ce questionnaire auto-rapporté génère un score global continu pouvant varier théoriquement de 0 à 63 points, où des valeurs plus élevées reflètent une sévérité symptomatique accrue. À l’issue d’une intervention intensive de douze semaines de TCC, l’ensemble des douze patients complète à nouveau le même instrument métrologique au temps T2, dans des conditions environnementales rigoureusement identiques.
Le tableau ci-dessous collige les données brutes issues de cette expérimentation clinique. Chaque ligne correspond à un participant unique, préservant ainsi l’appariement intra-sujet entre son niveau d’anxiété pré-thérapeutique (T1) et son niveau d’anxiété post-thérapeutique (T2) :
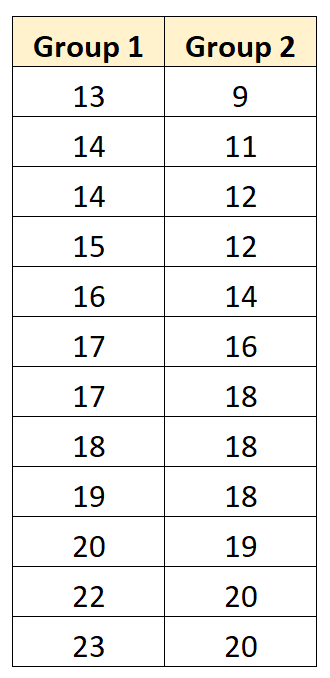
| Identifiant Sujet (i) | Score Pré-test T1 (X1i) | Score Post-test T2 (X2i) |
|---|---|---|
| Patient 01 | 30 | 22 |
| Patient 02 | 35 | 25 |
| Patient 03 | 24 | 21 |
| Patient 04 | 38 | 26 |
| Patient 05 | 27 | 23 |
| Patient 06 | 28 | 29 |
| Patient 07 | 34 | 23 |
| Patient 08 | 32 | 24 |
| Patient 09 | 25 | 23 |
| Patient 10 | 36 | 27 |
| Patient 11 | 29 | 24 |
| Patient 12 | 31 | 30 |
4.2 Structure matricielle de calcul pour le travail manuel
L’exécution manuelle d’une analyse statistique paramétrique requiert une discipline méthodologique absolue et une organisation spatiale méticuleuse des calculs. L’expérience montre que l’immense majorité des erreurs commises lors d’examens universitaires ou d’audits statistiques ne proviennent pas d’une incompréhension des concepts théoriques, mais de glissements d’attention arithmétiques, d’inversions de signes négatifs ou de décalages de lignes lors des sommations. Pour immuniser le chercheur contre ces défaillances opératoires, la mise en place d’une feuille de calcul matricielle standardisée est impérative.
Cette matrice de travail s’articule obligatoirement autour de cinq colonnes fondamentales ordonnées séquentiellement :
- Colonne 1 : L’identifiant du sujet (i), permettant d’assurer la traçabilité continue de chaque unité statistique de 1 à n.
- Colonne 2 : Le score initial (X1i) mesuré au temps T1 (pré-test).
- Colonne 3 : Le score final (X2i) mesuré au temps T2 (post-test).
- Colonne 4 : La différence individuelle brute (Di), résultant de la soustraction algébrique rigoureusement ordonnée.
- Colonne 5 : Le carré de la différence (Di2), étape préalable indispensable au calcul direct de la somme des carrés sans passer par des soustractions intermédiaires fastidieuses.
Une décision conventionnelle cruciale doit être entérinée avant de remplir la quatrième colonne : l’ordre de la soustraction. Deux conventions sont formellement recevables : calculer le changement prospectif (Post – Pré, soit X2i – X1i) ou calculer la réduction absolue des symptômes (Pré – Post, soit X1i – X2i). Dans le présent article, nous adopterons la convention internationale la plus répandue en modélisation mathématique du changement temporel : Di = X2i – X1i. Sous cette convention, tout soulagement de l’anxiété (score post-thérapeutique inférieur au score initial) se traduira mathématiquement par un nombre négatif. Une augmentation des symptômes générera à l’inverse un nombre positif. Cette approche force le chercheur à manipuler explicitement l’arithmétique des entiers relatifs, éliminant ainsi toute ambiguïté directionnelle.
5. Étape 1 : Calcul manuel des scores de différence individuelle
5.1 Soustraction algébrique systématique pour chaque paire
La première phase computationnelle consiste à procéder, pour chaque patient de l’échantillon pris isolément, à la soustraction algébrique exacte de son score de base (T1) de son score post-interventionnel (T2). Il est vital de traiter cette opération avec une rigueur absolue quant à la conservation du signe opératoire.
Examinons attentivement l’exécution détaillée pour chacun de nos douze patients :
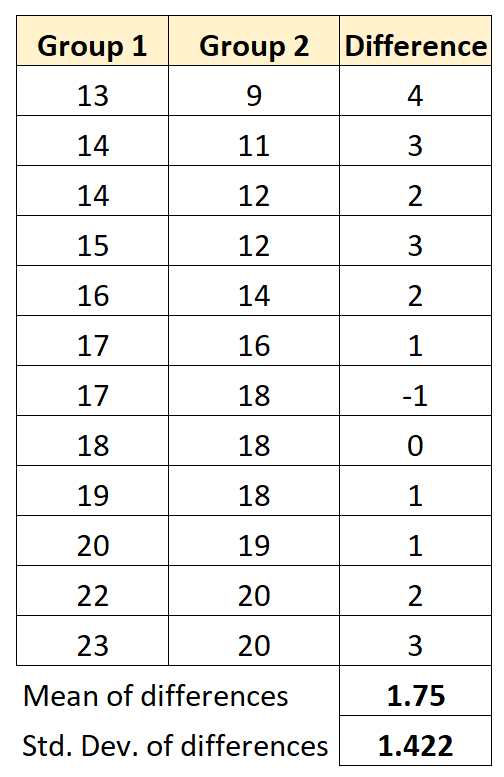
- Patient 01 : D1 = 22 – 30 = -8. Le score a décru de 8 points ; la valeur différentielle est négative.
- Patient 02 : D2 = 25 – 35 = -10. Le score a régressé de 10 points.
- Patient 03 : D3 = 21 – 24 = -3. Diminution modérée de 3 points.
- Patient 04 : D4 = 26 – 38 = -12. Forte baisse symptomatique de 12 points.
- Patient 05 : D5 = 23 – 27 = -4. Réduction de 4 points.
- Patient 06 : D6 = 29 – 28 = +1. Cas clinique remarquable : ce patient a vu son anxiété légèrement progresser d’un point entre le pré-test et le post-test. L’attribution du signe positif (+1) est ici primordiale, car elle empêche de biaiser artificiellement l’évaluation vers une efficacité absolue de l’intervention.
- Patient 07 : D7 = 23 – 34 = -11. Baisse majeure de 11 points.
- Patient 08 : D8 = 24 – 32 = -8. Baisse nette de 8 points.
- Patient 09 : D9 = 23 – 25 = -2. Amélioration discrète de 2 points.
- Patient 10 : D10 = 27 – 36 = -9. Réduction symptomatique de 9 points.
- Patient 11 : D11 = 24 – 29 = -5. Réduction de 5 points.
- Patient 12 : D12 = 30 – 31 = -1. Amélioration marginale d’un point.
L’observation clinique globale de cette série différentielle montre immédiatement que sur douze participants, onze présentent une valeur négative (traduisant une amélioration de leur état clinique) tandis qu’un seul présente une valeur positive discrète. La cohérence clinique est patente, mais seule l’inférence mathématique permettra d’établir si cette tendance globale dépasse le seuil du hasard.
5.2 Sommation des différences brutes
Une fois les douze différences individuelles scrupuleusement établies, l’expérimentateur procède à la sommation de cette série numérique pour obtenir la quantité fondamentale ΣD (somme de toutes les différences brutes). Cette opération requiert d’additionner des nombres relatifs de signes contraires :
ΣD = Σ (Di) = (-8) + (-10) + (-3) + (-12) + (-4) + (+1) + (-11) + (-8) + (-2) + (-9) + (-5) + (-1)
Pour éviter toute erreur mentale de calcul, regroupons méthodiquement les termes négatifs d’une part, et les termes positifs d’autre part :
Somme des composantes négatives :
(-8) + (-10) + (-3) + (-12) + (-4) + (-11) + (-8) + (-2) + (-9) + (-5) + (-1) = -73
Somme des composantes positives :
(+1) = +1
Somme différentielle totale :
ΣD = (-73) + (+1) = -72
Afin de valider de manière définitive ce résultat avant d’entamer les étapes suivantes, le chercheur dispose d’une procédure de vérification croisée infaillible, fondée sur les propriétés de distributivité de l’opérateur de sommation mathématique :
ΣD = Σ(X2 – X1) = ΣX2 – ΣX1
Calculons manuellement la somme brute de la colonne T1 (ΣX1) :
ΣX1 = 30 + 35 + 24 + 38 + 27 + 28 + 34 + 32 + 25 + 36 + 29 + 31 = 369
Calculons manuellement la somme brute de la colonne T2 (ΣX2) :
ΣX2 = 22 + 25 + 21 + 26 + 23 + 29 + 23 + 24 + 23 + 27 + 24 + 30 = 297
Vérifions l’égalité :
ΣX2 – ΣX1 = 297 – 369 = -72.
L’identité mathématique ΣD = ΣX2 – ΣX1 (-72 = -72) étant rigoureusement satisfaite, nous avons l’absolue certitude qu’aucune erreur arithmétique de signe ou de report n’entache la constitution initiale des données différentielles.
6. Étape 2 : Détermination de la moyenne empirique des différences
6.1 Formule de la moyenne des écarts (xdiff ou D-barre)
La deuxième étape majeure de la procédure consiste à quantifier l’ampleur moyenne du changement clinique éprouvé par les sujets de l’échantillon. Cette grandeur constitue l’estimateur ponctuel direct du paramètre théorique populationnel μD. Elle est traditionnellement notée D̄ (D-barre) ou x̄diff.
La définition mathématique standard de cette moyenne d’échantillon s’exprime par le quotient de la somme arithmétique des scores différentiels par l’effectif total n de l’échantillon :
D̄ = (ΣD) / n
En introduisant au sein de cette formule les valeurs numériques issues de nos calculs préalables, à savoir ΣD = -72 et n = 12, nous obtenons :
D̄ = (-72) / 12 = -6,000
L’interprétation directionnelle de cette grandeur est immédiate et fondamentale : au terme des douze semaines de thérapie cognitive et comportementale, les patients de cette cohorte expérimentale manifestent une réduction moyenne de 6,000 points sur l’inventaire d’anxiété standardisé. L’obtention d’un entier exact dans notre exemple pédagogique facilite les étapes ultérieures, mais dans la pratique de recherche, cette valeur comporte le plus souvent des décimales non nulles.
6.2 Propriétés statistiques de la moyenne des différences
Sur le plan métrologique, la moyenne des différences individuelles présente une propriété algébrique remarquable d’invariance linéaire : elle est strictement égale à la différence directe entre la moyenne terminale de l’échantillon et sa moyenne initiale. Démontrons-le de manière élémentaire :
Moyenne au temps T1 : X̄1 = (ΣX1) / n = 369 / 12 = 30,750 points d’anxiété.
Moyenne au temps T2 : X̄2 = (ΣX2) / n = 297 / 12 = 24,750 points d’anxiété.
Différence des moyennes : X̄2 – X̄1 = 24,750 – 30,750 = -6,000 points.
Nous constatons que D̄ = X̄2 – X̄1. Cette égalité constante garantit que l’effet thérapeutique moyen peut être appréhendé indifféremment sous l’angle du déplacement global de l’échantillon ou sous l’angle de la moyenne des trajectoires subjectives individuelles.
Cependant, en tant qu’indicateur de tendance centrale, la moyenne arithmétique possède une vulnérabilité reconnue : elle est extrêmement sensible aux valeurs extrêmes isolées. Dans notre cohorte, la présence du Patient 06, dont l’anxiété s’est accrue d’un point (D6 = +1), tire légèrement la moyenne vers le haut. Si ce sujet avait manifesté une baisse conforme au reste du groupe (par exemple -7), la moyenne des différences se serait établie à -6,67. Cette sensibilité démontre pourquoi la seule moyenne descriptive est impuissante à valider scientifiquement l’efficacité d’un traitement sans la prise en compte de la variabilité qui l’entoure.
D’un point de vue de la rigueur arithmétique lors des calculs à la main, lorsque D̄ n’est pas un nombre entier, il est impératif de conserver systématiquement un minimum de trois à quatre décimales lors de tous les calculs intermédiaires. Tronquer prématurément une moyenne à une seule décimale entraîne des erreurs d’arrondis cumulatives qui peuvent déformer substantiellement la statistique t finale.
7. Étape 3 : Calcul manuel de la variance et de l’écart-type des différences
7.1 Méthode des écarts à la moyenne (somme des carrés)
Connaître la magnitude moyenne du changement thérapeutique (-6 points) ne suffit pas à l’inférence : encore faut-il déterminer le degré d’hétérogénéité ou d’homogénéité avec lequel ce changement s’est manifesté à travers l’échantillon. Deux thérapies peuvent produire la même réduction moyenne de 6 points, l’une en réduisant l’anxiété de chacun des patients de 5 à 7 points (variabilité très faible), l’autre en améliorant certains patients de 25 points tout en en détériorant d’autres de 13 points (variabilité immense). La caractérisation de cette dispersion s’opère par le calcul de la Somme des Carrés des écarts (notée SCD ou SSD pour Sum of Squares).
La méthode fondamentale ou définitionnelle repose sur le calcul explicite de l’écart de chaque différence individuelle à la moyenne différentielle (Di – D̄), suivi de l’élévation au carré de cet écart pour annuler les signes négatifs. La formule s’écrit :
SCD = Σ (Di – D̄)2
Puisque notre moyenne empirique est D̄ = -6, procédons pas à pas pour les douze patients de l’étude :
- Patient 01 : D1 – D̄ = -8 – (-6) = -2 ⇒ (-2)2 = 4
- Patient 02 : D2 – D̄ = -10 – (-6) = -4 ⇒ (-4)2 = 16
- Patient 03 : D3 – D̄ = -3 – (-6) = +3 ⇒ (+3)2 = 9
- Patient 04 : D4 – D̄ = -12 – (-6) = -6 ⇒ (-6)2 = 36
- Patient 05 : D5 – D̄ = -4 – (-6) = +2 ⇒ (+2)2 = 4
- Patient 06 : D6 – D̄ = +1 – (-6) = +7 ⇒ (+7)2 = 49
- Patient 07 : D7 – D̄ = -11 – (-6) = -5 ⇒ (-5)2 = 25
- Patient 08 : D8 – D̄ = -8 – (-6) = -2 ⇒ (-2)2 = 4
- Patient 09 : D9 – D̄ = -2 – (-6) = +4 ⇒ (+4)2 = 16
- Patient 10 : D10 – D̄ = -9 – (-6) = -3 ⇒ (-3)2 = 9
- Patient 11 : D11 – D̄ = -5 – (-6) = +1 ⇒ (+1)2 = 1
- Patient 12 : D12 – D̄ = -1 – (-6) = +5 ⇒ (+5)2 = 25
Sommons l’ensemble de ces carrés de déviations :
SCD = 4 + 16 + 9 + 36 + 4 + 49 + 25 + 4 + 16 + 9 + 1 + 25 = 198
La somme des carrés des déviations s’élève exactement à 198. Cette méthode définitionnelle offre une limpidité conceptuelle totale, mais elle présente le désavantage de devenir extrêmement laborieuse dès lors que D̄ comporte des décimales multiples, obligeant à soustraire et élever au carré des valeurs fractionnaires à répétition.
7.2 Méthode computationnelle directe (formule de travail pratique)
Pour contourner l’écueil des soustractions décimales itératives et optimiser le calcul manuel avec une simple calculatrice de poche, les statisticiens ont développé une variante algébrique strictement équivalente, connue sous le nom de formule computationnelle ou formule machine de la somme des carrés :
SCD = Σ(D2) – [(ΣD)2 / n]
Cette méthode n’exige que deux grandeurs : la somme des carrés de chaque différence brute (ΣD2), et le carré de la somme globale préalablement obtenue [(ΣD)2].
Dressons le calcul individuel de chaque Di2 (colonne 5 de notre matrice de calcul) :
- Patient 01 : (-8)2 = 64
- Patient 02 : (-10)2 = 100
- Patient 03 : (-3)2 = 9
- Patient 04 : (-12)2 = 144
- Patient 05 : (-4)2 = 16
- Patient 06 : (+1)2 = 1
- Patient 07 : (-11)2 = 121
- Patient 08 : (-8)2 = 64
- Patient 09 : (-2)2 = 4
- Patient 10 : (-9)2 = 81
- Patient 11 : (-5)2 = 25
- Patient 12 : (-1)2 = 1
Calculons manuellement la somme Σ(D2) :
Σ(D2) = 64 + 100 + 9 + 144 + 16 + 1 + 121 + 64 + 4 + 81 + 25 + 1 = 630
Reprenons notre somme brute ΣD = -72, et élevons-la au carré :
(ΣD)2 = (-72)2 = 5184
Divisons ce produit par l’effectif n = 12 (terme de correction de la moyenne) :
(ΣD)2 / n = 5184 / 12 = 432
Appliquons la soustraction de travail :
SCD = 630 – 432 = 198
Le résultat obtenu (198) est rigoureusement identique au résultat issu de la méthode des écarts à la moyenne. Cette équivalence arithmétique absolue démontre la validité intégrale de nos calculs et confirme l’utilité pratique majeure de la formule machine lors des résolutions sur papier.
7.3 Estimation sans biais de la variance (s²_diff) et de l’écart-type (sdiff)
La somme des carrés (SCD = 198) exprime la variabilité totale agrégée des douze différences au sein de l’échantillon. Pour convertir cette valeur cumulative en une mesure de dispersion standardisée par unité d’observation, nous devons calculer la variance de l’échantillon.
Cependant, en théorie de l’échantillonnage, la variance d’un échantillon fini constitue un estimateur biaisé (légèrement sous-estimé) de la variance de la population parente si l’on se contente de diviser la somme des carrés par n. Pour obtenir un estimateur sans biais, la correction de Bessel impose d’utiliser comme diviseur le nombre de degrés de liberté, défini par ddl = n – 1 :
sdiff2 = SCD / (n – 1)
En substituant nos valeurs chiffrées :
sdiff2 = 198 / (12 – 1) = 198 / 11 = 18,000
La variance d’échantillonnage des différences (notée sdiff2) s’établit exactement à 18,000 points au carré. L’unité de la variance — des points psychométriques élevés au carré — n’étant pas intuitivement interprétable au regard du construit clinique de l’anxiété, il est indispensable de revenir à l’échelle métrique d’origine en extrayant la racine carrée arithmétique de la variance. Cette opération nous livre l’écart-type empirique des scores de différence, noté sdiff (ou SDdiff) :
sdiff = √(sdiff2) = √(18,000) ≈ 4,24264
En arrondissant à trois décimales conformément aux standards psychométriques usuels, nous obtenons :
sdiff = 4,243
Sur le plan de la sémiologie psychologique, cet écart-type de 4,243 points quantifie la dispersion des trajectoires d’évolution individuelle autour de la moyenne centrale de gain thérapeutique (-6,000). Il nous indique que si le gain thérapeutique moyen est bien d’environ 6 points de réduction d’anxiété, la variabilité typique d’un patient à l’autre autour de cette trajectoire moyenne oscille d’environ 4,24 points.
8. Étape 4 : Dérivation de l’erreur-type de la moyenne différentielle
8.1 Rôle conceptuel de l’erreur-type dans l’inférence statistique
L’une des étapes les plus fondamentales, et pourtant conceptuellement les plus délicates de l’inférence statistique, réside dans la transition métrologique entre l’écart-type d’échantillon (sdiff) et l’erreur-type de la moyenne (notée SEdiff pour Standard Error of the difference). Il est primordial d’expliciter sans ambiguïté la divergence ontologique séparant ces deux grandeurs.
L’écart-type sdiff que nous venons d’isoler (4,243) est une mesure descriptive de la variabilité biologique, psychologique et comportementale intrinsèque aux individus composant notre cohorte. Même si l’on augmentait la taille de notre échantillon clinique à 10 000 patients, cet écart-type ne convergerait pas vers zéro : il convergerait vers le véritable écart-type de la population σD, reflétant la diversité humaine réelle face à la psychothérapie.
À l’inverse, l’erreur-type (SEdiff) n’est pas une mesure de la dispersion individuelle des sujets, mais une mesure de la précision de l’estimation statistique de la moyenne. Si l’on réitérait l’expérience thérapeutique des milliers de fois en prélevant à chaque itération un nouvel échantillon aléatoire de douze patients, les moyennes différentielles obtenues (D̄) ne seraient jamais strictement identiques : elles fluctueraient autour de la moyenne réelle μD, constituant une distribution d’échantillonnage théorique. L’erreur-type représente précisément l’écart-type de cette distribution d’échantillonnage de la moyenne des différences.
Elle formalise mathématiquement le bruit de fond statistique, l’aléa lié au prélèvement d’un sous-ensemble restreint d’individus. Plus l’effectif n est massif, plus la moyenne d’échantillon est stable et digne de confiance, et plus l’erreur-type tend asymptotiquement vers zéro en proportion de la fonction 1 / √n.
8.2 Calcul arithmétique pas à pas de SE_diff
La dérivation formelle de l’erreur-type de la moyenne différentielle repose sur l’équation standard liant l’écart-type d’échantillon à la racine carrée de la taille de la cohorte observée :
SEdiff = sdiff / √n
Une écriture équivalente, particulièrement pratique pour les calculs manuels préservant la précision absolue, consiste à introduire directement la variance dans le radical :
SEdiff = √(sdiff2 / n)
Appliquons pas à pas ces deux formulations pour garantir une convergence arithmétique sans faille :
Tout d’abord, calculons manuellement la racine carrée de la taille de l’échantillon n = 12 :
√12 = √(4 × 3) = 2 × √3 ≈ 2 × 1,7320508 ≈ 3,4641016
Divisons à présent l’écart-type non tronqué sdiff = √18 ≈ 4,2426407 par cette valeur :
SEdiff = 4,2426407 / 3,4641016 ≈ 1,2247449
Vérifions par la méthode directe de la variance :
sdiff2 / n = 18 / 12 = 1,500
SEdiff = √(1,500) ≈ 1,2247449
Arrondie à trois décimales, la valeur définitive de l’erreur-type est :
SEdiff = 1,225
Ce résultat indique que l’incertitude métrologique imputable à l’échantillonnage de nos douze patients s’élève à 1,225 point d’anxiété. C’est à l’aune de ce calibrage du bruit que le signal clinique — la diminution observée de 6 points — va pouvoir être formellement évalué dans le ratio de Student.
9. Étape 5 : Calcul définitif de la statistique de test t observée
9.1 Assemblage des composantes dans le ratio de Student
Nous touchons au point culminant de la mécanique inférentielle : le calcul de la statistique de test elle-même, la valeur t observée (souvent notée tobs ou tcalc). Cette quantité est un nombre sans dimension qui matérialise le ratio classique entre le « signal » expérimental mis en évidence au numérateur, et le « bruit » d’échantillonnage consigné au dénominateur.
La formule maîtresse du test t de Student pour mesures appariées s’articule comme suit :
t = (D̄ – μ0) / SEdiff = (D̄ – μ0) / (sdiff / √n)
Dans le cadre strict de l’évaluation clinique où l’hypothèse nulle H0 postule l’absence de changement, la valeur théorique sous le test est invariablement μ0 = 0. L’équation se simplifie donc sous la forme canonique :
t = D̄ / SEdiff
Substituons les valeurs numériques calculées avec une précision maximale :
t = -6,000 / √(1,5) = -6,000 / 1,22474487 ≈ -4,898979
En arrondissant selon les conventions typographiques académiques à deux décimales (ou trois décimales intermédiaires) :
tobs = -4,90 (ou -4,899)
L’analyse géométrique et statistique de ce résultat est éloquente : la moyenne de changement clinique observée au sein de notre échantillon se situe à près de 4,90 erreurs-types en deçà de la valeur attendue sous l’hypothèse nulle d’absence d’effet. Un tel écartement constitue un signal d’une magnitude considérable dans le champ des essais cliniques en psychologie.
9.2 Sensibilité du signe algébrique du t observé
Le signe algébrique de la statistique t observée (-4,90) requiert une interprétation méthodique de la part de l’expérimentateur. Ce signe dépend exclusivement de la convention de soustraction choisie lors de l’Étape 1. Ayant posé Di = X2i – X1i (Post – Pré), une régression de la symptomatologie anxieuse engendre nécessairement une différence négative, et par voie de conséquence, un ratio t négatif.
Si nous avions opté pour la convention inverse, à savoir mesurer la quantité d’anxiété dissipée par le traitement (Di = X1i – X2i, Pré – Post), nos calculs auraient fourni une moyenne différentielle D̄ = +6,000, un écart-type rigoureusement identique sdiff = 4,243, une erreur-type inchangée SEdiff = 1,225, et une statistique de test strictement positive : t = +4,90.
Cette symétrie démontre qu’en matière de décision statistique dans le cadre d’un test bilatéral, le signe de la statistique t n’altère en rien la robustesse du rejet de l’hypothèse nulle : on considère simplement la valeur absolue du test, notée |tobs| = 4,90. En revanche, lors de la rédaction finale du compte-rendu psychologique, le signe doit impérativement être explicité en concordance avec la direction clinique réelle : une diminution des scores sur une échelle pathologique correspond à un bénéfice thérapeutique, tandis qu’une baisse sur une échelle d’affects positifs refléterait une détérioration.
10. Étape 6 : Fixation du seuil alpha et lecture critique de la table de Student
10.1 Détermination des degrés de liberté (ddl)
Pour statuer sur la plausibilité d’observer une valeur |t| aussi extrême que 4,90 sous la simple influence du hasard d’échantillonnage, nous devons confronter cette statistique empirique à la distribution de probabilité théorique de la loi de Student. Or, contrairement à la loi normale centrée réduite standard (loi Z) dont la courbure est invariable, la loi t de Student constitue une famille de distributions dont la morphologie géométrique dépend directement d’un paramètre unique : les degrés de liberté (notés ddl, ou df pour degrees of freedom).
Pour un test t apparié appliqué à un échantillon de n paires d’observations, les degrés de liberté sont universellement définis par :
ddl = n – 1
Dans notre étude clinique comprenant 12 patients :
ddl = 12 – 1 = 11
La justification mathématique sous-jacente à cette soustraction d’une unité est d’une grande limpidité : lors du calcul de la variance d’échantillon sdiff2, nous avons été contraints d’utiliser la moyenne empirique D̄ (-6,000) comme point de référence. Dès l’instant où cette moyenne est fixée et connue, seules n – 1 différences individuelles sont libres de varier arbitrairement ; la dernière différence est mathématiquement déterminée pour que la somme totale soit égale à -72.
Sur le plan distributionnel, une distribution de Student associée à un nombre restreint de degrés de liberté (comme ddl = 11) présente des « queues de distribution » (tails) nettement plus épaisses et étalées que la loi normale de Gauss. Cette sur-dispersion compense l’incertitude inhérente à l’estimation de l’écart-type de la population à partir d’un échantillon modeste. Au fur et à mesure que n croît vers l’infini, la distribution t converge asymptotiquement vers la distribution normale standard.
10.2 Consultation méthodologique de la table statistique de la loi t
L’extraction de la valeur seuil (dite valeur critique, notée tcrit) s’effectue en consultant une table statistique imprimée de la loi de Student, élément classique de tout manuel d’économétrie ou de psychométrie. Cette consultation repose sur un protocole en quatre temps rigoureux :
- Fixation du seuil de signification théorique (α) : En psychologie clinique comme dans l’ensemble des sciences du vivant, le consensus méthodologique conventionnel fixe le seuil du risque d’erreur de première espèce à α = 0,05 (soit 5 % de risque de rejeter l’hypothèse nulle alors qu’elle est en réalité vraie).
- Choix du type de test (bilatéral vs unilatéral) : Conformément aux réquisitions de prudence académique présentées à la section 3.2, nous retenons un test bilatéral (two-tailed). La surface de rejet de 5 % est donc partitionnée en deux zones de réjection égales de 2,5 % (α / 2 = 0,025) réparties à chaque extrémité de la distribution.
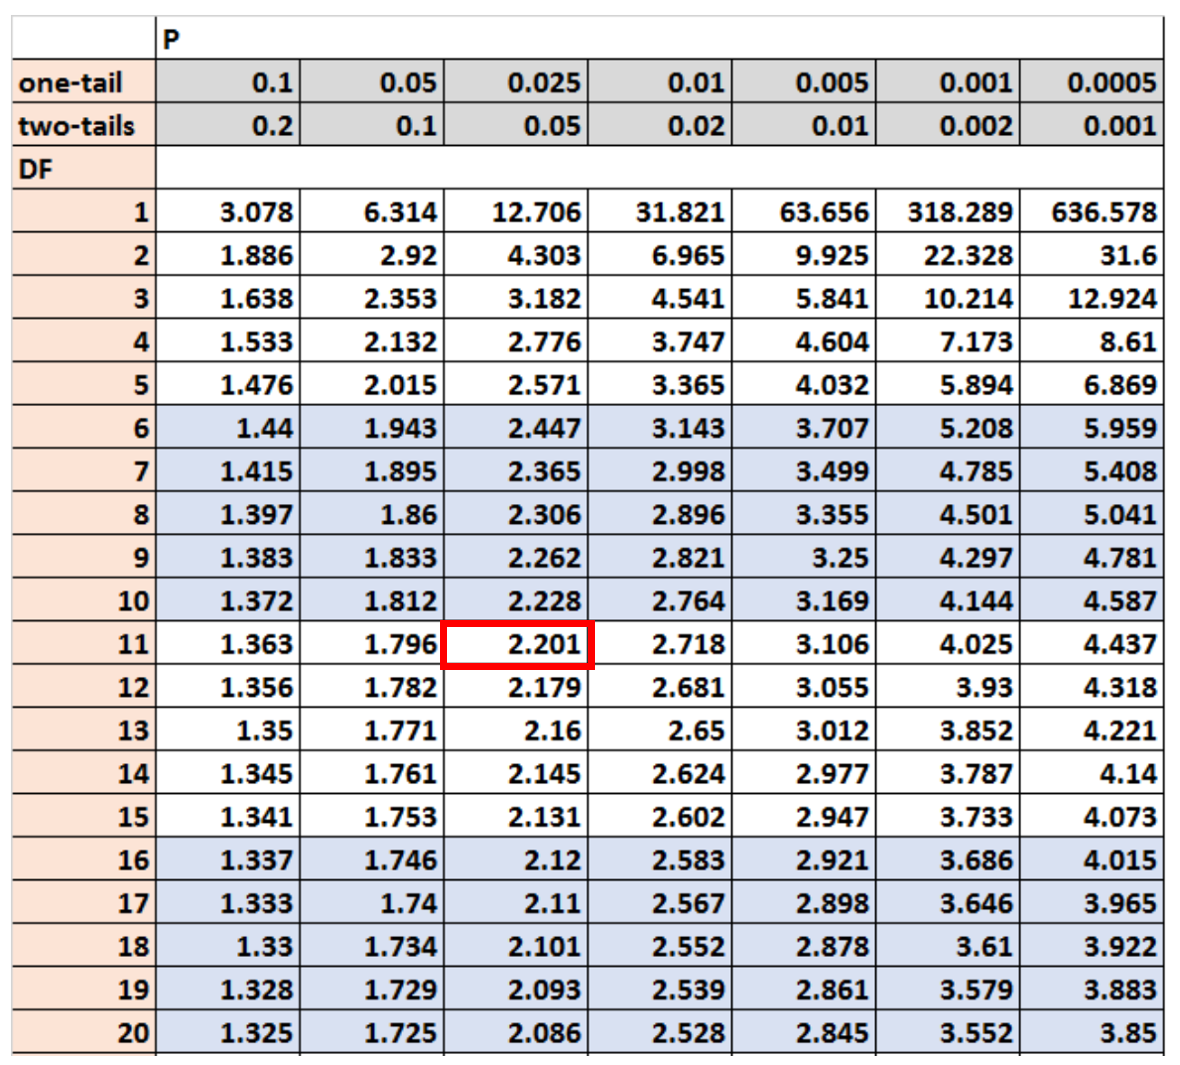
- Repérage de la ligne des degrés de liberté : Dans la colonne verticale dédiée aux ddl, nous descendons méthodiquement jusqu’à la ligne correspondant précisément à ddl = 11.
- Croisement avec la colonne bilatérale α = 0,05 : À l’intersection de la ligne ddl = 11 et de la colonne correspondant au test bilatéral α = 0,05 (ou unilatéral 0,025), nous extrayons le seuil critique :
tcritique (11 ; 0,05 bilatéral) = 2,201
Poussons l’investigation méthodologique un cran plus loin en examinant également les seuils critiques pour des niveaux d’exigence plus sévères à ddl = 11 :
- Pour un seuil α = 0,01 (bilatéral) : tcrit = 3,106
- Pour un seuil α = 0,001 (bilatéral) : tcrit = 4,437
Cette lecture critique délimite formellement la frontière géométrique entre deux régions fondamentales de l’espace d’échantillonnage :
- La zone de non-rejet de H0 : Tout t empirique dont la valeur absolue est inférieure ou égale à 2,201 (c’est-à-dire compris dans l’intervalle [-2,201 ; +2,201]) sera jugé compatible avec l’hypothèse nulle au seuil de 5 %.
- La zone critique de rejet de H0 : Tout t empirique dont la valeur absolue excède 2,201 (valeur < -2,201 ou > +2,201) commandera le rejet catégorique de l’hypothèse nulle.
11. Étape 7 : Règle de décision statistique et calcul de la taille d’effet
11.1 Prise de décision formelle (rejet ou non-rejet de H0)
La prise de décision formelle s’apparente à l’application d’un syllogisme déductif strict, guidé par la comparaison exclusive entre la statistique observée issue des calculs de terrain et la valeur critique extraite de la distribution théorique de Student.
La règle décisionnelle universelle s’énonce ainsi :
Si |tobs| > tcrit, alors Rejet de H0 en faveur de H1
Si |tobs| ≤ tcrit, alors Non-rejet de H0
Appliquons cette règle à nos grandeurs numériques :
Notre statistique observée en valeur absolue s’élève à |tobs| = |-4,899| = 4,899.
Notre valeur seuil critique pour α = 0,05 s’établit à tcrit = 2,201.
Puisque 4,899 > 2,201, la décision statistique est univoque : Nous rejetons formellement l’hypothèse nulle H0.
Nous pouvons même affiner notre décision au regard des seuils plus rigoureux identifiés précédemment : puisque notre statistique empirique (4,899) surpasse également la valeur critique requise pour α = 0,001 (qui était de 4,437), nous pouvons affirmer que la diminution des scores d’anxiété consécutive à l’intervention thérapeutique est statistiquement hautement significative, avec une probabilité critique p < 0,001. Moins d’une chance sur mille ne subsiste pour qu’un tel écart différentiel se manifeste sous l’empire exclusif des fluctuations aléatoires d’échantillonnage.
11.2 Quantification manuelle de la magnitude de l’effet : d de Cohen
Au cours des trois dernières décennies, la méthodologie de la recherche en psychologie a accompli une mutation épistémologique cruciale : la reconnaissance de l’insuffisance flagrante du seul test de signification de l’hypothèse nulle (NHST). Conclure à une « différence statistiquement significative » indique simplement que l’effet n’est très probablement pas nul ; cela ne fournit strictement aucune indication quant à l’importance clinique ou pratique de cet effet. Un traitement induisant une réduction d’anxiété dérisoire d’un quart de point peut devenir hautement significatif sur le plan du p-value si l’on recrute un échantillon gigantesque de 10 000 patients, tout en étant cliniquement inutile. Inversement, un essai sur échantillon modeste peut masquer un effet d’une intensité thérapeutique majeure.
Pour mesurer la magnitude clinique réelle de l’intervention indépendamment de l’effectif n, il est impératif de calculer un indice standardisé de taille d’effet. Dans le cadre des mesures répétées, l’estimateur de référence est le d de Jacob Cohen adapté aux scores différentiels (souvent noté dz ou ddiff) :
d = |D̄| / sdiff
Cette métrique exprime la moyenne de l’amélioration clinique en unités d’écarts-types de changement. Insérons nos paramètres arithmétiques :
d = |-6,000| / 4,24264 = 6,000 / 4,24264 ≈ 1,414
Le d de Cohen s’établit exactement à 1,414 (soit √2).
Pour apprécier la portée clinique de cette valeur, référons-nous à la grille interprétative universelle établie par Jacob Cohen (1988) en sciences du comportement :
- Effet de faible amplitude : d = 0,20 (le changement est subtil et difficilement perceptible au niveau individuel).
- Effet de moyenne amplitude : d = 0,50 (le changement est visible à l’œil nu par un clinicien averti).
- Effet de forte amplitude : d = 0,80 (le bénéfice thérapeutique est manifeste et substantiel).
- Effet très grand ou massif : d ≥ 1,20 (l’intervention bouleverse profondément la distribution du construit psychologique).
Avec un d = 1,41, notre protocole de TCC ne se limite pas à produire un effet statistiquement certifiable : il engendre un impact thérapeutique d’une magnitude clinique exceptionnelle, l’ampleur moyenne du soulagement symptomatique dépassant de près d’un écart-type et demi la dispersion naturelle des réponses des patients.
11.3 Calcul manuel de l’intervalle de confiance à 95 % de la différence
Le calcul de l’intervalle de confiance à 95 % (noté IC 95 %) constitue le complément inférentiel indispensable à la taille d’effet. Là où le test d’hypothèse offre une décision binaire (rejet/non-rejet) et la taille d’effet une estimation ponctuelle brute, l’intervalle de confiance délimite la plage de valeurs au sein de laquelle se situe vraisemblablement la véritable moyenne du changement thérapeutique dans la population générale, avec un niveau de certitude de 95 %.
La formule de dérivation manuelle de l’intervalle de confiance pour une moyenne différentielle s’articule autour de la moyenne empirique, modulée par le produit du seuil critique de Student par l’erreur-type :
IC 95 % = D̄ ± [tcrit (ddl = 11 ; 0,05) × SEdiff]
Rappelons les valeurs numériques isolées dans nos étapes précédentes :
D̄ = -6,000
tcrit = 2,201 (valeur bilatérale à 11 ddl pour α = 0,05)
SEdiff = 1,2247449
Calculons en premier lieu la marge d’erreur statistique (ME) :
ME = 2,201 × 1,2247449 ≈ 2,69566 ≈ 2,696
Calculons à présent les deux bornes extrêmes de l’intervalle :
Borne inférieure (la plus négative, reflétant la réduction maximale) :
Borne inférieure = D̄ – ME = -6,000 – 2,696 = -8,696 points d’anxiété.
Borne supérieure (la plus proche de zéro, reflétant la réduction minimale) :
Borne supérieure = D̄ + ME = -6,000 + 2,696 = -3,304 points d’anxiété.
Nous pouvons donc formaliser l’intervalle comme suit :
IC 95 % = [-8,70 ; -3,30]
L’analyse interprétative de cet intervalle de confiance apporte une double validation méthodologique fondamentale :
- Vérification de la significativité statistique : La valeur zéro (qui incarne l’hypothèse nulle d’absence d’effet) est totalement exclue de l’intervalle [-8,70 ; -3,30]. Lorsque l’intervalle de confiance à 95 % ne contient pas la valeur zéro, nous avons la garantie mathématique stricte que le test t est significatif au seuil bilatéral α = 0,05.
- Précision de l’estimation clinique : Nous pouvons affirmer avec un degré de confiance de 95 % que si l’ensemble de la population de patients souffrant d’anxiété suivait cette thérapie, la réduction moyenne véritable des scores d’anxiété serait comprise, au pire, d’au moins 3,30 points, et au mieux, de 8,70 points. Même en considérant le scénario le plus pessimiste de l’intervalle (-3,30), le bénéfice clinique demeure substantiel.
12. Formalisation académique aux normes APA et prévention des erreurs manuelles
12.1 Rédaction des résultats selon le style APA (7e édition)
La restitution écrite des résultats d’une analyse quantitative au sein d’un mémoire de recherche, d’une thèse de doctorat ou d’un manuscrit soumis à une revue internationale à comité de lecture est assujettie aux prescriptions rigoureuses du manuel de style de l’APA (7e édition). La syntaxe typographique doit respecter un formalisme précis où les symboles statistiques universels sont systématiquement mis en italique (M, SD, t, p, d), tandis que les valeurs numériques associées sont arrondies avec cohérence (généralement deux décimales pour les statistiques de test et tailles d’effet, et deux à trois décimales pour les valeurs de probabilité p).
Le gabarit syntaxique normé pour un test t apparié se présente sous la forme générique suivante :
t(ddl) = valeur_t, p = valeur_p (ou p < seuil), d = valeur_d
Toutefois, une communication scientifique irréprochable ne saurait se résumer à l’alignement mécanique de chiffres entre parenthèses. Les normes APA exigent une contextualisation narrative complète intégrant les statistiques descriptives préalables (moyennes et écarts-types des deux temps de mesure), la description explicite du sens de la variation observée, la quantification de l’erreur d’estimation, et la délimitation de l’intervalle de confiance.
Voici l’exemple textuel exhaustif, prêt à être inséré dans une section « Résultats », rédigé conformément aux standards les plus exigeants de la psychologie académique francophone :
« Une analyse statistique inférentielle au moyen d’un test t de Student pour échantillons appariés a été menée afin d’évaluer l’impact d’un protocole de thérapie cognitive et comportementale de 12 semaines sur la sévérité des symptômes anxieux (évalués via l’Inventaire d’Anxiété de Beck, BAI) auprès d’un échantillon clinique de 12 patients. L’analyse descriptive révèle une diminution des scores moyens d’anxiété entre la phase pré-thérapeutique (M = 30,75, SD = 4,49) et la phase post-thérapeutique (M = 24,75, SD = 2,93). Cette réduction différentielle moyenne de 6,00 points (SD = 4,24, SE = 1,22) s’avère statistiquement hautement significative, t(11) = -4,90, p < 0,001 (test bilatéral), avec un intervalle de confiance à 95 % de la différence moyenne compris entre -8,70 et -3,30 points. La magnitude de l’effet thérapeutique observé est particulièrement élevée au regard des critères de Cohen, d = 1,41, attestant d’une amélioration clinique substantielle et généralisée au sein de la cohorte. »
12.2 Audit des erreurs classiques lors des calculs manuels
L’expérience pédagogique accumulée auprès des étudiants et chercheurs met en lumière la récurrence de pièges méthodologiques et d’erreurs opératoires lors de la mise en œuvre manuelle du test t apparié. L’analyste averti réalisera un audit systématique de ses feuilles de travail en vérifiant méthodiquement les points critiques suivants :
- Confusion entre la dispersion différentielle et la dispersion des mesures initiales : L’erreur conceptuelle la plus dévastatrice consiste à introduire dans le dénominateur de l’erreur-type l’écart-type des scores bruts du pré-test ou du post-test (ou un regroupement moyen des deux) au lieu d’utiliser rigoureusement l’écart-type de la série des différences (sdiff). Le test t apparié opère exclusivement sur la variance de la variable différentielle D, qui intègre déjà la covariance existant entre les deux temps d’évaluation.
- Erreurs cumulatives d’arrondis prématurés : Tronquer la moyenne différentielle (par exemple utiliser 5,3 au lieu de 5,3333) dès les premières étapes se répercute en cascade sur la somme des carrés, la variance, l’erreur-type et aboutit à une déformation substantielle de la statistique t finale. La règle d’or est de conserver au minimum quatre décimales dans la mémoire de calculatrice ou sur le carnet de notes lors de toutes les phases intermédiaires, pour ne tronquer à deux ou trois décimales que le résultat finalisé.
- Confusion grossière sur les degrés de liberté : Une méprise fréquente consiste à appliquer la formule des degrés de liberté propre aux échantillons indépendants (ddl = n1 + n2 – 2 = 2n – 2), ce qui attribuerait ici 22 degrés de liberté au lieu de 11. Cette erreur conduit à une sous-estimation du seuil critique théorique et fausse entièrement le contrôle du risque alpha. Dans un test apparié, l’unité statistique est la paire, ce qui impose impérativement ddl = npaires – 1.
- Incohérence entre sens de l’hypothèse et signe de la statistique : Lors de l’exécution d’un test unilatéral préalable, les analystes commettent fréquemment l’erreur de rejeter l’hypothèse nulle sur la base d’une valeur absolue élevée de t, sans vérifier si le signe empirique correspond bel et bien à la direction théorique attendue. Si l’on postule une diminution des symptômes et que le t observé est fortement positif en raison d’une dégradation inattendue, le test unilatéral impose formellement de conclure à l’absence de significativité.
- Omission de la vérification de la somme brute : Négliger l’étape d’audit croisé ΣD = ΣX2 – ΣX1 constitue la cause première des erreurs de report lors des calculs d’examen. Prendre trente secondes pour valider cette égalité arithmétique élémentaire prévient l’effondrement de l’ensemble de la chaîne inférentielle subséquente.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beck, A. T., Epstein, N., Brown, G., & Steer, R. A. (1988). An inventory for measuring clinical anxiety: Psychometric properties. Journal of Consulting and Clinical Psychology, 56(6), 893–897. https://doi.org/10.1037/0022-006X.56.6.893
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554