
L’analyse de régression linéaire multiple constitue sans conteste l’un des piliers méthodologiques les plus mobilisés au sein des sciences quantitatives contemporaines, qu’il s’agisse de l’économétrie, de l’épidémiologie, de la sociologie empirique ou de la psychométrie. Lorsque les chercheurs s’efforcent d’élucider la dynamique liant une variable dépendante d’intérêt à un ensemble de prédicteurs covariants, la méthode des moindres carrés ordinaires (MCO) offre un cadre déductif à la fois élégant et intuitif. Cependant, l’élégance formelle de ce modèle repose sur une série d’hypothèses probabilistes fondamentales, dont le non-respect altère considérablement la portée inférentielle des résultats obtenus. Parmi ces postulats directeurs, l’hypothèse d’homoscédasticité — postulant l’invariance de la variance des perturbations aléatoires pour toute valeur prise par les variables explicatives — s’avère centrale pour garantir l’efficience et la validité probabiliste des estimateurs.
Dans la pratique de la recherche, il n’est pourtant pas rare d’observer une rupture nette de cette régularité géométrique et stochastique : l’hétéroscédasticité. Lorsque la dispersion des résidus se dilate ou se contracte le long du continuum prédictif, l’estimation des erreurs-types des coefficients est irrémédiablement faussée, entraînant des dérives critiques lors des tests de significativité statistique de Student et de Fisher. Déceler avec une rigueur inférentielle incontestable la présence d’une telle anomalie requiert dès lors l’utilisation de tests de diagnostic adéquats, au premier rang desquels figure le célèbre test développé par Trevor Breusch et Adrian Pagan en 1979, ultérieurement affiné par Roger Koenker en 1981. Ce test d’hypothèse offre une démarche paramétrique puissante pour déterminer si la variance inhérente aux perturbations du modèle présente une dépendance fonctionnelle systématique à l’égard des variables indépendantes.
Bien que des environnements logiciels spécialisés tels que R, Stata, SAS ou SPSS intègrent des routines automatisées dédiées à ce diagnostic, la maîtrise de sa mise en œuvre pas à pas au sein d’un tableur ubiquitaire comme Microsoft Excel revêt une portée pédagogique et pratique inestimable. Décomposer chaque phase du calcul dans Excel — de l’estimation de la régression principale à la régression auxiliaire des résidus au carré, jusqu’à la dérivation de la statistique de multiplicateur de Lagrange et de la p-valeur associée — permet au praticien d’acquérir une compréhension granulaire des mécanismes mathématiques sous-jacents, tout en garantissant une auditabilité intégrale de ses procédures empiriques. Ce guide exhaustif propose un cheminement rigoureux, exhaustif et méthodologiquement irréprochable pour exécuter et interpréter le test de Breusch-Pagan sous Excel.
1. Introduction aux postulats de la régression linéaire et à l’homoscédasticité
1.1 Le rôle fondamental des résidus dans la modélisation statistique
Dans tout protocole d’estimation linéaire, le modèle postule qu’une observation empirique résulte de la sommation d’une composante déterministe, incarnée par la combinaison linéaire des variables prédictives, et d’un élément stochastique résiduel inobservable, désigné couramment sous le vocable de perturbation ou d’erreur aléatoire. Le résidu observé, quant à lui, matérialise la divergence arithmétique directe entre la valeur empiriquement recueillie pour l’unité d’analyse et la valeur ajustée ou prédite par l’hyperplan de régression calculé. L’analyse fouillée de ces résidus ne constitue en rien une étape périphérique ou cosmétique de la modélisation ; elle représente le mécanisme vérificateur suprême par lequel le chercheur s’assure que la structure fonctionnelle sélectionnée a épuisé l’information intelligible contenue dans le jeu de données, ne laissant subsister dans le terme d’erreur qu’un bruit purement fortuit.
L’intégrité du paradigme des moindres carrés ordinaires (MCO) repose sur des conditions précises encadrant la distribution théorique de ces erreurs. Si l’espérance conditionnelle des perturbations doit impérativement être nulle pour certifier l’absence d’erreurs systématiques d’estimation, la structure de leur variance conditionnelle s’avère tout aussi déterminante. Les résidus constituent le seul vecteur empirique accessible permettant d’approximer la nature et le comportement des perturbations non mesurables. Dès lors qu’une organisation systématique ou une instabilité distributionnelle se manifeste au sein de l’espace résiduel, c’est l’ensemble de l’édifice probabiliste du modèle qui se trouve fragilisé, compromettant l’adéquation globale entre la théorie postulée et la réalité phénoménale observée.
La célèbre formulation du théorème de Gauss-Markov établit formellement que, sous réserve du respect strict d’un faisceau d’hypothèses axiomatiques — incluant l’exogénéité stricte, l’absence d’autocorrélation et l’homoscédasticité —, l’estimateur des moindres carrés ordinaires s’impose comme le meilleur estimateur linéaire non biaisé, communément désigné sous l’acronyme anglophone BLUE (Best Linear Unbiased Estimator). Cette propriété d’optimalité confère aux coefficients estimés la variance d’échantillonnage minimale parmi l’ensemble des estimateurs linéaires sans biais concevables. Lorsque la structure des résidus s’écarte de ces normes idéales, cette suprématie s’effondre : l’estimateur demeure certes non biaisé, mais il perd son efficience, ouvrant la voie à des inférences erronées.
1.2 Définition formelle de l’homoscédasticité et de l’hétéroscédasticité
L’hypothèse d’homoscédasticité, issue étymologiquement des racines grecques homo (semblable) et skedasis (dispersion), énonce que la variance conditionnelle des erreurs demeure rigoureusement constante, quel que soit le point considéré au sein de l’espace vectoriel engendré par les régresseurs. Exprimée en notation matricielle formelle, cette condition stipule que la variance conditionnelle de l’erreur $u_i$ sachant le vecteur des variables explicatives $X_i$ satisfait l’égalité constante : $operatorname{Var}(u_i mid X_i) = \sigma^2$, où $\sigma^2$ représente un scalaire fini et invariant pour l’ensemble des observations $i = 1, dots, N$. Cette symétrie implique géométriquement que la dispersion des points empiriques autour de la droite ou de l’hyperplan de régression se maintient dans un couloir d’amplitude invariante sur toute la plage de mesure.
À l’opposé, l’hétéroscédasticité désigne la violation manifeste de cette homogénéité stochastique, se caractérisant par une variance conditionnelle des erreurs dépendante de l’indice de l’observation ou des grandeurs prises par une ou plusieurs variables prédictives, soit : $operatorname{Var}(u_i mid X_i) = \sigma_i^2$. Dans les données empiriques, ce phénomène se traduit fréquemment par des configurations où l’incertitude prédictive croît ou décroît de manière proportionnelle à l’amplitude des régresseurs. Par exemple, l’étude de l’épargne des ménages révèle traditionnellement une hétéroscédasticité structurelle : les ménages à faibles revenus manifestent des capacités d’épargne contraintes et donc uniformément faibles, tandis que les ménages aisés présentent des comportements d’épargne d’une variabilité considérable, induisant une explosion de la variance résiduelle pour les quantiles supérieurs de revenu.
Il importe de dissocier méthodologiquement l’hétéroscédasticité dite « pure » de l’hétéroscédasticité induite par une mauvaise spécification du modèle mathématique. L’hétéroscédasticité pure découle de la nature ontologique du phénomène sous examen, où la variabilité intrinsèque du comportement humain ou des processus physiques s’accroît organiquement sous certaines conditions. En revanche, l’hétéroscédasticité imputable à une spécification erronée résulte d’une maladresse analytique, telle que l’omission délibérée ou fortuite d’une variable explicative non linéaire, l’absence de termes d’interaction pertinents, ou le recours inapproprié à une forme linéaire simple alors qu’une relation exponentielle ou logarithmique prévaut au sein du système observé.
1.3 Conséquences de l’hétéroscédasticité sur les inférences statistiques
Bien que l’hétéroscédasticité n’altère pas la propriété de non-biais des estimateurs de coefficients de régression issus des moindres carrés ordinaires — dans la mesure où l’espérance de l’erreur demeure conditionnellement nulle —, ses répercussions sur la chaîne inférentielle s’avèrent dévastatrices. L’impact premier s’observe sur l’estimation de la matrice de variance-covariance des coefficients estimés. Les formules standards déployées par les logiciels statistiques et les tableurs reposent sur l’hypothèse d’une variance unique $\sigma^2$. En présence de variances variables $\sigma_i^2$, la formule standard calcule des estimations faussées, sous-estimant ou surestimant significativement la variance réelle d’échantillonnage de chaque coefficient.
Cette distorsion de l’erreur-type des estimateurs entraîne directement l’invalidation formelle des tests statistiques paramétriques usuels. Le test $t$ de Student, employé pour évaluer la significativité individuelle de chaque paramètre partiel, ainsi que le test $F$ de Fisher, destiné à juger de la pertinence conjointe de la régression, s’appuient sur l’hypothèse d’un ratio régulier entre l’estimation du coefficient et son erreur-type standardisée. Si cette erreur-type est sous-estimée en raison de l’hétéroscédasticité, la statistique $t$ empirique sera artificiellement gonflée, conduisant l’analyste à conclure à tort à la significativité statistique d’une variable qui n’exerce en réalité aucun effet notable au sein de la population parente.
Il en résulte une amplification substantielle du risque d’erreur de type I, consistant à rejeter l’hypothèse nulle à tort en décelant des effets fallacieux. Inversement, si les erreurs-types sont surestimées, le risque d’erreur de type II croît de manière délétère, occultant des relations empiriques substantielles. Dans les disciplines axées sur la mesure psychométrique et l’évaluation clinique, où l’étalonnage des échelles et l’évaluation d’interventions comportementales requièrent une précision maximale, de telles dérives induisent des interprétations théoriques invalides, menaçant la reproductibilité des protocoles d’investigation et faussant les orientations méthodologiques subséquentes.
2. Fondements théoriques et mathématiques du test de Breusch-Pagan
2.1 Origine et hypothèses nulle et alternative du test
Confrontés aux écueils posés par la variance non constante des résidus dans les modèles économétriques et biostatistiques, les statisticiens britanniques et australiens Trevor S. Breusch et Adrian R. Pagan ont publié en 1979 dans la revue Econometrica un protocole inférentiel novateur fondé sur le principe du score. Leur contribution visait à supplanter les méthodes purement graphiques ou les tests restrictifs existants, tels que le test de Goldfeld-Quandt, qui exigeait un tri préalable des données selon une variable unique et l’exclusion arbitraire d’une portion centrale de l’échantillon. Le cadre de Breusch et Pagan propose une formalisation paramétrique flexible permettant d’éprouver simultanément la dépendance de l’erreur envers plusieurs variables explicatives.
Le protocole pose comme point d’ancrage une régression linéaire standard de la forme générale :
$$Y_i = \beta_0 + \beta_1 X_{i1} + \beta_2 X_{i2} + dots + \beta_k X_{ik} + u_i$$
Les auteurs modélisent la variance de la perturbation $u_i$ à travers une fonction paramétrique de régresseurs connus, généralement les mêmes variables indépendantes $X$ ou un sous-ensemble de celles-ci, via une fonction d’hétéroscédasticité arbitraire mais différentiable :
$$\sigma_i^2 = h(\alpha_0 + \alpha_1 Z_{i1} + dots + \alpha_p Z_{ip})$$
où la fonction $h(\cdot)$ est une fonction positive non spécifiée et $Z$ représente le vecteur des variables suspectées de générer la variance instable. L’hypothèse nulle ($H_0$) et l’hypothèse alternative ($H_1$) s’articulent alors formellement ainsi :
$$H_0 : \alpha_1 = \alpha_2 = dots = \alpha_p = 0$$
$$H_1 : \exists , j in {1, dots, p} \text{ tel que } \alpha_j \neq 0$$
Sous l’hypothèse nulle, l’ensemble des coefficients associés aux variables explicatives de la variance s’annule, ramenant la fonction à la constante $\sigma_i^2 = h(\alpha_0) = \sigma^2$. La variance résiduelle se trouve dès lors totalement émancipée de toute dépendance vis-à-vis des régresseurs, attestant la parfaite homoscédasticité du système stochastique étudié.
2.2 La statistique de test du multiplicateur de Lagrange (LM)
Le génie analytique du test de Breusch-Pagan réside dans l’exploitation du principe du multiplicateur de Lagrange (LM), dispensant l’analyste de devoir estimer le modèle sous l’hypothèse alternative, tâche souvent complexe et lourde en calculs d’optimisation non linéaire. La statistique se déduit exclusivement des résidus estimés sous l’hypothèse nulle d’homoscédasticité par les moindres carrés ordinaires conventionnels. En évaluant la propension de ces résidus au carré à varier de manière conjointe avec les régresseurs suspectés, le test mesure l’écart marginal du modèle par rapport à la contrainte d’homoscédasticité.
Sur le plan calculatoire, la formulation opérationnelle de la statistique de test s’exprime au moyen du coefficient de détermination — noté $R^2_{\text{aux}}$ — extrait d’une régression linéaire auxiliaire ayant pour variable dépendante les résidus primaires au carré (ou normalisés) et pour variables explicatives les prédicteurs sélectionnés. En considérant un échantillon de taille $N$, la statistique de test du multiplicateur de Lagrange s’écrit formellement :
$$\text{LM} = N \times R^2_{\text{aux}}$$
En vertu des théorèmes centraux limites et des propriétés asymptotiques démontrées par Breusch et Pagan, cette statistique converge asymptotiquement vers une loi du Khi-deux de Pearson ($\chi^2$) lorsque la taille de l’échantillon tend vers l’infini :
$$\text{LM} x\rightarrow{d} \chi^2(p)$$
Le nombre de degrés de liberté $p$ associé à cette distribution théorique correspond strictement au nombre de variables explicatives incorporées dans la régression auxiliaire (à l’exclusion de la constante). Cette propriété autorise une détermination probabiliste aisée du seuil critique au-delà duquel l’indépendance de la variance doit être rejetée avec un risque d’erreur consenti.
2.3 La variante de Koenker pour données non normales
En dépit de son élégance matricielle, la formulation primitive établie par Breusch et Pagan en 1979 souffre d’une sensibilité pathologique à une hypothèse auxiliaire fréquemment ignorée : la normalité stricte des perturbations stochastiques du modèle primaire. Dès lors que la distribution réelle des résidus s’écarte de la loi normale — notamment en présence de kurtosis excessif (distributions leptokurtiques ou à queues lourdes), omniprésent dans les sciences sociales et comportementales —, le test de Breusch-Pagan d’origine tend à rejeter l’hypothèse nulle avec une fréquence anormalement élevée, confondant la non-normalité avec une véritable hétéroscédasticité.
Pour parer à cette vulnérabilité, le statisticien et économètre Roger Koenker a formulé en 1981 une modification robuste du test, fréquemment labellisée dans la littérature scientifique comme le test de Breusch-Pagan-Koenker ou test de Koenker. Koenker a démontré que la statistique standard du multiplicateur de Lagrange sous la forme directe $N \times R^2_{\text{aux}}$ conserve une robustesse asymptotique face aux distorsions du kurtosis sans nécessiter la normalisation préalable par la variance moyenne théorique qui caractérisait la méthode de 1979. Dans sa variante robuste, la statistique ajuste l’échelle par le moment d’ordre quatre des résidus empiriques.
Au sein d’un environnement de tableur tel que Microsoft Excel, cette distinction méthodologique s’avère hautement stratégique. L’approche de Koenker basée sur le produit limpide de l’effectif total par le coefficient de détermination auxiliaire ($N \times R^2_{\text{aux}}$) se prête remarquablement à l’architecture computationnelle des cellules, garantissant à l’analyste un test plus tolérant face aux distributions empiriques imparfaites tout en allégeant les séquences arithmétiques intermédiaires. C’est précisément cette variante robuste que la majorité des progiciels économétriques contemporains exécutent sous l’appellation générique de Breusch-Pagan.
3. Configuration de l’environnement de travail dans Excel
3.1 Vérification et activation de l’Utilitaire d’analyse
Avant d’engager le traitement computationnel des régressions linéaires dans Microsoft Excel, il est indispensable de configurer convenablement le logiciel en s’assurant de la présence opérationnelle de son module de modélisation avancée. Bien qu’Excel intègre nativement des fonctions matricielles pour estimer les paramètres de régression — à l’instar de la commande DROITEREG —, la conduite fluide et transparente du test de Breusch-Pagan gagne en clarté par l’activation du complément officiel fourni par Microsoft : l’Utilitaire d’analyse (Analysis ToolPak).
Pour activer ce module sous l’environnement Windows, il convient de cheminer à travers l’interface en cliquant sur l’onglet Fichier situé à l’extrémité supérieure gauche du ruban, puis de sélectionner les Options en bas du volet de navigation. Dans la boîte de dialogue contextuelle, cliquez sur la rubrique Compléments. Dans la zone inférieure intitulée Gérer, assurez-vous que la sélection affiche Compléments Excel, puis actionnez le bouton Atteindre…. Une nouvelle fenêtre surgissante liste les extensions disponibles : il est impératif de cocher la case relative à l’Utilitaire d’analyse, puis de valider l’opération en cliquant sur OK.
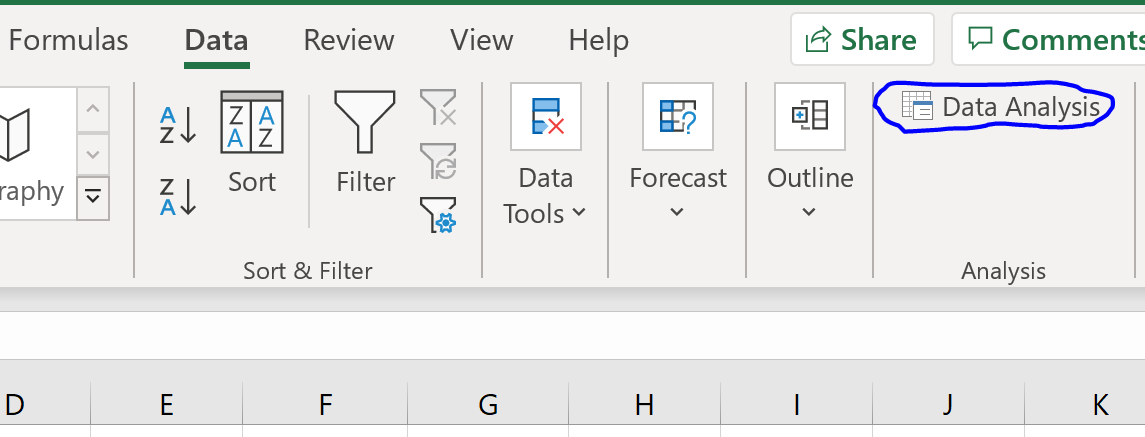
Pour les utilisateurs opérant sous l’environnement macOS, le cheminement d’accès s’effectue via le menu principal Outils, au sein duquel il faut sélectionner la ligne Compléments Excel…, puis cocher l’option analogue de l’Utilitaire d’analyse avant d’entériner par validation. Pour vous assurer du parfait déploiement de l’outil, rendez-vous sur l’onglet Données du ruban principal d’Excel : vous devez désormais constater l’apparition d’un nouveau groupe positionné à l’extrémité droite, dénommé Analyse, abritant le bouton Utilitaire d’analyse.
3.2 Avantages et limites des fonctionnalités statistiques d’Excel
Le recours à Microsoft Excel dans le cadre d’investigations économétriques ou méthodologiques avancées présente un intérêt pédagogique indéniable. Contrairement aux environnements de programmation en ligne de commande comme R, Python ou SAS, qui encapsulent les transformations mathématiques dans des fonctions fermées dont l’exécution est souvent assimilée à une « boîte noire », le tableur force le chercheur ou l’étudiant à manipuler directement les structures résiduelles, à observer la création de nouvelles variables et à maîtriser visuellement le chaînage séquentiel de l’inférence. Cette transparence favorise une appropriation conceptuelle supérieure des postulats stochastiques sous-jacents.
Néanmoins, une lucidité épistémologique s’impose quant aux limites intrinsèques du logiciel. Excel ne comporte aucune commande unifiée ou macro-instruction native permettant d’exécuter d’un simple clic le test de Breusch-Pagan, contrairement aux commandes standardisées des progiciels dédiés (comme bptest dans le package lmtest de R). L’analyste se trouve dans l’obligation de concevoir lui-même le protocole en couplant l’outil de régression automatisé avec des formules analytiques et matricielles manuelles. Cette exigence opérationnelle accroît le risque d’erreur humaine lors de la sélection des plages ou du recopiage des formules.
De surcroît, la gestion de modèles comportant un très grand nombre de régresseurs ou des volumes d’observations massifs (plusieurs centaines de milliers de lignes) peut induire des ralentissements significatifs dans l’évaluation dynamique des formules. Excel demeure un formidable outil de prototypage, de diagnostic transparent et de pédagogie statistique, mais sa rigueur dépend entièrement de la vigilance méthodologique déployée par l’opérateur dans l’orchestration de ses calculs.
3.3 Précautions relatives à la précision numérique du tableur
L’exactitude des résultats inférentiels produits au sein d’un tableur dépend directement de la gestion de la précision en arithmétique flottante. Historiquement, les versions antérieures d’Excel ont fait l’objet de critiques légitimes de la part des méthodologistes en raison de routines d’arrondi imprécises lors du calcul de sommes de carrés très élevées ou face à des matrices de données hautement colinéaires. Bien que le moteur de calcul d’Excel ait été considérablement fiabilisé pour respecter les standards modernes de calcul statistique, des précautions strictes s’imposent à l’analyste rigoureux.
Il est impératif d’éviter d’utiliser des valeurs intermédiaires arrondies pour alimenter les calculs ultérieurs. Lorsque vous calculez des indicateurs tels que la moyenne des résidus, la variance empirique ou le coefficient de détermination auxiliaire, veillez systématiquement à référencer directement les cellules hôtes contenant l’intégralité de la précision décimale plutôt que de ressaisir manuellement des valeurs tronquées au centième ou au millième. Les erreurs d’arrondi propagées au fil des étapes peuvent induire des écarts notables au moment de convertir la statistique de test en p-valeur.
Par ailleurs, l’utilisation méticuleuse du référencement absolu via le symbole $ (par exemple $A$2:$A$101) s’avère indispensable pour prémunir vos formules contre les glissements involontaires de plages de données lors de la duplication des cellules vers le bas. Une vérification d’intégrité doit être conduite périodiquement sur les plages cibles afin de s’assurer qu’aucune cellule vide, aucun décalage de ligne et aucun caractère textuel n’a été inséré par inadvertance au sein des blocs réservés aux variables continues de modélisation.
4. Structuration et nettoyage des données avant analyse
4.1 Organisation tabulaire rigoureuse des variables
La réussite de l’estimation économétrique sous l’Utilitaire d’analyse d’Excel exige une discipline rigide dans l’architecture spatiale de la feuille de calcul. L’algorithme de régression de l’extension impose en effet que l’ensemble des variables explicatives soit disposé de manière continue dans des colonnes adjacentes. Dès lors, le formatage des données brutes en amont de toute manipulation prévient les messages d’erreur d’exécution récurrents générés par le module.
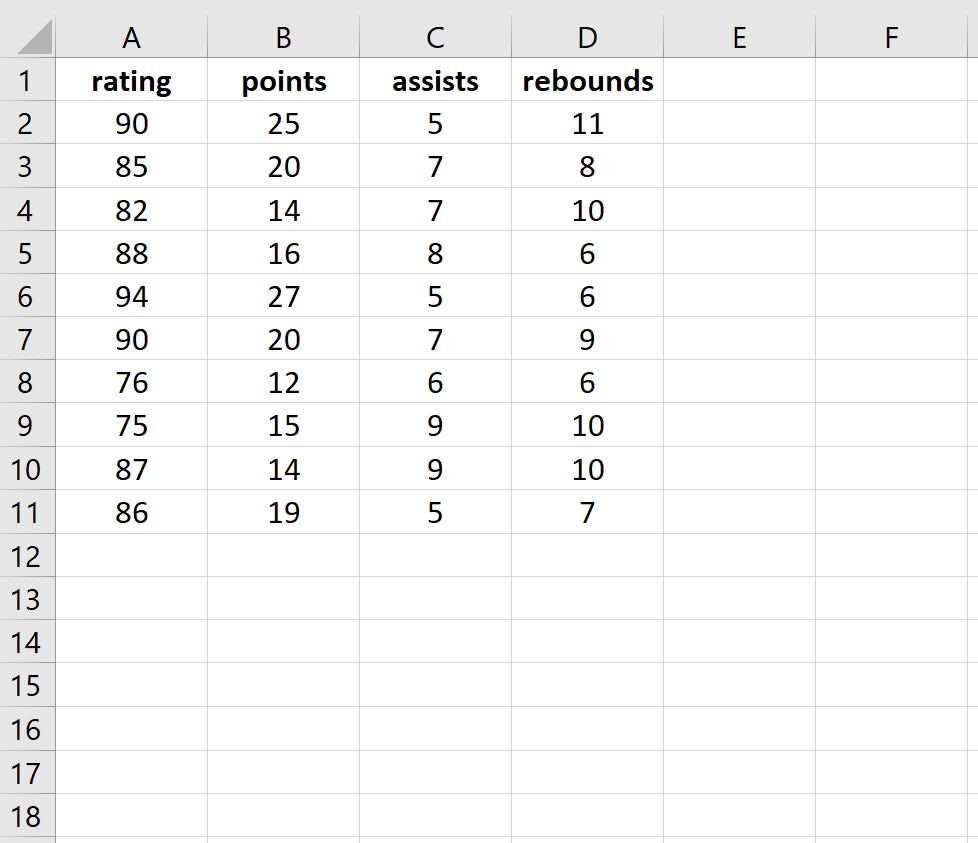
Il est préconisé de placer la variable dépendante continue, conventionnellement étiquetée $Y$, dans une colonne individualisée, par exemple la colonne A. Les variables explicatives ou prédicteurs ($X_1, X_2, dots, X_k$) doivent obligatoirement être agencés dans un bloc de colonnes contiguës immédiatement attenantes, telles que les colonnes B, C et D. La ligne sommitale (ligne 1) doit être expressément réservée à l’identification claire et univoque des variables au moyen d’étiquettes textuelles précises (telles que Score_Anxiete, Niveau_Stress, Performance_Cognitive), en évitant les caractères spéciaux ou les espaces superflus.
Chaque ligne subséquente, de la ligne 2 jusqu’à la ligne $N+1$, doit matérialiser une unité statistique d’observation singulière. Cette géométrie tabulaire stricte permettra une sélection continue des blocs de données sans manipulation complexe de matrices disjointes lors de la configuration des paramètres d’entrée du solveur de régression.
4.2 Traitement des valeurs manquantes et aberrantes
L’algorithme de régression des moindres carrés ordinaires implémenté dans l’Utilitaire d’analyse ne gère pas de façon adaptative les valeurs manquantes réparties au sein des plages de sélection. La présence d’une cellule vide ou d’un caractère non numérique au sein de la plage $Y$ ou $X$ entraîne inévitablement l’interruption prématurée du calcul, sanctionnée par une alerte d’incompatibilité de données. Il incombe donc à l’analyste de purger préalablement la matrice empirique.
La méthode de traitement la plus robuste au sein d’Excel consiste à recourir à une suppression méthodique par liste (listwise deletion). Cette procédure implique l’élimination intégrale de toute ligne statistique présentant une valeur manquante sur au moins l’une des variables retenues pour l’investigation. Bien que des techniques d’imputation multiple existent dans les logiciels avancés, l’Utilitaire d’analyse d’Excel nécessite impérativement une matrice pleine et complète pour stabiliser l’estimation des erreurs et l’ajustement de la table d’analyse de variance.
Parallèlement, une attention méthodique doit être accordée à la détection des valeurs aberrantes univariées ou multivariées (points de levier). Une observation présentant une valeur résiduelle colossale par rapport au reste du corpus statistique est susceptible de gonfler artificiellement la dispersion à l’une des extrémités de la distribution, simulant une hétéroscédasticité pure alors qu’il ne s’agit que d’un artéfact induit par un enregistrement aberrant ou une saisie erronée. Un filtrage initial ou un examen par diagrammes en boîte permet de sanctuariser la plausibilité distributionnelle des données.
4.3 Vérification préalable des distributions univariées
En conformité avec les standards méthodologiques les plus rigoureux, l’analyse inférentielle doit être précédée d’un examen systématique des distributions descriptives associées à chaque variable du modèle. Cet audit univarié préliminaire garantit que les postulats régissant la modélisation ne sont pas compromis en amont par des configurations distributionnelles déviantes.
Dans un secteur vierge de la feuille de calcul, il est opportun de calculer, pour chaque variable, les indicateurs de tendance centrale et de dispersion au moyen des fonctions dédiées d’Excel : la moyenne arithmétique via MOYENNE(), la médiane par MEDIANE(), l’écart-type d’échantillon au moyen de ECARTYPE.STANDARD(), ainsi que les valeurs extrêmes par MIN() et MAX(). Ces grandeurs permettent de valider la cohérence interne des ordres de grandeur observés et d’écarter toute erreur de frappe substantielle.
Par ailleurs, pour anticiper la sensibilité du test de Breusch-Pagan aux écarts de distribution, il est recommandé de calculer les coefficients de dissymétrie (skewness) et d’aplatissement (kurtosis) des variables continues via les formules respectives COEFFICIENT.ASYMETRIE() et KURTOSIS(). Une valeur d’aplatissement largement supérieure à zéro signale une distribution leptokurtique, caractérisée par des queues épaisses, ce qui constituera une justification analytique majeure pour privilégier l’approche robuste de Koenker lors du décompte de la statistique de test.
5. Étape 1 : Exécution de la régression linéaire multiple principale
5.1 Paramétrage du module de régression dans Excel
La première opération calculatoire concrète du protocole consiste à estimer le modèle de régression linéaire initial formulé par la théorie de recherche. Cette régression primaire permet d’obtenir les estimations de coefficients des variables explicatives et, surtout, d’extraire la suite vectorielle des résidus non standardisés d’ajustement.
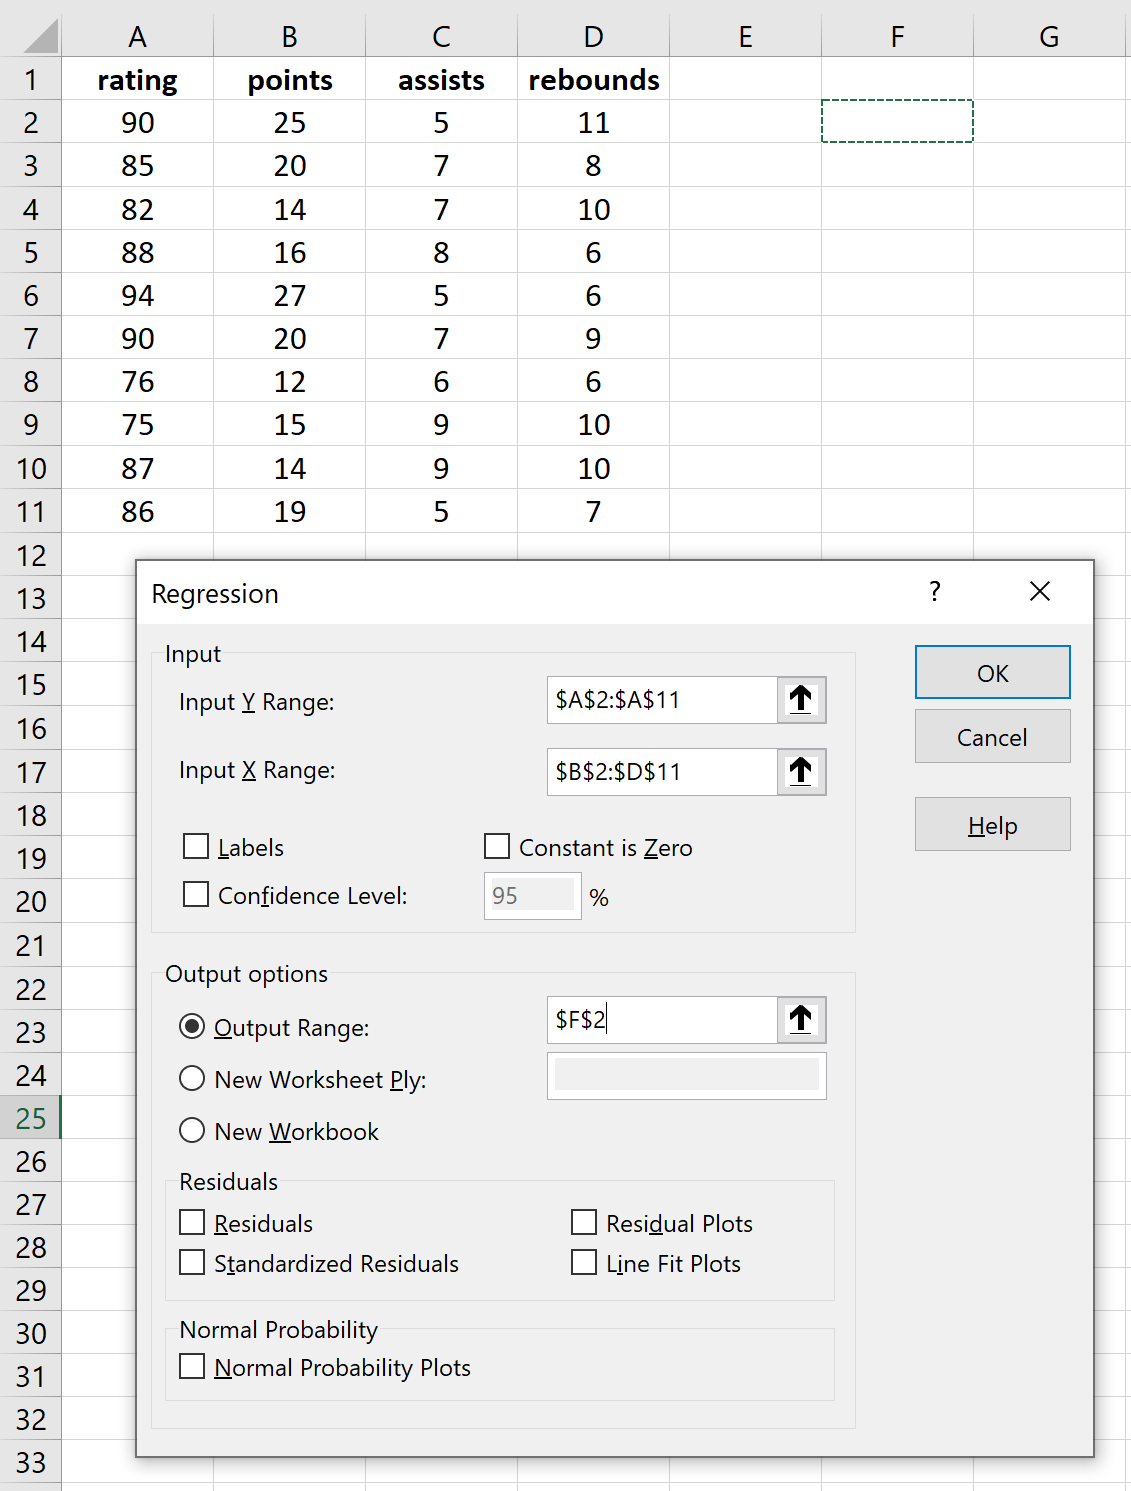
Pour lancer la procédure, rendez-vous sur le ruban principal d’Excel, cliquez sur l’onglet Données, puis ouvrez la boîte de dialogue en sélectionnant Utilitaire d’analyse. Au sein du menu déroulant répertoriant les fonctionnalités disponibles, faites défiler les entrées jusqu’à sélectionner l’item Régression, puis confirmez par OK. Une boîte de configuration détaillée se déploie alors à l’écran.
Dans le champ intitulé Plage d’entrée Y, renseignez la plage correspondant à votre variable dépendante (par exemple $A$1:$A$101 en incluant la ligne de titre). Dans le champ Plage d’entrée X, sélectionnez la matrice contiguë englobant l’intégralité des prédicteurs (par exemple $B$1:$D$101). Si vous avez inclus la première ligne contenant la désignation textuelle des variables, assurez-vous impérativement de cocher la case Intitulés, sous peine d’induire une erreur de compilation dans l’interpréteur numérique d’Excel.
5.2 Configuration des options de sortie résiduelles
Le paramétrage correct des options de sortie résiduelles conditionne directement la faisabilité de l’ensemble de la démarche. La boîte de dialogue Régression comporte une section basse expressément consacrée aux résidus, souvent ignorée dans les analyses superficielles, mais absolument pivotale pour la construction du test de Breusch-Pagan.
Au sein de cette section inférieure, cochez impérativement la case intitulée Résidus. Cette directive intime à Excel l’ordre formel de générer une table d’ajustement individuel détaillant, pour chacune des unités statistiques de l’échantillon, la valeur prédite par le modèle linéaire ainsi que le résidu non standardisé correspondant ($e_i = Y_i – \hat{Y}_i$). Les autres options résiduelles, telles que les Résidus standardisés ou les graphiques résiduels, peuvent être cochées à titre indicatif, bien que la conduite du test requière spécifiquement les résidus bruts.
Concernant le positionnement des résultats, il est préconisé d’opter pour un placement sur une Nouvelle feuille de calcul, que vous pourrez renommer méthodiquement Regression_Primaire. Cette compartimentation assure une clarté visuelle optimale et évite que les tables d’analyse générées par le tableur ne viennent écraser accidentellement des formules ou des colonnes préexistantes de votre matrice de données d’origine.
5.3 Interprétation préliminaire du modèle primaire
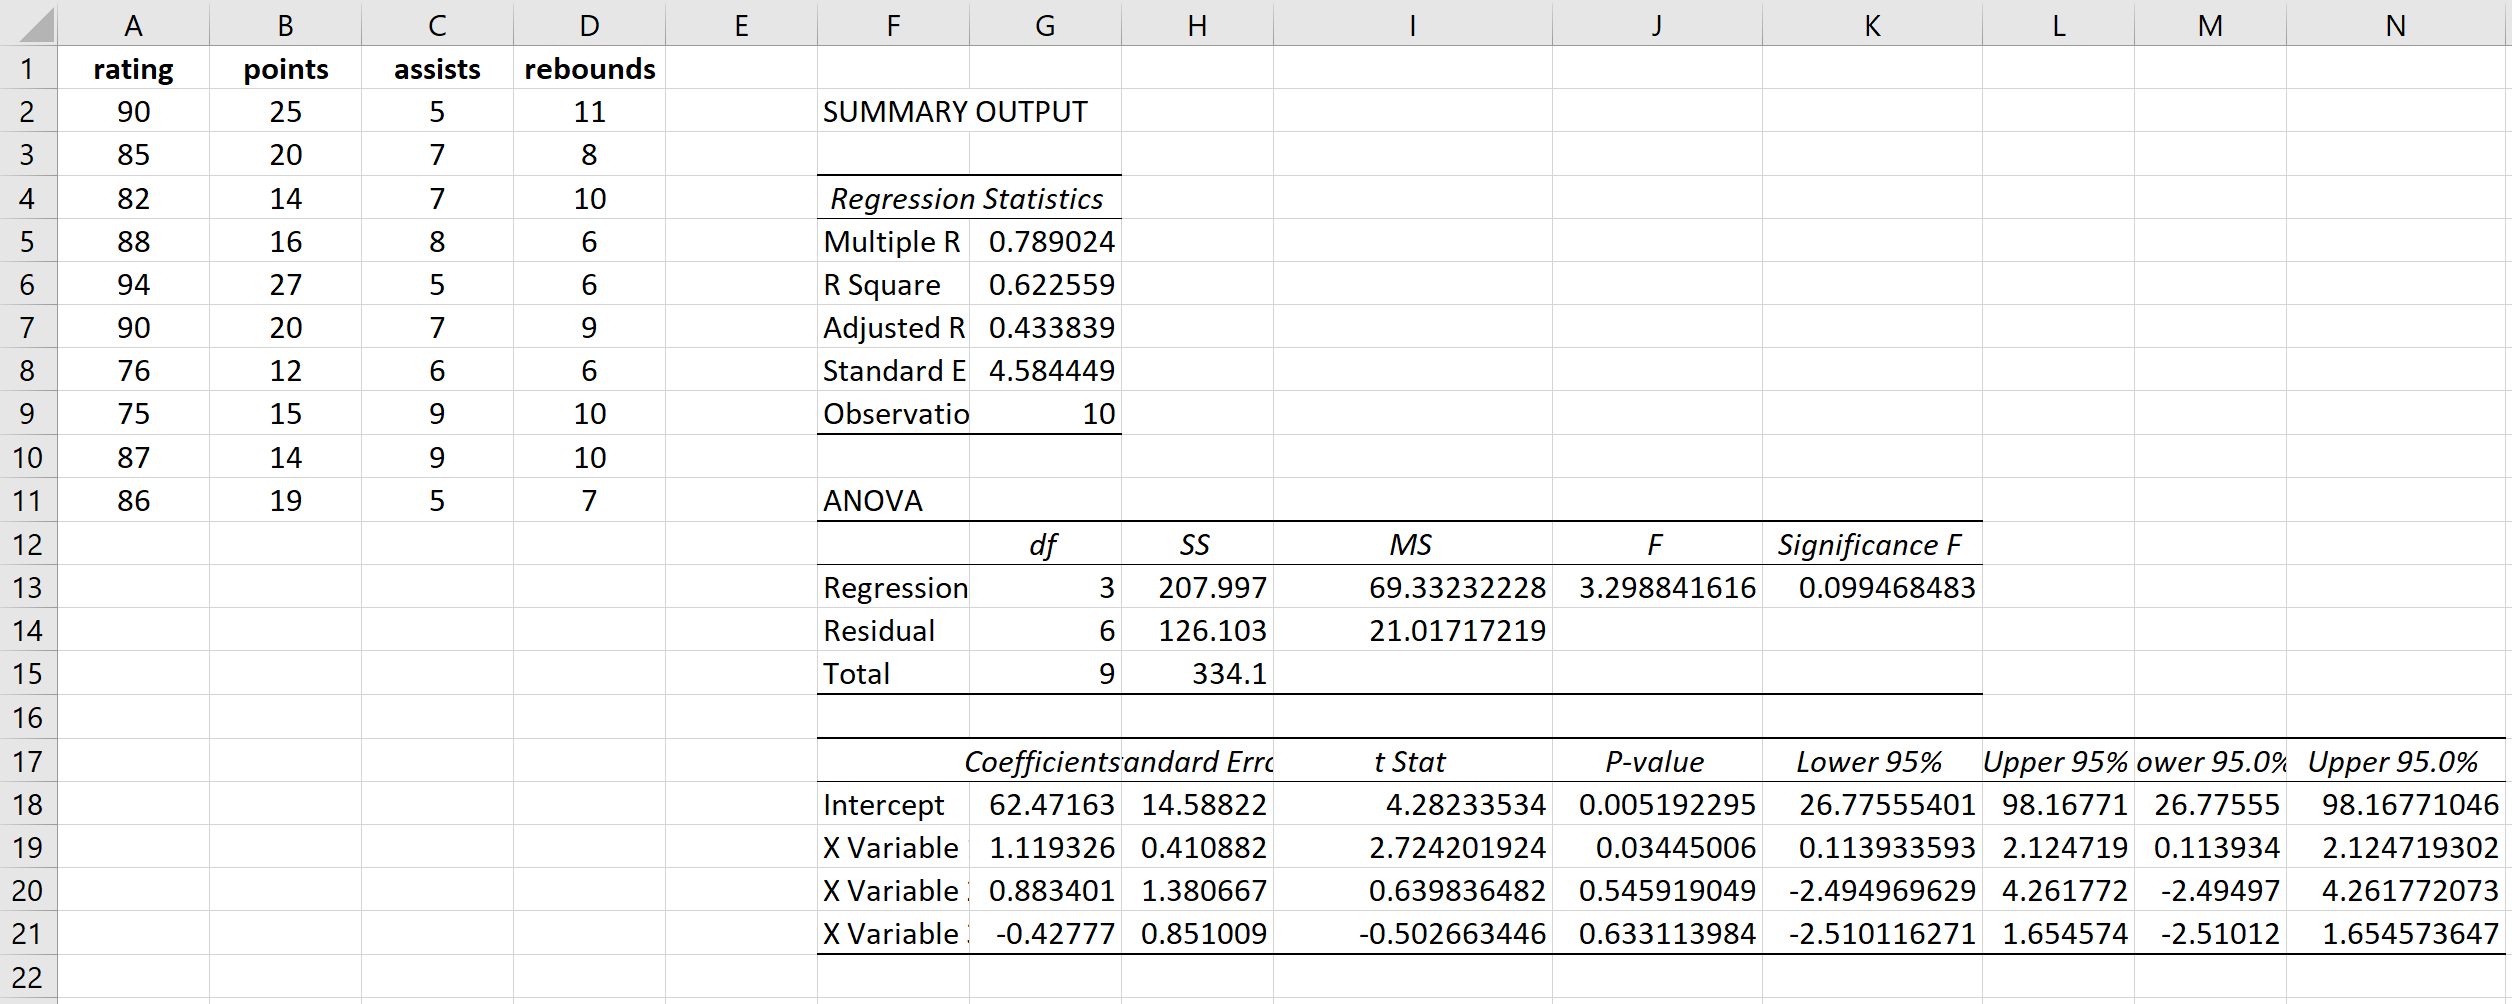
Dès la validation de l’opération par le bouton OK, Excel génère instantanément une série de trois tableaux récapitulatifs fondamentaux : les Statistiques de la régression, la table d’Analyse de variance (ANOVA) et le tableau des Paramètres estimés. Avant de basculer vers les calculs résiduels, une inspection académique de ces résultats primaires s’avère indispensable pour certifier la viabilité de la régression d’origine.
Le tableau des statistiques fournit le coefficient de détermination $R^2$ (mesurant la part globale de variance de la variable dépendante absorbée par les régresseurs) ainsi que l’erreur-type de l’estimation. Dans la table ANOVA, l’attention doit se porter sur la statistique $F$ de Fisher et sur sa significativité critique associée (la valeur étiquetée F significatif dans les versions françaises d’Excel). Si cette probabilité critique s’avère inférieure au seuil conventionnel de 0,05, l’hyperplan de régression améliore de façon statistiquement significative la prédiction comparativement à un modèle nul fondé sur la seule moyenne.
Enfin, le tableau inférieur permet de repérer la valeur des coefficients directeurs ($\beta_j$), leurs erreurs-types respectives, ainsi que les valeurs $t$ de Student et leurs probabilités critiques ($p$-valeurs). Toutefois, ainsi que nous l’avons théorisé à la section 1.3, cette analyse inférentielle préliminaire doit être considérée comme rigoureusement sous réserve : si le test de Breusch-Pagan venait à mettre en lumière une hétéroscédasticité significative, les erreurs-types affichées dans cette table seraient biaisées, rendant caduques les conclusions tirées quant à la significativité intrinsèque de ces coefficients.
6. Étape 2 : Extraction et calcul des résidus au carré
6.1 Localisation des valeurs résiduelles générées par Excel
En faisant défiler vers le bas la feuille Regression_Primaire générée par l’Utilitaire d’analyse, on observe, sous les tables d’ANOVA et de coefficients, un tableau substantiel étiqueté ANALYSE DES RÉSIDUS. Ce tableau comporte un nombre de lignes rigoureusement égal à la taille $N$ de votre échantillon statistique d’analyse.
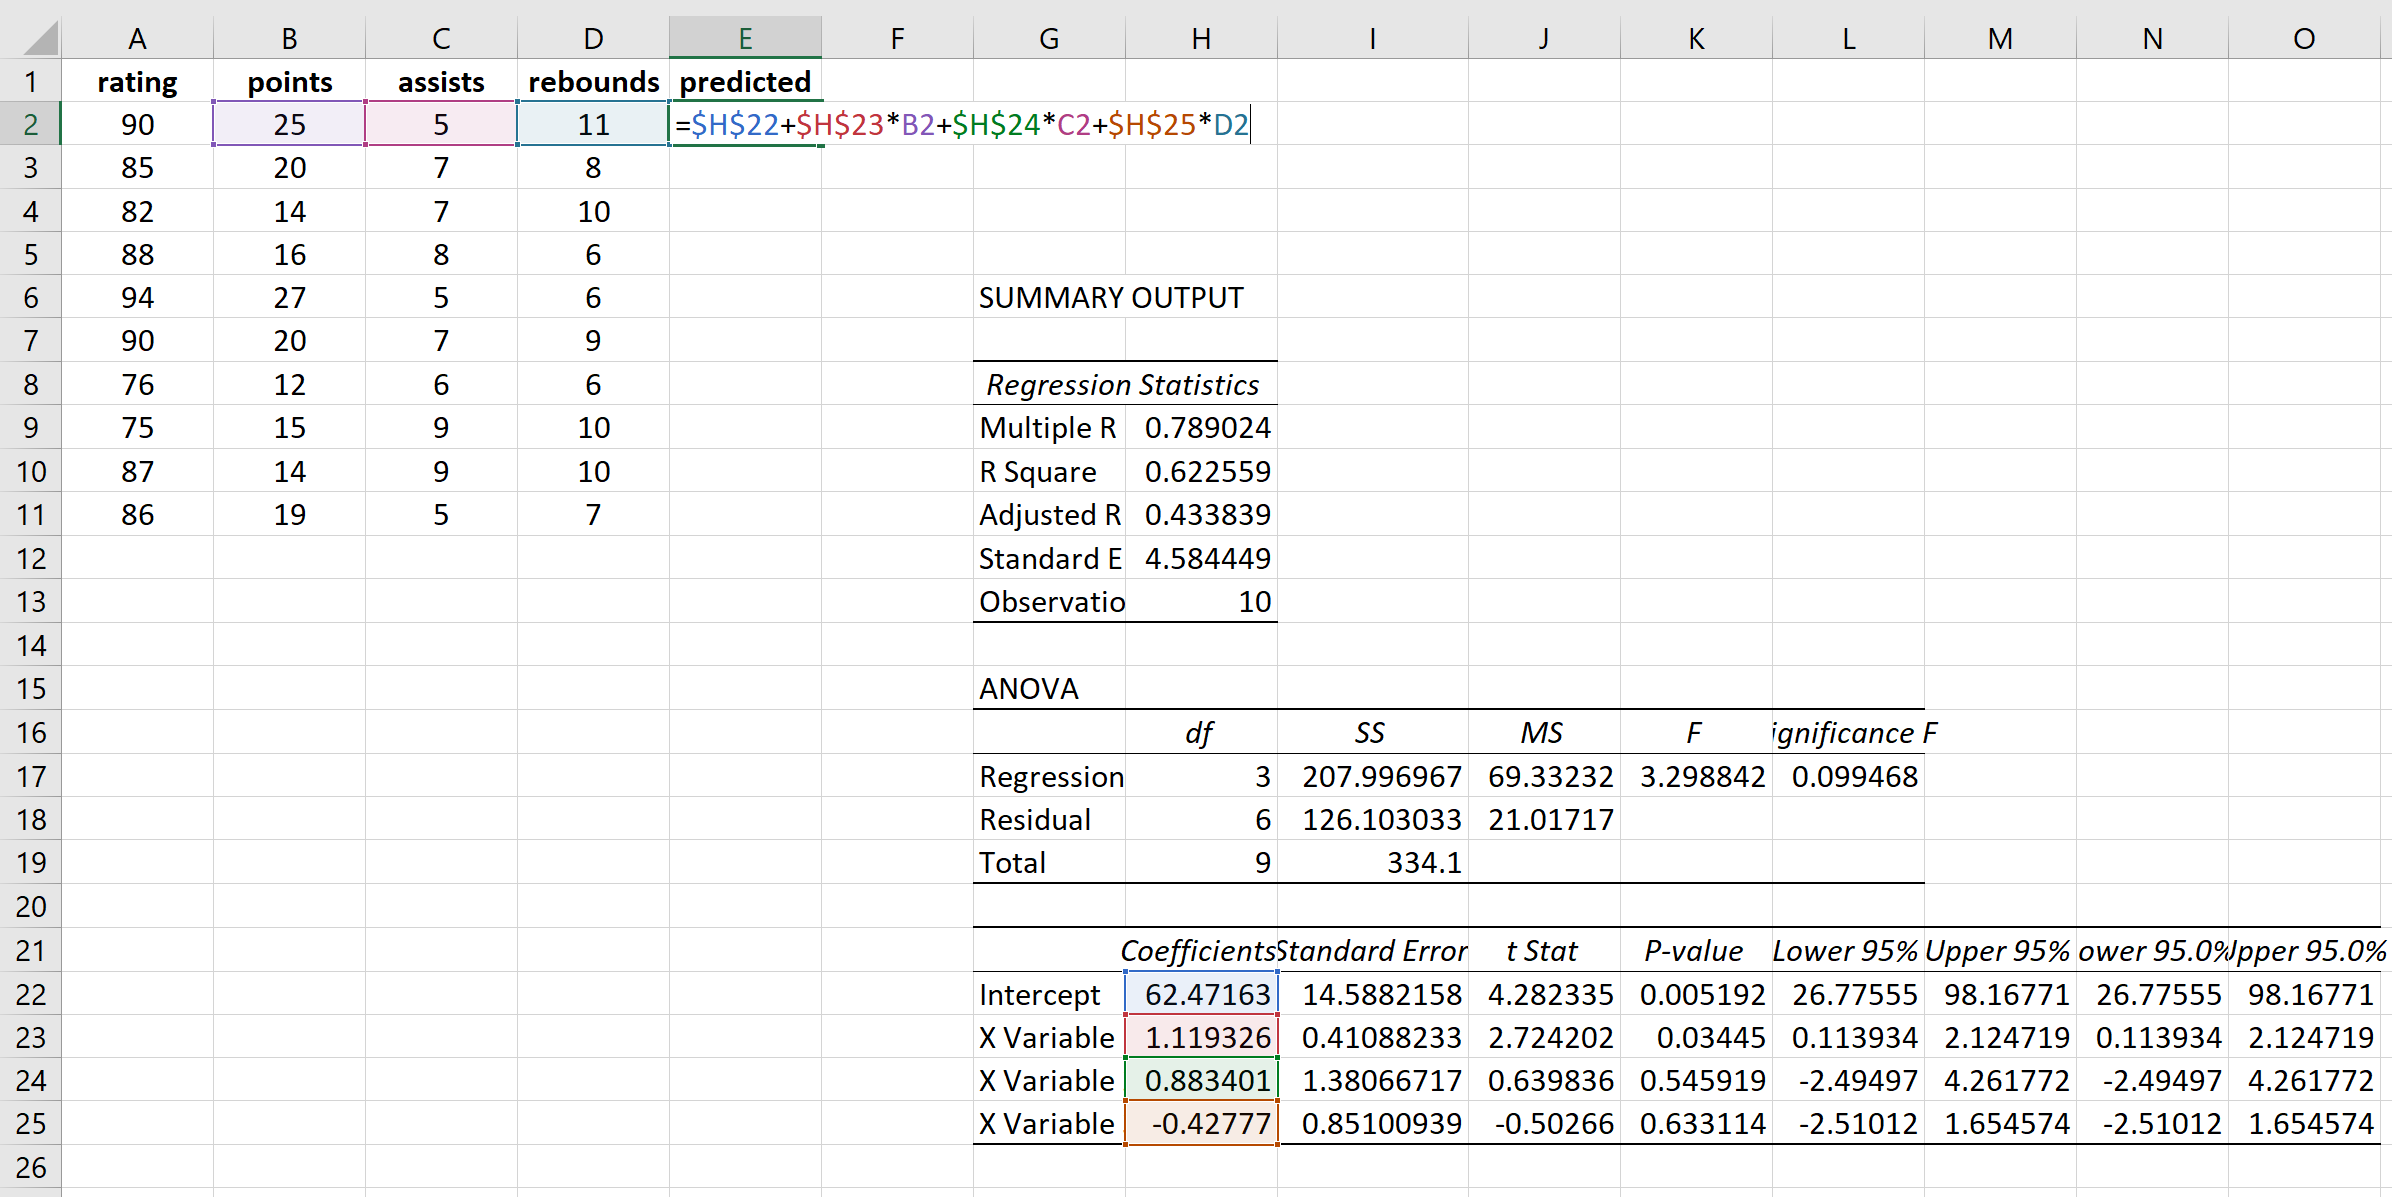
Ce tableau d’ajustement est structuré en trois colonnes majeures : la colonne Observation (qui numérote chaque sujet de 1 à $N$), la colonne Valeurs ajustées pour Y (qui détaille l’estimation prédite $\hat{Y}_i$) et la colonne Résidus (qui stocke la différence brute arithmétique $e_i = Y_i – \hat{Y}_i$). C’est cette dernière colonne qui constitue la matière première indispensable au déploiement du test de Breusch-Pagan.
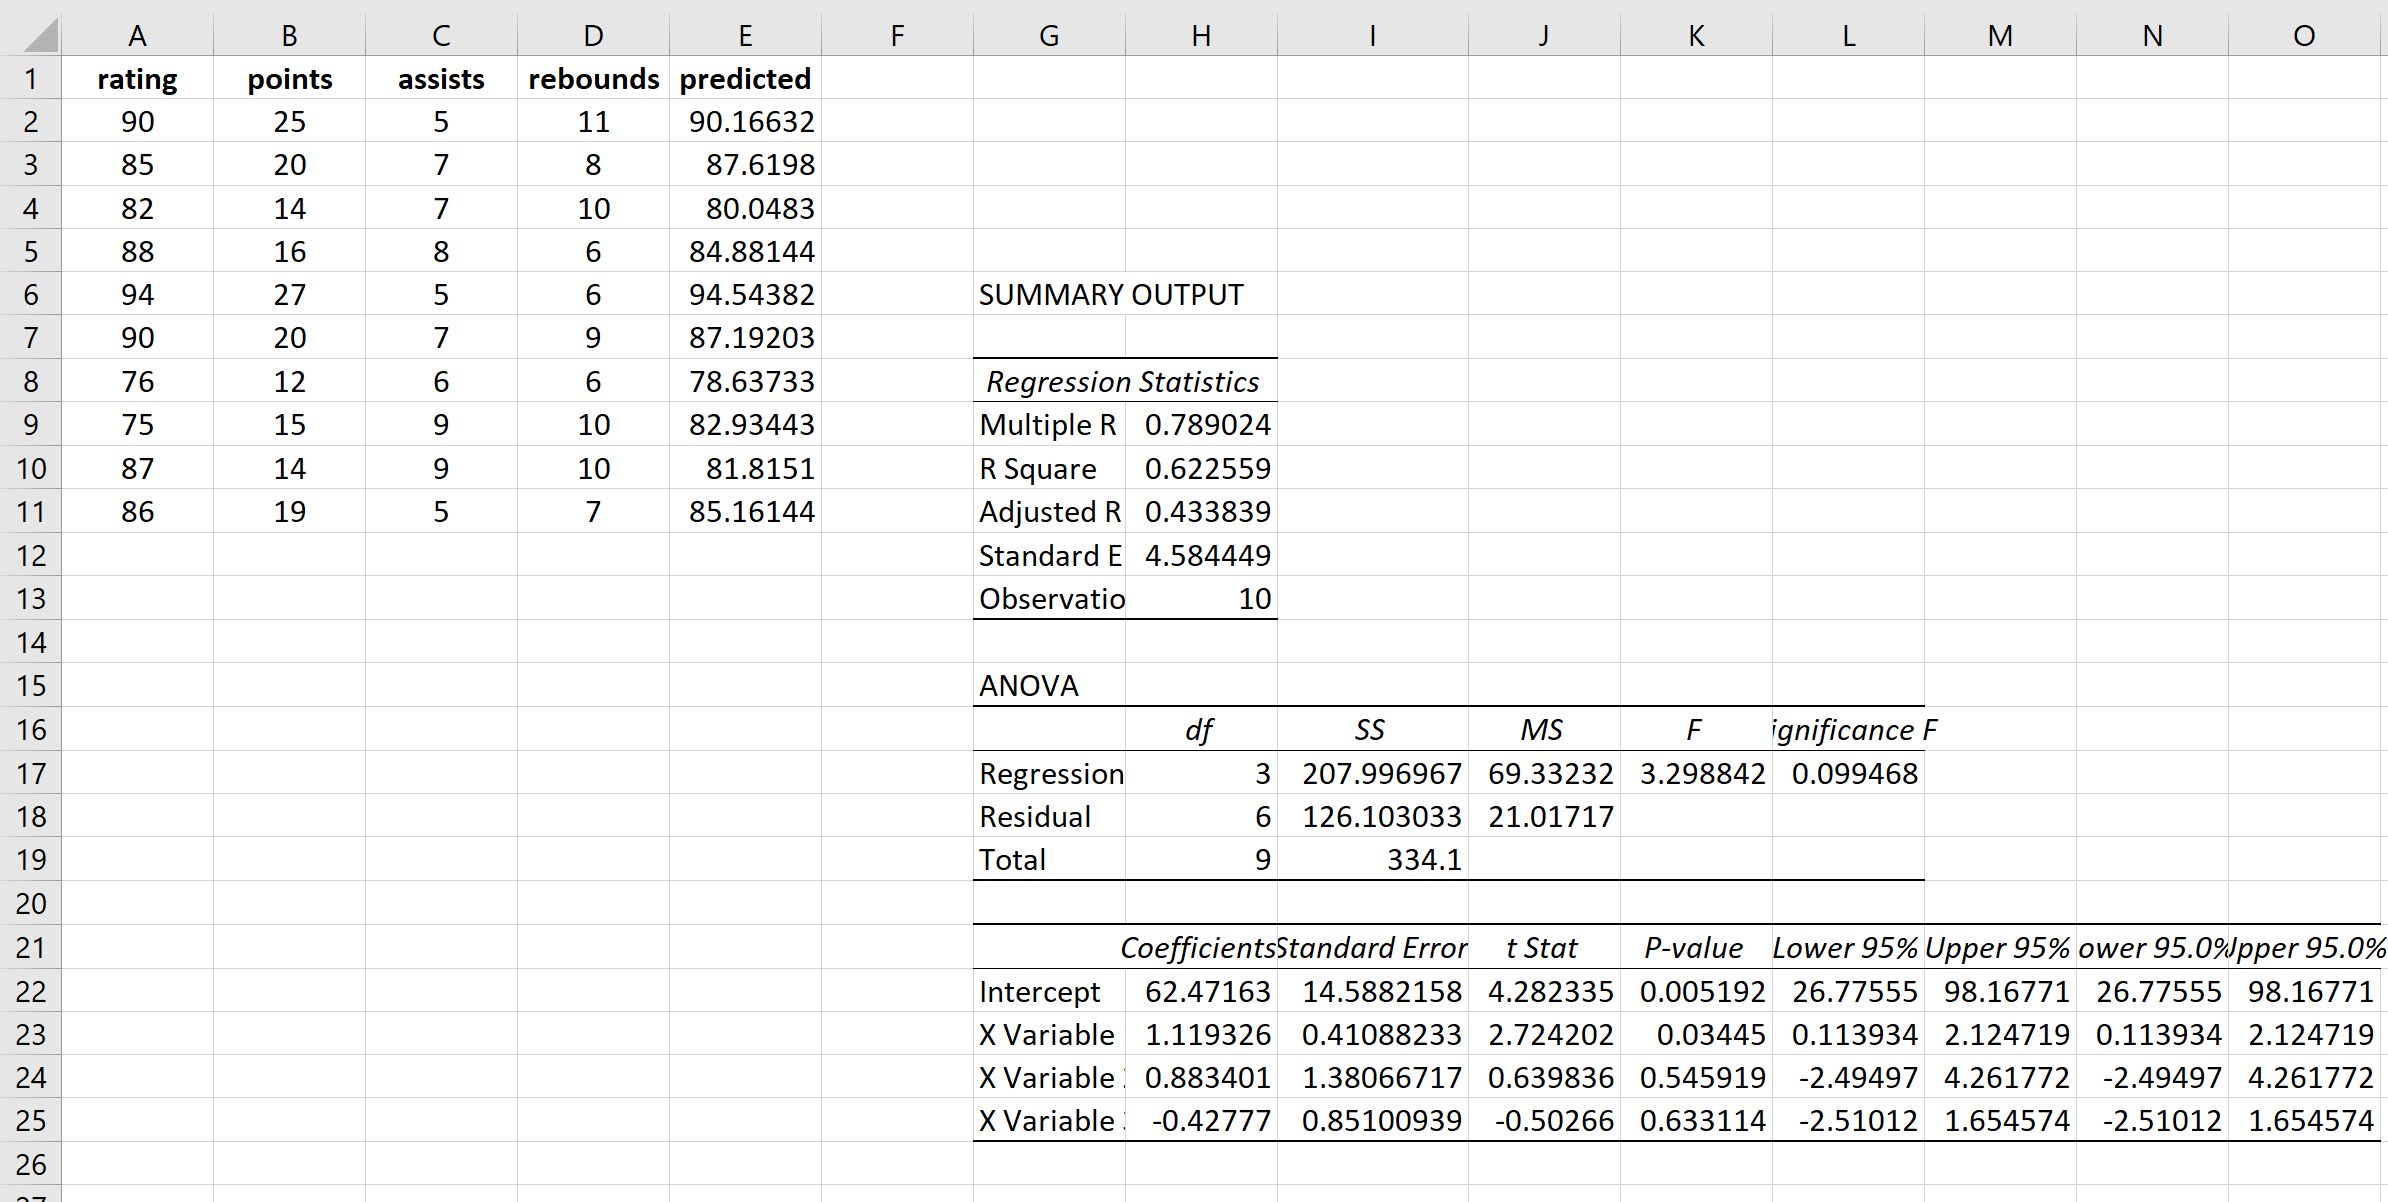
À des fins de contrôle d’intégrité numérique, il est formellement recommandé d’effectuer un test de validation en calculant la somme globale de cette colonne de résidus dans une cellule adjacente, en employant la commande =SOMME(C25:C124) (selon les coordonnées réelles de votre tableau). En conformité stricte avec les théorèmes mathématiques des moindres carrés ordinaires en présence d’une constante, cette sommation doit converger de façon imperceptible vers zéro, aux approximations infinitésimales près de la précision flottante du processeur (par exemple une valeur de l’ordre de $10^{-14}$).
6.2 Formulation arithmétique des résidus au carré
La mise en œuvre pratique du test exige que nous modélisions la variabilité locale des résidus indépendamment de leur sens de déviation (positif ou négatif). Pour ce faire, il convient de créer une variable auxiliaire représentant le carré de chaque résidu individuel estimé.
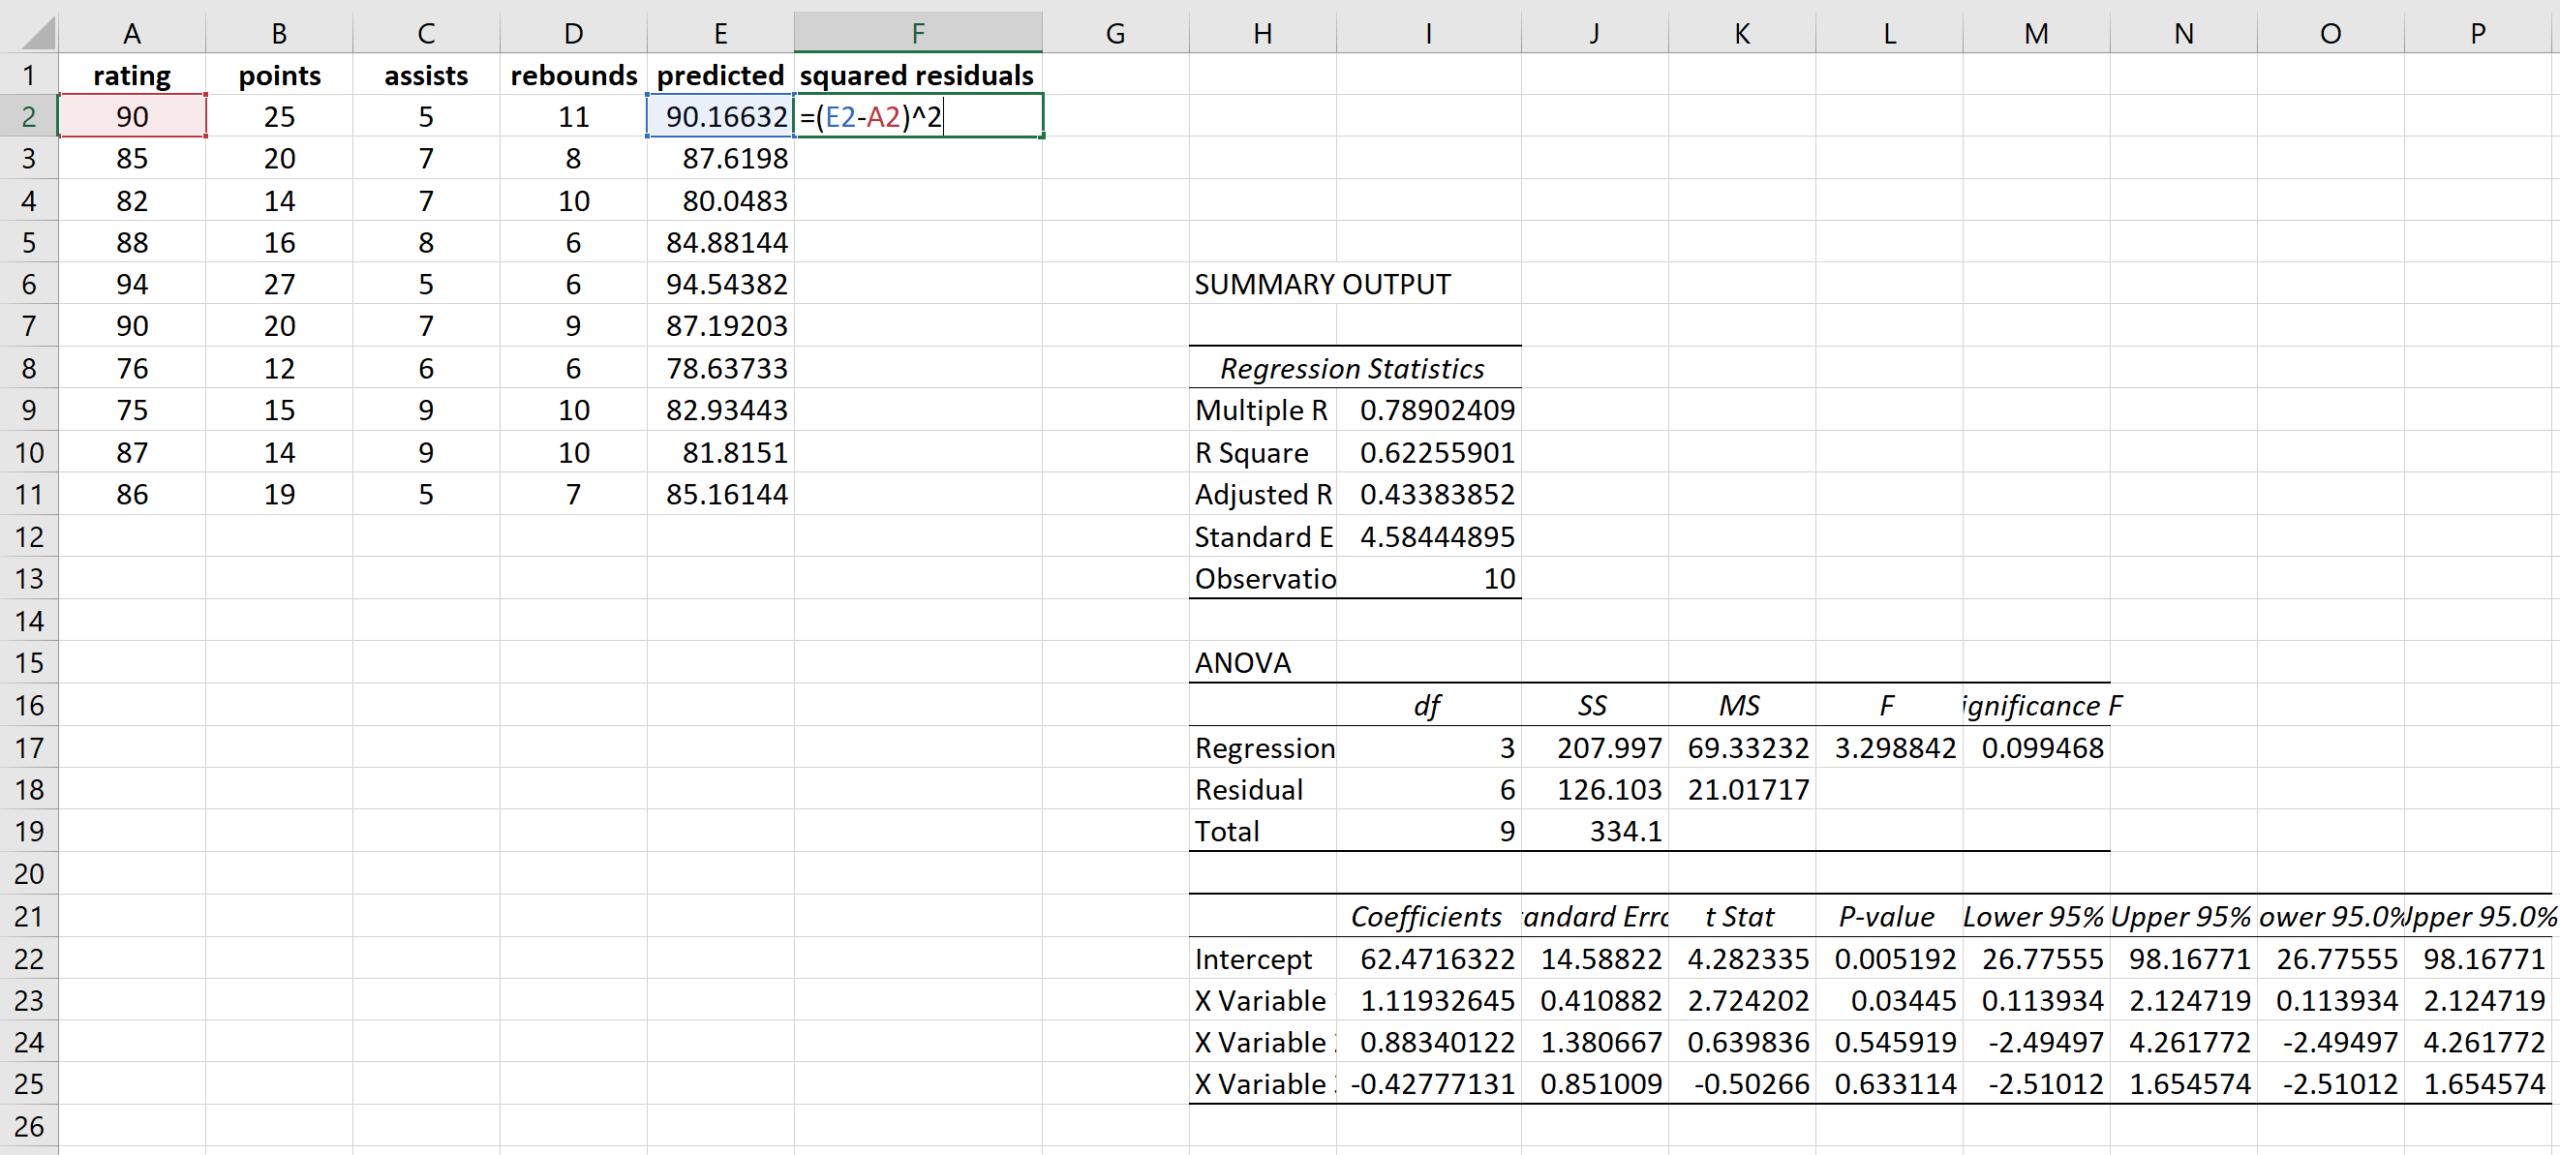
Positionnez-vous dans la cellule située immédiatement à droite de la première observation résiduelle du tableau, par exemple dans la colonne D en ligne 25. Attribuez à cette cellule un en-tête explicite, tel que Residus_Carre. Dans la cellule sous-jacente (ligne 26), saisissez la formule arithmétique d’élévation à la puissance deux en ciblant la cellule hébergeant le premier résidu brut :
=C26^2
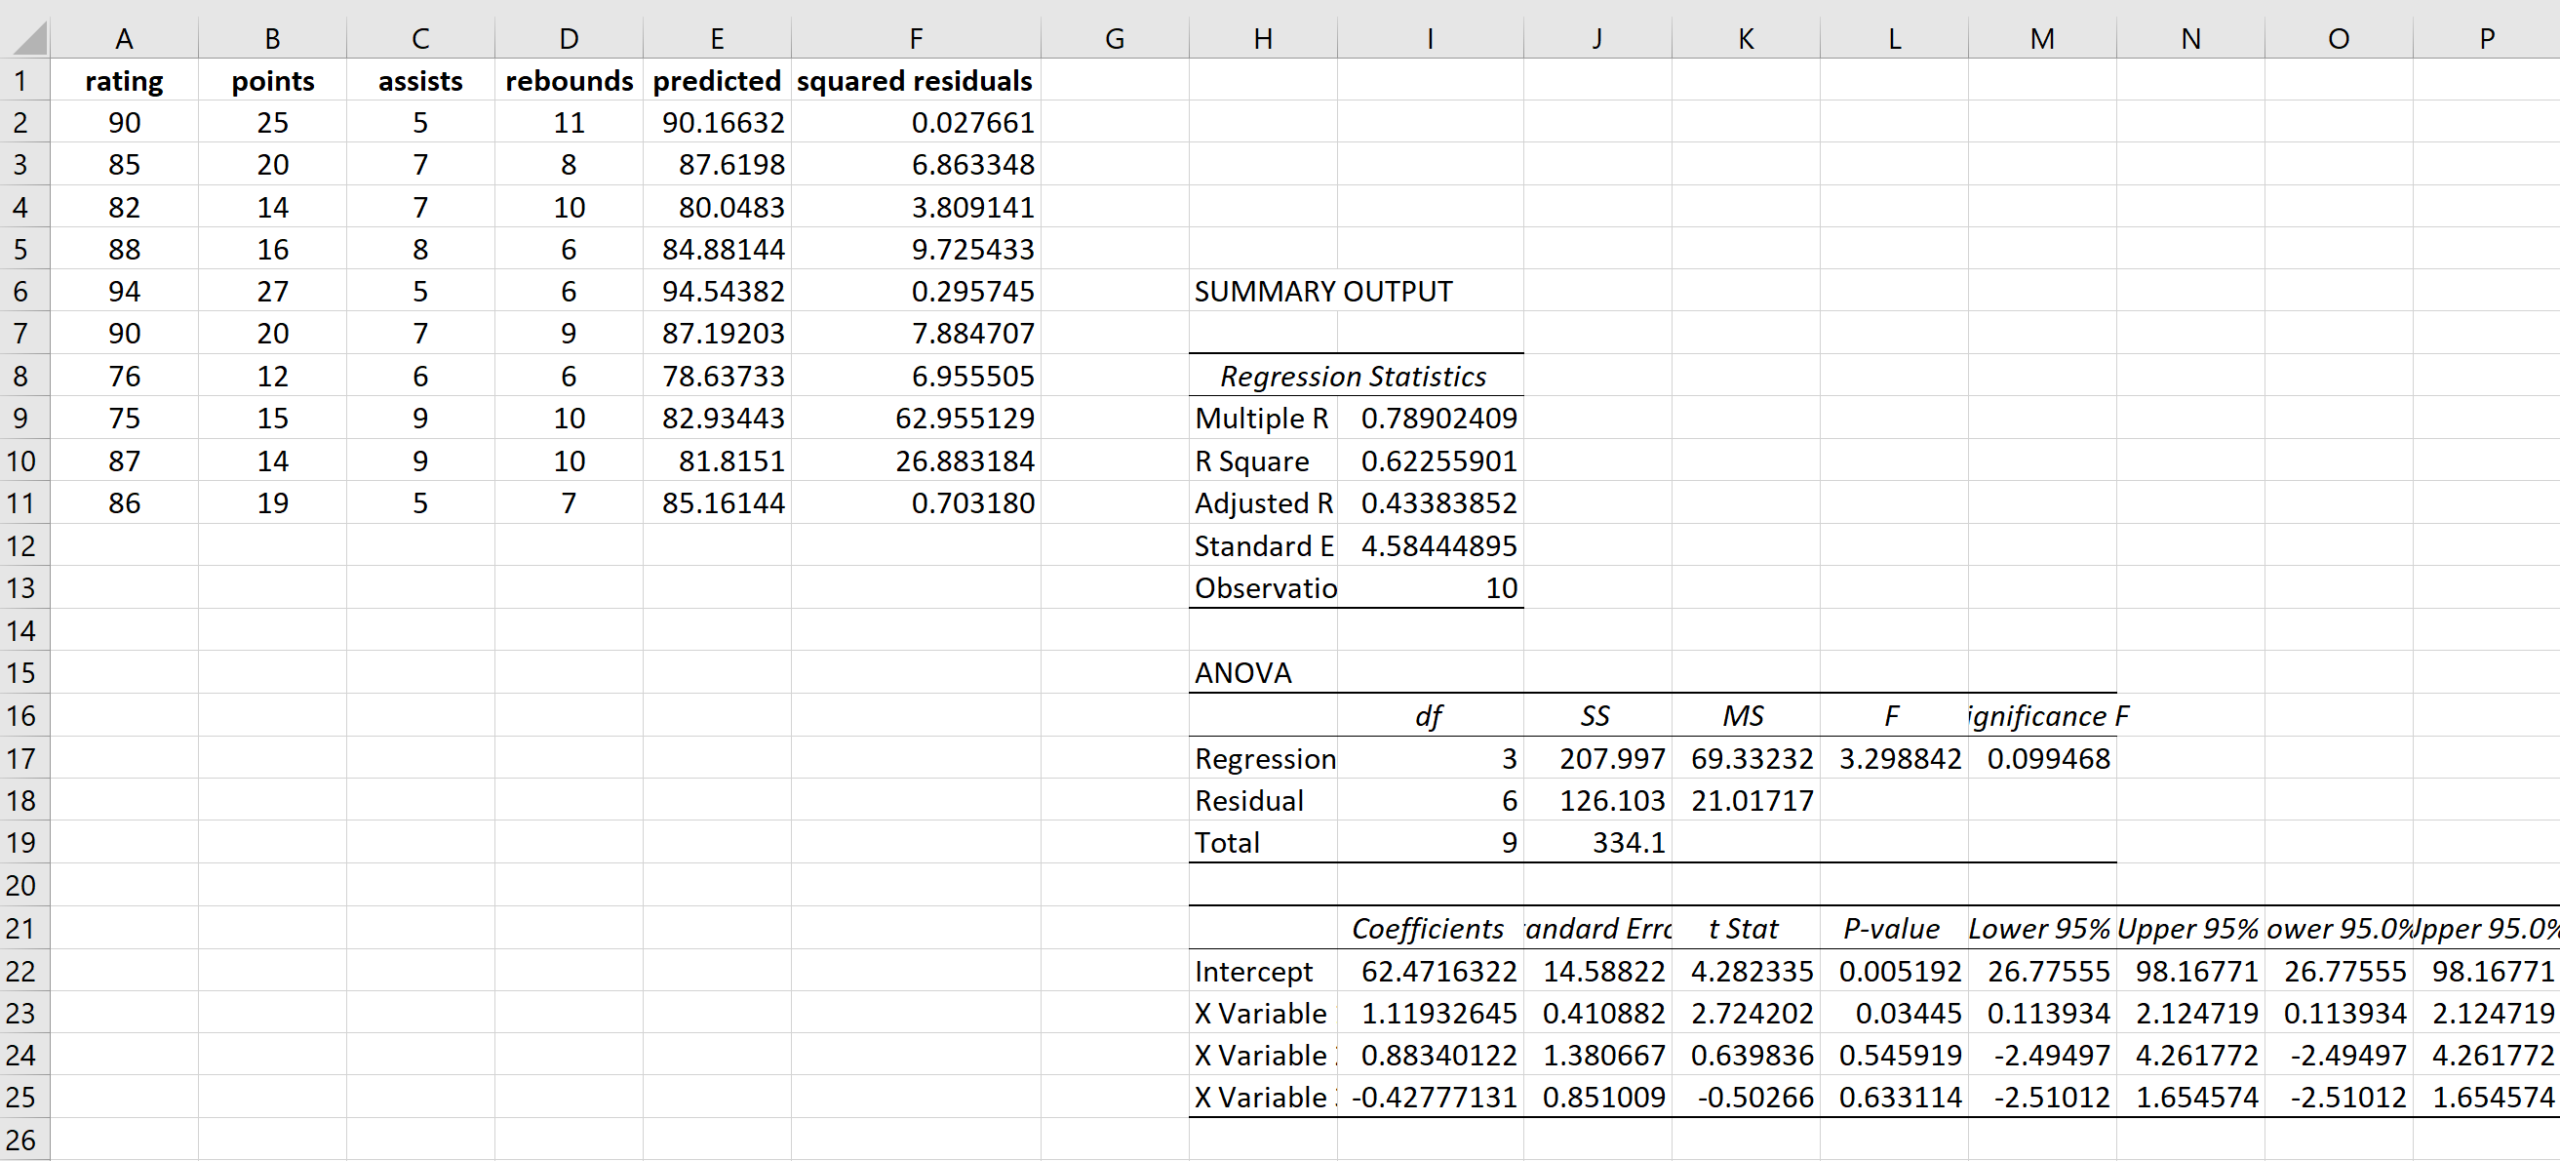
Validez l’entrée par la touche Entrée. Positionnez ensuite votre curseur sur le coin inférieur droit de la cellule nouvellement calculée jusqu’à l’apparition de la poignée de recopie (la croix noire fine), puis double-cliquez pour propager instantanément la formule sur l’intégralité des $N$ lignes du tableau. Vous disposez désormais, pour chaque observation de votre jeu de données, du terme résiduel quadratique $e_i^2$.
6.3 Compréhension de la variable dépendante auxiliaire
Il est fondamental de saisir la signification théorique et géométrique de cette nouvelle colonne de résidus au carré. Par définition, l’erreur pure aléatoire théorique $u_i$ est une grandeur inobservable dans le monde réel ; dès lors, sa variance conditionnelle théorique $\sigma_i^2 = operatorname{Var}(u_i mid X_i) = operatorname{E}(u_i^2 mid X_i)$ demeure intrinsèquement inaccessible à la mesure directe.
Puisque la moyenne théorique des erreurs est nulle ($operatorname{E}(u_i) = 0$), le carré de l’erreur empirique $e_i^2$ se comporte comme un estimateur ponctuel non biaisé, quoique extrêmement volatil à l’échelle unitaire, de la variance locale non observée de la perturbation. Élever le résidu au carré accomplit deux fonctions analytiques majeures : éliminer purement et simplement le signe de l’écart (un résidu fortement négatif indiquant une dispersion d’erreur tout aussi colossale qu’un résidu fortement positif) et pondérer de façon quadratique les grands écarts prédictifs.
En conséquence, les résidus au carré constituent la métrique empirique la plus idoine pour servir de variable dépendante opérationnelle dans notre régression auxiliaire. Si la variance des erreurs est homoscédastique, ces grandeurs quadratiques doivent fluctuer de manière totalement aléatoire et uniforme autour de leur moyenne globale, sans présenter de covariance appréciable avec les régresseurs de l’étude.
7. Étape 3 : Estimation du modèle de régression auxiliaire
7.1 Définition de l’équation de régression auxiliaire
Le cœur opératoire du test de Breusch-Pagan repose sur l’estimation d’une régression secondaire, qualifiée de régression auxiliaire. Cette équation ne cherche plus à modéliser la variable théorique originale $Y$, mais entreprend de prédire les fluctuations de l’indicateur empirique de la variance résiduelle, à savoir le vecteur des résidus au carré $e_i^2$, à partir de l’ensemble des prédicteurs du modèle initial.
L’équation de régression auxiliaire s’énonce formellement sous la forme :
$$e_i^2 = \gamma_0 + \gamma_1 X_{i1} + \gamma_2 X_{i2} + dots + \gamma_k X_{ik} + v_i$$
où $\gamma_0$ symbolise la constante de l’équation auxiliaire, $\gamma_1, dots, \gamma_k$ représentent les coefficients d’impact des prédicteurs sur la magnitude de la variance, et $v_i$ matérialise le terme d’erreur résiduelle propre à cette régression secondaire. Si l’hypothèse nulle d’homoscédasticité est satisfaite dans les données mères, aucun des régresseurs $X$ ne doit posséder de pouvoir explicatif statistiquement détectable sur la variabilité de $e_i^2$, impliquant théoriquement que l’ensemble des coefficients $\gamma_j$ soit conjointement égal à zéro.
7.2 Exécution de la seconde régression sous Excel
Pour exécuter cette équation sous Excel, il est opportun de copier préalablement la nouvelle colonne des résidus au carré ($e_i^2$) et de la coller — sous forme de valeurs uniquement, via l’option Collage spécial > Valeurs — au sein de votre feuille de données originelle, dans une colonne adjacente à vos prédicteurs. Cette disposition contiguë facilitera la sélection matricielle sous l’Utilitaire d’analyse sans générer de ruptures de coordonnées inter-feuilles.
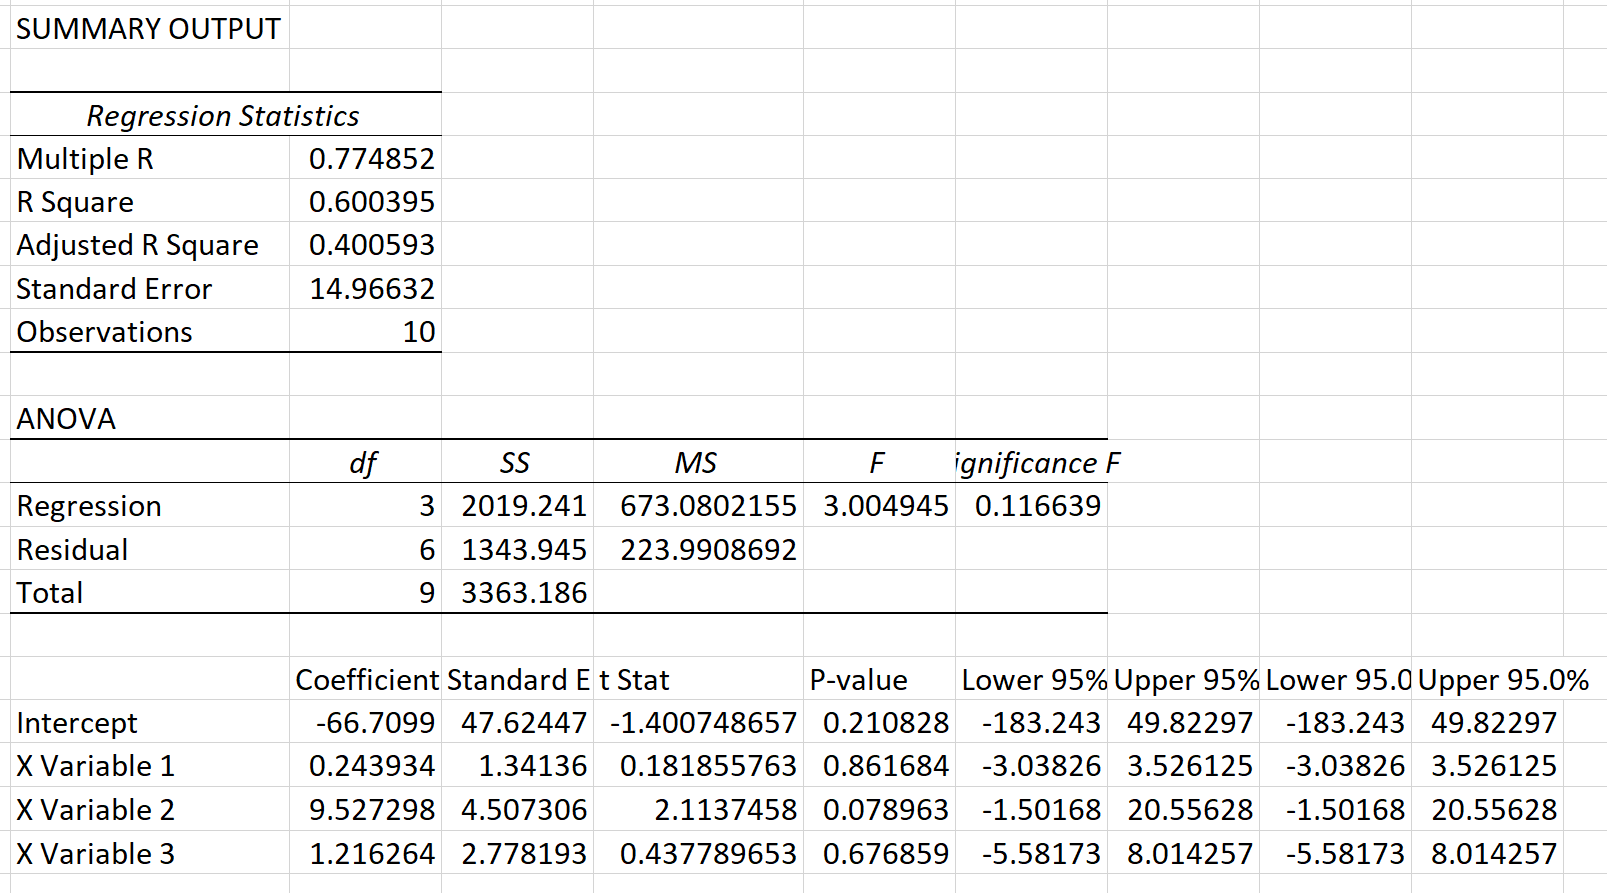
Une fois les variables alignées, revenez sur le ruban Données, cliquez sur Utilitaire d’analyse, sélectionnez de nouveau le module Régression et validez. Les paramètres doivent désormais être scrupuleusement ajustés :
- Dans le champ Plage d’entrée Y, renseignez la plage correspondant à votre colonne de résidus au carré (par exemple
$E$1:$E$101). - Dans le champ Plage d’entrée X, sélectionnez avec rigueur exactement les mêmes variables explicatives que celles ayant nourri le modèle principal (par exemple
$B$1:$D$101). - Cochez la case Intitulés si la première ligne sélectionnée comprend vos titres de colonnes.
- Veillez impérativement à décocher la case Résidus, car les résidus du modèle auxiliaire ne présentent aucune utilité pour le protocole de Breusch-Pagan.
- Indiquez une nouvelle feuille de destination pour la sortie des calculs, intitulée par exemple Regression_Auxiliaire.
Actionnez enfin le bouton OK pour que le tableur procède à la résolution analytique du modèle auxiliaire.
7.3 Extraction des paramètres clés du modèle secondaire
La feuille nouvellement générée affiche l’armature standard des résultats de régression d’Excel. Pour les besoins exclusifs du test de Breusch-Pagan, l’attention du chercheur doit converger vers deux grandeurs numériques fondamentales situées dans le premier tableau supérieur intitulé Statistiques de la régression.
La première grandeur est le R² (coefficient de détermination classique, non ajusté) de la régression auxiliaire, désigné dans notre formulation théorique par $R^2_{\text{aux}}$. Cette métrique chiffre avec exactitude la proportion de la variance des résidus au carré expliquée linéairement par la constellation des régresseurs d’origine. Même si ce coefficient paraît numériquement modeste (par exemple 0,08 ou 0,12), il peut s’avérer largement suffisant pour dénoter une hétéroscédasticité statistiquement inadmissible si l’échantillon comporte un effectif conséquent.
La seconde grandeur indispensable est le nombre total d’observations valides prises en compte, matérialisé par la ligne Observations au bas de cette même table statistique, symbolisé arithmétiquement par la lettre $N$. Il importe également de relever le nombre de degrés de liberté associé à la régression, visible sur la ligne Régression de la table ANOVA sous la colonne dl (degrés de liberté), qui correspond strictement au nombre $p$ de régresseurs intégrés dans l’équation auxiliaire.
8. Étape 4 : Calcul de la statistique de test de Breusch-Pagan
8.1 Calcul selon l’approche de Koenker (Multiplicateur de Lagrange)
Avec l’extraction du coefficient de détermination auxiliaire ($R^2_{\text{aux}}$) et de la taille effective de l’échantillon ($N$), nous disposons de l’ensemble des éléments requis pour calculer la statistique robuste de Breusch-Pagan-Koenker. Dans la feuille de synthèse de vos résultats, identifiez une cellule vierge destinée à recevoir cette valeur, par exemple la cellule B15, et attribuez-lui l’en-tête Statistique_BP_Koenker.
La formule arithmétique à implémenter dans cette cellule repose sur le produit pur de l’effectif total par le coefficient $R^2$ extrait de la régression auxiliaire. En supposant que le $R^2_{\text{aux}}$ soit consigné dans la cellule B5 de la feuille Regression_Auxiliaire et que le nombre d’observations $N$ figure dans la cellule B8, la formule s’écrit littéralement :
=B8*B5
Cette statistique de multiplicateur de Lagrange (LM), hautement estimée dans les sciences appliquées pour sa remarquable résilience face aux distorsions de normalité des données, condense en un scalaire unique l’intensité de la dépendance entre la dispersion des résidus et les variables prédictives. Plus ce produit est élevé, plus la présomption d’une variance résiduelle hétérogène et structurée devient irréfragable.
8.2 Calcul selon la formulation originelle de Breusch-Pagan
À des fins d’exhaustivité méthodologique ou de conformité historique avec certains protocoles académiques, il peut être exigé d’établir parallèlement la statistique selon la mouture formulée originellement par Breusch et Pagan en 1979. Cette dernière procède par une normalisation préalable des carrés résiduels par l’estimateur du maximum de vraisemblance de la variance d’erreur globale.
Pour dériver cette version classique, il convient de déterminer la variance moyenne des résidus ordinaires issus du modèle primaire :
$$\tilde{\sigma}^2 = \frac{\sum e_i^2}{N}$$
Chaque résidu au carré est alors divisé par cette grandeur moyenne pour créer un vecteur normalisé : $f_i = \frac{e_i^2}{\tilde{\sigma}^2}$. La régression auxiliaire est ensuite conduite en prenant ce vecteur $f_i$ comme variable dépendante sur les mêmes variables explicatives. La statistique de test originelle correspond alors exactement à la moitié de la Somme des Carrés de Régression (abrégée SC Régression ou SS Regression dans la table ANOVA d’Excel) générée par ce modèle normalisé :
$$\text{BP}_{\text{originel}} = \frac{1}{2} \text{SC}_{\text{régression}}$$
Bien que rigoureusement équivalente à l’approche de Koenker lorsque les erreurs suivent une loi normale parfaite, cette formulation originelle diverge considérablement dès que la distribution empirique manifeste un aplatissement lourd, produisant une inflation de faux rejets de l’homoscédasticité.
8.3 Choix de la statistique appropriée pour l’analyse empirique
Face à la dualité des formulations accessibles sous tableur, le chercheur contemporain doit opérer un arbitrage éclairé par la littérature scientifique de référence. Les traités d’économétrie appliquée récents, à l’instar des travaux de Jeffrey Wooldridge ou de William Greene, soulignent de manière unanime la supériorité opérationnelle de la variante modifiée de Koenker ($N \times R^2_{\text{aux}}$).
Cette préséance méthodologique s’explique par le fait que les données empiriques réelles — tout particulièrement au sein des sciences humaines, organisationnelles, économiques et cliniques — respectent exceptionnellement le postulat de normalité idéale des perturbations. L’approche de Koenker protège l’analyste contre le risque majeur d’imputer indûment à la variance une instabilité qui ne relève en réalité que de la forme leptokurtique des queues de distribution de l’échantillon.
Dans l’organisation de votre classeur Excel, il est hautement profitable d’indiquer de manière explicite et traçable l’algorithme retenu. Documentez la cellule hébergeant le calcul en la nommant formellement Statistique_Breusch_Pagan_Koenker. Cette transparence méthodologique facilite grandement les procédures d’audit analytique et garantit une parfaite communicabilité de vos calculs lors des évaluations par les pairs.
9. Étape 5 : Calcul de la p-valeur et prise de décision statistique
9.1 Utilisation de la fonction de répartition du Chi-deux dans Excel
Une fois la statistique numérique de Breusch-Pagan dérivée, la phase conclusive de l’inférence requiert la conversion probabiliste de cette grandeur en une p-valeur exacte. Puisque la statistique du test converge asymptotiquement vers une loi de distribution du Khi-deux sous l’hypothèse nulle, Excel met à notre disposition une fonction statistique native parfaitement calibrée : LOI.KHIDEUX.DROITE (ou CHISQ.DIST.RT dans les versions anglophones du logiciel).
La syntaxe opératoire de cette fonction requiert deux paramètres scalaires stricts : l’argument $x$, incarné par la valeur calculée de la statistique de test, et l’argument $degrés_liberté$, représenté par le nombre de variables explicatives présentes dans la régression auxiliaire. En supposant que votre statistique LM ($N \times R^2_{\text{aux}}$) soit localisée en cellule B15 et que votre modèle comprenne 3 prédicteurs explicatifs, la syntaxe à renseigner dans la cellule dévolue à la p-valeur s’énonce ainsi :
=LOI.KHIDEUX.DROITE(B15; 3)
Cette fonction calcule l’intégrale de la fonction de densité de probabilité du Khi-deux s’étendant depuis la valeur observée $x$ jusqu’à l’infini positif. La probabilité résultante quantifie avec exactitude la probabilité d’obtenir une dispersion résiduelle au moins aussi marquée que celle constatée dans l’échantillon sous l’hypothèse stricte où la variance réelle des perturbations serait parfaitement constante au sein de la population génératrice.
9.2 Comparaison avec la valeur critique théorique
Bien que la dérivation de la p-valeur suffise à sceller le verdict statistique, la tradition académique préconise fréquemment de formaliser la décision à travers l’identification du seuil critique théorique matérialisant la frontière de la région de rejet de l’hypothèse nulle. Cette valeur frontière dépend du seuil de risque d’erreur consenti ($\alpha$), conventionnellement fixé à 0,05 (soit 5 % de risque d’erreur de première espèce).
Excel intègre la fonction réciproque appropriée pour déterminer cette valeur critique théorique : INVERSE.KHIDEUX.DROITE (ou CHISQ.INV.RT en nomenclature internationale). Pour dériver le point d’inflexion critique associé à un risque $\alpha = 0,05$ pour 3 degrés de liberté, la formule à introduire s’établit comme suit :
=INVERSE.KHIDEUX.DROITE(0,05; 3)
Cette formule renvoie dans notre exemple la valeur théorique de 7,815. La règle géométrique d’inférence s’énonce alors sans équivoque : si la statistique empirique calculée dépasse cette valeur critique théorique (c’est-à-dire si elle se situe dans la queue supérieure de distribution marquant la région critique), le modèle s’émancipe de manière insoutenable de la structure d’homoscédasticité postulée par Gauss-Markov.
9.3 Interprétation formelle du résultat inférentiel
La formalisation du verdict inférentiel scelle le processus décisionnel quant à la validité des résidus de modélisation. Deux configurations polaires se dessinent alors devant le méthodologiste :
Dans le premier cas de figure, la p-valeur calculée s’avère inférieure au seuil de signification préétabli ($\alpha = 0,05$). L’analyste se trouve dans l’obligation méthodologique formelle de rejeter l’hypothèse nulle ($H_0$) en faveur de l’hypothèse alternative ($H_1$). Ce constat établit avec un contrôle probabiliste rigoureux que la variance des perturbations du modèle présente une dépendance fonctionnelle statistiquement significative vis-à-vis des régresseurs incorporés. L’hétéroscédasticité est formellement actée, frappant d’obsolescence immédiate les erreurs-types ordinaires et les tests de Student issus de la régression primaire.
Dans le second cas de figure, la p-valeur obtenue est supérieure ou égale à 0,05. Le corpus statistique ne fournit pas de preuves suffisantes pour discréditer l’homogénéité de la variance résiduelle. L’analyste ne peut rejeter l’hypothèse nulle d’homoscédasticité. Les erreurs-types calculées par l’Utilitaire d’analyse d’Excel peuvent dès lors être tenues pour fiables et non biaisées, autorisant une interprétation sans réserve de la significativité intrinsèque des paramètres partiels de modélisation.
10. Diagnostic visuel complémentaire : Les graphiques résiduels dans Excel
10.1 Construction d’un graphique de dispersion des résidus
Bien que le test formel de Breusch-Pagan offre un étalonnage probabiliste objectif indispensable, la pratique contemporaine de l’analyse de données exige impérativement de coupler ce diagnostic analytique avec une exploration visuelle systématique. L’examen graphique des résidus permet d’appréhender la morphologie spatiale de l’hétéroscédasticité, de repérer d’éventuelles non-linéarités sous-jacentes et de contextualiser la décision mathématique.
Pour concevoir le graphique résiduel standard sous Excel, sélectionnez conjointement les deux premières colonnes du tableau d’analyse résiduelle généré lors de la première étape : la colonne Valeurs ajustées pour Y ($\hat{Y}_i$) et la colonne Résidus ($e_i$). Dans le ruban principal, ouvrez l’onglet Insertion, localisez le groupe Graphiques, puis cliquez sur l’icône Nuage de points (ou dispersion simple sans courbe de liaison).
Une fois le visuel inséré sur la feuille, quelques ajustements ergonomiques s’avèrent impératifs. Les valeurs ajustées doivent occuper rigoureusement l’axe horizontal des abscisses (X), tandis que les résidus s’étirent le long de l’axe vertical des ordonnées (Y). Ajoutez une ligne géométrique de référence horizontale positionnée précisément à l’ordonnée zéro : cette ligne médiane matérialise l’espérance conditionnelle théorique d’erreur et sert d’ancre d’évaluation pour juger de la symétrie de dispersion des points empiriques.
10.2 Typologie des motifs visuels d’hétéroscédasticité
L’inspection du nuage de points révèle immédiatement la signature géométrique de la distribution d’erreur. Sous l’hypothèse idéale d’homoscédasticité, les points doivent se distribuer de manière totalement aléatoire, homogène et non structurée, formant une bande horizontale rectangulaire d’épaisseur invariante le long de tout l’axe des valeurs ajustées, semblable à un banc de brouillard uniforme.
À l’inverse, l’hétéroscédasticité se trahit par des déformations caractéristiques de ce nuage de dispersion :
- Le motif en entonnoir ou en mégaphone : la configuration la plus classique, où la dispersion verticale des points est ténue et resserrée pour les faibles valeurs de prédiction, puis s’évase considérablement à mesure que les valeurs prédites progressent vers l’extrémité droite du graphique, révélant une instabilité proportionnelle de la variance.
- Le motif en fuseau ou en amande : la dispersion résiduelle se gonfle de façon volumineuse dans la zone centrale des prédictions tout en se refermant étroitement aux deux extrémités polaires de l’échelle.
- Le motif incurvé ou parabolique : bien que témoignant fréquemment d’une non-linéarité fonctionnelle méconnue du modèle primaire, ce schéma induit presque systématiquement une instabilité apparente de la variance d’erreur le long du continuum prédictif.
10.3 Complémentarité entre test inférentiel et inspection visuelle
Il est capital pour le chercheur de cultiver une dialectique méthodologique entre l’inspection visuelle et le test inférentiel de Breusch-Pagan, dans la mesure où aucune de ces démarches ne saurait suffire isolément à un diagnostic irréprochable.
Le test de Breusch-Pagan, en sa qualité de test inférentiel paramétrique, est hautement tributaire de la taille d’échantillon $N$. Au sein de bases de données très massives (comportant par exemple des dizaines de milliers d’enregistrements), la puissance statistique devient si exponentielle que le test rejettera systématiquement l’hypothèse d’homoscédasticité pour des déviations résiduelles microscopiques et parfaitement anodines sur le plan pratique. L’examen graphique permet alors de relativiser l’ampleur phénoménale de l’hétéroscédasticité et d’attester que la violation demeure sans conséquence substantielle pour la robustesse opérationnelle des prédictions.
Inversement, sur des échantillons restreints ($N < 50$), l'œil humain s'avère particulièrement perméable aux biais d'interprétation cognitive, croyant discerner un motif en entonnoir au sein d'une configuration résultant de simples fluctuations d'échantillonnage aléatoires. La statistique de test de Breusch-Pagan agit dans ce cadre comme un garde-fou probabiliste indispensable, empêchant l'analyste de modifier arbitrairement son protocole d'estimation en l'absence d'une preuve statistique concluante.
11. Solutions et remèdes statistiques face à une hétéroscédasticité avérée
11.1 Transformation des données dans la feuille de calcul
Lorsque le test de Breusch-Pagan conclut formellement à un rejet de l’homoscédasticité, l’analyste ne peut maintenir son modèle linéaire en l’état sous peine de propager des inférences fallacieuses. La première voie de remédiation, particulièrement élégante et simple à opérer au sein d’Excel, réside dans la transformation fonctionnelle non linéaire des variables de l’étude.
La transformation la plus répandue consiste à appliquer l’opérateur logarithme népérien à la variable dépendante continue via la formule Excel =LN(A2), à la condition stricte que celle-ci ne prenne que des valeurs strictement positives. Ce changement d’échelle comprime de façon exponentielle les valeurs élevées de la série statistique, réduisant mécaniquement la dispersion relative des résidus sur les tranches supérieures. La régression auxiliaire conduite sur ce modèle semi-logarithmique révèle très fréquemment une stabilisation spectaculaire de la variance d’erreur.
Pour les variables quantitatives issues de comptages discrets ou soumises à des bornes strictes (comme certains indices psychométriques ou scores comportementaux), d’autres transformations stabilisatrices de variance reconnues par la littérature mathématique peuvent être déployées : la transformation par la racine carrée (formule =RACINE(A2)) ou la transformation puissance de Box-Cox. Suite à toute transformation de variable, le protocole complet du test de Breusch-Pagan doit être réexécuté sur la nouvelle spécification pour vérifier la résorption effective de l’anomalie.
11.2 Mise en œuvre des moindres carrés pondérés (MCP) dans Excel
Si les transformations fonctionnelles s’avèrent inopérantes ou dénaturent excessivement l’interprétabilité théorique directe des coefficients originels, la méthode d’estimation paramétrique alternative par excellence est celle des moindres carrés pondérés (MCP, ou WLS pour Weighted Least Squares). Cette technique consiste à pénaliser les observations associées à une forte variance d’erreur tout en accordant un poids déterminant aux observations caractérisées par une précision résiduelle élevée.
L’implémentation des moindres carrés pondérés dans Excel s’articule autour de la construction d’une métrique de pondération individuelle $w_i = \frac{1}{\hat{\sigma}_i}$, où $\hat{\sigma}_i$ représente l’écart-type résiduel estimé pour l’observation $i$, fréquemment approximé par la racine carrée des prédictions issues de la régression auxiliaire modélisant les résidus au carré. Chaque variable du système initial ($Y$, $X_1, dots, X_k$) ainsi que le terme constant unitaire doivent être multipliés au sein de nouvelles colonnes par ce coefficient de pondération spécifique :
$$Y_i^* = Y_i \times w_i, \quad X_{i1}^* = X_{i1} \times w_i, \quad \text{Constante}_i^* = 1 \times w_i$$
L’opérateur exécute ensuite l’outil Régression de l’Utilitaire d’analyse sur ces séries artificiellement pondérées en prenant soin de cocher expressément l’option Constante à zéro (puisque le terme constant pondéré constitue désormais un régresseur autonome inséré dans la matrice $X^*$). Le modèle transformé restitue l’efficience statistique suprême promise par Gauss-Markov sous des conditions d’hétéroscédasticité maîtrisée.
11.3 Recours aux erreurs-types robustes de White
Une alternative contemporaine fondamentale consiste à renoncer à la quête d’une homoscédasticité parfaite et à conserver les estimations ponctuelles non biaisées des coefficients des moindres carrés ordinaires d’origine, tout en corrigeant formellement l’estimation de leur matrice de variance-covariance au moyen d’un estimateur robuste à l’hétéroscédasticité. Cette approche a été formalisée par l’économètre Halbert White en 1980 à travers l’estimateur de variance robuste en sandwich, couramment désigné sous le label HC0 (ou ses améliorations pour échantillons finis, HC1, HC2 et HC3).
Sur le plan mathématique, l’estimateur sandwich de White s’exprime par le produit matriciel suivant :
$$operatorname{Var}_{\text{robuste}}(\hat{\beta}) = (X^T X)^{-1} (X^T \hat{\Omega} X) (X^T X)^{-1}$$
où $\hat{\Omega}$ matérialise une matrice diagonale contenant sur sa diagonale principale les résidus empiriques au carré $e_i^2$ de chaque observation statistique.
Bien qu’il soit théoriquement envisageable d’orchestrer cette algèbre matricielle au sein d’Excel en mobilisant les fonctions dynamiques PRODUITMAT(), TRANSPOSE() et INVERSEMAT(), la lourdeur d’une telle programmation sur des jeux de données étendus s’avère particulièrement fastidieuse et propice aux corruptions de plages. Dès lors que la recherche impose la restitution standardisée d’erreurs-types robustes de White pour étayer des publications scientifiques exigeantes, il est vivement conseillé de basculer la feuille de calcul épurée vers des environnements logiciels natifs spécialisés en économétrie ou biostatistique (tels que R, Stata ou le module Statsmodels de Python).
12. Application méthodologique en recherche psychologique et bonnes pratiques
12.1 Pertinence de l’homoscédasticité dans les mesures psychométriques
La question de l’invariance de la dispersion d’erreur n’est en rien cantonnée aux séries temporelles de la macroéconomie ; elle se pose avec une acuité particulière au sein de la psychologie différentielle, des neurosciences comportementales et de la psychométrie appliquée. Dans l’évaluation empirique des processus psychologiques, les aptitudes cognitives et les traits de personnalité sont fréquemment quantifiés le long de continuums d’échelles standardisées soumises à de fortes variations locales de fidélité de mesure.
Par exemple, lors de la modélisation de la performance cognitive en fonction des scores d’anxiété situationnelle, il est classique d’observer une hétéroscédasticité structurelle : les sujets manifestant un niveau d’anxiété très bas fournissent des performances cognitives d’une variabilité minime et stable, tandis que les individus confrontés à une anxiété sévère manifestent des réactions neurocognitives extrêmement polarisées, oscillant d’un effondrement attentionnel majeur à une compensation par hyper-vigilance, induisant une explosion de la variance des résidus pour les scores anxiogènes élevés.
De surcroît, la présence récurrente d’effets de plancher ou de plafond au sein des inventaires cliniques (comme les inventaires de dépression de Beck ou les échelles de stress perçu) comprime artificiellement la variance résiduelle aux extrémités d’observation. L’évaluation de l’homoscédasticité via le test de Breusch-Pagan sous Excel garantit aux chercheurs que les tests d’inférence menés sur des populations cliniques ou des cohortes d’intervention ne reposent pas sur des erreurs-types illusoires susceptibles de fausser les conclusions quant à l’efficacité d’une thérapie ou d’un dispositif psychopédagogique.
12.2 Rédaction des résultats selon les normes académiques (APA)
La restitution académique d’un protocole d’analyse de régression linéaire requiert une transparence absolue sur l’évaluation préalable des postulats de Gauss-Markov. Selon les directives rédactionnelles préconisées par l’American Psychological Association (normes APA, 7e édition), l’analyste se doit de rapporter textuellement les indices descriptifs et inférentiels justifiant le maintien ou la correction de son modèle.
Un paragraphe méthodologique standard rapportant les résultats du test de Breusch-Pagan doit formellement consigner le nom explicite de la procédure (en précisant s’il s’agit de la formulation de Koenker), la valeur numérique exacte de la statistique empirique du multiplicateur de Lagrange ($LM$ ou $\chi^2$), le nombre de degrés de liberté associé, ainsi que la p-valeur exacte. Une formulation exemplaire s’articule ainsi :
« L’évaluation de l’homoscédasticité des résidus a été menée au moyen du test de Breusch-Pagan avec la correction robuste de Koenker. Les résultats attestent que la variance des résidus ne présente pas de dépendance statistiquement significative à l’égard de l’ensemble des prédicteurs du modèle, $\chi^2(3) = 2,47$, $p = 0,481$. L’hypothèse nulle d’homoscédasticité des erreurs ne peut être rejetée au seuil conventionnel de $\alpha = 0,05$, garantissant la validité et l’efficience des erreurs-types ordinaires associées aux coefficients de régression. »
Si, à l’inverse, l’hétéroscédasticité est avérée, le texte scientifique doit documenter sans détour le rejet inférentiel (par exemple : « $\chi^2(3) = 14,82$, $p = 0,002$ ») et expliciter la stratégie de remédiation mise en œuvre, qu’il s’agisse d’une transformation logarithmique préalable des variables, de l’adoption des moindres carrés pondérés ou du recours formel à des erreurs-types robustes.
12.3 Liste de contrôle opérationnelle pour l’analyste sous Excel
Pour garantir une reproductibilité parfaite et une rigueur méthodologique sans faille lors de vos modélisations linéaires sous tableur, le protocole séquentiel d’évaluation de Breusch-Pagan peut être résumé à travers une liste de contrôle systématique à renseigner pas à pas :
- Configuration tabulaire : Présence de la variable $Y$ en colonne unique, adjacence contiguë stricte des régresseurs $X_1, dots, X_k$, et élimination préalable de toute valeur manquante par liste.
- Régression primaire : Exécution du module Régression de l’Utilitaire d’analyse en cochant impérativement la case Résidus et placement des sorties sur une feuille isolée.
- Contrôle résiduel : Vérification de la quasi-nullité arithmétique de la somme des résidus primaires bruts ($\sum e_i \approx 0$).
- Variable quadratique : Génération rigoureuse de la colonne auxiliaire des carrés résiduels ($e_i^2 = e_i^2$) et duplication intégrale jusqu’à l’observation $N$.
- Régression auxiliaire : Exécution du second modèle linéaire associant la nouvelle variable $e_i^2$ en Y et l’exact même bloc de régresseurs $X$ d’origine en entrée X.
- Calcul de la statistique : Dérivation précise de la statistique de Koenker par le produit direct de la taille de l’échantillon par le coefficient de détermination auxiliaire ($N \times R^2_{\text{aux}}$).
- Inférence probabiliste : Dérivation de la p-valeur via la commande
=LOI.KHIDEUX.DROITE(statistique; degrés_de_liberté)et confrontation au seuil d’alpha de 0,05. - Confrontation visuelle : Conception d’un nuage de points croisant valeurs ajustées $\hat{Y}$ et résidus $e_i$ pour contextualiser la morphologie de la variance d’erreur.
- Archivage analytique : Sauvegarde du classeur avec figeage et documentation textuelle des formules intermédiaires assurant l’auditabilité intégrale de l’investigation empirique.
Références
Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911957
Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
Koenker, R. (1981). A note on studentizing a test for heteroscedasticity. Journal of Econometrics, 17(1), 107–112. https://doi.org/10.1016/0304-4076(81)90022-2
White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.