
Dans le champ de l’analyse quantitative appliquée aux sciences humaines, sociales et biomédicales, l’évaluation de la divergence entre deux moyennes d’échantillons indépendants constitue l’un des gestes inférentiels les plus fondamentaux. Historiquement dominée par le test t proposé en 1908 par William Sealy Gosset sous le pseudonyme de Student, cette comparaison repose sur des postulats distributionnels stricts, parmi lesquels l’homoscédasticité, ou homogénéité des variances populationnelles, occupe une place déterminante. Or, dans la pratique empirique de la psychométrie, de la psychologie clinique et des neurosciences comportementales, cette égalité des variances s’avère bien plus souvent une exception théorique qu’une réalité de terrain. Lorsque les groupes expérimentaux manifestent des dispersions asymétriques, l’application aveugle du test de Student expose le chercheur à une altération sévère du taux d’erreur de première espèce, pouvant mener à des conclusions erronées et non reproductibles.
Face à cette vulnérabilité mathématique, le statisticien britannique Bernard Lewis Welch a formalisé une adaptation robuste connue sous le nom de test t de Welch, ou test t pour variances inégales. En affranchissant l’inférence statistique de l’obligation d’homogénéité des variances tout en calculant une approximation ajustée des degrés de liberté, le test de Welch s’est progressivement imposé dans la littérature méthodologique moderne comme la procédure par défaut à privilégier. Pourtant, une part considérable de la communauté des praticiens et des étudiants mène encore ses analyses exploratoires et protocolaires au sein de tableurs généralistes, principalement Microsoft Excel. Bien que ce logiciel ne soit pas un environnement statistique dédié au même titre que R, Python, SPSS ou JASP, il dispose d’outils intégrés performants capables d’exécuter cette procédure avec une rigueur absolue, à condition d’en maîtriser les spécificités de paramétrage et les limites inhérentes.
Ce guide exhaustif a pour vocation d’articuler les fondements mathématiques, les implications épistémologiques et les démarches opérationnelles nécessaires à la mise en œuvre rigoureuse du test t de Welch dans Microsoft Excel. À travers une analyse comparative des comportements d’échantillonnage, une décomposition pas-à-pas des menus et des fonctions natives, ainsi qu’une mise en situation concrète issue de la recherche en psychologie, ce manuel offre aux analystes de données un cadre méthodologique complet. Il aborde la vérification des postulats pré-analytiques, la manipulation des données brutes, la restitution normalisée selon les standards de l’American Psychological Association (APA) et le calcul des indices complémentaires que sont la taille d’effet et les intervalles de confiance.
1. 1. Fondements théoriques et épistémologiques du test t de Welch
1.1 Origine statistique et formulation par Bernard Lewis Welch
L’émergence du test t de Welch s’inscrit au cœur d’un débat mathématique classique et persistant de l’inférence fréquentiste : le problème de Behrens-Fisher. Ce problème consiste à déterminer une procédure de test d’hypothèse valide pour comparer les espérances de deux populations normalement distribuées sans postuler l’égalité de leurs variances respectives ($\sigma_1^2 \neq \sigma_2^2$). Dans le cadre conventionnel formulé par William Sealy Gosset (Student, 1908), l’estimation conjointe de la variance résiduelle repose sur une mise en commun (pooled variance), fondée sur l’hypothèse rigide que les deux échantillons sont issus de distributions dotées d’une dispersion identique. Dès lors que cette égalité théorique est enfreinte, le dénominateur de la statistique t classique cesse de suivre une distribution standard de Student sous l’hypothèse nulle, invalidant ainsi les tables de probabilité traditionnelles.
La théorie asymptotique standard démontre que lorsque la taille des échantillons tend vers l’infini, la distribution de la différence des moyennes converge vers la normalité en vertu du théorème central limite, atténuant l’impact des distorsions de variance si les groupes sont strictement équilibrés. Toutefois, dans le cadre d’échantillons de taille réduite ou modérée, caractéristiques des recherches de laboratoire, cette convergence asymptotique ne se réalise pas. Bernard Lewis Welch, dans ses articles séminaux publiés dans Biometrika en 1938 et 1947, s’est attelé à résoudre cette impasse en proposant une modélisation analytique reposant sur une variance non groupée (unpooled variance), conjuguée à une modification ingénieuse de la loi d’échantillonnage de référence à travers une redéfinition dynamique des degrés de liberté.
L’apport déterminant de Welch réside dans le refus d’agréger arbitrairement les sommes des carrés des écarts. Au lieu de contraindre les données dans un modèle homoscédastique forcé, Welch a traité chaque variance d’échantillon comme un estimateur autonome de sa population respective. L’adaptation proposée ne modifie pas le numérateur du test, qui demeure la simple différence observée des moyennes, mais redéfinit intégralement l’erreur standard et assigne à la statistique résultante une distribution de Student dont les degrés de liberté sont recalculés en fonction du ratio des variances et des effectifs. Aujourd’hui, la communauté internationale des méthodologistes s’accorde à considérer la solution de Welch non plus comme un simple repli d’urgence en cas de violation d’hypothèse, mais comme la norme analytique de référence pour toute comparaison bivariée inter-sujets indépendante.
1.2 Pertinence du test dans les protocoles de recherche en psychologie
En psychologie cognitive, clinique, organisationnelle et développementale, l’hétérogénéité des variances n’est pas une simple anomalie stochastique, elle reflète fréquemment la dynamique sous-jacente des processus mentaux investigués. Considérons, à titre illustratif, l’évaluation de protocoles thérapeutiques ou l’administration de tâches de flexibilité cognitive. Il est systématiquement observé qu’un groupe clinique (atteint, par exemple, d’un trouble de l’attention ou d’une dépression caractérisée) présente une variabilité interindividuelle bien plus marquée qu’un groupe témoin d’individus sains. Les mécanismes de compensation cognitive, la réactivité différentielle aux stimuli psychométriques et les trajectoires évolutives pathologiques amplifient structurellement la variance au sein du groupe expérimental, tandis que les sujets neurotypiques manifestent une variance plus resserrée autour de la tendance centrale.
Cette sensibilité fondamentale des mesures psychométriques aux différences individuelles se double d’une contrainte logistique majeure : la difficulté récurrente à recruter des effectifs équilibrés. Dans les plans quasi-expérimentaux, la prévalence naturelle d’une condition clinique limite souvent l’échantillon de patients à quelques dizaines d’unités ($n_1 = 20$), alors qu’un groupe de contrôle universitaire peut aisément compter plusieurs centaines de volontaires ($n_2 = 100$). Dès lors qu’un déséquilibre d’effectif se combine avec une disparité de dispersion, le test t classique de Student subit une distorsion catastrophique. Si l’échantillon le plus restreint présente la variance la plus élevée, le taux d’erreur de première espèce ($\alpha$) s’envole, atteignant parfois 15 % à 30 % pour un seuil nominal initialement fixé à 5 %, engendrant une prolifération alarmante de faux positifs.
Le recours systématique au test t de Welch dans ces contextes méthodologiques assure une préservation rigoureuse du risque d’erreur $\alpha$, maintenant le taux nominal effectif à son niveau prescrit de 0,05, sans pour autant sacrifier la puissance statistique globale du protocole. Les chercheurs en psychologie préservent ainsi leur capacité à détecter de réelles divergences d’aptitudes cognitives ou de soulagement symptomatique, sans que leurs conclusions ne soient le produit d’un artéfact computationnel induit par la volatilité intrinsèque des mesures de leur cohorte clinique.
1.3 Équations sous-jacentes et calcul des degrés de liberté de Welch-Satterthwaite
D’un point de vue formel, l’architecture mathématique du test t de Welch repose sur une statistique dont la structure générale rappelle celle du test de Student, mais dont les composantes élémentaires dérivent d’hypothèses d’indépendance de distribution. Soient deux échantillons indépendants de tailles respectives $n_1$ et $n_2$, de moyennes empiriques $\bar{X}_1$ et $\bar{X}_2$, et de variances d’échantillon non biaisées $s_1^2$ et $s_2^2$. Le numérateur quantifie de manière invariante la différence observée entre les deux estimateurs de tendance centrale :
$$\Delta = \bar{X}_1 – \bar{X}_2$$
À l’inverse du test de Student conventionnel, qui agrège les variances en pondérant par les degrés de liberté globaux ($n_1 + n_2 – 2$), le dénominateur de la statistique de Welch utilise l’erreur standard non combinée de la différence des moyennes, formulée comme la somme quadratique des erreurs standards individuelles de chaque échantillon :
$$SE_{\Delta} = \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}$$
La statistique différentielle $t_{Welch}$ est par conséquent définie par le ratio suivant :
$$t_{Welch} = \frac{\bar{X}_1 – \bar{X}_2}{\sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}}$$
La difficulté théorique inhérente à ce ratio réside dans le fait que sa distribution d’échantillonnage ne suit pas rigoureusement une loi de Student standard si les variances populationnelles $\sigma_1^2$ et $\sigma_2^2$ sont distinctes et inconnues. Pour contourner cet écueil, Welch (1947), en s’appuyant sur les développements préliminaires de Franklin E. Satterthwaite (1946) sur les combinaisons linéaires de variances, a déterminé une approximation des degrés de liberté effectifs, désignée sous l’appellation d’équation de Welch-Satterthwaite :
$$\nu_{Welch} = \frac{\left( \frac{s_1^2}{n_1} + \frac{s_2^2}{n_2} \right)^2}{\frac{\left(\frac{s_1^2}{n_1}\right)^2}{n_1 – 1} + \frac{\left(\frac{s_2^2}{n_2}\right)^2}{n_2 – 1}}$$
Une caractéristique mathématique fondamentale de cette équation réside dans le fait que la valeur calculée pour les degrés de liberté $\nu_{Welch}$ n’est presque jamais un nombre entier. Contrairement à la modélisation classique où les degrés de liberté correspondent strictement à une somme de grandeurs discrètes ($n_1 + n_2 – 2$), $\nu_{Welch}$ est une grandeur continue comprise impérativement entre le minimum des deux sous-échantillons moins un, soit $\min(n_1 – 1, n_2 – 1)$, et la somme totale des degrés de liberté classiques ($n_1 + n_2 – 2$). Cette valeur non entière pose un défi singulier lors de la transition vers les outils de calcul informatique, certains logiciels, dont les modules d’analyse d’Excel, procédant par défaut à un arrondi ou à une troncature pour faire correspondre l’indice à une table de probabilités discrète, alors que les fonctions analytiques continues calculent la probabilité exacte par interpolation intégrale de la fonction Gamma.
2. 2. Analyse comparée : Test t de Student classique versus Test t de Welch
2.1 Le postulat d’homoscédasticité et ses implications méthodologiques
Le postulat d’homoscédasticité stipule formellement que la variance de l’erreur résiduelle demeure constante à travers l’ensemble des modalités du facteur inter-sujets étudié. Dans l’espace paramétrique, cela se traduit par l’égalité $\sigma_1^2 = \sigma_2^2 = \sigma^2$. Cette hypothèse d’homogénéité est au fondement même de la dérivation analytique de Student : elle autorise la factorisation de la variance commune et justifie la sommation des carrés des écarts pour estimer un terme d’erreur partagé via l’estimateur combiné :
$$s_{pooled}^2 = \frac{(n_1 – 1)s_1^2 + (n_2 – 1)s_2^2}{n_1 + n_2 – 2}$$
Cependant, les implications méthodologiques de la violation de cette homoscédasticité sont asymétriques et tributaires du ratio d’échantillonnage. Lorsque le plan de recherche est équilibré ($n_1 = n_2$), la statistique de Student conserve une robustesse remarquable face à des disparités modérées de variance ; la variance combinée devient la simple moyenne arithmétique des variances, ce qui stabilise relativement l’erreur de type I, bien que des pertes mineures d’efficience puissent subsister. À l’opposé, lorsque le plan expérimental est déséquilibré ($n_1 \neq n_2$), l’hétéroscédasticité altère profondément la validité des déductions inférentielles.
Dans l’éventualité d’un couplage positif — c’est-à-dire lorsque le groupe le plus volumineux présente également la variance la plus étendue ($n_1 > n_2$ et $s_1^2 > s_2^2$) —, le terme d’erreur combinée $s_{pooled}^2$ est disproportionnellement surestimé par le poids de l’effectif le plus large. Cette surestimation gonfle le dénominateur de la formule de Student, réduisant mécaniquement la statistique t observée. Le test devient alors excessivement conservateur : le taux d’erreur de première espèce chute bien en deçà du seuil nominal (souvent sous la barre des 1 %), anéantissant la puissance statistique et empêchant la détection de disparités réelles entre les populations. Inversement, lors d’un couplage négatif ($n_1 > n_2$ et $s_1^2 < s_2^2$), la variance combinée sous-estime radicalement l'erreur standard effective du petit groupe. La statistique t est alors artificiellement majorée, induisant un gonflement drastique du risque de rejet à tort de l’hypothèse nulle ($H_0$). Les investigations approfondies menées par Delacre, Lakens et Leys (2017) soulignent que ce dysfonctionnement invalide une proportion considérable de résultats publiés en sciences expérimentales fondés sur le test standard.
2.2 Comportement du test sous variances égales et inégales
L’analyse des distributions d’échantillonnage par le recours aux simulations de Monte Carlo a permis d’éclairer définitivement le comportement comparé de ces deux épreuves statistiques. Lorsque les postulats de Student sont rigoureusement respectés (normalité parfaite des distributions et homoscédasticité stricte $\sigma_1^2 = \sigma_2^2$), on observe que la perte de puissance statistique occasionnée par l’utilisation non nécessaire de la correction de Welch est infinitésimale. Dans la quasi-totalité des scénarios de simulation, la divergence de puissance entre le test de Student et le test de Welch n’excède pas une fraction marginale de pourcent (généralement inférieure à 0,001 à 0,005 d’écart de puissance), y compris pour des échantillons aussi réduits que $n = 10$ par condition.
En revanche, dès que l’hypothèse nulle est examinée sous condition d’hétéroscédasticité, le comportement du test de Student diverge erratiquement de la distribution théorique, tandis que le test de Welch maintient le taux d’erreur $\alpha$ exactement au niveau fixé par l’expérimentateur, que le design soit équilibré ou déséquilibré. De surcroît, face à des distributions modérément asymétriques ou déviant de la symétrie gaussienne, le test de Welch fait preuve d’une résilience statistique au moins équivalente, voire supérieure, à celle de la méthode de Student, car le recalibrage dynamique des degrés de liberté compense en partie l’aplatissement de la distribution des moyennes d’échantillonnage.
Pendant plusieurs décennies, la communauté scientifique a enseigné une démarche analytique conditionnelle en deux étapes : procéder d’abord à un test préliminaire d’égalité des variances (tel que le test de Levene ou le test F de Bartlett), puis orienter le choix méthodologique vers le test de Student si le résultat s’avérait non significatif ($p ge 0,05$), ou vers le test de Welch en cas de rejet ($p < 0,05$). Le consensus contemporain en méthodologie quantitative et en modélisation rejette désormais formellement cette approche conditionnelle séquentielle. Comme l'ont démontré Graeme D. Ruxton (2006) ainsi que Donald W. Zimmerman (2004), cette stratégie séquentielle contamine le taux d’erreur global de la famille d’analyses (en accumulant les incertitudes de deux tests dépendants successifs) et présente une puissance de diagnostic médiocre précisément sur les petits échantillons où l’hétérogénéité pose le plus grand risque. Dès lors, le test de Welch s’impose non pas comme une alternative marginale, mais comme la stratégie universellement protectrice à employer de façon systématique pour comparer deux groupes indépendants.
3. 3. Vérification rigoureuse des hypothèses pré-analytiques
3.1 Indépendance des observations et échantillonnage
Bien que le test de Welch s’affranchisse de l’exigence d’égalité des dispersions, il n’élude en rien les impératifs structuraux relatifs à l’indépendance des observations. L’indépendance statistique postule que la valeur mesurée pour une unité d’observation donnée au sein du premier groupe ne fournit aucune information prédictive quant à la valeur obtenue par une quelconque unité du même groupe ou du groupe de comparaison. Cette condition requiert que l’attribution des sujets aux conditions expérimentales repose sur un processus d’assignation aléatoire intégrale, ou que l’échantillonnage probabiliste au sein de sous-populations naturelles garantisse l’absence totale de corrélations spatiales, temporelles ou interpersonnelles.
Il importe d’opérer une distinction conceptuelle nette entre les plans d’échantillonnage indépendants et les plans d’observations appariées ou à mesures répétées. Si le chercheur quantifie l’évolution d’un indice psychométrique chez les mêmes individus avant et après une intervention cognitive, ou s’il apparie des participants selon leur quotient intellectuel ou leur âge chronologique, les données sont corrélées. L’application du test de Welch pour échantillons indépendants sous-estimerait gravement la covariance intra-sujets, aboutissant à une analyse invalide de la variance inter-conditions. Dans une telle configuration, c’est le test t pour échantillons appariés qui s’avère requis, lequel traite la moyenne des différences intra-individuelles.
En contexte psychométrique et expérimental, l’analyste doit impérativement veiller aux effets de grappe ou de regroupement hiérarchique. Lorsque des élèves sont échantillonnés au sein de classes distinctes, ou que des patients sont pris en charge par différents thérapeutes au sein d’une clinique, des dynamiques écosystémiques introduisent une dépendance sérielle qui viole l’hypothèse d’indépendance élémentaire. Le calcul du coefficient de corrélation intraclasse (ICC) ou l’inspection graphique de l’autocorrélation des résidus constitue une précaution indispensable. Si les coefficients de dépendance s’avèrent substantiels, le cadre inférentiel doit basculer vers des modèles mixtes linéaires généralisés ou des régressions multiniveaux, sous peine de transformer des singularités contextuelles de groupes en pseudo-différences d’effet thérapeutique.
3.2 Évaluation de la normalité de la distribution des scores
L’assise mathématique de la distribution de Student repose sur le postulat d’une distribution normale des variables aléatoires sous-jacentes au sein de chaque population parente ($X_1 \sim \mathcal{N}(\mu_1, \sigma_1^2)$ et $X_2 \sim \mathcal{N}(\mu_2, \sigma_2^2)$). Dans l’éventualité d’échantillons de taille moyenne à large ($n ge 30$ par modalité), le théorème central limite garantit que la distribution des moyennes empiriques tend asymptotiquement vers une loi gaussienne, rendant le test de Welch remarquablement robuste face aux entorses modérées au principe de normalité univariée.
Pour des échantillons de taille modérée ou restreinte, une investigation minutieuse des propriétés distributionnelles s’impose préalablement au calcul inférentiel. Microsoft Excel permet une exploration diagnostique efficace au travers de deux axes complémentaires : la modélisation graphique et l’évaluation paramétrique des moments d’ordre supérieur. L’inspection visuelle se fonde préférentiellement sur la conception d’histogrammes de fréquence et, plus rigoureusement, sur l’élaboration de diagrammes quantile-quantile (Q-Q plots). Un Q-Q plot confronte les quantiles empiriques ordonnés des données psychométriques aux quantiles théoriques attendus d’une loi normale standardisée centrée-réduite. Tout alignement linéaire strict le long de la bissectrice confirme l’adéquation au modèle de Gauss, tandis que des courbures sigmoïdes ou paraboliques signalent la présence d’asymétries ou de queues de distribution épaisses.
Sur le plan quantitatif, l’analyste peut implémenter dans les cellules de calcul d’Excel les fonctions statistiques dédiées aux moments d’asymétrie (skewness) et d’aplatissement (kurtosis). La fonction COEFFICIENT.ASYMETRIE évalue le degré de distorsion latérale de la distribution : une valeur comprise dans l’intervalle $[-1, +1]$ est généralement tenue pour tolérable dans les protocoles psychosociaux. La fonction KURTOSIS (qui mesure l’excès de kurtosis par rapport à la distribution normale de référence) quantifie la leptocurticité ou la platycurticité des queues de distribution : des indices excédant un intervalle standard de $[-2, +2]$ traduisent des déviations majeures susceptibles d’affecter la fiabilité des estimations d’erreur type. Si les violations de la normalité sont extrêmes et associées à des micro-échantillons ($n < 15$), l'analyste devra envisager des procédures non paramétriques (comme le test d'alignement par rangs ou le test U de Mann-Whitney-Wilcoxon) ou des techniques de rééchantillonnage par bootstrap.
3.3 Diagnostic de l’hétérogénéité des variances
L’identification et la caractérisation formelle de l’inégalité des variances relèvent de méthodes descriptives et inférentielles diversifiées. Le moyen le plus classique d’évaluer la divergence des dispersions réside dans le test d’homogénéité des variances, incarné historiquement par le test F de Snedecor ou les approches plus robustes de Levene et de Brown-Forsythe. Le test F d’égalité de deux variances compare directement le ratio des variances échantillonnales :
$$F = \frac{\max(s_1^2, s_2^2)}{\min(s_1^2, s_2^2)}$$
Sous l’hypothèse nulle d’égalité des dispersions, ce ratio suit une loi de Fisher-Snedecor paramétrée par $n_1 – 1$ et $n_2 – 1$ degrés de liberté. Toutefois, l’utilisation du test F de Snedecor souffre d’une faille fondamentale : il présente une hypersensibilité pathologique aux déviations de normalité des données. Une distribution légèrement asymétrique génère des rejets erratiques de l’homoscédasticité, faussant l’évaluation méthodologique subséquente.
Dans la pratique de laboratoire, une règle heuristique empirique stipule que dès lors que le ratio entre la variance la plus forte et la variance la plus faible excède un seuil critique compris entre 1,5 et 2 (ce qui équivaut à un écart-type présentant un ratio supérieur à environ 1,4), le test de Student traditionnel se trouve fragilisé. Néanmoins, en accord avec les recommandations épistémologiques contemporaines développées à la section 2.2, l’étape diagnostique de l’hétérogénéité ne doit en aucun cas servir de filtre d’aiguillage binaire vers Student. Elle a pour objet exclusif de quantifier l’amplitude de la divergence d’hétéroscédasticité afin d’enrichir la discussion des résultats substantiels (par exemple, interpréter la variabilité clinique accrue d’une modalité pathologique). L’adoption inconditionnelle du test de Welch neutralise par avance tout risque inhérent à un défaut de diagnostic de l’hétéroscédasticité.
4. 4. Configuration préalable de l’environnement de travail Microsoft Excel
4.1 Activation et vérification du macro-complément Utilitaire d’analyse
Microsoft Excel n’intègre pas d’emblée l’ensemble de ses outils d’inférence avancée dans son ruban par défaut. Pour accéder aux modules dédiés aux tests de comparaison de moyennes, il est indispensable de procéder à l’activation d’un module complémentaire officiel fourni par Microsoft : l’Utilitaire d’analyse (connu sous le vocable Analysis ToolPak dans les environnements anglophones). Cette extension native s’exécute directement sur le moteur de calcul du tableur sans nécessiter l’installation de bibliothèques tierces non vérifiées.
Pour activer ce complément sous les versions modernes de Microsoft Excel pour Windows (Excel 2016, 2019, 2021 et Microsoft 365), la navigation s’opère selon la trajectoire suivante :
- Cliquez sur l’onglet Fichier situé dans le coin supérieur gauche du classeur, puis sélectionnez l’entrée Options tout en bas de la barre latérale gauche.
- Dans la boîte de dialogue contextuelle intitulée Options Excel, accédez à la catégorie Compléments située dans l’arborescence de navigation.
- Au bas de la fenêtre, repérez le menu déroulant nommé Gérer, assurez-vous que l’option Compléments Excel est bien active, puis cliquez sur le bouton Atteindre….
- Une boîte de dialogue compacte s’affiche à l’écran, listant les macro-compléments disponibles. Cochez explicitement la case accolée à Utilitaire d’analyse (veillez à ne pas confondre avec l’Utilitaire d’analyse – VBA, destiné au développement procédural de macros). Validez ensuite en cliquant sur OK.
Dès l’achèvement de cette opération, naviguez vers l’onglet Données du ruban principal. Vous constaterez l’apparition d’un nouveau groupe d’outils positionné à l’extrême droite, généralement libellé Analyse, au sein duquel figure l’icône interactive Utilitaire d’analyse (ou Analyse de données). Pour les utilisateurs opérant sur macOS, la démarche s’effectue via la barre des menus supérieure : rendez-vous dans le menu Outils, cliquez sur Compléments Excel…, cochez l’option Analysis ToolPak et confirmez. Si le bouton n’apparaît pas immédiatement, un redémarrage complet de l’application permet la recompilation du ruban personnalisé.
4.2 Paramétrage régional et conventions numériques
L’exécution rigoureuse de calculs statistiques sous Excel exige une vigilance particulière concernant les options régionales et les conventions de ponctuation numérique. Dans la quasi-totalité des versions distribuées dans la francophonie européenne et internationale, le séparateur décimal conventionnel est la virgule (ex. : 14,25), tandis que la convention anglo-saxonne recourt exclusivement au point (ex. : 14.25). Une discordance entre la convention numérique des données importées et les paramètres régionaux du système d’exploitation engendre une corruption critique du classeur : Excel interprète alors les valeurs chiffrées contenant un point comme des chaînes de caractères de type « texte » ou effectue des conversions involontaires en dates calendaires.
Pour s’assurer de l’homogénéité de ces paramètres, l’analyste peut intervenir directement dans Excel en sélectionnant Fichier > Options > Options avancées, puis en inspectant la section Options d’édition. En désactivant la case à cocher Utiliser les séparateurs système, il devient possible de définir explicitement la virgule comme séparateur de décimale et l’espace comme séparateur de milliers. Toute cellule contenant une donnée psychométrique doit faire l’objet d’un formatage explicite : sélectionnez l’ensemble des plages matricielles d’observation, appliquez un clic droit, choisissez Format de cellule, sélectionnez la catégorie Nombre et fixez le nombre de décimales souhaité (généralement deux ou trois selon la finesse de l’instrument psychométrique employé).
De surcroît, la politique d’encodage des valeurs manquantes ou des non-réponses au sein du tableur doit obéir à des impératifs stricts. Une erreur analytique courante consiste à coder une absence de mesure par le chiffre zéro (0). Dans les calculs d’inférence sous-jacents, Excel intégrerait ce zéro comme une observation réelle de performance ou de symptomatologie, faussant drastiquement le calcul de la moyenne arithmétique et hypertrophiant la variance. Les cellules correspondant à des données manquantes doivent être laissées rigoureusement vides, ou traitées en amont par des filtres de suppression par observation (listwise deletion) afin de préserver l’intégrité numérique des vecteurs d’entrée.
5. 5. Structuration optimale des données psychométriques dans le tableur
5.1 Format tabulaire adapté à l’Utilitaire d’analyse d’Excel
L’ergonomie des algorithmes de calcul statistique d’Excel impose une contrainte majeure d’architecture des données : le format d’entrée diffère notablement des structures relationnelles normalisées utilisées par les langages de programmation statistique contemporains. Alors que les progiciels comme R ou JASP requièrent un format dit « long » (une colonne dédiée à la variable dépendante continue et une seconde colonne codant l’appartenance au groupe sous forme de facteur catégoriel), l’Utilitaire d’analyse d’Excel exige impérativement un format dit « large » (wide format). Dans cette structure, chaque groupe d’observation occupe une colonne distincte et contiguë.
Pour illustrer de façon tangible cette organisation matricielle, considérons une recherche en psychologie clinique et cognitive évaluant l’efficacité d’une thérapie d’acceptation et d’engagement (ACT) combinée à une remédiation attentionnelle sur le niveau d’anxiété de performance de sujets adultes. La variable dépendante continue est le score total obtenu à un inventaire d’anxiété validé (par exemple l’Inventaire d’Anxiété Trait-État de Spielberger – STAI-Y, où les scores théoriques évoluent de 20 à 80 points). Le protocole compare un Groupe Témoin (modalité contrôle, recevant un protocole standard d’écoute non directive) et un Groupe Thérapie (modalité expérimentale active).
Dans la feuille de calcul Excel, cette expérimentation doit être modélisée au sein de deux colonnes adjacentes (par exemple les colonnes A et B) :
- La cellule
A1doit obligatoirement recevoir l’étiquette sémantique exacte :Groupe_Temoin. - La cellule
B1doit recevoir l’étiquette contextuelle :Groupe_Therapie. - Les cellules subséquentes de la colonne A (de
A2àA31, si ce groupe comprend 30 observations) accueillent les scores individuels d’anxiété des participants de cette condition. - Les cellules de la colonne B (de
B2àB23, si le groupe thérapie comporte 22 participants suite à des exclusions protocolaires) regroupent les scores psychométriques correspondants.
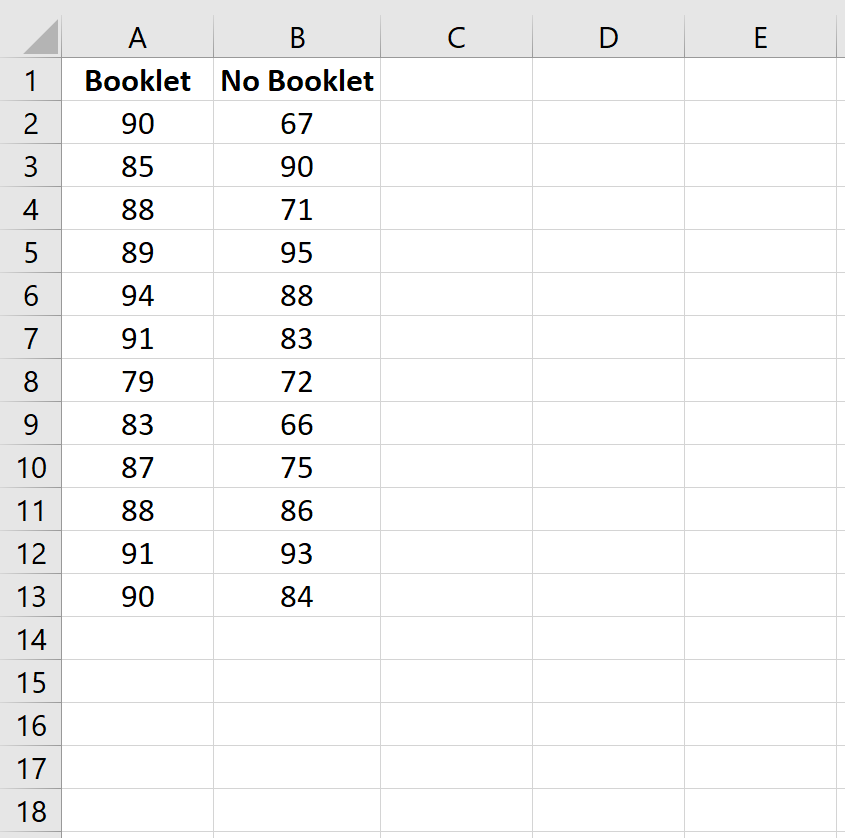
Il apparaît ici de manière cruciale que la présence d’échantillons de tailles inégales ($n_1 = 30$ versus $n_2 = 22$) ne constitue aucunement un obstacle technique : les données de la colonne B s’interrompent simplement à la ligne 23, laissant les cellules inférieures de cette colonne vierges de toute inscription. L’algorithme de calcul identifiera automatiquement la longueur respective de chaque vecteur lors de la sélection des plages matricielles, à la stricte condition qu’aucun artefact typographique, tel qu’un espace insécable, ne soit inséré dans les cellules sous-jacentes inoccupées.
5.2 Formatage des données issues de plateformes expérimentales
Dans les contextes de recherche contemporains, les données empiriques proviennent majoritairement de plateformes d’expérimentation en ligne (telles que Qualtrics, Gorilla Experiment Builder, Pavlovia ou PsychoPy) ou de logiciels de saisie clinique. Ces interfaces exportent quasi systématiquement les matrices de résultats sous un format brut rectangulaire long, structuré comme suit : une colonne contenant les identifiants uniques des sujets (ex. : Participant_ID), une colonne catégorisant la condition expérimentale (ex. : Condition prenant les modalités textuelles « Controle » ou « Traitement »), et une colonne recueillant la variable de mesure continue (ex. : Score_STAI).
Pour convertir ce format d’origine vers la matrice en colonnes séparées exigée par Excel, l’analyste dispose de plusieurs démarches techniques rigoureuses :
- La méthode du tri et de la copie directe : Sélectionnez la table brute intégrale, activez la fonctionnalité Trier dans l’onglet Données, puis appliquez un tri hiérarchique basé sur la colonne
Condition. Copiez ensuite le segment des scores correspondant au groupe témoin dans la colonneA, puis isolez le segment relatif au groupe expérimental pour le transposer dans la colonne contiguëB. - La méthode du tableau croisé dynamique (TCD) : Insérez un tableau croisé dynamique, positionnez l’identifiant du sujet ou l’index de ligne dans la zone Lignes, glissez la variable factorielle
Conditiondans la zone Colonnes, et assignez la mesure continueScore_STAIdans la zone Valeurs (en prenant soin de sélectionner la fonction d’agrégation Moyenne ou Somme, qui restitue la valeur exacte de l’observation individuelle si chaque ligne sujet est unique). - La méthode par formules matricielles dynamiques (Excel 365 / 2021) : Utilisez la fonction native
FILTREpour automatiser l’extraction sans altérer la base source. En celluleA2, insérez=FILTRE(C2:C100; B2:B100="Controle")et en celluleB2, insérez=FILTRE(C2:C100; B2:B100="Traitement"). Les scores se déversent dynamiquement dans chaque colonne respective.
Une fois les colonnes constituées, une opération de vérification de l’intégrité structurelle des données s’avère indispensable. L’analyste déploiera des fonctions de contrôle au bas de chaque vecteur : la formule =NB(A2:A100) atteste du nombre réel de valeurs numériques détectées, prévenant l’omission accidentelle d’une mesure, tandis que la formule =NB.SI(A2:A100; "<0") ou la recherche de valeurs limites via MIN et MAX permettent d’identifier d’éventuelles erreurs typographiques de saisie (comme un score STAI aberrant de 750 au lieu de 75) ou la persistance d’encodages de codes manquants négatifs traditionnels (ex. : -99) issus de progiciels externes.
6. 6. Procédure étape par étape via l’Utilitaire d’analyse
6.1 Initialisation du module statistique adapté
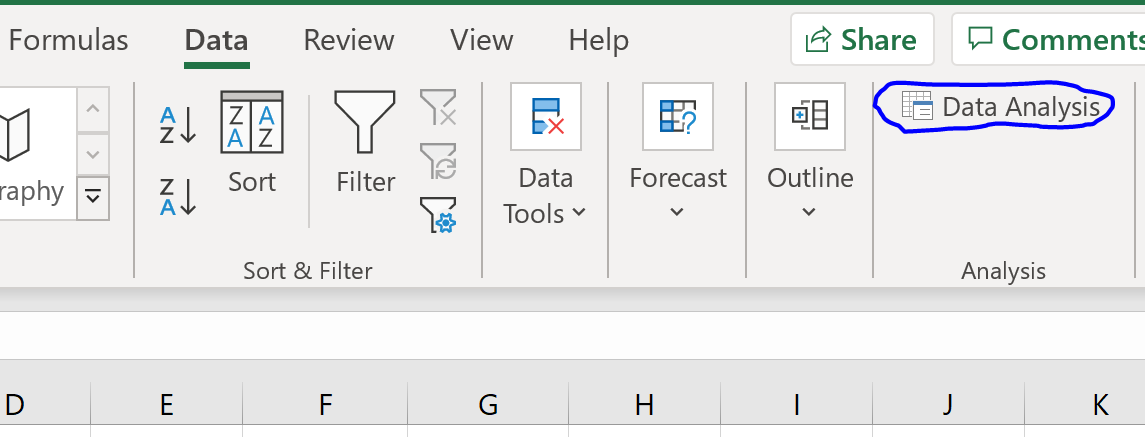
Dès lors que les données psychométriques sont convenablement nettoyées, structurées en colonnes adjacentes et dotées d’étiquettes distinctives sur leur première ligne, la mise en œuvre opérationnelle du test peut être initialisée. Pour ce faire, naviguez au sein de l’interface du ruban supérieur jusqu’à l’onglet Données, puis portez votre attention sur l’extrême droite où réside le groupe de commandes Analyse. Cliquez avec précision sur le bouton Analyse de données (ou Utilitaire d’analyse).
Cette action déclenche l’ouverture d’une boîte de dialogue modale répertoriant par ordre alphabétique ou fonctionnel les modules statistiques préprogrammés au sein d’Excel. Faites défiler la liste jusqu’à identifier la section consacrée aux tests de comparaison bivariés. Vous observerez la présence de trois dénominations très proches :
- Test t : Deux échantillons pour moyennes appariées
- Test t : Deux échantillons supposant des variances égales
- Test t : Deux échantillons supposant des variances inégales
Il est impératif de souligner que l’intitulé Test t : Deux échantillons supposant des variances inégales constitue l’implémentation algorithmique exacte et certifiée du test t de Welch (associé à l’approximation des degrés de liberté de Welch-Satterthwaite). Sélectionner l’option portant sur les « variances égales » invoquerait le modèle classique de Student avec variance combinée, exposant le chercheur aux failles d’hétéroscédasticité discutées précédemment. Quant au test pour « moyennes appariées », il mènerait à une faute de devis méthodologique en traitant les deux colonnes indépendantes comme des séries de mesures longitudinales répétées sur les mêmes sujets. Cliquez donc sur Test t : Deux échantillons supposant des variances inégales, puis confirmez l’ouverture de la fenêtre de paramétrage en cliquant sur le bouton OK.
6.2 Paramétrage des champs de la boîte de dialogue
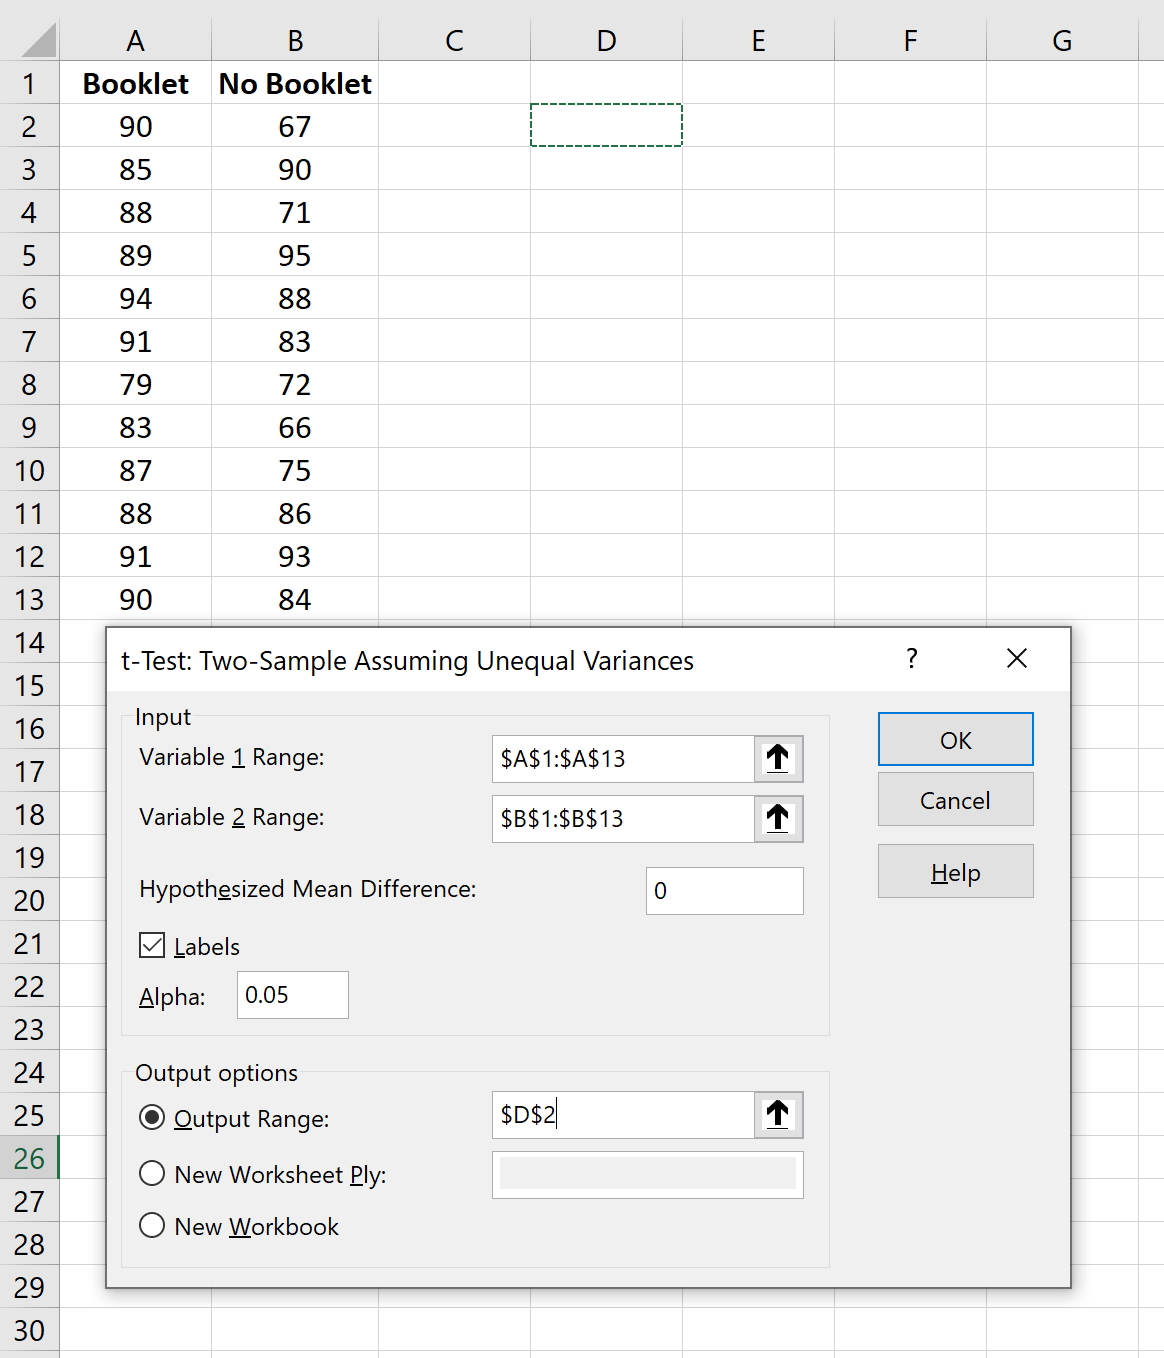
L’interface de configuration du test se présente sous la forme d’un formulaire interactif comprenant plusieurs zones de saisie textuelle et d’options à cocher. La précision du paramétrage détermine la validité de l’extraction des données. Suivez méthodiquement les assignations suivantes :
- Plage de la variable 1 : Cliquez dans le champ de saisie, puis sélectionnez à la souris la colonne relative au premier échantillon (par exemple,
$A$1:$A$31). Il est hautement recommandé d’inclure la toute première cellule contenant le libellé textuel de la condition expérimentale. - Plage de la variable 2 : De manière similaire, sélectionnez l’intégralité du vecteur correspondant au second échantillon, étiquette comprise (par exemple,
$B$1:$B$23). L’inégalité de hauteur des plages ne pose aucun conflit opératoire au module d’analyse. - Différence hypothétique des moyennes : Ce champ formalise la valeur postulée sous l’hypothèse nulle ($H_0$). Dans le cadre standard d’une recherche visant à vérifier si les deux conditions diffèrent globalement, l’hypothèse d’absence de différence implique une divergence théorique nulle. Saisissez rigoureusement le chiffre
0. Si vous omettez de remplir cette case, Excel assume implicitement la valeur zéro par défaut, mais l’explicitation évite toute ambiguïté de calcul. - Case à cocher « Intitulés » : Si vous avez, conformément aux recommandations, englobé les cellules d’en-tête (
A1etB1) lors de la sélection des plages matricielles, vous devez impérativement cocher cette case. Cet engagement informe l’algorithme que les premières occurrences des vecteurs ne représentent pas des données quantitatives aberrantes, mais doivent servir à nommer textuellement les colonnes du tableau de restitution final. Si vos sélections ne comprenaient que les valeurs purement numériques, laissez cette case décochée. - Alpha : Cette boîte de dialogue recueille le seuil d’erreur de première espèce toléré par l’expérimentateur pour la prise de décision statistique. Par convention internationale en psychologie et en sciences biomédicales, cette probabilité critique est calibrée à $\alpha = 0,05$. Excel préremplit nativement ce champ à
0,05; conservez cette constante, sauf si votre devis expérimental exige un ajustement conservateur particulier (par exemple, $\alpha = 0,01$ en cas de corrections pour comparaisons multiples préalablement définies).
6.3 Sélection et génération des options de sortie
La section inférieure de la boîte de dialogue concerne la restitution matérielle des calculs statistiques générés par le processeur matriciel d’Excel. L’utilisateur se voit offrir trois alternatives distinctes selon les impératifs de mise en page de son classeur de recherche :
- Plage de sortie : Permet d’imprimer la table de résultats directement sur la feuille de calcul active, à côté des colonnes de données brutes. Cochez cette option, puis cliquez dans le champ adjacent et désignez une cellule d’ancrage libre de tout contenu (par exemple,
$D$1). Veillez à disposer d’un espace libre suffisant vers la droite et vers le bas, sous peine d’écraser des informations préexistantes, incident pour lequel Excel demandera une confirmation de remplacement destructrice. - Nouvelle feuille de calcul : Il s’agit de l’option la plus judicieuse sur le plan de la gouvernance et de la propreté du classeur. Elle génère automatiquement un nouvel onglet au sein du document et y dépose la table de synthèse dès la cellule
A1. Vous pouvez saisir un nom d’onglet représentatif directement dans le champ textuel, par exempleResultats_Welch_STAI. - Nouveau classeur : Cette option projette le résultat dans un fichier Excel totalement indépendant du classeur source. Bien qu’utile pour des opérations de reporting confidentiel, elle brise le lien immédiat avec la matrice de données expérimentales de travail.
Une fois le mode d’affichage choisi, effectuez une validation définitive en cliquant sur le bouton OK. L’algorithme résout instantanément les équations matricielles et dresse une table synthétique ordonnée. Dès la génération du tableau, il est recommandé de procéder à une inspection immédiate de contrôle : vérifiez tout particulièrement que la ligne intitulée Observations reporte exactement le décompte des sujets attendus pour chaque modalité (dans notre exemple : 30 pour la Variable 1 et 22 pour la Variable 2). Tout écart numérique à ce niveau indiquerait la présence inopinée de cellules vides au milieu de la matrice, de données non numériques non reconnues ou d’un débordement erroné lors de la délimitation manuelle de la sélection.
7. 7. Méthode alternative : Calcul par les fonctions natives d’Excel
7.1 Utilisation de la fonction dynamique TEST.T
Bien que l’Utilitaire d’analyse offre une synthèse tabulaire rapide et structurée, il présente une limite fonctionnelle majeure : sa production est statique. Si une valeur de score psychométrique est ultérieurement corrigée, si de nouveaux participants intègrent la base de données ou si des données suspectes sont épurées, le tableau généré par l’Utilitaire d’analyse ne s’actualise pas dynamiquement. Pour obtenir une inférence vivante, synchronisée en temps réel avec les modifications de la feuille de calcul, l’analyste doit privilégier l’usage des fonctions statistiques natives d’Excel, et en premier lieu la fonction TEST.T.
La syntaxe canonique de la formule statistique s’articule autour de quatre arguments indispensables :
=TEST.T(matrice1; matrice2; unilatéral/bilatéral; type)
L’analyse détaillée des paramètres s’établit comme suit :
- matrice1 : La plage continue abritant les observations du premier groupe (ex. :
A2:A31). - matrice2 : La plage continue abritant les données du second groupe (ex. :
B2:B23). - unilatéral/bilatéral : Cet argument accepte exclusivement deux valeurs d’inférence directionnelle. Saisissez le chiffre
1si votre cadre théorique repose sur une hypothèse explicitement directionnelle a priori (par exemple, postuler formellement que la thérapie ne peut que réduire l’anxiété). Saisissez le chiffre2pour une évaluation bilatérale non directionnelle standard explorant toute forme de différence, qu’elle soit positive ou négative. Dans la grande majorité des recherches empiriques fondamentales, le test bilatéral ($2$) constitue l’exigence méthodologique minimale. - type : C’est cet argument qui scelle la nature algorithmique du test exécuté par le processeur d’Excel. Trois valeurs sont admises :
1= Test apparié (mesures répétées sur les mêmes individus).2= Test homoscédastique classique de Student (variances égales présumées).- 3 = Test hétéroscédastique de Welch (variances inégales / unpooled).
Ainsi, l’insertion dans une cellule libre de la formule exacte suivante :
=TEST.T(A2:A31; B2:B23; 2; 3)
restituera instantanément la probabilité critique exacte ($p$-valeur) bilatérale associée au test de Welch. Toute modification ultérieure d’un score au sein de la matrice A2:A31 ou B2:B23 mettra à jour en temps réel l’estimation de la probabilité d’erreur calculée, offrant un confort opératoire inestimable lors des phases exploratoires de nettoyage des données.
7.2 Décomposition manuelle des étapes algorithmiques
Pour l’analyste rigoureux ou l’enseignant en biostatistique, la décomposition pas-à-pas des composantes de l’équation de Welch au sein d’une grille Excel représente le moyen le plus pédagogique de s’assurer d’une parfaite transparence computationnelle. Cette architecture « déconstruite » permet en outre de récupérer les degrés de liberté continus exacts, souvent tronqués par les boîtes de dialogue automatisées.
Considérons la mise en place d’un tableau analytique personnalisé au sein du classeur. Dans une série de cellules ordonnées, implémentez les formules natives suivantes :
- Taille des échantillons ($n$) :
En celluleE2(Groupe 1) :=NB(A2:A31)
En celluleF2(Groupe 2) :=NB(B2:B23) - Moyennes arithmétiques ($\bar{X}$) :
En celluleE3:=MOYENNE(A2:A31)
En celluleF3:=MOYENNE(B2:B23) - Variances d’échantillon non biaisées ($s^2$) :
En celluleE4:=VAR.S(A2:A31)
En celluleF4:=VAR.S(B2:B23)
(Veillez à proscrire formellement la formuleVAR.P, qui calcule la variance de population divisée par $N$ sans correction de Bessel par $n-1$, ce qui introduirait un biais systématique d’estimation). - Composantes de variance d’échantillonnage ($v = s^2 / n$) :
En celluleE5:=E4/E2
En celluleF5:=F4/F2 - Erreur standard de la différence :
En celluleE7:=RACINE(E5 + F5) - Statistique $t$ observée de Welch :
En celluleE8:=(E3 - F3) / E7 - Calcul intégral des degrés de liberté de Welch-Satterthwaite :
En celluleE9, transcrivez fidèlement le formalisme mathématique continu :
=(E5 + F5)^2 / ((E5^2 / (E2 - 1)) + (F5^2 / (F2 - 1))) - Calcul de la $p$-valeur bilatérale exacte continue :
Ayant extrait la statistique $t$ enE8et les degrés de liberté continus non tronqués enE9, la probabilité critique exacte s’obtient via la fonction de distribution de Student :
=LOI.STUDENT.BILATERALE(ABS(E8); E9)
(L’utilisation de la fonctionABS, qui renvoie la valeur absolue, est obligatoire pour sécuriser la fonctionLOI.STUDENT.BILATERALE, laquelle n’admet intrinsèquement que des arguments de quantile strictement positifs).
Cette approche manuelle démontre la cohérence intrinsèque des mathématiques appliquées : le résultat obtenu en cellule E10 correspond rigoureusement, à la dixième décimale près, au résultat délivré par la macro-fonction dynamique TEST.T(A2:A31; B2:B23; 2; 3), tout en restituant l’estimation analytique exacte des degrés de liberté à l’état décimal non altéré.
8. 8. Décodage analytique de la table de résultats générée par Excel
8.1 Anatomie des paramètres descriptifs et différentiels
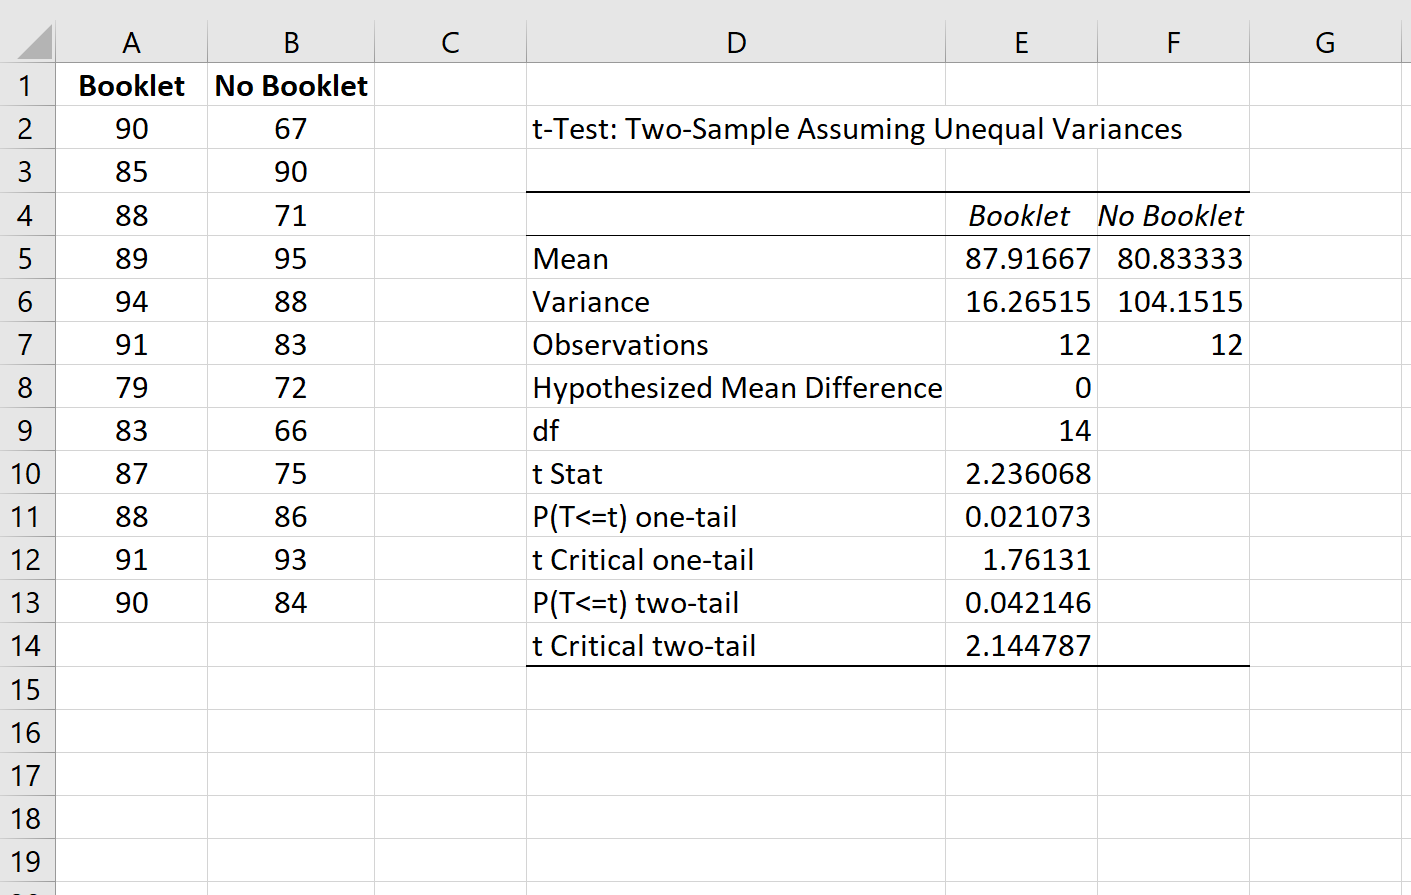
Lorsque le test t de Welch est exécuté par le biais de la boîte de dialogue de l’Utilitaire d’analyse, Microsoft Excel génère une table récapitulative standardisée comportant une dizaine de lignes analytiques. Chaque cellule de cette sortie textuelle documente un moment précis du raisonnement inférentiel. Pour illustrer cette nomenclature, analysons le tableau de données ci-dessous, issu d’une comparaison entre un groupe contrôle et un groupe expérimental :
| Paramètre statistique | Groupe_Temoin | Groupe_Therapie |
|---|---|---|
| Moyenne | 48,6333 | 41,2727 |
| Variance | 28,4471 | 74,6840 |
| Observations | 30 | 22 |
| Différence hypothétique des moyennes | 0 | |
| Degré de liberté | 31 | |
| Stat t | 3,4789 | |
| P(T<=t) unilatéral | 0,00074 | |
| Valeur critique de t (unilatérale) | 1,6955 | |
| P(T<=t) bilatéral | 0,00151 | |
| Valeur critique de t (bilatérale) | 2,0395 | |
Les trois premières lignes formalisent la statistique descriptive : la Moyenne arithmétique de chaque échantillon révèle un différentiel brut de $48,63 – 41,27 = 7,36$ points à l’inventaire d’anxiété. La ligne Variance atteste empiriquement de la pertinence absolue du recours au test de Welch : la variance du groupe expérimental ($74,68$) est plus de 2,6 fois supérieure à celle du groupe témoin ($28,45$), matérialisant une sévère hétéroscédasticité empirique associée à un design déséquilibré ($n_1 = 30$ vs $n_2 = 22$). La ligne Différence hypothétique des moyennes rappelle la contrainte du modèle théorique ($H_0: \mu_1 – \mu_2 = 0$).
La métrique Stat t représente la coordonnée empirique calculée par l’équation de Welch. Sa valeur ($3,48$) indique que la différence observée entre nos deux moyennes d’échantillons est située à près de 3,5 erreurs standards de l’origine nulle de la distribution. Le signe positif atteste simplement que la moyenne de la colonne sélectionnée comme première variable est arithmétiquement supérieure à celle de la seconde. Si l’ordre des plages d’entrée avait été interverti lors du paramétrage initial, la statistique afficherait une valeur symétrique de $-3,48$, sans aucune incidence sur la probabilité critique bilatérale.
8.2 Compréhension des degrés de liberté tronqués dans Excel
L’une des singularités algorithmiques majeures de Microsoft Excel réside dans l’affichage reporté sur la ligne Degré de liberté. Alors que l’application intégrale de la formule mathématique de Welch-Satterthwaite détaillée à la section 1.3 produit une grandeur fractionnaire continue (dans notre cas précis : $\nu \approx 31,84$), l’Utilitaire d’analyse d’Excel affiche un chiffre entier strict : 31.
Historiquement, l’algorithme sous-jacent de l’outil d’analyse applique une opération de troncature ou d’arrondi vers l’entier inférieur (fonction plancher). Cette décision logicielle trouve son origine dans une démarche conservative datant des premières versions informatiques : arrondir les degrés de liberté à l’entier inférieur abaisse artificiellement le nombre de degrés de liberté disponible, ce qui élargit imperceptiblement les queues de la distribution de Student et engendre ainsi une estimation de la probabilité critique $p$ très légèrement plus conservatrice (plus élevée). En revanche, des progiciels académiques spécialisés tels que R, SPSS ou JASP conservent rigoureusement les décimales réelles ($\nu = 31,84$) et résolvent l’intégrale de probabilité par interpolation de la fonction bêta incomplète ou de la fonction gamma d’Euler.
Quel est l’impact de cette approximation discrète pour le chercheur ? Dans l’immense majorité des applications empiriques, l’erreur d’approximation engendrée sur la $p$-valeur se cantonne à la quatrième ou cinquième décimale (par exemple, $p = 0,00151$ sous Excel tronqué contre $p = 0,00148$ sous R avec décimales continues). Les conclusions déductives relatives au franchissement du seuil critique nominal de 0,05 ou 0,01 demeurent dès lors rigoureusement inchangées. Néanmoins, pour des protocoles psychométriques à forts enjeux de reproductibilité ou lors de la soumission de manuscrits au sein de revues scientifiques internationales exigeantes, il est impératif d’avoir conscience de ce comportement propre au tableur pour justifier d’éventuelles divergences marginales entre Excel et les rapports générés par d’autres logiciels.
8.3 Interprétation des probabilités critiques et seuils critiques
La portion terminale du tableau d’Excel scinde l’inférence en deux perspectives directionnelles distinctes, présentant pour chacune la probabilité exacte et la valeur de coupure géométrique correspondante :
- La perspective unilatérale :
L’indice P(T<=t) unilatéral ($p = 0,00074$) quantify l’intégrale de probabilité située au-delà de la statistique observée sous une seule queue de distribution. La Valeur critique de t (unilatérale) ($1,6955$) définit le seuil spatial à partir duquel une valeur $t$ tombe dans la zone de rejet au niveau $\alpha = 0,05$. Comme notre statistique observée ($t = 3,4789$) excède largement cette frontière critique ($3,48 > 1,70$), le résultat est considéré comme unilatéralement significatif. - La perspective bilatérale :
L’indice P(T<=t) bilatéral ($p = 0,00151$) intègre les deux extrémités symétriques de la densité de probabilité ($|T| ge |t|$). Il correspond exactement au double de la valeur unilatérale. La Valeur critique de t (bilatérale) s’établit à $2,0395$. Notre statistique $t$ observée de $3,48$ étant supérieure en magnitude absolue à ce seuil critique de $2,04$ (soit $|3,48| > 2,04$), la décision formelle s’impose sans équivoque : le rejet de l’hypothèse nulle est proclamé.
Dans l’épistémologie contemporaine des sciences empiriques, la $p$-valeur ne doit plus être interprétée comme un couperet binaire exclusif (« significatif » versus « non significatif »), mais bien comme un continuum de preuve quantitative attestant du degré de compatibilité entre les données observées et le modèle hypothétique de l’absence de différence. Avec un $p$ bilatéral de $0,0015$, la probabilité d’observer une divergence d’au moins 7,36 points d’anxiété sous la stricte supposition que la thérapie n’a strictement aucun effet différentiel par rapport au contrôle est d’environ 15 chances sur 10 000, constituant une réfutation empirique robuste de l’hypothèse nulle.
9. 9. Interprétation substantielle dans le contexte psychologique
9.1 Prise de décision statistique et validation d’hypothèses
L’aboutissement de la mécanique computationnelle du test t de Welch ne marque pas la fin du travail analytique ; il inaugure la phase de contextualisation substantielle des résultats au regard des cadres théoriques de la psychologie. Le rejet de l’hypothèse nulle ($H_0: \mu_1 = \mu_2$) valide l’hypothèse alternative de recherche ($H_1: \mu_1 \neq \mu_2$), signifiant que les populations sous-jacentes dont sont issus les participants diffèrent véritablement quant à leur expression du trait d’anxiété.
Cependant, l’analyste scrupuleux doit opérer une dissociation conceptuelle stricte entre la signification statistique et la pertinence clinique ou écologique. Un différentiel de moyennes peut s’avérer hautement significatif sur le plan statistique (spécialement si les effectifs $n_1$ et $n_2$ atteignent des volumes massifs de plusieurs centaines d’individus) tout en étant trivial sur le plan psychologique ou clinique. Par exemple, une réduction d’anxiété de 1,5 point sur une échelle qui en compte 80 ne possède aucun impact tangible sur la trajectoire fonctionnelle quotidienne d’un patient, bien qu’une statistique t associée puisse afficher un $p < 0,001$. À l'inverse, dans notre cas pratique, une baisse moyenne de plus de 7 points à l'inventaire STAI-Y dépasse le seuil conventionnel de changement cliniquement significatif (souvent calibré autour de 5 points dans les études de validation psychométrique), confirmant une valeur thérapeutique tangible de l'intervention testée.
En outre, l’interprétation des résultats issus du test de Welch doit systématiquement intégrer l’analyse des biais d’échantillonnage potentiels. Pourquoi la variance du groupe expérimental ($s_2^2 = 74,68$) s’est-elle avérée considérablement plus étendue que celle du groupe témoin ($s_1^2 = 28,45$) ? En psychothérapie empirique, ce phénomène traduit fréquemment une réactivité hétérogène des patients : une proportion des sujets répond de façon spectaculaire au traitement (générant des scores d’anxiété extrêmement bas), tandis qu’une fraction réfractaire ne manifeste aucune amélioration, étirant ainsi l’éventail des scores post-test. Loin d’être un simple parasite statistique que le test de Welch neutralise, cette divergence de variance constitue en elle-même un fait psychologique capital, invitant à concevoir des analyses secondaires sur les modulateurs individuels de la réponse thérapeutique.
9.2 Étude de cas appliquée en psychologie de l’éducation
Afin de transposer cette méthodologie à un champ d’application complémentaire, examinons une recherche menée en psychologie de l’éducation et en neuro-éducation. Une équipe universitaire souhaite évaluer l’efficacité d’un nouvel environnement pédagogique numérique basé sur l’apprentissage multisensoriel gamifié comparativement à un enseignement magistral traditionnel sur l’expansion de la mémoire de travail opérationnelle chez de jeunes adolescents scolarisés.
Le protocole implique deux cohortes d’élèves de collège. Le premier groupe (Groupe Traditionnel, condition témoin) réunit 35 élèves soumis à l’approche pédagogique classique. Le second groupe (Groupe Multisensoriel, condition innovante) compte 24 élèves ayant suivi le programme numérique immersif. La variable dépendante continue correspond au score normalisé obtenu à une batterie informatisée d’empan de mémoire de travail (Working Memory Capacity, score étalonné sur 100 points). À l’issue des dix semaines d’intervention, les données sont collectées, organisées en colonnes adjacentes sous Excel, puis traitées par le module de Welch.
Les paramètres statistiques restitués par le tableur se résument comme suit :
- Groupe Traditionnel ($n_1 = 35$) : Moyenne empirique $\bar{X}_1 = 62,40$ ; Variance empirique $s_1^2 = 38,50$ (soit un écart-type $s_1 = 6,20$).
- Groupe Multisensoriel ($n_2 = 24$) : Moyenne empirique $\bar{X}_2 = 70,85$ ; Variance empirique $s_2^2 = 125,20$ (soit un écart-type $s_2 = 11,19$).
- Différence des moyennes observée : $\bar{X}_2 – \bar{X}_1 = +8,45$ points en faveur du programme multisensoriel.
- Ratio d’hétérogénéité des variances : $125,20 / 38,50 = 3,25$. La variance du groupe innovant est plus de trois fois supérieure à celle du groupe témoin, combinée à une taille d’échantillon plus réduite ($n_2 = 24 < n_1 = 35$), ce qui représente le scénario classique de couplage négatif où le test de Student gonflerait artificiellement les erreurs.
- Calcul des degrés de liberté de Welch : la formule de Welch-Satterthwaite délivre $\nu = 32,31$ (tronqué à $32$ par l’Utilitaire d’analyse).
- Statistique de Welch : $t_{Welch} = 3,371$ ; Probabilité critique bilatérale : $p = 0,0019$.
L’interprétation substantive déduit de ces métriques que le programme multisensoriel induit un gain moyen d’empan mnésique statistiquement robuste ($p < 0,01$). Toutefois, la variance considérablement accrue au sein du groupe innovant ($s_2^2 = 125,20$) suggère que l'outil numérique n'a pas bénéficié de manière uniforme à l'ensemble des collégiens. Certains élèves ont exploité pleinement les affordances multimédias pour décupler leurs stratégies mnésiques, tandis que d'autres ont pu subir une surcharge cognitive attentionnelle, limitant leurs progrès. Cette découverte préconise que l'intégration de telles approches pédagogiques en milieu scolaire soit impérativement accompagnée d'une différenciation pédagogique individualisée pour éviter de creuser les écarts de performance au sein de la classe.
10. 10. Au-delà de la p-valeur : Taille d’effet et intervalles de confiance
10.1 Calcul et ajustement du d de Cohen pour variances inégales
L’estimation exclusive de la probabilité critique $p$ est aujourd’hui jugée notoirement insuffisante par la communauté scientifique internationale pour rendre compte de la force d’un phénomène expérimental. La publication d’indices de taille d’effet standardisés s’impose désormais comme une exigence méthodologique absolue dans les revues à comité de lecture, conformément aux recommandations répétées de l’American Psychological Association (APA). L’indicateur le plus répandu pour les comparaisons bivariées est le $d$ de Jacob Cohen (1988), qui quantifie l’écart entre deux moyennes en unités d’écart-type.
Toutefois, la formule traditionnelle du $d$ de Cohen repose structurellement sur l’écart-type combiné standard ($s_{pooled}$), fondé sur le postulat d’homoscédasticité. Sous conditions d’hétérogénéité des variances, l’utilisation de cette formule classique produit une estimation biaisée de l’amplitude de l’effet. Pour pallier cette distorsion, l’analyste doit implémenter sous Excel des alternatives méthodologiques adaptées aux contextes d’hétéroscédasticité :
1. Le delta de Glass ($\Delta$) : Proposé par Gene V. Glass, cet indice contourne le problème en standardisant la différence des moyennes exclusivement par l’écart-type du groupe contrôle ($s_{control}$), considérant que la variance de ce dernier reflète la dispersion naturelle de la population sans l’altération induite par le traitement expérimental :
$$\Delta = \frac{\bar{X}_1 – \bar{X}_2}{s_1}$$
Dans notre feuille Excel, si la colonne A abrite le groupe témoin, la formule s’écrit avec une simplicité déconcertante : =(MOYENNE(A2:A31) - MOYENNE(B2:B23)) / ECARTYPE.STANDARD(A2:A31).
2. Le $d$ de Cohen ajusté par la moyenne quadratique des écarts-types : Préconisé par des statisticiens contemporains pour les situations où aucune condition ne peut être strictement désignée comme un groupe témoin neutre, cet estimateur remplace la variance combinée pondérée par la simple moyenne non pondérée des variances échantillonnales :
$$s_{unweighted} = \sqrt{\frac{s_1^2 + s_2^2}{2}}$$
$$d_{Welch} = \frac{\bar{X}_1 – \bar{X}_2}{\sqrt{\frac{s_1^2 + s_2^2}{2}}}$$
Son implémentation directe dans une cellule de synthèse sous Excel prend la structure suivante :
=(MOYENNE(A2:A31) - MOYENNE(B2:B23)) / RACINE((VAR.S(A2:A31) + VAR.S(B2:B23)) / 2)
Selon les conventions qualitatives établies par Cohen, un indice de $|d| \approx 0,20$ reflète un effet de faible amplitude ; $|d| \approx 0,50$ traduit un effet moyen, tandis que $|d| ge 0,80$ atteste d’un effet massif. Dans notre recherche sur l’anxiété, l’application de cet ajustement délivre $d_{Welch} \approx 1,02$, confirmant que la divergence induite par le programme clinique correspond à un effet de grande envergure théorique et pratique.
10.2 Construction manuelle de l’intervalle de confiance de la différence
L’intervalle de confiance à 95 % appliqué à la différence des moyennes ($\mu_1 – \mu_2$) représente sans doute l’outil le plus puissant d’estimation paramétrique. Il circonscrit la plage de valeurs au sein de laquelle se situe l’écart populationnel véritable avec une probabilité de couverture de 95 %. L’Utilitaire d’analyse d’Excel ne générant pas nativement cet intervalle dans sa sortie pour variances inégales, l’analyste doit procéder à sa construction algébrique manuelle au sein du tableur.
L’armature formelle de l’intervalle de confiance repose sur la borne d’estimation ponctuelle bornée par la marge d’erreur critique :
$$IC_{1 – \alpha} = (\bar{X}_1 – \bar{X}_2) \pm t_{critique} \times SE_{\Delta}$$
Pour implémenter cette estimation avec une rigueur absolue sous Excel en intégrant les spécificités de Welch, appliquez la séquence de calcul suivante à partir des cellules définies à la section 7.2 :
- Extraction du quantile $t$ critique ajusté :
Pour un intervalle de confiance conventionnel à 95 %, le risque d’erreur bilatéral est de 5 % ($\alpha = 0,05$). Utilisez la fonction d’inversion de la loi de Student en lui transmettant le risque $\alpha$ et les degrés de liberté exacts de Welch-Satterthwaite calculés enE9:
En celluleE12:=LOI.STUDENT.INVERSE.N(1 - 0,05/2; E9)
(Cette formule extrait avec une précision continue le seuil théorique de coupure pour une probabilité cumulée de 0,975, donnant approximativement $2,037$). - Calcul de la marge d’erreur :
Multipliez le quantile critique par l’erreur standard non combinée stockée enE7:
En celluleE13:=E12 * E7 - Calcul de la Borne Inférieure (à 95 %) :
En celluleE14:=(E3 - F3) - E13 - Calcul de la Borne Supérieure (à 95 %) :
En celluleE15:=(E3 - F3) + E13
Dans notre cas expérimental, l’exécution de ces commandes formule un intervalle de confiance compris entre $[+3,05 ; +11,67]$. Cet intervalle offre une richesse interprétative infiniment plus vaste que la simple $p$-valeur. D’une part, il n’englobe pas la valeur zéro, ce qui équivaut formellement au rejet de l’hypothèse nulle au seuil de $\alpha = 0,05$. D’autre part, il quantifie l’incertitude de l’estimation : à l’état le plus pessimiste de l’échantillonnage, la thérapie réduit l’anxiété d’au moins 3,05 points ; à son niveau d’efficacité maximal compatible avec les données, cette réduction peut atteindre 11,67 points, renseignant avec clarté les praticiens sur les limites de performance clinique attendues.
11. 11. Diagnostic des erreurs fréquentes et limites du tableur
11.1 Erreurs méthodologiques récurrentes chez l’analyste
L’utilisation d’un logiciel généraliste non bridé tel que Microsoft Excel pour l’analyse inférentielle expose le chercheur à plusieurs erreurs classiques de manipulation ou d’interprétation. L’identification proactive de ces écueils permet de sécuriser la chaîne de traitement empirique :
- La confusion directionnelle entre test unilatéral et bilatéral : L’Utilitaire d’analyse juxtapose les deux résultats dans sa grille sans imposer de choix préalable. Une erreur scientifique fréquente consiste à sélectionner a posteriori la $p$-valeur unilatérale simplement parce qu’elle est deux fois plus restreinte et permet de faire passer artificiellement sous le seuil symbolique des 0,05 un résultat qui n’aurait pas atteint la significativité en mode bilatéral. Tout recours au test unilatéral doit impérativement avoir fait l’objet d’un pré-enregistrement protocolaire strict et d’une justification épistémologique formelle où tout effet inverse est conceptuellement impossible ou dénué de sens.
- L’inversion fortuite des plages d’entrée : L’assignation de la colonne du groupe expérimental dans la case « Plage 1 » et de celle du contrôle dans la « Plage 2 » inverse purement et simplement le signe arithmétique de la statistique $t$ (qui devient négative). Bien que sans impact sur la $p$-valeur bilatérale, cette inversion entraîne fréquemment des lapsus rédactionnels majeurs dans les manuscrits, les auteurs concluant par inadvertance à une diminution du score alors qu’il s’agissait d’un accroissement.
- L’incompréhension de la notation scientifique compacte : Lorsque la probabilité critique est extrêmement faible, Excel bascule automatiquement son affichage en notation exponentielle normalisée (par exemple,
3,42E-05). Des étudiants ou analystes novices omettent régulièrement de lire le suffixe exponentiel et interprètent ce résultat comme un score de $p = 3,42$, concluant erronément à une absence totale de significativité car $3,42 > 0,05$. Il convient de rappeler que3,42E-05représente mathématiquement $3,42 \times 10^{-5} = 0,0000342$, soit un résultat hautement significatif. - La contamination par des caractères invisibles : Lors de copier-coller depuis des pages web, des questionnaires en ligne ou des fichiers PDF, des espaces insécables (code ASCII 160) se greffent fréquemment au sein des cellules numériques. Ces données sont alors muées en chaînes de texte. La fonction
NBles ignore, et l’Utilitaire d’analyse peut émettre une erreur cryptique d’interruption sans expliciter l’origine du blocage. L’inspection systématique via la fonctionESTNUMpermet de certifier le statut strictement numérique de chaque cellule.
11.2 Limites inhérentes à Microsoft Excel en psychométrie avancée
Malgré sa remarquable accessibilité et son ubiquité dans les infrastructures professionnelles, Microsoft Excel demeure un tableur comptable et financier détourné à des fins statistiques, et non un environnement de calcul scientifique certifié pour la psychométrie avancée. Il importe que le chercheur prenne conscience des limites infranchissables de cet outil pour savoir à quel moment précis basculer vers des plateformes spécialisées (telles que le langage R, Python avec SciPy, ou JASP) :
- Incomplétude des sorties d’analyse : Comme détaillé précédemment, le module d’analyse d’Excel omet dramatiquement la génération des intervalles de confiance de la différence et n’offre aucune estimation automatisée des tailles d’effet ($d$ de Cohen, $\eta^2$ ou $g$ de Hedges). L’analyste est contraint de coder manuellement ces indices, multipliant les risques d’erreurs de frappe dans les formules.
- Absence de modules formels de normalité : Excel est incapable d’exécuter de manière native les tests de normalité de référence universellement reconnus dans les revues internationales, tels que le test de Shapiro-Wilk, le test d’Anderson-Darling ou le test de Kolmogorov-Smirnov avec correction de Lilliefors. L’évaluation de la normalité y reste cantonnée à des approximations heuristiques d’asymétrie ou à des graphiques rudimentaires.
- Rigidité face aux devis factoriels complexes : Dès que le protocole s’enrichit d’une troisième condition (nécessitant une ANOVA unidirectionnelle robuste de Welch), d’un second facteur croisé (ANOVA factorielle) ou de covariables continues à neutraliser (ANCOVA), l’Utilitaire d’analyse d’Excel s’avère totalement obsolète. Il ne gère pas les contrastes planifiés robustes ni les modèles mixtes intégrant des effets aléatoires de sujets ou de stimuli.
- Absence de scriptage et de traçabilité scientifique : À l’ère de la science ouverte et de la crise de la reproductibilité, les comités de rédaction exigent de plus en plus le dépôt des scripts computationnels (code scripts). L’enchaînement de manipulations manuelles dans des fenêtres de dialogue d’Excel ne laisse aucune trace algorithmique auditable, rendant la réplication exacte des étapes de nettoyage et d’analyse particulièrement opaque comparativement à un script documenté sous R Markdown ou Jupyter Notebook.
12. 12. Standardisation et rédaction des résultats selon les normes APA
12.1 Règles formelles de présentation textuelle (APA 7e édition)
La transcription des résultats statistiques au sein d’un rapport de recherche, d’un mémoire universitaire ou d’un article scientifique soumis à une revue internationale doit obéir scrupuleusement aux conventions typographiques et structurelles formalisées par le manuel de publication de l’American Psychological Association (APA, 7e édition). La restitution ne se limite jamais à un copier-coller brut d’un tableau d’Excel, mais prend la forme d’un énoncé narratif rigoureusement standardisé.
Les règles typographiques fondamentales imposent que l’ensemble des lettres et symboles désignant des métriques statistiques d’échantillon soient formatés en italique. Sont ainsi impérativement mis en italique : la statistique différentielle ($t$), le coefficient de probabilité ($p$), la moyenne empirique ($M$), l’écart-type ($SD$, pour Standard Deviation), l’indicateur de taille d’effet ($d$) et l’intervalle de confiance ($CI$). À l’inverse, les chiffres, les parenthèses, les crochets, les indices d’identification et les opérateurs d’égalité ou d’inégalité conservent une typographie droite romaine standard.
La structure canonique de l’énoncé inférentiel se présente sous le schéma formel suivant :
$$t(\text{degrés de liberté}) = \text{valeur calculée}, p = \text{valeur exacte}, d = \text{taille d’effet}$$
Dans le cas spécifique du test t de Welch, les recommandations de l’APA imposent d’expliciter explicitement dans le corps du texte le recours à cette correction pour variances inégales, et d’indiquer de façon transparente les degrés de liberté effectivement utilisés (qu’ils soient tronqués par le moteur d’Excel ou rapportés avec leurs décimales réelles issues des formules manuelles). Voici des formulations académiques exemplaires prêtes à l’insertion dans un manuscrit :
Exemple de formulation pour un résultat hautement significatif (cas de l’anxiété) :
« Un test t de Welch pour échantillons indépendants a été conduit afin d’évaluer l’efficacité de la thérapie sur les scores d’anxiété de performance. L’analyse révèle une réduction statistiquement significative du niveau d’anxiété au sein du groupe ayant bénéficié de la thérapie ($M = 41,27$, $SD = 8,64$) comparativement au groupe témoin ($M = 48,63$, $SD = 5,33$), $t(31) = 3,48$, $p = 0,002$, bilatéral. L’ampleur de cette divergence correspond à un effet majeur selon les critères de Cohen, $d_{Welch} = 1,02$, la différence observée se situant dans un intervalle de confiance à 95 % allant de $3,05$ à $11,67$ points. »
Exemple de formulation pour un résultat non significatif :
« Les scores de flexibilité cognitive mesurés chez les participants exposés au stimulus auditif ($M = 52,14$, $SD = 12,45$) ne diffèrent pas de manière statistiquement significative de ceux observés dans la condition silencieuse ($M = 50,82$, $SD = 7,18$), comme l’indique le test t de Welch pour variances inégales, $t(24,6) = 0,42$, $p = 0,676$, $d = 0,13$, $95% \text{ } CI \text{ } [-5,21 ; 7,85]$. L’hypothèse nulle d’équivalence des performances de mémoire de travail ne peut par conséquent être rejetée. »
12.2 Création de visualisations graphiques rigoureuses sous Excel
L’accompagnement des inférences de Welch par une représentation visuelle claire et normalisée décuple l’intelligibilité des conclusions expérimentales. Dans les standards contemporains de la communication scientifique, les graphiques dits « en dynamite » (simples barres pleines surmontées d’un minuscule écart-type) sont de plus en plus dépréciés au profit de graphiques combinant l’illustration de la moyenne et de son intervalle de confiance à 95 %, voire d’une superposition de la dispersion brute des points d’observation individuels.
Pour élaborer une figure de niveau professionnel directement au sein de Microsoft Excel, suivez le protocole de construction ci-après :
- Génération de la table d’ancrage graphique : Sur votre feuille de calcul, agencez une petite matrice synthétique isolant le nom textuel des deux conditions, la valeur de leur moyenne respective ($M$), ainsi que la demi-marge d’erreur de leur intervalle de confiance individuel (calculée via la formule
=INTERVALLE.CONFIANCE.T(0,05; SD; n)). - Insertion du graphique de base : Sélectionnez les moyennes et leurs étiquettes, rendez-vous dans l’onglet Insertion, puis insérez un Histogramme 2D groupé ou, préférentiellement pour les publications, un Graphique à nuage de points avec lignes de repère.
- Intégration des barres d’erreur asymétriques personnalisées : Cliquez sur les barres ou les points de la série générée, cliquez sur l’icône « + » (Éléments de graphique) située dans le coin supérieur droit du tracé, puis cochez Barres d’erreur. Cliquez sur la flèche adjacente et sélectionnez Autres options…. Dans le volet latéral de configuration, choisissez l’orientation Les deux et le style d’extrémité Avec empattement. Cochez impérativement la case radio Personnalisée, puis cliquez sur Spécifier une valeur. Définissez la plage positive et la plage négative en pointant rigoureusement sur la cellule contenant la marge d’erreur à 95 % préalablement calculée.
- Épuration esthétique conforme aux normes APA : Supprimez le quadrillage horizontal en arrière-plan (gridlines), qui pollue la lecture visuelle. Formatez les axes en noir uni d’une épaisseur de 1 point. Supprimez le titre générique automatique placé au sommet du graphique sous Excel ; selon les normes de l’APA, la désignation des figures s’opère par une légende textuelle autonome insérée au-dessus ou au-dessous du graphique dans le traitement de texte, jamais incrustée dans l’image elle-même. Ajustez l’échelle de l’axe vertical des ordonnées afin qu’elle reflète un segment psychométriquement significatif de l’instrument d’évaluation employé sans écraser artificiellement la variance visible.
En respectant scrupuleusement ces règles typographiques et visuelles, le chercheur s’assure que la restitution de ses analyses sous Microsoft Excel satisfait aux standards les plus exigeants de la communication scientifique moderne, garantissant une transmission transparente, rigoureuse et reproductible de ses découvertes empiriques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. Frontiers in Psychology, 8, Article 846. https://doi.org/10.3389/fpsyg.2017.00846
- Glass, G. V., Peckham, P. D., & Sanders, J. R. (1972). Consequences of failure to meet assumptions underlying the fixed effects analyses of variance and covariance. Review of Educational Research, 42(3), 237–288. https://doi.org/10.3102/00346543042003237
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Ruxton, G. D. (2006). The unequal variance t-test is an underused alternative to Student’s t-test and the Mann–Whitney U test. Behavioral Ecology, 17(4), 688–690. https://doi.org/10.1093/beheco/arl004
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Welch, B. L. (1938). The significance of the difference between two means when the population variances are unequal. Biometrika, 29(3/4), 350–362. https://doi.org/10.2307/2332010
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222