
L’analyse quantitative des données en sciences humaines, et tout particulièrement en psychologie expérimentale et clinique, repose sur une modélisation rigoureuse de la variabilité interindividuelle. Lors de l’administration d’épreuves psychométriques, d’échelles d’auto-évaluation ou de tâches chronométriques, les chercheurs postulent très fréquemment que les scores observés se distribuent selon une courbe en cloche symétrique. Cette assomption théorique constitue l’un des piliers cardinaux sur lesquels reposent les modèles inférentiels les plus puissants de la biométrie et de la statistique classique. Cependant, présumer de la normalité d’une série empirique sans en administrer la preuve empirique expose le chercheur à des distorsions méthodologiques majeures, conduisant à des inférences erronées et à une reproductibilité compromise des résultats expérimentaux.
Le recours à des logiciels d’analyse de pointe tels que SPSS, R ou SAS est fréquent dans les laboratoires de recherche contemporains. Néanmoins, l’omniprésence, l’accessibilité universelle et la transparence algorithmique de Microsoft Excel en font un environnement de calcul remarquablement formateur et parfaitement opérationnel pour la vérification empirique des postulats distributionnels. Contrairement aux systèmes automatisés « en boîte noire », l’exécution d’un test de normalité au sein d’un tableur impose la décomposition minutieuse des moments statistiques d’ordre supérieur, offrant ainsi au psychologue, au clinicien ou à l’étudiant-chercheur une maîtrise analytique totale de ses données.
Le présent guide a pour vocation d’exposer de manière exhaustive, systématique et didactique la mise en œuvre pas à pas d’un test de normalité sous Microsoft Excel, en se focalisant sur la statistique de Jarque-Bera, complétée par des explorations graphiques quantiles-quantiles et des histogrammes à densité théorique. À travers ce parcours méthodologique ancré dans les réalités de la recherche en psychologie, nous explorerons les implications mathématiques, les risques inférentiels associés à la violation de la normalité et les protocoles décisionnels indispensables à la validation de vos jeux de données expérimentales.
1. Introduction à l’évaluation de la normalité des données psychologiques
1.1 Importance de la normalité dans la recherche quantitative en psychologie
Dans l’écosystème de la psychométrie contemporaine, le postulat selon lequel les aptitudes cognitives, les traits de personnalité et les manifestations affectives s’ordonnent selon une distribution de Gauss-Laplace est omniprésent. Depuis les travaux pionniers de Sir Francis Galton et d’Alfred Binet, la construction des instruments psychométriques standardisés repose sur l’hypothèse fondamentale qu’un phénomène psychologique complexe résulte de l’agrégation d’une multiplicité de micro-déterminants génétiques, environnementaux et neuronaux indépendants. En vertu des principes probabilistes fondamentaux, cette sommation de variables aléatoires élémentaires produit spontanément une dispersion des scores où la majorité des individus se concentre autour de la valeur centrale, tandis que les performances exceptionnelles ou déficitaires se raréfient symétriquement vers les extrémités.
Les inventaires de personnalité majeurs, tels que le modèle à cinq facteurs (NEO-PI-R), ainsi que les batteries d’évaluation de l’efficience intellectuelle comme l’échelle de Wechsler (American Psychological Association), étalonnent leurs populations de référence sur cette géométrie gaussienne. Dès lors, lorsqu’un échantillon expérimental s’écarte significativement de ce gabarit théorique, la sensibilité métrologique de l’instrument s’en trouve profondément compromise. Une asymétrie non détectée des données empiriques biaise l’estimation de la variance vraie et gonfle artificiellement l’erreur de mesure, limitant l’exactitude des diagnostics cliniques ou différentiels.
Les conséquences d’une distribution asymétrique ou aplatie sur le calcul des scores normés sont particulièrement sévères. Dans la pratique psychologique standard, les scores bruts sont fréquemment convertis en notes étalonnées standardisées telles que les notes T (moyenne de 50, écart-type de 10), les stanines (échelle en neuf classes standard) ou les percentiles. Cette transposition linéaire ou quasi-linéaire postule une équivalence absolue entre l’écart à la moyenne et la surface sous la courbe normale. Si la distribution empirique sous-jacente est leptocurtique ou présente un étalement asymétrique prononcé, un score situé à deux écarts-types de la moyenne n’isolera plus exactement 2,27 % de la population théorique, mais potentiellement une fraction beaucoup plus vaste ou restreinte. Les percentiles calculés sur la base de tables gaussiennes perdent alors toute fidélité descriptive, faussant l’évaluation pronostique ou neuropsychologique du sujet testé.
1.2 Le rôle charnière de la distribution normale dans les statistiques inférentielles
La validité des conclusions dérivées des modèles statistiques inférentiels paramétriques dépend étroitement du respect de conditions mathématiques préalables. Au premier rang de ces exigences figure la normalité distributionnelle, qui s’applique avec une acuité particulière aux résidus des modèles linéaires généraux. Qu’il s’agisse de l’analyse de variance univariée (ANOVA), de l’analyse de covariance (ANCOVA) ou des régressions linéaires multiples, la théorie d’estimation par les moindres carrés ordinaires suppose que les erreurs aléatoires résiduelles sont identiquement et indépendamment distribuées selon une loi normale d’espérance nulle et de variance constante. Lorsque cette condition d’homoscédasticité et de normalité des résidus est transgressée, les estimateurs des paramètres demeurent non biaisés, mais ils perdent leur propriété d’efficacité optimale garantie par le théorème de Gauss-Markov.
L’impact direct de la non-normalité se répercute avec gravité sur les métriques décisionnelles fondamentales : l’erreur de première espèce (l’erreur de type I, ou taux de faux positifs) et la puissance statistique du test. Si la distribution empirique est fortement asymétrique ou présente des queues de distribution épaisses (« fat tails »), la probabilité empirique de rejeter à tort l’hypothèse nulle d’absence d’effet s’écarte radicalement du seuil alpha conventionnellement fixé à 5 %. Dans certaines configurations distributionnelles, le test F de Fisher ou le test t de Student deviennent indûment libéraux, générant des associations illusoires. Dans d’autres circonstances, ils se révèlent excessivement conservateurs, privant le chercheur de la puissance requise pour détecter un effet thérapeutique ou expérimental pourtant réel.
Il importe en outre de formaliser la distinction méthodologique cruciale entre la normalité univariée et la normalité multivariée dans les protocoles cliniques. Tandis que la normalité univariée se préoccupe de la distribution isolée de chaque variable dépendante prise individuellement, la normalité multivariée exige que toute combinaison linéaire des variables suive également une loi normale multidimensionnelle. Bien qu’une normalité univariée satisfaite sur chaque échelle clinique ne garantisse pas mathématiquement une normalité multivariée au sein d’une analyse multivariée de variance (MANOVA), elle constitue néanmoins une condition nécessaire sine qua non. Ignorer l’étape de criblage distributionnel univarié revient à fragiliser l’ensemble de l’édifice mathématique d’un protocole de recherche translationnelle.
1.3 Excel comme instrument d’analyse statistique rigoureux en sciences humaines
L’utilisation de Microsoft Excel dans la recherche académique en sciences humaines a longtemps suscité des réserves au sein des comités d’éthique méthodologique, en raison d’imprécisions algorithmiques documentées dans les versions antérieures à 2010. Cependant, les itérations modernes du tableur ont bénéficié d’une refonte substantielle de leurs moteurs de calcul probabilistes, adoptant des algorithmes standardisés conformes aux recommandations de l’Institut National des Standards et de la Technologie (NIST). Excel s’avère aujourd’hui un instrument statistique rigoureux, caractérisé par une accessibilité universelle et une portabilité inégalée, dispensant les équipes de recherche des coûts d’acquisition prohibitifs des suites logicielles propriétaires spécialisées.
L’atout méthodologique majeur d’Excel réside dans la transparence algorithmique qu’il impose à l’analyste. Dans des logiciels statistiques traditionnels dotés d’interfaces graphiques prêtes à l’emploi, l’obtention d’un test d’hypothèse se résume souvent à l’actionnement d’un bouton contextuel générant une sortie prédéfinie. Cette approche occulte les opérations matricielles sous-jacentes et peut induire une illusion de compétence computationnelle. À l’inverse, modéliser un test de normalité au sein d’une feuille de calcul requiert une décomposition explicite de chaque étape mathématique : calcul des sommes de carrés, standardisation des scores individuels, estimation des moments statistiques d’ordre 3 et 4, et sommation quadratique. Cette décomposition analytique garantit une reproductibilité intégrale et force le chercheur à interroger la provenance de chaque fluctuation métrique.
Il convient néanmoins de cerner avec lucidité les limites inhérentes à l’environnement tableur et de respecter scrupuleusement certaines précautions opératoires. Excel ne possède pas de fonction native monobloc pour exécuter directement des tests de normalité formels tels que le test de Shapiro-Wilk ou le test de Kolmogorov-Smirnov corrigé par Lilliefors. L’analyste doit dès lors programmer les formules matricielles ou implémenter la statistique de Jarque-Bera à l’aide des fonctions mathématiques de base. Par ailleurs, la gestion des jeux de données massifs (« big data ») peut induire des ralentissements d’exécution, et l’absence d’un journal d’audit automatique des modifications exige une rigueur absolue dans la sauvegarde des formules et le verrouillage structurel des classeurs.
2. Cadre conceptuel et fondements mathématiques de la loi normale
2.1 Propriétés géométriques et probabilistes de la courbe de Gauss-Laplace
La distribution normale, souvent dénommée courbe de Gauss ou loi de Gauss-Laplace, constitue un modèle probabiliste continu d’une importance cardinale dans la modélisation mathématique du vivant. Mathématiquement, la fonction de densité de probabilité d’une variable aléatoire continue X suivant une loi normale est formulée par l’expression analytique suivante :
f(x) = (1 / (σ * √(2π))) * exp( – (x – μ)² / (2σ²) )
Dans cette équation intemporelle, μ (mu) symbolise l’espérance mathématique ou moyenne de la population, qui gouverne le positionnement du sommet de la cloche le long de l’axe des abscisses, tandis que σ (sigma) représente l’écart-type de la population, qui paramètre la dispersion et l’étalement horizontal de la courbe. Le produit σ² correspond à la variance théorique. L’intégrale de cette fonction sur l’intervalle infini allant de moins l’infini à plus l’infini est strictement égale à 1, attestant qu’elle délimite la totalité de l’espace probabiliste de l’événement étudié.
D’un point de vue géométrique, la distribution normale se caractérise par une symétrie axiale parfaite autour de sa droite verticale d’abscisse x = μ. En ce point d’inflexion culminant, les trois mesures fondamentales de la tendance centrale — la moyenne arithmétique, la médiane et le mode — sont rigoureusement superposées et confondues. De surcroît, la courbe présente deux points d’inflexion géométriques situés très exactement aux coordonnées x = μ – σ et x = μ + σ, zones où la concavité de la fonction bascule de vers le bas à vers le haut.
Cette morphologie rigide sous-tend la célèbre règle empirique des trois sigmas, fréquemment invoquée dans l’interprétation des scores d’aptitude cognitive :
- Environ 68,27 % de la surface totale sous la courbe se situe dans l’intervalle interquartile élargi compris entre μ – σ et μ + σ.
- Environ 95,45 % des observations empiriques sont contenues à l’intérieur de l’intervalle défini par μ – 2σ et μ + 2σ.
- Exactement 99,73 % des cas sont circonscrits entre μ – 3σ et μ + 3σ, laissant une proportion congrue de seulement 0,27 % au-delà de ces frontières distales.
2.2 Le théorème central limite et ses conditions d’application
L’omniprésence de la loi normale dans les sciences empiriques n’est pas un artefact du hasard, mais découle d’un résultat probabiliste d’une élégance mathématique exceptionnelle : le Théorème Central Limite (TCL). Ce théorème postule que, lorsque l’on extrait une série d’échantillons aléatoires indépendants de taille n d’une population quelconque caractérisée par une moyenne finie μ et une variance finie σ² (indépendamment du fait que la distribution d’origine soit asymétrique, uniforme ou bimodale), la distribution d’échantillonnage de la moyenne arithmétique converge asymptotiquement vers une loi normale de moyenne μ et d’erreur standard égale à σ / √n à mesure que n tend vers l’infini.
Dans la tradition statistique universitaire, il est d’usage d’admettre la taille critique d’échantillon n ≥ 30 comme seuil pratique à partir duquel le théorème central limite opère efficacement, autorisant l’usage de tests paramétriques pour l’inférence sur la moyenne. Toutefois, ce recours systématique à un seuil fixe engendre de profondes confusions méthodologiques dans la recherche expérimentale et clinique contemporaine. Si le TCL garantit la normalité de la moyenne d’échantillonnage, il n’altère en rien la distribution des données individuelles brutes au sein de l’échantillon fini observé.
Cette nuance s’avère primordiale dans l’étude des populations cliniques atypiques (patients souffrant de traumatismes crâniens sévères, troubles envahissants du spectre autistique, phobies spécifiques aiguës). Dans de tels groupes, l’asymétrie structurelle des scores ou la prévalence d’individus atypiques peut distordre si profondément les valeurs observées qu’un effectif de trente sujets s’avère radicalement insuffisant pour stabiliser l’inférence. Le chercheur en psychologie ne peut donc s’abriter derrière l’invocation aveugle du théorème central limite pour s’exonérer du contrôle de la normalité de son échantillon spécifique, en particulier lorsque l’objectif vise à étalonner des scores individuels ou à estimer des quantiles de prédiction clinique.
2.3 Moments statistiques d’ordre supérieur : asymétrie et aplatissement
Pour décrire exhaustivement la géométrie d’une série de données quantitatives, les statistiques descriptives sollicitent les moments centrés d’une variable aléatoire. Si le premier moment correspond à l’espérance (moyenne, mesurant l’emplacement central) et le deuxième moment centré représente la variance (mesurant l’écartement global), la forme intrinsèque de la distribution dépend entièrement des moments d’ordre supérieur : le troisième et le quatrième moment centré.
Le troisième moment centré standardisé quantifie l’asymétrie statistique, internationalement désignée sous le terme de Skewness. L’asymétrie évalue le degré de déformation unilatérale de la distribution par rapport à sa médiane. Une distribution parfaitement symétrique affiche un coefficient d’asymétrie théorique rigoureusement égal à zéro. On distingue fondamentalement deux modalités de déviation asymétrique :
- L’asymétrie positive (dextrogyre ou étalée à droite) : La queue de distribution s’étire vers les valeurs élevées positives. La moyenne arithmétique est supérieure à la médiane. Dans ce cas, la majorité des observations s’agglutine sur les scores faibles.
- L’asymétrie négative (lévogyre ou étalée à gauche) : La queue de distribution s’étend vers les valeurs faibles. La moyenne se positionne à gauche de la médiane, traduisant une concentration de participants sur les scores élevés de l’épreuve.
Le quatrième moment centré standardisé définit quant à lui l’aplatissement, désigné sous l’appellation technique de Kurtosis. Le kurtosis analyse le comportement probabiliste des queues de distribution par rapport au centre de la masse de données. Il renseigne sur l’épaisseur des queues et la propension de l’échantillon à générer des valeurs aberrantes ou extrêmes (« outliers »). Pour une loi normale canonique, la valeur mathématique du kurtosis brut est égale à 3. Afin de simplifier l’analyse, les statisticiens emploient quasi-systématiquement la notion d’excès de kurtosis, définie par la formule C = Kurtosis – 3, qui normalise la valeur de référence gaussienne à zéro.
La typologie morphologique distingue ainsi trois configurations de courbure distributionnelle :
- Le profil mésocurtique : Excès de kurtosis proche de 0. La morphologie correspond fidèlement à la courbure gaussienne normale standard.
- Le profil leptocurtique : Excès de kurtosis strictement supérieur à 0. La distribution arbore un pic central proéminent et élancé, associé à des queues de distribution épaisses et lourdes, signifiant une occurrence inhabituellement élevée de scores extrêmes.
- Le profil platicurtique : Excès de kurtosis strictement négatif. La courbe est aplatie, les épaules de la cloche sont renflées et les queues sont anormalement légères, indiquant une dispersion diffuse des données sans sommet central accusé.
3. Fondements théoriques du test de Jarque-Bera
3.1 Formulation mathématique et logique de la statistique de test
Développé conjointement par les économètres et statisticiens Carlos Jarque et Anil Bera au début des années 1980 (International Statistical Review), le test de Jarque-Bera est un test d’adéquation probabiliste conçu pour vérifier si les coefficients d’asymétrie et de kurtosis d’un échantillon empirique coïncident avec les paramètres théoriques d’une population gaussienne normale. L’élégance de cette méthode repose sur son caractère omnibus : au lieu de dissocier l’évaluation de la symétrie de celle de l’aplatissement, la statistique combine harmonieusement ces deux propriétés dimensionnelles en un indicateur synthétique unifié.
L’équation canonique de la statistique de test de Jarque-Bera s’articule comme suit :
JB = (n / 6) * [ S² + ((K – 3)² / 4) ]
Où les symboles constitutifs représentent :
- n : la taille totale de l’échantillon expérimental (nombre d’observations indépendantes valides).
- S : le coefficient d’asymétrie empirique (Sample Skewness).
- K : le coefficient d’aplatissement brut d’échantillon (Sample Kurtosis).
Lorsque le calcul s’effectue dans un environnement logiciel comme Microsoft Excel, qui renvoie automatiquement l’excès de kurtosis (noté usuellement C ou Excess Kurtosis, où C = K – 3), la formule se condense de manière opérationnelle :
JB = (n / 6) * [ S² + (C² / 4) ]
La logique algébrique sous-jacente mérite d’être soulignée : les déviations par rapport à la normalité théorique sont élevées au carré, à savoir S² pour l’asymétrie et C² pour l’excès d’aplatissement. Cette élévation à la puissance deux annule les signes négatifs et assure que toute distorsion, qu’elle traduise un étalement à gauche ou un profil platicurtique, pénalise additivement le résultat. De surcroît, le terme d’excès de kurtosis est divisé par 4, ce qui reflète exactement le rapport entre les variances asymptotiques des estimateurs de l’asymétrie (dont la variance théorique sous H0 est 6/n) et de l’aplatissement (dont la variance asymptotique sous H0 est 24/n). Le facteur multiplicateur externe n / 6 standardise la métrique globale.
3.2 Définition formelle des hypothèses nulle et alternative
Comme toute procédure relevant de l’inférence statistique formelle, le test de Jarque-Bera est adossé à un schéma de décision binaire régi par deux hypothèses statistiques mutuellement exclusives. Le chercheur en psychologie doit formaliser explicitement ces propositions avant de procéder à l’acquisition et au traitement de ses mesures de laboratoire :
- Hypothèse nulle (H0) : S = 0 et K – 3 = 0. L’échantillon statistique examiné est extrait d’une population globale distribuée selon une loi normale standard ou générale. La distribution sous-jacente est parfaitement symétrique et présente une courbure mésocurtique conforme à la densité de Gauss-Laplace.
- Hypothèse alternative (HA) : S ≠ 0 ou K – 3 ≠ 0 (ou les deux simultanément). La population source dévie substantiellement des spécifications de la loi normale, soit en raison d’une asymétrie unilatérale, soit en raison d’un aplatissement anormal (leptocurtique ou platicurtique), soit par la combinaison conjointe de ces deux anomalies géométriques.
Dans la pratique académique, la gestion des risques probabilistes impose la fixation préalable d’un seuil de significativité, noté conventionnellement alpha (α). En psychologie expérimentale et cognitive, la convention universelle fixe ce seuil à α = 0,05, ce qui signifie que l’analyste accepte un risque de 5 % de rejeter à tort l’hypothèse de normalité alors que les données sont issues d’un univers gaussien (erreur de type I). Dans les protocoles de neuropsychologie clinique ou d’évaluation pharmacologique où l’exigence de précision méthodologique est maximale, un seuil plus conservateur fixé à α = 0,01 est fréquemment déployé afin d’éviter les requalifications injustifiées des modèles d’analyse sous-jacents.
3.3 La loi du Chi-deux à deux degrés de liberté comme distribution de référence
L’assise statistique qui confère au test de Jarque-Bera toute sa robustesse asymptotique réside dans la loi de probabilité suivie par la statistique JB lorsque l’hypothèse nulle est satisfaite. Sous l’hypothèse d’une population normale sous-jacente, les estimateurs standardisés de l’asymétrie et du kurtosis convergent asymptotiquement vers deux variables aléatoires normales centrées réduites indépendantes. Dès lors, la somme de leurs carrés pondérés suit rigoureusement, pour de grands échantillons, une loi de distribution du Chi-deux (χ²).
Puisque la statistique de Jarque-Bera compile les déviations orthogonales issues de deux paramètres descriptifs distincts (le moment d’ordre 3 et le moment d’ordre 4), la distribution de référence associée est celle du Chi-deux à exactement deux degrés de liberté (k = 2 ddl) :
JB ~ χ²(2) lorsque n tend vers l’infini
Cette propriété distributionnelle détermine directement la topologie de la zone de rejet. La statistique JB étant composée d’une somme de termes strictement positifs pondérés par un effectif n positif, sa valeur numérique minimale est zéro (atteinte uniquement dans le cas théorique parfait d’une symétrie totale et d’un kurtosis identique à la courbe de Gauss). Plus la distribution empirique est asymétrique ou bombée, plus la valeur calculée de JB progresse positivement vers l’infini. Le test de Jarque-Bera est donc par nature un test unilatéral supérieur : la région critique de rejet de l’hypothèse nulle se situe exclusivement dans la queue supérieure droite de la loi du Chi-deux.
La p-valeur associée au test s’obtient alors en calculant l’intégrale de la fonction de densité du Chi-deux à deux degrés de liberté, depuis la valeur observée de la statistique JB jusqu’à l’infini positif. Mathématiquement, pour une loi du Chi-deux à deux degrés de liberté, cette probabilité cumulative résiduelle bénéficie d’une solution analytique simplifiée particulièrement remarquable : p = exp( – JB_observé / 2 ). Si cette probabilité s’avère inférieure ou égale au seuil de significativité α retenu, le chercheur se trouve dans l’obligation méthodologique de rejeter l’hypothèse de normalité distributionnelle.
4. Préparation et structuration des données expérimentales dans Excel
4.1 Organisation architecturale de la feuille de calcul
L’intégrité et la fiabilité des analyses quantitatives sous Microsoft Excel reposent fondamentalement sur une rigueur architecturale sans compromis lors de la conception de la feuille de calcul. Trop d’erreurs d’interprétation méthodologique proviennent d’un enchevêtrement désordonné de variables d’intérêt, de données d’identification et de formules intermédiaires au sein des mêmes colonnes. L’adoption d’un paradigme de mise en page standardisé constitue la première ligne de défense de l’expérimentateur contre les erreurs de manipulation logicielle.
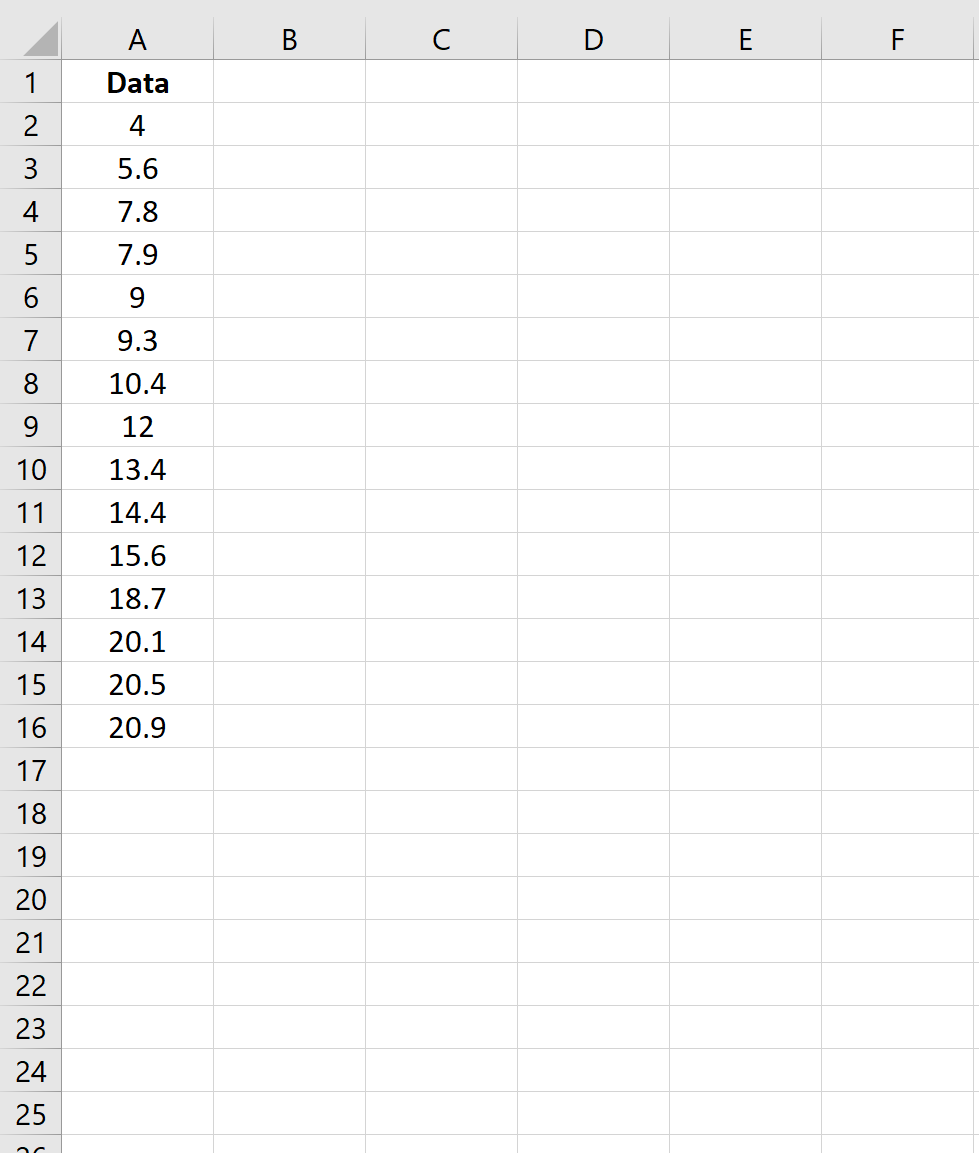
Il est préconisé d’ordonner la feuille de calcul en sections fonctionnelles indépendantes et rigoureusement étiquetées. La première colonne (Colonne A) doit être systématiquement dévolue aux identifiants alphanumériques anonymisés des participants (ex. : SUJ_001, SUJ_002, etc.), prévenant toute confusion entre les numéros d’ordre et les scores métriques réels. La colonne contiguë (Colonne B) accueille la variable empirique brute mesurée au laboratoire. Une convention hautement recommandée consiste à nommer explicitement les plages de cellules via le Gestionnaire de noms d’Excel (par exemple, désigner la plage B2:B31 par l’étiquette sémantique Scores_Anxiete). Cette désignation garantit la transparence des formules mathématiques ultérieures en éliminant les erreurs de décalage de références relatives lors de duplications de colonnes.
Avant d’engager le moindre calcul de moment d’ordre supérieur, une phase impérative de nettoyage des données doit être entreprise. Cette étape de dépouillement vise à purger l’échantillon des valeurs aberrantes provenant d’erreurs typographiques évidentes (telle que la saisie d’un score de 700 sur une échelle bornée à 70), à identifier le codage des valeurs manquantes et à éliminer les espaces insécables qui convertissent insidieusement les nombres en chaînes textuelles invisibles pour les algorithmes mathématiques du tableur.
4.2 Vérification des conditions préalables d’échantillonnage
L’administration légitime d’un test de conformité statistique requiert la validation rigoureuse des conditions d’échantillonnage expérimental. La condition première, d’ordre épistémologique et méthodologique, est celle de l’indépendance des observations. Le test de Jarque-Bera présume que chaque mesure résulte d’une observation aléatoire individuelle non corrélée aux autres unités de l’échantillon. Cette hypothèse fondamentale exclut formellement l’introduction simultanée de mesures longitudinales répétées issues d’un même individu au sein du même vecteur d’analyse sans ajustement pour mesures répétées préalable. Si deux scores sont dépendants (cas de jumeaux homozygotes, de couples ou de sessions de testing sérielles), la variance d’échantillonnage est sous-estimée, ce qui déforme artificiellement la distribution d’échantillonnage de la statistique JB.
La question de la taille de l’échantillon (n) constitue un arbitrage méthodologique de premier ordre dans l’usage du test de Jarque-Bera. Reposant sur la convergence asymptotique vers une loi du Chi-deux, le test présente des propriétés d’optimalité remarquable pour des tailles d’échantillons moyennes à grandes (idéalement n ≥ 30, et de façon optimale n ≥ 50). Pour des cohortes très restreintes (n < 20), la statistique empirique a tendance à sous-estimer la probabilité de queue de distribution, rendant le test légèrement conservateur. Le chercheur travaillant sur des micro-échantillons cliniques devra intégrer cette contrainte lors de la lecture des p-valeurs.
Enfin, une vigilance spécifique s’impose quant à la continuité de la variable. La loi normale est un modèle mathématique continu défini sur l’ensemble des réels. Or, en psychologie, un volume substantiel de données provient d’échelles de Likert courtes (ex. items gradués de 1 à 5). La projection d’une variable éminemment discrète sur un modèle continu introduit inévitablement des paliers distributionnels susceptibles de générer un excès de kurtosis artificiel. Le recours au test de Jarque-Bera s’avère particulièrement légitime lorsque les scores psychologiques procèdent de scores composites continus, tels que la sommation de multiples items ordonnés ou des temps de réaction chronométriques continus exprimés en millisecondes.
4.3 Création d’un jeu de données psychologiques illustratif
Afin d’ancrer notre démarche dans un cadre appliqué et reproductible, nous concevons un jeu de données expérimentales représentatif des recherches cliniques en psychopathologie cognitive. Imaginons un protocole d’investigation évaluant le niveau d’anxiété-état chez un échantillon de 15 jeunes adultes soumis à une épreuve de stress aigu en laboratoire. L’instrument de mesure mobilisé est le sous-test d’anxiété cognitive de l’inventaire STAI-Y (State-Trait Anxiety Inventory de Spielberger), dont les scores standardisés oscillent théoriquement entre 20 et 80 points.
Procédons à la saisie de ces 15 observations empiriques dans la première colonne de notre feuille de calcul Excel, en disposant les valeurs au sein de la plage A2:A16 (la ligne 1 étant réservée à l’intitulé conceptuel de la variable, par exemple Score_STAI_Etat) :
- Cellule A2 : 34
- Cellule A3 : 38
- Cellule A4 : 41
- Cellule A5 : 42
- Cellule A6 : 44
- Cellule A7 : 45
- Cellule A8 : 46
- Cellule A9 : 47
- Cellule A10 : 48
- Cellule A11 : 49
- Cellule A12 : 51
- Cellule A13 : 53
- Cellule A14 : 55
- Cellule A15 : 58
- Cellule A16 : 65
Après la saisie manuelle de ces scores, une vérification immédiate du format de cellule s’impose. Sélectionnez la plage A2:A16, effectuez un clic droit, choisissez la rubrique Format de cellule, et assurez-vous formellement que la typologie sélectionnée est configurée sur Nombre ou Standard, avec un alignement spontané des valeurs sur le bord droit de la cellule. Si un nombre apparaît aligné sur le bord gauche, cela signale qu’Excel l’interprète comme une chaîne de caractères typographiques, ce qui fausserait l’intégralité des opérations arithmétiques ultérieures.
5. Étape 1 : Calcul des paramètres descriptifs fondamentaux dans Excel
5.1 Détermination de la taille de l’échantillon d’étude (n)
L’estimation rigoureuse de la taille d’échantillon valide n est la condition première de tout l’édifice computationnel de Jarque-Bera, dans la mesure où ce paramètre intervient directement comme facteur multiplicateur global dans l’équation de la statistique de test. Pour automatiser cette extraction numérique et garantir la dynamique de calcul si de nouvelles observations sont insérées ultérieurement, nous devons mobiliser les fonctions de dénombrement natives d’Excel.
Positionnez-vous sur une cellule dédiée à l’affichage des synthèses descriptives, par exemple la cellule D2 pour inscrire l’étiquette textuelle Taille de l'échantillon (n), puis activez la cellule contiguë E2 pour y injecter la formule de dénombrement suivante :
=NB(A2:A16)
Une distinction méthodologique essentielle doit être opérée entre les fonctions NB et NBVAL. La fonction NB ne comptabilise exclusivement que les cellules contenant des valeurs numériques valides, ignorant délibérément les cellules vides ou les saisies textuelles accidentelles (telles qu’une annotation « absent » ou « refus »). À l’inverse, la fonction NBVAL comptabilise l’intégralité des cellules non vides, y compris les chaînes textuelles ou les caractères d’espacement involontaires. L’emploi strict de la fonction =NB(A2:A16) protège le chercheur contre une surévaluation de la taille effective de son échantillon. Dans notre cas concret, le résultat renvoyé dans la cellule E2 est rigoureusement égal à 15.
5.2 Calcul de la tendance centrale et de la dispersion
L’appréciation de la structure de l’échantillon requiert l’estimation des deux paramètres fondamentaux de la loi normale : l’espérance empirique (la moyenne arithmétique de l’échantillon, x̄) et la dispersion des observations autour de ce pôle (l’écart-type d’échantillon, s). Ces indicateurs serviront ultérieurement de repères théoriques pour la standardisation des données et la projection des densités gaussiennes.
Pour calculer la moyenne empirique, renseignez la cellule D3 avec l’étiquette Moyenne arithmétique, puis insérez dans la cellule de calcul E3 la formule suivante :
=MOYENNE(A2:A16)
L’évaluation de la dispersion exige une vigilance accrue quant au choix de la formule statistique. Dans la cellule D4, spécifiez l’intitulé Écart-type standardisé, puis introduisez dans la cellule E4 la fonction :
=ECARTYPE.STANDARD(A2:A16)
Il est impératif d’écarter l’usage de la fonction concurrente =ECARTYPE.PEARSON(plage) (ou =ECARTYPE.P). En effet, ECARTYPE.P divise la somme des carrés des écarts par l’effectif total n, ce qui fournit un estimateur biaisé (sous-estimé) de la variance pour un échantillon expérimental issu d’une population plus vaste. À l’inverse, la formule ECARTYPE.STANDARD (héritière de l’ancienne fonction ECARTYPE) applique la correction de Bessel en divisant la somme quadratique par n – 1 degrés de liberté, délivrant ainsi un estimateur non biaisé de la variabilité populationnelle. Pour notre cohorte de 15 sujets, nous observons une moyenne de 47,73 points et un écart-type corrigé de 7,62 points.
5.3 Inspection de la médiane et de l’étendue interquartile
Bien que le test formel de Jarque-Bera s’articule autour des moments centrés d’ordre supérieur, une inspection préliminaire robuste de la distribution passe nécessairement par l’analyse des statistiques d’ordre non paramétriques, au premier rang desquelles trônent la médiane et l’intervalle interquartile. Cette confrontation heuristique permet d’anticiper visuellement l’émergence d’une éventuelle asymétrie.
Pour calculer la valeur médiane de notre série, saisissez en cellule D5 l’intitulé Médiane, et programmez la cellule E5 avec la formule :
=MEDIANE(A2:A16)
Poursuivez en caractérisant la dispersion interne via le premier quartile (Q1, 25e percentile) et le troisième quartile (Q3, 75e percentile). Inscrivez en D6 l’étiquette Premier Quartile (Q1) et en E6 la formule =QUARTILE.INC(A2:A16; 1). De manière analogue, inscrivez en D7 l’intitulé Troisième Quartile (Q3) et en E7 l’instruction =QUARTILE.INC(A2:A16; 3). L’utilisation de QUARTILE.INC (méthode inclusive) est conforme aux standards les plus universellement reconnus dans les didacticiels psychométriques.
L’observation analytique conjointe de la moyenne et de la médiane constitue un premier diagnostic distributionnel :
- Dans une distribution normale théorique, Moyenne = Médiane.
- Dans notre échantillon d’anxiété STAI, la médiane obtenue s’établit à 47,00 points, tandis que la moyenne arithmétique est de 47,73 points.
Cette discrète dérive positive de la moyenne arithmétique par rapport à la médiane signale la présence probable d’une asymétrie dextrogyre légère, imputable à l’influence mécanique exercée par les scores élevés de l’échantillon (notamment le score maximal de 65 points) qui attirent le centre de gravité gravitationnel des données vers la droite.
6. Étape 2 : Estimation de l’asymétrie (Skewness) sous Excel
6.1 Fonctions intégrées pour l’asymétrie d’échantillon
Pour quantifier avec rigueur mathématique la distorsion de symétrie sans contraindre l’utilisateur à de fastidieux calculs de tables intermédiaires, Microsoft Excel met à disposition des chercheurs une fonction algorithmique native hautement sophistiquée. Cependant, une ambiguïté linguistique et technique persiste souvent quant à l’instruction exacte à convoquer.
Dans votre tableau de bord statistique, positionnez l’intitulé Asymétrie (Skewness S) dans la cellule D8, puis insérez dans la cellule E8 la commande analytique suivante :
=COEFFICIENT.ASYMETRIE(A2:A16)
Il importe de bien distinguer cette instruction de la fonction =COEFFICIENT.ASYMETRIE.P(plage). Cette dernière calcule l’asymétrie sur la population globale exhaustive sans ajustement pour échantillon fini, en utilisant un diviseur strict en n. Or, dans les investigations empiriques en sciences psychologiques, le chercheur manipule systématiquement un échantillon extrait d’un univers infini d’observations potentielles. La formule COEFFICIENT.ASYMETRIE incorpore automatiquement le facteur de correction de biais d’échantillonnage développé par Fisher, délivrant un estimateur sans biais du troisième moment centré standardisé.
Le modèle mathématique déployé en arrière-plan par le moteur computationnel d’Excel pour cette fonction correspond rigoureusement à l’équation suivante :
S = [ n / ((n – 1)(n – 2)) ] * ∑ [ (x_i – x̄) / s ]³
Où s symbolise l’écart-type non biaisé de l’échantillon. L’exécution de cette formule sur nos données expérimentales produit une valeur numérique d’asymétrie S approximativement égale à 0,534.
6.2 Vérification par calcul manuel étape par étape
Afin de démystifier les mécanismes internes d’Excel et d’assurer une totale reproductibilité scientifique, il est particulièrement instructif de reconstituer manuellement l’asymétrie par le déploiement de colonnes arithmétiques intermédiaires. Cette méthodologie garantit une traçabilité intégrale pour les comités d’éthique et les évaluateurs de revues scientifiques.
Commençons par calculer les scores standardisés (les scores réduits centrés, désignés communément par la notation z). Dans l’en-tête de la colonne B (cellule B1), inscrivez le label z_scores. Dans la cellule B2, insérez la formule de centrage-réduction en mobilisant les références absolues bloquées à l’aide du symbole dollar pour la moyenne ($E$3) et l’écart-type ($E$4) :
=(A2-$E$3)/$E$4
Étendez cette formule arithmétique vers le bas, depuis la cellule B2 jusqu’à la cellule B16, en double-cliquant sur la poignée de recopie située dans le coin inférieur droit de la sélection. Chaque participant dispose désormais de son score d’anxiété standardisé, exprimé en unités d’écart-type.
Créez ensuite une deuxième colonne intermédiaire en configurant l’en-tête de la colonne C (cellule C1) avec l’intitulé z_cube (z^3). Dans la cellule C2, programmez l’élévation au cube du score standardisé correspondant :
=B2^3
Recopiez cette formule jusqu’au bas de la colonne (cellule C16). Dans une cellule libre, par exemple en C17, procédez à la sommation globale de ces scores au cube via la commande =SOMME(C2:C16).
Enfin, appliquez manuellement le facteur multiplicateur de correction d’échantillon fini de Fisher : n / [ (n – 1)(n – 2) ]. Dans notre exemple, où n = 15, ce coefficient correcteur s’établit exactement à 15 / (14 * 13) = 15 / 182 ≈ 0,082417. En multipliant ce facteur scalaire par la somme obtenue en C17, le résultat concorde rigoureusement et à la décimale près avec la valeur issue de la fonction native =COEFFICIENT.ASYMETRIE(A2:A16), validant l’exactitude de l’implémentation.
6.3 Interprétation psychologique du coefficient d’asymétrie
L’interprétation de la valeur numérique de l’asymétrie ne doit pas se confiner à une lecture mathématique désincarnée ; elle doit s’articuler étroitement avec la réalité psychométrique du construit évalué. Sur le plan purement statistique standard, les lignes directrices préconisées par Bulmer suggèrent la grille de lecture conventionnelle suivante :
- Si le coefficient d’asymétrie est compris entre -0,5 et +0,5, la distribution est jugée approximativement symétrique.
- Si l’asymétrie est comprise entre -1,0 et -0,5 (asymétrie négative modérée) ou entre +0,5 et +1,0 (asymétrie positive modérée), la distribution s’écarte notablement de la symétrie gaussienne sans pour autant compromettre irrémédiablement l’usage de certains tests paramétriques robustes.
- Si la valeur excède +1,0 ou plonge sous -1,0, la déformation distributionnelle est considérée comme hautement prononcée, exigeant une révision méthodologique immédiate.
Dans notre échantillon illustratif, le coefficient d’asymétrie mesuré s’établit à S = 0,534, ce qui classe nos scores d’anxiété STAI à la lisière immédiate d’une asymétrie positive modérée. En psychologie clinique, une asymétrie positive substantielle traduit fréquemment la présence d’un effet plancher (« floor effect »). Lors de l’administration d’échelles de dépression (comme l’inventaire BDI de Beck) ou de symptomatologie traumatique au sein d’une cohorte issue de la population générale saine, la vaste majorité des participants coche les scores minimaux d’absence de détresse psychologique, étirant la distribution vers la droite par le truchement d’une minorité souffrant de pathologie active.
À l’opposé, une asymétrie négative marquée (S < -0,5) reflète couramment un effet plafond (« ceiling effect »). Ce phénomène se manifeste fréquemment lors de l’administration d’épreuves de fluidité verbale élémentaire, de mémorisation de travail simple ou de tâches de discernement perceptif chez des étudiants universitaires hautement performants. Les participants accumulent le score maximal autorisé par l’outil, condensant la masse des observations sur les valeurs sommitales et étirant artificiellement la queue vers les faibles scores.
7. Étape 3 : Estimation de l’aplatissement (Kurtosis) sous Excel
7.1 Utilisation de la fonction COEFFICIENT.APLATISSEMENT
La caractérisation géométrique complète de la distribution requiert l’examen simultané du quatrième moment centré, qui appréhende la concentration centrale et la lourdeur des queues distributionnelles. Dans l’écosystème de Microsoft Excel, l’estimation de l’aplatissement repose sur une instruction dédiée dont la manipulation requiert une précaution d’interprétation méthodologique fondamentale.
Au sein de votre zone de synthèse, intitulez la cellule D9 avec la dénomination formelle Excès d'Aplatissement (Kurtosis C), puis introduisez dans la cellule de calcul E9 la formule suivante :
=COEFFICIENT.APLATISSEMENT(A2:A16)
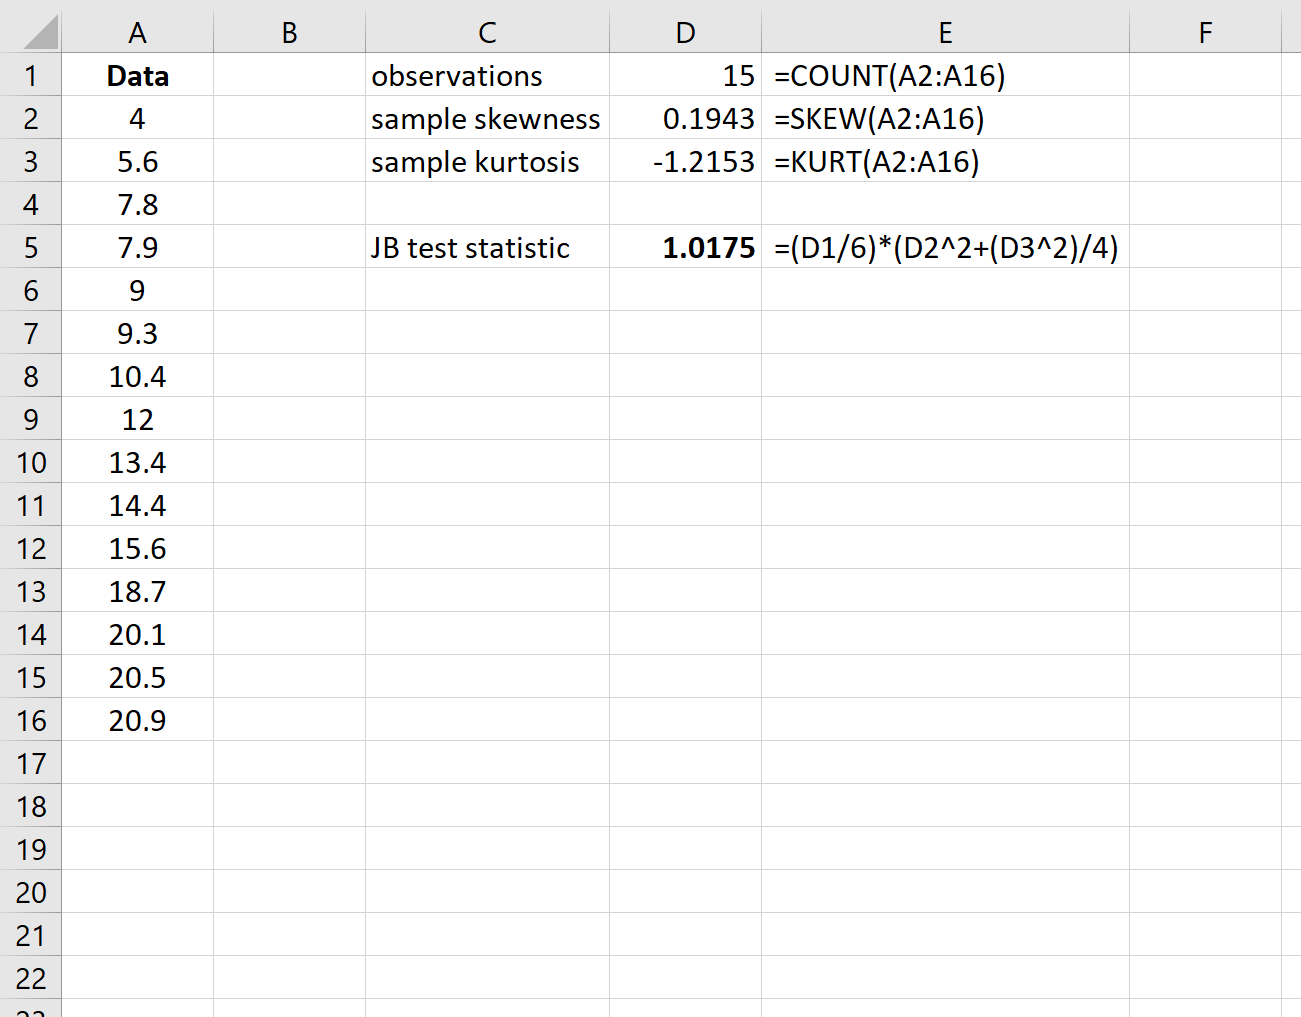
Le point névralgique à assimiler réside dans le fait qu’Excel ne restitue pas le coefficient de kurtosis brut (qui vaut 3 pour la distribution normale), mais délivre d’office l’excès de kurtosis non biaisé d’échantillon (identifié par la notation C ou K – 3). Le moteur algorithmique applique une soustraction automatique de la constante 3 à l’issue d’une double correction d’échantillonnage complexe. Cette standardisation opérationnelle constitue un avantage majeur pour le calcul de la statistique de Jarque-Bera : le chiffre affiché dans la cellule E9 représente déjà l’écart quadratique direct à intégrer dans la formule finale, sans qu’il soit requis de procéder manuellement au retranchement de la valeur 3.
L’application de la fonction =COEFFICIENT.APLATISSEMENT(A2:A16) sur notre série d’anxiété STAI génère une valeur numérique d’environ 0,381.
7.2 Décomposition manuelle du quatrième moment centré
Tout comme pour le troisième moment, la décomposition manuelle du quatrième moment centré dans Excel permet d’appréhender la mécanique computationnelle sous-jacente et de saisir comment chaque sujet expérimental contribue à la morphologie de la distribution.
Pour exécuter cette vérification didactique pas à pas, implémentez une nouvelle colonne de traitement dans votre feuille de calcul. Dans l’en-tête de la colonne D (cellule D1, ou dans une colonne adjacente libre), inscrivez l’intitulé z_puissance_4 (z^4). Dans la cellule sous-jacente, faites référence au score standardisé de la colonne B élevé à la puissance quatre :
=B2^4
Recopiez la formule vers le bas jusqu’à la cellule finale de la cohorte. Procédez à la sommation de cette série dans une cellule d’agrégation via l’opérateur =SOMME(...).
L’estimateur non biaisé de l’excès d’aplatissement déployé par les concepteurs de logiciels statistiques obéit à la formulation de Fisher et Cramér :
C = [ (n(n + 1)) / ((n – 1)(n – 2)(n – 3)) ] * ∑ [ (x_i – x̄) / s ]⁴ – [ (3(n – 1)²) / ((n – 2)(n – 3)) ]
En introduisant notre effectif n = 15 dans les deux facteurs correcteurs complexes de cette équation matricielle, le calcul manuel converge exactement vers la valeur de 0,381 extraite directement par la formule COEFFICIENT.APLATISSEMENT. Cette concordance confirme que les scores extrêmes subissent une pondération exponentielle (puissance 4), ce qui démontre pourquoi la présence d’une seule donnée aberrante isolée est susceptible de déstabiliser profondément l’estimation de l’aplatissement au sein d’un échantillon restreint.
7.3 Interprétation clinique et psychométrique de l’aplatissement
L’excès de kurtosis constitue un indicateur diagnostique sensible pour les chercheurs en psychologie, car il caractérise la propension d’un test psychométrique à générer des événements distaux rares par rapport à ce que prophétise le modèle de Gauss. Trois configurations structurales guident le raisonnement évaluatif :
- Le profil mésocurtique (C ≈ 0) : Les queues de distribution déclinent selon le taux exponentiel prévu par la loi normale. L’occurrence des scores hautement déviants correspond aux probabilités classiques de la métrologie standard.
- Le profil leptocurtique (C > 0) : La distribution exhibe une forme élancée avec des queues lourdes (« heavy tails »). Dans un inventaire clinique de personnalité, un kurtosis fortement positif signale qu’un nombre inhabituel de patients manifestent des scores ultra-extrêmes situés à trois ou quatre écarts-types de la moyenne, alors même que le corps central des participants est extrêmement compacté autour du mode. Cette configuration traduit une polarisation clinique aiguë.
- Le profil platicurtique (C < 0) : La courbe présente une silhouette évasée et aplatie. En psychométrie de l’éducation ou en sélection professionnelle, ce schéma dénote souvent une faible capacité discriminative des items au centre de l’échelle, les scores des individus se dispersant de manière quasi-uniforme sur l’ensemble du continuum sans créer de pic de normalité structurant.
Dans notre groupe expérimental de scores d’anxiété STAI, l’excès de kurtosis calculé s’élève à C = 0,381. Cette grandeur positive très modérée classe notre distribution dans la catégorie des structures légèrement leptocurtiques. La légère élévation de ce coefficient provient de la présence du sujet numéro 15 (score de 65, situé à plus de deux écarts-types de la moyenne arithmétique), qui alourdit modestement l’extrémité supérieure de la série sans pour autant provoquer d’anomalie morphologique invalidante.
8. Étape 4 : Calcul de la statistique de test de Jarque-Bera dans Excel
8.1 Assemblage des composantes dans la formule finale
Ayant désormais extrait avec rigueur la totalité des paramètres constitutifs fondamentaux au sein de notre tableau de bord synthétique, nous pouvons procéder à l’assemblage computationnel de la statistique de Jarque-Bera. L’architecture de notre zone de restitution statistique se présente comme suit :
- Cellule
E2: Taille de l’échantillon (n = 15) - Cellule
E8: Coefficient d’asymétrie empirique non biaisé (S ≈ 0,534) - Cellule
E9: Excès d’aplatissement non biaisé (C ≈ 0,381)
Sélectionnez une nouvelle cellule pour consigner le label méthodologique, par exemple en D10, et inscrivez l’étiquette Statistique de Jarque-Bera (JB). Positionnez-vous ensuite dans la cellule opérationnelle E10 pour programmer la formule globale unifiée :
=(E2/6)*(E8^2 + (E9^2)/4)
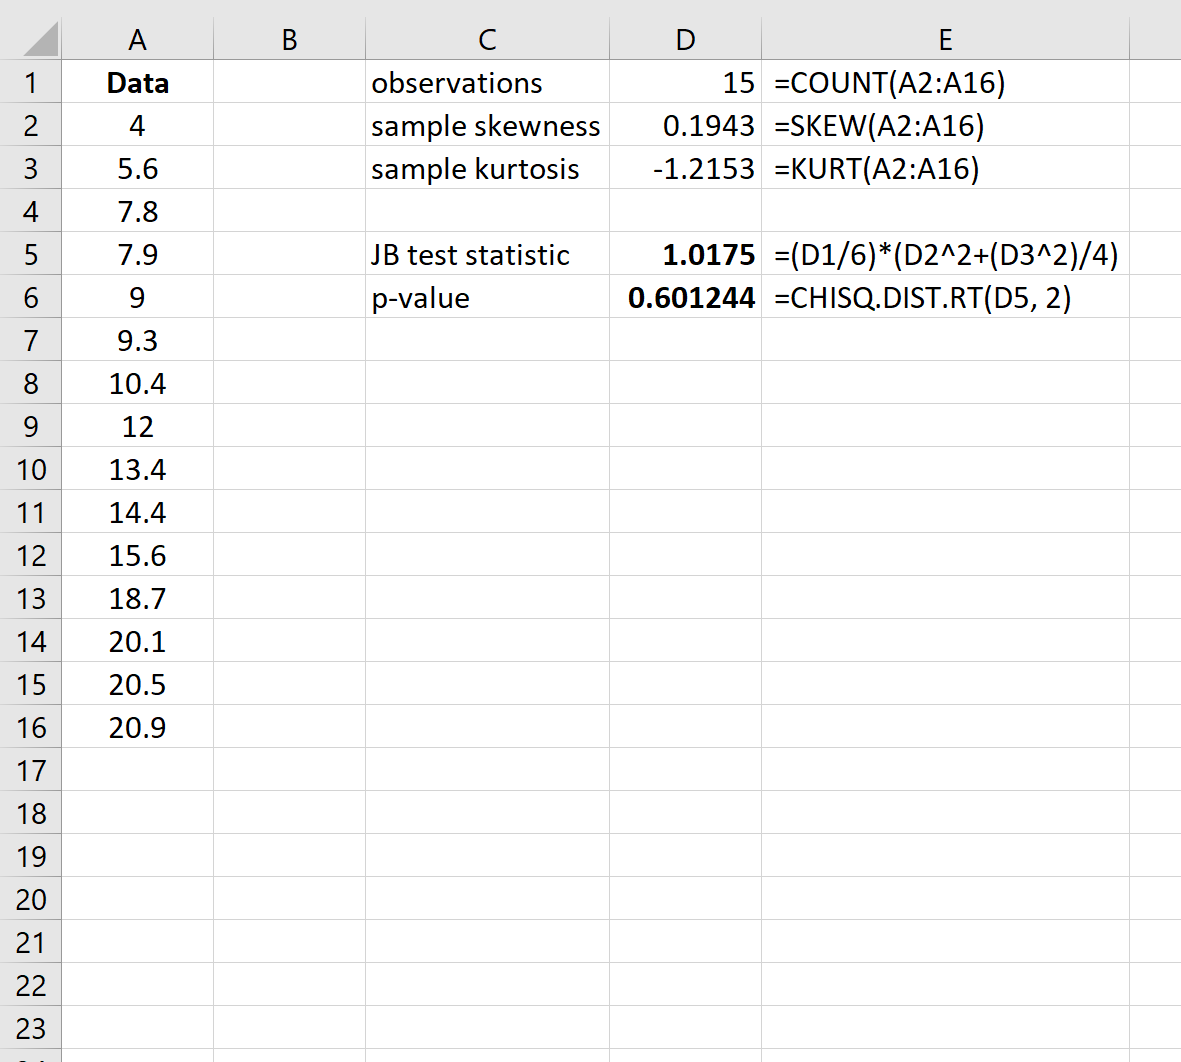
Une vigilance syntaxique absolue s’impose quant à l’agencement des parenthèses et au respect des priorités arithmétiques du moteur de calcul d’Excel. L’expression (E9^2)/4 doit être impérativement isolée pour que seul l’excès d’aplatissement élevé au carré soit divisé par 4, avant d’être sommé au carré de l’asymétrie E8^2. La sommation binomiale résultante est ensuite multipliée par le facteur scalaire (E2/6). Toute omission de parenthèse sur le premier membre (E2/6) induirait une fausse distribution séquentielle des termes et générerait une statistique de test erronée.
8.2 Analyse de la contribution relative de l’asymétrie et de l’aplatissement
L’un des avantages heuristiques majeurs de l’implémentation de la statistique de Jarque-Bera sous Excel réside dans la possibilité de partitionner immédiatement la valeur globale observée afin d’identifier la source prédominante de non-normalité au sein des données psychologiques.
Observons la décomposition numérique concrète sur nos mesures expérimentales d’anxiété STAI :
- Élévation au carré du coefficient d’asymétrie : S² = (0,534)² ≈ 0,2852. Multiplié par (n / 6) = 15 / 6 = 2,5, la contribution isolée de l’asymétrie à la statistique de test s’élève à 0,713.
- Élévation au carré de l’excès de kurtosis divisée par 4 : (C² / 4) = (0,381)² / 4 ≈ 0,1452 / 4 ≈ 0,0363. Multiplié par le même facteur scalaire de 2,5, la contribution spécifique de l’aplatissement s’établit à seulement 0,091.
- Sommation des deux composantes vectorielles : JB = 0,713 + 0,091 ≈ 0,804.
Cette décomposition analytique révèle avec netteté que la déviation de notre échantillon par rapport au modèle théorique de la loi normale est imputable à près de 89 % à l’asymétrie de distribution (l’étirement vers les scores d’anxiété élevés), tandis que l’excès d’aplatissement ne participe qu’à hauteur de 11 % à la constitution de la statistique de test. Dans un compte rendu de laboratoire, cette finesse de diagnostic permet au chercheur d’attester que ses données ne souffrent pas d’une prolifération de cas aberrants en queue de distribution (kurtosis préservé), mais simplement d’un étalement unilatéral prévisible dans l’évaluation d’une réaction émotionnelle de stress aigu.
8.3 Validation de l’exactitude des calculs et détection d’erreurs
Avant d’engager la prise de décision inférentielle, tout protocole quantitatif exige une procédure d’audit et de contrôle de cohérence algorithmique. Microsoft Excel intègre dans son ruban un jeu d’outils d’audit particulièrement efficace, accessible via l’onglet Formules, dans la section Audit de formules.
Sélectionnez la cellule E10 (contenant la statistique JB) et actionnez la commande Repérer les antécédents. Excel déploie instantanément des flèches graphiques bleues pointant précisément vers les cellules sources E2, E8 et E9. Vérifiez minutieusement qu’aucune référence décalée n’a été accidentellement sélectionnée (par exemple pointer vers l’écart-type au lieu de l’asymétrie). Répétez l’opération sur les cellules E8 et E9 pour confirmer que leurs antécédents respectifs embrassent l’intégralité de la plage brute A2:A16.
Une méthode de contrôle croisé infaillible consiste à tester le comportement de la feuille de calcul face à des jeux de données de calibration théorique parfaitement maîtrisés :
- Test de symétrie théorique : Si vous remplacez temporairement vos scores dans la colonne A par une série numérique parfaitement symétrique et uniformément espacée (ex. : 10, 20, 30, 40, 50, 60, 70), la cellule d’asymétrie
E8doit obligatoirement basculer à la valeur stricte de 0,000. - Simulation d’une valeur extrême artificielle : Si vous introduisez un score extrême fictif de 250 dans la cellule
A16, vous devez constater une envolée fulgurante et simultanée du kurtosisE9et de la statistique globaleE10, attestant de l’extrême réactivité du modèle aux valeurs aberrantes.
Une fois ces contrôles d’intégrité opérés, rétablissez les données expérimentales initiales du STAI pour procéder à la décision statistique.
9. Étape 5 : Détermination de la p-valeur et décision statistique
9.1 Calcul probabiliste via la loi du Chi-deux unilatérale
L’obtention d’une statistique de test empirique (ici JB ≈ 0,804) ne constitue que la première phase de l’inférence ; il s’avère indispensable d’associer à cette grandeur une métrique probabiliste universelle : la p-valeur (ou degré de significativité statistique). La p-valeur représente la probabilité exacte d’observer, sous l’hypothèse nulle d’une population purement normale, une valeur de la statistique JB au moins aussi extrême que celle mesurée dans notre échantillon expérimental.
Conformément aux fondements théoriques développés à la section 3.3, la statistique de Jarque-Bera converge asymptotiquement vers une loi du Chi-deux à deux degrés de liberté. Pour calculer cette probabilité résiduelle unilatérale droite dans les versions actuelles de Microsoft Excel (éditions 2010 à Microsoft 365), nous sollicitons la fonction statistique standardisée LOI.KHIDEUX.DROITE.
Inscrivez dans la cellule D11 l’intitulé formel p-valeur du test (p), puis saisissez dans la cellule d’évaluation E11 l’instruction suivante :
=LOI.KHIDEUX.DROITE(E10; 2)
Dans cette syntaxe, le premier argument E10 fait référence à la cellule logeant la statistique JB observée (0,804), tandis que le second paramètre impose de façon intangible la valeur scalaire 2, correspondant aux 2 degrés de liberté de la modélisation (asymétrie et aplatissement). Pour les chercheurs opérant sur des versions patrimoniales antérieures du tableur, l’instruction équivalente s’exécute via la commande =LOI.KHIDEUX(E10; 2). L’évaluation de cette fonction probabiliste sur nos données expérimentales délivre une p-valeur d’environ 0,669 (soit 66,9 %).
9.2 Calcul de la valeur critique théorique sous Excel
Une approche décisionnelle complémentaire, héritée de l’école statistique néo-classique de Neyman et Pearson, consiste à confronter directement la statistique observée à un seuil d’exclusion géométrique immuable : la valeur critique théorique. Cette méthode permet de tracer une ligne de démarcation binaire nette entre la zone de rétention et la zone de rejet de l’hypothèse de normalité.
Pour déterminer sous Excel la valeur critique de Jarque-Bera associée au seuil de significativité conventionnel en psychologie (α = 0,05), inscrivez en D12 l’intitulé Valeur critique théorique (alpha = 0,05), et programmez dans la cellule E12 la fonction quantile inverse :
=LOI.KHIDEUX.INVERSE.DROITE(0,05; 2)
Le moteur d’Excel renvoie instantanément la constante théorique canonique :
JB_critique ≈ 5,991
Si l’analyste décide d’adopter un niveau de rigueur supérieur en abaissant le risque d’erreur de première espèce au seuil de α = 0,01, la formule adaptée =LOI.KHIDEUX.INVERSE.DROITE(0,01; 2) renverra un seuil critique plus conservateur d’environ 9,210.
La règle décisionnelle formelle se décline ainsi sous une double conditionnalité équivalente :
- Si JB_observé ≤ JB_critique (et corrélativement si p > 0,05) : Absence de rejet de l’hypothèse nulle (H0). La distribution des données est statistiquement compatible avec une loi normale.
- Si JB_observé > JB_critique (et corrélativement si p ≤ 0,05) : Rejet catégorique de l’hypothèse nulle en faveur de l’hypothèse alternative (HA). La distribution empirique présente une non-normalité statistiquement significative.
9.3 Formulation formelle de la conclusion inférentielle
Dans notre protocole clinique portant sur l’anxiété STAI, l’analyse comparative des grandeurs métriques met en évidence une statistique de Jarque-Bera calculée égale à 0,804, valeur largement inférieure au seuil critique théorique de 5,991. De surcroît, la p-valeur associée s’établit à p = 0,669, excédant très largement le seuil alpha nominal de 0,05.
D’un point de vue inférentiel, nous échouons à rejeter l’hypothèse nulle (H0). Les fluctuations géométriques d’asymétrie et de kurtosis répertoriées au sein de notre échantillon relèvent exclusivement de l’aléa d’échantillonnage et ne dénotent aucune distorsion pathologique de la loi normale au niveau de la population parente. Le chercheur est dès lors pleinement autorisé à maintenir le postulat de normalité pour cette variable dépendante.
La rédaction de cette conclusion statistique au sein d’un article scientifique destiné à une revue indexée à comité de lecture (respectant scrupuleusement les standards éditoriaux de l’American Psychological Association – APA 7e édition) doit obéir à un formalisme académique rigoureux :
« L’examen de la distribution des scores d’anxiété cognitive état (STAI-Y) révèle une asymétrie modérée (S = 0,534) et un excès d’aplatissement discret (C = 0,381). Le test omnibus de normalité de Jarque-Bera ne met en évidence aucune violation statistiquement significative du postulat de distribution normale, JB = 0,80, p = 0,67. Par conséquent, l’utilisation de méthodes statistiques inférentielles paramétriques fondées sur le modèle linéaire général est pleinement justifiée. »
10. Approches graphiques complémentaires de la normalité dans Excel
10.1 Construction d’un histogramme avec superposition de la courbe normale
Un test statistique formel ne doit jamais être conduit dans une cécité visuelle totale. L’inspection graphique directe constitue un complément épistémologique indispensable à la détection de particularités locales indétectables par les statistiques de moments agrégées. La méthode visuelle canonique sous Excel consiste à édifier un histogramme de fréquences réelles surmonté du profil continu d’une courbe normale théorique calibrée sur les paramètres de l’échantillon.
Pour construire cette représentation sous Excel sans recourir à des macros complexes, procédez selon les étapes séquentielles suivantes :
- Définition des classes de scores (Bins) : Déterminez l’étendue des données (dans notre série : de 34 à 65 points). Créez une série de bornes de classes équidistantes dans une colonne libre (ex. : colonne G, cellules
G2:G8), en inscrivant des intervalles de 5 points : 35, 40, 45, 50, 55, 60, 65. - Calcul des fréquences empiriques : Dans la colonne contiguë H, sélectionnez la plage
H2:H8, et utilisez la fonction matricielle=FREQUENCE(A2:A16; G2:G8)en validant par la combinaison de touches Ctrl + Maj + Entrée (sur les versions modernes de Microsoft 365, une validation simple par Entrée propage automatiquement le tableau dynamique). - Génération des ordonnées théoriques de Gauss : Dans la colonne I, calculez la densité de probabilité normale théorique pour chaque borne de classe en mobilisant la fonction :
=LOI.NORMALE.N(G2; $E$3; $E$4; FAUX)
Puisque cette fonction délivre une densité de probabilité unitaire continue infinitésimale, multipliez ce terme par la taille totale de l’échantillon (n = 15) et par la largeur d’intervalle de classe (largeur = 5) pour exprimer cette valeur sur la même échelle métrique que les fréquences absolues observées :
=LOI.NORMALE.N(G2; $E$3; $E$4; FAUX) * $E$2 * 5 - Génération du graphique combiné : Sélectionnez l’ensemble des colonnes G, H et I. Rendez-vous dans l’onglet Insertion, choisissez Graphiques recommandés, puis optez pour un Graphique combiné. Paramétrez la série des fréquences réelles sous forme d’Histogramme groupé (colonnes verticales) et affectez à la série théorique de Gauss un tracé en Courbe adoucie sans points de marquage.
L’analyse visuelle directe de ce graphique permet de constater la concordance globale entre le tracé théorique en cloche et l’étagement des rectangles empiriques, consolidant visuellement le verdict d’absence de rejet délivré par le test de Jarque-Bera.
10.2 Conception pas à pas d’un diagramme Quantile-Quantile (Q-Q Plot)
Le diagramme Quantile-Quantile (Q-Q Plot) représente la méthode graphique reine adoptée par les biométriciens et psychométriciens chevronnés pour diagnostiquer la normalité d’une distribution. Il confronte sur un plan cartésien orthogonal les quantiles empiriques réels observés au sein de l’échantillon expérimental aux quantiles théoriques précis qu’aurait dû produire une distribution normale idéale dotée de la même moyenne et de la même dispersion.
La construction manuelle d’un tracé Q-Q sous Excel constitue un exercice d’une grande valeur didactique :
- Classement séquentiel croissant : Les données brutes doivent être ordonnées de la plus faible à la plus élevée. Copiez la plage
A2:A16dans une nouvelle colonne (ex. colonne K, cellulesK2:K16), appliquez la commande Trier du plus petit au plus grand, ou mobilisez la formule dynamique contemporaine=TRIER(A2:A16). Ces scores constituent l’axe vertical des ordonnées (Quantiles observés). - Attribution des rangs empiriques (i) : Dans la colonne L adjacente (cellules
L2:L16), saisissez la suite ordinale des entiers naturels de 1 à 15, représentant l’indice séquentiel de chaque participant. - Estimation des probabilités cumulées empiriques (p_i) : Il existe plusieurs formulations théoriques de positionnement de tracé (« plotting positions »). La formule de Blom, largement plébiscitée dans les algorithmes de SPSS et de R pour son absence de biais sur les quantiles normaux, est définie par :
p_i = (i – 0,375) / (n + 0,25)
Dans la celluleM2, programmez cette estimation de probabilité :
=(L2 - 0,375) / ($E$2 + 0,25)
Étendez la formule jusqu’enM16. (La formule simplifiée de Hazen=(L2 - 0,5)/$E$2constitue une alternative tout à fait acceptable). - Conversion en quantiles théoriques normaux standardisés (z_théoriques) : Dans la colonne N (cellules
N2:N16), convertissez ces probabilités cumulatives en écarts réduits gaussiens en recourant à la fonction de répartition inverse de la loi normale standard :
=LOI.NORMALE.STANDARD.INVERSE(M2)
Cette colonne constitue l’axe horizontal des abscisses. - Traçage du nuage de points et de la droite de référence : Sélectionnez la colonne N (abscisses) puis, en maintenant la touche Ctrl enfoncée, sélectionnez la colonne K (ordonnées des scores ordonnés). Rendez-vous dans l’onglet Insertion et générez un graphique de type Nuage de points (XY). Ajoutez sur le graphique une Courbe de tendance linéaire.
La lecture du tracé Q-Q repose sur un principe d’alignement géométrique direct : si l’échantillon provient fidèlement d’une population gaussienne normale, la totalité des points expérimentaux doit s’agencer de manière rectiligne le long de la droite de référence diagonale. Toute déviation en « S » dénote une distorsion de kurtosis (épaississement ou amincissement des queues), tandis qu’une courbure parabolique concave ou convexe signale une asymétrie unilatérale marquée.
10.3 Complémentarité entre inférence formelle et inspection visuelle
L’analyste de données quantitatives ne doit jamais commettre l’erreur épistémologique de dissocier les tests d’adéquation formels de l’inspection sémiologique des représentations visuelles. Ces deux méthodologies s’éclairent mutuellement et préviennent les écueils inhérents à chaque approche prise isolément.
D’une part, les tests d’hypothèse formels comme celui de Jarque-Bera présentent une dépendance mécanique vis-à-vis de la taille de l’échantillon n. Face à des cohortes expérimentales massives comprenant plusieurs milliers de sujets, la sensibilité mathématique des tests devient tellement aigüe qu’une déviation infime, psychométriquement négligeable et totalement anodine pour la validité d’une régression linéaire déclenchera une p-valeur hautement significative (p < 0,001), incitant à tort le chercheur à rejeter le modèle normal. Dans cette situation, l’inspection d’un Q-Q Plot rectiligne permet d’attester de la normalité pratique des données et de neutraliser l’alarmisme injustifié du test statistique.
D’autre part, sur de petits échantillons cliniques (tels que notre groupe de 15 sujets), un test statistique omnibus souffre d’une puissance limitée et peut échouer à rejeter H0 en raison de marges d’erreur larges. L’examen minutieux de l’histogramme et du tracé Q-Q permet alors d’identifier des anomalies locales fondamentales — telles qu’une bimodalité naissante suggérant la présence de deux sous-populations cliniques distinctes au sein du groupe — qu’une statistique globale non significative aurait totalement occultées. La triangulation analytique croisant test de Jarque-Bera, histogramme superposé et diagramme Quantile-Quantile constitue le standard de rigueur méthodologique le plus abouti en sciences humaines.
11. Conduite à tenir face à la violation de la normalité dans les études psychologiques
11.1 Transformations mathématiques correctives de la variable dépendante
Lorsqu’un test de normalité conclut à un rejet catégorique de l’hypothèse nulle (p ≤ 0,05) et que les représentations graphiques corroborent une distorsion morphologique substantielle, l’analyste ne se trouve nullement dans une impasse computationnelle. La première stratégie de remédiation consiste à appliquer des transformations mathématiques fonctionnelles non linéaires à la variable dépendante brute, afin de contraindre sa distribution à épouser la symétrie et l’aplatissement de la courbe de Gauss.
Le choix de la fonction corrective dépend directement de la géométrie de la distorsion diagnostiquée :
- La transformation logarithmique : Particulièrement souveraine pour juguler l’asymétrie positive prononcée (étalement à droite) et réduire l’hétéroscédasticité des variances résiduelles. Elle comprime drastiquement les scores élevés tout en étirant les scores faibles. Sous Excel, elle s’implémente via la formule
=LN(x)(logarithme népérien) ou=LOG10(x)(logarithme décimal). Si la variable comporte des scores nuls, l’analyste adoptera la transformation de Poisson modifiée=LN(x + 1). En chronométrie cognitive, les temps de réaction sont quasi-universellement soumis à une transformation logarithmique préalable avant injection dans des modèles ANOVA. - La transformation racine carrée : Préconisée face à des distributions discrètes de comptage présentant une asymétrie positive modérée (ex. : nombre d’erreurs commises lors d’une tâche d’inhibition de Stroop). Elle s’exécute sous Excel par la fonction native
=RACINE(x). - La transformation inverse : Très agressive pour compresser des queues de distribution extrêmement étalées à droite, programmée via l’expression
=1/x(ou=1/(x + 1)). Attention toutefois : cette transformation inverse l’ordre hiérarchique des scores et nécessite une réinversion algébrique pour maintenir le sens conceptuel des variables psychologiques. - La transformation puissance de Box-Cox : Procédure paramétrique paramétrée par un exposant optimal lambda (λ) qui subsume l’ensemble des transformations précédentes au sein d’une famille continue unifiée.
Toutefois, une réserve méthodologique majeure doit être formulée quant à l’usage systématique des transformations de données en psychologie : elles altèrent l’interprétabilité métrique originale des échelles. Exprimer un niveau d’anxiété en « logarithme de points STAI » complique l’appréhension clinique des tailles d’effet et prive les praticiens d’une lecture intuitive des scores de leurs patients.
11.2 Bascule vers les méthodes non paramétriques
Lorsque la déformation distributionnelle résiste aux tentatives de normalisation mathématique, ou lorsque la taille restreinte de l’échantillon clinique rend risquée toute extrapolation paramétrique, la bascule vers les méthodes statistiques non paramétriques (dites « sans distribution ») s’impose comme une nécessité méthodologique. Ces techniques s’émancipent intégralement de l’exigence de normalité des populations sous-jacentes.
Le tableau d’équivalence classique répertorie les alternatives non paramétriques majeures aux protocoles paramétriques standard :
- En lieu et place du test t de Student pour échantillons indépendants, l’analyste déploiera le test U de Mann-Whitney (ou test de la somme des rangs de Wilcoxon).
- En alternative au test t de Student pour mesures répétées (échantillons appariés), la solution réside dans le test des rangs signés de Wilcoxon.
- Face à une ANOVA à un facteur inter-sujets transgressant les postulats gaussiens, la procédure d’arbitrage est le test de Kruskal-Wallis par analyse de variance sur les rangs.
- En remplacement de l’ANOVA à mesures répétées, le chercheur mobilisera le test de Friedman.
- Pour évaluer l’interdépendance de deux métriques, le coefficient de corrélation des rangs de Spearman (rho) ou le tau de Kendall supplanteront le coefficient de corrélation linéaire de Pearson.
Le principe computationnel cardinal des méthodes non paramétriques consiste à substituer aux scores métriques bruts leurs rangs ordinaux séquentiels au sein de l’échantillon combiné. Bien que ces méthodes protègent impeccablement le chercheur contre les hausses indues de l’erreur de type I, elles s’accompagnent d’une légère déperdition de puissance statistique relative (souvent estimée à environ 95 % de l’efficacité asymptotique paramétrique lorsque la normalité est satisfaite) et limitent l’exploration des termes d’interaction factorielle complexes au sein des designs expérimentaux factoriels élaborés.
11.3 Approches statistiques robustes et rééchantillonnage
L’essor de la puissance informatique contemporaine a favorisé l’émergence d’une troisième voie méthodologique d’une remarquable élégance : la statistique computationnelle robuste et les méthodes de rééchantillonnage. Préconisées avec insistance par la commission statistique de l’American Psychological Association (APA Task Force on Statistical Inference), ces approches contournent l’hypothèse de normalité sans subir l’atrophie métrique inhérente à la conversion en rangs non paramétriques.
La méthodologie reine en ce domaine est le bootstrapping (ou rééchantillonnage avec remise). Le principe fondamental consiste à considérer l’échantillon empirique initial comme une pseudo-population représentative, au sein de laquelle l’algorithme extrait par itérations successives des milliers de sous-échantillons de taille n avec remise aléatoire des observations. À partir des milliers d’estimations obtenues (par exemple, 5 000 moyennes ou différences de moyennes recalculées), l’ordinateur construit une distribution empirique d’échantillonnage du paramètre d’intérêt. Les intervalles de confiance à 95 % sont ensuite dérivés directement par la méthode des percentiles ou par la méthode BCa (Bias-Corrected and Accelerated), sans jamais présumer que la variable suit une loi normale.
Parallèlement, les estimateurs robustes de tendance centrale et de dispersion, tels que les moyennes tronquées (« trimmed means ») de Yuen ou les M-estimateurs de Huber, offrent des alternatives performantes face aux distributions à queues lourdes. En éliminant symétriquement une fraction contrôlée des extrêmes distaux (couramment 10 % ou 20 % dans chaque queue), ces estimateurs stabilisent la variance sans biaiser le pointage central des populations, offrant une résistance algorithmique maximale à la présence de valeurs aberrantes.
12. Synthèse méthodologique, limites d’Excel et perspectives
12.1 Limites inhérentes au test de Jarque-Bera pour la recherche
Bien que le test de Jarque-Bera présente des atouts exceptionnels en termes de clarté computationnelle et d’adaptabilité pédagogique sous tableur, l’honnêteté épistémologique commande de cerner avec lucidité ses limites intrinsèques dans la recherche biométrique et psychologique contemporaine.
La faiblesse structurelle majeure du test de Jarque-Bera réside dans sa nature asymptotique. L’hypothèse de convergence vers la loi du Chi-deux à deux degrés de liberté n’est rigoureusement exacte que pour de grands volumes d’échantillonnage. Lorsque la taille du groupe expérimental chute sous le seuil de n < 20 (configuration fréquente lors de protocoles cliniques lourds d’imagerie cérébrale fonctionnelle ou d’études de cas neuropsychologiques rares), la statistique JB perd en puissance statistique, ce qui augmente le risque d’erreur de deuxième espèce (non-rejet d’une non-normalité pourtant effective).
Dans ce contexte précis, les tests d’adéquation concurrents s’avèrent structurellement supérieurs :
- Le test de Shapiro-Wilk (W) : Universellement reconnu dans la littérature biostatistique comme le test de normalité le plus puissant pour les petits et moyens échantillons (jusqu’à n = 50). Il analyse le rapport linéaire entre les quantiles ordonnés des observations et les coefficients de covariance théoriques issus d’une loi normale. Son implémentation sous Excel nécessite toutefois des tables matricielles de coefficients de pondération très lourdes, difficilement paramétrables en formules standards directes.
- Le test de Kolmogorov-Smirnov corrigé par Lilliefors : Fondé sur la divergence maximale absolue entre la fonction de répartition empirique cumulative et la fonction de répartition théorique gaussienne estimée. Bien que moins sensible aux anomalies de queues de distribution que le test de Jarque-Bera, il s’avère plus robuste face à des distributions discrétisées.
De surcroît, le test de Jarque-Bera manifeste une vulnérabilité extrême aux données aberrantes uniques. En élevant les écarts centrés aux puissances 3 et 4, un seul score hautement erratique introduit accidentellement dans un échantillon de taille modérée peut démultiplier artificiellement la statistique globale et forcer le rejet de la normalité, alors même que l’ensemble du corpus sous-jacent est parfaitement régulier.
12.2 Bonnes pratiques de documentation et traçabilité sous Excel
Pour hisser l’environnement Microsoft Excel au niveau de rigueur, de traçabilité et d’auditabilité exigé par le paradigme de la Science Ouverte (« Open Science Framework »), les analystes de données expérimentales doivent adopter des normes professionnelles strictes de conception logicielle.
La première règle d’or consiste à instaurer un verrouillage structurel des formules. Une fois la chaîne de calcul opérationnelle (effectif, moyenne, écart-type, asymétrie, kurtosis, JB et p-valeur), sélectionnez l’ensemble des cellules de formules, accédez au menu Format de cellule, cochez la propriété Verrouillée, puis activez la Protection de la feuille via l’onglet Révision en interdisant la modification de ces cellules stratégiques. Seule la plage dédiée aux données brutes (ex. : A2:A100) doit demeurer accessible à la saisie. Cette précaution prévient toute altération accidentelle d’un opérateur arithmétique ou d’une référence absolue lors du traitement de nouvelles cohortes.
La seconde exigence repose sur l’explicitation documentaire exhaustive des métadonnées. Chaque colonne doit comporter des commentaires structurés décrivant la métrique mobilisée, l’unité de mesure, les valeurs bornées théoriques de l’échelle psychométrique, ainsi que la date et l’opérateur ayant administré le protocole. La création d’un onglet distinct faisant office de dictionnaire de variables constitue un gage de transparence absolue pour la reproductibilité internationale des résultats.
Enfin, l’élaboration d’un modèle standardisé dynamique (.xltx) réutilisable s’impose comme une stratégie d’optimisation majeure pour tout laboratoire de psychologie. En calibrant une matrice d’accueil pré-programmée capable d’ajuster automatiquement les bornes d’analyse via des fonctions de plages dynamiques (comme DECALER ou CHOISIRCOLS), les équipes de recherche disposent d’un outil de screening distributionnel immédiat, standardisé et hautement sécurisé pour l’ensemble de leurs protocoles cliniques ultérieurs.
12.3 Arbre décisionnel récapitulatif pour l’analyste en psychologie
Pour clore ce traité méthodologique et guider pas à pas le psychologue, le clinicien ou l’étudiant-chercheur dans ses arbitrages d’analyse quantitative, nous synthétisons l’ensemble des règles opérationnelles sous la forme d’un protocole décisionnel séquentiel clair :
- Phase 1 : Collecte et assainissement des mesures brutes
- Vérification de l’indépendance statistique des observations expérimentales.
- Nettoyage des erreurs d’encodage et typographiques ; typage strict des cellules au format numérique sous Excel.
- Diagnostic de la métrique : s’agit-il d’une variable quantitative continue ou d’une échelle ordinale discrète à faible nombre d’échelons ?
- Phase 2 : Analyse exploratoire descriptive et visuelle
- Calcul conjoint de la moyenne et de la médiane sous Excel : divergence suspecte signalant une asymétrie ?
- Génération de l’histogramme de fréquences avec projection de la courbe continue de Gauss.
- Conception du tracé Quantile-Quantile (Q-Q Plot) : concordance rectiligne des points le long de la droite de référence à 45 degrés ?
- Phase 3 : Exécution du test formel de Jarque-Bera
- Calcul du coefficient d’asymétrie non biaisé
Svia=COEFFICIENT.ASYMETRIE(). - Calcul de l’excès de kurtosis non biaisé
Cvia=COEFFICIENT.APLATISSEMENT(). - Calcul de la statistique
JB = (n/6) * (S² + C²/4). - Extraction de la p-valeur unilatérale droite via
=LOI.KHIDEUX.DROITE(JB; 2).
- Calcul du coefficient d’asymétrie non biaisé
- Phase 4 : Arbitrage et choix du modèle inférentiel
- Scénario A : p > 0,05 ET le Q-Q Plot est rectiligne. Maintien de l’hypothèse de normalité. Vous êtes pleinement autorisé à déployer les tests paramétriques classiques du modèle linéaire général (test t de Student, ANOVA, régressions linéaires par moindres carrés).
- Scénario B : p ≤ 0,05 OU le Q-Q Plot montre une distorsion géométrique sévère. Rejet de la normalité. Engagez l’évaluation des options correctives :
- Si la distribution manifeste une asymétrie positive nette sans valeurs négatives, appliquez une transformation fonctionnelle adaptée (ex. transformation logarithmique
LN(x)) et ré-exécutez le test de normalité sur la série transformée. - Si la transformation est théoriquement inopportune ou inefficace, orientez l’analyse vers les équivalents non paramétriques fondés sur les rangs (test U de Mann-Whitney, Wilcoxon, Kruskal-Wallis, corrélations de Spearman).
- Pour les dispositifs expérimentaux multivariés complexes requérant une puissance optimale, implémentez des méthodes de rééchantillonnage par bootstrapping ou recourez à l’estimation statistique robuste.
- Si la distribution manifeste une asymétrie positive nette sans valeurs négatives, appliquez une transformation fonctionnelle adaptée (ex. transformation logarithmique
La rigueur quantitative n’est pas une simple exigence formelle destinée à satisfaire les comités éditoriaux ; elle est l’armature méthodologique fondamentale qui garantit la véracité des découvertes psychologiques. En dominant la modélisation mathématique de la distribution normale au sein de l’environnement transparent de Microsoft Excel, l’expérimentateur en sciences humaines s’émancipe des automatismes aveugles et redonne à l’analyse de données sa pleine dimension scientifique : une quête exigeante de vérité empirique adossée à une probité méthodologique absolue.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bera, A. K., & Jarque, C. M. (1981). Efficient tests for normality, homoscedasticity and serial independence of regression residuals: Monte Carlo evidence. Economics Letters, 7(4), 313–318. https://doi.org/10.1016/0165-1765(81)90035-5
- Bulmer, M. G. (1979). Principles of Statistics. Dover Publications.
- Cramér, H. (1946). Mathematical Methods of Statistics. Princeton University Press.
- Field, A. (2018). Discovering Statistics Using IBM SPSS Statistics (5th ed.). SAGE Publications.
- Jarque, C. M., & Bera, A. K. (1980). Efficient tests for normality, homoscedasticity and serial independence of regression residuals. International Statistical Review, 48(2), 255–259. https://doi.org/10.2307/2530198
- Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review, 55(2), 163–172. https://doi.org/10.2307/1403192
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- National Institute of Standards and Technology. (2010). NIST/SEMATECH e-Handbook of Statistical Methods. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21–33.
- Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
- Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594