
Dans le champ de l’analyse quantitative et de la psychométrie appliquée, l’évaluation de la distribution des données constitue une étape préalable incontournable avant toute tentative de modélisation statistique inférentielle. Les tests paramétriques classiques — tels que l’analyse de variance (ANOVA), les modèles de régression linéaire multiple ou la modélisation par équations structurelles — reposent fondamentalement sur le postulat que les résidus ou les variables sous-jacentes suivent une distribution normale multivariée ou univariée. Lorsque cette condition de gaussianité est compromise, la validité des inférences statistiques se trouve directement menacée, exposant le chercheur à une inflation incontrôlée de l’erreur de type I ou à un effondrement dramatique de la puissance statistique.
Parmi l’arsenal méthodologique développé pour tester l’hypothèse de normalité, le test de Jarque-Bera occupe une place singulière et privilégiée. Contrairement aux tests fondés sur la comparaison des fonctions de répartition empiriques et théoriques, tels que les tests de Kolmogorov-Smirnov ou de Cramér-von Mises, le test de Jarque-Bera repose sur les propriétés fondamentales des moments d’ordre supérieur de la distribution : le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement (kurtosis). Cette approche offre une sensibilité analytique remarquable aux anomalies morphologiques des distributions empiriques, particulièrement dans les queues de distribution où se concentrent fréquemment les phénomènes psychopathologiques, les biais de réponse ou les scores extrêmes.
Bien que des logiciels statistiques spécialisés comme R, SPSS ou SAS intègrent des routines automatisées pour ce test, la maîtrise de son implémentation pas à pas dans Microsoft Excel présente des vertus pédagogiques et pratiques inestimables. Excel permet de décomposer chaque étape algébrique du calcul, d’auditer avec rigueur la structure des données brutes, et de s’affranchir de la nature opaque des algorithmes « boîte noire ». Le présent traité propose une exploration exhaustive, théorique et opérationnelle, du test de Jarque-Bera dans Microsoft Excel, guidant le chercheur depuis les fondements épistémologiques du test jusqu’à son interprétation clinique et psychométrique rigoureuse.
1. Introduction théorique et épistémologique au test de Jarque-Bera
1.1 Origine et définition du test d’adéquation de Jarque-Bera
Le test d’adéquation de Jarque-Bera a été formalisé au début des années 1980 par les économètres Carlos M. Jarque et Anil K. Bera, initialement dans le cadre de l’évaluation de la normalité des résidus de régression économétrique (Jarque & Bera, 1980, 1987). Face aux limites computationnelles et conceptuelles des tests d’adéquation conventionnels, les auteurs ont cherché à concevoir une procédure fondée sur le principe du multiplicateur de Lagrange (Lagrange Multiplier test), capable de vérifier simultanément si les troisième et quatrième moments standardisés d’une distribution d’échantillonnage s’écartent significativement des valeurs théoriques dictées par la loi normale de Gauss-Laplace.
Sur le plan épistémologique, le test de Jarque-Bera se classe dans la catégorie des tests d’adéquation (goodness-of-fit) fondés sur les moments d’échantillonnage. Alors que les tests d’adéquation dits globaux ou « omnibus » traditionnels analysent la distance spatiale suprémum ou quadratique entre la distribution cumulative observée et la distribution cumulative théorique, l’approche de Jarque-Bera postule que l’identité morphologique d’une loi normale est intégralement encapsulée dans la nullité de son asymétrie et la fixation stricte de son aplatissement à une valeur de référence. Tout écart substantiel observé sur ces moments d’ordre supérieur traduit une déformation structurelle incompatible avec l’hypothèse d’une genèse stochastique gaussienne.
Cette méthodologie tire sa force de ses propriétés asymptotiques optimales. Sous les conditions d’un grand échantillon, le test de Jarque-Bera bénéficie du statut de test uniformément le plus puissant parmi les tests invariants pour détecter des déviations issues de la famille des lois de Pearson. En sciences humaines et en psychologie, où les instruments de mesure capturent des réalités latentes complexes, l’évaluation conjointe de la déviation latérale et de l’épaisseur des queues fournit un diagnostic qualitatif bien supérieur à une simple statistique de distance scalaire.
1.2 Hypothèses statistiques formelles et formulation décisionnelle
Toute démarche d’inférence statistique formelle exige une explicitation rigoureuse des hypothèses rivales soumises à l’épreuve des données. Dans le cadre du test de Jarque-Bera, l’hypothèse nulle, notée $H_0$, postule que l’échantillon observé est issu d’une population dont la distribution sous-jacente suit une loi normale d’espérance mathématique $\mu$ et de variance $\sigma^2$, paramètres pouvant être inconnus et estimés à partir des données :
$$H_0 : S = 0 \quad \text{et} \quad K = 3$$
Dans cette formulation canonique, $S$ représente le coefficient théorique d’asymétrie (skewness) et $K$ désigne le coefficient théorique d’aplatissement (kurtosis brut). Si l’on choisit de travailler en termes d’excès d’aplatissement, noté $C$, où $C = K – 3$, l’hypothèse nulle se réduit élégamment à la conjonction : $H_0 : S = 0 \text{ et } C = 0$. L’hypothèse nulle affirme donc que les données observées ne présentent aucune distorsion morphologique d’asymétrie ni aucune anomalie dans l’épaisseur de leurs queues de distribution comparativement au profil gaussien standard.
À l’inverse, l’hypothèse alternative, notée $H_1$, est formulée de manière composite et non directionnelle. Elle stipule que la distribution parente dévie de la normalité en raison d’une asymétrie non nulle, d’un aplatissement anormal, ou d’une combinaison simultanée de ces deux altérations :
$$H_1 : S \neq 0 \quad \text{ou} \quad K \neq 3 \quad (\text{soit } C \neq 0)$$
La statistique de test de Jarque-Bera, couramment désignée par l’acronyme $JB$, quantifie précisément la distance quadratique conjointe séparant le vecteur d’échantillonnage $(S, C)$ de l’origine théorique $(0, 0)$. Dès lors, la règle de décision repose sur une logique de rejet unilatéral à droite : plus la valeur observée de $JB$ s’éloigne de zéro pour atteindre des magnitudes élevées, plus la plausibilité de l’hypothèse nulle s’étiole. La confrontation de la statistique empirique à une valeur critique issue de la loi du Chi-carré, pour un seuil d’erreur de première espèce prédéterminé (conventionnellement $\alpha = 0{,}05$), permet de trancher de façon catégorique entre le rejet ou le maintien de l’hypothèse de normalité.
1.3 Cadre d’application générale et prérequis distributionnels
Pour garantir la validité métrologique et théorique des conclusions tirées du test de Jarque-Bera, plusieurs prérequis fondamentaux doivent être impérativement satisfaits lors du recueil et de la structuration des données. Le premier postulat réside dans la nature probabiliste de l’échantillonnage : les observations composant la série doivent être indépendantes et identiquement distribuées (i.i.d.). Toute violation de l’indépendance statistique, qu’elle résulte d’une autocorrélation temporelle au sein de mesures longitudinales répétées ou d’une dépendance groupale (effets de grappes scolaires ou cliniques), fausse dramatiquement la variance asymptotique des moments empiriques, conduisant à des rejets abusifs de la normalité.
Le second prérequis a trait à la nature métrique de la variable analysée. Le test de Jarque-Bera présuppose que la grandeur mesurée est une variable quantitative continue. L’application directe de ce formalisme à des données strictement catégorielles, ordinales pures ou binomiales constitue une hérésie méthodologique, dans la mesure où les moments d’ordre supérieur de variables discrètes sont contraints par le support fini de l’échelle, invalidant les distributions limites standardisées. En psychométrie, son emploi sur des scores composites issus d’échelles de Likert n’est toléré que si l’échelle globale présente un continuum suffisant de valeurs (généralement plus de 15 à 20 graduations distinctes).
Enfin, le comportement asymptotique du test impose une vigilance extrême quant à la taille de l’échantillon ($n$). Dérivé sous des conditions limites où $n$ tend vers l’infini, le test de Jarque-Bera présente des distorsions notables dans les échantillons de taille modeste ($n < 30$ ou $n < 50$). Dans ce contexte restreint, les estimateurs d'échantillon des moments d'ordre 3 et 4 manifestent une forte variabilité d'échantillonnage, ce qui peut altérer le taux réel d'erreur de première espèce. Le test exprime toute sa robustesse et sa puissance de discrimination sur des échantillons de taille modérée à grande ($n ge 100$), configuration fréquente dans les protocoles de recherche en psychologie différentielle, cognitive ou sociale.
2. Fondements mathématiques de l’asymétrie et de l’aplatissement
2.1 Le troisième moment centré : Mesure de l’asymétrie (Skewness)
L’architecture interne du test de Jarque-Bera s’enracine dans la théorie statistique des moments d’une variable aléatoire. Pour une variable aléatoire continue $X$ d’espérance $\mu = \mathbb{E}[X]$, le moment centré d’ordre $k$ est formellement défini par l’expression mathématique :
$$\mu_k = \mathbb{E}\left[(X – \mu)^k\right] = \int_{-\infty}^{+\infty} (x – \mu)^k f(x) , dx$$
Le troisième moment centré, correspondant à $k = 3$, quantifie le degré d’asymétrie de la fonction de densité de probabilité $f(x)$ autour de son centre de gravité. Afin d’obtenir une métrique adimensionnelle, insensible aux unités d’échelle de la mesure, ce moment centré est standardisé par la puissance correspondante de l’écart-type $\sigma = \sqrt{\mu_2}$, donnant naissance au coefficient théorique d’asymétrie de Fisher-Pearson :
$$S = \beta_1^{1/2} = \frac{\mu_3}{\sigma^3} = \frac{\mathbb{E}\left[(X – \mu)^3\right]}{\left(\mathbb{E}\left[(X – \mu)^2\right]\right)^{3/2}}$$
Sur le plan géométrique, une distribution rigoureusement symétrique par rapport à sa moyenne possède une valeur $S = 0$. Les déviations positives et négatives s’annulent intégralement deux à deux lors de l’élévation à la puissance impaire 3. Une asymétrie positive ($S > 0$) signale un étalement prédominant de la queue de distribution vers la droite (valeurs élevées), tandis que la masse médiane des observations est concentrée sur la gauche. Inversement, une asymétrie négative ($S < 0$) traduit un étirement de la queue gauche, révélant une accumulation de valeurs dans les zones supérieures de l'échelle de mesure.
Dans un contexte d’échantillonnage fini comportant $n$ observations $x_1, x_2, dots, x_n$ de moyenne $\bar{x}$, l’estimateur empirique de l’asymétrie peut être calculé selon deux formulations distinctes : l’estimateur direct avec biais :
$$m_3 / m_2^{3/2} = \frac{\frac{1}{n} \sum_{i=1}^n (x_i – \bar{x})^3}{\left(\frac{1}{n} \sum_{i=1}^n (x_i – \bar{x})^2\right)^{3/2}}$$
et l’estimateur sans biais corrigé pour les petits échantillons, formalisé par Fisher, qui intègre un facteur de correction polynomial multiplicatif :
$$G_1 = \frac{n}{(n – 1)(n – 2)} \sum_{i=1}^n \left(\frac{x_i – \bar{x}}{s}\right)^3$$
où $s$ représente l’écart-type d’échantillon corrigé. Cette distinction technique revêt une importance capitale lors de la manipulation des fonctions natives du tableur Excel.
2.2 Le quatrième moment centré : Mesure de l’aplatissement (Kurtosis)
Le quatrième moment centré, correspondant à la puissance paire $k = 4$, mesure la distribution relative de la masse probabiliste entre le centre, les flancs et les queues de la distribution. Standardisé par le carré de la variance (soit $\sigma^4$), il définit le coefficient d’aplatissement brut (raw kurtosis), traditionnellement noté $\alpha_4$ ou $\beta_2$ :
$$K = \beta_2 = \frac{\mu_4}{\sigma^4} = \frac{\mathbb{E}\left[(X – \mu)^4\right]}{\left(\mathbb{E}\left[(X – \mu)^2\right]\right)^2}$$
Pour la loi normale théorique, l’intégration par parties de l’intégrale gaussienne révèle une propriété immuable : $\mu_4 = 3\sigma^4$, ce qui implique rigoureusement que $K = 3$. En raison de cette constante fondamentale, les statisticiens privilégient quasi systématiquement l’usage du coefficient d’excès d’aplatissement (excess kurtosis), noté $C$ ou $\gamma_2$, qui opère un centrage direct par rapport à la référence gaussienne :
$$C = K – 3 = \frac{\mu_4}{\sigma^4} – 3$$
Une typologie tridimensionnelle standard permet de classifier les formes de distribution selon l’amplitude de cet excès :
- Distributions mésokurtiques ($C = 0$, $K = 3$) : La dispersion des données dans les queues et autour du centre reproduit fidèlement la dynamique de la loi normale.
- Distributions leptokurtiques ($C > 0$, $K > 3$) : La distribution se caractérise par un pic central acéré et, corollaire mathématique inévitable, par des queues épaisses et lourdes (fat tails). La probabilité d’observer des événements extrêmes est considérablement plus élevée que sous une loi normale.
- Distributions platykurtiques ($C < 0$, $K < 3$) : La courbe présente un sommet aplati, voire tronqué, et des queues particulièrement légères et effilées. Les observations se dispersent de manière diffuse sur une plage élargie sans concentration extrême aux limites.
L’estimation de l’aplatissement sur un échantillon fini nécessite, elle aussi, une correction structurelle pour éliminer les biais d’échantillonnage. L’estimateur sans biais corrigé de l’excès de kurtosis, désigné par $G_2$, s’exprime selon une relation algébrique complexe faisant intervenir les degrés de liberté résiduels $(n-1)$, $(n-2)$ et $(n-3)$, garantissant que son espérance mathématique sous condition de normalité soit strictement nulle.
2.3 Interaction des moments dans l’évaluation de la normalité
L’élégance méthodologique du test de Jarque-Bera repose sur la dynamique conjointe de ces deux descripteurs distributionnels. Sous l’hypothèse nulle de normalité, une propriété probabiliste fondamentale issue des travaux de Ronald Fisher stipule que les coefficients d’échantillonnage de l’asymétrie et de l’aplatissement sont asymptotiquement indépendants. Cela signifie qu’à mesure que la taille de l’échantillon croît, la covariance entre l’estimateur de l’asymétrie $\hat{S}$ et l’estimateur de l’excès de kurtosis $\hat{C}$ converge vers zéro :
$$operatorname{Cov}(\hat{S}, \hat{C}) x\rightarrow[n to \infty]{} 0$$
Cette orthogonalité asymptotique autorise une additionnalité quadratique directe des déviations standardisées dans un espace vectoriel bidimensionnel. L’évaluation de la normalité ne procède donc pas par une succession de tests marginaux disjoints — qui souffriraient du problème des comparaisons multiples et de l’inflation de l’erreur globale — mais par une métrique globale synthétisant la distance euclidienne pondérée du couple $(\hat{S}, \hat{C})$ par rapport au centre normatif $(0, 0)$.
Cette interaction confère au test une sensibilité différentielle remarquable. Une distribution peut présenter une symétrie exemplaire ($S \approx 0$) tout en affichant un profil hautement leptokurtique qui invalide les calculs de puissance d’un test paramétrique. Inversement, une distribution modérément platykurtique peut dissimuler une asymétrie prononcée. En sommant quadratiquement ces deux sources d’écart après normalisation de leurs variances d’échantillonnage respectives, le test de Jarque-Bera empêche qu’une anomalie sur un moment ne soit occultée ou neutralisée par la conformité apparente de l’autre moment.
3. La statistique de test de Jarque-Bera et sa distribution asymptotique
3.1 Démonstration de la formule générale de la statistique JB
La formulation algébrique canonique de la statistique de Jarque-Bera est le résultat direct de la normalisation asymptotique des moments d’échantillonnage. Soit un échantillon aléatoire de $n$ observations indépendantes issues d’une population gaussienne. En vertu du théorème central limite appliqué aux moments empiriques, l’estimateur de l’asymétrie $\hat{S}$ converge en loi vers une distribution normale d’espérance nulle et de variance asymptotique égale à $6/n$ :
$$\hat{S} x\rightarrow{\mathcal{D}} \mathcal{N}\left(0, \frac{6}{n}\right) \quad iff \quad \frac{\hat{S}}{\sqrt{6/n}} x\rightarrow{\mathcal{D}} \mathcal{N}(0, 1)$$
Simultanément, l’estimateur de l’excès de kurtosis $\hat{C}$ converge vers une loi normale d’espérance nulle, mais avec une variance asymptotique quatre fois supérieure, égale à $24/n$ :
$$\hat{C} x\rightarrow{\mathcal{D}} \mathcal{N}\left(0, \frac{24}{n}\right) \quad iff \quad \frac{\hat{C}}{\sqrt{24/n}} x\rightarrow{\mathcal{D}} \mathcal{N}(0, 1)$$
Puisque $\hat{S}$ et $\hat{C}$ sont asymptotiquement indépendants sous $H_0$, la somme des carrés de leurs formes standardisées constitue une combinaison quadratique naturelle. En élevant chacune de ces variables normales centrées réduites au carré, on obtient l’équation explicite de la statistique de Jarque-Bera :
$$JB = \left(\frac{\hat{S}}{\sqrt{6/n}}\right)^2 + \left(\frac{\hat{C}}{\sqrt{24/n}}\right)^2 = \frac{\hat{S}^2}{6/n} + \frac{\hat{C}^2}{24/n} = \frac{n}{6} \left( \hat{S}^2 + \frac{\hat{C}^2}{4} \right)$$
Cette écriture met en exergue le rôle pondérateur déterminant de la taille de l’échantillon $n$. Ce facteur multiplicateur externe agit comme un amplificateur d’échelle : à déviations morphologiques d’asymétrie et de kurtosis constantes, la valeur de la statistique $JB$ croît de façon strictement linéaire avec le nombre d’observations. Par ailleurs, la division de $\hat{C}^2$ par 4 au sein de la parenthèse découle directement du ratio des variances asymptotiques ($24 / 6 = 4$), illustrant que l’estimation de l’aplatissement requiert quatre fois plus de variabilité théorique pour peser de manière équivalente à l’asymétrie dans la statistique globale.
3.2 Convergence vers la loi du Chi-carré à deux degrés de liberté
La dérivation de la distribution théorique de la statistique $JB$ repose sur un théorème élémentaire des probabilités fondamentales : la somme des carrés de $k$ variables aléatoires normales centrées réduites indépendantes suit rigoureusement une distribution du Chi-carré ($\chi^2$) à $k$ degrés de liberté. Posons :
$$Z_1 = \frac{\hat{S}}{\sqrt{6/n}} \sim \mathcal{N}(0, 1) \quad \text{et} \quad Z_2 = \frac{\hat{C}}{\sqrt{24/n}} \sim \mathcal{N}(0, 1)$$
Sous l’hypothèse nulle $H_0$ et lorsque $n to \infty$, la statistique $JB = Z_1^2 + Z_2^2$ converge asymptotiquement en loi vers une variable aléatoire distribuée selon une loi du Chi-carré possédant deux degrés de liberté ($df = 2$) :
$$JB x\rightarrow{\mathcal{D}} \chi^2(2)$$
L’attribution exacte de deux degrés de liberté ($df = 2$) est mathématiquement incontestable : elle correspond au nombre exact de restrictions paramétriques imposées sous l’hypothèse nulle, à savoir la nullité stricte du coefficient d’asymétrie ($S = 0$) et la nullité stricte de l’excès de kurtosis ($C = 0$).
Toutefois, il est primordial de souligner le danger de distorsion asymptotique en présence d’échantillons finis de petite dimension. Pour des effectifs restreints (typiquement $n < 30$), les variances réelles d'échantillonnage de l'asymétrie et du kurtosis s'écartent significativement de leurs limites théoriques $6/n$ et $24/n$, et la convergence normale de $\hat{C}$ s'avère particulièrement lente en raison de la lourdeur des moments d'ordre 4. Il en résulte que pour de petits échantillons sous $H_0$, la distribution empirique de $JB$ a tendance à présenter une queue droite plus épaisse que celle de la loi théorique du $\chi^2(2)$, générant un conservatisme ou une imprécision décisionnelle qui exige des précautions méthodologiques rigoureuses.
3.3 Propriétés métrologiques du test de Jarque-Bera
La statistique de Jarque-Bera possède des propriétés métrologiques fondamentales qui en facilitent l’usage et l’interprétation dans les analyses quantitatives appliquées :
- Non-négativité structurelle : Par construction, la statistique $JB$ est la somme de deux termes quadratiques affectés d’un coefficient strictement positif ($n/6 > 0$). En conséquence, la statistique $JB$ est rigoureusement bornée inférieurement par zéro :
$$JB ge 0$$
La valeur $JB = 0$ ne se réalise empiriquement que dans le cas idéal d’une série présentant une asymétrie parfaitement nulle et un aplatissement rigoureusement égal à la valeur normale de référence. - Monotonie de la déviation : Il existe une relation monotone directe entre l’amplitude de la statistique $JB$ et l’écart à la structure gaussienne. Toute aggravation unilatérale de l’asymétrie ou de l’aplatissement gonfle mécaniquement la valeur de $JB$, traduisant une détérioration continue de l’adéquation distributionnelle.
- Invariance par translation et changement d’échelle : La statistique $JB$ est strictement invariante vis-à-vis des transformations linéaires affines de la forme $Y = aX + b$ (avec $a \neq 0$). Ni l’ajout d’une constante (translation du niveau de base), ni la multiplication par un facteur d’échelle (changement d’unités de mesure, passage de millisecondes en secondes, etc.) ne modifient la valeur calculée de la statistique, les coefficients standardisés $S$ et $C$ étant adimensionnels.
4. Pertinence et applications du test de Jarque-Bera en recherche psychologique
4.1 Validation des postulats pour les modèles statistiques paramétriques
En sciences du comportement et en recherche psychologique contemporaine, le test de Jarque-Bera constitue un outil privilégié pour l’audit des modèles linéaires généraux. Une méconnaissance répandue consiste à exiger la normalité brute des variables prédictives et des variables critères. En réalité, le postulat de normalité sous-tendant la validité des tests de Student, des modèles de régression linéaire multiple et de l’analyse de variance (ANOVA) porte spécifiquement sur la distribution des résidus d’échantillonnage :
$$\varepsilon_i = y_i – \hat{y}_i \sim \mathcal{N}(0, \sigma^2)$$
L’application du test de Jarque-Bera sur les séries résiduelles permet d’authentifier la légitimité des erreurs types d’estimation, des intervalles de confiance et des seuils de significativité associés aux coefficients de régression. Lorsque les résidus présentent un kurtosis excessif (distribution leptokurtique), la variance d’échantillonnage des coefficients estimés tend à être sous-évaluée par les logiciels, induisant un rétrécissement artificiel des intervalles de confiance et augmentant exponentiellement le risque de déclarer un effet psychologique significatif alors qu’il ne s’agit que d’un artefact stochastique (erreur de type I). L’intégration d’un test de normalité robuste comme Jarque-Bera sur les résidus constitue donc un gage indispensable d’intégrité méthodologique.
4.2 Spécificités des mesures psychométriques et distribution des scores
Les instruments psychométriques — qu’il s’agisse de batteries d’évaluation cognitive, d’inventaires de traits de personnalité ou d’échelles de psychopathologie clinique — engendrent des profils distributionnels singuliers qui s’écartent fréquemment de la stricte cloche gaussienne :
Dans les populations cliniques, l’évaluation de symptômes tels que la symptomatologie dépressive (mesurée par exemple via l’inventaire BDI-II) ou l’anxiété état-trait présente de manière presque systématique une asymétrie positive prononcée. La majorité des participants non cliniques cumulent des scores faibles proches du plancher de l’échelle (effet de plancher), tandis qu’une minorité clinique s’étire le long d’une queue droite particulièrement longue. L’asymétrie $S$ capture fidèlement cette déformation, évaluant si le niveau d’étirement compromet l’inférence paramétrique.
De même, les inventaires de personnalité administrés dans des contextes à fort enjeu (sélection professionnelle, expertise médico-légale) sont souvent biaisés par la désirabilité sociale, provoquant des effets de plafond (asymétrie négative). D’autre part, les tests neuropsychologiques d’évaluation de la vitesse de traitement de l’information ou du temps de réaction face à des stimuli émotionnels engendrent presque universellement des profils leptokurtiques marqués par des queues de distribution lourdes, dues à des ralentissements cognitifs occasionnels. Le test de Jarque-Bera quantifie ces anomalies d’une manière directement lisible pour le clinicien et le chercheur.
4.3 Conséquences méthodologiques de la taille d’échantillon en psychologie
L’utilisation du test de Jarque-Bera en psychologie exige une mise en perspective critique dictée par la taille de la cohorte analysée. Cette problématique confronte le chercheur à un dilemme méthodologique symétrique :
Dans les études épidémiologiques ou les enquêtes de panel à très grand effectif ($n > 1,000$ ou $n > 5,000$), le facteur multiplicatif $n/6$ amplifie la moindre variation microscopique d’asymétrie ou d’aplatissement. Dans ces conditions de surpuissance statistique, le test de Jarque-Bera rejettera quasi systématiquement l’hypothèse nulle ($p < 0{,}001$), même si les scores présentent un alignement visuel et fonctionnel quasi parfait avec la courbe gaussienne. La rigueur scientifique impose alors de distinguer la significativité statistique de la significativité pratique, en jaugeant directement l'amplitude brute des coefficients $\hat{S}$ et $\hat{C}$ plutôt qu'en se soumettant aveuglément au verdict de la p-valeur.
À l’opposé, les études cliniques neurofonctionnelles ou les protocoles de psychothérapie expérimentale reposant sur des échantillons restreints ($n 0{,}05$) comme la preuve irréfutable de la normalité, et complétera obligatoirement son diagnostic par des outils graphiques complémentaires.
5. Préparation et structuration des données psychométriques dans Microsoft Excel
5.1 Nettoyage et inspection initiale de l’échantillon brut
Avant d’engager le moindre calcul statistique dans Microsoft Excel, l’intégrité de la série de données doit être scrupuleusement vérifiée. Les scores psychométriques bruts importés depuis des plateformes d’évaluation en ligne (Qualtrics, Google Forms, Gorilla Experiment Builder) comportent régulièrement des scories techniques qui corrompent les algorithmes matriciels d’Excel : codes de valeurs manquantes numériques (tels que $-99$, $999$ ou des chaînes textuelles comme "NA", "Absent"), ou encore espaces insécables invisibles issus d’un copier-coller malencontreux.
Le chercheur doit standardiser les valeurs manquantes en laissant les cellules cibles rigoureusement vides, ce qui permet aux fonctions natives d’Excel de les exclure automatiquement de l’analyse sans altérer les calculs d’effectif effectif. L’inspection préliminaire des valeurs aberrantes (outliers) extrêmes est également indispensable : une faute de saisie isolée (par exemple un score de $550$ saisi à la place de $50$ sur une échelle bornée à $100$) exerce un effet disproportionné sur le quatrième moment centré, le kurtosis augmentant à la puissance 4 de l’écart à la moyenne. L’ensemble des cellules contenant les observations doit être expressément converti au format « Nombre » avec un paramétrage uniforme de deux décimales.
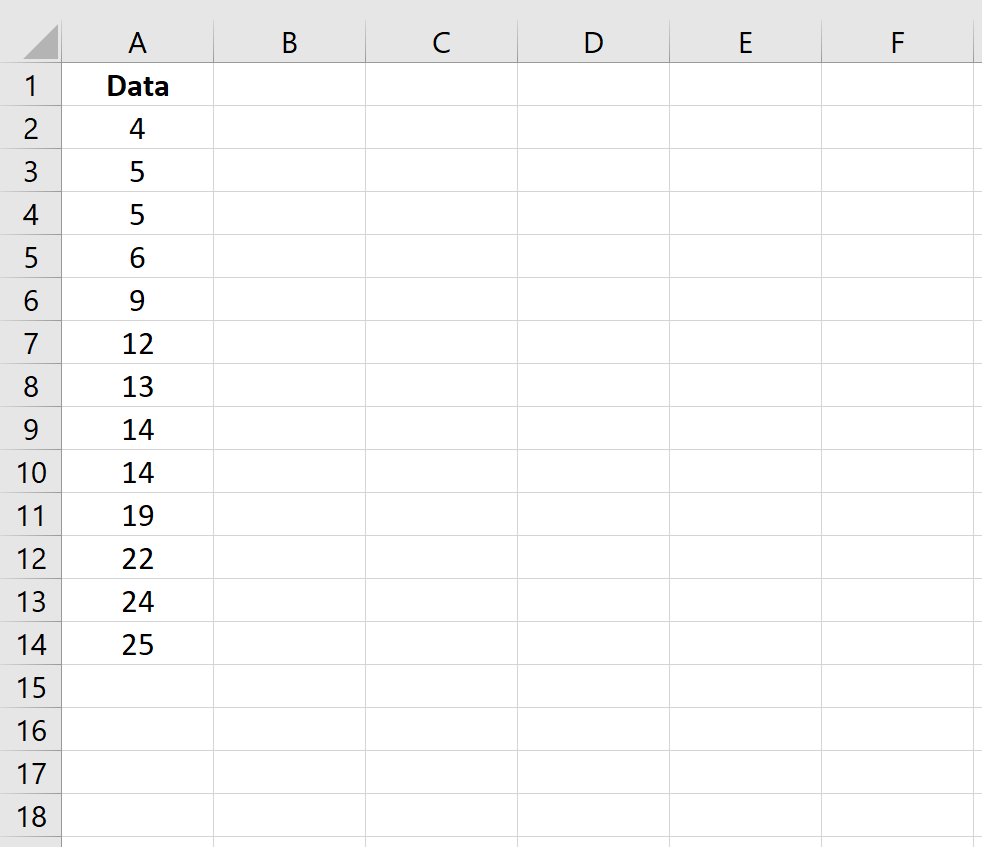
5.2 Organisation de la feuille de calcul pour un protocole reproductible
La pérennité et la reproductibilité d’un protocole d’analyse statistique dans Excel reposent sur une compartimentation spatiale rigoureuse de la feuille de calcul. Il est fortement recommandé d’adopter une structure tabulaire normalisée divisée en trois blocs fonctionnels :
- Le bloc des données brutes (Colonnes A et B) : La colonne A accueille les identifiants uniques des sujets (ex.
SUJET_001àSUJET_150) et la colonne B contient la série de scores quantitatifs continue analysée (par exemple, le score total à l’inventaire d’anxiété de Beck, notéSCORE_BAI). Les en-têtes sont positionnés sur la ligne 1, et les données s’étendent deB2àB151. - Le bloc des paramètres d’échantillonnage intermédiaires (Colonnes D et E) : Ce cadre dédié regroupe verticalement l’ensemble des grandeurs scalaires nécessaires à l’équation de Jarque-Bera, chacune associée à son intitulé explicite : taille d’échantillon $n$, moyenne arithmétique, écart-type d’échantillon, asymétrie ($S$) et excès de kurtosis ($C$).
- Le bloc inférentiel et décisionnel (Colonnes G et H) : Cet espace synthétise le calcul de la statistique finale $JB$, le nombre de degrés de liberté, la p-valeur asymptotique calculée via la loi du $\chi^2$, et la cellule conditionnelle formulant textuellement la décision de rejet ou de conservation de $H_0$.
L’attribution de Plages Nommées (Named Ranges) dans Excel constitue une bonne pratique pour optimiser la clarté syntaxique. En sélectionnant la plage B2:B151 et en la nommant formellement ScoresPsy dans la zone de nom, les équations ultérieures gagnent en lisibilité, éliminant les risques d’erreurs de pointage lors des copies de cellules.
5.3 Audit des prérequis techniques dans Excel
L’implémentation opérationnelle du test requiert un examen attentif des spécificités de la version d’Excel mobilisée et de son environnement linguistique. Depuis la version Excel 2010, Microsoft a procédé à une refonte substantielle de sa bibliothèque de fonctions statistiques afin d’améliorer la précision des algorithmes en double précision et de se conformer aux normes de l’ISO/IEC. Il convient donc de privilégier systématiquement les fonctions statistiques modernes (dont l’intitulé comporte des séparateurs par point) au détriment des anciennes fonctions de compatibilité héritées des versions 2003 et antérieures.
Un autre point de vigilance concerne le séparateur décimal défini par les paramètres régionaux du système d’exploitation hôte. Dans l’environnement francophone standard, la virgule (,) constitue le séparateur décimal légal, tandis que le point-virgule (;) sépare les arguments au sein d’une fonction Excel. Une mauvaise interprétation de ces caractères, fréquente lors de l’importation de fichiers CSV configurés à l’anglo-saxonne (point décimal et virgule d’argument), transforme les données numériques en chaînes textuelles inertes, ce qui fausse intégralement les calculs d’échantillonnage.
6. Calcul pas à pas des paramètres d’échantillonnage intermédiaires dans Excel
6.1 Dénombrement rigoureux de l’échantillon effectif
La première composante scalaire indispensable à l’édification de la statistique de Jarque-Bera est l’effectif effectif des observations valides, noté $n$. L’utilisation empirique de la taille géométrique de la colonne serait une erreur conceptuelle majeure en présence de cellules non renseignées. Pour dénombrer strictement les entrées numériques, on implémente la fonction NB :
Formule dans la cellule cible (par exemple E2) :
=NB(ScoresPsy) ou =NB(B2:B151)
La fonction NB ignore automatiquement les cellules textuelles, les cellules vides ou les codes d’erreur, garantissant que l’entier retourné reflète exclusivement le nombre de mesures réelles disponibles pour le calcul des moments. Si la série analysée comporte des données filtrées dynamiquement, on pourra recourir alternativement à la fonction SOUS.TOTAL(102; B2:B151) pour ne comptabiliser que les cellules visibles à l’écran.
L’exactitude de cette grandeur $n$ est décisive : elle intervient non seulement dans le facteur de mise à l’échelle global $n/6$, mais conditionne également la variance asymptotique sous-jacente des moments. Toute sous-estimation ou surestimation de $n$ invalide l’ensemble de la chaîne d’inférence.
6.2 Calcul de la moyenne et de l’écart-type d’échantillon
Bien que l’équation finale synthétique de Jarque-Bera puisse être calculée directement à l’aide des fonctions de moments préprogrammées, la détermination du premier moment brut (la moyenne d’échantillon) et du second moment centré (la variance ou l’écart-type) s’impose pour auditer le jeu de données et pour permettre la décomposition manuelle didactique.
La moyenne empirique arithmétique $\bar{x}$ s’obtient par l’insertion de la fonction standard dans la cellule E3 :
=MOYENNE(ScoresPsy)
Cette grandeur représente l’estimateur sans biais de l’espérance mathématique $\mu$. Pour la dispersion empirique, une distinction mathématique s’impose : l’écart-type d’échantillon sans biais, noté $s$, calculé avec le dénominateur $n – 1$ selon le théorème de Bessel, doit être mobilisé en lieu et place de l’écart-type de population basé sur $n$. Dans la cellule E4, on inscrira la fonction statistique contemporaine :
=ECARTYPE.STANDARD(ScoresPsy)
L’obtention de ces deux estimateurs permet de situer l’ordre de grandeur de l’échelle psychométrique analysée et sert de point d’ancrage fondamental pour l’éventuelle standardisation individuelle des scores en notes réduites (scores $z$).
6.3 Tableau récapitulatif des variables fondamentales
Pour garantir une traçabilité rigoureuse au sein du classeur Excel, les paramètres d’échantillonnage doivent être agencés au sein d’un bloc récapitulatif clair et ordonné. La matrice suivante illustre l’architecture recommandée pour documenter les variables fondamentales avant le traitement des moments d’ordre supérieur :
- Cellule D2 : Étiquette « Effectif valide (n) » | Cellule E2 :
=NB(B2:B151) - Cellule D3 : Étiquette « Moyenne arithmétique (M) » | Cellule E3 :
=MOYENNE(B2:B151) - Cellule D4 : Étiquette « Écart-type d’échantillon (s) » | Cellule E4 :
=ECARTYPE.STANDARD(B2:B151) - Cellule D5 : Étiquette « Variance empirique (s^2) » | Cellule E5 :
=VAR.S(B2:B151)
Afin de sécuriser ce tableau contre toute défaillance de calcul en cascade, il est judicieux d’adjoindre une cellule de vérification logique utilisant la fonction ESTNUM. Par exemple, la formule =SI(ET(ESTNUM(E2); ESTNUM(E3); ESTNUM(E4); E2 > 3); "Valide"; "Erreur de données") garantit d’un coup d’œil que tous les paramètres préalables sont intègres et que la taille d’échantillon minimale est respectée avant d’aborder les calculs de moments d’ordre 3 et 4.
7. Formules Excel pour l’asymétrie et le kurtosis empiriques
7.1 Calcul de l’asymétrie via les fonctions intégrées d’Excel
Microsoft Excel intègre deux fonctions distinctes pour le calcul du coefficient d’asymétrie, générant souvent une confusion conceptuelle : la fonction COEFFICIENT.ASYMETRIE et la fonction COEFFICIENT.ASYMETRIE.P. La distinction réside dans la correction des biais pour petits échantillons :
La fonction COEFFICIENT.ASYMETRIE.P calcule l’asymétrie basée sur le moment centré direct divisé par $n$ (estimateur de population avec biais), sans appliquer le coefficient d’expansion d’échantillon :
$$\text{COEFFICIENT.ASYMETRIE.P} = \frac{\frac{1}{n} \sum (x_i – \bar{x})^3}{\left(\frac{1}{n} \sum (x_i – \bar{x})^2\right)^{3/2}}$$
À l’inverse, la fonction standard COEFFICIENT.ASYMETRIE calcule l’estimateur corrigé sans biais $G_1$ de Fisher-Pearson :
$$\text{COEFFICIENT.ASYMETRIE} = \frac{n}{(n – 1)(n – 2)} \sum_{i=1}^n \left(\frac{x_i – \bar{x}}{s}\right)^3$$
Dans la dérivation théorique originale de Jarque et Bera (1980, 1987), les auteurs utilisent formellement les moments d’échantillonnage non corrigés, puisque les corrections d’échantillon s’estompent asymptotiquement lorsque $n to \infty$. Toutefois, dans la pratique empirique moderne et au sein des principaux progiciels d’analyse de données, l’usage des coefficients corrigés s’est imposé comme le standard opératoire le plus rigoureux afin de compenser les distorsions sur des tailles d’échantillons finies.
Dans la cellule E6, dédiée au coefficient d’asymétrie $S$, on saisira donc :
=COEFFICIENT.ASYMETRIE(ScoresPsy) ou =COEFFICIENT.ASYMETRIE(B2:B151)
L’interprétation clinique du signe obtenu est immédiate : une valeur positive substantielle (ex. $+1{,}25$) signale que la distribution des scores d’anxiété s’étire vers les valeurs pathologiques aiguës, tandis qu’une valeur négative (ex. $-0{,}85$) révélera un plafonnement massif de l’échantillon.
7.2 Calcul de l’aplatissement via la fonction d’excès de kurtosis
L’exploitation de la fonction d’aplatissement d’Excel recèle un piège méthodologique fondamental que tout chercheur doit maîtriser sous peine de vicier l’intégralité de sa démarche : la fonction native d’Excel est intitulée KURTOSIS dans sa version internationale et KURTOSIS (ou parfois APLATISSEMENT selon les versions régionales spécifiques) dans l’interface francophone standard :
=KURTOSIS(ScoresPsy)
Avertissement technique fondamental : La fonction KURTOSIS d’Excel calcule exclusivement l’excès de kurtosis corrigé pour les petits échantillons (soit $G_2 \approx K – 3$), et non pas le kurtosis brut ($K$). L’algorithme interne programmé par Microsoft soustrait d’office la valeur 3 de la formulation de base, comme l’illustre son équation d’exécution interne :
$$\text{KURTOSIS} = \left{\frac{n(n + 1)}{(n – 1)(n – 2)(n – 3)} \sum \left(\frac{x_i – \bar{x}}{s}\right)^4\right} – \frac{3(n – 1)^2}{(n – 2)(n – 3)}$$
Cette caractéristique algorithmique d’Excel constitue, par une heureuse coïncidence de conception, un avantage direct pour l’implémentation du test de Jarque-Bera. En effet, la variable $C$ intégrée dans l’équation opérationnelle de Jarque-Bera ($JB = \frac{n}{6}(S^2 + \frac{C^2}{4})$) correspond rigoureusement à l’excès de kurtosis ($C = K – 3$). Il ne faut donc en aucun cas soustraire à nouveau 3 du résultat retourné par la cellule Excel, sous peine d’évaluer une distorsion par rapport à $-3$, ce qui détruirait totalement la validité de la statistique.
Dans la cellule E7, on insère la formule :
=KURTOSIS(B2:B151)
Une valeur proche de zéro ($0 \pm 0{,}2$) témoigne d’un profil mésokurtique conforme à la normalité gaussienne ; une valeur positive élevée ($> +1{,}0$) signale une leptokurticité pathologique marquée par des queues de distribution épaisses.
7.3 Alternative par décomposition manuelle des moments centrés
Pour appréhender concrètement la mécanique interne des moments sans recourir aux fonctions automatisées d’Excel, il est pédagogiquement enrichissant d’implémenter une décomposition manuelle pas à pas par colonnes adjacentes :
- Étape 1 : Construction des écarts standardisés ($z$-scores) dans la colonne C : En cellule
C2, on calcule la note réduite individuelle :
=(B2 - $E$3) / $E$4
Cette formule est étirée verticalement jusqu’à la celluleC151. Chaque cellule exprime l’écart de l’observation à la moyenne arithmétique en unités d’écart-type. - Étape 2 : Calcul des puissances troisièmes pour l’asymétrie dans la colonne D : En cellule
D2, on élève le score standardisé au cube :
=C2^3
On propage la formule sur l’ensemble de la série. La moyenne empirique brute de cette colonneD, calculée par=MOYENNE(D2:D151), fournit l’estimateur de l’asymétrie brute non corrigée $\hat{S}$. - Étape 3 : Calcul des puissances quatrièmes pour l’aplatissement dans la colonne E : En cellule
E2, on élève le score standardisé à la puissance 4 :
=C2^4
On étire la formule jusqu’à la dernière ligne. La moyenne de cette colonne, calculée par=MOYENNE(E2:E151), correspond au kurtosis brut non corrigé $\hat{K}$. Pour obtenir l’excès brut non corrigé $\hat{C}$, il suffit de poser=MOYENNE(E2:E151) - 3.
La comparaison de ces calculs manuels élémentaires avec les sorties de COEFFICIENT.ASYMETRIE et de KURTOSIS met en lumière l’action des facteurs de correction d’échantillon fini $n / [(n-1)(n-2)]$. Plus la taille de l’échantillon s’accroît, plus les résultats de la méthode manuelle directe et des fonctions natives d’Excel deviennent rigoureusement indiscernables, illustrant la convergence asymptotique.
8. Implémentation mathématique de la statistique JB dans la feuille de calcul
8.1 Traduction syntaxique de l’équation de Jarque-Bera en formule Excel
Une fois les paramètres scalaires $n$, $S$ et $C$ rigoureusement isolés dans le tableau récapitulatif, la statistique de test de Jarque-Bera peut être assemblée. Rappelons l’architecture de la formule mathématique à modéliser :
$$JB = \frac{n}{6} \left( S^2 + \frac{C^2}{4} \right)$$
Supposons que nos paramètres soient spatialement organisés dans les cellules suivantes de la feuille de calcul :
- Cellule
E2: Taille de l’échantillon effectif ($n$) - Cellule
E6: Coefficient d’asymétrie ($S$), obtenu par=COEFFICIENT.ASYMETRIE(B2:B151) - Cellule
E7: Excès de kurtosis ($C$), obtenu par=KURTOSIS(B2:B151)
Dans la cellule cible destinée à accueillir la statistique de test (par exemple la cellule H2), l’écriture de l’équation algébrique exige un respect strict de la hiérarchie des opérateurs arithmétiques et un parenthésage méthodique :
=(E2 / 6) * (E6^2 + (E7^2 / 4))
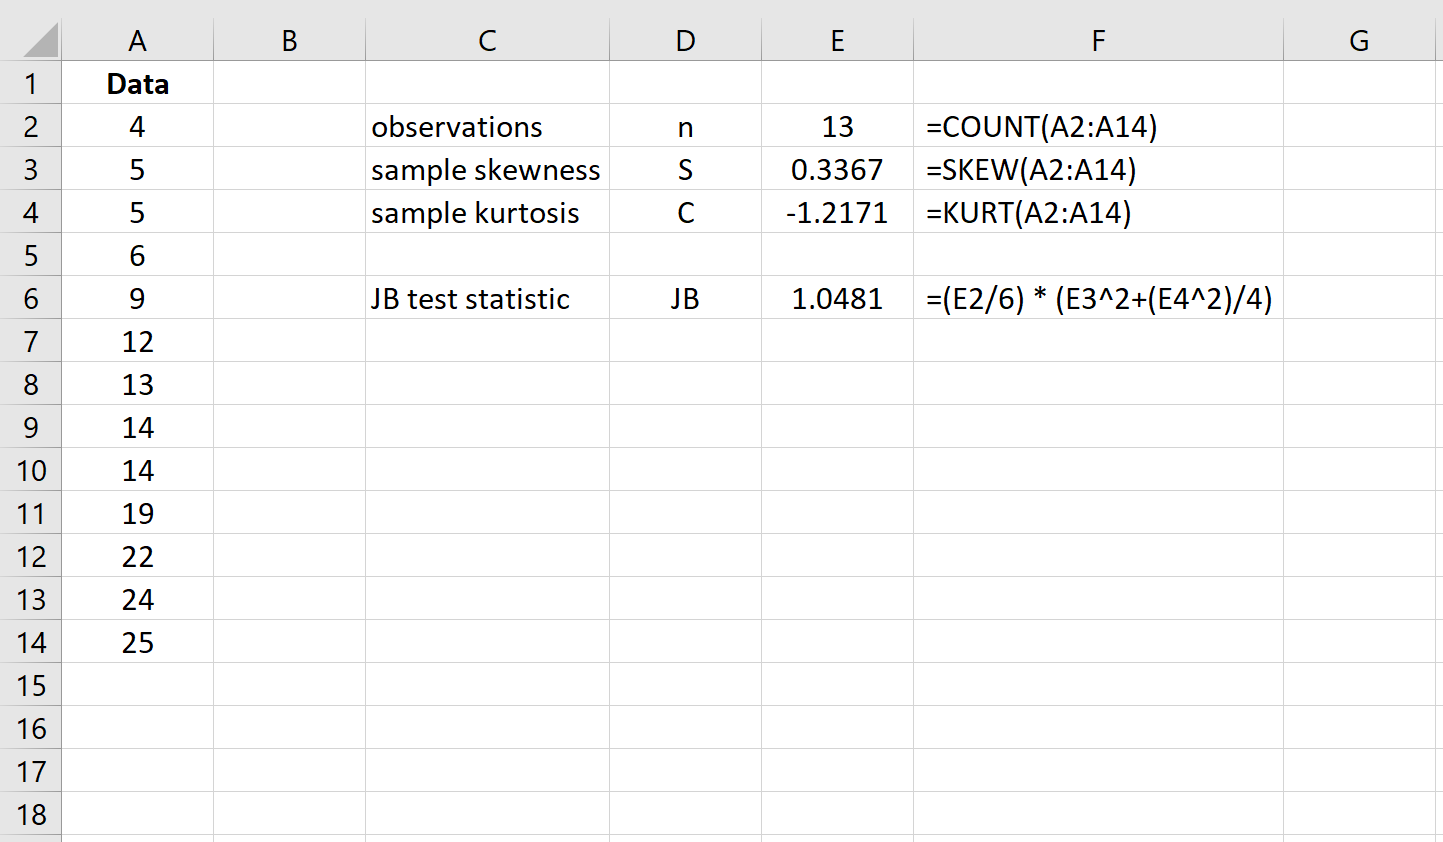
Analysons la chronologie d’exécution de cette syntaxe par le moteur de calcul d’Excel :
- Le premier opérateur
(E2 / 6)établit le coefficient multiplicateur linéaire d’échantillon. - Le terme
E6^2élève l’asymétrie au carré, convertissant tout écart latéral (positif ou négatif) en une magnitude scalaire strictement positive. - L’opérateur
(E7^2 / 4)procède à l’élévation au carré de l’excès de kurtosis, suivie immédiatement de sa division par 4, reflétant sa variance asymptotique quadruple. L’insertion de parenthèses explicites autour deE7^2 / 4sécurise l’ordre d’opération, bien que l’exponentiation possède une priorité naturelle sur la division dans les conventions d’Excel. - L’addition interne effectue la somme quadratique composite des deux déviations morphologiques.
- Le produit final délivre la valeur de la statistique $JB$.
8.2 Encapsulation dans une formule matricielle consolidée sans cellules intermédiaires
Dans le cadre du développement de classeurs statistiques automatisés, de tableaux de bord de recherche ou de macros analytiques, il s’avère souvent avantageux de synthétiser le calcul de la statistique de Jarque-Bera en une unique formule consolidée. Cette démarche dispense le chercheur de créer des cellules intermédiaires pour $n$, $S$ et $C$, réduisant l’encombrement spatial et annulant le risque de suppression accidentelle d’une cellule de dépendance.
En exploitant la plage de données B2:B151 (ou la plage nommée ScoresPsy), on peut encapsuler directement l’ensemble des fonctions d’échantillonnage au sein de l’équation maîtresse dans la cellule de destination :
=(NB(B2:B151)/6) * (COEFFICIENT.ASYMETRIE(B2:B151)^2 + (KURTOSIS(B2:B151)^2 / 4))
Cette écriture présente une efficacité algorithmique remarquable : elle est entièrement dynamique. Si de nouveaux scores psychométriques sont ajoutés ou si des valeurs aberrantes sont corrigées au sein de la plage source, la statistique $JB$ se recalcule instantanément en ajustant conjointement l’effectif $n$, l’asymétrie et l’aplatissement.
Néanmoins, sur le plan de la communication scientifique et de la vérification des calculs (auditabilité), cette compacité présente l’inconvénient d’occulter les poids relatifs de l’asymétrie et du kurtosis dans la composition de la statistique globale. Il incombe au chercheur de peser le bénéfice d’une macro-formule compacte face à la clarté didactique offerte par un tableau décomposant les étapes intermédiaires.
8.3 Validation métrologique et détection d’erreurs potentielles
Dès l’implémentation de la formule de Jarque-Bera, un protocole d’audit doit être appliqué pour valider la conformité numérique des résultats et prévenir toute anomalie d’exécution :
- Contrôle de positivité absolue : En vertu des axiomes probabilistes détaillés à la section 3.3, la cellule contenant la statistique $JB$ doit impérativement afficher une valeur supérieure ou égale à zéro. L’apparition d’un nombre négatif est l’indice irréfutable d’une erreur d’implémentation syntaxique (par exemple, la soustraction erronée d’un terme au lieu de son élévation au carré).
- Diagnostic des codes d’erreur d’Excel : L’erreur
#DIV/0!survient systématiquement si la fonctionNBdénombre un effectif $n le 2$ pour l’asymétrie ou $n le 3$ pour le kurtosis, car les dénominateurs des fonctions d’échantillonnage corrigées s’annulent ($n-1, n-2, n-3$). L’erreur#VALEUR!trahit la présence pernicieuse d’un caractère textuel ou d’un espace parasite au sein de la plage de données chiffrées. - Test de cohérence sur données gaussiennes synthétiques : Pour valider l’intégrité de la feuille de calcul, la méthode la plus rigoureuse consiste à simuler un échantillon gaussien théorique. À l’aide de l’outil d’échantillonnage d’Excel ou en appliquant la transformation de Box-Muller via la formule matricielle
=LOI.NORMALE.STANDARD.INVERSE(ALEA())sur 1 000 lignes, on génère une série normale simulée. En connectant la formule de Jarque-Bera à cette distribution idéale, la statistique $JB$ obtenue doit être modeste (généralement comprise entre 0,01 et 4,0), confirmant que l’algorithme est parfaitement calibré.
9. Détermination et calcul de la p-valeur via la distribution du Chi-carré dans Excel
9.1 Choix de la fonction Excel adaptée pour la queue supérieure
L’obtention de la valeur scalaire de la statistique de Jarque-Bera ne constitue que la première moitié du parcours inférentiel. Pour déterminer si cette magnitude s’écarte de façon statistiquement significative de ce qui est imputable aux seules fluctuations d’échantillonnage, le chercheur doit calculer la p-valeur associée, c’est-à-dire la probabilité d’obtenir, sous l’hypothèse nulle $H_0$, une statistique au moins aussi extrême que celle observée.
La statistique $JB$ convergeant vers une loi du Chi-carré à deux degrés de liberté ($\chi^2(2)$), et toute déviation de la normalité gonflant unilatéralement la valeur de $JB$ vers des grandeurs positives, le test de normalité de Jarque-Bera est structurellement un test unilatéral à droite (queue supérieure de la distribution). Dans l’écosystème contemporain d’Excel, la fonction statistique de référence pour calculer cette probabilité d’extrême queue supérieure est :
=LOI.KHIDEUX.DROITE(x; degres_liberte)
Il est impératif d’abandonner l’usage de l’ancienne fonction LOI.KHIDEUX présente dans les versions obsolètes d’Excel, ainsi que la fonction LOI.KHIDEUX.N(x; df; VRAI) qui retourne par défaut la probabilité cumulée unilatérale à gauche (la fonction de répartition cumulative $P(X le x)$). Utiliser LOI.KHIDEUX.N à la place de la queue droite reviendrait à calculer $1 – \text{p-valeur}$, inversant diamétralement la conclusion du test statistique.
9.2 Exécution du calcul de la p-valeur associée à la statistique JB
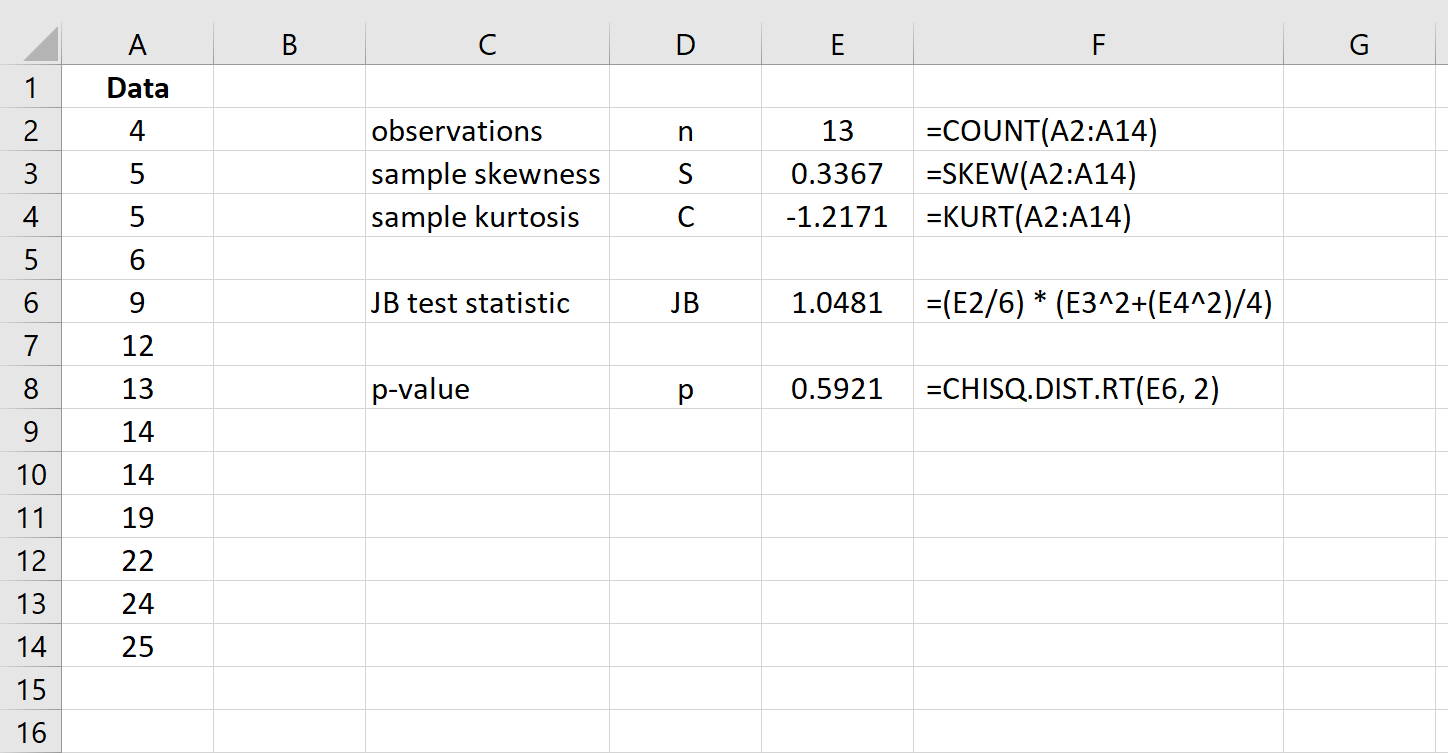
L’exécution de la formule probabiliste dans la feuille de calcul se distingue par sa concision mathématique. Si la statistique de Jarque-Bera a été calculée dans la cellule H2, la formule à saisir dans la cellule dédiée à la p-valeur (par exemple H3) est formulée ainsi :
=LOI.KHIDEUX.DROITE(H2; 2)
Le second argument est impérativement fixé à 2, traduisant les deux degrés de liberté associés aux deux moments testés ($S$ et $C$). Le comportement mathématique de cette fonction répond aux lois asymptotiques :
- Si la statistique $JB$ est très proche de zéro (par exemple $JB = 0{,}15$), la fonction retourne une p-valeur tendant vers $1$ (dans cet exemple, $p = \exp(-0{,}15/2) \approx 0{,}928$), attestant d’une concordance morphologique remarquable entre les données et la loi normale.
- À mesure que la statistique $JB$ augmente, la p-valeur décline de façon exponentielle. Pour une valeur de $JB = 5{,}991$, la p-valeur atteint exactement le seuil critique conventionnel de $0{,}05$.
- Pour des valeurs de $JB$ particulièrement élevées (par exemple $JB = 45{,}8$), la p-valeur plonge vers des valeurs infinitésimales (ex. $1{,}13 \times 10^{-10}$), qu’Excel affichera sous forme de notation scientifique
1,13E-10, signalant un rejet écrasant de l’hypothèse de normalité.
9.3 Automatisation du verdict décisionnel via des conditions logiques
Afin de minimiser le risque d’erreur humaine dans l’interprétation des résultats statistiques et de concevoir des outils de diagnostic directement exploitables par des assistants de recherche ou des cliniciens, il est hautement recommandé d’automatiser le verdict inférentiel au moyen de fonctions logiques conditionnelles.
Dans la cellule H4, adjacente à la p-valeur (cellule H3), on insère la formule conditionnelle SI suivante :
=SI(H3 < 0,05; "Rejet de la normalité (Distribution Non Normale)"; "Maintien de H0 (Distribution Compatible avec la Normalité)")
Pour affiner le niveau de granularité scientifique et documenter les seuils d’invalidation traditionnels en psychologie ($\alpha = 0{,}05$, $\alpha = 0{,}01$, $\alpha = 0{,}001$), il est possible d’imbriquer plusieurs conditions logiques :
=SI(H3 < 0,001; "Déviation extrême (p < 0,001) : Non Normale"; SI(H3 < 0,01; "Déviation forte (p < 0,01) : Non Normale"; SI(H3 < 0,05; "Déviation modérée (p = 0,05)"))))
Enfin, l’application d’une Mise en forme conditionnelle sur cette cellule d’inférence constitue une valeur ajoutée ergonomique majeure : un remplissage rouge clair alertant le chercheur sur un rejet franc de la normalité ($p < 0{,}05$), et un remplissage vert pastel confirmant la recevabilité de la distribution pour les modélisations paramétriques ultérieures.
10. Interprétation statistique, seuils décisionnels et inférence en psychologie
10.1 Règles formelles de décision statistique
L’interprétation statistique du test de Jarque-Bera obéit aux règles universelles de l’inférence fréquentiste fondées sur le cadre épistémologique de Neyman-Pearson. Le chercheur fixe a priori, avant toute manipulation empirique des données, un seuil de risque d’erreur de première espèce, universellement établi à $\alpha = 0{,}05$. La confrontation de la p-valeur obtenue avec ce seuil critique dicte la décision méthodologique :
- Règle de rejet ($p < \alpha$) : Lorsque la p-valeur issue de la distribution du Chi-carré à deux degrés de liberté est strictement inférieure à $0{,}05$, l’hypothèse nulle $H_0$ est formellement rejetée. Le chercheur en conclut que la probabilité d’observer de telles déviations conjointes d’asymétrie et de kurtosis sous l’hypothèse d’une population gaussienne est inférieure à 5 %. La distribution des données est alors déclarée significativement non normale.
- Règle de non-rejet ($p ge \alpha$) : Lorsque la p-valeur est supérieure ou égale à $0{,}05$, l’hypothèse nulle ne peut être rejetée. L’interprétation de ce résultat exige cependant une vigilance épistémologique scrupuleuse : l’absence de preuve n’est pas la preuve de l’absence. On ne dit jamais que l’échantillon « prouve la normalité », mais plutôt que les données empiriques ne fournissent pas de preuves suffisantes pour réfuter l’hypothèse d’une distribution normale parente.
10.2 Diagnostic différentiel : dissocier l’asymétrie du kurtosis dans l’anomalie
L’un des immenses atouts de la décomposition opérée dans notre protocole Excel réside dans la possibilité de réaliser un diagnostic différentiel de la morphologie distributionnelle. Puisque la statistique $JB$ est la somme pondérée de deux composantes distinctes, il est essentiel d’examiner la contribution relative de chacune à la statistique finale :
$$\text{Part de l’Asymétrie} = \frac{n}{6} \hat{S}^2 \quad \text{versus} \quad \text{Part du Kurtosis} = \frac{n}{24} \hat{C}^2$$
Cette distinction clinique et psychométrique éclaire la nature du phénomène sous-jacent :
Cas d’une anomalie par asymétrie prédominante : Si la contribution du terme $\hat{S}^2$ représente 85 % de la statistique $JB$, le trouble distributionnel provient d’un déséquilibre latéral. En psychopathologie, cela traduit souvent une prévalence clinique asymétrique (la majorité des participants présente un score sain bas, une minorité présentant un score aigu). Sur le plan psychométrique, cela peut révéler des items trop sévères ou trop faciles, induisant des effets de saturation.
Cas d’une anomalie par kurtosis prédominant : Si la statistique est dominée par le terme d’aplatissement $\hat{C}^2/4$, la distribution peut être parfaitement symétrique mais présenter des queues épaisses (profil leptokurtique). Dans les inventaires de performance neurocognitive ou de temps de réaction, cette structure trahit la présence de sous-groupes cliniques singuliers générant des observations extrêmes bilatérales. Cette configuration s’avère particulièrement toxique pour la stabilité des estimations de variance dans les modèles d’équations structurelles.
10.3 Prise de décision méthodologique suite au résultat du test
Face à un rejet formel de l’hypothèse de normalité ($p < 0{,}05$), le chercheur ne doit pas sombrer dans l'impasse méthodologique. Trois orientations stratégiques s'offrent à lui :
- Le recours à la robustesse des tests paramétriques : Si la taille d’échantillon est substantielle ($n > 100$) et que les déviations morphologiques demeurent modérées (asymétrie comprise entre $-1$ et $+1$, excès de kurtosis entre $-1{,}5$ et $+1{,}5$), le théorème central limite garantit une robustesse satisfaisante pour les tests paramétriques simples comme le test $t$ de Student ou l’ANOVA à un facteur équilibrée. Le rejet du test de Jarque-Bera peut alors être documenté comme une déviation sans incidence opérationnelle majeure.
- L’inférence non paramétrique : Si la déviation est sévère ou que l’échantillon est modeste, le chercheur basculera vers des équivalents non paramétriques affranchis de tout postulat distributionnel : substitution du test $t$ pour échantillons indépendants par le test $U$ de Mann-Whitney, substitution de l’ANOVA par le test de Kruskal-Wallis, ou substitution du coefficient de corrélation de Pearson par le rho de Spearman.
- La transformation mathématique de la variable : Il est tout à fait possible d’appliquer des transformations d’échelle dans une nouvelle colonne d’Excel pour restaurer la normalité avant modélisation : la transformation logarithmique
=LN(x + 1)pour corriger une asymétrie positive marquée, la racine carrée=RACINE(x)pour les données de comptage, ou la transformation Box-Cox pour les profils distributionnels plus complexes. Le test de Jarque-Bera sera alors exécuté à nouveau sur la variable transformée pour valider l’efficacité de la normalisation.
11. Comparaison critique : Jarque-Bera face à Shapiro-Wilk et Kolmogorov-Smirnov
11.1 Le test de Shapiro-Wilk : Étalon-or pour les petits effectifs
Pour situer la place du test de Jarque-Bera dans le paysage méthodologique, il est indispensable de le confronter au test de Shapiro-Wilk (Shapiro & Wilk, 1965), unanimement considéré comme l’étalon-or pour l’évaluation de la normalité sur de petits et moyens échantillons ($n < 50$).
Le formalisme mathématique de Shapiro-Wilk repose sur l’analyse de la régression linéaire des statistiques d’ordre d’échantillon (les observations ordonnées de manière croissante) par rapport aux valeurs attendues des quantiles de la loi normale théorique standard. La statistique $W$ mesure le carré du coefficient de corrélation linéaire entre ces grandeurs : une valeur proche de 1 atteste de la parfaite linéarité et donc de la normalité du profil distributionnel.
Sur le plan de la puissance statistique, Shapiro-Wilk surpasse systématiquement Jarque-Bera pour les échantillons de taille restreinte ($n < 30$), car il intègre l'ensemble de l'information ordinale et quantile plutôt que de se focaliser exclusivement sur deux moments globaux. En contrepartie, le test de Shapiro-Wilk s'avère extrêmement difficile à implémenter de manière native dans Microsoft Excel sans faire appel à des macros VBA complexes ou à des tables matricielles prédéfinies contenant les poids polynomiaux dépendants de $n$. Le test de Jarque-Bera présente donc une supériorité opérationnelle et pédagogique indéniable pour une mise en œuvre immédiate dans un tableur.
11.2 Le test de Kolmogorov-Smirnov / Lilliefors : Comparaison des fonctions cumulées
Le test historique de Kolmogorov-Smirnov repose sur un principe mathématique fondamentalement différent : la comparaison de la fonction de répartition empirique par paliers $S_n(x)$ avec la fonction de répartition cumulative théorique $F_0(x)$ de la loi normale. La statistique de test, notée $D$, est définie par la distance suprémum absolue séparant ces deux courbes intégrées :
$$D = \sup_x |S_n(x) – F_0(x)|$$
Lorsque les paramètres de moyenne et d’écart-type de la population sont inconnus et estimés à partir des données d’échantillon (ce qui constitue la quasi-totalité des contextes en recherche psychologique), le test doit impérativement adopter la correction de Lilliefors sous peine de sous-estimer drastiquement le taux de rejet sous $H_0$.
La faiblesse structurelle bien documentée du test de Kolmogorov-Smirnov / Lilliefors réside dans son manque notoire de puissance statistique pour détecter les anomalies logées spécifiquement dans les queues de distribution. Étant un test fondé sur l’écart vertical maximal, sa sensibilité est concentrée au voisinage de la médiane où la pente de la fonction de répartition est la plus raide. Une distribution présentant des queues très lourdes mais un centre bien calibré échappera couramment à la détection par le Kolmogorov-Smirnov, alors que le test de Jarque-Bera, grâce à son terme d’excès de kurtosis au carré, identifiera immédiatement la violation.
11.3 Avantages opérationnels et limites propres au test de Jarque-Bera
La synthèse comparative des forces et faiblesses du test de Jarque-Bera permet d’éclairer son positionnement méthodologique en sciences du comportement :
- Avantages opérationnels majeurs : Simplicité algorithmique absolue dans Excel ne nécessitant aucune fonction matricielle complexe ; sensibilité extrême à l’épaisseur des queues (détection optimale des distributions leptokurtiques et des mélanges de populations hétérogènes) ; indépendance par rapport au rangement ordinal des données (inutile de trier la colonne par ordre croissant).
- Limites structurelles : Puissance statistique dégradée sur de très petits échantillons ($n < 30$), avec une inflation possible de l'erreur de première espèce en raison de l'approximation par la loi du $\chi^2(2)$ ; vulnérabilité aux valeurs aberrantes individuelles extrêmes qui faussent instantanément le moment d'ordre 4, pouvant conduire au rejet de la normalité d'une distribution par ailleurs très bien calibrée.
12. Résolution des problèmes fréquents, limites de puissance et bonnes pratiques sur Excel
12.1 Corrections pour petits échantillons du test de Jarque-Bera
Pour pallier les faiblesses asymptotiques du test de Jarque-Bera sur des cohortes restreintes, plusieurs adaptations mathématiques ont été formalisées dans la littérature statistique. La modification la plus élégante a été proposée par Carlos Urzúa (1996), qui standardise rigoureusement les moments d’échantillonnage par leurs moyennes et variances exactes en échantillon fini sous $H_0$ :
Dans la formulation d’Urzúa, la variance exacte de l’estimateur d’asymétrie pour un échantillon fini $n$ s’écrit :
$$operatorname{Var}(\hat{S}) = \frac{6(n – 2)}{(n + 1)(n + 3)}$$
tandis que la variance exacte de l’estimateur d’aplatissement brut s’exprime selon :
$$operatorname{Var}(\hat{K}) = \frac{24n(n – 2)(n – 3)}{(n + 1)^2(n + 3)(n + 5)}$$
La statistique corrigée de Jarque-Bera ajustée pour petits échantillons ($JB^*$) s’implémente dans Excel en substituant les dénominateurs asymptotiques $6/n$ et $24/n$ par ces équations exactes :
=(E6^2 / ((6*(E2-2))/((E2+1)*(E2+3)))) + (E7^2 / ((24*E2*(E2-2)*(E2-3))/(((E2+1)^2)*(E2+3)*(E2+5))))
Cette statistique ajustée converge beaucoup plus fidèlement vers la loi du $\chi^2(2)$ dès que $n ge 20$, réduisant de façon spectaculaire les risques d’invalidation décisionnelle dans les études cliniques ou les protocoles de psychologie expérimentale à effectifs modérés.
12.2 Erreurs techniques typiques rencontrées dans Microsoft Excel
La mise en œuvre pratique du test dans Excel expose le praticien à plusieurs écueils algorithmiques récurrents qu’il convient d’anticiper :
- La double soustraction de la référence 3 dans le Kurtosis : Comme explicité à la section 7.2, la formule d’Excel
KURTOSIScalcule déjà l’excès d’aplatissement. Tenter d’écrire=(KURTOSIS(plage) - 3)dans l’équation de Jarque-Bera détruit la validité mathématique du test en déplaçant artificiellement le centre normatif à $-3$. - L’inversion de fonction Chi-carré : Une erreur fréquente réside dans la confusion entre les probabilités directes et les quantiles inverses. L’usage de la fonction
LOI.KHIDEUX.INVERSEouLOI.KHIDEUX.INVERSE.DROITEà la place deLOI.KHIDEUX.DROITEgénère une valeur d’abscisse au lieu d’une p-valeur probabiliste, déclenchant l’incompréhension face à des résultats textuels incohérents. - L’erreur d’adressage relatif lors des recopies incrémentées : Si le chercheur applique le test de Jarque-Bera sur plusieurs colonnes psychométriques adjacentes (par exemple 10 sous-échelles de personnalité), il doit veiller à verrouiller les lignes d’indices d’échantillonnage au moyen du caractère dollar (
$) pour éviter que les références aux moyennes ou aux effectifs ne dérivent verticalement lors des opérations de duplication.
12.3 Bonnes pratiques pour la documentation et le reporting académique (normes APA)
La finalisation d’un protocole d’analyse de normalité implique une restitution textuelle conforme aux standards méthodologiques internationaux de l’American Psychological Association (APA 7th edition). Les résultats d’un test de Jarque-Bera doivent obligatoirement documenter la valeur de la statistique $JB$, ses degrés de liberté, la p-valeur exacte ainsi que les valeurs brutes de l’asymétrie et de l’aplatissement :
Exemple de formulation académique normalisée :
« L’adéquation de la distribution des scores d’anxiété de l’échantillon ($N = 150$) aux postulats de la normalité a été évaluée au moyen du test de Jarque-Bera. Les coefficients d’asymétrie d’échantillon ($S = 0{,}18$) et d’excès de kurtosis ($C = 0{,}34$) n’ont révélé aucune distorsion morphologique critique. La statistique globale de Jarque-Bera s’est avérée non significative, $JB(2) = 0{,}98$, $p = 0{,}612$, confirmant que la distribution empirique est pleinement compatible avec le postulat de normalité pour les modèles linéaires subséquents. »
Enfin, dans l’esprit de l’Open Science et de la transparence méthodologique, il est fortement conseillé d’archiver la feuille de calcul Excel native dans des dépôts publics de recherche (comme le Center for Open Science – OSF). La conservation d’une feuille Excel aux formules intégralement déployées et commentées garantit l’auditabilité parfaite de la démarche et assure une réplicabilité optimale des protocoles empiriques en recherche psychologique.
Références
- Bera, A. K., & Jarque, C. M. (1981). Efficient tests for normality, homoscedasticity and serial independence of regression residuals: Monte Carlo evidence. Economics Letters, 7(4), 313-318. https://doi.org/10.1016/0165-1765(81)90035-5
- Biau, D. J., Kernéis, S., & Porcher, R. (2008). Statistics in brief: The importance of testing for normality and what to do about it. Clinical Orthopaedics and Related Research, 466(9), 2284-2288. https://doi.org/10.1007/s11999-008-0348-1
- Cain, M. K., Zhang, Z., & Yuan, K. H. (2017). Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation. Behavior Research Methods, 49(5), 1716-1735. https://doi.org/10.3758/s13428-016-0814-1
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). Sage Publications. https://www.sagepub.com
- Jarque, C. M., & Bera, A. K. (1980). Efficient tests for normality, homoscedasticity and serial independence of regression residuals. Economics Letters, 6(3), 255-259. https://doi.org/10.1016/0165-1765(80)90024-5
- Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review / Revue Internationale de Statistique, 55(2), 163-172. https://doi.org/10.2307/1403192
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156-166. https://doi.org/10.1037/0033-2909.105.1.156
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21-33. https://www.semanticscholar.org
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson. https://www.pearson.com
- Urzúa, C. M. (1996). On the correct use of Omnibus tests for normality. Economics Letters, 53(3), 247-251. https://doi.org/10.1016/S0165-1765(96)00923-8