
Dans le champ des sciences quantitatives contemporaines, de l’économétrie à la psychologie cognitive et comportementale, la modélisation par régression linéaire constitue un outil fondamental pour appréhender les dynamiques associatives et prédictives entre variables d’intérêt. L’estimation par les moindres carrés ordinaires (MCO) repose néanmoins sur un ensemble d’hypothèses strictes formalisées par le théorème de Gauss-Markov. Parmi ces postulats, l’absence de corrélation sérielle entre les termes d’erreur stochastiques s’avère particulièrement critique dès lors que les données collectées comportent une dimension temporelle, séquentielle ou hiérarchique. Lorsque les résidus d’un modèle présentent une dépendance séquentielle, l’ensemble des inférences déduites des tests d’hypothèse classiques se trouve irrémédiablement compromis, augmentant drastiquement le risque de rejeter à tort l’hypothèse nulle d’absence d’effet.
Le test développé conjointement par James Durbin et Geoffrey Watson au début des années 1950 demeure la procédure diagnostique de référence pour détecter l’autocorrélation d’ordre un au sein des résidus de régression. Bien que les environnements informatiques spécialisés tels que R, SAS ou SPSS intègrent nativement des routines d’évaluation de cette statistique, la maîtrise de son exécution dans Microsoft Excel revêt un intérêt pédagogique et analytique exceptionnel. Le tableur impose une désagrégation explicite des différentes composantes arithmétiques du test, offrant ainsi aux chercheurs, analystes de données et étudiants une compréhension intime des mécanismes de variance et de covariance qui sous-tendent la détection de la dépendance sérielle.
Cet article propose un traité méthodologique exhaustif guidant le lecteur à travers les fondements mathématiques, les implications théoriques et les étapes concrètes de mise en œuvre du test de Durbin-Watson au sein de Microsoft Excel. De la configuration initiale de l’Utilitaire d’analyse jusqu’à l’implémentation de macros automatisées en Visual Basic for Applications (VBA), en passant par le traitement rigoureux des tables de valeurs critiques et des zones d’indécision, ce guide offre une référence complète pour consolider la validité interne de vos modélisations linéaires séquentielles.
1. Fondements théoriques de la régression linéaire et hypothèse d’indépendance des résidus
1.1 Les postulats fondamentaux de Gauss-Markov en modélisation statistique
L’estimation des paramètres au sein d’une régression linéaire classique par la méthode des moindres carrés ordinaires s’appuie sur le respect scrupuleux des conditions énoncées par le théorème de Gauss-Markov. Selon ce cadre fondamental, les estimateurs des coefficients de régression sont qualifiés de BLUE (Best Linear Unbiased Estimators, soit les meilleurs estimateurs linéaires non biaisés), garantissant qu’ils possèdent la variance minimale parmi l’ensemble des estimateurs linéaires sans biais envisageables. L’un des piliers de cette démonstration est l’hypothèse stipulant que l’espérance conditionnelle des perturbations stochastiques est nulle, doublée de l’homoscédasticité, qui requiert une variance constante de ces erreurs sur l’ensemble des observations.
Au-delà de ces deux premières exigences, l’hypothèse de non-corrélation sérielle des termes d’erreur joue un rôle déterminant. Elle postule formellement que la covariance entre le terme d’erreur d’une observation donnée à l’instant t et celui d’une observation antérieure ou ultérieure à l’instant s est strictement égale à zéro pour tout t différent de s. En psychologie quantitative et dans l’étude des séries temporelles comportementales, cette condition d’orthogonalité temporelle est fréquemment menacée. Les mesures répétées issues d’un même sujet ou les séries chronologiques macro-sociales intègrent naturellement une persistance mémorielle qui défie l’indépendance statistique supposée des résidus.
Il importe de clarifier la distinction conceptuelle majeure entre les erreurs stochastiques sous-jacentes, notées traditionnellement par la lettre grecque epsilon, et les résidus observés, notés e. Les perturbations stochastiques représentent une entité théorique inobservable, reflétant l’ensemble des influences aléatoires omises dans l’équation de la population parente. En revanche, les résidus correspondent aux déviations empiriques mesurées entre la valeur observée de la variable dépendante et la prédiction générée par la droite de régression estimée sur l’échantillon. Bien que le théorème de Gauss-Markov formule ses exigences vis-à-vis des erreurs inobservables, les praticiens sont contraints de porter leur diagnostic exclusivement sur les résidus d’échantillonnage, rendant indispensable l’application d’outils statistiques spécifiquement calibrés pour cette extrapolation.
1.2 La notion d’autocorrélation des résidus : typologies et mécanismes sous-jacents
L’autocorrélation sérielle survient lorsque les erreurs successives d’un modèle de régression ne sont pas indépendantes les unes des autres, mais manifestent une structure de dépendance interne. La forme la plus élémentaire et la plus répandue de cette distorsion est l’autocorrélation de premier ordre, formellement modélisée comme un processus autorégressif d’ordre 1, abrégé AR(1). Dans un tel schéma, l’erreur stochastique à la période courante t s’exprime comme une fraction de l’erreur observée à la période précédente t-1, à laquelle s’ajoute un bruit blanc purement aléatoire. Le coefficient d’autocorrélation rho quantifie l’intensité et le signe de cette association linéaire.
On distingue traditionnellement l’autocorrélation positive de l’autocorrélation négative. L’autocorrélation positive, de loin la plus fréquente dans les sciences comportementales et économiques, se manifeste par une persistance systématique : un résidu positif à l’instant t a une probabilité accrue d’être suivi par un résidu également positif à l’instant t+1. Inversement, des résidus négatifs ont tendance à s’agréger en grappes consécutives. L’autocorrélation négative, bien que plus rare, se caractérise par une alternance oscillatoire rapide et contre-nature, où les résidus positifs et négatifs se succèdent de façon pendulaire d’une mesure à la suivante.
Les origines de cette violation sont plurielles. L’omission d’une variable explicative structurante présentant elle-même une dynamique temporelle constitue la cause première la plus récurrente. De surcroît, une mauvaise spécification de la forme fonctionnelle du modèle—par exemple l’utilisation d’une relation strictement linéaire pour approximer un phénomène biologique ou cognitif fondamentalement quadratique ou exponentiel—induit mécaniquement des résidus corrélés dans le temps. Dans les protocoles expérimentaux répétés et les études longitudinales, l’inertie émotionnelle des participants, les effets d’apprentissage progressif ou encore l’accumulation de fatigue constituent des vecteurs psychologiques directs de corrélation sérielle non modélisée.
1.3 Conséquences statistiques de la violation du postulat d’indépendance
La persistance de l’autocorrélation des résidus engendre des distorsions analytiques sévères qui sapent l’ensemble de la démarche inférentielle. Il est essentiel de souligner que la présence d’une corrélation sérielle n’affecte pas la propriété de convergence ni le caractère sans biais des estimateurs des coefficients de régression calculés par les moindres carrés ordinaires, pourvu que les prédicteurs demeurent strictement exogènes. En d’autres termes, les coefficients calculés convergent toujours vers la véritable valeur du paramètre de population à mesure que la taille de l’échantillon tend vers l’infini.
Néanmoins, la violation du postulat d’indépendance détruit irrémédiablement l’efficacité statistique des estimateurs. Les estimateurs MCO cessent d’être à variance minimale, ce qui signifie qu’il existe d’autres estimateurs, tels que ceux issus des moindres carrés quasi-généralisés, offrant une précision nettement supérieure. Plus grave encore, la formule conventionnelle utilisée par les logiciels pour calculer la matrice de variance-covariance des coefficients devient structurellement invalide. En présence d’une autocorrélation positive, la variance estimée des coefficients est systématiquement sous-estimée, donnant l’illusion trompeuse d’une précision analytique accrue.
Cette sous-estimation de la variance standard engendre une inflation spectaculaire des statistiques de Student (test t) et de Fisher (test F). Les intervalles de confiance se trouvent artificiellement rétrécis, tandis que les valeurs de significativité empirique (valeurs-p) s’effondrent artificiellement. Ce phénomène conduit à une explosion incontrôlée du taux d’erreur de type I : le chercheur conclut triomphalement à la significativité statistique de prédicteurs comportementaux ou cliniques qui ne sont en réalité que des artefacts imputables à la structure séquentielle non corrigée des résidus du modèle.
2. Le test de Durbin-Watson : principes statistiques et formulation mathématique
2.1 Formulation formelle des hypothèses nulle et alternative
Le test développé par Durbin et Watson (1950) repose sur un cadre inférentiel paramétrique strict, conçu pour évaluer la présence d’une structure autorégressive de premier ordre au sein des erreurs d’une régression. La formulation formelle des hypothèses s’énonce à partir du paramètre d’autocorrélation rho de l’équation des perturbations. L’hypothèse nulle (H0) pose de manière principielle l’absence totale de dépendance séquentielle entre les observations contiguës, soit rho égal à 0. Sous cette hypothèse, le modèle satisfait pleinement le postulat d’indépendance sérielle de Gauss-Markov.
L’hypothèse alternative (HA) peut être formulée de manière unilatérale ou bilatérale selon les attendus théoriques du protocole de recherche. Dans la majorité des applications en sciences sociales et comportementales, où l’on soupçonne une inertie temporelle, l’hypothèse alternative teste unilatéralement la présence d’une autocorrélation positive, soit rho strictement supérieur à 0. Cependant, une formulation bilatérale stipulant simplement que rho est non nul permet de couvrir simultanément l’éventualité d’une alternance négative des termes d’erreur, garantissant ainsi un balayage diagnostique exhaustif.
La validité méthodologique du test de Durbin-Watson exige le respect de conditions structurelles intransigeantes. D’une part, le modèle de régression linéaire doit obligatoirement inclure un terme constant (l’ordonnée à l’origine), sous peine de biaiser la distribution de référence de la statistique de test. D’autre part, et cela représente une contrainte analytique déterminante, les variables explicatives doivent être strictement exogènes et ne peuvent en aucun cas intégrer la variable dépendante retardée (par exemple y à l’instant t-1). La présence d’un terme autorégressif parmi les régresseurs entraîne une convergence de la statistique de test vers la valeur 2, masquant entièrement l’autocorrélation sous-jacente.
2.2 Dérivation algébrique de la statistique d
La statistique de test d de Durbin-Watson est construite à partir de l’analyse comparative des résidus successifs générés par l’ajustement aux moindres carrés ordinaires. D’un point de vue algébrique, la formule s’articule sous la forme d’un ratio confrontant la variance des écarts séquentiels à la variance globale de l’échantillon. Le numérateur mesure la somme des carrés des différences observées entre le résidu à l’instant t et le résidu immédiatement antérieur à l’instant t-1, cette sommation débutant nécessairement à la deuxième observation (t = 2) jusqu’à la dernière (t = n).
Le dénominateur de la fraction correspond quant à lui à la somme totale des carrés de l’ensemble des résidus du modèle, sommation calculée pour t variant de 1 à n. Cette normalisation confère à la statistique une propriété invariante d’échelle, permettant de neutraliser l’amplitude absolue des unités de mesure employées dans l’étude. En développant le carré présent au numérateur, l’expression se décompose en trois termes distincts : la somme des carrés des résidus courants, la somme des carrés des résidus retardés, et le double de la somme des produits croisés entre résidus consécutifs.
Lorsque la taille d’échantillon n devient modérément large, la somme des résidus décalés au carré converge asymptotiquement vers la somme des résidus courants au carré. En factorisant cette approximation fondamentale, il apparaît une relation mathématique universelle reliant la statistique d au coefficient d’autocorrélation empirique des résidus, noté r ou rho chapeau. L’expression se simplifie de manière remarquable sous la forme : d est approximativement égal à 2 multiplié par le facteur (1 moins rho chapeau). Cette équivalence algébrique fonde l’ensemble de la grille d’interprétation empirique de la statistique.
2.3 Échelle d’interprétation et intervalle théorique de la statistique
L’intervalle théorique au sein duquel peut fluctuer la statistique d de Durbin-Watson est strictement borné entre 0 et 4, conséquence directe de la dérivation mathématique précédente. Si les perturbations stochastiques sont rigoureusement indépendantes les unes des autres, le coefficient d’autocorrélation rho chapeau converge vers zéro. En appliquant la formule d’approximation, la statistique d adopte une valeur exactement égale ou très proche de 2. Ainsi, toute valeur gravitant dans le voisinage immédiat de 2 constitue un indice robuste en faveur de l’absence de corrélation sérielle d’ordre 1.
À l’inverse, lorsque l’échantillon est contaminé par une autocorrélation positive maximale, le coefficient empirique rho tend vers sa limite supérieure de +1. Par substitution dans l’équation, le terme (1 moins 1) s’annule, entraînant l’effondrement de la statistique d vers sa borne inférieure de 0. Par conséquent, plus la statistique d observée s’approche de 0, plus la certitude d’une dépendance temporelle positive s’accroît. Une valeur inférieure à 1,5 éveille couramment de sérieuses inquiétudes quant à la validité des écarts-types estimés par le modèle linéaire standard.
Symétriquement, lorsqu’un phénomène de balancement pendulaire induit une autocorrélation négative extrême, le coefficient rho s’approche de -1. L’expression mathématique devient alors 2 multiplié par (1 moins -1), ce qui propulse la statistique d vers sa limite supérieure absolue de 4. Toutefois, la détermination des seuils de décision ne peut s’effectuer à partir d’un point de rupture unique. En raison de la dépendance de la distribution exacte de d vis-à-vis de la matrice particulière des variables explicatives X, l’espace d’évaluation comporte des bornes d’indécision statistiques irréductibles, articulées autour d’une borne inférieure dL et d’une borne supérieure dU.
3. Configuration préalable de Microsoft Excel pour l’analyse de régression
3.1 Activation de l’Utilitaire d’analyse (Analysis ToolPak)
Pour procéder au calcul des résidus d’une régression au sein de Microsoft Excel sans devoir coder manuellement l’inversion matricielle de Gauss, l’activation du complément intégré nommé Utilitaire d’analyse (Analysis ToolPak) s’avère indispensable. Sous les environnements Windows récents, cette opération nécessite d’accéder au menu principal en sélectionnant l’onglet Fichier, puis en cliquant sur Options situé tout en bas de la barre latérale. Dans la boîte de dialogue contextuelle qui s’affiche, la navigation s’oriente vers la rubrique dédiée aux Compléments.
Au bas de la fenêtre des compléments, un menu déroulant intitulé Gérer affiche par défaut la mention Compléments Excel. Un clic sur le bouton Atteindre… ouvre une sous-fenêtre spécifique recensant les modules analytiques natifs du logiciel. Il convient alors de cocher expressément la case intitulée Utilitaire d’analyse, puis de valider l’opération en cliquant sur OK. Pour les utilisateurs évoluant sous l’environnement macOS, le cheminement diffère légèrement : l’accès s’effectue via le menu supérieur Outils, puis en sélectionnant la commande Compléments Excel… pour atteindre la même boîte de sélection.
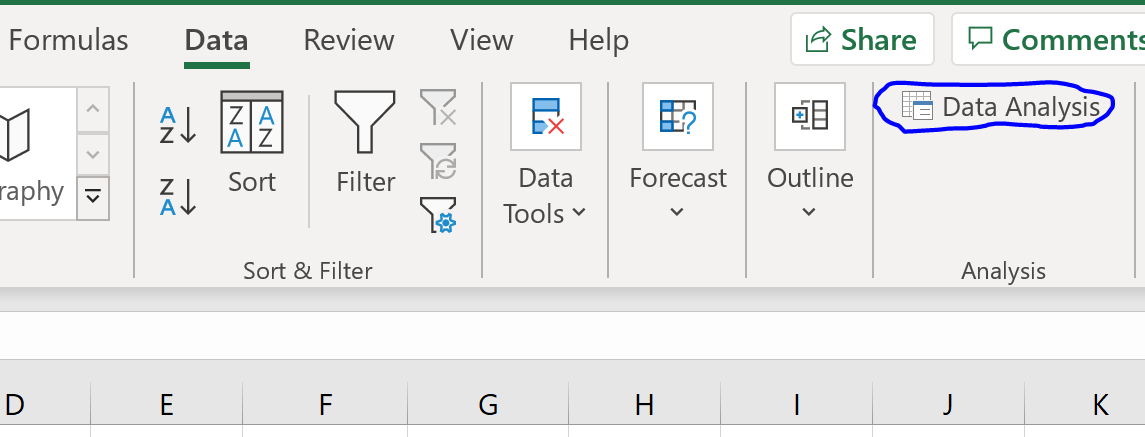
Une fois cette validation exécutée, l’intégration du module se matérialise visuellement par l’apparition d’un nouveau bloc fonctionnel nommé Analyse à l’extrémité droite de l’onglet Données du ruban Excel. Ce bloc arbore le bouton Utilitaire d’analyse. Dans l’éventualité où le bouton ne se chargerait pas convenablement ou demeurerait grisé, un redémarrage complet de l’application permet généralement de purger le cache et d’ancrer définitivement la référence dynamique aux bibliothèques de calcul matriciel requises.
3.2 Organisation méthodologique de la feuille de calcul
La mise en œuvre d’un diagnostic d’autocorrélation exige une rigueur absolue dans la spatialisation des données tabulaires. Une feuille de calcul mal structurée induit inévitablement des erreurs de pointage référentiel lors de l’application des formules de décalage chronologique. Il est hautement recommandé de dédier une zone spécifique, typiquement les premières colonnes de la feuille (colonnes A à D), aux données primaires brutes. La première colonne doit impérativement être réservée à l’index temporel ou au numéro séquentiel d’observation, allant de 1 jusqu’à n sans interruption.
L’ordre chronologique des observations doit être maintenu de façon inflexible. Contrairement aux analyses de variance transversales où l’ordonnancement des lignes n’a aucun impact statistique, la logique séquentielle du test de Durbin-Watson repose sur la contiguïté stricte des mesures dans le temps. Tout tri alphabétique ou reclassement intempestif des observations selon une valeur de variable anéantirait irrémédiablement la structure de corrélation sérielle recherchée, rendant le calcul de la statistique dépourvu de sens.
De surcroît, la standardisation préalable des formats de cellules constitue un rempart essentiel contre les anomalies d’exécution. Les variables doivent être explicitement configurées en format Nombre avec un séparateur décimal uniforme (point ou virgule selon les paramètres régionaux du système d’exploitation). Enfin, il est méthodologiquement vertueux d’anticiper l’implantation des calculs futurs en segmentant visuellement l’espace de travail : une zone pour la matrice de données primaires, une zone dédiée aux résultats de régression générés par l’utilitaire, et une zone adjacente réservée aux colonnes arithmétiques du test de Durbin-Watson.
3.3 Contrôle qualité initial et nettoyage des données
Avant d’ajuster le moindre modèle de régression, un audit qualité rigoureux de la série séquentielle s’impose. La présence de données manquantes (cellules vides ou valeurs nulles non codées) représente l’écueil le plus dommageable pour le test de Durbin-Watson. Si une valeur est absente au sein d’une série chronologique, l’écart temporel entre l’observation précédente t-1 et l’observation subséquente t+1 passe de une à deux unités. Ce saut brise l’homogénéité du pas d’échantillonnage et biaise l’estimation de la corrélation sérielle de premier ordre.
Le chercheur doit arbitrer entre plusieurs techniques de prétraitement pour résoudre ces discontinuités : l’imputation par interpolation spline ou linéaire pour des données à dynamique stable, ou le fractionnement de l’analyse en sous-périodes continues étanches si les lacunes sont massives. De manière complémentaire, l’inspection visuelle préalable via un graphique de dispersion ou une boîte à moustaches permet de détecter les valeurs aberrantes (outliers) sévères. Un score déviant isolé exerce un effet de levier considérable sur la droite de régression, produisant localement un résidu artificiellement colossal qui faussera l’ensemble du calcul de la variance des différences.
Toute transformation mathématique préliminaire appliquée aux données—telle qu’une normalisation logarithmique pour stabiliser la variance ou une réduction z-score pour uniformiser les échelles psychométriques—doit être intégralement documentée sur la feuille de calcul. Ces ajustements préalables garantissent la reproductibilité scientifique de l’étude et certifient que l’analyse des résidus portera sur une série stabilisée respectant au mieux la linéarité fonctionnelle requise par l’outil de régression d’Excel.
4. Étape 1 : Saisie et préparation des données empiriques
4.1 Définition opérationnelle des variables du modèle
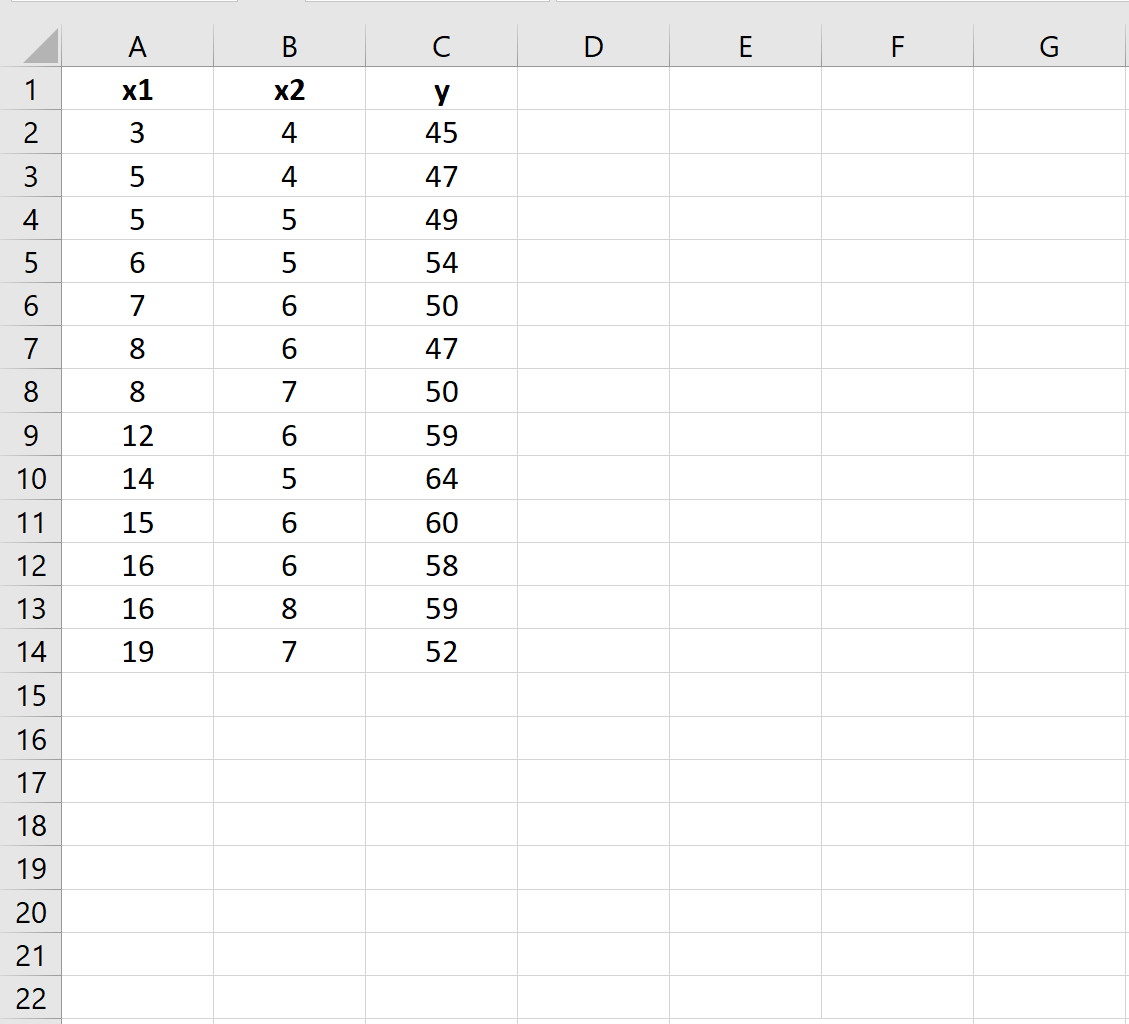
Pour exemplifier la procédure d’une manière concrète et opérationnelle, considérons une étude de cas issue de la recherche en neuropsychologie cognitive et du travail. Un laboratoire analyse l’influence de la charge cognitive cumulée et du niveau d’anxiété situationnelle sur les temps de réaction de contrôleurs aériens au cours d’un quart de travail intensif simulé de 60 périodes de mesure successives (n = 60). La définition rigoureuse des variables constitue le socle de toute l’architecture de régression.
La variable à expliquer, ou variable dépendante notée Y, est représentée par le Temps de réaction moyen exprimé en millisecondes. Il s’agit d’une variable quantitative continue capturant la vitesse de traitement de l’information. D’autre part, deux prédicteurs quantitatifs continus sont intégrés au titre de variables indépendantes : la Charge cognitive perçue (X1), évaluée sur une échelle continue de 0 à 100 via des indices physiologiques de connectivité frontale, et l’Indice de stress physiologique (X2), quantifié par la conductance électrodermale moyenne au cours de chaque intervalle séquentiel.
Les variables de contrôle potentielles, telles que la température ambiante de la cabine de contrôle ou l’intensité lumineuse moyenne, doivent faire l’objet d’un recueil similaire ou être maintenues constantes au niveau expérimental. Il est impératif que toutes les métriques sélectionnées satisfassent aux propriétés de l’échelle d’intervalle ou de rapport afin de légitimer le recours aux opérations arithmétiques linéaires de l’estimation MCO et de préserver la validité conceptuelle des résidus qui en seront extraits.
4.2 Disposition matricielle des données dans la feuille de calcul
L’Utilitaire d’analyse de régression d’Excel impose une contrainte topologique formelle : l’ensemble des prédicteurs indépendants (les colonnes X) doit impérativement être structuré sous la forme d’un bloc contigu de colonnes adjacentes. Dès lors, si le modèle incorpore plusieurs variables explicatives, ces dernières ne peuvent être séparées par la variable dépendante ou par des colonnes d’annotations textuelles. La disposition doit être pensée pour épouser la logique matricielle interne de l’algorithme de résolution.
Une configuration optimale au sein de la feuille de calcul s’organise selon l’architecture suivante :
- Colonne A (A1:A61) : L’index séquentiel ou temporel (intitulé Période_t, de 1 à 60).
- Colonne B (B1:B61) : La variable dépendante Y (intitulée Temps_Reaction).
- Colonne C (C1:C61) : Le premier prédicteur X1 (intitulé Charge_Cognitive).
- Colonne D (D1:D61) : Le second prédicteur X2 (intitulé Stress_Physiologique).
Chaque ligne d’observation de 2 à 61 capture un instant séquentiel unique, garantissant que l’axe chronologique progresse de manière unidirectionnelle du haut vers le bas du tableau sans discontinuité.
L’inclusion d’en-têtes explicites en ligne 1 est vivement recommandée. Elle évite toute confusion lors de la manipulation des plages de données et fiabilise le paramétrage ultérieur des boîtes de dialogue. Enfin, il convient de figer les volets supérieurs pour maintenir la visibilité de la dénomination des variables lors du défilement des dizaines de lignes de données temporelles, minimisant ainsi les risques d’erreur de saisie manuelle ou de désynchronisation de vecteur.
4.3 Inspection exploratoire préalable des variables
Avant d’engager le processus d’ajustement économétrique ou psychométrique, une inspection visuelle préliminaire de la distribution temporelle des données est indispensable. Au moyen de l’onglet Insertion d’Excel, la génération d’un graphique linéaire de type Courbe 2D représentant la variable dépendante Y en fonction du temps permet d’apprécier la morphologie globale de la série. Cette démarche initiale vise à identifier la présence manifeste d’une tendance linéaire déterministe ou de cycles périodiques prononcés.
L’absence apparente de stationnarité—illustrée par exemple par une dérive continue à la hausse du temps de réaction sous l’effet de l’épuisement neurophysiologique—constitue une source prévisible d’autocorrélation résiduelle si cette tendance n’est pas modélisée par l’introduction d’un prédicteur de temps explicite. De façon analogue, le tracé des variables X1 et X2 offre l’opportunité de repérer des sauts structurels brutaux ou des ruptures de dynamique induites par un incident d’enregistrement expérimental.
Le calcul de statistiques descriptives élémentaires (moyenne empirique, écart-type, coefficient d’asymétrie) via les formules standards `MOYENNE()` et `ECARTYPE.STANDARD()` permet d’étalonner la dispersion des variables. Si un prédicteur présente une variance quasi-nulle, il risque d’induire une singularité quasi-singulière dans l’inversion de la matrice X’X, perturbant le calcul des coefficients de régression et faussant l’évaluation finale du test de Durbin-Watson.
5. Étape 2 : Ajustement du modèle de régression linéaire multiple
5.1 Paramétrage de la boîte de dialogue de régression d’Excel
L’ajustement du modèle linéaire s’opère en sollicitant l’Utilitaire d’analyse. Depuis l’onglet Données, cliquez sur Utilitaire d’analyse, faites défiler la liste alphabétique des outils analytiques disponibles et sélectionnez la mention Régression, puis confirmez par OK. Une interface modale s’ouvre, exigeant le renseignement rigoureux des coordonnées spatiales des variables à traiter.
Dans le champ intitulé Plage d’entrée Y, sélectionnez avec précision la plage englobant la variable dépendante ainsi que son en-tête, à savoir la référence absolue $B$1:$B$61 pour notre jeu de données expérimental. Dans le champ Plage d’entrée X, pointez la souris sur le bloc contigu des prédicteurs, en sélectionnant l’ensemble des colonnes C et D incluant leurs titres respectifs, soit la plage $C$1:$D$61.
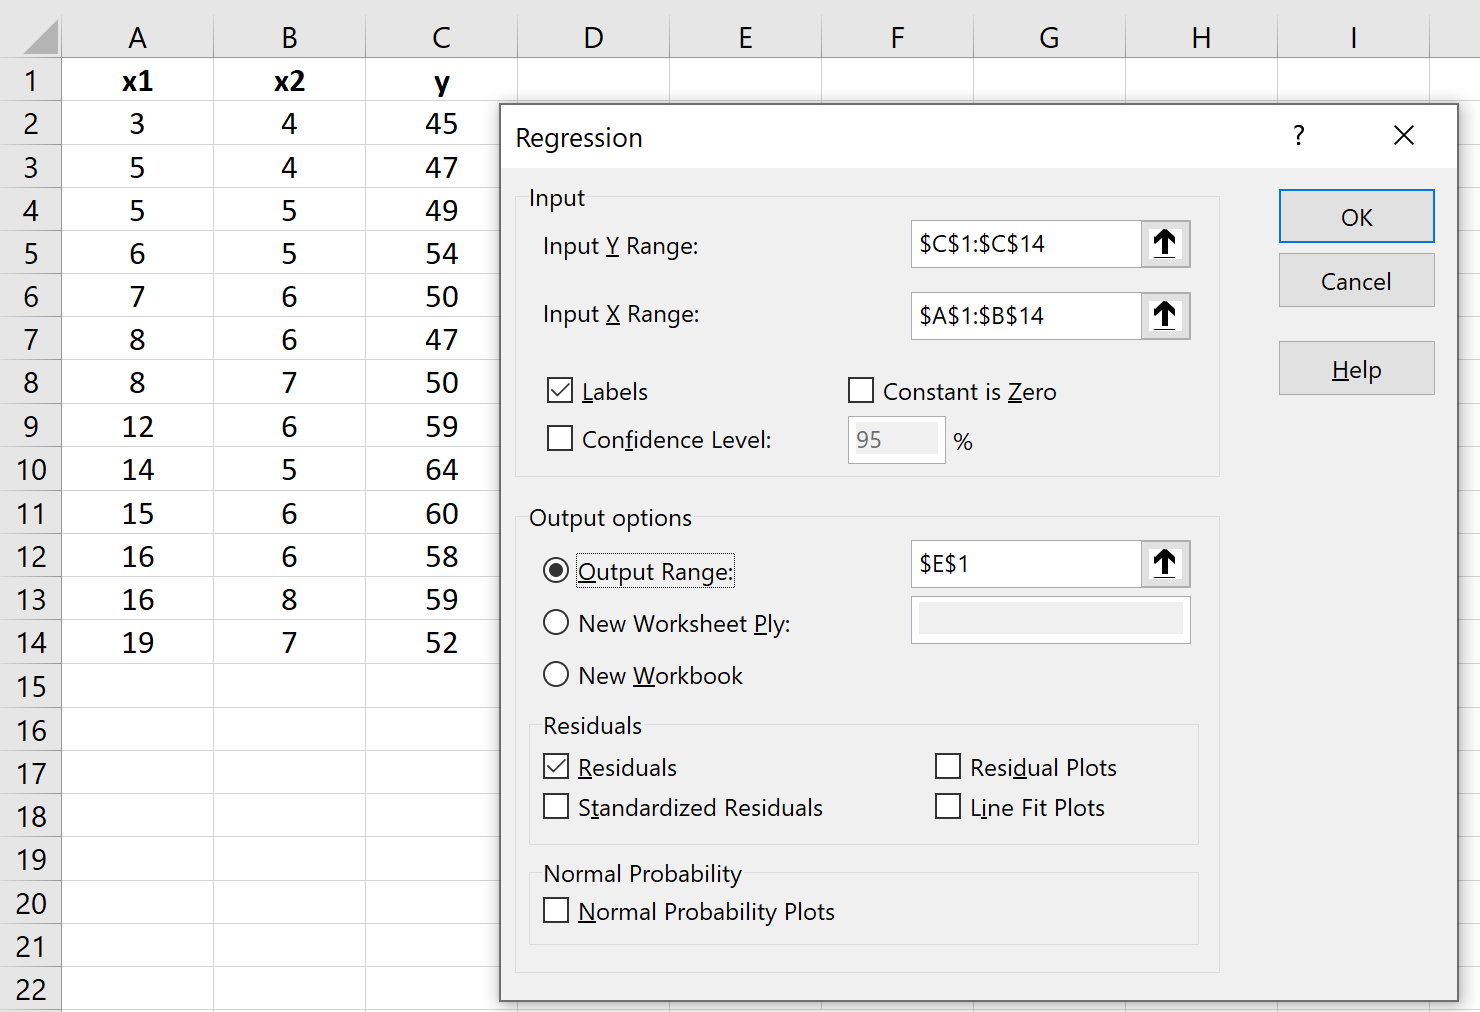
Il est impératif de cocher la case Intitulés (ou Labels dans les versions anglophones), ce qui signale explicitement au compilateur statistique d’Excel que la première cellule de chaque vecteur correspond à un nom textuel de variable et non à une donnée numérique. Le niveau de confiance par défaut est fixé à 95 %, ce qui correspond au seuil conventionnel alpha de 5 % utilisé dans la vaste majorité des recherches empiriques ; cette option peut demeurer cochée telle quelle.
5.2 Extraction obligatoire des résidus du modèle
La réussite méthodologique du diagnostic repose entièrement sur la configuration des options de sortie situées dans la moitié inférieure de la boîte de dialogue de régression. Par défaut, Excel se limite à générer les tables de synthèse statistique (R², ANOVA et coefficients). Pour pouvoir calculer la statistique de Durbin-Watson, il est absolument indispensable de cocher la case d’option intitulée Résidus (Residuals).
Il importe de ne pas confondre les Résidus ordinaires avec les Résidus normalisés (ou standardisés). Les résidus ordinaires correspondent aux écarts bruts e_t = y_t – y_chapeau_t, exprimés dans l’unité métrique originelle de la variable dépendante. La statistique de Durbin-Watson s’appuie historiquement sur ces résidus bruts. La sélection des résidus normalisés produirait un résultat numériquement quasi-identique du fait du ratio d’homogénéité, mais s’écarterait du formalisme algébrique standard.
Au niveau des options de restitution spatiale des résultats, il est fortement préconisé de cocher l’option Une nouvelle feuille de calcul en la nommant par exemple Sortie_Regression, ou de désigner une Plage de sortie locale débutant à la cellule $F$1 sur la même feuille si l’on préfère conserver l’ensemble des calculs sur un panneau visuel unifié. Une fois les sélections confirmées, cliquez sur OK pour lancer le calcul matriciel des moindres carrés ordinaires.
5.3 Interprétation préliminaire du sommaire de sortie
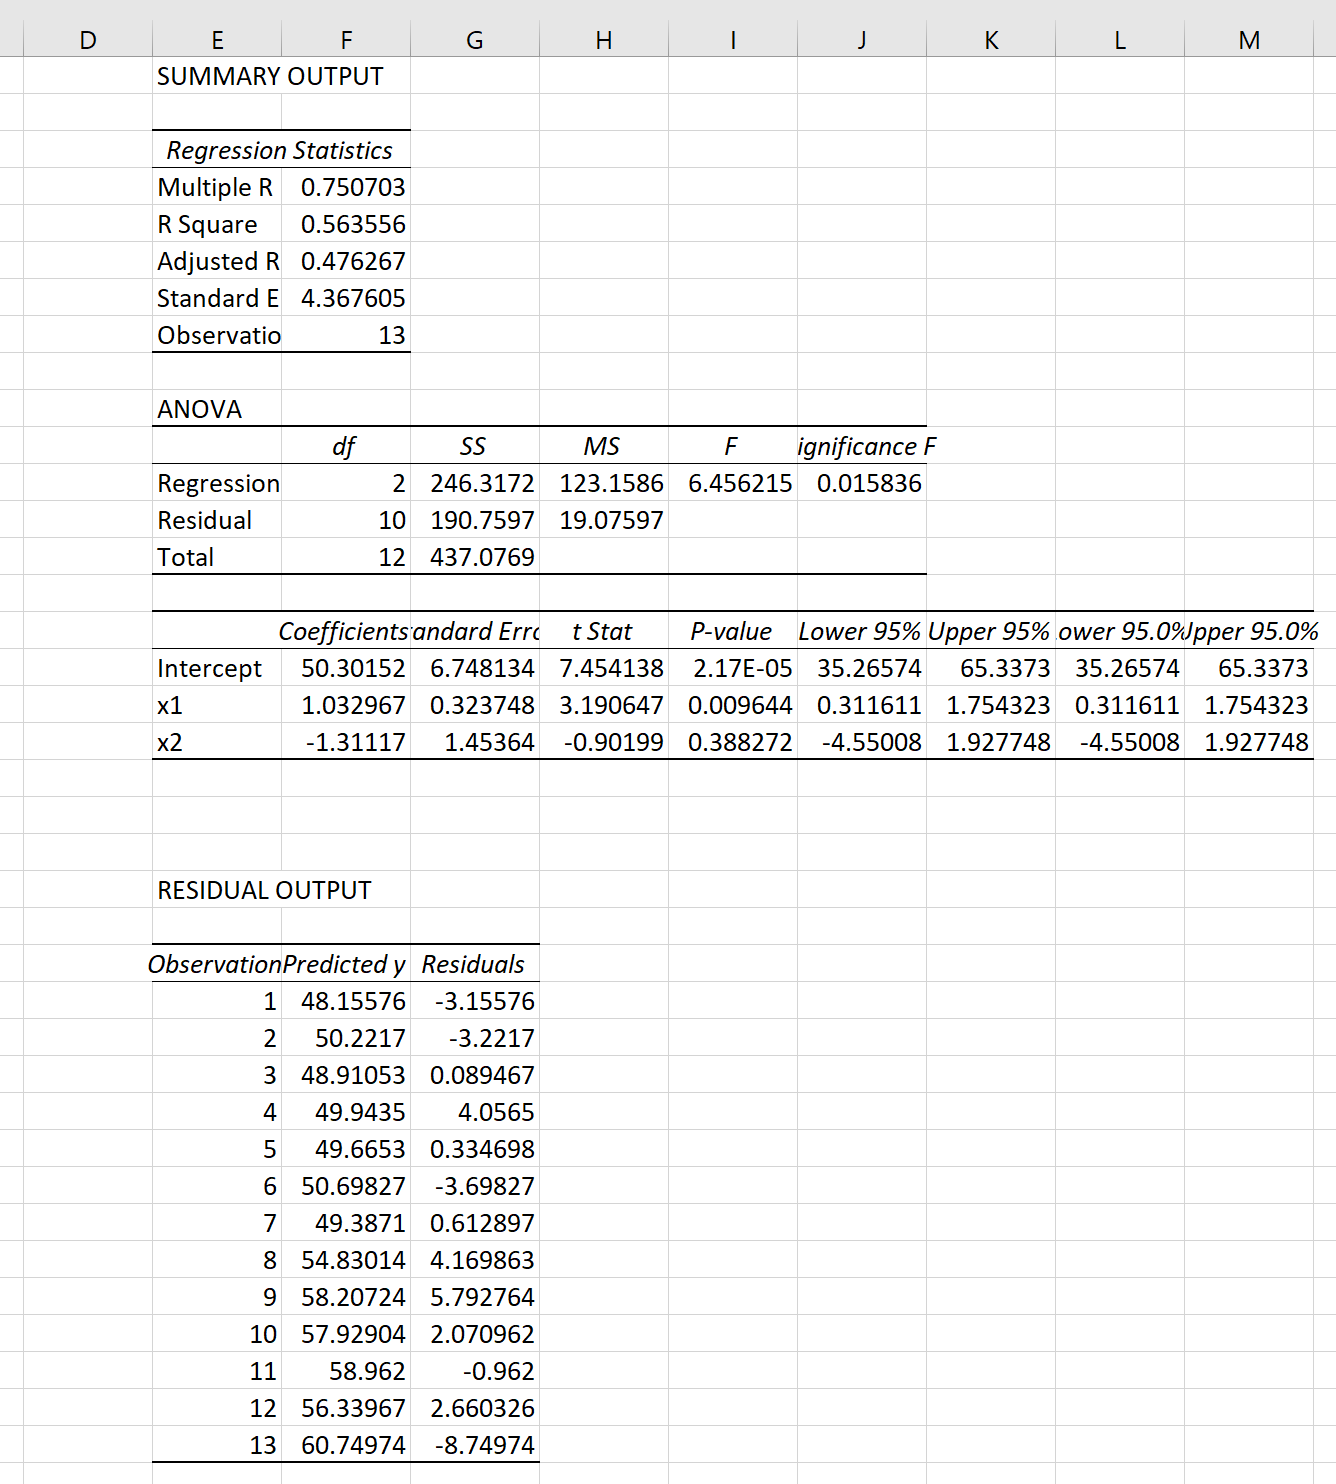
L’exécution de la routine génère instantanément trois tableaux canoniques d’analyse statistique : le tableau des Statistiques de la régression, la table de l’Analyse de variance (ANOVA) et la table d’estimation des Coefficients. L’examen attentif du coefficient de détermination R² et du R² ajusté offre un premier éclairage sur la proportion de variance des temps de réaction expliquée conjointement par la charge cognitive et le stress physiologique.
L’examen de la ligne de régression dans le tableau de l’ANOVA permet de vérifier si la statistique F globale atteint le seuil critique de significativité statistique (valeur critique de F inférieure à 0,05). Si le modèle dans son ensemble ne s’avère pas statistiquement prédictif, l’interprétation des résidus perd de sa substance méthodologique, car les erreurs reflètent principalement le bruit de fond d’un modèle non pertinent. Dans notre cas de figure hypothétique, la significativité globale est pleinement établie.
Enfin, en dessous de la table des coefficients, se trouve le bloc névralgique pour notre objectif : la Table des sorties des résidus. Ce tableau comprend trois colonnes : le numéro de l’observation (de 1 à 60), la Valeur prédite pour Y calculée par l’équation de régression, et la colonne vitale des Résidus bruts. C’est à partir de ce vecteur de déviations individuelles que va s’opérer la construction manuelle des sommes nécessaires au test de Durbin-Watson.
6. Étape 3 : Calcul des composantes arithmétiques du test dans Excel
6.1 Génération de la série des résidus décalés dans le temps
Une fois les résidus bruts extraits, l’étape suivante consiste à construire méthodiquement l’architecture arithmétique de la formule de Durbin-Watson. Supposons que, pour des raisons de clarté analytique, vous ayez recopié la colonne des résidus bruts sur une nouvelle feuille dédiée au diagnostic, ou que vous vous positionniez directement à droite de la table des résidus générée. Supposons que vos résidus bruts se situent dans la plage B2:B61, la cellule B2 correspondant au premier résidu e_1 et la cellule B61 au dernier résidu e_60.
Pour construire la série des résidus retardés d’une période, couramment désignée par la notation e_{t-1}, insérez un en-tête explicite dans la colonne adjacente, par exemple en cellule C1 : Residu_Lag1. Dans la cellule C2, qui correspond à la première période temporelle t = 1, il est formellement impossible de disposer d’une valeur antérieure, puisque l’observation t = 0 n’existe pas dans le protocole empirique. La cellule C2 doit donc demeurer impérativement vide ou contenir la mention `#N/A` pour prévenir tout calcul erroné.
Le calcul du retard débute concrètement à la ligne 3 (correspondant à la deuxième observation, t = 2). Dans la cellule C3, saisissez l’instruction d’affectation dynamique suivante :
=B2
Cette syntaxe affecte à la période courante le résidu de la période immédiatement précédente. Étendez ensuite cette formule vers le bas par double-clic sur la poignée de recopie jusqu’à la cellule C61. Vous obtenez ainsi un alignement rigoureux où chaque cellule de la colonne C présente le terme résiduel de rang t-1 associé au terme résiduel courant de rang t situé dans la colonne B.
6.2 Calcul des différences successives de résidus
La formulation algébrique de Durbin-Watson exige de mesurer l’amplitude du changement intervenu dans les résidus d’une unité de temps à la suivante, soit la différence finie e_t – e_{t-1}. Positionnez-vous sur la colonne adjacente D et inscrivez en cellule D1 l’en-tête suivant : Diff_Residus. Tout comme pour la colonne de décalage, la ligne 2 (observation 1) ne peut faire l’objet d’aucune soustraction valide en raison de l’absence de terme antérieur.
Le calcul des écarts commence donc strictement à la ligne 3. Dans la cellule D3, entrez la formule arithmétique suivante :
=B3-C3
Cette opération soustrait le résidu de l’instant précédent (C3, qui équivaut à B2) du résidu de l’instant courant (B3). Le résultat reflète la fluctuation nette de l’erreur entre les deux pas d’échantillonnage consécutifs. Si les résidus manifestent une forte autocorrélation positive, ils sont de signe identique et d’amplitude très proche, rendant cette différence particulièrement ténue.
Copiez cette formule vers le bas jusqu’à la cellule D61 en utilisant la poignée d’extension incrémentielle. Veillez scrupuleusement à ce qu’aucune référence circulaire ne vienne parasiter le tableau. Un contrôle visuel rapide permet de s’assurer de la cohérence des signes : si B3 vaut -4,2 et C3 vaut -4,0, la cellule D3 doit obligatoirement afficher -0,2. La précision de calcul doit être conservée au format standard sans troncature artificielle par des arrondis prématurés.
6.3 Élévation au carré et calcul des sommes requises
La statistique de test d s’appuie sur la somme des carrés de ces variations d’une part, et sur la somme des carrés de l’intégralité des résidus d’autre part. Pour préserver la décomposition pédagogique du processus, nous allons allouer deux colonnes supplémentaires aux opérations d’élévation à la puissance 2 avant de procéder aux sommations consolidées.
Dans la colonne E, intitulée Diff_Au_Carre, positionnez-vous sur la cellule E3 et insérez la formule arithmétique :
=D3^2
Déployez cette formule de E3 à E61. Chaque cellule de cette plage contient désormais le carré de la variation séquentielle entre deux résidus contigus. Les valeurs obtenues sont nécessairement toutes positives ou nulles, neutralisant les effets d’annulation mutuelle des signes négatifs lors de la sommation ultérieure.
Parallèlement, dans la colonne F, intitulée Residu_Au_Carre, saisissez en cellule F2 la formule d’élévation au carré du résidu brut individuel :
=B2^2
Cette instruction doit s’appliquer impérativement dès la ligne 2 (observation t = 1) et s’étendre jusqu’à la cellule F61. En effet, le dénominateur de la formule théorique de Durbin-Watson cumule les carrés de l’ensemble des résidus de l’échantillon, de 1 à n, et non pas uniquement à partir de la seconde observation.
Il ne reste plus qu’à dériver les deux termes scalaires essentiels au sein de deux cellules isolées, par exemple en H2 et H3 :
- En H2 (le Numérateur) : saisissez
=SOMME(E3:E61). Cette expression calcule la somme des carrés des différences de résidus consécutifs sur les n – 1 transitions. - En H3 (le Dénominateur) : saisissez
=SOMME(F2:F61), ou alternativement en utilisant la fonction native dédiée=SOMME.CARRES(B2:B61)directement appliquée sur la colonne des résidus bruts.
7. Étape 4 : Dérivation finale et automatisation de la statistique d
7.1 Calcul de la statistique d à partir des sommes obtenues
La dérivation finale de la statistique de Durbin-Watson s’opère par une opération de division élémentaire confrontant le numérateur et le dénominateur précédemment calculés. Dans une cellule dédiée et mise en exergue, par exemple la cellule H5 assortie de l’étiquette descriptive Statistique_d_Durbin_Watson en G5, insérez l’instruction arithmétique suivante :
=H2/H3
Le résultat numérique produit correspond à la valeur observée exacte de la statistique de test d pour votre modèle de régression.
Il convient de formater la cellule d’affichage pour présenter une précision usuelle à quatre décimales, conformément aux standards éditoriaux de l’American Psychological Association (APA) et des revues biométriques internationales. Si vos calculs intermédiaires sont rigoureusement exacts, la valeur obtenue doit obligatoirement s’insérer dans l’intervalle théorique compris entre 0 et 4. Une valeur négative ou supérieure à 4 signerait de manière infaillible une erreur de programmation, telle qu’une inversion entre le numérateur et le dénominateur ou un débordement de plage matricielle.
À titre d’auto-validation de la robustesse analytique, vous pouvez procéder à une estimation empirique directe du coefficient d’autocorrélation rho chapeau en saisissant dans une cellule voisine la formule suivante calculant la corrélation linéaire entre les résidus contemporains et les résidus décalés : =COEFFICIENT.CORRELATION(B3:B61; C3:C61). En appliquant la formule d’approximation théorique d = 2 * (1 – rho), la valeur obtenue doit converger de manière spectaculaire vers le résultat calculé en H5, apportant une confirmation croisée de l’exactitude de votre chaîne de calculs.
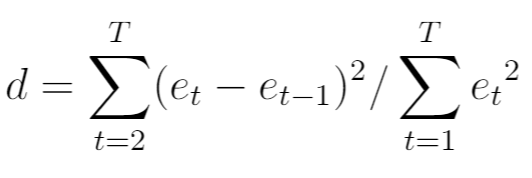
7.2 Alternative par fonctions matricielles sans colonnes intermédiaires
Bien que la décomposition pas à pas en colonnes intermédiaires soit incomparablement didactique, il s’avère souvent précieux dans la pratique professionnelle de pouvoir dériver la statistique de Durbin-Watson de manière compacte au sein d’une seule formule matricielle condensée, sans polluer la feuille de calcul avec de multiples colonnes auxiliaires de différences et de carrés.
Cette condensation élégante est rendue possible grâce à la puissance combinatoire de la fonction `SOMMEPROD()` d’Excel, capable de gérer nativement des opérations vectorielles sur des plages de données sans nécessiter la validation matricielle historique (Ctrl + Maj + Entrée) sous les versions modernes de Microsoft 365. En supposant toujours que le vecteur des résidus bruts généré par la régression est implanté sur la plage B2:B61, la statistique d peut être obtenue instantanément dans une cellule unique via la syntaxe compacte suivante :
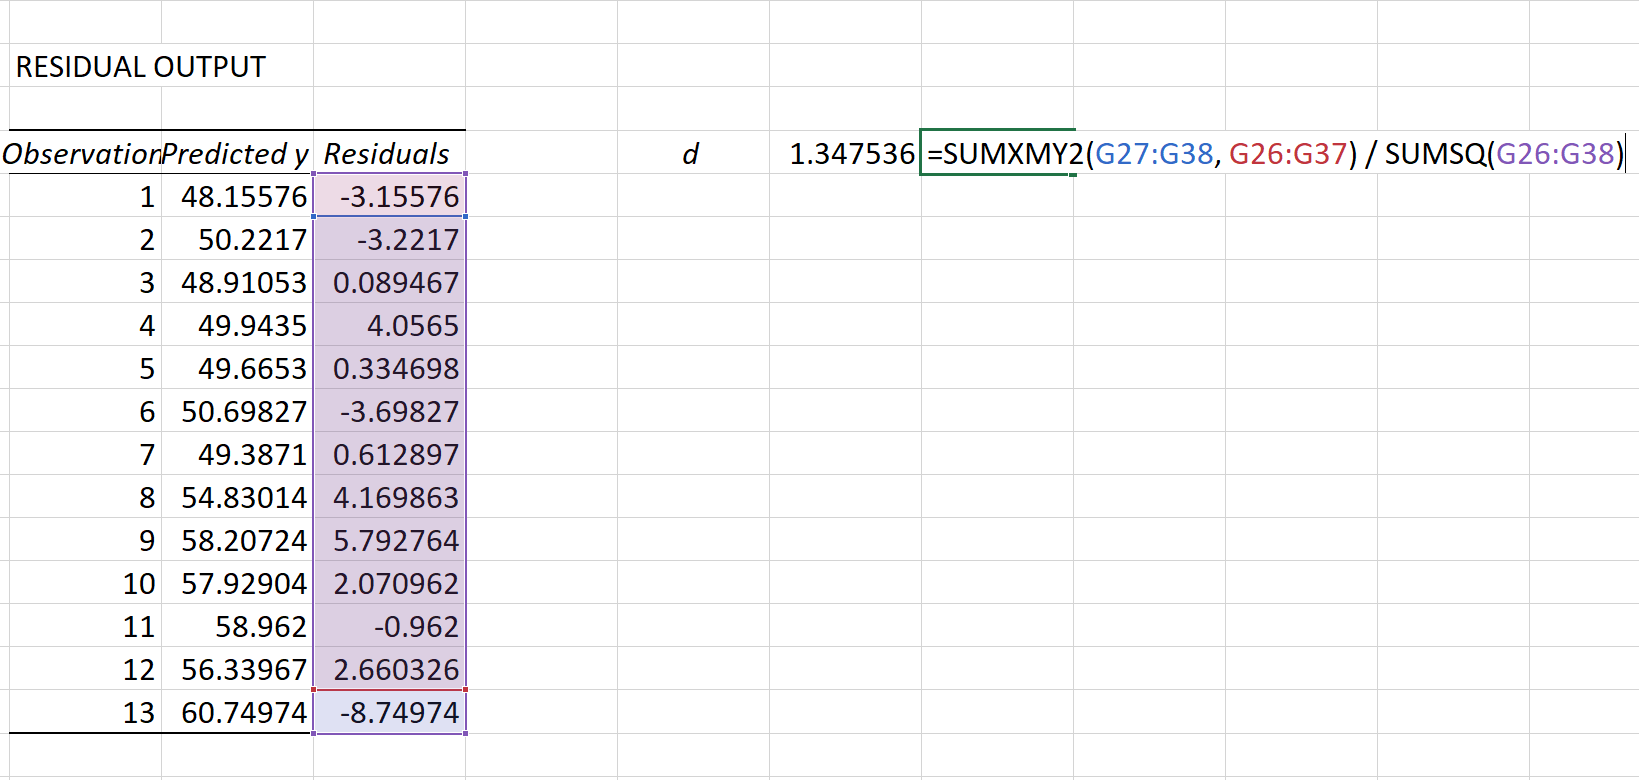
=SOMMEPROD((B3:B61-B2:B60)^2) / SOMME.CARRES(B2:B61)
Analysons l’anatomie interne de cette formule magistrale : le terme vectoriel (B3:B61 - B2:B60) calcule dynamiquement et de manière volatile les 59 différences séquentielles consécutives e_t – e_{t-1}. L’opérateur de puissance ^2 élève chacun de ces écarts élémentaires au carré dans la mémoire vive du tableur, et `SOMMEPROD()` en opère la sommation intégrale, générant sans aucune colonne d’appui le numérateur exact. Le dénominateur est quant à lui instantanément fourni par la fonction native `SOMME.CARRES(B2:B61)`. Cette approche procure un gain d’espace substantiel et immunise la feuille contre les décalages accidentels lors du redimensionnement de l’échantillon.
7.3 Vérification automatisée et tests de résistance de la formule
Afin de certifier la résilience de votre feuille de diagnostic avant son utilisation sur des protocoles de recherche critiques, il est judicieux de soumettre vos formules à des tests de résistance (stress tests) à l’aide de jeux de données artificiels aux propriétés sérielles extrêmes connues. Un premier test de validation consiste à remplacer temporairement la colonne des résidus réels par une série parfaitement sinusoïdale ou alternée : 1, -1, 1, -1, 1, -1… Dans cette configuration d’autocorrélation négative parfaite (rho = -1), la formule condensée ou décomposée doit rigoureusement renvoyer une valeur tendant vers 4,0000.
À l’opposé, la simulation d’une série résiduelle persistante et continue, comme une suite monotone croissante de valeurs infinitésimales (0.1, 0.2, 0.3…), doit faire s’effondrer la statistique de test d vers une valeur résolument proche de 0, attestant de la captation infaillible d’une autocorrélation positive majeure. Un test sur des données aléatoires indépendantes générées par la fonction `=ALEA.ENTRE.BORNES(-100;100)` doit quant à lui produire, sur un échantillon suffisamment large, une statistique oscillant paisiblement entre 1,85 et 2,15.
Enfin, il convient de prémunir la feuille contre l’erreur d’exécution fatale de division par zéro (`#DIV/0!`), qui surviendrait si le modèle de régression s’avérait parfaitement déterministe avec une variance résiduelle strictement nulle (somme des carrés égale à 0). L’encapsulation de la dérivation au moyen de la structure conditionnelle `=SIERREUR(SOMMEPROD((B3:B61-B2:B60)^2)/SOMME.CARRES(B2:B61); « Variance résiduelle nulle »)` apporte une sécurité logicielle optimale et parachève l’ingénierie de votre classeur.
8. Interprétation rigoureuse des résultats et lecture des tables critiques
8.1 Structure et lecture des tables statistiques de Durbin-Watson
Contrairement aux tests statistiques standards tels que le test t de Student ou le test du Chi-deux, pour lesquels il suffit de confronter la valeur calculée à une valeur critique unique déterminée par les degrés de liberté, la statistique de Durbin-Watson ne possède pas de distribution d’échantillonnage universelle indépendante des données. La distribution de d dépend intimement de la matrice spécifique des prédicteurs X. Pour surmonter cet obstacle fondamental, les pères fondateurs de la méthode ont établi des tables de distribution tabulant deux bornes critiques fondamentales : la borne inférieure (notée dL pour Lower) et la borne supérieure (notée dU pour Upper).
Pour exploiter adéquatement une table critique de Durbin-Watson, trois paramètres méthodologiques doivent être préalablement isolés :
- Le niveau de risque alpha retenu (traditionnellement fixé à 5 % ou 1 % selon le niveau de conservatisme requis).
- La taille totale de l’échantillon d’observations, notée n (dans notre cas, n = 60).
- Le nombre de variables explicatives ou prédicteurs du modèle, désigné par la lettre k.
Une mise en garde cruciale doit être formulée concernant la définition du paramètre k : dans la nomenclature statistique internationale de Durbin-Watson, k représente exclusivement le nombre de variables indépendantes, en excluant strictement le terme constant (l’ordonnée à l’origine). Dès lors, pour notre modèle comportant deux prédicteurs (Charge cognitive et Stress physiologique), k est rigoureusement égal à 2, et non à 3.
En croisant la ligne n = 60 avec la colonne k = 2 au seuil alpha de 0,05 dans une table de référence certifiée (comme celle publiée par Savin et White), nous identifions les valeurs de seuil suivantes : dL = 1,514 et dU = 1,652. Ces deux grandeurs délimitent les frontières décisionnelles qui vont gouverner l’ensemble de notre verdict statistique.
8.2 Application systématique des règles de décision statistique
L’inférence statistique découlant du test de Durbin-Watson ne se résume pas à une dichotomie simpliste rejet/non-rejet, mais s’organise autour d’une partition complexe de l’espace numérique en cinq zones distinctes, incluant deux zones d’indécision formelle. Les règles canoniques de décision s’articulent selon le protocole suivant :
Pour le test de l’autocorrélation positive (le scénario le plus prégnant en pratique) :
- Règle 1 : Rejet formel de H0. Si la statistique observée d est strictement inférieure à la borne inférieure dL (d < dL), l’hypothèse nulle est rejetée au seuil alpha choisi. La présence d’une autocorrélation sérielle positive d’ordre 1 est statistiquement avérée.
- Règle 2 : Non-rejet de H0. Si la statistique observée d est supérieure à la borne supérieure dU tout en restant inférieure à 4 – dU (dU < d < 4 – dU), l’hypothèse nulle ne peut être rejetée. Il n’existe pas d’indice d’autocorrélation séquentielle au sein des résidus.
- Règle 3 : Zone d’indécision positive. Si la statistique observée d se situe précisément entre les deux bornes critiques (dL <= d <= dU), le test s’avère formellement non conclusif. Il est méthodologiquement impossible de trancher avec certitude sur l’indépendance des erreurs à partir de ce seul test.
Pour le dépistage symétrique de l’autocorrélation négative, les seuils sont transposés en miroir par rapport à la valeur centrale 2 :
- Règle 4 : Rejet de H0 en faveur d’une autocorrélation négative. Si la statistique observée d est supérieure à 4 – dL (soit dans notre cas d > 4 – 1,514 = 2,486), l’hypothèse nulle d’indépendance est rejetée, attestant d’une structure oscillatoire anormale.
- Règle 5 : Zone d’indécision négative. Si d est compris entre 4 – dU et 4 – dL (soit 2,348 <= d <= 2,486), le diagnostic s’avère à nouveau inconclusif.
8.3 Interprétation pratique et formulation des conclusions de recherche
Supposons que notre procédure Excel ait abouti à une statistique d observée de 1,1850 pour notre cohorte de 60 mesures cognitives. En confrontant ce score à notre borne inférieure critique dL de 1,514, le constat statistique est immédiat : d étant substantiellement inférieur à dL, nous rejetons formellement l’hypothèse nulle d’absence de corrélation sérielle au seuil alpha de 5 %. Les résidus du modèle d’évaluation des temps de réaction sont donc sévèrement contaminés par une autocorrélation positive de premier ordre.
Sur le plan rédactionnel, la transcription de ces résultats dans un rapport d’expertise ou un article scientifique soumis aux normes de l’APA doit adopter une formulation précise et nuancée : « L’indépendance sérielle des termes d’erreur a été évaluée au moyen du test de Durbin-Watson. L’analyse révèle la présence d’une autocorrélation résiduelle positive statistiquement significative (d = 1,19, dL = 1,51, dU = 1,65, p < ,05), indiquant une violation patente du postulat d’indépendance de Gauss-Markov. Par conséquent, les erreurs-types associées aux prédicteurs de la charge cognitive et du stress physiologique sont potentiellement sous-estimées, imposant le recours à des estimateurs robustes. »
Si la statistique calculée s’était en revanche échouée dans la zone d’indécision (par exemple avec d = 1,58), l’éthique méthodologique prescrirait d’éviter toute conclusion hâtive. Il serait formellement erroné d’affirmer l’absence de corrélation sous prétexte que d dépasse dL. La neutralité s’impose : le chercheur doit alors expliciter le caractère indéterminé du test et solliciter des diagnostics complémentaires plus flexibles, au premier rang desquels figure le test du multiplicateur de Lagrange de Breusch-Godfrey.
9. Applications pratiques en recherche psychologique et comportementale
9.1 Analyses longitudinales et suivi thérapeutique individuel
Dans le domaine de la psychologie clinique appliquée et de la psychothérapie fondée sur les preuves, les protocoles expérimentaux à cas unique (SCED pour Single-Case Experimental Designs) et les protocoles de suivi longitudinal intensif représentent des cadres d’application privilégiés pour le test de Durbin-Watson. Considérons le suivi quotidien d’un patient souffrant d’un trouble dépressif majeur, dont l’humeur et les ruminations sont évaluées chaque soir pendant trois mois consécutifs au moyen de méthodes d’échantillonnage de l’expérience (méthode ESM pour Ecological Momentary Assessment).
Lorsqu’un chercheur régresse le score quotidien de détresse psychologique sur le nombre d’activités comportementales gratifiantes réalisées dans la journée, les résidus de cette régression ont une probabilité colossale d’être sériellement corrélés. Ce phénomène découle directement de ce que les psychologues cliniciens nomment l’inertie émotionnelle : l’état affectif d’un individu ne se réinitialise pas à zéro à chaque lever de soleil ; un état d’abattement persistant à l’instant t-1 exerce une pression gravitationnelle sur l’état d’humeur du jour t, indépendamment des événements contextuels intervenus.
Si le praticien ignore ce mécanisme et constate une statistique d de Durbin-Watson de 0,82 sans y remédier, il s’expose à surestimer massivement l’effet protecteur supposé des activités gratifiantes. Les tests t révéleront un coefficient hautement significatif alors même que la trajectoire du patient pourrait simplement être tributaire de sa dynamique autorégressive interne. La surveillance de la statistique de Durbin-Watson dans Excel offre au clinicien un garde-fou méthodologique indispensable pour différencier l’efficacité clinique réelle d’une intervention des rémanences émotionnelles spontanées du patient.
9.2 Études chronopsychologiques et processus d’apprentissage continu
Les paradigmes de chronopsychométrie et de psychologie expérimentale du laboratoire imposent fréquemment aux participants l’exécution de blocs massifs d’essais comportementaux consécutifs (tâches de type Stroop, tâches de détection de signaux ou paradigmes d’inhibition motrice de type Go/No-Go). L’unité d’analyse temporelle se chiffre ici en fractions de seconde ou en minutes au fil de centaines d’essais successifs.
Dans ce contexte hautement condensé, les violations de l’indépendance sérielle des temps de réponse ou des taux d’erreur ne sont pas l’exception, mais la norme empirique absolue. Trois facteurs psychophysiologiques majeurs induisent une autocorrélation systématique :
- Les effets de report (carryover effects) : la confrontation à un stimulus hautement conflictuel à l’essai t-1 laisse une trace résiduelle d’activation cognitive qui module inévitablement la réponse à l’essai t.
- La fatigue neurocognitive progressive : au fur et à mesure que la tâche progresse, l’épuisement de l’attention exécutive entraîne un ralentissement graduel non parfaitement linéaire des temps de réponse.
- Les oscillations attentionnelles endogènes : l’alternance spontanée de phases d’hyper-vigilance et de décrochages attentionnels (mind-wandering) engendre des grappes cycliques de résidus positifs et négatifs.
L’application du test de Durbin-Watson sur les résidus d’une modélisation linéaire des performances permet aux neuropsychologues de quantifier précisément l’empreinte de cette mémoire procédurale. L’identification d’une statistique d anormalement basse démontre que le modèle linéaire échoue à capturer la temporalité inhérente de l’architecture cognitive humaine, incitant à intégrer des termes de tendance polynomiale ou des composantes de lissage exponentiel pour épurer les estimateurs.
9.3 Dynamiques de groupe et interactions sociales séquentielles
L’observation des interactions humaines en temps réel, qu’il s’agisse de la négociation dyadique, de la synchronisation motrice au sein d’une équipe ou des flux conversationnels entre partenaires conjugaux, engendre des architectures de données séquentielles d’une grande complexité. L’analyse des données de codage comportemental image par image (évaluation de l’expressivité faciale, du tonus vocal ou des postures corporelles) met en relief des couplages dynamiques intenses.
Dans l’étude des signaux d’actimétrie mesurant le niveau d’agitation motrice synchronisée entre deux individus en interaction, la régression de l’activité motrice du sujet A sur celle du sujet B révèle fréquemment des résidus hautement corrélés séquentiellement. Cette interdépendance reflète la boucle de rétroaction cybernétique constitutive de toute communication humaine : le geste de l’un répond à la posture prise par l’autre une seconde auparavant, créant une trame temporelle serrée où chaque instant est génétiquement lié au passé immédiat.
Si ces séries sont analysées au moyen de régressions transversales ordinaires sans vérification par le test de Durbin-Watson, le chercheur s’expose à attribuer une valeur psychométrique déterminante à des corrélations illusoires. La détection précoce d’une dépendance sérielle dans Excel permet aux psychologues sociaux d’éviter la publication de faux positifs retentissants quant aux facteurs présidant à l’harmonie ou au conflit relationnel, réorientant l’appareil analytique vers des approches autorégressives en vecteur (VAR) adaptées à l’interactivité des conduites humaines.
10. Solutions méthodologiques et correctives face à une autocorrélation avérée
10.1 Transformation des variables et méthode de différenciation première
Lorsque le couperet du test de Durbin-Watson tombe et confirme sans ambiguïté la présence d’une autocorrélation sérielle positive au sein du modèle empirique, le chercheur ne peut laisser le modèle en l’état. La panoplie des remèdes économétriques et statistiques offre plusieurs stratégies curatives. La première réponse méthodologique, d’une remarquable simplicité de mise en œuvre dans Microsoft Excel, réside dans la méthode des différences premières.
Si la corrélation sérielle est extrêmement aiguë et que le coefficient d’autocorrélation rho chapeau approche de la valeur 1 (ce qui correspond à une statistique d plongeant sous le seuil de 0,60), le modèle sous-jacent est très probablement assimilable à une marche aléatoire avec dérive. Dans cette situation, la transformation s’opère en substituant aux variables de niveau brut les variations inter-périodes. Pour chaque variable du modèle, on calcule la variation séquentielle : Delta y_t = y_t – y_{t-1}, et de manière analogue Delta x_t = x_t – x_{t-1}.
Dans Excel, il suffit d’insérer de nouvelles colonnes calculant cette soustraction simple entre les lignes t et t-1, puis de réexécuter l’Utilitaire d’analyse de régression en utilisant ces vecteurs différenciés comme nouvelles plages d’entrée X et Y. Cette opération élimine instantanément les tendances stochastiques sous-jacentes et restaure quasi-systématiquement la stationnarité et l’indépendance des résidus, matérialisée par un bond spectaculaire de la nouvelle statistique de Durbin-Watson vers la valeur 2. Le chercheur doit néanmoins avoir conscience de la contrepartie épistémologique : le modèle différencié n’explique plus le niveau absolu du phénomène, mais sa dynamique de changement marginal.
10.2 Procédure d’estimation de Cochrane-Orcutt appliquée dans Excel
Lorsque l’autocorrélation est modérée (par exemple avec un rho estimé oscillant entre 0,30 et 0,70), la différenciation première intégrale s’avère trop brutale car elle sur-corrige la série et détruit l’information structurelle de long terme contenue dans les niveaux des variables. Dans ce scénario de dépendance partielle, la procédure itérative développée par Donald Cochrane et Guy Orcutt en 1949 offre une solution de quasi-différenciation infiniment plus élégante et respectueuse de la variance du système.
La mise en œuvre de l’algorithme de Cochrane-Orcutt dans Excel se déploie selon les phases séquentielles suivantes :
- Phase 1 : Estimation initiale MCO. On ajuste le modèle standard et on extrait la série des résidus bruts e_t.
- Phase 2 : Estimation du paramètre d’autocorrélation rho. On estime rho en régressant les résidus non retardés e_t sur les résidus retardés e_{t-1} sans constante, ou par la formule directe
=COEFFICIENT.CORRELATION(B3:B61; C3:C61). Supposons que l’on obtienne rho_1 = 0,42. - Phase 3 : Génération des séries quasi-différenciées. On crée pour chaque variable du modèle une nouvelle série ajustée selon la transformation mathématique suivante : y*_t = y_t – (rho_1 * y_{t-1}) et x*_t = x_t – (rho_1 * x_{t-1}). Ces calculs s’opèrent trivialement le long des colonnes de la feuille à partir de la ligne 3.
- Phase 4 : Réestimation du modèle. On lance l’outil de régression sur ces variables transformées. Les nouveaux coefficients calculés sont désormais débarrassés de l’inefficacité MCO.
Cette routine peut être réitérée de manière récursive en calculant un nouveau rho à partir des résidus transformés, jusqu’à ce que la valeur estimée du paramètre se stabilise d’une itération à la suivante à moins de 0,001 près. Le recalcul final du test de Durbin-Watson sur les résidus quasi-différenciés valide formellement le retour de la statistique au sein de l’intervalle de non-rejet [dU ; 4 – dU].
10.3 Modélisation dynamique et inclusion de retards temporels
Une perspective théorique alternative postule souvent que l’autocorrélation des résidus n’est pas un problème de perturbation stochastique, mais le symptôme flagrant d’une omission de spécification dynamique. Si l’état passé de la variable dépendante conditionne son état présent en vertu de mécanismes de mémoire comportementale, la solution la plus rigoureuse consiste à introduire explicitement la variable dépendante retardée y_{t-1} en tant que régresseur explicatif à part entière dans la matrice X.
Toutefois, cette décision méthodologique engendre une conséquence immédiate d’une gravité exceptionnelle pour notre diagnostic : l’invalidation totale du test de Durbin-Watson conventionnel. Comme démontré formellement dans la littérature économétrique, la présence conjointe d’un prédicteur autorégressif (la variable dépendante retardée) et de perturbations corrélées biaise de manière asymétrique la statistique d vers le haut. La valeur calculée de d converge artificiellement vers 2, offrant l’illusion factice d’une parfaite indépendance sérielle là où une autocorrélation sévère subsiste.
Face à ce piège bien connu, James Durbin a conçu une statistique de substitution spécifiquement calibrée pour les modèles autorégressifs dynamiques : la statistique h de Durbin. Cette métrique complexe pondère la corrélation sérielle empirique rho par la variance estimée du coefficient associé à la variable dépendante retardée et par la taille de l’échantillon. La statistique h suit asymptotiquement une loi normale centrée réduite N(0, 1), autorisant une prise de décision directe via la fonction de répartition standard d’Excel `=LOI.NORMALE.STANDARD.N()`. Dès lors qu’une variable retardée intègre le classeur, la statistique classique d doit être immédiatement abandonnée au profit de la statistique h.
11. Automatisation avancée du calcul via les macros et Visual Basic for Applications (VBA)
11.1 Conception d’une fonction personnalisée (UDF) pour le test de Durbin-Watson
L’exécution manuelle des soustractions séquentielles, des élévations au carré et des sommations croisées s’avère indéniablement formatrice pour l’esprit, mais devient fastidieuse et propice aux coquilles de frappe lors du traitement récurrent de vastes cohortes expérimentales. La programmation d’une fonction définie par l’utilisateur (User Defined Function ou UDF) au moyen de l’environnement Visual Basic for Applications (VBA) intégré nativement à Excel permet de transformer ce long protocole en une simple instruction fonctionnelle appelable directement depuis la feuille de calcul.
L’objectif algorithmique consiste à créer une fonction personnalisée, que nous baptiserons DURBIN_WATSON, acceptant un argument d’entrée unique sous la forme d’une plage continue de cellules correspondant aux résidus bruts générés par l’utilitaire de régression. Le moteur VBA doit parcourir ce vecteur au moyen d’une boucle itérative optimisée, calculer à la volée le dénominateur de la somme globale des carrés, extraire les écarts séquentiels consécutifs, et renvoyer avec une exactitude arithmétique absolue la statistique d scalaire finale.
Cette approche logicielle confère une productivité incomparable au chercheur. Une fois le script compilé dans le classeur de macros personnelles ou sauvegardé dans un fichier modèle prenant en charge les macros, il suffit d’écrire dans n’importe quelle cellule du tableur `=DURBIN_WATSON(B2:B61)` pour voir apparaître instantanément le résultat du test sans nécessiter la moindre colonne additionnelle de calcul.
11.2 Implémentation pas à pas du script VBA
Pour implémenter cette fonction diagnostique au sein de votre environnement Excel, la démarche opérationnelle s’effectue en respectant scrupuleusement la chronologie suivante :
- Ouvrez votre classeur Excel et accédez à l’environnement de développement intégré en actionnant le raccourci clavier universel Alt + F11 (ou Option + F11 sous macOS) pour ouvrir l’éditeur Visual Basic (VBE).
- Dans la barre de menus de l’éditeur, sélectionnez Insertion, puis cliquez sur Module. Un espace d’édition textuel vierge s’affiche au centre de l’écran.
- Copiez et collez l’intégralité du code d’ingénierie statistique présenté ci-dessous au sein de ce module standard :
Function DURBIN_WATSON(PlageResidus As Range) As Variant
Dim NbObs As Long
Dim i As Long
Dim Num As Double
Dim Denom As Double
Dim TabResidus() As Double
Dim Cellule As Range
Dim Compteur As Long
‘ Validation dimensionnelle de la plage
NbObs = PlageResidus.Cells.CountLarge
If NbObs < 3 Then
DURBIN_WATSON = CVErr(xlErrValue)
Exit Function
End If
ReDim TabResidus(1 To NbObs)
Compteur = 1
‘ Transfert des résidus dans un tableau en mémoire
For Each Cellule In PlageResidus
If Not IsNumeric(Cellule.Value) Or IsEmpty(Cellule.Value) Then
DURBIN_WATSON = CVErr(xlErrNum)
Exit Function
End If
TabResidus(Compteur) = CDbl(Cellule.Value)
Compteur = Compteur + 1
Next Cellule
Num = 0#
Denom = 0#
‘ Calcul du dénominateur (somme de tous les carrés)
For i = 1 To NbObs
Denom = Denom + (TabResidus(i) ^ 2)
Next i
‘ Sécurité face à une variance nulle
If Denom = 0# Then
DURBIN_WATSON = CVErr(xlErrDiv0)
Exit Function
End If
‘ Calcul du numérateur (différences successives au carré)
For i = 2 To NbObs
Num = Num + ((TabResidus(i) – TabResidus(i – 1)) ^ 2)
Next i
‘ Ratio final de Durbin-Watson
DURBIN_WATSON = Round(Num / Denom, 4)
End Function
Une fois le code collé, refermez simplement l’éditeur Visual Basic pour revenir à votre feuille de calcul. Votre classeur dispose dorénavant d’une fonction analytique de haut niveau, parfaitement interopérable avec l’ensemble des formules natives du tableur.
11.3 Création d’une macro complète de diagnostic de régression
Pour pousser l’automatisation à son niveau d’efficience le plus abouti, il est possible d’orchestrer au sein d’une procédure subordonnée (Sub) unique l’ensemble de la chaîne de traitement : l’appel automatisé de l’Utilitaire d’analyse de régression à partir d’un jeu de données brut, l’interception automatique de la plage des résidus nouvellement calculée, le calcul de la statistique de Durbin-Watson, et la restitution visuelle d’un rapport synthétique enrichi d’un diagnostic d’aide à la décision contextuel.
Dans cette architecture avancée, la macro peut interroger dynamiquement les tables de Durbin-Watson préalablement insérées dans un onglet caché du classeur pour récupérer automatiquement les bornes dL et dU relatives à la taille d’échantillon effective n et au nombre de prédicteurs k identifiés par le code. En articulant une structure décisionnelle `Select Case`, la procédure affiche dans une boîte de dialogue (MsgBox) ou au sein d’un encart coloré de la feuille un message explicite : alerte rouge clignotante en cas d’autocorrélation positive sévère nécessitant une correction immédiate, voyant orange d’incertitude pour les zones d’indécision, ou voyant vert certifiant la pleine validité de l’hypothèse d’indépendance de Gauss-Markov.
Il est fondamental de rappeler une exigence technique essentielle : pour que ces développements VBA demeurent pérennes et opérationnels lors des sessions ultérieures, le document Excel doit obligatoirement être enregistré sous le format spécifique de Classeur prenant en charge les macros Excel (*.xlsm). L’enregistrement au format conventionnel .xlsx entraînerait la destruction immédiate et irréversible de l’ensemble des modules de programmation lors de la fermeture du fichier, anéantissant l’infrastructure logicielle mise en place.
12. Comparaison critique du test de Durbin-Watson avec d’autres diagnostics statistiques
12.1 Le test de Breusch-Godfrey comme alternative généraliste
Bien que la statistique de Durbin-Watson jouisse d’une longévité historique exceptionnelle et d’une remarquable simplicité de compréhension géométrique, la statistique contemporaine en a documenté avec rigueur les limites intrinsèques. La première restriction rédhibitoire tient au fait que le test de Durbin-Watson est calibré de manière rigide et exclusive pour la détection d’une autocorrélation d’ordre 1 (processus AR(1)). Il est par construction aveugle aux dépendances d’ordre supérieur, telles que des autocorrélations d’ordre 4 courantes dans les séries trimestrielles ou des effets de saisonnalité d’ordre 12 ou 24 fréquents dans les rythmes circadiens psychophysiologiques.
De surcroît, ainsi que nous l’avons souligné dans la section consacrée aux modèles dynamiques, le test s’effondre totalement dès lors qu’un régresseur autorégressif y_{t-1} intègre l’équation. C’est pour surmonter ces deux écueils majeurs que Trevor Breusch et Leslie Godfrey ont développé à la fin des années 1970 le test du multiplicateur de Lagrange (test LM). Ce test généraliste s’avère capable de sonder simultanément des structures autorégressives et de moyennes mobiles (processus AR(p) et MA(q)) jusqu’à l’ordre p choisi délibérément par l’analyste, tout en conservant une validité asymptotique parfaite en présence de variables dépendantes retardées.
La mise en œuvre simplifiée du test de Breusch-Godfrey dans Excel demeure tout à fait accessible sans recours à des logiciels spécialisés. Elle consiste à extraire les résidus e_t d’une première régression MCO, puis à exécuter une régression auxiliaire dans laquelle ces résidus e_t constituent la nouvelle variable dépendante à expliquer par l’ensemble des prédicteurs initiaux X ainsi que par les p séries de résidus retardés (e_{t-1}, e_{t-2}, …, e_{t-p}). La statistique de test est ensuite directement obtenue en multipliant le coefficient de détermination R² issu de cette régression auxiliaire par la taille d’échantillon n. Le produit n * R² suit une distribution du Chi-deux à p degrés de liberté, facilement évaluable au moyen de la formule native d’Excel `=LOI.KHIDEUX.DROITE(n*R2; p)`.
12.2 Comparaison des capacités d’Excel avec les progiciels spécialisés
L’utilisation de Microsoft Excel pour conduire un test de Durbin-Watson suscite des débats réguliers au sein de la communauté des statisticiens et des méthodologues de la recherche. Les environnements spécialisés dans le traitement de données tels que R (via la bibliothèque `lmtest` et la fonction `dwtest()`), IBM SPSS Statistics (au travers de l’option Durbin-Watson intégrée au module de régression linéaire) ou le logiciel libre Jamovi présentent l’avantage indéniable de fournir instantanément non seulement la statistique d, mais surtout la valeur-p exacte associée par inversion de transformation de Fourier ou algorithme de Pan.
Ce calcul automatisé de la valeur-p exacte émancipe totalement l’utilisateur de l’obligation de consulter manuellement des tables statistiques de bornes critiques et élimine instantanément le fardeau des zones d’indécision, dans lesquelles les tables papier contraignent souvent l’analyste à suspendre son jugement. De plus, les progiciels dédiés intègrent de base des corrections modernes d’hétéroscédasticité et d’autocorrélation conjointes, au premier rang desquelles figure l’estimateur de matrice de variance-covariance robuste de Newey-West (HAC), d’une complexité algorithmique rédhibitoire pour une feuille de calcul Excel standard.
Néanmoins, Microsoft Excel conserve des vertus pédagogiques et épistémologiques incomparables qui justifient amplement son utilisation préférentielle lors de la phase d’apprentissage ou pour des analyses exploratoires rapides. Dans les progiciels intégrés (« boîtes noires »), l’obtention d’un résultat d’un simple clic masque fréquemment la réalité arithmétique de la variance résiduelle, favorisant des interprétations dogmatiques sans compréhension intime des écarts séquentiels. En forçant l’opérateur à manipuler physiquement les résidus bruts, à aligner les vecteurs retardés et à confronter le numérateur des transitions au dénominateur de variance totale, Excel transforme une routine d’évaluation abstraite en une expérience tangible de mécanique statistique appliquée.
12.3 Recommandations méthodologiques pour la recherche contemporaine
Au terme de cette analyse approfondie de l’évaluation de l’autocorrélation résiduelle dans Microsoft Excel, il convient de synthétiser les bonnes pratiques indispensables pour garantir l’intégrité, la robustesse et la reproductibilité de vos modélisations linéaires :
- Systématisation du diagnostic d’indépendance : Le calcul de la statistique de Durbin-Watson ne doit jamais être considéré comme une option marginale, mais comme une étape obligatoire et incontournable dès lors que les données analysées ont été recueillies selon un ordonnancement chronologique, séquentiel ou hiérarchique direct.
- Couplage visuel impératif : Une métrique scalaire unique, fût-elle aussi reconnue que la statistique d, ne doit jamais être interprétée de manière isolée. L’inspection conjointe du graphique de dispersion chronologique des résidus (e_t tracé en ordonnée en fonction du temps t en abscisse) demeure primordiale pour repérer des anomalies locales, des inversions de cycle ou des ruptures de variance que l’agrégation arithmétique du test pourrait estomper.
- Rigueur absolue dans le décompte des régresseurs : Lors de la consultation des tables statistiques de dL et dU, veillez à ne jamais inclure la constante dans le paramètre k. Une erreur sur le décompte des variables indépendantes fausserait directement le positionnement des seuils critiques et conduirait à des jugements biaisés dans les zones frontières.
- Transparence éditoriale dans les publications : Lorsque vous communiquez vos résultats scientifiques, ne vous contentez pas d’affirmer de manière lapidaire que l’hypothèse de Gauss-Markov est respectée. Spécifiez systématiquement la valeur observée de la statistique d, les bornes critiques de référence retenues au seuil alpha correspondant, et documentez précisément les transformations correctives (Cochrane-Orcutt, différenciation) mises en œuvre en cas de violation préalable.
En appliquant avec rigueur cette architecture méthodologique au sein de vos feuilles de calcul Microsoft Excel, vous conférerez à vos modèles de régression une validité statistique indiscutable, garantissant que vos inférences comportementales et cognitives reposent sur un socle de postulats scrupuleusement vérifié.
Références
Breusch, T. S. (1978). Testing for autocorrelation in dynamic linear models. Australian Economic Papers, 17(31), 334-355. https://doi.org/10.1111/j.1467-8454.1978.tb00635.x
Cochrane, D., & Orcutt, G. H. (1949). Application of least squares regression to relationships containing auto-correlated error terms. Journal of the American Statistical Association, 44(245), 32-61. https://doi.org/10.1080/01621459.1949.10483290
Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409-428. https://doi.org/10.1093/biomet/37.3-4.409
Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression: II. Biometrika, 38(1/2), 159-177. https://doi.org/10.1093/biomet/38.1-2.159
Durbin, J. (1970). Testing for serial correlation in least-squares regression when some of the regressors are lagged dependent variables. Econometrica, 38(3), 410-421. https://doi.org/10.2307/1909547
Godfrey, L. G. (1978). Testing against general autoregressive and moving average error models when the regressors include lagged dependent variables. Econometrica, 46(6), 1293-1301. https://doi.org/10.2307/1913829
Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
Savin, N. E., & White, K. J. (1977). The Durbin-Watson test for serial correlation with extreme sample sizes or many regressors. Econometrica, 45(8), 1989-1996. https://doi.org/10.2307/1914122
Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.