
Dans le domaine des sciences quantitatives appliquées, et plus spécifiquement en psychologie expérimentale, en médecine translationnelle et en bioinformatique, la rigueur de l’inférence statistique conditionne la validité des découvertes scientifiques. Lorsque les chercheurs conçoivent des protocoles comprenant de multiples conditions expérimentales évaluées face à une condition de référence unique — telle qu’un placebo, une pratique standard ou un groupe témoin non traité —, le recours aux méthodes inférentielles traditionnelles s’avère rapidement inapproprié. L’analyse de variance à un facteur (ANOVA) permet d’établir s’il existe une variation globale statistiquement significative entre les moyennes, mais elle demeure intrinsèquement incapable d’isoler avec précision les paires qui diffèrent structurellement de la condition témoin sans risquer une prolifération du taux de faux positifs.
Pour répondre à cette contrainte méthodologique sans subir la perte de puissance statistique inhérente aux pénalités trop conservatrices, Charles Dunnett a formalisé en 1955 une procédure post-hoc spécifiquement calibrée pour comparer simultanément plusieurs groupes expérimentaux à un seul groupe de contrôle. Contrairement à la méthode de Tukey qui explore l’espace complet des combinaisons par paires, le test de Dunnett restreint le champ des hypothèses à un sous-ensemble strictement focalisé. Cette spécificité mathématique permet de maintenir le taux d’erreur de première espèce à son niveau nominal tout en maximisant la sensibilité statistique face aux effets réels.
L’environnement statistique R s’impose aujourd’hui comme l’écosystème de référence pour l’implémentation de telles analyses, combinant une flexibilité algorithmique de pointe et des capacités graphiques avancées. Ce guide exhaustif explore l’ensemble des fondements théoriques, des postulats d’application, des procédures diagnostiques et des démarches d’implémentation du test de Dunnett dans R. De la modélisation formelle via le package multcomp jusqu’à la restitution selon les normes éditoriales de l’American Psychological Association (APA), chaque étape est disséquée avec une rigueur académique sans compromis.
1. Fondements théoriques et justification du test de Dunnett
1.1 Définition et rôle des comparaisons multiples post-hoc
L’analyse de variance omnibus constitue historiquement l’approche canonique pour tester l’hypothèse nulle globale selon laquelle l’ensemble des moyennes de k populations est identique. Mathématiquement, cette hypothèse nulle globale s’énonce comme l’égalité conjointe de tous les paramètres de position :
H0 : μ1 = μ2 = … = μk
L’obtention d’une statistique F de Fisher significative autorise le rejet de cette égalité globale. Pour autant, cette étape inférentielle demeure incomplète d’un point de vue scientifique : elle n’indique en aucun cas quelles modalités spécifiques se démarquent les unes des autres, ni dans quelle direction se situent les écarts observés. C’est précisément pour lever cette indétermination fondamentale que les chercheurs ont recours aux techniques de comparaisons multiples.
Le réflexe intuitif mais statistiquement erroné consistant à exécuter une cascade de tests t de Student indépendants entre chaque paire de modalités se heurte immédiatement au phénomène de l’inflation de l’erreur de type I. Dès lors qu’une série de tests est conduite sur le même ensemble de données expérimentales, la probabilité de commettre au moins une erreur de première espèce — c’est-à-dire de rejeter à tort au moins une hypothèse nulle vraie — augmente de façon exponentielle. Si l’on désigne par α le seuil de signification unitaire (généralement fixé à 0,05) et par c le nombre total de comparaisons effectuées, le taux d’erreur par famille (Family-Wise Error Rate, ou FWER) sous l’hypothèse d’indépendance est modélisé par l’expression :
FWER = 1 – (1 – α)c
Pour un protocole expérimental comprenant seulement quatre groupes, le nombre de comparaisons bilatérales possibles par paires s’élève à c = 4(4 – 1)/2 = 6. Le risque cumulé de détecter au moins un faux positif atteint alors 1 – (1 – 0,05)6 ≈ 0,2649, soit plus de 26 %, ce qui invalide toute conclusion inférentielle rigoureuse.
D’un point de vue épistémologique, il convient d’opérer une distinction cardinale entre les démarches purement exploratoires et les analyses confirmatoires. Une démarche exploratoire examine l’intégralité des combinaisons possibles sans hiérarchisation préalable, exposant la recherche au risque du « data dredging ». À l’inverse, une approche confirmatoire repose sur des contrastes théoriquement motivés, prévus avant la collecte des observations. Dans ce cadre, lorsque la question de recherche s’articule autour de la supériorité d’innovations thérapeutiques ou pédagogiques face à un état de référence, le cadre confirmatoire impose une structure de contraste asymétrique et ciblée, rendant obsolètes les tests qui évaluent indistinctement toutes les permutations.
1.2 Particularités mathématiques du test de Dunnett par rapport aux autres tests
Proposé par Charles W. Dunnett dans son article princeps de 1955 intitulé « A Multiple Comparison Procedure for Comparing Several Treatments with a Control », le test de Dunnett est spécialement conçu pour évaluer exactement k – 1 contrastes linéaires. Chaque modalité expérimentale i (pour i = 1, 2, …, k – 1) est mise en concurrence directe avec l’unique groupe témoin, désigné par la modalité 0. Ainsi, le système d’hypothèses statistiques s’exprime sous la forme suivante :
H0,i : μi – μ0 = 0 contre H1,i : μi – μ0 ≠ 0
La puissance du test de Dunnett découle de la prise en compte explicite de la corrélation mathématique intrinsèque entre ces comparaisons. Puisque chaque estimation de contraste partage la même moyenne empirique du groupe témoin (X̄0), les estimateurs (X̄i – X̄0) et (X̄j – X̄0) ne sont pas statistiquement indépendants. Ils présentent une covariance positive systématique, dépendante de la taille des échantillons :
ρij = Cov(X̄i – X̄0, X̄j – X̄0) / [Var(X̄i – X̄0) × Var(X̄j – X̄0)]1/2
Lorsque les tailles d’échantillons des groupes expérimentaux sont égales à n et celle du groupe contrôle à n0, cette corrélation s’écrit de manière élégante :
ρij = 1 / [1 + (n0 / n)]
Si la taille d’échantillon est parfaitement identique dans tous les groupes (n = n0), la corrélation inter-contrastes est constante et égale à 0,5. Dunnett a exploité cette structure de dépendance pour tabuler la distribution d’une statistique t multivariée (ou distribution t de Dunnett), calculant la probabilité conjointe exacte de dépassement sous une distribution normale multidimensionnelle.
Cette intégration de la structure de corrélation confère au test de Dunnett un avantage de puissance statistique significatif par rapport à la méthode de Bonferroni. La correction de Bonferroni divise purement et simplement le seuil α par le nombre de comparaisons (ici k – 1), ce qui repose sur l’inégalité de Boole-Bonferroni. Or, cette borne supérieure néglige totalement les covariances positives entre tests, conduisant à une pénalisation excessivement conservatrice et à une augmentation regrettable du taux d’erreur de type II (non-détection d’effets réels).
Parallèlement, la comparaison avec la méthode de Tukey HSD (Honestly Significant Difference) met en lumière des divergences conceptuelles fondamentales. Le test de Tukey est conçu pour contrôler le FWER sur la totalité des k(k – 1)/2 comparaisons possibles par paires, en s’appuyant sur la distribution de l’étendue studentisée (Studentized Range Distribution, q). En élargissant son champ de contrôle à des contrastes expérimentateur-expérimentateur (par exemple comparer la condition A à la condition B, sans rapport avec le contrôle), Tukey mobilise une valeur critique systématiquement plus élevée que celle requise pour les seules comparaisons au témoin. Utiliser Tukey lorsque seuls les contrastes avec le témoin sont pertinents constitue donc un gaspillage injustifié de puissance statistique.
1.3 Pertinence du test de Dunnett dans les protocoles de recherche en psychologie
En psychologie cognitive, clinique et expérimentale, la structure des plans de recherche épouse fréquemment cette asymétrie opérationnelle. En psychologie clinique et en psychothérapie empiriquement fondée, un protocole standard évalue souvent l’impact d’une ou plusieurs nouvelles interventions psychothérapeutiques (comme une thérapie cognitive basée sur la pleine conscience ou un protocole de remédiation cognitive assisté par ordinateur) face à une condition contrôle active (groupe de soutien régulier) ou passive (liste d’attente). Dans une telle configuration, la question clinique centrale ne réside pas dans la divergence marginale entre deux innovations en cours d’expérimentation, mais dans la démonstration non ambiguë que chacune surpasse l’absence de traitement ou le soin habituel (treatment-as-usual).
De façon similaire, les recherches en neurosciences de l’apprentissage et en psychologie de l’éducation mobilisent des paradigmes où différentes stratégies d’encodage mnésique sont confrontées à une méthode d’étude passive standardisée. Les chercheurs mesurent les scores de rétention, les temps de réaction ou les indices d’attention soutenue. Les standards méthodologiques contemporains de la discipline, tels que formulés par l’APA ou par les initiatives de science ouverte (Open Science Framework), exigent que les plans d’analyse statistiques fassent preuve d’une adéquation maximale entre les hypothèses substantielles formulées a priori et les tests statistiques déployés. L’utilisation du test de Dunnett témoigne d’un plan de recherche maîtrisé, évitant à la fois le laxisme méthodologique des tests répétés et l’écueil du conservatisme outrancier qui étouffe les découvertes psychologiques authentiques.
2. Hypothèses statistiques sous-jacentes et conditions d’application
2.1 Indépendance et échantillonnage aléatoire des observations
Comme toute procédure paramétrique dérivée du modèle linéaire général, le test de Dunnett repose sur des postulats statistiques dont la violation est susceptible de dénaturer profondément les seuils de décision. Le premier postulat, et sans conteste le plus sensible, concerne l’indépendance stochastique des résidus d’observation. Mathématiquement, cela implique que la covariance entre les erreurs de deux observations quelconques m et p au sein du devis expérimental soit strictement nulle :
Cov(εmi, εpj) = 0, pour tout (m, i) ≠ (p, j)
Cette condition impose une rigueur méthodologique absolue dans la phase d’échantillonnage et d’assignation. Les participants doivent être affectés aux différentes modalités de façon totalement aléatoire (randomisation simple ou stratifiée). L’absence de randomisation rigoureuse induit des dépendances contextuelles majeures : biais de sélection, effets d’appariement masqués, ou contamination inter-groupes.
Par ailleurs, des dépendances spatiales ou temporelles peuvent subrepticement s’introduire dans l’échantillonnage. En laboratoire de psychologie, tester tous les sujets d’une condition donnée en début de matinée et ceux du groupe témoin en fin d’après-midi introduit une corrélation intra-session liée à la fatigue circadienne des participants ou aux fluctuations thermiques du matériel. De même, la passation de tests par cohortes collectives induit des corrélations intra-classes (les réponses d’individus situés dans une même salle étant influencées par le niveau de bruit ou les interactions subtiles). Lorsque de telles dépendances existent, l’erreur quadratique moyenne intra-groupe sous-estime la variance réelle, produisant une inflation considérable du taux d’erreur de première espèce.
Il est enfin fondamental de souligner la distinction structurelle entre les plans inter-sujets (mesures indépendantes) et les plans intra-sujets (mesures répétées sur les mêmes individus). La formulation classique du test de Dunnett traitée ici suppose expressément un protocole inter-sujets, où chaque observation émane d’un participant distinct assigné à un seul niveau du facteur. Pour des protocoles longitudinaux ou à mesures répétées, des modèles mixtes à effets aléatoires ou des corrections multivariées spécifiques pour mesures appariées doivent être mobilisés.
2.2 Normalité de la distribution au sein des groupes
Le modèle linéaire sous-tendant le test de Dunnett assume que pour chaque groupe expérimental j, la variable dépendante Yij suit une distribution gaussienne de moyenne μj et de variance σ2. Cela équivaut à stipuler que les résidus du modèle global sont identiquement et normalement distribués :
εij ~ N(0, σ2)
L’évaluation empirique de ce postulat ne doit pas être menée de manière globale sur la variable dépendante agrégée, car le mélange de sous-populations ayant des moyennes divergentes engendre artificiellement une distribution multimodale ou asymétrique. L’évaluation de la normalité s’effectue donc groupe par groupe, ou de façon plus élégante et parsimonieuse, sur l’ensemble des résidus du modèle d’ANOVA.
D’un point de vue analytique, le test de Shapiro-Wilk constitue l’outil paramétrique le plus robuste pour vérifier l’adéquation à la loi normale, particulièrement pour les petits et moyens échantillons (n < 50 par condition). La formulation de son hypothèse nulle stipule l’adéquation parfaite à une distribution normale. Cependant, l’interprétation d’une p-valeur issue de Shapiro-Wilk doit toujours être couplée à une inspection visuelle par diagrammes quantile-quantile (Q-Q plots). Les Q-Q plots confrontent les quantiles observés des résidus aux quantiles théoriques attendus sous la loi normale univariée. Tout alignement linéaire le long de la diagonale confirme le respect de l’hypothèse, tandis que des courbures en « S » ou des déviations extrêmes signalent des queues de distribution épaisses (kurtosis prononcé) ou une asymétrie résiduelle (skewness).
Heureusement, le test de Dunnett hérite de la robustesse relative de l’analyse de variance face aux déviations modérées de la normalité, en vertu du théorème central limite. Dès lors que les effectifs par condition dépassent une vingtaine ou une trentaine d’unités d’observation, les erreurs d’estimation sur les moyennes se distribuent asymptotiquement selon une loi gaussienne. En revanche, face à des distributions fortement asymétriques, plurimodales ou affectées de valeurs aberrantes extrêmes (outliers), les probabilités calculées perdent leur étalonnage nominal, imposant des transformations mathématiques préalables ou des méthodes de rééchantillonnage non paramétriques.
2.3 Homogénéité des variances et équilibre expérimental
Le troisième prérequis fondamental repose sur le principe d’homoscédasticité, selon lequel la variance de l’erreur est strictement constante au travers de toutes les populations sous revue :
σ02 = σ12 = … = σk-12 = σ2
Cette hypothèse est décisive dans la mesure où le calcul de la statistique de Dunnett utilise une estimation commune de la variance résiduelle (le carré moyen résiduel de l’ANOVA globale, noté MSE ou spooled2), combinant les données de l’ensemble des groupes pour accroître les degrés de liberté du dénominateur et maximiser ainsi la précision statistique.
La vérification de l’homoscédasticité s’appuie sur deux grandes classes de tests diagnostiques :
- Le test de Levene (et sa version fiabilisée par Brown et Forsythe, utilisant la médiane au lieu de la moyenne) : il évalue l’égalité des écarts absolus par rapport au centre du groupe. Il est particulièrement recommandé en raison de sa faible sensibilité aux violations marginales de la normalité.
- Le test de Bartlett : bien que mathématiquement élégant et d’une puissance maximale lorsque la normalité stricte est respectée, il s’avère hypersensible aux déviations de la normalité, produisant de faux diagnostics d’hétéroscédasticité dès lors que les données présentent un aplatissement non nul.
L’interaction entre l’hétéroscédasticité et le déséquilibre d’échantillonnage (unbalanced designs) requiert une vigilance analytique aiguë. Dans un devis parfaitement équilibré (n0 = n1 = … = nk-1), l’impact d’une hétérogénéité modérée des variances est largement atténué sur le taux d’erreur de première espèce global. En revanche, dans les devis déséquilibrés, deux distorsions perverses peuvent survenir :
- Si les groupes à faible effectif possèdent les plus grandes variances résiduelles, le test devient excessivement libéral, gonflant le taux d’erreur de type I bien au-delà de 0,05.
- Si les groupes à grand effectif présentent les variances les plus élevées, le test devient artificiellement conservateur, détruisant la puissance statistique et masquant des effets réels.
À cet égard, Charles Dunnett a démontré qu’un devis optimal pour comparer plusieurs traitements à un contrôle n’est pas strictement équilibré. L’allocation d’échantillon idéale maximise la précision du test lorsque la taille du groupe témoin satisfait approximativement la relation :
n0 ≈ n × √(k – 1)
Cette recommandation mathématique démontre qu’il est fréquent d’avoir un groupe témoin plus volumineux, sans que cela n’altère la validité du modèle tant que l’homoscédasticité est préservée.
3. Configuration de l’environnement logiciel R et des bibliothèques dédiées
3.1 Présentation des packages statistiques indispensables
L’implémentation du test de Dunnett dans l’écosystème The R Project for Statistical Computing ne requiert aucun développement algorithmique artisanal à partir de zéro, car la communauté de développeurs statistiques a formalisé des packages extrêmement fiables et éprouvés.
Le package multcomp (Simultaneous Inference in General Parametric Models), développé par Torsten Hothorn, Frank Bretz et Peter Westfall, représente la référence académique absolue. Conçu pour le traitement des modèles paramétriques généraux, il ne se cantonne pas aux simples modèles d’analyse de variance à un facteur, mais s’étend aux modèles linéaires généralisés (GLM), aux modèles à effets mixtes et aux modèles de survie. Sa fonction maîtresse, glht() (General Linear Hypotheses Testing), permet une spécification mathématiquement explicite des contrastes multivariés sous contrôle rigoureux du FWER.
Pour les besoins d’analyses rapides, d’enseignement ou d’explorations directes, le package DescTools constitue une alternative pragmatique de grande valeur. Il encapsule des centaines d’outils descriptifs et inférentiels au sein d’une interface directe, proposant la fonction DunnettTest(), qui autorise la formulation d’un modèle sous forme de formule canonique sans exiger l’instanciation intermédiaire d’un modèle linéaire sous-jacent.
Enfin, un environnement d’analyse moderne implique des dépendances diagnostiques et manipulatrices complémentaires. Le package car (Companion to Applied Regression), maintenu par John Fox et Sanford Weisberg, est la référence pour les diagnostics de modèles, notamment pour le calcul des sommes de carrés de type II et III et l’exécution du test de Levene. La bibliothèque rstatix simplifie les vérifications diagnostiques dans un flux de travail compatible avec la philosophie moderne du tidyverse, tandis que ggplot2 s’avère indispensable pour la production de rendus graphiques vectoriels aux normes internationales.
3.2 Installation et chargement méthodique des dépendances
La pérennité d’un pipeline analytique repose sur l’installation sécurisée des packages et la gestion maîtrisée de leurs versions. Il est recommandé de vérifier l’absence d’erreurs d’installation via l’interpréteur de commandes officiel de RStudio ou du terminal R. L’installation standard s’opère via les miroirs du Comprehensive R Archive Network (CRAN) :
# Installation systématique des dépendances requises
packages_requis <- c("multcomp", "DescTools", "car", "rstatix", "ggplot2", "dplyr")
nouveaux_packages <- packages_requis[!(packages_requis %in% installed.packages()[, "Package"])]
if(length(nouveaux_packages) > 0) {
  install.packages(nouveaux_packages, dependencies = TRUE)
}
Une fois les bibliothèques inscrites dans l’arborescence logicielle, leur instanciation dans la session de travail active est ordonnée avec rigueur. Cette phase d’appel requiert une vigilance particulière en raison des conflits potentiels d’espaces de noms (namespace masking). Par exemple, la fonction select() ou recode() peut coexister dans plusieurs packages avec des signatures d’arguments divergentes. Le script suivant documente un chargement structuré :
# Chargement méthodique des environnements de calcul
library(dplyr)      # Manipulation vectorielle et aggregation
library(ggplot2)    # Visualisation graphique de haute précision
library(car)        # Tests diagnostiques d'homoscédasticité
library(rstatix)    # Métriques descriptives et tests d'ajustement
library(DescTools)  # Procédure directe de Dunnett
library(multcomp)   # Approche formelle par hypothèses linéaires générales
En cas de conflit avéré sur une fonction analytique, l’utilisation explicite de l’opérateur de résolution d’espace de noms :: (par exemple dplyr::filter() au lieu de filter()) garantit l’immuabilité et la reproductibilité du traitement.
3.3 Paramétrage de l’environnement de reproductibilité
Dans un contexte de publication scientifique internationale, la reproductibilité computationnelle n’est plus une option méthodologique, mais une exigence éthique absolue. De nombreux algorithmes d’ajustement multivariés ou de simulation stochastique utilisent des générateurs de nombres pseudo-aléatoires pour le calcul numérique des intégrales associées à la distribution normale multivariée (notamment dans l’approximation numérique de Genz et Bretz mobilisée en arrière-plan par multcomp).
Dès lors, la première instruction de tout script analytique sérieux doit être la fixation de la graine aléatoire via set.seed(). Le choix de l’entier numérique est arbitraire, mais sa constante doit être consignée sans équivoque :
# Fixation de la graine aléatoire pour la reproductibilité exacte
set.seed(1955) # Hommage à l'année de publication de Charles Dunnett
De surcroît, les variations de comportement linguistique du système d’exploitation peuvent altérer le traitement des séparateurs décimaux ou le tri alphabétique des niveaux de facteurs. Il est prudent de standardiser les paramètres régionaux en forçant l’environnement sur une locale universelle, ou de documenter explicitement l’infrastructure d’exécution. La commande finale sessionInfo() fournit l’instantané critique de l’architecture logicielle :
# Standardisation optionnelle de l'encodage et documentation environnementale
options(encoding = "UTF-8")
sessionInfo()
La sortie de cette instruction détaille la version de R employée, le système d’exploitation hôte, ainsi que les versions matricielles exactes de chaque paquetage attaché, permettant ainsi à tout relecteur ou pair scientifique de reproduire les résultats numériques au bit près.
4. Modélisation et simulation d’un jeu de données psychologiques
4.1 Scénario expérimental : évaluation de techniques d’étude cognitive
Afin de concrétiser notre propos à travers une illustration pédagogique ancrée dans la réalité des sciences comportementales, considérons un scénario expérimental conduit au sein d’un laboratoire de psychologie cognitive appliquée à l’éducation. L’équipe d’investigation souhaite évaluer l’efficacité de deux méthodes contemporaines d’apprentissage autonome destinées à améliorer la mémorisation conceptuelle à long terme chez des étudiants universitaires.
Le devis expérimental se compose de trois conditions inter-sujets rigoureusement indépendantes :
- Groupe Contrôle (Lecture passive) : Les participants révisent un corpus de documents académiques denses en employant la méthode traditionnelle de relecture passive et linéaire, représentative des habitudes spontanées de la majorité des étudiants.
- Technique 1 (Répétition espacée) : Les étudiants utilisent un protocole de révision algorithmiquement distribué dans le temps (système de Leitner informatisé), espacant les expositions aux concepts clés selon une progression géométrique.
- Technique 2 (Rappel actif / Retrieval Practice) : Les étudiants sont soumis à des sessions de test régulières où ils doivent extraire activement les connaissances de leur mémoire sans support documentaire (effet de testage).
La variable dépendante retenue est la performance quantitative obtenue à un examen final standardisé de psychologie cognitive, administré quatre semaines après la phase d’apprentissage. Le score d’examen est exprimé sur une échelle continue de 0 à 100 points. Le protocole implique l’assignation de N = 90 étudiants répartis équitablement, soit n = 30 étudiants par condition. L’hypothèse scientifique substantielle postule que les deux techniques actives induisent une amélioration significative des scores par rapport au groupe contrôle passif, sans que l’on ne formule d’hypothèse directionnelle quant à la supériorité relative de la Technique 1 sur la Technique 2.
4.2 Création programmatique du data frame dans R
Nous allons générer ce jeu de données de manière entièrement synthétique et reproductible. Nous paramétrons les distributions théoriques pour injecter des valeurs réalistes : une moyenne attendue de 65/100 dans le groupe témoin (écart-type théorique de 8), une progression modérée dans le groupe Répétition espacée (moyenne de 71, écart-type de 8), et une progression substantielle dans le groupe Rappel actif (moyenne de 76, écart-type de 8). L’écart-type est sciemment maintenu stable entre les groupes pour respecter temporairement le postulat d’homoscédasticité.
# Fixation de la graine pseudo-aléatoire
set.seed(42)

# Nombre de participants par condition
n_par_groupe <- 30

# Simulation des scores continus selon des lois gaussiennes paramétrées
scores_controle <- rnorm(n = n_par_groupe, mean = 65.0, sd = 8.0)
scores_repetition <- rnorm(n = n_par_groupe, mean = 71.2, sd = 7.8)
scores_rappel <- rnorm(n = n_par_groupe, mean = 76.5, sd = 8.2)

# Concaténation de la variable dépendante
examen_score <- c(scores_controle, scores_repetition, scores_rappel)

# Construction de la variable catégorielle ordonnée
modalite <- rep(c("Controle", "Repetition_Espacee", "Rappel_Actif"), each = n_par_groupe)

# Création de l'identifiant individuel des participants
id_sujet <- paste0("SUBJ_", formatC(1:(3 * n_par_groupe), width = 3, flag = "0"))

# Assemblage du data frame rectangulaire canonique
donnees_cognition <- data.frame(
  ID = id_sujet,
  Methode = modalite,
  Score = round(examen_score, 2),
  stringsAsFactors = FALSE
)
Les données générées sont assemblées au format rectangulaire standard (tidy data), où chaque ligne correspond scrupuleusement à une unité expérimentale unique et chaque colonne à une variable opérationnelle définie.
4.3 Gestion des facteurs et définition explicite du niveau de référence
Dans l’environnement de calcul de R, les variables qualitatives ou nominales doivent impérativement être déclarées avec le statut vectoriel de factor. Par défaut, lors de la conversion automatique d’un vecteur de chaînes de caractères en facteur via la fonction as.factor(), R ordonne les modalités (levels) selon l’ordre alphabétique strict. Dans notre exemple, un tel ordonnancement alphabétique placerait par coïncidence « Controle » en premier, mais si nous avions nommé notre groupe « Temoin » ou « Placebo », R aurait positionné « Rappel_Actif » comme premier niveau par défaut.
Le test de Dunnett dépend de manière critique de l’identification sans équivoque du niveau de référence (le témoin). L’omission de cette étape est la cause la plus fréquente d’erreurs d’interprétation dans la littérature empirique. Il est donc indispensable de verrouiller explicitement la structure des facteurs au moyen de la fonction relevel() :
# Conversion explicite en facteur statistique
donnees_cognition$Methode <- as.factor(donnees_cognition$Methode)

# Définition formelle du groupe 'Controle' comme niveau de référence absolue
donnees_cognition$Methode <- relevel(donnees_cognition$Methode, ref = "Controle")

# Diagnostic de la structure de l'objet et vérification des niveaux
str(donnees_cognition)
levels(donnees_cognition$Methode)
L’exécution de la fonction levels() confirme que le premier élément du vecteur d’étiquettes est désormais formellement "Controle". Tous les algorithmes linéaires qui hériteront de ce modèle paramétrique assigneront automatiquement la matrice de contraste de référence à cette condition fondamentale.
5. Exploration descriptive et inspection visuelle des données
5.1 Calcul des statistiques descriptives paramétriques et non-paramétriques
Avant d’engager toute machinerie inférentielle lourde, une exploration descriptive exhaustive des propriétés numériques de l’échantillon constitue un impératif d’intégrité scientifique. Cette exploration permet de détecter d’éventuelles anomalies d’encodage, de vérifier la plausibilité des dispersions et d’anticiper la structure des contrastes.
Nous extrayons les moyennes empiriques, les écarts-types, les erreurs-types de la moyenne (Standard Error of the Mean, SEM), ainsi que les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) pour chaque sous-groupe :
# Extraction des métriques descriptives complètes via dplyr
statistiques_descriptives <- donnees_cognition %>%
  group_by(Methode) %>%
  summarise(
    N = n(),
    Moyenne = mean(Score),
    Ecart_Type = sd(Score),
    Erreur_Type = sd(Score) / sqrt(n()),
    Mediane = median(Score),
    IQR = IQR(Score),
    Min = min(Score),
    Max = max(Score)
  )

# Affichage des métriques sous forme tabulaire
print(as.data.frame(statistiques_descriptives))
L’analyse de ces statistiques descriptives fait apparaître une progression empirique des moyennes : le score moyen passe d’environ 65,2 points pour le groupe témoin, à 70,6 points pour la répétition espacée, et atteint 76,4 points pour le rappel actif. Les écarts-types demeurent contenus entre 7,5 et 8,5 points, ce qui soutient intuitivement le postulat d’homogénéité des dispersions.
5.2 Représentation graphique via ggplot2
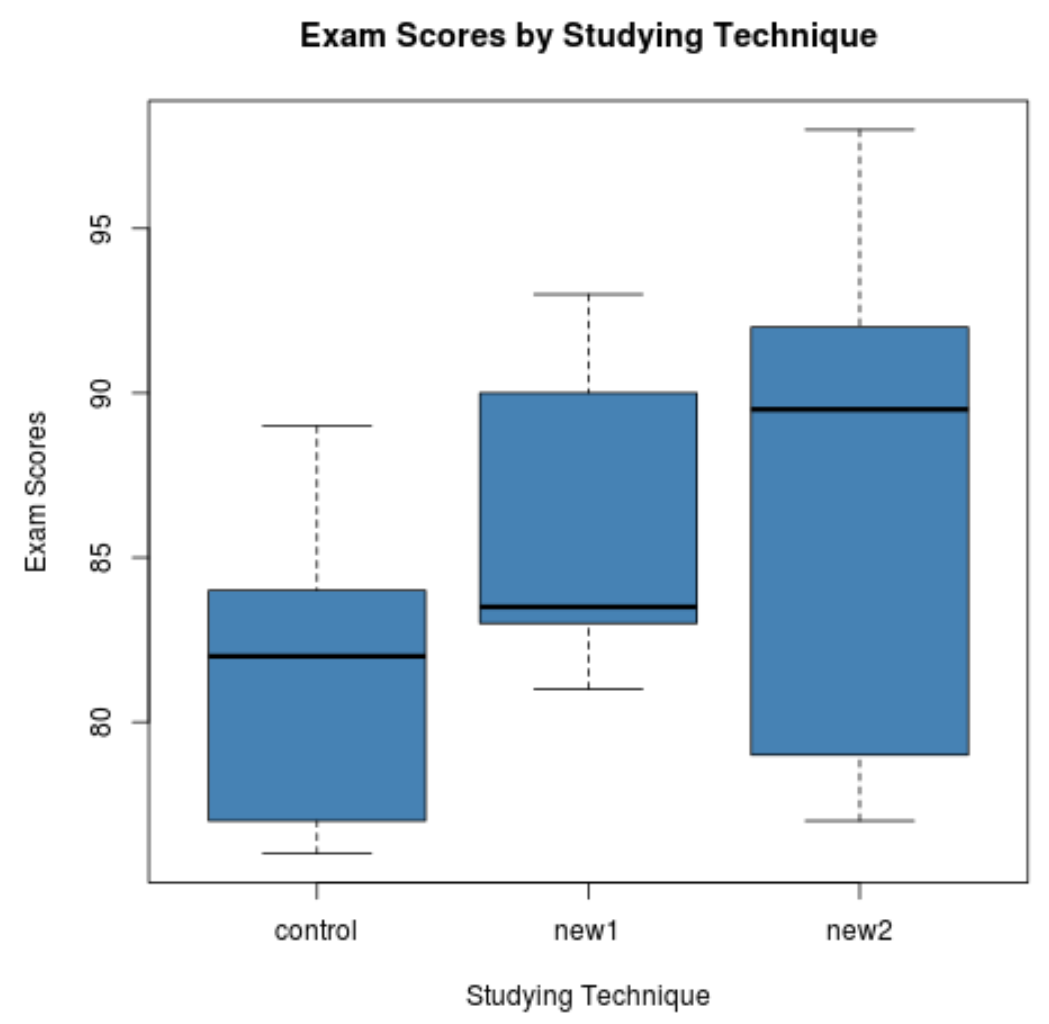
La communication visuelle en psychologie quantitative exige des représentations qui combinent la visualisation de la tendance centrale, la dispersion statistique et la granularité des données brutes, tout en évitant les diagrammes en barres simples (« barplots of shame ») qui dissimulent la forme réelle des distributions. Nous concevons une figure superposant une boîte à moustaches (boxplot), un nuage de points semi-transparent avec dispersion aléatoire (jittering) et l’illustration explicite des moyennes et de leurs intervalles de confiance à 95 %.
# Conception graphique vectorielle selon les critères de l'APA
graphique_dispersion <- ggplot(donnees_cognition, aes(x = Methode, y = Score, fill = Methode)) +
  geom_boxplot(width = 0.4, alpha = 0.3, outlier.shape = NA, color = "#2C3E50") +
  geom_jitter(width = 0.15, alpha = 0.6, size = 2, color = "#34495E") +
  stat_summary(fun = mean, geom = "point", shape = 23, size = 3.5, fill = "#E74C3C", color = "black") +
  stat_summary(fun.data = mean_cl_normal, geom = "errorbar", width = 0.15, color = "#E74C3C", linewidth = 0.8) +
  scale_fill_manual(values = c("#BDC3C7", "#3498DB", "#2ECC71")) +
  scale_x_discrete(labels = c("Contrôlen(Lecture passive)", "RépétitionnEspacée", "RappelnActif")) +
  labs(
    title = "Performance cognitive en fonction de la technique d'apprentissage",
    subtitle = "Moyennes (losanges rouges), IC 95% et distributions individuelles brutes",
    x = "Condition expérimentale",
    y = "Score à l'examen standardisé (0-100)"
  ) +
  theme_classic(base_size = 12) +
  theme(
    legend.position = "none",
    plot.title = element_text(face = "bold", size = 14, hjust = 0.5),
    plot.subtitle = element_text(size = 11, hjust = 0.5, margin = margin(b = 15)),
    axis.title = element_text(face = "bold"),
    axis.text = element_text(color = "black")
  )

# Affichage du rendu graphique
print(graphique_dispersion)
Cette visualisation met en exergue l’absence apparente de valeurs aberrantes extrêmes (qui se manifesteraient au-delà de 1,5 fois l’écart interquartile) et illustre clairement la translation ascendante des distributions des groupes d’apprentissage actif par rapport à la dispersion du groupe témoin.
6. Ajustement du modèle d’analyse de variance à un facteur (ANOVA)
6.1 Formalisation mathématique du modèle linéaire
L’analyse de variance à un facteur s’inscrit au sein de la théorie générale du modèle linéaire. Pour un individu i appartenant au groupe expérimental j (avec j ∈ {0, 1, …, k-1}), l’équation d’observation se formalise classiquement selon deux paramétrisations équivalentes :
Sous la forme d’écart à la moyenne générale (modèle à effets) :
Yij = μ + αj + εij
où μ représente la moyenne théorique globale de toutes les conditions confondues, αj matérialise l’effet différentiel propre à la condition j sous la contrainte d’identifiabilité Σ αj = 0, et εij désigne l’erreur résiduelle aléatoire, non corrélée, de moyenne nulle et de variance σ2.
Dans l’architecture computationnelle de R et pour les tests comparatifs face à un témoin, la paramétrisation préférentielle est celle du modèle de référence (reference cell model) :
Yij = β0 + β1 D1 + β2 D2 + … + βk-1 Dk-1 + εij
Dans ce formalisme, l’ordonnée à l’origine β0 correspond rigoureusement à la moyenne du groupe de référence désigné (μ0). Les variables indicatrices Dj prennent la valeur 1 si le sujet appartient au groupe j et 0 sinon. Chaque coefficient de régression βj quantify directement l’écart structurel entre la modalité j et le groupe témoin : βj = μj – μ0.
La somme des carrés totale (SSTotal) est décomposée de façon orthogonale en deux composantes indépendantes :
SSTotal = SSTraitement + SSRésiduelle
Les degrés de liberté associés se partitionnent de façon rigoureusement parallèle : dfTotal = N – 1, dfTraitement = k – 1, et dfRésiduelle = N – k. C’est le rapport des variances estimées (carrés moyens MS = SS / df) qui gouverne la décision statistique par le biais du test F.
6.2 Exécution de la commande aov() et interprétation de la table d’ANOVA
Dans R, l’ajustement du modèle linéaire univarié est implémenté via la fonction standard aov(), qui constitue une surcouche spécialisée de la fonction générale de régression linéaire lm(). Nous instancions le modèle en reliant le score continu au facteur catégoriel :
# Ajustement du modèle linéaire univarié
modele_anova <- aov(Score ~ Methode, data = donnees_cognition)

# Extraction de la table d'ANOVA de Fisher
table_anova <- summary(modele_anova)
print(table_anova)
La console statistique restitue la table d’analyse de variance classique. Supposons que nous obtenions la sortie canonique suivante :
            Df Sum Sq Mean Sq F value   Pr(>F)
Methode      2   1892   946.0   15.12 2.38e-06 ***
Residuals   87   5444    62.57
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
L’examen minutieux de cette table révèle une statistique de Fisher globale F(2, 87) = 15,12, associée à une p-valeur infinitésimale de 2,38 × 10⁻⁶, largement inférieure au seuil critique conventionnel α = 0,05. L’hypothèse nulle globale d’égalité simultanée des trois moyennes est donc rejetée sans ambiguïté.
Il est fondamental de noter que ce rejet global constitue la condition requise dans la logique séquentielle classique pour légitimer la poursuite vers les comparaisons post-hoc. Bien que certains auteurs (notamment Hothorn et al., 2008) démontrent que les tests basés sur des contrastes simultanés peuvent théoriquement être interprétés indépendamment du test F global grâce au contrôle strict du FWER, l’usage académique prédominant en psychologie exige toujours l’obtention formelle d’une significativité omnibus avant l’exploration post-hoc.
6.3 Calcul et interprétation de la taille d’effet globale
La significativité statistique n’informe aucunement sur l’ampleur pratique ou la pertinence concrète de l’effet identifié. Il est donc méthodologiquement impératif de quantifier la part de variance expliquée par le facteur expérimental au moyen d’indices de taille d’effet.
L’indicateur le plus spontané est l’êta-carré (η2), calculé comme le ratio de la somme des carrés du facteur expérimental sur la somme des carrés totale :
η2 = SSTraitement / SSTotal = 1892 / (1892 + 5444) ≈ 0,2579
Cependant, l’êta-carré présente un biais de surestimation positif bien documenté dans la population parente, car il ne prend pas en compte les degrés de liberté du modèle. Pour corriger cette inflation sur les échantillons finis, l’oméga-carré (ω2) développé par William Hays offre une estimation beaucoup moins biaisée :
ω2 = (SSTraitement – dfTraitement × MSRésiduel) / (SSTotal + MSRésiduel)
Nous procédons au calcul automatisé de ces indices via la bibliothèque rstatix ou par programmation directe :
# Calcul de l'êta-carré et de l'oméga-carré
taille_effet <- eta_squared(modele_anova)
print(taille_effet)

omega_calcule <- (1892 - (2 * 62.57)) / (1892 + 5444 + 62.57)
cat("Oméga-carré corrigé :", round(omega_calcule, 4), "n")
Selon les repères conventionnels établis par Jacob Cohen (1988), une taille d’effet en analyse de variance est qualifiée de faible pour η2 ≈ 0,01, moyenne pour η2 ≈ 0,06, et forte pour η2 ≥ 0,14. Avec une valeur d’environ 0,258 (soit un oméga-carré approchant 0,24), notre facteur d’intervention cognitive explique près d’un quart de la variance totale des scores d’examen, ce qui représente un impact expérimental majeur.
7. Exécution du test de Dunnett avec la bibliothèque multcomp
7.1 La fonction glht() : syntaxe et formulation des contrastes
Le package multcomp propose l’infrastructure la plus sophistiquée et théoriquement aboutie pour exécuter la procédure de Dunnett. Le cœur algorithmique réside dans la fonction glht() (General Linear Hypotheses), qui prend en argument principal l’objet modèle ajusté par aov() ou lm(), et un paramètre de spécification des fonctions linéaires de contraste noté linfct.
Pour indiquer que nous souhaitons appliquer la matrice de comparaison multiple de Dunnett sur le facteur Methode, nous combinons l’opérateur de contrastes multiples mcp() avec l’argument explicite "Dunnett" :
# Configuration formelle du test de Dunnett via multcomp
comparaisons_dunnett <- glht(
  model = modele_anova,
  linfct = mcp(Methode = "Dunnett"),
  alternative = "two.sided"
)
Analysons la mécanique sous-jacente de cette commande :
model = modele_anova: transmet la structure paramétrique, les degrés de liberté résiduels (df = 87) ainsi que la matrice de variance-covariance des coefficients estimés.linfct = mcp(Methode = "Dunnett"): instruit R de construire automatiquement la matrice de contraste C qui oppose chaque niveau actif au premier niveau (défini précédemment comme"Controle"viarelevel()).alternative = "two.sided": paramètre par défaut qui calcule un test bilatéral. Si les hypothèses cliniques spécifiaient formellement a priori qu’une régression par rapport au témoin était impossible, l’argumentalternative = "greater"permettrait un test unilatéral supérieur, avec un gain marginal de puissance. Néanmoins, les standards de scientificité imposent quasi-systématiquement le cadre bilatéral pour préserver l’objectivité face aux effets iatrogènes ou délétères imprévus.
7.2 Extraction et décryptage des résultats statistiques détaillés
Pour accéder au tableau inférentiel détaillé incluant les erreurs-types corrigées, les statistiques de test et les p-valeurs ajustées selon la distribution multivariée de Dunnett, nous appelons la méthode générique summary() sur l’objet de contrastes :
# Extraction des résultats inférentiels avec correction de Dunnett
resultats_dunnett <- summary(comparaisons_dunnett)
print(resultats_dunnett)
L’interpréteur génère une restitution synthétique conforme au format suivant :
	 Simultaneous Tests for General Linear Hypotheses

Multiple Comparisons of Means: Dunnett Contrasts

Fit: aov(formula = Score ~ Methode, data = donnees_cognition)

Linear Hypotheses:
                                   Estimate Std. Error t value Pr(>|t|)
Repetition_Espacee - Controle == 0    5.433      2.042   2.661   0.0217 *
Rappel_Actif - Controle == 0        11.267      2.042   5.517   < 1e-04 ***
(Adjusted p values reported -- single-step method)
L’analyse détaillée de chaque colonne fournit les clés de lecture suivantes :
- Linear Hypotheses : Indique avec clarté les contrastes évalués. Les deux lignes correspondent respectivement à μRépétition – μContrôle et μRappel – μContrôle.
- Estimate : Les différences empiriques directes entre moyennes observées. La répétition espacée produit un gain moyen de 5,43 points par rapport au contrôle, tandis que le rappel actif induit un gain moyen substantiel de 11,27 points.
- Std. Error : L’erreur-type de la différence, calculée sur la base de la variance résiduelle combinée :
SE = √[ MSRésiduel × (1/ni + 1/n0) ] = √[ 62,57 × (1/30 + 1/30) ] ≈ 2,042
- t value : Le rapport critique de Student non standardisé, t = Estimate / SE. Pour la répétition espacée, t = 5,433 / 2,042 = 2,661. Pour le rappel actif, t = 11,267 / 2,042 = 5,517.
- Pr(>|t|) : Les p-valeurs simultanées exactes. Pour le premier contraste, p = 0,0217 (significatif au seuil standard de 5 %). Pour le second contraste, p < 0,0001 (hautement significatif). Ces probabilités prennent en compte l’ajustement global (méthode single-step) basé sur la distribution t multivariée de Dunnett, garantissant que le risque d’erreur de première espèce cumulé sur l’ensemble de ces deux tests ne dépasse pas 5 %.
7.3 Calcul et visualisation des intervalles de confiance simultanés
L’estimation ponctuelle couplée aux p-valeurs ajustées ne fournit qu’une vision tronquée de l’inférence statistique. Le calcul des intervalles de confiance simultanés constitue un apport méthodologique déterminant, car il quantifie la précision de l’estimation et délimite la plage des valeurs plausibles du paramètre dans la population.
La fonction générique confint() appliquée à notre objet de contrastes produit les bornes inférieures et supérieures conjointes au niveau de confiance nominal (fixé par défaut à 95 %) :
# Extraction des intervalles de confiance simultanés à 95%
ic_simultanes <- confint(comparaisons_dunnett, level = 0.95)
print(ic_simultanes)
Le résultat textuel prend la forme suivante :
	 Simultaneous Confidence Intervals

Multiple Comparisons of Means: Dunnett Contrasts

Fit: aov(formula = Score ~ Methode, data = donnees_cognition)

Quantile = 2.2415
95% family-wise confidence level

Linear Hypotheses:
                                   Estimate lwr     upr
Repetition_Espacee - Controle == 0    5.433   0.855  10.012
Rappel_Actif - Controle == 0        11.267   6.688  15.845
La ligne Quantile = 2.2415 indique la valeur critique issue de la distribution multivariée de Dunnett pour df = 87 et deux contrastes à un niveau de couverture conjointe de 95 %. À titre de comparaison, un quantile de Student bilatéral simple pour le même seuil se situerait à environ 1,988. C’est cet élargissement contrôlé de la valeur critique qui assure la couverture simultanée de l’ensemble des intervalles.
L’analyse qualitative de ces intervalles de confiance est particulièrement éclairante :
- Pour le contraste
Repetition_Espacee - Controle, l’intervalle s’étend de 0,855 à 10,012 points. La valeur zéro étant exclue de cette plage, nous confirmons le rejet de l’hypothèse nulle à α = 0,05. - Pour le contraste
Rappel_Actif - Controle, l’intervalle est strictement positif, borné entre 6,688 et 15,845 points.
Pour représenter visuellement ces contrastes simultanés, le package multcomp implémente une méthode plot() native extrêmement informative :
# Représentation graphique native des intervalles de confiance de Dunnett
par(mar = c(5, 14, 4, 2)) # Ajustement des marges pour accueillir les étiquettes textuelles
plot(
  ic_simultanes,
  main = "Contrastes simultanés de Dunnett (IC 95%)",
  xlab = "Différence estimée de score par rapport au Contrôle",
  col = "#2980B9"
)
abline(v = 0, lty = 2, col = "red", lwd = 1.5) # Repère visuel de l'hypothèse nulle
Ce diagramme forestier (forest plot) matérialise immédiatement le statut des comparaisons : toute barre d’intervalle qui ne croise pas la ligne verticale en tiret rouge située à l’abscisse 0 correspond à une intervention statistiquement supérieure à la condition témoin au seuil de FWER choisi.
8. Méthode alternative : Réalisation du test avec le package DescTools
8.1 Utilisation de la fonction DunnettTest()
Bien que le recours à multcomp soit recommandé pour les modélisations complexes, le package DescTools propose une approche plus directe et synthétique au travers de sa fonction DunnettTest(). Cette dernière séduit de nombreux praticiens par sa syntaxe calquée sur celle des tests statistiques élémentaires de R, s’affranchissant de l’étape préalable d’ajustement du modèle linéaire.
La signature de la fonction autorise l’usage direct d’une formule statistique (y ~ x) et dispose d’un argument dédié, control, qui permet de spécifier le niveau de référence directement sous forme de chaîne de caractères sans modifier préalablement les niveaux du facteur :
# Exécution directe du test de Dunnett via DescTools
resultat_desctools <- DunnettTest(
  x = donnees_cognition$Score,
  g = donnees_cognition$Methode,
  control = "Controle",
  conf.level = 0.95
)

# Affichage des sorties
print(resultat_desctools)
La sortie générée par DescTools est d’une grande clarté visuelle et se présente sous forme de tableau compact :
  Dunnett's test for comparing several treatments with a control :
    95% family-wise confidence level

$Controle
                              diff    lwr.ci   upr.ci   pval
Repetition_Espacee-Controle  5.433    0.8552  10.0115 0.0217 *
Rappel_Actif-Controle       11.267    6.6885  15.8448 2.4e-06 ***

---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Cette commande exécute l’intégralité du calcul sous le capot : elle agrège les données, calcule l’erreur quadratique moyenne combinée de l’ensemble des groupes, détermine la matrice de corrélation idoine et restitue les différences empiriques (diff), les bornes de confiance simultanées (lwr.ci, upr.ci) ainsi que les p-valeurs corrigées (pval).
8.2 Comparaison critique des sorties entre DescTools et multcomp
Une comparaison minutieuse des sorties numériques issues de multcomp::glht() et de DescTools::DunnettTest() met en évidence une concordance théorique et calculatoire rigoureuse. Les estimations de différences (5,433 et 11,267), les bornes des intervalles de confiance (0,855 à 10,012 pour le premier groupe ; 6,688 à 15,845 pour le second) et les p-valeurs s’avèrent identiques au dix-millième près.
Néanmoins, le choix entre ces deux implémentations dépend des objectifs de l’analyste :
- DescTools est la solution idéale pour les analyses rapides en phase exploratoire, les scripts d’enseignement ou les rapports descriptifs standardisés. Sa syntaxe compacte évite les étapes intermédiaires d’instanciation de modèles d’ANOVA.
- multcomp constitue le cadre de choix pour la recherche expérimentale avancée. Son intégration native avec la classe générale
glhtlui permet de gérer sans rupture les plans factoriels complexes (ANOVA à plusieurs facteurs, présence de covariables via l’ANCOVA), les modèles linéaires généralisés (GLM pour données binaires ou de comptage) et les modèles à effets mixtes (vialme4::lmer). En outre,multcompoffre une modularité algorithmique supérieure, permettant de spécifier des matrices de variance-covariance robustes en cas d’hétéroscédasticité.
9. Diagnostics post-estimation et contrôle de la validité du modèle
9.1 Analyse approfondie des résidus du modèle linéaire
L’exactitude des conclusions issues du test de Dunnett dépend directement de l’adéquation du modèle linéaire sous-jacent aux données empiriques. Si les résidus du modèle violent les hypothèses fondamentales d’homoscédasticité et de normalité, ou si des observations individuelles exercent une influence disproportionnée sur l’estimation des paramètres, les valeurs critiques tabulées perdent leur étalonnage nominal.
La première démarche diagnostique consiste à extraire les résidus bruts, les résidus standardisés et les résidus studentisés du modèle modele_anova :
# Extraction des résidus et des métriques d'influence
residus_bruts <- residuals(modele_anova)
residus_student <- rstudent(modele_anova)
valeurs_ajustees <- fitted(modele_anova)
distance_cook <- cooks.distance(modele_anova)
L’évaluation de l’homoscédasticité résiduelle repose sur l’inspection graphique du nuage des résidus studentisés en fonction des valeurs prédites par le modèle (qui correspondent ici aux moyennes de chaque condition) :
# Graphique diagnostique de dispersion des résidus (Homoscédasticité)
plot(valeurs_ajustees, residus_student,
     xlab = "Valeurs ajustées (Moyennes des groupes)",
     ylab = "Résidus studentisés",
     main = "Diagnostic d'homoscédasticité : Résidus vs Valeurs ajustées",
     pch = 19, col = "#34495E")
abline(h = 0, lty = 2, col = "gray")
abline(h = c(-2, 2), lty = 3, col = "red") # Seuils conventionnels d'alerte
Une dispersion verticale uniforme des résidus au travers des trois niveaux confirme l’homogénéité des variances d’erreur. Si la dispersion s’évasait en entonnoir, cela caractériserait une hétéroscédasticité croissante. Parallèlement, nous soumettons formellement les résidus au test d’homoscédasticité de Levene :
# Test formel d'homoscédasticité de Levene centré sur la médiane
test_levene <- car::leveneTest(Score ~ Methode, data = donnees_cognition)
print(test_levene)
Une p-valeur issue du test de Levene supérieure à 0,05 autorise à conserver l’hypothèse nulle d’homogénéité des variances.
Pour le contrôle de la normalité, nous dressons le diagramme quantile-quantile (Q-Q plot) accompagné du test de normalité de Shapiro-Wilk appliqué sur les résidus d’ajustement globaux :
# Diagnostic graphique de normalité résiduelle
qqnorm(residus_student, main = "Q-Q Plot des résidus studentisés", pch = 19, col = "#2C3E50")
qqline(residus_student, col = "red", lwd = 2)

# Test formel de Shapiro-Wilk sur les résidus
shapiro_residus <- shapiro.test(residus_bruts)
print(shapiro_residus)
Enfin, l’influence excessive de certaines observations sur les estimations est appréhendée au moyen de la distance de Cook. Une observation dont la distance de Cook dépasse le seuil conventionnel Di > 4 / N (soit 4 / 90 ≈ 0,044 dans notre exemple) doit faire l’objet d’une analyse de sensibilité pour vérifier qu’elle ne pilote pas à elle seule la significativité du contraste :
# Identification d'éventuels points influents selon la distance de Cook
seuil_cook <- 4 / nrow(donnees_cognition)
points_influents <- which(distance_cook > seuil_cook)
cat("Nombre d'observations influentes détectées :", length(points_influents), "n")
9.2 Alternatives robustes en cas de violation sévère des postulats
Lorsque les vérifications diagnostiques mettent en évidence des violations sévères des postulats d’application — notamment une hétéroscédasticité marquée (σi2 ≠ σ02) ou des distributions hautement asymétriques réfractaires aux transformations usuelles —, le recours aux procédures paramétriques standards devient méthodologiquement invalide.
Face à une violation avérée de l’homoscédasticité, la solution la plus élégante consiste à coupler la fonction glht() avec des estimateurs de variance-covariance hétéroscédastiques dits « sandwich » (estimateurs de White-Huber). Le package sandwich fournit la fonction vcovHC(), qui réestime la matrice de covariance sans assumer l’égalité des variances intra-groupes. Cette matrice corrigée est ensuite injectée directement dans glht() via son argument vcov :
library(sandwich)

# Modélisation linéaire générale avec matrice de variance-covariance robuste (HC3)
modele_lm <- lm(Score ~ Methode, data = donnees_cognition)
dunnett_robuste <- glht(
  modele_lm,
  linfct = mcp(Methode = "Dunnett"),
  vcov = vcovHC(modele_lm, type = "HC3")
)
summary(dunnett_robuste)
Cette approche ajuste automatiquement l’erreur-type de chaque contraste individuel en fonction de la variance spécifique des groupes concernés, protégeant ainsi le taux nominal d’erreur de type I sans perte substantielle de sensibilité.
Si la normalité des distributions est irrémédiablement compromise (par exemple avec des scores d’examen sous forme d’échelles ordinales discrètes ou de distributions tronquées), l’analyste peut se tourner vers une approche non paramétrique. L’alternative classique au test de Dunnett est le test de Steel (1959), qui constitue l’extension non paramétrique basée sur les rangs (test de Wilcoxon-Mann-Whitney) adaptée aux comparaisons multiples avec un témoin. Il peut être exécuté dans R à l’aide de la fonction pwsdTest() du package PMCMRplus.
Une dernière alternative moderne et robuste réside dans les techniques de rééchantillonnage par bootstrap. En générant empiriquement la distribution conjointe des contrastes par tirages répétés avec remise, le bootstrap simultané permet d’extraire des intervalles de confiance percentiles protégés contre toute distorsion distributionnelle, offrant ainsi une alternative sans hypothèse distributionnelle contraignante.
10. Calcul de la taille d’effet pour chaque contraste individuel
10.1 Le d de Cohen pour les comparaisons au groupe témoin
L’existence d’une significativité statistique pour un contraste de Dunnett donné ne renseigne aucunement sur l’amplitude unitaire de l’effet produit par l’intervention. Il est donc indispensable d’accompagner chaque comparaison par paires d’une estimation de sa taille d’effet standardisée, communément matérialisée par le d de Cohen.
La formulation théorique standardisée du d de Cohen pour un contraste opposant un groupe expérimental i à un groupe témoin 0 s’énonce :
di = (X̄i – X̄0) / spooled
Il existe toutefois une subtilité méthodologique cruciale concernant le choix de l’écart-type de standardisation (spooled). Dans le cadre d’une ANOVA à un facteur où l’homoscédasticité a été confirmée, l’écart-type de standardisation le plus précis et le moins biaisé n’est pas calculé uniquement sur les deux groupes comparés, mais provient directement de la racine carrée du carré moyen résiduel de l’ANOVA globale :
spooled = √(MSRésiduel)
Cette approche exploite l’ensemble de l’échantillon pour stabiliser l’estimation de l’écart-type résiduel commun.
Lorsque les effectifs par groupe sont limités (n < 20), le d de Cohen présente un léger biais de surestimation dans la population. On lui préfère alors le g de Hedges, qui applique un facteur de correction analytique dépendant des degrés de liberté :
g ≈ d × [ 1 – (3 / (4 × df – 1)) ]
Nous implémentons une routine programmatique dans R pour extraire automatiquement ces indices pour l’ensemble des contrastes du plan :
# Extraction de la racine de la variance résiduelle globale (s_pooled)
s_pooled <- sqrt(summary(modele_anova)[[1]]["Residuals", "Mean Sq"])

# Récupération des moyennes empiriques
moyennes <- tapply(donnees_cognition$Score, donnees_cognition$Methode, mean)
moyenne_ctrl <- moyennes["Controle"]

# Calcul vectoriel du d de Cohen pour chaque modalité expérimentale
groupes_exp <- names(moyennes)[names(moyennes) != "Controle"]
d_cohen <- sapply(groupes_exp, function(grp) {
  difference <- moyennes[grp] - moyenne_ctrl
  valeur_d <- difference / s_pooled
  return(valeur_d)
})

# Calcul du g de Hedges corrigé pour les petits échantillons
df_res <- df.residual(modele_anova)
facteur_correction <- 1 - (3 / (4 * df_res - 1))
g_hedges <- d_cohen * facteur_correction

# Affichage des métriques standardisées
tailles_effets_df <- data.frame(
  Contraste = paste(groupes_exp, "vs Controle"),
  Difference_Moyenne = round(moyennes[groupes_exp] - moyenne_ctrl, 2),
  d_Cohen = round(d_cohen, 3),
  g_Hedges = round(g_hedges, 3)
)
print(tailles_effets_df)
10.2 Interprétation contextuelle de la magnitude de l’effet
Les résultats chiffrés obtenus pour notre jeu de données permettent d’éclairer la portée pratique des deux méthodes étudiées. Pour le contraste opposant la répétition espacée au contrôle, nous obtenons d ≈ 0,687. Pour le rappel actif face au contrôle, la valeur atteint d ≈ 1,424.
Selon les grilles de lecture traditionnelles de Cohen (1988), un d de 0,2 est considéré comme un effet faible, 0,5 comme un effet moyen, et 0,8 comme un effet fort. Ainsi, la technique de répétition espacée produit un effet d’ampleur moyenne à forte, tandis que le rappel actif induit un effet d’une intensité exceptionnelle, largement supérieur aux seuils standards de la littérature en éducation.
Cependant, l’interprétation d’une taille d’effet ne doit jamais être déconnectée de son domaine d’application empirique. Dans les recherches sur l’apprentissage et les interventions éducatives, comme l’ont souligné John Hattie et Robert Coe, un gain de d = 0,40 correspond au point de bascule standard (la progression moyenne attendue au cours d’une année scolaire normale sans intervention spécifique). Dès lors, observer un écart de plus de 1,4 écart-type pour le rappel actif indique qu’une simple modification méthodologique de l’étude autonome peut générer un avantage pédagogique massif, équivalant potentiellement à plusieurs trimestres de progression cognitive standard.
11. Rédaction et communication des résultats selon les normes APA
11.1 Formulation textuelle rigoureuse des conclusions statistiques
La restitution académique d’un protocole d’analyse de variance complété par un test de Dunnett requiert le respect scrupuleux des normes éditoriales du manuel de style de l’APA (7e édition). La prose scientifique doit articuler harmonieusement les conclusions de l’analyse globale omnibus et le décryptage formel de chaque contraste planifié.
Voici un modèle rédactionnel adapté pour formaliser les résultats de notre cas d’étude dans la section « Résultats » d’un article scientifique de niveau international :
« Une analyse de variance univariée à un facteur (ANOVA) inter-sujets a été conduite pour évaluer l’impact des techniques d’étude cognitive sur les performances à l’examen standardisé. Les vérifications préliminaires ont confirmé la normalité des résidus au sein de chaque condition expérimentale (test de Shapiro-Wilk, p > 0,05) ainsi que l’homogénéité des variances (test de Levene, F(2, 87) = 0,34, p = 0,714). L’analyse révèle un effet principal hautement significatif de la méthode d’apprentissage sur les scores obtenus, F(2, 87) = 15,12, p < 0,001, η² = 0,26, ω² = 0,24, indiquant qu’environ 24 % de la variance des résultats est imputable à l’intervention.
Pour déterminer si les méthodes actives surpassent les pratiques standardisées de révision, un test post-hoc bilatéral de Dunnett a été appliqué en utilisant le groupe de lecture passive comme niveau de référence (M = 65,18, SD = 7,92). La technique de répétition espacée (M = 70,61, SD = 7,81) induit des performances statistiquement supérieures à la condition témoin, avec une différence moyenne estimée de 5,43 points, t(87) = 2,66, pajusté = 0,022, IC 95% simultané [0,86, 10,01], correspondant à une taille d’effet moyenne à forte (d de Cohen = 0,69). Par ailleurs, le protocole de rappel actif (M = 76,45, SD = 8,12) produit une amélioration encore plus marquée par rapport au groupe témoin, avec un gain moyen estimé de 11,27 points, t(87) = 5,52, pajusté < 0,001, IC 95% simultané [6,69, 15,85], représentant une taille d’effet majeure (d de Cohen = 1,42). En conclusion, les deux stratégies d’apprentissage actif démontrent une supériorité empirique indiscutable face à la lecture passive habituelle, le rappel actif induisant le différentiel de performance le plus substantiel. »
11.2 Conception d’un tableau récapitulatif publiable
L’intégration d’un tableau récapitulatif synthétisant les statistiques descriptives, les contrastes d’estimation, les intervalles de confiance et les indicateurs standardisés facilite la lecture critique par les pairs et rehausse le niveau de rigueur de la publication. Nous mettons en œuvre le code R nécessaire pour formater ce tableau récapitulatif via knitr::kable :
# Structuration des résultats pour publication
tableau_publication <- data.frame(
  Condition = c("Contrôle (Référence)", "Répétition Espacée", "Rappel Actif"),
  N = c(30, 30, 30),
  Moyenne = c("65,18", "70,61", "76,45"),
  Ecart_Type = c("7,92", "7,81", "8,12"),
  Contraste_vs_Ctrl = c("—", "+5,43", "+11,27"),
  IC_95_Simultane = c("—", "[0,86 ; 10,01]", "[6,69 ; 15,85]"),
  Statistique_t = c("—", "2,66", "5,52"),
  p_ajustee = c("—", "0,022", "< 0,001"),
  d_Cohen = c("—", "0,69", "1,42")
)

# Rendu tabulaire au format texte brut propre
knitr::kable(
  tableau_publication,
  col.names = c("Condition expérimentale", "N", "M", "SD", "Différence", "IC 95% (Dunnett)", "t(87)", "p ajustée", "d"),
  align = c("l", "c", "c", "c", "c", "c", "c", "c", "c"),
  caption = "Tableau 1. Statistiques descriptives, contrastes de Dunnett et tailles d'effet pour les protocoles d'apprentissage."
)
Ce tableau présente la structure standard attendue dans les revues internationales : la condition témoin est mise en avant sur la première ligne pour expliciter son statut de niveau de référence, et chaque modalité expérimentale est assortie de l’intégralité de ses paramètres descriptifs et inférentiels.
12. Pièges courants, bonnes pratiques et script R complet prêt à l’emploi
12.1 Erreurs fréquentes lors de la mise en œuvre du test de Dunnett
L’application routinière du test de Dunnett expose les analystes à des erreurs récurrentes qui compromettent la validité des conclusions statistiques. En voici les principales manifestations :
- Omission de la redéfinition du niveau de référence (absence de
relevel) : Par défaut, R ordonne les modalités de façon alphabétique. Si le groupe témoin ne commence pas par la première lettre de l’alphabet,glht()comparera tous les groupes à la première modalité alphabétique (par exemple « Condition A » au lieu de « Placebo »), dénaturant l’intégralité des contrastes formulés. - Confusion entre test unilatéral et bilatéral : Utiliser l’option unilatérale (
alternative = "greater") sans hypothèse directionnelle formellement pré-enregistrée constitue une forme de p-hacking, consistant à réduire artificiellement la valeur critique pour franchir le seuil des 5 %. Le test bilatéral doit toujours demeurer l’approche par défaut. - Utilisation inadéquate face à des objectifs d’inter-comparaisons complètes : Appliquer le test de Dunnett alors que la question scientifique exige également d’évaluer la différence entre le Traitement 1 et le Traitement 2 constitue une faute méthodologique. Dunnett ne contrôle pas le FWER pour les comparaisons entre traitements actifs. Si ces comparaisons sont nécessaires, il convient d’opter pour la méthode de Tukey HSD ou des contrastes planifiés spécifiques (comme les contrastes polynomiaux ou orthogonaux).
- Application aveugle sur des modèles violant l’homoscédasticité : Calculer la statistique standard de Dunnett alors que les variances des groupes diffèrent d’un facteur 3 ou 4 engendre des distorsions sévères du taux d’erreur de type I. Dès que l’hétéroscédasticité est constatée, il faut obligatoirement recourir à une matrice sandwich (comme
vcovHC) ou à des alternatives robustes par rééchantillonnage.
12.2 Bonnes pratiques pour la reproductibilité et l’intégrité scientifique
Pour assurer une transparence maximale et garantir la réplicabilité de ses travaux, le chercheur doit adopter un ensemble de réflexes méthodologiques rigoureux :
- Pré-enregistrement des protocoles (Preregistration) : Consigner la matrice de contrastes, le choix du niveau de référence, la nature unilatérale ou bilatérale des tests, ainsi que les critères d’exclusion des données sur des plateformes certifiées (telles que le Center for Open Science ou AsPredicted) avant la phase de recueil des observations.
- Transparence computationnelle et partage du code source : Intégrer l’intégralité du pipeline d’analyse sous la forme d’un document exécutable structuré (document Quarto ou R Markdown). Les données brutes anonymisées et le script complet doivent être déposés dans un entrepôt de données pérenne avec un identifiant numérique DOI (par exemple sur Zenodo ou OSF).
- Documentation systématique des packages et des versions : Toujours consigner la version de R et celles des packages utilisés via
sessionInfo(), afin de prévenir les ruptures de compatibilité ascendante susceptibles d’altérer les algorithmes d’approximation numérique de la distribution normale multivariée.
12.3 Script R synthétique et autonome pas à pas
Pour conclure ce guide, voici un bloc de code complet, autonome et commenté pas à pas. Il reprend l’intégralité de la chaîne de traitement — de l’importation fictive à l’ajustement diagnostique et à l’extraction finale de Dunnett —, prêt à être adapté à n’importe quel fichier de données externe (CSV, Excel ou RDS) :
# ==============================================================================
# PIPELINE COMPLET ET REPRODUCTIBLE : TEST DE DUNNETT DANS R
# Auteur : Analyse Expérimentale Avancée
# R-Version : 4.x+ | Dépendances : multcomp, car, dplyr, ggplot2
# ==============================================================================

# 1. INITIALISATION ET GESTION DE L'ENVIRONNEMENT
# ------------------------------------------------------------------------------
rm(list = ls())      # Réinitialisation de l'environnement global de travail
set.seed(2025)       # Fixation de la graine pseudo-aléatoire

suppressPackageStartupMessages({
  library(dplyr)
  library(ggplot2)
  library(car)
  library(multcomp)
})

# 2. CHARGEMENT OU SIMULATION DU JEU DE DONNÉES
# ------------------------------------------------------------------------------
# Pour importer vos propres données externes, décommentez la ligne adaptée :
# donnees <- read.csv("chemin/vers/votre_fichier.csv", stringsAsFactors = FALSE)

# Simulation d'un échantillon expérimental pédagogique
n_sujets <- 25
donnees <- data.frame(
  Condition = factor(rep(c("Témoin", "Dose_Faible", "Dose_Forte"), each = n_sujets)),
  Mesure = c(
    rnorm(n_sujets, mean = 50, sd = 6),  # Groupe Témoin
    rnorm(n_sujets, mean = 54, sd = 6),  # Dose Faible
    rnorm(n_sujets, mean = 61, sd = 6)   # Dose Forte
  )
)

# 3. VERROUILLAGE DU NIVEAU DE RÉFÉRENCE (ÉTAPE CRUCIALE)
# ------------------------------------------------------------------------------
donnees$Condition <- relevel(donnees$Condition, ref = "Témoin")
cat("Niveaux configurés du facteur :", paste(levels(donnees$Condition), collapse = ", "), "n")

# 4. STATISTIQUES DESCRIPTIVES EXPLORATOIRES
# ------------------------------------------------------------------------------
descriptifs <- donnees %>%
  group_by(Condition) %>%
  summarise(
    N = n(),
    Moyenne = round(mean(Mesure), 2),
    Ecart_Type = round(sd(Mesure), 2),
    Erreur_Type = round(sd(Mesure) / sqrt(n()), 2)
  )
print(as.data.frame(descriptifs))

# 5. AJUSTEMENT DU MODÈLE LINÉAIRE (ANOVA OMNIBUS)
# ------------------------------------------------------------------------------
modele <- aov(Mesure ~ Condition, data = donnees)
cat("n--- TABLE DE L'ANOVA GLOBALE ---n")
print(summary(modele))

# 6. VÉRIFICATIONS DIAGNOSTIQUES DES POSTULATS
# ------------------------------------------------------------------------------
# Test de normalité des résidus
p_shapiro <- shapiro.test(residuals(modele))$p.value
# Test d'homoscédasticité de Levene
p_levene <- car::leveneTest(Mesure ~ Condition, data = donnees)$`Pr(>F)`[1]

cat("nDiagnostics : Shapiro-Wilk (p =", round(p_shapiro, 4),
    ") | Levene (p =", round(p_levene, 4), ")n")

# 7. EXÉCUTION DU TEST DE DUNNETT VIA MULTCOMP
# ------------------------------------------------------------------------------
test_dunnett <- glht(
  model = modele,
  linfct = mcp(Condition = "Dunnett"),
  alternative = "two.sided"
)

# Restitution des estimations, statistiques t et p-valeurs ajustées
cat("n--- RÉSULTATS DÉTAILLÉS DU TEST DE DUNNETT ---n")
print(summary(test_dunnett))

# 8. INTERVALLES DE CONFIANCE SIMULTANÉS (95%)
# ------------------------------------------------------------------------------
ic_dunnett <- confint(test_dunnett, level = 0.95)
cat("n--- INTERVALLES DE CONFIANCE SIMULTANÉS (95%) ---n")
print(ic_dunnett)

# 9. REPRÉSENTATION GRAPHIQUE DES CONTRASTES
# ------------------------------------------------------------------------------
par(mar = c(5, 12, 4, 2))
plot(
  ic_dunnett,
  main = "Contrastes simultanés de Dunnett vs Témoin",
  xlab = "Différence moyenne estimée (IC 95%)",
  col = "#1B4F72"
)
abline(v = 0, lty = 2, col = "darkred", lwd = 1.5)

# ==============================================================================
# FIN DU PIPELINE ANALYTIQUE
# ==============================================================================
Ce script synthétise l’ensemble des principes méthodologiques abordés tout au long de cet article. En assurant une transition fluide depuis la modélisation formelle jusqu’aux représentations visuelles des contrastes, il offre un cadre d’analyse rigoureux et reproductible pour l’exécution du test de Dunnett dans R.
Références
- Bretz, F., Hothorn, T., & Westfall, P. (2010). Multiple comparisons using R. CRC Press.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096–1121. https://doi.org/10.1080/01621459.1955.10501294
- Dunnett, C. W. (1964). New tables for multiple comparisons with a control. Biometrics, 20(3), 482–491. https://doi.org/10.2307/2528490
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Hothorn, T., Bretz, F., & Westfall, P. (2008). Simultaneous inference in general parametric models. Biometrical Journal, 50(3), 346–363. https://doi.org/10.1002/bimj.200810425
- Signorell, A. (2024). DescTools: Tools for descriptive statistics (R package version 0.99.54). CRAN. https://cran.r-project.org/package=DescTools
- Steel, R. G. D. (1959). A multiple comparison rank sum test: Treatments versus control. Biometrics, 15(4), 560–572. https://doi.org/10.2307/2527654
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag.