
L’analyse des relations quantitatives entre des variables psychologiques, comportementales ou organisationnelles constitue l’un des piliers fondamentaux de la recherche empirique contemporaine. Dans le domaine des sciences humaines et sociales, les chercheurs et analystes de données sont fréquemment confrontés à la nécessité d’évaluer avec précision dans quelle mesure deux construits théoriques — tels que le niveau d’anxiété et la performance cognitive, ou encore la satisfaction au travail et le présentéisme — varient de concert. Pour répondre à ces interrogations méthodologiques, le coefficient de corrélation produit-moment de Pearson s’impose historiquement et pratiquement comme l’outil d’association linéaire le plus largement mobilisé dans la littérature scientifique internationale.
Bien que des progiciels spécialisés d’analyse statistique avancée soient couramment employés dans les laboratoires universitaires, le tableur Microsoft Excel demeure un instrument d’une remarquable puissance, omniprésent dans les environnements de recherche, d’enseignement supérieur et d’entreprise. Pour autant, l’exécution d’un test de corrélation rigoureux au sein d’Excel ne saurait se résumer à la simple application mécanique d’une formule isolée. Une démarche scientifique exigeante impose de valider méticuleusement l’ensemble des postulats paramétriques sous-jacents, d’examiner visuellement la configuration spatiale des distributions empiriques, de calculer la statistique d’inférence appropriée et de contextualiser l’intervalle de confiance encadrant le paramètre de population estimé.
Ce guide exhaustif a pour vocation d’accompagner pas à pas les chercheurs, doctorants, étudiants de cycle supérieur et praticiens de la psychométrie dans l’exécution intégrale d’un test de corrélation de Pearson dans Microsoft Excel. En alliant précision mathématique, rigueur épistémologique et consignes opérationnelles concrètes, cet article couvre chaque phase du protocole : depuis la vérification des postulats distributionnels jusqu’à la restitution formelle des résultats selon les normes de publication les plus récentes de l’American Psychological Association (APA 7e édition).
1. Introduction théorique au coefficient de corrélation de Pearson en psychologie
1.1 Définition et fondements mathématiques de la corrélation linéaire
Le coefficient de corrélation linéaire produit-moment, désigné universellement par la lettre latine minuscule r pour un échantillon empirique et par la lettre grecque ρ (rhô) pour le paramètre théorique d’une population, représente une mesure statistique standardisée de la covariance unissant deux variables quantitatives continues. D’un point de vue conceptuel, la covariance brute entre deux séries de mesures quantifie la tendance globale des observations individuelles à s’écarter conjointement de leurs moyennes respectives. Cependant, la valeur numérique brute de cette covariance dépend directement des unités de mesure dans lesquelles les variables sont exprimées, ce qui rend son interprétation clinique ou scientifique particulièrement ardue lorsqu’il s’agit de comparer des métriques hétérogènes.
Pour s’émanciper de cette dépendance métrique, Karl Pearson a formalisé à la fin du dix-neuvième siècle, sous l’influence directe des travaux pionniers de Sir Francis Galton sur l’hérédité et la régression vers la moyenne, une standardisation mathématique élégante. Cette formulation consiste à diviser la covariance bivariée par le produit strict des écarts-types marginaux des deux variables analysées. En substance, le coefficient r correspond à la moyenne des produits croisés des scores préalablement transformés en notes standardisées (notes z). Cette opération fondamentale a permis d’inaugurer l’ère de la psychométrie moderne, en offrant un cadre analytique unifié pour quantifier la force des associations entre des construits psychologiques intangibles tels que l’intelligence, la motivation ou les traits de personnalité.
Il demeure néanmoins impératif d’opérer une distinction épistémologique stricte entre la notion de covariation statistique et celle de causalité directionnelle. L’observation d’un coefficient de corrélation élevé entre deux indicateurs atteste exclusivement d’un mouvement conjoint prévisible le long d’un modèle rectiligne ; elle ne permet en aucun cas d’affirmer qu’une variable exerce une influence causale sur la seconde. En l’absence d’un protocole expérimental contrôlé impliquant la manipulation active d’une variable indépendante et la randomisation intégrale des participants, toute déduction de causalité demeure un sophisme méthodologique désigné classiquement sous la maxime latine cum hoc ergo propter hoc.
1.2 L’échelle de valeur du coefficient r et son interprétation quantitative
Sur le plan mathématique, le coefficient de Pearson est une mesure rigoureusement bornée au sein d’un intervalle fermé s’étendant de −1,00 à +1,00. Une valeur empirique égale à +1,00 caractérise une association linéaire positive parfaite, signifiant que chaque augmentation constante observée sur la variable prédictive s’accompagne d’une élévation proportionnellement exacte et invariante sur la variable critère, l’ensemble des points d’un diagramme de dispersion s’alignant sur une droite de pente positive. Réciproquement, une valeur atteignant exactement −1,00 traduit une association linéaire négative parfaite, au sein de laquelle toute augmentation sur un axe engendre une diminution strictement proportionnelle sur le second axe.
Une valeur numérique de r équivalente à 0,00 reflète quant à elle l’absence totale de relation linéaire entre les deux séries de mesures. Il convient de souligner avec gravité qu’un coefficient nul n’indique pas nécessairement l’indépendance statistique absolue des variables, mais uniquement l’inadéquation d’un modèle linéaire à capturer leur éventuelle dépendance. Des relations fonctionnelles complexes de nature curvilinéaire ou quadratique peuvent produire un coefficient de corrélation proche de zéro tout en manifestant une interdépendance empirique totale.
Dans le domaine des sciences comportementales, l’appréciation substantielle de la magnitude d’un coefficient repose couramment sur les critères conventionnels établis par le statisticien et psychologue Jacob Cohen. Selon la taxonomie de Cohen (1988), une corrélation est qualifiée de faible aux alentours d’une valeur absolue de 0,10, de modérée à partir d’un seuil de 0,30, et de forte lorsqu’elle atteint ou dépasse 0,50. Bien que ces repères fournissent une grille de lecture utile pour calibrer les effets psychologiques, leur application aveugle est déconseillée par les méthodologistes modernes, qui recommandent d’évaluer la pertinence pratique d’une corrélation à la lumière des standards spécifiques de la discipline concernée et de la précision métrique des instruments d’évaluation mobilisés.
1.3 Importance de la vérification de significativité inférentielle
Dans la quasi-totalité des investigations empiriques, les analyses sont conduites sur des échantillons restreints prélevés au sein d’une population cible plus vaste. Par conséquent, la valeur numérique du coefficient r obtenue sur un groupe d’observation donné ne représente qu’une estimation ponctuelle, intrinsèquement vulnérable aux fluctuations d’échantillonnage aléatoires. Il est théoriquement possible d’observer une corrélation d’une magnitude respectable (par exemple, r = 0,45) au sein d’un petit collectif d’individus sans que cette relation n’existe réellement au niveau de la population sous-jacente, le résultat observé n’étant que le fruit d’une coïncidence stochastique.
Cette vulnérabilité face au hasard expose directement le chercheur au risque d’erreur de type I (l’erreur α), qui consiste à rejeter indûment l’hypothèse d’une absence de relation et à revendiquer la découverte d’un effet psychologique illusoire. Afin de prémunir la communauté scientifique contre ces faux positifs méthodologiques, le calcul descriptif de l’ampleur de l’association doit impérativement être subordonné à un test d’hypothèse inférentiel. Ce test a pour finalité d’estimer avec précision la probabilité d’observer un coefficient au moins aussi extrême que celui calculé dans l’échantillon, sous la prémisse théorique où la véritable corrélation dans la population cible serait rigoureusement nulle.
Pour opérationnaliser cette décision statistique, il est indispensable de confronter la valeur calculée à la distribution théorique d’échantillonnage de la statistique de test associée. Dans le cadre paramétrique développé par Pearson et formalisé ultérieurement par Ronald Fisher et William Sealy Gosset (Student), cette distribution converge de manière optimale vers une loi de Student à n − 2 degrés de liberté, dès lors que les postulats fondamentaux régissant la nature des données sont formellement satisfaits.
2. Les postulats statistiques préalables à l’utilisation du r de Pearson
2.1 Niveau de mesure des données et indépendance des observations
La validité mathématique du coefficient de corrélation de Pearson repose sur l’assignation préalable d’un niveau d’échelle métrique approprié aux variables sous examen. Les deux séries de données doivent obligatoirement appartenir à des échelles d’intervalles constants ou à des échelles de rapports, au sens de la typologie universelle introduite par Stanley Smith Stevens. Ces échelles garantissent que la distance numérique séparant deux scores consécutifs possède une signification spatiale et quantitative identique sur l’ensemble du continuum de mesure, condition sine qua non pour autoriser le calcul d’écarts à la moyenne et de produits croisés.
L’utilisation erronée du r de Pearson sur des variables purement ordinales — telles que des classements hiérarchiques ou des items individuels de type Likert en trois ou quatre modalités — expose l’analyste à des distorsions mathématiques sévères. Lorsque les distances subjectives entre les échelons ne peuvent être présumées strictement équidistantes, l’application d’un modèle paramétrique standard altère les propriétés de la métrique. Dans un tel cas de figure, l’investigateur doit se tourner vers des équivalents non paramétriques tels que le rhô de Spearman ou le tau de Kendall, ou agréger un nombre suffisant d’items psychométriques pour justifier l’émergence d’un score composite continu.
Parallèlement au niveau de mesure, le principe d’indépendance des observations constitue un impératif méthodologique non négociable. Chaque paire de coordonnées (Xi, Yi) doit être recueillie auprès d’un participant distinct, sans interaction, appariement dissimulé ou mesure répétée au cours du temps au sein de la même série d’analyse. La présence de dépendances sérielles ou de structures hiérarchiques nichées (comme des élèves partageant la même classe ou des patients pris en charge par le même thérapeute) viole cette hypothèse d’indépendance, entraînant une inflation artificielle des degrés de liberté et une déflation trompeuse de la p-valeur calculée.
2.2 Hypothèse de normalité bivariée et distribution des variables
Le test de significativité inférentielle adossé au coefficient de Pearson repose sur l’hypothèse formelle de normalité bivariée. Cette distribution implique non seulement que chacune des deux variables examinées de manière isolée suive une distribution normale univariée en forme de cloche, mais que leur combinaison dans l’espace tridimensionnel forme une surface ellipsoïdale symétrique. Bien qu’une déviation modérée de la normalité univariée soit tolérée lorsque les effectifs de l’échantillon sont substantiels (en vertu des propriétés stabilisatrices du théorème central limite), des distorsions distributionnelles prononcées dégradent lourdement l’exactitude de l’inférence statistique.
L’audit préliminaire des distributions s’effectue traditionnellement par le calcul des indices d’asymétrie (skewness) et d’aplatissement (kurtosis). En règle générale, au sein de la communauté psychométrique, des valeurs absolues de skewness comprises entre −1,0 et +1,0 et des valeurs de kurtosis situées entre −2,0 et +2,0 sont considérées comme compatibles avec une approximation raisonnable de la normalité univariée. Des déviations plus marquées indiquent une concentration anormale des scores ou une traîne excessive, nécessitant soit des transformations mathématiques correctrices (logarithmiques, racine carrée), soit l’abandon du modèle de Pearson au profit d’alternatives basées sur les rangs.
Sur le plan conceptuel, la normalité bivariée garantit que pour toute valeur donnée assignée à la variable X, la distribution correspondante des valeurs conditionnelles de Y s’avère parfaitement gaussienne, et vice versa. Cette propriété géométrique est la seule condition mathématique assurant que la distribution d’échantillonnage de la transformation de Student suive rigoureusement la loi théorique de probabilité mobilisée lors du test d’hypothèse bilatéral.
2.3 Linéarité de la relation et homoscédasticité
Le modèle sous-tendant le coefficient r de Pearson postule rigoureusement que la trajectoire d’association liant les deux variables étudiées soit rectiligne. Le coefficient ne mesure en effet que la conformité des données empiriques à une ligne droite idéale. Dès lors qu’une relation psychologique prend une orientation curvilinéaire — à l’instar de la célèbre loi de Yerkes-Dodson décrivant l’impact de l’éveil attentionnel sur la performance sous forme de U inversé —, le r de Pearson échoue dramatiquement à rendre compte de l’intensité de la liaison, pouvant afficher une valeur proche de 0,00 en présence d’une interdépendance fonctionnelle pourtant déterministe.
L’homoscédasticité, quant à elle, désigne la constance de la dispersion ou de la variance des résidus autour de la droite de régression sur toute l’étendue de l’échelle d’évaluation. Pour que l’estimation inférentielle demeure valide, la variabilité des scores de Y doit demeurer homogène, que les scores de X soient faibles, médians ou élevés. Lorsque l’on observe un phénomène d’hétéroscédasticité — fréquemment visualisé sous la forme d’un entonnoir ou d’un cône où la variance explose aux valeurs élevées —, les erreurs types associées aux coefficients de test deviennent biaisées, compromettant irrémédiablement le calcul de la valeur p.
Le non-respect combiné de la linéarité et de l’homoscédasticité constitue l’un des motifs les plus fréquents de rétractation ou d’invalidation des conclusions scientifiques dans les revues à comité de lecture. Ces distorsions ne pouvant être captées par la seule inspection des indices statistiques synthétiques univariés, l’étape de diagnostic graphique préalable s’érige en un prérequis méthodologique d’une absolue nécessité.
2.4 Sensibilité aux valeurs extrêmes et détection des aberrances
D’un point de vue algorithmique, la formule de Pearson implique le calcul de la somme des produits croisés des écarts à la moyenne. Cette formulation quadratique confère au coefficient une vulnérabilité extrême face aux observations atypiques, communément désignées sous les vocables de valeurs aberrantes (outliers) ou de points leviers. Un seul individu présentant des valeurs marginales disproportionnées par rapport au reste de la cohorte peut artificiellement gonfler une corrélation par ailleurs inexistante, ou à l’inverse, anéantir totalement une corrélation substantielle partagée par 99 % de l’échantillon.
Il est fondamental de distinguer les points leviers univariés — repérables par des scores z individuels excédant classiquement les seuils de ±3,00 ou ±3,29 — des valeurs aberrantes bivariées. Ces dernières correspondent à des paires d’observations qui, bien que situées dans des limites acceptables sur chaque axe pris isolément, se positionnent à une distance anormale de la dynamique relationnelle globale du nuage de points (par exemple, un participant manifestant un niveau d’intelligence verbale exceptionnel combiné à un score d’expression écrite quasi nul).
Face à de telles observations discordantes, le chercheur doit adopter une politique de traitement scientifique scrupuleuse, exempte de tout biais de confirmation rétrospectif. Toute suppression d’un participant de la matrice de calcul doit être minutieusement documentée dans le rapport de recherche final, en précisant si l’exclusion résulte d’une anomalie technique avérée (erreur d’encodage, non-respect manifeste des consignes expérimentales) ou d’un critère de troncature statistique prédéfini avant la collecte des données.
3. Formulation des hypothèses et cadre de la décision statistique
3.1 Définition formelle des hypothèses nulle et alternative
Toute démarche d’inférence statistique s’articule autour de la confrontation de deux propositions probabilistes mutuellement exclusives : l’hypothèse nulle, notée conventionnellement H0, et l’hypothèse alternative ou de recherche, désignée par H1. Dans le cadre d’un test de corrélation bivariée paramétrique, l’hypothèse nulle pose formellement l’absence intégrale de relation linéaire entre les deux variables au sein de la population cible, ce qui s’exprime par l’égalité mathématique H0 : ρ = 0.
Le choix de l’hypothèse alternative dépend étroitement de l’état d’avancement des connaissances théoriques et de la nature de la question de recherche. Lorsque l’investigation est purement exploratoire ou que la littérature scientifique livre des prédictions divergentes quant au sens du lien attendu, le chercheur formule une hypothèse alternative bilatérale (ou non directionnelle), spécifiée par l’inégalité H1 : ρ ≠ 0. Dans cette configuration, tout écart substantiel par rapport à zéro, qu’il s’oriente vers le pôle positif ou le pôle négatif de l’axe, contribuera au rejet potentiel de l’hypothèse nulle.
À l’inverse, lorsqu’un corpus théorique robuste et des données antérieures convergentes prédisent sans ambiguïté la directionnalité de l’association — par exemple, l’affirmation que l’épuisement professionnel (burnout) entretient une relation strictement inverse avec l’engagement organisationnel —, l’investigateur peut opter pour une hypothèse alternative unilatérale directionnelle, posant soit H1 : ρ > 0, soit H1 : ρ < 0. Bien que cette approche augmente mécaniquement la sensibilité statistique en concentrant la région critique de rejet d’un seul côté de la courbe, les standards académiques contemporains privilégient très majoritairement le test bilatéral afin de prévenir le risque de confirmation complaisante d’hypothèses orientées.
3.2 Sélection du seuil de risque alpha et puissance statistique
Le seuil de signification, universellement formalisé par la lettre α (alpha), représente le niveau maximal de tolérance consenti par le chercheur quant à la probabilité de commettre une erreur de type I. Par convention quasi universelle en psychologie et dans les sciences du comportement, ce seuil est fixé à α = 0,05, ce qui signifie que l’analyste accepte un risque de 5 % d’affirmer l’existence d’une corrélation alors que la dynamique relationnelle observée n’est générée que par les aléas de l’échantillonnage. Dans des contextes de recherche médicale ou clinique à fort enjeu diagnostique, ce critère peut être durci à α = 0,01 ou α = 0,001.
Ce choix ne doit cependant jamais être découplé de la notion de puissance statistique, définie comme le complémentaire de l’erreur de type II (1 − β). La puissance mesure la probabilité d’identifier et de déclarer statistiquement significative une corrélation d’une magnitude donnée dès lors que celle-ci existe véritablement au sein de la population. Trois facteurs gouvernent conjointement cette puissance : le seuil α retenu, la taille de l’échantillon n, et l’amplitude de l’effet ρ sous-jacent. Un échantillon de dimension trop modeste face à une corrélation réelle ténue conduira inexorablement à une impuissance statistique, empêchant le rejet de H0.
En outre, lorsque la démarche analytique implique la passation de multiples tests de corrélation au sein d’une vaste matrice de variables, le risque global de commettre au moins une erreur de type I (taux d’erreur familial ou familywise error rate) croît de manière exponentielle selon la formule 1 − (1 − α)k, où k représente le nombre d’associations testées. Face à cette prolifération de tests, l’analyste doit envisager l’application de procédures d’ajustement conservatrices, telles que la correction de Bonferroni ou la régulation du taux de fausse découverte de Benjamini-Hochberg.
3.3 La statistique de test t et le calcul des degrés de liberté
Pour arbitrer objectivement entre l’hypothèse nulle et l’hypothèse alternative, le coefficient d’échantillon brut r doit être converti en une variable standardisée régie par une loi de probabilité parfaitement documentée. Cette transformation repose sur l’équation de Student, qui modélise le rapport entre la magnitude de la corrélation observée et son erreur type asymptotique sous la condition de validité de H0.
La formulation mathématique exacte permettant cette dérivation s’exprime comme suit :
t = r × √(n − 2) / √(1 − r²)
Au sein de cette structure algorithmique, le paramètre n désigne le nombre total de paires d’observations valides incluses dans l’analyse. L’expression n − 2 correspond aux degrés de liberté (notés usuellement dl ou df pour degrees of freedom). Cette soustraction de deux unités résulte de la contrainte statistique imposée par l’estimation préalable des moyennes d’échantillon des deux variables étudiées lors du calcul des écarts individuels.
Ces degrés de liberté exercent un rôle structurel fondamental dans la géométrie de la distribution de Student. Lorsque les degrés de liberté sont restreints, la courbe de Student arbore un profil leptokurtique aux traînes plus épaisses que celles d’une loi normale centrée réduite standard, reflétant une plus grande incertitude due aux faibles effectifs. Au fur et à mesure que la taille de l’échantillon progresse vers des cohortes volumineuses, la distribution de Student converge asymptotiquement vers la loi normale standard, rendant les critères de décision statistique de plus en plus stables et fiables.
4. Étape 1 : Structuration et préparation rigoureuse des données dans Excel
4.1 Organisation matricielle des variables psychologiques
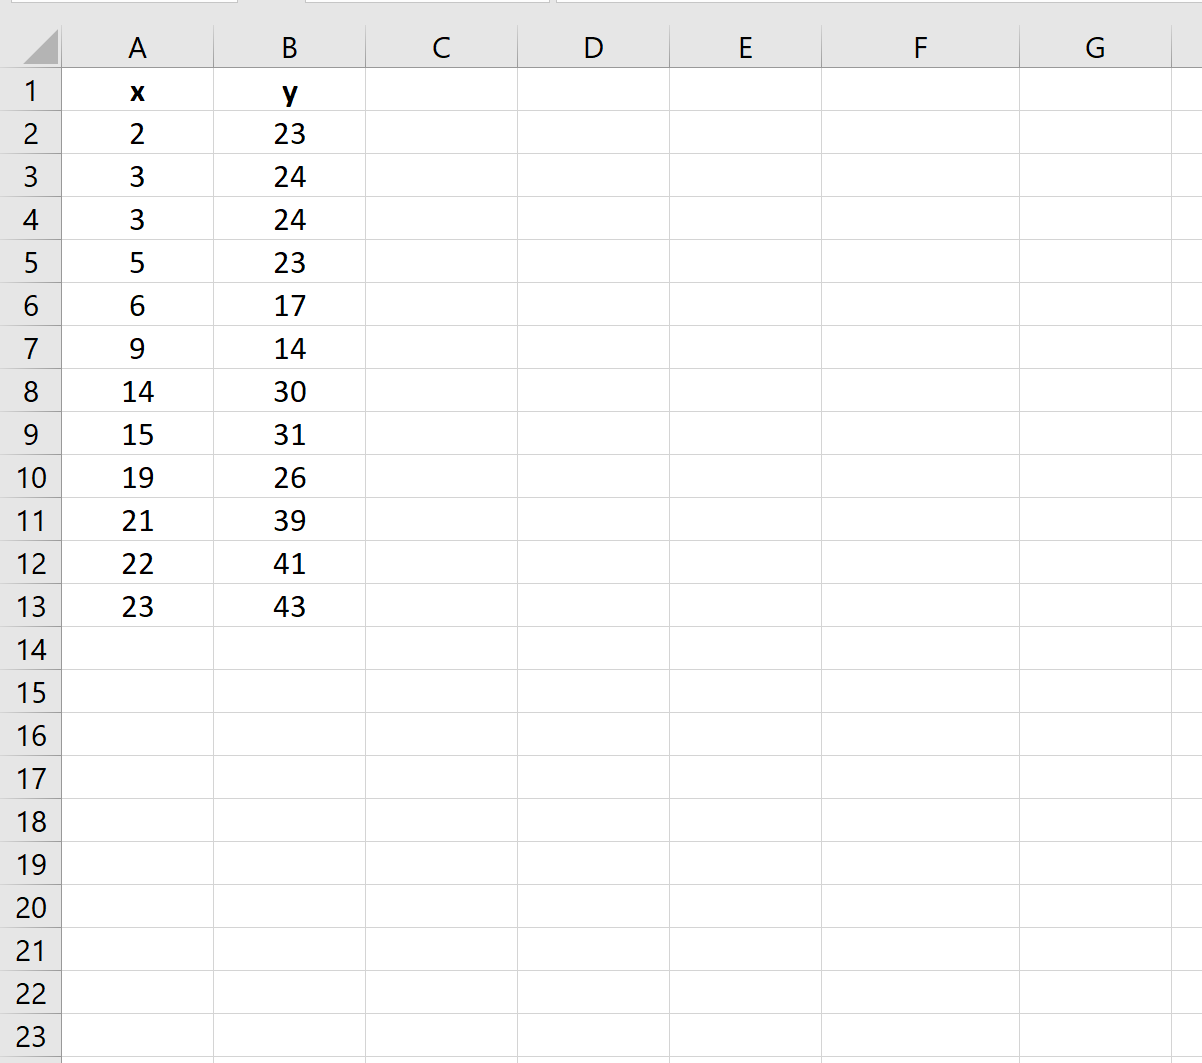
La première exigence opérationnelle pour mener une analyse exempte d’erreurs au sein du tableur Microsoft Excel réside dans l’adoption d’une architecture tabulaire rigoureusement rectangulaire. La convention scientifique universelle impose que chaque ligne horizontale de la feuille de calcul corresponde de manière exclusive et biunivoque à une unité d’échantillonnage unique (c’est-à-dire un participant, un patient ou un sujet expérimental déterminé), tandis que chaque colonne verticale représente une variable psychologique ou démographique distincte.
La première ligne du tableau matriciel — couramment désignée sous le terme de ligne d’en-tête — doit être réservée à la dénomination explicite des construits évalués. Il est primordial d’attribuer des libellés synthétiques mais univoques, en évitant formellement l’incorporation de caractères diacritiques complexes, d’espaces accidentels, de retours à la ligne forcés ou de symboles mathématiques susceptibles d’interférer avec les moteurs de calcul ou les scripts ultérieurs (par exemple, privilégier Anxiete_Score et Performance_Score plutôt que des dénominations ambiguës ou morcelées).
De surcroît, le chercheur doit s’assurer que les scores attribués à un même sujet sur les différentes colonnes soient rigoureusement alignés sur la même ligne physique. L’altération accidentelle du tri d’une colonne isolée par rapport au reste du classeur constituerait un sinistre méthodologique absolu, brisant l’appariement bivarié des mesures et générant des corrélations totalement fictives issues du mélange aléatoire des participants.
4.2 Gestion des données manquantes et audit de cohérence
Dans la pratique de la recherche empirique, la survenue de données manquantes — résultant de l’omission d’une réponse à un questionnaire, du dysfonctionnement passager d’un appareil de mesure ou de l’abandon d’un protocole par un sujet — constitue un défi récurrent. Dans le contexte de l’environnement Excel, la règle cardinale consiste à laisser la cellule correspondante strictement vide. L’utilisation d’encodages numériques conventionnels historiques issus d’anciens progiciels (tels que les valeurs arbitraires -99, 999 ou 0 pour désigner l’absence de donnée) doit être catégoriquement bannie, faute de quoi le tableur intégrera ces valeurs extrêmes dans ses équations de sommation, faussant irrémédiablement le calcul des moyennes et de la covariance.
Il importe également de distinguer le mécanisme d’exclusion par paire (pairwise deletion) de l’exclusion par observation complète (listwise deletion). Si une feuille de calcul contient une douzaine de variables mais que l’analyse ne porte que sur deux colonnes spécifiques, seules les lignes présentant un vide au sein de ces deux colonnes précises doivent être écartées du calcul effectif de n. L’analyste peut déployer les fonctionnalités natives de filtrage automatique d’Excel afin d’isoler visuellement les cellules vides et de s’assurer qu’aucun artefact n’échappe à la vigilance méthodologique.
Pour prévenir les dérives lors de la phase de saisie manuelle des données, l’activation des outils de Validation des données d’Excel représente un rempart hautement recommandé. En verrouillant les plages de saisie autorisées (par exemple, en n’autorisant que des valeurs entières comprises entre 0 et 100 pour une échelle d’évaluation psychométrique circonscrite), l’investigateur neutralise préventivement les fautes de frappe susceptibles de corrompre l’intégrité de la matrice.
4.3 Formatage adéquat des variables numériques
L’un des dysfonctionnements les plus insidieux au sein d’Excel réside dans la présence de valeurs numériques silencieusement formatées sous le type de données texte. Lorsqu’un jeu de données est importé depuis une plateforme d’enquête en ligne ou un fichier au format texte délimité (CSV), certaines cellules peuvent être interprétées par le logiciel comme des chaînes de caractères littérales, en particulier si le séparateur décimal utilisé (point versus virgule) diverge des paramètres régionaux configurés sur le système d’exploitation de la machine hôte.
Les fonctions statistiques d’Excel, à commencer par la formule du coefficient de corrélation, ignorent automatiquement et silencieusement les cellules contenant du texte. Si de telles anomalies parsèment la feuille de calcul, Excel réduira mécaniquement la taille effective de l’échantillon sans émettre de message d’erreur bloquant, introduisant un biais d’échantillonnage par omission involontaire. Une inspection visuelle attentive permet fréquemment d’identifier ces éléments, les valeurs textuelles étant par défaut justifiées à gauche de la cellule, tandis que les valeurs numériques s’alignent rigoureusement à droite.
Pour assainir formellement la matrice, l’utilisateur peut appliquer systématiquement la fonction conditionnelle =ESTNUM(cellule) sur une colonne témoin pour confirmer la nature numérique de chaque entrée, ou recourir à la fonction de conversion =CNUM(cellule) pour contraindre une chaîne textuelle ambiguë à adopter un encodage numérique réel. Une fois le nettoyage parachevé, l’application explicite du format de cellule « Nombre » à l’ensemble du bloc de données garantit une exécution algorithmique fluide et sans distorsion.
5. Étape 2 : Inspection graphique préliminaire via le nuage de points
5.1 Génération du diagramme de dispersion bivarié
Préalablement à toute sollicitation d’un quelconque algorithme de calcul mathématique, le premier réflexe épistémologique du chercheur consiste à matérialiser visuellement la relation étudiée au moyen d’un diagramme de dispersion bivarié, universellement désigné sous le terme de nuage de points (scatter plot). Cette représentation cartésienne projette chaque participant sous la forme d’un point géométrique dont les coordonnées scalaires correspondent exactement à ses scores sur les axes horizontal et vertical.
Pour concevoir ce graphique au sein de l’environnement Excel, il convient de surligner précisément les deux plages de cellules continues renfermant les données quantitatives des deux variables d’intérêt. L’utilisateur accède ensuite au ruban supérieur du tableur, clique sur l’onglet « Insertion », localise le groupe thématique « Graphiques », puis sélectionne l’icône « Nuage de points (X, Y) », en choisissant rigoureusement le modèle standard composé de points isolés non reliés par des segments continus.
La convention académique veut que la variable désignée comme prédictrice ou indépendante soit systématiquement assignée à l’axe des abscisses (axe horizontal X), tandis que la variable critère ou dépendante soit projetée sur l’axe des ordonnées (axe vertical Y). Une fois le graphique incorporé, il est impératif d’affiner son habillage professionnel : éliminer le quadrillage parasite surnuméraire, ajuster les bornes minimales et maximales des axes pour éviter une compression visuelle inutile des données dans un quadrant étriqué, et adjoindre des titres d’axes explicites incluant le nom de la variable et son unité métrique d’évaluation.
5.2 Intégration et analyse de la droite d’ajustement linéaire
Une fois le nuage de coordonnées déployé sur la surface graphique, l’étape diagnostique subséquente consiste à modéliser la tendance centrale de l’association au moyen d’une droite d’ajustement régie par la méthode des moindres carrés ordinaires. Sous Excel, cette opération s’exécute avec une remarquable simplicité en effectuant un clic droit directement sur l’une des marques de données au sein du graphique, puis en sélectionnant la commande « Ajouter une courbe de tendance… » dans le menu contextuel.
Dans le volet de configuration latérale qui s’affiche à l’écran, le modèle « Linéaire » doit demeurer sélectionné par défaut. Deux cases à cocher fondamentales situées dans la partie inférieure de ce volet doivent être impérativement activées par le chercheur : « Afficher l’équation sur le graphique » et « Afficher le coefficient de détermination (R²) sur le graphique ». L’activation de ces options enrichit instantanément le diagramme de dispersion d’une composante analytique formelle en surimposant l’équation fondamentale de la droite sous la forme canonique y = ax + b.
La droite ainsi tracée permet d’apprécier immédiatement la trajectoire globale du phénomène : une pente ascendante témoigne d’une dynamique relationnelle positive, tandis qu’une inclinaison descendante traduit une corrélation inverse. De son côté, la valeur numérique du R² exprime la proportion exacte de la variance globale de la variable Y directement expliquée par la variation de la variable X. La racine carrée arithmétique directe de ce coefficient de détermination correspond formellement à la valeur absolue du r de Pearson d’échantillon, offrant ainsi une première vérification croisée intuitive de l’amplitude de l’effet.
5.3 Diagnostic des violations d’hypothèses par inspection visuelle
L’utilité primordiale du diagramme de dispersion réside avant tout dans sa fonction d’avertisseur méthodologique face aux violations potentielles des postulats paramétriques. Aucun indice numérique agrégé, qu’il s’agisse de la moyenne ou du coefficient de corrélation lui-même, ne peut rivaliser avec la sagacité de l’œil humain pour identifier des anomalies spatiales complexes. Le célèbre quartette d’Anscombe a historiquement démontré que quatre jeux de données pourvus de moyennes, d’écarts-types et de coefficients r strictement identiques peuvent dissimuler des réalités phénoménologiques radicalement divergentes, allant de la parfaite ligne droite à une parabole continue ou à une série totalement orthogonale dominée par un unique point aberrant.
Lors de l’inspection, l’investigateur doit scruter la présence d’une éventuelle courbure systématique au sein du nuage. Si les points épousent une forme parabolique en U, une dynamique sigmoïde ou une trajectoire logarithmique asymptotique, le modèle linéaire de Pearson doit être immédiatement déclaré inopérant. Tenter d’ajuster une droite sur un phénomène fondamentalement curvilinéaire aboutirait à une sous-estimation dramatique de la véritable force de liaison unissant les concepts psychologiques sous étude.
Simultanément, l’attention doit se porter sur l’homogénéité de la dispersion latérale. Si l’écartement vertical des points par rapport à la droite de tendance est faible pour les valeurs basses de X mais s’accroît démesurément à mesure que l’on progresse vers la droite du graphique, l’analyste fait face à un diagnostic patent d’hétéroscédasticité. Enfin, la présence d’un point isolé à la périphérie lointaine de la matrice constitue un signal d’alerte critique imposant de vérifier si ce sujet atypique n’exerce pas une influence indue — un effet levier dévastateur — sur la trajectoire globale de la droite de régression.
6. Étape 3 : Calcul direct du coefficient r à l’aide de la fonction COEFFICIENT.CORRELATION
6.1 Syntaxe formelle et utilisation de la formule native
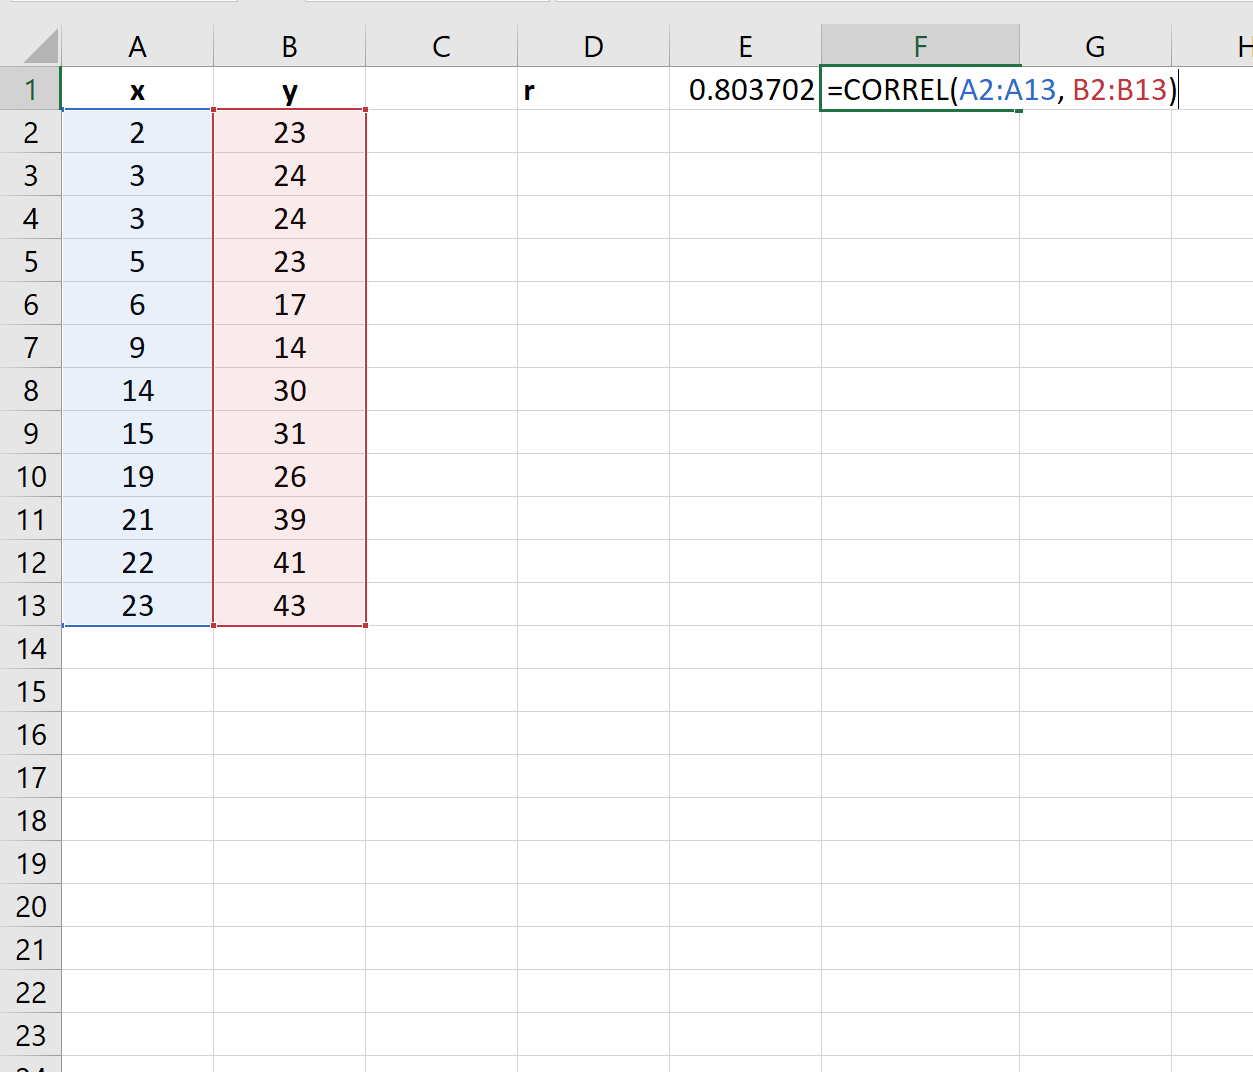
Au-delà de la visualisation graphique, la détermination exacte de l’indice de Pearson exige une quantification algorithmique précise. À cette fin, Microsoft Excel intègre dans son répertoire de calcul une fonction native dédiée. Au sein de la version francophone du logiciel, cette commande s’énonce sous la syntaxe formelle :
=COEFFICIENT.CORRELATION(matrice1; matrice2)
Il est précieux de noter qu’au sein de la version internationale anglophone du tableur, ou lors de l’exécution de scripts de programmation inter-logiciels, cette instruction équivaut rigoureusement à la commande =CORREL(array1, array2). Les deux appellations mobilisent un moteur de calcul strictement identique, garantissant une reproductibilité numérique absolue des opérations quelle que soit la déclinaison linguistique exploitée.
Pour mettre en œuvre cette instruction, l’utilisateur sélectionne une cellule inactive de son classeur destinée à héberger le résultat descriptif, saisit le signe d’égalité conventionnel, tape le nom de la fonction, puis définit en premier argument la plage continue de la variable indépendante (par exemple, B2:B101 pour une cohorte de cent individus). Après insertion du point-virgule séparateur (ou de la virgule selon les configurations régionales anglo-saxonnes), l’utilisateur indique la seconde plage correspondant à la variable dépendante (par exemple, C2:C101). Une exigence structurelle absolue et non négociable de cette fonction réside dans la parité dimensionnelle des arguments : les deux matrices doivent comporter un nombre rigoureusement identique de cellules, sous peine de déclencher instantanément une erreur système bloquante de type #N/A.
6.2 Précision computationnelle et traitement automatique des cellules vides
Le moteur computationnel d’Excel traite les arguments de la fonction COEFFICIENT.CORRELATION selon des règles logiques strictes qu’il convient de parfaitement maîtriser afin d’éviter toute méprise interprétative. Lorsqu’une paire de données comporte une cellule vide, le tableur ignore automatiquement et silencieusement l’ensemble de l’observation correspondante. En d’autres termes, Excel opère de manière autonome une procédure d’exclusion par paire lors du calcul de la covariance et des variances associées, sans exiger de l’utilisateur une suppression manuelle des rangées incomplètes.
Néanmoins, une vigilance absolue s’impose à l’égard de la valeur zéro (« 0 »). Pour les algorithmes mathématiques du tableur, un zéro ne saurait être assimilé à une donnée manquante ; il constitue un score métrique empirique légitime et doté d’une pleine valeur quantitative. Par conséquent, si un enquêteur a encodé par négligence la valeur 0 pour signifier une absence de réponse d’un participant à une échelle d’attitude, ce zéro numérique sera inclus à part entière dans le calcul de la moyenne, déformant considérablement l’écart résiduel de ce sujet et altérant la justesse du coefficient final.
Par ailleurs, bien que les versions contemporaines d’Excel (notamment issues de Microsoft 365 et des suites Office postérieures à 2010) bénéficient d’algorithmes statistiques grandement fiabilisés ayant corrigé les faiblesses historiques de troncature numérique constatées dans les versions antérieures à 2003, une précaution demeure : si une colonne de données présente une variance rigoureusement égale à zéro (c’est-à-dire si tous les participants obtiennent exactement le même score sur un construit psychologique), le dénominateur de la formule de Pearson s’annule mathématiquement, induisant l’affichage immédiat du message d’erreur d’interdiction arithmétique #DIV/0!.
6.3 Interprétation de l’indice numérique brut obtenu
L’évaluation de la cellule hébergeant le résultat de la fonction livre un nombre réel décimal compris entre −1 et +1. La lecture diagnostique de cet indice commence par l’analyse de sa polarité algébrique. Un signe positif confirme que les participants qui affichent des scores supérieurs à la moyenne sur le premier construit ont une probabilité statistique accrue de se positionner également au-dessus de la moyenne sur le second construit. À l’inverse, un signe négatif établit une dynamique antagoniste, où l’exaltation d’un trait psychologique s’accompagne tendanciellement de l’attrition de l’autre.
Dans un second temps, le chercheur doit calculer immédiatement le coefficient de détermination partagée, désigné par r². Ce paramètre s’obtient simplement sous Excel en élevant le coefficient calculé à la puissance deux au moyen de la formule auxiliaire =cellule^2. Si une analyse empirique met en évidence un coefficient de corrélation r = 0,40 entre deux construits psychométriques, l’élévation au carré révèle que r² = 0,16. Cette métrique indique de manière transparente que seulement 16 % de la variance totale observée sur la variable d’évaluation est commune ou explicable par la dynamique de la variable prédictive, laissant 84 % de la variance résiduelle sous l’emprise d’autres sources de variabilité non mesurées ou de l’erreur d’évaluation.
Toutefois, il est fondamental de rappeler qu’à ce stade du protocole, l’indice r brut ne constitue qu’un indicateur purement descriptif circonscrit à l’échantillon prélevé. Revendiquer la portée scientifique de ce résultat sans vérifier si cette amplitude excède les simples fluctuations aléatoires de l’échantillonnage relèverait d’une imprudence méthodologique majeure, justifiant l’obligation d’engager sans délai la phase de modélisation inférentielle.
7. Étape 4 : Dérivation mathématique de la statistique t dans la feuille de calcul
7.1 Décomposition des composants de l’équation de Student
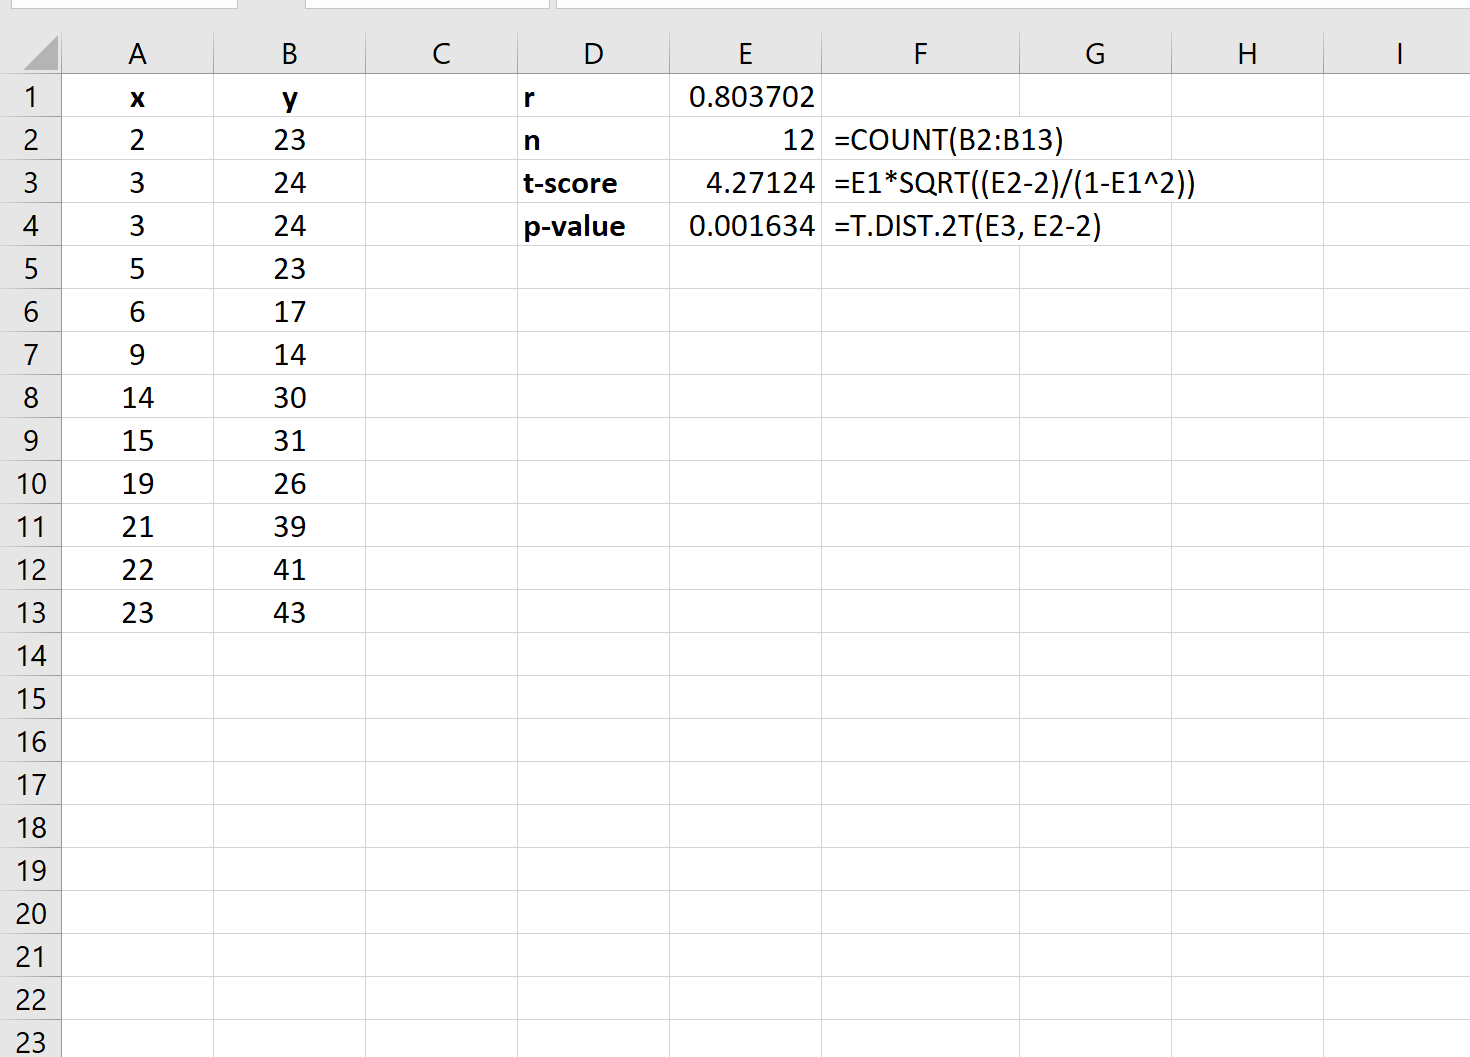
Pour soumettre le coefficient descriptif de Pearson à l’épreuve de l’inférence statistique au sein d’Excel, il est nécessaire de décomposer formellement les paramètres requis pour la résolution de l’équation de Student. La première inconnue opérationnelle réside dans la détermination rigoureuse de la taille d’échantillon effective n. Afin de se prémunir contre toute erreur de comptage manuel — particulièrement en présence de cellules vides dissimulées —, il est hautement recommandé d’extraire cette valeur au moyen de la fonction mathématique native de comptage :
=NB(plage_donnees)
Dès lors que la taille n est établie dans une cellule référencée, les degrés de liberté sont formalisés par la relation élémentaire =n - 2. Le calcul de la statistique de test t s’organise ensuite autour de la confrontation de deux blocs arithmétiques distincts : le numérateur, qui pondère la corrélation par la racine carrée des degrés de liberté, et le dénominateur, qui modélise l’erreur type de l’estimation de Pearson sous l’hypothèse nulle.
Le numérateur correspond à l’expression formelle r * RACINE(n - 2). Il reflète l’amplitude de la relation brute potentialisée par le volume de l’échantillon examiné. Le dénominateur, quant à lui, s’énonce sous la forme RACINE(1 - r^2). Ce dernier terme quantify l’ampleur de la variance inexpliquée résiduelle : plus la corrélation empirique r est substantielle, plus la valeur sous le radical diminue, ce qui a pour effet direct d’amplifier la valeur absolue du score t résultant.
7.2 Implémentation d’une formule unifiée pour le calcul du score t
Bien qu’il soit pédagogiquement instructif de ventiler les composants du calcul au sein de plusieurs cellules intermédiaires, l’élaboration d’une feuille d’analyse robuste et synthétique gagne à s’appuyer sur une formulation unifiée. En supposant que le coefficient de corrélation r de Pearson a été calculé dans la cellule E2 et que la taille effective de l’échantillon n a été consignée dans la cellule E3, l’utilisateur peut inscrire dans la cellule dédiée à la statistique t l’équation intégrée suivante :
=E2*RACINE(E3-2)/RACINE(1-(E2^2))
Cette instruction condensée garantit une précision de calcul maximale en éliminant les biais d’arrondi susceptibles de survenir lors de la manipulation de valeurs intermédiaires tronquées. L’analyste averti veillera toutefois à la protection de l’algorithme : si le jeu de données génère un coefficient parfait où |r| = 1, le terme 1 - (E2^2) devient rigoureusement égal à zéro, provoquant une erreur de division illicite. Pour pallier cette éventualité extrême dans les routines d’automatisation, la formule peut être encapsulée dans une condition préventive évaluant la non-unitarité du coefficient.
Il est fondamental d’observer que la statistique t ainsi générée hérite naturellement du signe algébrique du coefficient r. Une corrélation négative produira une valeur de t négative, située dans l’hémisphère inférieur de la distribution de Student, tandis qu’une corrélation positive déploiera une statistique positive. Cette parfaite symétrie assure la correspondance géométrique intégrale entre la déviation de la covariance observée et le positionnement du point sous la courbe théorique de probabilité.
7.3 Consignation des résultats intermédiaires dans un bloc d’analyse
Pour assurer la traçabilité, la reproductibilité et la transparence totale des analyses statistiques — des exigences déontologiques centrales dans la science ouverte contemporaine —, l’agencement visuel des métriques sur la feuille de calcul doit respecter une stricte harmonie. Il est préconisé de constituer un encadré ou « cartouche d’analyse inférentielle » à l’écart de la matrice des données brutes, au sein duquel chaque étape du traitement fait l’objet d’un affichage didactique.
Une disposition optimale s’articule généralement sur deux colonnes adjacentes : la colonne de gauche accueille les libellés normalisés des paramètres (Taille d’échantillon [n], Degrés de liberté [dl], Coefficient de Pearson [r], Coefficient de détermination [r²], Statistique empirique [t], Seuil de signification [α]), tandis que la colonne de droite héberge les formules dynamiques correspondantes. Cette architecture permet à tout auditeur extérieur de vérifier immédiatement l’exactitude des calculs sans devoir disséquer le maillage des formules complexes.
Afin de parfaire cette rigueur opérationnelle, il est particulièrement avantageux de recourir à la fonctionnalité de dénomination des plages de cellules d’Excel (« Gestionnaire de noms »). En attribuant formellement le nom explicite r_empirique à la cellule du coefficient et n_sujets à celle de la taille de l’échantillon, la formule de Student se réécrit élégamment sous la forme didactique =r_empirique*RACINE(n_sujets-2)/RACINE(1-(r_empirique^2)). Cette pratique élimine les risques de dérive des références relatives lors des opérations de copier-coller et facilite la validation croisée des calculs intermédiaires avec les données de la littérature.
8. Étape 5 : Calcul de la significativité bilatérale via les lois de distribution d’Excel
8.1 Application de la fonction LOI.STUDENT.BILATERALE
Une fois la statistique empirique t dûment calculée, le palier décisif du protocole inférentiel consiste à déterminer la probabilité exacte d’obtenir une valeur au moins aussi polarisée sous l’hypothèse d’une absence de relation au sein de la population. Au sein des versions actuelles de Microsoft Excel, l’algorithme dédié à la quantification probabiliste d’un test bilatéral s’exécute au moyen de la formule officielle :
=LOI.STUDENT.BILATERALE(x; degres_liberte)
Dans l’architecture computationnelle de cette instruction, le premier argument x représente la valeur de la statistique de test t, tandis que le second paramètre correspond aux degrés de liberté (n − 2). Une règle de programmation impérative régissant cette fonction précise que l’argument x doit obligatoirement être un nombre réel positif ou nul. Si l’utilisateur y introduit directement un score t négatif — consécutif à l’observation d’une corrélation inverse —, Excel bloque le traitement et renvoie immédiatement l’erreur #NOMBRE!.
Pour neutraliser définitivement cette contrainte technique et conférer une robustesse universelle à la feuille de calcul, il convient de coupler systématiquement l’instruction avec la fonction de valeur absolue ABS(). Ainsi, en supposant que la statistique t est consignée dans la cellule E6 et les degrés de liberté dans la cellule E4, la syntaxe infaillible s’énonce comme suit :
=LOI.STUDENT.BILATERALE(ABS(E6); E4)
Le résultat généré par cette formule constitue la p-valeur bilatérale (two-tailed p-value). Ce nombre réel, compris strictement entre 0 et 1, cumule la surface des deux queues symétriques de la distribution théorique situées au-delà de +|t| et en deçà de −|t|. Si le chercheur avait préalablement justifié sur le plan théorique la réalisation d’un test strictement unidirectionnel, il conviendrait de diviser cette valeur bilatérale par deux, ou de mobiliser la fonction générique =LOI.STUDENT.N(x; degres_liberte; VRAI) afin d’isoler l’intégrale unilatérale appropriée.
8.2 Comparaison entre fonctions modernes et anciennes versions d’Excel
Lors de la manipulation de classeurs de recherche partagés entre plusieurs équipes académiques ou laboratoires internationaux, il n’est pas rare de constater la présence de variations syntaxiques héritées des générations antérieures du tableur. Avant l’édition Excel 2010, le traitement de la loi de Student s’opérait de manière quasi monopolistique à travers l’ancienne formule de compatibilité =LOI.STUDENT(x; degres_liberte; unilit/bilit), au sein de laquelle l’analyste spécifiait le mode unilatéral ou bilatéral via le chiffre 1 ou 2 renseigné en troisième argument.
Bien que Microsoft continue d’assurer la rétrocompatibilité technique de ces anciennes instructions — identifiables par l’icône de triangle d’avertissement jaune dans l’assistant de formules —, leur emploi dans de nouvelles investigations empiriques est formellement déconseillé. Les nouvelles fonctions scindées, à l’image de LOI.STUDENT.BILATERALE et de LOI.STUDENT.DROITE, ont bénéficié d’améliorations substantielles de leurs algorithmes d’intégration numérique, offrant une précision de calcul nettement supérieure dans les zones critiques extrêmes des traînes de distribution.
Pour garantir une pérennité maximale aux feuilles de travail destinées à être archivées dans le cadre d’initiatives de science ouverte, il est de bonne pratique méthodologique de standardiser l’ensemble des requêtes sur les syntaxes modernes. La conversion systématique des anciens classeurs vers les standards contemporains prémunit le chercheur contre les incohérences de calcul susceptibles de survenir lors de la migration vers des environnements infonuagiques récents tels qu’Excel pour le Web ou Microsoft 365.
8.3 Règle de décision statistique et arbitrage de l’hypothèse nulle
L’arbitrage ultime de l’investigation empirique repose sur la confrontation mécanique de la p-valeur obtenue avec le seuil critique d’erreur α consenti a priori (habituellement α = 0,05). La règle de décision s’énonce avec une clarté binaire absolue : si la p-valeur est rigoureusement inférieure ou égale au seuil critique (p ≤ 0,05), l’analyste déclare le rejet formel de l’hypothèse nulle H0 au profit de l’acceptation de l’hypothèse alternative H1. On conclut alors à l’existence d’une corrélation statistiquement significative au sein de la population cible au seuil de confiance de 95 %.
Pour automatiser cette sentence diagnostique au sein de la feuille Excel et éliminer toute équivoque d’interprétation humaine, l’utilisateur peut intégrer une formule conditionnelle logique dans une cellule dédiée à la décision :
=SI(E7<=0,05; "Rejet de H0 : Corrélation statistiquement significative"; "Non-rejet de H0 : Absence d'effet statistiquement significatif")
Il importe néanmoins de tempérer cette vision binaire de l’inférence en rappelant la position épistémologique défendue par l’American Statistical Association (ASA) dans ses déclarations contemporaines. Une p-valeur ne doit jamais être assimilée à une mesure magique séparant le « vrai » du « faux ». Elle représente un continuum probabiliste mesurant le degré de compatibilité théorique des données observées avec le modèle postulé sous l’hypothèse nulle. Une relation affichant p = 0,051 ne diffère pas fondamentalement d’une association attestée à p = 0,049 ; seule la taille de l’échantillon et la stabilité de la mesure imposent une lecture prudente, nuancée par l’amplitude brute de l’effet et la précision de son intervalle de confiance.
9. Approche automatisée : Utilisation de l’Utilitaire d’analyse de données
9.1 Activation et configuration du complément d’analyse
Pour les investigations psychométriques impliquant un nombre élevé de variables ou exigeant un traitement automatisé rapide, la saisie répétitive de formules manuelles peut s’avérer fastidieuse. Microsoft Excel dispose d’un module d’extension puissant et hautement standardisé, spécifiquement développé pour les analyses quantitatives complexes : le complément « Utilitaire d’analyse » (ou Analysis ToolPak dans les versions anglophones).
Par défaut, ce composant statistique avancé n’est pas activé lors de l’installation primaire de la suite bureautique. Pour rendre cet outil opérationnel, l’utilisateur doit suivre la procédure suivante : cliquer sur le menu supérieur « Fichier », sélectionner l’option « Options » située au bas du volet latéral, puis cliquer sur l’onglet « Compléments ». Dans le menu déroulant « Gérer » présent au bas de la fenêtre, veiller à ce que l’option « Compléments Excel » soit sélectionnée, puis cliquer sur le bouton « Atteindre… ». Une boîte de dialogue modale surgit alors : il suffit d’y cocher la case relative à l’« Utilitaire d’analyse », puis de valider l’opération en cliquant sur « OK ».
Dès cette validation accomplie, une nouvelle commande intitulée « Utilitaire d’analyse » (ou « Analyse de données ») s’installe de façon permanente à l’extrémité droite du ruban supérieur sous l’onglet « Données ». L’activation de cette commande ouvre un vaste répertoire d’outils statistiques paramétriques et non paramétriques préprogrammés, offrant un gain de productivité considérable pour les explorations multidimensionnelles.
9.2 Génération de la matrice de corrélation bivariée
L’une des fonctions les plus prisées du complément d’analyse réside dans l’outil « Corrélation ». Ce module permet de traiter simultanément plusieurs colonnes de données quantitatives et de dresser en quelques secondes une table matricielle complète exposant l’ensemble des coefficients de Pearson croisés unissant l’intégralité des variables évaluées.
L’opération s’exécute en sélectionnant l’outil « Corrélation » dans la liste thématique de la boîte de dialogue, puis en validant. Dans le champ « Plage d’entrée », l’opérateur surligne l’intégralité du bloc tabulaire englobant toutes les colonnes d’intérêt. Si la sélection intègre la ligne sommitale contenant le nom des variables, il convient d’activer impérativement la case à cocher « Intitulés en première ligne ». Dans la zone des options de regroupement, l’option « Groupé par Colonnes » doit être maintenue active. L’utilisateur spécifie enfin la destination du rapport dans la section « Options de sortie », en privilégiant couramment la génération sur une nouvelle feuille de calcul dédiée afin de préserver l’intégrité de la feuille source.
La matrice résultante adopte une disposition triangulaire inférieure d’une remarquable élégance, pourvue d’une diagonale unitaire (les coefficients d’une variable avec elle-même étant rigoureusement égaux à 1,00). Cependant, cette procédure automatisée présente une limite méthodologique de taille qu’il est crucial de dénoncer : le module de corrélation de l’Utilitaire d’analyse d’Excel fournit exclusivement les coefficients descriptifs r bruts ; il omet totalement d’éditer les statistiques t d’inférence ainsi que les p-valeurs associées, privant ainsi l’analyste des critères requis pour statuer formellement sur la significativité statistique de chaque cellule de la matrice.
9.3 Recours à l’outil Régression pour obtenir un tableau inférentiel exhaustif
Pour contourner l’impasse inférentielle de la simple matrice de corrélation et obtenir un bilan statistique d’une exhaustivité absolue sans recourir à la formulation manuelle, l’analyste dispose d’un stratagème particulièrement efficace au sein de l’Utilitaire d’analyse : l’exécution d’une régression linéaire simple. Dans le cas de deux variables quantitatives, les mathématiques sous-tendant la corrélation de Pearson et la régression linéaire univariée sont strictement isomorphes.
En sélectionnant la commande « Régression » dans le menu de l’Utilitaire d’analyse, l’utilisateur assigne la colonne critère au champ « Plage d’entrée Y » et la variable explicative au champ « Plage d’entrée X », tout en prenant soin de cocher la case « Intitulés ». Après validation, Excel produit un ensemble complet de tables analytiques structurées, articulé autour de trois blocs de résultats majeurs : les statistiques de la régression, le tableau de l’analyse de variance (ANOVA), et la table détaillée des coefficients du modèle.
La lecture transversale de ce rapport livre immédiatement toutes les réponses inférentielles recherchées :
- Dans la table des statistiques de la régression, la métrique libellée « R multiple » correspond rigoureusement et exactement à la valeur absolue du coefficient de corrélation r de Pearson d’échantillon.
- Le paramètre « R-deux » restitue le coefficient de détermination r².
- Dans la table finale des coefficients, la ligne dévolue à la variable prédictive X affiche sur ses colonnes successives l’erreur type de l’estimation, la statistique « t Stat » — dont la valeur numérique est rigoureusement identique à celle issue de l’équation manuelle de Student — et la « Probabilité » exacte, qui correspond sans la moindre ambiguïté à la p-valeur bilatérale tant convoitée.
10. Calcul de l’intervalle de confiance du r de Pearson par transformation z de Fisher
10.1 Justification théorique de la transformation z de Fisher
L’estimation ponctuelle d’un coefficient de corrélation r au sein d’un échantillon ne saurait fournir une vision complète de l’incertitude métrologique. Les recommandations contemporaines de l’APA imposent d’adjoindre systématiquement à tout indice de corrélation un intervalle de confiance — usuellement calibré au seuil de 95 % — délimitant la plage au sein de laquelle le véritable paramètre populationnel ρ a une probabilité déterminée de se situer. Néanmoins, la construction d’un tel intervalle se heurte à une complexité mathématique majeure : la distribution d’échantillonnage de r n’est symétrique que dans l’hypothèse très particulière où ρ = 0.
Dès lors que la corrélation populationnelle s’écarte de zéro, la distribution empirique des coefficients d’échantillonnage se contracte à mesure qu’elle approche des bornes asymptotiques structurelles (−1 ou +1), développant une asymétrie marquée. Tenter de construire un intervalle symétrique classique sous la forme conventionnelle r ± 1,96 × SE aboutirait à une modélisation théoriquement aberrante, susceptible de générer des bornes franchissant les limites mathématiques de l’échelle unitaire.
Pour résoudre cette distorsion distributionnelle, Ronald Aylmer Fisher a formalisé en 1921 une transformation non linéaire remarquable reposant sur la fonction de la tangente hyperbolique inverse. La transformation z de Fisher convertit l’échantillon borné de Pearson en une nouvelle variable continue zr dont la distribution d’échantillonnage converge de façon spectaculaire vers une loi normale symétrique, affichant une variance asymptotique totalement indépendante de la valeur du paramètre de corrélation sous-jacent.
10.2 Mise en œuvre des formules mathématiques de conversion dans Excel
L’exécution de la transformation de Fisher au sein du tableur Microsoft Excel bénéficie de fonctions trigonométriques hyperboliques natives de haute précision algorithmique. En supposant que le coefficient de corrélation empirique r réside dans la cellule E2, la conversion vers la métrique standardisée z de Fisher s’opère par l’application directe de la fonction :
=ARCTANH(E2)
Cette instruction équivaut mathématiquement à la formule logarithmique originelle développée par Fisher : 0,5 * LN((1 + E2) / (1 - E2)). Une fois cette valeur zr générée, l’analyste doit déterminer l’erreur type asymptotique associée à cette nouvelle échelle. Dans la métrique transformée de Fisher, cette erreur type (notée SEz) dépend de façon quasi exclusive du volume de l’échantillon n consigné en E3, selon la formulation élémentaire suivante :
=1/RACINE(E3-3)
Il est fondamental de noter la soustraction de trois unités au dénominateur, condition théorique requise pour stabiliser le troisième moment de la distribution d’échantillonnage. Pour calculer la marge d’erreur au niveau de confiance bilatéral de 95 %, il suffit de multiplier cette erreur type par la valeur critique de la loi normale centrée réduite correspondant au centile 97,5 %, laquelle s’extrait dynamiquement sous Excel via l’instruction =LOI.NORMALE.STANDARD.INVERSE(0,975), livrant la valeur canonique universelle de 1,95996 (approximée couramment à 1,96).
10.3 Transformation inverse et restitution de l’intervalle sur l’échelle de Pearson
Une fois la marge d’erreur établie dans l’espace stabilisé de Fisher, l’analyste calcule les bornes inférieure et supérieure de l’intervalle de confiance au moyen d’additions et de soustractions élémentaires. La borne inférieure en coordonnées de Fisher correspond à l’expression z_Fisher - (1,96 * SE_z), tandis que la borne supérieure s’énonce sous la forme z_Fisher + (1,96 * SE_z).
Toutefois, ces valeurs numériques intermédiaires sont exprimées dans l’échelle abstraite de la tangente hyperbolique ; elles sont donc dépourvues de signification psychométrique directe pour le lecteur d’un manuscrit scientifique. Il est indispensable d’opérer la rétro-conversion de ces bornes afin de les restituer sur l’échelle métrique originale bornée entre −1 et +1 du coefficient r de Pearson. Cette opération s’exécute avec une remarquable fluidité grâce à la fonction de la tangente hyperbolique directe native d’Excel :
=TANH(cellule_borne_z)
Cette rétro-transformation restitue un intervalle de confiance asymétrique par rapport à la valeur ponctuelle de l’échantillon r, respectant rigoureusement la courbure distributionnelle du modèle. L’interprétation méthodologique de cet intervalle est d’une portée heuristique majeure : si l’intervalle de confiance calculé — par exemple IC 95 % [0,12 ; 0,62] — ne chevauche à aucun moment la valeur numérique zéro, l’analyste dispose d’une confirmation visuelle et inférentielle irréfutable du rejet de l’hypothèse nulle au seuil de signification bilatéral correspondant.
11. Erreurs méthodologiques fréquentes et diagnostics de validité
11.1 Confusion pernicieuse entre covariation et inférence causale
L’écueil interprétatif le plus tenace et le plus documenté au sein de la littérature scientifique réside dans la propension compulsive à déduire un rapport de cause à effet à partir de la seule observation d’un coefficient de corrélation statistiquement significatif. Cette illusion explicative fait l’impasse sur l’existence quasi universelle de mécanismes de confusion non mesurés, désignés dans la littérature sous le concept du « problème de la troisième variable » (variable confondante).
À titre d’illustration classique en psychologie environnementale, une corrélation positive substantielle peut être observée entre la consommation marchande de glaces et le nombre d’actes d’agression violente enregistrés dans les métropoles urbaines. Conclure sur cette base que l’ingestion de produits laitiers sucrés stimule le passage à l’acte criminel constitue une absurdité patente ; les deux phénomènes covarient sous l’égide exclusive d’une troisième variable contextuelle omise, en l’occurrence la température thermique ambiante en période estivale, qui favorise simultanément la fréquentation des commerces de plein air et les interactions interpersonnelles conflictuelles sur la voie publique.
Par ailleurs, les études transversales observationnelles — cadre préférentiel d’application du test sous Excel — s’avèrent structurellement impuissantes à résoudre l’énigme de la causalité inverse. Si un chercheur met en évidence un lien étroit entre une faible estime de soi et un niveau élevé de dépression clinique, aucune manipulation statistique paramétrique ne permet de trancher si c’est la fragilité narcissique qui précipite l’effondrement thymique, ou si c’est l’épisode dépressif majeur qui érode rétroactivement le sentiment de valeur personnelle du sujet.
11.2 Impact du phénomène de restriction d’étendue (range restriction)
La restriction d’étendue — ou homogénéisation artificielle de l’échantillon — constitue un piège psychométrique insidieux capable de masquer totalement des relations pourtant massives au sein de la population générale. Ce phénomène survient dès lors que le recrutement de la cohorte d’étude s’effectue sur un segment particulièrement étroit du spectre de variation théorique de l’un des construits évalués.
Le cas paradigmatique se rencontre fréquemment dans les études d’évaluation de la validité prédictive des concours de sélection universitaire ou militaire. Si un chercheur évalue la corrélation entre les résultats obtenus au test d’admission d’une grande école d’ingénieurs et la performance académique subséquente en ne mesurant que les candidats admis, il observera très fréquemment une corrélation de Pearson dérisoire, voire quasi nulle. Cette atrophie de l’effet ne traduit pas une faillite de l’instrument d’évaluation, mais reflète simplement le fait que les postulants dotés de scores faibles ou moyens ont été éliminés en amont de la modélisation.
D’un point de vue mathématique, la réduction drastique de la variance de la variable prédictive comprime artificiellement le numérateur de la formule de covariance de Pearson. Dans les investigations avancées où cette restriction est inhérente au terrain d’enquête, les psychométriciens appliquent les formules de correction rétrospectives de Thorndike afin de reconstituer une estimation non biaisée du coefficient matriciel de population attendu.
11.3 Non-linéarité et alternatives non paramétriques
Face à des configurations de données dérogeant formellement aux postulats paramétriques de Pearson — qu’il s’agisse de distributions asymétriques réfractaires aux transformations ou de relations non linéaires monotones —, l’obstination à appliquer le modèle produit-moment conduit à des conclusions scientifiquement frelatées. L’analyste se doit de mobiliser des alternatives statistiques robustes fondées sur le rang des observations, au premier rang desquelles trône le coefficient de corrélation de Spearman, noté ρs.
Le coefficient rhô de Spearman neutralise l’impact délétère des valeurs extrêmes et de la non-linéarité modérée en substituant aux scores continus bruts leurs rangs hiérarchiques respectifs au sein de la série ordonnée. Au sein de Microsoft Excel, l’opérationnalisation d’un test de Spearman ne requiert aucun module tiers : elle se déploie très simplement en convertissant les colonnes de mesures brutes au moyen de la fonction native de classement :
=RANG.MOYENNE(cellule; plage_reference; 1)
L’utilisation scrupuleuse de RANG.MOYENNE — par opposition à la fonction concurrente RANG.EQ — est méthodologiquement impérative car elle assure la gestion équitable des ex æquo (les observations partageant la même valeur métrique brute reçoivent la moyenne des rangs qu’elles auraient occupés en l’absence d’égalité). Une fois les deux colonnes de rangs constituées, il suffit d’appliquer la fonction canonique =COEFFICIENT.CORRELATION() directement sur ces rangs calculés pour obtenir le rhô de Spearman rigoureux, conférant à la démarche empirique une résilience distributionnelle optimale.
12. Rédaction et standardisation des résultats selon les normes APA 7
12.1 Directives typographiques et formalisme statistique officiel de l’APA
La communication scientifique des résultats au sein de revues scientifiques internationales exige une conformité absolue avec les standards de présentation formalisés dans la septième édition du manuel de publication de l’American Psychological Association. Ce protocole codifie avec une précision quasi chirurgicale la typographie des indices statistiques, la gestion des décimales et la structure syntaxique des rapports de recherche.
Sur le plan de la typographie, toutes les lettres latines désignant des variables statistiques, des indices d’échantillon ou des tests inférentiels doivent obligatoirement être composées en italique (notamment le coefficient r, la statistique t, le seuil de signification p, la taille de l’échantillon N ou d’un sous-groupe n, ainsi que le coefficient de détermination R²). En revanche, les lettres grecques (telles que ρ, α ou β) ainsi que les désignations mathématiques sous forme d’acronymes ou d’indices subscriptes conservent impérativement une graisse droite normale non inclinée.
En matière d’arrondis décimaux, la règle canonique de l’APA impose de rapporter les coefficients de corrélation r et les statistiques de test t avec exactement deux chiffres après la virgule (ou le point selon la langue de rédaction). La p-valeur doit quant à elle être consignée avec une précision de trois chiffres après la virgule (par exemple, p = 0,024). Une règle stylistique cardinale de l’APA stipule en outre que le zéro initial précédant la virgule décimale doit être formellement omis pour tous les indices statistiques bornés par construction dans l’intervalle [0, 1] ou [−1, 1]. Ainsi, on écrira rigoureusement r = ,42 et p = ,038, mais l’on conservera le zéro pour la statistique de Student (par exemple, t(98) = 2,45) car cette métrique n’est théoriquement pas limitée à l’unité.
12.2 Modèles de phrases types pour la section Résultats d’un manuscrit
L’intégration narrative des analyses statistiques au sein du corps du texte d’un article ou d’une thèse de doctorat doit allier fluidité stylistique, précision contextuelle et restitution exhaustive des paramètres inférentiels. Le protocole méthodologique proscrit l’affirmation isolée d’un verdict de significativité sans la mention conjointe des degrés de liberté, de l’amplitude de l’effet et de l’intervalle de confiance encadrant le paramètre.
Pour un résultat empirique concluant au rejet de l’hypothèse nulle, le modèle rédactionnel standard se déploie selon la trame narrative suivante :
« Une analyse de corrélation produit-moment de Pearson a été conduite afin d’évaluer la relation linéaire unissant le niveau d’anxiété d’évaluation et la performance mnémotechnique au sein de la cohorte d’étudiants. Les résultats révèlent l’existence d’une corrélation négative modérée statistiquement significative, r(98) = −,41, p < ,001, IC 95 % [−,56, −,23]. L’anxiété d’évaluation explique ainsi 16,8 % de la variance globale de la performance mnémotechnique (r² = ,17). »
À l’inverse, lorsque l’investigation ne parvient pas à invalider l’hypothèse nulle, le chercheur doit formuler son constat avec prudence, en évitant d’affirmer dogmatiquement l’égalité absolue à zéro :
« L’examen de la liaison linéaire entre le temps d’exposition aux écrans et le niveau d’empathie cognitive n’a pas permis de mettre en évidence d’association statistiquement significative au seuil conventionnel retenu, r(73) = ,11, p = ,342, IC 95 % [−,12, ,33]. Les données empiriques recueillies apparaissent pleinement compatibles avec l’hypothèse d’une absence d’effet linéaire dans la population cible. »
12.3 Conception d’une table de corrélation académique sous Excel
La présentation synthétique de multiples corrélations sous la forme d’un tableau matriciel exige une structuration rigoureuse conforme aux normes APA. L’un des préceptes visuels majeurs réside dans l’interdiction formelle des bordures verticales : un tableau académique ne comporte exclusivement que trois lignes horizontales principales (une bordure supérieure fermant la table, une ligne séparatrice isolant la rangée d’en-tête, et une ligne terminale inférieure délimitant la base du tableau avant les notes de bas de page).
La matrice s’organise selon une structure triangulaire inférieure, au sein de laquelle les variables sont énumérées et numérotées sur la colonne de gauche, tandis que les numéros correspondants couronnent les colonnes horizontales adjacentes. L’insertion systématique des moyennes (M) et des écarts-types (ET ou SD) sur les colonnes précédant la matrice relationnelle enrichit considérablement la portée descriptive du document. Les cellules de la diagonale unitaire sont couramment laissées vides ou marquées d’un tiret d’émigration, évitant la surcharge cognitive induite par la répétition redondante du chiffre 1,00.
Les niveaux de significativité statistique sont traditionnellement signalés au moyen d’astérisques superposés aux coefficients (par exemple, * p < ,05 ; ** p < ,01 ; *** p < ,001). Ces mentions doivent impérativement être explicitées au sein d’une section de notes positionnée sous la table, introduite par le terme Note. composé en italique. En agençant scrupuleusement ces éléments typographiques directement dans les cellules d’Excel avant d’effectuer l’exportation vers un logiciel de traitement de texte, l’analyste garantit une transition sans faille vers la publication académique de haut rang.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.sciencedirect.com/book/9780121790608/statistical-power-analysis-for-the-behavioral-sciences
- Fisher, R. A. (1921). On the « probable error » of a coefficient of correlation deduced from a small sample. Metron, 1, 3–32.
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263. https://doi.org/10.2307/2841583
- Microsoft Corporation. (2024). Fonction COEFFICIENT.CORRELATION dans Microsoft Excel. Support Microsoft. https://support.microsoft.com/fr-fr/office/coefficient-correlation-fonction-coefficient-correlation-995dcef7-0c0a-4bed-a3fb-239d7b68ca92
- Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108