
L’évaluation rigoureuse des distributions empiriques constitue l’un des piliers méthodologiques les plus critiques de la recherche quantitative contemporaine, particulièrement dans les sciences du comportement, la psychiatrie biologique et la psychométrie. La validité des conclusions inférentielles repose presque invariablement sur le respect d’hypothèses distributionnelles sous-jacentes. Parmi ces hypothèses, la normalité univariée occupe une position hégémonique, conditionnant la légitimité des tests paramétriques traditionnels tels que les analyses de variance, les modèles de régression linéaire ou encore la modélisation par équations structurelles. Ignorer la distribution réelle d’un score psychologique ou d’une mesure neurobiologique expose le chercheur à des distorsions majeures du taux d’erreur de première espèce, à des compressions artificielles de la puissance statistique et, in fine, à des interprétations cliniques erronées susceptibles de compromettre la reproductibilité des résultats scientifiques.
Face à cet enjeu épistémologique, la boîte à outils du statisticien propose une variété d’épreuves d’adéquation, communément désignées sous l’appellation de tests de conformité distributionnelle (goodness-of-fit tests). Si le test de Shapiro-Wilk et celui de Kolmogorov-Smirnov demeurent historiquement les plus enseignés et appliqués dans les cursus universitaires de sciences humaines, ils présentent des vulnérabilités documentées, notamment lorsqu’il s’agit d’inspecter le comportement des données aux extrêmes du spectre empirique. C’est précisément pour remédier aux faiblesses structurelles des tests fondés sur la distance maximale que le test d’Anderson-Darling a été conceptualisé. En accordant une pondération différentielle et ciblée aux queues de distribution, ce test fournit une sensibilité sans égale aux déviations périphériques, là où se manifestent fréquemment les phénomènes psychopathologiques, les réponses atypiques ou les effets de bordure inhérents aux instruments d’évaluation psychologique standardisés.
L’environnement statistique R s’est imposé au fil des décennies comme la plateforme de prédilection pour l’analyse computationnelle reproductible. Grâce à son écosystème modulaire et à sa flexibilité algorithmique, R permet non seulement d’exécuter le test d’Anderson-Darling avec une grande rigueur mathématique, mais également d’intégrer ce diagnostic au sein d’une chaîne de traitement des données moderne, fluide et ouverte. Le présent guide propose une exploration exhaustive, théorique et appliquée, de la conduite du test d’Anderson-Darling sous R. Du formalisme mathématique sous-tendant la statistique de décision jusqu’aux protocoles de remédiation en cas de violation avérée de la normalité, cet article offre aux chercheurs, cliniciens et analystes de données les fondations méthodologiques nécessaires pour auditer leurs jeux de données avec une précision chirurgicale.
1. Introduction aux tests d’adéquation et au test d’Anderson-Darling en psychométrie
1.1 Origine théorique et évolution du test d’adéquation
L’histoire de la statistique mathématique au cours du vingtième siècle est marquée par une quête constante d’optimisation de la puissance des tests de conformité distributionnelle. En 1952, les statisticiens Theodore W. Anderson et Donald A. Darling ont publié dans les Annals of Mathematical Statistics un article fondateur introduisant une modification substantielle du critère classique de Cramér-von Mises. Alors que ce dernier calculait l’intégrale quadratique de l’écart entre la fonction de répartition empirique et la fonction de répartition théorique visée, il traitait l’ensemble du support distributionnel avec une égale pondération, conférant de facto une importance démesurée au centre de la distribution au détriment des zones marginales.
Anderson et Darling ont démontré que les écarts situés dans les queues de distribution possédaient une variance asymptotique intrinsèquement plus faible, ce qui rendait leur détection particulièrement malaisée avec les métriques non pondérées. En introduisant une fonction de pondération proportionnelle à l’inverse de la variance théorique des quantiles extrêmes, ils ont créé un estimateur quadratique capable de révéler des anomalies locales souvent invisibles pour d’autres épreuves statistiques. Dans le champ de l’évaluation psychologique et de la recherche comportementale, cette avancée théorique s’est avérée révolutionnaire. Les mesures psychométriques se caractérisent en effet fréquemment par des phénomènes d’asymétrie ou d’aplatissement atypiques induits par des seuils de sensibilité clinique ou des limitations instrumentales, rendant l’emploi d’un test hautement sensible aux extrémités absolument indispensable.
L’évolution computationnelle ultérieure, portée notamment par les travaux de Michael A. Stephens dans les années 1970 et 1980, a permis d’adapter la statistique originale aux cas où les paramètres de la distribution cible (typiquement la moyenne et la variance d’une loi normale) ne sont pas postulés a priori mais doivent être estimés directement à partir des données de l’échantillon. Cette modification structurelle a consacré le test d’Anderson-Darling comme l’un des outils les plus performants de l’analyse exploratoire et confirmatoire moderne.
1.2 Rôle de la normalité dans la modélisation psychologique
Au sein des sciences psychologiques, l’hypothèse de normalité ne relève pas d’une simple commodité mathématique, mais participe d’une conception théorique fondamentale de la mesure des attributs humains. La plupart des modèles psychométriques classiques, issus des travaux de Francis Galton, Charles Spearman et Louis Leon Thurstone, postulent que les traits latents sous-jacents aux comportements observables — qu’il s’agisse des aptitudes cognitives générales, des dimensions de la personnalité ou des tendances affectives — se distribuent de manière continue et gaussienne au sein des populations de référence. Cette hypothèse repose épistémologiquement sur le théorème central limite, concevant la performance ou le trait mesuré comme la résultante sommative d’une multitude de facteurs génétiques, neurobiologiques et environnementaux indépendants exerçant chacun des effets infinitésimaux.
Toutefois, le passage du trait latent abstrait au score composite observé, obtenu via l’agrégation d’items sur une échelle de type Likert ou un temps de réaction chronométrique, introduit inévitablement des distorsions distributionnelles. Lorsque l’hypothèse de normalité univariée est enfreinte, les postulats fondamentaux de la théorie classique des tests sont menacés. L’erreur standard de mesure (SEM), qui sert à définir les intervalles de confiance entourant le score observé d’un patient ou d’un sujet expérimental, suppose l’homoscédasticité et la symétrie de la distribution des erreurs. Une déviation marquée par rapport à la loi normale génère une instabilité des erreurs standardisées, compromettant directement la validité diagnostique et augmentant le risque d’attribuer une signification clinique fallacieuse à des variations relevant du simple bruit métrologique.
La validation formelle de l’adéquation d’un échantillon à la loi gaussienne constitue ainsi un préalable méthodologique non négociable. Avant de procéder à des modélisations causales, des analyses factorielles confirmatoires ou des comparaisons de moyennes intergroupes, le psychomètre doit s’assurer que les propriétés distributionnelles des variables observées n’invalident pas les mécanismes d’inférence probabiliste déployés dans ses modèles mathématiques.
1.3 Positionnement méthodologique dans le logiciel R
L’environnement open-source de calcul statistique R représente aujourd’hui le véhicule privilégié pour implémenter ces protocoles diagnostiques avancés. Contrairement aux interfaces de traitement de données monolithiques et propriétaires qui restreignent fréquemment l’utilisateur à une sortie standardisée et souvent opaque, R offre une modularité totale. Son architecture repose sur une séparation claire entre les fonctions du noyau mathématique et les bibliothèques spécialisées développées et maintenues par la communauté scientifique mondiale sur le Comprehensive R Archive Network (CRAN).
Cette approche modulaire permet d’aborder l’adéquation distributionnelle non pas comme une procédure isolée que l’on coche machinalement dans un menu déroulant, mais comme une composante intégrée d’un pipeline d’analyse de données reproductible. L’intégration de scripts rigoureux garantit que chaque étape — du chargement des données brutes au calcul des p-valeurs exactes d’Anderson-Darling en passant par le tracé des diagrammes diagnostiques — peut être réexécutée, auditée et partagée selon les normes strictes de la science ouverte (Open Science Framework). La souplesse de R permet également d’automatiser ces vérifications sur des dizaines de sous-échelles psychométriques simultanément, réduisant considérablement l’erreur humaine tout en élevant le standard de rigueur de la recherche en psychologie quantitative.
2. Fondements mathématiques et statistiques de la statistique d’Anderson-Darling
2.1 Formulation mathématique de la statistique A²
La mécanique interne du test d’Anderson-Darling s’articule autour d’une quantification rigoureuse de la divergence entre la fonction de répartition théorique postulée, notée F(x), et la fonction de répartition empirique, notée Fn(x), construite à partir d’un échantillon de taille n. Formellement, la statistique générale d’Anderson-Darling, traditionnellement désignée par le symbole A², s’exprime sous la forme d’une intégrale quadratique pondérée définie sur l’ensemble du support réel des observations :
L’équation maîtresse s’écrit : A² = n ∫ [Fn(x) – F(x)]² · ψ(x) dF(x), où les bornes de l’intégrale s’étendent de moins l’infini à plus l’infini. La fonction de pondération spécifique conçue par Anderson et Darling est définie par ψ(x) = 1 / [F(x) · (1 – F(x))]. Cette forme analytique est décisive : lorsque x s’éloigne de la médiane pour s’approcher des queues inférieure (où F(x) tend vers 0) ou supérieure (où F(x) tend vers 1), le dénominateur de ψ(x) décroît dramatiquement vers zéro. En conséquence, la fonction de pondération tend vers l’infini aux extrémités, conférant un poids mathématique disproportionné mais statistiquement optimal aux écarts périphériques.
D’un point de vue computationnel, le calcul d’une intégrale continue sur des données discrètes nécessiterait des approximations numériques coûteuses. Anderson et Darling ont donc dérivé une formule algébrique exacte pour un échantillon préalablement ordonné de valeurs x(1) ≤ x(2) ≤ … ≤ x(n). Pour une variable standardisée z(i) = (x(i) – μ) / σ et sa probabilité cumulée théorique p(i) = Φ(z(i)), la formule algorithmique opérationnelle s’énonce comme suit :
A² = -n – (1/n) · ∑ [ (2i – 1) · ln(p(i)) + (2(n – i) + 1) · ln(1 – p(i)) ], où la sommation s’exécute pour l’indice i allant de 1 jusqu’à n. Lorsque les paramètres de localisation (moyenne) et d’échelle (écart-type) ne sont pas fixés a priori mais estimés par la moyenne empirique et l’écart-type de l’échantillon, la statistique A² fait l’objet d’une correction spécifique pour petits échantillons afin d’ajuster son comportement asymptotique : A*² = A² · (1 + 0.75/n + 2.25/n²).
2.2 Système d’hypothèses et règle de décision
Le test d’Anderson-Darling est structuré autour d’un système d’hypothèses statistiques classique d’adéquation distributionnelle. L’hypothèse nulle, formellement notée H0, stipule que l’échantillon continu observé provient d’une population parente distribuée selon la loi normale théorique N(μ, σ²), où les paramètres de moyenne et de variance peuvent être connus ou inconnus. Sous H0, tout écart observé entre la courbe empirique et la courbe théorique est strictement imputable aux fluctuations d’échantillonnage stochastiques inhérentes à la taille finie de l’échantillon n.
À l’inverse, l’hypothèse alternative, notée H1, affirme que la loi sous-jacente ayant généré les données dévie significativement de la fonction de répartition normale. Cette déviation peut prendre des formes multiples : une asymétrie unilatérale prononcée, une bimodalité latente, une troncature due à des limitations d’échelle, ou encore des queues anormalement épaisses ou courtes. Contrairement aux tests bilatéraux courants portant sur des paramètres ponctuels, le test d’Anderson-Darling est intrinsèquement unilatéral supérieur concernant sa statistique de test : seule une valeur exceptionnellement élevée de A² témoigne d’une divergence empirique majeure et conduit au rejet de l’hypothèse de normalité.
La règle de décision repose sur le calcul de la p-valeur associée à la valeur empirique A*². Les distributions nulles de A*² ne suivant pas une loi analytique simple fermée, les logiciels modernes recourent à des équations polynomiales d’approximation empirique hautement précises, calibrées par des simulations de Monte-Carlo massives (notamment les tables interpolées de Stephens). Si la p-valeur ainsi estimée est inférieure ou égale au seuil de significativité nominal α conventionnellement fixé (typiquement α = 0,05 ou α = 0,01), le statisticien rejette formellement H0 et conclut à la non-normalité de la distribution étudiée, avec un risque contrôlé de commettre une erreur de première espèce.
2.3 Sensibilité comparée aux queues de distribution
La supériorité méthodologique du test d’Anderson-Darling réside dans son comportement vis-à-vis des moments statistiques d’ordre supérieur : l’asymétrie (troisième moment standardisé ou skewness) et l’aplatissement (quatrième moment standardisé ou kurtosis). De nombreuses distributions psychologiques réelles présentent une symétrie centrale apparente tout en affichant un kurtosis d’excès substantiel, qualifié de leptokurticité lorsque les queues sont plus épaisses que celles d’une loi normale, ou de platykurticité lorsqu’elles sont plus fines ou tronquées.
Dans une distribution leptokurtique, une proportion anormale d’observations se concentre très loin de la moyenne centrale. Le test de Kolmogorov-Smirnov, dont la statistique repose exclusivement sur la borne supérieure D = sup |Fn(x) – F(x)|, enregistre généralement son écart maximal au voisinage de la médiane ou des points d’inflexion de la courbe en cloche, restant quasi insensible aux légers décalages probabilistes intervenant au-delà de deux ou trois écarts-types. Le test d’Anderson-Darling, grâce à son facteur de division [F(x)·(1-F(x))], amplifie l’impact de chaque observation située dans ces régions distales. Une seule observation extrême non prise en compte par le modèle gaussien produira une augmentation drastique du terme logarithmique ln(1 – p(i)) ou ln(p(i)), entraînant une élévation immédiate de la statistique A².
Cette propriété mathématique fait d’Anderson-Darling l’outil par excellence pour diagnostiquer les distorsions rencontrées dans les populations cliniques. Dans l’étude des pathologies dépressives majeures ou des troubles anxieux généralisés, les scores des échelles psychométriques manifestent fréquemment un effet de plancher massif au sein des populations témoins et une queue d’étalement leptokurtique sévère chez les sujets symptomatiques. Le test d’Anderson-Darling identifie ces distorsions avec une acuité statistique inaccessible aux méthodes concurrentes non pondérées.
3. L’importance de l’hypothèse de normalité dans la recherche psychologique
3.1 Présupposés des analyses univariées et bivariées
L’échafaudage statistique sur lequel s’appuie l’immense majorité des publications empiriques en psychologie et en neurosciences cognitives repose sur la famille des tests paramétriques de première génération. Le test t de Student pour échantillons indépendants ou appariés, par exemple, formalise le rapport entre la différence de deux moyennes observées et l’erreur standard de cette différence. Ce ratio n’adopte formellement une distribution théorique t de Student sous l’hypothèse nulle que si les populations parentes d’où sont extraits les échantillons suivent une loi normale, ou si les résidus du modèle manifestent une adéquation parfaite à la gaussianité.
Il en va de même pour l’analyse de variance univariée (ANOVA) et multivariée (MANOVA). Bien que le test F de Fisher-Snedecor soit réputé bénéficier d’une certaine robustesse face à des entorses modérées de la normalité — en vertu des propriétés stabilisatrices du théorème central limite lorsque la taille totale d’échantillon est substantielle et les effectifs cellulaires équilibrés —, cette robustesse s’effondre dramatiquement en présence d’hétéroscédasticité combinée à une asymétrie prononcée. Les probabilités d’erreur de première espèce calculées par les logiciels peuvent alors s’écarter drastiquement du seuil nominal de 0,05, générant une proportion alarmante de faux positifs.
Au niveau bivarié, l’estimation du coefficient de corrélation linéaire r de Pearson postule rigoureusement la normalité bivariée des deux vecteurs de scores considérés. Une violation univariée chez l’une ou l’autre des variables détruit de facto la normalité conjointe. L’apparition de valeurs aberrantes en queue de distribution peut soit fabriquer artificiellement une corrélation fallacieuse là où règne une indépendance stochastique totale, soit masquer une relation fonctionnelle forte mais non gaussienne. Auditer l’adéquation d’Anderson-Darling sur chaque variable continue préalablement à toute analyse corrélationnelle constitue le seul rempart méthodologique contre ces artefacts d’interprétation.
3.2 Implications pour les modèles de régression et modèles linéaires généraux
L’extension des analyses univariées vers la régression linéaire multiple et les modèles linéaires généraux (GLM) déplace l’exigence de normalité des variables brutes observées vers la composante stochastique du modèle : les résidus d’estimation. Dans un modèle linéaire de la forme Y = Xβ + ε, les théorèmes fondamentaux de Gauss-Markov démontrent que les estimateurs des moindres carrés ordinaires (MCO) sont les meilleurs estimateurs linéaires sans biais (BLUE) même en l’absence de normalité des erreurs. Cependant, l’inférence statistique valide — incluant le calcul exact des erreurs-types des coefficients de régression, les tests t associés aux paramètres partiels et la construction des intervalles de confiance à 95 % — exige expressément que le terme d’erreur ε soit distribué selon une loi normale i.i.d. N(0, σ²).
Lorsque les résidus manifestent des queues lourdes ou une asymétrie non corrigée décelable au test d’Anderson-Darling, la variance asymptotique des coefficients estimés est systématiquement sous-évaluée ou surévaluée par les algorithmes standards. Il en résulte que les tests de significativité des prédicteurs comportementaux perdent leur calibrage nominal. Les intervalles de confiance calculés par les méthodes traditionnelles fournissent alors une couverture probabiliste erronée, tombant souvent bien en deçà des 95 % attendus. Bien que le recours au rééchantillonnage par bootstrapping offre une voie de contournement reconnue, identifier précisément la nature de la non-normalité résiduelle via la statistique A² demeure impératif pour décider si une transformation de variable ou une régression robuste s’impose.
3.3 Enjeux en psychométrie et théories de la mesure
Dans le domaine de l’ingénierie des tests psychologiques et des échelles d’évaluation neuropsychologique, la normalité conditionne la comparabilité des profils individuels et l’établissement des normes d’étalonnage. La standardisation d’un score brut en scores dérivés — qu’il s’agisse des classiques scores Z (de moyenne 0 et d’écart-type 1), des scores T (de moyenne 50 et d’écart-type 10), ou des stanines — opère par le biais d’une transformation linéaire qui préserve strictement la forme géométrique de la distribution originale. Si le score brut d’un inventaire d’estime de soi ou d’anxiété clinique n’est pas normalement distribué dans la population de référence, attribuer un percentile sur la base d’une table théorique gaussienne constitue une faute métrologique grave.
Dans le cadre de la théorie classique des tests (TCT), la décomposition du score observé X en un score vrai T et une composante d’erreur aléatoire E (X = T + E) s’accompagne du postulat formel selon lequel l’erreur de mesure E suit une loi normale centrée en zéro. Ce postulat garantit que la probabilité d’observer une déviation d’une amplitude donnée décroît exponentiellement avec son éloignement. Si cette distribution d’erreur présente une leptokurticité résiduelle mise en évidence par un test d’Anderson-Darling sur les scores différentiels ou les résidus d’ajustement, les indices de fidélité tels que le coefficient alpha de Cronbach ou le coefficient oméga de McDonald voient leurs hypothèses de validité compromises.
Enfin, lors des processus d’adaptation transculturelle d’instruments psychométriques, la vérification de l’équivalence distributionnelle entre la population d’origine et la population cible nécessite un examen approfondi de la normalité au sein de chaque groupe linguistique. Une différence d’adéquation distributionnelle peut révéler des biais d’items différentiels, des incompréhensions sémantiques ou des variations culturelles profondes dans l’utilisation des extrêmes des échelles d’auto-évaluation.
4. Préparation de l’environnement de travail dans le logiciel R
4.1 Installation et chargement des packages requis
Pour mettre en œuvre le test d’Anderson-Darling avec l’ensemble des corrections d’échantillonnage requises, l’installation de bibliothèques spécialisées hébergées sur le CRAN s’avère nécessaire. Le moteur de base de R fournit nativement la fonction de Shapiro-Wilk (shapiro.test) et celle de Kolmogorov-Smirnov (ks.test), mais ne dispose pas d’implémentation directe d’Anderson-Darling intégrant l’estimation des paramètres inconnus de la loi normale. La référence mondiale absolue pour combler cette lacune est le package nortest, développé spécifiquement pour rassembler les tests de normalité avancés dérivés de la fonction de répartition empirique.
L’installation s’effectue via l’interpréteur de commandes à l’aide de l’instruction canonique install.packages("nortest"). Il est vivement recommandé d’adjoindre à cette bibliothèque un ensemble de packages méthodologiquement complémentaires : le métapackage tidyverse pour la manipulation et la restructuration fluide des matrices de données avec dplyr et tidyr, le package psych développé par William Revelle pour le calcul des indicateurs descriptifs multivariés, et le package car (Companion to Applied Regression) de John Fox pour la génération de graphiques quantile-quantile enrichis d’enveloppes de confiance paramétriques et bootstrappées.
Le chargement séquentiel au début de la session de travail s’exécute selon les instructions suivantes :
library(nortest)
library(tidyverse)
library(psych)
library(car)
L’exécution conjointe de ces environnements garantit que l’analyste dispose de l’ensemble des fonctions analytiques, diagnostiques et graphiques requises pour mener à bien un audit distributionnel complet et conforme aux standards académiques contemporains.
4.2 Configuration des options de reproductibilité
La recherche psychologique contemporaine accorde une importance primordiale à la reproductibilité stricte des calculs computationnels. Toute simulation de Monte-Carlo, tout partitionnement d’échantillon et toute procédure d’estimation impliquant une composante pseudo-aléatoire doivent être rigoureusement documentés. Bien que le calcul de la statistique d’Anderson-Darling sur un vecteur empirique statique soit entièrement déterministe, les procédures de diagnostic complémentaire — comme l’estimation de p-valeurs bootstrappées ou la simulation de distributions gaussiennes de référence pour la comparaison graphique — dépendent du générateur de nombres pseudo-aléatoires de R.
Il est donc impératif d’initialiser systématiquement la graine de génération au sommet de chaque script R au moyen de l’instruction set.seed(), en utilisant un entier fixe, par exemple set.seed(42) ou set.seed(12345). Par ailleurs, pour prévenir les erreurs de lecture et les confusions d’arrondi lors de l’examen des p-valeurs infinitésimales générées par le test d’Anderson-Darling sur de très larges échantillons, il convient de calibrer les options globales d’affichage numérique de R. L’ajustement du nombre de décimales affichées et la modulation de la notation scientifique s’effectuent au moyen de la directive :
options(digits = 5, scipen = 999)
Ce paramétrage force R à présenter les p-valeurs sous une notation décimale conventionnelle plutôt qu’exponentielle (évitant des représentations cryptiques du type 2.34e-05), facilitant grandement la transcription immédiate des métriques vers les manuscrits scientifiques sans risque d’erreur humaine de transcription.
4.3 Nettoyage et structuration préliminaire des données
L’exécution de fonctions statistiques dans R requiert une stricte adéquation entre la structure de la structure de données (data frame ou tibble) et les exigences algorithmiques des fonctions cibles. La fonction ad.test() du package nortest exige impérativement un vecteur numérique continu à une dimension. Tenter d’injecter une colonne mal typée — par exemple une variable numérique importée accidentellement sous forme de chaîne de caractères (character) ou de variable catégorielle ordonnée (factor) en raison de la présence d’espaces invisibles ou de séparateurs décimaux francophones (virgules au lieu de points) — génère une interruption fatale de l’algorithme.
Le protocole préparatoire débute donc systématiquement par l’audit typologique des colonnes cibles via la fonction str() ou la méthode moderne dplyr::glimpse(). Toute conversion requise s’exécutera via as.numeric(). L’autre écueil majeur concerne la présence de données manquantes, encodées sous forme de valeurs NA. Par défaut, la plupart des fonctions statistiques sous R refusent de calculer une statistique sur un vecteur corrompu par des absences partielles de réponse. Pour neutraliser ce problème sans dénaturer la base de données brute originale, il convient d’extraire la colonne psychométrique sous forme de vecteur épuré en appliquant la fonction na.omit() :
vecteur_epure <- na.omit(donnees$score_anxiete)
Enfin, l’intégrité de la structure des données impose la vérification systématique de l’absence de doublons d’identification de participants et l’évaluation de la longueur effective du vecteur (n ≥ 8 étant la borne inférieure minimale absolue requise pour qu’Anderson-Darling fournisse une approximation algorithmique stable de la p-valeur).
5. Implémentation pas-à-pas du test d’Anderson-Darling avec le package nortest
5.1 Génération de distributions théoriques de référence
Avant d’appliquer le test à des mesures psychologiques complexes dont la distribution réelle demeure incertaine, il est didactiquement et méthodologiquement formateur de valider le comportement du test d’Anderson-Darling sur des données de contrôle synthétiques dont les propriétés probabilistes sont rigoureusement maîtrisées par construction mathématique. R offre pour cela des générateurs pseudo-aléatoires pour l’ensemble des lois fondamentales.
Nous pouvons générer une distribution strictement gaussienne au moyen de la fonction rnorm(), en configurant une taille d’échantillon représentative des études cliniques intermédiaires (par exemple n = 150), avec une moyenne fixée à 50 et un écart-type de 10 :
distribution_normale <- rnorm(n = 150, mean = 50, sd = 10)
En miroir, générons une distribution intentionnellement asymétrique et leptokurtique, simulant le profil typique d’une variable clinique pathologique présentant un effet d’agglutination vers les valeurs basses, telle que mesurée par une distribution du Chi-carré à 3 degrés de liberté, ou une loi gamma :
distribution_asymetrique <- rchisq(n = 150, df = 3)
Le contrôle dimensionnel et structurel de ces vecteurs au moyen des fonctions length() et summary() confirme immédiatement l’adéquation formelle des données avant leur transmission à l’algorithme d’Anderson-Darling.
5.2 Exécution syntaxique de la fonction ad.test()
L’implémentation opérationnelle du test d’Anderson-Darling au sein de la bibliothèque nortest se distingue par une syntaxe canonique épurée et remarquablement intuitive :
ad.test(x)
Dans cette formulation, l’argument unique x représente le vecteur numérique continu à soumettre au test. L’exécution de la commande sur notre vecteur gaussien synthétique s’articule comme suit :
resultat_norm <- ad.test(distribution_normale)
print(resultat_norm)
L’objet retourné dans l’environnement R appartient à la classe standard htest (hypothesis test). Cette structure sous forme de liste contient l’ensemble des métadonnées analytiques générées par l’algorithme. L’utilisateur peut extraire programmatiquement chaque composante interne à des fins d’automatisation : resultat_norm$statistic isole la valeur numérique précise de A, tandis que resultat_norm$p.value permet de récupérer la p-valeur exacte.
Dans le contexte d’une batterie de tests psychométriques comportant de nombreuses sous-échelles, il est inefficient d’exécuter manuellement cette syntaxe de manière séquentielle pour chaque variable. La puissance de la programmation vectorielle de R permet d’automatiser l’épreuve sur un tableau de données entier au moyen de la fonction sapply() ou des verbes modernes du package purrr :
resultats_multiples <- sapply(donnees_psychometriques, ad.test)
Cette approche synthétique génère une matrice structurée récapitulant les statistiques de test et les p-valeurs associées à l’ensemble du profil évalué en une seule opération computationnelle.
5.3 Structure et lecture de la sortie R
L’affichage de l’objet htest produit dans la console R adopte une mise en forme standardisée hautement lisible. La sortie se décompose en trois éléments informatifs primordiaux :
1. Le titre explicite du test : Anderson-Darling normality test.
2. La désignation formelle du vecteur soumis à l’évaluation (la ligne data:).
3. La valeur de la statistique calculée, étiquetée A = ..., accompagnée de sa p-valeur interpolée, notée p-value = ....
Sur notre échantillon normal synthétique, R retourne typiquement une statistique A très faible (par exemple A = 0.2841) associée à une p-valeur largement supérieure au seuil usuel (par exemple p-value = 0.6214). À l’inverse, l’application de ad.test(distribution_asymetrique) produit immédiatement une élévation substantielle de la statistique d’adéquation (par exemple A = 7.4589) et une p-valeur infinitésimale (notée p-value < 2.2e-16).
Il est crucial de prêter attention aux avertissements textuels (warnings) que R peut émettre lors de l’exécution. L’avertissement le plus fréquent signale la présence d’ex-aequo (ties), c’est-à-dire de valeurs rigoureusement identiques partagées par plusieurs observations dans l’échantillon. Bien que le test d’Anderson-Darling soit formellement dérivé pour des variables continues au sens strict — pour lesquelles la probabilité théorique que deux valeurs soient strictement identiques est nulle —, la discrétisation des scores en psychométrie (notes entières sur des échelles de 1 à 7) génère inévitablement des ex-aequo. Tant que le nombre d’observations uniques demeure substantiel, l’approximation de Stephens reste robuste, mais une répétition massive de scores identiques altère la calibration de la p-valeur.
6. Interprétation statistique et psychométrique des résultats obtenus
6.1 Évaluation du seuil alpha et décision statistique
L’inférence statistique issue du test d’Anderson-Darling repose sur la confrontation directe de la p-valeur observée au seuil d’erreur alpha prédéterminé avant l’analyse des données. Dans le paradigme neyman-pearsonien conventionnel, un seuil bilatéral de α = 0,05 est retenu par défaut dans les sciences comportementales. Deux configurations décisionnelles mutuellement exclusives se présentent alors à l’analyste :
Dans le premier scénario, la p-valeur calculée est strictement inférieure au seuil critique (p < 0,05). La décision méthodologique s’impose avec netteté : l’analyste rejette formellement l’hypothèse nulle H0. Il conclut que l’échantillon de données empiriques fournit une preuve statistique suffisante d’une déviation non aléatoire par rapport à une loi normale. Le maintien d’analyses paramétriques classiques reposant sans nuance sur la normalité des scores bruts devient dès lors scientifiquement injustifiable sans correctifs préalables.
Dans le second scénario, la p-valeur se maintient au-dessus du seuil de significativité (p ≥ 0,05). La formulation épistémologique de la décision est ici d’une importance capitale : l’analyste échoue à rejeter H0. En aucun cas cette décision ne doit être interprétée comme une confirmation positive ou une preuve formelle que la distribution observée est parfaitement gaussienne. Il s’agit simplement d’un constat d’insuffisance de preuves : la taille d’échantillon et la configuration empirique ne permettent pas de distinguer la distribution observée d’un processus normal standard. Confondre « absence de preuve de non-normalité » avec « preuve de normalité » constitue un écueil méthodologique récurrent dans la littérature psychologique.
6.2 Sensibilité à la taille de l’échantillon (N)
L’évaluation brute de la p-valeur d’un test d’adéquation ne peut jamais être dissociée de la taille de l’échantillon (N). Comme tout test d’hypothèse nulle fondé sur un critère asymptotique, la puissance statistique du test d’Anderson-Darling est une fonction strictement croissante de N. Cette propriété introduit deux dynamiques opposées mais également périlleuses pour le chercheur :
D’une part, dans le cadre d’études épidémiologiques massives ou de cohortes psychométriques à très grand effectif (par exemple N > 1000 ou N > 5000), le test acquiert une « sur-puissance » statistique. Dans ces conditions, la statistique A² détecte des divergences infinitésimales et triviales entre la courbe empirique et la loi gaussienne — des écarts sans aucune incidence clinique ni impact pratique sur la robustesse des tests inférentiels ultérieurs —, aboutissant quasi systématiquement à des rejets hautement significatifs (p < 0,001). Rejeter l’utilisation d’une ANOVA ou d’un modèle de régression uniquement sur la base de ce rejet automatique relèverait d’un dogmatisme méthodologique préjudiciable.
D’autre part, sur de petits échantillons cliniques (N < 30 ou N < 50), fréquents dans les recherches en neuropsychologie lésionnelle ou en imagerie cérébrale fonctionnelle, le test souffre d’un déficit marqué de puissance statistique. Une déviation modérée à sévère par rapport à la normalité peut échouer à franchir le seuil de rejet p < 0,05 faute d’un nombre d’observations suffisant. Le clinicien risque alors d’utiliser des tests paramétriques fragiles en croyant à tort ses données normales. Pour cette raison, la décision statistique finale doit impérativement combiner la lecture de la statistique d’Anderson-Darling avec l’estimation de la taille d’effet de l’écart (coefficients d’asymétrie et de kurtosis) et un examen visuel attentif.
6.3 Rédaction académique des résultats aux normes APA
La communication transparente des diagnostics distributionnels dans les revues internationales à comité de lecture doit se conformer strictement aux normes stylistiques de l’American Psychological Association (APA 7e édition). Selon ces directives, toute statistique inférentielle doit être rapportée avec son symbole mathématique en italique, sa valeur numérique arrondie à deux ou trois décimales, et la p-valeur exacte associée (sans zéro devant la virgule décimale lorsque la borne supérieure ne peut théoriquement pas dépasser 1).
Dans la section « Analyses de données » ou dans la partie préliminaire des « Résultats », la rédaction académique d’un test d’Anderson-Darling concluant à l’adéquation distributionnelle adoptera une formulation rigoureuse :
« L’adéquation de la distribution des scores d’anxiété pré-interventionnelle à la loi normale a été vérifiée au moyen du test d’Anderson-Darling. Les résultats indiquent que les scores observés ne dévient pas significativement du modèle gaussien théorique, A = 0,31, p = ,587. En conséquence, l’application de modèles paramétriques linéaires a été maintenue. »
À l’inverse, si une violation sévère de la normalité est détectée, le reporting académique devra préciser la décision méthodologique consécutive :
« L’examen de la normalité des temps de réaction au moyen du test d’Anderson-Darling a révélé une déviation statistiquement significative par rapport à la distribution normale, A = 3,84, p < ,001. En raison de cette violation distributionnelle prononcée et de la présence d’une leptokurticité marginale, des procédures de rééchantillonnage non paramétriques ont été appliquées pour l’ensemble des inférences ultérieures. »
7. Diagnostic visuel complémentaire : QQ-plots et représentations graphiques
7.1 Diagrammes quantile-quantile (Q-Q plots)
L’inférence statistique formelle ne doit jamais opérer dans un vide perceptif. Le diagramme quantile-quantile normal (couramment désigné sous le terme de Q-Q plot) représente le compagnon visuel indispensable du test d’Anderson-Darling. Sa construction mathématique repose sur la mise en relation graphique bidimensionnelle : en abscisse figurent les quantiles théoriques issus de la fonction de répartition de la loi normale centrée réduite N(0,1), et en ordonnée sont projetés les quantiles empiriques standardisés extraits directement de l’échantillon ordonné. Si la variable suit parfaitement une loi normale, les points forment une droite diagonale rigoureuse à 45 degrés.
En R de base, ce diagnostic s’exécute immédiatement au moyen des fonctions conjointes qqnorm(vecteur) et qqline(vecteur, col = "red", lwd = 2). Cependant, l’appréciation de la dispersion stochastique naturelle aux abords de la ligne de référence est souvent délicate pour l’analyste. C’est ici qu’intervient la fonction avancée qqPlot() issue du package car. Cette fonction trace automatiquement une droite d’ajustement robuste et superpose une enveloppe de confiance à 95 % calculée par simulation paramétrique ou bootstrapping :
car::qqPlot(vecteur, id = FALSE, envelope = 0.95, main = "Q-Q Plot avec Enveloppe de Confiance")
L’interprétation visuelle devient immédiate : tant que les points empiriques restent confinés à l’intérieur de l’enveloppe bleue ombrée, les fluctuations constatées sont compatibles avec le bruit d’échantillonnage. Dès que les points situés aux extrémités distales s’échappent en dehors de l’enveloppe — formant par exemple une courbure en « S » caractéristique d’une asymétrie ou un étalement vertical aux bords révélant des queues lourdes —, le chercheur dispose d’une confirmation visuelle directe des déviations sanctionnées numériquement par la statistique A² d’Anderson-Darling.
7.2 Visualisation par histogrammes et densités avec ggplot2
Si le Q-Q plot excelle dans l’évaluation des quantiles, la représentation directe de la fonction de densité offre une compréhension morphologique intuitive de la distribution empirique. L’écosystème graphique ggplot2 permet de superposer harmonieusement l’histogramme des fréquences observées, l’estimateur de densité par noyau non paramétrique (KDE) et la courbe théorique de Gauss paramétrée sur la moyenne et l’écart-type de l’échantillon.
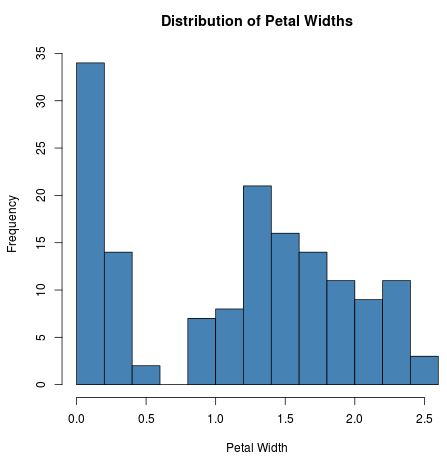
La séquence de code R suivante illustre la standardisation graphique d’une telle représentation à des fins de publication :
ggplot(data.frame(x = vecteur), aes(x = x)) +
geom_histogram(aes(y = after_stat(density)), bins = 25, fill = "#2c3e50", color = "white", alpha = 0.7) +
geom_density(color = "#e74c3c", linewidth = 1.2, linetype = "solid") +
stat_function(fun = dnorm, args = list(mean = mean(vecteur), sd = sd(vecteur)), color = "#2980b9", linewidth = 1, linetype = "dashed") +
theme_minimal(base_size = 14) +
labs(title = "Morphologie Distributionnelle et Courbe Normale Ajustée", x = "Score Psychométrique Observé", y = "Densité Probabiliste")
Cette visualisation synthétique permet d’opposer instantanément la courbe théorique bleue en tirets à la courbe rouge empirique. Le clinicien peut ainsi repérer en un coup d’œil une troncature survenue lors du protocole expérimental, une dépression bimodale traduisant la présence de sous-groupes non diagnostiqués, ou un étalement atypique corroborant le diagnostic du test d’Anderson-Darling.
7.3 Intégration d’indicateurs de forme distributionnelle
L’exploration distributionnelle moderne exige une convergence méthodologique tripartite combinant le test formel d’Anderson-Darling, l’inspection visuelle et la quantification numérique des moments d’ordre 3 et 4. La fonction describe() du package psych calcule automatiquement le coefficient d’asymétrie (skewness) et le kurtosis d’excès (kurtosis), en appliquant les corrections nécessaires pour les échantillons finis.
Pour une loi normale théorique parfaite, le coefficient d’asymétrie est strictement égal à zéro, tout comme le kurtosis d’excès (la distribution mésokurtique de référence ayant un kurtosis brut égal à 3, soustrait conventionnellement de 3 dans les logiciels statistiques). Des règles empiriques robustes établies dans la littérature méthodologique (notamment par Kline et West) suggèrent que des valeurs d’asymétrie comprises entre -1 et +1, et un kurtosis d’excès compris entre -2 et +2, indiquent des déviations légères qui ne compromettent pas gravement la plupart des estimateurs paramétriques.
L’extraction de ces indicateurs sous R s’opère facilement :
stats_formes <- psych::describe(vecteur)
asymetrie <- stats_formes$skew
aplatissement <- stats_formes$kurtosis
L’articulation dialectique entre ces mesures est éclairante : un test d’Anderson-Darling très significatif (p < 0,001) associé à une asymétrie de 0,12 et un kurtosis d’excès de 0,25 au sein d’un échantillon massif de 5 000 sujets témoigne d’un rejet mécanique dû à la sur-puissance, autorisant la poursuite d’analyses paramétriques. En revanche, le même résultat d’Anderson-Darling accompagné d’un kurtosis d’excès s’élevant à 4,80 signale une leptokurticité sévère imposant une remédiation statistique immédiate.
8. Étude de cas empirique : Analyse de données psychologiques réelles dans R
8.1 Contexte de la recherche : Évaluation de l’anxiété et des performances cognitives
Afin de concrétiser l’ensemble de ces préceptes au sein d’un paradigme de recherche réaliste, examinons une étude empirique portant sur les répercussions de l’anxiété d’évaluation sur la mémoire de travail chez de jeunes adultes universitaires. Dans cette modélisation, une cohorte clinique de N = 120 participants a été soumise à l’inventaire d’anxiété état-trait de Spielberger (STAI Form Y-1), produisant un score d’anxiété état continu compris entre 20 et 80. L’échantillon est scindé en deux groupes expérimentaux équilibrés de 60 individus : un groupe témoin placé en condition de relaxation neutre, et un groupe sous induction de stress évaluatif chronométré.
Le chercheur souhaite vérifier si les distributions des scores d’anxiété au sein de chaque condition satisfont au postulat de normalité avant d’exécuter un test t de Student pour échantillons indépendants. L’importation des données depuis un fichier CSV structuré et le premier contrôle de conformité se programment via les fonctions canoniques de l’environnement moderne :
donnees_anxiete <- read_csv("donnees_experience_anxiete.csv")
glimpse(donnees_anxiete)
Une première analyse descriptive globale révèle une moyenne générale de 46,3 points avec un écart-type de 12,8 points. Toutefois, l’analyse globale d’un échantillon composite combinant deux conditions expérimentales distinctes est une aberration méthodologique : l’hypothèse de normalité doit être vérifiée conditionnellement au sein de chaque niveau du facteur expérimental ou sur les résidus du modèle complet.
8.2 Application séquentielle du test d’Anderson-Darling par groupe
L’utilisation judicieuse des fonctions combinées de dplyr permet d’automatiser l’application du test d’Anderson-Darling au sein de chaque groupe expérimental sans devoir scinder manuellement le tableau de données d’origine en sous-matrices isolées. Le pipeline computationnel suivant illustre cette opération d’audit stratifié :
resultats_groupes <- donnees_anxiete %>%
group_by(Condition) %>%
summarise(
N = n(),
Moyenne = mean(Score_STAI, na.rm = TRUE),
Ecart_Type = sd(Score_STAI, na.rm = TRUE),
Statistique_A = nortest::ad.test(Score_STAI)$statistic,
P_Valeur = nortest::ad.test(Score_STAI)$p.value
)
print(resultats_groupes)
L’examen des sorties console révèle un contraste méthodologique frappant. Pour le groupe « Témoin » (N = 60), le test d’Anderson-Darling produit une statistique A = 0,38 avec une p-valeur associée de p = 0,402. En conséquence, l’hypothèse nulle d’adéquation à la loi normale ne peut être rejetée pour ce sous-échantillon. À l’inverse, pour le groupe soumis au « Stress évaluatif » (N = 60), le test produit une statistique A = 2,14 avec une p-valeur estimée à p = 0,00004. L’hypothèse de normalité est donc catégoriquement rejetée au seuil conventionnel α = 0,05.
8.3 Discussion psychométrique des résultats obtenus
L’asymétrie distributionnelle constatée au sein du groupe soumis au stress reflète un phénomène psychologique fréquemment documenté lors d’inductions expérimentales aiguës : la réactivité différentielle. Tandis qu’une fraction des participants manifeste une résilience psychologique maintenant des scores stables, une proportion significative bascule vers des scores d’anxiété extrêmes flirtant avec le plafond instrumental du STAI (scores > 70), générant un étalement asymétrique droit prononcé combiné à une leptokurticité marginale.
Face à ce constat d’hétérogénéité des formes distributionnelles entre les deux conditions, le recours au test t de Student standard pour échantillons indépendants est formellement prohibé. Non seulement le postulat de normalité est enfreint dans l’un des groupes, mais cette déviation s’accompagne d’une inflation de la variance dans la condition expérimentale, brisant l’hypothèse connexe d’homoscédasticité. Deux options s’ouvrent alors au chercheur dans le respect strict des préceptes de la science ouverte : opérer une transformation stabilisatrice sur les scores ou basculer vers une inférence non paramétrique robuste par rééchantillonnage.
9. Comparaison critique : Anderson-Darling face à Shapiro-Wilk et Kolmogorov-Smirnov
9.1 Le test de Shapiro-Wilk comme standard de référence
Dans l’arsenal méthodologique du psychologue, le test de Shapiro-Wilk (implémenté via shapiro.test() sous R) est universellement considéré comme le standard historique d’évaluation de la normalité. Sa formulation théorique repose sur une logique mathématique radicalement distincte de celle d’Anderson-Darling : au lieu de mesurer des intégrales d’écart entre fonctions de répartition cumulées, Shapiro et Wilk ont conçu un ratio quadratique fondé sur la régression linéaire des statistiques d’ordre observées sur les espérances des quantiles d’une loi normale standard (la statistique W). Le test évalue la linéarité parfaite de cette relation au sein du Q-Q plot.
Sur le plan de la puissance statistique pure pour détecter une asymétrie générale ou un aplatissement modéré sur des échantillons de taille modeste (n compris entre 20 et 200), le test de Shapiro-Wilk affiche des performances équivalentes, voire marginalement supérieures d’environ 1 à 2 % à celles d’Anderson-Darling. Toutefois, Shapiro-Wilk souffre d’une contrainte technique majeure sous R : la fonction native shapiro.test() impose une limite stricte sur la taille d’échantillon admissible, bornée entre 3 et 5 000 observations. Dès que n franchit le seuil de 5 000, R interrompt le traitement avec un message d’erreur explicite. Le test d’Anderson-Darling, ne subissant aucune restriction algorithmique de ce type, prend immédiatement le relais sur les grands ensembles de données psychométriques ou épidémiologiques contemporains.
9.2 Les faiblesses notoires du test de Kolmogorov-Smirnov / Lilliefors
Le test de Kolmogorov-Smirnov (accessible sous R via la fonction ks.test()) est sans doute le plus mal compris et le plus mal employé dans la recherche expérimentale. À l’origine, le théorème de Glivenko-Cantelli sur lequel repose Kolmogorov-Smirnov a été formalisé pour tester la conformité d’un échantillon à une distribution théorique entièrement spécifiée à l’avance, incluant la connaissance exacte et a priori des paramètres μ et σ. En psychologie, ces paramètres réels ne sont jamais connus d’avance et sont systématiquement estimés à partir des données de l’échantillon. Appliquer ks.test() en y injectant mean(x) et sd(x) constitue une faute statistique majeure conduisant à une sous-estimation dramatique de la statistique de test et à une prolifération d’erreurs de seconde espèce (non-rejet erroné de H0).
Bien que la correction de Lilliefors (accessible via nortest::lilliefors.test()) ajuste les tables critiques pour pallier cette estimation des paramètres, le test de Kolmogorov-Smirnov/Lilliefors demeure fondamentalement sous-puissant par rapport à Anderson-Darling. En ne retenant que la valeur maximale absolue D = sup |Fn(x) – F(x)|, il ignore la quasi-totalité de l’information structurelle portée par les queues de distribution. Des simulations numériques répétées ont amplement démontré qu’une contamination sévère des extrémités par des données aberrantes ou une leptokurticité marquée peut passer entièrement inaperçue au test de Kolmogorov-Smirnov, alors qu’elle déclenche un rejet immédiat et sans appel sous le test d’Anderson-Darling.
9.3 Autres alternatives du package nortest
L’écosystème nortest développé par Juergen Gross et Uwe Ligges ne se cantonne pas au test d’Anderson-Darling et propose un éventail d’épreuves d’adéquation basées sur la fonction de répartition empirique (EDF), constituant une boîte à outils comparative de premier plan :
- Le test de Cramér-von Mises (
cvm.test) : Il calcule l’intégrale non pondérée des écarts quadratiques W². Moins sensible aux queues que le test d’Anderson-Darling, il fournit une évaluation excellente de l’adéquation au centre de la cloche gaussienne, utile lorsque l’on suspecte une anomalie modale sans vouloir sur-pénaliser des valeurs périphériques sporadiques. - Le test de Shapiro-Francia (
sf.test) : Version simplifiée et optimisée du test de Shapiro-Wilk adaptée aux échantillons de grande taille (pouvant atteindre jusqu’à 5 000 observations), particulièrement efficace pour détecter les déviations d’asymétrie générale. - Le test du Chi-carré d’adéquation de Pearson (
pearson.test) : Méthode historique discrétisant la variable continue en classes d’intervalles théoriques. Bien qu’utile à des fins pédagogiques ou sur des distributions structurellement discrétisées, ce test souffre d’une perte d’information majeure due au choix arbitraire du nombre et de la largeur des intervalles de regroupement.
Face à cet éventail, la matrice décisionnelle contemporaine place le test d’Anderson-Darling au sommet des recommandations méthodologiques chaque fois que le chercheur postule que les déviations cliniquement pertinentes ou métrologiquement invalidantes résident dans les queues du spectre observé.
10. Gestion des violations de normalité et solutions alternatives dans R
10.1 Techniques de transformation de variables
Lorsqu’un test d’Anderson-Darling rejette formellement l’hypothèse de normalité, la première stratégie traditionnelle de remédiation consiste à soumettre le vecteur empirique à une transformation mathématique continue afin de remodeler sa géométrie distributionnelle. Pour les distributions psychométriques présentant une asymétrie positive prononcée (queue droite étalée), trois transformations classiques sont hiérarchiquement préconisées : la transformation racine carrée (sqrt(x)) pour les asymétries modérées, la transformation logarithmique népérienne ou décimale (log(x) ou log10(x)) pour les asymétries sévères, et la transformation inverse (1/x) pour les profils hyperboliques extrêmes.
Une démarche plus systématique consiste à recourir à la famille paramétrique de transformations de Box-Cox, implémentée sous R au sein du package MASS via la fonction boxcox(). L’algorithme recherche par maximisation de vraisemblance la valeur optimale du paramètre lambda (λ) permettant de normaliser au mieux la variable cible :
modele_lineaire <- lm(Score_STAI ~ 1, data = donnees_anxiete)
MASS::boxcox(modele_lineaire, lambda = seq(-2, 2, 0.1))
Il importe toutefois de souligner une mise en garde méthodologique sévère : si les transformations mathématiques résolvent l’adéquation distributionnelle en rendant le test d’Anderson-Darling non significatif sur la variable transformée, elles altèrent profondément l’interprétabilité clinique des scores. Exprimer une différence intergroupe en « logarithmes d’unités d’anxiété » ou en « racines carrées de temps de latence » complique considérablement le dialogue translationnel avec les praticiens de terrain et rend la comparaison des tailles d’effet (telles que le d de Cohen) périlleuse entre différentes études de la littérature.
10.2 Recours aux méthodes non paramétriques
Lorsque la transformation est proscrite pour des motifs d’interprétabilité ou lorsqu’elle échoue à corriger une leptokurticité persistante décelée par Anderson-Darling, la transition vers des modèles non paramétriques fondés sur les rangs représente l’alternative canonique. Dans ce cadre épistémologique, les valeurs numériques absolues sont abandonnées au profit de leur ordre sériel, neutralisant mécaniquement l’influence distordante des queues lourdes et des observations périphériques.
Sous R, la substitution d’un test t de Student par son équivalent non paramétrique s’exécute nativement via la fonction wilcox.test() :
wilcox.test(Score_STAI ~ Condition, data = donnees_anxiete, exact = FALSE)
Cette commande exécute le test de somme des rangs de Wilcoxon (analogue fonctionnel du test U de Mann-Whitney). De même, pour des designs expérimentaux impliquant plus de deux groupes, l’analyse de variance à un facteur (ANOVA) cède la place au test de Kruskal-Wallis via l’instruction kruskal.test(Score ~ Groupe, data = donnees).
Toutefois, cette transition vers le non-paramétrique classique n’est pas dépourvue de coût méthodologique. L’efficacité statistique relative asymptotique (ARE) du test de Wilcoxon par rapport au test t tourne autour de 95,5 % sous l’hypothèse d’une loi normale sous-jacente, ce qui constitue une perte de puissance très modeste. Cependant, ces tests ne testent plus une stricte égalité des moyennes mais plutôt une stochasticité ordinale ou une translation de médiane, ce qui peut diverger des hypothèses théoriques initialement formulées par le chercheur.
10.3 Statistiques robustes et rééchantillonnage
La statistique computationnelle moderne propose une troisième voie infiniment plus élégante et féconde que les transformations artificielles ou la conversion en rangs : l’application de statistiques robustes et de techniques de rééchantillonnage de Monte-Carlo. Développées notamment par Rand Wilcox, ces méthodes permettent de modéliser directement les paramètres de localisation d’intérêt (tels que des moyennes tronquées ou des M-estimateurs) tout en garantissant un contrôle rigoureux des erreurs statistiques même sous des violations drastiques mises en lumière par Anderson-Darling.
Le package spécialisé WRS2 offre une suite d’outils particulièrement performants pour l’analyste comportemental. Par exemple, la fonction yuen() permet de comparer deux groupes au moyen du test de Yuen pour moyennes tronquées à 20 %, une méthode insensible aux perturbations dans les queues de distribution :
WRS2::yuen(Score_STAI ~ Condition, data = donnees_anxiete, tr = 0.2)
Conjointement, le bootstrapping non paramétrique (accessible via le package boot) permet de dériver des intervalles de confiance à 95 % par rééchantillonnage avec remise (typiquement B = 2 000 ou 5 000 répétitions). En calculant des intervalles corrigés de l’asymétrie et accélérés (intervalles BCa), le chercheur s’affranchit intégralement du postulat de normalité des résidus tout en maintenant l’inférence sur l’échelle métrique d’origine, garantissant une validité scientifique maximale à ses conclusions expérimentales.
11. Bonnes pratiques méthodologiques et écueils fréquents en recherche psychologique
11.1 L’illusion du test d’hypothèse préalable systématique
L’une des dérives procédurales les plus solidement ancrées dans la pratique de la recherche psychologique consiste à appliquer un protocole en deux étapes rigides : d’abord un test automatique d’hypothèse nulle sur la normalité (comme le test d’Anderson-Darling), puis, conditionnellement au résultat, la sélection mécanique entre un test t paramétrique (si p ≥ 0,05) ou un test de Wilcoxon non paramétrique (si p < 0,05). Cette routine méthodologique, bien qu’apparemment prudente, est formellement déconseillée par les statisticiens méthodologues contemporains.
Ce processus de sélection conditionnelle modifie en profondeur la distribution d’échantillonnage du test inférentiel subséquent. Des simulations exhaustives ont prouvé que ce conditionnement séquentiel déforme le taux d’erreur de première espèce global du flux analytique, augmentant paradoxalement le risque de faux positifs dans des proportions non négligeables. De plus, sur les petits échantillons, la sous-puissance d’Anderson-Darling conduit à orienter à tort l’analyste vers le test paramétrique précisément lorsqu’il est le plus fragile. Les consensus actuels recommandent de fonder le choix des modèles sur une analyse exploratoire globale intégrant l’expertise théorique du domaine, la taille de l’échantillon et l’inspection visuelle, ou de planifier a priori des modèles linéaires mixtes ou des estimateurs robustes dont la validité ne dépend pas d’un pré-test formel binaire.
11.2 Gestion rigoureuse des observations extrêmes (outliers)
L’extrême sensibilité du test d’Anderson-Darling aux queues de distribution soulève inévitablement la question de la gestion des données aberrantes ou extrêmes (outliers). Une seule observation déviante — par exemple un participant ayant répondu au hasard en sélectionnant systématiquement la valeur maximale de l’échelle ou un temps de réaction corrompu par une distraction environnementale — suffit fréquemment à faire exploser la statistique A² et à provoquer un rejet catégorique de H0.
L’analyste doit impérativement distinguer une déviation distributionnelle globale (une population parente structurellement asymétrique ou leptokurtique) de la présence de quelques observations exogènes polluant un échantillon par ailleurs parfaitement gaussien. Cette distinction s’opère par des métriques d’identification multivariées comme la distance de Mahalanobis ou, en univarié, par l’utilisation d’écarts-types robustes fondés sur l’écart absolu médian (MAD via stats::mad()) :
mediane <- median(vecteur)
mad_val <- mad(vecteur)
scores_z_robustes <- abs(vecteur - mediane) / mad_val
outliers_potentiels <- which(scores_z_robustes > 3)
D’un point de vue éthique et déontologique, la suppression manuelle de ces observations dans le seul but de « forcer » le test d’Anderson-Darling à devenir non significatif relève de la manipulation de données (p-hacking). Toute exclusion de données doit être explicitement consignée dans les protocoles pré-enregistrés, justifiée par un dysfonctionnement matériel documenté ou menée dans le cadre d’analyses de sensibilité comparant les résultats avec et sans les cas aberrants.
11.3 Règles pour une documentation reproductible
Pour s’inscrire dans les standards les plus élevés de la recherche scientifique ouverte et reproductible, l’exécution du test d’Anderson-Darling et des diagnostics connexes sous R doit être documentée de manière à pouvoir être répliquée bit pour bit par n’importe quel évaluateur indépendant. L’élaboration d’un script structuré implique l’encapsulation de l’environnement matériel et logiciel au moyen de l’instruction finale sessionInfo(), qui liste précisément la version de R exploitée, le système d’exploitation et les versions exactes des packages chargés (tels que nortest ou tidyverse).
Pour un niveau d’exigence professionnel, l’adoption du système de gestion des dépendances renv permet de figer l’état exact des bibliothèques logicielles dans un fichier de verrouillage (lockfile), prévenant tout bris de code futur lié aux mises à jour des algorithmes du CRAN. Enfin, l’intégration du code au sein de documents computationnels dynamiques via Quarto ou R Markdown offre la possibilité d’entremêler harmonieusement la prose explicative académique, le code R source et les figures diagnostiques haute définition dans un rapport PDF ou HTML unique, prêt pour la soumission éditoriale ou le dépôt sur des répertoires institutionnels certifiés (tels que l’Open Science Framework ou Zenodo).
12. Conclusion et intégration dans le flux d’analyse de données reproductible
12.1 Synthèse du protocole opérationnel sous R
La conduite rigoureuse du test d’Anderson-Darling sous R ne doit jamais être conçue comme un acte mécanique isolé, mais comme une composante d’un protocole d’assurance qualité statistique structuré et progressif. Ce flux d’analyse canonique s’articule autour d’une succession d’étapes rationnelles :
- Préparation : Typage strict du vecteur de scores, exclusion contrôlée des valeurs manquantes et initialisation de l’environnement avec
library(nortest). - Exploration multivariée : Calcul conjoint des coefficients d’asymétrie et de kurtosis d’excès via
psych::describe(). - Diagnostic visuel : Tracé simultané d’un diagramme quantile-quantile normal avec enveloppes de confiance à 95 % (
car::qqPlot()) et d’un histogramme enrichi de l’estimateur de densité empirique. - Test formel d’adéquation : Exécution de
ad.test(), extraction rigoureuse de la statistique A² corrigée de Stephens et de la p-valeur interpolée. - Arbitrage méthodologique pondéré : Mise en perspective de la décision statistique en fonction de la taille d’échantillon N. Si N est faible (N < 50) et que le test ne rejette pas H0 mais que le Q-Q plot montre des anomalies périphériques, la prudence impose d’éviter le paramétrique pur. Si N est massif (N > 1 000) et que le test rejette H0 mais que l’asymétrie et le kurtosis restent proches de zéro, le maintien des modèles linéaires est pleinement justifié.
Cette approche équilibrée transcende le piège du décisionnisme binaire rigide fondé sur la seule p-valeur pour réhabiliter le jugement d’expertise clinique et méthodologique au cœur de la pratique de la science des données comportementales.
12.2 Perspectives et approfondissements en science des données comportementales
L’exploration de la normalité univariée via le test d’Anderson-Darling constitue la première pierre d’un édifice quantitatif plus vaste. Dans la recherche psychologique contemporaine, les données sont de plus en plus rarement isolées ; elles s’inscrivent au sein de vecteurs multidimensionnels mesurant simultanément des profils cognitifs, émotionnels ou neurobiologiques imbriqués. L’extension naturelle de cette démarche réside donc dans le diagnostic de la normalité multivariée. Des épreuves mathématiques dérivées, telles que le test d’adéquation multivarié de Henze-Zirkler ou de Royston (disponibles au sein du package MVN sous R), étendent l’exigence d’adéquation distributionnelle à l’espace multidimensionnel défini par les matrices de covariance.
Parallèlement, la montée en puissance de l’inférence bayésienne — propulsée sous R par des environnements probabilistes tels que brms et rstan — offre un changement de paradigme radical. Dans le cadre bayésien, l’obligation de conformer ses données à une loi normale par commodité algorithmique disparaît complètement. Le chercheur peut spécifier de manière native et explicite des distributions de réponse à queues lourdes (telles que la loi t de Student multivariée ou des distributions asymétriques exponentielles), modélisant directement la réalité empirique plutôt que de tenter de la corriger artificiellement. Qu’il serve de garde-fou pour les modèles paramétriques classiques ou de boussole préliminaire pour les architectures computationnelles bayésiennes, le test d’Anderson-Darling demeure un instrument méthodologique incontournable pour quiconque aspire à traiter les données psychologiques avec le plus haut degré de rigueur scientifique.
Références
- Anderson, T. W., & Darling, D. A. (1952). Asymptotic theory of certain « goodness of fit » criteria based on stochastic processes. The Annals of Mathematical Statistics, 23(2), 193–212. https://doi.org/10.1214/aoms/1177729437
- Anderson, T. W., & Darling, D. A. (1954). A test of goodness of fit. Journal of the American Statistical Association, 49(268), 765–769. https://doi.org/10.1080/01621459.1954.10501232
- Fox, J., & Weisberg, S. (2019). An R Companion to Applied Regression (3e éd.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Gross, J., & Ligges, U. (2015). nortest: Tests for Normality (R package version 1.0-4). The Comprehensive R Archive Network. https://CRAN.R-project.org/package=nortest
- Kline, R. B. (2016). Principles and Practice of Structural Equation Modeling (4e éd.). The Guilford Press.
- R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Revelle, W. (2023). psych: Procedures for Psychological, Psychometric, and Personality Research (R package version 2.3.9). Northwestern University. https://CRAN.R-project.org/package=psych
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Stephens, M. A. (1974). EDF statistics for goodness of fit and some comparisons. Journal of the American Statistical Association, 69(347), 730–737. https://doi.org/10.1080/01621459.1974.10480196
- Stephens, M. A. (1986). Tests based on EDF statistics. Dans R. B. D’Agostino & M. A. Stephens (Éds.), Goodness-of-Fit Techniques (pp. 97–193). Marcel Dekker.
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., Takahashi, K., Vaughan, D., Wilke, C., Woo, K., & Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686
- Wilcox, R. R. (2022). Introduction to Robust Estimation and Hypothesis Testing (5e éd.). Academic Press. https://doi.org/10.1016/C2019-0-01931-2