
Dans le domaine de l’économétrie appliquée, de la biométrie et de l’ingénierie cognitive, la modélisation des relations quantitatives repose souvent, par commodité initiale, sur l’hypothèse de linéarité. Cette simplification commode stipule que la variation d’une variable indépendante engendre une réponse proportionnelle et constante au sein de la variable dépendante. Cependant, la réalité empirique contredit fréquemment ce postulat élémentaire : les phénomènes naturels, industriels et comportementaux manifestent quasi systématiquement des dynamiques non linéaires marquées par des seuils critiques, des zones de rendements marginaux décroissants, des points de saturation ou des inversions complètes de trajectoire. Réduire de telles interactions à une droite par le biais d’une régression linéaire ordinaire constitue une erreur d’inférence majeure, susceptible de masquer des propriétés fonctionnelles essentielles et de vicier lourdement les capacités prédictives des modèles statistiques.
Face à ces configurations curvilignes, la régression polynomiale s’impose comme une extension naturelle, élégante et particulièrement puissante du modèle linéaire classique. En incorporant des puissances successives d’une variable explicative continue au sein d’une équation d’estimation, ce cadre d’analyse permet de capturer avec une flexibilité mathématique remarquable les inflexions, concavités et complexités structurelles observées sur le terrain. L’ajustement polynomial offre ainsi un compromis épistémologique précieux : il conserve les propriétés computationnelles favorables de l’estimation par les moindres carrés tout en élargissant considérablement le spectre des trajectoires fonctionnelles modélisables.
Bien que les logiciels spécialisés tels que R, Python, SPSS ou Stata soient traditionnellement plébiscités pour l’analyse statistique avancée, Microsoft Excel demeure un environnement analytique ubiquitaire et universellement accessible au sein des organisations académiques et industrielles. Doté d’algorithmes matriciels robustes et d’outils graphiques interactifs sophistiqués, le tableur permet d’exécuter des régressions polynomiales de haute précision selon plusieurs approches méthodologiques complémentaires. L’objet de ce guide exhaustif est de décomposer minutieusement les fondements mathématiques, les procédures d’implémentation pratique, les protocoles diagnostiques et les pièges interprétatifs inhérents à l’exécution d’une régression polynomiale sous Microsoft Excel, afin d’armer le chercheur ou l’analyste d’une méthodologie d’une rigueur irréprochable.
1. Introduction théorique à la régression polynomiale et ses applications
1.1 Définition formelle du modèle de régression polynomiale
Sur le plan mathématique, le modèle de régression polynomiale relie une variable dépendante continue, conventionnellement notée Y, à une variable indépendante continue X via une combinaison linéaire de puissances entières successives de cette dernière. Pour un ordre polynomial désigné par la constante entière positive k, l’équation générale du modèle s’énonce selon la formulation suivante :
Yi = β0 + β1Xi + β2Xi2 + β3Xi3 + … + βkXik + εi
Dans cette formulation rigoureuse, les coefficients βj (avec j variant de 0 à k) représentent les paramètres réels à estimer à partir de l’échantillon empirique, où β0 désigne l’ordonnée à l’origine (ou constante du modèle) et εi correspond au terme d’erreur stochastique, supposé indépendamment et identiquement distribué selon une loi normale centrée de variance constante (σ2). L’aspect le plus fondamental de cette modélisation réside dans sa classification taxonomique : bien que la fonction d’ajustement soit non linéaire par rapport à la variable explicative X, le modèle demeure rigoureusement linéaire par rapport à ses coefficients inconnus β. Cette propriété structurelle classe d’emblée la régression polynomiale comme un cas particulier de la régression linéaire multiple.
D’un point de vue géométrique, l’ordre k du polynôme dicte la topologie de la courbe théorique. Un ordre k = 2 génère une parabole présentant un extremum unique (sommet ou creux), tandis qu’un ordre k = 3 engendre une courbe cubique présentant potentiellement un point d’inflexion où la concavité change d’orientation. À cet égard, la régression polynomiale se distingue fondamentalement des modèles non linéaires purs (tels que les fonctions logistiques, de Michaelis-Menten ou de Gompertz) ainsi que des modèles exponentiels ou logarithmiques transformables. Alors que ces derniers reposent souvent sur des théories asymptotiques restreignant les valeurs de sortie dans un intervalle borné, le polynôme constitue une approximation locale par développement en série de Taylor, sans bornage naturel hors du domaine expérimental.
1.2 Pertinence dans l’analyse de relations curvilignes complexes
L’utilité méthodologique de la régression polynomiale réside principalement dans sa disposition intrinsèque à modéliser des phénomènes dynamiques gouvernés par des accélérations, des décélérations, des seuils de basculement ou des rendements marginaux non constants. Dans les processus physiques, chimiques ou économiques, il est exceptionnel qu’un système conserve un taux d’accroissement constant à travers l’ensemble de son domaine opératoire. Les saturations mécaniques, la raréfaction des ressources ou l’inertie thermodynamique induisent presque systématiquement une dégradation progressive de la réponse marginale, phénomène qu’un polynôme de second degré traduit fidèlement par sa dérivée seconde constante (β2).
Lorsque la complexité du processus s’accroît, notamment en présence de mécanismes antagonistes intervenant séquentiellement selon la magnitude de la stimulation, les modèles d’ordre 3 ou plus fournissent un cadre paramétrique capable d’épouser des profils sigmoïdes ou oscillatoires. À titre d’illustration, la phase initiale d’accélération d’une réaction catalysée, suivie d’une phase de quasi-linéarité puis d’un ralentissement par encombrement stérique, peut être décrite efficacement par un polynôme cubique. Ce dernier intègre deux courbures distinctes sans exiger de l’analyste qu’il spécifie au préalable les équations différentielles sous-jacentes du système, faisant du polynôme un outil d’ajustement empirique particulièrement polyvalent.
En outre, face à des distributions d’échantillonnage fortement asymétriques où la variance des résidus s’avère corrélée à une mauvaise spécification fonctionnelle linéaire, l’introduction des degrés polynomiaux restaure l’homoscédasticité en éliminant les courbures systématiques résiduelles. L’analyse exploratoire de séries temporelles microéconomiques, de cinétiques enzymatiques ou de profils de contrainte-déformation métallurgiques tire ainsi un bénéfice immédiat de cette capacité à courber la droite prédictive sans devoir abandonner le formalisme des moindres carrés.
1.3 Contextualisation dans les sciences comportementales et quantitatives
L’application paradigmatique de la régression polynomiale se retrouve de manière éclatante dans l’opérationnalisation de lois psychologiques et physiologiques fondamentales. Le cas le plus célèbre en psychologie expérimentale et en neuroergonomie est incontestablement la loi de Yerkes-Dodson, qui postule l’existence d’une relation en cloche (forme de U inversé) reliant le niveau d’éveil neurophysiologique (arousal) à la performance cognitive globale lors de l’exécution d’une tâche complexe. Un niveau d’éveil excessivement faible plonge le sujet dans la léthargie, réduisant son acuité attentionnelle, tandis qu’un niveau d’activation excessivement intense engendre une désorganisation anxieuse annihilant l’efficacité opérationnelle. L’équation quadratique standard (k = 2) permet non seulement de valider empiriquement cette théorie, mais offre surtout le moyen mathématique d’isoler avec précision l’optimum d’activation pour un protocole expérimental donné.
De façon analogue, l’évaluation du stress professionnel en ergonomie cognitive et en médecine du travail démontre que la charge de travail perçue n’agit pas de manière linéaire sur l’épuisement psychologique (burnout). Les modèles quadratiques et cubiques révèlent fréquemment une phase de tolérance homéostatique où l’augmentation de la charge est amortie par les ressources cognitives de l’individu, suivie d’un point d’inflexion critique au-delà duquel les marqueurs de stress connaissent une élévation exponentielle avant d’atteindre un plateau d’épuisement total.
Enfin, l’étude des courbes d’acquisition des compétences motrices et du déclin mnésique d’Ebbinghaus illustre l’impératif de quantifier rigoureusement les décélérations d’apprentissage. L’accumulation de la pratique génère des gains initiaux spectaculaires qui s’amenuisent progressivement au fur et à mesure que l’apprenant s’approche de ses plafonds physiologiques. La quantification précise de ces cinétiques non linéaires via des polynômes d’ordre supérieur conditionne la validation d’hypothèses dans les protocoles de rééducation neuropsychologique, l’optimisation des programmes de formation industrielle et le paramétrage des interfaces homme-machine modernes.
2. Distinction fondamentale entre régression linéaire simple et régression polynomiale
2.1 Limites de la régression linéaire face à la non-linéarité empirique
L’utilisation non critique de la régression linéaire simple face à des données présentant une courbure structurelle engendre un ensemble de distorsions méthodologiques sévères, au premier rang desquelles figure le biais systématique de spécification. Lorsque l’analyste contraint artificiellement un nuage de points curviligne à s’aligner sur une trajectoire rectiligne unique régie par l’équation Y = β0 + β1X, la droite résultante traverse la trajectoire empirique sans en capturer l’essence. Elle sous-estime systématiquement la réponse au centre de la distribution tout en la surestimant aux points d’inflexion intermédiaires, ou inversement selon l’orientation de la concavité observée.
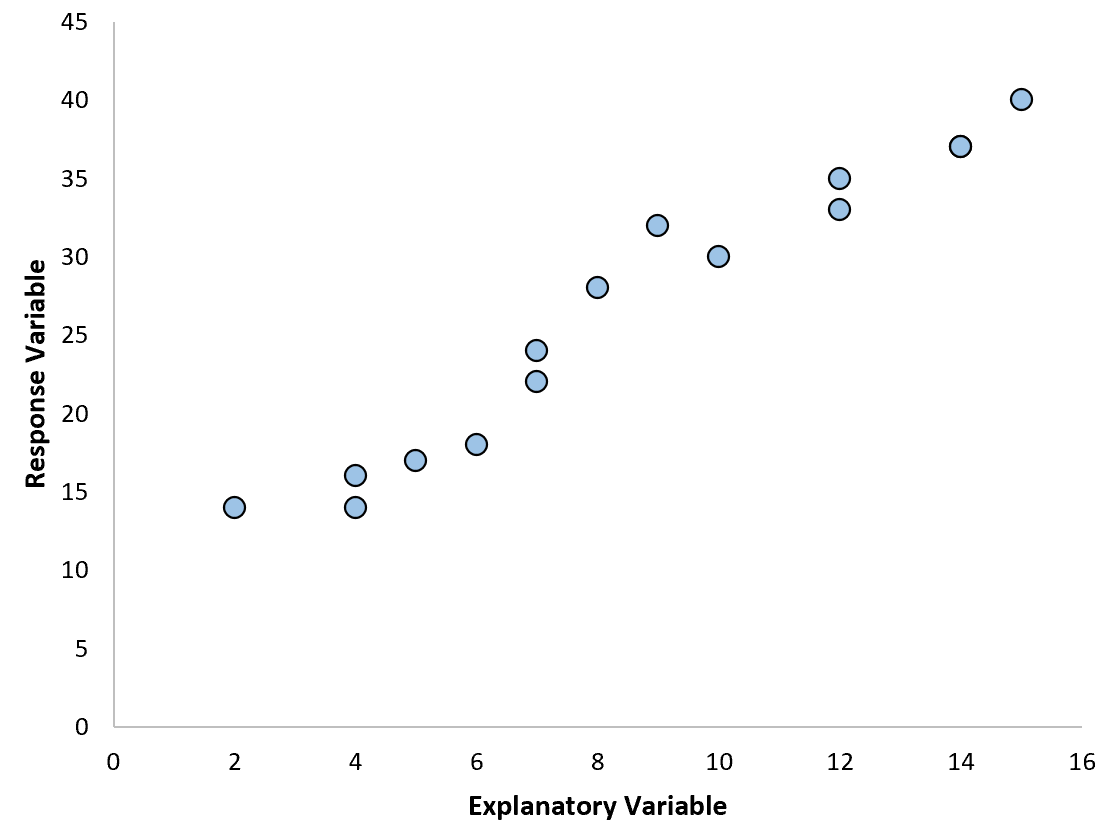
Cette imposition d’une trajectoire unitaire rectiligne détruit toute information concernant les optima locaux du système. Dans une problématique agronomique ou pharmaceutique où l’on cherche à identifier la concentration exacte d’un principe actif maximisant la prolifération cellulaire tout en minimisant sa toxicité, la régression linéaire simple est intrinsèquement incapable d’identifier la présence d’un sommet. Elle conclura de façon erronée à un effet purement positif si la pente globale est ascendante, ou purement négatif dans le cas contraire, incitant l’expérimentateur à augmenter indéfiniment le dosage ou à le bannir, deux décisions potentiellement désastreuses.
Par ailleurs, la violation formelle du postulat d’espérance conditionnelle nulle des erreurs (E[ε|X] = 0) altère gravement les inférences inférées. Les résidus ne se répartissent plus de manière aléatoire autour de l’axe zéro, mais dessinent une forme sinueuse ou parabolique manifeste. Enfin, aux extrémités de la distribution (extrapolations locales), le modèle linéaire simple génère des prédictions délétères qui divergent de manière drastique par rapport au comportement réel du phénomène physique, invalidant l’ensemble de la démarche prédictive.
2.2 Formulation mathématique comparée
Pour appréhender rigoureusement les mutations analytiques induites par le passage au cadre polynomial, il convient de juxtaposer formellement les architectures mathématiques des modèles. La régression linéaire simple est gouvernée par deux degrés de liberté paramétriques :
Yi = β0 + β1Xi + εi
Dans ce cadre, le taux marginal d’accroissement, matérialisé par la dérivée première de Y par rapport à X, est une constante immuable : dY / dX = β1. Quelle que soit la valeur de départ de X, une incrémentation d’une unité de cette variable induit invariablement une translation de magnitude β1 sur l’espérance mathématique de Y.
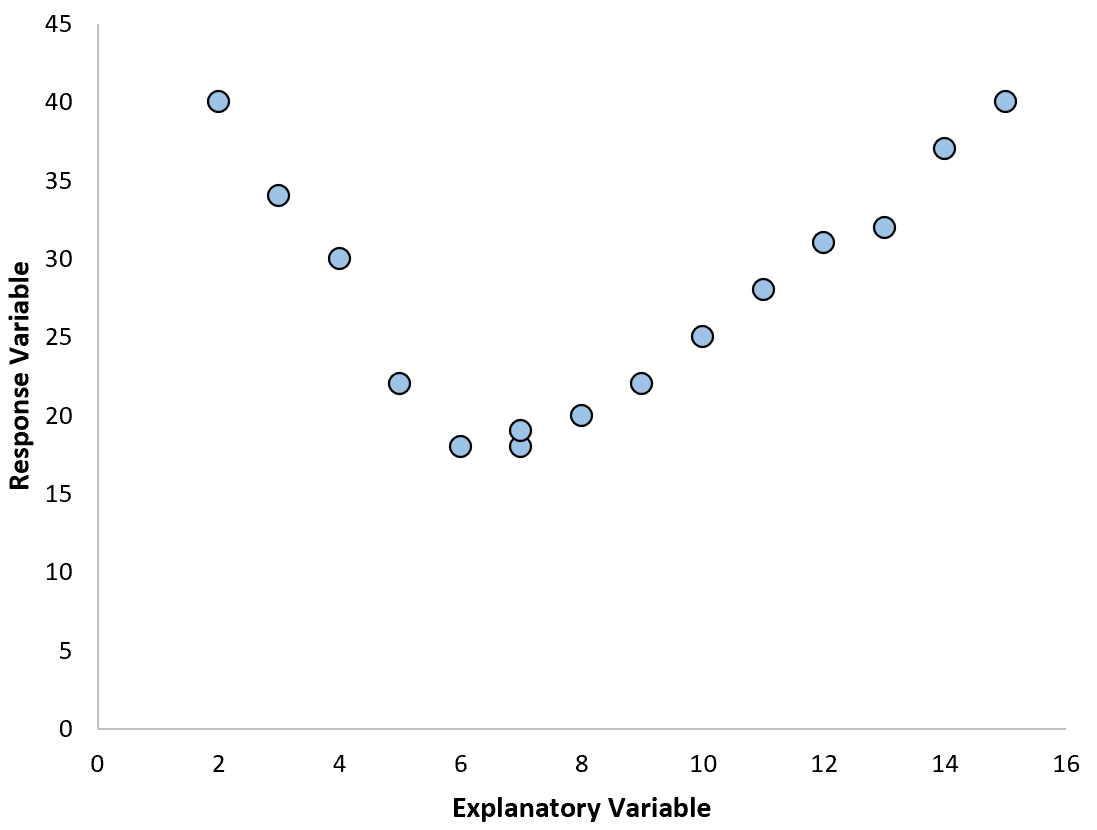
À l’inverse, l’équation polynomiale d’ordre 2 (modèle quadratique) introduit un degré de liberté supplémentaire via son terme au carré :
Yi = β0 + β1Xi + β2Xi2 + εi
La dérivée première prend alors la forme d’une fonction linéaire de la variable prédictive : dY / dX = β1 + 2β2X. Le taux de variation n’est plus statique : il dépend directement de la position instantanée occupée sur l’axe des abscisses. Le terme quadratique β2 agit ainsi comme un modérateur direct de la pente locale, conférant à la courbe sa propriété de concavité (si β2 < 0) ou de convexité (si β2 > 0). Si l’on généralise à l’ordre n, la formulation matricielle intègre des puissances progressives :
Yi = β0 + ∑j=1..n (βjXij) + εi
Chaque terme additionnel enrichit l’expression analytique de la dérivée, offrant au modèle la latitude d’inverser successivement l’orientation de sa concavité. Néanmoins, l’adjonction systématique de ces composantes engendre une complexification paramétrique qui nécessite des vérifications méthodologiques d’autant plus vigilantes.
2.3 Le paradoxe de la linéarité dans les paramètres
L’un des paradoxes conceptuels les plus féconds de la théorie statistique appliquée réside dans la distinction fondamentale entre la linéarité par rapport aux variables observées et la linéarité par rapport aux paramètres estimés. Bien que la courbe tracée dans le repère bidimensionnel (X, Y) affiche des courbures géométriques évidentes, la régression polynomiale n’entre nullement dans la catégorie des régressions non linéaires au sens de l’estimation statistique théorique.
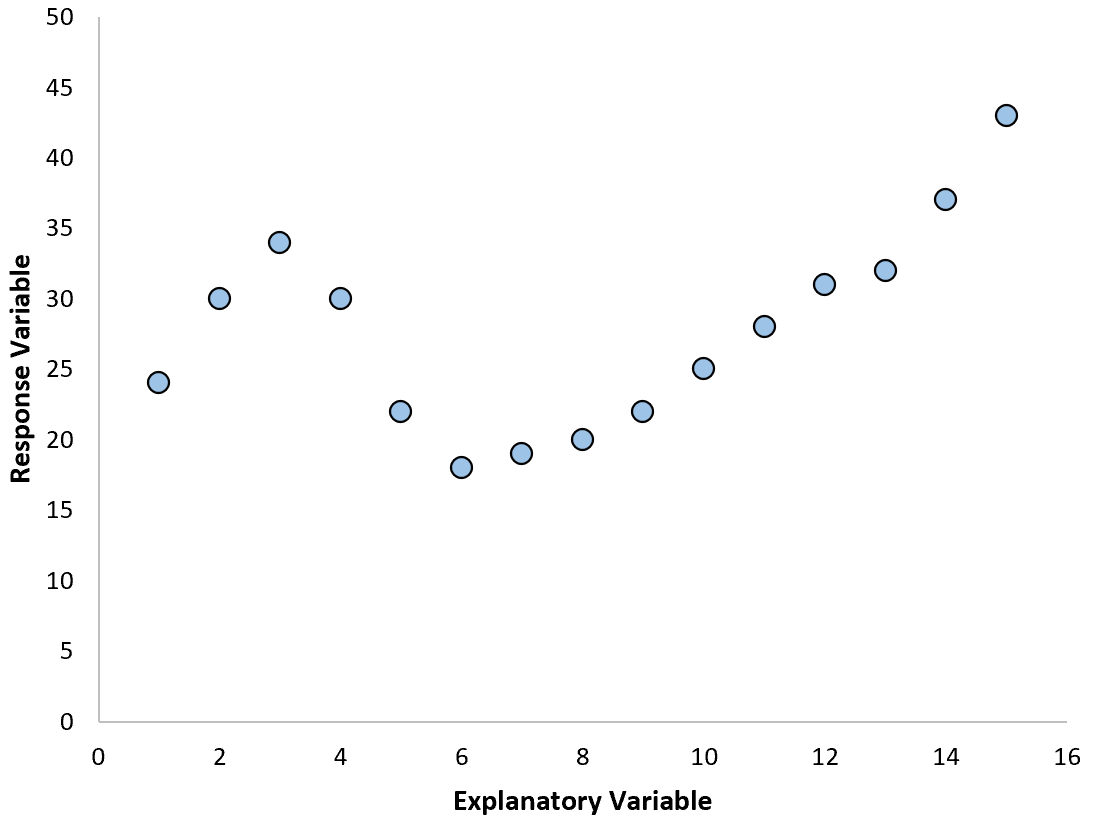
En effet, en définissant des variables intermédiaires auxiliaires telles que Z1 = X, Z2 = X2, …, Zk = Xk, l’équation polynomiale se réécrit sous la forme stricte d’un modèle linéaire standard à régresseurs multiples :
Yi = β0 + β1Z1i + β2Z2i + … + βkZki + εi
Puisque chaque dérivée partielle par rapport aux paramètres βj ne dépend aucunement des paramètres eux-mêmes (∂Y / ∂βj = Xj), le système d’équations normales reste parfaitement linéaire. Cette linéarité intrinsèque des paramètres autorise l’application directe du théorème de Gauss-Markov et la mise en œuvre sans altération de la méthode des moindres carrés ordinaires (MCO), dont la solution matricielle universelle β = (XTX)-1XTY fournit les estimateurs sans biais et à variance minimale parmi la classe des estimateurs linéaires (propriété BLUE).
Ce fondement épistémologique est capital pour l’implémentation opérationnelle au sein d’environnements tabulaires comme Microsoft Excel. Il implique que l’analyste n’a aucunement besoin de recourir à des algorithmes itératifs complexes d’optimisation non linéaire sous contraintes (tels que l’algorithme de Gauss-Newton ou de Levenberg-Marquardt du Solveur), mais peut mobiliser les moteurs de calcul matriciel standard, garantissant une convergence instantanée, analytique et exempte de pièges liés aux optima locaux.
3. Préparation et structuration des données expérimentales dans Excel
3.1 Organisation tabulaire rigoureuse des variables
L’intégrité de toute modélisation polynomiale sous Excel est conditionnée par l’architecture spatiale des données au sein de la feuille de calcul. L’exigence fondamentale est l’agencement strict en format tabulaire rectangulaire ou sous la forme d’un tableau officiel Excel (activé via la combinaison de touches Ctrl + L ou Ctrl + T). La variable prédictive continue X doit être consubstantiellement ségréguée au sein d’une colonne unitaire et dédiée, sans la moindre fusion de cellules adjacentes, les cellules fusionnées constituant l’une des causes majeures d’échec de lecture pour les fonctions de calcul matriciel.
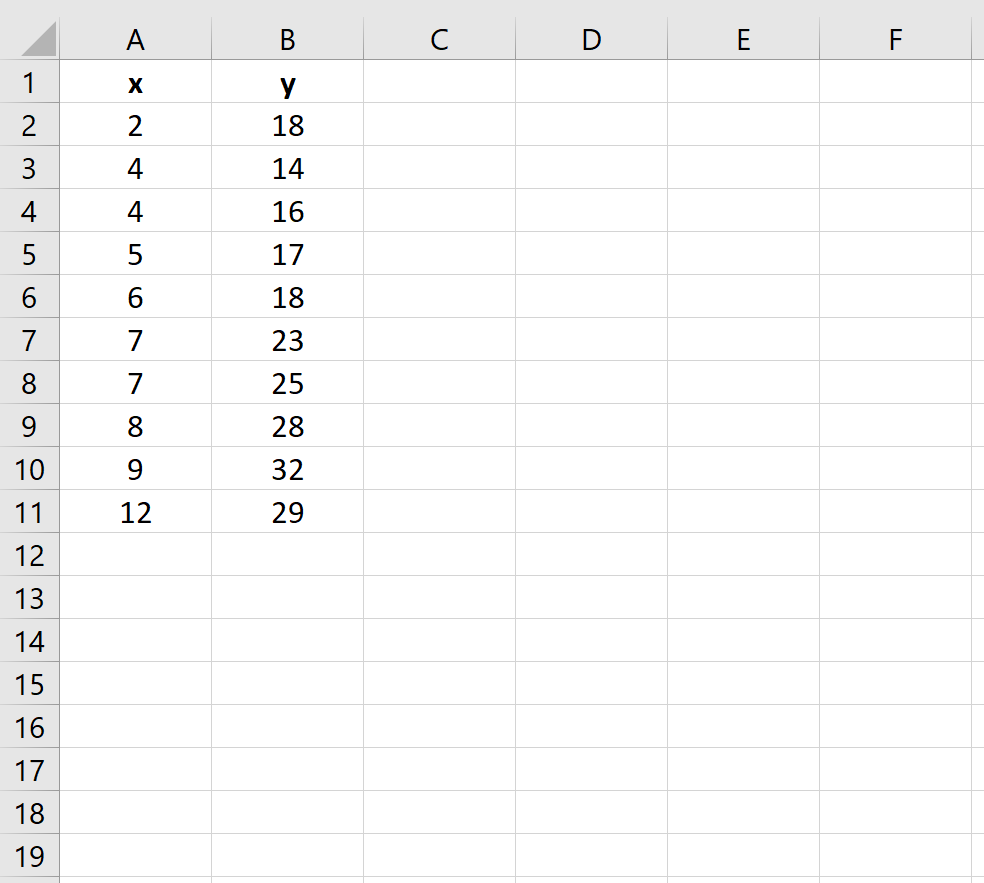
La variable dépendante continue Y doit idéalement être positionnée dans une colonne adjacente, sur la même ligne pour chaque observation expérimentale. La contiguïté des colonnes n’est pas un impératif absolu pour les équations fonctionnelles, mais elle facilite drastiquement les sélections de plages lors de l’appel de l’Utilitaire d’analyse ou de la création dynamique de graphiques. Il convient de s’assurer de l’homogénéité stricte de chaque cellule de la plage de données : aucune chaîne textuelle, espace insécable invisible ou caractère d’échappement ne doit altérer les valeurs numériques.
De surcroît, le typage des cellules doit être validé. Il arrive fréquemment, lors de l’importation de fichiers au format CSV ou texte issus de capteurs de mesure, que le séparateur décimal d’origine (le point anglo-saxon) ne corresponde pas aux paramètres régionaux du système d’exploitation hôte (la virgule française). Dans ce cas de figure, Excel interprète silencieusement les nombres comme des chaînes de caractères alignées à gauche, ce qui bloque instantanément les algorithmes d’estimation de la régression en retournant des messages d’erreur de type #VALEUR!. Une inspection visuelle initiale et une opération de remplacement global (Ctrl + H) du point par la virgule sont des préalables techniques incontournables.
3.2 Identification et gestion des valeurs aberrantes
Une propriété mathématique impitoyable de l’élévation d’une variable à des puissances supérieures (au carré, au cube ou à la puissance quatrième) réside dans l’amplification disproportionnée de la dispersion spatiale des points extrêmes. Une observation présentant une déviation modérée sur l’axe des abscisses voit cette déviation multipliée de façon spectaculaire lorsqu’elle est portée au cube ou à la puissance 4. Par conséquent, les modèles polynomiaux démontrent une sensibilité exacerbée aux points aberrants (outliers) et aux points à fort levier (high leverage points), susceptibles de faire pivoter artificiellement l’ensemble de la trajectoire d’ajustement.
Le protocole de vérification rigoureux implique la quantification statistique de l’anomalie au préalable. Deux méthodes complémentaires doivent être implémentées dans des colonnes dédiées de la feuille de calcul : le calcul du score standardisé (score z) et l’examen de l’intervalle interquartile (IQR). Le score standardisé est obtenu via la combinaison des fonctions d’Excel :
=(A2 – MOYENNE($A$2:$A$100)) / ECARTYPE.STANDARD($A$2:$A$100)
Toute observation dont la valeur absolue du score standardisé excède le seuil conventionnel de 2,58 (correspondant à un niveau de confiance bilatéral de 99 %) ou 3,0 (seuil strict d’anomalie) doit faire l’objet d’un examen minutieux. Alternativement, la méthode de Tukey reposant sur l’intervalle interquartile requiert le calcul du premier quartile via QUARTILE.INC($A$2:$A$100; 1) et du troisième via QUARTILE.INC($A$2:$A$100; 3). Les bornes de coupure sont définies par Q1 – 1,5*(Q3 – Q1) et Q3 + 1,5*(Q3 – Q1).
L’expérimentateur ne doit jamais éliminer arbitrairement une donnée déviante. Il convient de distinguer avec discernement les artefacts techniques (erreur de frappe, défaillance matérielle d’un transducteur, désynchronisation d’un protocole) des manifestations de la variabilité biologique ou comportementale réelle. Si l’observation résulte d’un artéfact prouvé, son exclusion est légitime et documentée ; si elle reflète un état rare mais valide du système, sa conservation est obligatoire, quitte à explorer des techniques de régression robuste ultérieures.
3.3 Problématique du centrage des variables prédictives
L’un des défis méthodologiques les plus sous-estimés dans la conduite d’une régression polynomiale réside dans l’émergence de la multicollinéarité structurelle induite. Étant donné que le terme X2 est calculé directement et de manière purement déterministe à partir de la valeur de X, la corrélation empirique entre la colonne de base et sa puissance est inévitablement élevée, en particulier si l’ensemble des observations de X se situe exclusivement sur le domaine strictement positif avec une espérance largement éloignée de zéro. Cette forte dépendance artificielle entre régresseurs gonfle artificiellement la variance d’échantillonnage des coefficients estimés.
La solution mathématique standard consiste à procéder au centrage sur la moyenne (mean-centering) de la variable indépendante continue avant toute élévation à la puissance. Cette transformation élémentaire se formalise ainsi :
xi = Xi – X̄
Au sein d’Excel, la procédure se déploie avec aisance. Si les observations brutes de la variable explicative occupent la plage de cellules A2:A101, la colonne de centrage (colonne B) recevra la formule suivante en cellule B2 :
=A2 – MOYENNE($A$2:$A$101)
Grâce à l’adressage absolu matérialisé par les symboles du dollar ($), la moyenne empirique reste parfaitement verrouillée lors de la propagation de la formule vers le bas via un double-clic sur la poignée de recopie. Ce centrage garantit que la covariance entre le terme centré x et son carré x2 converge vers zéro si la distribution de X est symétrique, éradiquant presque intégralement la collinéarité parasite.
En outre, cette transformation modifie l’interprétation substantielle de l’ordonnée à l’origine β0 : dans le modèle non centré, β0 correspond à la valeur prédite de Y lorsque X = 0, ce qui représente souvent une extrapolation biologiquement ou physiquement absurde (par exemple, un poids corporel ou un rythme cardiaque nul). Dans le modèle centré, β0 représente précisément la valeur moyenne attendue de Y lorsque X se situe exactement à sa valeur moyenne empirique X̄, conférant au modèle une assise interprétative immensément supérieure.
4. Méthode 1 : Visualisation graphique et insertion du nuage de points
4.1 Construction du diagramme de dispersion initial
L’étape inaugurale de toute analyse prédictive rigoureuse sous Excel consiste à projeter les données dans un espace bidimensionnel via un nuage de points cartésien. Cette démarche exploratoire visuelle permet d’appréhender la topologie globale de la distribution avant toute opération d’estimation numérique. Pour ce faire, l’analyste sélectionne simultanément les plages de données contenant la variable indépendante X et la variable dépendante Y, en veillant à ne pas inclure des cellules d’en-tête incompatibles ou des lignes de totaux partiels.
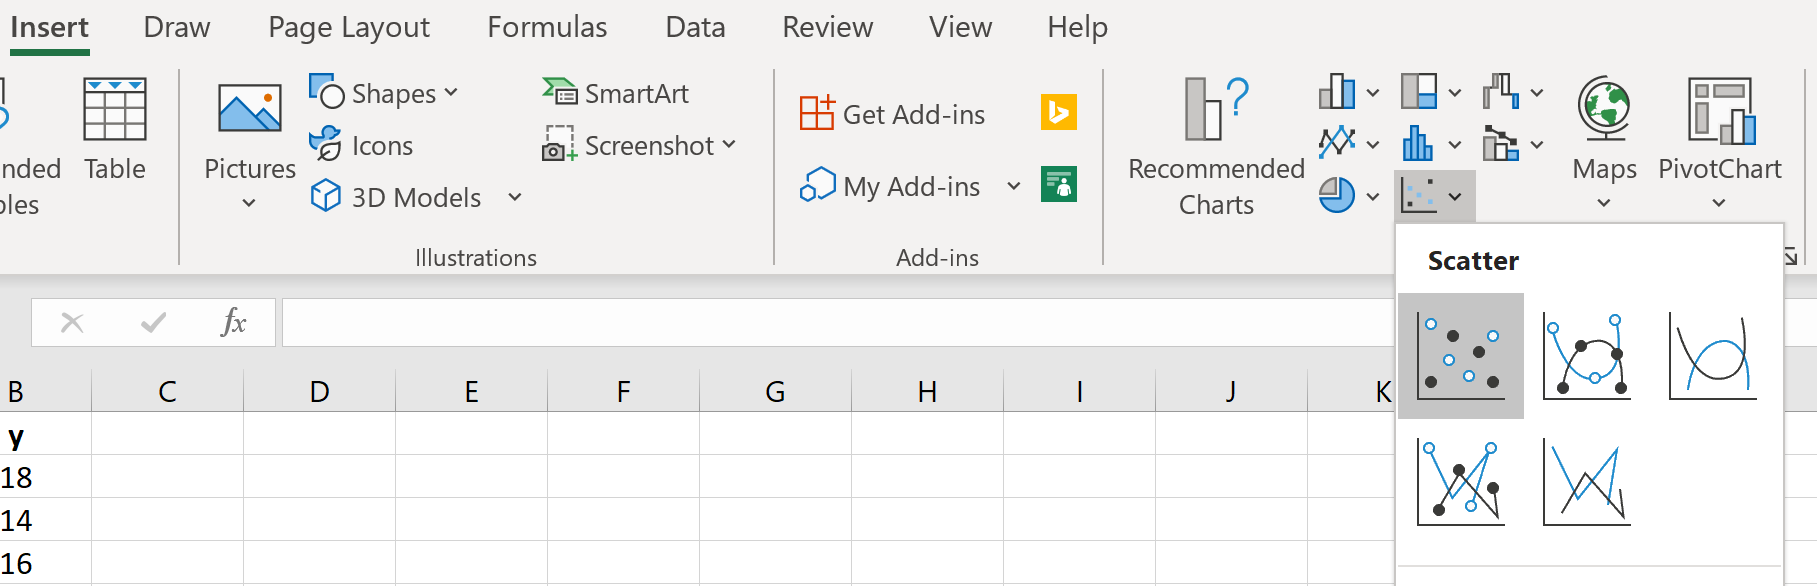
La sélection s’effectue idéalement au clavier en se positionnant sur la première cellule de X et en combinant les touches Maj + Ctrl + Flèche Bas, puis en appliquant une sélection connexe similaire sur la colonne Y à l’aide de la touche Ctrl. Il convient ensuite d’accéder au ruban Insertion, de repérer le groupe Graphiques, et de cliquer sur le symbole Nuage de points (Scatter). L’analyste doit impérativement opter pour le sous-type Nuage de points classique avec marqueurs uniquement, en excluant formellement les options avec lignes directes ou lissées.
Une faute de méthodologie récurrente consiste à sélectionner un graphique de type Courbe standard au lieu d’un Nuage de points. Dans un graphique en courbes, Excel traite arbitrairement l’axe des abscisses comme une succession d’étiquettes qualitatives catégorielles équidistantes, ignorant la métrique continue réelle de la variable X. Cela fausse complètement les distances spatiales et invalide le calcul des dérivées géométriques de la régression polynomiale subséquente.
4.2 Configuration des axes et du format visuel académique
Dès l’apparition du canevas graphique au centre de la feuille de calcul, une série d’ajustements ergonomiques et scientifiques s’impose pour transmuter l’ébauche par défaut en une figure respectant les normes de publication académique (style APA). La première manipulation porte sur l’optimisation des échelles d’abscisse et d’ordonnée afin de maximiser le ratio données-encre théorisé par Edward Tufte. Un double-clic sur l’axe des abscisses déploie le panneau latéral Format de l’axe. Dans l’onglet Options d’axe, l’analyste doit modifier les bornes minimale et maximale pour enserrer strictement la variabilité expérimentale et éliminer les zones de vide stérile.
La documentation textuelle des axes constitue un impératif épistémologique non négociable. L’analyste doit cliquer sur le bouton Ajouter un élément de graphique (matérialisé par le symbole vert + en bordure supérieure droite de l’objet graphique) et cocher la case Titres des axes. Chaque axe doit recevoir une désignation rigoureuse explicitant la nature de la grandeur physique ou psychologique mesurée, assortie de ses unités de mesure universelles entre crochets ou parenthèses (par exemple, « Charge cognitive perçue [score NASA-TLX] » en abscisse et « Taux d’erreurs opératoires [%] » en ordonnée).
Pour parfaire l’austérité et la lisibilité du graphique, il est vivement préconisé d’atténuer ou de supprimer l’épais quadrillage grisâtre par défaut en désactivant le Quadrillage principal, de supprimer le titre supérieur automatique si la figure est destinée à être insérée dans un mémoire scientifique où une légende inférieure spécifique est prévue, et d’ajuster le diamètre et la teinte des marqueurs de données (Remplissage uni sobre, bordure contrastée) afin de garantir une séparation visuelle distincte des points d’observation individuels.
4.3 Inspection clinique de la non-linéarité
L’observation attentive du diagramme de dispersion ainsi mis en forme constitue une étape de diagnostic perceptif que les algorithmes automatisés ne sauraient supplanter intégralement. L’analyste doit scruter le nuage de points pour évaluer qualitativement la trajectoire moyenne de la masse de données. La présence d’une courbure unilatérale continue suggère immédiatement une structure polynomiale. Si le nuage s’élève pour atteindre un palier avant de plonger de manière symétrique vers des valeurs inférieures, une configuration quadratique en U inversé est hautement probable, pointant directement vers un modèle d’ordre 2 gouverné par un coefficient β2 négatif.
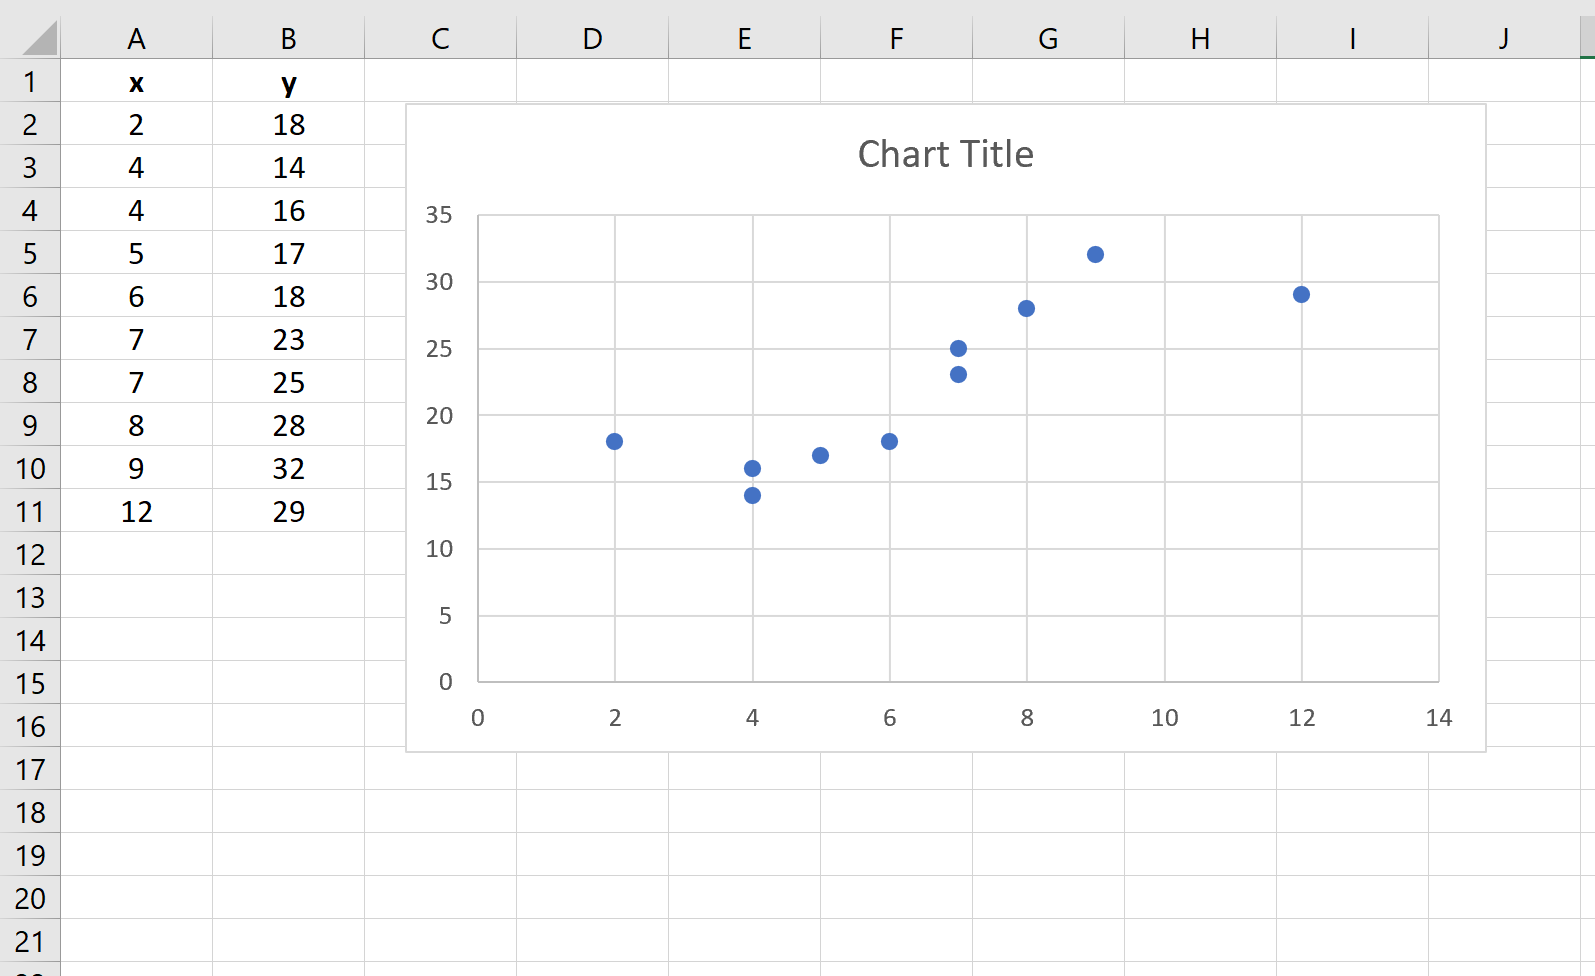
Si la dispersion manifeste une inversion séquentielle de son orientation — par exemple une première phase concave suivie d’un point d’inflexion où la courbure devient convexe —, la morphologie du nuage oriente l’investigation vers une équation cubique d’ordre 3. L’inspection clinique cherche également à repérer des discontinuités structurelles locales : la présence de grappes de points disjointes ou d’un élargissement asymétrique de la distribution le long de la courbure peut signaler un phénomène d’hétéroscédasticité ou l’influence cachée d’une troisième variable modératrice catégorielle.
Cette phase préliminaire de lecture visuelle apporte une justification empirique irréfutable à la décision d’abandonner l’hypothèse de linéarité pure. Si la courbure est manifeste pour un œil exercé, tenter de faire passer une droite au travers du nuage résulterait en une modélisation dont les résidus présenteraient des autocorrélations spatiales évidentes, disqualifiant les tests d’hypothèses conventionnels.
5. Méthode 1 : Ajustement d’une courbe de tendance polynomiale
5.1 Procédure d’insertion de la courbe de tendance
Excel intègre au sein de son moteur graphique interactif un module d’ajustement dynamique permettant de projeter instantanément une fonction de régression polynomiale sur le nuage de points préalablement configuré. La procédure opérationnelle requiert une interaction directe avec l’objet graphique : l’utilisateur sélectionne d’un clic gauche l’un quelconque des marqueurs de la série de données, ce qui engendre la mise en surbrillance simultanée de l’intégralité des points de la cohorte.
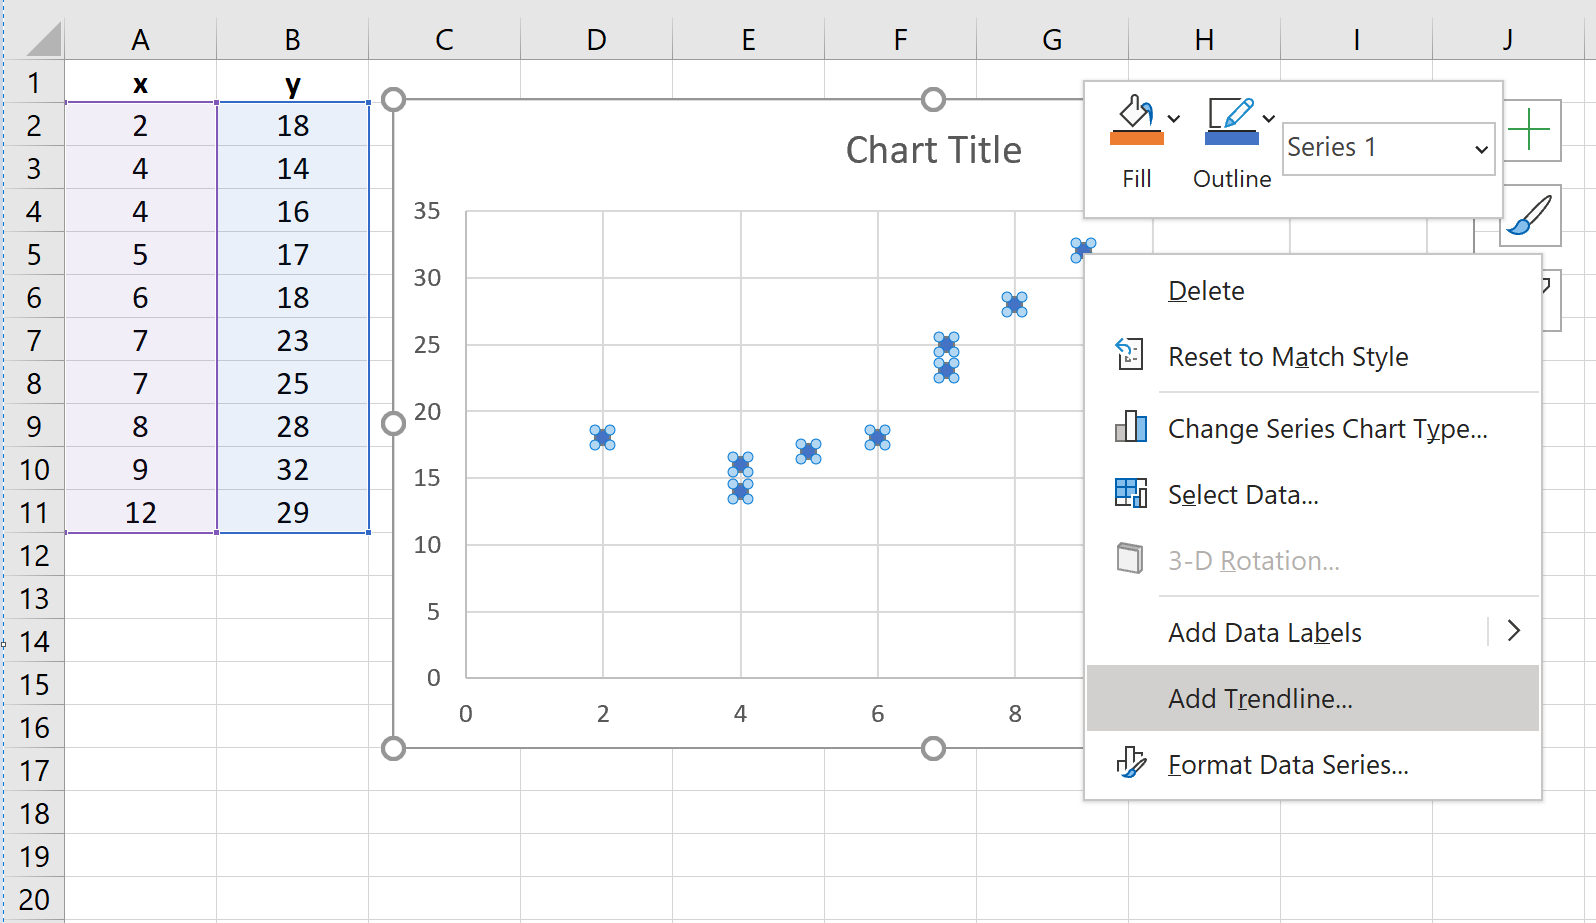
Un clic droit sur l’un des points sélectionnés déploie le menu contextuel au sein duquel figure la commande critique Ajouter une courbe de tendance… (Add Trendline). L’activation de cette commande ouvre instantanément, sur le flanc droit de la fenêtre logicielle, le volet d’ancrage ergonomique Format de la courbe de tendance. Ce panneau synthétise l’ensemble des familles mathématiques d’ajustement prises en charge par le tableur : exponentielle, linéaire, logarithmique, polynomiale, puissance et moyenne mobile.
L’analyste sélectionne alors la case d’option radio intitulée Polynomiale. Par défaut, Excel applique un modèle d’ordre 2. Visuellement, le tableur calcule à la volée, en tâche de fond, les paramètres de l’équation normale associée et trace une ligne continue épousant la trajectoire de régression estimée à travers la distribution de données.
5.2 Spécification manuelle du degré polynomial
Immédiatement sous l’option radio Polynomiale se situe le champ numérique interactif libellé Ordre (Degree). Ce paramètre d’ajustement structurel accepte des valeurs entières comprises strictement entre 2 et 6. Ce calibrage représente la puissance maximale k assignée à la variable indépendante dans l’équation estimée. L’utilisateur peut incrémenter ou décrémenter cet ordre en saisissant manuellement le chiffre désiré ou en manipulant les flèches de réglage incrémental.
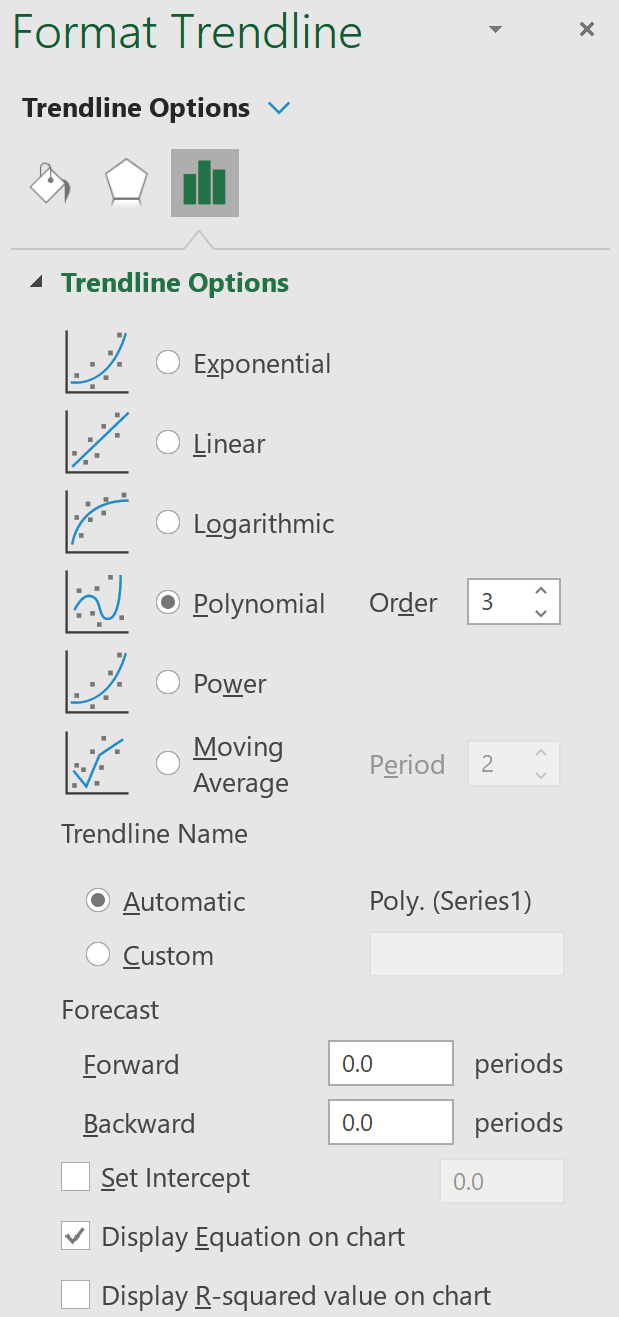
Dès la modification de la valeur de l’ordre, le moteur de tracé d’Excel recalcule instantanément les paramètres selon le formalisme des moindres carrés et modifie la silhouette de la courbe sur le graphique. Cette réactivité offre une visualisation pédagogique saisissante de l’accroissement de flexibilité du modèle : le passage de l’ordre 2 à l’ordre 3 libère un point d’inflexion ; le passage à l’ordre 4 autorise deux inversions de concavité distinctes (forme en M ou en W), et ainsi de suite jusqu’au degré 6, qui constitue la limite logicielle absolue imposée par l’architecture d’ajustement graphique du tableur.
Néanmoins, une vigilance intellectuelle intransigeante s’impose ici. La facilité déconcertante avec laquelle un clic permet d’atteindre le degré 6 induit fréquemment chez les utilisateurs novices une tentation réductionniste : sélectionner systématiquement l’ordre le plus élevé dans le seul dessein de faire passer visuellement la courbe par un maximum d’observations individuelles. Cette approche naïve, dénuée de tout contrôle statistique, ignore les dangers dévastateurs du surapprentissage algorithmique.
5.3 Affichage de l’équation mathématique et du coefficient R²
L’obtention d’une ligne d’ajustement visuelle demeure insuffisante pour une exploitation scientifique rigoureuse des résultats ; il est impératif d’extraire la formulation analytique quantitative et l’indice d’adéquation globale associés au modèle tracé. Pour ce faire, l’analyste fait défiler vers le bas le panneau latéral Format de la courbe de tendance afin de localiser deux options fondamentales :
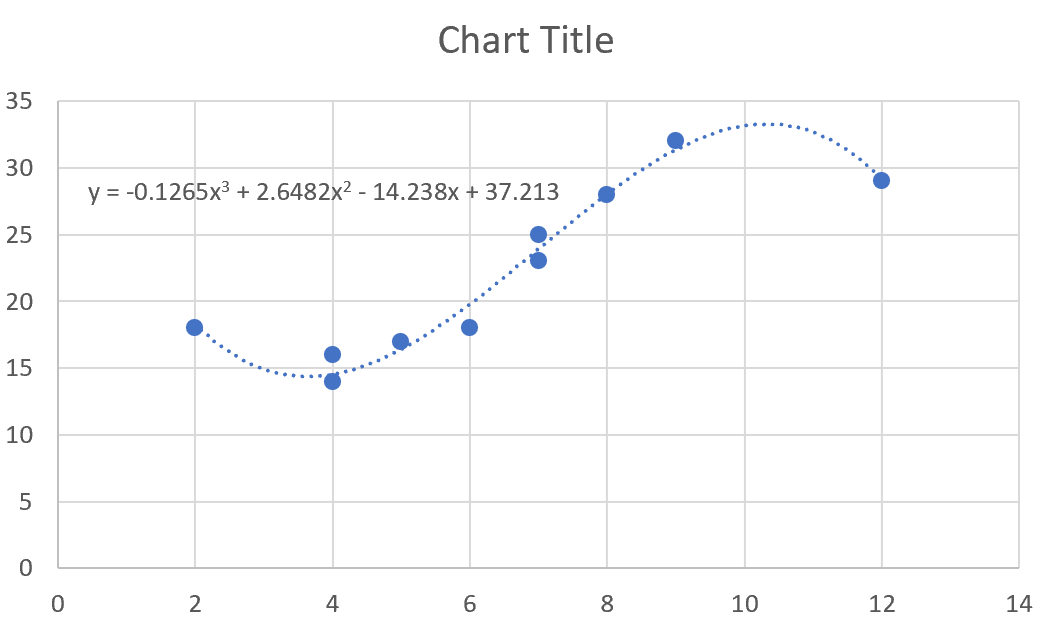
- Afficher l’équation sur le graphique : Cette fonction génère une zone de texte vectorielle flottante sur le canevas affichant l’expression mathématique explicite de la fonction estimée, libellée sous la forme générique : y = akxk + … + a1x + b.
- Afficher le coefficient de détermination (R-carré) sur le graphique : Cette commande insère immédiatement sous l’équation la valeur numérique normalisée du coefficient R2, qui synthétise la fraction de la variance totale de Y directement expliquée par la structure polynomiale choisie.
Une fois ces éléments projetés sur le graphique, il est indispensable de repositionner manuellement l’étiquette de texte à un emplacement dégagé du tracé afin d’éviter tout chevauchement illisible avec les marqueurs de données ou les lignes d’axes. Toutefois, un écueil majeur guette l’utilisateur à cette étape : par défaut, l’affichage numérique d’Excel applique un format de nombre standard tronquant sévèrement les coefficients à deux ou trois décimales significatives. Pour des termes de puissances élevées (comme x3 ou x4), les coefficients réels sont souvent de l’ordre de 0,000145, et Excel les arrondit sommairement à « 0,000 », ce qui rend l’équation affichée totalement inopérante pour tout recalcul manuel. Il est donc impératif de formater cette étiquette (clic droit sur la zone de texte de l’étiquette, Format des étiquettes de courbe de tendance, onglet Nombre, catégorie Scientifique avec 6 à 10 décimales).
6. Méthode 2 : Préparation des termes polynomiaux d’ordre supérieur
6.1 Génération explicite des colonnes de puissances
Si la méthode d’ajustement graphique de la courbe de tendance séduit par son immédiateté, elle souffre d’une lacune épistémologique rédhibitoire : elle constitue une boîte noire ne délivrant aucun tableau d’analyse de variance (ANOVA), aucune erreur type sur les paramètres, et aucun test de significativité statistique (p-values). Pour accéder à ces diagnostics inférentiels capitaux au moyen de l’Utilitaire d’analyse de données d’Excel, l’analyste doit basculer vers une modélisation sous forme de régression linéaire multiple explicite.
Cette méthodologie requiert l’expansion manuelle préalable de la matrice de conception par la dérivation directe des puissances successives de la variable indépendante continue. Prenons une configuration expérimentale où les données brutes centrées de la variable explicative se situent dans la colonne B, de la cellule B2 à la cellule B100. L’analyste insère une série de colonnes additionnelles adjacentes immédiatement sur le flanc droit :
- En colonne C, désignée par l’en-tête X_carre, on implémente la formule arithmétique de puissance seconde :
=B2^2. - En colonne D, désignée par l’en-tête X_cube, on implémente la formule d’ordre 3 :
=B2^3. - En colonne E, si la modélisation l’exige, on appliquera de même :
=B2^4.
Une fois saisies sur la première ligne de calcul (ligne 2), ces expressions doivent être propagées de manière strictement synchrone jusqu’à la dernière ligne d’enregistrement (ligne 100). Il est capital que toutes ces colonnes dérivées soient strictement continues et contiguës spatialement. L’Utilitaire d’analyse d’Excel exige impérativement que la plage des variables prédictives indépendantes soit définie par une matrice rectangulaire unifiée en un seul tenant (par exemple B2:D100), sous peine d’interrompre l’exécution par un message de rejet de sélection.
6.2 Diagnostic de la multicollinéarité structurelle induite
L’introduction délibérée de colonnes calculées par l’élévation d’une même racine génère intrinsèquement un problème statistique critique dénommé multicollinéarité structurelle. Contrairement à la multicollinéarité empirique causale — qui résulte du fait que deux grandeurs physiques évoluent conjointement dans la nature —, la collinéarité polynomiale est un artefact mécanique induit par la construction analytique du modèle. Lorsque deux ou plusieurs colonnes prédictives présentent une forte corrélation mutuelle, la matrice XTX devient quasi singulière, son déterminant s’approche dangereusement de zéro, et l’inversion matricielle standard souffre d’une instabilité numérique aiguë.
L’impact statistique de ce phénomène est dévastateur : les erreurs types associées aux coefficients individuels βj explosent, ce qui réduit drastiquement les statistiques de Student associées (t = β / SE) et gonfle artificiellement les p-values. Le chercheur non averti est alors conduit à rejeter à tort des variables explicatives pourtant cruciales pour la dynamique du système, commettant ainsi une erreur de type II.
Pour documenter et quantifier formellement cette dépendance linéaire sous Excel, l’analyste peut mobiliser l’outil Corrélation présent dans l’Utilitaire d’analyse. En sélectionnant la matrice complète englobant la variable prédictive et ses puissances, le tableur génère la matrice d’intercorrélation de Pearson. Si les coefficients de corrélation bivariés r excèdent des valeurs absolues de 0,80 ou 0,90 entre la variable linéaire et son terme quadratique, l’analyste dispose de la preuve irréfutable de l’impératif de centrer préalablement les variables (conformément à la méthode exposée à la section 3.3). Lorsque la variable X est rigoureusement centrée sur sa moyenne empirique, la corrélation entre x et x2 chute spectaculairement vers des niveaux négligeables si la distribution est symétrique, neutralisant les distorsions d’estimation.
6.3 Documentation rigoureuse de la structure du tableau d’analyse
Avant d’engager la modélisation paramétrique via les modules statistiques d’Excel, l’architecture générale de la feuille de calcul doit répondre à des critères méthodologiques stricts pour prévenir toute erreur de sélection matricielle ou de manipulation accidentelle. Il est primordial d’attribuer des libellés textuels dénués de toute ambiguïté sur la ligne d’en-tête supérieure (ligne 1). Au lieu d’utiliser des intitulés génériques tels que « Colonne1 », l’analyste emploiera des étiquettes formelles et standardisées telles que « Reponse_Y », « Predict_X_Centre », « Predict_X_Carre » et « Predict_X_Cube ».
Pour stabiliser l’espace de travail au sein de volumineuses bases de données expérimentales, l’activation de la fonction Figer les volets (onglet Affichage, groupe Fenêtre) s’avère indispensable : elle garantit que la ligne d’en-tête descriptive demeure perpétuellement visible lors du défilement vertical vers les observations inférieures. L’analyste doit effectuer une vérification par scan booléen pour s’assurer de l’absence totale de cellules corrompues (#N/A, #VALEUR!, #DIV/0!) ou de cellules vides au sein de la plage d’intérêt. Une seule valeur invalide au sein d’une série de plusieurs milliers de lignes provoquera l’échec immédiat des algorithmes de calcul matriciel.
Enfin, il est judicieux de verrouiller la conformité dimensionnelle en s’assurant que la colonne de la variable dépendante Y et l’ensemble des colonnes composant la matrice de régression X partagent une longueur strictement identique. Une asymétrie de taille de plage est la cause la plus triviale — et paradoxalement la plus commune — des rejets de saisie émis par les boîtes de dialogue analytiques du tableur.
7. Méthode 2 : Utilisation de l’Utilitaire d’analyse de données
7.1 Activation préalable du complément Analysis ToolPak
L’Utilitaire d’analyse de données (connu sous l’appellation d’Analysis ToolPak dans les environnements anglophones) constitue l’extension analytique native de Microsoft Excel dédiée aux procédures inférentielles avancées. Bien que ce composant soit structurellement intégré dans le code de distribution d’Excel depuis ses premières versions, il demeure par défaut désactivé lors d’une installation standard et n’apparaît pas spontanément dans les onglets de commande.
Pour procéder à son activation permanente, la démarche est la suivante :
- Accéder au coin supérieur gauche de la fenêtre et cliquer sur l’onglet Fichier, puis sélectionner Options en bas du menu vertical.
- Dans la fenêtre des Options Excel, sélectionner la catégorie Compléments dans la colonne latérale gauche.
- Dans la zone inférieure de la page, repérer le menu déroulant intitulé Gérer, s’assurer que la valeur Compléments Excel est sélectionnée, puis cliquer sur le bouton Atteindre….
- Une boîte de dialogue contextuelle liste l’ensemble des compléments natifs. Il convient alors de cocher expressément la case Utilitaire d’analyse (il n’est pas nécessaire de cocher l’option VBA sauf si des automatisations de code sont expressément prévues).
- Valider par un clic sur OK.
À l’issue de cette opération, le ruban de travail se met à jour immédiatement : dans l’onglet Données, à l’extrémité droite au sein du groupe Analyse, apparaît désormais le bouton de commande officiel Utilitaire d’analyse. Sur les versions contemporaines d’Excel pour Mac, cette activation s’effectue directement via le menu Outils, sous-rubrique Compléments Excel.
7.2 Configuration des paramètres dans la boîte de dialogue Régression
L’analyste clique sur le bouton Utilitaire d’analyse, fait défiler la liste alphabétique des méthodes statistiques proposées, sélectionne l’entrée Régression, puis valide par OK pour afficher la boîte de dialogue de paramétrage de l’ajustement par les moindres carrés ordinaires. Le remplissage de ce formulaire nécessite une précision chirurgicale dans la désignation des vecteurs et matrices :
- Plage d’entrée Y : Il s’agit du vecteur colonne unitaire contenant la variable dépendante continue. L’analyste clique dans le champ textuel puis sélectionne la plage de cellules correspondante, y compris l’en-tête supérieur (par exemple :
$A$1:$A$101). - Plage d’entrée X : Il s’agit de la matrice multi-colonnes regroupant les puissances successives de la variable indépendante préparées à la section précédente. Si le modèle est une cubique, l’utilisateur sélectionne conjointement les colonnes linéaires, quadratiques et cubiques en incluant leurs en-têtes (par exemple :
$B$1:$D$101). La sélection doit impérativement englober un ensemble continu de colonnes adjacentes. - Option Intitulés (Labels) : Si l’analyste a inclus la ligne 1 contenant les étiquettes textuelles lors de la saisie des plages, il est absolument impératif de cocher la case à cocher « Intitulés ». Cette manipulation indique à Excel d’utiliser ces chaînes de caractères pour nommer explicitement chaque ligne de coefficients dans le tableau de sortie statistique, évitant ainsi que le logiciel ne tente d’interpréter du texte comme des valeurs numériques nulles.
- Niveau de confiance : Par défaut fixé à 95 %, il régit l’intervalle de confiance bilatéral calculé pour chaque paramètre. L’analyste peut modifier cette valeur (par exemple à 99 %) selon les exigences du protocole de recherche.
Il est formellement déconseillé de cocher l’option « Constante = zéro », qui forcerait l’ordonnée à l’origine β0 à s’annuler artificiellement. Même si des considérations physiques théoriques suggèrent qu’un phénomène s’annule à l’origine, contraindre la constante sans justification absolue entraîne une déformation globale de la droite de régression et fausse le calcul du coefficient de détermination R2 conventionnel.
7.3 Sélection des options de sortie et diagnostics résiduels
La section inférieure de la boîte de dialogue régit la destination spatiale du rapport statistique ainsi que la production des métriques d’analyse d’erreurs résiduelles. Il est hautement recommandé de sélectionner l’option de sortie radio Nouvelle feuille de calcul et de lui attribuer un nom intelligible tel que Regression_Polynomiale_Ordre3. Cette précaution garantit qu’aucun tableau de sortie ne viendra écraser par inadvertance les séries de données primaires hébergées sur la feuille initiale.
Dans le bloc d’options intitulé Résidus, l’analyste rigoureux doit systématiquement cocher trois cases complémentaires :
- Résidus : Force Excel à générer, sous le tableau principal, une table énumérant pour chaque observation expérimentale la valeur prédite correspondante (Ŷi) et le résidu brut associé (ε̂i = Yi – Ŷi).
- Résidus standardisés : Calcule les résidus normalisés par leur écart-type empirique, ce qui est indispensable pour isoler les points aberrants résiduels (observations excédant les seuils ±2,5 ou ±3 déviations standard).
- Tracé des résidus : Commande la génération automatique d’un diagramme de dispersion affichant les résidus sur l’axe vertical face aux valeurs de la variable prédictive X sur l’axe horizontal, premier jalon indispensable pour la détection visuelle des violations d’hypothèses de linéarité et d’homoscédasticité.
L’activation éventuelle de l’option Tracé d’ajustement linéaire génère un tracé comparant visuellement les points observés aux points prédits par le modèle. Une fois toutes les options méthodiques arrêtées, un clic sur le bouton OK lance le calcul matriciel, générant instantanément un rapport statistique structuré et exhaustif au sein de la nouvelle feuille de calcul.
8. Méthode 3 : Emploi de la fonction matricielle DROITEREG
8.1 Syntaxe formelle et mécanique matricielle de DROITEREG
La fonction DROITEREG (ou LINEST dans les versions anglophones) représente le pinacle de l’analyse de régression par formules dans Microsoft Excel. Contrairement à l’Utilitaire d’analyse qui produit un rapport figé nécessitant d’être régénéré à chaque modification des données, DROITEREG constitue un moteur d’estimation dynamique en temps réel : toute modification apportée aux cellules sources se répercute instantanément sur l’ensemble des coefficients et statistiques calculés. La syntaxe formelle de cette fonction matricielle s’articule autour de quatre arguments :
=DROITEREG(y_connus; [x_connus]; [constante]; [statistiques])
La puissance cachée de cette fonction réside dans la formulation de son second argument, [x_connus]. L’analyste n’est nullement contraint de préparer des colonnes de puissances physiques au sein de sa feuille de calcul ; il peut forcer le calcul matriciel de puissances successives « à la volée » en exploitant l’opérateur d’élévation matriciel combiné aux accolades de tableau. Pour un ordre polynomial 3 sur une plage de données X occupant B2:B101, l’argument s’écrira :
B2:B101^{123} (ou B2:B101^{1.2.3} selon le séparateur de matrice défini par les paramètres régionaux d’Excel).
Le troisième argument, [constante], est un booléen : lorsqu’il est fixé à VRAI (ou omis), le modèle estime librement le paramètre d’ordonnée à l’origine β0. S’il est fixé à FAUX, l’ordonnée est contrainte à zéro. Le quatrième argument, [statistiques], est absolument décisif : s’il est fixé à VRAI, la fonction ne se contente pas de retourner les seuls coefficients d’ajustement, mais génère une matrice rectangulaire complète de 5 lignes comportant l’ensemble des grandeurs inférentielles du modèle (erreurs types, R2, statistique de Fisher, degrés de liberté, sommes des carrés).
8.2 Déploiement pratique de la formule dans les versions modernes et classiques d’Excel
Le mode d’insertion de la fonction DROITEREG diffère selon la génération du moteur de calcul d’Excel utilisé par l’analyste. Avec le déploiement des versions contemporaines de Microsoft 365 et d’Excel 2021, le tableur a intégré le moteur de calcul à matrices dynamiques (Dynamic Arrays). Sous cet environnement moderne, le déploiement de la fonction ne requiert aucun dimensionnement préalable de plage : l’analyste se positionne simplement sur une cellule unitaire vierge (par exemple G2) et saisit l’instruction complète :
=DROITEREG(A2:A101; B2:B101^{123}; VRAI; VRAI)
Une simple pression sur la touche Entrée déclenche le calcul instantané. La formule « déborde » (phénomène de spill) et propage automatiquement ses résultats sur une matrice de 5 lignes de haut sur 4 colonnes de large (soit k + 1 colonnes pour un modèle d’ordre k). Si une cellule adjacente bloque physiquement l’expansion de cette matrice, Excel renvoie l’erreur explicite #PROPAGATION! (ou #SPILL!), invitant l’analyste à purger les cellules périphériques encombrantes.
En revanche, sous les versions historiques d’Excel antérieures à 2019, la validation matricielle traditionnelle dite « CSE » s’impose impérativement. L’analyste doit d’abord sélectionner manuellement à la souris une plage rectangulaire vide dimensionnée avec exactitude : 5 lignes verticalement et autant de colonnes horizontalement que de paramètres à estimer (soit le degré k plus 1 colonne pour la constante). Sans désélectionner la zone, l’utilisateur tape la formule dans la barre d’édition supérieure, puis valide en pressant simultanément les trois touches Ctrl + Maj + Entrée (Ctrl + Shift + Enter). La formule s’enveloppe alors automatiquement d’accolades globales, certifiant son ancrage matriciel dans la plage réservée.
8.3 Décodage complet de la matrice de sortie statistique générée
La matrice de 5 lignes résultant de l’exécution de la fonction DROITEREG condense une quantité substantielle d’informations statistiques critiques. Cependant, son architecture spatiale déroute fréquemment les utilisateurs néophytes en raison d’une particularité de conception fondamentale : l’ordonnancement horizontal des coefficients polynomiaux est inversé par rapport à l’ordre d’écriture mathématique habituel.
Voici la grille de lecture systématique de cette matrice pour un polynôme d’ordre 3 (générant une matrice de 5 lignes sur 4 colonnes) :
- Ligne 1 : Les estimateurs des coefficients (β)
- Colonne 1 : Coefficient cubique (β3 associé au terme X3).
- Colonne 2 : Coefficient quadratique (β2 associé au terme X2).
- Colonne 3 : Coefficient linéaire (β1 associé au terme X).
- Colonne 4 : Ordonnée à l’origine ou constante (β0).
- Ligne 2 : Les erreurs types des coefficients (SE)
- Chaque cellule présente l’erreur type asymptotique associée au coefficient situé directement au-dessus : SE(β3), SE(β2), SE(β1), SE(β0).
- Ligne 3 : L’ajustement global et la dispersion
- Colonne 1 : Le coefficient de détermination global (R2).
- Colonne 2 : L’erreur standard d’estimation du modèle (se), mesurant l’écart moyen des résidus autour de la trajectoire d’ajustement.
- Colonnes 3 et 4 : Retournent la valeur non applicable
#N/A.
- Ligne 4 : Le test de Fisher global
- Colonne 1 : La statistique de test F de Fisher-Snedecor pour le modèle global.
- Colonne 2 : Les degrés de liberté du terme d’erreur résiduel (dfrésidus = n – k – 1).
- Colonnes 3 et 4 : Retournent la valeur non applicable
#N/A.
- Ligne 5 : Les sommes des carrés de la variance
- Colonne 1 : Somme des carrés expliquée par la régression (SSrégression).
- Colonne 2 : Somme des carrés des erreurs résiduelles (SSrésidus).
- Colonnes 3 et 4 : Retournent la valeur non applicable
#N/A.
Ce décodage spatial démontre la puissance de DROITEREG : à partir de cette seule grille de sortie, il devient aisé de reconstituer analytiquement les tests t individuels de chaque paramètre en divisant la valeur de la ligne 1 par celle de la ligne 2 (t = βj / SE(βj)), puis en appliquant la fonction LOI.STUDENT.BILATERALE pour extraire les p-values associées.
9. Évaluation et sélection du degré optimal du polynôme (Ordre 2, 3, 4+)
9.1 Le dilemme biais-variance et le risque de surapprentissage (Overfitting)
L’un des écueils théoriques majeurs de la modélisation polynomiale réside dans la gestion de la complexité structurelle du modèle, conceptualisée en statistique mathématique et en apprentissage machine sous le terme de dilemme biais-variance. Lorsqu’un analyste spécifie un polynôme d’ordre trop modeste (par exemple, un ajustement linéaire sur une trajectoire parabolique), le modèle est en situation de sous-apprentissage (underfitting) : il souffre d’un biais élevé, incapable de capturer les courbures réelles de la distribution empirique.
À l’inverse, l’élévation effrénée du degré polynomial (ordres 4, 5, 6 dans Excel) entraîne le modèle vers un surapprentissage aigu (overfitting). Dans cette configuration, le modèle perd sa vocation de généralisation : doté d’une flexibilité paramétrique excessive, il se met à modéliser le bruit stochastique résiduel et les micro-fluctuations d’échantillonnage propres à l’échantillon observé, au lieu d’en capturer la loi génératrice sous-jacente. La variance de l’estimateur explose : la moindre modification d’un seul point de mesure entraîne une réorganisation convulsive de l’ensemble de la trajectoire de la courbe.
Ce surapprentissage se manifeste de manière spectaculaire par le phénomène de Runge. Découvert par le mathématicien Carl Runge lors de l’interpolation polynomiale équidistante, ce phénomène se traduit par l’apparition d’oscillations parasites violentes et incontrôlées à proximité immédiate des bornes du domaine expérimental (vers Xmin et Xmax). Alors que le polynôme d’ordre élevé passe docilement au centre des points intermédiaires, il plonge ou s’envole de manière vertigineuse aux extrémités. Le coefficient R2 brut augmente de façon purement mécanique à chaque incrémentation de degré, créant une illusion d’amélioration continue du modèle, alors même que le pouvoir prédictif hors échantillon est en réalité irrémédiablement ruiné.
9.2 Critères quantitatifs de sélection : R² ajusté et pénalisation
Pour neutraliser l’illusion d’ajustement générée par le R2 standard — dont la valeur s’accroît mathématiquement dès qu’un régresseur est introduit, fût-il constitué d’une série de nombres purement aléatoires —, l’analyste doit impérativement mobiliser des métriques de sélection pénalisant l’inflation paramétrique. Le premier instrument est le coefficient de détermination ajusté (R̄2 ou Adjusted R-Square), dont la formulation mathématique corrige la valeur brute en fonction du nombre d’observations (n) et de paramètres estimés (k) :
R̄2 = 1 – [(1 – R2) × (n – 1) / (n – k – 1)]
Si l’adjonction d’un terme cubique X3 à un modèle quadratique n’engendre qu’un gain marginal de variance expliquée, le ratio d’ajustement dégrade le coefficient : le R̄2 diminuera alors par rapport au modèle d’ordre 2, signalant objectivement que le gain d’ajustement est inférieur au coût statistique induit par la perte d’un degré de liberté.
Pour aller plus loin, les critères d’information basés sur la théorie de la parcimonie et la vraisemblance, tels que le critère d’Akaike (AIC) et le critère bayésien de Schwarz (BIC), peuvent être aisément calculés manuellement au sein de la feuille Excel à partir de la somme des carrés résiduels (SSrésidus) issue de DROITEREG ou de la table ANOVA :
AIC = n * LN(SS_residus / n) + 2 * (k + 1)
BIC = n * LN(SS_residus / n) + LN(n) * (k + 1)
La règle décisionnelle formelle stipule que le modèle affichant la valeur d’AIC ou de BIC la plus basse doit être retenu comme offrant le compromis optimal entre adéquation descriptive et économie paramétrique.
9.3 Application du principe de parcimonie (Rasoir d’Ockham)
Au-delà des métriques d’optimisation numérique, la sélection du degré polynomial final doit être guidée par l’impératif philosophique et scientifique du principe de parcimonie, traditionnellement attribué à Guillaume d’Ockham (le Rasoir d’Ockham). Énoncé simplement : parmi deux explications ou modèles mathématiques aux performances explicatives empiriquement équivalentes, il convient systématiquement d’adopter le plus sobre.
Dans la pratique de la modélisation statistique, cette règle méthodologique impose qu’aucun degré polynomial supérieur à 2 (modèle quadratique) ne soit intégré au rapport d’analyse final sans une justification théorique, mécanistique ou biomécanique préexistante. Un modèle d’ordre 2 décrit une accélération ou une décélération physique constante, ce qui possède un ancrage phénoménologique compréhensible dans la quasi-totalité des disciplines quantitatives. Un modèle d’ordre 3 traduit un basculement de concavité avec un point d’inflexion intermédiaire, ce qui peut encore se concevoir pour des cinétiques à transitions d’état.
En revanche, les polynômes de degré 4 (ordre quartique), 5 (quintique) ou 6 ne correspondent presque jamais à une réalité causale naturelle univariée. Leur apparente supériorité statistique locale n’est que la conséquence de leur capacité à agir comme une interpolation spline artisanale absorbant le bruit de mesure. L’introduction d’un polynôme de degré 4 ou plus en l’absence d’une démonstration théorique formelle — déduite par exemple d’équations différentielles régissant le système physique — doit être considérée comme un vice méthodologique invalidant les conclusions d’un rapport de recherche rigoureux.
10. Interprétation statistique approfondie des résultats obtenus
10.1 Interprétation substantive des coefficients individuels
L’analyse des paramètres d’un modèle polynomial ne s’effectue pas selon la même logique directe que celle d’un modèle linéaire standard, où chaque paramètre β représente la pente invariable de l’effet univarié de sa variable associée. Dans une régression polynomiale, les différents termes de puissance (X, X2, X3) interagissent conjointement pour sculpter la réponse globale de Y, rendant l’interprétation isolée des coefficients particulièrement délicate.
Prenons un modèle quadratique ajusté sur une variable explicative centrée : Ŷ = β0 + β1x + β2x2. Les coefficients se décodent ainsi de façon rigoureuse :
- L’ordonnée à l’origine (β0) : Elle représente la valeur prédite moyenne de Y lorsque la variable indépendante centrée x est égale à zéro (c’est-à-dire précisément lorsque la variable brute X est égale à sa propre moyenne empirique X̄).
- Le coefficient linéaire (β1) : Il quantifie la pente instantanée (la dérivée première de la fonction) évaluée exactement au point de centrage x = 0. Il indique le taux de variation marginal de Y pour une variation infinitésimale de X autour de sa valeur moyenne. Si la variable n’a pas été préalablement centrée, β1 n’a de sens qu’au point abstrait X = 0, qui peut se situer à des kilomètres de la distribution réelle observée.
- Le terme quadratique (β2) : Il caractérise la courbure globale de la trajectoire, directement liée à la dérivée seconde de la fonction (d2Y / dX2 = 2β2). Le signe de β2 gouverne l’orientation géométrique fondamentale : un coefficient négatif (β2 < 0) démontre une concavité dirigée vers le bas (trajectoire parabolique en U inversé, traduisant un point culminant optimal), tandis qu’un coefficient positif (β2 > 0) caractérise une fonction convexe (trajectoire en U, traduisant une minimisation locale).
Le calcul analytique de cet extremum (sommet ou creux) constitue souvent l’objectif prioritaire de l’investigation expérimentale. En annulant la dérivée première de l’équation estimée (dY / dX = β1 + 2β2X = 0), l’analyste déduit immédiatement la coordonnée critique optimale de la variable prédictive :
Xoptimum = – β1 / (2 × β2)
Cette formulation élégante peut être saisie directement au sein d’une cellule Excel dédiée pour isoler la posologie médicamenteuse idéale, la température de réaction maximisant un rendement de synthèse ou la durée d’entraînement optimisant une performance cognitive.
10.2 Analyse de la variance globale (Tableau ANOVA)
Le rapport généré par l’Utilitaire d’analyse ou reconstruit via la fonction matricielle DROITEREG comprend obligatoirement un tableau d’analyse de variance (ANOVA), dont l’objet est de décomposer la variabilité géométrique totale observée sur la variable dépendante Y. Cette décomposition repose sur l’identité fondamentale de la somme des carrés :
SStotale = SSrégression + SSrésiduelle
La somme des carrés de la régression quantifie la part d’inertie de la distribution capturée par la courbure polynomiale modélisée, tandis que la somme des carrés résiduels agrège la variabilité inexpliquée dispersée autour de cette courbe. En divisant chaque somme des carrés par ses degrés de liberté respectifs (k pour la régression, où k représente l’ordre du polynôme ; n – k – 1 pour les résidus), Excel calcule les carrés moyens correspondants (MSrégression et MSrésiduelle).
Le ratio de ces deux carrés moyens engendre la statistique globale de Fisher-Snedecor :
F = MSrégression / MSrésiduelle
L’analyste examine avec une attention soutenue la métrique libellée Seuil de signification F (qui correspond à la p-value globale du test). Cette valeur probabiliste traduit la probabilité d’obtenir une réduction de variance résiduelle au moins aussi spectaculaire que celle observée sous l’hypothèse nulle (H0 : β1 = β2 = … = βk = 0), postulant l’absence totale de relation entre Y et l’ensemble du bloc de régresseurs polynomiaux. Si ce seuil de signification est inférieur au seuil critique conventionnel α = 0,05 (ou 0,01), l’hypothèse nulle est rejetée avec vigueur : le modèle polynomial dans sa globalité apporte une contribution statistiquement significative à l’explication de la variance de la variable dépendante.
10.3 Tests de significativité des paramètres individuels (Tests t)
La validation globale du tableau ANOVA ne dispense en aucun cas l’analyste de disséquer la significativité individuelle de chaque coefficient d’ordre via les tests t de Student. Dans la table récapitulative des paramètres issue de l’Utilitaire d’analyse, chaque ligne associée à une puissance spécifique présente l’estimation de son coefficient βj, l’erreur type standard de l’estimation SE(βj), la statistique de Student empirique associée (tstat = βj / SE(βj)) et la p-value bilatérale correspondante (P > |t|).
Une observation analytique récurrente et particulièrement troublante mérite d’être soulignée : il arrive fréquemment qu’au sein d’un modèle quadratique ou cubique, le terme polynomial de plus haut degré (par exemple X2) démontre une significativité éclatante (p < 0,001), tandis que le terme d’ordre inférieur linéaire direct (X) présente une p-value non significative (par exemple p = 0,38). Face à ce scénario, certains analystes non avertis sont tentés de supprimer le terme linéaire pour ne conserver que la constante et la puissance carrée au sein de l’équation.
Cette tentation constitue une violation caractérisée de la règle méthodologique universelle dite de hiérarchie marginale (principle of marginality). Les modèles polynomiaux doivent impérativement demeurer hiérarchiquement bien formulés. Un modèle incluant une puissance d’ordre supérieur (X2) doit impérativement conserver l’ensemble de ses composantes subalternes (le terme d’ordre 1 et la constante), même si ces dernières n’atteignent pas isolément le seuil de significativité statistique. La suppression arbitraire d’un terme d’ordre inférieur altère la propriété d’invariance d’échelle : le modèle devient dépendant de l’origine arbitraire du système d’axes choisi, modifie artificiellement l’emplacement spatial de l’optimum estimé et fausse le calcul des résidus. Dès lors qu’un degré supérieur est statistiquement validé, ses soubassements de degrés inférieurs doivent obligatoirement être préservés.
11. Diagnostics des résidus et vérification des postulats statistiques dans Excel
11.1 Examen de la structure des résidus vis-à-vis des valeurs ajustées
La validité des conclusions inférentielles d’une régression polynomiale repose sur le respect des postulats gaussiens classiques régissant les résidus d’estimation (ε̂i = Yi – Ŷi). La première obligation diagnostique réside dans l’examen visuel du diagramme de dispersion confrontant les valeurs estimées par le modèle (Ŷ, en abscisse) aux résidus bruts calculés (ε̂, en ordonnée). Ce graphique se génère aisément dans Excel à partir du tableau des résidus produit par l’Utilitaire d’analyse.
Dans une spécification modèle idéale, le nuage de points résiduels doit se répartir de façon totalement stochastique, amorphe et symétrique à l’intérieur d’une bande horizontale d’épaisseur constante centrée sur l’axe horizontal zéro, évoquant la silhouette d’un « ciel étoilé homogène ». Deux pathologies structurelles majeures doivent être traquées lors de cet examen :
- La persistance d’une forme géométrique courbée (patterning) : Si les résidus dessinent clairement une courbure parabolique ou une ondulation résiduelle en forme de S, cela signifie de façon univoque que le modèle polynomial souffre d’une sous-spécification. L’ordre mathématique choisi s’avère insuffisant pour épuiser la composante déterministe de la courbure : le modèle impose une trajectoire d’ordre 2 alors que la réalité empirique est d’ordre 3, ou utilise un modèle linéaire sur une réalité quadratique. L’analyste doit immédiatement élever le degré du polynôme pour résorber cette dépendance structurelle.
- Le motif en entonnoir (hétéroscédasticité) : Si l’écartement vertical des résidus s’élargit ou se resserre de manière continue à mesure que les valeurs estimées augmentent sur l’axe horizontal, le postulat d’homoscédasticité (variance constante des erreurs, Var(ε) = σ2) est formellement violé. Bien que les coefficients restent sans biais, leurs erreurs types sont compromises, rendant les tests t et F caducs. L’application d’une transformation stabilisatrice de variance (telle que le logarithme népérien appliqué sur la variable dépendante Y via
LN(Y)) devient alors requise.
11.2 Vérification de la normalité des erreurs sous Excel
L’évaluation de la normalité de la distribution des perturbations aléatoires est une condition absolue pour garantir la validité mathématique exacte des distributions de Student et de Fisher sous-tendant les intervalles de confiance et les tests de significativité des coefficients. L’analyste extrait la série des résidus standardisés calculée par l’Utilitaire d’analyse et déploie un ensemble de vérifications graphiques et paramétriques.
La première quantification paramétrique s’effectue via le calcul formel des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) en mobilisant les fonctions natives :
=COEFFICIENT.ASYMETRIE(plage_residus_standardises)
=KURTOSIS(plage_residus_standardises)
Dans une distribution parfaitement conforme à la loi normale univariée, ces deux indices convergent théoriquement vers zéro. En pratique expérimentale, des valeurs d’asymétrie comprises dans l’intervalle [-0,5 ; +0,5] et d’aplatissement dans [-1,0 ; +1,0] traduisent une conformité tout à fait satisfaisante autorisant la poursuite sereine de l’inférence.
Pour parachever cette vérification, la construction pas à pas d’un diagramme Quantile-Quantile (Q-Q Plot) au sein de la feuille Excel constitue le standard méthodologique d’excellence :
- Trier la colonne des résidus standardisés par ordre croissant.
- Créer une colonne adjacente attribuant le rang empirique i de 1 à n.
- Calculer la probabilité cumulative empirique standardisée via l’approximation de Blom ou de Hazen, en saisissant pour chaque ligne :
=(i - 0,375) / (n + 0,25). - Calculer les quantiles théoriques attendus sous la loi normale univariée via la fonction inverse :
=LOI.NORMALE.STANDARD.INVERSE(probabilite_cumulee). - Tracer un graphique Nuage de points projetant les quantiles théoriques sur l’axe des abscisses face aux résidus standardisés réels triés sur l’axe des ordonnées.
Si la distribution des erreurs est rigoureusement normale, l’ensemble des points d’observation s’aligne fidèlement le long d’une ligne diagonale à 45 degrés. Une déviation systématique des points aux extrémités (décollement de la ligne) dénonce la présence de queues de distribution épaisses ou d’une asymétrie marquée, incitant l’analyste à la prudence dans l’interprétation des p-values marginales.
11.3 Détection de l’autocorrélation résiduelle
La modélisation polynomiale est abondamment mobilisée pour l’ajustement de tendances séculaires au sein de séries chronologiques ou d’enregistrements physiologiques continus (électroencéphalographie, cinétique de dégradation thermique au fil des minutes). Dans ce contexte temporel séquentiel, le postulat d’indépendance mutuelle des termes d’erreur (εi indépendant de εi-1) est fréquemment violé par l’émergence d’une autocorrélation sérielle de premier ordre.
Pour auditer formellement cette dépendance sans quitter l’environnement Excel, l’analyste peut implémenter manuellement le calcul de la statistique classique de Durbin-Watson (d). Cette statistique repose sur le ratio de la somme des carrés des différences résiduelles successives sur la somme des carrés résiduels totaux :
d = ∑t=2..n (ε̂t – ε̂t-1)2 / ∑t=1..n (ε̂t)2
L’implémentation opérationnelle s’exécute aisément :
- En colonne D, les résidus ordonnés chronologiquement occupent les cellules D2 à D101.
- En colonne E, en cellule E3, on calcule le carré de la différence séquentielle :
=(D3 - D2)^2, formule propagée jusqu’en bas du tableau. - En cellule F2, on calcule le terme d’erreur au carré classique :
=D2^2. - Dans une cellule récapitulative, on applique la division matricielle :
=SOMME(E3:E101) / SOMME(F2:F101).
L’indice d de Durbin-Watson oscille structurellement entre 0 et 4. Une valeur calculée gravitant à proximité immédiate de 2,0 atteste de l’indépendance statistique absolue des erreurs résiduelles. En revanche, une magnitude substantiellement inférieure à 1,5 révèle la présence d’une autocorrélation positive sévère : une erreur positive à l’instant t tend mécaniquement à être suivie d’une erreur positive à l’instant suivant. Ce biais sériel indique souvent qu’une composante cyclique périodique ou saisonnière est absente du modèle, incitant à enrichir l’équation par des fonctions trigonométriques combinées au polynôme de tendance.
12. Erreurs courantes, limites méthodologiques et bonnes pratiques
12.1 Le piège de l’extrapolation en dehors de la plage d’échantillonnage
S’il existe un impératif méthodologique catégorique en modélisation polynomiale, c’est la proscription totale et sans appel de toute démarche d’extrapolation au-delà des frontières de l’intervalle d’échantillonnage couvert par les observations empiriques. Alors qu’une droite de régression linéaire simple dérive de manière proportionnelle et relativement modérée lorsqu’elle s’aventure hors du domaine observé [Xmin, Xmax], les fonctions polynomiales manifestent des comportements d’évasion asymptotique totalement incontrôlables.
Considérons à titre d’exemple une régression cubique modélisant avec une fidélité graphique absolue l’évolution de la concentration sanguine d’une hormone sur un intervalle temporel expérimental borné entre 10 et 60 minutes. La trajectoire d’ajustement suit fidèlement les montées et descentes physiologiques du sujet. Si l’expérimentateur utilise cette même formule mathématique pour extrapoler la concentration attendue à 75 minutes, le terme en X3, prenant le pas absolu sur les composantes linéaires et quadratiques en vertu de sa croissance exponentielle, entraînera le modèle vers des valeurs infiniment positives ou négatives, aboutissant à des estimations biologiques aberrantes (telles que des concentrations sanguines négatives ou mortelles pour l’organisme).
Le polynôme ne constitue en aucune manière une loi de comportement universelle déduite des premiers principes physiques ; il s’agit d’une approximation locale purement phénoménologique, analogue à un développement limité de Taylor valable exclusivement dans le voisinage immédiat des points de mesure effectifs. L’utilisation d’une régression polynomiale sous Excel doit strictement se limiter à des opérations d’interpolation à l’intérieur du périmètre expérimental circonscrit par les bornes observées.
12.2 Problèmes de précision numérique et troncature des équations graphiques
L’une des causes les plus courantes d’erreurs méthodologiques recensées lors de l’utilisation d’Excel pour l’analyse polynomiale réside dans la recopie manuelle, au sein d’une formule de calcul, des coefficients numériques affichés directement sur l’étiquette graphique de la courbe de tendance. Comme évoqué précédemment, le tableur applique par défaut un format de présentation tronquant l’affichage des coefficients à un nombre dérisoire de chiffres significatifs (souvent 2 ou 3 décimales).
Pour illustrer la catastrophe numérique qui en découle, considérons le terme quartique suivant au sein d’une équation d’ajustement :
Y = 0,00014829X4 – 0,0231X3 + 1,12X2 + 4,5X + 12,3
Si Excel affiche ce terme sur le graphique sous la forme arrondie « 0,0001 », et que l’analyste recopie servilement « 0,0001 » dans une formule de tableur pour calculer une prédiction sur une observation où X = 80, l’élévation à la puissance 4 donne : 804 = 40 960 000. La différence induite par l’omission des décimales tronquées est monumentale :
0,00014829 × 40 960 000 = 6073,99
0,00010000 × 40 960 000 = 4096,00
L’erreur absolue de prédiction sur cette seule composante s’élève à près de 2000 unités, introduisant un biais massif qui démolit l’intégralité du travail d’analyse statistique. Pour contourner définitivement ce péril, l’analyste rigoureux doit appliquer l’une de ces deux démarches :
- Modifier impérativement le format de l’étiquette graphique en appliquant une catégorie Scientifique avec au minimum 10 décimales.
- Privilégier systématiquement l’extraction automatisée des coefficients via la fonction matricielle
DROITEREG(section 8). Les valeurs stockées dans la matrice de sortie conservent l’intégralité de la précision machine à virgule flottante en double précision standard IEEE 754 (64 bits, soit environ 15 à 17 chiffres significatifs), écartant tout risque d’erreur d’arrondi.
12.3 Protocole de synthèse pour une analyse polynomiale robuste sous Excel
Pour garantir une régularité méthodologique absolue lors de l’exécution d’une régression polynomiale au sein de Microsoft Excel, il est opportun de consigner les étapes opératoires sous la forme d’un protocole standardisé en huit phases successives, articulant rigoureusement les dimensions graphiques, analytiques et diagnostiques :
- Vérification spatiale et typage : Structurer les données en colonnes continues, vérifier les séparateurs décimaux, éliminer les formats textuels parasites et isoler les éventuelles valeurs aberrantes au moyen du calcul des scores standardisés (scores z).
- Centrage sur la moyenne : Calculer la moyenne de la variable prédictive X et générer une colonne centrée (x = X – X̄) pour neutraliser d’emblée la multicollinéarité structurelle entre puissances.
- Inspection exploratoire initiale : Insérer un graphique en Nuage de points classique (sans courbe reliée), ajuster les échelles d’axes pour saturer l’espace de données, et évaluer cliniquement la courbure globale pour émettre une hypothèse sur le degré polynomial minimal plausible (forme en U → ordre 2 ; forme sinueuse → ordre 3).
- Génération des composantes de puissance : Produire manuellement les colonnes dérivées d’ordre supérieur (x2, x3) de manière continue et contiguë, ou préparer l’expression matricielle correspondante.
- Estimation paramétrique via l’Utilitaire d’analyse : Exécuter l’outil Régression en sélectionnant l’ensemble des colonnes de puissances, en conservant la constante, en cochant les intitulés de colonnes et en réclamant systématiquement la sortie du tableau des résidus et des résidus standardisés sur une feuille dédiée.
- Évaluation de la parcimonie : Comparer le modèle estimé avec les modèles d’ordres voisins via l’examen du coefficient de détermination ajusté (R̄2) et le calcul des critères d’information (AIC/BIC). Rejeter tout ordre supérieur à 2 qui ne présenterait pas un gain de variance expliquée significatif ou une justification théorique solide.
- Vérification des postulats d’inférence : Examiner la distribution des résidus face aux valeurs estimées pour certifier l’absence de motif résiduel courbé (sous-spécification) et d’hétéroscédasticité. Construire le diagramme Q-Q pour valider la normalité des erreurs, et calculer si nécessaire la statistique de Durbin-Watson sur les séries chronologiques.
- Interprétation des paramètres : Dériver analytiquement l’optimum expérimental (Xoptimum = -β1 / 2β2), documenter rigoureusement les intervalles de confiance à 95 %, et borner formellement les prédictions futures à l’intérieur du strict domaine d’échantillonnage [Xmin, Xmax].
Si les exigences d’une recherche scientifique excèdent les capacités analytiques d’Excel — notamment en présence de structures de données longitudinales à effets mixtes, de modèles à erreurs non gaussiennes nécessitant des modèles linéaires généralisés (GLM), ou d’inflexions locales multiples requérant des fonctions de lissage par splines cubiques pénalisées —, l’analyste averti devra alors considérer cette étude sous Excel comme un jalon exploratoire précieux, avant de transférer son corpus de données vers des environnements spécialisés de programmation statistique tels que le langage R ou l’écosystème Python (avec les bibliothèques NumPy et Statsmodels).
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications.
- Bates, D. M., & Watts, D. G. (1988). Nonlinear regression analysis and its applications. John Wiley & Sons. https://doi.org/10.1002/9780470316757
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Gujarati, D. N., & Porter, D. C. (2009). Basic econometrics (5th ed.). McGraw-Hill Education.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning.
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Montgomery, D. C., Peck, E. A., & Vining, G. G. (2021). Introduction to linear regression analysis (6th ed.). John Wiley & Sons.
- Runge, C. (1901). Über empirische Funktionen und die Interpolation zwischen äquidistanten Ordinaten. Zeitschrift für Mathematik und Physik, 46, 224-243.
- Seber, G. A. F., & Lee, A. J. (2003). Linear regression analysis (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9780471722199
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459-482. https://doi.org/10.1002/cne.920180503