
L’inférence statistique au sein des sciences comportementales, sociales et biomédicales repose très largement sur le cadre général de la modélisation linéaire. Qu’il s’agisse d’évaluer l’impact d’une intervention psychothérapeutique, d’analyser la relation entre la charge cognitive et le temps de traitement de l’information, ou de modéliser les trajectoires de développement intellectuel, la régression linéaire par les moindres carrés ordinaires (OLS, pour Ordinary Least Squares) constitue fréquemment le point d’ancrage méthodologique privilégié des chercheurs. Cette prédominance historique s’explique par son élégance mathématique, sa relative simplicité computationnelle et, surtout, par les garanties théoriques offertes par le célèbre théorème de Gauss-Markov lorsque ses postulats fondateurs sont satisfaits.
Cependant, les contextes de recherche empirique s’écartent fréquemment des conditions idéalisées des manuels de statistique. Parmi ces violations, la rupture du postulat d’homoscédasticité — c’est-à-dire l’hypothèse selon laquelle la variance des erreurs résiduelles demeure constante pour chaque niveau des variables prédictives — constitue un écueil méthodologique fréquent. Lorsqu’une structure d’hétéroscédasticité émerge au sein des données, l’utilisation aveugle des moindres carrés ordinaires compromet l’optimalité de l’estimation : bien que les coefficients de régression demeurent non biaisés, leurs erreurs-types associées deviennent erronées, entraînant une invalidation systématique des tests de significativité statistique, des valeurs p et des intervalles de confiance.
Face à cette vulnérabilité analytique, la régression par les moindres carrés pondérés (WLS, pour Weighted Least Squares) représente une solution robuste et formellement rigoureuse. En modulant l’influence de chaque observation en fonction inverse de sa variance d’erreur, le modèle WLS rétablit les propriétés d’efficacité statistique des estimateurs et garantit la validité des conclusions inférentielles. Ce guide exhaustif explore en profondeur les fondements théoriques, la détection empirique, la dérivation mathématique et la mise en œuvre computationnelle complète de la régression linéaire pondérée sous le logiciel statistique R.
1. Fondements théoriques de l’homoscédasticité et postulats du modèle linéaire classique
1.1 Le théorème de Gauss-Markov et les hypothèses fondamentales
Le modèle de régression linéaire classique s’articule autour d’une équation structurelle liant une variable dépendante continue, notée Y, à un ensemble de p variables explicatives ou régresseurs, rassemblés dans une matrice X de dimension n × (p + 1), selon l’expression matricielle Y = Xβ + ε. Dans ce formalisme, le vecteur β rassemble les paramètres d’intérêt inconnus de la population, tandis que ε représente le vecteur des perturbations aléatoires inobservables, ou erreurs de mesure et d’omission. L’ajustement standard par les moindres carrés ordinaires repose sur un ensemble d’hypothèses critiques formalisées par le théorème de Gauss-Markov.
Parmi ces postulats fondamentaux figurent l’exogénéité stricte des régresseurs, stipulant que l’espérance conditionnelle des erreurs sachant la matrice de conception est strictement nulle, soit E(ε | X) = 0, ainsi que l’absence d’autocorrélation entre les termes d’erreur individuels, soit Cov(εi, εj | X) = 0 pour tout i ≠ j. Le postulat au cœur de notre propos concerne l’homoscédasticité : la variance conditionnelle des erreurs doit être invariante quel que soit le niveau ou la configuration prise par les variables explicatives, ce qui se traduit algébriquement par Var(εi | X) = σ2 pour tout i ∈ {1, …, n}. Lorsque l’ensemble de ces conditions est rigoureusement satisfait, le théorème de Gauss-Markov établit que l’estimateur OLS, défini analytiquement par β̂OLS = (XTX)-1XTY, est le meilleur estimateur linéaire non biaisé (connu sous l’acronyme anglais BLUE pour Best Linear Unbiased Estimator).
Dans le champ particulier de la psychologie quantitative et des sciences cognitives, ce postulat d’homoscédasticité est pourtant constamment mis à rude épreuve par la nature intrinsèque des phénomènes étudiés. Les chercheurs s’intéressent couramment à des processus comportementaux caractérisés par des dynamiques individuelles complexes, où la variabilité des réponses n’a aucune raison théorique d’être stationnaire sur l’ensemble du continuum de la variable indépendante. Il importe de souligner avec netteté la distinction conceptuelle entre l’espérance conditionnelle nulle des erreurs — qui garantit que le modèle ne sous-estime ni ne surestime systématiquement la réponse moyenne — et la dispersion de ces résidus autour de leur moyenne conditionnelle. Si l’hétéroscédasticité n’affecte pas l’espérance conditionnelle, elle détruit l’efficacité statistique qui conférait à l’estimateur OLS son statut privilégié au sein de la boîte à outils statistique.
1.2 Définition formelle et manifestations de l’hétéroscédasticité
Formellement, l’hétéroscédasticité désigne la situation dans laquelle la variance conditionnelle des termes d’erreur n’est plus scalaire. Dans le cadre matriciel, la matrice de variance-covariance conditionnelle des erreurs, conventionnellement notée Σ = Var(ε | X), ne se réduit plus au produit d’un scalaire unique par la matrice identité, soit σ2In, mais prend la forme d’une matrice diagonale où chaque élément diagonal reflète une variance spécifique à chaque observation : diag(σ12, σ22, …, σn2). Dans les cas les plus complexes incluant une corrélation structurelle entre résidus, les termes extradiagonaux peuvent également être non nuls, bien que la forme purement hétéroscédastique classique maintienne l’indépendance conditionnelle entre les observations individuelles.
Les origines de cette hétérogénéité de variance au sein des données expérimentales et quasi-expérimentales sont multiples. D’une part, les erreurs de mesure varient fréquemment selon l’instrument employé ou les conditions environnementales de passation : par exemple, un test psychométrique standardisé peut présenter une excellente fidélité au centre de sa distribution, mais une imprécision métrologique croissante à mesure que l’on s’approche des valeurs extrêmes. D’autre part, les effets de seuil psychophysiques, tels que les effets de plancher (impossibilité d’obtenir un score inférieur à une limite prédéterminée) ou de plafond (saturation des performances maximales), induisent mécaniquement un rétrécissement artificiel de la variance pour les sujets très peu ou très hautement performants, générant une hétéroscédasticité structurelle prononcée.
Il convient d’opérer une distinction méthodologique fondamentale entre une hétéroscédasticité structurelle — inhérente au processus générateur de données sous-jacent — et une hétéroscédasticité artificielle induite par une mauvaise spécification fonctionnelle du modèle linéaire. L’omission d’une variable explicative déterminante ou la négligence d’une composante non linéaire (comme un terme quadratique ou une interaction d’ordre supérieur) peut générer des résidus dont la dispersion apparente s’élargit ou se contracte le long de l’axe des valeurs prédites. Qu’elle soit d’origine substantielle ou issue d’une modélisation imparfaite, l’hétéroscédasticité influe directement sur l’exactitude des calculs asymptotiques relatifs aux matrices d’échantillonnage, provoquant une distorsion majeure des erreurs-types qui gouvernent l’inférence statistique.
1.3 Conséquences inférentielles sur les tests statistiques
L’impact direct de la présence d’hétéroscédasticité réside dans l’invalidation de la formule classique de calcul de la matrice de variance-covariance de l’estimateur OLS. Sous l’hypothèse théorique d’homoscédasticité, la variance de l’estimateur des moindres carrés s’exprime selon la relation compacte Var(β̂OLS) = σ2(XTX)-1, dans laquelle le terme σ2 est traditionnellement estimé sans biais par la moyenne des carrés des résidus divisée par les degrés de liberté résiduels, soit s2 = (eTe) / (n – p – 1). En revanche, lorsque la matrice de variance des erreurs est non scalaire, l’expression exacte de la variance de l’estimateur devient ce que les théoriciens désignent sous le terme de formule « sandwich » : Var(β̂OLS) = (XTX)-1(XTΣX)(XTX)-1.
En calculant la variance au moyen de la formule classique en présence d’une matrice Σ hétérogène, les logiciels statistiques sous-estiment ou surestiment couramment la véritable dispersion d’échantillonnage des coefficients de régression. Cette distorsion des erreurs-types estimées se répercute de manière immédiate sur les statistiques de test : la statistique de Student t = β̂j / SE(β̂j) et la statistique de Fisher F associées aux tests d’hypothèses linéaires nulles ne suivent plus rigoureusement leurs distributions théoriques respectives sous H0. Dans la très grande majorité des cas observés empiriquement, notamment lorsque la variance résiduelle croît conjointement avec les valeurs de la variable indépendante, l’erreur-type conventionnelle est sévèrement déflatée, générant une inflation spectaculaire du risque d’erreur de type I (rejet à tort d’une hypothèse nulle authentiquement vraie).
Ce phénomène est particulièrement préjudiciable pour la validité et la reproductibilité de la littérature scientifique contemporaine. Un chercheur appliquant sans précaution les moindres carrés ordinaires à des données hétéroscédastiques conclura couramment à l’existence d’un effet psychologique ou comportemental statistiquement significatif au seuil nominal de 5 %, alors même que la variabilité réelle du phénomène ne permet pas d’écarter le hasard. Parallèlement, les intervalles de confiance construits selon la formule canonique β̂j ± tcritical × SE(β̂j) voient leur taux de couverture nominal s’effondrer : un intervalle supposé contenir la vraie valeur du paramètre dans 95 % des réplications ne couvrira parfois la cible que dans 80 % ou 85 % des occurrences réelles, compromettant gravement l’accumulation des savoirs scientifiques.
2. Détection de l’hétéroscédasticité en sciences psychologiques et comportementales
2.1 Manifestations concrètes dans les données psychologiques
Dans le champ de la psychologie différentielle et cognitive, l’invariance de la variance constitue bien plus l’exception que la règle générale. L’étude des temps de réaction chronométriques illustre parfaitement ce phénomène : lorsqu’un protocole expérimental mesure la vitesse de décision motrice face à des stimuli perceptifs visuels complexes, les sujets jeunes et performants présentent non seulement une moyenne de réponse plus basse, mais également une variance intra-individuelle et inter-individuelle remarquablement compacte. À l’inverse, chez les populations cliniques, les sujets âgés ou les participants soumis à une privation prolongée de sommeil, on observe une dégradation de la performance qui se caractérise par une asymétrie positive marquée et une variabilité résiduelle considérablement accrue, trahissant des lapses attentionnels périodiques.
Un phénomène comparable se manifeste de manière omniprésente dans l’étude des processus affectifs et du stress. Lorsque des chercheurs modélisent l’impact de l’exposition à des événements de vie stressants sur le score d’anxiété générale évalué sur une échelle psychométrique, les individus peu exposés à l’adversité affichent des scores d’anxiété regroupés de façon dense autour d’une ligne de base adaptative minimale. Dès lors que l’adversité environnementale atteint des intensités élevées, les mécanismes psychologiques de régulation émotionnelle, les soutiens sociaux perçus et les vulnérabilités génétiques différentielles entrent en jeu : certains sujets font preuve d’une résilience remarquable en maintenant une anxiété basse, tandis que d’autres s’effondrent vers des niveaux pathologiques aigus. Cette divergence substantielle des réponses individuelles sous forte contrainte génère une dispersion résiduelle proportionnelle à l’intensité du stress.
L’agrégation des scores issus d’échelles de type Likert en psychométrie appliquée représente une source additionnelle d’hétérogénéité des variances. La variance d’un score composite calculé sur plusieurs items dépend structurellement de la fidélité locale du test, qui tend à diminuer drastiquement aux extrémités des compétences cognitives sous-jacentes. Selon les postulats de la théorie des réponses aux items (TRI), l’information apportée par un test psychologique culmine à des niveaux d’aptitude θ précis et s’effondre lorsque le sujet s’éloigne de ces zones de discrimination optimale. Par conséquent, toute régression modélisant un trait latent continu à partir de batteries d’items composites introduira intrinsèquement une hétérogénéité de variance résiduelle conditionnée par le niveau d’habileté cognitive des répondants.
2.2 Analyses graphiques exploratoires des résidus
Avant d’avoir recours à des tests inférentiels formalisés, le diagnostic d’hétéroscédasticité repose prioritairement sur une inspection graphique rigoureuse et multidimensionnelle des composantes résiduelles du modèle ajusté par les moindres carrés ordinaires. Le graphique diagnostique le plus puissant et le plus universellement recommandé consiste à projeter les résidus ordinaires ei — ou, de manière encore plus informative, les résidus studentisés ou standardisés ri = ei / (s × √(1 – hii)), où hii représente le levier de l’observation — en ordonnée, face aux valeurs prédites ou ajustées (Fitted Values, Ŷi) en abscisse. Dans des conditions théoriques parfaites d’homoscédasticité, les points doivent se répartir de façon aléatoire et homogène au sein d’une bande horizontale d’épaisseur constante de part et d’autre de la ligne zéro.
La présence d’hétéroscédasticité se traduit visuellement par l’émergence d’un motif caractéristique en forme d’entonnoir (désigné couramment par l’expression anglaise funnel shape). Ce motif s’évase généralement de la gauche vers la droite de l’axe horizontal, révélant que pour des valeurs prédites faibles, les résidus restent étroitement circonscrits à proximité de l’espérance conditionnelle nulle, tandis que pour des valeurs prédites élevées, la dispersion verticale des points augmente de façon exponentielle ou quadratique. Dans d’autres contextes cliniques, on peut observer des formes en diamant ou en fuseau, signalant que la dispersion maximale survient pour les valeurs moyennes de la variable critère, les effets de plancher et de plafond venant resserrer la distribution aux marges extrêmes.
L’analyse graphique exploratoire doit également intégrer l’examen attentif du diagramme quantile-quantile (Q-Q plot) normal appliqué aux résidus studentisés. Bien que le diagramme Q-Q serve en premier lieu à contrôler l’hypothèse de normalité de la distribution conditionnelle des erreurs, une divergence simultanée des queues de distribution supérieure et inférieure informe fréquemment l’analyste sur la présence de sous-groupes structurellement plus variables ou sur une instabilité globale de la variance de dispersion. De plus, il s’avère particulièrement éclairant de construire des diagrammes bivariés confrontant directement les résidus standardisés à chacun des prédicteurs continus inclus dans le modèle, permettant d’isoler avec exactitude la ou les variables indépendantes responsables de l’inflation de la variance locale.
2.3 Tests d’hypothèse formels pour valider l’homoscédasticité
Si l’approche graphique offre une intuition visuelle fondamentale, la confirmation de la violation du postulat d’invariance de variance nécessite l’exécution de tests d’hypothèse formels dotés de propriétés statistiques contrôlées. Le premier outil canonique est le test de Breusch-Pagan, introduit en 1979 par les économètres Trevor Breusch et Adrian Pagan. Ce test formule l’hypothèse nulle H0: σ12 = σ22 = … = σn2 = σ2 contre l’hypothèse alternative postulant que la variance dépend linéairement d’un ensemble de variables explicatives via la relation σi2 = h(ziTα), où zi inclut généralement les variables du modèle original. La procédure consiste à régresser les résidus au carré mis à l’échelle sur ces régresseurs et à évaluer la significativité globale du coefficient de détermination multiplié par la taille de l’échantillon, qui suit asymptotiquement une loi du Chi-deux (χ2).
Une faiblesse reconnue du test classique de Breusch-Pagan réside dans son extrême sensibilité à la non-normalité de la distribution des erreurs sous-jacentes. Pour pallier cette limitation, Koenker et Bassett ont proposé une variante studentisée robuste (connue sous le nom de test de Koenker-Bassett ou test de Breusch-Pagan modifié par Koenker). Cette adaptation ajuste le multiplicateur du Chi-deux par le moment d’ordre quatre empirique des résidus (le kurtosis), garantissant que le taux d’erreur de première espèce demeure contrôlé même en présence de distributions de données modérément asymétriques ou leptokurtiques, ce qui en fait un standard particulièrement recommandé lors du traitement d’échelles psychologiques.
Une alternative encore plus générale est offerte par le test de White (1980). Contrairement au test de Breusch-Pagan qui présuppose une structure de dépendance linéaire, le test de White n’exige aucune présomption sur la forme fonctionnelle de l’hétéroscédasticité. Il procède en régressant les résidus ordinaires au carré sur l’ensemble des régresseurs originaux, sur leurs termes quadratiques respectifs (puissances au carré) ainsi que sur la totalité de leurs produits croisés (interactions du second ordre). Enfin, le test de Goldfeld-Quandt constitue une méthode non asymptotique adaptée lorsque l’hétéroscédasticité est soupçonnée de diviser l’échantillon en deux sous-groupes contrastés selon un ordre monotone : après avoir classé les données selon le régresseur suspecté et supprimé un segment central d’observations, il compare directement le rapport des variances résiduelles des deux sous-ensembles extrêmes au moyen d’un test de Fisher classique.
3. Principes mathématiques de la régression par les moindres carrés pondérés (WLS)
3.1 Formulation algébrique de la méthode des moindres carrés généralisés
La méthode des moindres carrés pondérés constitue un cas particulier fondamental de la famille plus vaste des moindres carrés généralisés (GLS, pour Generalized Least Squares), développée initialement par Alexander Aitken en 1935. Lorsque l’on abandonne le postulat de scalaire de variance des perturbations au profit d’une matrice de variance-covariance diagonale Σ = diag(σ12, σ22, …, σn2), la fonction objectif de minimisation ne cherche plus à amoindrir la somme simple des carrés des écarts entre les observations observées et les valeurs modélisées, mais une somme pondérée où chaque carré d’écart est modulé par un coefficient scalaire strictly positif wi :
S(β) = ∑i=1n wi (Yi – xiTβ)2
Sous forme vectorielle et matricielle, cette quantité s’écrit avec une concision remarquable : S(β) = (Y – Xβ)T W (Y – Xβ), où W désigne une matrice de pondération diagonale de dimension n × n, définie par W = diag(w1, w2, …, wn). Pour identifier l’estimateur qui minimise analytiquement cette somme quadratique, on différencie cette fonction vectorielle par rapport au vecteur de paramètres β et on annule le gradient résultant :
∂S(β) / ∂β = -2 XT W (Y – Xβ) = 0 ⟹ XT W X β = XT W Y
En supposant que la matrice XT W X est inversible (ce qui requiert que X soit de plein rang de colonnes et que tous les poids wi soient strictement positifs), la solution analytique de cette équation normale prend la forme matricielle canonique de l’estimateur des moindres carrés pondérés :
β̂WLS = (XT W X)-1 XT W Y
Le théorème d’Aitken démontre avec rigueur que si la matrice de pondération W est exactement proportionnelle à l’inverse de la matrice de variance-covariance des erreurs, soit W = Σ-1 = diag(1/σ12, 1/σ22, …, 1/σn2), alors l’estimateur β̂WLS rétablit l’ensemble des propriétés d’optimalité établies par Gauss-Markov : il redevient le meilleur estimateur linéaire non biaisé (BLUE) du système.
3.2 Attribution et logique du schéma de pondération
La logique intuitive sous-jacente au schéma de pondération wi = 1 / σi2 est d’une remarquable limpidité conceptuelle. Chaque point de données recueilli dans une investigation scientifique n’apporte pas la même quantité d’information empirique utile à l’estimation de la pente globale : une observation associée à une variance d’erreur minuscule σi2 est intrinsèquement très précise et fournit un signal net quant à la localisation spatiale de la droite de régression. À l’opposé, une observation caractérisée par une variance résiduelle colossale est hautement bruitée, son écart par rapport à la moyenne conditionnelle étant dominé par l’aléa plutôt que par la dynamique structurelle du phénomène sous étude.
En attribuant un poids analytique inversement proportionnel à la variance de l’erreur, l’algorithme WLS opère une réallocation méthodique de l’influence statistique. Les points fiables et précis sont surpondérés, forçant la droite ajustée à passer au plus près de leurs coordonnées, tandis que les observations volatiles et incertaines sont systématiquement sous-pondérées, les empêchant de tirer arbitrairement le modèle vers leurs trajectoires désordonnées. D’un point de vue de transformation des variables, le WLS revient mathématiquement à multiplier chaque ligne du système linéaire (la variable dépendante et chaque prédicteur, constante incluse) par la racine carrée du poids correspondant, soit wi1/2 = 1 / σi. En divisant chaque terme de l’équation par son propre écart-type théorique, le modèle transformé Yi / σi = (xiTβ) / σi + εi / σi satisfait à nouveau scrupuleusement la condition d’homoscédasticité, puisque la variance de l’erreur transformée Var(εi / σi) est rigoureusement égale à 1 pour toutes les observations de l’échantillon.
Cette formalisation trouve également un ancrage direct dans les paradigmes de méta-analyse ou d’agrégation de données groupées. Supposons qu’un chercheur analyse la relation entre deux construits psychologiques à partir de moyennes obtenues au sein de k groupes distincts de tailles d’échantillon variables nj. D’après le théorème central limite, la variance d’échantillonnage de chaque moyenne empirique s’exprime par Var(Ȳj) = σ2 / nj. Pour estimer une régression linéaire sur ces données agrégées sans déformer les paramètres, il apparaît alors méthodologiquement impératif d’assigner à chaque groupe un poids proportionnel à son effectif effectif, soit wj = nj, matérialisant parfaitement la nature intrinsèque de la pondération par l’inverse de la variance.
3.3 Propriétés asymptotiques et robustesse de l’estimateur WLS
Sous des conditions de régularité standard — incluant la compacité de l’espace des paramètres, la finitude des moments d’ordre supérieur et l’exogénéité stricte —, l’estimateur WLS possède des propriétés asymptotiques exemplaires de convergence en probabilité (consistance) et de normalité asymptotique lorsque la taille de l’échantillon n tend vers l’infini. Sa distribution limite s’exprime selon la formule :
√n (β̂WLS – β) xrightarrow{d} N(0, plim [ n (XT W X)-1 ])
Cette efficacité statistique maximale dépend toutefois de manière cruciale d’une condition d’application sévère : la matrice de pondération théorique W doit correspondre fidèlement à la véritable structure de variance sous-jacente des données. Dans les applications empiriques réelles, les variances vraies σi2 sont presque systématiquement inconnues du statisticien et doivent être inférées à partir des résidus de régressions auxiliaires préliminaires. On parle alors de moindres carrés pondérés réalisables ou estimés (FGLS, pour Feasible Generalized Least Squares).
La sensibilité critique de l’estimateur WLS face à une mauvaise spécification fonctionnelle de la variance constitue son talon d’Achille méthodologique. Si la fonction régissant la variabilité résiduelle est mal identifiée — par exemple, en présupposant une dépendance linéaire par rapport à un régresseur alors que la dispersion réelle suit une trajectoire quadratique ou dépend d’une variable omise —, l’estimateur FGLS conserve sa propriété de non-biais asymptotique (à condition que la moyenne conditionnelle soit bien modélisée), mais il peut paradoxalement devenir moins efficace statistiquement que l’estimateur OLS conventionnel. De surcroît, les estimateurs de variance de second ordre calculés sur de faibles échantillons peuvent être substantiellement sous-estimés, entraînant une inflation insidieuse du taux d’erreur de première espèce.
C’est pourquoi la pratique contemporaine confronte fréquemment le modèle WLS aux approches fondées sur les estimateurs de variance sandwich robustes à l’hétéroscédasticité (tels que les corrections HC0 à HC4 proposées par Halbert White, J. Scott Long et Ervin Ervin). Si les estimateurs de type White-Huber conservent l’estimation de pente brute OLS tout en corrigeant a posteriori l’erreur-type sans formuler d’hypothèse sur la structure mathématique de Σ, la méthode WLS conserve une supériorité notable : lorsque la fonction de variance est correctement spécifiée, WLS ré-estime directement le vecteur de coefficients β vers sa trajectoire de variance minimale absolue, garantissant une puissance statistique et une précision d’estimation qu’aucune simple correction d’erreur-type ne peut atteindre.
4. Préparation de l’environnement R et structure des données empiriques
4.1 Configuration des bibliothèques nécessaires
Pour mener à bien une modélisation complète par les moindres carrés pondérés sous le langage de programmation statistique R, il est indispensable de charger un ensemble cohérent de paquets complémentaires spécialisés dans la modélisation linéaire, le calcul d’erreurs-types robustes et les diagnostics graphiques avancés. L’écosystème comprend notamment lmtest pour l’exécution des tests formels d’hétéroscédasticité, car pour le calcul des statistiques de diagnostic de colinéarité et de résidus studentisés, sandwich pour l’évaluation comparative des matrices de variance-covariance robustes, et enfin le métapaquet tidyverse qui englobe ggplot2, dplyr et tibble pour une manipulation fluide et graphique des jeux de données.
L’installation de ces paquets s’effectue via l’interface canonique du Comprehensive R Archive Network (CRAN). Il est judicieux de fixer les options générales de la console R afin de contrôler le nombre de décimales affichées pour l’interprétation des valeurs statistiques fines et de neutraliser la conversion automatique des chaînes de caractères en facteurs nominaux.
Dans une logique rigoureuse de reproductibilité de la recherche scientifique, il est fortement préconisé de vérifier la version courante de R et de consigner les dépendances logicielles au moyen d’environnements virtuels isolés (tels que ceux fournis par le paquet renv). Cette discipline prévient les disparités d’arrondis numériques susceptibles de survenir au fil des mises à jour des algorithmes matriciels sous-jacents.
4.2 Création du jeu de données illustratif
Afin d’ancrer les développements mathématiques dans une démarche empirique tangible propre aux sciences comportementales et éducatives, considérons une étude expérimentale simulant la relation entre l’investissement temporel consenti par des étudiants universitaires dans la préparation d’un examen complexe de psychométrie quantitative (mesuré en heures d’étude individuelles) et leur performance finale normalisée à cet examen (évaluée sur une échelle continue de 0 à 100 points).
Dans ce paradigme, il est plausible d’anticiper une hétéroscédasticité croissante : les étudiants ne consacrant que très peu d’heures à l’apprentissage obtiennent de manière presque systématique des notes médiocres regroupées autour d’un score bas. En revanche, chez les étudiants fournissant un volume horaire d’étude massif, les différences interindividuelles d’aptitude mathématique préalable, de stratégies mnémotechniques et de vulnérabilité au stress d’évaluation provoquent une dispersion majeure des résultats : certains atteignent des sommets d’excellence académique tandis que d’autres plafonnent à des niveaux modérés en dépit de leurs efforts prolongés.
Pour matérialiser ce phénomène, nous pouvons concevoir un échantillon synthétique représentatif comportant n = 100 observations. Le vecteur de la variable indépendante hours est échantillonné de manière continue entre 2 et 40 heures d’étude. La variable dépendante score est alors générée selon un modèle linéaire structurel d’équation Yi = 35 + 1.4 × Xi + εi, où le terme d’erreur εi est issu d’une distribution normale d’espérance nulle dont l’écart-type est rigoureusement asservi à la valeur du régresseur selon la fonction linéaire σi = 1.2 + 0.35 × Xi.
La vérification structurelle de la matrice de données nouvellement instanciée constitue une étape indispensable. L’application des commandes fondamentales de diagnostic d’intégrité permet d’attester que l’objet est convenablement encapsulé sous forme de tableau de données à deux dimensions numériques de type double précision, et qu’aucune cellule ne contient de valeur manquante ou non assignée susceptible de biaiser le calcul matriciel ultérieur.
4.3 Statistiques descriptives préalables
L’étape préliminaire à toute modélisation inférentielle consiste à dresser un bilan exhaustif des propriétés descriptives univariées et bivariées de l’échantillon recueilli. Pour les deux grandeurs continues, il convient d’extraire la moyenne arithmétique, l’écart-type d’échantillon, la médiane, l’écart interquartile, ainsi que les valeurs extrêmes minimale et maximale afin de détecter toute aberration de saisie ou présence d’outliers manifestes.
La corrélation de Pearson entre le temps d’étude et le résultat d’examen permet de quantifier l’intensité du lien linéaire global qui unit ces deux métriques. Les visualisations univariées au moyen d’histogrammes enrichis de courbes d’estimation de densité par noyau gaussien offrent une première appréciation de la distribution marginale de la performance académique. De surcroît, le découpage de l’échantillon en sous-classes ordinales de temps d’étude (par exemple par tranches de dix heures) permet de calculer les écarts-types locaux des scores.
Cette tabulation descriptive préliminaire met généralement en lumière un accroissement monotone de l’écart-type empirique le long des strates successives de temps d’apprentissage : alors que l’écart-type peut être inférieur à 3 points pour le groupe des étudiants ayant révisé moins de dix heures, il atteint fréquemment plus de 12 à 15 points pour la tranche supérieure dépassant trente heures d’entraînement. Ce constat visuel et quantitatif primitif constitue le signal d’alerte classique incitant l’analyste chevronné à suspecter une rupture flagrante du postulat d’homogénéité de la variance.
5. Ajustement du modèle de régression linéaire simple ordinaire (OLS)
5.1 Implémentation de l’ajustement de base via la fonction lm()
L’ajustement canonique du modèle de régression linéaire ordinaire s’effectue dans R au moyen de la fonction native lm() (pour Linear Model). Cette fonction fait appel en arrière-plan à une décomposition QR de la matrice de conception X, assurant une remarquable stabilité numérique face aux risques de quasi-colinéarité. La formulation syntaxique standard adopte l’écriture symbolique score ~ hours, dans laquelle le symbole tilde dissocie la variable dépendante des termes prédicteurs, l’interception à l’origine étant implicitement intégrée sauf instruction contraire explicite.
L’exécution de cette commande instancie en mémoire un objet de classe lm renfermant l’ensemble des composantes analytiques du modèle : les coefficients de régression estimés, le vecteur des valeurs prédites, la matrice des résidus ordinaires ainsi que la table de décomposition des sommes de carrés nécessaires à l’analyse de variance.
L’affichage structuré des résultats d’ajustement est traditionnellement sollicité via la commande summary(). Ce rapport statistique présente de manière synthétique les quartiles de la distribution des résidus ordinaires, la table des coefficients incluant les estimations ponctuelles, leurs erreurs-types non corrigées, les statistiques t associées ainsi que les p-valeurs bilatérales correspondantes, et s’achève par le rappel de l’écart-type résiduel global (Residual Standard Error) et des coefficients de détermination R2 brut et ajusté.
5.2 Interprétation des coefficients non corrigés
À l’issue de l’estimation par les moindres carrés ordinaires, les paramètres du modèle décrivent la trajectoire moyenne de la performance en fonction de l’effort consenti. Le coefficient associé à la constante (l’ordonnée à l’origine) représente la performance moyenne estimée pour un étudiant n’ayant consacré aucune heure de travail à la préparation du test. Dans le cadre de notre simulation théorique, cette valeur s’établit généralement aux alentours de 35 points, traduisant le niveau de compétence résiduel ou la part de réussite accessible par simple déduction logique spontanée.
Le coefficient de régression affecté à la variable hours quantifie quant à lui la pente moyenne du modèle empirique : il indique de combien d’unités de score augmente, en moyenne d’échantillon, la performance de l’étudiant pour chaque tranche horaire supplémentaire de révision. Si ce coefficient s’élève par exemple à environ 1,40 point par heure, l’étudiant ayant accompli vingt heures de révision supplémentaire verra son score attendu s’accroître en moyenne de 28 points. Le test t associé affiche une significativité statistique éclatante (avec une valeur de p généralement très inférieure au seuil alpha conventionnel de 0,001), incitant le praticien naïf à conclure immédiatement à la validité indiscutable de son équation prédictive.
L’appel à la fonction confint() permet de délimiter les intervalles de confiance paramétriques conventionnels à 95 % autour de ces estimations de coefficients. Cependant, en dépit de leur élégance formelle, ces intervalles sont potentiellement fallacieux. Dans la mesure où le calcul de l’erreur-type SE(β̂) utilise un estimateur global unique de la variance des perturbations s2, les erreurs-types affichées partent du postulat non vérifié que l’incertitude autour de la ligne de régression est rigoureusement identique pour un novice complet affichant deux heures au compteur et pour un étudiant acharné totalisant quarante heures de révision intensive.
5.3 Extraction des composantes résiduelles du modèle
Pour diagnostiquer la validité empirique des hypothèses de modélisation, il est impératif d’extraire les grandeurs calculées observation par observation et de les adjoindre formellement à la matrice de données originale. La fonction générique residuals() isole le vecteur colonne des résidus ordinaires d’échantillon, définis mathématiquement pour chaque individu par l’écart arithmétique ei = Yi – Ŷi.
Conjointement, l’application de la fonction fitted() permet de récupérer le vecteur des valeurs ajustées conditionnelles Ŷi = β̂0 + β̂1 Xi, représentant la projection orthogonale des points observés sur l’hyperplan ajusté par les moindres carrés. L’intégration de ces deux vecteurs au sein du tableau de bord d’analyse s’effectue aisément via des opérations d’assignation directe ou par l’entremise de la fonction mutate() du paquet dplyr.
Une propriété mathématique élémentaire mais essentielle de l’estimateur OLS standard est la contrainte algébrique selon laquelle la somme des résidus ordinaires (et par conséquent leur moyenne arithmétique simple) est rigoureusement nulle : ∑i=1n ei = 0, dès lors qu’un terme d’interception constante est incorporé dans la matrice de conception. Cette vérification numérique triviale confirme le bon déroulement algorithmique de l’optimisation, mais elle ne dit absolument rien de la constance de la dispersion de ces mêmes résidus sur l’axe des abscisses.
6. Diagnostic statistique et graphique de l’hétéroscédasticité sous R
6.1 Exploration visuelle des résidus du modèle linéaire
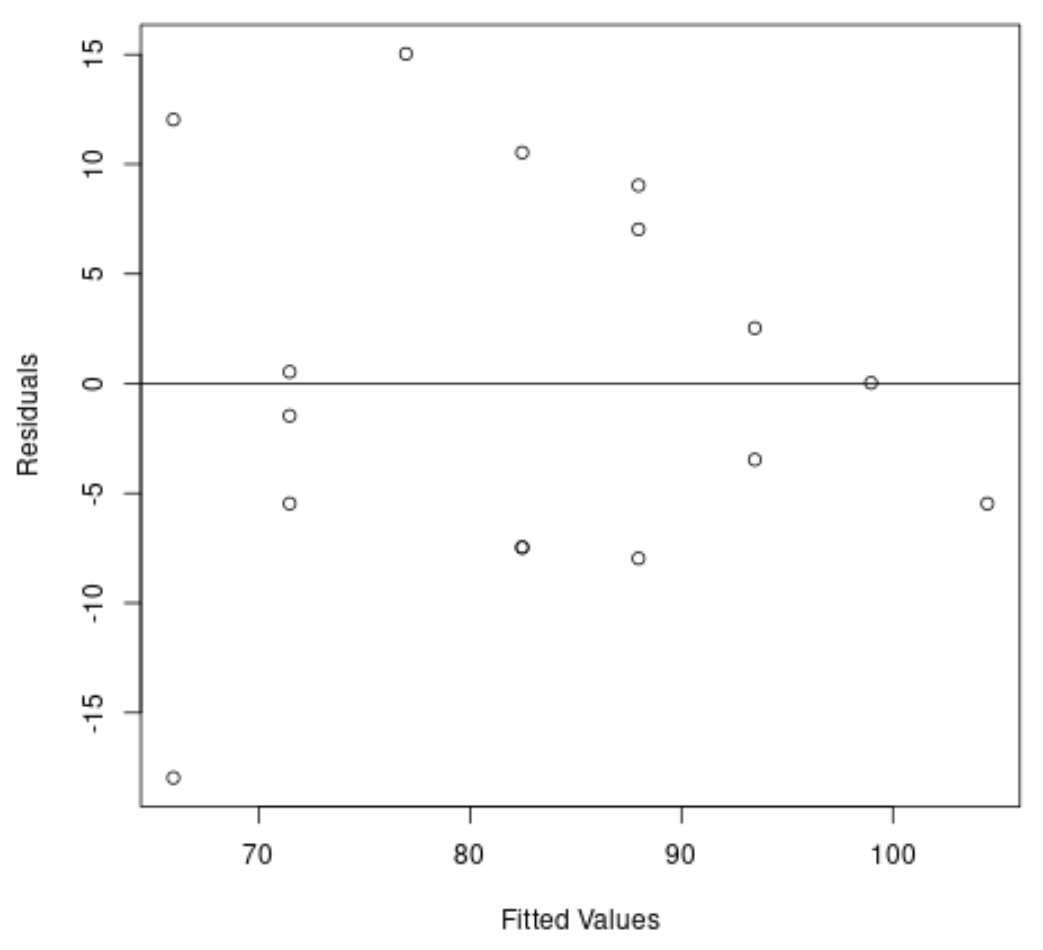
La mise en évidence de l’hétéroscédasticité repose sur la construction d’une visualisation graphique explicite reliant les résidus ordinaires aux valeurs ajustées. Au moyen du moteur de rendu graphique ggplot2, l’analyste trace un nuage de points où l’axe des abscisses consigne les valeurs prédites Ŷi et l’axe des ordonnées porte les résidus ei. L’adjonction d’une ligne de référence horizontale discontinue à y = 0 sert de repère de symétrie fondamentale.
Pour dépasser la simple subjectivité visuelle, il est méthodologiquement recommandé de superposer à ce nuage de points une courbe de lissage non paramétrique locale de type LOESS (Locally Estimated Scatterplot Smoothing). Si la trajectoire centrale du lissage LOESS doit demeurer rectiligne et accolée au zéro d’ordonnée (attestant de la linéarité globale de la relation sous-jacente), ce sont les frontières supérieure et inférieure de l’enveloppe de dispersion des points qui focalisent toute l’attention.
L’apparition manifeste d’une forme en entonnoir évasé vers la droite matérialise l’hétéroscédasticité : pour les faibles valeurs ajustées de performance, la bande de résidus est extrêmement étroite, s’étendant par exemple de -4 à +4 points autour du zéro. En progressant vers les prédictions de score élevées, l’amplitude des résidus explose pour franchir des bornes oscillant entre -25 et +30 points. Ce graphique diagnostique prouve sans équivoque que la dispersion conditionnelle de l’erreur est intimement corrélée au niveau de la performance attendue, violant frontalement le postulat de variance constante.
6.2 Application rigoureuse des tests statistiques sous R
Pour corroborer formellement les constats issus de l’exploration graphique, l’analyste déploie les tests d’hypothèse dédiés disponibles au sein du paquet lmtest. L’appel à la fonction bptest() permet d’exécuter de façon standard le test de Breusch-Pagan studentisé (implémentation de Koenker). La syntaxe prend directement en argument l’objet de régression ols_model :
library(lmtest)

bptest(ols_model)
Le résultat retourné par la console R fournit la valeur numérique de la statistique du test du multiplicateur de Lagrange (notée BP), le nombre de degrés de liberté associé (égal au nombre de régresseurs non constants testés, soit 1 dans le cas présent), et la p-valeur asymptotique calculée sous la loi du Chi-deux. L’obtention d’une valeur p substantiellement inférieure aux seuils critiques usuels (typiquement p < 0.001) impose le rejet formel et sans appel de l’hypothèse nulle d’homoscédasticité au profit de l’hypothèse alternative d’une variance d’erreur dépendante des covariables.
Dans les configurations où l’on souhaite tester une hétérogénéité fonctionnelle non linéaire sans formuler de restriction d’ordre 1, le test de White généralisé peut être exécuté au moyen de la même fonction bptest(), en fournissant une formule auxiliaire quadratique étendue incluant le terme au carré de la variable prédictive :
bptest(ols_model, ~ hours + I(hours^2), data = df)
La convergence de ces différentes épreuves inférentielles vers un rejet hautement significatif de l’invariance de dispersion apporte la justification scientifique impérative nécessaire à l’abandon du modèle OLS au profit d’un réajustement par les moindres carrés pondérés.
6.3 Analyse de la structure de l’hétéroscédasticité
Le rejet de l’homoscédasticité accompli, l’étape analytique consécutive consiste à élucider la forme mathématique qui lie l’amplitude de la dispersion résiduelle au prédicteur hours. L’écart-type des perturbations σi augmente-t-il de manière proportionnellement linéaire avec le temps d’étude, ou suit-il plutôt une cinétique exponentielle, logarithmique ou polynomiale d’ordre supérieur ?
D’un point de vue psychométrique, une variabilité résiduelle proportionnelle au niveau de l’effort d’apprentissage s’interprète comme l’expression d’un déverrouillage de potentiel différencié. Lorsque les étudiants ne travaillent pas, leurs compétences individuelles latentes demeurent inexprimées, bridées par l’ignorance pure du matériel d’examen ; l’aléa résiduel est donc contraint et minimal. Dès lors que l’apprentissage s’intensifie, le temps d’étude agit comme un catalyseur révélant les capacités intrinsèques et la plasticité cognitive différentielle des individus : certains progressent à une cadence fulgurante tandis que d’autres butent sur des paliers conceptuels ardus, induisant un éventail de résultats de plus en plus dispersé.
La clarification de cette relation fonctionnelle est déterminante car elle oriente directement le choix de l’algorithme d’estimation des poids analytiques. Si la variance Var(εi) est modélisable comme une fonction puissance de la variable indépendante de la forme σi2 = σ2 × Xiγ, ou si elle suit une expansion exponentielle σi2 = σ2 × exp(γ Xi), la procédure d’extraction des estimateurs de variance préliminaires ne sera pas identique. Une modélisation approximative de la structure d’hétéroscédasticité dégradera la précision des poids calculés et réduira les gains théoriques d’efficacité statistique attendus de la régression pondérée.
7. Méthodologie d’estimation et calcul des poids analytiques
7.1 Approche fondée sur les résidus absolus de la régression OLS
La première stratégie classique d’estimation des poids analytiques dans le cadre des moindres carrés pondérés réalisables repose sur la modélisation directe des valeurs absolues des résidus ordinaires issus du premier ajustement OLS. Dans la mesure où l’espérance mathématique de la valeur absolue d’une variable aléatoire normale d’écart-type σi est proportionnelle à cet écart-type selon la constante E(|εi|) = σi × √(2/π), les résidus bruts en valeur absolue |ei| constituent un estimateur empirique non biaisé (à un facteur scalaire près) de la dispersion locale d’échantillonnage.
L’implémentation algorithmique de cette approche se déploie en quatre étapes séquentielles :
1. Extraction du vecteur des résidus absolus à partir du modèle non corrigé : abs_res <- abs(residuals(ols_model)).
2. Ajustement d’une régression linéaire auxiliaire régressant ces résidus absolus sur la variable explicative continue : aux_model <- lm(abs_res ~ hours, data = df).
3. Calcul des valeurs ajustées issues de ce modèle secondaire, qui fournissent une estimation modélisée et lissée de l’écart-type d’erreur pour chaque individu : sigma_hat <- fitted(aux_model).
4. Dérivation du vecteur de pondération wi par inversion et élévation au carré de ces écarts-types prédits : weights_abs <- 1 / (sigma_hat^2).
Une vigilance mathématique absolue s’impose lors de l’application de cette méthode : il convient de vérifier impérativement que l’ensemble des valeurs de sigma_hat prédites par le modèle auxiliaire sont strictement positives. Si la droite auxiliaire venait à intercepter l’axe horizontal pour les petites valeurs de la variable prédictive, elle engendrerait des prédictions d’écarts-types négatives ou nulles, ce qui conduirait à des poids infinis ou dénués de signification physique, provoquant le plantage immédiat de l’optimiseur numérique sous R.
7.2 Approche fondée sur le logarithme des résidus au carré
Pour contourner définitivement l’écueil des variances prédites négatives et conférer une robustesse statistique supérieure à la procédure d’estimation, la modélisation logarithmique proposée initialement par Harvey (1976) représente la méthodologie de référence la plus élégante. Elle part du principe que la variance conditionnelle peut être avantageusement exprimée sous une forme exponentielle multiplicative : σi2 = exp(γ0 + γ1 Xi).
En appliquant la transformation logarithmique népérienne aux carrés des résidus ordinaires, on linéarise l’équation structurelle de dispersion :
ln(ei2) = γ0 + γ1 Xi + ui
L’ajustement de ce modèle auxiliaire s’exécute dans R par la commande syntaxique suivante :
log_res2 <- log(residuals(ols_model)^2)

aux_log_model <- lm(log_res2 ~ hours, data = df)
L’obtention des estimations de variance modélisée σ̂i2 s’opère ensuite en appliquant la fonction exponentielle aux valeurs prédites issues de cette régression secondaire : fitted_variance <- exp(fitted(aux_log_model)). La transformation exponentielle garantit par construction algébrique stricte que la variance prédite demeure positive sur l’intégralité du domaine de définition, éliminant tout risque de valeurs aberrantes nulles ou négatives.
Le vecteur final de pondération analytique est alors instantanément obtenu par l’inversion arithmétique :
weights_log <- 1 / exp(fitted(aux_log_model))
Cette méthode stabilise remarquablement le comportement des poids aux extrémités de la distribution et préserve le modèle des influences disproportionnées d’observations ponctuelles excessivement volatiles.
7.3 Pondération par variance empirique de sous-groupes
Une troisième approche empirique d’attribution des poids, particulièrement appréciée en psychologie expérimentale lorsque la variable prédictive est discrète ou organisée en facteurs catégoriels présentant de multiples réplications par modalité, consiste à calculer directement la variance intra-groupe empirique pour chaque sous-échantillon. Supposons que le temps de préparation ait été mesuré non pas de façon continue fine, mais selon des conditions expérimentales fixées à 5, 10, 20 et 40 heures, chaque groupe comportant un effectif suffisant de participants.
Sous cette configuration expérimentale, l’analyste n’a pas besoin de supposer une forme paramétrique spécifique reliant la variance au régresseur. Au moyen des fonctions d’agrégation de dplyr, on calcule pour chaque modalité j la variance d’échantillon non biaisée sj2 = ∑ (Yij – Ȳj)2 / (nj – 1). Chaque participant appartenant au groupe j se voit alors assigner de façon rigide un poids d’observation égal à l’inverse exact de la variance mesurée au sein de son propre sous-groupe : wij = 1 / sj2.
Si cette méthode présente l’avantage séduisant de l’agnosticisme fonctionnel complet, elle recèle des écueils considérables lorsque les effectifs locaux sont réduits (par exemple moins de 15 à 20 observations par strate). Dans ce contexte d’échantillonnage ténu, l’estimateur de la variance d’échantillon sj2 est lui-même affecté d’une forte variance d’échantillonnage ; des fluctuations stochastiques aléatoires peuvent rendre un groupe artificiellement compact, lui assignant un poids démesuré qui distordra la régression globale. En présence d’un régresseur continu comme le temps d’étude de notre exemple, l’approche semi-paramétrique fondée sur le logarithme des résidus au carré demeure incontestablement la démarche la plus stable, la plus reproductible et la plus scientifiquement défendable.
8. Ajustement et exécution du modèle de moindres carrés pondérés sous R
8.1 Utilisation de l’argument weights dans la commande lm()
L’estimation concrète du modèle de régression par les moindres carrés pondérés s’exécute dans R avec une fluidité déconcertante grâce à l’argument natif weights intégré au cœur de la fonction lm(). Cet argument attend un vecteur numérique de longueur strictement égale au nombre d’observations du jeu de données, composé exclusivement de valeurs réelles finies et strictement positives.
La syntaxe opérationnelle s’écrit formellement comme suit :
wls_model <- lm(score ~ hours, data = df, weights = weights_log)
Dès lors que cet argument est renseigné, le compilateur interne de R modifie son algorithme d’optimisation matricielle. Plutôt que d’appliquer la décomposition orthogonale QR directement à la matrice originale X et au vecteur Y, il opère un rééchelonnement préalable de chaque vecteur de ligne en les multipliant par la racine carrée des coefficients de pondération, soit X* = W1/2 X et Y* = W1/2 Y, avant de résoudre le système linéaire par décomposition standard.
Il est impératif de souligner un détail computationnel fondamental propre à R : les poids fournis dans l’argument weights sont interprétés comme étant inversement proportionnels aux variances des erreurs d’observation, et non pas aux écarts-types. Toute inadvertance consistant à injecter l’inverse des écarts-types résiduels 1 / σ̂i en lieu et place de l’inverse des variances 1 / σ̂i2 conduirait à une sous-correction sévère de l’hétéroscédasticité, divisant par deux l’ajustement requis sur la matrice d’échelle.
8.2 Examen du sommaire statistique du modèle WLS
L’interrogation de l’objet wls_model au moyen de la commande générique summary(wls_model) dévoile les réajustements structurels majeurs opérés par la méthode WLS. Dès la première ligne du compte rendu, le sommaire indique que les résidus affichés ne sont plus les écarts simples ei, mais les résidus pondérés, définis par ei* = √wi × (Yi – Ŷi). Ces grandeurs transformées doivent idéalement présenter une symétrie presque parfaite autour de zéro, illustrée par une médiane résiduelle approchant le zéro et des quartiles symétriquement espacés.
Au sein de la table des coefficients, l’analyste constate les modifications conjointes intervenues sur la droite estimée. Les estimations ponctuelles de la constante β̂0 et de la pente β̂1 diffèrent de celles obtenues par l’ajustement OLS non corrigé : le modèle WLS a ajusté la ligne pour qu’elle réponde prioritairement aux observations dotées de fortes pondérations (les étudiants aux temps d’apprentissage réduits présentant des notes homogènes), sans se laisser dériver par les étudiants dispersés aux temps d’étude massifs.
Simultanément, les erreurs-types estimées associées à chaque paramètre subissent une réévaluation méthodologique radicale. L’erreur-type de la pente est recalculée sur la base de la matrice de covariance restaurée Var(β̂WLS) = sw2 (XT W X)-1, où sw2 représente la somme des carrés des résidus pondérés divisée par les degrés de liberté résiduels. Les statistiques de test t et les p-valeurs associées reflètent désormais la précision d’échantillonnage théorique optimale garantie par le théorème de Gauss-Markov sous son extension d’Aitken.
8.3 Calcul des intervalles de confiance corrigés
L’extraction des intervalles de confiance par la commande confint(wls_model, level = 0.95) offre une perspective éclatante de la rentabilité méthodologique de la procédure WLS. En restaurant la matrice de dispersion d’échantillonnage adéquate, l’algorithme génère des bornes de confiance qui traduisent fidèlement l’incertitude paramétrique épurée du bruit parasite provoqué par l’hétéroscédasticité.
Lorsque l’on compare ces intervalles corrigés aux intervalles délivrés par le modèle linéaire ordinaire, on relève généralement une reconfiguration substantielle : la largeur totale de l’intervalle autour de la pente d’apprentissage peut se resserrer sensiblement si l’essentiel de l’échantillon se concentre dans des régions de faible variance d’erreur, conférant au chercheur une certitude métrologique accrue sur l’amplitude de l’effet d’apprentissage testé.
Pour l’inférence des effets psychologiques, cette précision restaurée est déterminante. Elle permet d’attester la significativité substantielle de l’accroissement des compétences sans risquer d’imputer indûment au prédicteur une variabilité d’estimation qui ne relevait en réalité que de l’hétérogénéité stochastique des sous-populations étudiées, sécurisant ainsi les recommandations pédagogiques ou cliniques tirées des résultats du modèle.
9. Analyse comparative et validation croisée des modèles OLS et WLS
9.1 Comparaison directe des paramètres estimés
Pour appréhender avec clarté la portée des rectifications introduites par la pondération analytique, il est instructif de synthétiser dans une table comparative directe les coefficients, leurs erreurs-types et les grandeurs inférentielles issues de chaque modélisation.
Cette confrontation chiffrée met en exergue l’évolution des erreurs-types : dans la plupart des contextes empiriques marqués par une variance croissante avec le régresseur, l’erreur-type de l’ordonnée à l’origine est notablement contractée sous WLS, reflétant l’abondance d’observations fiables et peu dispersées au voisinage immédiat de X = 0. La pente peut quant à elle voir son coefficient légèrement modulé ; bien que l’estimateur OLS soit asymptotiquement sans biais, les fluctuations d’échantillonnage locales d’un échantillon fini de 100 observations entraînent toujours un ajustement ponctuel différencié dès lors que l’on accorde une préséance mathématique aux points les plus précis.
Sur le plan des conclusions scientifiques, une telle comparaison atteste de la stabilité substantielle des résultats : si la pente demeure hautement significative sous les deux prismes méthodologiques, le modèle WLS confère à l’affirmation scientifique une robustesse mathématique irréprochable face aux exigences de publication des comités de lecture internationaux les plus stricts.
9.2 Interprétation prudente des métriques de qualité d’ajustement
L’un des pièges méthodologiques les plus redoutables dans lesquels trébuchent couramment les chercheurs réside dans la tentative de comparaison directe du coefficient de détermination R2 fourni respectivement par le sommaire du modèle OLS et par celui du modèle WLS. Dans le sommaire d’un objet WLS sous R, le R2 affiché est calculé sur les données transformées et pondérées, selon la formule :
Rw2 = 1 – ( ∑ wi (Yi – Ŷi)2 ) / ( ∑ wi (Yi – Ȳw)2 )
Cette statistique mesure la proportion de variance pondérée expliquée par le modèle pondéré au sein de l’espace géométrique transformé. Elle n’est en aucun cas comparable arithmétiquement au R2 standard du modèle OLS, qui quantifie la proportion de variance brute non pondérée expliquée sur l’échelle originale de la variable dépendante. Vouloir juger de la supériorité d’un ajustement WLS sur un modèle OLS en comparant leurs R2 respectifs constitue un contresens théorique majeur.
Pour arbitrer objectivement entre modèles sur l’échelle originale de mesure, l’analyste doit calculer des grandeurs invariantes telles que l’erreur quadratique moyenne prédictive brute (RMSE, pour Root Mean Squared Error) définie par √[ (1/n) ∑ (Yi – Ŷi)2 ], évaluée en appliquant les deux équations de prédiction directement aux scores observés non transformés. Concernant les critères d’information théorique d’Akaike (AIC) et bayésien (BIC), leur utilisation comparative entre OLS et WLS exige une précaution algorithmique extrême : il faut s’assurer que la fonction de log-vraisemblance intègre formellement le terme de normalisation du Jacobien lié à la transformation par les poids, condition indispensable pour que les log-vraisemblances soient évaluées sur un espace de probabilité strictement identique.
9.3 Diagnostic de résidus pondérés standardisés
L’étape ultime de la validation croisée consiste à administrer au modèle WLS les mêmes épreuves diagnostiques que celles ayant conduit au rejet initial de la régression ordinaire. Pour ce faire, l’analyste extrait les résidus standardisés de Pearson propres au modèle pondéré en exploitant la commande rstandard(wls_model).
La projection graphique de ces résidus pondérés standardisés face aux valeurs prédites doit révéler une transformation morphologique éclatante : l’ancien motif en entonnoir évasé qui caractérisait les résidus ordinaires a désormais totalement disparu au profit d’un nuage de points parfaitement stationnaire, uniformément confiné au sein d’une bande de largeur constante comprise typiquement entre -2 et +2 sur toute l’étendue de l’axe horizontal.
L’application d’un nouveau test de Breusch-Pagan appliqué aux résidus standardisés transformés vient sceller cette validation numérique en délivrant une p-valeur largement non significative (par exemple p > 0.40). Cette absence de rejet de l’hypothèse nulle prouve avec éclat que la structure d’hétéroscédasticité qui viciait le modèle d’origine a été neutralisée avec succès par le schéma de pondération calculé, conférant à la modélisation finale son plein statut d’optimalité statistique.
10. Approches itératives et extensions avancées sous R
10.1 Les moindres carrés pondérés itératifs (IRLS)
Bien que la procédure d’estimation des poids en deux étapes (FGLS) détaillée précédemment fournisse des résultats asymptotiquement cohérents, elle présente l’inconvénient d’asservir la pondération finale aux seuls résidus du modèle OLS d’origine, qui sont eux-mêmes affectés d’inefficacité statistique. L’algorithme des moindres carrés pondérés itératifs (IRLS, pour Iteratively Reweighted Least Squares) pousse la logique mathématique à son terme en instaurant un processus d’actualisation réciproque en boucle fermée.
Le protocole algorithmique de l’IRLS se déploie selon le cycle suivant :
1. Ajustement initial par moindres carrés ordinaires pour obtenir une première série de résidus e(0).
2. Estimation des poids initiaux w(1) = f(e(0)) au moyen de la modélisation de la variance retenue.
3. Réajustement de la régression linéaire pondérée avec ces nouveaux poids pour dériver de nouveaux coefficients β(1).
4. Calcul des nouveaux résidus issus de ce modèle réajusté : e(1) = Y – Xβ(1).
5. Ré-estimation d’une nouvelle matrice de pondération w(2) = f(e(1)), et répétition du processus d’itération jusqu’à ce que la différence relative entre les coefficients des étapes successives ||β(k+1) – β(k)|| devienne inférieure à un seuil de convergence infinitésimal prédéterminé (par exemple 10-6).
Sous R, l’IRLS constitue le cœur moteur de la fonction rlm() disponible au sein du paquet MASS, fréquemment mobilisée dans le cadre de la régression robuste face aux valeurs aberrantes (via les fonctions de perte de Huber ou de bisquare de Tukey). Dans ces extensions robustes, la pondération ne vise pas uniquement à modéliser une variance hétéroscédastique continue, mais à écraser de manière itérative le levier d’observations extrêmes atypiques suspectées d’appartenir à une distribution d’erreur contaminée.
10.2 Alternative par erreurs-types robustes (HC / Newey-West)
L’adoption des moindres carrés pondérés impose à l’analyste un choix de modélisation explicite sur la forme fonctionnelle régissant l’hétérogénéité de variance. Une alternative méthodologique largement répandue en économétrie et de plus en plus populaire en psychologie consiste à conserver intégralement l’estimation des coefficients de pente non pondérés OLS β̂OLS, tout en substituant à l’erreur-type conventionnelle une estimation robuste issue d’un estimateur sandwich hétéroscédastique-cohérent (HC).
Le paquet sandwich, développé par Achim Zeileis, met à disposition la fonction vcovHC() qui permet d’extraire instantanément diverses variantes de ces matrices de covariance corrigées :
library(sandwich)

library(lmtest)

coeftest(ols_model, vcov = vcovHC(ols_model, type = "HC3"))
La correction de type HC3 (recommandée par Long et Ervin pour les échantillons de taille modeste inférieure à 250 observations) pondère chaque résidu ordinaire au carré par le facteur (1 – hii)2, neutralisant efficacement l’influence des points à fort levier sur le calcul de la variance d’échantillonnage sans toucher aux coefficients de pente d’origine.
L’arbitrage scientifique entre WLS et correction sandwich repose sur une balance méthodologique claire : si le chercheur éprouve des doutes majeurs quant à la forme exacte de la fonction de variance et craint une mauvaise spécification des poids, l’estimateur sandwich HC3 constitue un filet de sécurité défensif optimal. En revanche, si la structure d’hétéroscédasticité peut être fidèlement théorisée et modélisée, le modèle WLS demeure l’approche reine, car elle seule procure un gain authentique de précision sur l’estimation des paramètres en réorientant activement l’angle de la droite de régression.
10.3 Généralisation aux modèles linéaires mixtes et multiniveaux
Dans les dispositifs de recherche comportementale contemporains, les données collectées adoptent fréquemment une architecture hiérarchique, emboîtée ou longitudinale (mesures répétées dans le temps au sein des mêmes participants). Dans un tel cadre multiniveau, l’hétéroscédasticité peut se déployer simultanément au niveau intra-individuel (variance résiduelle fluctuante au cours des sessions expérimentales) et au niveau inter-individuel (variance des pentes aléatoires conditionnée par un trait de personnalité stable).
Pour traiter avec rigueur ces architectures complexes, la modélisation par les moindres carrés généralisés étendue aux modèles mixtes s’avère indispensable. Le paquet nlme de Pinheiro et Bates offre à cet égard la puissante fonction gls() (Generalized Least Squares), qui permet de paramétrer directement la structure de variance des erreurs au moyen de l’argument weights, en faisant appel à des fonctions analytiques prédéfinies :
library(nlme)

gls_model <- gls(score ~ hours, data = df,

                 weights = varPower(form = ~ hours))
Dans cette commande avancée, la fonction varPower() instruit le logiciel d’estimer simultanément, par la méthode du maximum de vraisemblance restreinte (REML, pour Restricted Maximum Likelihood), le vecteur de coefficients de régression et l’exposant de puissance δ régissant l’accroissement de variance selon la formulation Var(εi) = σ2 × |Xi|2δ.
D’autres fonctions d’hétérogénéité telles que varIdent() (permettant d’attribuer des variances d’erreur distinctes à chaque niveau d’un facteur qualitatif de groupement) ou varExp() (modélisant une dispersion exponentielle) illustrent la plasticité totale de cette approche, unifiant harmonieusement la régression linéaire pondérée classique et l’analyse avancée des séries temporelles ou des plans d’expérience longitudinaux.
11. Pièges méthodologiques, limites et vérifications d’influence
11.1 Détection des observations influentes sous pondération
L’intégration d’un schéma de pondération modifie profondément la topographie géométrique de l’espace de régression et redéfinit intégralement les métriques traditionnelles d’influence et de levier statistique. Dans un modèle OLS standard, le levier d’une observation dépend uniquement de l’éloignement de ses valeurs de prédicteurs par rapport au centre de gravité multidimensionnel de l’échantillon. Dans une régression WLS, la matrice chapeau (Hat Matrix) intègre formellement la matrice de pondération :
Hw = W1/2 X (XT W X)-1 XT W1/2
Par conséquent, une observation peut acquérir un levier démesuré non pas parce que ses valeurs de prédicteurs sont extrêmes, mais simplement parce qu’elle s’est vu attribuer un coefficient de pondération analytique gigantesque. À l’inverse, un point très distant géométriquement sur l’axe des abscisses peut voir son influence totalement neutralisée si son poids wi est résiduel.
Il est impératif d’évaluer la distance de Cook adaptée au cadre pondéré, accessible dans R par l’application directe de la fonction cooks.distance(wls_model). L’analyste doit inspecter attentivement les diagrammes d’influence projetant les résidus pondérés studentisés en fonction du levier pondéré. L’émergence d’observations combinant un fort résidu et un poids massif présente le risque redoutable d’une déformation unilatérale de l’hyperplan ajusté sous la dépendance d’un seul sujet atypique, imposant une vérification de robustesse systématique consistant à ré-estimer le modèle après exclusion itérative des points les plus influents.
11.2 Mauvaise spécification de la structure de pondération
L’application des moindres carrés pondérés ne constitue pas une panacée universelle exempte de risques méthodologiques. Le danger prépondérant réside dans la spécification erronée de la fonction de variance auxiliaire. Si l’analyste choisit une modélisation inadaptée des résidus (en supposant par exemple que la variance dépend de la variable X1 alors qu’elle est en réalité conditionnée par une variable omise X2 ou par un effet de groupe latent), la matrice de poids dérivée W sera arbitraire et inexacte.
Dans ce cas de figure pathologique, l’estimateur FGLS subit une dégradation théorique pénalisante :
* Bien qu’il conserve son asymptotique non-biais (pour autant que l’espérance conditionnelle des erreurs soit nulle), il perd l’intégralité de ses propriétés de variance minimale d’Aitken.
* Son efficacité empirique en échantillon fini peut devenir nettement inférieure à celle de l’estimateur OLS non corrigé, augmentant substantiellement la dispersion réelle d’échantillonnage des coefficients.
* Les erreurs-types conventionnelles affichées par le sommaire du modèle WLS, calculées sous la présomption aveugle que les poids sont exactement inverses aux vraies variances, deviennent fallacieuses et sous-estiment l’aléa réel, restaurant l’inflation de l’erreur de type I que la procédure était censée juguler.
Pour se prémunir contre cette dérive, une stratégie éprouvée consiste à combiner l’ajustement WLS avec une correction de variance de type sandwich appliquée à l’objet pondéré (en utilisant vcovHC(wls_model)). Cette approche hybride garantit que même si le schéma de pondération est modérément imparfait, l’erreur-type finale demeurera asymptotiquement robuste à toute hétérogénéité résiduelle résidant au sein des résidus transformés.
11.3 Hypothèses secondaires du modèle pondéré
L’attention focalisée sur la résolution de l’hétéroscédasticité ne doit pas occulter le contrôle méthodique des autres postulats fondamentaux régissant la validité du modèle linéaire général. Une fois le modèle WLS ajusté, il est indispensable de vérifier la distribution normale des résidus pondérés standardisés. L’exécution du test de normalité de Shapiro-Wilk (via shapiro.test(rstandard(wls_model))) conjointement à l’inspection du diagramme Q-Q plot permet d’attester que la procédure de pondération n’a pas induit une asymétrie artificielle ou accentué le caractère leptokurtique des perturbations.
De même, l’absence d’autocorrélation entre les termes d’erreur résiduels doit être certifiée au moyen du test de Durbin-Watson, disponible via la commande dwtest(wls_model) du paquet lmtest. La présence d’une autocorrélation sérielle positive non traitée invaliderait la structure diagonale présumée de la matrice W et exigerait le recours à des structures d’autorégression plus élaborées de type AR(1).
Enfin, la question de la linéarité fonctionnelle de la relation moyenne demeure primordiale. Il arrive fréquemment dans la pratique clinique qu’une apparente hétéroscédasticité des résidus ne soit que le symptôme d’une relation sous-jacente fondamentalement non linéaire (comme une fonction exponentielle de saturation ou une trajectoire polynomiale cubique). L’évaluation des composantes de courbure résiduelle au moyen du test RESET de Ramsey (via resettest(wls_model)) permet de s’assurer que l’équation ne souffre d’aucune omission de puissance fonctionnelle majeure, garantissant ainsi que la pondération traite une réelle instabilité de variance stochastique et non une simple mauvaise formulation de la trajectoire moyenne.
12. Applications empiriques en psychologie et communication des résultats académiques
12.1 Rédaction et présentation des résultats selon les normes APA
La rédaction scientifique des résultats d’une régression par les moindres carrés pondérés au sein d’un article soumis à une revue académique internationale exige le respect scrupuleux des normes de l’American Psychological Association (APA, 7e édition). La restitution ne peut se borner à délivrer les seuls coefficients finaux : elle doit impérativement documenter la chaîne décisionnelle méthodologique complète ayant justifié l’abandon du modèle OLS standard.
Le corps du texte de la section méthodologie ou résultats doit s’articuler selon une logique rigoureuse :
1. Justification initiale de l’évaluation du postulat d’homoscédasticité et rapport formel des tests diagnostiques initiaux (par exemple : « L’inspection visuelle des résidus de la régression linéaire simple préliminaire a révélé un motif manifeste d’hétéroscédasticité en entonnoir, confirmé formellement par le test de Breusch-Pagan modifié par Koenker, BP(1) = 14.82, p < .001 »).
2. Présentation explicite de la procédure d’estimation des poids retenue (par exemple : « Pour restaurer l’efficacité statistique des estimateurs, une régression par les moindres carrés pondérés a été appliquée en définissant les poids analytiques comme l’inverse de la variance estimée par modélisation exponentielle du logarithme des résidus au carré, wi = 1 / exp(γ̂0 + γ̂1 Xi) »).
3. Rapport des paramètres inférentiels corrigés incluant les coefficients de régression non standardisés B avec leurs intervalles de confiance à 95 %, les erreurs-types corrigées SE, la statistique de Student t avec ses degrés de liberté résiduels précis, et la valeur p exacte (par exemple : « Le temps de révision prédit de façon statistiquement significative le score à l’examen final, B = 1.38, SE = 0.09, t(98) = 15.33, p < .001, 95% IC [1.20, 1.56] »).
4. Précision expresse relative à la métrique de qualité d’ajustement globale pour prévenir toute méprise (en spécifiant clairement s’il s’agit du coefficient de détermination pondéré Rw2 ou de la réduction de l’erreur quadratique moyenne non pondérée sur les données d’origine).
La présentation sous forme de tableau normalisé constitue le format idéal pour offrir une lisibilité optimale, juxtaposant côte à côte le modèle OLS préliminaire non corrigé et le modèle WLS définitif afin de mettre en lumière l’affinement des erreurs-types.
12.2 Cas d’usage appliqués en psychométrie et sciences cognitives
Les champs d’application concrets de la régression WLS abondent dans l’ensemble des sous-disciplines des sciences cognitives et du comportement. Dans l’exploration des temps de réaction chronométriques confrontés à la charge mentale de travail (quantifiée par le nombre d’éléments maintenus en mémoire de travail dans un protocole d’empan complexe), l’hétérogénéité de variance est systématique : les blocs expérimentaux à haute charge génèrent une augmentation spectaculaire de la variabilité résiduelle intra-sujet. L’assignation de poids inversement proportionnels à la variance temporelle locale de chaque condition permet de modéliser avec une fidélité optimale la vitesse d’épuisement des ressources attentionnelles.
Dans le champ de l’évaluation des interventions psychothérapeutiques ou neuropsychologiques, les protocoles cliniques multicentriques évaluent fréquemment l’efficacité d’un traitement en colligeant des moyennes de scores de dépression ou d’anxiété issues de diverses cohortes hospitalières locales. Dans la mesure où les effectifs recrutés varient grandement d’un centre hospitalier à l’autre (certains centres incluant 150 patients tandis que d’autres n’en comptent que 20), la variance d’échantillonnage de chaque moyenne de centre est intrinsèquement disparate. La mise en œuvre d’un modèle WLS pondérant chaque centre par son effectif d’échantillon nj constitue le standard incontournable pour éviter que les petits centres instables ne déforment l’estimation de l’efficacité thérapeutique globale.
De même, l’étude des courbes d’apprentissage et de rétention mnésique en psychologie de l’éducation démontre que la variabilité interindividuelle de l’acquisition s’amplifie considérablement au fur et à mesure que les sessions de répétition espacée s’accumulent. L’application du formalisme WLS assure que les modélisations de trajectoires de rétention à long terme ne soient pas artificiellement biaisées par la dispersion accrue des phases tardives, procurant aux théoriciens de l’apprentissage des estimations précises et stables des asymptotes de maîtrise conceptuelle.
12.3 Bonnes pratiques pour la science ouverte et la reproductibilité
L’adoption de méthodes quantitatives avancées telles que la régression pondérée s’inscrit au cœur du mouvement contemporain en faveur de la science ouverte (Open Science) et de la reproductibilité computationnelle des résultats empiriques. L’implémentation de la régression WLS faisant intervenir des étapes d’estimation auxiliaire des résidus et des calculs de poids paramétriques, la transparence algorithmique totale doit être garantie à la communauté scientifique.
Pour satisfaire aux standards les plus exigeants :
* Le script R d’analyse complet, autonome et minutieusement commenté doit être déposé sur un entrepôt public institutionnel pérenne (tel que l’Open Science Framework ou Zenodo).
* En cas de recours à des simulations stochastiques ou à des sous-échantillonnages préliminaires de validation croisée, l’initialisation de la graine aléatoire via l’instruction set.seed() doit être rigoureusement documentée dès les premières lignes du code source pour permettre une régénération exacte des valeurs numériques à la virgule près.
* Le cahier de laboratoire numérique (de type R Markdown ou Quarto) doit consigner l’intégralité des diagnostics graphiques bruts ayant motivé le passage au modèle WLS, incluant les graphiques initiaux résidus-valeurs prédites, les sorties textuelles complètes des tests de Breusch-Pagan et de White, ainsi que les diagnostics post-ajustement attestant de l’homogénéisation réussie des résidus transformés.
* Enfin, l’environnement logiciel complet (version exacte de R, versions précises des paquets lmtest, car, sandwich et compilateur C/Fortran sous-jacent) doit être formalisé au moyen de la commande sessionInfo() annexée en fin de script de traitement.
En intégrant ces préceptes de rigueur statistique, d’élégance computationnelle et de transparence méthodologique, le chercheur contemporain garantit que ses analyses de régression par les moindres carrés pondérés sous R constituent non seulement un modèle d’excellence mathématique, mais également une contribution solide, reproductible et durable au progrès des sciences empiriques.
Références
Aitken, A. C. (1936). On least squares and linear combinations of observations. Proceedings of the Royal Society of Edinburgh, 55, 42-48. https://doi.org/10.1017/S0370164600014431
Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716-723. https://doi.org/10.1109/TAC.1974.1100705
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287-1294. https://doi.org/10.2307/1911963
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
Goldfeld, S. M., & Quandt, R. E. (1965). Some tests for homoscedasticity. Journal of the American Statistical Association, 60(310), 539-547. https://doi.org/10.1080/01621459.1965.10480811
Harvey, A. C. (1976). Estimating regression models with multiplicative heteroscedasticity. Econometrica, 44(3), 461-465. https://doi.org/10.2307/1913974
Koenker, R. (1981). A note on studentizing a test for heteroscedasticity. Journal of Econometrics, 17(1), 107-112. https://doi.org/10.1016/0304-4076(81)90062-2
Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217-224. https://doi.org/10.1080/00031305.2000.10474549
Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817-838. https://doi.org/10.2307/1912934
Zeileis, A. (2004). Econometric computing with HC and HAC covariance matrix estimators. Journal of Statistical Software, 11(10), 1-17. https://doi.org/10.18637/jss.v011.i10