
L’analyse statistique au sein des sciences comportementales et de la psychologie contemporaine repose sur une exigence constante d’objectivation des phénomènes observables et latents. Dans cette démarche empirique, la modélisation des relations fonctionnelles entre construits psychologiques — qu’il s’agisse de mesurer l’impact du stress sur la mémoire de travail, l’effet du temps de sommeil sur l’attention soutenue ou l’influence du sentiment d’auto-efficacité sur la performance académique — constitue le cœur battant de la recherche expérimentale et corrélationnelle. Parmi l’arsenal méthodologique disponible pour le chercheur, la régression linéaire simple demeure la méthode fondamentale et la pierre angulaire à partir de laquelle s’érigent les architectures statistiques plus complexes telles que les modèles linéaires généralisés et les équations structurelles.
Le langage de programmation et environnement statistique R s’est imposé, au fil des deux dernières décennies, comme la référence mondiale incontournable pour l’analyse computationnelle des données psychométriques. Grâce à son écosystème modulaire ouvert, à sa rigueur mathématique sans compromis et à des capacités graphiques d’une expressivité inégalée, R permet non seulement d’ajuster des modèles statistiques avec une précision chirurgicale, mais également de sonder en profondeur le respect de leurs postulats sous-jacents. La mise en œuvre d’une régression linéaire simple dans R ne se résume pas à l’exécution machinale d’une fonction d’estimation ; elle exige une compréhension théorique approfondie des hypothèses sous-jacentes, une exploration méthodique de la structure des résidus et une interprétation rigoureuse des paramètres estimés à l’aune des théories psychologiques sous-jacentes.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, psychologues quantitativistes, étudiants doctorants et analystes de données à travers chaque dimension théorique, computationnelle et interprétative de la régression linéaire simple dans l’environnement R. En déployant une pédagogie pas à pas qui articule les principes mathématiques des moindres carrés ordinaires, la syntaxe idiomatique moderne, le diagnostic minutieux des violations de postulats et les exigences de publication scientifique dictées par l’American Psychological Association (APA), cet article fournit un cadre complet, reproductible et robuste pour transformer des observations brutes en inférences scientifiques irréprochables.
1. Introduction aux fondements théoriques de la régression linéaire simple en psychologie
1.1 Définition et objectifs de la régression linéaire simple
D’un point de vue épistémologique, la modélisation par régression linéaire simple dépasse fondamentalement la simple description de l’association mutuelle mesurée par une corrélation bivariée. Tandis que le coefficient de Pearson se contente d’évaluer la force et la direction de la co-variation symétrique entre deux grandeurs sans assigner de rôle directionnel à l’une ou l’autre, la régression postule une structure asymétrique. Dans ce cadre, une variable explicative — qualifiée de variable indépendante, de variable prédictive ou de régresseur — est mobilisée pour expliquer, prédire ou contraindre la variabilité observée au sein d’une variable de réponse, désignée comme variable dépendante ou variable critère. Ce basculement paradigmatique est crucial en psychologie empirique : il autorise le passage d’une simple observation de concordance comportementale à un modèle prédictif formel, voire à une perspective causale lorsque le protocole expérimental garantit la manipulation temporelle du prédicteur et le contrôle strict des variables parasites.
Dans l’étude des processus cognitifs, des dynamiques émotionnelles et des caractéristiques de la personnalité, l’application de la régression linéaire simple poursuit deux objectifs cardinaux. Le premier consiste à quantifier l’ampleur de l’effet d’une manipulation ou d’un trait individuel sur un comportement donné. Il ne s’agit plus uniquement de déterminer si deux dimensions psychométriques sont liées de façon statistiquement significative, mais de modéliser avec précision le gain unitaire attendu sur le score critère pour chaque augmentation marginale d’une unité sur l’échelle du prédicteur. Le second objectif relève de l’inférence statistique formelle : tester des hypothèses réfutables concernant la population cible en extrapolant les régularités observées sur un échantillon représentatif, tout en circonscrivant l’incertitude inhérente à l’échantillonnage aléatoire.
1.2 L’équation fondamentale de la droite de régression
L’architecture formelle de la régression linéaire simple s’exprime au moyen de l’équation mathématique définissant la population :
yi = β0 + β1xi + εi
Dans cette formulation analytique, yi représente la valeur observée de la variable réponse pour le sujet i au sein de la cohorte d’étude, tandis que xi désigne la valeur correspondante de la variable explicative pour ce même participant. Le terme β0 symbolise l’ordonnée à l’origine de la droite théorique, communément appelée constante du modèle. Sur le plan psychométrique, sa signification dépend fortement du calibrage des instruments de mesure : elle reflète la valeur attendue de la réponse lorsque le prédicteur est strictement égal à zéro. Lorsque x représente une échelle psychométrique brute où le zéro est absent ou arbitraire — tel qu’un score de quotient intellectuel ou une note sur une échelle de Likert allant de 1 à 7 —, la constante peut s’avérer dépourvue de sens théorique immédiat, incitant le méthodologiste à recourir à un centrage préalable pour rendre ce paramètre directement interprétable au niveau de la moyenne de l’échantillon.
Le paramètre β1 incarne la pente de la droite de régression, c’est-à-dire le taux de variation marginale de la variable réponse par unité d’augmentation de la variable indépendante. Il constitue le coefficient de régression proprement dit, dont le signe positif ou négatif indique la direction de la relation et dont la valeur absolue renseigne sur l’intensité de l’impact exercé par le prédicteur. Enfin, εi représente le terme d’erreur résiduelle aléatoire associé à l’observation individuelle. En psychologie, où l’hétérogénéité interindividuelle est indissociable de la condition humaine, ce terme stochastique englobe l’ensemble des déterminants non mesurés, la variabilité physiologique transitoire, les erreurs inhérentes à la fidélité des tests psychométriques et le hasard probabiliste. Ce résidu est formellement modélisé comme une variable aléatoire dont la distribution théorique est censée suivre une loi normale de moyenne nulle et de variance constante σ2.
1.3 Le principe d’estimation par les moindres carrés ordinaires (MCO)
La dérivation empirique des coefficients de régression inconnus (β0 et β1) à partir des données échantillonnées repose traditionnellement sur la méthode des moindres carrés ordinaires (MCO). Le principe géométrique fondamental de cette approche consiste à identifier, parmi l’infinité de trajectoires linéaires concevables au sein du plan cartésien bivarié, la droite unique qui minimise la somme des carrés des écarts verticaux séparant chaque point d’observation empirique de sa projection orthogonale sur la droite prédite. Algébriquement, il s’agit de minimiser la fonction de coût connue sous le terme de somme des résidus au carré (notée SSE, pour Sum of Squared Errors) :
SSE = Σ (yi – (β̂0 + β̂1xi))2
Par différentiation partielle et annulation des dérivées premières par rapport aux deux estimateurs, les équations normales de Gauss permettent d’aboutir à des solutions analytiques uniques sous forme fermée. Le célèbre théorème de Gauss-Markov stipule que, sous réserve du respect des postulats classiques de linéarité, d’indépendance, d’espérance conditionnelle nulle et d’homogénéité de la variance, les estimateurs issus des MCO possèdent la propriété remarquable d’être les meilleurs estimateurs linéaires sans biais disponibles (désignés par l’acronyme BLUE, pour Best Linear Unbiased Estimators). Cela implique qu’aucun autre estimateur linéaire n’est capable d’afficher une variance d’échantillonnage inférieure à celle obtenue par les moindres carrés ordinaires.
Il importe toutefois de souligner la vulnérabilité mathématique inhérente au critère quadratique des moindres carrés. En élevant au carré les distances résiduelles, l’algorithme accorde un poids disproportionné aux points situés aux marges extrêmes de la distribution empirique. Par conséquent, l’existence d’une asymétrie marquée ou la présence d’observations aberrantes est susceptible de dévier substantiellement la trajectoire de la droite, distordant les conclusions statistiques. Si l’approche par le maximum de vraisemblance (MLE) constitue une alternative conceptuelle puissante — convergeant vers des estimations parfaitement identiques à celles des MCO sous l’hypothèse stricte de normalité gaussienne des erreurs —, les MCO conservent la primauté en pratique clinique et expérimentale en raison de leur simplicité computationnelle et de leur robustesse opérationnelle éprouvée.
2. Formulation mathématique et postulats sous-jacents du modèle linéaire
2.1 Hypothèse de linéarité de la relation
L’hypothèse primordiale conditionnant la validité interne d’un modèle de régression linéaire simple postule que la relation fonctionnelle reliant la variable indépendante à la variable dépendante est de nature linéaire. Mathématiquement, cela implique que l’espérance conditionnelle de la réponse pour une valeur fixée du prédicteur, notée E(Y|X = x), constitue une transformation affine stricte de cette valeur explicative. Cette contrainte fondamentale impose que le changement marginal attendu au niveau de la variable critère pour un incrément d’une unité de x demeure rigoureusement invariant, quel que soit le niveau initialement considéré sur le continuum du prédicteur.
En sciences du comportement, la violation de ce postulat survient fréquemment lors de l’étude de mécanismes régulés par des lois psychophysiques ou psychobiologiques non monotones. L’illustration paradigmatique en est la célèbre loi de Yerkes-Dodson, qui théorise une relation en cloche (en U inversé) entre le niveau d’éveil ou de stress d’un sujet et sa performance cognitive. Si un chercheur tente d’ajuster un modèle linéaire strict sur des données régies par un processus curviligne quadratique ou exponentiel, les estimations de la pente β̂1 s’avéreront biaisées et masqueront la réalité phénoménologique. L’évaluation de la linéarité requiert par conséquent une exploration minutieuse des trajectoires empiriques par l’entremise de fonctions non paramétriques lissées avant de statuer sur la pertinence d’une spécification linéaire directe.
2.2 Indépendance et homoscédasticité des erreurs
Le second corpus de postulats concerne les propriétés intrinsèques du terme d’erreur résiduelle. En premier lieu, l’hypothèse d’indépendance mutuelle des résidus exige que la covariance stochastique entre deux erreurs distinctes, Cov(εi, εj), soit nulle pour tout couple d’observations i ≠ j. Dans le contexte de la recherche psychologique, cette hypothèse est systématiquement compromise dès lors que les données présentent une structure hiérarchique, emboîtée ou séquentielle : c’est le cas typique des cohortes scolaires où les élèves d’une même classe partagent des influences pédagogiques communes, ou encore des protocoles longitudinaux impliquant des mesures répétées sur les mêmes sujets à intervalles réguliers. La présence d’autocorrélation résiduelle altère drastiquement le calcul des degrés de liberté et conduit à une sous-estimation artificielle des erreurs-types, générant un risque d’inflation dramatique de l’erreur de type I (faux positifs).
En second lieu, l’hypothèse d’homogénéité de la variance des erreurs, dénommée homoscédasticité, stipule que la variance conditionnelle des perturbations stochastiques Var(εi|X = xi) = σ2 doit demeurer rigoureusement constante sur l’intégralité du domaine de définition du prédicteur. À l’opposé, l’hétéroscédasticité caractérise une configuration pathologique où la dispersion des résidus s’accroît ou s’amenuise en fonction de la magnitude de x. En psychopathologie expérimentale, il est courant de constater que les sujets affichant des niveaux modérés d’anxiété présentent une variance comportementale restreinte, tandis que les individus hautement anxieux développent des réponses motrices erratiques et hautement dispersées. Bien que l’hétéroscédasticité ne biaise pas les estimations ponctuelles des coefficients par les MCO, elle détruit l’optimalité asymptotique de leur variance et invalide les tests statistiques basés sur la statistique t et la statistique F.
2.3 Normalité conditionnelle des résidus
Le postulat de normalité des résidus stipule que la distribution d’échantillonnage de l’erreur stochastique, conditionnellement à n’importe quel niveau de la variable explicative, se conforme à une loi de distribution gaussienne de moyenne nulle : εi ~ N(0, σ2). Il est fondamental d’opérer une distinction conceptuelle nette entre la normalité marginale des variables brutes et la normalité des résidus du modèle ajusté. En effet, la régression linéaire simple n’impose aucunement que la variable indépendante x ou la variable réponse y suivent isolément une loi normale non conditionnelle dans la population. Il est tout à fait licite d’intégrer des prédicteurs asymétriques, uniformes ou bivalents, pourvu que la dispersion des écarts autour du plan de régression soit, elle, normalement distribuée.
Sur le plan inférentiel, ce postulat conditionne la validité exacte des distributions d’échantillonnage mobilisées pour le calcul des valeurs p et l’établissement des intervalles de confiance à seuil nominal garanti. Néanmoins, en vertu du théorème central limite, le modèle linéaire bénéficie d’une robustesse asymptotique considérable : au sein de grands échantillons (généralement n > 100 ou 200 en psychométrie), les estimateurs des coefficients convergent vers une loi normale même lorsque la distribution empirique des résidus s’écarte modérément de la gaussianité idéale. Pour autant, dans les études cliniques restreintes ou les protocoles de neuro-imagerie fonctionnelle impliquant des effectifs limités, le non-respect avéré de cette normalité conditionnelle peut compromettre l’interprétation des seuils de significativité statistique, requérant alors des ajustements méthodologiques spécifiques.
3. Étape 1 : Préparation de l’environnement R et chargement des données
3.1 Configuration de l’espace de travail et bibliothèques essentielles
Pour assurer la rigueur et la reproductibilité computationnelle exigées par les sciences ouvertes contemporaines, la mise en place d’une session de travail R standardisée constitue un préalable méthodologique absolu. L’écosystème Tidyverse, conçu sous la direction méthodologique d’Hadley Wickham, fournit une suite intégrée et cohérente de packages optimisés pour l’ingestion, la manipulation et la restitution visuelle des données psychométriques. L’intégration harmonieuse des packages readr pour l’importation délimitée, dplyr pour les opérations de filtrage et de transformation vectorielle, et ggplot2 pour la grammaire graphique garantit une syntaxe claire et pérenne.
Au-delà du chargement des bibliothèques fondamentales, le chercheur doit obligatoirement verrouiller le générateur de nombres pseudo-aléatoires au moyen de l’instruction set.seed() lorsque des procédures de simulation, de permutation ou de partitionnement sont engagées. De surcroît, le paramétrage des options globales de la session — notamment la gestion du nombre de chiffres significatifs affichés à l’écran via l’option options(digits = 4, scipen = 999) — prévient l’irruption impromptue de notations scientifiques cryptiques dans les fenêtres d’émulation de la console, facilitant ainsi la lecture immédiate des métriques de précision numérique par l’expérimentateur.
3.2 Création d’un jeu de données psychologique expérimental
Afin de concrétiser l’exposé des méthodes d’estimation tout au long de cette monographie, nous concevons un jeu de données expérimental réaliste, simulant une étude menée en psychologie cognitive et différentielle. Supposons qu’un laboratoire universitaire s’intéresse à l’impact mesurable du volume horaire hebdomadaire alloué à la révision autonome (noté Temps_Etude, exprimé en heures) sur le score final obtenu lors d’un examen standardisé d’évaluation des capacités de raisonnement inductif (noté Score_Examen, calibré sur une échelle psychométrique standardisée de 0 à 100 points).
L’échantillon d’étude comprend une cohorte de n = 120 étudiants universitaires de premier cycle ayant consenti à faire monitorer leur travail préparatoire via une plateforme d’apprentissage numérique. Chaque enregistrement intègre un identifiant alphanumérique unique pour chaque individu (ID_Sujet), écartant ainsi toute ambiguïté sur l’unité d’observation. Les valeurs de la variable explicative continue sont modélisées pour refléter la variabilité empirique typique d’une population étudiante, avec une moyenne théorique de 20 heures et un écart-type de 5 heures, tandis que la réponse est déterminée par une fonction linéaire augmentée d’un terme stochastique hétérogène, mimant les fluctuations individuelles réelles observées sur le terrain expérimental.
3.3 Inspection initiale et nettoyage des données
L’importation ou la génération d’un tableau d’observations (qu’il se présente sous la forme canonique d’un data.frame de base ou d’un tibble optimisé) ne saurait déboucher directement sur l’ajustement mécanique d’un modèle sans un contrôle qualité préalable. L’analyse structurale par le biais des fonctions système str() ou dplyr::glimpse() permet de certifier le typage strict des colonnes. Il est impératif que les deux variables d’intérêt soient encodées sous forme de vecteurs numériques à double précision (double ou numeric), et non sous forme de facteurs catégoriels ou de chaînes de caractères textuelles, un piège récurrent résultant de formats d’importation mal configurés.
En second lieu, l’expérimentateur doit auditer de manière systématique l’existence de données manquantes (notées NA dans la terminologie interne de R). L’évaluation du pourcentage de vacance par variable via colSums(is.na(donnees)) permet de déterminer si une stratégie de suppression univariée (na.omit()) est méthodologiquement acceptable ou si des protocoles d’imputation multiple s’avèrent nécessaires afin d’éviter tout biais d’attrition systématique. Enfin, le contrôle des bornes numériques au moyen de summary() permet d’identifier d’éventuelles erreurs d’encodage matériel, telles qu’un score de 150 sur un barème limité à 100, qui dénatureraient les résultats de toute modélisation ultérieure.
4. Étape 2 : Analyse exploratoire et corrélation bivariée préalable
4.1 Statistiques descriptives univariées
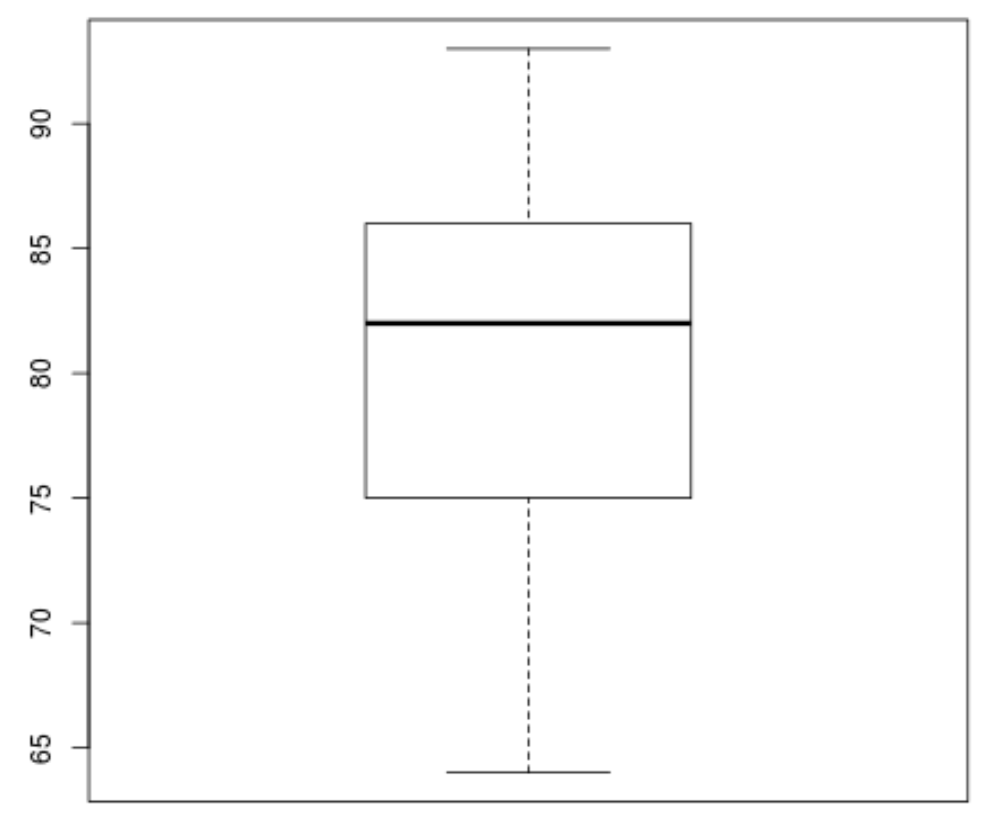
L’analyse exploratoire des données représente l’étape indispensable à toute entreprise de modélisation inférentielle. Avant d’articuler un lien fonctionnel entre deux construits, le psychologue quantitativiste doit maîtriser l’architecture univariée de chaque dimension prise individuellement. La caractérisation des tendances centrales s’opère par l’extraction conjointe de la moyenne arithmétique et de la médiane, dont la proximité relative éclaire le degré de symétrie de la distribution. En parallèle, la métrique de dispersion est jaugée par le truchement de l’écart-type empirique ajusté (fourni par la fonction sd()) et de l’intervalle interquartile (calculé par IQR()), fournissant un contrepoint robuste face aux variations atypiques.
L’examen des propriétés morphologiques des distributions impose l’évaluation des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis), couramment disponibles au sein du package e1071 ou psych. Une asymétrie marquée témoigne d’un tassement des scores vers le plancher ou le plafond de l’épreuve psychométrique, une pathologie d’échantillonnage fréquente en psychologie scolaire. La spatialisation visuelle de ces métriques s’effectue au moyen d’histogrammes calibrés selon la règle de Freedman-Diaconis ou de boîtes à moustaches (boxplots) standardisées selon l’algorithme de Tukey, révélant les discontinuités distributionnelles majeures.
4.2 Évaluation du coefficient de corrélation de Pearson
Préalablement à l’évaluation paramétrique de la droite de régression, il convient de quantifier l’intensité du couplage linéaire brut par le calcul du coefficient de corrélation produit-moment de Bravais-Pearson, conventionnellement symbolisé par r. L’exécution de la commande standard cor.test(donnees$Temps_Etude, donnees$Score_Examen) renvoie non seulement l’estimation ponctuelle du coefficient, mais également la statistique de Student associée, les degrés de liberté inhérents (df = n – 2), la valeur p bilatérale et l’intervalle de confiance encadrant le paramètre dans la population au seuil de confiance de 95 %.
L’interprétation clinique de ce coefficient requiert une circonspection épistémologique stricte. Un coefficient d’une magnitude élevée (par exemple r = 0.65, dénotant un grand effet selon les balises empiriques actualisées de Jacob Cohen pour les sciences humaines) certifie une relation linéaire consistante au sein de l’échantillon, mais ne garantit en rien l’absence de biais de confusion causé par un tiers facteur non modélisé, tel que la motivation intrinsèque ou le quotient intellectuel sous-jacent. Il n’en demeure pas moins que dans le cadre univarié de la régression linéaire simple, le carré du coefficient de Pearson (r2) coïncide rigoureusement avec le coefficient de détermination du modèle linéaire estimé, marquant la continuité analytique intime unissant corrélation et régression.
4.3 Construction du diagramme de dispersion exploratoire
Aucune synthèse numérique univariée ou bivariée ne saurait suppléer l’inspection visuelle globale des données brutes au moyen d’un diagramme de dispersion cartésien (scatterplot). L’adage statistique formalisé par le quartet d’Anscombe illustre avec acuité que des jeux de données aux propriétés descriptives élémentaires et aux coefficients de Pearson rigoureusement identiques peuvent découler de structures phénoménologiques fondamentalement dissemblables, englobant des relations paraboliques pures, des séparations de sous-groupes ou des artefacts d’échantillonnage extrêmes.
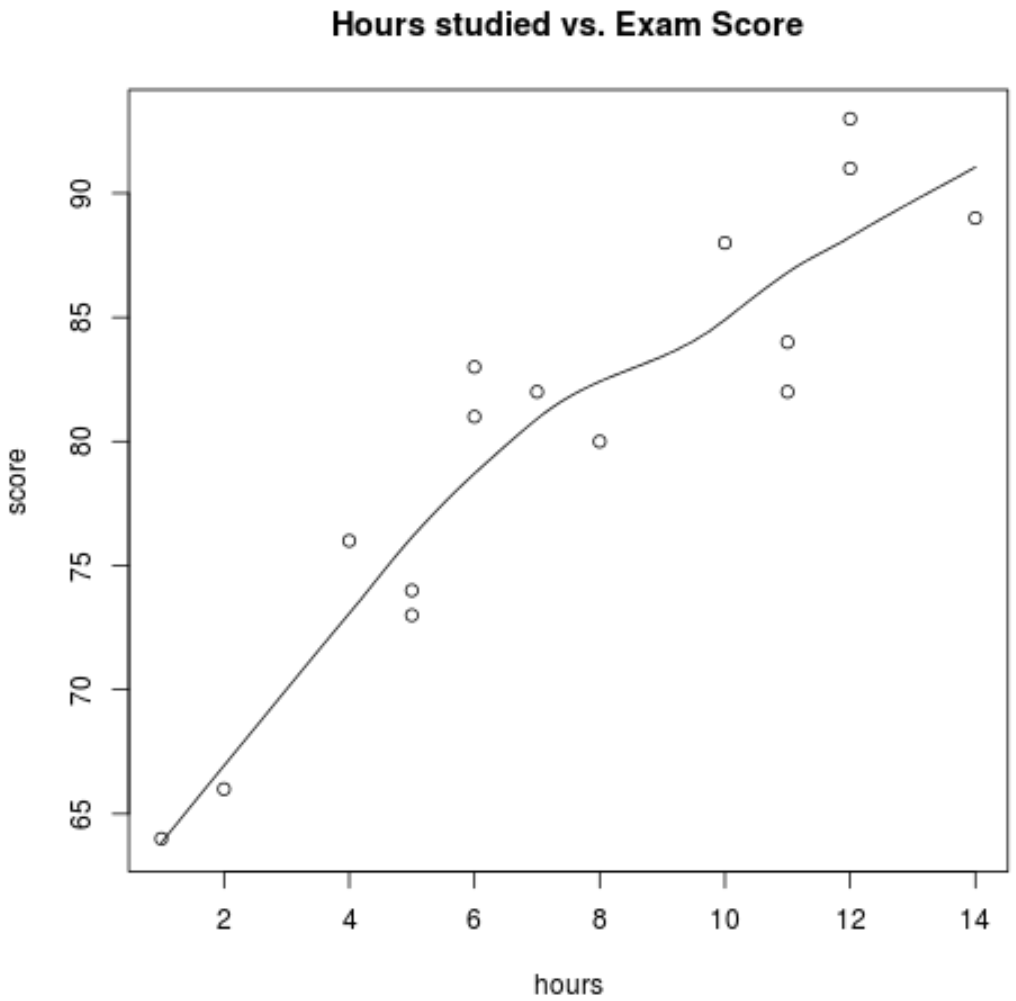
La mobilisation de ggplot2 via la superposition de points géométriques individuels (geom_point()) permet de scruter la disposition spatiale des données psychométriques. L’intégration systématique d’une ligne de tendance lissée non paramétrique basée sur la régression locale LOESS (geom_smooth(method = « loess », se = TRUE)) fournit un point d’appui visuel fondamental. Si la trajectoire de lissage locale épouse sans torsion manifeste une tendance rectiligne, le postulat de linéarité est corroboré par l’expérience visuelle, validant le recours subséquent à un ajustement paramétrique linéaire global.
5. Étape 3 : Ajustement du modèle de régression linéaire simple avec lm()
5.1 Syntaxe formelle de la fonction lm()
L’opération de modélisation linéaire dans R est gouvernée par la fonction fondamentale lm(), issue du package central stats. Sa syntaxe repose sur l’implémentation de la grammaire symbolique introduite historiquement par Wilkinson et Rogers en 1973. L’argument central consiste en une formule formelle où la variable réponse se positionne à gauche de l’opérateur tilde (~), tandis que le terme prédictif se situe immédiatement à sa droite :
modele_reg <- lm(Score_Examen ~ Temps_Etude, data = donnees)
L’utilisation explicite du paramètre data constitue une bonne pratique logicielle cardinale. Elle garantit que l’interpréteur R évalue les noms de variables au sein de l’environnement lexical confiné du tableau d’observations passé en argument, prévenant l’injection involontaire de vecteurs homonymes flottant dans l’espace de travail global (Global Environment). L’affectation du résultat à un objet structuré, ici nommé avec cohérence modele_reg, évite la dispersion des calculs et préserve l’état complet du modèle ajusté en mémoire en vue d’opérations d’extraction ou de diagnostics ultérieurs.
5.2 Exploration interne de l’objet de classe ‘lm’
L’objet retourné par l’appel à la fonction lm() appartient formellement à la classe S3 éponyme lm. Sous cette désignation formelle se dissimule une liste complexe contenant une douzaine d’éléments computationnels cruciaux découlant de l’application de la décomposition matricielle QR aux données empiriques. L’inspection des composantes de l’objet via names(modele_reg) révèle l’existence d’éléments matriciels indispensables tels que coefficients, residuals, fitted.values, rank, weights et df.residual.
Pour extraire les métriques de modélisation avec rigueur, le chercheur doit privilégier les fonctions d’accès génériques plutôt que l’indexation directe manuelle par le symbole dollar. Ainsi, l’instruction coef(modele_reg) extrait fidèlement le vecteur à deux éléments formalisant l’ordonnée à l’origine (β̂0) et le coefficient directeur de la pente (β̂1). Parallèlement, l’appel à fitted(modele_reg) et residuals(modele_reg) permet d’isoler instantanément les 120 prédictions ajustées conditionnelles et les 120 écarts résiduels bruts, assurant un pipeline de traitement fluide et résistant aux éventuelles restructurations d’objets au sein des versions logicielles de R.
5.3 Gestion des facteurs d’échelle et standardisation
L’interprétation brute des coefficients de régression dépend intrinsèquement des unités de mesure physiques ou psychométriques assignées aux instruments. Dans de multiples contextes de recherche comparée ou méta-analytique, il s’avère hautement profitable de s’affranchir des unités arbitraires en calculant les coefficients de régression standardisés, communément désignés par la lettre grecque bêta (β*). Un coefficient standardisé traduit le nombre d’écarts-types de déplacement sur la variable réponse consécutif à l’accroissement d’un écart-type sur le continuum du prédicteur.
Dans l’environnement R, cette standardisation s’opère élégamment sans altérer les structures de données originelles en incorporant la fonction vectorielle scale() directement au sein de la formule de modélisation : lm(scale(Score_Examen) ~ scale(Temps_Etude), data = donnees). Sous cette configuration standardisée, l’ordonnée à l’origine converge rigoureusement vers une valeur nulle en raison du centrage des deux vecteurs autour de zéro, tandis que la pente estimée β* devient mathématiquement indiscernable du coefficient de corrélation bivarié de Pearson r. Cette symétrie offre un pont conceptuel immédiat pour comparer l’ampleur d’un effet psychologique à travers des protocoles ayant employé des métriques de mesure divergentes.
6. Étape 4 : Interprétation exhaustive des sorties statistiques du modèle
6.1 Décomposition de la sortie de la fonction summary()
La commande canonique summary(modele_reg) constitue le passage obligé pour l’interrogation synoptique du modèle de régression. Sa restitution textuelle s’organise selon une architecture modulaire standardisée. La section liminaire rappelle l’appel symbolique (Call) ayant généré l’objet, garantissant la traçabilité de la commande. Elle est immédiatement suivie d’une synthèse distributionnelle des erreurs résiduelles découpée selon cinq repères quantiles fondamentaux : le minimum, le premier quartile, la médiane, le troisième quartile et le maximum. Pour un modèle respectant rigoureusement la normalité et la symétrie théorique, la médiane des résidus doit osciller de manière infinitésimale autour de zéro, et les valeurs absolues des quartiles 1Q et 3Q doivent afficher une quasi-isométrie.
Le tableau centralisé des coefficients (Coefficients) synthétise les composantes inférentielles majeures réparties en quatre colonnes analytiques :
- Estimate : L’évaluation numérique ponctuelle issue des moindres carrés pour β0 et β1. La pente indique l’incrément moyen sur la variable d’examen par heure de révision additionnelle.
- Std. Error : L’erreur-type d’échantillonnage associée au paramètre. Elle quantifie la variabilité stochastique attendue de l’estimateur à travers une infinité théorique de réplications de l’expérience avec la même taille d’échantillon.
- t value : La statistique de Student dérivée du ratio élémentaire entre l’estimation ponctuelle et son erreur-type : t = Estimate / Std. Error. Elle teste formellement l’hypothèse nulle d’orthogonalité selon laquelle le coefficient sous-jacent équivaut à zéro dans la population.
- Pr(>|t|) : La valeur p bilatérale exacte conditionnelle à la distribution de Student avec n – 2 degrés de liberté. Elle mesure la probabilité d’observer une statistique de test au moins aussi déviante que celle constatée empiriquement dans l’éventualité où l’hypothèse nulle serait strictement exacte.
6.2 Évaluation de la qualité d’ajustement globale
L’évaluation de la performance prédictive globale du modèle ne peut se cantonner à la lecture des valeurs p des coefficients. Le coefficient de détermination, universellement symbolisé par R2 (figurant à la ligne Multiple R-squared), traduit la proportion de la variance totale de la variable réponse expliquée par la droite de régression linéaire empirique. Il se formalise analytiquement comme le complément à l’unité du rapport entre la somme des carrés résiduels (SSE) et la somme totale des carrés de la variable dépendante (SST) :
R2 = 1 – (SSE / SST) = SSM / SST
Au sein de la régression univariée simple, le Multiple R-squared coïncide avec le carré de la corrélation bivariée. En revanche, le R2 ajusté (mentionné sous Adjusted R-squared) applique une pénalité marginale calculée d’après le nombre de paramètres ajustés au regard des degrés de liberté globaux de l’échantillon, prévenant l’optimisme trompeur inhérent aux petits collectifs. Parallèlement, l’erreur résiduelle standardisée (Residual Standard Error, ou RSE) fournit une indication empirique irremplaçable : exprimée rigoureusement dans l’unité métrique originelle de la réponse (ici en points d’examen), elle caractérise l’écart-type de la dispersion stochastique des observations individuelles autour du plan de prédiction théorique avec les degrés de liberté résiduels correspondants.
6.3 Test d’hypothèse globale et statistique F
La ligne conclusive de la sortie summary() expose les résultats du test F global d’ajustement (dénommé test de Fisher-Snedecor). Dans le cadre spécifique de la régression linéaire simple comportant un unique prédicteur continu, le test F poursuit un objectif identique à celui du test t univarié appliqué à la pente β1 : tester l’hypothèse nulle conjointe H0 : β1 = 0 contre l’alternative H1 : β1 ≠ 0. Il existe d’ailleurs une congruence mathématique absolue unissant ces deux tests au sein du modèle linéaire simple : la valeur de la statistique F rapportée équivaut exactement au carré de la statistique de Student obtenue sur la ligne du prédicteur :
F(1, n-2) = (t(n-2))2
Le rejet sans ambiguïté de l’hypothèse nulle globale (attesté par une valeur p infinitésimale, par exemple inférieure au seuil conventionnel α = 0.05 ou 0.001) autorise le chercheur à conclure que la prise en compte du prédicteur réduit la variance d’erreur de manière statistiquement significative par rapport à un modèle réduit ne comportant que la constante (la moyenne de la variable réponse). Cette conclusion d’inférence confirme la pertinence statistique de la modélisation fonctionnelle engagée, sans préjuger toutefois de la validité interne des postulats diagnostiques qu’il convient d’instruire méticuleusement.
7. Étape 5 : Vérification diagnostique des postulats statistiques
7.1 Inspection graphique par les graphiques résiduels standardisés
L’inférence statistique n’a de validité pérenne que si les données se conforment aux postulats formels du modèle des moindres carrés. Dans l’environnement R, le moyen le plus direct d’engager cette vérification repose sur la fonction graphique générique appliquée à l’objet ajusté : plot(modele_reg). Cette commande engendre une matrice séquentielle de quatre graphiques analytiques standardisés fournissant une radiographie clinique complète du modèle linéaire.
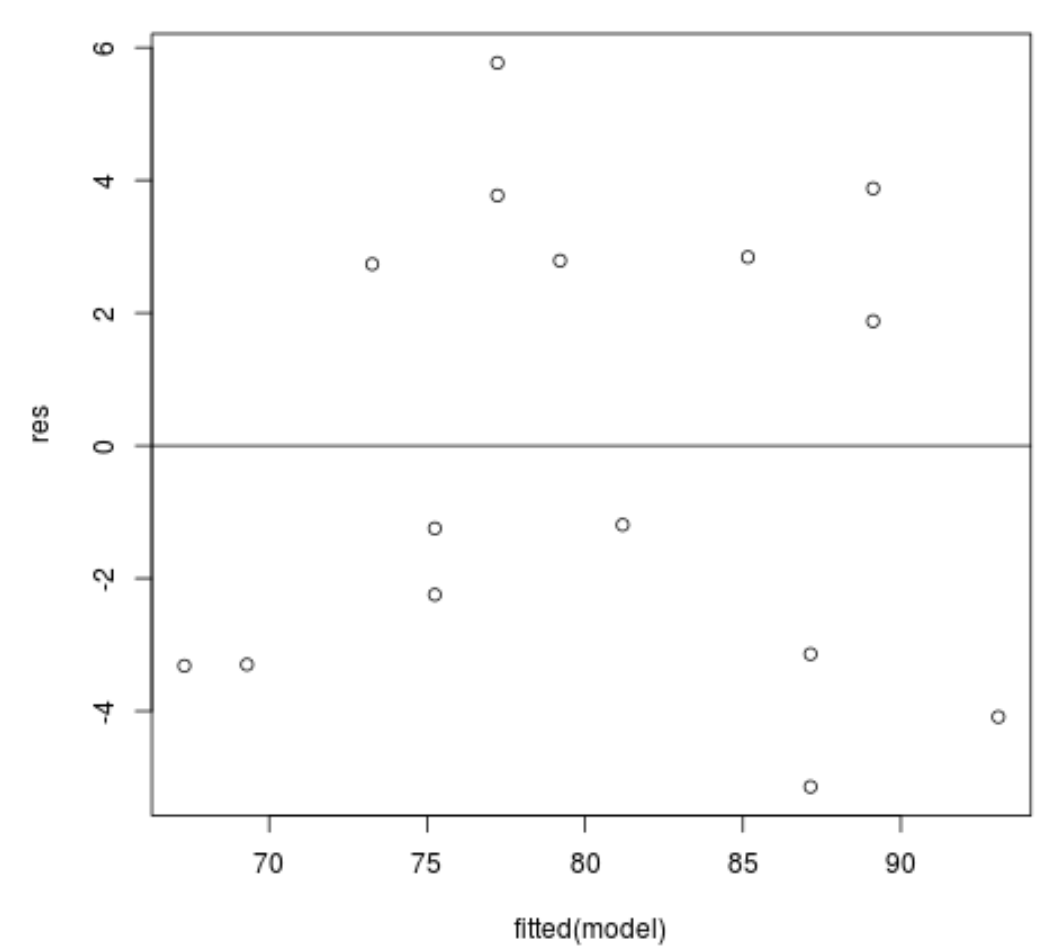
Le premier de ces panneaux, intitulé Residuals vs Fitted, trace les résidus bruts en fonction des valeurs ajustées prédites. Deux composantes exigent une lecture attentive : la ligne rouge de lissage local et la répartition spatiale de l’essaim de points. Une courbure systématique ou une ondulation prononcée de la ligne médiane indique une violation de l’hypothèse de linéarité, signalant que le modèle ne parvient pas à capter un phénomène non linéaire sous-jacent. Parallèlement, une dispersion verticale dont l’envergure s’accroît ou s’amenuise au fur et à mesure que l’on progresse de gauche à droite sur l’axe des abscisses (dessinant une forme classique d’entonnoir ou de pavillon de trompette) constitue l’attestation visuelle flagrante d’une hétéroscédasticité problématique.
Le troisième panneau, baptisé Scale-Location (ou Spread-Location), trace la racine carrée des résidus standardisés en valeur absolue en fonction des valeurs ajustées. Cette transformation stabilise la variance et supprime la directionnalité positive ou négative de l’écart. Dans des conditions parfaites d’homoscédasticité, la ligne de lissage rouge doit se déployer de manière rigoureusement horizontale à travers l’espace graphique, et la dispersion des résidus normalisés doit demeurer aléatoirement distribuée le long de cet horizon neutre.
7.2 Évaluation formelle de la normalité des résidus
L’examen de la normalité des résidus requiert le recours conjoint à des artefacts graphiques dédiés et à des tests d’inférence non paramétriques. Le deuxième graphique du panneau générique plot() correspond au diagramme quantile-quantile normal, universellement désigné sous le vocable de Normal Q-Q plot. Il confronte les quantiles empiriques de la distribution des résidus standardisés aux quantiles théoriques d’une distribution gaussienne unitaire parfaite.
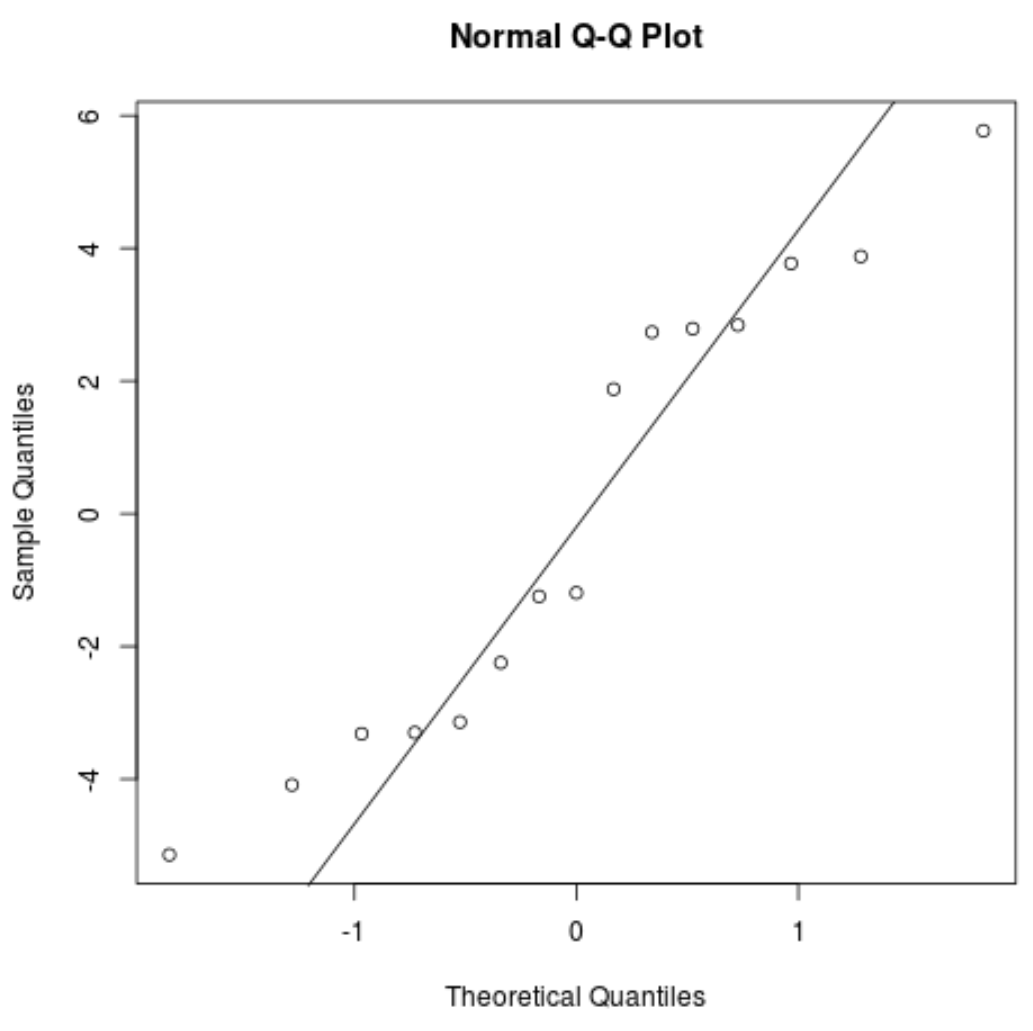
Le respect du postulat se traduit visuellement par l’adhérence stricte des points expérimentaux à la ligne diagonale pointillée de référence. Toute divergence systématique se manifestant aux extrémités distales — matérialisée par des points décollant vers le haut à droite ou plongeant vers le bas à gauche — reflète une distribution à queues épaisses (leptokurtique) ou à forte asymétrie. En appui à cette sémiologie graphique, l’expérimentateur peut formaliser la décision par le truchement du test d’ajustement de Shapiro-Wilk au moyen de la syntaxe shapiro.test(residuals(modele_reg)). Un résultat statistiquement non significatif (p > 0.05) permet de conserver l’hypothèse nulle de normalité résiduelle. Si le test est rejeté dans un contexte de faible échantillon, l’application d’une transformation mathématique stabilisatrice de la réponse (telle que la transformation logarithmique ou la famille de Box-Cox) doit être rigoureusement envisagée.
7.3 Tests d’homoscédasticité et d’indépendance
Bien que l’inspection graphique des résidus fournisse des indications probantes, le standard méthodologique contemporain impose de corréler cette lecture visuelle à des tests d’hypothèses diagnostiques formels disponibles au sein du package spécialisé lmtest. Pour corroborer l’homoscédasticité des variances résiduelles, l’application du test de Breusch-Pagan via l’instruction lmtest::bptest(modele_reg) teste explicitement si la variance des résidus dépend linéairement de la variable explicative. Le maintien de l’hypothèse nulle (p > 0.05) atteste de l’homogénéité de la dispersion.
En ce qui concerne l’indépendance séquentielle des erreurs résiduelles au sein d’échantillons ordonnés chronologiquement ou spatialement, le test de Durbin-Watson via lmtest::dwtest(modele_reg) permet d’estimer le coefficient d’autocorrélation d’ordre 1. Une statistique d divergeant nettement de la valeur pivot de 2 signale la présence d’une dépendance stochastique résiduelle. Dans l’éventualité avérée d’une violation persistante de l’homoscédasticité sans rupture de la linéarité, le chercheur évitera l’abandon du modèle linéaire en substituant à l’erreur-type conventionnelle une matrice de variance-covariance robuste aux hétéroscédasticités (HC3 ou HC4) via les packages sandwich et car, préservant ainsi la validité nominale des tests d’inférence.
8. Étape 6 : Identification des observations atypiques et influentes
8.1 Mesure des résidus standardisés et studentisés
L’intégrité inférentielle d’un modèle linéaire peut être compromise par l’existence de quelques observations singulières dont l’écartement par rapport à la tendance centrale est susceptible de fausser les estimations. Dans ce contexte, les résidus bruts ei = yi – ŷi ne permettent pas une détection normalisée dans la mesure où leur variance théorique n’est pas constante le long du domaine de prédiction. Il est indispensable de recourir à deux transformations métriques spécifiques : les résidus standardisés (internally studentized) et les résidus studentisés (externally studentized).
Dans R, la fonction rstandard() calcule les résidus standardisés en divisant chaque résidu brut par son écart-type conditionnel estimé, intégrant le facteur de projection de la matrice chapeau. La fonction rstudent() perfectionne cette démarche en recalculant l’erreur-type résiduelle après avoir éliminé la i-ème observation du jeu d’entraînement, empêchant ainsi l’observation divergente d’écraser artificiellement sa propre marge d’erreur. Les balises analytiques courantes considèrent que tout sujet présentant un résidu studentisé excédant en valeur absolue le seuil de |2| ou de |3| constitue une valeur résiduelle aberrante (outlier), méritant un réexamen clinique pour déceler un potentiel artefact d’acquisition ou une singularité psychopathologique authentique.
8.2 Calcul du levier mathématique (Leverage / Hat values)
Une observation atypique n’est pas nécessairement définie par un grand résidu : elle peut posséder une valeur exceptionnellement distale sur l’axe de la variable explicative x sans s’écarter de la trajectoire de régression. Ce positionnement géométrique périphérique est quantifié par le levier mathématique, mesuré par les éléments diagonaux hii de la matrice de projection orthogonale (matrice chapeau ou hat matrix). Dans R, l’extraction de ces composantes s’opère au moyen de la commande hatvalues(modele_reg).
Sur le plan computationnel, la somme de l’ensemble des leviers au sein d’un modèle linéaire équivaut rigoureusement au nombre total de paramètres libres estimés, soit p + 1 (la pente et la constante, valant 2 pour une régression simple). La valeur moyenne du levier pour un échantillon de taille n s’établit par conséquent à h̄ = (p + 1) / n. Selon les critères d’alerte méthodologiques formalisés par Belsley, Kuh et Welsch, une observation individuelle est désignée comme possédant un fort effet de levier dès lors que sa valeur hii franchit le seuil critique de deux à trois fois la valeur moyenne, soit la borne formelle hii > 2(k + 1) / n (où k représente le nombre de prédicteurs, soit 4/120 ≈ 0.033 dans notre protocole expérimental).
8.3 Distance de Cook et graphique Residuals vs Leverage
La conjonction délétère entre un résidu d’amplitude modérée à forte et un niveau de levier élevé produit ce que la littérature statistique qualifie d’observation influente. Un point influent est une observation dont l’omission unitaire altérerait de manière substantielle la magnitude des coefficients de régression estimés. L’indice quantitatif le plus célèbre pour quantifier cet impact est la distance de Cook (Cook’s distance), notée Di, qui agrège harmonieusement le résidu standardisé et l’effet de levier de chaque individu.
Le calcul automatisé s’obtient via cooks.distance(modele_reg). Si le seuil théorique classique de coupure D > 1 était historiquement préconisé, la recherche contemporaine en psychométrie privilégie le seuil plus sensible et calibré sur l’échantillon Di > 4 / n (ou 4 / (n – k – 1)). Le quatrième volet du panneau générique plot(modele_reg), intitulé Residuals vs Leverage, met en perspective ces trois indicateurs simultanément : il cartographie les résidus standardisés face aux leviers mathématiques, tout en incrustant les courbes de niveau isotropes de la distance de Cook (lignes pointillées rouges à 0.5 et 1.0). Face à l’identification d’un point influent validé, la déontologie scientifique impose de mener une analyse de sensibilité scrupuleuse, comparant et publiant conjointement les paramètres du modèle calculés avec et sans l’observation litigieuse.
9. Étape 7 : Visualisation graphique avancée des résultats de régression
9.1 Représentation élégante avec ggplot2
La communication scientifique moderne requiert des représentations graphiques répondant aux plus hautes exigences esthétiques et fonctionnelles de l’édition scientifique. La production d’une figure de régression prête pour l’évaluation par les pairs s’articule élégamment au sein de la grammaire de graphiques implémentée dans ggplot2. En reliant les attributs esthétiques fondamentaux — la variable explicative en abscisse et la réponse en ordonnée —, l’utilisateur superpose de manière modulaire les couches vectorielles des données individuelles et de la tendance paramétrique globale.
L’adjonction de la droite de régression s’effectue au moyen de la composante geom_smooth(method = « lm », formula = y ~ x, se = TRUE). Cette syntaxe explicite assure la conformité géométrique absolue entre le modèle matriciel ajusté via lm() et la droite matérialisée à l’écran. L’habillage graphique doit ensuite épurer l’affichage en évacuant les grilles d’arrière-plan intrusives au moyen du thème académique épuré theme_classic() ou theme_minimal(), tout en adaptant la typographie des labels d’axes, la lisibilité des échelles et l’incorporation d’une sémantique visuelle limpide conforme aux normes éditoriales les plus strictes.
9.2 Affichage de la bande d’intervalle de confiance
L’argument booléen se = TRUE intégré au sein de geom_smooth() génère une zone ombrée semi-transparente entourant étroitement la droite de régression. Cette bande graphique matérialise l’intervalle de confiance à 95 % (ou à tout autre seuil configuré par l’argument level = 0.95) calculé pour l’espérance mathématique de la réponse conditionnelle. D’un point de vue morphologique, cette enveloppe ne présente pas des frontières rigoureusement parallèles à la droite, mais adopte une configuration hyperbolique s’évasant symétriquement au fur et à mesure que l’on s’écarte du centre de gravité des données (x̄).
Cette géométrie s’explique par la formule computationnelle de l’erreur-type de la prédiction moyenne, dont l’incertitude est minimale au barycentre de l’échantillon et s’amplifie quadratiquement vers les marges périphériques du domaine d’observation. L’affichage de cette bande permet aux pairs évaluateurs d’appréhender d’un seul coup d’œil la précision de l’estimation de la pente : plus la taille de l’échantillon n est substantielle, plus cette enveloppe hyperbolique se resserre vers une mince pellicule linéaire encadrant la droite moyenne, conférant une visibilité tangible à la puissance statistique du dispositif expérimental.
9.3 Annotation directe des paramètres du modèle sur le graphique
Pour démultiplier l’impact visuel de la communication scientifique, il est hautement recommandable d’incruster directement les paramètres statistiques clés au sein même de la zone de traçage du graphique. Le recours au package spécialisé ggpubr (notamment la fonction stat_regline_equation() couplée à stat_cor()) ou l’injection programmatique de balises textuelles via annotate() permet d’afficher en typographie soignée l’équation complète de la droite de régression, le coefficient de détermination R2, la taille d’échantillon n et la valeur p exacte du test d’hypothèse.
L’exportation finale de la composition graphique doit répondre aux contraintes techniques rigoureuses des revues internationales de premier rang indexées sur le Web of Science ou Scopus. L’instruction standardisée ggsave(« figure_regression_apa.tiff », width = 7, height = 5, units = « in », dpi = 300, compression = « lzw ») génère un fichier matriciel haute résolution à 300 DPI sans perte d’information, tandis que l’exportation vectorielle en format PDF ou SVG garantit une netteté absolue des polices et des tracés vectoriels à n’importe quel facteur d’agrandissement typographique.
10. Étape 8 : Calcul de prédictions et d’intervalles d’inférence
10.1 Génération de prédictions ponctuelles avec predict()
Au-delà de la description des covariations empiriques, la modélisation statistique poursuit une finalité d’anticipation et de projection sur de nouveaux profils psychologiques. Dans le langage R, le moteur universel de génération prédictive repose sur la fonction d’inférence predict(). Pour évaluer la réponse modélisée d’un futur sujet sans réexécuter le processus d’ajustement global, l’analyste doit formater les nouvelles entrées au sein d’une structure de tableau conforme, en veillant scrupuleusement à ce que le nom de la colonne du régresseur corresponde à celui utilisé lors de la spécification initiale du modèle :
nouveaux_sujets <- data.frame(Temps_Etude = c(10, 22, 35))
predict(modele_reg, newdata = nouveaux_sujets)
Cette opération computationnelle calcule instantanément la prédiction ponctuelle ŷ = β̂0 + β̂1xnouveau. L’expérimentateur doit toutefois observer une retenue épistémologique stricte à l’égard de l’écueil de l’extrapolation. Prédire le comportement d’un individu dont la valeur d’étude se situe substantiellement au-delà de l’enveloppe convective des observations empiriques (par exemple en assignant une valeur de 60 heures de révision alors que le maximum observé plafonne à 35) constitue une dérive inférentielle hasardeuse, postulant sans garantie empirique la persistance indéfinie de la linéarité au-delà des territoires échantillonnés.
10.2 Calcul de l’intervalle de confiance pour la réponse moyenne
L’estimation ponctuelle est par essence incomplète sans l’adjonction de son enveloppe de confiance stochastique. Il convient de distinguer avec une rigueur absolue l’intervalle de confiance encadrant la moyenne conditionnelle de l’intervalle de prédiction individuel. L’obtention de l’intervalle de confiance s’active via l’instruction predict(modele_reg, newdata = nouveaux_sujets, interval = « confidence », level = 0.95).
La sortie matricielle délivre pour chaque niveau de prédicteur la valeur ajustée fit, flanquée d’une borne inférieure lwr et d’une borne supérieure upr. La signification théorique de cette plage correspond à l’intervalle qui, sous l’hypothèse de réplications infinies de l’échantillonnage expérimental, contiendrait 95 fois sur 100 la véritable espérance de performance académique de l’ensemble de la sous-population partageant ce volume horaire précis d’étude. La variance sous-jacente à ce calcul intègre uniquement l’erreur d’échantillonnage pesant sur les paramètres β̂0 et β̂1, ce qui explique sa compacité relative.
10.3 Calcul de l’intervalle de prédiction pour une observation individuelle
Lorsque le praticien hospitalier, le neuropsychologue ou le conseiller en orientation quitte le plan de la moyenne populationnelle pour formuler un pronostic ciblé à l’échelle d’un patient individuel unique, le recours à l’intervalle de confiance moyen s’avère erroné et illusoire. Il est alors requis de paramétrer l’instruction sous la forme predict(modele_reg, newdata = nouveaux_sujets, interval = « prediction », level = 0.95).
L’intervalle de prédiction ainsi généré est systématiquement et notablement plus large que l’intervalle de confiance. Cette divergence mathématique découle de sa formule de variance d’erreur, laquelle cumule deux composantes indépendantes : l’incertitude relative à l’estimation des coefficients de la droite d’une part, et la variabilité stochastique résiduelle irréductible propre au sujet individuel (σ2) d’autre part :
Var(ŷindividuel – yindividuel) = σ̂2 [1 + (1 / n) + ((xnouveau – x̄)2 / Σ(xi – x̄)2)]
Cette modélisation réaliste rappelle à l’intervenant clinique que même si une tendance linéaire s’avère hautement significative à l’échelle d’un collectif d’étudiants, la prédiction clinique individuelle demeure soumise à des fluctuations stochastiques larges qu’il convient de rapporter aux bénéficiaires avec une probité déontologique sans faille.
11. Étape 9 : Rapport scientifique des résultats selon les normes APA (7e édition)
11.1 Directives de rédaction des résultats textuels
La diffusion des découvertes quantitatives au sein des revues affiliées à l’American Psychological Association obéit aux normes typographiques et formelles consolidées dans la 7e édition du Manuel de publication de l’APA. La transcription textuelle d’un modèle de régression linéaire simple impose de renseigner l’ensemble des paramètres structuraux indispensables pour permettre aux pairs d’effectuer des méta-analyses indépendantes et de vérifier la robustesse des conclusions tirées par les auteurs.
La règle typographique fondamentale prescrit la mise en italique stricte de l’ensemble des symboles statistiques latins représentant des métriques estimées ou des distributions probabilistes (notamment b, SE, t, p, F, R2), tandis que les lettres grecques standardisées (telles que β pour le coefficient standardisé ou ε pour le résidu) demeurent en caractères droits romains. De surcroît, le manuel proscrit l’adjonction d’un zéro initial devant la virgule décimale pour les métriques probabilistes dont la valeur mathématique maximale est bornée à 1 (telles que la valeur p, les coefficients de corrélation r ou le R2). Par conséquent, une probabilité estimée s’écrit conventionnellement p = .003 ou p < .001, et jamais p = 0.003.
11.2 Construction d’un tableau récapitulatif standardisé APA
Bien que le modèle linéaire univarié puisse être consigné dans le corps du texte narratif en raison de sa parcimonie, la publication d’un tableau récapitulatif synthétique standardisé s’impose dès lors que plusieurs modèles comparatifs sont instruits ou que le chercheur souhaite rapporter de multiples indices diagnostiques. L’écosystème R contemporain dispose de packages spécialisés de premier plan tels que gtsummary, modelsummary ou sjPlot, capables d’exporter des tables conformes aux normes APA sans intervention manuelle fastidieuse.
Un tableau aux normes APA 7e édition s’interdit formellement toute grille quadrillée interne et proscrit rigoureusement l’usage de lignes de séparation verticales. Seules trois lignes horizontales continues doivent border la structure : une bordure supérieure fermant l’en-tête, une bordure séparant les intitulés de colonnes du corps de données, et une bordure inférieure scellant la table avant les notes explicatives de bas de page. Les colonnes obligatoires doivent consigner successivement l’intitulé du prédicteur, le coefficient non standardisé (B), l’intervalle de confiance à 95 % afférent, l’erreur-type (SE B), le coefficient standardisé (β), la statistique de Student (t) et la valeur exacte de probabilité (p).
11.3 Exemples concrets de paragraphes de résultats
Afin d’outiller directement les chercheurs dans la mise en forme de leurs manuscrits, nous fournissons ci-après un gabarit textuel canonique conforme aux normes APA reflétant les résultats d’un ajustement significatif :
« Une régression linéaire simple a été réalisée afin d’évaluer dans quelle mesure le volume horaire hebdomadaire consacré à l’étude autonome permet de prédire les performances obtenues à l’examen standardisé de raisonnement. L’évaluation diagnostique préalable des postulats a confirmé la linéarité fonctionnelle de la relation ainsi que l’homoscédasticité des résidus via le test de Breusch-Pagan, BP(1) = 0.42, p = .518. L’inspection du diagramme quantile-quantile normal et l’exécution du test de Shapiro-Wilk corroborent la normalité conditionnelle de la distribution des erreurs, W = 0.989, p = .452. Les résultats révèlent que le temps d’étude constitue un prédicteur statistiquement significatif de la réussite académique, F(1, 118) = 84.62, p < .001. Le modèle rend compte de 41.8 % de la variance totale des scores à l’épreuve (R2 = .418, R2 ajusté = .413). L’accroissement d’une heure de révision hebdomadaire est associé à un gain moyen de 1.84 point sur le score final d’examen (B = 1.84, IC 95 % [1.44, 2.24], SE = 0.20, β = .646, t(118) = 9.20, p < .001). »
À titre d’illustration complémentaire, voici la formulation rigoureuse adoptée face à un prédicteur s’avérant non significatif :
« L’ajustement du modèle linéaire simple n’a pas permis de mettre en évidence d’effet prédictif du niveau d’anxiété pré-test sur la rapidité de traitement perceptif, F(1, 118) = 1.24, p = .268, R2 = .010. Le coefficient de pente associé à l’anxiété ne diverge pas significativement de zéro (B = -0.12, IC 95 % [-0.33, 0.09], SE = 0.11, β = -.102, t(118) = -1.11, p = .268). L’analyse de puissance a posteriori indique que notre échantillon (n = 120) offrait une puissance statistique adéquate (1 – β > .80) pour détecter un effet de magnitude moyenne (r ≥ .25), suggérant que l’absence de significativité reflète une absence d’effet substantiel dans la population plutôt qu’un manque de sensibilité expérimentale. »
12. Limites méthodologiques, alternatives non paramétriques et perspectives d’extension
12.1 Limites inhérentes à la régression linéaire simple
En dépit de son élégance mathématique et de son accessibilité computationnelle, la régression linéaire simple souffre de vulnérabilités méthodologiques intrinsèques qui appellent une grande vigilance lors de l’interprétation. En premier lieu, la nature strictement bivariée du modèle l’expose au biais d’omission de variables, un écueil majeur dans les protocoles observationnels en sciences comportementales. Lorsqu’un tiers facteur corrélé à la fois au prédicteur et au critère est omis du modèle, l’estimation de la pente β̂1 capte indûment une partie de cette variance partagée, produisant une estimation biaisée et instable de la dynamique relationnelle réelle.
En second lieu, la régression linéaire simple suppose implicitement que la variable explicative est mesurée avec une exactitude absolue, exempte d’erreur de mesure. En psychologie empirique, où les variables dérivent d’échelles psychométriques dotées d’une fidélité imparfaite (coefficient alpha de Cronbach ou oméga de McDonald substantiellement inférieurs à 1.0), le non-respect de ce postulat engendre un phénomène pernicieux dénommé biais d’atténuation. Ce processus mathématique compresse artificiellement la pente observée vers zéro, conduisant le chercheur à sous-estimer de manière systématique l’impact réel de son prédicteur au sein de la population cible.
12.2 Alternatives robustes en cas de violation des postulats
Lorsque les vérifications diagnostiques mettent en exergue des violations flagrantes des postulats fondamentaux — qu’il s’agisse d’hétéroscédasticité irréductible, de distributions fortement leptokurtiques ou de la persistance de points influents non artefactuels —, le chercheur ne doit pas renoncer à la modélisation mais mobiliser les alternatives non paramétriques et robustes offertes par R. L’une des solutions de référence consiste en la régression robuste fondée sur les M-estimateurs d’Huber ou de Tukey, implémentée au moyen de la fonction rlm() du package MASS. Cette méthodologie assigne de manière itérative des poids dégressifs aux observations proportionnellement à leur éloignement résiduel, neutralisant l’influence délétère des valeurs extrêmes sans nécessiter d’exclusion de données.
Une seconde alternative féconde réside dans la régression quantile, accessible via le package quantreg et sa fonction rq(). Plutôt que de modéliser l’espérance conditionnelle moyenne de la réponse, cette approche permet d’estimer la médiane conditionnelle (quantile 0.50) ou n’importe quel autre quantile distributionnel (par exemple le 10e ou le 90e percentile). Cette technique est insensible aux asymétries distributionnelles et offre une vision granulaire des effets différentiels d’une intervention sur différents profils d’individus. Enfin, le recours aux procédures de rééchantillonnage par bootstrap non paramétrique (via le package boot) permet de construire des intervalles de confiance empiriques par permutations répétées, s’affranchissant définitivement du postulat de normalité des résidus.
12.3 Transition vers la régression multiple et la modélisation avancée
La régression linéaire simple constitue le point de départ d’une trajectoire méthodologique plus vaste. L’extension la plus immédiate consiste en la transition vers la régression linéaire multiple, permettant d’intégrer simultanément une pluralité de prédicteurs continus ou catégoriels au sein de la syntaxe de modélisation : lm(Score_Examen ~ Temps_Etude + Motivation + Stress, data = donnees). Cette architecture autorise le contrôle statistique rigoureux des variables de confusion et permet d’isoler la contribution semi-partielle spécifique de chaque construit psychologique dans l’explication de la réponse.
De surcroît, le modèle linéaire permet d’explorer des architectures relationnelles plus sophistiquées en modélisant des effets d’interaction multiplicative (modération) via la syntaxe lm(y ~ x1 * x2), permettant de tester si l’intensité de l’effet d’une variable dépend du niveau d’une seconde caractéristique individuelle. Enfin, lorsque les unités d’échantillonnage sont structurellement corrélées au sein de grappes naturelles (élèves au sein d’écoles, patients au sein de centres de soins) ou dans le cadre de protocoles longitudinaux, le chercheur basculera naturellement vers la modélisation linéaire mixte à effets fixes et aléatoires via le package lme4, assurant une continuité théorique et technique irréprochable au service de la psychologie quantitative moderne.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686
Wilkinson, G. N., & Rogers, C. E. (1973). Symbolic description of factorial models for analysis of variance. Journal of the Royal Statistical Society: Series C (Applied Statistics), 22(3), 392–399. https://doi.org/10.2307/2346786