
L’analyse des données quantitatives modernes confronte fréquemment le chercheur et le statisticien à des configurations empiriques qui défient les postulats traditionnels de linéarité et de normalité. Dans de nombreux domaines scientifiques, allant de l’économétrie à la psychométrie computationnelle, les phénomènes observés ne s’organisent pas selon des trajectoires rectilignes simples, mais empruntent des dynamiques complexes, marquées par des asymptotes, des changements de pente abrupts ou des ondulations non monotones. Tenter de contraindre arbitrairement de telles observations au sein d’un modèle paramétrique rigide risque d’induire un biais de spécification majeur, masquant les véritables mécanismes sous-jacents qui gouvernent la génération des données.
Face à cet impératif méthodologique, les techniques d’ajustement non paramétrique et semi-paramétrique se sont imposées comme des outils indispensables pour appréhender la structure intrinsèque d’un continuum bivarié. Parmi ces méthodes, le lissage par régression locale pondérée, mondialement connu sous l’acronyme Lowess (Locally Weighted Scatterplot Smoothing), représente un jalon fondamental dans l’histoire de l’analyse exploratoire des données. Conçu pour extraire le signal déterministe enfoui sous un bruit stochastique hétérogène, l’algorithme Lowess combine l’intuition géométrique du voisinage mobile avec la robustesse mathématique de l’ajustement polynomial pondéré.
L’environnement de programmation statistique R constitue le milieu d’élection par excellence pour déployer, paramétrer et diagnostiquer ce type de régression non paramétrique. Grâce à des fonctions natives éprouvées et à des extensions graphiques de pointe, R offre une flexibilité totale permettant d’adapter la finesse du lissage, d’atténuer l’influence déstabilisatrice des valeurs atypiques et d’extraire des résidus précis pour la validation statistique. Ce guide exhaustif a pour vocation d’exposer étape par étape, depuis ses fondements théoriques jusqu’à son intégration dans des protocoles de recherche avancés, la mise en œuvre pratique et rigoureuse du lissage Lowess dans R.
1. Introduction théorique au lissage Lowess (Locally Weighted Scatterplot Smoothing)
1.1 Définition et origine épistémologique de la méthode Lowess
Le lissage Lowess, formalisé pour la première fois par le statisticien américain William S. Cleveland en 1979 au sein des laboratoires Bell, est né d’une réflexion épistémologique profonde sur les limites de l’inférence paramétrique classique. À une époque où la puissance computationnelle naissante permettait d’envisager des algorithmes itératifs appliqués à des jeux de données denses, Cleveland a cherché à dépasser le cadre contraignant de la droite des moindres carrés ordinaires. L’objectif était de concevoir un dispositif algorithmique capable d’épouser fidèlement la topologie d’un nuage de points sans que l’analyste n’ait à postuler a priori une équation fonctionnelle globale telle qu’un polynôme de degré élevé, une fonction exponentielle ou une sigmoïde logistique.
Sur le plan conceptuel, le lissage Lowess repose sur l’hypothèse fondamentale selon laquelle toute fonction différentiable, aussi complexe et non linéaire soit-elle à l’échelle globale, peut être approximée de manière satisfaisante par un segment de droite ou un polynôme de bas degré au sein d’un voisinage infinitésimal ou localement restreint. Cette démarche s’inscrit en rupture avec la modélisation paramétrique classique : au lieu de contraindre chaque observation à peser de façon uniforme sur une pente globale unique, Lowess accorde une souveraineté primordiale à la proximité spatiale des données le long de l’axe des abscisses. Ainsi, le modèle s’adapte en continu à la forme locale du signal.
L’utilité fondamentale de cette approche réside dans sa neutralité distributionnelle. Contrairement aux modèles de régression classiques qui reposent souvent sur des hypothèses strictes d’homoscédasticité et de normalité des erreurs pour assurer la validité des estimations, le lissage Lowess fonctionne comme un estimateur purement non paramétrique. Il ne présume ni de la distribution sous-jacente des variables ni de la constance de leur variance, ce qui en fait un instrument de choix pour déceler des relations émergentes dont la forme fonctionnelle demeure inconnue du chercheur.
1.2 Pertinence et utilité dans l’analyse exploratoire des données
Dans le cadre de l’analyse exploratoire des données, conceptualisée par John Tukey, l’inspection visuelle ne saurait se limiter à la simple contemplation d’un nuage de points brut. Lorsque les observations s’accumulent par centaines ou par milliers, la dispersion aléatoire et la superposition des coordonnées engendrent un bruit visuel intense qui sature la perception humaine. Le recours à Lowess permet d’introduire une ligne médiane directrice fluide, agissant tel un filtre passe-bas numérique qui sépare la composante déterministe continue des fluctuations stochastiques individuelles.
Cette filtration visuelle s’avère particulièrement décisive pour identifier les zones de transition comportementale au sein d’un système complexe. Dans de nombreux jeux de données empiriques, les trajectoires présentent des points d’inflexion critiques, des seuils de basculement qualitatif ou des plateaux de saturation qu’une régression linéaire globale écraserait irrémédiablement. Par exemple, une relation qui croît rapidement avant de stagner en raison de capacités matérielles ou cognitives limitées sera immédiatement mise en exergue par la courbure adaptative de la trajectoire lissée, offrant à l’analyste des indices cruciaux pour guider la modélisation théorique ultérieure.
De surcroît, le lissage localisé évite l’écueil classique de l’effet de levier exercé par les regroupements marginaux d’observations. Dans une régression ordinaire, un amas de points situé à une extrémité du domaine de définition peut faire basculer l’ensemble de la pente directrice, conduisant à des interprétations fallacieuses sur le reste de l’échantillon. Lowess isole ces dynamiques régionales : le comportement local aux bornes n’altère pas l’ajustement réalisé au centre de la distribution, préservant ainsi l’intégrité séquentielle de l’interprétation exploratoire.
1.3 Applications types dans les sciences quantitatives et psychométriques
Les sciences quantitatives, et plus singulièrement les neurosciences cognitives et la psychométrie, offrent un terrain d’application particulièrement fécond pour le lissage Lowess. L’un des cas d’école concerne l’analyse des temps de réaction au cours du vieillissement normal. La relation liant l’âge chronologique à la vitesse de traitement de l’information ne suit pas une trajectoire rectiligne : elle se caractérise généralement par une relative stabilité durant la période adulte intermédiaire, suivie d’une accélération graduelle du déclin cognitif à partir de la sixième décennie. Lowess trace cette non-linéarité avec une fidélité remarquable, permettant de localiser empiriquement le début de la décélération sans imposer arbitrairement une courbure parabolique symétrique.
Dans l’étude des processus d’apprentissage et de consolidation mnésique, les courbes d’acquisition révèlent typiquement des phases d’accélération initiale suivies de consolidations en paliers, entrecoupées parfois de légers régressions temporaires. La modélisation par lissage local permet de caractériser précisément le moment où le gain de performance par unité de temps commence à décroître de manière asymptotique. Cela permet aux psychologues expérimentaux d’évaluer l’efficacité différentielle de protocoles d’entraînement sans biaiser les résultats par le choix a priori d’un modèle logarithmique ou hyperbolique trop contraignant.
Enfin, l’évaluation des liens entre l’activation physiologique, l’anxiété mesurée et l’efficacité de la performance cognitive fournit une autre illustration éclatante. Historiquement théorisée sous la forme de la célèbre courbe en U inversé de la loi de Yerkes-Dodson, cette interaction présente souvent des asymétries majeures selon la complexité de la tâche requise. Le lissage Lowess permet de tester si l’optimum de performance correspond effectivement à un niveau intermédiaire de stress perçu et si la dégradation subséquente de la performance s’opère de manière brutale ou graduelle, apportant ainsi des preuves tangibles pour la validation ou la révision des modèles théoriques en psychologie différentielle.
2. Fondements mathématiques et algorithmiques de la régression locale pondérée
2.1 Le principe des moindres carrés pondérés localement
L’assise mathématique de Lowess repose sur le cadre formalisé des moindres carrés pondérés, appliqué de façon itérative à une succession de sous-ensembles glissants de données. Soit un ensemble de paires d’observations numériques noté (x_i, y_i) pour i variant de 1 à n, où x désigne la variable prédictive indépendante et y la variable réponse continue. Pour chaque valeur cible x_0 située le long du spectre des abscisses où l’on souhaite estimer la valeur lissée correspondante y_0, l’algorithme définit une fenêtre de voisinage englobant une fraction déterminée k des observations totales les plus proches de ce point focal.
Au sein de cette fenêtre spatiale restreinte, l’algorithme ajuste un polynôme local d’ordre d, la valeur d étant généralement fixée à 1 (régression linéaire locale) ou à 2 (régression quadratique locale). Contrairement à la régression ordinaire qui cherche à minimiser la simple somme des résidus au carré, l’estimation des paramètres polynomiaux locaux nécessite la minimisation d’une fonction d’erreur quadratique pondérée. L’équation de minimisation locale s’exprime sous la forme mathématique suivante :
Minimiser la somme pour i allant de 1 à n du produit entre le poids local w_i(x_0) et le carré de l’écart [y_i – (beta_0 + beta_1 * x_i + … + beta_d * (x_i)^d)].
Dans ce formalisme, le coefficient bêta dépendant de x_0 capture la trajectoire instantanée au point d’évaluation. La valeur lissée finale en x_0 découle directement de l’évaluation de ce polynôme au point d’ancrage. Ce procédé est répété pour chaque point du jeu de données, conférant à la courbe finale sa continuité structurelle sans recourir à un raccordement artificiel de segments discontinus.
2.2 La fonction de pondération tricubique
Le choix de la structure de pondération w_i(x_0) conditionne fondamentalement la régularité mathématique et les propriétés différentielles de la courbe estimée. Cleveland a introduit à cette fin la fonction noyau tricubique, qui allie une décroissance monotone élégante à des propriétés remarquables d’annulation de ses dérivées première et seconde aux frontières du domaine local. Soit d(x_0) la distance euclidienne séparant le point cible x_0 de la k-ième observation la plus éloignée au sein de la fenêtre de voisinage retenue. La distance relative normalisée pour tout point x_i s’exprime par le rapport u_i = |x_i – x_0| / d(x_0).
La fonction de pondération tricube W(u) est alors définie de manière rigoureuse par les relations analytiques suivantes :
W(u) = (1 – u^3)^3, lorsque la valeur absolue de u est strictement inférieure à 1 ; et W(u) = 0 dès lors que la valeur absolue de u est supérieure ou égale à 1.
Cette formulation mathématique confère une décroissance douce et progressive des poids. Les points observés situés au centre immédiat du voisinage reçoivent un poids unitaire maximal, tandis que les observations s’éloignant progressivement vers la périphérie de la fenêtre voient leur influence s’amenuiser continûment. L’attribution stricte d’un poids nul aux données situées au-delà de la distance critique d(x_0) garantit une isolation parfaite du calcul local vis-à-vis des données lointaines. De plus, l’annulation des dérivées en u = 1 assure que la courbe lissée finale ne présentera aucune discontinuité de pente ou d’inflexion artificielle lors de l’entrée ou de la sortie de points dans la fenêtre mobile.
2.3 L’ajustement robuste par réitération
L’un des défis majeurs rencontrés par les estimateurs basés sur les moindres carrés réside dans leur sensibilité extrême aux données aberrantes ou atypiques, communément qualifiées d’outliers. Une observation marginale présentant un résidu démesuré peut fausser l’estimation locale et dévier la courbe dans sa direction. Pour conférer à Lowess une insensibilité éprouvée face à ces contaminations, Cleveland a adjoint au processus un algorithme d’ajustement robuste itératif, fondé sur une réévaluation rétroactive des résidus d’ajustement.
Après un premier lissage initial générant un ensemble de valeurs estimées y_hat_i, l’algorithme calcule les résidus individuels e_i = y_i – y_hat_i. Une échelle de dispersion robuste des résidus est alors déterminée par la médiane de leurs valeurs absolues, notée s = median(|e_i|). Pour chaque point de données, un poids de robustesse r_i est attribué en appliquant la fonction biweight de Tukey au résidu normalisé, définie comme suit :
r_i = B(e_i / (6 * s)), où B(u) = (1 – u^2)^2 si |u| = 1.
Lors de l’itération suivante, le poids global accordé à l’observation x_i pour calculer le lissage autour de x_0 devient le produit direct du poids spatial tricubique initial et de ce poids de robustesse résiduelle : W_global_i = w_i(x_0) * r_i. Les observations caractérisées par des résidus massifs (supérieurs à 6 fois l’écart médian absolu) sont ainsi complètement exclues des itérations ultérieures grâce à un poids nul. L’algorithme réitère cette phase de recalcul un nombre déterminé de fois (typiquement deux à trois cycles), stabilisant progressivement les coefficients d’ajustement vers une solution insensible aux artefacts de mesure.
3. Présentation de la syntaxe et des arguments de la fonction lowess() dans R
3.1 Structure générale et signature de la commande de base
Dans l’écosystème du logiciel R, le lissage non paramétrique de base repose sur l’implémentation originelle accessible directement dans le package natif stats à travers l’appel de la commande standard lowess(). Cette fonction bénéficie d’une optimisation computationnelle codée en langage C et Fortran, garantissant une rapidité d’exécution instantanée même sur des jeux de données comportant plusieurs dizaines de milliers de lignes. Sa signature générique classique se déploie selon la syntaxe suivante :
L’instruction formelle s’articule autour de : lowess(x, y = NULL, f = 2/3, iter = 3, delta = 0.01 * diff(range(xy$x[o]))). Les vecteurs d’entrée x et y constituent le substrat numérique fondamental de l’analyse. Ils doivent obligatoirement contenir des grandeurs quantitatives réelles de longueurs strictement identiques. Lorsque y est omis, l’argument x peut être transmis sous la forme d’un objet bivarié compatible, tel qu’une matrice à deux colonnes, une liste structurée ou un data frame contenant deux coordonnées numériques.
Il convient également de souligner que, bien que la commande classique lowess() privilégie historiquement la notation vectorielle, elle accepte, sous certaines versions et wrappers fonctionnels, la notation par formule statistique usuelle de type y ~ x, bien que cette dernière soit plus généralement réservée à son extension multivariée loess(). La maîtrise de ces subtilités d’interface évite de commettre des erreurs de coercition de type lors de l’intégration du lissage au sein de scripts automatisés d’analyse de données.
3.2 Rôle et impact du paramètre de lissage f (span)
L’argument central qui gouverne le comportement mathématique de la fonction lowess() est indéniablement le paramètre f, fréquemment désigné sous le vocable anglo-saxon de span ou bande passante locale. Ce paramètre correspond à un nombre réel strictement compris entre 0 et 1, représentant la fraction globale des données totales qui doit être incluse dans chaque voisinage mobile pour estimer l’ordonnée lissée de chaque observation cible. La valeur par défaut attribuée par le système est f = 2/3, soit environ 66,7 % des points d’échantillon.
La sélection de la grandeur numérique de f instancie de manière très directe le compromis classique entre biais et variance, pivot fondamental de la théorie statistique non paramétrique. Une valeur de f excessivement petite contraint la régression locale à ne considérer qu’une poignée d’observations contiguës. Ce choix confère à la courbe une flexibilité géométrique extrême, capable d’épouser les moindres inflexions, mais au prix d’une variance d’échantillonnage considérable : la courbe absorbe le bruit stochastique résiduel et engendre un phénomène destructeur de surajustement (overfitting).
À l’inverse, lorsque l’analyste accroît la valeur de f pour la faire converger vers 1, la fenêtre glissante s’élargit jusqu’à englober la quasi-totalité de l’échantillon pour chaque évaluation locale. Le poids relatif accordé aux points éloignés devient important, ce qui stabilise la variance au détriment du biais : la courbe s’aplatit, estompe les inflexions réelles du signal et converge asymptotiquement vers une simple droite de régression globale pondérée par la distance tricubique. La calibration judicieuse de f représente dès lors la tâche analytique la plus critique de l’utilisateur.
3.3 Paramètres secondaires : itérations et optimisation du calcul
Au-delà de la sélection de la largeur de bande, la signature de lowess() propose deux arguments secondaires fondamentaux pour le contrôle fin de l’algorithme : iter et delta. Le paramètre iter régit le nombre de cycles itératifs de réajustement robuste selon la méthode du biweight de Tukey décrite précédemment. Par défaut, sa valeur est fixée à iter = 3, ce qui offre un niveau d’assainissement robuste suffisant pour la vaste majorité des configurations expérimentales tout en prévenant les dérives causées par des contaminants extrêmes.
Pour sa part, le paramètre delta constitue une innovation algorithmique majeure introduite par Cleveland pour optimiser le temps de calcul lors du traitement de très volumineux jeux de données. Plutôt que de procéder à l’évaluation intégrale d’une régression locale pondérée pour chacun des n points expérimentaux individuels, l’algorithme effectue l’ajustement complet uniquement pour des points d’abscisse séparés par une distance au moins égale à delta. Les valeurs lissées pour les observations intermédiaires situées dans ces intervalles sont ensuite interpolées par raccordement linéaire rapide.
Par défaut, R configure ce paramètre selon l’instruction delta = 0.01 * diff(range(x)), ce qui segmente l’étendue totale de la variable explicative en une centaine de tranches d’interpolation. Cette approximation n’induit aucune perte perceptible de précision graphique, tout en diminuant drastiquement la charge de calcul machine. Enfin, l’objet résultant renvoyé par un appel standard à lowess() ne consiste pas en un modèle de régression classique au sens de la classe lm, mais prend la forme rigoureuse d’une liste R à deux éléments vectoriels nommés $x et $y, contenant respectivement les abscisses d’origine triées et leurs correspondances lissées calculées.
4. Étape 1 : Création et manipulation du jeu de données expérimental
4.1 Définition programmatique du vecteur de variables indépendantes et dépendantes
Afin d’illustrer la mécanique opératoire du lissage Lowess dans R avec une clarté méthodologique irréprochable, il est opportun de générer un jeu de données expérimental contrôlé mais réaliste. Ce cadre simulé permettra de confronter l’algorithme à un signal théorique non linéaire complexe, délibérément perturbé par l’adjonction d’un bruit gaussien hétérogène et de valeurs aberrantes ponctuelles. L’instanciation de ce jeu de données s’effectue au moyen de vecteurs numériques intégrés au sein d’un data frame standard.
Nous pouvons définir une variable prédictive indépendante représentant, par exemple, un continuum temporel ou une échelle d’évaluation psychologique continue s’étendant sur un intervalle déterminé. Pour ce faire, on génère un vecteur d’abscisses comprenant 200 points équidistants ou aléatoirement distribués. La variable dépendante sera ensuite formulée à partir d’une combinaison de fonctions trigonométriques et polynomiales, capable d’engendrer une accélération initiale suivie d’une dépression puis d’une remontée tardive, simulant ainsi une dynamique cognitive ou biologique non monotone.
Une fois les équations déterministes spécifiées dans R, l’incorporation d’une composante d’erreur stochastique s’opère via la fonction de génération aléatoire normale rnorm(). L’ensemble de ces vecteurs est consolidé au sein d’une structure rectangulaire via la fonction data.frame(). La vérification de la parfaite correspondance dimensionnelle entre les colonnes et le contrôle des premières lignes à l’aide de l’utilitaire head() garantissent que le substrat de calcul est parfaitement prêt pour les étapes d’audit et de lissage statistique.
4.2 Contrôle des types de données et nettoyage initial
Préalablement à toute manipulation algorithmique dans R, un audit rigoureux de l’intégrité typologique des variables s’impose. L’exécution de fonctions exploratoires telles que class(), typeof() et str() permet de certifier que les colonnes assignées au lissage appartiennent strictement au type numérique (numeric ou double). La présence inopinée d’un facteur, d’une chaîne de caractères ou d’une valeur textuelle parasite entraînerait l’interruption immédiate de l’algorithme de calcul des distances locales de Lowess.
Une attention tout aussi vigilante doit être portée à la gestion des valeurs manquantes, encodées sous la forme de constantes NA, ou des valeurs non numériques résultant d’opérations illicites telles que NaN ou l’infini mathématique Inf. L’algorithme mathématique sous-jacent à lowess() ne tolère pas la présence de données indéfinies, lesquelles génèrent des erreurs d’exécution ou la propagation d’indéterminations sur l’ensemble de la trajectoire lissée. Le recours aux opérateurs logiques d’identification is.na() et l’extraction subséquente des observations complètes au moyen de la directive na.omit() s’avèrent indispensables.
Enfin, bien que l’algorithme natif lowess() procède en interne à un réarrangement ordonné des abscisses pour calculer sa progression locale, il constitue une saine pratique d’ingénierie statistique de procéder en amont au tri explicite du jeu de données selon les valeurs croissantes de la variable explicative via l’instruction d’indexation order(). Cette précaution garantit une parfaite homogénéité séquentielle lors de l’extraction des résidus ou lors du raccordement graphique ultérieur à l’aide des outils de visualisation conventionnels.
4.3 Statistiques descriptives préalables à l’ajustement
Avant d’ajuster une quelconque courbe de régression non paramétrique, l’analyste se doit de quantifier la géométrie empirique de ses variables au moyen de statistiques descriptives univariées et bivariées. L’estimation des moments statistiques fondamentaux — à savoir la moyenne arithmétique, l’écart-type empirique, la médiane et l’intervalle interquartile — fournit un diagnostic quantitatif direct de la dispersion centrale et de la dispersion relative de la distribution expérimentale.
L’évaluation rigoureuse de l’étendue des variables s’obtient via la fonction range(), complétée par l’identification minutieuse des quantiles extrêmes au moyen de la commande quantile(). L’inspection des écarts entre les premier, deuxième et troisième quartiles permet de déceler la présence d’une asymétrie de distribution (skewness) ou d’un aplatissement anomal (kurtosis). Une variable explicative présentant des regroupements denses alternant avec de vastes déserts de données imposera une vigilance décuplée quant au comportement des fenêtres de voisinage local de Lowess.
Ce panorama statistique est consolidé par l’appel classique à la fonction summary() sur le data frame d’étude. Les résumés numériques synthétiques issus de cette étape établissent le cadre de référence objectif indispensable pour juger ultérieurement si la courbe de lissage respecte les grandeurs d’échelle du phénomène modélisé ou si elle subit des distorsions indésirables causées par une mauvaise calibration des hyperparamètres de l’algorithme.
5. Étape 2 : Visualisation initiale et inspection du nuage de points
5.1 Construction du graphique de dispersion de base avec plot()
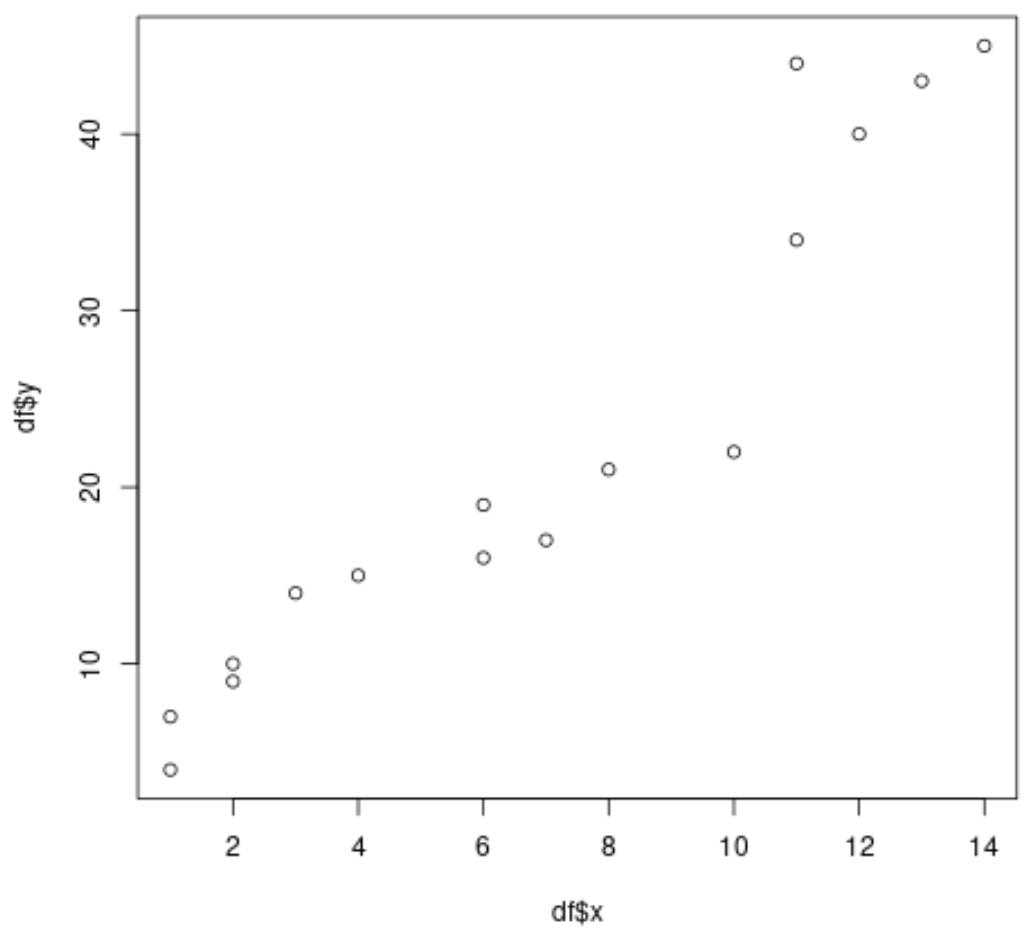
L’acte inaugural de toute analyse exploratoire bivariée réside dans la génération du diagramme de dispersion (scatterplot), qui projette spatialement chaque paire d’observations au sein d’un plan cartésien à deux dimensions. Dans le moteur graphique natif de R, cette opération s’effectue au moyen de l’appel élémentaire à la commande plot(), en passant en arguments successifs le vecteur de la variable indépendante et celui de la réponse observée.
Afin de conférer à cette représentation initiale une rigueur documentaire conforme aux exigences académiques, la configuration précise des axes s’avère primordiale. Les arguments optionnels xlim et ylim permettent de borner strictement l’espace d’affichage afin d’englober la totalité des points tout en évitant les marges excessives qui écrasent la lisibilité des gradients locaux. De même, la personnalisation des étiquettes des axes via les paramètres textuels xlab et ylab permet de nommer explicitement les grandeurs mesurées en y adjoignant leurs unités de quantification respectives.
La génération de ce canevas géométrique constitue le repère visuel fondamental sur lequel le statisticien va pouvoir projeter son intuition théorique. Sans l’adjonction prématurée d’un modèle mathématique quelconque, cette vue brute des observations permet de s’imprégner de la topologie globale de l’échantillon, première condition indispensable pour guider judicieusement la paramétrisation des algorithmes d’estimation non linéaire.
5.2 Typographie graphique et sémiologie visuelle
La transmission efficace de l’information visuelle repose sur le respect des préceptes de la sémiologie graphique, théorisés notamment par Jacques Bertin et Edward Tufte. Dans le système graphique de R base, la personnalisation formelle des marqueurs de données s’opère par l’intermédiaire d’une série d’arguments typographiques spécialisés au sein de l’instruction plot(). L’argument pch (plotting character) contrôle la géométrie du symbole utilisé pour figurer chaque observation.
Dans les contextes d’analyse où la densité de points est élevée, l’utilisation de cercles pleins translucides (comme le symbole 19 ou le cercle évidé 1 ou 21) s’avère infiniment supérieure aux croix ou aux étoiles qui saturent l’espace. La dimension physique des glyphes est modulée via le paramètre d’échelle cex (character expansion) ; l’assignation d’une valeur inférieure à l’unité (par exemple cex = 0.8) réduit la surface de chaque marqueur, dégageant ainsi les espaces interstitiels et prévenant les chevauchements opaques.
Sur le plan colorimétrique, le recours aux codes hexadécimaux pourvus d’un canal alpha de transparence, ou l’utilisation de teintes feutrées issues de palettes académiques, permet d’atténuer la dureté du noir standard. L’argument col permet ainsi de colorer les observations dans un gris ardoise soutenu ou un bleu marine atténué. Cette retenue stylistique permet de reléguer les observations individuelles à un rôle d’arrière-plan contextuel, préparant idéalement le terrain pour la superposition éclatante de la courbe de lissage déterministe qui viendra s’y inscrire.
5.3 Diagnostic exploratoire du nuage de points
Une fois le graphique de dispersion rendu visible, l’analyste doit procéder à une lecture diagnostique approfondie du nuage de points, structurée autour de trois axes de vigilance prioritaires. Le premier concerne l’évaluation de la densité locale le long du continuum de l’abscisse. Il convient de vérifier si les observations sont réparties de manière uniforme ou si l’on constate des agglomérats massifs concentrés dans certaines plages, séparés par de véritables lacunes spatiales. La présence de sous-espaces clairsemés impose une mise en garde immédiate : dans ces zones, la fenêtre mobile de Lowess devra s’étendre sur de très vastes distances physiques pour agréger le quota requis d’observations, ce qui risque d’engendrer des effets de lissage distendus.
Le deuxième axe diagnostique porte sur le repérage qualitatif des ruptures de pente et des points d’inflexion. L’observateur attentif scrute l’émergence d’éventuelles dynamiques biphasiques ou triphasiques : une croissance initiale fulgurante suivie d’un plafonnement asymptotique, ou encore une trajectoire oscillatoire suggérant un comportement périodique sous-jacent. L’identification de ces structures guide le choix ultérieur de la largeur de fenêtre, car une courbure trop abrupte ne pourra être fidèlement restituée que par une bande passante suffisamment étroite.
Le troisième axe enfin concerne l’évaluation visuelle de l’hétéroscédasticité le long du continuum. Il est fréquent dans les données réelles que la dispersion verticale des points autour de la tendance centrale s’accroisse ou se rétrécisse drastiquement au fur et à mesure que la variable explicative augmente. Bien que Lowess soit intrinsèquement robuste à l’hétéroscédasticité quant à l’estimation de la moyenne locale conditionnelle, le repérage de cette instabilité de variance fournit des indices substantiels pour l’interprétation future des résidus et des intervalles d’incertitude.
6. Étape 3 : Calcul et superposition de la courbe Lowess de base
6.1 Exécution de l’algorithme et stockage des coordonnées
L’exécution de la modélisation s’articule autour de l’appel formel à la commande lowess() appliquée aux colonnes sélectionnées du jeu de données expérimental. Dans cette première phase de mise en œuvre, il est hautement recommandé d’adopter initialement les valeurs par défaut programmées dans le moteur statistique de R, notamment une largeur de bande f = 2/3 et un nombre d’itérations robustes iter = 3, afin d’établir un point de comparaison analytique de référence.
Plutôt que d’emboîter directement l’instruction de calcul au sein d’une commande d’affichage graphique sans conserver la mémoire des calculs, la démarche de programmation rigoureuse impose de stocker le résultat de la fonction dans un objet dédié au sein de l’espace de travail. L’assignation d’une variable nommée par exemple ajustement_lowess permet de figer les estimations numériques et de rendre possible leur manipulation programmatique ultérieure.
L’inspection structurelle de l’objet ainsi généré au moyen de la commande str(ajustement_lowess) ou names(ajustement_lowess) met en évidence la présence des deux listes numériques univariées $x et $y. Il est fondamental de vérifier que le nombre d’éléments contenus dans ajustement_lowess$y correspond rigoureusement à la longueur du vecteur initial non manquant, et que l’ordre des éléments $x est scrupuleusement monotone croissant. Cette validation dimensionnelle confirme la bonne exécution des calculs et prépare la phase de rendu graphique.
6.2 Superposition de la courbe lissée avec la fonction lines()
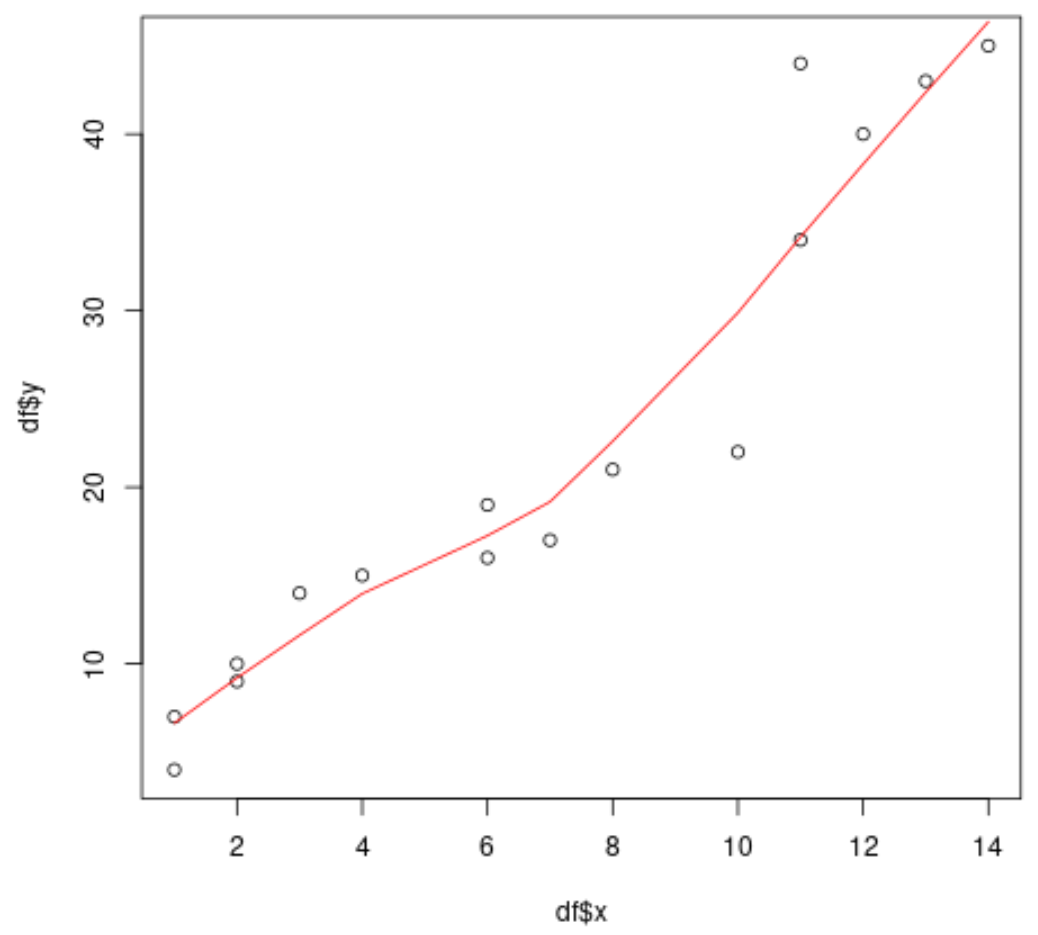
L’intégration de la tendance lissée sur le graphique de dispersion préalable illustre la modularité du moteur graphique de base de R, qui fonctionne selon une logique de stratification par couches successives d’encres virtuelles. La fonction complémentaire lines() est spécifiquement conçue pour lire des coordonnées bivariées et tracer des segments continus connectant les points successifs, sans régénérer ni réinitialiser le système de coordonnées du graphique existant.
La syntaxe opératoire consiste à invoquer lines(ajustement_lowess) immédiatement après l’exécution de la commande plot(). La lisibilité optimale de la trajectoire requiert une différenciation visuelle marquée par rapport aux marqueurs d’arrière-plan. Cela s’obtient au moyen de l’argument lwd (line width) en fixant une épaisseur généreuse, typiquement lwd = 2.5 ou lwd = 3, assurant une présence optique sans équivoque au premier plan du tracé.
Le paramétrage du style de ligne via lty (line type) offre la possibilité d’opter pour un trait continu (lty = 1) ou pour une déclinaison en tirets (lty = 2), bien que le trait plein soit quasi universellement privilégié pour matérialiser le signal déterministe central. Conjointement, l’application d’une teinte contrastante vive au moyen de l’argument col — tel qu’un rouge carmin ou un bleu cyan saturé — détache instantanément la dynamique modélisée du nuage de points sous-jacent, réalisant ainsi l’objectif premier du lissage exploratoire.
6.3 Ajout d’éléments de lisibilité graphique
Un document graphique à vocation scientifique ne saurait être considéré comme achevé sans l’adjonction d’éléments contextuels explicatifs permettant son interprétation autonome par le lecteur. L’intégration d’une légende formelle au sein du graphique s’effectue au moyen de l’instruction spécialisée legend(), positionnée stratégiquement dans une région dégagée de la zone d’affichage (par exemple "topright" ou "bottomleft").
La configuration de la légende doit expliciter clairement la signification respective des glyphes individuels et du trait continu de régression. Cela implique de paramétrer les vecteurs textuels descriptifs legend = c("Observations empiriques", "Lissage Lowess (f = 2/3)"), en veillant à synchroniser méticuleusement les paramètres de symboles pch, d’épaisseurs lwd et de palettes colorimétriques col afin de garantir une correspondance parfaite avec les couches préalablement dessinées.
Enfin, le couronnement de la figure implique la spécification d’un titre général explicite au moyen de l’argument main et, le cas échéant, d’un sous-titre méthodologique via l’argument sub. Ce dernier constitue un emplacement de choix pour consigner de manière transparente les hyperparamètres clés du modèle non paramétrique, tels que la fraction de lissage f retenue et le nombre de réitérations de robustesse exécutées, garantissant ainsi la reproductibilité de l’analyse visuelle.
7. Paramétrage approfondi : Le rôle critique du paramètre d’étendue (span ‘f’)
7.1 Sous-lissage (Under-smoothing) : impact d’une faible valeur de f
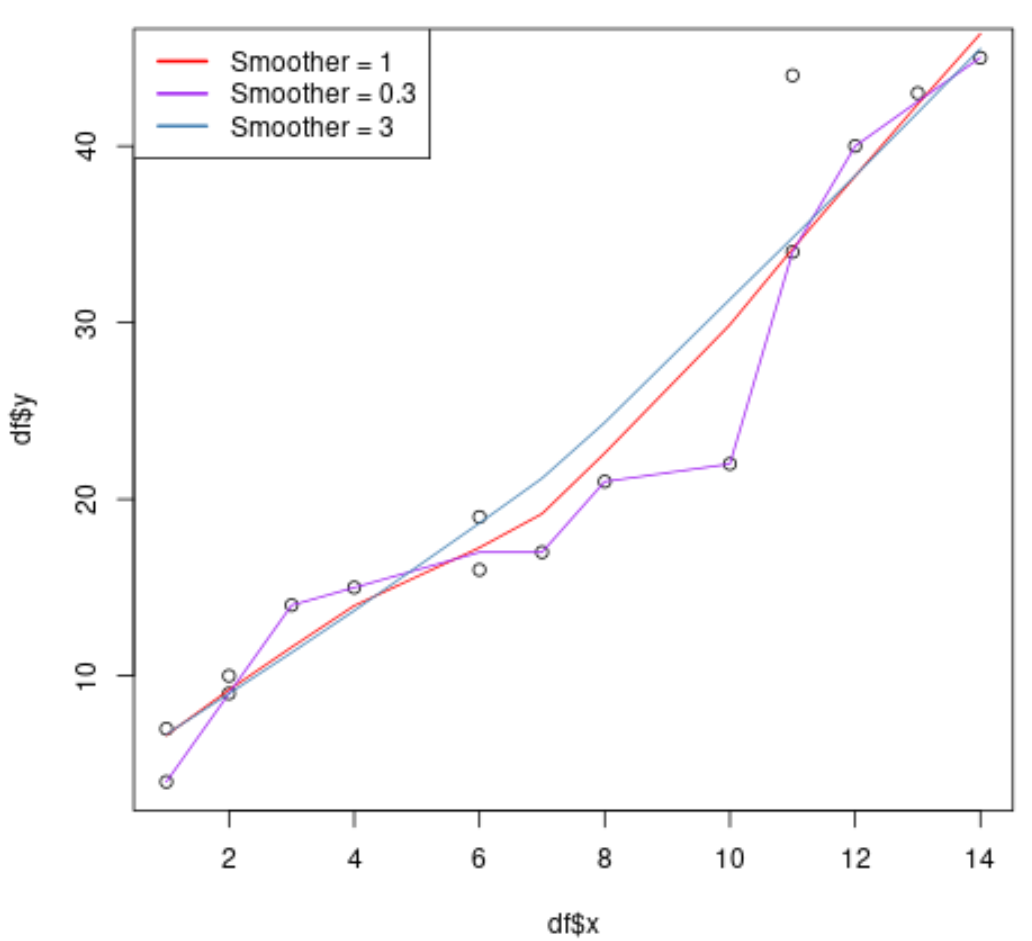
L’exploration des variations de la largeur de fenêtre constitue l’étape la plus formatrice pour comprendre le fonctionnement intime du lissage par régression locale. L’attribution d’une valeur anormalement réduite au paramètre d’étendue — par exemple en configurant f = 0.05 ou f = 0.10 — contraint l’algorithme à n’agréger qu’un pourcentage infime des données contiguës pour calculer chaque ordonnée lissée. Dans un échantillon de 200 observations, une valeur de f = 0.05 signifie que chaque régression polynomiale locale n’est ajustée que sur un groupe restreint d’une dizaine de points voisins.
Sur le plan géométrique, ce sous-lissage prononcé (under-smoothing) se traduit par une trajectoire extrêmement tourmentée et chaotique. La courbe présente une multitude d’ondulations aiguës, de micro-pics et de vallées abruptes qui ne correspondent à aucune réalité physique ou biologique sous-jacente. L’estimateur perd sa fonction première de filtration pour devenir une éponge qui absorbe intégralement les fluctuations d’échantillonnage aléatoires.
D’un point de vue épistémologique et inférentiel, le sous-lissage détruit tout pouvoir de généralisation théorique. En cherchant à coller servilement aux particularités contingentes du jeu de données présent, le modèle souffre d’une variance excessive : répéter l’expérience sur un nouvel échantillon extrait de la même population engendrerait une courbe aux ondulations radicalement différentes. L’analyste se trouve alors piégé dans l’écueil du surajustement, interprétant à tort des bruits de mesure comme des propriétés structurales du phénomène étudié.
7.2 Sur-lissage (Over-smoothing) : impact d’une valeur élevée de f
À l’opposé diamétral du spectre analytique, le sur-lissage (over-smoothing) résulte de l’attribution d’une valeur particulièrement élevée au paramètre de bande passante, typiquement lorsque f = 0.85, f = 0.95 ou converge vers l’unité. Dans cette configuration, chaque fenêtre mobile englobe la quasi-totalité de l’échantillon expérimental. La décroissance de la fonction de pondération tricubique s’opère sur une échelle spatiale si vaste que l’impact de la distance locale s’amenuise considérablement.
La conséquence visuelle immédiate d’un tel choix est un aplatissement drastique de toutes les variations dynamiques réelles du système. Les pics réels de performance sont rabotés, les concavités prononcées sont comblées et les seuils de rupture temporelle sont dilués dans une inertie globale excessive. La courbe lissée adopte une rigidité artificielle qui masque délibérément les non-linéarités fines qui faisaient précisément tout l’intérêt du recours à une méthode non paramétrique.
Sur le plan statistique, le sur-lissage introduit un biais d’estimation prohibitif. Bien que la variance d’échantillonnage de la courbe devienne extrêmement faible — ce qui confère au tracé une stabilité visuelle rassurante mais illusoire —, l’espérance mathématique de l’estimateur s’écarte lourdement de la véritable fonction génératrice des données. Dans le cas limite où f = 1 avec une régression locale d’ordre 1, Lowess tend asymptotiquement vers une régression linéaire globale, anéantissant ainsi tout le bénéfice méthodologique de l’approche locale.
7.3 Méthodologie de sélection optimale du paramètre de lissage
La recherche du paramètre de lissage optimal procède de la résolution du compromis canonique entre réduction du biais et contrôle de la variance. En pratique, deux approches méthodologiques complémentaires s’offrent au chercheur : l’inspection graphique comparative multi-panneaux et les procédures computationnelles de validation croisée. L’inspection visuelle conjointe peut être facilement mise en place dans R en partitionnant la fenêtre graphique à l’aide de la commande par(mfrow = c(2, 2)), afin de tracer côte à côte l’ajustement obtenu pour différentes valeurs de test (par exemple f = 0.15, f = 0.35, f = 0.65 et f = 0.90).
Cette confrontation visuelle permet d’identifier qualitativement la zone de stabilisation où les artefacts d’oscillation haute fréquence disparaissent sans que les macro-structures d’inflexion ne soient encore rabotées. Cependant, pour conférer à cette démarche une rigueur quantitative opposable, le recours à la validation croisée (notamment la validation croisée leave-one-out ou k-fold) constitue la référence scientifique standard. Elle consiste à omettre séquentiellement une partie des données, à ajuster la courbe Lowess sur le sous-ensemble restant pour une grille de valeurs de f candidates, puis à évaluer l’erreur quadratique moyenne de prédiction sur les points mis en réserve.
La valeur de f qui minimise la fonction de perte quadratique empirique est alors retenue comme la solution d’ajustement la plus parcimonieuse. Cette hybridation entre contrôle formel par validation croisée et vérification visuelle de la plausibilité théorique garantit que la courbe retenue ne constitue ni un artefact computationnel surajusté, ni une simplification grossière de la réalité empirique sous-jacente.
8. Robustesse statistique et itérations : Gestion des valeurs aberrantes
8.1 Mécanisme de réduction de l’influence des valeurs extrêmes
Dans tout protocole de recueil de données expérimentales, qu’il s’agisse de temps de réponse psychophysiologiques ou d’enregistrements biométriques automatisés, l’émergence d’observations aberrantes causées par des erreurs de mesure, des décrochages d’attention ou des artefacts instrumentaux est inévitable. Si l’on applique une régression locale sans précaution de robustesse, un seul point extrêmement déviant situé dans un voisinage clairsemé va attirer vers lui la droite locale des moindres carrés, provoquant une cloque artificielle sur la trajectoire lissée.
Le génie de l’architecture algorithmique de Cleveland réside dans son protocole itératif de réajustement pondéré par la magnitude des résidus. À l’issue du premier lissage spatial standard, l’algorithme évalue l’ampleur du désaccord entre chaque donnée brute et la valeur théorique proposée par la courbe locale. Plus ce résidu absolu est massif comparativement à l’échelle globale de dispersion, plus l’observation est suspectée de constituer un contaminant étranger à la dynamique générale.
Le mécanisme de dévaluation des points marginaux opère de manière continue grâce à l’application de la fonction biweight de Tukey. Contrairement à un élagage arbitraire (trimming) qui éliminerait brutalement les données selon un seuil rigide, la fonction attribue un coefficient d’influence qui décroît progressivement jusqu’à s’annuler totalement pour les déviations excédant six fois la déviation absolue médiane. Ainsi, les observations hautement discordantes perdent immédiatement tout effet de levier sur le recalcul subséquent de la trajectoire.
8.2 Modulation de l’argument iter dans lowess()
Le contrôle programmatique de ce processus robuste s’effectue dans R au moyen de la modification directe de l’argument iter au sein de la commande lowess(). Par défaut, la fonction opère avec la valeur iter = 3, ce qui implique que l’algorithme exécute un ajustement initial tricubique spatial suivi de trois cycles consécutifs complets de recalcul des poids de Tukey et de réajustement polynomial local.
Pour appréhender concrètement l’action purificatrice de ce paramètre, il est particulièrement instructif de comparer graphiquement le comportement d’un ajustement non robuste sans itération de correction (iter = 0) face à un lissage intensément robustifié (par exemple iter = 6). En présence d’un jeu de données contaminé par quelques valeurs aberrantes extrêmes délibérément insérées, la courbe tracée avec iter = 0 présente des déformations asymétriques flagrantes au droit des anomalies, traduisant la vulnérabilité intrinsèque des moindres carrés purs.
Dès lors que l’on incrémente iter vers 2, 3 ou 4, la courbe s’émancipe de l’attraction des valeurs divergentes pour recouvrer sa fluidité théorique centrale, ignorant souverainement les artefacts dispersés. Pousser le paramètre au-delà de iter = 5 ou iter = 6 n’apporte généralement aucun gain mesurable supplémentaire, les poids de robustesse ayant déjà atteint leur point de convergence asymptotique, tout en engendrant un surcoût de temps de calcul superflu lors du traitement de jeux de données massifs.
8.3 Critères de décision face aux anomalies de distribution
L’existence de cette capacité d’autoréparation algorithmique ne doit pas dispenser le statisticien d’une réflexion méthodologique approfondie quant à la nature ontologique des valeurs atypiques détectées. Une observation rejetée par l’algorithme robuste de Lowess peut résulter d’une erreur d’enregistrement triviale — auquel cas sa neutralisation computationnelle est parfaitement justifiée —, mais elle peut également constituer l’expression d’un phénomène biologique ou psychologique authentique et rare.
Par exemple, dans le cadre de l’évaluation de performances cognitives sous privation de sommeil, l’apparition de temps de réaction démesurément longs peut correspondre à des épisodes réels de micro-sommeil comportemental. Neutraliser ces valeurs via un paramétrage agressif de iter risque de masquer une propriété émergente critique du système étudié. L’analyste doit donc impérativement croiser l’inspection des poids de robustesse générés par l’algorithme avec la connaissance clinique et théorique du domaine d’application.
Dans la pratique de restitution des résultats, il est primordial de documenter formellement les choix opérés. Les publications scientifiques doivent expliciter clairement si le lissage présenté a été conduit avec les paramètres robustes par défaut ou si une désactivation délibérée (iter = 0) a été préférée afin de rendre compte de l’hétérogénéité réelle de la distribution empirique. Cette transparence méthodologique constitue le garant absolu de l’intégrité des conclusions analytiques.
9. Visualisation moderne avec ggplot2 : geom_smooth(method = ‘loess’)
9.1 Transition du système graphique de base vers la grammaire des graphiques
Bien que le système graphique natif de R demeure un modèle d’efficacité pour l’inspection exploratoire immédiate, la production de figures vectorielles destinées à l’édition scientifique internationale s’appuie désormais massivement sur la bibliothèque ggplot2, composante maîtresse de l’écosystème Tidyverse conçu par Hadley Wickham. Fondée sur la théorie formelle de la « Grammaire des graphiques » initiée par Leland Wilkinson, cette approche décompose la création visuelle en strates modulaires indépendantes articulant données, représentations géométriques et échelles de projection.
L’un des avantages conceptuels déterminants de ggplot2 réside dans l’intégration native et automatisée des méthodes de modélisation statistique directement au cœur de la syntaxe graphique. L’analyste n’a plus besoin d’extraire manuellement des coordonnées estimées, de synchroniser des tris vectoriels ou d’aligner laborieusement des légendes disparates : l’interface se charge de l’ensemble de l’architecture inférentielle et de son rendu visuel de façon unifiée.
Cette standardisation esthétique et programmatique facilite grandement la reproductibilité des analyses. Le passage d’un modèle linéaire global à un lissage non paramétrique s’opère par la modification d’un simple argument de chaîne de caractères au sein d’une couche géométrique dédiée, réduisant drastiquement le risque d’erreurs de codage et harmonisant les standards de restitution graphique au sein des équipes de recherche internationales.
9.2 Configuration technique de geom_smooth()
Au sein de la syntaxe de ggplot2, la matérialisation d’un lissage par régression locale s’opère au moyen de l’invocation de la fonction d’ajustement statistique geom_smooth(). Par défaut, pour les jeux de données comportant moins de mille observations, cette directive fait appel sous le capot à l’algorithme loess(). Pour paramétrer explicitement ce comportement de manière transparente, l’analyste spécifie l’argument fonctionnel formel method = "loess".
La modulation de la fenêtre de lissage s’effectue au moyen de l’argument span, qui joue dans geom_smooth() le rôle rigoureusement équivalent au paramètre f de la fonction basique lowess(). Ainsi, spécifier l’instruction geom_smooth(method = "loess", span = 0.5) ordonne au moteur graphique d’incorporer 50 % des observations voisines pour bâtir localement le modèle de régression polynomiale de degré 2.
Une supériorité technique majeure de l’implémentation offerte par geom_smooth() réside dans le calcul et l’affichage entièrement automatisés des bandes d’incertitude statistique associées à la trajectoire lissée. Grâce à l’argument logique se = TRUE (activé par défaut), la fonction projette un ruban translucide matérialisant l’intervalle de confiance à 95 % entourant la courbe d’estimation centrale. Cette zone d’ombre s’élargit naturellement aux extrémités du domaine ou au sein des régions pauvres en observations, fournissant au lecteur une évaluation immédiate de la fiabilité locale de l’inférence non paramétrique.
9.3 Personnalisation typographique et stylistique avancée
L’obtention d’une figure de publication répondant aux standards les plus stricts de l’American Psychological Association (APA) ou des revues savantes de haut rang implique le déploiement d’une personnalisation esthétique poussée. Cette démarche s’amorce par l’éradication des fonds gris quadrillés par défaut au profit de thèmes épurés tels que theme_classic() ou theme_minimal(), qui rétablissent des axes cartésiens nets et un fond blanc pur indispensable pour l’impression typographique.
Au sein de la couche géométrique geom_smooth(), la coloration de la courbe et de son ruban d’incertitude peut être finement harmonisée. L’utilisation d’instructions telles que color = "#1B4F72" confère à la ligne un ton bleu nuit académique d’une grande distinction, tandis que l’argument fill = "#85C1E9" conjugué à un niveau de transparence optimisé via alpha = 0.25 permet au ruban de confiance de signaler la marge d’erreur sans masquer la densité des points de données sous-jacents dessinés via geom_point().
Le contrôle des titres, sous-titres, légendes et intitulés d’axes est ensuite entièrement consolidé via la fonction labs(), garantissant une clarté sémantique absolue. Enfin, l’exportation finale de la composition graphique vers un format vectoriel non destructif haute résolution (tel que le PDF vectoriel ou le format TIFF à 600 DPI) s’exécute de manière élégante et parfaitement calibrée au moyen de la commande ggsave(), en fixant explicitement les dimensions physiques en centimètres ou en pouces adaptées à la mise en page de la revue visée.
10. Comparaison méthodologique : Lowess vs Loess vs Splines vs Régression Linéaire
10.1 Distinction fondamentale entre lowess() et loess() sous R
L’une des sources de confusion les plus fréquentes au sein de la communauté des utilisateurs du langage R réside dans la coexistence de deux fonctions aux appellations quasi identiques : lowess() et loess(). Bien qu’elles partagent la même filiation épistémologique et le même inventeur — William S. Cleveland —, ces deux fonctions incarnent deux générations d’implémentation logicielle aux caractéristiques architecturales profondément distinctes.
La commande originelle lowess() (développée dès 1979) est un algorithme purement bidimensionnel, strictement réservé à la modélisation univariée d’une variable réponse continue y en fonction d’un unique prédicteur continu x. Son ajustement repose localement sur des droites de régression de degré 1. En contrepartie de cette simplicité, elle offre une rapidité d’exécution fulgurante et une empreinte mémoire minime, ce qui en fait l’outil d’élection pour le lissage rapide au fil de l’eau dans l’analyse exploratoire interactive.
En revanche, la commande plus récente loess() (Locally Estimated Scatterplot Smoothing, formalisée par Cleveland, Grosse et Shyu en 1992) représente une généralisation mathématique multivariée complète. Elle permet d’ajuster des surfaces de régression locale dépendant de deux, trois, voire plusieurs prédicteurs simultanés, en supportant des polynômes locaux d’ordre 1 ou d’ordre 2. De plus, loess() est pleinement intégrée au système de modélisation formel de R : elle génère un objet complexe de classe loess qui supporte la méthode générique predict(). Cette caractéristique est fondamentale, car elle autorise l’analyste à prédire l’espérance mathématique de la réponse pour de nouvelles matrices d’observations indépendantes (données de test), fonctionnalité que la structure rudimentaire de lowess() ne permet pas nativement.
10.2 Confrontation avec les splines de lissage (Smoothing Splines)
Face à la régression locale pondérée, les splines cubiques de lissage — accessibles dans R via la fonction classique smooth.spline() ou au sein des modèles additifs généralisés (GAM) avec le package mgcv — représentent l’autre paradigme non paramétrique majeur. La divergence entre ces deux méthodologies réside dans leur formulation mathématique intrinsèque : alors que Lowess résout une succession discrète de régressions locales sur des fenêtres spatiales glissantes, la spline de lissage résout un problème d’optimisation fonctionnelle globale sous contrainte de régularité.
L’algorithme de spline cherche la fonction globale continue f(x) qui minimise la somme des résidus aux moindres carrés augmentée d’une pénalité proportionnelle à l’intégrale du carré de sa dérivée seconde. Cette pénalité de courbure garantit mathématiquement une régularité et une dérivabilité parfaites sur l’ensemble du domaine continu. Le paramètre d’ajustement ne s’exprime pas ici en termes de pourcentage de points de voisinage, mais sous la forme d’un coefficient de pénalité de rugosité (souvent noté lambda) ou de degrés de liberté effectifs (df).
Dans la pratique expérimentale, les splines de lissage surpassent souvent Lowess lorsque l’analyste a besoin de calculer avec une grande stabilité les dérivées première ou seconde de la fonction lissée (par exemple pour déterminer avec une précision analytique la vitesse instantanée ou l’accélération d’un processus biologique). En revanche, Lowess conserve une supériorité ergonomique et conceptuelle indéniable lors des phases exploratoires brutes, de par la transparence intuitive de son paramètre de voisinage f et son insensibilité naturelle aux oscillations parasites aux frontières des sous-intervalles.
10.3 Avantages et limites face aux modèles paramétriques classiques
Le tableau comparatif entre modélisation locale non paramétrique et modélisation paramétrique classique (telle que la régression linéaire simple ou polynomiale standard via lm()) cristallise les arbitrages fondamentaux de la démarche scientifique. L’atout majeur de Lowess réside dans son agnosticisme fonctionnel absolu : le chercheur s’affranchit du risque de spécification vicieuse consistant à imposer à la nature une linéarité ou une symétrie qui n’existe que dans ses équations théoriques préalables. La méthode laisse les données s’exprimer selon leur géométrie intrinsèque.
Néanmoins, cette liberté méthodologique s’accompagne de limites formelles substantielles qu’il importe de reconnaître avec lucidité. La première limite concerne l’absence d’équation analytique compacte : Lowess ne fournit pas d’équation mathématique fermée constituée d’une constante et de coefficients bêta transposables dans un tableau synthétique d’article scientifique. Il est impossible de résumer le modèle en une formule unique permettant à un tiers de reproduire manuellement le calcul de prédiction sans disposer du jeu de données originel complet.
La seconde limite majeure a trait aux effets de bord prononcés qui affectent invariablement les extrémités du domaine de définition des variables. Aux frontières inférieure et supérieure de la variable explicative, la fenêtre de voisinage mobile devient asymétrique : l’algorithme ne peut agréger des observations que d’un seul côté du point cible. Il en résulte un risque d’accroissement brutal de la variance d’estimation et d’inflexions parasites aux marges externes du nuage de points. Enfin, Lowess s’avère totalement impropre à l’extrapolation : toute tentative d’estimer des valeurs en dehors de l’étendue stricte range(x) observée est mathématiquement invalide et algorithmiquement proscrite.
11. Diagnostic statistique et analyse des résidus de lissage Lowess
11.1 Extraction et calcul programmatique des résidus
La validation de la qualité d’ajustement d’un lissage Lowess exige une analyse rigoureuse des écarts résiduels, définie comme la différence algébrique entre les valeurs observées empiriquement et les estimations théoriques produites par la courbe. Toutefois, l’extraction de ces résidus nécessite une étape computationnelle spécifique due à la structure de sortie de la fonction lowess(). Étant donné que le vecteur ajustement$x retourné correspond aux valeurs ordonnées et peut comporter des interpolations dues au paramètre delta, une simple soustraction vectorielle directe avec le vecteur de données initial non trié risque d’associer des observations dépareillées.
Pour contourner cet écueil avec une rigueur mathématique sans faille, le protocole standard consiste à recourir à la fonction d’interpolation linéaire continue native approx(). Cette instruction permet d’évaluer exactement la valeur de l’ordonnée lissée pour chaque valeur d’abscisse x originelle, en projetant les observations sur la grille des coordonnées estimées par Lowess. La syntaxe générale s’articule comme suit :
L’estimation des valeurs ajustées synchronisées s’obtient par l’instruction : y_ajuste = approx(ajustement$x, ajustement$y, xout = x_origine)$y.
Dès lors que les prédictions locales y_ajuste sont parfaitement alignées ligne par ligne avec les observations initiales y_origine, le calcul vectoriel des résidus devient immédiat via l’équation residus = y_origine - y_ajuste. L’analyste peut alors consigner ces nouvelles grandeurs au sein de colonnes dédiées du data frame expérimental, ouvrant la voie aux tests formels de validation diagnostique des erreurs.
11.2 Inspection graphique de l’homoscédasticité et de l’indépendance
La première vérification diagnostique post-ajustement réside dans l’analyse de l’homoscédasticité et de la structure relationnelle des erreurs. À cette fin, la construction d’un graphique confrontant sur l’axe des ordonnées les résidus calculés et sur l’axe des abscisses les valeurs prédites lissées (ou la variable explicative x) s’avère indispensable. Dans un modèle parfaitement équilibré où le signal a été intégralement capturé par le lissage, les résidus doivent se répartir de manière homogène et aléatoire sous la forme d’une bande horizontale d’épaisseur constante de part et d’autre de la ligne zéro.
Si l’inspection visuelle révèle une structure géométrique identifiable — par exemple une configuration en entonnoir où la dispersion verticale des résidus s’élargit massivement le long de l’axe —, l’existence d’une hétéroscédasticité sous-jacente est formellement confirmée. Bien que le lissage Lowess demeure non biaisé dans l’estimation de la tendance centrale en présence de variances inégales, cette information s’avère capitale pour relativiser la confiance accordée aux observations situées dans les plages de haute dispersion.
De plus, l’analyste doit impérativement scruter l’éventuelle persistance de formes sinusoïdales ou d’ondulations régulières au sein du nuage de résidus. La présence de résidus consécutifs partageant massivement le même signe (agrégats positifs suivis d’agrégats négatifs) signale de manière indubitable un phénomène de sous-lissage : le paramètre f a été configuré de façon trop rigide ou trop lâche, laissant échapper une composante déterministe majeure qui a été indûment reléguée au rang de simple erreur stochastique.
11.3 Vérification de la normalité des erreurs locales
Bien que l’algorithme Lowess n’impose pas de postulat de normalité pour effectuer ses ajustements locaux — ce qui constitue l’une de ses vertus cardinales face aux modèles de régression des moindres carrés gaussiens —, l’évaluation de la distribution des résidus fournit des enseignements cruciaux sur la nature du processus stochastique sous-jacent. Si l’objectif ultime de l’étude implique de calculer ultérieurement des intervalles de confiance paramétriques ou de réaliser des tests d’hypothèse sur des résidus d’analyse, l’exploration de leur conformité gaussienne devient obligatoire.
L’instrument graphique privilégié pour ce diagnostic est le diagramme quantile-quantile normal, généré dans R par les commandes conjointes qqnorm(residus) et qqline(residus). L’alignement rigoureux des points empiriques le long de la droite théorique bissectrice confirme l’adéquation à une loi normale. En revanche, des décrochages prononcés aux extrémités — sous forme de courbures en S ou d’étirements asymétriques — révèlent l’existence de distributions à queues lourdes (leptokurtiques) ou d’une asymétrie résiduelle marquée.
Pour étayer cette observation graphique par une métrique probabiliste formelle, le statisticien peut appliquer des tests d’adéquation tels que le test de Shapiro-Wilk au moyen de la commande shapiro.test(residus). Toutefois, sur de grands échantillons empiriques, ce test statistique devient hyper-sensible à des déviations infinitésimales sans pertinence pratique. L’analyste privilégiera donc l’interprétation croisée de la dispersion interquartile et l’examen du Q-Q plot pour juger si les hypothèses de travail demeurent raisonnablement soutenables pour les modélisations subséquentes.
12. Applications pratiques en psychologie et recommandations de publication
12.1 Étude de cas : Relation non linéaire entre stress et efficacité cognitive
Pour matérialiser la puissance analytique de la régression locale dans le champ des sciences du comportement, considérons une étude empirique simulant l’impact du niveau d’anxiété situationnelle (évalué sur une échelle biométrique continue de 0 à 100) sur l’efficacité de la mémoire de travail (mesurée par le score de rappel d’items complexes). Selon la théorie classique de la loi de Yerkes-Dodson, la performance optimale n’est pas atteinte lors d’un état de quiétude absolue, mais sous un niveau d’activation physiologique modéré stimulant l’attention, avant qu’un stress excessif n’entraîne une dégradation rapide de l’efficience exécutive.
Si le chercheur applique une simple régression linéaire ordinaire à ce jeu de données, la pente globale estimée oscillera autour de zéro, conduisant à la conclusion erronée selon laquelle le niveau d’anxiété n’exerce aucune influence sur la performance cognitive. Si, conscient de la non-linéarité, il tente de forcer un modèle polynomial quadratique standard de type score ~ anxiete + I(anxiete^2), il imposera arbitrairement une parabole symétrique contraignant la phase de dégradation à reproduire exactement la pente de la phase d’activation ascendante.
Le déploiement du lissage Lowess avec une bande passante calibrée à f = 0.45 révèle la réalité dynamique du phénomène : la courbe progresse avec modération jusqu’à un pic de performance culminant vers 42 unités de stress, avant d’amorcer un décrochage brutal et hautement asymétrique au-delà de 65 unités. L’identification clinique de ce point de bascule critique et de cette non-symétrie fournit aux neuropsychologues des repères diagnostiques d’une précision inaccessible aux modélisations paramétriques rigides, illustrant tout l’apport pratique de l’ajustement non paramétrique.
12.2 Pièges fréquents et écueils méthodologiques à éviter
L’utilisation experte du lissage Lowess nécessite néanmoins d’éviter plusieurs pièges méthodologiques majeurs qui grèvent fréquemment la littérature scientifique quantitative. Le premier écueil réside dans la surinterprétation des ondulations locales mineures. Confrontés à une courbe lissée avec un paramètre f trop restreint, certains auteurs succombent à la tentation de bâtir des hypothèses ad hoc pour expliquer chaque micro-inflexion du tracé, alors même que ces artefacts géométriques ne constituent que l’empreinte fortuite du bruit d’échantillonnage.
Le second piège concerne la tentation de l’extrapolation périlleuse. Certains analystes commettent l’erreur conceptuelle de prolonger visuellement ou mathématiquement la trajectoire lissée au-delà des bornes empiriques des données collectées. Il convient de réaffirmer qu’en l’absence de points d’ancrage, les algorithmes de voisinage n’ont aucune légitimité théorique pour projeter une dynamique dans le vide expérimental ; toute extrapolation à partir d’un lissage Lowess relève de la pure spéculation dénuée de fondement scientifique.
Le troisième écueil enfin relève du manque d’intégrité dans la communication des résultats : il est méthodologiquement inacceptable de tester secrètement une multitude de valeurs de f jusqu’à sélectionner arbitrairement celle qui conforte les hypothèses théoriques initiales de l’auteur. Cette pratique s’apparente à une forme insidieuse de p-hacking visuel. La sélection de la bande passante doit être guidée par des critères objectifs (validation croisée ou règles de Silverman) et faire l’objet d’une divulgation exhaustive dans les manuscrits soumis à évaluation.
12.3 Bonnes pratiques de reporting selon les normes académiques (APA)
Afin d’assurer une transparence scientifique totale et de garantir la reproductibilité intégrale des protocoles d’analyse conformément aux directives éditoriales de l’American Psychological Association (normes APA 7e édition), la description du lissage Lowess au sein de la section « Matériel et Méthodes » doit obéir à des règles de formulation rigoureuses.
Le texte méthodologique doit impérativement spécifier :
- Le logiciel d’analyse utilisé ainsi que sa version exacte (par exemple : R version 4.3.2).
- Le package ou la fonction computationnelle sollicitée (par exemple : fonction native
lowess()du package stats ougeom_smooth(method = "loess")de la bibliothèque ggplot2 version 3.4.4). - La valeur précise du paramètre de fraction de lissage locale retenue (le span f ou span) et la justification méthodique ayant présidé à ce choix (par exemple, minimisation de l’erreur quadratique par validation croisée leave-one-out).
- Le nombre de cycles de réajustement robuste exécutés (l’argument iter) afin de documenter la politique de neutralisation des valeurs extrêmes.
Sur le plan iconographique, les normes académiques proscrivent la présentation d’une courbe lissée isolée de son contexte d’émergence. La figure publiée doit obligatoirement superposer le tracé de lissage continu à l’ensemble du nuage de points originels évidés ou translucides, assorti de ses bandes d’intervalle de confiance lorsque l’implémentation logicielle le permet. Cette coexistence visuelle offre aux pairs et aux relecteurs la possibilité d’auditer en toute indépendance la justesse du compromis biais-variance et l’honnêteté intellectuelle de l’ajustement non paramétrique exposé.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Cleveland, W. S. (1979). Robust locally weighted regression and scatterplot smoothing. Journal of the American Statistical Association, 74(368), 829–836. https://doi.org/10.1080/01621459.1979.10481038
- Cleveland, W. S. (1981). LOWESS: A program for smoothing scatterplots by robust locally weighted regression. The American Statistician, 35(1), 54–54. https://doi.org/10.2307/2683591
- Cleveland, W. S., & Devlin, S. J. (1988). Locally weighted regression: An approach to regression analysis by local fitting. Journal of the American Statistical Association, 83(403), 596–610. https://doi.org/10.1080/01621459.1988.10478639
- Cleveland, W. S., Grosse, E., & Shyu, W. M. (1992). Local regression models. In J. M. Chambers & T. J. Hastie (Eds.), Statistical Models in S (pp. 309–376). Wadsworth & Brooks/Cole.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized additive models. Chapman & Hall/CRC.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503