
L’analyse quantitative des données en sciences humaines, particulièrement en psychologie cognitive, sociale et clinique, repose sur la vérification rigoureuse d’hypothèses au moyen de tests statistiques inférentiels. Lorsqu’un protocole expérimental implique la comparaison simultanée de plusieurs conditions ou groupes, les chercheurs s’exposent inévitablement au phénomène pernicieux de l’inflation de l’erreur de première espèce, communément désigné sous le terme de problème des comparaisons multiples. Si l’analyse de variance (ANOVA) permet dans un premier temps d’attester de l’existence d’une hétérogénéité globale entre les moyennes observées, elle s’avère incapable d’identifier la localisation précise des divergences intergroupes. L’investigation approfondie requiert ainsi le déploiement de comparaisons par paires, dont l’accumulation désordonnée menace directement la validité des conclusions scientifiques.
Pour parer à cette dérive méthodologique, diverses procédures d’ajustement ont été conceptualisées, au premier rang desquelles figure la correction de Bonferroni. Réputée pour son élégance conceptuelle et sa simplicité d’implémentation, cette méthode de contrôle du taux d’erreur global par famille d’hypothèses constitue un standard incontournable dans la littérature biomédicale et psychologique. Bien que les progiciels statistiques spécialisés intègrent nativement cette correction, la maîtrise de son exécution au sein d’un tableur ubiquitaire tel que Microsoft Excel demeure une compétence analytique fondamentale. Cette approche « pas à pas » démystifie les calculs sous-jacents, renforce la transparence des processus d’analyse et offre une flexibilité incomparable pour l’automatisation de tableaux de bord de recherche personnalisés.
Cet article constitue un guide d’autorité exhaustif dédié à l’application rigoureuse de la correction de Bonferroni dans Excel. Du rappel approfondi des fondements probabilistes et des théorèmes d’inégalité jusqu’à la modélisation dynamique de formules matricielles, en passant par le respect strict des normes de publication académique de l’American Psychological Association (APA 7e édition), chaque étape est disséquée avec une précision d’orfèvre. Les chercheurs, doctorants et praticiens des sciences du comportement trouveront ici l’ensemble des clés théoriques et techniques pour traiter leurs données expérimentales sans écueil méthodologique.
1. Introduction théorique : Le problème des comparaisons multiples en psychologie
1.1 Le risque d’erreur de type I cumulé (Family-wise Error Rate)
Dans le cadre de l’inférence statistique néo-fisherienne ou neyman-pearsonienne, l’erreur de type I (notée α) correspond à la probabilité de rejeter à tort une hypothèse nulle ($H_0$) qui est pourtant vérifiée dans la population générale. Traditionnellement, le seuil de signification est fixé à $\alpha = 0,05$, tolérant ainsi un risque de 5 % de déclarer faussement l’existence d’un effet ou d’une différence. Cette convention, bien qu’arbitraire, fonctionne adéquatement tant que le chercheur se limite à l’évaluation d’une hypothèse unique au sein d’un échantillon indépendant. Cependant, dès lors que l’on multiplie les tests d’hypothèses au sein d’une même famille analytique, la probabilité d’observer au moins un résultat statistiquement significatif sous l’effet du seul hasard croît de manière quasi exponentielle.
Le taux d’erreur par famille d’hypothèses (connu dans la littérature anglophone sous l’acronyme Family-wise Error Rate ou FWER) formalise cette dérive stochastique. Sous l’hypothèse de l’indépendance mutuelle entre $k$ tests statistiques indépendants, la probabilité de ne commettre aucune erreur de type I sur l’ensemble de la famille de tests équivaut au produit des probabilités individuelles de rétention correcte de l’hypothèse nulle, soit $(1 – \alpha)^k$. Par conséquent, la probabilité cumulée de commettre au moins une erreur de type I, représentant le FWER effectif, est rigoureusement définie par l’équation fondamentale :
FWER = 1 – (1 – α)^k
L’application numérique de cette fonction révèle la gravité de l’illusion de découverte fortuite. Si un protocole d’évaluation psychologique nécessite l’exécution de seulement trois comparaisons indépendantes au seuil nominal $\alpha = 0,05$, le taux d’erreur global effectif s’élève à : $1 – (1 – 0,05)^3 = 1 – 0,95^3 = 1 – 0,857375 = 0,1426$, soit un risque réel de près de 14,3 %. Lorsque le dispositif expérimental implique la comparaison croisée de cinq conditions (générant dix paires de contrastes), ce risque bondit spectaculairement à $1 – (1 – 0,05)^{10} \approx 0,4013$, soit plus de 40 % de probabilité d’enregistrer au moins un faux positif sans qu’aucun effet réel ne soit présent. Les conséquences méthodologiques s’avèrent désastreuses : prolifération de théories spécieuses, faillite de la réplication empirique et gaspillage de ressources cognitives et financières au sein de la communauté scientifique.
1.2 La spécificité des plans de recherche en sciences du comportement
Les sciences psychologiques et les neurosciences comportementales présentent des particularités méthodologiques qui accentuent de manière disproportionnée le risque de comparaisons multiples fallacieuses. Rarement limitées à un paradigme binaire « contrôle contre traitement », les investigations empiriques contemporaines sollicitent des plans expérimentaux factoriels complexes impliquant de multiples groupes diagnostiques (par exemple : sujets sains, patients présentant un trouble dépressif caractérisé, patients en rémission), des modalités thérapeutiques concurrentes (thérapie cognitivo-comportementale, pharmacothérapie, pleine conscience, liste d’attente) ou encore une chronométrie d’interventions longitudinales (pré-test, post-test, relance à 3 mois, suivi à 6 mois).
Parallèlement, la nature intrinsèque des mesures psychométriques, souvent issues d’échelles composites, d’inventaires d’auto-évaluation multiaxiaux ou de biomarqueurs neurophysiologiques (tels que les potentiels évoqués ou les voxels d’imagerie par résonance magnétique fonctionnelle), multiplie le nombre de variables dépendantes analysées en parallèle. Cette abondance dimensionnelle favorise l’apparition de corrélations fallacieuses et d’artefacts d’échantillonnage que le chercheur peu rigoureux pourrait ériger en découvertes substantielles. Dans le sillage de la crise de la reproductibilité documentée notamment par l’Open Science Collaboration, les comités de lecture des revues internationales de premier rang imposent désormais un verrouillage statistique drastique, exigeant la pré-spécification des contrastes et l’application stricte d’ajustements correctifs pour toute batterie de comparaisons post-hoc.
1.3 Définition et principe fondamental de la procédure de Bonferroni
La correction de Bonferroni, bien qu’attribuée par l’usage historiographique au mathématicien italien Carlo Emilio Bonferroni pour ses contributions à la théorie des probabilités dans les années 1930, a été formalisée dans le champ de la statistique inférentielle moderne par Olive Jean Dunn au début des années 1960. Son postulat opérationnel repose sur le principe de partition conservative du risque d’erreur de type I : afin de garantir que le taux d’erreur cumulé pour l’ensemble d’une famille de $m$ tests statistiques ne dépasse jamais le seuil global toléré $\alpha_{global}$ (typiquement 0,05), la méthode prescrit de subdiviser équitablement ce capital de risque entre chaque test individuel.
Le principe fondamental consiste à substituer au seuil d’inférence nominal standard un seuil de signification ajusté, beaucoup plus sévère, appliqué de façon uniforme à chaque contraste univarié. Ce mécanisme instaure une dissociation conceptuelle capitale entre le niveau de signification nominal (le seuil de rejet standard fixé arbitrairement par le chercheur) et le niveau effectif (la probabilité opérationnelle requise pour déclarer la significativité statistique d’une différence observée). Par cette austérité mathématique, la procédure de Bonferroni neutralise le laxisme induit par la répétition des calculs, érigeant une barrière protectrice robuste contre les artefacts inférentiels.
2. Fondements mathématiques de l’ajustement de Bonferroni
2.1 L’inégalité de Boole comme socle probabiliste
L’assise formelle de la correction de Bonferroni réside dans un résultat classique de la théorie de la mesure et des probabilités connu sous le nom d’inégalité de Boole (ou première inégalité de Boole-Fréchet). Soit un espace probabilisé $(\Omega, \mathcal{F}, P)$ et une famille finie d’événements stochastiques désignés par $E_1, E_2, dots, E_m$. Le théorème énonce que la probabilité de l’union disjonctive de ces événements est structurellement bornée supérieurement par la somme de leurs probabilités marginales individuelles :
P(⋃_{i=1}^m E_i) ≤ ∑_{i=1}^m P(E_i)
Dans l’architecture de la décision statistique, définissons l’événement $E_i$ comme la survenue d’une erreur de type I lors de la réalisation du $i$-ième test d’hypothèse (c’est-à-dire le rejet erroné de l’hypothèse nulle $H_{0,i}$ sachant que celle-ci est vraie). L’événement « commettre au moins une erreur de type I sur l’ensemble des $m$ tests conduits » correspond exactement à l’union stochastique $\big\cup_{i=1}^m E_i$. En vertu de l’inégalité de Boole, nous déduisons directement que :
FWER = P(⋃_{i=1}^m E_i) ≤ ∑_{i=1}^m α_i
Cette relation démontre avec rigueur que le risque d’erreur global est majoré par la somme arithmétique des seuils de signification assignés à chaque comparaison. Contrairement au calcul binomial $(1 – (1 – \alpha)^m)$, qui requiert impérativement l’indépendance mutuelle des variables aléatoires, l’inégalité de Boole conserve son entière validité probabiliste que les tests statistiques soient parfaitement indépendants, corrélés positivement ou même négativement interdépendants. Cette universalité confère à la méthode une robustesse absolue, au prix toutefois d’un conservatisme mathématique accru lorsque les structures de corrélation sous-jacentes sont fortes.
2.2 Dérivation de la formule standard du seuil corrigé
À partir de la borne supérieure établie par l’inégalité de Boole, la formalisation de la règle de décision devient immédiate. L’objectif consiste à contraindre le FWER de telle sorte qu’il n’excède sous aucune condition le niveau de risque global préétabli $\alpha_{global}$ :
∑_{i=1}^m α_i ≤ α_{global}
En adoptant une stratégie d’équi-répartition du risque d’erreur — c’est-à-dire en accordant un poids probabiliste strictement identique à chacune des hypothèses testées au sein de la famille d’intérêt, soit $\alpha_1 = \alpha_2 = dots = \alpha_m = \alpha_{ajuste}$ —, l’inégalité se simplifie en :
m × α_{ajuste} ≤ α_{global} ⟹ α_{ajuste} = α_{global} / m
Où le paramètre $m$ (parfois noté $n$ ou $k$ selon les nomenclatures) quantifie le nombre total de comparaisons d’hypothèses planifiées ou conduites. L’analyse du comportement asymptotique de cette fonction révèle sans équivoque la décroissance rapide du seuil critique à mesure que le nombre de contrastes augmente. Pour un niveau conventionnel $\alpha_{global} = 0,05$, un ensemble de 5 tests abaisse le seuil de décision à 0,01 ; pour 10 tests, il descend à 0,005 ; pour 50 tests, il atteint 0,001. Cette raréfaction progressive de la zone de rejet impose des preuves empiriques d’une intensité drastique pour franchir le filtre de la significativité.
2.3 Ajustement du seuil alpha versus ajustement de la valeur p
Dans la pratique de l’analyse computationnelle et de la rédaction scientifique, deux paradigmes strictement équivalents d’un point de vue décisionnel coexistent pour matérialiser la correction de Bonferroni : l’ajustement du seuil d’alpha critique et l’ajustement de la valeur $p$ empirique observée (ou p-value).
La première approche maintient la valeur $p$ calculée par le test statistique dans son format originel non modifié et la compare au seuil divisé : la décision de rejet de $H_0$ survient si $p_{brute} le \alpha_{global} / m$. La seconde approche, préconisée par les environnements logiciels modernes et les normes de publication, préfère conserver le seuil de référence universel ($\alpha = 0,05$) tout en modulant la valeur $p$ brute par une transformation multiplicative :
p_{ajustee} = min(1, p_{brute} × m)
L’introduction de la fonction de troncature $\min(1, \cdot)$ est mathématiquement impérative, car une probabilité ne peut par définition axiologique excéder l’unité. Dès lors qu’une valeur $p$ brute élevée (par exemple 0,35) est multipliée par un nombre substantiel de comparaisons (par exemple $m = 4$), le produit théorique ($1,40$) contredirait les axiomes élémentaires de Kolmogorov. L’équivalence formelle entre les deux démarches se vérifie immédiatement par manipulation algébrique basique :
p_{brute} ≤ α_{global} / m ⟺ p_{brute} × m ≤ α_{global}
Dans une feuille de calcul Excel, le choix de l’une ou l’autre de ces formulations influe sur la clarté visuelle des tableaux de bord, la seconde option étant particulièrement prisée pour standardiser la lecture comparative de plusieurs contrastes expérimentaux.
3. Conditions d’application et pertinence méthodologique
3.1 Le contexte post-hoc suite à une ANOVA unidirectionnelle
L’une des configurations les plus classiques de déploiement de la correction de Bonferroni en psychologie concerne l’analyse post-hoc (a posteriori) consécutive à une analyse de variance à un facteur (ANOVA unidirectionnelle). L’ANOVA repose sur l’évaluation globale d’un test $F$ de Fisher-Snedecor calculant le ratio de la variance intergroupes sur la variance intragroupe (résiduelle). Ce test omnibus teste l’hypothèse nulle générale d’équivalence absolue de toutes les moyennes populationnelles : $H_0 : \mu_1 = \mu_2 = dots = \mu_k$.
Lorsque la valeur critique de $F$ est franchie avec une probabilité inférieure à 0,05, l’expérimentateur valide l’existence d’une variance systématique non imputable aux seules fluctuations d’échantillonnage. Cependant, le test $F$ demeure muet quant à la configuration précise de cette hétérogénéité : s’agit-il d’une divergence isolée entre un groupe singulier et l’ensemble des autres, d’un effet d’escalier régulier ou de polarités bidirectionnelles opposées ? La tentation de recourir directement à une cascade de tests $t$ de Student ordinaires sans ajustement pour élucider ces contrastes expose inéluctablement l’analyste au fléau de l’erreur cumulée évoqué précédemment. La correction de Bonferroni trouve ici sa légitimité épistémologique la plus solide, garantissant un contrôle hermétique du risque d’illusion lors de l’investigation systématique des paires de moyennes.
3.2 Contrastes planifiés a priori versus comparaisons a posteriori
Une distinction méthodologique fondamentale doit impérativement guider le chercheur avant toute manipulation dans Excel : la frontière étanche entre comparaisons orthogonales planifiées a priori et comparaisons multiples exploratoires a posteriori. Cette distinction dicte le calibrage du dénominateur $m$ dans l’équation d’ajustement.
Lorsque les questions de recherche découlent directement d’un modèle théorique solide préétabli, le plan expérimental ne requiert pas le calcul de toutes les paires possibles. Si un chercheur évalue trois nouveaux protocoles psychothérapeutiques face à un groupe témoin inactif sans s’intéresser aux divergences intermédiaires entre les thérapies actives, seules trois comparaisons sont justifiées théoriquement. Intégrer l’ensemble exhaustif des six paires possibles dans la correction pénaliserait lourdement et indûment la puissance statistique des tests d’intérêt. En revanche, si l’étude revêt un caractère exploratoire sans prédiction directionnelle stricte, imposant le passage en revue de toutes les permutations envisageables, la totalité des combinaisons doit composer l’ensemble de référence de la famille d’hypothèses, imposant la division du seuil par la totalité combinatoire des paires.
3.3 Impact direct sur la puissance statistique et le risque bêta
L’adoption de la correction de Bonferroni n’est pas sans contrepartie méthodologique majeure : elle soulève le problème de l’arbitrage fondamental entre l’erreur de type I (faux positif) et l’erreur de type II (faux négatif, notée $\beta$). La puissance statistique d’un test, quantifiée par $1 – \beta$, représente la sensibilité du protocole à identifier une différence réelle lorsque celle-ci existe effectivement dans la population sous-jacente.
En comprimant drastiquement le seuil de rejet $\alpha$, la procédure de Bonferroni élargit mécaniquement la zone de non-rejet de l’hypothèse nulle. Ce phénomène induit une inflation substantielle du risque $\beta$. Dans les études comportementales où la taille d’effet attendue est modeste (par exemple un $d$ de Cohen compris entre 0,20 et 0,40) et les effectifs d’échantillons restreints ($N < 30$ par modalité), l'utilisation non critique de Bonferroni peut anéantir la puissance expérimentale, reléguant des effets cliniquement substantiels au statut d'effets non significatifs. Le chercheur avisé doit donc naviguer prudemment entre protection contre l'aléa et préservation de la sensibilité heuristique de ses investigations.
4. Préparation et structuration des données expérimentales dans Excel
4.1 Organisation tabulaire conforme aux analyses statistiques
L’intégrité de toute modélisation statistique dans Microsoft Excel dépend de la structuration rigoureuse des données sources dans la grille du tableur. Deux formats organisationnels prévalent : le format long (idéal pour les bases de données relationnelles et les logiciels comme R ou SPSS) et le format large (largement privilégié pour exploiter l’Utilitaire d’analyse et les fonctions natives matricielles d’Excel).
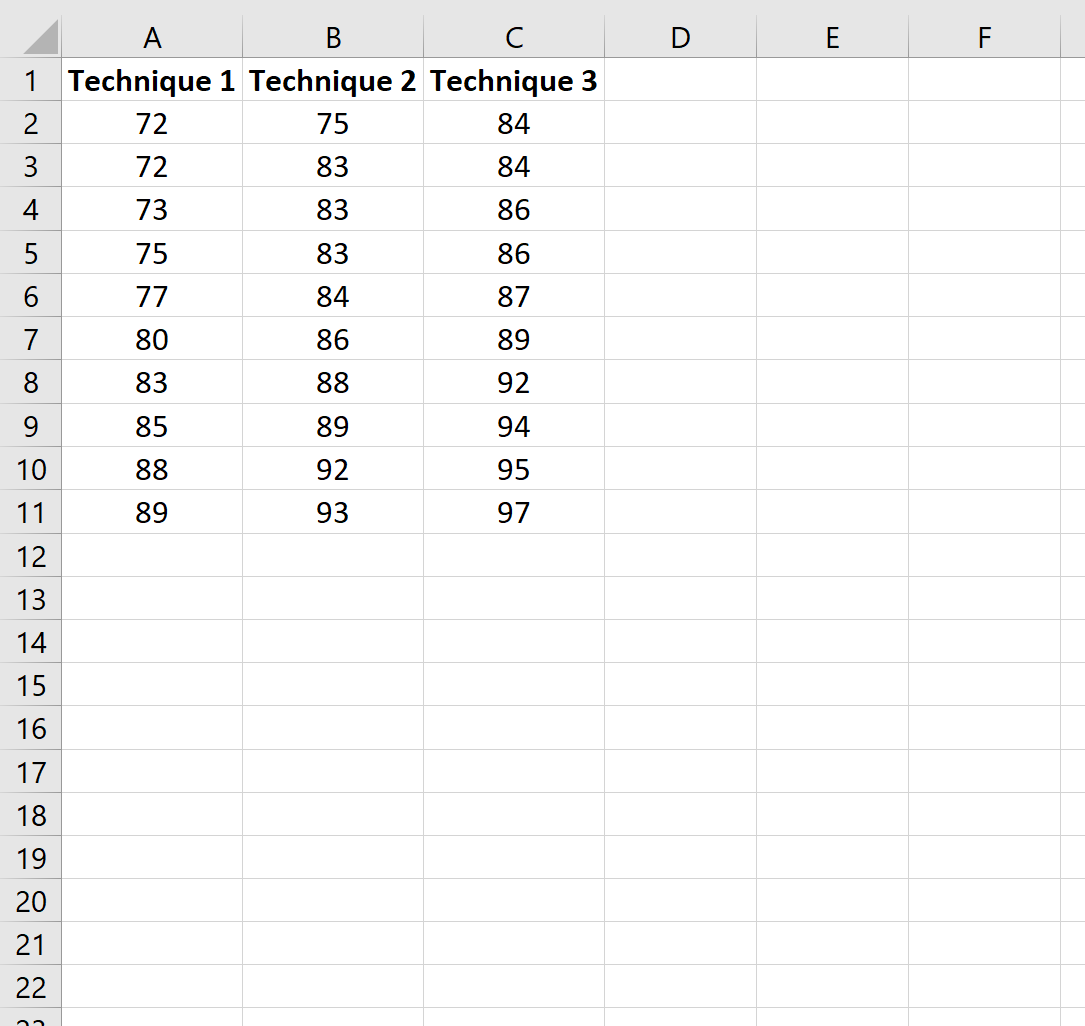
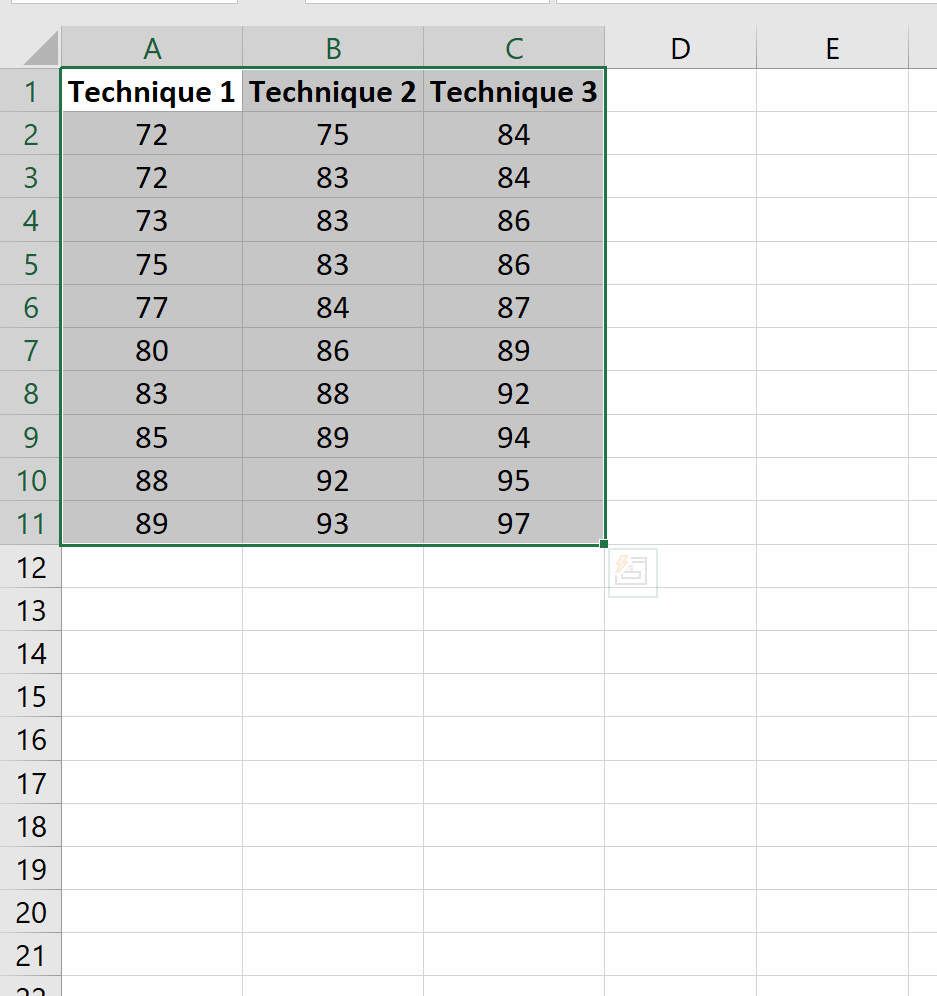
Dans le cadre d’un plan factoriel inter-sujets (mesures indépendantes), il convient de disposer chaque condition expérimentale ou groupe clinique dans une colonne dédiée continue. La première ligne doit être réservée aux intitulés explicites des modalités (par exemple, Groupe_Controle en colonne A, Therapie_A en colonne B, Therapie_B en colonne C). Les lignes subséquentes reçoivent exclusivement les mesures scalaires individuelles sans inclusion de texte parasite, d’unités de mesure accolées aux chiffres (éviter impérativement d’écrire « 12 ms », consigner uniquement le scalaire « 12 ») ou de formules intercalaires. Pour fiabiliser les calculs ultérieurs, il est vivement recommandé de nommer explicitement les plages de données via le Gestionnaire de noms d’Excel (par exemple, assigner le nom Plage_Controle à la référence $A$2:$A$31).
4.2 Vérification des postulats distributionnels dans le tableur
Avant d’engager la chaîne de traitement ANOVA et les tests $t$ post-hoc, la validité des conclusions inférentielles repose sur la satisfaction de trois postulats distributionnels fondamentaux : l’indépendance des observations, la normalité univariée au sein de chaque modalité et l’homogénéité des variances intergroupes (homoscédasticité).
Excel fournit des fonctions analytiques permettant une évaluation préliminaire de la normalité distributionnelle. Pour chaque colonne expérimentale, le chercheur calculera le coefficient d’asymétrie statistique (skewness) au moyen de la formule =COEFFICIENT.ASYMETRIE(plage) ainsi que le coefficient d’aplatissement (kurtosis) via la syntaxe =KURTOSIS(plage). En règle générale, des coefficients compris dans un intervalle de $[-1, +1]$ attestent d’une divergence modérée tolérable vis-à-vis d’une distribution gaussienne idéale. Cette estimation numérique gagne à être complétée par l’inspection visuelle d’histogrammes de distribution générés via l’onglet Insertion > Graphiques recommandés > Histogramme.
L’évaluation de l’homogénéité des variances entre paires de groupes peut être amorcée dans Excel au moyen du test de Fisher sur deux échantillons disponible dans les fonctions du tableur : =TEST.F(matrice1; matrice2). Une valeur $p$ résultante supérieure à 0,05 corrobore l’hypothèse de variances résiduelles équivalentes, guidant ultérieurement le choix du paramétrage des tests bilatéraux.
4.3 Gestion rigoureuse des données manquantes et valeurs aberrantes
La présence de valeurs manquantes (cellules vides ou codes non numériques de type « NA ») et d’observations aberrantes (outliers) constitue une source fréquente de biais de calcul dans les fonctions matricielles d’Excel. Les fonctions statistiques telles que MOYENNE ou TEST.T traitent par défaut les cellules vides en les ignorant, mais la présence d’espaces invisibles ou de caractères typographiques erronés peut entraîner des erreurs de calcul de type #VALEUR! ou fausser le décompte des degrés de liberté.
Pour l’identification rigoureuse des valeurs aberrantes univariées, il est méthodologiquement recommandé d’appliquer la règle empirique des scores centrés réduits ($z$-scores) ou la clôture de Tukey basée sur l’écart interquartile. Dans Excel, le calcul du score $z$ pour une observation $X_i$ s’automatise aisément par l’instruction : =(A2 - MOYENNE(A$2:A$31)) / ECARTYPE.STANDARD(A$2:A$31). Toute observation présentant un score absolu $|z| > 3$ ou dépassant les barrières $Q_1 – 1,5 \times IQR$ et $Q_3 + 1,5 \times IQR$ doit faire l’objet d’un examen critique approfondi. L’exclusion d’une donnée ne doit jamais résulter d’une volonté d’ajuster artificiellement les résultats aux hypothèses préconçues, mais doit obéir à des critères méthodologiques transparents dûment documentés dans le rapport expérimental.
5. Étape 1 : Réalisation de l’ANOVA à un facteur via l’Utilitaire d’analyse
5.1 Activation et configuration du complément d’analyse statistique
Bien que les calculs de variance puissent être exécutés par le déploiement de formules arithmétiques pures, l’utilisation du module d’extension officiel de Microsoft nommé « Utilitaire d’analyse » (Analysis ToolPak) procure une fiabilité et une vitesse d’exécution incomparables. Par défaut, ce composant n’est pas activé lors de l’installation standard de la suite bureautique.
Pour rendre cet outil opérationnel sous les environnements Windows :
- Accédez au menu supérieur et cliquez sur Fichier, puis sélectionnez Options dans le panneau latéral gauche.
- Dans la fenêtre modale des Options Excel, orientez-vous vers l’onglet Compléments.
- Au bas de l’interface, vérifiez que le menu déroulant Gérer affiche la mention Compléments Excel, puis cliquez sur le bouton Atteindre…
- Une boîte de dialogue s’affiche : cochez explicitement la case Utilitaire d’analyse (laissez l’option VBA décochée sauf programmation macro spécifique) et validez par OK.
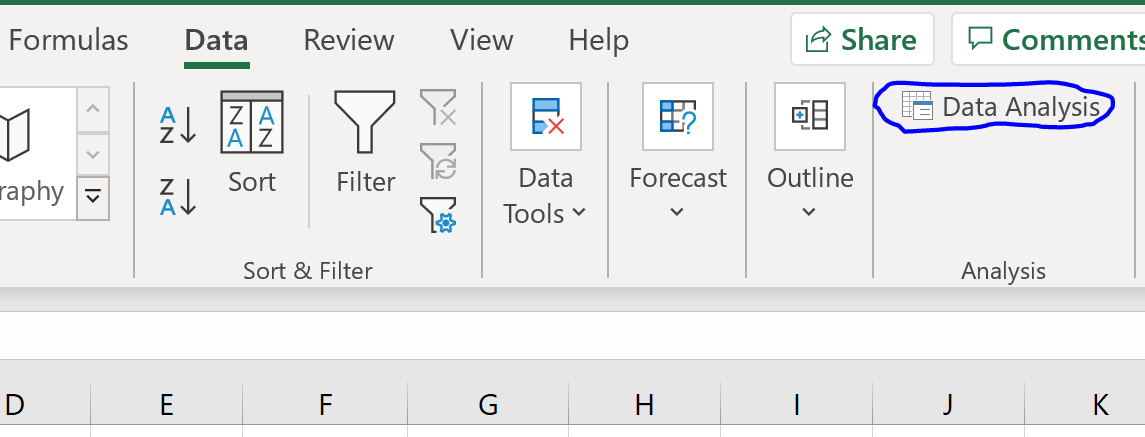
Dès cette validation, un nouveau bloc intitulé Analyse hébergeant le bouton Utilitaire d’analyse devient visible à l’extrémité droite de l’onglet Données du ruban Excel. Sur macOS, la procédure équivalente s’opère directement par le menu Outils > Compléments Excel….
5.2 Exécution de la commande ANOVA à un facteur
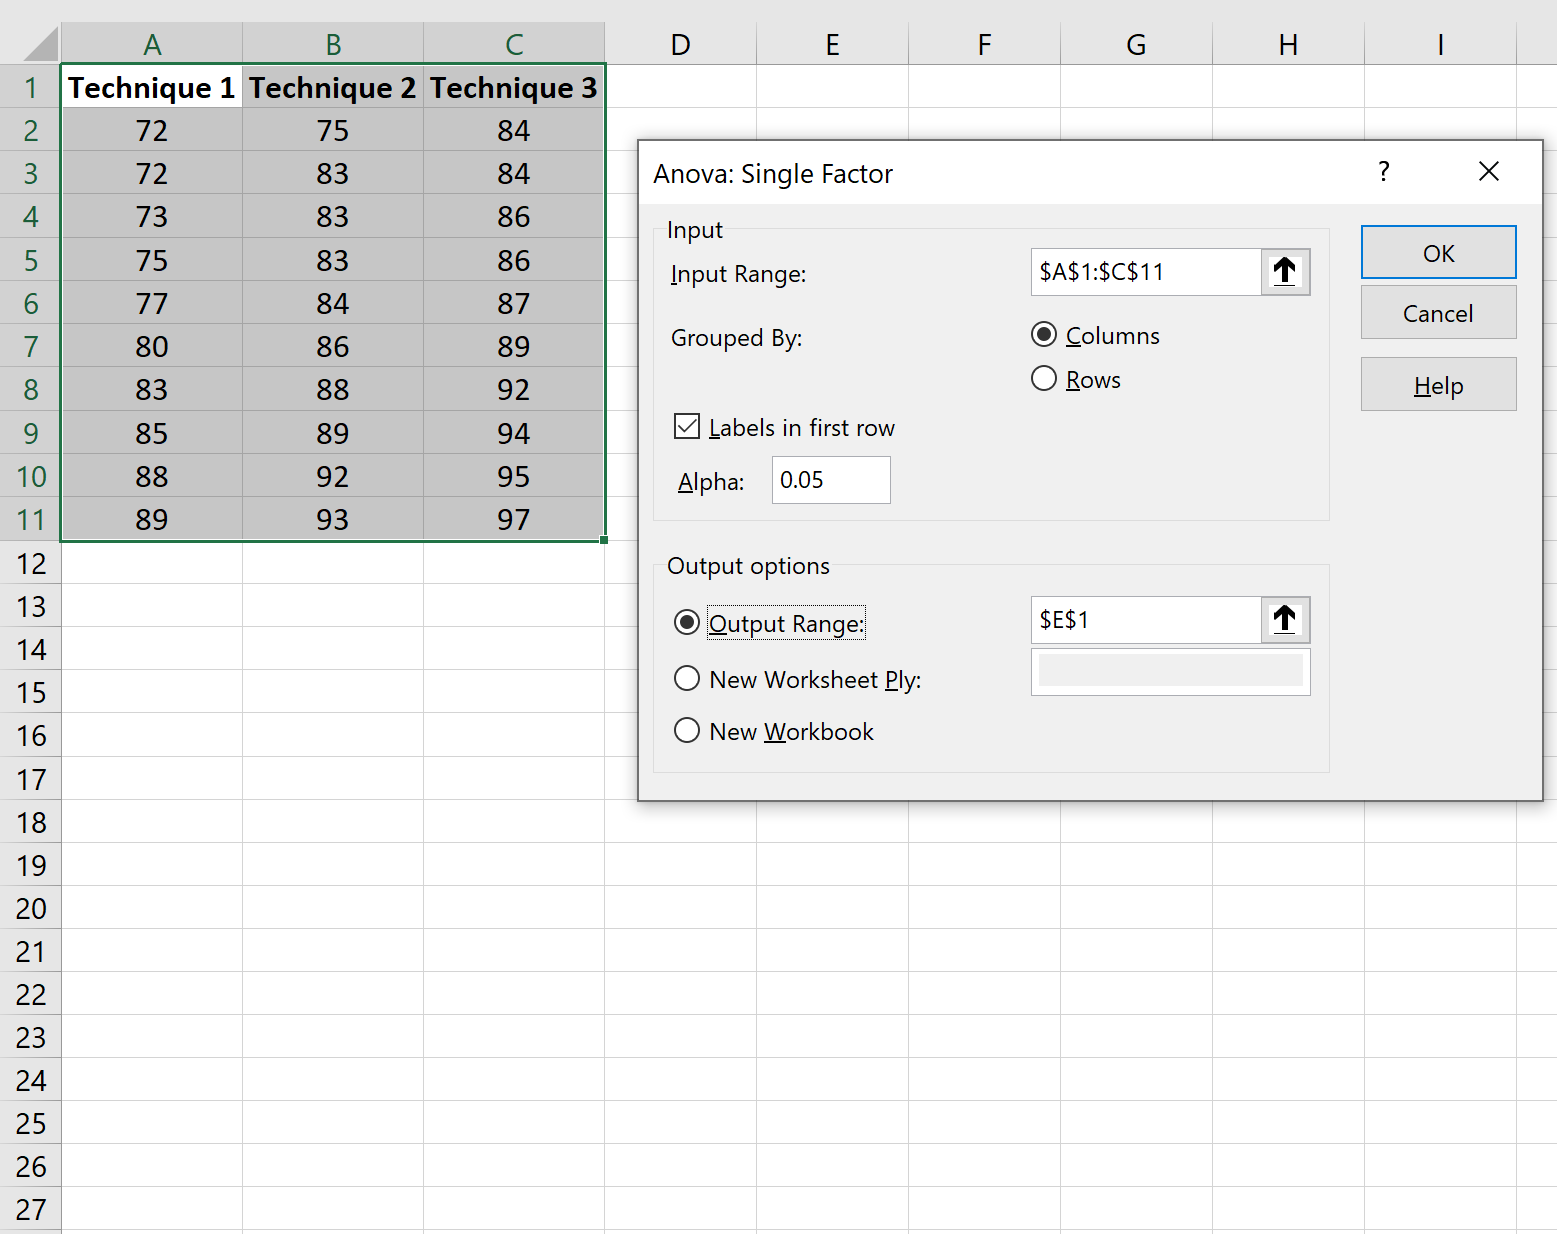
L’exécution de l’analyse globale s’initie en cliquant sur le bouton Utilitaire d’analyse au sein de l’onglet Données. Dans la liste défilante des outils statistiques intégrés, sélectionnez l’entrée Anova : facteur unique (ou ANOVA à un facteur selon les versions) et confirmez par le bouton OK pour faire émerger la boîte de dialogue de paramétrage.
La configuration requiert le renseignement scrupuleux des champs suivants :
- Plage d’entrée : Délimitez la matrice englobant l’intégralité de vos colonnes expérimentales (par exemple,
$A$1:$C$31). Prenez soin d’inclure la première ligne contenant les étiquettes textuelles désignant vos conditions. - Groupé par : Cochez l’option Colonnes (conformément à l’organisation large préconisée à la section 4.1).
- Intitulés en première ligne : Cochez impérativement cette case si votre sélection inclut les libellés de variables, ce qui permettra à Excel d’étiqueter intelligemment les tables de sortie.
- Alpha : Maintenez la valeur par défaut fixée à
0,05, représentant le seuil critique nominal de l’analyse omnibus préalable. - Options de sortie : Choisissez d’implanter les résultats sur la même feuille en désignant une cellule d’ancrage libre (par exemple
$E$1), ou optez pour une nouvelle feuille de calcul dédiée afin d’isoler les résultats bruts.
5.3 Interprétation académique de la table de sortie ANOVA
Le module génère instantanément deux tableaux analytiques : un premier récapitulatif descriptif détaillant pour chaque groupe le nombre d’observations ($N$), la somme arithmétique, la moyenne empirique ($\bar{X}$) ainsi que la variance d’échantillon ($s^2$) ; et un second tableau constituant la matrice canonique de décomposition de la variance (Source de variations : Entre groupes, À l’intérieur des groupes, Total).
L’attention de l’analyste doit immédiatement converger vers trois valeurs charnières du tableau ANOVA :
- La statistique F calculée (qui quantifie le rapport entre le carré moyen intergroupes et le carré moyen résiduel).
- La valeur de Probabilité (qui n’est autre que la $p$-value omnibus globale associée au test $F$).
- La Valeur critique pour F (déterminée par la table théorique de Snedecor pour les degrés de liberté considérés au seuil $\alpha = 0,05$).
La condition méthodologique préalable et incontournable pour légitimer la poursuite des analyses et la réalisation de tests post-hoc est la confirmation d’un effet omnibus significatif : la valeur de Probabilité doit être strictement inférieure à 0,05, ce qui correspond géométriquement à une statistique $F$ supérieure à la valeur critique pour $F$. Si cette condition d’hétérogénéité générale est rejetée ($p ge 0,05$), la démarche inférentielle doit théoriquement s’interrompre afin d’éviter la prolifération de détections fortuites sur des données statistiquement homogènes.
6. Étape 2 : Détermination combinatoire du nombre de comparaisons
6.1 Formule mathématique du nombre de paires possibles
Une fois l’effet omnibus validé par l’ANOVA, la seconde étape computationnelle consiste à déterminer avec une rigueur mathématique exacte la quantité de comparaisons deux à deux réalisables au sein du système expérimental. Cette grandeur, désignée par la variable scalaire $m$, constitue le diviseur direct ou le multiplicateur stochastique au cœur de l’algorithme de Bonferroni.
Lorsque le protocole ne repose sur aucune hypothèse directionnelle restrictive et implique l’analyse croisée de chaque modalité face à toutes les autres, le décompte des comparaisons distinctes relève de l’analyse combinatoire élémentaire. Il s’agit du calcul du nombre de combinaisons sans répétition de 2 éléments choisis parmi un ensemble de $k$ groupes disponibles, régi par la formule :
m = C_k^2 = k! / (2! × (k – 2)!) = k × (k – 1) / 2
Pour un dispositif expérimental comportant 3 modalités thérapeutiques, l’application de l’équation livre : $m = 3 \times (3 – 1) / 2 = 3 \times 2 / 2 = 3$ comparaisons possibles. Toutefois, la cinétique de cette progression est parabolique : pour 4 groupes, $m = 6$ ; pour 5 groupes, $m = 10$ ; pour 6 groupes, $m = 15$, et pour 10 groupes expérimentaux, le nombre de paires explose à 45 contrastes distincts. Cette expansion combinatoire démontre pourquoi la pénalité imposée par Bonferroni devient excessivement restrictive sur des plans factoriels étalés.
6.2 Distinction entre comparaisons toutes paires et comparaisons avec contrôle
L’une des fautes méthodologiques les plus communes documentées dans la recherche empirique réside dans l’application aveugle de la formule $k(k-1)/2$ alors même que le design de recherche ne requiert fonctionnellement qu’une fraction restreinte de ces tests. La distinction conceptuelle entre une stratégie « toutes paires » (approche exhaustive de type Tukey) et une stratégie « plusieurs contre un témoin » (approche ciblée de type Dunnett) altère profondément la valeur de $m$.
Si l’objectif scientifique consiste exclusivement à évaluer l’efficacité de plusieurs traitements novateurs par rapport à un groupe contrôle unique servant de référence constante (sans aucune comparaison mutuelle entre les traitements novateurs eux-mêmes), le nombre de tests réels conduits se réduit strictement à :
m = k – 1
Dans une configuration expérimentale impliquant 5 groupes (1 contrôle et 4 thérapies actives), l’approche comparative ciblée requiert $m = 5 – 1 = 4$ comparaisons, tandis que la formule combinatoire exhaustive en comptabiliserait 10. Assigner la valeur 10 comme dénominateur de Bonferroni dans une telle architecture constituerait une surgélation statistique injustifiable, divisant le seuil alpha par 10 au lieu de 4, entraînant une chute drastique et évitable de la puissance statistique expérimentale.
6.3 Implémentation automatisée du décompte dans une cellule Excel
Afin de concevoir une feuille de calcul résiliente et dynamique, immunisée contre les erreurs humaines de saisie manuelle, il est opportun de déléguer le calcul de la valeur $m$ à une combinaison de fonctions natives intégrées au tableur Excel.
Supposons que la ligne supérieure de vos données expérimentales contienne les étiquettes de vos $k$ groupes au sein de la plage horizontale A1:D1. Le nombre de groupes actifs $k$ s’obtient dynamiquement par le dénombrement des cellules textuelles non vides : =NBVAL(A1:D1). Pour calculer directement le nombre de combinaisons binaires exhaustives résultant de cet effectif, Excel dispose de la fonction combinatoire dédiée COMBIN. Vous pouvez ainsi consigner dans une cellule technique (par exemple la cellule E5) l’instruction suivante :
=COMBIN(NBVAL(A1:D1); 2)
Si vous choisissez ultérieurement d’étendre votre plan expérimental en ajoutant une cinquième colonne de données, la cellule E5 actualisera instantanément sa sortie numérique de 6 à 10 sans nécessiter la moindre intervention manuelle dans la chaîne de propagation des formules de décision statistique.
7. Étape 3 : Exécution des tests t post-hoc par paires dans Excel
7.1 Choix de la fonction Excel appropriée : TEST.T ou Utilitaire
Pour quantifier la significativité statistique de l’écart séparant chaque couple de moyennes, l’analyste peut théoriquement mobiliser l’Utilitaire d’analyse via la fonction de comparaison de moyennes pour deux échantillons. Cependant, cette méthode génère des blocs de texte statiques et déconnectés qui ne s’actualisent pas dynamiquement lors de la modification des données sources. La meilleure pratique d’ingénierie statistique sous Excel consiste donc à utiliser la fonction algorithmique native TEST.T (ou T.TEST dans les interfaces anglophones).
La syntaxe canonique de cette fonction fondamentale requiert l’alimentation rigoureuse de quatre arguments ordonnés :
=TEST.T(matrice1; matrice2; unilatéral/bilatéral; type)
Dans le cadre d’investigations post-hoc exploratoires, le troisième paramètre (déterminant la directivité de l’hypothèse) doit être impérativement configuré sur la valeur 2 (test bilatéral ou two-tailed). Adopter un test unilatéral (paramètre 1) à ce stade de l’analyse empirique constituerait une entorse méthodologique majeure, car les comparaisons post-hoc explorent d’éventuelles divergences vectorielles dans les deux sens possibles de l’échelle d’évaluation.
7.2 Gestion de l’homoscédasticité dans le paramétrage du test t
Le quatrième argument de la fonction TEST.T, désigné par le paramètre scalaire type, contrôle la formulation mathématique de la variance d’échantillonnage et des degrés de liberté associés. Il supporte trois valeurs fonctionnelles :
- Type = 1 : Test apparié (pour des mesures répétées sur les mêmes sujets).
- Type = 2 : Test pour deux échantillons indépendants avec présomption d’homoscédasticité (variances égales).
- Type = 3 : Test pour deux échantillons indépendants sans présomption d’égalité des variances (approximation de Welch-Satterthwaite).
D’un point de vue de cohérence théorique avec le modèle ANOVA standard classique (qui postule l’homogénéité stricte des variances au sein de la somme des carrés résiduelle), le chercheur oriente conventionnellement son paramétrage vers le type 2. Néanmoins, si les tests préalables (tels que le test de Levene ou le test $F$) ont mis en lumière une violation caractérisée de l’homoscédasticité, le recours au type 3 (test de Welch) s’impose impérativement. Ce dernier ajuste dynamiquement les degrés de liberté vers le bas pour pénaliser l’hétérogénéité des dispersions empiriques.
7.3 Création d’un tableau récapitulatif des comparaisons par paires
La structuration méthodologique optimale exige la compilation de tous les contrastes binaires au sein d’un tableau synthétique ordonné. Définissez une matrice claire dans la feuille de calcul dont les colonnes hébergeront les informations suivantes :
| Comparaison | Moyenne 1 | Moyenne 2 | Différence (Δ) | p-valeur brute (non ajustée) |
|---|---|---|---|---|
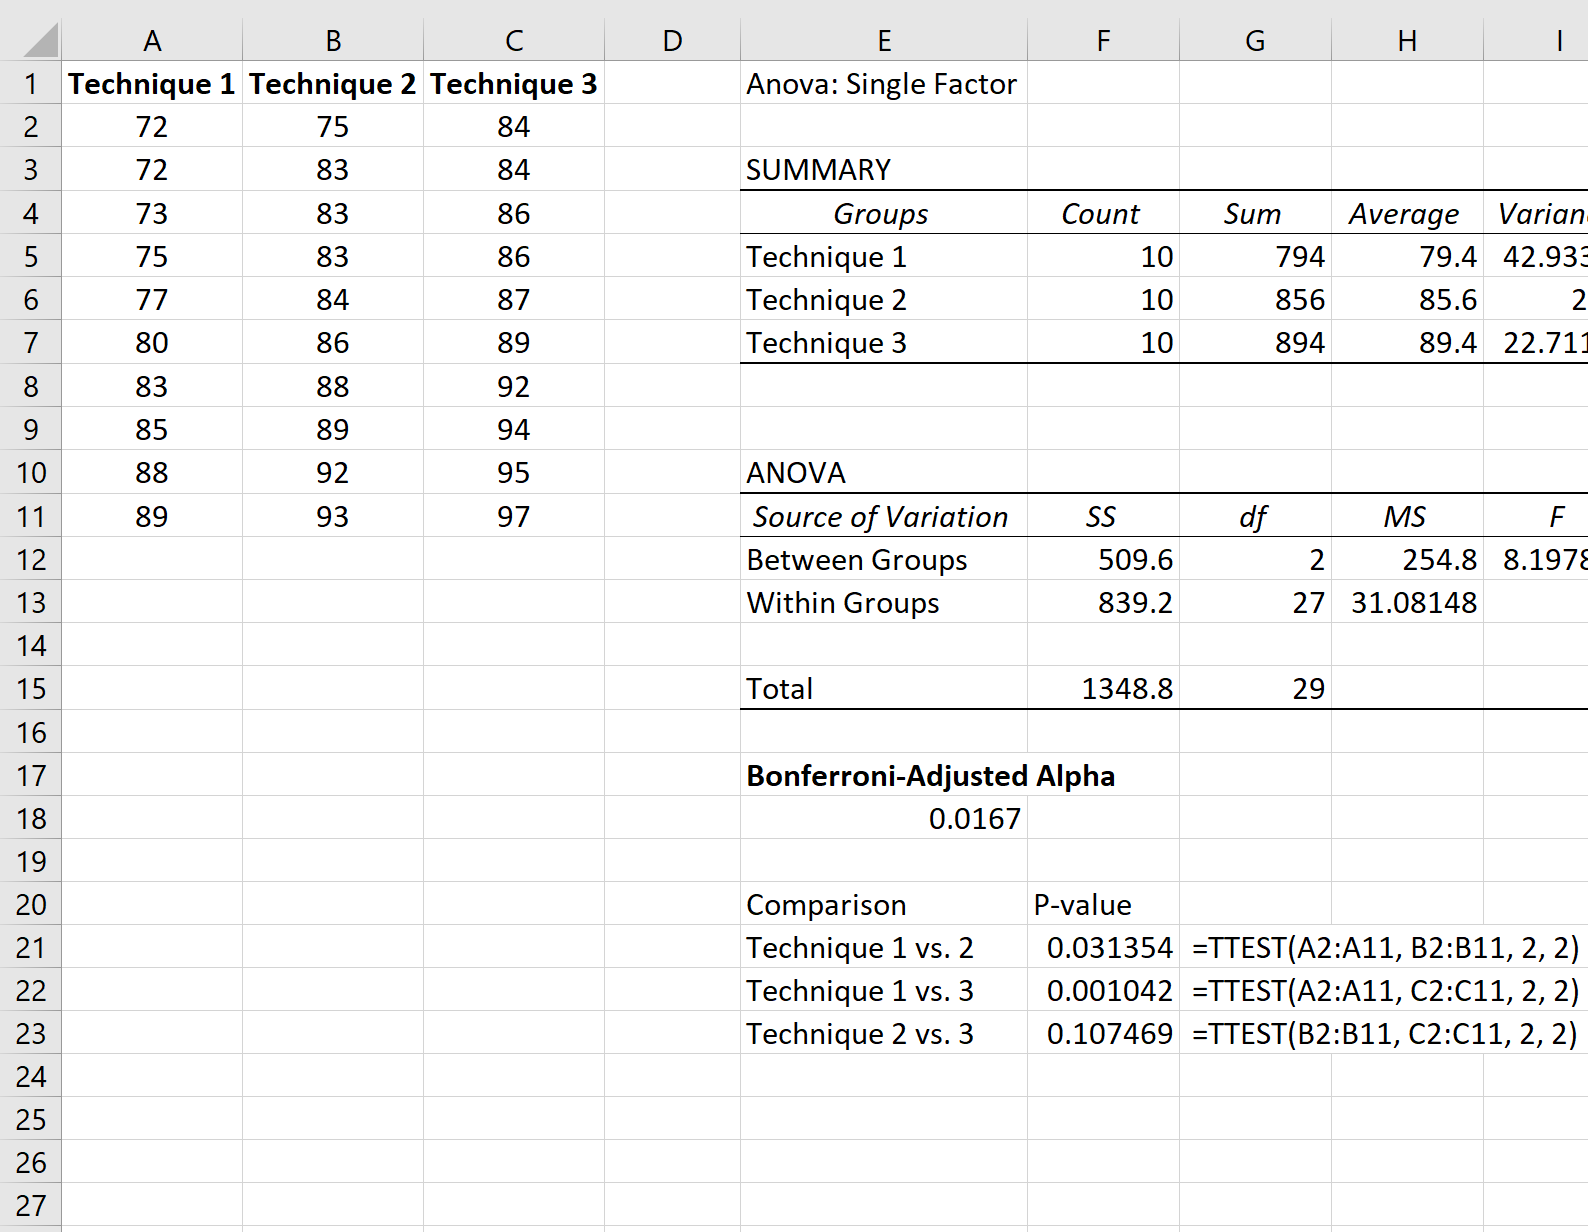
| Groupe 1 vs Groupe 2 | =MOYENNE(A2:A31) | =MOYENNE(B2:B31) | =G2-H2 | =TEST.T(A2:A31; B2:B31; 2; 2) |
| Groupe 1 vs Groupe 3 | =MOYENNE(A2:A31) | =MOYENNE(C2:C31) | =G3-H3 | =TEST.T(A2:A31; C2:C31; 2; 2) |
| Groupe 2 vs Groupe 3 | =MOYENNE(B2:B31) | =MOYENNE(C2:C31) | =G4-H4 | =TEST.T(B2:B31; C2:C31; 2; 2) |
Cette disposition tabulaire fournit une cartographie exhaustive et lisible des écarts observés et extrait directement la probabilité de queue associée à chaque test individuel, préalable indispensable à la greffe de l’ajustement correctif.
8. Étape 4 : Application du seuil alpha corrigé selon Bonferroni
8.1 Calcul explicite du seuil alpha ajusté dans la feuille de calcul
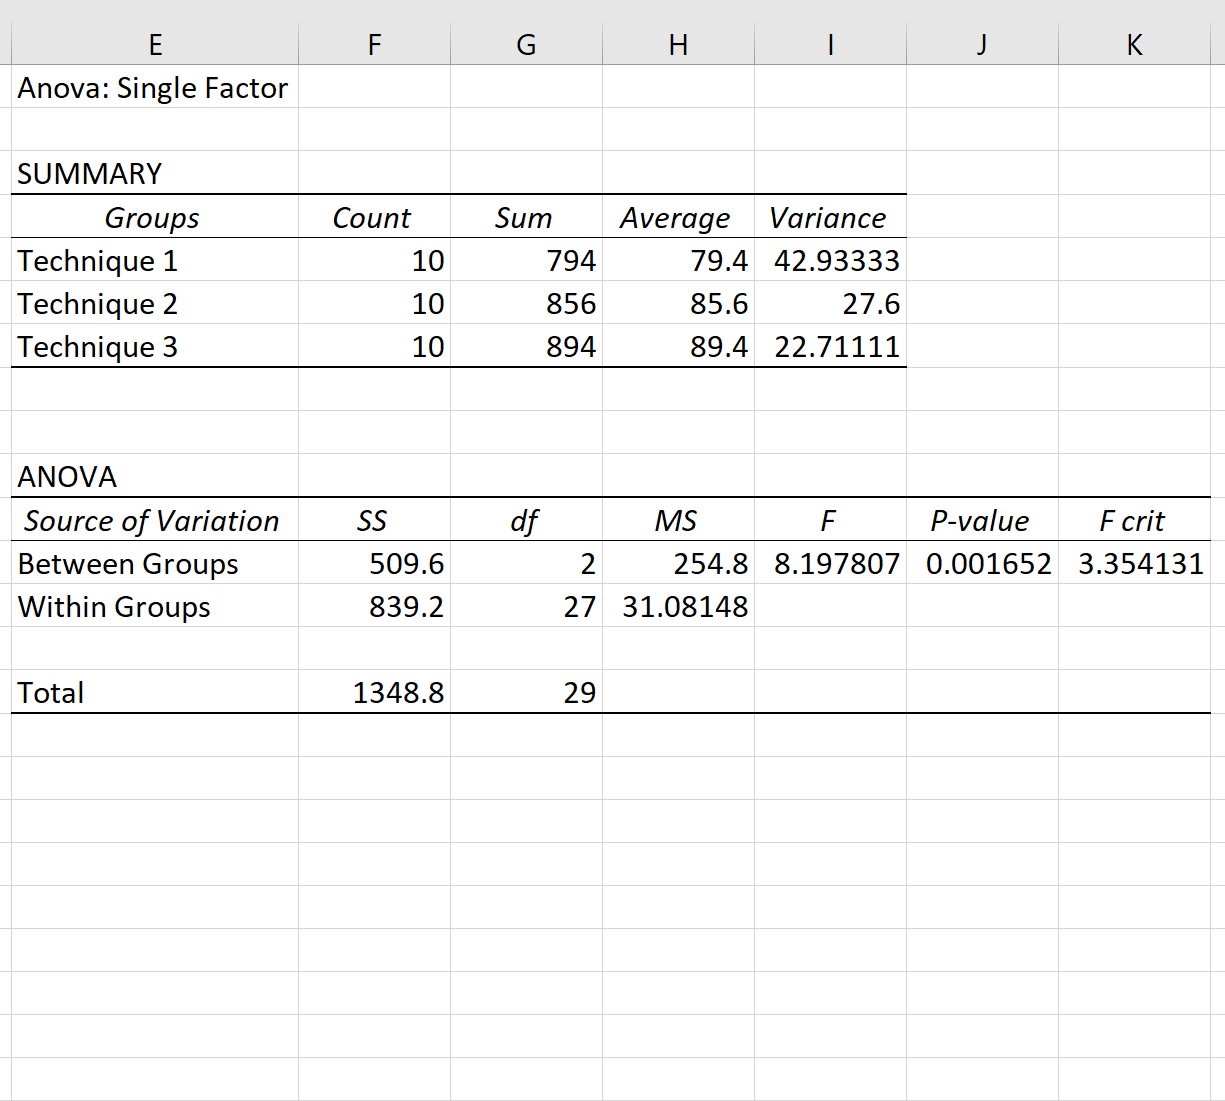
Pour matérialiser la première variante décisionnelle de Bonferroni (l’ajustement du seuil critique de rejet), consacrez une section spécifique de votre classeur à l’affichage des paramètres d’inférence. Dans une cellule dédiée (par exemple E8), inscrivez le seuil de tolérance nominal standard, soit 0,05.
Dans la cellule immédiatement sous-jacente (par exemple E9), insérez la formule arithmétique de scission stochastique en référençant la cellule hébergeant le décompte combinatoire des comparaisons obtenu précédemment à l’étape 6.3 :
=E8 / E5
Si la cellule E5 affiche la valeur 3 (correspondant à 3 paires analysées), la cellule E9 restituera la quantité décimale précise 0,01666667. Ce nouveau nombre représente la frontière décisionnelle révisée : seuls les tests $t$ dont la valeur $p$ brute est strictement inférieure ou égale à cette valeur seront reconnus comme porteurs d’une différence statistiquement significative au niveau global de 5 %.
8.2 Automatisation de la décision statistique via la fonction SI
L’évaluation manuelle des valeurs numériques expose l’opérateur à des erreurs cognitives de lecture, notamment face à des nombres comportant de multiples zéros décimaux ou exprimés en notation scientifique (par exemple $3,42E-03$). L’automatisation booléenne de la décision statistique s’avère indispensable pour garantir une neutralité absolue.
Au sein de votre tableau de synthèse des comparaisons par paires, implémentez dans la colonne réservée à la décision statistique la fonction logique conditionnelle SI. En supposant que la première $p$-value brute réside dans la cellule J2 et que le seuil de Bonferroni calculé soit ancré dans la cellule $E$9, encodez la formule suivante :
=SI(J2 <= $E$9; "Significatif"; "Non significatif")
L’usage du caractère dollar $ (référencement absolu) pour figer la coordonnée $E$9 est fondamental : il permet de propager la formule par incrémentation verticale (double-clic sur la poignée de recopie vers le bas) sur l’intégralité des lignes de comparaisons sans dériver de la cellule source du seuil ajusté. L’analyste bénéficie immédiatement d’un diagnostic d’inférence explicite, binaire et exempt de toute ambiguïté subjective.
8.3 Formatage conditionnel pour une restitution visuelle immédiate
Pour métamorphoser ce tableau analytique en un tableau de bord ergonomique destiné à la communication des résultats ou à la soutenance de travaux de recherche, l’application d’une règle de mise en forme conditionnelle constitue une étape de finition recommandée.
Sélectionnez l’ensemble des cellules de la colonne décisionnelle nouvellement renseignée, puis :
- Accédez au menu principal sous l’onglet Accueil > Style > Mise en forme conditionnelle.
- Optez pour l’instruction Règles de mise en surbrillance des cellules > Texte qui contient….
- Dans le champ textuel de condition, saisissez exactement la chaîne de caractères
Significatif. - Dans le menu déroulant de style adjacent, sélectionnez Remplissage vert avec texte vert foncé (ou définissez un format personnalisé selon vos standards typographiques institutionnels).
- Réitérez éventuellement l’opération pour la mention
Non significatifen lui assignant une neutralité chromatique (remplissage gris clair ou absence de couleur) afin d’éviter la pollution visuelle des contrastes non informatifs.
Cette restitution chromatique met instantanément en relief les contrastes résistant à la pénalisation statistique, facilitant la transition vers l’écriture du compte-rendu d’expérience.
9. Étape alternative : Calcul direct des p-values ajustées de Bonferroni
9.1 Principe et formule d’ajustement direct des valeurs p
Bien que la méthode de scission du seuil critique soit pédagogiquement limpide, l’usage académique international moderne privilégie très largement la communication de valeurs $p$ ajustées. Cette pratique offre un avantage herméneutique précieux : elle permet au lecteur de mesurer le degré de significativité d’un test par comparaison immédiate au seuil universel habituel de 0,05, sans devoir mentalement recalculer la sévérité d’un seuil spécifique fractionné ($0,0167$, $0,0083$, etc.).
Le calcul unitaire de la $p$-value ajustée de Bonferroni consiste à multiplier la probabilité résiduelle univariée calculée par la fonction TEST.T par le cardinal $m$ de la famille de comparaisons :
p_{ajustee} = p_{brute} × m
Dans la structure tabulaire d’Excel, si la valeur brute issue du test $t$ est logée dans la cellule J2 et que la constante combinatoire $m$ réside dans la cellule $E$5, l’amorce de la formulation correspond simplement à l’opération de produit arithmétique : =J2 * $E$5.
9.2 Intégration du plafonnement à 1 avec la fonction MIN
Cependant, l’implémentation brute de cette multiplication soulève une anomalie probabiliste manifeste dès lors que la valeur $p$ non corrigée excède $1/m$. Par exemple, si une comparaison entre deux groupes statistiquement similaires génère une probabilité non ajustée de 0,40 dans le cadre d’un plan factoriel comprenant 4 comparaisons ($m = 4$), la multiplication aveugle produit le scalaire aberrant suivant : $0,40 \times 4 = 1,60$. Or, une probabilité supérieure à 1 représente un non-sens mathématique formel qui décrédibiliserait instantanément le protocole d’analyse s’il était publié tel quel.
Pour neutraliser cette dérive tout en automatisant le traitement computationnel, il convient d’enchâsser la multiplication au sein de la fonction native MIN d’Excel. Cette fonction renvoie la plus petite valeur parmi les arguments fournis, imposant ainsi un plafond asymptotique infranchissable à 1,000 :
=MIN(1; J2 * $E$5)
Grâce à cette précaution formelle, toute valeur $p$ ajustée dont le produit dépasse 1 sera automatiquement tronquée et affichée sous la valeur limite de 1 (ou notée textuellement > .999 dans les rapports standardisés). Cette écriture robuste prémunit le modèle contre toute anomalie de borne stochastique.
9.3 Comparaison méthodologique entre les deux approches dans Excel
Il importe de souligner avec force que les deux démarches implémentées dans le tableur aboutissent à un verdict décisionnel rigoureusement identique. La table de vérité ci-dessous illustre l’invariance parfaite de la décision statistique, quel que soit le paradigme retenu :
| Méthode | Calcul d’entrée | Seuil de référence | Condition de significativité |
|---|---|---|---|
| Ajustement du seuil alpha | p-valeur brute (ex. 0,012) | α / m (ex. 0,05 / 3 = 0,0167) | 0,012 ≤ 0,0167 ➔ Significatif |
| Ajustement de la p-valeur | MIN(1; p * m) (ex. 0,012 * 3 = 0,036) | α standard (0,05) | 0,036 ≤ 0,0500 ➔ Significatif |
L’intégration conjointe de ces deux variantes au sein de la même feuille de calcul Excel constitue un excellent moyen d’autocontrôle pour l’expérimentateur. Elle facilite en outre l’alignement des sorties du tableur avec les standards éditoriaux de publication scientifique, qui réclament quasi systématiquement la mention textuelle de la $p$-value corrigée.
10. Mise en œuvre d’un cas pratique pas à pas : Données en psychologie cognitive
10.1 Présentation du jeu de données : Effet de trois techniques d’apprentissage
Afin d’ancrer ces développements théoriques dans la réalité concrète de la pratique de laboratoire, concevons une investigation expérimentale simulée en psychologie cognitive de l’éducation. L’expérience s’intéresse à l’efficacité différentielle de trois techniques d’encodage mnésique sur la rétention d’informations textuelles complexes auprès d’étudiants de premier cycle universitaire.
Le devis expérimental adopte un plan inter-sujets à un facteur constitué de trois modalités ($k = 3$) :
- Groupe A (Répétition passive) : Relecture standard linéaire des documents d’étude.
- Groupe B (Cartes mémoire / Flashcards) : Récupération espacée en mémoire au moyen d’indices d’interrogation.
- Groupe C (Auto-explication guidée) : Formulation réflexive des mécanismes logiques sous-jacents aux contenus.
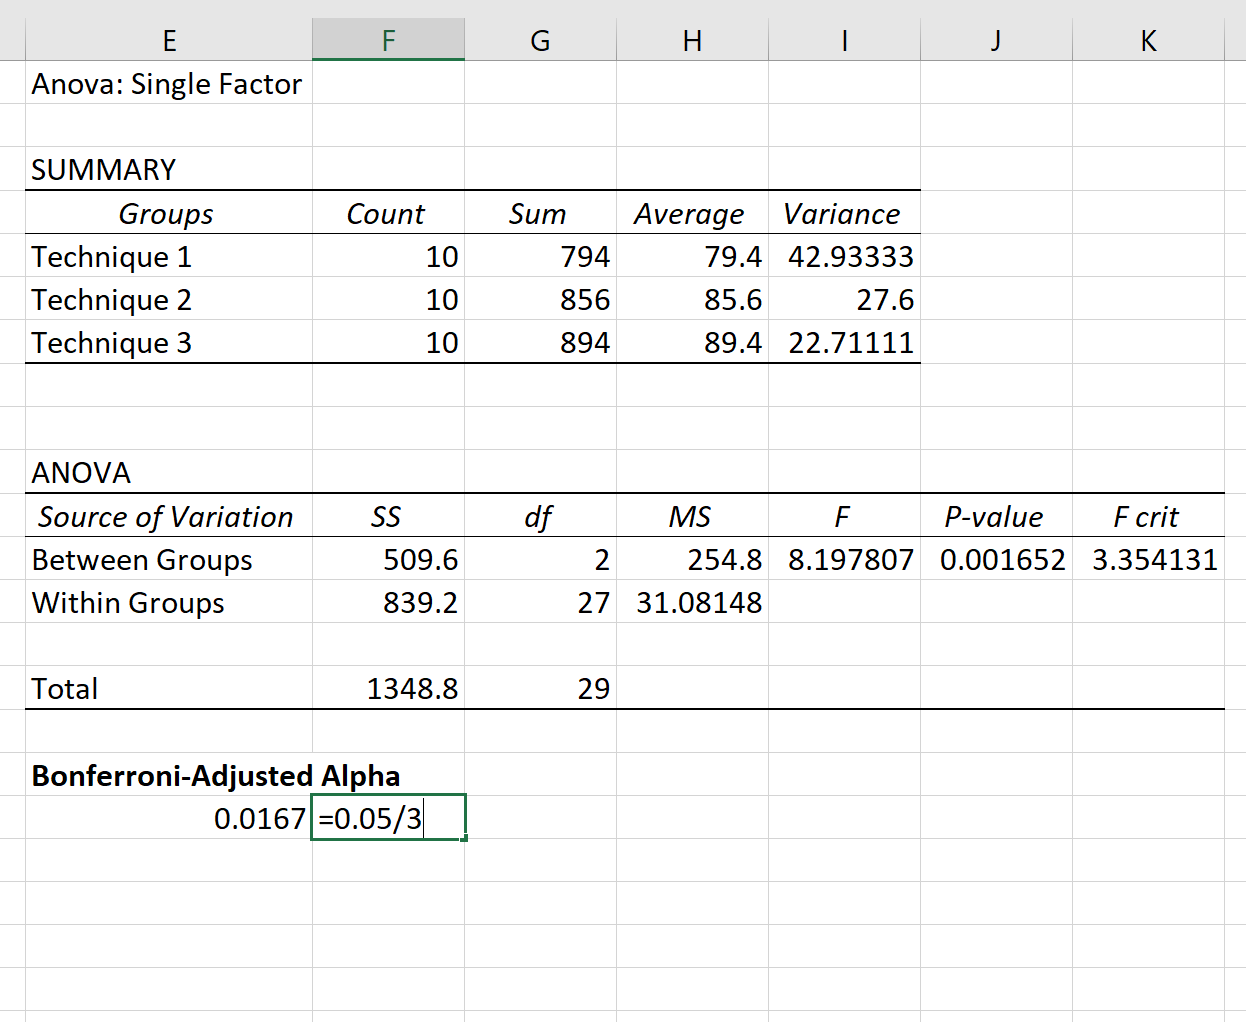
Trente participants indépendants ($N = 30$) sont assignés aléatoirement et équitablement aux trois conditions (soit $n = 10$ sujets par groupe). La variable dépendante continue représente le score obtenu à un examen standardisé de rétention conceptuelle administré 48 heures après la phase d’apprentissage (notation sur une échelle scalaire de 0 à 100 points). Les données empiriques brutes sont consignées dans les cellules A2:C11 du tableur Excel.
10.2 Déroulement exhaustif des calculs dans les cellules
Considérons les observations distribuées comme suit au sein de notre classeur :
- Colonne A (
Repetition) :52, 58, 63, 49, 55, 60, 51, 57, 62, 53 - Colonne B (
Flashcards) :68, 74, 71, 65, 76, 79, 72, 67, 75, 73 - Colonne C (
Auto_Explication) :61, 66, 70, 59, 67, 64, 63, 69, 65, 66
Le calcul des métriques descriptives dans les cellules sous-jacentes révèle :
- Moyenne Groupe A (
=MOYENNE(A2:A11)) = 56,00 ; Écart-type (=ECARTYPE.STANDARD(A2:A11)) = 4,85 - Moyenne Groupe B (
=MOYENNE(B2:B11)) = 72,00 ; Écart-type (=ECARTYPE.STANDARD(B2:B11)) = 4,37 - Moyenne Groupe C (
=MOYENNE(C2:C11)) = 65,00 ; Écart-type (=ECARTYPE.STANDARD(C2:C11)) = 3,43
L’exécution préliminaire de l’ANOVA via l’Utilitaire d’analyse produit une statistique de Fisher $F(2, 27) = 36,92$ avec une probabilité omnibus $p = 4,12 \times 10^{-8}$, confirmant sans équivoque une hétérogénéité générale hautement significative. Le nombre de comparaisons possibles s’élève à $m = 3 \times 2 / 2 = 3$. Le seuil alpha corrigé de Bonferroni est donc configuré dans la cellule E9 par la formule =0,05 / 3, soit $\alpha_{ajuste} = 0,01667$.
Déployons les formules des tests $t$ bilatéraux à variances égales (type 2) pour les trois paires de modalités :
- Contraste 1 (A vs B) :
=TEST.T(A2:A11; B2:B11; 2; 2)renvoie une $p$-value brute de 0,00000018 (notée $1,8 \times 10^{-7}$). - Contraste 2 (A vs C) :
=TEST.T(A2:A11; C2:C11; 2; 2)renvoie une $p$-value brute de 0,00016. - Contraste 3 (B vs C) :
=TEST.T(B2:B11; C2:C11; 2; 2)renvoie une $p$-value brute de 0,00114.
10.3 Synthèse des sorties numériques et interprétation concrète
Construisons dans Excel le tableau récapitulatif définitif en intégrant les calculs de $p$-values ajustées par la commande =MIN(1; p_brute * 3) et le verdict automatisé :
| Comparaison binaire | Écart de moyenne (Δ) | p-valeur brute | p-valeur ajustée (Bonferroni) | Statut (α = 0,05) |
|---|---|---|---|---|
| Groupe A vs Groupe B | -16,00 | 0,00000018 | 0,00000054 | Significatif |
| Groupe A vs Groupe C | -9,00 | 0,00016 | 0,00048 | Significatif |
| Groupe B vs Groupe C | +7,00 | 0,00114 | 0,00342 | Significatif |
L’examen des données ajustées démontre que l’ensemble des comparaisons par paires résiste avec succès à la pénalisation conservatrice de Bonferroni. Même après multiplication par un facteur 3, la divergence entre les flashcards (Groupe B) et l’auto-explication (Groupe C) conserve une probabilité ajustée de $p = 0,00342$, très inférieure au seuil conventionnel de 0,05. L’expérimentateur en conclut avec assurance que si les deux techniques actives surpassent la révision passive, l’utilisation de flashcards produit des gains de mémorisation significativement supérieurs à l’auto-explication guidée dans les conditions de l’étude.
11. Rédaction académique des résultats aux normes APA (7e édition)
11.1 Règles stylistiques et typographiques pour rapporter Bonferroni
La publication de résultats statistiques dans les périodiques affiliés à l’American Psychological Association (APA) obéit à un corpus de règles typographiques et stylistiques d’une rigueur absolue. L’incorporation d’une correction pour comparaisons multiples impose la transparence totale quant à la procédure retenue et aux métriques brutes et ajustées manipulées.
Les prescriptions centrales de la 7e édition du manuel de style de l’APA stipulent notamment que :
- Toutes les lettres latines servant de symboles statistiques doivent être composées en italique : M pour la moyenne, SD pour l’écart-type (ou ET dans les publications francophones strictes), t pour le test de Student, F pour l’ANOVA, et p pour la valeur de probabilité.
- Le zéro initial précédant la virgule décimale (ou le point selon la langue d’édition) doit être supprimé pour les grandeurs probabilistes bornées par l’intervalle $[0, 1]$ telles que la valeur p (écrire p = ,017 et non p = 0,017).
- La formulation textuelle doit explicitement stipuler que les valeurs p mentionnées ont été ajustées selon la méthode de Bonferroni (par exemple : pbonf ou par une mention explicative liminaire).
- Les degrés de liberté du test doivent figurer entre parenthèses immédiatement accolés au symbole de la statistique de test : t(18) = 4,21.
11.2 Intégration conjointe de la taille d’effet (d de Cohen)
L’épistémologie contemporaine et les directives éditoriales proscrivent formellement le recours exclusif au test de nullité de l’hypothèse nulle (NHST) sans quantification de l’amplitude pratique du phénomène mesuré. Il est impératif d’adjoindre à chaque statistique de test post-hoc une mesure standardisée de taille d’effet, le plus souvent le d de Cohen pour les comparaisons de moyennes indépendantes.
Pour deux échantillons de tailles identiques ($n_1 = n_2 = n$), le d de Cohen se calcule par la différence brute des moyennes divisée par l’écart-type combiné pondéré ($SD_{pooled}$) :
SD_{pooled} = √((SD_1^2 + SD_2^2) / 2)
d = (M_1 – M_2) / SD_{pooled}
Dans Excel, cette formule s’implémente aisément pour chaque couple de groupes. Pour le contraste opposant le Groupe B ($M = 72,00$, $SD = 4,37$) au Groupe C ($M = 65,00$, $SD = 3,43$), l’écart-type combiné s’élève à $\sqrt{(4,37^2 + 3,43^2) / 2} = \sqrt{(19,10 + 11,76) / 2} = \sqrt{15,43} = 3,93$. Le calcul du d donne : $(72,00 – 65,00) / 3,93 = 1,78$. Cette métrique colossale atteste que l’effet observé ne relève pas simplement d’une significativité statistique abstraite, mais matérialise une supériorité pédagogique substantielle selon les balises interprétatives de Cohen ($d > 0,80$ signalant un effet de grande amplitude).
11.3 Modèle de paragraphe rédigé pour publication empirique
Voici un gabarit canonique d’intégration textuelle des résultats conformes aux exigences de l’APA (7e édition), synthétisant l’ensemble de la chaîne inférentielle exécutée dans Excel :
« Une analyse de variance unidirectionnelle inter-sujets a été réalisée afin d’évaluer l’impact des techniques d’apprentissage sur les performances mnésiques à l’examen. Les résultats indiquent un effet principal hautement significatif du type d’encodage, F(2, 27) = 36,92, p < ,001, η² = ,73. Afin de déterminer la localisation précise de ces divergences, des comparaisons post-hoc par paires ont été exécutées au moyen de tests t de Student pour échantillons indépendants, en appliquant une correction de Bonferroni pour contrôler le taux d'erreur par famille (m = 3, seuil critique ajusté α = ,0167). Les analyses révèlent que les participants ayant utilisé les cartes mémoire (M = 72,00 ; SD = 4,37) obtiennent des scores significativement supérieurs à ceux ayant pratiqué la répétition passive (M = 56,00 ; SD = 4,85), t(18) = 7,74, p_ajusté < ,001, d = 3,46, IC à 95 % [11,62 ; 20,38]. De surcroît, la technique des cartes mémoire surpasse significativement l'auto-explication guidée (M = 65,00 ; SD = 3,43), t(18) = 3,99, p_ajusté = ,003, d = 1,78, IC à 95 % [3,32 ; 10,68]. Enfin, l'auto-explication s'avère significativement plus efficiente que la simple répétition passive, t(18) = 4,81, p_ajusté < ,001, d = 2,15, IC à 95 % [5,08 ; 12,92]. L'ensemble de ces constats corrobore la primauté cognitive des méthodes d'interrogation active. »
12. Limites de Bonferroni, alternatives modernes et pièges fréquents dans Excel
12.1 Le conservatisme excessif et les procédures séquentielles concurrentes
En dépit de son élégance mathématique et de son universalité opérationnelle, la correction univariée de Bonferroni fait l’objet de critiques récurrentes au sein de la communauté méthodologique en raison de son conservatisme excessif. En postulant un scénario du pire issu de l’inégalité de Boole (indépendance absolue ou orthogonalité nulle), la méthode inflige une pénalité trop sévère dès lors que le nombre de comparaisons dépasse une dizaine de contrastes ou lorsque les variables dépendantes manifestent une corrélation positive intrinsèque élevée.
Pour pallier cette perte dramatique de puissance statistique sans pour autant relâcher le contrôle strict du FWER, plusieurs alternatives séquentielles dites « pas à pas » (stepwise) ont été théorisées. La plus célèbre est la procédure descendante de Holm-Bonferroni (1979). Son algorithme ordonne préalablement les $m$ valeurs $p$ brutes de la plus petite à la plus grande ($p_{(1)} le p_{(2)} le dots le p_{(m)}$). Le plus petit résultat est évalué face à un seuil ajusté $\alpha / m$ ; s’il est significatif, le test suivant est comparé à un seuil légèrement relaxé $\alpha / (m – 1)$, et ainsi de suite jusqu’à ce qu’un test échoue à franchir le filtre. Cette méthode domine mathématiquement Bonferroni : elle contrôle le FWER avec la même rigueur tout en offrant une puissance statistique uniformément supérieure.
Dans les champs disciplinaires manipulant des volumes massifs de données (génomique, neuro-imagerie fonctionnelle), le contrôle du FWER est lui-même souvent abandonné au profit de la régulation du taux de fausses découvertes (False Discovery Rate ou FDR), formalisé par Benjamini et Hochberg (1995), qui accepte une proportion définie de faux positifs parmi les résultats rejetés plutôt que de verrouiller la survenue d’un faux positif isolé.
12.2 Erreurs courantes commises lors de l’implémentation sous Excel
L’utilisation d’un tableur grand public comme Excel pour réaliser des analyses statistiques avancées expose l’expérimentateur à des pièges techniques spécifiques qu’il convient de répertorier scrupuleusement :
- Omission du référencement absolu ($) : Lors de l’écriture des formules conditionnelles (
=SI(J2 <= E9; ...)), l’oubli d’ancrer la cellule de seuil sous la forme$E$9entraîne une dérive relative des coordonnées lors de l’étirement vertical de la formule, comparant les tests inférieurs à des cellules vides équivalentes à zéro. - Confusion de directivité dans TEST.T : Assigner la valeur 1 au paramètre de directivité au lieu de 2 divise indûment la $p$-value par deux, introduisant un biais libéral unilatéral non justifié scientifiquement.
- Calibrage erroné de la constante m : Inclure dans le dénominateur $m$ des contrastes non testés ou, à l’inverse, sous-estimer le nombre réel de combinaisons explorées informellement par le chercheur (biais de sélection post-hoc ou p-hacking).
- Usage impropre des fonctions de dispersion : Confondre l’écart-type d’un échantillon (
ECARTYPE.STANDARD, divisant par $n – 1$) et l’écart-type d’une population complète (ECARTYPE.PE, divisant par $N$), altérant la quantification des tailles d’effet.
12.3 Recommandations pour un flux de travail pérenne et reproductible
Afin de prémunir vos classeurs Excel contre les altérations accidentelles et de garantir l’auditabilité scientifique de vos traitements de données, il est recommandé d’adopter un flux de travail standardisé et documenté :
- Verrouillage structurel : Isolez les données brutes sur un onglet source protégé en lecture seule. Développez les modules d’analyse et les matrices d’inférence post-hoc sur un onglet analytique distinct.
- Documentation intégrée : Utilisez massivement les commentaires contextuels de cellules (clic droit > Nouveau commentaire) pour consigner la justification méthodologique des formules, l’explication des arguments (par exemple, préciser pourquoi le type 2 a été privilégié pour
TEST.T) et la date d’exécution. - Validation croisée externe : Avant toute diffusion ou soumission de manuscrit, procédez systématiquement à un contrôle croisé par double saisie des sorties Excel avec un logiciel de référence en code ouvert tel que le logiciel Jamovi ou le langage R (au moyen du package
statset de la commande nativepairwise.t.test(..., p.adjust.method = "bonferroni")). Cette convergence computationnelle garantit la reproductibilité intégrale de vos découvertes expérimentales.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Bonferroni, C. E. (1936). Teoria statistica delle classi e calcolo delle probabilità. Pubblicazioni del Regio Istituto Superiore di Scienze Economiche e Commerciali di Firenze, 8, 3–62.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Dunn, O. J. (1961). Multiple comparisons among means. Journal of the American Statistical Association, 56(293), 52–64. https://doi.org/10.1080/01621459.1961.10482090
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2017). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), aac4716. https://doi.org/10.1126/science.aac4716