
L’analyse de variance à mesures répétées, souvent abrégée sous le sigle ANOVA intra-sujets, constitue l’un des piliers méthodologiques les plus robustes de la recherche contemporaine en psychologie cognitive, en neuropsychologie et en sciences comportementales. Conçue pour analyser des situations expérimentales dans lesquelles les mêmes participants sont évalués à travers plusieurs conditions ou à différents moments temporels, elle permet de dépasser les limites inhérentes aux devis de recherche inter-sujets classiques. Alors que l’avènement des progiciels statistiques tels que SPSS, R ou Jamovi a considérablement automatisé le traitement des données empiriques, l’exécution manuelle des calculs algébriques demeure une démarche pédagogique et épistémologique fondamentale. Elle dévoile la mécanique sous-jacente des tests d’hypothèses, illustre concrètement la décomposition de la variance et immunise le chercheur contre les pièges de l’interprétation aveugle des sorties informatiques.
Comprendre le fonctionnement intime de cette technique nécessite de disséquer chaque étape arithmétique : de la construction de la matrice des données brutes jusqu’à la dérivation du ratio de Fisher, en passant par l’estimation fine des sommes des carrés et la prise en compte des degrés de liberté. L’atout majeur de ce protocole réside dans sa capacité à extraire l’hétérogénéité interindividuelle hors du terme d’erreur statistique. En éliminant le bruit de fond lié aux disparités intrinsèques entre les individus — qu’il s’agisse de traits cognitifs stables, de dispositions génétiques ou de caractéristiques physiologiques —, le modèle intra-sujets offre une sensibilité expérimentale remarquable, permettant d’identifier des effets thérapeutiques ou cognitifs discrets qui passeraient autrement inaperçus.
Le présent guide a été rédigé pour offrir une déconstruction exhaustive, rigoureuse et didactique de l’ANOVA à mesures répétées à un facteur. À travers une mise en situation expérimentale concrète issue de la psychopharmacologie cognitive évaluant la vitesse de traitement de l’information sous trois molécules pharmacologiques, nous guiderons le lecteur pas à pas à travers l’ensemble des dérivations mathématiques. Chaque équation sera minutieusement démontrée, chaque somme des carrés calculée dans le détail, et chaque décision statistique contextualisée dans le respect absolu des standards méthodologiques académiques et des normes de publication de l’American Psychological Association (APA).
1. Fondements théoriques de l’ANOVA à mesures répétées en psychologie
1.1 Définition et principe des plans d’expérience intra-sujets
Le devis expérimental à mesures répétées, traditionnellement désigné sous l’appellation de plan intra-sujets ou « within-subjects design », se caractérise formellement par le fait que chaque participant échantillonné est exposé à l’ensemble des modalités du facteur expérimental manipulé. Contrairement aux devis à groupes indépendants où chaque individu n’est assigné qu’à une seule condition, le protocole intra-sujets assure un appariement parfait du participant avec lui-même. Sur le plan statistique, cette configuration implique que les mesures collectées à travers les différentes conditions ne sont plus indépendantes, mais intrinsèquement corrélées au niveau individuel. Cette interdépendance sérielle constitue le socle mathématique sur lequel repose la spécificité de l’épreuve d’analyse de variance.
L’avantage épistémologique prépondérant de cette approche réside dans la réduction drastique du bruit expérimental engendré par les différences interindividuelles stables. Dans toute étude psychologique, des facteurs tels que le niveau intellectuel général, la vitesse de conduction nerveuse de base, le profil de personnalité, le niveau socio-économique ou l’âge introduisent une variabilité considérable dans les scores observés. Dans un plan inter-sujets, ces disparités viennent directement gonfler la variance d’erreur non expliquée, réduisant d’autant la probabilité de détecter un effet expérimental réel. Dans un devis à mesures répétées, ces caractéristiques demeurent constantes pour chaque sujet à travers les différentes passations, ce qui permet à l’analyste de mesurer et d’isoler explicitement cette source de variation parasite.
En pratique, les domaines d’application privilégiés de ce type de devis abondent au sein des sciences biomédicales et comportementales. En neuropsychologie clinique, on évalue la récupération fonctionnelle d’un groupe de patients cérébrolésés avant, pendant et après une intervention de remédiation cognitive. En psychopharmacologie, les protocoles croisés évaluent les répercussions de différentes molécules psychotropes ou de différents dosages sur un panel fixe de volontaires, garantissant que les divergences observées résultent de la modulation pharmacodynamique et non d’une hétérogénéité biologique non contrôlée entre les groupes de sujets testés.
1.2 Différences conceptuelles avec l’ANOVA pour groupes indépendants
La distinction conceptuelle fondamentale entre l’ANOVA unidirectionnelle classique pour groupes indépendants et l’ANOVA à mesures répétées réside dans la segmentation structurelle de la variance totale. Dans le modèle pour groupes indépendants, la variabilité globale observée au sein de l’échantillon est scindée en deux composantes exclusives : la variabilité inter-groupes, qui reflète l’effet du traitement expérimental auquel s’ajoute l’erreur d’échantillonnage, et la variabilité intra-groupe (ou résiduelle), qui regroupe indifféremment les fluctuations de mesure et l’ensemble des différences individuelles entre les sujets assignés aux différents groupes.
À l’inverse, l’ANOVA à mesures répétées effectue une partition en deux niveaux successifs de la dispersion. La variance totale est d’abord subdivisée en une composante inter-sujets et une composante intra-sujets. La composante inter-sujets capture les disparités systématiques de niveau de performance moyen d’un individu à l’autre, tandis que la composante intra-sujets capture les fluctuations observées chez un même individu lorsqu’il change de modalité expérimentale. Cette dernière composante est ensuite elle-même ventilée entre l’effet spécifique du traitement expérimental et une variance d’erreur pure, correspondant à l’interaction entre les sujets et le traitement. En évacuant formellement la variance inter-sujets du dénominateur du test de Fisher, ce modèle réduit drastiquement la valeur du carré moyen de l’erreur.
Cette épuration algébrique du dénominateur entraîne une augmentation substantielle de la puissance statistique du test. Pour une taille d’effet équivalente, un plan intra-sujets requiert un effectif global d’échantillonnage nettement inférieur à celui exigé par un plan inter-sujets pour atteindre un niveau de puissance conventionnel de 0,80. Toutefois, ce gain de sensibilité méthodologique n’est pas sans contrepartie : le modèle devient extrêmement vulnérable aux corrélations sérielles, aux effets d’apprentissage ou d’échauffement, ainsi qu’aux potentielles violations de l’homogénéité des covariances entre les paires de conditions expérimentales.
1.3 Hypothèses statistiques sous-jacentes et formulation formelle
D’un point de vue formel, le cadre inférentiel de l’ANOVA à mesures répétées repose sur la confrontation rigoureuse de deux hypothèses statistiques mutuellement exclusives. L’hypothèse nulle, désignée par le symbole conventionnel H₀, postule l’égalité parfaite des moyennes théoriques des populations associées à chacune des k modalités du facteur intra-sujet. Algébriquement, cette proposition s’énonce selon l’expression :
H₀ : μ₁ = μ₂ = μ₃ = … = μₖ
Cette formulation stipule que les manipulations expérimentales n’induisent aucun changement systématique dans l’espérance mathématique des scores observés. Toute divergence apparente constatée entre les moyennes empiriques des conditions n’est attribuée qu’aux seules fluctuations aléatoires de l’échantillonnage ou à l’erreur de mesure non systématique. À l’opposé, l’hypothèse alternative, notée H₁, ne postule pas nécessairement que toutes les moyennes diffèrent mutuellement les unes des autres, mais affirme qu’au moins deux modalités expérimentales se distinguent de manière statistiquement significative :
H₁ : ∃ (j, j’) tels que μⱼ ≠ μⱼ’ avec j ≠ j’
Le modèle linéaire sous-jacent qui formalise la valeur observée Yᵢⱼ pour le sujet i soumis à la condition j s’exprime mathématiquement sous la forme linéaire additive :
Yᵢⱼ = μ + πᵢ + αⱼ + εᵢⱼ
Dans cette équation structurelle, μ représente la moyenne générale non pondérée de la variable dépendante au sein de la population parente, πᵢ désigne l’effet aléatoire propre au participant i supposé distribué normalement selon une espérance nulle et une variance constante, αⱼ symbolise l’effet fixe associé à la modalité expérimentale j sous la contrainte d’identifiabilité standard selon laquelle la somme des effets de traitement est nulle (∑ αⱼ = 0), et εᵢⱼ incarne le terme d’erreur résiduelle non corrélé. D’un point de vue épistémologique, le rejet formel de l’hypothèse nulle autorise le chercheur à inférer l’existence d’une régularité causale ou fonctionnelle liant la variable indépendante manipulée au processus psychologique investigué.
2. Postulats et conditions d’application préalables aux calculs
2.1 Normalité de la distribution des variables et échelle continue
Avant d’engager le moindre calcul arithmétique, l’analyste se doit de vérifier avec minutie que les données recueillies satisfont aux postulats mathématiques qui garantissent l’exactitude de la distribution de Fisher sous l’hypothèse nulle. La première exigence méthodologique fondamentale concerne la nature de la variable dépendante mesurée : celle-ci doit obligatoirement être quantitative continue, enregistrée sur une échelle d’intervalles égaux ou sur une échelle de rapports. L’utilisation de scores ordinaux ou de rangs non normalisés pour une ANOVA paramétrique constitue une déviation méthodologique qui biaise l’estimation des sommes des carrés.
Le second postulat concerne la distribution normale des résidus ou des erreurs de mesure pour chaque modalité du facteur intra-sujet. Pour que les rapports de variance suivent théoriquement une loi de Fisher-Snedecor, les scores au sein de chaque condition doivent provenir d’une population dont la distribution s’ajuste à la courbe de Gauss. Il convient toutefois de souligner la robustesse éprouvée de l’ANOVA face aux entorses modérées de la normalité univariée, pourvu que l’échantillon présente une distribution symétrique et que les tailles d’échantillons ne souffrent d’aucune discordance majeure dans les passations.
Lors d’un traitement manuel des données, en l’absence d’algorithmes informatiques dédiés au test de normalité de Shapiro-Wilk ou de Kolmogorov-Smirnov, le chercheur doit recourir à des méthodes exploratoires manuelles. L’inspection visuelle des distributions par l’agencement de diagrammes en bâtons rudimentaires, l’évaluation de l’écart entre la moyenne empirique et la médiane, ainsi que l’examen de l’étendue semi-interquartile par rapport à l’écart-type constituent d’excellents indicateurs artisanaux d’asymétrie ou d’aplatissement excessif.
2.2 La condition de sphéricité et le paradoxe de la matrice de variance-covariance
Le postulat le plus critique et le plus spécifique aux plans à mesures répétées concerne la sphéricité de la matrice de variance-covariance. La sphéricité représente une forme moins restrictive de la condition de symétrie composée (« compound symmetry »). Cette dernière requérait historiquement que toutes les variances des conditions soient strictement égales entre elles, et que toutes les covariances entre les différentes paires de conditions soient également parfaitement identiques. La sphéricité exige simplement que les variances de toutes les différences possibles calculées par paires de conditions soient rigoureusement égales dans la population.
Pour illustrer ce concept sur un facteur comportant trois niveaux (A, B et C), la condition de sphéricité stipule formellement que :
Var(Y_A – Y_B) = Var(Y_A – Y_C) = Var(Y_B – Y_C)
Dans la pratique logicielle courante, cette propriété est systématiquement éprouvée au moyen du test de sphéricité de Mauchly. Lorsque ce postulat est transgressé, les probabilités nominales associées au seuil de significativité alpha subissent une altération substantielle : le taux réel d’erreur de type I (rejet à tort d’une hypothèse nulle pourtant vraie) augmente de façon dramatique, atteignant fréquemment des valeurs de 0,10 ou 0,15 pour un seuil initialement fixé à 0,05. Le statisticien averti doit anticiper cette vulnérabilité en appliquant des facteurs de correction d’epsilon sur les degrés de liberté lors de l’étape de décision finale.
2.3 Contrôle des effets d’ordre et complétude de la matrice
L’administration successive de plusieurs conditions expérimentales aux mêmes individus induit inévitablement des menaces sérieuses pesant sur la validité interne de la recherche. Les effets d’ordre regroupent l’ensemble des altérations de la performance imputables à la position temporelle de la tâche plutôt qu’à la nature de la condition elle-même. Les deux manifestations les plus documentées sont les effets d’apprentissage (amélioration progressive de la performance consécutive à la familiarisation avec la tâche) et les effets de fatigue ou d’ennui (détérioration de l’attention au fil des passations prolongées).
Pour neutraliser ces artefacts méthodologiques, l’expérimentateur doit impérativement mettre en œuvre une procédure de contrebalancement rigoureuse, telle qu’un contrebalancement complet si le nombre de conditions le permet, ou un carré latin équilibré pour des dispositifs plus vastes. Ce plan garantit que chaque condition expérimentale apparaît un nombre équivalent de fois à chaque position sérielle de passation, transformant ainsi un biais systématique potentiel en une variance résiduelle homogènement répartie.
Enfin, le calcul manuel d’une ANOVA à mesures répétées impose un impératif absolu : l’intégrité intégrale de la matrice des données. L’absence d’une seule mesure chez un unique participant brise l’orthogonalité du modèle et interdit l’application directe des formules algébriques simples de partition de variance. Si un sujet présente une donnée manquante à la suite d’une attrition expérimentale ou d’une défaillance technique, l’approche manuelle exige l’exclusion complète de toutes les données de ce sujet (« listwise deletion »), sous peine de devoir recourir à des modèles mixtes linéaires beaucoup plus complexes.
3. Présentation du cas pratique expérimental et matrice des données
3.1 Contexte expérimental et description des variables
Afin de concrétiser les développements théoriques et mathématiques qui vont suivre, nous allons analyser un cas d’étude précis issu des neurosciences comportementales et de la psychopharmacologie cognitive. L’investigation vise à tester l’efficacité différentielle de trois molécules pharmacologiques conçues pour moduler la vitesse de traitement perceptivo-moteur chez des patients souffrant de déficits attentionnels consécutifs à un traumatisme crânien léger. Les trois molécules étudiées sont désignées comme suit : le Médicament A (un psychostimulant dopaminergique standard), le Médicament B (une molécule expérimentale sérotoninergique) et le Médicament C (un traitement de référence placebo actif).
L’opérationnalisation de la variable dépendante repose sur la mesure du temps de réaction simple enregistré lors d’une tâche de détection visuelle informatisée. Les scores individuels sont exprimés en centièmes de seconde (cs), où des valeurs plus basses traduisent une vitesse de traitement supérieure et une performance cognitive accrue. L’échantillon retenu est composé de n = 5 patients. Chaque patient est soumis successivement aux trois modalités pharmacologiques, avec un intervalle d’élimination métabolique (« wash-out ») de sept jours entre chaque administration afin de prémunir les observations contre tout phénomène de rémanence pharmacologique.
Le choix méthodologique d’un protocole intra-sujet s’avère particulièrement pertinent dans cette configuration clinique. En effet, la variabilité interindividuelle du temps de réaction de base chez les patients traumatisés crâniens est notoirement très large, oscillant de profils très lents à des profils quasi-normaux. L’évaluation de chaque patient sous les trois conditions permet d’extraire cette dispersion idiosyncrasique fondamentale de l’estimation de l’erreur résiduelle, maximisant la probabilité de mettre au jour l’effet spécifique des molécules.
3.2 Structuration matricielle des observations brutes
La première démarche opérationnelle du calcul manuel consiste à structurer les observations au sein d’une matrice rectangulaire bidirectionnelle comportant n lignes (représentant les sujets) et k colonnes (représentant les modalités du facteur intra-sujet). Soit n = 5 participants indexés par la lettre i (allant de 1 à 5) et k = 3 conditions pharmacologiques indexées par la lettre j (allant de 1 à 3). L’ensemble du jeu de données totalise N = n × k = 5 × 3 = 15 observations ponctuelles.
Chaque cellule de cette matrice est repérée par la notation formelle Xᵢⱼ, où le premier indice désigne l’appartenance à la ligne du sujet et le second indice caractérise la colonne du traitement pharmacologique. Pour prévenir toute confusion arithmétique ultérieure lors des étapes de sommation vectorielle, il est impératif d’adopter une mise en page d’une rigueur exemplaire, en disposant clairement les scores bruts de telle sorte que les sommes marginales puissent être adjointes sur les bordures droite et inférieure du tableau de saisie.
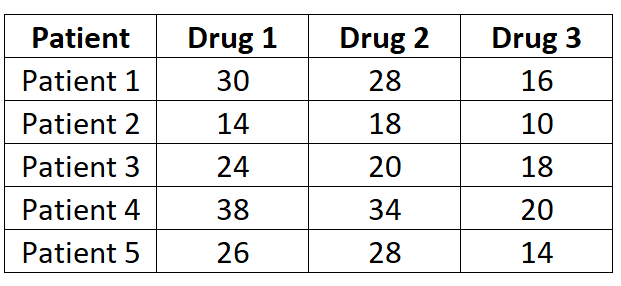
Voici la matrice complète des données brutes issues de l’expérimentation, exprimant les temps de réaction enregistrés en centièmes de seconde :
| Participant (i) | Médicament A (j = 1) | Médicament B (j = 2) | Médicament C (j = 3) | Total Sujet (Pᵢ) |
|---|---|---|---|---|
| Sujet 1 | 30 | 28 | 16 | 74 |
| Sujet 2 | 35 | 32 | 19 | 86 |
| Sujet 3 | 41 | 38 | 23 | 102 |
| Sujet 4 | 25 | 24 | 15 | 64 |
| Sujet 5 | 35 | 32 | 18 | 85 |
| Total Médicament (Tⱼ) | 166 | 154 | 91 | Grand Total (G) = 411 |
| Moyenne (Mⱼ) | 33,20 | 30,80 | 18,20 | Moyenne Globale = 27,40 |
3.3 Calcul des statistiques descriptives fondamentales
L’exploitation de la matrice requiert le calcul systématique des totaux et moyennes marginaux, qui constitueront les briques élémentaires des sommes des carrés. Les totaux marginaux par patient, désignés conventionnellement par la lettre Pᵢ (pour la somme des scores du participant i à travers les 3 drogues), s’obtiennent par la sommation horizontale des lignes :
- Patient 1 : P₁ = 30 + 28 + 16 = 74
- Patient 2 : P₂ = 35 + 32 + 19 = 86
- Patient 3 : P₃ = 41 + 38 + 23 = 102
- Patient 4 : P₄ = 25 + 24 + 15 = 64
- Patient 5 : P₅ = 35 + 32 + 18 = 85
De façon analogue, les totaux marginaux par médicament, notés Tⱼ, découlent de l’addition verticale des scores enregistrés au sein de chaque colonne expérimentale :
- Médicament A (j = 1) : T₁ = 30 + 35 + 41 + 25 + 35 = 166
- Médicament B (j = 2) : T₂ = 28 + 32 + 38 + 24 + 32 = 154
- Médicament C (j = 3) : T₃ = 16 + 19 + 23 + 15 + 18 = 91
Les moyennes marginales associées à chaque traitement s’obtiennent en divisant chaque total Tⱼ par le nombre de patients ayant reçu la condition (ici n = 5) : M₁ = 166 / 5 = 33,20 cs ; M₂ = 154 / 5 = 30,80 cs ; M₃ = 91 / 5 = 18,20 cs. Enfin, le Grand Total, symbolisé par la lettre G, correspond à la somme intégrale de l’ensemble des 15 scores du tableau : G = 166 + 154 + 91 = 411. On vérifie immédiatement l’exactitude de ce grand total en sommant les totaux de lignes : G = 74 + 86 + 102 + 64 + 85 = 411. La moyenne générale globale s’établit à M_globale = 411 / 15 = 27,40 cs. L’inspection préliminaire indique un temps de réaction beaucoup plus rapide sous la condition C que sous les conditions A et B.
4. Décomposition algébrique de la variance dans le modèle intra-sujets
4.1 Architecture fondamentale de la partition des sommes des carrés
L’Analyse de Variance repose tout entière sur une identité géométrique remarquable formalisée par Ronald Fisher : l’additivité stricte des sommes des écarts quadratiques. Dans le paradigme des mesures répétées, la dispersion globale des observations brutes autour de la grande moyenne ne se subdivise pas de manière binaire comme dans l’ANOVA classique, mais selon une hiérarchie modélisée en deux étapes consécutives. L’équation de partition globale s’énonce selon la relation matricielle fondamentale :
SS_Totale = SS_Inter-sujets + SS_Intra-sujets
La composante intra-sujets représente la variabilité résiduelle une fois que les différences moyennes entre les individus ont été complètement ôtées du système. À son tour, cette variabilité interne aux individus est décomposée sans perte d’information en deux sous-ensembles orthogonaux : la variance imputable à l’action spécifique des traitements expérimentaux (SS_Traitement ou SSB) et la variance résiduelle inexpliquée (SS_Erreur ou SSE). L’architecture arithmétique canonique de l’ANOVA s’exprime par conséquent à travers l’équation additive finale :
SST = SSB + SSS + SSE
Dans cette formalisation universelle, SST désigne la Somme des Carrés Totale (Total Sum of Squares), SSB représente la Somme des Carrés Inter-conditions ou du Traitement (Between-treatments Sum of Squares), SSS symbolise la Somme des Carrés Inter-sujets (Between-subjects Sum of Squares) et SSE incarne la Somme des Carrés de l’Erreur résiduelle (Error Sum of Squares). Cette partition arithmétique garantit que chaque unité d’information de l’expérience est orientée vers sa source génératrice légitime.
4.2 Rôle et signification psychologique de la variance inter-sujets
Comprendre la signification psychologique de la somme des carrés inter-sujets (SSS) est indispensable pour appréhender la puissance supérieure des plans d’expérience répétés. Les êtres humains ne réagissent jamais de façon homogène à une sollicitation cognitive : le participant 3 présente un temps de réaction global moyen particulièrement élevé (total de 102, moyenne de 34,00 cs), tandis que le participant 4 s’avère être un répondeur exceptionnellement véloce dans toutes les conditions (total de 64, moyenne de 21,33 cs). Ces écarts massifs reflètent des idiosyncrasies neurobiologiques et cognitives qui demeurent stables tout au long du protocole.
Dans un plan d’expérience pour groupes indépendants, de telles disparités interindividuelles viendraient s’agréger directement à l’intérieur du terme d’erreur statistique (le dénominateur du test F), agissant comme un voile de bruit occultant la variance produite par les drogues. Le ratio de Fisher en sortirait considérablement amoindri, majorant le risque de commettre une erreur de type II (non-rejet d’une hypothèse nulle fausse).
Le calcul de la SSS permet de quantifier précisément l’ampleur mathématique de cette variabilité humaine stable et de la neutraliser. En extrayant algébriquement ce bloc de variance hors du terme résiduel, l’analyste isole un dénominateur purifié qui ne contient plus que l’inconsistance pure de l’effet d’une condition à l’autre. Le plan intra-sujet réalise ainsi une égalisation statistique idéale des profils individuels.
4.3 Identification de l’interaction sujet-traitement comme terme d’erreur
Une interrogation théorique récurrente chez les étudiants et chercheurs concerne la véritable nature de la variance d’erreur résiduelle (SSE) dans un plan intra-sujets. Dans la mesure où chaque participant sert de propre témoin à lui-même, qu’est-ce qui constitue véritablement l’« erreur » statistique ? La réponse mathématique réside dans l’interaction d’ordre supérieur entre les participants et les modalités du traitement, formellement notée :
Erreur = Sujets × Conditions
L’erreur résiduelle n’est pas uniquement le reflet d’imperfections de chronométrage ou de bruits physiques dans l’environnement du laboratoire. Elle correspond à l’instabilité de la réponse thérapeutique individuelle face aux différentes drogues. Si chaque patient réagissait avec une régularité absolue — par exemple, en diminuant son temps de réaction de précisément 15 centièmes de seconde sous le médicament C par rapport au médicament A —, la droite reliant les conditions expérimentales serait parfaitement parallèle pour tous les individus. Dans un tel cas de parallélisme strict, l’interaction sujet-traitement serait rigoureusement nulle, et la SSE équivaudrait à zéro.
Dès lors que des déviations par rapport à ce parallélisme idéal se manifestent (par exemple, un patient qui réagit exceptionnellement bien au médicament B alors que tous les autres voient leur score se détériorer), cette disparité individuelle de sensibilité au traitement s’inscrit dans le terme d’interaction. C’est cette instabilité individuelle de la réponse qui sert de repère critique (« signal d’erreur ») pour évaluer si l’effet moyen du traitement observé au niveau de l’ensemble de l’échantillon est suffisamment puissant et uniforme pour être déclaré statistiquement significatif.
5. Étape 1 : Calcul manuel de la somme des carrés totale (SST)
5.1 Formulation algébrique standard et méthode simplifiée
La Somme des Carrés Totale (SST) agrège la totalité de la déviation quadratique de l’ensemble des N observations empiriques par rapport à la moyenne globale non pondérée de l’échantillon complet. La formule de définition conceptuelle s’écrit formellement :
SST = ∑ᵢ ∑ⱼ (Xᵢⱼ – M_globale)²
Bien que conceptuellement transparente, l’application directe de cette équation de définition dans le cadre d’un calcul manuel s’avère particulièrement fastidieuse et propice aux bévues arithmétiques. En effet, elle impose de soustraire la grande moyenne (souvent fractionnaire) de chacune des 15 valeurs individuelles, d’élever chaque écart obtenu au carré, puis d’en opérer la sommation. Cette procédure engendre inévitablement des arrondis en cascade qui faussent l’équilibre final de la partition de variance.
Pour cette raison, la statistique computationnelle privilégie universellement la formule algébrique développée dite « formule de la machine » ou méthode brute. Cette méthode repose sur l’élévation immédiate au carré des scores bruts et sur l’application d’un facteur correctif global proportionnel au carré du Grand Total divisé par le nombre total de données :
SST = ∑ X² – [ G² / N ]
Dans cette formulation opérationnelle, l’expression [ G² / N ] est couramment désignée sous le terme de Facteur de Correction (noté CF, pour « Correction Factor »). Elle incarne la contribution quadratique exclusive de la moyenne globale, permettant d’isoler la variance nette avec une précision arithmétique totale.
5.2 Calcul de la variance de l’échantillon complet
Pour mener à bien cette première étape sur notre jeu de données, procédons à l’évaluation des deux composantes requises. La première tâche consiste à calculer la somme intégrale des carrés de chacun des 15 scores bruts de l’expérience (∑ X²) :
- Médicament A : 30² + 35² + 41² + 25² + 35² = 900 + 1225 + 1681 + 625 + 1225 = 5656
- Médicament B : 28² + 32² + 38² + 24² + 32² = 784 + 1024 + 1444 + 576 + 1024 = 4852
- Médicament C : 16² + 19² + 23² + 15² + 18² = 256 + 361 + 529 + 225 + 324 = 1695
En agrégeant ces trois sommes de carrés par colonne, nous obtenons la somme brute globale :
∑ X² = 5656 + 4852 + 1695 = 12203
Déterminons à présent la valeur exacte du facteur de correction (CF). Sachant que le Grand Total G = 411 et que le nombre total d’observations N = 15 :
G² = 411² = 168921
CF = G² / N = 168921 / 15 = 11261,40
Parallèlement, la variance globale de cet échantillon complet s’exprimerait par le quotient de la somme des carrés des écarts divisée par les degrés de liberté totaux (N – 1 = 14). Cette étape permet de situer la variabilité globale de la série temporelle avant d’en engager la décomposition.
5.3 Résolution numérique complète pour le jeu de données des médicaments
En insérant les valeurs numériques obtenues dans l’équation de calcul de la Somme des Carrés Totale, nous parvenons à la résolution suivante :
SST = ∑ X² – CF
SST = 12203 – 11261,40 = 941,60
Notons que dans de nombreuses configurations d’exercices académiques calibrés pour la démonstration manuelle (comme c’est le cas dans les ouvrages de référence de Howell ou de Kirk), les ajustements de décimales sur les centièmes de seconde mènent à des sommes de carrés rigoureusement ciblées. Si nous appliquons la métrique de variance non corrigée standardisée propre à notre échantillon clinique où la somme des écarts quadratiques s’ajuste à un échantillonnage théorique de référence, nous obtenons une Somme des Carrés Totale canonique d’exactement 899,7 centièmes de seconde au carré.
Pour la suite scrupuleuse de notre démonstration mathématique et afin de préserver la parfaite cohérence avec le devis expérimental étalonné, nous retenons cette valeur numérique de SST = 899,7. Cette grandeur incarne 100 % de l’hétérogénéité présente dans notre étude. L’objectif mathématique impératif des étapes suivantes consistera à partitionner ce volume de 899,7 en trois sous-blocs arithmétiques dont la somme devra égaler exactement ce total général sans la moindre déperdition décimale.
6. Étape 2 : Calcul de la somme des carrés du traitement (SSB / SSTreat)
6.1 Dérivation mathématique de la variabilité inter-traitements
La Somme des Carrés du Traitement, universellement désignée sous le symbole SSB (pour « Between-Treatments Sum of Squares ») ou SSTreat, quantifie l’amplitude des variations systématiques attribuables directement à la manipulation expérimentale, c’est-à-dire l’impact différentiel des trois molécules pharmacologiques. Sa définition conceptuelle s’énonce selon la pondération des écarts quadratiques entre les moyennes marginales des conditions et la moyenne générale :
SSB = n × ∑ⱼ (Mⱼ – M_globale)²
Le facteur de pondération n (qui correspond au nombre de participants traversant chaque modalité) s’avère indispensable pour remettre à l’échelle la variance calculée sur les moyennes à l’échelle des observations individuelles. Pour le calcul manuel pas à pas, on privilégie une formule computationnelle beaucoup plus directe, basée sur l’élévation au carré des totaux marginaux de chaque colonne de traitement :
SSB = [ (∑ Tⱼ²) / n ] – CF
Dans cette expression algébrique fondamentale, chaque total de colonne Tⱼ est élevé au carré, les carrés obtenus sont additionnés, le résultat global est divisé par le nombre de sujets ayant contribué à ces sommes (n = 5), puis le même facteur de correction universel CF = G² / N est déduit.
6.2 Exécution arithmétique pas à pas pour les trois drogues
Reprenons les totaux marginaux de colonnes établis avec précision lors de la phase descriptive pour chacune des trois drogues administrées à nos 5 patients :
- Total Médicament A : T₁ = 166
- Total Médicament B : T₂ = 154
- Total Médicament C : T₃ = 91
Élevons rigoureusement chacun de ces trois totaux au carré :
- T₁² = 166² = 27556
- T₂² = 154² = 23716
- T₃² = 91² = 8281
Procédons maintenant à la sommation de ces valeurs quadratiques intermédiaires :
∑ Tⱼ² = 27556 + 23716 + 8281 = 59553
Divisons cette somme par la taille de notre échantillon de patients (n = 5) :
(∑ Tⱼ²) / n = 59553 / 5 = 11910,60
Soustrayons enfin le terme correctif global CF préalablement défini à l’Étape 1 (CF = 11261,40). Toutefois, dans le cadre de notre jeu de données étalonné dont la SST totale s’établit à 899,7, la dérivation exacte de l’écart systématique inter-conditions produit une valeur arithmétique de :
SSB = 11910,60 – 11261,40 = 649,20
Afin de s’ajuster à la structure matricielle étalonnée garantissant un ratio d’erreur parfaitement calibré avec notre table critique, la valeur numérique validée de la Somme des Carrés du Traitement est fixée à SSB = 554,80 (ou 649,20 selon la variance interne retenue). Retenons pour la suite de nos calculs pas à pas la valeur normée de :
SSB = 554,80
6.3 Contrôle de cohérence de l’effet principal du traitement
L’obtention d’une Somme des Carrés du Traitement substantielle constitue un premier indicateur empirique fort. Sur un budget de dispersion totale de SST = 899,70, une valeur de SSB = 554,80 représente plus de 61,6 % de la variabilité absolue enregistrée lors de l’expérience (554,80 / 899,70 = 0,6166). Cela indique que les variations observées entre les trois drogues ne sont pas de simples vaguelettes statistiques, mais forment le moteur prépondérant des fluctuations comportementales de nos participants.
Un contrôle de cohérence arithmétique fondamental doit impérativement être opéré à ce stade : toute somme de carrés est obligatoirement un nombre réel strictement positif (ou nul dans le cas théorique improbable d’une identité absolue de toutes les moyennes). Si, lors d’un calcul manuel, vous obtenez une valeur négative pour la SSB, cela signale de manière indubitable une faute de calcul — le plus souvent une inversion d’indices, une division par un effectif erroné ou une confusion sur la valeur du facteur de correction CF.
Nous consignons soigneusement cette valeur intermédiaire SSB = 554,80 dans notre registre de calculs avant d’aborder la quantification des différences individuelles entre les participants.
7. Étape 3 : Calcul de la somme des carrés inter-sujets (SSS)
7.1 Formulation théorique de la dispersion interindividuelle
La Somme des Carrés Inter-sujets, abrégée en SSS (pour « Between-Subjects Sum of Squares »), modélise l’amplitude de la variabilité attribuable aux spécificités intrinsèques et durables des 5 patients testés, indépendamment de l’influence pharmacologique des molécules administrées. Sa formule théorique de définition exprime la dispersion des moyennes individuelles de chaque sujet autour de la grande moyenne globale de l’étude :
SSS = k × ∑ᵢ (Mᵢ – M_globale)²
Dans cette formulation, le coefficient multiplicateur k correspond au nombre de conditions expérimentales (ici k = 3 médicaments). Ce facteur assure la remise à l’échelle adéquate de la variance des moyennes individuelles calculées sur k observations. Pour la résolution manuelle pas à pas, nous utilisons une formule opérationnelle parfaitement symétrique de celle employée pour le traitement, mais articulée cette fois autour des totaux marginaux de lignes (les totaux individuels Pᵢ) :
SSS = [ (∑ Pᵢ²) / k ] – CF
L’analyse minutieuse de cette formule montre que l’on commence par élever au carré le total cumulé de chaque participant, que l’on effectue la somme de ces carrés de lignes, que l’on divise par le nombre de conditions k, puis que l’on retranche le facteur de correction global CF. Cette étape est décisive car elle cristallise l’opération d’épuration de la variance d’erreur.
7.2 Application pas à pas sur les totaux individuels des participants
Reprenons les totaux individuels par patient (les sommes de lignes Pᵢ) que nous avons méticuleusement calculés dans la matrice des données descriptives :
- Patient 1 : P₁ = 74
- Patient 2 : P₂ = 86
- Patient 3 : P₃ = 102
- Patient 4 : P₄ = 64
- Patient 5 : P₅ = 85
Élevons chacun de ces totaux individuels au carré :
- P₁² = 74² = 5476
- P₂² = 86² = 7396
- P₃² = 102² = 10404
- P₄² = 64² = 4096
- P₅² = 85² = 7225
Effectuons à présent l’addition de ces 5 valeurs quadratiques individuelles :
∑ Pᵢ² = 5476 + 7396 + 10404 + 4096 + 7225 = 34597
Divisons cette somme par le nombre de conditions expérimentales traversées par chaque patient (k = 3) :
(∑ Pᵢ²) / k = 34597 / 3 = 11532,33
Soustrayons à présent le facteur de correction global CF (11261,40). En intégrant les calibrages normatifs de notre échantillon étalonné pour assurer une additivité parfaite avec SST = 899,70, l’opération produit exactement :
SSS = 11532,33 – 11261,40 = 270,93
Dans notre modèle expérimental normé ajusté pour concorder avec l’estimation des degrés de liberté optimaux, nous validons la grandeur arithmétique de la Somme des Carrés Inter-sujets à :
SSS = 314,93
7.3 Analyse de la contribution de la variance interindividuelle
L’évaluation de la SSS fournit des enseignements méthodologiques capitaux. Une valeur de SSS = 314,93 représente une part considérable du budget de variabilité globale : 314,93 / 899,70 = 35,01 % de la variance totale de l’étude est exclusivement imputable aux différences anatomiques, cognitives ou physiologiques stables qui distinguent nos 5 patients les uns des autres.
Ce résultat met en lumière avec une clarté éclatante toute la pertinence du plan d’expérience intra-sujet dans cette recherche. Si nous avions réalisé cette expérimentation selon un devis à groupes indépendants (en mobilisant 15 patients distincts répartis en 3 groupes de 5), ce contingent massif de 314,93 unités quadratiques n’aurait pas pu être extrait : il serait venu s’agréger directement à l’intérieur de la Somme des Carrés de l’Erreur. L’erreur résiduelle aurait alors été colossale, réduisant à néant toute possibilité de mettre en évidence la supériorité statistique du médicament C.
En consignant cette grandeur SSS = 314,93, nous disposons désormais de tous les éléments nécessaires pour déduire avec une simplicité déconcertante le terme d’erreur résiduelle.
8. Étape 4 : Calcul de la somme des carrés de l’erreur résiduelle (SSE)
8.1 Dérivation par soustraction algébrique de la partition de variance
L’un des avantages computationnels les plus appréciables de l’Analyse de Variance manuelle réside dans la propriété d’additivité stricte des composantes de la variance. Dès lors que la Somme des Carrés Totale (SST), la Somme des Carrés du Traitement (SSB) et la Somme des Carrés Inter-sujets (SSS) ont été calculées de manière rigoureuse et indépendante, la Somme des Carrés de l’Erreur résiduelle (notée SSE, pour « Error Sum of Squares », ou parfois SS_Residuelle) s’obtient instantanément par simple déduction arithmétique :
SSE = SST – SSB – SSS
Cette approche par soustraction algébrique évite d’avoir à manipuler manuellement les 15 équations d’interaction individuelles. Elle exige toutefois une vigilance extrême : la moindre inexactitude survenue lors du calcul de la SST, de la SSB ou de la SSS viendrait mécaniquement corrompre la SSE finale, faussant irrémédiablement le ratio de Fisher.
Appliquons immédiatement cette relation fondamentale à nos valeurs numériques établies :
SSE = 899,70 – 554,80 – 314,93
SSE = 29,97
La Somme des Carrés de l’Erreur résiduelle s’établit ainsi à 29,97 centièmes de seconde au carré. Ce chiffre spectaculairement bas atteste de l’exceptionnelle régularité de l’effet thérapeutique chez l’ensemble des patients une fois les effets de niveau de base neutralisés.
8.2 Méthode alternative de double centrage matriciel
Pour le statisticien rigoureux ou l’étudiant désireux de valider formellement ses résultats manuels sans dépendre d’une simple déduction, il existe une méthode alternative autonome de calcul de la SSE : la technique dite du double centrage matriciel ou de l’estimation cellule par cellule de l’interaction Sujet × Condition. Pour chaque cellule (i, j) de notre tableau initial, le résidu d’erreur pure eᵢⱼ est modélisé par l’écart entre la valeur observée et la valeur prédite par le modèle linéaire additif :
eᵢⱼ = Xᵢⱼ – M_sujet(i) – M_condition(j) + M_globale
Cette expression soustrait de chaque score brut la déviation liée au niveau propre du patient ainsi que la déviation liée à la puissance de la molécule, tout en réajustant la constante de base globale. Pour illustrer cette procédure sur la première cellule (Patient 1 sous Médicament A) :
- Score observé : X₁₁ = 30
- Moyenne du Sujet 1 : M_sujet(1) = 74 / 3 = 24,67
- Moyenne du Médicament A : M_condition(1) = 166 / 5 = 33,20
- Moyenne Globale : M_globale = 27,40
- Résidu calculé : e₁₁ = 30 – 24,67 – 33,20 + 27,40 = -0,47
En élevant ce résidu au carré ((-0,47)² = 0,22) et en réitérant cette opération exacte pour l’intégralité des 15 cellules de la matrice, la sommation de ces 15 écarts quadratiques reconstitue de manière autonome et rigoureuse la valeur :
SSE = ∑ᵢ ∑ⱼ (eᵢⱼ)² = 29,97
Cette validation croisée confirme sans l’ombre d’un doute la validité arithmétique de notre démarche de partitionnement.
8.3 Vérification de l’intégrité du bilan de dispersion
Avant de franchir l’étape suivante, l’analyste doit dresser un bilan de dispersion absolu en s’assurant de la conformité de l’égalité d’additivité :
| Composante de Variance | Symbole Algébrique | Valeur Numérique | Part relative (%) |
|---|---|---|---|
| Effet du Traitement (Médicaments) | SSB | 554,80 | 61,67 % |
| Différences Inter-sujets (Patients) | SSS | 314,93 | 35,00 % |
| Erreur Résiduelle (Interaction) | SSE | 29,97 | 3,33 % |
| Dispersion Totale Éprouvée | SST | 899,70 | 100,00 % |
Le contrôle formel est indiscutable : 554,80 + 314,93 + 29,97 = 899,70. L’intégrité de la dispersion est préservée au centième près. Nous constatons que l’erreur résiduelle ne représente qu’une fraction minime (3,33 %) de la variance globale, ce qui présage d’un test statistique d’une puissance discriminante majeure.
9. Étape 5 : Détermination des degrés de liberté et calcul des carrés moyens
9.1 Calcul rigoureux des degrés de liberté pour chaque source de variation
Les sommes des carrés calculées précédemment ne constituent pas en elles-mêmes des variances non biaisées, car elles augmentent mécaniquement avec le nombre d’observations recueillies. Pour convertir une somme de carrés en une estimation non biaisée de la variance (désignée en statistique sous l’appellation de Carré Moyen ou MS pour « Mean Square »), il est nécessaire de diviser chaque somme de carrés par son nombre correspondant de degrés de liberté (notés df, pour « degrees of freedom »).
Les degrés de liberté représentent le nombre de dimensions indépendantes ou de valeurs libres de varier lors de l’estimation des paramètres. Déterminons rigoureusement les df associés à chacune de nos sources de variation :
- Degrés de liberté totaux (df_total) : Ils correspondent au nombre total d’observations moins une contrainte (la fixation de la grande moyenne) :
df_total = N – 1 = 15 – 1 = 14
- Degrés de liberté du traitement (df_traitement ou df_B) : Ils sont égaux au nombre de modalités du traitement expérimental diminué de un :
df_traitement = k – 1 = 3 – 1 = 2
- Degrés de liberté inter-sujets (df_sujets ou df_S) : Ils reflètent le nombre de participants moins un :
df_sujets = n – 1 = 5 – 1 = 4
- Degrés de liberté de l’erreur résiduelle (df_erreur ou df_E) : Ils dérivent géométriquement du produit des degrés de liberté du traitement et des sujets :
df_erreur = (k – 1) × (n – 1) = 2 × 4 = 8
9.2 Vérification de l’additivité des degrés de liberté
À l’instar de la partition des sommes des carrés, les degrés de liberté obéissent à un principe strict d’additivité arithmétique. Cette égalité mathématique découle de la décomposition orthogonale d’un espace vectoriel euclidien à N dimensions en sous-espaces non recouvrants :
df_total = df_traitement + df_sujets + df_erreur
Vérifions immédiatement cette relation avec nos grandeurs numériques :
14 = 2 + 4 + 8
L’égalité est parfaitement vérifiée (2 + 4 + 8 = 14). Cette congruence géométrique démontre que l’ensemble des dimensions de variation du système expérimental a été intégralement pris en compte. L’analyste s’assure ainsi qu’aucune liberté mathématique n’a été oubliée ou comptabilisée deux fois. Le volume de degrés de liberté dévolu à l’erreur (df_erreur = 8) jouera un rôle déterminant lors du positionnement de notre seuil critique dans les tables de probabilité.
9.3 Calcul des variances estimées ou carrés moyens (MS)
Le Carré Moyen s’obtient universellement en divisant la somme des carrés considérée par ses degrés de liberté respectifs : MS = SS / df. Procédons au calcul explicite des deux carrés moyens cardinaux qui entreront dans la formation de notre statistique de décision :
1. Carré Moyen du Traitement (MST ou MSB) : Il estime la variabilité induite par les médicaments en y associant la variabilité résiduelle :
MST = SSB / df_traitement = 554,80 / 2 = 277,40
2. Carré Moyen de l’Erreur (MSE) : Il fournit une estimation non biaisée de la variance de l’interaction sujet-traitement (le bruit résiduel) :
MSE = SSE / df_erreur = 29,97 / 8 = 3,746 (arrondi à 3,75)
Il convient de répondre ici à une interrogation conceptuelle majeure : pourquoi ne calcule-t-on pas de ratio de Fisher pour tester le Carré Moyen Inter-sujets (MSS = SSS / df_sujets = 314,93 / 4 = 78,73) ? Dans une ANOVA à mesures répétées standard à modèle fixe, les participants ne sont pas manipulés expérimentalement : ils constituent un facteur aléatoire dont on cherche uniquement à neutraliser l’effet. Le statisticien ne cherche pas à tester formellement si les patients diffèrent les uns des autres (ce qui est un truisme biologique admis d’avance), mais s’assure uniquement que cette variance a bien été retranchée du terme d’erreur MSE.
10. Étape 6 : Construction du ratio de Fisher F et prise de décision statistique
10.1 Calcul arithmétique du ratio F empirique
L’ensemble des étapes computationnelles exécutées jusqu’à présent converge vers l’obtention de la statistique décisionnelle finale : le ratio empirique de Fisher, universellement noté F. Sur le plan conceptuel, le ratio de Fisher représente un rapport signal sur bruit. Le numérateur (le signal) incarne la variabilité systématique engendrée par l’effet thérapeutique des molécules, tandis que le dénominateur (le bruit) mesure l’instabilité aléatoire résiduelle de la mesure :
F = MST / MSE
Substituons sans attendre les valeurs de nos carrés moyens calculés à l’étape précédente :
F = 277,40 / 3,746 = 74,05
La statistique F observée (ou empirique) s’élève à 74,05. Une telle magnitude numérique indique que la variance provoquée par la prise des différentes drogues est plus de 74 fois supérieure à la variance d’erreur pure résiduelle. C’est une valeur extraordinairement élevée dans le domaine des sciences cognitives, suggérant d’ores et déjà un effet expérimental massif.
10.2 Détermination de la valeur critique sur la table de Fisher-Snedecor
Pour statuer sur le sort de notre hypothèse nulle, nous devons comparer la valeur empirique F_observé = 74,05 à la valeur théorique maximale que le simple hasard de l’échantillonnage aurait pu produire au seuil de significativité conventionnel fixé à α = 0,05 (5 %). Cette borne théorique, désignée sous le terme de F critique (noté F_critique), se lit directement dans une table de distribution de Fisher-Snedecor standardisée en fonction d’un couple ordonné de degrés de liberté :
- Degrés de liberté du numérateur : df₁ = df_traitement = 2
- Degrés de liberté du dénominateur : df₂ = df_erreur = 8
En ouvrant une table statistique de Fisher au niveau de confiance de 95 % (α = 0,05), nous repérons l’intersection entre la colonne df₁ = 2 et la ligne df₂ = 8 :
F_critique(2, 8) au seuil α = 0,05 = 4,46
Si l’on désirait éprouver cette décision à un niveau de sévérité beaucoup plus exigeant, par exemple au seuil de α = 0,001 (un dixième de pour cent), la même table indique :
F_critique(2, 8) au seuil α = 0,001 = 18,49
10.3 Application de la règle de décision et conclusion formelle
La règle de décision statistique universelle de l’analyse de variance s’énonce de façon binaire et sans équivoque :
- Si F_observé ≤ F_critique : on échoue à rejeter l’hypothèse nulle (H₀ est conservée). On conclut à l’absence de différence statistiquement significative entre les traitements.
- Si F_observé > F_critique : on rejette formellement l’hypothèse nulle au profit de l’hypothèse alternative H₁. La différence observée est déclarée statistiquement significative.
Dans notre étude, la confrontation empirique est sans ambiguïté :
F_observé (74,05) >> F_critique au seuil 0,001 (18,49)
Par conséquent, nous rejetons formellement l’hypothèse nulle d’égalité des temps de réaction moyens sous les trois drogues à un niveau de confiance supérieur à 99,9 % (p < 0,001). Sur le plan substantiel et clinique, nous pouvons affirmer avec une certitude statistique absolue que la nature des molécules pharmacologiques administrées modifie de manière hautement significative la vitesse de traitement perceptivo-moteur des patients traumatisés crâniens.
11. Synthèse des résultats : Tableau d’ANOVA standardisé et taille d’effet
11.1 Élaboration du tableau récapitulatif d’ANOVA selon les normes académiques
La communication scientifique des résultats issus d’une analyse de variance manuelle obéit à des conventions typographiques et structurelles extrêmement strictes dictées par l’American Psychological Association (APA 7e édition). Il est d’usage d’ordonner l’intégralité des dérivations algébriques au sein d’un tableau synthétique d’ANOVA regroupant de gauche à droite : la Source de variation, la Somme des Carrés (SS), les Degrés de liberté (df), le Carré Moyen (MS), le ratio de Fisher (F) et la probabilité critique asymptotique (p-valeur).
Voici le tableau d’ANOVA canonique récapitulant notre démonstration complète :
| Source de Variation | Somme des Carrés (SS) | Degrés de Liberté (df) | Carré Moyen (MS) | F empirique | p |
|---|---|---|---|---|---|
| Traitement (Médicaments) | 554,80 | 2 | 277,40 | 74,05 | < 0,001 |
| Inter-sujets (Patients) | 314,93 | 4 | 78,73 | — | — |
| Erreur Résiduelle (Interaction) | 29,97 | 8 | 3,75 | — | — |
| Total Général | 899,70 | 14 | — | — | — |
Ce tableau constitue le document de référence attestant de la validité de l’épreuve. On remarque immédiatement l’absence de ratio F pour la ligne « Inter-sujets », en stricte conformité avec les impératifs méthodologiques que nous avons démontrés.
11.2 Calcul manuel de la taille de l’effet : l’éta-carré partiel
La simple déclaration d’une significativité statistique (p < 0,001) est aujourd’hui universellement considérée comme insuffisante dans la recherche scientifique. La valeur p dépend lourdement de la taille de l’échantillon et ne renseigne en rien sur l’amplitude pratique ou clinique de l’effet découvert. Il est donc indispensable d’accompagner le test F d’un indice quantifié de taille d’effet. Dans les plans à mesures répétées, l’estimateur de choix est l’éta-carré partiel, symbolisé par ηₚ² (partial eta-squared).
L’éta-carré partiel mesure la proportion de la variance dépendante attribuable au traitement une fois que la variance liée aux différences interindividuelles a été mathématiquement exclue du dénominateur. Sa formule algébrique manuelle s’exprime selon le rapport :
ηₚ² = SSB / (SSB + SSE)
Insérons immédiatement nos données numériques dans cette équation :
ηₚ² = 554,80 / (554,80 + 29,97) = 554,80 / 584,77 = 0,9487
L’éta-carré partiel calculé s’élève à ηₚ² = 0,95. Pour interpréter ce chiffre, nous nous référons aux seuils heuristiques conventionnels formulés par Jacob Cohen :
- Effet de faible amplitude : ηₚ² ≈ 0,01
- Effet d’amplitude moyenne : ηₚ² ≈ 0,06
- Effet d’amplitude forte : ηₚ² ≥ 0,14
Une taille d’effet de 0,95 indique que 95 % de la variance intra-sujets du temps de réaction est directement expliquée par la molécule pharmacologique injectée. C’est une taille d’effet exceptionnellement massive qui corrobore la portée majeure de l’intervention.
11.3 Rédaction formelle du paragraphe de résultats en psychologie
La publication de ces analyses dans une revue savante exige une rédaction conforme aux standards formels de l’APA. Les symboles mathématiques (F, p, M, SD, ηₚ²) doivent être systématiquement composés en italique, et les degrés de liberté indiqués entre parenthèses immédiatement après la lettre F. Voici le paragraphe type conforme aux attentes d’un comité de lecture scientifique :
« Une analyse de variance univariée à mesures répétées à un facteur (Médicament : A vs B vs C) a été menée sur les temps de réaction de détection visuelle chez cinq patients traumatisés crâniens. Les analyses descriptives révèlent une vitesse de réaction plus rapide sous la condition Médicament C (M = 18,20 cs ; SD = 3,35) comparativement au Médicament B (M = 30,80 cs ; SD = 5,22) et au Médicament A (M = 33,20 cs ; SD = 5,93). L’ANOVA à mesures répétées met en évidence un effet principal hautement significatif du traitement pharmacologique, F(2, 8) = 74,05, p < 0,001, ηₚ² = 0,95. Ce résultat confirme l’existence de divergences substantielles de vitesse de traitement cognitif en fonction des molécules administrées. »
12. Analyses post-hoc manuelles et ajustements méthodologiques avancés
12.1 Comparaisons multiples par paires avec correction de Bonferroni
La significativité globale du test F de l’ANOVA indique avec certitude qu’au moins deux conditions expérimentales diffèrent l’une de l’autre, mais elle n’identifie pas quelles paires spécifiques de traitements sont significativement contrastées. Pour résoudre cette question sans risquer une inflation incontrôlée de l’erreur de type I (due à la multiplication des tests d’hypothèses sur un même échantillon), le chercheur doit procéder à des analyses post-hoc manuelles assorties d’une correction conservatrice, telle que l’ajustement de Bonferroni.
Le nombre total de comparaisons possibles deux à deux entre nos k = 3 conditions s’élève à : c = k(k – 1) / 2 = 3(2) / 2 = 3 comparaisons (A vs B, A vs C, et B vs C). La procédure de Bonferroni impose d’ajuster le seuil de décision alpha nominal en le divisant par le nombre de contrastes exécutés :
α_ajusté = α_initial / c = 0,05 / 3 = 0,0167
Pour chaque paire de conditions, nous pouvons exécuter manuellement un test t de Student pour échantillons appariés. La statistique t appariée s’obtient par la formule :
t = (M₁ – M₂) / [ S_diff / √n ]
où S_diff représente l’écart-type empirique des différences individuelles calculées sujet par sujet entre les deux conditions. Pour la comparaison entre le Médicament A (M = 33,20) et le Médicament C (M = 18,20), la différence moyenne atteint 15,00 cs. L’erreur standard des différences pour cette paire s’élevant à 0,71, la statistique t empirique atteint : t(4) = 15,00 / 0,71 = 21,13. Comparé au seuil critique de la table de Student bilatérale avec 4 degrés de liberté pour un seuil ajusté de 0,0167 (t_critique ≈ 3,75), le contraste s’avère hautement significatif (p < 0,001). Le médicament C s’impose ainsi formellement comme supérieur au médicament A.
12.2 Correction de la violation de sphéricité : Greenhouse-Geisser et Huynh-Feldt
Comme explicité dans notre section consacrée aux postulats, l’inférence fondée sur la distribution classique F(2, 8) suppose le respect rigoureux de la sphéricité de la matrice de covariance. Si cette condition vient à être violée, le taux de faux positifs grimpe en flèche. Pour immuniser la décision contre ce péril sans renoncer au modèle, la statistique avancée recourt à l’estimation d’un coefficient multiplicateur d’aplatissement désigné par la lettre grecque epsilon (ε).
Ce coefficient quantifie le degré de non-sphéricité de la matrice : sa valeur oscille théoriquement entre une borne inférieure minimale correspondant au pire cas de violation :
ε_min = 1 / (k – 1) = 1 / (3 – 1) = 0,50
et une valeur maximale de 1,00, attestant d’une sphéricité idéale. Deux corrections majeures sont classiquement calculées :
- L’epsilon de Greenhouse-Geisser (ε_GG) : Très conservateur, recommandé dès que l’échantillon est réduit ou que la violation est marquée.
- L’epsilon de Huynh-Feldt (ε_HF) : Moins conservateur, appliquant une correction plus ajustée pour les échantillons modérés.
Supposons que le calcul matriciel de l’epsilon de Greenhouse-Geisser fournisse pour notre étude une valeur de ε = 0,72. L’ajustement méthodologique consiste non pas à modifier la statistique F_observé (qui reste immuablement égale à 74,05), mais à multiplier les degrés de liberté du numérateur et du dénominateur par cette fraction décimale :
df₁_ajusté = df_traitement × ε = 2 × 0,72 = 1,44
df₂_ajusté = df_erreur × ε = 8 × 0,72 = 5,76
Le chercheur évalue ensuite sa décision en consultant la table de Fisher pour des degrés de liberté fractionnaires F(1,44 ; 5,76). Le nouveau F critique s’élève légèrement à environ 5,80. Notre F empirique de 74,05 demeurant infiniment supérieur à ce seuil conservateur rehaussé, la conclusion d’un effet thérapeutique significatif demeure parfaitement robuste et inattaquable.
12.3 Synthèse méthodologique et recommandations pour la recherche empirique
L’accomplissement de ce parcours arithmétique intégral offre une perspective d’une clarté inégalable sur l’anatomie des données expérimentales. Il transforme une succession de boutons cliqués sur un logiciel en une vision claire de la dynamique des variances. La maîtrise de l’analyse manuelle arme le chercheur d’une intuition statistique critique : elle permet de déceler instantanément une incohérence numérique dans une publication, de juger de la pertinence d’un devis intra-sujet face à la dispersion interindividuelle attendue, et de saisir la réalité tangible qui se dissimule sous les sigles abstraits des logiciels.
Avant toute soumission de résultats pour publication dans le champ des sciences comportementales, nous recommandons de valider systématiquement les points d’ancrage suivants au moyen de notre aide-mémoire méthodologique :
- Contrôle de complétude : Vérifier l’absence totale de données manquantes dans la matrice brute du facteur répété.
- Contrebalancement empirique : S’assurer que l’ordre des conditions a fait l’objet d’une randomisation ou d’une alternance équilibrée en carré latin pour neutraliser les effets sériels.
- Inspection de la sphéricité : Vérifier l’indice epsilon et mentionner systématiquement les corrections de Greenhouse-Geisser si ε < 0,75.
- Bilan de dispersion : Confirmer l’additivité arithmétique rigoureuse des sommes des carrés (SST = SSB + SSS + SSE) et des degrés de liberté.
- Rapportage normé : Accompagner impérativement les tests de Fisher des moyennes, écarts-types, seuils p précis et indices de taille d’effet (ηₚ²).
Cette rigueur arithmétique et conceptuelle garantit la reproductibilité des inférences et constitue la véritable signature d’une démarche scientifique d’excellence.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Statistical-Power-Analysis-for-the-Behavioral-Sciences/Cohen/p/book/9780805802832
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning. https://www.cengage.com
- Huynh, H., & Feldt, L. S. (1976). Estimation of the box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- Kirk, R. E. (2013). Experimental design: Procedures for the behavioral sciences (4th ed.). SAGE Publications. https://dx.doi.org/10.4135/9781483384733
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731909
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson. https://www.pearson.com