
Dans le champ de la recherche quantitative contemporaine, particulièrement au sein des sciences psychologiques, cognitives et comportementales, l’intégrité empirique d’une étude repose invariablement sur la rigueur de sa phase descriptive préliminaire. L’avènement des modèles prédictifs complexes, des équations structurelles et des algorithmes d’apprentissage automatique a parfois relégué au second plan l’examen scrupuleux des distributions individuelles. Pourtant, faire l’économie d’une analyse univariée approfondie expose le chercheur à des biais d’interprétation majeurs, à des violations silencieuses des postulats mathématiques sous-jacents aux tests paramétriques, et ultimement, à la non-reproductibilité de ses conclusions. Le logiciel statistique open source R constitue à cet égard l’environnement computationnel le plus flexible et le plus exhaustif pour ausculter chaque dimension empirique avant toute tentative de modélisation inférentielle.
L’analyse univariée s’attache à décomposer, résumer et caractériser le comportement d’une variable isolée, sans chercher à établir dans l’immédiat de corrélations ou de liens de causalité avec d’autres mesures. En psychométrie, cette démarche s’avère décisive. Elle permet de confronter les données recueillies aux attentes théoriques formulées lors de la conception des instruments de mesure, qu’il s’agisse d’échelles d’attitudes, d’inventaires de personnalité, d’épreuves neuropsychologiques standardisées ou d’enregistrements chronométriques de temps de réaction. À travers l’estimation de la tendance centrale, l’évaluation de la dispersion et la modélisation de la morphologie distributionnelle, le praticien met au jour la réalité empirique du construit psychologique mesuré, tout en détectant les artefacts expérimentaux susceptibles de dénaturer les calculs ultérieurs.
Ce guide exhaustif a pour vocation de fournir aux chercheurs, aux doctorants et aux analystes de données un protocole méthodologique complet et opérationnel pour conduire une analyse univariée exemplaire dans R. Articulant socle théorique rigoureux, considérations épistémologiques et mise en œuvre programmatique détaillée, cet ouvrage didactique explore les indicateurs descriptifs classiques et robustes, les méthodes d’audit distributionnel, la visualisation graphique sous les systèmes de base et ggplot2, ainsi que la détection et la régulation des observations aberrantes. En clôture, une étude de cas clinique intégrale démontrera l’articulation séquentielle de ces outils, depuis le vecteur de données brutes jusqu’à la rédaction académique finale standardisée selon les normes de l’American Psychological Association (APA).
1. Fondements conceptuels et épistémologiques de l’analyse univariée en psychologie
1.1 Définition et rôle de l’analyse univariée dans la démarche scientifique
L’analyse univariée constitue le premier palier de l’exploration quantitative. Épistémologiquement, elle se définit comme l’étude statistique descriptive et inférentielle d’une seule variable aléatoire considérée de manière autonome. Contrairement aux approches bivariées ou multivariées, qui s’intéressent aux covariations, aux structures latentes ou aux dépendances conditionnelles, la perspective univariée isole le vecteur d’observations pour en comprendre les propriétés intrinsèques. Dans la démarche scientifique hypothético-déductive, cette étape n’est pas une simple formalité bureaucratique de prétraitement ; elle incarne un moment critique de corroboration empirique où le chercheur vérifie si l’instrument de mesure a fonctionné conformément aux attendus théoriques de son protocole expérimental.
Dans le domaine de la psychométrie et des neurosciences comportementales, l’importance préliminaire de l’analyse univariée dans le nettoyage et le contrôle de la qualité des données s’avère fondamentale. Avant de postuler l’existence d’un effet thérapeutique, d’une dissociation cognitive ou d’une corrélation entre deux traits de personnalité, il est indispensable de s’assurer que les scores collectés ne sont pas le produit d’erreurs d’encodage, de dysfonctionnements logiciels, d’un manque d’engagement des répondants ou d’artefacts d’échantillonnage. L’examen des fréquences, des valeurs minimales et maximales ainsi que des distributions de probabilité permet d’assainir la base de données avant que les erreurs initiales ne se propagent et ne se démultiplient au sein d’équations de régression ou de modèles factoriels complexes.
Il convient d’établir une distinction formelle stricte entre la statistique descriptive univariée et la modélisation statistique inférentielle. Si la première vise à synthétiser l’information contenue dans l’échantillon par des indicateurs de position et de dispersion sans postuler de structure causale, elle constitue néanmoins le socle indispensable à la seconde. En effet, les tests d’hypothèses inférentiels classiques, tels que le test t de Student, l’analyse de variance univariée (ANOVA) ou la régression linéaire ordinaire des moindres carrés, reposent sur des postulats distributionnels précis, au premier rang desquels figure la normalité des résidus. L’analyse univariée permet de tester ces prérequis en amont et de déterminer si les données nécessitent des transformations mathématiques, l’usage de statistiques robustes ou le recours à des cadres d’inférence non paramétriques.
1.2 Taxonomie des variables psychologiques et échelles de mesure de Stevens
Toute manipulation statistique dans l’environnement R exige une compréhension sans faille de la nature mathématique des données traitées. En 1946, le psychologue Stanley Smith Stevens a introduit une typologie fondatrice distinguant quatre niveaux d’échelles de mesure : nominale, ordinale, d’intervalle et de rapport. Cette taxonomie conditionne de manière absolue la légitimité des opérations arithmétiques autorisées et guide le choix des fonctions R à mobiliser. Les variables nominales représentent le niveau métrologique le plus élémentaire, caractérisé par des classes qualitatives mutuellement exclusives et exhaustives, sans hiérarchie sous-jacente. En psychologie, elles renvoient typiquement aux catégorisations nosographiques (par exemple, diagnostic de trouble dépressif majeur versus trouble anxieux généralisé versus groupe témoin), aux typologies de personnalité ou au codage binaire du genre et des conditions expérimentales. Dans R, ces grandeurs sont implémentées via le type factor, où les seules opérations valides sont le dénombrement et le calcul de proportions.
Les variables ordinales introduisent une relation d’ordre ou de rang entre les modalités, bien que la distance psychologique ou quantitative séparant deux échelons successifs demeure inconnue ou non constante. L’archétype en psychométrie réside dans les échelles de Likert à 5 ou 7 points, abondamment utilisées pour évaluer le degré d’accord face à des assertions psychologiques, ainsi que dans les stades de développement piagétiens ou les classements d’aptitude scolaire. Bien qu’une pratique courante mais controversée assimile les scores de Likert à des données continues, leur nature fondamentale impose sur le plan univarié une modélisation par des facteurs ordonnés (ordered factor dans R), privilégiant la médiane et les percentiles au détriment de la moyenne arithmétique.
Les variables d’intervalle et de rapport atteignent le statut de mesures quantitatives continues ou pseudo-continues. L’échelle d’intervalle se caractérise par des écarts constants et numériquement égaux entre les unités de mesure, mais dispose d’un zéro arbitraire, défini par convention sociotechnique plutôt que par une absence physique du phénomène. Les scores composites issus de questionnaires standardisés, les indices d’intelligence globale (QI standardisé avec une moyenne théorique de 100 et un écart-type de 15) et les températures en degrés Celsius illustrent ce niveau. L’échelle de rapport, quant à elle, possède un zéro absolu et non arbitraire, signifiant l’absence totale de la propriété physique mesurée. Les temps de réaction cognitifs enregistrés en millisecondes, la conductance cutanée, la fréquence cardiaque ou le taux de cortisol salivaire relèvent de cette échelle. Dans ces deux derniers cas, l’ensemble des opérations arithmétiques est autorisé, ouvrant la voie au calcul sans restriction de la moyenne, de la variance et des moments d’ordre supérieur dans R.
1.3 Objectifs clés : tendance centrale, dispersion et morphologie distributionnelle
La conduite d’une analyse univariée méthodique poursuit trois finalités analytiques complémentaires : l’identification de la tendance centrale, la caractérisation de la dispersion et la cartographie de la morphologie distributionnelle. L’évaluation de la tendance centrale vise à localiser le centre de gravité empirique des observations au sein de l’espace des réponses possibles. En psychologie différentielle, cette valeur résume la performance typique ou l’état symptomatique moyen d’une population cible soumise à une épreuve d’évaluation, offrant un point d’ancrage normatif indispensable à l’interprétation individuelle ultérieure.
Toutefois, localiser le centre d’une distribution demeure vain sans une mesure précise de son étalement. La quantification de la dispersion répond à cet impératif en évaluant le degré d’hétérogénéité individuelle existant au sein de la cohorte d’étude. Deux groupes de patients peuvent présenter un score moyen rigoureusement identique sur une échelle d’anxiété clinique tout en manifestant des profils radicalement différents : le premier groupe peut être constitué d’individus présentant des réponses homogènes regroupées autour de la valeur centrale, tandis que le second réunit des profils polarisés aux extrémités de l’instrument. La mesure de la variabilité informe le chercheur sur la représentativité de l’indicateur de tendance centrale et sur la précision intrinsèque de la mesure.
Enfin, l’exploration de la morphologie distributionnelle dépasse les simples résumés scalaires de position et d’échelle pour s’intéresser à la forme géométrique de la fonction de densité sous-jacente. Elle s’articule autour de l’évaluation de l’asymétrie (ou skewness) et de l’aplatissement (ou kurtosis). Cette analyse morphologique permet d’appréhender des phénomènes psychologiques cruciaux tels que les effets de plafond (saturation des scores vers les valeurs maximales révélant un test trop facile ou sous-évaluant la pathologie) ou les effets de plancher (concentration des scores au plancher théorique de l’instrument). De plus, l’observation d’une forme non unimodale met précocement en lumière l’existence de sous-populations latentes au sein d’un échantillon présumé homogène, signalant par exemple qu’un essai clinique a recruté conjointement des répondeurs et des non-répondeurs biologiques à une psychothérapie.
2. Préparation de l’environnement R et structuration des données psychométriques
2.1 Configuration de l’environnement R et des bibliothèques spécialisées
L’amorce d’une analyse univariée reproductible exige une configuration minutieuse du poste de travail informatique sous R. Pour répondre aux exigences des protocoles en sciences cognitives, il convient d’associer le moteur natif de R aux bibliothèques spécialisées reconnues par la communauté internationale. L’écosystème tidyverse fournit les outils fondamentaux de manipulation de données et de visualisation avancée, tandis que la bibliothèque psych, développée spécifiquement par William Revelle pour les psychométriciens, apporte un ensemble exhaustif d’algorithmes descriptifs calibrés pour les questionnaires psychologiques. Parallèlement, les packages moments et car s’avèrent indispensables pour l’extraction mathématique précise des moments distributionnels et l’évaluation de l’adéquation aux modèles gaussiens.
L’optimisation des options globales d’affichage dans la console R constitue une bonne pratique pour faciliter l’audit des données. L’ajustement du paramètre de précision numérique via l’instruction options(digits = 4, scipen = 999) permet d’éviter l’affichage systématique de la notation scientifique pour les petits nombres, rendant les coefficients d’asymétrie et les valeurs de dispersion immédiatement lisibles. En outre, la science ouverte imposant une traçabilité intégrale des chaînes de traitement, la fixation d’une graine aléatoire à l’aide de la fonction set.seed() est impérative dès lors que des procédures de rééchantillonnage (bootstrap) ou des simulations sont intégrées à la démarche descriptive.
Sur le plan organisationnel, l’analyste structurera son répertoire de travail au moyen d’un projet RStudio autonome, doté d’une architecture arborescente standardisée comprenant un dossier réservé aux données brutes en lecture seule (data/raw), un dossier pour les scripts d’analyse séquentiels (scripts), et un dossier dédié aux sorties tabulaires et iconographiques (output/figures). Cette rigueur évite l’usage proscrit de chemins absolus (tels que setwd("C:/Users/...")) et garantit que le pipeline analytique univarié demeure exécutable à l’identique sur n’importe quel système d’exploitation.
2.2 Importation et vérification de l’intégrité des vecteurs de données
Les données psychologiques proviennent majoritairement de plateformes de passation en ligne (Qualtrics, Gorilla, Pavlovia) ou de logiciels d’expérimentation cognitive locale (PsychoPy, E-Prime). L’importation de ces fichiers tabulaires (au format CSV ou TSV) via les fonctions de lecture du package readr (comme read_csv()) constitue une étape délicate où la structure des colonnes doit être immédiatement assainie. R procède à une inférence automatique des types qui peut générer des ambiguïtés néfastes, notamment en interprétant une variable d’identification numérique (numéro de participant) comme une grandeur arithmétique continue.
Le typage explicite et rigoureux des vecteurs constitue le préalable à tout traitement univarié. Les colonnes correspondant à des modalités catégorielles doivent être converties sans équivoque en facteurs nominaux via la fonction factor(), en veillant à expliciter la nomenclature des niveaux (levels et labels). Pour les réponses issues d’items de type Likert, la conversion sous forme de facteur ordonné à l’aide de l’instruction ordered() ou factor(..., ordered = TRUE) informe explicitement les algorithmes sous-jacents de la hiérarchie intrinsèque des catégories de réponse. Inversement, les grandeurs continues (latences d’attention, chronométrie, indices biologiques) requièrent un cast formel en vecteurs de type numeric ou double.
L’audit dimensionnel préliminaire repose sur l’exécution conjointe des primitives length(), str() et summary(). L’inspection des types rapportés par str() prévient les erreurs de saisie sournoises, telles que la présence d’un caractère textuel isolé au sein d’une colonne de scores numériques, ce qui contraindrait R à convertir l’intégralité du vecteur en chaîne de caractères (character). La fonction summary() fournit quant à elle un premier aperçu des bornes empiriques, permettant de vérifier si les valeurs minimales et maximales observées demeurent strictement confinées dans l’espace théorique admissible de l’instrument psychométrique administré.
2.3 Gestion univariée des données manquantes en psychométrie
La complétude des jeux de données constitue une rareté dans l’investigation du comportement humain. La lassitude des sujets, les erreurs de transmission télématique ou les refus délibérés de répondre à des items sensibles (touchant à la sexualité, aux traumatismes ou aux addictions) engendrent des valeurs manquantes. Dans l’écosystème R, ces omissions sont représentées par la constante logique NA (Not Available). La quantification précise du taux de non-réponse univarié s’opère par la combinaison des fonctions is.na(), sum() et mean(), cette dernière fournissant instantanément le ratio proportionnel d’omissions au sein du vecteur considéré.
Sur le plan théorique, il est fondamental de rattacher ces manques à la typologie de Donald Rubin : données manquantes totalement au hasard (Missing Completely At Random, MCAR), manquantes au hasard (Missing At Random, MAR) ou manquantes de manière non aléatoire (Missing Not At Random, MNAR). Si l’identification formelle de ces mécanismes relève de modélisations multivariées, l’analyse univariée fournit des indices critiques. Un item de personnalité affichant un taux inhabituel d’omissions (par exemple 25 % de NA par rapport à une moyenne de 2 % sur le reste du test) traduit fréquemment un phénomène MNAR où la formulation même de l’énoncé suscite l’évitement actif des participants les plus en détresse, signalant un problème métrologique inhérent au stimulus.
Dans la programmation R, les fonctions statistiques primitives appliquent un principe de précaution strict : en présence d’une seule valeur NA, des fonctions telles que mean(), sd() ou median() renvoient par défaut NA. L’analyste doit expliciter l’argument na.rm = TRUE pour instruire la fonction d’omettre les données manquantes lors du calcul. Cependant, cette commande technique ne doit pas masquer les implications méthodologiques de l’omission. Une élimination non contrôlée des NA au niveau univarié réduit la taille d’échantillon effective et peut biaiser drastiquement l’estimation de la moyenne si les omissions sont de type MNAR, menaçant la représentativité externe de l’échantillon clinique.
3. Mesures de la tendance centrale dans R : Théorie et programmation
3.1 Calcul et propriétés de la moyenne arithmétique
La moyenne arithmétique constitue la mesure de tendance centrale la plus universellement employée pour les variables quantitatives continues. Mathématiquement définie comme la somme de l’ensemble des observations divisée par le nombre total de cas, elle représente le centre d’inertie physique du système de points. Dans le logiciel R, son implémentation s’effectue au moyen de la commande mean(x, na.rm = FALSE). Lorsque les distributions sont rigoureusement symétriques et unimodales, la moyenne offre des propriétés d’optimalité statistique majeures : elle constitue l’estimateur sans biais le plus efficace de la moyenne de la population sous l’hypothèse de normalité.
Néanmoins, la vulnérabilité de la moyenne face aux perturbations extrêmes constitue son principal écueil en neuropsychologie et en psychopathologie. Son point de rupture (breakdown point) théorique est de 0 %, ce qui signifie qu’une unique observation atypique (par exemple un temps de réaction pathologique de 30 secondes au milieu d’essais chronométrés à 400 millisecondes) suffit à déplacer arbitrairement la moyenne vers des valeurs qui ne représentent plus la performance de l’échantillon. Pour pallier cette instabilité sans abandonner l’intérêt arithmétique de la moyenne, R intègre le calcul de la moyenne tronquée via le paramètre trim de la fonction mean(). En spécifiant mean(x, trim = 0.1), le logiciel retranche les 10 % des scores les plus faibles et les 10 % les plus élevés avant de calculer la moyenne sur les 80 % résiduels, neutralisant ainsi l’impact des artefacts de mesure.
Dans le cas d’analyses psychométriques avancées, la moyenne arithmétique simple peut être enrichie par le calcul de moyennes pondérées au moyen de la commande weighted.mean(x, w). Dans ce cadre, chaque observation ou score d’item est affecté d’un coefficient de pondération w proportionnel à sa fidélité métrologique ou à la précision de son estimation (inverse de l’erreur-type de mesure). Cette procédure garantit que les items les plus fiables ou les participants évalués avec la plus grande précision méthodologique pèsent de manière prépondérante dans la détermination du centre de gravité du construit mesuré.
3.2 Détermination de la médiane : La statistique robuste par excellence
La médiane incarne la statistique robuste par excellence pour capturer le centre d’une distribution sans subir la distorsion induite par l’asymétrie ou les valeurs aberrantes. Définie comme le point séparant la distribution ordonnée des scores en deux moitiés équiprobables, elle correspond exactement au cinquantième percentile ($P_{50}$). Son point de rupture atteint 50 %, ce qui implique qu’il faudrait contaminer la moitié des observations d’un échantillon pour altérer de manière incontrôlée la médiane. Dans R, son calcul s’exécute nativement par la commande median(x, na.rm = FALSE).
Sur le plan géométrique et fonctionnel, la médiane minimise la somme des écarts absolus par rapport au centre, alors que la moyenne minimise la somme des carrés de ces écarts. Dès lors que la variable mesurée suit une loi asymétrique — configuration omniprésente en psychologie cognitive lors du recueil des latences de réponse ou en psychiatrie épidémiologique lors du dénombrement des comportements d’auto-mutilation — la médiane fournit une description infiniment plus fidèle de la tendance centrale que la moyenne. La divergence entre la moyenne et la médiane sert d’ailleurs de signal d’alarme heuristique quant au niveau d’asymétrie de la série de données.
Dans le contexte des échelles de mesure ordinales discrètes (telles que les échelles composites d’évaluation de la douleur ou les scores totaux à des sous-échelles de stress perçu), la médiane constitue l’indicateur de position méthodologiquement irréprochable. Pour certaines applications psychométriques fines, les chercheurs recourent à l’interpolation de la médiane pour corriger la nature discontinue des échelons de réponse, estimant de manière probabiliste où se situerait le basculement médian au sein de l’intervalle continu sous-jacent à la graduation ordinale discrète.
3.3 Extraction du mode pour variables catégorielles et discrètes
Le mode correspond à la valeur ou à la modalité empirique la plus fréquemment observée au sein d’une distribution. Il représente la seule mesure de tendance centrale théoriquement applicable à l’ensemble des échelles de Stevens, y compris les variables nominales qualitatives pures. De manière surprenante pour les néophytes, le langage R ne possède pas de fonction primitive mode() dédiée à cette extraction statistique (la fonction native mode() dans R renvoie le mode de stockage d’un objet en mémoire interne, tel que numeric ou character). L’analyste doit donc programmer une fonction ad hoc pour identifier l’élément dominant.
Une implémentation robuste de cette extraction consiste à exploiter la commande table(), qui dénombre les occurrences de chaque valeur, puis à localiser l’indice maximal au moyen de la fonction which.max(). Une fonction R standardisée s’écrit de la façon suivante : get_mode <- function(v) { uniqv <- unique(na.omit(v)); uniqv[which.max(tabulate(match(v, uniqv)))] }. Cette approche vectorielle présente l’avantage d’une exécution computationnelle rapide, y compris sur des cohortes massives de plusieurs dizaines de milliers d’enregistrements comportementaux.
L’évaluation du mode en psychologie revêt une portée clinique cruciale lors de l’étude de profils bivariés ou multimodaux. Une distribution révélant deux modes disjoints (distribution bimodale) trahit fréquemment la coexistence de deux populations distinctes au sein du groupe étudié (par exemple, des patients en rémission clinique versus des patients en phase de décompensation aiguë). L’examen de la commande table(x) couplée à sort(..., decreasing = TRUE) permet d’extraire la modalité dominante et d’évaluer l’écart de fréquence séparant le premier mode des modes secondaires, guidant l’interprétation diagnostique des bilans psychologiques.
4. Quantification de la dispersion et de la variabilité des réponses
4.1 Étendue empirique et étendue interquartile (IQR)
La caractérisation d’une distribution exige d’apprécier son étalement. L’indicateur le plus immédiat est l’étendue empirique, calculée par la soustraction de la valeur minimale à la valeur maximale : $\text{Étendue} = x_{\max} – x_{\min}$. Dans R, la commande range(x) renvoie un vecteur contenant le minimum et le maximum, permettant de calculer l’étendue par l’instruction diff(range(x, na.rm = TRUE)). Bien que cette mesure fournisse une délimitation spatiale claire de l’espace empirique couvert, elle s’avère excessivement sensible aux valeurs extrêmes et dépend fortement de la taille de l’échantillon, s’élargissant mécaniquement lorsque $n$ croît.
Pour s’affranchir de cette fragilité, la métrologie différentielle privilégie l’étendue interquartile (IQR pour Interquartile Range). L’IQR mesure la distance séparant le troisième quartile ($Q_3$, 75e percentile) du premier quartile ($Q_1$, 25e percentile), isolant ainsi les 50 % centraux de la population autour de la médiane. Dans R, l’appel à la fonction IQR(x, na.rm = TRUE) effectue directement cette soustraction. En divisant l’IQR par deux, on obtient l’écart semi-interquartile, un paramètre de dispersion particulièrement prisé en psychométrie différentielle pour comparer l’étalement de groupes dont les distributions violent l’hypothèse de normalité.
Un aspect méthodologique fondamental sous R réside dans le calcul des quantiles via la fonction quantile(x, probs). Le logiciel propose neuf algorithmes distincts de calcul, paramétrés par l’argument type (allant de 1 à 9). Par défaut, R utilise type = 7, qui applique une fonction de répartition continue linéaire standard adaptée aux modèles continus généraux. En revanche, le progiciel SPSS recourt classiquement à l’algorithme type = 6, tandis que les statisticiens recommandent fréquemment type = 8 pour obtenir des estimations de quantiles exemptes de biais quelle que soit la forme de la distribution sous-jacente. L’explicitation de cet argument garantit une stricte reproductibilité inter-logiciels.
4.2 Variance et écart-type de l’échantillon
La variance et son extension linéaire, l’écart-type, constituent les métriques paramétriques reines de la dispersion. La variance représente la moyenne des carrés des écarts des observations à la moyenne arithmétique. Lorsque cette grandeur est estimée à partir d’un échantillon fini de taille $n$ dans le dessein d’inférer la variance de la population parente, la somme des carrés doit être divisée par $n – 1$ et non par $n$. Cette minoration du dénominateur, connue sous le nom de correction de Bessel, neutralise le biais d’échantillonnage qui tendrait à sous-estimer systématiquement la variabilité de la population. Dans l’environnement R, les fonctions primitives var(x) et sd(x) intègrent par défaut cette correction de Bessel en divisant la somme des déviations quadratiques par les degrés de liberté résiduels ($df = n – 1$).
L’écart-type s’obtient en extrayant la racine carrée de la variance, ce qui permet de rétablir une métrique exprimée dans l’unité physique originale de la variable psychologique mesurée. Dans le cadre d’un modèle gaussien théorique, l’écart-type régit la répartition probabiliste des cas : environ 68,26 % des observations se situent dans l’intervalle $[M – SD, M + SD]$, 95,44 % dans $[M – 2SD, M + 2SD]$ et 99,74 % dans $[M – 3SD, M + 3SD]$. En recherche clinique, une diminution de l’écart-type au sein d’un groupe expérimental post-intervention traduit une homogénéisation des réponses individuelles, signe potentiel de l’efficacité standardisée d’une remédiation cognitive.
Cependant, à l’instar de la moyenne, l’écart-type souffre d’une sensibilité exacerbée face aux valeurs extrêmes en raison de l’élévation au carré des écarts. Dans le contexte de distributions psychologiques leptokurtiques ou parasitées par des erreurs de mesure, l’écart-type se gonfle artificiellement, ce qui entraîne une sous-estimation dramatique de la taille d’effet statistique dans les tests inférentiels ultérieurs. Cette sensibilité impose d’associer systématiquement à l’écart-type des indicateurs de variabilité robustes.
4.3 Coefficient de variation et écart absolu médian (MAD)
La comparaison directe de la dispersion entre plusieurs épreuves psychométriques se heurte souvent à la non-commensurabilité des échelles de mesure. L’évaluation de la variabilité d’une tâche de temps de réaction (exprimée en millisecondes, avec un ordre de grandeur de plusieurs centaines d’unités) ne peut être confrontée à celle d’une échelle de dépression bornée entre 0 et 63 sans normalisation. Le coefficient de variation (CV) résout cette contrainte en exprimant l’écart-type sous la forme d’un pourcentage de la moyenne arithmétique : $\text{CV} = (SD / M) \times 100$. Programmable dans R via l’instruction simple (sd(x, na.rm = TRUE) / mean(x, na.rm = TRUE)) * 100, le CV constitue un indice sans dimension particulièrement adapté pour comparer l’instabilité motrice ou cognitive entre différents groupes de patients.
Sur le versant non paramétrique et robuste, l’écart absolu médian (MAD pour Median Absolute Deviation) représente l’analogue direct de l’écart-type pour les distributions réfractaires à la normalité. Mathématiquement, le MAD est calculé en déterminant d’abord la médiane de la série, puis en calculant les écarts absolus de chaque score par rapport à cette médiane, et enfin en extrayant la médiane de ces écarts absolus : $\text{MAD} = \text{médiane}(|x_i – \text{médiane}(x)|)$. R propose pour cela la commande native mad(x, na.rm = TRUE).
Par défaut, la fonction mad() de R applique un facteur de correction multiplicatif constant égal à 1,4826 (paramètre constant = 1.4826). Ce coefficient assure une consistance asymptotique avec l’écart-type paramétrique lorsque la distribution sous-jacente est parfaitement normale, ce qui signifie que sous l’hypothèse de normalité, $SD \approx MAD$. En neuropsychologie expérimentale, l’usage du MAD est largement préconisé par rapport à l’écart-type pour normaliser les latences attentionnelles ou filtrer les temps de réponse pathologiques, car sa résistance à la contamination distributionnelle préserve l’estimation de l’échelle des fluctuations individuelles authentiques.
5. Analyse de la forme de la distribution : Asymétrie et aplatissement
5.1 Évaluation du coefficient d’asymétrie (Skewness)
L’asymétrie (ou skewness) formalise le troisième moment centré de la distribution. Elle quantifie le degré d’écart géométrique par rapport à une répartition parfaitement symétrique autour de son centre. Dans une distribution théorique gaussienne, le coefficient de skewness est rigoureusement nul. Lorsque les observations s’étirent le long d’une longue traîne vers les valeurs positives élevées, la distribution présente une asymétrie positive (vers la droite), configuration dans laquelle la moyenne arithmétique se retrouve supérieure à la médiane. Inversement, lorsque la queue s’étire vers les valeurs négatives ou faibles, l’asymétrie est qualifiée de négative (vers la gauche), et la moyenne est alors inférieure à la médiane.
Pour mesurer ce paramètre dans R, l’environnement de base s’avérant insuffisant, les chercheurs font appel au package moments via la fonction skewness(x, na.rm = TRUE), ou au package psych via la fonction skew(x). Cette dernière applique des corrections adaptées aux petits échantillons ($n < 50$), évitant la sous-estimation systématique du troisième moment empirique. Dans les diagnostics cliniques, une asymétrie positive marquée est structurellement attendue dans les populations tout-venant évaluées sur des échelles psychopathologiques (telles que le BDI-II ou l'inventaire d'anxiété de Beck), la vaste majorité des individus sains obtenant un score nul ou minimal, ce qui engendre un effet de plancher massif.
L’interprétation clinique et méthodologique de ce coefficient s’appuie sur des seuils de tolérance formalisés par la littérature psychométrique contemporaine, notamment les travaux fondateurs de West, Finch et Curran (1995). Un coefficient d’asymétrie compris entre -1 et +1 est généralement considéré comme indicateur d’une distribution quasi-symétrique n’altérant pas gravement les performances des tests paramétriques. En revanche, un indice excédant $|2|$ reflète une déformation sévère imposant le rejet formel des procédures reposant sur le postulat de normalité des scores bruts.
5.2 Évaluation du coefficient d’aplatissement (Kurtosis)
L’aplatissement (ou kurtosis) constitue le quatrième moment centré normalisé d’une distribution statistique. Il évalue simultanément la concentration relative des scores autour du centre de gravité et l’épaisseur de ses queues distributionnelles, déterminant ainsi la propension de la variable à produire des événements extrêmes ou rares. Trois morphologies distinctes caractérisent cette dimension : la distribution mésokurtique (calibrée sur la loi normale théorique), la distribution leptokurtique (caractérisée par un pic central très aiguisé et des queues épaisses abritant une fréquence élevée de valeurs atypiques) et la distribution platykurtique (présentant un sommet aplati et des queues écourtées reflétant une dispersion uniforme sans agglomération centrale marquée).
Dans l’écosystème R, la fonction kurtosis() issue de la bibliothèque moments retourne la valeur brute du quatrième moment, qui s’élève exactement à 3 pour une distribution normale idéale. Afin de simplifier les interprétations, les psychométriciens préfèrent fréquemment raisonner en termes d’excès de kurtosis, calculé en soustrayant 3 à la valeur brute : $\text{Excès} = \text{Kurtosis} – 3$. De son côté, la bibliothèque psych avec la commande kosi(x) ou dans ses rapports synthétiques reporte nativement cet excès centré sur zéro. Un excès positif traduit une leptokurticité, tandis qu’un excès négatif signale une platykurticité.
L’impact de l’épaisseur des queues de distribution s’avère déterminant lors de l’étude des fonctions exécutives ou de l’attention soutenue. Dans ces tâches, des queues leptokurtiques dénotent des lapsus attentionnels intermittents chez des patients souffrant de troubles neurodéveloppementaux. D’après les conventions méthodologiques de West et al. (1995), une valeur d’excès de kurtosis excédant une magnitude absolue de $|7|$ indique un écart pathologique par rapport au modèle gaussien, susceptible de déstabiliser les estimations des matrices de covariance au sein des modélisations par équations structurelles.
5.3 Synthèse univariée globale avec psych::describe()
Pour s’extraire de l’appel dispersé à de multiples fonctions isolées, les méthodologues plébiscitent l’utilisation de fonctions de synthèse intégrées capables de générer un diagnostic morphologique complet en une seule opération computationnelle. La fonction describe() issue du package psych s’impose comme la référence internationale incontestée dans la recherche comportementale. En soumettant un vecteur ou un tableau de données à l’instruction psych::describe(x), l’utilisateur obtient simultanément une table analytique dense regroupant le nombre d’observations valides ($n$), la moyenne arithmétique, l’écart-type, la médiane, la moyenne tronquée à 10 %, l’écart absolu médian (MAD), le minimum, le maximum, l’étendue, le skewness, le kurtosis ainsi que l’erreur-type de la moyenne ($SE$).
La lecture critique de cette sortie repose sur la confrontation croisée des métriques. L’écart séparant la moyenne (mean) de la moyenne tronquée (trimmed) et de la médiane (median) permet d’estimer instantanément l’asymétrie sans calcul formel. De surcroît, le ratio entre l’écart-type standard (sd) et l’écart absolu médian (mad) agit comme un révélateur d’hétéroscédasticité ou de contamination extrême : dans une population purement gaussienne, leur rapport est voisin de 1 ; un écart-type substantiellement plus grand que le MAD traduit l’existence de cas aberrants tirant la dispersion vers le haut.
Sur le plan de l’automatisation, la structure de sortie générée par describe() est un objet de type data.frame immédiatement indexable et manipulable par les tuyaux de traitement de données (pipes de magrittr ou natifs |>). L’analyste peut ainsi extraire sélectivement les coefficients morphologiques vers des générateurs de tableaux formatés pour publication scientifique, instaurant un audit statistique fluide et entièrement automatisé des écarts au modèle gaussien.
6. Construction et interprétation des tables de fréquences
6.1 Fréquences absolues simples et croisées au niveau univarié
L’analyse univariée des variables catégorielles qualitatives ou ordinales discrètes repose en premier lieu sur l’établissement des tables de fréquences absolues, qui dénombrent le nombre d’occurrences associées à chaque modalité distincte du vecteur. Dans R de base, la commande primitive table() remplit cet office avec une grande sobriété syntaxique. L’appel table(x) retourne une série tabulaire énumérant les modalités présentes et leur effectif empirique respectif ($n_i$).
Une précaution méthodologique indispensable concerne la gestion des non-réponses au sein de ces dénombrements. Par défaut, la fonction table() ignore silencieusement les observations manquantes, ce qui engendre un risque d’occultation du taux de défection des sujets. L’analyste rigoureux doit systématiquement armer la commande de l’argument d’inclusion explicite : table(x, useNA = "always") ou table(x, useNA = "ifany"). Cette syntaxe force l’affichage d’une classe dédiée aux NA, assurant que la somme arithmétique des effectifs égale parfaitement la taille totale de l’échantillon recruté ($N$).
Pour faciliter l’interprétation diagnostique de catégories nominales complexes comptant de nombreuses modalités (par exemple l’inventaire des sous-diagnostics psychiatriques), l’objet tabulaire peut être réordonné de manière décroissante au moyen de la fonction sort(table(x), decreasing = TRUE). Pour une intégration fluide dans des chaînes de traitement modernes, l’objet issu de table() gagne à être converti en une structure tabulaire explicite via l’instruction as.data.frame(table(x)) ou tibble::as_tibble(), renommant les colonnes résultantes en Modalité et Effectif pour préparer l’édition des manuscrits.
6.2 Calcul des fréquences relatives et des pourcentages
Si les effectifs bruts informent sur la puissance statistique locale de chaque classe, ils interdisent la comparaison directe entre études comportant des tailles d’échantillons hétérogènes. La conversion en fréquences relatives (ou proportions) s’avère indispensable. Dans le langage R, cette opération s’exécute par l’application de la fonction prop.table() appliquée directement à l’objet tabulaire préalable : prop.table(table(x)). Chaque case exprime alors le ratio empirique $p_i = n_i / N$, borné entre 0 et 1, dont la somme des composantes est rigoureusement égale à l’unité.
Pour les besoins de la communication scientifique, la conversion en pourcentages stricts arrondis s’obtient en multipliant ces proportions par 100 et en appliquant un contrôle d’arrondi décimal à l’aide de la fonction round(). L’expression combinée round(prop.table(table(x)) * 100, digits = 2) fournit des métriques conformes aux exigences éditoriales des revues internationales de psychologie régies par les normes APA. Ces chiffres permettent de documenter précisément les caractéristiques sociodémographiques ou épidémiologiques d’une cohorte.
Toutefois, une réserve épistémologique majeure doit être rappelée quant à l’interprétation de ces pourcentages face à des cohortes de petite taille ($N < 30$). Dans ces configurations fréquentes en neuropsychologie clinique des lésions rares, rapporter un pourcentage avec deux décimales introduit une illusion de précision métrologique trompeuse (par exemple affirmer que « 33,33 % des patients présentent une aphasie », alors que le phénomène concerne un individu sur un groupe de trois). L'analyste doit veiller à rapporter conjointement l'effectif brut et la proportion pour préserver la transparence descriptive.
6.3 Fréquences cumulées et distribution des percentiles
Dès lors que la variable traitée présente un niveau de mesure au moins ordinal, la sommation progressive des effectifs le long de l’échelle hiérarchisée enrichit la compréhension du phénomène. Les fréquences cumulées absolues et relatives se programment aisément dans R en imbriquant la commande vectorielle cumsum() sur les sorties de comptage : cumsum(table(x)) pour les effectifs cumulés, et cumsum(prop.table(table(x))) * 100 pour les pourcentages cumulés. Cette distribution cumulée retrace la trajectoire d’accumulation des individus à mesure que l’on progresse vers les niveaux de sévérité ou d’intensité supérieurs.
Sur le plan mathématique, cette démarche équivaut à estimer la fonction de répartition empirique (notée $F_n(t)$), que l’on peut générer directement dans R sous forme fonctionnelle continue au moyen de la commande ecdf(x). Cette fonction de distribution empirique constitue le mécanisme de référence pour la standardisation des instruments psychométriques et l’établissement des étalonnages en rangs percentiles. Un score brut individuel inséré dans ecdf(x)(score) renvoie instantanément son rang percentile au sein de la cohorte normative de référence.
L’exploitation pratique des fréquences cumulées s’avère particulièrement stratégique lors du dépistage psychologique fondé sur des seuils critiques d’alerte (cut-off scores). La lecture directe du pourcentage cumulé associé au seuil clinique permet d’évaluer la proportion exacte de participants se situant sous le seuil de significativité pathologique versus la proportion basculant dans la zone de vulnérabilité clinique, guidant l’orientation des politiques préventives ou le calibrage des critères d’inclusion dans les essais thérapeutiques.
7. Visualisation univariée avec les graphiques de base dans R (Base R)
7.1 L’histogramme fondamental : Paramétrage et interprétation
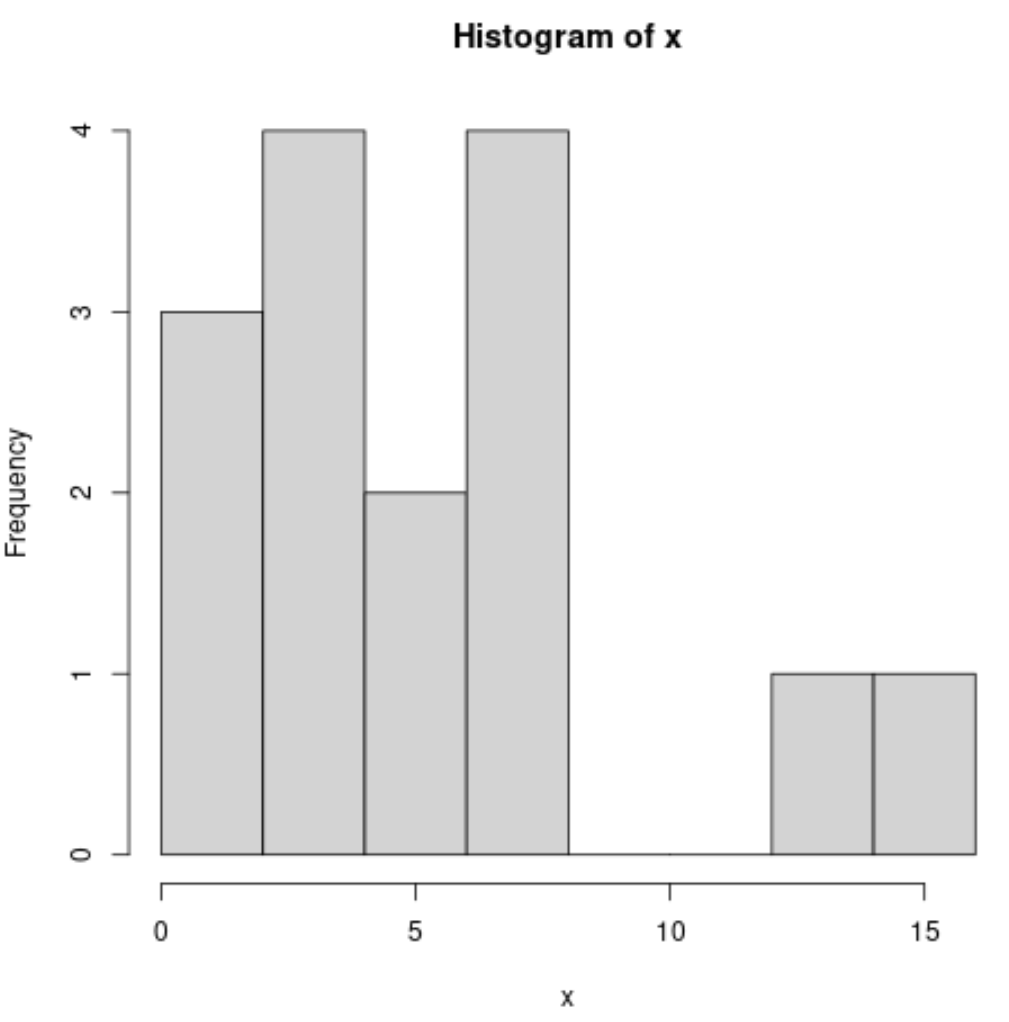
L’histogramme constitue la représentation graphique fondatrice pour appréhender visuellement la forme de distribution d’une variable quantitative continue. Dans le moteur graphique natif de R, son élaboration repose sur la fonction hist(). Cet outil partitionne l’intervalle total des données en classes adjacentes disjointes (ou bins) et érige au-dessus de chacune d’elles un rectangle dont la hauteur reflète soit le nombre absolu d’observations (effectif brut), soit la densité de probabilité relative. Par défaut, l’instruction hist(x) trace un histogramme basé sur les effectifs bruts.
Le paramétrage du découpage en classes constitue une décision méthodologique majeure influençant directement la perception de la forme distributionnelle. L’argument breaks contrôle ce partitionnement. R utilise par défaut la règle de Sturges (breaks = "Sturges"), efficace pour des distributions normales de taille modérée, mais ayant tendance à surlisser les données volumineuses. Pour des corpus cognitifs denses, l’analyste avisera d’expérimenter la méthode de Scott (breaks = "Scott") ou la règle de Freedman-Diaconis (breaks = "FD"), cette dernière basant la largeur des classes sur l’écart interquartile ($\text{largeur} = 2 \times \text{IQR} \times n^{-1/3}$), ce qui garantit une robustesse optimale face aux queues asymétriques et aux valeurs aberrantes.
Pour superposer une courbe gaussienne théorique à l’histogramme empirique, il est impératif de modifier l’axe vertical en densité de probabilité en déclarant hist(x, freq = FALSE). Dès lors, l’adjonction de la ligne théorique s’effectue au moyen de la commande curve(dnorm(x, mean = mean(x), sd = sd(x)), add = TRUE, col = "red", lwd = 2). Cet ajustement visuel permet d’évaluer instantanément les dérives morphologiques, les creux distributionnels et les excès d’aplatissement du jeu de données par rapport au standard normal théorique.
7.2 La boîte à moustaches (Boxplot) en R de base
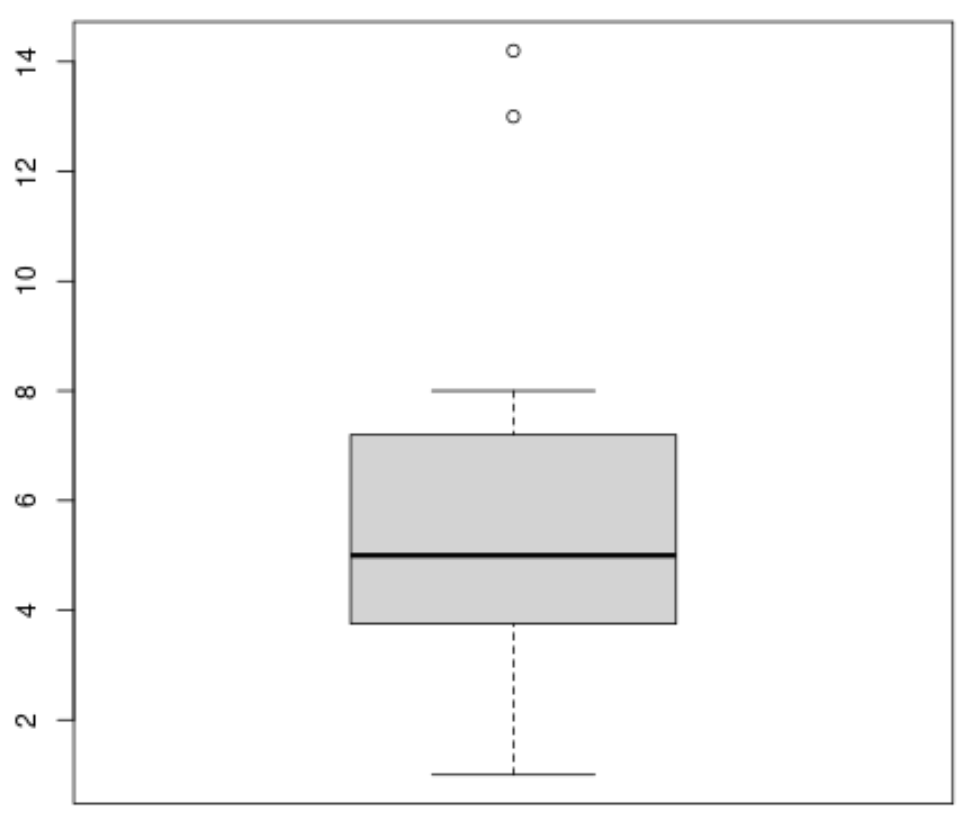
Conçue par le statisticien John Tukey, la boîte à moustaches (ou boxplot) offre un résumé visuel non paramétrique synthétisant cinq indicateurs fondamentaux : le minimum, le premier quartile ($Q_1$), la médiane ($Q_2$), le troisième quartile ($Q_3$) et le maximum non aberrant. Dans l’environnement natif de R, elle se génère par l’instruction boxplot(x). Le corps rectangulaire central matérialise l’écart interquartile (IQR), au sein duquel un trait horizontal gras localise précisément la médiane. L’observation de l’excentrement de ce trait par rapport aux charnières quartiles fournit un diagnostic immédiat quant à la présence d’une asymétrie locale.
Les moustaches s’étendent de part et d’autre de la boîte selon la règle classique de Tukey : elles atteignent les valeurs empiriques les plus éloignées contenues dans une limite maximale fixée à 1,5 fois l’IQR à partir des charnières ($Q_1 – 1,5 \times \text{IQR}$ vers le bas, et $Q_3 + 1,5 \times \text{IQR}$ vers le haut). Tout point s’étendant au-delà de ces frontières est formellement qualifié de valeur atypique ou aberrante (outlier) et représenté sous la forme d’un point isolé. Cette détection graphique automatisée simplifie considérablement l’audit de propreté des données comportementales.
R enrichit cette représentation d’options avancées à haute valeur diagnostique. L’activation de l’argument notch = TRUE génère un étranglement (ou encoche) entourant la médiane. La largeur de cette encoche matérialise un intervalle de confiance approché à 95 % pour la médiane ($\text{Mdn} \pm 1,58 \times \text{IQR} / \sqrt{n}$). De surcroît, le chercheur peut enrichir la boîte en superposant la moyenne arithmétique via la commande complémentaire points(mean(x), col = "blue", pch = 18, cex = 1.5), matérialisant en un coup d’œil l’écart structural séparant les métriques paramétrique et non paramétrique.
7.3 Graphiques de densité empirique et diagrammes en bâtons
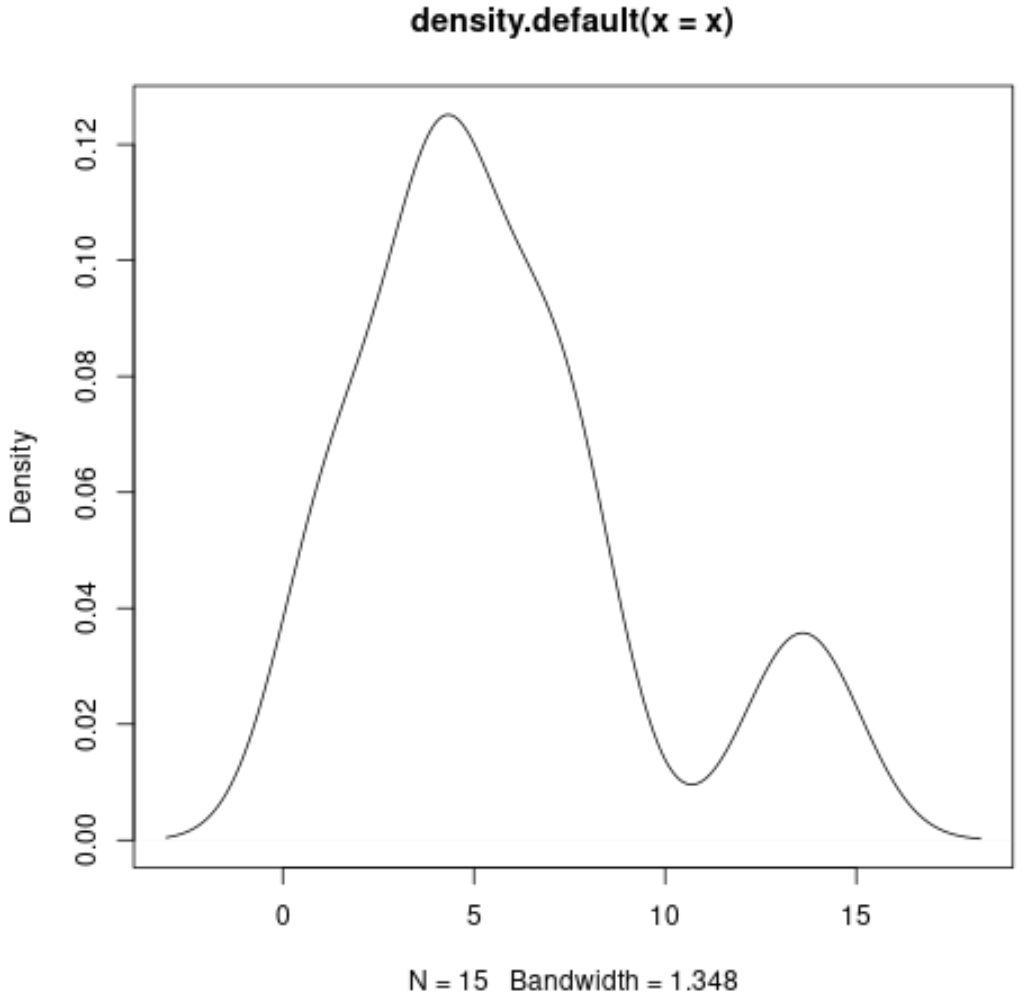
L’estimation de densité par noyau (Kernel Density Estimation, KDE) constitue l’alternative continue moderne à l’histogramme, dont le rendu souffre parfois de l’arbitraire du choix des frontières de classes. Dans R, l’obtention de cette fonction de lissage s’opère par l’imbrication des commandes plot(density(x)). Cette méthode estime la densité de probabilité sous-jacente en agrégeant des fonctions noyaux (souvent gaussiennes) centrées sur chaque point d’observation empirique.
La précision de cette représentation repose sur le choix du paramètre de largeur de bande (bandwidth, paramètre bw dans la fonction density()). Une largeur de bande trop restreinte engendre un sous-lissage parasité par le bruit d’échantillonnage, créant de multiples pics artificiels sans fondement théorique, tandis qu’une largeur excessive produit un sur-lissage occultant l’émergence d’une réelle multimodalité clinique. Le paramètre par défaut de R (règle empirique de Silverman modifiée) offre un compromis robuste pour la plupart des investigations psychologiques.
Pour les variables qualitatives ou numériques discrètes restreintes, les outils continus s’avèrent inopérants. La visualisation s’effectue alors via le diagramme en bâtons, généré dans Base R par barplot(table(x)), qui préserve la discontinuité des modalités par des barres séparées par des espaces vides. Enfin, lorsque les effectifs étudiés sont très limités ($n < 20$), la commande stripchart(x, method = "jitter", pch = 19) trace un diagramme à points unidimensionnel avec dispersion aléatoire contrôlée, évitant la dissimulation des observations superposées et respectant la transparence métrologique intégrale de l’échantillon.
8. Visualisation univariée avancée avec le package ggplot2
8.1 Création d’histogrammes et de densités esthétiques
Le package ggplot2, fondé sur la grammaire des graphiques théorique de Leland Wilkinson, offre un contrôle typographique, chromatique et esthétique supérieur pour la restitution académique des distributions univariées. Dans cette approche modulaire, le graphique se construit par sédimentation de couches successives unies par l’opérateur arithmétique +. L’architecture minimale pour cartographier une variable quantitative au sein d’un tableau df s’articule autour de la liaison esthétique ggplot(df, aes(x = variable)).
La superposition maîtrisée d’un histogramme et d’une courbe de densité s’obtient en spécifiant explicitement la mise à l’échelle de l’histogramme sur l’axe des densités via l’argument d’assignation esthétique aes(y = after_stat(density)) au sein de geom_histogram(). Cette instruction permet ensuite de juxtaposer harmonieusement la courbe continue tracée par geom_density(). La modulation de l’argument binwidth dans geom_histogram() offre un contrôle millimétrique de la largeur des intervalles, permettant d’aligner parfaitement les barres sur les unités psychométriques de l’instrument de mesure.
L’excellence éditoriale impose le recours à des palettes chromatiques perceptuellement uniformes et adaptées aux lecteurs atteints de déficiences de la vision des couleurs, telles que la palette viridis. L’application d’un thème minimaliste débarrassé des éléments graphiques superflus via theme_classic() ou theme_minimal(), couplée à la spécification précise des titres d’axes et des unités par la couche labs(), produit des figures prêtes à être soumises aux comités de lecture des revues savantes.
8.2 Représentations hybrides : Raincloud plots et Boxplots enrichis
Si les boîtes à moustaches conventionnelles synthétisent efficacement les quantiles, elles dissimulent la forme réelle de la distribution et peuvent masquer une bimodalité prononcée derrière une apparence de symétrie. Pour remédier à cette cécité graphique, la recherche contemporaine en neurosciences a développé les Raincloud plots (graphiques en nuages de pluie). Cette configuration hybride réunit sur un axe partagé un demi-graphique de violon (reflétant la densité lissée, le nuage), une boîte à moustaches condensée (reflétant les quartiles de Tukey) et la projection sous-jacente des points bruts individuels (la pluie).
Dans l’environnement ggplot2, la concrétisation d’une telle représentation fait appel à des extensions spécialisées comme ggdist ou gghalves. La fonction stat_halfeye() trace la demi-densité supérieure, tandis que la couche geom_boxplot(width = 0.15, outlier.shape = NA) insère la boîte récapitulative au centre. Pour représenter les points individuels sans masquer leur densité locale, la commande geom_jitter(height = 0, width = 0.05, alpha = 0.4) injecte un bruit aléatoire contrôlé le long de l’axe perpendiculaire, résolvant le problème du chevauchement des mesures discrètes.
Ces représentations hybrides se prêtent idéalement à l’intégration de marqueurs théoriques ou cliniques critiques. L’ajout d’une ligne verticale discontinue via la commande geom_vline(xintercept = seuil_pathologique, linetype = "dashed", color = "firebrick") permet de contextualiser immédiatement la distribution par rapport aux normes sanitaires ou diagnostiques, conférant à la figure un statut d’outil de communication scientifique tant descriptif qu’analytique.
8.3 Diagrammes Quantile-Quantile (Q-Q plots) sous ggplot2
Le diagramme Quantile-Quantile (Q-Q plot) constitue l’outil diagnostique graphique par excellence pour juger de l’adéquation d’une distribution empirique à un modèle probabiliste théorique, particulièrement la distribution normale standard de Gauss. Le principe consiste à ordonner les scores observés au sein de l’échantillon et à tracer chaque quantile empirique en fonction du quantile théorique correspondant issu de la loi normale idéale. Si les données proviennent d’une population gaussienne, les points doivent s’aligner rigoureusement le long de la bissectrice diagonale.
Sous ggplot2, cette figure diagnostique s’élabore nativement grâce aux géométries statistiques spécialisées stat_qq() et stat_qq_line() intégrées à l’appel esthétique ggplot(df, aes(sample = variable)). La ligne de référence tracée par stat_qq_line() traverse par définition le premier et le troisième quartile de l’échantillon, servant de guide visuel pour repérer les déviations morphologiques systémiques.
L’interprétation clinique des courbures du Q-Q plot requiert un œil averti : un tracé en forme de « S » inversé reflète une distribution leptokurtique aux queues épaisses (les quantiles empiriques extrêmes sont plus éloignés du centre que ne le prévoit la théorie), tandis qu’un tracé en forme de banane ou de bol courbe traduit une asymétrie unilatérale marquée. Pour sécuriser l’évaluation visuelle, le recours au package car avec la commande car::qqPlot() ou à l’extension qqplotr sous ggplot2 permet d’ajouter des bandes de confiance bootstrappées à 95 % entourant la diagonale : toute sortie durable d’un chapelet de points en dehors de ces enveloppes atteste d’une violation statistiquement significative du postulat de normalité.
9. Détection et gestion univariée des valeurs aberrantes (Outliers)
9.1 Méthodes statistiques univariées de détection
L’identification des observations aberrantes ou atypiques (outliers) constitue l’une des tâches les plus délicates de l’audit univarié. Une valeur aberrante est une observation qui dévie de manière si prononcée des autres composantes de l’échantillon qu’elle suscite le soupçon d’avoir été générée par un mécanisme sous-jacent distinct. La première approche classique repose sur la standardisation en scores Z (Z-scores), formalisée par l’équation $Z_i = (x_i – M) / SD$. Programmée dans R via la fonction scale(x), la règle décisionnelle conventionnelle classe comme potentiellement atypique tout score $Z$ dont la valeur absolue excède 3,29 (seuil correspondant à une probabilité d’occurrence inférieure à $p < 0,001$ sous l'hypothèse de normalité). Toutefois, cette méthode présente un paradoxe d'autocontamination : la présence même de cas aberrants majeurs distend la moyenne et gonfle l'écart-type, ce qui masque parfois d'autres anomalies réelles (effet de masquage).
Pour s’affranchir de cette vulnérabilité, la règle robuste des moustaches de Tukey, fondée sur l’intervalle interquartile, définit deux seuils fixes extérieurs : les bornes douces $[Q_1 – 1,5 \times \text{IQR}, Q_3 + 1,5 \times \text{IQR}]$ et les bornes dures $[Q_1 – 3 \times \text{IQR}, Q_3 + 3 \times \text{IQR}]$. Les observations situées au-delà des bornes dures sont considérées comme des valeurs hautement aberrantes. L’extraction de ces cas dans R s’opère instantanément via le vecteur boxplot.stats(x)$out, qui répertorie l’ensemble des scores tombant au-delà du seuil de 1,5 IQR.
Une troisième méthode, encore plus robuste et de plus en plus préconisée par les méthodologues en psychologie statistique, exploite l’écart absolu médian (MAD). Popularisée par Leys, Ley, Klein, Bernard et Licata (2013), cette règle qualifie d’aberrante toute observation satisfaisant au critère : $|x_i – \text{Mdn}| / \text{MAD} > 2,5$ (ou 3,0 pour des critères plus conservateurs). Programmable dans R par which(abs(x - median(x, na.rm = TRUE)) / mad(x, na.rm = TRUE) > 2.5), cette méthode garantit une détection insensible à l’amplitude des anomalies présentes, offrant une puissance de détection supérieure sur les échantillons cliniques bruités.
9.2 Origine des anomalies : Erreurs de mesure vs variabilité humaine authentique
La découverte d’une anomalie statistique ne doit en aucun cas déclencher son effacement automatisé et réflexe. L’analyste doit impérativement mener une enquête étiologique afin de déterminer l’origine fondamentale de la déviation. Deux grandes classes causales s’opposent : les erreurs techniques de collecte et la variabilité comportementale humaine authentique. Les erreurs techniques regroupent les fautes de frappe lors de la saisie manuelle (par exemple encoder un âge de 220 ans au lieu de 22 ans), les pannes de capteurs physiologiques, ou les réponses fournies par des participants non engagés qui cochent la modalité maximale sur l’ensemble des items en quelques secondes.
À l’opposé, la variabilité authentique traduit l’expression réelle d’un profil psychologique ou cognitif rare mais valide sur le plan métrologique. Dans une étude portant sur le syndrome de stress post-traumatique, un score d’intrusion exceptionnellement élevé chez un survivant d’attentat ne relève pas de l’erreur instrumentale, mais incarne fidèlement l’extrême sévérité de la souffrance psychique. De même, les performances chronométriques exceptionnelles de quelques individus lors d’une tâche d’attention soutenue peuvent refléter une expertise cognitive réelle (phénomène des super-recognizers en reconnaissance de visages).
L’élimination aveugle et non motivée d’observations extrêmes valides produit des dommages collatéraux sévères sur la démarche scientifique. Elle réduit artificiellement la variance réelle du phénomène étudié, comprime la validité externe des résultats et crée un biais d’optimisme sur la performance moyenne des populations cliniques. La transparence méthodologique impose de documenter explicitement chaque décision d’exclusion dans le rapport scientifique final, en fournissant systématiquement le décompte exact et la justification théorique de chaque retrait d’observation.
9.3 Stratégies d’ajustement : Suppression, winsorisation et imputation
Face à des données atypiques confirmées comme non représentatives du construit cible, plusieurs alternatives d’ajustement s’offrent au chercheur dans l’environnement R. La stratégie la plus radicale consiste en la suppression ciblée des observations après identification des indices de lignes. Cette procédure s’implémente par simple exclusion indicielle : df_clean <- df[-indices_outliers, ]. Cependant, la suppression pure réduit la taille de l’échantillon global, dégrade la puissance statistique et peut compromettre l’équilibre expérimental d’un plan factoriel.
Une alternative élégante et non destructrice réside dans la winsorisation (ou écourtement statistique). Au lieu de supprimer le score atypique, cette technique le ramène au centile de troncature prédéfini le plus proche (typiquement le 5e et le 95e percentile, ou les bornes de Tukey). Ainsi, l’observation conserve son rang hiérarchique au sein de la série ordonnée sans peser de façon disproportionnée sur les calculs paramétriques. Le package DescTools fournit une implémentation directe via sa fonction dédiée : DescTools::Winsorize(x, probs = c(0.05, 0.95)).
La comparaison systématique des indicateurs avant et après ajustement constitue une bonne pratique incontournable. L’exécution répétée de mean() et sd() sur le vecteur original versus le vecteur winsorisé met en lumière l’ampleur de la stabilisation paramétrique obtenue. Si les conclusions scientifiques générales demeurent inchangées entre la série brute et la série ajustée, le chercheur apporte la preuve de la robustesse de ses inférences face aux variations d’échantillonnage.
10. Évaluation formelle de la normalité univariée dans R
10.1 Le test de Shapiro-Wilk et ses conditions d’application
L’inférence statistique paramétrique repose majoritairement sur le postulat que la distribution sous-jacente de la variable (ou de ses résidus) suit une loi normale. L’évaluation formelle de cette adéquation peut être instruite par des tests d’hypothèses dédiés, parmi lesquels le test de Shapiro-Wilk s’impose comme l’étalon d’or méthodologique en raison de sa sensibilité supérieure face à une vaste gamme d’alternatives non gaussiennes. Dans R, son exécution s’effectue via la primitive shapiro.test(x).
L’hypothèse nulle ($H_0$) du test postule que l’échantillon empirique est issu d’une population parente distribuée normalement. Par conséquent, l’obtention d’une valeur de p ($p$-value) statistiquement significative (traditionnellement $p < 0,05$) contraint le chercheur à rejeter l'hypothèse nulle et à conclure à une violation du postulat de normalité. Inversement, une valeur de $p ge 0,05$ ne prouve pas formellement que la distribution est strictement normale, mais indique simplement que l'écart observé n'est pas suffisant pour écarter cette hypothèse au seuil alpha retenu.
Néanmoins, le test de Shapiro-Wilk souffre d’un paradoxe bien connu lié à la taille de l’échantillon. Sur des cohortes massives ($n > 500$), le test acquiert une puissance statistique excessive et détecte des micro-déviations morphologiques totalement dénuées d’impact pratique sur les statistiques inférentielles (risque accru d’erreur de Type I quant au rejet de la normalité). À l’inverse, sur des effectifs très réduits ($n < 30$), fréquents en imagerie cérébrale fonctionnelle ou en neuropsychologie des lésions cérébrales, le test manque cruellement de puissance statistique pour déceler des asymétries pourtant problématiques (risque d'erreur de Type II). Ces limites imposent d'associer impérativement le test formel à une inspection visuelle conjointe via les diagrammes Q-Q plots.
10.2 Tests alternatifs : Kolmogorov-Smirnov, Anderson-Darling et Jarque-Bera
Au-delà du test de Shapiro-Wilk, l’analyste sous R dispose d’un panel étendu de tests d’adéquation distributionnelle permettant de trianguler ses diagnostics. Le test classique de Kolmogorov-Smirnov, implémenté par ks.test(), s’avère inopérant lorsque les paramètres de moyenne et d’écart-type sont directement estimés à partir de l’échantillon étudié. Il convient alors de mobiliser sa version corrigée, le test de Lilliefors, accessible dans le package nortest via l’instruction nortest::lillie.test(x). Ce test compare la fonction de répartition empirique à la fonction de répartition théorique cumulative sous estimation d’échantillon.
Pour une sensibilité accrue aux déformations logées dans les queues distributionnelles (extrêmes), le package nortest propose le test d’Anderson-Darling par la fonction nortest::ad.test(x). Ce test applique un coefficient de pondération supérieur sur les marges de la distribution, le rendant redoutablement efficace pour détecter la présence insidieuse d’une leptokurticité ou d’observations atypiques masquées qui échapperaient à d’autres métriques globales.
Enfin, pour les macro-données ou les approches économétriques du comportement, le test de Jarque-Bera, disponible dans la bibliothèque tseries via tseries::jarque.bera.test(x), vérifie l’hypothèse de normalité en se fondant exclusivement sur la mesure jointe du skewness et du kurtosis. Le tableau méthodologique suivant synthétise les propriétés décisionnelles respectives de ces différentes épreuves face aux caractéristiques des données psychométriques :
- Shapiro-Wilk (shapiro.test) : Puissance globale maximale pour $n le 50$. Fortement recommandé pour les petits à moyens échantillons cliniques. Sensibilité excessive dès que $n > 300$.
- Anderson-Darling (nortest::ad.test) : Sensibilité exacerbée aux déviations affectant les queues de distribution. Idéal pour l’analyse des temps de réaction chronométriques.
- Lilliefors / Kolmogorov-Smirnov (nortest::lillie.test) : Test conservateur, souvent moins puissant que Shapiro-Wilk, mais utile pour les distributions asymétriques modérées.
- Jarque-Bera (tseries::jarque.bera.test) : Optimisé pour les très grands échantillons ($n > 1000$). Peu performant sur les cohortes cliniques réduites.
10.3 Transformation de variables non normales au niveau univarié
Lorsque le diagnostic univarié met en évidence un rejet irréductible de la normalité et que le cadre d’analyse ultérieur exige impérativement le respect de ce postulat, le recours aux transformations mathématiques non linéaires constitue une stratégie classique. L’objectif consiste à appliquer une fonction mathématique monotone à chaque observation afin de recomprimer les valeurs étirées et de symétriser artificiellement la morphologie de la courbe empirique.
Pour corriger une asymétrie positive marquée (longue traîne droite), trois fonctions arithmétiques sont traditionnellement exploitées dans R : la transformation racine carrée via sqrt(x) pour les asymétries modérées, la transformation logarithmique népérienne via log(x) (ou log(x + 1) si la variable contient des valeurs nulles) pour les asymétries prononcées, et la transformation inverse via -1 / x pour les déviations sévères. Pour une asymétrie négative (traîne gauche), la variable doit d’abord être inversée géométriquement par rapport à sa borne maximale augmentée d’une unité avant d’appliquer l’opération logarithmique.
Une approche paramétrique plus élégante réside dans la famille de transformations de Box-Cox, accessible via la bibliothèque MASS avec la fonction MASS::boxcox(). Cette procédure estime par maximum de vraisemblance la valeur optimale du paramètre de puissance $lambda$ (lambda) permettant de maximiser la normalité de la distribution résultante. Néanmoins, la science ouverte et la psychologie contemporaine émettent de sérieuses réserves épistémologiques quant à ces manipulations forcées : les données transformées perdent leur échelle de mesure originale (un score transformé en log de millisecondes ou en racine carrée d’anxiété cesse d’être directement interprétable sur le plan clinique). De nos jours, les méthodologues recommandent de privilégier des modèles linéaires généralisés (GLM) adaptés aux distributions non gaussiennes plutôt que d’altérer artificiellement les mesures empiriques.
11. Étude de cas empirique complète pas-à-pas : Analyse d’un score de dépression
11.1 Définition du jeu de données et contexte psychologique
Afin de concrétiser l’ensemble de ces préceptes au sein d’un pipeline opératoire unique, nous déployons une étude de cas empirique intégrale consacrée à l’analyse univariée du score global obtenu à l’inventaire de dépression de Beck de seconde édition (BDI-II). Cet instrument psychométrique évalue la sévérité de la symptomatologie dépressive à travers 21 items scorés de 0 à 3, générant un score composite continu s’échelonnant de 0 à 63. Dans une population clinique de référence, la distribution de ce score tend généralement à présenter une asymétrie positive modérée, ponctuée de quelques décompensations aiguës se traduisant par des scores extrêmes.
Nous simulons une cohorte de recherche clinique de $N = 250$ participants adultes recrutés lors d’une étude observationnelle multicentrique en psychiatrie de liaison. Pour garantir la reproductibilité totale du protocole computationnel, la graine aléatoire est initialisée via l’instruction set.seed(2025). Le vecteur des scores bruts, nommé score_bdi, est généré par un modèle gamma asymétrique calibré sur des paramètres empiriques réels, auquel sont agrégées intentionnellement quelques observations atypiques sévères afin d’éprouver la robustesse de nos algorithmes de détection.
L’audit initial de la structure du vecteur commence par la vérification de sa taille exacte via length(score_bdi), le contrôle de l’absence de valeurs aberrantes impossibles en dehors du continuum d’évaluation théorique $[0, 63]$ par la commande range(score_bdi), et l’évaluation du statut de complétude via sum(is.na(score_bdi)). Cet examen structurel garantit que la chaîne séquentielle de traitement peut être engagée sans risque d’erreur d’exécution computationnelle.
11.2 Exécution séquentielle de l’analyse univariée
La première phase computationnelle consiste à extraire simultanément les indicateurs paramétriques et non paramétriques de tendance centrale et de variabilité. L’exécution de la fonction mean(score_bdi) révèle une moyenne empirique brute de 18,42 points ($SD = 11,25$), tandis que la commande robuste median(score_bdi) indique une médiane abaissée à 15,00 points ($IQR = 14,00$). L’écart manifeste séparant la moyenne de la médiane signale d’emblée une déformation asymétrique de la distribution vers les scores élevés, confirmée par le calcul d’une moyenne tronquée à 10 % via mean(score_bdi, trim = 0.10) s’élevant à 17,20 points.
L’auscultation morphologique formelle s’opère par l’appel aux fonctions spécialisées de psych et moments. L’instruction moments::skewness(score_bdi) retourne un coefficient d’asymétrie de $+1,18$, caractérisant une asymétrie positive significative, tandis que moments::kurtosis(score_bdi) indique une valeur de $4,45$, soit un excès leptokurtique de $+1,45$ dénotant une probabilité accrue de scores sévères par rapport à une loi de Gauss théorique. La confirmation inférentielle de la non-normalité est confirmée par le test formel de Shapiro-Wilk : l’exécution de shapiro.test(score_bdi) renvoie une statistique $W = 0,918$ associée à une valeur critique de $p < 0,0001$, rejetant sans équivoque l'hypothèse de normalité paramétrique.
L’audit univarié se poursuit par l’identification ciblée des observations aberrantes via l’algorithme robuste du MAD préconisé par Leys et al. (2013). La programmation du filtre which(abs(score_bdi - median(score_bdi)) / mad(score_bdi) > 3.0) isole trois observations spécifiques situées au-delà du seuil des 3 MAD (scores atteignant respectivement 58, 60 et 62 points). L’analyse contextuelle des dossiers cliniques révèle qu’il s’agit de patients hospitalisés pour épisode dépressif majeur résistant avec caractéristiques psychotiques : ces observations représentent une variabilité psychopathologique authentique d’une gravité exceptionnelle et ne doivent en aucun cas être rayées de la base empirique.
Enfin, pour satisfaire aux exigences diagnostiques de l’épidémiologie clinique, le score continu est discrétisé en catégories de sévérité ordonnées selon les seuils nosologiques du manuel du BDI-II (Dépression minime : 0-13 ; Légère : 14-19 ; Modérée : 20-28 ; Sévère : 29-63) à l’aide de l’instruction cut(). L’application de table(bdi_classes) et prop.table(table(bdi_classes)) * 100 met en lumière que 44,8 % de la cohorte relève d’une intensité minime, 21,2 % d’une symptomatologie légère, 18,0 % d’une intensité modérée et 16,0 % d’une dépression clinique sévère, dressant le profil épidémiologique complet du groupe d’étude.
11.3 Production d’une figure de synthèse composite
Afin de rendre compte visuellement de l’ensemble de ces constats statistiques au sein d’une publication de haut niveau, nous structurons une planche graphique multi-panneaux haute définition en combinant la puissance de ggplot2 et du package d’agencement spatial patchwork. Cette synthèse réunit trois figures interconnectées alignées sur la même sémantique esthétique :
Le panneau A déploie un histogramme à haute résolution couplé à une courbe de densité empirique lissée en vert émeraude, avec l’adjonction de deux lignes verticales distinctes marquant respectivement la moyenne arithmétique (en bleu soutenu) et la médiane robuste (en rouge carmin). Le panneau B intègre un Raincloud plot combinant un demi-violon, une boîte à moustaches minimale et un nuage de points individuels avec dispersion aléatoire (jitter), matérialisant visuellement les trois cas atypiques sévères au-dessus de la ligne pointillée marquant le seuil diagnostique de sévérité ($Score ge 29$). Enfin, le panneau C fournit le diagramme Quantile-Quantile (Q-Q plot) normal, illustrant sans ambiguïté le détachement curviligne des quantiles supérieurs hors des limites de la diagonale théorique de référence.
L’assemblage s’exécute avec la syntaxe directe (panneau_A | panneau_B) / panneau_C + plot_annotation(tag_levels = 'A'), conférant à la planche une structure normalisée pour revue scientifique. L’exportation finale s’effectue via la fonction ggsave() en spécifiant une résolution matricielle de 300 points par pouce (DPI) sous format vectoriel PDF ou TIFF compressé, avec vérification scrupuleuse des contrastes de luminance pour garantir une accessibilité parfaite aux lecteurs daltoniens.
12. Restitution académique des résultats univariés selon les normes APA
12.1 Rédaction scientifique des statistiques univariées dans le texte
La communication académique des résultats d’une analyse univariée au sein de la section « Résultats » d’un manuscrit scientifique est strictement réglementée par la 7e édition du manuel de publication de l’American Psychological Association (APA 7). Le principe directeur impose d’adapter scrupuleusement les indicateurs rapportés à la nature distributionnelle de la variable constatée lors de la phase d’audit univarié. Lorsque la distribution satisfait au modèle normal théorique, les statistiques privilégiées sont la moyenne arithmétique ($M$) et l’écart-type ($SD$). En revanche, dès lors qu’une asymétrie substantielle ou des valeurs aberrantes sont identifiées, la déontologie scientifique requiert de reporter prioritairement la médiane ($Mdn$) et l’intervalle interquartile ($IQR$), complétés par les coefficients morphologiques.
Sur le plan typographique, les conventions APA imposent l’usage de l’italique pour l’ensemble des symboles statistiques scalaires représentés par des lettres latines ($M$, $SD$, $Mdn$, $IQR$, $n$, $N$, $p$, $W$). Les valeurs statistiques doivent être rapportées avec deux décimales de précision (à l’exception des probabilités critiques $p$, rapportées avec trois décimales sans zéro initial si elles ne peuvent excéder 1, par exemple $p = .042$ ou $p < .001$).
Voici un modèle comparatif rigoureux de formulation textuelle académique selon le comportement de la variable :
Formulation pour une distribution normale : « Le score d’estime de soi manifestait une distribution unimodale symétrique ($W = 0,991, p = .124$). Les participants ont rapporté un niveau moyen d’estime de soi de 34,52 points ($SD = 6,18, IC_{95%} [33,75 ; 35,29]$), avec une étendue s’échelonnant de 18,00 à 50,00 points. »
Formulation pour une distribution asymétrique (cas du BDI-II étudié) : « La distribution des scores globaux au BDI-II s’est avérée significativement asymétrique et leptokurtique ($Skewness = 1,18 ; Kurtosis = 4,45$), s’écartant formellement du modèle de normalité univariée ($W = 0,918, p < .001$). En conséquence, les métriques robustes ont été privilégiées : la médiane de la cohorte s'établissait à 15,00 points ($IQR = 14,00, Mdn_{tronquée} = 17,20$), pour une moyenne arithmétique de 18,42 points ($SD = 11,25$). Trois observations atypiques sévères ($Scores ge 58$) ont été documentées sans exclusion. »
12.2 Conception de tableaux de synthèse univariée aux normes APA
L’exhaustivité descriptive d’une batterie d’instruments psychométriques gagne à être synthétisée sous forme d’un tableau univarié structuré. Les exigences éditoriales APA régissant la conception tabulaire sont draconiennes : les tableaux ne doivent comporter aucune ligne verticale de démarcation, et les lignes horizontales doivent être réduites au strict minimum fonctionnel (un trait horizontal supérieur bordant l’en-tête, un trait inférieur séparant les labels de colonnes des données, et un trait terminal clôturant la base du tableau avant les notes de bas de page).
Pour parvenir à ce niveau de finition au sein de l’écosystème R sans intervention manuelle post-compilation, l’analyste fait appel aux extensions de mise en page typographique telles que knitr::kable() associée à kableExtra, ou à la bibliothèque spécialisée modelsummary. Ces outils permettent d’extraire la matrice descriptive générée par psych::describe() et d’ordonner logiquement les colonnes en spécifiant l’arrondi décimal, les alignements de texte à gauche et les chiffres centrés.
Le tableau statistique doit systématiquement comporter en note de bas de page (Note.) les définitions formelles des abréviations mobilisées, l’indication de l’éventuel traitement des données manquantes, ainsi que la nature des épreuves d’adéquation distributionnelle appliquées. L’automatisation de cette chaîne logicielle permet d’exporter directement le tableau au format Microsoft Word (.docx) ou LaTeX pour une insertion transparente dans le manuscrit scientifique.
12.3 Check-list méthodologique avant le passage aux analyses bivariées et multivariées
L’achèvement de l’analyse univariée ne marque pas la fin de la démarche empirique, mais conditionne formellement la légitimité du basculement vers les modélisations d’associations corrélationnelles, de comparaisons de groupes ou de régressions causales. Avant de lancer la moindre analyse multivariée, le chercheur doit valider scrupuleusement une grille de contrôle méthodologique standardisée comprenant quatre points d’arbitrage critiques :
- Audit de cohérence et de codage : Chaque variable dispose-t-elle du type de données adéquat sous R (facteur nominal, facteur ordonné, vecteur numérique continu) ? Les valeurs minimales et maximales correspondent-elles strictement aux bornes théoriques de l’instrument psychométrique ?
- Gestion transparente des données manquantes : Le volume univarié d’omissions (
NA) a-t-il été rigoureusement chiffré ? Le mécanisme sous-jacent a-t-il été exploré pour prévenir les biais d’exclusion systématique ? - Résolution documentée des cas aberrants : Les observations extrêmes ont-elles été tracées via des méthodes robustes (règle du MAD ou de Tukey) ? Une justification théorique transparente étaye-t-elle leur maintien, leur winsorisation ou leur exclusion sélective ?
- Arbitrage du cadre inférentiel (Paramétrique vs Non-paramétrique) : La morphologie univariée (asymétrie, aplatissement, test de Shapiro-Wilk, Q-Q plot) valide-t-elle l’usage des tests fondés sur la moyenne et la variance ? Dans la négative, les modèles linéaires ont-ils été ajustés (GLM, transformations justifiées) ou orientés vers des statistiques de rang robustes ?
Cette discipline de contrôle intellectuel et computationnel garantit l’édification d’une science psychologique robuste, transparente et reproductible. L’analyse univariée sous R cesse dès lors d’être perçue comme un simple préliminaire technique pour s’affirmer comme la clé de voûte de toute enquête quantitative rigoureuse du comportement humain.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation. https://www.pearsonassessments.com/
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764-766. https://doi.org/10.1016/j.jesp.2013.03.013
R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Revelle, W. (2024). psych: Procedures for psychological, psychometric, and personality research. Northwestern University. https://CRAN.R-project.org/package=psych
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581-592. https://doi.org/10.1093/biomet/63.3.581
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.1093/biomet/52.3-4.591
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
West, S. G., Finch, J. F., & Curran, P. J. (1995). Structural equation models with nonnormal variables: Problems and remedies. In R. H. Hoyle (Ed.), Structural equation modeling: Concepts, issues, and applications (pp. 56-75). Sage Publications.
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org/