
Dans le champ de l’analyse statistique appliquée aux sciences humaines, cognitives et comportementales, l’exploration graphique préliminaire constitue le socle indispensable sur lequel repose toute inférence méthodologique rigoureuse. L’histogramme s’impose historiquement et techniquement comme le dispositif de visualisation univariée le plus fondamental pour appréhender la distribution empirique d’une variable continue. Loin de se réduire à un simple agencement de barres rectangulaires juxtaposées, l’histogramme offre une cartographie sensible de la variabilité psychométrique, révélant la dispersion latente, la tendance centrale, la présence d’hétérogénéités sous-jacentes et les déviations structurelles par rapport aux modèles théoriques idéalisés.
Pour le chercheur en psychologie, le clinicien ou le data scientist, maîtriser l’art de décrire la morphologie d’un histogramme ne relève pas d’une compétence purement cosmétique ou pédagogique. Il s’agit d’une étape de diagnostic sémiologique des données, conditionnant directement la validité des modèles statistiques paramétriques ultérieurs, tels que l’analyse de variance, la régression linéaire multiple ou la modélisation par équations structurelles. Une lecture erronée ou superficielle de la silhouette distributionnelle expose l’analyste à des biais d’interprétation majeurs, notamment l’inflation de l’erreur de première espèce ou la sous-estimation de phénomènes psychologiques complexes marqués par des scissions comportementales ou des effets d’échelle.
Ce guide exhaustif propose une déconstruction méthodique et académique des formes d’histogrammes. À travers une formalisation rigoureuse de leurs dimensions structurales, l’examen détaillé des morphologies canoniques et atypiques, l’analyse critique de l’impact du découpage en classes (binning) et la fourniture de protocoles rédactionnels normalisés, ce traité vise à outiller les chercheurs pour transformer l’inspection visuelle en un argumentaire scientifique reproductible, précis et cliniquement pertinent.
1. Fondements de l’histogramme dans l’analyse de données psychologiques
1.1 Définition et structure fondamentale de l’histogramme
L’histogramme, introduit dans sa formalisation moderne par le polymathe Karl Pearson à la fin du dix-neuvième siècle, est un instrument d’estimation non paramétrique de la densité de probabilité d’une variable quantitative continue. Il convient de dissiper d’emblée une confusion taxonomique récurrente dans les sciences comportementales : l’histogramme ne doit en aucun cas être assimilé à un diagramme en bâtons (bar chart). Tandis que le diagramme en bâtons disjoint représente des fréquences associées à des catégories discrètes ou qualitatives sans continuité topologique sous-jacente, l’histogramme matérialise le continuum métrique d’une échelle de mesure en segmentant l’étendue des données en intervalles adjacents mutuellement exclusifs, couramment désignés sous le vocable de « classes » ou de bins.
Sur le plan structural, l’axe des abscisses (horizontal) supporte l’échelle numérique continue de la variable psychologique mesurée, découpée en intervalles de classe $[x_i, x_{i+1}[$. L’axe des ordonnées (vertical) matérialise soit la fréquence absolue (le décompte effectif d’observations tombant dans chaque intervalle), soit la fréquence relative (proportion de l’échantillon total), soit, de manière plus rigoureuse sur le plan probabiliste, la densité de fréquence. Lorsque la largeur des intervalles est variable, seule la densité garantit l’intégrité de l’interprétation : c’est la surface de chaque rectangle — produit de la base par la hauteur — qui est rigoureusement proportionnelle au nombre d’individus ou d’événements observés, et non sa seule hauteur brute.
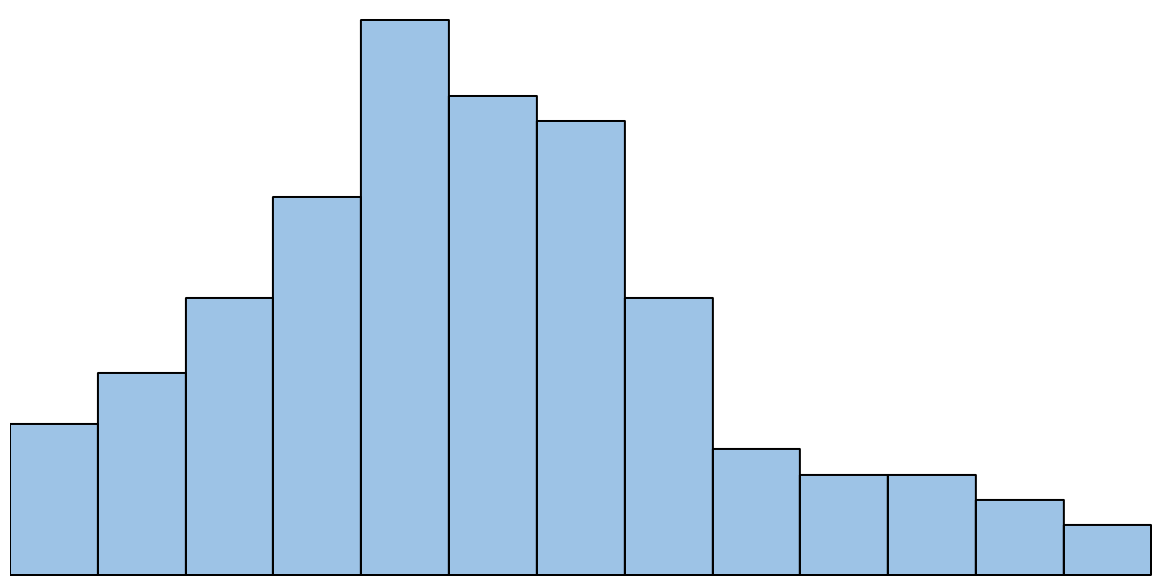
Dans la phase d’exploration initiale des données psychométriques (Exploratory Data Analysis, EDA), l’histogramme permet de dépasser les réductions synthétiques parfois trompeuses des estimateurs ponctuels. La surface totale cumulée de l’ensemble des rectangles représente l’intégralité de l’échantillon ($N$) ou une probabilité totale égale à 1 dans le cas d’un histogramme de densité normalisé. Cette géométrie surfacique offre une appréciation immédiate de la variabilité interindividuelle, permettant d’identifier la répartition des forces au sein de la population étudiée, depuis le noyau central des performances ordinaires jusqu’aux marges extrêmes du spectre comportemental.
1.2 L’importance de l’évaluation visuelle de la forme en psychologie
Dans la recherche empirique en psychologie et en neurosciences cognitives, l’observation minutieuse de la configuration d’un histogramme constitue la première ligne de défense contre les inférences fallacieuses. Elle permet d’identifier sans délai les anomalies empiriques flagrantes, telles que les erreurs de saisie d’opérateurs, les dysfonctionnements dans les chaînes d’acquisition informatique des temps de latence, ou encore des biais massifs d’échantillonnage clinique, par exemple lorsqu’un protocole visant des sujets sains intègre involontairement une fraction de participants manifestant une décompensation pathologique aiguë.
Par ailleurs, cette inspection visuelle conditionne la vérification intuitive des postulats paramétriques fondamentaux. La vaste majorité des tests d’hypothèse classiques — à l’instar du test t de Student pour échantillons indépendants ou des modèles d’analyse de variance univariée et multivariée — postulent la normalité de la distribution des résidus ou des scores au sein des populations mères. L’examen attentif de la silhouette distributionnelle alerte immédiatement le chercheur sur les risques d’invalidation de ces postulats, orientant d’emblée la décision méthodologique vers des transformations de variables stabilisatrices ou vers l’adoption d’approches non paramétriques, robustes ou basées sur le rééchantillonnage (bootstrapping).
L’histogramme révèle également avec une acuité particulière les biais inhérents à la collecte de données psychologiques : phénomènes d’attrition différentielle au fil d’une étude longitudinale, désirabilité sociale comprimant les réponses vers des valeurs normatives acceptables, ou artefacts liés à la formulation d’un questionnaire d’auto-évaluation. En somme, l’évaluation graphique ne saurait être considérée comme une étape subalterne ; elle constitue le complément qualitatif indispensable des indices numériques descriptifs classiques. Deux séries de données possédant une moyenne et un écart-type rigoureusement identiques peuvent présenter des silhouettes graphiques radicalement dissemblables, phénomène spectaculairement illustré par le célèbre quartet d’Anscombe.
1.3 Critères d’observation systématique d’une distribution
Afin de transformer une simple impression visuelle subjective en une analyse scientifique standardisée et reproductible, l’observateur doit déployer un cadre d’investigation séquentiel fondé sur quatre repères morphologiques cardinaux :
- La localisation du centre de gravité et la dispersion globale : Il s’agit d’identifier la région de l’abscisse où se concentre la majorité de la masse des données, d’évaluer la médiane visuelle et d’observer l’étendue totale couverte par les barres le long du continuum métrique.
- La modalité : L’analyse porte sur le dénombrement précis des sommets (modes empiriques). L’observateur examine si la distribution s’organise autour d’un pic unique prépondérant, si elle manifeste une dualité morphologique nette suggérant une bipartition de la population, ou si elle se fragmente en une pluralité d’ondulations locales.
- Le degré d’équilibre ou de déformation latérale (symétrie) : Il convient d’évaluer si la silhouette présente une invariance par réflexion par rapport à son centre, ou si elle subit une traction différentielle étirant une queue de distribution de manière disproportionnée vers les valeurs faibles ou vers les valeurs élevées.
- Le comportement des queues de distribution et la continuité : Cette dimension examine l’amincissement ou au contraire l’épaisseur des extrémités latérales du tracé, la présence d’espaces vides séparant des blocs de données (gaps) et l’émergence d’observations totalement détachées du corps central (valeurs aberrantes ou outliers).
2. Les quatre dimensions structurales pour caractériser une forme graphique
2.1 La modalité : quantification des pics de fréquence
La modalité d’un histogramme réfère au nombre de maxima locaux prééminents observables sur la silhouette de distribution. Sur le plan statistique, le mode correspond à la valeur ou à la classe d’intervalles qui enregistre la plus forte densité de fréquence. Dans un profil unimodal, l’ensemble des observations semble converger vers un unique pôle d’attraction, traduisant une dynamique comportementale homogène au sein de laquelle les individus oscillent autour d’une norme psychologique dominante.
À l’inverse, l’émergence d’une distribution bimodale (deux pics distincts) ou multimodale (trois pics ou davantage) témoigne géométriquement de la superposition de sous-populations distinctes ou de la présence de variables modératrices latentes n’ayant pas été initialement isolées dans le protocole expérimental. En psychologie clinique, un pic secondaire peut révéler la présence clandestine d’un cluster symptomatique particulier au sein d’une cohorte supposée uniforme.
Toutefois, la prudence méthodologique impose de distinguer rigoureusement un véritable mode distributionnel de fluctuations d’échantillonnage purement aléatoires. Chez de petits effectifs ($N < 50$), des variations stochastiques créent fréquemment des aspérités de surface qui miment la multimodalité sans recouvrir la moindre réalité psychologique sous-jacente. L'analyste doit évaluer la saillance relative des sommets en examinant la profondeur des dépressions qui les séparent : un mode authentique s'enracine dans un creux persistant et statistiquement robuste lors de la variation du paramètre de lissage.
2.2 La symétrie et l’asymétrie (Skewness)
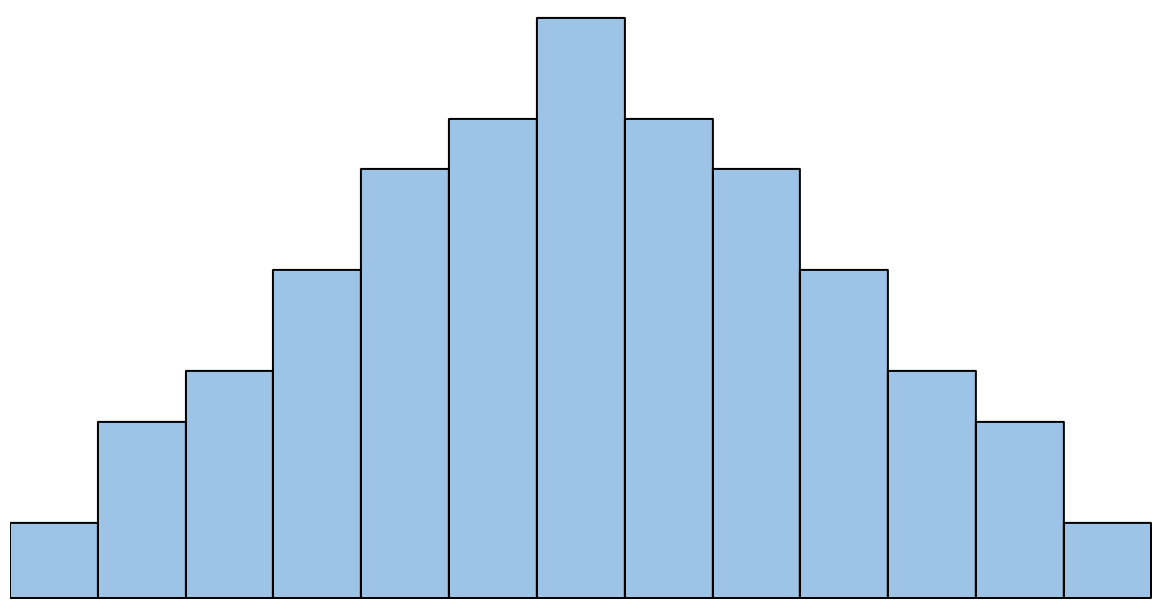
La symétrie d’un histogramme se définit par l’existence d’un axe vertical de réflexion bilatérale, situé au niveau du centre de la distribution, divisant l’aire totale sous le tracé en deux moitiés géométriquement équivalentes. Dans une telle configuration, la probabilité d’observer un écart d’une amplitude donnée au-dessus du centre est strictement identique à celle d’observer le même écart en deçà. Dans ce cas idéal, la moyenne arithmétique, la médiane ordinale et le mode nominal coïncident parfaitement en un point unique d’équilibre gravitationnel.
Lorsque cette harmonie axiale est rompue, la distribution est qualifiée d’asymétrique, phénomène quantifié par le coefficient d’asymétrie ou skewness de Pearson ($\gamma_1$). On distingue deux polarités morphologiques :
- L’asymétrie positive (étalée vers la droite / right-skewed) : La masse des données est comprimée dans la région inférieure de l’échelle métrique, tandis qu’une traînée décroissante d’observations s’étire vers les valeurs élevées de l’abscisse. Cette configuration induit un décalage hiérarchique systématique : $\text{Mode} < \text{Médiane} < \text{Moyenne}$. La moyenne est mécaniquement attirée vers la droite par le poids gravitationnel des valeurs extrêmes positives.
- L’asymétrie négative (étalée vers la gauche / left-skewed) : La majorité des scores s’accumulent au sommet de l’échelle, créant une chute abrupte du côté droit et une queue résiduelle allongée s’étirant vers les valeurs faibles. La relation mathématique s’inverse : $\text{Moyenne} < \text{Médiane} < \text{Mode}$, la moyenne arithmétique se trouvant tirée vers la gauche par les scores anormalement bas.
2.3 L’aplatissement et le comportement des queues (Kurtosis)
Le troisième axe morphologique majeur concerne la nature des queues de distribution et la proéminence du pic central, concept formalisé sous le terme de kurtosis ou coefficient d’aplatissement ($\gamma_2$). La distribution normale standard sert ici de jalon fondamental, qualifiée d’état mésocurtique (kurtosis d’excès nul, $\gamma_2 = 0$). Les barres de l’histogramme s’y déploient selon un compromis équilibré entre la hauteur de la voûte centrale et l’effilement progressif des bordures externes.
Une distribution est qualifiée de leptocurtique ($\gamma_2 > 0$) lorsqu’elle présente une morphologie en flèche acérée, caractérisée par une hyper-concentration des effectifs autour d’une valeur cible centrale combinée, de façon indissociable, à des queues de distribution épaisses ou « lourdes ». Visuellement, cela se traduit par des barres médianes inhabituellement hautes, une chute très rapide des fréquences intermédiaires, mais la persistance anormale de barres non nulles très éloignées du centre. En neuropsychologie, ce profil signale souvent que la majorité des sujets réussissent uniformément une tâche élémentaire, à l’exception d’une frange vulnérable manifestant des déficits massifs.
À l’opposé, une configuration platycurtique ($\gamma_2 < 0$) se manifeste par un sommet surbaissé, émoussé, dessinant un dôme aplati ou un plateau horizontal, associé à des queues de distribution tronquées ou extrêmement minces s'éteignant très rapidement. Ce profil traduit une dispersion relativement uniforme des compétences ou des attitudes au sein de la cohorte, sans consensus unitaire marqué ni émergence d'atypicités périphériques marginales.
2.4 La continuité et l’identification des lacunes (Gaps)
Une observation rigoureuse de la topographie d’un histogramme exige d’examiner attentivement les solutions de continuité sur l’axe horizontal. Une distribution empirique saine sur une variable continue présente généralement une suite ininterrompue de barres adjacentes. L’apparition d’un « trou » ou d’une lacune (gap) — c’est-à-dire un ou plusieurs intervalles de classe affichant un effectif rigoureusement égal à zéro, insérés entre deux zones actives de données — constitue un événement sémiotique d’une grande valeur clinique.
Il convient de mener un diagnostic différentiel rigoureux face à une lacune distributionnelle. Une discontinuité peut résulter d’un biais méthodologique : un défaut de sensibilité de l’instrument de mesure qui ignore les valeurs intermédiaires, un artéfact d’arrondi numérique lors de la numérisation des scores, ou encore une censure accidentelle des données durant le traitement informatique. Mais une lacune peut également refléter une discontinuité psychopathologique naturelle, telle qu’une ligne de démarcation franche entre une population indemne et un sous-groupe franchissant un seuil de décompensation critique sans état de transition intermédiaire.
Ces lacunes servent fréquemment de zone tampon mettant en relief la présence d’observations isolées ou aberrantes (outliers). Lorsqu’une barre unique de très faible hauteur émerge à une distance substantielle de la masse principale, au-delà d’un vaste désert d’effectifs nuls, l’analyste se trouve confronté soit à une défaillance de mesure (erreur de transcription, non-respect des consignes expérimentales), soit à un profil neuropsychologique exceptionnel nécessitant une extraction du protocole nomothétique pour faire l’objet d’une étude de cas idiographique spécifique.
3. Les distributions en cloche ou normales (Bell-Shaped)
3.1 Propriétés visuelles et mathématiques de la courbe en cloche
La distribution en cloche, archétype visuel de la loi normale ou distribution gaussienne, représente le modèle de référence universel dans les sciences quantitatives du comportement. Sa géométrie idéale se distingue par une régularité esthétique et mathématique stricte : elle est parfaitement unimodale et présente une symétrie axiale spéculaire autour de sa moyenne arithmétique. Les profils latéraux décroissent de manière monotone selon une cinétique d’atténuation exponentielle quadratique régie par la densité de probabilité :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} e^{-\frac{1}{2}\left(\frac{x-\mu}{\sigma}\right)^2}$$
Sur le plan géométrique, la silhouette de l’histogramme gaussien exhibe deux points d’inflexion morphologiques notables situés exactement à une distance d’un écart-type ($\mu \pm 1\sigma$) de part et d’autre de l’axe central. C’est en ces points précis que la concavité de la courbe s’inverse, passant d’un profil concave orienté vers le bas à un profil convexe s’évasant doucement pour former les queues de distribution. Cette configuration spatiale fonde visuellement la fameuse règle empirique 68-95-99.7 : environ 68,26 % de la surface totale de l’histogramme est confinée entre $\mu – \sigma$ et $\mu + \sigma$, 95,44 % entre $\mu – 2\sigma$ et $\mu + 2\sigma$, et 99,74 % au sein de l’intervalle délimité par trois écarts-types.
Au niveau de son sommet central prédominant, la superposition des trois paramètres descriptifs est absolue :
$$\text{Moyenne} = \text{Médiane} = \text{Mode} = \mu$$
Dans un histogramme d’échantillon réel issu de mesures psychologiques, une conformité stricte au micromètre n’est jamais observée en raison des aléas d’échantillonnage ; l’analyste conclut à une morphologie en cloche dès lors que l’allure générale converge visiblement vers cette structure symétrique sans distorsion substantielle de ses queues ni affaissement de sa crête.
3.2 Exemples concrets en sciences psychologiques et cognitives
L’omniprésence visuelle des distributions en cloche dans l’évaluation psychologique n’est pas fortuite ; elle est la conséquence macroscopique directe du théorème central limite. Dès lors qu’un trait psychologique latent résulte de la sommation additive d’un grand nombre de déterminants infinitésimaux indépendants — qu’ils soient d’origine génétique, épigénétique ou environnementale —, la distribution des scores composites converge inévitablement vers la loi normale.
L’illustration la plus emblématique réside dans l’étalonnage des quotients intellectuels (QI) issus des échelles standardisées de Wechsler (WISC, WAIS). Les batteries de subtests compilant des aptitudes verbales, visuo-spatiales, de mémoire de travail et de vitesse de traitement génèrent, au sein de la population générale, un histogramme rigoureusement symétrique centré sur une moyenne conventionnelle de 100 avec un écart-type de 15. Les barres culminent dans l’intervalle 90-110 pour décroître de manière symétrique et prévisible vers les scores d’efficience supérieure ($> 130$) ou de déficience intellectuelle ($< 70$).
On retrouve également cette morphologie typique lors de la mesure des grands domaines de la personnalité issus du modèle des Big Five (inventaire NEO-PI-R). Des dimensions fondamentales telles que l’extraversion, l’agréabilité ou le caractère consciencieux se déploient sous la forme d’un dôme équilibré lorsque l’échantillon est représentatif et suffisamment étendu. De même, les mesures d’estime de soi globale chez des populations non cliniques (évaluées par exemple via l’échelle de Rosenberg) dessinent classiquement une courbe en cloche régulière, attestant que la plupart des individus maintiennent un sentiment de valeur personnelle modéré et adaptatif, tandis que les formes de dévalorisation profonde ou de narcissisme hypertrophié occupent symétriquement les bordures marginales de l’histogramme.
3.3 Formulation descriptive académique d’un profil en cloche
Dans le cadre de la rédaction d’un rapport de recherche ou d’un article soumis aux comités de lecture, la description textuelle d’un histogramme en cloche requiert une terminologie standardisée, alliant précision géométrique et rigueur probabiliste selon les conventions académiques en vigueur (notamment les normes de l’American Psychological Association).
L’analyste veillera à proscrire les assertions absolues et péremptoires telles que « la variable est normale », au profit de formules soulignant l’adéquation distributionnelle empirique : « L’inspection visuelle de l’histogramme révèle une distribution approximativement normale, unimodale et symétrique, exempte de déviation latérale notable ou de valeurs marginales aberrantes ». Cette appréciation morphologique doit être systématiquement étayée par la citation conjointe des indices de centralité et des coefficients de forme :
« Les scores obtenus à l’épreuve de mémoire de travail se répartissent selon une silhouette en cloche canonique ($M = 50{,}12$, $SD = 9{,}84$, $Md = 50{,}00$). La proximité quasi parfaite entre la moyenne et la médiane, conjuguée à des coefficients d’asymétrie ($S = -0{,}04$, $SE = 0{,}12$) et d’aplatissement ($K = 0{,}08$, $SE = 0{,}24$) proches de zéro, autorise l’application sans réserve des modèles linéaires généraux paramétriques. » Cette rigueur sémantique permet d’établir formellement la licéité des tests d’inférence ultérieurs aux yeux des réviseurs scientifiques.
4. Les distributions uniformes et rectangulaires
4.1 Caractéristiques morphologiques de l’absence de pic
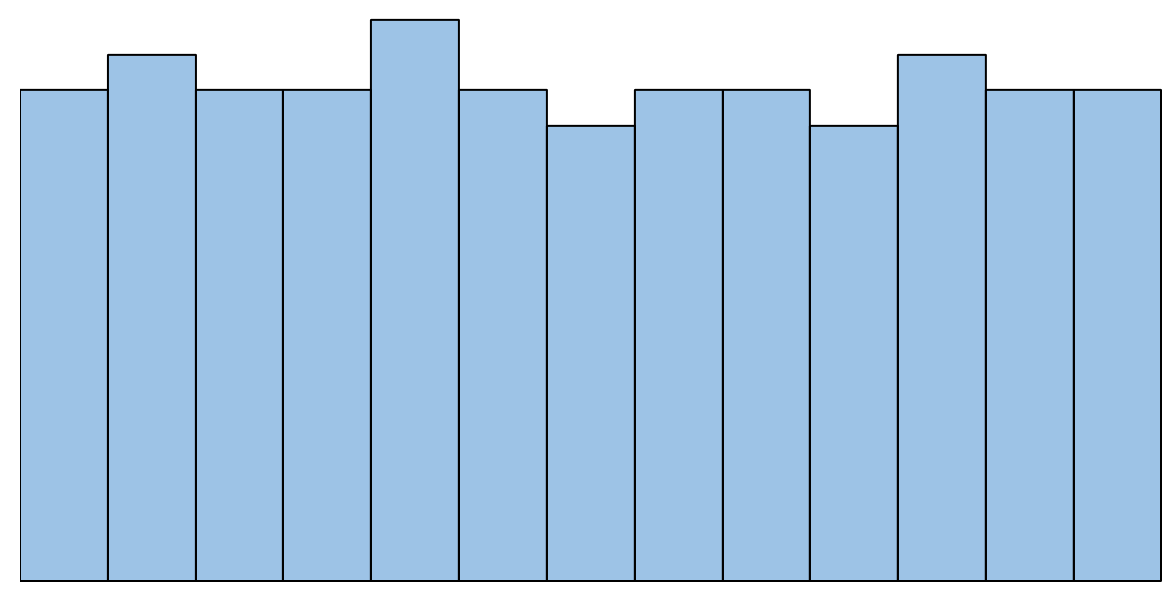
La distribution uniforme, fréquemment désignée sous l’appellation de distribution rectangulaire, incarne l’antithèse absolue du profil en cloche. Sa spécificité géométrique fondamentale réside dans l’absence totale de sommet prédominant ou d’un quelconque gradient d’attraction central. Sur l’histogramme, l’ensemble des rectangles juxtaposés affiche une altitude sensiblement constante sur l’intégralité du domaine de définition $[a, b]$ de la variable continue.
La densité de probabilité s’y formule mathématiquement de manière invariante par :
$$f(x) = \frac{1}{b – a} \quad \text{pour } x in [a, b]$$
D’un point de vue morphologique, le tracé dessine un pavé régulier dont les bordures s’effondrent perpendiculairement à zéro dès que l’on franchit les bornes théoriques de l’intervalle. Aucune concentration d’effectifs ne permet de distinguer un mode opérant ; tous les intervalles de même largeur se voient assigner une masse probabiliste équiprobable. La variance n’y découle pas d’une fluctuation autour d’un barycentre naturel, mais d’une dispersion équidistribuée couvrant la totalité de l’espace métrique accordé aux observations.
4.2 Scénarios expérimentaux et comportementaux types
L’émergence d’une forme rectangulaire dans un protocole psychologique correspond presque exclusivement à des dispositifs méthodologiques artificiellement contrôlés ou à des situations de désengagement cognitif total :
- Le choix au hasard pur : Dans une tâche de psychologie expérimentale informatisée exigeant la sélection continue d’une position sur une ligne visuelle sans indice directionnel, une distribution uniforme des clics atteste que les participants répondent de manière aléatoire, traduisant une absence complète d’apprentissage ou une perte de motivation globale.
- La randomisation des protocoles : Lors de la constitution de plans expérimentaux factoriels, la vérification de l’attribution aléatoire des sujets au sein des différentes conditions d’exposition doit idéalement générer un histogramme des assignations rigoureusement plat, gage d’une répartition sans biais initial.
- La manipulation temporelle en attention soutenue : Dans les paradigmes de vigilance continue (par exemple, la tâche de performance continue de Conners), la distribution des intervalles inter-stimulus (laps de temps séparant l’apparition de deux cibles) est programmée pour être uniformément distribuée dans une fenêtre temporelle (ex. 1000 à 3000 millisecondes) afin de neutraliser tout phénomène d’anticipation ou d’habituation temporelle chez le sujet testé.
4.3 Interprétation critique et pièges de modélisation
La découverte impromptue d’une distribution uniforme lors de l’évaluation d’un construit psychologique censé refléter un trait humain stable doit susciter la plus grande méfiance chez le chercheur. Dans la majorité des cas, cette régularité rectangulaire masque un échec expérimental patent ou un biais méthodologique majeur.
L’analyste doit en premier lieu veiller à ne pas confondre une uniformité véritable avec une dispersion chaotique due à un sous-échantillonnage sévère. Lorsqu’un échantillon comprend un effectif résiduel ($N < 30$), un histogramme doté de classes étroites affichera souvent des barres de hauteur comparable, mimant une platitude globale qui n'est que le reflet d'un déficit d'observation statistique masquant la convergence vers une courbe normale.
Sur le plan analytique, la présence d’une structure rectangulaire proscrit l’usage aveugle de l’écart-type comme indicateur pertinent de variabilité psychométrique. Dans un univers uniforme, la dispersion est structurellement déterminée par la formule $\sigma = \frac{b – a}{\sqrt{12}}$, ce qui démontre que l’écart-type n’est que le simple reflet linéaire de l’amplitude globale de l’échelle, et non de la variabilité naturelle d’une force comportementale. Si une échelle de Likert d’anxiété produit un profil uniforme dans une population clinique, cela signale fréquemment que les items ont été formulés de façon si ambiguë que les patients ont sélectionné leurs réponses de manière parfaitement erratique.
5. Les distributions bimodales : reflets de scissions comportementales
5.1 Morphologie visuelle d’un profil bimodal
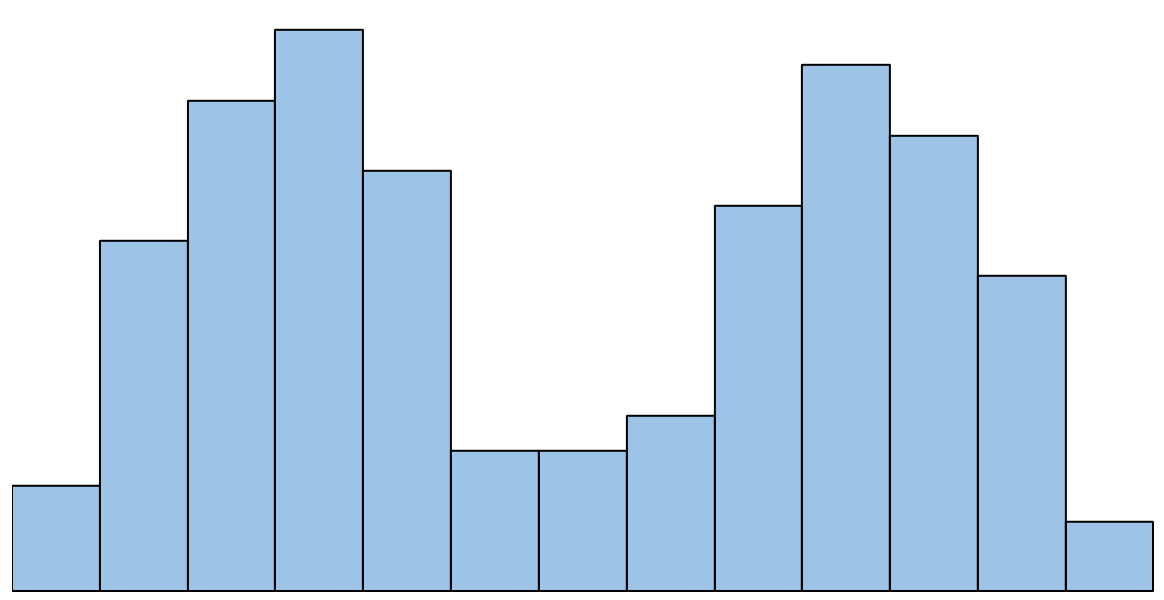
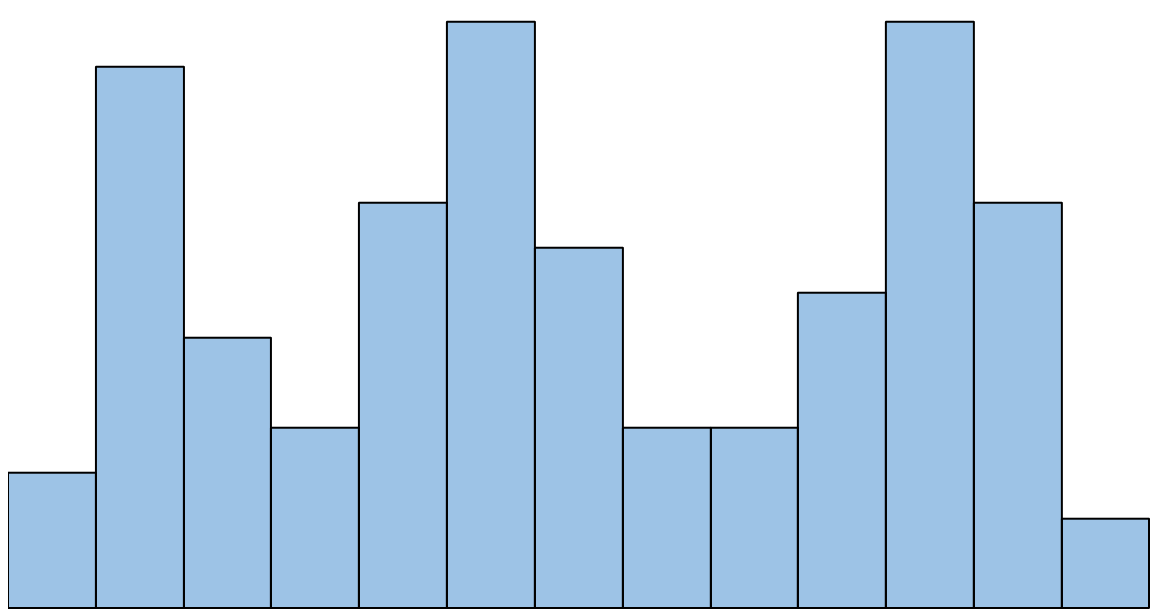
Une distribution est qualifiée de bimodale lorsque son histogramme est dominé par l’apparition ostensible de deux sommets distincts (pics d’effectifs), séparés l’un de l’autre par un creux substantiel, désigné techniquement sous le terme de « vallée » ou de dépression inter-modale. Cette silhouette évoque le profil à double bosse d’un dromadaire et brise l’unicité de la tendance centrale.
L’observateur doit analyser deux attributs morphologiques déterminants :
- Le degré de symétrie bimodal : Les deux sommets peuvent afficher des hauteurs comparables (bimodalité symétrique), signalant que les deux cohortes sous-jacentes sont de tailles numériques équivalentes, ou au contraire présenter un pic dominant flanqué d’un pic secondaire moins élevé, attestant d’une asymétrie de représentativité entre les deux groupes.
- La profondeur et la largeur de la vallée : Plus la dépression séparant les deux pics plonge profondément vers le plancher de l’axe des abscisses, plus la séparation morphologique et fonctionnelle entre les deux sous-populations est nette. Une vallée superficielle suggère un simple début de différenciation ou une forte dispersion des deux composantes qui se chevauchent de manière importante.
L’implication mathématique cardinale d’un tel agencement réside dans le paradoxe de la tendance centrale : la moyenne arithmétique globale vient fréquemment se positionner en plein cœur de la vallée centrale, c’est-à-dire précisément dans une région métrique où la probabilité empirique d’observer des individus est quasiment nulle. Citer la moyenne globale pour résumer un histogramme bimodal constitue une faute méthodologique grave, car cette valeur ne représente aucun des participants réels.
5.2 Cas cliniques et différentiels en psychologie
L’émergence d’une bimodalité dans une distribution psychologique constitue presque invariablement la signature visuelle d’un facteur classificatoire masqué ou d’un processus psychologique dichotomique :
- Le panachage d’une cohorte clinique et d’un groupe témoin : Lors de l’administration d’une échelle d’inventaire de la dépression (comme le BDI-II de Beck) au sein d’un échantillon non trié en milieu hospitalier, l’histogramme des scores agrégés exhibera typiquement un premier pic massif vers les valeurs basses (représentant la fraction des sujets sains ou en rémission) et un second sommet localisé dans la zone des scores sévères (sujets en épisode dépressif majeur caractérisé). L’absence de stratification préalable engendre visuellement cette bimodalité artificielle.
- La polarisation des attitudes et opinions sociales : En psychologie sociale, l’évaluation des attitudes relatives à des enjeux sociétaux hautement clivants (adhésion à des mesures sanitaires coercitives, jugements bioéthiques) produit classiquement des profils bimodaux, matérialisant l’effondrement des positions modérées au profit de camps idéologiques fermement ancrés aux deux antipodes de l’échelle d’opinion.
- La dualité des stratégies de résolution cognitive : Face à une tâche de rotation mentale complexe, l’histogramme des temps de réponse ou des taux de réussite peut se scinder en deux modes : les participants mobilisant une stratégie de transformation visuo-spatiale globale et rapide s’amassent sur le premier sommet, tandis que ceux utilisant une vérification séquentielle analytique composent le second pic, caractérisé par des latences nettement plus prolongées.
5.3 Démarche d’analyse face à un histogramme bimodal
La découverte d’un profil bimodal sur un histogramme interdit l’application immédiate de tests statistiques paramétriques standard fondés sur le postulat d’homogénéité de l’échantillon. L’analyste doit initier une démarche de décomposition systématique de sa base de données.
La première phase consiste à formuler des hypothèses différentielles en explorant des variables catégorielles modératrices susceptibles de segmenter l’échantillon (le sexe biologique, l’âge chronologique, le niveau d’expertise, le statut diagnostique clinique ou le milieu socio-éducatif). En superposant les histogrammes conditionnels de ces sous-groupes, l’analyste cherche à vérifier si la distribution globale se résout en deux distributions unimodales distinctes et homogènes.
Si aucune variable manifeste n’explique cette scission morphologique, il devient impératif de recourir à des modélisations statistiques avancées, plus particulièrement aux modèles de mélange de finis (finite mixture models ou modèles de mélange gaussien). Cette approche algorithmique estime conjointement les paramètres distributionnels ($\mu_k, \sigma_k$) de chaque composante sous-jacente ainsi que leur poids relatif ($\pi_k$) dans la population globale :
$$f(x) = \sum_{k=1}^{K} \pi_k , \mathcal{N}(x; \mu_k, \sigma_k^2) \quad \text{a\vec} \quad \sum_{k=1}^{K} \pi_k = 1$$
Cette formalisation confère à l’histogramme le statut d’outil de découverte heuristique, révélant l’existence de taxonomies latentes dans le comportement humain.
6. Les distributions multimodales : complexité et sous-groupes latents
6.1 Reconnaissance d’une pluralité de sommets
La distribution multimodale repousse les limites de la complexité visuelle en affichant une succession de trois pics locaux ou davantage le long du spectre continu de la variable d’intérêt. L’histogramme adopte alors l’allure d’une silhouette crénelée ou d’une chaîne de collines irrégulières, reflétant un état de fragmentation structurelle poussé de la population observée.
Face à une telle topographie, l’analyste doit répertorier et hiérarchiser les modes :
- Le mode principal (ou primaire) : Il correspond au pic enregistrant l’altitude de fréquence absolue la plus élevée au sein de l’histogramme, marquant la classe où se trouve la densité la plus forte de l’échantillon.
- Les modes secondaires et tertiaires : Ce sont les pics d’amplitudes moindres mais suffisamment proéminents par rapport aux dépressions adjacentes pour attester de concentrations locales d’observations non attribuables au simple hasard.
Cette hétérogénéité morphologique est le signe indubitable que la variable quantitative continue étudiée capture, de manière intriquée, l’influence simultanée de multiples mécanismes causaux ou l’agrégation de plusieurs typologies individuelles qui coexistent au sein du protocole expérimental sans avoir été formellement discriminées au départ.
6.2 Exemples d’hétérogénéité multidimensionnelle
Les distributions multimodales se manifestent avec prédilection dans les contextes où les scores composites résultent de dynamiques évolutives par paliers ou d’évaluations cliniques à spectres larges :
- Les stades développementaux de Piaget : Si l’on applique une batterie d’épreuves mesurant la conservation de la matière et la pensée logique opératoire à une cohorte scolaire non triée d’enfants âgés de 4 à 12 ans, l’histogramme des scores totaux affichera de multiples pics successifs. Ces sommets visualisent matériellement les différents stades et sous-stades cognitifs stabilisés (pensée préopératoire, opérations concrètes, émergence des opérations formelles), séparés par des zones de transition développementale moins peuplées.
- L’hétérogénéité des troubles du spectre de l’autisme (TSA) : Sur des échelles globales mesurant les compétences en communication adaptative au sein d’une large cohorte d’individus diagnostiqués d’un TSA, l’histogramme présente fréquemment un agencement multimodal. Un premier pic regroupe les profils non verbaux avec déficit intellectuel associé ; un deuxième sommet médian capture les formes intermédiaires ; enfin, un troisième pic supérieur rassemble les profils sans déficience cognitive présentant un langage fluide mais des atypicités pragmatiques spécifiques.
- L’observance thérapeutique en psychiatrie : La mesure du taux d’adhésion pharmacologique dans une population de patients atteints de troubles bipolaires révèle une multimodalité typique : un mode d’arrêt complet ($0-10%$), un mode d’observance intermittente ou erratique ($40-60%$), et un mode de conformité thérapeutique stricte ($90-100%$).
6.3 Modalités de description et décomposition statistique
Rapporter scientifiquement un histogramme multimodal interdit toute simplification abusive visant à résumer la dispersion par un écart-type unique ou la tendance par une moyenne arithmétique solitaire. La rédaction académique doit obligatoirement inventorier l’ensemble des modes observés, en consignant pour chacun sa localisation métrique sur l’abscisse et son altitude relative.
Pour s’assurer que les multiples sommets ne constituent pas des artefacts visuels induits par le calibrage arbitraire des barres de l’histogramme, l’analyste chevronné adjoindra systématiquement une courbe de lissage non paramétrique par estimation de densité par noyau (Kernel Density Estimation, KDE). Cette méthode superpose au tracé rectangulaire une courbe continue régularisée, gouvernée par un paramètre de bande passante ($h$), permettant d’attester de la robustesse topologique des modes :
$$\hat{f}_h(x) = \frac{1}{nh} \sum_{i=1}^{n} K\left(\frac{x – x_i}{h}\right)$$
Dans un second temps, l’analyste procède à un basculement de paradigme statistique, délaissant l’approche de la régression univariée au profit de l’analyse de classes latentes (LCA) ou du partitionnement non supervisé (clustering k-means). Ces algorithmes permettent d’extraire mathématiquement les centroïdes des différentes classes composant la distribution multimodale et de catégoriser objectivement les profils de participants.
7. L’asymétrie positive ou étalée à droite (Right-Skewed)
7.1 Structure visuelle : queue allongée vers les valeurs élevées
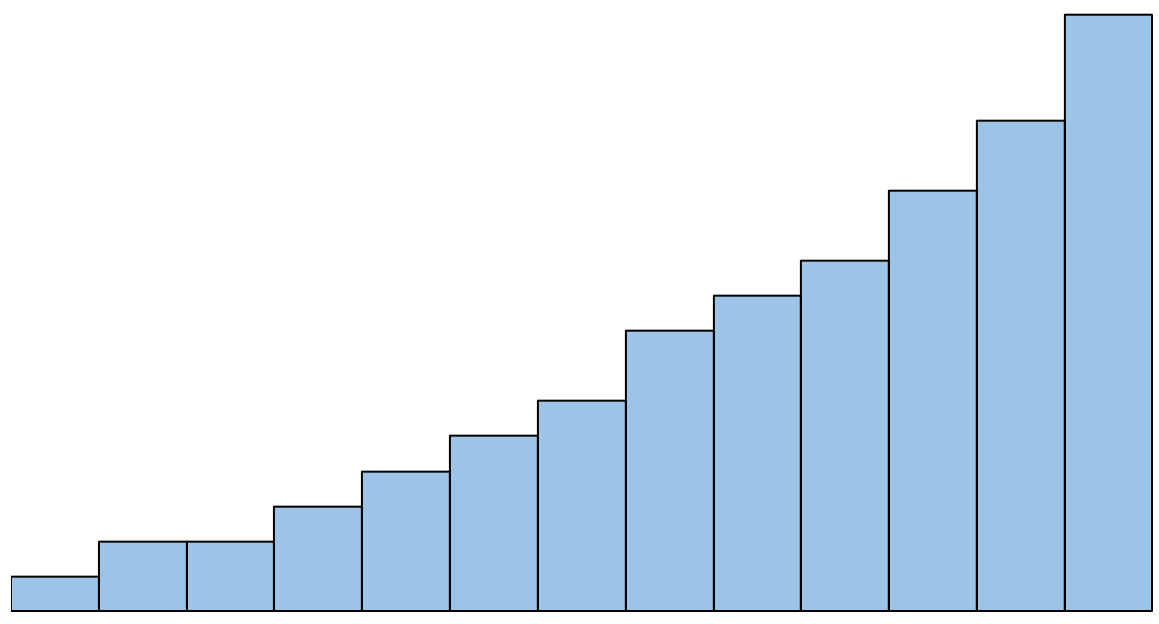
L’asymétrie positive, conventionnellement désignée sous les vocables d’étalement à droite, de biais dextre ou de right-skewed distribution, offre une silhouette immédiatement identifiable. La masse prépondérante des observations est condensée et comprimée dans la section gauche de l’histogramme — c’est-à-dire vers les valeurs basses de l’échelle métrique. À partir de ce noyau compact émerge une longue traîne effilée qui s’étire progressivement vers la droite, se dissolvant lentement dans les valeurs élevées de l’abscisse.
Cette morphologie dissymétrique découle quasi universellement de la présence d’une borne inférieure absolue infranchissable — une frontière mathématique ou biologique située le plus souvent à zéro —, combinée à l’absence corrélative de borne supérieure stricte, ou du moins à un plafond extrêmement distant du mode. La liberté de variation des individus ne peut donc s’exprimer que dans une direction unique : vers le haut.
L’impact géométrique sur les indices de centralité obéit à une séquence hiérarchique absolue :
$$\text{Mode} < \text{Médiane} < \text{Moyenne}$$
Le mode correspond à la crête du pic initial où se pressent la majeure partie des sujets. La médiane se situe un peu plus à droite, garantissant le découpage équitable des effectifs cumulés en deux parts de 50 %. Enfin, la moyenne arithmétique est entraînée encore plus loin vers la droite, disproportionnellement attirée par le produit des valeurs extrêmement élevées de la longue queue traînante.
7.2 Manifestations classiques en psychologie cognitive et clinique
L’asymétrie positive constitue incontestablement la forme distributionnelle la plus abondante dans les laboratoires de psychologie expérimentale et les contextes épidémiologiques :
- Les temps de réaction (TR) chronométriques : Dans toute tâche cognitive de décision lexicale, de détection de cible de Stroop ou de temps de réaction simple, l’histogramme des latences en millisecondes est inexorablement étalé à droite. Il existe une frontière physiologique incompressible liée au temps de conduction synaptique et axonal (typiquement autour de 150 à 200 ms). Les réponses s’agglutinent massivement entre 250 et 400 ms, formant le mode principal, tandis qu’une queue de distribution diffuse s’allonge jusqu’à 1500 ou 2000 ms, représentative d’épisodes d’inattention transitoire, de distractions perceptives ou de défaillances motrices occasionnelles. Ce comportement empirique est fidèlement ajusté par des distributions théoriques d’ex-Gaussienne ou de Weibull.
- Les inventaires d’anxiété et de psychopathologie en population générale : Lorsque l’on administre l’inventaire d’anxiété de Spielberger (STAI) ou le questionnaire de santé générale (GHQ-12) à un échantillon normatif non clinique, la vaste majorité des individus ne manifeste que très peu ou pas de symptômes, formant un pic abrupt tout près du zéro. Seule une fraction restreinte et décroissante de la population rapporte une anxiété sévère, générant cette traînée caractéristique vers les scores pathologiques élevés.
- Le nombre d’erreurs commises à une tâche standard : Chez des adultes sans altération neurologique, le nombre d’erreurs commises lors du test du tracé (Trail Making Test, partie A) se concentre sur zéro, un ou deux, avec de très rares individus commettant des nombres d’erreurs plus élevés en raison de difficultés praxiques ponctuelles.
- La consommation hebdomadaire de substances : L’histogramme du nombre de verres d’alcool bus par semaine au sein d’une cohorte universitaire démontre un étalement dextre massif, la médiane se fixant à des niveaux modérés, tandis qu’un groupe marginal d’utilisateurs à risque étire la queue vers des volumes de consommation très élevés.
7.3 Impact psychométrique et transformations de données
Sur le plan psychométrique, la survenue d’une asymétrie positive aiguë peut signaler la présence d’un effet de plancher (floor effect). Ce dysfonctionnement instrumentaire survient lorsque l’épreuve proposée s’avère trop ardue ou trop sélective pour la population ciblée : une grande proportion des participants échoue uniformément à franchir les premiers items de l’échelle, agglutinant leurs scores sur la valeur minimale possible et détruisant le pouvoir de discrimination métrique de l’instrument dans les basses zones de compétence.
De surcroît, l’inflation mathématique de la moyenne arithmétique constitue un danger analytique réel. Employer la moyenne pour quantifier les temps de réaction d’un groupe expérimental conduit inévitablement à surestimer le temps de traitement cognitif caractéristique de ce groupe, altérant la validité des comparaisons inter-groupes.
Face à un histogramme fortement étiré vers la droite ($\gamma_1 > 1{,}0$), la démarche de normalisation statistique implique fréquemment l’application de fonctions de transformation mathématique univariées non linéaires aux données brutes. Les transformations les plus éprouvées sont la transformation logarithmique népérienne ou décimale :
$$x_{\text{trans}} = \ln(x + c)$$
où $c$ est une constante assurant la positivité stricte des arguments, la transformation par racine carrée ($x_{\text{trans}} = \sqrt{x}$), particulièrement appropriée pour les données de comptage (nombre d’erreurs), ou encore la transformation inverse ($x_{\text{trans}} = \frac{1}{x}$), cette dernière convertissant avantageusement un temps de latence en une vitesse de traitement cognitif.
8. L’asymétrie négative ou étalée à gauche (Left-Skewed)
8.1 Structure visuelle : queue allongée vers les valeurs faibles
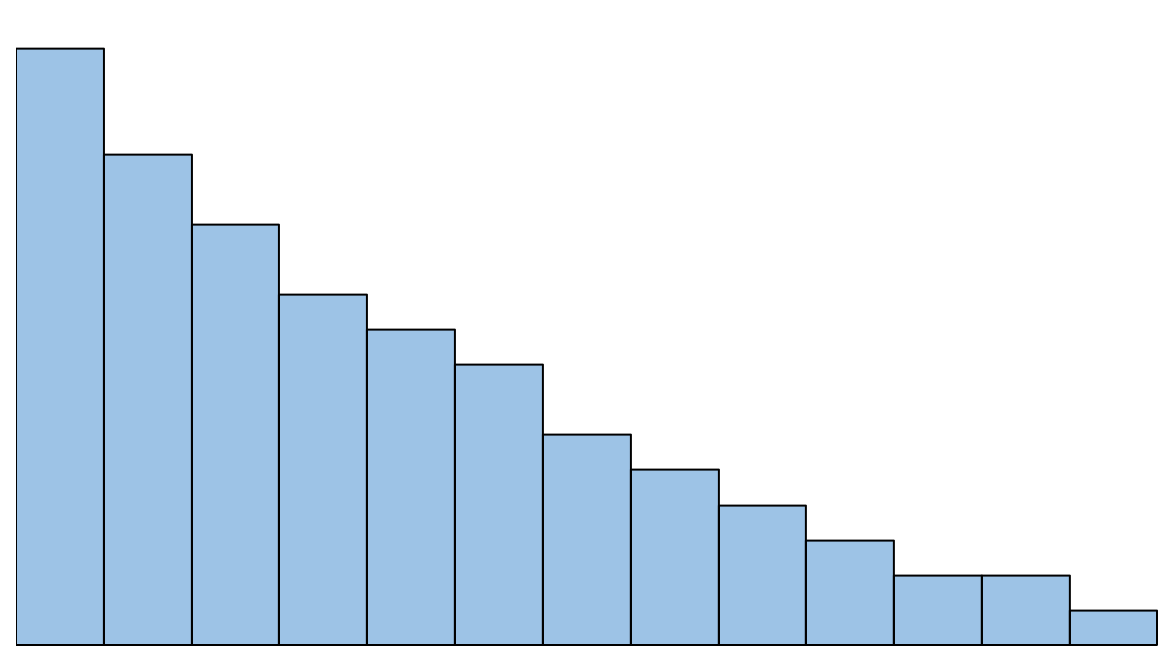
L’asymétrie négative, également désignée sous le nom d’étalement à gauche, d’asymétrie senestre ou de left-skewed distribution, offre l’image spéculaire inversée du phénomène décrit précédemment. L’examen graphique de l’histogramme met en évidence une concentration massive d’observations confinées dans la section droite de l’axe métrique, c’est-à-dire au voisinage des scores maximaux envisageables. La silhouette s’achève brusquement sur le versant droit par une chute quasi verticale, tandis qu’elle s’étiole doucement vers la gauche, déployant une longue queue résiduelle d’effectifs déclinants qui descend vers les valeurs minimales de l’échelle.
Cette organisation morphologique est le corollaire structurel d’une barrière supérieure ou d’une butée maximale stricte qui restreint la progression des scores. Les participants s’accumulent au voisinage de cette limite asymptotique, et les variations de performance ne peuvent s’exprimer que de façon unidirectionnelle vers le bas.
Le découplage gravitationnel des indicateurs de tendance centrale s’établit selon la séquence géométrique inversée :
$$\text{Moyenne} < \text{Médiane} < \text{Mode}$$
Le mode nominal coïncide avec le pic d’altitude culminant dans les scores supérieurs. La médiane se trouve localisée en deçà, assurant l’équipartition des rangs, tandis que la moyenne arithmétique est lourdement tirée vers la gauche sous l’influence pénalisante des quelques scores extrêmement faibles logés dans la queue inférieure de la distribution.
8.2 Exemples empiriques dans l’évaluation psychologique
L’asymétrie négative est typique des contextes d’évaluation standardisée où l’instrumentation mesure des aptitudes consolidées ou des jugements évaluatifs favorables :
- Les examens académiques excessivement aisés : Lorsqu’une épreuve d’évaluation des acquis universitaires s’avère insuffisamment discriminante, la masse des étudiants se regroupe entre 80 % et 100 % de réussite. L’histogramme présente alors un mur compact de barres à droite, avec une longue traînée vers la gauche constituée des rares étudiants n’ayant pas investi de travail préparatoire.
- Le Mini-Mental State Examination (MMSE) chez des personnes âgées sans démence : Dans un groupe témoin de personnes âgées saines, le MMSE (noté sur 30 points) génère une distribution asymétrique négative exacerbée. La grande majorité des sujets valide sans peine les items élémentaires d’orientation et de calcul, obtenant des scores de 28, 29 ou 30. La queue de distribution s’étire vers la gauche chez les quelques individus manifestant une fatigue attentionnelle ou un trouble neurocognitif débutant non diagnostiqué.
- Les échelles de satisfaction de vie et d’alliance thérapeutique : En psychothérapie, l’évaluation de la relation par le patient via le Working Alliance Inventory (WAI) affiche presque invariablement un étalement à gauche. Par politesse, bienveillance ou engagement thérapeutique réel, les patients attribuent massivement les échelons maximaux de l’échelle, les ruptures d’alliance ne se manifestant que chez une minorité isolée dans la queue gauche de l’histogramme.
8.3 Conséquences pour l’analyse des données
L’expression graphique d’une asymétrie négative sévère sonne l’alarme quant à l’émergence d’un effet de plafond (ceiling effect). L’instrument de mesure n’a pas été calibré avec un niveau de difficulté suffisant pour séparer les individus hautement performants : ceux disposant d’un niveau supérieur se trouvent artificiellement limités au même score maximal que les individus de niveau modérément élevé, ce qui entraîne une perte dramatique de variance et détruit le pouvoir de corrélation de la variable.
En outre, l’analyste doit se remémorer que la moyenne arithmétique devient un estimateur défaillant, excessivement pessimiste quant à la performance centrale réelle du groupe, car quelques scores déficitaires atypiques suffisent à faire chuter mécaniquement le niveau moyen global.
Pour restaurer l’indispensable symétrie requise par les approches statistiques classiques, les données d’un histogramme étiré à gauche doivent subir un traitement mathématique préalable, le plus souvent une « réflexion » suivie d’une transformation standard. Cette procédure consiste à inverser l’orientation des scores en retranchant chaque valeur individuelle d’une constante fixée au score maximal possible majoré de un :
$$x_{\text{réflé\chi}} = (X_{\max} + 1) – x_i$$
Cette manœuvre géométrique transpose formellement l’asymétrie négative en une asymétrie positive classique, sur laquelle peuvent alors être appliquées avec efficacité les transformations par logarithme ou par racine carrée.
9. L’aplatissement (Kurtosis) : profils leptocurtiques et platycurtiques
9.1 Distributions leptocurtiques : concentration aiguë et valeurs extrêmes
Le profil leptocurtique — du grec leptos signifiant mince, étroit ou élancé — désigne une distribution caractérisée à la fois par une pointe centrale d’une acuité exceptionnelle et par des queues de distribution épaisses et chargées d’observations éloignées. Le coefficient d’aplatissement ou kurtosis d’excès y enregistre une valeur positive statistiquement significative ($\gamma_2 > 0$).
Sur l’histogramme, cette silhouette se matérialise par un clocher étroit où les barres adjacentes au mode s’élèvent de manière fulgurante au-dessus du plan d’ensemble, signalant qu’une part disproportionnée de l’échantillon partage exactement le même niveau de score. Mais la particularité la plus critique réside dans ses extrémités latérales : au lieu de s’éteindre harmonieusement comme dans une distribution gaussienne, les queues de l’histogramme persistent sur une longue étendue horizontale, portant des barres de faible effectif mais ininterrompues.
Ce phénomène s’illustre particulièrement lors de la mesure des réactions émotionnelles physiologiques (telles que la réponse électrodermale) face à un stimulus subliminal : l’immense majorité des sujets ne manifeste aucune réactivité mesurable (formant le pic aigu sur le zéro), tandis qu’un sous-ensemble de sujets hyper-réactifs génère des déflections physiologiques massives qui étendent les queues de distribution à des distances extrêmes de la tendance centrale.
9.2 Distributions platycurtiques : aplatissement et dispersion étendue
À la polarité opposée de la voûte distributionnelle, le profil platycurtique — forgé sur le grec platys signifiant large et plat — se manifeste visuellement par un dôme surbaissé, émoussé, rappelant la coupe transversale d’une colline d’érosion douce. Son coefficient de kurtosis d’excès est négatif ($\gamma_2 < 0$).
L’histogramme d’une distribution platycurtique se caractérise par l’absence d’une classe d’intervalles nettement dominante. Les barres constituant la zone centrale s’alignent à des hauteurs très proches les unes des autres sur une large bande métrique, suggérant une équipartition relative des sujets autour du milieu. Corrélativement, les queues de distribution sont remarquablement courtes, fines et s’interrompent brutalement sans dispersion résiduelle lointaine.
Cette configuration émerge classiquement dans les évaluations d’attitudes psychosociales mesurées sur des échelles composites continues en l’absence de toute pression de conformité sociale ou de norme culturelle dominante. Les opinions s’y étalent de façon diffuse et diversifiée sur l’ensemble de l’éventail proposé, sans qu’aucun consensus d’opinion ne polarise le centre de la distribution ni qu’aucune déviance extrême ne prolifère sur les bords.
9.3 Distinction cruciale entre variance et kurtosis
Une confusion théorique et graphique extrêmement répandue parmi les utilisateurs de statistiques descriptives consiste à amalgamer la variance d’une distribution et son kurtosis, en déduisant à tort qu’une silhouette aplatie reflète simplement une grande variance, et qu’une silhouette étroite reflète une petite variance.
La variance ($\sigma^2$) est un opérateur de dispersion d’ordre deux qui quantifie l’écart quadratique moyen des observations par rapport à leur centre de gravité. Le kurtosis ($\beta_2$ ou $\gamma_2$) est un opérateur morphologique d’ordre quatre normalisé qui ne s’intéresse aucunement à la largeur absolue du nuage de points, mais à la façon dont cette variabilité s’articule entre le centre, les flancs intermédiaires et les queues :
$$\gamma_2 = \frac{\frac{1}{n} \sum_{i=1}^{n} (x_i – \bar{x})^4}{\left(\frac{1}{n} \sum_{i=1}^{n} (x_i – \bar{x})^2\right)^2} – 3$$
Une distribution peut afficher une variance colossale tout en conservant une géométrie parfaitement mésocurtique (gaussienne). Le kurtosis mesure fondamentalement le poids relatif des queues de distribution, c’est-à-dire la propension des données à générer des valeurs marginales extrêmes (heavy tails). La reconnaissance visuelle d’un profil leptocurtique n’avertit pas tant de la compacité de l’échantillon que du risque accru d’instabilité des estimateurs statistiques basés sur la variance, les modèles paramétriques linéaires classiques devenant particulièrement vulnérables aux dérives d’échantillonnage induites par ces queues épaisses.
10. Distributions tronquées, censurées et formes atypiques
10.1 Distributions tronquées et censurées en psychométrie
L’observation visuelle d’un histogramme révèle parfois des ruptures géométriques brutales et totalement antinaturelles, sous la forme de parois verticales nettes interrompant arbitrairement le déploiement de la distribution à l’une de ses extrémités. Il convient de distinguer conceptuellement deux mécanismes générateurs majeurs : la troncature et la censure.
Une distribution est dite tronquée lorsque les individus dont les scores se situent au-delà ou en deçà d’une valeur seuil spécifique ont été purement et simplement exclus du protocole d’observation ou de l’échantillon analysé. Visuellement, l’histogramme présente une silhouette normale qui s’arrête net, amputée d’un de ses pans, sans qu’aucune barre ne subsiste au-delà de cette frontière. Cela survient typiquement dans les concours de sélection académique très exigeants, où l’on n’analyse que les performances des candidats admis, tronquant mathématiquement toute la fraction inférieure du bassin de postulants.
À l’inverse, une distribution est qualifiée de censurée lorsque les individus hors seuil demeurent inclus dans l’échantillon, mais que l’instrument de mesure s’avère incapable d’enregistrer la véritable magnitude de leur performance au-delà de cette borne, en leur assignant d’office le score plancher ou plafond disponible. Sur l’histogramme, ce mécanisme se traduit par une silhouette tronquée surmontée d’une barre géante artificielle terminale (une véritable « pointe de censure ») qui agrège tous les scores des sujets censurés. Ce profil est omniprésent dans les tests de dépistage rapide (ex. seuil de détection olfactive ou auditive limité par la puissance maximale du transducteur).
10.2 Formes en U et distributions en J
Certains phénomènes comportementaux s’écartent radicalement des paradigmes gaussiens pour adopter des silhouettes topologiques non linéaires remarquables :
- La forme en U (profil bimodal extrême) : L’histogramme présente des fréquences massives concentrées aux deux extrémités de l’échelle d’abscisse, tandis que la portion centrale est totalement désertée par les barres de données. Cette configuration matérialise une polarisation affective totale ou un état de scission identitaire sans concession. On l’observe par exemple dans les dynamiques d’engagement militant face à un vote binaire dramatisé, où les postures de neutralité s’annulent au profit d’adhésions inconditionnelles à l’un ou l’autre des pôles antagonistes.
- La distribution en J ou en J inversé : Le profil en J inversé se caractérise par une fréquence maximale dès la première barre de départ à gauche, suivie d’une décroissance monotone fulgurante, souvent quasi exponentielle, vers la droite. C’est la signature universelle des conduites hautement réprouvées socialement ou des pathologies rares dans des populations tout-venant : l’histogramme du nombre de comportements d’automutilation ou d’actes de violence délinquante autodéclarés par des adolescents commence par une barre écrasante à zéro acte, pour s’éteindre immédiatement sur des effectifs infimes pour une, deux ou plusieurs occurrences.
10.3 Présence de valeurs aberrantes isolées (Outliers)
L’observation méticuleuse d’un histogramme exige d’explorer scrupuleusement la périphérie immédiate et distante du tracé principal. L’identification visuelle d’une valeur aberrante (outlier) se traduit par la présence d’une ou deux barres isolées de très faible hauteur, situées à une distance considérable du corps principal de la distribution, séparées de celui-ci par un large espace vide (gap).
L’apparition d’un tel élément commande l’ouverture immédiate d’un diagnostic d’imputabilité méthodologique :
- L’artéfact technique : Erreur manifeste d’encodage (par exemple, la saisie accidentelle d’un âge de 220 ans au lieu de 22), défaillance ponctuelle du capteur chronométrique ou non-respect flagrant des consignes par un sujet expérimental (appui continu sur une touche). Ces cas imposent une exclusion pure et simple après documentation rigoureuse.
- L’hétérogénéité d’échantillonnage : Le participant appartient en réalité à une autre population parente (par exemple, un participant atteint de tremblement essentiel non déclaré lors d’une tâche motrice de précision).
- L’atypicité clinique authentique : Le sujet présente un fonctionnement neuropsychologique hors norme (par exemple, un individu à très haut potentiel mémoriel validant l’intégralité d’une tâche de rétention supra-liminaire). L’exclure arbitrairement fausserait la compréhension de la plasticité cognitive humaine.
Pour préserver l’intégrité de l’analyse inférentielle sans compromettre la puissance du modèle, le chercheur arbitrera entre la suppression justifiée de l’observation, l’application d’estimateurs robustes non sensibles aux points leviers (médiane, moyennes tronquées), ou le recours à la winsorisation, technique consistant à ramener la valeur aberrante au seuil du dernier centile valide acceptable (par exemple le 99e percentile).
11. L’influence critique du choix des intervalles (Bins) sur la forme observée
11.1 Le biais de sous-lissage (Overfitting par bins trop étroits)
L’histogramme possède une vulnérabilité inhérente à sa condition d’estimateur non paramétrique discontinu : sa forme apparente est entièrement tributaire du choix du nombre de classes ($k$) et de leur largeur ($h$). Si l’analyste commet l’erreur de sélectionner des intervalles excessivement étroits — biais de sous-lissage —, la distribution souffre d’un phénomène de sur-apprentissage (overfitting visuel).
Sur le plan graphique, l’histogramme se fragmente de façon spectaculaire en une multitude de fines barres disjointes, alternant artificiellement sommets décharnés et micro-lacunes à zéro. Ce motif en peigne brise la continuité perceptive et noie la véritable dynamique distributionnelle sous un bruit d’échantillonnage stochastique stérile.
Le lecteur académique se trouve induit en erreur, susceptible de surinterpréter chaque petite oscillation locale comme un mode clinique indépendant ou une bimodalité latente, alors qu’il ne s’agit que de l’instabilité statistique d’effectifs dérisoires répartis dans trop d’intervalles distincts.
11.2 Le biais de sur-lissage (Underfitting par bins trop larges)
Le biais inverse, consistant à choisir des classes excessivement larges — sur-lissage ou underfitting —, engendre des dégâts méthodologiques plus délétères encore. En agrégeant indistinctement les scores au sein d’un nombre restreint de blocs monolithiques, l’analyste procède à un nivellement destructeur de l’information statistique.
Cette approche occulte les détails morphologiques cardinaux : une bimodalité clinique sous-jacente se verra lissée et fusionnée au sein d’une unique barre médiane imposante, masquant l’existence de deux populations thérapeutiques distinctes. De même, une asymétrie dextre modérée sera écrasée et assimilée à un profil pseudo-symétrique grossier.
Le sur-lissage comprime arbitrairement la variance apparente du phénomène mesuré, induisant le chercheur en erreur sur l’adéquation de ses postulats méthodologiques et ruinant la sensibilité des seuils diagnostiques définis sur la variable.
11.3 Règles algorithmiques d’optimisation du binning
Pour soustraire le tracé de l’histogramme à l’arbitraire subjectif de l’utilisateur, la communauté statistique a élaboré plusieurs règles algorithmiques formalisées, adaptées aux spécificités de l’échantillon :
La règle de Sturges : Historiquement implémentée par défaut dans de nombreux logiciels statistiques, elle formule le nombre de classes optimal ($k$) pour un échantillon de taille $n$ selon :
$$k = 1 + \log_2(n) = 1 + 3{,}322 \log_{10}(n)$$
Bien qu’efficace pour de petits échantillons ($n < 200$) issus de populations approximativement gaussiennes, la formule de Sturges tend à sous-estimer lourdement le nombre d'intervalles nécessaires dès que l'échantillon augmente substantiellement, provoquant un sur-lissage involontaire des données volumineuses.
La formule de Scott : Elle calcule directement la largeur optimale d’intervalle ($h$) en minimisant l’erreur quadratique moyenne intégrée de l’estimateur de densité, en intégrant l’écart-type de l’échantillon ($s$) :
$$h = \frac{3{,}49 , s}{n^{1/3}}$$
Cette approche est robuste et parfaitement calibrée pour les distributions continues unimodales sans aplatissement extrême.
La méthode de Freedman-Diaconis : Elle constitue le standard d’excellence pour l’analyse des données psychologiques, particulièrement résiliente face aux distributions asymétriques ou parasitées par des valeurs aberrantes. Elle substitue à l’écart-type l’intervalle interquartile ($IQR = Q_3 – Q_1$), une mesure de dispersion hautement robuste :
$$h = 2 , \frac{\text{IQR}(x)}{n^{1/3}}$$
Les logiciels d’analyse contemporains tels que R ou SPSS offrent la possibilité de paramétrer interactivement ces différentes heuristiques, permettant au chercheur de contrôler la robustesse morphologique de sa visualisation avant d’en figer l’illustration pour publication.
12. Guide pratique pour rédiger la description d’un histogramme selon les normes académiques
12.1 Structure séquentielle du paragraphe descriptif
La rédaction de la section descriptive des résultats dans un article de psychologie expérimentale obéit à un protocole rhétorique rigoureux. La transcription verbale de l’histogramme doit suivre une séquence canonique en quatre volets structurés, guidant méthodiquement le lecteur de la perception macroscopique vers les singularités locales :
- Énonciation globale de la silhouette : Déclarer d’emblée la modalité principale (unimodale, bimodale), l’allure générale (en cloche, étalée, rectangulaire) et le caractère de symétrie de la distribution.
- Rapport des paramètres de centralité et de dispersion : Fournir les valeurs étalonnées de la moyenne et de l’écart-type, complétées obligatoirement de la médiane si une quelconque distorsion géométrique émerge.
- Rapport formel des coefficients de forme et erreurs-types associées : Consigner les valeurs numériques normalisées du coefficient d’asymétrie (skewness) et du coefficient d’aplatissement (kurtosis), accompagnées impérativement de leurs erreurs-types respectives ($SE$).
- Localisation des déviations et éléments remarquables : Mentionner la présence éventuelle de lacunes distributionnelles, d’effets de seuil (plancher/plafond) ou l’existence d’observations périphériques isolées, en précisant le traitement méthodologique appliqué à ces dernières.
12.2 Modèles de phrases et vocabulaire technique conforme aux normes APA
Pour assurer la rigueur et l’homogénéité rédactionnelle de vos manuscrits scientifiques, voici plusieurs canevas rédactionnels adaptés aux scénarios morphologiques les plus fréquemment rencontrés :
Pour une distribution symétrique approximativement normale :
« L’inspection visuelle de l’histogramme des scores d’efficience mnésique révèle une distribution unimodale et approximativement symétrique, dessinant une silhouette en cloche canonique (voir Figure 1). Les indices de tendance centrale s’avèrent harmonieusement superposés ($M = 104{,}32$, $SD = 14{,}87$, $Md = 104{,}00$). Les valeurs d’asymétrie ($S = 0{,}08$, $SE = 0{,}15$) et d’aplatissement ($K = -0{,}14$, $SE = 0{,}30$) demeurent parfaitement contenues dans la fenêtre de tolérance de $\pm 1{,}0$, confirmant l’adéquation des données aux postulats d’application de l’analyse de variance paramétrique. »
Pour une distribution asymétrique positive (temps de réaction) :
« La distribution des latences de réponse motrice affiche une asymétrie positive ostensible (étalement vers la droite), caractérisée par une accumulation d’observations rapides ($Mode = 320\text{ ms}$) et une longue traînée de valeurs ralenties s’étirant jusqu’à $1150\text{ ms}$. Conformément à cette configuration dissymétrique, la moyenne arithmétique ($M = 438{,}20\text{ ms}$, $SD = 112{,}40$) surévalue notablement la médiane ($Md = 405{,}00\text{ ms}$). Le coefficient de skewness très élevé ($S = 1{,}68$, $SE = 0{,}18$) imposant une rectification distributionnelle, les données ont été soumises à une transformation logarithmique népérienne ($ln$) préalablement aux analyses inférentielles. »
Pour une comparaison morphologique entre deux groupes d’intervention :
« L’histogramme comparatif des scores de symptomatologie dépressive post-thérapeutique met en lumière une scission distributionnelle marquée entre les conditions expérimentales. Alors que le groupe témoin sur liste d’attente conserve une silhouette symétrique centrée sur des niveaux de détresse élevés ($M = 24{,}10$, $SD = 5{,}20$), le groupe ayant bénéficié du protocole cognitivo-comportemental adopte une morphologie en J inversé fortement étalée vers la droite ($Md = 7{,}00$, $S = 1{,}82$), objectivant visuellement une rémission massive chez 72 % des participants, corrélée à un puissant effet de plancher sur l’instrument d’évaluation. »
12.3 Check-list méthodologique pour la publication scientifique
Avant d’insérer définitivement une figure d’histogramme dans le corps d’un mémoire universitaire ou d’un manuscrit soumis à évaluation par les pairs, il est indispensable de confronter le rendu graphique à une grille d’audit méthodologique :
- Lisibilité et complétude des axes : L’axe des abscisses porte-t-il explicitement le nom de la variable psychologique et son unité de mesure (ex. « Latence de décision en millisecondes ») ? L’axe des ordonnées mentionne-t-il clairement la nature de la métrique (« Fréquence absolue », « Pourcentage », ou « Densité ») ?
- Cohérence multi-méthodes : L’évaluation morphologique de l’histogramme concorde-t-elle avec les tests d’ajustement formels (test de normalité de Shapiro-Wilk ou de Kolmogorov-Smirnov avec correction de Lilliefors) et avec l’inspection visuelle du diagramme quantile-quantile (Q-Q plot) ?
- Transparence de l’algorithme de partitionnement : Le choix de la largeur d’intervalle (binning) est-il explicité et adossé à une formule scientifique reconnue (Freedman-Diaconis, Scott) plutôt qu’à un choix arbitraire non documenté ?
- Clarté sémiotique des barres : Les bordures des rectangles sont-elles tracées avec un liseré contrasté distinct de la couleur de remplissage, évitant que des barres adjacentes fusionnent en un aplat monochrome indiscernable pour le lecteur ?
- Reproductibilité computationnelle : Le script d’analyse statistique (sous R, Python ou syntaxe SPSS) permettant de recalculer exactement les classes de l’histogramme à partir des données brutes est-il archivé dans un dépôt de données ouvert (par exemple sur l’Open Science Framework, OSF) ?
En observant scrupuleusement ces standards de rigueur morphologique, le chercheur s’assure que l’histogramme dépasse le stade d’illustration graphique pour devenir un instrument analytique puissant, garant de la transparence et de la reproductibilité des inférences scientifiques en sciences comportementales.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning. https://www.cengage.com/
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Pearson, K. (1895). Contributions to the mathematical theory of evolution. II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London (A), 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman & Hall/CRC. https://doi.org/10.1201/9781315140919
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley. https://www.pearson.com/
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4