
Dans le domaine des sciences psychologiques, du comportement et des neurosciences cognitives, l’analyse quantitative constitue le fondement sur lequel repose la validation des hypothèses empiriques. Lorsqu’un chercheur ou un praticien recueille des données issues d’inventaires de personnalité, d’échelles cliniques standardisées ou d’épreuves chronométriques mesurant des temps de réaction, il se retrouve confronté à un ensemble volumineux d’observations numériques désordonnées. L’agrégation de ces données brutes sans traitement préparatoire obscurcit les structures sous-jacentes, rendant impossible toute interprétation clinique ou expérimentale immédiate. C’est dans ce cadre méthodologique précis que la distribution de fréquences intervient en tant qu’instrument fondamental de la statistique descriptive, permettant de transformer une masse informe de chiffres en une structure ordonnée, intelligible et propice à l’inférence.
Le logiciel Microsoft Excel, ubiquitaire dans les laboratoires universitaires et les structures hospitalières, offre un écosystème computationnel remarquable pour modéliser et visualiser ces distributions. Bien que souvent perçu comme un simple tableur bureautique, Excel intègre des moteurs de calcul matriciel avancés, des algorithmes d’agrégation dynamique et des utilitaires d’analyse capables d’exécuter des partitionnements de classes avec une rigueur mathématique irréprochable. Maîtriser l’élaboration d’une distribution de fréquences au sein de cet outil ne relève pas simplement de l’apprentissage technique d’une fonction logicielle ; il s’agit d’une démarche épistémologique consistant à choisir judicieusement la granularité de discrétisation du réel afin d’en extraire le signal informationnel sans en dénaturer la variance intrinsèque.
Ce guide exhaustif a pour vocation d’articuler l’ensemble des fondements théoriques, des choix paramétriques et des procédures opérationnelles indispensables à la construction d’une distribution de fréquences scientifiquement valide dans Excel. De la modélisation mathématique des fonctions matricielles natives jusqu’aux exigences typographiques les plus strictes édictées par l’American Psychological Association (normes APA de 7e édition), chaque étape est disséquée avec la plus haute exigence méthodologique. Les chercheurs, statisticiens, doctorants et cliniciens y trouveront les protocoles précis pour assainir leurs jeux de données, automatiser le partitionnement en classes, diagnostiquer les anomalies distributionnelles et concevoir des représentations graphiques d’une pureté académique exemplaire.
1. Fondements théoriques de la distribution de fréquences en recherche psychologique
1.1 Définition et rôle dans l’analyse de données psychométriques
L’administration d’outils psychométriques standardisés — tels que l’Inventaire de Dépression de Beck (BDI-II), l’Échelle d’Anxiété État-Trait (STAI) ou le Questionnaire de Personnalité NEO-PI-3 — génère des séries quantitatives reflétant l’intensité de traits psychologiques latents. Une distribution de fréquences constitue un dispositif de condensation statistique qui associe à chaque valeur observée, ou à chaque intervalle de valeurs disjointes, le dénombrement effectif des occurrences empiriques au sein de l’échantillon étudié. Ce passage de la série statistique brute individuelle, souvent notée sous la forme d’un vecteur non ordonné X = (x₁, x₂, …, xₙ), à un tableau d’effectifs synthétique constitue la première étape de réduction des données. Cette opération permet d’extraire la morphologie générale du phénomène psychologique étudié en synthétisant la dispersion des scores sans effacer la variabilité interindividuelle.
Au-delà de cette simplification descriptive, la distribution de fréquences joue un rôle de passerelle méthodologique irremplaçable entre la collecte des observations et l’évaluation des paramètres de tendance centrale et de dispersion. En observant la manière dont les effectifs se répartissent le long du continuum de mesure, le chercheur appréhende immédiatement si la population d’étude s’organise selon un mode unique central, si elle présente une bimorphologie révélatrice de deux sous-groupes cliniques distincts, ou si elle subit une dispersion anormale due à une hétérogénéité d’échantillonnage. Cette organisation préliminaire des données offre une visibilité directe sur la concentration des scores, guidant ainsi l’interprétation des moyennes, médianes et écarts-types qui en découleront inévitablement.
Dans le contexte spécifique des inventaires cliniques, la distribution d’effectifs permet d’objectiver instantanément la prévalence de certains niveaux de sévérité symptomatique au sein d’une cohorte de patients. Par exemple, la structuration des scores de dépression en classes de sévérité (minimale, légère, modérée, sévère) facilite l’identification immédiate de la proportion de sujets nécessitant une prise en charge thérapeutique prioritaire. L’évaluation de la dispersion à travers une table de distribution met également en lumière l’étalement des données : une distribution excessivement resserrée autour de la médiane peut dénoter un manque de sensibilité de l’instrument de mesure pour la population considérée, tandis qu’un étalement démesuré signale une variabilité exacerbée nécessitant la recherche de variables modératrices sous-jacentes.
1.2 Typologie des variables et échelles de mesure
La structuration rigoureuse d’une distribution de fréquences exige une compréhension préalable de la nature de la variable observée et du niveau de mesure sous-jacent, théorisé par le psychologue Stanley Smith Stevens. On distingue fondamentalement les variables quantitatives continues des variables quantitatives discrètes. Une variable discrète ne peut prendre que des valeurs isolées, généralement entières, issues d’un processus de comptage (par exemple, le nombre d’erreurs commises lors d’une tâche de rappel libre ou le nombre de crises de panique hebdomadaires). À l’inverse, une variable continue peut théoriquement assumer une infinité indénombrable de valeurs au sein d’un intervalle donné, à l’image des temps de réaction cognitifs enregistrés en millisecondes ou des concentrations hormonales de cortisol salivaire mesurées en nanomoles par litre.
Cette distinction conceptuelle dicte la morphologie des classes de distribution. Pour une variable discrète à faible étendue, chaque modalité numérique distincte peut constituer sa propre classe, évitant ainsi tout regroupement arbitraire. Pour les variables continues, le regroupement en intervalles de classe (ou « bins ») devient une obligation mathématique absolue, car la probabilité d’observer exactement deux fois la même valeur au millième de seconde près est virtuellement nulle. Entre ces deux extrêmes se situent les échelles de type Likert, omniprésentes dans les questionnaires d’auto-évaluation psychologique (allant par exemple de 1 « Pas du tout d’accord » à 5 « Tout à fait d’accord »). Bien que formellement ordinales, les scores totaux issus de la sommation d’items de Likert sont fréquemment traités comme des variables pseudo-continues d’intervalle dans la littérature psychométrique, à condition que la structure factorielle et la métrique de l’instrument en soutiennent la légitimité psychologique.
Le niveau de mesure détermine également la permissivité des opérations algébriques applicables lors de la discrétisation. Sur une échelle d’intervalles ou de rapports, les distances entre les valeurs sont constantes et signifiantes, ce qui autorise la création d’intervalles de classe d’amplitudes strictement égales le long de l’axe empirique. En revanche, si l’on manipule des rangs purement ordinaux, l’établissement de classes d’amplitudes métriques constantes est théoriquement proscrit, car la distance séparant un rang 1 d’un rang 2 n’est pas nécessairement congruente à celle séparant un rang 4 d’un rang 5. La conséquence méthodologique directe sur la structuration sous Excel réside dans l’obligation d’adapter le découpage aux propriétés intrinsèques de l’échelle afin de préserver l’intégrité de l’information psychométrique.
1.3 Objectifs académiques du regroupement en classes
L’objectif épistémologique premier du regroupement en classes réside dans la réduction de l’entropie informationnelle. Face à un tableau comprenant plusieurs centaines ou milliers d’enregistrements psychophysiologiques bruts, le système cognitif de l’analyste se heurte à une surcharge de détails bruités. En discrétisant la série de données en un nombre fini et parcimonieux de classes d’intervalles, le chercheur filtre les fluctuations aléatoires mineures pour mettre en exergue la forme fondamentale de la distribution sous-jacente. Cette réduction de la complexité cognitive doit néanmoins opérer sans perte de l’information critique relative à la forme générale, au centrage et à l’étalement de l’échantillon.
Un deuxième objectif académique majeur concerne l’identification immédiate des anomalies distributionnelles et des singularités d’échantillonnage. Une distribution tabulaire correctement paramétrée révèle instantanément la présence d’observations aberrantes (outliers), de concentrations inattendues de scores dans des zones limites (effets de plancher ou effets de plafond), ou encore de distributions multimodales. Dans le champ de l’évaluation neuropsychologique, par exemple, un regroupement anormalement dense d’individus dans la classe des scores les plus bas d’un test de fluence verbale peut mettre en évidence un sous-groupe souffrant d’une détérioration cognitive débutante qui serait passée inaperçue lors de la simple lecture d’une moyenne arithmétique globale diluée par le reste de la cohorte.
Enfin, la distribution de fréquences constitue la condition préalable indispensable à la réalisation des tests d’hypothèses inférentielles d’ajustement. Qu’il s’agisse de procéder au test d’adéquation du Chi-deux (χ²) de Pearson ou de préparer les données pour un test de normalité par comparaison des fréquences théoriques et observées, la structuration préalable en classes empiriques d’effectifs fournit les entrées fondamentales requises par ces algorithmes mathématiques. Elle permet de confronter rigoureusement les distributions empiriques collectées sur le terrain aux grands modèles probabilistes théoriques — tels que la loi normale de Laplace-Gauss, la loi log-normale pour les latences cognitives ou la loi de Poisson pour les événements comportementaux discrets à faible probabilité d’occurrence.
2. Anatomie et syntaxe rigoureuse de la fonction FREQUENCE
2.1 Décomposition des arguments de la fonction
Au sein du catalogue algorithmique d’Excel, la fonction native FREQUENCE (nommée FREQUENCY dans la déclinaison anglophone du logiciel) représente le mécanisme computationnel le plus performant pour calculer des tables d’effectifs. Conçue spécifiquement pour le traitement matriciel, sa syntaxe canonique se décline sous la forme épurée : =FREQUENCE(tableau_données; tableau_intervalles). Chacun de ces deux arguments assume un rôle structurel distinct et non interchangeable dans l’exécution de l’algorithme d’affectation.
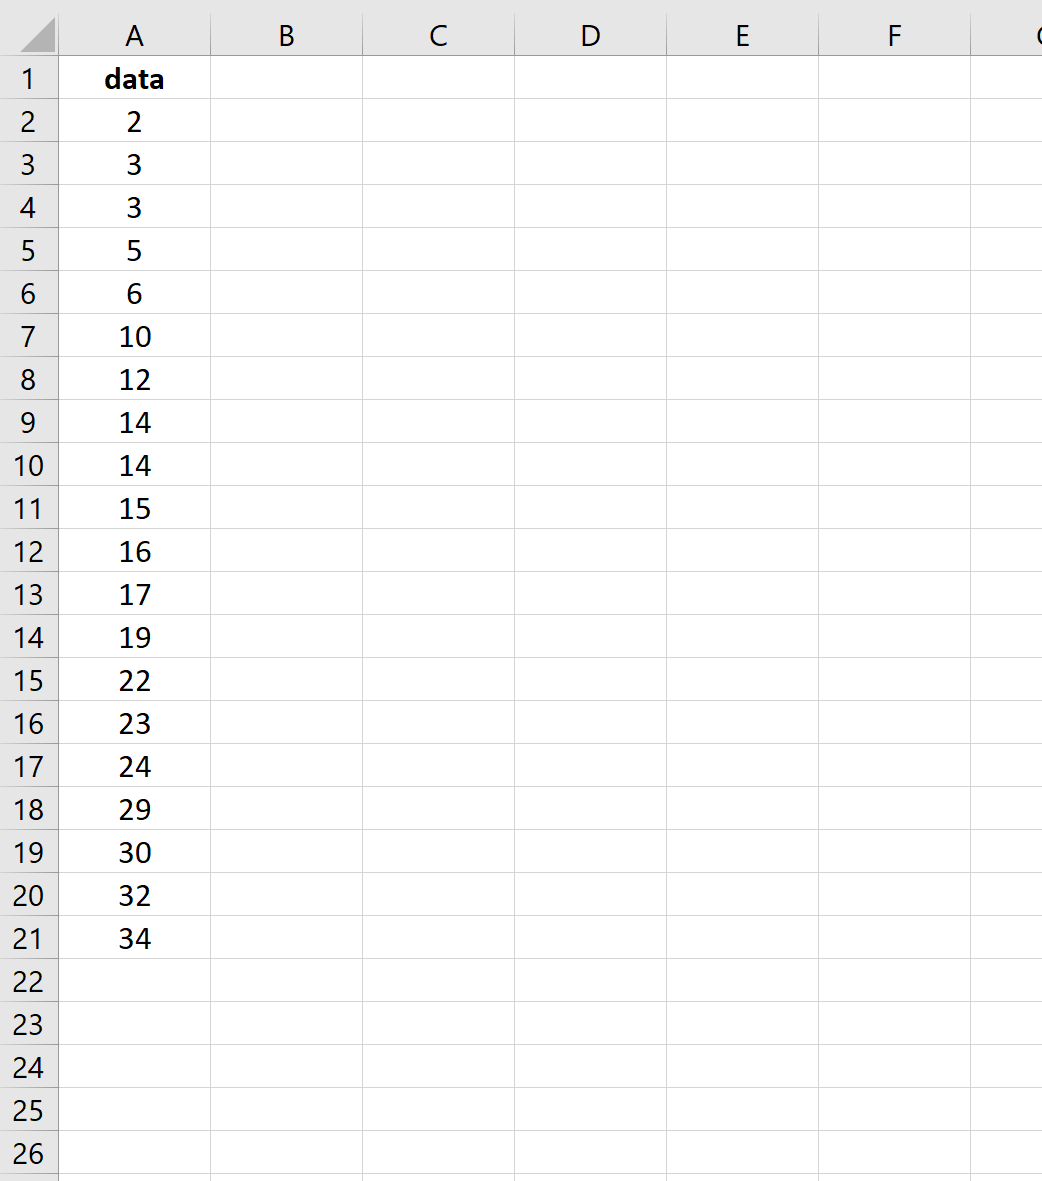
L’argument tableau_données représente la référence à la plage de cellules ou au vecteur contenant l’ensemble des observations quantitatives empiriques à dénombrer. Cette série peut se présenter sous un format non ordonné, comporter des valeurs décimales, des entiers positifs ou négatifs. Le moteur de calcul d’Excel traite cette matrice en ignorant d’emblée les cellules textuelles ou les champs strictement vides, évitant ainsi des erreurs d’interruption lors de la lecture des données. Cependant, la rigueur méthodologique impose que cette plage soit préalablement nettoyée afin d’éviter tout artefact statistique.
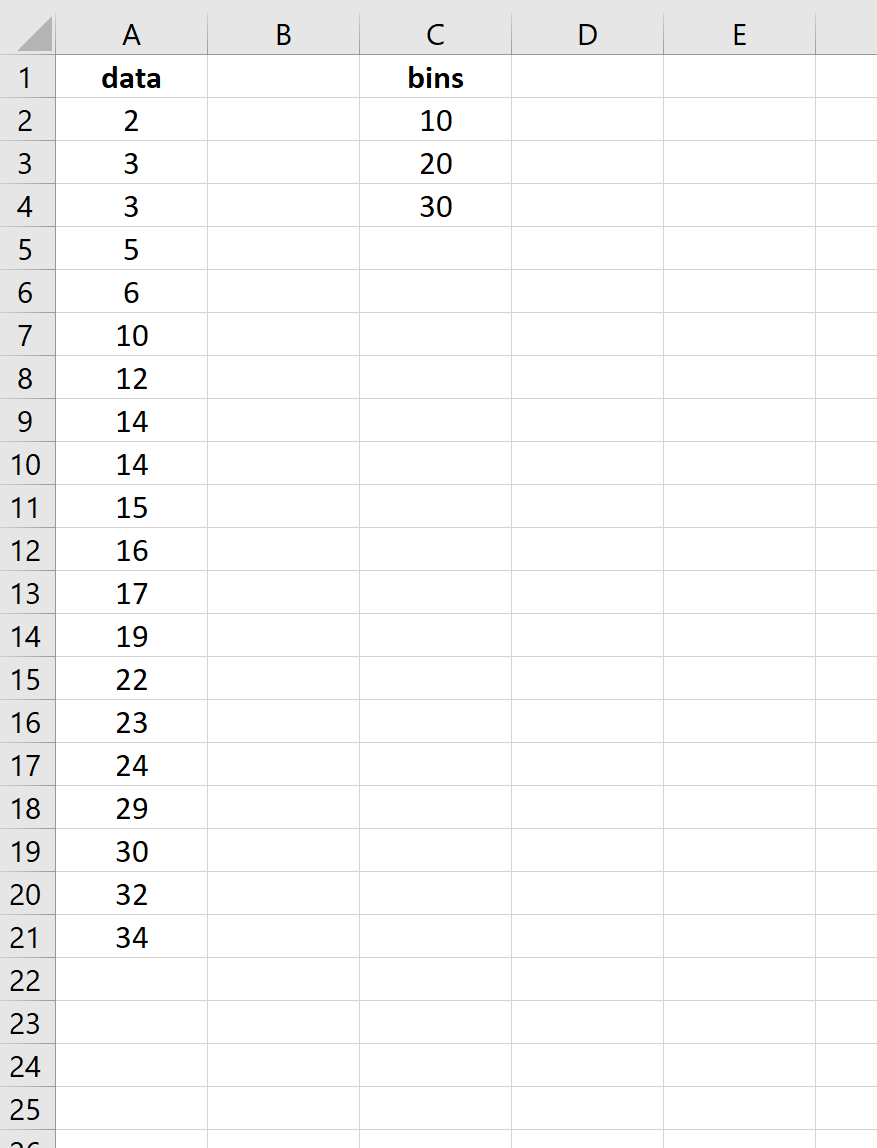
Le second argument, tableau_intervalles, désigne la plage de cellules hébergeant les valeurs seuils ordonnées qui vont servir à découper l’espace continu des observations. Ces valeurs, qualifiées techniquement de bornes supérieures d’intervalles (ou « bin limits »), dictent la partition de la droite réelle en segments successifs. Excel examine chaque valeur issue de tableau_données et la compare itérativement à ces seuils afin de l’assigner à une classe unique. La gestion interne de cet argument par le logiciel suit un principe d’exclusion stricte : une observation est intégrée à un intervalle si elle est inférieure ou égale à la borne supérieure de celui-ci, et strictement supérieure à la borne supérieure de l’intervalle précédent.
2.2 Comportement matriciel et dimensionnement du résultat
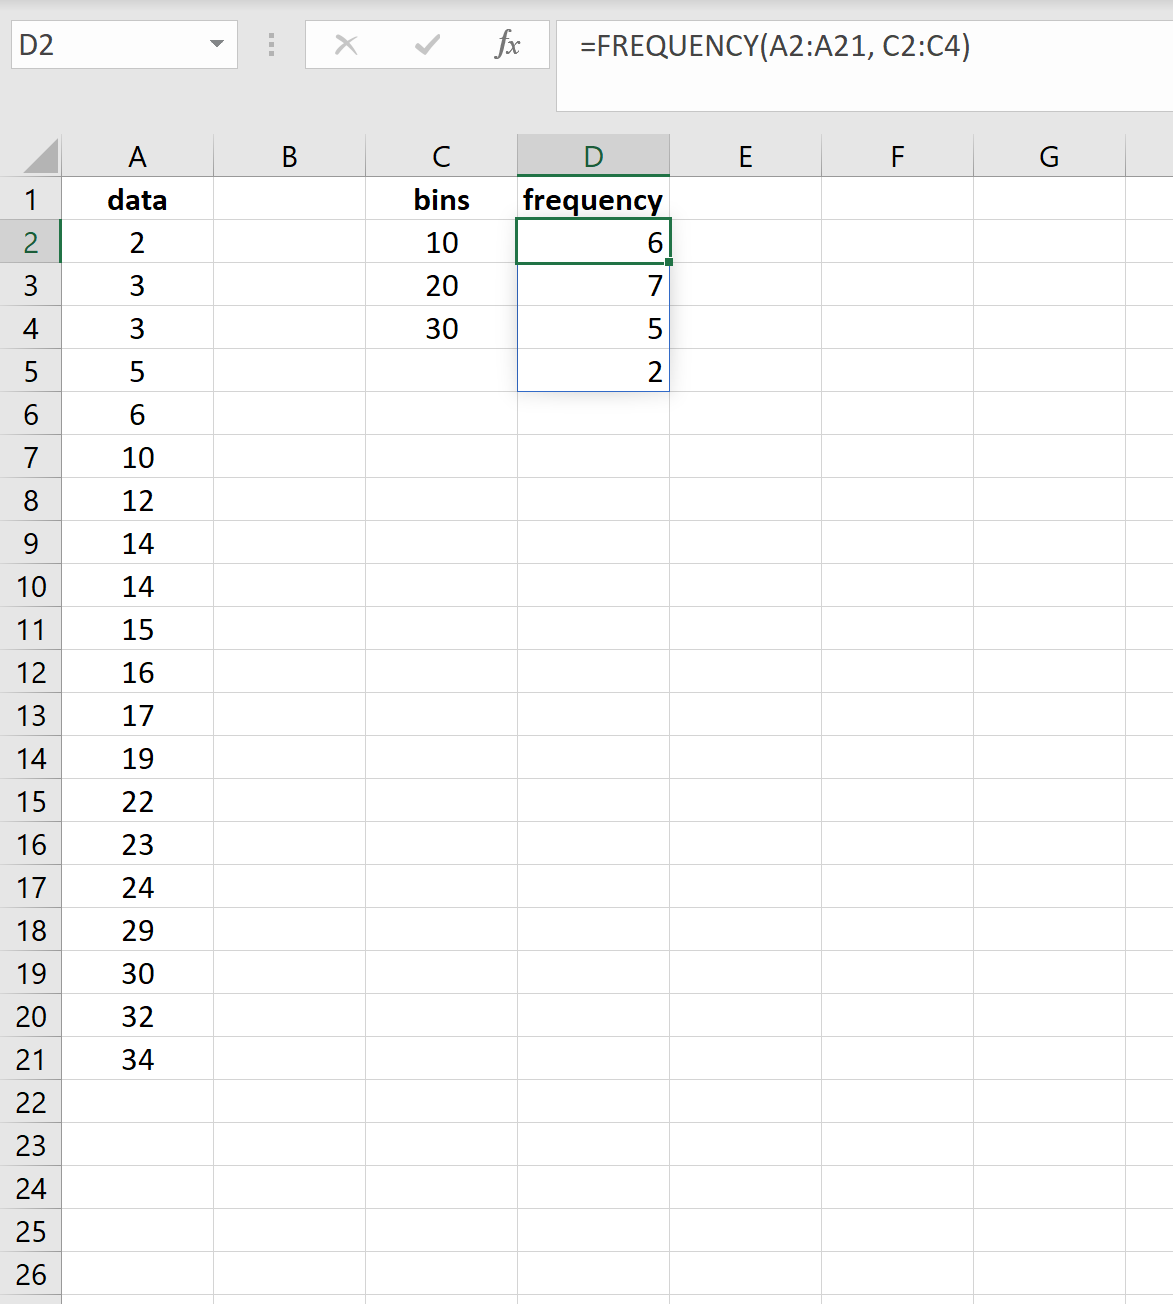
La spécificité architecturale majeure de la fonction FREQUENCE réside dans sa nature strictement matricielle verticale. Contrairement aux fonctions scalaires usuelles comme SOMME ou MOYENNE qui renvoient une valeur atomique unique dans une seule cellule, FREQUENCE génère systématiquement un vecteur unidimensionnel de dimensions (n + 1) × 1, où n correspond précisément au nombre d’intervalles spécifiés dans l’argument tableau_intervalles. Cette dimension supplémentaire constitue une caractéristique fondamentale du modèle de partitionnement d’Excel.
Cette dernière cellule excédentaire, systématiquement retournée à la base du vecteur de résultat, héberge le décompte de l’ensemble des valeurs empiriques qui s’avèrent strictement supérieures au seuil numérique le plus élevé mentionné dans le tableau des intervalles. Elle agit comme une classe résiduelle semi-infinie à droite, garantissant qu’aucune donnée de l’échantillon ne soit omise lors du traitement. En recherche psychologique, si cette (n + 1)-ième cellule affiche une valeur strictement supérieure à zéro, cela indique formellement que le partitionnement choisi n’a pas englobé la valeur maximale de la distribution, signalant une coupure artificielle qu’il conviendra de corriger par un ajustement des bornes.
L’interaction opérationnelle de l’utilisateur avec cette structure matricielle a connu une mutation radicale avec l’introduction du moteur de calcul à tableaux dynamiques dans Microsoft 365. Dans les versions modernes d’Excel, la saisie de la formule dans une seule cellule entraîne un phénomène d’expansion dynamique automatique (le déversement ou « spill »), projetant instantanément l’intégralité du vecteur de résultats sur les n + 1 cellules sous-jacentes. À l’inverse, dans les versions héritées (Excel 2019 et antérieures), le dimensionnement exigeait une sélection rigoureuse et manuelle d’une plage verticale exacte de n + 1 cellules avant la validation impérative par la combinaison tri-touches classique Ctrl + Maj + Entrée.
2.3 Logique mathématique d’inclusion des bornes
D’un point de vue topologique, le partitionnement opéré par la fonction FREQUENCE obéit à la règle stricte des intervalles semi-ouverts à gauche et fermés à droite, symbolisés conventionnellement en mathématiques sous la forme ]a ; b]. Cela implique qu’un individu présentant un score rigoureusement identique à la borne supérieure b d’un intervalle sera comptabilisé dans la classe définie par cette borne, tandis qu’un score infiniment proche mais égal à a sera consigné dans l’intervalle antérieur ]…, a]. Cette règle structurelle garantit une partition étanche de l’espace métrique, rendant tout chevauchement ou double comptage rigoureusement impossible.
Pour illustrer cette logique, supposons un tableau de bornes spécifiant les valeurs 10, 20 et 30. Le résultat généré par FREQUENCE ventilera les données selon quatre compartiments distincts : le premier réunit les observations vérifiant la condition x ≤ 10 ; le deuxième capture l’ensemble des scores répondant à 10 < x ≤ 20 ; le troisième isole les données soumises à 20 < x ≤ 30 ; enfin, la quatrième cellule résiduelle collecte toutes les valeurs obéissant à x > 30. Cette mécanique d’exclusion de la borne inférieure et d’inclusion de la borne supérieure doit être intégrée dans la rédaction des étiquettes textuelles finales pour éviter toute fausse interprétation par les pairs lors de la publication.
Cette approche native se distingue avantageusement de l’utilisation concurrente de la fonction NB.SI.ENS. Bien que cette dernière permette de répliquer manuellement un partitionnement en paramétrant deux critères croisés (par exemple NB.SI.ENS(plage; ">10"; plage; "<=20")), elle s’avère particulièrement vulnérable aux erreurs de syntaxe manuelle, alourdit considérablement le temps de calcul lors du traitement de volumineux jeux de données psychophysiologiques et requiert la saisie répétitive de formules indépendantes sujettes aux corruptions d’adresses relatives. FREQUENCE demeure, par sa conception algorithmique compilée en bas niveau, immensément plus rapide, mathématiquement sécurisée et élégante.
3. Nettoyage préalable et structuration du jeu de données expérimentales
3.1 Audit et purification des données brutes
L’application d’un traitement statistique sur un jeu de données non audité viole les principes directeurs de l’intégrité de la recherche scientifique. Préalablement à tout calcul d’effectifs, il est indispensable de conduire un audit rigoureux de la matrice empirique afin de neutraliser trois menaces courantes : les valeurs manquantes, les erreurs de saisie aberrantes et les divergences de typage numérique. Les omissions de passation ou refus de réponse doivent faire l’objet d’un codage standardisé clair. Dans l’écosystème Excel, l’utilisation de codes numériques arbitraires d’ancienne génération tels que « -999 » ou « 9999 » pour désigner un item manquant est fortement déconseillée, car la fonction FREQUENCE les intégrera comme de véritables mesures empiriques extrêmes, faussant dramatiquement la distribution.
Les données manquantes doivent être représentées soit par des cellules strictement vides, soit par le code d’erreur standard #N/D (généré par la formule =NA()), qu’Excel exclut formellement de ses calculs matriciels de comptage continu. Concernant les valeurs aberrantes (outliers), il convient de distinguer les anomalies de saisie matérielle (telles qu’un score de 150 saisi par inadvertance sur une échelle plafonnant à 15) des véritables scores atypiques mais cliniquement authentiques. Les erreurs matérielles doivent être impérativement purgées ou corrigées par confrontation aux formulaires de passation physiques originaux.
Enfin, la vérification du formatage des données constitue un passage obligé. Dans les protocoles expérimentaux informatisés collectés via des plateformes en ligne ou des scripts d’expérimentation (Psychopy, E-Prime), les variables numériques sont parfois importées sous la forme insidieuse de chaînes de caractères (texte). Une cellule contenant la valeur textuelle « 24 » apparaît visuellement identique au nombre 24, mais sera purement et simplement ignorée par l’algorithme de calcul de fréquences, minorant artificiellement la taille effective de l’échantillon. L’usage de la fonction ESTNUM permet d’attester de la conformité du typage pour l’ensemble des observations du tableau.
3.2 Conversion en tableau structuré Excel
L’organisation optimale d’un protocole d’analyse dans Excel repose sur l’abandon des plages de cellules statiques (telles que A2:A500) au profit des Tableaux Structurés officiels (fonctionnalité accessible via le raccourci Ctrl + L ou l’onglet Insertion > Tableau). L’attribution d’un nom sémantique explicite à cet objet, par exemple Tbl_Recherche_Clinique, élève immédiatement le niveau de robustesse computationnelle du protocole expérimental.
Le bénéfice technique prééminent des tableaux structurés réside dans la mise en œuvre des références structurées. La colonne hébergeant les scores de la variable d’intérêt est désormais adressée sous une forme syntaxique transparente : Tbl_Recherche_Clinique[Score_Anxiete]. Cette désignation confère une lisibilité immédiate aux formules, éliminant tout risque d’erreur d’adressage relatif lors du déplacement ou de la duplication des feuilles de travail. Plus important encore, les références structurées sont intrinsèquement auto-extensibles : chaque fois que de nouveaux sujets expérimentaux sont intégrés au protocole et saisis en continu à la suite du tableau, la plage couverte par la colonne s’élargit automatiquement sans nécessiter la moindre intervention manuelle de l’opérateur dans les paramètres des formules statistiques dépendantes.
Cette dynamicité structurelle neutralise le risque récurrent de décalage temporel entre la collecte et l’analyse. Dans les projets de recherche longitudinaux ou les campagnes d’évaluations cliniques s’étalant sur plusieurs mois, l’analyste peut ainsi bâtir l’ensemble de sa chaîne de distribution de fréquences, de calculs dérivés et d’histogrammes associés sur un échantillon préliminaire de 50 sujets, en conservant la certitude absolue que le modèle recalculera dynamiquement les classes à mesure que les inclusions s’élèveront jusqu’à atteindre les 500 sujets finaux requis par la puissance statistique cible.
3.3 Contrôle d’intégrité avant traitement statistique
Avant d’exécuter la fonction de partitionnement, un tableau de contrôle d’intégrité préliminaire doit être mis en place sur la feuille de calcul. Ce tableau a pour objectif de consigner les paramètres cardinaux de la série de données brute afin d’offrir une base de vérification croisée immuable. Les trois métriques indispensables à calculer sont l’effectif valide, la borne minimale observée et la borne maximale enregistrée.
L’évaluation de la taille de l’échantillon valide s’effectue au moyen de la fonction NB, selon la formulation : =NB(Tbl_Recherche_Clinique[Score_Anxiete]). Cette fonction ne dénombre que les cellules hébergeant des données numériques authentiques, fournissant ainsi la valeur exacte de l’effectif N exploitable. Ce chiffre constitue la référence pivot à laquelle la somme de toutes les fréquences de classes calculées ultérieurement devra rigoureusement égaler. Toute divergence numérique entre ce compte de base et la sommation des classes dénotera un vice de partitionnement ou un débordement matriciel non maîtrisé.
L’identification de l’étendue empirique nécessite l’application conjointe des fonctions MIN et MAX appliquées à la même référence : =MIN(Tbl_Recherche_Clinique[Score_Anxiete]) et =MAX(Tbl_Recherche_Clinique[Score_Anxiete]). Ces deux jalons statistiques bornent formellement le domaine empirique de la variable. Ils fournissent les informations indispensables pour garantir que le futur vecteur d’intervalles débutera strictement en dessous de la valeur minimale observée et que sa borne supérieure ultime couvrira intégralement la valeur maximale observée. Ce protocole de contrôle d’intégrité documente le processus d’analyse conformément aux exigences de traçabilité et de reproductibilité méthodologique universellement requises dans les standards contemporains de la recherche empirique.
4. Détermination méthodique du nombre et de la largeur des intervalles
4.1 Formulations empiriques d’optimisation de partitionnement
L’un des écueils méthodologiques les plus fréquents en analyse descriptive consiste à fixer le nombre d’intervalles de manière arbitraire ou intuitive. Un découpage comportant un nombre insuffisant de classes agrège excessivement les scores, masquant la bimodalité potentielle ou les spécificités de la dispersion. À l’inverse, un sur-découpage pulvérise l’échantillon en une multiplicité de classes à effectifs nuls ou unitaires, réintroduisant le bruit stochastique que la distribution de fréquences avait précisément pour mission d’éliminer. La littérature statistique académique a formalisé plusieurs règles mathématiques d’optimisation pour déterminer objectivement le nombre idéal de classes k.
La règle empirique la plus classique, historiquement introduite par Herbert Sturges en 1926, est particulièrement adaptée aux distributions unimodales et symétriques d’effectif modéré (N < 200). Sa formulation s’énonce : k = 1 + log₂(N), ce qui s’exprime sous Excel au moyen du logarithme en base 10 par la syntaxe rigoureuse : =ARRONDI.SUP(1 + 3,322 * LOG10(N); 0). Bien que robuste et universellement implantée dans les didacticiels, la règle de Sturges présente l’inconvénient d’avoir tendance à sur-lisser les données lorsque l’échantillon devient très volumineux, conduisant à une sous-estimation du nombre optimal d’intervalles pour les grandes cohortes épidémiologiques.
Pour pallier cette limite sur les distributions continues étendues, le statisticien David Scott a formulé une règle basée sur la dispersion gaussienne standard, déterminant non pas directement le nombre de classes, mais leur largeur optimale h : h = 3,49 * σ / (N^(1/3)), où σ représente l’écart-type de la population. Sous Excel, cette formule se transpose fidèlement via : =(3,49 * ECARTYPE.STANDARD(données)) / (NB(données)^(1/3)). Une troisième formulation, encore plus robuste face aux distributions asymétriques ou parasitées par des valeurs cliniques extrêmes, est celle de Freedman et Diaconis. Cette dernière substitue à l’écart-type l’étendue interquartile (IQR), moins sensible aux perturbations marginales : h = 2 * IQR / (N^(1/3)), traduisible sous Excel par : =2 * (QUARTILE.INC(données; 3) - QUARTILE.INC(données; 1)) / (NB(données)^(1/3)).
4.2 Calcul opérationnel de l’amplitude de classe
Une fois le nombre optimal de classes k ou la largeur théorique h estimé, l’analyste doit déterminer l’amplitude empirique opérationnelle de chaque classe, notée a. Ce calcul procède d’une équation fondamentale reliant l’étendue totale des données E au nombre de compartiments retenu. L’étendue se définit mathématiquement par la différence algébrique : E = Max - Min, implémentée sous la forme d’une formule Excel dédiée : =MAX(données) - MIN(données).
L’amplitude mathématique brute s’obtient simplement par le quotient de l’étendue par le nombre de classes : a_brut = E / k. Cependant, l’application aveugle de ce quotient brut aboutit presque systématiquement à des largeurs d’intervalles assorties de décimales irrationnelles (par exemple une largeur de 4,7381 unités), hautement perturbantes pour l’esprit humain et incompatibles avec la métrique sous-jacente des instruments psychologiques. La granularité de la mesure doit impérativement être prise en considération lors de cette étape d’arrondi opérationnel.
Il est donc d’usage académique d’arrondir cette amplitude brute au nombre entier ou au multiple décimal signifiant immédiatement supérieur au moyen de la fonction PLAFOND.PRECISION d’Excel. Par exemple, si l’on mesure une latence cognitive dont l’amplitude brute calculée est de 43,2 millisecondes, le chercheur appliquera la fonction : =PLAFOND.PRECISION(43,2; 10) ou =PLAFOND.PRECISION(43,2; 50) pour obtenir une amplitude harmonieuse de 50 millisecondes. Sur un inventaire de personnalité mesuré en nombres entiers discrets, l’arrondi s’effectuera au pas unitaire supérieur par ARRONDI.SUP(a_brut; 0), garantissant que la somme des k classes couvrira une étendue totale légèrement supérieure à l’étendue empirique, scellant ainsi l’inviolabilité du partitionnement.
4.3 Construction concrète du vecteur de bornes dans la feuille de calcul
La constitution du vecteur d’intervalles constituant le paramètre d’entrée de la future fonction FREQUENCE exige une méthodologie rigoureuse. L’analyste réserve une colonne dédiée sur sa feuille d’analyse, intitulée expressément Bornes_Superieures. Ce vecteur ne doit comporter que les limites supérieures de chaque classe, agencées dans un ordre strictement croissant continu, sans omission ni retour en arrière.
La première borne supérieure doit être fixée de manière à ce que la première classe englobe la valeur minimale observée tout en préservant la logique de la métrique. Par exemple, si la valeur minimale empirique est de 12 et que l’amplitude unitaire retenue est de 5, la première borne supérieure peut être établie à 15 (la classe couvrant ainsi l’intervalle ]10 ; 15] ou [11 ; 15] en nombres entiers). Les cellules descendantes successives s’obtiennent en incrémentant la cellule précédente de l’amplitude constante déterminée : =Cellule_Précédente + Amplitude. Cette formulation dynamique garantit l’alignement et la régularité arithmétique de l’ensemble de la progression.
La validation formelle du vecteur de bornes requiert que la dernière valeur numérique explicitement saisie dans cette colonne soit rigoureusement supérieure ou égale à la valeur maximale observée issue de la fonction MAX. Si la dernière borne est strictement inférieure au maximum empirique, la fonction FREQUENCE basculera inévitablement les observations les plus élevées dans sa cellule résiduelle terminale, ce qui scinderait artificiellement le dernier regroupement. L’exhaustivité du domaine de variation empirique doit ainsi être certifiée avant de procéder au calcul matriciel effectif des fréquences.
5. Implémentation technique de la formule FREQUENCE sous Excel
5.1 Exécution sous Microsoft 365 et Excel moderne
L’évolution du moteur de calcul d’Excel vers l’architecture de tableaux dynamiques (moteur de calcul recalculé en 2018-2019) a profondément simplifié l’implémentation opérationnelle de la fonction FREQUENCE. Dans Microsoft 365 et les versions contemporaines d’Excel, l’utilisateur n’a plus à anticiper manuellement la géométrie de la matrice de sortie ni à mémoriser de combinaisons de touches absconses. Le processus est devenu direct, intuitif et hautement sécurisé.
Pour exécuter le calcul, le chercheur sélectionne une cellule unique, idéalement contiguë à son tableau de paramètres de classes, par exemple la cellule E2. Il saisit directement l’instruction algorithmique complète : =FREQUENCE(Tbl_Recherche_Clinique[Score_Anxiete]; D2:D11), où D2:D11 correspond au vecteur ordonné des bornes supérieures établi au chapitre précédent. Dès la validation par une simple pression sur la touche Entrée, le moteur d’Excel calcule instantanément les fréquences et déverse (spills) le résultat sur une colonne verticale occupant exactement le nombre d’intervalles plus une cellule (soit 11 cellules dans cet exemple précis).
Le périmètre matriciel ainsi généré est entouré d’une bordure fine bleutée lorsque la cellule d’ancrage supérieure est active, signalant visuellement le statut de matrice dynamique déversée. Il convient de souligner que seules les coordonnées de la cellule initiale (E2) hébergent physiquement la formule modifiable ; toutes les cellules subordonnées en dessous affichent la formule grisée dans la barre de formule et ne peuvent être altérées unitairement. Si l’analyste souhaite référencer ce vecteur d’effectifs déversé dans un calcul subséquent (comme un calcul de pourcentage global), il lui suffit d’utiliser l’opérateur d’ancrage dièse : =E2#, ce qui garantit une adaptabilité dynamique absolue si la taille de la matrice venait ultérieurement à fluctuer.
5.2 Exécution sous les versions classiques héritées d’Excel
Dans les environnements hospitaliers ou académiques utilisant des versions pérennes plus anciennes du logiciel (telles que Microsoft Office 2013, 2016 ou 2019 hors abonnement 365), la mécanique d’affectation matricielle obéit aux règles strictes des formules dites « CSE » (Ctrl + Maj + Entrée). L’ignorance de ces mécanismes historiques constitue la source principale des échecs d’implémentation documentés chez les jeunes chercheurs formés aux interfaces modernes.
La procédure classique exige une sélection préparatoire méticuleuse de la zone réceptrice : l’opérateur doit sélectionner à la souris une plage verticale comprenant rigoureusement n + 1 cellules vides, où n représente le nombre exact de cellules contenues dans le tableau des intervalles de classes. Une erreur d’une seule cellule en excès ou en défaut tronquera le vecteur ou générera des valeurs d’erreur indésirables. Sans désélectionner cette plage active, l’utilisateur positionne le curseur dans la barre de formule et rédige la syntaxe : =FREQUENCE(A2:A501; D2:D11).
La validation ne doit sous aucun prétexte s’effectuer par la touche Entrée standard, sous peine de ne renvoyer que la fréquence de la première classe dans la première cellule sélectionnée. L’utilisateur doit impérativement presser simultanément la combinaison matricielle Ctrl + Maj + Entrée (ou Cmd + Shift + Enter sous macOS). Cette action enjoint à Excel de compiler le bloc sous forme de matrice unifiée, ce qui se manifeste visuellement par l’apparition d’accolades entourant l’ensemble de la formule : {=FREQUENCE(A2:A501; D2:D11)}. Ces accolades ne peuvent en aucun cas être saisies manuellement au clavier, sous peine d’être interprétées comme du texte brut dépourvu de valeur calculatoire.
5.3 Vérification algorithmique des fréquences obtenues
Dès l’exécution de la formule FREQUENCE sous l’une ou l’autre des architectures techniques, une procédure de vérification algorithmique croisée doit être systématiquement engagée. Cette vérification prévient toute erreur d’étendue ou omission de données marginales. Elle s’articule autour de deux tests de cohérence arithmétique formels.
Le premier test porte sur la conformité de l’effectif total reconstitué. Dans une cellule réservée sous la colonne des fréquences calculées, le chercheur formule une sommation globale : =SOMME(E2:E12) (ou =SOMME(E2#) sous Microsoft 365). La valeur résultante doit être rigoureusement identique à la métrique N établie lors de l’audit préliminaire au moyen de la fonction NB. Si un différentiel numérique émerge, ne serait-ce que d’une seule unité, cela indique la présence de valeurs textuelles parasitaires non converties au sein de la série brute, ou l’existence de cellules mal référencées lors de la sélection de la plage de données empiriques.
Le second test cible l’inspection de la dernière cellule du vecteur matriciel, correspondant à la (n + 1)-ième composante déversée. Ainsi que précisé antérieurement, cette cellule cumule l’ensemble des observations empiriques strictement supérieures à la dernière borne supérieure paramétrée. Dans le cadre d’une distribution théoriquement close dont les classes sont censées couvrir l’intégralité du continuum mesuré, cette cellule résiduelle doit impérativement afficher une valeur de zéro (0). La présence d’une valeur positive démontre formellement qu’au moins une observation de l’échantillon outrepasse la borne maximale prévue, imposant l’adjonction d’une classe supplémentaire ou le réajustement de l’amplitude du découpage.
6. Calcul des métriques dérivées : Fréquences relatives et cumulées
6.1 Calcul et interprétation des fréquences relatives
Bien que les fréquences absolues (les effectifs bruts nᵢ) constituent le résultat fondamental du dénombrement, elles demeurent tributaires de la taille globale de la cohorte étudiée. Pour autoriser des comparaisons inter-groupes légitimes — par exemple pour comparer la distribution des scores d’anxiété d’un groupe clinique expérimental (N = 45) à celle d’une cohorte témoin normée (N = 1250) —, la conversion des effectifs en fréquences relatives (proportions fᵢ ou pourcentages pᵢ) est indispensable.
Mathématiquement, la fréquence relative d’une classe i se définit comme le rapport de son effectif propre nᵢ sur l’effectif total de l’échantillon valide N : fᵢ = nᵢ / N. Sous Excel, cette conversion s’opère par une formule arithmétique élémentaire mais protégée par un adressage rigoureux. Si le premier effectif absolu réside dans la cellule E2 et que la sommation totale est fixée en E13, la formule à inscrire dans la colonne des proportions s’énonce : =E2 / $E$13. L’usage du verrouillage absolu par le symbole dollar $ sur la cellule d’effectif total permet d’étirer la formule vers le bas sans déplacement intempestif du dénominateur.
L’application d’un formatage visuel de type « Pourcentage » assorti d’une ou deux décimales (selon la granularité souhaitée) parachève la présentation de la métrique. Sur le plan psychométrique, ces fréquences relatives correspondent aux probabilités empiriques discrétisées d’observer un individu tiré aléatoirement dans l’échantillon au sein de ladite tranche de scores. La somme vectorielle de l’ensemble de ces fréquences relatives doit rigoureusement converger vers 1,000 (ou 100,0 %), toute variance résiduelle ne pouvant être imputée qu’à des arrondis de calcul mineurs.
6.2 Génération de la distribution des fréquences cumulées
L’analyse distributionnelle s’enrichit considérablement de l’établissement des effectifs cumulés (ascendants) et de leurs pendants relatifs : les pourcentages cumulés. L’effectif cumulé d’une classe donnée représente la somme de l’effectif de cette classe et de l’ensemble des effectifs de toutes les classes qui la précèdent dans la hiérarchie métrique croissante. Cette métrique répond directement à la question clinique essentielle : « Combien de participants obtiennent un score inférieur ou égal à un seuil pathologique donné ? ».
Dans l’environnement Excel, la modélisation de cette sommation itérative ascendante s’effectue traditionnellement par deux approches. La première, dite récursive classique, initialise la première cellule cumulée par une liaison directe avec la première fréquence absolue : =E2, puis incrémente la cellule sous-jacente par l’addition de l’effectif absolu adjacent et du cumul antérieur : =G2 + E3, formule ensuite étirée verticalement jusqu’au bas du tableau. La seconde méthode, plus élégante et moins vulnérable aux suppressions accidentelles de lignes, utilise la fonction SOMME avec une référence mixte semi-bloquée : =SOMME($E$2:E2). Lors de l’étirement vers le bas, la plage s’étend dynamiquement ($E$2:E3, $E$2:E4, etc.), réalisant la totalisation progressive.
Les pourcentages cumulés, calculés par la division des effectifs cumulés par la taille totale N, constituent les approximations empiriques directes des rangs centiles. Dans la pratique psychométrique et neuropsychologique, les rangs centiles permettent de situer la performance d’un patient individuel par rapport à sa population de référence. Identifier que la classe correspondant à un score de 35 sur une échelle de mémoire culmine à un pourcentage cumulé de 5 % établit formellement que 95 % des sujets sains de la norme font mieux que ce score, caractérisant ainsi un déficit cognitif potentiel conforme aux seuils critiques de la nosographie clinique.
6.3 Construction d’une table de distribution normalisée
L’aboutissement de ces phases de calcul réside dans l’ordonnancement d’une table de distribution complète, normée et conforme aux canons académiques internationaux. Cette table doit comporter une juxtaposition ordonnée et claire de colonnes identifiées par des en-têtes explicites. Une structure canonique intègre successivement : l’identifiant de la classe, le libellé formel de l’intervalle, la borne supérieure, l’effectif absolu (f), la fréquence relative en pourcentage (%), l’effectif cumulé (f_cum) et le pourcentage cumulé (%_cum).
Pour assurer une parfaite lisibilité et prévenir toute ambigüité d’interprétation mathématique, les libellés de classes textuels doivent être formulés selon les conventions de la théorie des ensembles. Un libellé tel que ]10 - 20] ou 10,01 à 20,00 explicite sans équivoque le caractère semi-ouvert de l’intervalle. L’analyste peut concaténer automatiquement ces libellés en combinant des fonctions de texte avec son vecteur de bornes : ="] " & D1 & " - " & D2 & " ]", conférant une modularité intégrale à son interface descriptive.
L’application d’un formatage conditionnel modéré peut enrichir la lecture clinique de cette table standardisée. Il est méthodologiquement recommandé d’appliquer un surlignage doux sur la classe au sein de laquelle s’effectue le basculement du cinquantième centile (la médiane empirique), ainsi que sur les jalons des premier et troisième quartiles (25e et 75e centiles). Cette disposition visuelle met en lumière la symétrie centrale de la distribution et accélère la contextualisation des seuils diagnostiques sans encombrer la structure sémiotique du document.
7. Création d’une distribution de fréquences via les Tableaux Croisés Dynamiques
7.1 Initialisation du tableau croisé dynamique à partir des données sources
Si la fonction FREQUENCE représente l’approche algorithmique la plus directe et computationnellement robuste, les Tableaux Croisés Dynamiques (TCD) d’Excel constituent une modalité alternative particulièrement attractive pour l’analyste recherchant une flexibilité interactive sans saisie de formules complexes. Cette méthodologie permet d’agréger, de segmenter et de filtrer des milliers d’observations en quelques manipulations d’interface.
Le processus débute par la sélection intégrale du tableau structuré de données sources Tbl_Recherche_Clinique. L’opérateur navigue ensuite vers l’onglet Insertion du ruban supérieur et actionne la commande Tableau croisé dynamique, en confirmant son implantation sur une nouvelle feuille de calcul dédiée. L’environnement d’analyse présente alors la liste des champs disponibles et les quatre zones de disposition fonctionnelles (Filtres, Colonnes, Lignes et Valeurs).
La configuration requise pour bâtir une distribution de fréquences impose une manipulation spécifique de la variable quantitative étudiée (par exemple Score_Depression). L’analyste doit glisser ce champ unique simultanément dans deux zones distinctes : en premier lieu dans la zone Lignes, ce qui a pour effet immédiat de lister l’ensemble des valeurs numériques uniques observées dans la colonne empirique ; en second lieu dans la zone Valeurs. Par défaut, Excel peut tenter d’appliquer une agrégation de type « Somme » sur une variable numérique. L’opérateur doit impérativement corriger ce paramètre en accédant aux Paramètres des champs de valeurs et en sélectionnant la fonction d’agrégation Nombre (ou Nb), assurant ainsi le comptage des occurrences physiques et non la sommation arithmétique des scores.
7.2 Utilisation de la fonction de groupement automatique
À ce stade préparatoire, le tableau croisé affiche une simple liste exhaustive de chaque score individuel associé à son dénombrement unitaire, ce qui ne constitue pas encore une distribution par intervalles de classes. La puissance opérationnelle des TCD réside dans leur moteur de groupement numérique automatisé intégré.
Pour activer cette fonction, l’analyste effectue un clic avec le bouton droit de la souris sur n’importe quelle valeur numérique de la première colonne du tableau croisé (zone des étiquettes de lignes), puis sélectionne dans le menu contextuel l’option Grouper…. Une boîte de dialogue de paramétrage spécialisée s’affiche, présentant trois paramètres numériques cruciaux : Début, Fin et Par.
Ces paramètres correspondent fidèlement aux concepts métriques développés au chapitre 4 :
- Début : Fixe la borne inférieure de la toute première classe. Bien qu’Excel pré-remplisse cette case avec le minimum observé, il est statistiquement plus judicieux de fixer une borne arrondie (par exemple 0 ou 10) pour garantir la lisibilité clinique.
- Fin : Fixe la limite supérieure de la dernière classe souhaitée, englobant le maximum de l’échantillon.
- Par : Spécifie l’amplitude constante a de chaque classe d’intervalles (par exemple 5 ou 10 unités métriques).
Dès validation par la touche OK, Excel reconfigure instantanément l’intégralité du tableau en agrégeant les observations individuelles au sein d’intervalles de classes générés automatiquement (par exemple 10-19, 20-29, 30-39).
7.3 Affichage simultané des fréquences absolues et pourcentages
L’un des avantages compétitifs majeurs des tableaux croisés dynamiques par rapport aux formules matricielles réside dans la facilité avec laquelle il est possible d’adjoindre de multiples perspectives métriques sur la même distribution d’un simple mouvement de souris, sans avoir à réécrire la moindre équation de référence.
Pour générer l’affichage concomitant des fréquences absolues et des pourcentages relatifs, il suffit de glisser une nouvelle fois la variable Score_Depression depuis la liste des champs vers la zone Valeurs, positionnant ainsi deux instances identiques de la métrique côte à côte. La première instance est maintenue en mode Nombre standard, fournissant la colonne des effectifs bruts (nᵢ).
L’opérateur configure ensuite la seconde instance en effectuant un clic droit sur son en-tête, puis en sélectionnant Afficher les valeurs suivi de l’option % du total général. Instantanément, la seconde colonne se transmute en une distribution de fréquences relatives normalisées, intégrant les décalages décimaux de manière fluide. La flexibilité du tableau croisé dynamique est telle qu’un simple clic sur l’option % de la ligne parente ou Résultat cumulé par… permet de métamorphoser la table en distribution de pourcentages cumulés. Cependant, cette flexibilité s’accompagne d’une dépendance structurelle : le TCD ne se recalcule pas de manière synchrone et continue en temps réel lors de la modification des données brutes, exigeant une commande manuelle d’actualisation (Données > Actualiser tout), à la différence de la réactivité immédiate et inviolable de la fonction matricielle FREQUENCE.
8. Utilisation du module Utilitaire d’analyse statistique
8.1 Activation et configuration préalable du complément
Pour les chercheurs habitués aux environnements logiciels de biostatistique dédiés tels que SPSS, SAS ou R, Excel intègre un sous-système analytique orienté vers l’expérimentation scientifique : l’Utilitaire d’analyse (Analysis ToolPak). Ce module complémentaire natif, codé en bibliothèques de liens dynamiques C++, fournit une suite d’algorithmes mathématiques préconfigurés, incluant des modules d’ANOVA, de régression linéaire et, spécifiquement, un module de discrétisation par histogramme.
Par défaut, lors de l’installation standard de la suite bureautique, ce complément d’analyse est fréquemment désactivé afin d’alléger l’empreinte mémoire du logiciel. L’activation préalable constitue donc une étape de configuration obligatoire. La procédure s’opère selon le cheminement canonique :
- Cliquer sur l’onglet Fichier dans le coin supérieur gauche, puis sélectionner Options à la base du volet latéral.
- Dans la fenêtre des paramètres, sélectionner la rubrique Compléments dans la colonne de navigation gauche.
- Dans la section inférieure, repérer le menu déroulant intitulé Gérer :, s’assurer que la mention Compléments Excel est active, puis presser le bouton Atteindre….
- Une boîte de dialogue affiche la liste des compléments internes disponibles. Cocher la case dédiée intitulée Utilitaire d’analyse, puis valider par OK.
Dès l’achèvement de cette manipulation, un nouveau groupe d’outils nommé Analyse apparaît à l’extrémité droite de l’onglet Données du ruban principal, arborant l’icône de commande Utilitaire d’analyse.
8.2 Paramétrage précis de l’outil Histogramme
L’utilisation du module dédié s’initialise en cliquant sur l’icône Utilitaire d’analyse au sein de l’onglet Données, puis en surlignant la commande Histogramme dans la liste des outils statistiques disponibles. La confirmation déclenche l’ouverture d’un panneau d’interfaçage hautement spécialisé dont chaque champ d’entrée requiert un paramétrage rigoureux.
Le premier paramètre, intitulé Plage d’entrée, attend la sélection de la matrice empirique contenant les mesures comportementales du protocole (par exemple $A$1:$A$501). Le second paramètre pivot, désigné par Plage des classes, exige la sélection explicite de la colonne préalablement construite hébergeant le vecteur des bornes supérieures (par exemple $D$1:$D$11). Il est impératif de souligner que si les cellules d’en-tête textuelles de ces deux colonnes ont été intégrées dans les sélections respectives, la case d’option Intitulés (ou Étiquettes) doit être formellement cochée. L’omission de cette coche lorsque des en-têtes sont inclus entraînera une interruption d’exécution pour non-conformité numérique des données.
Dans la section inférieure dédiée aux Options de sortie, le chercheur sélectionne l’emplacement de destination du calcul : soit sur la même feuille de calcul via un point d’ancrage cellulaire (Plage de sortie), soit sur une feuille vierge indépendante. Trois cases à cocher aux fonctionnalités distinctes complètent l’interface :
- Pareto (histogramme trié) : À proscrire formellement en analyse continue psychologique, car elle réordonne les classes par ordre d’effectifs décroissants, anéantissant la métrique ordonnée du trait mesuré.
- Pourcentage cumulé : Génère conjointement au tableau des effectifs la série normalisée de la courbe ascendante.
- Graphique : Crée directement un objet graphique associé à la table statistique générée.
8.3 Évaluation critique de l’approche par l’Utilitaire d’analyse
L’exécution de l’outil Histogramme génère un tableau de distribution de fréquences complet ainsi qu’un graphique préliminaire. Toutefois, une évaluation méthodologique critique s’impose quant à la pertinence de cette approche en regard des exigences contemporaines de la recherche expérimentale. La faille architecturale majeure de l’Utilitaire d’analyse réside dans le caractère strictement statique des résultats produits.
À la différence des fonctions matricielles ou des tableaux croisés dynamiques, l’Utilitaire d’analyse ne dépose aucune formule vivante dans les cellules réceptrices ; il y imprime des valeurs scalaires figées (« hardcodées ») correspondant à un instantané instantané des données d’entrée. En conséquence, la moindre modification ultérieure d’un score expérimental dans la base source, l’élimination d’une observation jugée a posteriori aberrante ou l’intégration de nouveaux participants n’entraînera strictement aucune mise à jour automatique du tableau d’effectifs ou de l’histogramme associé. L’analyste se trouve contraint de réexécuter manuellement l’intégralité de la procédure d’analyse depuis le panneau de configuration.
Cette approche par complément conserve néanmoins une utilité méthodologique avérée dans des contextes spécifiques : l’audit rapide d’échantillons stabilisés en fin de protocole, la validation didactique ou l’extraction conjointe standardisée de la courbe d’Ogive (pourcentages cumulés) pour les annexes techniques de rapports d’évaluation. Pour toute construction d’un tableau de bord de monitoring clinique pérenne ou pour la conception d’un protocole de traitement destiné à être partagé entre plusieurs évaluateurs, la supériorité computationnelle des formules matricielles FREQUENCE demeure indiscutable.
9. Représentation graphique rigoureuse : Conception d’histogrammes scientifiques
9.1 Conversion de la distribution de fréquences en graphique à colonnes
L’aboutissement naturel d’une table d’effectifs réside dans son incarnation géométrique sous la forme d’un histogramme scientifique. Si l’être humain éprouve des difficultés à appréhender la forme probabiliste globale d’un phénomène à travers une lecture purement tabulaire, l’œil perçoit instantanément la symétrie, l’asymétrie ou la multimodalité d’une distribution graphique. Toutefois, la réalisation d’un histogramme scientifiquement authentique dans Excel requiert de contourner certains pièges sémiotiques inhérents aux graphiques par défaut.
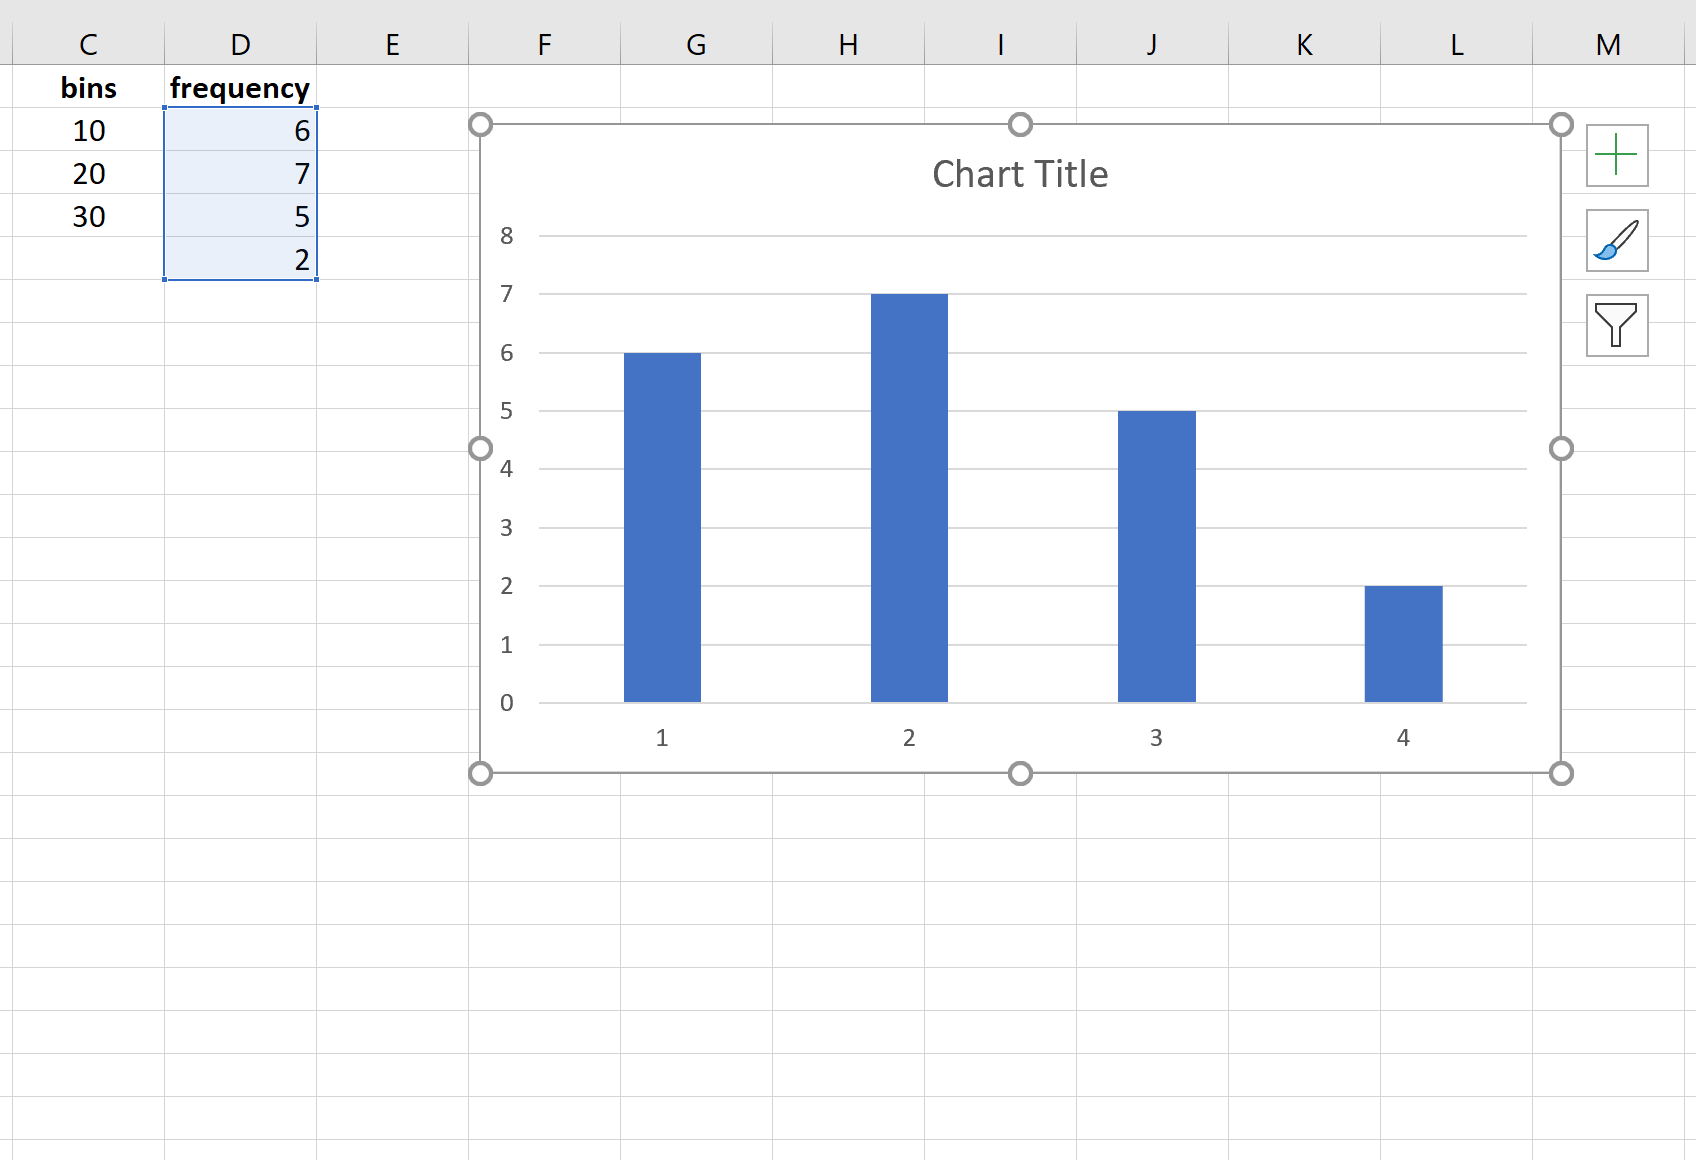
Bien que les versions récentes d’Excel intègrent un type de graphique préconfiguré nommé directement Histogramme dans le sous-menu statistique, ce composant automatisé prive l’expérimentateur d’un contrôle rigoureux sur le partitionnement mathématique de ses bornes en imposant ses propres algorithmes de discrétisation internes. La méthode académique standard consiste donc à bâtir le graphique à partir de la table d’effectifs préalablement calculée via la fonction FREQUENCE. Pour ce faire, le chercheur sélectionne l’ensemble de la colonne des fréquences absolues calculées, se dirige vers l’onglet Insertion, clique sur l’icône des graphiques de type Histogramme ou Barres et opte impérativement pour le modèle de base : Colonnes groupées 2D.
À ce stade de l’insertion, le graphique présente deux anomalies méthodologiques majeures : l’axe horizontal d’abscisse n’est numéroté que par une séquence générique d’entiers (1, 2, 3…) dépourvue de signification expérimentale, et les colonnes verticales sont espacées par de larges bandes blanches. Pour remédier au premier point, l’analyste actionne un clic droit au centre du graphique, choisit Sélectionner des données…, clique sur le bouton Modifier du bloc Étiquettes de l’axe horizontal (abscisse), et sélectionne la plage de cellules contenant les libellés textuels rigoureusement formulés (par exemple ]10-20], ]20-30]). L’axe d’abscisse reflète désormais formellement les véritables segments métriques de la variable comportementale.
9.2 Ajustement technique de la largeur d’intervalle
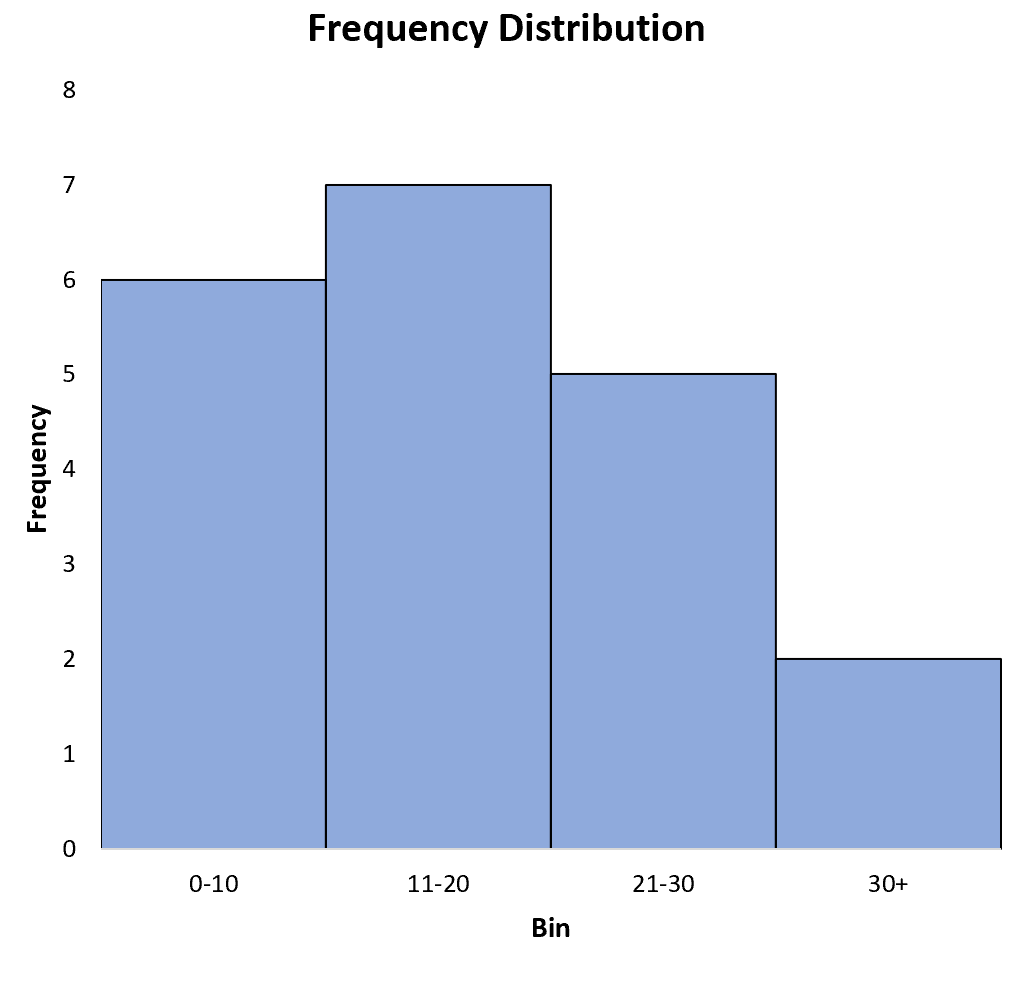
D’un point de vue épistémologique et sémiotique, il existe une distinction fondamentale et infranchissable entre un diagramme en barres (bar chart) et un véritable histogramme statistique. Le diagramme en barres représente des variables catégorielles ou qualitatives discrètes (telles que des groupes diagnostics ou des genres) ; par conséquent, les barres doivent être visuellement séparées par des espaces vides symbolisant l’absence de continuité sous-jacente entre les catégories. À l’inverse, l’histogramme représente la discrétisation d’une variable quantitative continue ; la surface des barres matérialise la densité probabiliste et les rectangles doivent impérativement être jointifs pour signifier visuellement la continuité ininterrompue de la droite réelle.
Sous Excel, le graphique en colonnes groupées inséré par défaut applique un espacement standard d’environ 219 % entre les barres, ce qui constitue une hérésie de représentation pour une variable métrique continue. L’ajustement technique de ce paramètre s’exécute selon le protocole suivant :
- Effectuer un double-clic gauche sur l’une des colonnes verticales du graphique pour ouvrir le panneau latéral de formatage intitulé Mise en forme des séries de données.
- Dans la section arborant l’icône d’histogramme (Options des séries), repérer le curseur de réglage nommé Largeur du fractionnement (ou Largeur de l’intervalle).
- Modifier manuellement la valeur numérique présente pour la porter rigoureusement à 0 %.
Cette réduction à zéro pour cent efface instantanément les séparations artificielles, soudant visuellement les rectangles contigus les uns aux autres. Cependant, les colonnes se fondant désormais en un bloc monochromatique informe, il devient impératif d’adjoindre une délimitation physique entre les classes. L’analyste bascule alors vers l’onglet de remplissage (icône du pot de peinture), déploie le sous-menu Bordure, active l’option Ligne pleine, sélectionne une couleur contrastée (généralement un blanc pur ou un gris anthracite foncé pour les publications monochromes) et fixe l’épaisseur du trait à 1 ou 1,5 point. L’histogramme acquiert alors sa structure géométrique canonique, matérialisant chaque classe comme une portion d’aire discrétisée sous la courbe empirique globale.
9.3 Normalisation esthétique selon les standards académiques
La finalisation graphique doit se conformer aux prescriptions typographiques et stylistiques de l’American Psychological Association (normes de publication APA, 7e édition). L’objectif est d’atteindre une clarté sémiotique maximale en éradiquant toute surcharge décorative inutile (ce que le théoricien de la visualisation Edward Tufte désigne sous le concept de « chartjunk »).
La première règle de normalisation impose la suppression pure et simple des lignes de quadrillage horizontales par défaut. Bien que destinées à faciliter la lecture des ordonnées, ces lignes surchargent visuellement l’espace sans apporter de précision analytique significative dans un article de recherche. L’opérateur sélectionne simplement ces lignes au clic et les efface via la touche Suppr. De même, la légende automatique latérale, redondante dans le cas d’une série univariée unique, doit être systématiquement supprimée.
Le traitement des axes exige une rigueur académique exemplaire. L’axe des ordonnées (vertical) doit comporter un titre explicite spécifiant la nature du dénombrement, tel que « Effectif (n) » ou « Fréquence relative (%) », et être doté d’une ligne d’axe fine de couleur sombre assortie de graduations extérieures. L’axe des abscisses (horizontal) doit porter un libellé exhaustif indiquant le nom de la variable psychologique mesurée, son sigle conventionnel et son unité métrique entre parenthèses, par exemple : « Score au test de Stroop – Effet d’interférence (en millisecondes) ».
Les typographies employées au sein du graphique doivent être harmonisées avec le corps du texte du manuscrit final (polices standard sans empattement telles que Calibri, Arial ou polices académiques avec empattement comme Times New Roman), avec une taille minimale de 9 à 10 points assurant une lisibilité parfaite lors de la réduction d’échelle à l’impression. Le graphique scientifique ne doit porter aucun titre interne supérieur voyant ; selon les conventions APA, le titre descriptif d’une figure (par exemple Figure 1 / Distribution des scores d’anxiété pré-interventionnelle) est systématiquement composé en typographie standard au-dessus du cadre de l’illustration dans le logiciel de traitement de texte éditeur, et non incrusté dans l’image vectorielle elle-même.
10. Diagnostic distributionnel et analyse des propriétés statistiques
10.1 Évaluation visuelle et calculée de l’asymétrie
L’observation morphologique d’une distribution de fréquences ne constitue pas une fin en soi ; elle ouvre la voie à l’analyse diagnostique des propriétés biométriques fondamentales de la population observée. La première propriété distributionnelle majeure concerne le paramètre d’asymétrie (skewness), qui renseigne sur la déviation de la distribution par rapport à une forme parfaitement équilibrée et symétrique autour de son sommet modal.
Dans l’évaluation des états psychopathologiques, il est fréquent d’observer une distribution présentant une asymétrie positive (ou étalement à droite). Dans cette configuration, la majorité des observations se concentrent dans les classes d’amplitudes faibles situées à gauche de l’histogramme, tandis qu’une longue traîne de scores s’étire vers les valeurs élevées de l’échelle. Ce profil est typique des échelles de symptomatologie dépressive administrées en population générale non clinique : la majorité des participants sains cumulent des scores minimaux (mode bas), alors qu’une fraction marginale de sujets sévèrement affectés génère des scores pathologiques très élevés. À l’opposé, une asymétrie négative (ou étalement à gauche) présente une concentration des scores vers les classes supérieures avec une traîne s’étirant vers les valeurs faibles, situation fréquemment observée lors d’effets de plafonnement cognitif sur des épreuves de dépistage de la démence trop simples administrées à des adultes jeunes performants.
Pour dépasser l’impression visuelle subjective issue de l’histogramme, Excel intègre un opérateur de calcul standardisé du coefficient d’asymétrie empirique non biaisé de Fisher-Pearson : la fonction COEFFICIENT.ASYMETRIE. La syntaxe opérationnelle s’exécute directement sur la série des scores bruts : =COEFFICIENT.ASYMETRIE(Tbl_Recherche_Clinique[Score_Anxiete]). Un coefficient rigoureusement nul atteste d’une symétrie théorique parfaite. En pratique psychométrique, une valeur comprise entre -0,5 et +0,5 dénote une symétrie relative acceptable ; une valeur excédant +1,0 ou plongeant sous -1,0 signale une déviation structurelle substantielle qui disqualifie l’usage exclusif de la moyenne arithmétique au profit de la médiane et impose une vigilance quant aux tests d’hypothèses subséquents.
10.2 Caractérisation de l’aplatissement de la distribution
La seconde composante morphologique cardinale est le degré d’aplatissement ou voussure de la distribution, théoriquement désigné sous le terme de kurtosis (ou coefficient de voussure de Pearson). Le kurtosis qualifie la façon dont la variance de la population est distribuée le long du continuum métrique, mesurant spécifiquement l’épaisseur relative des queues de distribution et la propension de l’échantillon à générer des valeurs extrêmes atypiques par rapport à la concentration centrale autour de la moyenne.
L’analyse académique catégorise les distributions en trois grandes typologies morphologiques :
- Mésocurtique : La distribution présente un aplatissement rigoureusement identique à celui d’une loi normale théorique standard. Les observations se répartissent de façon harmonieuse entre le centre et les extrêmes.
- Leptocurtique : La distribution est caractérisée par un pic central extrêmement acéré et resserré, combiné à des queues de distribution épaisses et lourdes (« fat tails »). Cela révèle qu’une vaste proportion d’individus partage une performance quasi-identique au mode, tout en coexistant avec quelques scores sporadiques démesurément distants du centre.
- Platycurtique : La distribution est visuellement écrasée, étalée et aplanie sur un large plateau horizontal, avec des queues fines et peu peuplées. Cette morphologie traduit une hétérogénéité étendue au sein de l’échantillon, où aucune valeur centrale ne parvient à émerger de manière dominante.
Le calcul de cette métrique s’opère sous Excel via la fonction native KURTOSIS : =KURTOSIS(Tbl_Recherche_Clinique[Score_Anxiete]). Il importe de noter qu’Excel implémente le coefficient de kurtosis sous sa forme centrée (ou excès de kurtosis). Ainsi, une distribution mésocurtique normale génère une valeur algorithmique de zéro (0). Un excès de kurtosis strictement positif caractérise un profil leptocurtique, tandis qu’une valeur strictement négative signe une dynamique platycurtique. Une déviation marquée du kurtosis (excédant généralement la plage [-2 ; +2]) constitue une infraction sévère au postulat d’homogénéité distributionnelle.
10.3 Confrontation à l’hypothèse de normalité gaussienne
L’examen approfondi d’une distribution de fréquences constitue le jalon méthodologique préalable déterminant dans la prise de décision statistique : le choix paradigmatique entre l’application de tests inférentiels paramétriques (comme le test t de Student ou l’ANOVA de Fisher) ou de tests non paramétriques (tels que le test U de Mann-Whitney ou le test de Kruskal-Wallis). Les tests paramétriques reposent fondamentalement sur l’hypothèse que la variable dépendante sous-jacente suit une distribution normale (gaussienne) au sein de la population d’origine.
L’analyste peut superposer visuellement une courbe normale théorique calée sur les paramètres de son échantillon directement sur son histogramme expérimental Excel. Pour exécuter cette modélisation, une colonne de fréquences théoriques est insérée au sein de la table statistique. Dans cette colonne, l’opérateur applique la fonction LOI.NORMALE.N pour chaque borne de classe, selon la syntaxe suivante : =(LOI.NORMALE.N(Borne_Actuelle; Moyenne; EcartType; VRAI) - LOI.NORMALE.N(Borne_Précédente; Moyenne; EcartType; VRAI)) * N_Total. Cette équation calcule l’intégrale probabiliste sous la courbe de Gauss délimitée par chaque segment d’intervalle, multipliée par la taille de l’échantillon pour restituer des effectifs théoriques directement comparables aux effectifs réels calculés par FREQUENCE.
L’intégration de cette série sous forme de courbe lissée sur l’histogramme empirique met en lumière les zones de divergence critique. Si des écarts massifs apparaissent — matérialisés par des creux inexpliqués, une scission bimodale des effectifs ou des traînes asymétriques outrancières —, le chercheur dispose d’une preuve graphique que l’hypothèse de normalité est compromise. Bien que cette évaluation visuelle doive être corroborée par des tests formels de normalité (tels que les tests de Shapiro-Wilk ou de Kolmogorov-Smirnov, réalisables par scripts ou compléments dédiés), la confrontation directe de l’histogramme empirique au modèle théorique fournit la justification méthodologique requise pour délaisser les statistiques paramétriques au profit de modèles robustes préservant la validité des conclusions de la recherche.
11. Résolution des anomalies et pièges techniques fréquents
11.1 Gestion de l’erreur d’écrasement matriciel
Avec la généralisation du moteur de calcul matriciel dynamique au sein de Microsoft 365, une anomalie logicielle nouvelle et omniprésente est apparue dans les feuilles d’analyse : l’erreur #PROPAGATION! (ou #SPILL! dans les versions anglophones d’Excel). Cette erreur survient lorsque la formule FREQUENCE calcule avec succès son vecteur de résultats de dimensions (n + 1) × 1, mais se trouve dans l’incapacité matérielle de déverser l’intégralité de ces valeurs sur les cellules sous-jacentes de la feuille de calcul.
Le mécanisme déclencheur de ce blocage réside invariablement dans l’obstruction de la zone de projection spatiale. Si une seule cellule située sur la trajectoire d’expansion verticale du résultat n’est pas rigoureusement vide — qu’elle héberge une formule préexistante, une étiquette textuelle résiduelle, un chiffre oublié ou même un caractère d’espace insécable invisible —, le moteur d’Excel interrompt immédiatement le déversement par mesure de protection afin de ne pas écraser de données potentielles, affichant le code d’erreur #PROPAGATION! dans la cellule d’ancrage d’origine.
La résolution technique de cet incident s’avère directe et immédiate :
- Cliquer sur la cellule d’ancrage affichant le code d’erreur
#PROPAGATION!. Une bordure en pointillés bleus apparaît automatiquement, matérialisant l’emprise physique exacte requise par le vecteur pour se déployer. - Inspecter scrupuleusement l’intérieur de ce rectangle de démarcation pour identifier la ou les cellules fautives contenant du contenu résiduel.
- Sélectionner les cellules parasites et appliquer une commande d’effacement radical via la touche
Suppr(ou Accueil > Effacer > Effacer tout).
Dès l’assainissement de la zone de dégagement, le moteur d’Excel libère la formule et déverse instantanément les fréquences numériques calculées sur l’ensemble de la colonne sans exiger la réécriture de l’équation.
11.2 Anomalies structurelles des données sources
Une seconde catégorie d’incidents techniques, d’une perversité méthodologique accrue car elle s’exécute de manière totalement silencieuse sans lever le moindre code d’erreur explicite, concerne la pollution des données numériques sources par des formats textuels ou des incohérences de caractères typographiques. Dans ce scénario, la formule FREQUENCE semble fonctionner parfaitement et déverse un vecteur de résultats, mais la somme de ces effectifs s’avère drastiquement inférieure à la taille attendue de l’échantillon.
L’origine première de ce phénomène réside dans l’importation de bases de données issues de questionnaires en ligne où les nombres ont été emballés sous forme de chaînes de caractères (« string »). La fonction FREQUENCE élimine d’office tout contenu non strictement numérique de son décompte matriciel. Une seconde source critique de divergence concerne la discordance des séparateurs décimaux. Dans les environnements francophones, le séparateur standard est la virgule décimale (,), alors que les logiciels d’expérimentation anglo-saxons exportent universellement les latences chronométriques avec un point décimal (.). Un score chronométrique saisi sous la forme « 245.8 » sera interprété par un système Excel configuré en langue française comme du texte pur et sera irrémédiablement ignoré lors du calcul de la distribution.
Pour assainir globalement une colonne polluée sans intervention manuelle cellule par cellule, l’analyste peut mobiliser la fonctionnalité Convertir du tableur :
- Sélectionner l’intégralité de la colonne de scores bruts au sein de la matrice source.
- Se diriger vers l’onglet Données et cliquer sur la commande Convertir.
- Dans l’assistant pas-à-pas, choisir l’option Délimité, avancer jusqu’à la troisième étape, puis cliquer sur le bouton Avancé….
- Configurer explicitement le champ Séparateur décimal sur le caractère présent dans les données brutes (par exemple le point
.), puis valider.
Excel convertit instantanément l’intégralité du vecteur textuel en véritables scalaires numériques de format natif, provoquant le recalcul et la réintégration immédiate de toutes les observations omises dans les compartiments de la table d’effectifs.
11.3 Mauvaise calibration des bornes de classes
La troisième source majeure d’anomalie réside dans l’agencement logique et arithmétique de la colonne des bornes supérieures (tableau_intervalles). La fonction FREQUENCE postule mathématiquement que ce vecteur d’entrée s’organise selon une progression arithmétique strictement croissante. Si ce postulat logique est violé, les résultats produits deviendront incohérents sans qu’Excel n’en avertisse formellement l’utilisateur.
Si un analyste saisit par inadvertance ses bornes supérieures selon un ordre chaotique ou décroissant (par exemple en alignant successivement les seuils 10, 30, 20, 40), l’algorithme interne de traitement appliquera ses règles d’exclusion de manière séquentielle. Il comptabilisera dans le premier intervalle les scores inférieurs ou égaux à 10 ; dans le deuxième, ceux compris entre 10 et 30 ; puis, arrivant à la borne 20, il cherchera les scores strictement supérieurs à 30 mais inférieurs ou égaux à 20 — une impossibilité mathématique absolue qui renverra systématiquement un effectif de zéro (0). La classe suivante se trouvera par conséquent faussée par une concentration artificielle des observations résiduelles.
La parade méthodologique impose de verrouiller la génération de cette colonne au moyen d’équations d’incrémentation automatisées (comme détaillé au point 4.3) plutôt que par une saisie manuelle libre. Alternativement, l’analyste peut soumettre son vecteur de seuils à l’outil de tri d’Excel (Données > Trier du plus petit au plus grand) préalablement à toute injection dans la fonction matricielle. Une inspection visuelle finale attestant de la progression arithmétique continue et constante des écarts entre chaque seuil garantit l’intégrité de la segmentation.
12. Automatisation et valorisation dans les rapports scientifiques
12.1 Dynamisation intégrale via les fonctions modernes
L’intégration récente dans le catalogue computationnel d’Excel de fonctions d’évaluation avancées telles que LET et SEQUENCE autorise désormais la conception de modules de distribution de fréquences entièrement autonomes, autocalibrés et affranchis de toute colonne auxiliaire intermédiaire. Cette architecture logicielle avancée permet d’injecter une série de scores bruts et d’obtenir, au sein d’une seule formule matricielle vivante, l’intégralité du tableau de distribution calculé.
La fonction LET permet de déclarer des variables locales au sein d’une expression Excel, optimisant drastiquement les temps de calcul et la maintenance du code. Associée à SEQUENCE, elle permet de calculer automatiquement l’étendue empirique, de déterminer le nombre de classes optimal selon la règle de Sturges ou de Scott, de générer le vecteur des bornes supérieures virtuelles en mémoire vive, et de lui appliquer la fonction FREQUENCE sans jamais avoir à imprimer manuellement ces bornes physiques sur la feuille de travail. Une telle formulation avancée prend typiquement la forme structurelle suivante :
=LET(

  donnees; FILTRE(Tbl_Recherche[Scores]; ESTNUM(Tbl_Recherche[Scores]));

  n; NB(donnees);

  min_val; MIN(donnees);

  max_val; MAX(donnees);

  k; ARRONDI.SUP(1 + 3,322 * LOG10(n); 0);

  largeur; PLAFOND.PRECISION((max_val - min_val) / k; 1);

  bornes; min_val + (SEQUENCE(k; 1; 1; 1) * largeur);

  effectifs; FREQUENCE(donnees; bornes);

  effectifs

)
Cette approche algorithmique encapsulée représente le sommet de la robustesse computationnelle sous Excel. Dès lors qu’une modification intervient au sein de la base de données clinique — inclusion de dizaines de nouveaux patients, correction d’un score —, l’ensemble du partitionnement, du redimensionnement du nombre de classes et du recalcul matriciel s’exécute de manière transparente et instantanée en arrière-plan, garantissant une reproductibilité sans faille du protocole statistique.
12.2 Mise en forme conforme aux directives de l’APA
La valorisation des résultats d’une analyse quantitative au sein d’un manuscrit soumis pour publication académique exige le respect scrupuleux des directives typographiques édictées par l’American Psychological Association (APA Style, 7e édition). L’APA prescrit une esthétique tabulaire hautement épurée et codifiée, caractérisée par une prohibition absolue de tout quadrillage vertical.
Pour préparer le tableau de distribution de fréquences sous Excel préalablement à son transfert vers le traitement de texte final, les principes de mise en forme suivants doivent être rigoureusement appliqués :
- Structure des bordures : Le tableau ne doit comporter que trois lignes horizontales principales d’épaisseur standard (environ 0,5 à 1 point). La première borde le sommet du tableau (au-dessus des en-têtes de colonnes) ; la deuxième isole la base des en-têtes de colonnes du premier corps de données ; la troisième scelle la base du tableau, sous la ligne de totalisation globale. Les bordures verticales, qu’elles soient internes ou externes, sont formellement proscrites.
- Alignement typographique des données : Les libellés textuels des classes d’intervalles sont rigoureusement alignés à gauche. Toutes les valeurs numériques quantitatives (effectifs absolus, pourcentages, fréquences cumulées) doivent impérativement être centrées ou alignées sur la virgule décimale afin de permettre une comparaison visuelle instantanée des ordres de grandeur.
- Typographie des en-têtes statistiques : Les symboles statistiques doivent être rédigés selon leurs normes d’abréviation universelles en italique : n pour l’effectif d’un sous-groupe ou d’une classe, N pour la taille totale de la population ou cohorte d’étude, % pour les pourcentages relatifs, et M pour la moyenne arithmétique.
- Apparat textuel : Le numéro de la table doit apparaître en gras au-dessus du tableau (par exemple Tableau 1), suivi sur la ligne immédiatement inférieure du titre complet composé en italique (par exemple Distribution de fréquences des scores d’anxiété préopératoire). Le bas du tableau est réservé aux notes explicatives introduites par la mention en italique Note. précisant la signification des bornes d’intervalles et justifiant le cas échéant l’exclusion de cas atypiques.
12.3 Exportation et reproductibilité des calculs
La dernière étape du flux de travail scientifique concerne l’exportation des visualisations et tables vers le rapport de recherche (rédigé typiquement sous Microsoft Word ou LaTeX), en garantissant que les formats préservent l’intégrité numérique et la netteté vectorielle des éléments produits.
Pour les tableaux de distribution, il est vivement déconseillé de procéder à de simples captures d’écran matricielles (« screenshots ») qui dégradent la lisibilité typographique et détruisent la résolution lors de la mise en page finale. La procédure académique standard consiste à copier la plage de cellules Excel formatée selon les normes APA et à la coller dans le traitement de texte en sélectionnant l’option Lier et conserver la mise en forme source (ou de procéder à un collage natif de tableau éditable). Cette liaison dynamique offre l’avantage exceptionnel de mettre à jour le manuscrit textuel si les calculs de distribution sont ultérieurement raffinés dans la feuille Excel source.
Concernant les histogrammes scientifiques, le maintien de la pureté vectorielle constitue un critère d’excellence. Un graphique Excel copié peut être collé directement dans les suites d’édition sous forme d’Image vectorielle améliorée (.EMF / Enhanced Metafile) ou exporté au format PDF haute résolution. Cette méthode vectorielle garantit que les axes, les polices de caractères et les bordures de colonnes conservent une netteté mathématique infinie, sans pixellisation ni flou de compression, quel que soit le niveau de grossissement ou le mode de reproduction d’impression appliqué par la revue scientifique éditrice. Enfin, la conservation conjointe du fichier tableur brut annoté et de la version finalisée du rapport garantit l’alignement avec les principes contemporains de la science ouverte (Open Science) et assure la reproductibilité intégrale du protocole de traitement analytique.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L₂ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
Microsoft Corporation. (2024). Fonction FREQUENCE. Support Microsoft. https://support.microsoft.com/fr-fr/office/fonction-frequence-44e3be2b-de06-4567-96fe-4d9b4ba2891b
Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.